


Image Generators are Generalist Vision Learners 요약 설명
22 Apr 2026 | Paper Review Generative Pretraining Instruction Tuning Open-Vocabulary Segmentation Monocular Depth Estimation목차
- 요약
- 1. Introduction
- 2. Method
- 3. Vision Banana - Generalist Vision Model from Image Generator
- 4. Discussion
- 부록
- 짧은 생각
이번 글에서는 Image Generators are Generalist Vision Learners 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 22일(Arxiv)
- Gabeur, Valentin, Long, Shangbang, Peng, Songyou, Voigtlaender, Paul, Sun, Shuyang, Bao, Yanan, Truong, Karen, Wang, Zhicheng, Zhou, Wenlei, Barron, Jonathan T., et al.
- Google DeepMind
- 논문 링크
요약
- Image Generators are Generalist Vision Learners는 이미지 생성 사전학습이 과제별 전용 아키텍처 없이 경쟁력 있는 시각 이해를 뒷받침할 수 있는지 살펴본다. Vision Banana는 Nano Banana Pro의 기존 생성 데이터에 낮은 비율의 시각 과제 데이터를 섞어 instruction tuning을 수행한다. Segmentation, metric depth, surface normal은 디코딩할 수 있는 RGB 이미지로 표현한다.
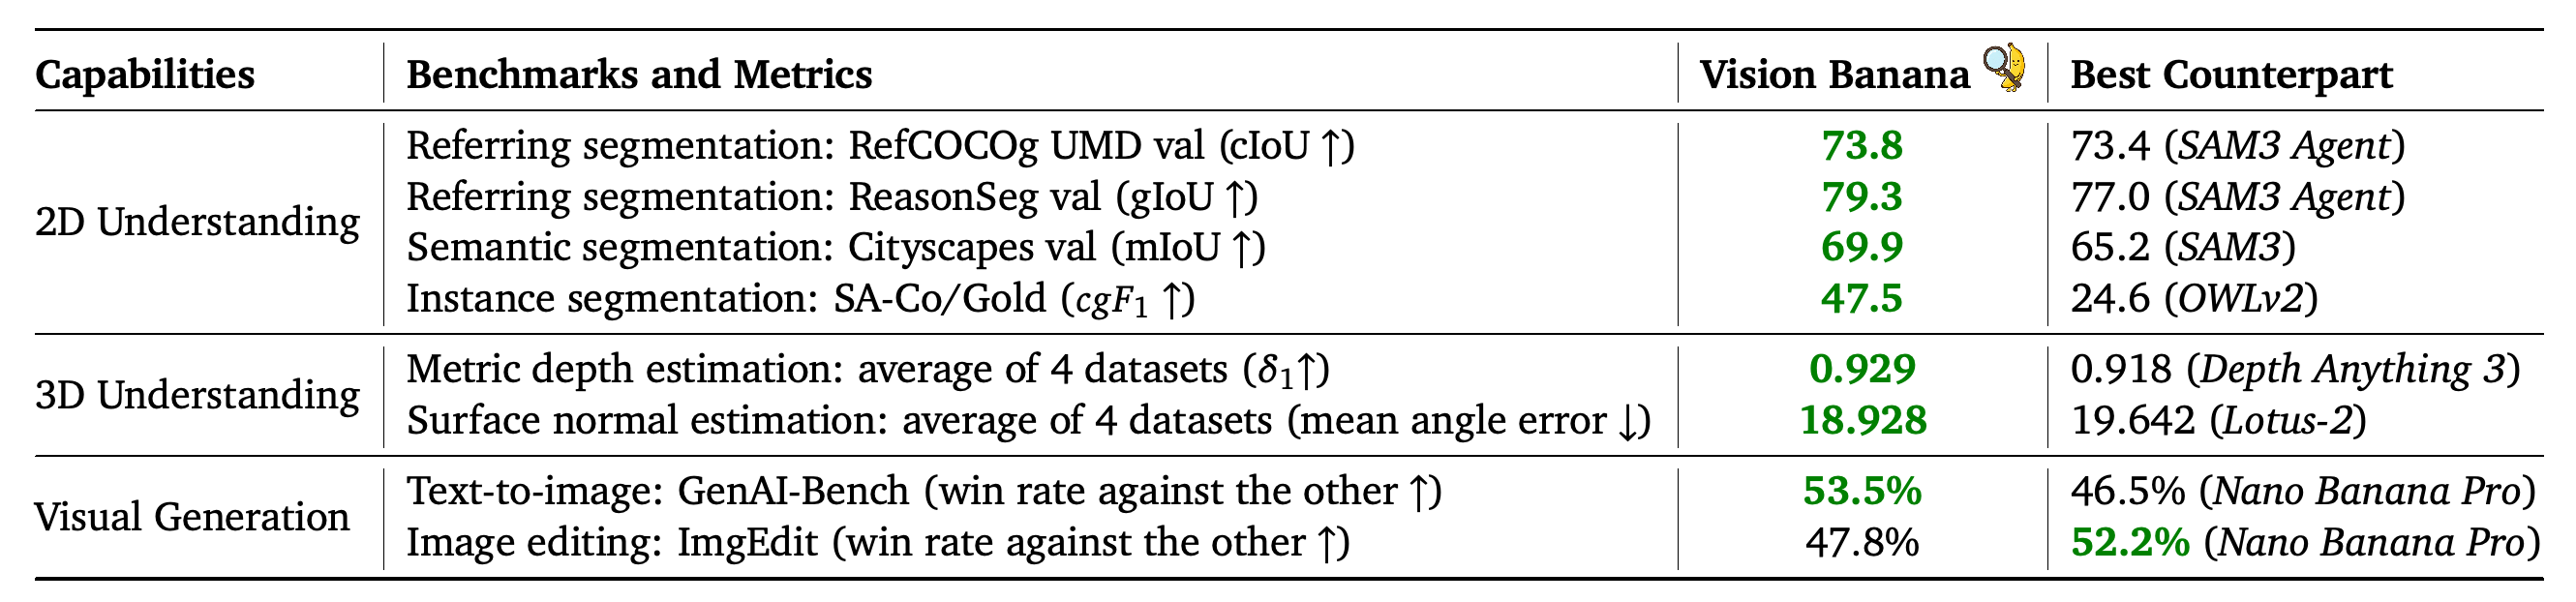
- 평가 벤치마크로의 zero-shot transfer에서 Vision Banana는 Cityscapes에서 69.9 mIoU, RefCOCOg UMD val에서 73.8 cIoU, ReasonSeg val에서 79.3 gIoU를 달성한다. ReasonSeg 결과는 쿼리를 해석하는 Gemini 2.5 Pro의 도움을 받는다. SA-Co/Gold에서 얻은 47.5 cgF1도 객체 존재 여부를 필터링하는 Gemini 3.1 Flash-Lite를 사용한 결과다.
- Metric depth의 instruction tuning은 합성 깊이 감독 신호를 사용하며 카메라 파라미터를 사용하지 않는다. 깊이 추론에도 카메라 파라미터가 필요하지 않다. Vision Banana는 6개 데이터셋에서 평균 δ1 0.882를 달성한다. Depth Anything 3의 결과가 보고된 4개 데이터셋에서는 0.929를 기록해 해당 전문 모델의 0.918을 앞선다. Surface normal 예측에서는 비교한 방법 중 가장 낮은 실내 평균 각도 오차인 15.549를 기록하지만, 모든 데이터셋에서 앞서지는 않는다.
- Nano Banana Pro와 비교한 사람의 선호도 평가에서 text-to-image 생성 승률은 53.5%, 이미지 편집 승률은 47.8%다. 생성 능력이 유지되었다는 해석과 부합하지만, 통계적 동등성을 입증하기에는 부족하다. 한계로는 경량 전문 모델보다 높은 연산 부담, 인스턴스를 합치거나 그룹을 나누는 오류, 2개 벤치마크에서 외부 모델의 도움을 받은 점, 튜닝 규모와 비용을 보고하지 않은 점이 있다.
1. Introduction
논문은 사전학습된 이미지 생성기가 디코딩과 정량 평가에 충분히 정밀한 시각 인식 출력을 만들 수 있는지 검증한다. 기존 방법은 출력 형식을 안정적으로 지키지 못하는 시각화를 생성하거나, 생성기를 과제별 전용 시스템으로 바꾸었다. 이 때문에 시각 인식과 생성 전반에 걸친 범용성이 제한되었다.
- 논문은 언어 모델에서 사용하는 생성 사전학습과 instruction tuning의 구분을 따른다. Instruction tuning은 기존 생성기가 요청된 과제와 출력 형식을 따르도록 정렬한다.
- Figure 1은 5개 시각 인식 과제와 text-to-image 생성 및 편집이 공유하는 RGB 출력을 보여준다. Table 1은 정량적 근거를 요약한다.
- 프로젝트 페이지는 vision-banana.github.io다.
이 도식은 생성기를 교체하지 않고 지시를 바꾸어 다양한 시각 인식 결과를 생성하는 방식을 보여준다. 레이더 차트는 선별된 결과를 요약한다. 학습 조건과 보조 모델 사용 여부를 구분하려면 함께 제시된 표를 확인해야 한다.
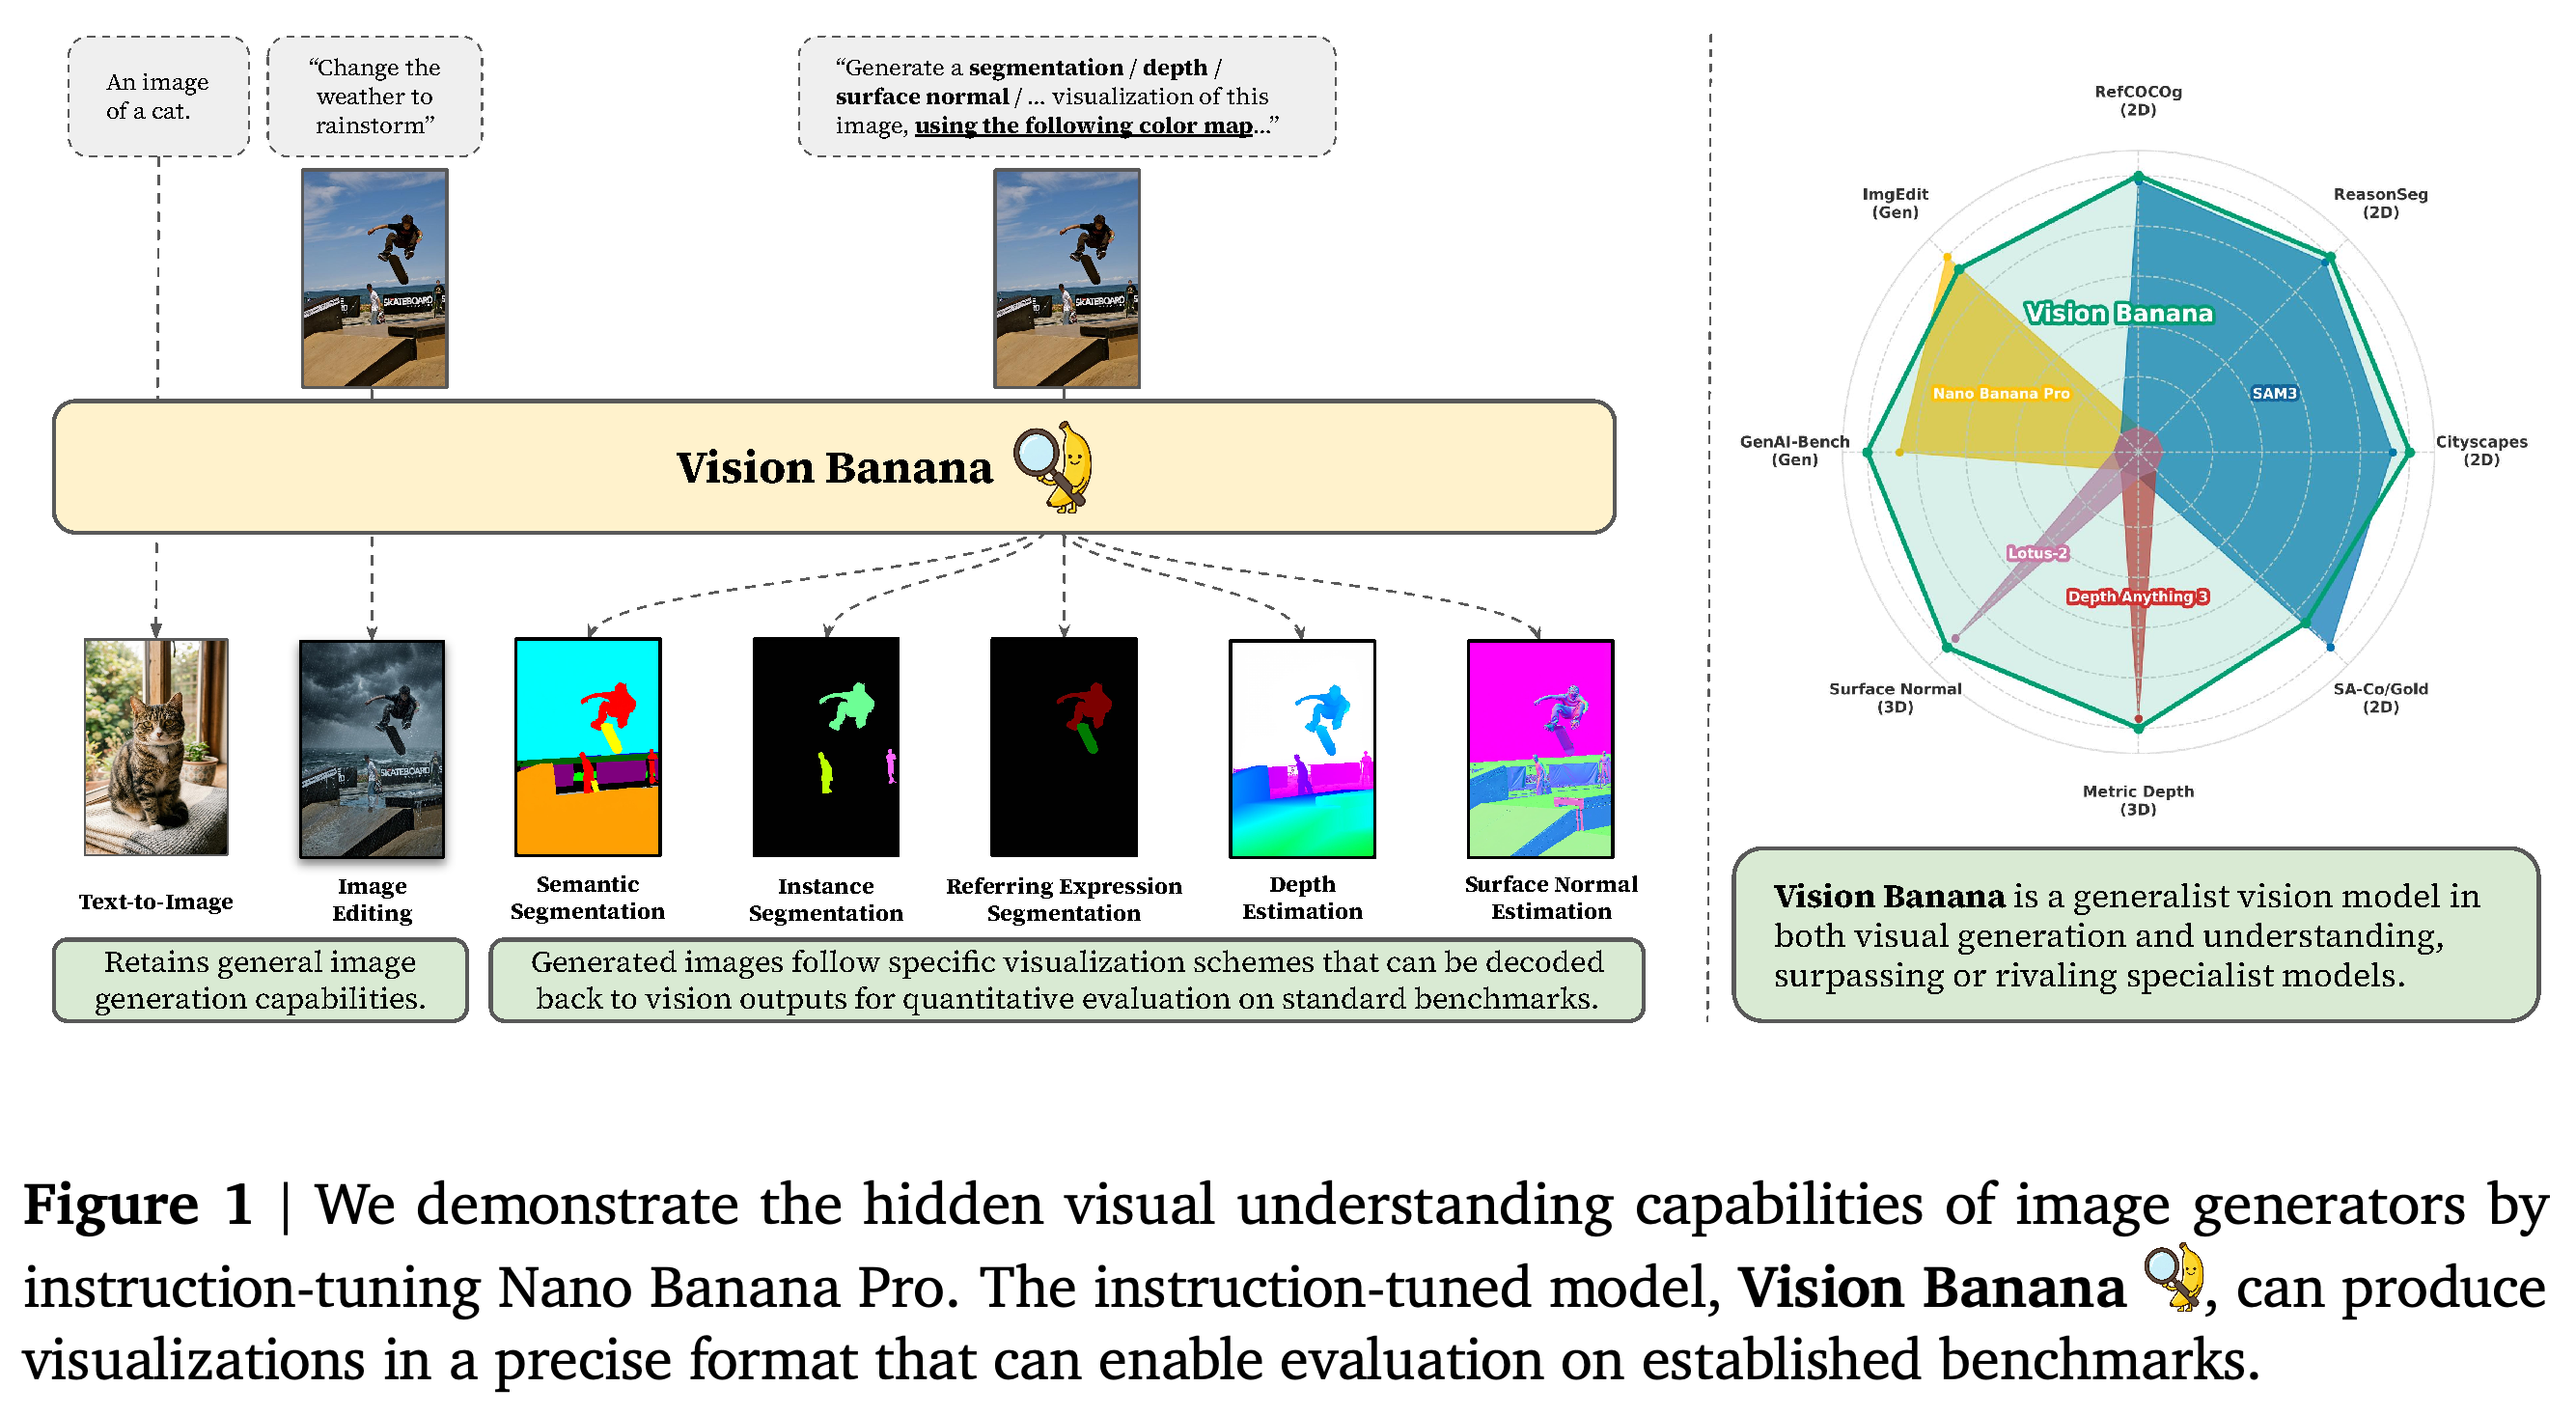
이 개요는 segmentation, 기하 예측, 생성 결과를 함께 비교한다. 깊이 값은 상세 결과의 6개 데이터셋 평균이 아니라 4개 데이터셋 평균이다. Instance segmentation과 ReasonSeg 항목은 보조 모델을 사용하는 파이프라인의 결과다.
2. Method
Vision Banana는 Nano Banana Pro의 기존 학습 데이터에 시각 과제 데이터를 매우 낮은 비율로 섞는다. 전용 아키텍처나 과제별 맞춤 손실 함수를 도입하지 않고 공통 RGB 출력 인터페이스를 유지한다.
- 2D 과제에는 웹에서 수집한 이미지를 자체 모델로 주석 처리한 데이터를 사용한다. 3D 과제의 감독 신호는 렌더링 엔진에서 얻는다.
- 저자들은 평가 벤치마크의 학습 데이터를 instruction tuning 데이터에서 제외했다고 밝힌다. 다만 이 설명만으로 기반 모델의 사전학습 데이터에 무엇이 포함되었는지는 알 수 없다.
- PDF는 정확한 혼합 비율, 시각 과제 예제 수, 튜닝 기간, 연산 예산을 보고하지 않는다. 따라서 저자들이 주장하는 경량 적응을 독립적으로 평가하기 어렵다.
이미지 생성 데이터를 유지하는 목적은 시각 인식 과제에 정렬하는 동안 기반 모델의 생성 능력을 보존하는 데 있다. Nano Banana Pro와 비교한 사람의 평가에서 GenAI-Bench 승률은 53.5%, ImgEdit 승률은 47.8%다.
- 이 결과는 2개 과제 모두에서 성능이 향상되었다기보다 생성과 편집 성능이 대체로 비슷하게 유지되었다는 해석과 부합한다.
- PDF는 선호도 평가의 표본 수나 불확실성 구간을 제공하지 않는다.
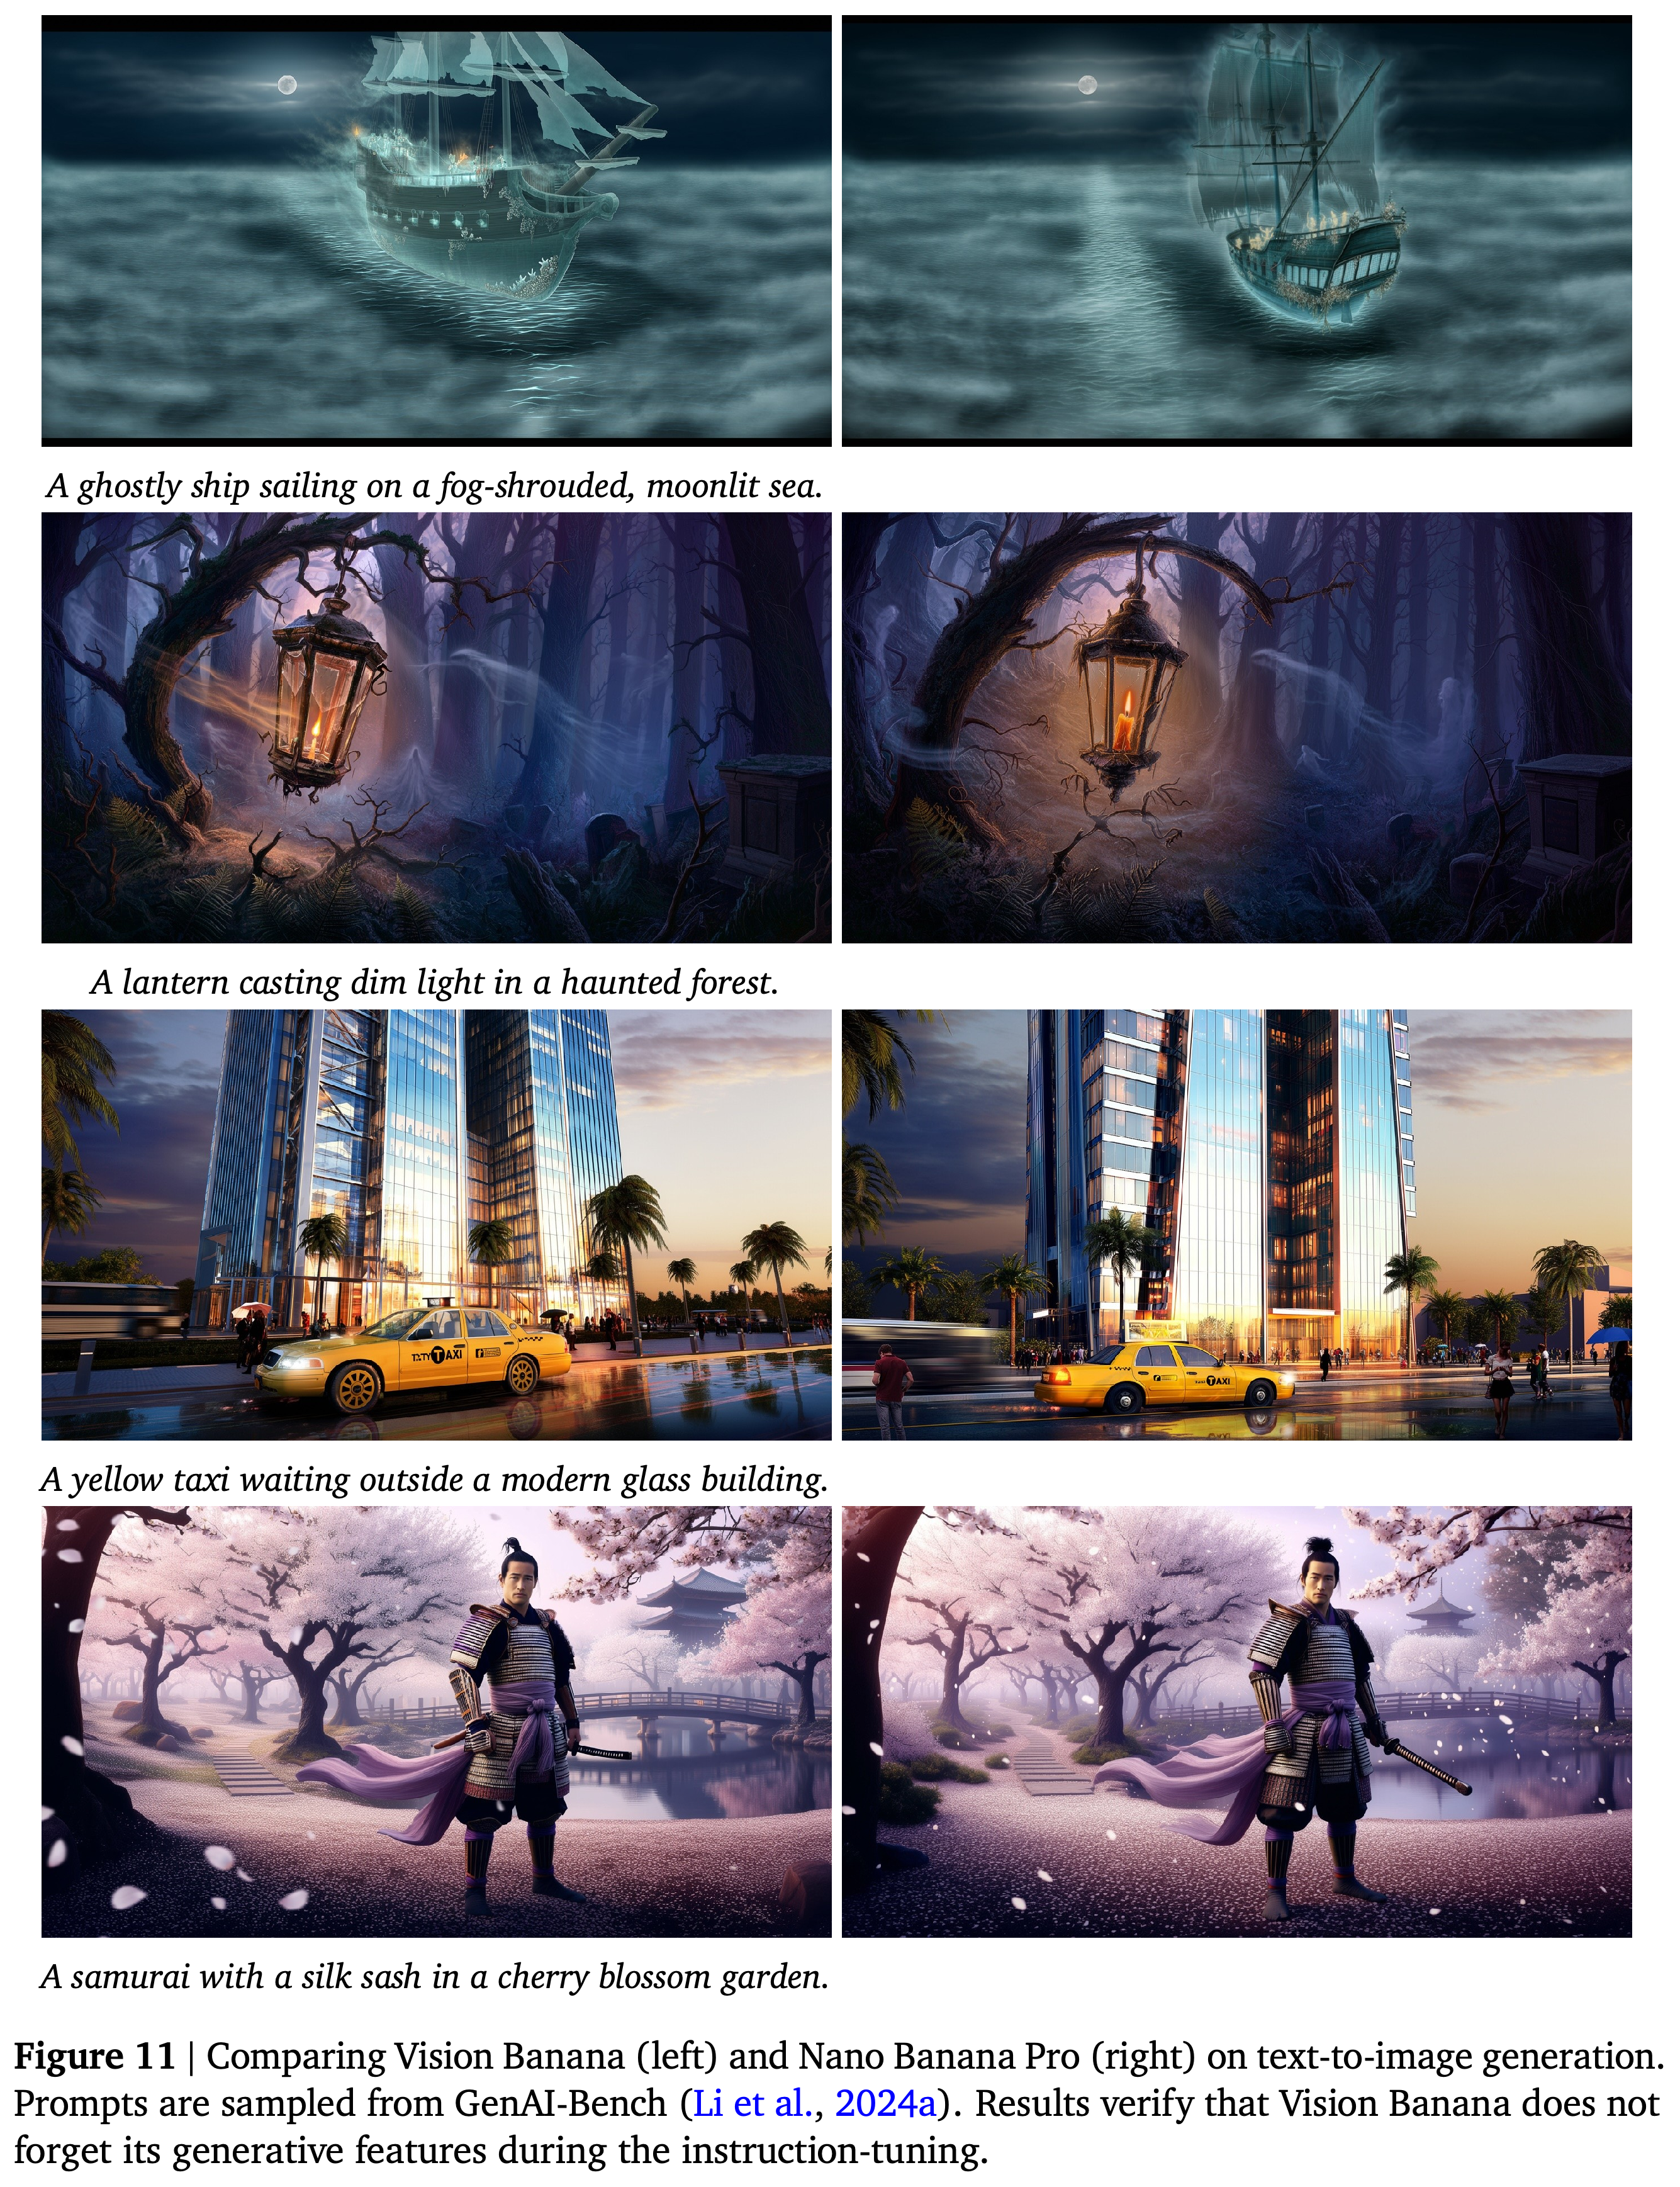
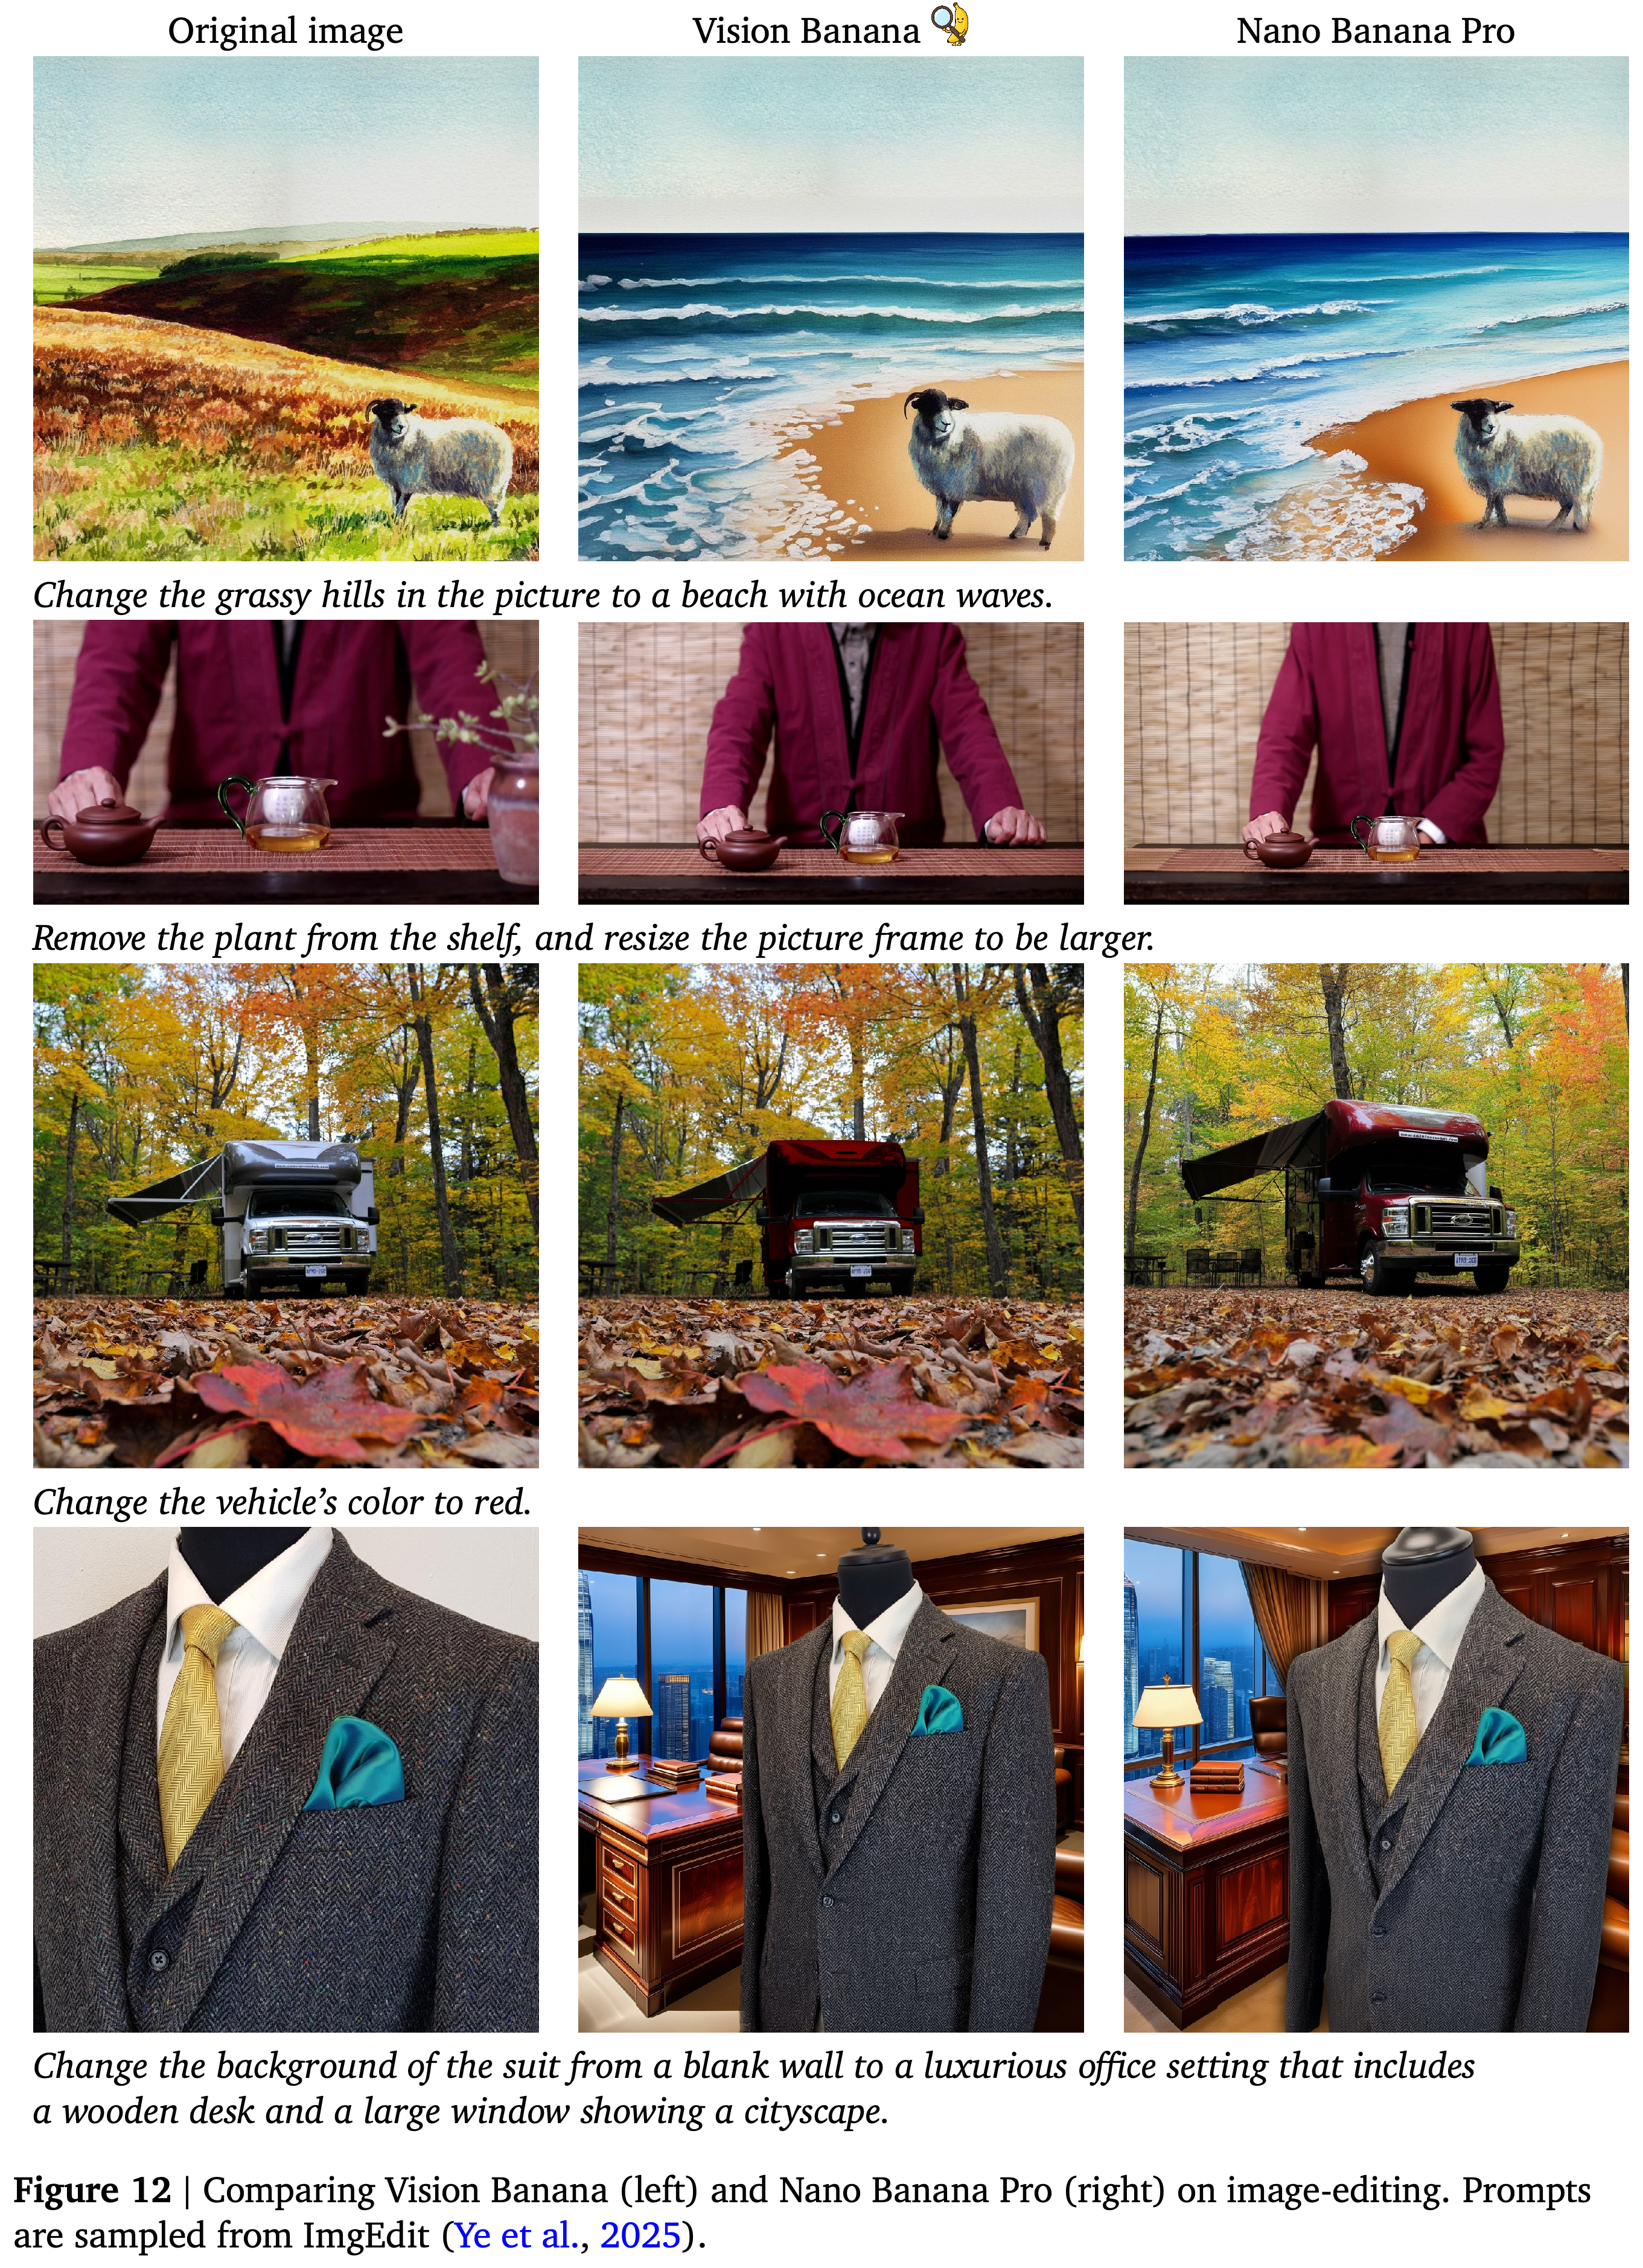
- Figures 11과 12는 생성 및 편집 출력을 나란히 제시해 이러한 종합 결과를 보완한다.
양쪽 체크포인트는 동일한 프롬프트 4개에서 세밀한 이미지를 생성하며, 이미지 합성 능력의 유지를 정성적으로 뒷받침한다. 선별된 비교 예시는 보고된 GenAI-Bench 사람 선호도 결과를 보완하지만 대체하지는 않는다.
3. Vision Banana - Generalist Vision Model from Image Generator
평가는 referring expression segmentation, semantic segmentation, instance segmentation과 단안 metric depth 및 surface normal 추정을 다룬다. Instruction tuning을 거친 1개 모델이 시각 인식 출력을 제공한다. 과제마다 프롬프트와 디코딩 절차가 달라지며, 2개 벤치마크의 파이프라인은 멀티모달 LLM을 추가로 사용한다.
- “Zero-Shot Transfer”는 해당 방법이 벤치마크의 도메인 내 학습 분할로 학습되지 않았다는 뜻이다. Vision Banana가 과제 감독 신호를 받지 않았다는 뜻은 아니다.
- 표는 벤치마크 데이터로 학습한 방법과 전이 방법을 구분한다. 전문 모델과의 비교를 해석할 때 이 구분이 필요하다.
3.1. 2D Semantic Understanding
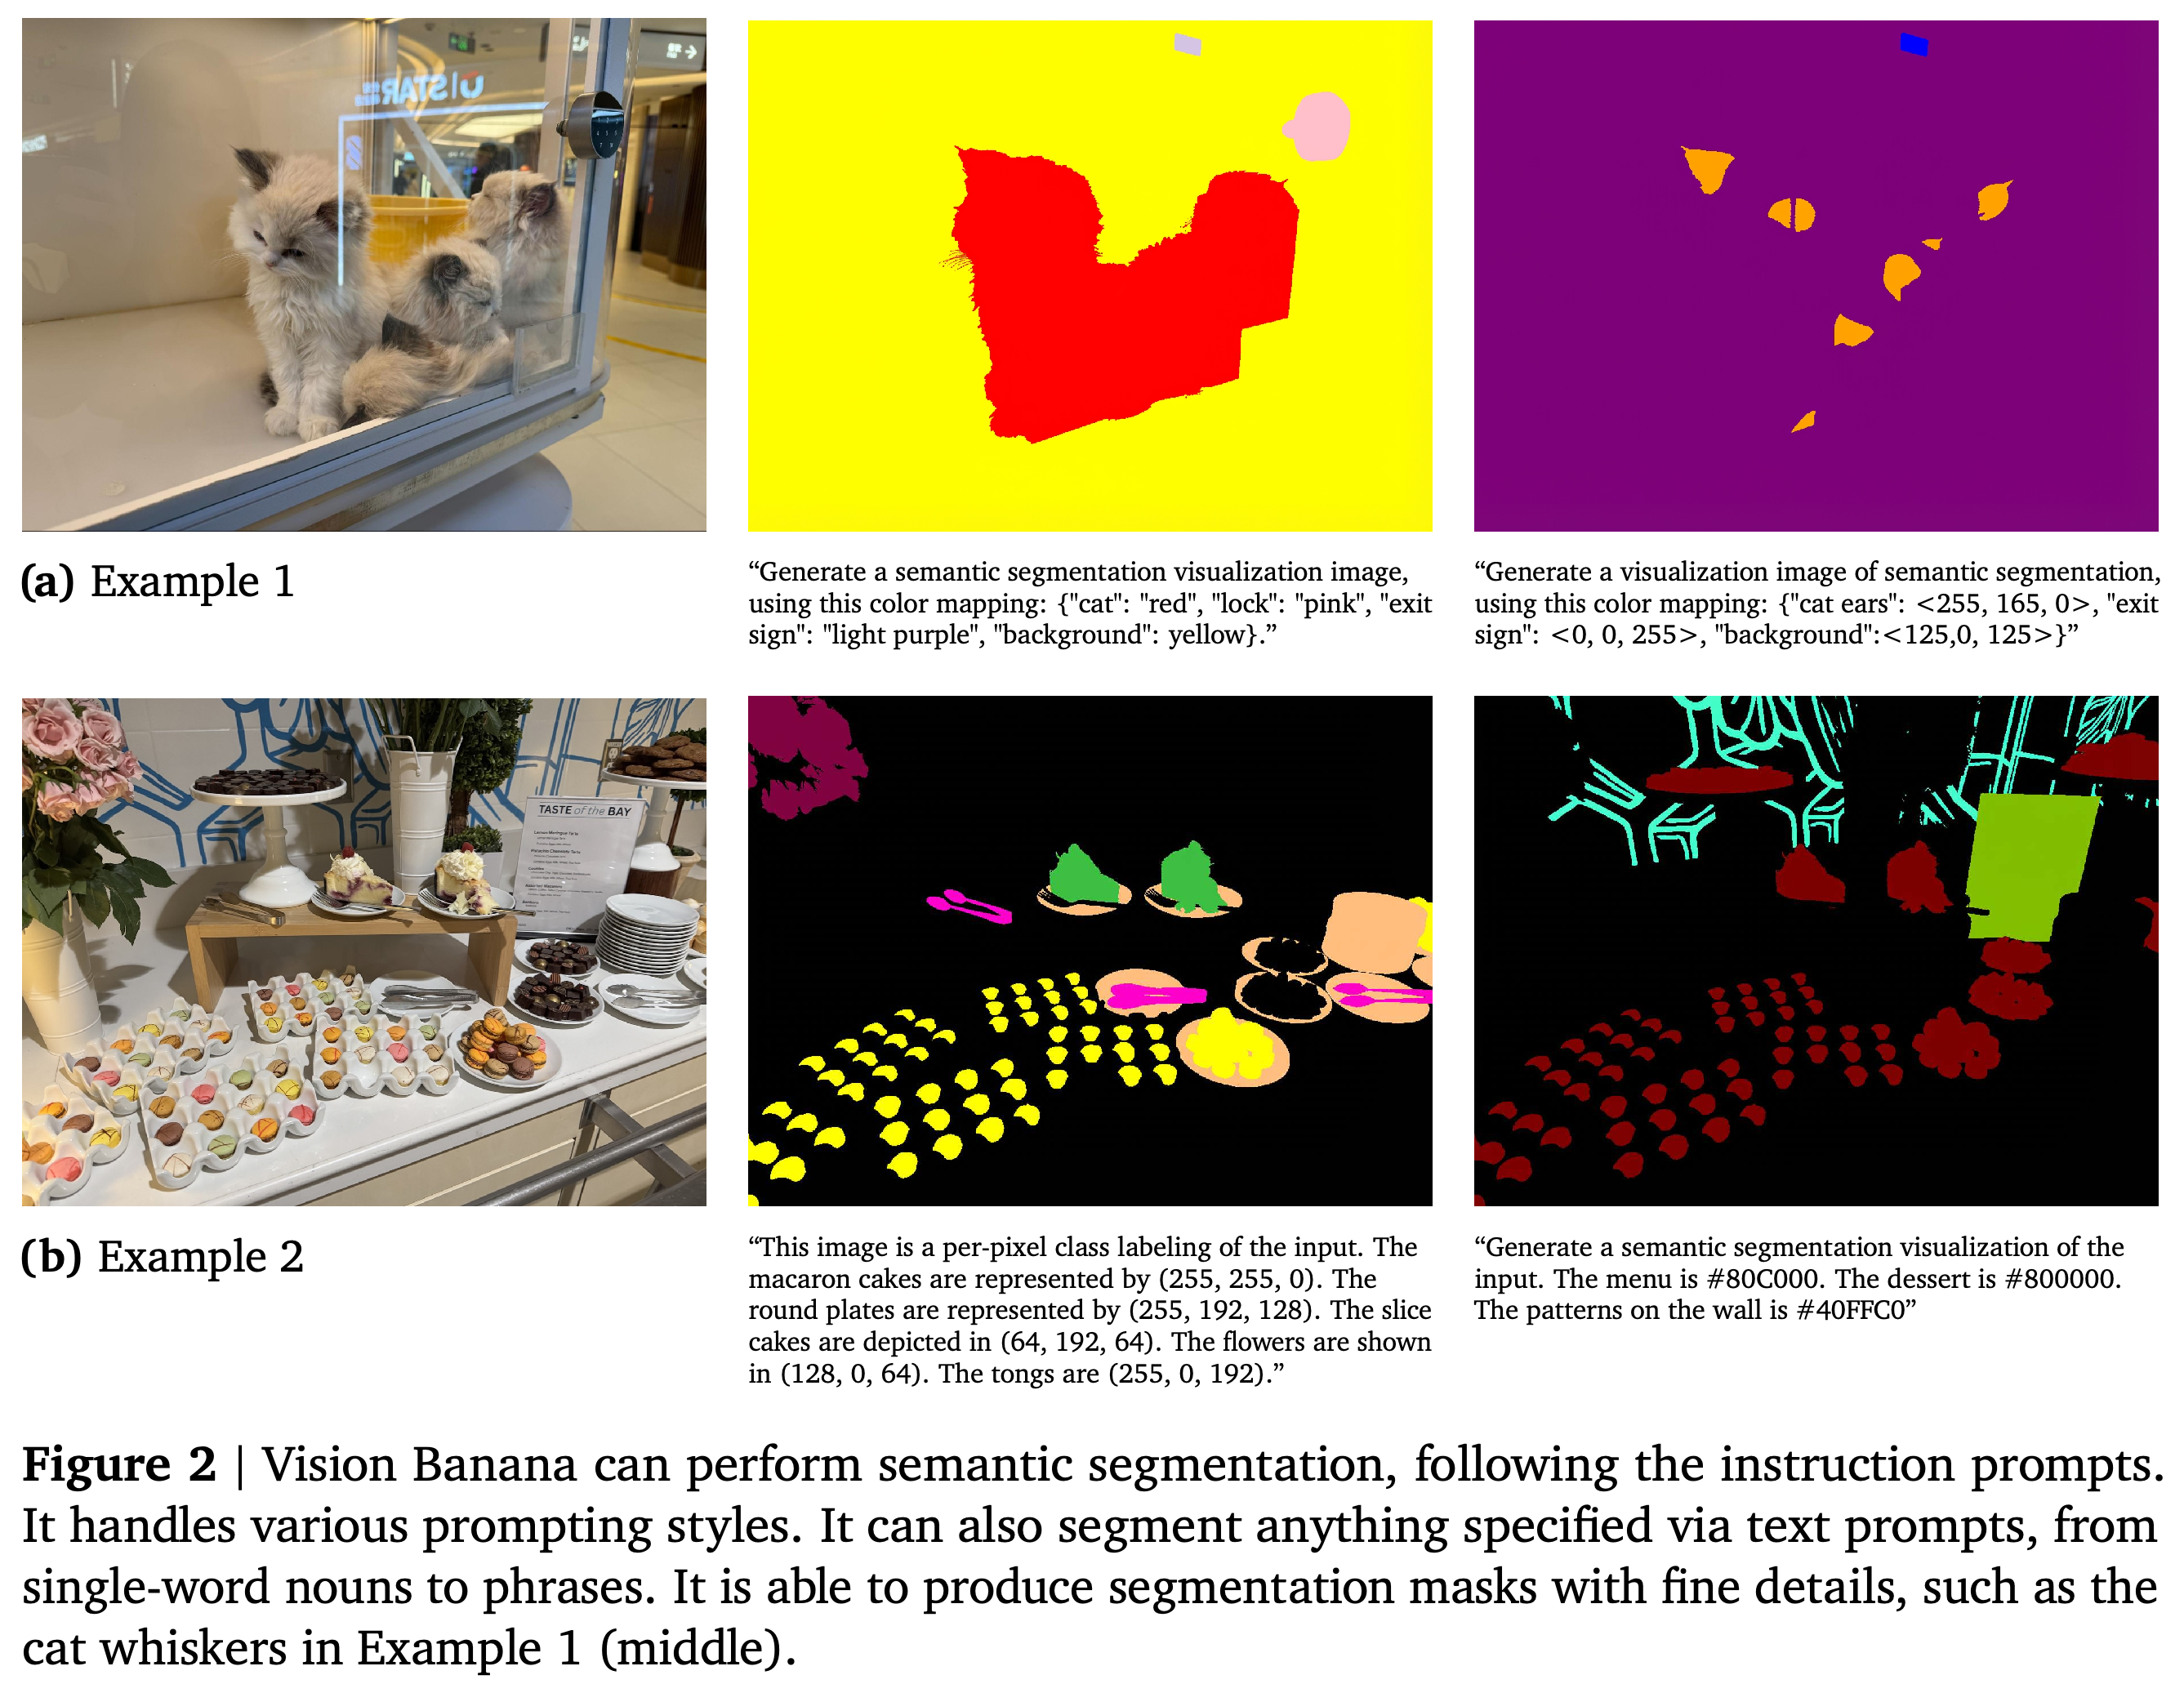
Semantic segmentation 프롬프트는 범주별 색상을 지정한다. 생성된 각 픽셀은 RGB 공간에서 가장 가까운 목표 색상으로 디코딩한다. Cityscapes 평가에서는 각 이미지에 없는 클래스까지 포함해 19개 클래스 전체에 동일한 색상 매핑을 적용한다.
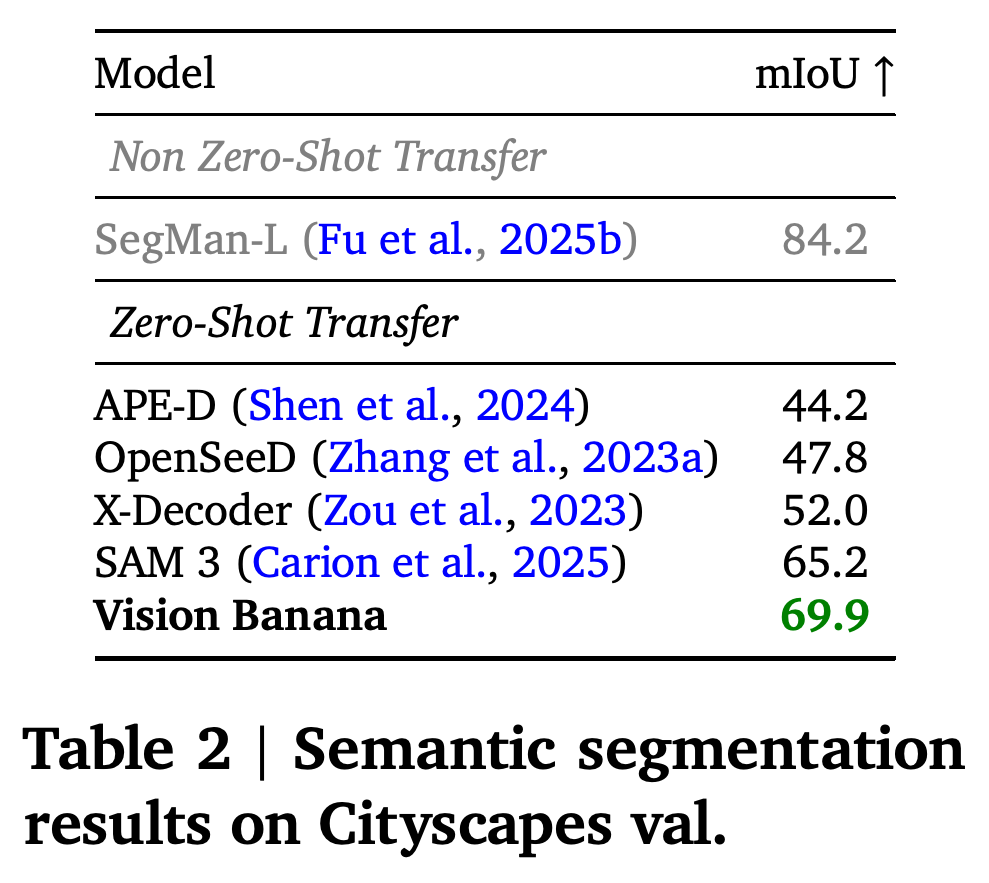
- Table 2에서 Vision Banana는 69.9 mIoU를 기록한다. 나열된 zero-shot transfer 방법 중 SAM 3의 65.2보다 4.7점 높다.
- 벤치마크 데이터로 학습한 SegMan-L은 84.2를 기록하므로, Vision Banana가 모든 학습 조건을 통틀어 가장 좋은 결과를 얻은 것은 아니다.
- Figure 2는 색상 이름, RGB 튜플, hex code와 함께 객체의 부분 및 “patterns on the wall” 같은 서술적 범주를 요청하는 예시를 보여준다.
Vision Banana는 나열된 zero-shot transfer 방법 중 가장 높은 69.9 mIoU를 기록하며, SAM 3보다 4.7점 높다. SegMan-L의 84.2는 벤치마크별 학습을 허용하면 이 결과가 전체 최고는 아님을 보여준다.
범주와 색상 지정을 바꾸면 같은 입력 이미지에서 다른 맵이 생성된다. 예시는 일반적인 범주뿐 아니라 객체의 부분과 서술적 표현도 지원함을 보여준다. 다만 이러한 쿼리 전반에서의 신뢰성을 측정하지는 않는다.
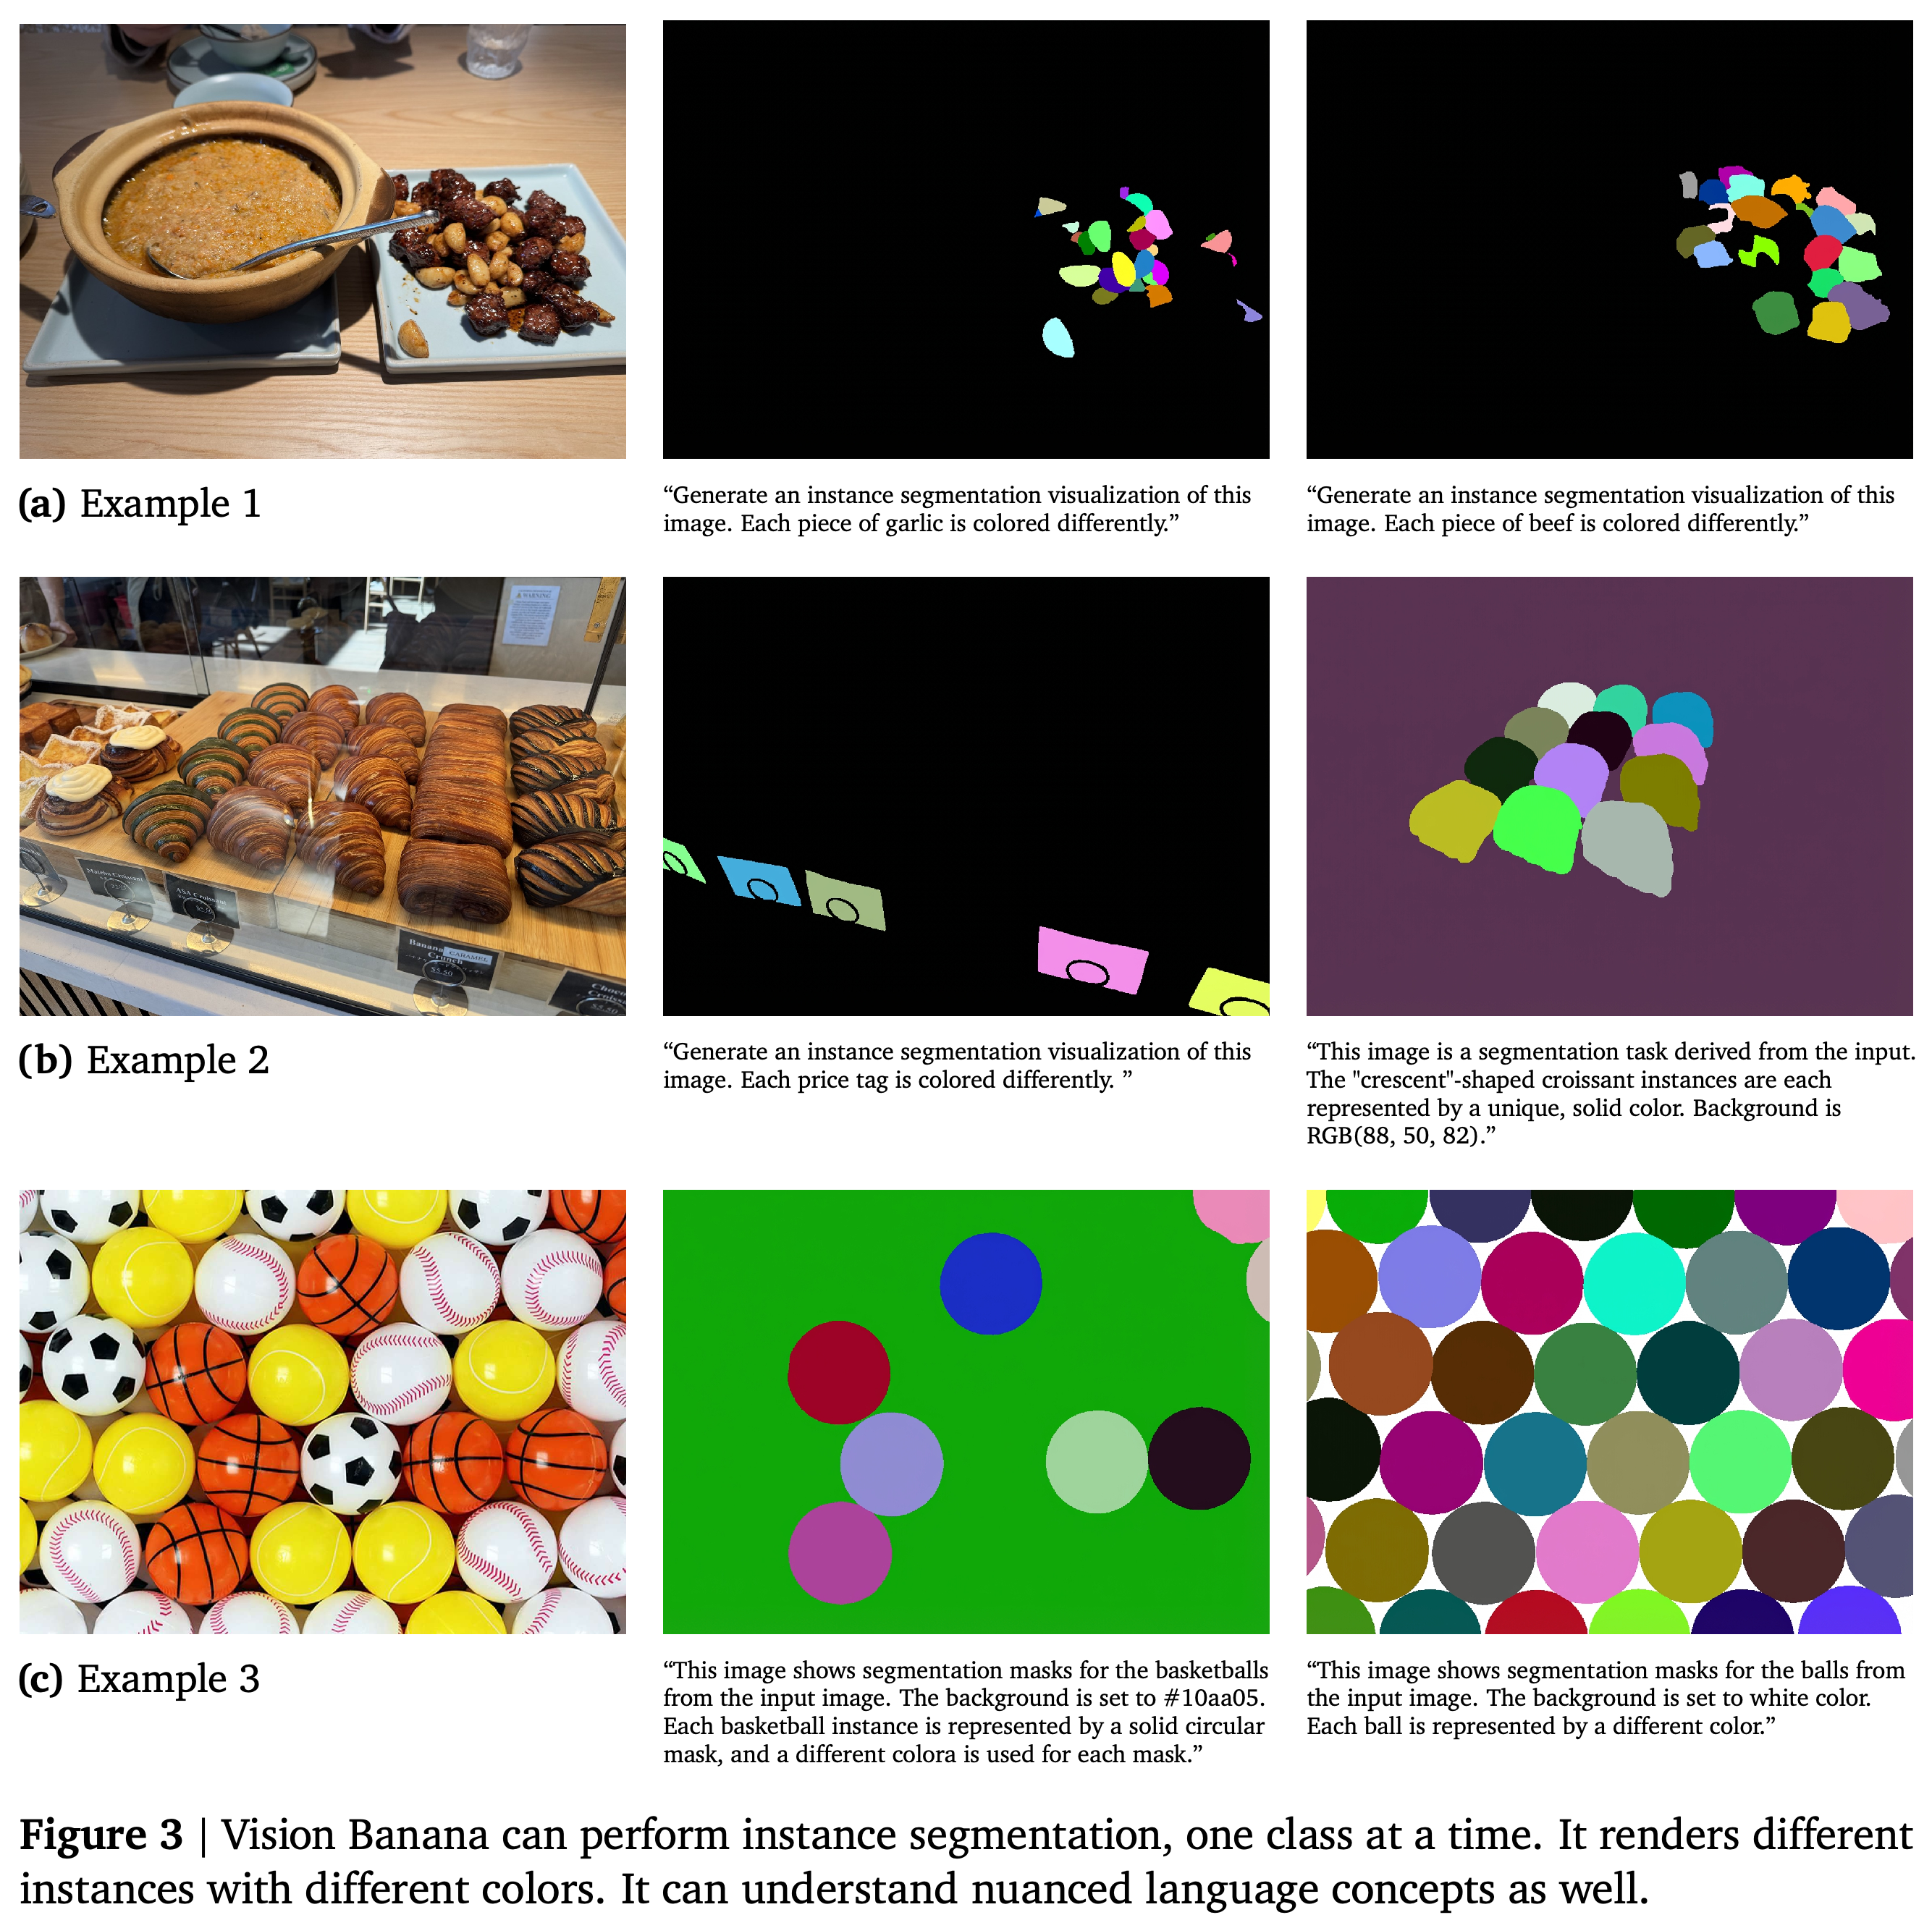
Instance segmentation 프롬프트는 목표 클래스와 배경색을 지정하고, 생성기가 인스턴스마다 다른 색상을 선택하도록 한다. 인스턴스 수와 팔레트를 미리 알 수 없으므로, 다단계 클러스터링 알고리즘으로 생성된 시각화를 개별 마스크로 변환한다.
- Figure 3은 마늘, 소고기, 가격표, 초승달 모양 크루아상, 농구공, 공을 클래스별로 분리하는 예시를 보여준다.
- SA-Co/Gold에는 Image-NP 쌍 168k개가 있으며, 대부분은 대상이 없는 부정 쿼리다. 모델이 빈 마스크를 생성하도록 튜닝되지 않았으므로, Gemini 3.1 Flash-Lite가 먼저 대상의 존재 여부를 분류한다. Vision Banana는 대상이 있다고 예측된 경우만 처리한다.
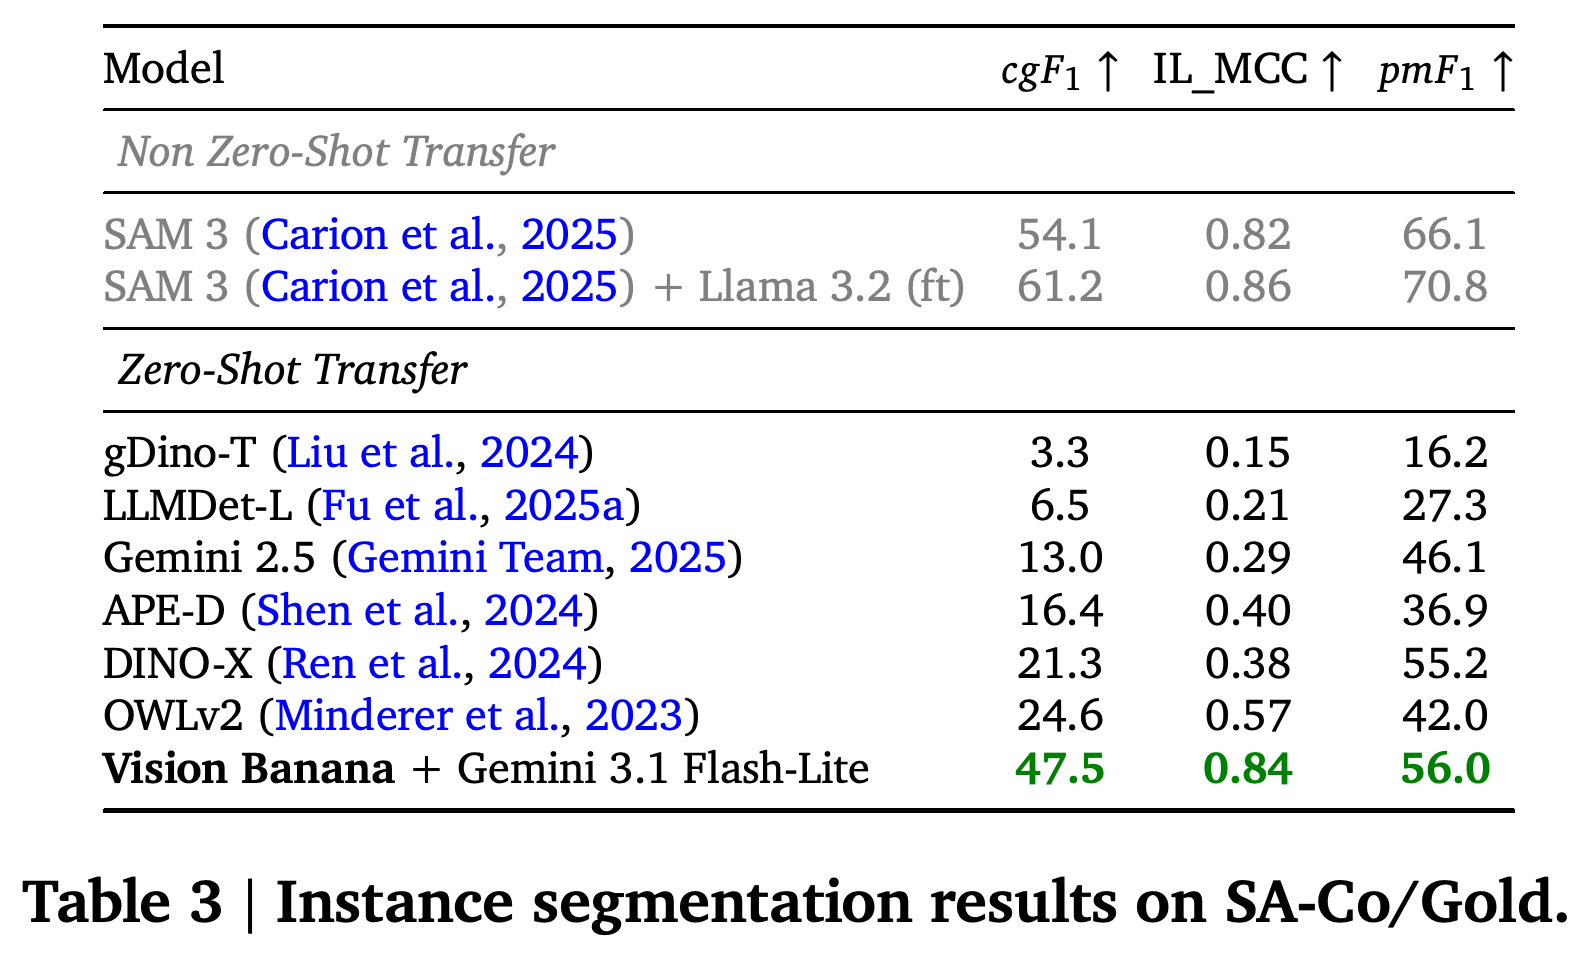
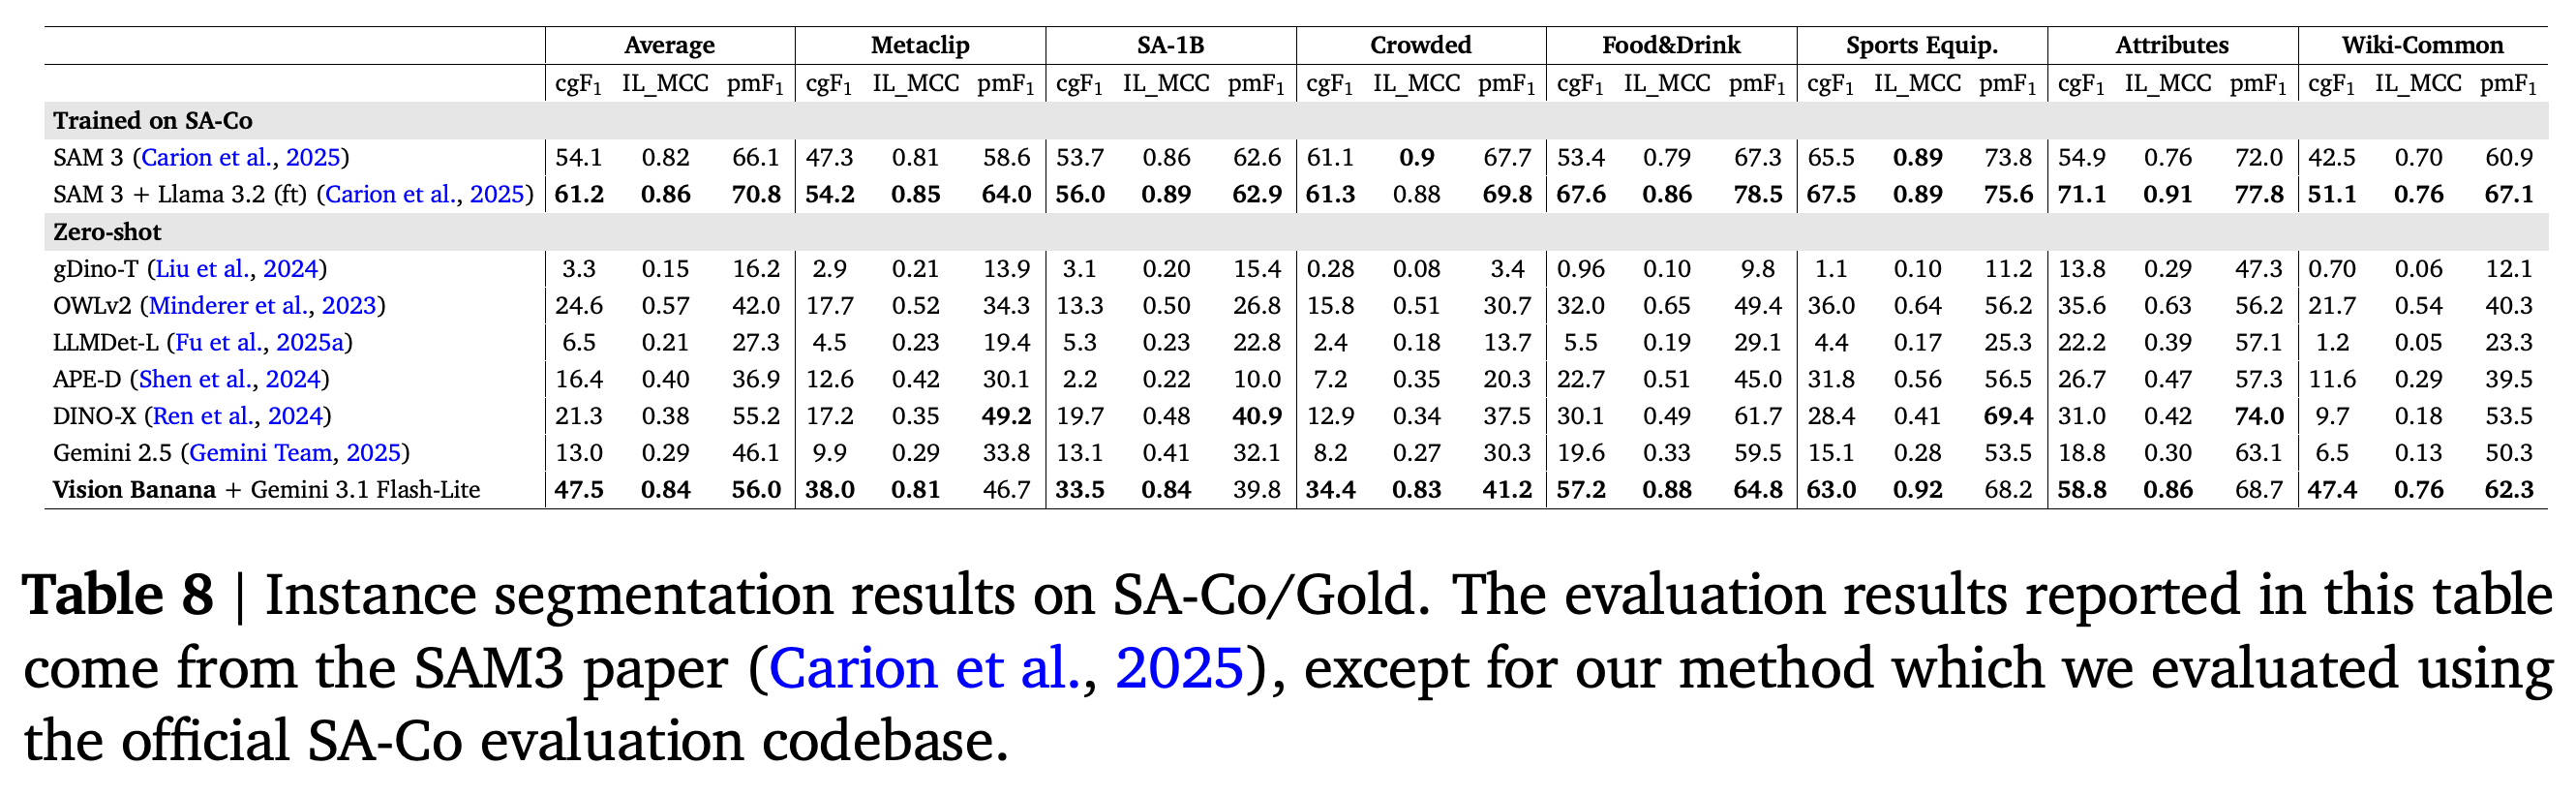
- Table 3에서 결합 파이프라인은 47.5 cgF1, 0.84 IL_MCC, 56.0 pmF1을 기록한다. OWLv2는 각각 24.6, 0.57, 42.0을 기록한다. 벤치마크 데이터로 학습한 SAM 3는 54.1 cgF1로 여전히 앞서며, fine-tuning한 Llama 3.2를 함께 사용하면 61.2를 기록한다.
Vision Banana + Gemini 3.1 Flash-Lite 파이프라인은 47.5 cgF1, 0.84 IL_MCC, 56.0 pmF1을 기록한다. 대상 존재 여부 분류가 gated score에 기여하며, SA-Co-trained SAM 3 파이프라인은 종합적으로 여전히 앞선다.
출력은 모델이 선택한 색상으로 인스턴스를 구분하며, 명사구가 바뀌면 대상도 달라진다. 농구공과 공을 비교한 예시는 요청한 클래스에 따라 출력에 포함되는 인스턴스가 달라짐을 보여준다.
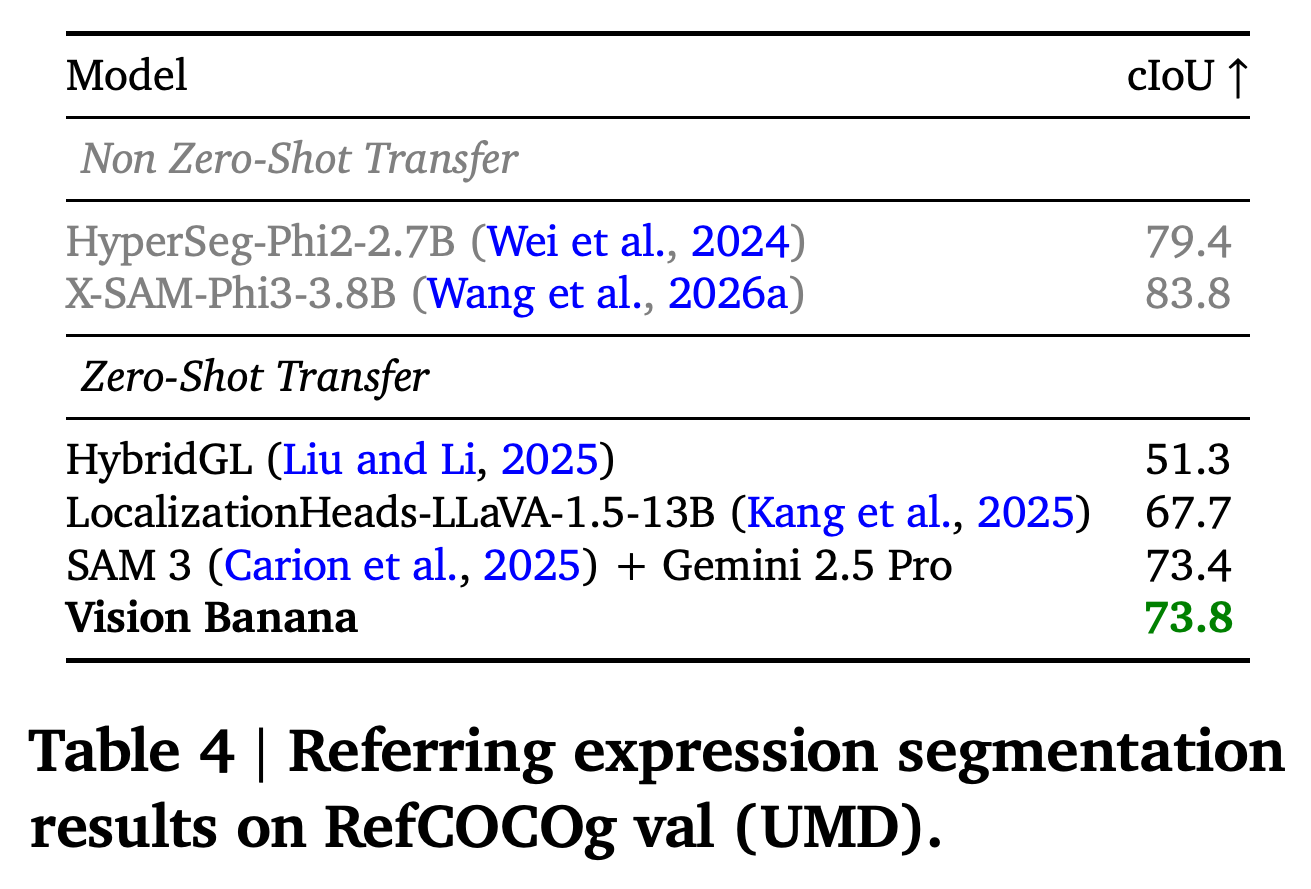
Referring expression segmentation은 자유로운 형식의 객체 설명을 이미지에 grounding하는 능력을 평가한다. Vision Banana는 RefCOCOg UMD val에서 73.8 cIoU를 기록해 SAM 3 + Gemini 2.5 Pro 파이프라인의 73.4를 소폭 앞선다. 벤치마크 데이터로 학습한 X-SAM-Phi3-3.8B는 83.8을 기록한다.
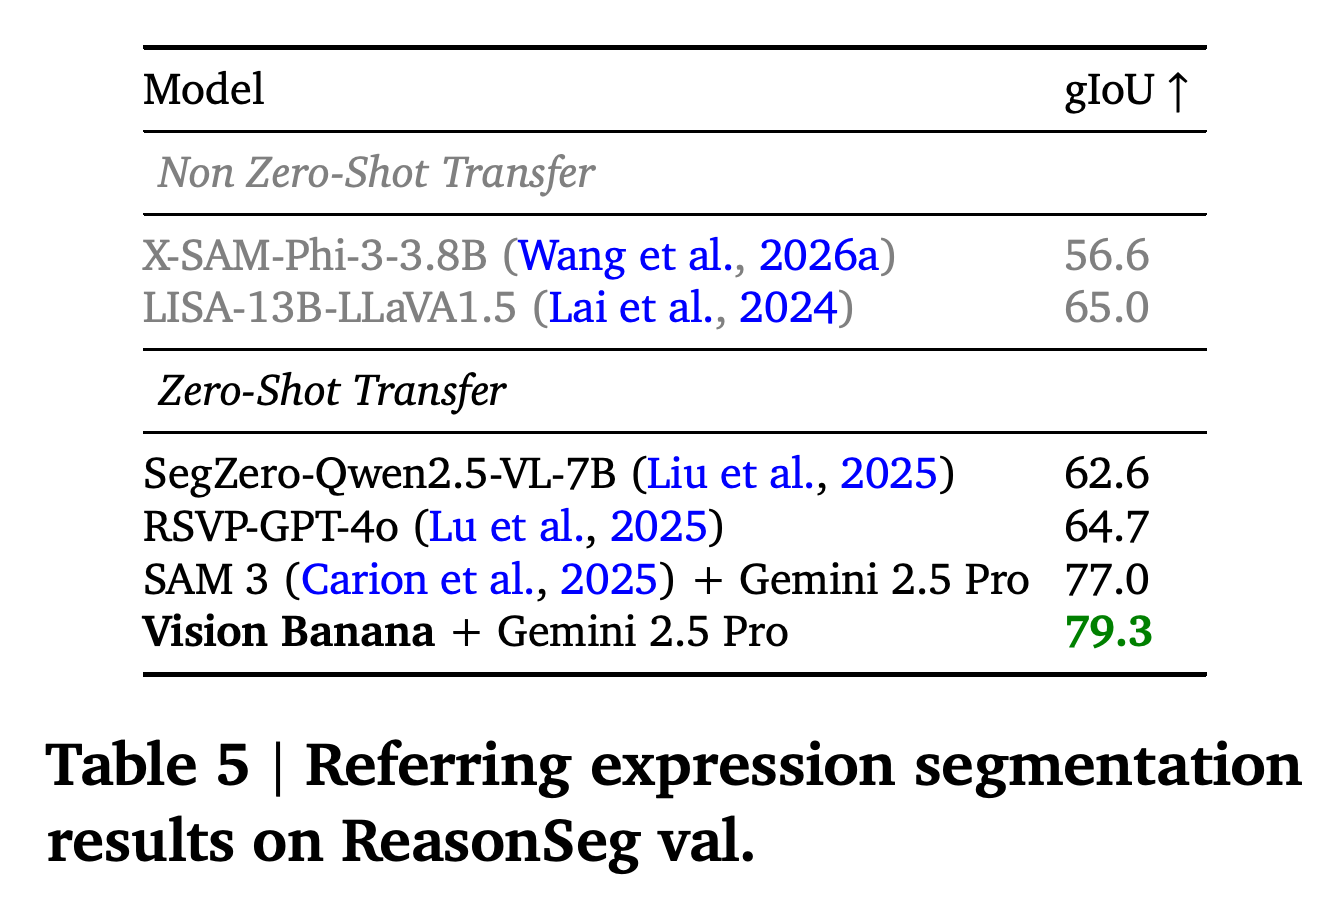
- ReasonSeg val에서는 Gemini 2.5 Pro가 추론 쿼리를 서술적 지칭 표현으로 변환하고, Vision Banana가 이를 바탕으로 segmentation을 수행한다. 이 단일 턴 파이프라인에서는 Gemini와 Vision Banana를 각각 정확히 1회 호출한다.
- 보조 모델을 사용하는 이 파이프라인은 79.3 gIoU를 기록하며, SAM 3 + Gemini 2.5 Pro는 77.0을 기록한다. 양쪽 파이프라인은 같은 이름의 추론 보조 모델을 사용하지만, 논문은 중간에 생성된 지칭 표현이 동일한지는 밝히지 않는다.
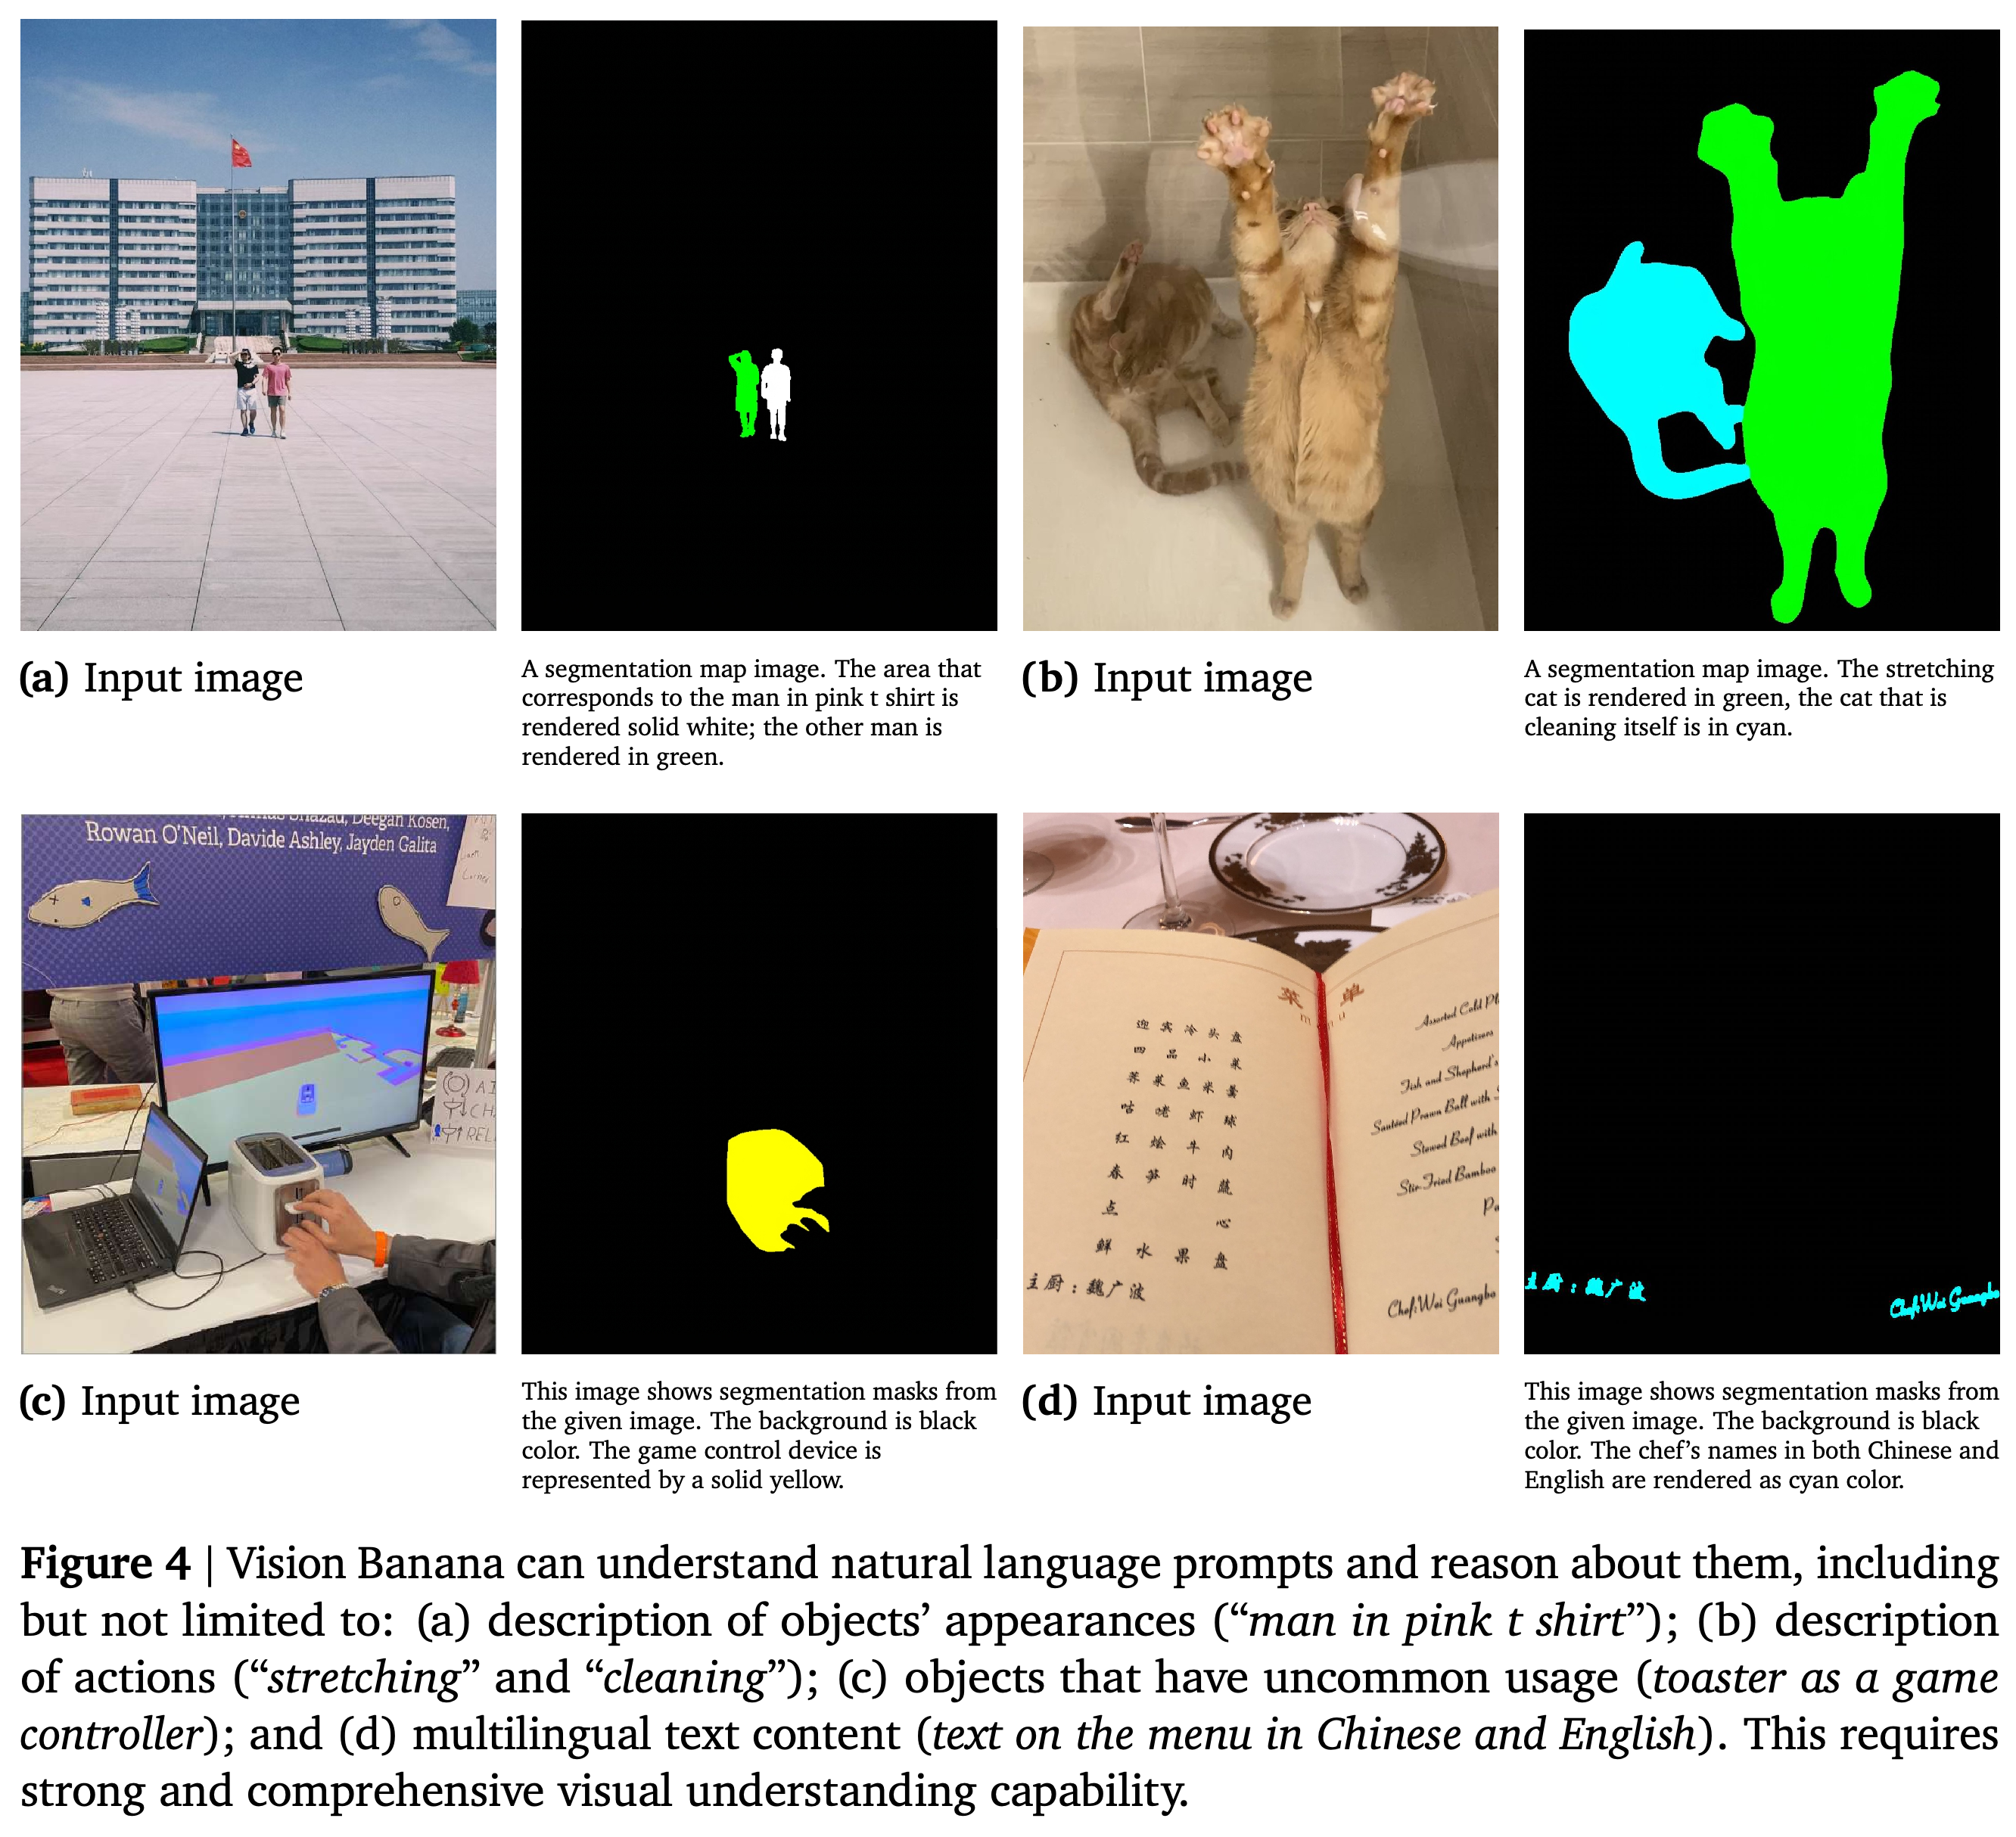
- Figure 4는 외형, 행동, 비전형적인 객체 사용 방식, 중국어 및 영어 텍스트를 통한 grounding을 보여준다. 선별된 예시는 능력을 보여주지만, 그 능력이 얼마나 자주 안정적으로 발휘되는지는 정량화하지 않는다.
73.8 대 73.4 cIoU라는 비교는 zero-shot transfer 조건에서 SAM 3 + Gemini 2.5 Pro보다 수치상 소폭 앞섰음을 보여준다. 벤치마크 데이터로 학습한 방법의 더 높은 결과는 이 우위가 성립하는 범위를 제한한다. 불확실성 추정치는 보고되지 않는다.
비교한 양쪽 파이프라인 모두 Gemini 2.5 Pro의 도움을 받으며, Vision Banana는 79.3 gIoU, SAM 3는 77.0을 기록한다. 이 결과는 Vision Banana의 단독 추론이 아니라 보조 모델을 사용하는 segmentation 파이프라인을 평가한 것이다.
선별된 마스크는 외형, 활동, 비전형적인 기능적 사용, 다국어 텍스트를 단서로 지칭된 대상을 찾아낸 결과다. 토스터 예시는 기능에 따른 지칭을 해석하는 능력을 보여준다. 다만 이 그림은 체계적인 추론 평가를 제공하지 않는다.
3.2. 3D Understanding from Monocular Images
Metric depth는 Barron (2025)의 거듭제곱 변환을 적용한 뒤 RGB 정육면체의 모서리를 따라 이어지는 구간별 선형 경로에서 보간하여 인코딩한다. Equation (1)은 (f(d,\lambda,c)=1-\left(1-\frac{d}{\lambda c}\right)^{\lambda+1})이며, λ < −1이다. 모든 실험에서 λ = −3과 c = 10/3을 사용한다.
- 이 변환은 음이 아닌 실제 거리를 [0, 1)로 매핑하며, 가까운 깊이에 더 높은 표현 해상도를 할당한다.
- Figure 5는 검정에서 흰색으로 이어지는 색상 경로를 보여준다. 생성된 색상을 가장 가까운 경로 구간에 투영한 뒤, 보간과 깊이 변환을 역으로 적용한다.
- 가역적인 대응은 깊이와 선택한 색상 경로 사이에 성립하며, RGB 정육면체의 모든 점에 성립하는 것은 아니다. 학습에는 Plasma, Inferno, Viridis, grayscale 표현도 포함된다.
RGB 정육면체 경로에 표시된 거리값은 색상 해상도를 비선형적으로 할당해 가까운 깊이를 더 세밀하게 구분하는 방식을 보여준다. 디코딩할 때는 생성된 색상을 이 경로에 투영한 뒤 실제 거리를 복원한다. 이 매핑은 RGB 정육면체 전체에 대한 전단사 대응이 아니다.
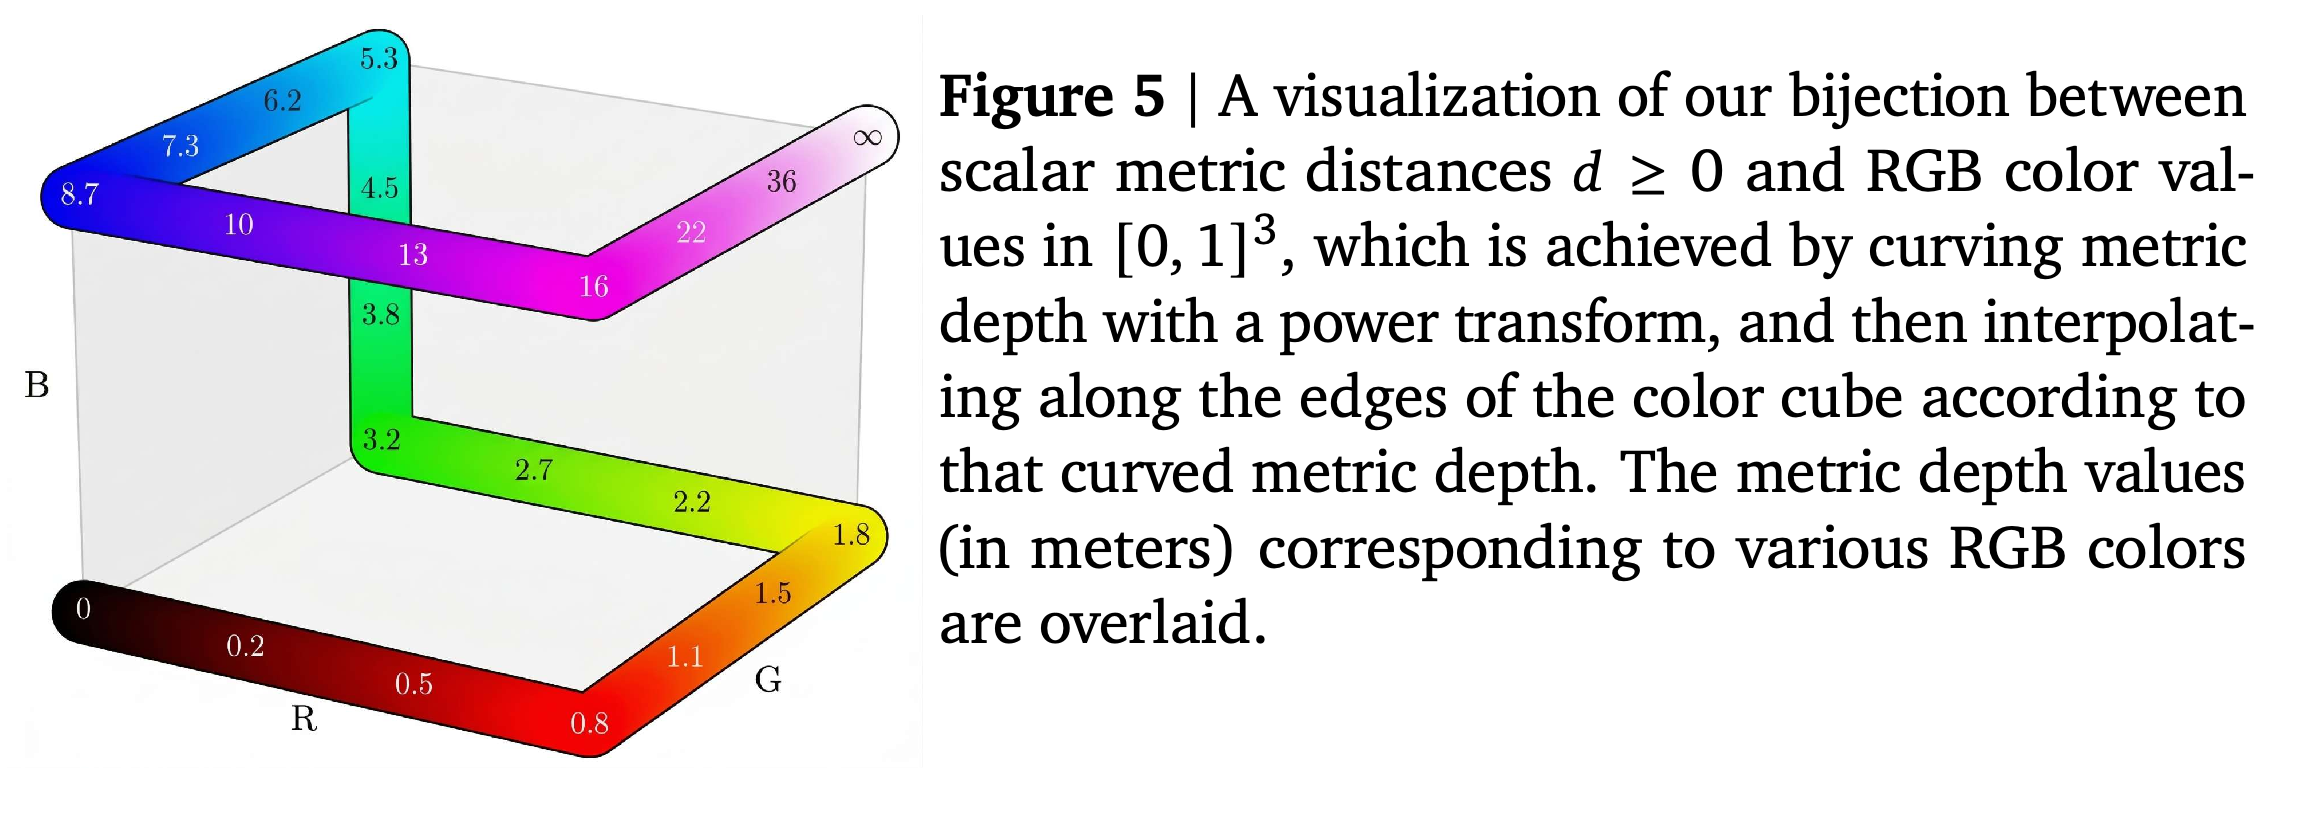
Table 6은 NYU, iBims1, ETH3D, DIODE-Indoor, KITTI, nuScenes에서 metric depth를 평가한다. Vision Banana의 깊이 과제 감독 신호는 전부 합성 데이터에서 얻는다. 저자들은 깊이 학습과 추론에 카메라 내부 및 외부 파라미터를 사용하지 않았다고 보고한다. 평균 δ1은 0.882, AbsRel은 0.116이다.
- Depth Anything 3의 결과가 보고된 동일한 4개 데이터셋인 NYU, ETH3D, DIODE, KITTI에서 평균 δ1은 0.929로, 비교 모델의 0.918을 앞선다.
- 성능은 고르지 않다. Vision Banana는 ETH3D에서 0.935, DIODE-Indoor에서 0.917을 기록하지만, nuScenes에서는 0.643으로 UniK3D의 0.840과 MoGe-2의 0.820보다 낮다.
- Depth Anything 3는 NYU와 KITTI에서도 Vision Banana를 앞선다. 종합 지표에서의 우위가 모든 도메인에서의 우위를 뜻하지는 않는다.
이 표는 깊이 추정의 종합적인 우위를 뒷받침하면서도 도메인별 약점을 드러낸다. 특히 nuScenes의 δ1은 0.643이다. 각주는 동일한 4개 데이터셋에 대한 비교를 명시하고, DepthLM의 nuScenes 결과가 zero-shot이 아님을 밝힌다.
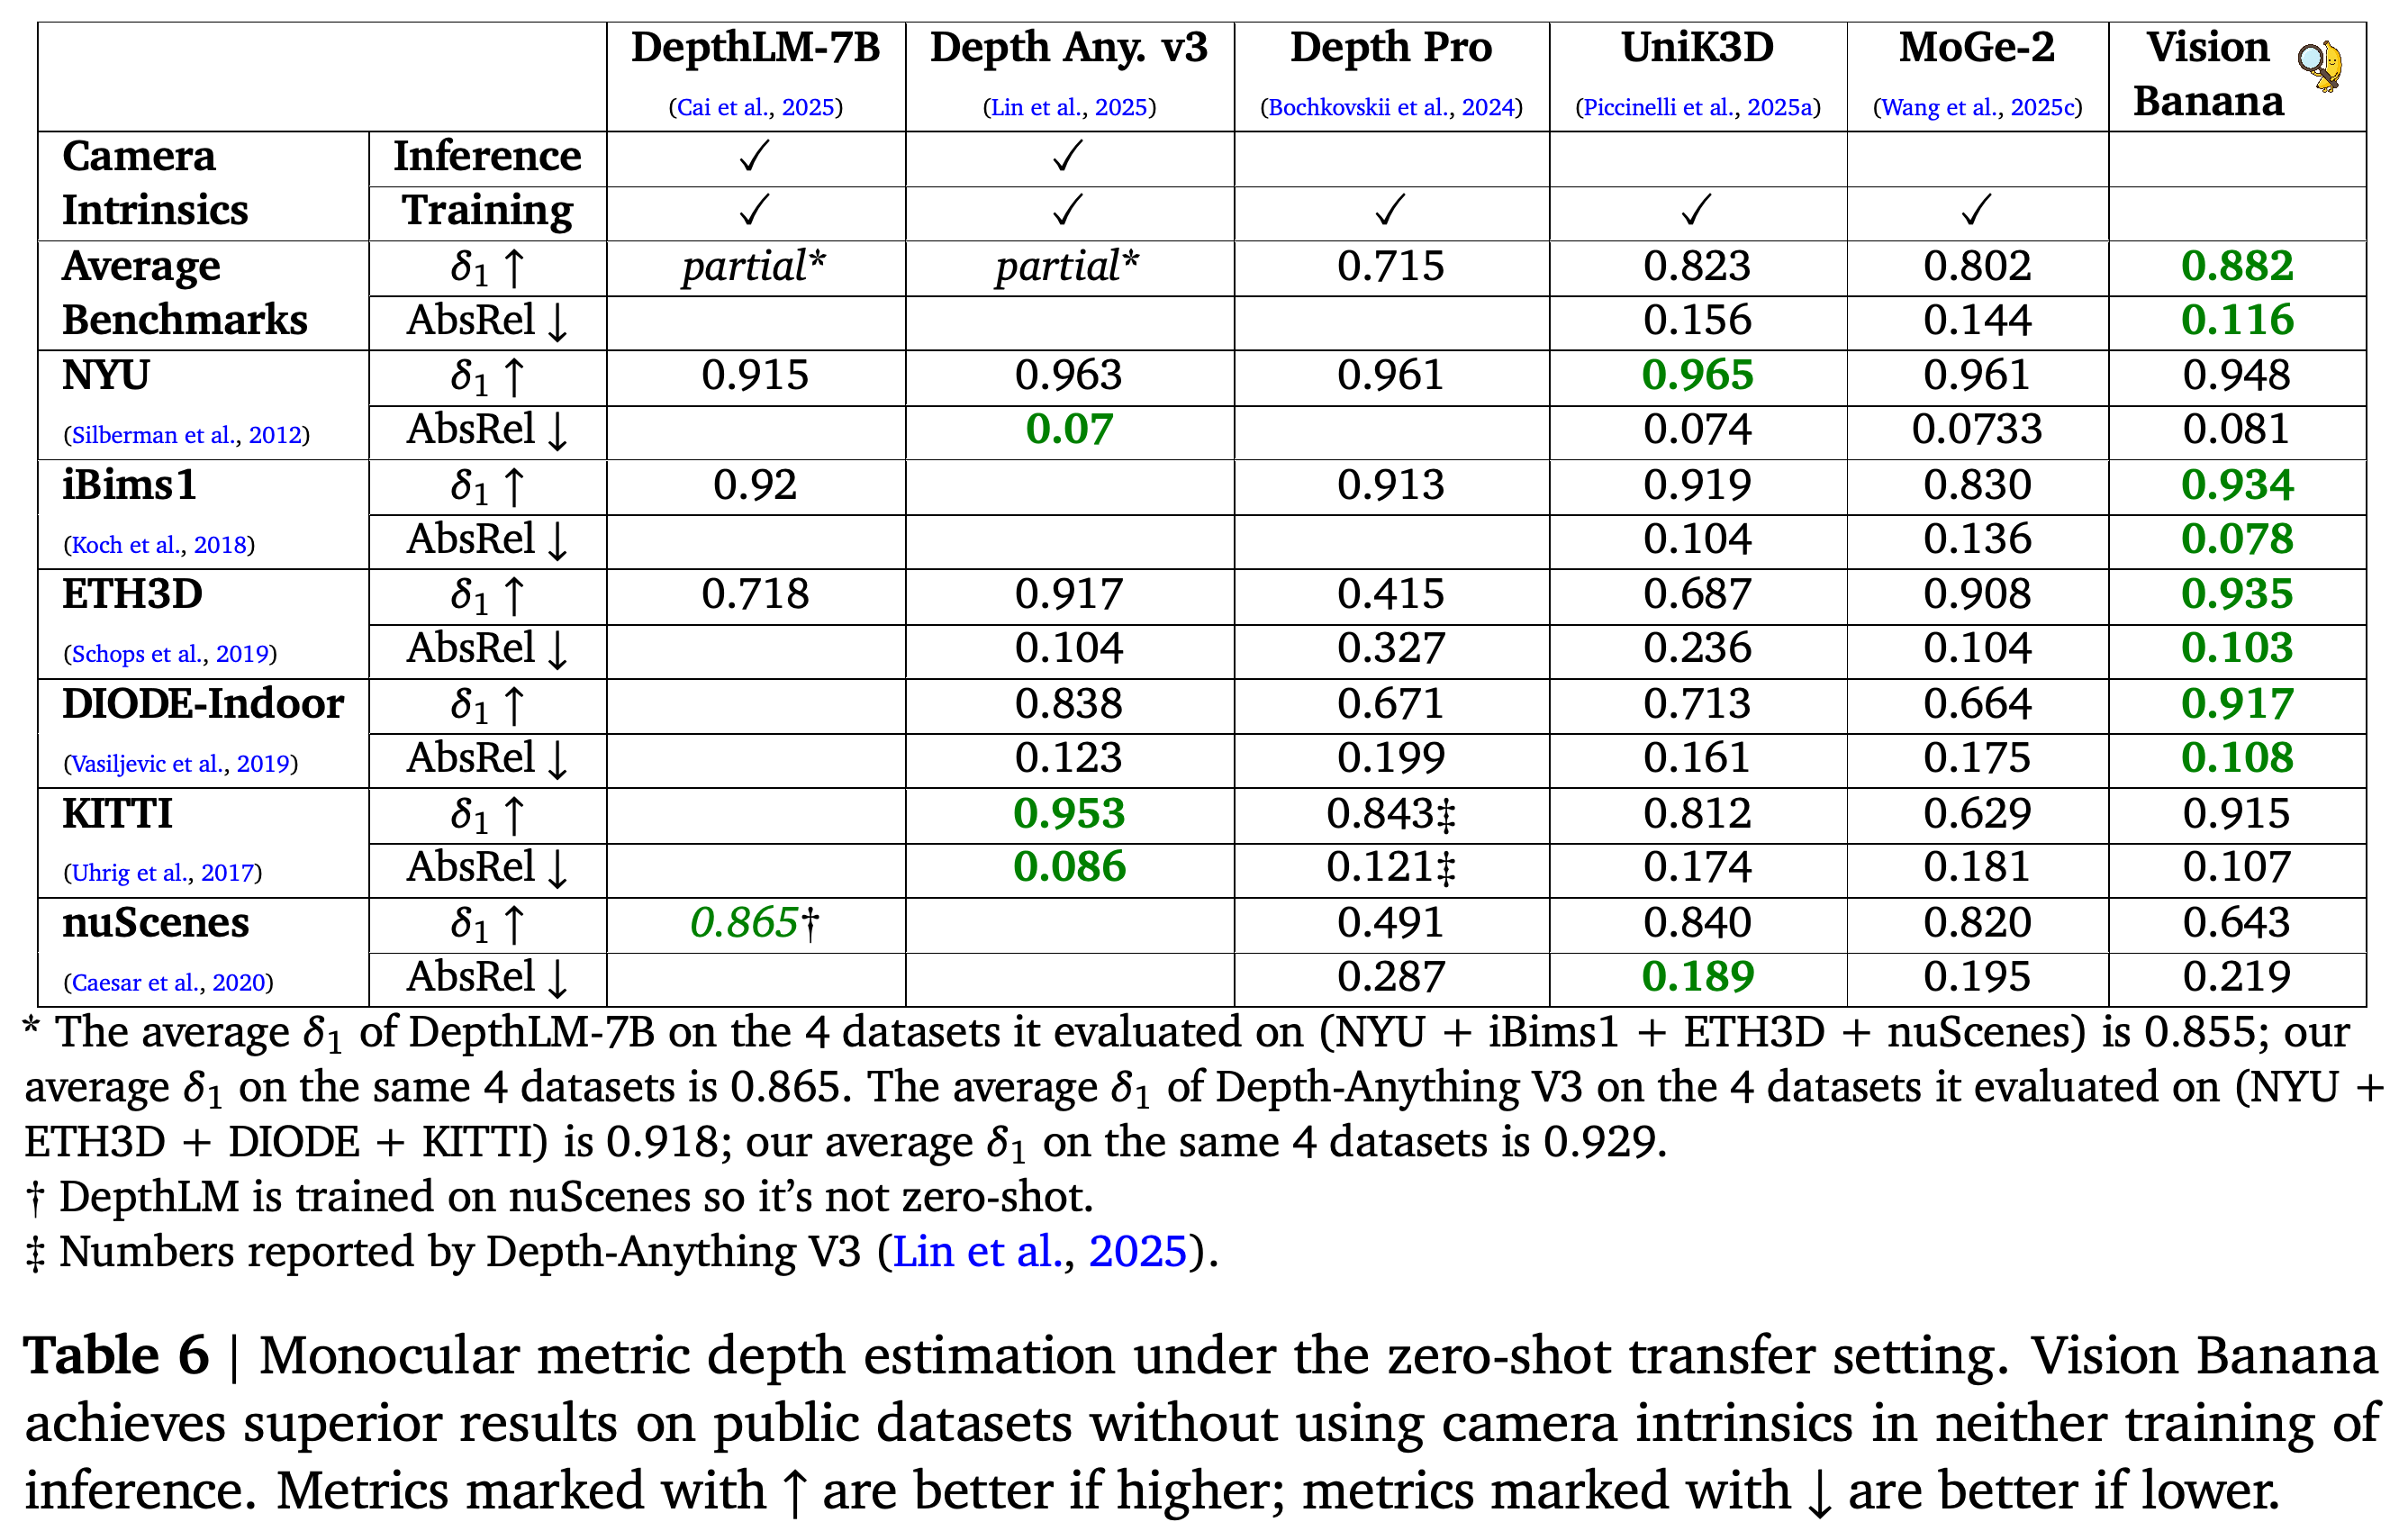
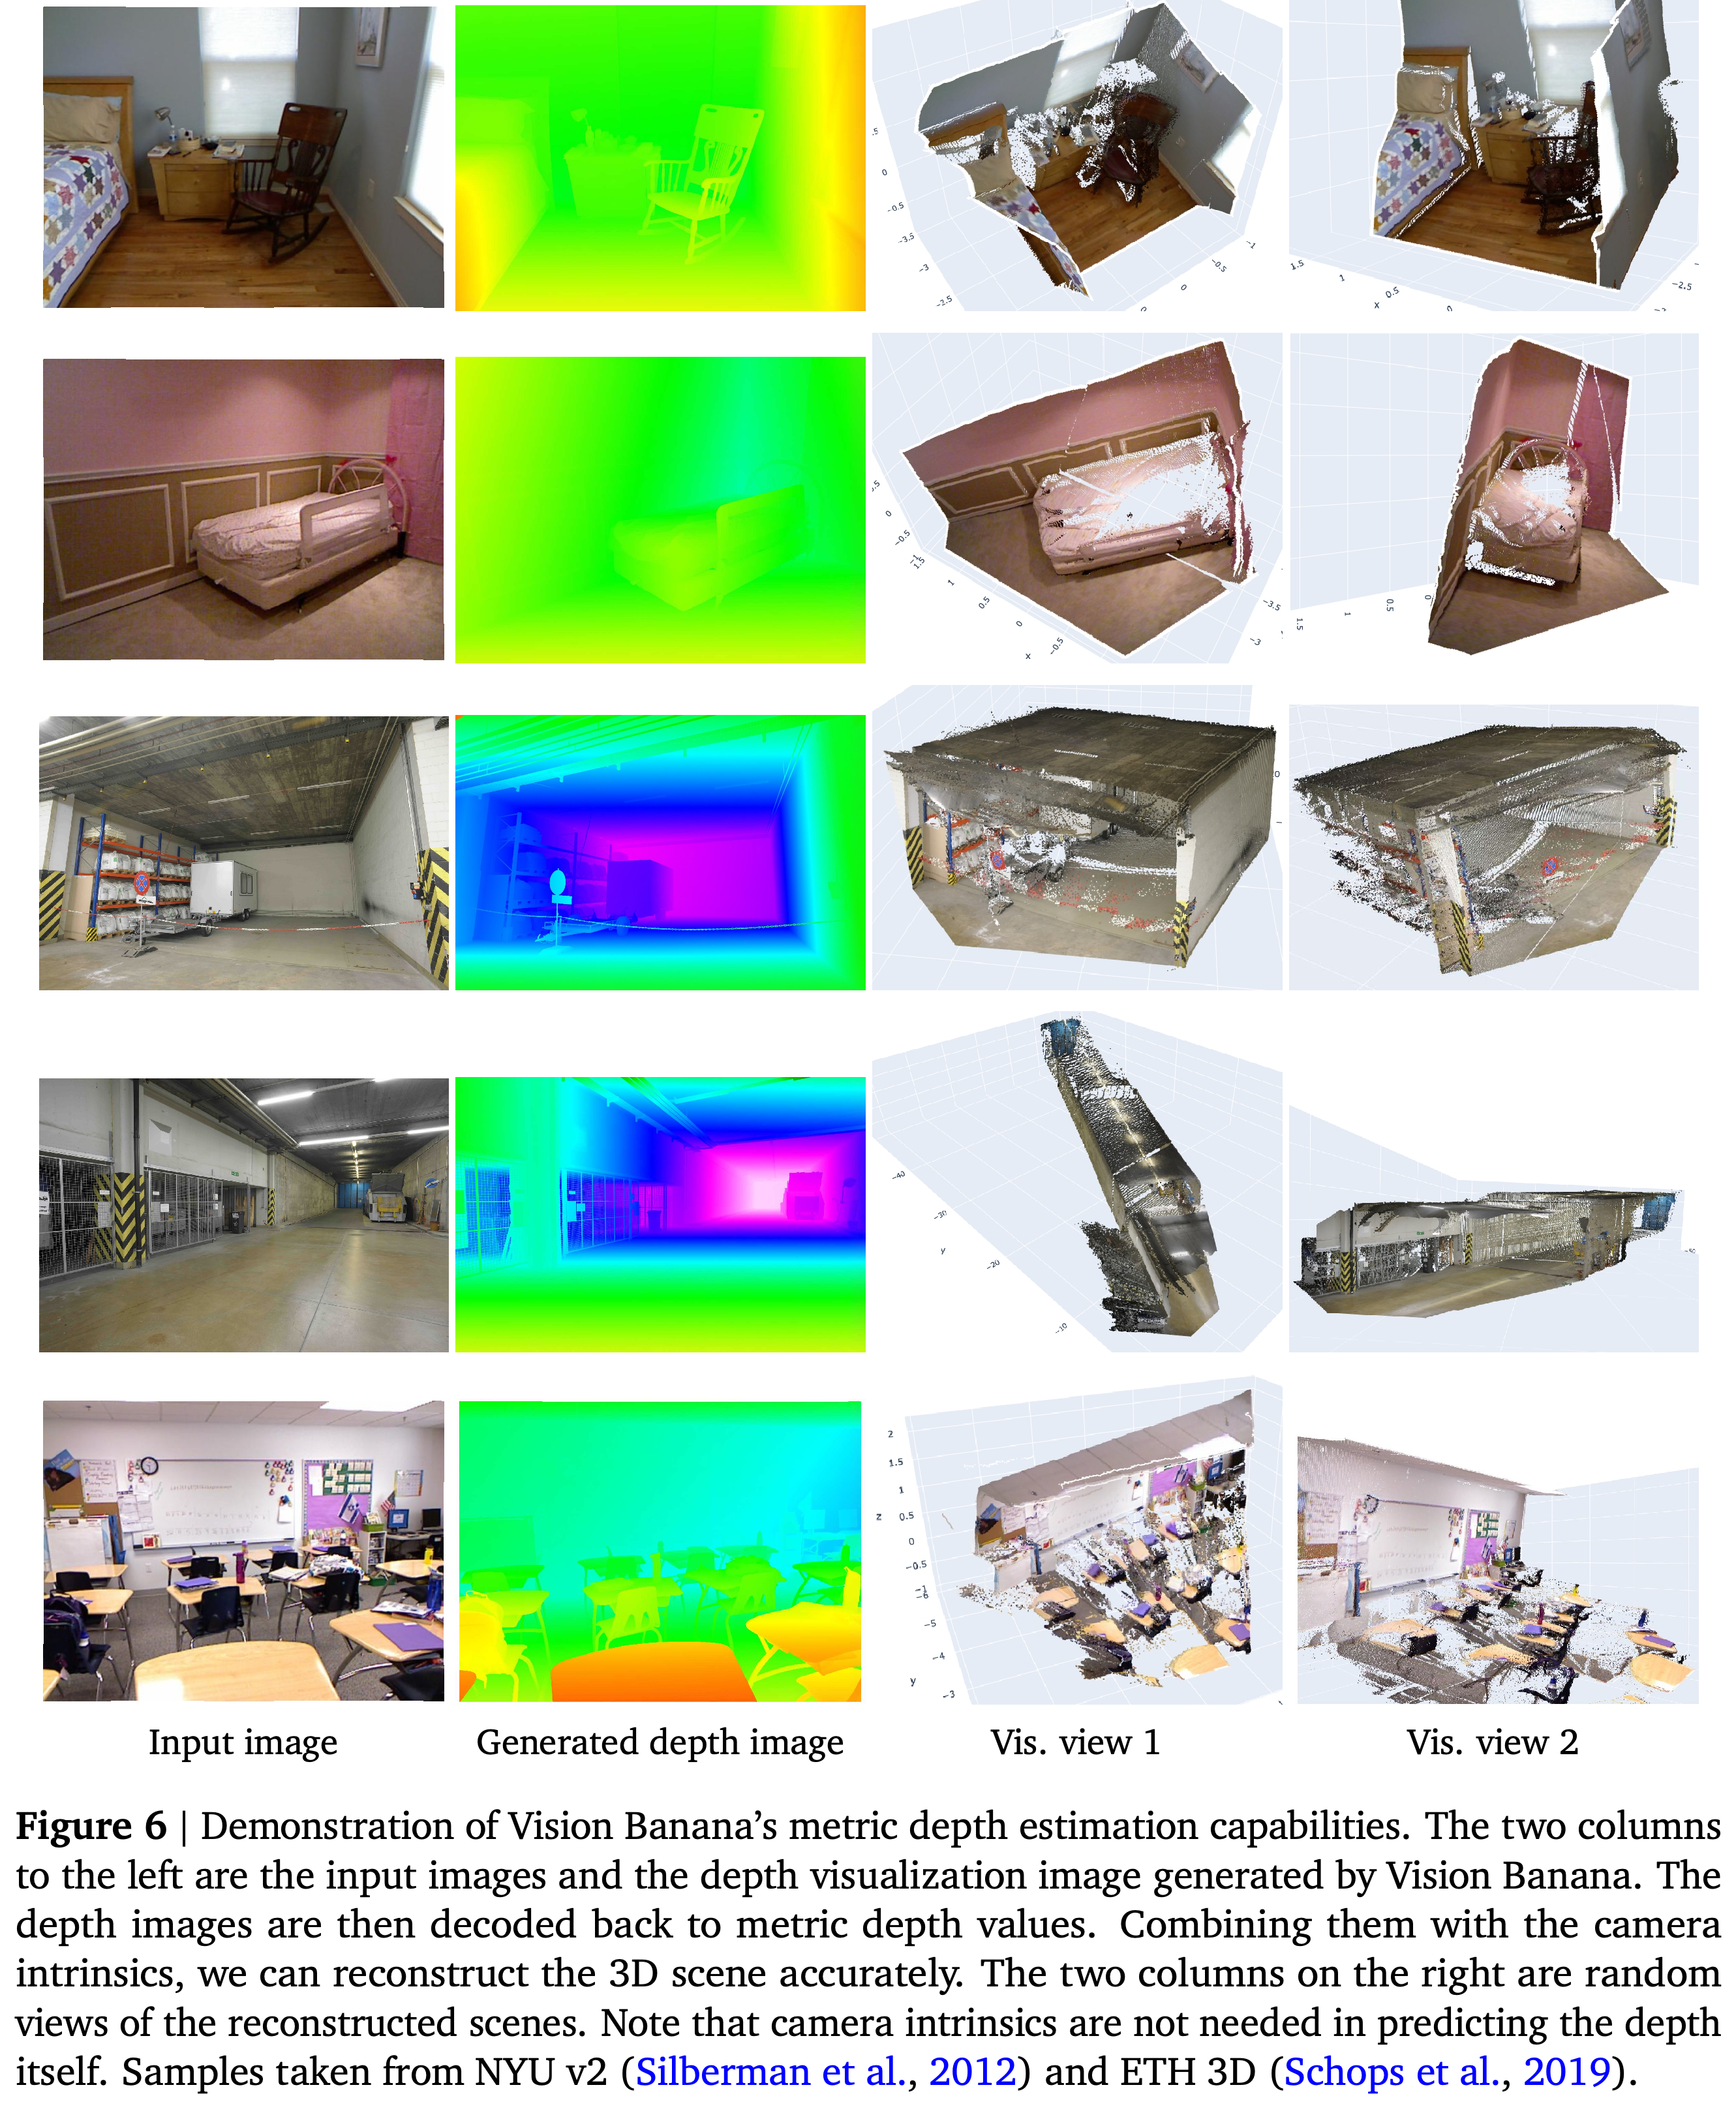
Figure 6은 생성된 깊이 이미지를 디코딩한 뒤 카메라 내부 파라미터로 역투영하여 point cloud를 만든다. 선별된 NYU v2 및 ETH3D 장면에서 평면 구조와 객체 형상을 보여준다. 내부 파라미터는 깊이 예측이 아니라 재구성에 사용한다.
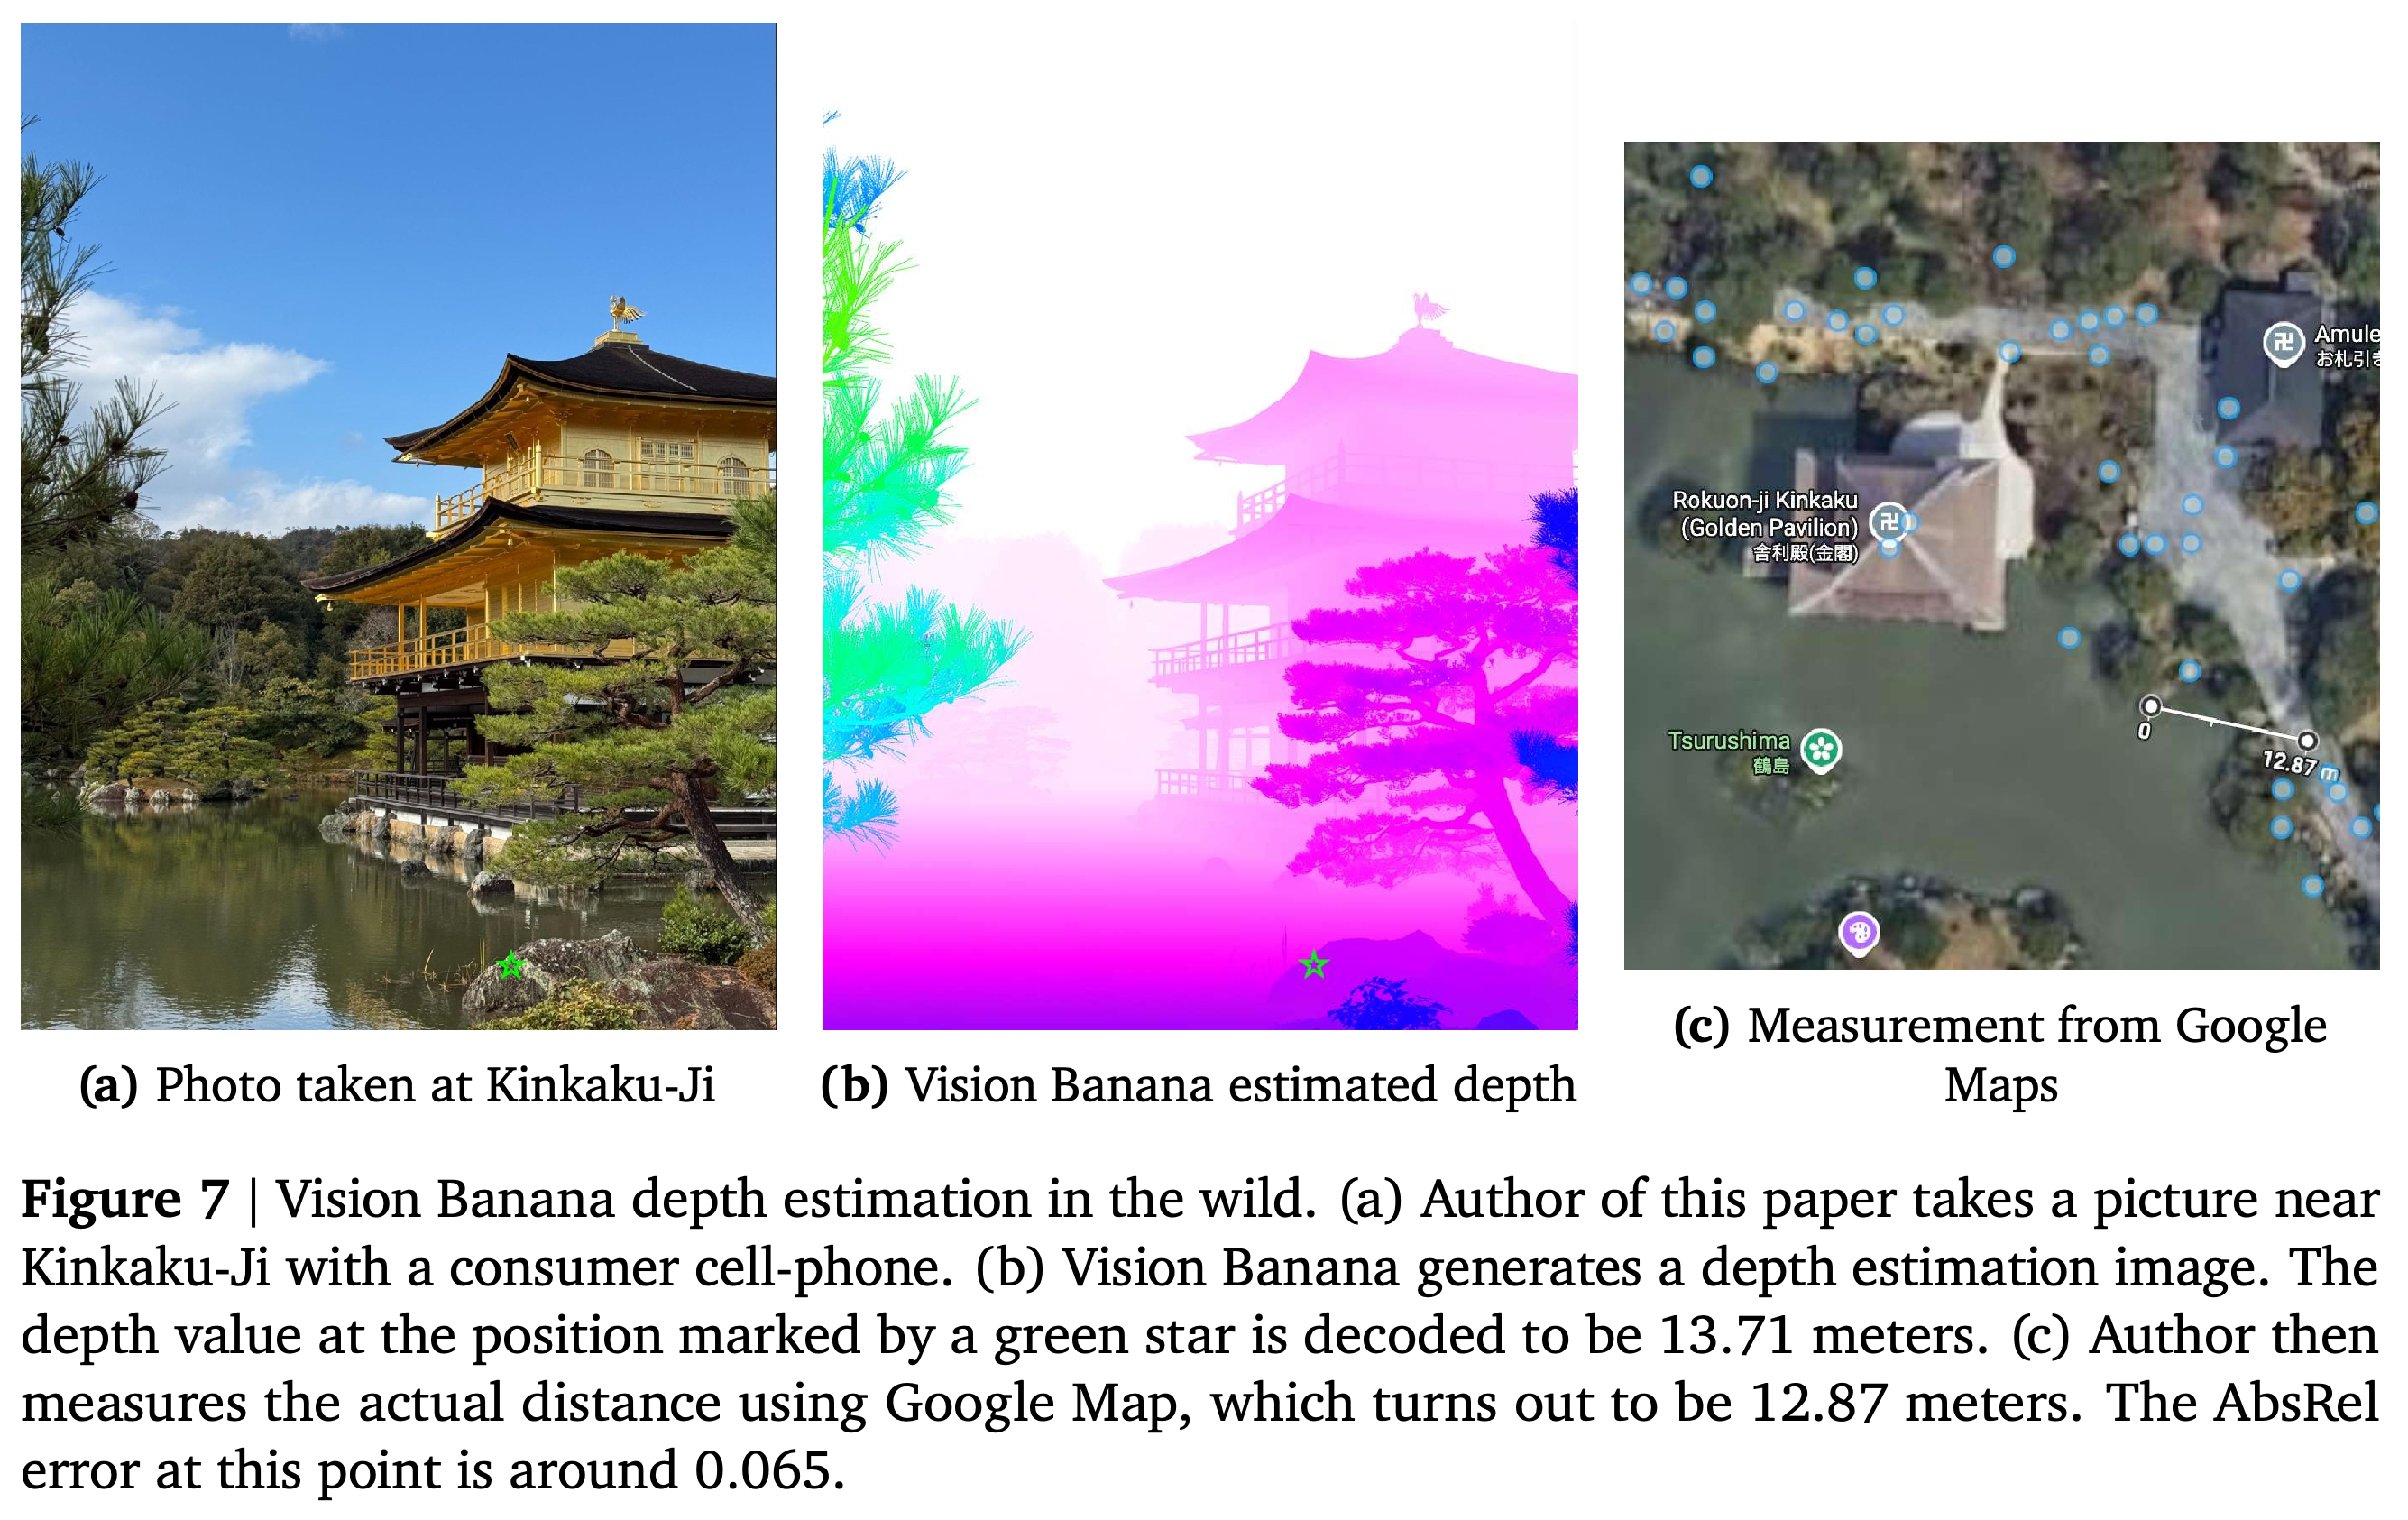
- Figure 7은 Kinkaku-Ji 근처에서 촬영한 스마트폰 이미지로 비공식적인 검증을 수행한다. 표시된 1개 지점의 예측 거리는 13.71미터이고 Google Maps 측정값은 12.87미터이며, 보고된 AbsRel은 약 0.065다.
- 이 단일 지점 검증은 예시 수준의 근거다. 보정된 깊이 정답이나 소비자 기기로의 일반화를 체계적으로 평가한 결과는 아니다.
깊이 예측을 역투영한 뒤 새로운 시점에서 본 결과는 선별된 장면의 실내 표면과 객체 배치를 보여준다. 카메라 내부 파라미터는 깊이 추정 모델이 아니라 point cloud 재구성 단계에 사용한다. 이러한 시점별 결과는 정성적 검증이며, 독립적인 재구성 지표는 아니다.
표시된 지점에서 예측값 13.71미터와 Google Maps 측정값 12.87미터를 비교한다. 비공식적인 거리 스케일 검증이지만, 측정한 위치는 1곳뿐이며 기준값도 보정된 깊이 맵이 아니다.
Surface normal은 +x가 오른쪽, +y가 위쪽, +z가 이미지 평면 밖을 향하는 카메라 좌표계를 사용한다. 각 성분은 R = trunc((1 − x)/2, min = 0, max = 1) × 255, G = trunc((1 + y)/2, min = 0, max = 1) × 255, B = trunc((1 + z)/2, min = 0, max = 1) × 255로 인코딩한다.
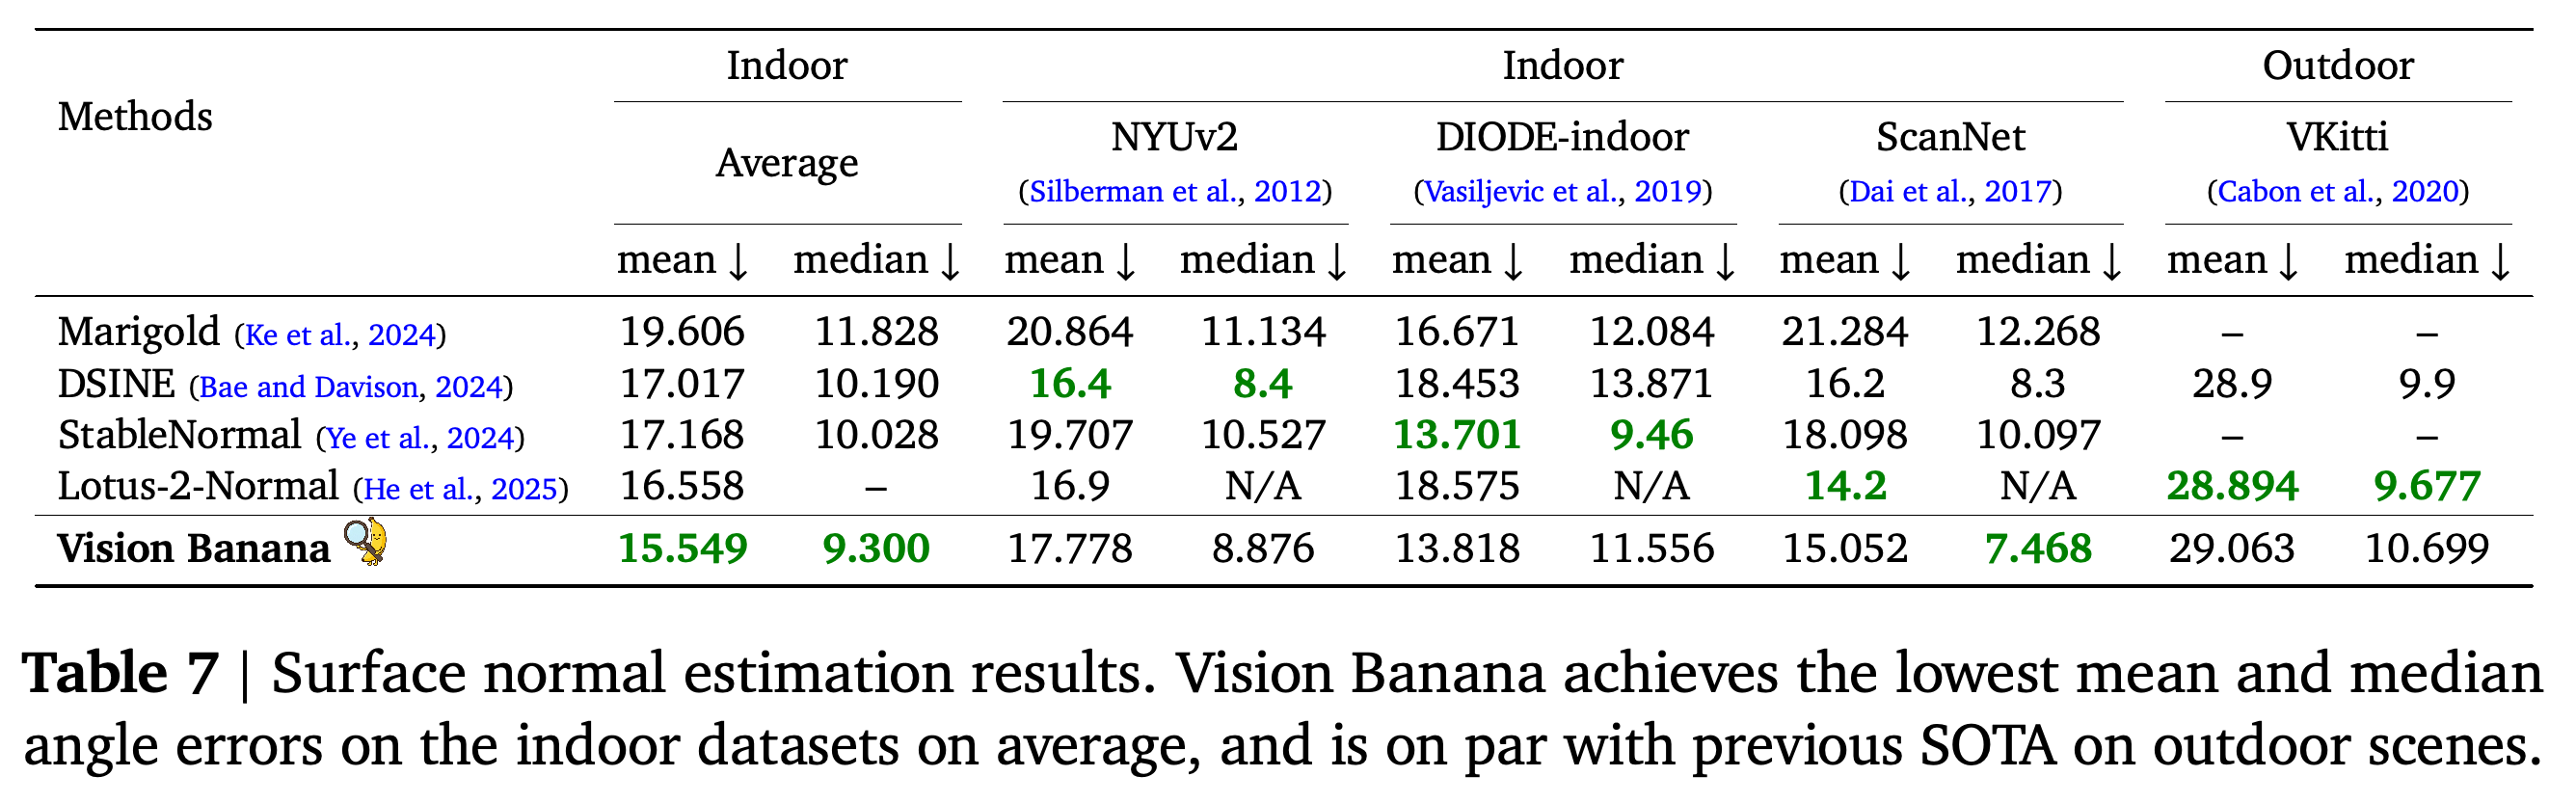
- Table 7에서 NYUv2, DIODE-indoor, ScanNet에 걸친 실내 평균 각도 오차와 중앙값 각도 오차의 평균은 각각 15.549와 9.300이다. 비교한 방법 중 보고된 평균값이 가장 낮다. Lotus-2-Normal의 실내 중앙값 오차는 제공되지 않는다.
- Table 1에 요약된 4개 데이터셋의 평균 오차는 18.928이며, Lotus-2는 19.642다. VKitti만 보면 Vision Banana의 결과가 더 나쁘다. 평균과 중앙값은 29.063과 10.699이며, 비교 모델은 28.894와 9.677이다.
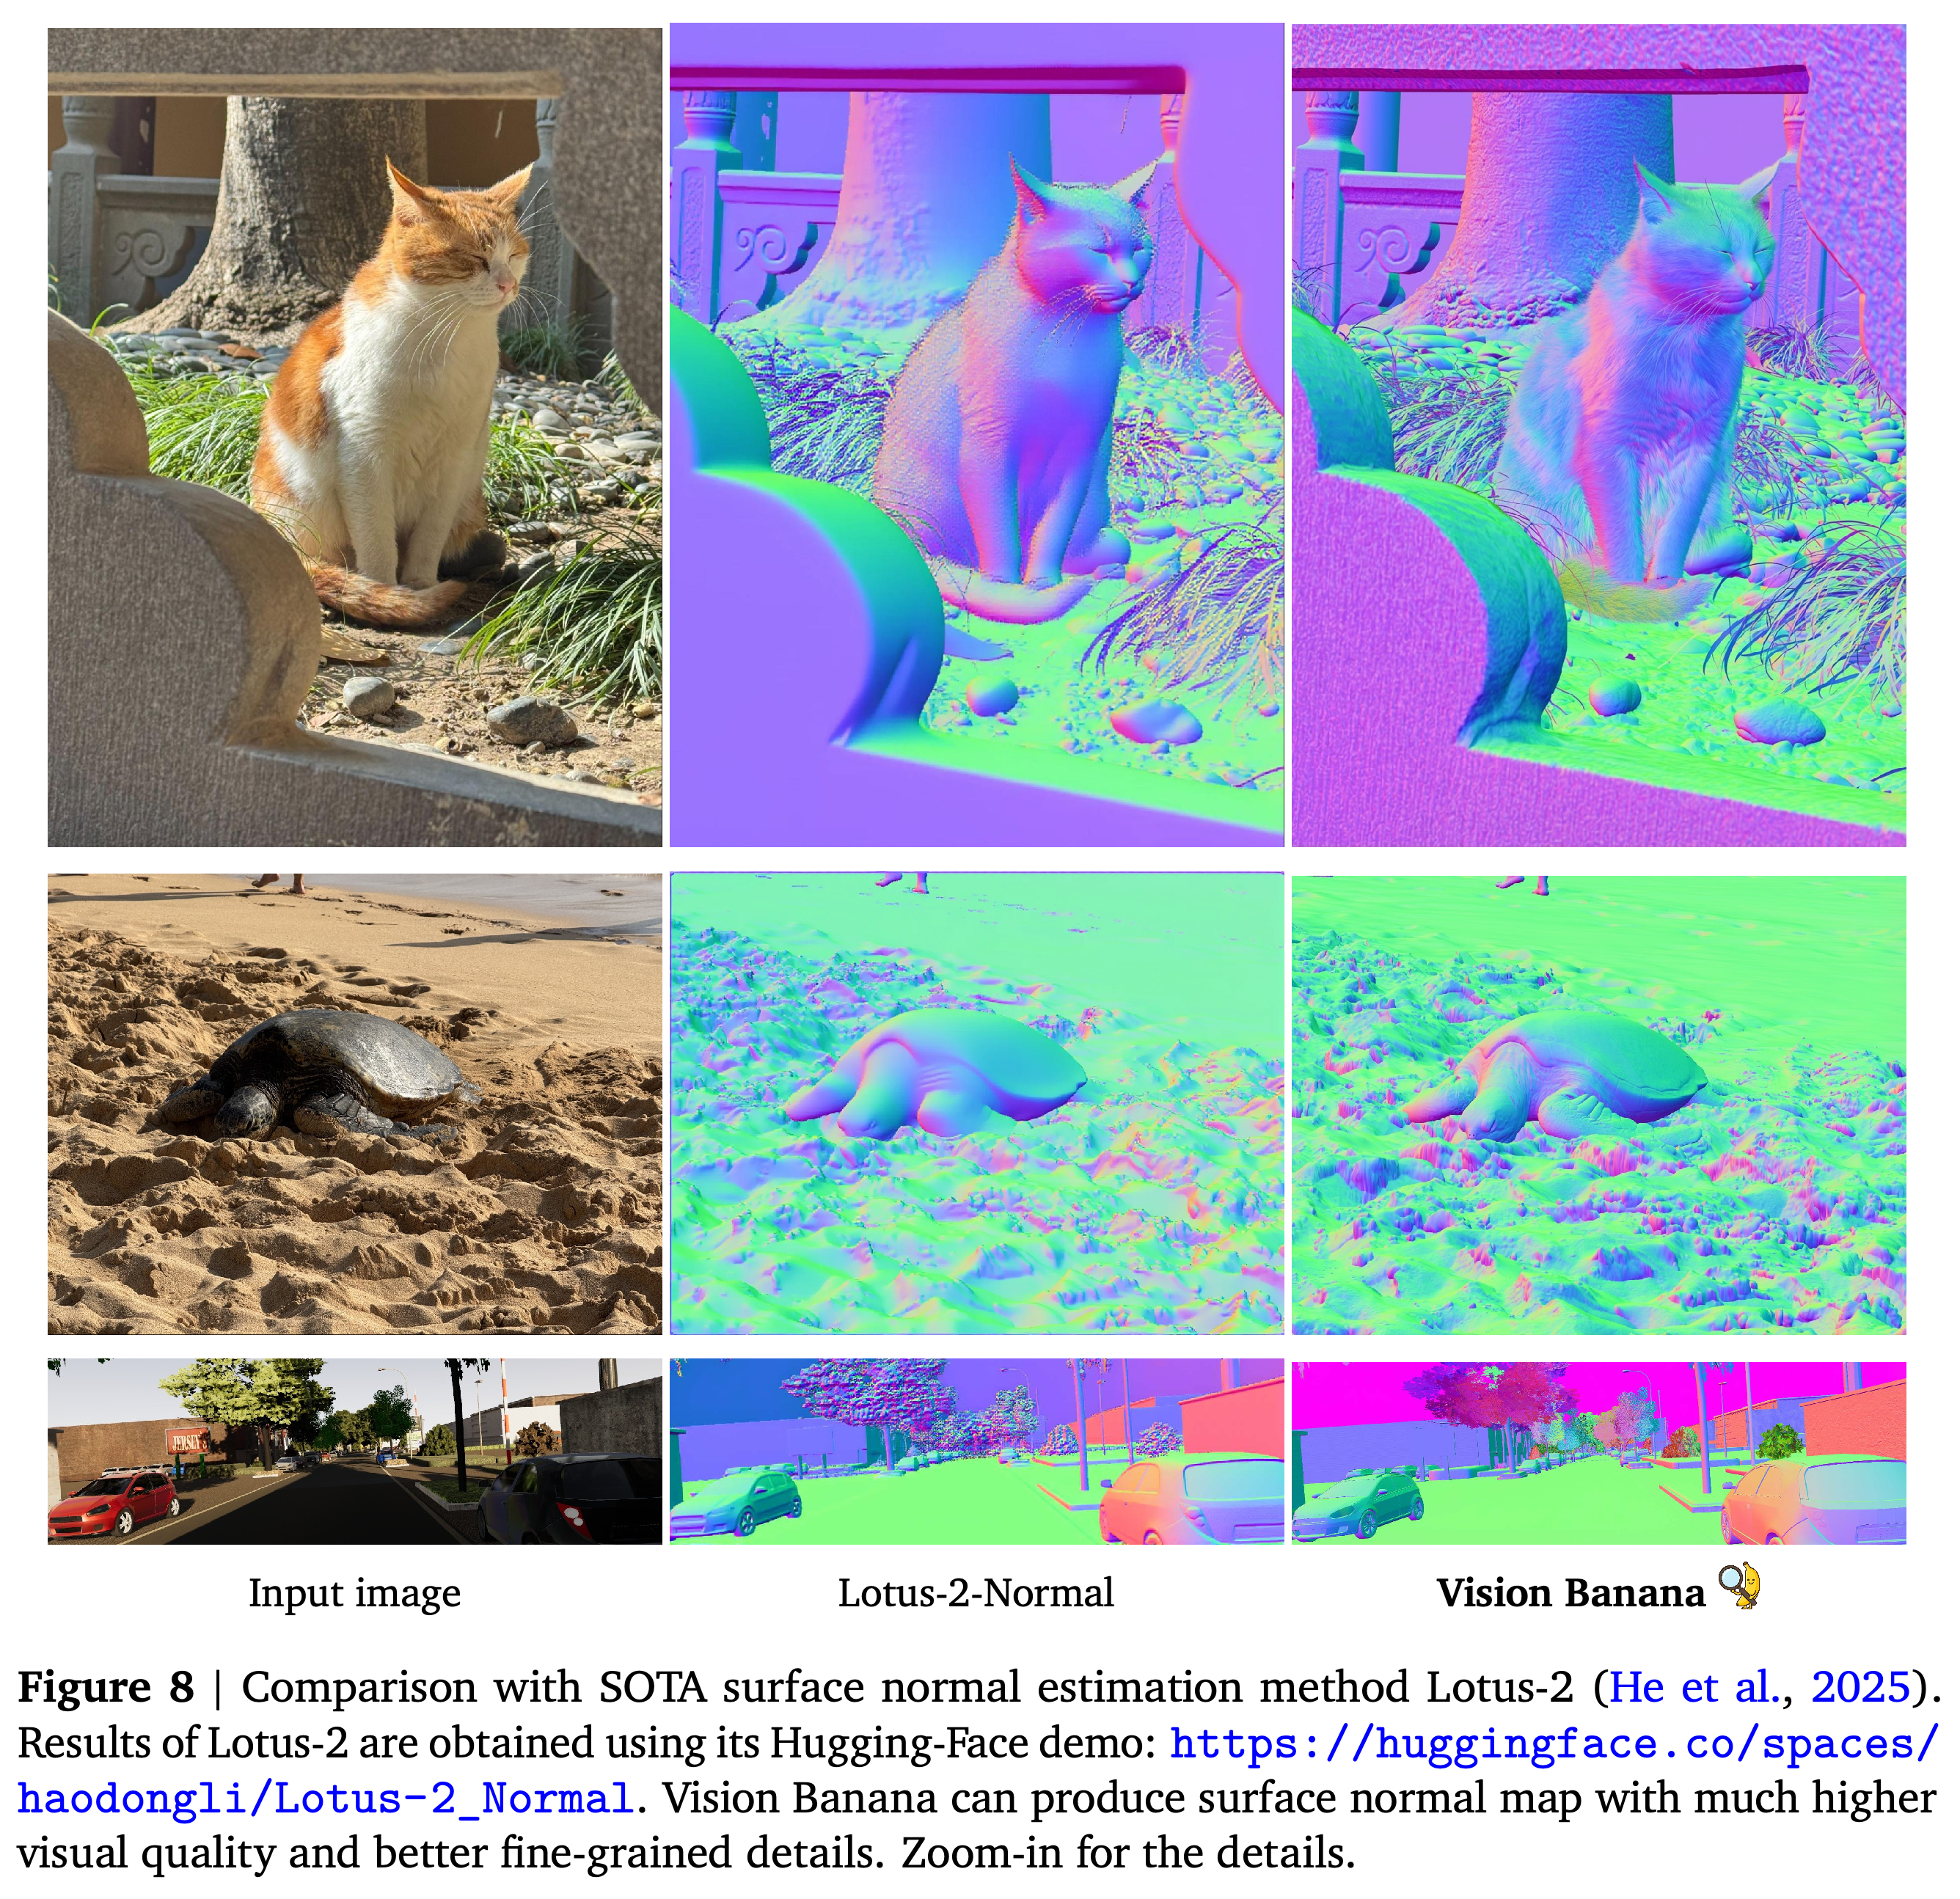
- Figure 8의 선별된 출력에서는 Vision Banana가 Lotus-2-Normal보다 더 세밀한 디테일을 보여준다. Lotus-2-Normal의 예측은 https://huggingface.co/spaces/haodongli/Lotus-2_Normal 에서 얻었다. 논문은 Lotus-2가 Virtual KITTI 2로 학습되었지만 Vision Banana는 그렇지 않다고 명시한다.
Vision Banana는 보고된 실내 평균 오차와 중앙값 오차의 평균이 가장 낮다. 다만 개별 데이터셋의 지표에서는 서로 다른 방법이 앞서며, Lotus-2-Normal의 실내 중앙값은 제공되지 않는다. Vision Banana의 VKitti 오차는 Lotus-2-Normal보다 약간 높다.
고양이와 거북이 예시에서 Vision Banana의 normal map은 제시된 Lotus-2 출력보다 국소적인 디테일을 더 많이 유지한다. 실외 예시는 겉으로 보이는 선명도와 벤치마크 각도 정확도를 별도로 평가해야 하는 이유를 보여준다.
4. Discussion
결과는 RGB 이미지 생성이 여러 dense perception 과제의 공통 인터페이스가 될 수 있으며, 평가한 이미지 합성 및 편집 능력도 유지할 수 있음을 뒷받침한다. 저자들은 생성 모델링이 일관된 출력 모드를 선택해 모호한 목표를 해결한다고도 주장한다. 그러나 실험은 이 메커니즘의 효과를 사전학습 규모, 데이터, instruction tuning의 효과와 분리하지 않는다.
- 패러다임 전환과 Artificial General Intelligence from Vision에 관한 주장은 저자들의 해석이며, 실험으로 입증된 결과는 아니다.
- 평가는 단안 이미지로 제한된다. 더 다양한 과제 구성, 다중 시점 입력, 비디오 입력과 생성기, 언어 모델과의 통합은 향후 연구 방향으로 제시된다.
- 저자들은 경량 전문 모델보다 연산 부담이 상당히 크다는 점을 인정한다. PDF는 지연 시간이나 비용 비교를 제공하지 않는다.
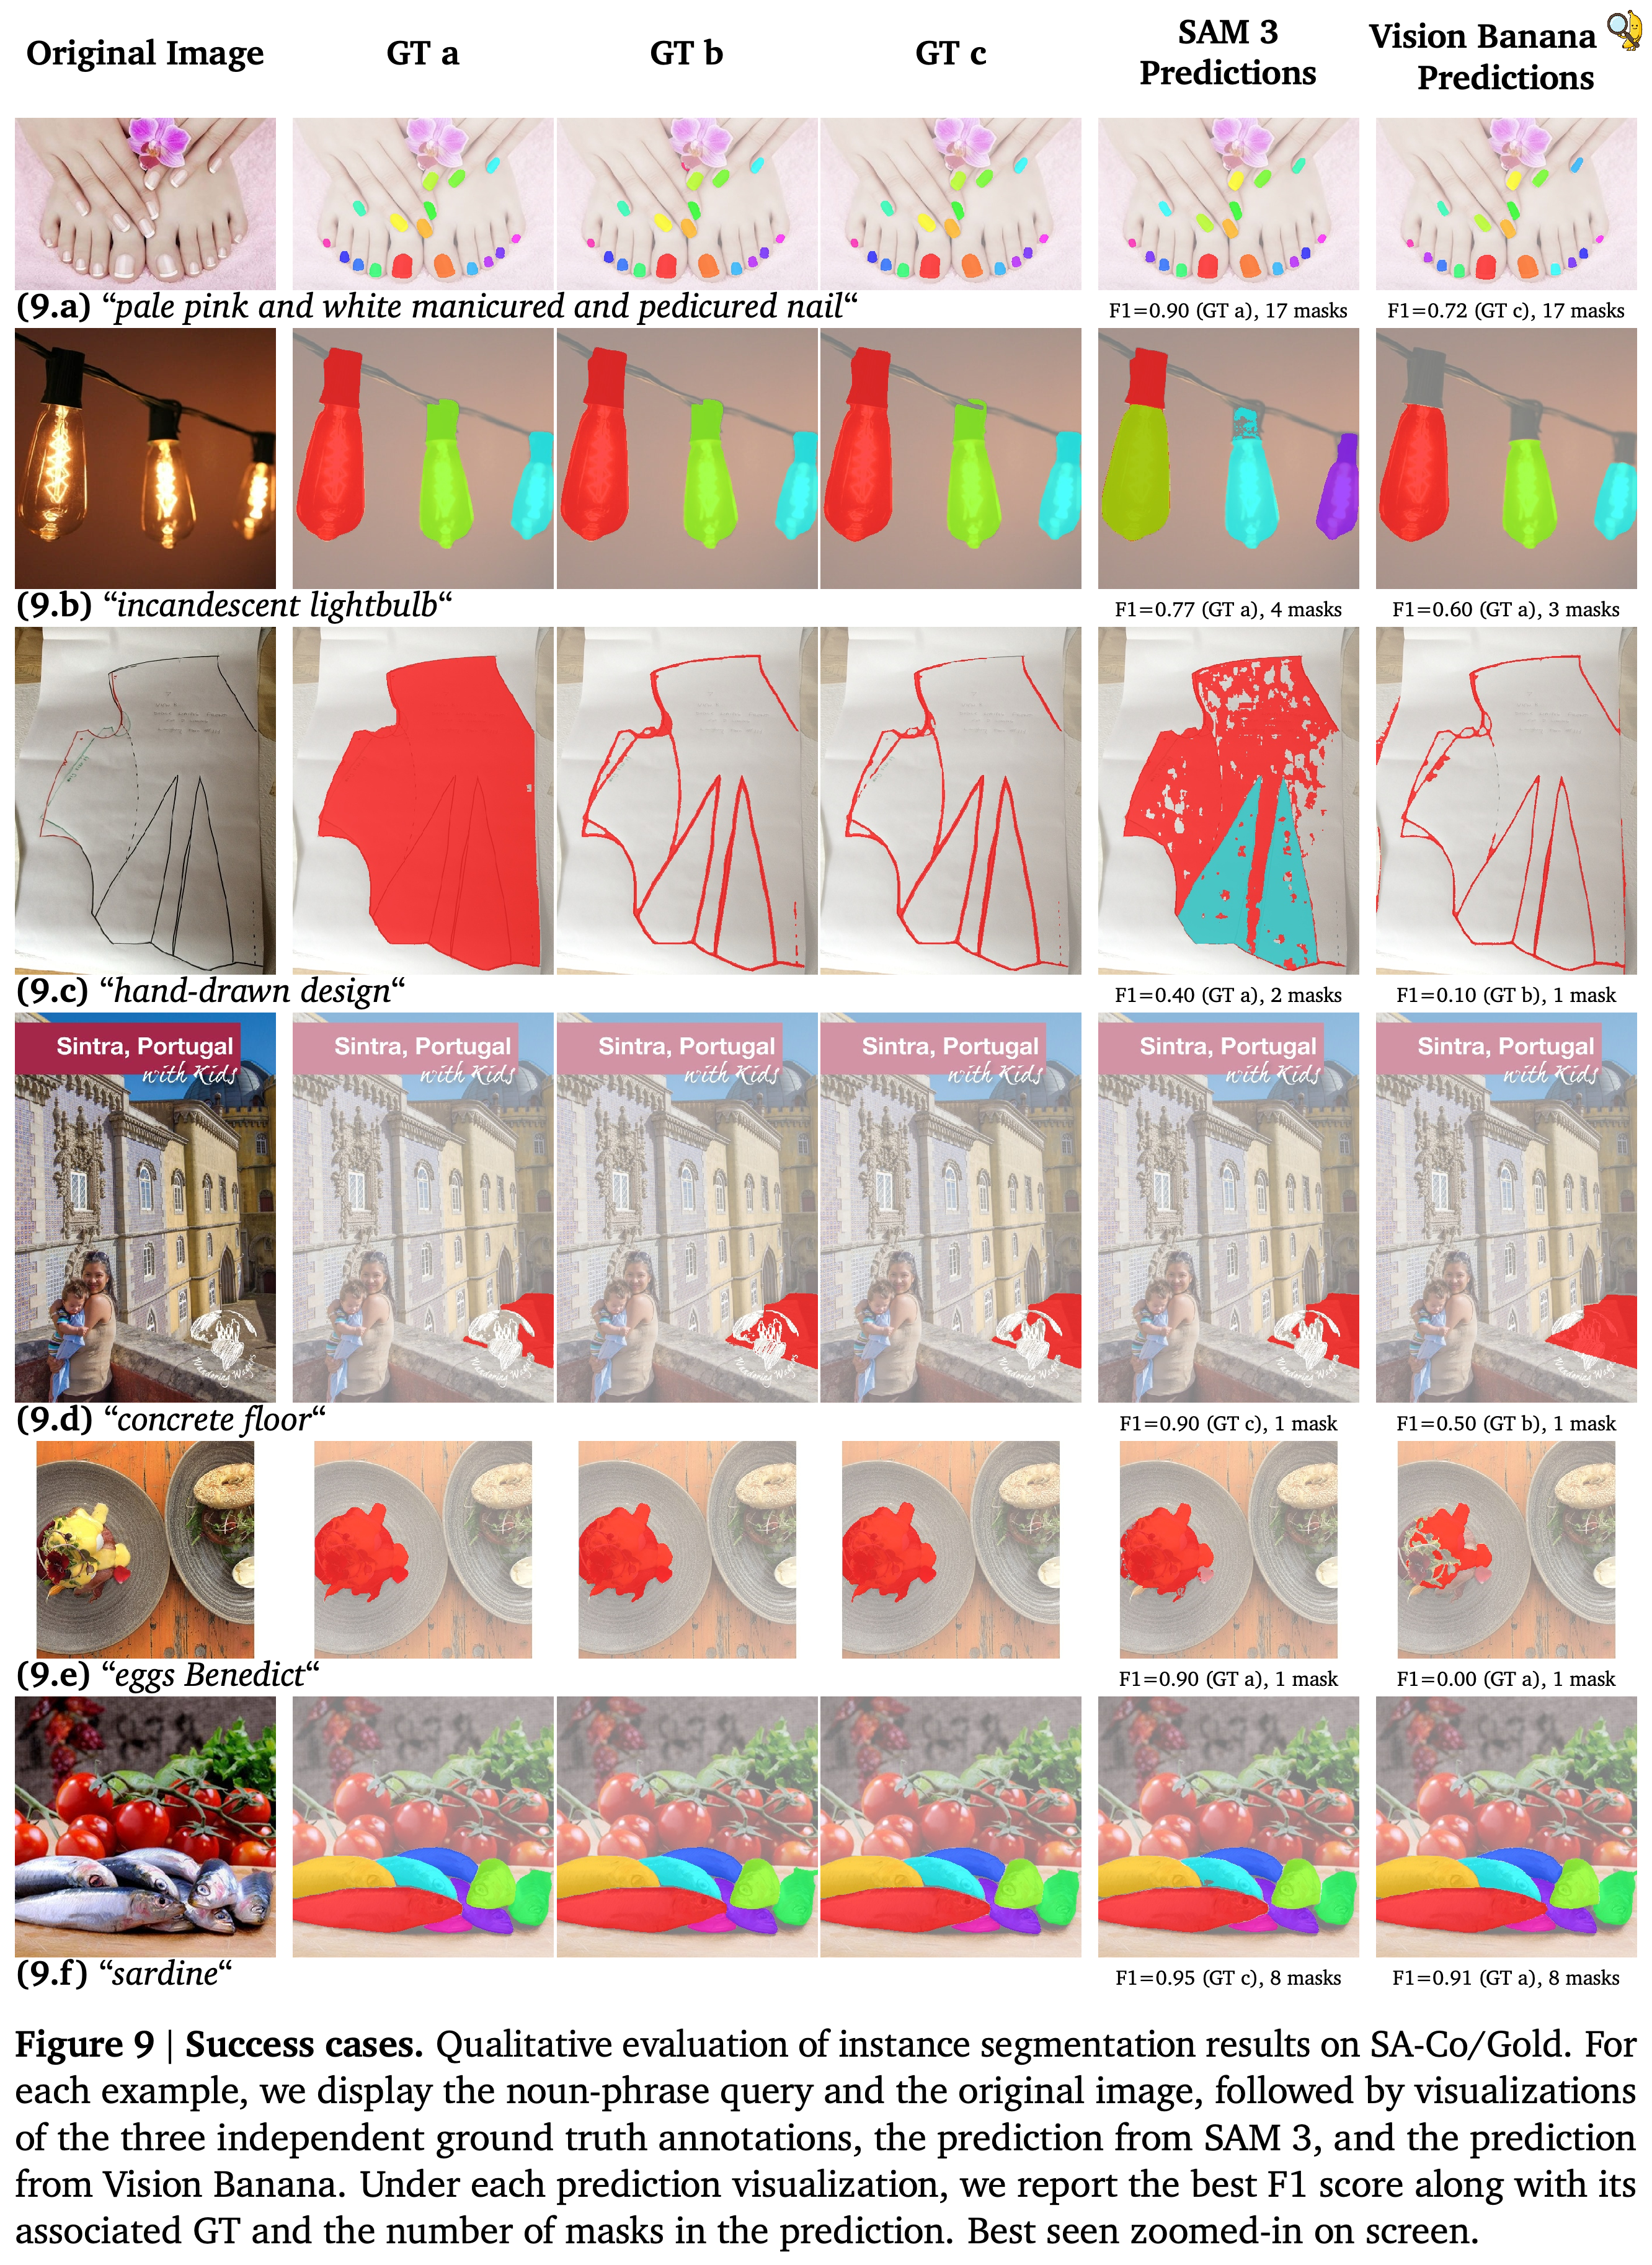
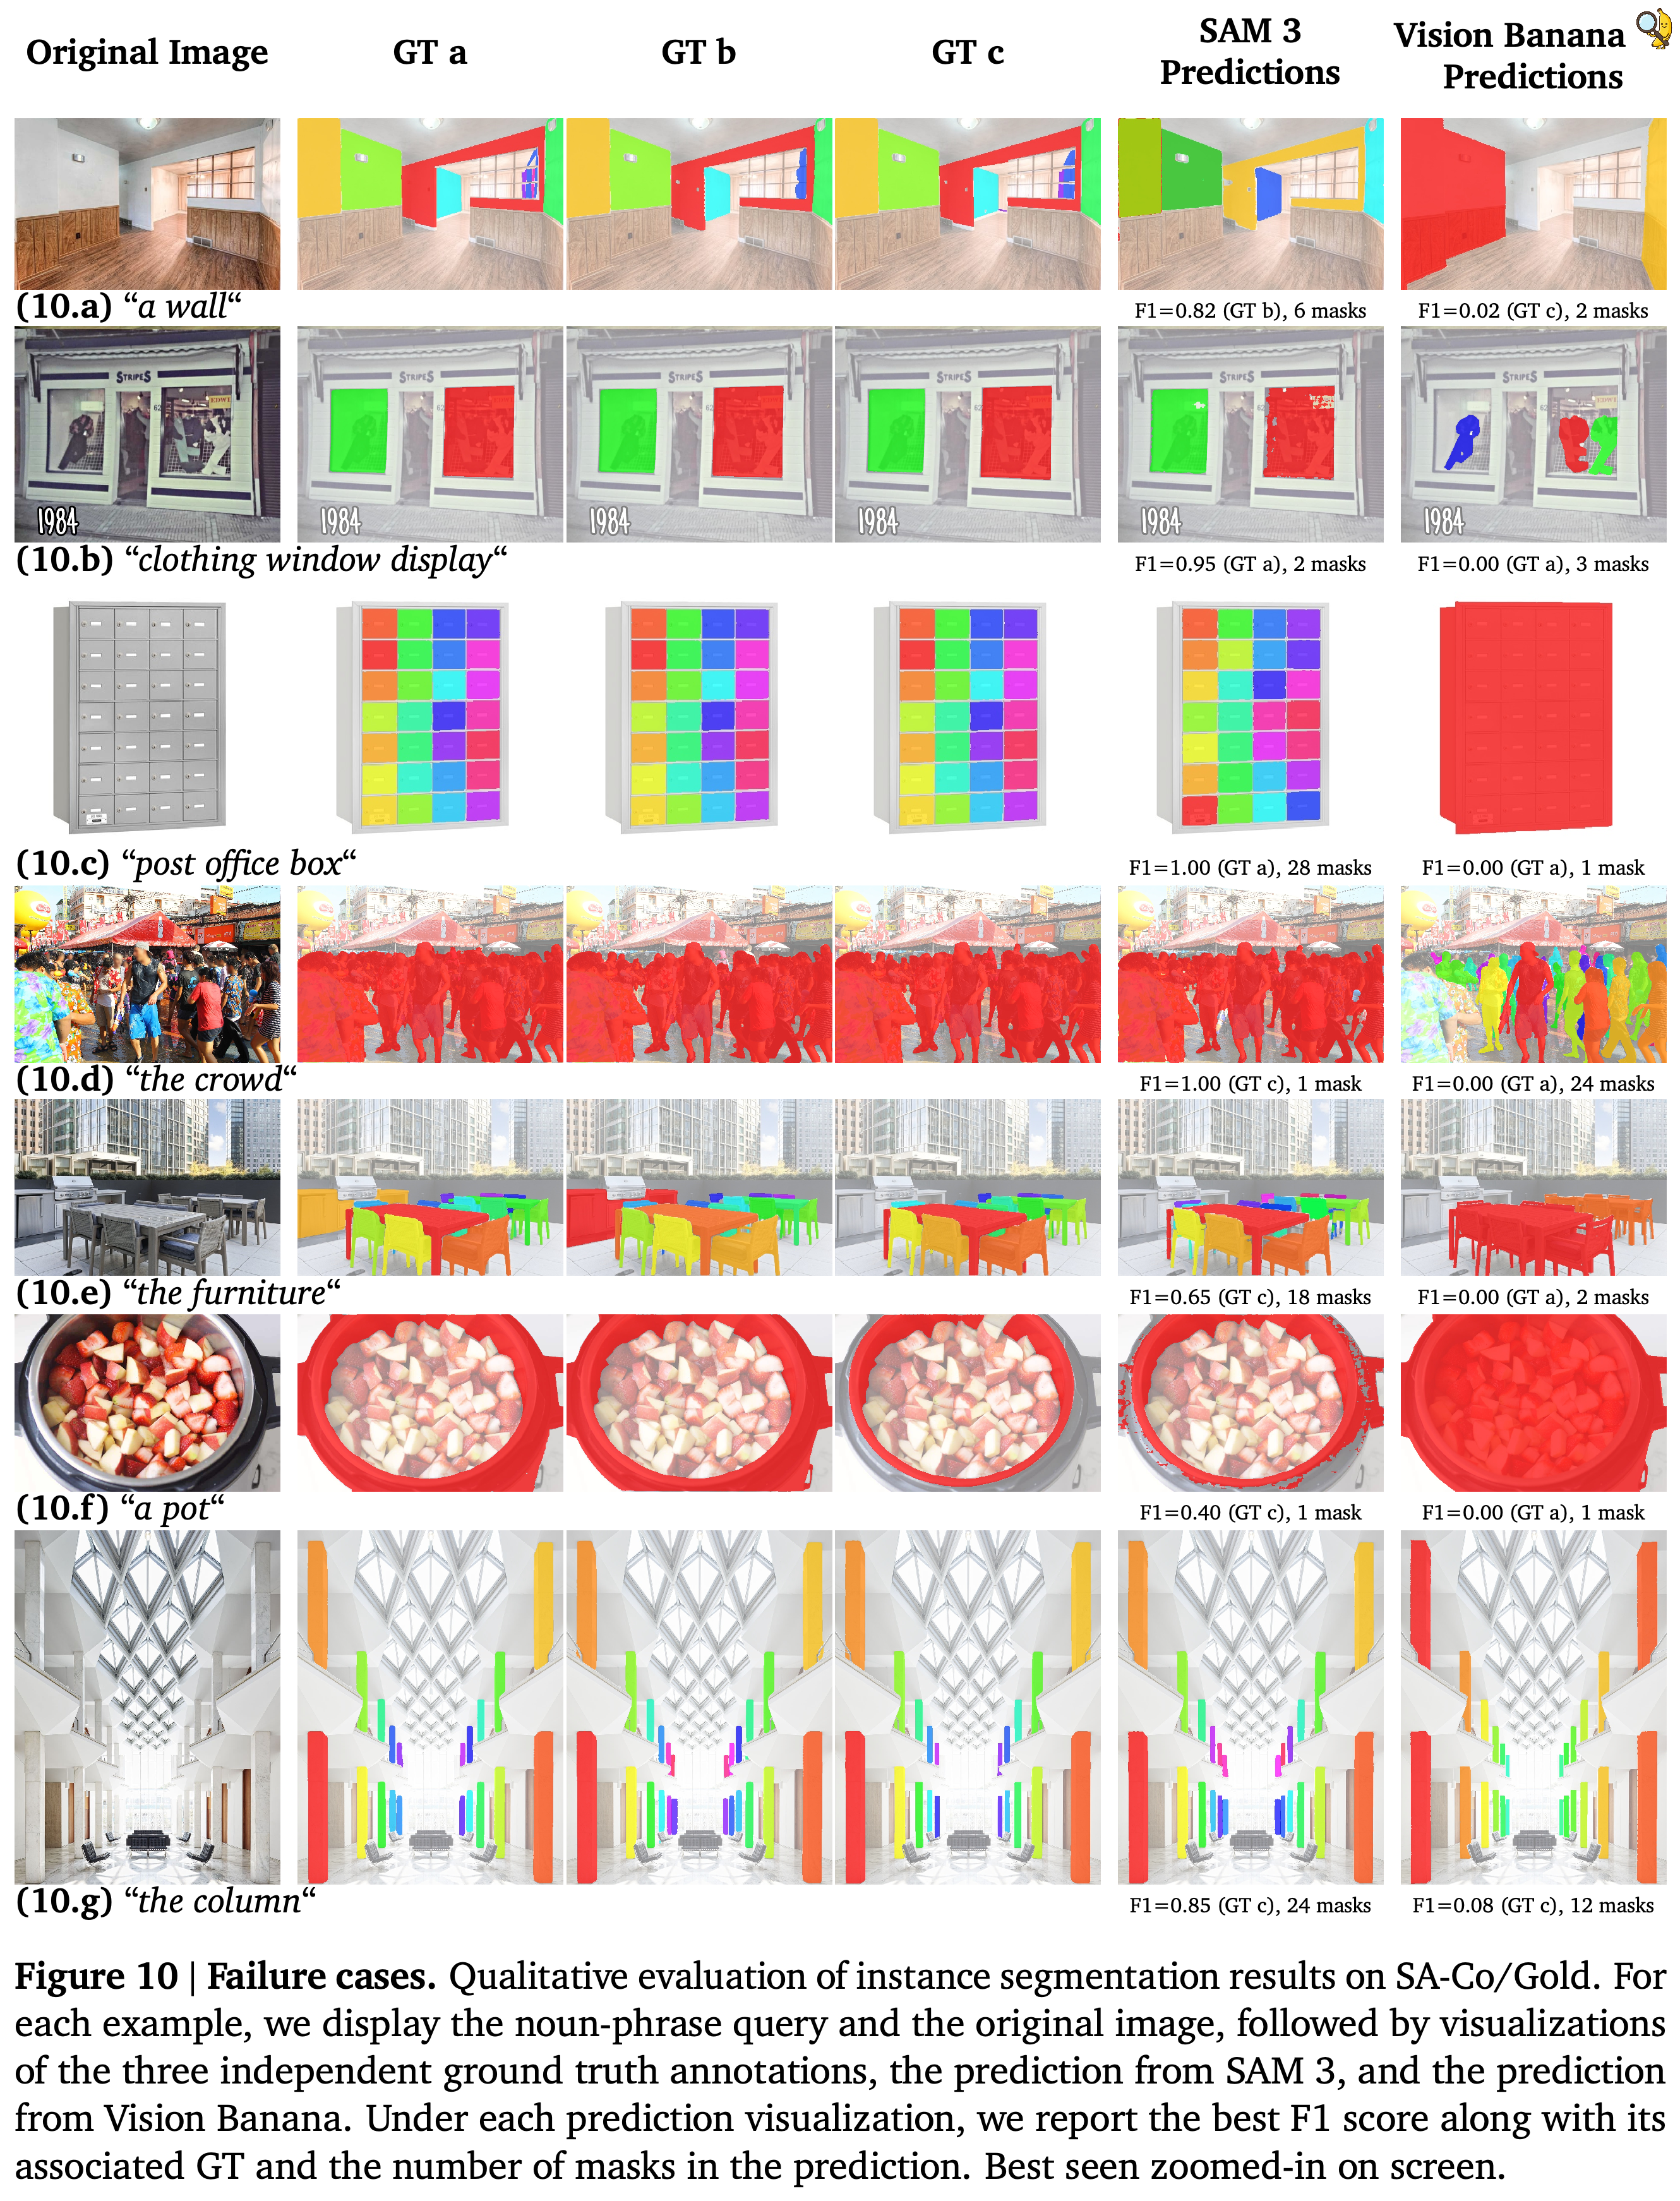
보충 자료는 인스턴스 마스크 품질과 대상 존재 여부 분류를 구분하고, 인스턴스를 나누는 단위에서 발생하는 오류를 보여준다. Table 8은 하위 집합별 결과를 제공한다. Figures 9와 10은 예측을 독립적인 정답 주석 3개와 비교하며, 그럴듯해 보이는 마스크와 벤치마크 정답에 맞는 마스크를 구분한다.
- DINO-X 대비 평균 pmF1 우위는 56.0 대 55.2로 작지만, cgF1 우위는 47.5 대 21.3으로 훨씬 크다. 저자들은 높은 IL_MCC 결과에 Gemini가 기여했음을 인정한다.
- Figure 9에는 손발톱 마스크 17개와 전구 마스크 3개가 있으며, 정답 주석과 비교한 최고 F1은 각각 0.72와 0.60이다. 저자들은 더 작거나 세밀한 마스크가 SAM으로 생성한 주석과 다르기 때문에 점수 차이가 일부 발생한다고 설명한다. 이는 정성적 설명이지 통제된 편향 분석은 아니다.
- Figure 10은 우체국 사서함 28개를 1개 마스크로 합친 결과와, 요청된 군중을 마스크 24개로 나눈 결과를 보여준다. Figures 11과 12는 생성 및 편집 능력의 유지를 보여주지만, 표시된 2번째 편집 지시는 해당 티 테이블 이미지와 맞지 않는다.
하위 집합별 결과는 대상 존재 여부 분류와 양성 쿼리의 마스크 품질을 구분한다. Vision Banana의 평균 pmF1은 56.0으로 DINO-X의 55.2를 근소하게 앞선다. 그러나 DINO-X는 평균 gated score가 더 낮음에도 여러 하위 집합의 해당 지표에서 앞선다. 비교 모델의 결과는 SAM 3 paper에서 가져왔으며, 저자들은 공식 SA-Co 코드베이스로 자신들의 파이프라인을 평가한다.
예시는 시각적으로 그럴듯한 마스크도 엄격한 IoU 임계값 아래에서는 낮은 점수를 받을 수 있음을 보여준다. Vision Banana는 손발톱 마스크 17개를 예측해 정답 주석과 비교한 최고 F1 0.72를 기록하고, 전구 마스크 3개에서는 0.60을 기록한다. 저자들이 제시한 주석 편향 설명은 정성적 수준에 머문다. “eggs Benedict”라고 표시된 행은 선별된 성공 사례에 포함되어 있지만 점수는 0.00이다.
실패 사례는 인스턴스를 구분하는 단위가 잘못된 경우를 보여준다. 우체국 사서함 28개는 1개 마스크로 합쳐지고, 군중은 마스크 24개로 나뉜다. 벽 영역 누락과 가구 병합도 대상 영역을 빠짐없이 포함하고 개별 대상을 분리하는 데 오류가 있음을 보여준다.
해변, 차량 색상 변경, 사무실 배경 예시는 편집 능력이 유지되었음을 보여준다. 표시된 2번째 지시는 선반과 액자를 언급하지만 이미지는 티 테이블 장면을 보여준다. 따라서 해당 행으로는 인쇄된 지시를 따랐는지 입증할 수 없다.
부록
- A. Multi-stage clustering algorithm for parsing instance masks는 색상 변화, 생성 노이즈, 경계 주변의 후광을 처리한다. 색상 허용 오차 τ = 14로 배경 픽셀을 초기화하고, 16-connectivity를 사용하는 시드 기반 floodfill을 수행한다. 이미지 면적에서 차지하는 비율이 θsize = 2 × 10⁻⁴보다 작은 연결 요소를 제거하고, 3 × 3 erosion 후 보존 면적 비율이 θerosion = 0.1보다 낮은 요소도 제거한다. 이후 색상이 비슷한 요소들은 합친 bounding box의 면적이 개별 bounding box 면적 합에 배율 γ = 5.0 times를 적용한 값을 넘지 않을 때 병합할 수 있다.
- B. Detailed SA-Co/Gold Quantitative Evaluation은 Metaclip, SA-1B, Crowded, Food&Drink, Sports Equip., Attributes, Wiki-Common 결과를 보고한다. Positive Micro-F1은 [0.5 : 0.05 : 0.95]의 IoU 임계값 10개에 걸쳐 마스크를 평가하며, IL_MCC는 명사구가 가리키는 대상의 존재 여부 분류를 평가한다. Equation (7)은 (cgF_1=100\cdot pmF_1\cdot IL_MCC)로 정의하며, 여기서 pmF1은 표의 백분율 값이 아니라 비율로 표현한다. 결합 방법은 나열된 zero-shot 방법 중 평균 cgF1과 pmF1에서 앞서지만, 모든 하위 집합의 pmF1에서 앞서지는 않는다. 보고된 평균 cgF1은 표에 표시된 평균 구성 지표를 곱한 값이 아니다.
- C. Qualitative Instance Segmentation Analysis는 예측을 독립적인 정답 주석 3개와 비교한다. 각 예측에 대해 벤치마크의 IoU 임계값 10개에 걸쳐 평균 F1을 계산하고, 정답 주석과 비교한 최고 점수를 보고한다. 저자들은 주석 불일치, 일관되고 서로 겹치지 않는 마스크, 잘못된 인스턴스 병합, 요청된 그룹의 분할, 객체 누락을 논의한다. 혼잡하고 복잡한 장면은 단순한 평가상의 문제가 아니라 실질적인 약점으로 남는다.
- D. Image generation and editing capabilities는 GenAI-Bench와 ImgEdit 프롬프트에 대한 Nano Banana Pro와 Vision Banana의 출력을 나란히 제시한다. 이러한 정성적 비교는 본문의 사람 선호도 평가를 보완하며, 세밀한 이미지 합성과 지시 기반 편집 능력이 유지되었음을 뒷받침한다. 다만 체크포인트 간 통계적 동등성을 입증하지는 않는다.
짧은 생각
핵심 기여는 1개의 RGB 생성 인터페이스로 경쟁력 있는 segmentation과 기하 예측을 수행하면서, 평가한 이미지 합성 능력도 유지할 수 있음을 보여준 점이다. 깊이 결과는 과제 적응에 합성 감독 신호를 사용하고 추론에 카메라 파라미터가 필요하지 않다는 점에서 특히 주목할 만하다.
실험적 근거의 범위는 제목의 일반적인 주장보다 좁다. 연구는 기반 생성기 1개를 평가하며, 통제된 사전학습 또는 튜닝 ablation을 제공하지 않는다. 적응에 사용한 데이터 규모와 비용도 명시하지 않는다. 외부 모델의 도움과 인스턴스 수준의 오류 역시 자율적 추론과 일관되게 우월한 범용 시각 인식에 관한 결론을 제한한다.