


Multi-Resolution Flow Matching: Training-Free Diffusion Acceleration via Staged Sampling 요약 설명
02 Jul 2026 | Paper Review Diffusion Acceleration Flow Matching Text-to-Image Generation Super-Resolution목차
이번 글에서는 Multi-Resolution Flow Matching: Training-Free Diffusion Acceleration via Staged Sampling 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 2일(Arxiv)
- Zheng, Xingyu, Liu, Xianglong, Ding, Yifu, Feng, Weilun, Lin, Junqing, Guo, Jinyang, Qin, Haotong.
- State Key Laboratory of Complex & Critical Software Environment, Beihang University, School of Computer Science and Engineering, Beihang University, Nanyang Technological University, State Key Laboratory of AI Safety, Institute of Computing Technology, Chinese Academy of Sciences, University of Chinese Academy of Sciences, University of Science and Technology of China, School of Artificial Intelligence, Beihang University, ETH Zürich
- 논문 링크
- Github
요약
- MrFlow는 사전 학습된 텍스트-이미지 flow-matching 모델의 추론을 가속한다. 저해상도에서 구조를 생성하고, 픽셀 공간에서 초해상도를 적용한 뒤, 잠재변수에 약한 노이즈를 더해 고해상도에서 짧게 정제한다. 이 샘플링 과정에는 추가 학습이나 실행 중 영역 식별이 필요하지 않지만, 사전 학습된 Real-ESRGAN 모델은 사용한다.
- 1024 × 1024에서 Qwen-Image MrFlow는 저해상도 12스텝과 고해상도 1스텝으로 종단 간 10.3× 가속을 달성한다. OneIG-En과 OneIG-Zh 점수는 각각 0.53/0.53에서 0.52/0.51로 바뀐다. 이에 대응하는 FLUX.1-dev 설정은 8.25× 가속을 달성한다.
- 사전 학습된 Pi-Flow 가중치와 이 과정을 결합하면 Qwen-Image에서 25.1× 가속을 달성한다. 다만 원래 flow 모델에 MrFlow를 적용하는 경우와 달리, 이 조합에는 별도로 학습된 증류 모델이 필요하다.
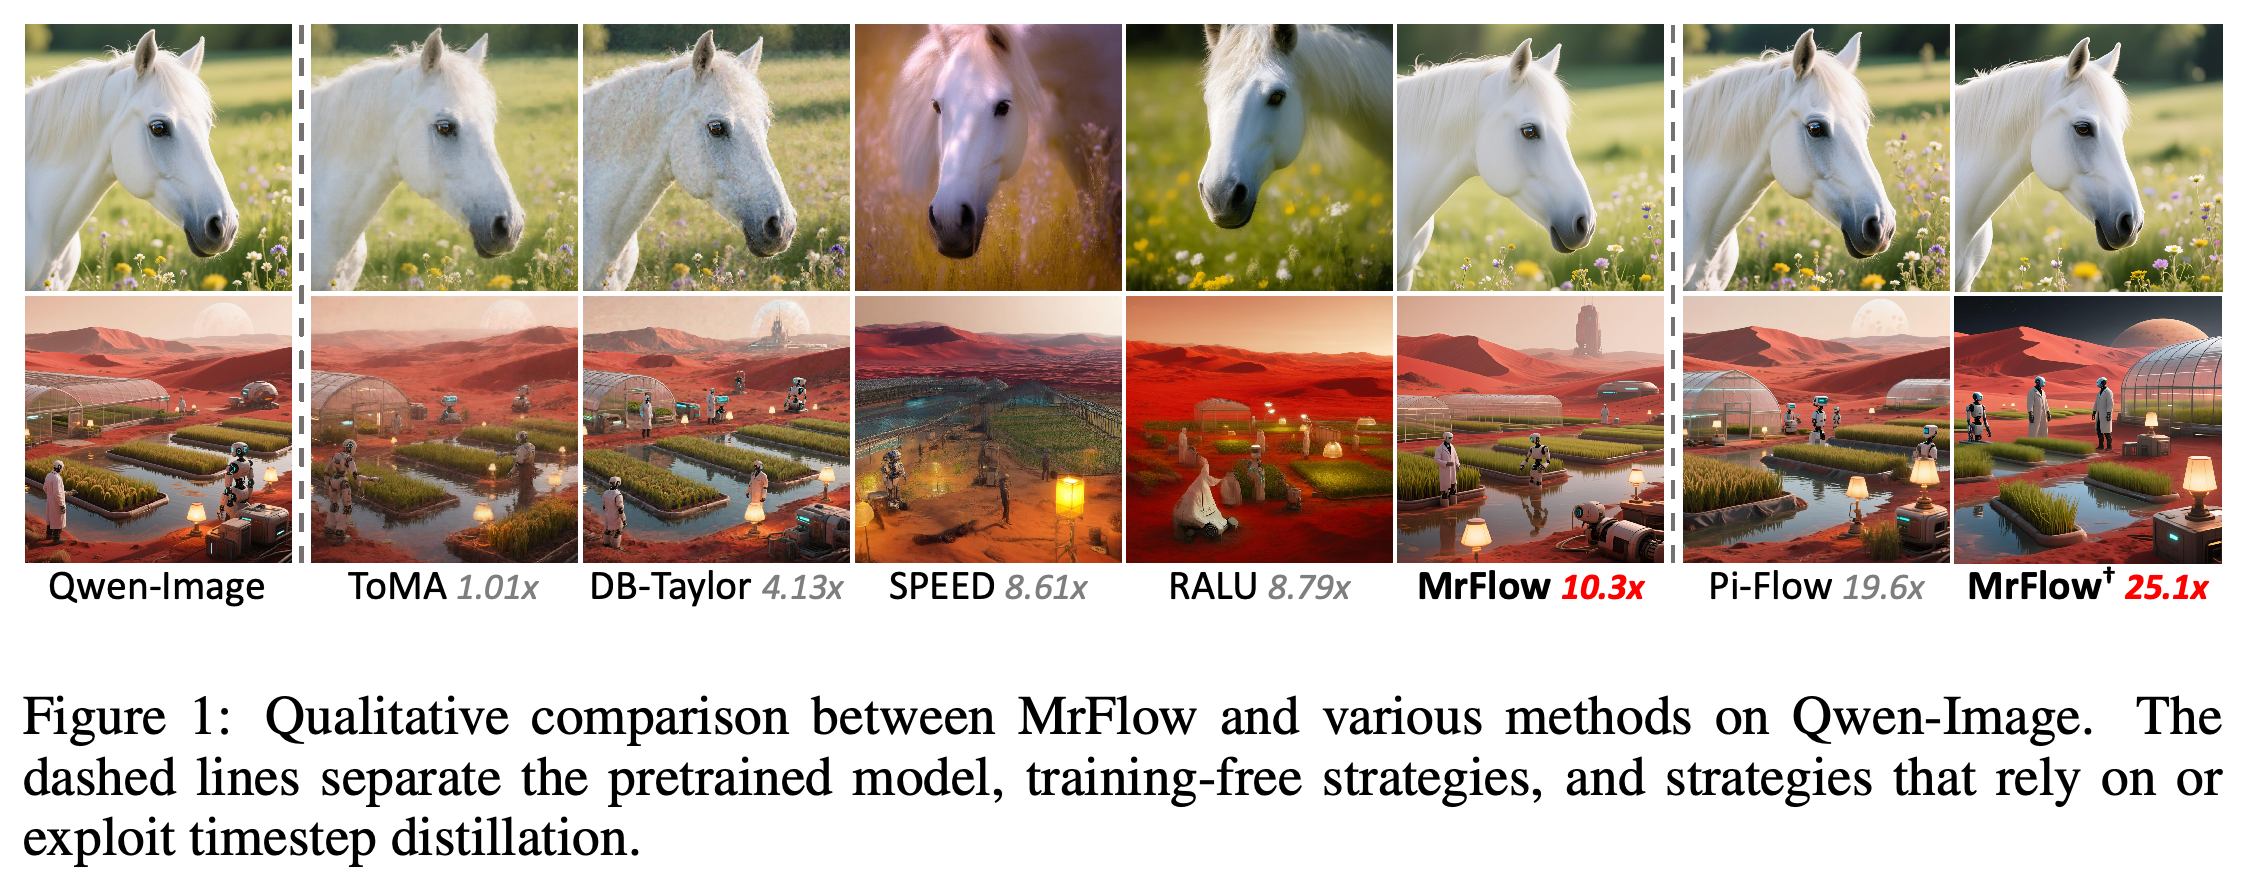
Qwen-Image 예시는 기본 모델의 출력과 여러 가속 방법의 출력을 나란히 보여주며, 10.3× 가속의 MrFlow도 포함한다. 점선은 기본 모델, 학습이 필요 없는 방법, 그리고 Pi-Flow와 증류 가중치를 사용해 25.1× 가속을 달성한 MrFlow 조합을 구분한다. 이미지에서는 벤치마크 점수만으로 알기 어려운 국소적인 출력 차이를 살펴볼 수 있다.
1 Introduction
논문은 Nvidia A100에서 Qwen-Image-20B의 1024 × 1024 확산 샘플링에 최대 47s가 걸린다고 보고한다. timestep distillation은 모델 평가 횟수를 줄이지만 학습이 필요하다. 여기서 다룬 비교에서는 학습이 필요 없는 캐싱과 토큰 축소의 가속 폭이 더 작다. 기존 다중 해상도 가속 기법은 잠재 공간이나 주파수 공간에서 이미지를 확대하며, 저자들은 일부 출력에서 흐림이나 아티팩트가 나타난다고 보고한다.
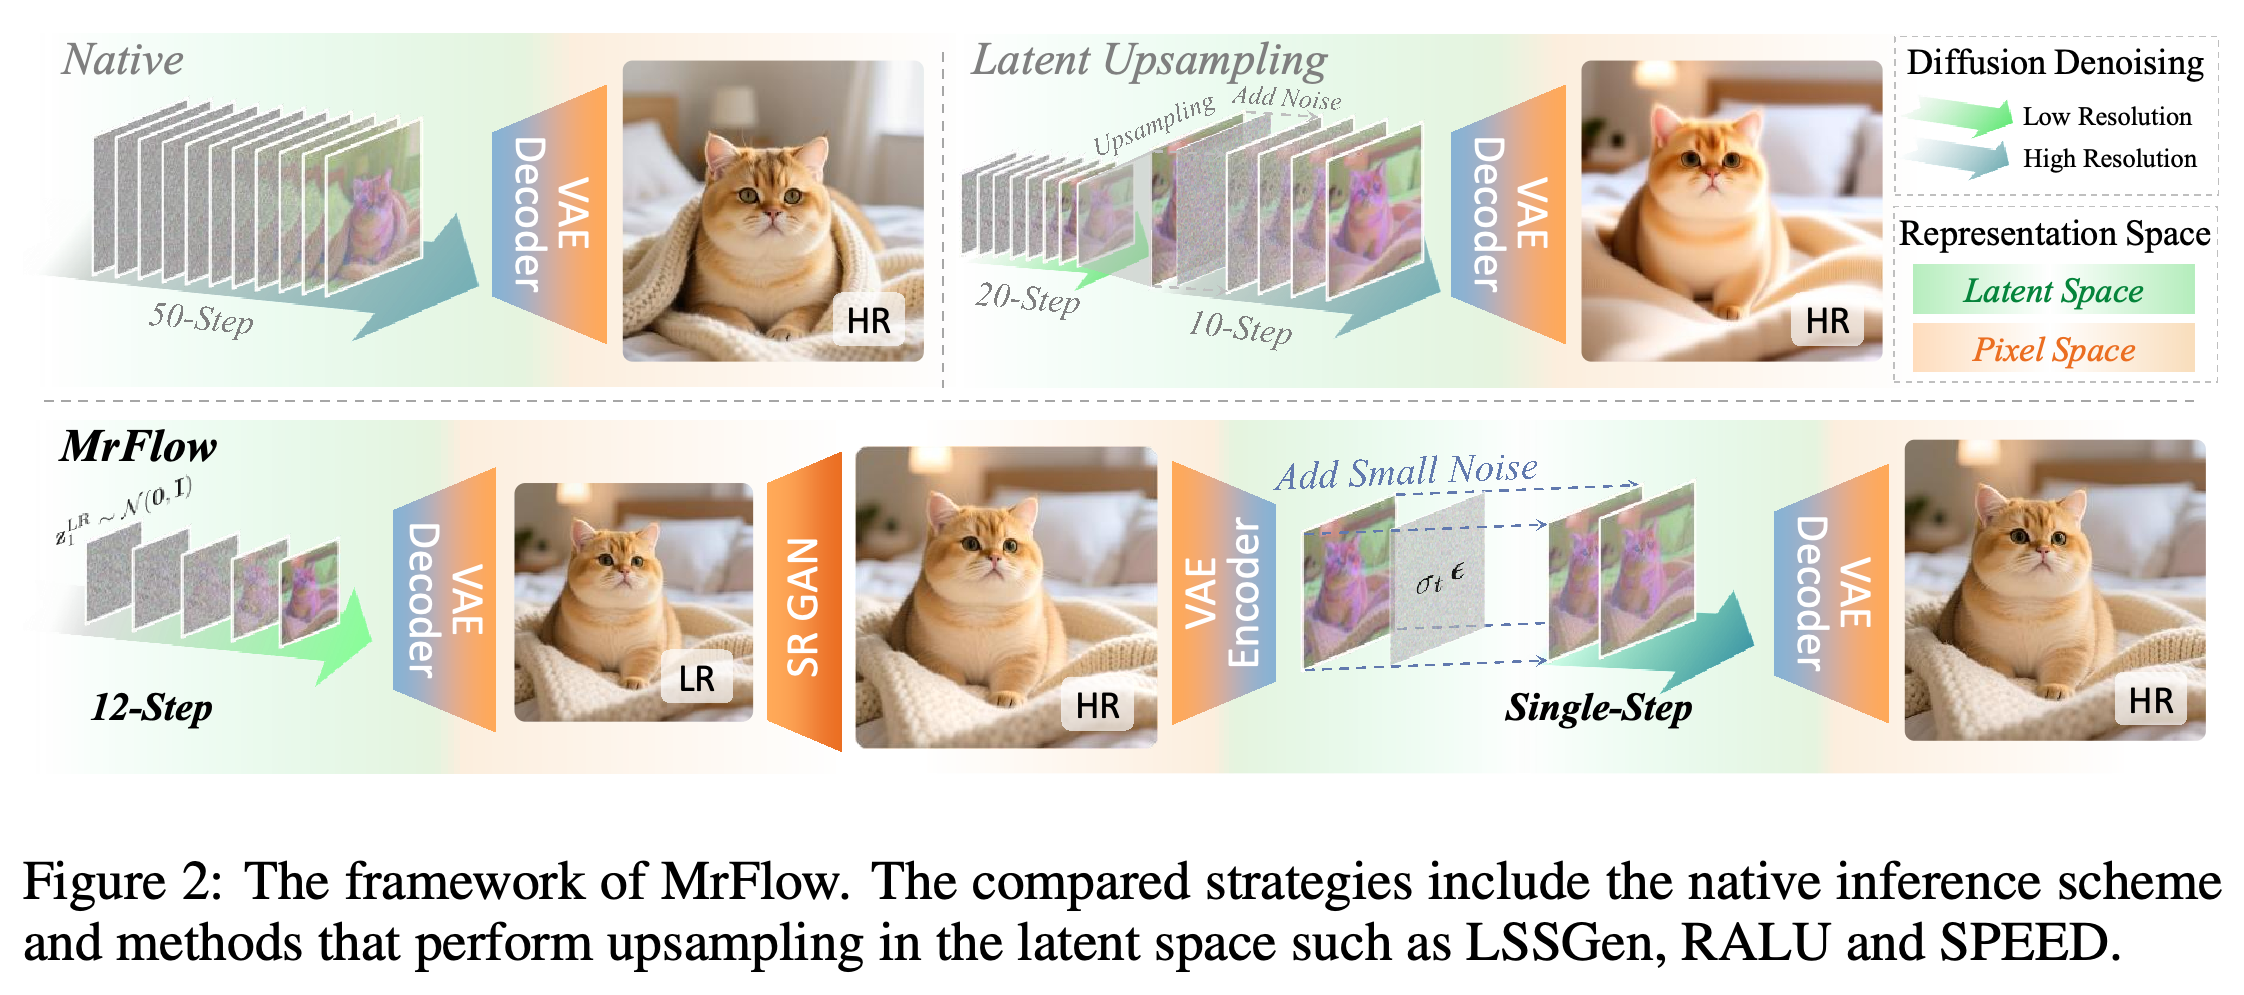
MrFlow는 프롬프트에 따른 레이아웃 구성을 저해상도 샘플링에, 국소적인 수정을 고해상도 샘플링에 맡긴다. Figure 2는 픽셀 공간 초해상도와 VAE 재인코딩을 사용하는 방식이 잠재 표현을 직접 확대하는 방식과 어떻게 다른지 보여준다.
MrFlow는 저해상도 잠재변수 샘플링에서 시작해 VAE 디코딩, 픽셀 공간 GAN 초해상도, VAE 재인코딩, 약한 노이즈 주입, 고해상도 노이즈 제거를 거친다. 별도로 표시된 기본 추론과 잠재변수 업샘플링 경로를 보면 MrFlow가 표현 공간을 바꾸는 지점을 확인할 수 있다.
2 Related Work
관련 연구에는 flow matching, timestep 축소, 특징 캐싱, 토큰 압축, 다중 해상도 생성, 초해상도, 이미지 repainting이 포함된다. MrFlow는 모델이 평가되는 해상도에서의 연산을 줄이는 데 초점을 맞춘다. 잠재 표현을 잠재 공간이나 주파수 공간에서 직접 확대하는 대신, 디코딩한 이미지에 사전 학습된 픽셀 공간 초해상도를 적용한 다음 잠재변수로 재인코딩하고 노이즈를 더해 정제한다.
3 Method
이 과정은 저해상도 잠재변수를 샘플링하고 VAE로 디코딩한 다음, 픽셀 공간 초해상도를 적용한다. 확대된 이미지를 VAE로 인코딩하고 노이즈를 더한 뒤 고해상도 flow 샘플링을 수행하고 최종 결과를 디코딩한다. 일반적인 설정은 저해상도 Euler 12스텝, 노이즈 강도 0.1, 고해상도 1스텝을 사용하며, 두 샘플링 단계는 동일한 사전 학습 속도 네트워크와 텍스트 조건을 사용한다.
3.1 Low-Resolution Structure Generation
저해상도 생성은 Gaussian 잠재 노이즈에서 시작해 사전 학습된 flow ODE를 Euler 방식으로 적분하고, VAE 디코딩에 사용할 잠재변수를 얻는다. 이미지의 각 변을 절반으로 줄이면 이미지 토큰 수가 4배 적어지고, 측정된 스텝당 처리 속도는 약 4× 빨라진다. 논문은 더 적은 스텝으로도 전체 구조를 형성할 수 있는지 시험한다.
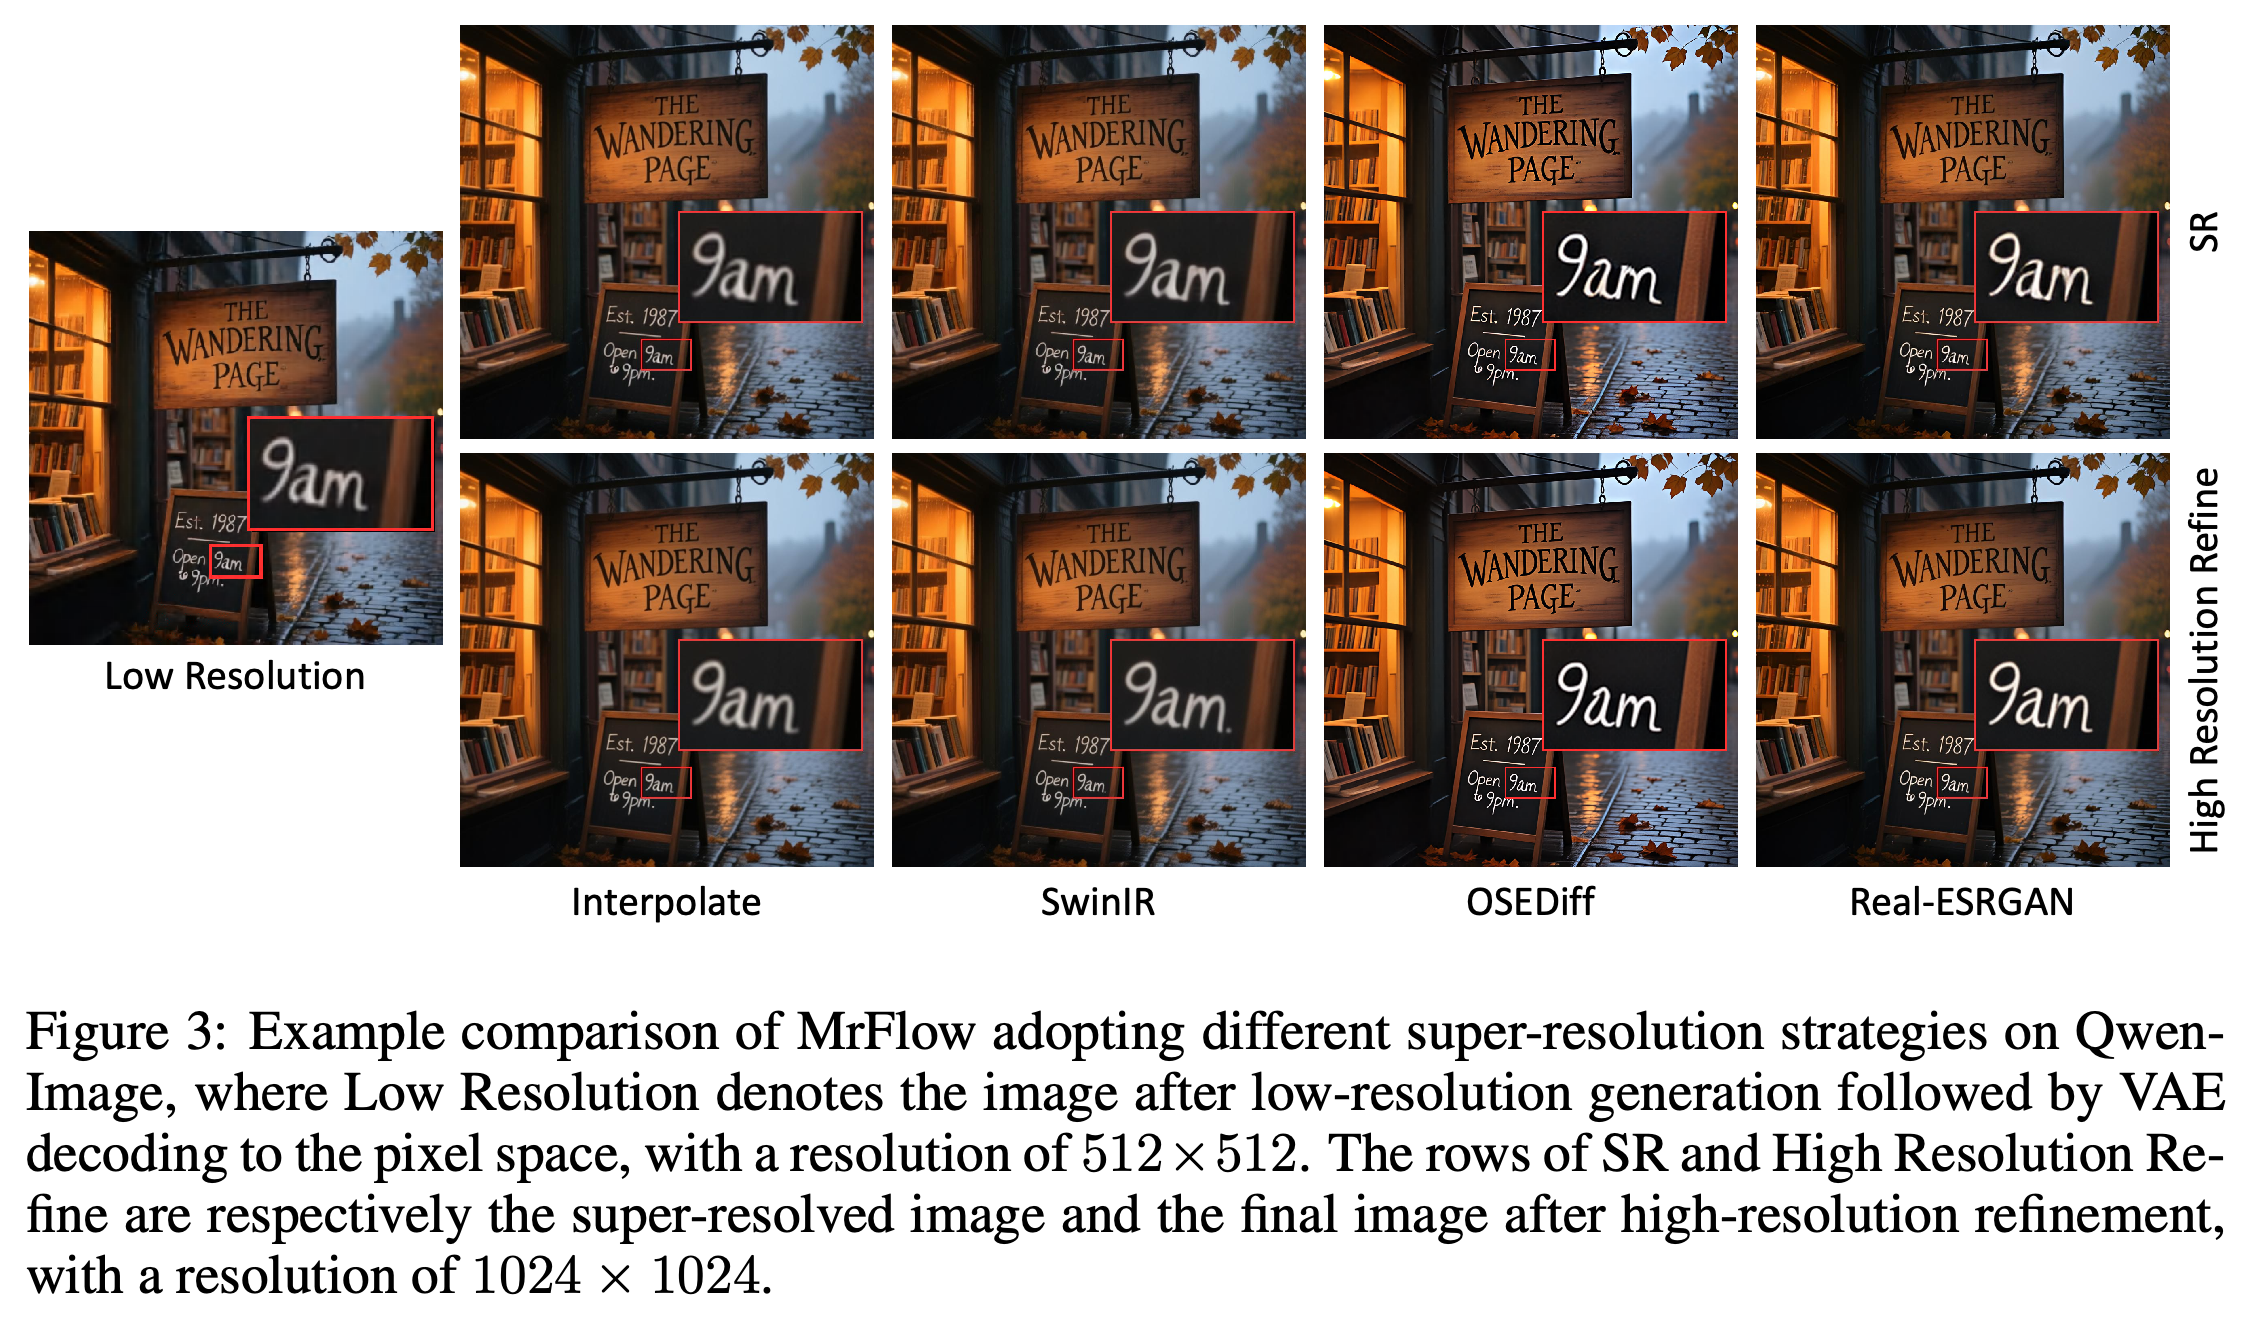
서점 예시는 각 초해상도 결과를 해당 고해상도 정제 결과 위에 배치한다. 확대된 간판의 세부 요소에서는 종합 초해상도 점수가 비슷해도 구별하기 어려운 흐림과 글자 차이를 확인할 수 있다.
3.2 Pixel-Space Super-Resolution
사전 학습된 Real-ESRGAN은 디코딩된 이미지를 픽셀 공간에서 확대하며, 일반적으로 ×2 배율을 사용한다. 이 방식은 정제에 필요한 대략적인 레이아웃을 유지하면서 선명한 세부 요소를 제공한다. 다만 초해상도 네트워크는 프롬프트를 조건으로 사용하지 않으므로, 확대된 이미지에 아티팩트나 위치가 어긋난 글자 획이 남을 수 있다.
3.3 Low-Strength Noise for High-Frequency Resampling
확대된 이미지를 VAE로 인코딩한 뒤 정제 timestep에서 Gaussian 노이즈와 혼합하며, 일반적으로 σt는 [0.1, 0.15] 범위다. 국소 Gaussian 사전분포와 고주파 오차를 가정하면, σt ≥ √λhf/(1 + √λhf)는 지정된 고주파 방향에서 주입한 노이즈의 전력이 깨끗한 신호의 전력 이상이 되도록 한다. 이 경계는 재샘플링에 필요한 노이즈 규모를 나타낼 뿐, 짧은 정제로 임의의 초해상도 오류나 넓게 퍼진 흐림을 바로잡을 수 있다고 보장하지는 않는다.
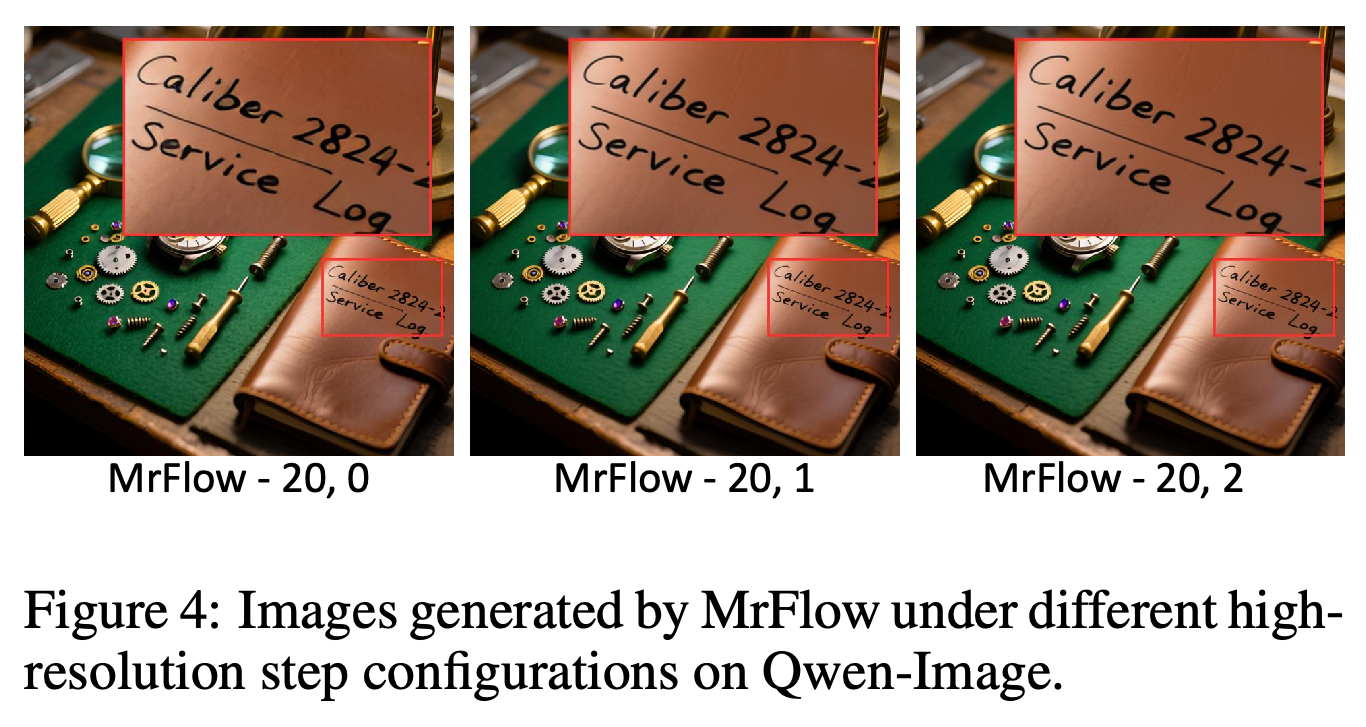
시계 제작자 예시에서는 저해상도 단계의 20 step을 고정하고 고해상도 정제를 생략한 경우부터 2 step까지 비교한다. 노트의 글씨는 정제를 생략한 경우와 첫 정제를 마친 경우 사이에 가장 크게 개선되며, 추가 정제에 따른 차이는 더 작다.
3.4 High-Resolution Detail Refinement
고해상도 샘플링은 노이즈를 더한 초해상도 잠재변수에서 시작하며, 기본적으로 최종 VAE 디코딩 전에 Euler 방식으로 단일 스텝을 수행한다. 강도 0.1의 Qwen-Image에서 8 step 정제 결과를 기준으로 한 CLIP 이미지 유사도는 1 step 정제했을 때 0.9974이며, 5 step 정제했을 때는 0.9999다. 논문은 이 결과를 깨끗한 끝점 부근에서 측정한 속도장 변화와 연결한다. CLIP에 대해서는 이 글을 참조하라.
4 Empirical Results
주요 실험은 FLUX.1-dev와 Qwen-Image-20B에서 생성 지표와 종단 간 추론 속도를 평가한다. 학습이 필요 없는 방법과 공개된 timestep-distillation 또는 잠재변수 업샘플링 가중치를 사용하는 비교 방법을 구분한다.
4.1 Implementation Details
정량 평가는 1024 × 1024 이미지와 Geneval, DPG-Bench, OneIG-Bench를 사용한다. 각 실험은 Nvidia A100 단일 장치에서 실행하며, 종단 간 시간에는 텍스트 인코딩, 노이즈 생성, VAE 연산, 초해상도, 확산 모델의 순전파를 포함한다. 기본 Qwen-Image는 true CFG를 위해 스텝당 순전파 2회를 수행한다. 사전 학습된 가중치가 필요한 방법에는 이 실험에서 재학습하지 않고 공개 가중치를 사용한다.
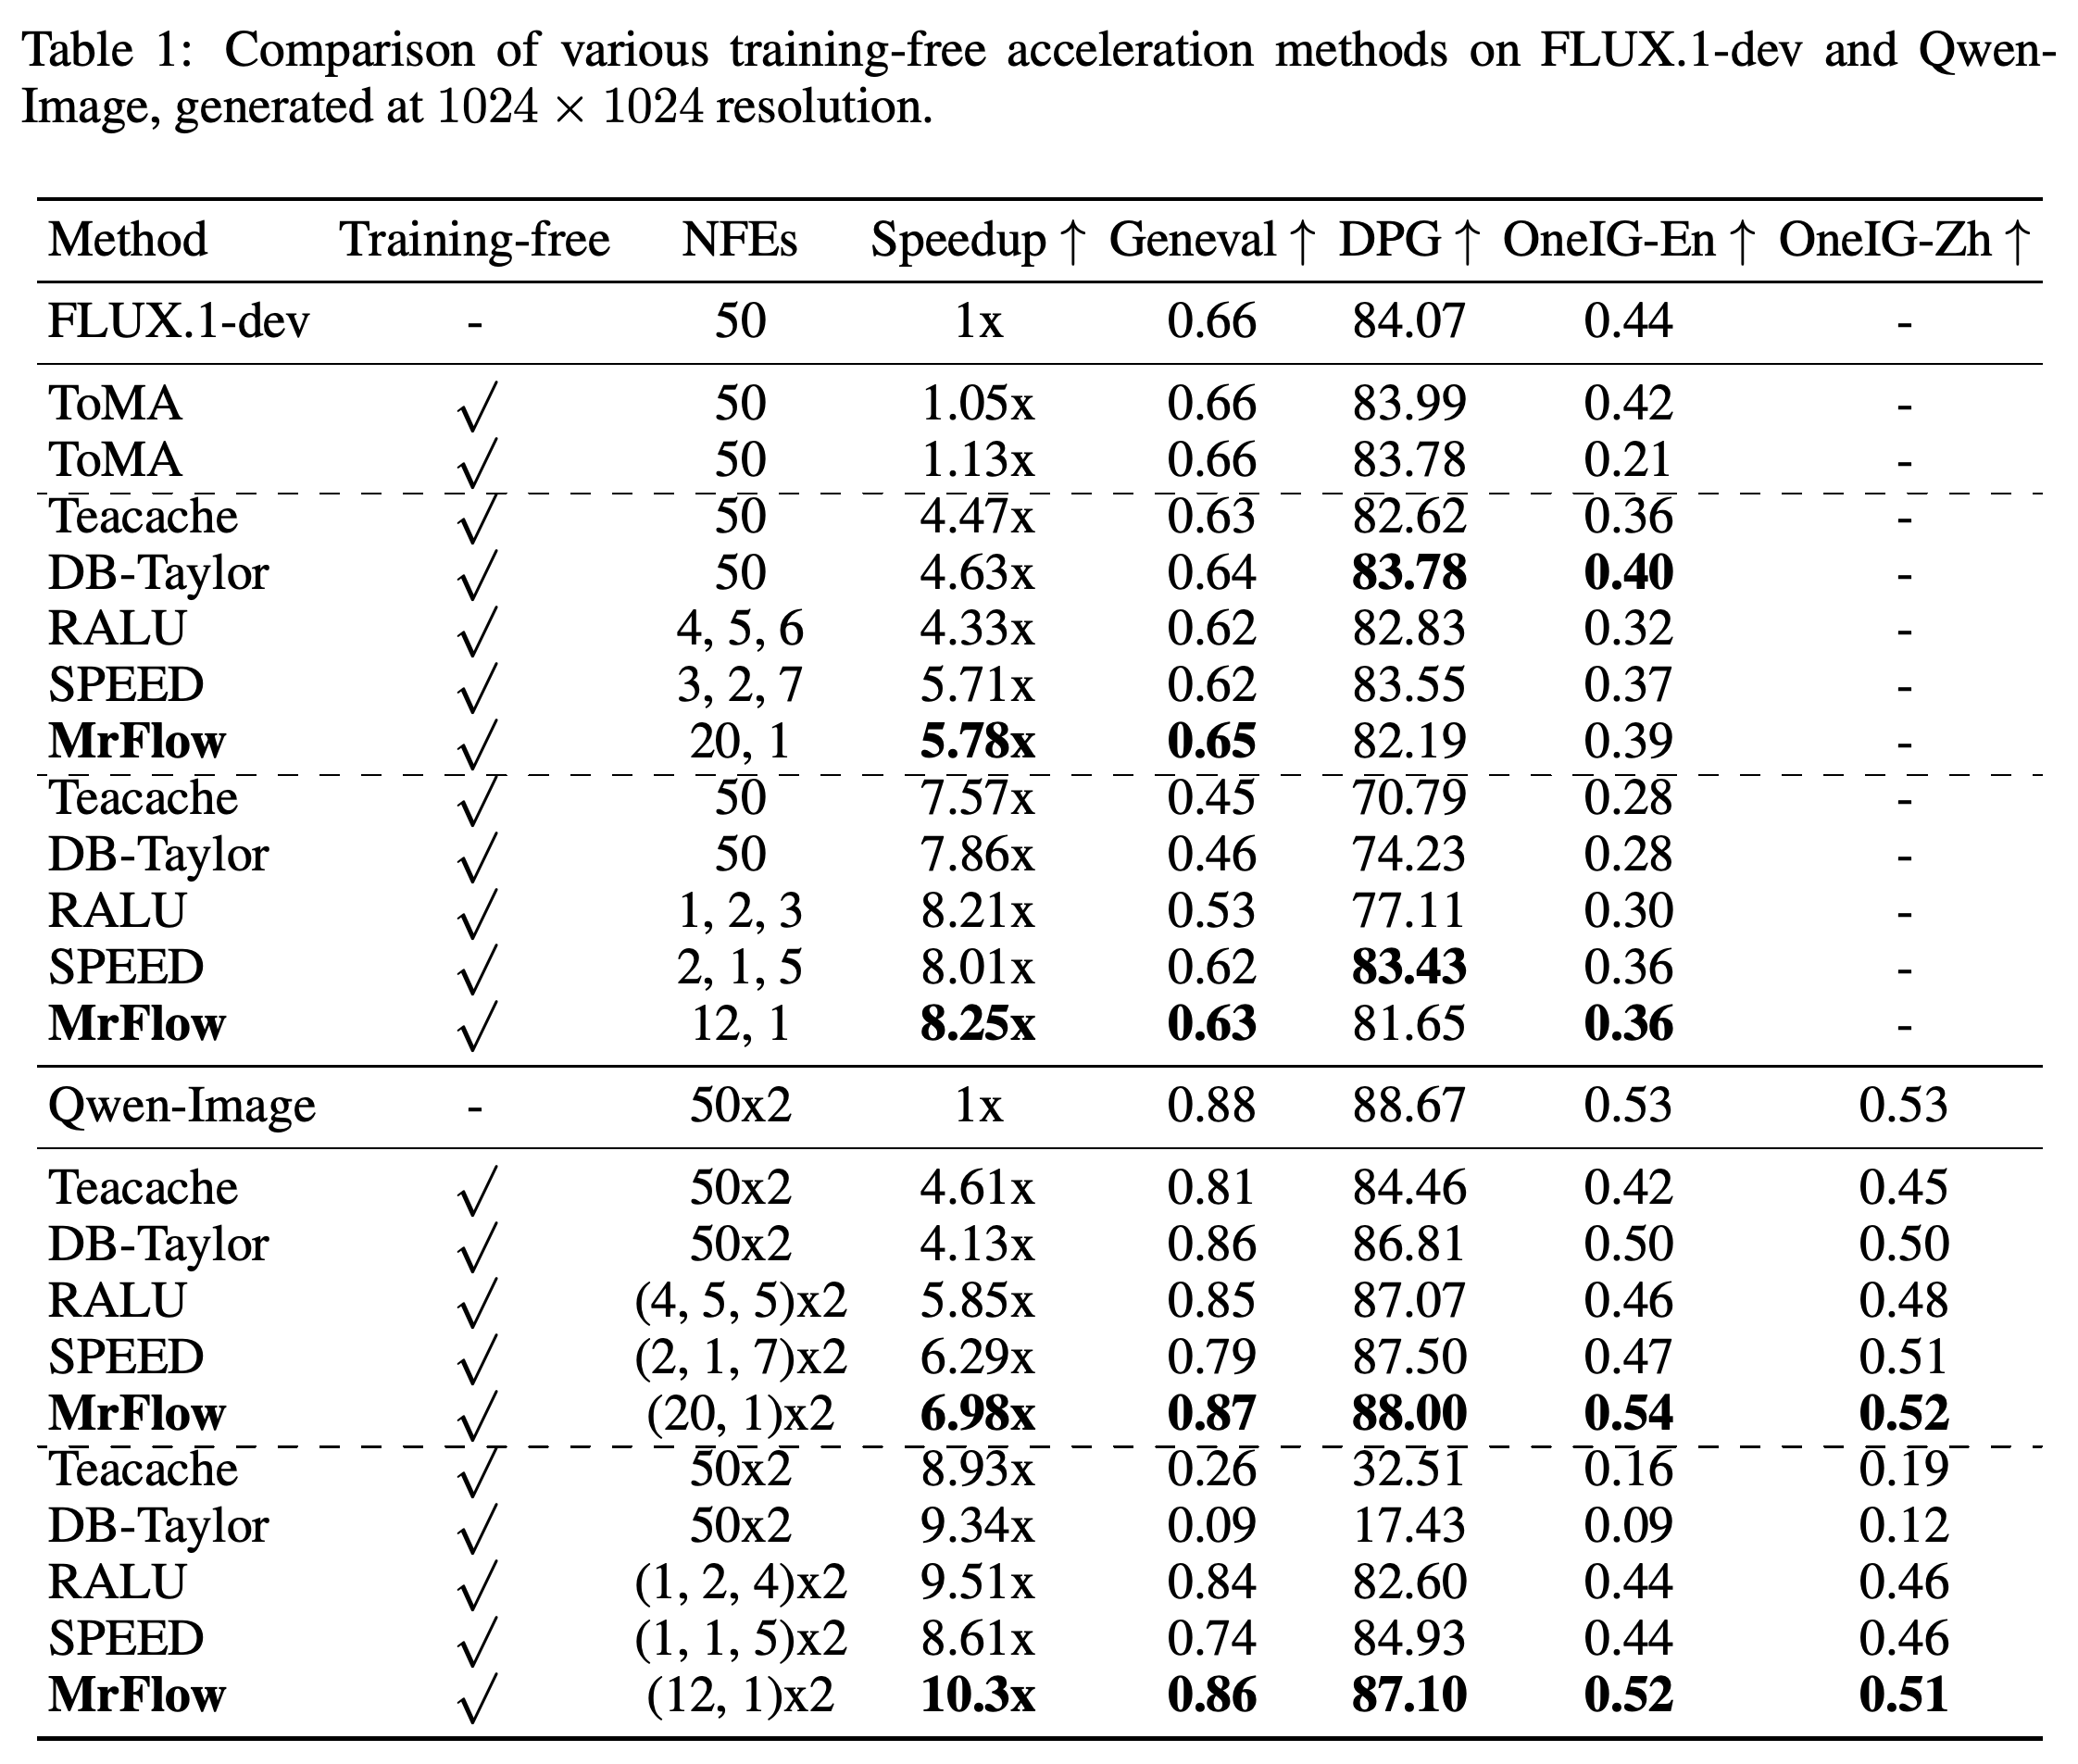
Qwen-Image에서 가속률을 높인 설정의 MrFlow는 10.3× 가속과 Geneval 0.86을 기록한다. 9× 부근의 특징 캐시 방식 2개 행은 각각 0.26과 0.09를 기록한다. FLUX.1-dev의 (12, 1) 행에서는 8.25× 가속, Geneval 0.63, DPG 81.65를 기록한다.
4.2 Main Results
Table 1에서 Qwen-Image MrFlow의 (12, 1)×2 설정은 10.3× 가속과 Geneval 0.86, DPG 87.10, OneIG-En 0.52, OneIG-Zh 0.51을 기록한다. 기본 모델의 점수는 각각 0.88, 88.67, 0.53, 0.53이다. 비슷한 수준으로 속도를 높인 설정에서 DB-Taylor는 9.34×에 Geneval 0.09를, RALU는 9.51×에 0.84를 기록한다. FLUX.1-dev에서 MrFlow는 8.25× 가속과 Geneval 0.63을 달성하며, 기본 모델의 Geneval은 0.66이다.
Qwen-Image 결과에서는 학습이 필요 없는 MrFlow와 사전 학습된 Pi-Flow 가중치를 사용하는 MrFlow†를 구분한다. Pi-Flow와 비교하면 MrFlow†는 Geneval 0.85를 유지하면서 가속률을 19.6×에서 25.1×로 높이지만, OneIG 점수는 약간 낮다.
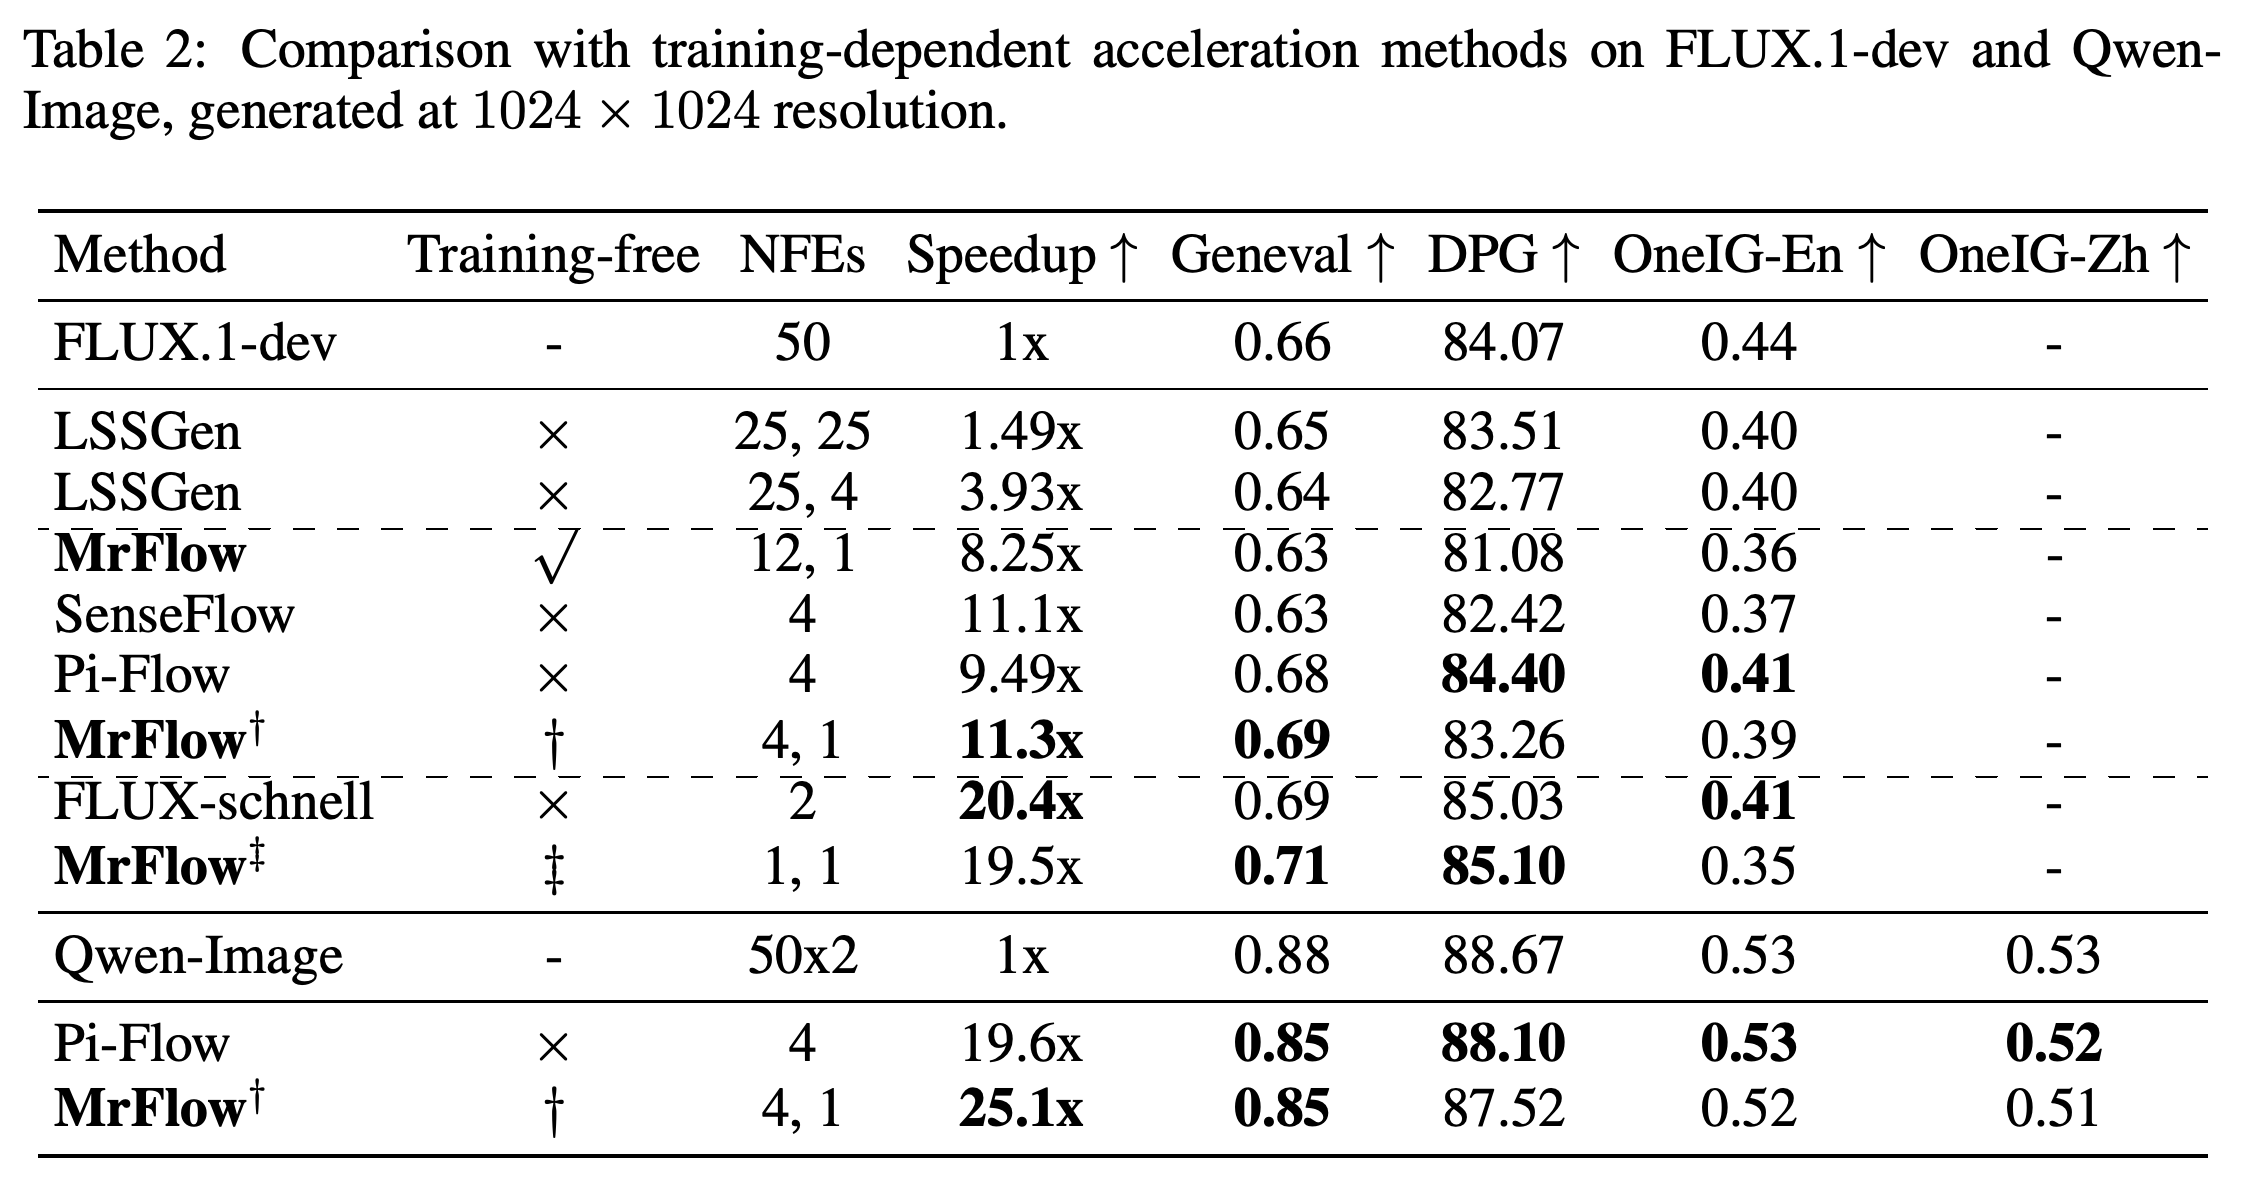
사전 학습된 Pi-Flow 가중치를 사용하면 Qwen-Image MrFlow†는 25.1× 가속을 달성하며, Pi-Flow 단독 사용 시에는 19.6×다. 두 방법의 Geneval은 모두 0.85다. MrFlow†의 OneIG-En/OneIG-Zh는 0.52/0.51로, Pi-Flow의 0.53/0.52보다 낮다. 이 조합은 샘플링 과정에 추가 학습을 요구하지 않지만, 앞서 증류된 가중치에 의존한다.
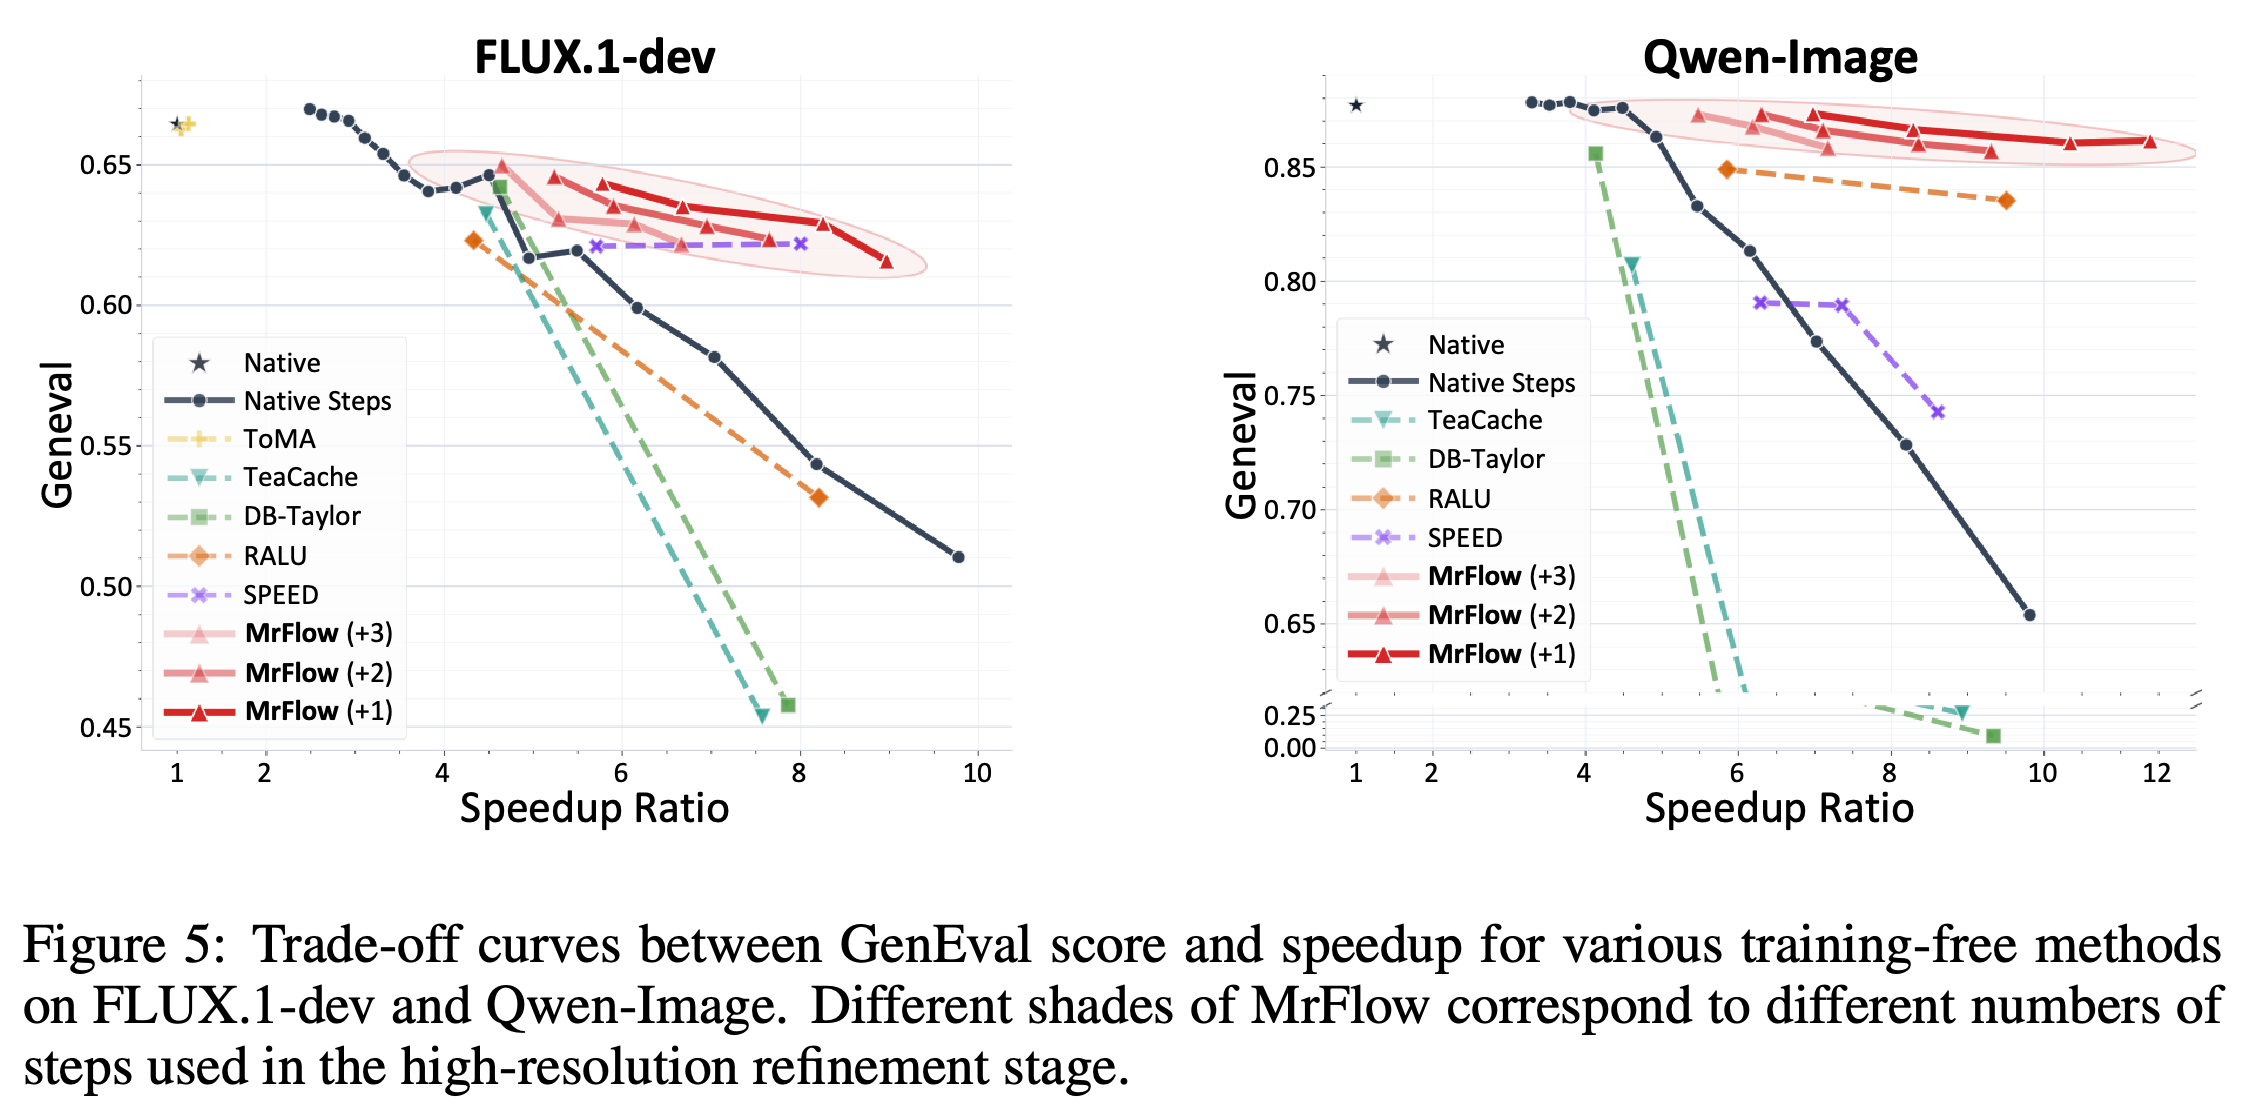
그래프는 FLUX.1-dev와 Qwen-Image에서 시험한 방법 및 스텝 설정의 Geneval 점수를 측정 가속률에 대비해 보여준다. 고해상도 스텝 수가 다른 MrFlow 곡선들이 가까이 모여 있는 모습은 정제 스텝을 추가해도 이러한 지표의 절충 관계가 크게 개선되지 않는다는 절제 실험 결과와 일치한다.
4.3 Ablation Study
실험한 스텝 수 범위에서는 저해상도 스텝을 늘릴수록 Geneval과 가속률 사이의 절충이 개선되지만, 고해상도 스텝을 늘려도 지표상 이점은 크지 않다. 시각적 비교에서는 정제하지 않았을 때보다 1스텝 정제한 뒤 노트의 글씨가 더 선명하며, 2번째 스텝을 추가했을 때의 차이는 더 작다.
(12, 1)×2에서 interpolation과 Real-ESRGAN은 모두 OneIG-En 0.52와 OneIG-Zh 0.51을 기록하며, 가속률은 각각 10.7×와 10.3×다. SwinIR의 가속률은 4.67×다. OneIG 값이 거의 같다는 사실만으로는 Figure 3에 나타난 국소적인 시각적 결함을 구별할 수 없다.
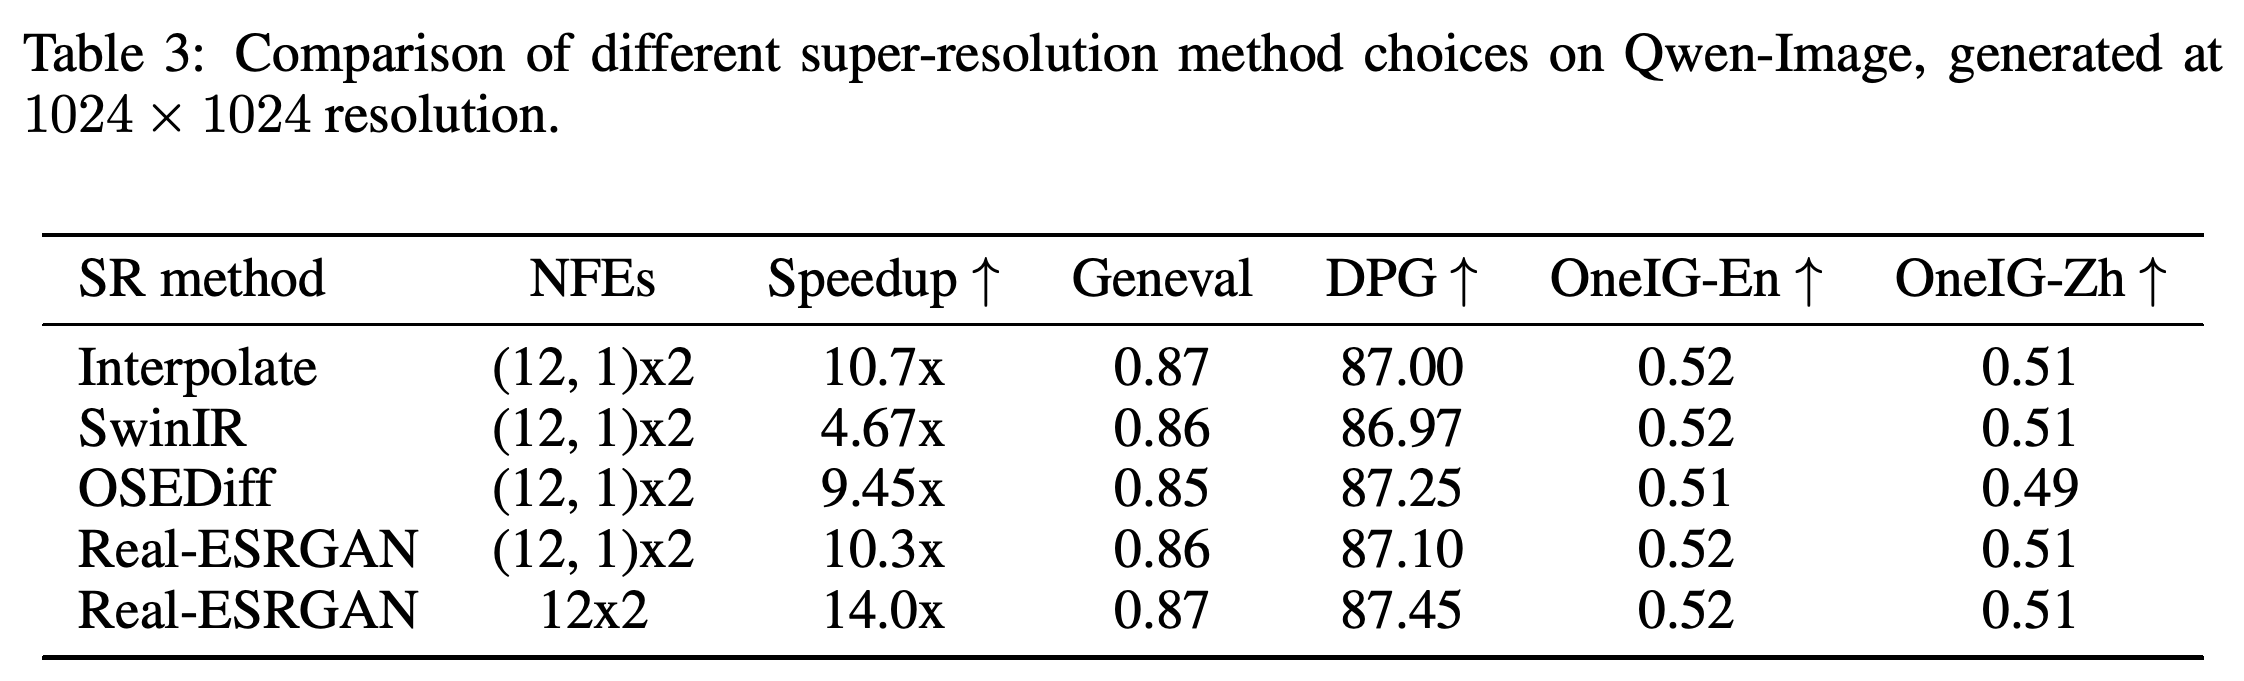
초해상도 절제 실험은 interpolation, SwinIR, OSEDiff, Real-ESRGAN을 비교한다. (12, 1)×2에서 interpolation과 Real-ESRGAN은 모두 OneIG-En 0.52와 OneIG-Zh 0.51을 기록하지만, Figure 3에서는 interpolation과 SwinIR의 흐림, OSEDiff의 부정확한 글자가 보인다. 저자들은 시험한 조건에서 시각적 세부 표현과 속도의 균형을 고려해 Real-ESRGAN을 선택한다.
5 Conclusion
MrFlow는 샘플링의 대부분을 연산 비용이 낮은 저해상도로 옮기면서 짧은 고해상도 수정 단계를 유지한다. 보고된 Qwen-Image의 추가 학습이 필요 없는 설정은 종단 간 10.3× 가속을 달성한다. 이 과정을 사전 학습된 timestep distillation 가중치와 결합하면 25.1×에 도달하지만, 이는 학습된 가중치에 의존하는 별도 설정이다.
부록
- Appendix A는 가속 기법, 잠재 공간의 다중 해상도 방법, 초해상도, repainting과의 비교를 확장한다. Appendix B는 비교 방법의 설정, guidance, 시간 측정 범위를 기록한다. Appendix C는 Qwen-Image에서 표본으로 고른 3개 층의 텍스트-이미지 attention 비중이 1024 해상도보다 512 해상도에서 더 크다고 측정하고, LR10 HR1의 5.08s와 HR11의 10.96s를 보고한다. 초해상도와 주파수 대역 분석에서는 짧은 정제가 시험한 고주파 교란보다 저주파 교란을 복구하는 데 더 어려움을 겪는다.
- Appendix C는 국소 비등방성 Gaussian 사전분포를 가정해 노이즈 임계값을 유도하고, 깨끗한 잠재변수 18개에서 고주파 임계값을 약 0.075로 보고한다. 별도로 제시한 분포 수준의 Gaussian smoothing 경계는 방향별 재샘플링에 관한 더 약한 조건과 달리 전체 분포의 정렬을 다룬다. 정제 스텝과 시드 민감도 실험은 측정된 구조와 세부 표현의 역할 분담을 뒷받침하지만, 국소 사전분포와 고주파 잔차에 관한 가정이 적용된다.
- Appendices D와 E는 FLUX.2 Klein, Z-Image, 스텝을 줄인 변형으로 평가를 확장하고, Qwen-Image 실행 시간을 기본 모델 49.32s와 MrFlow 4.77s로 보고한다. 측정된 지표에서 모델 간 전이 결과는 균일하지 않다. Z-Image의 (12, 1)×2 설정은 10.8× 가속을 달성하지만 OneIG-En/OneIG-Zh는 0.56/0.52에서 0.51/0.46으로 떨어진다. Appendix F는 방법 간 비교, 추가 이미지 예시와 프롬프트를 제공하며, PDF 압축 때문에 미세한 세부 요소가 잘 보이지 않을 수 있다고 설명한다.
짧은 생각
종단 간 시간 측정에는 추가 VAE 연산과 초해상도 작업이 포함된다. 초해상도 방법별 자동 평가 점수가 비슷하므로 국소적인 시각적 비교도 중요하다. 노이즈 분석은 초해상도가 구조를 보존하고, 남은 오차가 국소적으로 그럴듯하며 주로 고주파에 분포할 때 적용된다. Z-Image 결과는 백본이 달라도 품질 유지 수준이 같다고 가정해서는 안 됨을 보여준다. 또한 Table 1과 Table 2는 동일한 FLUX.1-dev MrFlow (12, 1) 설정에 대해 서로 다른 DPG 값인 81.65와 81.08을 보고한다.