


4DAnyone: Create Anyone in 4D from a Casual Monocular Video 요약 설명
20 Aug 2026 | Paper Review 4D Human Reconstruction Multiview Video Generation Video Diffusion Models 4D Gaussian Splatting목차
이번 글에서는 4DAnyone: Create Anyone in 4D from a Casual Monocular Video 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 20일(Arxiv)
- Jin, Yudong, Xie, Tao, Zhang, Qihang, Shen, Zehong, Xu, Zhen, Shen, Yujun, Bao, Hujun, Zhou, Xiaowei, Xu, Yinghao.
- State Key Lab of CAD&CG, Zhejiang University, China, Robbyant, China, Chinese University of Hong Kong, China, Ant Group, China, Hong Kong University of Science and Technology, China
- 논문 링크
- Github
- Project Page
요약
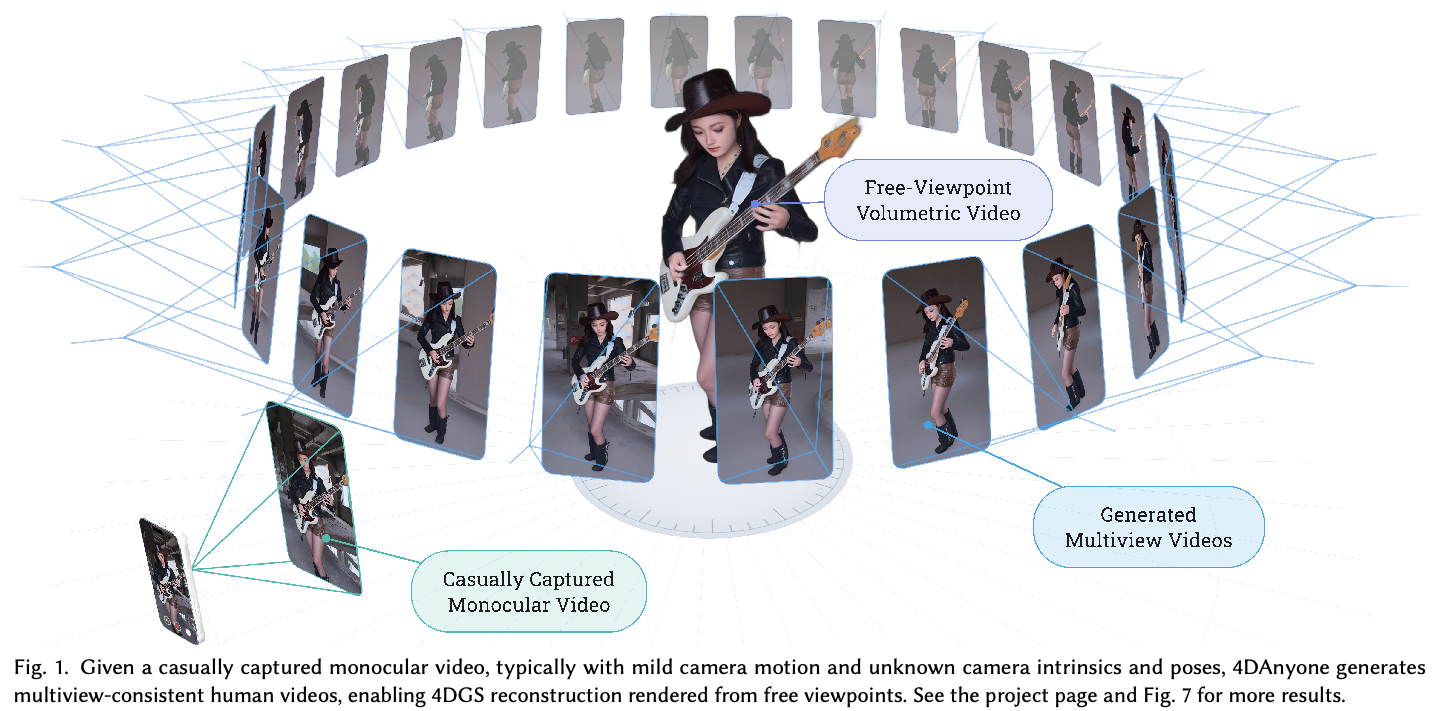
- 4DAnyone은 보정되지 않은 일상 단안 비디오에서 복원용 다중 시점 비디오를 생성한 뒤 FreeTimeGS를 적용해 자유 시점 4D 인간을 복원한다. 핵심 확장성 문제는 제한된 DiT 어텐션이다. 4D Gaussian Splatting(4DGS)에 필요한 수십 개 시점을 생성하려면 목표 시점을 그룹으로 나누어야 한다. 그러나 누적된 참조 시점은 컨디셔닝 규모를 (O(N))으로 키우고, 분리된 목표 그룹은 구조적으로 드리프트할 수 있다.
개요는 의도한 파이프라인을 보여 준다. 일상적으로 촬영한 단안 클립을 다중 시점 일관성을 갖는 목표 비디오로 확장하고, 이를 이용해 자유 시점 볼류메트릭 비디오를 구성한다.
1 Introduction
직접 단안 아바타 복원은 가려진 외형을 복원하기 어렵고 일반적으로 카메라 파라미터에 의존한다. 카메라 제어 확산 모델은 그럴듯한 새 시점을 합성할 수 있지만, 복원에 필요한 규모의 시점 수에서는 일관성을 유지하지 못한다. 논문은 조밀한 깊이 또는 원본 카메라 파라미터 대신 희소한 3D 스켈레톤 컨디셔닝을 사용한다. 또한 외형 컨디셔닝과 그룹 간 생성 일관성을 해결하기 위해 Reference Context Packing(RCP)과 Target Context Routing(TCR)을 도입한다.
3 Method
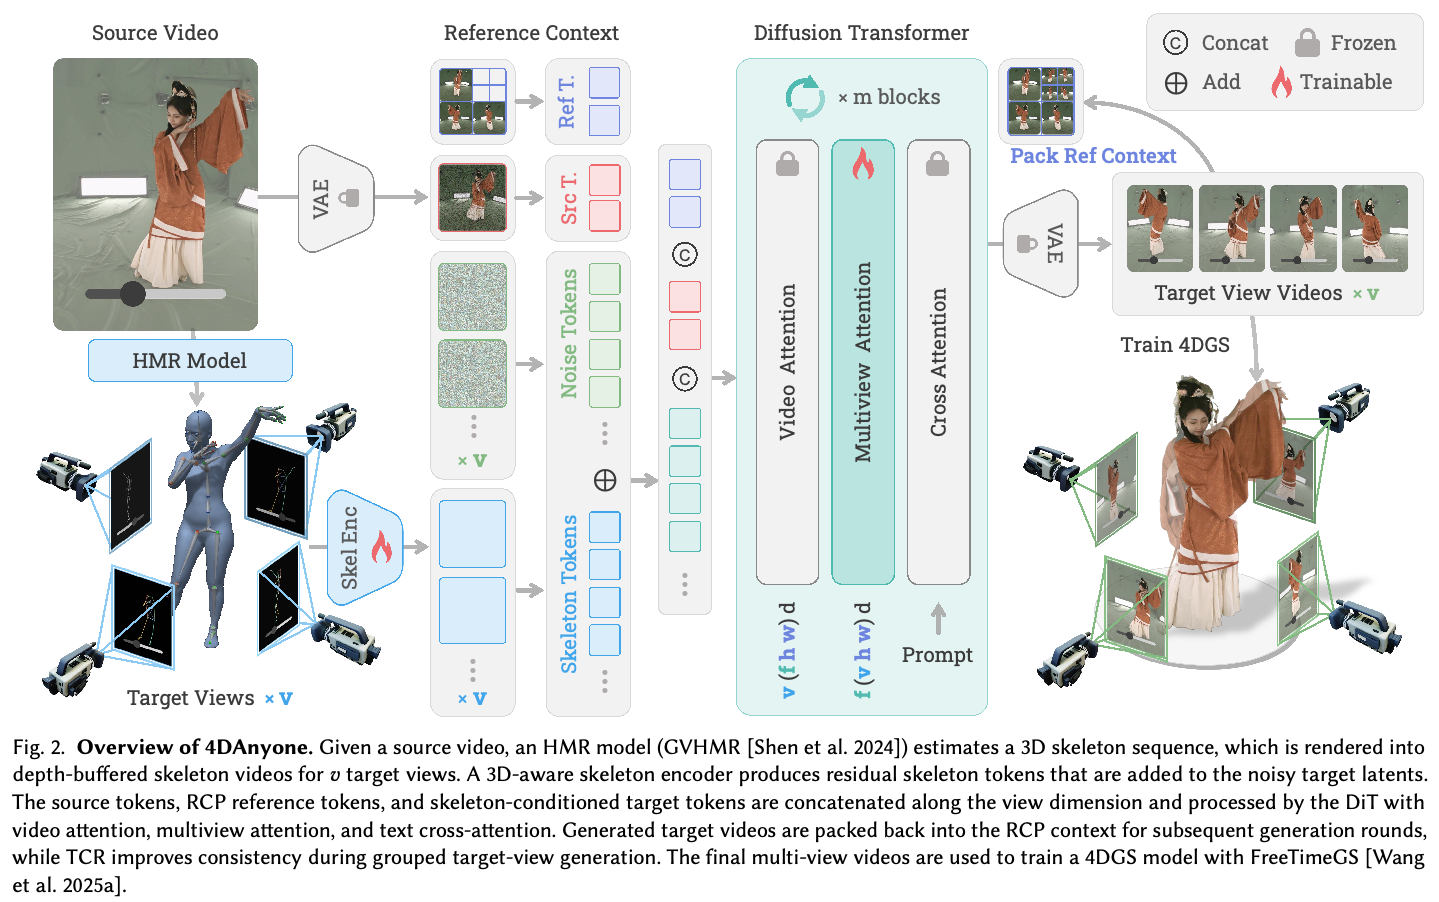
알 수 없는 내부 파라미터와 포즈를 지닌 원본 비디오 Vsrc가 주어지면, 이 방법은 지정된 고정 시점에서 비디오를 생성하고 이를 FreeTimeGS로 복원한다. GVHMR은 3D 스켈레톤 시퀀스를 추정한다. 깊이 버퍼를 적용한 목표 시점 스켈레톤 렌더링이 Wan2.2-based DiT를 조건화하고, 생성 비디오는 4DGS를 위한 다중 시점 관측으로 사용된다.
3.1 Overview
아키텍처는 원본 비디오, 패킹된 참조 컨텍스트, 잡음이 섞인 목표 잠재 표현, 스켈레톤 조건을 인코딩한다. DiT는 비디오 어텐션, 다중 시점 어텐션, 텍스트 크로스 어텐션을 결합한다. 생성 비디오는 점진적으로 참조 컨텍스트에 포함된다. TCR은 고정된 그룹별 메모리 예산 안에서 목표 시점 그룹의 디노이징을 조정한다. 디노이징에 대해서는 이 글을 참조하라.
도식은 HMR에서 추정한 깊이 버퍼 스켈레톤이 스켈레톤 인코더와 확산 트랜스포머를 거쳐 목표 비디오로 이어지는 경로를 보여 준다. 이 비디오는 이후 FreeTimeGS 복원 학습에 사용된다.
3.2 3D-Aware Skeleton Conditioning
복원한 3D 스켈레톤은 픽셀 단위 z-buffer로 래스터화하여 가까운 팔다리가 먼 팔다리를 가리게 한다. 이 방식은 추가 입력 채널 없이 일반 2D 포즈 렌더링의 앞뒤 모호성을 해결한다. 방법은 Goliath 키포인트 40개를 유지한다. 구성은 신체 17개, 발 6개, 손바닥 수준 손 10개, 보조 랜드마크 7개이며, 얼굴 점과 개별 손가락 관절은 제외한다. 0으로 초기화한 스켈레톤 인코더는 잡음이 섞인 잠재 표현에 잔차 토큰을 더한다.
3.3 Scalable Multiview Consistency
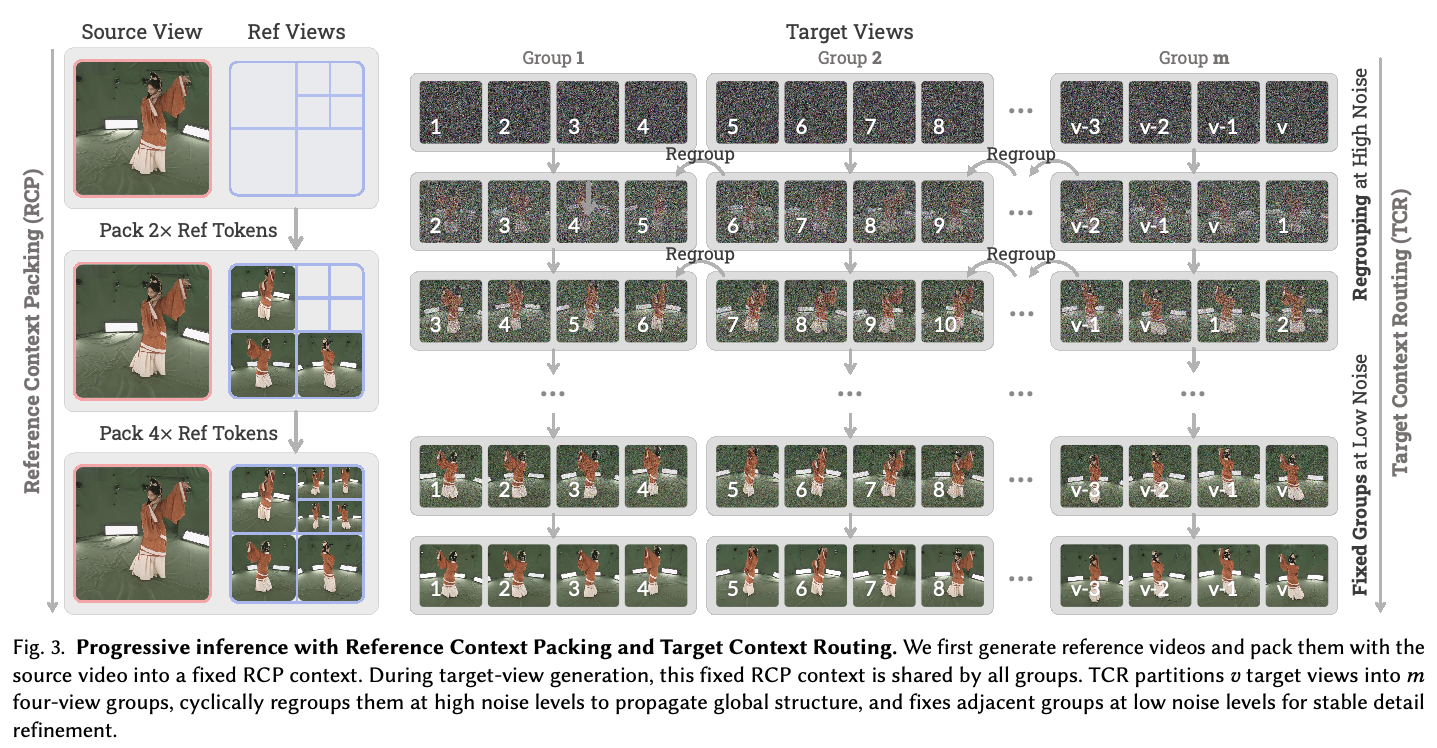
RCP는 2× 및 4× 다중 해상도 패치화 계층으로 누적된 생성 참조 비디오를 고정된 토큰 예산에 압축한다. 이로써 참조 컨텍스트의 증가를 (O(N))에서 (O(1))로 바꾼다. TCR은 고잡음 단계에서 전역 구조를 전달하도록 4개 목표 시점을 순환식으로 다시 그룹화한다. 저잡음 단계에서는 인접한 4개 시점 그룹을 고정해 국소 세부 정보를 정제한다. 기본 전환 비율은 (t_s/T = 0.2)다.
그림은 2가지 확장성 기법을 구분한다. RCP는 누적된 참조 시점에 대해 고정 크기 컨텍스트를 유지하고, TCR은 디노이징 초기에 목표 그룹 구성을 바꾸며 후반에는 인접 그룹을 고정한다.
3.4 Training Protocol
학습은 3단계 커리큘럼을 따른다. 전경만 남긴 DNA-Rendering으로 스켈레톤 조건부 카메라 제어를 학습하고, 마스크를 적용하지 않은 다중 시점 데이터로 배경과 조명을 학습한다. Pexels와 TedTalk 단안 비디오는 실제 환경 일반화를 높인다. 모델은 704×1280에서 Wan2.2-TI2V-5B를 미세 조정하며, 잠재 공간 흐름 정합 MSE와 (\lambda = 0.25)로 가중한 LPIPS를 사용한다. Stage 3에서는 손가락 키포인트를 제거한다.
4 Experiments
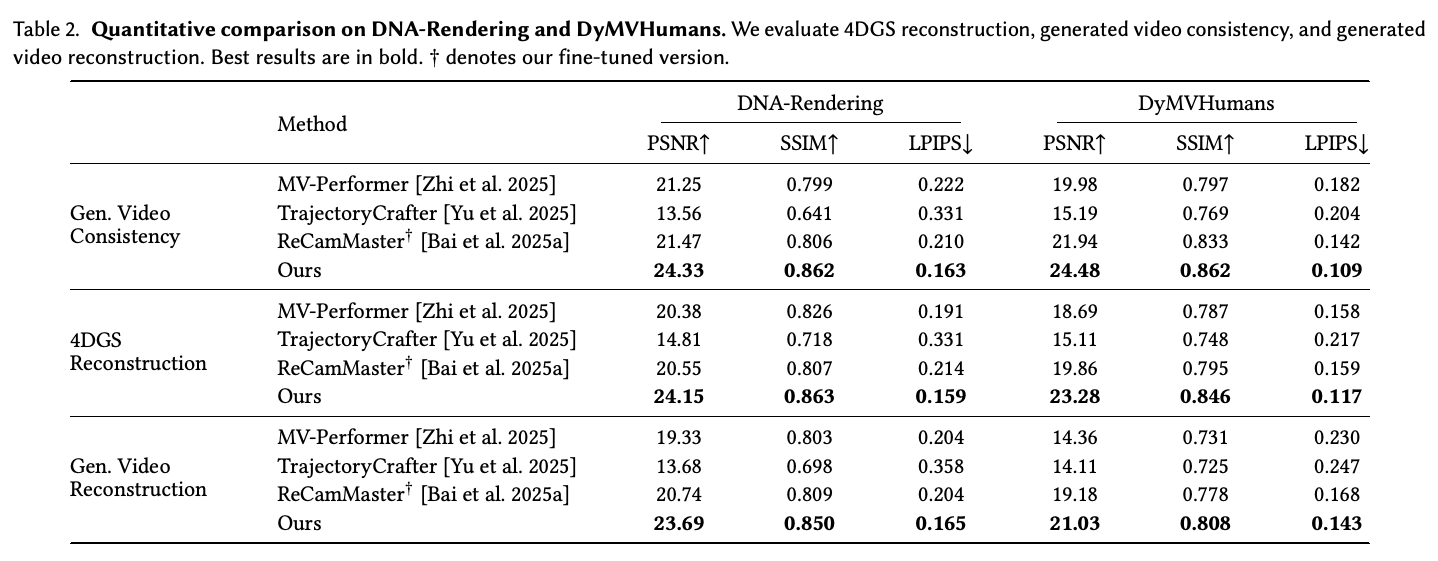
실험은 직접 생성 비디오 복원, 생성 시점 간 일관성, 후속 4DGS 복원을 학습에서 제외한 DNA-Rendering 장면과 분포 밖 DyMVHumans 장면에서 평가한다. 연구는 MV-Performer, TrajectoryCrafter, 그리고 동일한 데이터셋·RCP·TCR로 미세 조정한 ReCamMaster 변형을 비교한다. 3개 평가 차원은 모두 PSNR, SSIM, LPIPS를 사용한다.
4.1 Experimental Setup
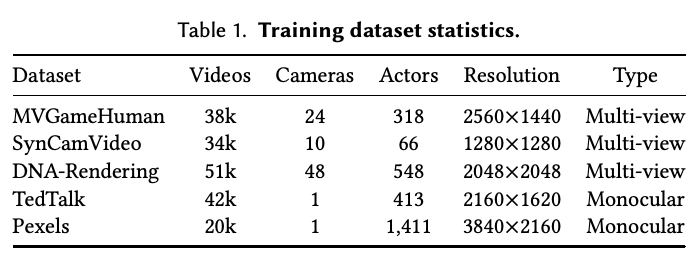
학습 데이터는 MVGameHuman, SynCamVideo, DNA-Rendering, TedTalk, Pexels로 구성된다. 정량 평가는 DNA-Rendering 장면 10개와 DyMVHumans 장면 3개에서 수행한다. 대략 균일하게 분포한 목표 카메라 16개와 단일 정면 시점 원본으로부터 장면당 프레임 98개를 사용한다. 추론은 디노이징 단계 20개와 4개 시점 목표 그룹을 사용한다.
표는 학습 코퍼스의 규모와 구성을 제시한다. 3개 데이터셋은 다중 시점 범위를 제공하고, TedTalk과 Pexels는 일반화를 위한 단안 비디오 다양성을 제공한다.
4.2 Comparison with State-of-the-Art
4DAnyone은 보고된 Table 2의 모든 지표에서 가장 우수하다. 4DGS 복원에서 DNA-Rendering은 24.15 PSNR, 0.863 SSIM, 0.159 LPIPS를 기록하고, DyMVHumans는 23.28, 0.846, 0.117을 기록한다. 생성 비디오 일관성은 각각 24.33/0.862/0.163과 24.48/0.862/0.109다. 정성 비교는 기준 방법의 실패를 측면·후면 시점 왜곡, 깊이 오차 누적, 부정확한 카메라 제어와 연관 짓는다.
표는 생성 비디오 일관성, 후속 4DGS 복원, 직접 생성 비디오 복원을 정량 비교한다. 4DAnyone은 모든 DNA-Rendering 및 DyMVHumans 열에서 가장 좋은 보고 수치를 보인다.
4.3 Ablation Study
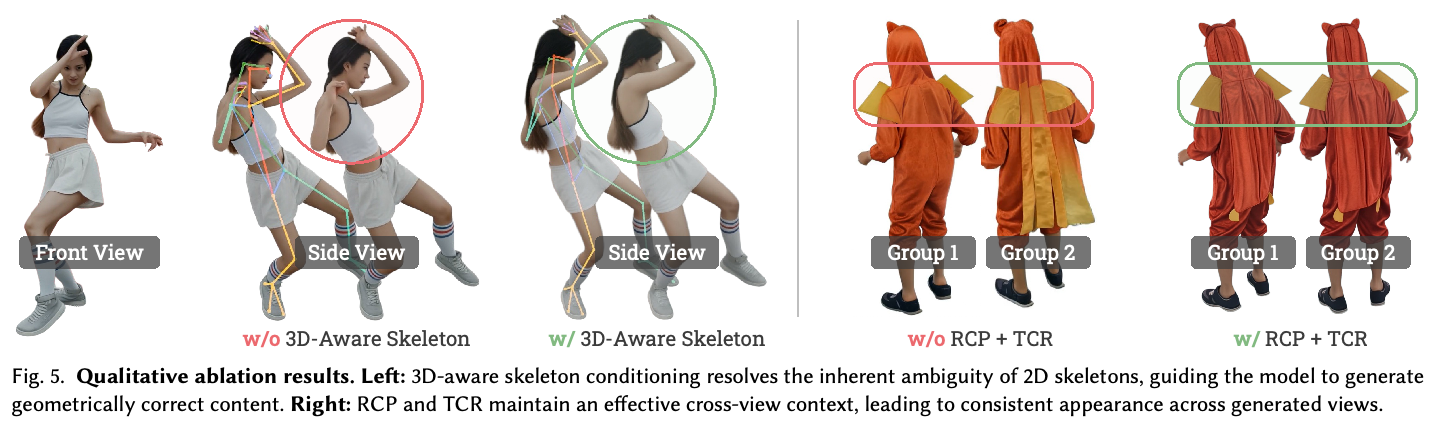
RCP와 TCR을 모두 제거하면 DNA-Rendering 생성 비디오 일관성 어블레이션에서 21.09 PSNR, 0.766 SSIM, 0.216 LPIPS를 기록한다. 이는 전체 Sliding 구성의 22.63, 0.796, 0.191과 비교된다. 각 구성 요소는 결과를 개선한다. Sliding 라우팅은 보고된 Random 및 Strided 대안보다 우수하다. 깊이 버퍼를 적용한 스켈레톤은 2D 스켈레톤 컨디셔닝에서 나타나는 모호성을 시각적으로 해결한다. 보충 자료의 전환 시점 탐색은 (t_s/T = 0.2)가 포화 구간의 시작점임을 보이지만, 더 낮은 여러 비율도 매우 유사한 점수를 낸다.
왼쪽 사례는 깊이 인식 스켈레톤 렌더링이 2D 스켈레톤 컨디셔닝에서 보인 측면 시점 신체 부위 모호성을 해결함을 보여 준다. 오른쪽 사례는 독립적으로 그룹화한 목표 시점 2개를 비교하며, RCP와 TCR을 활성화했을 때 더 일관된 외형을 보인다.
4.4 Generalization to In-the-Wild Videos
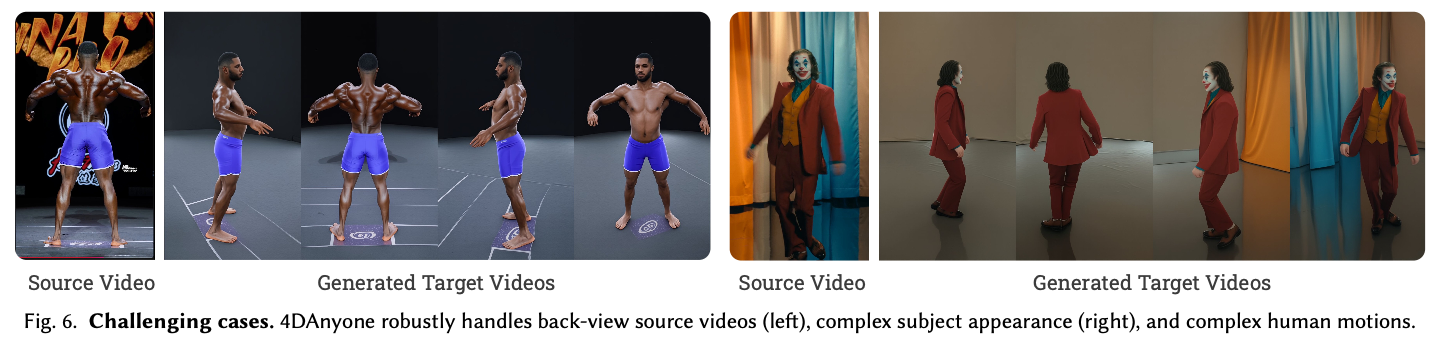
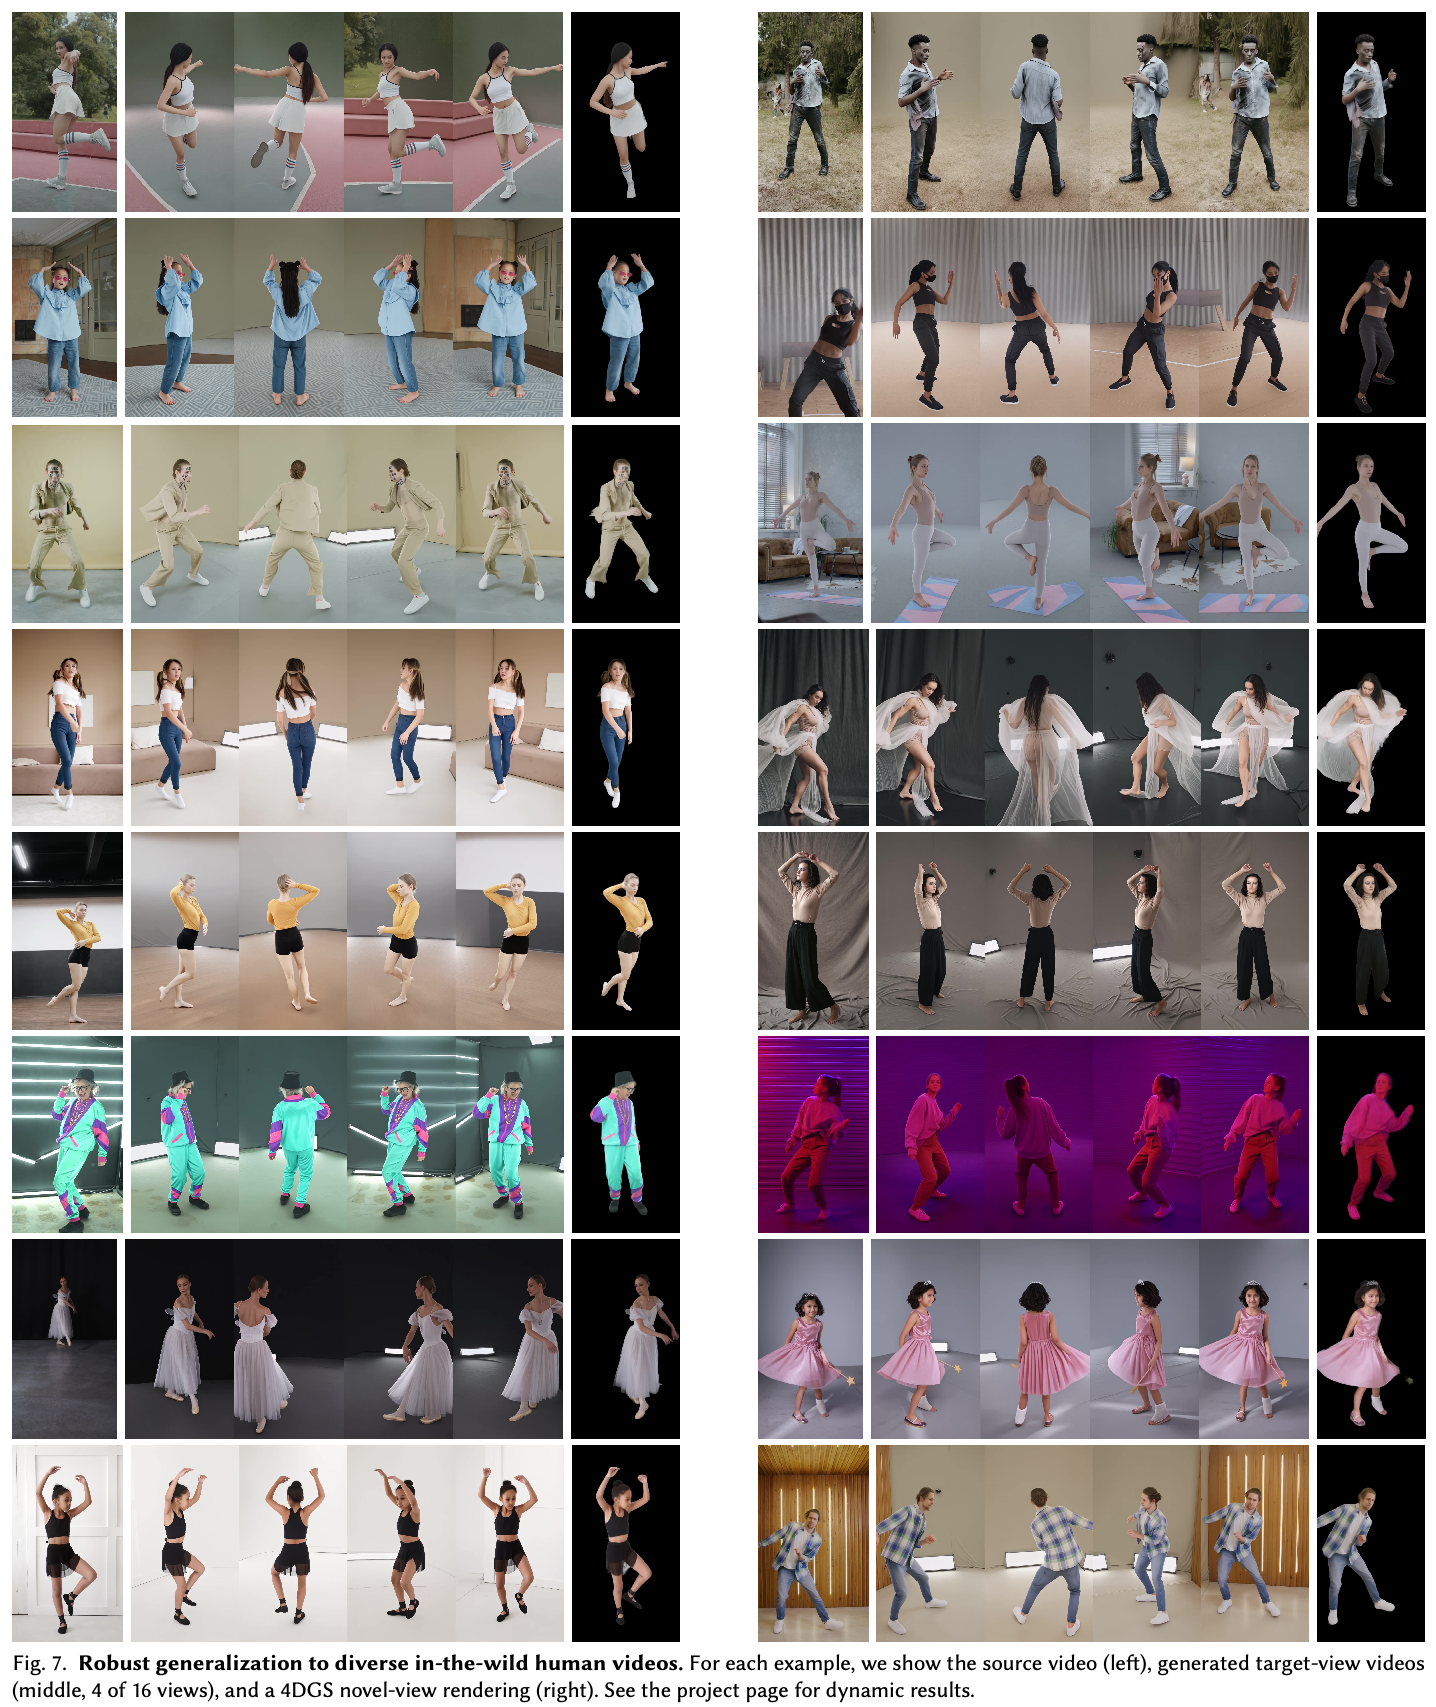
논문은 후면 시점 원본, 복잡한 외형, 복잡한 움직임을 포함한 다양한 실제 환경 비디오에서 생성한 목표 시점과 4DGS 렌더링의 정성 결과를 제시한다. 이 사례는 통제된 벤치마크를 넘어선 정성적 일반화를 뒷받침하지만, 별도의 정량 실제 환경 비디오 벤치마크는 아니다.
사례는 후면 시점 원본, 세부적인 외형, 복잡한 움직임을 포함해 표준 정면 시점 설정 밖의 어려운 원본 조건을 시험한다. 이는 목표 시점 생성의 견고성에 관한 정성적 근거를 제공한다.
각 행은 실제 인간 비디오의 원본 비디오, 생성된 16개 시점 중 4개, 4DGS 렌더링을 나란히 배치한다. 이 그림은 논문에서 실제 환경 일반화를 보여 주는 주요 시각적 근거다.
부록
- 보충 자료는 10-layer Conv3d 스켈레톤 인코더, 318명 배우의 동기화된 24-camera 비디오 38k개로 구성된 MVGameHuman, SMPL-X-to-Goliath70 회귀기의 학습 제외 키포인트 오차 3.5 mm를 명시한다. 16-camera, 121-frame 복원에는 RTX 4090 1개에서 약 2 min의 전처리, H20 GPU 1개에서 비디오 4개 생성에 ∼7 min, RTX 4090 1개에서 FreeTimeGS 최적화에 ∼30 min이 필요하다고 보고한다. 한계로는 몸에서 멀리 움직이는 느슨한 의복의 시점 간 불일치와 생성 시점으로 전파되는 HMR 포즈 오차가 있다.
짧은 생각
논문은 4D 복원에 필요한 시점 수에서 다중 시점 확산을 적용할 때 그룹 간 드리프트가 실질적인 장애물이라고 지적한다. 이를 보정된 원본 카메라나 조밀한 깊이 없이 컨텍스트 패킹과 추론 시 라우팅으로 해결한다. 근거는 통제된 DNA-Rendering 및 DyMVHumans 평가와 구성 요소 어블레이션에서 가장 강하다. 성능은 여전히 신뢰할 수 있는 인간 동작 복원과 신체 스켈레톤이 의복 움직임을 충분히 표현하는지에 의존한다. 논문은 현실적인 인간 비디오 합성의 딥페이크 오용, 신원 프라이버시, 저작권 위험도 언급한다.