2025년 4월 AI 논문 동향
30 Apr 2025 | Paper Review Monthly Papers Efficient Inference Multimodal Reasoning Constrained Generation목차
이달의 트렌드
2025년 4월의 주제는 연산을 구성하는 방법이며, 선정된 3편의 논문은 수치 정밀도, 선택적 매개변수 사용, 실행 가능한 생성 절차를 통해 모델 효율이나 과제 성능을 높이는 방법을 탐구한다. BitNet은 {−1, 0, +1}로 제한한 삼진 가중치로 학습한다. Kimi-VL은 토큰을 선택된 전문가 모듈로 보내는 Mixture-of-Experts 디코더를 사용한다. Self-Steering Language Models는 작은 모델의 동작을 조율하는 프로그램을 생성한다. 각 연구가 측정하는 결과가 다르므로 메모리 절감, 활성화 매개변수 수, 제약 충족률을 각각 구분해 해석해야 한다. 1, 2, 3
추론 연산량을 늘렸을 때 얻는 성능 향상은 과제에 따라 다르다. Kimi-VL의 thinking 확장은 중간 추론 과정을 명시적으로 생성하며, 시각적 수학 문제에서 성능을 크게 높인다. 다만 MathVista에서는 thinking 예산이 4k-token을 넘으면 추가 향상이 작다. Self-Steering Language Models는 실행 가능한 탐색 및 채점 절차를 통해 여러 생성 후보에 연산을 배분한다. 이 방법은 정확한 제약 충족률을 높이지만, 생성된 채점 절차가 필수 내용에 불이익을 주면 후보를 늘릴수록 결과가 나빠질 수 있다.
효율을 판단하려면 시스템 전체를 측정해야 한다는 점도 드러난다. BitNet은 노트북에서 측정한 디코딩 지연 시간을 보고하지만, 가중치 메모리 수치에는 학습된 토큰 표현인 임베딩이 빠져 있고 에너지 수치는 산술 연산 비용의 추정치다. Kimi-VL의 활성화 매개변수 수만으로는 실행 시 메모리나 지연 시간을 알 수 없다. Self-Steering Language Models에서는 작은 모델의 실행 비용이 낮아도 큰 계획 모델에 프롬프트를 제공하는 과정이 추정 비용의 대부분을 차지한다. 이러한 결과는 실제 사용할 하드웨어와 입력 및 출력 조건에서 전체 배포 시스템을 평가해야 함을 뒷받침한다.
2025년 4월의 주요 논문
1. BitNet b1.58 2B4T Technical Report
- https://arxiv.org/abs/2504.12285
- BitNet b1.58 2B4T Technical Report 요약 설명
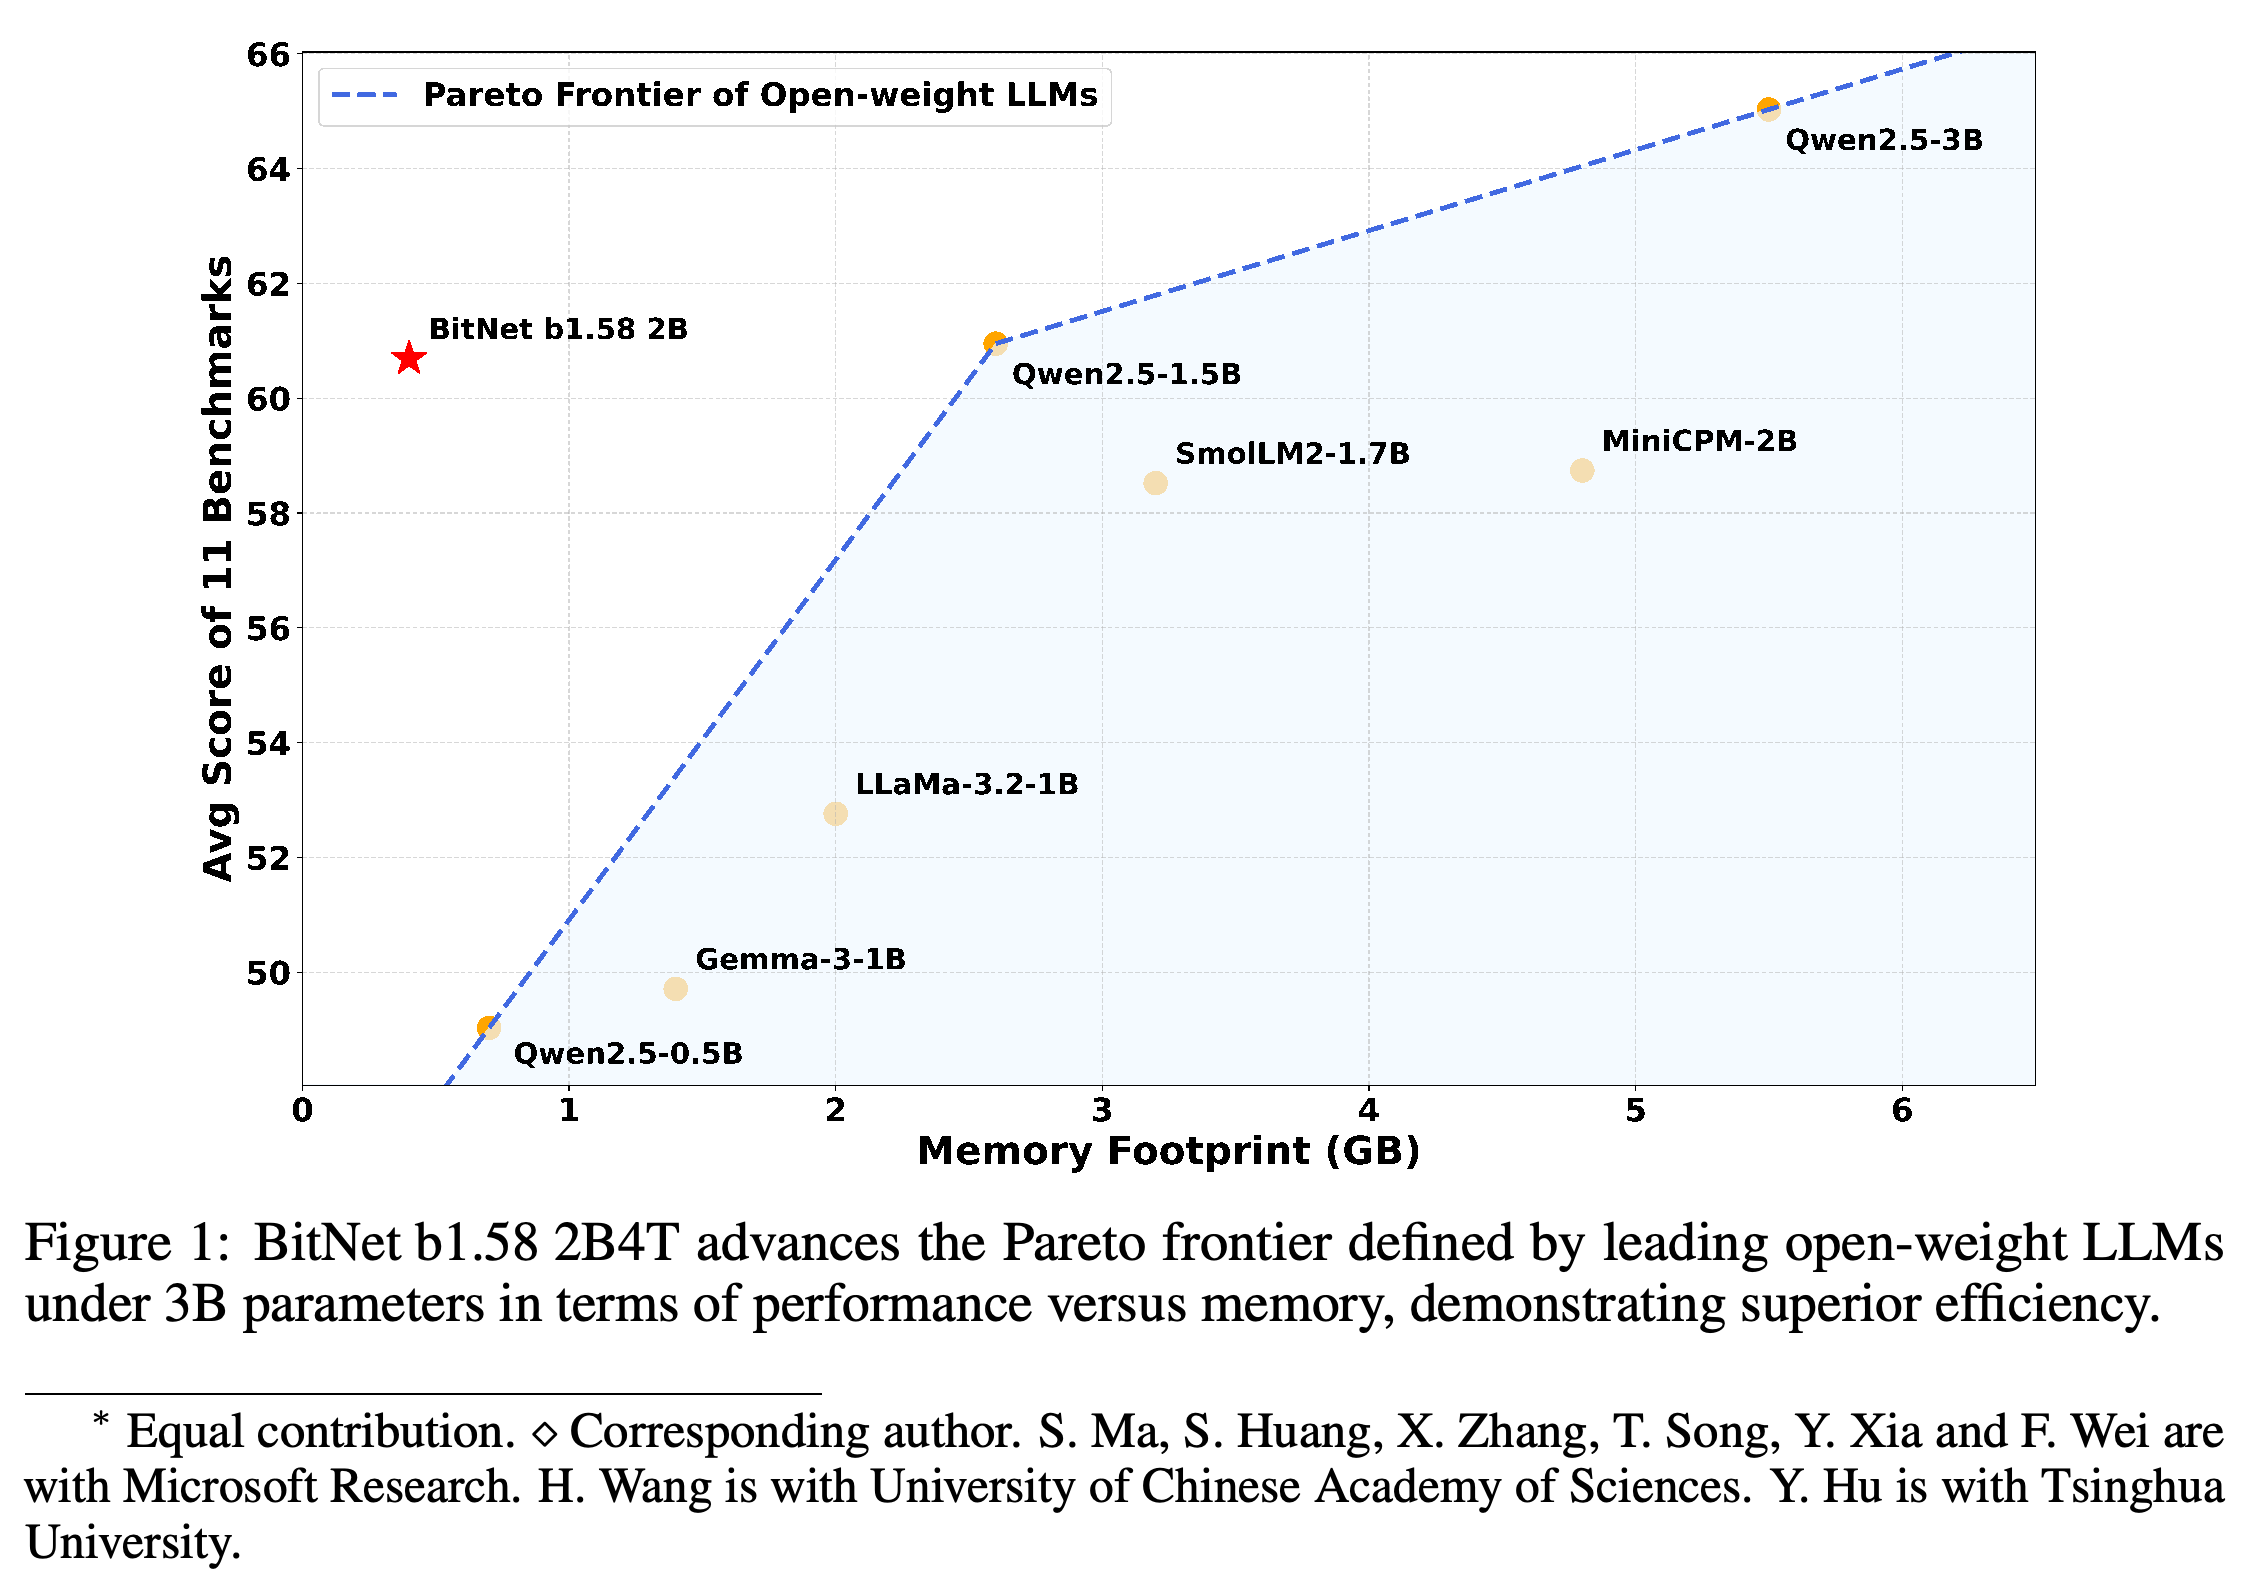
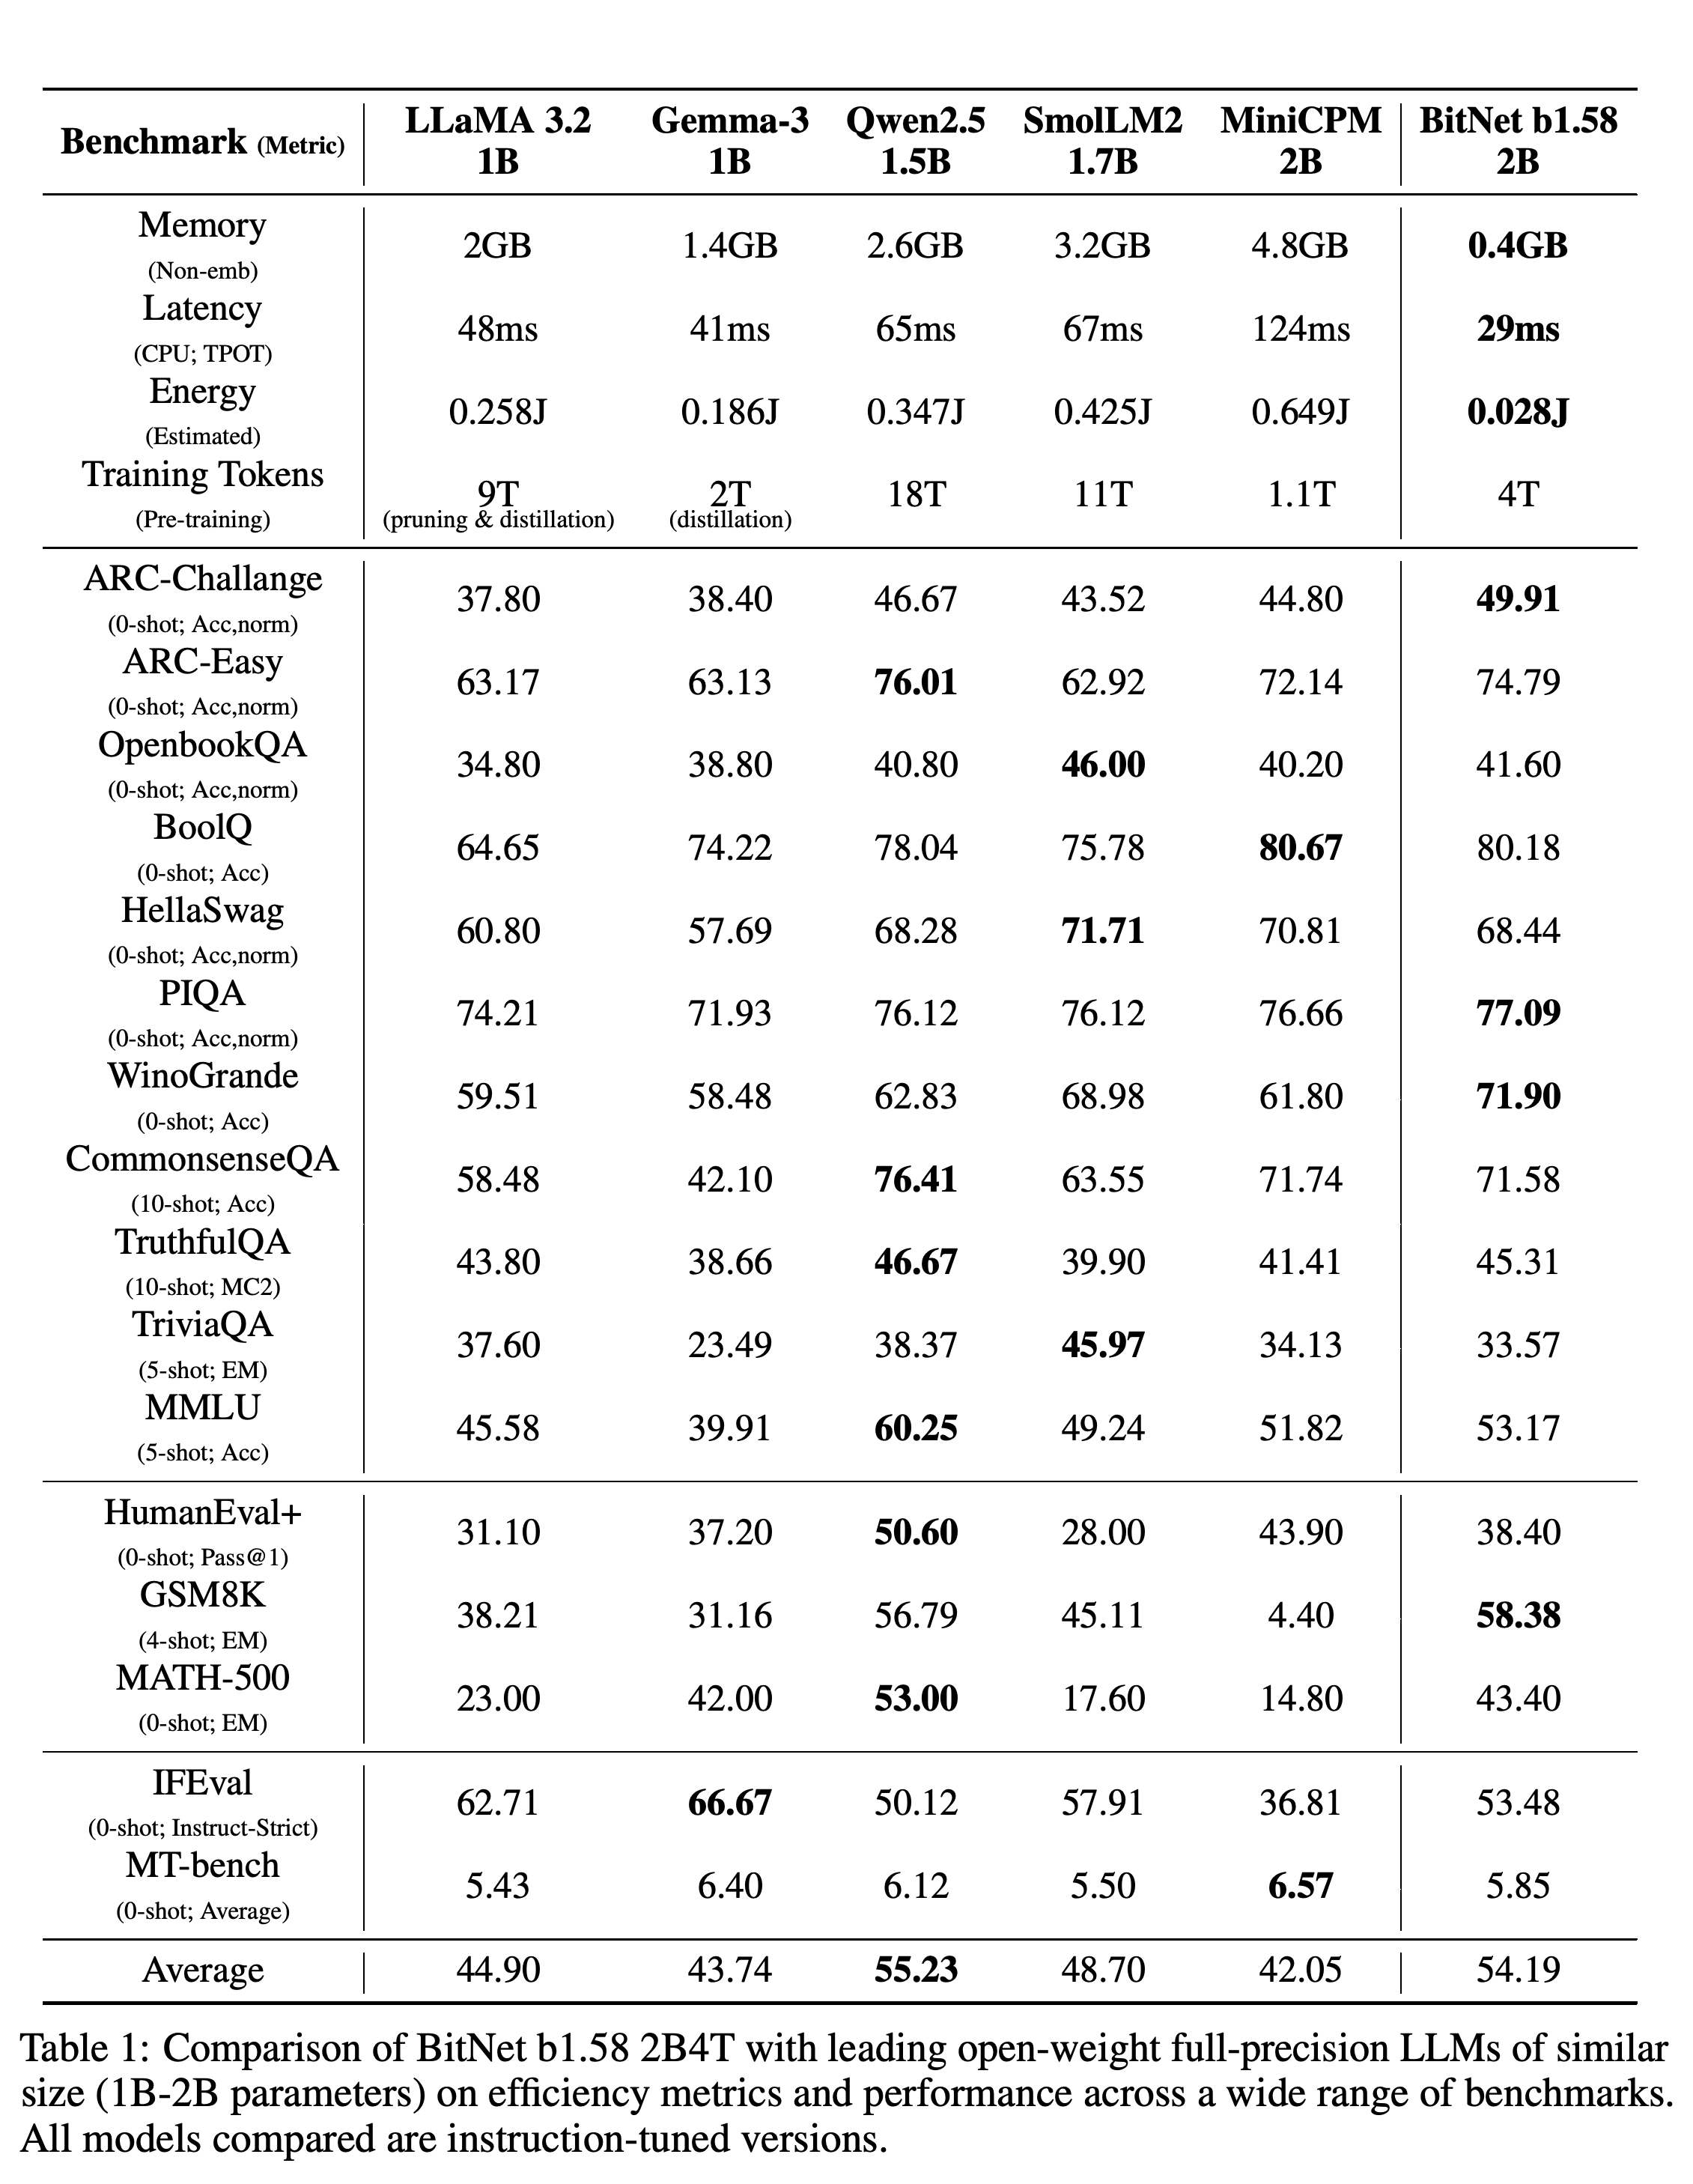
- BitNet b1.58 2B4T Technical Report는 삼진 가중치와 8비트 정수 활성화값을 사용해 4 trillion 토큰으로 처음부터 학습한 2B 매개변수 언어 모델을 제시한다. 활성화값은 계층 사이에 전달되는 중간값이다. 1.58비트라는 명칭은 가중치를 가리키며, 학습이나 추론에 쓰이는 모든 값의 정밀도를 뜻하지는 않는다. 전용 BitLinear 계층이 양자화 연산을 수행한다.
- Table 1에서 평균 벤치마크 점수는 BitNet이 54.19, 지시 학습을 거친 Qwen2.5 1.5B가 55.23이다. 임베딩을 제외한 가중치 메모리는 각각 0.4 GB와 2.6 GB다. Intel Core i7-13800H가 탑재된 Surface Laptop Studio 2에서 중앙처리장치 스레드 8개를 사용해 토큰 128개를 생성하는 동안 측정한 출력 토큰당 평균 디코딩 시간은 각각 29 ms와 65 ms다. BitNet은 bitnet.cpp를 사용하고, 비교 모델은 llama.cpp를 사용한다.
- 평가한 소형 모델들과의 비교에서는 배포 효율의 가능성을 보이지만, 성능은 과제마다 다르다. BitNet은 예시 4개를 제공하는 GSM8K 수학 평가에서 58.38을 기록하지만, 지식을 평가하는 MMLU와 코드 생성을 평가하는 HumanEval+에서는 Qwen2.5보다 낮은 점수를 기록한다. 보고된 에너지 0.028 J는 시퀀스 길이 512토큰에서 행렬 곱셈의 산술 연산 비용을 추정한 값이며, 기기 전체의 에너지를 측정한 값은 아니다. 학습 절차와 추론 라이브러리가 서로 달라 개선 효과를 가중치 정밀도만의 영향으로 해석하는 데는 한계가 있다.
2. Kimi-VL Technical Report
- https://arxiv.org/abs/2504.07491
- Kimi-VL Technical Report 요약 설명
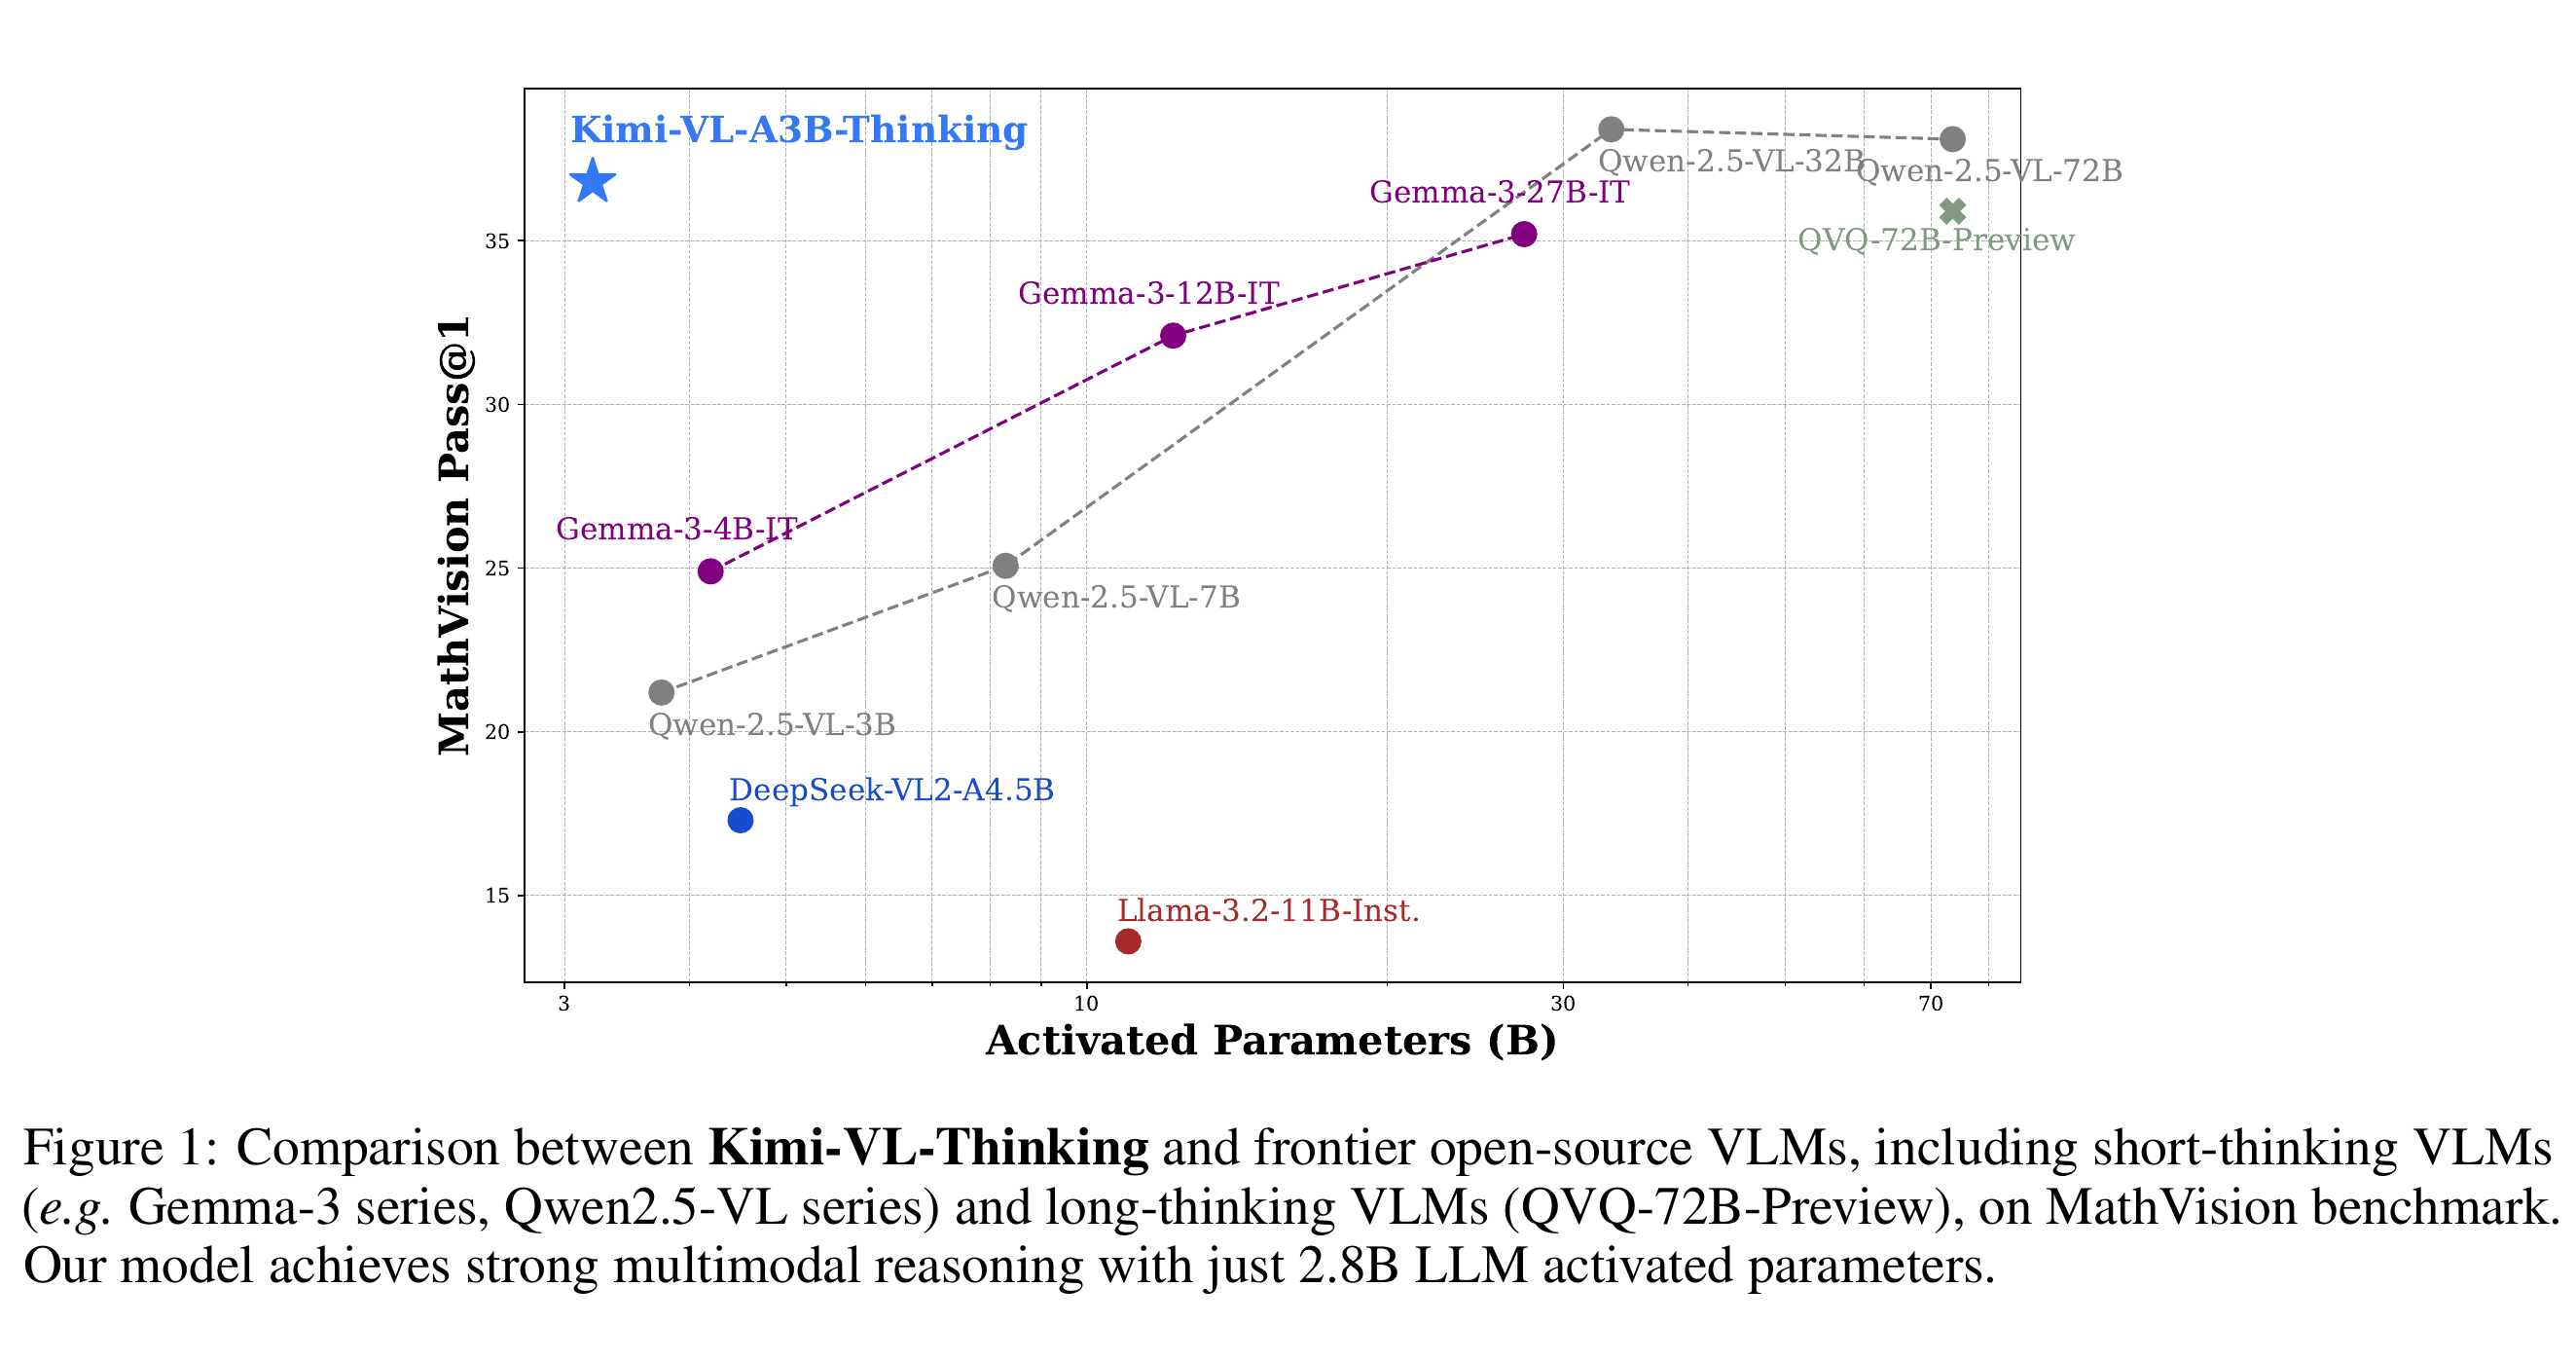
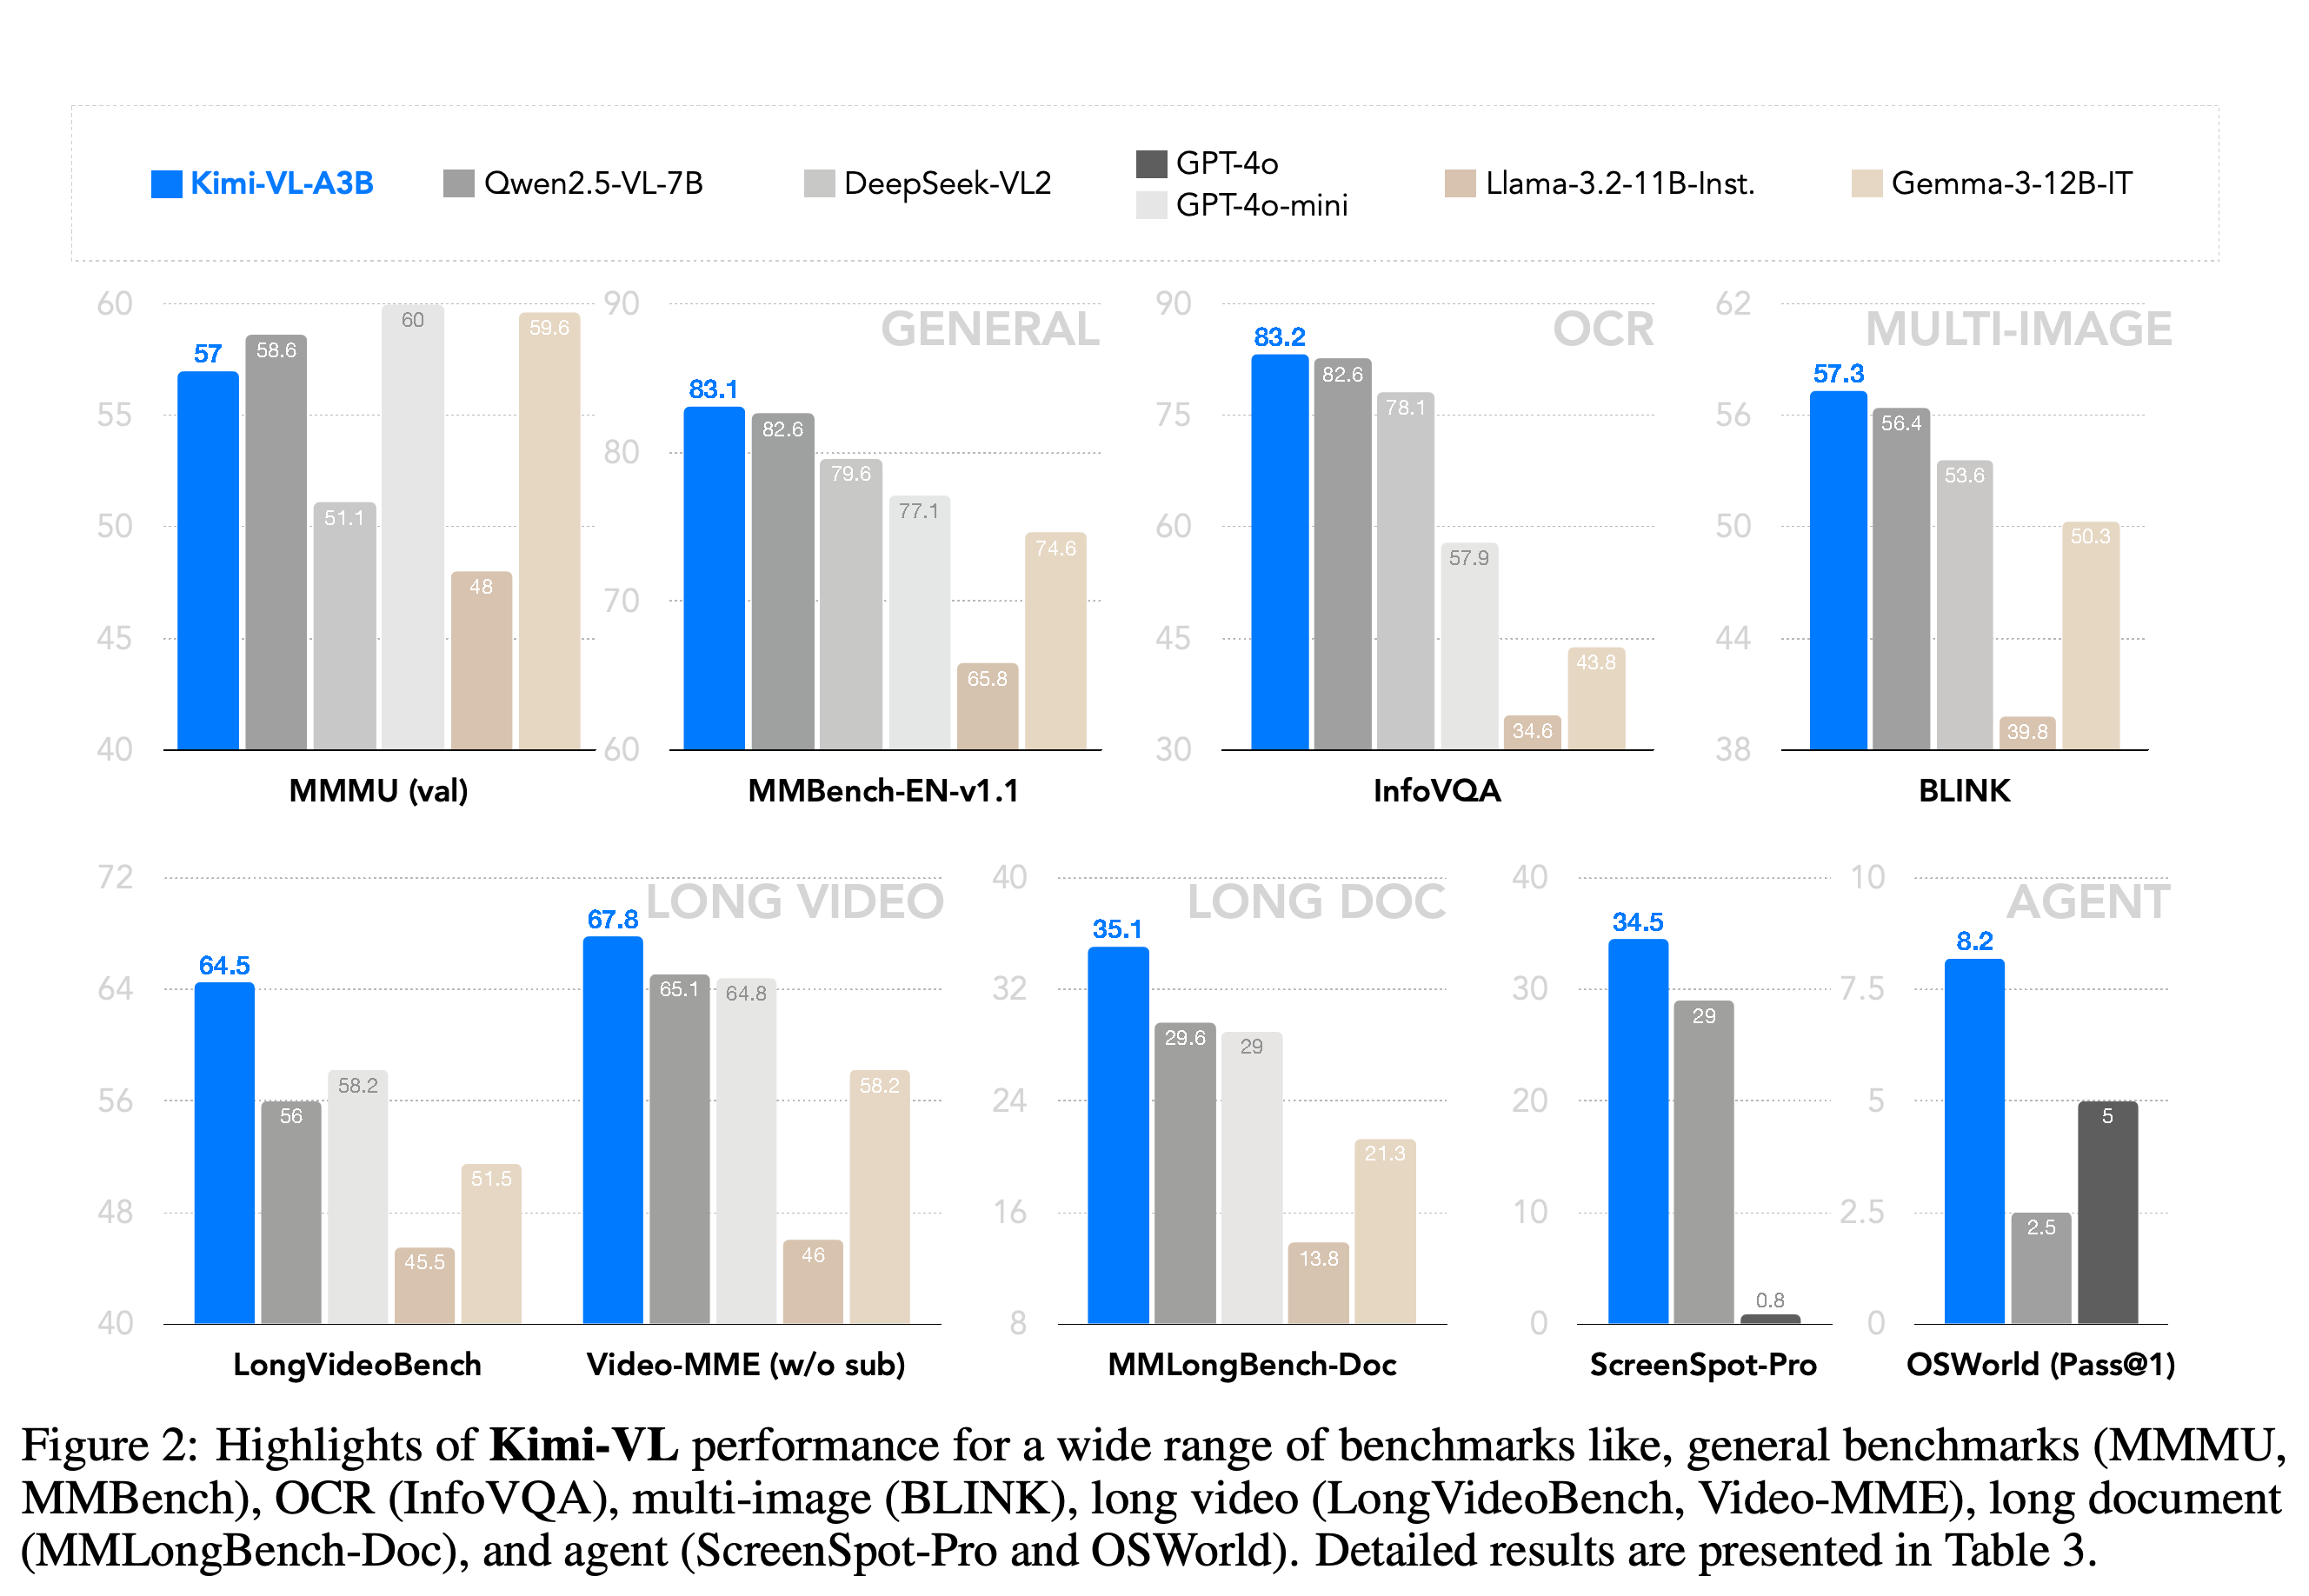
- Kimi-VL Technical Report는 다양한 해상도를 받는 이미지 인코더 MoonViT와 토큰을 전문가 모듈로 보내는 언어 디코더를 결합한다. 이를 통해 이미지와 텍스트를 함께 처리하는 시각-언어 과제를 다룬다. 디코더의 전체 매개변수는 16B, 활성화 매개변수는 2.8B이며, 별도로 400M-parameter 시각 인코더를 사용한다. 텍스트와 시각 데이터의 공동 학습으로 최대 입력 시퀀스 길이인 컨텍스트 윈도를 131072토큰까지 확장한다.
- Kimi-VL-A3B-Thinking은 긴 추론 예시를 활용한 지도 학습과 답변의 정답 여부에 보상을 주는 강화학습을 추가한다. 시각적 수학 경시대회 문제 벤치마크인 MathVision 전체 세트에서 답변을 1회 생성했을 때의 성공률인 Pass@1은 기본 Kimi-VL의 21.4%에서 36.8%로 높아진다. MathVista mini는 68.7%에서 71.3%로, 대학 수준의 멀티모달 질문 벤치마크인 MMMU 검증 세트는 57.0%에서 61.7%로 높아진다. 이 결과는 2025년 4월 10일 버전인 arXiv:2504.07491v1을 따른다.
- 긴 입력에서의 검색과 thinking 연산량 확대에는 모두 측정된 한계가 있다. 긴 시퀀스에 삽입한 정보를 검색하는 Needle-in-a-Haystack 테스트에서 65536토큰까지의 재현율은 100.0%지만, (65536, 131072] 구간에서는 텍스트가 87.0%, 동영상이 91.7%로 낮아진다. MathVista는 thinking 예산이 4k-token일 때 70.9%, 16k일 때 71.3%를 기록한다. 따라서 배포를 평가할 때는 활성화 매개변수 수와 함께 입력 크기와 출력 예산을 고려해야 한다. 인코더, 옵티마이저, 데이터 혼합, 강화학습의 효과를 각각 분리하는 통제 실험은 제시하지 않는다.
3. Self-Steering Language Models
- https://arxiv.org/abs/2504.07081
- Self-Steering Language Models 요약 설명
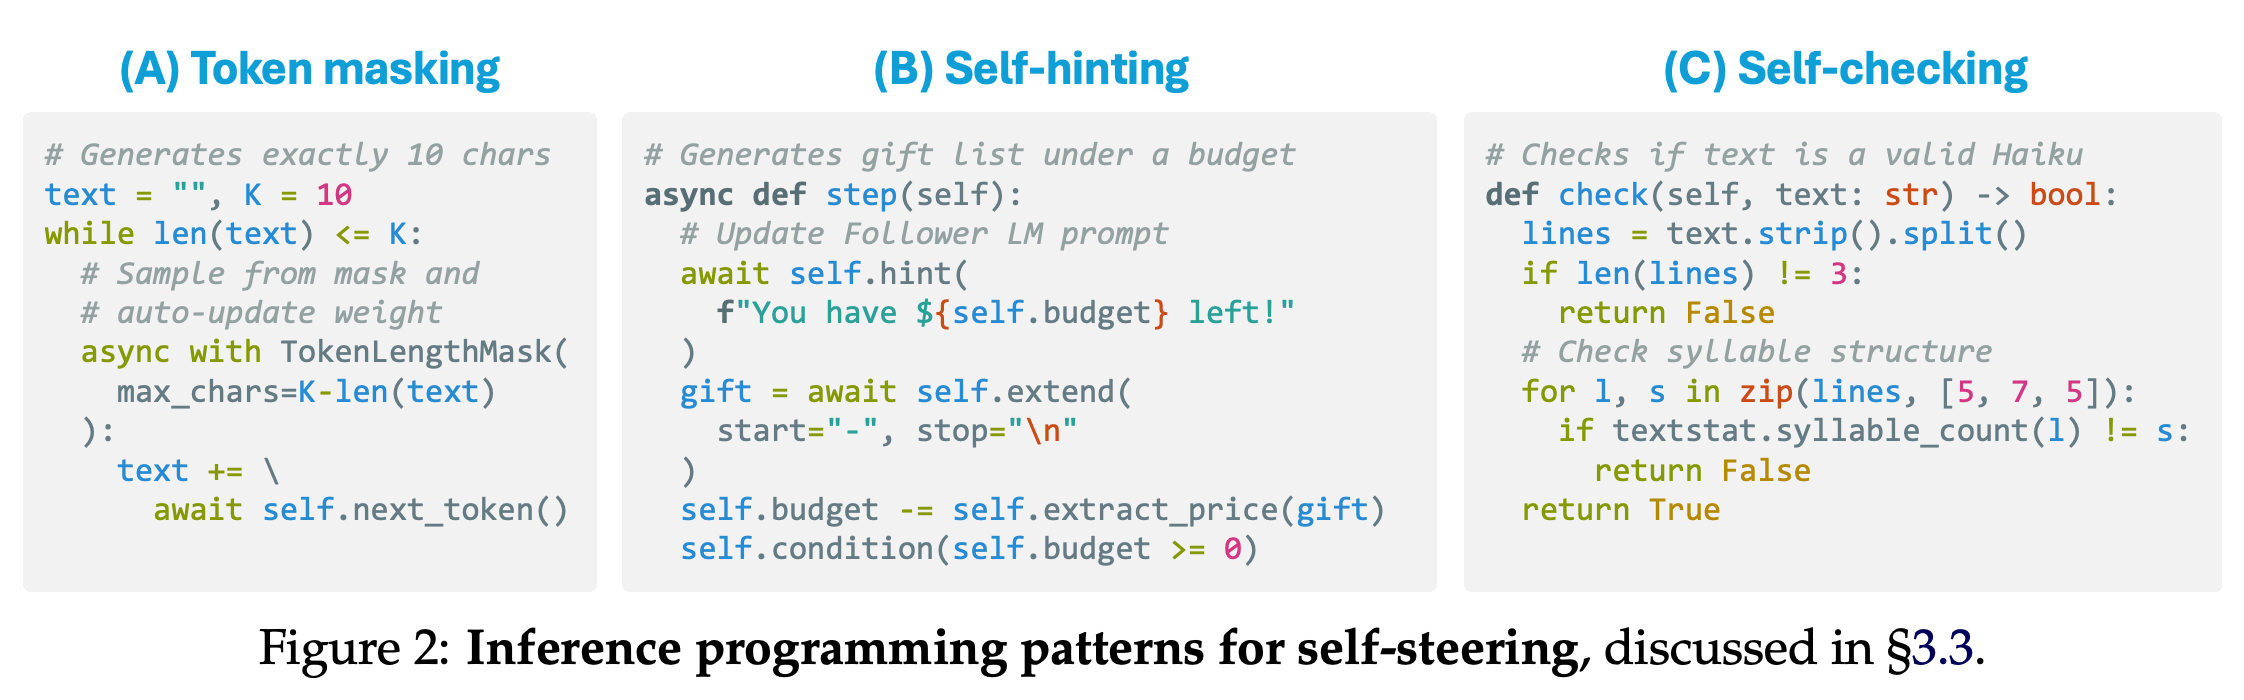
- Self-Steering Language Models는 DISCIPL, 즉 Distributional Constraints by Inference Programming with Language Models를 제안한다. 큰 Planner가 실행 가능한 생성 및 채점 절차를 작성하고, 작은 Follower 모델이 미세조정 없이 이를 실행한다. 구현에는 Python 확률적 프로그래밍 프레임워크인 LLAMPPL을 사용한다. 이를 통해 생성을 제어하고 확률을 추적하며, 정확한 길이나 필수 단어의 위치 같은 제약을 적용한다.
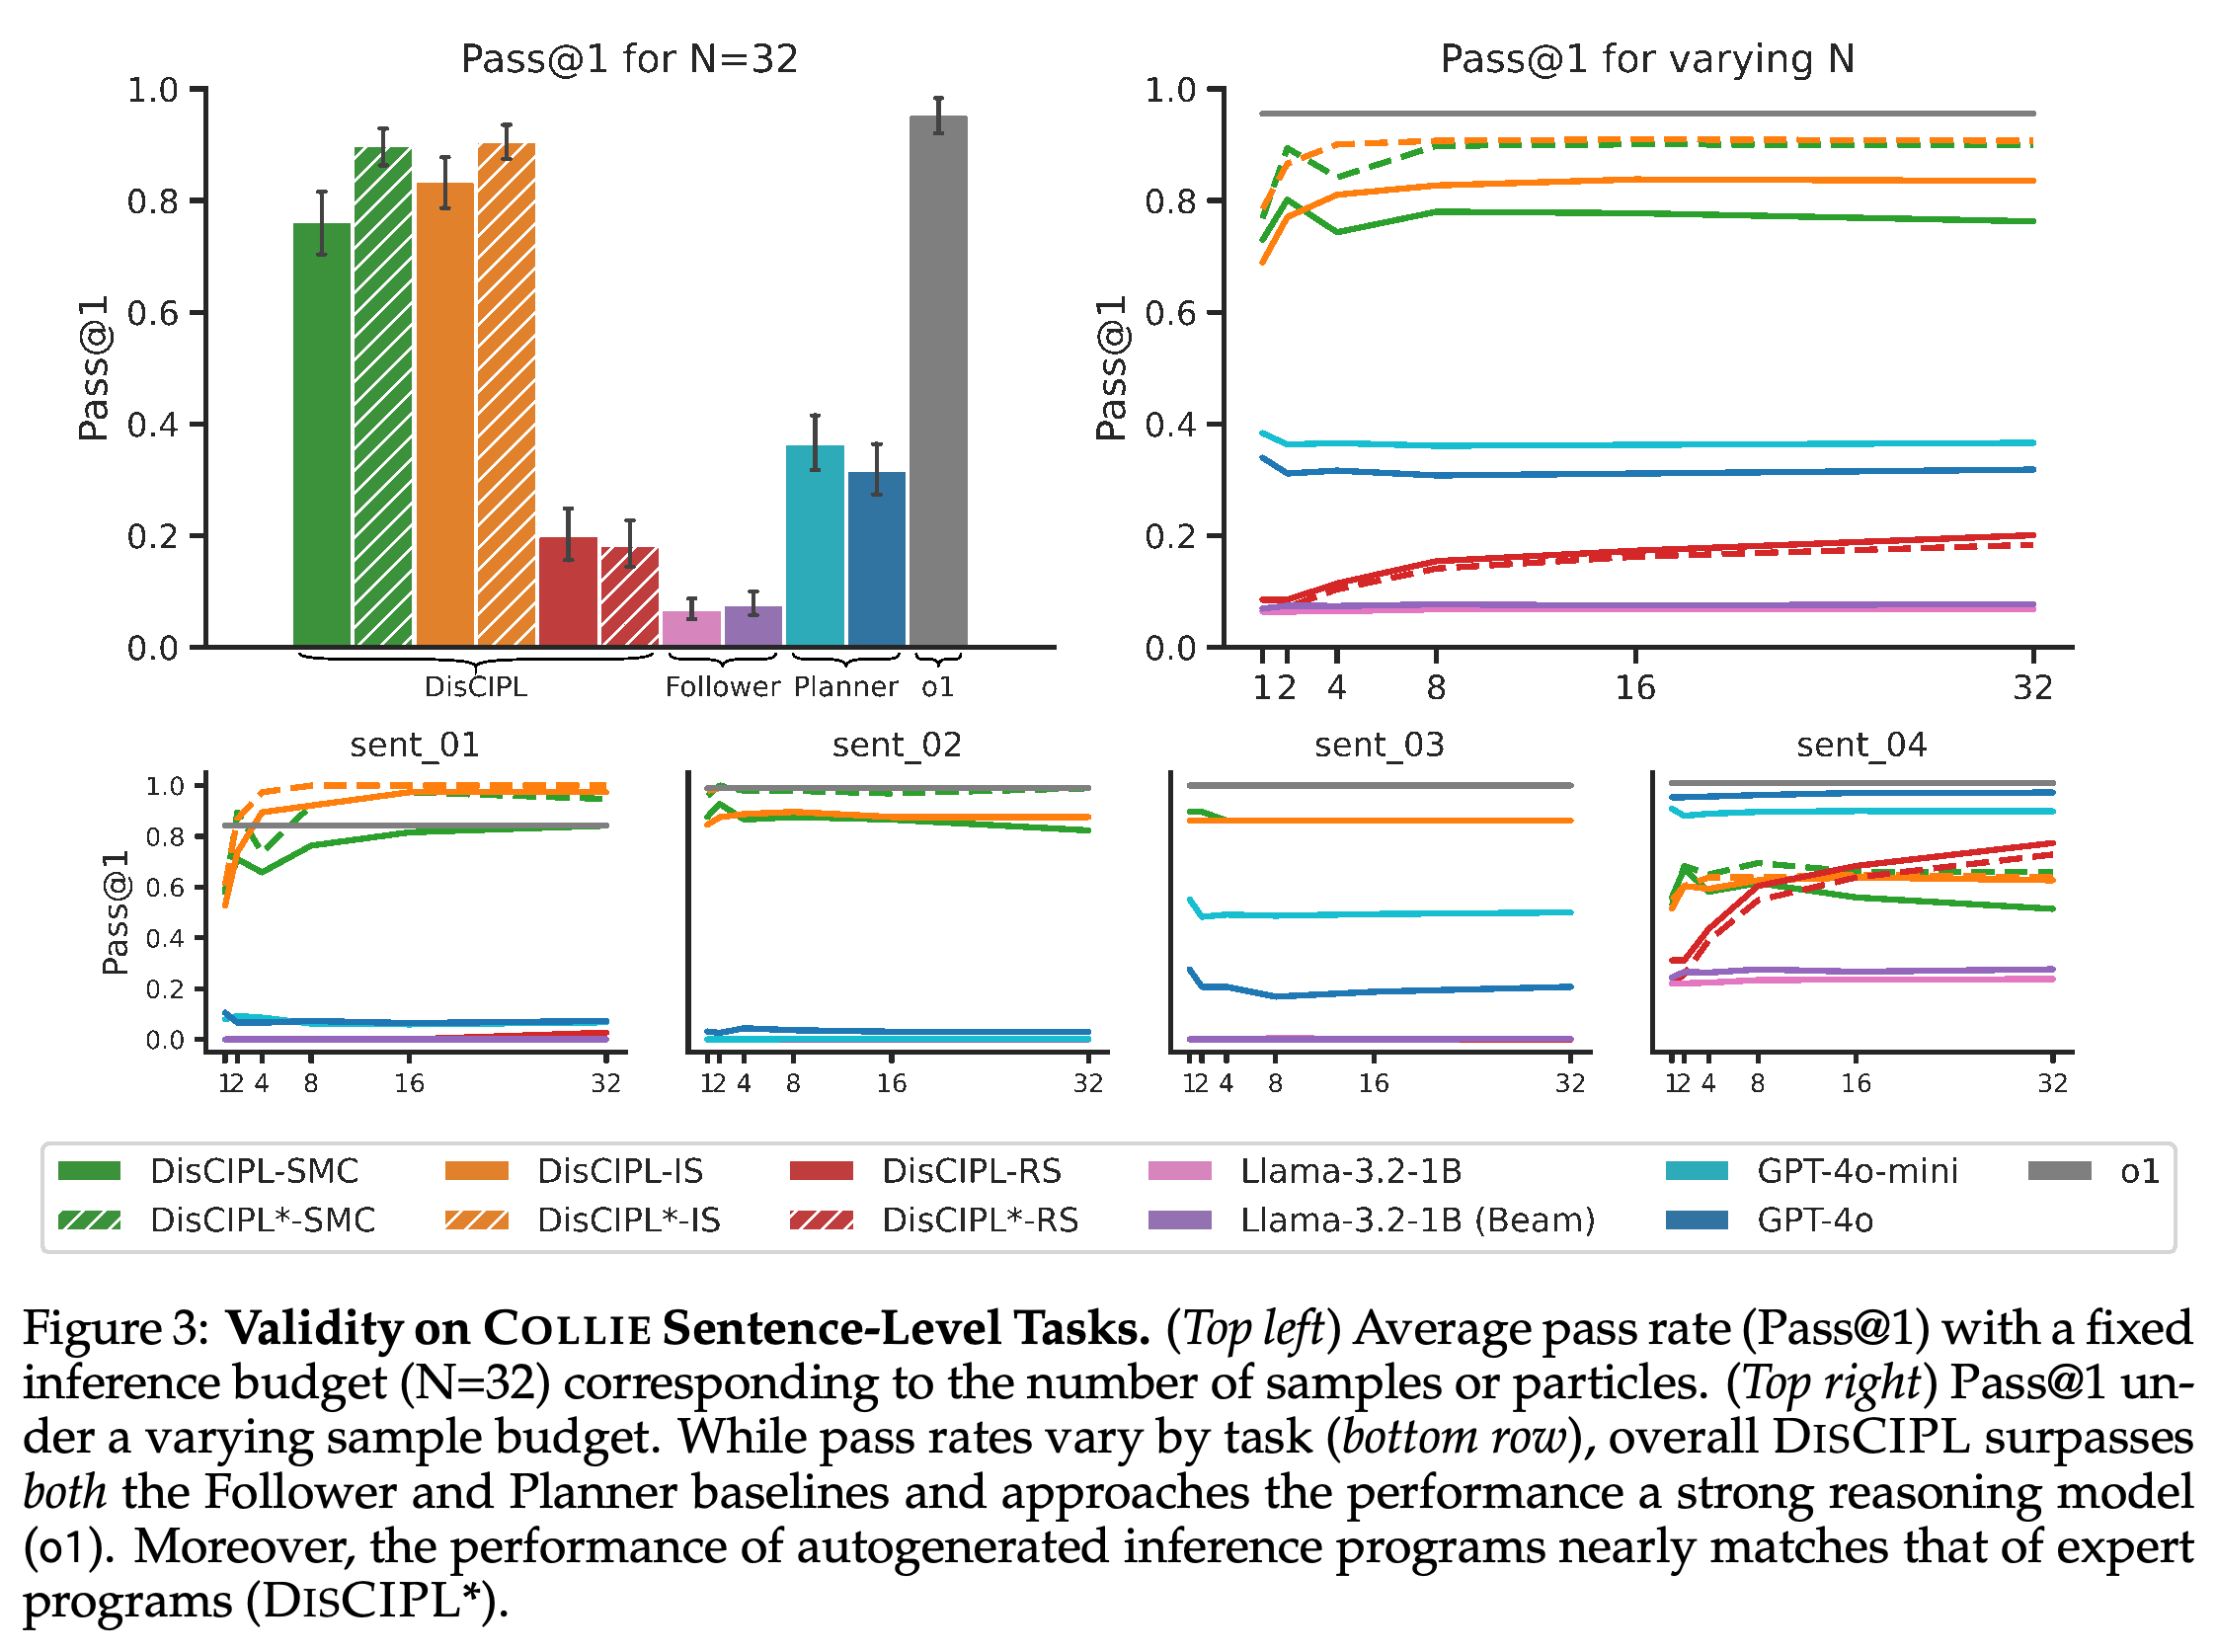
- 제약 글쓰기 벤치마크인 COLLIE의 문장 과제에서 GPT-4o Planner와 Llama-3.2-1B Follower는 후보 32개 예산으로 기대 Pass@1 0.84를 기록한다. 이 설정은 독립적으로 생성한 후보에 가중치를 부여하는 importance sampling을 사용한다. 여기서 Pass@1은 선택한 답변이 제약을 충족할 확률이다. Follower의 직접 샘플링은 0.07, 단계별 자연어 추론을 사용하는 GPT-4o는 0.46, o1은 0.96을 기록한다. 참조 결과인 o1은 max_tokens=25000으로 과제마다 1회 질의하며, DISCIPL과 연산 예산을 맞추지 않는다.
- 점수가 낮은 부분 후보를 유망한 후보의 복사본으로 교체하는 Sequential Monte Carlo는 평가한 3개 영역 모두에서 importance sampling보다 논문의 유창성 점수가 높다. 두 방법 모두 Follower의 직접 생성보다 유창성 점수가 낮으며, 생성된 프로그램은 실행 중 오류가 발생하거나 잘못된 논리로 실행될 수 있다. 1개의 문장 과제에서는 재샘플링이 확률이 낮은 필수 단어를 제거하기 때문에 후보가 8개를 넘으면 제약 충족률이 낮아진다. 따라서 공학적으로는 제약 충족률과 유창성, 프로그램 신뢰성 사이의 상충 관계를 고려해야 하며, 총비용은 큰 Planner에 제공하는 프롬프트에도 영향을 받는다.