


2026년 9월 AI 논문 동향
30 Sep 2026 | Paper Review Monthly Papers Agent Evaluation Harness Optimization Representation Superposition목차
이달의 트렌드
2026년 9월의 주제는 측정된 능력이 실제 사용에서도 유지되는지 검증하는 것으로, 선정된 논문 3편은 탐색 점수, 혼합 입력의 예측, 서면 문제 풀이에서 얻은 성과가 각각 미관측 과제 성능, 개별 텍스트 생성, 상호작용 실행으로 이어지는지 살펴본다. RRSI는 언어 모델을 둘러싼 프롬프트, 도구, 메모리, 제어 흐름으로 구성된 에이전트 하네스를 연구한다. 중첩 연구는 입력 토큰을 나타내는 벡터인 토큰 임베딩을 평균해 텍스트 2개의 정보가 얼마나 보존되는지 검증한다. VHD-Play는 해를 구한 수학적 의사결정 모델에서 상태가 유지되는 환경을 생성한다. 이 연구들은 중간 측정값과 그 측정값으로 뒷받침하려는 실제 결과를 구분해 평가한다. 1, 2, 3 에이전트 하네스에 대해서는 Meta-Harness: End-to-End Optimization of Model Harnesses 요약 설명 글을 참조하라.
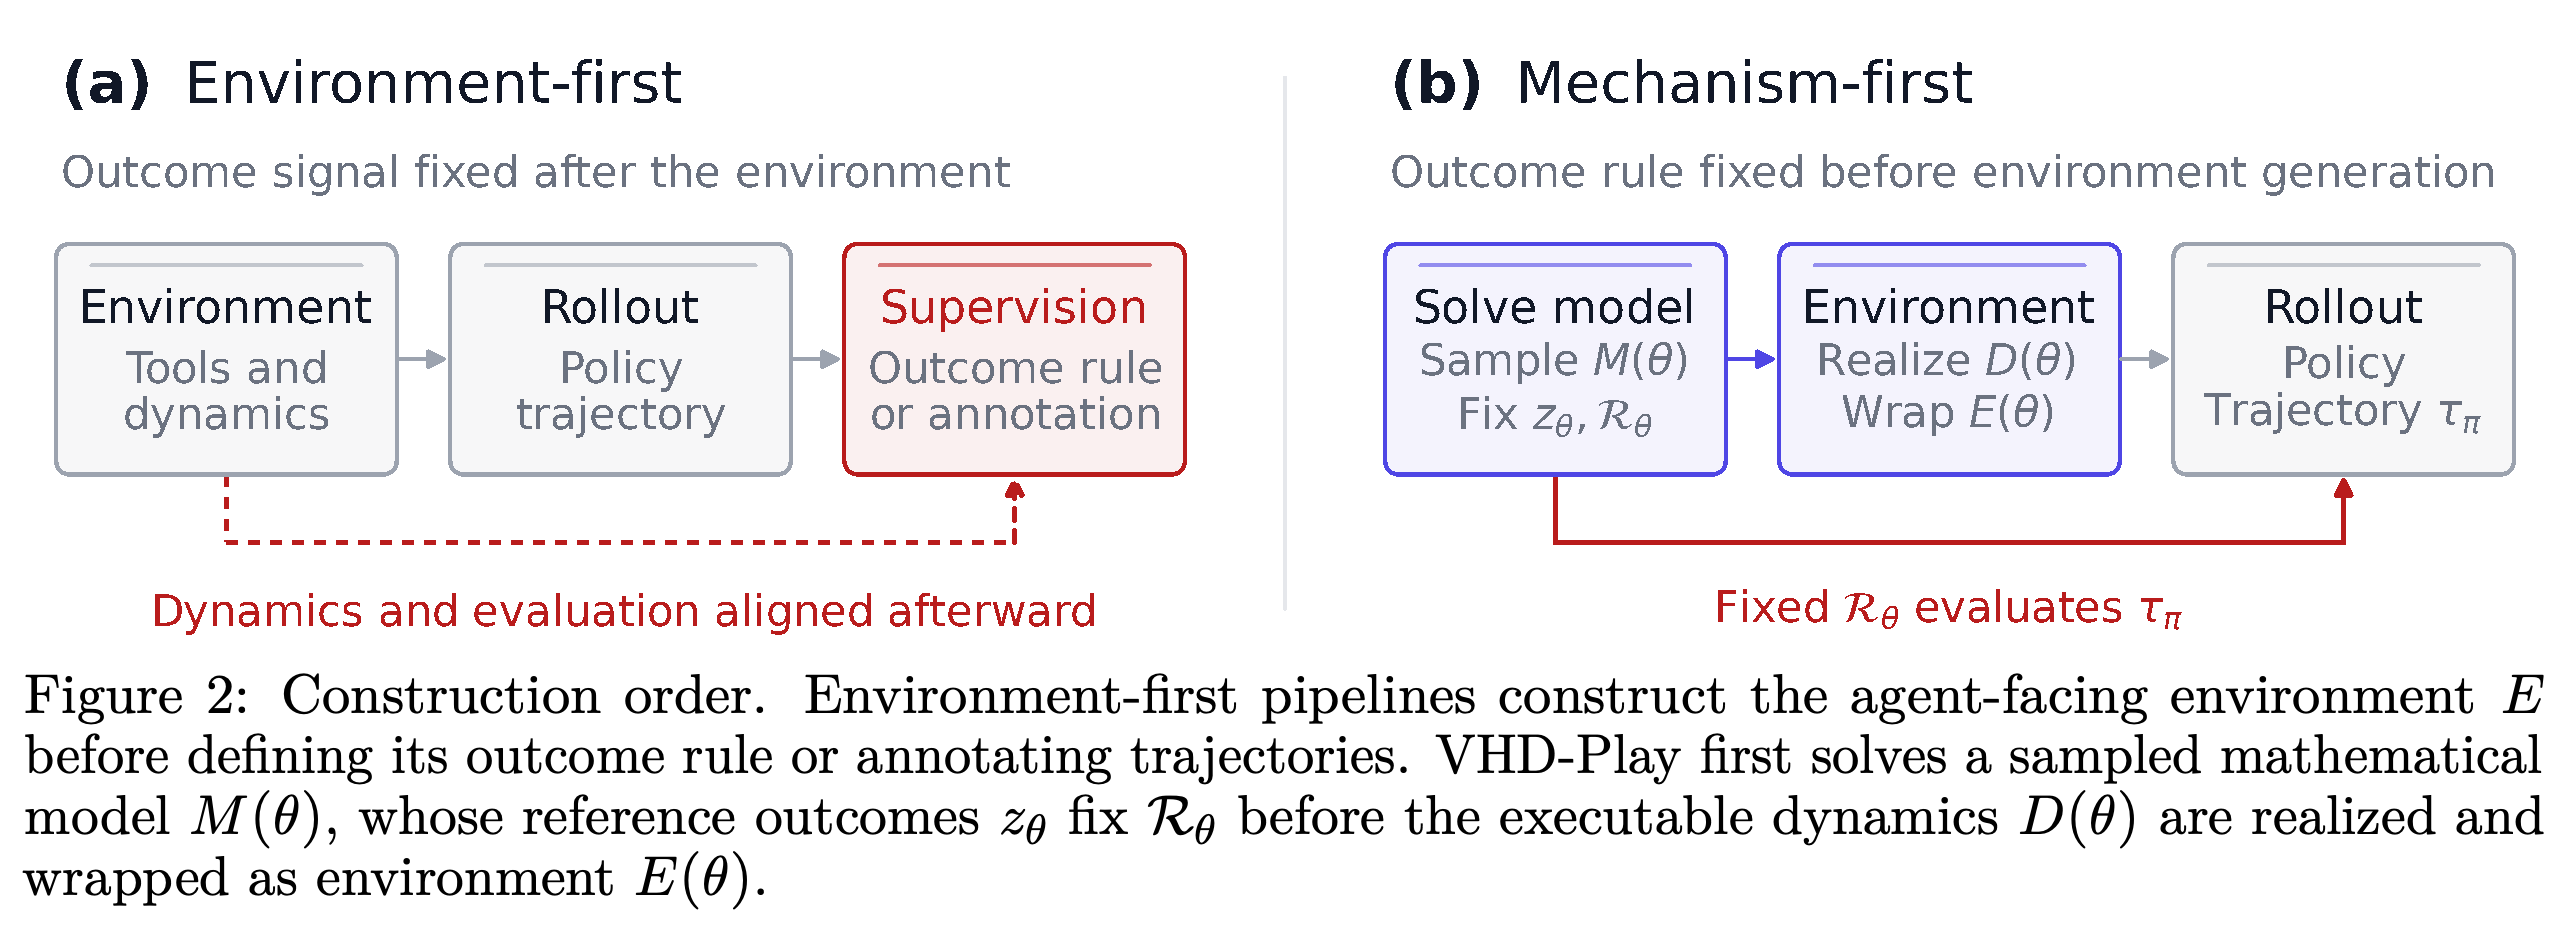
에이전트 개선은 피드백을 구성하고 재사용하는 방식에 따라 달라진다. RRSI는 Regularized Recursive Self-Improvement of Agent Harnesses의 약자로, 반복해서 평가하는 과제에 대한 과적합을 줄이기 위해 후보 수정과 채택에 제약을 둔다. 이 제약을 제거하면 탐색 과제 점수는 높아지지만 미관측 벤치마크 성능은 낮아진다. VHD-Play는 Verifiable Hidden Dynamics Play의 약자로, 에이전트가 사용할 인터페이스를 생성하기 전에 해를 구한 동일한 모델에서 환경의 동작과 채점 기준을 도출한다. 서면 제시 방식과 상호작용 제시 방식을 비교한 결과, 모든 매개변수를 공개해도 큰 실행 격차가 남는다. 이러한 결과는 피드백의 신뢰성과 피드백을 제공한 조건 밖으로의 전이를 함께 확인해야 한다는 판단을 뒷받침한다.
효율성 주장에도 명확한 비교 기준이 필요하다. RRSI의 최종 workspace 하네스는 정규화 없는 진화보다 언어 모델 실행 토큰을 적게 사용하지만 초기 하네스보다는 많이 사용한다. 이 측정값에는 전체 탐색 비용이 포함되지 않는다. 중첩 연구에서 평균 예측 분포를 보존한다는 사실만으로 서로 분리된 후속 텍스트 2개를 신뢰할 수 있게 생성한다고 볼 수는 없다. 가이던스를 사용한 최상의 디코딩 결과도 작은 가이드 모델의 독립 추론 정확도보다 낮으며, 가이던스에는 추가 연산이 필요하다. 스트림마다 별도의 출력 매핑을 사용하는 헤드 2개 변형은 일반적인 입력 2개 배치 추론과 처리량이 비슷하다. 이 결과들은 중간 표현이나 출력의 충실도를 측정할 때 실행 비용과 과제 품질도 함께 확인해야 함을 보여준다.
2026년 9월의 주요 논문
1. RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
- https://arxiv.org/abs/2609.24972
- RRSI: Regularized Recursive Self-Improvement of Agent Harnesses 요약 설명
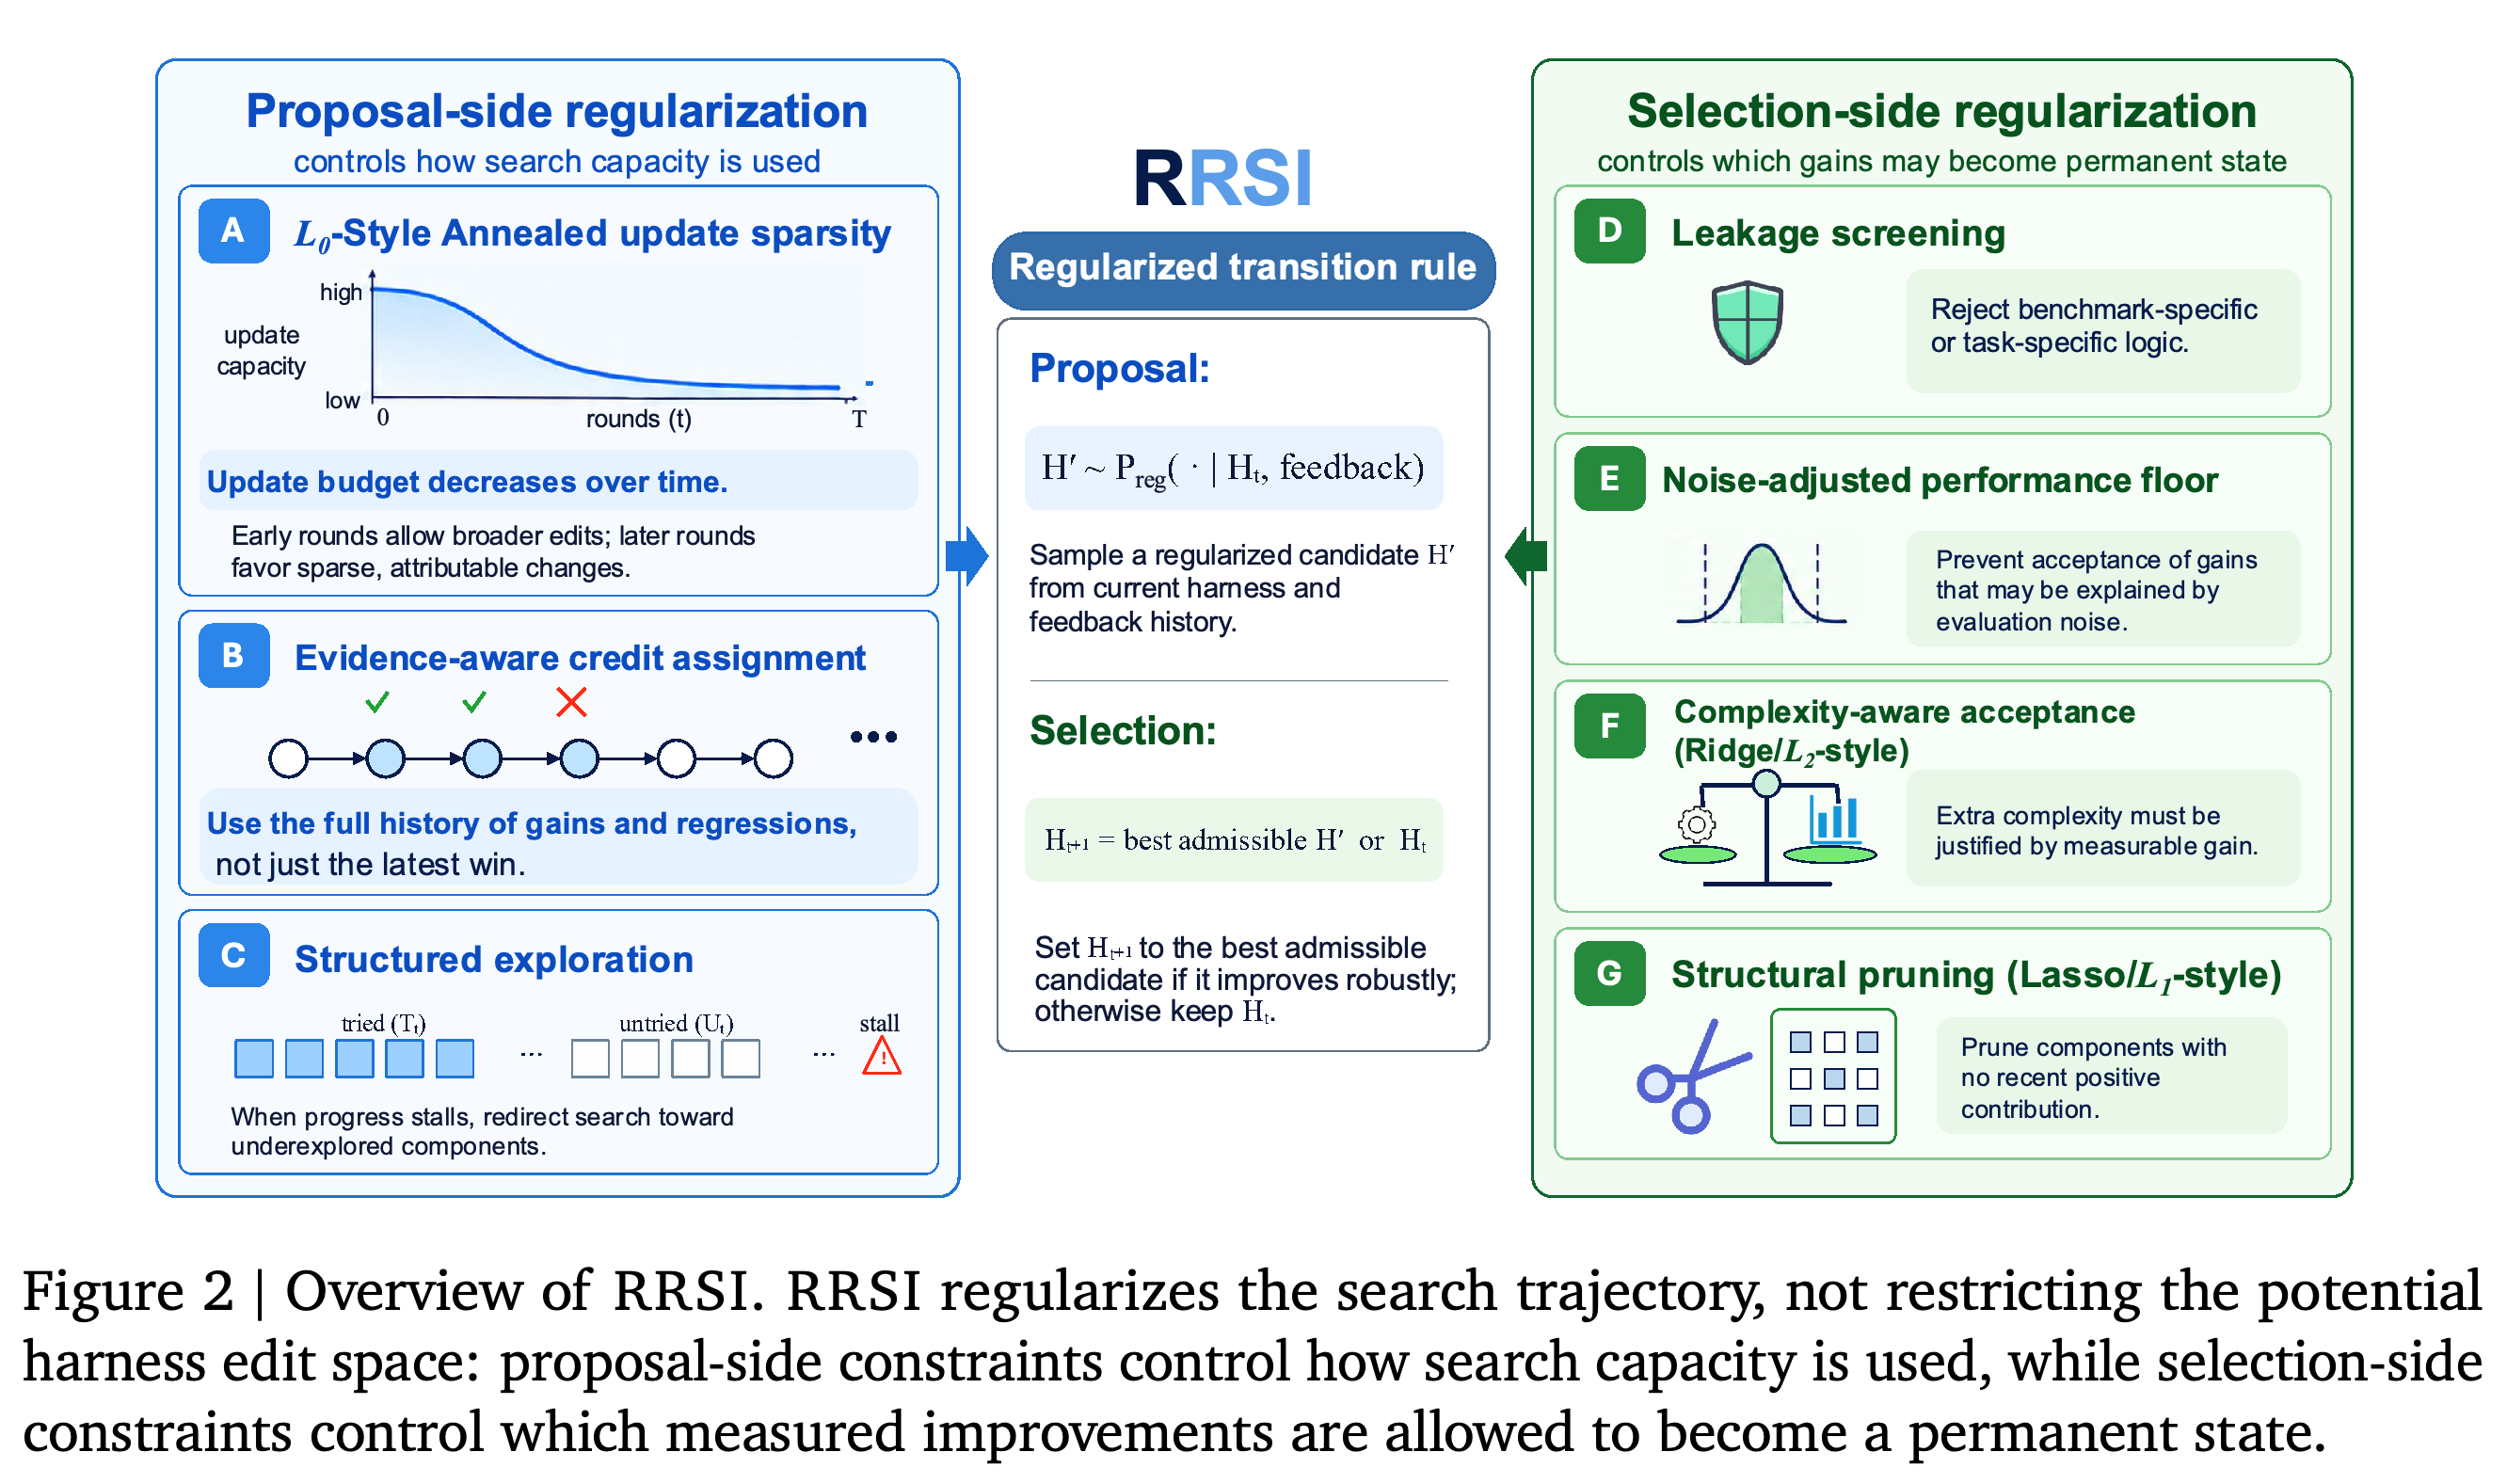
- RRSI는 모델 가중치를 고정한 채 하네스를 진화시킨다. 후보마다 묶어서 적용하는 수정 수를 점차 줄이고, 이전 평가 근거를 보존하며, 활용이 적었던 구성 요소를 탐색한다. 벤치마크 특화 로직을 걸러내고, 변경을 채택하기 전에 성능과 토큰 비용을 확인한다. 하네스에 대해서는 An Empirical Study of Harness Design for Coding Agents 요약 설명 글을 참조하라.
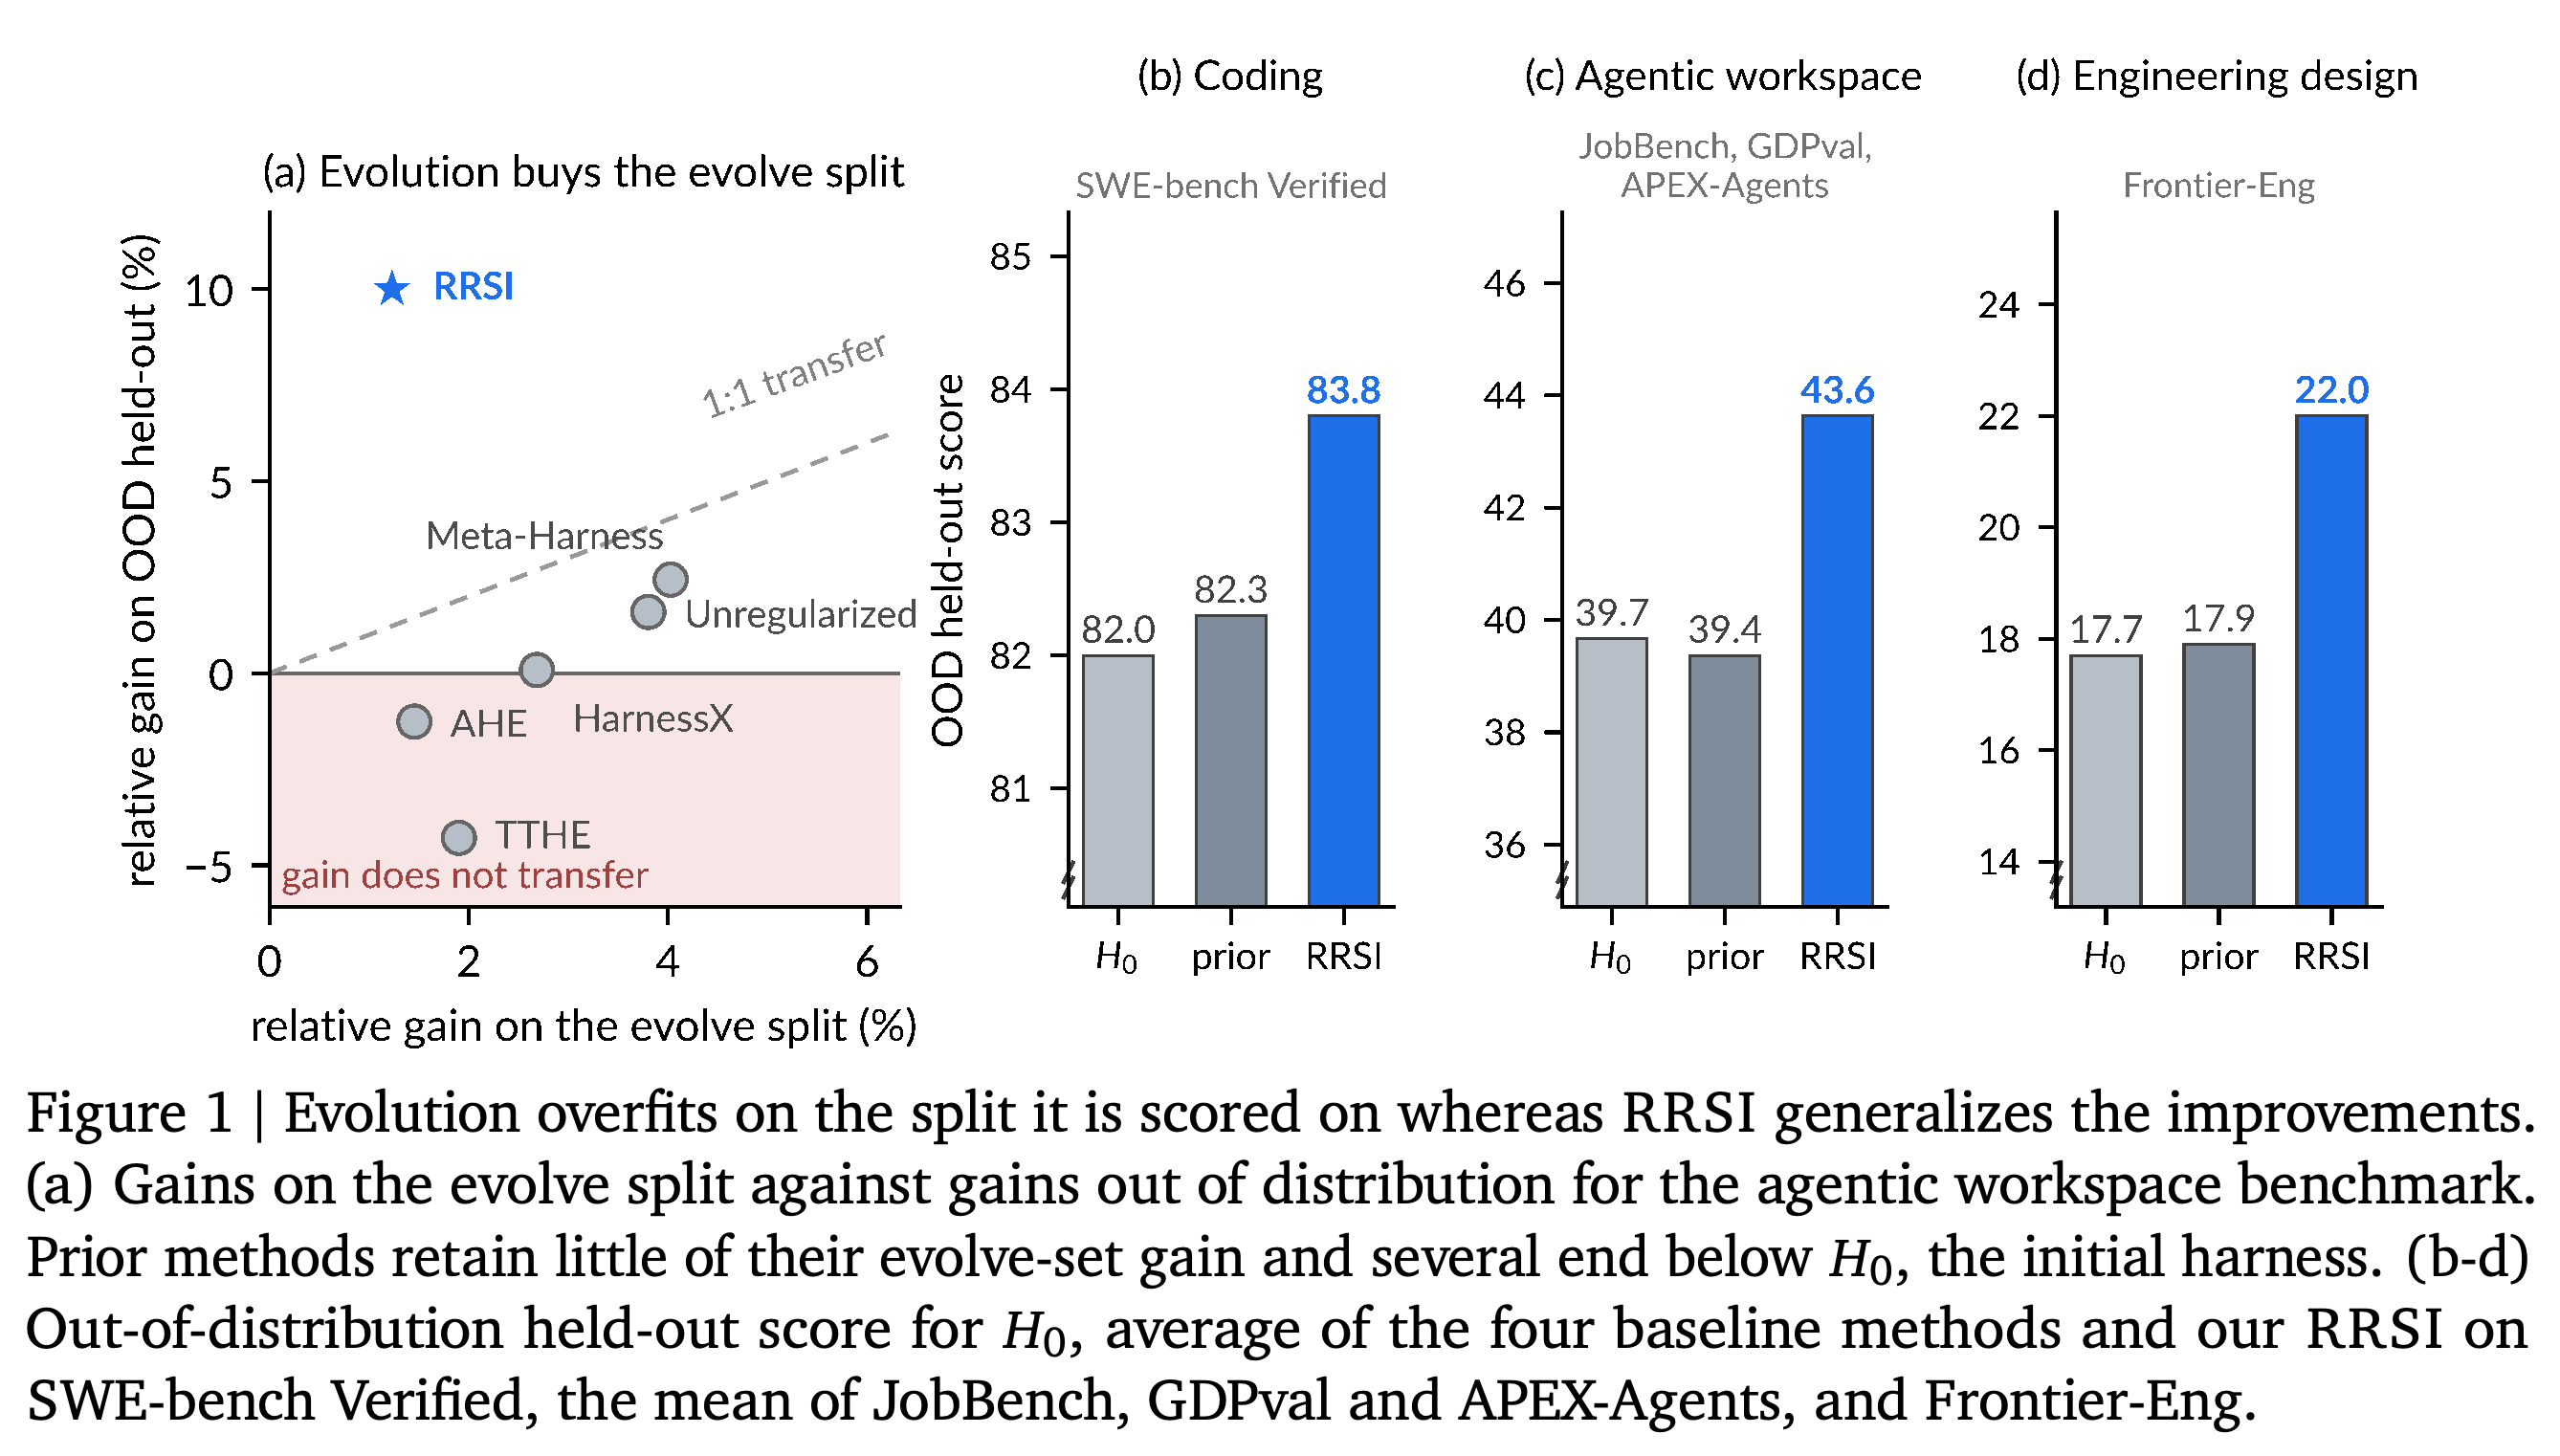
- 주 실험에서는 초기 하네스보다 홀드아웃 평가 분할 6개 모두에서 성능이 높아진다. 저장소 버그 수정 벤치마크인 SWE-bench Verified 점수는 82.0에서 83.8로 오른다. 미관측 전문 업무 벤치마크 3개에서는 3.5–4.7점 향상된다. 공학 최적화 벤치마크인 Frontier-Eng에서는 순위별 성능 기준 달성 여부에 점수를 부여하는 Medal 점수가 17.7에서 22.0으로 오른다.
- 미관측 workspace 벤치마크에서 전체 RRSI는 평균 43.6을 얻는다. 제안과 채택 제약을 모두 제거하면 탐색 과제 점수는 90.5에서 92.8로 높아지지만, 미관측 벤치마크 평균은 40.3에 그친다. 진화 분할에서 시행당 policy token 사용량은 전체 RRSI가 2.42 million개, 두 제약을 모두 제거한 경우가 3.80 million개다. Policy token은 고정된 언어 모델이 소비하는 토큰이다. 표의 비용으로 계산하면 RRSI의 실행 토큰 사용량은 약 36% 적다. 같은 진화 분할의 초기 하네스는 1.56 million개 토큰을 사용하므로 여전히 비용이 더 낮다.
2. Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
- https://arxiv.org/abs/2609.29845
- Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs 요약 설명
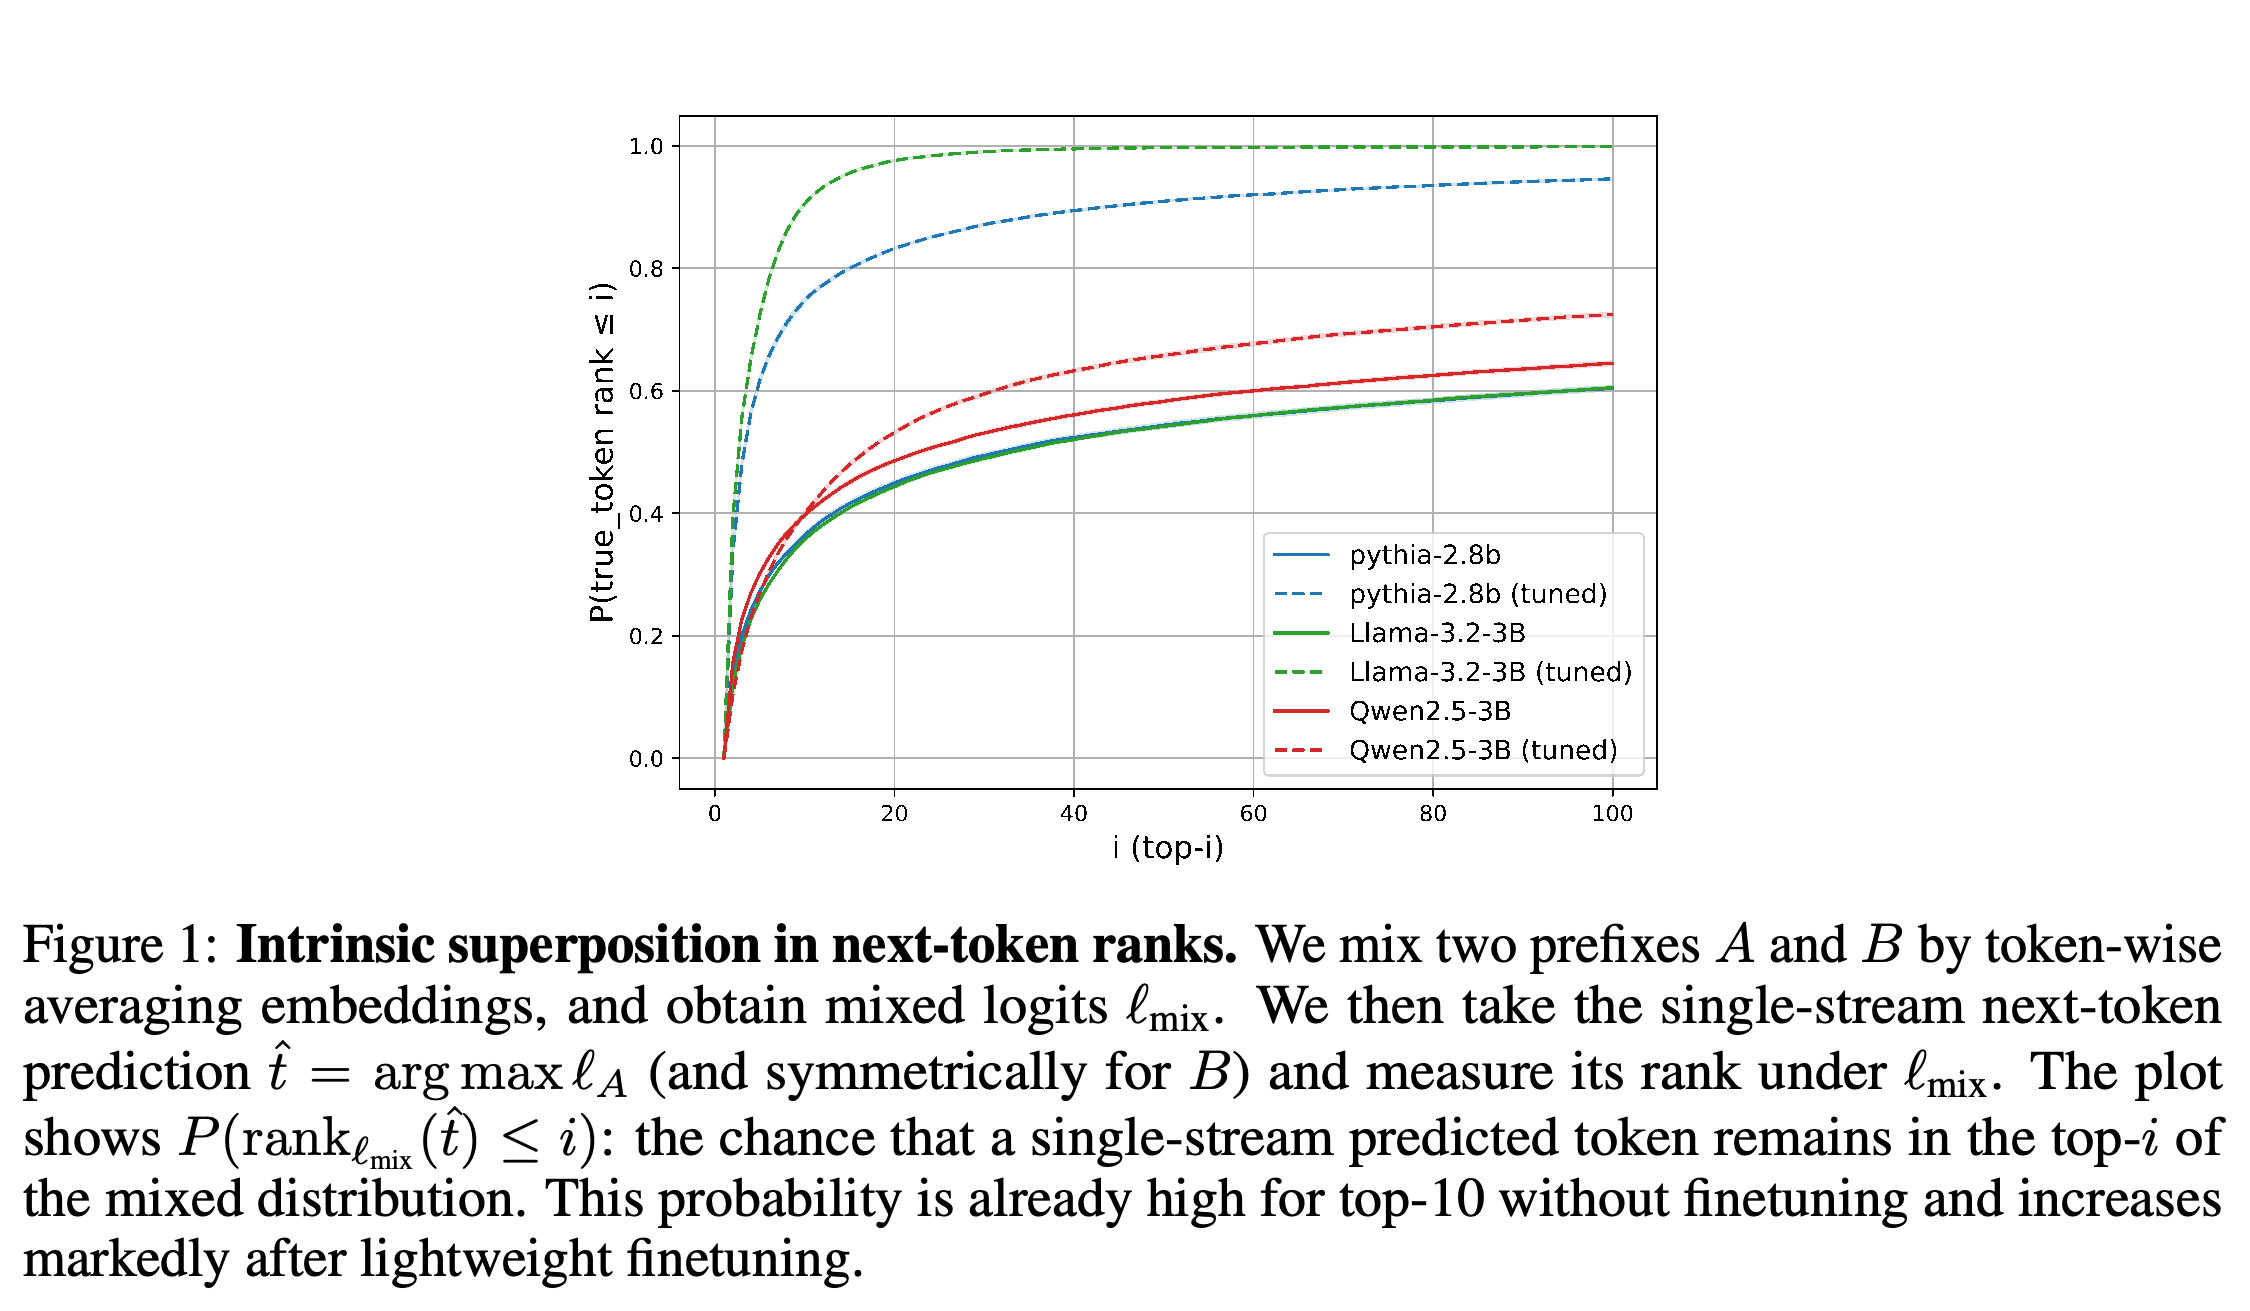
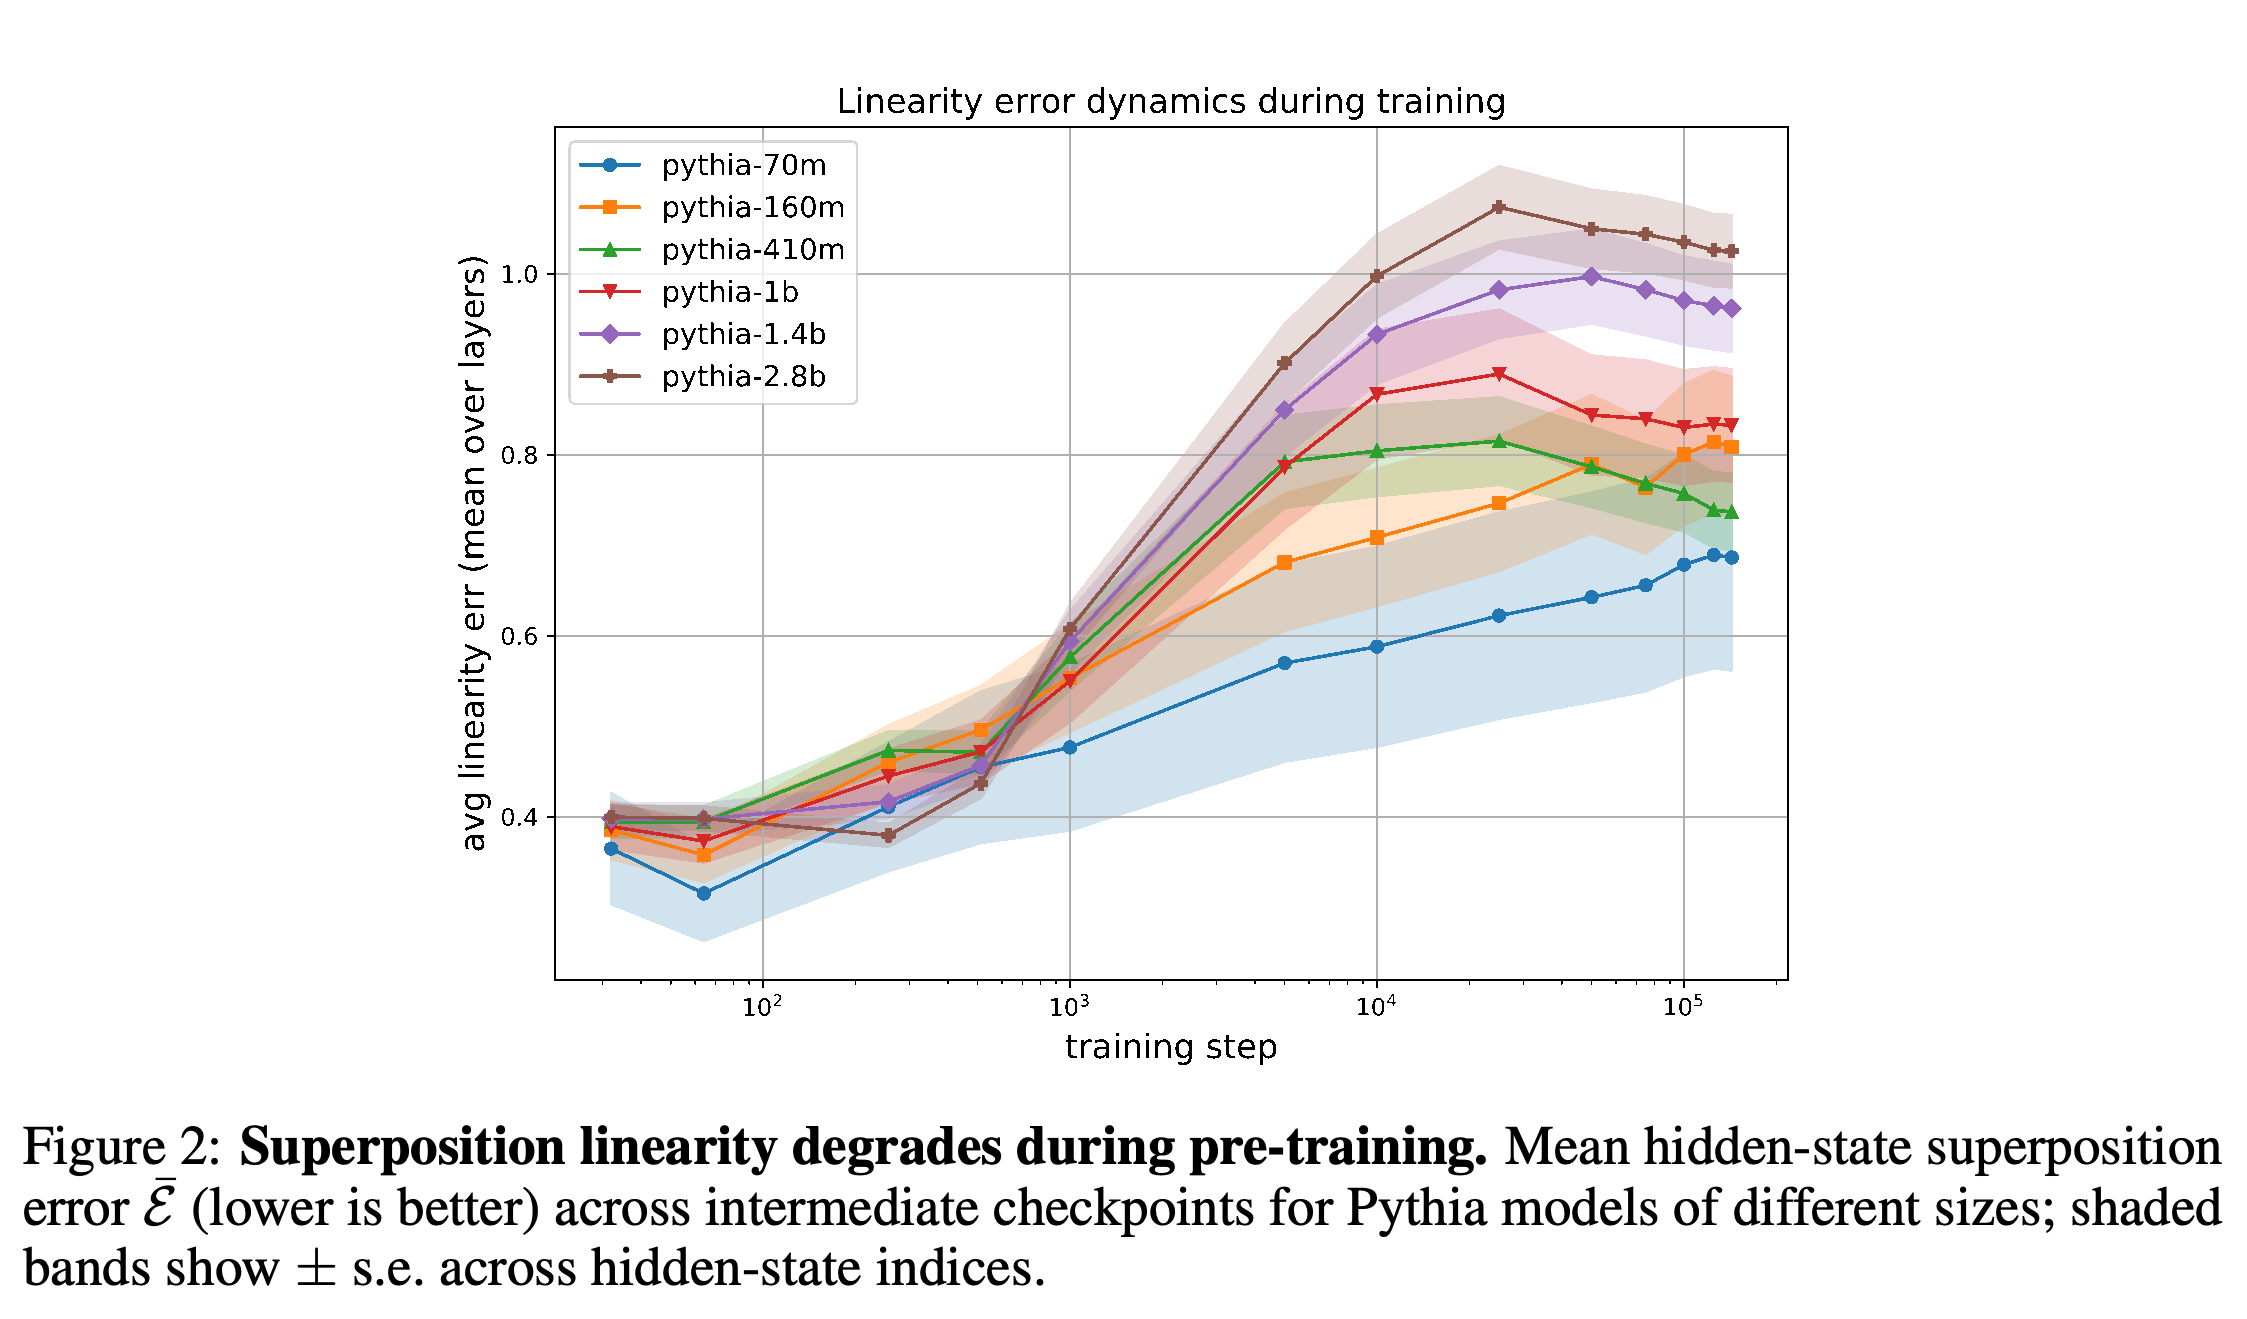
- Your Transformer Can Hold Two Thoughts at Once는 텍스트 2개의 입력 표현을 평균하면 각 텍스트를 독립적으로 처리한 다음 토큰 확률 분포의 평균이 근사적으로 보존되는지, 즉 선형 중첩을 검증한다. 그림에 제시된 수정하지 않은 모델에서는 독립 추론의 최상위 확률 예측 중 약 30–40%가 혼합 출력의 상위 10개 안에 남는다. 이 지표는 관측된 텍스트에 대한 정답 여부가 아니라 독립 예측과의 일치도를 측정한다.
- 동결된 모델 복사본이 각 텍스트를 독립적으로 예측한 분포의 평균을 목표로 학습하면, Pythia-2.8B에서 보고된 Kullback–Leibler 발산이 1.86에서 0.27로 줄어든다. 이 발산은 분포의 불일치를 측정한다. Qwen2.5-3B에서는 내용 토큰 위치의 순위 중앙값이 284에서 5로 개선된다. 일반적인 단일 스트림 품질은 낮아진다. 넓은 서사 문맥을 바탕으로 단어를 예측하는 LAMBADA에서 이 모델의 정확도는 0.602에서 0.460으로 떨어진다.
- Joint Contrastive 디코딩은 작은 모델이 제공하는 해당 스트림의 가이던스를 더하고 다른 스트림의 가이던스를 뺀다. Llama-3.2-3B의 혼합 입력 LAMBADA 정확도는 0.182에서 0.430으로 높아지지만, 작은 가이드 모델의 독립 추론 정확도인 0.540보다 낮다. 배포 효율성은 아직 입증되지 않았다. 프롬프트와 생성 길이가 각각 128일 때 Pythia-2.8B의 헤드 2개 변형은 109.6 ± 0.8 tokens/s, 일반적인 배치 크기 2의 추론은 113.1 ± 0.6 tokens/s, 가이던스 디코딩은 79.4 ± 0.5 tokens/s를 기록한다. 각 구간은 실행 100회에서 구한 95% 신뢰구간이다.
3. Verifiable Hidden Dynamics Play: Generating Agentic RL Environments from Solved Mechanisms
- https://arxiv.org/abs/2609.27321
- Verifiable Hidden Dynamics Play: Generating Agentic RL Environments from Solved Mechanisms 요약 설명
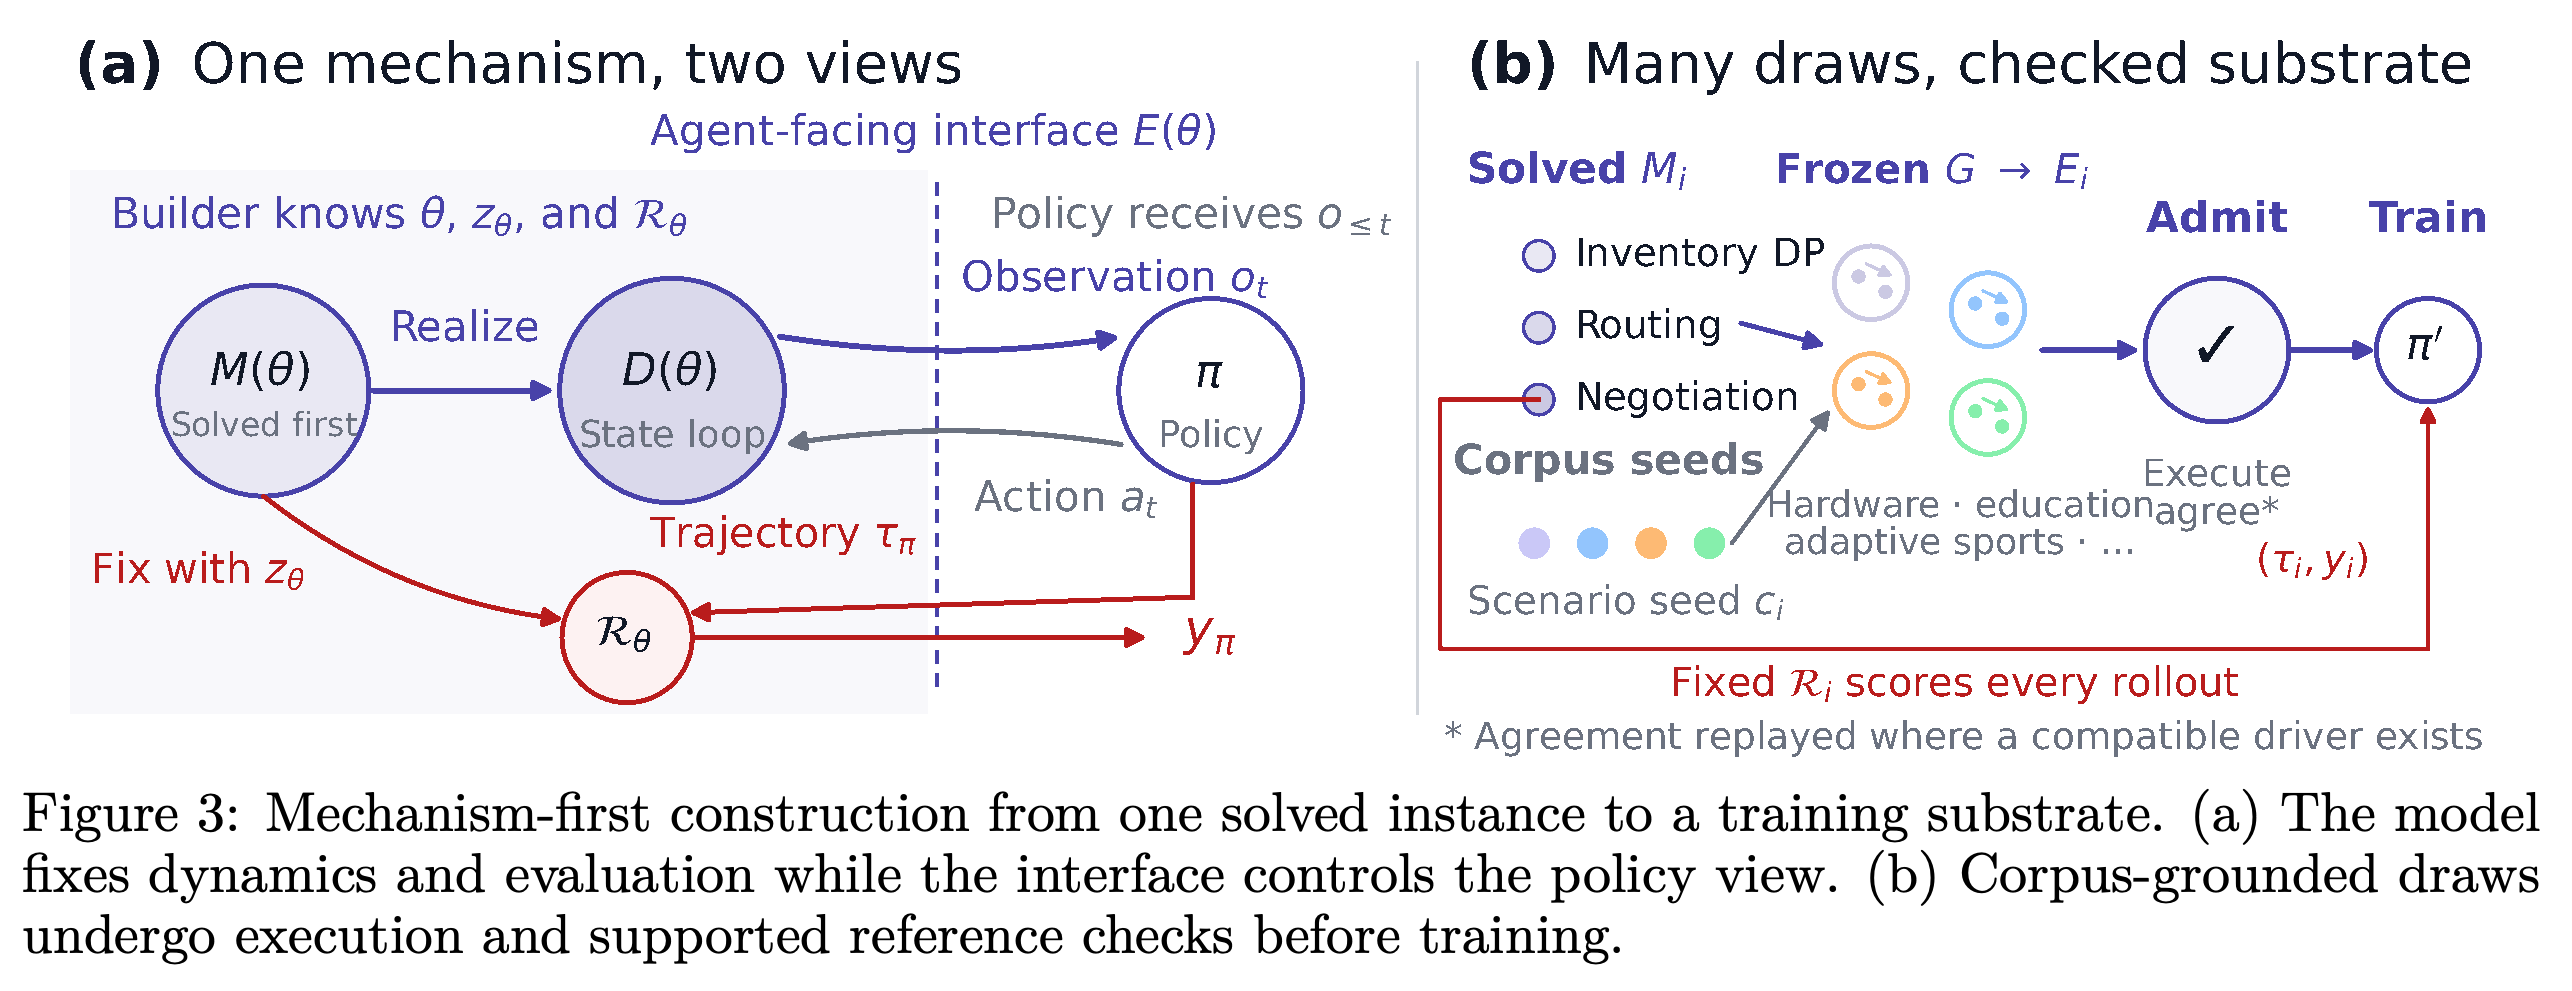
- VHD-Play는 샘플링한 수학적 의사결정 모델의 해를 구한 뒤 실행 가능한 환경과 인터페이스를 생성한다. 동일한 모델에서 상태 전이와 채점 기준을 도출하므로 언어 모델 심판이 필요하지 않다. 정규화 보상은 고정된 기본 전략을 0에, 완전한 정보를 사용하는 상한 기준을 1에 대응시킨다. 일부 정보가 숨겨진 상태에서 행동해야 하는 에이전트는 이 상한 기준에 도달하지 못할 수도 있다.
- 코퍼스는 수학적 구조를 공유하는 의사결정 문제 집합인 메커니즘 계열 11개에 걸쳐 훈련 환경 2,200개와 평가 환경 1,100개로 구성된다. Qwen3.6-35B-A3B를 결과 보상으로 학습하는 강화학습을 통해 계열 3개에서 훈련하면, 최적화 계열 5개의 평균 상호작용 점수가 0.204에서 0.815로 높아진다. 매개변수를 처음부터 공개한 상호작용 점수는 0.231에서 0.875로, 문제를 완전히 명시한 서면 점수는 0.962에서 0.992로 높아진다. 이는 상태가 유지되는 환경에서의 실행이 중요한 학습 대상임을 뒷받침한다.
- 외부 벤치마크로의 전이에서는 함수 호출 점수가 61.25에서 64.08로 높아지고, 영어 과제 20개의 여행 계획 품질이 0.700에서 0.794로 높아진다. 365일 모의 사업에서는 모델당 실행 5회의 평균 최종 잔액이 54,294에서 182,844로 증가한다. 생성한 메커니즘 계열의 주요 결과는 훈련 실행 1회와 평가 시드 1개를 사용한다. 기준 전략을 실행해 생성된 결과를 확인하는 기준 재실행은 계열 11개 중 8개만 다루므로 검증 범위가 제한된다. 함수 호출에 대해서는 Towards General Agentic Intelligence via Environment Scaling 요약 설명 글을 참조하라.
출처
[1] RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
[2] Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs
[3] Verifiable Hidden Dynamics Play: Generating Agentic RL Environments from Solved Mechanisms