


Towards Agentic Robots: Model, Data, Environment, and Harness 요약 설명
14 Oct 2026 | Paper Review Embodied Agents Robotic Learning Harness Optimization목차
- 요약
- 1 Introduction
- 2 Evolution of Robot Learning
- 3 Foundations of Agentic Robots
- 4 Model: What Should the Agent Learn, Understand, Decide, and Control?
- 5 Data: How Should the Agent Collect, Annotate, and Refine Robot Data?
- 6 Environment: What Worlds, Tasks, and Tests Should the Agent Build?
- 7 Harness: How Should Robot Capabilities Be Orchestrated, Recovered, and Evolved?
- 8 Outlook: What Comes Next for Agentic Robots?
- 9 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Towards Agentic Robots: Model, Data, Environment, and Harness 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 10월 14일(Arxiv)
- Qin, Chonghan, Wu, Dongming, Feng, Kaituo, Wang, Jiaxu, Yu, Xinlei, Sun, Peiwen, Fan, Yijia, He, Xilin, Chen, Bingao, Lian, Weitong, et al.
- MMLab, The Chinese University of Hong Kong, Fudan University, NovaXBot, Tsinghua University, Zhejiang University, Sun Yat-sen University
- 논문 링크
- Github
요약
- 다음 동작을 예측하는 것만으로 과제를 안정적으로 완수하기 어려울 때, 로봇은 행동을 조율하고 진행 상황을 추적하며 실패에서 복구해야 한다. 이 서베이는 이러한 필요성을 보여주는 근거로 RoboDojo 시뮬레이션 과제 42개에서 과제별 미세 조정 없이 평균 성공률 22.48%를 달성한 GPT-6 Astra를 인용한다. 비교 대상인 DM0.5는 관측을 행동으로 변환하도록 학습된 로봇 정책이며, 성공률은 19.34%다. 이 비교는 서베이 자체 실험이 아니라 인용한 연구에서 나온 결과다.
- Towards Agentic Robots: Model, Data, Environment, and Harness는 기존 연구를 기능 영역 4개에 걸친 중첩 가능한 범주 17개로 정리한다. 이 논문은 agentic robot을 관측과 피드백을 바탕으로 실행을 계획하고 조율하는 시스템으로 정의한다. Harness는 시스템 기능을 사용할 수 있도록 제공하고, 기능 호출을 관리하며, 실행을 점검하고 재사용을 지원하는 소프트웨어로 정의한다. Harness에 대해서는 An Empirical Study of Harness Design for Coding Agents 요약 설명 글을 참조하라.
- 이 서베이는 보고된 성능이 사용 가능한 제어기, 관측 접근 권한, 피드백, 상호작용 예산을 포함한 전체 실행 조건에 따라 달라진다고 주장한다. 상호작용 예산은 허용된 시간, 호출 횟수, 시도 횟수를 뜻한다. 이 논문의 기여는 기능별 분류 체계와 비교 분석이며, 통제된 조건에서 새로운 성능 순위를 제시하지는 않는다. 공정한 벤치마킹, 실제 로봇 배치, 효율성, 로봇 플랫폼 간 전이를 미해결 과제로 제시한다.
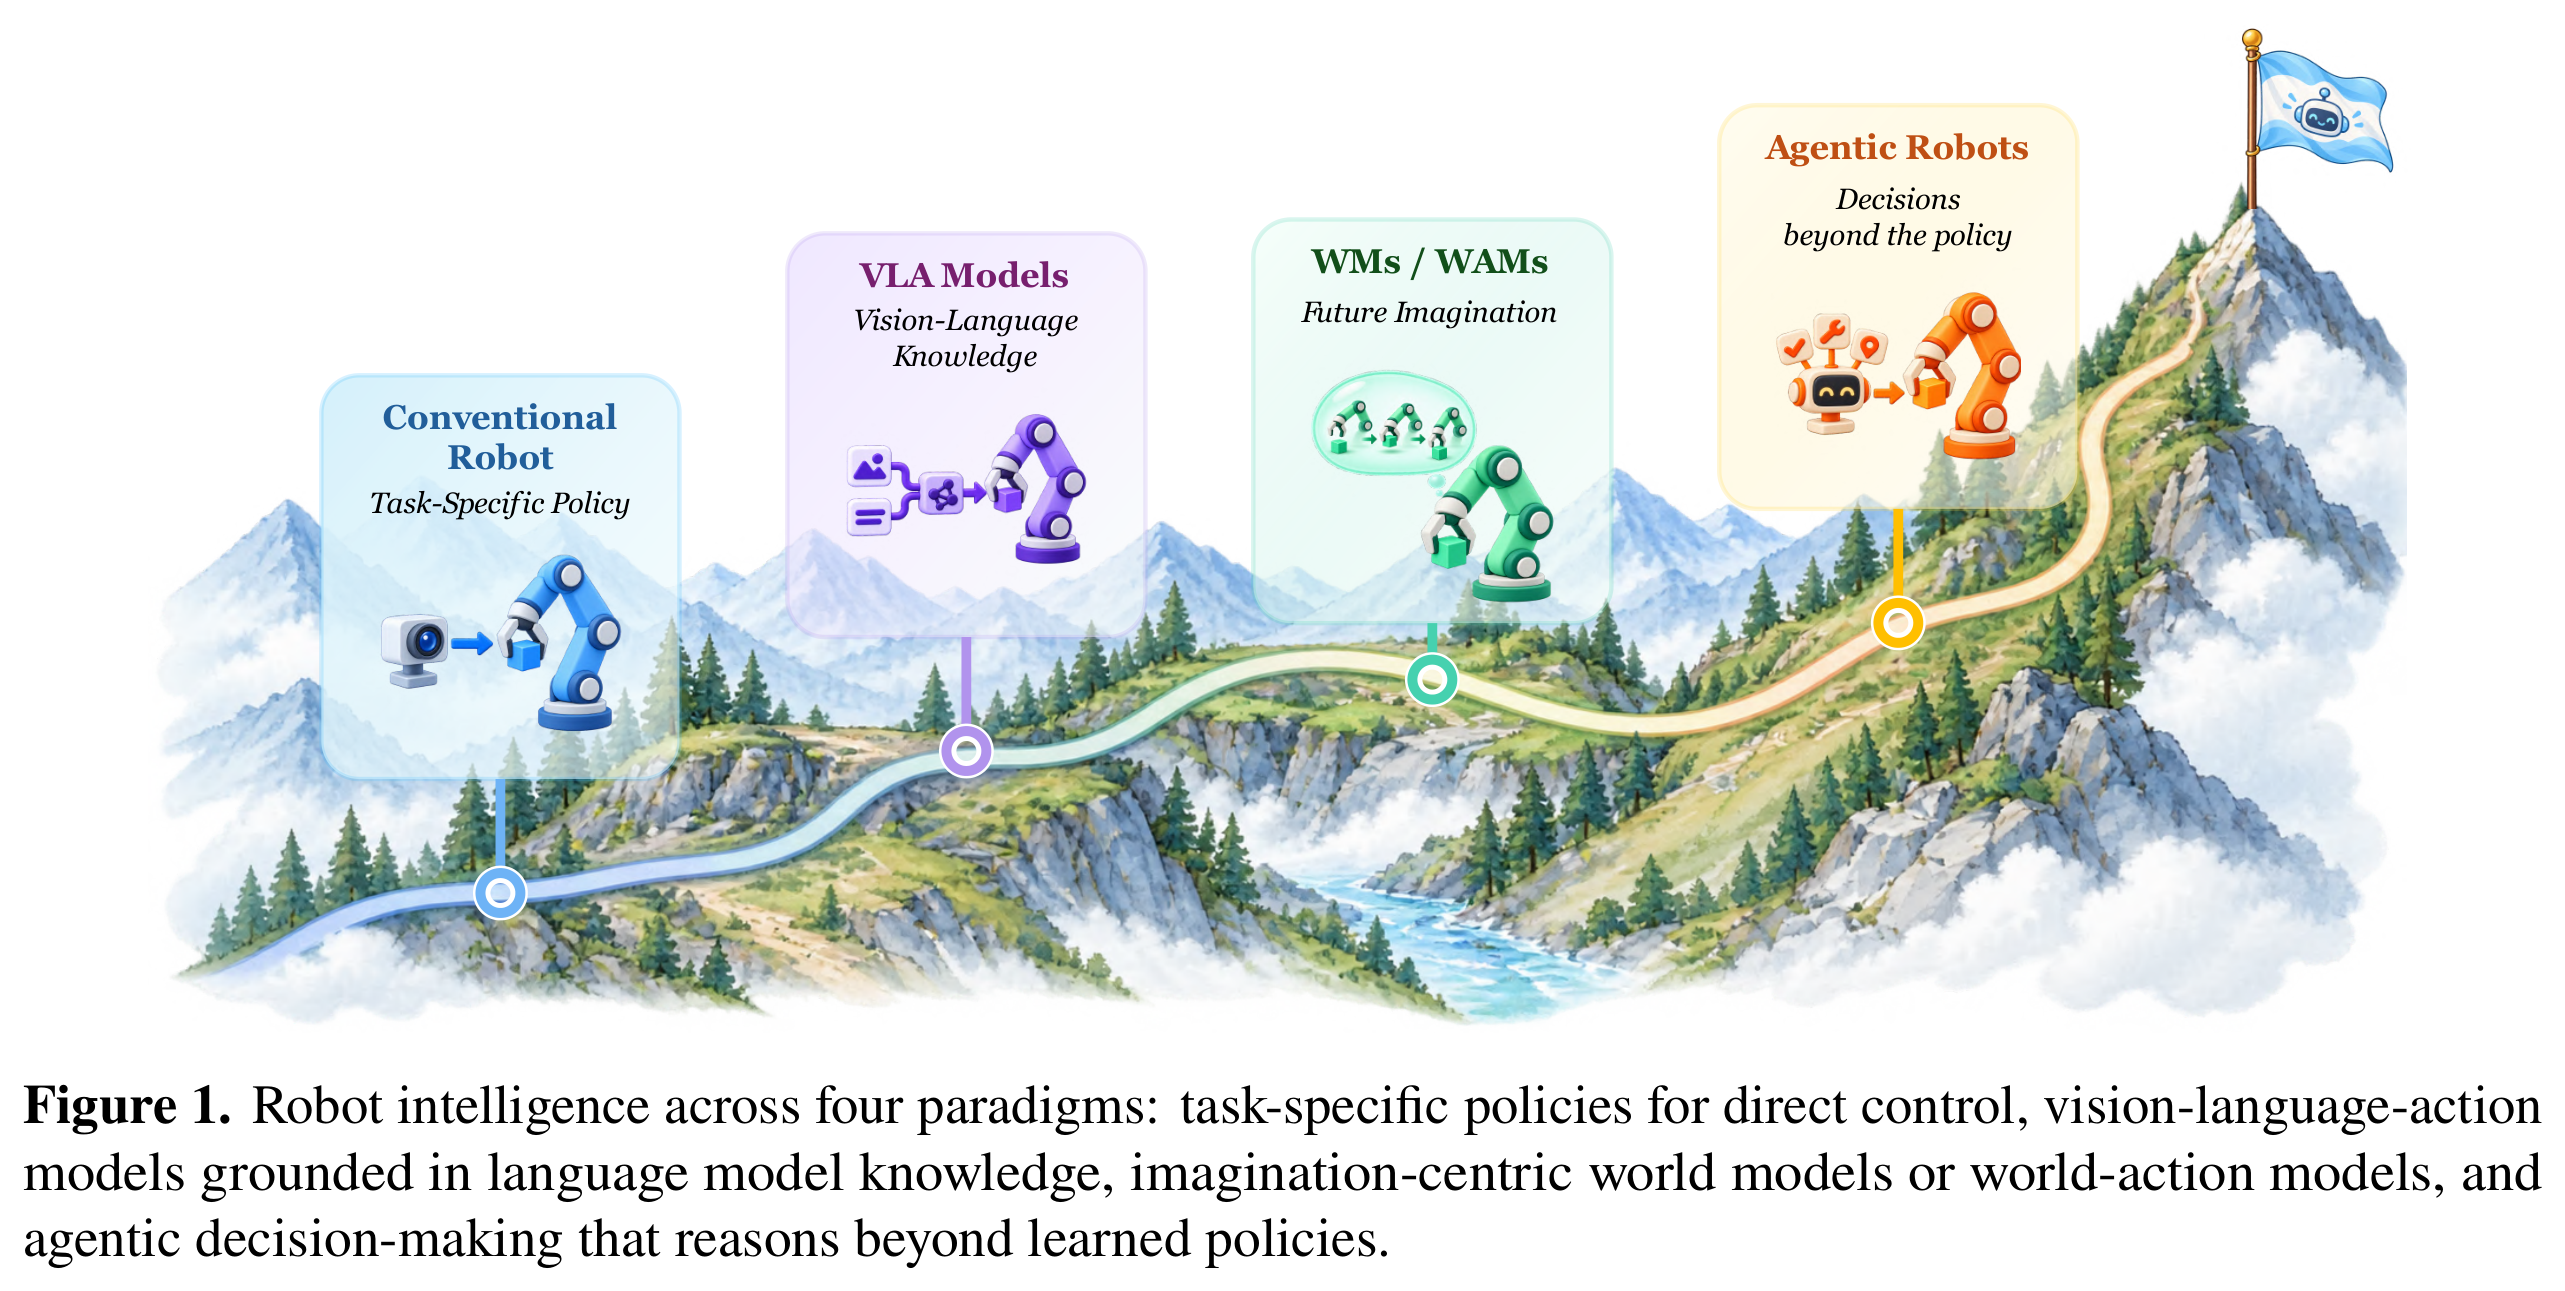
이 발전 과정은 실행 가능한 행동 학습, 지식과 행동의 연결, 결과 예측, 정책을 넘어선 의사결정 조율을 구분한다. 본문은 역량들이 서로 겹친다고 설명하므로, 산을 이용한 도식이 각 패러다임이 이전 패러다임을 대체한다는 근거가 되지는 않는다.
1 Introduction
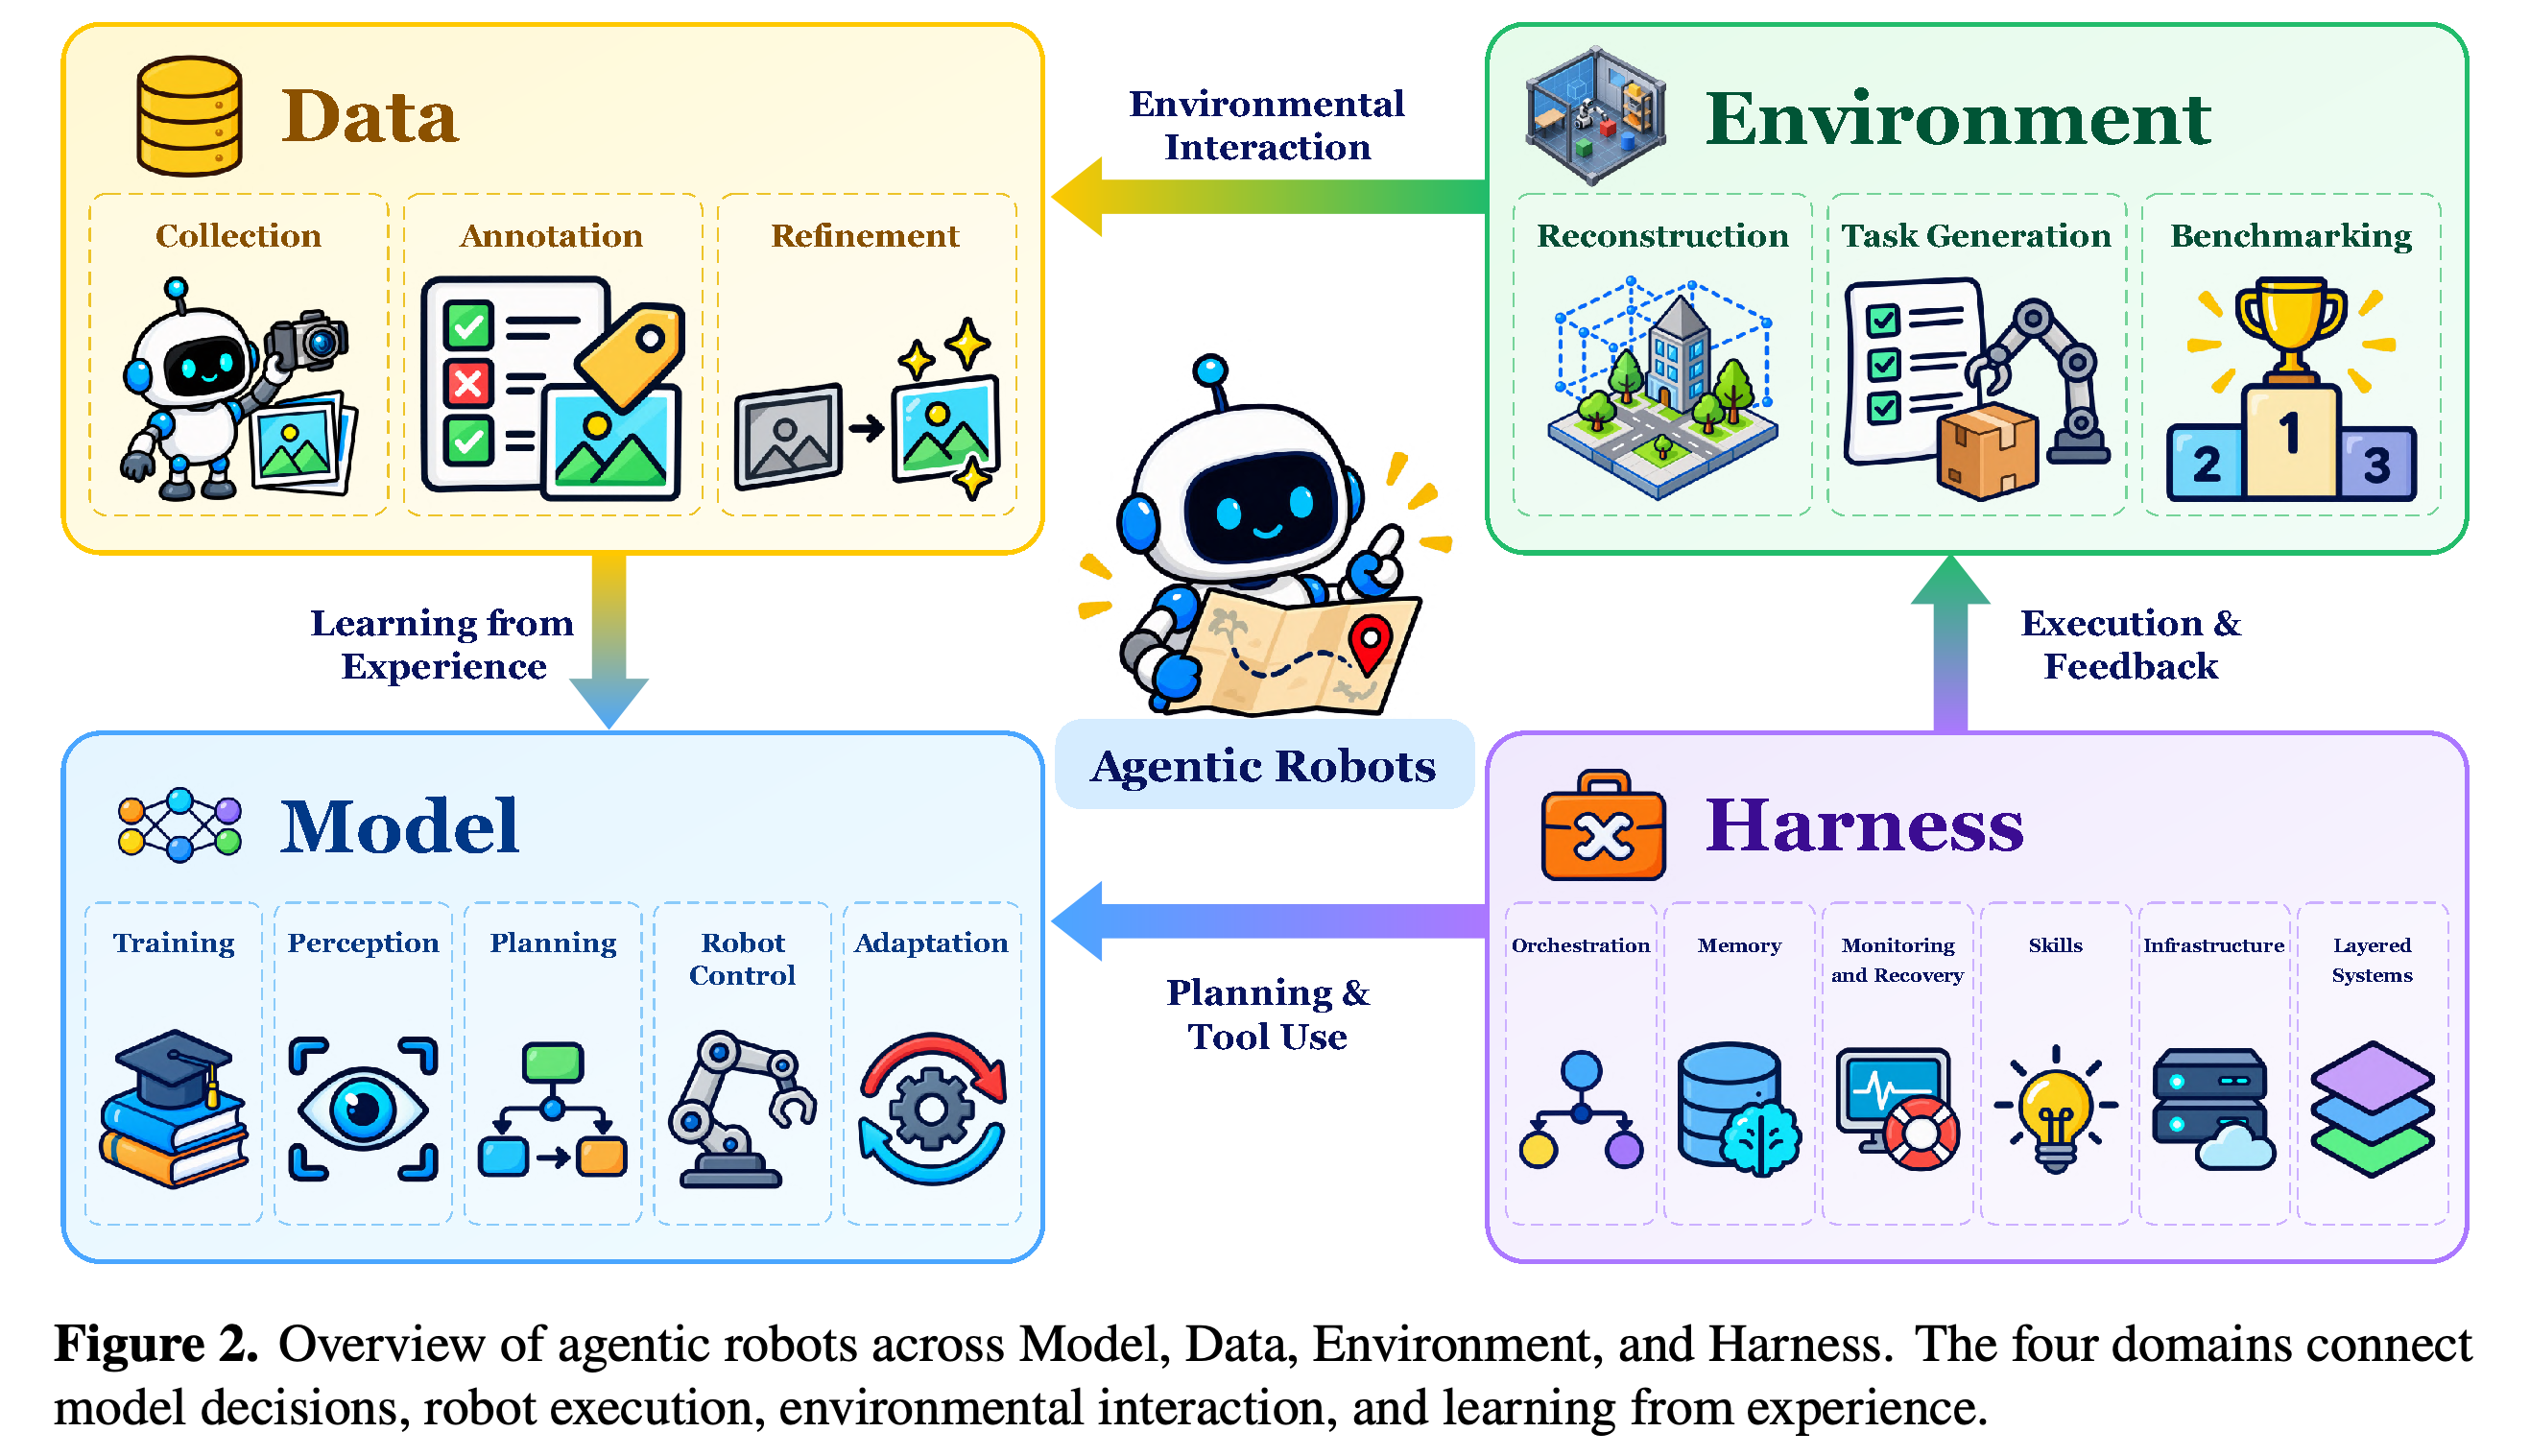
행동 예측이 개선되어도 서로 의존하는 여러 단계를 거쳐야 하는 과제를 안정적으로 실행할 수 있다는 보장은 없다. 서론은 Figure 2와 같이 학습, 데이터 수집, 환경 구축, 실행 소프트웨어 전반에서 에이전트가 기여하는 방식을 연결한다.
- 인용된 RoboDojo 비교에서는 GalaxeaVLA G0.5가 14.88%, Xiaomi-Robotics-1이 13.93%, OpenWAM-α가 11.92%, π0.5가 6.91%를 기록했다. 이 수치는 서베이의 문제의식을 뒷받침하지만 에이전트 조율의 기여만을 분리해 보여주지는 않는다.
- 논문이 제시하는 기여는 통합된 분류 체계, 대표 메커니즘과 그 의존 관계에 대한 분석, 실제 배치를 위한 연구 과제다.
화살표는 환경 상호작용과 데이터, 경험과 모델 학습, harness의 결정과 계획 및 도구 사용, 실행과 환경을 연결한다. 이러한 의존 관계는 시스템 행동을 설명할 때 모델 이외의 요소도 포함해야 하는 이유를 보여준다.
2 Evolution of Robot Learning
논문은 서로 연결된 연구 계열 4개를 설명한다. 기존 정책, 시각 및 언어 지식을 로봇 행동에 연결하는 vision-language-action model(VLA), 환경 변화를 예측하는 world model, 실행과 개선을 조율하는 agentic system이다. Figure 1은 이 계열들을 발전 과정으로 나타내지만, 본문은 각 역량이 시스템 1개 안에 공존할 수 있음을 명시한다. vision-language-action model(VLA)에 대해서는 ThinkAct: Vision-Language-Action Reasoning via Reinforced Visual Latent Planning 요약 설명 글을 참조하라.
2.1 Conventional Robot Policies
기존 로봇 정책은 시연이나 보상 기반 경험으로 행동을 학습한다. 이 서베이는 행동 공간의 차원이 아니라 장면 표현에 따라 이미지 기반 정책과 장면의 기하 구조를 반영하는 3D-aware 정책을 구분한다.
- 이미지 기반 사례로는 기록된 시연에서 학습하는 RoboMimic, 행동 시퀀스를 모델링하는 ACT, 반복적인 잡음 제거로 행동을 생성하는 Diffusion Policy가 있다. 잡음 제거는 후보 행동에서 잡음을 점진적으로 없애는 과정이다.
- 기하 구조를 활용하는 사례로는 3D 셀 격자인 PerAct의 복셀, RVT가 렌더링한 가상 시점 영상, 표본화한 3D 위치 집합인 희소 포인트 클라우드에서 추출한 DP3의 특징이 있다. 장면 표현, 학습 목적, 행동을 출력하는 구성 요소인 행동 디코더는 각각 독립적으로 선택하고 조합할 수 있다.
2.2 Vision-Language-Action Models
VLA는 로봇 상태와 행동의 시퀀스인 로봇 궤적으로 학습하여 사전 학습된 vision-language backbone을 조정한다. Backbone은 시각 및 언어 특징을 제공하는 모델이다. 행동 표현에는 이산 토큰, 잡음을 행동 시퀀스로 변환하는 연속 diffusion 또는 flow 기반 디코더, 압축된 행동 토큰, 동작 곡선이 포함된다.
- 메모리는 이전 관측과 과제 진행 상황을 제공한다. NativeMEM은 각 카메라 시점에서 얻은 과거 프레임 각각을 이후 행동 예측에 사용할 수 있는 압축 표현인 메모리 토큰 1개로 압축한다. 메모리에 대해서는 Adaptation of Agentic AI: A Survey of Post-Training, Memory, and Skills 요약 설명 글을 참조하라.
- 중간 추론은 행동 생성에 앞서 언어로 표현한 하위 과제, 공간적 지침, 시각적 목표를 제공한다.
- 미래 예측은 실행 중 미래 이미지를 요구하지 않으면서 정책 표현의 학습을 지도할 수 있다. 한편 BagelVLA는 언어 추론, 시각 예측, 행동 생성을 번갈아 수행한다.
2.3 World Models and World-Action Models
World model은 행동의 효과를 예측하며, 시뮬레이션 환경으로 쓰이거나 시각적 계획을 제공할 수 있다. 시각적 계획은 원하는 미래를 묘사하는 예측 관측이다. World-action model(WAM)은 미래 시각 예측과 행동 학습을 결합하여 생성한 행동을 예상되는 환경 변화와 연결한다. World-action model(WAM)에 대해서는 Long-WAM: Scaling the Context of World-Action Models 요약 설명 글을 참조하라.
- 4D world modeling은 3D 기하 구조가 시간에 따라 어떻게 변하는지 표현한다. PointWorld는 장면 내 점의 변위를 예측하며, TesserAct와 MVISTA-4D는 예측한 미래 기하 구조를 로봇 행동과 연결한다.
- 역동역학은 예측 관측이나 내부 표현을 행동으로 변환하여 시각적 계획을 실행할 수 있게 한다. 이 과정은 예측의 실현 가능성과 로봇별 제어 능력에 달려 있다.
- Fast-WAM은 비디오 공동 학습으로 학습하며, 추론 시 미래를 상상하지 않는다. ImageWAM은 미래 이미지를 디코딩하지 않고 사전 학습된 이미지 편집 특징을 활용한다.
2.4 Agentic Robots
Agentic robot은 실행 가능한 기능을 선택하고 조율하며, 결과를 해석하고 목표에 맞게 후속 작업을 수정한다. 이 관점은 경험 수집, 학습 실험 관리, 평가 피드백을 활용한 향후 과제 수행 역량 개선까지 포함한다.
3 Foundations of Agentic Robots
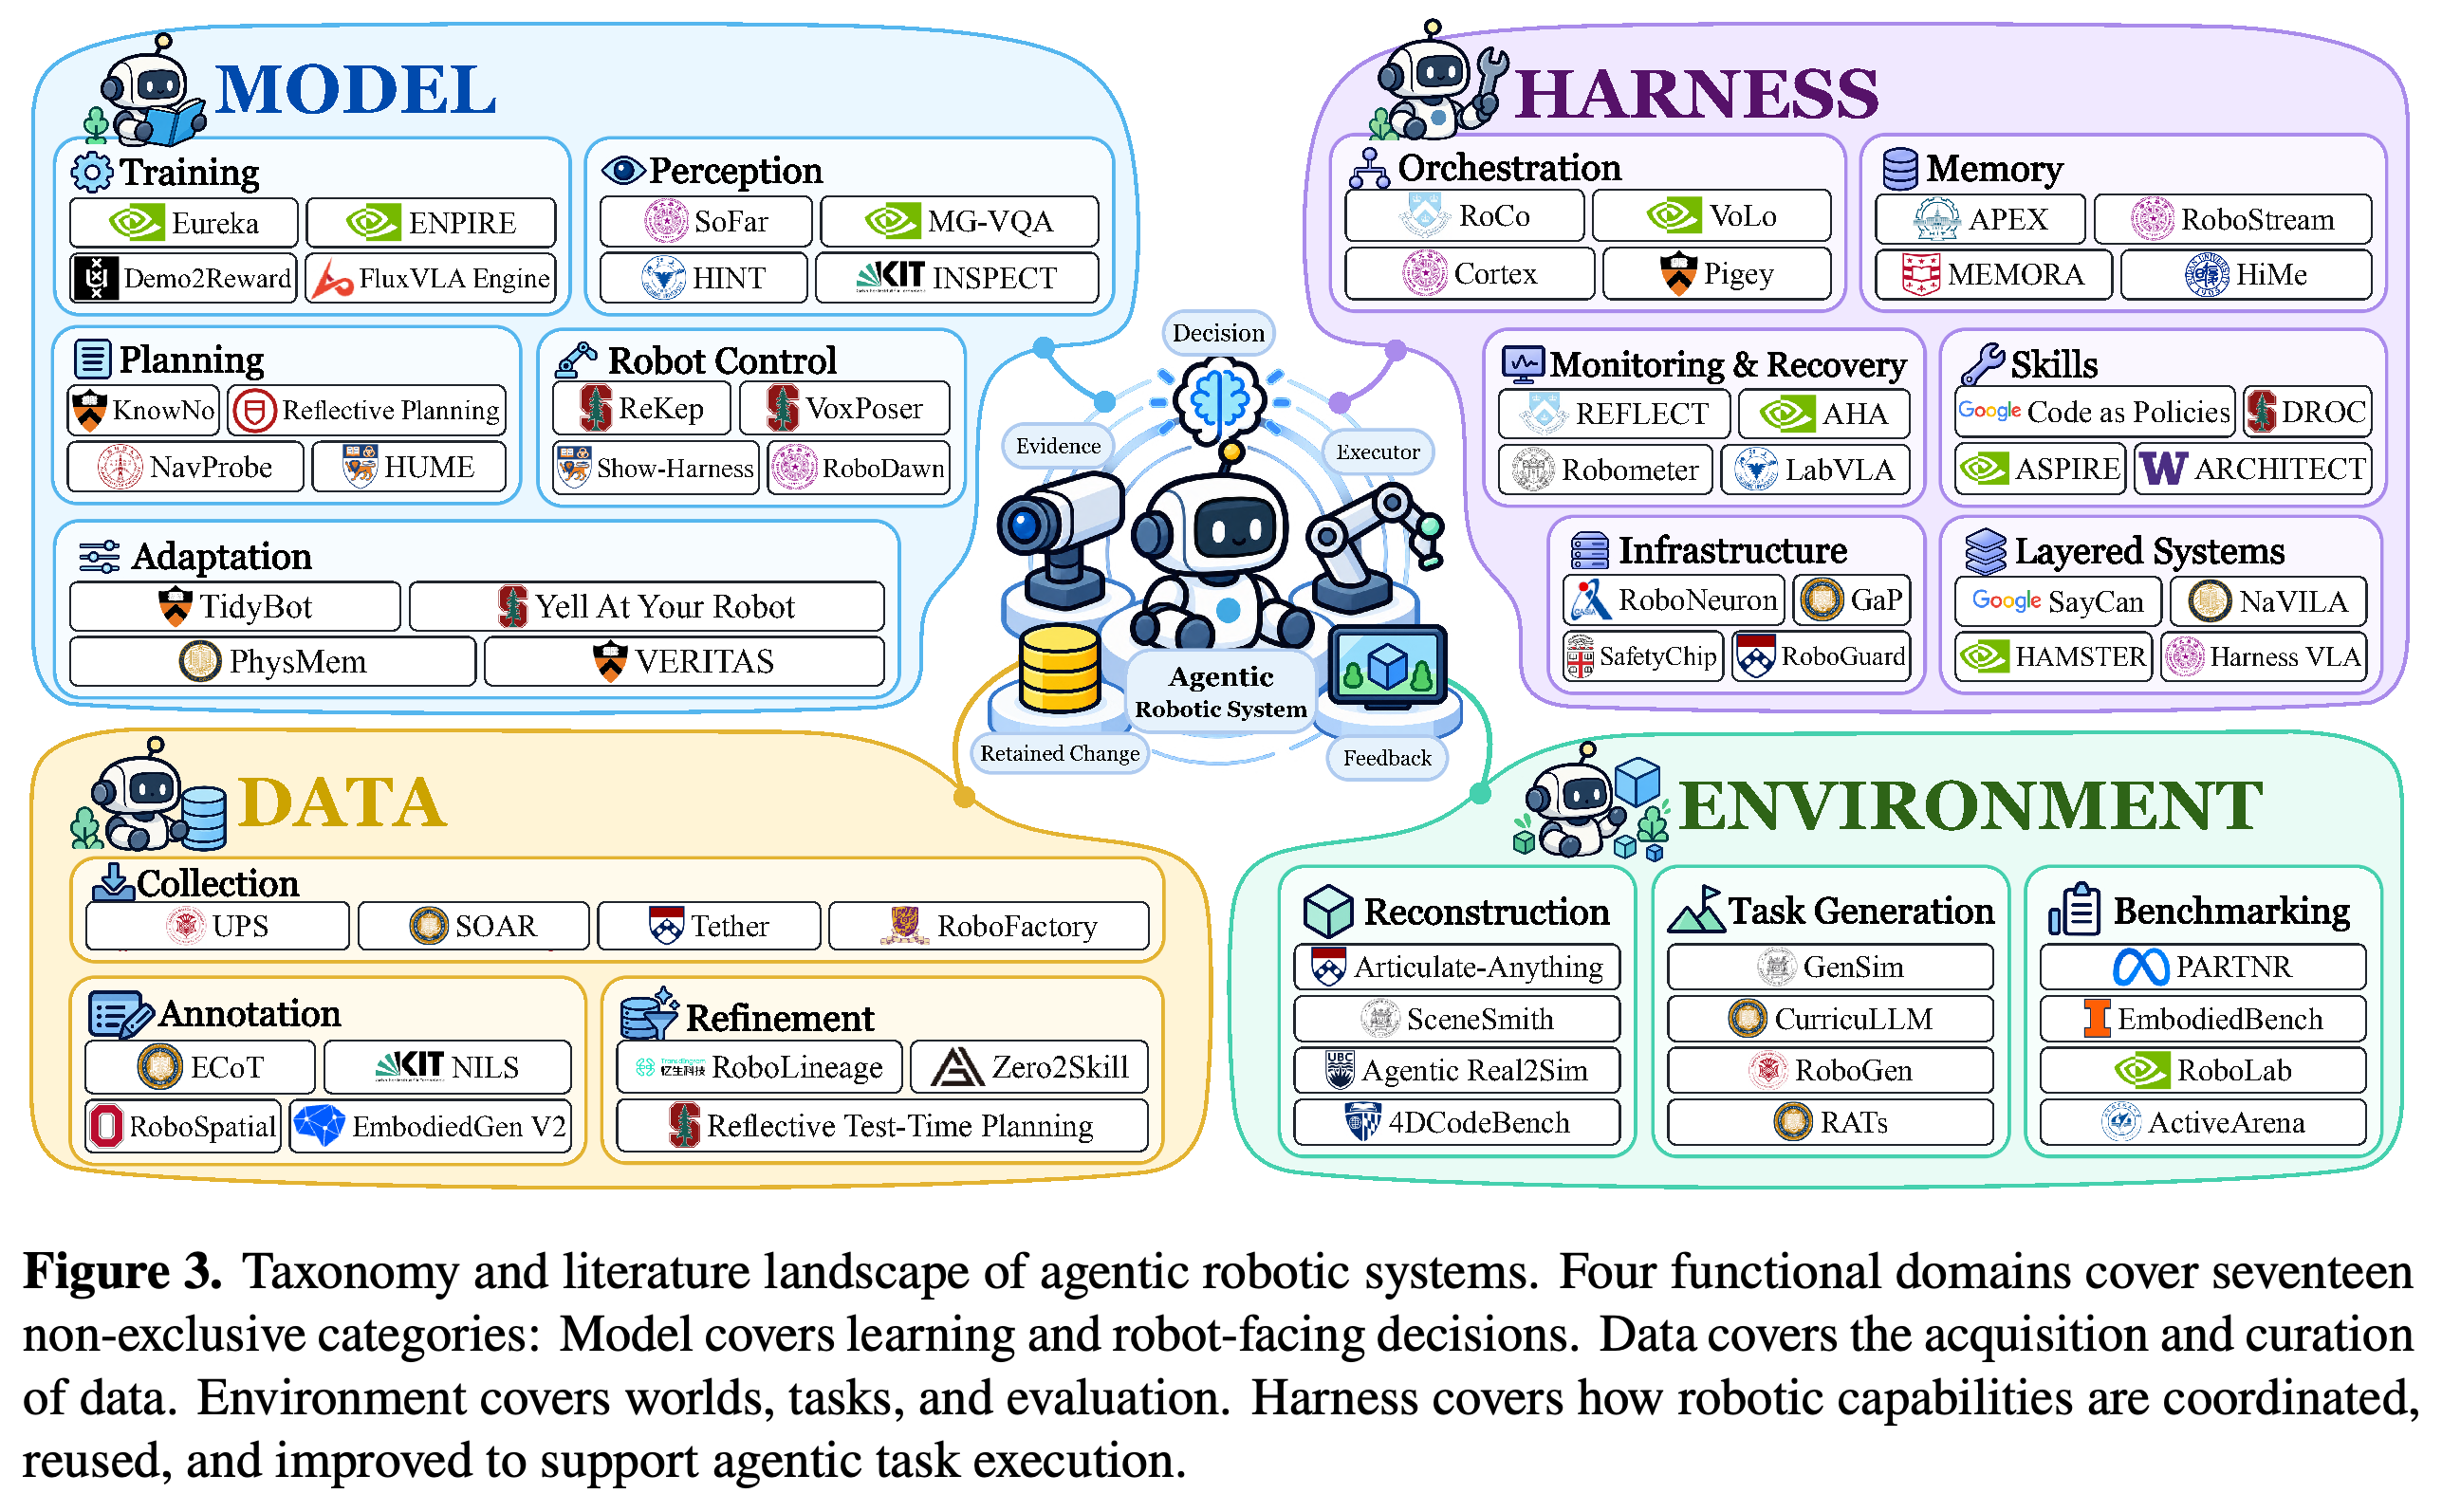
기초 개념 절은 agentic robot을 정의하고 기능별 분류 체계를 소개하며 관련 개념과 범위를 비교한다. Figure 3은 대표 시스템을 영역 4개에 배치하며, 각 연구가 여러 범주에 기여할 수 있도록 한다.
대표 연구들을 범주 17개에 배치하여 분류 체계가 다루는 기능의 사례를 제시한다. 각 위치는 기능적 기여를 나타내며, 서로 배타적인 시스템 유형이나 효과의 순위를 뜻하지 않는다.
3.1 Definition and Scope
Agentic robot은 사람이 모든 단계를 지정하지 않아도 환경 관측과 실행 피드백을 바탕으로 실행을 자율적으로 계획하고 조율한다. 통합 모델 1개로 구현하든 모델, 정책, 프로그램, 도구의 조합으로 구현하든, 작업을 계속하거나 정보를 구하고 계획을 수정하거나 실패에서 복구할 수 있다.
- 서랍 사례는 이 정의가 실제로 무엇을 뜻하는지 보여준다. 재사용 가능한 절차나 실행 가능한 행동인 서랍 열기 스킬을 선택하고, 서랍이 열렸는지 확인한 뒤, 물체를 꺼낼지 아니면 시도 방식을 수정할지 결정한다.
- 이 정의는 실제 로봇과 시뮬레이션을 모두 포함한다. 행동 예측이나 저수준 피드백 제어만으로는 여기서 정의한 조율 역량을 갖췄다고 볼 수 없다.
3.2 Taxonomy
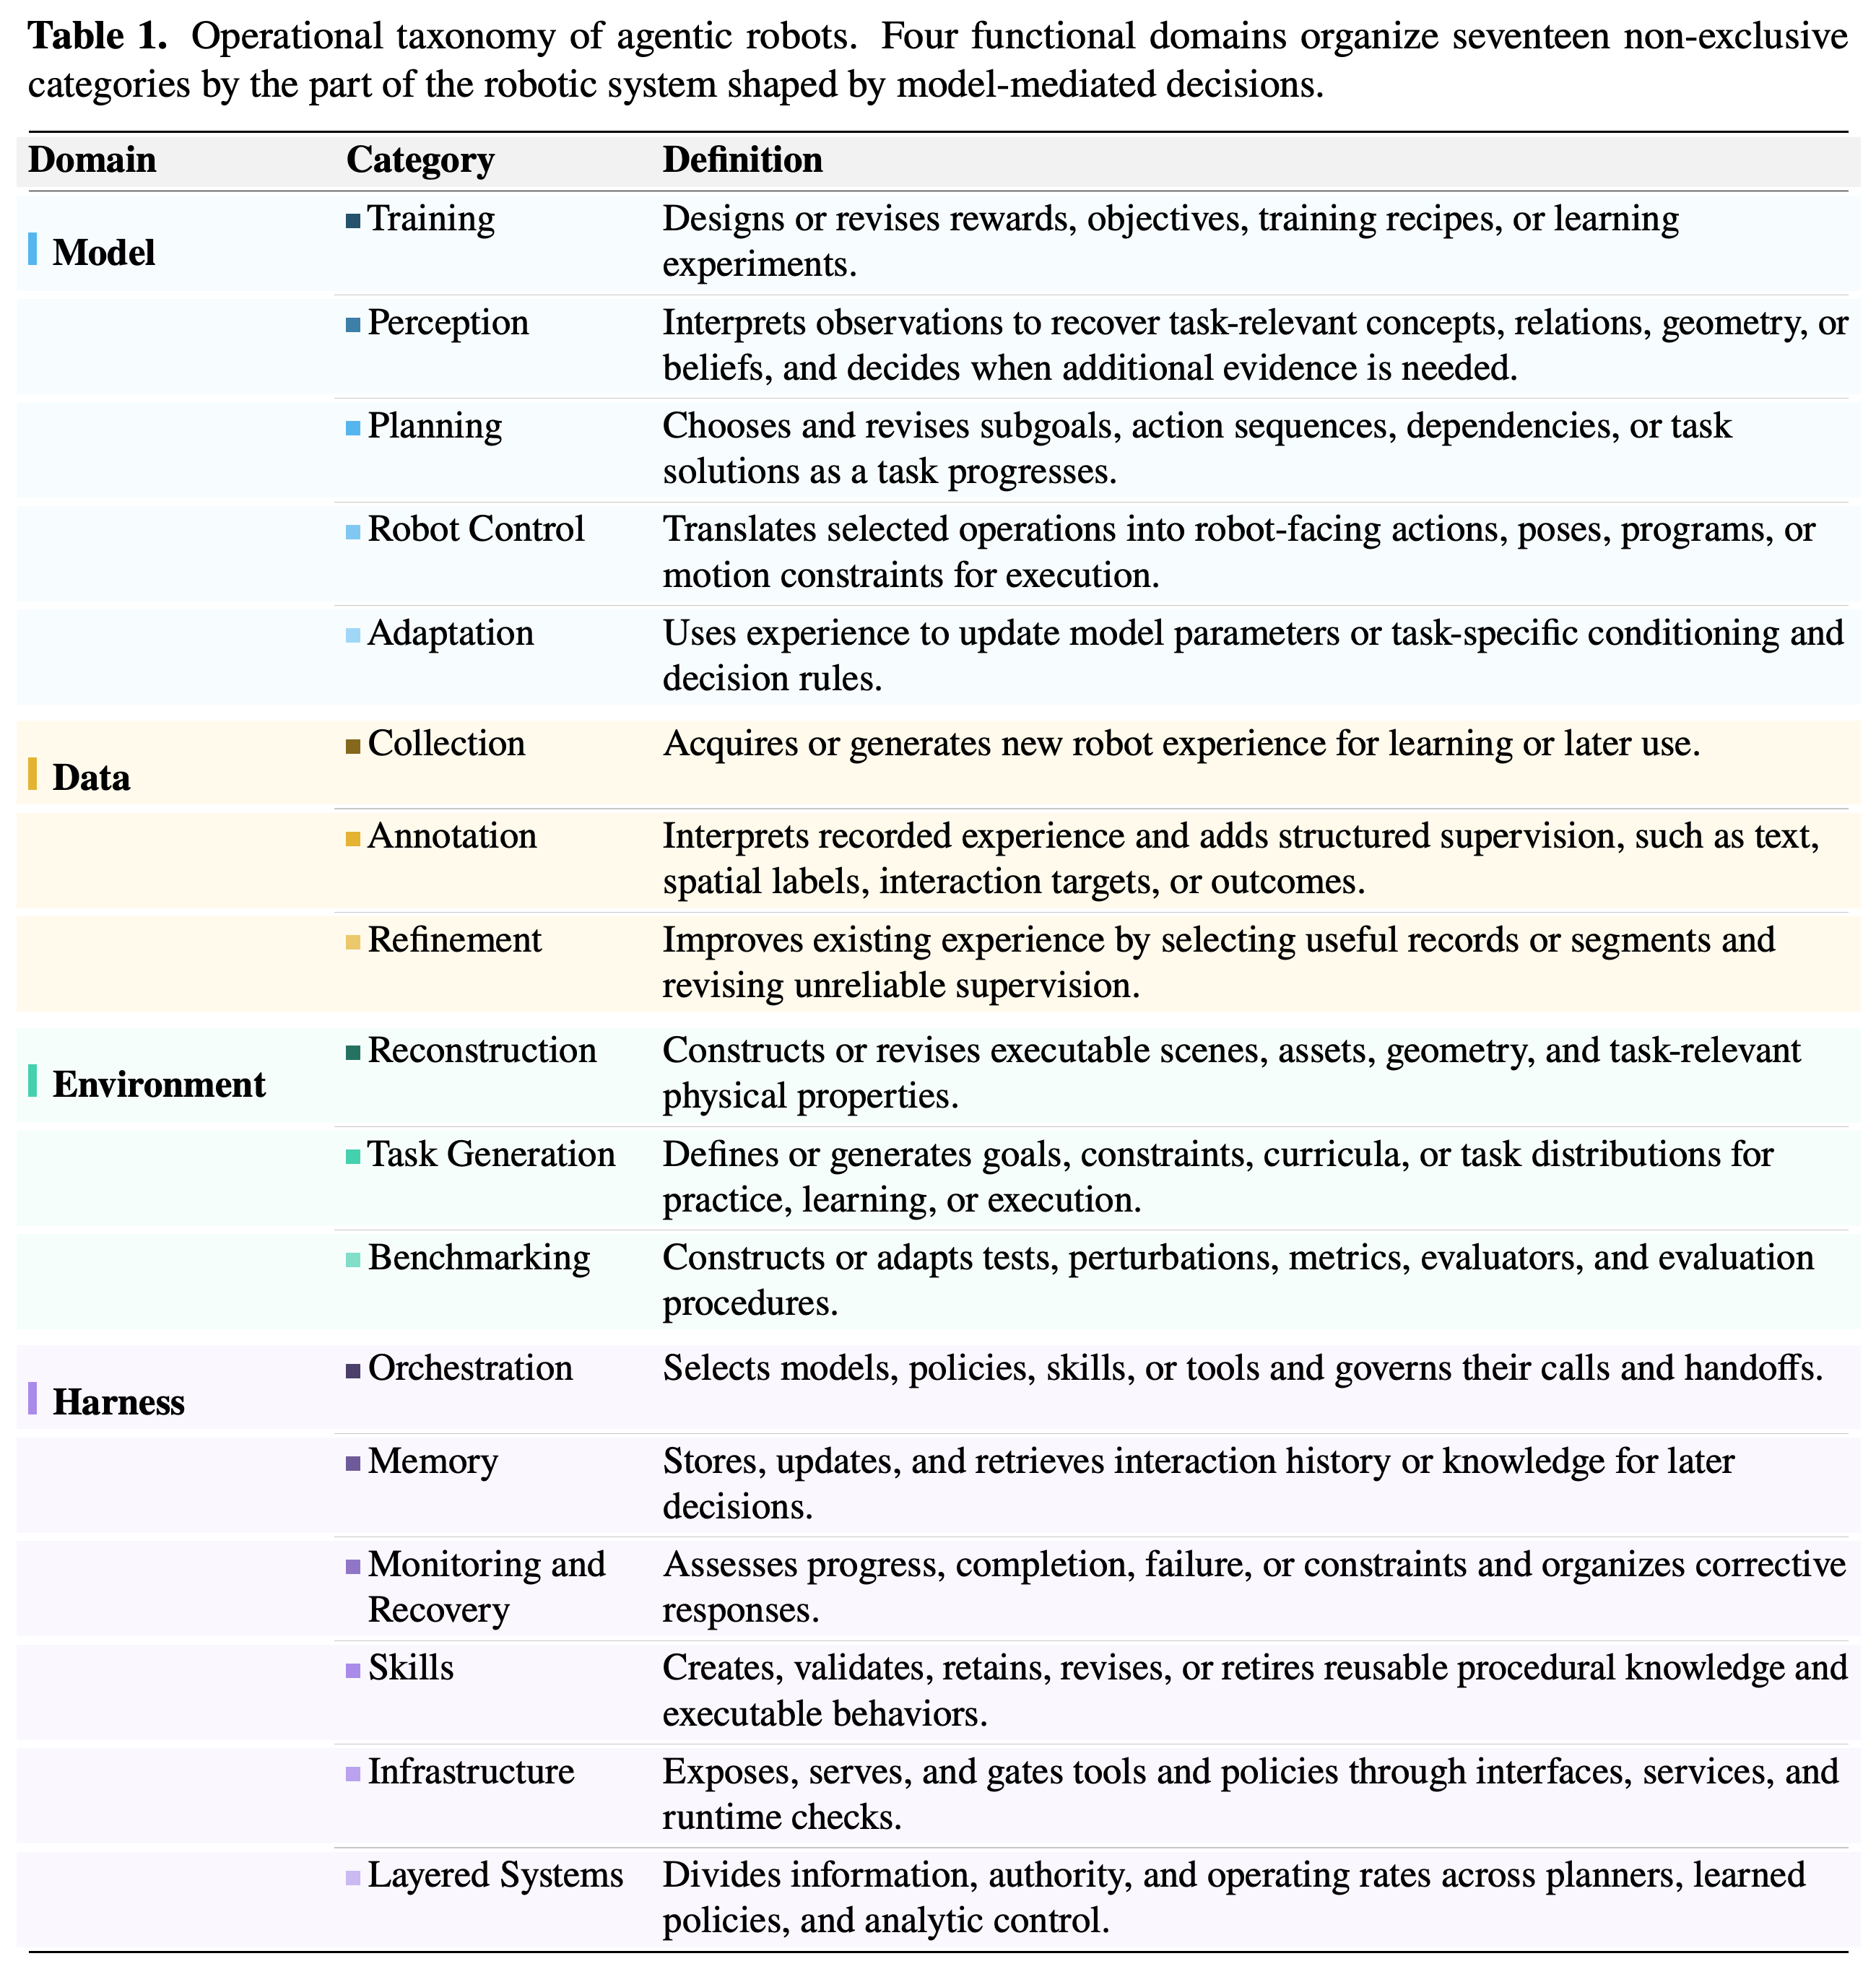
Table 1은 서로 배타적이지 않은 범주 17개를 정의한다. Model에 5개, Data에 3개, Environment에 3개, Harness에 6개가 속한다. 분류 기준은 에이전트의 결정이 영향을 미치는 기능이며, 같은 연구도 관련 기여가 있는 여러 범주에 포함될 수 있다.
- Zero2Skill은 데이터 수집과 준비를 정책 학습에 연결한다. Harness VLA는 선택한 작업을 수행하는 구성 요소인 고정된 실행기를 중심으로 여러 harness 기능을 결합한다.
- ENPIRE는 실험 관리를 정책 개선과 연결하여 역량 개발과 과제 실행을 같은 틀에서 다루는 이유를 보여준다.
각 정의는 개입 지점을 구분한다. 학습은 학습 과정을 바꾸고, 적응은 경험을 통해 파라미터나 조건 정보를 바꾸며, harness 기능은 호출, 보존 정보, 복구, 재사용을 관리한다. 따라서 같은 시스템이 여러 범주에 기여할 수 있다.
3.3 Comparison with Related Concepts
환경과의 상호작용을 통해 지능을 연구하는 embodied artificial intelligence(AI)는 지각, 추론, 행동 전반에서 agentic robotics와 겹친다. 자율 로봇 연구는 이미 계획과 모니터링을 포함하며, 로봇 파운데이션 모델은 폭넓은 학습으로 재사용 가능한 역량을 습득한다. 이 서베이는 이러한 역량이 실행 중 이어지는 의사결정에 어떻게 참여하는지에 초점을 둔다.
- 논문은 “agentic”이 인간의 지도로부터 완전히 독립하거나 더 높은 수준의 자율성을 갖는다는 뜻은 아니라고 명시한다.
- Hi Robot은 시각 및 언어 정보를 해석하는 vision-language model(VLM)과 갱신된 중간 지시를 실행하는 VLA를 결합하여 이 관점들이 양립할 수 있음을 보여준다.
4 Model: What Should the Agent Learn, Understand, Decide, and Control?
Model 영역은 학습, 지각, 계획, 로봇 제어, 적응에 대한 개입을 구분한다. Figure 4는 서랍에서 물체를 꺼내는 과제를 통해 손잡이 정보 부족, 부적절한 행동 순서, 실행 불가능한 파지, 반복되는 정책 실패에 서로 다른 해결책이 필요한 이유를 보여준다.
공통된 서랍 과제로 목표를 고정한 채 개입 지점 5개를 구분한다. 손잡이 정보 부족, 잘못된 행동 순서, 과제에 적합하지 않은 학습된 정책에는 서로 다른 진단 근거와 수정이 필요하다.
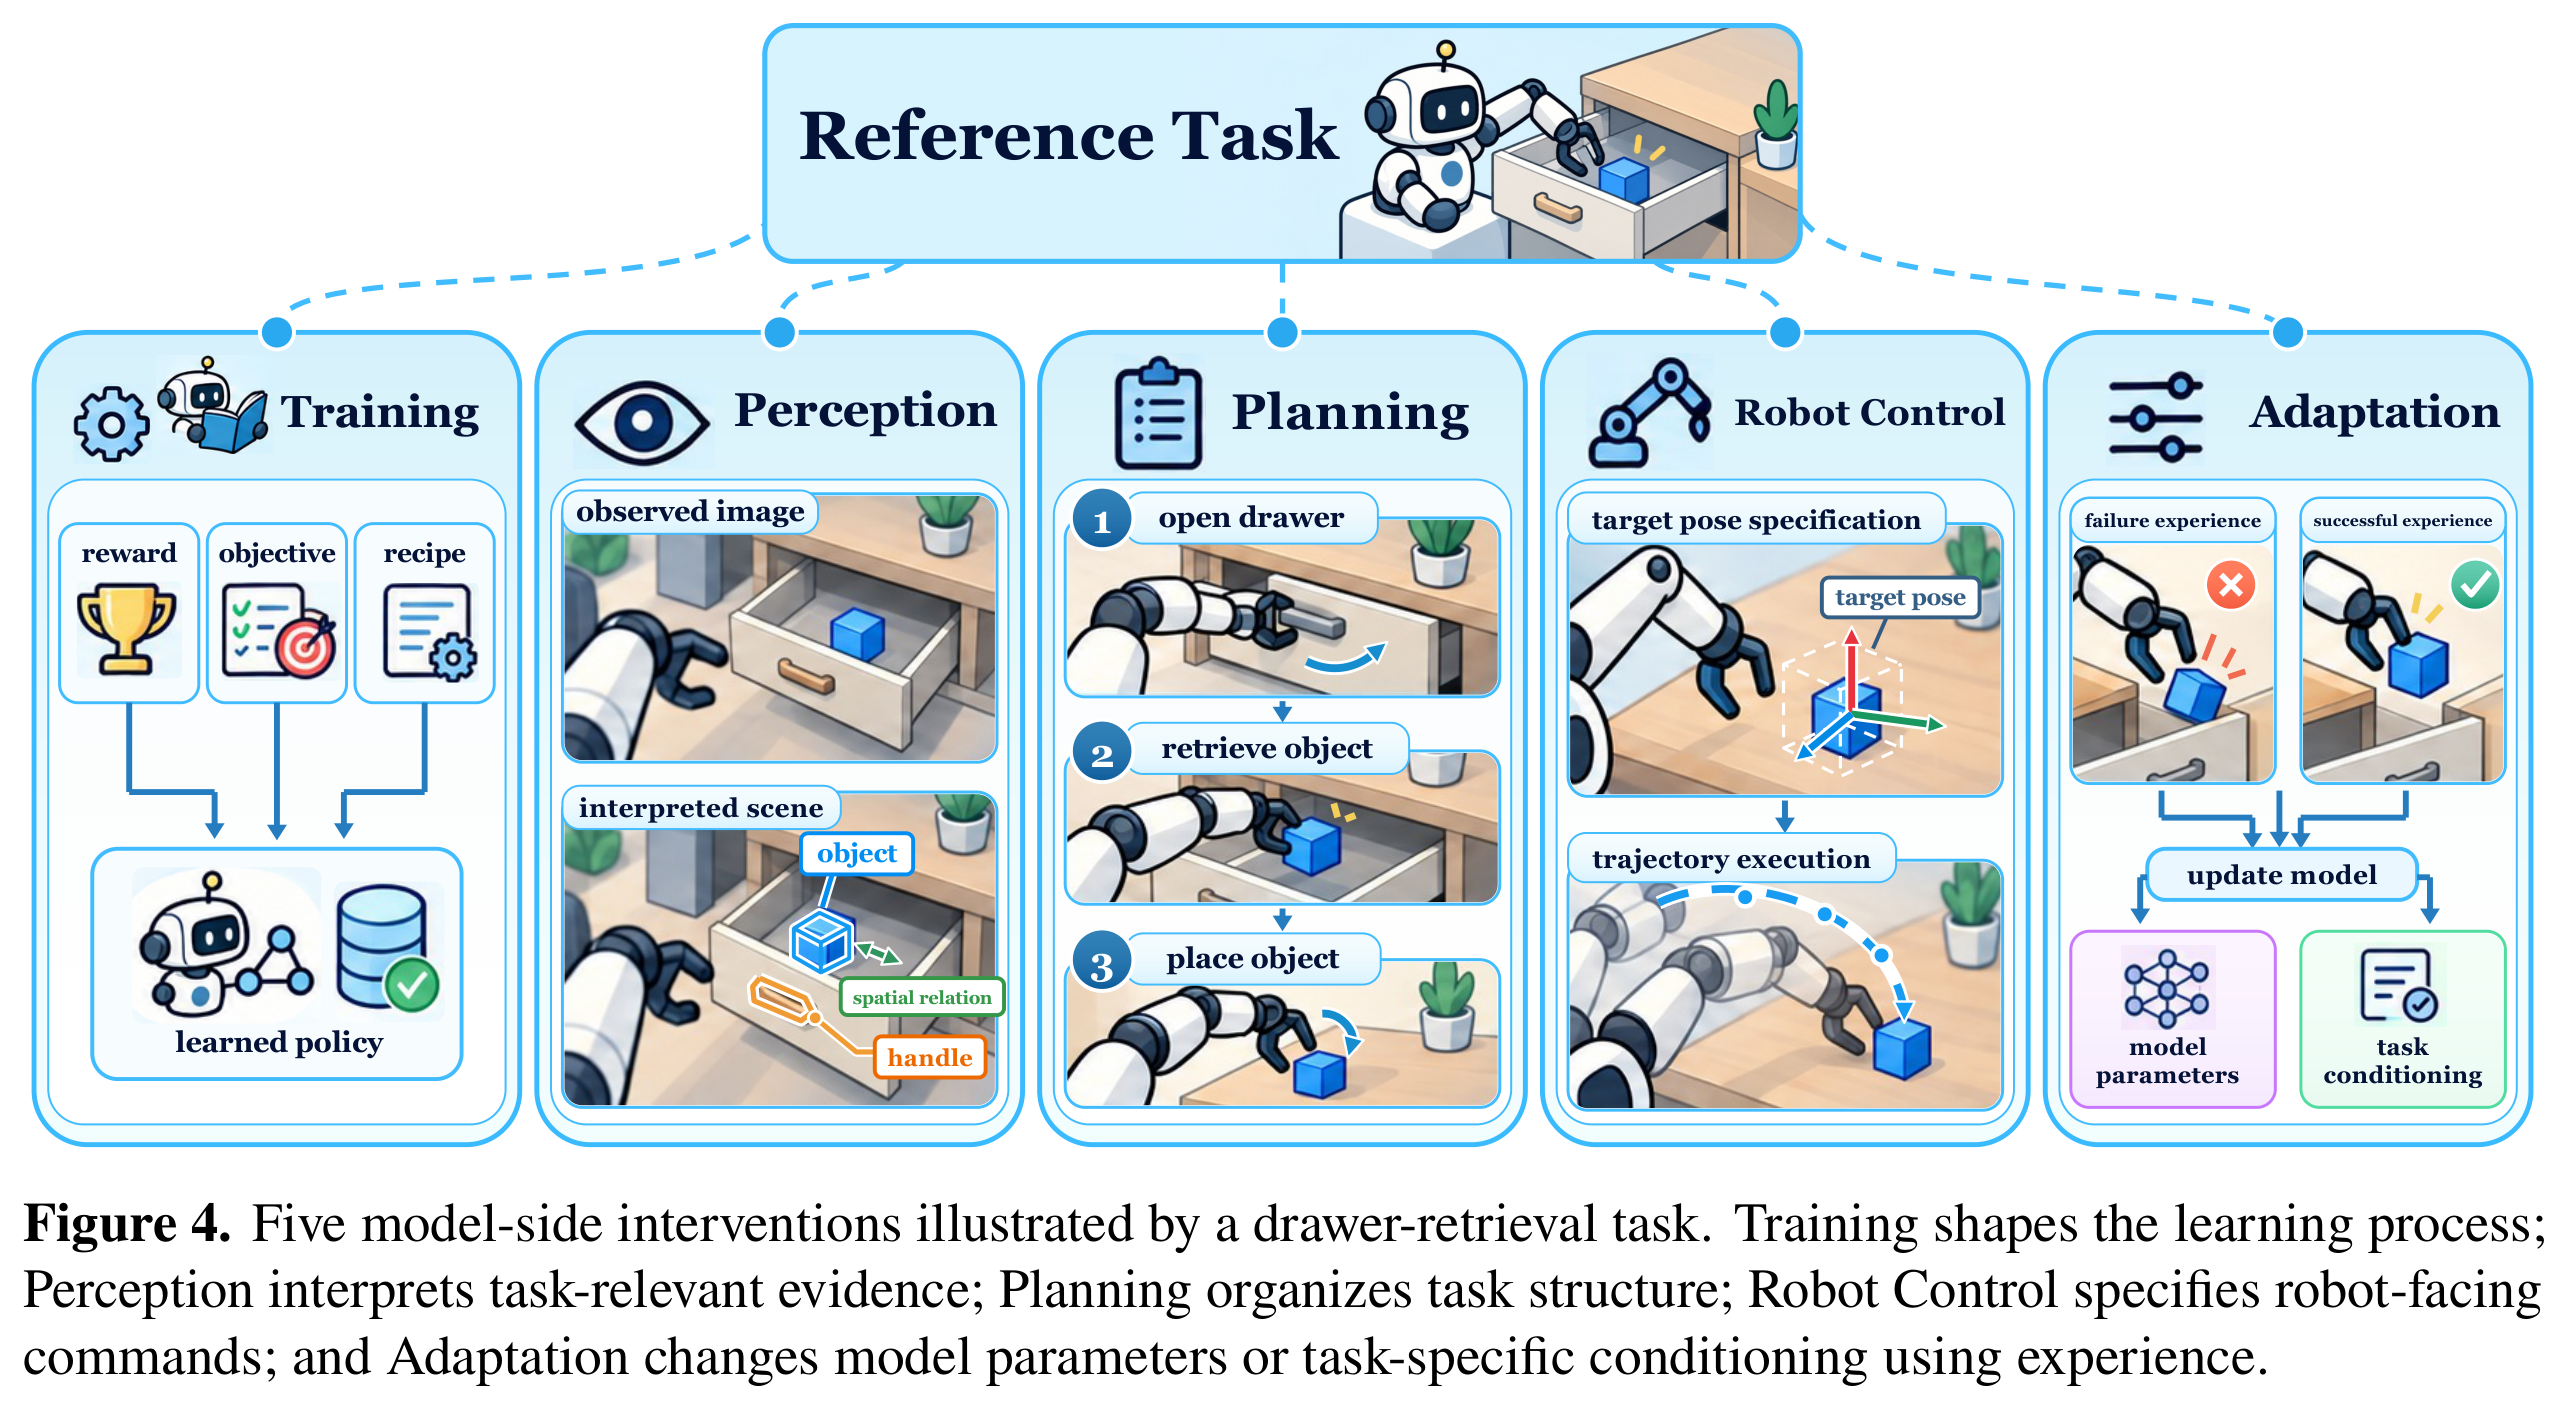
4.1 Training
학습 방법에서는 에이전트가 보상 신호, 정책 코드, 학습 설정, 실험 절차를 수정할 수 있다. Eureka는 보상 코드를 생성하고 학습 피드백으로 수정한다. ENPIRE는 정책이나 학습 코드를 수정하는 코딩 에이전트에 실제 로봇 초기화, 검증, 안전 인터페이스를 제공한다.
- 보상 후보마다 정책을 끝까지 학습하면 보상 평가 비용이 커진다. 더 저렴한 대안으로는 짧은 대리 학습 실행, 오프라인 인과 정보, 레이블이 있는 시연, 미리 정의한 보상 구성 요소가 있다. 각 대안은 후보를 판단할 때 사용할 수 있는 근거를 제한한다.
- HARBOR는 보상 기반 상호작용으로 학습하는 시뮬레이션 강화학습을 타입이 지정된 산출물과 검증을 거치는 단계로 구조화한다. 신뢰성은 과제, 보상, 알고리즘 인터페이스의 호환성에 달려 있다. ENPIRE는 실제 로봇을 안정적으로 초기화할 수 있어야 한다.
- 이 절은 에이전트가 보상, 프롬프트, 도구, 데이터, 학습 방식을 수정하더라도 측정 기준을 일정하게 유지하도록 권고한다. 그래야 변경과 함께 그 변경을 판단하는 기준까지 바뀌는 일을 막을 수 있다.
4.2 Perception
지각은 관측을 과제와 관련된 개념, 관계, 기하 구조, 믿음 상태로 변환하며, 다음에 어떤 근거를 확보할지 결정하는 과정도 포함할 수 있다. 부족한 정보를 드러내기 위해 행동하는 능동 지각에는 카메라 이동과 가려진 물체를 드러내는 조작이 포함된다.
- SCOPE는 카메라 방향과 줌을 명시적인 행동으로 다룬다. MG-VQA는 시각 질문에 답하기 전에 물체를 잡아 치우거나 미는 도구를 호출할 수 있다.
- 출력은 후속 실행기와 맞아야 한다. 예를 들어 “upright” 같은 의미적 설명으로 동작을 유도하려면 호환되는 기하 표현이 필요하다.
- 평가 조건은 결과 해석의 범위를 제한한다. CoRelNav는 시뮬레이션이 제공하는 정답 물체 영역과 식별자인 oracle instance mask와 identifier를 사용한다. INSPECT는 행동으로 새로운 관측을 얻는 폐루프 실제 로봇 검사 대신, 주석이 있는 재생 기록과 고정된 로봇 이미지 집합으로 평가한다.
4.3 Planning
계획에는 작업이나 하위 목표 생성, 실행 전 후보 계획 점검, 실행 결과를 바탕으로 한 갱신이 포함된다. 이 절은 다음 행동을 선택하는 것과 여러 작업의 의존 관계를 정의하거나 계획에 쓰는 모델을 수정하는 것을 구분한다.
- Hi Robot은 학습된 행동 정책에 언어 하위 목표를 제공한다. EmboTeam은 기호적 탐색 결과를 조건, 대체 경로, 동기화를 담은 실행 구조인 행동 트리로 변환한다.
- SayPlan과 GAVEL은 물체와 그 관계를 표현하는 그래프 기반 장면 모델로 후보 계획을 점검한다. ReflectVLM은 상상한 시각적 결과를 평가한다.
- HUME는 계획 모델에 추가할 내용을 불확실한 가설로 취급하며, 지각을 통해 이를 확인하거나 기각할 수 있다. 몇 단계 앞까지 계획할지를 뜻하는 적절한 계획 지평은 행동 결과를 얼마나 안정적으로 예측할 수 있는지에 따라 달라진다.
4.4 Robot Control
로봇 제어는 행동 또는 언어 명령, 목표 자세와 프로그램, 허용되거나 선호되는 움직임을 지정하는 동작 제약과 비용 함수를 통해 선택한 작업을 물리적 움직임으로 변환한다. 출력에 필요한 상세 수준은 실행 계층이 이미 처리하는 기능에 따라 달라진다. 여기에는 목표 위치와 방향에 맞는 관절 구성을 계산하는 역기구학과 충돌 검사가 포함된다.
- GPT-Policy는 자세 보간, 동작 타이밍, 운동학 검사를 실행 소프트웨어에 위임한다. 이러한 검사만으로 충돌 회피나 과제 완료가 입증되지는 않는다.
- ReKep은 물체에서 선택한 공간 위치인 키포인트 사이의 관계를 지정한다. VoxPoser는 가능한 움직임에 점수를 부여하는 공간 가치 맵을 만들어 최적화기에 제공한다. 이들의 솔버는 제어 단계마다 언어 모델을 호출하지 않아도 기하 구조 변화에 대응할 수 있다.
- FAEA의 프로그램 수정 평가는 물체와 그리퍼의 정답 상태를 제공한다. 카메라 이미지를 입력으로 사용하려면 인터페이스가 요구하는 상태를 지각 모듈이 추가로 제공해야 한다.
4.5 Adaptation
적응은 유지된 맥락, 플래너 설정, 학습된 모델 파라미터를 바꿀 수 있으며, 변경의 지속성과 범위는 각각 다르다. 이 서베이는 시도 도중의 즉각적인 복구, 재학습 후 개선, 다른 과제로의 일반화를 구분한다.
- TidyBot과 DROC는 모델 가중치를 갱신하지 않고도 예시나 수정 사항을 의사결정에 반영할 수 있다. SERP는 계획 파라미터를 조정한다.
- OLAF는 말로 전달한 수정을 변경된 행동 레이블로 변환한다. Yell At Your Robot은 저수준 제어기를 고정한 채 고수준 정책을 갱신한다.
- Self-Improving Embodied Foundation Models는 별도 정책을 학습하면서 고정된 체크포인트를 보상과 성공 판정에 사용한다. 실제 로봇 실험에는 LanguageTable을 사용하며, ALOHA의 자기 개선은 시뮬레이션에서 평가한다.
5 Data: How Should the Agent Collect, Annotate, and Refine Robot Data?
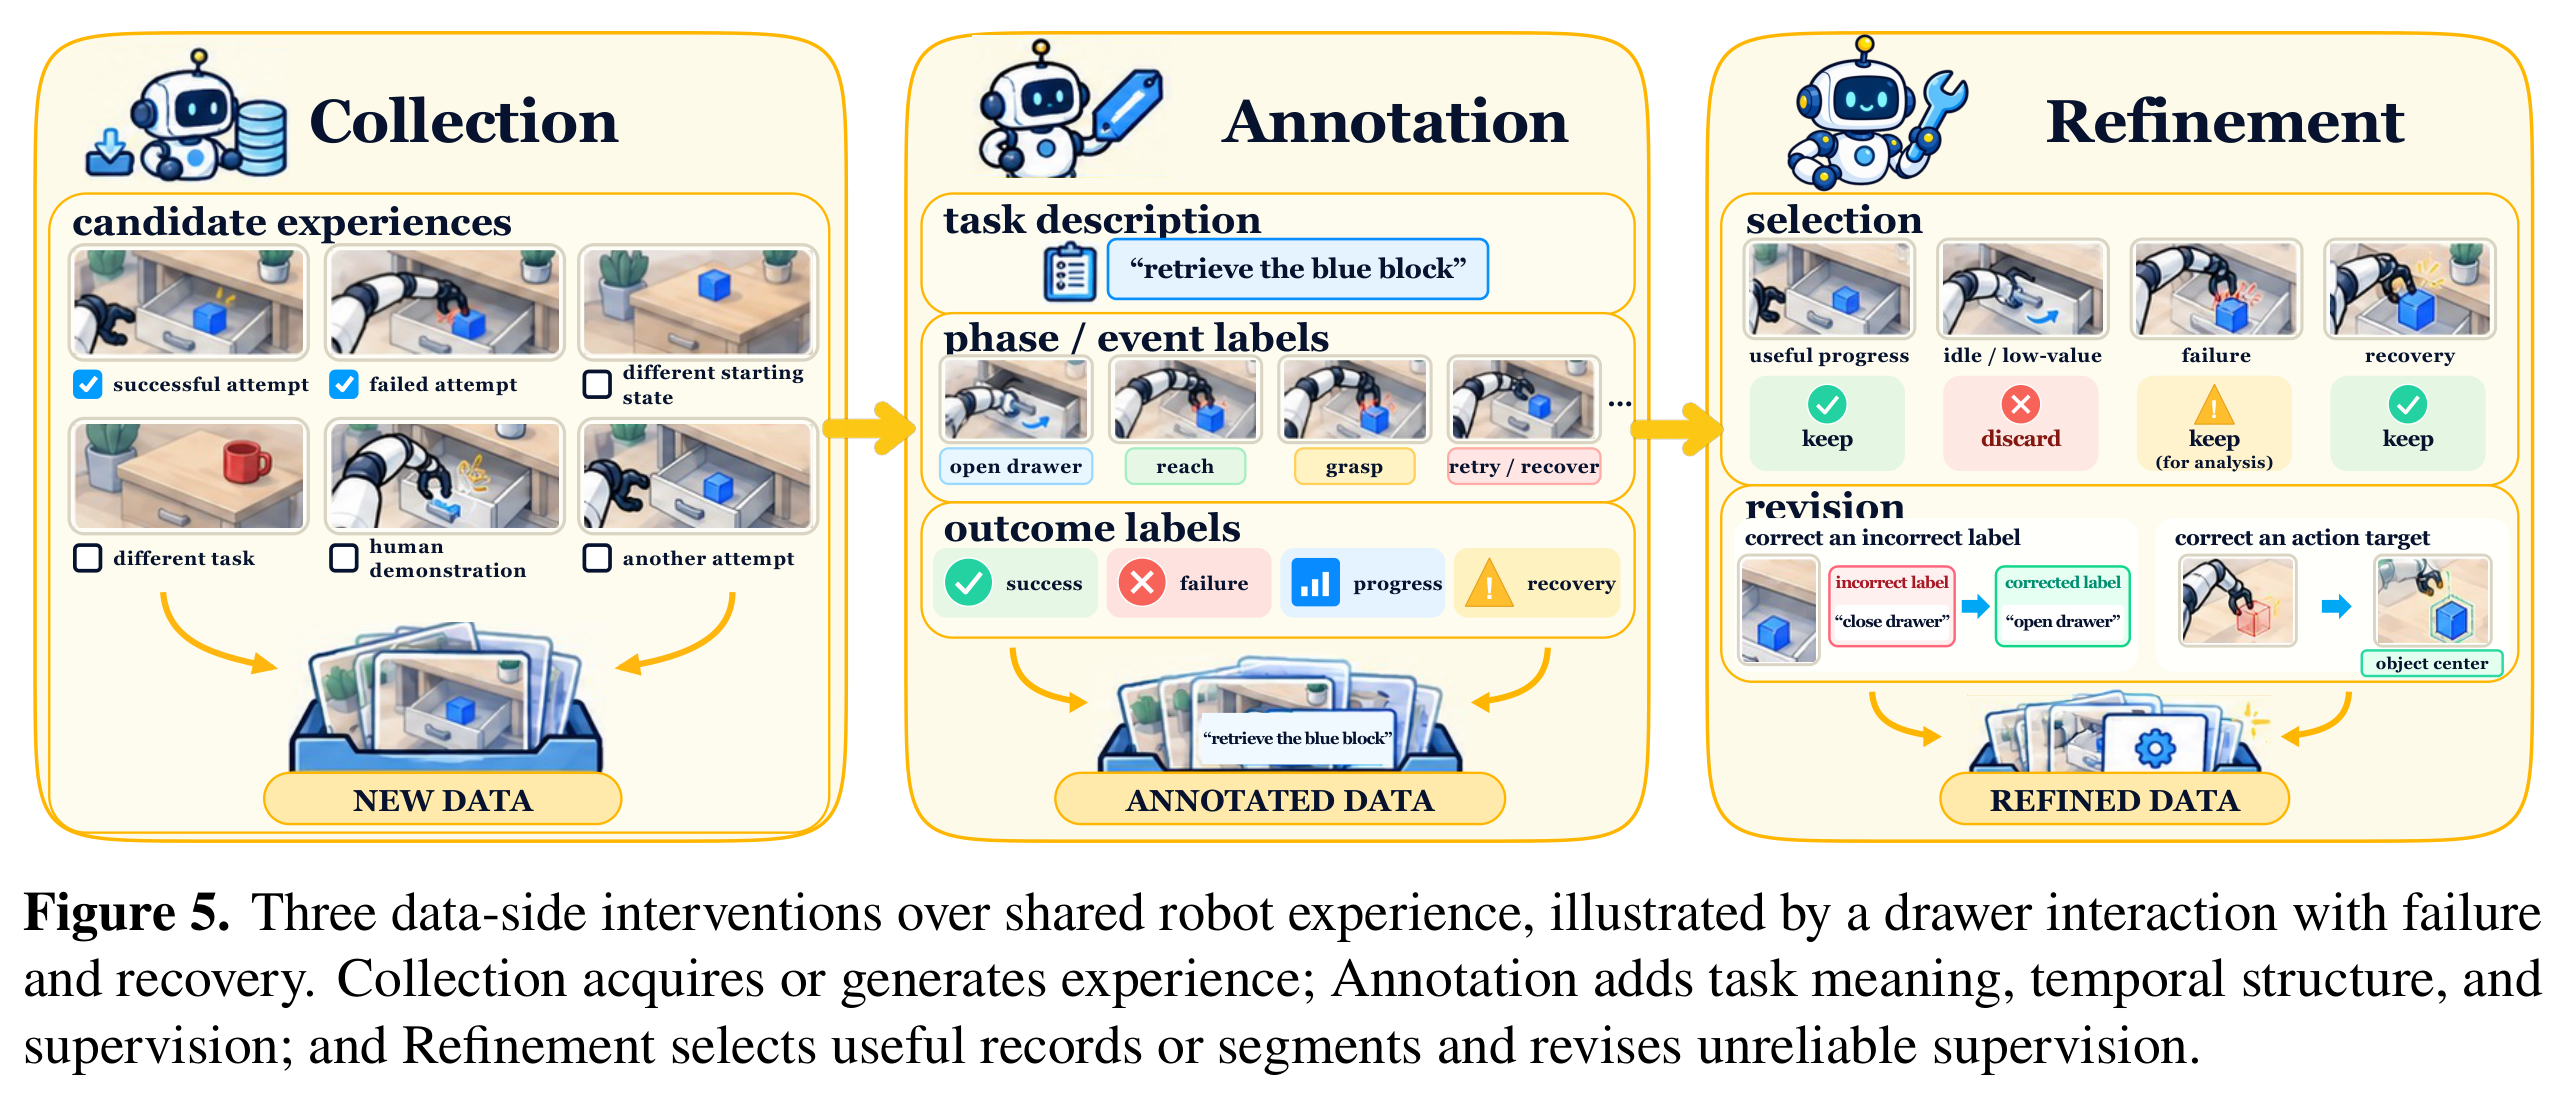
Data 영역은 새로운 경험 확보, 구조화된 지도 정보 추가, 기존 기록 개선을 구분한다. Figure 5는 실패와 복구 구간을 포함한 동일한 서랍 상호작용이 수집, 주석, 정제 과정을 거치는 모습을 보여준다.
같은 경험이 새로운 기록, 레이블이 붙은 기록, 선별되거나 수정된 학습 예시로 바뀐다. 유용한 복구 구간은 보존하고 유휴 행동은 버리는 과정은 실패한 시도에도 유용한 학습 데이터가 들어 있을 수 있는 이유를 보여준다.
5.1 Collection
수집 방법은 실제 로봇 경험을 확보하거나, 시뮬레이션에서 과제를 실행하거나, 생성 모델을 조율하여 관측과 동작을 합성한다. 에이전트는 데이터가 부족한 과제를 선택하고 장면을 준비하거나 초기화하며, 결과를 판정하고 관측된 약점에 맞춰 추가 수집을 진행할 수 있다.
- 보고된 규모는 단위와 범위가 서로 다르다. SOAR는 약 30,500개 궤적을 공개하며, Tether는 1,946회 시도 중 1,085회 성공을 보고하고, FIND는 6시간 동안 456개 에피소드를 수집한다.
- Zero2Skill은 미리 정한 재시도 한도에 도달하면 사람의 도움을 요청한다. RoboClaw는 과제 완료를 확인한 뒤 대응하는 초기화 정책을 호출한다.
- RoboCurate는 생성 비디오와 예측 행동을 시뮬레이터에서 재생한 결과의 일관성을 점검한다. 생성 궤적 10,000개는 필터링 전 수량이다.
5.2 Annotation
주석은 기록된 경험에 텍스트, 공간 레이블, 상호작용 대상, 결과 레이블을 추가한다. 조사한 파이프라인은 의미 해석과 지각 도구, 기하 계산, 시뮬레이터 기록, 실행 근거를 결합하여 지도 정보를 생성하고 검증한다.
- NILS는 과제 설명을 생성하기 전에 물체 움직임, 상태 변화, 그리퍼 상호작용을 기준으로 시연을 분할한다.
- 상호작용 레이블은 접촉이나 원하는 조작에 적합한 물체 영역인 affordance를 설명한다. 결과 레이블은 진행 상황, 성공, 실패, 안전 위반을 설명한다.
- 추론 기록은 하위 과제와 다음 행동에 대한 설명을 추가한다. 기하 구조에서 도출한 질문과 답변 쌍은 장면 기하 구조로 계산한 답을 통해 공간적 지도 정보를 제공한다.
5.3 Refinement
정제는 유용한 궤적이나 구간을 선택하고 신뢰하기 어려운 지도 정보를 수정한다. HELP와 ARS는 실패한 시도에서도 과제 수행에 도움이 되는 구간을 보존한다. Zero2Skill은 사람이 수정한 성공 기준을 이전에 수집한 시연에 적용한다.
- Reflective Test-Time Planning은 이후 실행 결과를 활용하여 앞선 행동 점수와 성찰 내용을 수정하고, 수정된 기록을 보존하여 후속 학습에 활용한다.
- 선별의 신뢰성은 과제 진행 상황을 추정하는 모델인 progress critic이나 사건 검증 절차에 달려 있다. 이들은 유용한 진행과 복구를 유휴 행동이나 유해한 행동과 구분하는 데 쓰인다.
6 Environment: What Worlds, Tasks, and Tests Should the Agent Build?
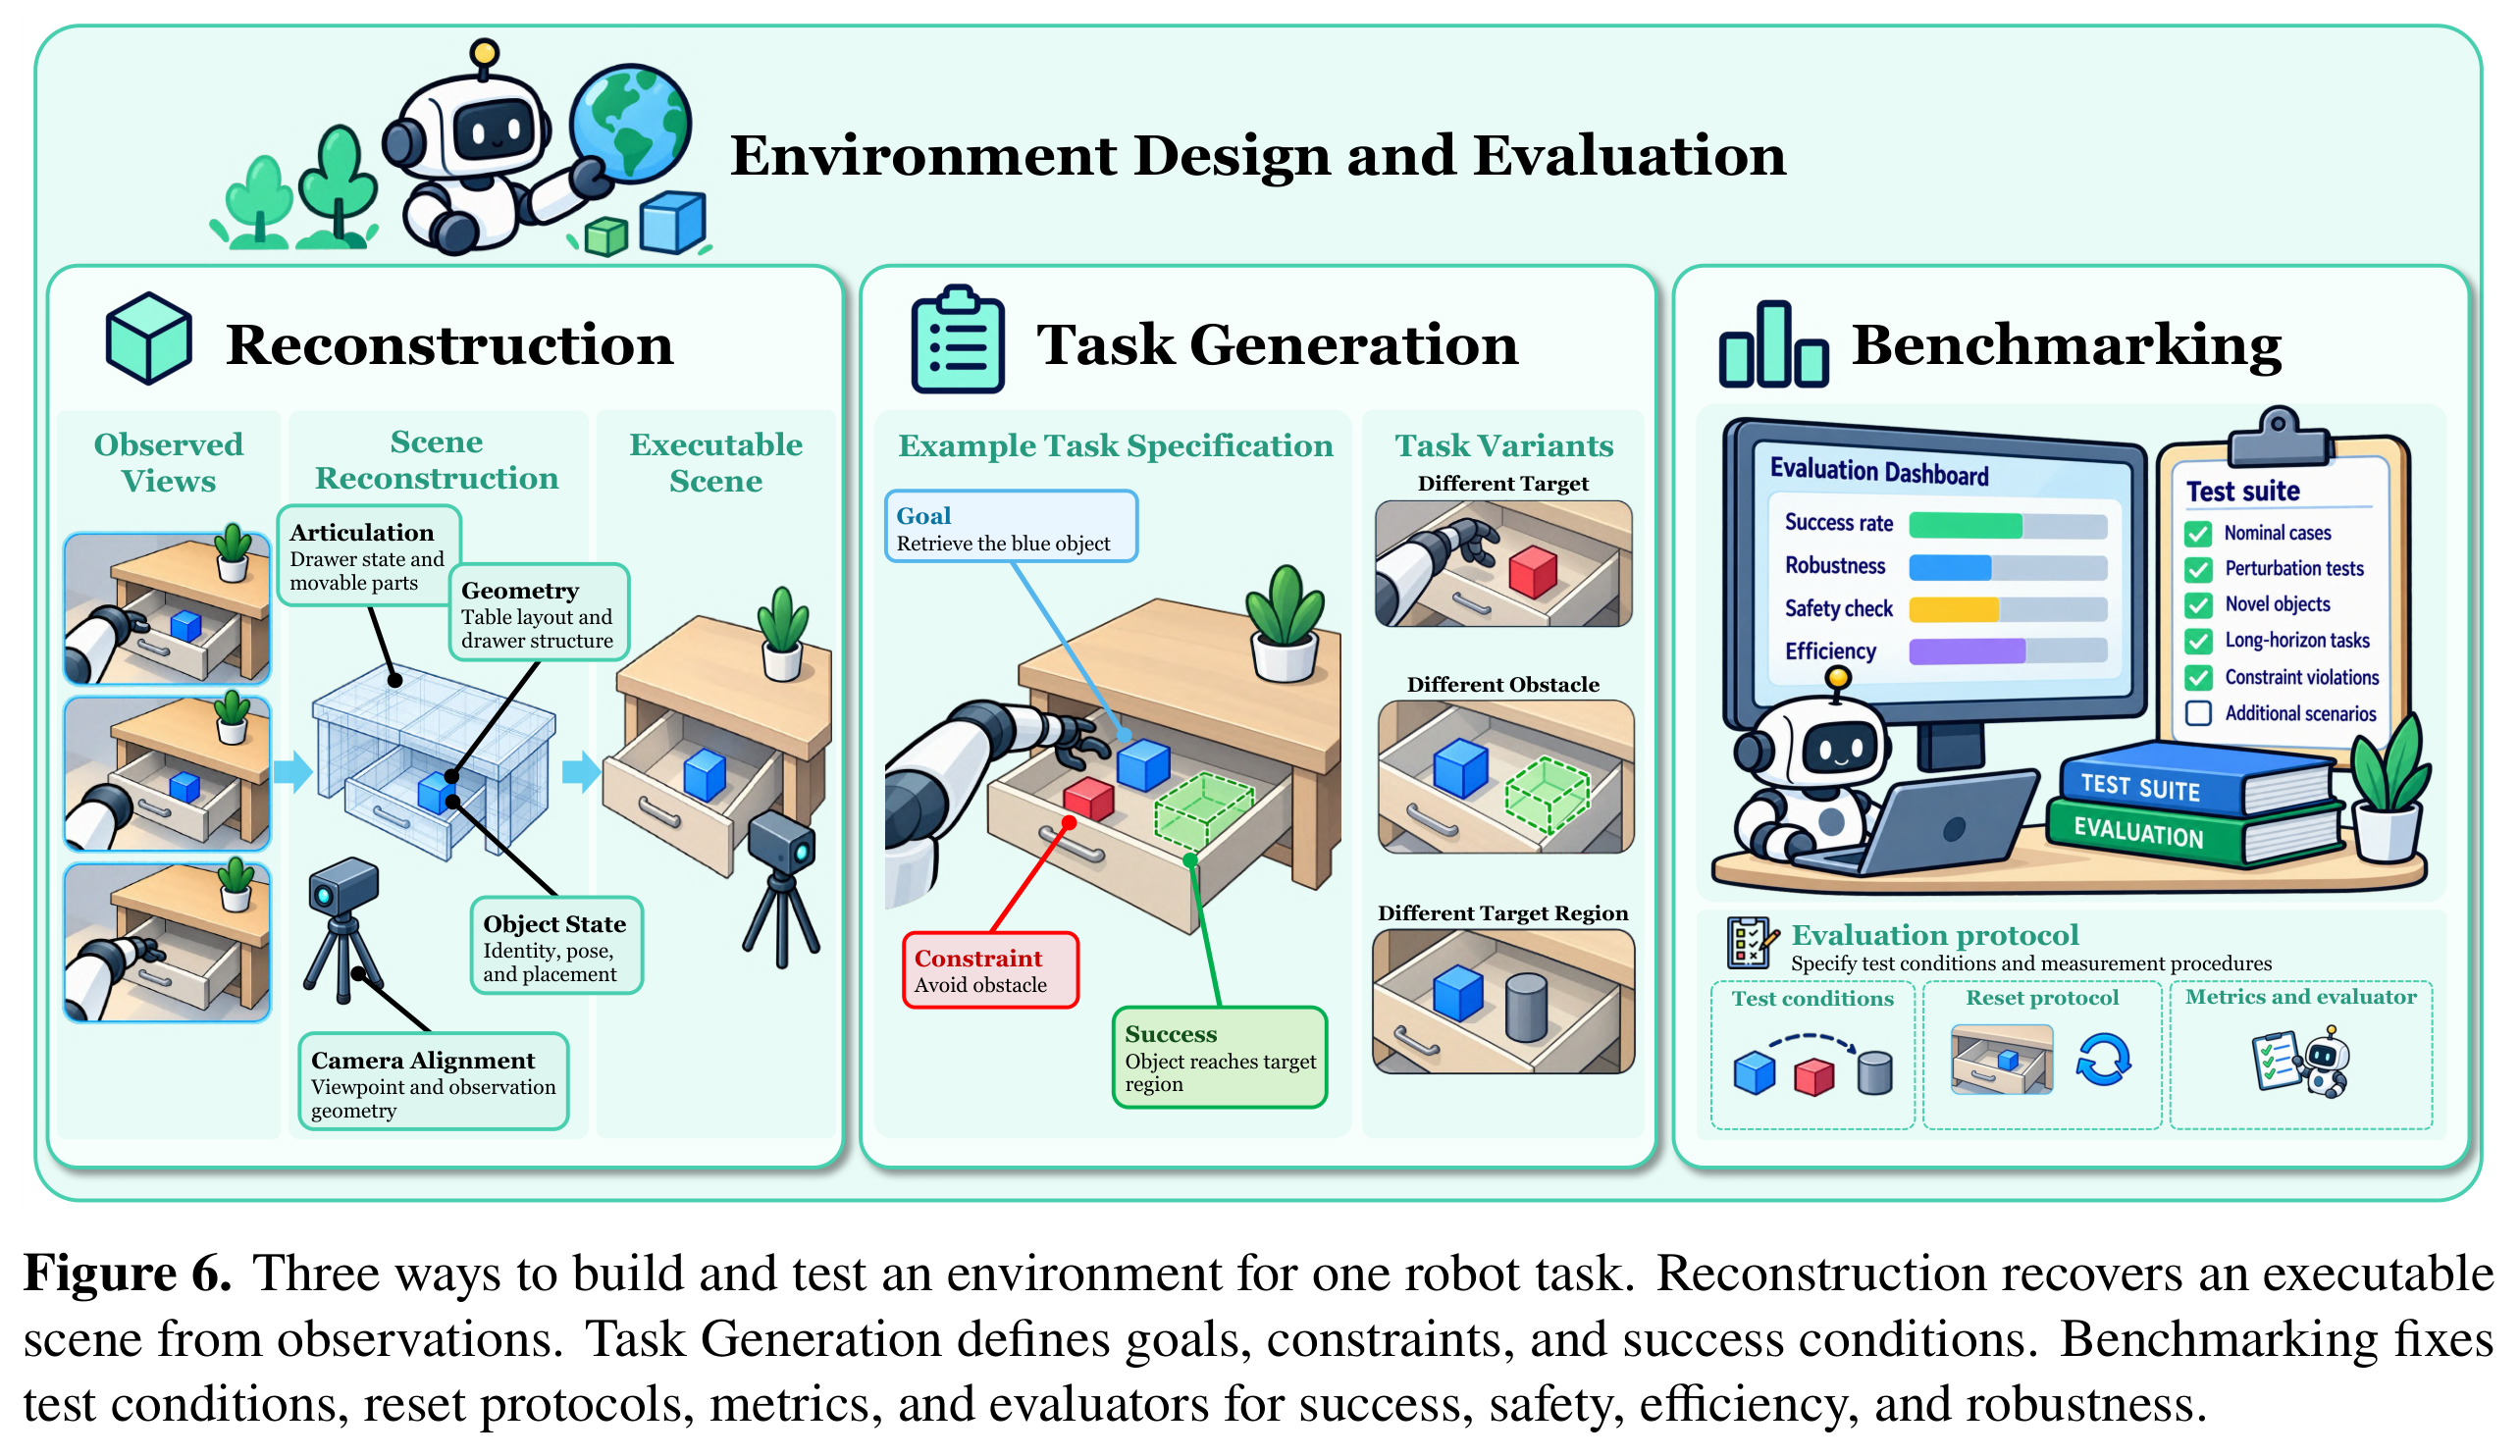
Environment 영역은 실행 가능한 세계, 과제 명세, 평가기를 구분한다. Figure 6은 불안정한 장면, 실현 불가능한 목표, 잘못된 성공 신호가 서로 다른 실패 원인이며 각각 다른 수정이 필요함을 보여준다.
각 패널은 실행을 지원하는 장면 구축, 로봇이 달성해야 할 내용의 정의, 성능 측정 방식의 확정을 구분한다. 따라서 테스트 실패에는 기하 구조 수정, 과제 수정, 평가기 교정 중 서로 다른 대응이 필요할 수 있다.
6.1 Reconstruction
재구성은 관측, 시연, 요청된 배치를 실행과 상호작용이 가능한 장면으로 변환한다. 검증은 시각적 유사성에 그치지 않고 정적인 지지 관계, 동적 반응, 연결된 관절을 통한 운동, 과제와 관련된 물리적 속성을 다뤄야 한다.
- Articulate-Anything은 렌더링 결과를 비교하여 링크와 관절 코드를 수정한다. DiagGen은 시뮬레이션 진단 결과를 분할, 재질, 메시 수정 과정으로 전달한다.
- 구조화된 장면 인터페이스는 가능한 편집을 제한한다. 생성 코드는 더 폭넓은 변경을 허용하지만 소프트웨어, 기하 구조, 물리 검사가 필요하다.
- 관측된 움직임을 재현했다고 해서 새로운 행동에 올바르게 반응한다는 보장은 없다. 시뮬레이션에서 안정적이고 실행 가능하다는 사실도 실제 환경에서의 타당성을 입증하지는 않는다.
6.2 Task Generation
과제 생성은 목표, 초기 상태, 제약, 성공 조건을 지정하며, 학습자가 변함에 따라 연습 과제의 분포를 조정할 수 있다. 논문은 새로운 과제를 생성하는 것과 변하지 않은 과제에 새로운 해결책을 생성하는 것을 구분한다.
- FATE는 정적인 의미 및 기하 검사와 동적 실행 검사를 구분하고, 실패한 구성 요소를 수정한다.
- CurricuLLM은 연습용 하위 과제의 시퀀스인 커리큘럼을 보상 또는 목표 분포 코드와 함께 생성한다. RATs는 장면 정보, 사용 가능한 스킬, 실패 메모리에서 연습 목표를 선택한다.
- 수정 과정에서 난이도나 의미가 바뀔 수 있다. 학습자 자신의 성공 신호로 최적화한 커리큘럼은 목표 역량을 개선하지 않은 채 더 쉬워질 수 있다. 따라서 독립적으로 명세한 과제에서 평가해야 한다.
6.3 Benchmarking
벤치마킹은 역량을 측정하는 데 쓰는 과제, 인터페이스, 초기화 절차, 채점 규칙을 정의한다. 같은 과제 모음도 관측 접근 권한, 제어기 지원, 피드백 시점, 상호작용 예산이 달라지면 서로 다른 역량을 시험할 수 있다.
- RoboDojo는 시뮬레이션 과제 42개와 실제 환경 과제 18개를 결합한다. RobotWorld는 조작, 이동 조작, 이동 운동, 주행, 비행 제어에 걸친 시뮬레이션 과제 84개를 다룬다.
- KinDER의 개루프 스킬 조합은 피드백 기반 재계획 없이 실행하므로 재계획 역량을 측정하지 않는다. ReactHuman은 추론 중 시뮬레이션을 멈추므로 실시간 반응이 아니라 위험 대응 의사결정을 측정한다.
- 에이전트가 생성한 평가에는 검증된 채점 방식과 적절한 실행 근거가 필요하다. 평가기 개선과 평가 대상 로봇의 개선은 별개의 결과다.
7 Harness: How Should Robot Capabilities Be Orchestrated, Recovered, and Evolved?
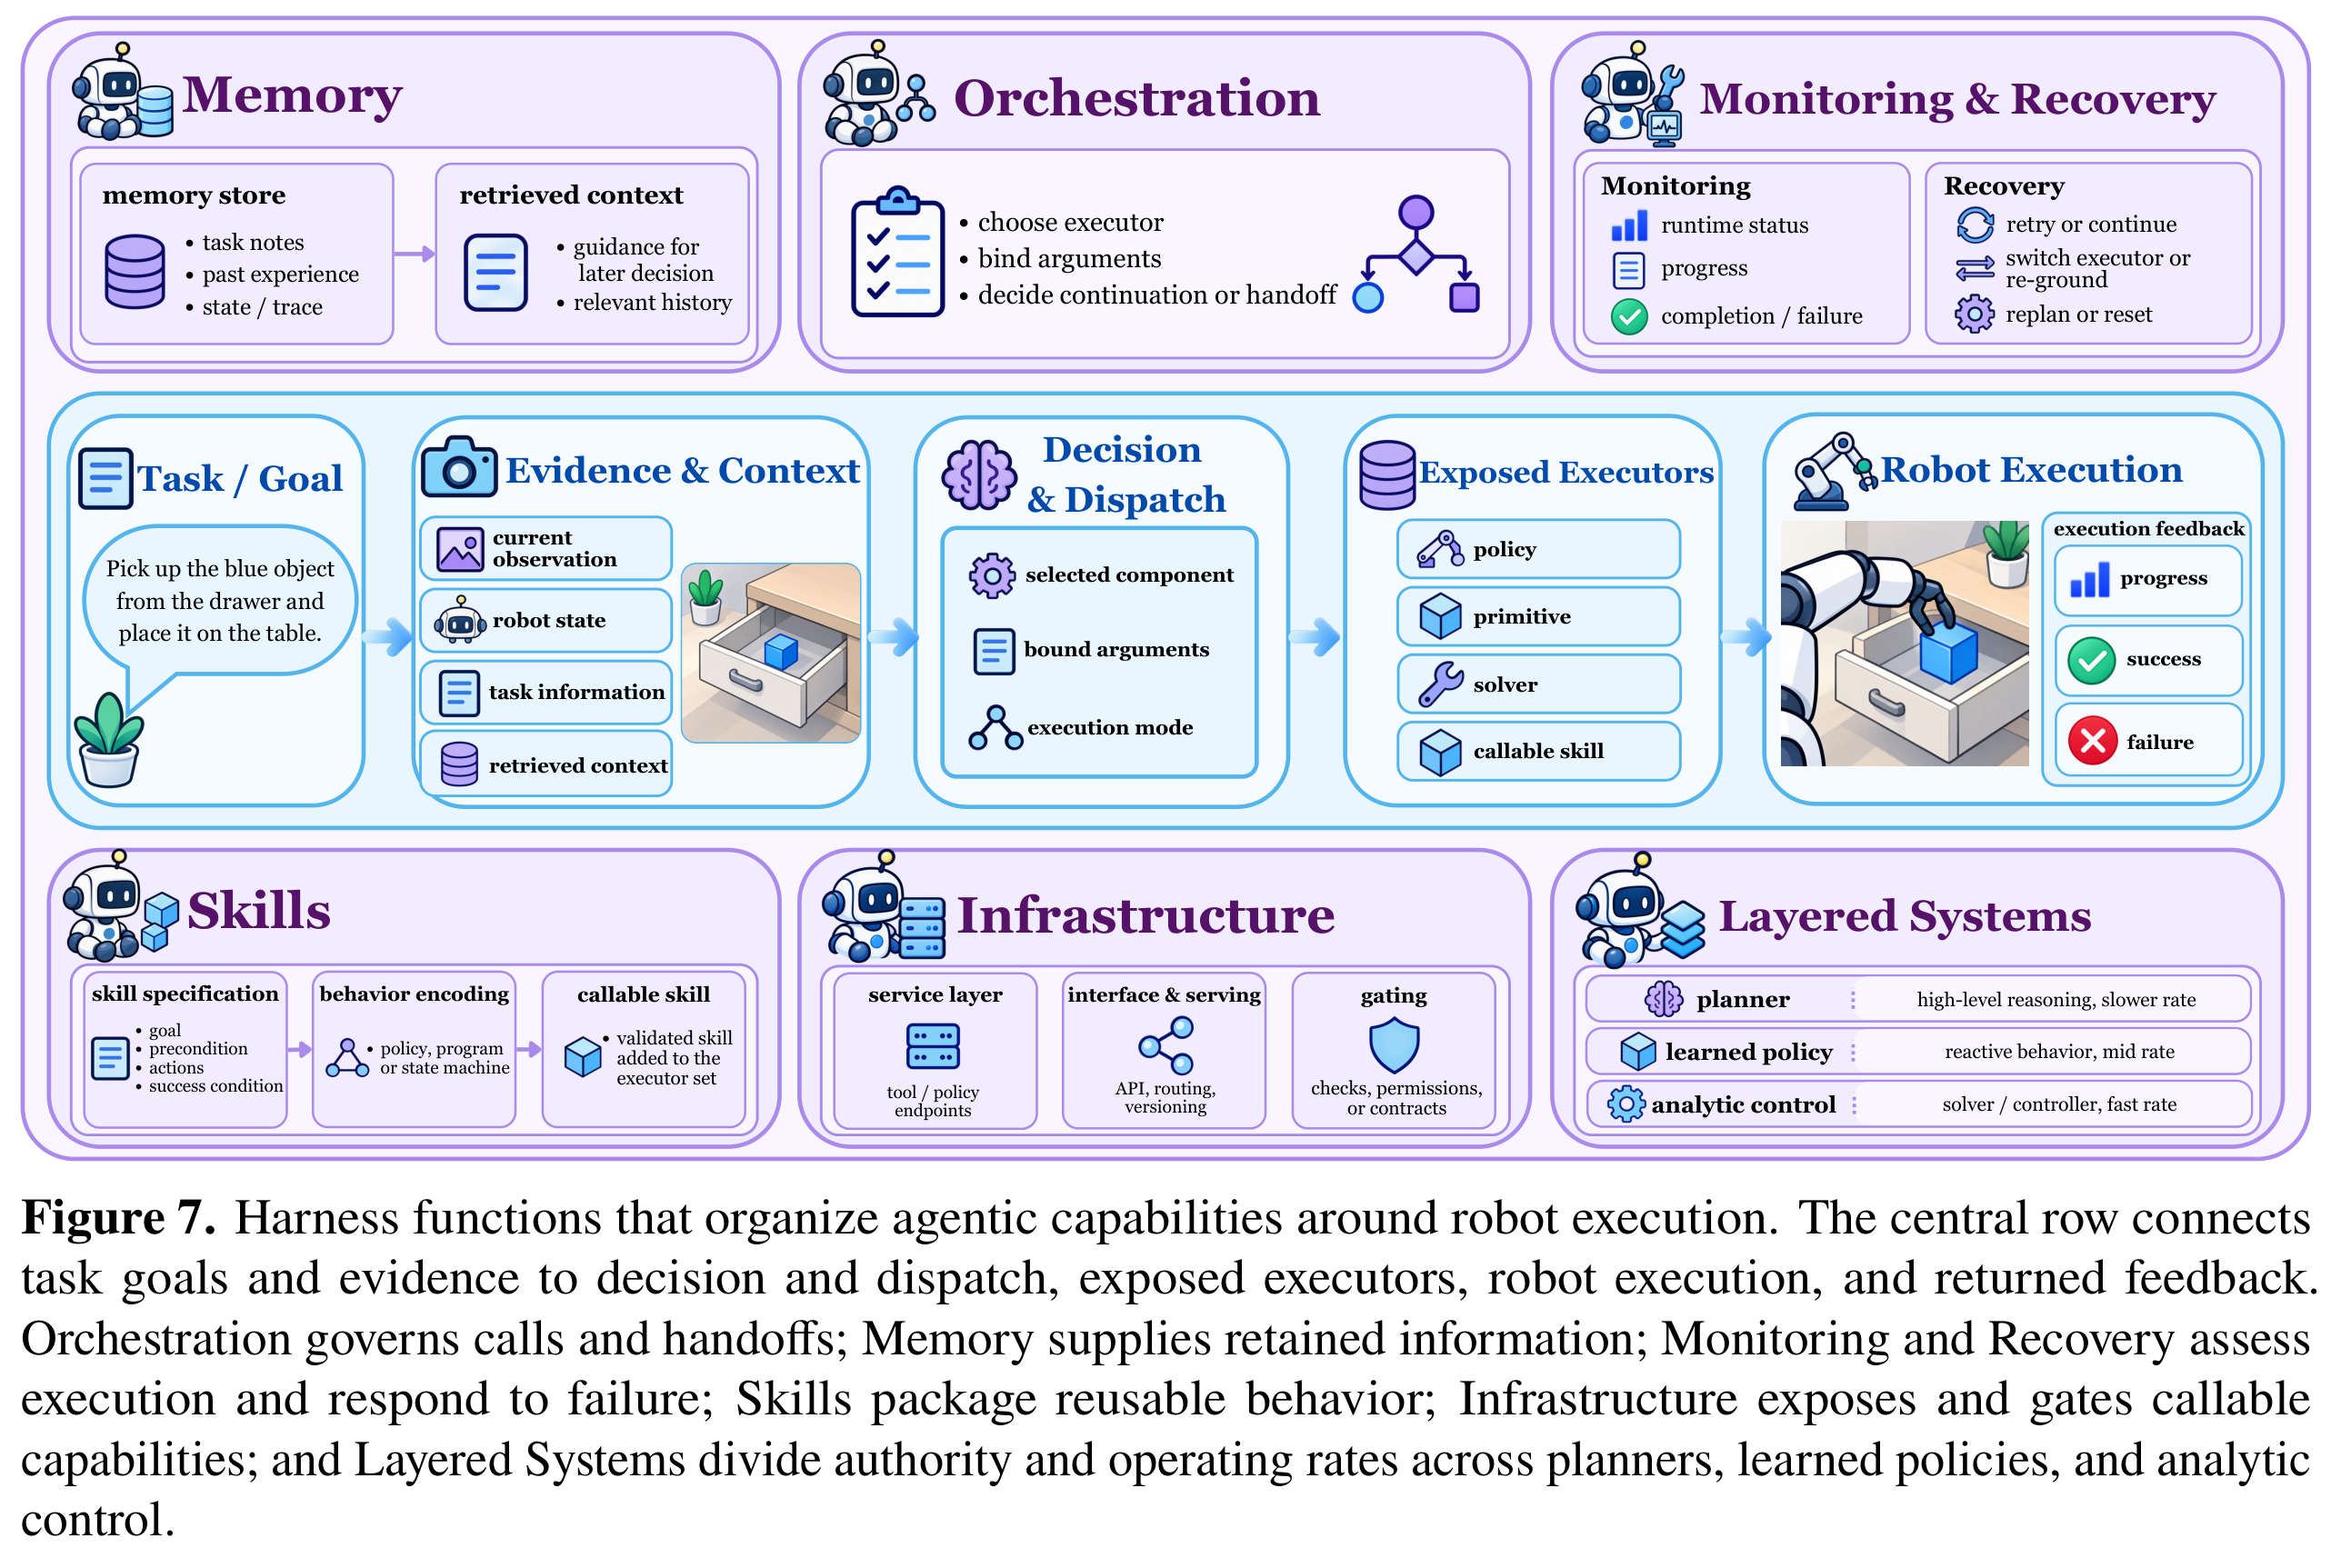
Harness 소프트웨어는 조율, 메모리, 모니터링과 복구, 스킬, 인프라, 계층형 시스템을 통해 실행을 중심으로 기능을 구성한다. Figure 7은 과제 목표와 근거를 실행 가능한 구성 요소에 작업을 할당하는 dispatch, 물리적 실행, 반환된 피드백과 연결한다.
중앙 실행 경로 주위에는 맥락 제공, 실행기 선택, 결과 점검, 행동 보존, 인터페이스 준수를 담당하는 기능이 배치된다. 이 그림은 정책 자체와 함께 dispatch, 근거, 피드백 처리가 실행에 관여하는 지점을 보여준다.
7.1 Orchestration
조율은 어떤 구성 요소를 실행할지, 무엇을 입력받고 반환할지, 시작 조건이 충족되는지, 언제 의사결정 과정으로 제어권을 돌려줄지 결정한다. 신뢰할 수 있는 선택에는 기능에 대한 지식과 연속된 실행 상태 사이의 호환성이 모두 필요하다.
- VoLo는 실패 중인 VLA를 중단하고 사람이 설계한 스킬로 전환할 수 있다. RoboHarness는 다음 정책이 기대하는 시작 상태를 향해 로봇을 이동시킨다.
- 함수 프로토콜은 유효한 인자, 반환할 근거, 성공 조건을 정의한다. 상세한 실행 결과도 실행기 자신의 보고이므로 독립적인 점검이 유용하다.
- 구성 요소 사이의 제어권 인계는 진행 이벤트, 실행 예산, 주기적 일정에 따라 이뤄질 수 있다. 너무 늦게 반환하면 실패가 길어지고, 너무 일찍 반환하면 성공할 수 있는 행동을 중단할 수 있다.
7.2 Memory
메모리는 모델 가중치를 바꾸지 않고 이전 관측, 시도, 과제 진행 상황을 보존하여 이후 의사결정에 활용한다. 메모리의 기능은 유용한 기록을 쓰고, 장면 변화에 맞춰 갱신하며, 다음 결정에 필요한 부분을 검색하는 것이다.
- Mimir는 과제 메모리와 세계 메모리를 분리한다. RoboStream은 계획 단계마다 근거를 갱신하며, OVAL은 기억한 후보에 의존하기 전에 이를 검증한다.
- BATON은 다음 스킬의 전이 조건을 검색하고 실시간 손목 카메라 영상과 대조한다. 2AM은 자체 메모리가 없는 행동 모델에 압축된 과제 상태 요약을 제공한다.
- 이전 결과를 재사용하면 계산량을 줄일 수 있지만 유효성을 살펴야 한다. MeCo는 전이한 해결책을 검증한다. APEX는 현재 장면보다 시점이 뒤처질 수 있는 공간적 근거를 활용하여 탐색을 이어간다.
7.3 Monitoring and Recovery
모니터링은 실행 전, 실행 중, 실행 후에 진행 상황, 완료, 실패, 제약을 점검한다. 복구는 문제를 감지한 뒤 행동을 바꾼다. 이 서베이는 문제 감지, 대응 선택과 검증, 복구 실행을 구분한다.
- 실행 전 점검은 후보의 순위를 매기거나 후보를 기각한다. 동작 중 점검은 실행을 멈추거나 조정할 수 있다. 실행 후 점검은 전체 기록으로 실패를 설명할 수 있다.
- 복구는 정책 입력 수정, 실행기 전환, 다른 과제 분기 선택, 동작 파라미터 조정으로 이뤄질 수 있다. 시스템이 고칠 수 있는 문제의 범위는 사용 가능한 복구 행동에 의해 제한된다.
- 교란된 장면에서 계속 실행하는 것은 초기화 후 재시도하는 것과 다르며, LIBERO-RECOVER는 이 조건들을 따로 평가한다. 재시도 예산과 상위 대응 요청 규칙도 실행 프로토콜의 일부다.
7.4 Skills
스킬은 harness가 지침으로 불러오거나 실행 가능한 행동으로 호출할 수 있는 재사용 가능한 절차적 지식 묶음이다. 이 절은 고정 스킬 선택, 제어 프로그램 생성, 지속적으로 유지되는 라이브러리, 검증된 수정, 실행기나 코드 생성 모델의 학습을 살펴본다.
- Code as Policies는 지각과 제어 인터페이스를 조합하여 프로그램을 만든다. Teach and Grow는 스킬 개발에 사용하지 않은 held-out 상태에서 정해진 범위의 테스트를 통과한 행동만 재사용 대상으로 받아들인다.
- ASPIRE는 검증된 수정 사항을 정식으로 채택하며, RATs는 반복적으로 실패하는 스킬을 퇴출할 수 있다. RoboRSI는 리뷰, 기능 테스트, 회귀가 없는 재생 검증으로 수정 사항을 점검한다.
- 개선이 반드시 누적되는 것은 아니다. Explore, Execute, Evolve는 연속된 갱신에서 성능이 일관되게 높아지지 않는다고 보고하며, 인용된 123라운드 연구에서는 승인된 변경들이 목표 과제의 성공으로 이어지지 않았다.
7.5 Infrastructure
인프라는 인터페이스, 지각 및 조작 도구 체계, 정책 서빙 시스템, 하드웨어 실행 전 명령을 검사하는 런타임 게이트를 통해 로봇 기능을 제공한다. 이 서베이는 특정 평가 조건에서 이러한 선택이 측정 성능에 미치는 영향을 보여주는 비교 결과를 인용한다.
- NavMCP의 전체 3채널 프로토콜을 에피소드형 인터페이스로 대체하면 질의응답 정확도가 74.0%에서 59.1%로 낮아진다. Show-Harness의 행동 스텝 크기를 절반으로 줄이면 과제별 학습 없이 얻는 zero-shot 성공률이 60%에서 82%로 높아진다.
- 인용된 연구는 시뮬레이터의 전체 관측을 사용했을 때 성공률 65.0%, 특권 시뮬레이터 상태 없이 컬러 이미지인 RGB만 사용했을 때 22.5%를 보고한다. ASPIRE의 실행 엔진을 추가하면 평가한 LIBERO-Pro 교란 조건에서 교란별 성공률의 평균인 macro-average 성공률이 14%에서 62%로 높아진다.
- SmolVLA는 추론과 대기 중인 행동을 겹쳐 수행하는 비동기 실행으로 성공률이 소폭 낮아지는 대신 과제 시간을 약 30% 줄인다. RoboGuard는 보고된 평가에서 금지된 로봇 행동을 유도하는 공격의 성공률인 jailbreak 성공률을 92.3%에서 2.3%로 낮춘다.
7.6 Layered Systems
계층형 시스템은 System 2 플래너, System 1 학습 기반 시각운동 정책, System 0 해석적 제어기 사이에 권한과 작동 주기를 나눈다. 이는 각각 고수준 추론, 시각 관측을 바탕으로 학습된 행동 생성, 명시적 제어를 가리키는 서베이의 기능별 명칭이다.
- Helix는 7–9 Hz vision-language model에서 200 Hz 정책으로 내부 학습 표현인 잠재 벡터를 전달한다. GR00T N1은 10 Hz 추론 모듈과 120 Hz action chunk를 사용하며, action chunk는 함께 생성되는 행동 시퀀스다. Ground Slow, Move Fast는 2 Hz 플래너, 30 Hz 정책, 예측 결과를 활용해 동작을 반복 최적화하는 모델 예측 제어를 결합한다.
- 고정된 VLA를 미리 정의한 제어 연산인 analytic primitive와 함께 도구로 호출하면 구성 요소를 교체하고 호출을 점검할 수 있다. 다만 제어권을 인계할 때마다 호환되는 상태와 의도를 복원해야 한다.
- 주어진 선택지 중에서 고르는 인터페이스인 decision application programming interface(API)는 더 빠른 중간 계층을 지원할 수 있다. 선택지 확률은 로봇 의사결정에 맞게 보정해야 하며, 물리적 성공 확률을 직접 나타내지는 않는다.
8 Outlook: What Comes Next for Agentic Robots?
전망 절은 미해결 질문 4개를 제시한다. 에이전트의 기여를 분리해 측정하는 방법, 결정을 실제 로봇에서 안정적으로 실행하는 방법, 자원 제약 안에서 작동하는 방법, 익숙하지 않은 플랫폼에 적응하는 방법이다. 유능한 모델과 도구를 결합하는 것만으로 이 측면들이 개선되었다고 볼 수는 없다.
8.1 Fair Benchmarking
공정한 벤치마킹을 위해서는 실행기, 관측 접근 권한, 상호작용 예산을 맞춰 비교하고 메모리나 재계획을 비활성화하는 구성 요소 제거 실험을 함께 수행해야 한다. 전체 시스템 평가에서는 계산량, 실행 시간, 관측, 재시도, 사람의 지원도 보고해야 한다.
- 불완전한 정보, 예상하지 못한 장면 변화, 스킬 간 조율이 필요한 과제는 고정 정책 1개로는 드러나지 않을 수 있는 에이전트의 기여를 보여줄 수 있다.
- 데이터, 모델, 스킬을 수정하는 시스템은 최적화에 사용한 피드백을 넘어 학습에 사용하지 않은 과제에서 평가해야 한다.
8.2 Real-robot Agentic Robotics
실제 로봇에 배치하려면 스킬을 적용할 수 있는 상황, 필요한 조건, 완료 확인 방법을 설명하는 인터페이스가 필요하다. 유효한 명령도 지각 잡음, 보정 오류, 예상하지 못한 접촉, 장면 변화로 실패할 수 있다.
- 정지 요청만으로 동작이 멈췄다고 볼 수는 없다. 재계획에는 현재 상태와 이미 수행한 행동의 효과를 확인하는 피드백이 필요하다.
- 실제 로봇 평가는 에이전트에 제공한 정보, 저수준 제어기에 위임한 책임, 가정이 성립하지 않을 때의 복구 행동을 공개해야 한다.
8.3 Efficient Robot Use
효율적인 로봇 사용은 모델 추론 속도뿐 아니라 추론을 언제 호출하는지에도 달려 있다. HarnessWAM과 VLAs-as-Tools는 가벼운 진행 피드백으로 필요할 때 고수준 결정을 요청하는 방식을 보여준다.
- 평가는 추론 시간, 도구 호출, 통신, 물리적 완료 시간을 포함해야 한다. 호출을 줄여도 실패, 재시도, 이동 시간이 늘어나면 전체 효율은 나빠질 수 있다.
- 적절한 호출 시점은 진행 상황, 불확실성, 개입 지연의 결과에 따라 달라진다. 클라우드 계산과 로컬 계산은 지연 시간과 자원 측면에서 서로 다른 절충을 수반한다.
8.4 Cross-Embodiment Generalization
몸체, 센서, 제어 인터페이스가 다른 로봇 사이에 역량을 전이하는 Cross-Embodiment Generalization은 아직 해결되지 않았다. 바퀴형 로봇, 휴머노이드, 드론은 비슷한 목표에도 서로 다른 계획이 필요할 수 있으므로 같은 명령을 다른 인터페이스로 변환하는 것만으로는 충분하지 않다.
- 논문은 계획에 앞서 익숙하지 않은 로봇의 역량을 파악하고, 로봇별 동작 세부 사항이 그대로 전이된다고 가정하지 않으면서 일반적인 전략을 보존할 것을 제안한다.
- 제안된 평가는 이전에 접하지 않은 로봇에서의 성공률, 필요한 추가 설정이나 학습의 양, 다른 플랫폼의 경험이 성능을 개선하는지를 측정한다.
9 Conclusion
결론은 에이전트가 사용할 수 있는 관측, 실행 가능한 기능, 피드백을 통해 범주 17개를 연결한다. 데이터, 모델, 스킬, 소프트웨어 변경을 새로운 과제에서 시험하면서 기존에 습득한 역량이 보존되는지 확인하고, 시간과 자원 비용도 고려해야 한다고 강조한다.
부록
- 제공된 PDF에는 부록이 없으며, References는 49–79페이지에 해당한다. 저자들은 관련 문헌 저장소를 https://github.com/chonghanqin/Awesome-Agentic-Robots 에서 제공한다.
짧은 생각
이 분류 체계는 에이전트의 결정과 그 결정이 효과를 내게 하는 실행 조건을 구분하는 데 유용하다. 특권 관측과 지각으로 얻은 관측 사이의 차이, 인터페이스나 실행 엔진에 따른 차이를 보여주는 인용 결과는 로봇 시스템 전체를 평가해야 한다는 주장을 뒷받침한다. 중첩 가능한 범주는 개입 지점과 실패 원인을 찾는 데 도움이 되지만, 이 서베이는 검토한 방법들을 통제된 조건에서 인과적으로 비교하지는 않는다. 스킬 개선이 누적되지 못한 사례에 대한 논의는 근거의 한계를 보여준다. 검증된 국소 수정과 추가 반복만으로 목표 과제에서 지속적인 성능 향상이 입증되는 것은 아니다.