


3DCodeVerse: Exploring 3D Worlds as Code 요약 설명
15 Oct 2026 | Paper Review Code Generation 3D Scene Generation Harness Optimization Supervised Fine-Tuning목차
이번 글에서는 3DCodeVerse: Exploring 3D Worlds as Code 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 10월 15일(Arxiv)
- Gao, Yipeng, Zeng, Ziyao, Huang, Jinfa, Li, Yijiang, Xiong, Haolin, Qin, Wang, Yu, Xinlei, Yao, Youheng, Zhang, Jie, Lin, Kun-Yu, et al.
- University of Southern California, Yale University, University of Rochester, University of California, San Diego, Columbia University, Nanyang Technological University, University of California, Santa Cruz, Google DeepMind, Philo Labs
- 논문 링크
- Github
- Project Page
요약
- 실행 가능한 프로그램으로 편집 가능한 3D 콘텐츠를 생성하는 분야에는 코딩 환경 전반에서 공유할 학습 데이터와 검증 인프라가 부족하다. 코딩 에이전트의 출력을 실행하고 검사하는 워크플로인 3DCodeVerse Harness는 Claude Design과의 3D 객체 비교에서 인간 선호도 90%를 얻었다. 이 비교에서는 시스템 2개 모두 Claude Opus 5.5를 사용했다.
- 이 연구는 3DCodeVerse-2M에 자동 계획, 코드 조립, 기하 검사, 시각 평가를 결합한다. 데이터셋에는 여러 표현 형식으로 내보낸 2,028,286개 행이 있으며, 배포용 카탈로그에는 고유한 실행 가능 프로그램 269,597개가 있다. 따라서 이름에 내세운 규모는 고유 프로그램 수가 아니라 내보낸 예제 수를 뜻한다.
- 코드로 수행하는 절차적 3D 모델링을 평가하는 벤치마크인 3DCodeBench에서 미세 조정은 Qwen3.5-9B의 실행률을 0.0%에서 84.9%로, Qwen3.8-27B의 실행률을 51.9%에서 92.9%로 높였다. 이 결과는 디코딩 온도 T=0.7과 시드 1개를 사용한 평가에서 나왔다. Harness는 주요 비교에서 인간 선호도와 명시된 품질 기준에 따른 점수도 높였다. 다만 단일 패스 베이스라인보다 생성 연산량이 훨씬 많으며, 일부 부록 비교에서는 개선 폭이 작거나 성능이 하락했다.
1 Introduction
논문은 3D 프로그램을 편집 가능한 제작 명세로 다룬다. 이 명세는 기하 구조, 연결된 가동 부품의 관절 운동, 장면 구성, 그래픽 효과를 표현할 수 있다. 기존 자료는 특정 환경에서 학습 신호나 피드백을 제공하지만, 이러한 작업 전반에서 공유할 수 있는 인프라는 제한적이다.
- 3DCodeVerse는 코퍼스 구축, 프로그램 생성, 검증, 수정, 모델 학습을 연결한다. 성공한 프로그램, 실패한 시도, 수정 내역, 선호도 비교를 학습 기록으로 활용할 수 있다.
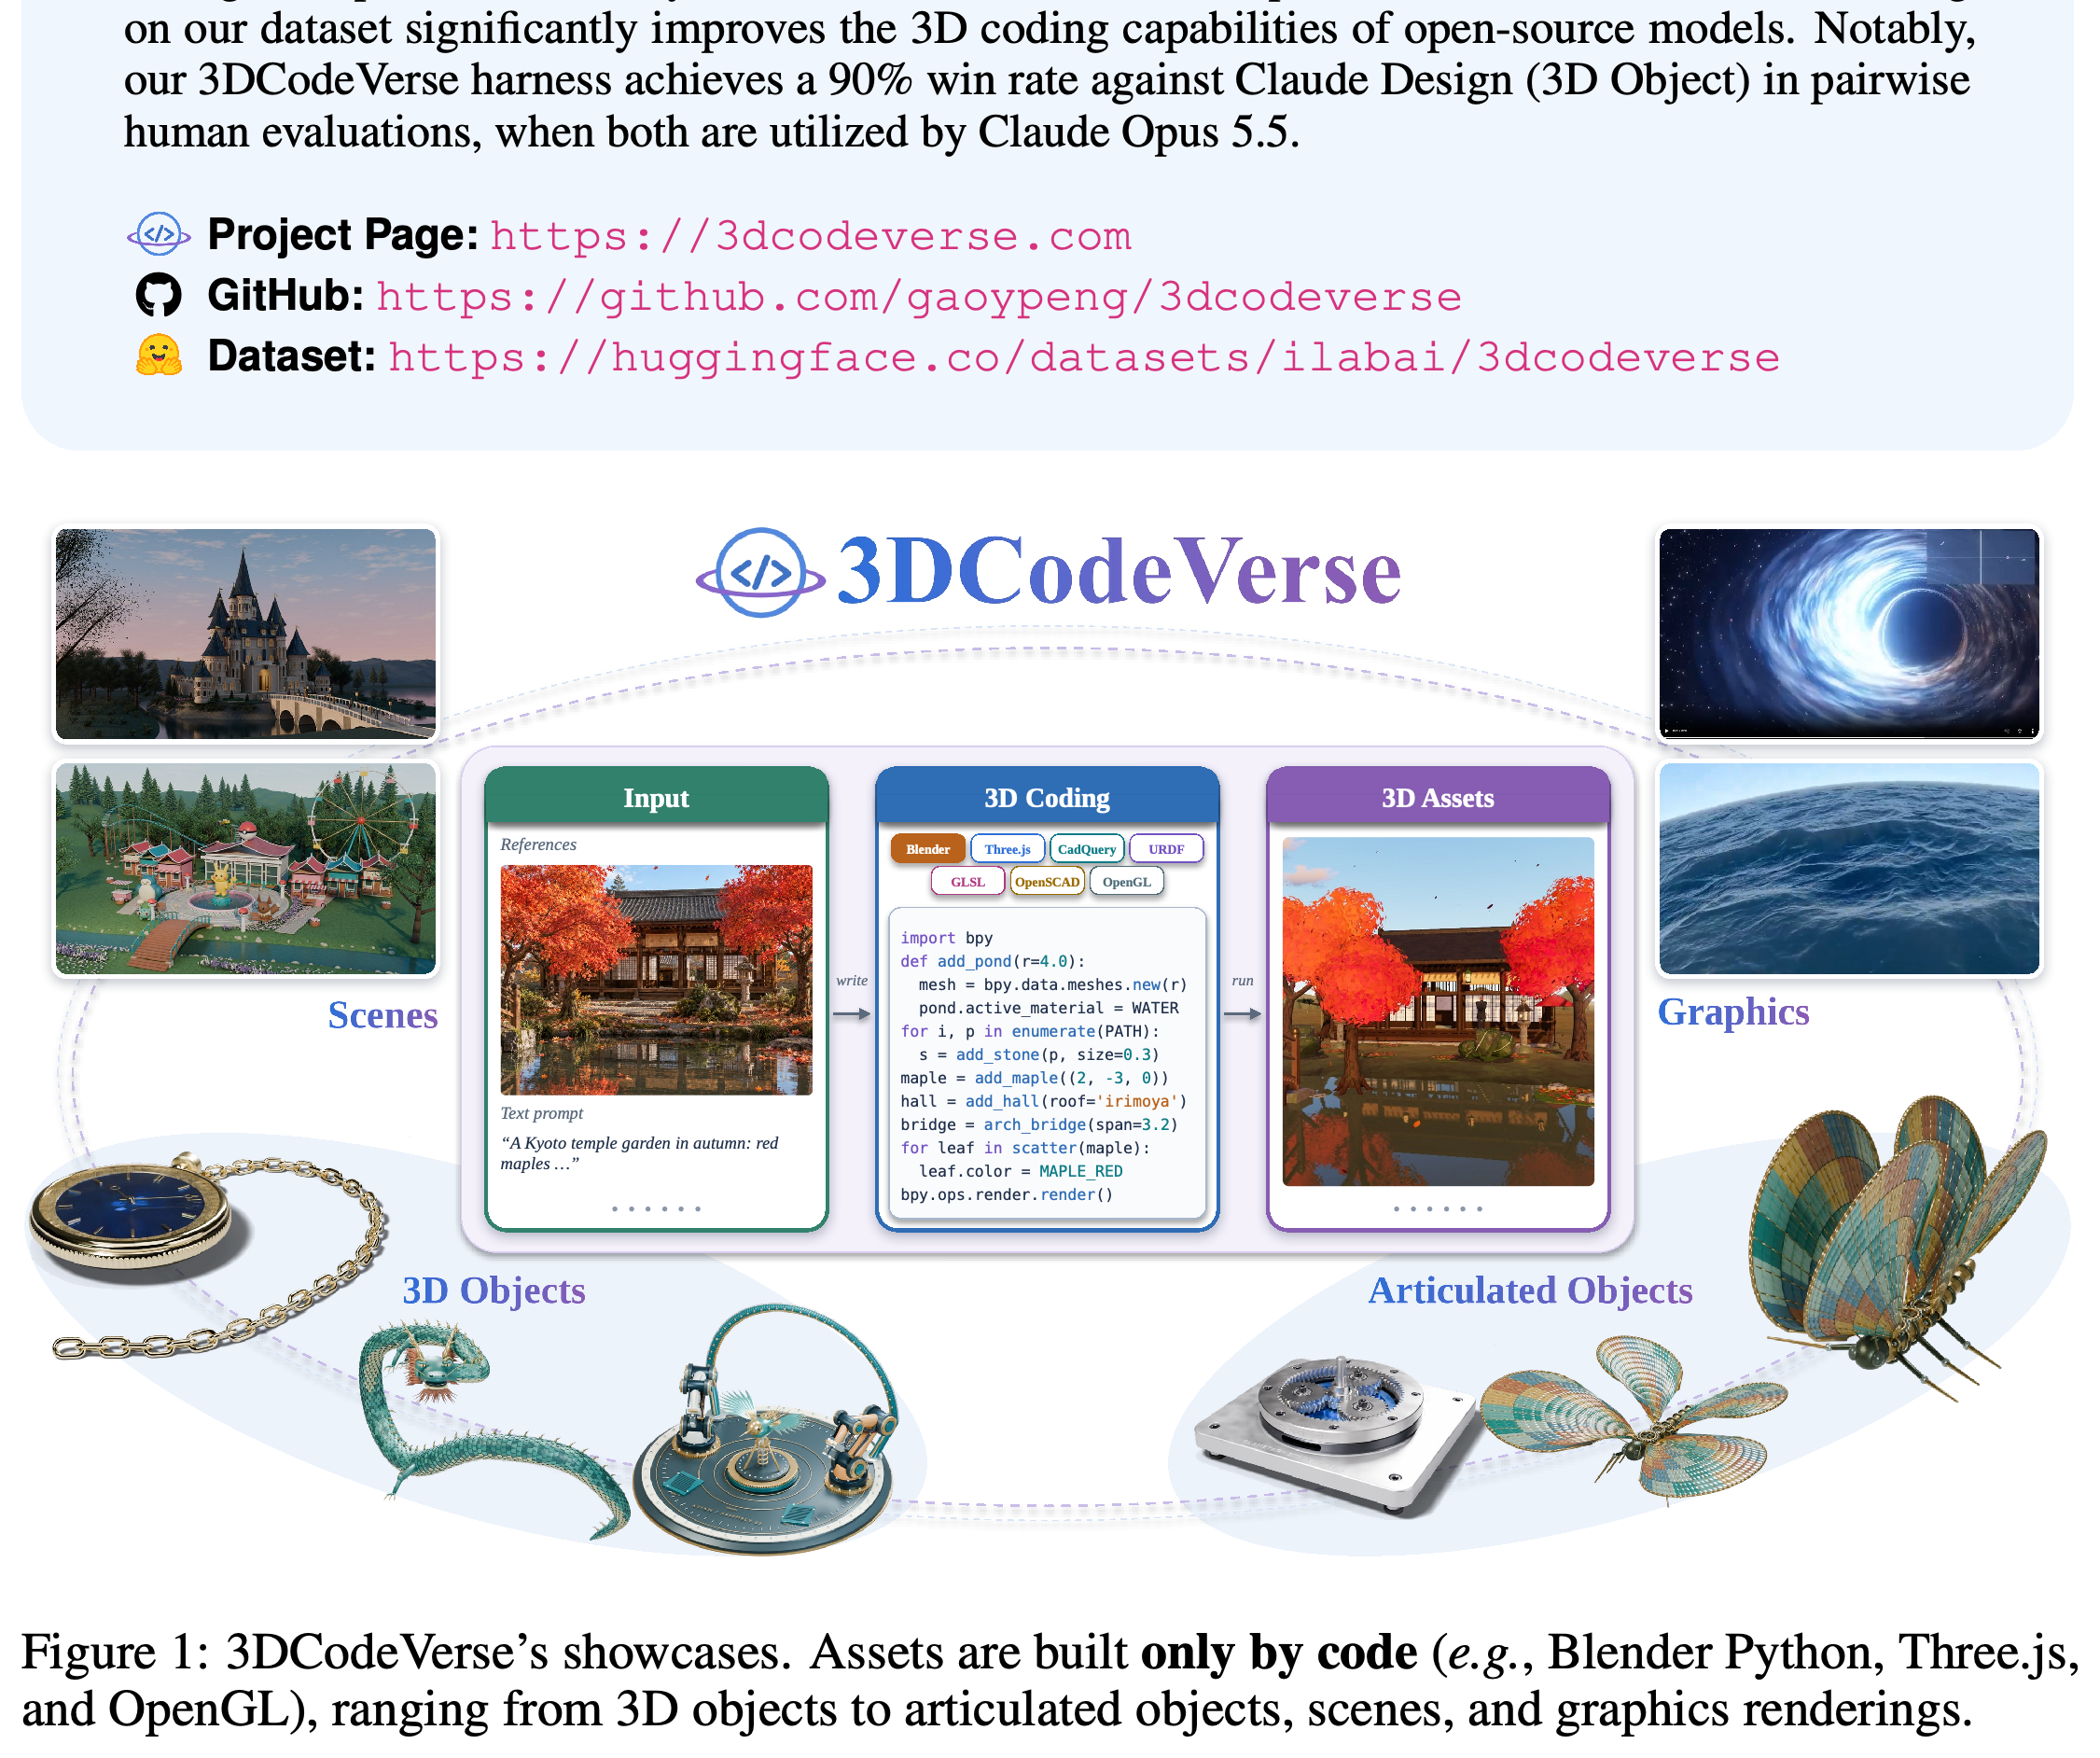
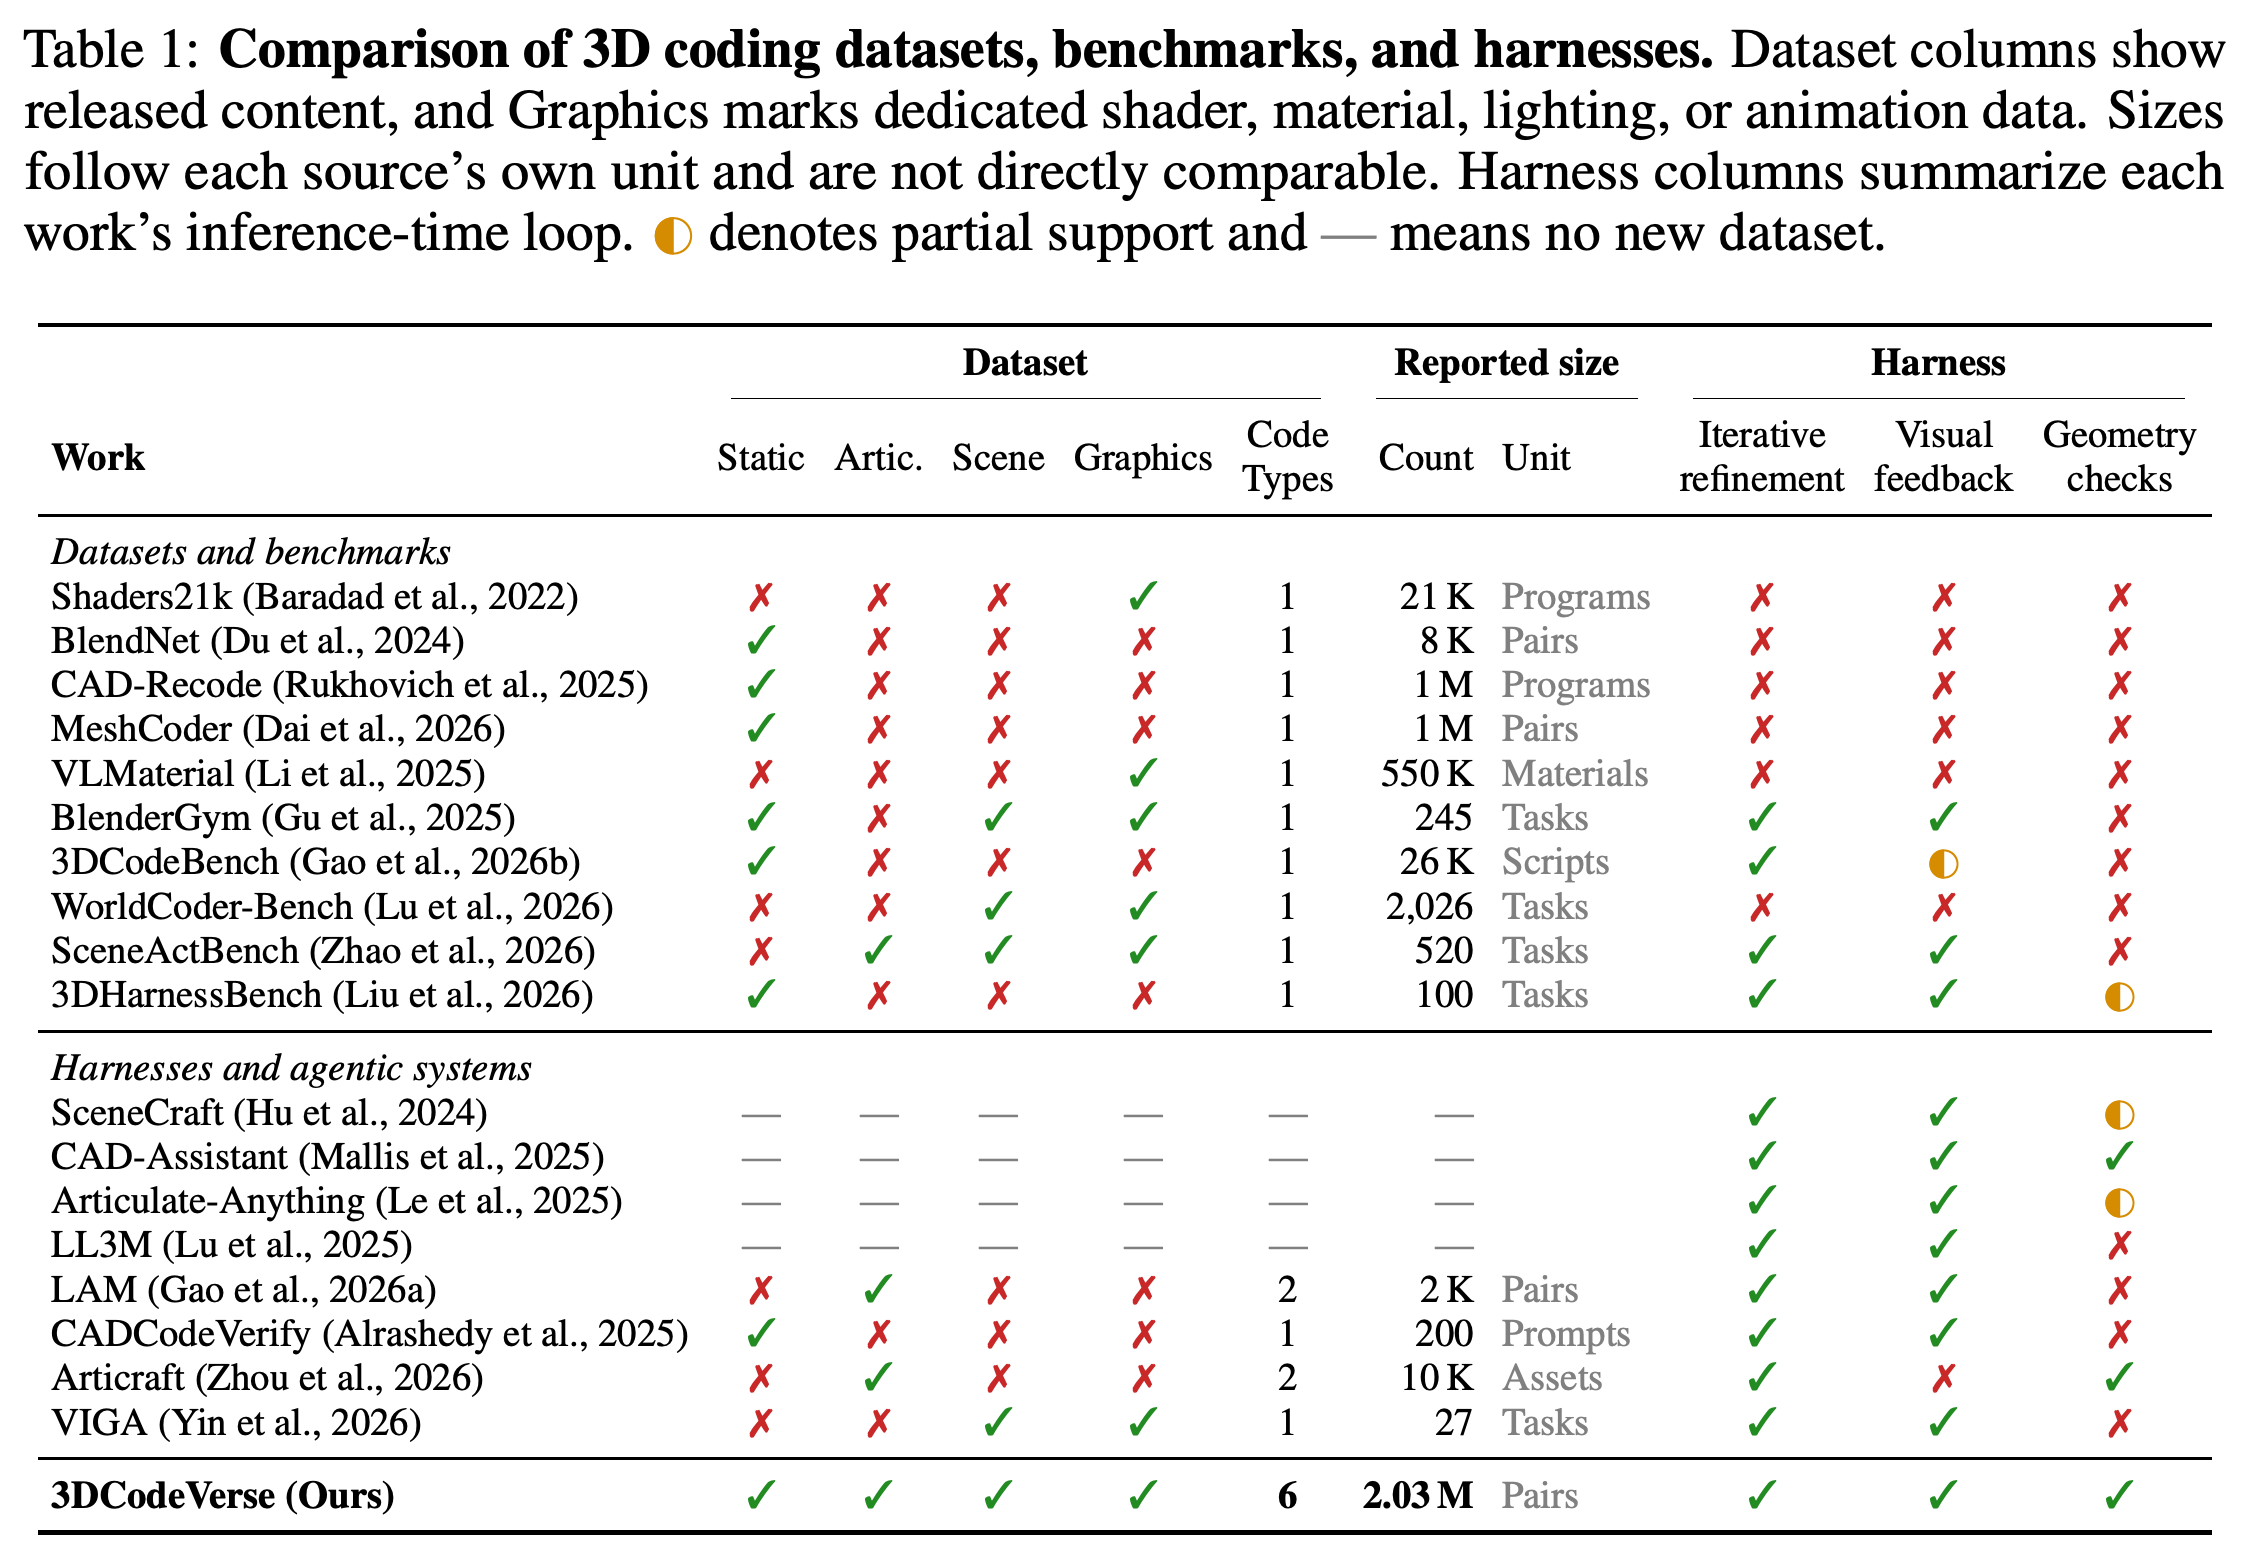
- Figure 1은 전적으로 코드로 제작한 정적 객체, 관절 객체, 장면, 그래픽을 보여준다. Table 1은 이러한 지원 범위를 기존 데이터셋 및 Harness와 비교한다. 표에 보고된 규모는 집계 단위가 달라 직접 비교할 수 없다.
예제는 객체, 가동 조립체, 장면, 그래픽을 포괄하는 목표 범위를 보여준다. 공통 표현은 실행 가능한 코드이며, 이를 통해 편집과 검사가 가능하다. 이 예제 모음은 생성 신뢰성을 정량화하지 않는다.
이 비교는 3DCodeVerse가 폭넓은 콘텐츠 범위, 여러 코드 형식, 반복 개선, 시각 피드백, 기하 검사를 결합한다는 점을 보여준다. 행마다 집계 단위가 다르므로, 이 표는 지원 범위를 비교하는 근거이며 데이터셋 크기를 정규화한 순위는 제공하지 않는다.
2 Related Work
관련 연구에서는 제작 절차에 대한 학습 신호와 프로그램을 실행, 검사, 수정하는 생성 워크플로를 구분한다. DeepCAD와 Fusion 360 Gallery는 컴퓨터 지원 설계(CAD)의 제작 순서를 제공한다. 다른 자료는 실행 가능한 스크립트, 절차적으로 생성한 장면, 그래픽 프로그램을 제공한다.
- SceneCraft, BlenderAlchemy, CADCodeVerify, VIGA는 계획이나 시각적 개선을 활용한 선행 사례다. Articraft는 관절 에셋에 구조화된 검증을 추가한다.
- 이 연구는 코딩 환경 전반에서 재사용할 수 있는 실행 및 검증 기능을 학습 데이터 자동 선별과 통합한다. 프로그램 생성, 렌더링 피드백, 구조 검증에는 각각 선행 사례가 있다.
3 3Dcodeverse-2m: A Large-SCALE 3D Coding DATASET
작업은 텍스트 요청과 선택적 참조 이미지로 구성된 조건 c, 그리고 명시된 실행 환경 e를 지정한다. 독립 실행형 프로그램을 실행하면 산출물과 실행 피드백이 나온다. 성공하려면 프로그램을 실행할 수 있어야 하며, 생성한 3D 콘텐츠도 요구를 충족해야 한다.
- Equation (1)의 (a, ℓ) = E_e(f), x = I[a ≠ ⊥]는 산출물 생성과 실패를 구분한다. f는 프로그램, a는 산출물, ℓ은 실행 피드백, ⊥는 실패, I는 산출물 생성 성공 여부를 나타내는 지시 함수다.
- 프로그램을 생성하는 대규모 언어 모델(LLM)은 코드를 직접 출력할 수 있다. 코딩 에이전트는 Equation (2)에 정식화된 것처럼 이전 프로그램, 런타임 피드백, 렌더링 관측을 활용해 코드를 수정한다.
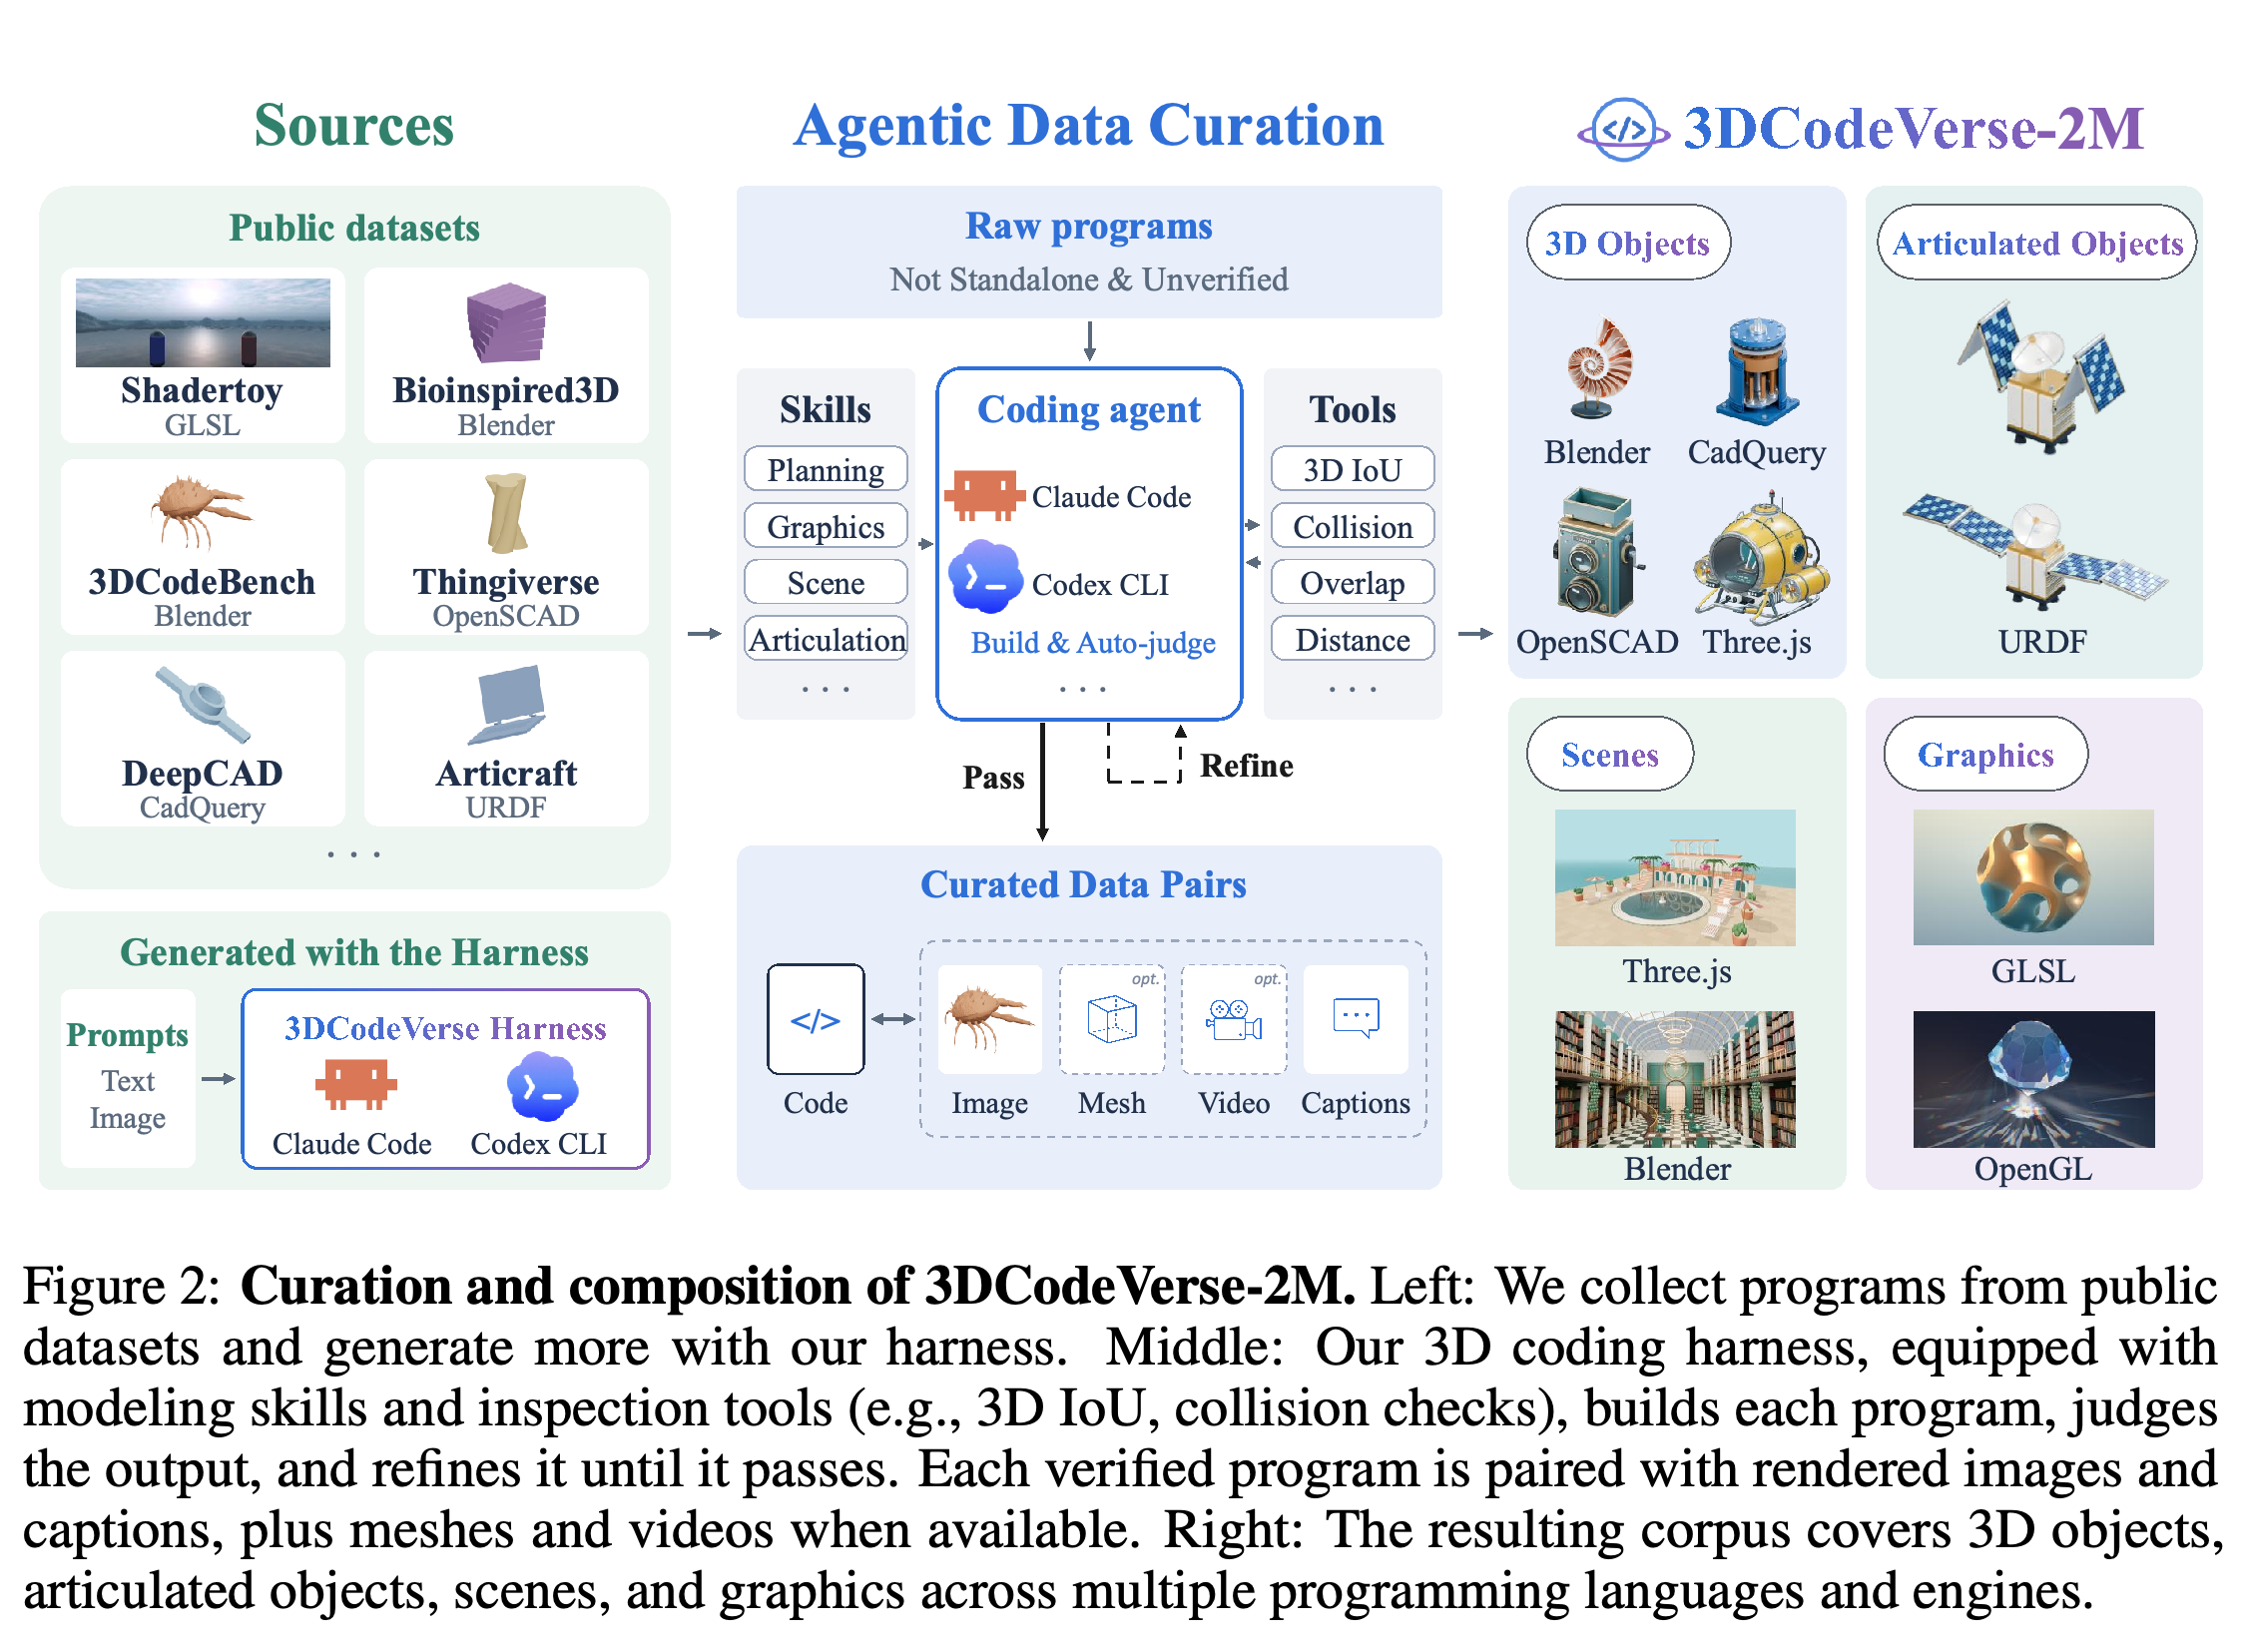
3DCodeVerse-2M은 수집한 프로그램, 변환한 표현 형식, 새로 생성한 프로그램을 결합한다. DeepCAD의 제작 순서는 코드로 CAD 모델을 만드는 독립 실행형 CadQuery 스크립트로 변환한다. Articraft의 기하 루틴은 독립 실행형 프로그램에 통합하며, 링크와 관절을 명시하는 Unified Robot Description Format(URDF)은 유지한다.
- 검사는 부품 목록, 경계 상자, 지지 관계, 접촉, 충돌, 샘플링한 관절 자세, 렌더링 프레임을 다룬다. 변환 충실도는 DeepCAD에서는 점유 부피의 겹침을 측정하는 voxel intersection over union(IoU)으로, Articraft에서는 샘플링한 형상 사이의 거리를 측정하는 Chamfer distance로 평가한다.
- 이미지와 텍스트를 함께 처리하는 비전 언어 모델(VLM)이 코드와 렌더링을 바탕으로 지시, 시각적 설명, 제작 절차 캡션을 제공한다. 기록에는 출처, 라이선스, 관련 에셋과 함께 실행, 기하, 시각 검증 신호를 구분해 보존한다.
- 검증 범위는 출처마다 다르다. 수집하거나 변환한 프로그램은 런타임을 사용할 수 있을 때 실행 및 렌더링 검사를 받는다. Harness로 생성한 프로그램에는 결정적 검사 게이트의 결과와 시각 판정 결과도 포함된다.
수집한 프로그램과 새로 생성한 코드는 공통 빌드, 검사, 수정 과정을 거친다. 사용 가능한 경우 코드, 렌더링, 캡션에 메시와 비디오가 함께 제공된다. 주변 본문은 검증 범위가 출처에 따라 다르다고 명시한다.
4 3DCodeVerse HARNESS: A DATA Engine for 3D Coding
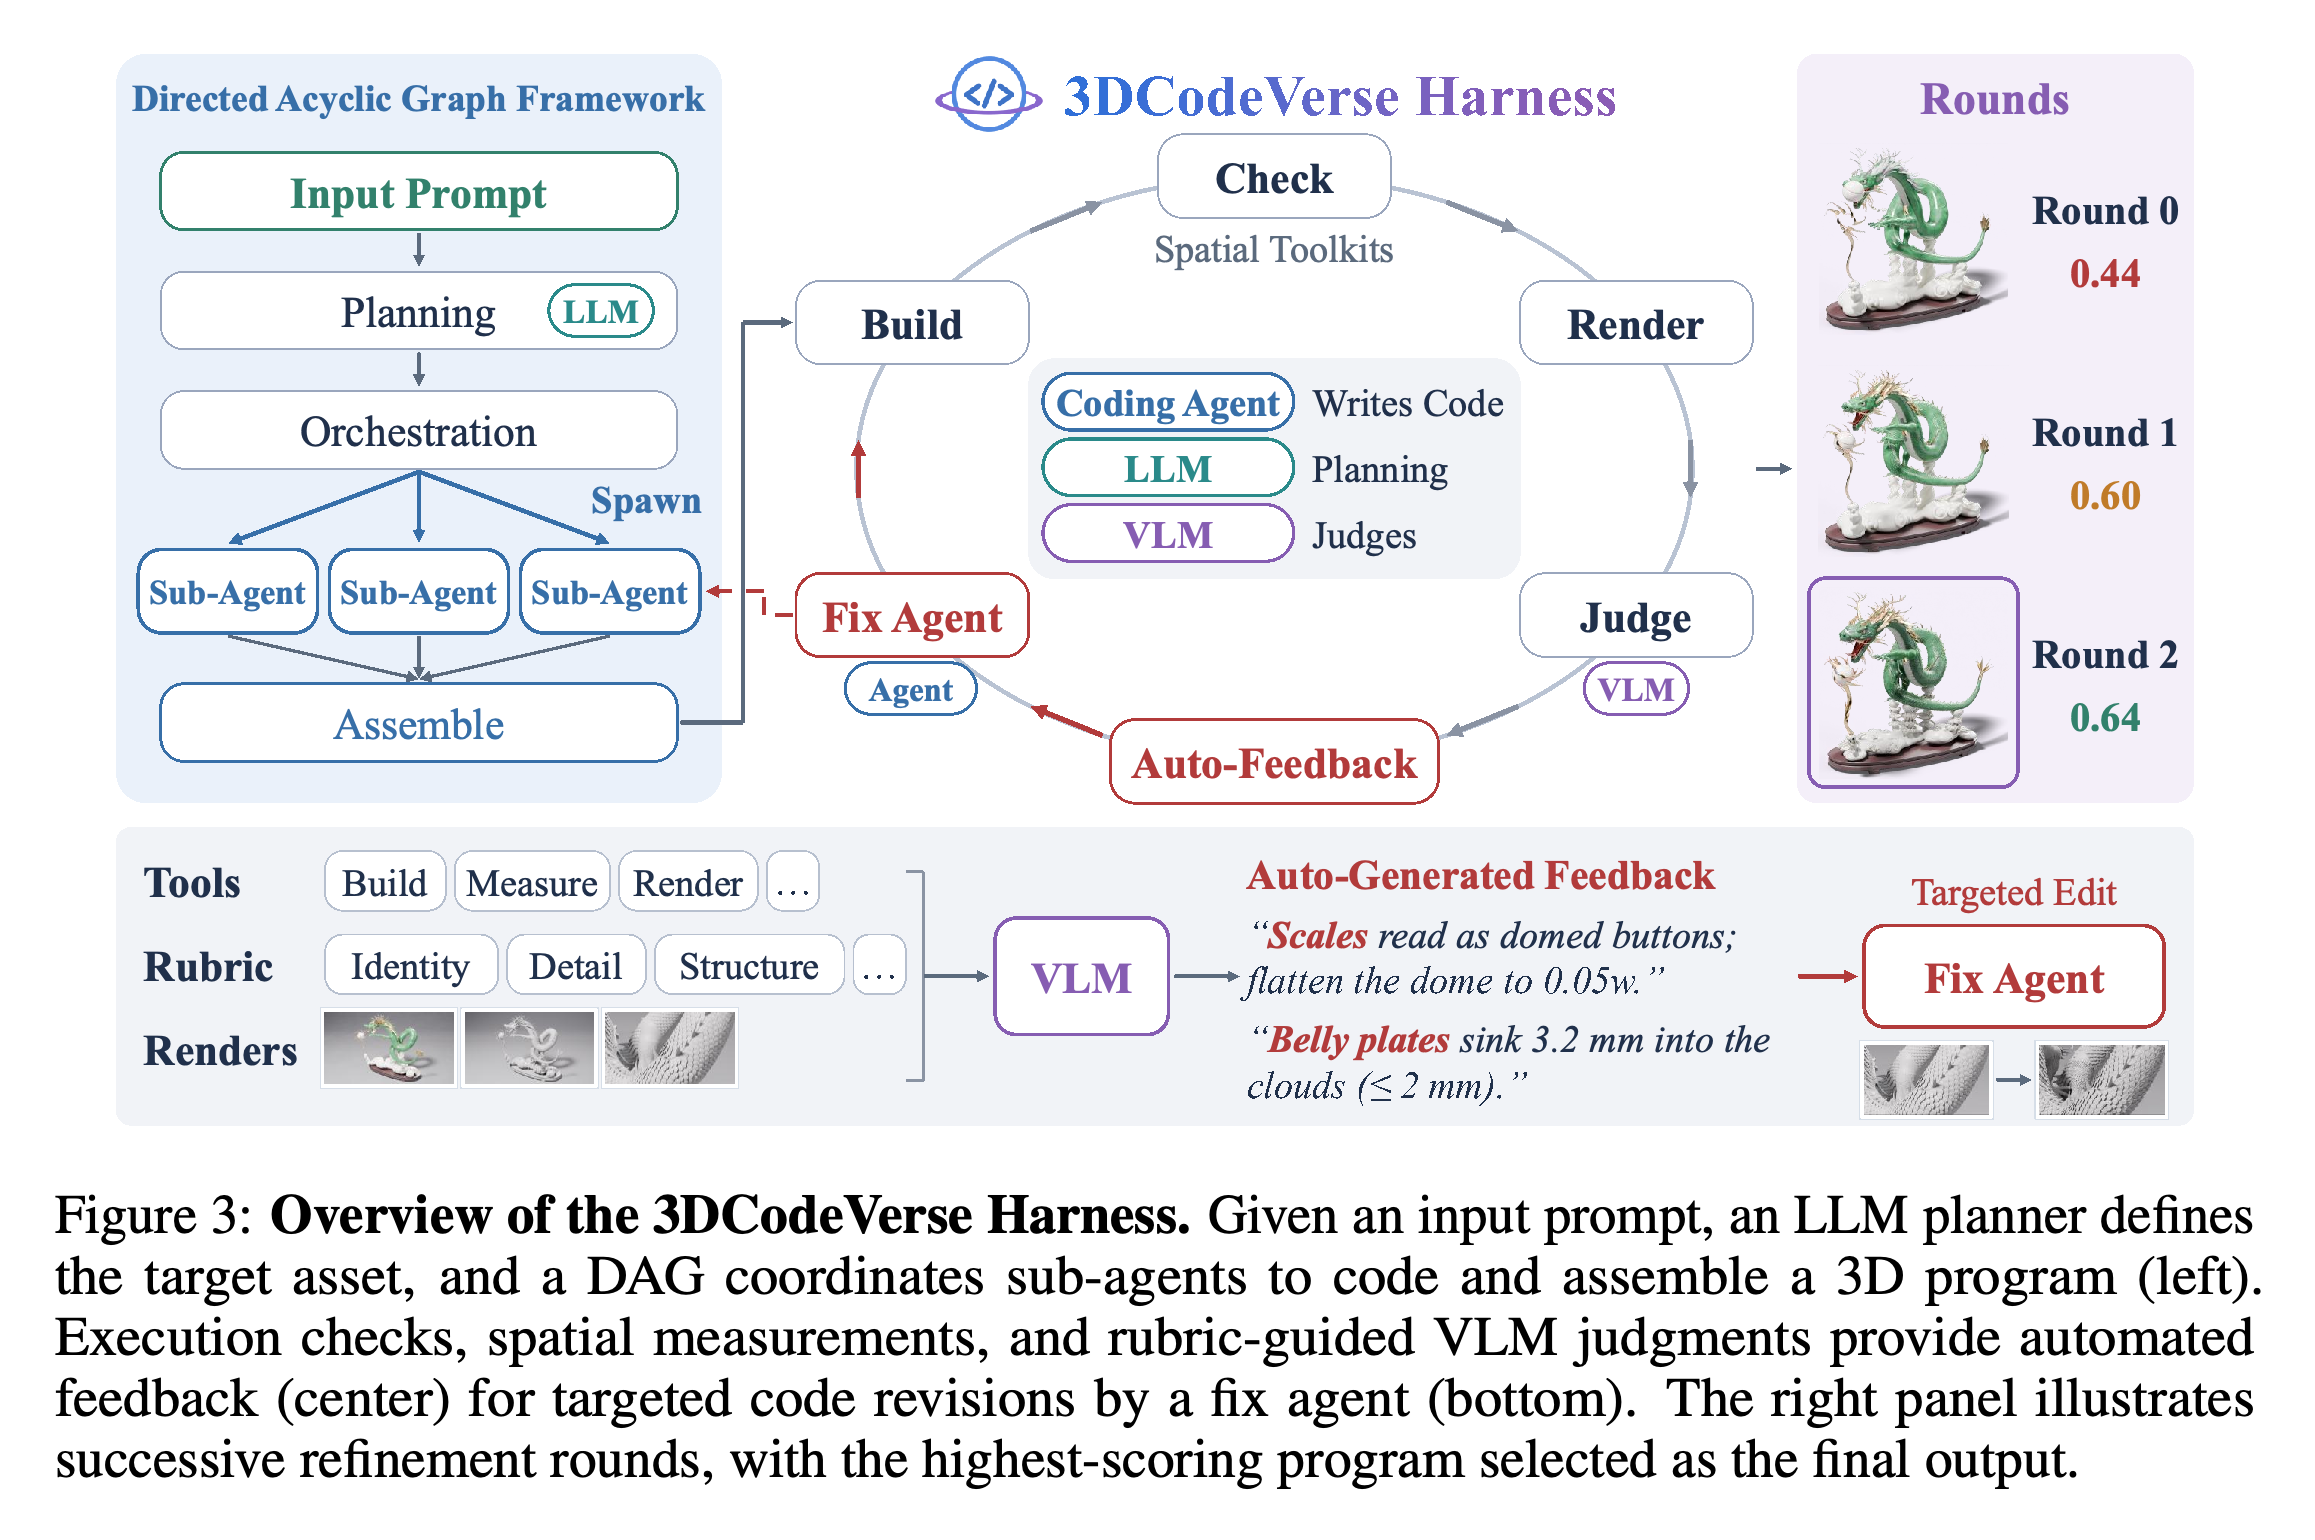
Harness는 요청을 구성 요소, 치수, 재질, 공간 관계, 수용 기준을 포함한 구조 계획으로 변환한다. 코딩과 조립은 순환이 없는 의존성 그래프인 directed acyclic graph(DAG)로 구성하며, 독립적인 에이전트 작업마다 파일 소유권을 명시한다.
- 각 라운드는 실행 로그, 수치로 측정한 공간 정보, 시각 판정을 수집한다. 실행에 실패하면 산출물이 없으므로 실행 피드백만 사용할 수 있다.
- 공간 도구는 구성 요소별 위반 사항과 수치 보정값을 반환한다. 시각 판정 모델은 여러 렌더링 뷰를 요청 및 수용 기준과 대조한 뒤 수정안을 제시한다.
- 점수는 가중 품질 기준과 결함 감점을 결합하며, 측정된 위반 사항과 충족하지 못한 요구사항에 따른 상한을 적용한다. 적용 가능한 기하 검사를 통과하면 그 결과와 모순되는 시각적 결함 주장을 기각할 수 있다. 수정 작업은 실행, 측정, 시각 피드백 순으로 우선순위를 둔다.
개발 단계의 적대적 루프는 판정 모델 수정과 생성 워크플로 수정을 번갈아 수행한다. 판정 모델 수정은 고정된 산출물 모음으로 시험해 평가기 변화와 생성 변동을 분리한다. 워크플로 수정은 동일한 프롬프트를 사용해 비교한다.
- Equation (3)은 반복 평가 점수의 분산과 측정 결과에 모순되는 주장을 결합한 일관성 목표를 나타낸다. 논문은 산출물의 품질 차이에 대한 민감도도 별도의 요구사항으로 남는다고 명시한다.
- Equation (4)는 선택한 출력의 점수와 잘못된 계획, 불필요한 도구 재시도, 빌드 실패처럼 관측 가능한 워크플로 실패 사이의 균형을 잡는다. 이 목표들은 Harness를 설계하고 개선하는 기준을 설명한다. 논문은 워크플로 전체를 종단 간 경사 기반 방식으로 최적화한 결과를 보고하지 않는다.
도식은 의존성 기반 코드 조립을 실행, 공간 검사, 렌더링, 판정, 결함별 수정과 연결한다. 표시된 라운드 점수는 실험 전체를 집계한 결과가 아니라 개별 과정에서 후보가 개선되고 선택되는 예를 보여준다.
5 Experiments
실험은 Harness가 기존 코딩 에이전트를 개선하는지, 코퍼스를 통한 학습이 공개 모델을 개선하는지 평가한다. 실행 신뢰성은 참조 형상 충실도, 인간 선호도, 자동 품질 점수와 구분한다.
5.1 RESULTS of 3DCodeVerse HARNESS
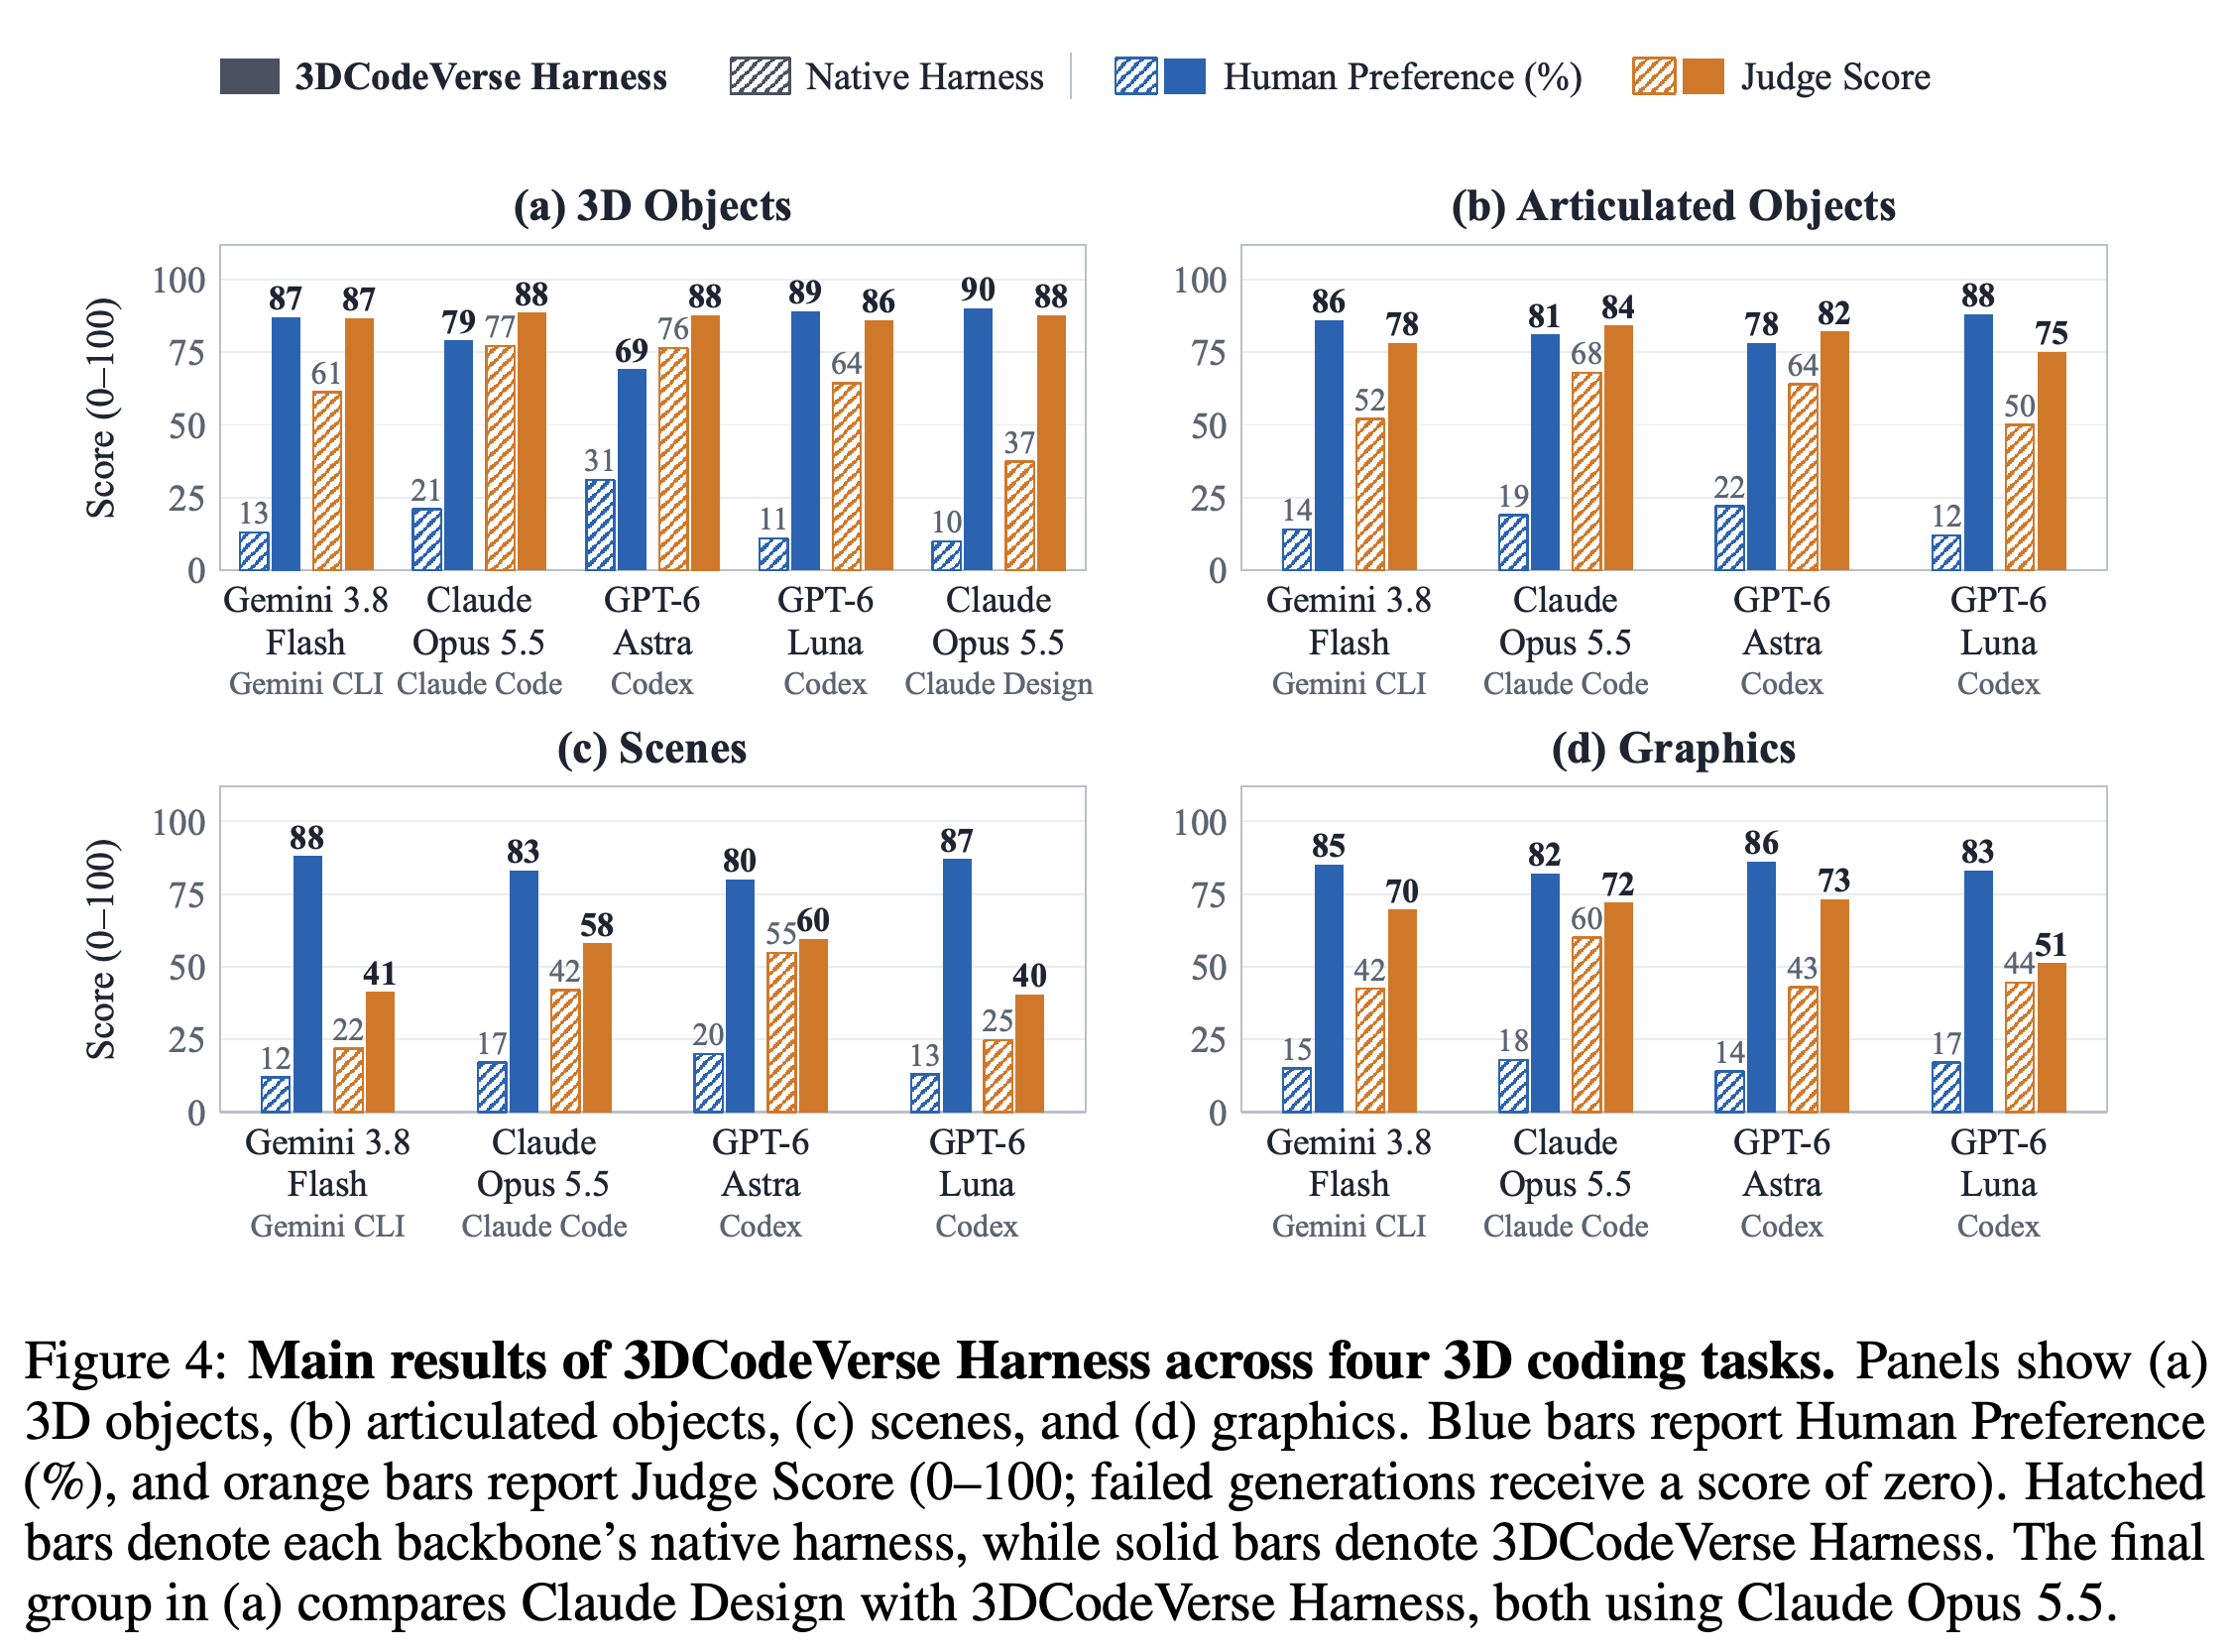
주요 평가는 텍스트 기반 3D 객체 프롬프트 100개로 구성된 집합, 관절 객체 생성, 장면 프롬프트 50개, 그래픽 프롬프트 50개를 다룬다. Human Preference와 VLM Preference는 익명화한 쌍별 선택을 측정하며, 동률은 승리의 절반으로 계산한다. Judge Score는 Gemini 3.1 Pro가 가중 품질 기준, 감점, 상한을 적용해 0–100 척도로 부여하는 점수이며, 생성 실패는 0점으로 처리한다.
- 객체 생성에서 대응하는 기본 워크플로 대비 Harness의 인간 선호도는 69%에서 89%다. Table 14의 Judge Score는 Gemini 3.8 Flash에서 61.3에서 86.6으로, Claude Opus 5.5에서 77.2에서 88.5로, GPT-6 Astra에서 76.4에서 87.7로, GPT-6 Luna에서 64.4에서 85.9로 높아졌다.
- Claude Opus 5.5를 사용하는 Claude Design과 비교할 때, 같은 백본을 사용하는 Harness는 인간 선호도 90%를 얻었다. Table 14의 점수는 각각 87.7과 37.4다. Figure 4는 이 점수를 88과 37로 반올림해 표시한다.
- Figure 4는 관절 객체, 장면, 그래픽에서 인간 선호도 78–88%를 보고한다. 프롬프트와 렌더링 사이의 유사도를 측정하는 텍스트–이미지 인코더인 SigLIP-2도 추가 지표로 사용하며, 객체의 4개 뷰에 대한 평균을 구한다.
Appendix C.3은 주요 객체 실험에서 후속 개선 라운드를 0회, T=0으로 지정한다. 다만 최초 계획에 따른 생성, 대화형 도구, 자동 빌드 수정, 최종 검증은 유지한다. Gemini 3.8 Flash와 Claude Opus 5.5는 프롬프트 60개로 평가하고, 다른 여러 백본은 균형을 맞춘 프롬프트 30개 하위 집합으로 평가한다. 별도 연구에서는 T=4회의 개선 라운드를 허용한다. 여기서 T는 디코딩 온도가 아니라 라운드 수다.
- 최종 평가는 전달된 프로그램을 처음부터 다시 빌드하며, 내부 계획, 체크리스트, 개선 이력을 제거한다. Gemini 3.1 Pro는 원래 요청과 프롬프트에서 도출한 체크리스트를 기준으로 각 출력을 3회 평가한다.
- 이러한 평가 절차와 인간 선호도는 전체 워크플로의 이점을 뒷받침한다. 생성 예산은 동일하지 않다. Table 8은 실행 후 평가 비용을 제외한 객체당 비용을 Harness를 사용한 Flash에서 $3.312, 베이스라인에서 $0.035로 추정한다.
- 추가로 산정한 상한 없는 시각 점수는 비율 및 크기 기준과 전체 감점 및 상한을 제외한다. 프롬프트 60개 비교에서 Harness를 사용한 Flash의 점수는 88.1, Claude Design의 점수는 62.4다. 이는 대체 채점 규칙에서도 보고된 우위가 유지됨을 보여준다.
백본을 맞춘 비교에서 Harness는 표시된 작업 4개 전반에서 더 높은 인간 선호도를 얻었다. 객체 Judge Score도 상승했으며, 동일 백본을 사용한 Claude Design 비교도 포함된다. 이 결과는 생성 예산이 다른 전체 워크플로 간 비교다.
5.2 Fine-Tuning OPEN Models on 3Dcodeverse-2m
저자들은 LLaMA-Factory 학습 프레임워크에서 소규모 파라미터 갱신을 학습하는 low-rank adaptation(LoRA)으로 Qwen3.5-9B와 Qwen3.8-27B를 미세 조정한다. 보고된 단계에는 요청–프로그램 예제로 학습하는 supervised fine-tuning(SFT)과 선호 및 비선호 완성 예제로 학습하는 direct preference optimization(DPO)이 포함된다.
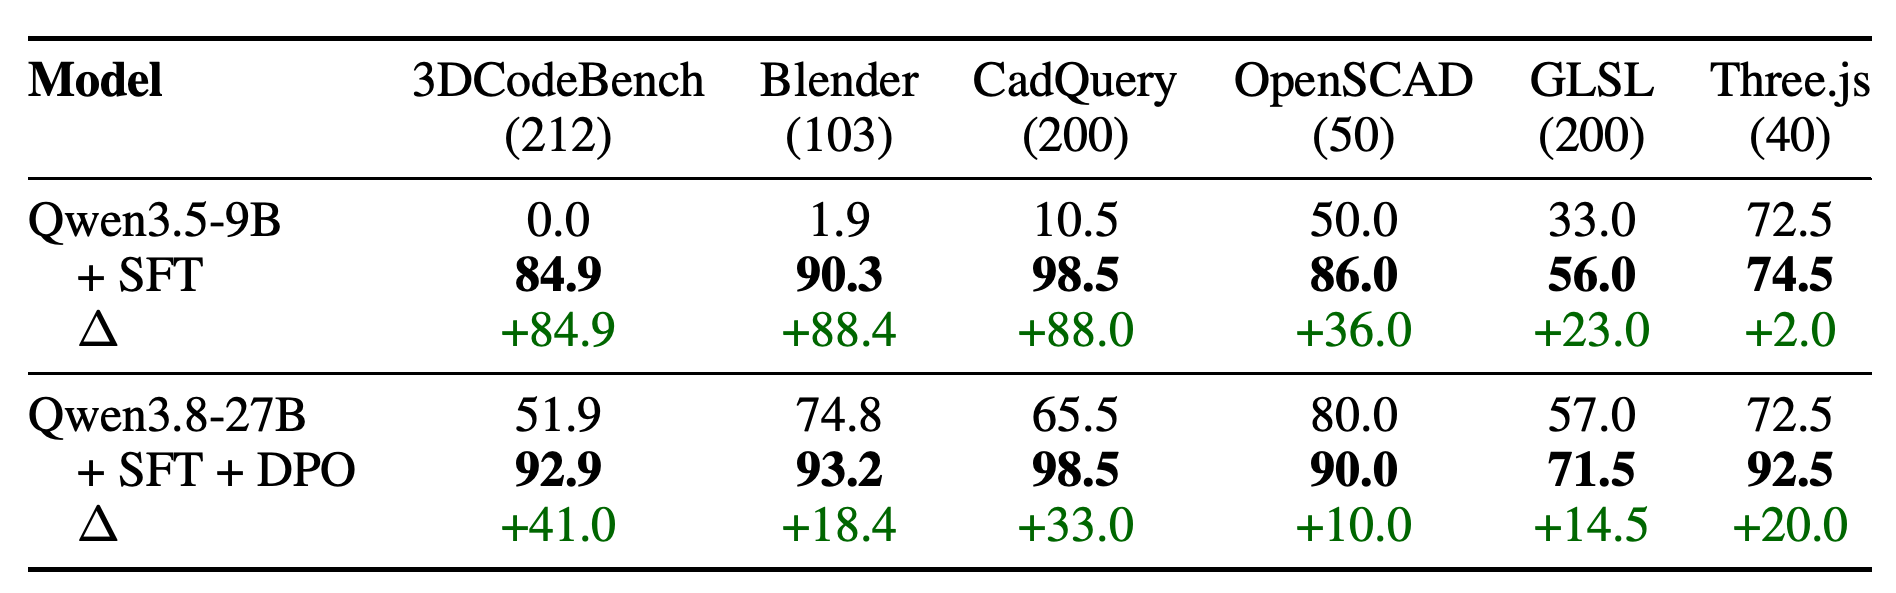
- 평가는 고정된 작업 805개를 다룬다. 3DCodeBench 212개, Blender 객체 103개, CadQuery 부품 200개, OpenSCAD 모델 50개, 렌더링된 외형을 계산하는 프로그램인 OpenGL Shading Language(GLSL) 셰이더 200개, Three.js 단일 객체 장면 40개로 구성된다. Blender는 3D 제작 환경이며, OpenSCAD는 스크립트 기반 솔리드 모델링을 제공하고, Three.js는 브라우저 기반 3D 그래픽을 지원한다.
- 모델에는 예제 없이 동일한 요청과 코드 형식별 시스템 프롬프트를 제공한다. 디코딩 온도 T=0.7과 시드 1개를 사용하며, 지정된 버전으로 고정한 런타임에서 실행한다. 실행은 해당 런타임에서 결과를 생성하는 것을 뜻하며, GLSL에서는 셰이더 컴파일을 뜻한다.
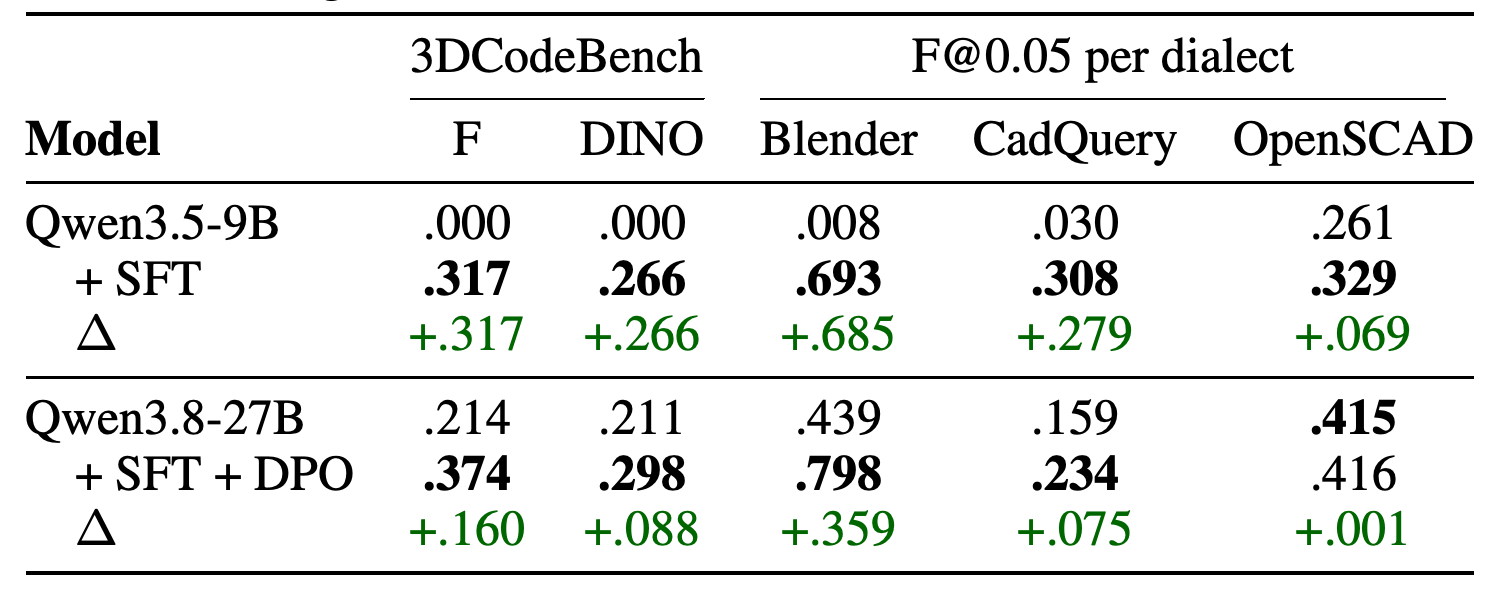
- 형상 충실도는 크기 정규화 후 거리 임계값 0.05에서 계산한 표면 점 F-score인 F@0.05와, 재질 차이를 억제한 4개 뷰의 클레이 렌더링 사이에서 구한 DINOv2-L 이미지 특징 유사도로 평가한다. 실패한 프로그램에는 지표 2개 모두 0점을 부여한다.
Table 2는 3DCodeBench 실행률이 Qwen3.5-9B에서 0.0%에서 84.9%로, Qwen3.8-27B에서 51.9%에서 92.9%로 높아졌다고 보고한다. Table 3에서는 참조 형상 충실도도 높아졌다. 3DCodeBench F@0.05는 9B 모델에서 0.000에서 0.317로, 27B 모델에서 0.214에서 0.374로 상승했다.
- 9B 모델은 Blender에서 90.3%, CadQuery에서 98.5%의 실행률을 기록했다. 27B 모델은 각각 93.2%와 98.5%를 기록했다. 사전 학습된 9B 모델은 Blender 5에서 사용할 수 없는 장면 초기화 연산자를 자주 호출하므로, 평가 런타임에 대한 적응도 이러한 개선에 기여한다.
- 실행률과 충실도는 구분해야 한다. 예를 들어 Table 3에서 27B의 OpenSCAD 실행률은 80.0%에서 90.0%로 높아졌지만, F@0.05는 0.415에서 0.416으로 거의 변하지 않았다. 다만 최종 충실도 값은 부록과 일치하지 않는다.
- Table 2는 9B + SFT의 Three.js 실행률을 74.5%로 보고하지만, Table 11은 나머지 결과가 일치하는 270K 혼합 데이터에서 32.5%를 제시한다. Table 3은 27B + SFT + DPO의 OpenSCAD F@0.05를 0.416으로 보고하지만, Table 11은 0.314를 제시한다. PDF는 이러한 불일치를 해소하지 않는다.
학습은 실행률을 크게 높였으며, 특히 사전 학습 모델이 평가 환경에서 거의 실행되지 못하던 경우에 효과가 컸다. 3DCodeBench 실행률은 9B에서 0.0%에서 84.9%로, 27B에서 51.9%에서 92.9%로 높아졌다. 실행률만으로 형상 충실도를 입증할 수는 없으며, 보고된 9B Three.js 값은 Table 11과 다르다.
5.3 Qualitative Analysis
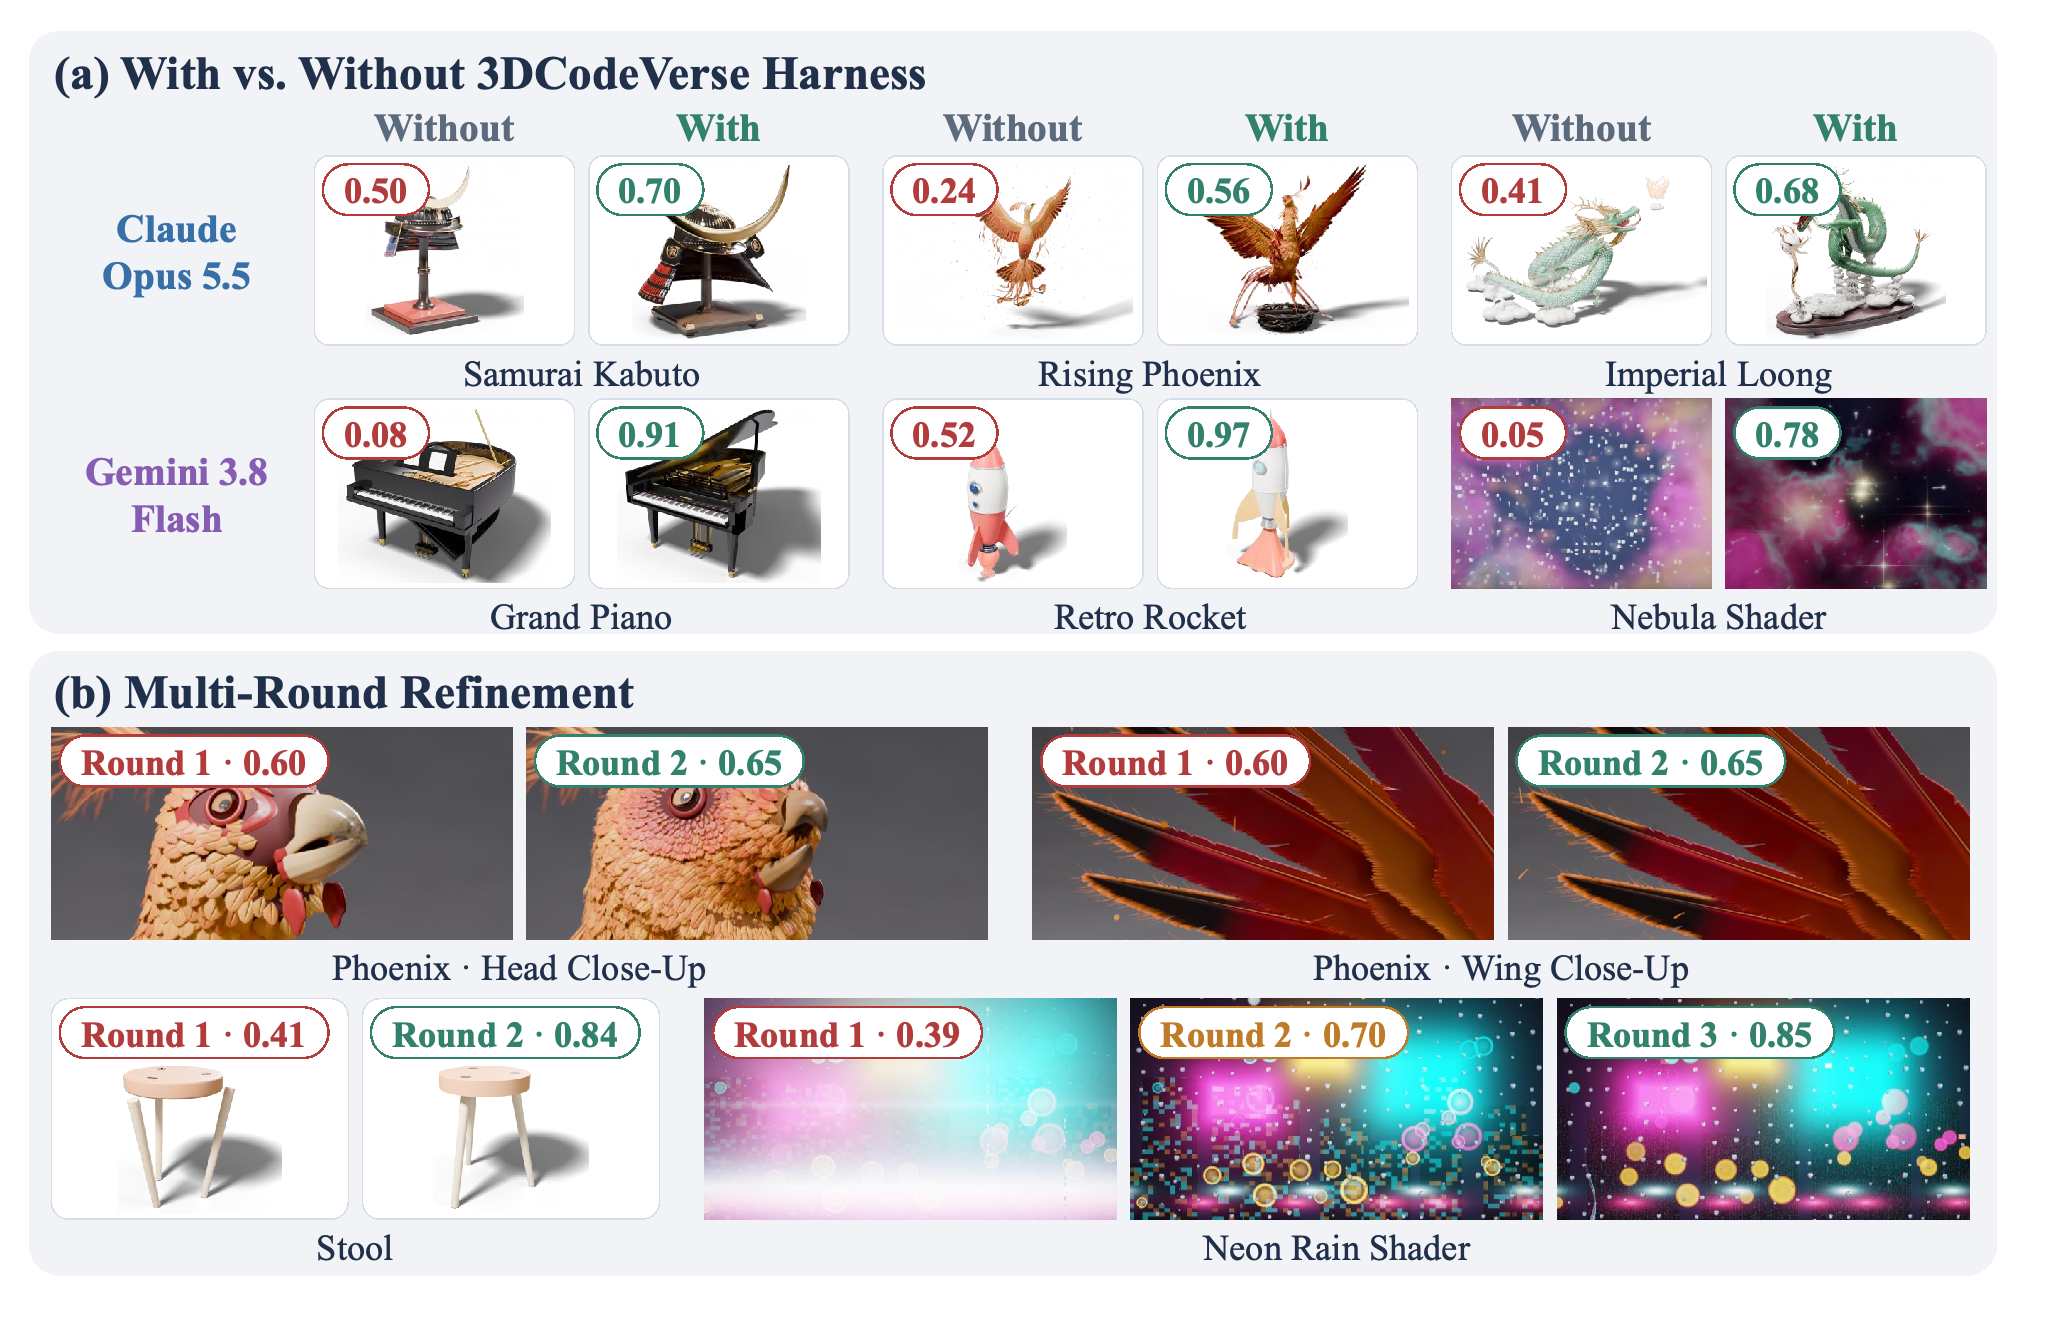
Figure 5의 대응 예제에서는 Harness를 사용할 때 구조가 더 완전하고 세부 표현도 더 정교하다. 불사조의 다리와 둥지, 피아노 내부가 그 예다. 연속된 수정은 얼굴 깃털을 개선하고, 스툴 다리를 좌판에 연결하며, 네온 셰이더의 블록 아티팩트를 줄인다.
- 선별된 예제들은 추가적인 인간 지시 없이 수행한 수정을 보여준다. 점수는 각 대응 쌍이나 개선 과정 안에서 비교할 수 있으며, 작업 전반의 평균 개선을 추정하지는 않는다.
선별된 대응 쌍은 구조의 완전성과 세부 표현의 변화를 보여준다. 개선 과정에서는 깃털, 스툴 부착부, 셰이더 아티팩트에 대한 국소적 수정을 확인할 수 있다. 논문에 명시된 대로 점수는 각 쌍이나 과정 안에서 비교할 수 있다.
보고된 평가 모음 대부분에서 참조 형상 충실도가 높아졌으며, 27B의 3DCodeBench F@0.05는 0.214에서 0.374로 상승했다. 보고된 OpenSCAD 값은 실행률 상승에도 거의 변하지 않았지만, 최종 값이 Table 11과 일치하지 않으며 이 불일치는 해소되지 않았다.
6 Applications of 3D Coding
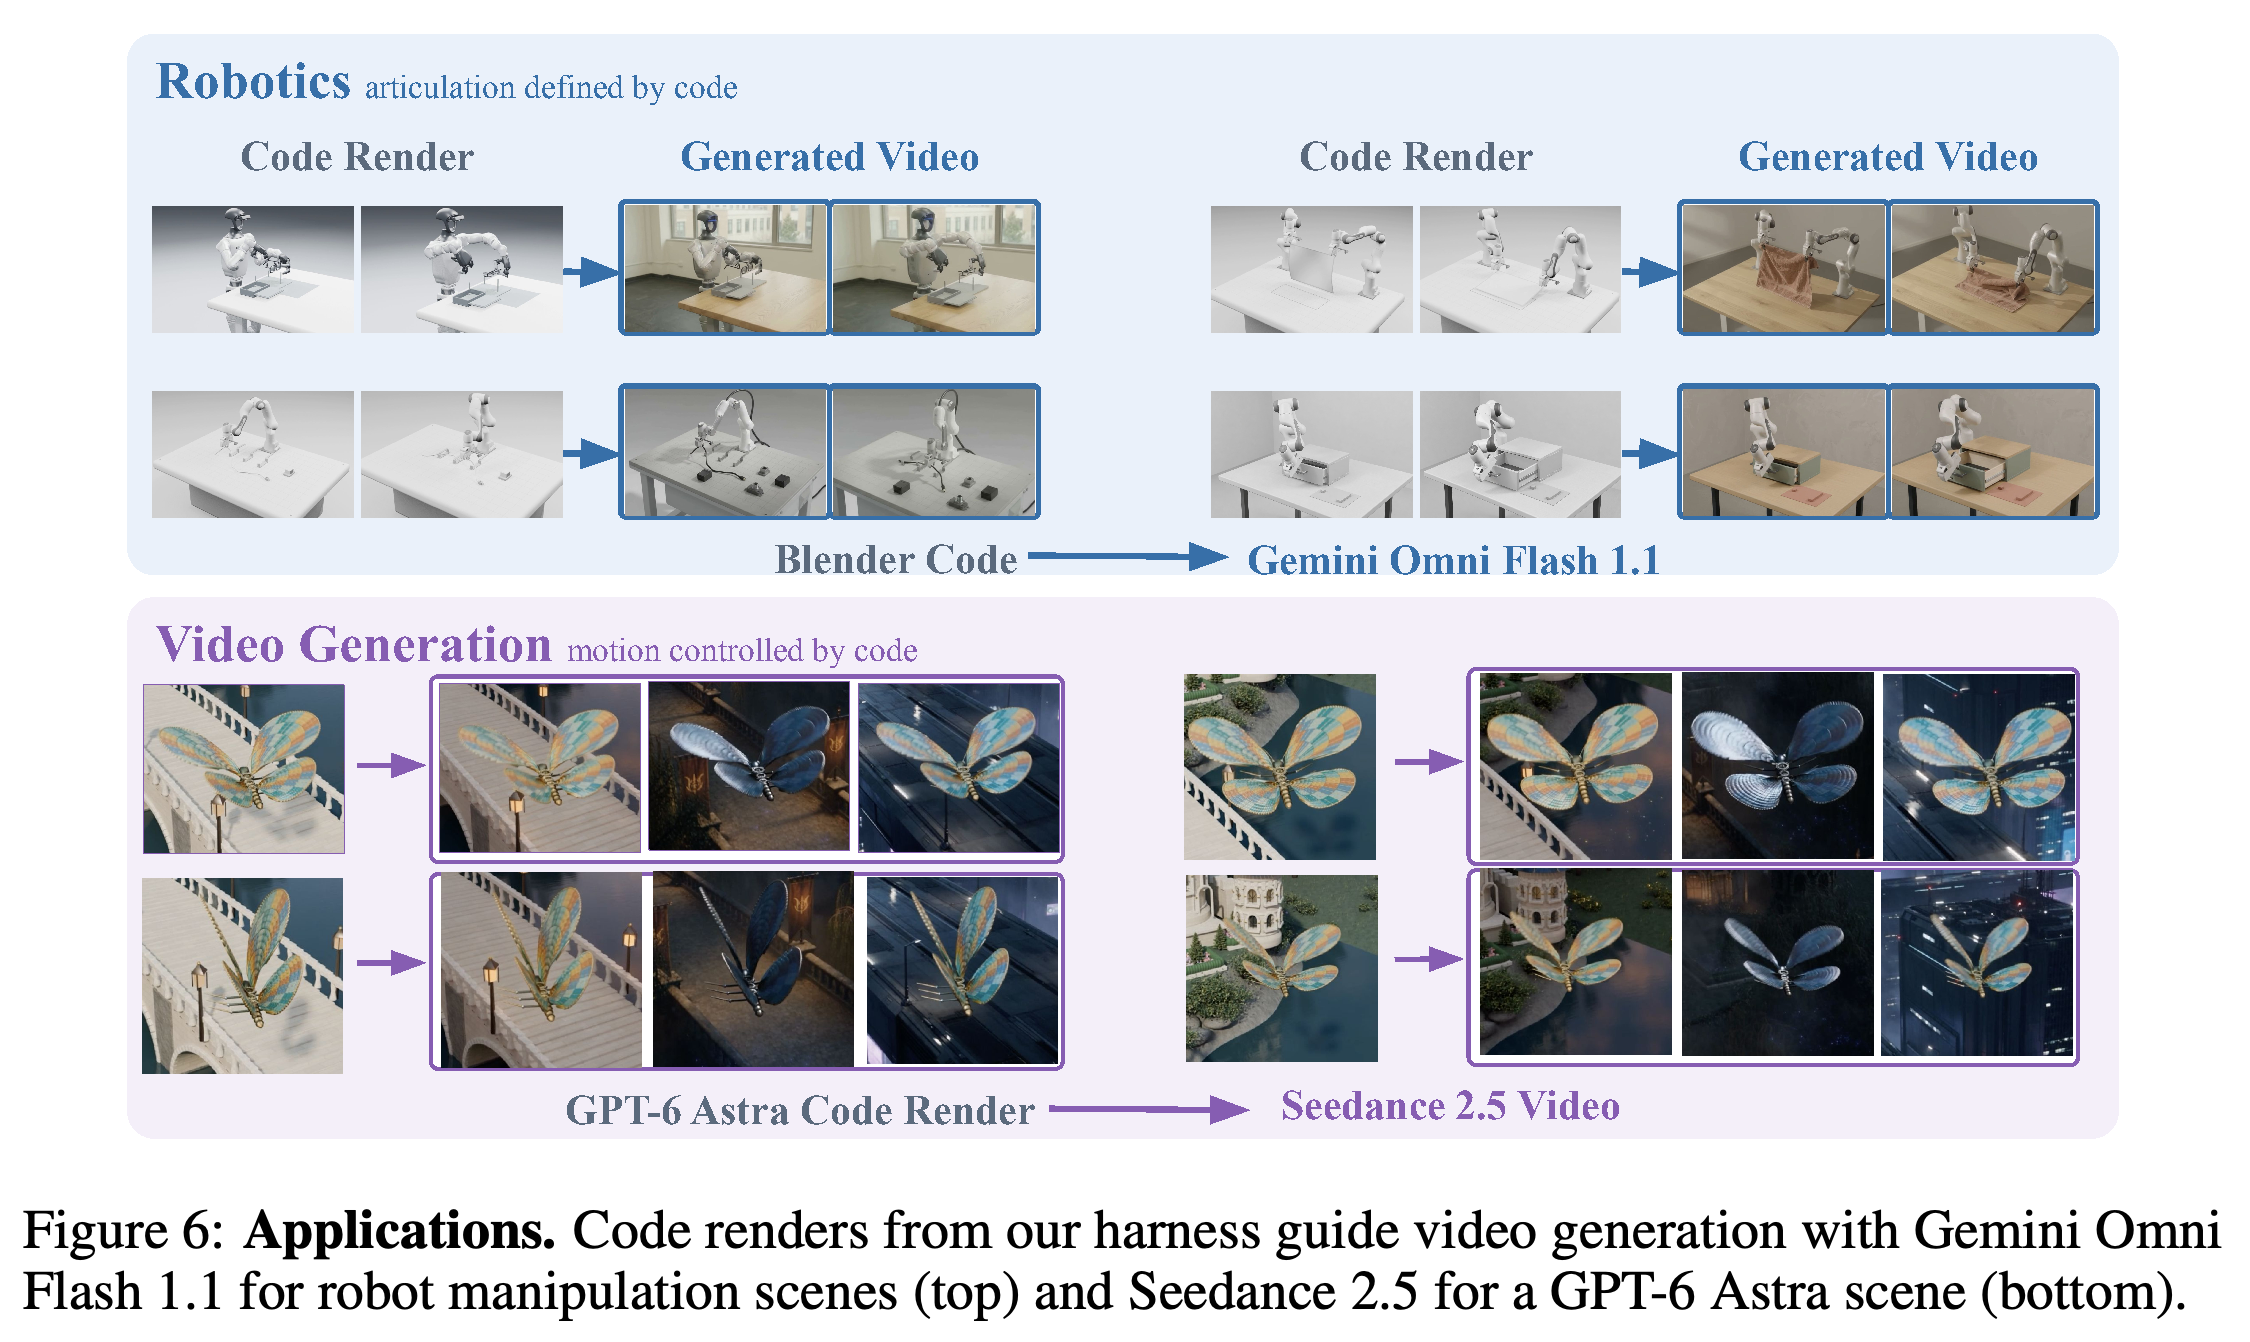
로보틱스 응용에서는 코드로 MuJoCo 물리 시뮬레이터에 사용할 편집 가능한 강체 링크 기하 구조, 관절 축, 관절 한계를 명시한다. 에셋 2개, 초기 접촉 상태 2개, 제어 시퀀스 3개로 구성된 사례 12개에서 직접 코드 렌더링과 Unified World Models(UWM)의 고정된 variational autoencoder(VAE)를 거친 복원은 각각 12/12개 출력에서 시험 대상인 문과 손잡이의 기하 구조를 보존했다. VAE는 이미지 인코더–디코더다. UWM의 행동 조건부 비디오 예측은 롤아웃 7/36개에서 통과했다.
- 이는 예비적인 구조 보존 실험이다. 코드 시뮬레이션에는 완전한 장면 상태를 제공하고, UWM에는 이미지 이력과 대응하는 로봇 명령을 제공한다. 따라서 이 비교로 상태 추론이나 로봇 작업 성공에서의 우위를 입증할 수는 없다.
- 비디오 생성에서는 코드로 렌더링한 시퀀스를 Gemini Omni Flash와 Seedance 2.5의 조건으로 사용한다. 프로그램은 배치, 객체 운동, 카메라 궤적을 지정하고 비디오 모델은 외형을 개선한다. Figure 6은 정량적 비디오 벤치마크가 아니라 정성적 예제를 제공한다.
대응 프레임은 코드 렌더링이 외형을 수정하는 비디오 모델에 공간 및 운동 정보를 제공하는 모습을 보여준다. 이 예제는 제안된 응용 인터페이스를 시연한다. 로보틱스 기하 구조에 대한 정량적 결과는 별도의 통제 실험에서 나온다.
7 Conclusion
논문은 코드로 3D 콘텐츠를 생성하기 위한 실행 가능 데이터셋, 재사용 가능한 검증 인프라, 공개 모델 베이스라인을 제시한다. 학습 후 실행 가능성이 높아지고 Harness를 통해 콘텐츠 품질이 향상되었다고 보고하며, 데이터셋, Harness, 모델, 학습 레시피를 공개할 계획을 밝힌다.
- PDF에는 https://3dcodeverse.com, https://github.com/gaoypeng/3dcodeverse, https://huggingface.co/datasets/ilabai/3dcodeverse가 기재되어 있다.
부록
- A THE 3DCODEVERSE HARNESS: DESIGN AND IMPLEMENTATION은 생성과 데이터 선별을 수행하는 실제 시스템을 설명한다. 모듈화된 모델 역할, 구조화된 계획, 결정적 검증, 시각 판정, 수정 일정 관리, 출력 보관을 다룬다.
- A.1 COMPONENTS AND MODEL ROLES는 트랙 4개와 격리된 런타임 7개에서 계획 모델, 코딩 에이전트, 시각 판정 모델을 분리한다. 대상은 Blender Python, CadQuery, Three.js 객체, Blender로 제작한 링크를 사용하는 URDF, Three.js 장면, GLSL, OpenGL 그래픽용 Python 인터페이스인 moderngl이다. 에이전트는 Harness의 도구 인터페이스인 Model Context Protocol(MCP)을 통해 공간 도구에 접근한다.
- A.2 PLANNING AND THE JOB GRAPH는 이름이 지정된 부품, 미터법 단위의 경계, 재질, 부착 관계, 수용 기준을 명시한다. 최상위 부품이 8개 이상인 모듈형 객체에서는 각 세션이 최대 3개 부품으로 이루어진 부착 하위 트리를 처리한 뒤 조립한다. 파일을 공유하는 개선 작업은 함께 묶는다. 링크와 허용 운동을 기술하는 운동학 계획이 선언되지 않은 링크를 참조해 유효하지 않으면, 새로운 계획 컨텍스트에서 다시 시작한다.
- A.3 SPATIAL TOOLS AND DETERMINISTIC GATES는 유효한 검증 실패 판정과 도구 프로토콜 오류를 구분해, 측정된 결함 때문에 통신 재시도가 발생하지 않도록 한다. 연결성과 계획 준수 검사는 프로그램의 원래 좌표계에서 수치 보정값을 반환하며, 측정된 위반 사항은 점수를 제한한다. Figure 9는 접촉 기준을 ≤2 mm, 경계 상자 허용 오차를 max(1 cm, 계획된 크기의 10%)로 지정하며, 오차가 이 허용치의 3 times를 넘으면 오류로 처리한다.
- A.4 AUTOMATED JUDGMENT는 시각 판정 모델이 소스 코드나 생성 모델의 추론을 보지 않은 상태에서 점수를 매기기 전에 관측 내용을 보고하도록 한다. 기준별 점수는 평균을 구하고, 결함 투표는 다수결로 집계한다. 적용 가능한 결정적 검사가 감점과 점수 상한을 결정한다. 구조적 결함 주장을 기각하려면 해당 게이트가 오류 없이 통과해야 하며, 깊이가 8 mm 이상인 관통 경고도 없어야 한다. 고정된 의자와 수납장 산출물을 몽타주 순서를 섞어 반복 평가했을 때, [0,1] 척도에서 Gemini 3.1 Pro의 평균 점수 표준편차는 0.030이었고 Gemini 3.8 Flash는 0.083이었다.
- A.5 REFINEMENT ROUNDS, HISTORY, AND OUTPUT SELECTION은 각 라운드에서 수행하는 새 빌드, 측정, 렌더링, 판정, 보관을 설명하며, 최대 3회의 빌드 오류 수정 세션을 허용한다. 표준 설정은 T=4의 개선 라운드와 실제 경과 시간 60 minutes의 상한을 적용한다. 검증 작업이 해결되거나, 코드 변경이 없거나, 예산이 소진되면 조기 종료한다. 출력 선택은 보관된 라운드를 종합 점수, 게이트 오류, 라운드 순서에 따라 정렬한다. 최고 점수와 차순위 점수의 차이가 0.03 이하이면 선택적으로 쌍별 동률 판정을 수행하며, 차순위 후보가 정방향과 역방향 표시에서 모두 신뢰도 ≥0.60으로 이길 때만 순위를 올린다.
- A.6 A RECORDED RUN은 Three.js에서 “a three-legged wooden stool”을 생성하는 과정을 추적한다. 부품을 연결하고 기하 구조를 개선하면서 점수는 0.410에서 0.844로, 이후 0.933으로 높아졌다. 모델 호출 21개, 활성 처리 시간 4.0 active minutes, 비용 $0.74가 들었다. 선택된 출력은 여전히 바닥 점유 범위 요구사항을 충족하지 못하므로, 최고 점수를 받은 라운드가 모든 필수 조건을 만족하는 것은 아니다.
- A.7 ARTICULATED OBJECTS: GEOMETRY, KINEMATICS, AND JOINT SWEEPS는 Blender 링크 메시와 URDF 운동학 트리를 결합한다. 빌드 검증은 기본 자세의 정렬 불일치가 1 mm를 초과하거나 관통이 5 mm를 초과하면 빌드를 거부한다. 동적 검사는 관절 한계와 시드로 정한 다중 관절 구성 8개를 시험하며, 움직인 자세에서 관통이 2 mm를 초과하면 표시한다. 노트북 예제에서는 힌지와 본체 사이의 2.5 mm 충돌을 감지해, 다른 평가가 양호하더라도 점수 상한을 0.60으로 제한한다.
- A.8 SCENES AND GRAPHICS는 에셋과 구역을 단계적으로 구성하고, 필요하면 빠른 초안 생성에서 대화형 수정으로 전환하는 과정을 설명한다. 장면 준비에는 실제 경과 시간 예산의 55%까지만 사용한다. 배치, 노출, 운동을 검사하며, 렌더링 명령을 제한하기 위해 드로 콜 예산을 15,000회로 둔다. 그래픽은 루프 길이 이내로 제한한 t ∈ {0, 1, 2.5, 4, 6} s에서 1280 × 720 해상도로 렌더링한다. 프레임 검사에서는 유효하지 않은 픽셀, 검거나 과다 노출된 출력, 정적인 시퀀스, 깜빡임을 확인한다.
- A.9 SKILLS는 지침과 코드 참조를 재사용 가능한 패키지로 묶은 제작 번들 17개를 설명한다. 각 참조는 350줄과 약 2,500토큰으로 제한한다. 규칙 28개로 구성된 라우터가 현재 작업, 런타임, 계획된 구조, 앞선 진단 결과를 바탕으로 세션마다 최대 5개 번들을 선택한다.
- B 3DCODEVERSE-2M: DATASET DETAILS는 배포용 프로그램 카탈로그, 벤치마크 학습 쌍, 확장된 텍스트 내보내기 데이터를 구분한다. 이들은 집계 단위가 다르며, 개별 미세 조정 실험은 사용 가능한 기록에서 추출한 지정된 혼합 데이터를 사용한다.
- B.1 DATASET HIERARCHY AND COUNTING UNITS는 고유한 실행 가능 프로그램 269,597개, 891M 토큰을 포함하는 중복 제거된 벤치마크 학습 쌍 768,596개, 샤드 342개에 걸친 통합 내보내기 행 2,028,286개를 보고한다. 내보내기 데이터는 원래 형식의 행 891,788개, 표준화된 텍스트 내보내기 행 848,819개, 다중 패스 프로그램을 개별 렌더링 패스 대상으로 분리한 셰이더 행 287,679개로 구성된다. 벤치마크 학습 분할에서는 3DCodeBench 팩토리, 시드로 생성한 인스턴스, 코드 형식별 평가 모음을 제외한다.
- B.2 SOURCES AND CONVERSION PIPELINES는 중복 제거된 실행 가능 DeepCAD 변환 결과 128,201개를 보고하며, 48³ 해상도에서 평균 voxel IoU는 0.985다. Articraft CAD 변환 결과는 6,882개 중 6,878개가 기하 검증을 통과했다. 다른 출처에는 Shadertoy 셰이더 119,961개와 후속 학습에 사용하는 생성 예제인 실행 검증된 Harness 부트스트랩 프로그램 15,704개가 있다. Table 5는 데이터셋 수준의 CC-BY-NC-SA-4.0 조건과 출처별 조건을 함께 명시하며, 재사용에는 적용 가능한 조건 중 더 엄격한 조건이 우선한다.
- C EXPERIMENTAL DETAILS AND ADDITIONAL RESULTS는 학습 설정, 표현 형식별 데이터 규모에 따른 손실 곡선, 평가 프로토콜, 모델 및 혼합 데이터 비교, Harness 구성 요소 연구를 제공한다. 주요 결과를 해석하는 데 필요한 디코딩 설정, 학습 데이터 혼합, 개선 라운드 범위, 평가 하위 집합을 구분한다.
- C.1 TRAINING DETAILS는 bfloat16 수치 정밀도로 NVIDIA H100 (80 GB) GPU 4개를 사용하며, 활성화 메모리를 줄이는 gradient checkpointing과 예제를 결합하는 sequence packing을 적용한다. 표준 SFT 레시피는 rank-64 LoRA, α=128, dropout 0.05를 사용한다. DPO는 rank-16 LoRA, α=32, 선호 손실 파라미터 β=0.1, 학습률 5 × 10⁻⁶을 사용해 2 epochs 동안 학습한다. 컨텍스트 한도는 9B에서 8,192토큰, 27B에서 4,096이며, 이를 초과하는 예제는 자르지 않고 제외한다.
- C.2 TRAINING CURVES OF THE 27B DATA-SCALE RUNS는 서로 다른 내보내기 표현을 사용한 1-epoch rank-16 LoRA runs를 비교한다. 실험군 A, B, C는 각각 1,992,816개, 1,160,630개, 292,690개 행을 사용하며, 평활화한 최종 학습 손실은 각각 0.274, 0.314, 0.292다. 이 손실은 서로 다른 학습 데이터 혼합에서 예측 오차를 측정한다. 곡선만으로는 별도 평가 데이터의 생성 품질 차이를 입증할 수 없다.
- C.3 EVALUATION PROTOCOL은 결정적 코드 추출, 실행 제한 시간 300 s, 단위 크기로 정규화한 메시, 샘플링한 표면 점 10,000개, 90° 간격의 yaw 회전 4개 중 최적 정렬을 사용하는 기하 평가를 명시한다. Harness 비교에서는 후속 인간 수정 없이 사용자 요청 1개를 사용하되 내부 도구와 수정을 허용한다. 고정된 평가기는 출력을 독립적으로 다시 빌드한다. 쌍별 판정은 익명화한 뷰를 사용하며, 인간 평가의 표시 순서를 무작위화하고 VLM 선호도는 표시 순서 2개에서 일치해야 한다.
- C.4 ADDITIONAL OPEN-MODEL RESULTS는 학습 데이터 혼합과 선호 신호가 성능의 서로 다른 측면에 영향을 준다는 점을 보여준다. 실행 피드백 DPO를 2라운드 적용하면 9B 5.2K 체크포인트의 greedy 3DCodeBench 실행률이 보고된 베이스라인 75.0%에서 96.2%로 높아진다. Greedy는 매 단계에서 확률이 가장 높은 토큰을 선택하는 방식이다. 디코딩 온도 T=0.7에서 샘플링한 완성 4개 중 최소 1개가 성공하는 비율인 pass@4는 91.0%에서 99.1%로 높아진다. 기하 피드백 DPO는 실행에 성공한 경우의 형상 충실도를 높이고, 종료 피드백 DPO는 반복 출력을 줄인다. 개선은 체크포인트나 지표 전반에서 균일하지 않다.
- C.5 ADDITIONAL HARNESS RESULTS는 설정마다 프롬프트 8–11개를 사용한 별도 연구에서 대응 비교 점수가 +15.5점에서 +52.3점 높아졌다고 보고한다. 명시적인 관절 결합 계획 필드를 추가하면, 한 관절의 운동을 다른 관절의 함수로 지정하는 유효한 URDF mimic 선언이 3/10에서 10/10으로 늘어난다. 구성 요소 실행 기록에서는 잘못된 계획이 4.7%에서 0.7%로, 불필요한 재시도가 26.6%에서 1.3%로 줄었다고 보고한다. Appendix C의 다른 보조 결과에는 예외도 있다. Table 9는 Claude Sonnet 5의 그래픽 평균 변화가 −5.4점이며, 95% 신뢰구간은 [−20.8, 10.1]이라고 보고한다.
- D EXECUTABLE ARTICULATION AND COMPARISON WITH UWM은 에셋 2개 × 초기 상태 2개 × 제어 방식 3개를 평가한다. 20 Hz로 명령 16개를 사용하며, 사례마다 UWM 시드 3개를 적용한다. 직접 시뮬레이션과 VAE로 복원한 렌더링은 각각 12/12개 사례에서 평가 가능한 윤곽을 보존했으며, UWM 롤아웃은 7/36개에서 보존했다. 마지막 프레임을 정지 상태로 유지한 대조군도 운동 없이 12/12개를 통과했다. 따라서 이 결과는 전반적인 동적 예측 품질이 아니라 해당 설정에서의 강체 기하 구조 보존을 측정한다.
짧은 생각
실행 가능한 소스, 측정에 기반한 구조 피드백, 재사용 가능한 학습 기록의 결합이 이 논문에서 가장 유용한 기여다. 수치 보정값과 측정에 기반한 점수 제약은 렌더링된 외형만으로 놓칠 수 있는 결함을 에이전트가 구체적으로 수정할 방법을 제공한다. 학습 결과와 인간 선호도 결과도 통합 워크플로를 뒷받침한다.
근거는 연산 효율이나 일관된 성능 향상보다 워크플로 수준의 품질 개선을 더 명확하게 뒷받침한다. 생성 비용은 크게 증가하고, 일부 보조 연구는 규모가 작으며, 검증 범위는 출처마다 다르고, 본문 표의 값은 부록과 일치하지 않는다. 동일 예산 비교, 결과 표의 불일치 해소, 더 폭넓은 반복 실행 평가가 실제 활용에서의 장단점을 판단하는 데 도움이 될 것이다.