


RRSI: Regularized Recursive Self-Improvement of Agent Harnesses 요약 설명
21 Sep 2026 | Paper Review Harness Optimization Recursive Self-Improvement Self-Evolving Agents목차
이번 글에서는 RRSI: Regularized Recursive Self-Improvement of Agent Harnesses 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 21일(Arxiv)
- Xia, Peng, Han, Rujun, Wang, Zifeng, Chen, Yanfei, Zhuang, Yufan, Lee, Yoonho, Huang, Chengsong, Yu, Han, CuiZhu, Zhongying, Ming, Yifei, et al.
- Google Cloud AI Research, UNC-Chapel Hill, Stanford University, Washington University in St. Louis
- 논문 링크
- Github
- Project Page
요약
- 고정된 언어 모델을 둘러싼 프롬프트, 제어 흐름, 도구, 메모리, 컨텍스트 관리 체계를 에이전트 하네스라고 한다. 하네스를 자동으로 개선하면 변경 사항을 선택할 때 사용한 과제에 과적합될 수 있다. RRSI(Regularized Recursive Self-Improvement of Agent Harnesses)는 주 실험에서 초기 하네스보다 홀드아웃 평가 분할 6개 모두의 성능을 높인다. Workspace 환경에서 시행당 policy token 소비량은 2.42 million 토큰으로, 정규화 없는 진화의 3.80 million 토큰보다 적다. Policy token은 고정된 언어 모델이 사용하는 토큰을 뜻한다.
- RRSI는 모든 하네스 구성 요소를 수정할 수 있도록 유지하면서 후보 생성과 선택에 정규화를 적용한다. 후보에 묶어서 적용하는 수정 수를 점차 줄이고, 이전 평가의 근거를 보존하며, 활용이 적었던 구성 요소를 탐색한다. 또한 벤치마크에 특화된 코드를 걸러내고, 변경 사항을 채택하기 전에 성능과 추론 비용을 확인한다.
- 주 평가는 코딩, 전문 업무용 workspace 과제, 공학 설계에 걸친 벤치마크 8개를 다루며, 탐색 내내 모델 가중치를 고정한다. 도메인마다 평가 모음 1개에서 진화시킨 하네스를 그대로 적용하면, 저장소 버그 수정 벤치마크인 SWE-bench Verified에서 1.8점, 미관측 workspace 벤치마크 3개에서 3.5–4.7점 향상된다. 공학 최적화 벤치마크인 Frontier-Eng에서는 순위별 성능 기준 달성 여부로 산정하는 Medal 점수가 4.3점 높아진다.
- 제안 정규화나 채택 정규화 중 어느 쪽을 제거해도 진화 과제 점수는 높아지지만 전이 성능은 낮아진다. 과제 수준의 불확실성 추정과 2번째 독립 탐색도 보고된 향상을 뒷받침한다. 다만 실험은 모델 가중치를 고정한 제한된 탐색만 다루므로, 무기한 자기 개선이나 가중치 갱신 과정에서의 동작까지 입증하지는 않는다.
1. Introduction
이 논문에서 재귀적 자기 개선(Recursive Self-Improvement, RSI)은 에이전트 시스템의 피드백을 반복적으로 사용해 자체 하네스를 수정하는 것을 뜻한다. 이 과정에서는 후보 변경 사항을 평가하는 유한한 과제 집합인 evolve set을 재사용한다. 이러한 적응적 재사용은 미관측 과제의 성능을 높이지 못하면서도 벤치마크에 특화된 패턴, 유리하게 작용한 평가 잡음, 추가 연산에 보상을 줄 수 있다.
- 논문은 일반화를 과제 설명, 도구 인터페이스, verifier가 다른 벤치마크로 진화된 하네스를 전이하는 것으로 정의한다. Verifier는 과제 결과에 점수를 매기는 프로그램이다.
- RRSI는 모든 하네스 구성 요소를 변경할 수 있도록 허용하면서 후보 제안 방식과 선택 방식을 제약한다.
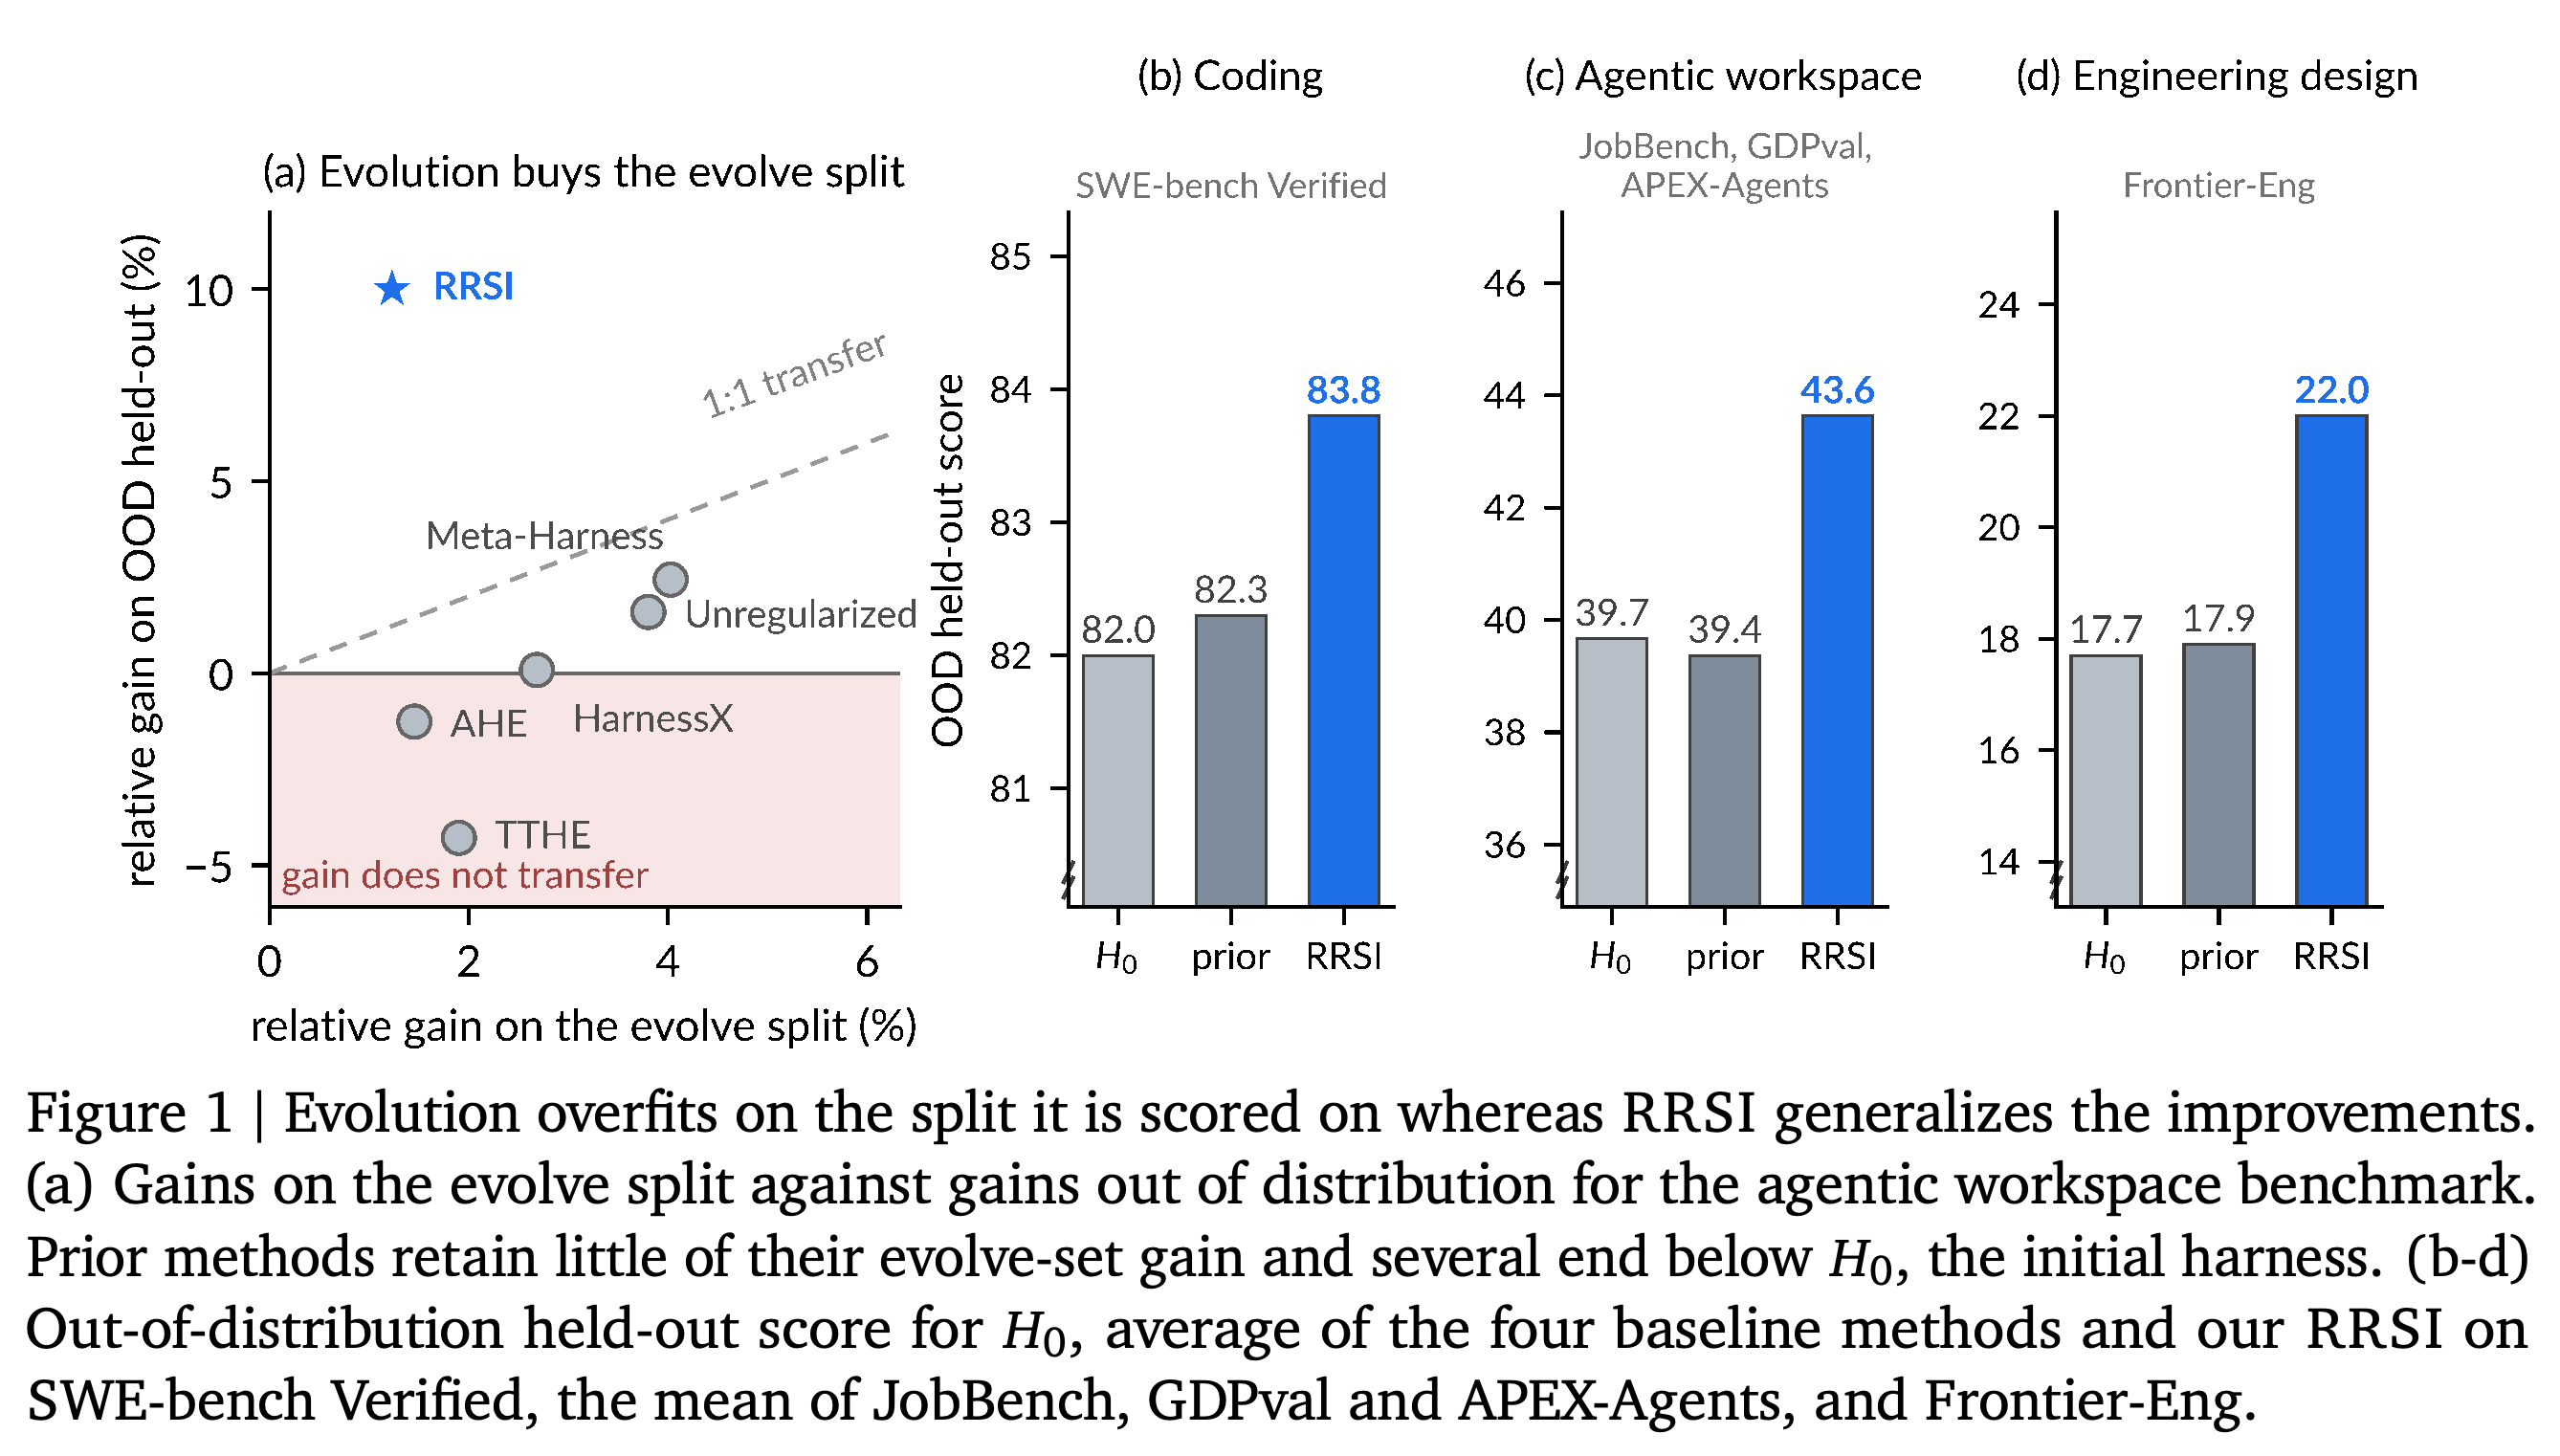
- Figure 1은 evolve set에서의 향상과 미관측 workspace 벤치마크에서의 향상을 구분한다. 여러 기존 방법은 전자에서 개선되지만 후자에서는 성능이 낮아진다.
Workspace 산점도는 진화 과제의 상대적 향상과 미관측 벤치마크의 향상을 구분한다. 여러 기존 탐색은 evolve set에서 얻은 향상을 거의 유지하지 못하거나 초기 하네스보다 낮은 성능을 보인다. 나머지 패널에서 RRSI의 홀드아웃 점수는 코딩 83.8, workspace 벤치마크 평균 43.6, 공학 설계 22.0이다. 모두 초기 하네스와 기존 베이스라인 평균이라는 비교 기준 2개를 앞선다.
2. Preliminaries
에이전트는 행동을 선택하는 고정된 언어 모델인 backbone policy와 수정 가능한 하네스로 구성된다. 과제를 실행하면 에이전트의 행동과 관측으로 이루어진 궤적 및 산출물이 생성되고, verifier가 0과 1 사이의 점수를 부여한다. 성능은 verifier 점수의 기댓값이며, 비용은 policy token 수의 기댓값이다.
- Verifier는 코딩 테스트 모음일 수도 있고, workspace 산출물을 평가하는 언어 모델일 수도 있다.
- 일반적인 하네스 진화는 현재 하네스를 실행하고, 궤적을 피드백으로 요약한 뒤, 후보를 제안하고 같은 evolve set에서 평가한다. 이후 최고 점수 후보를 선택하거나 현재 하네스를 유지한다.
- 점수와 비용은 과제당 k회 시행의 평균으로 추정한다. 후속 제안은 같은 과제에서 앞서 측정한 결과에 의존하므로, 최적화 과정은 적응적으로 진행된다.
3. RRSI
RRSI는 실행 가능한 하네스 변경 사항을 반복 탐색하는 과정에 과적합을 줄이기 위한 제약인 정규화를 적용한다. 희소한 갱신은 함께 바뀌는 메커니즘 수를 제한하고, 과거 평가 근거는 실패한 가설을 반복해서 시도하는 일을 억제한다. 보수적인 선택은 벤치마크 특화 내용, 평가 잡음, 정당한 근거가 없는 자원 증가가 하네스에 남는 것을 제한한다.
3.1. A Regularization View of Harness Evolution
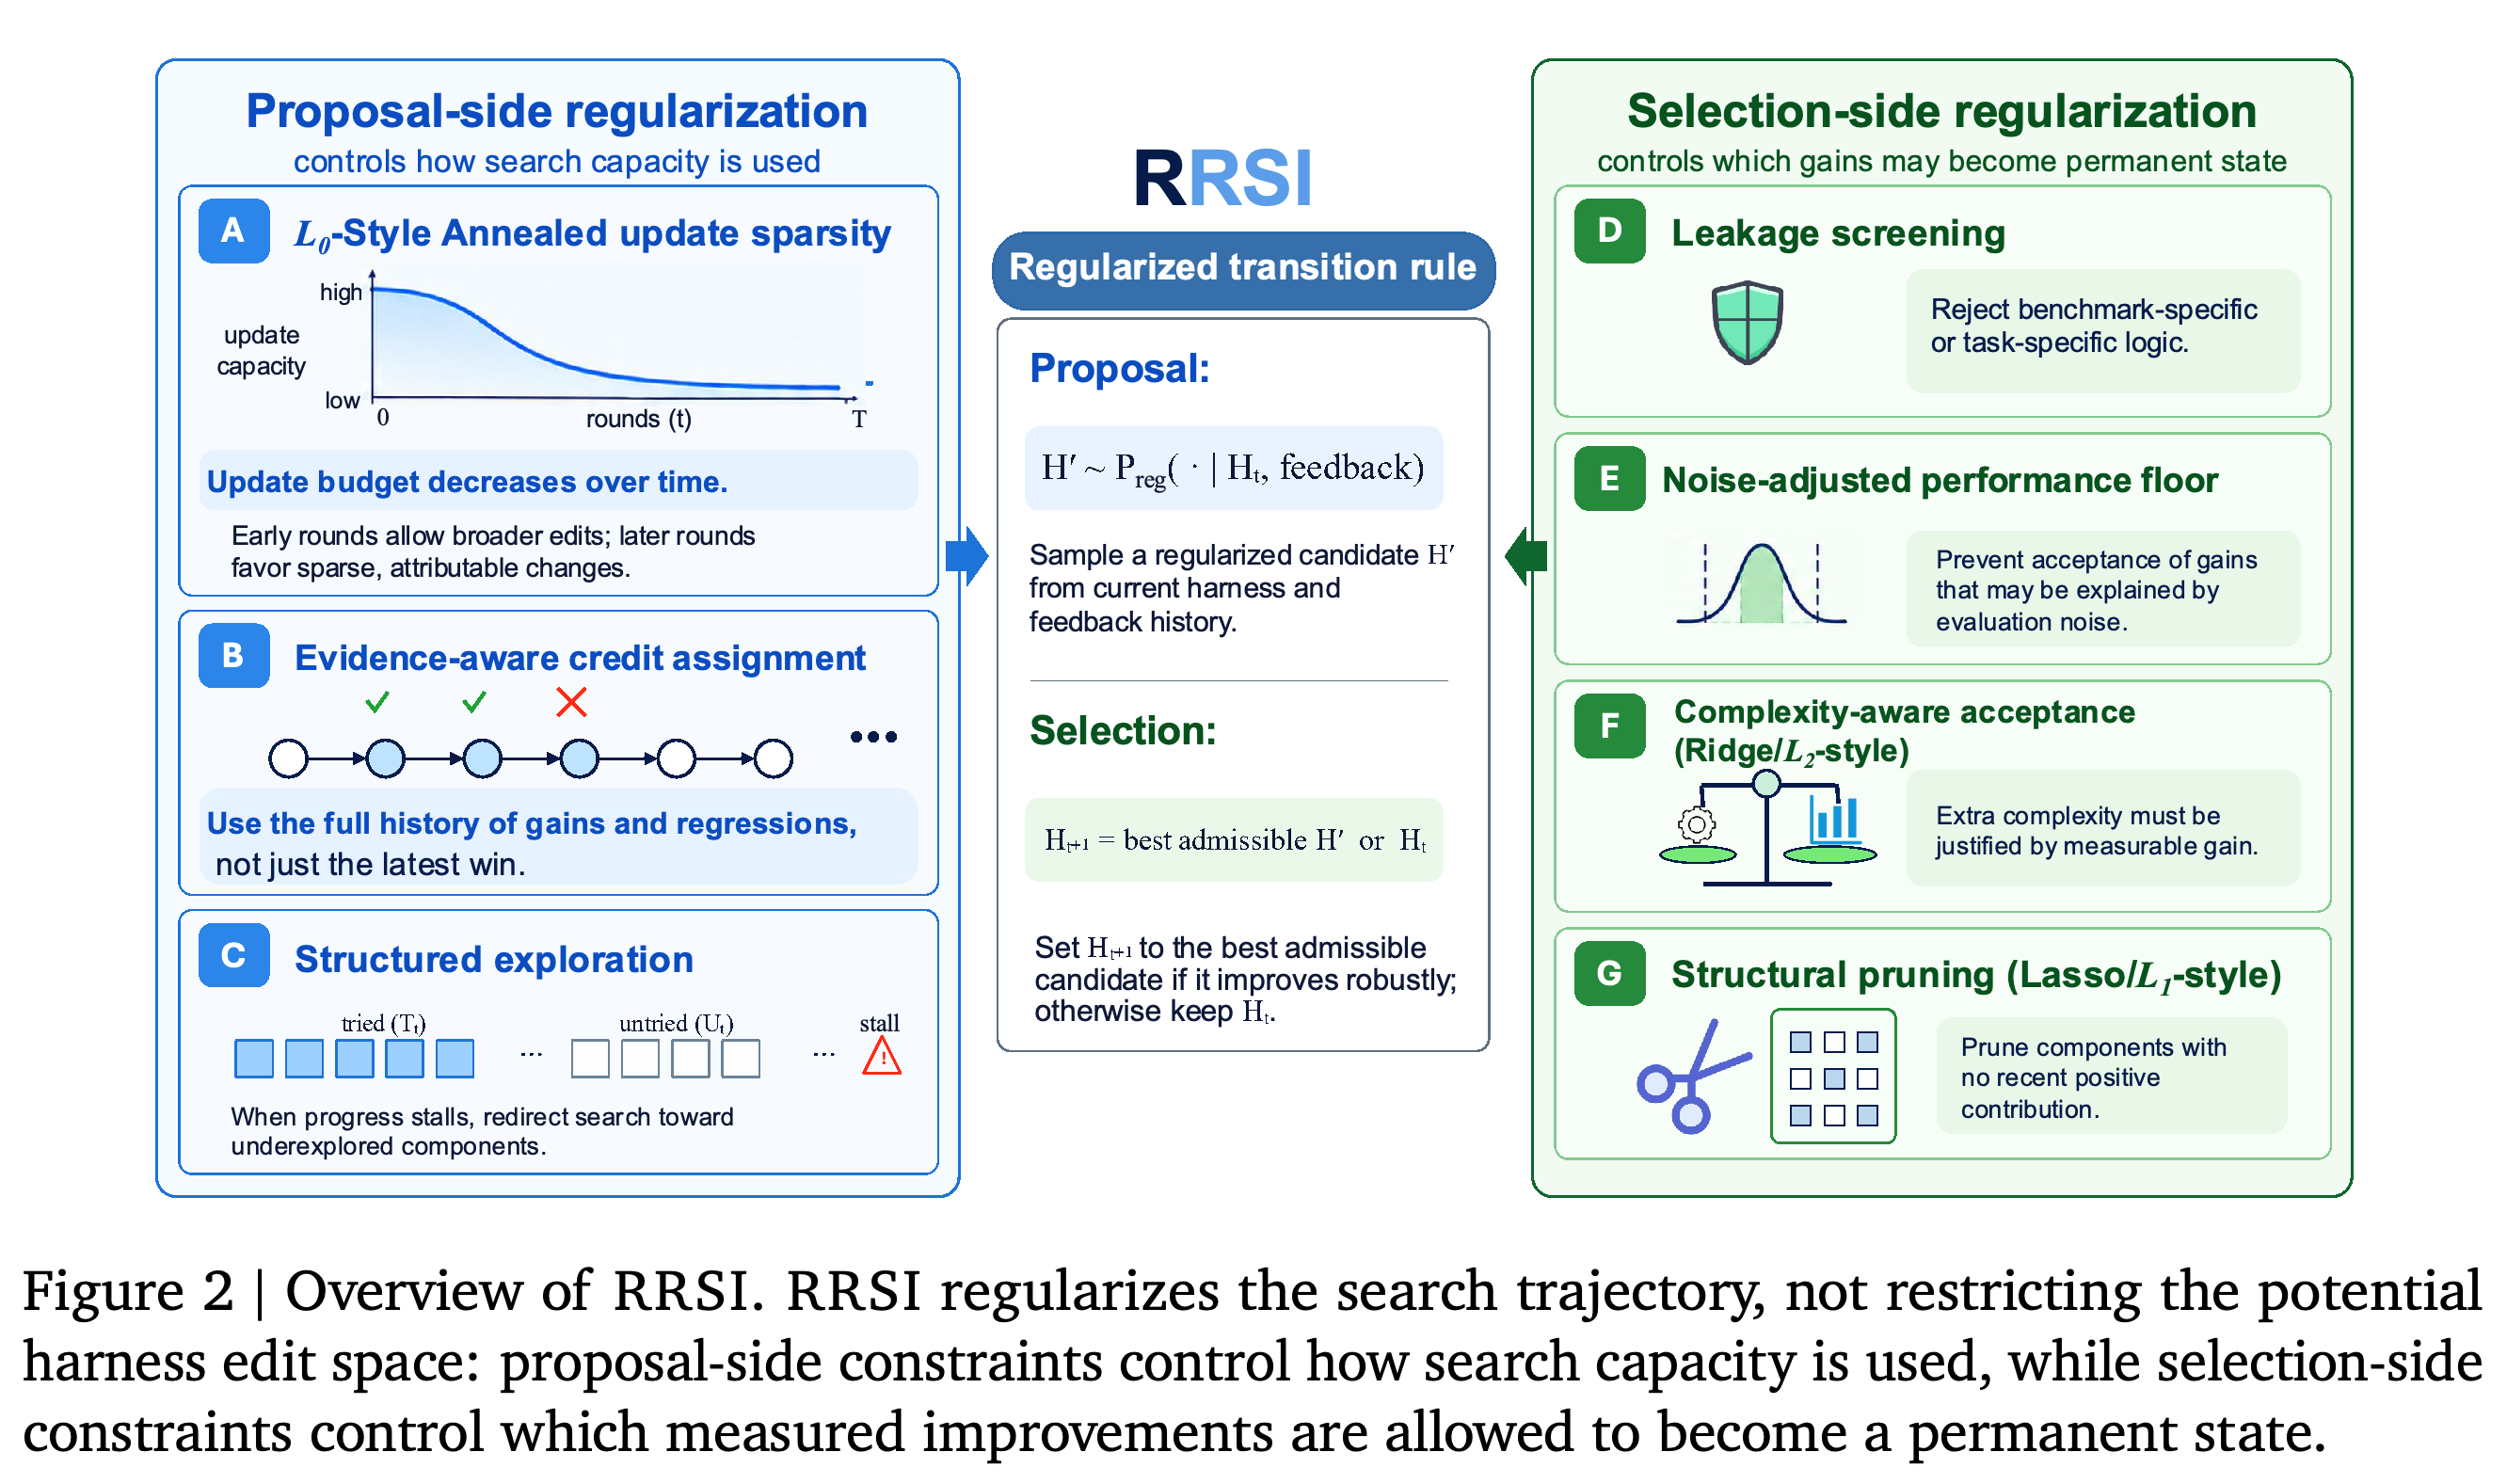
탐색 가능한 하네스 범위를 제한하지 않는다. 프롬프트, 제어 흐름, 설정, 컨텍스트 관리, 도구, skill, 메모리, subagent를 수정하거나 추가하거나 제거할 수 있다. 제안 제약은 탐색할 수정의 수와 유형을 조절하고, 선택 제약은 어떤 후보가 현재 하네스를 대체할 수 있는지 결정한다.
- L0 방식에 대한 비유는 1회 갱신에 포함되는 수정 중 효과를 독립적으로 구분할 수 있는 수정의 수를 제한한다는 뜻이다.
- Lasso/L1 방식의 가지치기는 성과가 없는 이산적 구성 요소를 삭제한다는 뜻이다. Ridge/L2 방식의 채택은 특정 구성 요소를 반드시 제거하지 않으면서 전체 자원 증가를 제한한다는 뜻이다.
- 이들은 고전적 정규화와 기능이 유사하다는 비유다. RRSI는 공통 연속 매개변수 벡터에 해당 노름 페널티를 적용한 목적함수를 최적화하지 않는다.
도식은 후보 생성 제어 3개와 후보 채택 제어 4개를 구분한다. 이 제어는 탐색할 수정의 수와 유형을 제한하고 벤치마크 특화 내용을 걸러낸다. 또한 후보가 현재 하네스를 대체하기 전에 성능과 자원 사용량이 허용 기준을 충족하도록 요구한다.
3.2. Regularizing the Proposal Distribution
후보 생성에는 탐색 라운드가 진행될수록 한도를 낮추는 수정 예산, 이전 수정과 결과를 기록하는 근거 기반 기여도 귀속, 활용이 적었던 구성 요소의 구조적 탐색을 사용한다. 코사인 스케줄에 따라 후보에 묶을 수 있는 최대 수정 수를 1개에 가깝게 줄인다. 이에 따라 초기에는 연계된 변경을 허용하고, 후기에는 결과의 원인을 더 쉽게 파악할 수 있다.
- 평가한 모든 후보에 대해 수정한 구성 요소, 검증한 가설, 소스 diff, 점수와 비용 변화, 채택 결과를 기록한다. 제안자는 이후 라운드에서 실패한 결과까지 포함한 이 기록을 활용한다.
- 이전 w개 라운드의 진전이 경험적 잡음 허용치 δ를 넘지 못하면 탐색이 정체된 것으로 판단한다. δ는 반복 평가에서 추정한 변동이다. 정체 중에는 아직 수정 효과를 측정하지 않은 구성 요소 유형에 예약된 제안 슬롯을 배정한다.
- 수정 후보 집합은 라운드마다 바뀔 수 있다. 예산은 각 갱신을 제약하며, 특정 구성 요소 유형을 영구적으로 제외하지 않는다.
3.3. Regularizing Candidate Selection
후보 선택은 누출, 안정성, 비용에 별도 요건을 적용한다. 누출은 evolve 벤치마크에 특화된 내용을 하네스에 넣는 것을 뜻한다. 전체 평가 전에 critic이 소스 diff를 읽고 과제명, 개체명, 과제별 값, 정답, 그 밖의 벤치마크 특화 로직과 실질적으로 작동하지 않는 장치를 걸러낸다.
- 변경하지 않은 기본 하네스를 반복 평가해 δ를 정한다. 후보 점수는 지금까지 채택된 최고 점수에서 δ를 뺀 값 이상이어야 한다. 이를 통해 작은 퇴보가 연속해서 발생하더라도 기준 점수가 계속 낮아지는 것을 막는다.
- 후보가 현재 하네스보다 얻은 점수 향상이 δ를 넘으면, 상대적 토큰 비용 증가는 기본 허용량과 향상 폭에 따른 허용량의 합을 넘지 않아야 한다. 향상이 δ를 넘지 않으면 점수 변화, 비용 변화, 이전에 사용하지 않은 구조적 구성 요소 유형을 결합한 별도 규칙을 적용한다.
- 가지치기 관찰 구간에서 양수인 측정 기여도를 보이지 못한 구성 요소는 후속 제안의 삭제 대상이 된다. 후보는 도메인별 검사도 통과해야 한다. 선택기는 허용된 후보 중 최고 점수 후보를 고르고, 적격 후보가 없으면 현재 하네스를 유지한다.
4. Experiments
실험은 비교 성능, 미관측 과제와 벤치마크로의 전이, 정규화 요소의 기여, 추론 비용을 평가한다. 벤치마크 8개는 코딩 분야의 터미널 과제인 Terminal-Bench 2.1과 SWE-bench Verified, workspace 분야의 법률 문서 업무용 Harvey LAB과 전문 업무용 JobBench, GDPval, APEX-Agents, 공학 설계 분야의 EngDesign과 Frontier-Eng로 구성된다.
4.1. Experimental Setup
진화에는 89개의 컨테이너화된 Terminal-Bench 2.1 tasks, 고정된 Harvey LAB evolve set의 120 tasks, 또는 EngDesign의 61 tasks를 사용한다. Harvey LAB은 같은 평가 모음에서 가져온 미관측 과제로 구성된 별도의 분포 내 홀드아웃 집합 40 tasks도 제공한다. 다른 다섯 벤치마크는 탐색에 사용한 평가 모음 밖의 성능을 검증하는 분포 외(OOD) 평가에 사용한다.
- 주 실험에서는 Claude Opus 4.8을 backbone policy로 고정한다. 제안자, 라운드 간 실패 분석기, 누출 critic도 Claude Opus 4.8을 사용한다.
- 코딩은 Terminus-2에서 시작한다. Workspace와 공학 환경은 추론과 행동을 결합하는 ReAct 루프를 사용한다. 이 루프는 외부 도구를 제공하는 MCP 도구 게이트웨이, 동적 도구 모음, 모델의 작업 컨텍스트를 관리하는 ReSum 방식의 컨텍스트 관리를 활용한다.
- 진화 베이스라인 4개는 초기 하네스, 고정 policy, evolve set, 후보 예산을 공유한다. 실행 가능한 하네스 코드를 최적화하는 Meta-Harness, 실행 관측에 기반해 진화하는 Agentic Harness Engineering(AHE), 모델 가중치를 고정한 채 궤적을 바탕으로 적응하는 Test-Time Harness Evolution(TTHE), 모듈형 하네스 구성 요소를 대상으로 적응하는 HarnessX를 비교한다. Meta-Harness에 대해서는 Meta-Harness: End-to-End Optimization of Model Harnesses 요약 설명 글을 참조하라.
4.2. Main Results
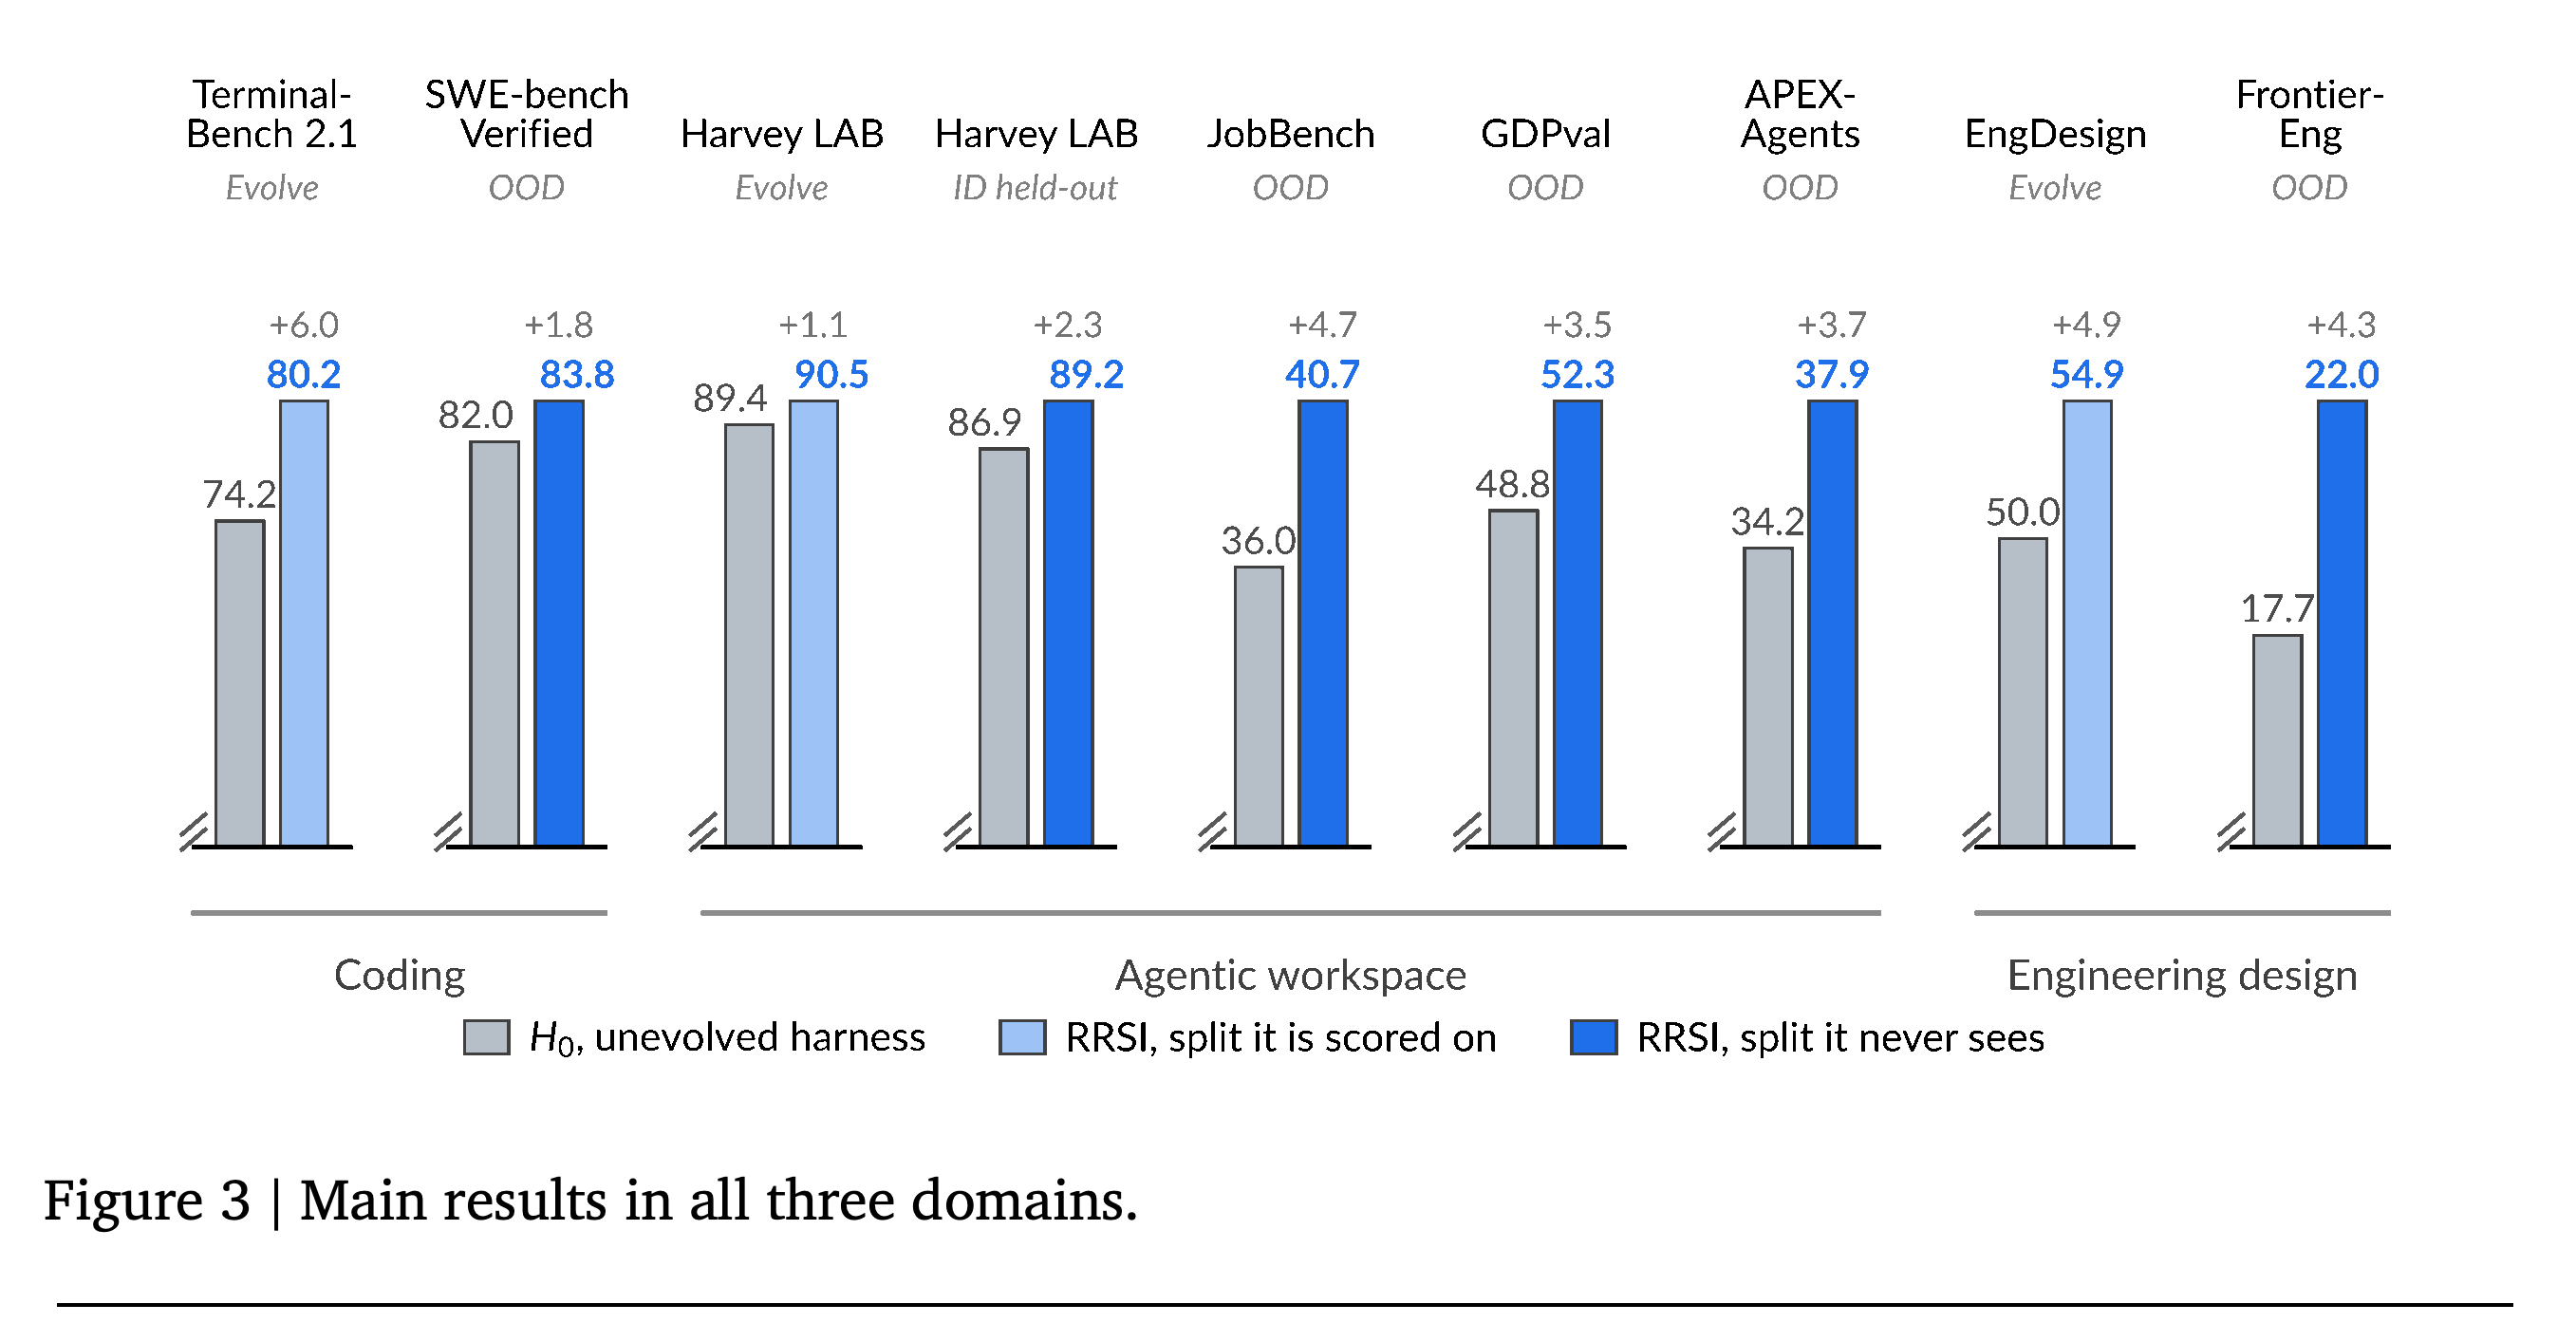
같은 평가 기간에 측정한 초기 하네스와 비교하면, RRSI는 Terminal-Bench 2.1을 74.2에서 80.2로, Harvey LAB evolve를 89.4에서 90.5로, EngDesign을 50.0에서 54.9로 높인다. 홀드아웃 분할 6개도 모두 향상된다. SWE-bench Verified는 82.0에서 83.8로, Harvey LAB 홀드아웃은 86.9에서 89.2로, JobBench는 36.0에서 40.7로, GDPval은 48.8에서 52.3으로, APEX-Agents는 34.2에서 37.9로, Frontier-Eng는 17.7에서 22.0으로 높아진다.
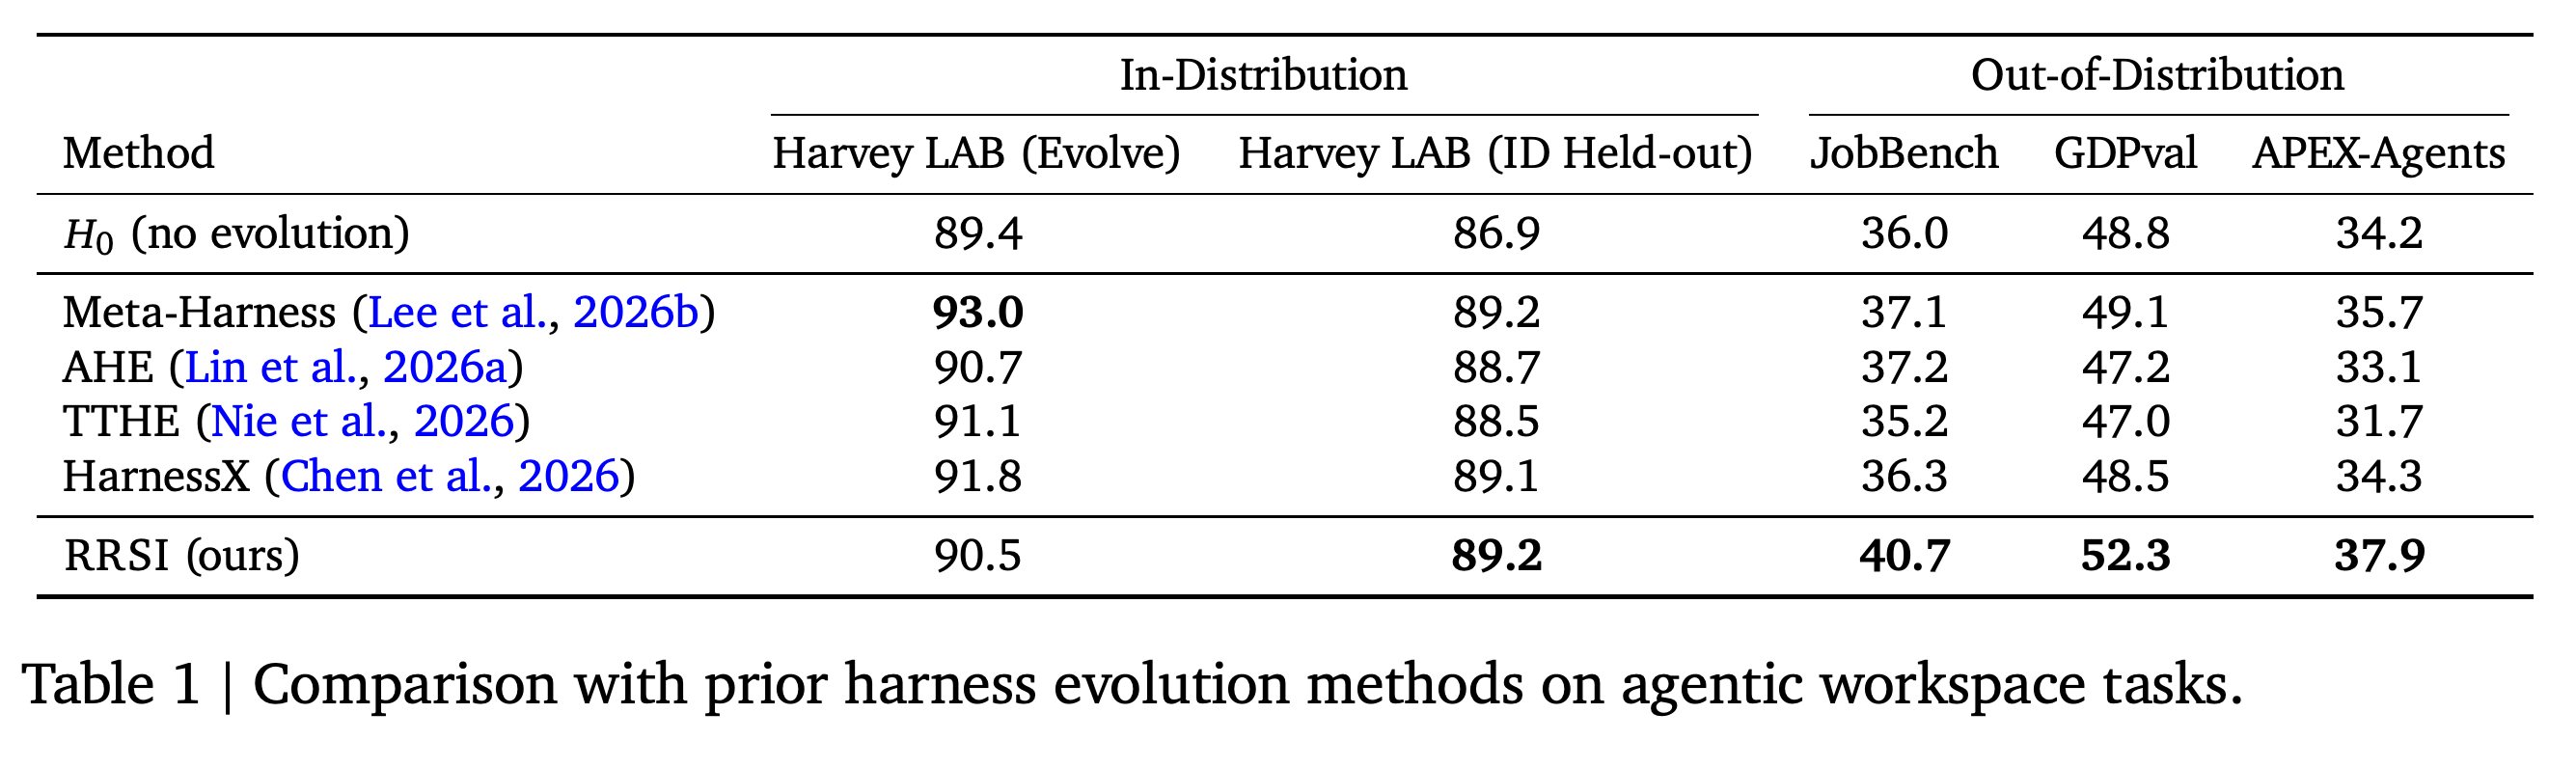
- Workspace 비교에서 RRSI는 Harvey LAB 홀드아웃에서 Meta-Harness와 89.2로 동률이며, OOD 벤치마크 3개 각각에서 모든 기존 방법을 앞선다. OOD 평균은 43.6으로, 초기 하네스의 39.7과 Meta-Harness의 약 40.6보다 높다.
- Harvey LAB evolve 최고 점수는 Meta-Harness의 93.0이며, RRSI는 90.5다. Evolve set과 OOD에서 순위가 역전된다는 점은 진화 점수만으로 전이를 평가하기 어렵다는 것을 보여준다.
- 공학 전이는 결정론적 시뮬레이터나 테스트벤치로 점수를 매기므로, 언어 모델 평가를 넘어서는 근거를 제공한다. 초록에 기재된 최대 OOD 향상 4.3점은 Figure 3과 Table 1의 JobBench 향상 4.7점과 일치하지 않는다.
나란히 배치한 막대는 초기 하네스와 비교해 진화 분할 3개와 홀드아웃 분할 6개 모두에서 성능이 향상됨을 보여준다. 미관측 workspace의 향상은 4.7, 3.5, 3.7점이다. JobBench 결과는 초록에 기재된 최대 OOD 향상 4.3점을 넘는다.
Meta-Harness는 Harvey LAB 진화 과제에서 93.0으로 가장 높다. RRSI는 미관측 workspace 벤치마크 3개에서 40.7, 52.3, 37.9로 가장 높다. 분포 내 홀드아웃 집합에서는 RRSI와 Meta-Harness가 89.2로 동률이므로, 모든 홀드아웃 데이터셋에서 베이스라인을 앞선다는 논문의 주장은 이 동률을 고려해 해석해야 한다.
4.3. Analysis
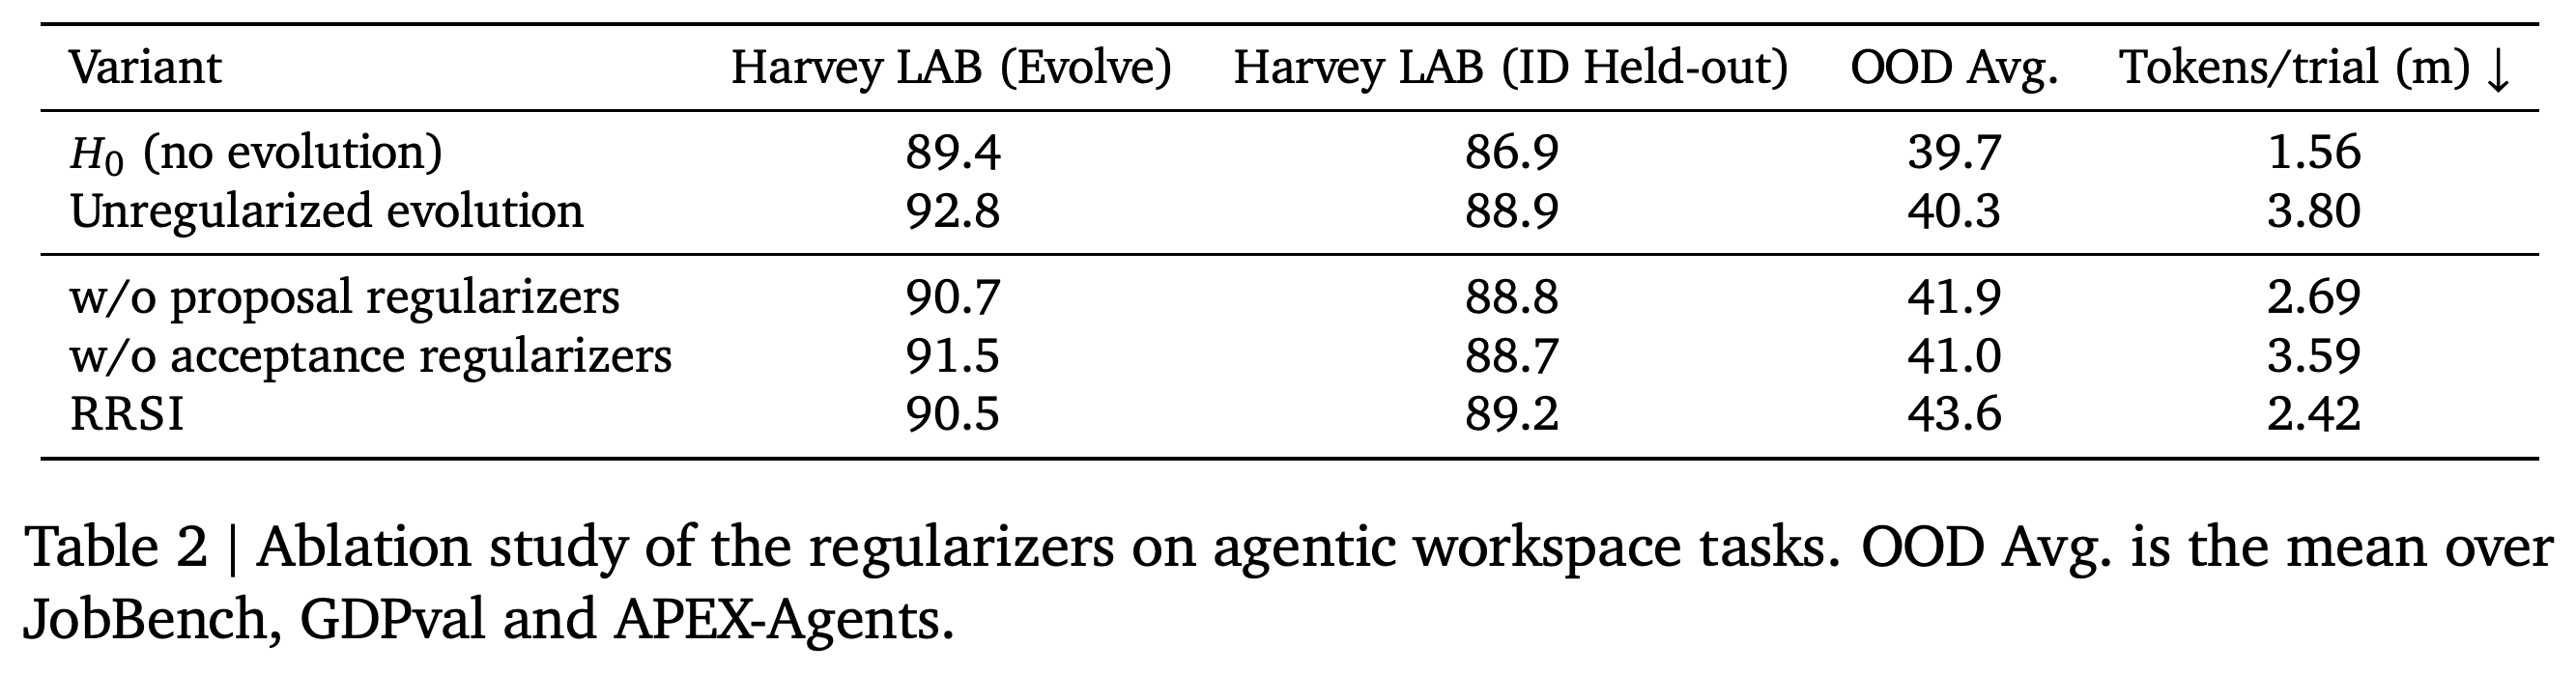
방법의 일부를 제거해 비교한 workspace 실험은 제안 정규화와 채택 정규화를 함께 사용하는 것을 뒷받침한다. RRSI는 시행당 2.42 million 토큰으로 OOD 평균 43.6을 얻는다. 제안 정규화를 제거하면 2.69 million 토큰에서 41.9, 채택 정규화를 제거하면 3.59 million 토큰에서 41.0, 정규화 2종을 모두 제거하면 3.80 million 토큰에서 40.3을 얻는다.
- 구성 요소를 제거한 탐색은 모두 evolve set에서 RRSI보다 높은 점수를 얻는다. 제안 정규화가 없으면 90.7, 채택 정규화가 없으면 91.5, 어느 정규화도 없으면 92.8이며, RRSI는 90.5다.
- 이러한 그룹 단위 제거 실험은 제어 방식 2개 묶음을 평가하지만, 개별 메커니즘의 기여를 분리하지는 않는다.
- 표의 토큰 비용으로 계산하면 정규화 없는 진화보다 소비량이 약 36% 적지만, 초록은 30%로 보고한다. RRSI의 소비량은 시행당 1.56 million 토큰을 사용하는 초기 하네스보다 여전히 많다.
어느 정규화 그룹을 제거해도 진화 점수는 높아지지만 OOD 성능은 낮아지고 토큰 사용량은 늘어난다. 전체 RRSI는 시행당 2.42 million 토큰에서 43.6을 얻으며, 정규화 없는 진화는 3.80 million 토큰에서 40.3을 얻는다. 이 비용으로 계산하면 소비량은 약 36% 적다.
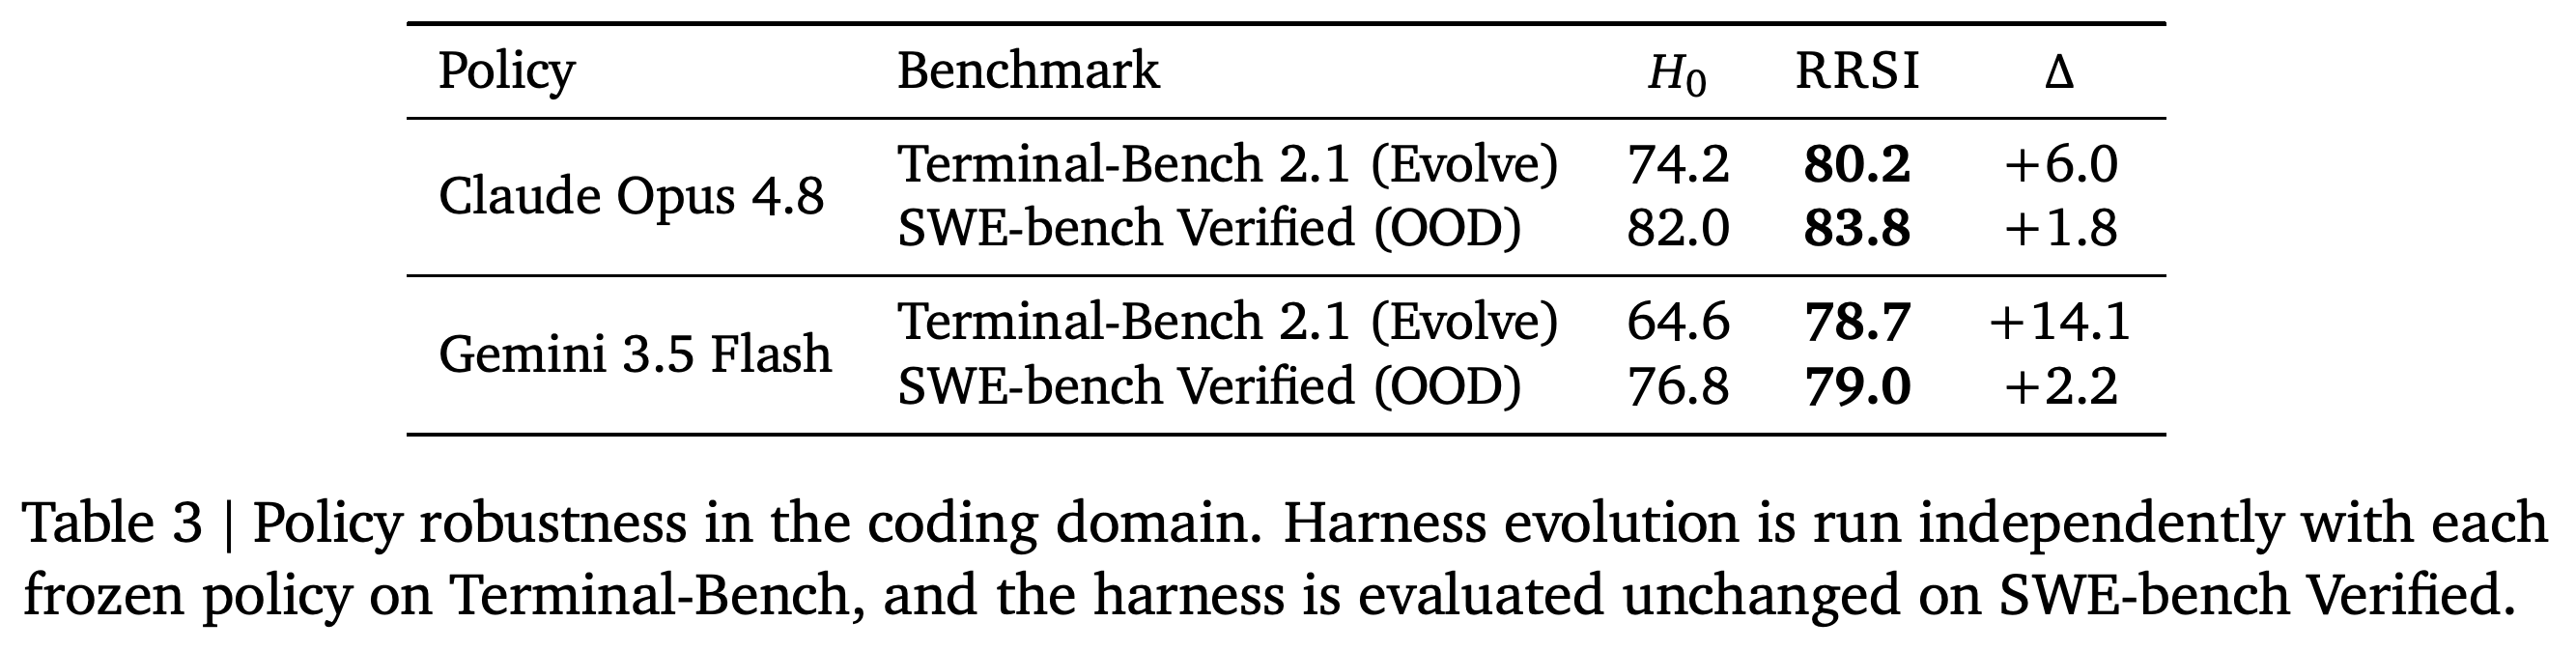
Backbone 계열 2개로 수행한 독립적인 코딩 탐색은 모두 SWE-bench Verified로 전이된다. Claude Opus 4.8에서는 Terminal-Bench 2.1이 6.0점, SWE-bench Verified가 1.8점 향상된다. Gemini 3.5 Flash에서는 각각 14.1점과 2.2점 향상된다.
- Gemini 3.5 Flash 탐색은 Terminal-Bench 2.1을 64.6에서 78.7로, SWE-bench Verified를 76.8에서 79.0으로 높인다.
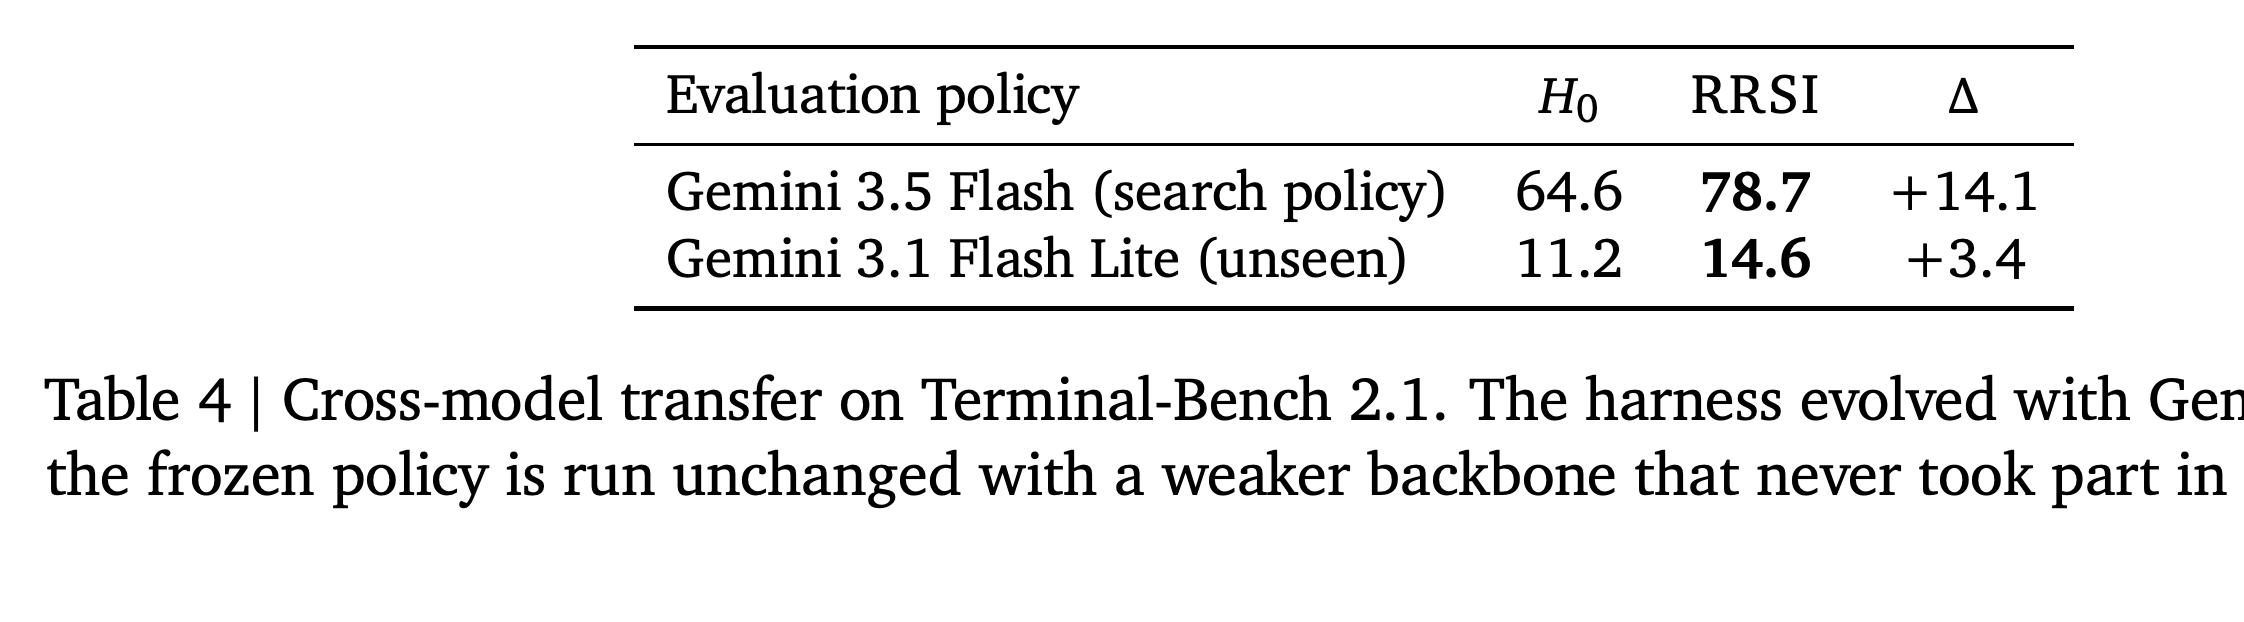
- 이 최종 하네스를 이전에 사용하지 않은 Gemini 3.1 Flash Lite에 그대로 적용하면 Terminal-Bench 2.1이 11.2에서 14.6으로 높아진다. 절대 향상은 3.4점, 상대 향상은 30.4%다.
- Policy 계열별 독립 탐색과 미관측 backbone에서의 재사용은 서로 다른 검증이다. 후자는 추가 backbone 1개와 벤치마크 1개에서 입증된다.
Claude Opus 4.8과 Gemini 3.5 Flash로 각각 수행한 탐색은 모두 미관측 SWE-bench Verified 성능을 높이며, 향상 폭은 각각 1.8점과 2.2점이다. 이 실험은 탐색 policy 2개에서 방법의 효과를 뒷받침한다. 같은 진화 하네스를 이들 사이에서 재사용하는지는 검증하지 않는다.
Gemini 3.5 Flash로 진화시킨 하네스는 수정 없이 Gemini 3.1 Flash Lite의 Terminal-Bench 2.1 점수를 11.2에서 14.6으로 높인다. 이는 진화에 사용한 벤치마크에서, 탐색에 참여하지 않은 backbone으로 하네스를 재사용하는 실험이다.
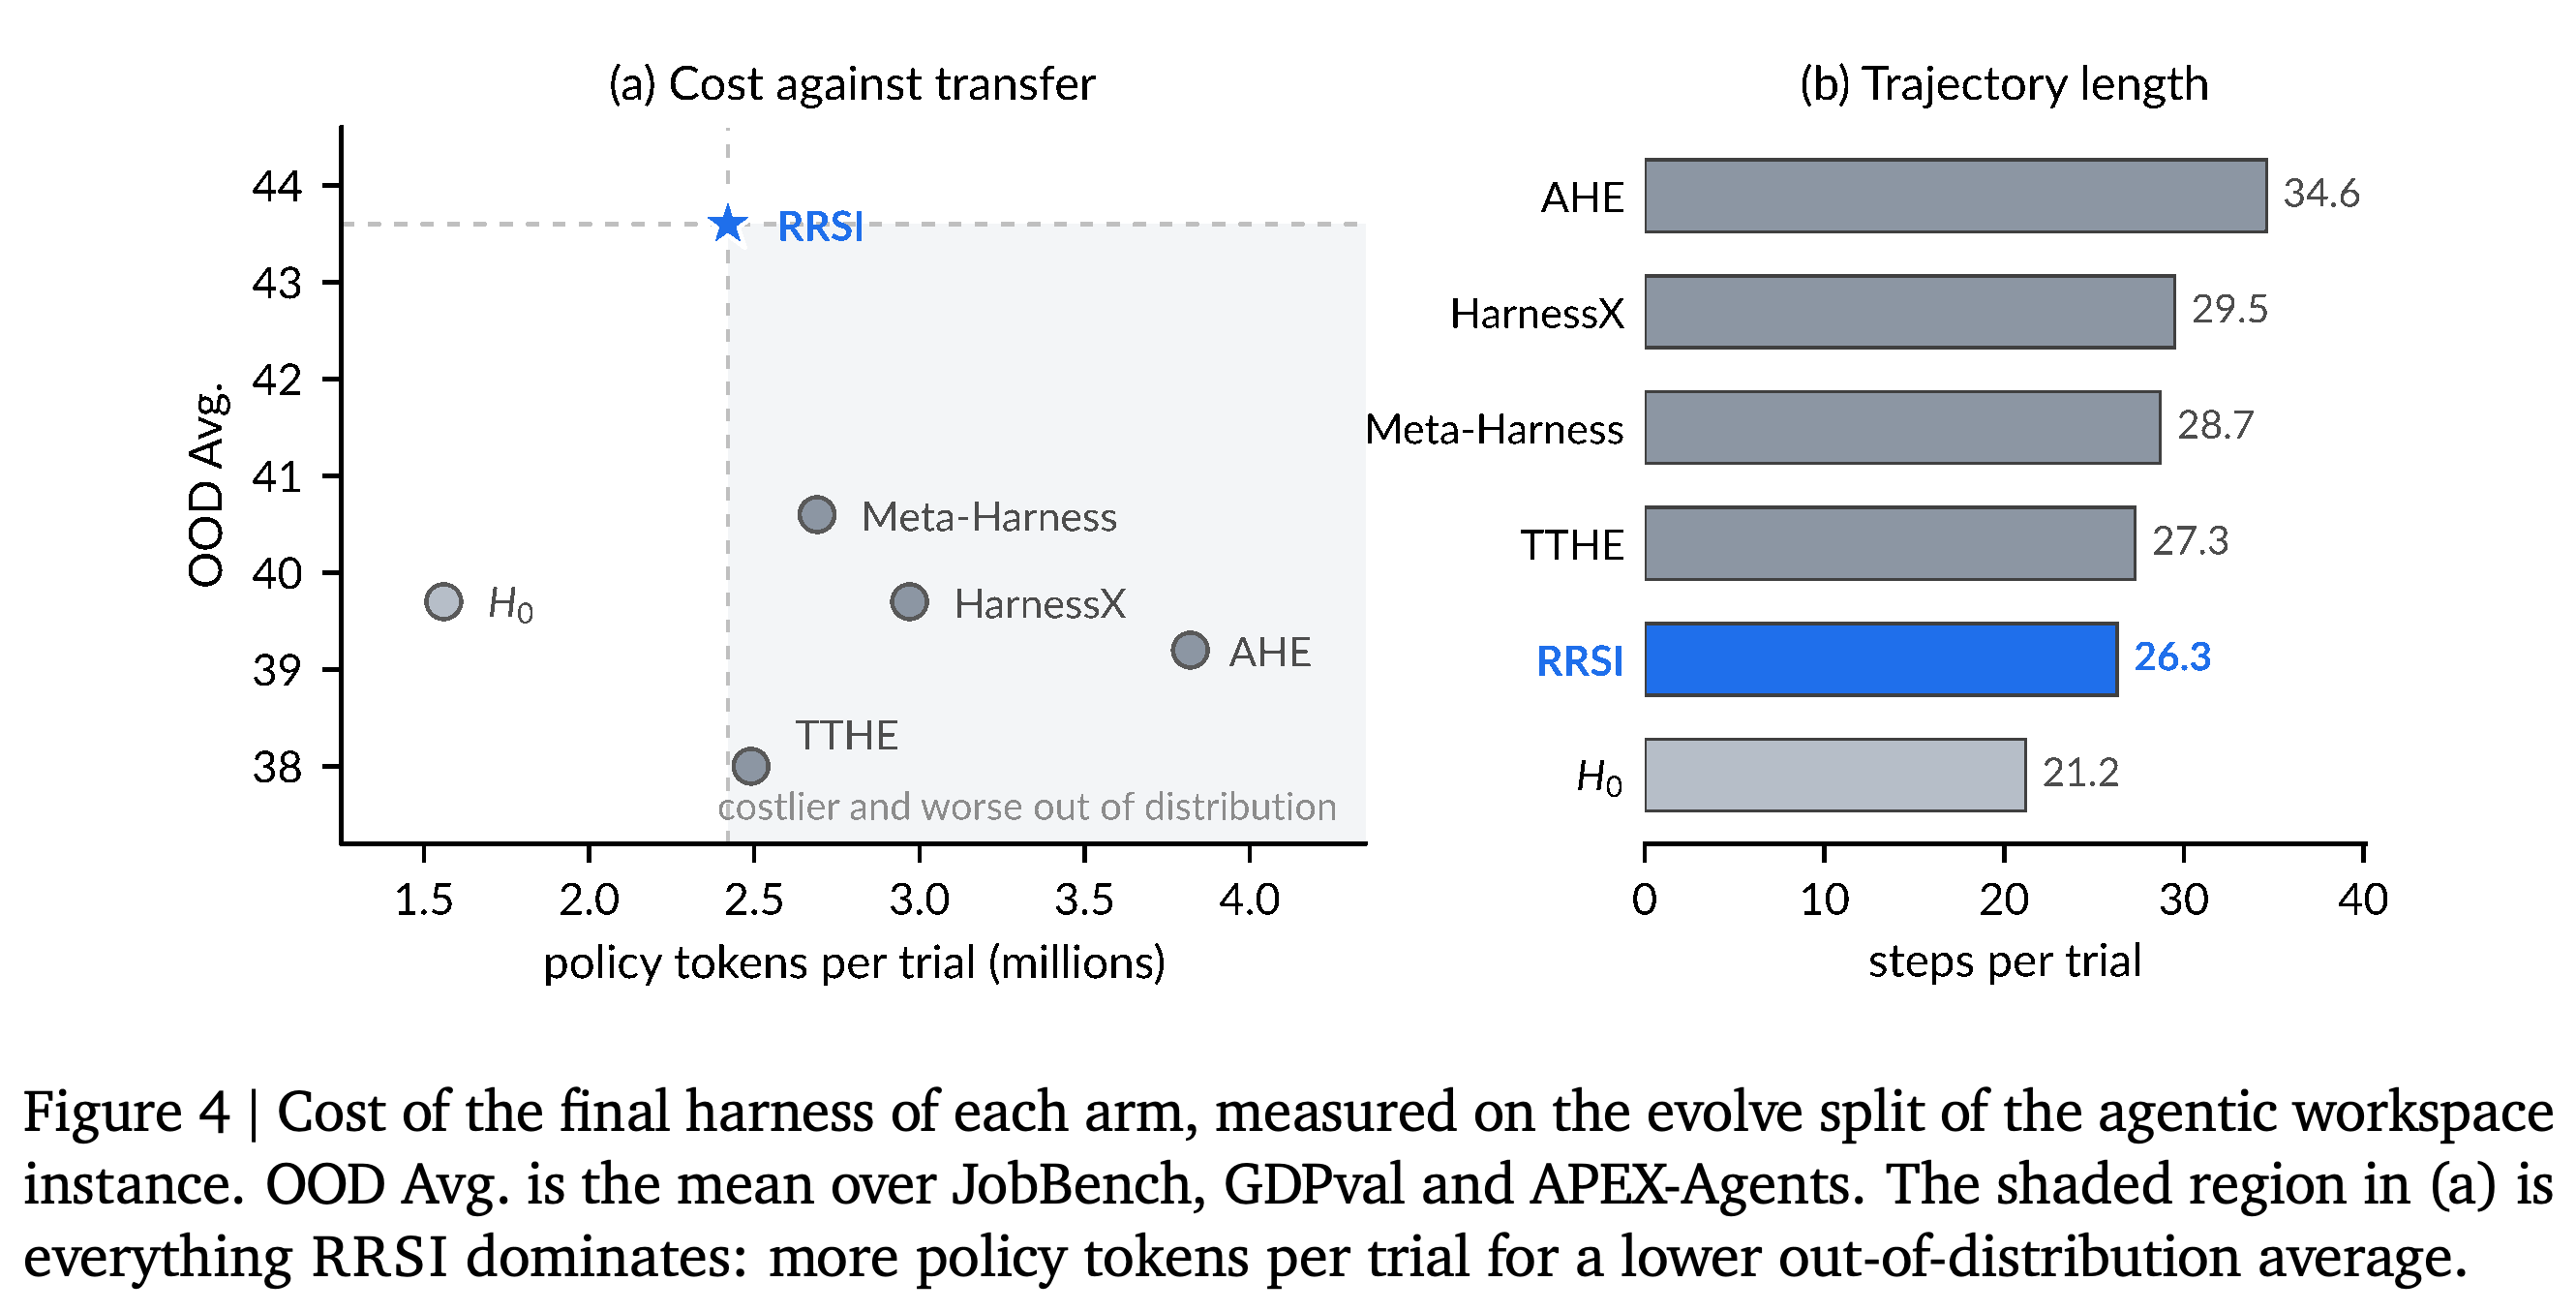
RRSI의 최종 workspace 하네스는 기존 진화 하네스 4개보다 OOD 성능이 높으면서 policy token 소비량이 적고 궤적이 짧다. 시행당 평균 26.3단계를 수행하며, 기존 방법은 27.3–34.6단계, 초기 하네스는 21.2단계를 수행한다.
- AHE는 시행당 3.82 million 토큰을 사용한다. 논문은 이를 RRSI보다 58% 많은 양으로 보고하며, OOD 평균 점수는 RRSI보다 4.4점 낮다.
- 이 측정값은 최종 하네스의 실행 비용을 나타낸다. 제안, 비평, 후보 평가를 포함한 진화 전체 비용을 입증하지는 않는다.
RRSI는 기존 진화 하네스 4개 모두보다 실행 토큰이 적으면서 OOD 성능이 높고, 시행당 단계 수도 적다. 초기 하네스는 여전히 비용이 더 낮고 궤적도 더 짧으므로, 효율성 우위는 다른 진화 하네스와 비교한 결과다.
5. Related Work
논문은 하네스 엔지니어링, 자동 하네스 진화, 자체 코드를 탐색하는 자기 개선 에이전트 연구를 연결한다. 기존 방법은 전체 하네스나 skill, 메모리 같은 구성 요소를 최적화한다. 동시기 연구는 명시적인 탐색 목적함수나 다양한 후보를 보존하는 아카이브를 통해 일반화를 다룬다.
- RRSI가 내세우는 차별점은 탐색 과정의 제어다. 전체 수정 이력을 활용하고, 점수를 매기기 전에 과제 특화 로직을 걸러내며, 잡음을 반영해 조정한 성능 기준에 따라 후보를 선택한다.
- 이러한 제어는 하네스 수정 범위를 제한하지 않은 상태에서 작동하므로, 탐색 절차와 수정 가능한 구성 요소의 선택을 분리한다.
6. Conclusion
결론에서는 유한한 evolve set의 반복 피드백을 지속적인 하네스 변경으로 반영하는 방식에 정규화가 필요하다고 주장한다. 실험한 도메인에서는 제안과 선택 제약이 홀드아웃 및 벤치마크 간 전이 성능을 높이고, 정규화 없는 진화보다 최종 하네스 실행 비용을 낮춘다.
Limitations
이 연구는 고정된 backbone 모델을 둘러싼 하네스 변경을 다루며, 모델 가중치를 갱신하는 진화는 평가하지 않는다. 효과는 피드백 품질, 정규화 설정, 탐색 예산에 따라 달라질 수 있다. 크게 다른 아키텍처와 도구 생태계, 더 긴 자기 개선 과정에서는 아직 검증되지 않았다.
부록
- A. Limitations는 모델 가중치를 고정한다는 제약과 피드백 및 탐색 설정에 대한 의존성을 다시 설명한다. B. Evaluation은 각 하네스와 베이스라인의 평가 기간, 도구 환경, 평가자, 시행 횟수를 맞추도록 명시한다. B.1. Terminal-Bench 2.1은 숨겨진 테스트를 통과해야만 성공으로 집계하며, 비교 조건 사이에 컨테이너를 재구축한다. B.2. SWE-bench Verified는 이전에 실패하던 테스트가 통과하고, 이전에 통과하던 테스트는 계속 통과해야 한다.
- B.3. Harvey LAB은 기준별로 독립 평가하며, 과제당 기준 20–100개와 전체 평가당 약 14,000건의 판정을 사용한다. 산출물이 누락되면 해당 필수 기준에서 실패로 처리한다. B.4. JobBench는 가중 평가표를 사용하고 Gemini-3.5-Flash와 Claude Opus 4.8의 판정을 평균한다. B.5. GDPval은 평가자 3명과 제시 순서 2가지를 사용해 출력을 인간 전문가 산출물과 비교한다. 본문은 과제 185개와 평가자당 비교 204건을 보고하지만, 이 수치 사이의 관계를 설명하지 않는다.
- B.6. APEX-Agents는 과제 480개 전체를 pass@1, 즉 샘플링한 rollout 1회의 성공 여부로 평가하며, 누락된 rollout은 실패로 집계한다. B.7. EngDesign은 라이선스가 필요 없는 과제 61개 전체에서 진화하며, 분포 내 홀드아웃 분할은 두지 않는다. B.8. Frontier-Eng는 gold, silver, bronze 기준 달성에 각각 1, 0.67, 0.33을 부여한 값의 평균인 Medal Score를 보고한다. EngDesign과 겹치는 과제는 제외하고, 환경을 사용할 수 없으면 점수를 부여하지 않는다. 보고된 공통 분모를 적용하면 과제 47개 중 38개가 점수에 기여한다.
- C. Baseline Methods는 Meta-Harness를 누적 궤적을 활용한 실행 코드 최적화, AHE를 실행 관측에 기반한 진화, TTHE를 궤적 기반 테스트 시점 적응, HarnessX를 타입이 지정된 모듈형 구성 요소의 적응으로 설명한다. D. Method Details는 고전적 정규화 용어가 노름 페널티 최적화가 아니라 기능적 유사성을 뜻한다고 강조한다. D.1. Round-Level Formulation은 현재 피드백, 수정 이력, 수정 예산, 탐색 지시, 가지치기 대상을 바탕으로 후보를 생성한 뒤, 허용된 후보 중에서 선택하거나 현재 하네스를 유지하는 절차를 명시한다.
- D.2. Proposal-Side Bookkeeping은 각 원자적 수정의 구성 요소, 가설, 소스 diff, 측정된 점수와 비용 변화, 채택 플래그를 기록한다. 묶여 있는 수정은 해당 후보의 측정값을 공유한다. D.3. Selection-Side Bookkeeping은 client_tool, skill, memory, subagent에만 신규성 점수를 부여한다. 점수 향상이 잡음 허용치를 넘지 않으면 점수 변화, 상대 비용 변화, 구조적 신규성을 결합한다. 잡음 허용 범위 내 점수 향상에 대해 코딩은 가중치 0을, workspace와 공학 환경은 양의 가중치를 부여한다. 본문은 해당 가중치를 Table 5에서 확인하도록 안내하지만, 표에는 이 값이 빠져 있다.
- E. Experiments와 E.1. Hyperparameter Setting은 코딩, workspace, 공학에서 각각 진화 라운드 20, 20, 40회와 과제당 시행 2, 2, 4회를 사용한다고 보고한다. 잡음 허용치는 0.017, 0.004, 0.020이고, 초기 수정 예산은 4, 3, 4이며, 최종 예산은 모든 환경에서 1이다. 설정은 홀드아웃이나 OOD 벤치마크를 참조하지 않고 각 실행 전에 고정한다. 잡음 허용치는 기본 하네스 평가에서 구하고, 비용 허용량은 초기 라운드 결과에 맞춰 보정한다. E.2. Reliability of the Reported Gains는 대응하는 과제를 복원 추출하는 과제 수준의 paired bootstrap 재표본추출 10,000회로, 표에 기재된 모든 향상에 대해 양의 95% 신뢰구간을 얻는다. 2번째 독립 탐색도 모든 분할에서 성능을 높이며, workspace OOD 평균은 각각 43.6과 43.7이다.
- F. Qualitative Case Study는 선택 규칙의 사례를 제시한다. 코딩 R0-A는 3.93점 향상으로 채택되고, R0-B는 1.69점 향상에도 비용이 26.1% 늘어 거부된다. R8-B는 비용을 13.6% 줄였지만 점수가 2.81점 낮아져 거부된다. 공학 과제의 복구 힌트는 토큰이 1.6% 늘면서 통과 수가 122/244에서 128/244로 증가해 채택된다. 최종 workspace 하네스는 20개 라운드에서 평가한 후보 32개 중 수정 네 개를 유지한다. 이는 범위 충족 여부 재점검과 산출물 검사 probe 세 개로 구성된다. 저자들은 이를 Meta-Harness와 TTHE에 남은 평가기 지향 지시나 문서 장르 특화 지시와 비교한다. 코드와 궤적은 https://github.com/google-research/rrsi 및 https://regularized-rsi.com/ 에 연결되어 있다.
짧은 생각
가장 명확한 결과는 진화 점수와 전이 성능의 역전이다. RRSI는 evolve set에서의 향상이 더 작지만, 미관측 workspace 벤치마크에서는 정규화 없는 탐색과 기존 방법보다 우수하다. 결정론적 공학 평가, 과제 수준에서 양수인 신뢰구간, 2번째 탐색이 이 결과를 뒷받침한다. 다만 그룹 단위 제거 실험만으로는 개별 메커니즘의 기여를 구분하기 어렵다. 누락된 잡음 허용 범위 내 가중치와 설명되지 않은 GDPval 집계 수치는 PDF에서 재현에 필요한 정보가 부족한 부분이다. 주 설정별 탐색 2회는 탐색 변동성을 판단하는 데 제한적인 근거를 제공한다. 미관측 backbone 전이 실험은 벤치마크 1개에서 이식 가능성을 추가로 뒷받침하지만, 임의의 backbone 전반으로 전이된다는 점까지 입증하지는 않는다. 효율성 우위는 다른 진화 하네스와 비교한 실행 비용에 관한 것이다. RRSI는 시작 하네스보다 여전히 비싸며, 최종 하네스의 토큰 측정값으로 전체 탐색 비용을 알 수는 없다.