


Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players 요약 설명
24 Oct 2026 | Paper Review AI Research Agents Self-Evolving Agents Reinforcement Learning목차
이번 글에서는 Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 10월 24일(Arxiv)
- Ma, Changlian, Wang, Limin.
- Nanjing University, Shanghai AI Laboratory
- 논문 링크
- Github
요약
- 이 논문은 대규모 언어 모델(LLM) 연구 에이전트가 숨겨진 정보와 무작위 전투가 있는 8인 게임 Hearthstone Battlegrounds에서 경쟁력 있는 시스템을 만들 수 있는지 살펴본다. 각 플레이어의 최근 공개 리더보드 기록 20개를 비교하면, TAVERNAGENT의 추정 평균 순위는 1.60위, 1위 비율은 80%였다. 서버에서 레이팅이 가장 높은 플레이어 10명의 기록을 합산한 결과는 각각 2.34위와 59%였다. 연구 에이전트에 대해서는 Agent Laboratory: Using LLM Agents as Research Assistants 요약 설명 글을 참조하라.
- AUTOTAVERN은 버전 관리되는 연구 기록, 검증 절차, 실제 게임의 피드백을 통해 전문 에이전트들을 조율한다. 20일 동안 시뮬레이터를 만들고 강화학습 정책 23개 버전을 완성했다. 공통 TAVERNBENCH 테스트에서 이 정책은 플레이 과제 점수 91%를 기록했으며, 직접 답변한 LLM 중 최고 점수는 63%였다. 강화학습에 대해서는 SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training 요약 설명 글을 참조하라.
- 실험 근거는 게임과 패치 1개, 짧은 리더보드 기록 기간, 시스템마다 시뮬레이터 접근 조건이 다른 벤치마크에 한정된다. 인간 연구자는 목표를 설정하고 모호한 규칙을 판정했으며, 실제 게임에서 에이전트가 지정한 키를 눌렀다.
1 Introduction
저자들은 연구 에이전트가 원시 게임 데이터에서 출발해 사람과 비교 평가할 수 있는 시스템까지 만들 수 있는지 연구한다. AUTOTAVERN은 시뮬레이션과 실제 게임의 차이를 이용해 학습 환경, 상대, 연구 과정을 수정한다.
2 Related Work
기존 Battlegrounds 도구는 게임의 일부만 시뮬레이션하거나 기능을 생략하거나 인간 플레이어에게 조언한다. 이 논문은 에이전트가 구축한 환경과 강화학습 방법인 proximal policy optimization(PPO)을 결합하고 실제 랭크전에서 성과를 측정한다.
3 Hearthstone Battlegrounds
각 플레이어는 상대와 자동으로 싸우는 유닛인 하수인을 최대 7개까지 모집하고 배치한다. 플레이어는 1명이 남을 때까지 탈락한다. 패치 36.6.3에는 게임 객체 978개가 있으며, 게임은 약 15턴 동안 진행되고 플레이어당 약 450개 행동이 이뤄진다. 상대에 관한 정보는 일부만 공개된다.
4 The AUTOTAVERN System
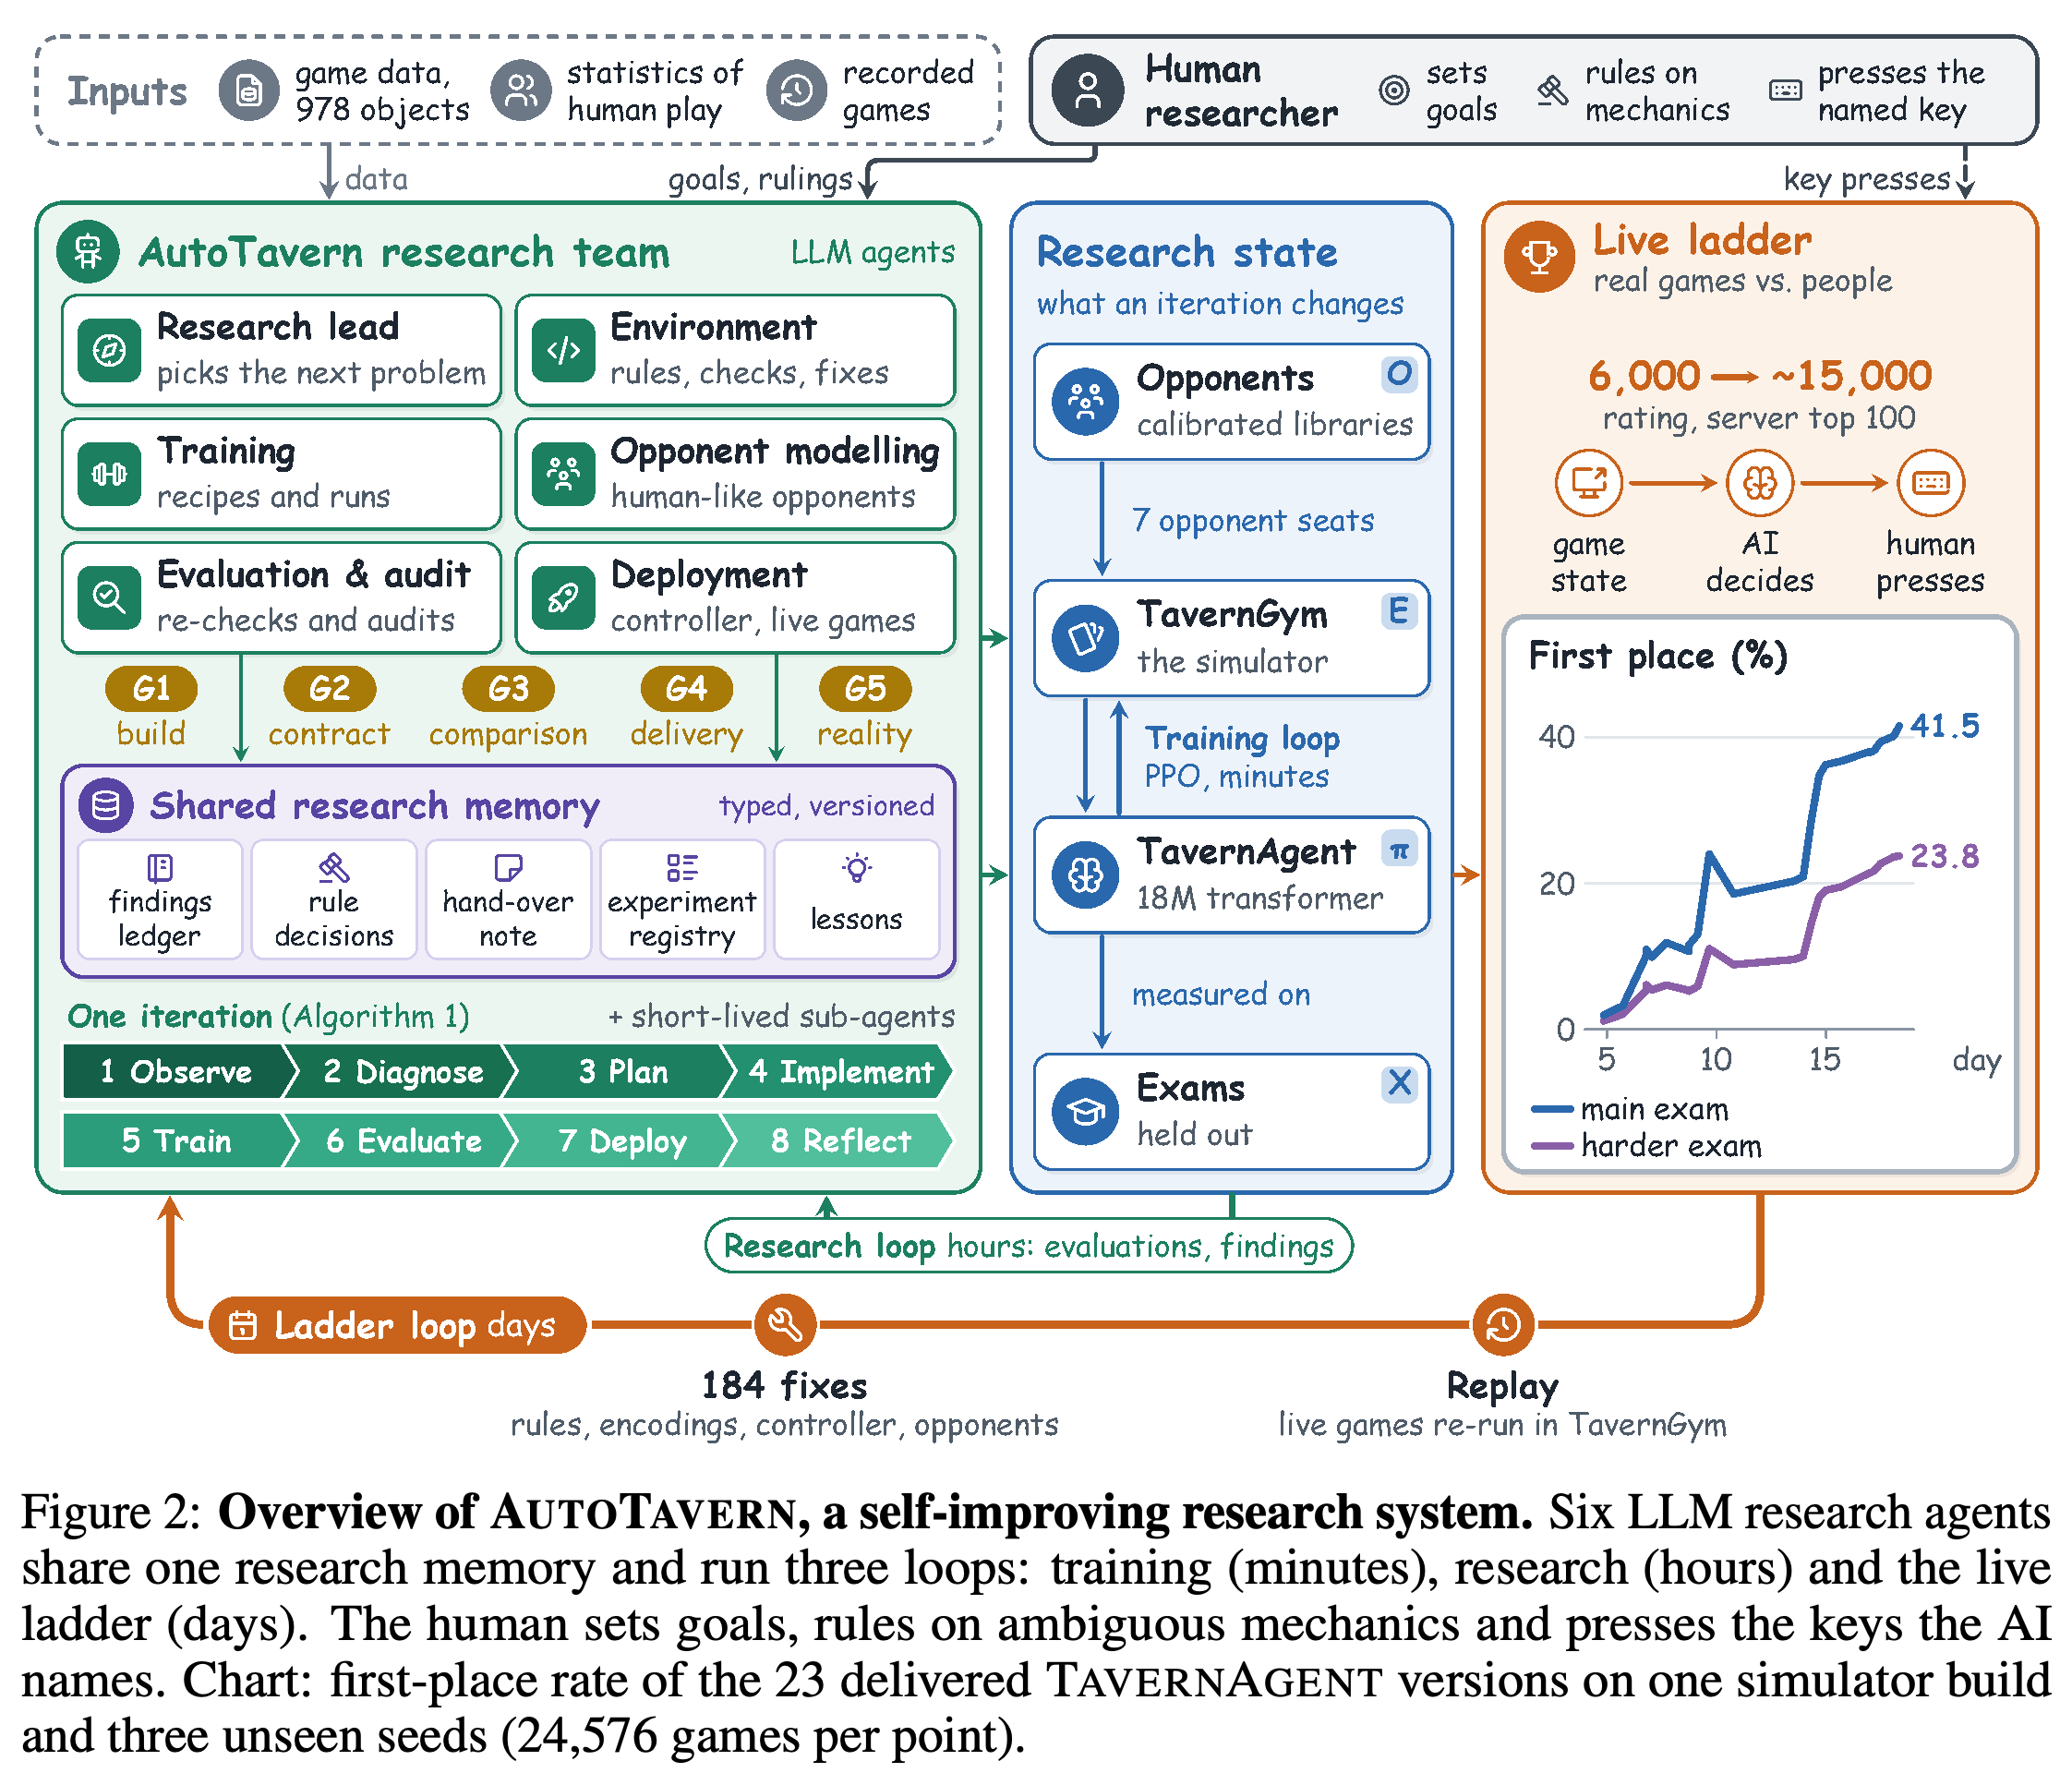
역할이 서로 다른 에이전트 6개가 발견 사항, 결정, 실험, 교훈을 정해진 형식으로 기록하고 버전 관리하며 협업한다. 검증 관문 5개는 빌드 테스트, 모델과 시뮬레이터 버전의 호환성, 동일 빌드 내 비교, 후보 선정에 사용하지 않은 무작위 시드 검증, 실제 게임 재현을 요구한다.
도식은 전문 에이전트와 공유 메모리를 시뮬레이터 학습 및 실제 게임 재현에 연결한다. 차트는 완성된 버전이 발전하면서 시험 2개 모두에서 1위 비율이 상승한 모습을 보여준다.
4.1 The iteration cycle
각 반복은 관찰, 진단, 계획, 구현, 학습, 평가, 배포, 회고 순서로 진행된다. 학습은 수초에서 수분, 연구는 수시간, 실제 게임 피드백은 수일에 걸쳐 진행되며, 스케줄러가 자원 예산 내에서 실험을 대기열에 넣는다.
4.2 Autonomy in numbers
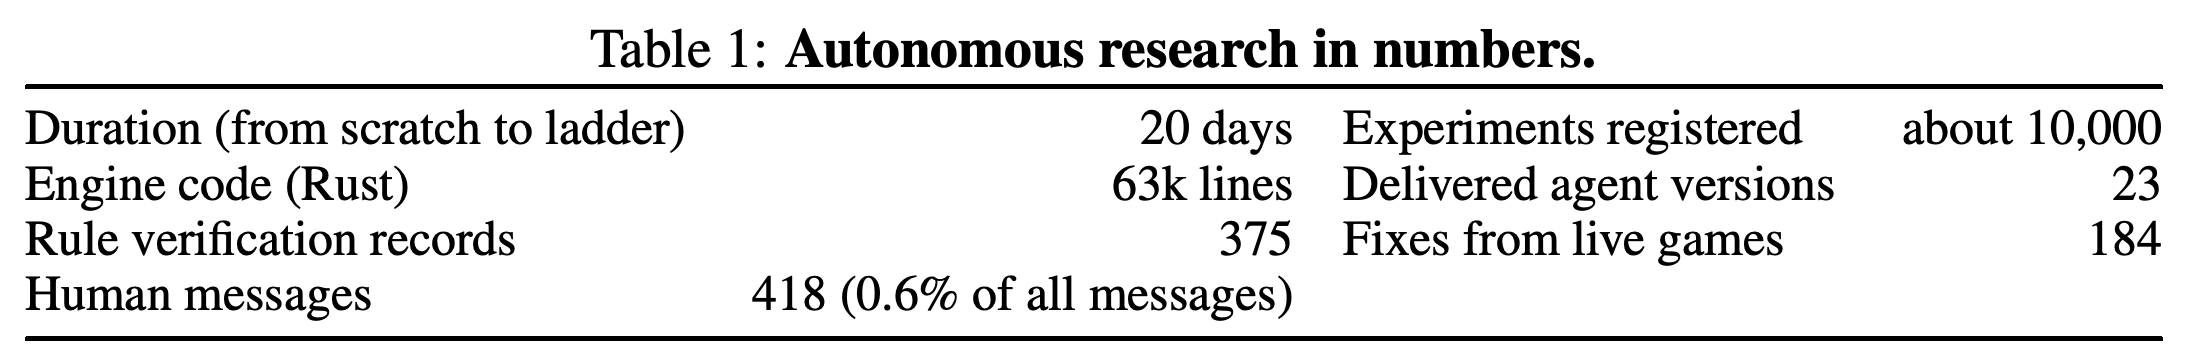
에이전트들은 20일 동안 약 10,000개 실험을 등록하고 23개 버전을 완성했다. 인간이 보낸 메시지는 418개로 전체 메시지의 0.6%였다. 프로젝트에는 규칙 검증 375건과 실제 게임을 계기로 한 수정 184건이 기록됐다.
수치는 20일 프로젝트의 규모와 보고된 인간 참여 수준을 보여준다. 약 10,000개 실험이 등록되는 동안 인간은 메시지 418개를 보냈다.
5 TAVERNGYM: Reproducing the Real Game
TAVERNGYM은 Python 바인딩을 제공하는 Rust 게임 엔진이다. 연구 대상 패치의 객체 978개를 모두 포함하며, 가능한 행동을 표시하는 마스크와 함께 이산 행동 245개를 제공한다. 시드와 행동 순서로 게임을 정확히 재현할 수 있다. 스크립트 봇을 사용하면 코어 1개에서 초당 8인 게임 190–280판을 완주하며, 단위 테스트, 무작위 검사, 실제 게임 재현으로 충실도를 검증한다.
6 TAVERNAGENT: Learning to Play the Live Game
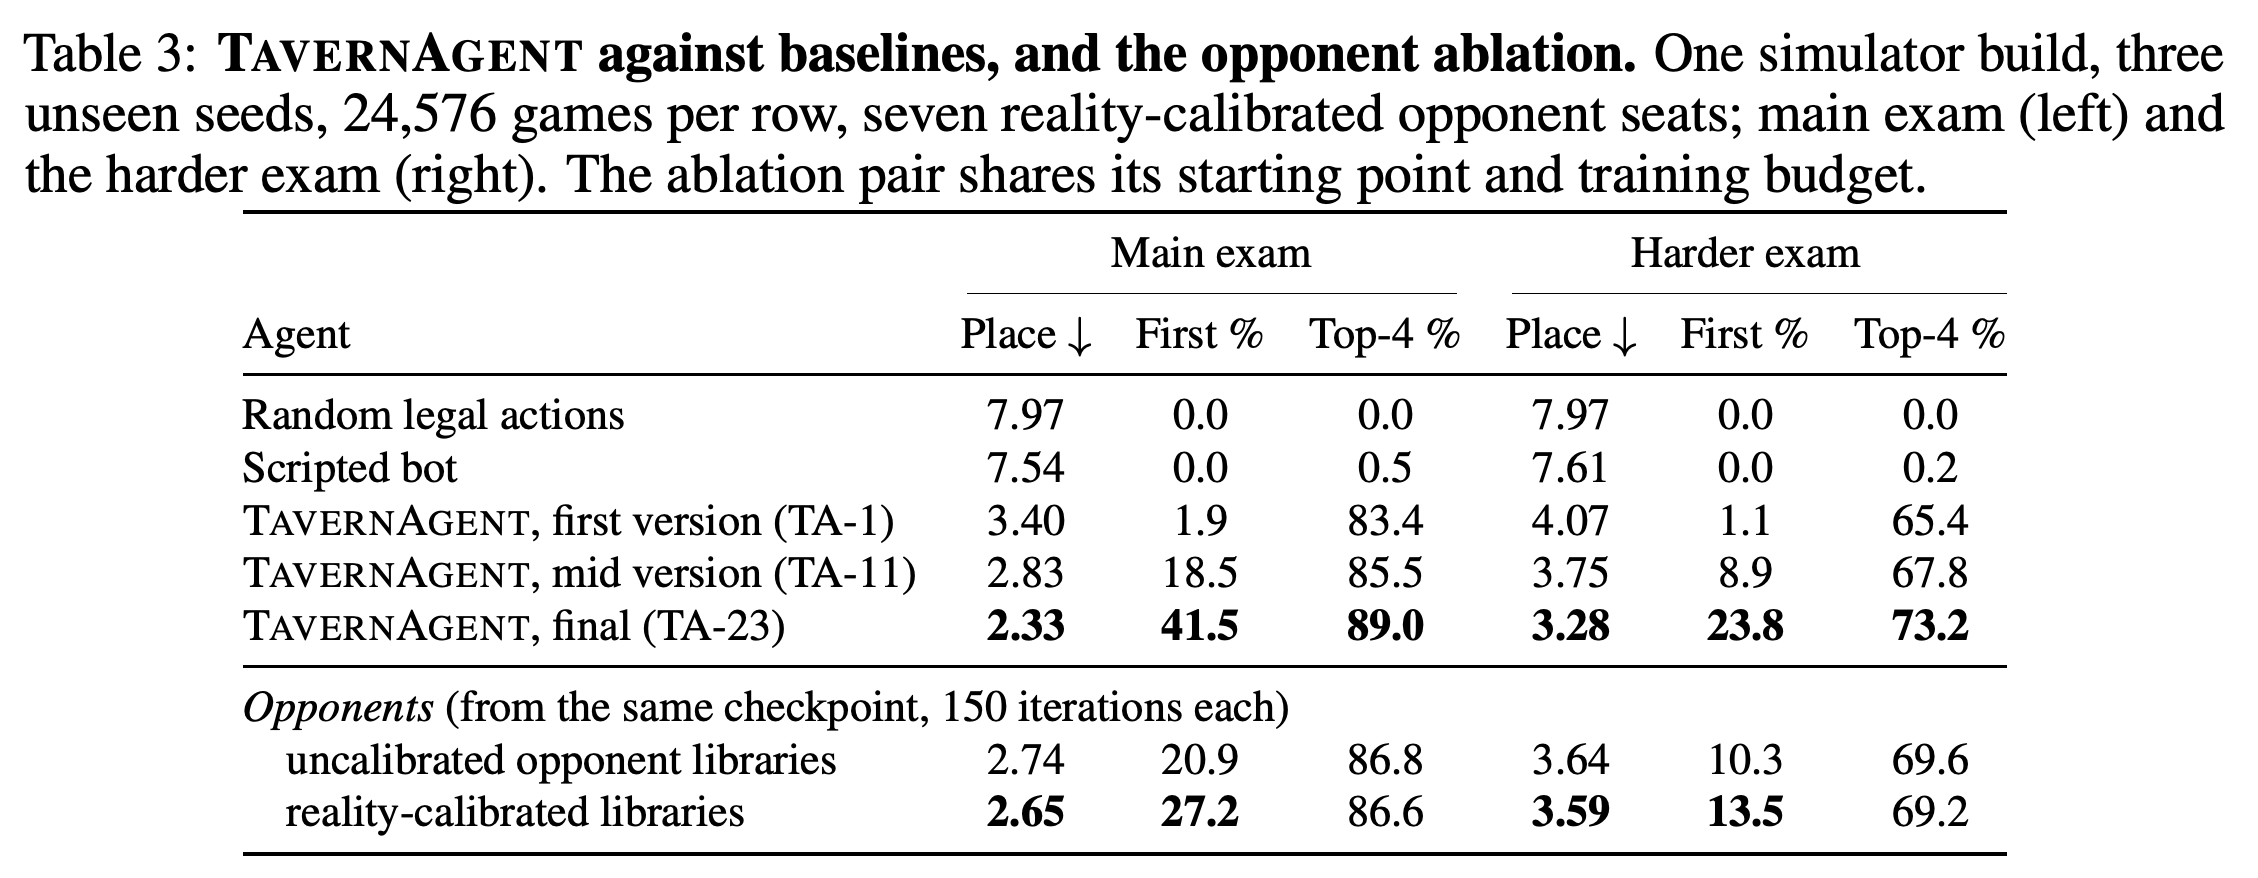
TAVERNAGENT는 인간 통계와 실제 게임에 맞춰 보정한 게임 상태 라이브러리에서 상대 일곱 자리를 채워 PPO로 학습한 18M-parameter 트랜스포머다. 시뮬레이터 빌드 하나에서 사용하지 않은 시드 셋과 표의 행당 게임 24,576판으로 평가했을 때, 주요 시험의 우승 비율은 TA-1의 1.9%에서 TA-23의 41.5%로 올랐다. 동일 조건의 학습 비교에서는 보정된 상대를 사용해 우승 비율이 20.9%에서 27.2%로 개선됐다.
최종 에이전트는 시험 2개 모두에서 이전 버전보다 개선됐다. 동일한 시작 체크포인트와 학습 예산을 사용한 상대 구성 비교는 보정에 따른 성능 향상을 따로 보여준다.
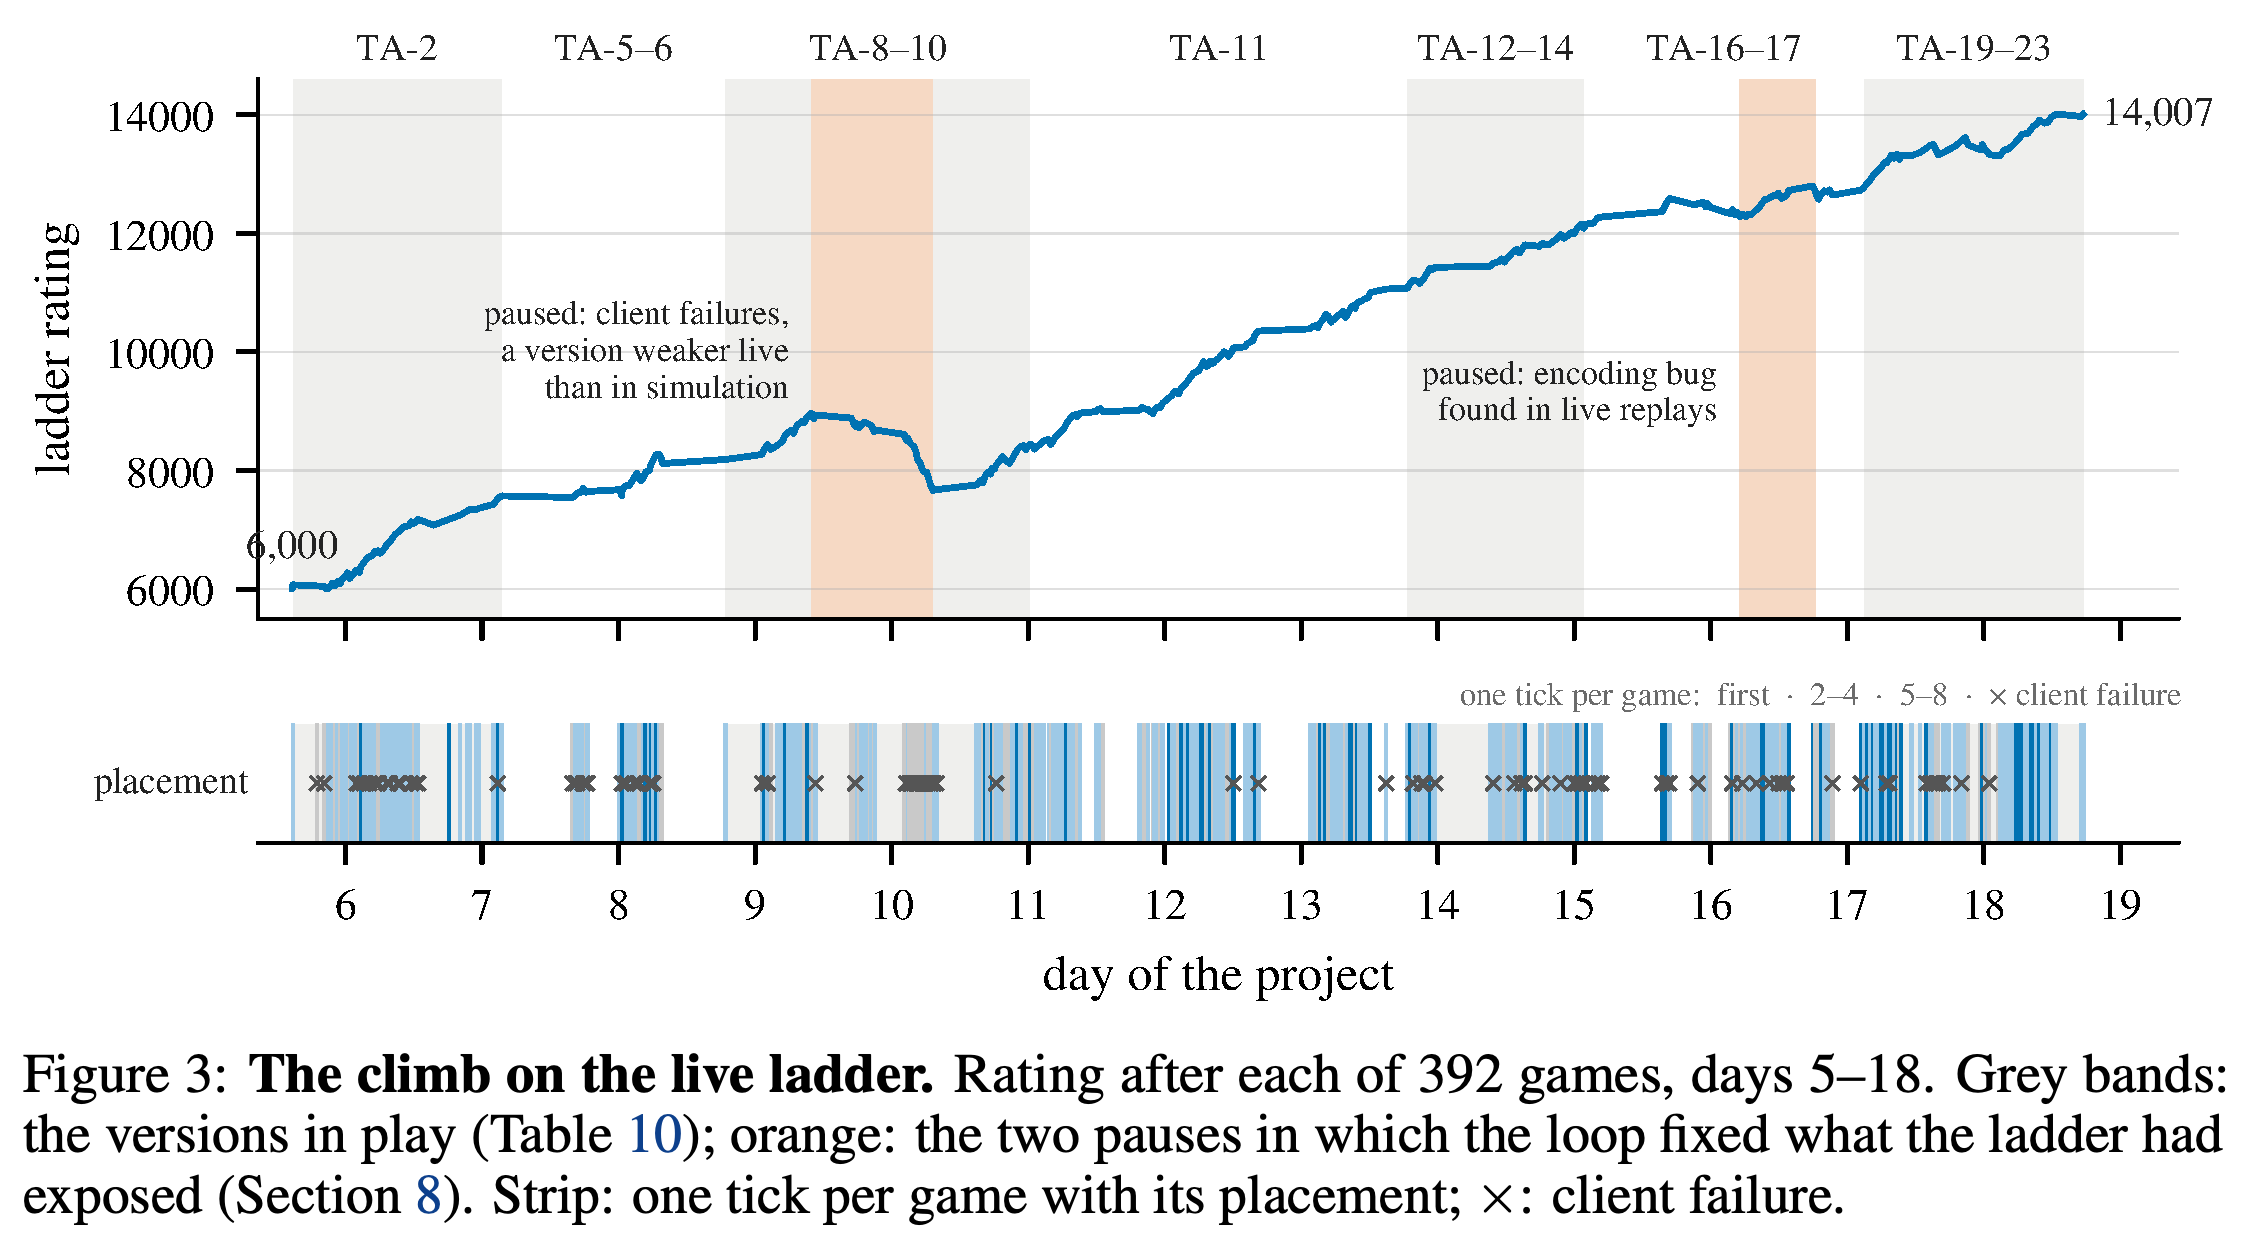
5–18일 차에 기록된 실제 게임 392판에서 레이팅은 6,000에서 14,007로 올랐다. 클라이언트 실패로 표시된 게임을 제외하고 단일 버전과 높은 신뢰도로 연결된 게임 46판에서 TA-19–23의 평균 순위는 2.37위, 1위 비율은 32.6%였다.
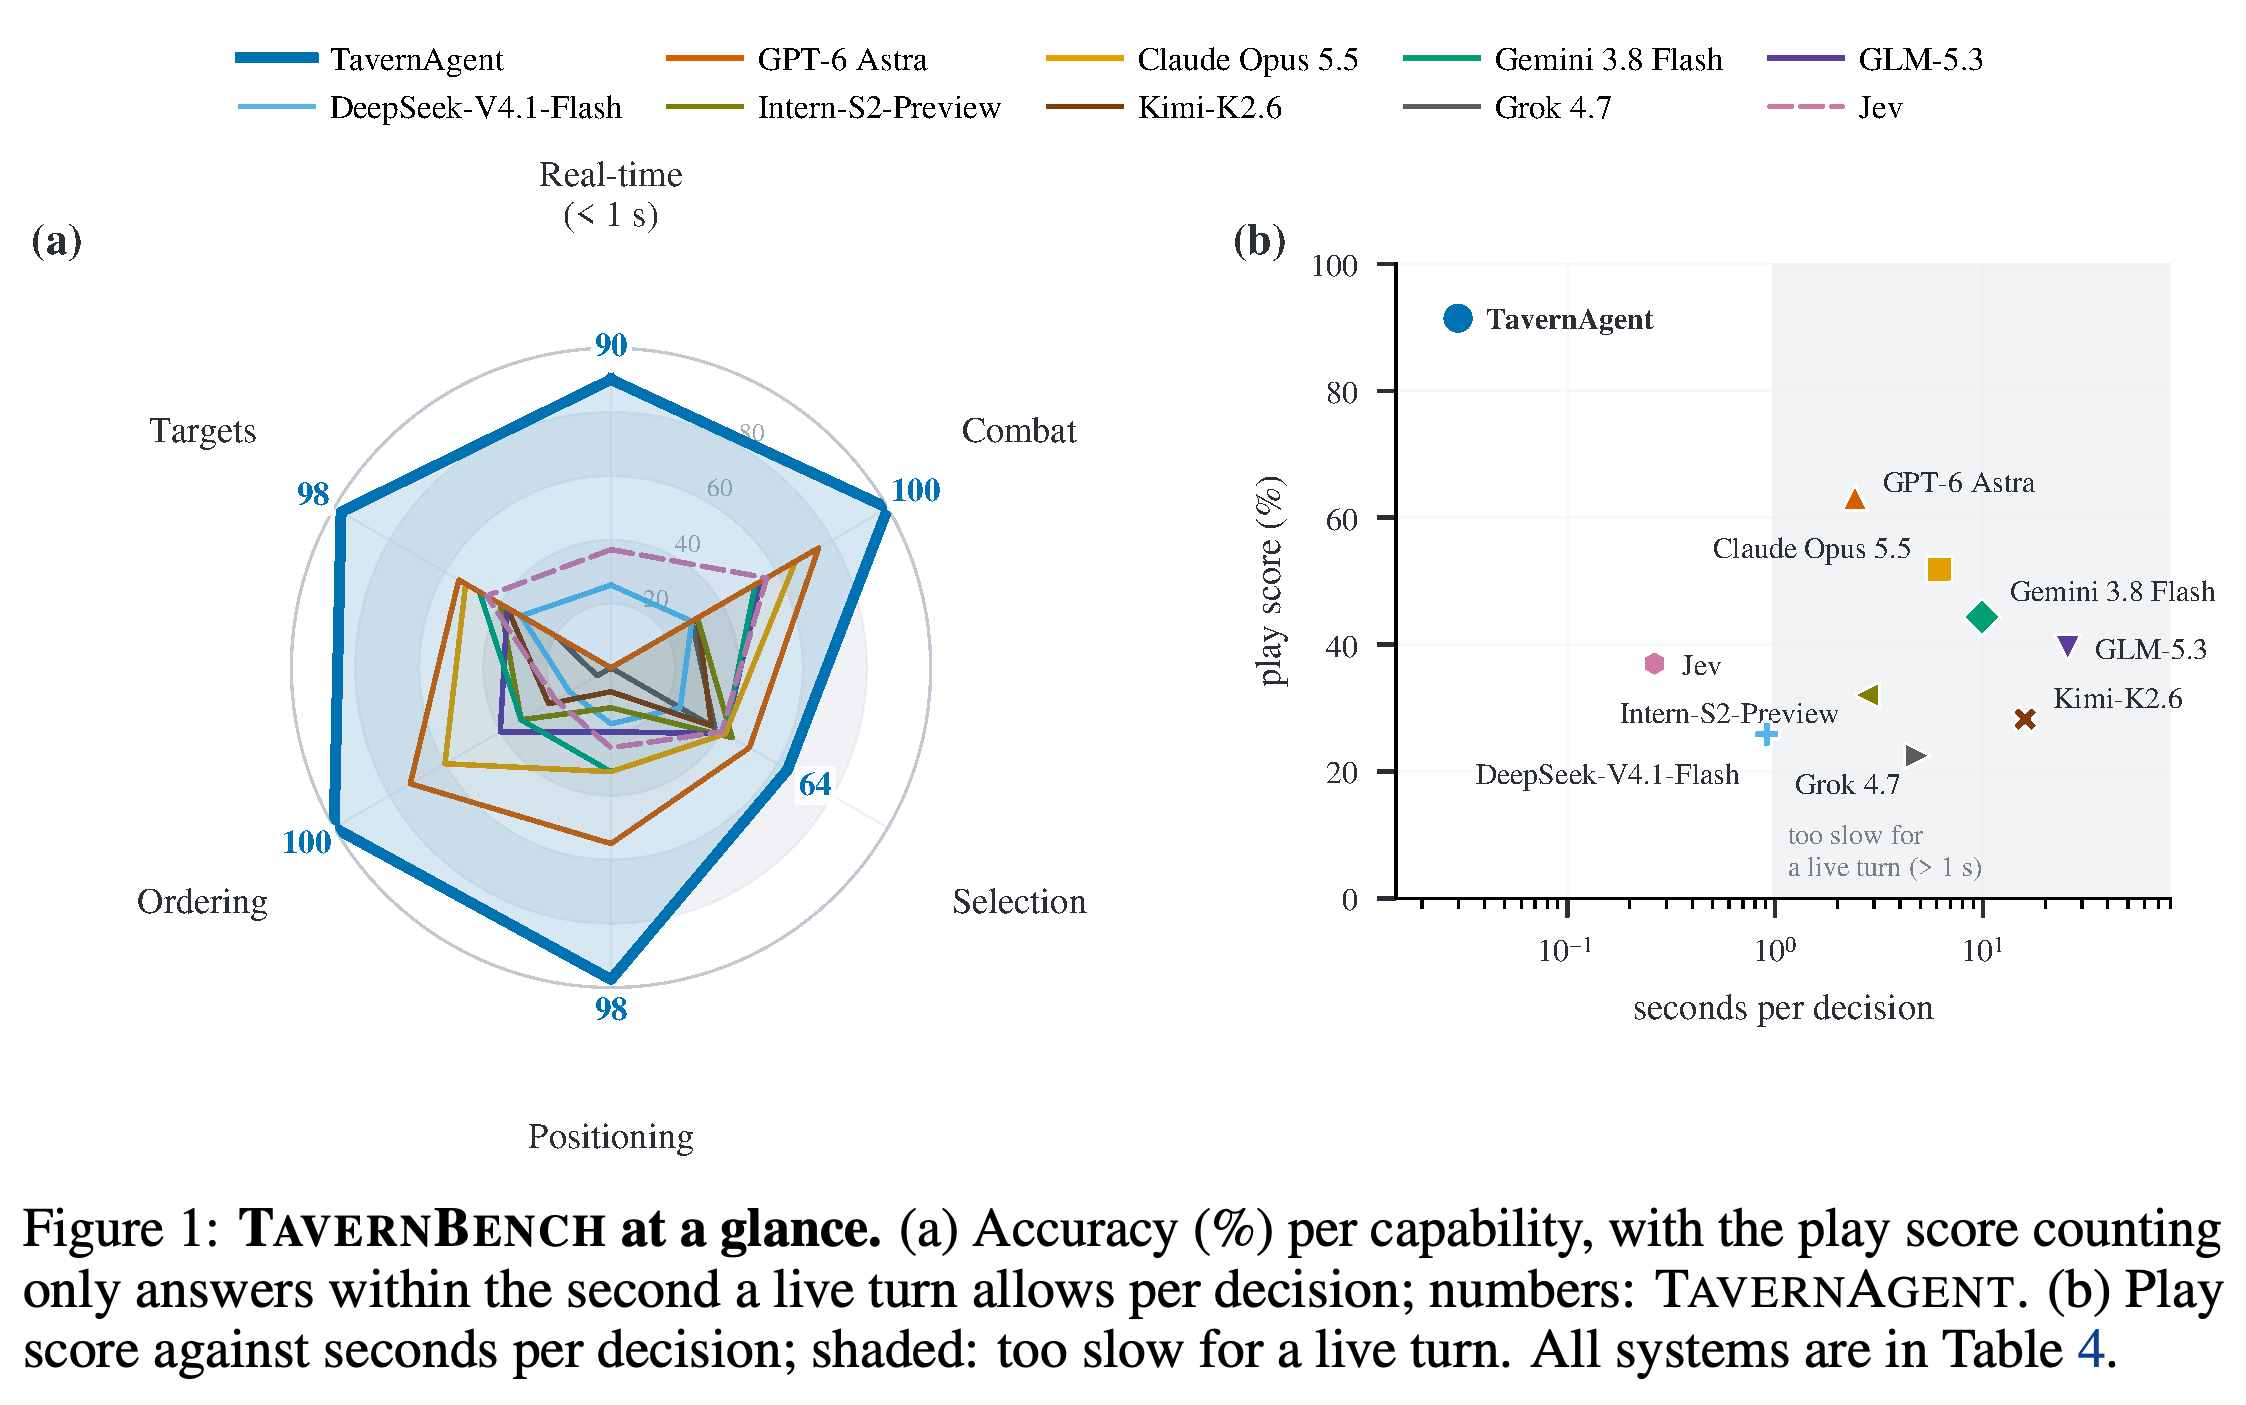
TAVERNAGENT는 높은 플레이 정확도와 0.03 s의 의사결정 시간을 함께 보인다. 평가 대상 LLM 대부분은 1초 기준을 넘으며, 그래프는 과제별로 서로 다른 강점도 보여준다.
레이팅 추이에는 실제 배포 문제 이후 발생한 중단 2회가 포함된다. 성과는 고르게 향상되지 않았으며, 배포에서 얻은 피드백을 바탕으로 문제가 수정됐다.
7 TAVERNBENCH: Build, Don’t Play
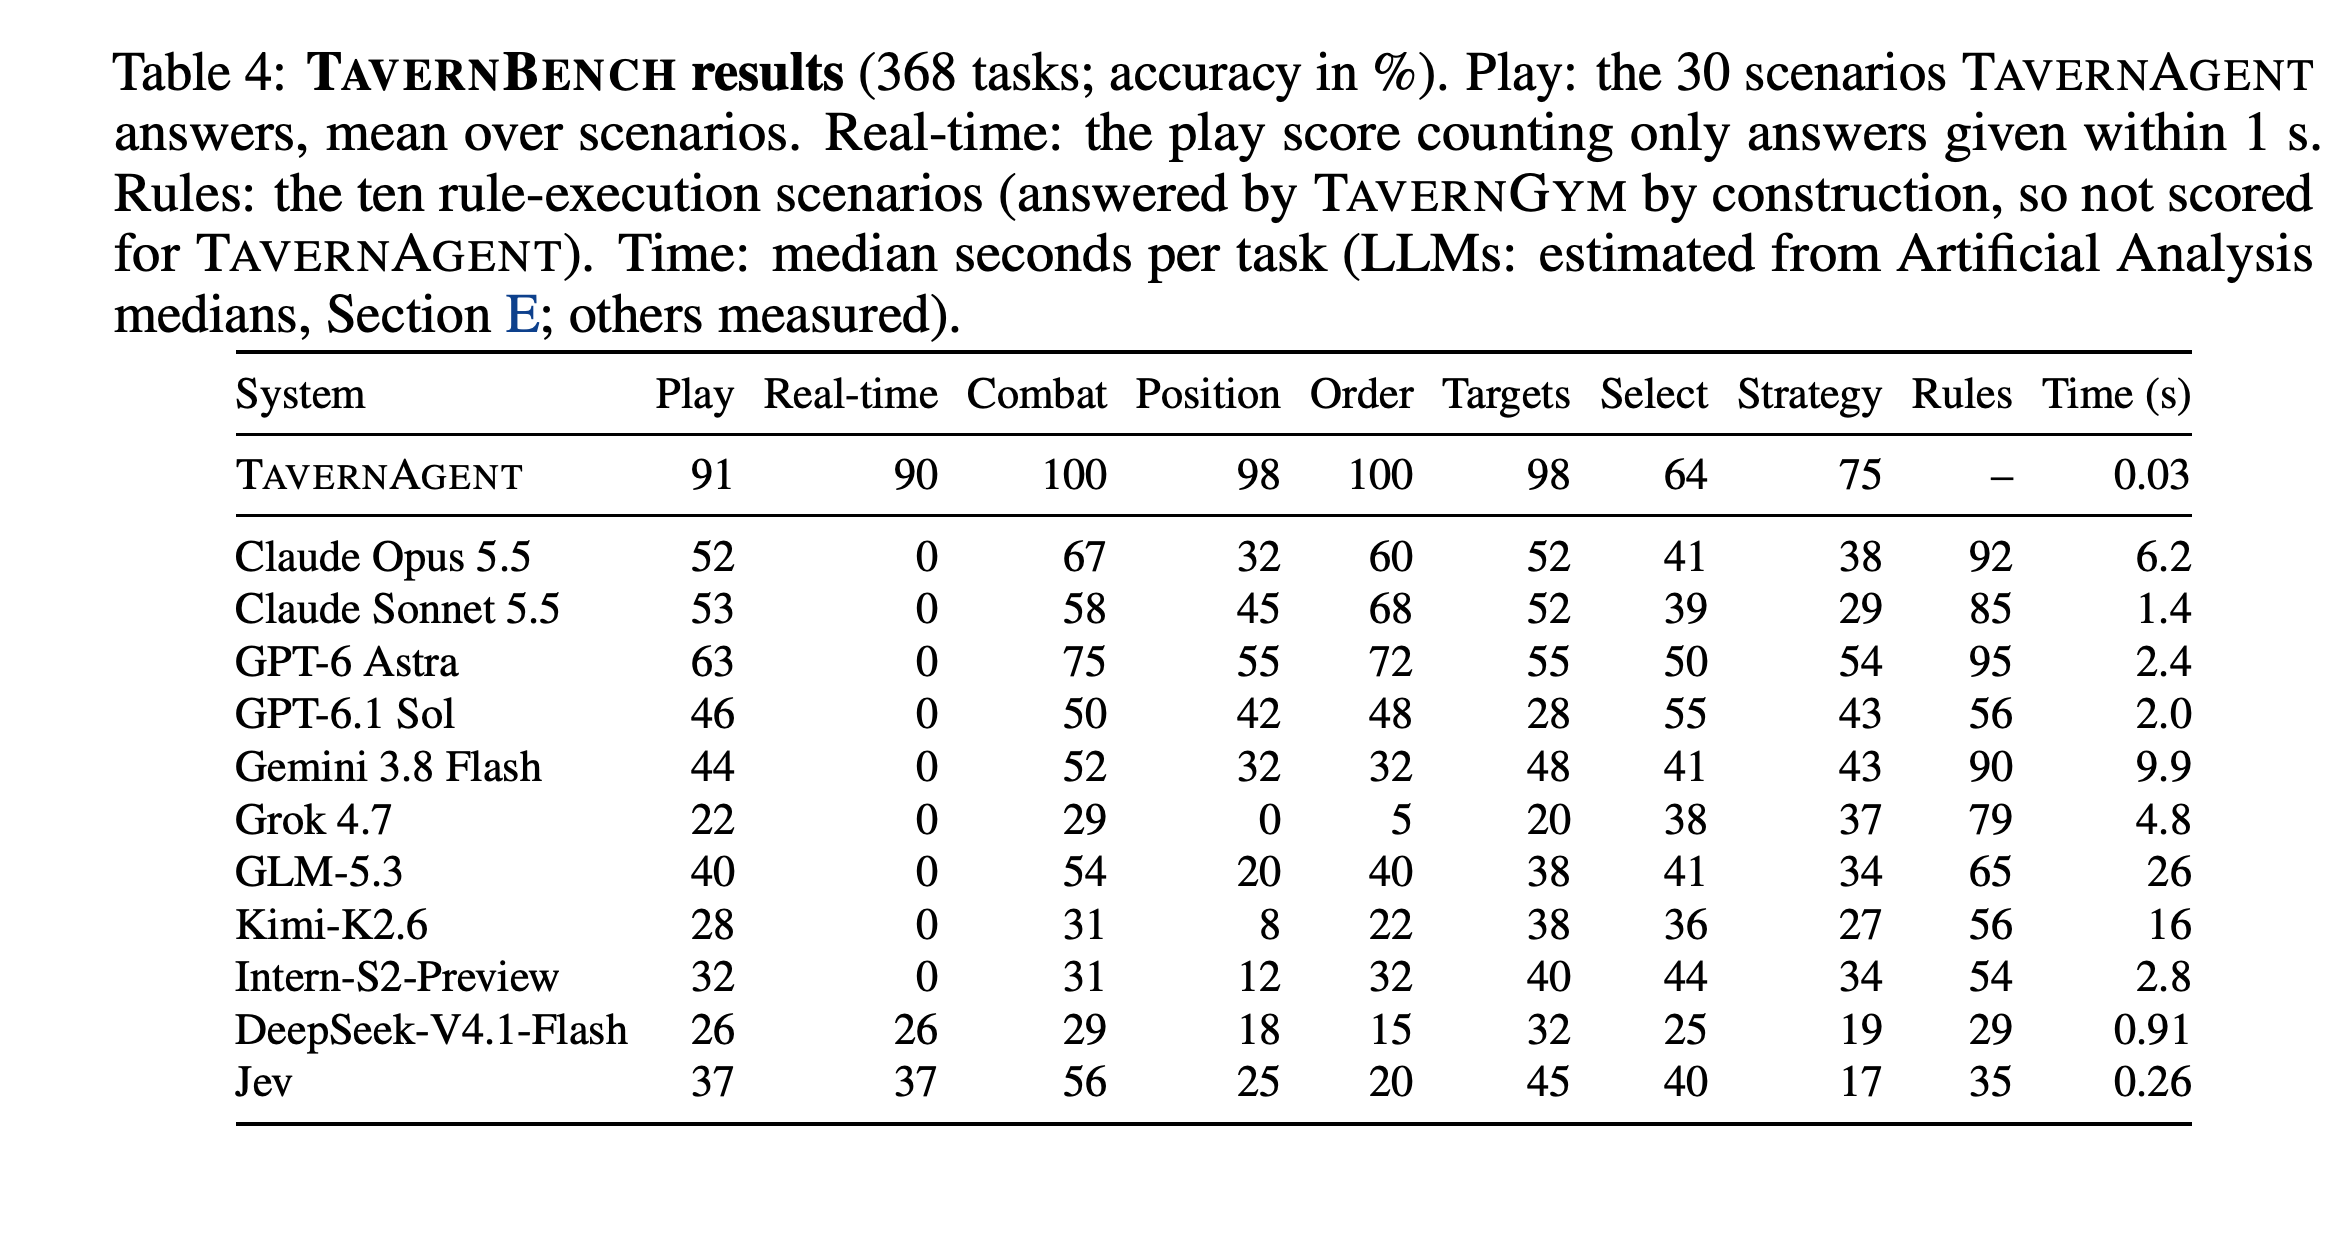
TAVERNBENCH는 시나리오 40개에 걸친 과제 960개로 구성되며, 모든 시스템을 과제 368개에서 비교했다. TAVERNAGENT는 구조화된 엔진 상태를 받고 단기 결정을 위해 후보마다 전투 256회를 시뮬레이션했다. LLM은 도구 없이 텍스트를 받았으며, 최고 플레이 점수는 63%로 TAVERNAGENT의 91%보다 낮았다.
논문에서 정한 의사결정 시간 제한 1초를 적용하면 TAVERNAGENT는 90%, DeepSeek-V4.1-Flash는 26%, 텍스트를 생성하지 않고 정해진 형식의 선택지에서 고르는 의사결정 모델 Jev는 37%를 기록했다. LLM 지연 시간은 공개된 API 중앙값으로 추정했고, TAVERNAGENT의 0.03 s는 실측했다.
표는 플레이 정확도, 1초 제한 점수, 규칙 실행, 소요 시간을 구분한다. TAVERNAGENT는 시뮬레이터가 규칙을 실행하므로 규칙 실행 점수를 받지 않았다.
8 Lessons from Self-Improvement
검증 과정에서 오해를 부르는 신호가 드러났다. 복사된 난수 생성기 상태 때문에 탐색이 1위 비율을 23.6%포인트 높인 것처럼 보였지만, 시드를 다시 설정하자 증가분은 −0.65 ± 1.14점으로 줄었다. TA-10은 시뮬레이션 1위 비율이 개선됐지만 실제 레이팅은 하락해 클라이언트 실패와 시험에서 드러나지 않은 약점을 조사하게 됐다. 별도의 입력 인코딩 불일치는 비트 수준 비교 관문을 추가하는 계기가 됐다.
9 Conclusion
저자들은 벤치마크 조건에서 연구 에이전트가 직접 플레이한 평가 대상 LLM보다 강하고 빠른 게임 플레이 시스템을 만들었다고 결론 내린다. 또한 TAVERNGYM과 TAVERNBENCH를 https://github.com/MCG-NJU/AutoTavern에 공개할 예정이라고 밝힌다.
부록
- A The AUTOTAVERN system in detail: 실제 게임에 따른 수정 184건은 규칙과 카드 데이터 수정 46건, 입력 인코딩 수정 73건, 클라이언트 컨트롤러 수정 51건, 상대 라이브러리 또는 시험 재보정 14건으로 구성됐다.
- B TAVERNGYM details: 약 63,000줄로 구성된 엔진은 시드를 지정한 난수, 버전 관리되는 규칙, 정확한 저장과 복원을 사용한다. 논문에 따르면 모든 게임 메커니즘에 단위 테스트가 있다.
- C TAVERNAGENT details: 300회 반복하는 각 학습 단계는 약 310,000,000개 결정과 게임 570,000판을 처리한다. 초기의 동일 학습 방식에 따른 모델 크기 비교에서 18M-parameter 모델은 시험 2개 모두에서 3.5M 및 8M 모델보다 평균 순위와 상위 4위 진입률이 좋았다.
- D Live deployment: 저자들은 자신의 계정을 사용했으며, 인간이 정책에서 지정한 단축키를 눌렀다. 유효한 순위가 기록된 게임 388판 중 96판에서 클라이언트 실패가 기록됐다. 해당 실패를 포함하면 TA-19–23의 게임 56판 평균 순위는 2.54위였다.
- E TAVERNBENCH details: 시뮬레이터 정답은 전투를 반복 시뮬레이션해 생성하고, 전략 정답은 계획마다 TA-21로 게임을 128회 이어 진행해 생성한다. 단기 과제 144개에서 GPT-6 Astra에 시뮬레이터 도구를 제공하자 정확도가 62%에서 97%로 올랐으며, TAVERNAGENT는 99%를 기록했다. 보고된 소요 시간은 과제당 21 s였다.
- F Compute resources: 주 학습에는 H200 GPU 8개와 CPU 코어 128개를 사용했다. 저자들은 완성된 단계에 약 1,900 GPU-hours, 기타 학습에 16,700 GPU-hours, 평가와 분석에 1,300 GPU-hours를 사용했으며 연구 에이전트의 출력 토큰은 약 100,000,000개라고 보고했다.
짧은 생각
실제 게임 피드백을 통해 TA-10의 성능 퇴보와 인코더 불일치처럼 시뮬레이션 시험에서 놓친 실패가 드러났다. 리더보드 비교는 플레이어당 최근 기록 20개만 사용하며, 순위는 레이팅 변화로 추정했고 기록 하나가 여러 게임을 포함할 수 있다.
벤치마크 비교 결과는 접근 조건에 영향을 받는다. TAVERNAGENT는 구조화된 엔진 상태와 시뮬레이터를 이용한 선행 탐색을 사용하지만, 주요 LLM 비교에서는 도구 없이 텍스트를 사용한다. 도구를 제공한 실험은 시뮬레이터 접근으로 단기 의사결정 성능 격차가 상당 부분 줄어들지만 지연 시간은 늘어난다는 점을 보여준다.