


SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training 요약 설명
28 Jan 2025 | Paper Review Reinforcement Learning Supervised Fine-Tuning Out-of-Distribution Generalization목차
이번 글에서는 SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 28일(Arxiv), Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 2025
- Chu, Tianzhe, Zhai, Yuexiang, Yang, Jihan, Tong, Shengbang, Xie, Saining, Schuurmans, Dale, Le, Quoc V., Levine, Sergey, Ma, Yi.
- HKU, UC Berkeley, Google DeepMind, NYU, University of Alberta
- 논문 링크
- Github
- Project Page
요약
- 이 논문은 전문가 응답으로 학습하는 지도 미세조정(SFT)과 생성한 응답에 대한 보상으로 학습하는 강화학습(RL)이 사전 학습된 파운데이션 모델의 낯선 과제 규칙과 시각 입력 처리에 도움이 되는지 살펴본다. SFT로 초기화한 공통 체크포인트에서 추정 학습 연산량을 동일하게 맞추면, RL은 학습에 없던 내비게이션 행동 공간에서 단계별 정확도 45.0%를 달성한다. 단계별 정확도는 개별 내비게이션 행동을 정답으로 판정한 비율이다. 초기화 시점의 정확도는 35.7%이며, SFT를 추가로 수행한 뒤에는 2.5%다.
- 실험은 Llama-3.2-Vision-11B를 사용하며, 카드 4개로 산술 문제를 푸는 GeneralPoints와 거리뷰 내비게이션 환경인 V-IRL에서 진행한다. 텍스트 전용 입력과 이미지와 텍스트를 결합한 입력을 모두 평가한다. RL은 보상과 텍스트 피드백을 제공하는 자동 검사기인 verifier의 피드백을 받은 뒤 응답을 다시 생성하는 순차 수정 방식을 사용한다. 이를 통해 사후 학습에 없던 규칙이나 시각 조건에서 분포 외(OOD) 성능을 높인다.
- 과제 규칙을 고정하고 시각 조건을 바꾸면, RL은 GeneralPoints 성공률을 23.6%에서 41.2%로, 내비게이션 경로 성공률을 16.7%에서 77.8%로 높인다. 반면 SFT를 추가로 수행하면 성공률이 각각 13.7%와 11.1%로 낮아진다. 내비게이션 결과는 V-IRL mini benchmark에서 기존에 보고된 44.0%보다 33.8%포인트 높다.
- 이 결과는 해당 환경에서 지시를 따르고 요구된 응답 형식을 출력하도록 충분히 학습한 뒤 RL을 적용하는 방식의 효과를 뒷받침한다. SFT 없이 직접 RL을 적용하면 실패하며, 극도로 과적합된 SFT 체크포인트에서도 RL은 성능을 회복하지 못한다. 일반화에는 여전히 한계가 있다. 내비게이션 규칙을 바꾸면 단계별 정확도가 개선되어도 전체 경로 성공률은 약 1% 이하다.
1. Introduction
이 연구는 학습 예시에 적응하는 것과 새로운 텍스트 규칙 및 시각 조건으로 전이하는 것을 구분한다. 논문은 학습 데이터의 정보를 프롬프트로 제시했을 때 학습 예시와 거의 동일한 사본을 생성하는 것을 암기라고 정의한다. 실험은 이러한 재현을 직접 측정하기보다 과제 조건을 통제해 바꾸면서 전이 성능을 주로 평가한다.
- 텍스트 일반화 실험은 카드나 내비게이션 행동을 해석하는 규칙을 바꾼다. 시각 일반화 실험은 과제 규칙을 유지하면서 카드 색상이나 내비게이션 장소를 바꾼다.
- 학습 파이프라인은 먼저 SFT를 수행한 뒤, verifier 피드백을 사용하는 다중 턴 RL을 적용한다. 프로젝트 페이지는 https://tianzhechu.com/SFTvsRL 이다.
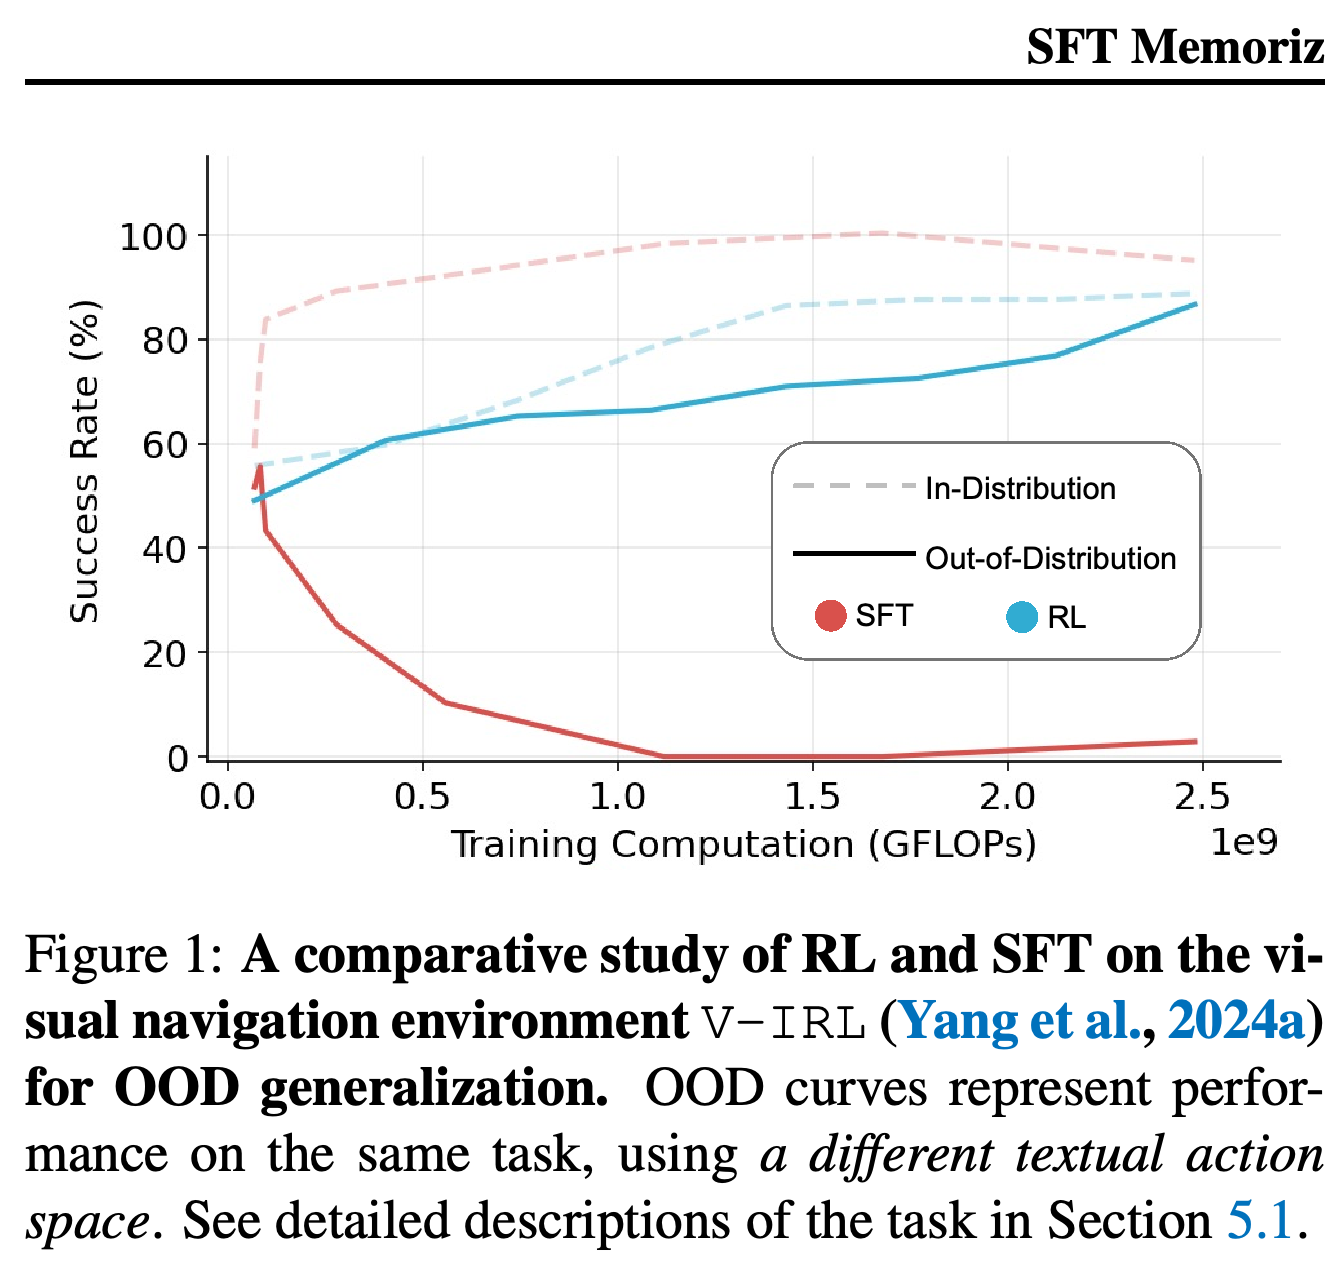
학습 연산량이 늘어나면 SFT는 학습한 내비게이션 행동 공간에서 높은 성능을 유지하지만, 변경된 행동 공간에서는 성능이 급락한다. RL은 곡선 2개의 성능을 모두 높인다. 이는 논문이 학습 과제의 성능 향상과 전이를 구분하는 근거가 된다. 이 곡선들은 Figure 5와 Figure 6의 단계별 지표와 달리 전체 내비게이션 성공률을 나타낸다.
2. Related Works
논문은 사후 학습, 암기와 일반화, 추론 시 연산, 시각 인식이라는 4개 연구 분야를 연결한다. 기존 SFT 연구는 응답 형식을 가르치는 역할의 근거가 되며, 기존 RL 연구는 보상에 기반한 과제 학습의 근거가 된다. 이 연구는 텍스트 전용 입력과 이미지에 텍스트를 결합한 시각 언어 입력에서 SFT와 RL 2가지 방법을 모두 평가한다.
- 사용 시점에 답변을 생성하고 검사하는 데 쓰는 추론 시 연산에 관한 연구는 검증과 수정을 반복하는 방식의 근거가 된다.
- 기존 시각 인식 접근법은 이미지를 표현하는 모델 구성 요소인 시각 인코더, 학습 데이터, SFT 학습법에 주목한다. 이 연구는 과제 수행을 위한 RL도 인식 능력을 높일 수 있는지 검증한다.
3. Preliminaries
이 방법은 응답 생성을 최대 단계 수가 정해진 의사결정 과정으로 다룬다. 모델은 현재 입력에서 출력을 선택하는 정책이며, 학습 목표는 누적 보상을 최대화하는 것이다. Verifier는 생성된 결과를 평가해 수치 보상과 텍스트 피드백을 반환한다. 모델 학습에는 정책 갱신 알고리즘인 proximal policy optimization(PPO)을 사용한다.
- 텍스트 전용 입력의 상태에는 입력 토큰 시퀀스가 포함된다. 이미지와 텍스트를 결합한 입력의 상태에는 이미지도 포함된다. 행동은 모델이 생성한 출력 시퀀스다.
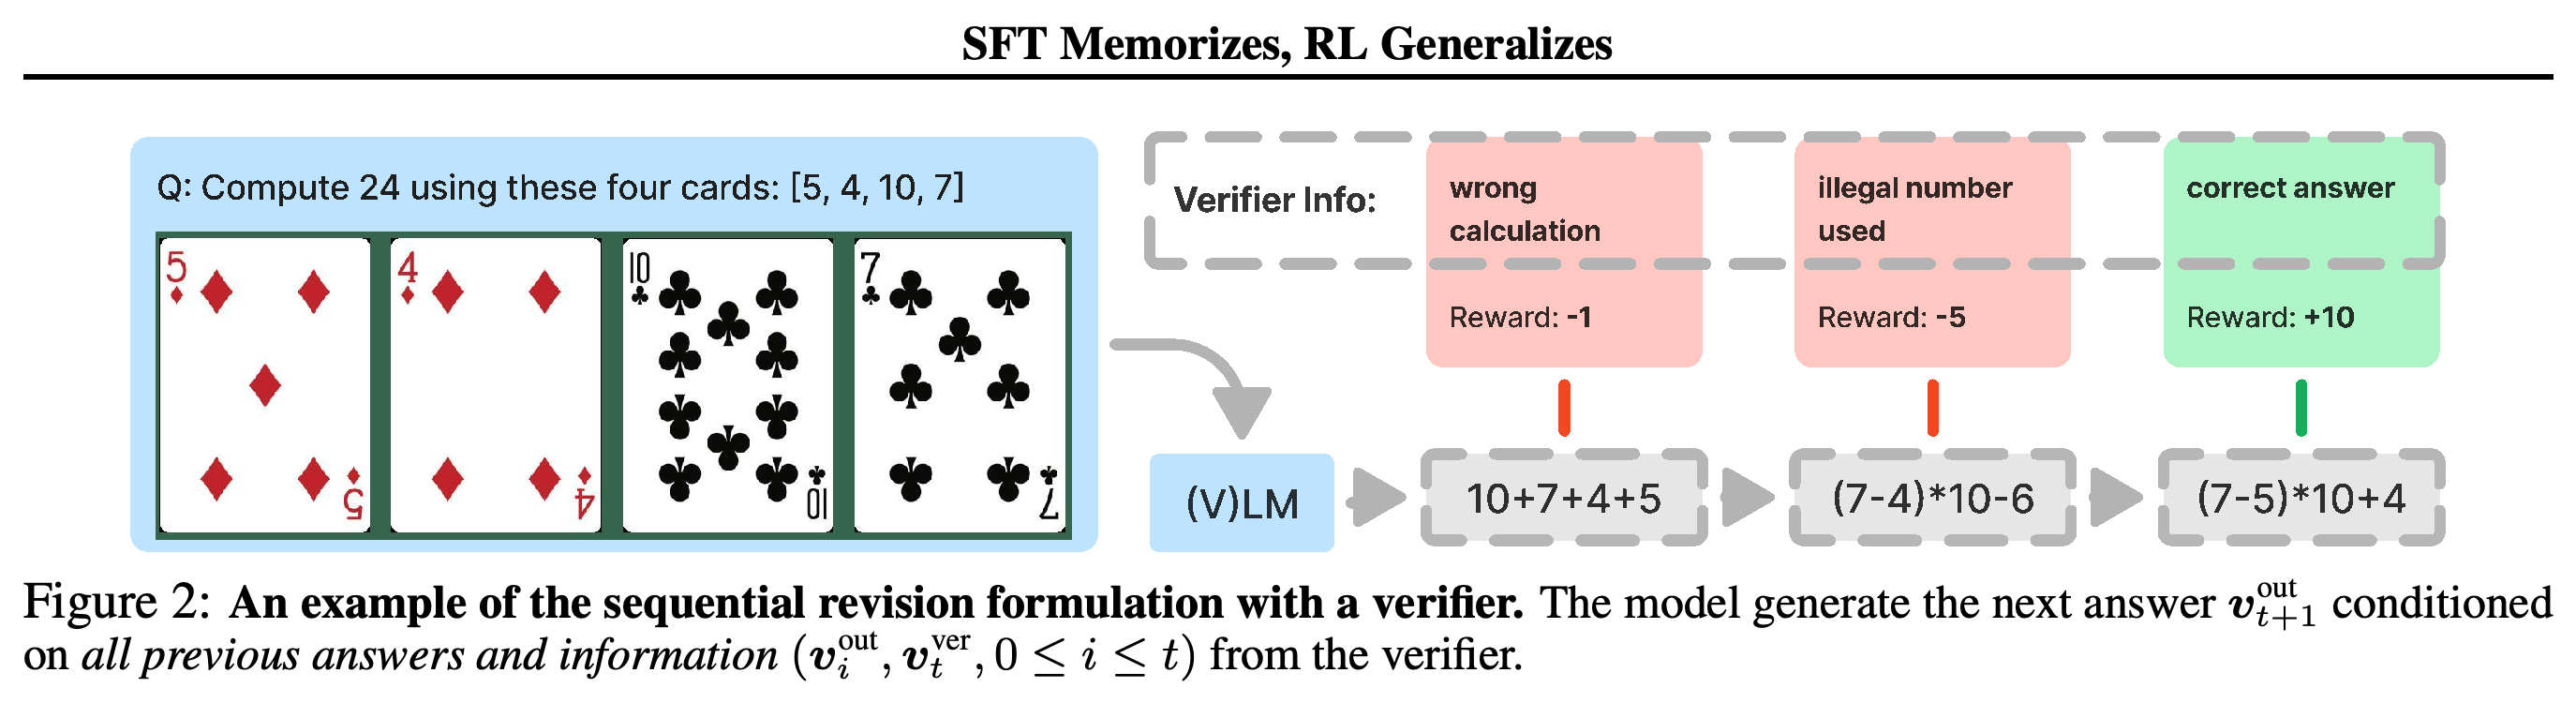
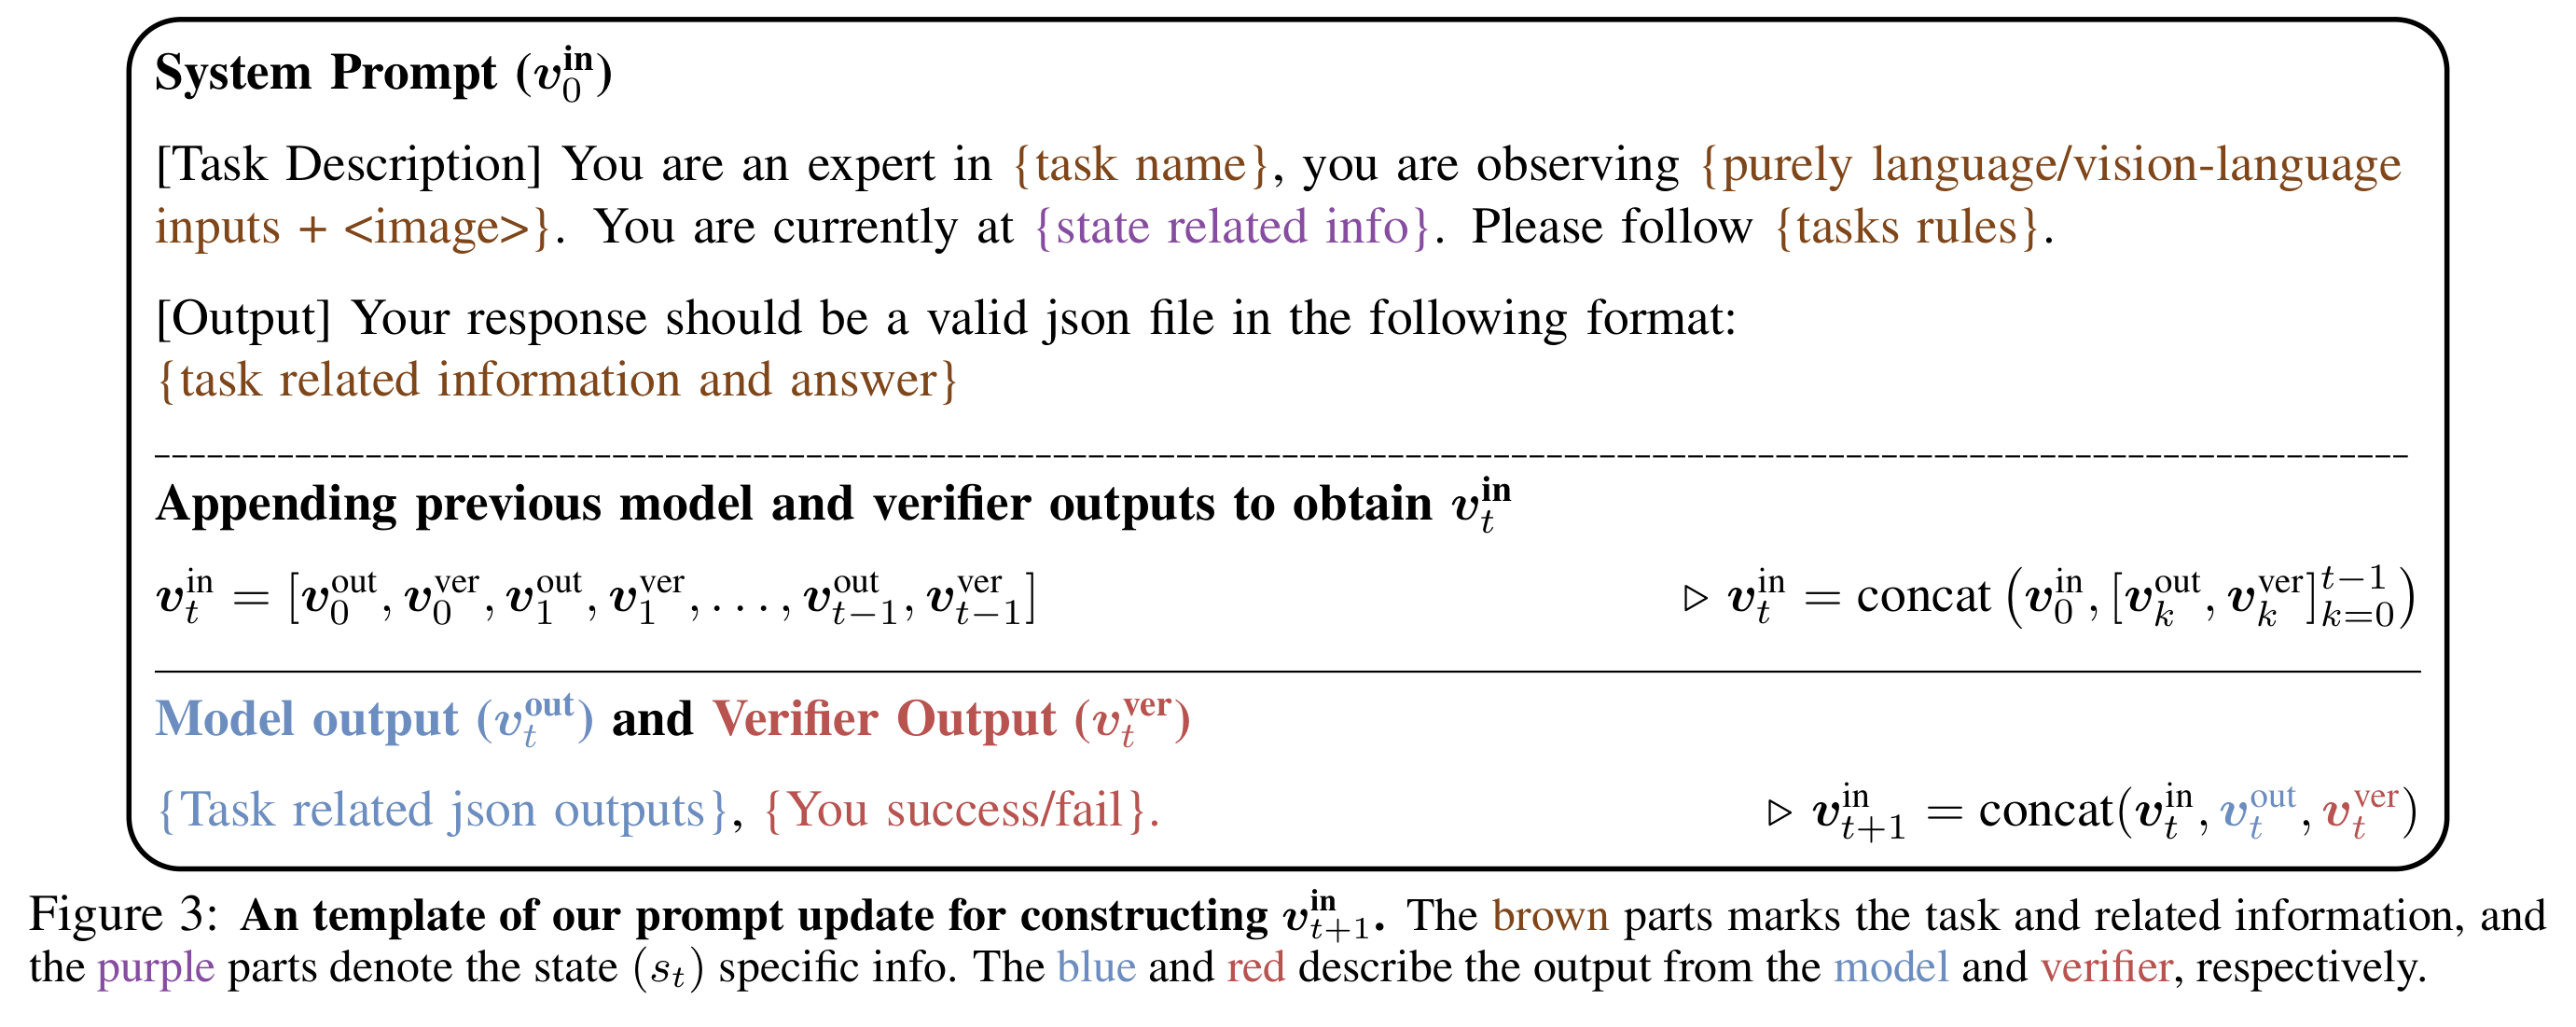
- 순차 수정은 이전의 모든 모델 출력과 verifier 피드백을 최초 프롬프트에 덧붙인다. 따라서 후속 응답에서 앞선 오류를 수정할 수 있으며, Figure 2와 Figure 3이 이를 보여준다.
카드 [5, 4, 10, 7]에 대해 verifier 피드백은 계산 오류와 주어지지 않은 숫자 사용을 구분하며, 이후 모델은 (7-5)*10+4를 생성한다. 이 도식은 수정 과정에서 피드백을 활용하는 방식을 설명한다. 예시 보상 값인 −1, −5, +10은 Appendix A.3의 환경 명세와 다르다.
다음 입력은 최초 과제 설명을 유지하면서 이전 응답과 verifier 메시지를 누적한다. 이로써 피드백이 모델 상태의 일부가 되어 앞선 답변을 수정할 수 있다.
4. Evaluation Tasks
평가는 텍스트 규칙 변경과 시각 조건 변경을 각각 지원하는 환경 2개를 사용한다. GeneralPoints는 산술 추론을 평가하고, V-IRL은 내비게이션 중 공간 추론과 인식을 평가한다. 각 환경에는 -L로 표기하는 텍스트 전용 변형과 -VL로 표기하는 이미지와 텍스트 입력 변형이 있다.
4.1. The General Points Environment
GeneralPoints는 카드 4장의 값을 각각 정확히 1번씩 사용해 값이 24인 수식을 만들도록 요구한다. GP-L은 카드 설명을 텍스트로 제공한다. GP-VL은 이미지를 제공하므로, 모델은 산술 문제를 풀기 전에 카드를 인식해야 한다.
- 규칙 변경 실험에서는 ‘J’, ‘Q’, ‘K’를 모두 10으로 처리하며 학습한 뒤, 평가할 때는 각각 11, 12, 13으로 처리한다. 적용할 규칙을 프롬프트에 명시하며, 평가 입력에는 그림 카드가 최소 1장 포함되어야 한다.
- 시각 조건 변경 실험에서는 검은 무늬인 ♠와 ♣로 학습한 뒤 빨간 무늬인 ♥와 ♦로 평가한다. 이를 통해 색상이 달라져도 카드 인식 능력이 전이되는지 검증한다.
4.2. The V-IRL Environment
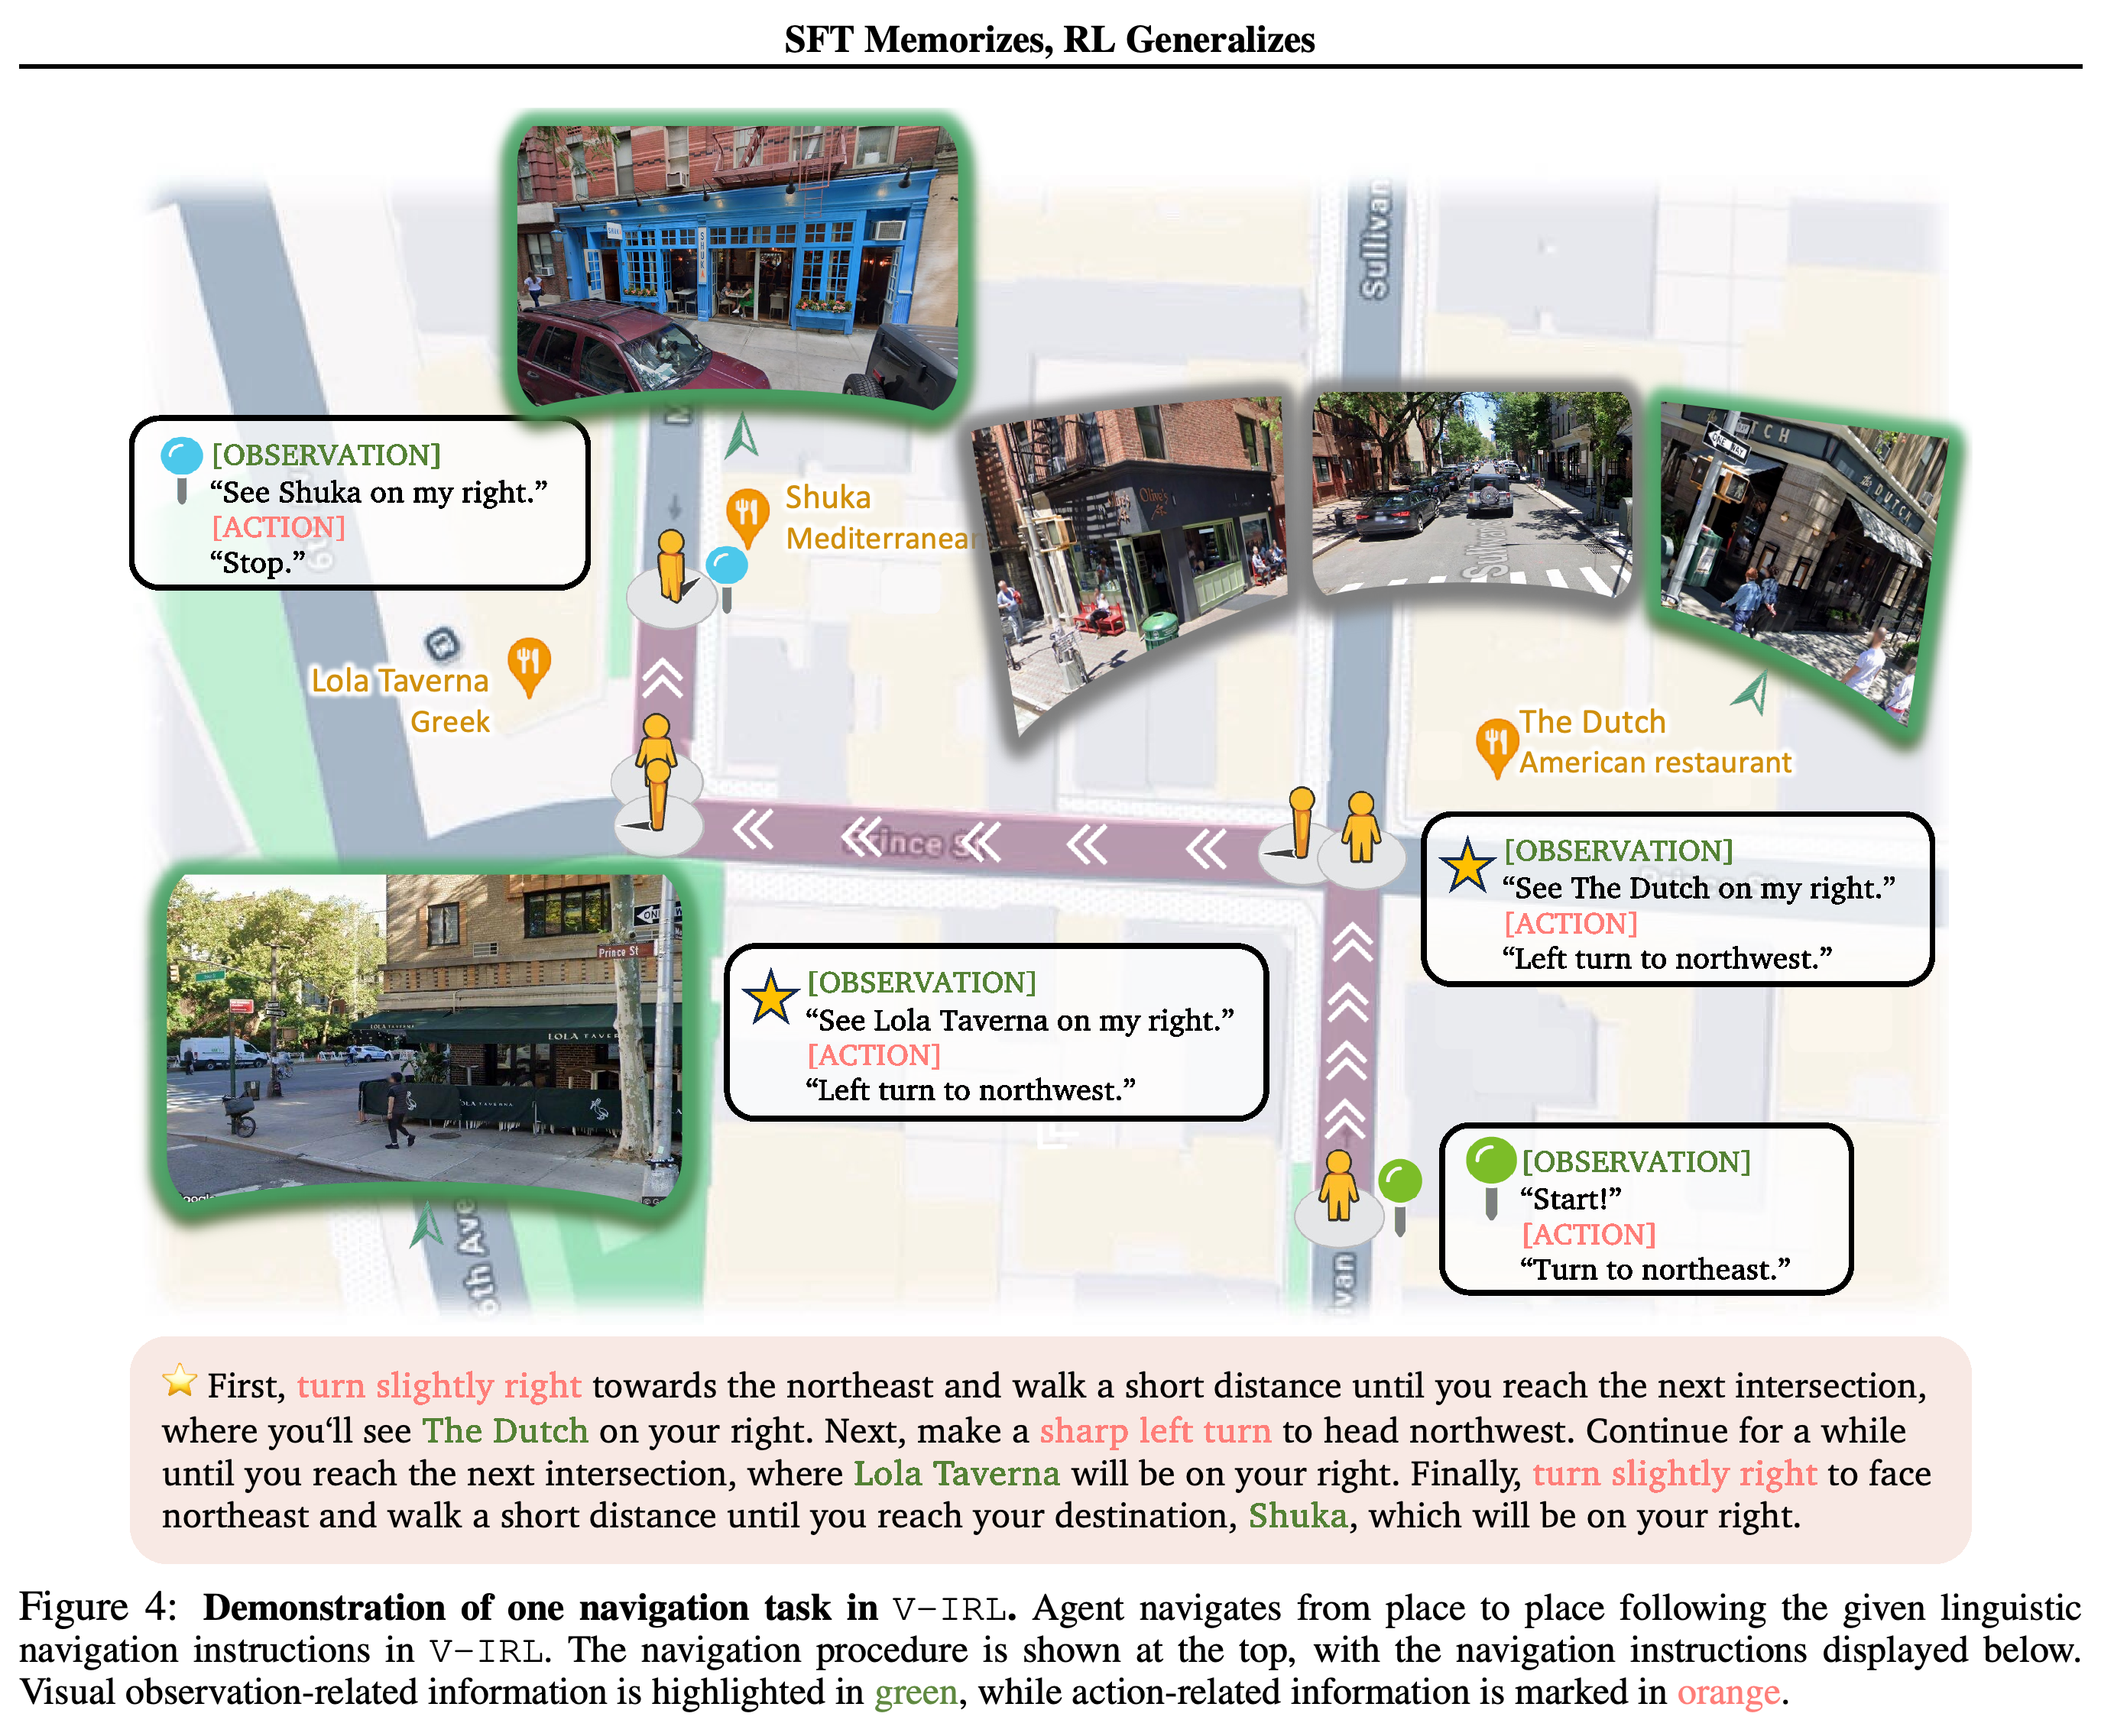
V-IRL은 관련 랜드마크를 식별하면서 공간 지시에 따라 목적지까지 이동하도록 요구한다. V-IRL-L은 관측 정보를 텍스트로 제공하고, V-IRL-VL은 거리뷰 이미지를 제공한다. Figure 4는 랜드마크 관측이 에이전트의 회전 또는 정지 시점을 어떻게 결정하는지 보여준다.
- 규칙 변경 실험은 ‘north’, ‘northeast’와 같은 절대 방향을 ‘left’, ‘right’, ‘slightly left’, ‘slightly right’라는 상대 회전 행동으로 바꾼다. 이 행동은 90도 또는 45도 회전에 해당하며, 전진과 정지 행동도 계속 사용할 수 있다.
- 시각 조건 변경 실험에서는 New York City 경로로 학습한 뒤 전 세계 경로 벤치마크로 평가하여 랜드마크 인식과 내비게이션 능력의 전이를 검증한다. 벤치마크에는 학습 경로와 겹치지 않는 New York 경로도 포함된다.
이 경로는 The Dutch, Lola Taverna, Shuka의 관측을 내비게이션 행동과 연결한다. 성공하려면 시각적으로 인식한 랜드마크를 해당 공간 지시와 연결해야 하는 이유를 보여준다.
5. Results
주요 실험은 Llama-3.2-Vision-11B를 사용한다. 비교할 학습 분기 2개를 모두 SFT로 학습한 체크포인트에서 초기화한 뒤, 각 분기의 SFT 또는 RL 연산량을 별도로 늘린다. 주요 실험에서는 모델의 모든 구성 요소를 학습하며, 각 실험 안에서 모든 구성 요소에 공통 학습률 1개를 적용한다.
- 결과에서는 규칙 전이, 시각 전이, 인식 정확도, SFT 초기화의 필요성, 검증 반복 횟수를 살펴본다.
- 연산량 비교는 부동소수점 연산 수를 추정해 기가 단위인 GFLOPs로 보고하며, RL 학습 응답 수집에 필요한 추가 생성 비용도 포함한다.
5.1. Generalization across Rules
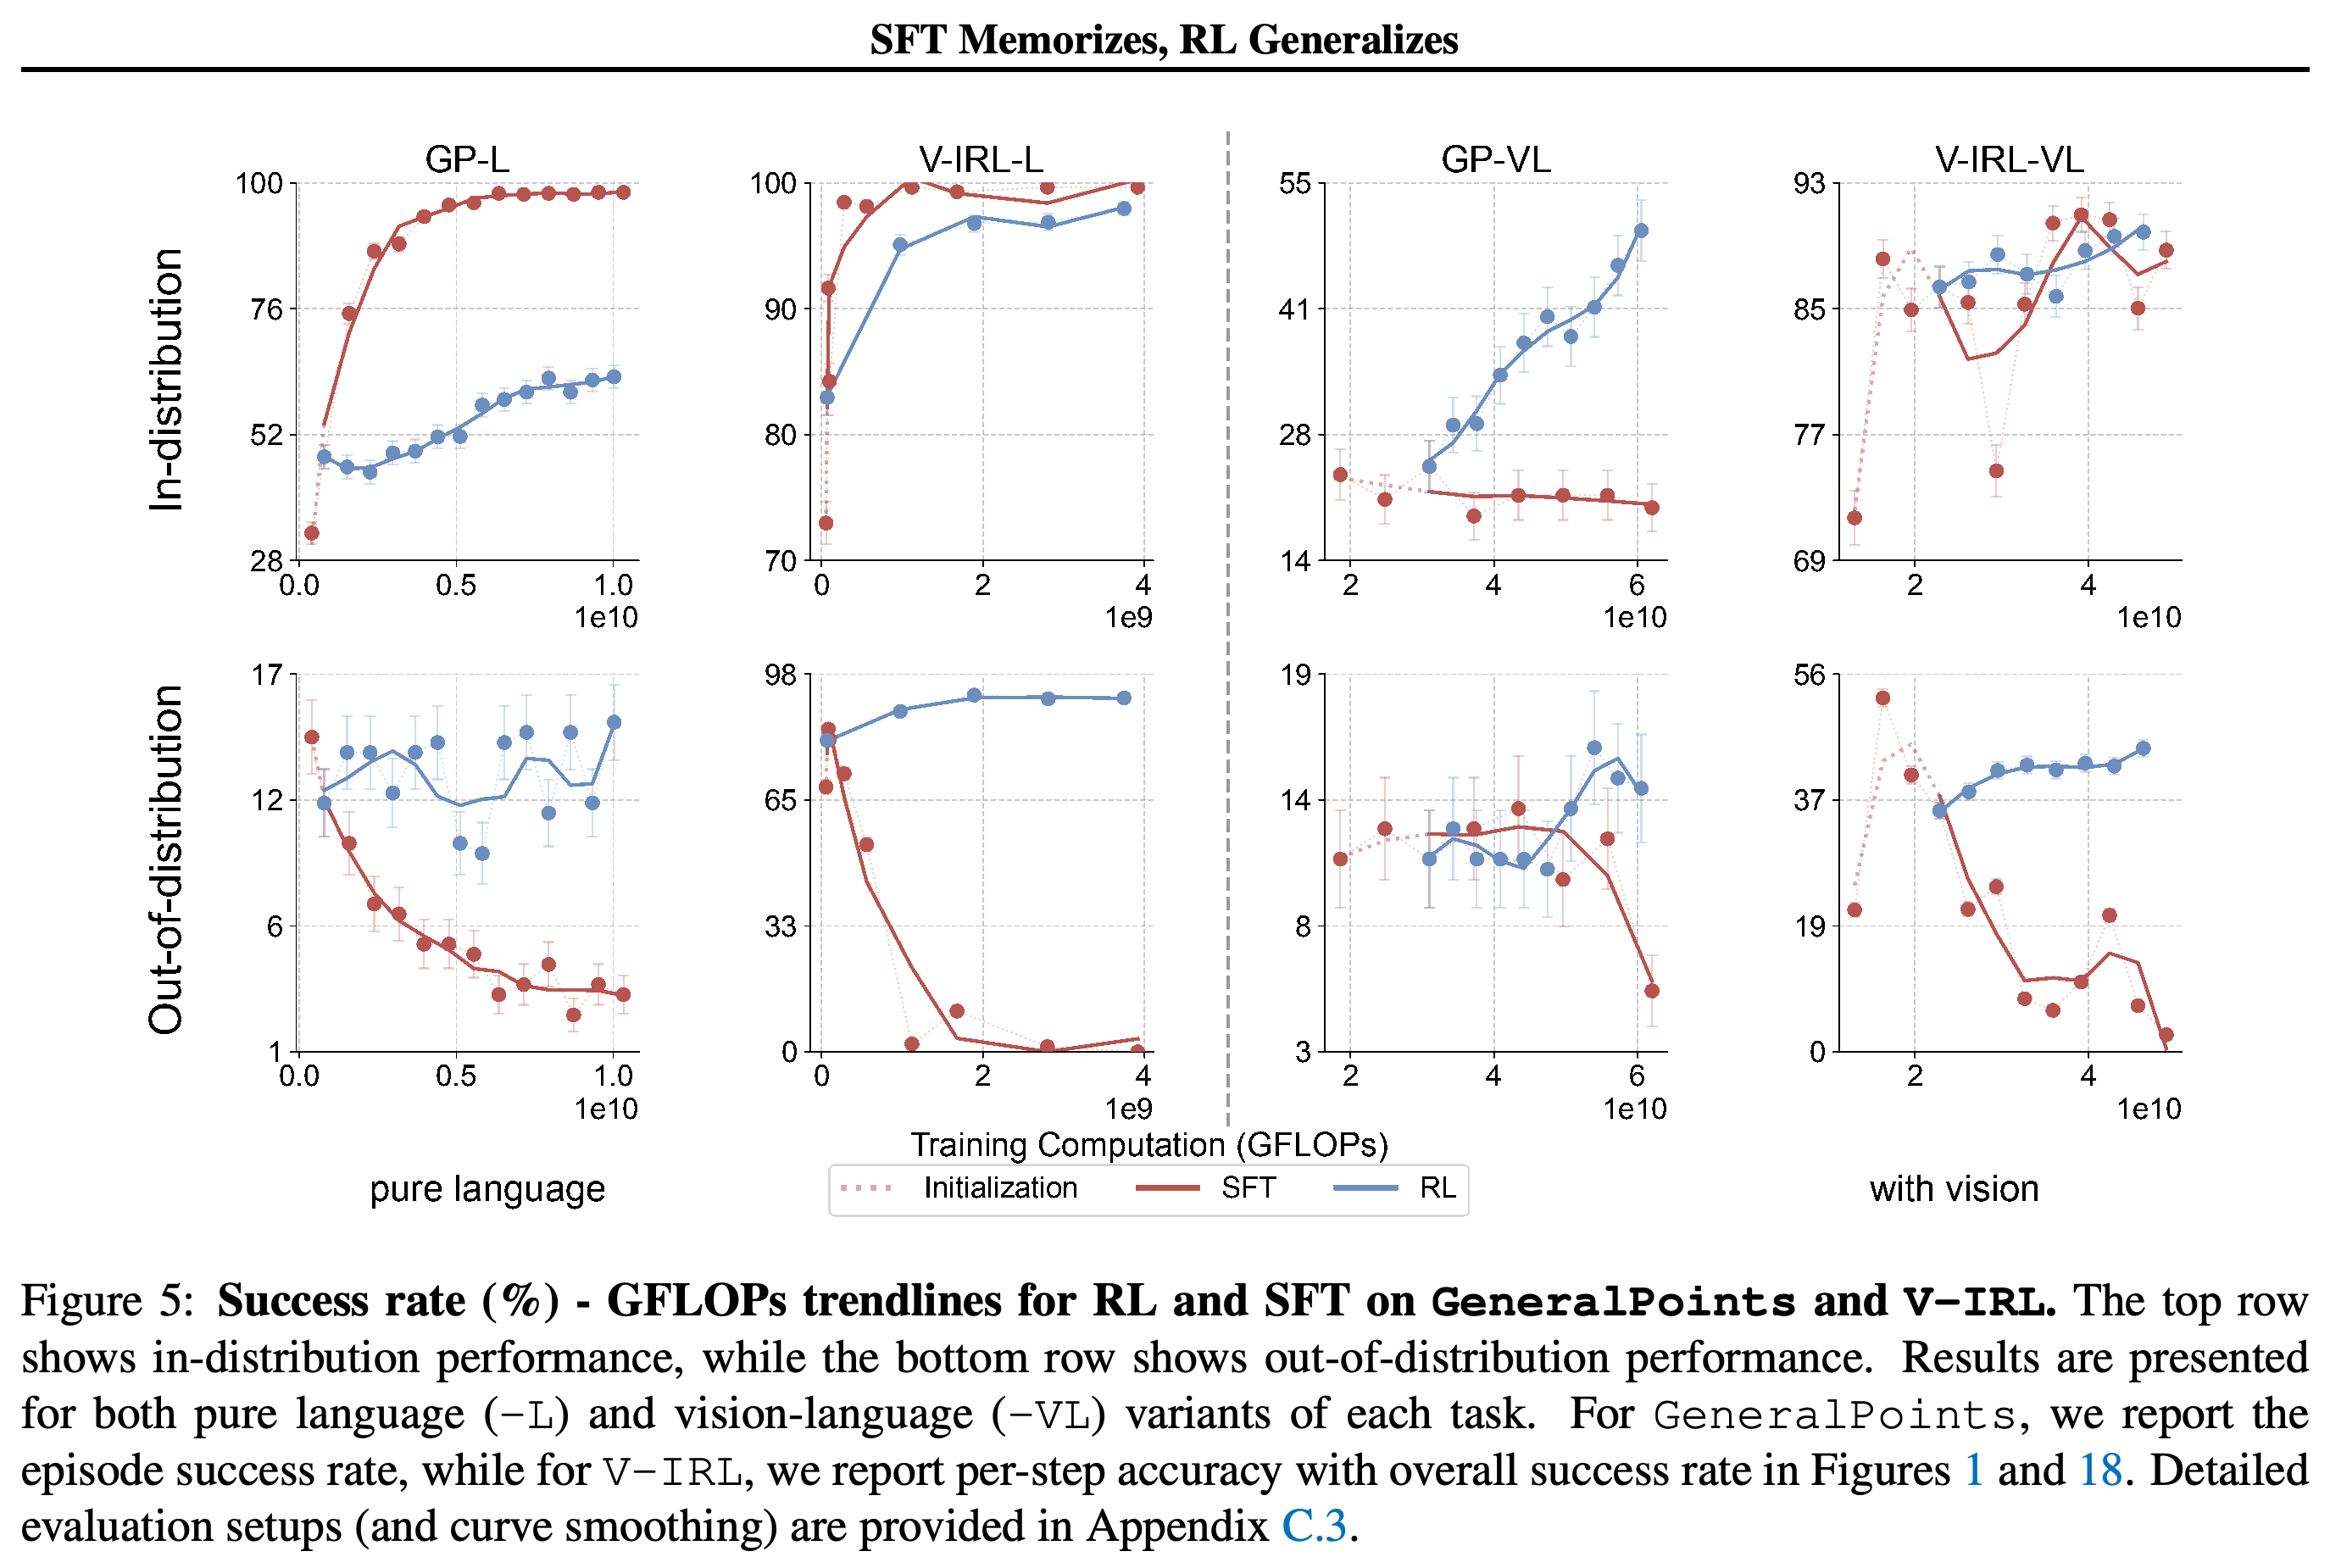
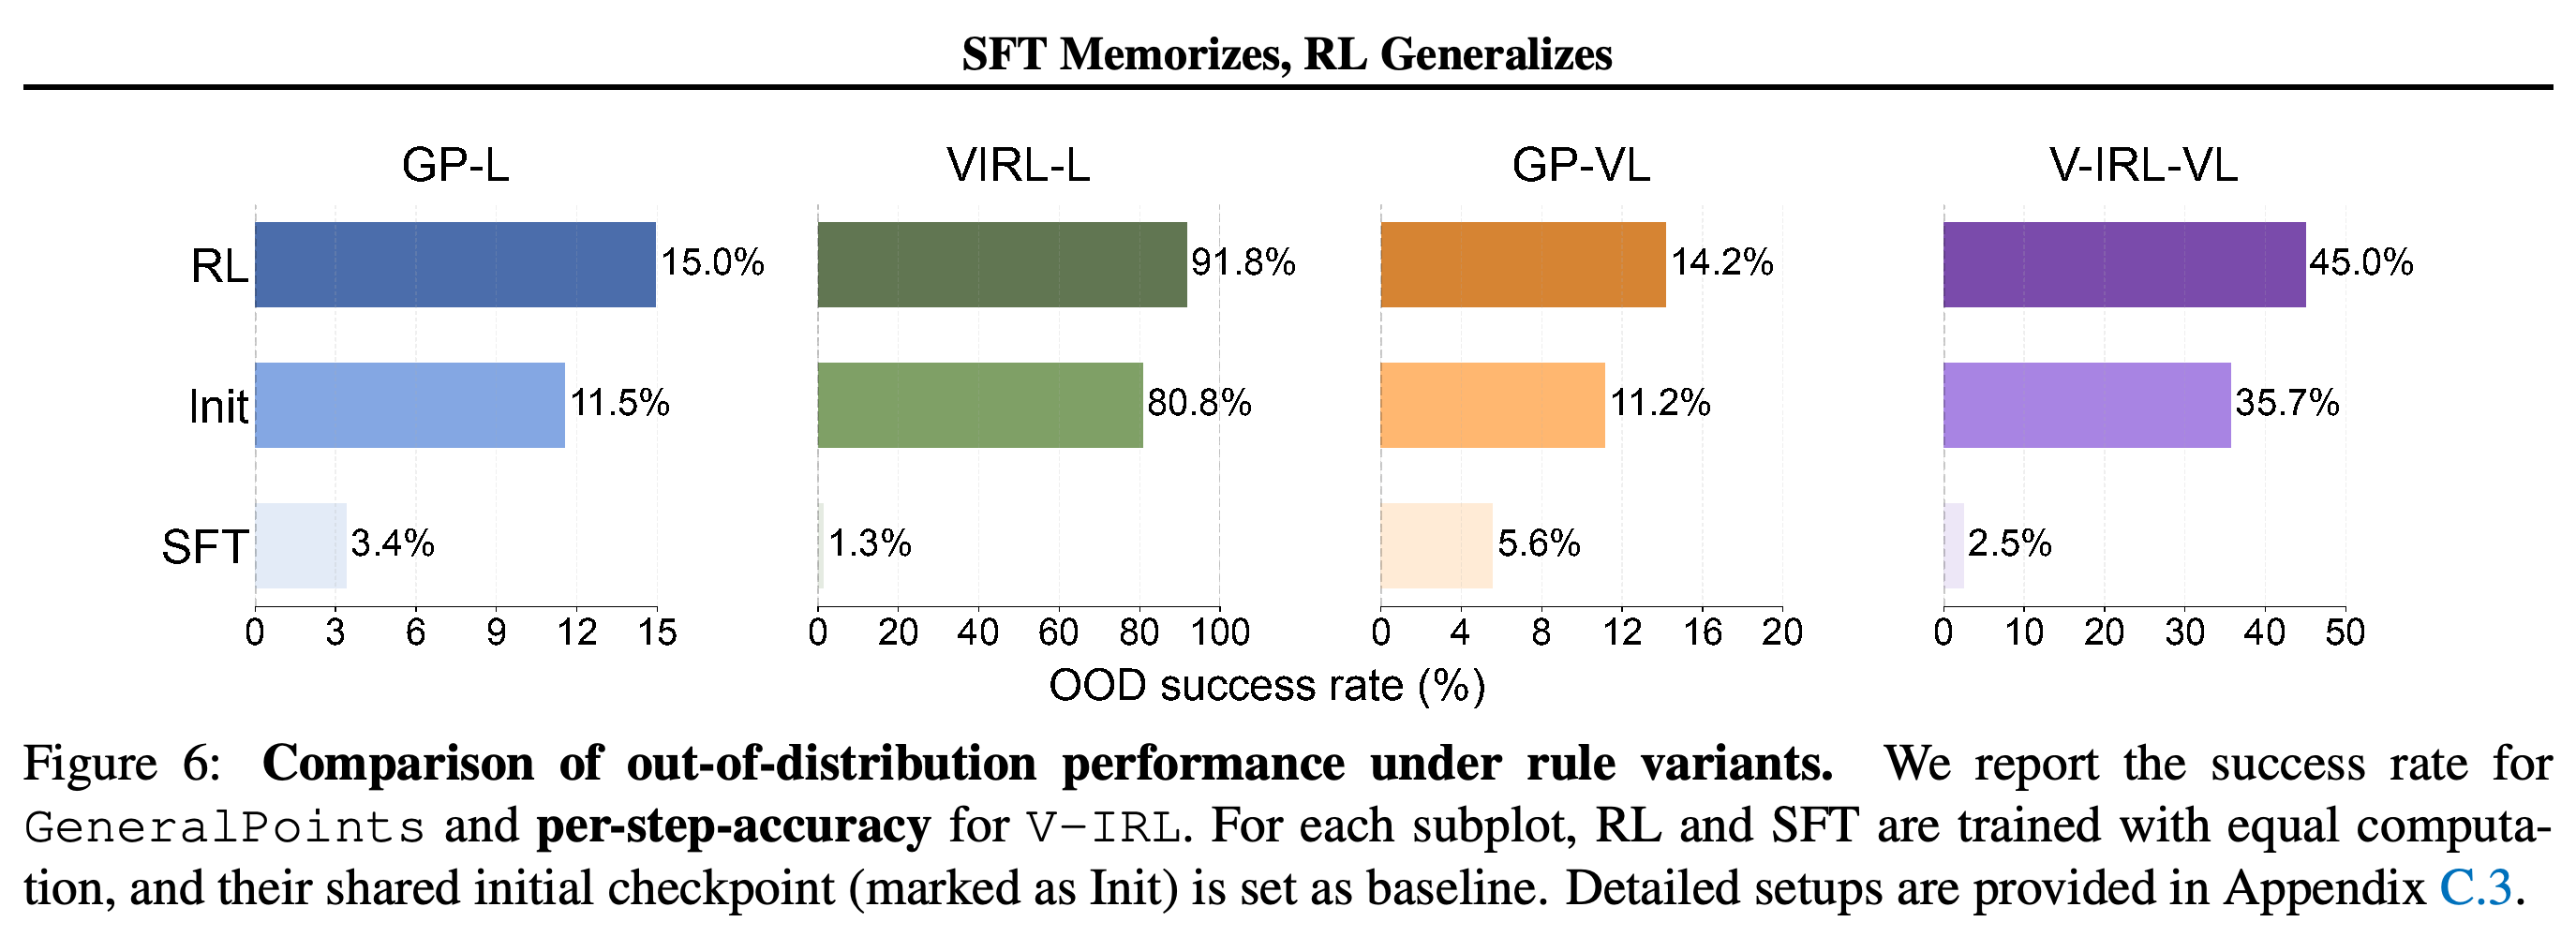
과제 변형 4개 모두에서 RL은 학습에 없던 규칙에 대한 성능을 높이고, 추가 SFT는 성능을 낮춘다. Figure 5와 Figure 6은 공통 초기화에서 시작한 학습 양상과 최종 성능을 비교한다. 최종 성능 비교에서는 추정 연산량을 동일하게 맞춘다.
- GeneralPoints의 에피소드 성공률은 허용된 검증 시도 안에 정답을 최소 1번 얻는 비율이다. GP-L에서는 11.5%에서 RL 적용 후 15.0%로, SFT 적용 후 3.4%로 바뀐다. GP-VL에서는 11.2%에서 RL 적용 후 14.2%로, SFT 적용 후 5.6%로 바뀐다.
- V-IRL의 단계별 정확도는 V-IRL-L에서 80.8%에서 RL 적용 후 91.8%로, SFT 적용 후 1.3%로 바뀐다. V-IRL-VL에서는 35.7%에서 RL 적용 후 45.0%로, SFT 적용 후 2.5%로 바뀐다.
- 이 내비게이션 수치는 개별 행동을 측정한다. Figure 18에서 규칙 변경 시 전체 경로의 OOD 성공률은 약 1% 이하이므로, 행동 수준의 개선만으로 안정적인 경로 완주가 입증되지는 않는다.
열 4개는 산술과 내비게이션, 텍스트 전용 입력과 이미지 및 텍스트 입력을 구분한다. 아래쪽 행에서 추가 SFT는 미학습 규칙 성능을 낮추지만, RL은 이를 유지하거나 높인다. 위쪽 행은 SFT가 GP-VL의 in-distribution 학습에서도 부진함을 보여준다. GeneralPoints는 에피소드 성공률을, 내비게이션은 단계별 정확도를 사용한다.
추정 연산량을 동일하게 맞춘 최종 성능은 모든 과제 변형에서 RL이 초기화보다 높고 SFT는 초기화보다 낮다. GeneralPoints는 에피소드 성공률을 보고하지만 V-IRL은 단계별 정확도를 보고하므로, 내비게이션 막대는 경로 완주율로 해석할 수 없다.
5.2. Generalization in Visual Out-of-Distribution Tasks
과제 규칙을 고정한 경우에도 RL은 낯선 시각 입력에 대한 전이 성능을 높인다. Figure 7에서 GeneralPoints 성공률은 초기화 시점에 23.6%, RL 적용 후 41.2%, SFT 적용 후 13.7%다. V-IRL 경로 성공률은 초기화 시점에 16.7%, RL 적용 후 77.8%, SFT 적용 후 11.1%다.
- GeneralPoints는 검은 무늬를 빨간 무늬로 바꾼다. V-IRL은 New York City 학습 경로에서 기존의 전 세계 내비게이션 mini benchmark로 평가 대상을 바꾼다.
- 77.8%는 기존에 보고된 44.0%보다 33.8%포인트 높다. 기존 시스템은 시각 언어 모델과 언어 모델을 연결한 2단계 파이프라인과 맞춤형 프롬프트를 사용했으므로, 이 결과는 서로 다른 시스템 간의 벤치마크 비교다.
5.3. RL Improves Visual Capabilities
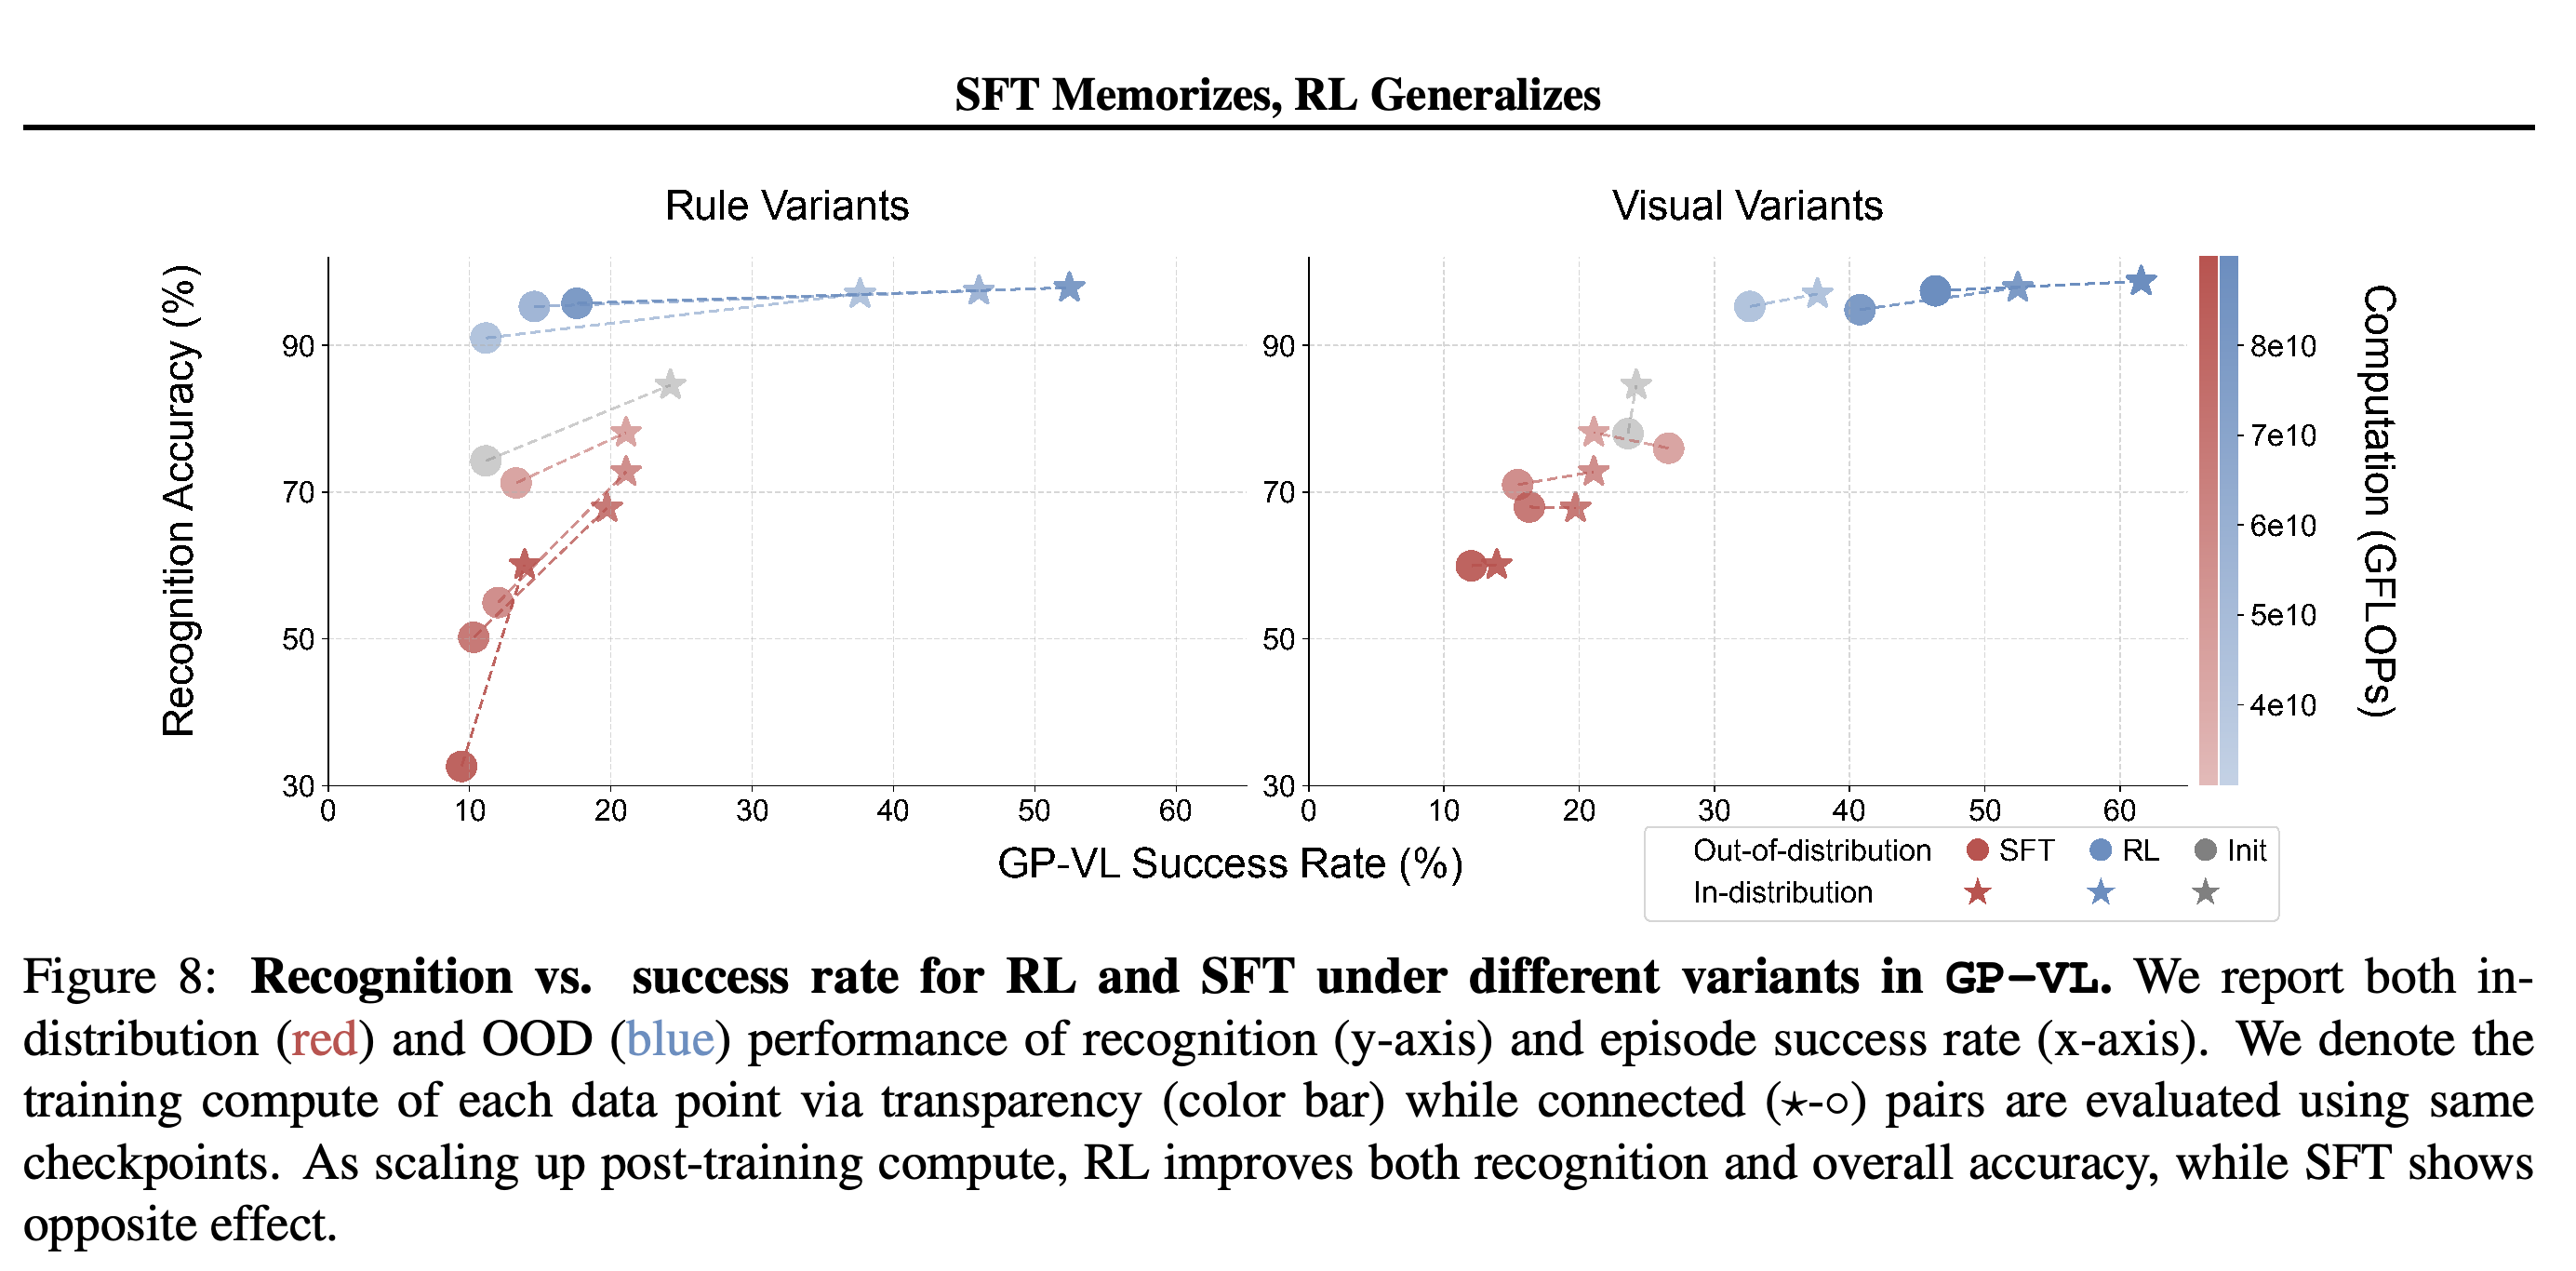
GP-VL 분석은 규칙 변경과 시각 조건 변경 2가지 모두에서 입력 카드 4장의 인식 정확도와 수식 풀이 성공률을 함께 측정한다. Figure 8에서 RL 연산량을 늘리면 인식 정확도와 에피소드 성공률이 함께 높아진다. 반면 이 실험들에서는 SFT 연산량을 늘리면 지표 2개가 모두 낮아진다.
- 이 관계는 시각 인식이 과제 성능에 기여한다는 해석을 뒷받침한다. 다만 이 분석은 인식 능력 향상이 추론 개선의 유일한 원인임을 입증하지는 않는다.
- Figure 16과 Figure 17에서는 학습률을 바꾸거나 선택한 모델 구성 요소를 학습 중 고정하는 추가 실험을 통해 GP-VL에서 SFT 성능이 낮은 이유를 살펴본다.
표시된 체크포인트는 과제 변경 2가지 모두에서 카드 인식 정확도와 산술 에피소드 성공률의 관계를 보여준다. RL 체크포인트는 인식 정확도와 성공률이 높아지는 방향으로 이동하고, SFT 체크포인트는 낮아지는 방향으로 이동한다. 이는 인식 능력이 성능 차이에 기여한다는 해석을 뒷받침한다. 범례는 학습 방법을 색상으로, 분포 조건을 마커 모양으로 구분하지만, 원문 캡션의 색상 설명은 이 범례와 충돌한다.
5.4. The Role of SFT for RL Training
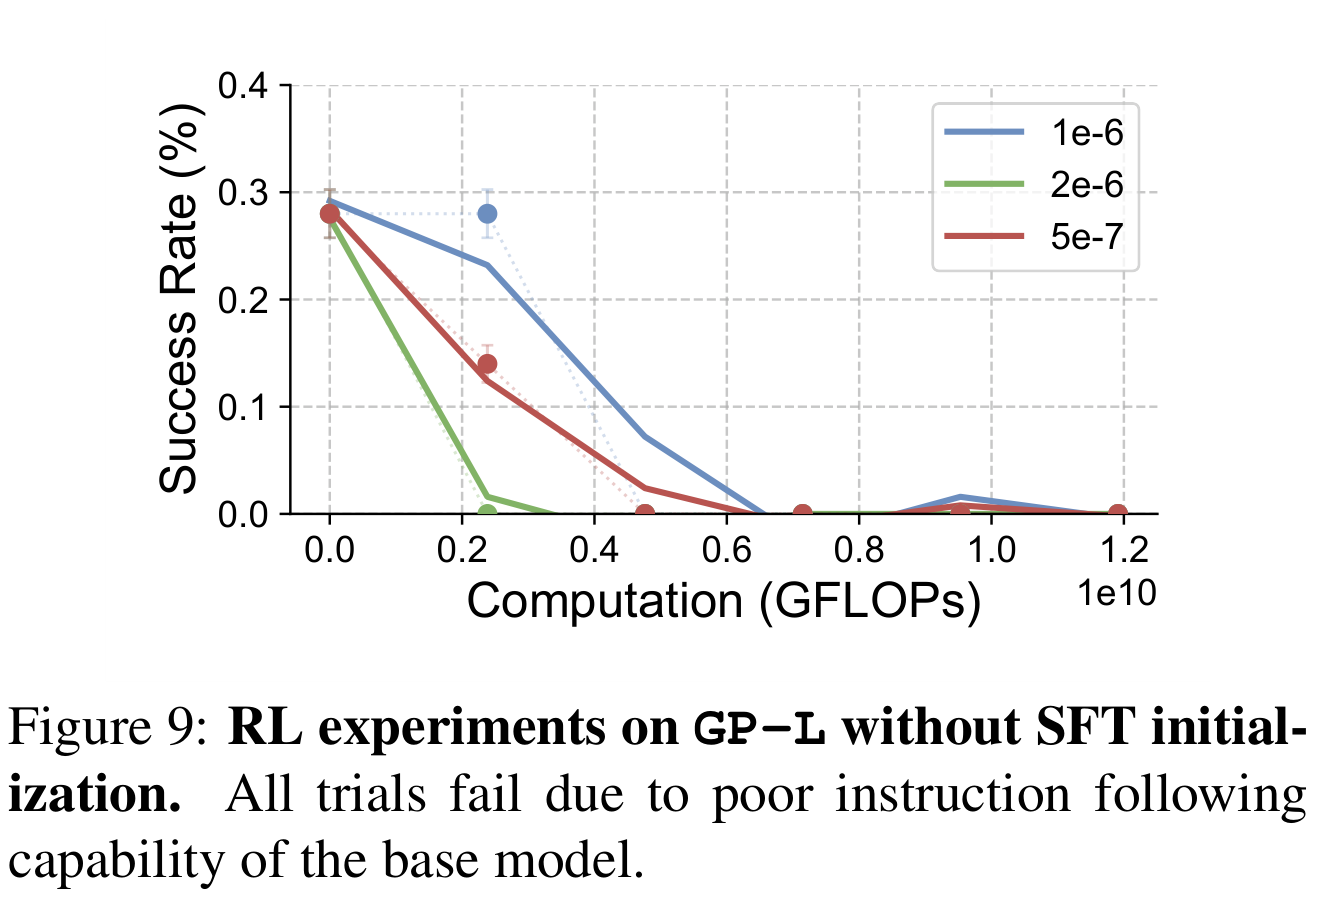
SFT 초기화 없이 기본 모델에 직접 RL을 적용하면, 보고된 모든 시도에서 GP-L 성능을 높이지 못한다. Figure 9에서는 성공률이 0에 가까워진다. Figure 20은 요구된 구조화된 답변 대신 Python 코드를 제공하려는 응답을 보여준다.
- 저자들은 지시 수행 능력이 부족해 과제 정보와 보상을 안정적으로 추출하지 못하기 때문에 이러한 실패가 발생한다고 설명한다.
- 이 결과는 실험한 백본과 설정에 한정된다. 논문은 SFT 없는 RL이 성공한 다른 모델의 결과와 이를 명시적으로 구분한다.
SFT 초기화가 없으면 학습률 실험 3개 모두에서 학습이 진행될수록 성공률이 0에 가까워진다. Figure 20의 출력 예시와 함께 보면, 실험 조건에서는 요구된 지시와 응답 형식을 따르는 초기화가 필요하다는 근거가 된다.
5.5. Role of Verification Iterations
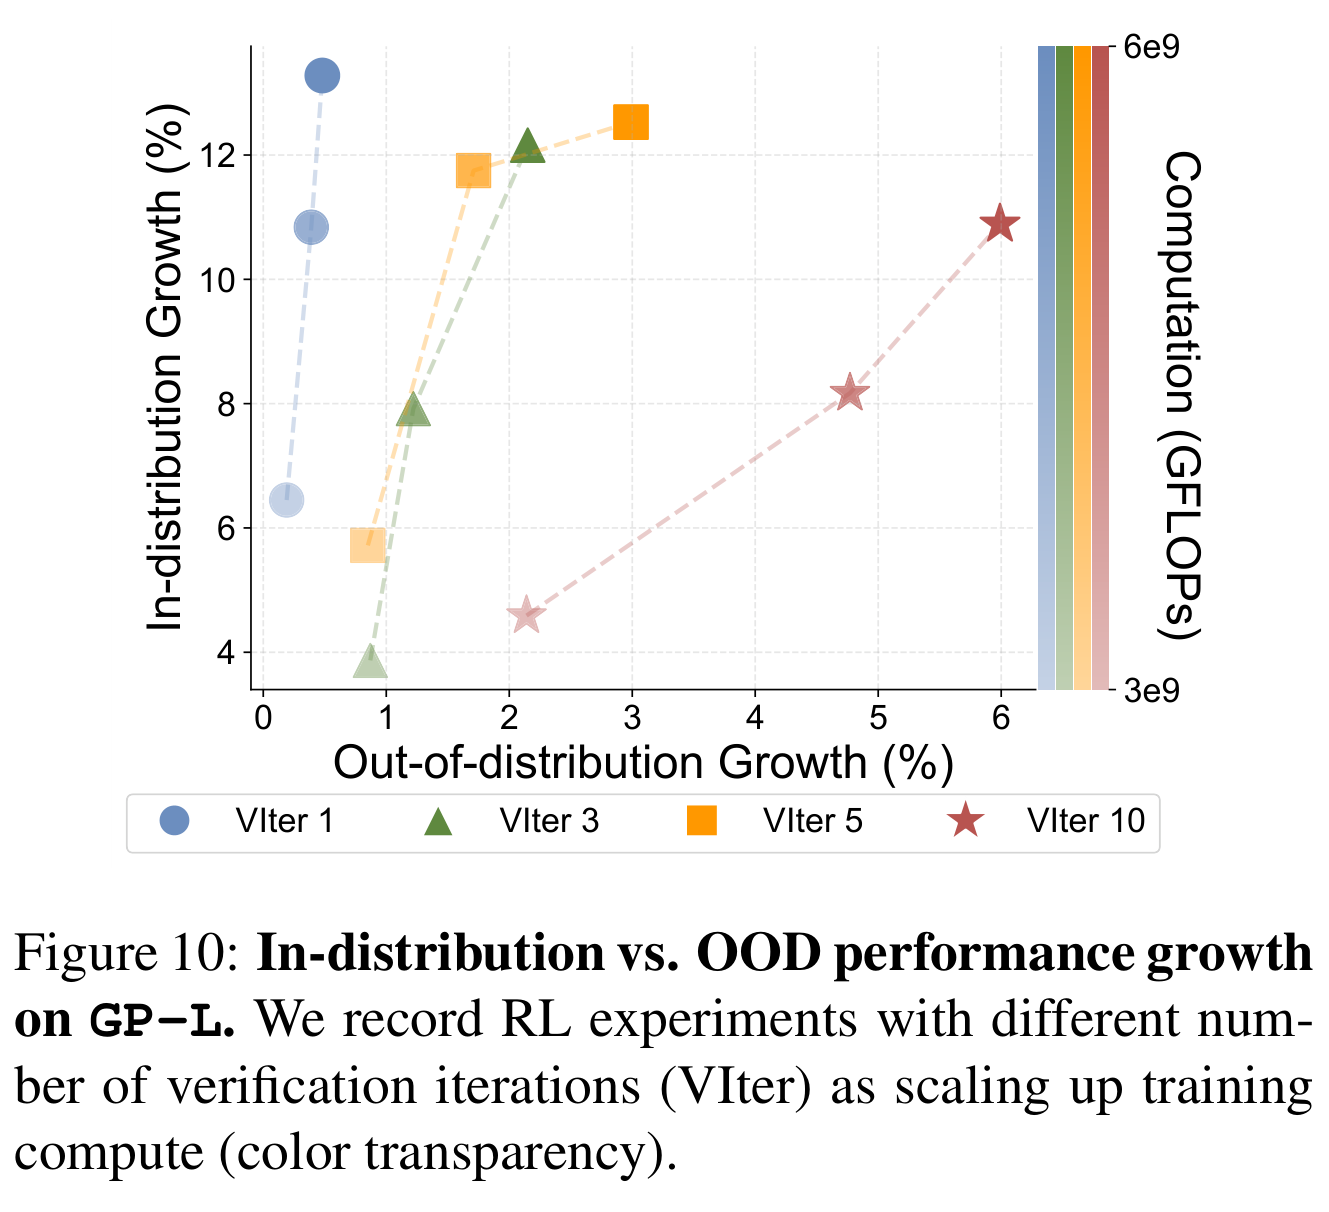
GP-L 실험은 최대 검증 반복 횟수를 {1, 3, 5, 10}으로 바꾼다. 동일한 연산 예산에서 OOD 성능은 각각 0.48, 2.15, 2.99, 5.99%포인트 높아진다. 이는 응답을 수정할 기회를 늘리는 것이 도움이 된다는 결과다.
- Figure 10은 학습한 규칙에 대한 성능 향상인 in-distribution 증가폭과 OOD 증가폭을 비교한다. In-distribution 증가폭은 검증을 1번 수행할 때 가장 크지만, 반복 횟수가 많을수록 OOD 증가폭은 더 크다.
공통 연산 예산에서 검증 상한을 1회에서 10회로 늘리면 미학습 규칙의 성능 증가폭이 0.48%포인트에서 5.99%포인트로 커진다. 이 양상은 전이 성능의 개선과 학습 규칙에 대한 성능 향상을 구분해 보여준다.
6. Conclusion, Discussion, and Limitations
논문은 실험한 산술 및 내비게이션 조건 변화에서 RL 파이프라인의 전이 성능이 추가 SFT보다 높다고 결론짓는 한편, 방법 2가지 모두에 해결되지 않은 문제가 있음을 지적한다. SFT는 추가 실험에도 GP-VL의 in-distribution 성능에서 RL에 근접하지 못하며, RL은 시작 체크포인트의 품질에 여전히 민감하다.
- 저자들은 SFT가 더 자주 등장하는 추론 토큰을 지나치게 강조하고 시각 인식 결과를 보고하는 토큰은 충분히 학습하지 않는다는 가설을 제시한다. 이 설명은 아직 가설이다.
- Figure 19에서 RL은 초기 OOD 단계별 정확도가 1% 미만인 극도로 과적합된 내비게이션 체크포인트의 규칙 전이 성능을 회복하지 못한다. Figure 21은 프롬프트가 상대 방향을 요구하는데도 모델이 절대 방향을 출력하는 사례를 보여준다.
- SFT 없이 진행한 실패 실험과 함께 보면, 이 실험들은 지시 수행 학습이 부족한 초기화와 심하게 과적합된 초기화 2가지 모두에서 실패가 발생함을 보여준다.
논문의 다른 결과에서 개별 행동 정확도가 높아져도, 내비게이션 규칙을 바꾸면 전체 경로 성공률은 약 1% 이하에 머문다. 경로를 완주하려면 올바른 행동을 연속으로 수행해야 하므로, 전체 경로 성공은 전이 능력을 훨씬 더 엄격하게 평가한다.
심하게 과적합된 체크포인트에서 시작하면, 실험한 RL 학습률 2개 모두 OOD 단계별 정확도가 0에 가까운 수준에 머물며 지속적인 회복을 보이지 않는다. 이 결과는 RL이 과도한 SFT로 생긴 성능 저하를 복구할 수 있다는 주장에 한계가 있음을 보여준다.
Impact Statement
Impact Statement는 GeneralPoints와 V-IRL을 통제된 연구 환경으로 설명하며, 내비게이션 환경을 현실 과제를 대신하는 시뮬레이션으로 사용한다고 서술한다. 저자들은 실제 현실 시스템이나 데이터를 대상으로 배포하거나 상호작용한 일이 없으며, 이 실험에서 예상되는 사회적 또는 윤리적 영향은 확인하지 못했다고 밝힌다.
부록
- A. Details on the General Points Environment, A.1. Data, A.2. Detailed Examples on the Transition Dynamics, A.3. Additional Eetails on the Environmental Design은 샘플링, 수정 예시, 설정 옵션, 보상을 명시한다. 표준 카드 덱 52장에서 카드 4장을 뽑으며, 전문가 풀이기로 값이 24인 해가 존재하는지 확인한다. 규칙 전이 평가에는 그림 카드가 최소 1장 필요하다. 목표값, 그림 카드 규칙, 샘플링, 무늬 색상을 설정할 수 있다. Figure 11과 Figure 12는 각각 이미지와 텍스트 입력 및 텍스트 전용 입력의 수정 과정을 보여준다. 에피소드는 성공하거나 검증 단계 5회에 도달하면 종료된다. 보상은 규칙에 맞는 정답 수식에 5, 규칙에 맞지만 오답인 수식 또는 검증 단계 소진에 −1, 주어지지 않은 숫자 사용에 −2, 그 밖의 규칙 위반 수식에 −3이다. GP-VL에서 카드 인식이 틀리면 −1.5의 추가 페널티를 부여한다. 이 보상 명세는 Figure 2의 예시 값과 다르다.
- B. Details on the V-IRL Environment, B.1. Data, B.2. Detailed Examples on the Transition Dynamics, B.3. Additional Details on the Environmental Design은 New York City의 고유 학습 경로 1000개, 내비게이션 예시, 단순화한 환경을 설명한다. 시각 전이 평가는 도시 9곳에서 도시당 2개씩 총 18개 경로를 사용하며, 평가용 New York 경로는 학습에서 제외한다. 경로에는 거리뷰, 지시, 전문가 관측, 정답 내비게이션 행동의 시퀀스인 전문가 궤적이 포함된다. Figure 13과 Figure 14는 각각 이미지와 텍스트 입력 및 텍스트 전용 입력의 상태 전이를 보여준다. 구현에서는 별도 시각 탐지기와 온라인 질의를 제거하고, 절대 또는 상대 회전 행동과 forward(), stop()을 지원하며, 직선 도로 길이를 제한한다. 보상은 올바른 행동에 1, 잘못된 행동 또는 최대 검증 단계 2회 초과에 −1, 랜드마크 탐지 실패에 −1.5다.
- C. Experimental Setup, C.1. Data, C.2. Training Pipeline, C.3. Evaluation Metric은 전문가 프롬프트와 응답 쌍, SFT 초기화, 연산량 산정, 평가를 설명한다. 본문의 SFT는 수정 과정 없이 최적의 단일 턴 예시를 사용한다. GP-L 추가 분석 실험에서는 오류가 포함된 궤적과 verifier 메시지를 추가하지만, OOD 성능은 여전히 나빠진다. 학습에는 각각 80GB 메모리를 갖춘 H800 그래픽 처리 장치 8개를 사용한다. GeneralPoints는 검증 중 정답을 최소 1번 얻으면 성공으로 처리한다. 내비게이션 경로는 이동 가능한 모든 지점에서 올바른 행동을 해야 성공으로 처리하며, 단계별 정확도는 중간 검증 시도를 각각 독립적으로 집계한다. 연산량 추정에는 초기화, 최적화, RL 응답 생성이 포함된다. 곡선에는 국소 다항식 평활화 방법인 Savitzky–Golay 필터를 다항식 차수 3으로 적용한다. 오차 막대는 측정한 성공 비율의 불확실성 추정치인 이항 표준오차를 근사한다.
- D. Additional Experimental Results, D.1. Ablation Studies on GP-VL, D.2. More results on V-IRL-VL, D.3. Failure Cases는 하이퍼파라미터 점검과 실패 근거를 제공한다. SFT 실험은 학습률을 바꾸고, 시각 인코더만 고정하거나 시각 인코더와 어댑터라는 구성 요소 2개를 모두 고정한다. 어댑터는 시각 표현을 언어 모델에 연결하는 구성 요소다. 이러한 실험에서도 in-distribution 성공률이 30%를 넘어 지속적으로 높아지지는 않는다. RL은 실험한 학습률 2개인 1 × 10⁻⁶과 2 × 10⁻⁶에서 모두 개선된다. Figure 18은 규칙 전이에서 단계별 성능과 전체 경로 성능 사이의 격차를 보여준다. Figure 19–21은 과적합에서 회복하지 못하는 사례와 SFT 없이 요구된 출력 형식을 따르지 못하는 사례를 보여준다.
짧은 생각
가장 강한 근거는 과제 2개, 입력 형식 2개, 별도로 수행한 규칙 변경과 시각 조건 변경에서 공통 체크포인트로 시작한 추가 SFT와 RL의 성능이 반복해서 서로 다른 방향으로 변한다는 점이다. 추정 연산량을 동일하게 맞춘 조건은 비교의 설득력을 높인다. 오류 궤적과 verifier 메시지를 추가한 GP-L 실험은 이러한 형태의 궤적 다양성을 늘려도 해당 설정에서 SFT의 전이 실패가 해소되지 않음을 보여준다.
논문 제목은 실험 조건 안에서 해석해야 한다. 핵심 근거는 학습 예시를 거의 그대로 재현하는지 직접 측정한 결과가 아니라 백본 1개의 전이 성능에 관한 결과다. 내비게이션 규칙 전이의 전체 경로 성공률은 여전히 매우 낮다. Figure 12와 Figure 20에 인쇄된 카드 프롬프트에도 그림 카드에 관한 상충하는 지시가 있다. PDF만으로는 이러한 불일치가 실제 평가 프롬프트에도 존재하는지 확인할 수 없다.