


Fin-R1: A Large Language Model for Financial Reasoning through Reinforcement Learning 요약 설명
20 Mar 2025 | Paper Review Financial Reasoning Reinforcement Learning Supervised Fine-Tuning목차
이번 글에서는 Fin-R1: A Large Language Model for Financial Reasoning through Reinforcement Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 20일(Arxiv)
- Liu, Zhaowei, Guo, Xin, Yang, Zhi, Lou, Fangqi, Zeng, Lingfeng, Niu, Jinyi, Li, Mengping, Qi, Qi, Liu, Zhiqiang, Han, Yiyang, et al.
- School of Statistics and Data Science, Shanghai University of Finance and Economics, China, School of Mathematical Sciences, Fudan University, China, School of Economics, Shanghai University of Finance and Economics, China, AI Finance Development and Service Center, Shanghai University of Finance and Economics, China, QuantaAlpha, China, Department of Statistics, Rice University, USA, Department of Statistics, London School of Economics and Political Science, UK, Qinghai Provincial Key Laboratory of Big Data in Finance and Artificial Intelligence Application Technology, Qinghai Institute of Technology, China
- 논문 링크
- Github
요약
- 이 논문은 수치 계산, 전문 지식, 맥락 추론이 함께 필요한 금융 질문에 소형 언어 모델을 적응시키는 방법을 다룬다. 논문의 자동 정답 판정 절차에 따라 금융 벤치마크 5개를 평가한 결과, 7-billion-parameter Fin-R1의 보고된 평균 점수는 75.2다. 기반 모델인 Qwen2.5-7B-Instruct는 65.6, DeepSeek-R1-671B는 78.2다. 제시된 점수 5개의 산술평균은 75.18이며, 소수점 첫째 자리까지 반올림하면 보고된 75.2와 일치한다.
- Fin-R1-Data는 DeepSeek-R1이 생성하고 Qwen2.5-72B-Instruct로 필터링한 중국어와 영어 예시 60,091개로 구성된다. 각 예시에는 중간 추론 단계를 순서대로 서술한 chain-of-thought가 포함된다. 학습은 응답 예시를 학습하는 지도 미세조정과 보상으로 생성 응답을 최적화하는 강화학습을 결합한다. 강화학습에는 같은 질문에 대한 응답들의 보상을 비교하는 Group Relative Policy Optimization을 사용한다.
- 결합 학습 절차는 보고된 평균을 지도 미세조정만 적용했을 때의 71.9에서 75.2로 높인다. 금융 데이터의 수치 추론을 평가하는 FinQA에서는 76.0, 대화 맥락이 필요한 금융 질의응답을 평가하는 ConvFinQA에서는 85.0을 기록해 평가 대상 모델 중 가장 높은 점수를 얻는다. 이 결과는 선택한 벤치마크에서 학습 절차의 효과를 뒷받침한다. 다만 학습 데이터와 테스트 데이터의 분리가 불명확하고, 학습 세부 정보가 제한적이며, 벤치마크 점수의 불확실성 추정치가 없어 일반화와 재현성에 관한 해석에는 한계가 있다.
1 Introduction
서론은 금융 언어 모델이 직면한 장애물 3가지를 제시한다. 경제, 법률, 정량 분석 자료에 정보가 분산되어 있고, 생성된 추론 과정을 파악하기 어려우며, 업무 시나리오 사이의 전이 성능이 낮다는 점이다. 이를 해결하기 위해 금융 추론 시범 데이터를 구축한 뒤, 지도학습과 보상 최적화를 차례로 적용해 소형 모델을 적응시킨다.
- Figure 1은 데이터 생성과 필터링을 2단계 학습 과정에 연결하며, 금융 코드, 전문 지식, 업무 지식에 걸친 활용 사례를 보여준다.
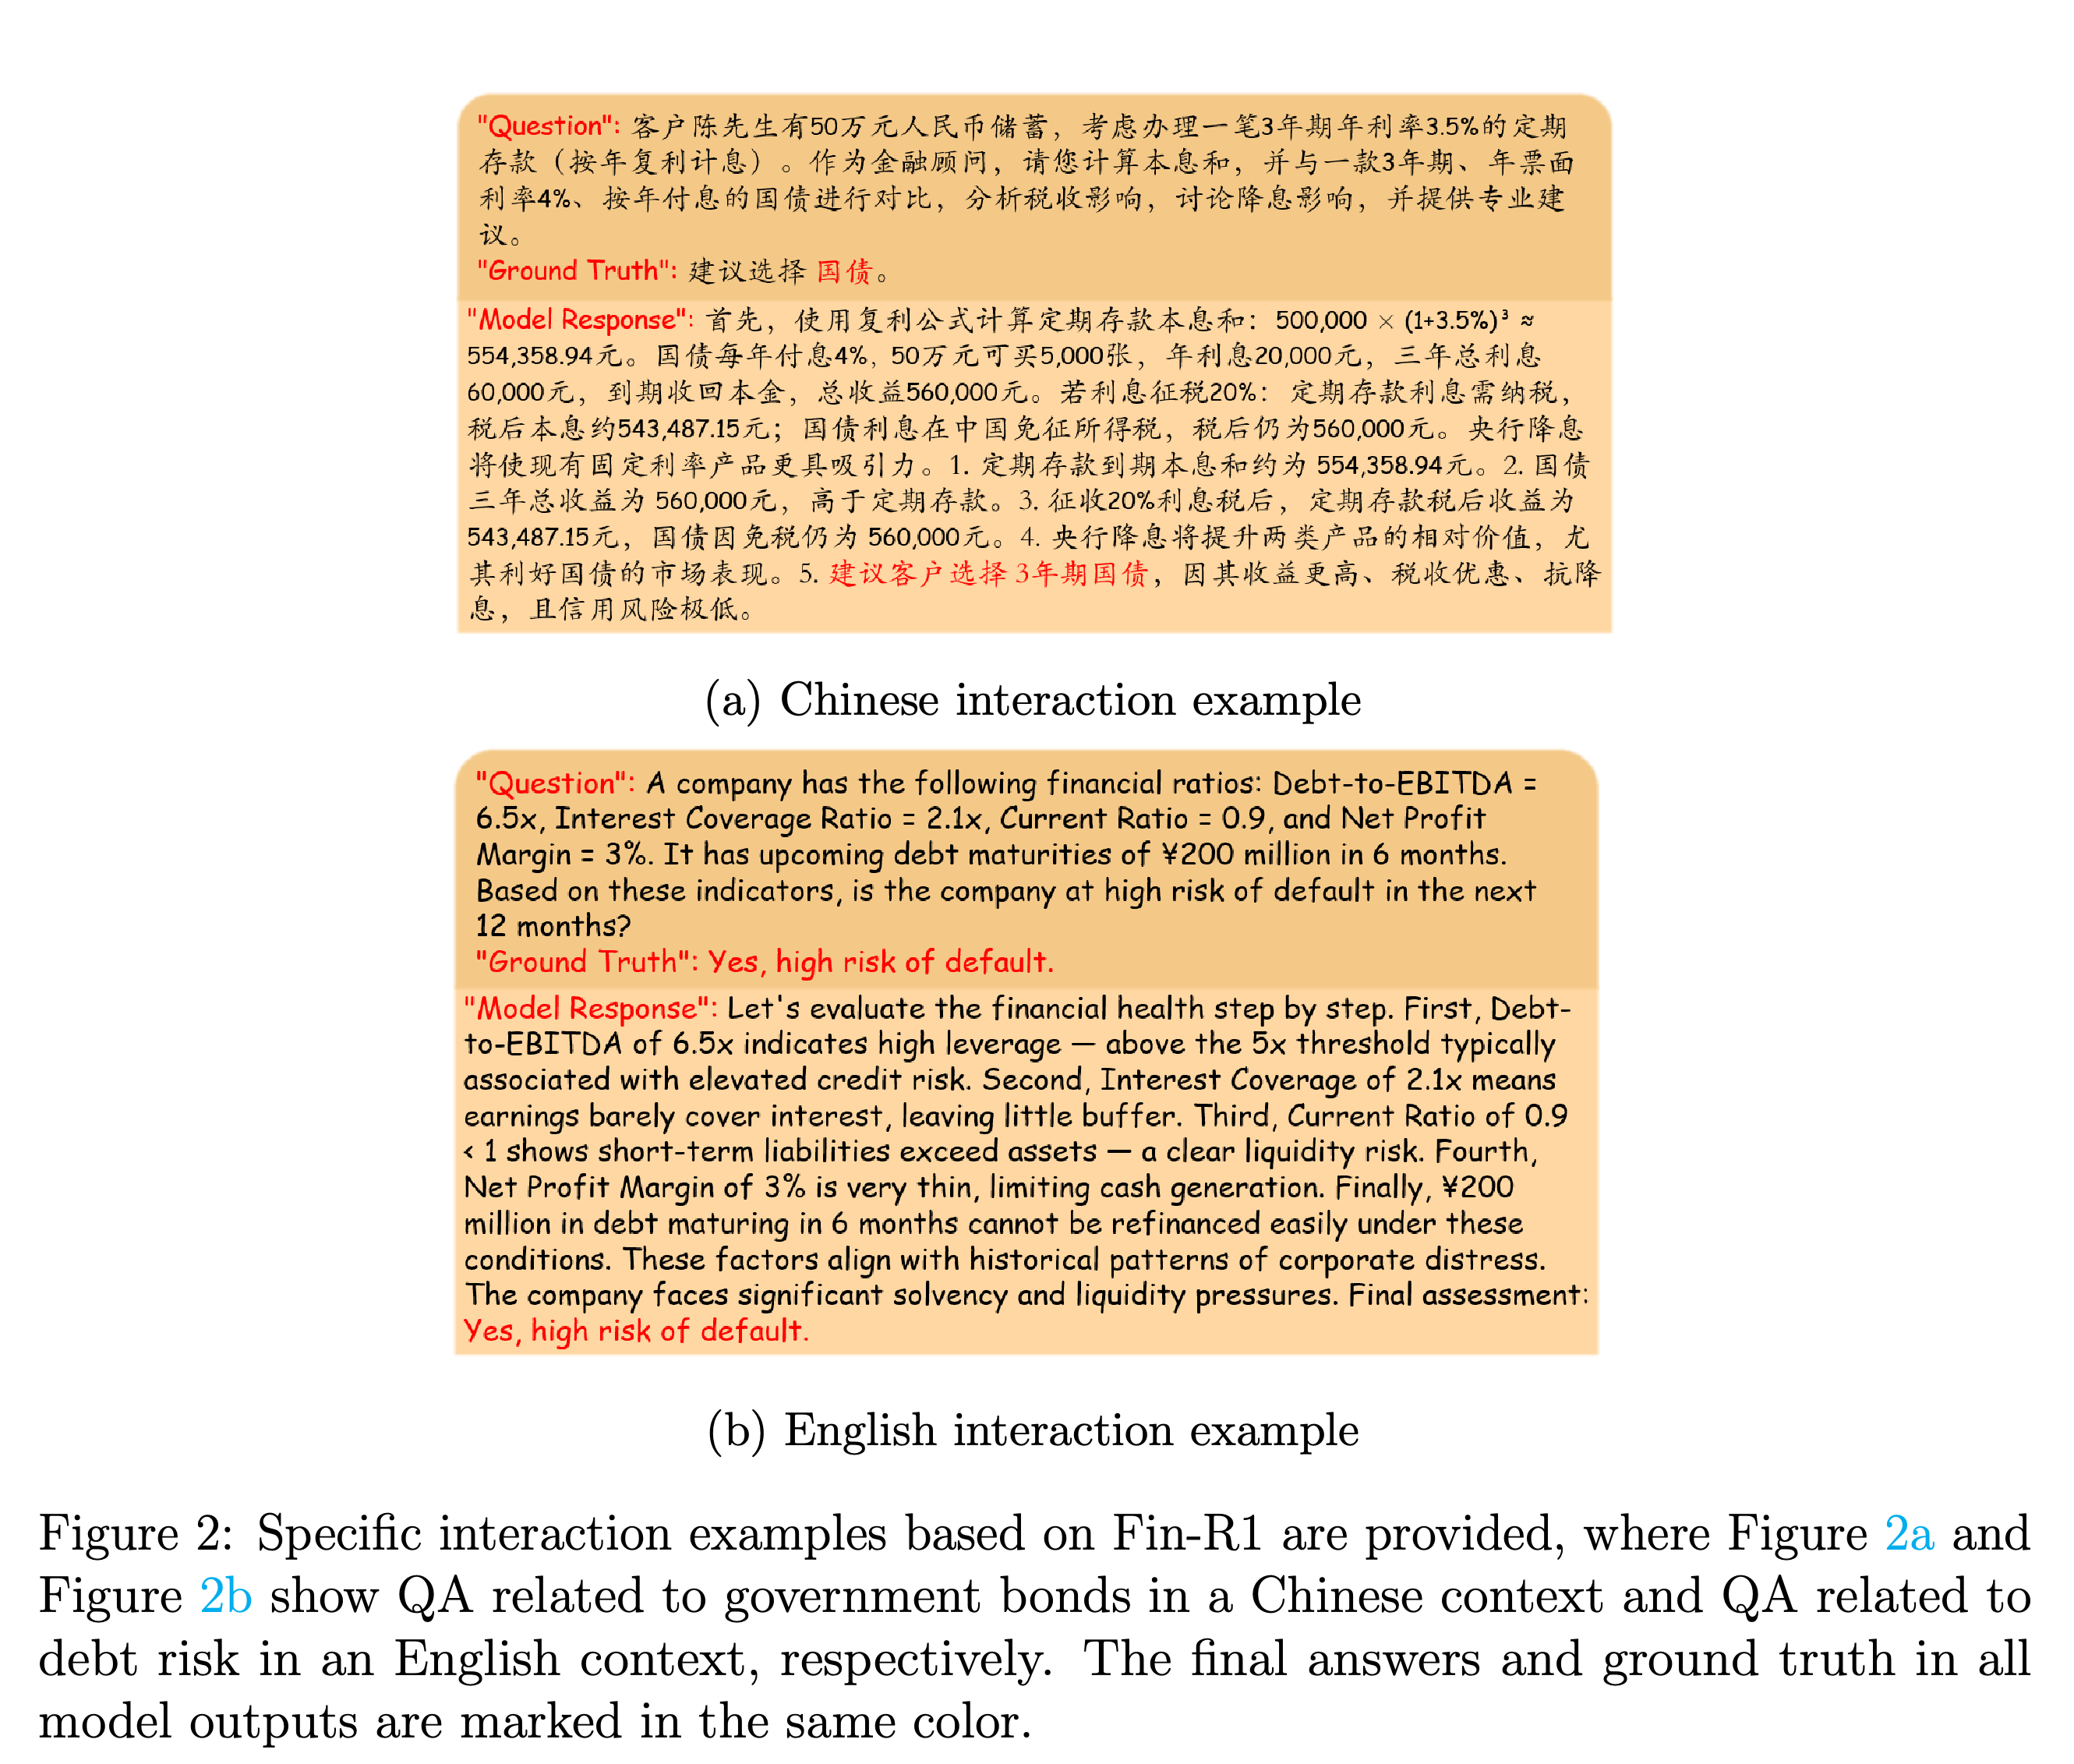
- Figure 2는 중국어 국채 투자 조언과 영어 부채 위험 평가 사례를 보여준다. 선택된 사례는 응답 구조와 이중 언어 지원을 보여주지만, 실제 활용 상황에서의 신뢰성을 측정하지는 않는다.
이 도식은 금융 질문의 용도를 2가지로 구분한다. 필터링한 추론 시범 데이터는 초기 적응을 위한 지도학습에 사용하고, 질문과 풀이 쌍은 이후 보상 최적화에 사용한다. 이 구분은 생성된 시범 응답이 탈락한 질문도 강화학습 단계에서 사용할 수 있는 이유를 설명한다.
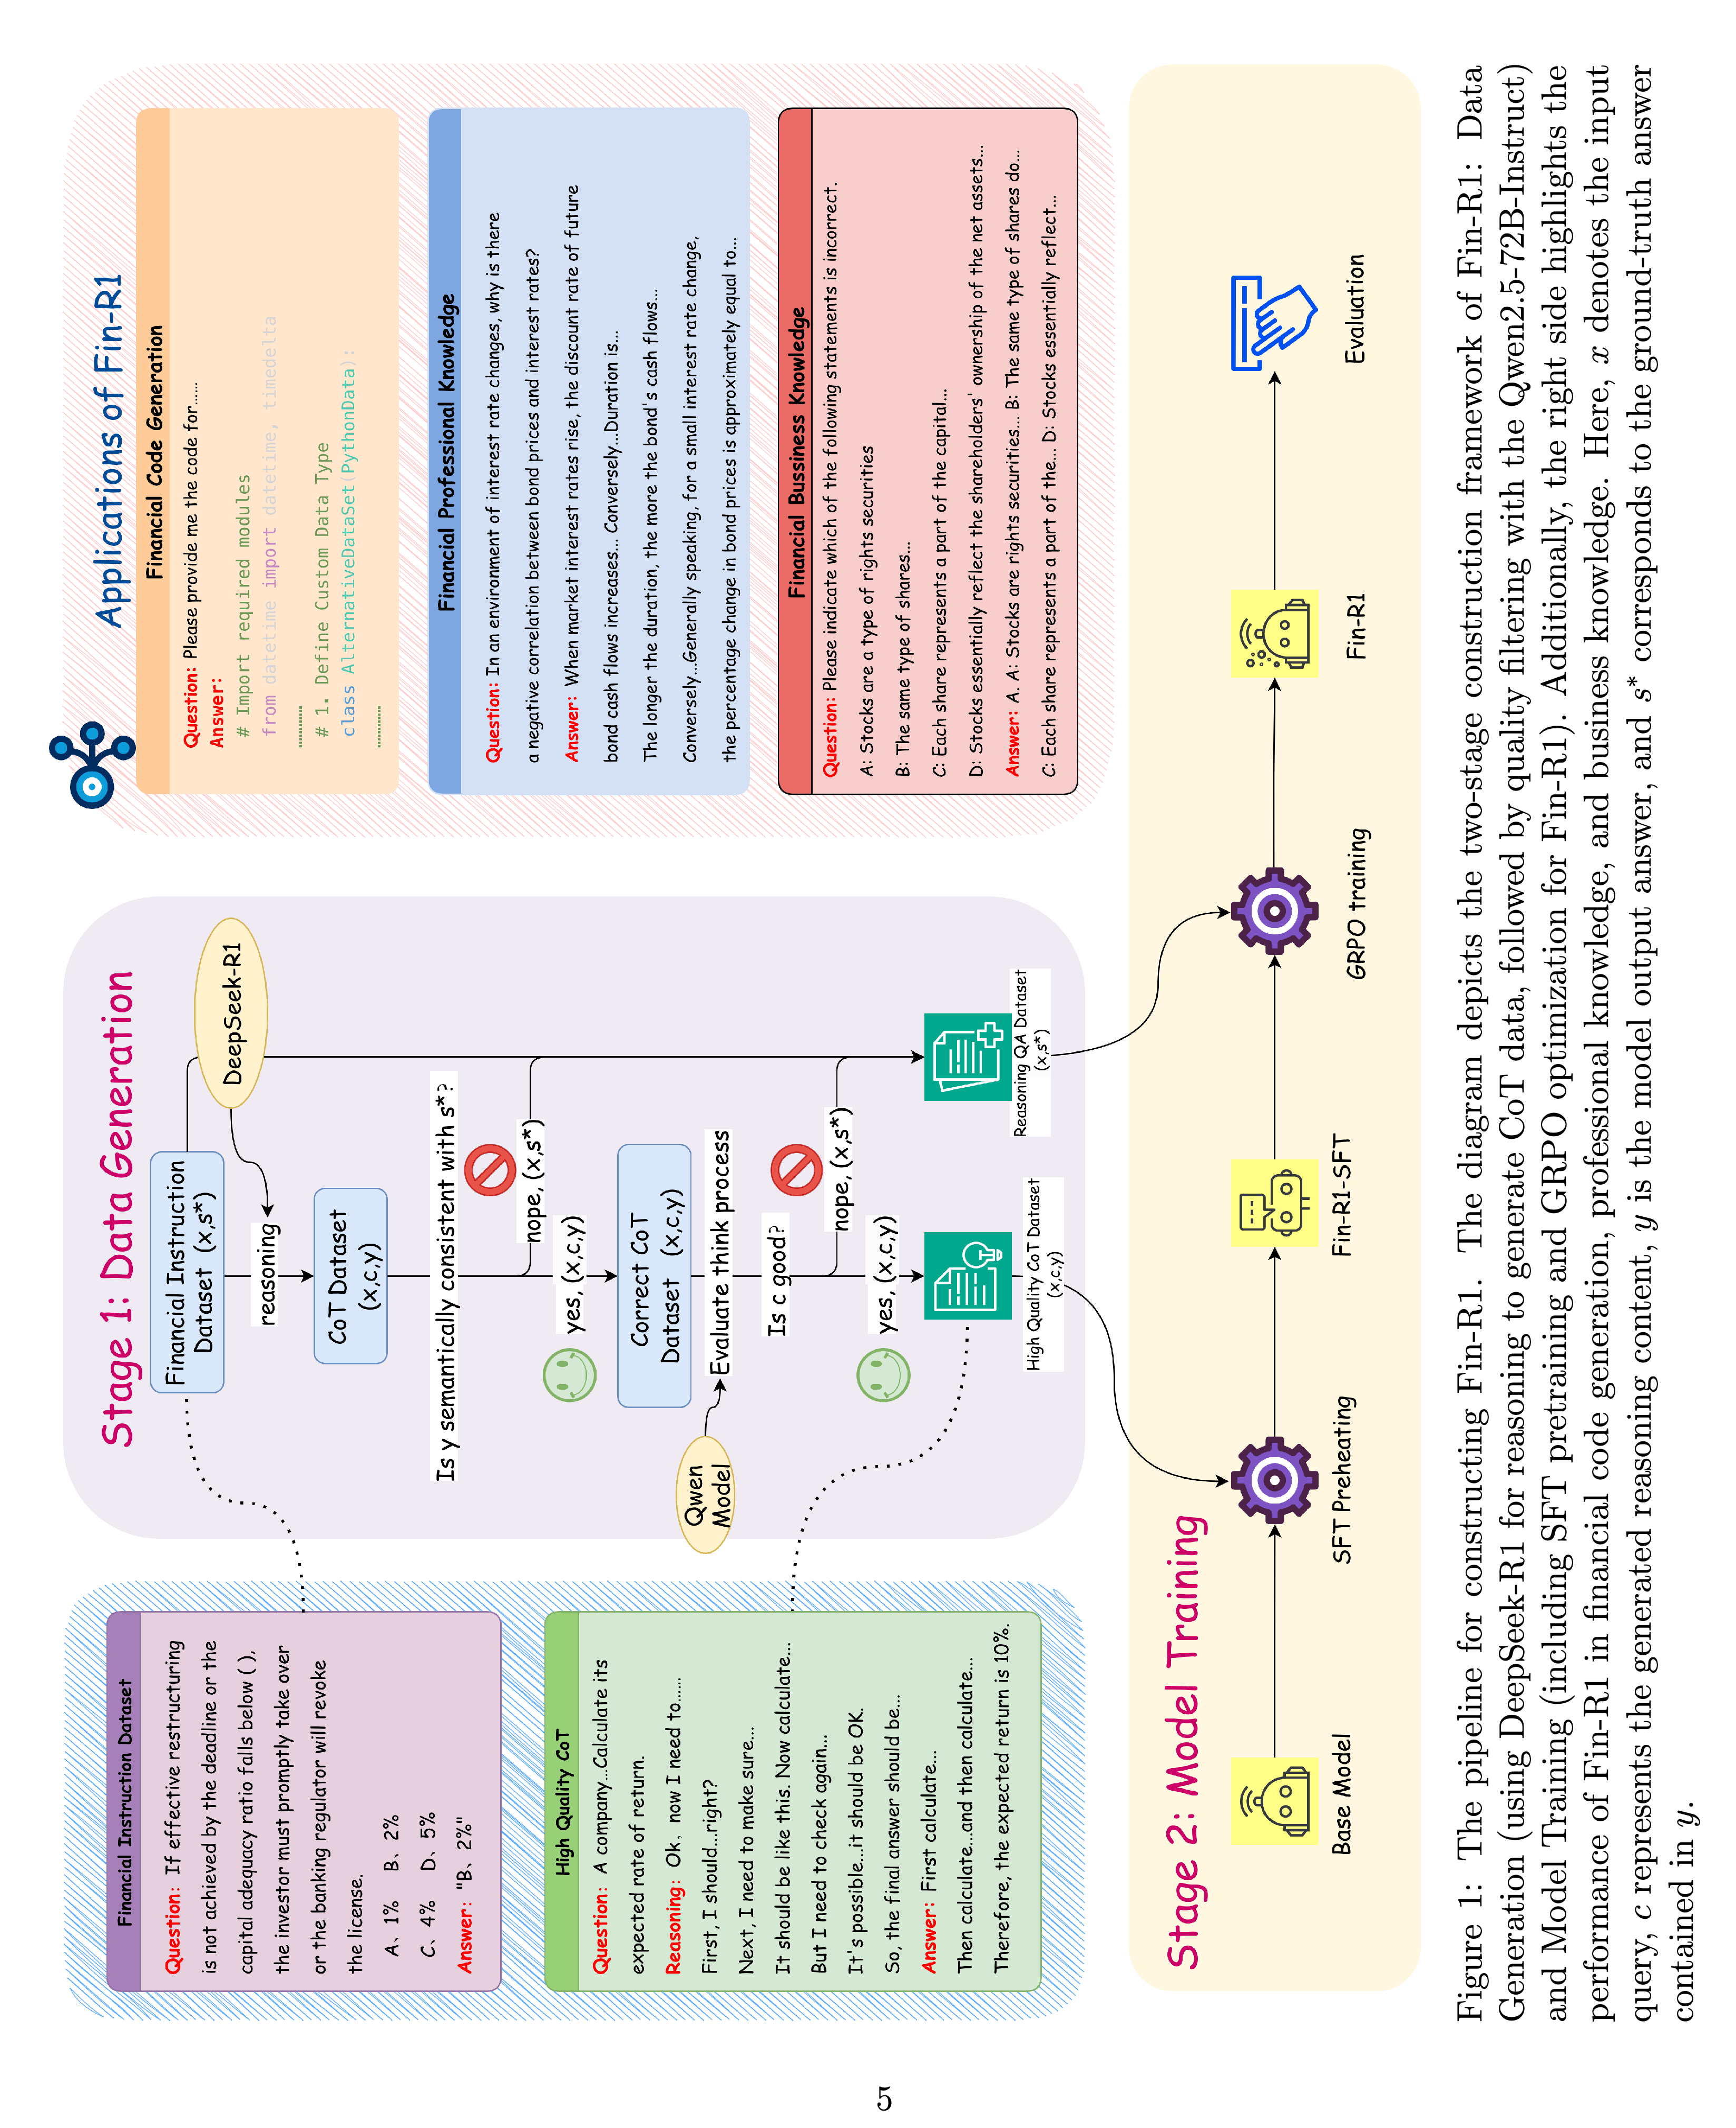
중국어 채권 비교와 영어 부채 위험 사례는 2개 언어의 금융 설명을 보여준다. 선택된 사례에서 주어진 답과 일치했다는 사실만으로 각 활용 분야의 신뢰성을 정량화할 수는 없다.
2 Related Work
관련 연구는 대규모 텍스트에서 일반적인 언어 패턴을 학습하는 사전학습, 시범 데이터나 피드백으로 기존 모델을 적응시키는 사후학습, 금융 언어 모델을 다룬다. 논문은 Fin-R1을 XuanYuan-FinX1-Preview, Fino1 등의 금융 추론 시스템과 함께 소개한다. 또한 기대 보상을 예측하는 별도 가치 네트워크를 학습하지 않아도 된다는 점을 그룹 상대 최적화의 도입 근거로 제시한다.
- Proximal policy optimization은 모델의 응답 분포가 변하는 정도를 제한하지만, 일반적으로 학습된 가치 함수가 필요하다. Direct preference optimization은 이러한 가치 함수 없이 응답 선호도로 학습한다.
- 논문은 Fin-R1 파이프라인 안에서 이러한 대안 최적화 알고리즘을 실험적으로 비교하지 않는다.
3 Data Construction
Fin-R1-Data는 공개 데이터셋과 비공개 시험 자료의 금융 질문을 결합한 이중 언어 사후학습 자료다. 구축 과정은 원천 과제를 정리하는 작업과 추론 시범 데이터를 생성하고 품질을 필터링하는 작업으로 구분된다.
3.1 Data Overview
데이터 60,091개는 금융 고급 업무 지식, 금융 기초 업무 지식, 금융 전문 지식, 금융 코드를 다룬다. 고급 업무 과제는 약 25%를 차지하며 수치 추론, 감성 분류, 인과관계 추출을 포함한다. 기초 업무 지식은 50%를 초과하며 금융 정보, 텍스트 생성, 규제 준수에 중점을 둔다.
- 전문 지식에는 용어, 전문 계산, 상하이재경대학교의 시험 문제로 구축한 금융 대학원 입학시험 데이터셋 FinPEE가 포함된다. 저자들은 문서 내용 추출 도구인 Mineru로 시험 텍스트를 추출하고, 금융 전문가에게 구조화된 질문과 정답 쌍을 검증받는다.
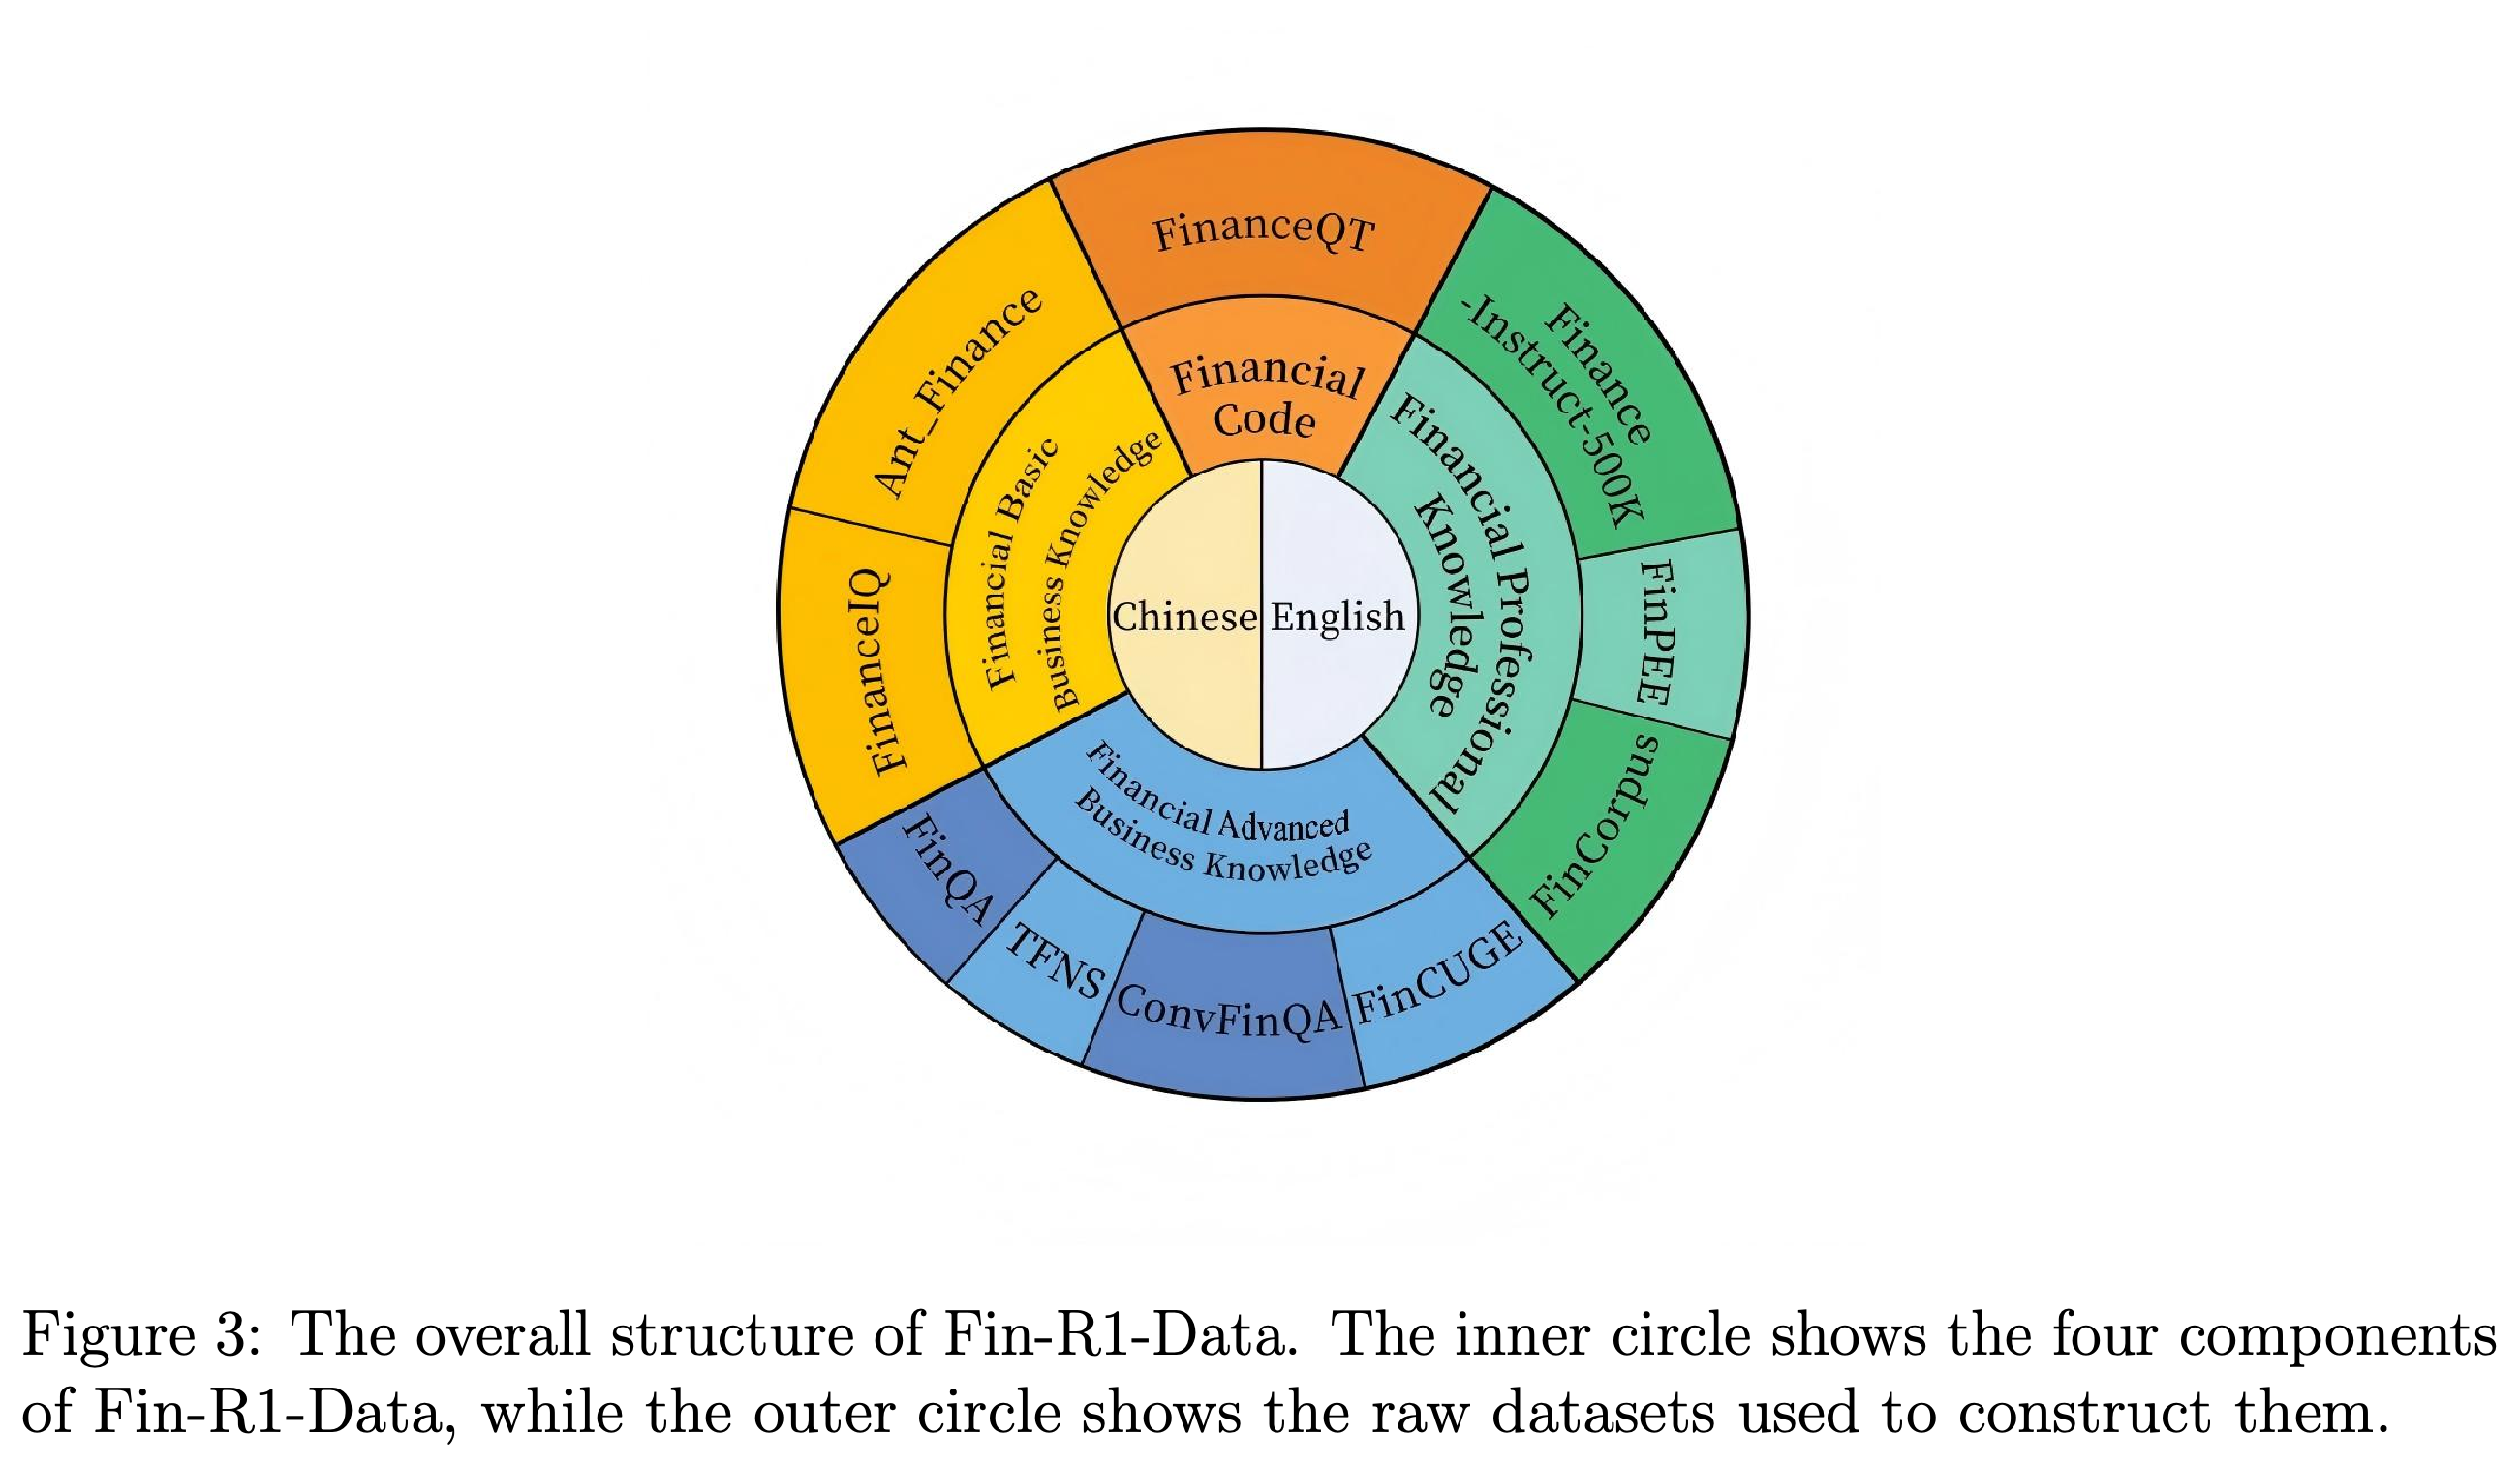
- 금융 코드는 스크립트와 정량 전략을 대상으로 하지만, Appendix Table 3에 따르면 예시는 152개로 전체 데이터셋의 0.25%에 불과하다. Figure 3은 원천 데이터와 범주의 관계를 보여주며, 이를 통해 얻은 역량을 평가하지는 않는다.
동심원 배치는 원천 데이터셋을 금융 과제 범주 4개에 연결하고 중국어와 영어의 포함 범위를 보여준다. 범주별 규모의 불균형을 파악하려면 부록의 데이터 수를 함께 확인해야 한다.
3.2 Data Processing
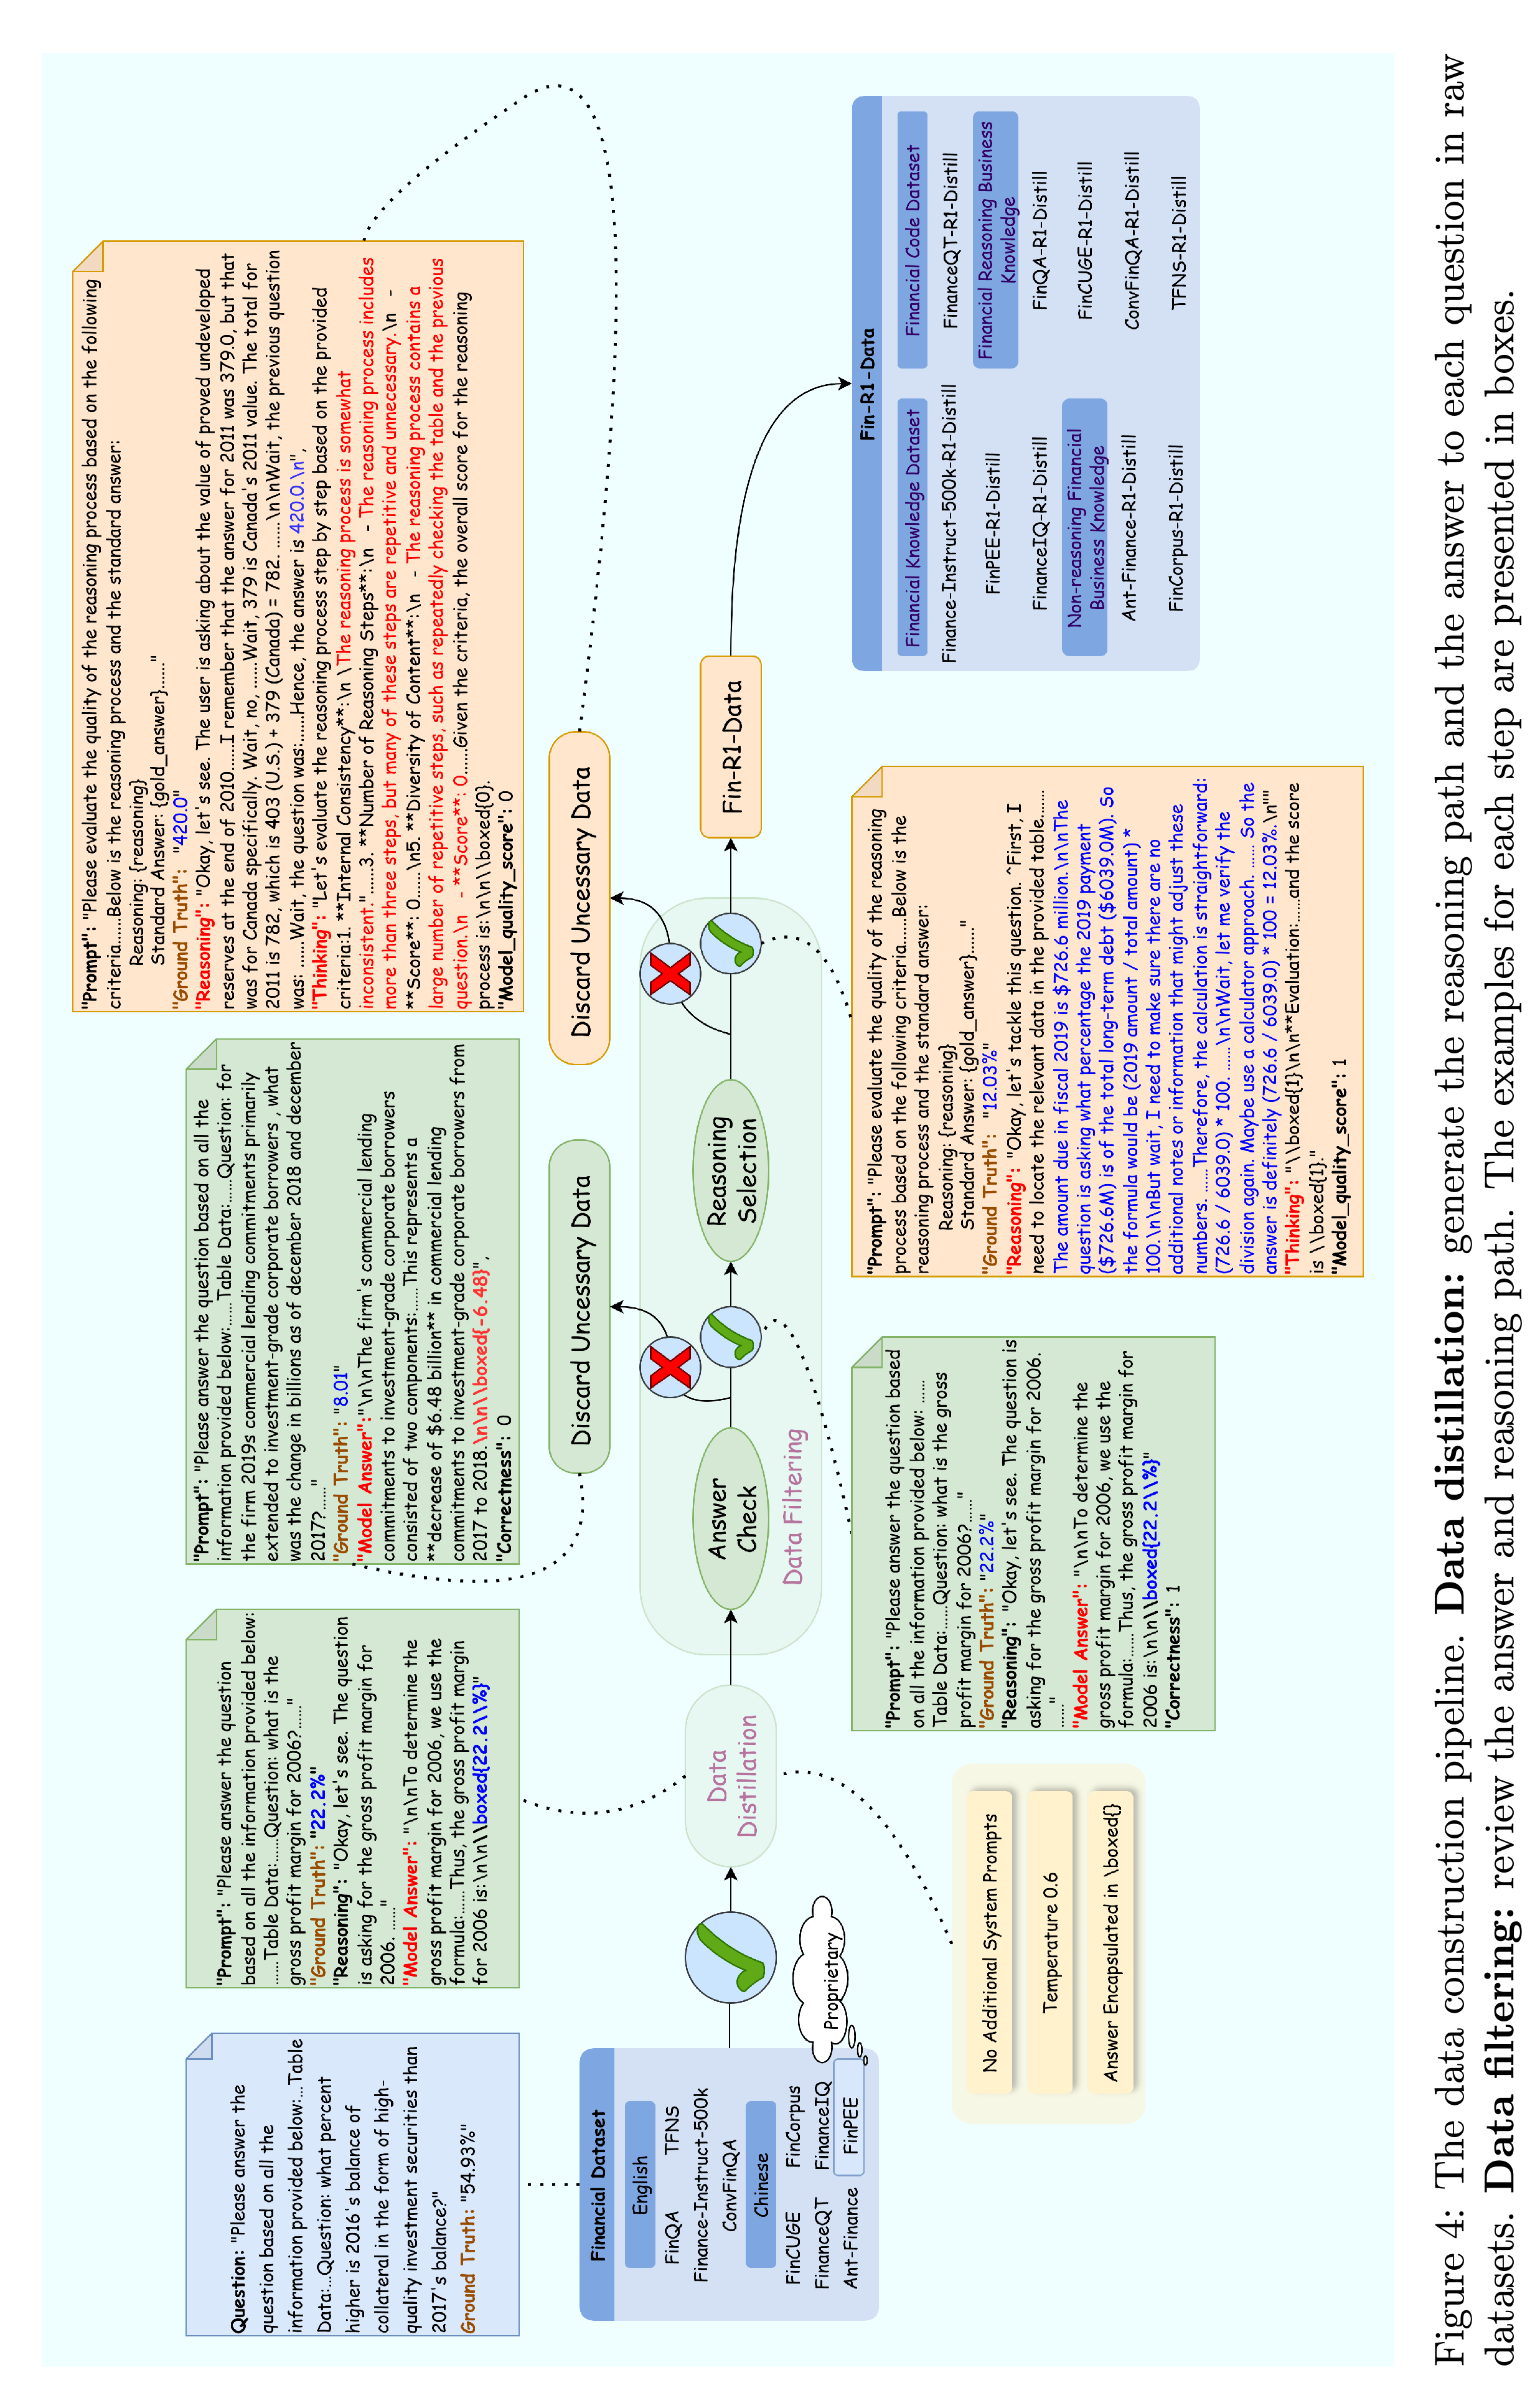
DeepSeek-R1-671B는 샘플링의 무작위성을 조절하는 temperature를 0.6으로 설정해 추론 경로와 답을 생성한다. 수학적 답은 \boxed{} 안에 넣고 응답은 줄바꿈으로 시작한다. 필터링은 먼저 답의 정확성을 확인한 다음 추론 품질을 평가한다. Figure 4는 정답을 맞혔다는 사실만으로 유용한 시범 데이터가 보장되지 않는 이유를 보여준다.
- 본문은 정답이 명확한 질문에는 정답과의 정확한 일치 여부를 확인하고, 주관적 판단이 필요한 질문에는 자동 언어 모델 판정기를 사용한다고 설명한다. 보충 자료의 정답 확인 프롬프트는 동등한 수치 표현과 반올림도 허용한다.
- 선택한 프롬프트 조건에서 FinQA 예시 100개를 5회 반복 평가한 결과, Qwen2.5-72B-Instruct는 사람의 정답 판정과 99.6% 일치했다. 저자들은 이 결과에 따라 GPT-4o 대신 Qwen2.5-72B-Instruct를 선택한다.
- 추론 선별은 내부 일관성, 용어 중복, 추론 단계 수, 논리적 정합성, 내용 다양성, 과제 분야와의 관련성, 지시 준수 여부를 확인한다. 보충 자료의 프롬프트는 추론 단계를 최소 3개 요구하며, 기준 7개를 모두 충족해야 예시를 채택한다.
정답 확인 단계에서 오답 출력을 제거한 뒤, 추론 선별 단계에서 남은 시범 데이터를 평가한다. 사례들은 최종 답의 정확성과 함께 제시된 추론의 품질을 구분해 필터링 단계 2개의 역할을 설명한다.
4 Model Training
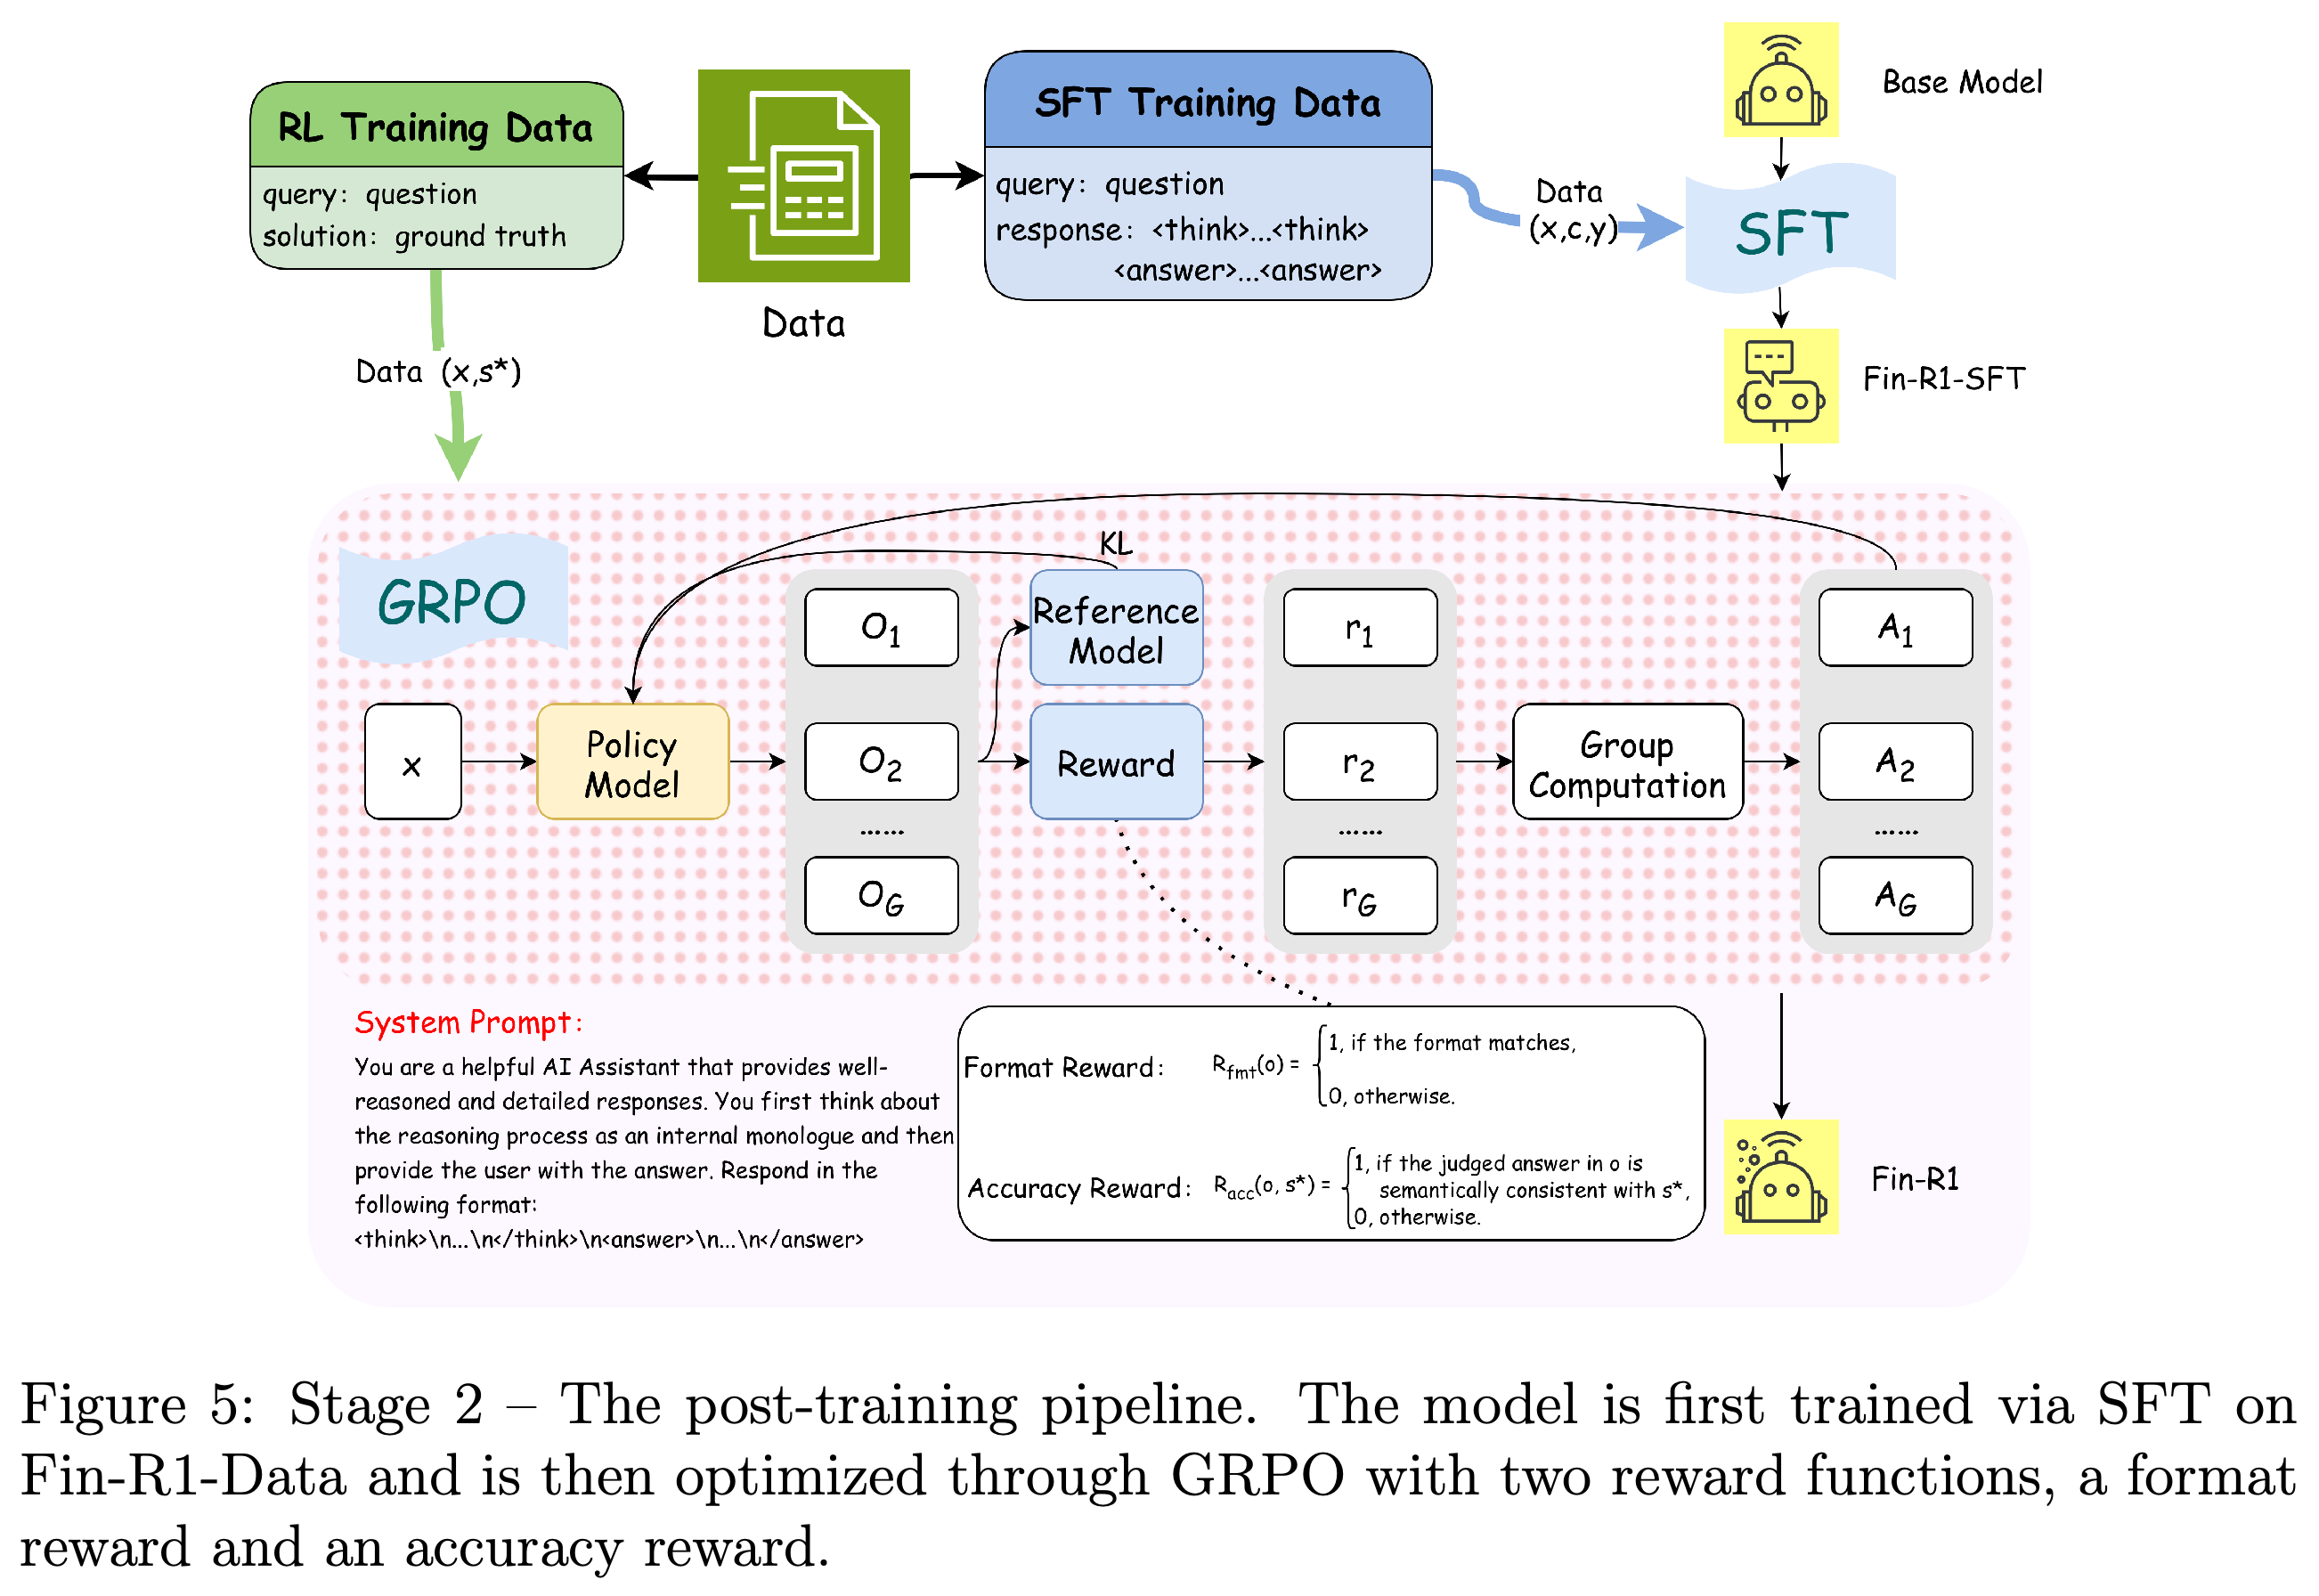
Fin-R1은 Qwen2.5-7B-Instruct를 기반으로 한다. 지도 미세조정으로 금융 응답 패턴과 명시적인 추론 구조를 학습한 뒤, Group Relative Policy Optimization에서 형식 보상과 정답 정확도 보상으로 모델을 개선한다.
- Figure 5는 시범 데이터 기반 학습과 보상 기반 학습을 구분한다. 1단계는 전체 응답을 사용하고, 2단계는 질문과 기준 풀이를 사용한다.
이 도식은 지도학습으로 초기화한 뒤 여러 응답을 샘플링하고, 보상을 계산하며, 그룹 내에서 상대적으로 비교하는 과정을 보여준다. 정확도 보상과 형식 보상은 최종 답의 일치 여부와 응답 구조를 평가하며, 각 추론 단계를 검증하지는 않는다.
4.1 Supervised Fine-tuning
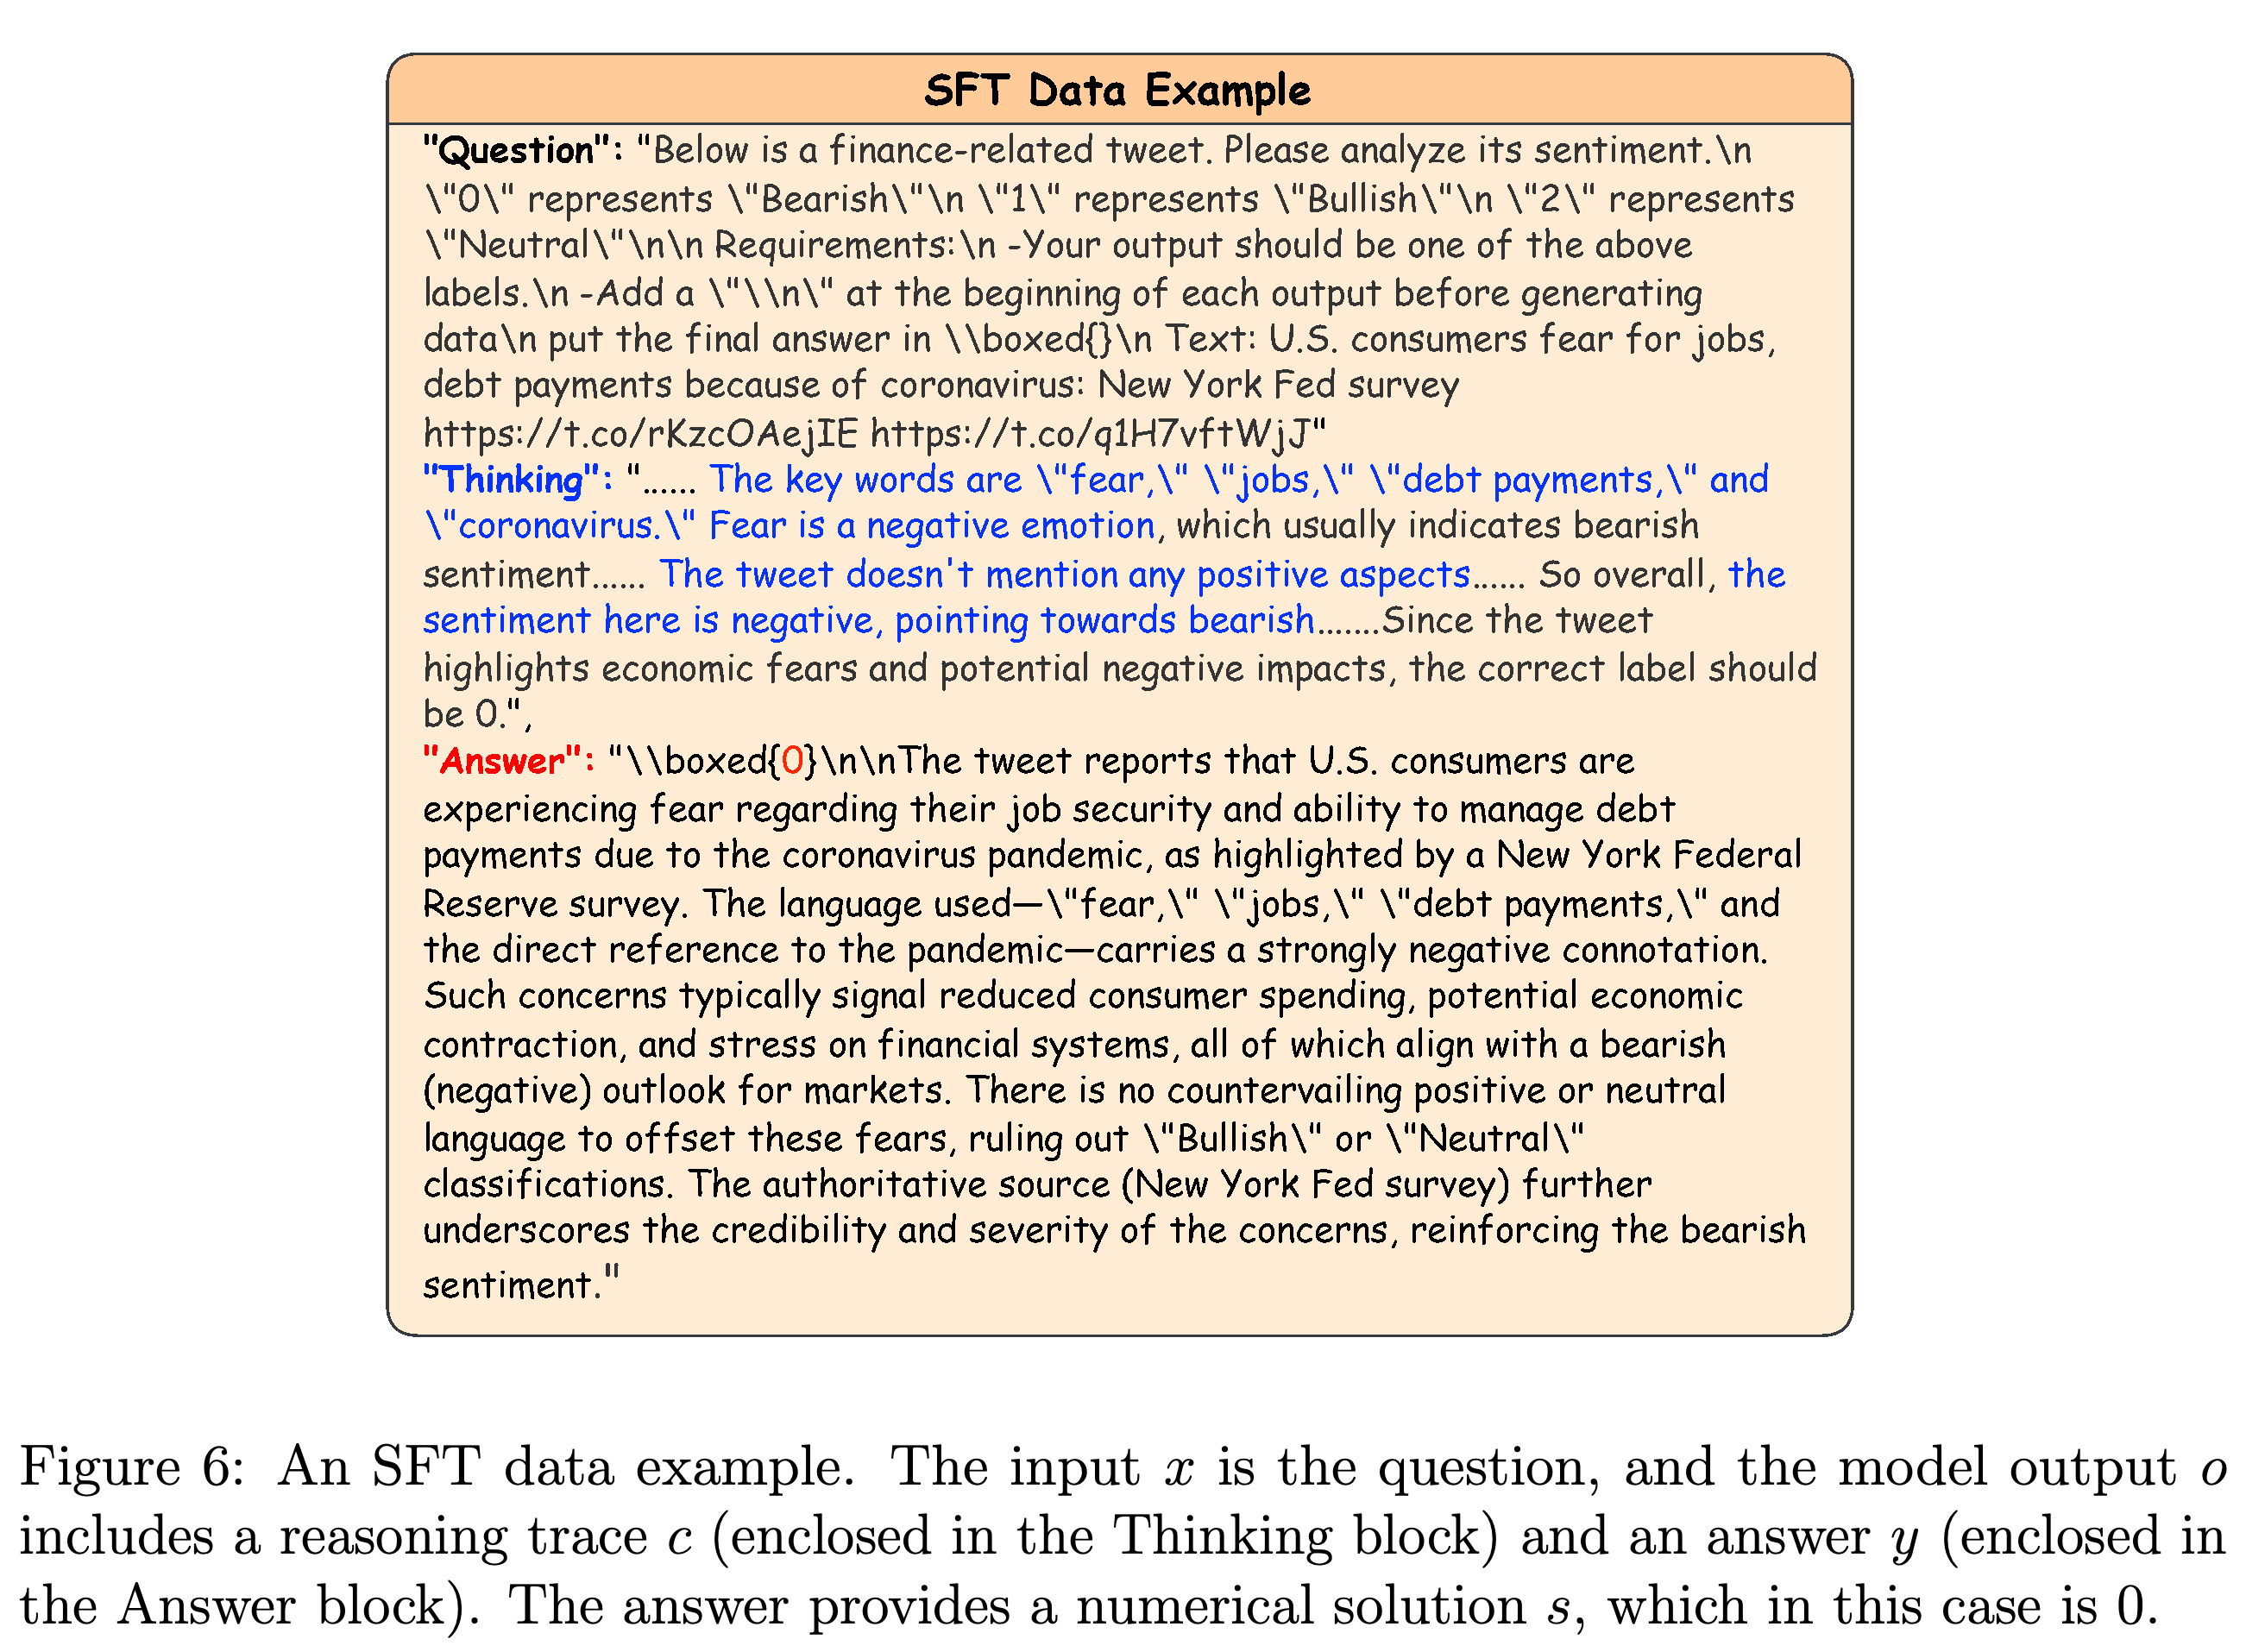
지도학습 예시는 질문과 완전한 응답을 짝지으며, 응답에는 <think>…</think> 안의 추론 과정과 <answer>…</answer> 안의 답이 포함된다. Equation (4.1)은 시범 응답에 낮은 확률을 부여할수록 손실이 커지는 음의 로그우도를 최소화한다. 이를 통해 모델이 추론 텍스트와 최종 답을 모두 재현하도록 유도한다.
- 정답이 명확한 질문의 답에는 설명과 함께 \boxed{} 안의 수치 풀이가 포함될 수 있다. Figure 6은 금융 뉴스 감성 분류로 이 구조를 보여주며, 부정 감성 클래스인 Bearish에 레이블 0을 사용한다.
- 저자들은 이 단계를 시범 데이터를 모방하는 행동 복제로 설명한다. 이후의 강화학습은 피드백으로 응답을 개선하기 위한 과정으로 제시한다.
감성 분류 예시에는 중간 설명과 레이블 0을 포함한 최종 답이 들어 있다. 따라서 지도학습은 목표 분류 레이블뿐 아니라 설명 텍스트도 모방한다.
4.2 Group Relative Policy Optimization
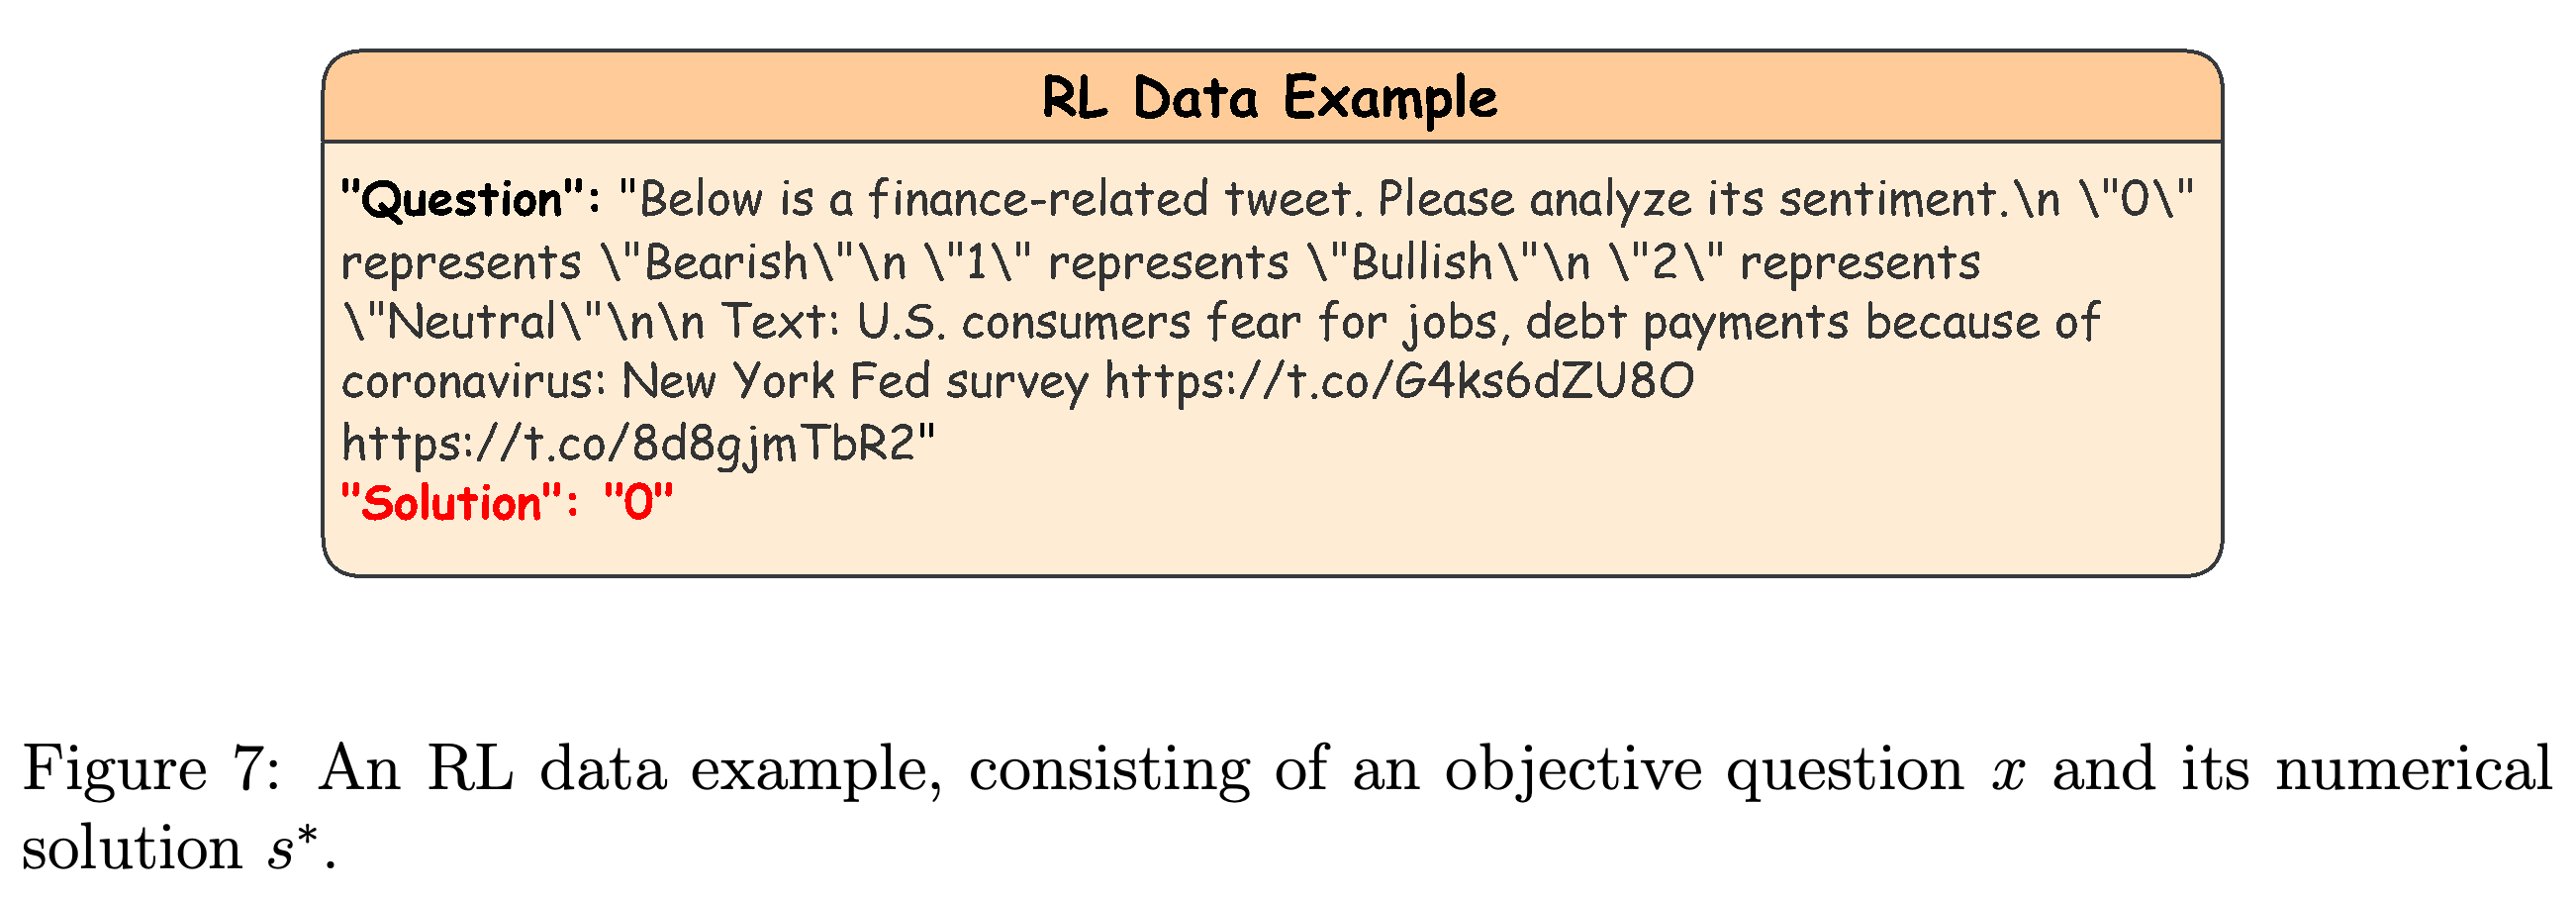
강화학습 데이터셋은 정답이 명확한 질문과 기준 풀이로 구성되며, 생성된 시범 응답이 지도학습에 적합하지 않았던 어려운 질문도 포함한다. 생성 텍스트에 대한 모델의 확률분포인 정책은 질문마다 후보 출력 최소 2개를 샘플링한다. 각 출력은 요구된 태그 준수 여부와 추출한 답이 기준 답과 의미상 일치하는지에 대한 이진 보상 2개의 합을 받는다.
- 형식 보상은 <think>…</think> 뒤에 <answer>…</answer>가 오고, 태그 밖에는 내용이 없도록 요구한다. 정확도는 Qwen2.5-Max가 판정하므로 정답 검증은 언어 모델 평가기에 의존한다.
- Equation (4.4)는 각 보상에서 그룹 평균을 빼고 그룹 보상의 표준편차로 나누며, 분모에는 10⁻⁸과 같은 작은 하한값을 둔다. 설명 문구는 이를 표준오차라고 부르지만, 제시된 식의 분모는 표준편차다.
- 정책 갱신은 현재 정책과 샘플링 정책의 확률비를 일정 범위로 제한하는 클리핑과 분포 차이를 측정하는 Kullback–Leibler divergence를 사용해 지도학습 정책에서 벗어나는 정도를 제약한다. 보상 2개 모두 중간 추론 단계의 정확성을 직접 검증하지 않는다.
강화학습용 예시는 금융 뉴스 질문과 기준 레이블을 유지하지만, 시범 응답은 제외한다. 모델은 보상 평가를 받을 응답을 직접 생성한다.
5 Experiment
실험은 금융 데이터셋 5개에서 Fin-R1과 모델 8개를 비교하고, 학습 단계 2개가 모두 유용한지 평가한다. 제시된 근거는 벤치마크 점수, 학습 단계 1개를 제외해 효과를 비교하는 학습 단계 제거 실험, 모델 출력 사례로 구성된다.
5.1 Evaluation Datasets and Methodology
평가에는 FinQA, ConvFinQA, 금융 업무 지식을 평가하는 Ant-Finance, 감성 분류를 위한 TFNS(Twitter Financial News Sentiment), 금융 전문 질문을 다루는 Finance-Instruct-500k를 사용한다. Finance-Instruct-500k는 데이터셋의 그룹별로 표본을 추출하는 층화 추출로 별도 선정한 10% 테스트 부분집합을 사용한다. 나머지 데이터셋은 각각 무작위로 뽑은 질문 1,000개를 사용하며, 질문이 1,000개보다 적으면 전체를 사용한다.
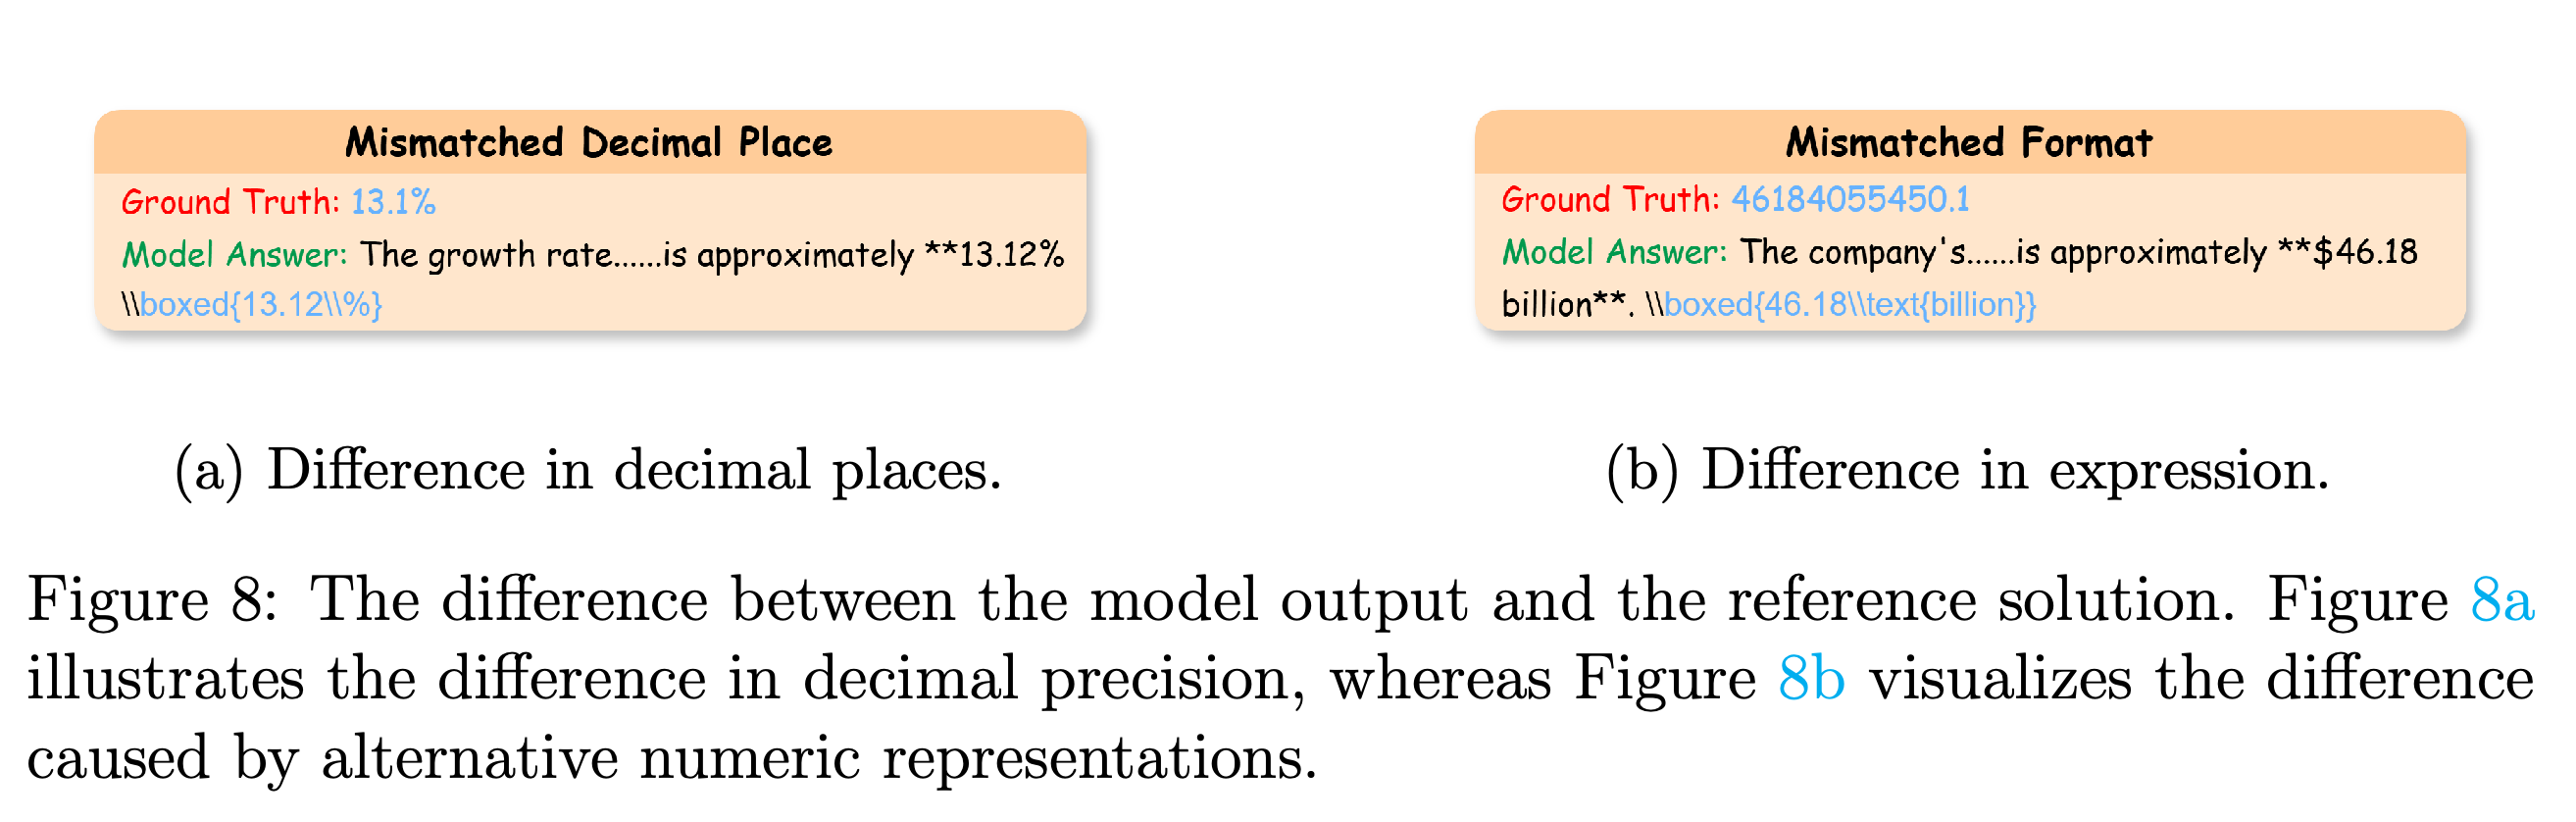
- Figure 8에서 보듯 자동 언어 모델 판정기는 소수점 이하 정밀도나 수치 표현이 달라도 의미가 같은 답을 허용한다. 점수는 정답으로 판정된 비율을 나타내는 100점 척도로 보고한다.
- 이 데이터셋들은 데이터 구축의 원천에도 포함된다. PDF에는 모든 평가 질문이 사후학습 데이터와 분리되어 있음을 확인할 만큼 명확한 데이터 분할별 제외 절차나 중복 제거 검토 결과가 없다.
사례들은 13.1%와 13.12%를 비교하고, 전체 숫자로 적은 금액과 billions 단위로 표현한 금액을 비교한다. 이는 동등성을 고려한 판정이 필요한 이유를 보여주며, 정답 인정 여부가 반올림과 표현 규칙에 달려 있음을 드러낸다.
5.2 Baselines
베이스라인은 DeepSeek-R1-671B, DeepSeek-R1-Distill-Qwen-7B, -14B, -32B, DeepSeek-R1-Distill-Llama-70B, 그리고 7B, 14B, 32B 규모의 Qwen2.5-Instruct 모델이다. 증류는 큰 교사 모델의 행동을 작은 학생 모델로 전달하는 방법이다. 따라서 이 비교는 모델 규모와 학습 계보라는 2개 측면을 함께 아우른다.
- 벤치마크 표에는 Related Work에서 논의한 금융 추론 특화 모델이 포함되지 않아, 해당 시스템보다 우수하다는 직접적인 근거는 제한된다.
5.3 Results
Table 1에 제시된 Fin-R1의 점수는 FinQA 76.0, ConvFinQA 85.0, Ant-Finance 81.0, TFNS 71.0, Finance-Instruct-500K 62.9이며, 보고된 평균은 75.2다. 보고된 평균 기준으로는 78.2를 기록한 DeepSeek-R1에 이어 2위이며, FinQA와 ConvFinQA 점수는 평가 대상 모델 중 가장 높다.
- 제시된 Fin-R1 점수 5개의 산술평균은 75.18이며, 소수점 첫째 자리까지 반올림하면 보고된 75.2가 된다.
- 보고된 평균을 사용하면 65.6을 기록한 Qwen2.5-7B-Instruct보다 9.6점, 58.0을 기록한 DeepSeek-R1-Distill-Qwen-7B보다 17.2점 높다. 따라서 서론에서 같은 규모 모델보다 17점 넘게 높다고 한 주장은 후자의 비교에 해당하며, 모든 7B 베이스라인에 적용되지는 않는다.
- 성능은 과제에 따라 다르다. Ant-Finance에서는 Fin-R1이 81.0으로 기반 모델의 85.0보다 낮지만, 나머지 4개 점수는 향상된다.
Fin-R1은 보고된 평균 기준으로 2위이며 FinQA와 ConvFinQA에서 가장 높은 점수를 얻지만, Ant-Finance 점수는 7B 기반 모델보다 낮다. 제시된 점수 5개의 평균은 75.18이며, 반올림하면 보고된 75.2가 된다.
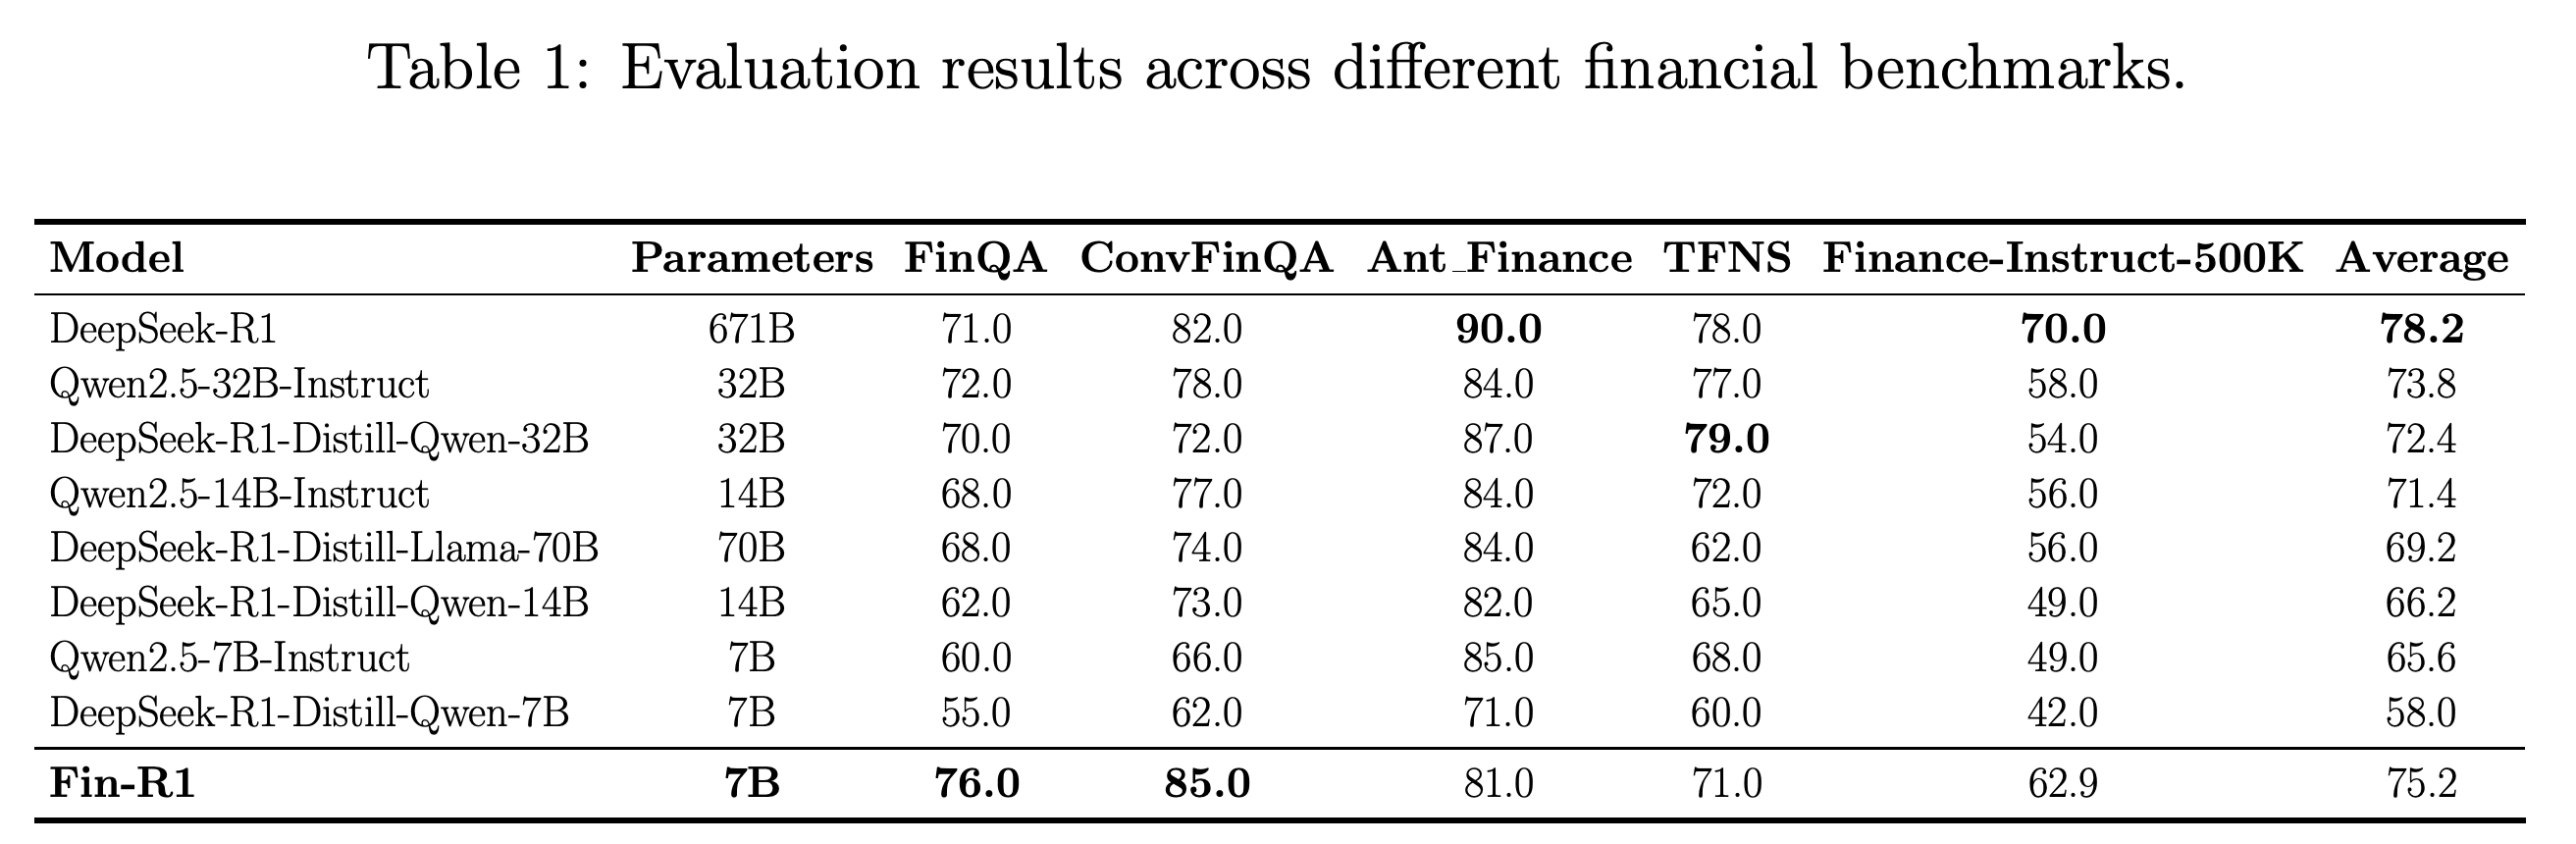
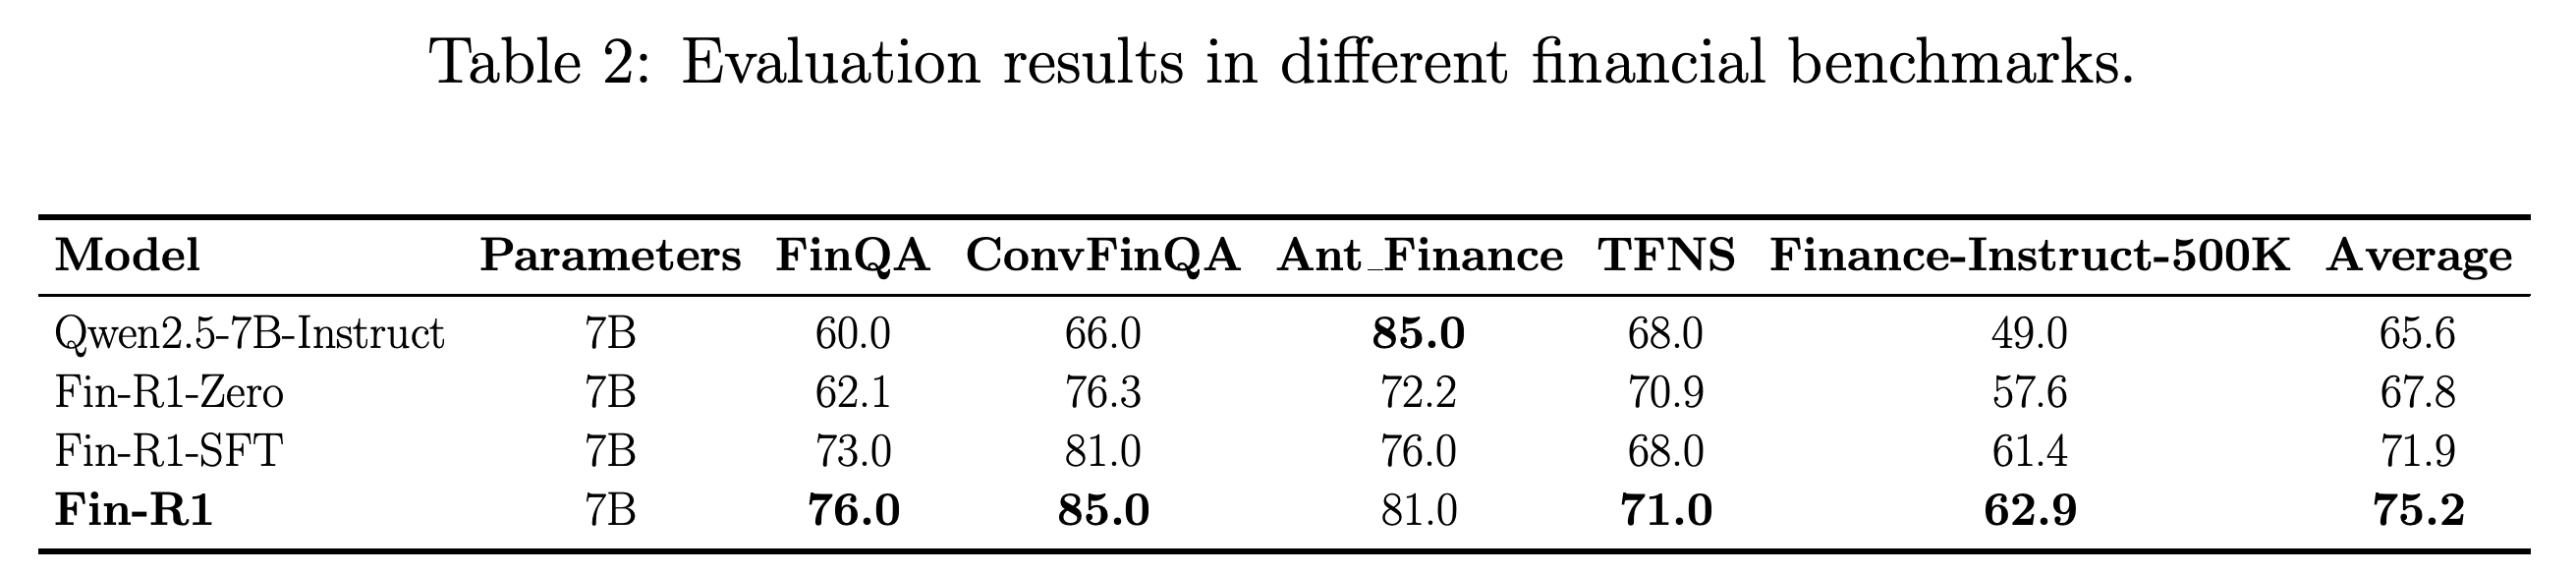
Table 2에 보고된 평균은 기반 모델 65.6, Group Relative Policy Optimization만 적용한 Fin-R1-Zero 67.8, 지도학습만 적용한 Fin-R1-SFT 71.9, 결합 절차 75.2다. 결합 모델은 제시된 모든 벤치마크에서 Fin-R1-SFT보다 높은 점수를 얻는다. 이는 이 실험 조건에서 지도학습 이후 보상 최적화를 적용하는 방법이 유용함을 뒷받침한다.
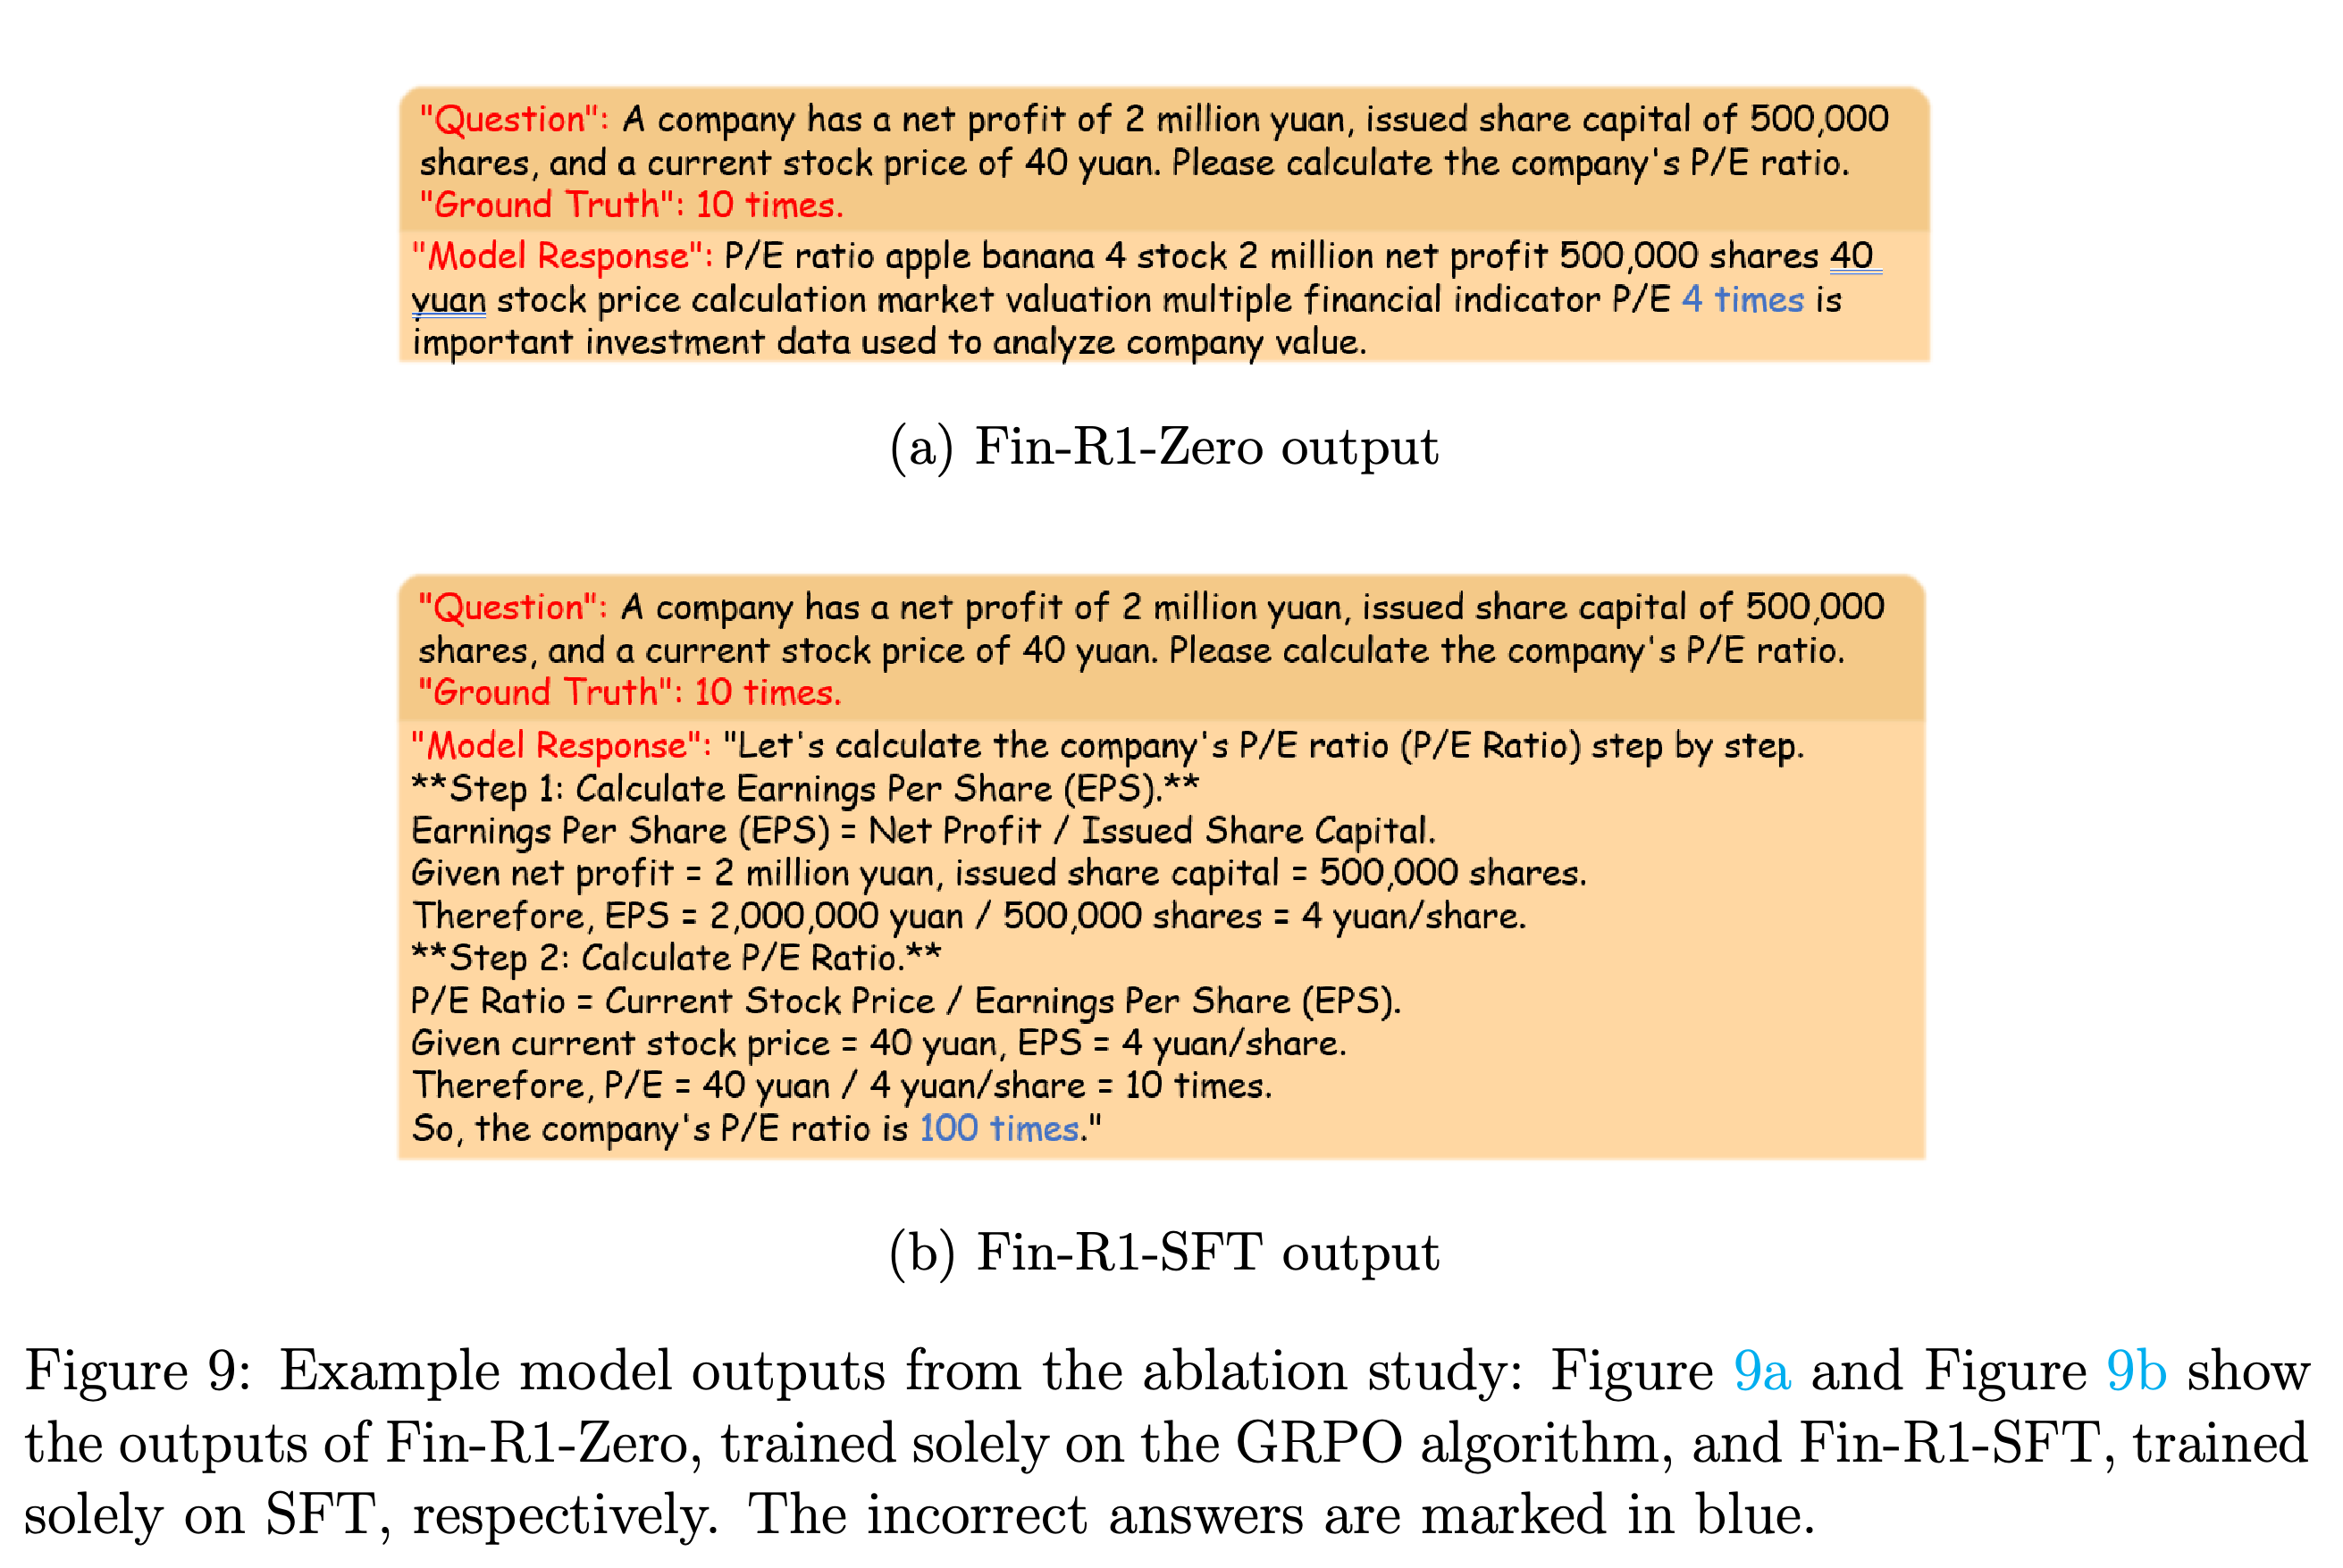
- Figure 9는 정성적인 실패 사례를 보여준다. Fin-R1-Zero는 일관성 없는 텍스트를 생성한다. Fin-R1-SFT는 주가를 주당순이익으로 나눈 주가수익비율을 10으로 계산하지만, 마지막에는 이와 모순되는 답 100을 제시한다.
- 이 비교는 각 학습 방식을 통째로 평가하므로, 개별 보상이나 필터링 기준의 효과를 분리하지 않는다. PDF는 벤치마크 점수의 신뢰구간이나 반복 실행에 따른 불확실성을 보고하지 않는다.
보고된 평균은 기반 모델 65.6, 보상 최적화만 적용했을 때 67.8, 지도 미세조정만 적용했을 때 71.9, 단계 2개를 모두 적용했을 때 75.2다. 결합 절차는 지도학습만 적용한 모델보다 제시된 모든 점수를 높인다. Fin-R1의 점수 5개 평균은 75.18이며, 반올림하면 보고된 75.2가 된다.
보상 학습만 적용한 모델은 일관성 없는 텍스트를 생성한다. 지도학습만 적용한 모델은 중간 계산에서 정확한 비율 10을 얻지만, 마지막 문장에서는 100이라고 답한다. 선택된 실패 사례들은 읽기 쉬운 추론과 최종 답의 정확성을 따로 검토해야 하는 이유를 보여준다.
6 Conclusion
결론은 금융 추론 데이터와 지도 미세조정, 그룹 상대 보상 최적화의 결합을 Fin-R1의 벤치마크 성능 요인으로 제시한다. 향후 확장 방향에는 텍스트 이외의 다양한 형태의 데이터를 포함하는 금융 멀티모달 입력과 위험 관리 및 규제 준수와의 긴밀한 통합이 포함된다. 이들은 앞으로 추진할 연구 방향이다.
- 논문에 제시된 코드 URL은 https://github.com/SUFE-AIFLM-Lab/Fin-R1 이다.
부록
- A Details for raw datasets는 원천 데이터 10개와 처리 후 남은 데이터 수를 정리한다. FinanceQT 152개, Finance-500K 11,300개, FinanceIQ 2,596개, FinPEE 179개, Ant-Finance 1,548개, FinCorpus 29,288개, FinQA 2,948개, ConvFinQA 7,629개, TFNS 2,451개, 여러 추론 과제를 다루는 금융 데이터셋 FinCUGE 2,000개다. 합계는 60,091개이며, Table 4는 FinPEE를 비공개로, 나머지 원천을 공개로 분류한다.
- B The Prompt of Data Construction은 B.1 The Prompt of Data Distillation, B.2 The Prompt of Answer Check, B.3 The Prompt of Reasoning Selection으로 구성된다. 증류 템플릿은 과제 입력, 지시, 상자로 감싼 최종 답, 응답 시작 부분의 줄바꿈을 지정한다. 정답 확인 템플릿은 수치적 동등성, 반올림, 이진 판정을 명시한다. 추론 선별 템플릿은 품질 기준 7개를 적용하며, 7개를 모두 충족할 때만 시범 데이터를 채택한다.
- C Model Selection for Data Construction은 자동 판정기를 평가한다. C.1 Model Selection for Answer Check는 무작위로 선택한 FinQA 예시 100개를 5회 반복해 프롬프트 형식 5개를 비교하며, 형식마다 판정 500개를 얻는다. 선택된 OF(our used format)에서 Qwen2.5-72B-Instruct의 분류 오류율은 0.4%, 형식 위반율은 0.0%다. GPT-4o는 각각 2.8%, 0.8%다. 질문을 포함하는 WQ(with-question) 형식에서는 Qwen의 분류 오류율이 8.0%로 높아져, 프롬프트 설계에 민감함을 보여준다.
- C.2 Model Selection for Reasoning Selection은 무작위로 선택한 예시 20개에서 Qwen2.5-72B-Instruct와 GPT-4o의 판정을 사람이 독립적으로 내린 판정과 비교한다. 기준 7개를 평가해 총점을 0에서 7까지 부여한다. 저자들은 Qwen이 사람의 판정과 더 가깝다고 보고하고 추론 선별에 사용한다. 다만 검증 표본이 작아 전체 데이터셋을 충분히 대표하기는 어렵다.
- D Case Study는 순이익 2 million yuan, 발행주식 500,000주, 주가 40 yuan인 기업에 대한 응답을 비교한다. 기반 모델은 추론 프롬프트가 없을 때 20, 있을 때 8이라고 답한다. Fin-R1은 주당순이익을 4 yuan, 주가수익비율을 10으로 정확히 계산한다. 이 선택된 사례는 산술 계산의 개선을 보여주지만, 투자 조언이나 규제 준수 판단을 체계적으로 검증하지는 않는다.
짧은 생각
학습 단계 제거 실험은 결합 절차의 효과를 가장 명확하게 보여준다. 지도학습 시범 데이터가 성능을 높이고, 이어서 적용한 보상 최적화가 지도학습만 적용했을 때보다 제시된 벤치마크 5개의 점수를 모두 높인다. 논문이 보고한 평균 향상 폭은 3.3점이다. Fin-R1의 점수 5개 평균은 75.18이며, 이는 반올림한 보고값 75.2와 일치한다.
명시적인 추론 텍스트는 응답을 검토하기 쉽게 만든다. 그러나 형식 보상과 최종 답 판정기는 그 텍스트가 모델의 계산 과정을 충실히 설명한다는 점을 입증하지 않는다. 학습 데이터와 테스트 데이터의 분리를 더 명확히 하고, 학습 및 추론 설정을 상세히 공개하며, 사람의 검증 범위를 넓히고 실제 배포 비용을 측정한다면 일반화, 투명성, 실용적 효율성에 관한 근거를 강화할 수 있다.