


Agent Laboratory: Using LLM Agents as Research Assistants 요약 설명
08 Jan 2025 | Paper Review AI Research Agents Human-Agent Interaction Agent Evaluation목차
이번 글에서는 Agent Laboratory: Using LLM Agents as Research Assistants 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 8일(Arxiv)
- Schmidgall, Samuel, Su, Yusheng, Wang, Ze, Sun, Ximeng, Wu, Jialian, Yu, Xiaodong, Liu, Jiang, Moor, Michael, Liu, Zicheng, Barsoum, Emad.
- AMD, Johns Hopkins University, ETH Zurich
- 논문 링크
- Github
- Project Page
요약
- Agent Laboratory는 인간의 연구 아이디어를 머신러닝 실험, 코드, 읽기 쉬운 보고서로 구현하는 데 드는 시간과 비용을 줄이기 위해 대규모 언어 모델(LLM) 에이전트를 활용한다. LLM 에이전트는 텍스트 생성 모델에 도구와 체계적인 워크플로를 결합한 시스템이다. gpt-4o를 사용한 워크플로의 보고된 비용은 논문당 $2.33이다. 저자들이 인용한 이전 gpt-4o 자율 연구 워크플로의 비용은 약 $15이며, 이 비교는 초록에서 제시한 추론 비용 약 84% 감소에 해당한다.
- 이 프레임워크는 Literature Review, Experimentation, Report Writing을 연결하며, 각 하위 작업이 끝난 뒤 선택적으로 인간의 피드백을 받을 수 있다. mle-solver 모듈은 실험 프로그램을 생성, 실행, 수정하고, paper-solver는 자동 리뷰어의 피드백을 활용해 보고서를 생성하고 수정한다.
- 5개 주제와 3개 기반 언어 모델로 자율 생성한 논문 15편을 인간 리뷰어가 평가했다. o1-preview는 유용성에서 4.4/5로 가장 높았고, o1-mini는 실험 품질에서 3.2/5로 가장 높았다. 자동 리뷰의 종합 점수 평균은 6.1/10, 인간 리뷰의 평균은 3.8/10이었다. 하위 작업마다 인간의 점검 단계를 추가한 co-pilot 모드는 외부 종합 평가에서 4.38/10을 받았으며, 이를 자율 모드 전체를 합산한 평균과 비교했다.
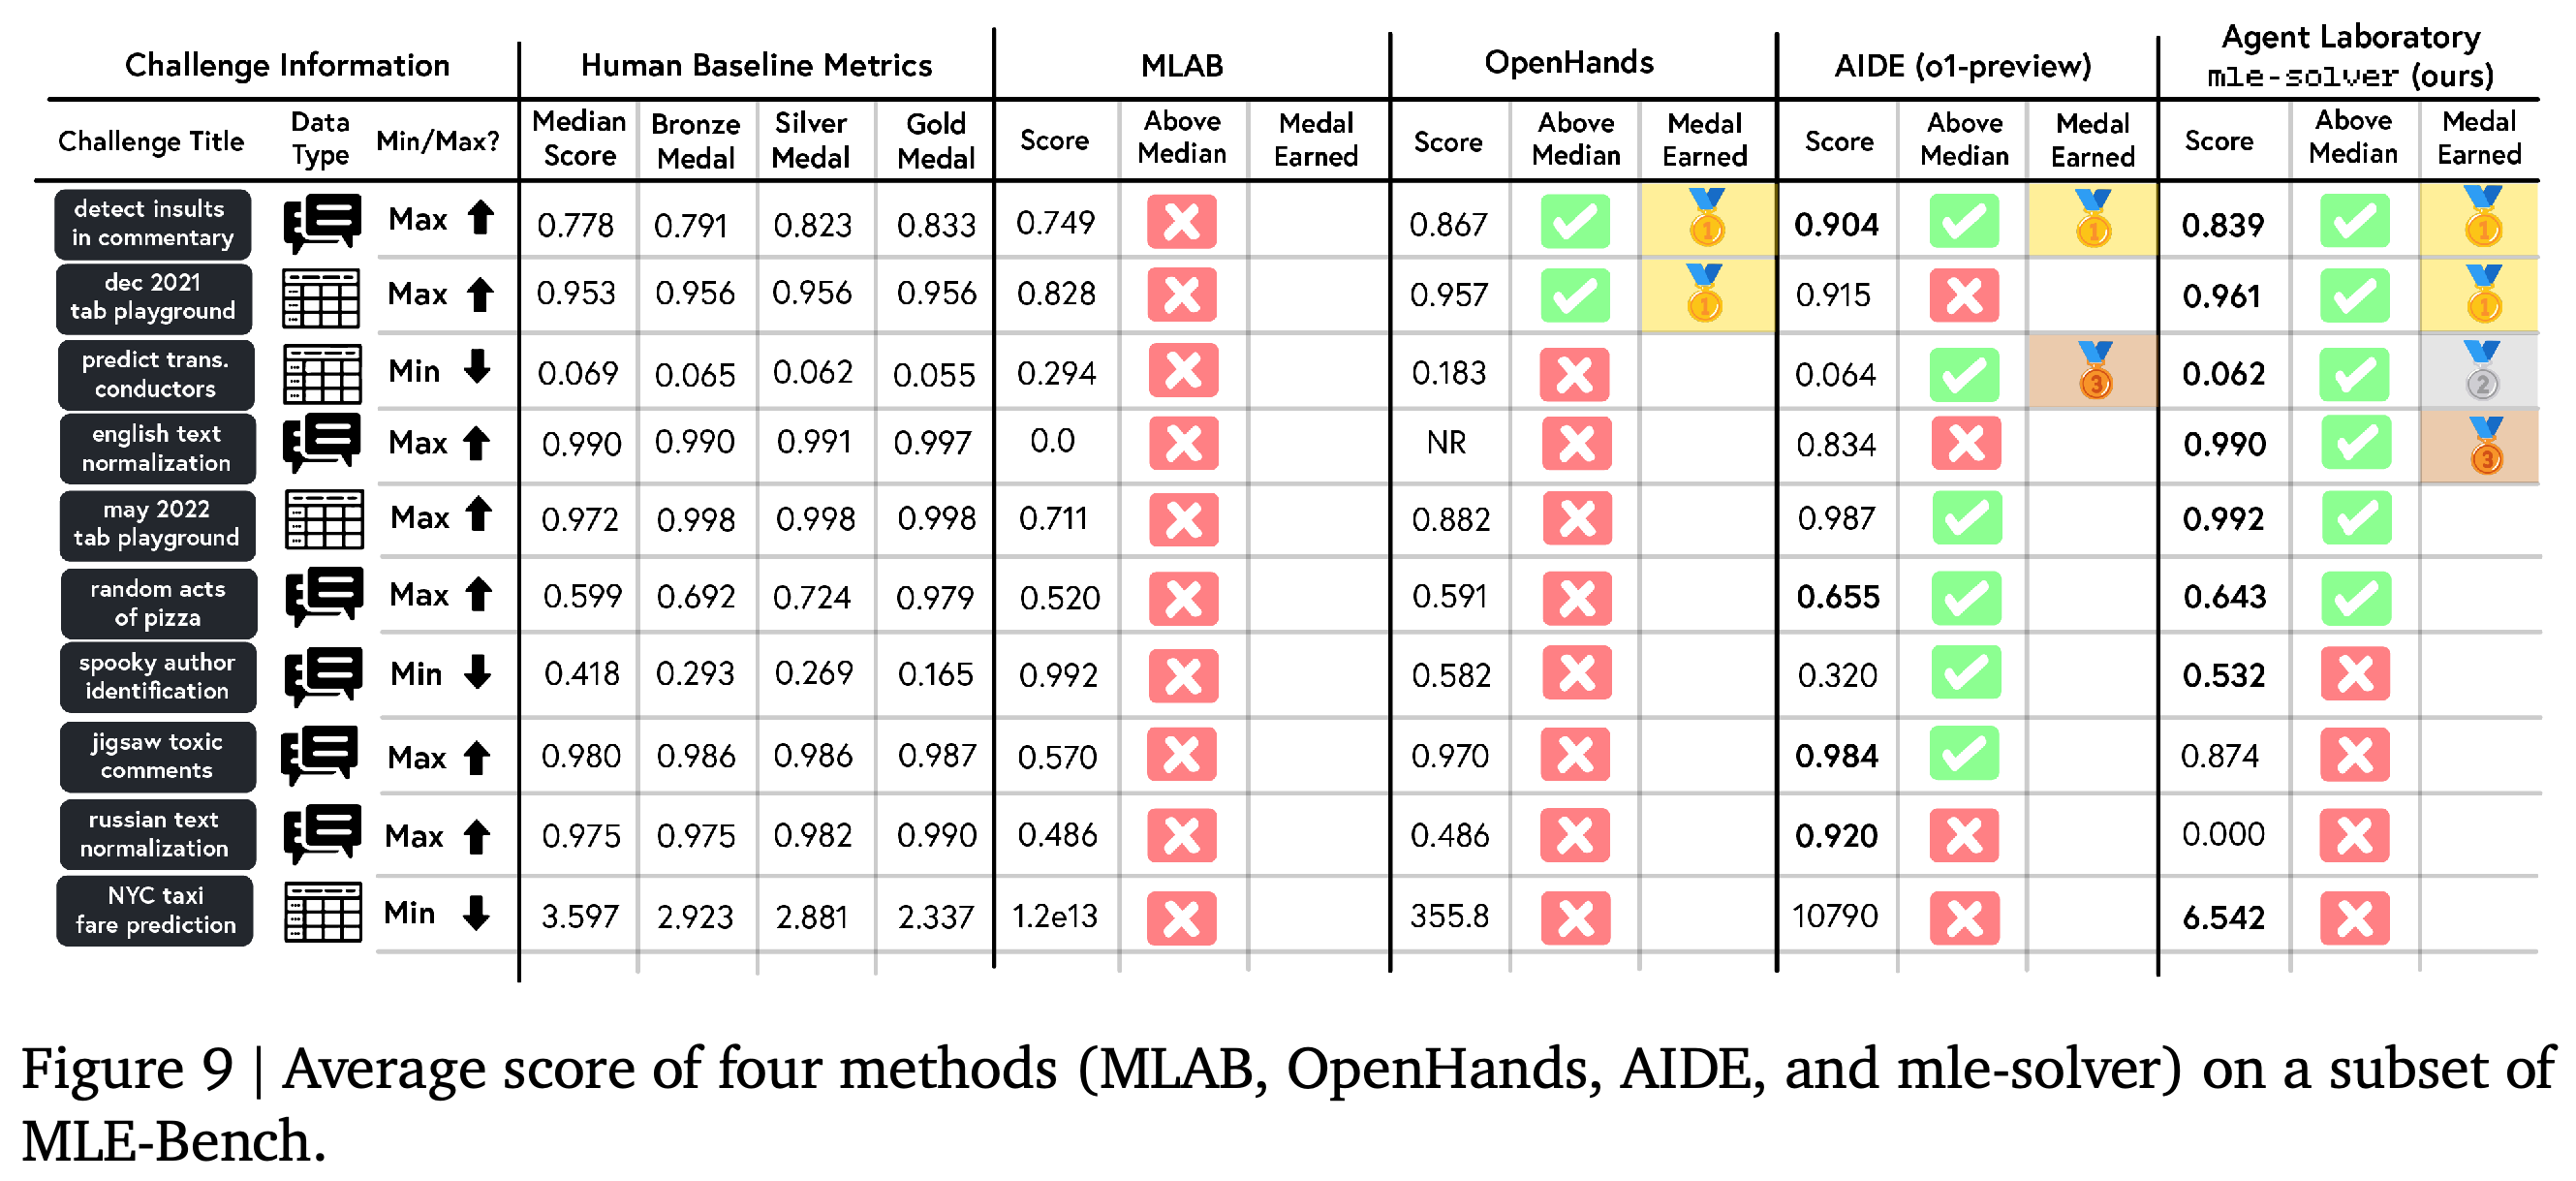
- Kaggle 머신러닝 대회를 바탕으로 만든 벤치마크 MLE-Bench에서 복잡도가 낮은 텍스트 및 표 형식 과제 10개를 평가한 결과, mle-solver는 메달 4개를 획득하고 과제 6개에서 인간 성능의 중앙값을 넘었다. 이 제한된 solver 평가는 논문 리뷰를 보완하지만, 지어낸 실험 세부 사항과 신뢰하기 어려운 자동 평가 때문에 이 결과만으로 자율 연구 능력을 판단하는 데는 한계가 있다.
1. Introduction
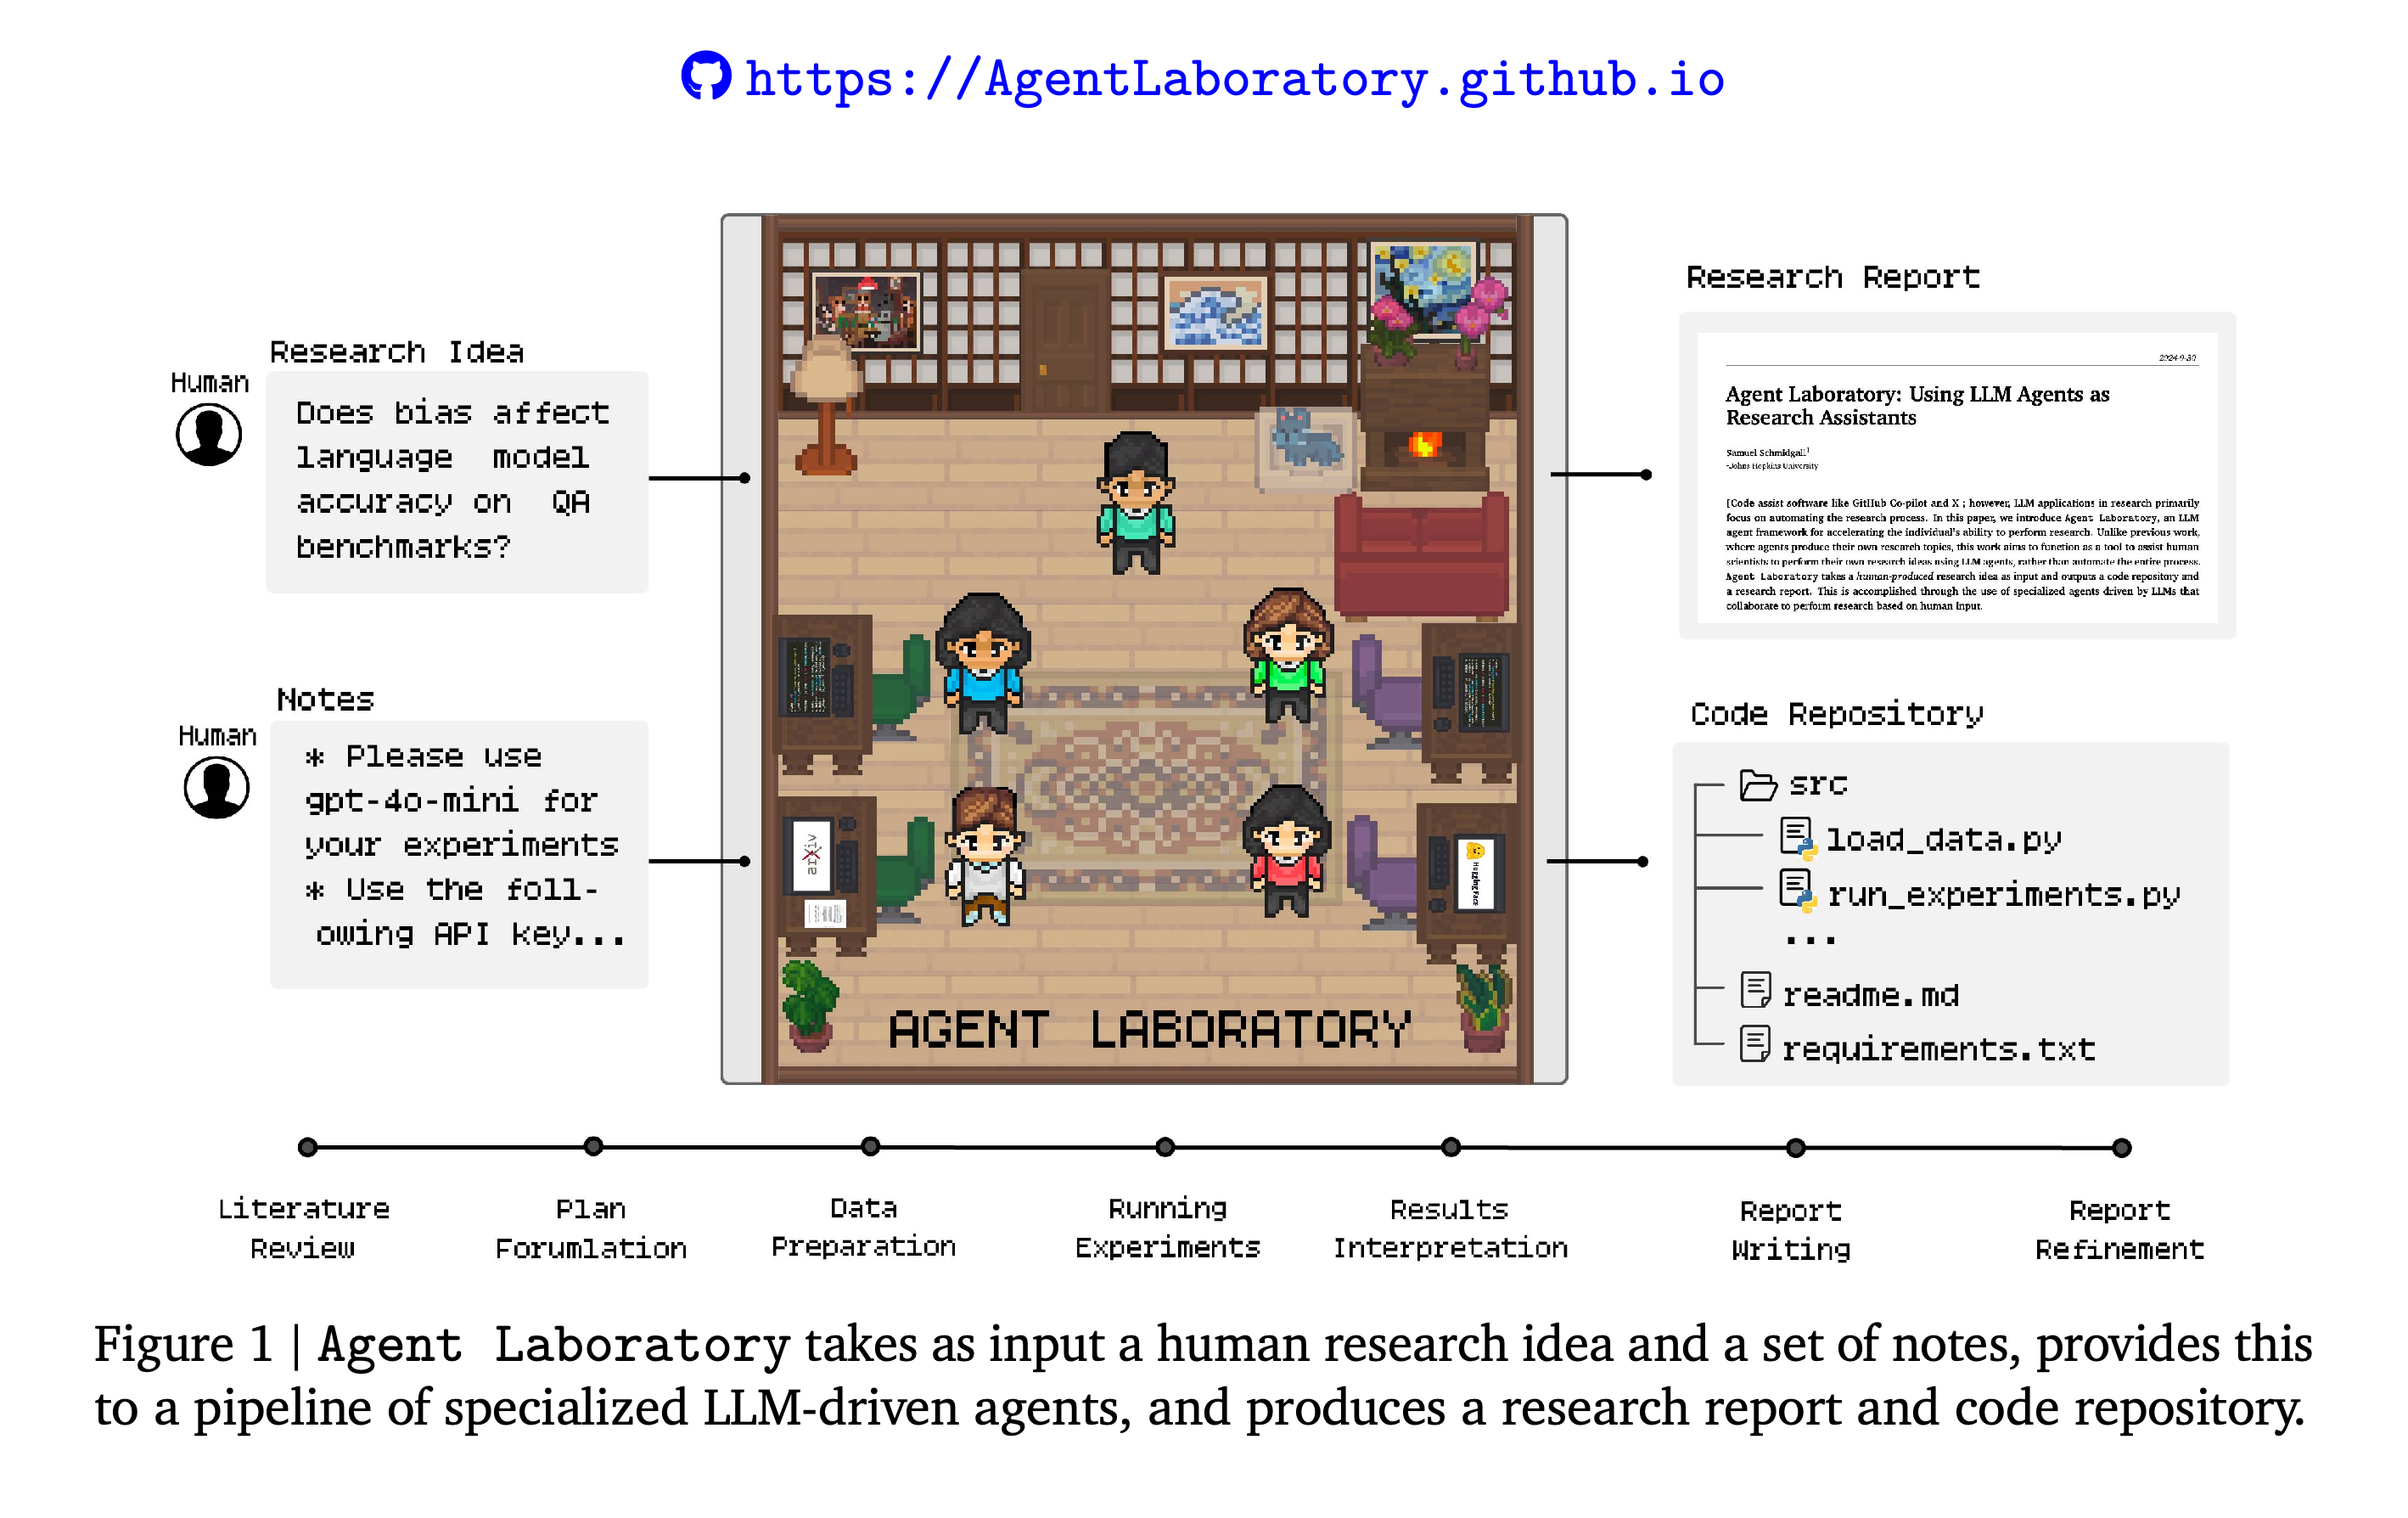
이 논문은 연구자들이 아이디어를 탐색할 때 겪는 시간, 컴퓨팅 자원, 연구비의 제약을 배경으로, 연구자 자신의 아이디어를 구현하는 보조 도구인 Agent Laboratory를 제시한다. 컴퓨팅 예산과 인간의 개입 수준을 조절할 수 있는 오픈소스 워크플로를 소개하고, 연구자 설문, 생성 논문 리뷰, 실행 시간 측정, mle-solver의 별도 평가로 이를 평가한다.
이 도식은 연구 방향과 초기 제약을 정하는 책임을 인간에게 둔다. 산출물과 하위 작업 7개는 의도한 지원 범위가 코딩뿐 아니라 해석과 보고서 개선까지 포함함을 보여준다.
2. Background & Related Work
배경에서는 앞선 텍스트를 바탕으로 다음 토큰을 예측하는 자기회귀 언어 모델과 외부 도구 및 반복 개선을 통해 작업을 수행하는 에이전트를 연결한다. 관련 연구는 자동화된 머신러닝, 과학적 발견, 문헌 검색, 연구 아이디어 생성, 코드 생성, 논문 리뷰를 다룬다.
- MLE-Bench, DS-bench, MLAgentBench는 각각 Kaggle 과제 75개, 74개, 6개를 사용해 머신러닝 엔지니어링의 여러 측면을 평가하는 벤치마크로 소개된다.
- ResearchAgent는 연구 아이디어를 생성하고 다듬으며, The AI Scientist는 실험과 원고 생성을 자동화한다. 저자들은 모델이 생성한 아이디어의 실현 가능성, 구현, 다양성에 약점이 있다는 선행 연구 결과를 근거로 인간이 연구 방향을 정하는 방식의 필요성을 설명한다.
- Virtual Lab은 인간 연구자와 에이전트가 함께 과학 연구를 수행하고, ChemCrow와 Coscientist는 화학 작업을 지원한다. 이러한 사례는 프레임워크를 제안하는 배경이지만, 논문은 전체 연구 시스템 간의 실험 비교를 수행하지 않는다.
3. Agent Laboratory
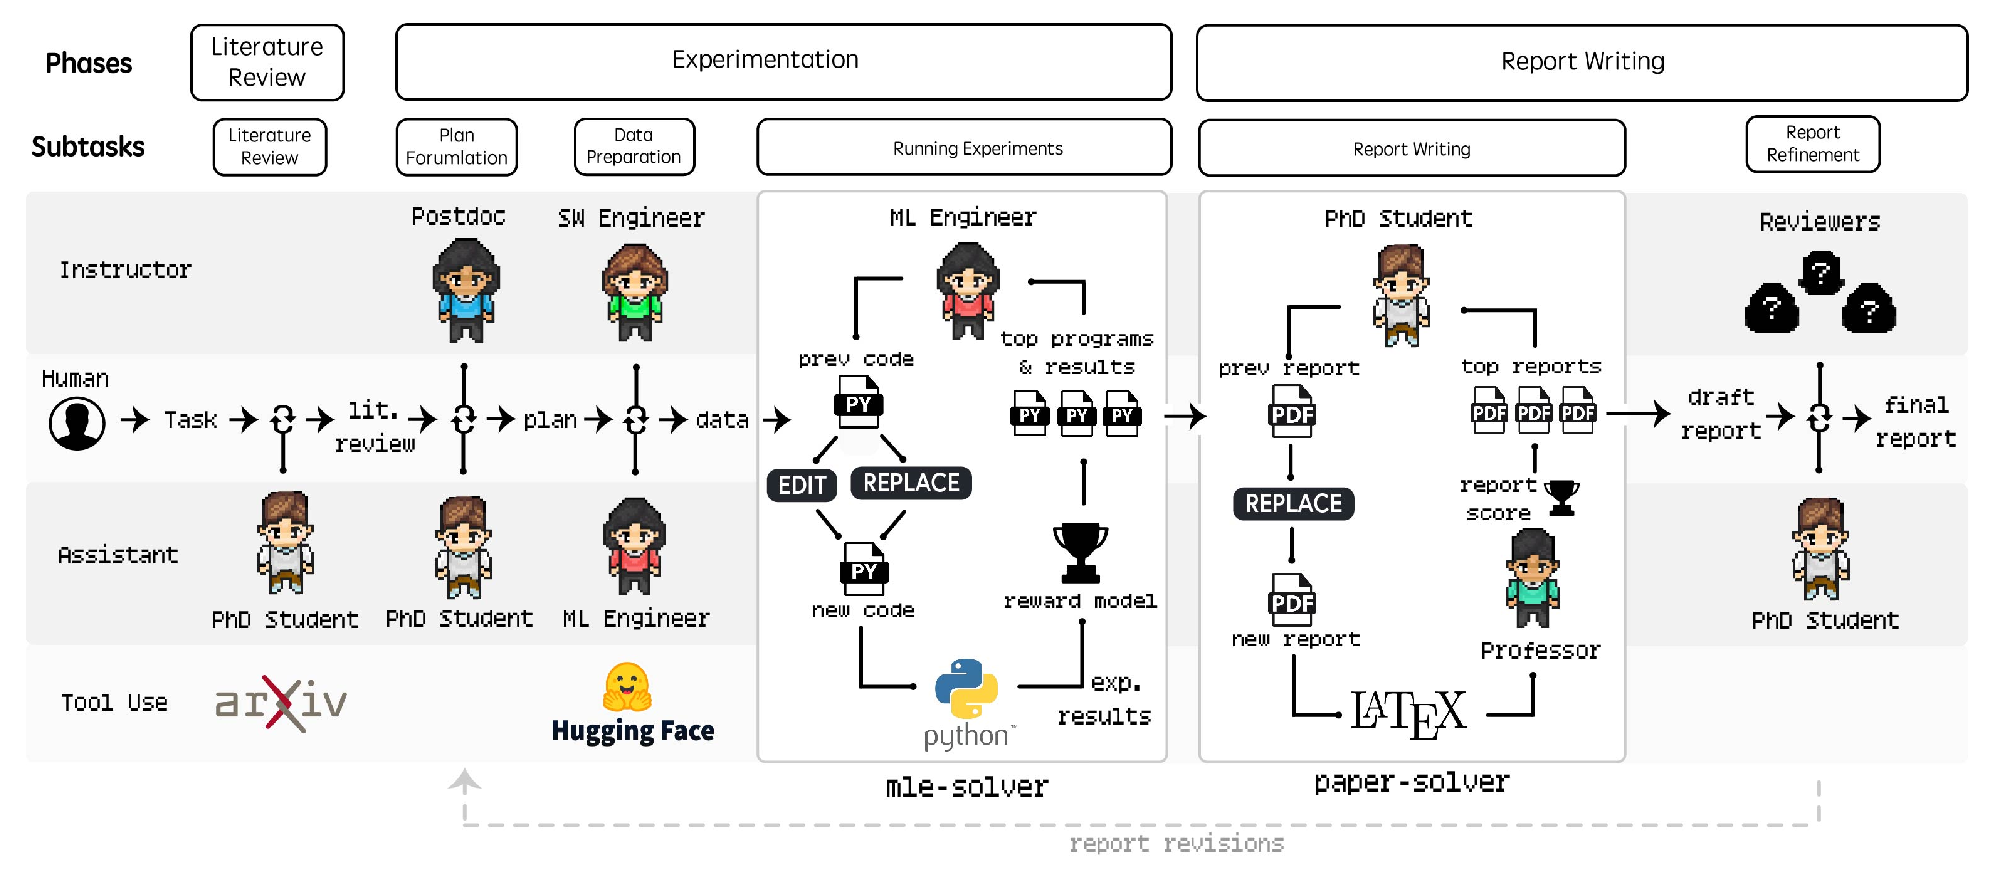
Agent Laboratory는 연구 아이디어와 메모를 입력받아 관련 문헌을 수집하고, 실험 계획을 세우고, 데이터를 준비하고, 실험을 실행하고, 결과를 해석한 뒤 보고서와 코드 저장소를 생성한다. 에이전트에는 PhD Student, Postdoc, ML Engineer, Professor 등의 역할을 프롬프트로 부여하며, 각 역할은 박사과정 연구, 박사후 연구, 머신러닝 엔지니어링, 학술 평가를 담당한다.
- 주요 단계 3개는 Literature Review, Experimentation, Report Writing이다.
- mle-solver는 실험 프로그래밍을 담당하고, paper-solver는 보고서 생성과 수정을 담당한다.
- 논문에 제시된 프로젝트 URL은 https://AgentLaboratory.github.io/이다.
이 워크플로는 주요 단계 3개 안에서 에이전트 대화, 외부 도구, solver 반복 과정이 수행되는 위치를 보여준다. 보고서 개선에서 앞선 작업으로 돌아가는 경로는 수정 과정에서 실험 절차를 다시 검토할 수 있음을 나타낸다.
3.1. Literature Review
PhD 에이전트는 연구 논문 저장소인 arXiv의 응용 프로그램 인터페이스를 통해 논문을 검색하고 후속 단계에서 사용할 참고 문헌을 선별한다. summary 작업은 검색어와 일치하는 상위 논문 20편의 초록을 가져오고, full text는 선택한 논문의 본문을 가져오며, add paper는 선택한 요약이나 본문을 문헌 검토에 추가한다.
- 에이전트는 검색어를 입력하고 관련성을 검토한 뒤 논문을 추가한다.
- 설정된 수만큼 관련 문헌을 추가하면 단계가 끝난다. Appendix A에 제시된 설정에서는 논문 요약 5개를 사용한다.
3.2. Experimentation
Experimentation은 PhD 에이전트와 Postdoc 에이전트가 대화하며 모델, 데이터셋, 실험 절차를 정하는 것으로 시작한다. 데이터 준비에는 Python 실행과 데이터셋 저장소인 HuggingFace 검색을 사용하며, 제출 전에 실행 피드백을 바탕으로 오류를 수정한다.
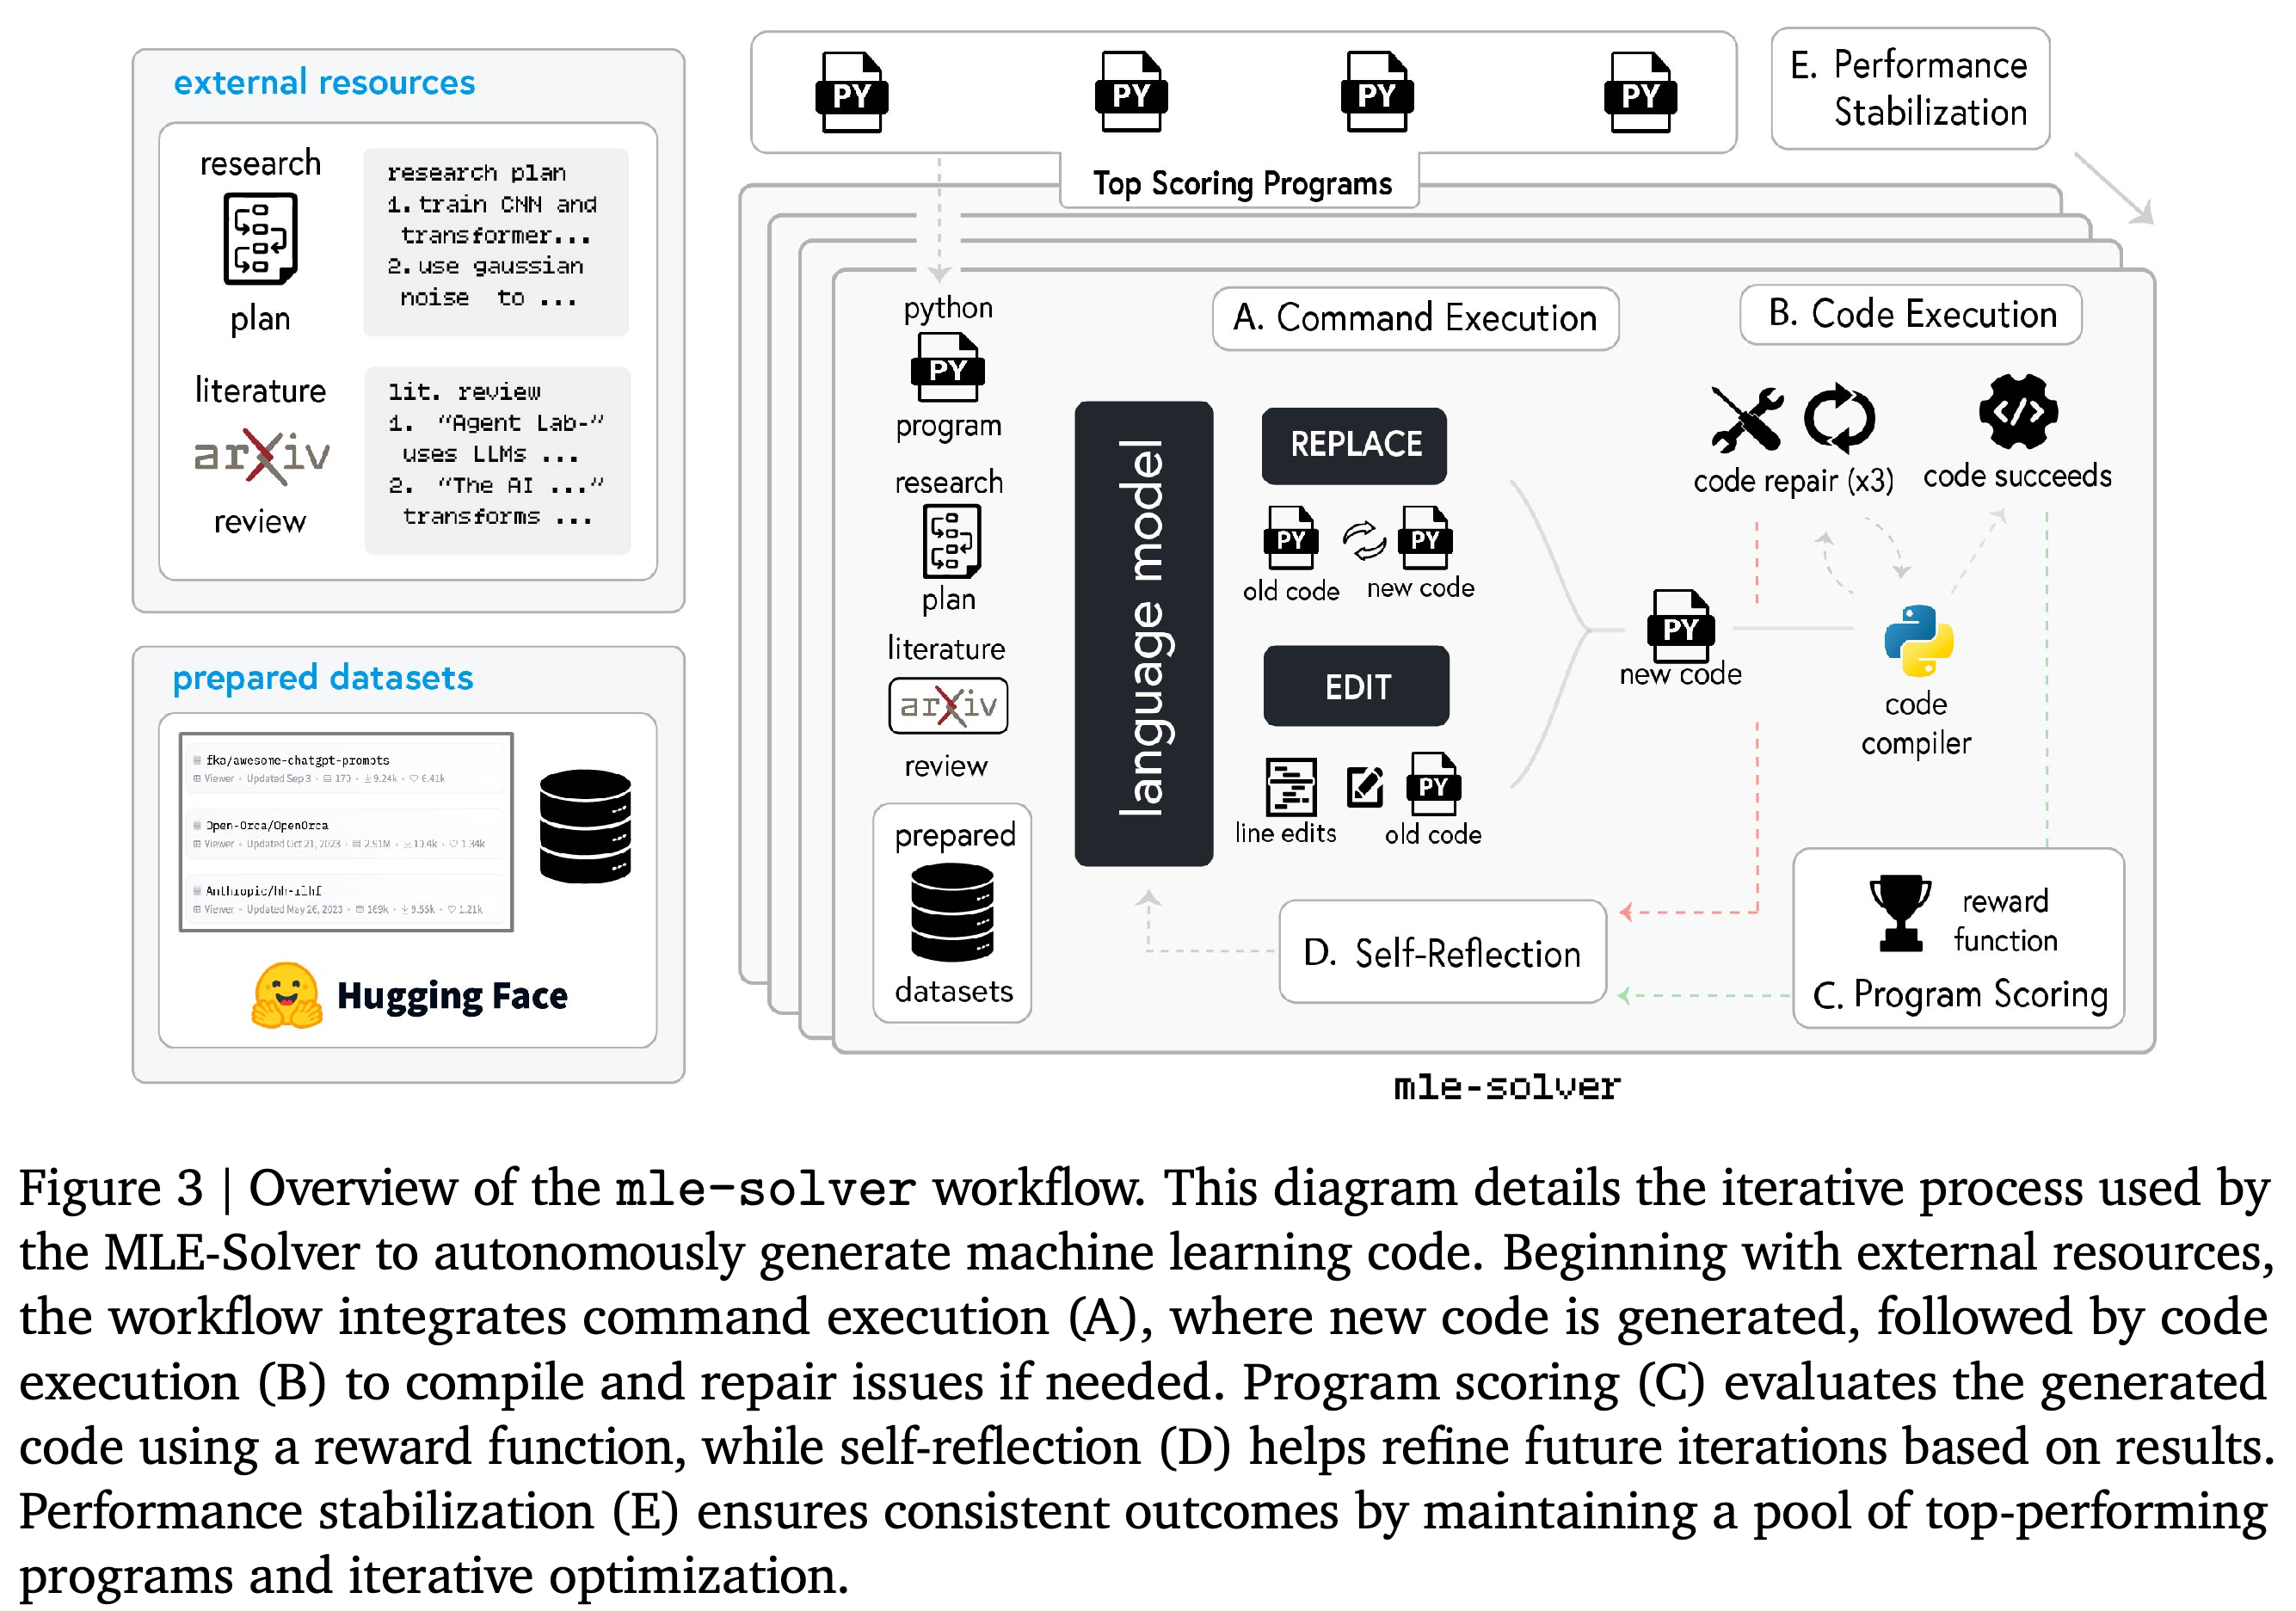
- mle-solver는 Python 프로그램을 초기화한 뒤, 지정한 줄 범위를 바꾸는 EDIT와 전체 프로그램을 다시 생성하는 REPLACE로 후보를 개선한다.
- 언어 모델 보상 함수는 연구 계획, 코드, 관측된 출력을 바탕으로 의도한 실험과의 일치도를 0에서 1까지 평가하는 모델 기반 채점 절차다. 이 점수는 작업 수행 여부를 평가하며, 과학적 타당성을 독립적으로 검증하지는 않는다.
- 자기 성찰 과정은 실행 오류나 결과를 바탕으로 개선안을 제시한다. solver는 점수가 높은 프로그램을 보관하고, 그중 하나를 무작위로 추출해 수정안을 병렬로 생성한 뒤, 가장 좋은 후보로 보관 중인 최저 점수 프로그램을 교체한다.
- PhD 에이전트와 Postdoc 에이전트가 실험 결과를 논의하고, Postdoc 에이전트가 보고서 작성에 사용할 해석을 제출한다.
실행 결과와 보상 함수가 프로그램 탐색을 유도하고, 보관된 프로그램 풀이 후속 수정의 후보를 제공한다. 따라서 채점 함수는 실행 가능한 프로그램 중 어떤 프로그램을 계속 개선할지에 영향을 준다.
3.3. Report Writing
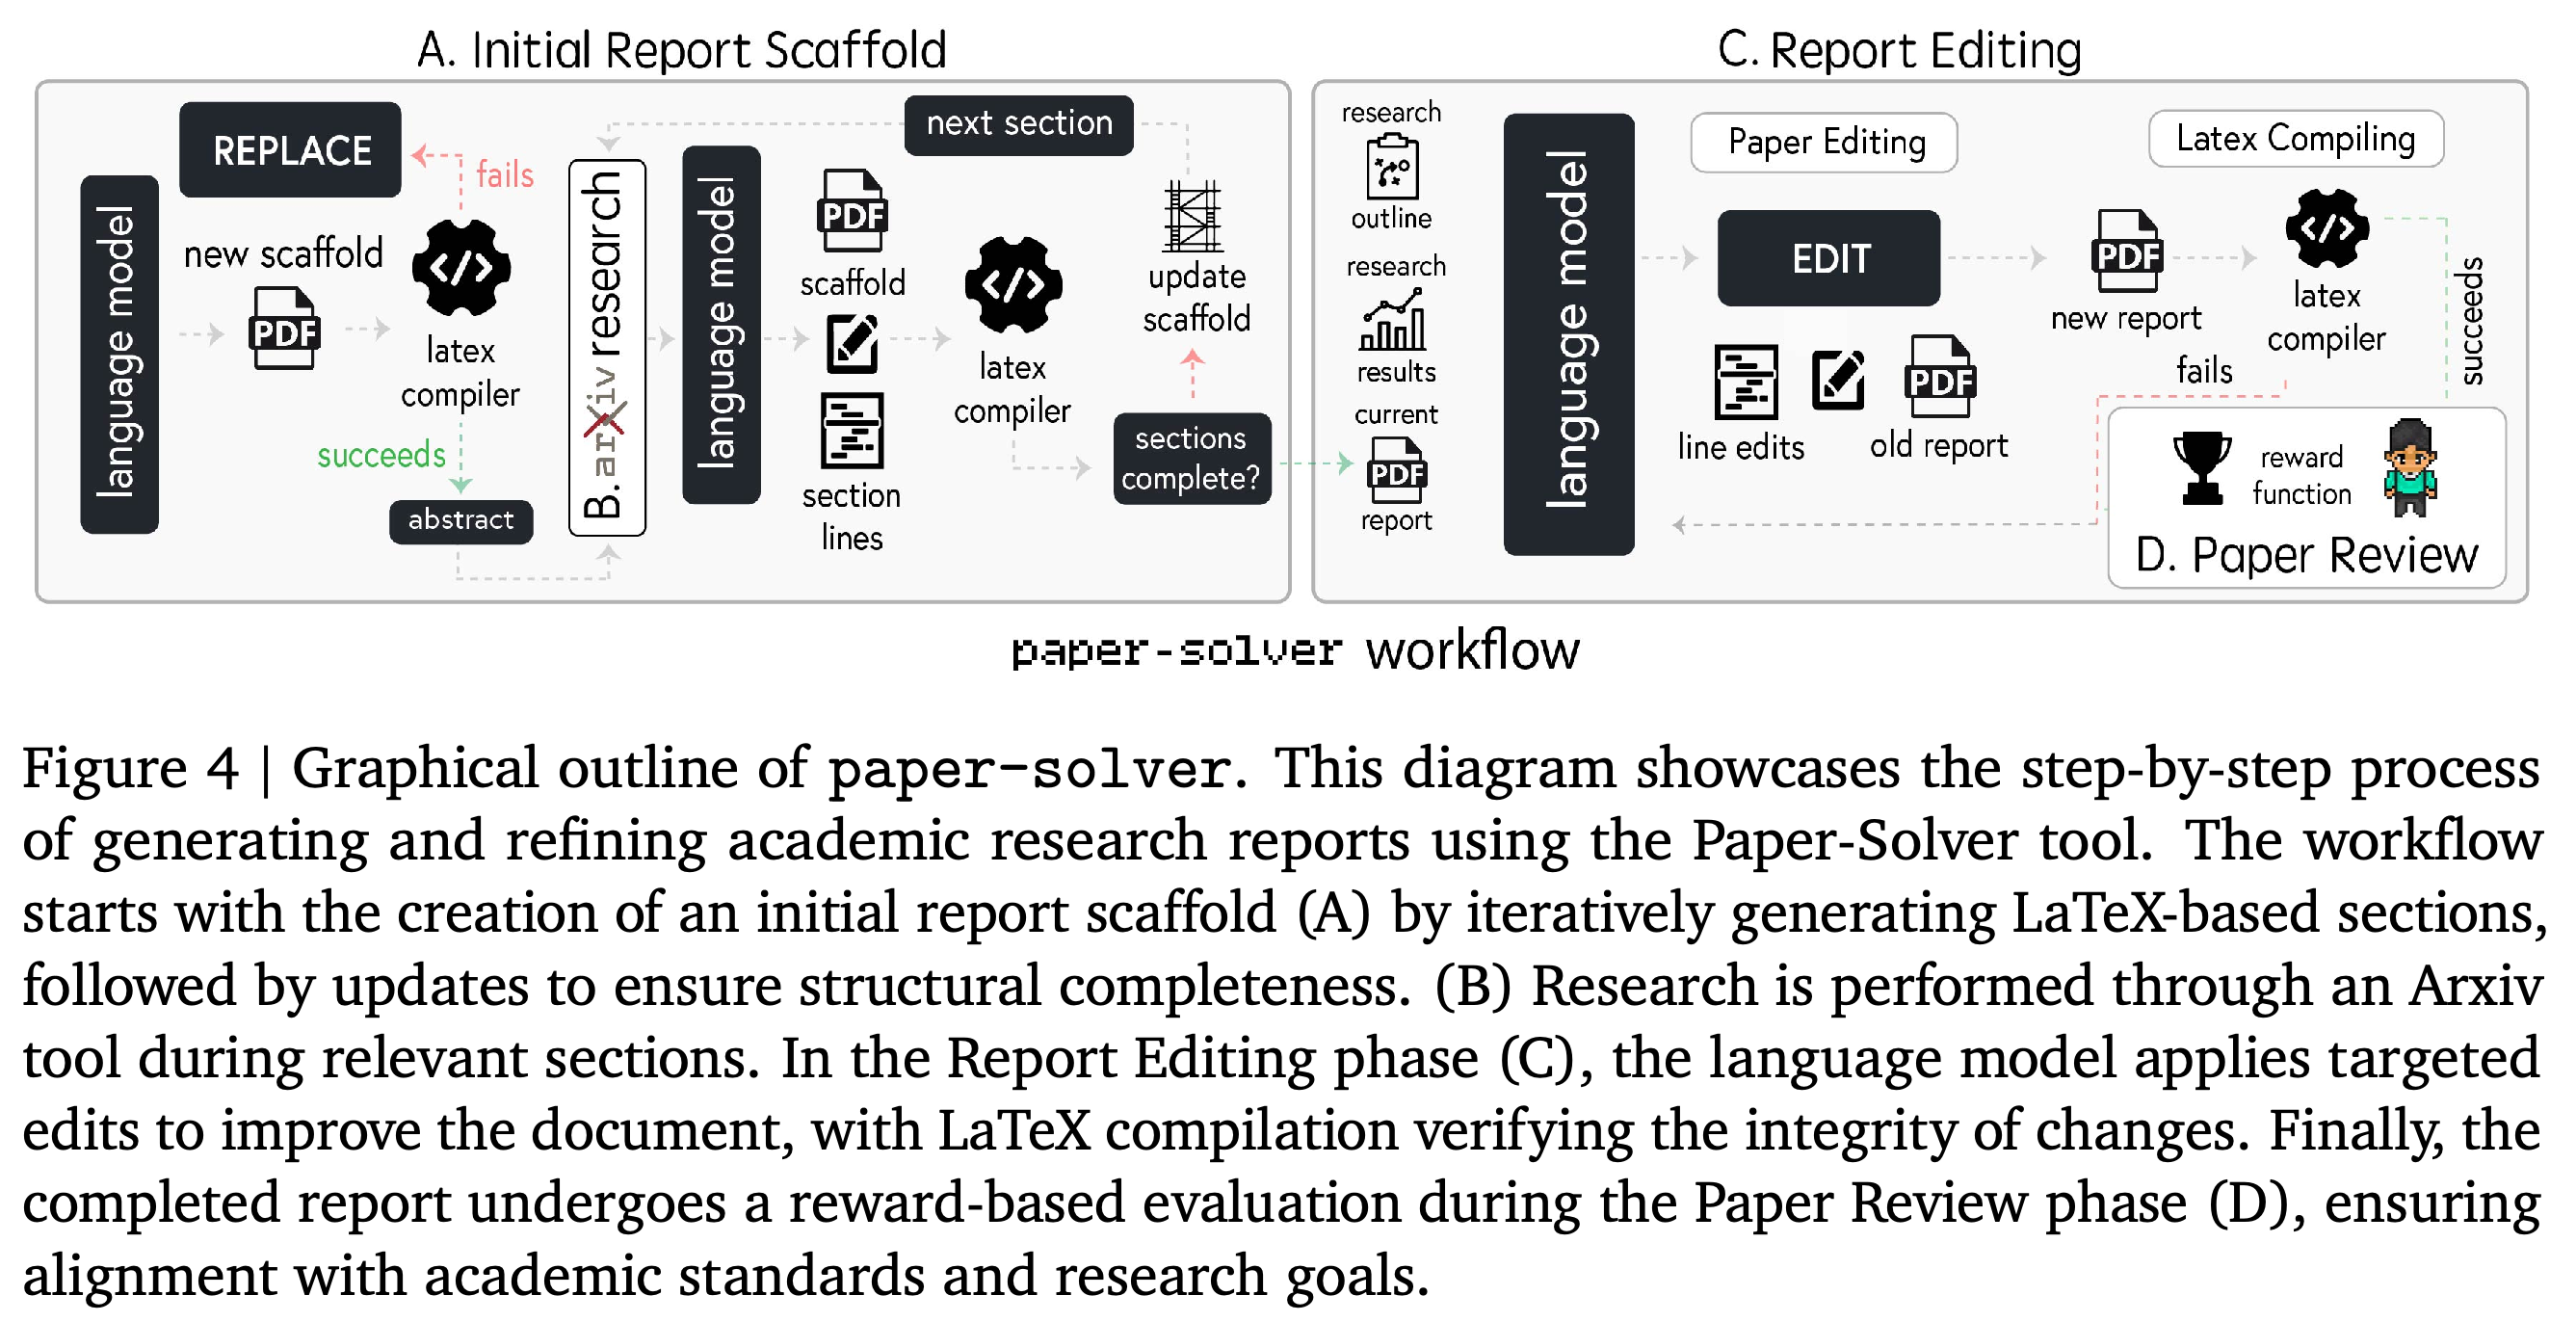
paper-solver는 연구자가 수행된 작업을 이해할 수 있도록 앞선 결과를 보고서로 정리한다. 보고서로 컴파일할 수 있는 문서 틀을 LaTeX로 만들며, 이 틀은 8개 절로 구성된다. 필요하면 arXiv 참고 문헌을 추가로 검색하고, 줄 단위로 수정하며, 기존 자동 리뷰 시스템을 조정해 보고서에 점수를 부여한다.
- 기본 구조는 Abstract, Introduction, Background, Related Work, Methods, Experimental Setup, Results, Discussion으로 구성된다. 수정안은 LaTeX 문서를 컴파일해 검사한다.
- 개선 과정에서는 리뷰어 에이전트 3개가 머신러닝 학회 NeurIPS의 평가 지침을 본떠 피드백을 제공한다. PhD 에이전트는 프로젝트를 마무리하거나 계획, 실험, 해석 단계로 돌아갈 수 있다.
- 3.3.1. Autonomous versus Co-Pilot Mode에서 자율 모드는 인간이 처음 제시한 연구 아이디어만 요구한다. Co-pilot 모드는 각 하위 작업 뒤에 점검 단계를 추가해 연구자가 진행 상황을 승인하거나 피드백과 함께 재수행을 요청할 수 있게 한다.
- 인용된 리뷰어의 보정 결과는 다른 머신러닝 학회인 ICLR 2022의 논문 500편을 다룬 선행 연구의 결과다. Agent Laboratory는 생성 보고서의 자동 점수가 인간 평가와 일치하는지 별도로 검증한다.
반복 과정은 초기 문서 구성과 편집 및 자동 리뷰를 구분한다. 컴파일은 문서가 정상적으로 빌드되는지 검사하고, 리뷰어는 품질을 판단하지만 모든 실험 주장을 실행 기록과 직접 대조하지는 않는다.
4. Results
평가는 자율 연구 산출물, co-pilot 사용, 워크플로 비용과 실행 시간, 대회 과제에서의 mle-solver 성능을 살핀다. 유용성과 논문 품질 평가는 대회 점수와 다른 성과를 측정하며, 대회 점수는 전체 연구 워크플로와 분리해 solver를 평가한다.
4.1. Evaluation of quality by language model
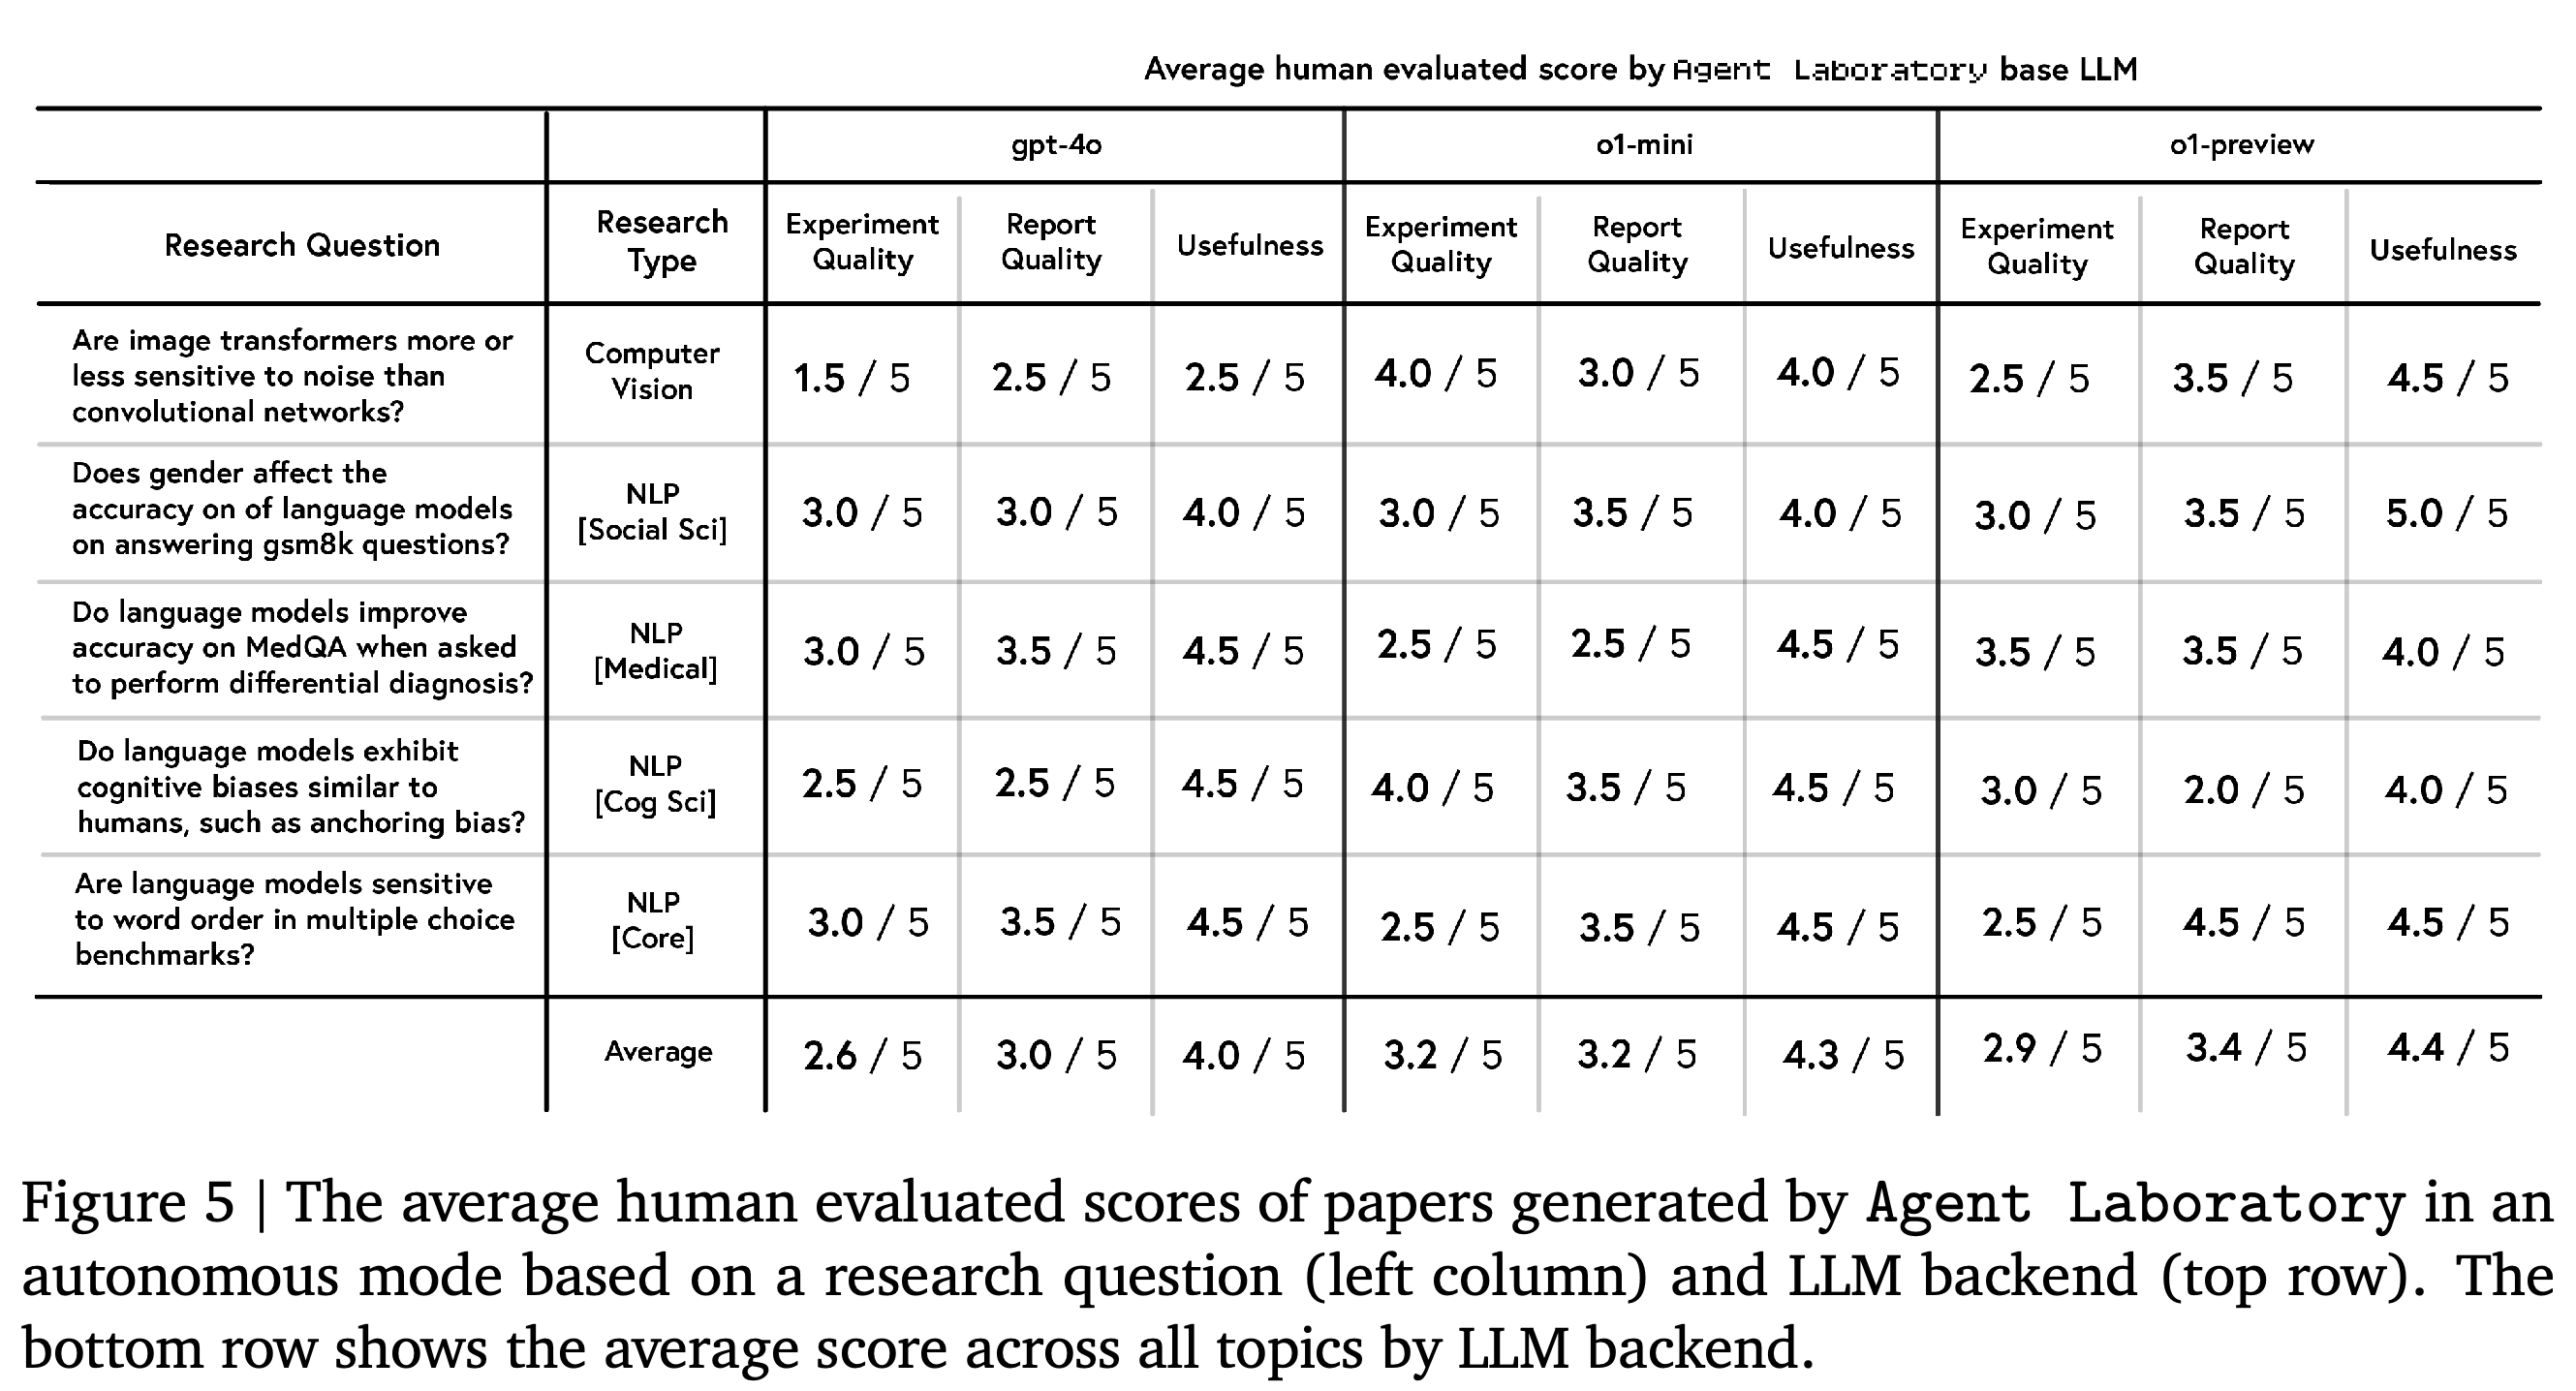
연구 질문 5개와 기반 모델인 gpt-4o, o1-mini, o1-preview의 백엔드 3개로 자율 모드 논문 15편을 생성했다. 자원한 PhD 학생 10명은 각자 무작위로 배정된 논문 3편을 검토하고 실험 품질, 보고서 품질, 유용성을 1에서 5까지 평가했다.
- 주제는 모델 판단에서 나타나는 체계적 경향인 인지 편향, 픽셀 잡음에 대한 이미지 모델의 민감도, 의료 질의응답 데이터셋 MedQA에서 가능한 다른 진단을 고려하는 감별 진단, 객관식 질문의 어순 민감도, 수학 질의응답에서의 성별 역할 수행이었다.
- gpt-4o의 평균 실험 품질, 보고서 품질, 유용성은 각각 2.6/5, 3.0/5, 4.0/5였다. o1-mini는 각각 3.2/5, 3.2/5, 4.3/5였고, o1-preview는 각각 2.9/5, 3.4/5, 4.4/5였다.
- 성능은 주제에 따라 달랐다. 이미지 잡음 주제에서 실험 품질은 gpt-4o의 1.5/5부터 o1-mini의 4.0/5까지 분포했다.
모든 백엔드에서 유용성 점수가 실험 품질 점수보다 높다. o1-preview는 평균 유용성과 보고서 품질에서 앞서고, o1-mini는 실험 품질에서 앞서므로 평가 항목에 따라 순위가 달라진다.
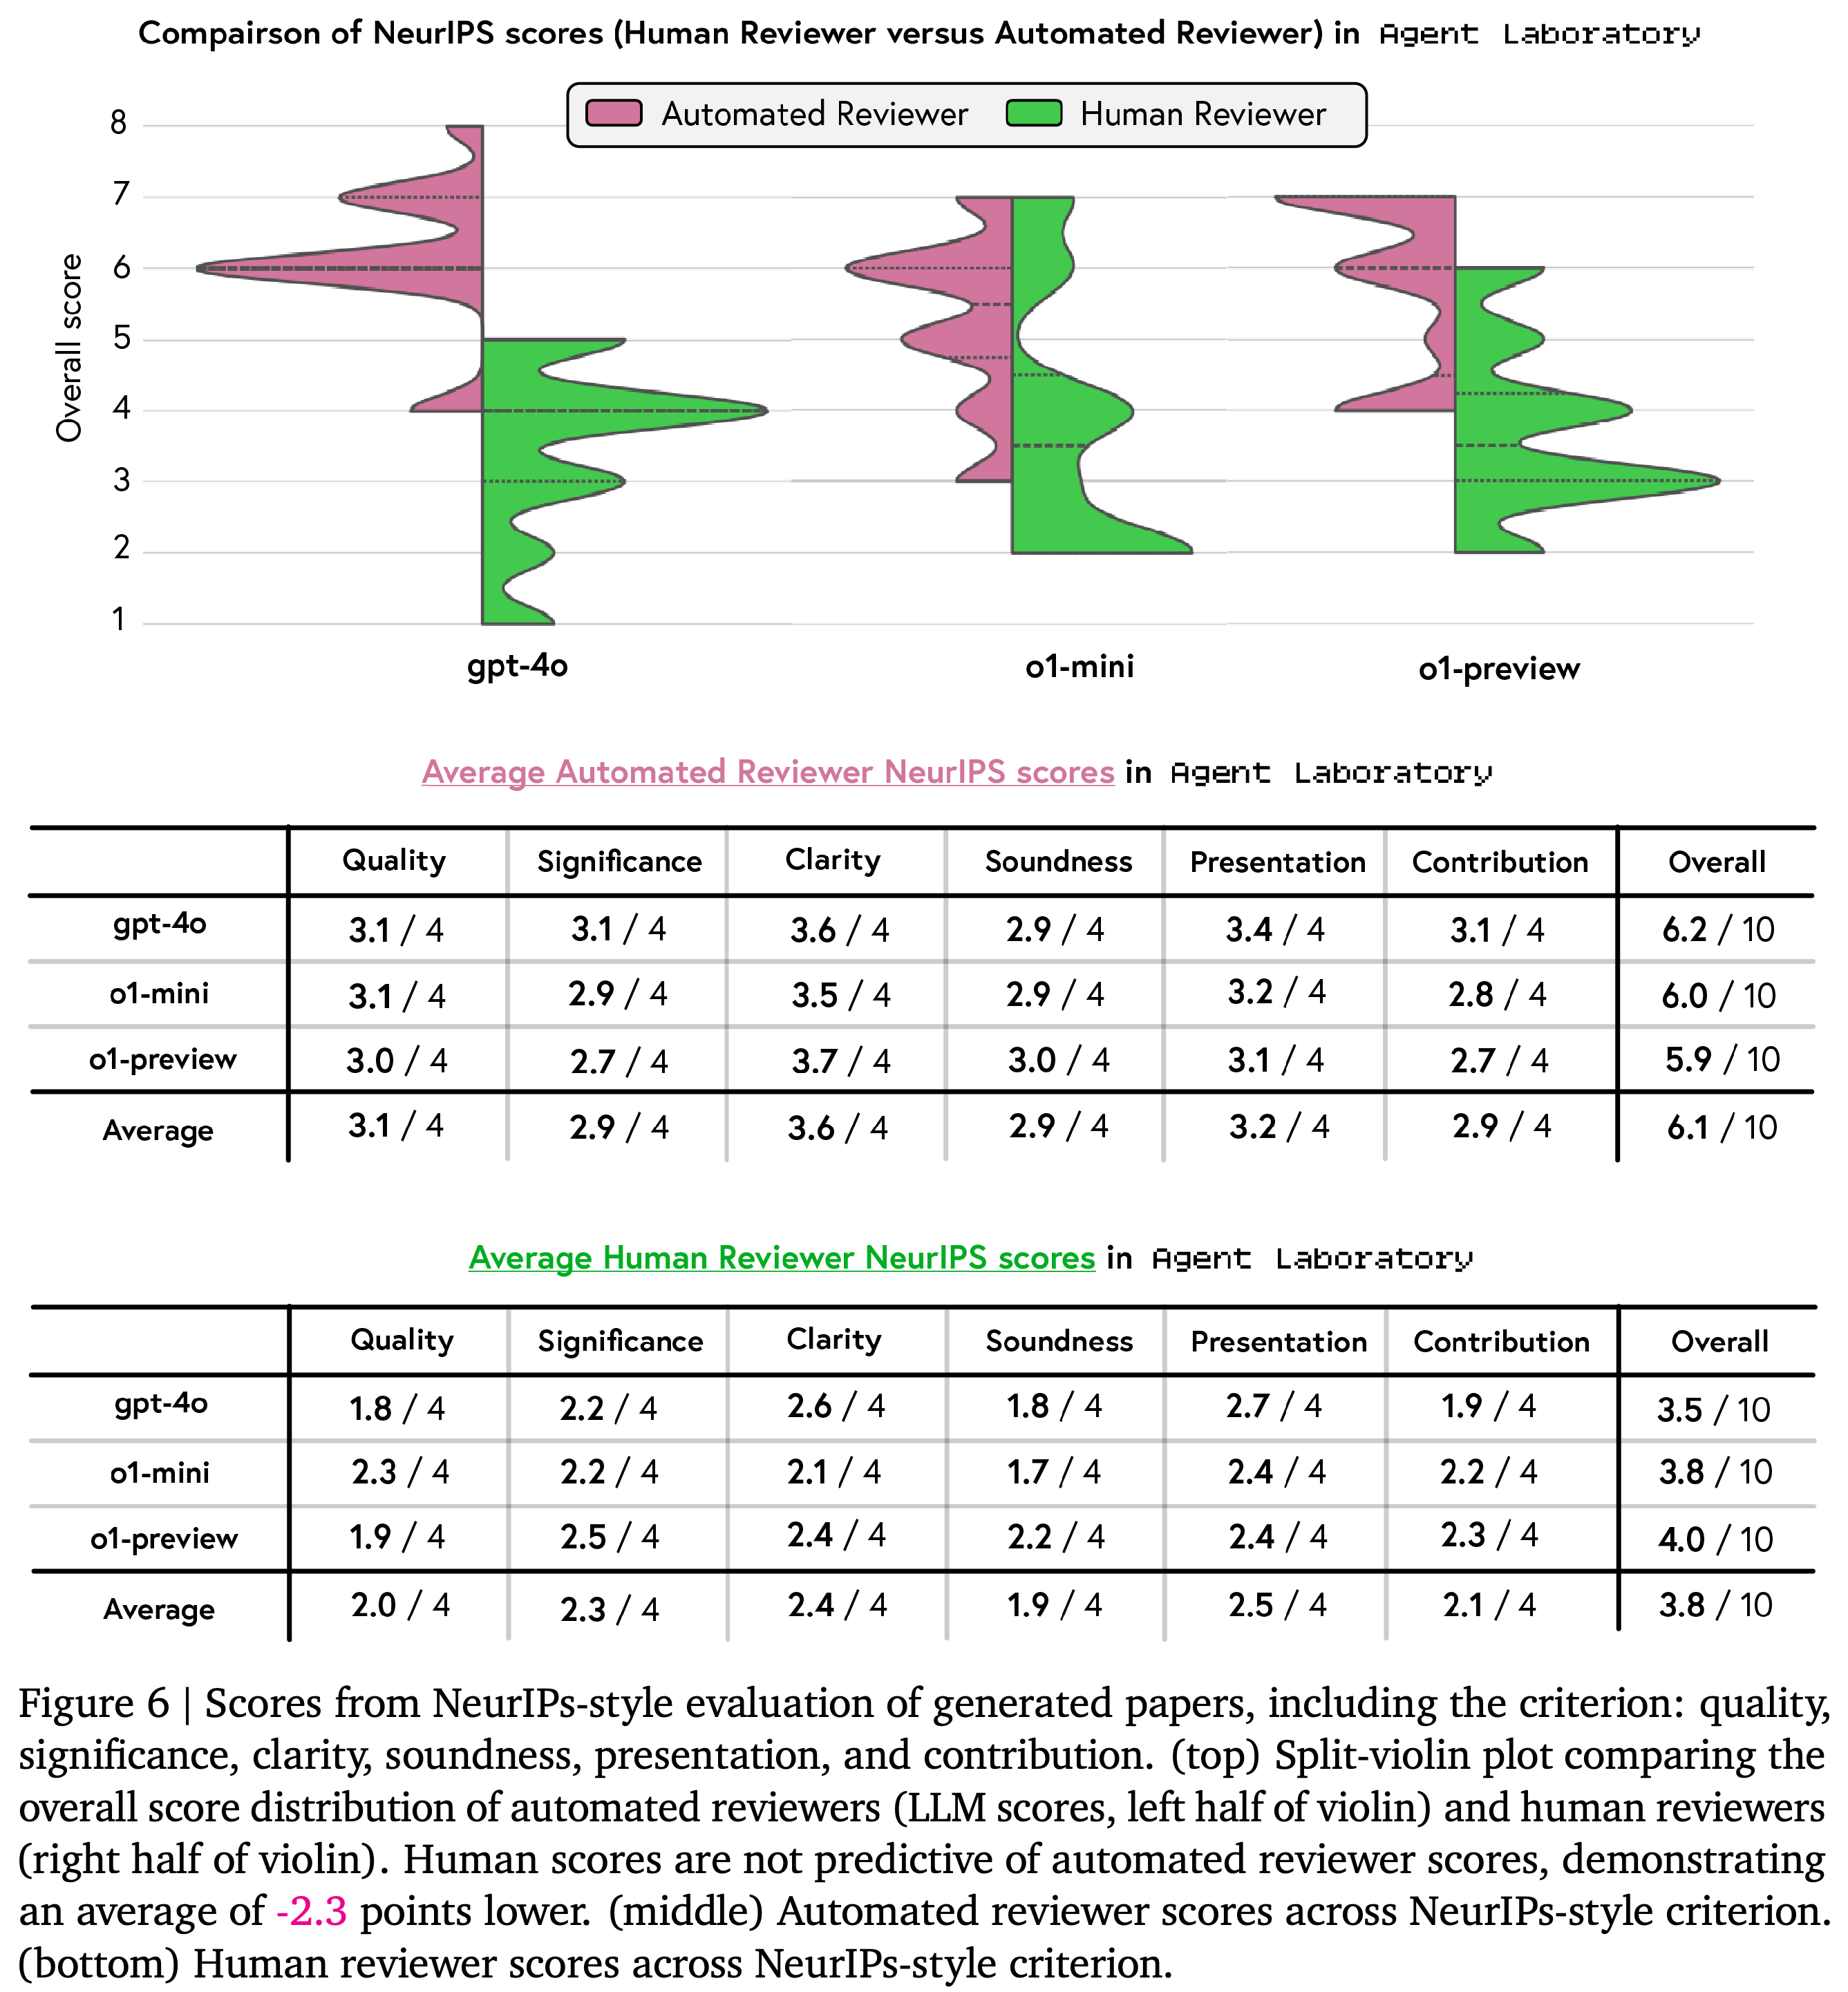
4.1.1. Human reviewer scores by language model은 같은 논문을 NeurIPS 방식의 기준으로 평가한다. 인간의 종합 점수는 gpt-4o가 3.5/10, o1-mini가 3.8/10, o1-preview가 4.0/10이었으며, 자동 리뷰어의 평균은 6.1/10으로 인간 평균 3.8/10보다 높았다.
- Figure 6에서 인간 평가의 평균은 품질 2.0/4, 중요성 2.3/4, 명확성 2.4/4, 타당성 1.9/4, 표현 2.5/4, 기여도 2.1/4이다. 타당성은 기술적 주장과 방법이 증거로 뒷받침되는지를 평가한다.
- 자동 리뷰어는 명확성에 3.6/4, 기여도에 2.9/4를 부여했고, 인간은 각각 2.4/4와 2.1/4를 부여했다. 보고된 모든 기준에서 자동 평가 점수가 더 높았다.
- 인용된 NeurIPS 2024 papers 중 채택된 논문의 평균은 5.85/10이다. 이는 채택 논문의 평균이며, 보편적인 채택 기준 점수는 아니다.
- 본문과 Figure 6은 gpt-4o와 o1-mini의 타당성 점수를 서로 뒤바꿔 제시한다. 그림에서는 각각 1.8/4와 1.7/4이며, 본문과 그림 2곳 모두 o1-preview에는 2.2/4를 부여한다.
점수 분포와 기준별 평균은 자동 평가가 인간 평가보다 더 우호적임을 보여준다. 자동 평가와 인간 평가의 종합 평균은 백엔드의 순위도 다르게 매겨, 자동 점수를 외부 리뷰의 대체 수단으로 사용하는 근거를 약화한다.
4.2. Evaluation of co-pilot quality
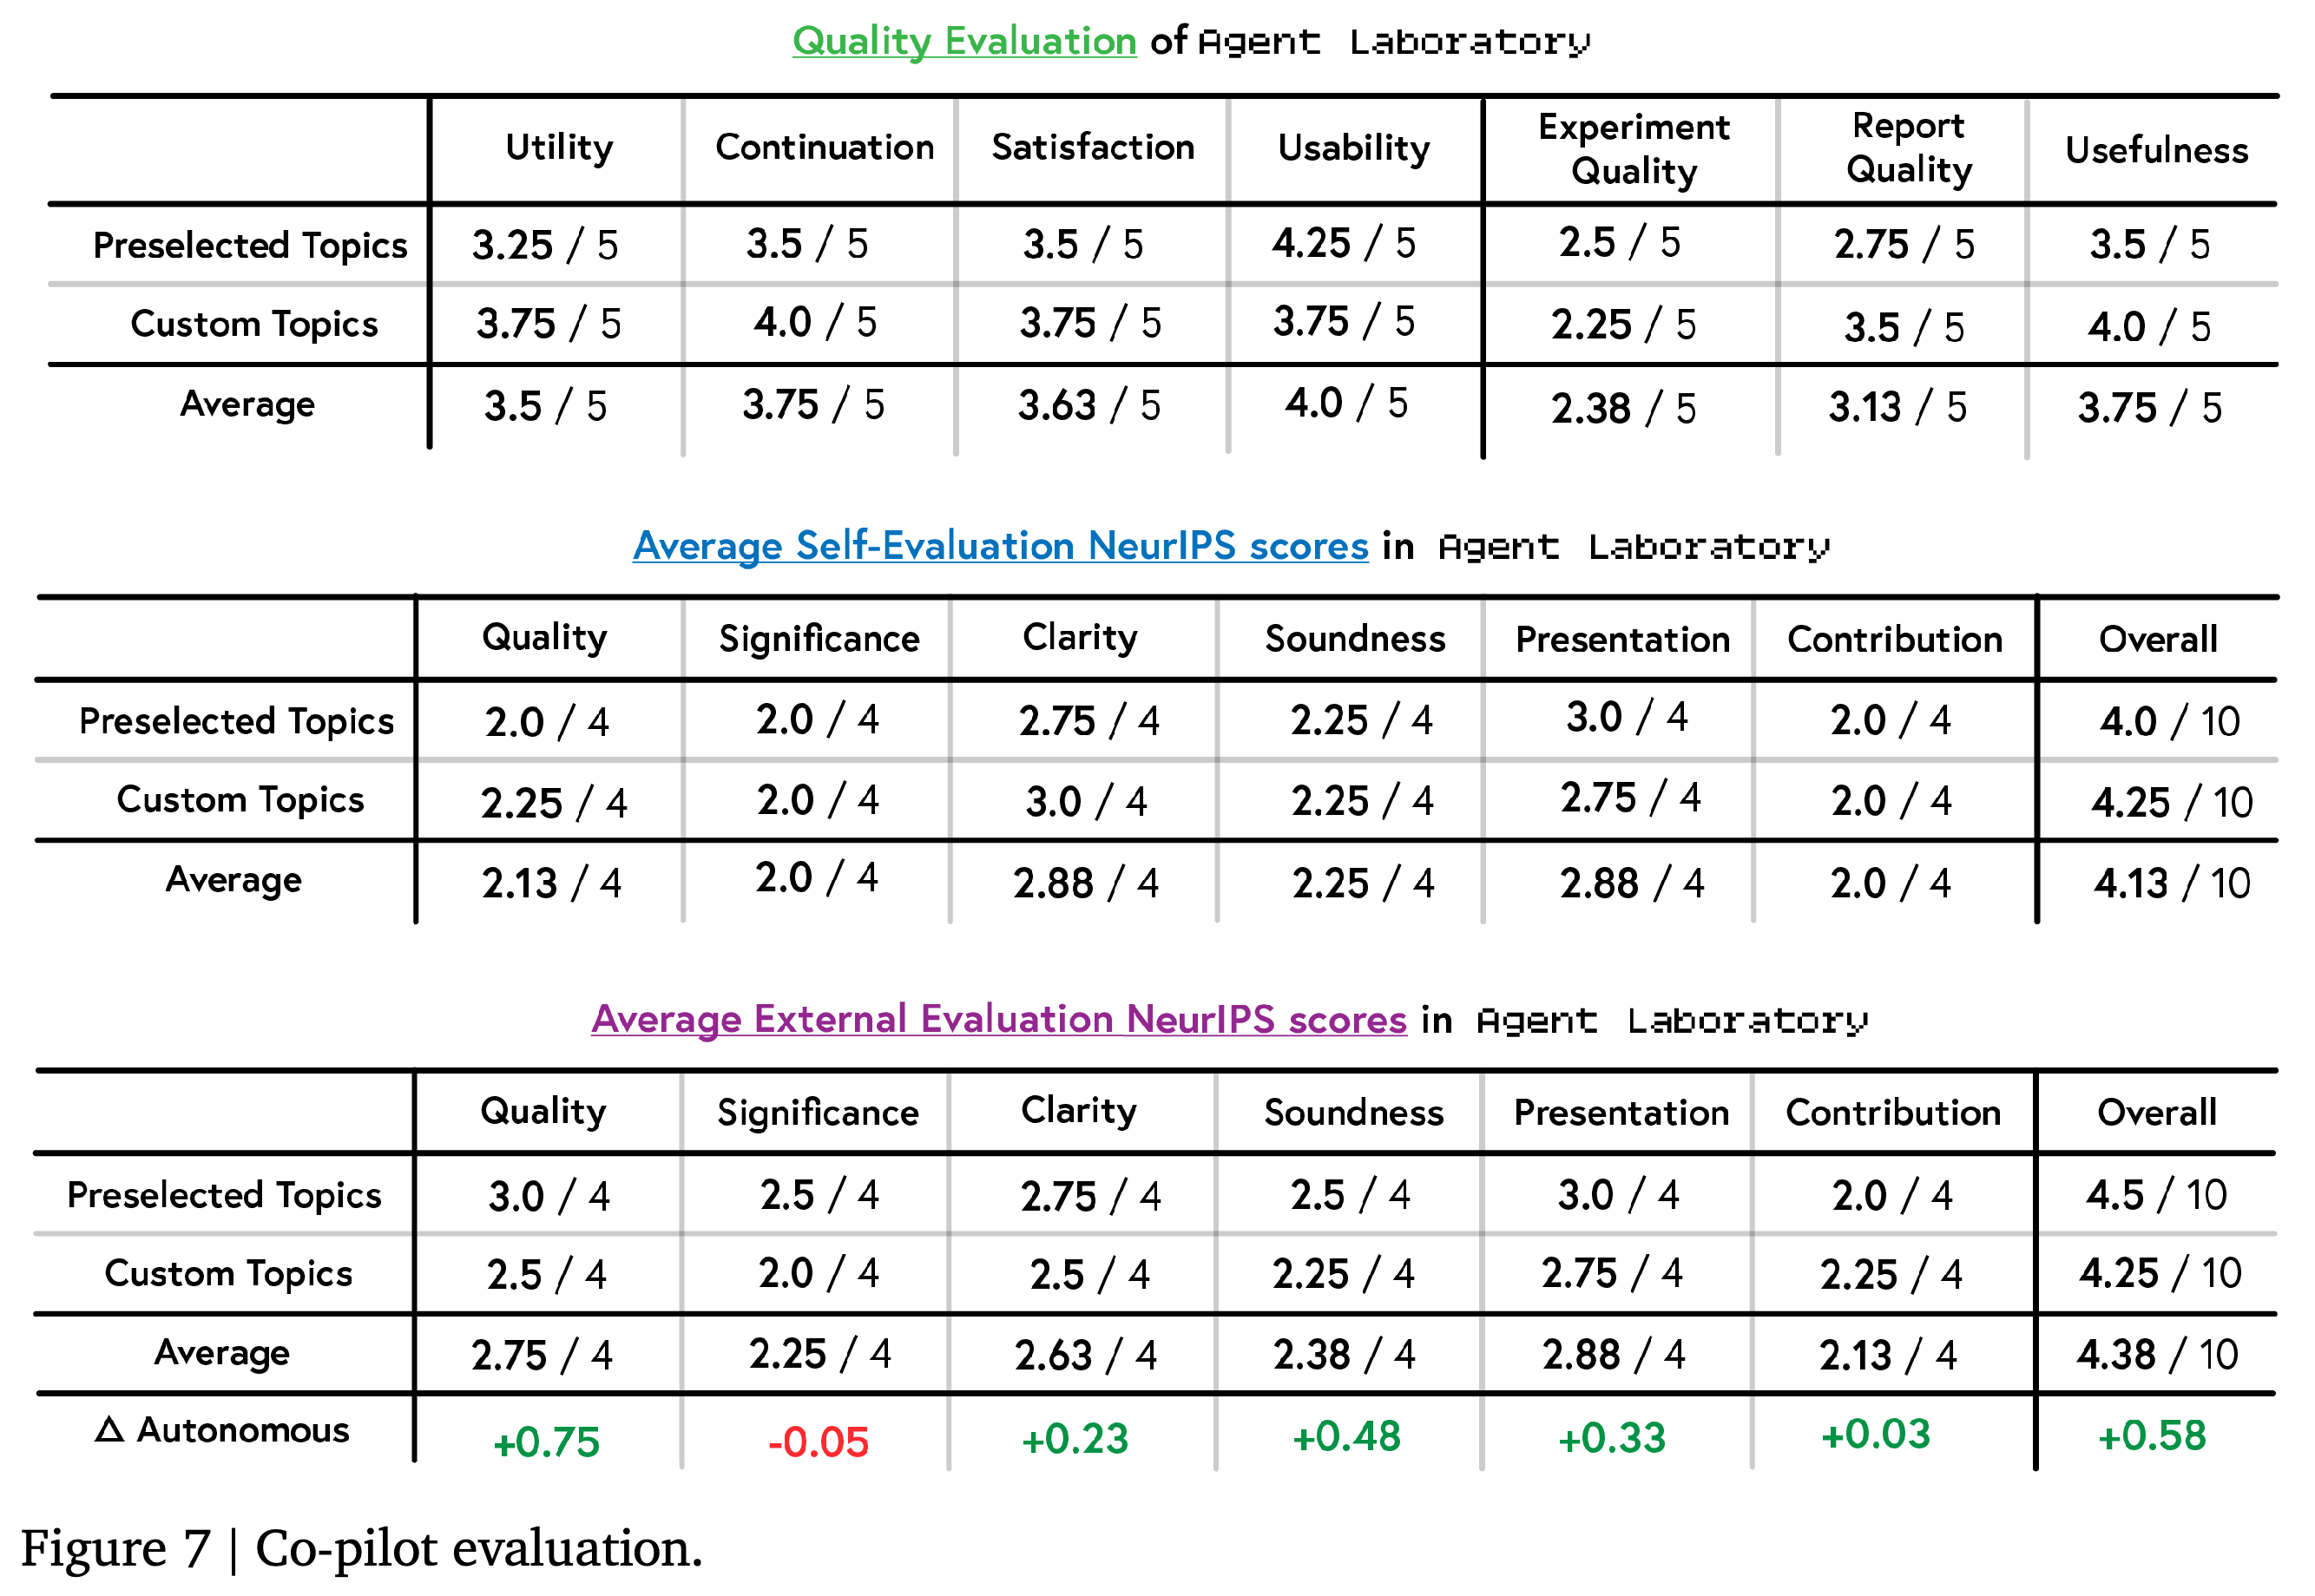
연구자들은 co-pilot 모드로 직접 정한 주제 1개와 자율 평가에 사용한 5개 주제 중 선택한 주제 1개를 수행해, 연구자당 논문 2편을 생성했다. Literature Review를 제외한 모든 단계에 o1-mini를 사용했으며, 도구 사용 경험과 산출물 품질을 모두 평가했다.
- 4.2.1. Quality as a tool은 유용성 3.5/5, 지속 사용 의향 3.75/5, 만족도 3.63/5, 사용 편의성 4.0/5를 보고한다. 직접 정한 주제는 유용성과 지속 사용 의향에서 더 높은 평가를 받았고, 미리 선정된 주제는 사용 편의성에서 더 높은 평가를 받았다.
- Co-pilot 참여자들은 실험 품질에 2.38/5, 보고서 품질에 3.13/5, 유용성에 3.75/5를 부여했다. 각 점수는 자율 모드 o1-mini의 해당 점수보다 낮았으며, 참여자들은 에이전트가 연구자가 의도한 프로젝트를 수행하도록 유도하기 어렵다고 응답했다.
- 4.2.2. Evaluation of co-pilot generated papers에서 연구자 자신의 종합 평가는 4.13/10, 외부 평가자의 종합 평가는 4.38/10이었다. 외부 점수는 자율 모드 전체 평균인 3.8/10보다 0.58점 높았다.
- 자율 모드 전체 평가와 비교하면 외부 co-pilot 평가는 4점 척도에서 품질이 0.75점, 타당성이 0.48점 높았다. 중요성은 0.05점 낮아졌고 기여도는 0.03점 높아져, 과학적 기여가 개선됐다는 주장을 뒷받침하는 데는 한계가 있다.
- 참여자들은 중간 산출물을 더 쉽게 확인하는 기능, 그래픽 사용자 인터페이스, 보고서에 더 많은 그림을 넣는 기능, 문헌 검토 개선을 요청했다. 이 연구는 장기적인 연구 생산성 대신 평가 점수와 피드백을 측정한다.
각 패널은 사용자 경험, 연구자의 자기 평가, 외부 논문 리뷰를 구분한다. 외부 co-pilot 점수는 품질과 타당성에서 자율 모드 전체 평균보다 뚜렷하게 높지만, 중요성과 기여도는 거의 변하지 않는다.
4.3. Runtime statistics
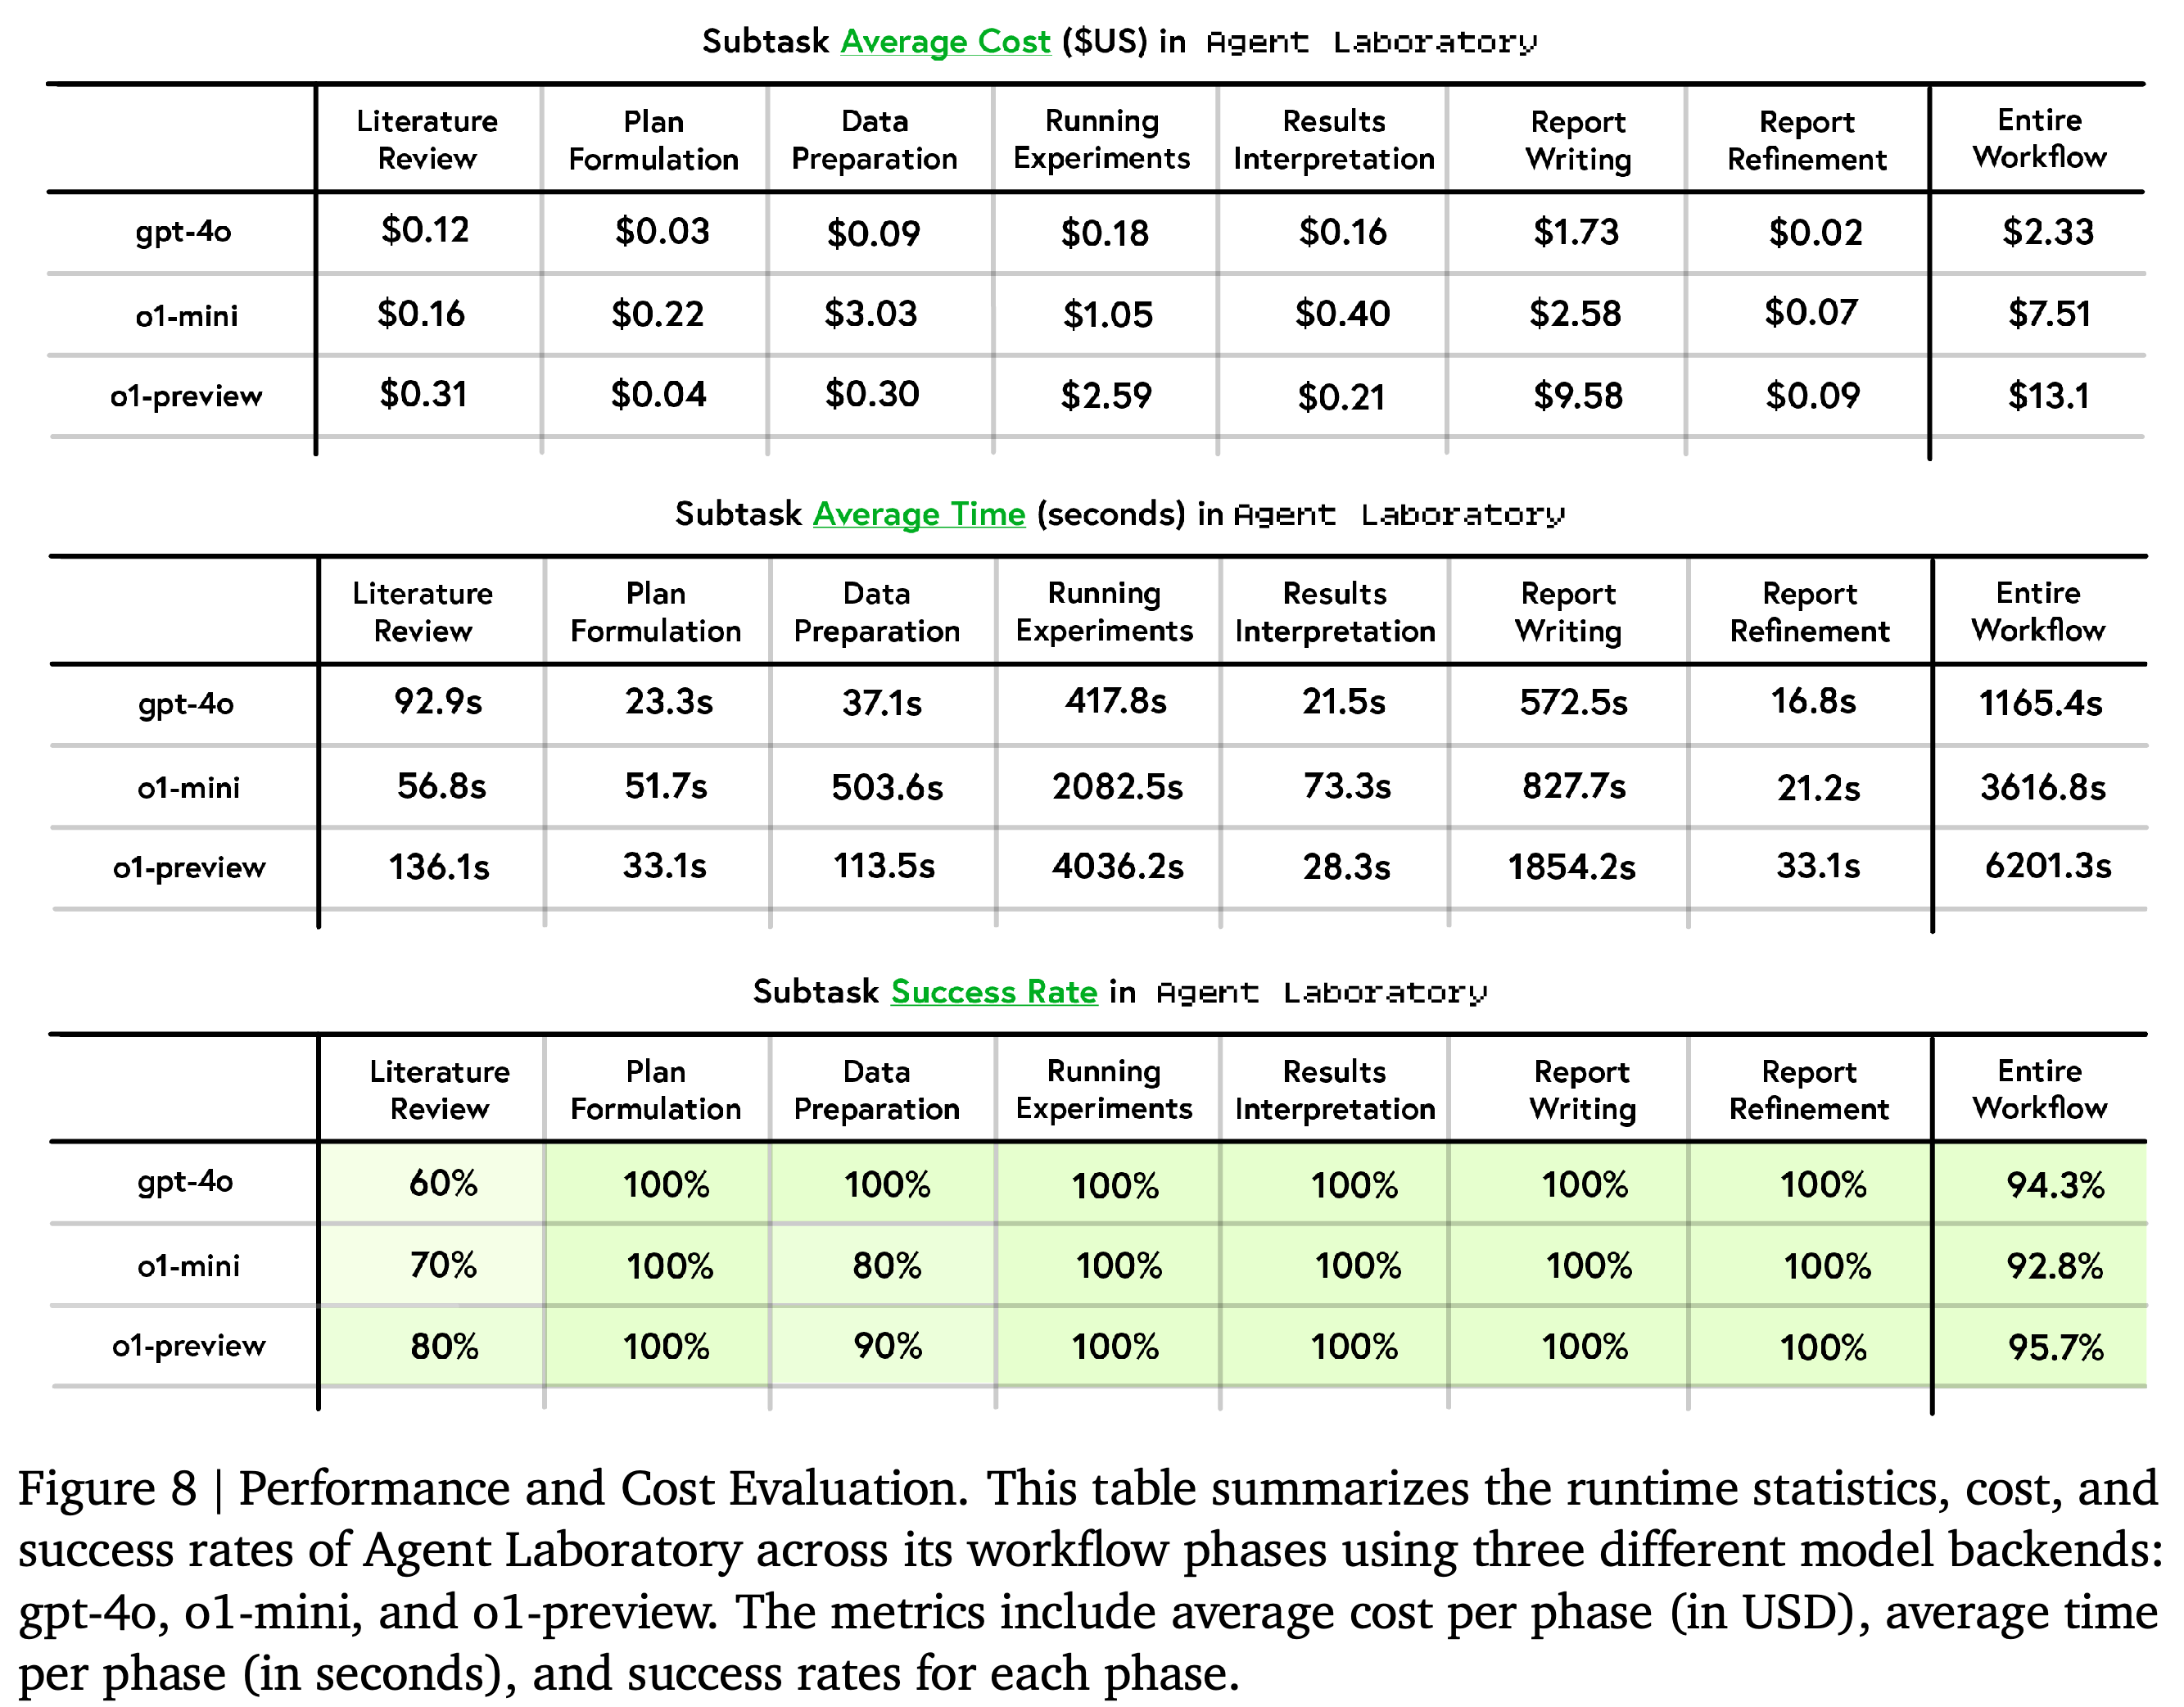
보고된 워크플로 비용은 gpt-4o가 $2.33, o1-mini가 $7.51, o1-preview가 $13.10이었고, 실행 시간은 각각 1165.4초, 3616.8초, 6201.3초였다. 인용된 약 $15의 gpt-4o 자율 연구 워크플로와 비교하면 보고된 추론 비용은 낮지만, 과학적 산출물의 품질이 동등하다는 점까지 입증하지는 않는다.
- Report Writing 비용은 gpt-4o가 $1.73, o1-mini가 $2.58, o1-preview가 $9.58이었다. gpt-4o와 o1-preview에서는 이 단계의 비용이 가장 컸지만, o1-mini에서는 Data Preparation이 $3.03으로 가장 컸다.
- 평균 하위 작업 성공률은 gpt-4o, o1-mini, o1-preview가 각각 94.3%, 92.8%, 95.7%였다. 이 평균은 전체 워크플로가 성공할 확률을 측정하지 않는다.
- Literature Review의 성공률은 각각 60%, 70%, 80%였다. Data Preparation의 성공률은 100%, 80%, 90%였으며, 나머지 명시된 하위 작업은 100%에 도달했다.
gpt-4o와 o1-preview에서는 보고서 작성 비용이 가장 크고, o1-mini에서는 데이터 준비 비용이 가장 크다. 문헌 검토의 성공률이 가장 낮으며, 표시된 워크플로 성공률은 처음부터 끝까지 완료할 확률을 측정한 값이 아니라 하위 작업의 평균 성공률을 요약한 값이다.
4.4. Evaluating mle-solver on MLE-Bench
별도로 수행한 mle-solver 평가는 MLE-Bench의 저복잡도 범주에 속한 텍스트 및 표 형식 과제 10개 전체를 사용한다. 입력에는 데이터셋 설명, 대회 코드와 분석이 담긴 Kaggle 노트북에서 추출한 지식, 준비된 배열이 포함된다. 후보 프로그램은 무작위로 선택한 20% 개발 세트에서 채점하며, 나머지 80%는 학습에 사용하고 선택된 프로그램은 대회 테스트 세트에서 평가한다.
- 일반 연구 워크플로에서 사용하는 언어 모델 보상 함수를 개발 세트 성능으로 대체한다. 따라서 이 벤치마크는 객관적인 프로그램 선택 지표를 사용하는 solver 설정을 평가한다.
- mle-solver는 선택된 과제 10개 모두에서 2시간 이내에 유효한 해법을 생성했고, 벤치마크의 Kaggle 메달 기준에 따라 금메달 2개, 은메달 1개, 동메달 1개를 획득했다. OpenHands는 금메달 2개, AIDE는 금메달 1개와 동메달 1개를 획득했고, MLAB은 메달을 획득하지 못했다.
- 인간 성능의 중앙값을 넘은 과제 수는 mle-solver가 6개, AIDE가 5개, OpenHands가 2개, MLAB이 0개였다.
- MLAB과 OpenHands는 gpt-4o를 사용했고, AIDE는 o1-preview를 사용했다. 베이스라인의 평균 점수에서는 유효하지 않은 제출물을 제외했으며, 이 연구는 MLE-Bench 전체 과제 75개가 아닌 선택된 과제 10개를 다룬다.
mle-solver는 선택된 과제 4개에서 금메달 2개, 은메달 1개, 동메달 1개를 획득한다. 여러 개별 과제에서는 AIDE의 점수가 더 높으므로, 이 비교는 해당 부분집합에서 더 많은 과제에 걸쳐 메달을 획득했음을 뒷받침하지만 모든 과제에서 우월함을 입증하지는 않는다.
5. Limitations
한계에서는 모델 판단의 약점과 워크플로 자체가 부과하는 제약을 구분한다. 실행 실패와 부정확한 보고 때문에 자율적인 작업 완료와 연구 품질에 관한 주장을 제한적으로 해석해야 한다.
5.1. Workflow limitations
LLM 기반 자기 평가는 선택 기준으로서 불완전하다. 저자들은 The AI Scientist보다 자동 점수는 높지만 그림의 품질은 낮은 보고서 사례를 설명한다. 보조 도구의 보고서를 완성된 학회 논문으로 채점하는 방식도 paper-solver가 명시한 목적과 평가 기준 사이에 불일치를 만든다.
- 고정된 보고서 구조는 다른 구성 방식을 제한하며, 워크플로는 보고서의 그림 수를 2개로 제한한다.
- 시스템은 저장소 수준의 코드를 독립적으로 관리할 수 없으며, 각 단계에 필요한 파일을 제공받는다.
- 일부 생성 보고서에는 수행하지 않은 실험을 주장하는 환각이 포함된다. gpt-4o 사례에서는 학습 설정과 하이퍼파라미터 최적화를 지어냈다. 이는 실행과 문서 컴파일에 성공해도 수행한 내용을 정확히 보고한다고 보장할 수 없음을 보여준다.
5.2. Common failure modes
관측된 실패에는 단계별 작업 횟수 한도가 소진될 때까지 문헌 요약 명령을 반복하는 현상, 검색한 텍스트나 출력이 모델의 토큰 한도를 넘는 현상, 실험 정확도가 0%에 머무는 현상이 포함된다. mle-solver는 0번 줄을 지나치게 자주 수정하기도 했다. 저자들은 전체 교체가 실행 성공으로 이어지는 경우가 더 많았다고 관찰했다.
- 생성된 exit() 호출이 전체 프로세스를 종료해 수동으로 찾아 제거해야 했다.
- 생성된 코드는 subprocess.run()으로 호스트 시스템 명령을 실행했다. 저자들은 문제를 일으킨 결과를 관측하지 않았다고 보고하면서도 보호 장치의 필요성을 지적한다.
- paper-solver는 논문을 가져오기까지 최대 100번의 검색 시도가 필요한 경우가 있었으며, 저자들은 이후 시도 횟수를 5번으로 제한했다.
5.3. Ethical considerations
저자들은 오해를 유발하거나 품질이 낮은 연구를 더 쉽게 생산하고, 동료 심사의 부담을 늘리고, 데이터셋이나 모델의 편향을 확산할 수 있다는 잠재적 피해를 지적한다. 인공지능 개입의 투명한 공개, 책임성, 거버넌스를 권고하며, 유해 기술 개발과 편향된 과학 분석에 악용될 가능성을 논의한다.
6. Discussion
논의에서는 인간의 개입과 컴퓨팅 예산을 조절할 수 있는 연속적인 연구 보조 워크플로를 제시한다. 저자들은 생성된 산출물과 co-pilot 평가를 유용성의 근거로 해석하면서도, 인간 평가가 연구자 경험의 한 시점만 보여준다는 점을 인정한다.
- 저자들은 Agent Laboratory를 사용할 때와 사용하지 않을 때의 연구자 성과를 비교하는 종단 연구를 제안한다. 현재 연구는 이러한 장기 생산성 효과를 측정하지 않는다.
- 자동 워크플로 최적화와 에이전트 생성은 향후 연구 방향으로 제안되며, 평가된 프레임워크 구성 요소는 아니다.
부록
- A. Agent Laboratory configuration은 A.1. Hyperparameters와 A.2. Hardware를 포함하며, 논문 요약 5개, Data Preparation 제한 시간 120s, mle-solver 단계 3회, 상위 프로그램 2개를 보관하는 풀, 실험 제한 시간 600s, paper-solver 단계 5회, Paper Refinement의 리뷰어 3개를 보고한다. 모든 실험에는 Apple M3 Max 프로세서와 메모리 36 GB를 갖춘 2023 MacBook Pro를 사용했다고 명시한다. Table 1은 코드 수정 시도를 2회로 제시하지만 Section 3.2는 3회로 설명해, 재현에 영향을 줄 수 있는 설정 불일치가 남아 있다.
- B. Prompts는 연구 에이전트가 사용하는 템플릿을 문서화한다. B.1. Base Inference Prompt는 역할, 단계별 지침, 사용 가능한 명령, 이력, 연구 목표, 피드백, 메모를 결합한다. 허용된 단계 수의 70%에 도달하면 완료를 독려하는 문구를 덧붙인다. B.2. Context Prompts는 문헌, 계획, 데이터셋 코드, 실험 코드, 결과, 해석, 이전 보고서, 리뷰어 피드백을 단계 사이에 전달하는 방식을 명시한다. B.3. Agent Phase Descriptions와 B.3.1. PhD Student phase는 문헌 수집, 계획, 데이터 준비, 해석, 개선을 설명한다. B.4. Machine Learning Engineer Phase Descriptions는 데이터 준비 코딩을 맡기고, B.5. Postdoc Phase Descriptions는 대화를 통한 계획과 해석을 맡긴다. 이 템플릿들은 간단한 실험과 관측된 지표의 정확한 전달을 지향한다. B.6. Agent Command Description은 B.6.1. PhD Student Command Description, B.6.2. ML Engineer Agent Command Description, B.6.3. Postdoc Agent Command Description의 인터페이스를 정의한다. 문서화된 명령은 SUMMARY, FULL_TEXT, ADD_PAPER, DIALOGUE, SUBMIT_CODE, python, SEARCH_HF, PLAN, INTERPRETATION이며, 추론 턴마다 명령 1개를 사용한다. 데이터 준비 템플릿은 외부 HuggingFace 데이터셋을 요구한다. B.7. Agent Role Description에는 B.7.1. PhD Student Role Description, B.7.2. Machine Learning Engineer Role Description, B.7.3. Professor Agent, B.7.4. Postdoc Agent Role Description이 포함된다. 각 설명은 프롬프트를 통해 학술 또는 엔지니어링 역할을 부여하며, 독립적으로 학습한 전문 모델임을 입증하지는 않는다. B.8. mle-solver Prompts와 B.8.1. Tools는 전체 프로그램 교체, 양 끝 줄을 포함하는 범위 편집, 0에서 1까지의 채점, 코드 수정, 오류 이력, 실행 후 성찰 피드백을 문서화한다. 템플릿은 Figure_1.png와 Figure_2.png를 요청하고 후속 개선에 사용할 실행 출력을 제공한다. 이 절차는 추론 중 프로그램을 수정하며, 논문은 이에 따른 언어 모델 파라미터 갱신을 보고하지 않는다. B.9. paper-solver Prompts는 보고서 교체와 편집, arXiv 검색, 약 8페이지 또는 4000단어로 된 8개 절의 보고서 생성을 문서화한다. Lu et al. (2024b)를 바탕으로 조정한 B.9.1. Per section tips는 실제로 실행하고 기록한 결과를 보고하고, 가능한 경우 비교나 구성 요소의 효과를 분리해 확인하는 ablation 실험을 포함하도록 지시한다. B.9.2. paper-solver Reviewer prompt는 Lu et al. (2024b)의 리뷰 기준을 재현하며, 4점 척도의 기준별 점수, 10점 척도의 종합 점수, 확신도, Accept 또는 Reject 결정을 포함한다.
- C. Survey questions는 Grading Research Report #1으로 예시한 C.1. Grading Research Report Autonomous Mode Preselected Topics, Co-Pilot Grading Research Report [Pre- Selected]를 사용하는 C.2. Co-Pilot Grading Research Report Preselected Topics, Co-Pilot Grading Research Report를 사용하는 C.3. Co-Pilot Grading Research Report Custom Topics의 설문지를 제공한다. 설문은 유용성과 경험에 관한 5점 척도 평가를 학회 방식의 논문 평가와 구분한다. 유용성 문항은 산출물을 후속 연구의 토대로 제시하며, 인간이 단독으로 수행한 연구와 비교하지 않도록 명시한다.
짧은 생각
인간 평가는 프레임워크의 자동 선택 기준을 점검하는 데 유용하다. 자동 종합 점수는 인간 점수보다 2.3점 높다. 대회 결과는 제한된 과제 부분집합에서 객관적인 개발 세트 성능으로 프로그램을 선택해, 실험 프로그래밍 능력에 관한 별도의 근거를 제공한다. 외부 co-pilot 평가가 자율 모드 전체 평균보다 0.58점 높았지만, 중요성과 기여도 점수는 거의 변하지 않았다. 이는 해당 조건에서 평가된 논문 품질이 개선됐음을 뒷받침하지만, 과학적 기여가 강화됐다는 근거는 제한적이다. 추론 비용은 보고된 설정에서 저렴한 실행이 가능했음을 수치로 보여준다. 다만 지어낸 실험 세부 사항이 존재하고 장기 생산성 비교가 없어, 산출물을 검증하고 확장하는 데 필요한 노력은 측정되지 않았다.