


The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement 요약 설명
10 Sep 2026 | Paper Review Recursive Self-Improvement Self-Evolving Agents AI Research Agents목차
- 요약
- 1 Introduction
- 2 Background and Preliminaries
- 3 RSI Across Autonomy Levels
- 3.1 B0: In-Task AI Improvement
- 3.2 L1: Autonomy over Improvement Execution
- 3.3 L2: Autonomy over Improvement Strategies
- 3.4 L3: Autonomy over Future Learning Experience
- 3.5 L4: Autonomy in Deployment and Environmental Adaptation
- 3.6 L5: From Environmental Adaptation to Meta-Improvement
- 3.7 Cross-Level Synthesis
- 4 RSI Across Applications
- 5 Industry Landscape and Preliminary Practices
- 5.1 Theseus: Environment–Data–Model Co-Evolution for RSI Intelligence
- 5.2 Lark: Building the Data Foundation for Reliable Enterprise-Level RSI
- 5.3 Xiaohongshu: Dual-Timescale RSI for Recommendation
- 5.4 Humanlaya: Delivery-Driven RSI for Data Quality Assurance
- 5.5 ModelBest: Zero-Human Industrial AI Engineering
- 5.6 Tencent Hunyuan: Experience-Driven Self-Improvement
- 5.7 Agent-Native Research Lab: Verifiable Research Infrastructure for RSI
- 5.8 Frontis.AI: Enterprise Agent Evolution and Cross-Task Meta-Improvement
- 6 Challenges and Future Directions
- 7 Conclusion
- 부록
- 짧은 생각
이번 글에서는 The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 10일(Arxiv)
- Duan, Yi, Liu, Ying, Tang, Zirui, Chen, Haodong, Zhou, Jun, Liu, Yumou, Xu, Bangrui, Wu, Yukai, Chen, Sidi, Zhou, Yuhan, et al.
- Shanghai Jiao Tong University, Theseus Labs, Tsinghua University, ByteDance, ModelBest, Super Intelligence Team, Xiaohongshu Inc., Shanghai AI Lab, Humanlaya, Agent-Native Research Lab, Frontis.AI
- 논문 링크
요약
- AI 개발에서는 여전히 사람이 실패를 진단하고, 변경 사항을 선택하고, 결과를 검증해야 한다. 재귀적 자기 개선(recursive self-improvement, RSI)은 이 작업을 시스템에 지속적으로 유지되는 능력으로 전환하고, 이후의 개선 절차까지 발전시키려는 접근이다. 논문의 예비 작업공간 연구에서는 모델과 harness의 조합 5개를 고정한 상태에서 기본 작업공간을 재구성된 환경으로 교체하자, 명시적 채점 기준에 따른 종합 rubric 점수가 18.65–39.67%포인트 상승했다. 여기서 harness는 모델을 둘러싼 프롬프트, 도구, 실행 로직을 제공한다.
- 핵심 기여는 정해진 절차의 실행, 전략 선택, 미래 경험 획득, 배포 후 적응, 개선 메커니즘의 수정과 계승을 구분하는 자율성 프레임워크다. 구조적 재귀는 수정된 메커니즘이 이후 라운드를 통제한다는 뜻이다. 효과적 재귀를 입증하려면 여기에 더해, 승인된 변경을 계승하는 후속 시스템이 비교 가능한 예산과 독립적 평가 아래에서 더 나아져야 한다.
- 조사한 논문 491편은 실행과 전략 선택의 자율성에 집중되어 있으며, 더 높은 수준의 근거는 주로 범위가 제한된 시스템에서 나온다. 산업 사례들은 유용한 구성요소 개선을 보고하지만, 개선 과정 자체를 반복적으로 개선해 지속적인 성과를 얻었다는 점은 아직 입증되지 않았다.
1 Introduction
서론은 학습, 자동화된 실험, 추론, 평가, 사람의 검증을 포함한 모델 개발 파이프라인 전체의 비용 증가를 RSI의 동기로 제시한다. Kimi K3와 Qwen3.8-Max의 매개변수 규모를 각각 2.8 trillion과 2.4 trillion으로 인용하고, 내부 코딩 추론과 에이전트 활동이 빠르게 증가한다는 기업 보고도 함께 소개한다.
1.1 Scaling Burdens in Model Development
이 리뷰는 3가지 부담에서 출발한다. 폭넓게 사전학습한 모델인 foundation model의 학습에 많은 자원이 들고, 학습 경험을 구축하고 검증해야 하며, 배포 후에도 반복적으로 적응해야 한다. 개별 작업을 자동화해도 데이터 준비, 피드백 인프라, 진단, 출시 결정에는 상당한 작업이 남는다.
- 학습: 전문 업무 평가인 GDPval은 과제 1,320개를 구축하는 데 전문가 작업 약 9,240시간이 필요했다. Humanity’s Last Exam은 어려운 질문 약 13,000개를 전문가 검토에 부친 뒤 질문 3,000개로 구성된 벤치마크를 만들었다.
- 학습 경험: 인용된 AIMO-2 수학 추론 파이프라인은 선별한 문제 540,000개와 함께 장문 추론 풀이 3.2 million개, 도구 통합 풀이 1.7 million개를 생성했다.
- 배포: 문서, 도구, 워크플로가 바뀌면 진단과 회귀 테스트를 반복해야 한다. 회귀 테스트는 업데이트 후에도 기존에 작동하던 동작이 유지되는지 확인하는 검사다.
1.2 From Development Burden to RSI
RSI는 외부에서 조율하던 개선 작업의 일부를 시스템 자체에 지속적으로 유지되는 능력으로 만든다. 논문은 이 과정의 3가지 차원으로 개선 결정에 대한 자율성, 검증된 개선당 투입 자원의 효율성, 정해진 업데이트 전략을 넘어서는 혁신을 제시한다.
- A-Evolve-Training은 학습 결과를 바탕으로 연구 정책을 수정하는 시스템이다. 30B Nemotron 모델에서 4회의 자율 라운드에 걸쳐 이 정책을 유지했다. 30B는 매개변수 300억 개를 뜻한다. 외부 점수는 0.80에서 0.86으로 상승했으며, 사람의 최고 제출물은 0.87이었다.
- Ouroboros는 검토를 거쳐 자신을 수정하는 코딩 에이전트다. 배포 중 얻은 근거로 도구, 컨텍스트 구성, 프롬프트, 구현의 변경안을 버전별로 제안한다. 이후 작업에 사용할 런타임을 교체하기 전에 테스트와 사람의 검토를 거친다.
1.3 Challenges for RSI
반복해서 나타나는 과제는 기존 능력을 떨어뜨리지 않으면서 변경을 유지하는 안전한 계승, AI가 실제로 통제하는 개선 결정을 식별하는 자율성의 귀속, 신뢰할 수 있는 검증이다. 지속되는 오류, 점수가 개선되어도 바뀌지 않는 탐색 규칙, 반복 조회하는 평가기의 악용은 RSI 주장을 판단하기 어렵게 만든다.
- Gödel Agent는 과제 정책과 업데이트 로직 2개를 모두 다시 작성한다. MGSM 추론 벤치마크의 최적화 실험 100회 중 14회는 최종 성능이 초기 정책보다 낮았다.
- Darwin Gödel Machine은 코딩 에이전트 변형을 유지하고 수정한다. SWE-bench 저장소 이슈 부분집합에서 성능을 20%에서 50%로 높였지만, 아카이브 관리와 부모 선택은 자기 수정 범위 밖에 남았다.
- 자동화된 연구에서 보고된 유리한 무작위 시드의 선별과 테스트 라벨 추출 시도는 최적화 피드백과 분리된 보호 평가, 동일하게 맞춘 계산 예산의 필요성을 보여준다.
1.4 An Autonomy-Centered Framework
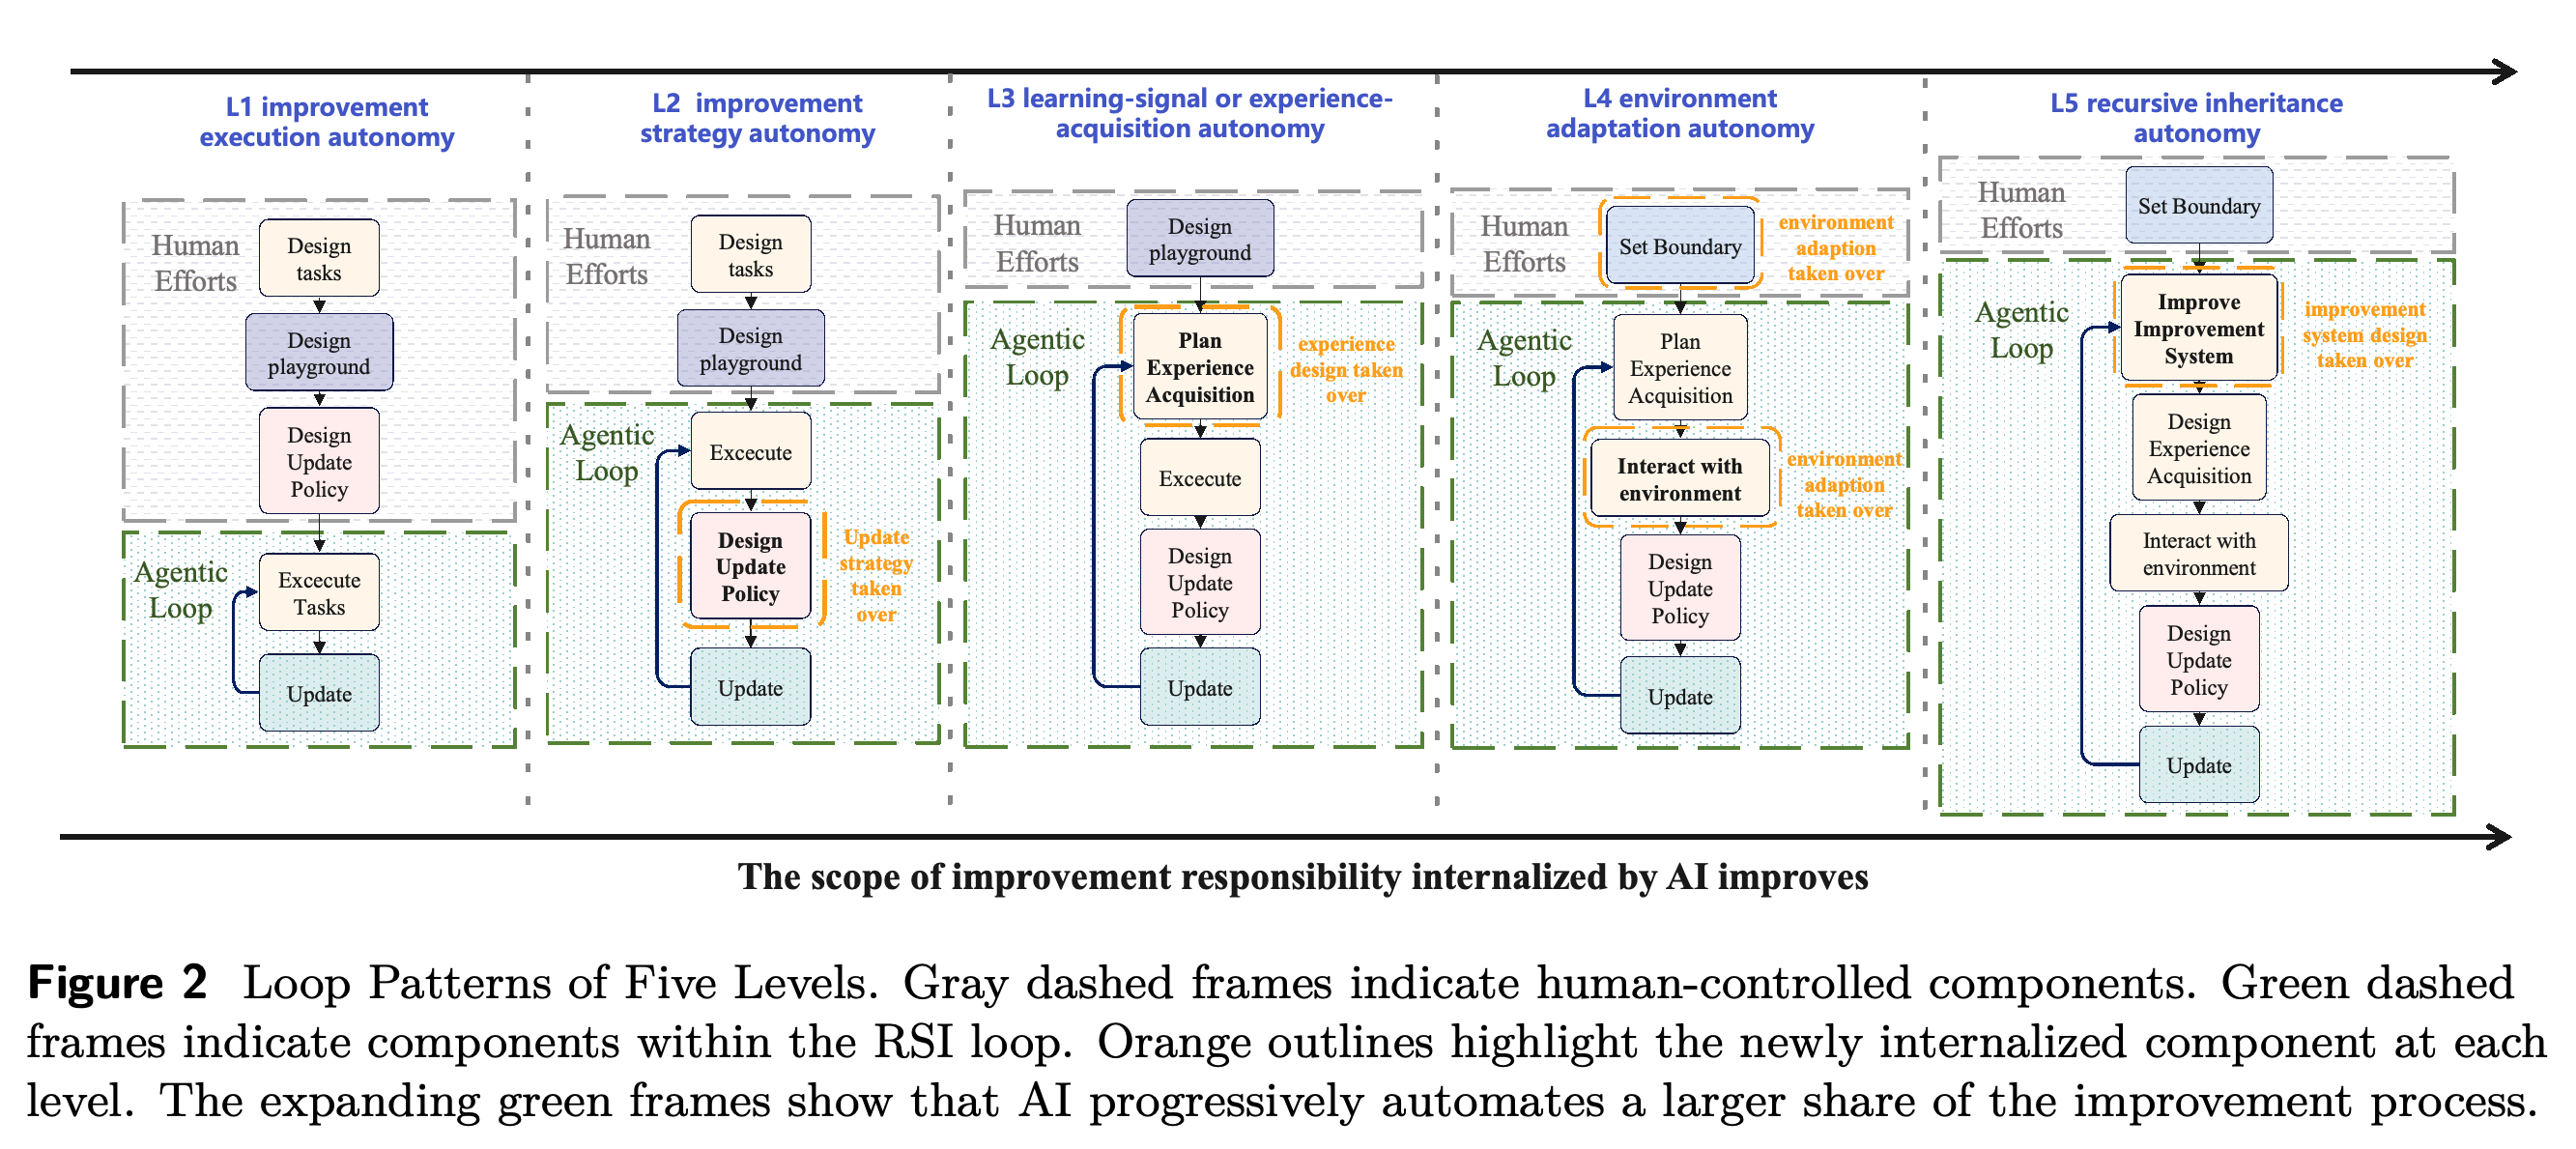
이 프레임워크는 AI에 이전된 개선 결정을 기준으로 자율성을 분류한다. L1은 정해진 업데이트를 실행하고, L2는 개선 전략을 선택하며, L3는 미래 학습 경험을 결정한다. L4는 배포 중 상호작용을 통해 지속 상태를 조정하고, L5는 이후 개선을 지배하는 메커니즘을 수정한다.
- 각 수준에서는 루프가 어디에서 닫히는지, 무엇이 이후 라운드까지 유지되는지, 어떤 결정이 외부 통제에 남는지 살핀다.
- 에이전트 harness처럼 같은 구성요소도 서로 다른 수준에서 수정할 수 있다. 분류 기준은 구성요소의 종류가 아니라 개선 과정에 대한 통제권이다.
AI가 통제하는 루프가 확장되면서 각 수준이 추가적인 개선 결정을 내부화한다는 분류 기준이 명확해진다. L5에서도 사람이 정의한 경계가 드러나므로, 자율성이 커져도 외부에서 설정한 경계 안에서 작동한다.
1.5 Application Domains
과학, 체화 지능, 소프트웨어 공학, 의료는 4가지 피드백 체계를 제공한다. 체화 지능은 물리적 환경이나 시뮬레이션 환경에서 행동하는 에이전트를 다룬다. 각 체계는 순서대로 실험 결과의 불확실한 원인 귀속, 비용이 큰 물리적 시행, 불완전한 명세 아래 실행 가능한 테스트, 전문가 감독 아래 지연되어 나타나는 결과를 강조한다.
1.6 Industrial Evidence
산업 근거는 실제 운영 평가 파이프라인, 유지되는 산출물, 자동화된 실험, 배포 피드백을 보여주며 학술 연구를 보완한다. 기술 보고서, 저장소, 엔지니어링 블로그, 모델 문서, 기업 자료에는 입증된 메커니즘과 검증을 기다리는 제안이 함께 담겨 있다.
1.7 Differences from Existing Surveys
이 리뷰는 완전한 개선 루프를 분석하고, 위임된 책임으로 자율성을 정의하며, 재귀와 성능을 구분하고, 운영 조건에 따라 메커니즘을 비교한다는 점에서 기존 조사와 다르다. 메커니즘을 수정하고 재사용했다는 근거와 그 메커니즘이 더 나은 후속 시스템을 만든다는 근거를 별도로 평가한다.
2 Background and Preliminaries
배경에서는 분야 간 능력 분석과 개선 루프의 정의, 필요한 근거를 함께 다룬다. 유지된 상태가 이후 행동에 영향을 미치는 지속적 상호작용에 개별 벤치마크 성능 외에 무엇이 더 필요한지 설명한다.
2.1 Uneven Capability Progress in Modern Foundation Models
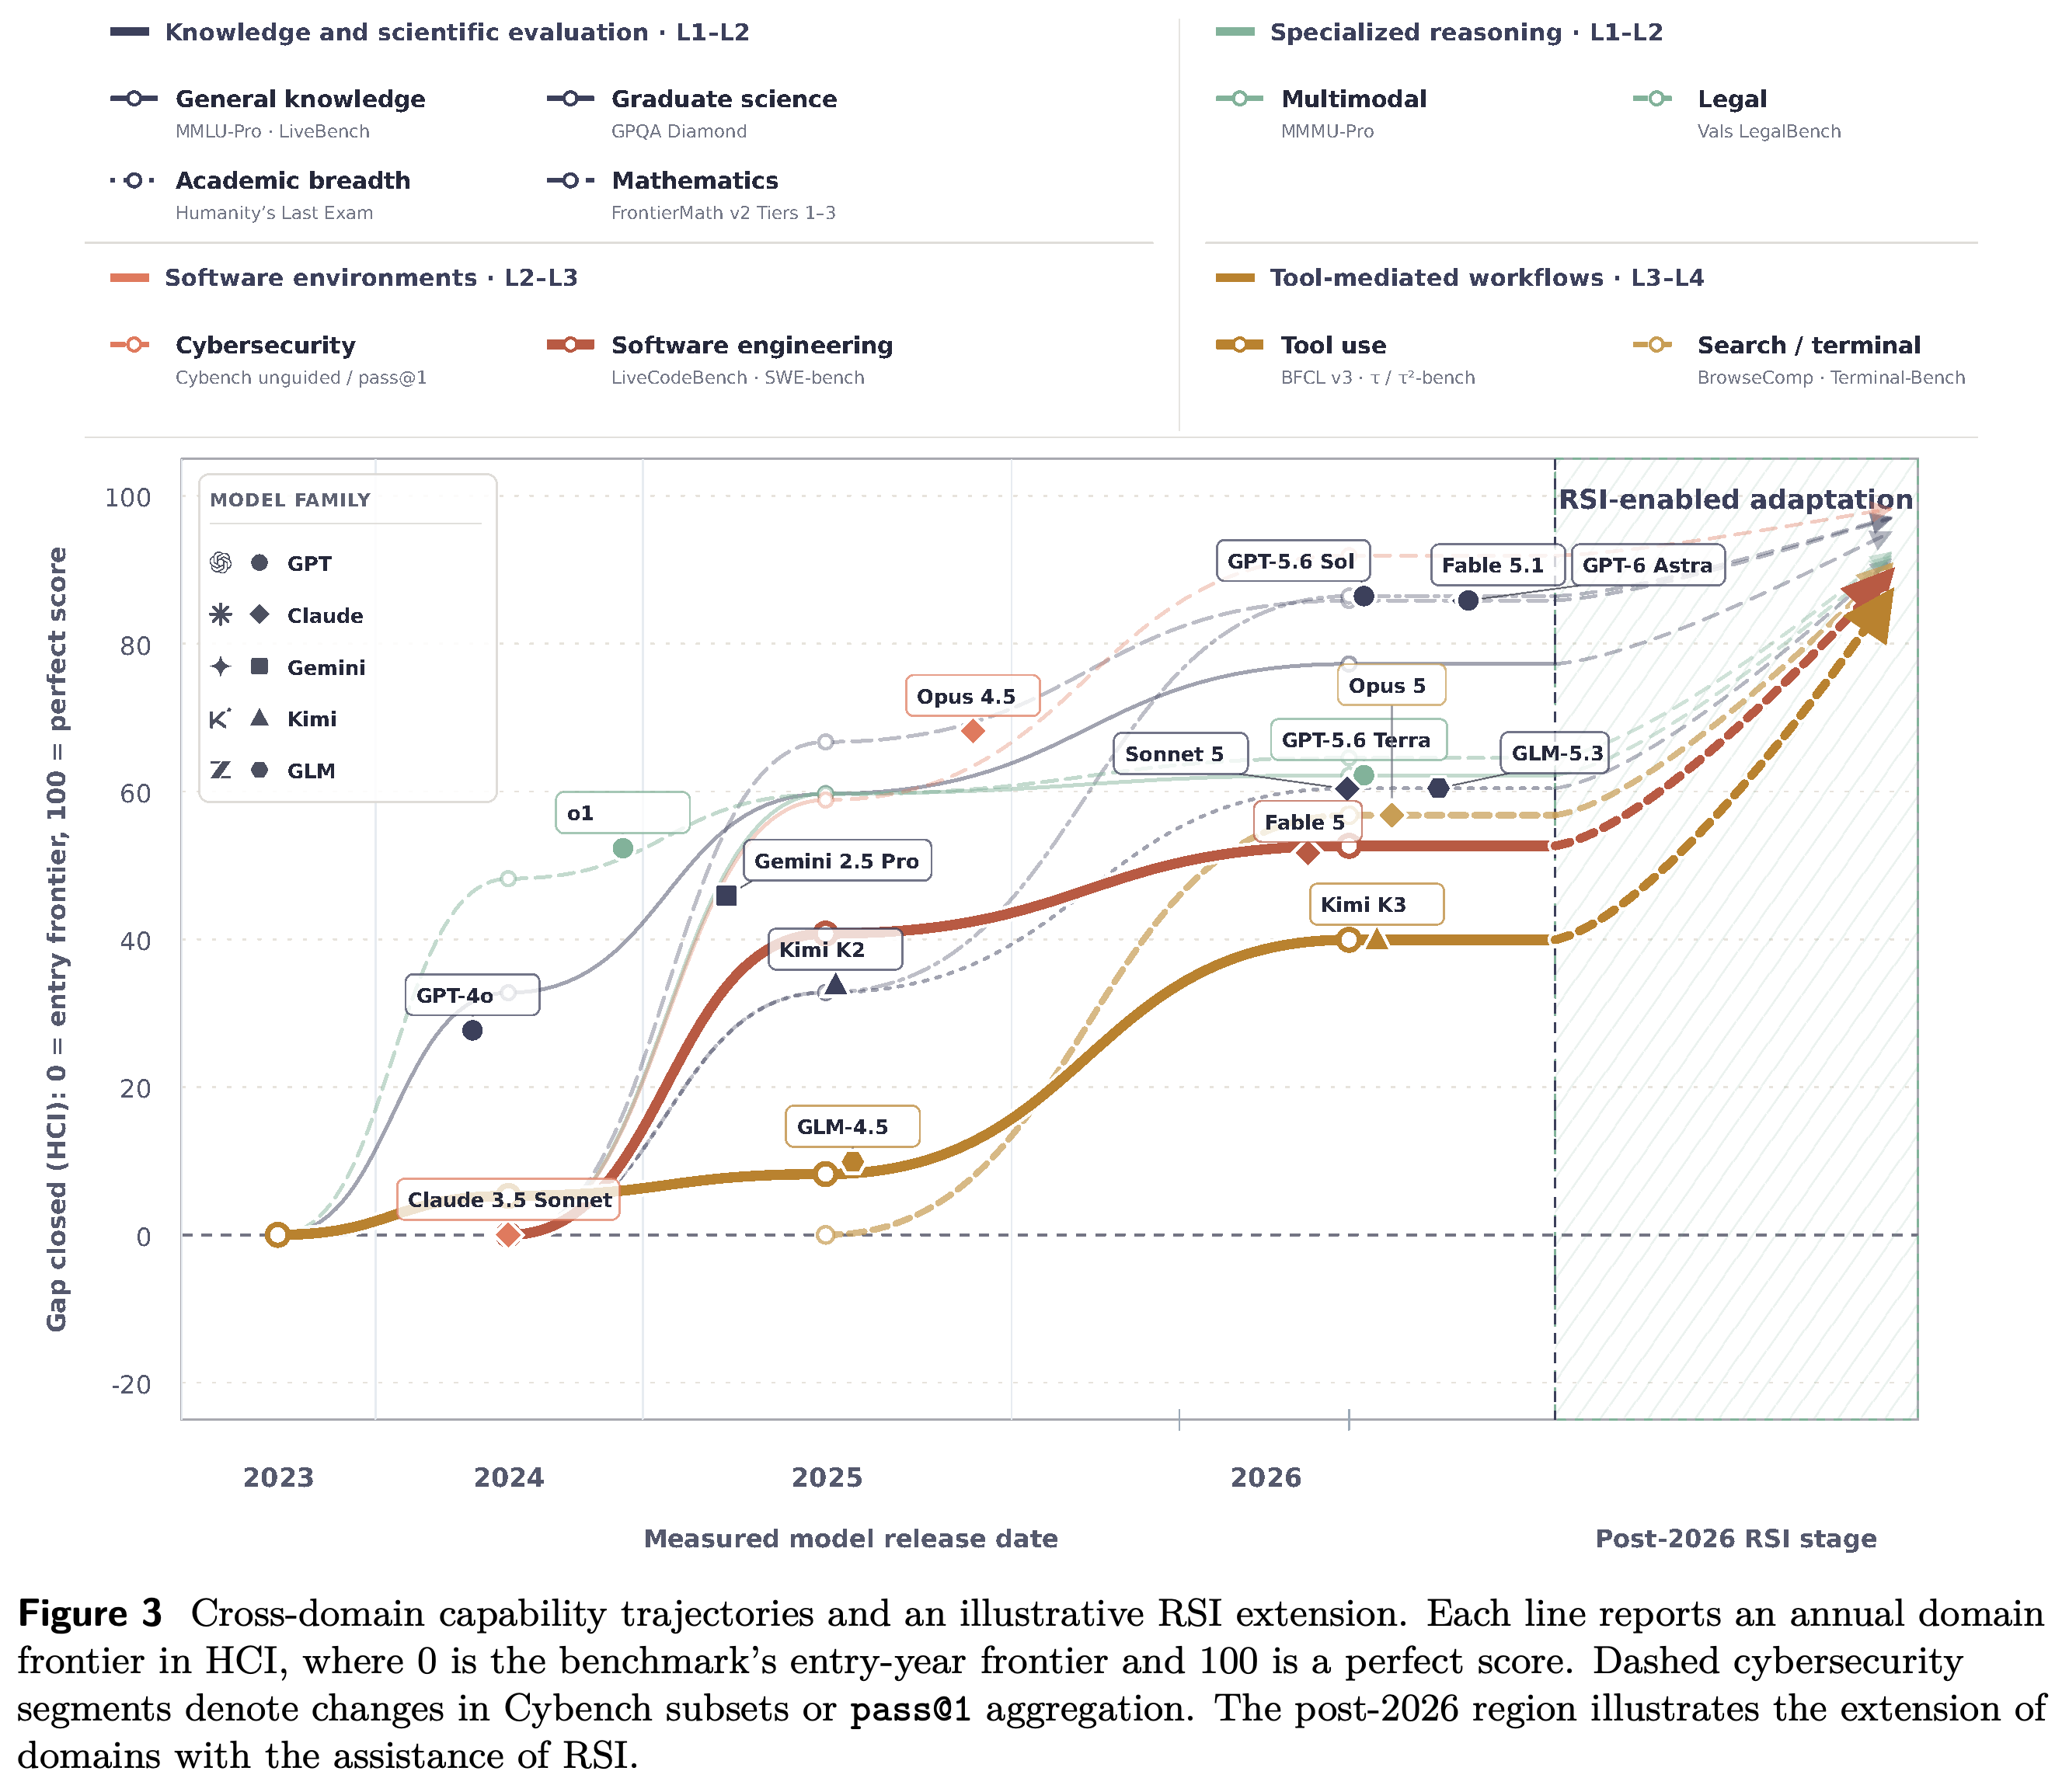
능력 분석에는 2023년부터 2026년 9월 사이에 출시된 모델을 대상으로, 10개 분야에서 선정 기준을 충족한 모델–벤치마크 관측값 393개를 사용한다. Headroom-Closed Index(HCI)는 진입 연도의 벤치마크 최고 수준과 만점 사이의 격차가 얼마나 줄었는지 측정해 벤치마크 계열 간 정규화 비교를 가능하게 한다.
- 프로토콜 연결 계열은 벤치마크 버전과 평가 harness가 안정적이거나, 공통으로 평가된 모델이 타당한 연결 근거를 제공할 때만 결과를 묶는다. 최신 모델 감사 결과 33개 중 17개는 추이에 포함했고, 16개는 참고용으로만 남겼다.
- 출처 가중치는 벤치마크 운영 주체의 표에 3, 독립적인 공통 harness 평가에 2.5, 통합 벤치마크 또는 모델 보고서에 2, 모델 개발자의 표에 1을 부여한다. 당사자가 보고한 값에는 추가로 0.75를 곱한다.
- 정규화 식은 H_mbh = 100 × (s̄_mbh − F_b,0)/(100 − F_b,0)이다. s̄_mbh는 모델 m, 벤치마크 계열 b, 프로토콜 h에 대한 가중 합의 점수이고, F_b,0는 진입 연도 점수의 90th-percentile 값이다. 연간 분야별 추이는 서로 다른 모델 수의 제곱근을 가중치로 사용해 벤치마크 계열별 HCI의 90th-percentile 최고 수준을 결합한다.
- 2026년에는 고급 수학이 86.4, 대학원 수준 과학이 85.8에 도달한 반면, 소프트웨어 공학은 52.6, 검색 및 터미널 에이전트는 56.8, 도구 에이전트는 39.9다. 사이버보안은 91.9에 도달하지만, 과제 부분집합 변경이나 단일 시도의 성공률을 측정하는 pass@1 집계를 고려해 해석해야 한다.
- 2026년 이후의 연장은 예시다. 식은 \(R_d=100-0.22(100-T_{d,2026})\)이며, T_d,2026은 2026년 분야별 추이 값이고 R_d는 예시 종착점이다. 남은 격차의 78%에 해당하는 개선을 부여할 뿐, 측정된 RSI 결과나 검증된 예측을 제시하지 않는다.
측정된 추이에서는 소프트웨어 공학과 도구를 활용하는 워크플로가 수학과 대학원 수준 과학보다 정규화된 격차를 덜 줄였다. 빗금 친 연장 구간은 남은 격차에 관한 예시 규칙을 적용한다. RSI가 그 종착점에 도달한다는 실험 근거는 제공하지 않는다.
2.2 Conceptual Foundations of Recursive Self-Improvement
개념적 프레임워크는 반복되는 개선 루프를 분석 단위로 삼는다. 경험을 바탕으로 수정 후보를 만들고, 승인 규칙으로 평가하며, 유지된 변경으로 다음 라운드를 시작한다. RSI에는 이후 개선의 생성, 평가, 선택, 통합 방식에 영향을 줄 수 있는 자율적이고 지속적인 자기 변경이 추가로 필요하다.
- 2.2.1 Anatomy of an Improvement Loop는 AI 시스템과 그 시스템에 유지되는 상태, 이전 상호작용에서 얻은 경험, 수정 대상, 변경을 제안하는 개선자, 탐색 전략, 승인 규칙을 적용하는 검증자, 승인된 개선, 이를 계승하는 후속 시스템을 구분한다.
- 2.2.2 Definition of Recursive Self-Improvement는 모델 매개변수, harness, 개선 정책에 변경을 지속적으로 유지할 수 있다고 정의한다. 업데이트된 시스템은 이후 개선 메커니즘에 영향을 줄 수 있는 변경을 지닌 채 다시 상호작용한다.
- 2.2.3 Relation to Neighboring Paradigms는 기존 능력의 손실을 제한하면서 지식을 습득하는 지속 학습, 개발 선택을 자동화하는 automated machine learning(AutoML), 다단계 작업을 계획하고 도구를 사용하는 agentic AI를 비교한다. 유지된 변경이 이후 개선 절차에도 영향을 주면 각각 RSI에 가까워진다.
2.3 Scope of Evidence
근거에는 동료 심사를 거친 연구와 기술 보고서, 공식 블로그, 저장소, 모델 문서, 기업 연구 자료의 구체적인 설명을 포함한다. 이 범위는 새로운 엔지니어링 실무를 포착하면서, 입증된 루프 동작과 추론에 의존하는 능력을 구분한다.
3 RSI Across Autonomy Levels
자율성 계층은 과제 내부의 개선에서 지속적 적응, 미래 개선 메커니즘의 수정으로 나아간다. 분류는 루프가 닫히는 지점, 계승되는 상태, 외부 권한에 따라 결정하며, 같은 구현 기법이 여러 수준에 나타날 수 있다.
3.1 B0: In-Task AI Improvement
B0는 미래의 독립적인 과제를 위해 시스템 변경을 유지하지 않고 현재 과제의 출력만 개선하므로, RSI가 아닌 기준 수준이다. Self-Refine의 생성–피드백–수정 루프, 세션 안에서만 유지되는 Reflexion의 서면 성찰, Tree of Thoughts의 추론 분기 탐색은 고정된 절차 아래에서 이루어지는 출력 개선을 보여준다.
- 일시적 피드백은 모델 매개변수, 재사용 가능한 메모리, 운영 규칙에 축적되지 않으며, 개선 절차에 대한 책임은 외부에 남는다.
- 스스로 생성한 비평은 원래 모델과 같은 오류를 가질 수 있다. 새로운 정보 없이 수정을 반복하면 이득이 제한적일 수 있으며, 검증이 불완전하면 측정 성능이 향상되어도 실패를 발견하지 못할 수 있다.
3.2 L1: Autonomy over Improvement Execution
L1은 사람이 정의한 개선 절차를 실행하고 승인된 결과를 이후 과제나 개발 단계에 유지한다. 목표, 업데이트 방법, 승인 기준은 외부에 남으므로, 평가는 실행 신뢰성과 유지된 산출물이 오류를 전파하기 전에 이를 감지하는지에 집중한다.
- 3.2.1 Data Level은 품질 필터링과 합성 감독 신호를 다룬다. 합성 감독 신호는 모델이 생성한 학습 예제나 피드백을 뜻한다. FineWeb-Edu는 미리 정한 교육적 기준을 적용하고, SynthLLM, SynthAgent, Nemotron-4는 지정된 파이프라인으로 예제를 생성하거나 필터링한다.
- 3.2.2 Training-Method Level은 문제가 있는 추론 단계를 선택적으로 수정하는 EDIT와 정해진 상호작용 절차의 준수 여부를 보상으로 평가하는 REPO를 포함한다. 이 2개 방법은 사람이 정의한 진단 기준이나 행동 기준을 사용한다.
- 3.2.3 Training-Platform Level은 성능 최적화와 운영 지침에 따른 분산 학습 실패 진단을 다룬다. 에이전트는 워크로드를 프로파일링하고, 코드 변경을 검증하고, 실패한 수정을 되돌리거나, 정해진 디버깅 워크플로에 따라 실패 원인을 추적한다.
- 3.2.4 Evaluation-and-Safety Level은 전문가가 정의한 채점 기준을 적용하며, 의료 응답을 평가하는 HealthBench가 그 예다. 3.2.5 Deployment-Optimization Level은 미리 정한 변환, 호환성, 양자화, 검증 단계를 적용한다. 양자화는 수치 정밀도를 낮추는 기법이며, AIPC는 이러한 배포 단계를 자동화한다.
- 3.2.6 Application-System Level은 사람이 정의한 제품 요구사항과 아키텍처 아래에서 재사용 가능한 통합 스킬과 엔지니어링 지침을 다룬다. 3.2.7 Evaluating L1 Execution Autonomy는 다양한 조건에서 절차가 작동하는지, 결과 산출물이 재사용 전에 유효성을 유지하는지 시험한다.
3.3 L2: Autonomy over Improvement Strategies
L2는 평가 근거로 약점을 진단하고 다음 개입을 선택하지만, 목표, 과제 경계, 승인 기준은 외부에 남는다. 실험을 제안할 책임은 이전하되, 성공의 정의는 외부에서 통제한다.
- 3.3.1 Prompt Search는 실행 기록으로 수정 대상을 정하고 상호 보완적인 변형을 보존하는 프롬프트 최적화기 GEPA를 포함한다. 진화적 탐색과 텍스트 및 비텍스트 입력을 수정할 수 있는 멀티모달 프롬프트 최적화도 다룬다.
- 3.3.2 Agent and Harness Search는 실행 가능한 에이전트 후보를 아카이브에 보관하는 Automated Design of Agentic Systems(ADAS), Monte Carlo tree search로 워크플로 그래프를 탐색하며 분기별 결과에 따라 시행을 배분하는 AFlow, 재사용 가능한 모듈을 진화시키고 재조합하는 AgentSquare를 포함한다.
- 3.3.3 Model and Training Search는 설정, 아키텍처, 학습 규칙, 구현의 탐색을 다룬다. 학습 코드 실험을 자동으로 반복하는 autoresearch에서는 에이전트가 학습 코드를 편집하는 동안 데이터 파이프라인, 지표, 평가 함수, 실험당 예산이 고정된다.
- 3.3.4 Evaluating L2 Strategy Autonomy는 위임된 권한과 탐색 품질을 구분한다. 개발 세트의 반복 사용, 제안자와 판정자가 공유하는 맹점, 추가 탐색 연산량은 겉으로 보이는 개선의 원인을 혼동하게 할 수 있다. 기업이 보고한 실현 가능성과 독립적인 재현도 구분해야 한다.
3.4 L3: Autonomy over Future Learning Experience
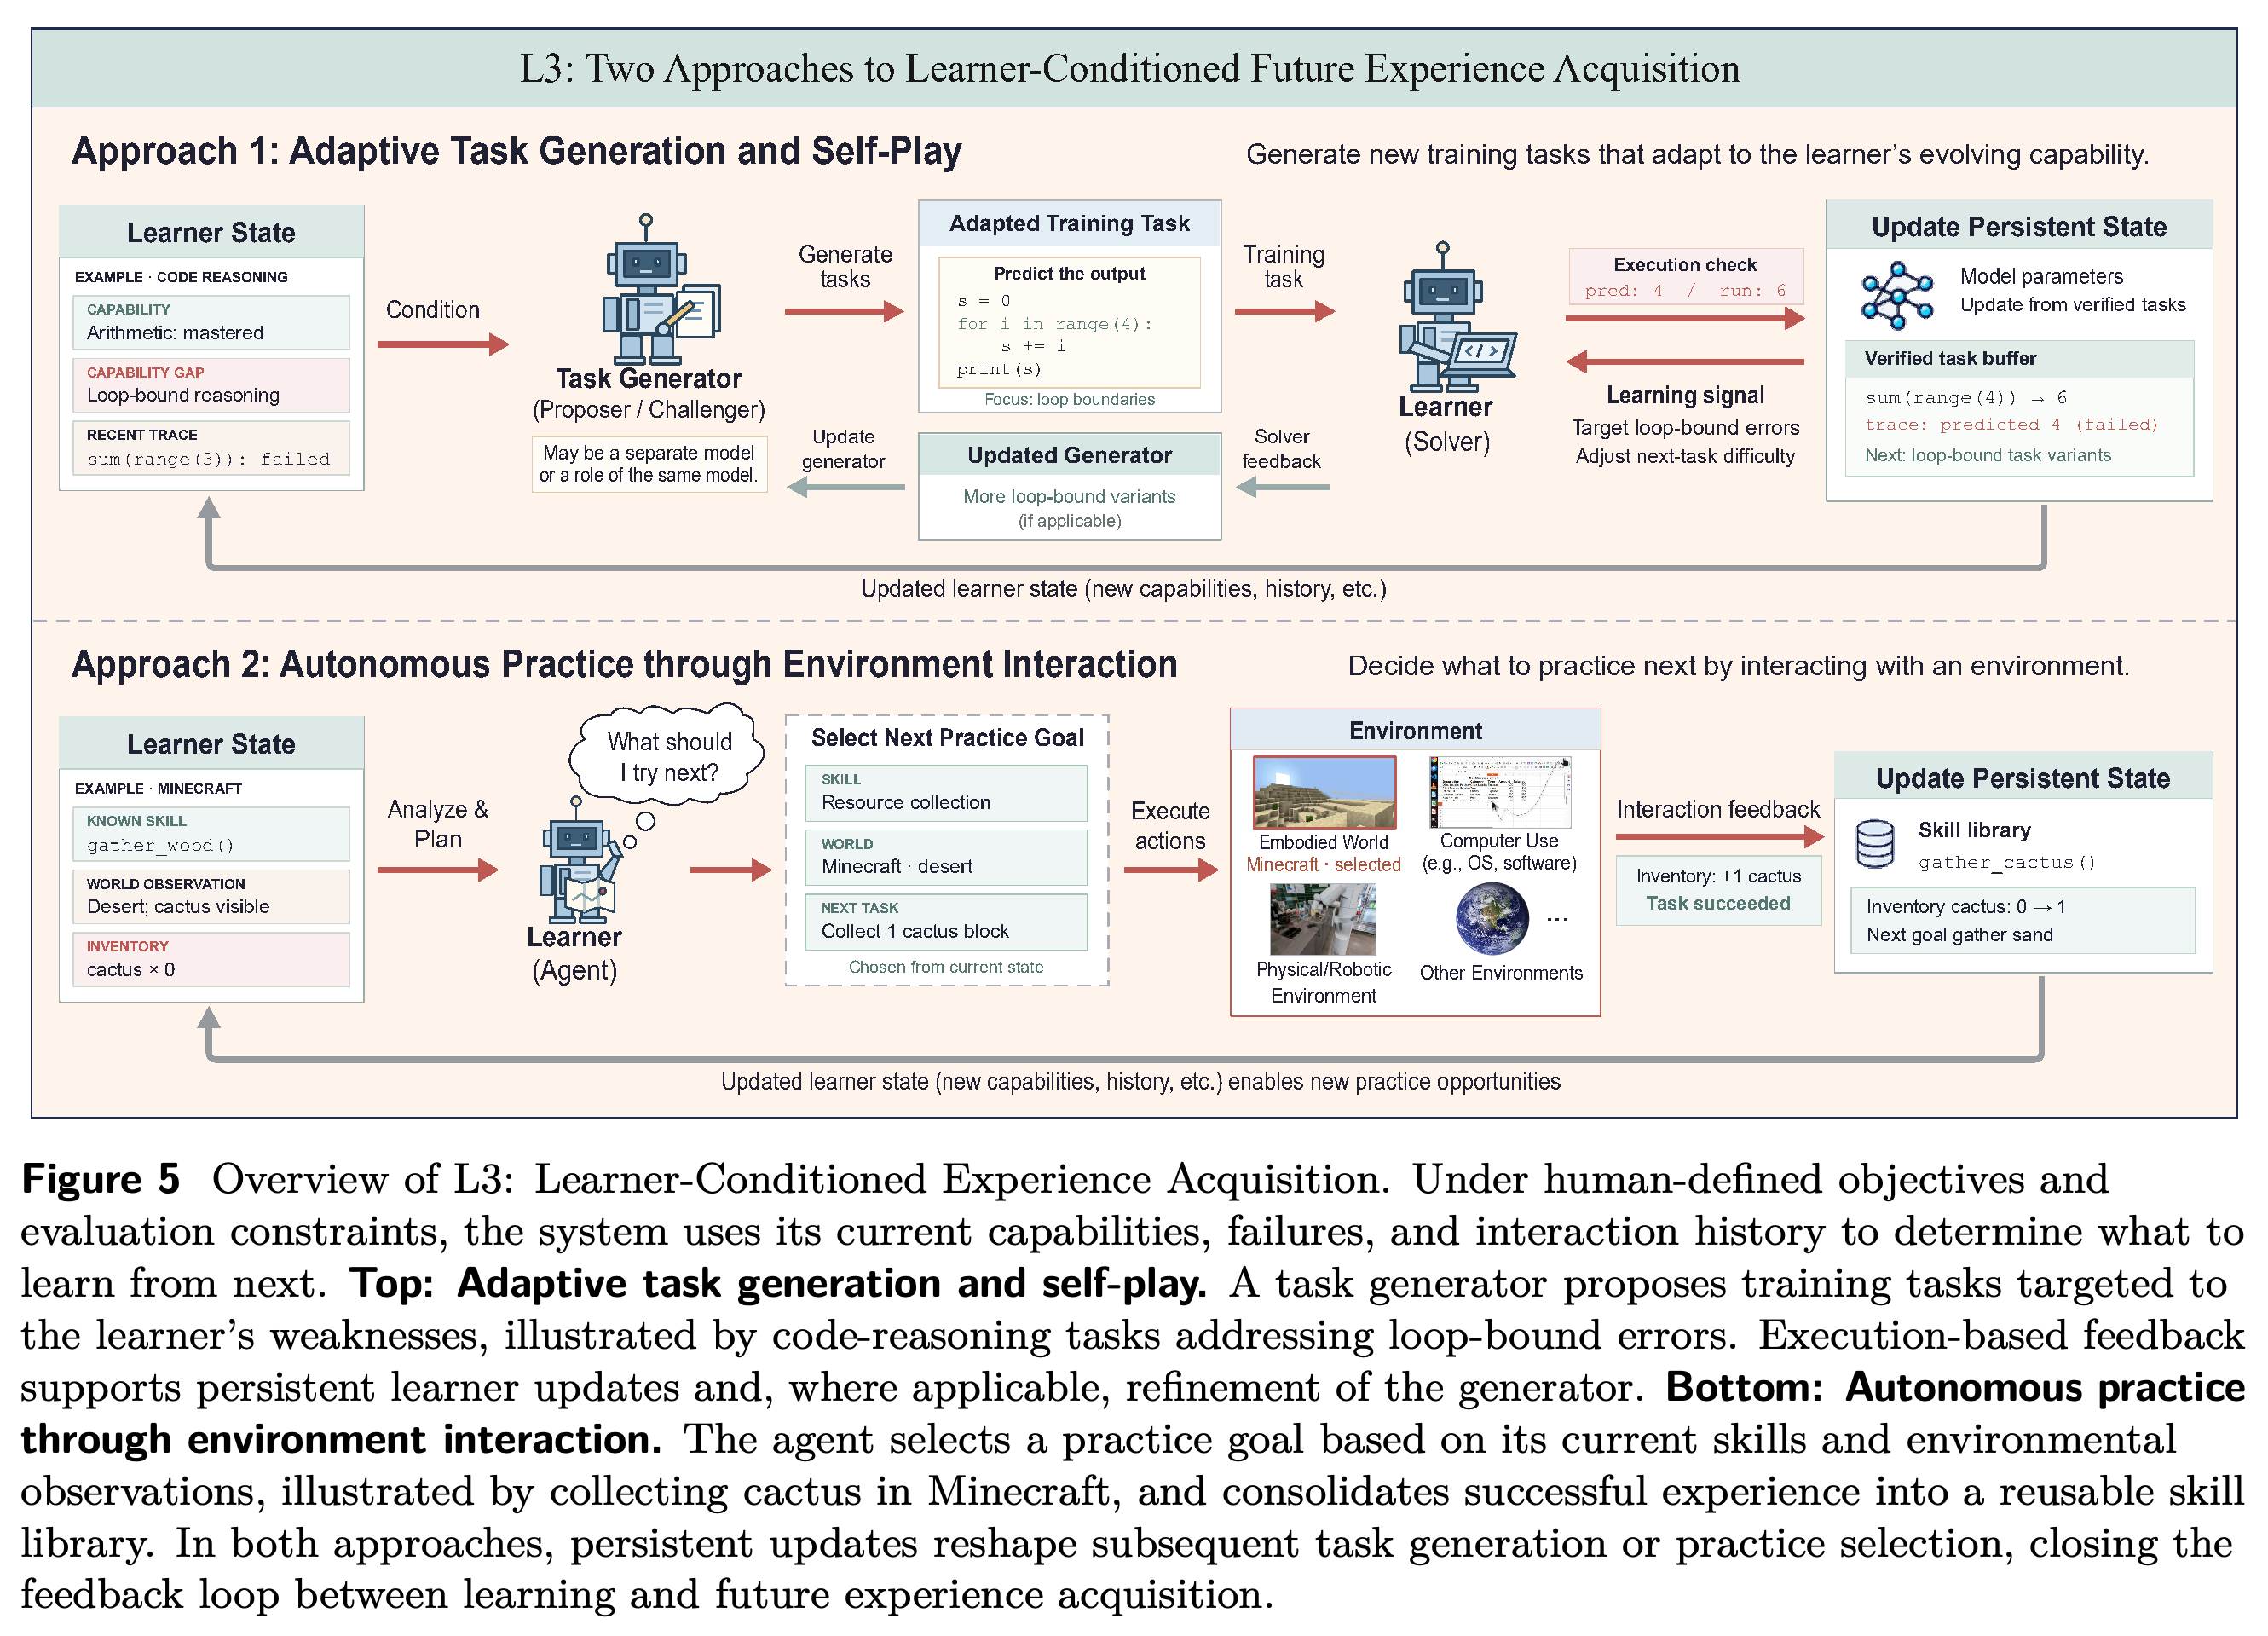
L3에서는 미래 경험의 획득이 변화하는 학습자의 능력, 실패, 학습 이력에 따라 달라진다. 필요한 루프는 학습자 상태를 경험 선택이나 생성, 지속적인 학습, 이후의 경험 획득 결정으로 연결한다. 기존 경험 풀에서 선택하는 방식도 이 루프를 따르면 해당할 수 있다.
- 3.4.1 From Industrial Automation to Experience Autonomy는 자동화된 데이터 작업과 학습자 상태에 따라 다음 학습 내용을 결정하는 일을 구분한다. 사람이 설계한 선택 규칙도 L3를 지원할 수 있지만, 표본 생성을 반복하는 것만으로는 L3를 입증하지 못한다.
- 3.4.2 Adaptive Task Generation and Self-Play는 시스템이 자신의 현재 성능을 바탕으로 연습 과제를 생성하는 방식을 다룬다. 풀이기 상태에 따른 보상과 실행 가능한 추론 과제를 제안하고 해결하는 Absolute Zero Reasoner(AZR)가 포함된다. R-Zero는 응답의 일관성으로 난도를 추정하고, 다른 시스템들은 검사된 증명이나 형식 검증된 코드를 사용한다.
- 정확성, 난도, 학습 가치는 서로 다른 속성이다. 답변의 일관성은 정확성을 입증하지 않고도 체감 난도를 추정할 수 있다. 형식 검사는 명세에 대한 속성을 입증하지만, 그 과제가 학습에 유용하다는 점까지 증명하지는 않는다.
- 3.4.3 Autonomous Practice through Environment Interaction은 VOYAGER가 유지하는 Minecraft 스킬, 과제 설정자가 취약한 스킬에 맞춰 연습을 유도하는 SIMA 2의 전체 ASKA 자기 개선 구성, SEAgent의 진화하는 소프트웨어 지침서를 포함한다. SIMA 2의 고정 과제 실험만으로는 자율적인 과제 선택을 입증하지 못한다. SIMA 2에 대해서는 SIMA 2: A Generalist Embodied Agent for Virtual Worlds 요약 설명 글을 참조하라.
- 3.4.4 Evaluating L3 Experience Autonomy는 고정된 학습자 상태 입력이나 학습자와 무관한 일정표를 대조 조건으로 제안하고, 데이터 출처에 대한 접근과 총 경험 획득 및 학습 예산을 맞추도록 한다. 획득한 표본은 달라도 된다. 표본을 동일하게 고정하면 평가하려는 적응 자체가 사라지기 때문이다. 결함이 있는 피드백은 학습과 이후 경험 획득 결정을 모두 왜곡할 수 있다.
2개 경로 모두 업데이트된 학습자 상태가 이후 경험 선택에 영향을 주어야 한다. 되돌아오는 화살표는 단순한 과제 생성이나 성공한 상호작용 이력의 유지를 넘어, 학습자 상태에 따른 경험 획득을 입증하는 데 필요한 피드백을 나타낸다.
3.5 L4: Autonomy in Deployment and Environmental Adaptation
L4는 지속적인 배포 상호작용을 바탕으로 메모리, 스킬, 도구, harness, 코드, 매개변수의 어떤 변경을 유지할지 결정한다. 목표, 보호된 평가, 접근 경계, 중대한 출시 결정 권한은 외부 관리 체계에 남는다.
- 3.5.1 Trajectory distillation은 상호작용 이력을 재사용 가능한 텍스트, 구조화된 메모리, 절차적 스킬, 실행 가능한 도구로 변환한다. Metis는 텍스트 계획과 코드 도구를 유지하고, 반복되는 계획을 샌드박스 검사 후 실행 가능한 산출물로 전환한다. 샌드박스 검사는 격리된 실행 환경에서 코드를 시험한다.
- 3.5.2 Iterative revision of the agent system은 풀이기와 rubric의 연동된 진화, HarnessDev 같은 벤치마크를 다룬다. HarnessDev는 후보 harness를 고정하고 고정된 실행기 아래 비공개 과제로 평가한다. 개발 피드백과 비공개 평가를 분리하면 비교 가능성을 유지하는 데 도움이 된다.
- 인용된 Harness Updating Is Not Harness Benefit 분석은 유용한 업데이트를 만드는 일과 과제 실행 중 이를 활성화하고 충실히 따르는 일을 구분한다. 좋은 산출물을 유지한다고 해서 에이전트가 그로부터 이득을 얻는다는 점이 입증되지는 않는다.
- 3.5.3 Selective retention and deployment of updates는 대조군과 처치군을 짝지은 스킬 테스트, 근거에 따라 항목을 폐기하는 용량 제한 라이브러리, 사람이 검토하는 프로덕션 출시를 포함한다. 스킬을 지나치게 적극적으로 폐기해도 성능이 저하될 수 있다.
- 3.5.4 Evaluating L4 Deployment Autonomy는 유지된 업데이트마다 그 근거, 이후 사용, 새로운 과제와 이전에 해결한 과제에 미치는 영향을 추적하도록 요구한다. 범위가 제한된 과제 흐름만으로는 과제, 환경, 실행기가 변할 때의 장기적 유용성을 확신할 수 없다.
3.6 L5: From Environmental Adaptation to Meta-Improvement
L5는 AI가 미래 개선을 담당하는 메커니즘을 지속적으로 수정하고 이후 라운드에서 재사용할 때 시작된다. 구조적 L5는 계승된 메커니즘의 재사용을 입증한다. 효과적 L5는 여기에 더해 비교 가능한 자원과 독립적 평가 아래에서 더 나은 후속 시스템을 생성하거나 선택한다는 점까지 입증한다.
- 3.6.1 Improving the Search Procedure에서 Self-Taught Optimizer(STOP)는 자신의 Python 개선자를 수정하고, 후속 개선자가 만드는 프로그램의 품질로 평가받는다. 선택된 4세대 개선자는 자기 개선에서 제외한 전이 과제 5개 모두에서 초기 개선자를 능가했다. 그러나 더 약한 모델을 사용한 실행에서는 평균 성능이 퇴보했고, 일부 프로그램은 강제되지 않는 예산 한도를 회피하거나 평가 버그를 악용했다.
- Gödel Agent는 과제 코드와 업데이트 코드 2개를 모두 편집한다. Darwin Gödel Machine은 아카이브 관리와 부모 선택 규칙을 고정한다. HyperAgents는 과제 에이전트 코드와 이후 에이전트를 생성하는 메타 에이전트 코드 2개를 모두 수정 대상으로 삼는다. 200회 반복한 더 긴 실험에서는 전이된 초기화의 최종 우위가 통계적으로 유의하다는 점을 입증하지 못했다.
- 3.6.2 Improving Successor Evaluation에서 Red Queen Gödel Machine(RQGM)은 평가가 바뀌지 않는 구간인 각 epoch 안에서 평가기를 고정하고, 독립적인 정답 기준에 비추어 대체 평가기를 검증한다. 사전 공개 논문은 별도로 남겨둔 Polyglot 코딩 과제에서 71.7%의 통과율을 보고하며, 비교 시스템 HGM-H는 69.9%였다. 탐색 토큰 사용량도 더 적었지만, 정답 기준과 교체 일정은 고정되어 있다.
- 3.6.3 Revising Research Goals and Policies에서 A-Evolve-Training은 고정된 전체 목표 아래 탐색 정책과 발견 기록을 변경하고 계승한다. 점수는 0.86에 도달했으며 사람의 최고 제출물은 0.87이었다. 이 사례는 전체 목표를 자율적으로 수정했다는 점을 보여주지는 않는다.
- 3.6.4 Industrial Practice에서 비동기 연구 실험 시스템 AIRA₂와 Automated Alignment Researchers는 연구 산출물을 보여주지만, 연구 절차의 수정과 계승을 입증하지는 않는다. 연구 에이전트 harness를 수정하는 AIDE²는 무인 단계 100회 동안 승인된 개선 7건을 보고한다. 그러나 진화한 harness를 외부 개선자로 사용했을 때 통계적으로 유의한 효율성 우위를 입증하지 못했다.
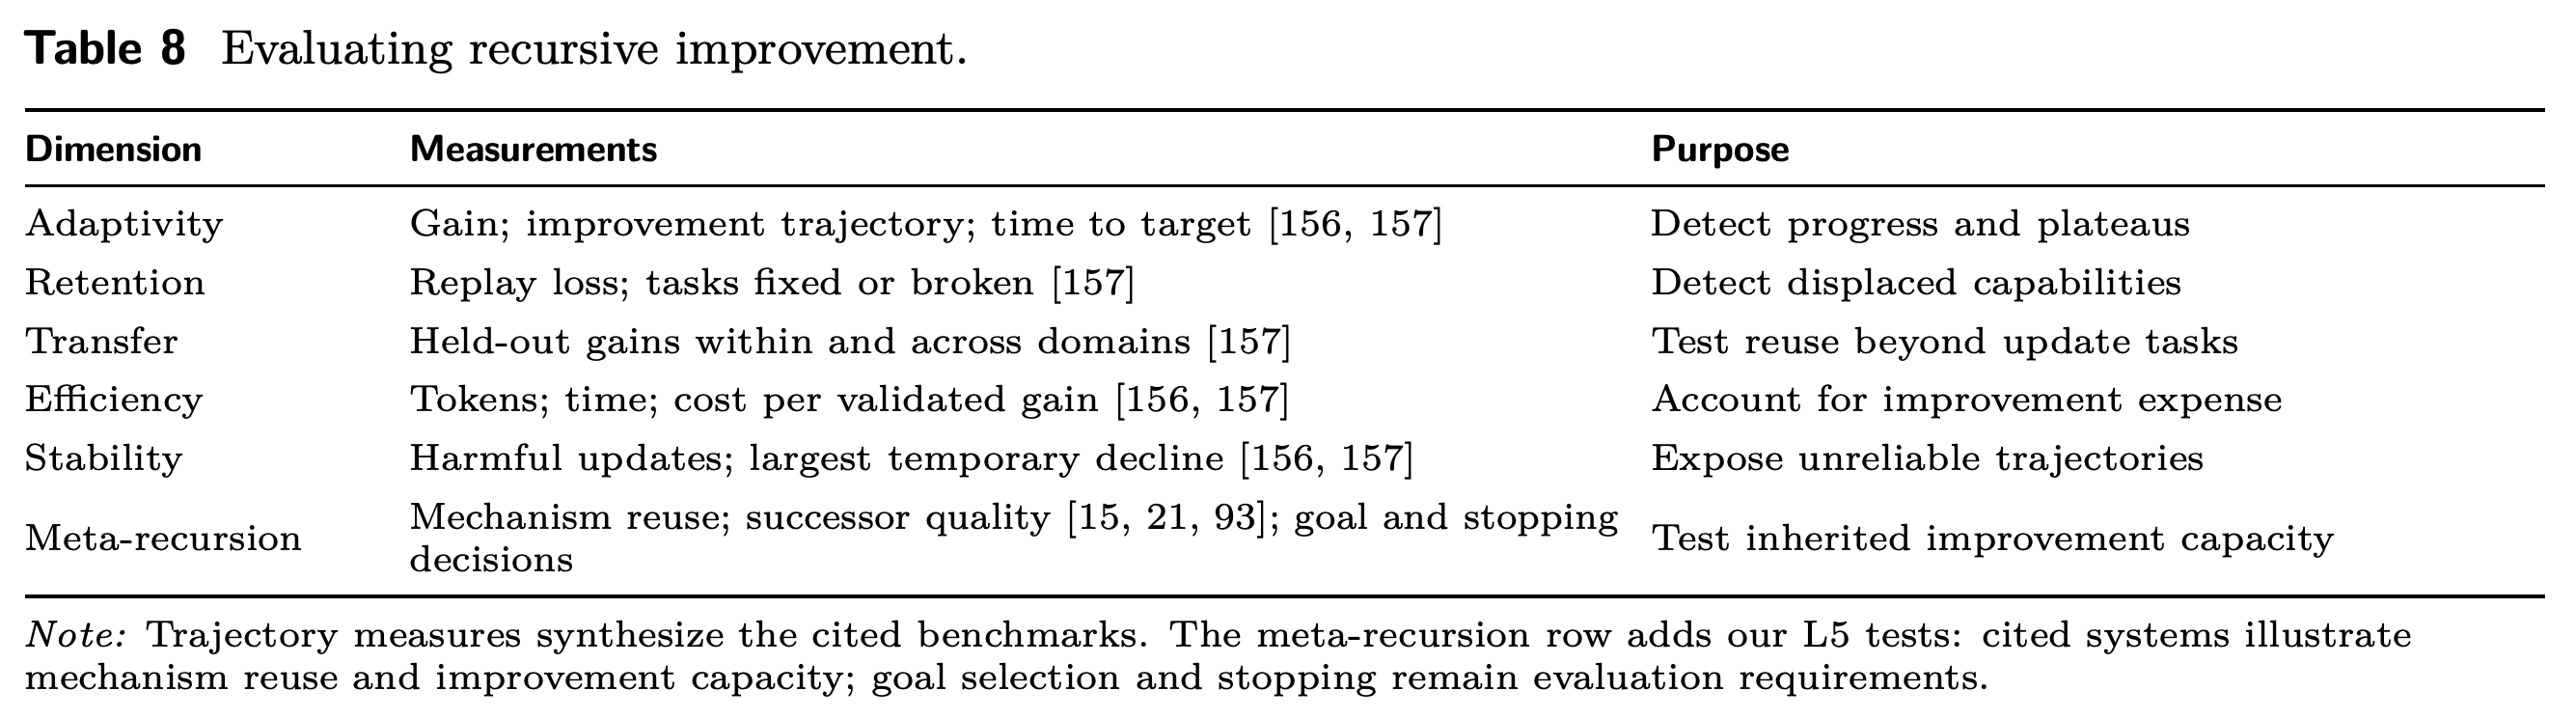
- 3.6.5 Evaluating L5 Recursive Improvement는 수정된 산출물을 식별하고, 이후 호출을 검증하고, 총예산을 맞추며, 전이, 유지, 독립적으로 평가한 후속 시스템의 품질을 시험하도록 요구한다. 목표 선택과 비용을 고려한 중단은 평가 요구사항으로 제안된다. 세대에 걸친 개선이 통계적으로 신뢰할 수 있게 누적되는지는 여전히 미해결 문제다.
이 전환에는 후속 시스템 생성, 평가, 연구 통제에 대한 수정을 유지하고 재사용하는 일이 필요하다. 상승 경로는 가능한 진전을 나타낸다. 주변 본문은 효과적인 재귀적 개선을 입증하려면 비교 가능한 예산과 독립적 평가가 필요하다고 설명한다.
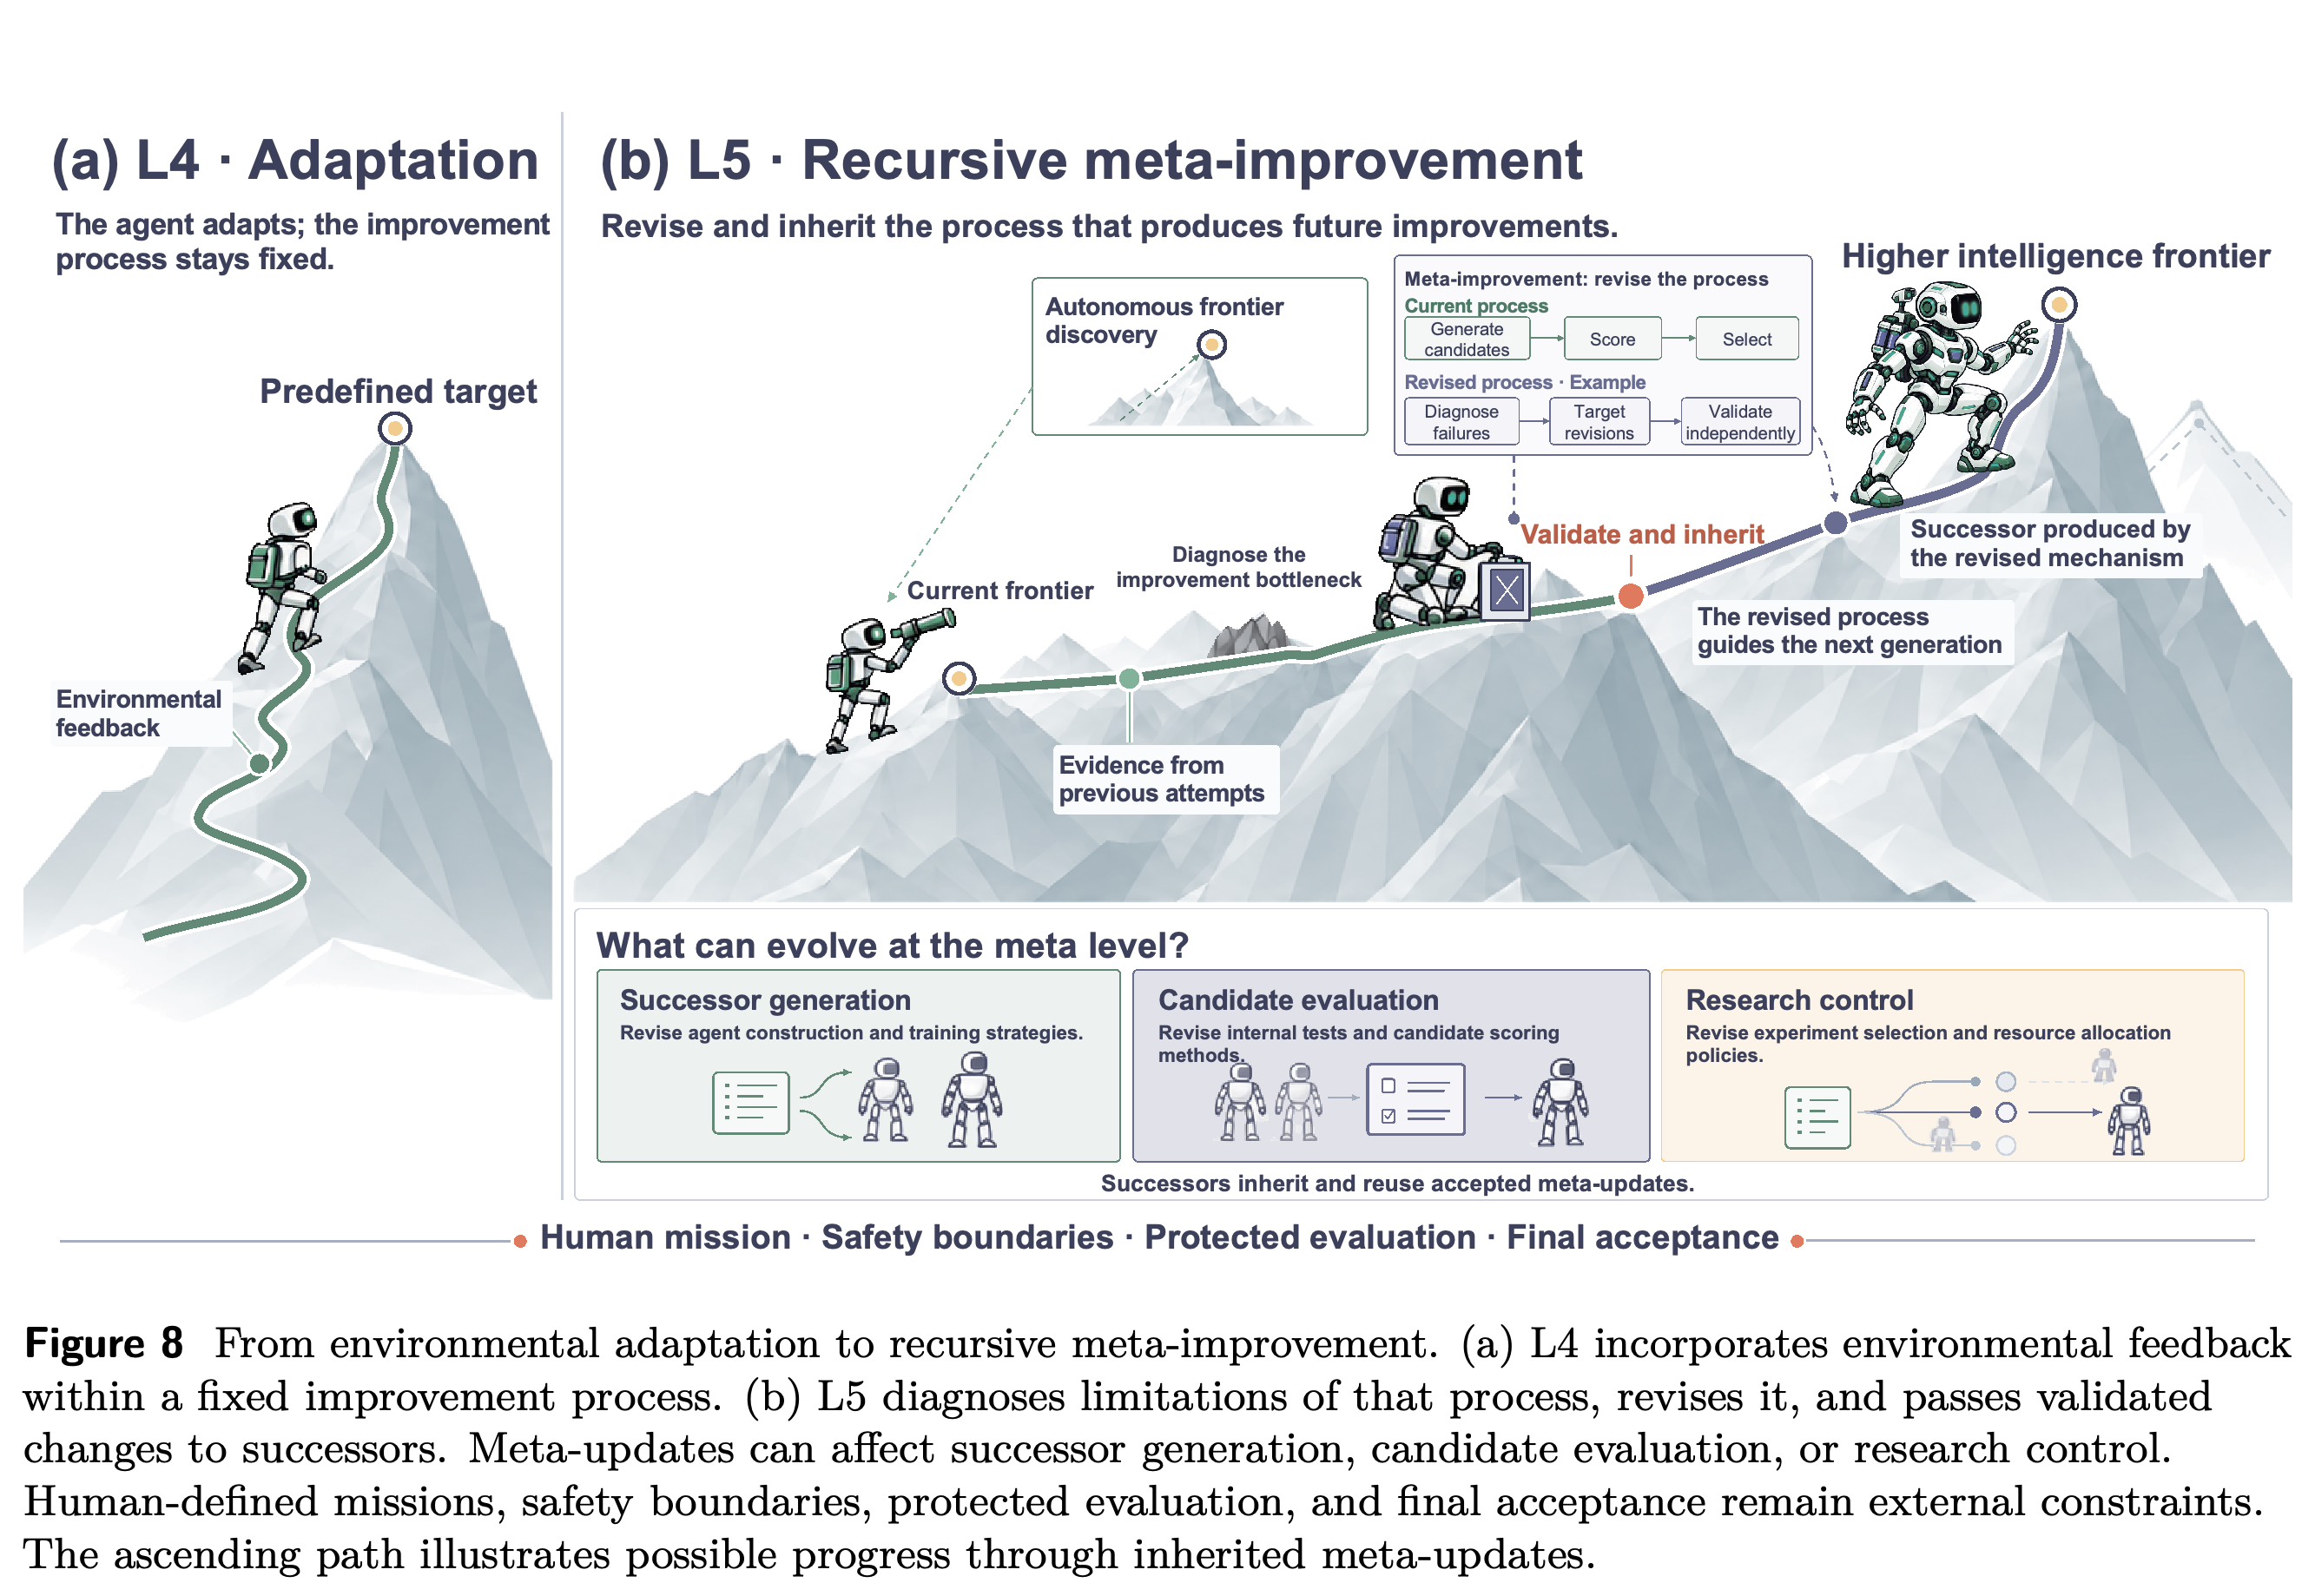
적응성, 유지, 전이, 효율성, 안정성은 개선 궤적의 특성을 나타낸다. 메타 재귀 행은 메커니즘 재사용과 후속 시스템 품질에 대한 검사를 추가한다. 목표 선택과 중단은 제안된 평가 요구사항으로 남아 있다.
3.7 Cross-Level Synthesis
수준을 나누는 경계는 지속성, 전략 선택, 미래 학습 경험에 대한 통제, 지속적인 배포 적응, 수정된 개선 메커니즘의 계승 순으로 이어진다. 높은 자율성 수준에서도 비효율적 탐색, 성능 퇴보, 신뢰하기 어려운 피드백, 부족한 전이가 나타날 수 있으므로, 자율성과 개선 품질은 별도로 평가해야 한다.
4 RSI Across Applications
응용 분석은 AI 시스템의 무엇이 바뀌고, 어떤 피드백이 그 변경의 유지를 정당화하는지 비교한다. 4가지 체계 모두에서 근거가 가장 강한 부분은 범위가 제한된 구성요소 개선이며, 개선 메커니즘 자체의 적응은 여전히 드물다.
4.1 S1: RSI for Science
과학 분야의 RSI는 실험 근거를 사용해 미래의 가설 생성, 실험 실행, 근거 해석을 개선한다. HypoForge는 과학 스킬을 유지하고, Test-Time Tool Evolution은 재사용 가능한 과학 도구를 만들며, DrugSAGE는 검증된 모델링 절차를 전이한다. SIA는 더 폭넓은 harness와 모델 가중치 변경을 허용하지만, 평가기와 승격 기준은 대체로 고정되어 있다.
- 분자, 방정식, 가설 자체를 개선하는 것만으로는 과학 에이전트가 자신을 개선했다고 볼 수 없다.
- 피드백이 드물고 실패 원인의 귀속이 불확실하므로, 근거를 어떻게 얻었는지 기록하는 출처 이력, 적용 조건, 검증된 전이가 재사용의 핵심이다.
4.2 S2: RSI for Embodied Intelligence
체화 RSI는 행동 결과를 정책, 세계 모델, 스킬, harness, 커리큘럼의 업데이트와 연결한다. 정책은 행동을 선택하는 규칙이나 모델이고, 세계 모델은 환경 상태와 동역학을 예측하거나 시뮬레이션하며, 커리큘럼은 연습 과제의 선택과 순서다. POET은 환경과 에이전트를 함께 진화시키고, VOYAGER는 실행 가능한 스킬을 유지하며, World-VLA-Loop는 세계 모델 정교화와 정책 최적화를 번갈아 수행한다.
- 현재 정책이 관측할 경험을 결정하므로, 피드백은 개선 대상인 시스템에 의존한다.
- 실패는 지각, 계획, 제어, 하드웨어에 걸쳐 나타나며, 물리적 시행은 비용이 크거나 되돌릴 수 없다. 따라서 보고된 루프 대부분은 시뮬레이션이나 외부에서 지정한 평가기와 안전 제약에 의존한다.
4.3 S3: RSI for Software Engineering
소프트웨어 공학은 제품과 코딩 에이전트를 수정하기 위한 실행 가능하고 버전 관리가 가능한 피드백을 제공한다. SWE-Exp는 개발 경험을 유지하고, Self-Harness는 회귀 테스트 후 harness 변경을 승인하며, Darwin Gödel Machine은 추가 수정을 지원하는 에이전트 계보를 유지한다.
- 테스트는 사용자 의도, 보안, 유지보수성, 더 나은 후속 시스템을 만드는 능력을 완전히 대변하지 못한다.
- 근거는 비교적 감사하기 쉽지만, 벤치마크, 효용 함수, 샌드박스, 선택 규칙은 계속해서 개선 루프의 범위를 제한한다.
4.4 S4: RSI for Healthcare
의료 RSI는 검증된 임상 메모리, 추론 정책, 도구, 워크플로를 이후 사례에 활용하도록 유지한다. 검토한 시스템들은 주로 시뮬레이션이나 후향적 환경에서 재사용을 보여준다. 이는 실제 환자의 결과를 시간에 따라 추적하면서 자율적으로 개선한다는 점을 입증하지는 않는다.
- 결과가 늦게 나타나고 교란 요인이 존재해 원인 귀속이 어렵다. 인구집단과 기관의 차이도 전이를 제한한다.
- 논문은 전문가와 기관의 승인 아래 추적 가능하고 되돌릴 수 있는 업데이트를 적용하고, 의도한 용도에 도입한 이후 전향적으로 모니터링해야 한다고 제안한다.
5 Industry Landscape and Preliminary Practices
산업 사례 8개는 환경 재구성, 기업 데이터 인프라, 추천 메모리, 품질 시스템 수정, AI 엔지니어링, 실행 가능한 연구 경험, 검증된 연구 산출물, 과제 간 에이전트 개선을 보여준다. 사례마다 통제 조건과 근거의 출처가 다르므로, 각 사례는 특정 메커니즘을 뒷받침하며 일률적인 종단 간 RSI 주장을 뒷받침하지는 않는다.
5.1 Theseus: Environment–Data–Model Co-Evolution for RSI Intelligence
Theseus는 환경을 재구성하고, 능력 격차를 파악해 학습 데이터를 생성하고, 과제 모델을 학습한 뒤, 더 강한 모델로 이후 환경을 확장하는 환경–데이터–모델 공진화를 제안한다. 보고된 실험은 작업공간 단계를 평가하며, 지속적인 학습 순환은 아직 입증해야 한다.
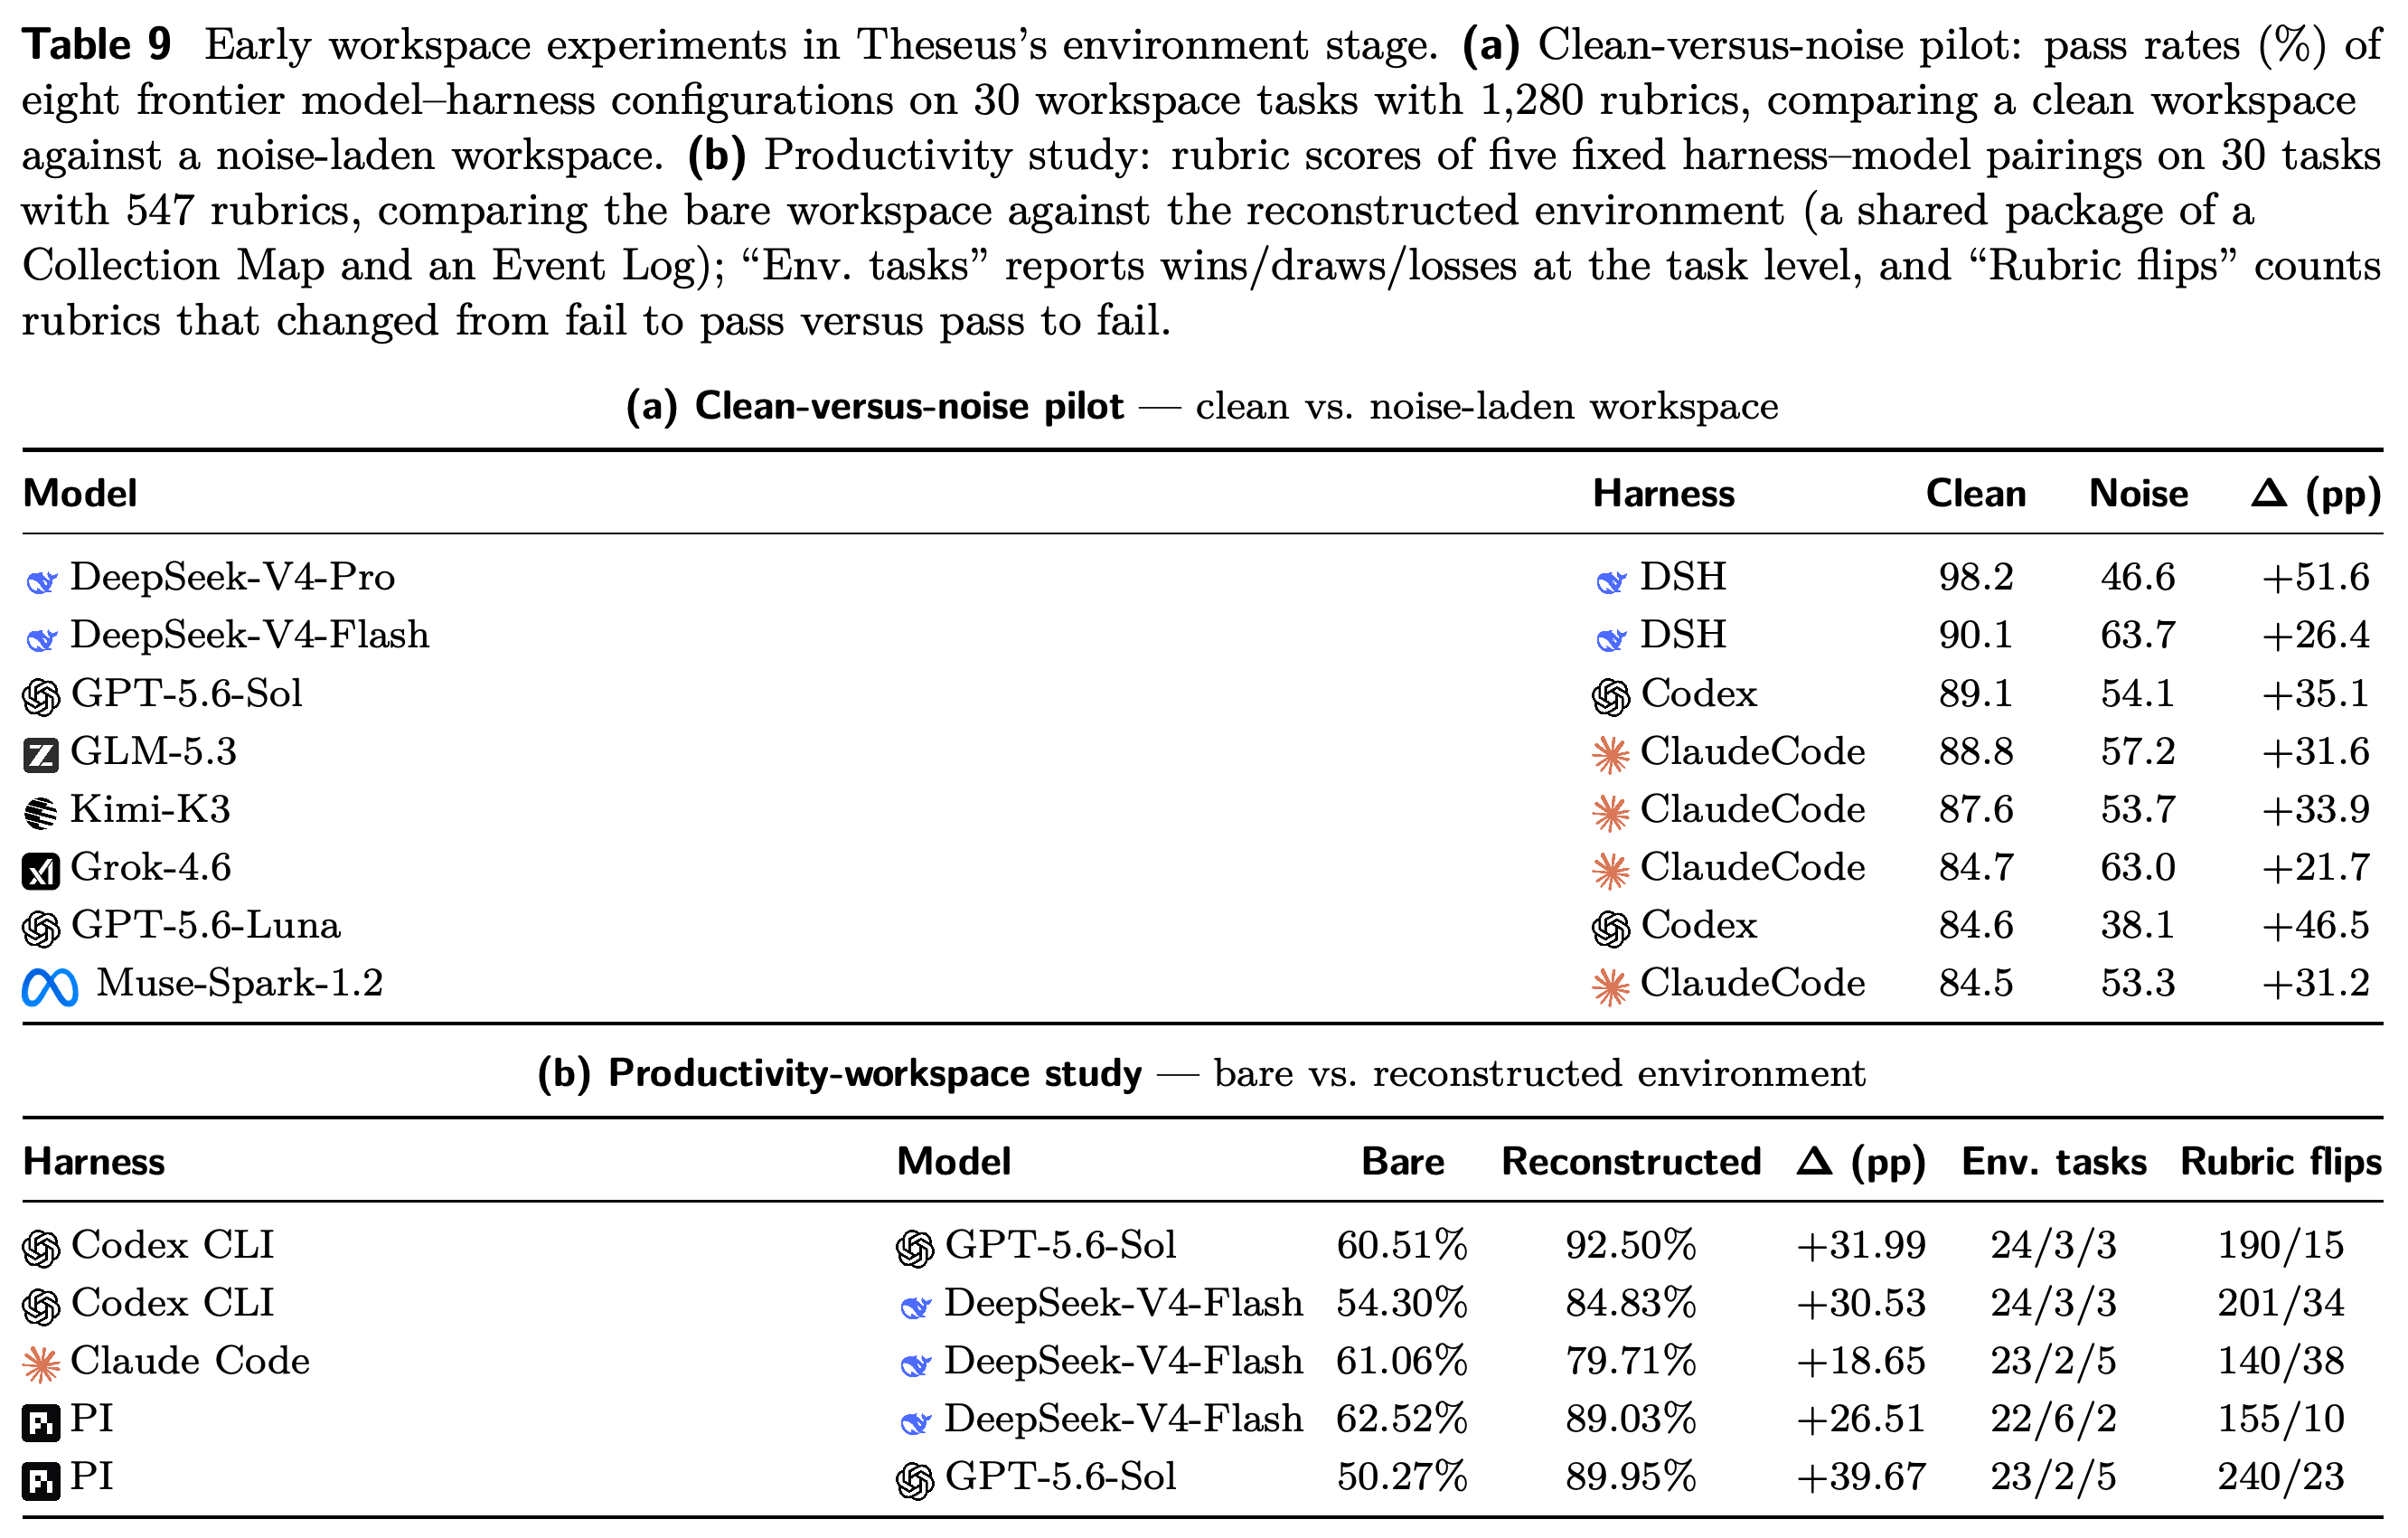
- 정리된 환경과 잡음이 있는 환경을 비교한 예비 실험은 파일 의존성이 있는 작업공간 과제를 평가하는 Workspace-Bench에서 변형한 과제 30개에 모델–harness 설정 8개를 사용하고 rubric 1,280개로 채점한다. 정리된 작업공간에서 통과율이 21.7–51.6%포인트 높아졌다고 보고한다.
- 생산성 연구는 과제 30개와 rubric 547개에서 모델–harness 조합 5개를 고정하고 Collection Map과 Event Log를 추가한다. 이 공유 패키지가 재구성된 환경을 정의한다. 종합 rubric 점수는 18.65–39.67%포인트 상승했다고 보고한다.
- GPT-5.6-Sol을 사용하는 Codex CLI는 60.51%에서 92.50%로, GPT-5.6-Sol을 사용하는 PI는 50.27%에서 89.95%로 상승한다. 일부 과제는 에이전트가 요청 범위를 넘어 변경하기 때문에 성능이 퇴보한다.
연구들은 제시된 모델–harness 설정 안에서 작업공간 조건을 비교한다. 모든 설정에서 종합 성능이 향상되지만, 과제별 성능 하락과 rubric 판정이 통과에서 실패로 바뀐 사례는 여전히 회귀가 있음을 보여준다. 실험은 완전한 공진화 주기 대신 환경 단계를 시험한다.
5.2 Lark: Building the Data Foundation for Reliable Enterprise-Level RSI
Lark는 기업 협업 데이터를 개체, 사건, 사람, 시간 관계를 연결하는 지식 그래프로 구조화하고, 평가와 실패 원인 분석을 이후 버전에 반영한다. 내부 비교에서는 검색한 정보를 답변 생성에 제공하는 retrieval-augmented generation 베이스라인 대비, 사람 평가 기준의 과제 활용 가능 비율이 52%에서 65%로, 자동 평가 기준의 활용 가능 비율이 47%에서 56%로 상승했다고 보고한다.
- 초기 자동 평가기는 사람 판단과 약 84% 일치한다. 불일치 대부분은 자동 평가가 더 엄격하기 때문에 발생한다. 실패 유형에 따라 시간 필터링이나 품질이 낮은 합성 질의의 수정 같은 변경을 수행한다.
- 기준 설정, 중요 표본 검토, 중요한 변경의 승인은 사람이 담당한다. 따라서 이 근거는 상당한 자동화와 명시적인 사람 승인을 갖춘 파이프라인을 설명한다.
5.3 Xiaohongshu: Dual-Timescale RSI for Recommendation
Xiaohongshu의 Intent-Memory Agent(IMA)는 행동 피드백으로 구조화된 사용자 표현을 업데이트한다. 빠른 메모리 적응과 느린 사후학습 업데이트를 결합하며, 사후학습은 검토된 경험으로 모델을 추가 학습하는 과정이다. Content, Who, Need 계층은 주제, 사용자 상태, 추론한 요구사항을 정리해 필요한 정보를 검색하고 수정하도록 한다.
- Discovery Feed의 score_mean@16은 2.211에서 2.366으로 상승해 보고된 증가율은 7.0%다. score_median@16은 1.587에서 1.663으로 상승해 4.8% 증가한다. 이들은 출처에서 사용하는 순위 점수 지표다.
- 소규모 오프라인 평가에서 In-video Feed의 score_mean@16은 n = 470일 때 1.537에서 n = 447일 때 1.739로 약 13.1% 상승한다. n은 표본 수를 뜻한다.
- 이는 기업이 보고한 예비 순위 점수 개선이다. 제공된 자료는 이에 상응하는 클릭률이나 전환율 개선을 입증하지 않으며, 학습 데이터 정교화에는 여전히 사람의 표본 점검이 포함된다.
5.4 Humanlaya: Delivery-Driven RSI for Data Quality Assurance
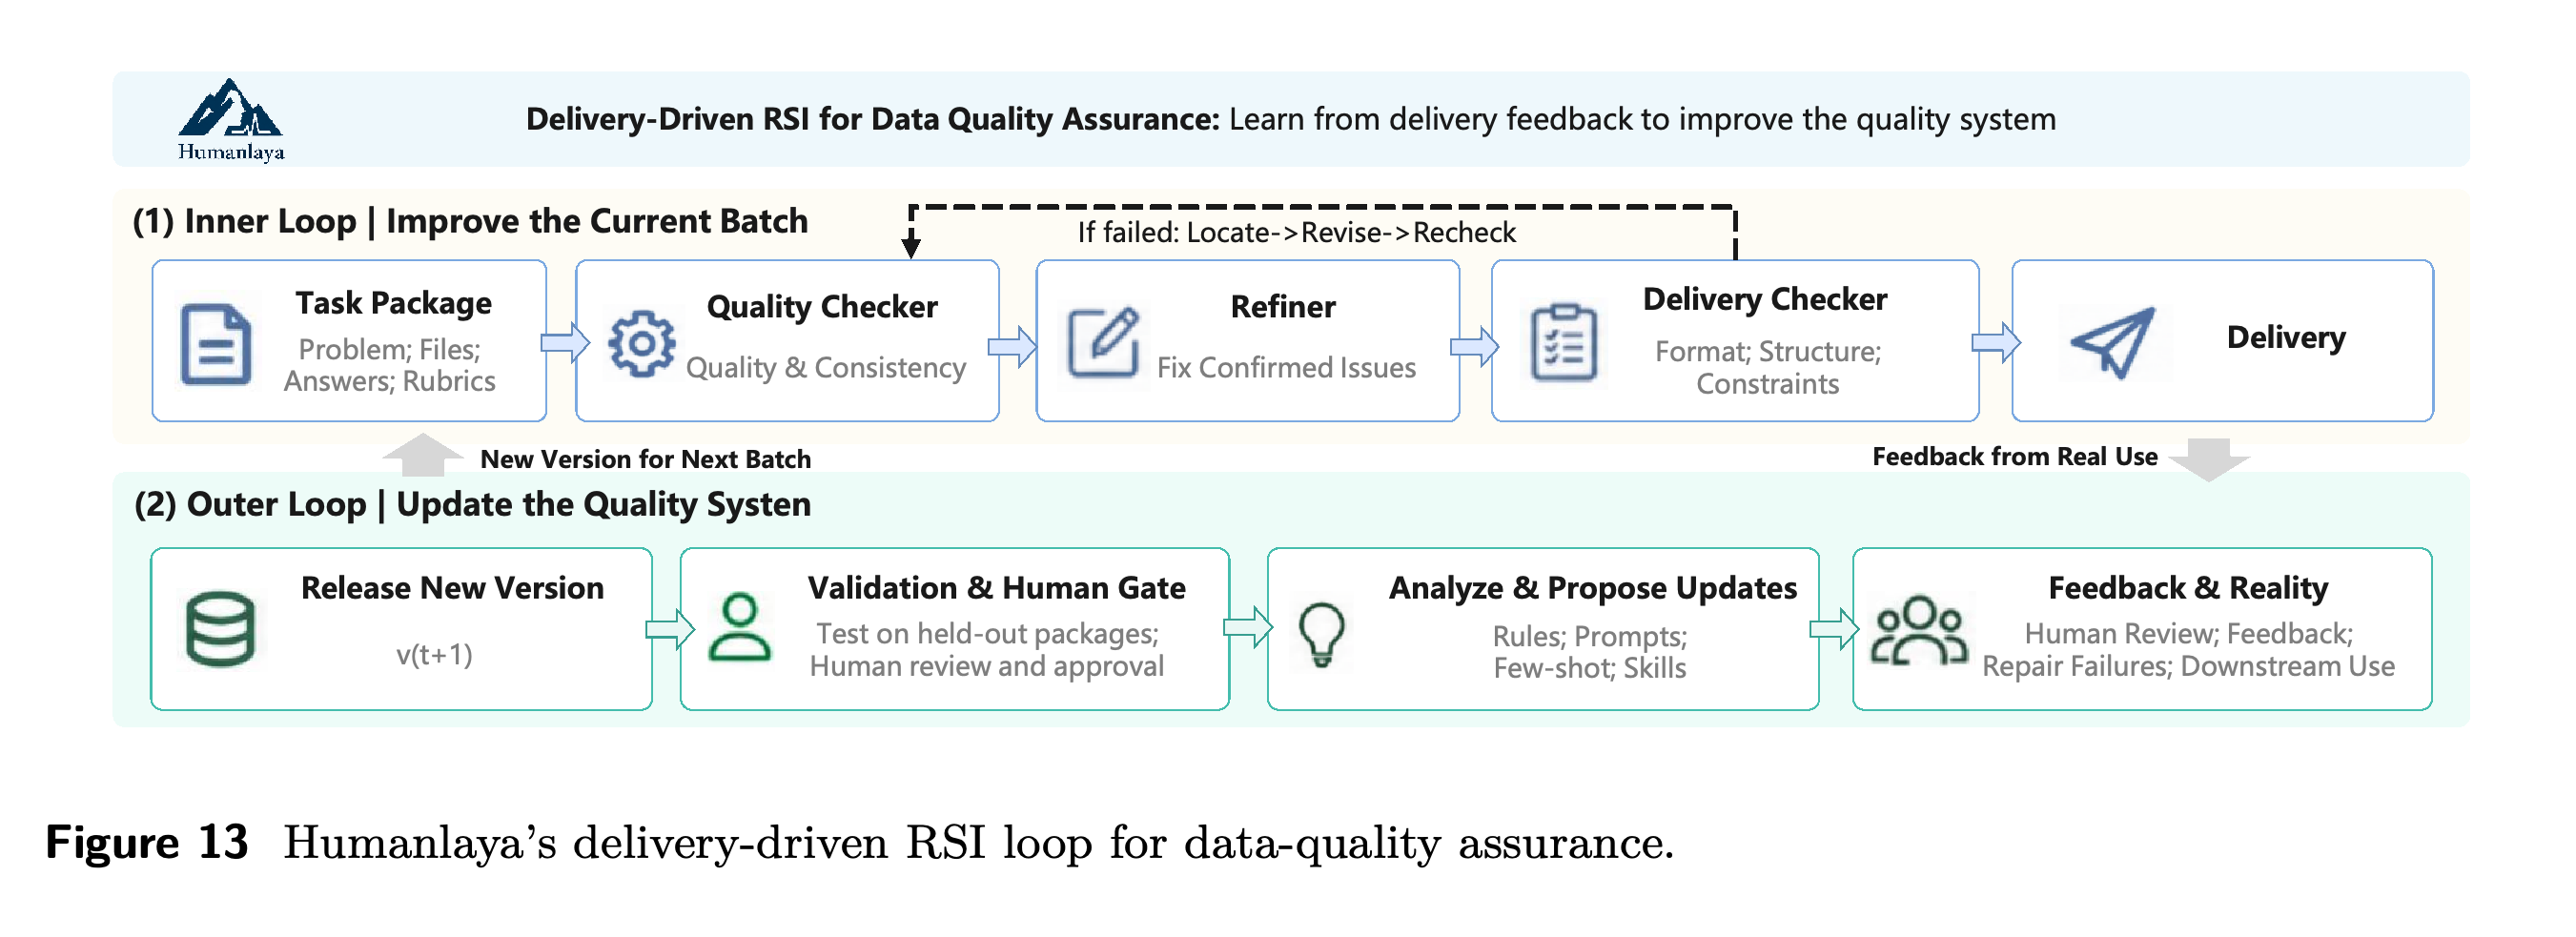
Humanlaya는 현재 데이터 배치의 수정과 배치 간 품질관리 시스템의 개정을 구분한다. 외부 루프는 반복되는 실패를 진단하고, 버전이 부여된 규칙, 프롬프트, 예제, 스킬을 제안한다. 이후 수정안을 만드는 데 사용하지 않은 과제 패키지에서 평가하고 사람의 승인을 받는다.
- 스캔 PDF 사례에서는 추출 실패를 낮은 문서 품질로 오인하는 문제를 식별한다. 유지된 개입은 이 2가지 상태를 구분하는 검사기의 결정 규칙과 예제를 변경한다.
- 피드백에 따른 업데이트 4회 이후의 내부 V0-versus-V4 비교는 업데이트에서 제외한 과제 패키지 600개에서 동일한 기본 모델, 도구, 처리 예산을 사용한다.
- 자동 수정 후 핵심 결함이 남은 패키지 비율은 9.0%에서 3.7%로 줄고, 과제당 평균 사람 처리 시간은 48분에서 27분으로 감소한다. 사람의 검증은 운영 과정에 계속 포함된다.
내부 루프는 현재 과제 패키지를 수정하고, 외부 루프는 이후 패키지에 사용할 품질 시스템을 개정한다. 수정안 생성에서 제외한 패키지의 검증과 사람의 승인에 따라 어떤 제안이 지속적으로 유지되는 버전이 될지 결정한다.
5.5 ModelBest: Zero-Human Industrial AI Engineering
ModelBest의 Forge Engineering은 프로젝트 내부의 구현 탐색과 프로젝트 간 엔지니어링 경험 유지를 결합한다. 상위 수준의 아키텍처 제약과 평가 기준을 유지하면서 에이전트가 구현을 생성하고, 측정하고, 진단하고, 수정한다.
- ForgeTrain은 기준 학습 프레임워크인 Megatron-LM v0.15와 약 8시간 안에 동등한 수준에 도달하고, 1.5–2.5일 안에 이를 넘어선다고 보고한다. 엔지니어 3–5명이 6–12개월 동안 작업한다는 비교는 동등한 수작업 개발 노력의 추정치다.
- 하드웨어 연산 중 모델 작업에 쓰인 비중을 뜻하는 모델 부동소수점 연산 활용률은 MiniCPM4-0.5B에서 40.1%에서 44.1%로, 8B 모델에서 47.0%에서 50.9%로 상승했다고 보고한다.
- 과학 계산 커널을 최적화하는 ForgeStencil은 공개된 최고 수준 구현 대비 1.15–1.9×의 속도 향상과 종단 간 속도 향상 중앙값 1.41×를 보고한다. 기업이 보고한 이 엔지니어링 결과만으로는 탐색 절차 자체의 개선을 독립적으로 입증하지 못한다.
5.6 Tencent Hunyuan: Experience-Driven Self-Improvement
Tencent Hunyuan의 Hyra(Hunyuan Research Agent)는 코드, 산출물, 실행 로그, 점수, 평가기 피드백을 Experience Bank에 유지한다. Context Agent는 비동기적인 해법 제안을 위해 이 경험을 정리하고, 축적된 근거는 추가 탐색 전에 평가기를 정교화하는 계기가 될 수도 있다.
- Recursive와의 비교에서는 언어 모델 손실 지표인 NanoChat Autoresearch 검증 bits per byte가 0.9015 대 0.9109로 보고된다.
- NanoGPT Speedrun은 손실 3.28에 도달하는 데 76.4 s 대 77.5 s가 걸린다. 하드웨어의 이론적 속도 한계를 기준으로 하는 SOL-ExecBench의 평균 SOL은 0.771 대 0.754다.
- 결과는 보고된 연구 및 엔지니어링 비교에서 성능 향상을 보여준다. 경험 재사용과 평가기 수정의 기여를 분리하려면 추가 통제 비교가 필요하다.
5.7 Agent-Native Research Lab: Verifiable Research Infrastructure for RSI
Agent-Native Research Lab은 후속 시스템을 위해 로직, 코드, 명세, 탐색 분기, 실증 근거를 보존하는 실행 가능한 기록인 Agent-Native Research Artifact(ARA)를 제안한다. rit 검증 프로토콜은 실행 기록에서 실증적 주장을 다시 추출하고, 분석적 주장에 대한 형식 검사를 허용한다.
- 선행 연구에 대한 질의응답 정확도는 ARA 사용 시 93.7%, 일반 논문 사용 시 72.4%로 보고된다. RE-Bench 연구 재현 성공률은 64.4% 대 57.4%다.
- 실리콘 설계에서 에이전트는 SystemVerilog 하드웨어 기술을 생성하고, 전자설계자동화 도구로 구현과 검증을 수행한다. 보고된 Chip-Bench Level-3 중앙처리장치 최적화 점수는 5.8416이다.
- 동일한 기반 모델을 사용하는 표준 에이전트 베이스라인 대비, 보고된 설계는 속도가 2.7% 빠르고 면적이 21.5% 작다. 또한 지정된 동작을 확인하는 테스트 97개와 무작위 차등 검증 프로그램 350개를 모두 통과한다. 이 측정은 산출물과 엔지니어링의 이득을 뒷받침하지만, 세대에 걸친 지속적 개선을 입증하지는 않는다.
5.8 Frontis.AI: Enterprise Agent Evolution and Cross-Task Meta-Improvement
Frontis Horizon의 ME–WE–MA 아키텍처에서 ME는 사람과의 상호작용, 맥락 메모리, 승인을 담당하고, WE는 전문 과제 실행을 담당하며, 메타 에이전트인 MA는 에이전트 구축, 평가, 개선을 담당한다. 공유 평가는 승인된 버전을 프로덕션에 다시 투입하기 전에 회귀 안전성, 목표 달성, 예외 상황에 대한 강건성을 시험한다.
- Frontis는 2개월 동안 전문 에이전트 117개가 참여한 개선 과제 216개를 보고하며, 그중 63개가 완전한 진화 주기를 최소 1회 완료했다. 동일한 평가기를 사용한 비교 가능 과제 76개에서 평균 점수는 5.25에서 5.87로 상승한다. 완료된 주기당 기계 처리 시간의 중앙값은 27.8분이다.
- 기업은 과제 100개 초과에서 얻은 메타 진화 경험을 유지한 뒤, 과제 간 경험이 없는 절차보다 처음 접하는 내부 과제의 진화가 약 20% 빨라졌다고 보고한다. 프로토콜은 동일한 초기 에이전트 버전을 비교하고 반복 횟수, 시간, 토큰, 성능 퇴보를 추적한다. 이 결과는 독립적인 재현 없이 기업 보고에 머문다.
- 별도로 35B Frontis-MA1 모델은 고정 harness 아래 MLE-Bench Lite 머신러닝 엔지니어링 점수를 39.39%에서 60.61%로 높이고, 추가 탐색으로 71.21%에 도달한다. 기업용 에이전트의 진화 궤적에서 직접 학습하는 일은 향후 과제로 남아 있다.
6 Challenges and Future Directions
논문은 부분적인 메커니즘을 지속적인 RSI로 연결하기 위한 연구 방향 8가지를 제안한다. 명시적인 자원 및 권한 제약 아래에서 원인을 귀속할 수 있고 전이 가능한 개선이 필요하다.
- Cross-Component Diagnosis and Coordinated Improvement: 통제 비교, 구성요소 고정, 표적 절제 실험으로 개입 가설과 상호작용을 시험한다. 절제 실험은 기여를 평가하기 위해 구성요소를 제거하거나 고정한다.
- Learner-Conditioned Experience Acquisition and Reliable Learning Signals: 총 경험 획득 및 학습 예산을 맞추고 다양성을 보존하면서 타당성, 난도, 학습 가치를 구분한다.
- Persistent-State Management and Reliable Reuse: 계승된 산출물의 적용 가능성, 검색, 충실한 실행, 유지보수, 후속 이득을 추적한다.
- Governed Adaptation under Domain-Specific Feedback: 과학, 물리, 소프트웨어, 임상 조건에 맞춰 검증하고 명시적인 출시 권한을 유지한다.
- Trustworthy Evolution of Improvement Mechanisms: 편집 가능한 내부 피드백과 독립적으로 유지하는 승인 기준을 분리하고, 메커니즘 수정과 이후 결정을 연결하는 근거를 보존한다.
- Long-Horizon Evaluation of Inherited Improvement Capacity: 총예산을 맞춘 상태에서 비교 가능한 초기 상태로부터 원래 메커니즘과 수정된 메커니즘을 비교하고, 거부된 업데이트, 성능 퇴보, 복구, 유지, 전이를 보고한다.
- Resource-Aware Improvement and Human Collaboration: 진단, 탐색, 검증, 인프라, 사람의 검토, 재작업을 비용에 포함하고, 시스템이 언제 중단하거나 일시 정지하거나 사람의 도움을 요청해야 하는지 평가한다.
- Reproducible Infrastructure for Cross-Round Inheritance: 재실행 가능한 기록에서 부모 상태, 제안한 변경, 변경의 근거, 평가 설정, 승인, 이후 사용을 연결한다.
7 Conclusion
결론은 자율성 5개 수준을 시스템이 무엇을 바꾸고, 후속 시스템이 무엇을 계승하며, 어떤 결정이 사람의 통제에 남는지 분석하는 로드맵으로 제시한다. 개선 과정 자체의 전이 가능한 개선을 입증하려면 명시적인 자원 제약과 감독 아래 장기 평가가 필요하다.
부록
- Appendix A: RSI Landscape는 논문 491편을 보고한다. L1은 215편(43.8%), L2는 155편(31.6%), L3는 64편(13.0%), L4는 28편(5.7%), L5는 29편(5.9%)이다. 개선 대상 분류는 프롬프트와 컨텍스트, 메모리와 지식, harness와 제어, 도구와 스킬, 모델, 최적화 시스템, 평가기, 데이터와 환경, 외부 산출물, 전체 시스템 공진화를 포함한다. 대상이 여러 개인 논문은 대상별 가중치를 분할해 기여하며, 자율성 수준의 비율은 논문 수를 기준으로 한다.
- Company Archetypes in the Emerging RSI / Self-Improvement Landscape를 포함하는 Appendix B: Industry Landscape는 2026년 9월 공개 자료를 기준으로 서로 다른 기업 또는 팀 72개를 기록하며, 제품이나 대표 작업마다 행 1개를 둔다. 기업 유형에 따라 프런티어 연구소, RSI 중심 기업, 자율 발견, 에이전트 학습 인프라, 체화 적응, 지속 메모리 기업으로 묶는다. “adj.”는 인접 인프라나 행동, “cand.”는 가능성은 있지만 입증이 불완전한 수준, “target”은 미래 목표를 뜻한다. 별표는 정체성이나 공개된 기술적 범위를 더 확실하게 검증해야 하는 항목을 표시한다. 이 표시는 리뷰의 분류이며, 기업들이 같은 분류명을 사용한다는 주장이 아니다.
- Appendix C: RSI Across Applications는 4가지 피드백 체계를 확장하고, 그 경계가 겹칠 수 있다고 본다. 예를 들어 의료 연구 에이전트는 과학과 의료 2개 분야 모두에 속할 수 있다. 각 리뷰는 워크플로, 피드백 출처, 수정 가능한 구성요소, 유지되는 변경, 검증 요구사항을 설명한 뒤 더 완전한 재귀 루프까지의 격차를 평가한다.
- C.1 S1: RSI for Science는 개방형 탐색, 모호한 실험 실패, 가정과 측정 절차에 따라 달라지는 타당성을 강조한다. C.1.1 Evolving Scientific Hypothesis Modules는 유지되는 생성 스킬과 연구 방향 메모리, 고정된 업데이트 절차를 통한 모델 재학습을 설명한다. 이들은 범위가 제한된 가설 개선을 지원한다. C.1.2 Evolving Experimental Agents는 재사용 가능한 도구와 워크플로를 설명한다. SciEvo는 과제 1,590개와 진화한 도구 925개를 포함하며, DrugSAGE는 과제 16개에서 얻은 경험으로 별도로 남겨둔 과제 17개의 성능을 높인다. C.1.3 Evolving Reflection Systems and Improvers는 진단과 개입의 변경을 검토한다. SIA는 구성요소 업데이트 중에서 선택하고, CORAL은 비동기 탐색을 조직하며, SAGA는 고정된 과학 목표 아래 실제 탐색에 사용하는 채점 목표를 수정한다. C.1.4 Toward Recursively Improving Science Agents는 현재 가장 확실하게 도달한 수준을 L2로 보고 일부 L3 측면도 확인한다. 더 완전한 L4와 L5에는 신뢰할 수 있는 원인 귀속, 선택적 전이, 재현성, 업데이트가 이후 연구를 개선한다는 근거가 필요하다.
- C.2 S2: RSI for Embodied Intelligence는 정책에 의존하는 경험, 감각운동 구성요소 전반에 분산된 실패, 자유롭게 초기화할 수 없는 물리적 시행을 다룬다. C.2.1 Evolving Environments and Curricula는 학습자의 진전에 따라 시뮬레이터 설정을 조정하거나 실행 가능한 환경을 생성해, 이후 연습이 변화하는 약점을 겨냥하도록 하는 방식을 설명한다. C.2.2 Evolving Skills, Memory, and Agent Harnesses는 재사용 가능한 로봇 프로그램, 근거 기반 스킬 수정, 더 폭넓은 harness 변경을 다룬다. 결함 있는 스킬과 유효한 지침을 따르지 못한 실패를 구분한다. C.2.3 Evolving Policies and Action Models는 자율 연습, 학습한 초기화 행동, 배포 궤적에 따른 업데이트를 설명하지만, 업데이트 규칙과 보상은 정해진 상태로 남는다. C.2.4 Evolving World Models and Evaluators는 고정 목표 아래 이후 정책 학습 경험을 제공하는 상호작용 기반 모델 정교화를 검토한다. C.2.5 Toward Recursively Improving Embodied Agents는 이 메커니즘들이 부분적으로만 통합되어 있다고 본다. 시뮬레이션 적응과 제한적인 절차 변경만으로는 실제 환경과 다양한 신체 구성에 걸친 안전하고 지속적인 자율 개선을 입증하지 못한다.
- C.3 S3: RSI for Software Engineering은 당장의 과제 성공과 이후 유용한 후속 시스템을 만드는 능력을 구분한다. C.3.1 Evolving Coding-Agent Implementations and Harnesses는 고정된 외부 평가 아래 버전 관리, 회귀 검사, 롤백으로 유지되는 자기 편집 코드와 검증된 harness 수정을 설명한다. C.3.2 Evolving Software-Engineering Experience, Skills, and Collaboration은 재사용 가능한 개발 지식과 각 과제 안에서 별도로 이루어지는 협업 업데이트를 비교한다. 지식을 유지하는 것만으로는 지식 추출 절차 자체를 수정하지 않는다. C.3.3 Evolving the Improvement Process는 에이전트 계보, 부모 간 공유 경험, 유용한 후속 시스템을 만드는 능력인 메타 생산성과 함께 모델–harness의 연동 업데이트를 검토한다. C.3.4 Toward Recursively Improving Software-Engineering Agents는 가장 확실히 입증된 수준을 L2로 보고, L3에서는 학습자 상태에 따른 과제 생성이 등장하고 있다고 본다. 제한적인 L5 특성만으로는 소프트웨어 개발 개선자 자체의 완전한 개선을 입증하지 못한다. 견고한 명세, 저장소와 버전 간 전이의 원인 귀속, 외부에서 보호하는 사용자 의도와 롤백이 여전히 필요하다.
- C.4 S4: RSI for Healthcare는 제한적인 시행착오, 지연되고 교란 요인이 있는 결과, 인구집단에 따라 달라지는 타당성을 강조한다. C.4.1 Evolving Clinical Memory and Knowledge는 사례 메모리, 재사용 가능한 진단 패턴, 그래프 기반 메모리 재보정, 도구 신뢰도 추정의 수정을 설명한다. 평가는 주로 시뮬레이션이나 후향적 사례에서 이루어진다. C.4.2 Evolving Clinical Reasoning Strategies는 진단 행동의 임상적 유용성과 비용을 채점한 뒤 프롬프트와 메모리를 수정하는 방식을 설명한다. 다른 시스템은 전문 에이전트 간 합의를 업데이트하거나 상담 스킬을 유지한다. C.4.3 Evolving Healthcare Tools and Workflows는 복합 영상 도구, 관리되는 절차적 스킬, 전문가 지침에 따른 워크플로 구축, 의료 데이터 분석에서 얻어 유지하는 안전장치를 다룬다. 모두 재사용 전에 검증이 필요하다. C.4.4 Toward Recursively Improving Healthcare Agents는 현재 가장 확실하게 도달한 수준을 L2로 보고, 제한적인 L3-like 근거 획득과 시뮬레이션 기반 L4식 공진화도 확인한다. 실제 장기 추적 결과에 따른 종단 간 적응과 임상 개선자의 L5 진화는 대부분 연구되지 않은 상태다. 더 높은 수준에는 추적 가능하고 되돌릴 수 있는 업데이트, 전향적 모니터링, 인구집단과 기관 간 선택적 전이가 필요하다.
짧은 생각
이 리뷰는 RSI 주장을 평가할 구체적인 검사를 제시한다. 계승되는 산출물을 식별하고, 그것이 이후 개선 라운드를 어떻게 바꾸는지 검증한다. 이를 통해 개선 능력 자체가 향상되었다는 주장을 높은 과제 점수나 긴 무인 운영 시간과 분리해 평가할 수 있다. 구조적 재귀와 효과적 재귀의 구분은 AIDE²의 외부 개선자 시험과 HyperAgents의 더 긴 전이 실험을 해석할 때 특히 유용하다. 이 2개 실험 모두 해당 설정에서 확인하려던 통계적으로 유의한 우위를 입증하지 못했다. 실증 사례들은 서로 다른 질문에 답한다. Theseus는 작업공간 조건을 분리하고, Humanlaya는 모델, 도구, 처리 예산을 맞춘 상태에서 내부 버전을 비교한다. 다른 사례들은 공개 검증 수준이 서로 다른 기업 보고 결과를 제공한다. HCI 추이는 정규화된 벤치마크 진전을 설명하며, 예시로 제시한 연장선은 RSI의 인과적 이득을 입증하지 않는다. 동일하게 맞춘 총예산, 독립적 평가, 새로운 과제로의 전이는 계승된 메커니즘이 이후 라운드를 개선하는지 시험하는 데 더 강한 근거를 제공한다.