


Long-WAM: Scaling the Context of World-Action Models 요약 설명
07 Oct 2026 | Paper Review World Models Robotic Learning Autoregressive Video Generation목차
이번 글에서는 Long-WAM: Scaling the Context of World-Action Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 10월 7일(Arxiv)
- Huang, Wei, Zhang, Bohan, Liu, Chenzhi, Liu, Isabella, Yang, Shuai, Mao, Weian, Wang, Luozhou, Xiao, Yicheng, Lin, Weifeng, Hu, Qixin, et al.
- NVIDIA, MIT, HKU, UCSD
- 논문 링크
- Github
- Project Page
요약
- 로봇 제어기는 움직임과 작업 진행 상태를 추론하려면 시각적 이력이 필요하지만, 이력을 처리하느라 응답이 늦어질 수 있다. RoboCasa GR-1 탁상 조작 시뮬레이션 벤치마크에서 Long-WAM의 관측 이력을 0.0초에서 19.2초로 늘리면 성공률이 63.3%에서 78.7%로 높아진다. 반면 시간의 양방향으로 attention을 적용해 사전학습한 초기 모델은 같은 구간의 시작과 끝을 비교했을 때 성능 향상을 보이지 않는다.
- Long-WAM은 먼저 행동 레이블이 없는 로봇 영상과 사람의 시점에서 촬영한 egocentric 영상으로 자기회귀(AR) 영상 예측을 학습한다. AR 영상 예측은 앞선 관측으로 미래 영상을 예측하는 방식이다. 이후 영상 기반 모델을 실행 가능한 로봇 행동과 영상 예측을 연결하는 world-action model (WAM)로 적응시킬 때도 이 시간 순서를 유지한다. 자기회귀(AR)에 대해서는 TiDAR: Think in Diffusion, Talk in Autoregression 요약 설명 글을 참조하라.
- 주로 사용하는 추론 전략은 압축된 영상 표현인 미래 시각 잠재변수를 먼저 예측한 뒤, 로봇 명령 시퀀스인 행동 청크를 생성한다. Long-WAM은 긴 조작 작업으로 구성된 LIBERO-Long에서 성공률 99.5%, 양팔 조작 벤치마크 RoboTwin 2.0에서 평균 성공률 94.4%를 달성한다. 동적 데이터로 미세조정한 뒤에는 동적 조작 벤치마크 DOMINO에서 성공률 34.9%를 달성한다. 이 결과들은 논문에서 비교한 방법 중 가장 높다.
- 하드웨어와 소프트웨어 최적화를 통해 RTX 5090에서 expert마다 4단계를 수행하는 추론 시간을 행동 청크당 356.0 ms에서 107.4 ms로 줄인다. 이 시간에는 전체 관측 인코딩이 포함된다. 별도로 스트리밍 인코딩을 적용하면 준비 작업을 추론 트리거 이전에 수행하며, 추론은 로봇 실행과 겹쳐 진행한다. 실제 로봇 실험에서는 동적 컵 쌓기에서 19/20회 성공한다. 비교 대상인 vision-language-action 정책 베이스라인 π₀.₅와 world-action 베이스라인 Fast-WAM은 2개 모두 0/20회 성공한다. YAM 양팔 조작기의 3개 작업에서는 평균 성공률 81.7%를 기록하며, 작업은 평균 40초 넘게 지속된다. vision-language-action에 대해서는 ThinkAct: Vision-Language-Action Reasoning via Reinforced Visual Latent Planning 요약 설명 글을 참조하라.
- 컨텍스트 연구는 이력 구간마다 별도의 정책을 학습하므로, 단일 정책이 추론 시점에 이력 길이를 조절할 수 있음을 입증하지는 않는다. 이력이 길어지면 계산량도 증가한다. RTX 5090의 청크 지연 시간은 이력이 2.4초일 때 107.4 ms에서 19.2초일 때 341.0 ms로 늘어난다. 가장 긴 시험 구간에서는 성공률이 낮아지며, 이때 샘플링한 이력 프레임의 80.4%가 패딩이다.
1. Introduction
단일 이미지는 물체 위치를 보여줄 수 있지만, 움직임과 상호작용의 진행 상태를 파악하기에는 부족할 수 있다. 논문은 관측 이력을 추가하면 제어 성능이 좋아지는지, 실시간 계산 제약 아래에서도 그 이점을 유지할 수 있는지 살펴본다.
- 관측을 보관한다고 모델이 그 관측을 바탕으로 예측하는 법까지 배우는 것은 아니다. 로봇 도메인 AR 초기 모델이 양방향 사전학습 초기 모델보다 앞서는 폭은 이력이 없을 때 3.3%포인트에서 이력이 19.2초일 때 17.1점으로 커진다.
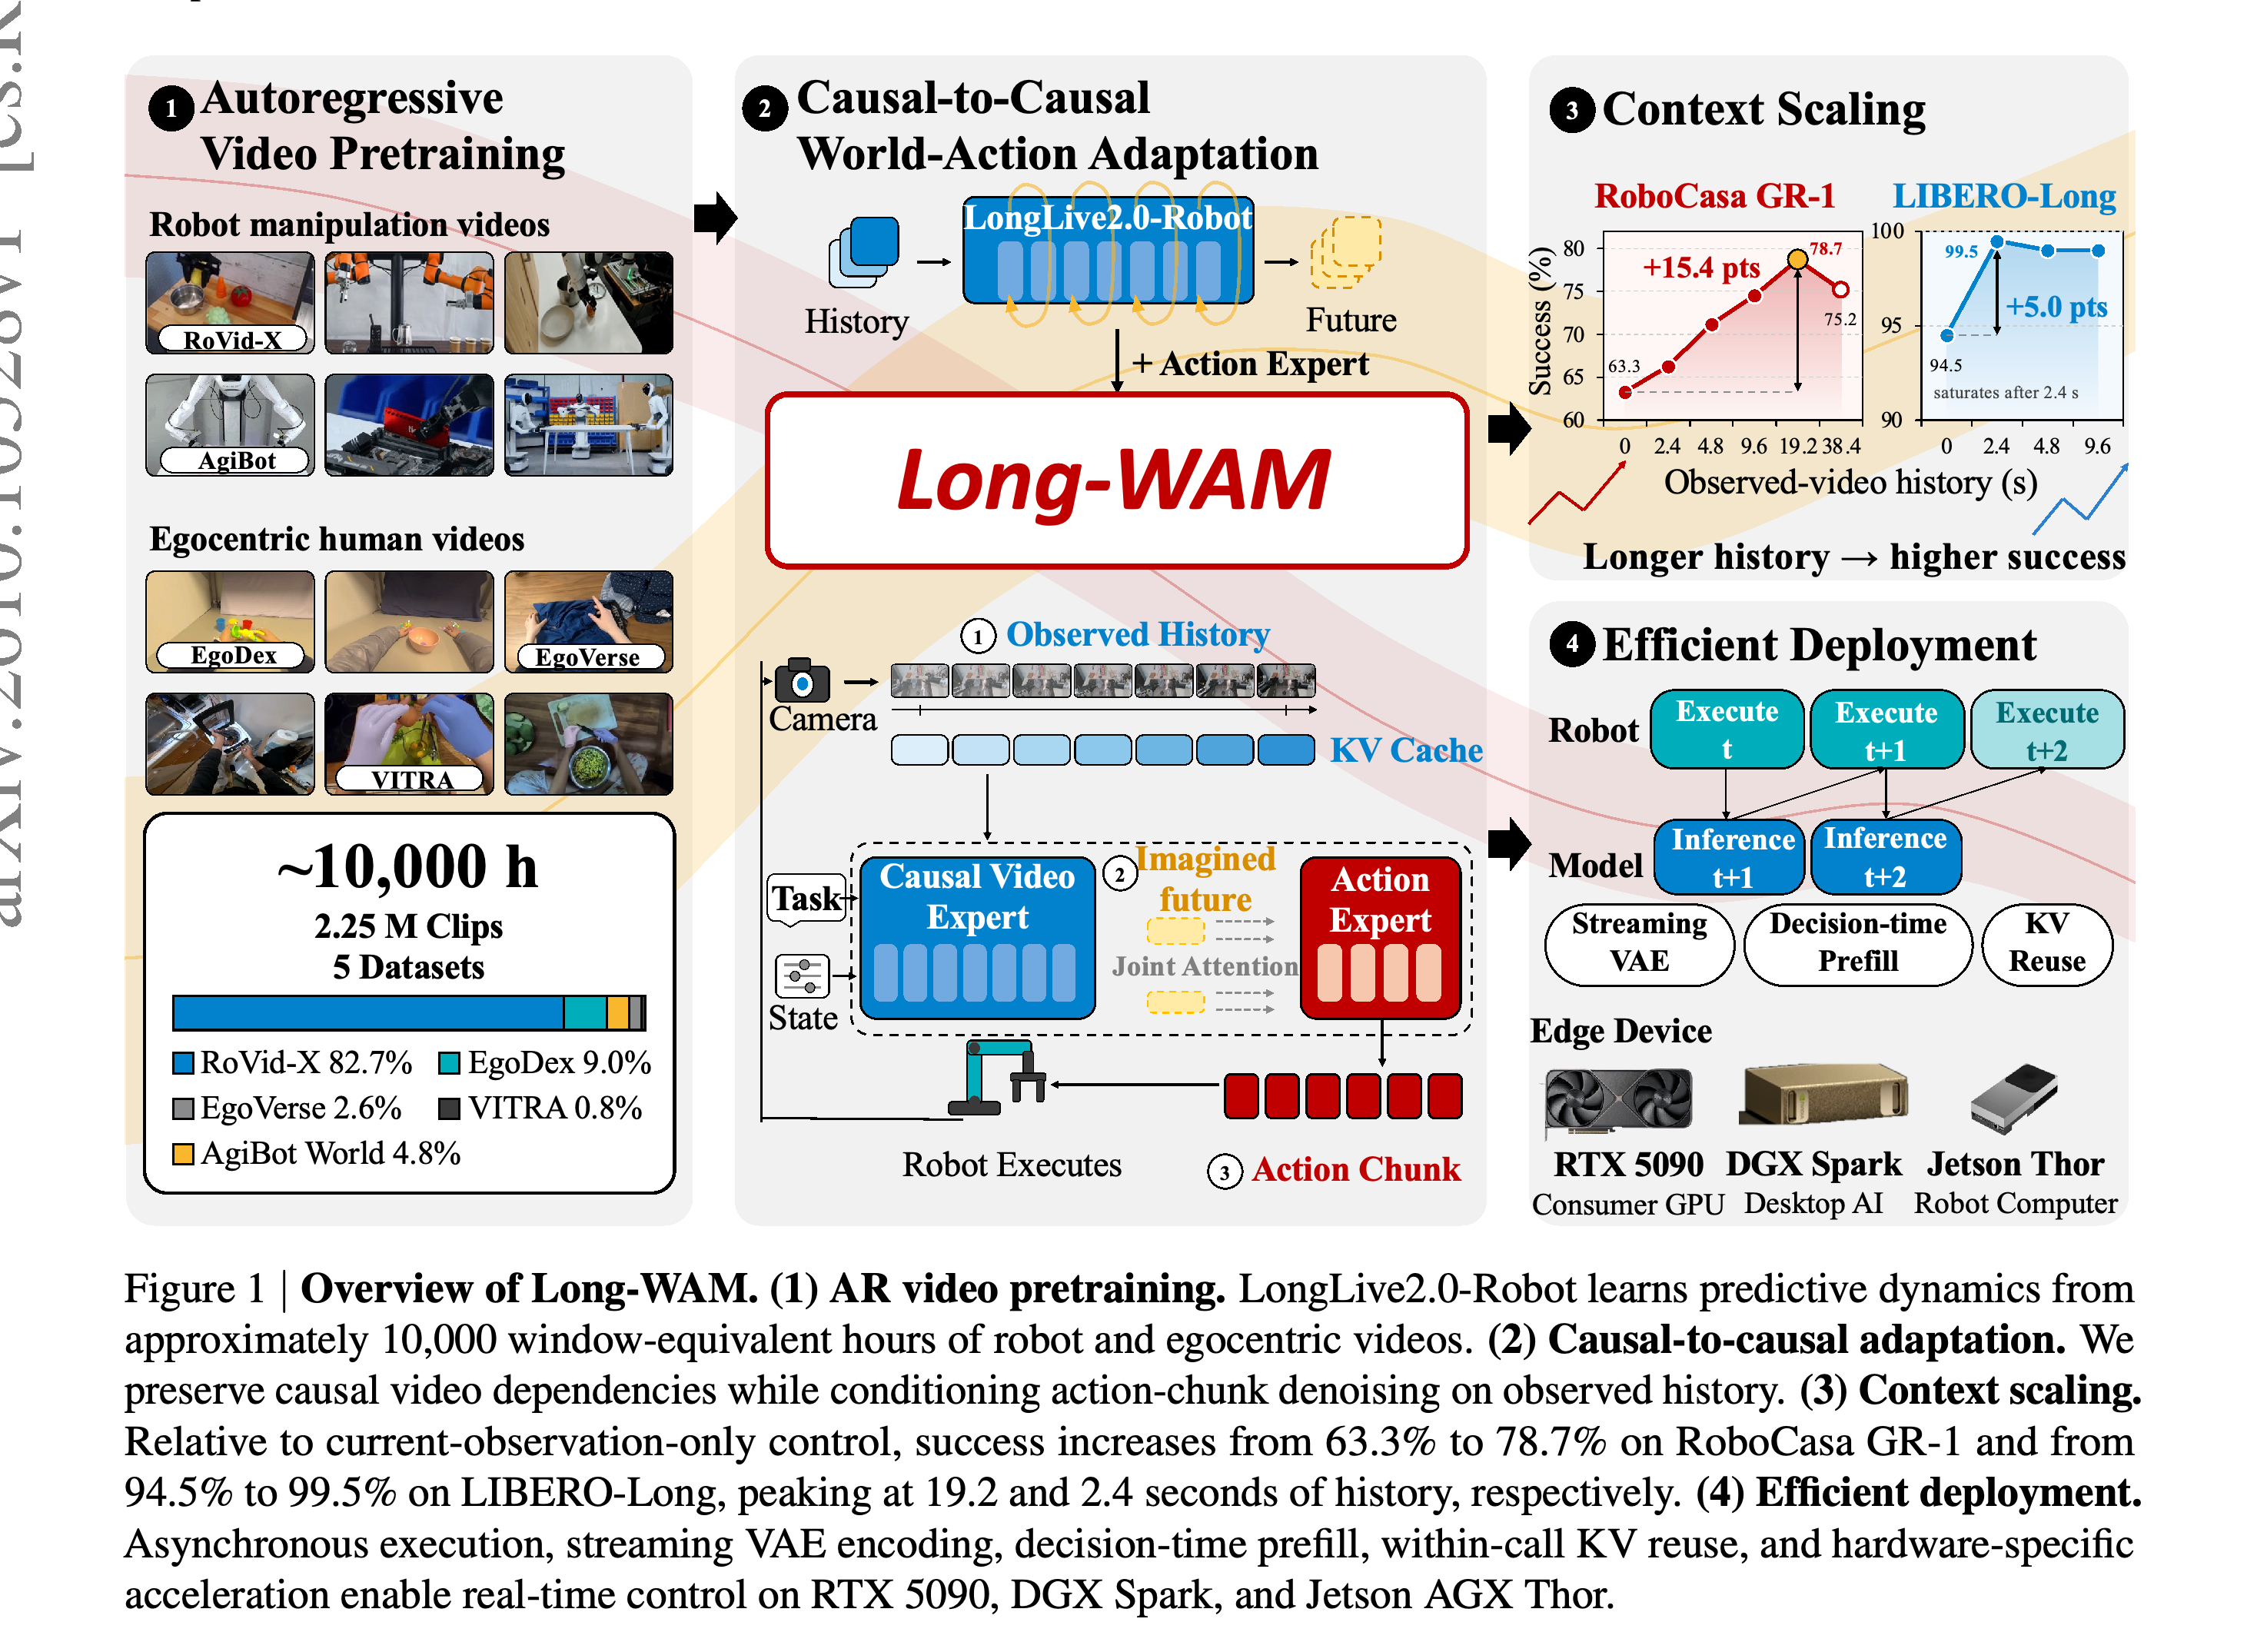
- Figure 1은 영상만을 이용한 예측 사전학습, 시간 순서를 유지하는 행동 적응, 컨텍스트 길이 평가, 실행 가속을 연결해 보여준다.
이 개요는 예측 사전학습을 행동 생성과 배포로 연결한다. 컨텍스트 곡선은 유용한 이력 길이가 LIBERO-Long과 RoboCasa GR-1에서 다름을 보여주므로, 모든 작업에 공통으로 적용할 최적 구간을 확립한 결과는 아니다.
2. Related Work
DreamZero와 LingBot-VA는 양방향으로 사전학습한 영상 생성기를 인과적 제어에 적응시킨다. 이때 시각 예측은 해당 시간 블록과 이전 시간 블록에만 의존한다. LingBot-VA 2.0은 인과적 영상과 학습된 잠재 행동을 함께 사전학습한다. Long-WAM은 행동 레이블을 사용하지 않는 예측 사전학습과 로봇 행동 표현 학습을 분리한다.
- 메모리 압축, 검색, 지속적 캐시는 이력을 보관하는 방법을 다룬다. Long-WAM은 로봇이 직접 관측한 이력의 길이가 예측 사전학습과 어떻게 상호작용하는지 살펴본다.
- 기존 배포 방법은 캐싱, 생성 단계 축소, 행동만 디코딩하는 방식, 행동 청크 사이의 전환 제약 등을 사용한다. Long-WAM은 미래 예측을 유지하며, 로봇이 앞선 청크를 실행하는 동안 추론을 수행하는 비동기 실행을 평가한다.
3. Scaling the Context of WAMs from AR Video Generation
이 방법은 긴 시퀀스의 AR 영상 사전학습으로 로봇 움직임과 물체 상호작용의 동역학을 학습한다. 이어 인과적 시간 구조를 유지하면서 이 기반 모델을 행동 생성에 전이한다. 행동은 관측 이력과 예측한 미래에 모두 의존하므로, 예측은 제어를 위한 중간 표현이 된다.
3.1. LongLive2.0-Robot: Robot-Domain AR Video Pretraining
LongLive2.0-Robot은 LongLive-2.0의 16초 AR 체크포인트에서 학습을 이어간다. RoVid-X, AgiBot World, EgoDex, EgoVerse, VITRA에서 확보한 데이터를 윈도 환산 기준 약 10,000시간 사용한다. 이 추정치는 중복을 제외한 영상의 총길이를 측정한 값이 아니라 각 학습 샘플에 고정 길이를 부여해 계산한 값이다. 영상만으로 학습하므로 데이터 출처마다 행동 좌표계나 액추에이터 차원이 달라도 활용할 수 있다.
- 최대 30초 길이의 시퀀스와 긴 시퀀스를 여러 그래픽 처리 장치(GPU)에 분산하는 시퀀스 병렬화를 사용해 학습한다. Teacher forcing은 각 노이즈 타깃 청크에 정답 prefix를 조건으로 제공하고, block-causal attention은 이후 청크에 접근하지 못하게 한다.
- Error recycling은 원래의 깨끗한 타깃을 유지하면서 버퍼에 저장한 모델 오류를 학습 입력에 주입한다. 이를 통해 rollout과 유사한 교란에서 회복하는 법을 학습한다. 조건 이미지는 깨끗하게 유지하며 손실 계산에서 제외한다.
3.2. Causal-to-Causal World-Action Adaptation
영상 expert와 행동 expert는 각 모달리티를 담당하는 모델 구성 요소이며, 비대칭 attention 인터페이스를 사용한다. 영상 query는 해당 시각 블록과 이전 시각 블록을 읽고 행동은 읽지 않는다. 행동 query는 관측 이력, 부분적으로 denoising한 미래 영상, 전체 노이즈 행동 청크를 읽는다.
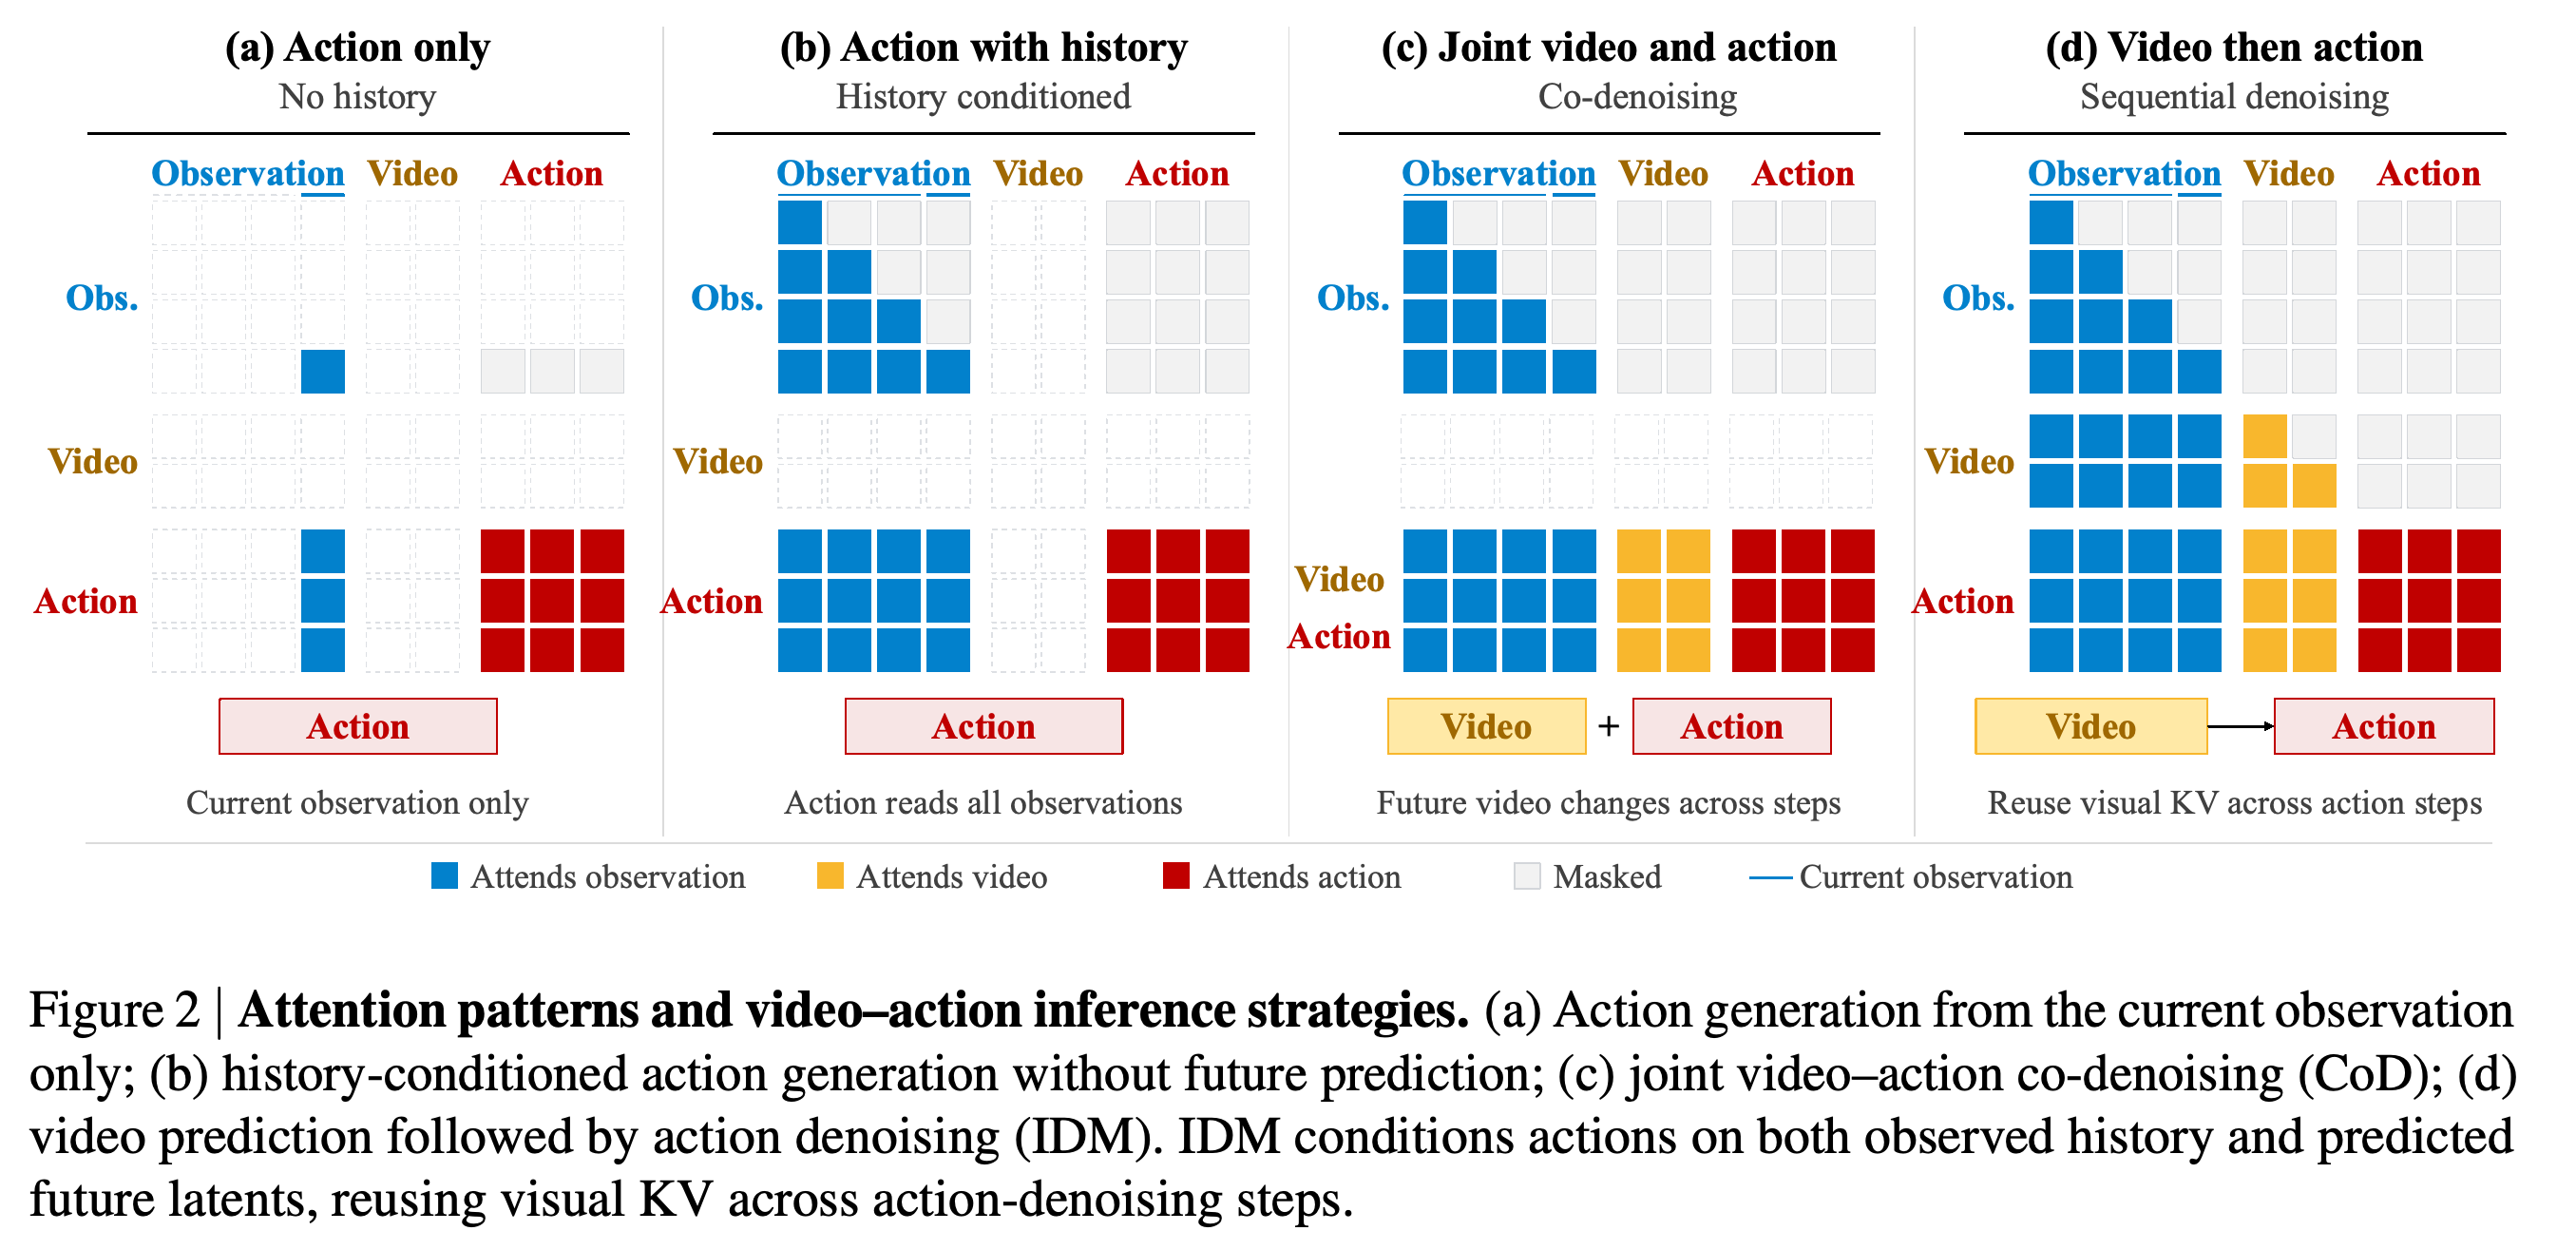
- 논문은 미래 시각 잠재변수를 먼저 예측하고 그 예측을 조건으로 행동을 추론하는 predict-then-act 전략을 inverse dynamics modeling (IDM)이라고 부른다. Figure 2는 IDM을 현재 관측만 사용하는 행동 생성, 미래 예측 없이 이력을 조건으로 사용하는 행동 생성, 영상과 행동을 함께 갱신하는 co-denoising (CoD)과 비교한다.
- 학습에서는 속도 예측을 통해 노이즈에서 데이터를 생성하는 법을 배우는 flow matching을 2회 수행한다. 영상 패스는 깨끗한 이력을 조건으로 사용하고, 행동 패스는 이력과 노이즈 수준 σ⋆ = 0.9로 forward noising한 정답 미래를 조건으로 사용한다. 행동 패스는 시각 캐시를 계산 그래프에서 분리한다. 따라서 행동 손실은 행동 expert와 로봇 상태를 반영하는 proprioceptive adapter를 갱신하지만, 해당 캐시를 통해 역전파하지 않는다.
- 추론에서는 영상 denoising을 4단계 수행하고 σ⋆ = 0.9에서 멈춘다. 미래 잠재변수는 픽셀로 디코딩하지 않으며, attention의 key와 value를 저장한 key–value (KV) 캐시를 행동 denoising 전반에서 재사용한다.
Attention 마스크는 행동이 이력에 접근하게 하는 방식과 명시적으로 예측한 미래를 조건으로 제공하는 방식을 구분한다. 영상을 먼저 예측하고 행동을 생성하는 순차 추론은 행동 denoising 중 미래 시각 특징을 재사용할 수 있게 하지만, 순차 실행에 따른 추론 비용이 든다.
3.3. Context Scaling of World-Action Models
컨텍스트 실험은 벤치마크별로 예측 범위와 행동 범위를 고정한 채 실제 관측의 길이를 바꾼다. 구간마다 별도로 학습한 정책을 사용하며, 학습 때와 같은 컨텍스트 길이로 평가한다. 이력이 0인 조건에서도 현재 관측은 유지하고, 초반에 확보할 수 없는 과거 이력은 초기 프레임을 반복해 채운다.
- 초기 모델은 양방향 사전학습을 거친 Wan2.2, AR 사전학습을 거친 LongLive-2.0, 로봇 도메인 AR 사전학습을 거친 LongLive2.0-Robot이다. 모두 인과적 WAM 적응을 거치므로, 양방향이라는 표현은 적응 후 정책의 시간 마스크가 아니라 사전학습 방식을 가리킨다.
- RoboCasa GR-1에서는 0–38.4초 범위를 평가하고, LIBERO-Long에서도 보완 실험을 수행한다. 이 프로토콜은 추가 관측이 동일한 단기 의사결정을 개선하는지 검증한다. 다만 prefix가 길어지면 attention 계산량, 캐시 저장 공간, 조건 캐시를 구축하는 prefill 계산이 증가한다.
4. Long-WAM Infrastructure: Real-Time Edge Deployment
배포 시스템은 비동기 실행과 RTX 5090, DGX Spark, Jetson AGX Thor에서의 로컬 추론 가속을 결합한다. 시각 잠재변수를 생성하는 영상 인코더인 스트리밍 인과적 변분 오토인코더(VAE)가 다음 추론 트리거 전에 들어오는 관측을 처리해, 트리거 이후의 준비 작업을 줄인다.
4.1. Asynchronous Execution
제어기는 연속된 예측을 혼합하는 action blending이나 이전 행동으로 새 청크를 제약하는 prefix guidance 없이 추론과 로봇 실행을 겹쳐 수행한다. 예측한 H단계 청크 중 앞의 R단계가 실행 대상이다. 추론의 명목상 간격은 S 제어 단계이며 R/2 ≤ S < R ≤ H를 만족한다. 이에 따라 중첩 구간은 O = R − S가 된다.
- 새 청크로 전환할 때 이미 지난 시점의 행동을 버리고, 시간에 맞춰 정렬한 새 청크의 나머지 부분을 실행한다. 대기 없이 전환하려면 T_ready ≤ OΔt = (R − S)Δt를 만족해야 한다. 여기서 Δt는 제어 간격이고, T_ready는 트리거 관측을 사용할 수 있게 된 뒤의 전송, 큐 대기, 계산 시간을 포함한다.
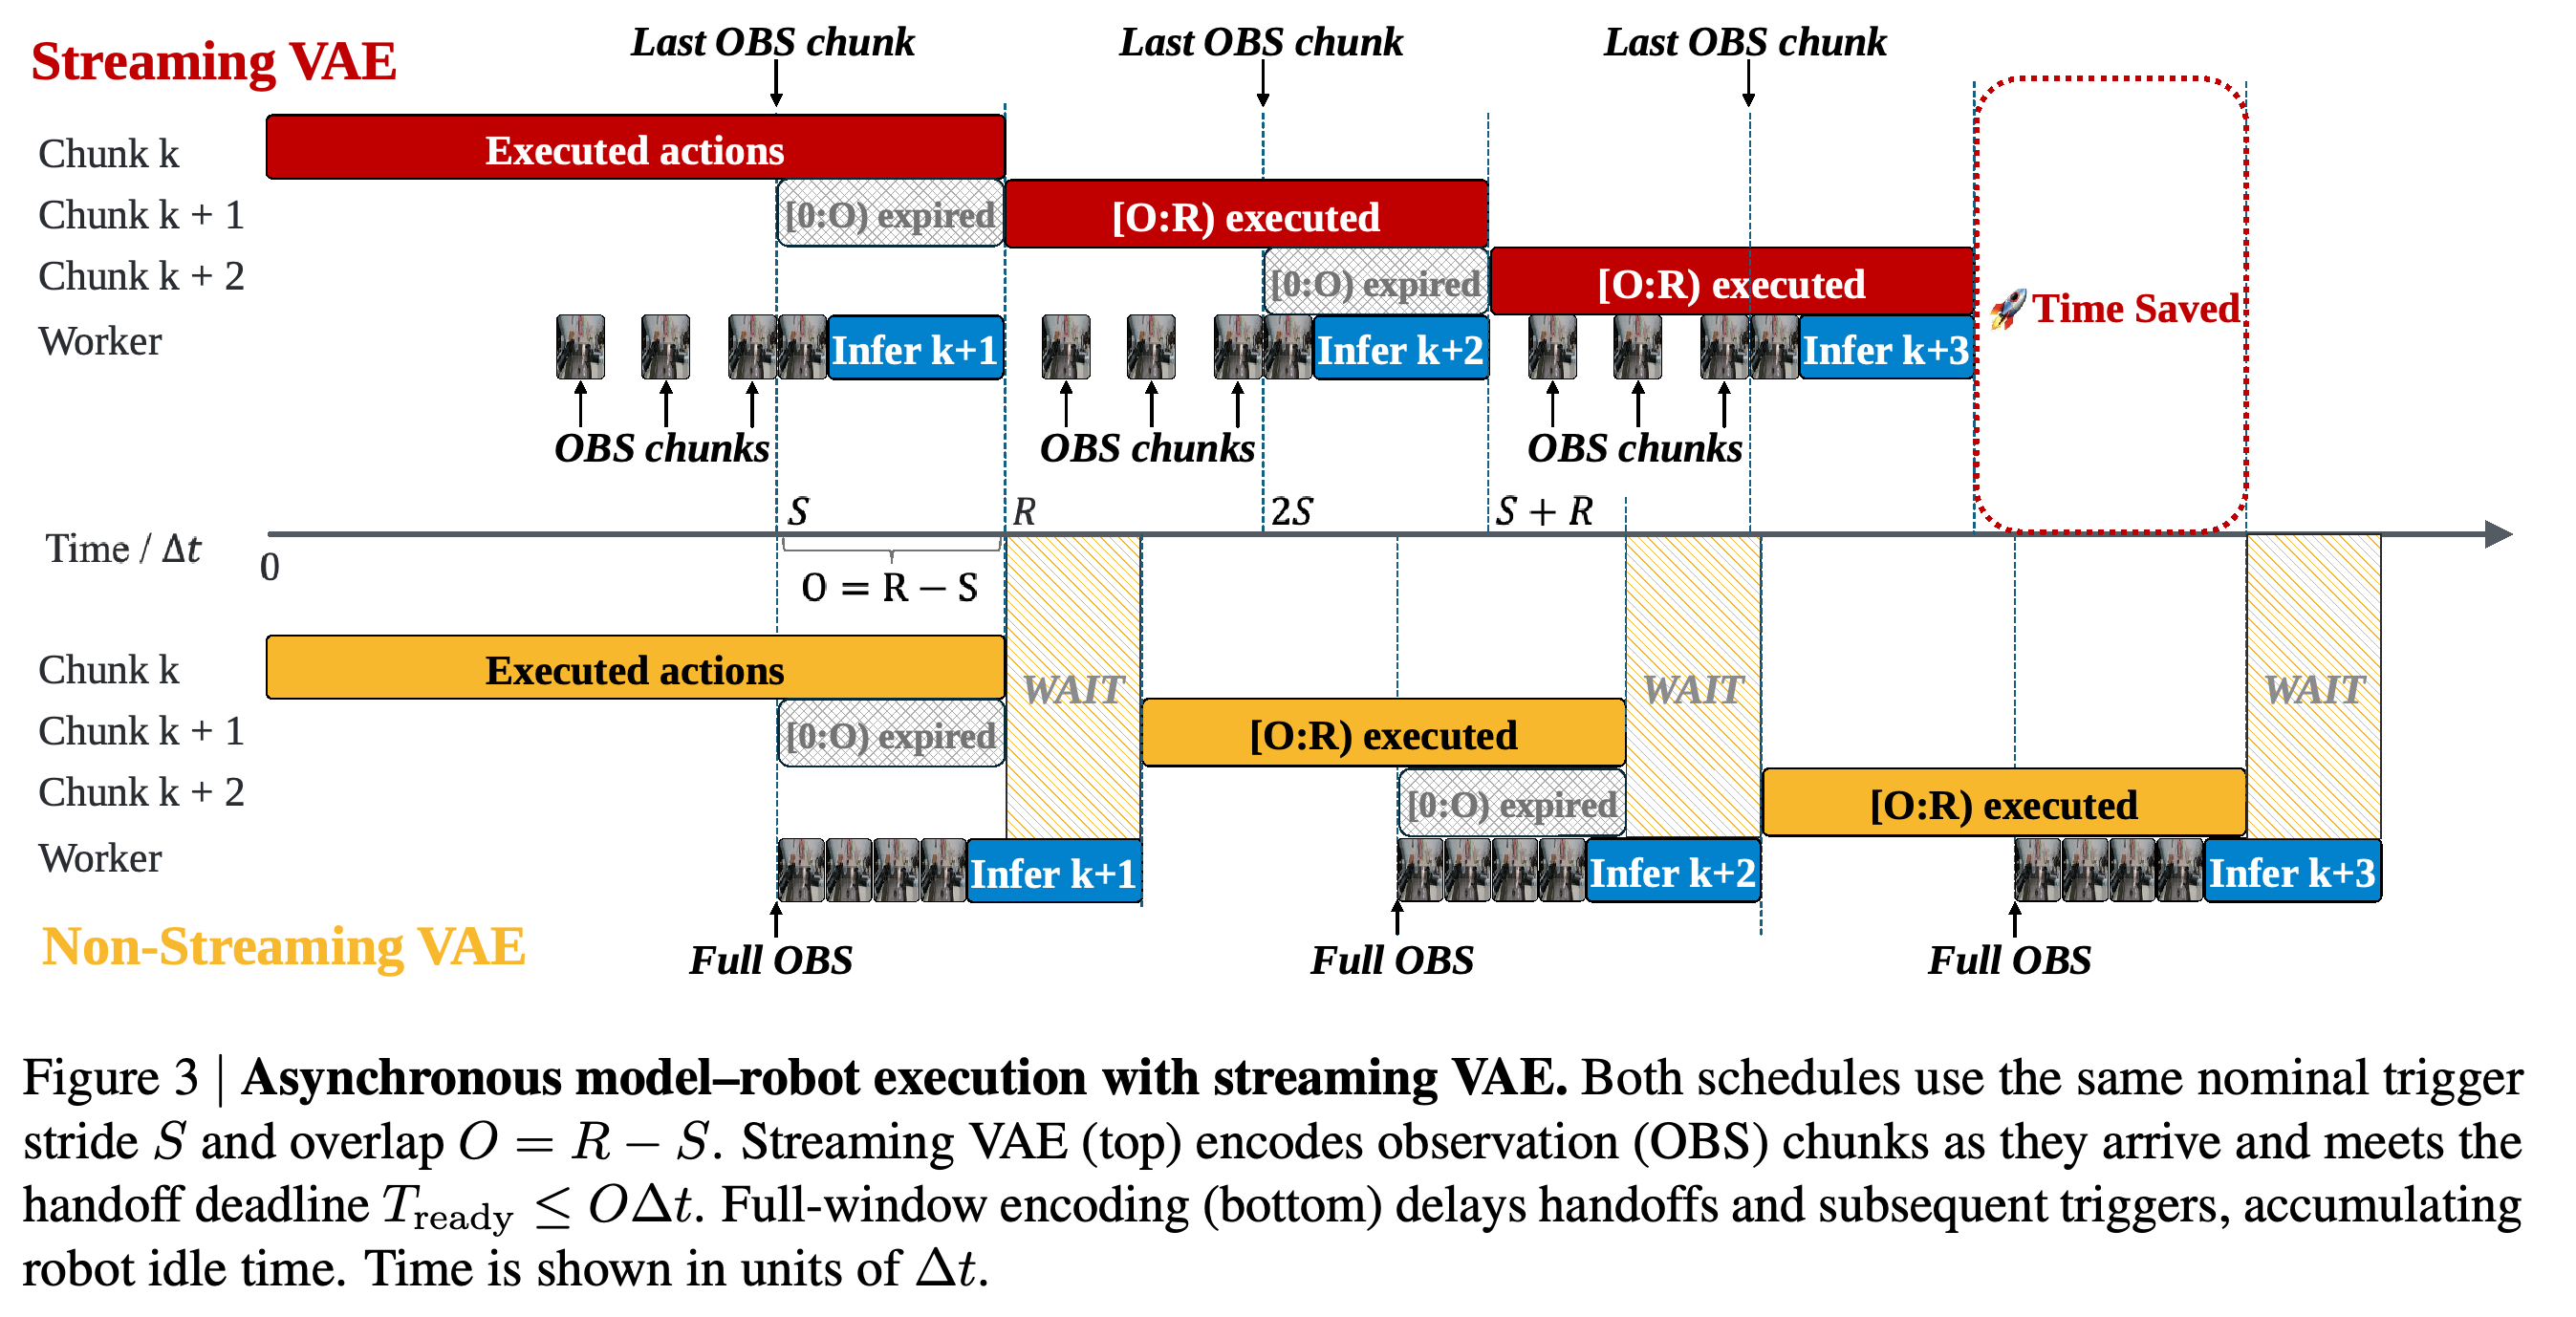
- Figure 3은 관측이 들어올 때마다 인코딩하면 전체 구간 인코딩으로 대기가 반복되는 상황에서도 이 기한을 맞출 수 있음을 보여준다. R이 고정되어 있을 때 중첩 구간을 줄이면 추론 트리거를 더 늦게 발생시킬 수 있지만, 준비에 쓸 시간도 줄어든다.
명목상 트리거 간격과 중첩 구간이 같을 때, 트리거 전에 관측을 처리하면 행동 청크 전환 전까지 남은 작업이 줄어든다. 아래 스케줄은 전체 구간 인코딩으로 유휴 시간이 누적되고 이후 트리거가 늦어질 수 있음을 보여준다.
4.2. Efficient Edge Deployment
영상 expert의 선형 계층에는 가중치와 활성화를 4비트로 표현하는 W4A4 NVFP4를 사용한다. 행동 계산과 KV 저장에는 16비트 부동소수점 형식인 BF16을 유지한다. 캡처한 연산을 재실행하는 CUDA Graph replay와 PyTorch 컴파일은 작은 양자화 커널로 인해 발생하는 커널 실행 오버헤드를 줄인다.
- 각 추론 호출 안에서는 denoising 단계가 바뀌어도 동일한 text/state KV, 관측 영상 KV, 토큰 위치를 인코딩하는 rotary position embedding 테이블 등을 재사용한다. Shared-input quantization은 query, key, value projection이 공유하는 입력을 1회 처리한다.
- Online softmax는 별도의 영상 버퍼와 행동 버퍼에 대한 attention을 공통 정규화로 결합해 버퍼 연결을 피한다. 장치별 튜닝은 행렬 곱셈 타일, 실행 구성, attention 또는 VAE backend를 바꾸어 각 플랫폼의 하드웨어 제약에 대응한다.
5. Experiments
평가는 시뮬레이션 벤치마크 4개와 실제 로봇 작업 구성 8개에 걸쳐 수행한다. 단일 팔과 양팔 조작, 움직이는 물체 포착, 가사 작업 시퀀스, 긴 탁상 작업을 다룬다. 컨텍스트, 예측 전략, 계획, 실행 지연 시간도 각각 분석한다.
5.1. Implementation Details
LongLive2.0-Robot 사전학습에는 NVIDIA H100 GPU 64개에서 약 30,720 GPU-hours를 사용하며, 후속 WAM 학습에는 GB200 GPU 16개를 사용한다. 행동 적응에는 AdamW optimizer, 최대 학습률 10⁻⁴, cosine decay, 5% warmup, BF16 정밀도, 1.0의 gradient clipping을 적용한다.
- 실제 로봇 평가에는 Unitree G1 휴머노이드와 YAM 양팔 조작기를 사용한다. LIBERO, RoboTwin 2.0, DOMINO의 주요 시뮬레이션 결과는 최대 2.4초의 컨텍스트를 사용한다.
5.2. Results on Simulation Benchmarks
Long-WAM (IDM)은 LIBERO suite 전체에서 평균 성공률 99.5%, LIBERO-Long에서 성공률 99.5%를 달성한다. LIBERO-Long 성능은 LingBot-VA보다 1.0%포인트, Fast-WAM보다 4.3점 높다.
- RoboTwin 2.0의 평가 조건 2개인 Clean과 Randomized에서 각각 94.7%, 94.2%를 기록해 평균 94.4%를 달성한다. 이 평균은 ABot-M0.5보다 0.3점, LingBot-VA 2.0보다 0.8점 높다.
- DOMINO에서 동적 데이터로 미세조정한 뒤 Long-WAM은 성공률 34.9%와 벤치마크의 추가 성능 지표인 manipulation score 45.1을 달성한다. 성공률은 Fast-WAM보다 15.0점 높고, manipulation score는 PUMA보다 10.1점 높다.
- 19.2초 이력을 사용하는 RoboCasa GR-1 정책은 78.7%를 달성한다. 이는 표에 제시된 베이스라인 중 가장 높은 Cosmos Policy의 67.1%보다 11.6점 높다.
5.3. Ablation Studies
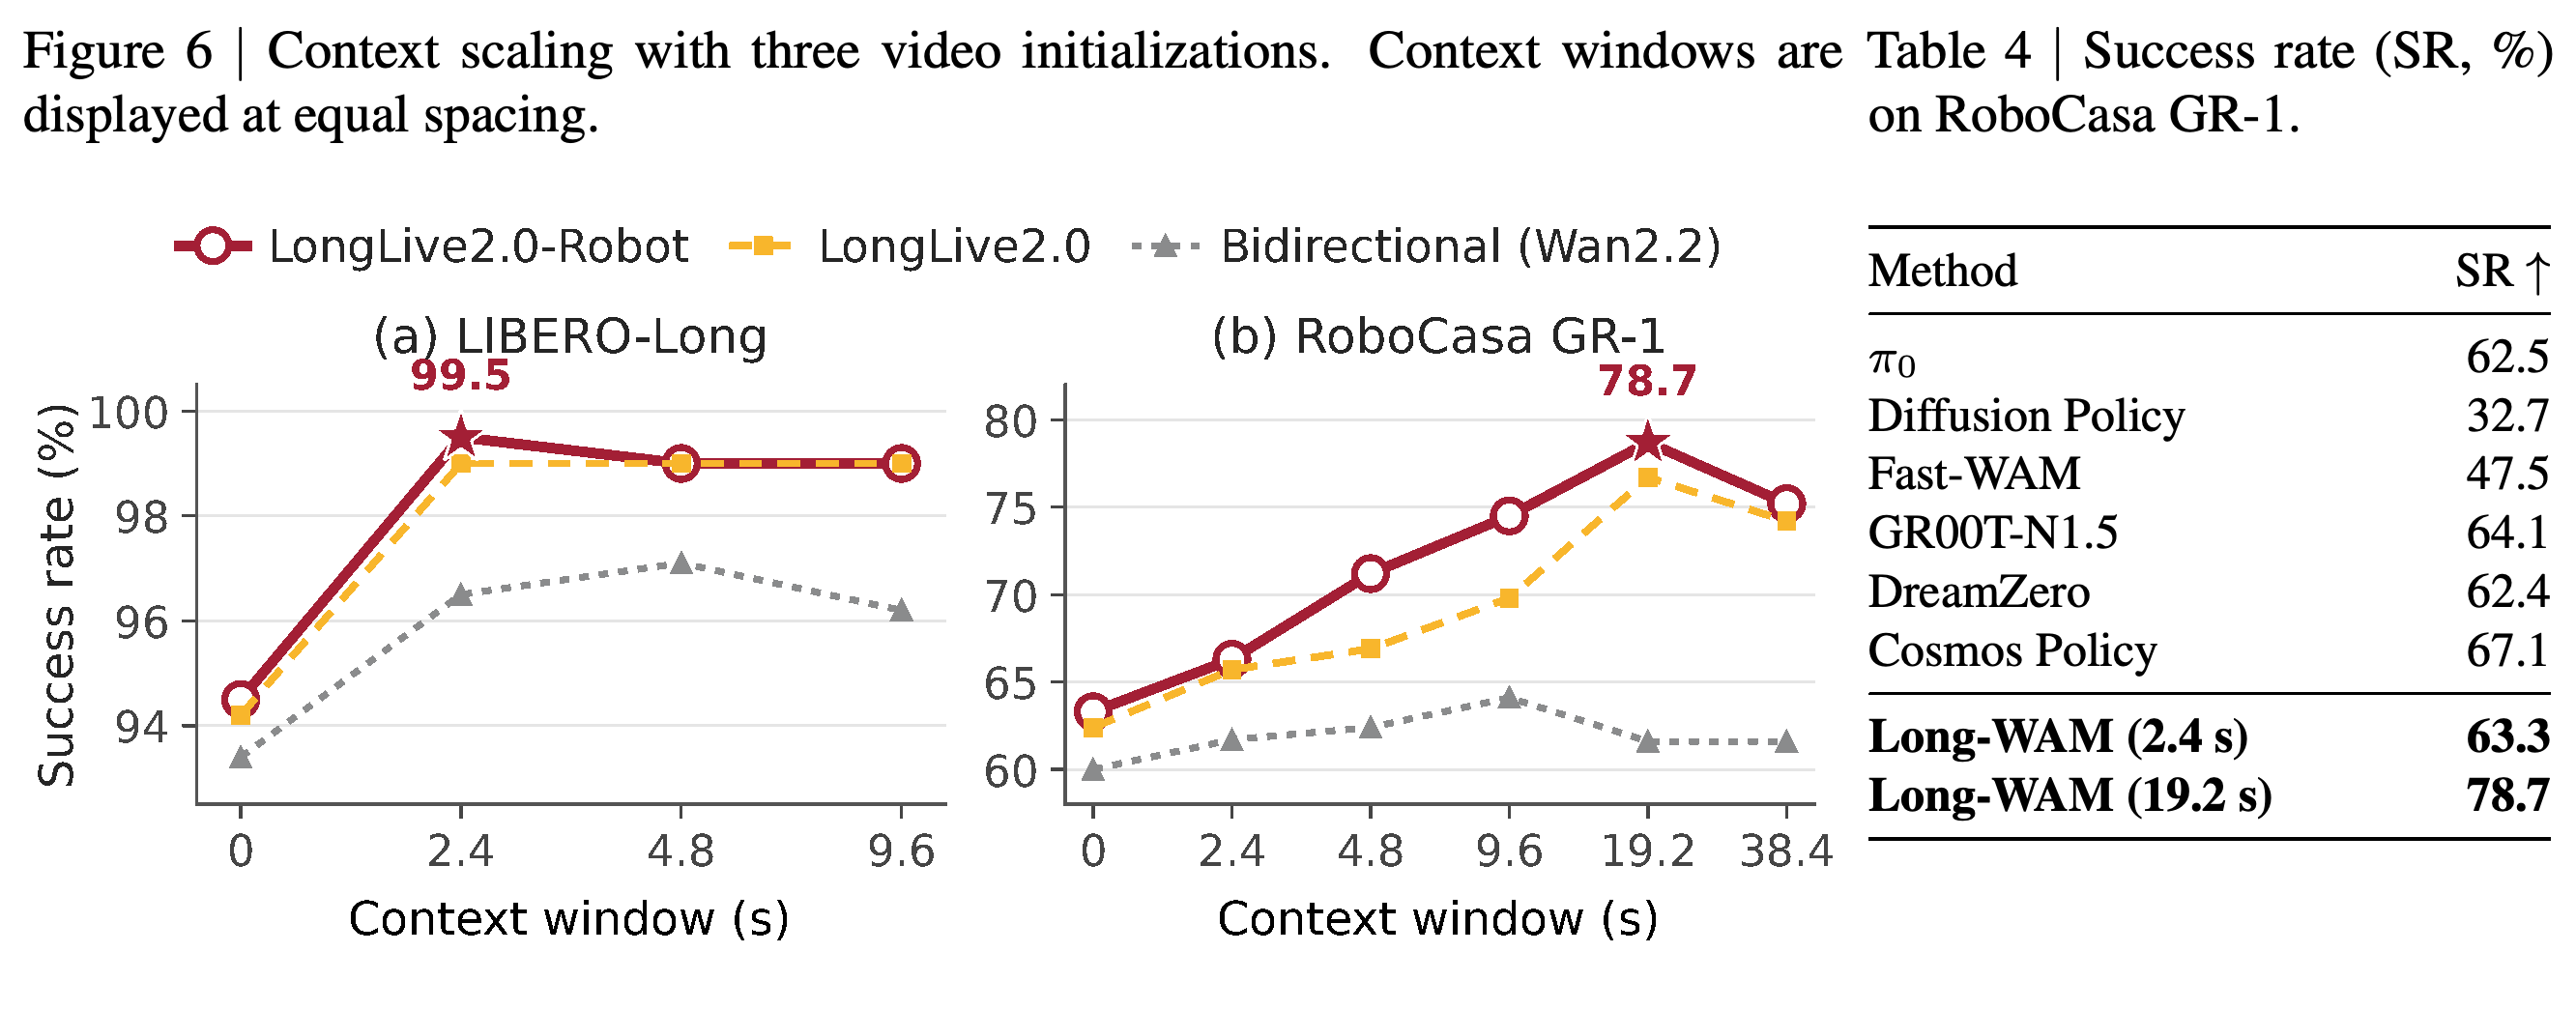
Figure 6은 컨텍스트의 이점이 작업에 따라 달라짐을 보여준다. LIBERO-Long은 2.4초에서 최고 성능을 보이는 반면, RoboCasa GR-1은 19.2초까지 이점을 얻는다. GR-1에서 컨텍스트를 2.4초에서 19.2초로 늘리면 로봇 도메인 AR 사전학습의 성공률은 66.3%에서 78.7%로, 일반 AR 초기 모델은 65.7%에서 76.7%로 높아진다.
- 양방향 초기 모델은 2.4초에서 61.7%, 9.6초에서 64.1%로 높아지지만, 19.2초에서는 61.6%로 떨어진다. 이 비교에서 인과적 이력에 접근하는 것만으로는 AR 변형의 성능 향상을 재현하지 못한다.
- 38.4초에서는 AR 변형의 성공률이 각각 75.2%와 74.2%로 낮아진다. 이 구간은 평균 학습 궤적 길이인 12.1초를 약 3회 합친 길이에 해당하며, 이력 프레임의 80.4%가 패딩이다. 데이터가 해당 길이를 충분히 포괄하지 못한다는 설명은 가설로 남아 있다.
- Table 1의 LIBERO-Long 성공률은 미래 영상 denoising이 없을 때 94.5%, CoD가 95.8%, IDM이 99.5%다. 반면 본문은 CoD에 대해 97.8%를 제시한다. 이는 표에 기재된 전체 평균값이므로 논문 내부에 불일치가 있다.
AR 초기 모델 2개는 모두 RoboCasa GR-1에서 긴 이력의 이점을 얻지만, 양방향 초기 모델은 더 일찍 최고 성능에 도달한 뒤 개선분을 잃는다. LIBERO-Long은 2.4초 이후 대체로 포화된다. 가로축에서 일정하게 배치된 지점들은 서로 다른 시간 간격을 나타내므로 선형 시간축이 아니다.
6. Atomic Execution and Compositional Planning
개별 가사 기술과 여러 단계로 구성된 작업을 구분하는 RoboCasa365에서, 저자들은 Human300-trained Long-WAM 체크포인트에 상위 planner로 GPT-6 Astra를 추가한다. 이 체크포인트는 시각 컨텍스트 2.4초를 사용하며 정책을 추가 학습하지 않는다. Planner는 목표를 단위 작업 지시로 분해하고, 각 청크에서 실행할 행동 수를 정하며, 로봇의 조작 도구인 end effector에 제한된 범위의 보정을 지시할 수 있다.
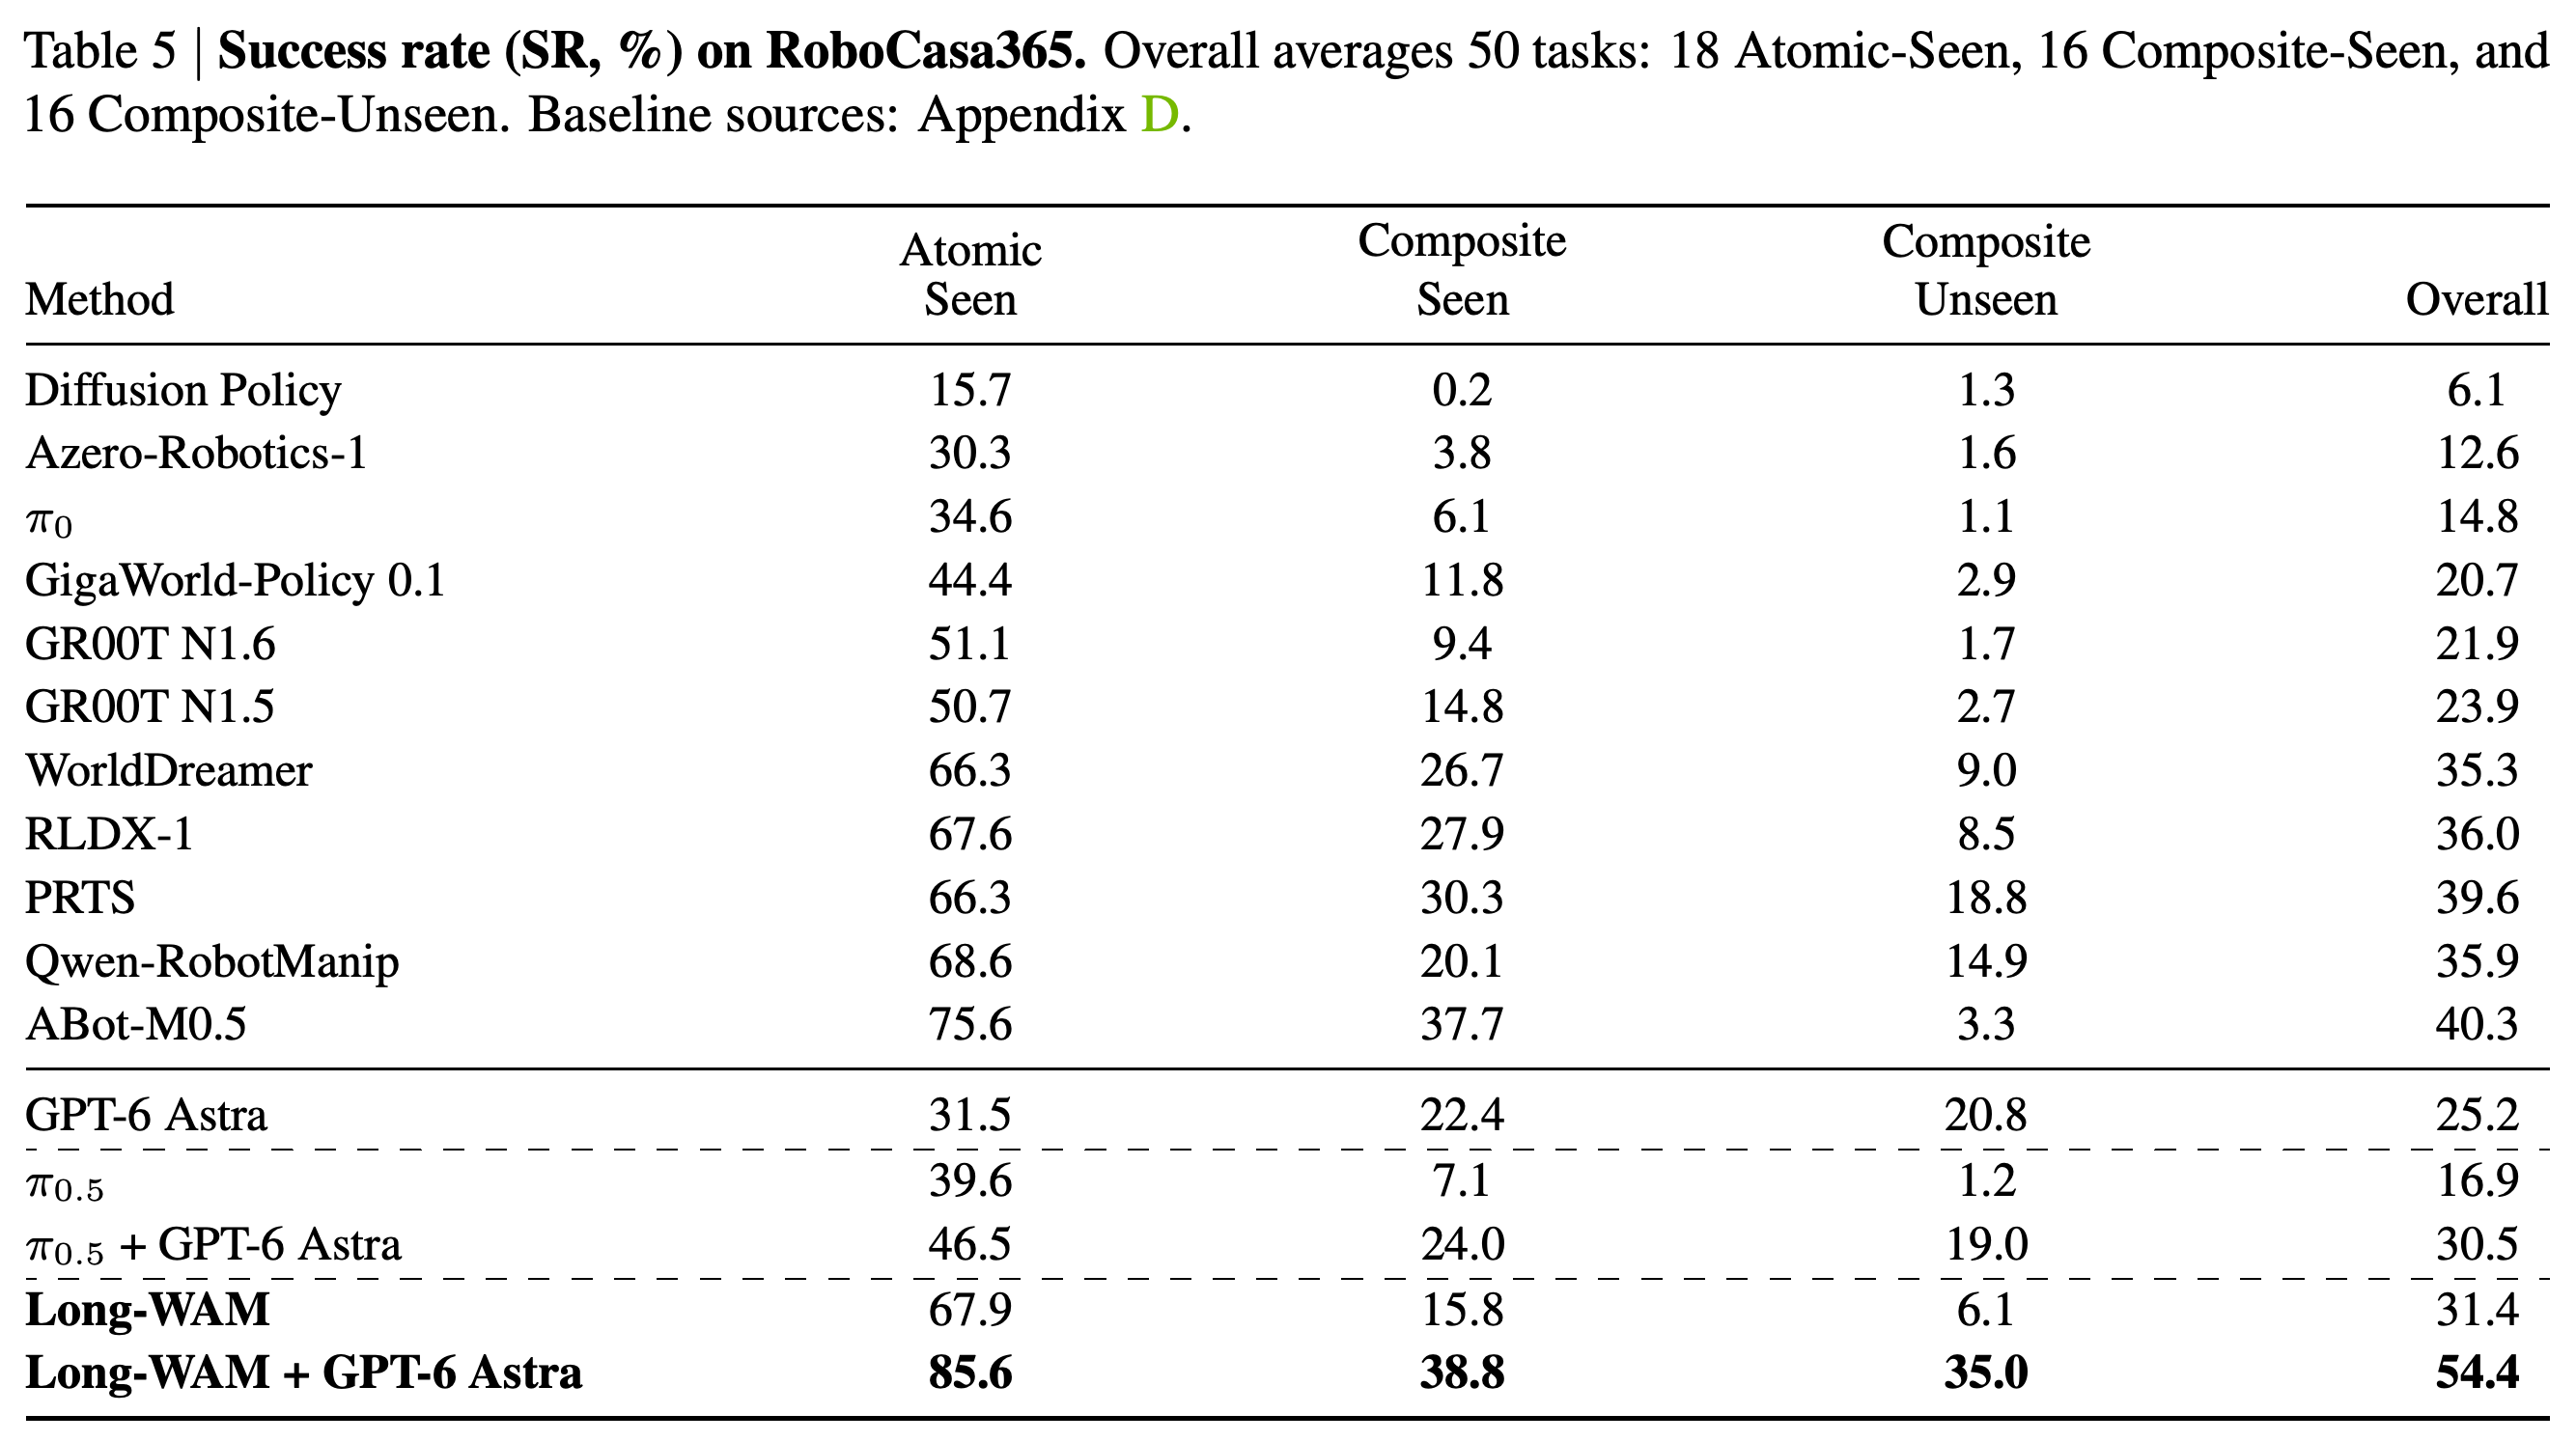
- 50개 작업에서 전체 성공률은 31.4%에서 54.4%로 높아진다. 학습에 포함된 조합인 Composite-Seen은 15.8%에서 38.8%로, 학습에서 보지 못한 기술 조합인 Composite-Unseen은 6.1%에서 35.0%로 높아진다. Planner만 사용할 때 전체 성공률은 25.2%다.
- Planner 없이 15단계마다 Long-WAM에 질의하면, 학습에서 본 개별 기술인 Atomic-Seen에서 성공률 84.4%를 달성해 계층적 시스템의 85.6%에 근접한다. 그러나 복합 작업 split에서는 11.2%와 5.0%에 그친다. 이 대조 실험은 실행 간격 단축 외에도 계획이 성능 향상에 기여함을 뒷받침한다.
- Planner를 추가하면 Long-WAM의 전체 성능은 23.0점 높아지고, π₀.₅는 13.6점 높아진다. 이 시스템 수준의 비교는 학습된 실행 능력과 작업 분해가 상호 보완적 역할을 한다는 해석을 뒷받침한다.
Planner를 추가하면 Long-WAM의 복합 작업 성능이 개선되며, Composite-Unseen 성공률은 6.1%에서 35.0%로 높아진다. 전체 결과 54.4%는 Atomic-Seen 18개, Composite-Seen 16개, Composite-Unseen 16개 작업의 평균이므로, 종합 수치를 해석하려면 split별 결과를 함께 살펴봐야 한다.
6.1. Real-world Deployment
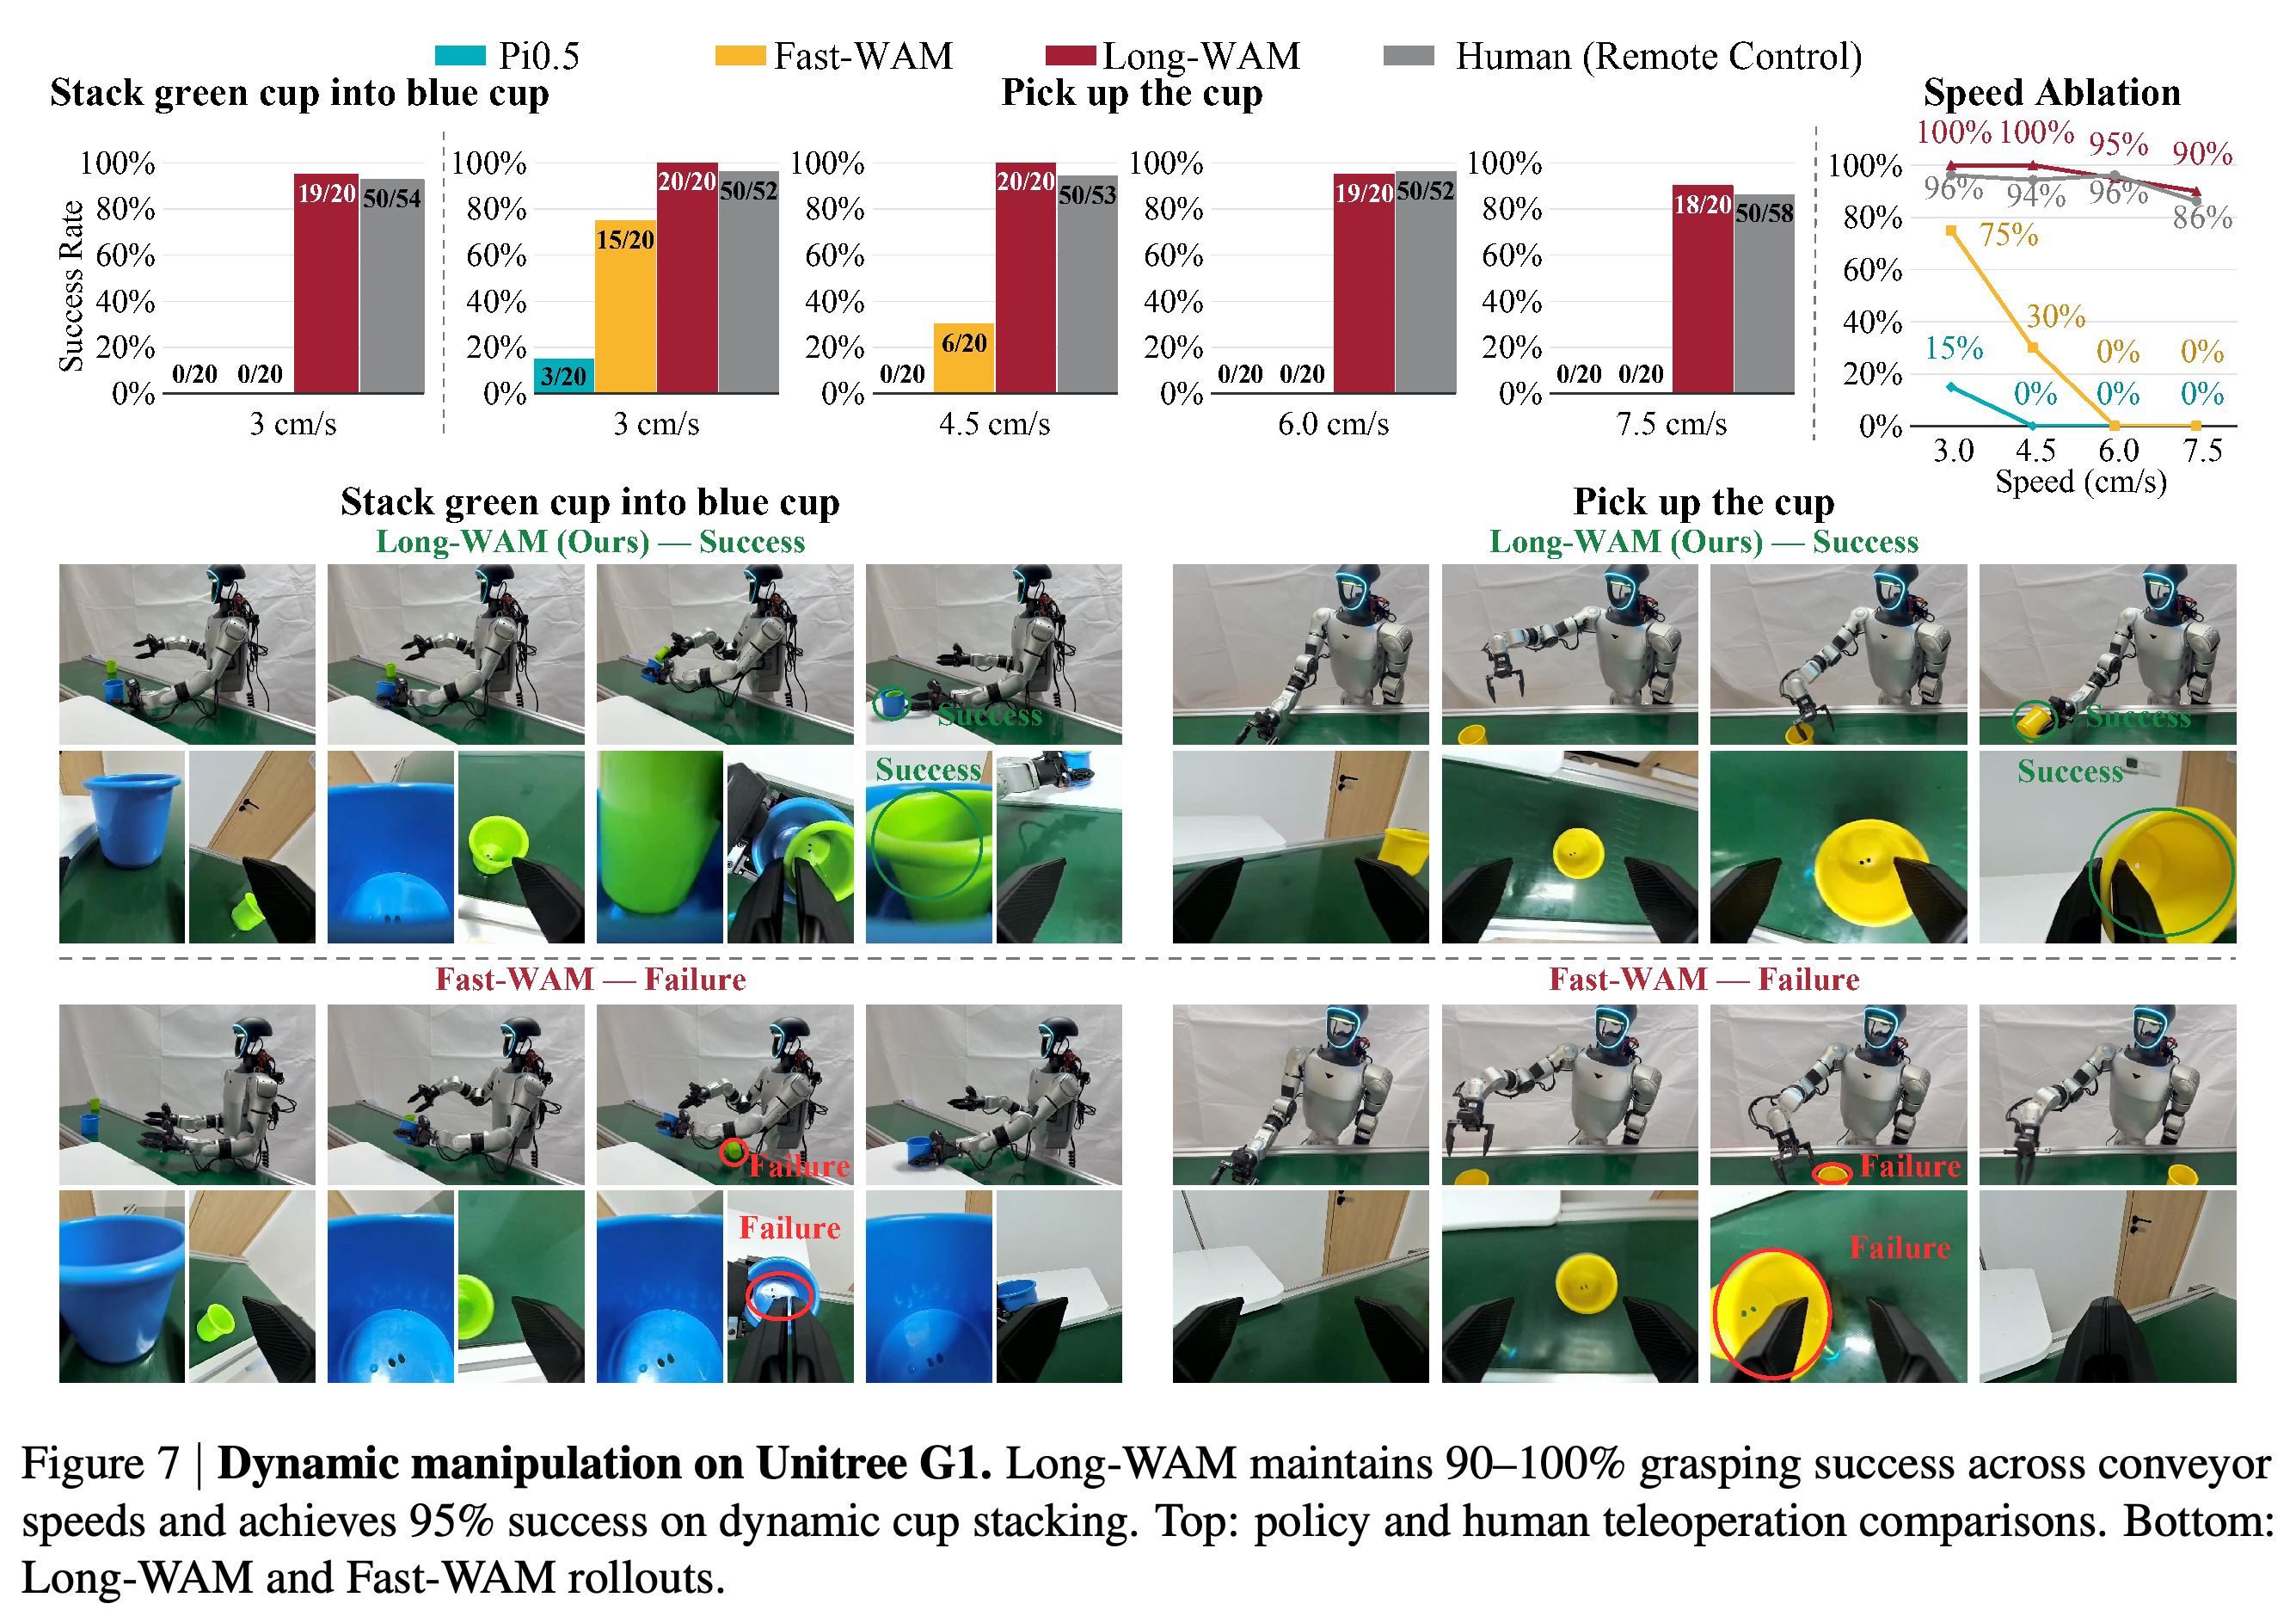
실제 로봇 정책 평가는 정책과 조건마다 20회 수행한다. 컨베이어 속도가 3.0, 4.5, 6.0, 7.5 cm/s일 때 Long-WAM의 컵 잡기 성공률은 각각 100%, 100%, 95%, 90%다. Fast-WAM은 75%에서 0%로, π₀.₅는 15%에서 0%로 낮아진다.
- 3 cm/s에서 수행하는 동적 쌓기는 움직이는 초록색 컵을 포착해 파란색 컵 안에 넣어야 한다. Long-WAM은 19/20회 성공하고, 비교 정책 2개는 모두 0/20회 성공한다.
- YAM에서 블록 색상 분류, 만두를 팬에 넣기, 그릇 쌓기는 각각 16/20회, 16/20회, 17/20회 성공한다. 작업은 평균 40초 넘게 지속되며 평균 성공률은 81.7%다. 보고된 YAM 결과에는 정책 베이스라인 비교가 없다.
컨베이어 속도가 높아지면 Long-WAM과 정책 베이스라인 2개의 차이가 드러난다. Long-WAM의 관측된 잡기 성공률은 90–100%를 유지하지만, 베이스라인 2개는 모두 최고 속도에서 0%에 도달한다. 쌓기는 포착 이후의 배치까지 조율해야 하며, Long-WAM은 19/20회 성공하고 어느 베이스라인도 성공하지 못한다.
6.2. Efficiency
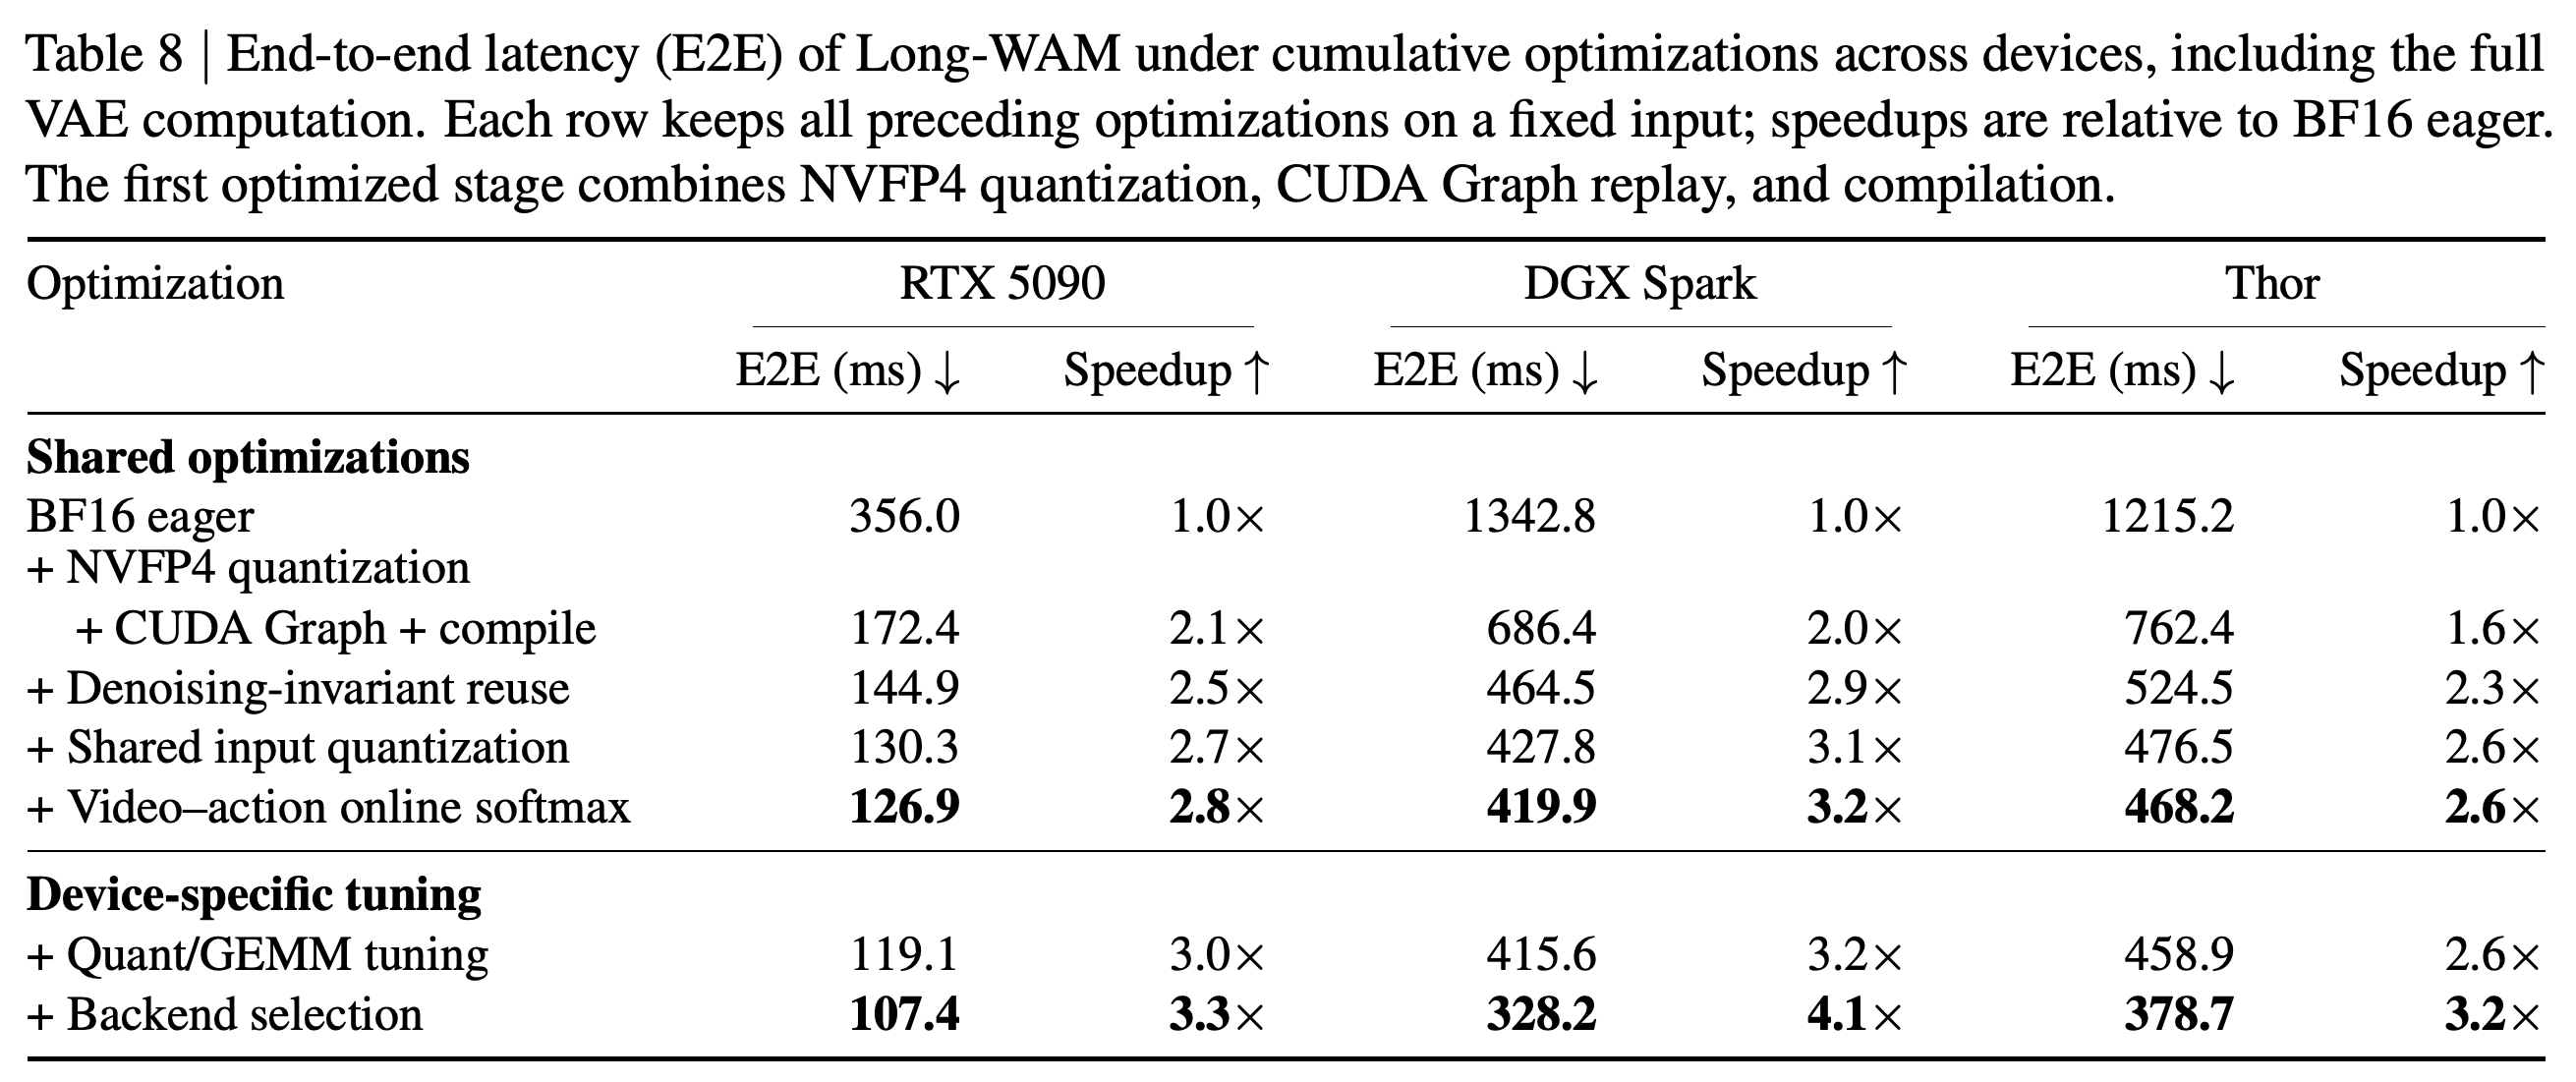
RTX 5090에서 각 expert가 denoising을 4단계 수행하는 V4/A4를 최적화하면 추론 지연 시간이 356.0 ms에서 107.4 ms로 줄어든다. 이때 RoboTwin 2.0 성공률은 94.4%에서 93.5%로 바뀐다. Expert마다 2단계를 수행하는 V2/A2는 81.8 ms와 성공률 92.5%를 달성한다.
- 최적화한 V4/A4의 지연 시간은 DGX Spark에서 328.2 ms, Thor에서 378.7 ms다. 이는 제시된 최적화를 적용하지 않고 실행하는 각 BF16 eager 베이스라인보다 각각 4.1×, 3.2× 빠르다. Table 8은 누적 개선을 보여주므로 각 행이 개별 최적화의 효과를 독립적으로 측정한 것은 아니다.
- 실행 범위 R = 24와 트리거 간격 S = 12에서 IDM 성공률은 동기 실행의 94.4%에서 비동기 실행의 94.2%로 바뀐다. Fast-WAM은 91.8%에서 76.4%로, LingBot-VA는 92.2%에서 46.7%로 낮아진다.
- 지연 시간 비교에는 각 베이스라인의 고유 구성과 denoising 예산을 사용한다. 측정에는 전체 관측의 VAE 계산이 포함되지만 전처리, 텍스트 인코딩, 제어기 오버헤드, 프로세스 간 통신은 제외된다. 따라서 이 값은 관측부터 실제 구동까지의 전체 지연 시간을 측정한 것이 아니다.
측정값은 공통 최적화에 플랫폼별 튜닝을 더했을 때의 누적 개선을 보여준다. 최종 지연 시간은 장치마다 다르며 각 행은 앞선 변경을 모두 유지하므로, 독립적으로 더할 수 있는 개별 효과를 측정한 표는 아니다.
부록
- A. Discussion and Conclusion은 유용한 이력 길이가 작업 요구사항과 사용 가능한 계산 자원에 따라 달라진다고 주장한다. 각 구간은 별도로 학습하며, 단일 정책 안에서 구간을 조절하는 방법과 실제 로봇의 컨텍스트 길이별 평가는 향후 과제로 남는다. 관측된 추세만으로 멱법칙이나 보편적인 최적 메모리 길이를 확립할 수는 없다.
- B.1. Pretraining Data를 포함한 B. Data and Model Training Details는 데이터셋 계열 5개와 원천 하위집합 6개에서 모델 입력용 샘플 2,294,889개를 구성했다고 명시한다. 학습, 검증, 테스트 split에는 각각 2,251,021개, 21,931개, 21,937개 샘플이 있다. 학습 샘플마다 16초를 부여하면 윈도 환산 기준 10,004.5시간이 되며, 이는 중복을 제외한 원본 영상의 총길이를 측정한 값이 아니다. 행동 레이블을 사용하지 않는 사전학습 자체가 학습에서 보지 못한 로봇 형태로의 전이 성능 향상을 입증하지는 않는다.
- B.2. Training Objectives and Inference Interface는 패딩된 미래 잠재변수와 행동을 적응 손실에서 마스킹한다고 설명한다. 학습에서는 forward noising한 정답 미래를 제공하지만, 추론에서는 Gaussian noise로부터 미래를 생성한다. σ⋆ = 0.9를 맞추더라도 이 조건 분포들이 같아지는 것은 아니다. 로봇 상태 변화, 오래된 컨텍스트 제거, 시간 위치 변화는 의사결정 사이에 저장된 시각 KV를 무효화할 수 있다. 따라서 호출 내부의 재사용만으로 제한 없는 지속적 캐시 재사용이 가능하다고 볼 수 없다.
- C. LongLive2.0-Robot Video Predictions는 이미지와 지시를 조건으로 생성한 뚜껑 배치, 신발 이동, 서랍 열기, 따르기, 티셔츠 접기의 예측 사례를 제시한다. 이 사례는 예측된 움직임이 서로 조화를 이루는 모습을 보여주지만, 종합 영상 예측 지표는 제공하지 않는다. D. Baseline Details는 외부 RoboCasa365 리더보드 점수와 Qwen-RobotManip 기술 보고서의 점수 등을 비교 자료의 출처로 명시한다.
- E. Discussion of Asynchronous Overlap Length는 R = 24로 고정하고 트리거 간격 12, 16, 20을 시험해 중첩 구간을 각각 12, 8, 4 제어 단계로 만든다. 성공률은 94.2%, 95.0%, 94.3%이며, 시간에 맞춰 정렬한 행동 예측 사이의 불일치를 측정하는 중첩 구간 root-mean-square error와 이산 jerk 대리 지표는 모두 감소한다. Jerk 대리 지표는 gripper를 제외한 관절 상태의 3차 차분을 사용해 급격한 변화를 측정하며 Δt³으로 나누지 않는다. 전환이 부드러워져도 작업 성공률이 단조롭게 증가하지는 않는다.
- F. IDM versus Co-Denoising: Capability and Inference Latency는 CoD의 지연 시간을 V4/A4에서 90.9 ms, V2/A2에서 65.7 ms로 보고한다. IDM은 각각 107.4 ms와 81.8 ms다. 시간 측정값은 독립 프로세스 2개에서 얻은 중앙값의 평균이다. 각 프로세스는 warmup 5회를 제외하고 정상 상태 샘플 30개를 측정한다. 각 변형은 자체적으로 학습한 스케줄과 캐시 구현을 사용하므로, 이 비교가 실행 순서만의 효과를 분리하지는 않는다. 추론 빈도는 이 지연 시간의 역수이며 로봇 제어 주파수가 아니다. 관측 영상 KV 재사용의 효과도 장치와 denoising 예산에 따라 달라진다.
- G. Context-Dependent Inference Latency는 이력이 0.0, 2.4, 4.8, 9.6, 19.2초일 때 RTX 5090의 청크 지연 시간을 각각 74.6, 107.4, 138.3, 204.5, 341.0 ms로 보고한다. 이력을 2.4초에서 19.2초로 8배 늘리면 지연 시간은 약 3.2×로 증가한다. 스트리밍 인코딩은 별도로 추론 트리거 이후에 수행하는 준비 작업을 줄인다.
- H. Additional Real-World Deployment Visualizations는 전체 장면과 손목 카메라로 촬영한 시퀀스 중 일부를 제공한다. H.1. Dynamic Composite Manipulation은 베이스라인의 포착 실패와 Long-WAM이 컵을 다른 컵 안에 넣는 데 성공한 모습을 보여준다. H.2. Moving-Object Grasping at Different Speeds는 컨베이어 속도 4개에서 선택한 잡기 사례를 보여준다. H.3. Long-Horizon Manipulation은 YAM 작업 3개에서 연속적으로 물체와 상호작용하는 모습을 보여준다. 이 몽타주는 동작을 예시하며, 추가적인 종합 성공률 추정치는 제공하지 않는다.
짧은 생각
가장 명확한 근거는 초기 모델과 컨텍스트 길이의 상호작용에 있다. 인과적 행동 적응을 적용했을 때 AR 기반 모델 2개는 모두 GR-1 이력이 길어질수록 개선되지만, 양방향 기반 모델은 개선을 유지하지 못한다. 이는 예측 사전학습이 유용한 설계 선택임을 뒷받침한다. 다만 서로 다른 사전학습 체크포인트를 비교하므로 시간 순서의 효과를 다른 모든 학습 차이로부터 분리하지는 못한다.
측정된 지연 시간 감소와 비동기 실행에서 거의 유지되는 성공률은 시스템 측면의 기여를 뒷받침한다. 다만 대표 수치인 107.4 ms는 이력 2.4초에 해당하며, GR-1에서 최고 성공률을 보이는 19.2초 이력에는 341.0 ms가 필요하다. 실제 로봇 결과는 신속한 반응을 보여주지만, 시뮬레이션의 컨텍스트 확장 추세가 실제 로봇에도 전이되는지 확인하려면 실제 로봇에서 컨텍스트 길이별 평가가 필요하다.
이력 길이별 지연 시간 측정은 긴 컨텍스트의 비용을 수치로 보여준다. 이력 19.2초는 청크당 341.0 ms가 필요하고, 2.4초는 107.4 ms가 필요하다. 따라서 GR-1 최고 성공률과 대표 지연 시간 107.4 ms는 서로 다른 컨텍스트 설정에 해당한다.
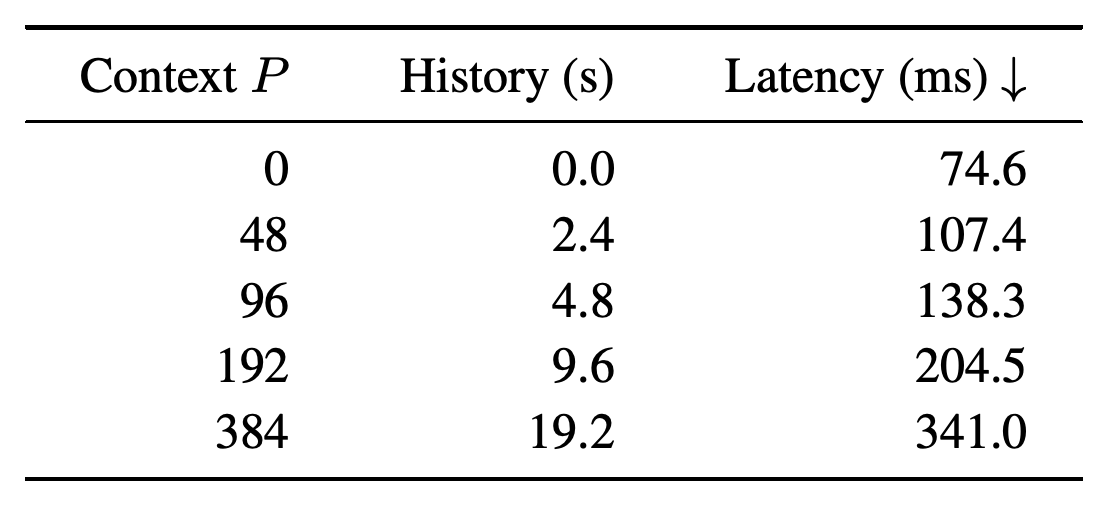
Table 4는 GR-1의 63.3% 결과를 2.4초로 표시하지만, Figure 6과 ablation 본문은 63.3%를 이력 0인 조건에, 66.3%를 2.4초에 연결한다. LIBERO-Long의 CoD 본문 수치도 Table 1과 충돌한다. 따라서 최고 성능은 일관되게 보고되지만, 해당 개별 비교는 이런 불일치를 감안해 해석해야 한다. 실제 로봇의 각 조건은 20회 시험하므로 성공률의 최소 변화 단위가 5%포인트이며, 가까운 성공률끼리 비교하는 데 한계가 있다.