


An Empirical Study of Harness Design for Coding Agents 요약 설명
17 Sep 2026 | Paper Review AI Coding Agents Harness Optimization Context Engineering Agent Planning목차
이번 글에서는 An Empirical Study of Harness Design for Coding Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 17일(Arxiv)
- Fan, Run-Ze, Zhang, Zihao, Ma, Simin, Hu, Yebowen, Wang, Shouju, Song, Kaiqiang, Liu, Fei, Zamani, Hamed, Wang, Xiaoyang.
- UMass Amherst, Zoom, Emory University, UNC Charlotte
- 논문 링크
요약
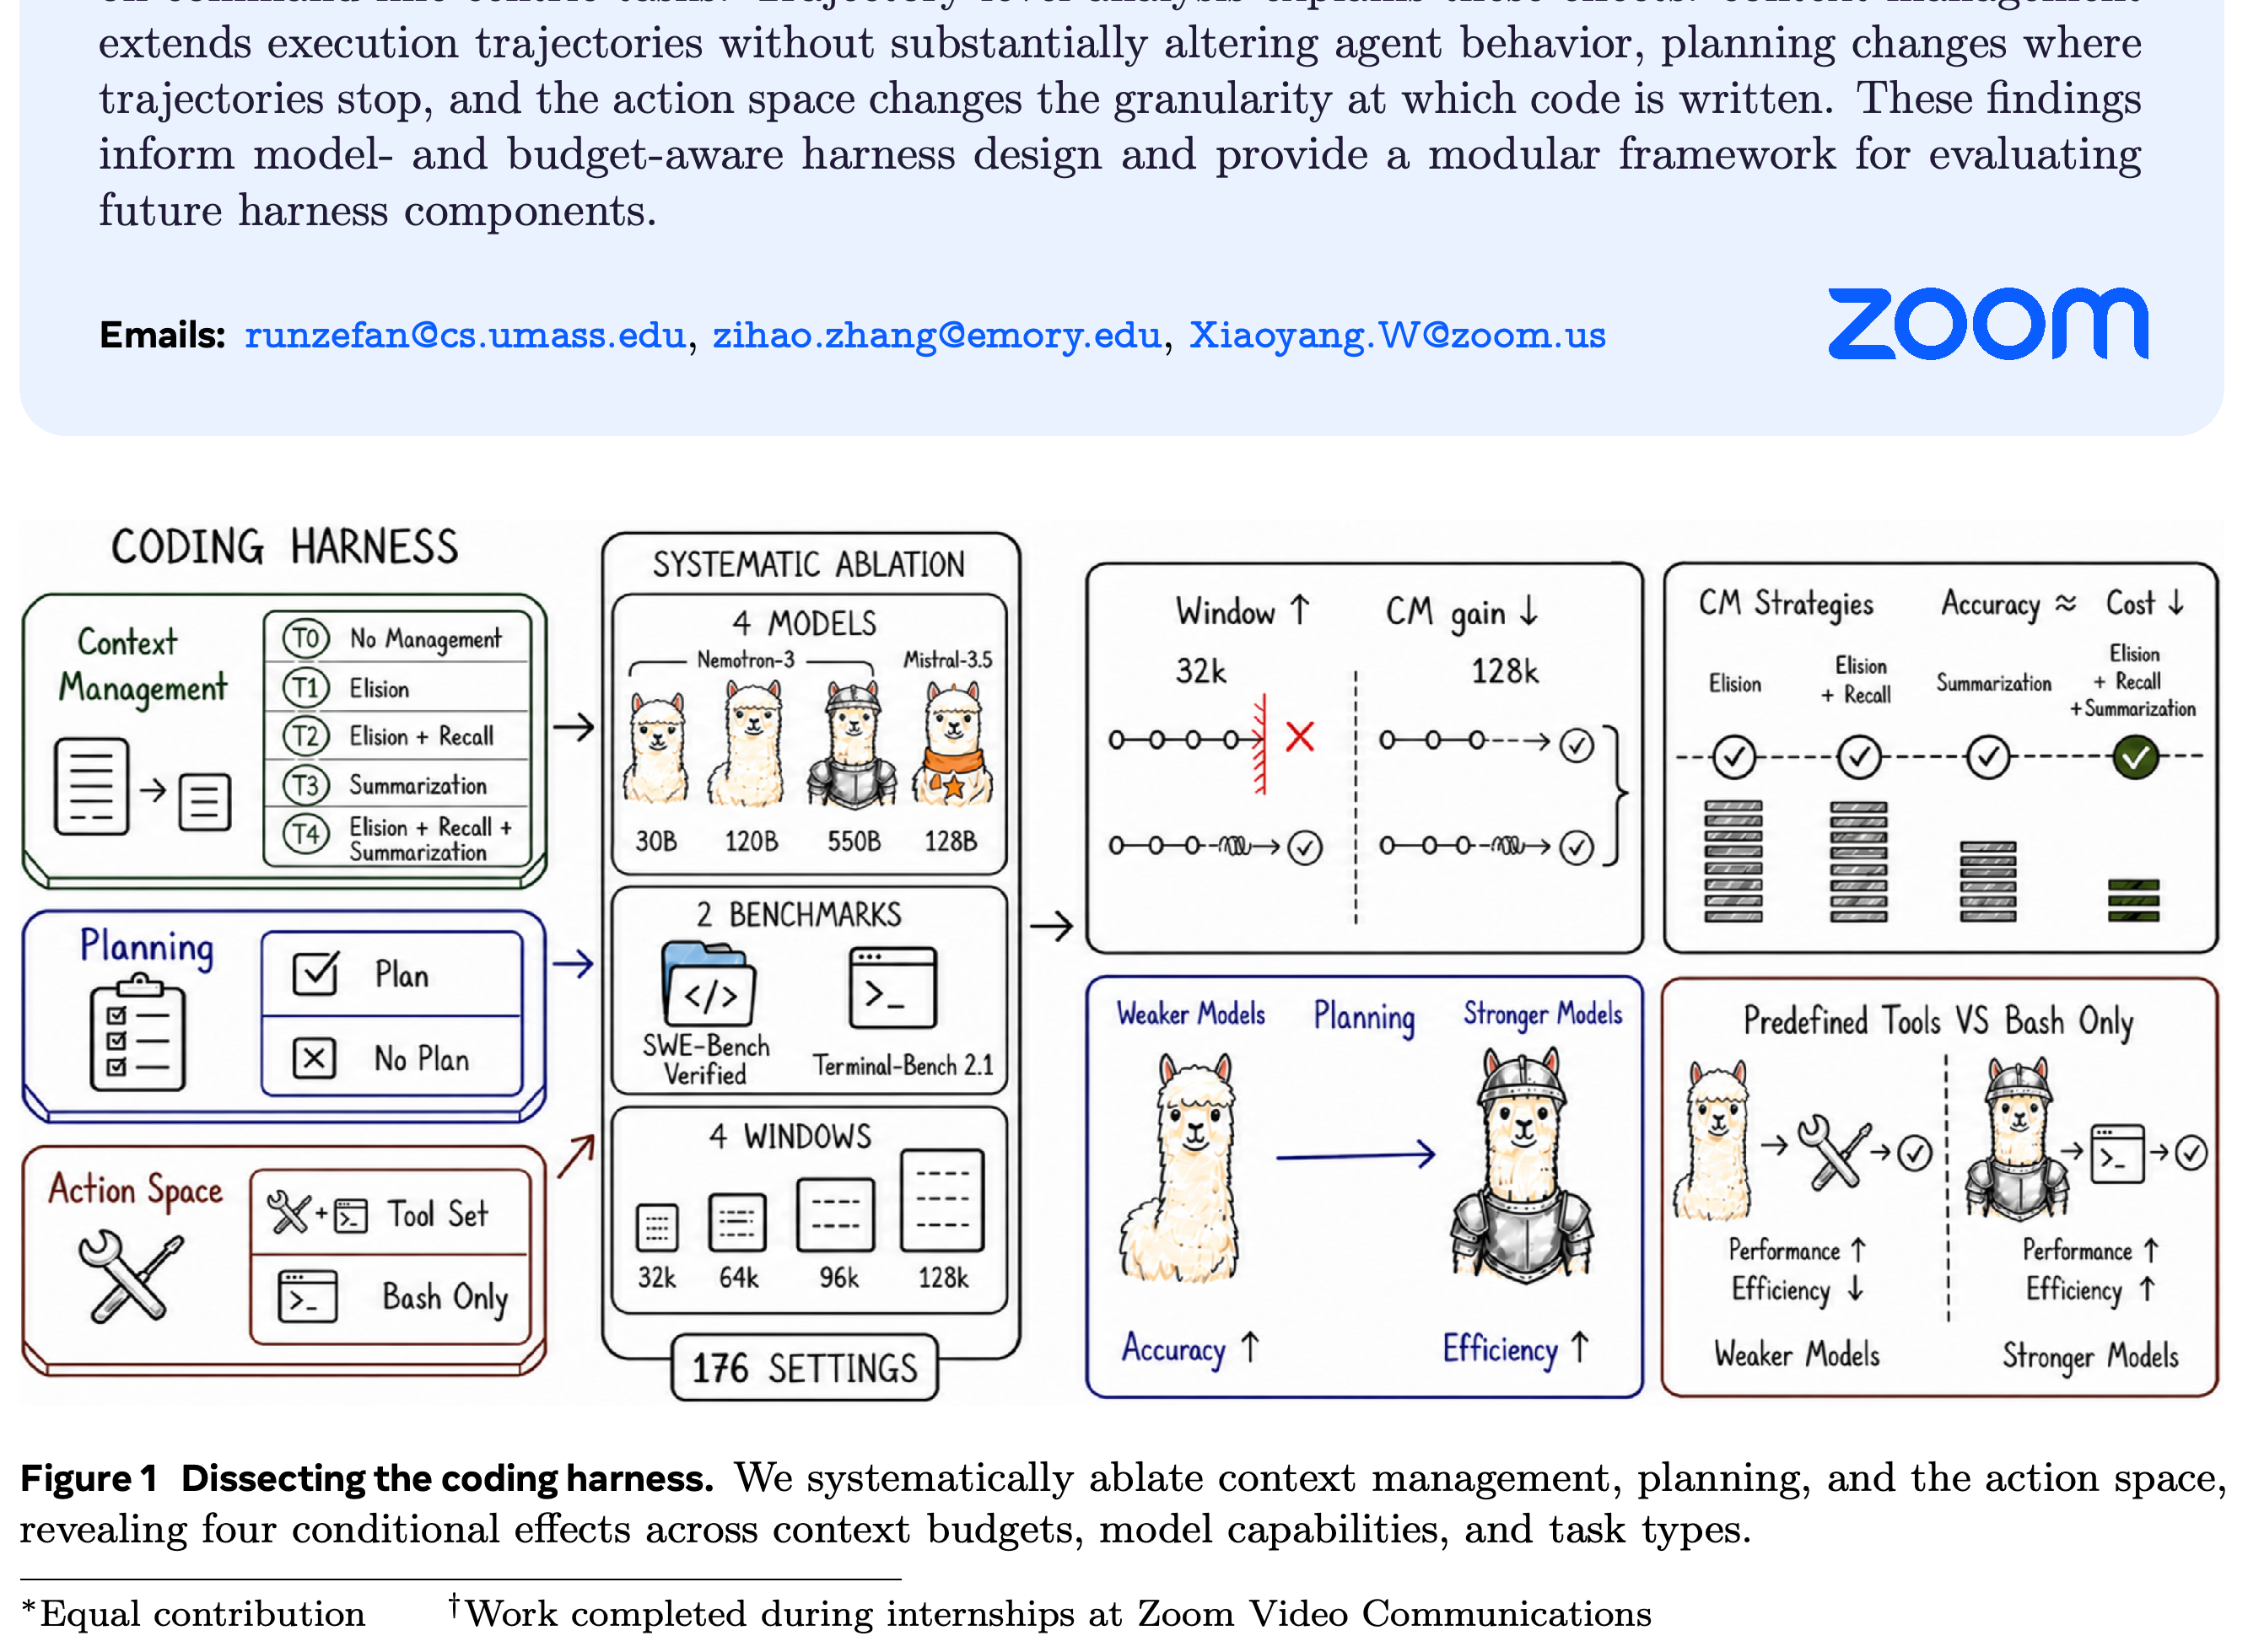
- 코딩 에이전트는 실행, 도구, 이용 가능한 상호작용 이력을 제어하는 소프트웨어 계층인 하네스에 의존한다. 그러나 완성된 시스템끼리 비교하면 어떤 구성 요소가 작업 완료에 기여하는지 파악하기 어렵다. 모델 4개와 조건을 맞춘 설정 176개를 비교한 결과, 상호작용 이력을 모델의 입력 윈도에 맞게 압축하는 컨텍스트 관리는 저장소 이슈 해결 벤치마크인 SWE-Bench Verified에서 32k 토큰일 때 관리하지 않는 경우보다 성공률을 평균 35.7%포인트 높였다. 128k에서는 향상 폭이 2.7점이었다.
- T4는 오래된 도구 출력 본문 제거, 외부에 저장한 출력 복원, 선택적인 대규모 언어 모델(LLM) 요약을 결합한 정책이다. 시험한 모든 컨텍스트 예산에서 관리 전략 중 전체 평균 비용이 가장 낮았으며, 성공률은 대체로 비슷하게 유지했다. 제거한 관측을 외부 저장소에서 다시 가져오는 recall을 추가해도 정확도가 일관되게 개선되지는 않았다. 조건을 맞춘 비교 32개에서 평균 성공률 변화는 −0.36%포인트였다.
- 실행 내내 명시적인 작업 계획을 갱신하고 모델에 제공하는 지속적 계획 관리는 128k-token 윈도와 사전 정의 도구를 사용하는 T4에서 Nemotron-3 30B의 SWE-Bench 성공률을 13.60%에서 25.20%로 높였다. 더 강한 모델에서는 주로 비용을 줄였다. 계획 관리를 활성화한 T4/128k에서 일반적인 작업 공간 조작에 셸 명령을 사용하는 bash-only 인터페이스는 벤치마크 모두에서 Nemotron-3 550B의 성공률과 비용을 개선했다. 반면 Mistral-Medium-3.5-128B의 SWE-Bench 성공률은 68.60%에서 45.40%로 낮췄다.
1 Introduction
완성된 코딩 에이전트 시스템을 비교하면 계획 관리, 도구 인터페이스, 컨텍스트 관리의 변화가 함께 반영되므로 각 요소의 기여를 분리하기 어렵다. 이 논문은 이러한 구성 요소가 일반적으로 유용한지, 아니면 모델 역량, 작업 유형, 자원 예산에 따라 효과가 달라지는지 묻는다.
- 실험은 각 비교에서 실행 루프와 비교 대상 외의 구성 요소를 고정하고, Nemotron-3의 3가지 크기 모델과 Mistral 모델 1개를 평가한다. 평가 대상은 저장소 수정 작업과 종단 간 명령줄 작업 벤치마크인 Terminal-Bench 2.1이다.
- 이 연구의 기여는 특정 구현의 특성을 실험으로 밝힌 데 있다. 실험 결과가 모든 상황에 최적인 하네스를 입증하는 것은 아니다.
이 도식은 설정 가능한 하네스 구성 요소 3개를 모델 4개, 벤치마크 2개, 윈도 크기 4개의 평가와 연결한다. 조건별 결과는 컨텍스트 부족 정도, 모델 행동, 작업에 따라 구성 요소의 가치가 달라지는 양상을 미리 보여준다.
2 Harness Design
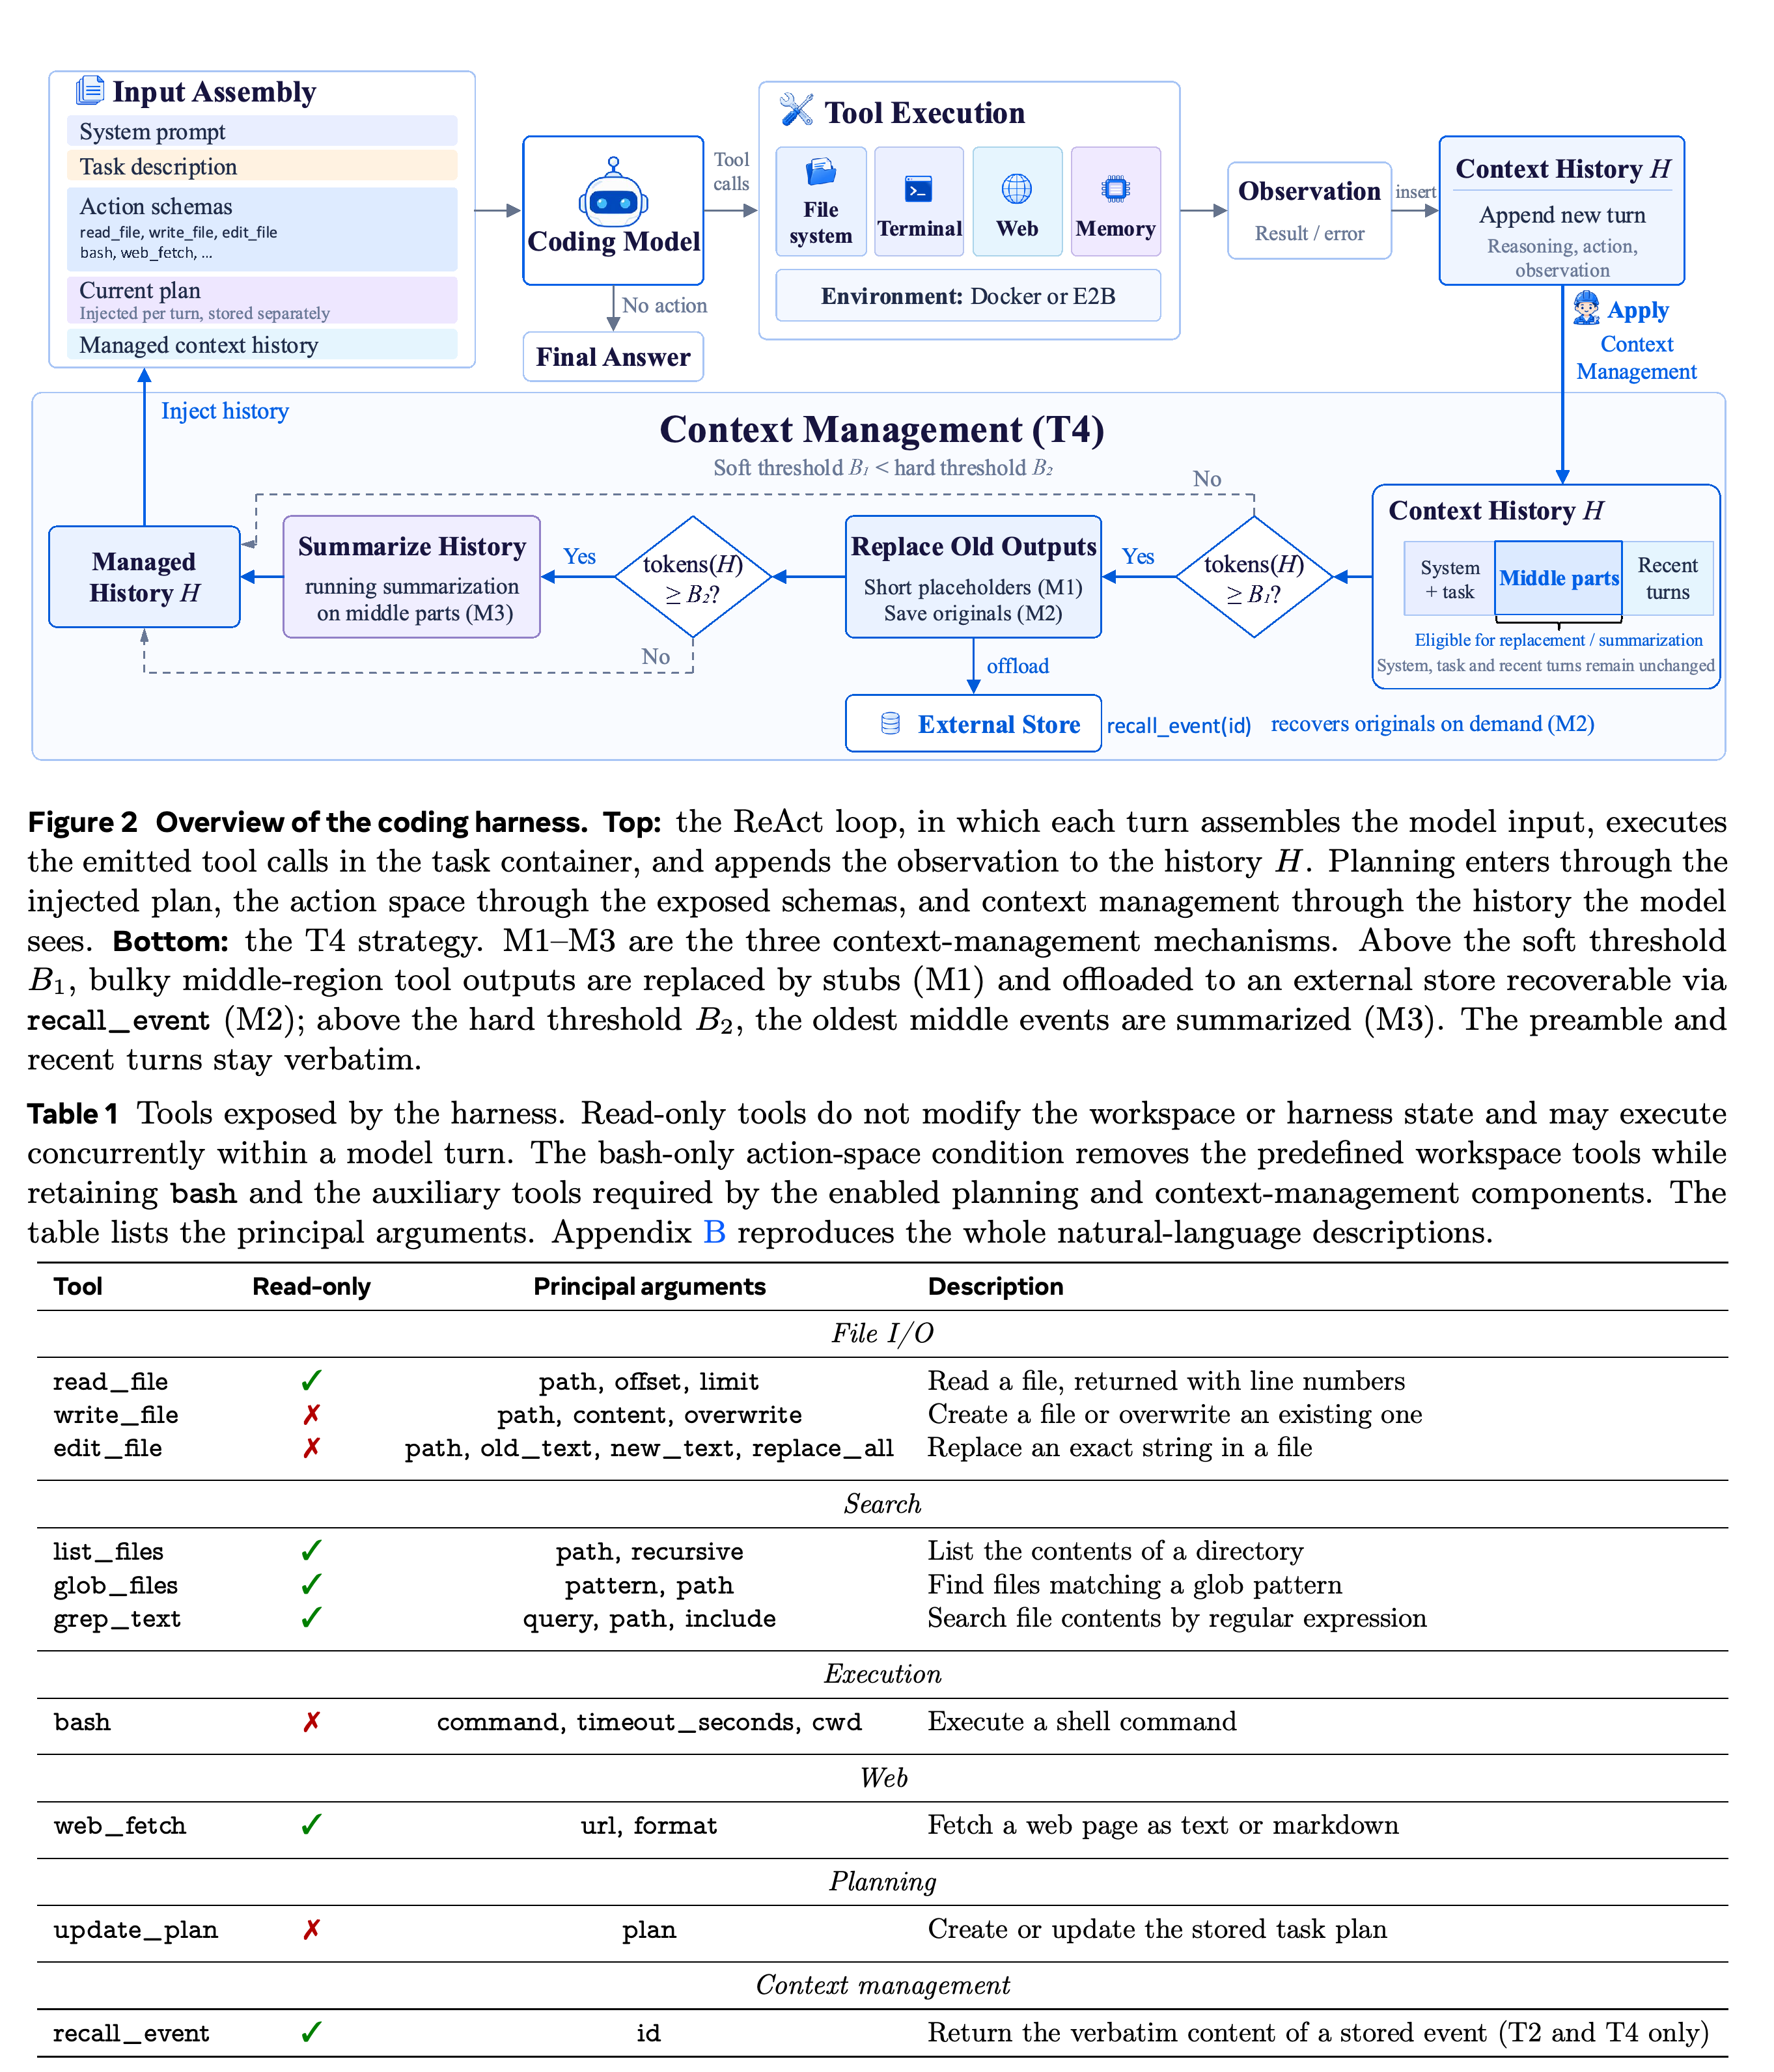
저자들은 각 턴이 추론, 행동, 관측으로 구성되는 ReAct 루프를 바탕으로 모듈형 하네스를 구축한다. 계획 관리는 작업 진행 상태를 유지하고, 행동 공간은 에이전트가 수행할 수 있는 작업을 정의하며, 컨텍스트 관리는 모델에 전달할 이력을 제어한다.
- 작업 공간 접근 제어, 수정 후 진단, 반복 행동 감지는 비교 전반에서 동일하게 설정한다.
- 행동 공간을 바꾸는 실험에서는 사용 가능한 도구뿐 아니라 인터페이스 지침, 파일 상태 추적, 검증 지원도 함께 바뀐다.
위쪽 루프는 계획, 행동 스키마, 관리된 이력이 모델 입력에 들어가는 위치를 보여준다. 아래쪽 흐름은 T4가 일부 요약 호출을 피하는 방식을 보여준다. 먼저 부피가 큰 오래된 출력을 대체한 뒤, 남은 이력이 하드 임계값에 도달하면 요약한다.
2.1 Planning
계획 관리에는 외부에 저장한 작업 계획을 사용하며, 현재 계획을 교체하는 도구인 update_plan으로 이를 유지한다. 시스템 지침이 프로토콜을 정의하고, 최초 알림이 계획 작성을 요청한다. 이후 모델을 호출할 때마다 현재 계획을 제공하되, 대화 이력에 이전 계획 사본이 쌓이지 않도록 한다.
- 계획 관리를 비활성화하면 관련 지침, 알림, 입력에 삽입한 계획, 도구를 제거하고 나머지 실행 설정은 유지한다.
- 이 비교는 해당 지속적 계획 관리 구현을 평가한다. 일반적인 추론 전략으로서 계획 수립의 효과를 분리하는 실험은 아니다.
2.2 Action space
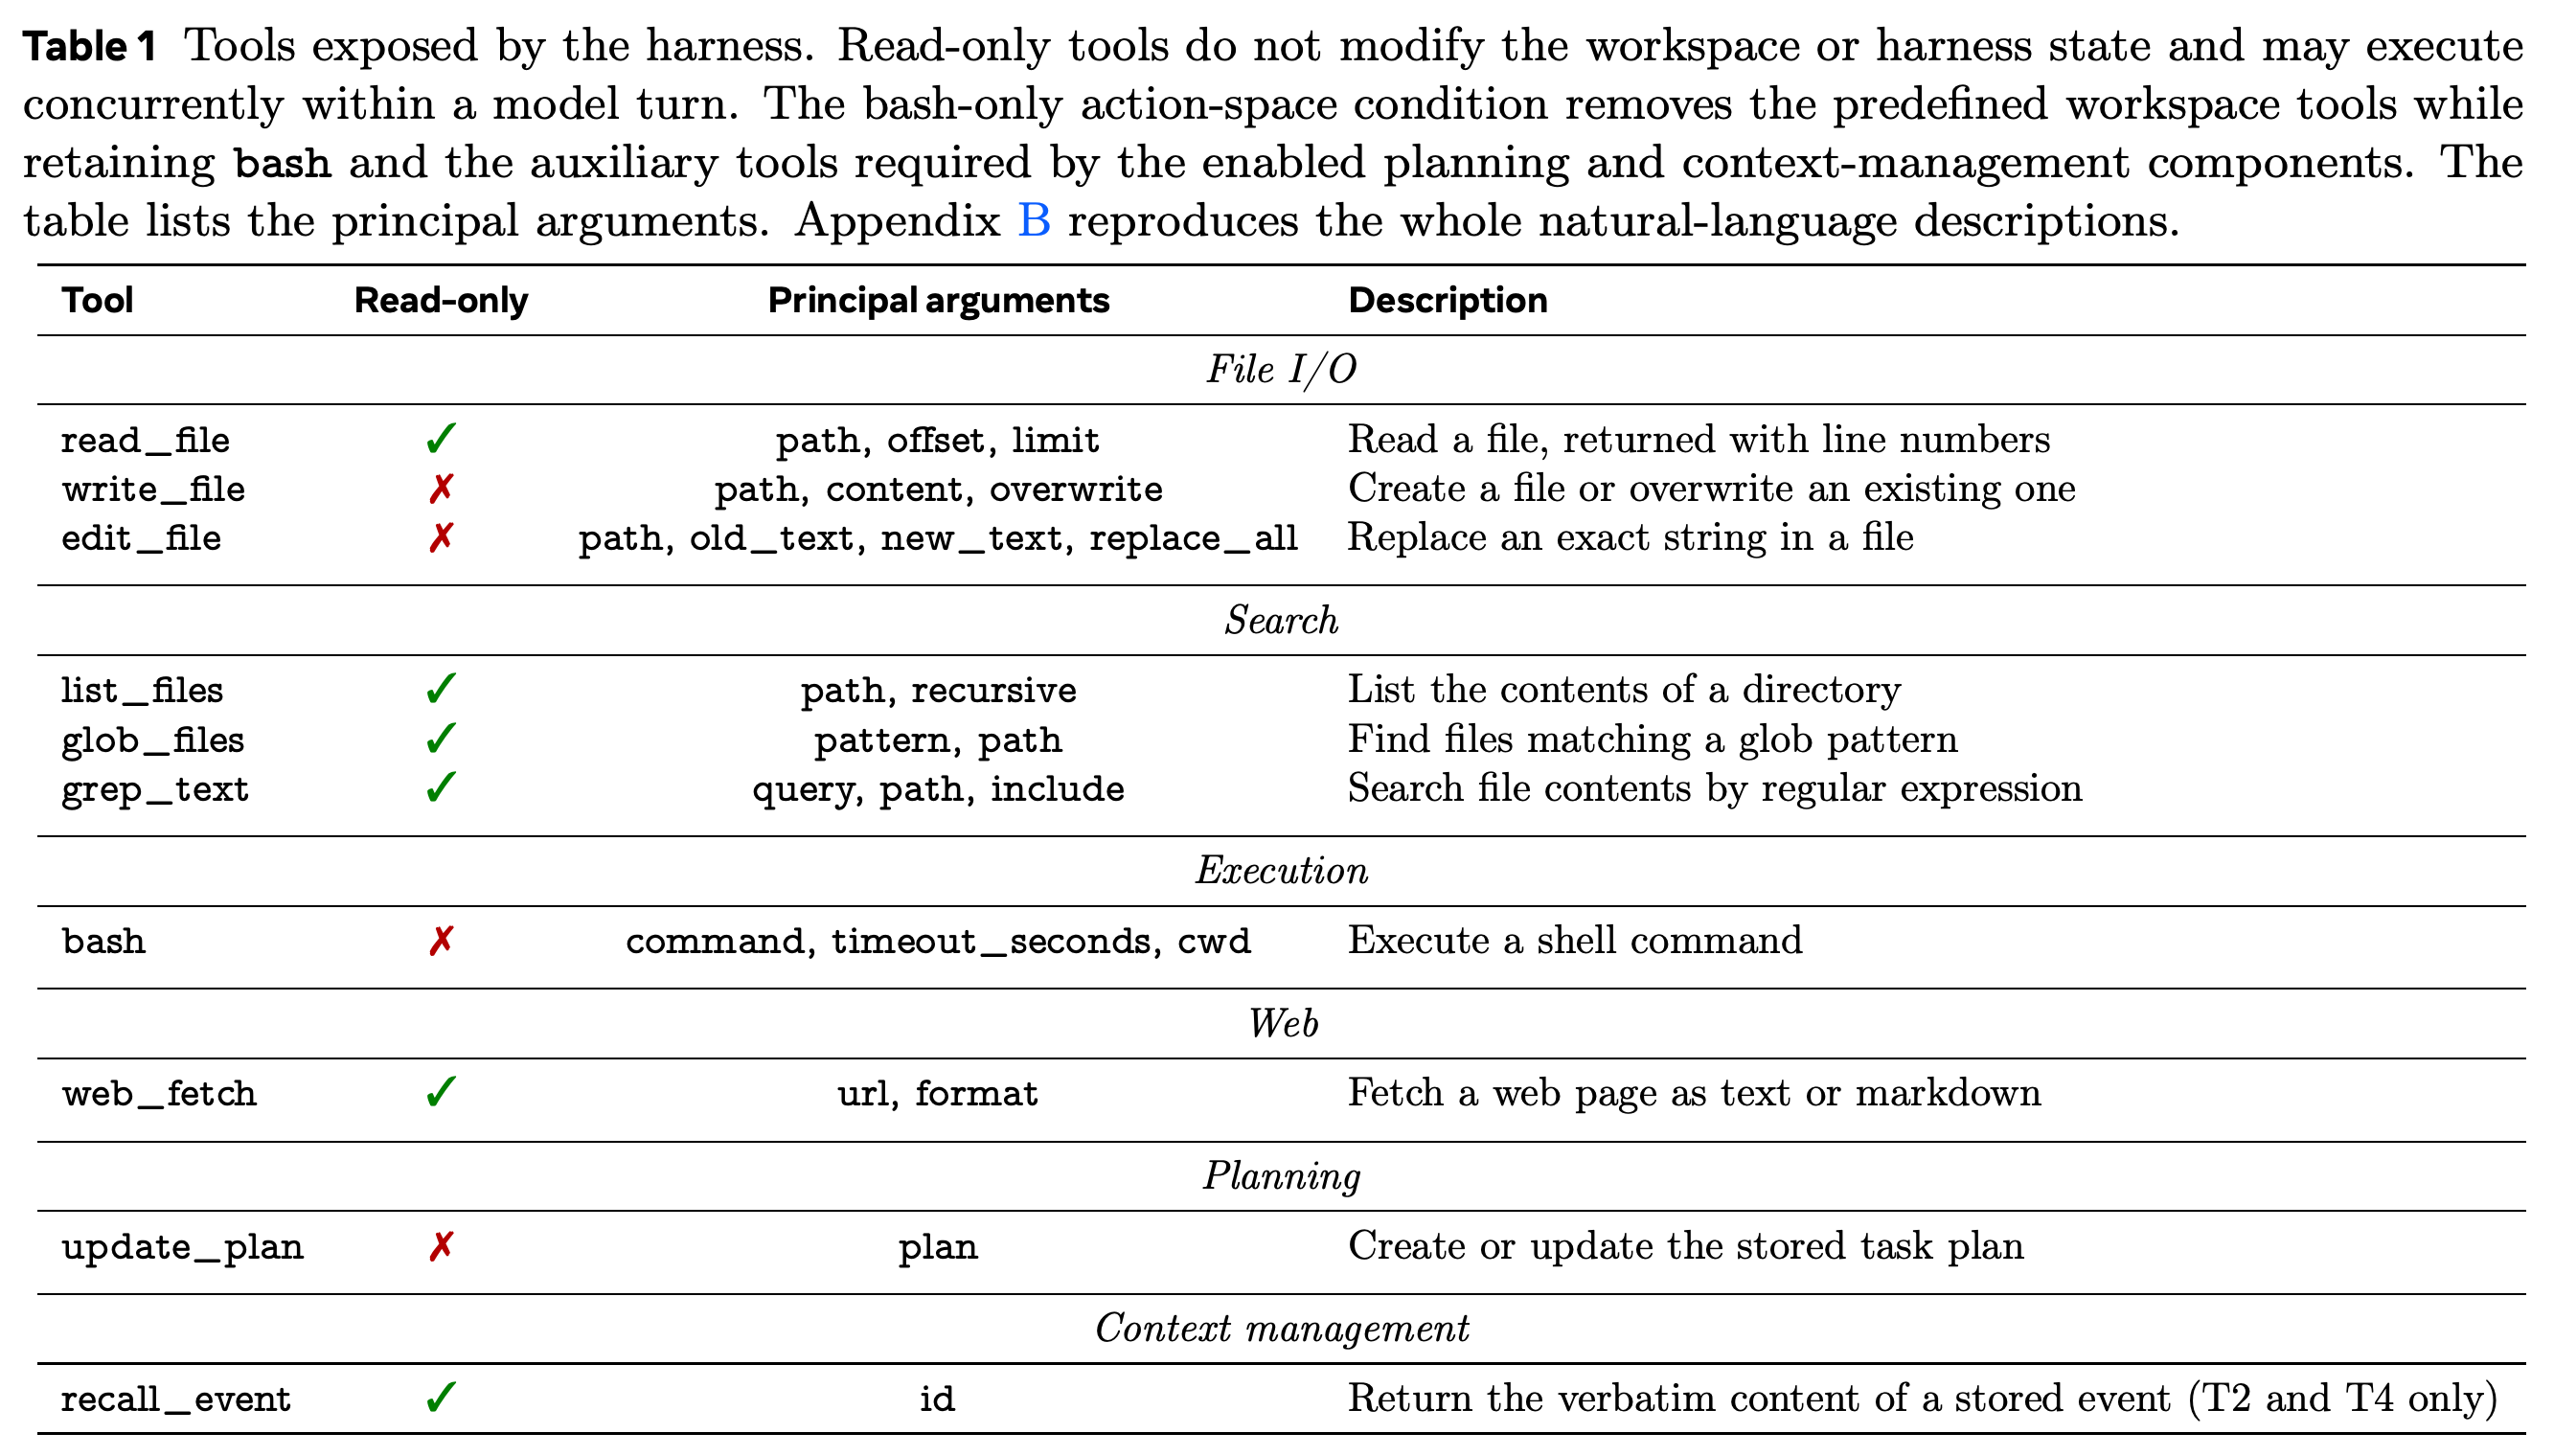
사전 정의 행동 공간은 파일 조작용 read_file, write_file, edit_file, 탐색과 검색용 list_files, glob_files, grep_text, 지정한 웹 페이지를 가져오는 web_fetch, 셸 실행용 bash를 제공한다. bash-only 조건은 사전 정의된 파일, 검색, 웹 도구를 제거하고, 일반적인 작업 공간 조작에 셸 명령을 사용한다. 활성화된 보조 계획 관리 도구나 recall 도구는 유지한다.
- 웹 검색은 SWE-Bench 이슈와 관련된 공개 pull request나 참조 패치를 노출할 수 있으므로 제외한다.
- 사전 정의 파일 도구로 기존 파일을 수정하려면 전체 파일을 읽은 기록이 있어야 한다. 이 도구들은 파일 상태를 갱신하고 지원되는 진단을 실행하지만, 셸을 통한 수정은 해당 절차를 거치지 않는다.
- 이 비교는 도구 제공 여부, 지침, 상태 추적, 검증 지원을 포함한 인터페이스 전체의 변화를 평가한다.
이 목록은 일반적인 작업 공간 조작과 보조 계획 관리 및 recall 기능을 구분한다. bash-only는 사전 정의 작업 공간 도구를 제거하면서 활성화된 보조 도구는 유지하므로, 이 비교에서도 일부 구조화된 도구 호출은 남는다.
2.3 Context management
컨텍스트 관리는 3가지 메커니즘을 결합한다. 생략(M1)은 오래된 도구 출력 본문을 짧은 대체 문구로 바꾼다. recall(M2)은 제거한 관측을 외부에 저장하고 recall_event로 복원한다. 요약(M3)은 오래된 메시지를 누적 자연어 요약으로 압축한다. 요약에는 평가 대상과 동일한 모델을 도구 없이 별도로 호출한다.
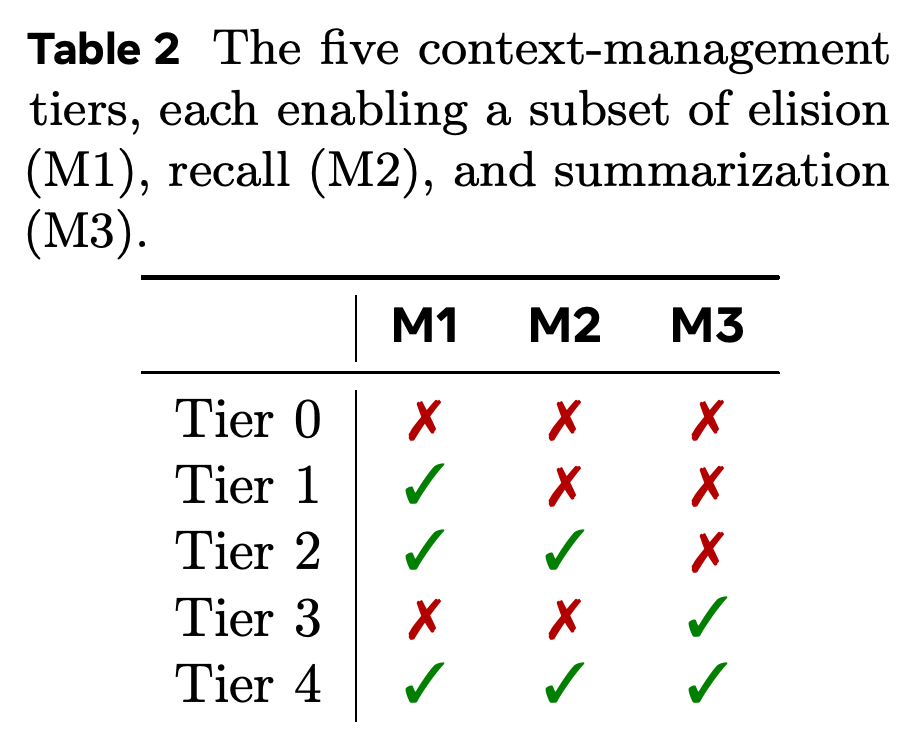
- T0는 관리를 비활성화하며, 이력이 가용 입력 윈도를 초과하는 컨텍스트 오버플로가 발생하면 종료한다. T1은 M1을, T2는 M1과 M2를, T3는 M3를, T4는 모든 메커니즘을 활성화한다.
- T4는 먼저 소프트 임계값에서 부피가 큰 관측을 생략하고, 남은 이력이 더 높은 하드 임계값에 도달할 때만 요약한다. T1–T3는 하드 임계값에서 작동한다.
- 시스템 프롬프트, 최초 작업 설명, 최소 2개 턴을 포함하는 최근 구간은 원문 그대로 유지한다. 압축은 그 사이의 이력에 적용한다.
메커니즘 행렬은 recall 제공 여부를 비교할 때 T1과 T2가 조건을 맞춘 비교 대상임을 보여준다. T4는 활성화된 메커니즘뿐 아니라 생략이 더 이른 임계값에서 수행된다는 점에서도 더 단순한 단계들과 다르다.
2.4 Other components
보조 구성 요소는 작업 공간 접근을 제한하고, 도구 실패를 복구 가능한 관측으로 반환하며, 지원되는 Python 수정 사항을 진단하고, 반복 호출을 감지한다. 경로 검사는 프로젝트 루트 밖으로 나가는 접근을 거부한다. 파일 상태 검사는 읽기 기록 이후 발생한 수정을 감지하며, 권한 계층은 행동을 allow, ask, deny로 분류한다.
- 수정 후 진단은 Python 코드 검사 도구인 ruff나 pyflakes를 사용하며, 사용할 수 없으면 구문 검사만 수행하는 대체 방식으로 구문 오류나 정의되지 않은 이름 등의 문제를 보고한다.
- 반복 호출 감지는 동일한 호출이나 동일하게 실패하는 호출이 5회 연속 발생하면 알림을 삽입하고, 동일하게 실패하는 호출이 8회 연속 발생하면 실행을 종료한다. 권한 거부는 이 메커니즘에서 실패로 계산하지 않는다.
- 자동 파일 추적과 진단은 사전 정의 파일 도구를 통해 적용된다. 동일한 수정을 bash로 수행하면 해당 절차를 거치지 않는다.
3 Experiment
실험은 해결된 작업의 비율인 작업 성공률과 토큰 가격으로 산정한 작업당 평균 비용을 측정한다. 컨텍스트 관리 전략과 예산을 바꾼 실험이 주요 비교를 구성한다. 여기에 구성 요소를 제거하거나 교체하는 계획 관리 및 행동 공간 절제 실험을 추가하고 T4/128k 기준 설정과 비교한다.
3.1 Setup
평가 모델은 Nemotron-3 30B, 120B, 550B와 Mistral-Medium-3.5-128B이며, B는 매개변수 수의 기가 단위를 뜻한다. SWE-Bench Verified에는 사람이 검증한 GitHub 이슈 500건이 있고, Terminal-Bench 2.1에는 종단 간 명령줄 작업 89개가 있다.
- 모델은 모델 서빙 시스템인 SGLang을 통해 로컬에서 실행하며, 16비트 수치 형식인 BF16을 사용한다. 생성 설정은 temperature 0, 누적 확률 기반 샘플링 기준인 top-p 0.95이며, 턴당 출력은 최대 16,384토큰이다.
- 하네스는 실행 워크플로에 LangGraph를 사용하고, 작업 컨테이너와 검증기 관리에 Harbor를 사용한다. 작업당 최대 300단계를 허용하고, 도구 결과는 24k자로 잘라내며, 읽기 전용 도구는 최대 8개까지 동시에 실행할 수 있다.
- 소프트 임계값과 하드 임계값은 사용 가능한 윈도의 각각 0.6과 0.85다. 원문을 유지하는 최근 구간에는 해당 윈도의 0.3을 배정하며, 최소 2개 턴을 보존한다.
32k, 64k, 96k, 128k 토큰에서 관리 전략 5개를 평가하여 모델–벤치마크 조합마다 설정 20개를 구성한다. 이 설정은 모두 계획 관리와 사전 정의 도구를 사용한다. T4/128k에서 계획 관리를 제거하거나 bash-only로 전환하는 설정 2개를 추가하여, 모델 4개와 벤치마크 2개에 걸쳐 총 176개 설정을 평가한다.
- 성공률 비교에는 짝지은 작업 결과를 비교하는 양측 정확 McNemar 검정을 사용한다. Benjamini–Hochberg 절차로 다중 비교를 보정하여, 각 비교군에서 기각한 가설 중 거짓 발견의 기대 비율인 거짓 발견율을 0.05로 통제한다.
- 비용은 2026년 8월에 조회한 OpenRouter 가격으로 산정한다. 입력/출력 1M 토큰당 요율은 앞서 나열한 모델 4개의 순서대로 $0.05/$0.20, $0.08/$0.45, $0.50/$2.20, $1.50/$7.50이다.
- 이 달러 금액은 토큰 사용량을 가격으로 환산한 값이며, 모델 자체는 로컬에서 서빙한다.
3.2 Main Results
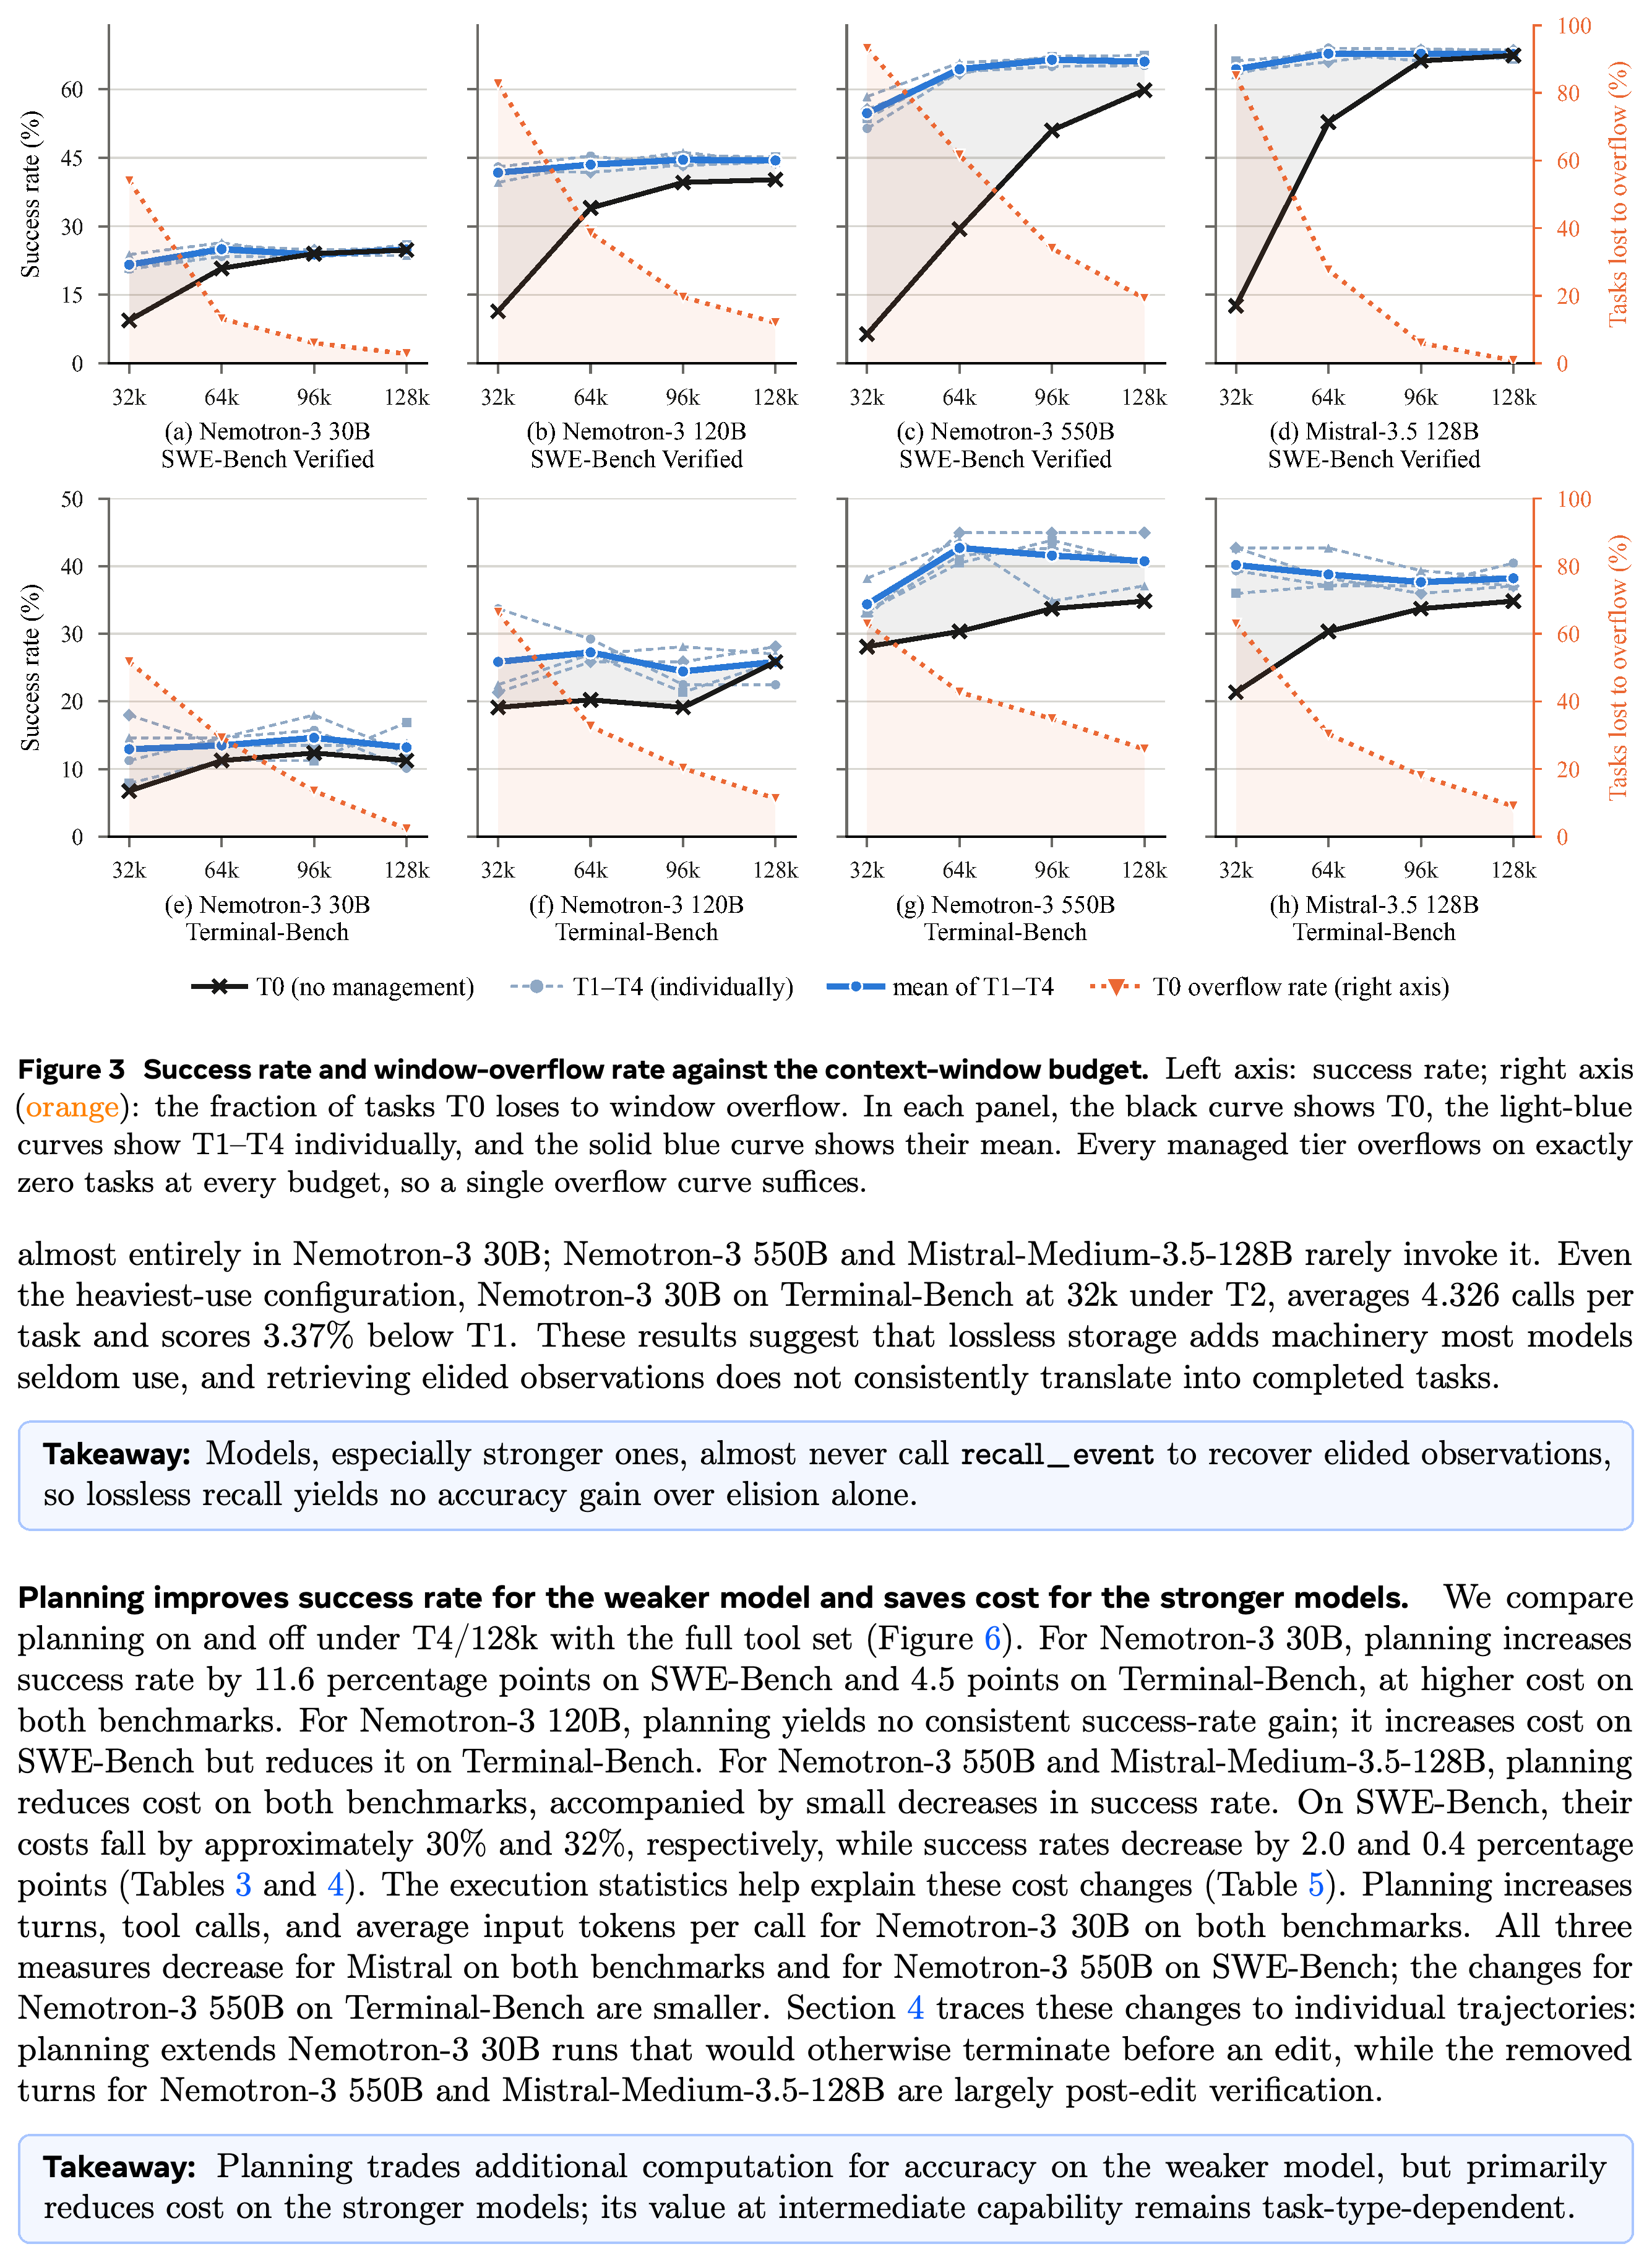
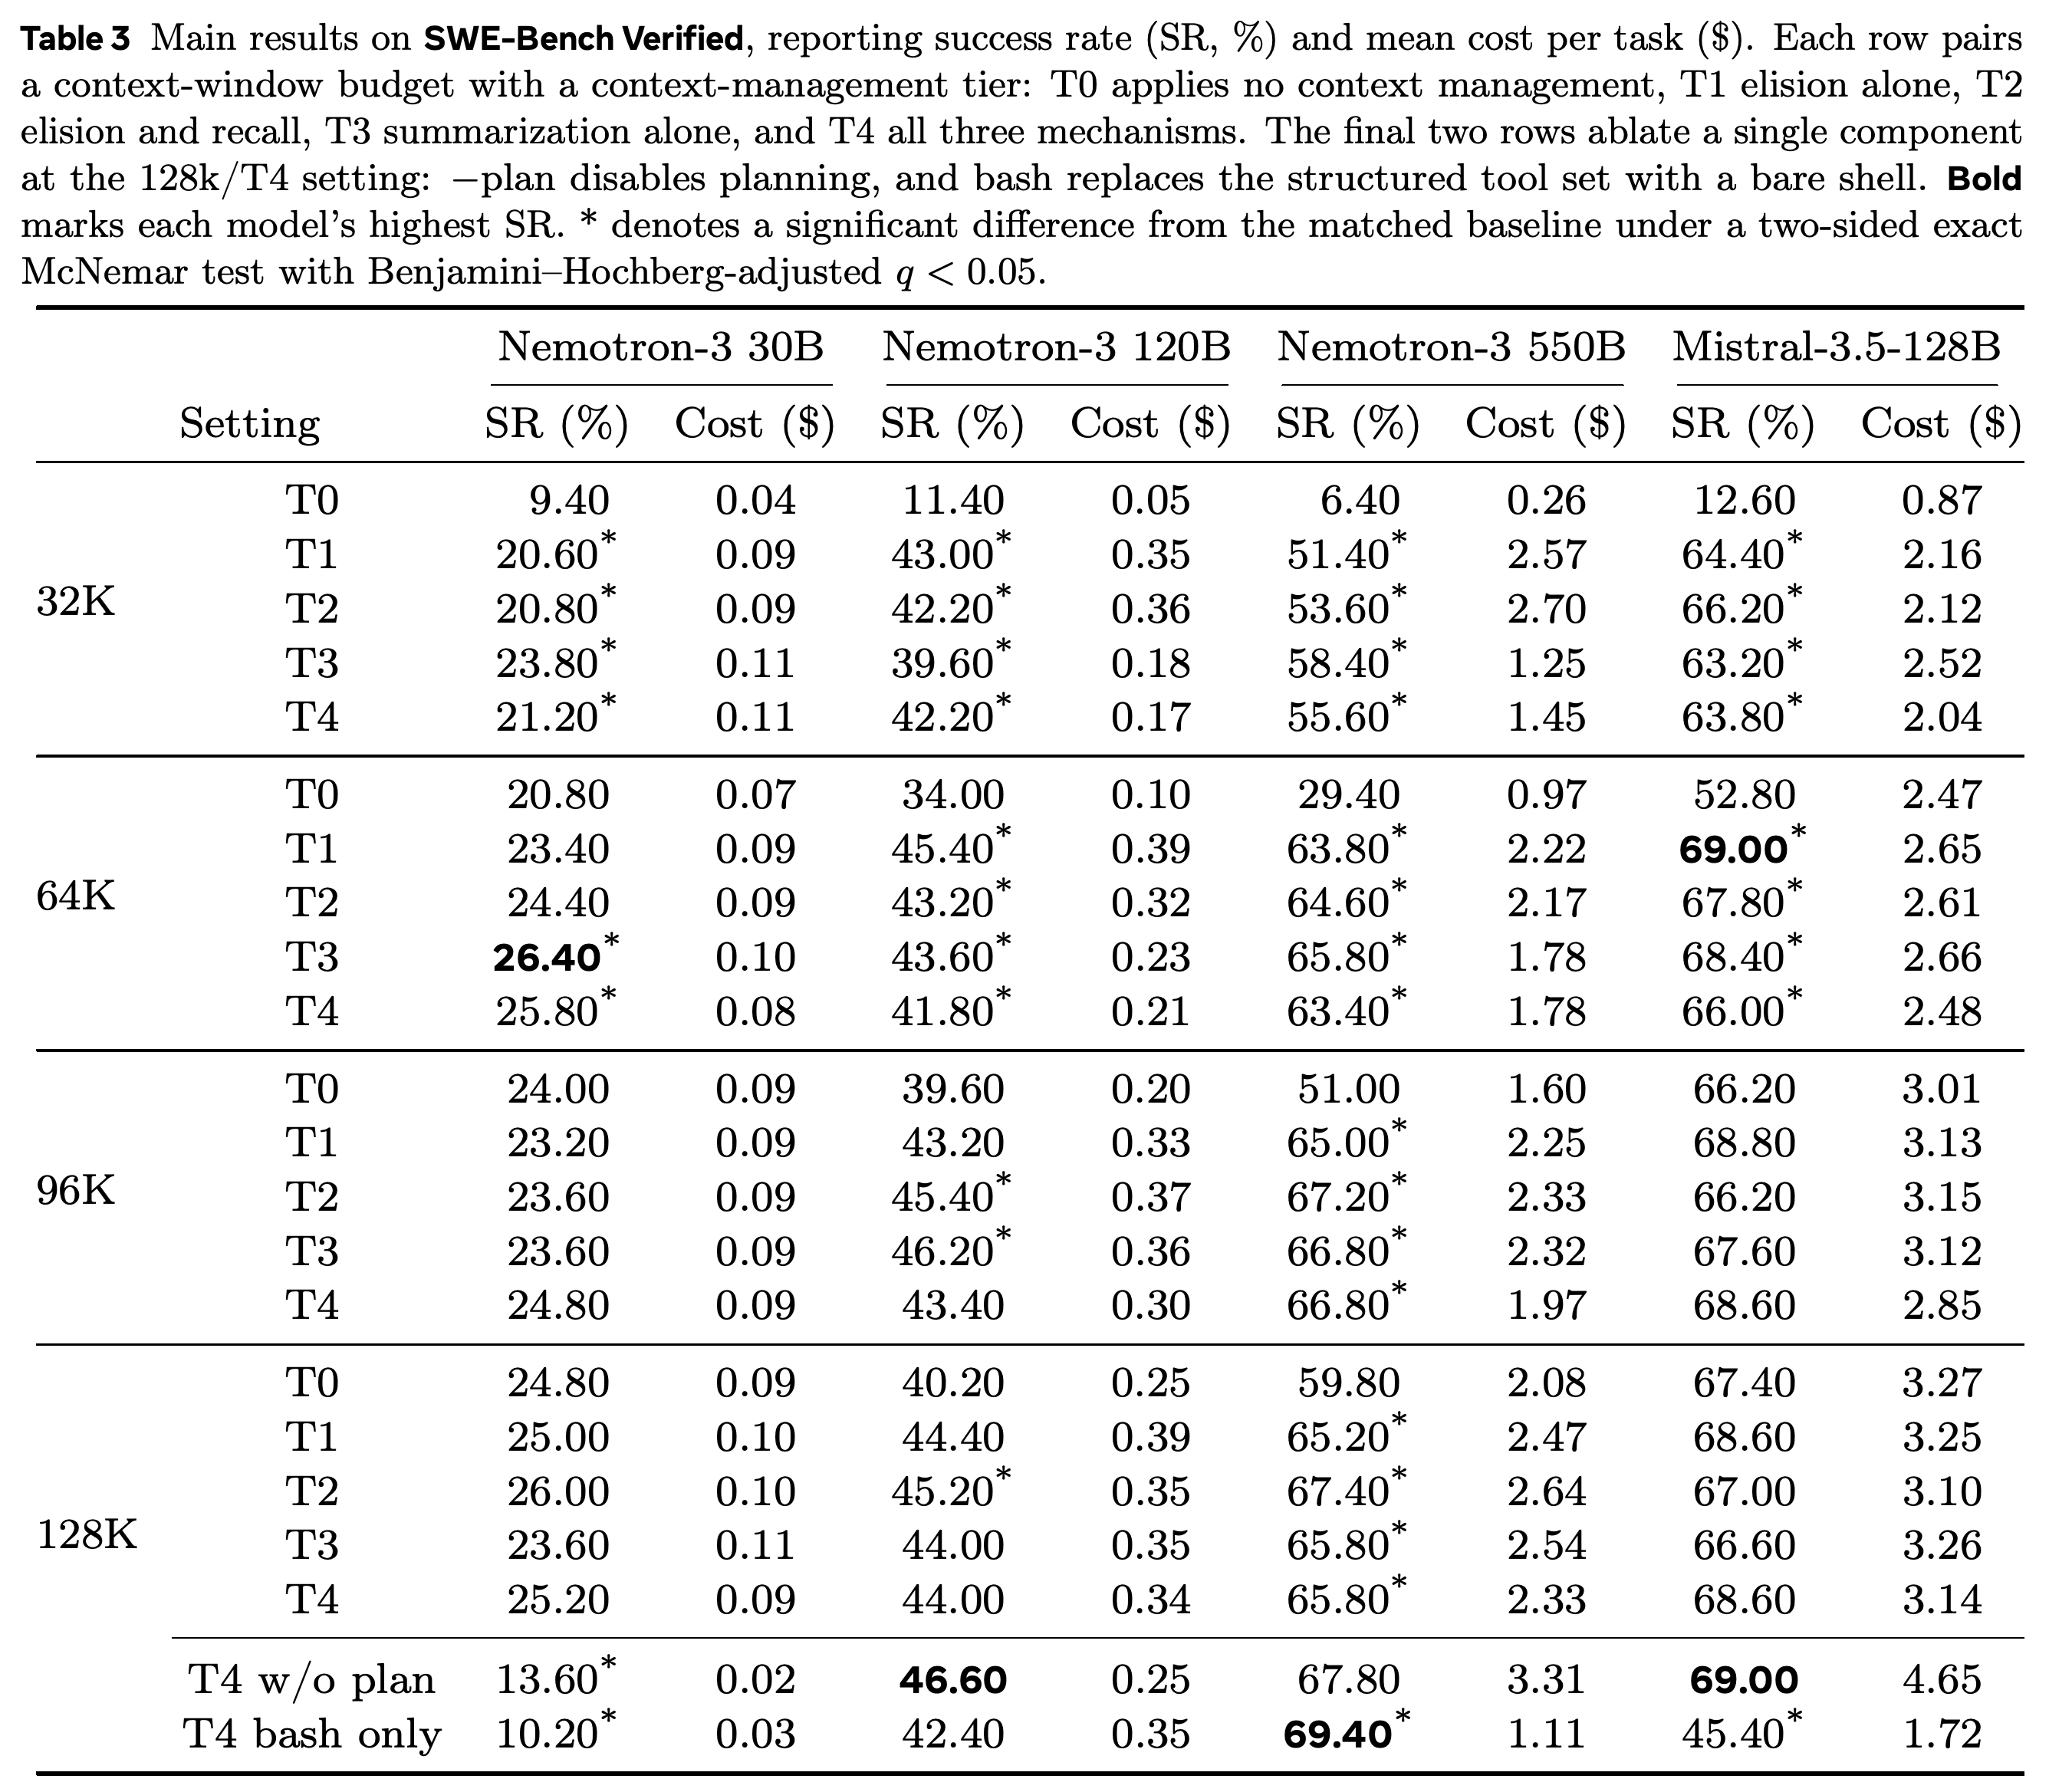
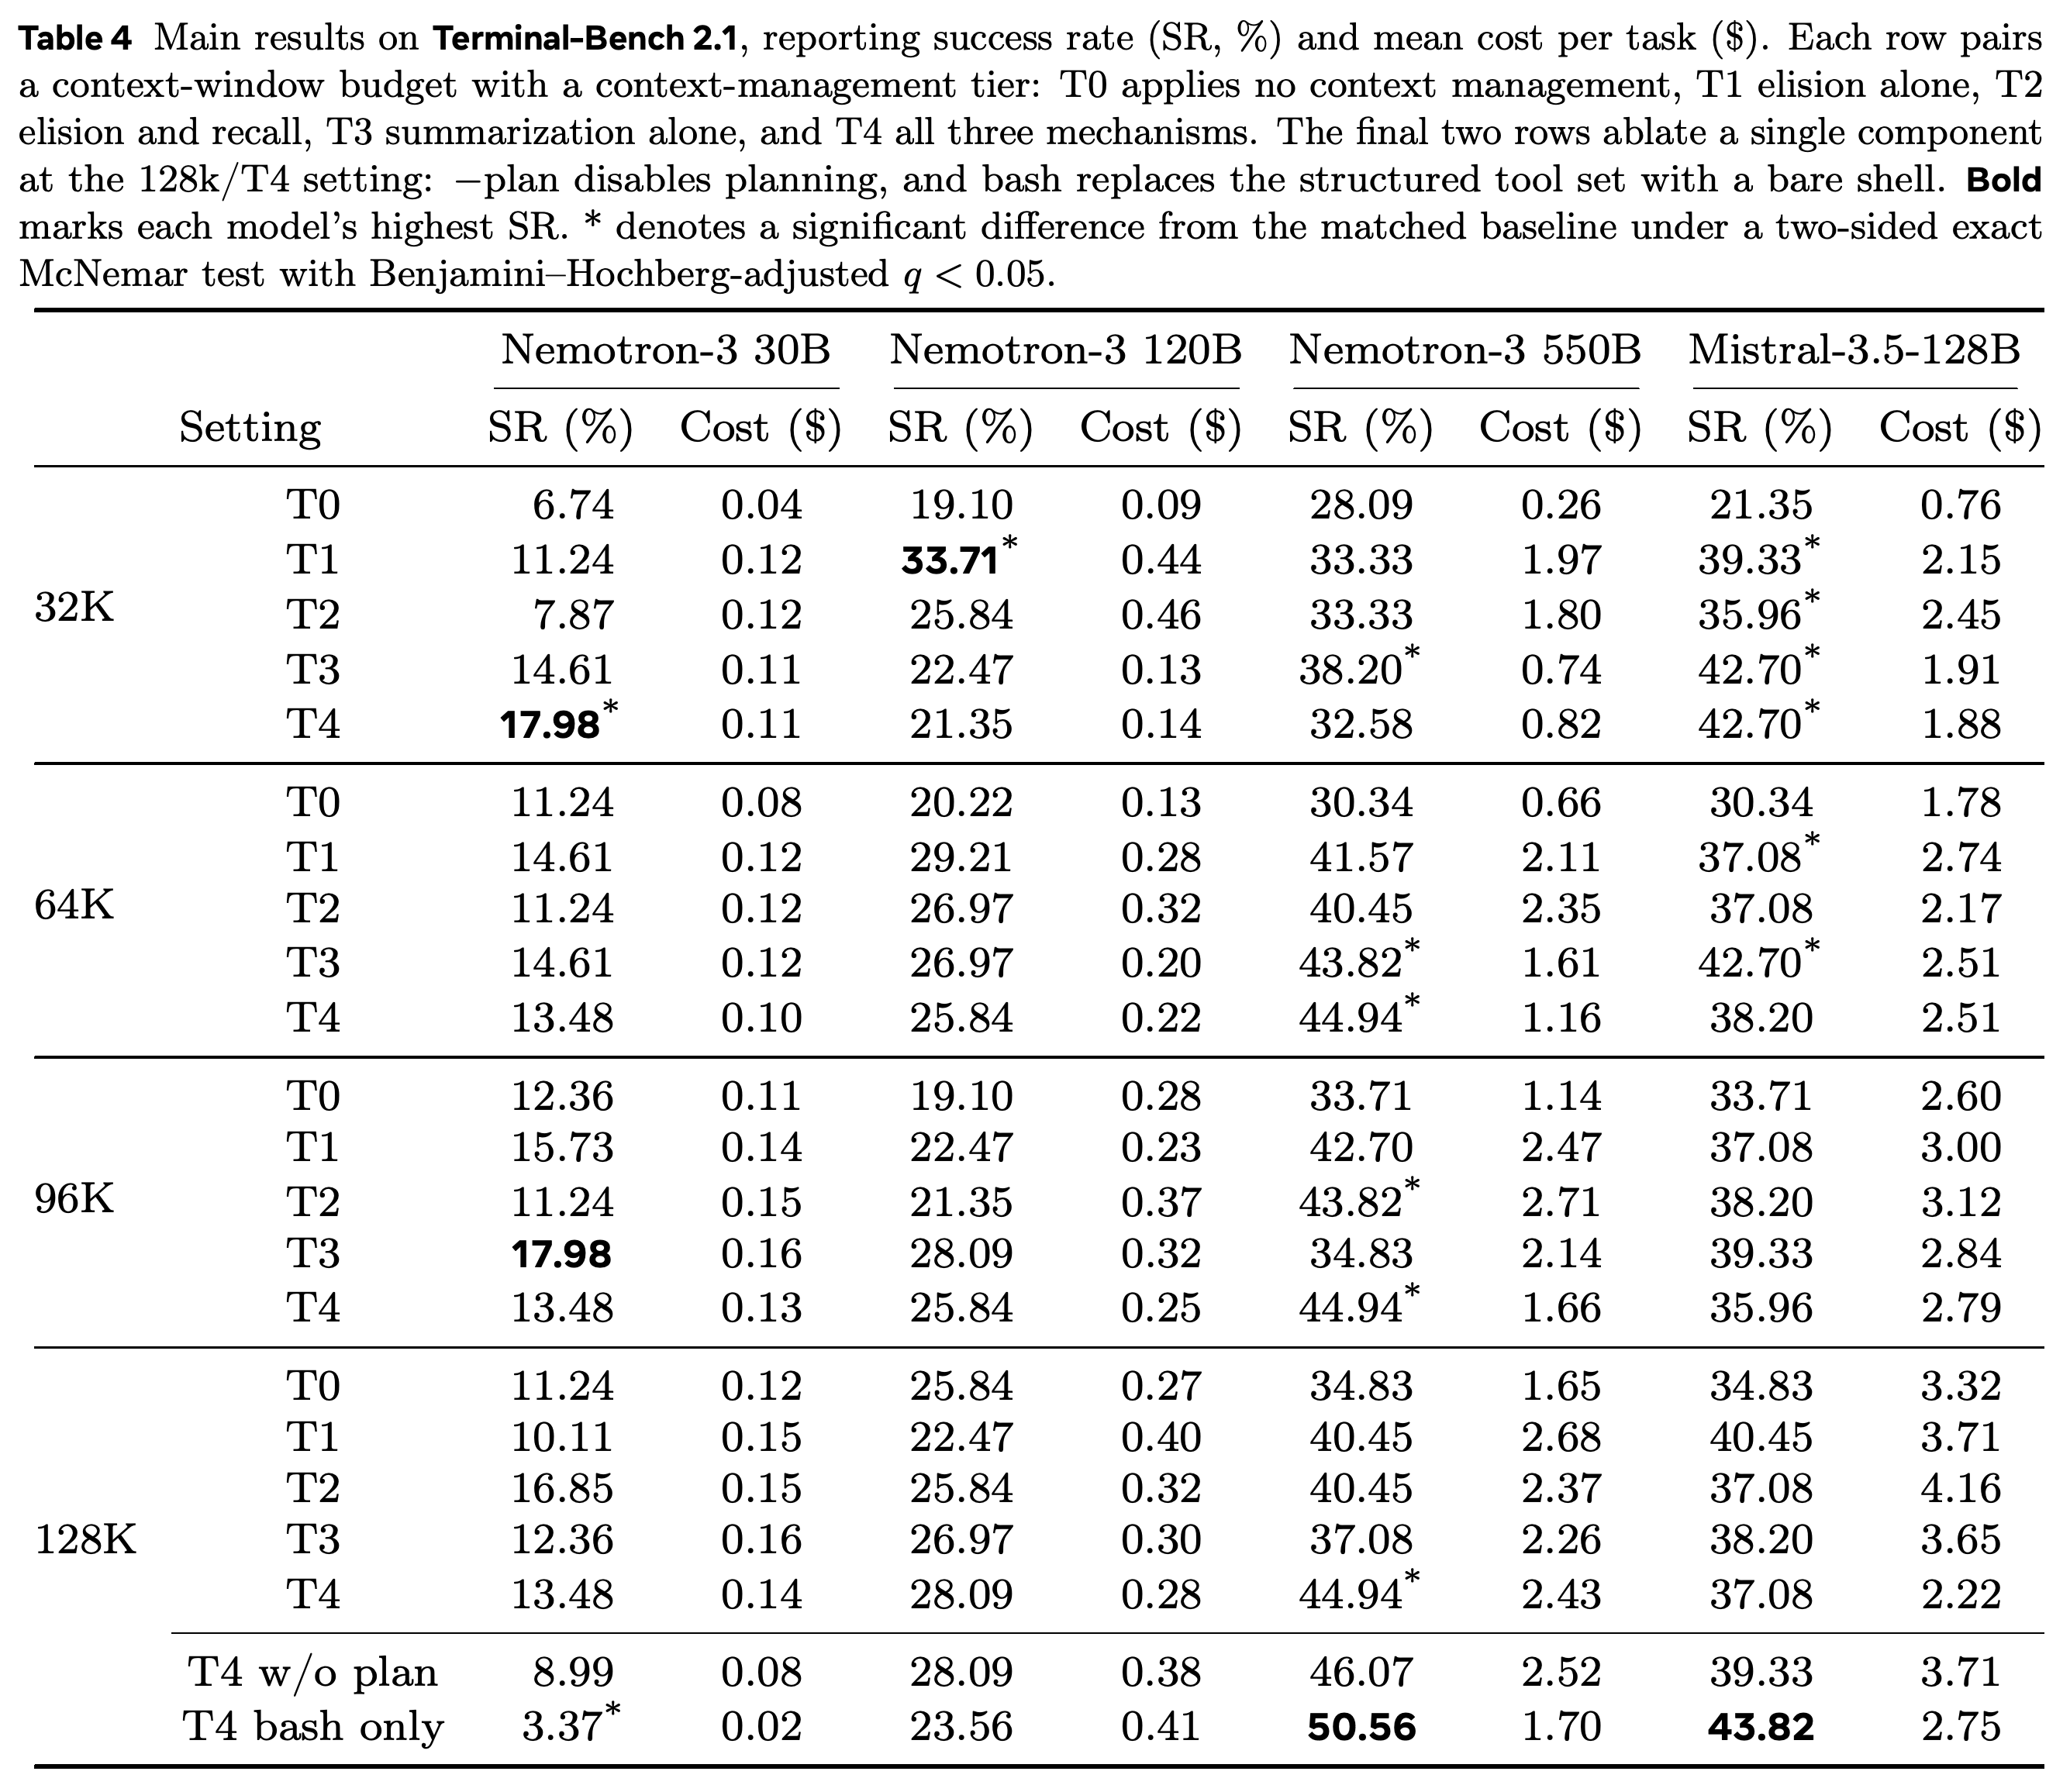
컨텍스트 관리는 주로 가용 이력 윈도 초과로 인한 조기 종료를 방지한다. 32k, 64k, 96k, 128k 예산에서 모델 평균으로 계산한 관리 전략과 T0의 성공률 차이는 SWE-Bench에서 35.7, 15.9, 5.5, 2.7%포인트로 줄어든다. Terminal-Bench에서는 9.5, 7.5, 4.8, 2.8점으로 줄어든다.
- 같은 예산 범위에서 T0의 평균 오버플로 비율은 SWE-Bench에서 78.7%에서 8.7%로, Terminal-Bench에서 61.0%에서 12.1%로 낮아진다.
- 모든 관리 전략은 시험한 모든 예산에서 오버플로 실패 0건을 기록한다. 성공률 차이와 오버플로 비율이 함께 줄어드는 결과는 작은 윈도에서 관측된 주된 이점이 오버플로 방지라는 해석을 뒷받침한다.
컨텍스트 용량이 커지면 관리하지 않는 경우의 성공률이 대체로 관리하는 경우에 가까워지고, 관리하지 않는 경우의 오버플로는 줄어든다. 모든 관리 전략에서 오버플로 실패는 0건이다. 이는 예산이 빠듯할 때 관측된 주된 이점이 오버플로 방지라는 해석을 뒷받침한다.
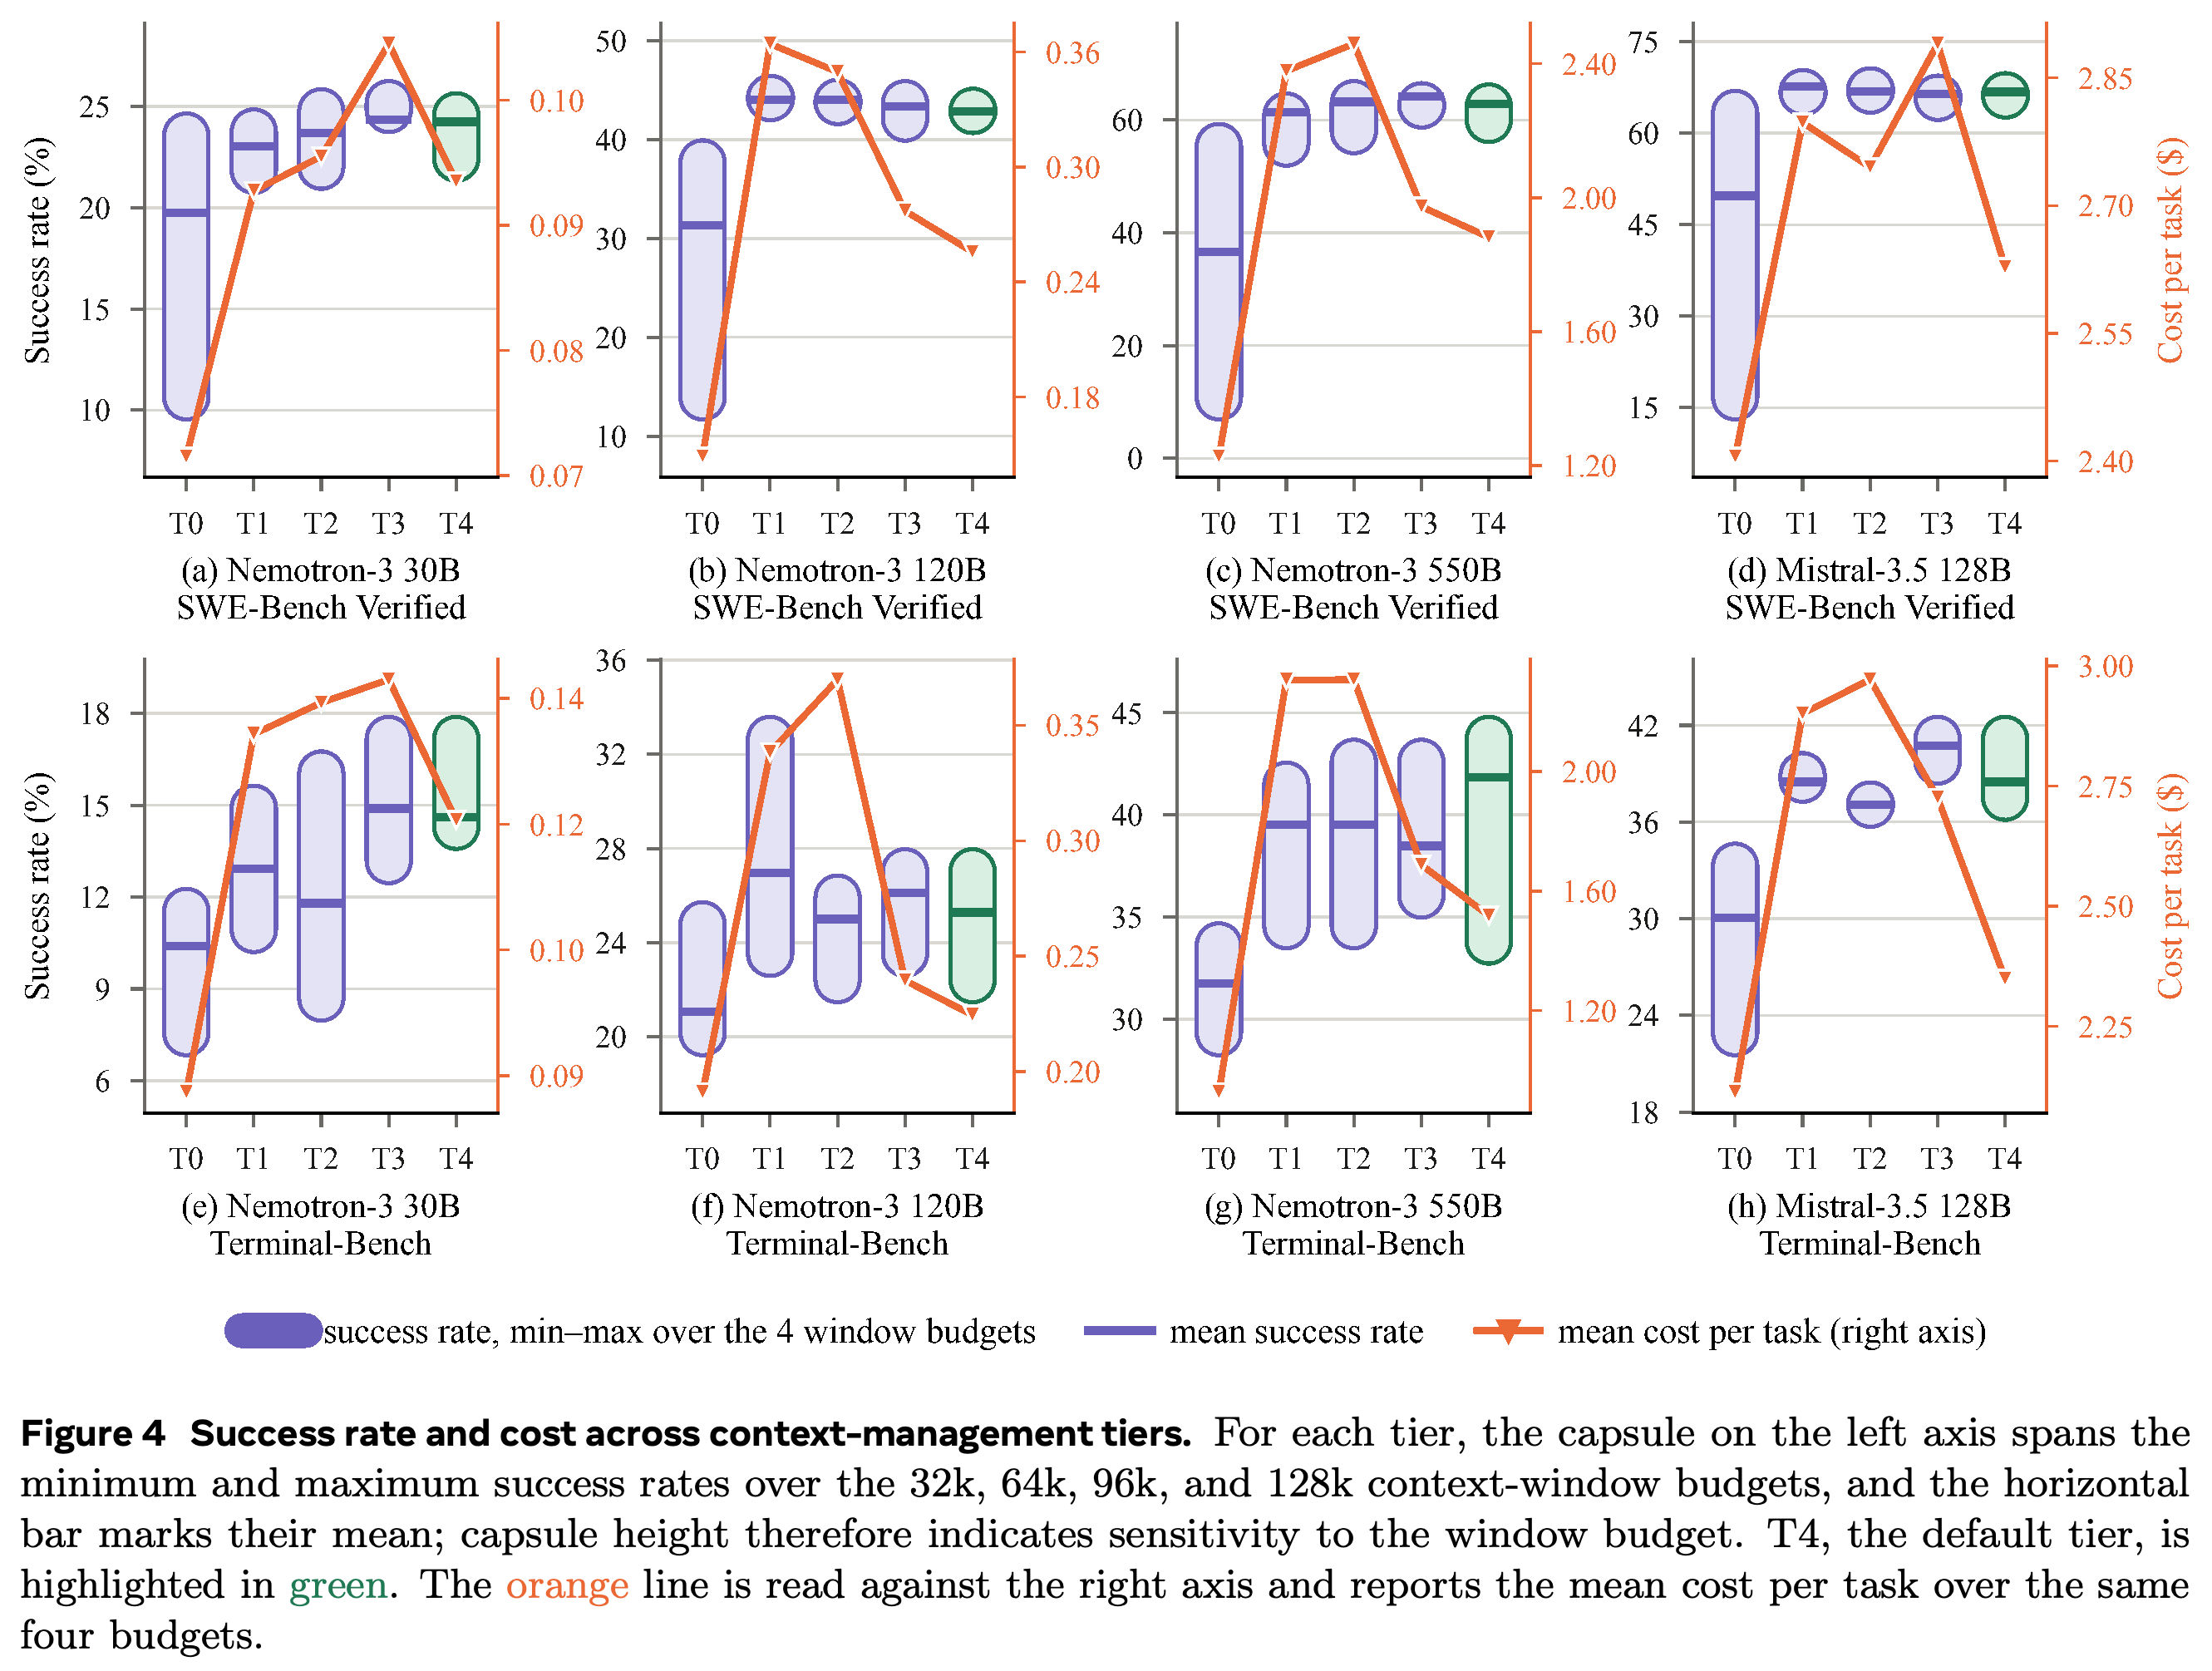
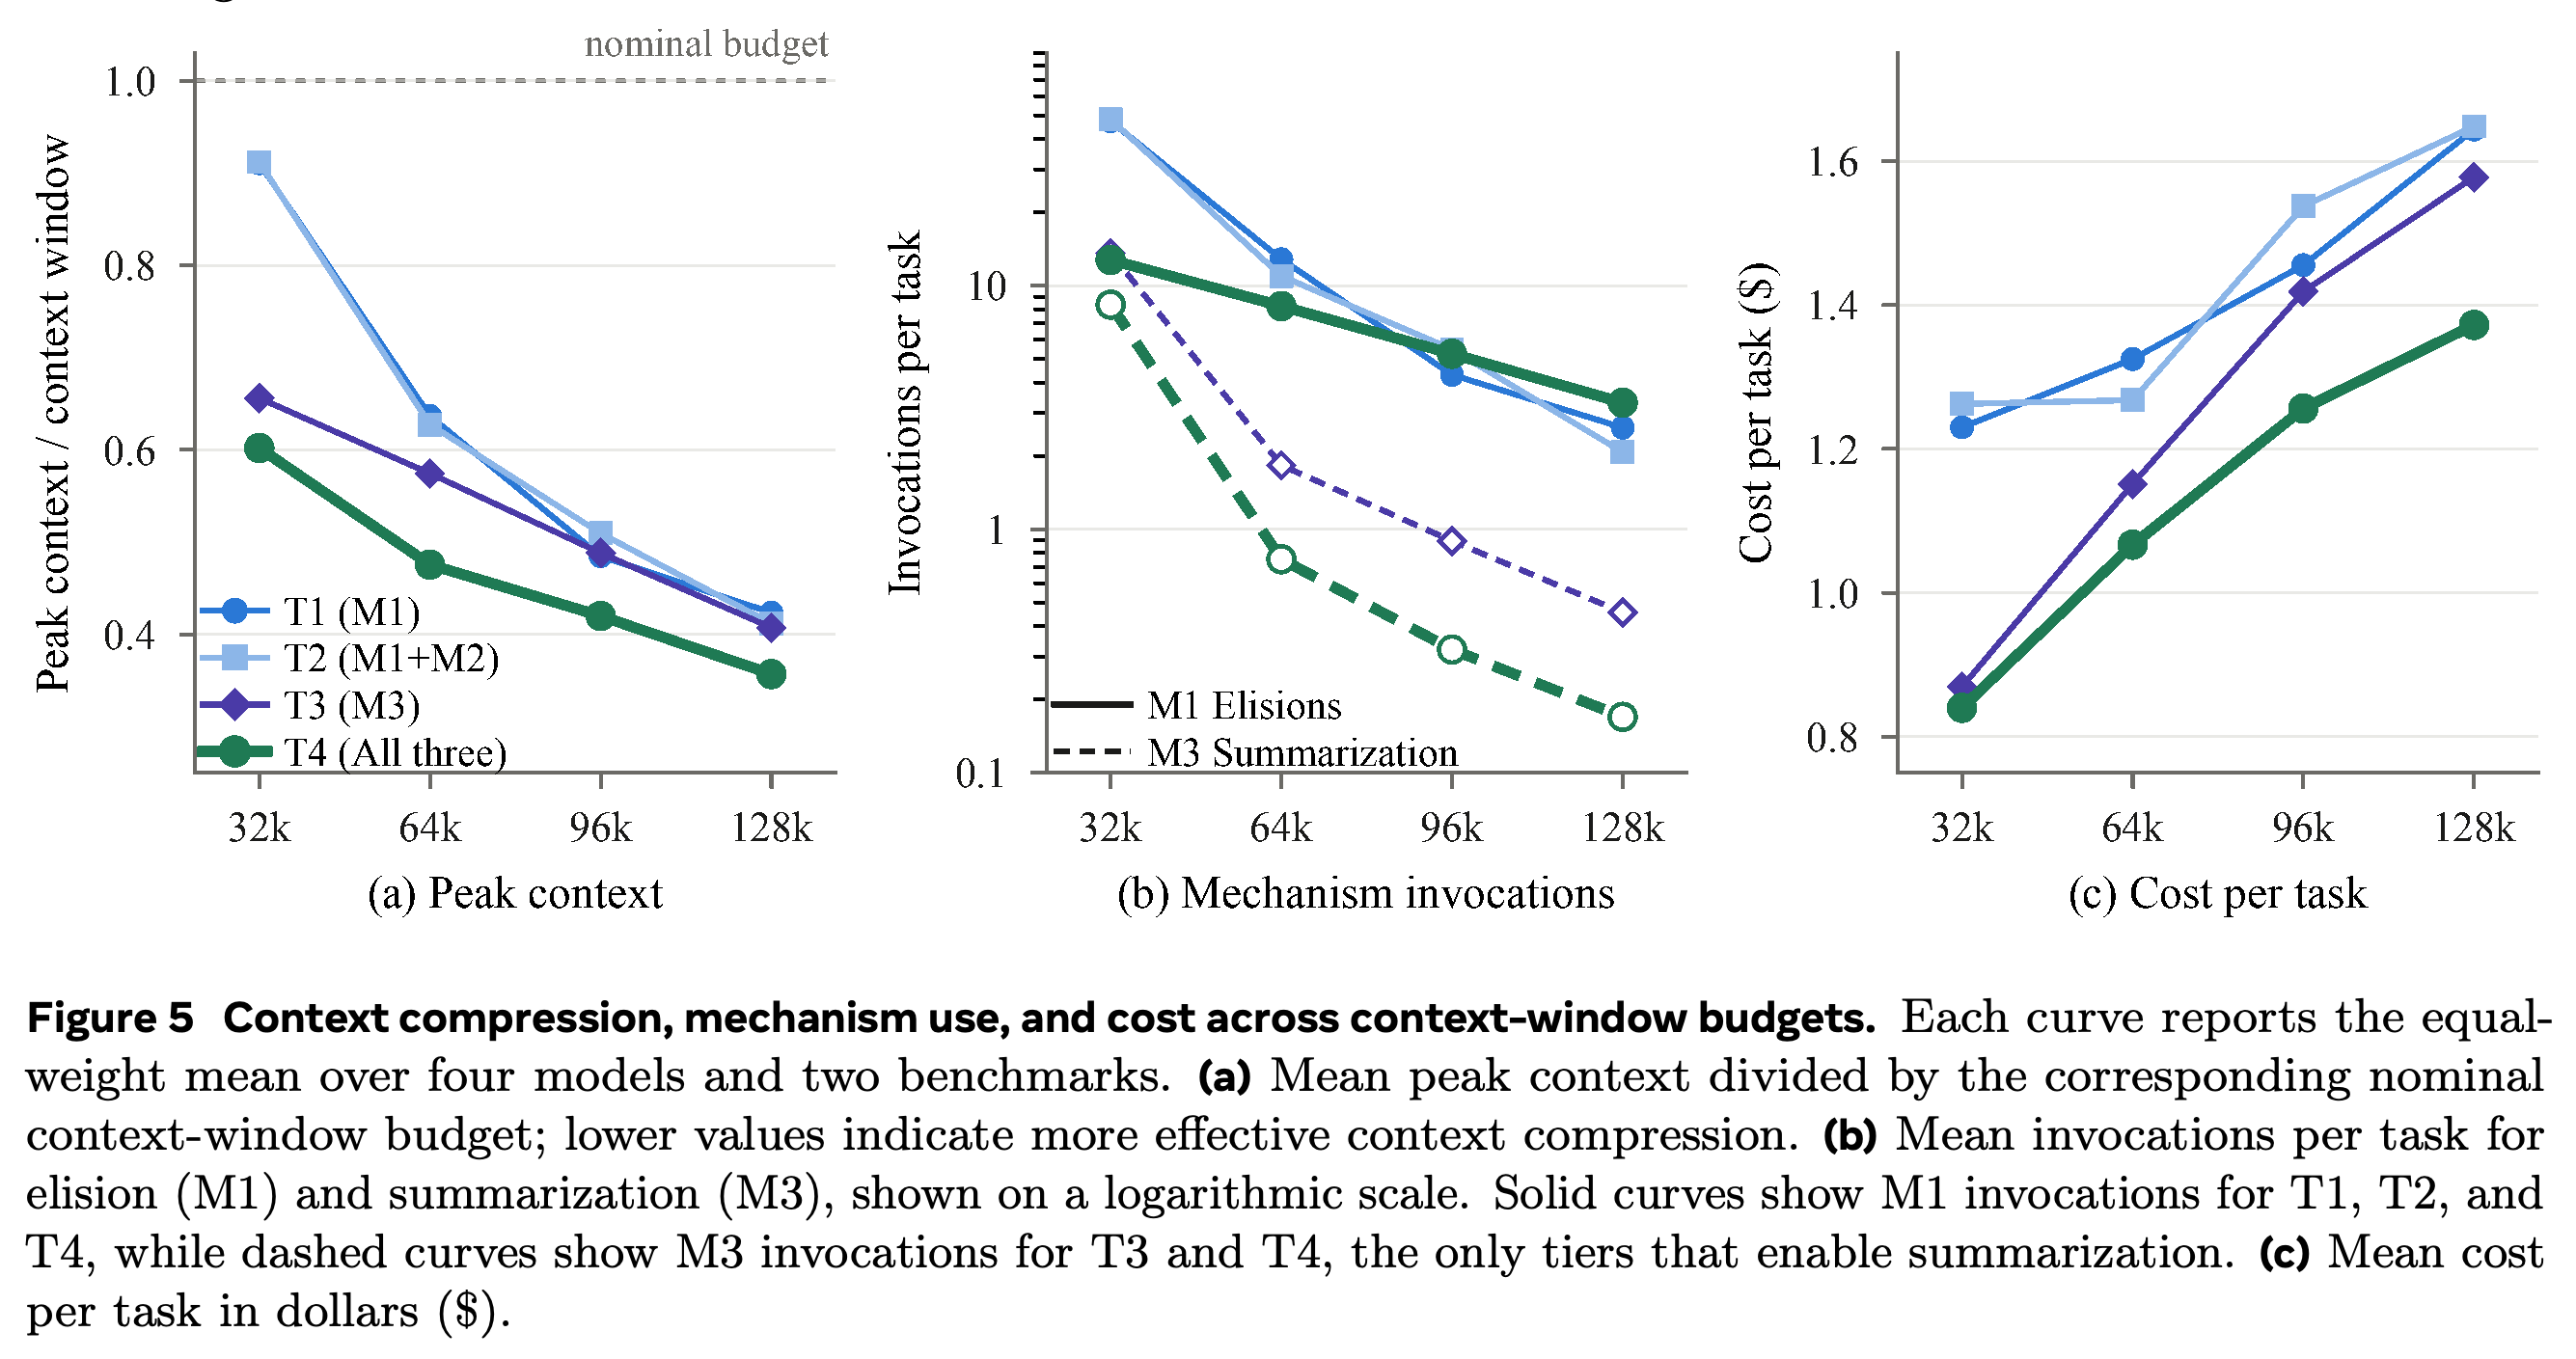
T4는 다른 관리 전략과 대체로 비슷한 성공률을 달성하며, 모델–벤치마크 패널 8개 중 7개에서 윈도 예산 전체의 평균 비용이 가장 낮다. 조합 8개를 모두 평균하면, 시험한 모든 예산에서 관리 전략 중 비용이 가장 낮고 정규화된 최대 컨텍스트도 가장 작다. 정규화된 최대 컨텍스트는 최대 이력 크기를 명목상 윈도 예산으로 나눈 값이다.
- T4는 모든 예산에서 요약만 사용하는 T3보다 평균 요약 호출 횟수가 적다. 이는 저렴한 조기 생략이 모델 호출 필요성을 줄인다는 해석과 부합한다.
- T4의 효율성 우위는 전체 평균에서 나타난다. 모든 개별 설정에서 성공률이 가장 높거나 비용이 가장 낮은 것은 아니다.
- T2와 T1을 비교하면 recall 제공 여부의 효과를 분리할 수 있다. T2는 설정 15개에서 우세하고 14개에서 열세이며 3개에서 동률이다. 동일 가중치로 계산한 평균 성공률 차이는 −0.36%포인트다.
성공률 범위는 통계적 불확실성이 아니라 컨텍스트 용량에 대한 민감도를 요약한다. 평균값과 비용 곡선은 T4의 전체 평균 효율성 우위와 모델별 예외를 함께 보여준다.
각 패널은 T4의 더 작은 정규화 최대 이력과 더 적은 요약 호출을 관리 전략 중 낮은 전체 평균 비용과 연결한다. 모델 4개와 벤치마크 2개에 동일 가중치를 적용한 평균은 개별 설정의 예외를 가릴 수 있다.
recall은 사용할 수 있어도 드물게 호출된다. T2와 T4 설정 64개 중 36개(56.3%)는 recall_event를 전혀 호출하지 않으며, 호출 빈도의 중앙값은 0이다.
- 작업당 평균 호출 횟수는 32k에서 0.540이며, 64k, 96k, 128k에서는 각각 0.069, 0.011, 0.007로 줄어든다.
- T4/128k에서 추가한 계획 관리 및 행동 공간 절제 설정 16개는 모두 recall 호출 0회를 기록한다.
- 이 recall 구현은 생략만 사용하는 경우보다 정확도를 일관되게 높이지 못한다. 사용 빈도가 낮다는 사실만으로 다른 에이전트 설계에서도 외부 메모리가 불필요하다고 볼 수는 없다.
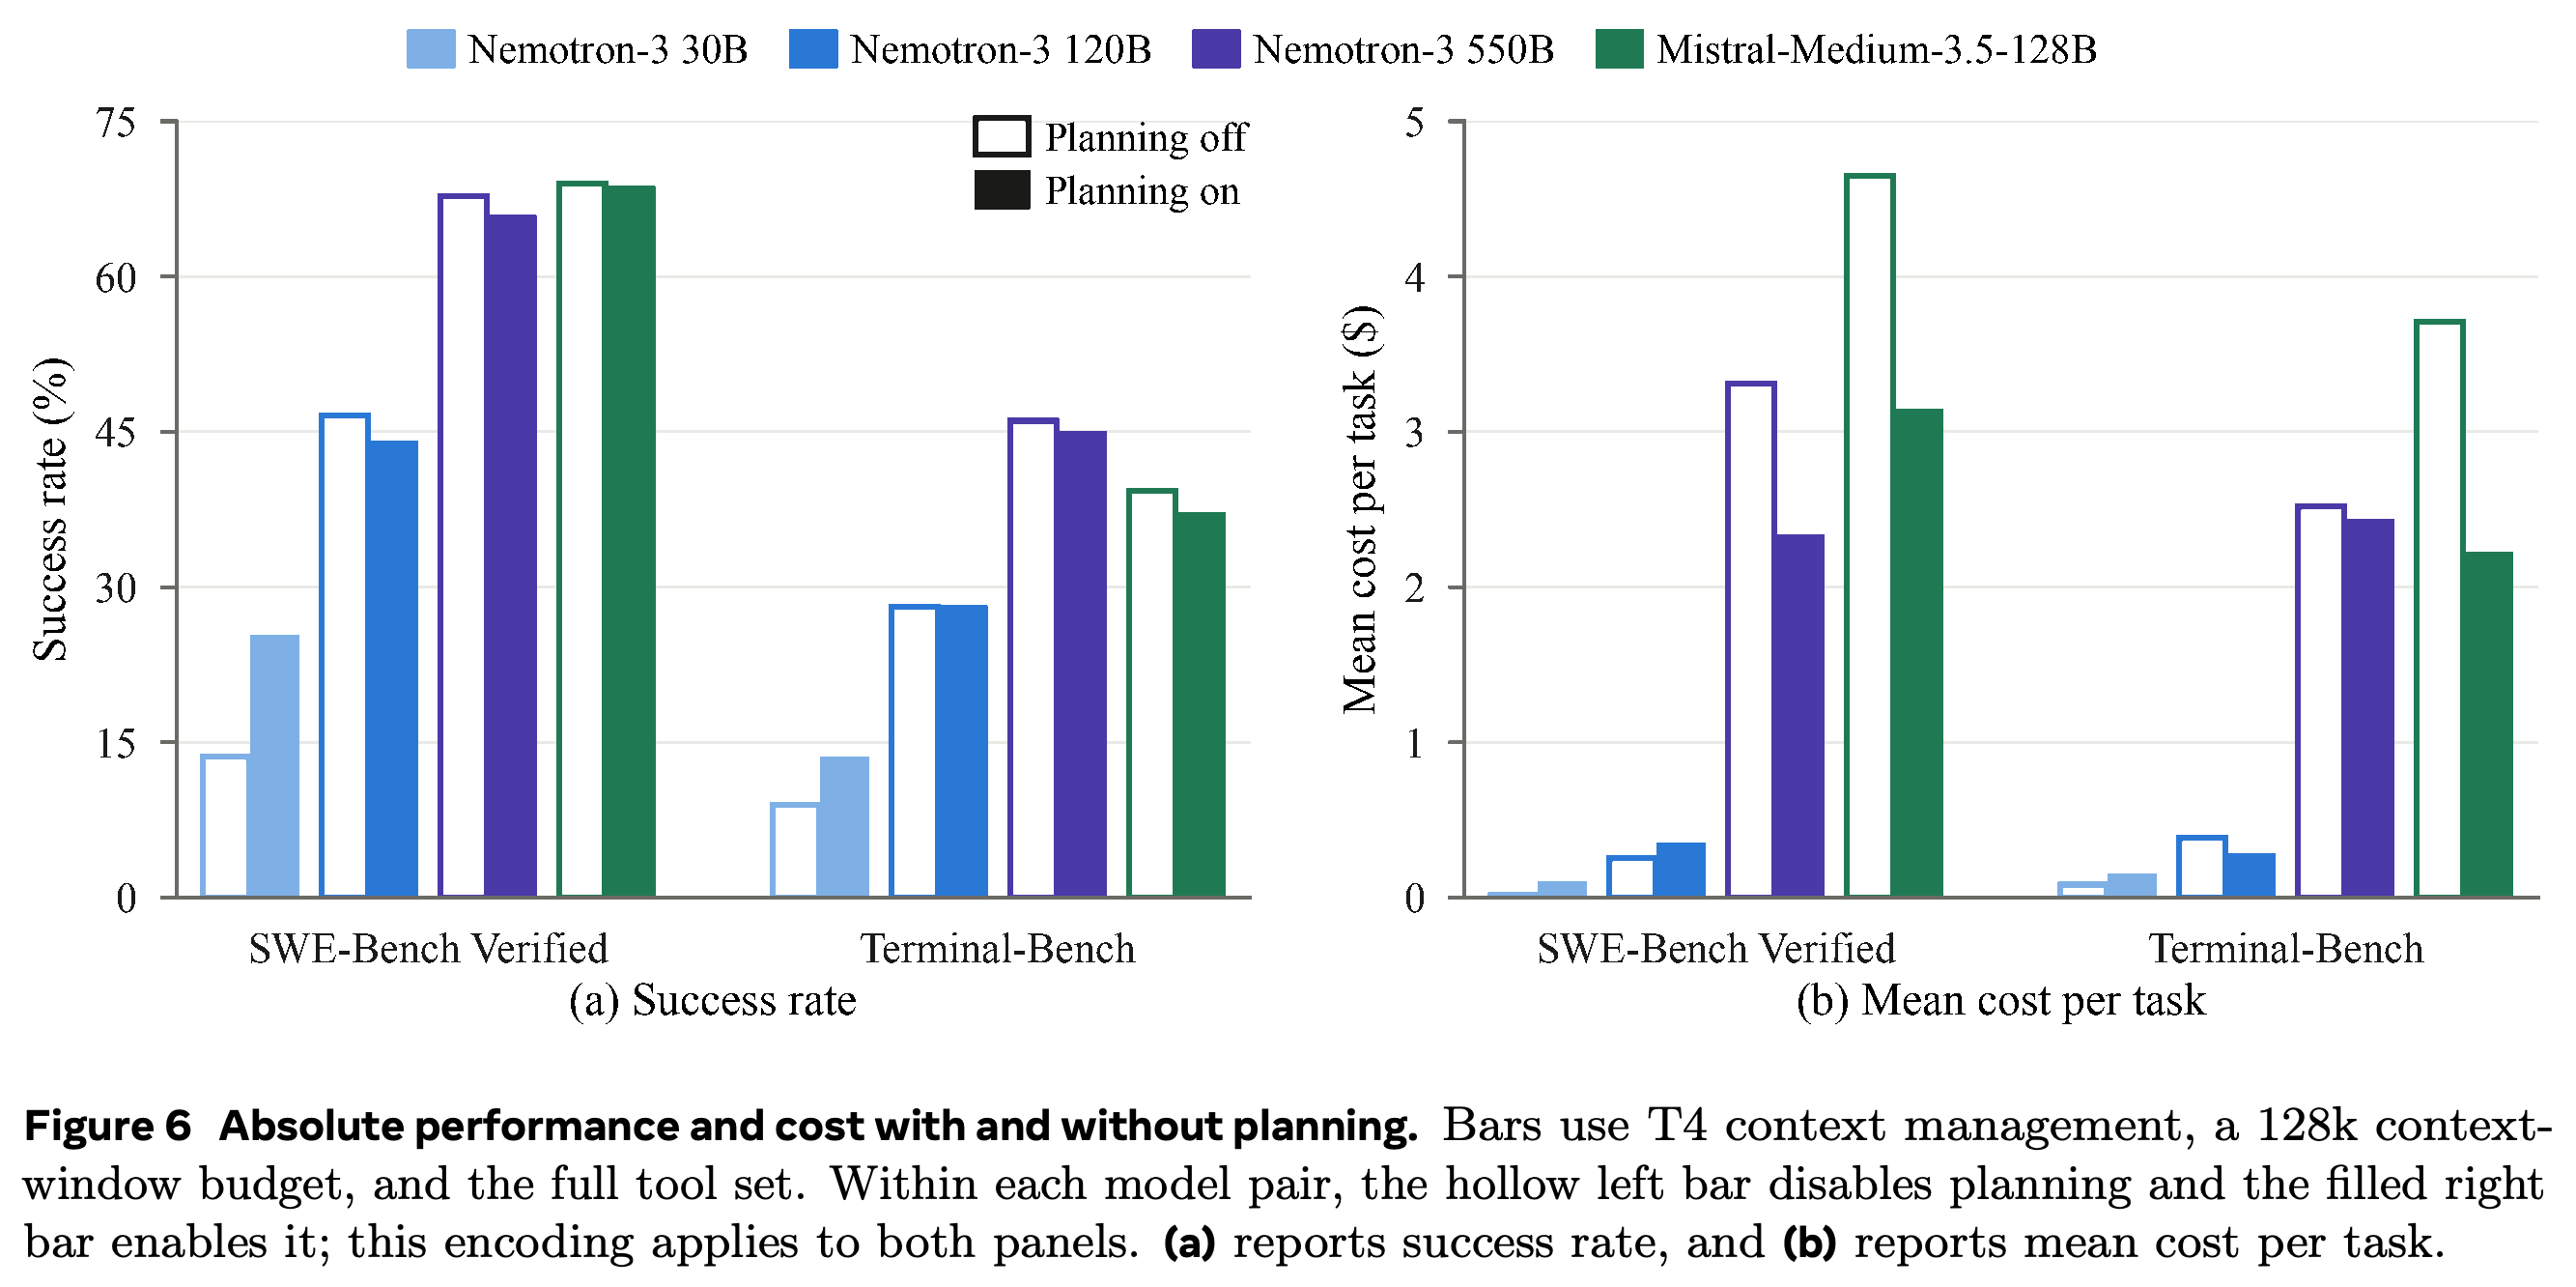
사전 정의 도구를 사용하는 T4/128k에서 계획 관리는 Nemotron-3 30B의 성공률을 SWE-Bench에서 11.6%포인트, Terminal-Bench에서 약 4.5점 높이지만 비용도 늘린다. Nemotron-3 550B와 Mistral-Medium-3.5-128B에서는 벤치마크 모두에서 성공률이 소폭 낮아지는 대신 비용이 줄어든다.
- SWE-Bench에서 계획 관리는 더 강한 모델들의 비용을 각각 약 30%와 32% 줄이며, 성공률은 각각 2.0%포인트와 0.4%포인트 낮춘다.
- Nemotron-3 120B에서는 일관된 성공률 향상이 없다. 계획 관리는 SWE-Bench 비용을 늘리지만 Terminal-Bench 비용은 줄인다.
- 실행 궤적 분석에서는 이러한 결과가 가장 약한 모델의 최초 수정 전 실행 연장, 더 강한 모델들의 수정 후 검증 감소와 관련되는 것으로 나타난다.
나란히 배치한 막대는 계획 관리의 상충 관계가 모델별로 다름을 보여준다. 동일한 T4/128k와 전체 도구 설정에서 계획 관리는 약한 모델의 성공률과 지출을 늘리는 반면, 더 강한 모델들에서는 성공률이 소폭 낮아지고 비용이 줄어든다.
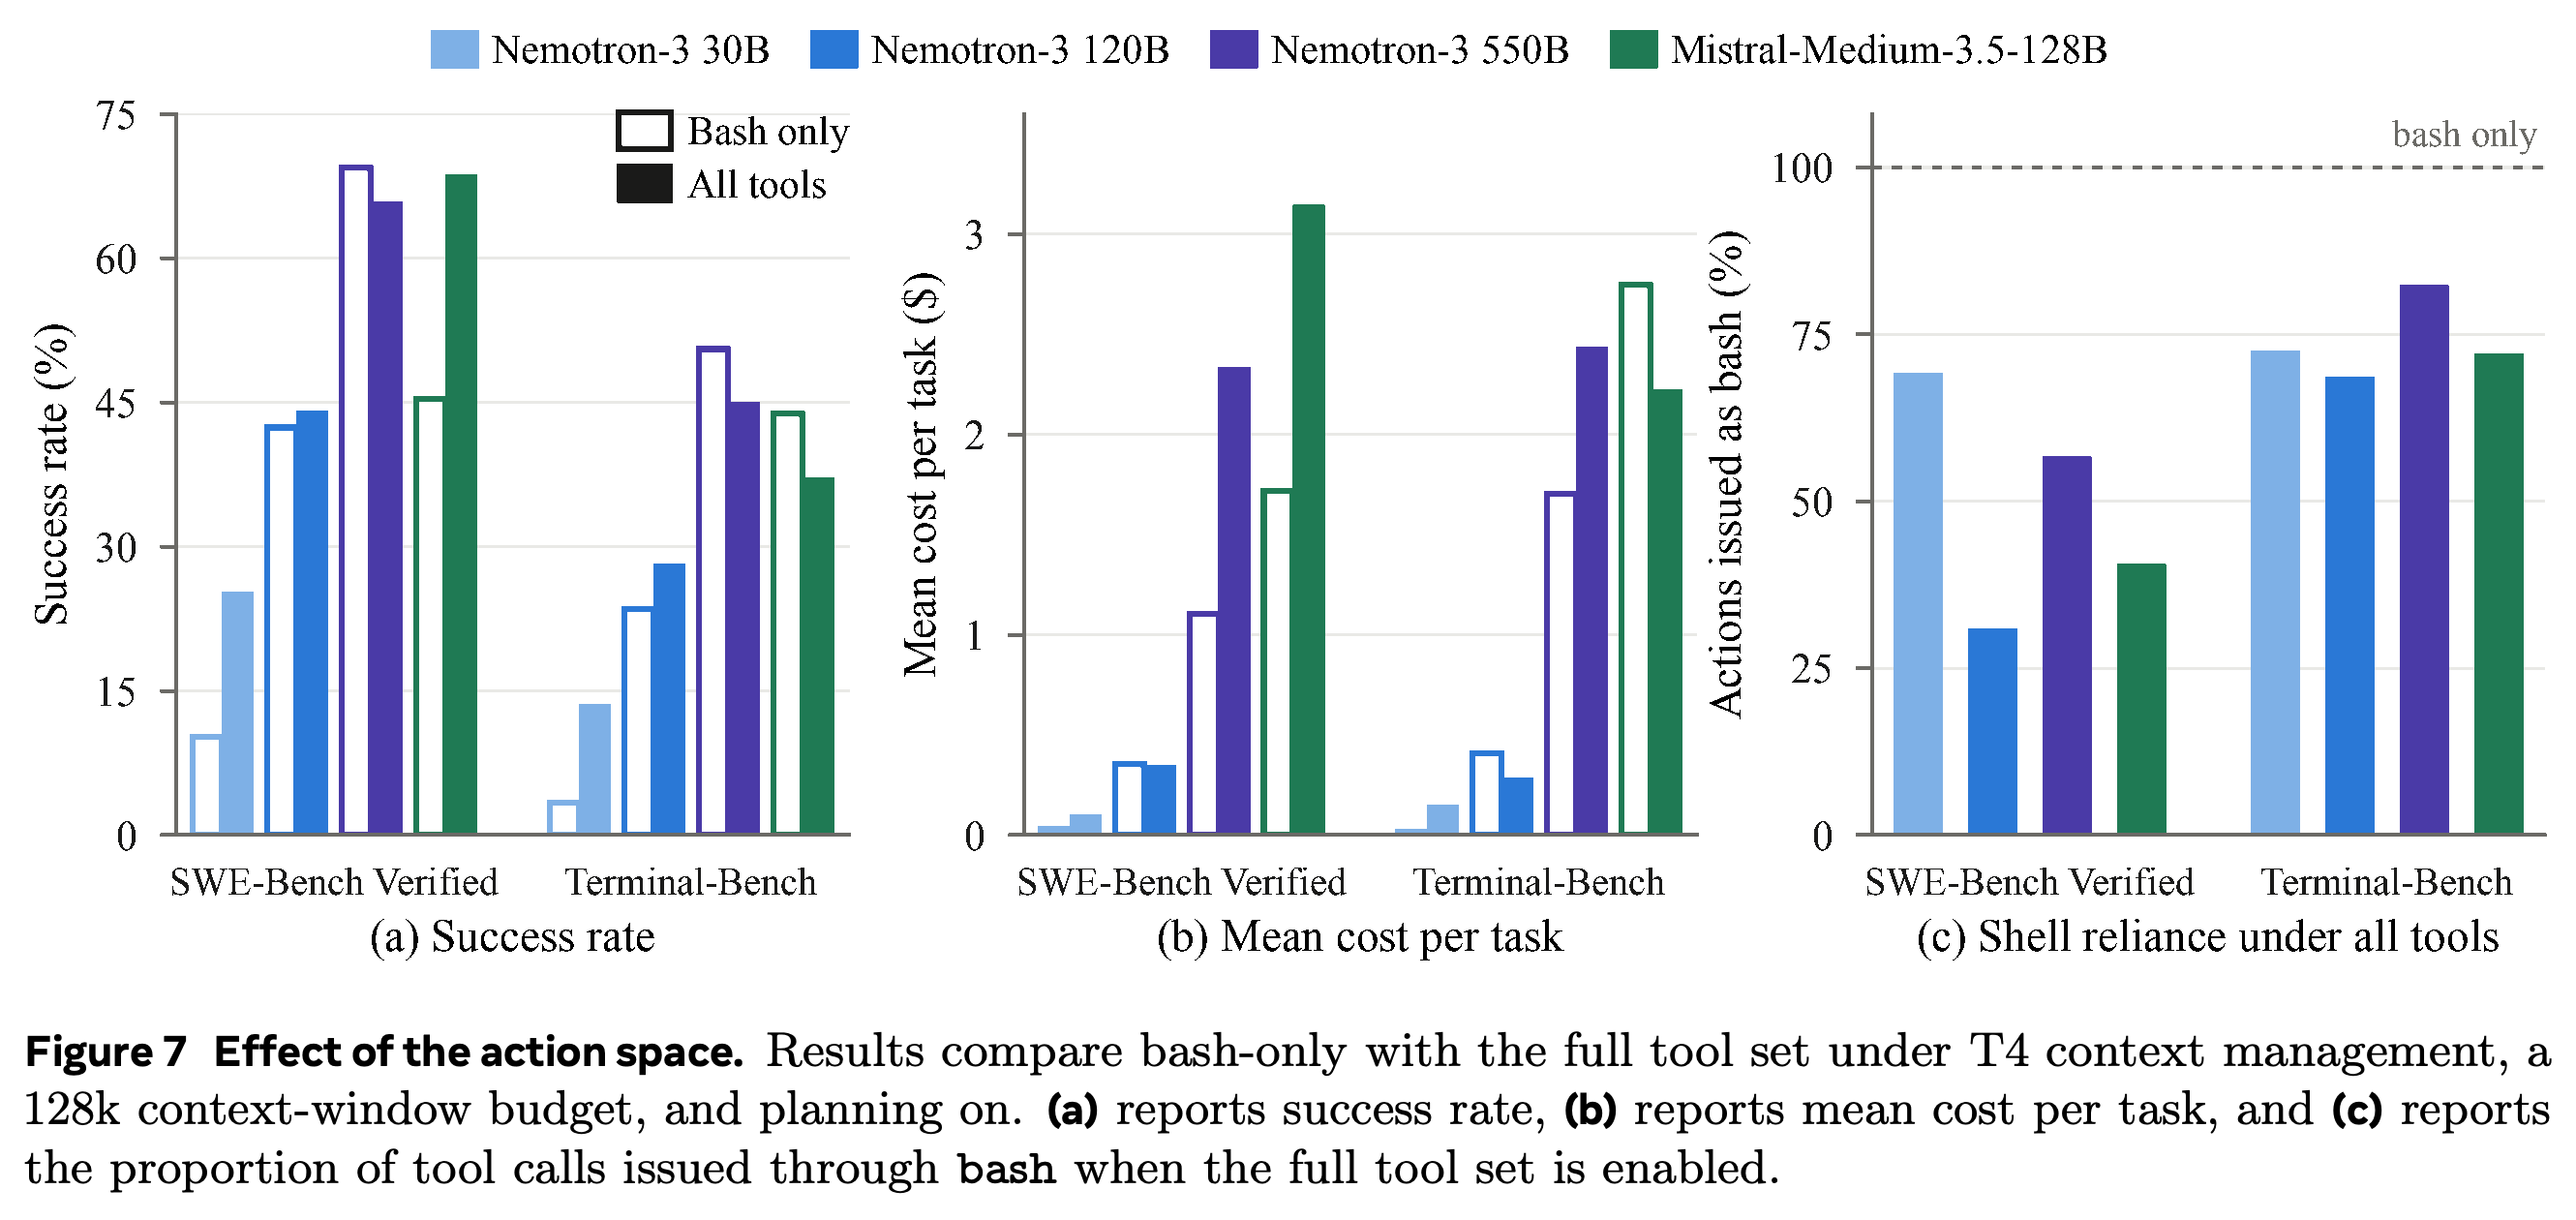
선호되는 행동 인터페이스는 모델과 벤치마크라는 2개 요소에 따라 달라진다. 계획 관리를 활성화한 T4/128k에서 사전 정의 도구는 Nemotron-3 30B의 성공률을 SWE-Bench에서 10.20%에서 25.20%로, Terminal-Bench에서 3.37%에서 13.48%로 높인다.
- Terminal-Bench에서 이 모델의 bash-only 실행 궤적 중 66%는 사용할 수 없는 도구를 호출한 뒤 종료된다. 이는 학습된 도구 호출 패턴과 제공된 인터페이스가 맞지 않음을 나타낸다.
- Nemotron-3 550B에서 bash-only는 SWE-Bench 성공률을 65.80%에서 69.40%로, Terminal-Bench 성공률을 44.94%에서 50.56%로 높이며, 비용은 각각 약 53%와 30% 줄인다.
- Mistral은 작업에 따라 결과가 역전된다. bash-only는 SWE-Bench 성공률을 68.60%에서 45.40%로 낮추지만, Terminal-Bench 성공률은 37.08%에서 43.82%로 높인다. Terminal-Bench 비용은 $2.22에서 $2.75로 늘어나므로 후자의 개선에는 추가 비용이 따른다.
SWE-Bench 결과에서 관리 전략은 32k에서 큰 이득을 보이고 128k에서는 차이가 작아진다. 마지막 절제 실험은 인터페이스 효과가 반대로 나타나는 사례를 보여준다. bash-only는 Nemotron-3 550B의 성공률을 69.40%로 높이고 비용을 작업당 $1.11로 낮추지만, Mistral의 성공률은 45.40%로 낮춘다.
인터페이스 선호는 저장소 수정에서 관측한 결과와 다르다. Mistral은 사전 정의 도구를 사용할 때 37.08%였던 성공률이 bash-only에서 43.82%로 높아지지만, 비용은 $2.22에서 $2.75로 늘어난다. 작업 89개로 구성된 이 벤치마크에서는 많은 개별 비교가 통계적 유의성에 도달하지 않는다.
성공률, 비용, 셸 사용 패널은 모델과 작업에 따라 달라지는 인터페이스 선호를 보여준다. 터미널 작업에서 Mistral의 셸 의존도가 더 높은 점은 벤치마크에 따른 결과 역전과 부합한다. 반면 Nemotron-3 30B는 bash-only에서 성능이 낮다.
4 Analysis
실행 궤적 분석은 에이전트의 모델 호출과 행동 시퀀스를 살펴보며, 전체 성과를 워크플로 변화와 연결한다. 모델 기반 주석은 SWE-Bench 턴을 관련 코드를 찾는 Localize, 버그를 재현하는 Reproduce, 소스를 수정하는 Fix, 결과를 확인하는 Verify, 보조 작업을 수행하는 Other로 분류한다. Terminal-Bench 행동에는 Understand, Write Code, Verify, Other를 사용한다.
- 32k에서 관리하지 않는 SWE-Bench 실행 길이의 중앙값은 20–30턴이며, 코드 위치를 찾는 도중에 멈추는 경우가 많다. 관리한 실행의 중앙값은 약 50–180턴까지 늘어나 더 많은 실행이 검증 단계에 도달한다.
- 128k에서는 관리 단계 간 차이가 줄어든다. SWE-Bench 중앙값 범위는 Nemotron-3 30B에서 39–42턴, Nemotron-3 550B에서 70–74턴에 불과하다.
- 이 프로파일은 컨텍스트가 부족할 때 워크플로 구성이 대체로 유지되면서 실행이 길어지는 양상을 보여준다. 그 자체로 행동 변화의 인과적 메커니즘을 입증하지는 않는다.
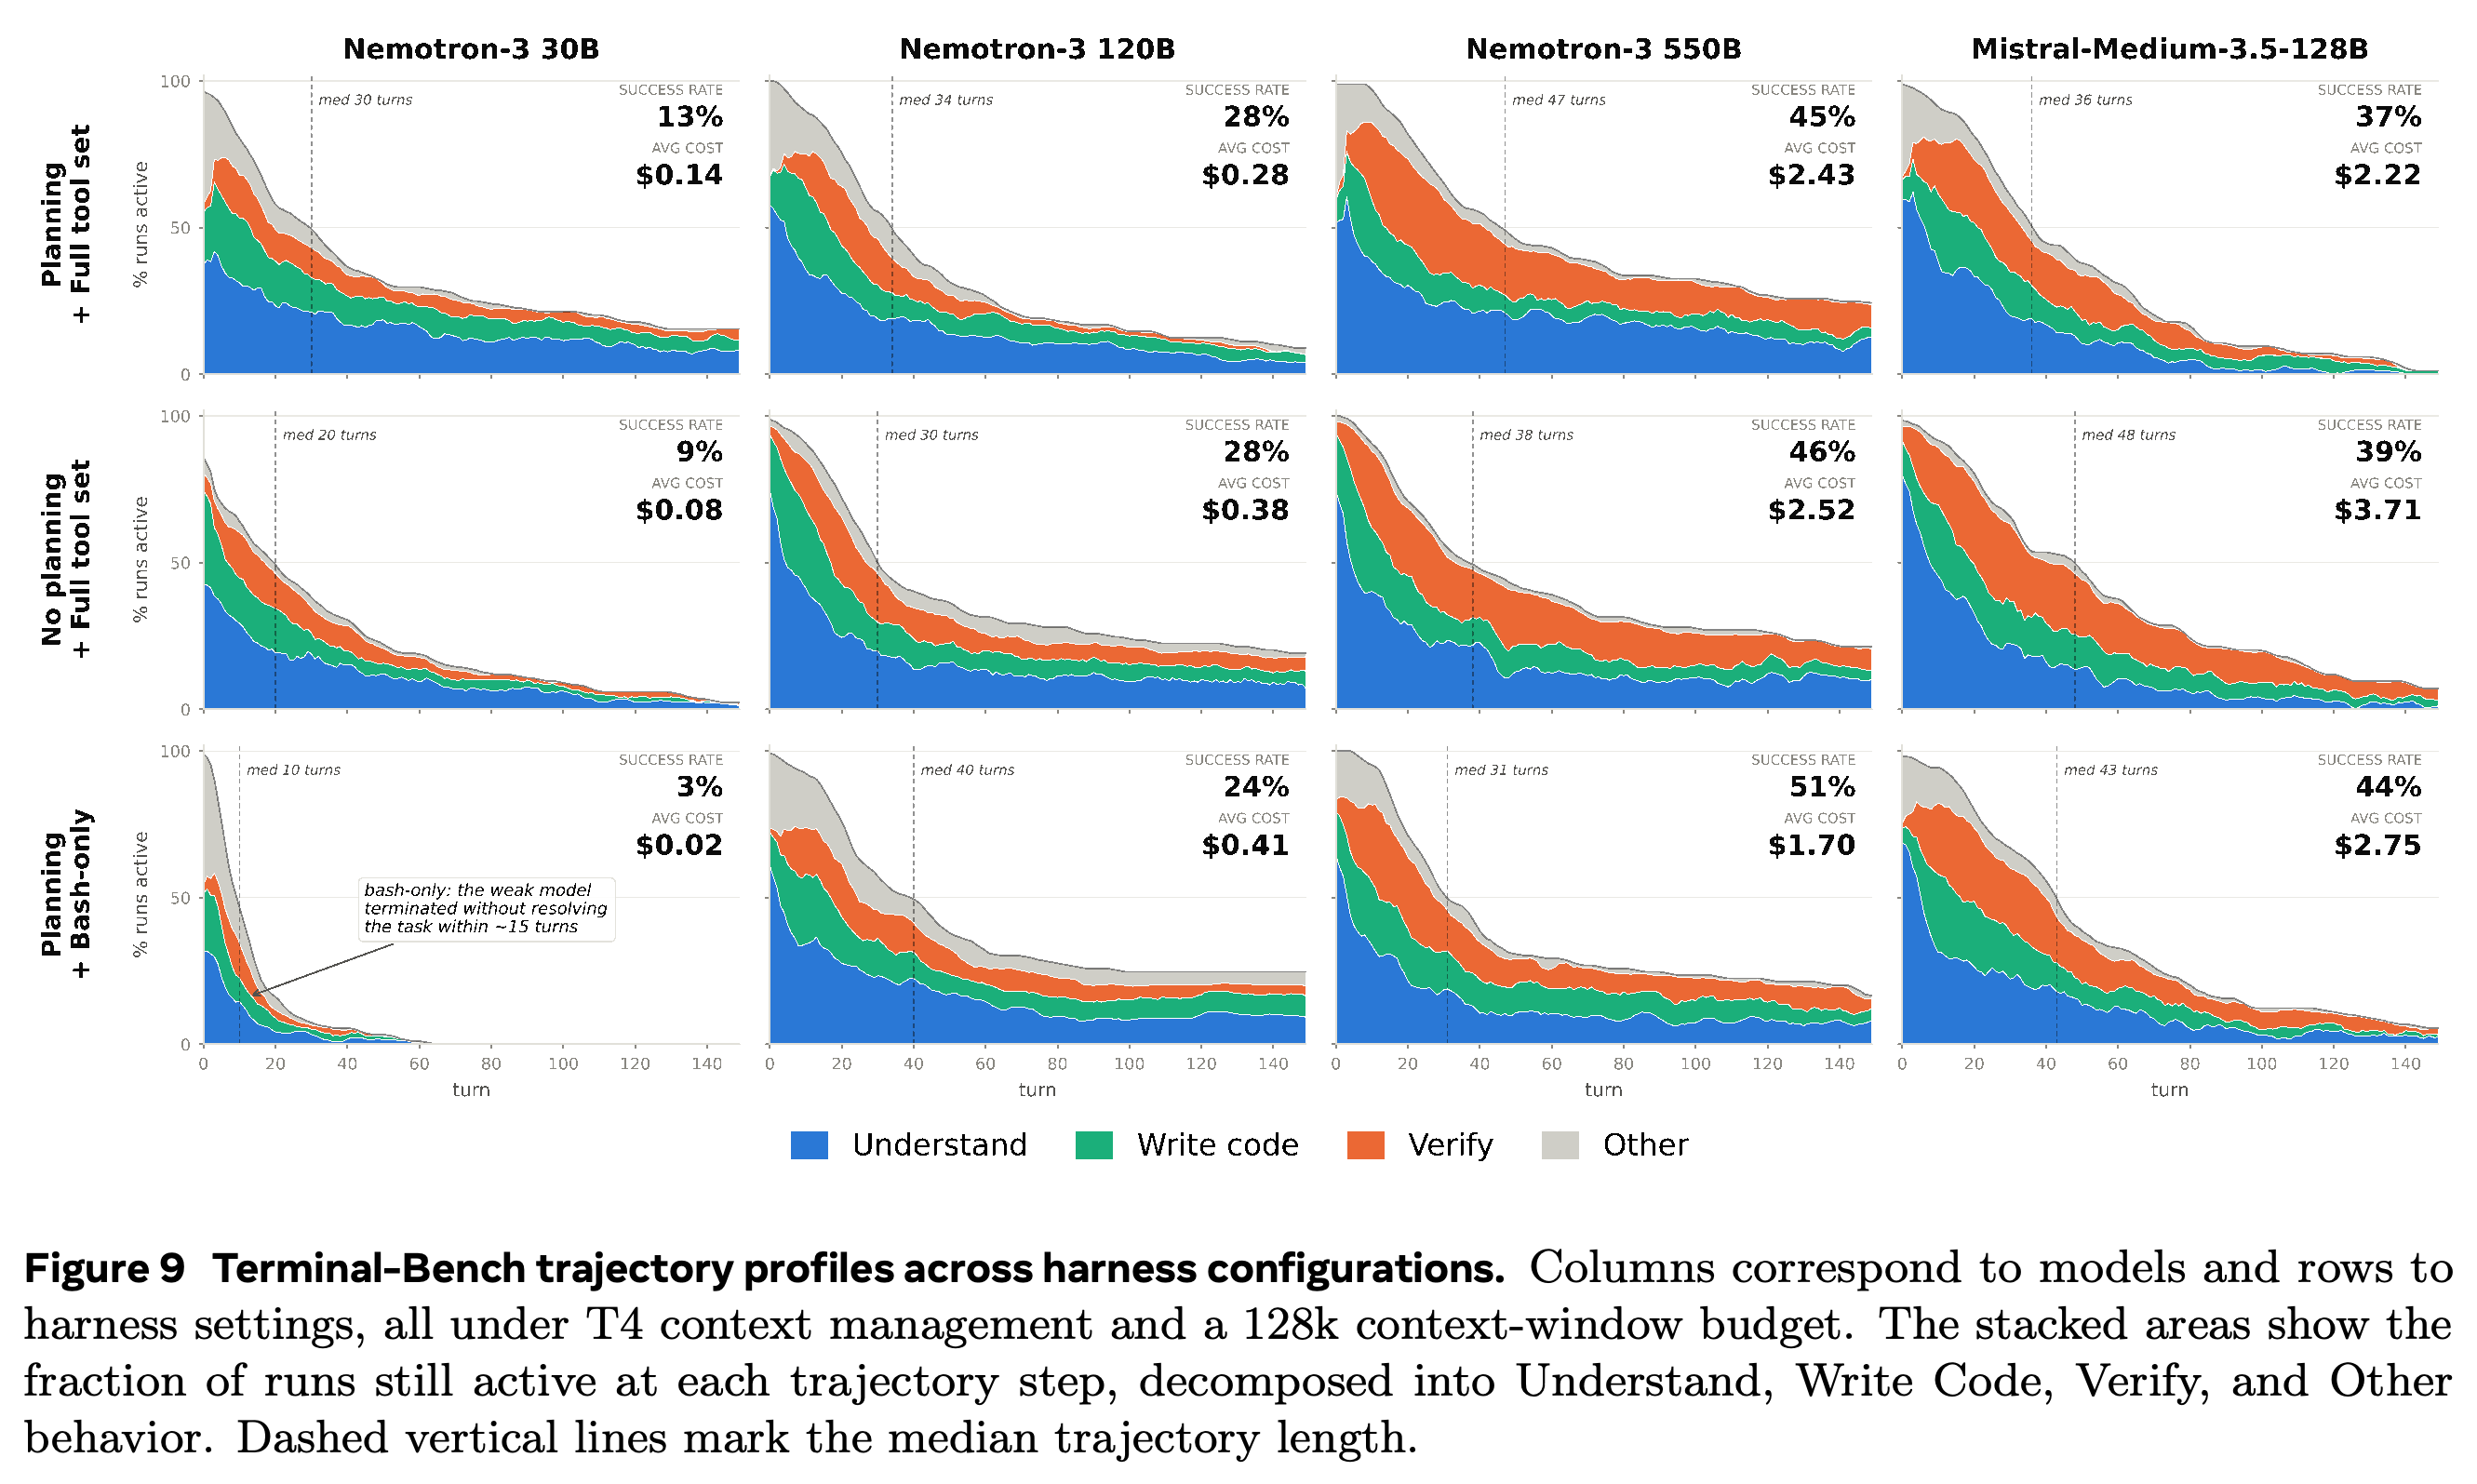
계획 관리는 모델에 따라 종료 행동을 다르게 바꾼다. SWE-Bench의 Nemotron-3 30B에서는 계획 관리를 활성화하면 실행 궤적 길이의 중앙값이 5턴에서 40턴으로 늘어나고, 수정 없이 종료되는 비율은 68.6%에서 27.8%로 줄어든다.
- 코드 위치 탐색에서 멈추는 비율은 58.4%에서 10.4%로 줄어든다. 이는 계획 관리가 이 모델을 최초 수정 시도까지 계속 실행하게 한다는 해석을 뒷받침한다.
- Nemotron-3 550B와 Mistral에서는 계획 관리가 SWE-Bench 실행 길이의 중앙값을 각각 108턴에서 74턴으로, 68턴에서 53턴으로 줄인다. 줄어든 활동은 대부분 수정 후 검증이다.
- Terminal-Bench에서 계획 관리는 일찍 끝나는 실행을 연장하면서 지나치게 오래 이어지는 실행은 단축할 수 있다. 이 때문에 전체 비용에 미치는 효과가 모델마다 달라진다.
진행 중인 실행의 프로파일은 조기 종료와 장시간 검증을 구분한다. 계획 관리를 제거하면 Nemotron-3 30B의 SWE-Bench 실행 궤적 중앙값은 5턴으로 줄지만, 더 강한 모델들의 실행 궤적은 주로 추가 검증 때문에 길어진다.
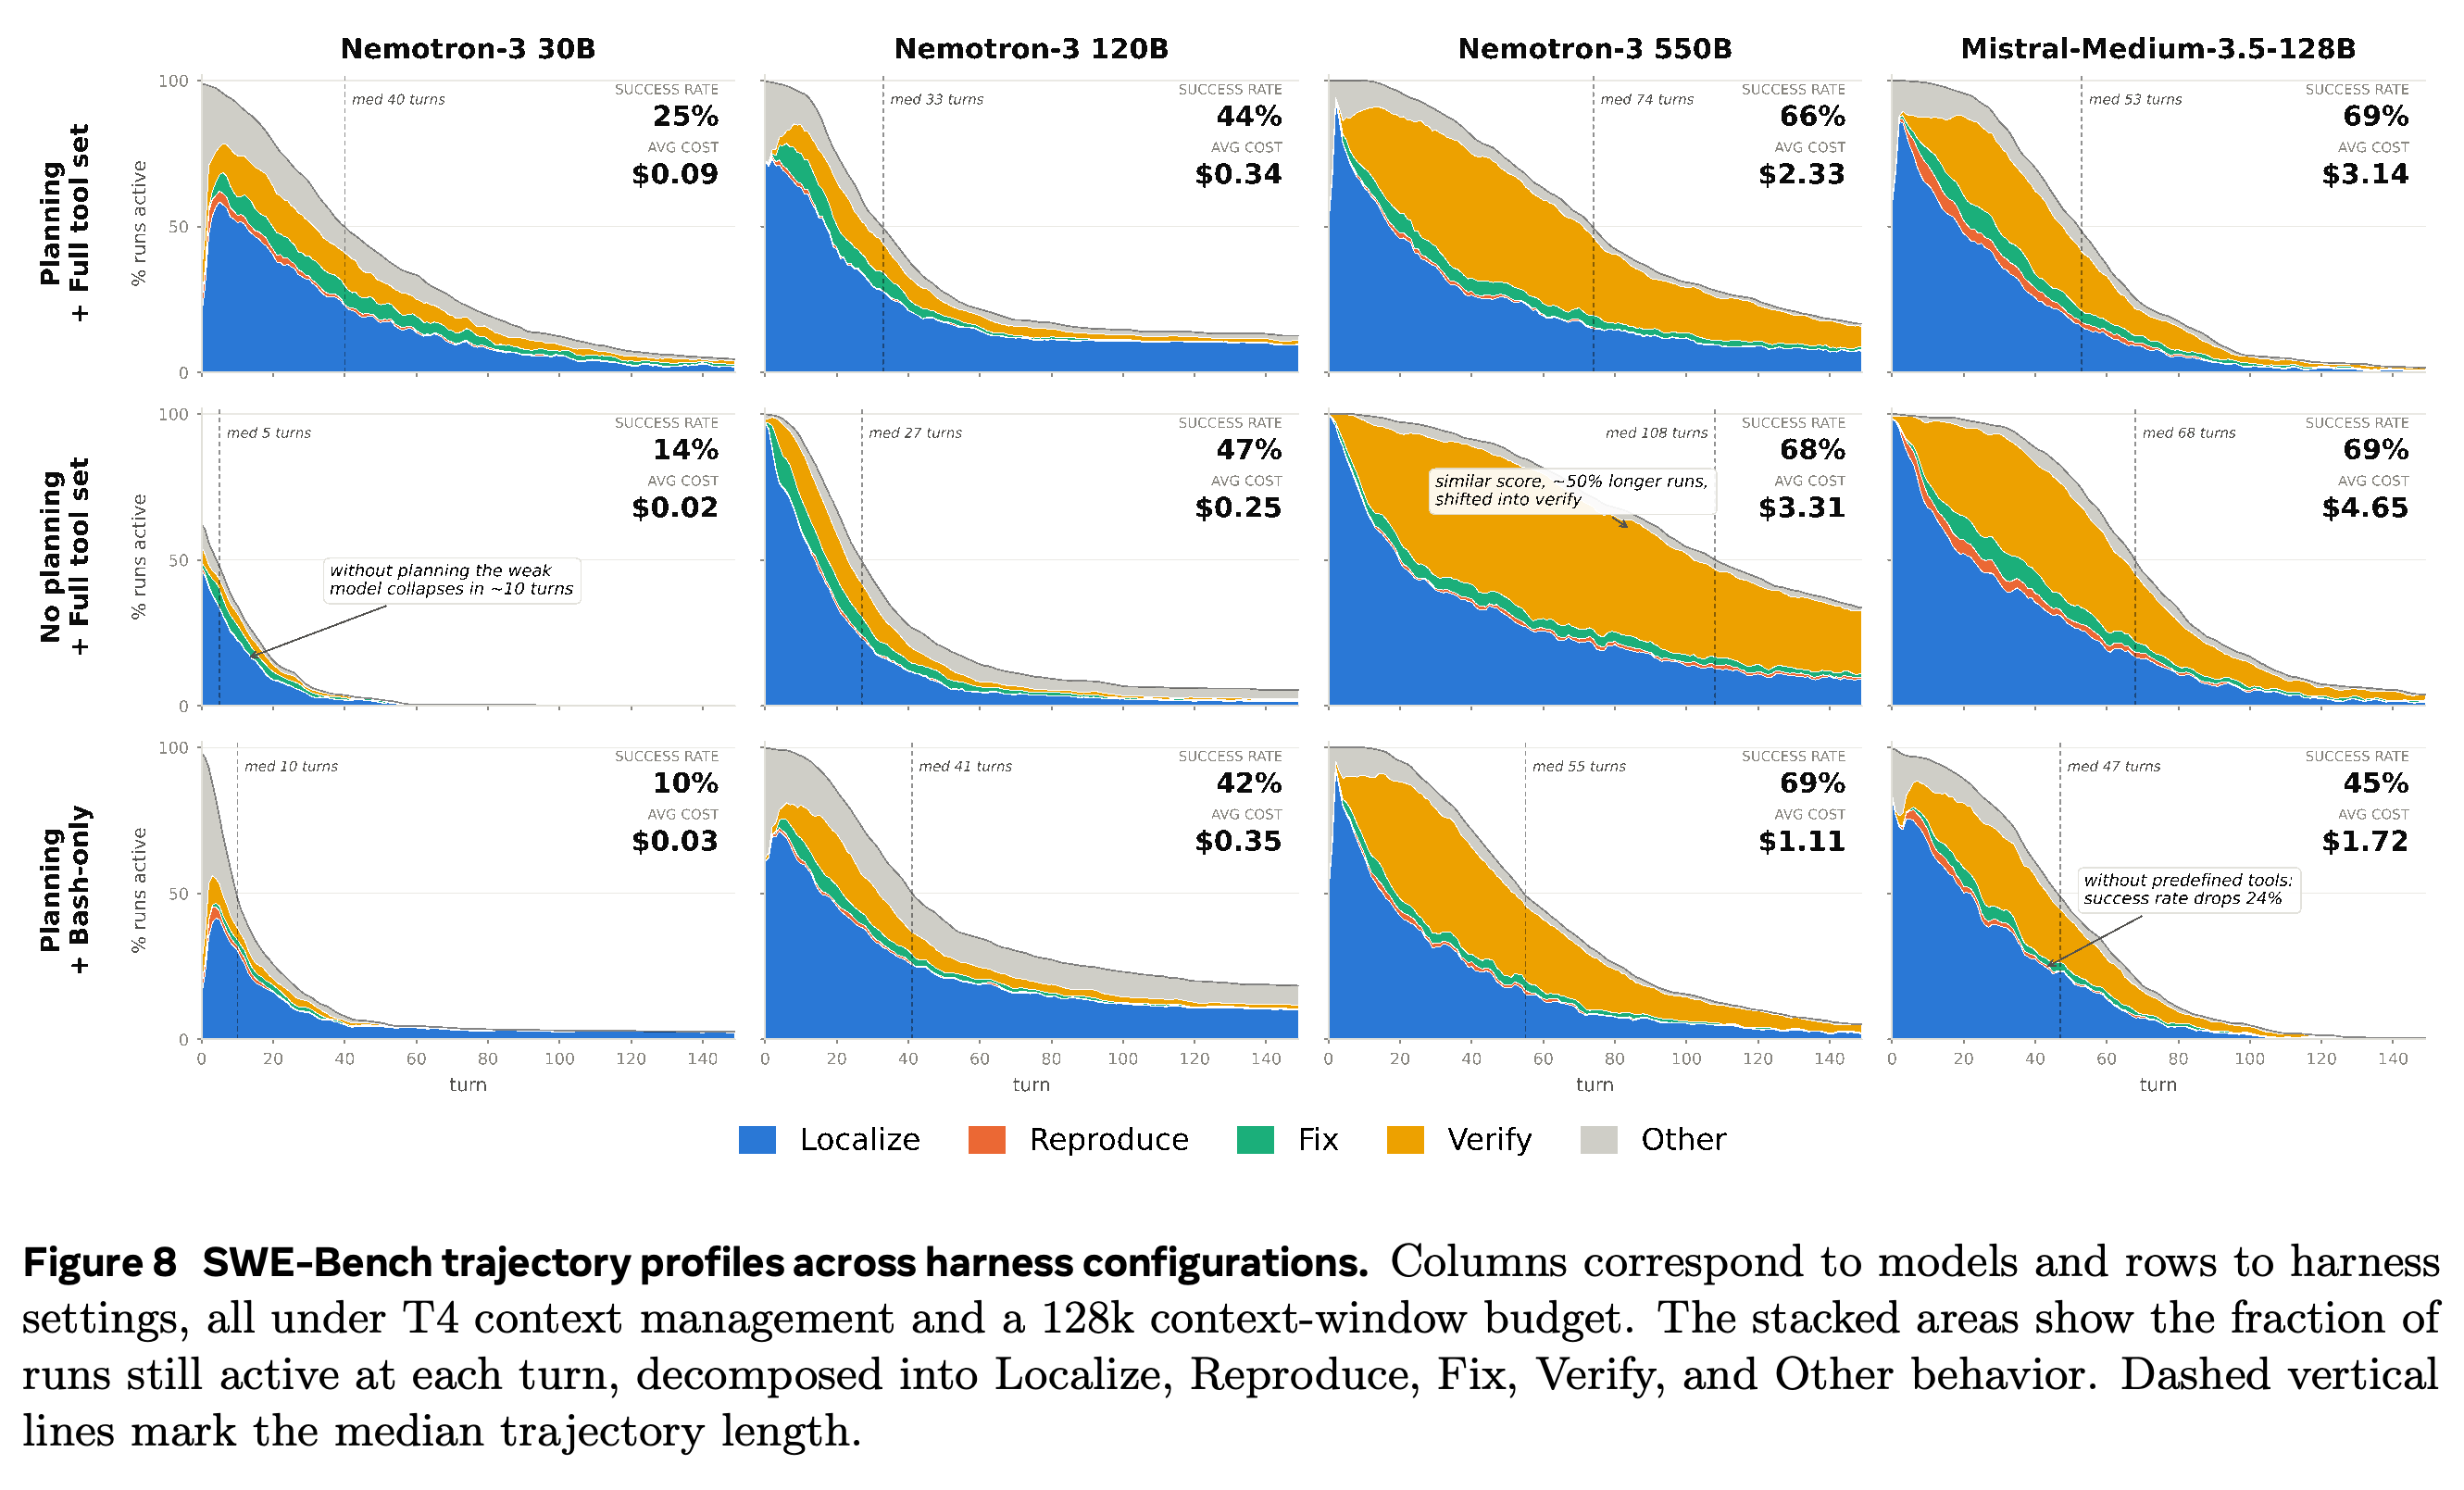
bash-only는 개별 작업에 담기는 일의 양인 행동 세분성을 바꾸어, 역량이 높은 모델이 더 큰 셸 명령이나 스크립트에 작업을 묶을 수 있게 한다. Terminal-Bench의 Nemotron-3 550B에서는 실행 궤적 중앙값을 47개 행동에서 31개 행동으로 줄이는 동시에 Write-code 비중을 16%에서 27%로 높인다.
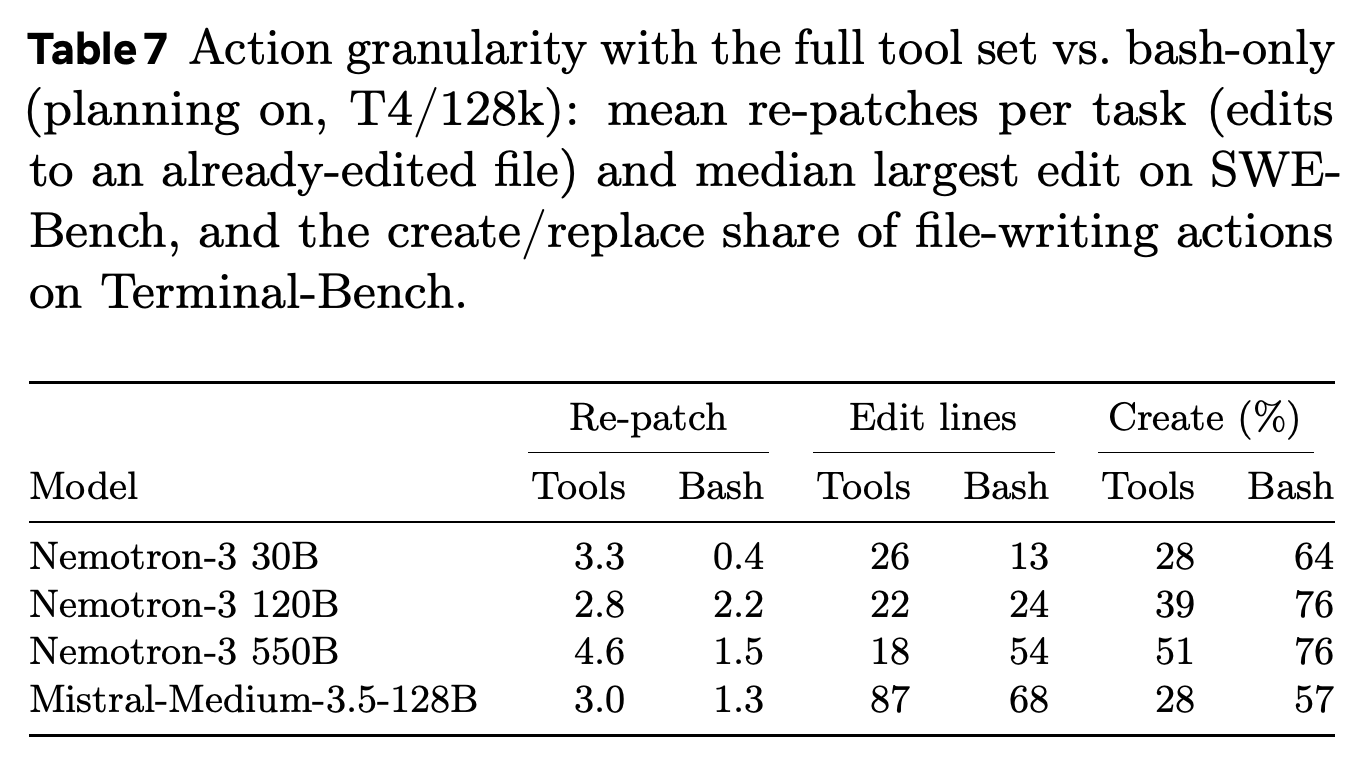
- SWE-Bench에서 이 모델이 이미 수정한 파일을 다시 수정하는 재패치 횟수는 작업당 평균 4.6회에서 1.5회로 줄고, 최대 수정 크기의 중앙값은 18줄에서 54줄로 늘어난다.
- 평가한 모든 모델은 bash-only에서 재패치를 덜 수행하며, Terminal-Bench의 파일 쓰기 행동에서는 파일 생성이나 교체의 비중이 높아진다. 최대 수정 크기가 모든 모델에서 늘어나는 것은 아니다.
- 이러한 관측은 작업을 묶어서 수행한다는 해석과 부합한다. 다만 인터페이스 절제 실험에서는 프롬프트, 추적, 진단도 함께 바뀌므로, 결과를 행동 세분성만의 효과로 돌릴 수는 없다.
터미널 작업 프로파일은 조기 종료와 장시간 실행이 함께 달라지는 양상을 보여준다. Nemotron-3 550B에서 bash-only는 코드 작성 행동의 비중이 더 높으면서도 실행 궤적이 더 짧다. 이는 더 적은 상호작용으로 작업을 묶어 수행한다는 해석과 부합한다.
bash-only에서 Nemotron-3 550B의 재패치 횟수는 4.6회에서 1.5회로 줄고, 최대 수정 크기의 중앙값은 18줄에서 54줄로 늘어난다. 다른 모델들도 재패치는 줄지만 최대 수정 크기가 모두 커지는 것은 아니므로, bash-only가 항상 더 큰 수정을 만든다고 일반화하기는 어렵다.
5 Related Work
관련 연구에서는 코딩 모델, 코딩 하네스, 이력 관리 방법을 다룬다. 이 연구는 모델 크기와 명시적인 컨텍스트 윈도 예산을 바꾸며 구현된 하네스 구성 요소를 살펴본다.
5.1 Coding Agents
실행 기반 코딩 벤치마크는 완성된 에이전트 시스템을 평가하므로, 점수에는 언어 모델뿐 아니라 주변 제어 루프, 도구 인터페이스, 이력 정책도 반영된다. 저자들은 이를 근거로 고정된 실행 프레임워크 안에서 구성 요소를 비교한다.
5.2 Coding Harness
기존 하네스 연구에는 통합 코딩 시스템, 코드 위치 탐색, 수정, 검증으로 제한된 파이프라인, 모듈형 에이전트, 모델별 아키텍처 선호 연구가 있다. 이 논문은 컨텍스트 가용량을 명시적으로 바꾸면서 긴 코딩 실행 궤적에서 구현 수준의 계획 관리와 작업 공간 인터페이스를 시험하여 기존 연구를 확장한다.
- 인용된 연구 중 가장 가까운 프롬프트 스캐폴딩 연구는 더 짧은 추론 작업에서 모든 구성 요소 조합을 시험하는 완전 요인 설계를 사용한다. 이 연구는 컨텍스트 용량 때문에 실행이 종료될 수 있는 더 긴 실행을 다룬다.
- 계획 관리와 인터페이스 실험은 T4/128k에 한정되므로 구성 요소 간 상호작용은 일부만 다룬다.
5.3 Context Management
논문은 제거, 검색, 요약을 포함한 고정 컨텍스트 정책과 모델이 스스로 컨텍스트를 관리하도록 학습하는 방법을 구분한다. 모델 계열 2개와 32k–128k 윈도에서 고정 정책을 평가하여, 가용 용량과 모델 행동에 따라 유용성이 어떻게 달라지는지 살펴본다.
6 Conclusion
연구는 대상 모델, 작업, 자원 예산에 맞춰 하네스 구성 요소를 선택해야 한다고 결론짓는다. 컨텍스트 관리는 오버플로에 대응하고, 지속적 계획 관리는 너무 이르거나 늦은 종료를 바꾸며, 행동 인터페이스는 모델이 작업 공간 조작을 표현하는 방식에 영향을 준다.
- 단계적 생략과 요약은 시험한 관리 전략 중 대체로 비슷한 성공률에서 전체 평균 비용이 가장 낮다.
- 계획 관리와 인터페이스 결과는 조건에 따른 선택을 뒷받침한다. Mistral의 선호가 벤치마크에 따라 달라지는 결과는 모든 작업에서 우세한 인터페이스가 없음을 보여준다.
Limitations
결과는 단일 계획 관리 프로토콜, 고정 압축 임계값, 도구와 프롬프트, 추적, 진단을 함께 바꾸는 행동 공간 등 특정 구현에 적용된다. 계획 관리와 행동 공간은 T4/128k에서만 시험했으므로, 더 작은 윈도나 다른 관리 전략과의 상호작용은 확인되지 않았다.
- 각 설정은 작업당 1회 실행한다. Terminal-Bench는 작업이 89개뿐이며, 많은 비교가 통계적 유의성에 도달하지 않는다. 따라서 방향성 있는 패턴과 유의한 개별 비교를 구분해야 한다.
- 평가 모델은 한 계열의 3가지 크기 모델과 다른 계열의 모델 1개로 구성된다. 학습과 사전 도구 사용 경험도 인터페이스 숙련도에 영향을 줄 수 있으므로, 모델 크기는 역량의 불완전한 척도다.
- SWE-Bench Verified는 Python만 다룬다. 다른 언어, 모델 계열, 하네스 구현, 소프트웨어 외 작업으로 결과를 확장하려면 추가 검증이 필요하다.
부록
- A Harness Prompts는 고정 지침과 실행 시점의 작업 정보를 결합하는 방식을 설명한다. A.1 System prompts는 인터페이스별 워크플로와 도구 사용 지침을 기록한다. A.2 Planning prompts는 계획 초기화와 재삽입을 명시한다. A.3 Context-management prompts는 누적 요약과 제거된 출력의 템플릿을 제공한다. A.4 Stuck-detection prompts는 반복 호출 5회에서 알림을 제공하고, 동일한 실패 호출 8회에서 종료하는 규칙을 정의한다.
- B Tool Descriptions는 프로토콜, 오류, 부수 효과를 제공한다. B.1 File input and output은 줄 번호가 있는 읽기와 파일 변경에 필요한 읽기 기록 요건을 설명한다. B.2 Search는 디렉터리, 파일명 패턴, 내용 검색을 다룬다. B.3 Execution and web access는 /bin/sh -c 실행과 지정한 URL의 콘텐츠를 가져오는 기능을 설명한다. B.4 Planning and context recall은 update_plan과 recall_event를 각각 독립적으로 활성화하는 보조 인터페이스로 설명한다.
- C Trajectory Analysis는 행동 분석의 근거를 정의한다. C.1 Annotation Schemes의 C.1.1 SWE-Bench Failure-Stage Attribution은 올바른 파일 찾기, 관련 줄 찾기, 패치 구현, 검증 중 가장 먼저 실패한 단계를 선택한다. C.1.2 SWE-Bench Behavior Encoding은 각 턴을 워크플로 단계 5개 중 하나로 분류한다. C.1.3 Terminal-Bench Action-Level Encoding은 개별 도구 호출을 단계 4개로 묶은 행동 유형 10개 중 하나로 분류한다.
- C.2 Judge Setup and Human Validation은 reasoning effort를 high로, temperature를 0.6으로 설정한 GPT-5.5를 주석에 사용한다. 사람 주석자 3명은 실행 궤적 200개를 서로 겹치지 않는 부분으로 나누어 독립적으로 라벨링하며, 총 15,610개 단위를 다룬다. 평가 모델과 사람의 전체 단순 일치율은 약 94.2%이며, 우연에 의한 일치를 보정하는 척도인 Cohen’s κ의 가중 평균은 0.929다. 이 검증은 명시된 라벨링 체계에서 평가 모델과 사람의 일치도를 측정한다. 서로 겹치지 않게 나누었으므로 같은 단위에 대한 사람 간 일치도는 측정하지 않는다.
- C.3 SWE-Bench Trajectory Results는 C.3.1 Failure-Stage Results와 C.3.2 Behavior Profiles를 함께 제시한다. 약한 모델의 실패는 올바른 파일 찾기에 더 집중되며, 강한 모델의 실패는 패치 구현과 관련된 경우가 더 많다. Mistral의 미해결 실행 중 파일 위치 탐색 실패 비중은 사전 정의 도구를 사용할 때 16.0%에서 bash-only일 때 41.4%로 높아진다. 행동 프로파일은 컨텍스트 예산 4개 전체에서 진행 중인 실행의 비율과 워크플로 단계를 보여준다. C.4 Terminal-Bench Trajectory Results는 계획 관리와 사전 정의 도구를 고정한 명령줄 작업의 대응 프로파일을 제공한다.
- C.5 Trajectory-Level Statistics at 128k는 전체 실행 궤적 길이, 도구 호출 횟수, 수정 세분성, 종료 단계 통계를 보고한다. 수정이나 코드 작성을 전혀 하지 않은 실행과 이를 수행했지만 해결하지 못한 실행을 구분한다. C.6 Recall-Event Usage는 recall을 사용한 실행의 비율이 아니라 작업당 평균 recall_event 호출 횟수를 보고한다. C.7 Judge Prompts는 워크플로와 실패 단계 주석에 사용한 분류 프로토콜을 재현한다.
짧은 생각
이 논문은 구성 요소별 비용과 성공률 차이를 관측 가능한 실행 행동에 연결한다. 오버플로 측정치, 수정 전 종료, 검증 프로파일은 전체 벤치마크 점수를 넘어 하네스 구성 요소가 언제 유용한지 설명하는 데 도움이 된다. 이력 용량이 제한된 상황에서는 단계적 생략과 요약을 시작 설정으로 삼을 근거가 있다. 다만 전체 평균 비용의 이점은 대상 모델의 개별 결과와 대조해 확인해야 한다. recall 결과는 구현 복잡성을 추가하기 전에 실제 검색 사용량을 측정해야 한다는 판단을 뒷받침한다. 모든 에이전트 설계에서 메모리를 제거해야 한다는 근거는 아니다. 더 폭넓은 상호작용 연구와 반복 실행은 계획 관리와 행동 인터페이스에 관한 결과를 강화할 수 있다. 특히 평가 규모가 작은 Terminal-Bench에서 필요하다.