


Verifiable Hidden Dynamics Play: Generating Agentic RL Environments from Solved Mechanisms 요약 설명
23 Sep 2026 | Paper Review Agentic Reinforcement Learning Synthetic Environments Reinforcement Learning With Verifiable Rewards목차
이번 글에서는 Verifiable Hidden Dynamics Play: Generating Agentic RL Environments from Solved Mechanisms 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 23일(Arxiv)
- Shen, Xinjie, Fan, Wei, Guo, Xudong, Tu, Jianhong, Su, Yang, Kuang, Chuqiao, Zhang, Yinger, Liu, Dayiheng.
- Georgia Institute of Technology, Alibaba Token Foundry, Alibaba Group
- 논문 링크
요약
- 언어 모델 에이전트를 훈련하려면 행동이 지속되는 상태를 바꾸고 최종 결과를 신뢰할 수 있게 채점하는 저비용 환경이 필요하다. Verifiable Hidden Dynamics Play(VHD-Play)는 해를 구한 수학적 의사결정 모델로 환경을 생성한다. 3개 계열로 훈련한 Qwen3.6-35B-A3B는 5개 최적화 계열에서 평균 상호작용 점수가 0.204에서 0.815로 높아진다. 이는 동일한 평가 프로토콜에서 초기 체크포인트와 비교한 결과다.
- VHD-Play는 환경을 생성하기 전에 기준 결과를 계산하고, 동일한 수학적 인스턴스에서 실행 가능한 동역학과 채점 기준을 도출한다. 동역학은 상태 변화와 결과를 결정하는 규칙이다. 시나리오와 도구를 만드는 언어 모델인 setter는 가중치를 고정한 채 실제 문서의 구절을 활용해 배경을 다양화한다. 훈련 대상 에이전트인 player는 상호작용을 통해 숨겨진 매개변수 중 허용된 정보를 얻는다. 이 파이프라인은 해당 생성 검사를 통과한 환경 3,300개를 만들며, 토큰 사용량과 공개 요금으로 재구성한 환경당 비용은 약 $0.01–$0.03이다.
- 결과 보상으로 훈련하는 강화학습은 평가한 메커니즘 계열 11개 모두에서 성능을 높이며, 함수 호출, 여행 계획, 365일 모의 사업으로 전이된다. 메커니즘 계열은 수학적 구조를 공유하는 의사결정 문제의 집합이다. 사업 벤치마크에서 모델당 5회 실행한 평균 최종 잔액은 54,294에서 182,844로 증가한다. 완전히 명시된 문제와 비교하면 초기 모델의 성능 격차 대부분은 상태가 유지되는 환경에서의 실행에서 발생한다. 생성한 메커니즘 계열의 주요 결과는 훈련 실행 1회와 평가 시드 1개를 사용한다. 기준 정책을 실행해 생성된 동작을 사전 계산한 결과와 대조하는 기준 재실행은 8개 계열을 다룬다.
1 Introduction
서론은 환경 생성과 신뢰할 수 있는 결과 채점을 함께 설계해야 하는 문제로 다룬다. 실행 가능한 행동은 관측과 행동의 연속인 궤적 중 무엇이 가능한지 정하고, 평가는 각 궤적의 가치를 정한다. 기존 접근법은 정확한 검사, 상호작용 동역학, 다양한 배경, 낮은 제작 비용을 서로 다른 방식으로 결합한다. VHD-Play는 메커니즘을 먼저 샘플링하고 해를 구한 뒤, 문서 구절로 배경을 구성한다. player에게는 샘플링한 전체 매개변수와 기준 결과를 공개하지 않는다. Figure 1은 명시된 문제를 푸는 능력과 상호작용하며 실행하는 능력 사이의 격차를 통해 이 설계의 동기를 보여준다.
2 Related Work
이 논문은 형식적 추론과 생성된 상호작용 환경을 연결한다. 솔버를 활용하는 추론과 수작업으로 명세한 시뮬레이터는 계산 가능한 결과를 제공하고, 생성된 도구와 환경은 도메인별 제작을 반복하는 부담을 줄인다. 학습하거나 생성한 평가기는 별도 검증이 필요하다. VHD-Play는 상호작용 동역학을 제공하는 메커니즘에서 사전 계산한 기준값을 유지하므로, 생성된 구현을 이 기준과 대조할 수 있다.
3 Formulation
에이전트 환경은 관측이 상태에 따라 달라지고 행동이 이후의 가능성을 바꾸는 과정이다. 논문은 수학적 의사결정 모델에서 출발해 상태 전이, 정보 구조, 제약, 목적을 환경으로 구현한다. 이 모델은 상호작용 과정과 평가 기준을 함께 제공하며, player가 모델을 기호 형태로 재구성할 필요는 없다.
3.1 Construction order
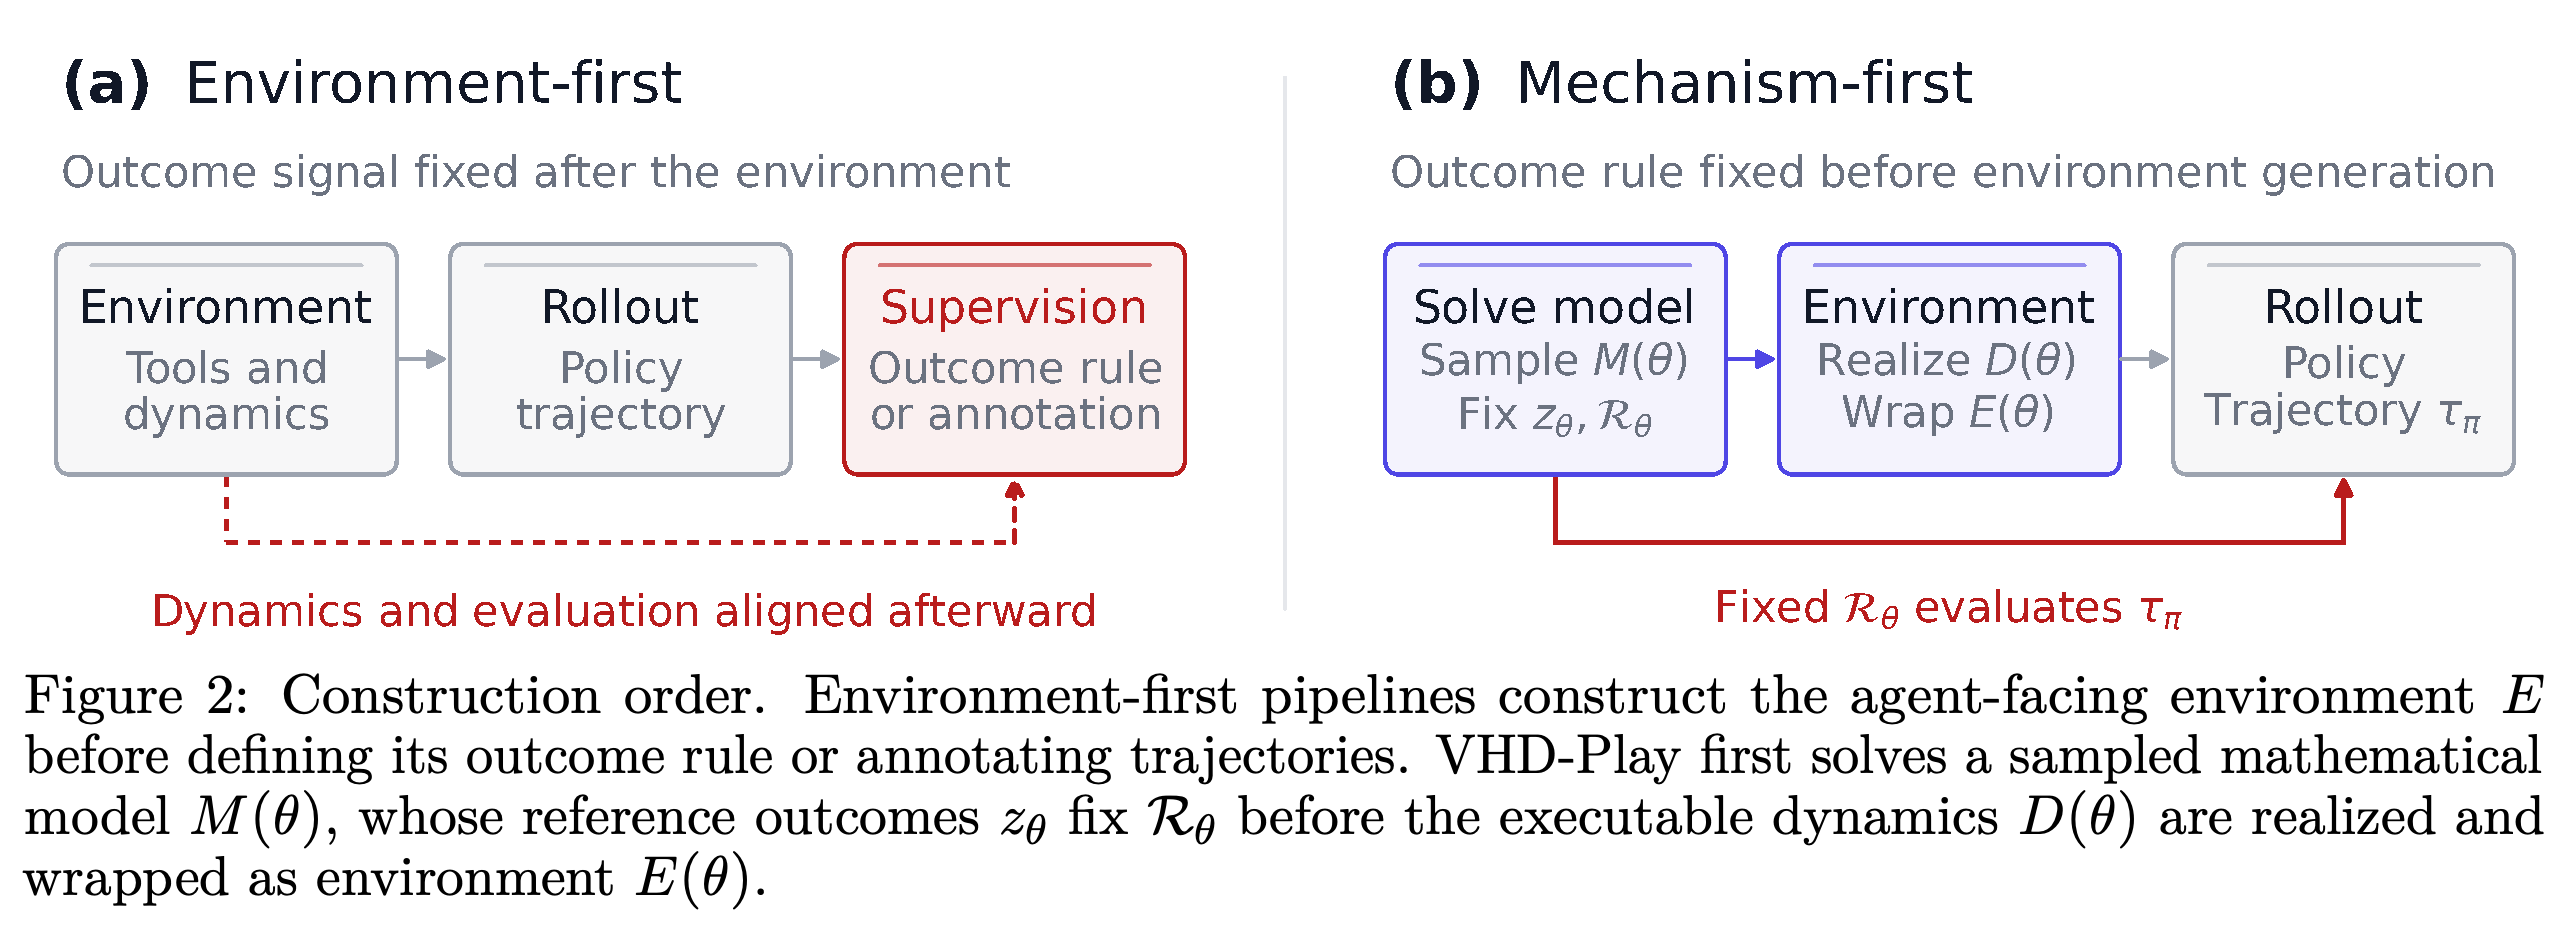
환경 우선 구성은 결과 규칙을 정의하거나 궤적에 주석을 달기 전에 환경을 확정한다. 메커니즘 우선 구성은 샘플링한 매개변수 θ를 갖는 수학적 모델 M(θ)의 해를 먼저 구해 기준 결과 zθ를 얻고 결과 규칙을 확정한다. 이후 실행 가능한 동역학 D(θ)를 구현하고 상호작용 인터페이스를 더해 player용 환경 E(θ)를 구성한다. Figure 2는 각 산출물을 언제 확보하는지 보여준다. 환경 우선 시스템도 정교하고 알려진 동역학을 가질 수 있다.
메커니즘의 해를 구하면 실행 가능한 환경을 구현하기 전에 기준 결과와 평가 규칙을 확정할 수 있다. 이후 궤적은 이 고정된 기준으로 평가한다. 환경 우선 분기에서는 환경을 만든 뒤 채점 규칙이나 주석을 도입한다.
3.2 Model, dynamics, and interface
메커니즘 계열은 여러 기간에 걸친 의사결정 문제의 분포를 정의한다. 각 환경은 실행 가능한 상태 전이와 효용, player가 볼 수 있는 정보를 정하는 관측 매핑, 행동 집합, 공통 턴 예산을 결합한다. 효용은 상호작용을 통해 누적되는 수치적 가치다. 턴은 응답을 받은 인터페이스 호출 1회를 뜻한다. 지정된 숨은 정보를 드러내는 탐색 행동과 상태를 바꾸는 의사결정은 모두 이 예산을 사용한다. 선택적으로 제공되는 계산 도구는 환경 상태를 읽거나 바꾸지 않는다.
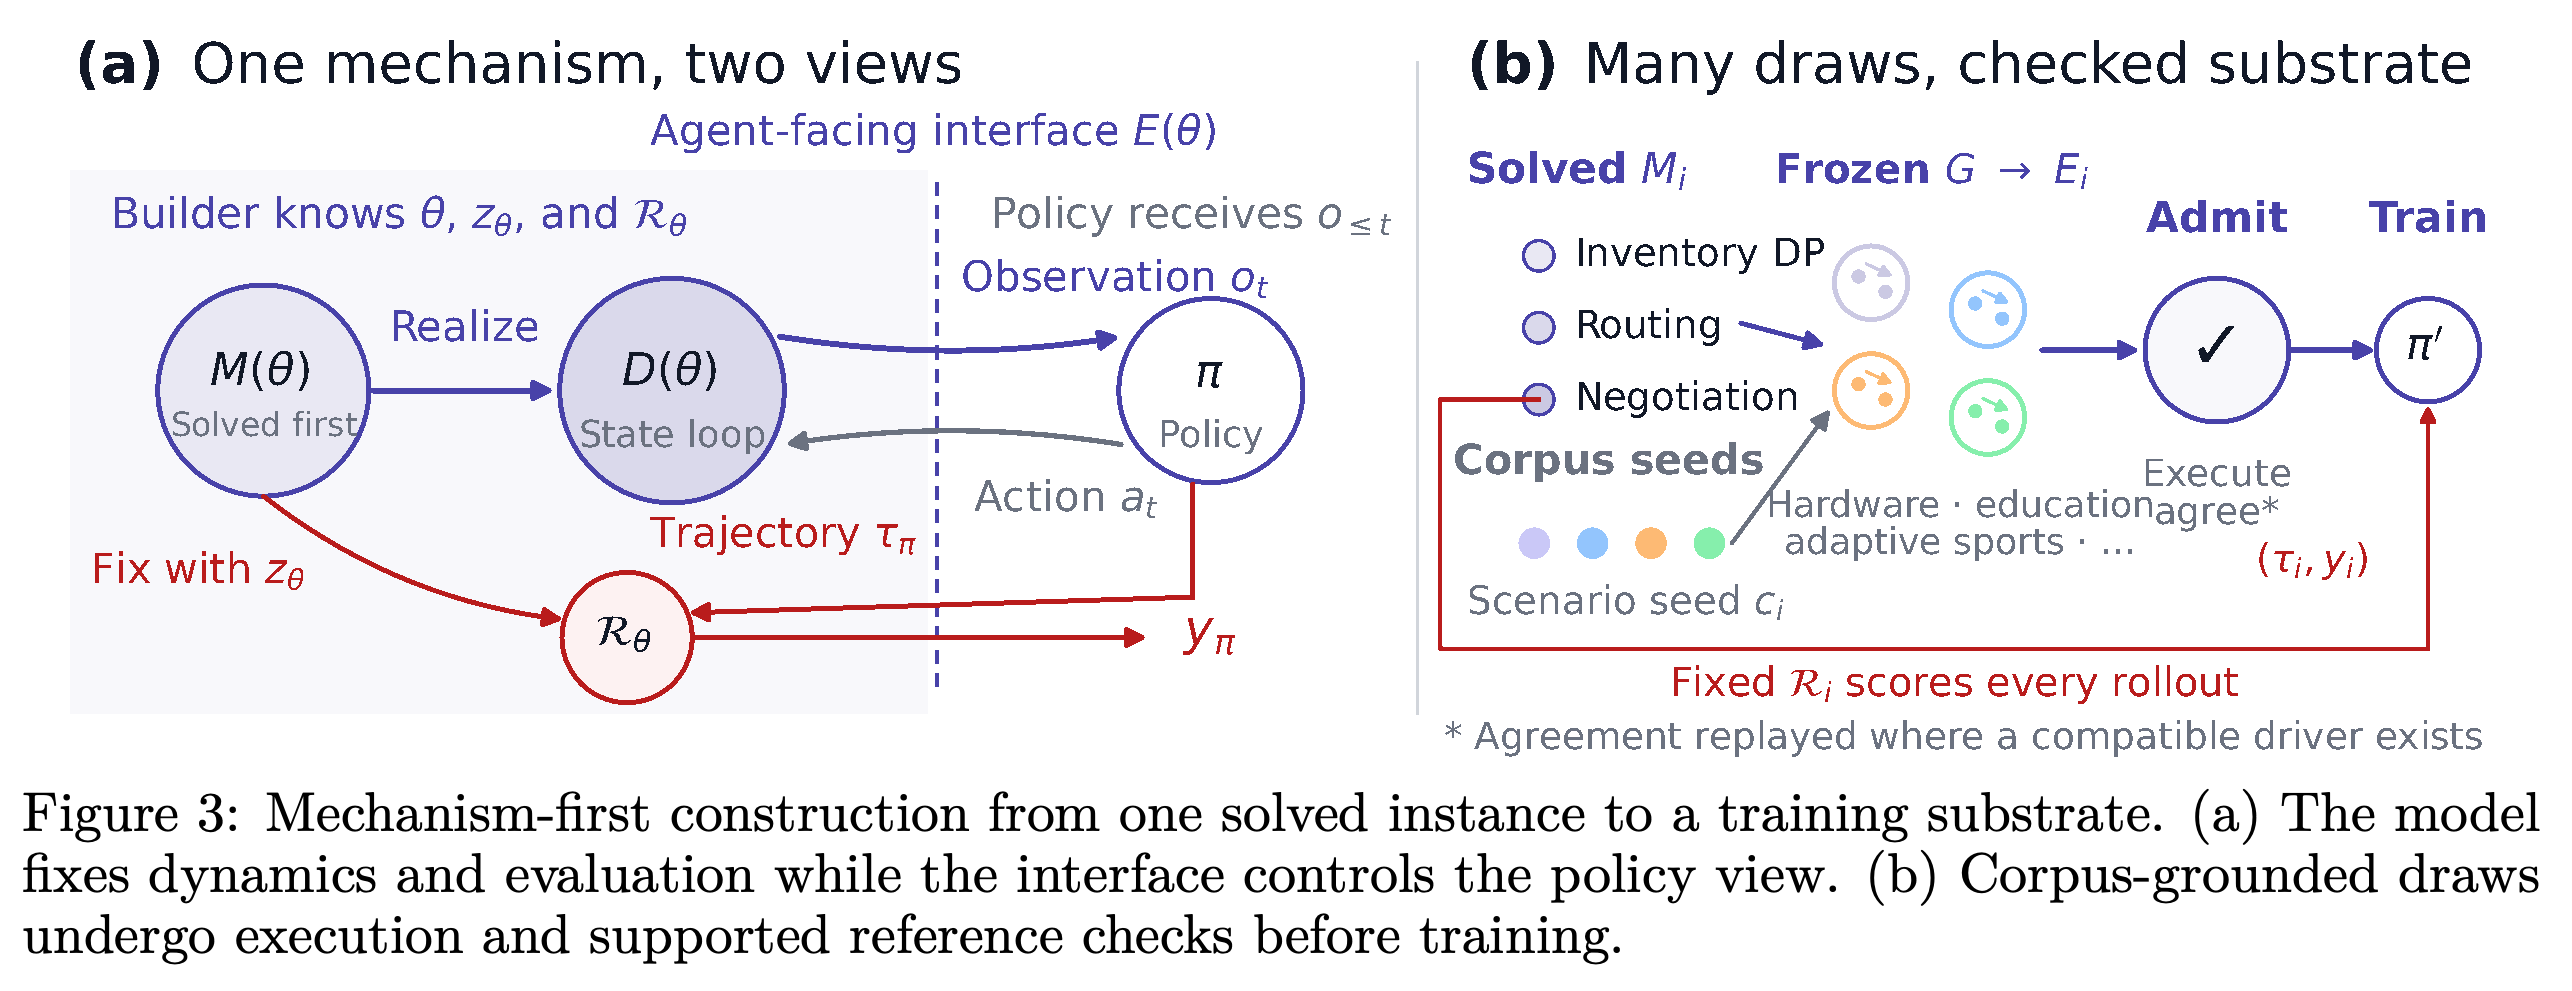
- 환경을 구성하는 builder는 샘플링한 전체 매개변수와 문서 시드를 받지만, player는 인터페이스가 노출하는 관측만 받는다. 따라서 상호작용으로 허용된 정보 외에는 관련 상태나 매개변수가 숨겨지는 부분 관측성이 생긴다.
- 모델과 인터페이스를 분리하면 동일한 인스턴스를 동일한 목적 아래 문제를 완전히 명시한 형태와 상호작용 형태로 제시할 수 있다. 재고 관리에서는 재고가 유지되고, 앞선 주문이 이후의 용량을 차지하며, 놓친 판매를 되돌릴 수 없다. 따라서 정보를 수집하고 장기적인 영향을 고려해 결정해야 한다.
- Figure 3은 이러한 정보 경계를 생성 과정과 연결한다. 해를 구한 인스턴스와 문서 시드로 만든 환경은 훈련 전에 실행 검사와 지원되는 기준 검사를 거친다.
왼쪽 패널은 builder가 가진 전체 지식과 player가 이용할 수 있는 관측을 구분하고, 실행과 평가를 1개 모델에 연결한다. 오른쪽 패널은 메커니즘 샘플과 문서 시드를 반복해서 뽑고 실행 검사와 지원되는 일치 검사를 거쳐 훈련 코퍼스를 구성하는 과정을 보여준다. 호환 가능한 재실행 driver가 필요하다는 조건은 기준 검증의 범위를 제한한다.
3.3 Outcome evaluation
계열별 솔버는 완전한 정보를 사용할 때의 상한 기준 u*(θ)와 고정된 기본 정책의 효용 u0(θ)를 계산한다. 기본 정책은 미리 정한 베이스라인 전략이다. 식 (4)는 player의 행동 선택 정책을 π라고 할 때 실제 효용 u(π;θ)를 \(r(\pi;\theta)=\operatorname{clip}_{[0,1]}\!\left(\frac{u(\pi;\theta)-u_0(\theta)}{u^*(\theta)-u_0(\theta)}\right)\)로 채점한다. clip[0,1]은 결과를 0부터 1까지의 구간으로 제한한다. 언어 모델 심판 없이 기본 정책은 0에, 상한 기준은 1에 대응한다. 부분 정보 조건에서는 지금까지 확보한 정보만으로 행동하는 온라인 정책이 상한 기준에 도달하지 못할 수도 있다. 언어 모델 심판에 대해서는 J1: Incentivizing Thinking in LLM-as-a-Judge via Reinforcement Learning 요약 설명 글을 참조하라.
4 Producing environments at scale
파이프라인은 매개변수를 샘플링하고 산술 계산이나 솔버로 기준 결과를 계산한다. 이어 의사결정, 제약, 목적을 실행 가능한 상태 갱신과 종료 효용으로 구현한다. 종료 효용은 에피소드가 끝날 때까지 누적된 가치다. 가중치를 고정한 setter는 문서에 근거한 시나리오, 관계형 데이터베이스, 도구 스키마와 구현, player 지침을 생성하며, 재사용 가능한 계열별 동역학이 있으면 활용한다. 승인 과정에서는 실행 검사나 적용 가능한 기준 일치 검사에 실패한 후보를 거부하거나 다시 생성한다.
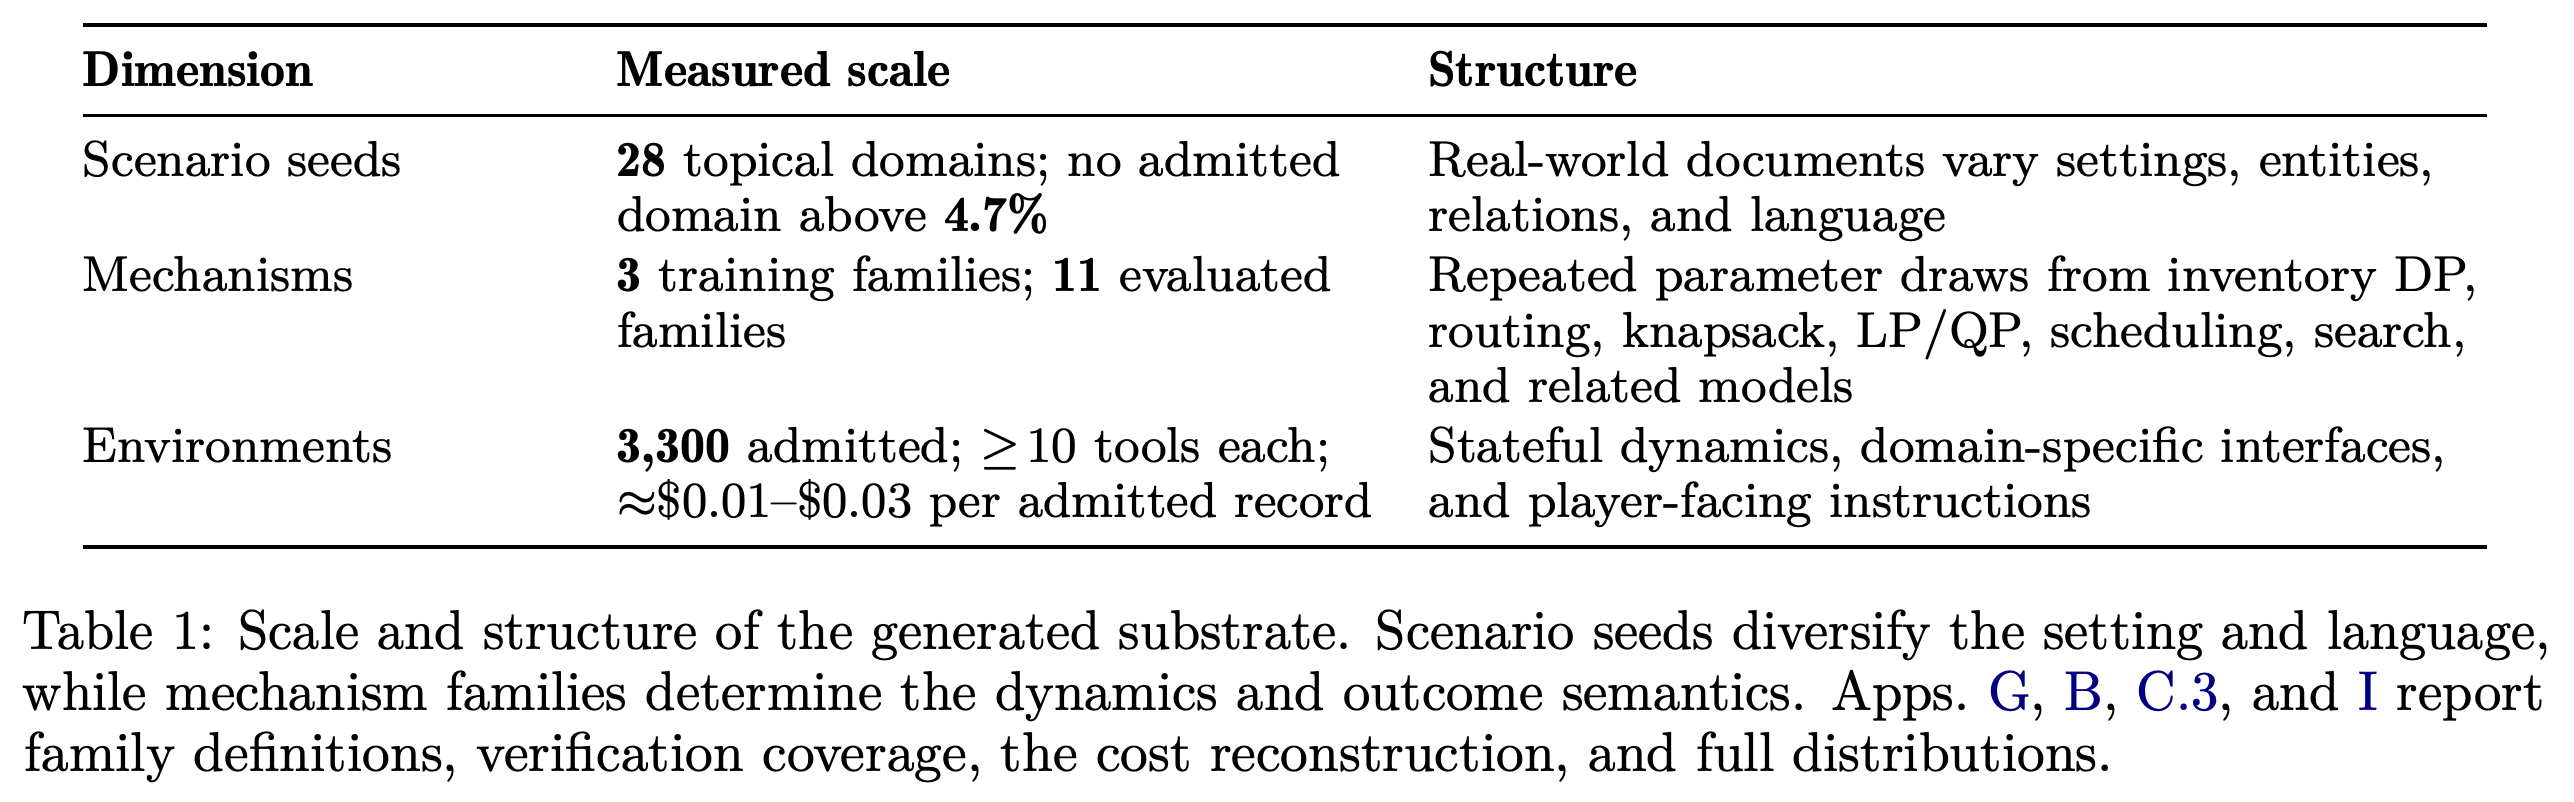
- Table 1은 승인된 환경 3,300개, 환경당 최소 10개 도구, 훈련 계열 3개, 평가 계열 11개, 28개 주제 도메인에서 가져온 시나리오 시드를 보고한다. 약 $0.01–$0.03의 한계비용은 재사용 가능한 계열 구성요소가 준비된 이후의 토큰 사용량과 공개 요금으로 재구성한 값이다.
- 도메인 라벨이 얼마나 고르게 분포하는지 나타내는 정규화된 주제 엔트로피는 0.997로, 균등 분포의 값인 1에 가깝다. 이 라벨은 배경과 언어를 설명하며, 의사결정 동역학은 메커니즘 계열이 결정한다.
- 정책 훈련에는 GRPO(group relative policy optimization)를 사용한다. GRPO는 동일한 인스턴스에서 샘플링한 상호작용 궤적인 rollout을 결과 보상으로 비교한다. 훈련된 체크포인트를 생성한 메커니즘 계열에서 평가한 에피소드는 평균 59.7회의 assistant 턴을 사용한다.
문서 도메인은 언어와 배경을 다양화하고, 메커니즘 계열은 의사결정 구조를 정하며, 승인된 레코드는 실행 가능한 환경을 구현한다. 환경 3,300개에는 훈련과 평가 환경이 포함된다. 약 $0.01–$0.03은 승인된 레코드당 한계비용을 재구성한 추정치다.
5 Experiments
실험은 훈련 메커니즘 밖으로의 전이, 문제 해결과 상태가 유지되는 환경에서의 실행 사이의 격차, 환경 크기와 정책 학습을 함께 확장할 수 있는지를 검증한다. 초기 정책은 Qwen3.6-35B-A3B이며, 훈련된 체크포인트를 동일한 프로토콜로 초기 정책과 비교한다. 데이터셋은 훈련 환경 2,200개, 훈련 계열 3개의 홀드아웃 환경 300개, 보지 못한 계열 8개의 환경 800개로 구성된다. 평가 계열마다 환경 100개를 사용한다.
- 생성한 메커니즘 계열은 솔버에서 도출한 정규화 점수로 평가하고, 외부 벤치마크는 각자의 고유 지표를 유지한다. 추가 비교 대상인 Qwen3.7-Max는 호스팅 모델을 호출할 때 사용하는 응용 프로그래밍 인터페이스 프로토콜에 따라 평가한다.
- 훈련 계열은 inventory DP, routing, negotiation이다. 주요 결과에 사용한 체크포인트는 최적화 34스텝을 거쳤다.
5.1 Training gains and transfer
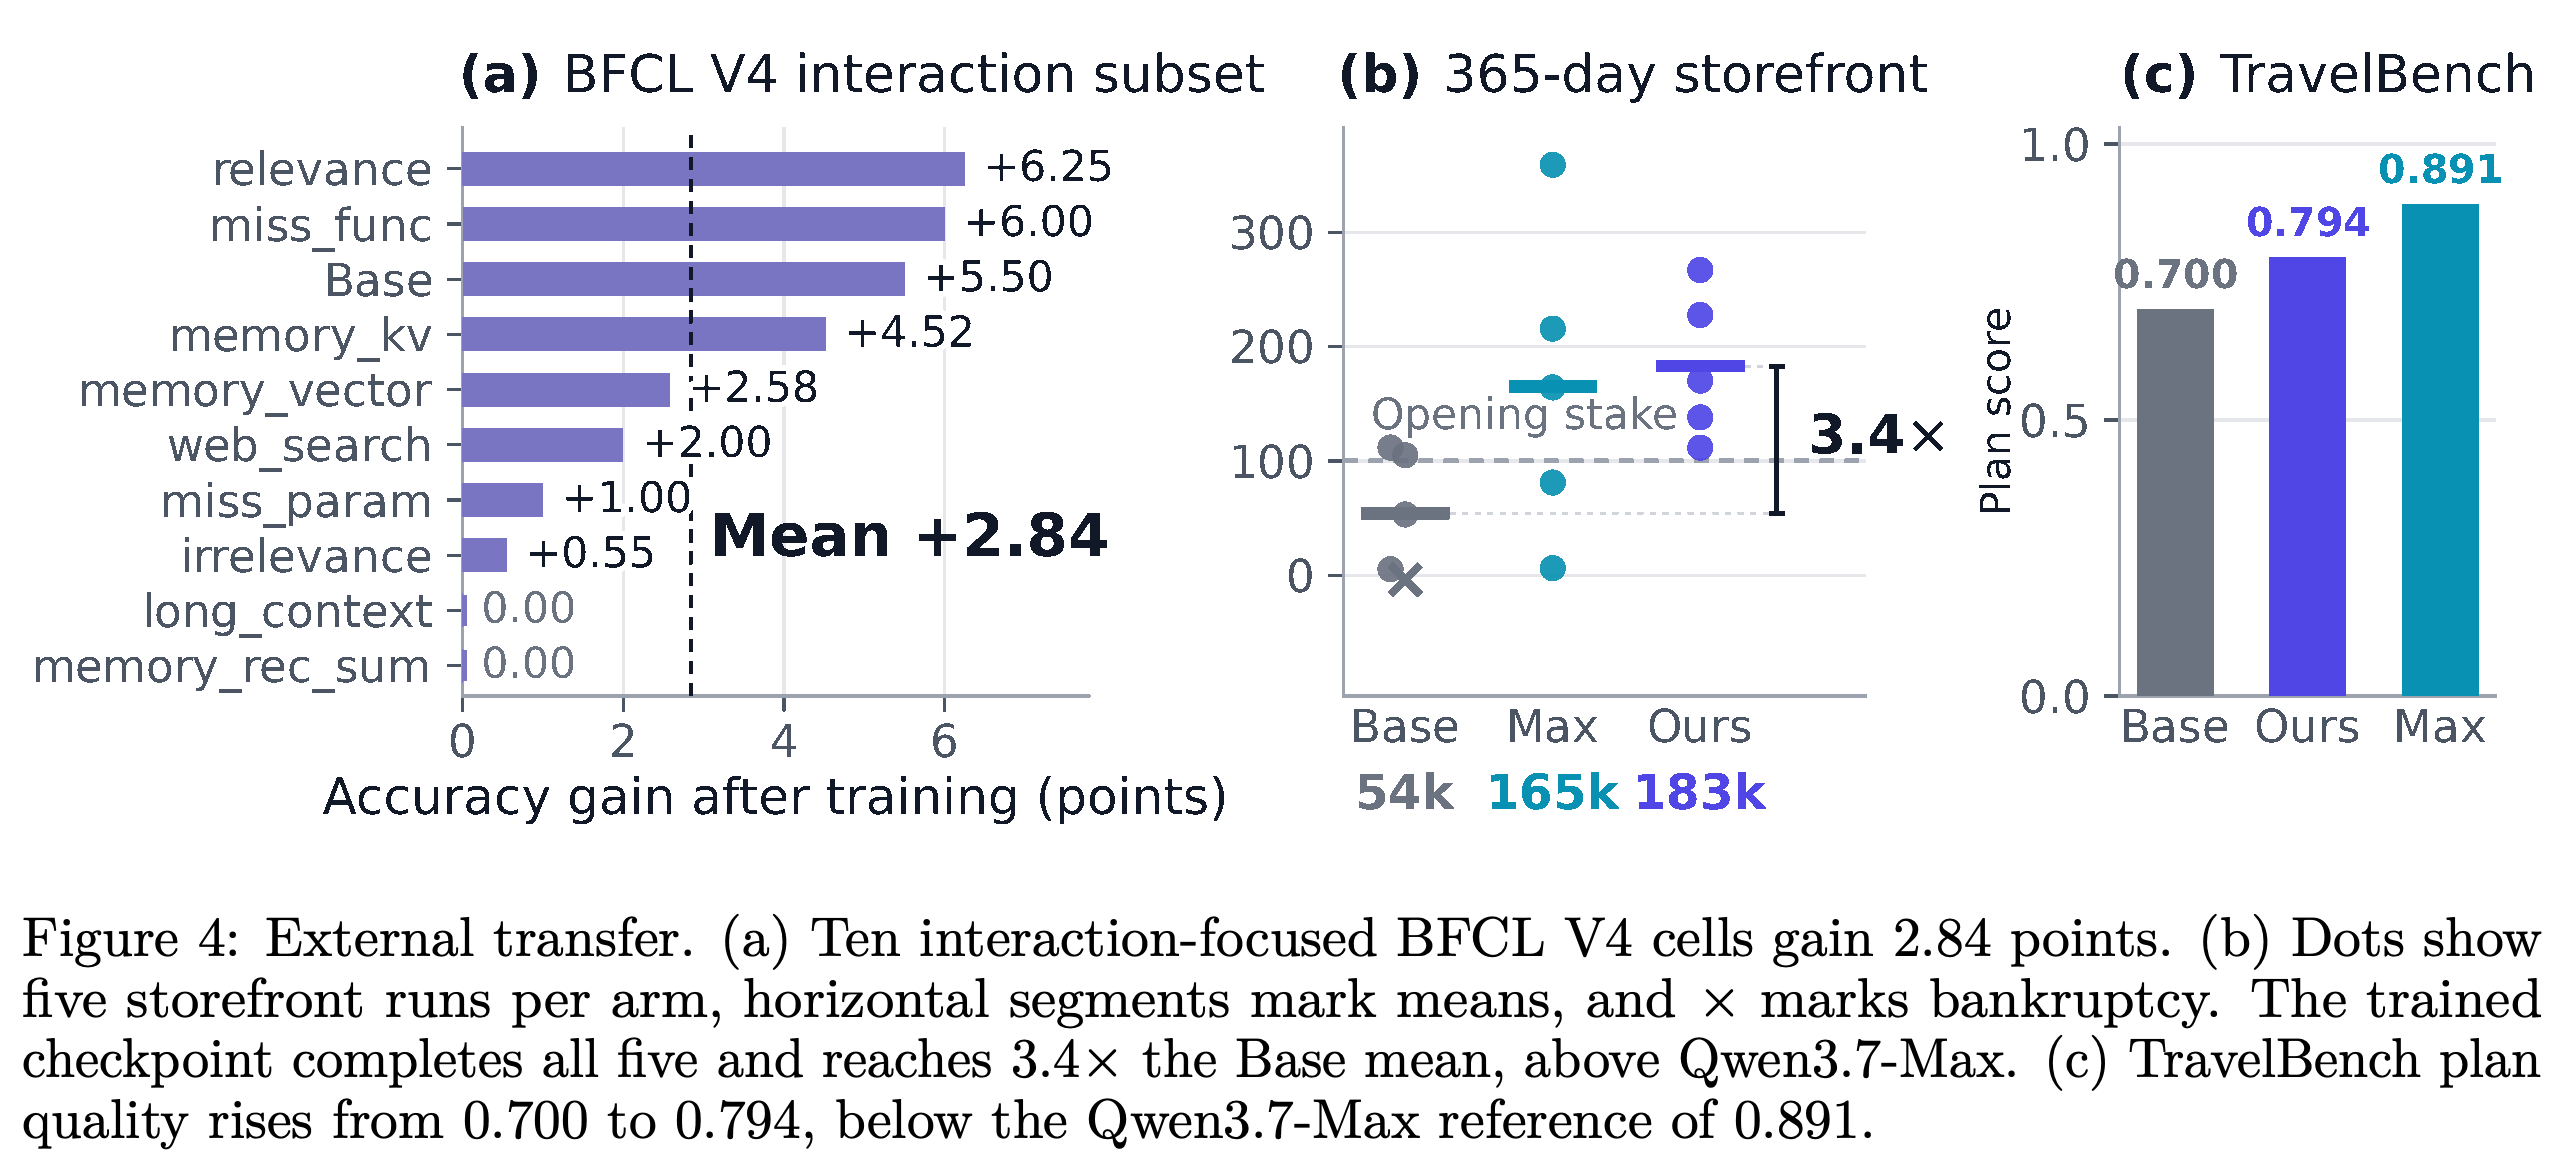
훈련은 평가한 생성 메커니즘 계열 모두에서 성능을 높인다. 훈련 계열의 홀드아웃 평가에서는 평균 +0.56, 훈련에서 보지 못한 분포 밖 최적화 계열인 near-OOD에서는 +0.63을 얻는다. 의사결정 구조가 다르거나 탐색이 제한된 far-OOD 집단에서는 각각 +0.24와 +0.16을 얻는다. Figure 4는 인스턴스와 인터페이스가 다른 외부 벤치마크 3개로의 전이를 보여준다.
- Berkeley Function Calling Leaderboard의 도구 사용 평가인 BFCL V4에서는 상호작용 중심의 개별 평가 하위 집합인 셀 10개의 평균이 61.25에서 64.08로 높아진다. 반올림 전에 계산한 향상 폭은 2.84점이다. 셀 8개는 개선되고 2개는 변하지 않는다.
- TravelBench는 시간, 예산, 상식, 개인화 제약이 서로 연결된 여러 날의 여행 일정을 구성하는 벤치마크다. 영어 과제 20개에서 계획 품질이 0.700에서 0.794로 높아진다. Qwen3.7-Max의 점수는 0.891이다.
- E-Commerce Bench의 365일 사업 시뮬레이션에서 훈련된 모델은 assistant 턴 1,147–1,825회에 걸쳐 실행 5회를 모두 파산 없이 완료한다. 평균 최종 잔액은 54,294에서 182,844로 3.4배가 되며, Qwen3.7-Max의 165,224를 넘어선다. Base는 실행 4회를 완료하고 1회는 파산한다.
패널은 평균 함수 호출 점수 2.84점 향상, 모의 사업 잔액 3.4배 증가, Qwen3.7-Max에는 미치지 못하지만 개선된 여행 계획을 보여준다. 각 벤치마크에서 향상 폭이 다른 양의 전이가 나타난다. 매장 운영의 개별 점은 실행 5회 사이의 변동과 Base의 파산을 나타낸다. 평균이 높아졌다고 모든 실행의 결과가 같아지는 것은 아니다.
5.2 A learnable gap under stateful interaction
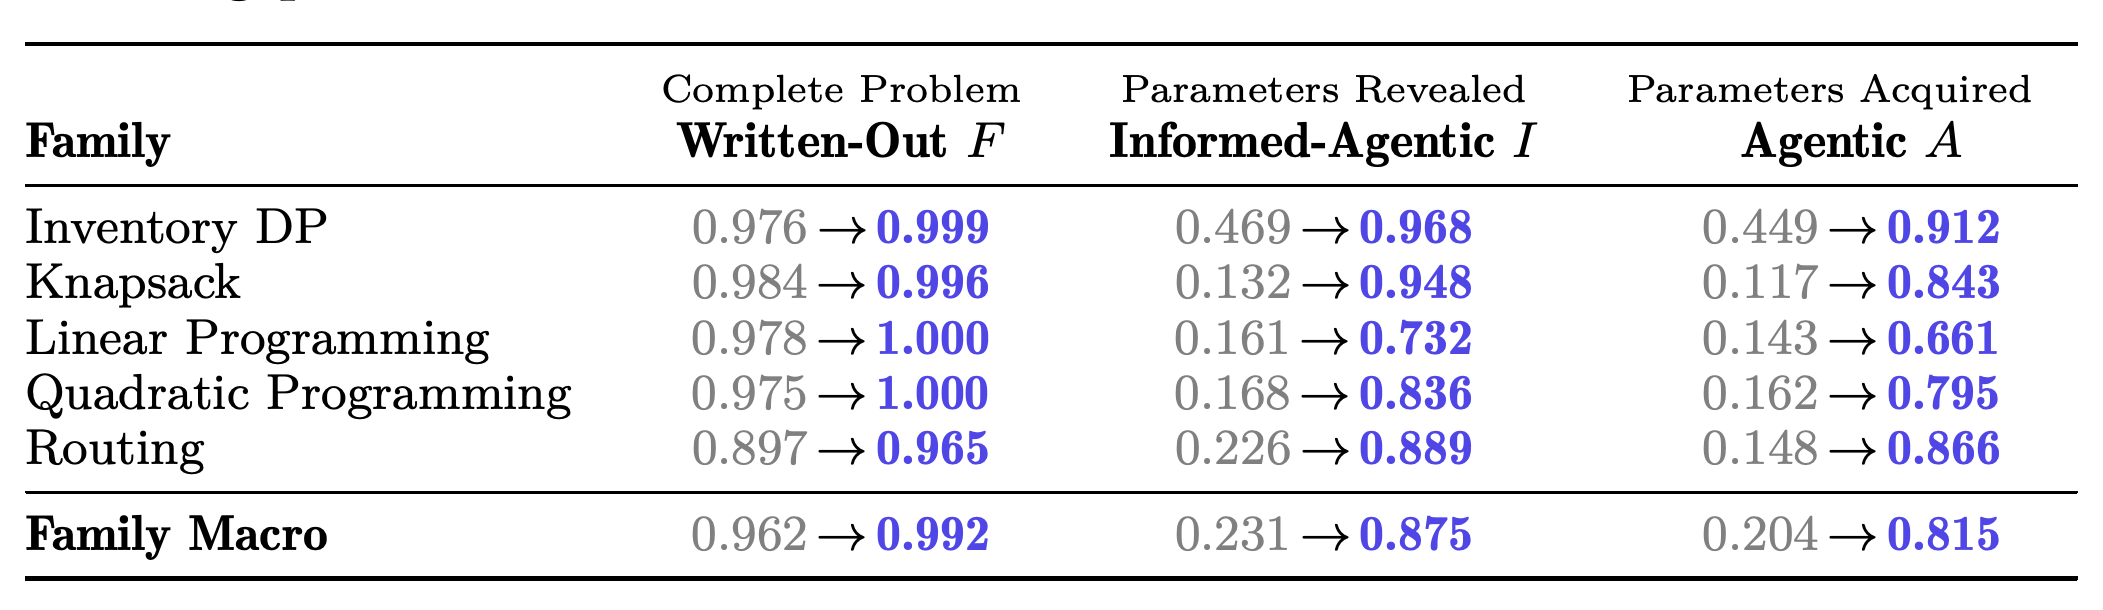
Table 2는 Python 도구를 사용할 수 있고 인스턴스를 완전히 명시한 Written-Out F, 동일한 상태 유지 환경에서 매개변수를 처음부터 공개한 Informed-Agentic I, 상호작용으로 매개변수를 얻는 Agentic A를 비교한다. 최적화 계열 5개에서 Base의 점수는 각각 0.962, 0.231, 0.204다. 이는 숨겨진 매개변수를 공개해도 초기 성능 격차 대부분이 남는다는 점을 보여준다. 훈련 후 점수는 0.992, 0.875, 0.815로 높아지며, Written-Out과 Informed-Agentic의 격차는 84%, Written-Out과 Agentic의 격차는 77% 줄어든다.
- 예시로 제시한 대응 궤적은 여러 기간이 공유하는 예산을 고려한 계획, 결정을 확정하기 전 관측 완료, 비용이 드는 탐색 중단이 개선됨을 보여준다. 이 예시는 실패의 발생 비율을 추정하지 않고 행동 변화를 설명한다.
- 최적화 계열 8개에서 관측된 점수 차이를 분해하면 평균 향상 +0.443 중 +0.030이 코드 도구 사용률 증가에 해당한다. 나머지 +0.413은 에피소드의 코드 도구 사용 여부로 나눈 고정 집단 내부의 향상이다. Linear programming에서는 모델 2개가 모든 에피소드에서 도구를 사용하므로 사용률 변화 항이 없다.
- 훈련된 모델과 초기 모델의 토큰 분포 차이를 측정하는 순방향 Kullback–Leibler(KL) 발산은 홀드아웃 궤적 상태에서 assistant 토큰당 0.089 nats다. 이는 기존 문제 해결 능력을 더 잘 활용하게 된다는 능력 유도 해석과 부합하지만, player가 기저 메커니즘을 재구성한다는 사실을 입증하지는 않는다.
모든 매개변수를 공개해도 큰 실행 격차가 남는다. 계열별 동일 가중 평균에서 Base는 Written-Out F의 0.962에서 Informed-Agentic I의 0.231로, 이어 Agentic A의 0.204로 낮아진다. 상호작용 형태 2개에서 크게 개선되고 완전히 명시한 형태에서는 소폭 개선된 결과는 상태가 유지되는 환경에서의 실행이 중요한 학습 대상임을 뒷받침한다.
5.3 Co-scaling environment and policy frontiers
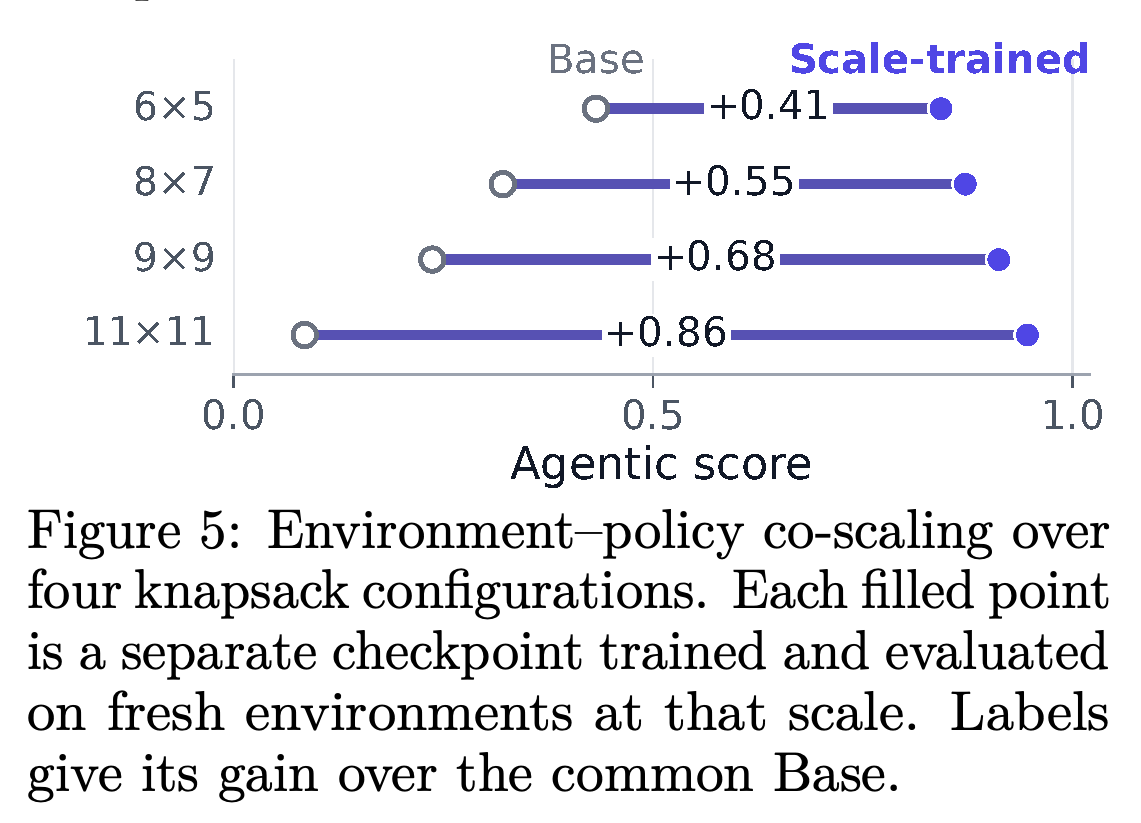
공동 확장 실험은 knapsack의 규모를 6×5, 8×7, 9×9, 11×11 items × decision periods로 늘린다. 이는 항목 수 × 의사결정 기간을 나타낸다. Knapsack allocation은 용량과 예산 제약 아래 항목의 부분집합을 선택하는 문제다. 가중치를 고정한 Qwen3.6-35B-A3B가 승인 환경을 구성하고, 별도 사본은 각 규모에서 Base로 시작해 동일하게 맞춘 예산으로 훈련한 뒤 해당 규모의 새로운 환경에서 평가받는다. Figure 5가 보고한 향상 폭은 +0.412, +0.551, +0.675, +0.861이다. 11×11에서 Base의 점수는 0.085이며, 해당 규모로 훈련한 체크포인트의 점수는 0.946이다.
- 각 규모는 별도로 훈련한 체크포인트를 사용한다. 이 실험은 규모에 맞춘 훈련으로 학습할 수 있음을 입증하며, 단일 체크포인트가 여러 규모로 전이되는지는 검증하지 않는다.
- 고정된 setter는 전체 메커니즘 구조와 기준 결과를 받지만, player는 인터페이스로 필요한 정보를 알아내야 한다. 이러한 정보 비대칭 덕분에 동일한 초기 모델이 자신의 초기 정책으로는 잘 처리하지 못하는 과제를 구성할 수 있다.
Knapsack의 크기와 기간이 늘어나면 Base 성능은 낮아지지만, 별도로 훈련한 체크포인트는 각자에 대응하는 규모에서 높은 성능을 보인다. 향상 폭이 커지는 결과는 규모에 맞춘 훈련에서 학습할 수 있음을 입증한다. 채워진 각 점은 서로 다른 체크포인트를 나타내므로, 이 그래프는 단일 정책의 규모 간 전이를 입증하지 않는다.
6 Conclusion
결론은 메커니즘 우선 구성을 해를 구한 공통 모델에서 상태가 유지되는 환경과 솔버 기반 궤적 점수를 생성하는 방법으로 제시한다. 평가한 메커니즘과 외부 벤치마크에서 훈련은 문제를 완전히 명시했을 때의 해결 능력을 유지하면서 상호작용 실행 능력을 높인다. Setter 실험과 크기 실험은 평가한 메커니즘 계열과 시험한 규모에서 생성과 학습이 가능함을 뒷받침한다.
부록
- A Discussion은 구성 단계에서 이용할 수 있는 전체 구조와 player가 알아낼 수 있는 정보 사이의 비대칭으로 결과를 해석한다. 수학적 메커니즘은 숨겨진 수량, 서로 연결된 제약, 지연된 결과를 제공하며, 인터페이스는 공개 범위를 제어한다. 실험은 시험한 계열에서 구현과 학습이 가능함을 입증한다. 다만 player가 수학적 모델을 명시적으로 재구성한다거나, 제약이 있는 의사결정을 수학적으로 모델링하는 경영과학만으로 일반적인 에이전트 역량을 확보할 수 있다는 사실을 입증하지는 않는다.
- B Admission and verification은 C1을 실행 가능성, C2를 목적에 적합한 기본 결과의 허용 영역, C3을 호환 가능한 재실행이 있을 때 최적점의 보상 일치로 명시한다. 감사에서는 재실행을 지원하는 계열 8개에서 각각 홀드아웃 환경 10개를 샘플링하고 oracle, default, idle 정책을 각각 2회 실행한다. 각 정책은 솔버에서 도출한 기준 전략, 미리 정한 베이스라인, 결정을 확정하지 않는 전략이다. 실행 480회가 모두 예외 없이 끝나고, 반복한 최종 결과 240개가 모두 일치하며, 원시 효용이 사전 계산한 상한 기준을 넘는 경우도 없다. Negotiation, sequential stopping, sequential search는 계산 가능한 기준을 갖지만 이 재실행 검증에는 포함되지 않는다.
- C Implementation and record structure는 재사용 가능한 계열별 구성요소와 환경 레코드를 설명한다. C.1 Reference computation은 상태별 재고 결정을 역방향으로 푸는 Bellman 재귀, 고객 부분집합별 경로를 푸는 Held–Karp 재귀, 열거, 선형계획 솔버 HiGHS, 분리 가능한 이차계획에 scipy.optimize를 통해 사용하는 수치 최적화 루틴 SLSQP를 활용한다. C.2 Setter passes는 개체 관계, 데이터베이스, 실행 가능한 도구 최소 10개, player 지침, 기본 정책, 출력 형식을 생성한다. 재사용 가능한 동역학이 있으면 제공하고, 그 밖의 동역학은 setter가 구현한다. 기준 결과는 항상 sampler가 계산한다.
- C.3 Setter capacity는 inventory DP, routing, tardiness scheduling에 걸쳐 요청한 환경 30개를 비교한다. Tardiness scheduling은 납기를 넘겨 완료한 작업에 페널티를 부과한다. 가중치를 고정한 Qwen3.6-35B-A3B는 레코드 22개를 생성하고 21개가 호환 가능한 재실행을 통과해 실질 승인율 70%를 기록한다. Qwen3.7-Max는 30개를 모두 생성하고 통과한다. 생성된 레코드당 평균 시도 횟수는 2.50에서 1.03으로, 인터페이스 수정 비율은 45.5%에서 0으로 낮아진다. 매개변수 샘플이 대응하지 않으므로 이 비교는 구현 가능성과 구현 부담을 측정한다. Setter 2개 모두 승인당 재구성 비용은 대략 $0.01–$0.03이다. 비용은 August 28, 2026에 확인한 공개 요금을 사용하며, 한시적인 Max 50%-off 할인과 US dollar당 ¥7의 환율을 포함한다.
- C.4 Environment and interpreter isolation은 숨겨진 매개변수와 기준값을 환경 동역학 내부에 유지하고, 선언된 인터페이스 연산만 노출한다. 모든 제시 방식은 환경 내부에 접근할 수 없고 상태에 의존하지 않는 계산 유틸리티를 공유한다. C.5 Training implementation은 스텝당 프롬프트 64개와 프롬프트당 유지할 rollout 16개를 사용하며, 과표집을 통해 시도 수를 18로 늘린다. 업데이트에 사용하는 advantage는 누적 보상에서 집단 평균을 뺀 차이다. 표준편차 정규화와 KL 페널티를 사용하지 않으며, 기대 누적 보상을 추정하는 가치 모델도 사용하지 않는다. 배치당 1 epoch를 학습률 2×10⁻⁶과 정책 업데이트를 제한하는 clip ratio 4×10⁻³으로 훈련한다. 총 34 steps에 걸쳐 환경 2,176개에서 채점된 rollout 34,816개를 생성한다.
- D Representative generated environments는 메커니즘 3개가 운영 시나리오로 구현되는 과정을 추적한다. 각 시나리오에서 기본 정책과 최적값의 격차는 양수이며 기준 재실행에 성공한다. D.1 Inventory control as hardware replenishment는 6일 동안 제품 3개, 공통 트럭 용량 6, 공동 준비 비용 37.69를 사용하며 원시 효용은 22.74→45.01이다. D.2 Routing as education logistics는 3일 동안 장소 7개와 용량 20을 사용하며 원시 효용은 −117.81→36.40이다. D.3 Knapsack allocation as adaptive-sports planning은 9일 동안 항목 11개, 선반 용량 17, 공통 예산 76을 사용하며 원시 효용은 371.45→1,340.96이다.
- E Construction, feedback, and optimization은 환경의 출처, 채점 기준이 어디서 나오는지를 뜻하는 결과 기준의 출처, 피드백 위치, 정책 최적화를 구분한다. E.1 Construction order and method coverage는 학습된 평가기, 평가 기준표, 궤적 주석, 실행 가능한 검증기를 이 독립적인 축에 따라 배치한다. E.2 A released environment-first comparison은 VHD-Play와 EnvScaler를 비교한다. EnvScaler는 상태, 규칙, 도구를 정의하는 재사용 가능한 코드인 상태 유지 프로그램 골격과 과제를 생성한 뒤, 최종 상태를 채점하는 체크리스트 검증기를 생성한다.
- E.2의 조건을 맞춘 EnvScaler 대조군은 동일한 초기 모델, GRPO 설정, 훈련 레코드 2,200개, 34-step 예산을 사용하며 프로그램 골격 51개에서 시나리오를 가져온다. 자체 훈련 보상은 0.854에 도달하지만 외부 전이는 일관되지 않는다. BFCL 평균은 대조군 58.56, Base 61.25, VHD-Play 64.08이다. TravelBench 점수는 같은 순서로 0.753, 0.700, 0.794다. 평균 매장 잔액은 같은 순서로 52,661, 54,294, 182,844이며, 훈련된 2개 모델 모두 실행 5회를 전부 파산 없이 완료한다. 이는 전체 훈련 파이프라인을 비교하므로 구성 순서를 인과 요인으로 분리하지는 못한다. E.3 Feedback and optimization은 메커니즘 우선 구성이 종료 피드백이나 궤적 도중 보상을 부여하는 과정 피드백, 서로 다른 최적화기를 허용한다고 별도로 설명한다. 이 구현은 GRPO와 종료 시점의 스칼라 보상을 사용한다.
- F Evaluation settings는 생성한 메커니즘 계열의 에피소드 길이를 최대 1,000턴, 턴당 생성 한도를 16,384토큰, 누적 생성 한도를 120,000토큰, 프롬프트 한도를 8,192토큰, 관리되는 문맥 창을 65,536토큰으로 정한다. 훈련된 모델을 생성한 메커니즘 계열에서 평가한 에피소드의 assistant 턴 수는 중앙값 31, 평균 59.7, 95백분위수 211턴이다. 환경 3,300개는 훈련 레코드 2,200개와 11개 계열에 걸친 평가 레코드 1,100개로 구성된다.
- G Mechanism families는 inventory DP, routing, negotiation, knapsack, linear programming, quadratic programming, sequential stopping, sequential search, facility location, scheduling, scheduling with tardiness를 정리한다. 여기에는 협상, 순차적으로 공개되는 선택지를 언제 수락할지 결정하는 문제, 비용을 내고 선택지를 조사한 뒤 고르는 문제, 서비스 시설 선택, 작업 순서 결정 등이 포함된다. 최적화 계열의 기본 정책은 표시된 값을 기준으로 행동하고, 공통 예산을 균등하게 나누며, 탐색하지 않는다. 다른 기본 정책은 계열마다 다르다. Sequential stopping과 sequential search는 온라인 행동 당시에는 알 수 없는 정보로 계산한 사후적 상한을 사용한다. 따라서 이 점수는 달성 가능한 온라인 최적값과의 거리를 측정하지 않고 공통 기준으로 모델을 비교한다.
- H Additional experimental results는 훈련 곡선, 전체 점수표, 행동 사례, 외부 평가 결과, 도구 사용 대조 분석을 제공한다. H.1 Training dynamics는 inventory 보상 0.408→0.904, routing 보상 0.150→0.898, negotiation 보상이 0에 가까운 값에서 0.470에 도달한 결과를 보고한다. 이 곡선은 훈련 인스턴스에서의 최적화를 보여주며, 전이의 근거는 홀드아웃 평가가 제공한다. H.2 Generated-family results는 sequential search의 +0.066부터 knapsack의 +0.726까지 모든 평가 계열에서 양의 agentic 점수 향상을 보고한다. 홀드아웃 상태 96개에서 순방향 KL은 토큰당 0.089 nats로 추정되며, 과제를 재표집한 task-bootstrap 95% 구간은 [0.082, 0.097]이다.
- H.3 Trajectory evidence는 대응되는 예시 사례 3개를 제시한다. H.3.1 Horizon-wide planning에서는 Base가 3개 기간에 예산 29단위 중 27단위를 쓰고 점수 0을 얻는 반면, 훈련된 모델은 7개 기간의 계획으로 점수 1을 얻는다. H.3.2 Information acquisition before commitment는 궤적 8개 중 4개를 확인하는 행동과 계획 전에 8개 전부를 확인하는 행동을 비교한다. H.3.3 Stopping costly information acquisition에서는 후보 14개를 조사해 비용 134와 순가치 −40.71을 얻는 경우와, 8회 조사로 비용 27과 순가치 66.29를 얻는 경우를 비교한다. 훈련된 모델의 점수는 0.799다.
- H.4 External-benchmark details는 BFCL 셀 10개의 전체 점수, 벤치마크 3개의 집계값, 훈련된 모델이 완료한 매장 운영의 평균 assistant 턴 수 1,359회를 제공한다. H.5 Code-tool adoption control은 도구 사용률 변화와 집단 내부의 점수 변화를 구분해 설명하는 Oaxaca–Blinder 분해를 사용한다. 코드 도구 사용률은 계열 11개에서 50.4%에서 79.2%로 높아지며, 최적화 계열 8개의 평균 향상 +0.443 중 +0.030이 사용률 변화에 해당한다. 차이 대부분은 도구 사용 여부를 고정한 집단 내부에 남는다. 이 분해는 인과적 매개 효과를 입증하지 않는다.
- I Admitted-environment statistics는 setter 시도 횟수의 평균, 중앙값, 최댓값을 1.41, 1, 5회로 보고한다. 첫 시도 승인율은 65.6%이며, 승인된 환경의 31.6%에서 인터페이스를 다시 작성한다. 집계 자료로 재구성한 승인당 토큰 사용량은 입력 약 900토큰과 출력 약 6,300토큰으로, 공개 요금 기준 약 $0.01–$0.03이라는 추정치를 뒷받침한다. 계열 3개의 생성 풀은 도메인 라벨 28개에 걸쳐 있으며, 전체 정규화 엔트로피는 0.997, 각 계열 내부에서는 최소 0.995로 주제의 균형을 나타낸다.
- J Environment-complexity sweep은 규모에 맞춰 훈련한 정확한 결과를 제시한다. 6×5는 0.432→0.843, 8×7은 0.321→0.872, 9×9는 0.237→0.912, 11×11은 0.085→0.946이다. 보고된 향상 폭은 각각 +0.412, +0.551, +0.675, +0.861이다. 각 훈련 점수는 별도 체크포인트를 훈련 규모와 같은 새로운 환경에서 평가한 결과다.
- K Limitations and scope는 근거의 범위를 기준 결과를 계산할 수 있는 메커니즘, 훈련 계열 3개, 평가 계열 11개, 계열 8개의 oracle, default, idle 경로에 대한 기준 재실행으로 한정한다. 주요 생성 메커니즘 계열 실험은 훈련 실행 1회와 평가 시드 1개를 사용하며, 훈련에는 종료 시점의 지도 신호만 제공한다. 제시 방식, 도구 사용, 규모 분석은 행동 특성을 설명한다. 다만 전체 구성으로 훈련했으므로 결과 규칙과 인터페이스가 향상에 각각 얼마나 기여했는지는 분리하지 못한다.
짧은 생각
핵심 방법론적 기여는 실행 가능한 동역학과 생성 전에 계산한 기준값이 동일한 모델에서 나온다는 점이다. F/I/A 비교는 상당한 실행 격차의 직접적인 근거를 제공한다. 정보를 수집할 필요가 없는 조건에서도, 완전히 공개된 매개변수를 상태가 유지되는 상호작용으로 활용해야 하면 성능이 0.962에서 0.231로 떨어진다.
외부 전이와 조건을 맞춘 EnvScaler 대조군은 시험한 초기 모델과 업데이트 예산에서 이 훈련 코퍼스의 실용적 가치를 뒷받침한다. 일반화 가능성을 판단하는 근거는 주요 훈련 실행 1회, 모델당 매장 운영 5회, TravelBench 과제 20개, 계열 8개로 제한된 재실행 검증에 머문다. 여러 훈련 시드와 인터페이스 및 결과 규칙을 통제한 변경 실험은 재현성을 평가하고 어떤 구성요소가 향상을 만드는지 파악하는 데 도움이 될 수 있다.