


J1: Incentivizing Thinking in LLM-as-a-Judge via Reinforcement Learning 요약 설명
15 May 2025 | Paper Review LLM-as-a-Judge Reinforcement Learning With Verifiable Rewards Synthetic Data목차
이번 글에서는 J1: Incentivizing Thinking in LLM-as-a-Judge via Reinforcement Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 5월 15일(Arxiv)
- Whitehouse, Chenxi, Wang, Tianlu, Yu, Ping, Li, Xian, Weston, Jason, Kulikov, Ilia, Saha, Swarnadeep.
- FAIR at Meta
- 논문 링크
요약
- 이 논문은 다른 모델의 응답을 평가하는 대규모 언어 모델인 LLM-as-a-Judge가 판정 전에 추론하고, 응답 순서가 바뀌어도 정확한 판정을 유지하도록 학습하는 방법을 연구한다. 선호 응답과 비선호 응답으로 구성된 합성 선호 쌍 22K개로 학습한 J1-Qwen-32B-MultiTask는 검증 가능한 응답 쌍으로 구성된 Preference Proxy Evaluations (PPE) Correctness에서 정확도 76.8%를 달성한다. 32B 기반 모델인 Qwen3-32B의 정확도는 66.5%이며, 같은 pairwise 평가 조건에서 비교한 결과다. LLM-as-a-Judge에 대해서는 Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (LLM-as-a-Judge) 요약 설명 글을 참조하라.
- J1은 생성한 출력에 부여한 보상으로 학습하는 강화학습을 통해 평가 추론과 최종 판정을 함께 최적화한다. 구성한 선호 레이블을 기준으로 판정 보상을 검증할 수 있게 만들고, 응답 순서 2가지를 모두 학습한다. 또한 응답 2개를 함께 비교하는 pairwise 평가와 각 응답에 독립적으로 점수를 부여하는 pointwise 평가를 결합한다.
- 각각의 평가 지표를 사용하는 벤치마크 5개에서 멀티태스크 모델은 종합 점수 80.8을 기록한다. Qwen3-32B는 77.3, DeepSeek-R1-671B는 78.4를 기록한다. Pointwise 평가는 응답 순서 2가지 모두에서 정답을 요구하는 정확도를 높이고, pairwise 평가는 무작위로 선택한 순서에서 더 높은 성능을 보인다. 다만 구성한 레이블의 타당성, 남아 있는 순서 민감도, 보고된 수치의 불일치를 고려해야 한다.
1 Introduction
J1은 새로 생성한 평가로 평가 모델을 갱신하는 온라인 학습을 연구한다. 기존 프롬프팅이나 오프라인 선호 학습만 사용하는 접근에서 더 나아간 방법이다. 기여는 3가지다. 합성 선호 데이터를 활용한 통합 학습, 판정 전에 생성하는 중간 추론인 chain-of-thought의 최적화, 응답 순서에 따라 판정이 달라지는 위치 편향을 줄이기 위한 멀티태스크 평가 모델을 제안한다.
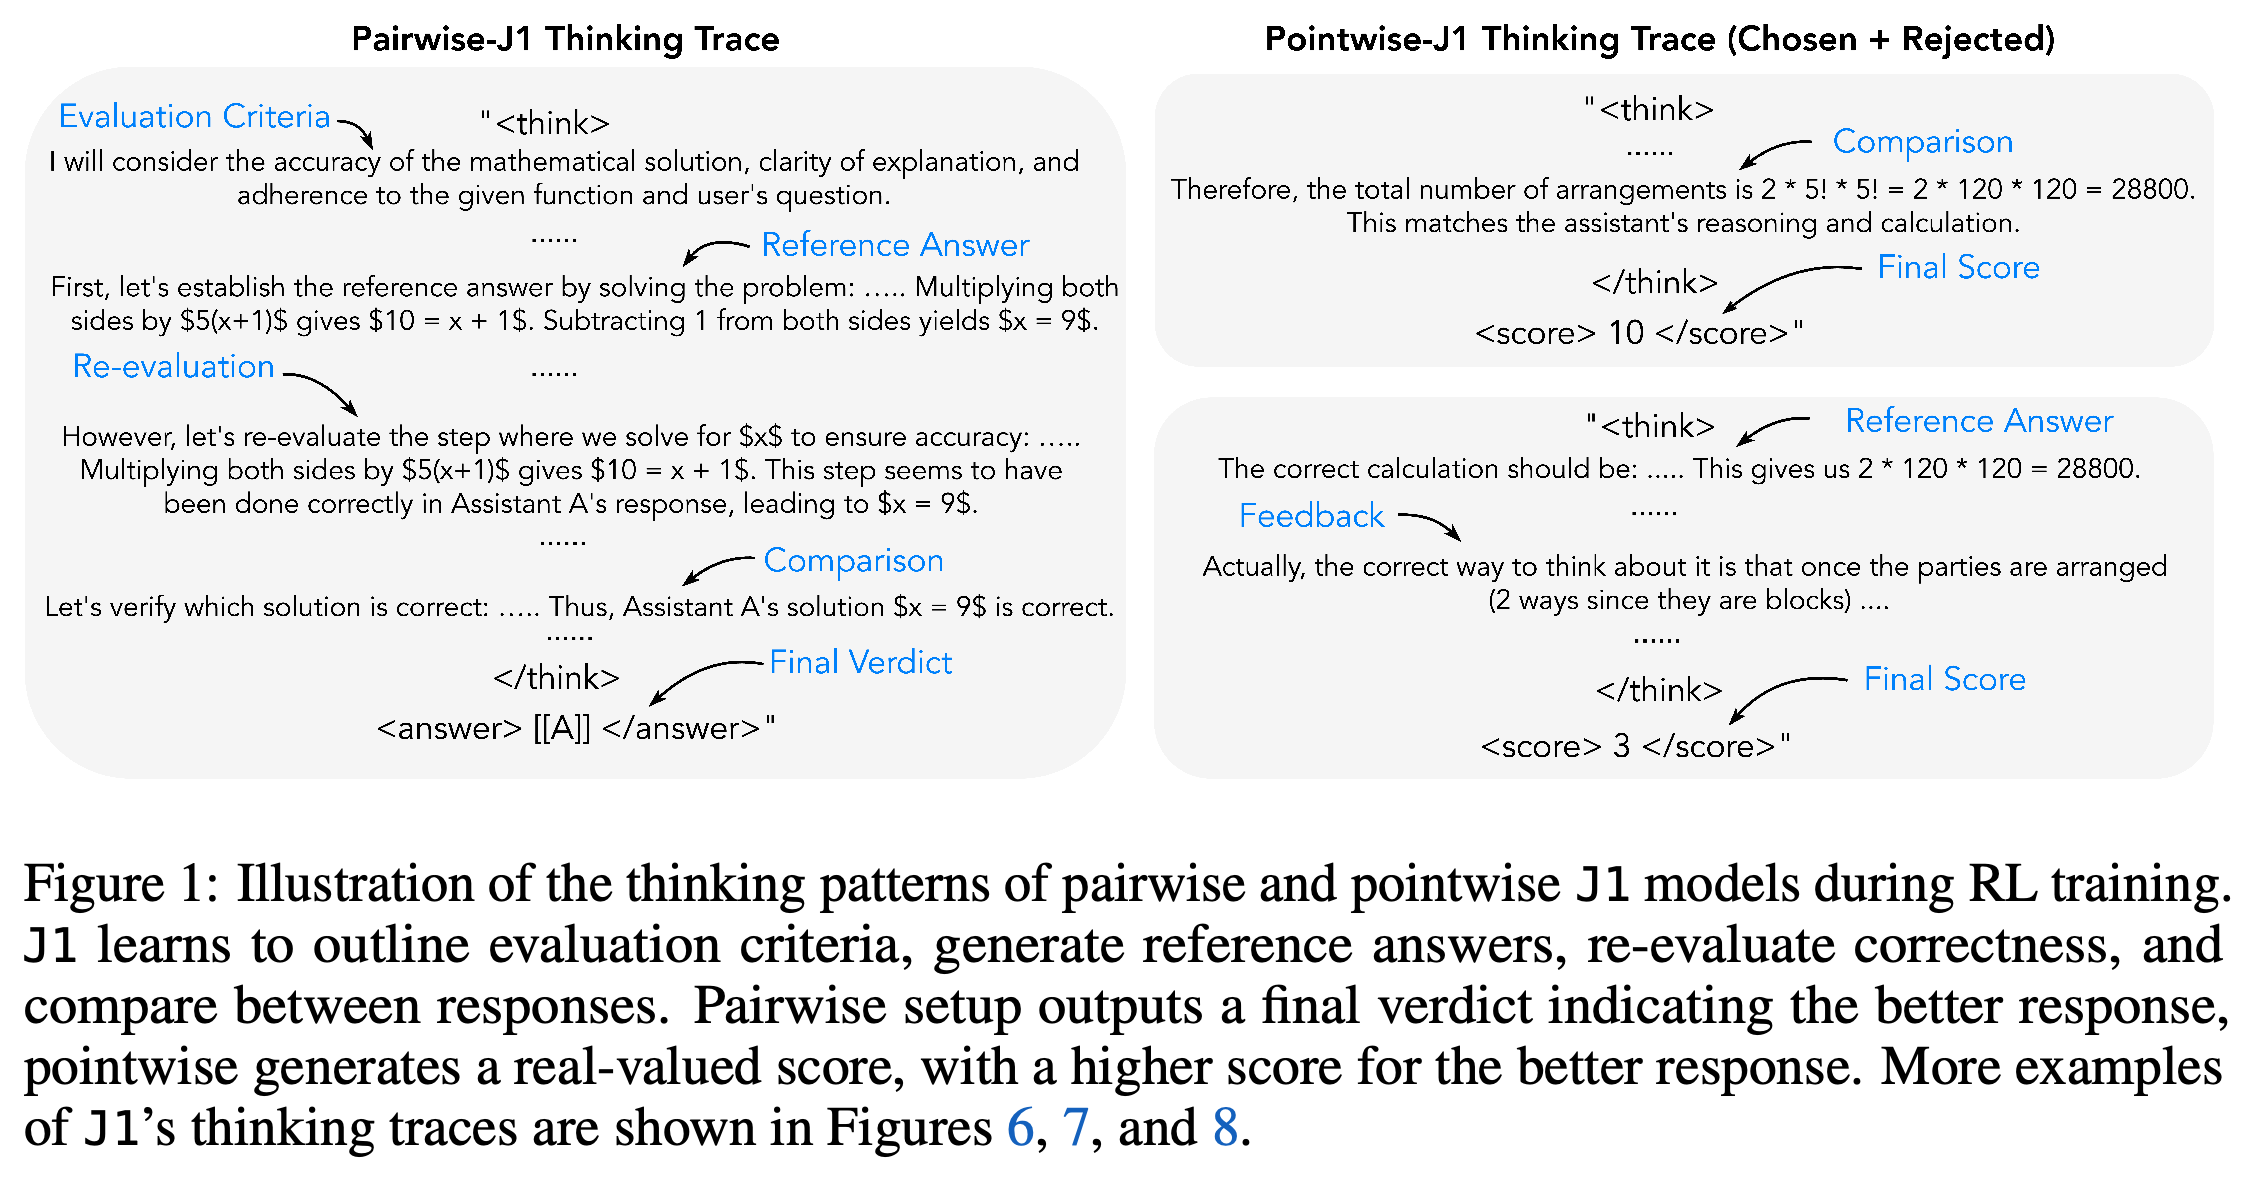
- Figure 1은 평가 기준, 참조 답변 생성, 재평가, 응답 비교를 예시로 보여준다. 이 예시에서는 출력에 드러나는 패턴을 확인할 수 있지만, 각 전략이 얼마나 자주 나타나는지는 측정하지 않는다.
예시는 평가 방식 2가지를 구체적인 출력 행동과 연결한다. Pairwise 평가 모델은 후보를 비교해 판정을 반환하고, pointwise 평가 모델은 독립적으로 점수를 출력한다. 주석은 참조 답변 구성, 재평가, 피드백을 보여주지만, 이러한 행동이 얼마나 흔한지는 측정하지 않는다.
2 J1: Thinking-LLM-as-a-Judge via Reinforcement Learning
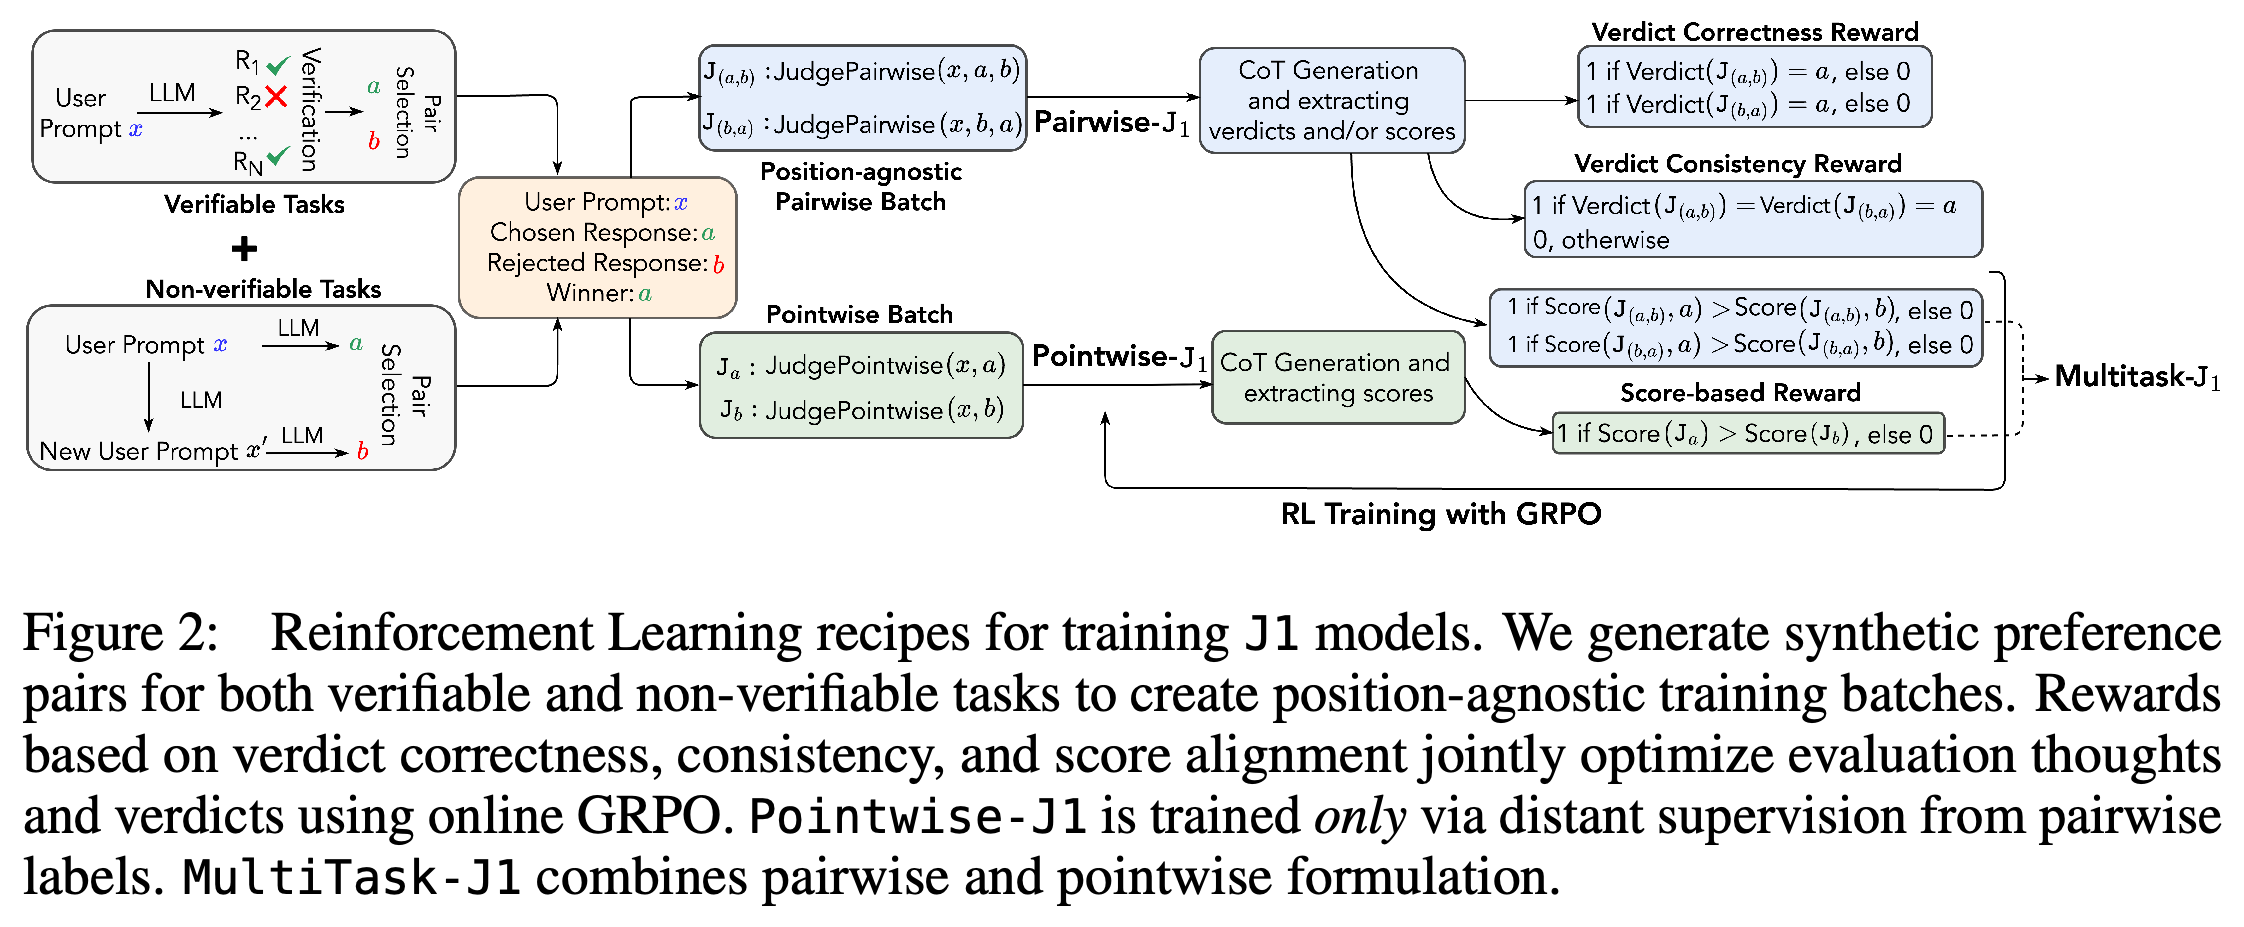
기본 평가 모델은 지시문 x와 응답 a, b를 입력받아 중간 추론 토큰 t를 생성하고, 선호 응답을 나타내는 판정 y를 반환한다. Figure 2는 합성 선호 데이터 구성, 응답 순서 2가지를 모두 포함한 배치, 규칙 기반 보상, GRPO의 관계를 보여준다. GRPO는 추론과 판정을 함께 학습하는 데 사용하는 온라인 강화학습 최적화 알고리즘이다.
도식은 구성한 동일한 선호 쌍을 여러 학습 목표에 사용하는 방법을 보여준다. 후보 순서 2가지를 모두 처리하면 일관성을 확인할 수 있다. 각 응답에 독립적으로 점수를 부여하면 개별 수치 점수 레이블 없이 pointwise 학습을 수행할 수 있다.
2.1 Synthetic Training Data Generation
학습에는 합성 선호 쌍 22K개를 사용한다. 사용자 대화에서 얻은 WildChat 프롬프트 17K개와 수학 문제에서 얻은 MATH 프롬프트 5K개로 구성한다. WildChat에서는 모델이 지시문을 수정하고 수정한 지시문에 대한 답변을 생성한다. 이 답변을 원래 지시문의 비선호 응답으로 사용한다. MATH에서는 정답에 도달하지 못한 생성 결과를 비선호 응답으로 사용한다.
- (x, a, b)와 (x, b, a) 2가지를 같은 학습 배치에 넣어, 응답 순서가 바뀌었을 때의 정답 여부를 함께 확인하는 보상을 계산한다.
- 이 구성은 판정이 선호 레이블과 일치하는지를 검증할 수 있게 한다. 주관적인 프롬프트에서는 구성한 모든 레이블이 인간의 선호를 반영하는지 독립적으로 확인하지 않는다.
2.2 Reward Modeling
Verdict Correctness는 평가 모델이 선호 응답을 맞히면 +1, 그렇지 않으면 0을 부여한다. Verdict Consistency는 응답 순서 2가지 모두에서 정답일 때만 +1을 부여하고, 어느 한 순서에서라도 틀리면 0을 부여한다. <think> 태그 사용을 강제하는 추가 보상은 뚜렷한 이점을 보이지 않는다.
2.3 J1 Formulations and Training
J1은 출력과 보상 규칙이 다른 5가지 구성을 탐색한다. 멀티태스크 구성은 pointwise 평가와 점수를 출력하는 pairwise 평가를 함께 학습해, 같은 모델을 어느 방식으로든 사용할 수 있게 한다.
- Pairwise J1 with Verdict (PaV)는 (t, y)를 출력한다. Pairwise J1 with Scores (PaS)는 (t, s_a, s_b)를 출력하며, s_a와 s_b는 응답 2개의 점수다. 이 방식은 더 높은 점수의 응답을 선택한다. Pairwise J1 with Scores&Verdict (PaVS)는 (t, s_a, s_b, y)를 출력하며, 보상은 y만으로 결정한다.
- Pointwise J1 (PoS)는 응답 1개에 대한 추론과 0에서 10 사이의 점수를 출력한다. 개별 점수 주석 없이 쌍별 선호 레이블로 개별 점수를 학습하는 distant supervision을 사용하며, 선호 응답에 더 높은 점수를 부여하면 보상을 준다.
- Multitask Pairwise & Pointwise J1 (MT)는 PoS와 PaS 학습을 결합한다. 주요 벤치마크 비교에서는 이 모델을 pairwise 방식으로 평가한다.
3 Experimental Setup
모든 변형은 실험에 사용한 학습 프레임워크인 verl로 동일한 합성 쌍 22K개를 학습한다. PPE, RewardBench, RM-Bench, JudgeBench, FollowBenchEval에서 평가하며, RewardBench 전체 정확도를 기준으로 모델을 선택한다. 추론에는 저자들이 사용한 추론 엔진인 vLLM을 사용한다.
- PPE Preference는 모델 20개와 121+개 언어에 걸친 인간 선호 쌍 10.2K개를 포함한다. PPE Correctness는 MMLU-Pro, MATH, GPQA, MBPP-Plus, IFEval의 샘플 12.7K개를 포함하며, 지식, 수학, 질의응답, 코딩, 지시 이행을 평가한다.
- JudgeBench는 GPT-4o 응답 부분집합의 어려운 선호 쌍 350개를 사용한다. RM-Bench는 미묘한 내용 차이와 문체 편향을 평가하는 샘플 4K개를 포함한다. FollowBenchEval은 여러 응답 제약을 평가하는 쌍 205개를 포함한다. RewardBench는 chat, chat-hard, safety, reasoning 범주의 샘플 3K개를 포함한다.
- PPE, RewardBench, RM-Bench는 응답 쌍의 순서를 무작위로 정했을 때의 정답률인 random-order accuracy를 사용한다. JudgeBench와 FollowBenchEval은 응답 순서 2가지 모두에서 올바른 판정을 요구하는 position-consistent accuracy를 사용한다.
4 Results
실험에서는 J1을 기반 평가 모델, 수치 보상을 직접 출력하는 scalar reward model, 점수나 판정 전에 추론을 생성하는 generative judge와 비교한다. 이어지는 분석에서는 평가 형식, 응답 순서에 따른 일관성, 보상 설계, 초기 프롬프트, 생성 길이, 추론 시 추가 샘플링을 살펴본다.
4.1 Main Results on Benchmarks with Pairwise-J1 and MultiTask-J1
Table 1에서 PPE Correctness 정확도는 J1-Llama-8B가 59.2, J1-Llama-70B가 72.9, J1-Qwen-32B가 74.6, J1-Qwen-32B-MultiTask가 76.8이다. 표에 기재된 값을 기준으로 멀티태스크 모델은 Qwen3-32B보다 10.3%포인트, EvalPlanner-Llama-70B보다 6.6점, DeepSeek-GRM-27B보다 17.0점 높다.
- 멀티태스크 모델은 MMLU-Pro에서 85.0, MATH에서 94.3, GPQA에서 68.6, MBPP-Plus에서 66.3, IFEval에서 69.5를 기록한다.
- EvalPlanner는 동일한 합성 데이터 분포를 사용하며, 선호 출력과 비선호 출력으로 학습하는 오프라인 방법인 direct preference optimization (DPO)을 적용한다. 이 비교는 J1 학습 방법의 효과를 뒷받침하지만, 모든 학습 차이의 영향을 개별적으로 분리하지는 않는다.
멀티태스크 32B 모델은 합성 쌍 22K개를 사용해 PPE Correctness에서 76.8을 기록한다. Qwen3-32B는 66.5, EvalPlanner-Llama-70B는 70.2를 기록한다. 세부 과제 중 가장 높은 점수는 MATH의 94.3이지만, 나열된 MBPP-Plus 결과에서는 가장 높지 않다.
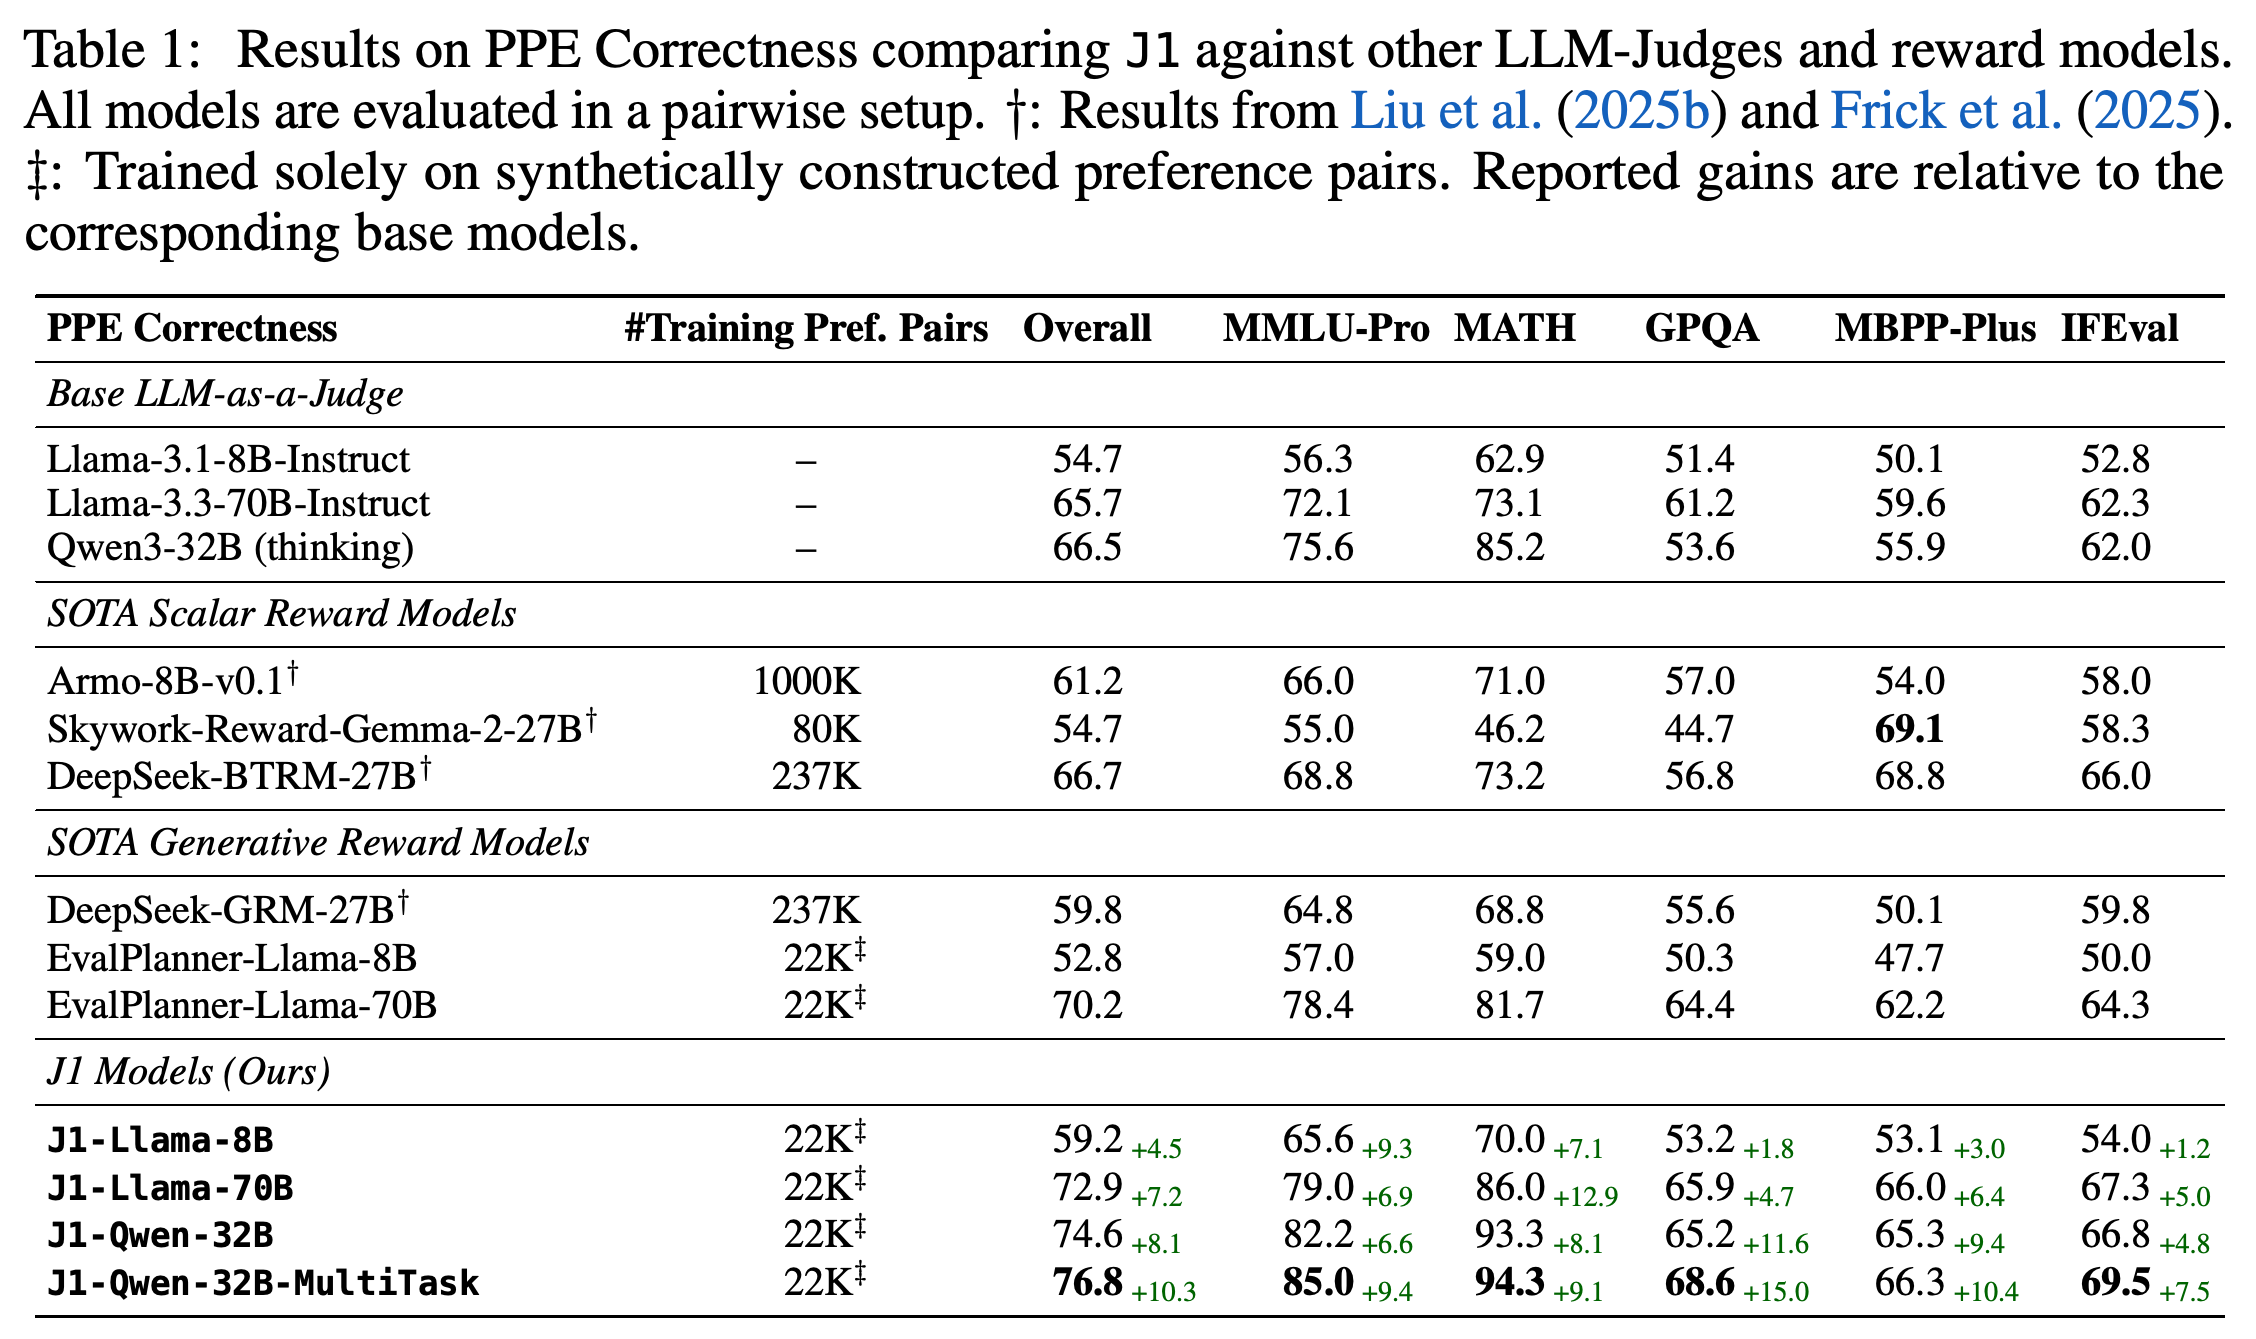
Table 2에서 J1-Qwen-32B-MultiTask는 PPE에서 71.8, RewardBench에서 93.6, RM-Bench에서 90.3, JudgeBench에서 71.4, FollowBenchEval에서 77.1을 기록한다. RewardBench, RM-Bench, FollowBenchEval에서는 OpenAI-o3와 DeepSeek-R1-671B 2개 모델보다 높고, PPE와 JudgeBench에서는 OpenAI-o3의 점수가 더 높다. 여기서 PPE 열은 preference와 correctness 부분집합 2가지를 모두 포함하므로, 71.8은 Table 1의 76.8과 다른 평가 집합에서 측정한 값이다.
- J1-Llama-8B와 J1-Llama-70B는 각각 대응하는 DeepSeek-R1-Distilled-Llama 모델보다 벤치마크 5개 모두에서 높은 성능을 보인다.
- Table 6의 RewardBench 비교에서 종합 점수는 93.6으로, 나열된 모델 중 가장 높다. 다만 SF-Foundation/TextEval-Llama3.1-70B보다 0.1 높으며, J1이 모든 범주에서 가장 높은 성능을 보이는 것은 아니다.
4.2 Ablations and Analyses of J1 in Pointwise vs. Pairwise Setups
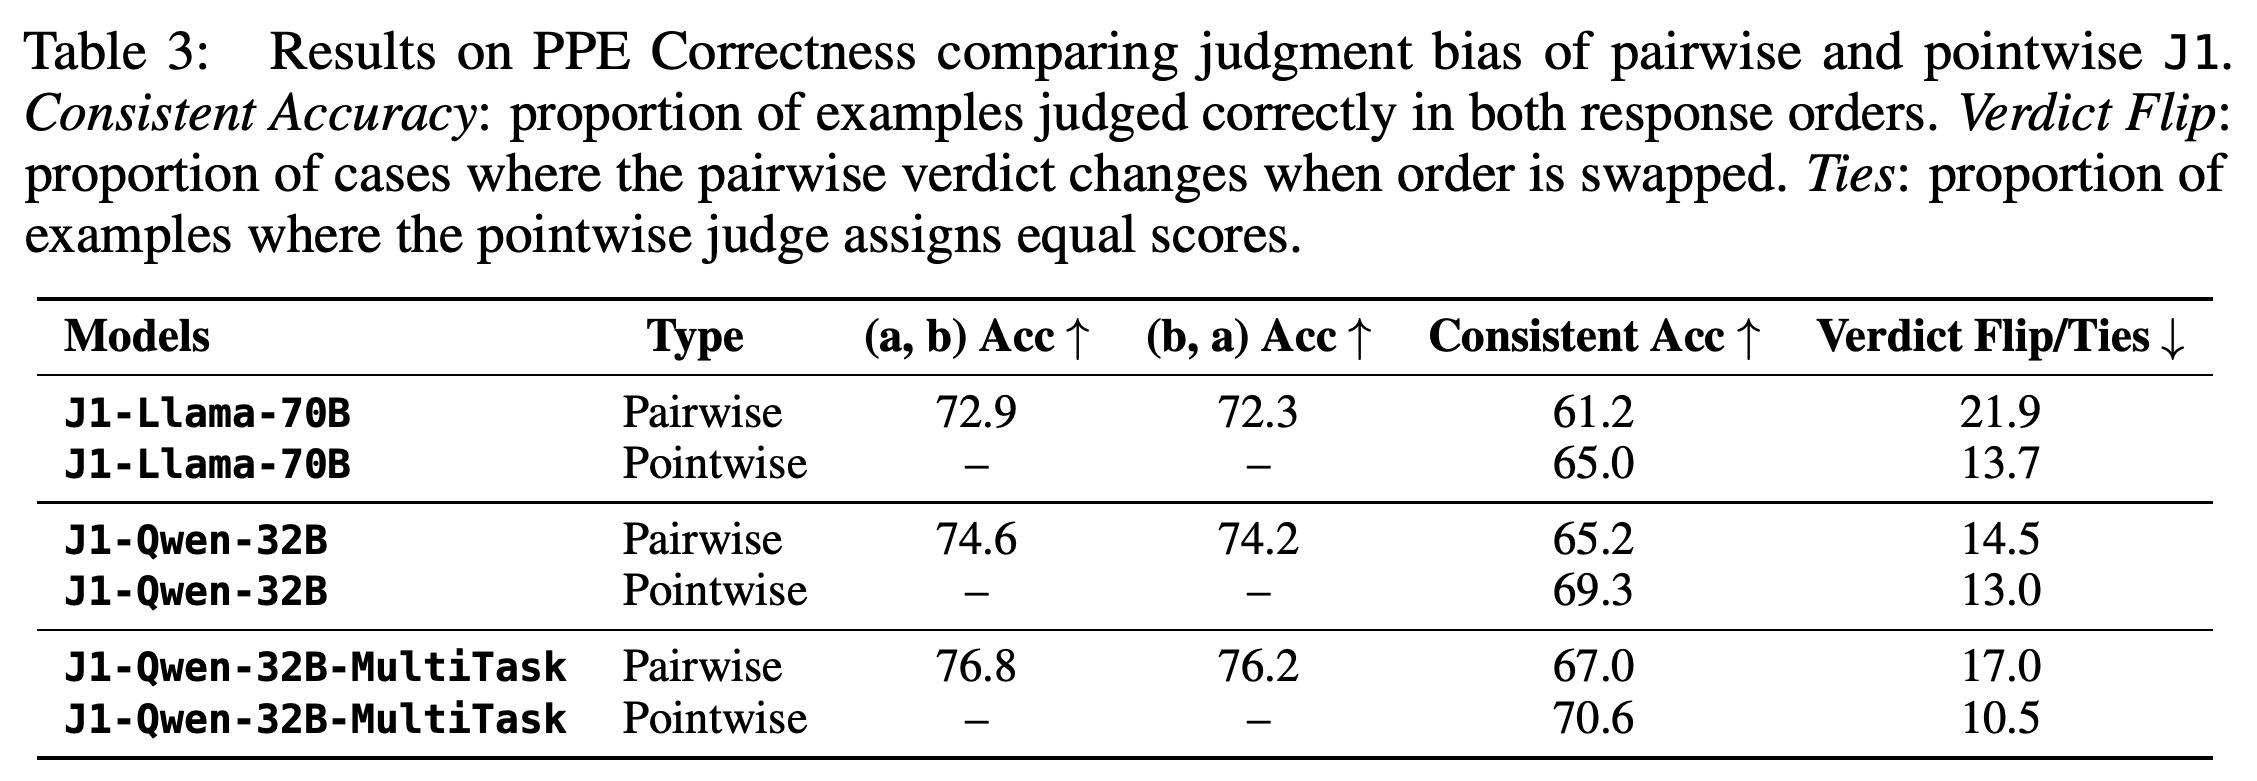
Table 3은 응답 2개에 같은 점수를 부여하는 동점이 남아 있지만 pointwise 평가가 position-consistent accuracy를 높인다는 점을 보여준다. J1-Qwen-32B-MultiTask의 pairwise 평가는 응답 순서 2가지에서 각각 76.8과 76.2를 기록하지만, 순서 2가지 모두에서 정답을 요구하면 67.0에 그친다. Pointwise 평가는 70.6을 기록하며 동점 비율은 10.5%다.
- Verdict flip은 응답 순서를 바꾸었을 때 선호하는 응답이 달라지는 현상이다. Pairwise 멀티태스크 모델의 verdict-flip 비율은 17.0%로, 별도로 학습한 J1-Qwen-32B의 14.5%보다 높다. 따라서 멀티태스크 학습은 정확도를 높이지만 순서 민감도까지 일관되게 개선하지는 않는다.
- Figure 3에서는 pairwise 평가의 선호 응답 점수에서 비선호 응답 점수를 뺀 값이 더 크게 나타난다. 저자들은 pointwise 평가와 달리 입력 1개에서 후보 응답 2개를 함께 볼 수 있기 때문이라고 설명한다.
독립적인 pointwise 점수 부여는 표에 나온 모든 모델의 position-consistent accuracy를 높인다. 반면 pairwise 평가에는 순서에 따른 verdict flip이 남는다. 멀티태스크 모델의 순서 1가지에서 측정한 pairwise 정확도는 76.8이지만, 응답 순서 2가지 모두에서 정답을 요구하면 67.0으로 낮아진다. 이는 대표 정확도만으로 드러나지 않는 한계를 보여준다.
Pairwise 평가는 독립적인 pointwise 평가보다 선호 응답과 비선호 응답 사이의 점수 차이를 더 크게 만든다. 0에 가까운 히스토그램 구간에는 1 미만의 양의 차이도 포함되므로, 해당 구간의 전체 높이를 동점 수로 해석할 수 없다.
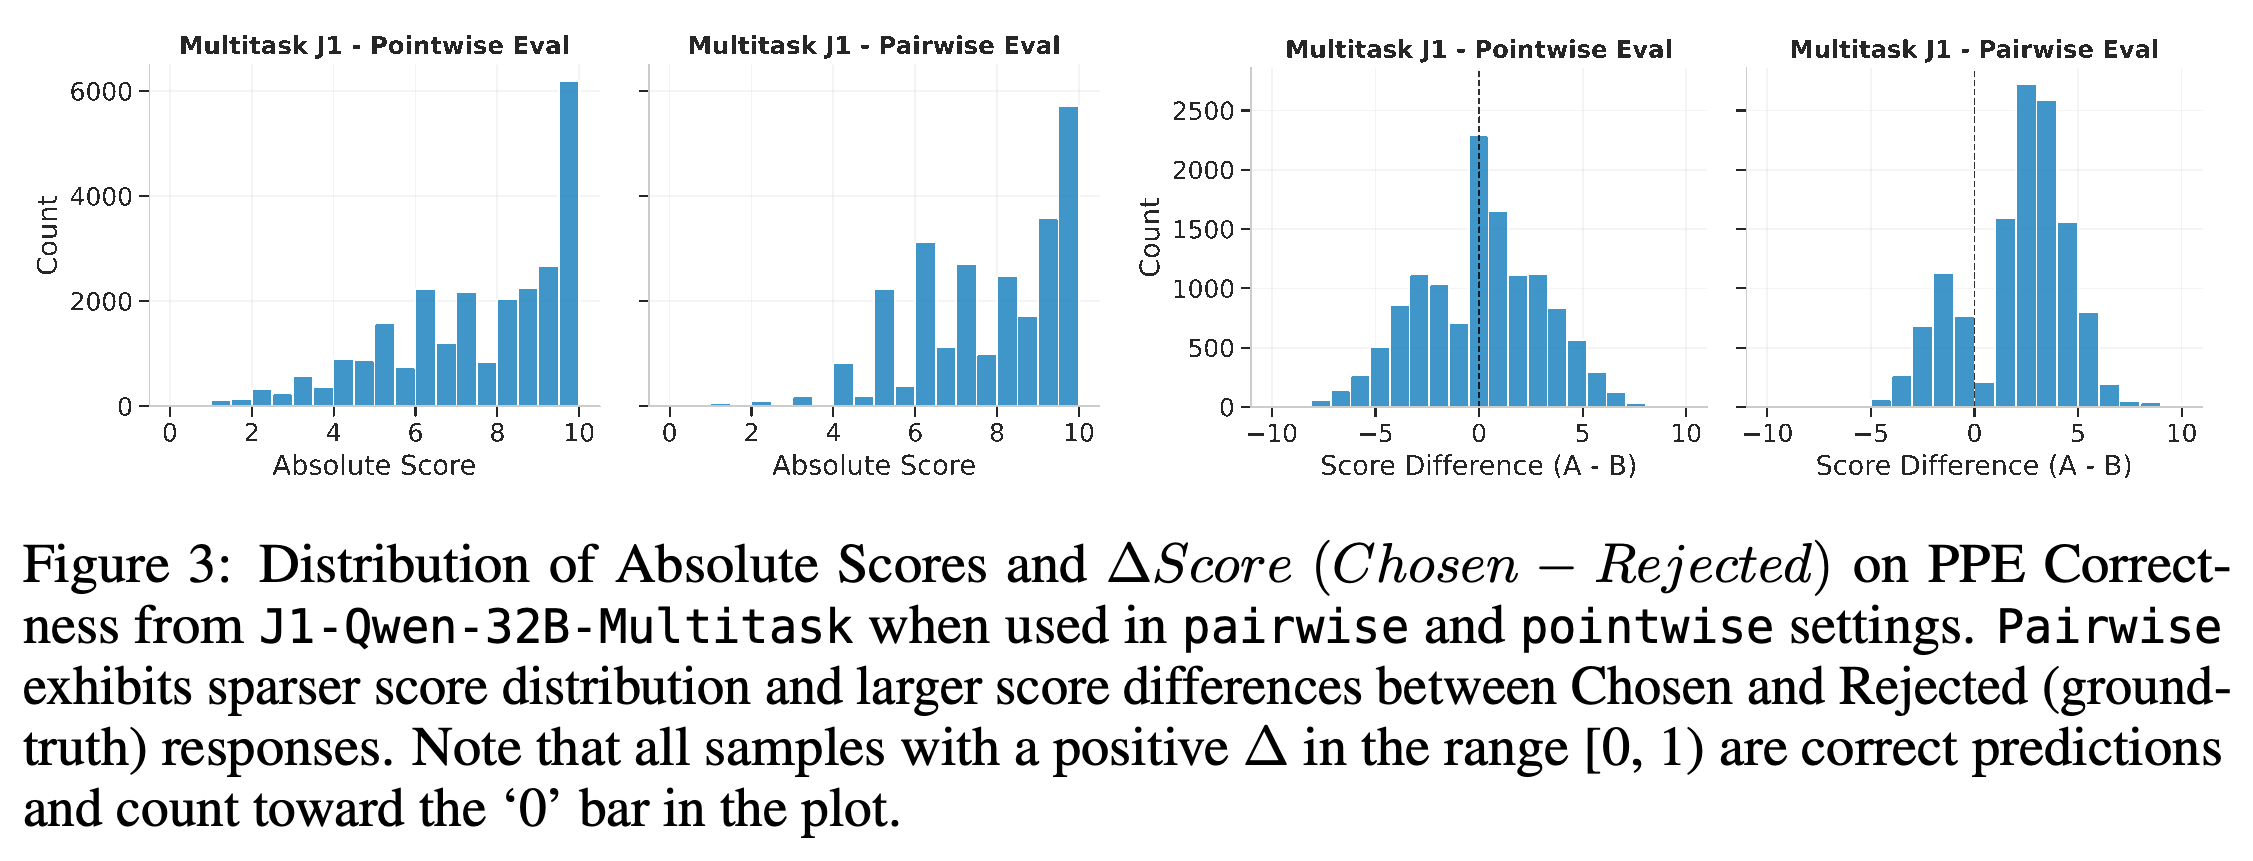
Figure 4는 샘플링한 생성 결과를 더 많이 사용해 점수를 평균하면 8B와 70B 모델 2개 모두에서 position-consistent accuracy가 높아지고 동점이나 verdict flip이 줄어든다는 점을 보여준다. 추가 결과에서는 점수 평균과 판정 다수결을 구분한다. 샘플 32개로 pointwise 점수를 평균하면 J1-Llama-70B의 정확도가 65.0에서 74.8로 높아지는 반면, pairwise 판정 다수결에서는 보고된 정확도가 72.9에서 73.7로 높아진다.
샘플링한 생성 결과를 32개까지 늘리면 모델 규모 2가지 모두에서 position-consistent accuracy가 높아지고, 모호하거나 순서에 따라 달라지는 결과가 줄어든다. Greedy 베이스라인은 점수 집계의 이점을 판단하는 데 도움이 되지만, 그래프는 지연 시간이나 금전적 비용을 정량화하지 않는다.
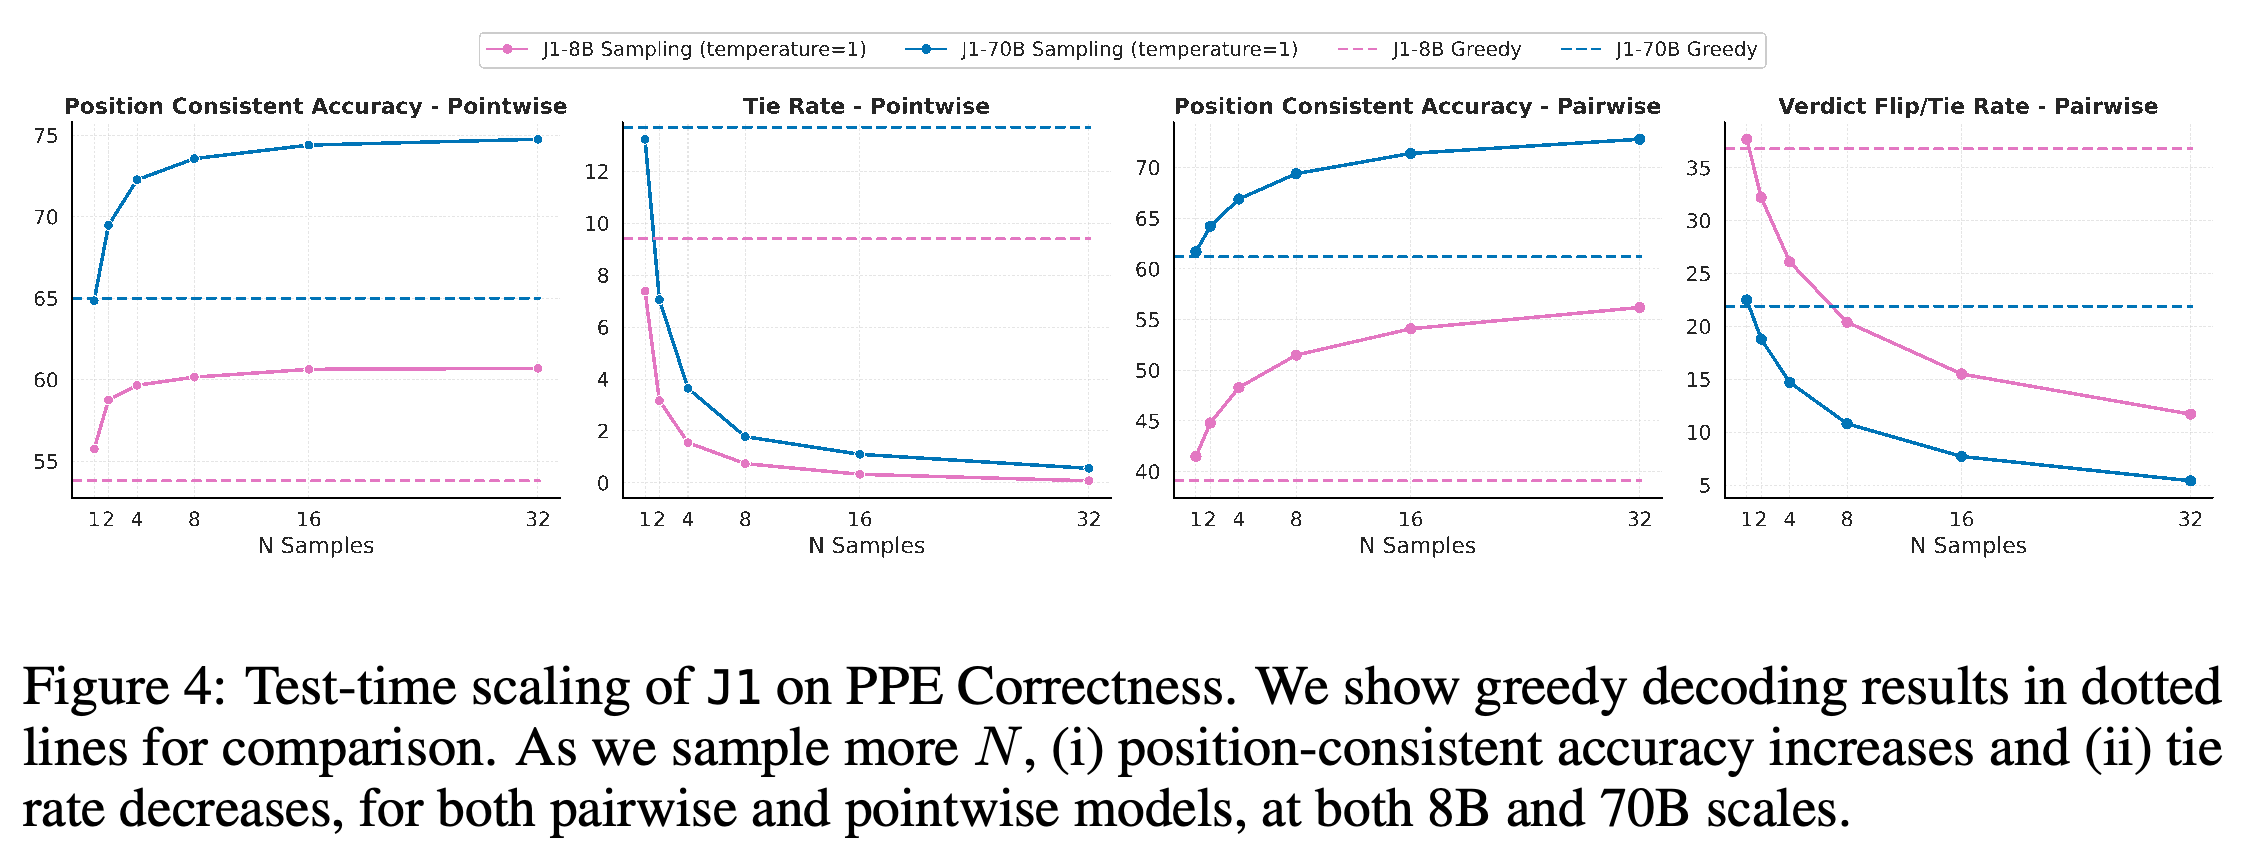
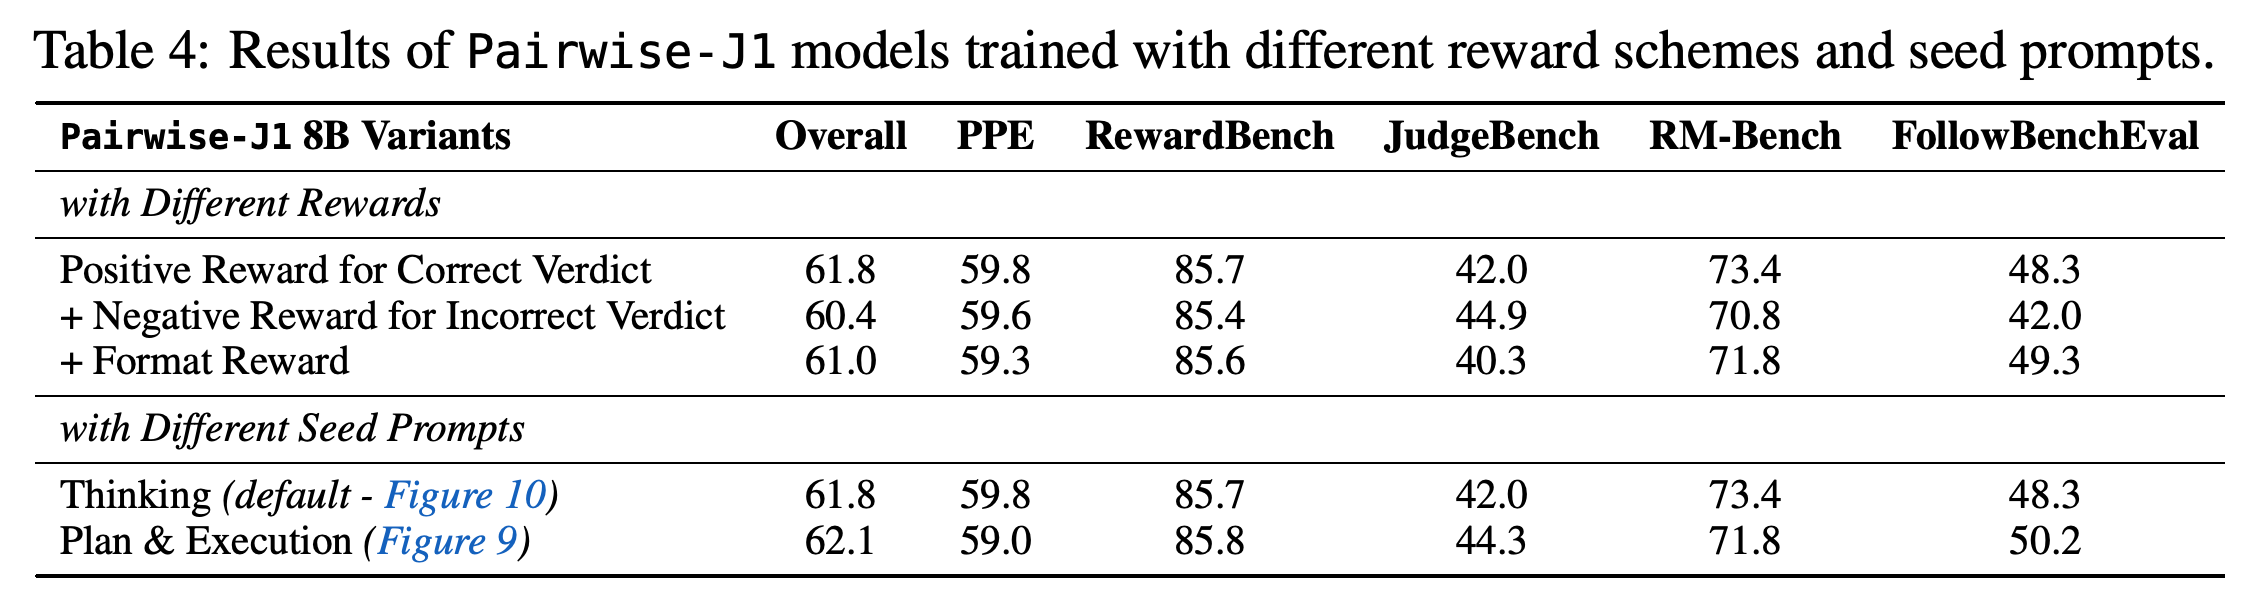
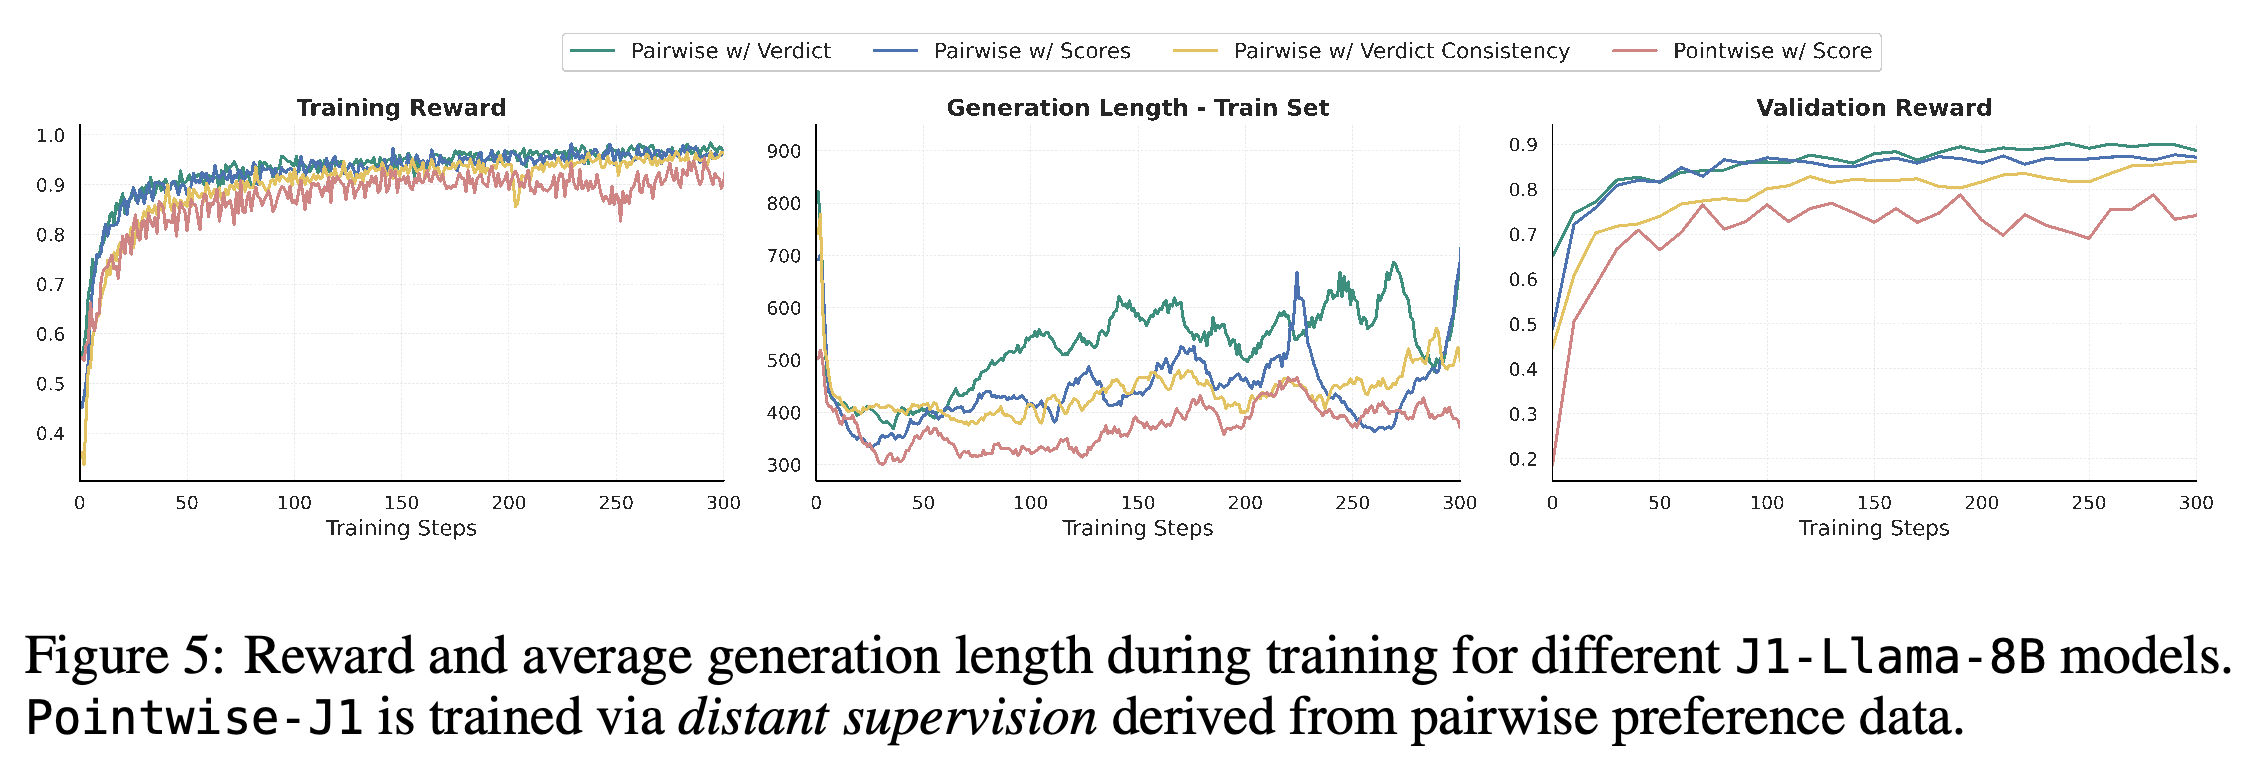
Table 4에서 올바른 판정에 양의 보상을 부여하면 종합 점수는 61.8이다. 잘못된 판정에 음의 보상을 추가하면 60.4, 형식 보상을 추가하면 61.0이다. 평가 추론을 유도하는 초기 지시문인 Thinking과 Plan & Execution 프롬프트는 각각 61.8과 62.1로 비슷한 성능을 보인다. Figure 5에서는 학습 보상이 증가하며, pairwise 생성 길이는 대부분 약 500토큰으로 안정되고 pointwise 생성 길이는 대체로 300–400토큰이다.
- 정성적 예시는 참조 답변 생성과 오류 진단을 보여준다. Figure 6에서 J1은 {1,2,3,4,5,6}에서 원소 2개로 이루어진 모든 부분집합의 원소 합을 더하면 105임을 확인하고, 비선호 응답이 제시한 합계 47이 잘못되었음을 지적한다.
- 이 예시에서는 체계적인 평가 행동을 확인할 수 있다. 다만 논문은 이러한 행동이 얼마나 자주 나타나는지 정량화하지 않으며, 생성한 추론이 모델의 결정을 충실히 설명하는지도 입증하지 않는다.
음의 보상이나 형식 보상을 추가하면 표의 종합 점수는 낮아지는 반면, 초기 프롬프트 방식 2가지는 비슷한 결과를 보인다. 개별 벤치마크의 변화는 서로 다르므로, 이 종합 비교가 각 추가 보상이 모든 과제의 성능을 떨어뜨린다는 뜻은 아니다.
모든 변형에서 학습 보상은 증가하지만, pointwise 검증 보상은 더 낮게 유지되고 생성한 평가도 더 짧다. 곡선은 보고된 생성 길이 차이를 뒷받침한다. 다만 추론이 길어지기 때문에 판정이 더 좋아진다는 인과관계까지 입증하지는 않는다.
5 Related Work
논문은 J1을 전통적인 scalar reward model, 비평이나 점수를 생성하는 평가 모델, 강화학습으로 추론형 평가 모델을 학습하는 동시기 연구와 비교한다. J1의 특징은 합성 데이터만을 이용한 선호 학습, 명시적인 응답 순서 분석, 쌍별 지도 신호로 학습한 pointwise 점수, pointwise와 pairwise의 공동 학습을 결합한 데 있다.
- 관련 연구에서는 기존 프롬프팅, 선택한 자체 생성 추론으로 학습하는 rejection-based fine-tuning, 오프라인 DPO를 생성한 판정의 온라인 최적화와 비교한다. 추론형 평가 모델에 강화학습을 적용한다는 점은 여러 동시기 방법과 공통된다.
6 Conclusion
결론에서는 선호 쌍을 구성하고, 레이블에 따라 판정에 보상을 부여하며, 생성한 추론과 결정을 온라인으로 최적화하는 학습 방법을 제시한다. 8B, 32B, 70B 실험은 각각의 기반 모델 대비 성능 향상을 뒷받침한다. 멀티태스크 구성은 응답 비교 평가와 독립적인 응답 점수 부여를 모두 지원한다.
Reproducibility Statement
Reproducibility Statement는 가중치가 공개된 Llama와 Qwen 기반 모델, 부록의 학습 및 데이터 생성 프롬프트, 오픈소스 verl 저장소를 기반으로 한 학습 구현, Appendix C의 하이퍼파라미터를 명시한다. J1 전용 코드나 체크포인트 URL은 제공하지 않는다.
부록
- A J1’S THINKING TRACES는 검증 가능한 기하 문제와 검증 불가능한 글쓰기 프롬프트의 추가 예시를 제공한다. 기하 예시는 잘못된 삼각형 넓이 계산을 진단하고, 글쓰기 예시는 지시문과의 관련성과 불필요한 내용을 비교한다. 이는 대표적인 동작을 보여주는 예시이며 체계적인 오류 분석은 아니다.
- B PROMPT TEMPLATES는 판정만 출력하는 pairwise 평가, 계획 후 실행하는 평가, pairwise 점수, 점수와 판정, 독립적인 pointwise 점수, 합성 비선호 응답 생성을 위한 프롬프트를 제공한다. 점수 프롬프트는 0에서 10까지의 범위와 최대 0.1 단위의 정밀도를 지정한다. Figure 9와 Figure 10은 각각 Thinking과 EvalPlanner 방식의 프롬프트를 제시하지만, Table 4에서는 이 그림 참조가 뒤바뀌어 있다.
- C EXPERIMENTAL SETUP은 프롬프트마다 평가 결과를 샘플링하는 rollout 5개, temperature 1.0, 학습률 1e−6, 배치 크기 512, 입력과 출력 모두의 최대 시퀀스 길이 4096토큰을 명시한다. Pairwise J1-Llama-70B는 이후 학습률 3e−7을 사용한다. 참조 모델에서 벗어나는 정도를 제어하는 KL 계수는 J1-Llama-8B에서 0.01, J1-Llama-70B에서 0을 선택한다. 학습에는 8B, 32B, 70B 모델별로 각각 8×A100, 32×A100, 64×A100 그래픽 처리 장치를 사용한다. 추론에는 8×A100, 모델 계산을 장치 8개에 분산하는 tensor parallelism 8, 최대 생성 길이 4096토큰을 사용한다.
- D ADDITIONAL RESULTS는 출력 구성, 순서 편향 완화, 디코딩, 학습 정규화, 같은 데이터로 학습한 scalar 베이스라인, 추론 시 결과 집계를 살펴본다. Table 8에서 일관성 보상을 적용한 변형은 PPE Correctness의 position-consistent accuracy 43.9와 verdict flip 28.7을 기록한다. 응답 순서 2가지를 모두 학습한 경우에는 각각 39.1과 36.8이다. Table 9는 가장 가능성이 높은 다음 토큰을 선택하는 greedy decoding과 temperature-0.6 샘플링을 비교한다. 샘플링 시드 8개에서 J1-Llama-70B의 결과는 각각 72.9와 72.8 ± 0.1이고, 멀티태스크 모델의 결과는 76.8과 77.0 ± 0.1이다. Table 11은 같은 데이터로 학습한 scalar 베이스라인보다 벤치마크 5개 중 4개에서 성능이 높다고 보고한다.
짧은 생각
가장 강한 근거는 각각의 기반 모델 대비 성능 향상과 응답 순서에 따른 실패를 직접 분석한 결과다. Random-order accuracy와 position-consistent accuracy를 구분하면 실제 운영에 도움이 된다. 순서 1가지에서 높은 정확도를 보이면서도 판정이 상당히 불안정할 수 있기 때문이다.
실험은 구성한 선호를 학습해 벤치마크 성능이 향상됨을 뒷받침하지만, 주관적인 판정이 보편적으로 옳다는 점까지 입증하지는 않는다. RewardBench는 모델 선택 기준으로도 사용되며, 보고된 실험에서는 J1으로 후속 응답 생성 모델을 학습했을 때의 개선을 검증하지 않는다. 추론 생성과 여러 샘플의 결과 집계에는 추가 연산이 필요하지만, 논문은 지연 시간이나 비용을 비교하지 않는다.
일부 수치는 주의해서 해석해야 한다. 본문은 EvalPlanner 비교를 70.2 → 76.6과 6.8% 향상으로 제시하지만, Table 1의 값은 76.8이다. Table 7과 Table 10은 판정 출력 변형의 Overall 값을 63.9로 보고하지만, 기재된 벤치마크별 값은 Table 4의 61.8 행과 같다. 이 불일치 때문에 해당 종합 값은 확정하기 어렵다. 앞선 비교에서는 출처를 명시한 표의 값을 유지한다.