


Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs 요약 설명
24 Sep 2026 | Paper Review Linear Superposition Parallel Decoding Self-Distillation목차
이번 글에서는 Your Transformer Can Hold Two Thoughts at Once: Evidence of Linear Superposition in LLMs 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 24일(Arxiv)
- Tikhonov, Pavel, Korznikov, Anton, Mikhalchuk, Matvey, Dragunov, Nikita, Rahmatullaev, Temurbek, Druzhinina, Polina, Razzhigaev, Anton, Oseledets, Ivan, Tutubalina, Elena.
- 논문 링크
요약
- 이 논문은 다음 텍스트 토큰을 예측하는 대규모 언어 모델(LLM)이 서로 무관한 텍스트 2개의 임베딩을 평균해도 각 텍스트의 정보를 보존할 수 있는지 살펴본다. 임베딩은 입력 토큰을 나타내는 벡터다. 중첩을 강화하도록 미세조정하면 혼합 입력의 출력과 독립 출력 2개의 평균 사이에서 측정한 Kullback–Leibler(KL) 발산이 수정하지 않은 Pythia-2.8B의 1.86에서 0.27로 줄어든다. KL 발산은 분포의 불일치를 측정하는 지표다.
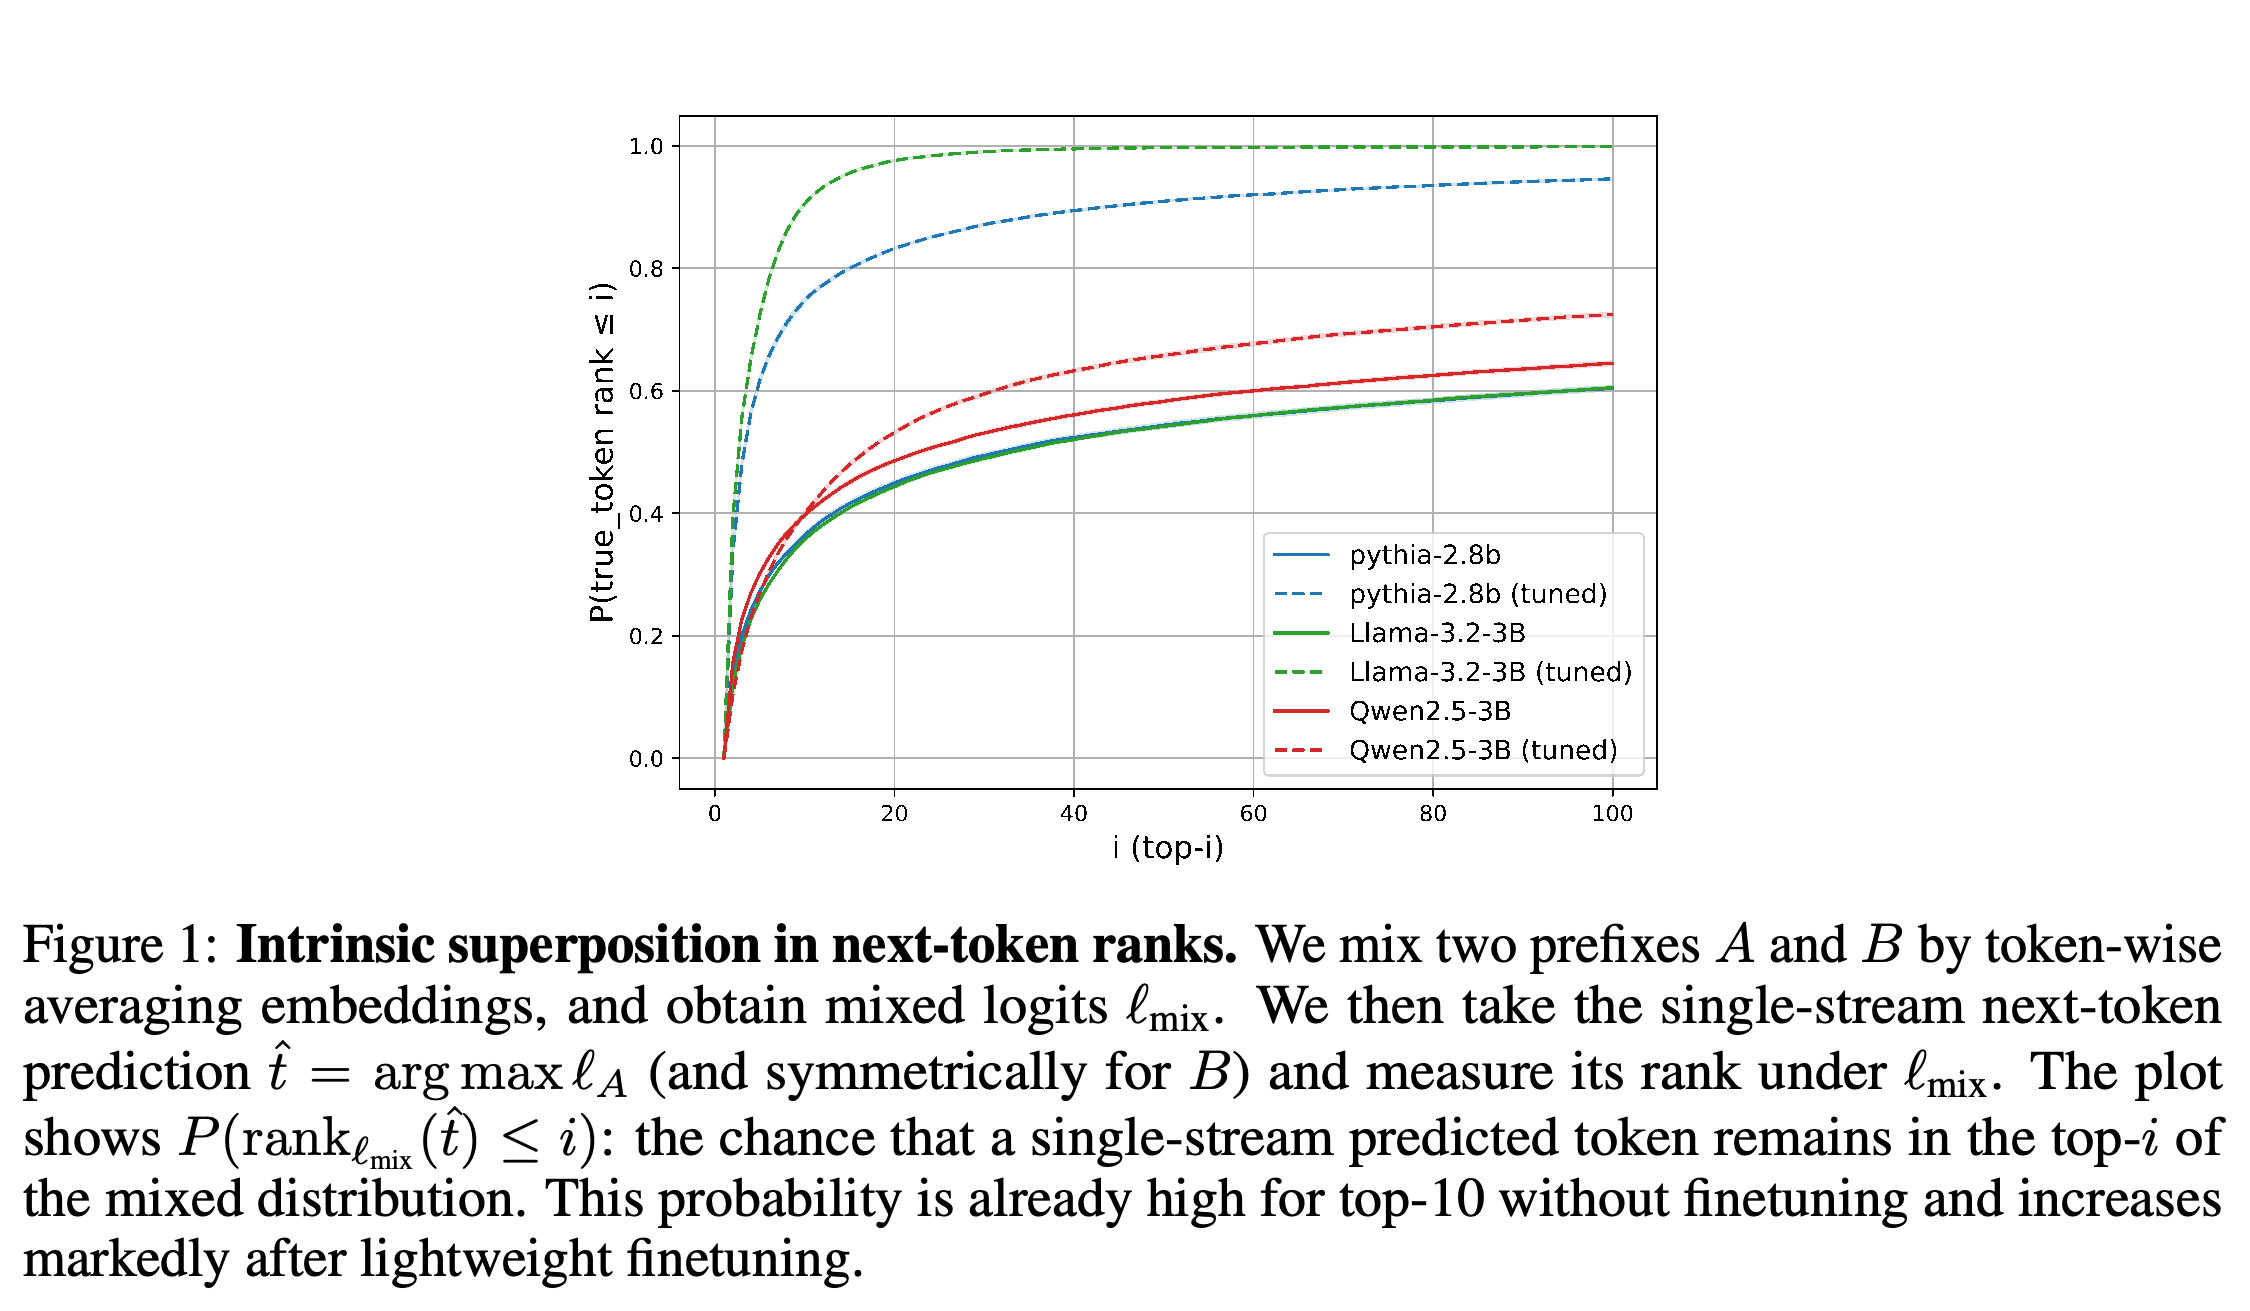
- Superposition Linearity Hypothesis는 입력 표현을 평균하면 각 입력의 독립적인 다음 토큰 분포를 평균한 결과가 근사적으로 보존된다는 가설이다. 그림에 제시된 수정하지 않은 모델에서는 독립 추론의 최상위 예측 토큰이 약 30–40%의 사례에서 혼합 분포의 top-10에 남는다. 다만 전체 복원율에는 어려운 내용어보다 예측하기 쉬운 토큰의 기여가 과도하게 반영된다.
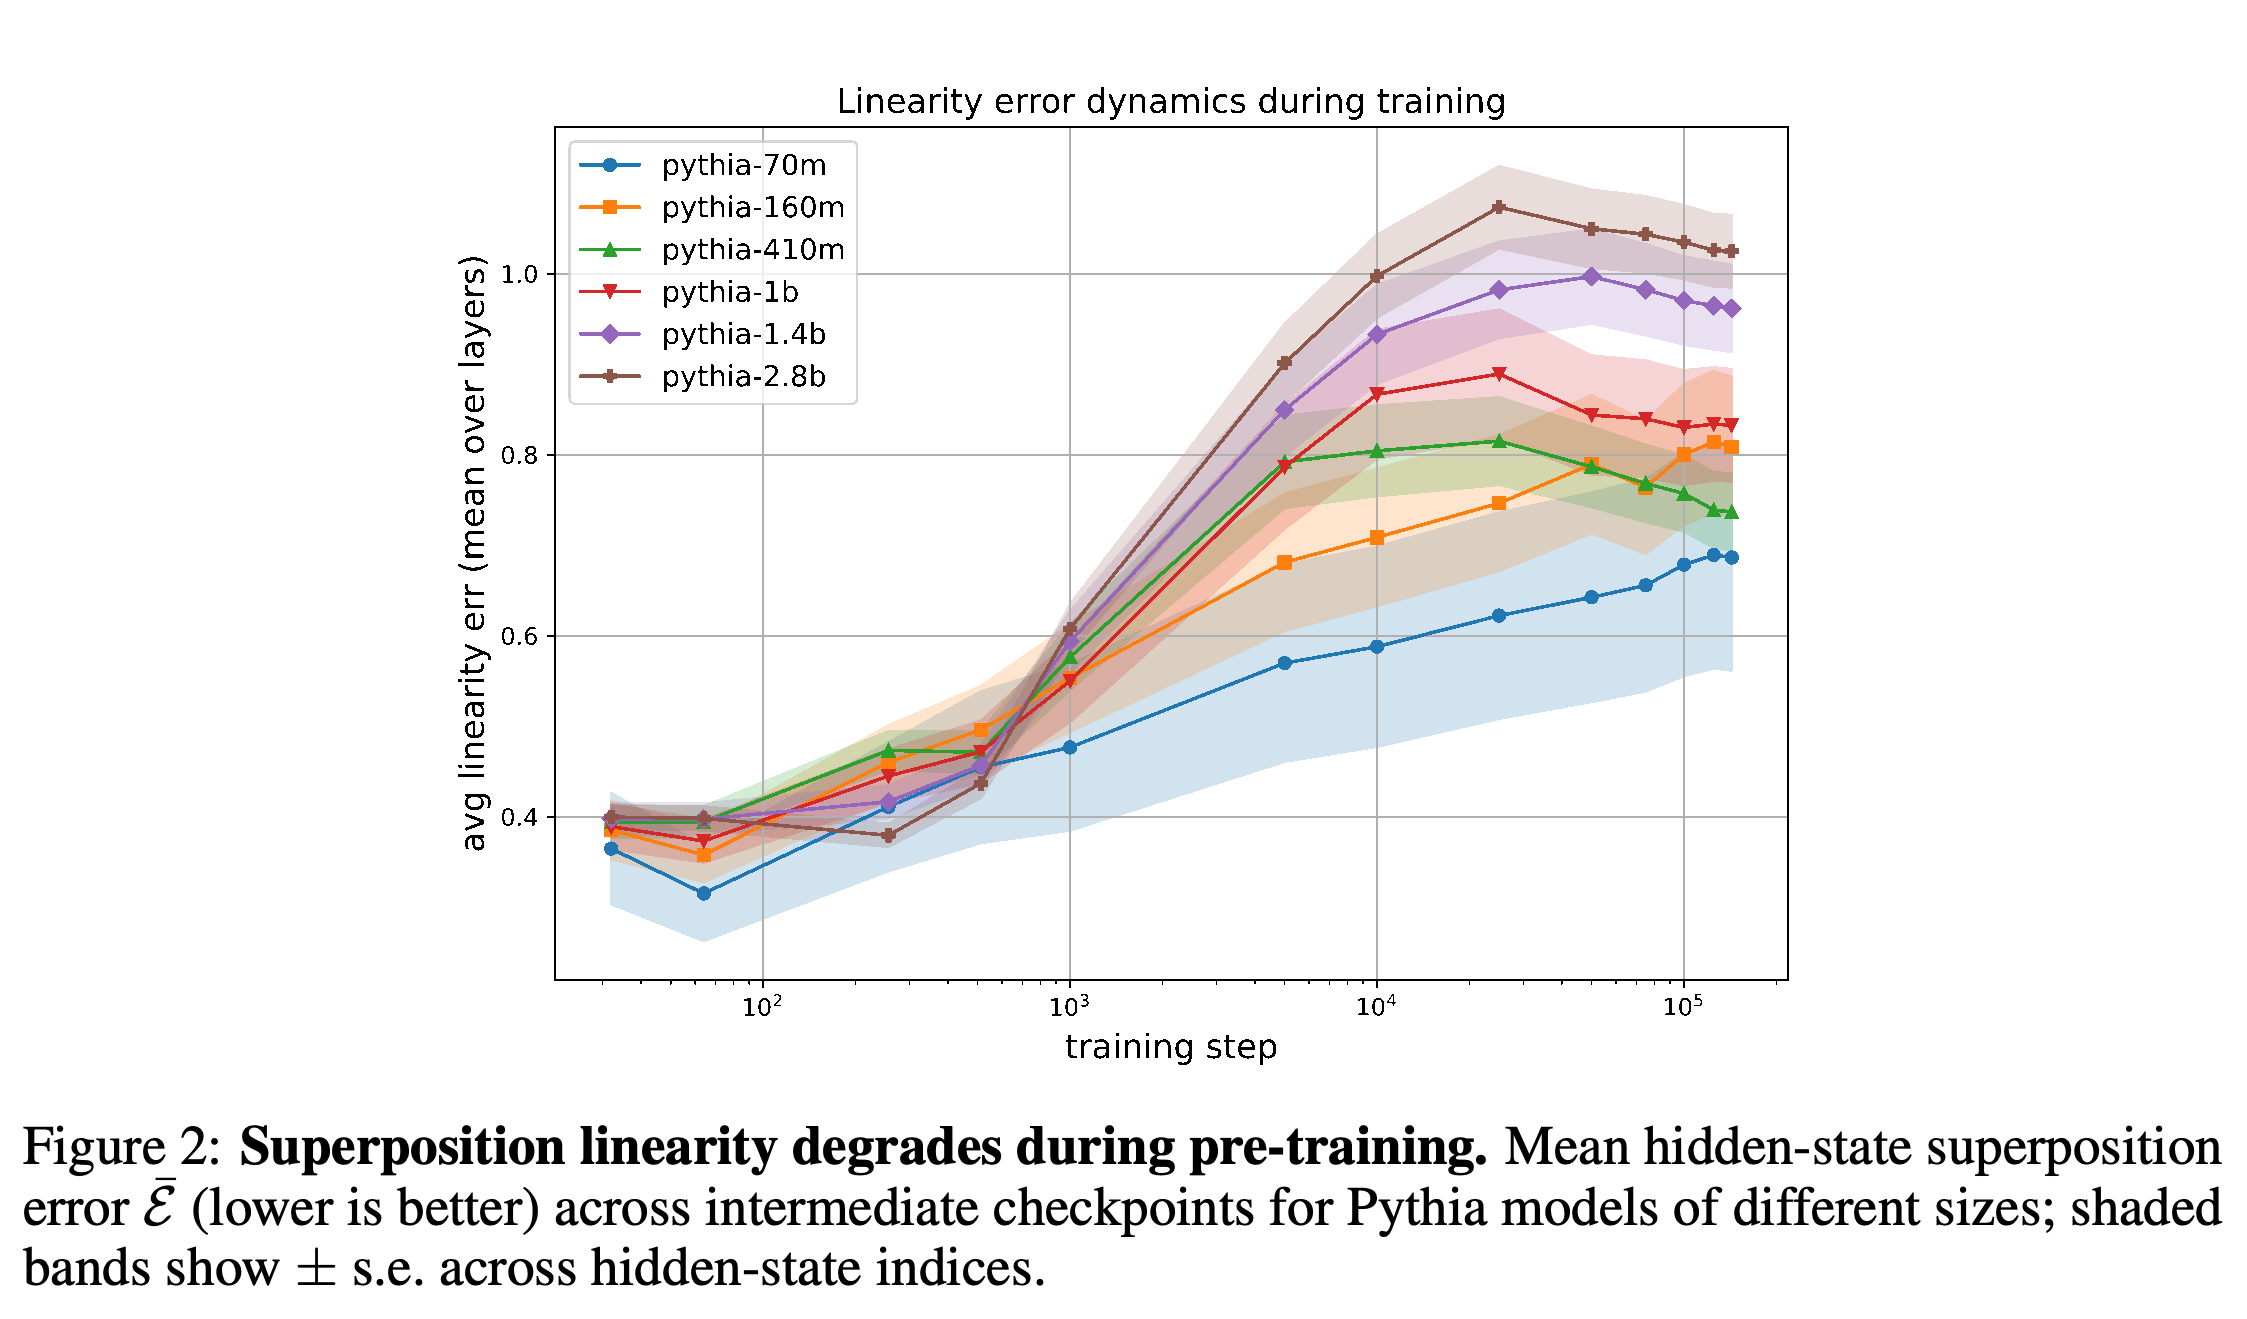
- 은닉 상태의 가산성은 혼합된 내부 표현과 독립 표현의 합이 일치하는 정도이며, Pythia 사전학습 과정에서 전반적으로 약해진다. 모델을 동결된 자기 복사본의 출력에 맞춰 학습하는 자기증류는 혼합 출력의 충실도를 높이고, Qwen2.5-3B의 내용 토큰 위치에서 순위 중앙값을 284에서 5로 개선한다. 하지만 일반적인 단일 스트림 예측 품질은 떨어진다.
- Joint Contrastive 디코딩은 작은 보조 모델을 사용해 한 스트림의 가이던스를 더하고 다른 스트림의 가이던스를 빼서 스트림을 분리한다. 단어 예측에 넓은 서사 문맥이 필요한 벤치마크인 LAMBADA에서 Llama-3.2-3B의 혼합 입력 정확도는 0.182에서 0.430으로 높아진다. 이는 작은 가이드 모델의 단일 스트림 정확도인 0.540보다 낮으며, 혼합 입력에서 각 스트림의 텍스트를 따로 생성하는 방법은 아직 개념 검증 수준이다.
1 Introduction
이 논문은 Transformer 계층 사이의 변환을 아핀 변환으로 근사할 수 있다는 기존 관찰을 전체 입력–출력 매핑으로 확장한다. 아핀 변환은 선형 변환에 오프셋을 더한 변환이다. Transformer는 어텐션과 비선형 변환으로 토큰 표현을 처리한다. 여기서는 스트림을 식별하는 정보를 인코딩하고 복원하는 전용 장치 없이도, 독립적인 텍스트 스트림 2개의 임베딩을 원소별로 평균했을 때 각 스트림의 정보가 보존되는지 살펴본다.
- 저자들은 사전학습 중간 체크포인트를 추적해 아키텍처 자체의 경향과 학습으로 얻은 능력을 구분한다.
- 원래 사전학습 데이터셋 크기의 0.025% 미만으로 이러한 성질을 복원했다고 보고한 뒤, 보존된 신호로 각각의 후속 텍스트를 생성할 수 있는지 조사한다.
2 Intrinsic Linearity in Large Language Models
초기 실험에서는 아키텍처를 바꾸지 않은 표준 사전학습 Transformer를 살펴본다. 개별 토큰 순위의 보존, 전체 출력 분포의 유사성, 학습 중 내부 표현의 변화를 나누어 분석한다.
2.1 Problem Formulation
길이가 같은 토큰 시퀀스 2개에서 위치 t의 혼합 임베딩은 e_t(z) = 1/2(E(x_t) + E(y_t))이며, E는 토큰을 벡터로 매핑한다. 앞선 문맥으로 다음 토큰을 예측하는 동결된 디코더 전용 Transformer가 이 시퀀스를 인과적 자기어텐션으로 처리한다. 따라서 각 위치는 현재 위치와 앞선 위치에만 접근한다. 모델은 P_mix(z) = softmax(ℓ(z))를 출력하며, ℓ은 softmax가 확률로 변환하는 예측 점수인 로짓을 나타낸다.
- 목표 분포는 산술평균인 P_target(x|A,B) = 1/2(P(x|A) + P(x|B))다.
- 평가 대상은 Pythia, Qwen, Llama, OLMo, Gemma 계열이다. 단순한 문법을 사용하는 TinyStories와 실제 웹 텍스트를 담은 FineWeb에서 무작위 텍스트 쌍을 뽑고 고정된 길이로 자른다.
2.2 Rank Analysis
실제 순위 지표는 각 독립 스트림에서 점수가 가장 높은 예측인 argmax 토큰이 혼합 출력 분포에서 차지하는 순위를 추적한다. 본문은 이 토큰을 때때로 “정답”이라고 부르지만, Figure 1과 공식 정의는 모델의 예측을 사용한다. 따라서 이 토큰의 보존은 관측된 텍스트에 대한 정답 여부가 아니라 독립 추론과의 일치도를 측정한다.
- 그림에 제시된 수정하지 않은 모델 전체에서 추적한 토큰의 약 30–40%가 top-10에, 50–60%가 top-50에, 60–65%가 top-100에 남는다.
- 이 순위는 최소 50,000개 토큰으로 구성된 어휘에서 신호가 보존됨을 보여주지만, 올바른 후속 텍스트 2개를 독립적으로 선택할 수 있음을 입증하지는 않는다.
임베딩을 혼합한 뒤에도 독립 추론의 최상위 예측은 높은 순위를 유지하는 경우가 많으며, 미세조정은 복원율을 높인다. 이 곡선은 관측된 다음 토큰에 대한 정답 여부가 아니라 독립 예측과의 일치도를 추적한다.
2.3 Distributional Shape Preservation
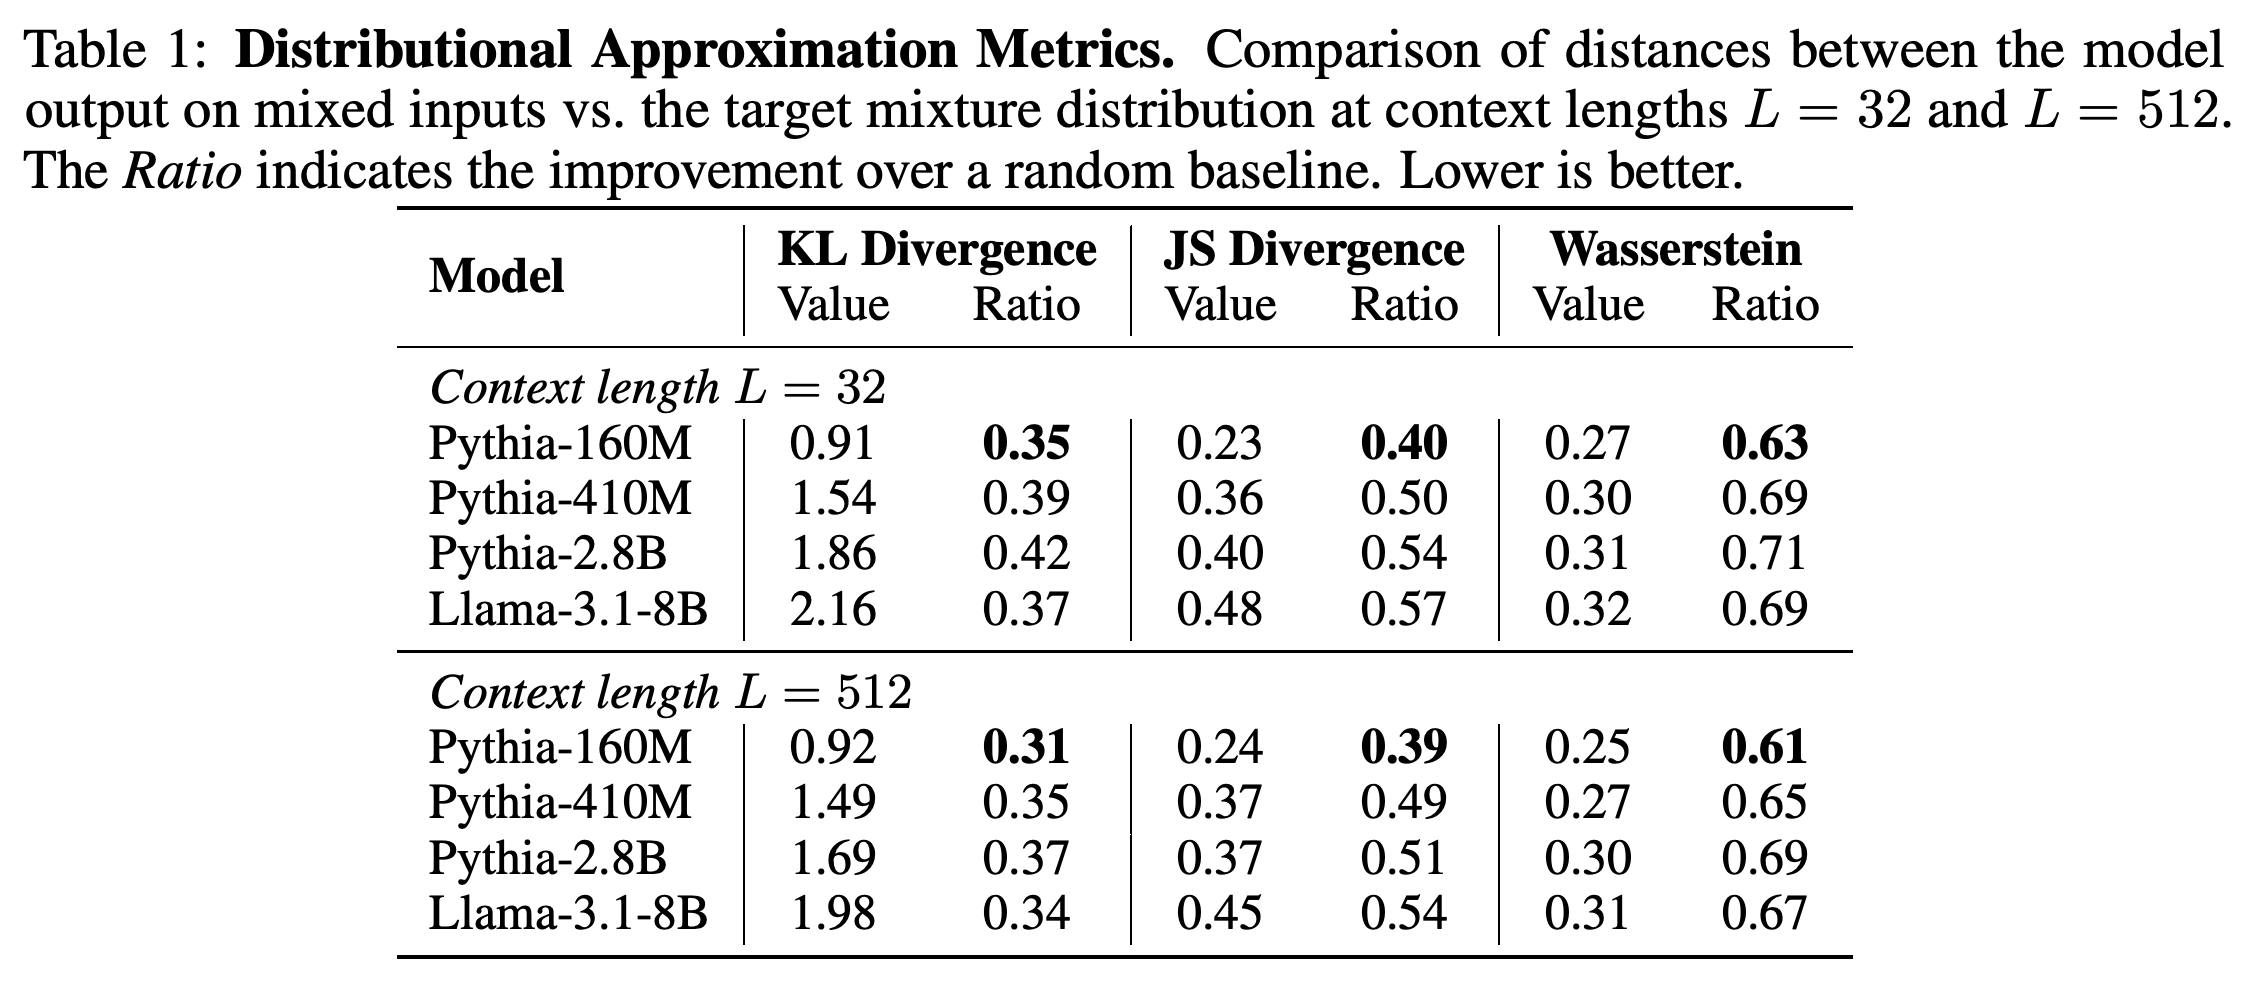
분포 보존은 KL 발산, 대칭적인 분포 불일치 지표인 Jensen–Shannon(JS) 발산, 토큰 임베딩의 유사성을 사용하는 수송 기반 거리인 Wasserstein 거리로 측정한다. KL과 JS에는 τ = 1.5의 온도 평활화를 적용해 확률을 완만하게 만들고 수치 안정성을 높인다. Wasserstein 거리는 top-256 토큰의 원래 확률과 임베딩 방향을 비교하는 코사인 거리를 사용한다.
- Superposition Approximation Ratio는 혼합 분포와 목표 분포 사이의 기대 불일치를 서로 무관한 독립 문맥 사이의 기대 불일치로 나눈 값이다. 비율이 1보다 작으면 기준보다 개선되었다는 뜻이며, 정확한 선형성을 의미하지는 않는다.
- FineWeb의 문맥 길이 L = 32와 L = 512에서 보고된 모든 비율은 1보다 작다. L = 32의 Pythia-2.8B에서 KL, JS, Wasserstein 비율은 각각 0.42, 0.54, 0.71이다.
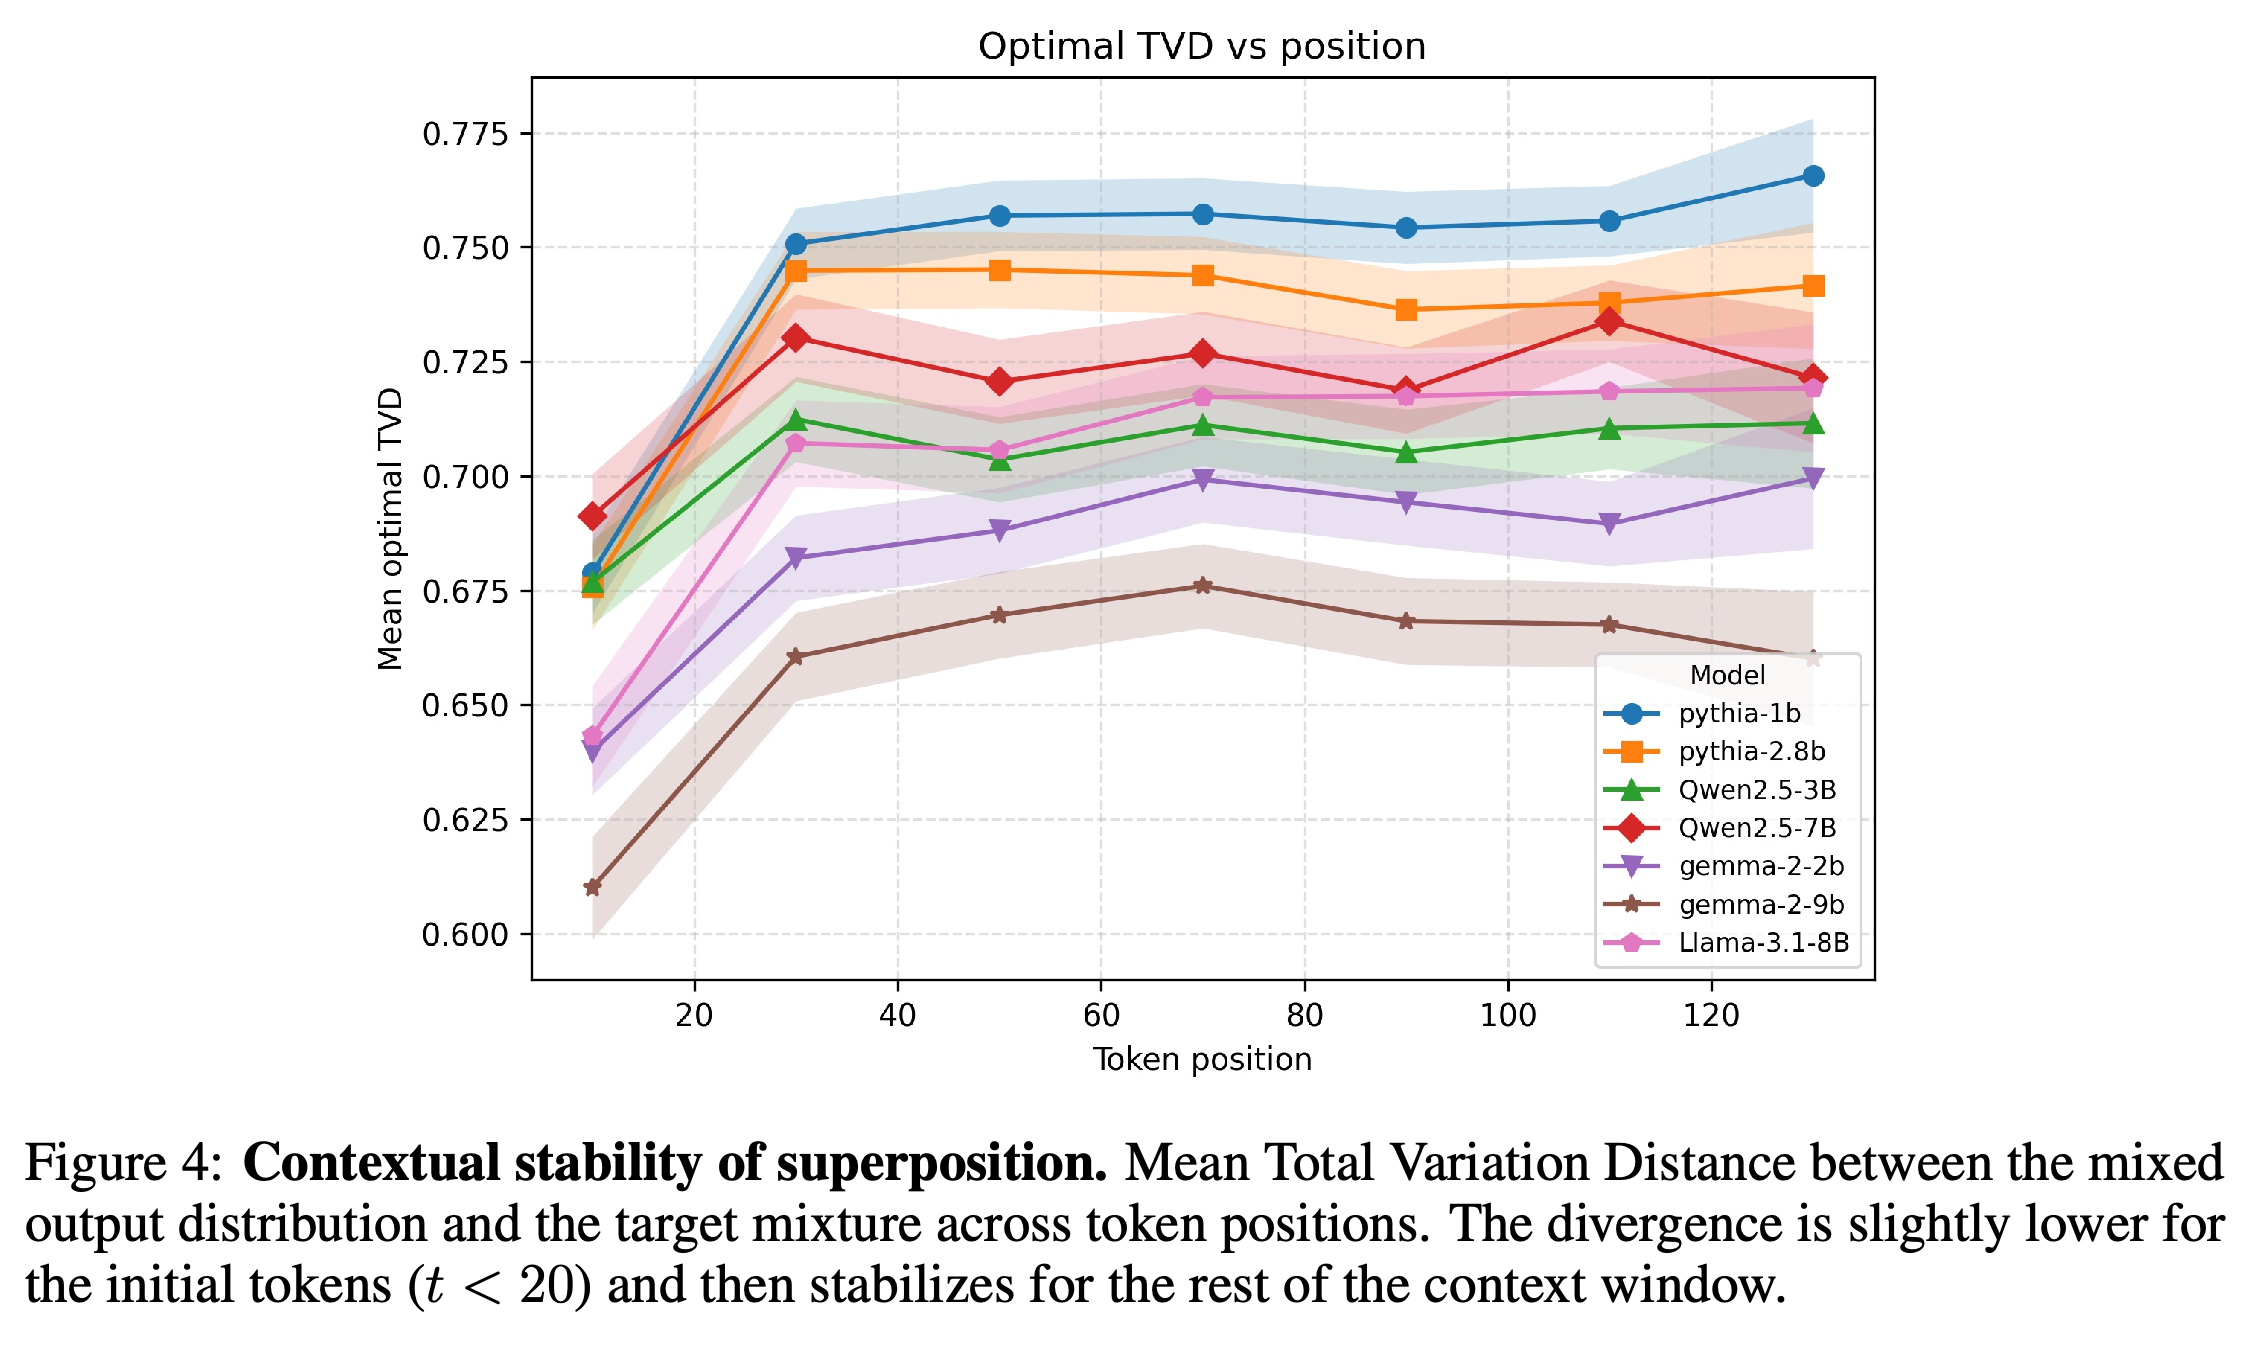
- 본문은 초기에 불일치가 더 크다고 설명하지만, Figure 4에서는 확률 질량의 차이를 측정하는 총변동거리(Total Variation Distance)가 초기에 더 낮고 이후 안정된다.
시험한 길이 2개 모두에서 보고된 정규화 거리는 무관한 문맥 기준보다 작다. 절대 발산이 남아 있으므로 보존은 근사적이다. 제시된 행에는 논문 후반부에서 인용한 미세조정 결과가 없다.
2.4 Linearity Dynamics During Training
저자들은 각 텍스트 쌍과 체크포인트에서 독립 스트림 2개와 혼합 스트림을 실행한다. 이후 계층별 평균을 빼서 은닉 상태를 중심화하고, 정규화한 혼합 상태와 독립 상태의 합을 정규화한 결과를 비교한다. 계층에 걸쳐 평균한 거리가 낮을수록 가산성이 강하다. Figure 2에서는 Pythia 사전학습 동안 거리가 전반적으로 증가하지만, 여러 곡선에서 국소적인 반전과 후반부 하락도 나타난다.
- 이 변화는 아키텍처가 가산성에 기여한다는 해석을 뒷받침하지만, 이 지표만으로 초기화 시점에 유용한 언어 처리가 가능하다고 볼 수는 없다.
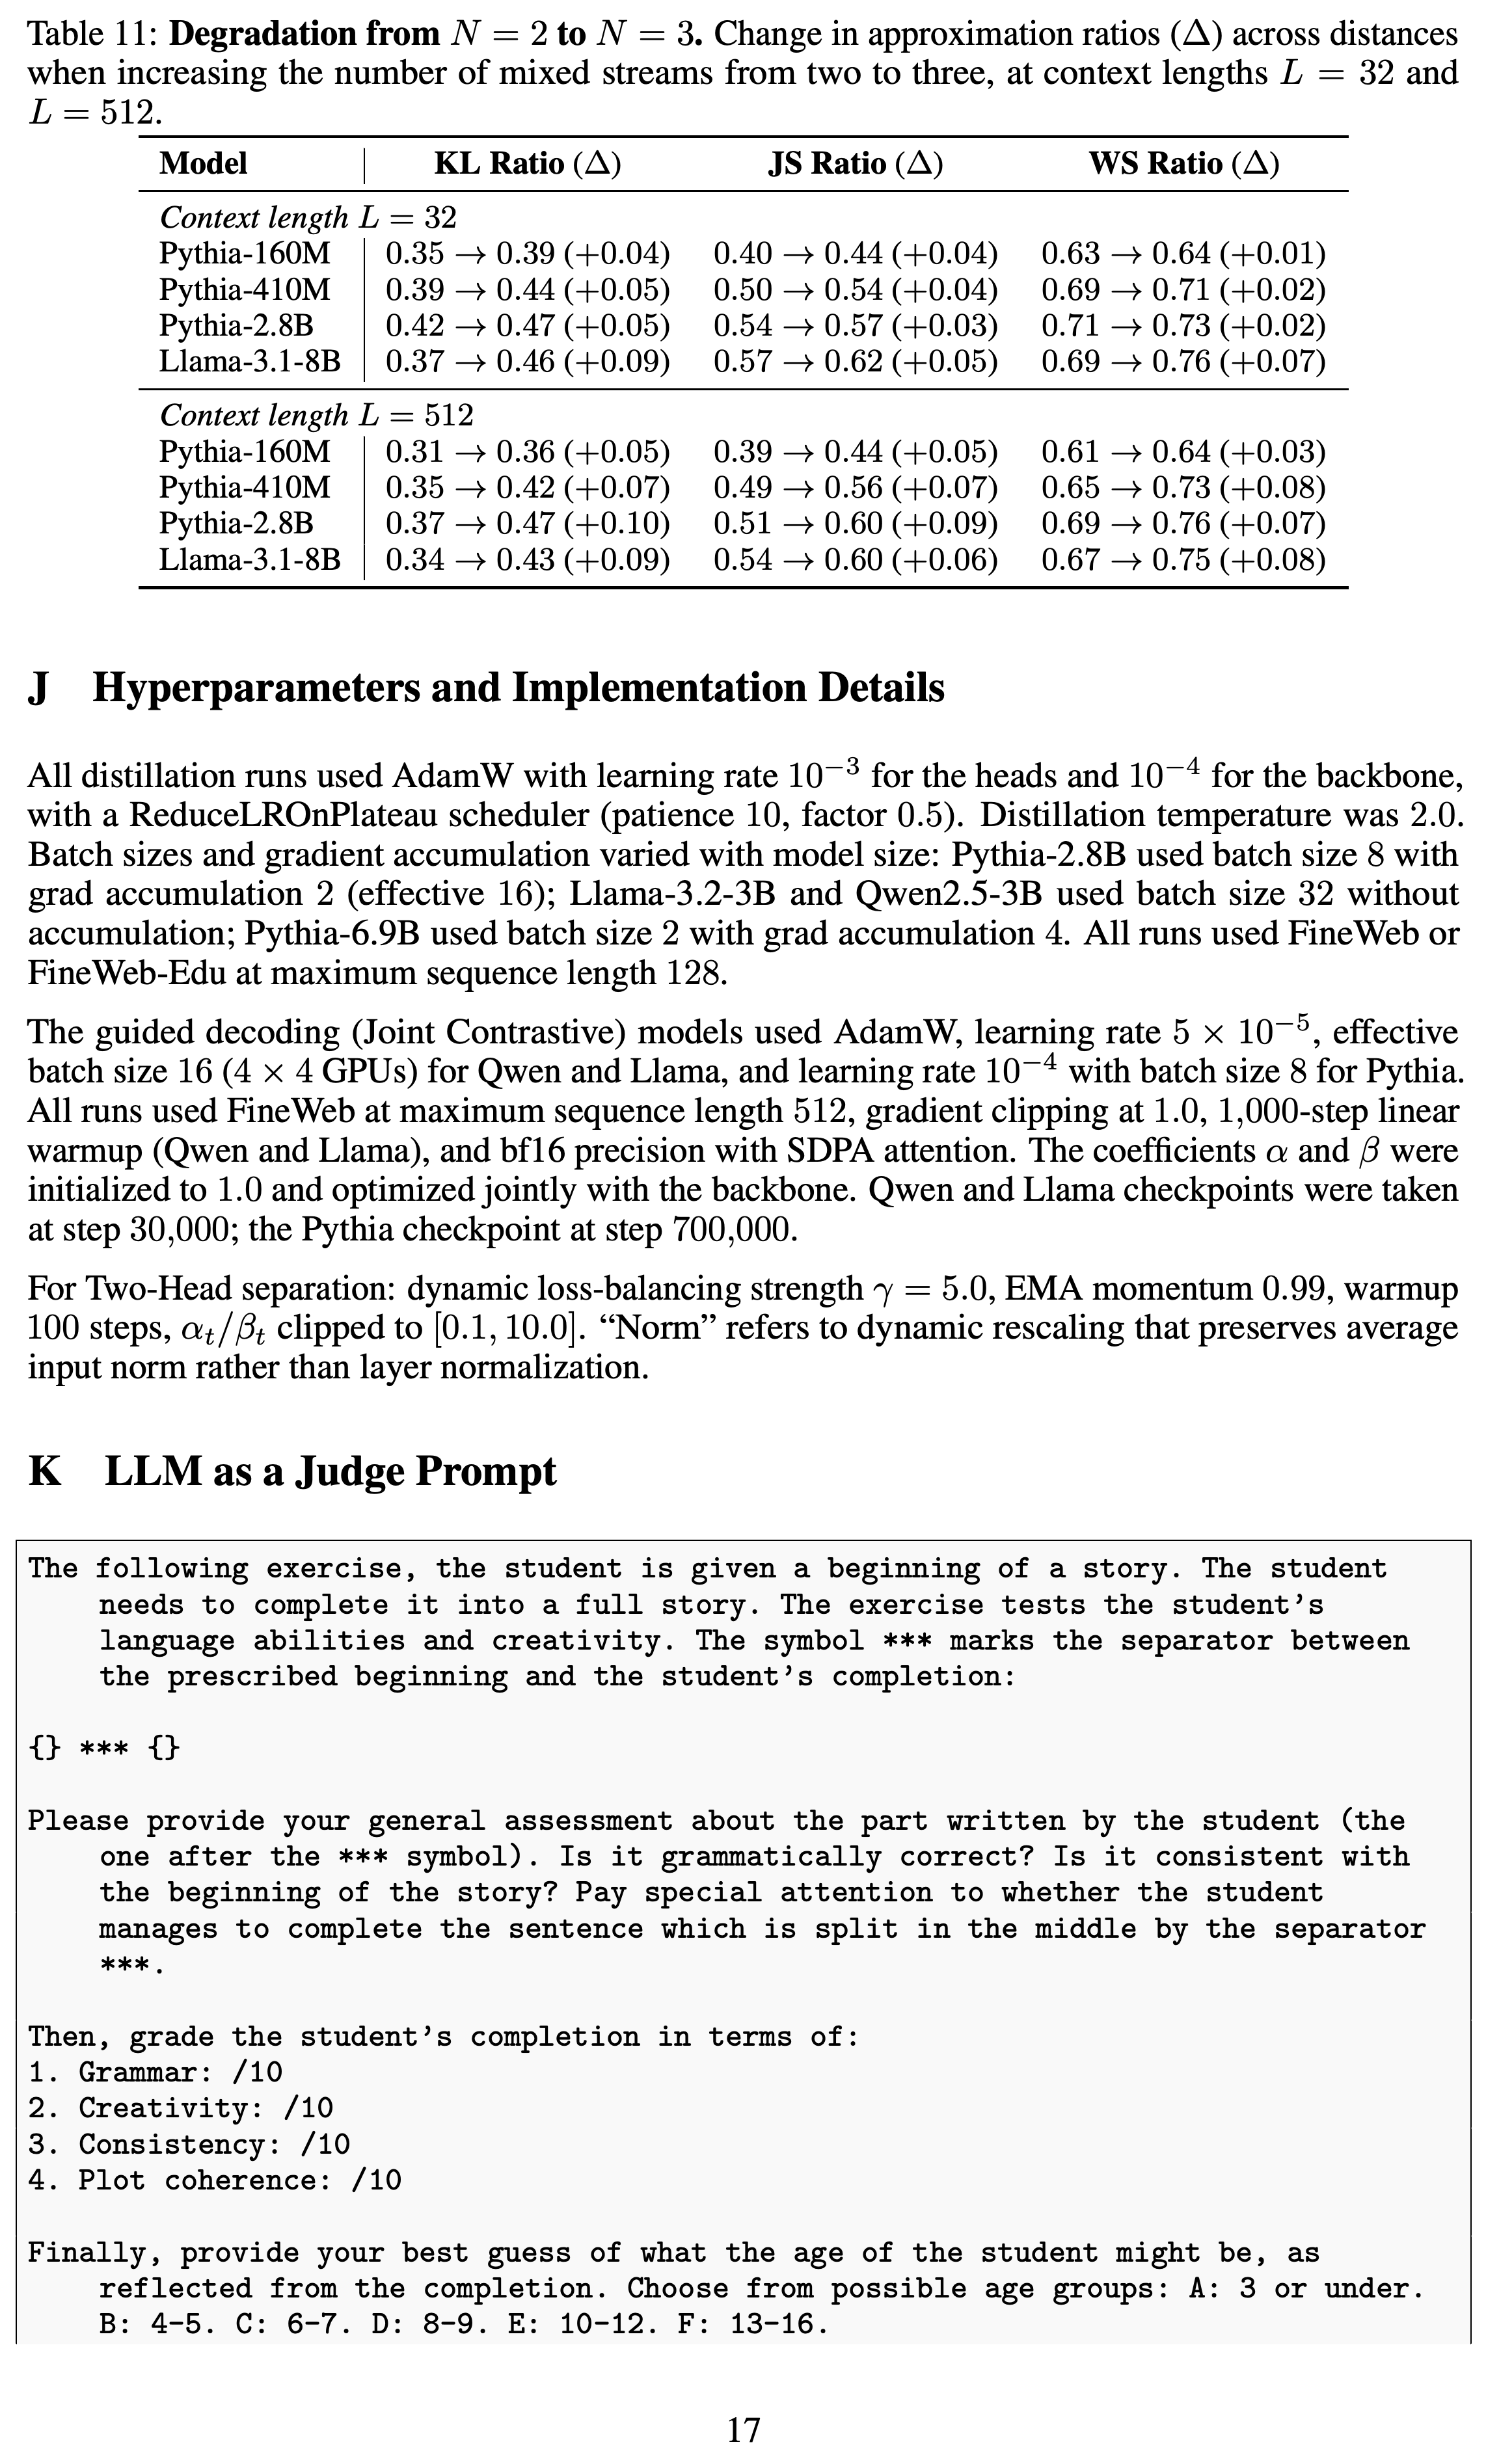
- 여러 스트림을 같은 가중치로 혼합해도 무관한 문맥을 기준으로 한 분포 유사성은 유지되지만 간섭은 커진다. 전체 표에서 KL 비율의 증가폭은 +0.04에서 +0.10이며, 본문이 제시한 +0.04에서 +0.09 범위를 벗어나는 +0.10 case가 포함된다.
Pythia의 초기 체크포인트에서 후기 체크포인트로 갈수록 가산성 오차가 전반적으로 커져, 사전학습 중 가산성이 약해진다는 해석을 뒷받침한다. 여러 곡선에서 국소적인 반전이나 후반부 하락이 나타나므로, 단조 증가한다는 본문의 주장은 제한적으로 해석해야 한다.
3 An attention-patching analysis
어텐션 패칭 실험은 어텐션 구조와 텍스트별 어텐션 가중치의 영향을 구분하기 위해 Qwen2.5-3B와 대조 실험용 텍스트 코퍼스인 FineWeb-Edu를 사용하며, 시퀀스 길이는 T = 128이다. donor patching은 모든 계층과 헤드의 정규화된 어텐션 가중치를 무관한 텍스트에서 얻은 가중치로 교체한다. permutation patching은 각 인과적 접두 구간 안에서 가중치를 무작위로 재배열하되, 각 행의 합과 값은 보존한다.
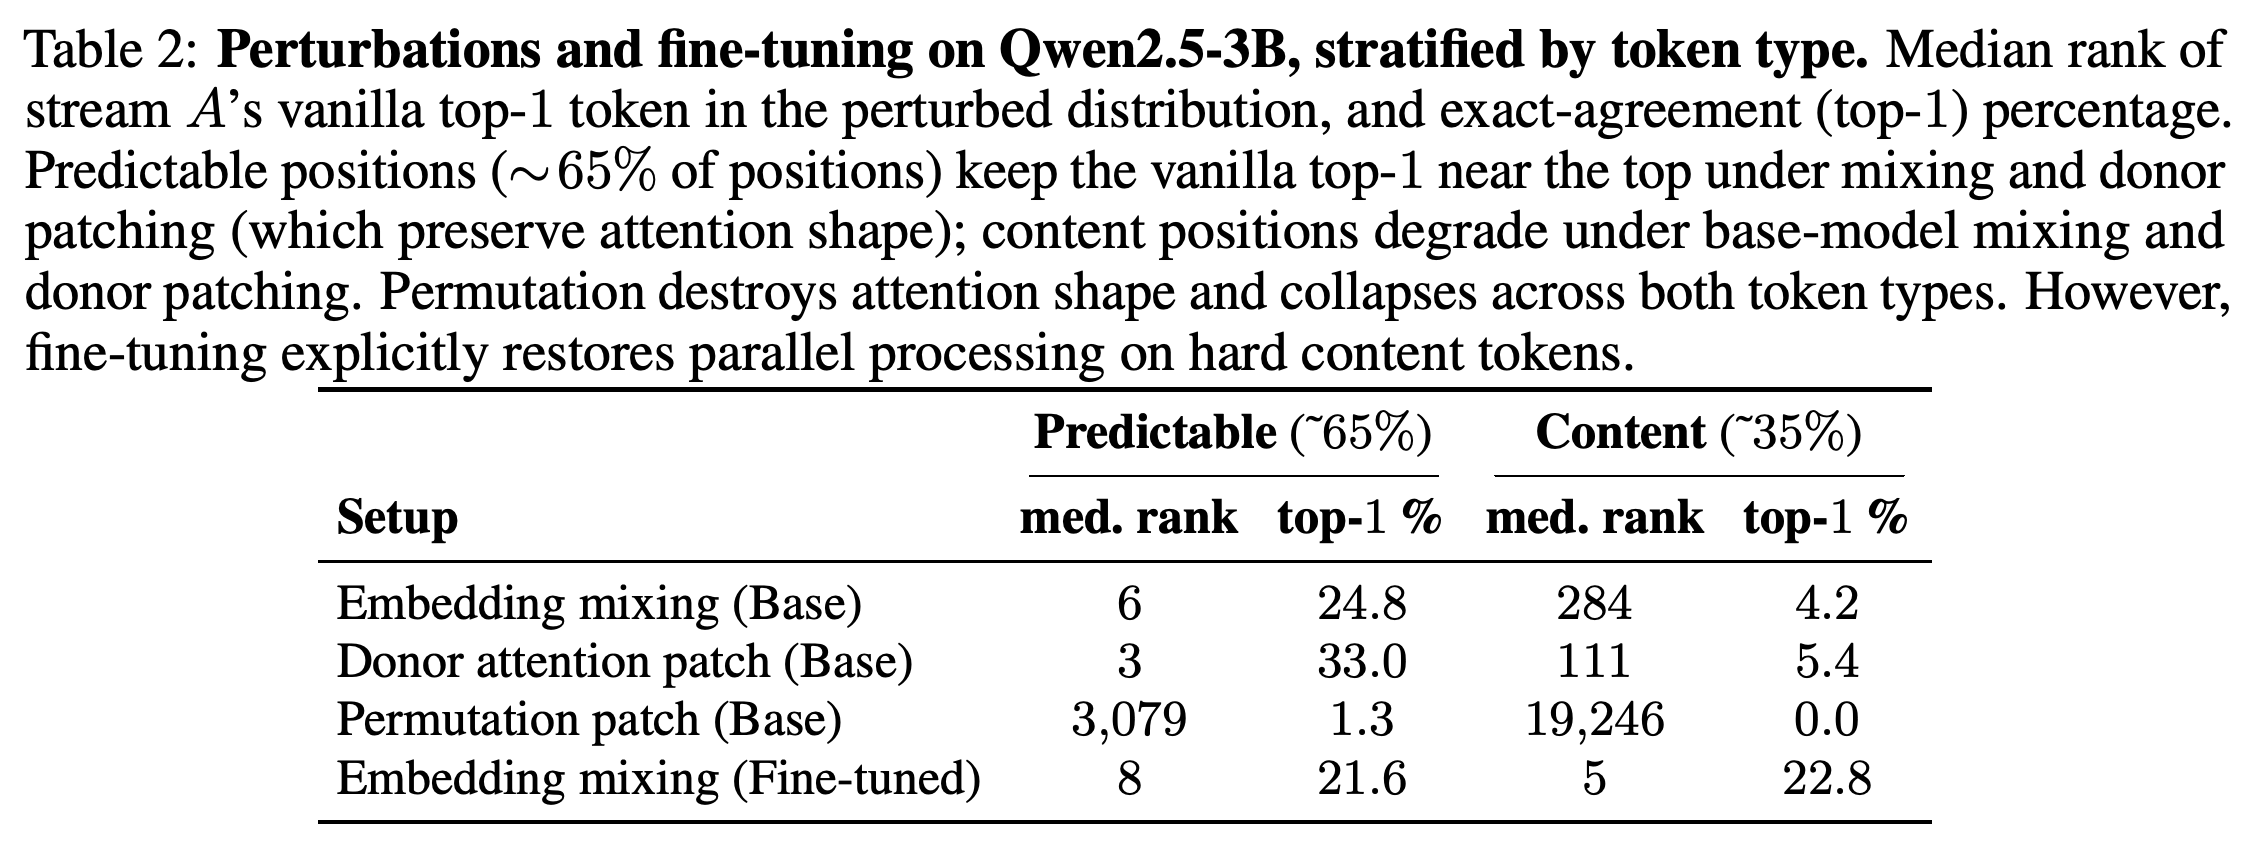
- 전체 위치의 약 65%인 예측하기 쉬운 위치에서는 임베딩 혼합과 donor patching의 순위 중앙값이 각각 6과 3이다. 약 35%인 내용 토큰 위치에서는 중앙값이 284와 111로 나빠진다. 부록은 이 위치들이 주로 내용어와 드문 토큰 조각에 해당한다고 설명한다.
- permutation patching의 순위 중앙값은 예측하기 쉬운 위치에서 3,079, 내용 토큰 위치에서 19,246이다. 따라서 어텐션 가중치의 분포만 보존하면 원래 예측은 유지되지 않는다.
- 미세조정 후 혼합 입력의 내용 토큰 위치에서 순위 중앙값은 5가 되고, 정확한 top-1 일치율은 4.2%에서 22.8%로 높아진다. 예측하기 쉬운 위치의 순위 중앙값은 6에서 8로 바뀐다.
위치를 토큰 유형별로 나누면 기본 모델이 문맥에 의존하는 예측을 잘 보존하지 못한다는 점이 드러난다. 미세조정은 내용 토큰 위치의 순위 중앙값을 284에서 5로, top-1 일치율을 4.2%에서 22.8%로 개선한다. 반면 예측하기 쉬운 위치의 지표는 조금 나빠진다.
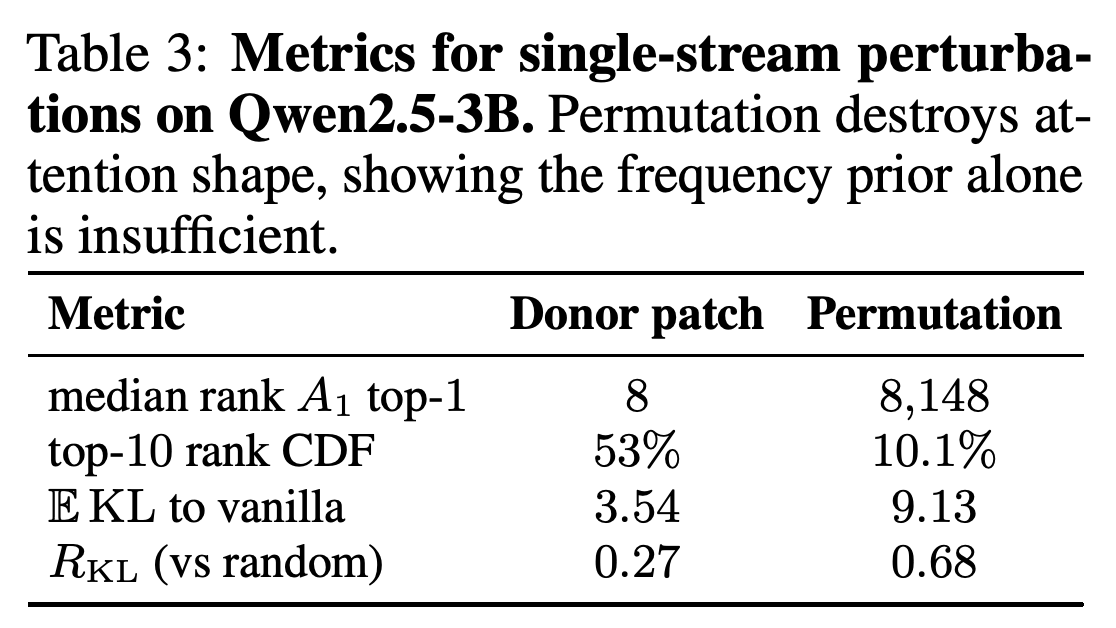
전체 일치도는 문맥에 의존하는 과제의 실패를 가릴 수 있다. donor patching은 전체 순위 중앙값 8과 KL 근사 비율 0.27을 유지한다. 하지만 왼쪽을 잘라 128토큰으로 맞춘 LAMBADA 프롬프트 200개에서는 정확도가 보고된 기본 추론의 73%에서 0.5%로 떨어진다.
- permutation은 전체 순위 중앙값을 8,148로 높이고, top-10 복원율을 53%에서 10.1%로 낮추며, KL 비율을 0.68로 높인다.
- 이 대조 실험은 자연스러운 어텐션 구조와 출력 계층의 토큰 빈도 선호가 함께 작용한다는 해석을 뒷받침한다. 전체 순위 일치도가 과제 정확도를 입증하지는 않는다.
어텐션 가중치를 재배열하면 자연스러운 donor 어텐션으로 교체할 때보다 훨씬 큰 손상이 발생한다. 이 차이는 변경되지 않은 출력 계층의 토큰 빈도 선호 외에 어텐션 구조도 역할을 한다는 해석을 뒷받침한다.
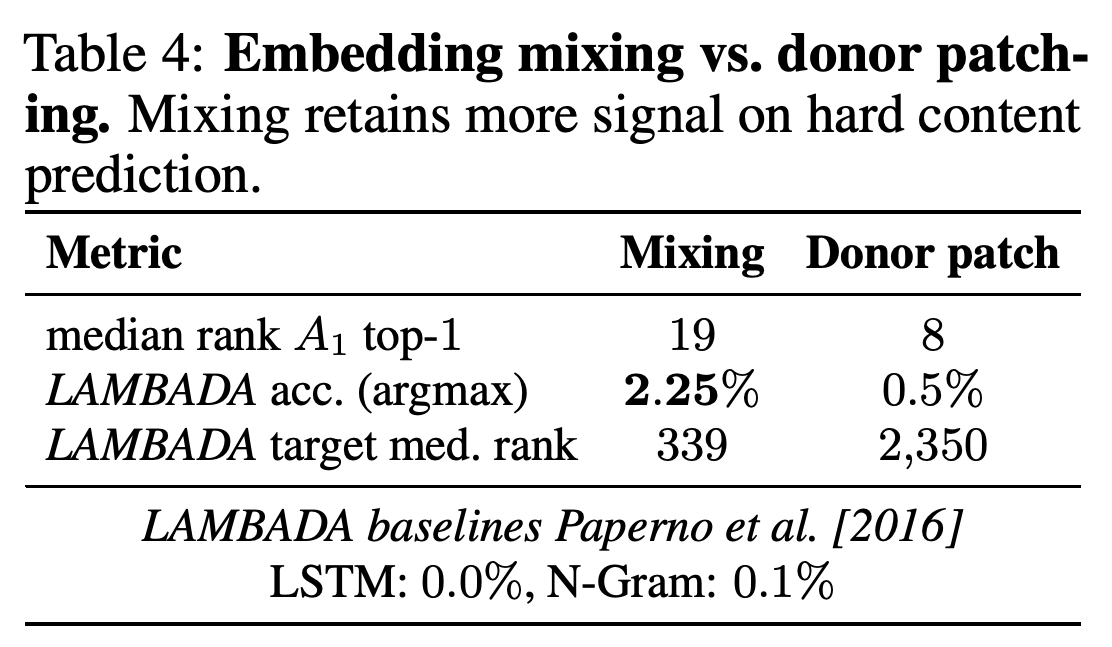
임베딩 혼합은 전체 일치도에서는 donor patching보다 낮은 성능을 보이며, 순위 중앙값은 각각 19와 8이다. 반면 어려운 LAMBADA 목표 토큰에서는 더 낫다. 별도 보정 없이 측정한 정확도는 각각 2.25%와 0.5%이며, 목표 토큰의 순위 중앙값은 339와 2,350이다.
- 이 비교는 무관한 텍스트의 어텐션 가중치로 교체해도 남는 정보 외에, 문맥에 특화된 신호가 일부 보존된다는 해석을 뒷받침한다.
- 절대 정확도는 여전히 낮으므로, 이 결과는 부분적인 신호 보존을 보여주며 신뢰할 만한 과제 수행을 입증하지는 않는다.
임베딩 혼합은 전체 일치도에서는 donor patching보다 낮지만, LAMBADA 정확도와 목표 토큰 순위에서는 더 낫다. 이 역전은 전체 예측 일치도가 보존된 문맥별 정보를 잘못 나타낼 수 있는 이유를 보여준다.
4 Improving Linearity with Finetuning
미세조정에서는 동결된 사전학습 교사 모델이 각 스트림을 독립적으로 예측하고, 그 확률 분포를 평균한 결과를 목표로 삼아 평균 입력 임베딩을 받는 학생 모델을 학습한다. 손실은 L = D_KL(P_target || M_student(z))다. 논문은 FineWeb 부분집합에서 약 200k스텝 동안 Pythia, Qwen, Llama에 이 절차를 적용했다고 설명한다.
- Pythia-2.8B에서 보고된 평균 KL 발산은 1.86에서 0.27로, 근사 비율은 0.42에서 0.06으로 줄어든다.
- 본문은 top-5 복원율도 약 30%에서 60% 초과로 높아진다고 보고한다. 다만 Table 1의 미세조정 행을 가리키는 인용은 부정확하다. 실제 표에는 기본 모델 비교만 제시되어 있다.
혼합 출력의 충실도를 높이면 단일 스트림 품질이 낮아진다. 본문에 따르면 LAMBADA 정확도는 Pythia-2.8B에서 0.544에서 0.357로, Qwen2.5-3B에서 0.602에서 0.460으로 떨어진다.
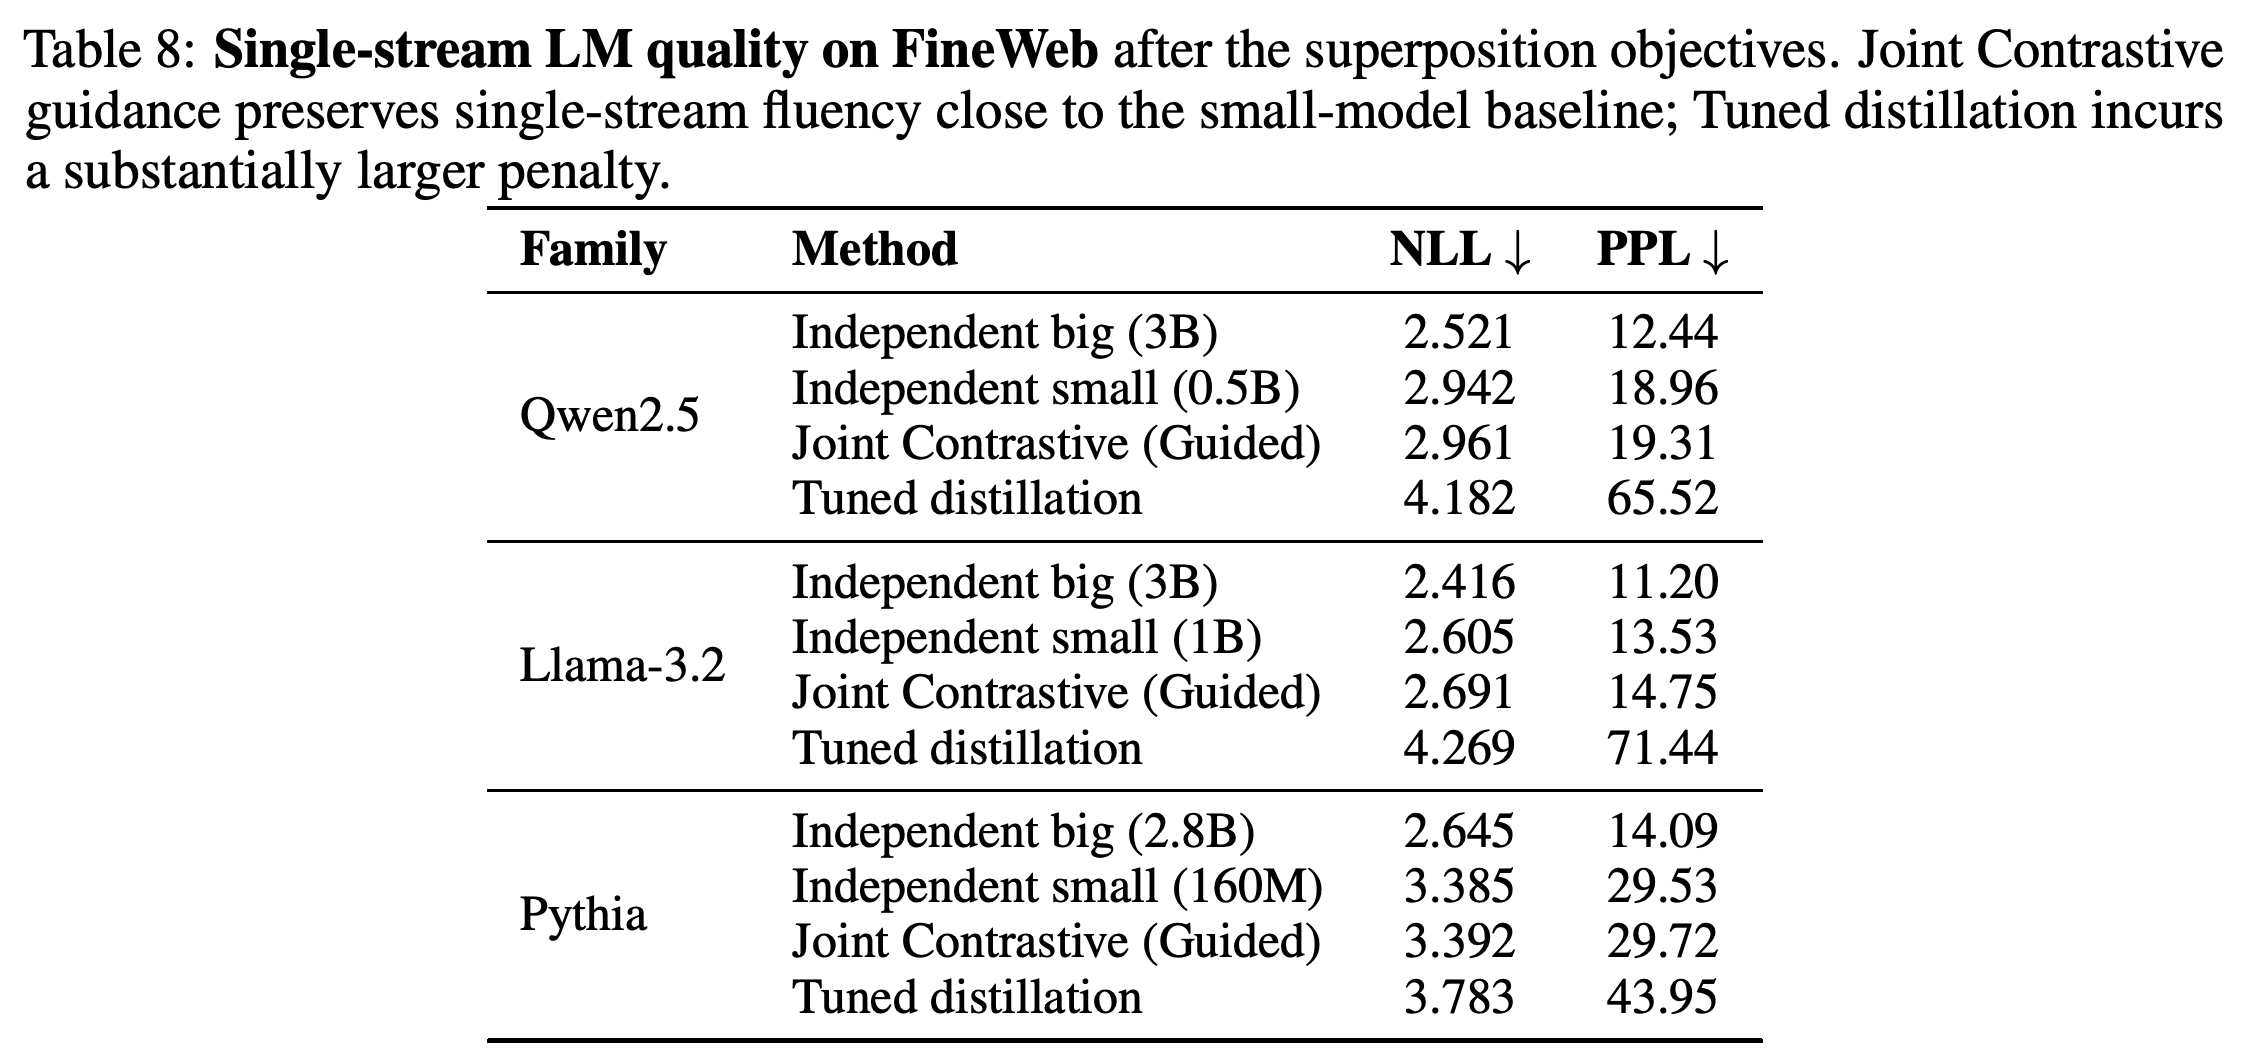
- Appendix G.4는 증류로 미세조정한 뒤 퍼플렉시티가 증가한다고 보고한다. 퍼플렉시티는 관측된 토큰의 평균 음의 로그우도에 지수함수를 적용한 값이다. Qwen2.5는 12.44에서 65.52로, Llama-3.2는 11.20에서 71.44로, Pythia는 14.09에서 43.95로 높아진다.
- Joint Contrastive 가이던스의 품질 저하는 더 작다. 퍼플렉시티는 각각 19.31, 14.75, 29.72이며, 작은 모델 베이스라인은 각각 18.96, 13.53, 29.53이다.
5 Decoding Two Streams Out of a Mixed Forward Pass
평균 출력 분포를 근사하는 것보다 각 스트림을 따로 디코딩하기가 더 어렵다. 직접 샘플링하면 문맥 2개 사이를 오갈 수 있다. 논문은 로짓을 평균한다는 조건에서 기하평균이 장애가 된다고 설명한다. P′_target(t) ∝ exp(1/2(ℓ_A(t) + ℓ_B(t))) ∝ √(P_A(t)P_B(t))이므로, 스트림 1개에서만 강하게 선호하는 토큰이 억제된다.
- 로짓 평균을 가정한 이 주장은 증류 목표로 사용하는 확률 분포의 산술평균과 다르다. 이 수식만으로 남아 있는 디코딩 오류의 원인을 입증할 수는 없다.
- Joint Contrastive 디코딩은 공유 대형 모델의 점수에 해당 스트림의 작은 모델 점수를 더하고 다른 스트림의 점수를 빼서 각 스트림의 점수를 구성한다. 계수 α와 β는 1로 시작하며, 관측된 다음 토큰에 보상을 주는 손실인 대칭적 스트림별 교차엔트로피로 주 모델인 백본과 함께 학습한다.
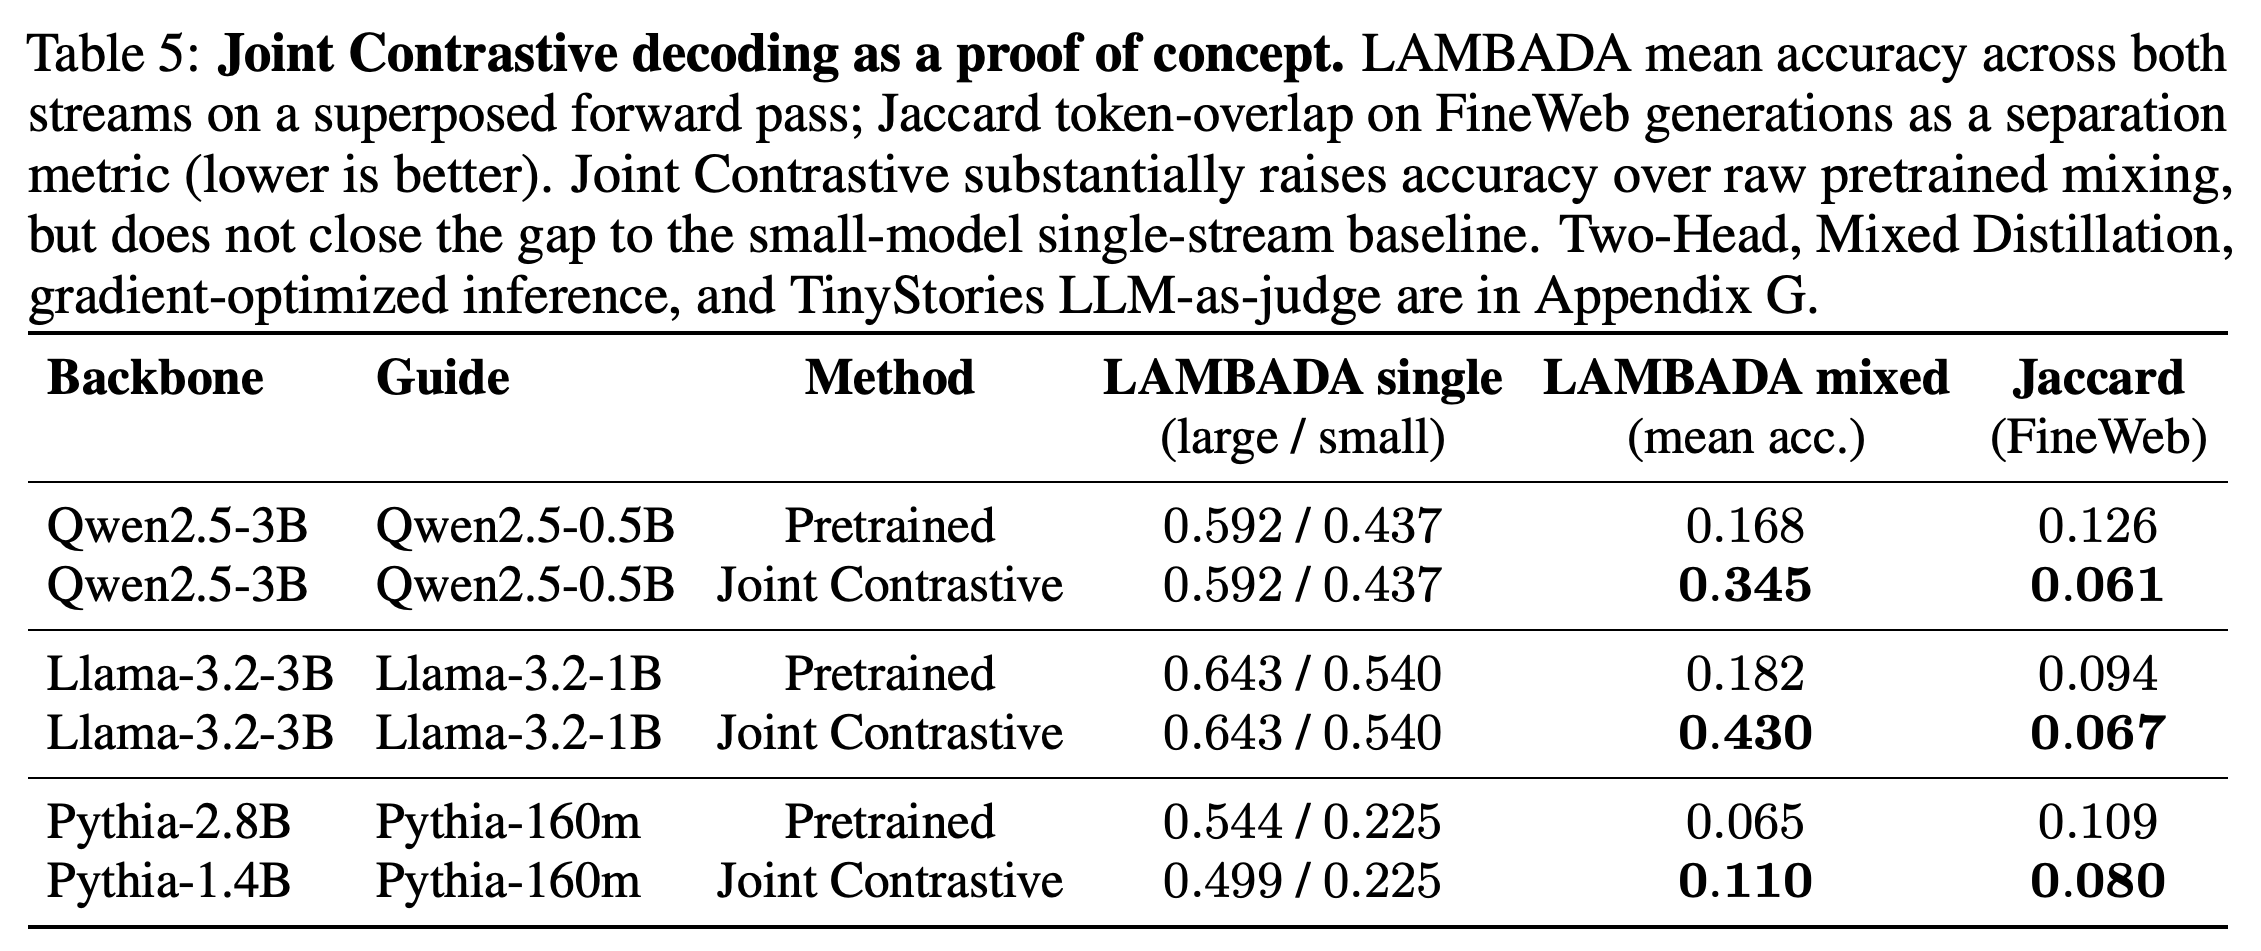
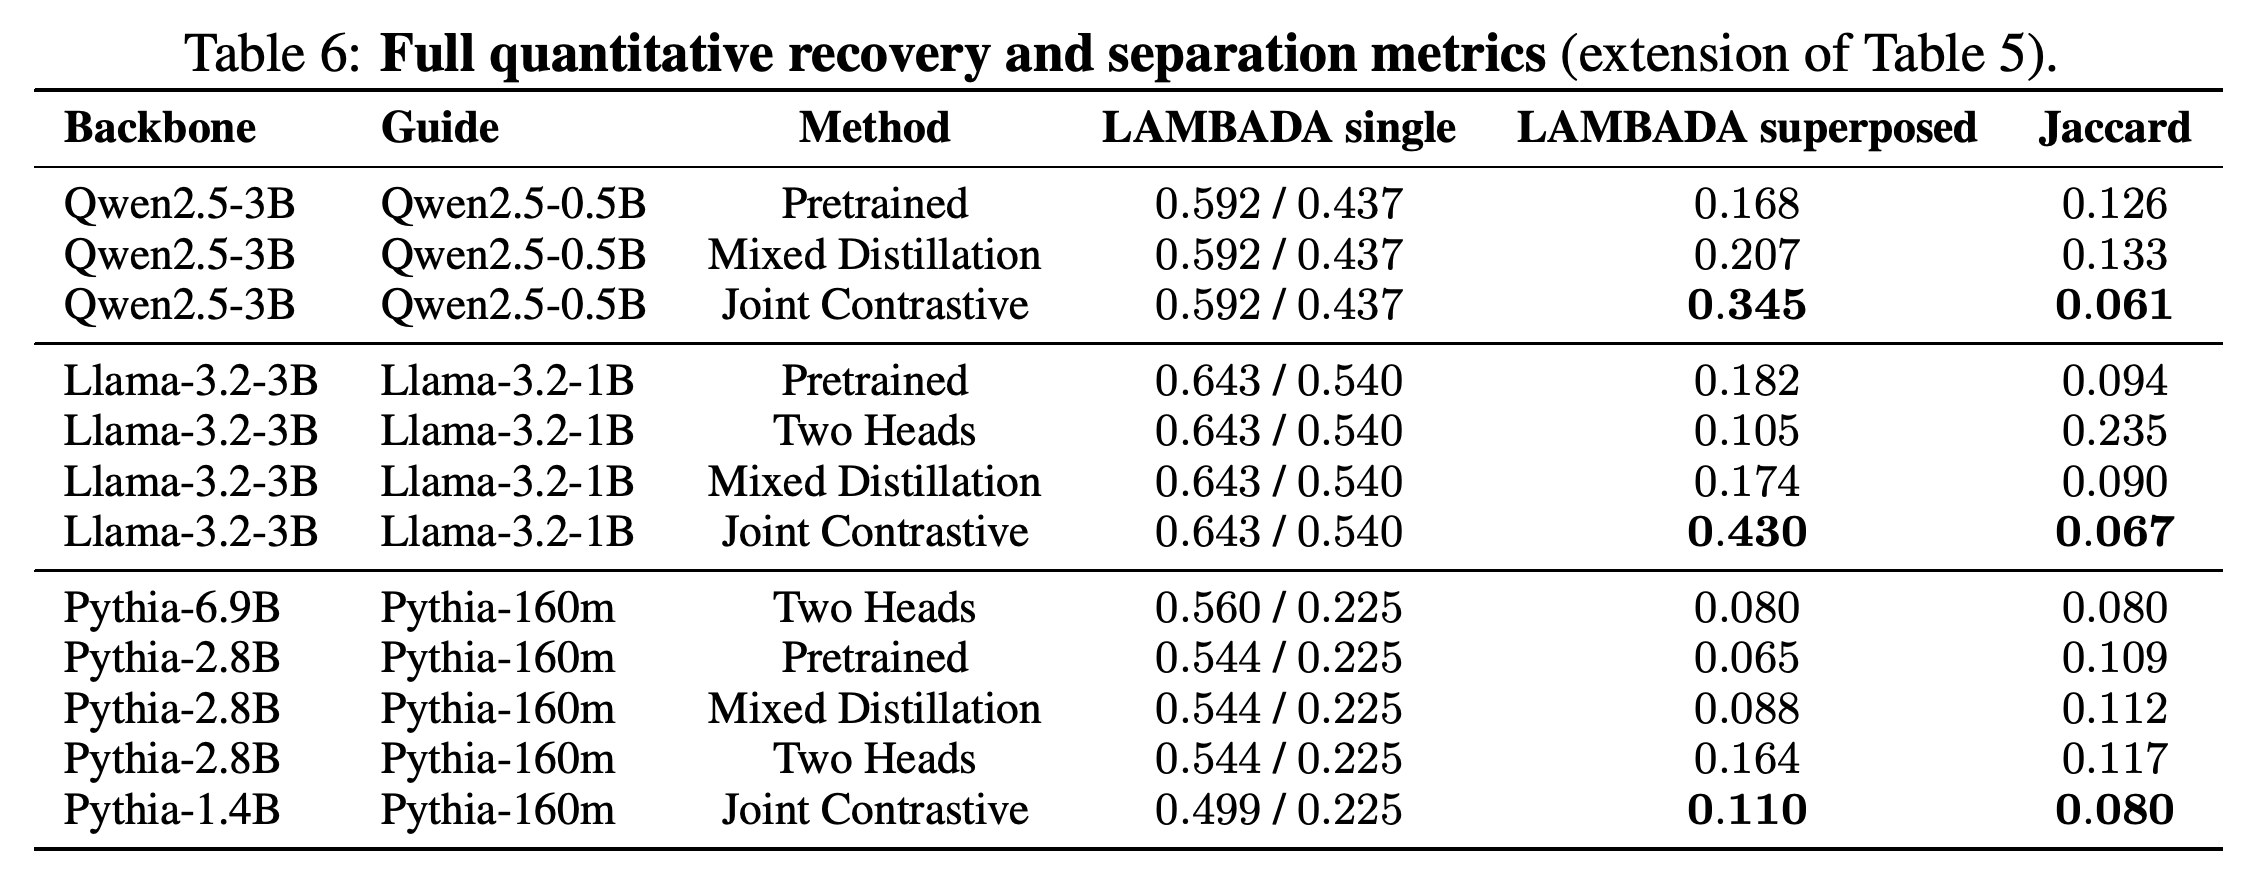
Joint Contrastive 디코딩을 적용하면 혼합 입력의 LAMBADA 정확도는 Qwen2.5-3B에서 0.168에서 0.345로, Llama-3.2-3B에서 0.182에서 0.430으로 높아진다. 공유 토큰 수를 합집합의 토큰 수로 나눈 FineWeb Jaccard 토큰 중복도는 각각 0.126에서 0.061로, 0.094에서 0.067로 낮아진다.
- 모델 2개의 정확도는 모두 각 작은 가이드 모델의 독립 정확도인 0.437과 0.540보다 낮다. 낮은 토큰 중복도는 분리 정도를 측정하지만, 그 자체로 일관되거나 올바른 후속 텍스트를 입증하지는 않는다.
- Pythia 비교에서는 백본 크기가 바뀐다. 사전학습 행은 Pythia-2.8B를 사용하며 정확도가 0.065이고, Joint Contrastive는 Pythia-1.4B를 사용하며 0.110이다. 따라서 같은 백본의 적용 전후를 통제해 비교한 결과가 아니다.
Joint Contrastive 디코딩은 같은 Qwen 및 Llama 백본을 비교했을 때 혼합 입력 정확도를 높이고 스트림 간 토큰 중복도를 낮춘다. 정확도 2개는 모두 해당 작은 모델의 독립 추론 베이스라인보다 낮으며, Pythia 행은 서로 다른 백본 크기를 사용한다.
6 Conclusion
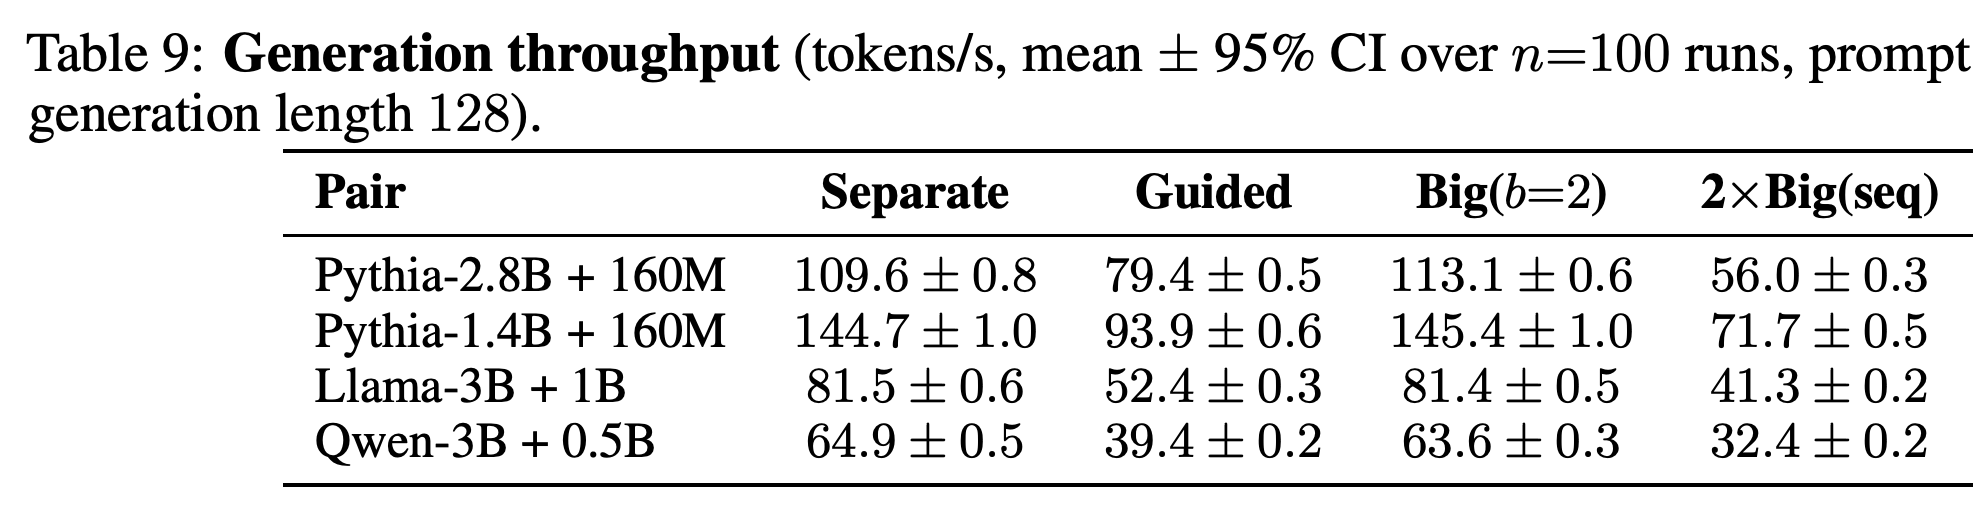
결론은 복원 가능한 중첩을 공유 백본의 순전파 1회로 후속 텍스트 2개를 얻을 수 있는 방법으로 제시한다. 이론적으로 처리량이 2×로 늘고, 어텐션의 키와 값을 저장하는 공유 키–값 캐시가 스트림당 절반으로 줄어들 가능성을 제시한다. 다만 부록의 측정 결과는 이 주장에 조건을 붙인다. 헤드 2개를 사용하는 모드의 처리량은 일반적인 배치 크기 2의 처리량과 비슷하며, 가이드 모드에는 보조 모델의 연산과 메모리가 추가로 필요하다.
7 Related Work
관련 연구에는 입력을 공유 표현으로 결합하고 개별 출력을 복원하는 DataMUX, MIMONets, RevMUX가 있다. Superposed Decoding은 초안 토큰의 임베딩을 혼합하고, superposition prompting은 여러 문서 경로를 처리한다. 이 논문을 구별하는 실증적 주장은 표준 사전학습 Transformer에서도 단순한 임베딩 평균만으로 측정 가능한 신호가 보존되며, 중첩을 강화하도록 최적화하면 이 성질이 강해진다는 점이다.
8 Limitations
명시된 한계는 짧고 주로 단일 언어로 된 텍스트 문맥을 사용했다는 점과, 텍스트와 이미지처럼 다른 입력 유형을 결합하는 멀티모달 실험이 없다는 점이다. 분석 실험은 주로 L ≤ 128을 사용하고, 분포 비교는 L = 512까지 확장하며, 가이드 학습의 최대 길이도 512다. 훨씬 긴 문맥, 다국어 입력, 텍스트와 이미지 표현의 혼합은 아직 검증하지 않았다.
- 생성 정확도는 여전히 독립 추론보다 낮고, 가장 좋은 가이드 결과에는 별도의 작은 모델이 필요하다.
- 부록의 측정 결과에서 처리량은 디코딩 방식에 따라 달라진다. 헤드 2개를 사용하는 분리는 배치 추론과 비슷하지만, 가이던스를 사용하면 더 느리다. 보고된 메모리 수치는 전체 배포 메모리가 일반적으로 절반으로 줄어든다는 점을 입증하지 않는다.
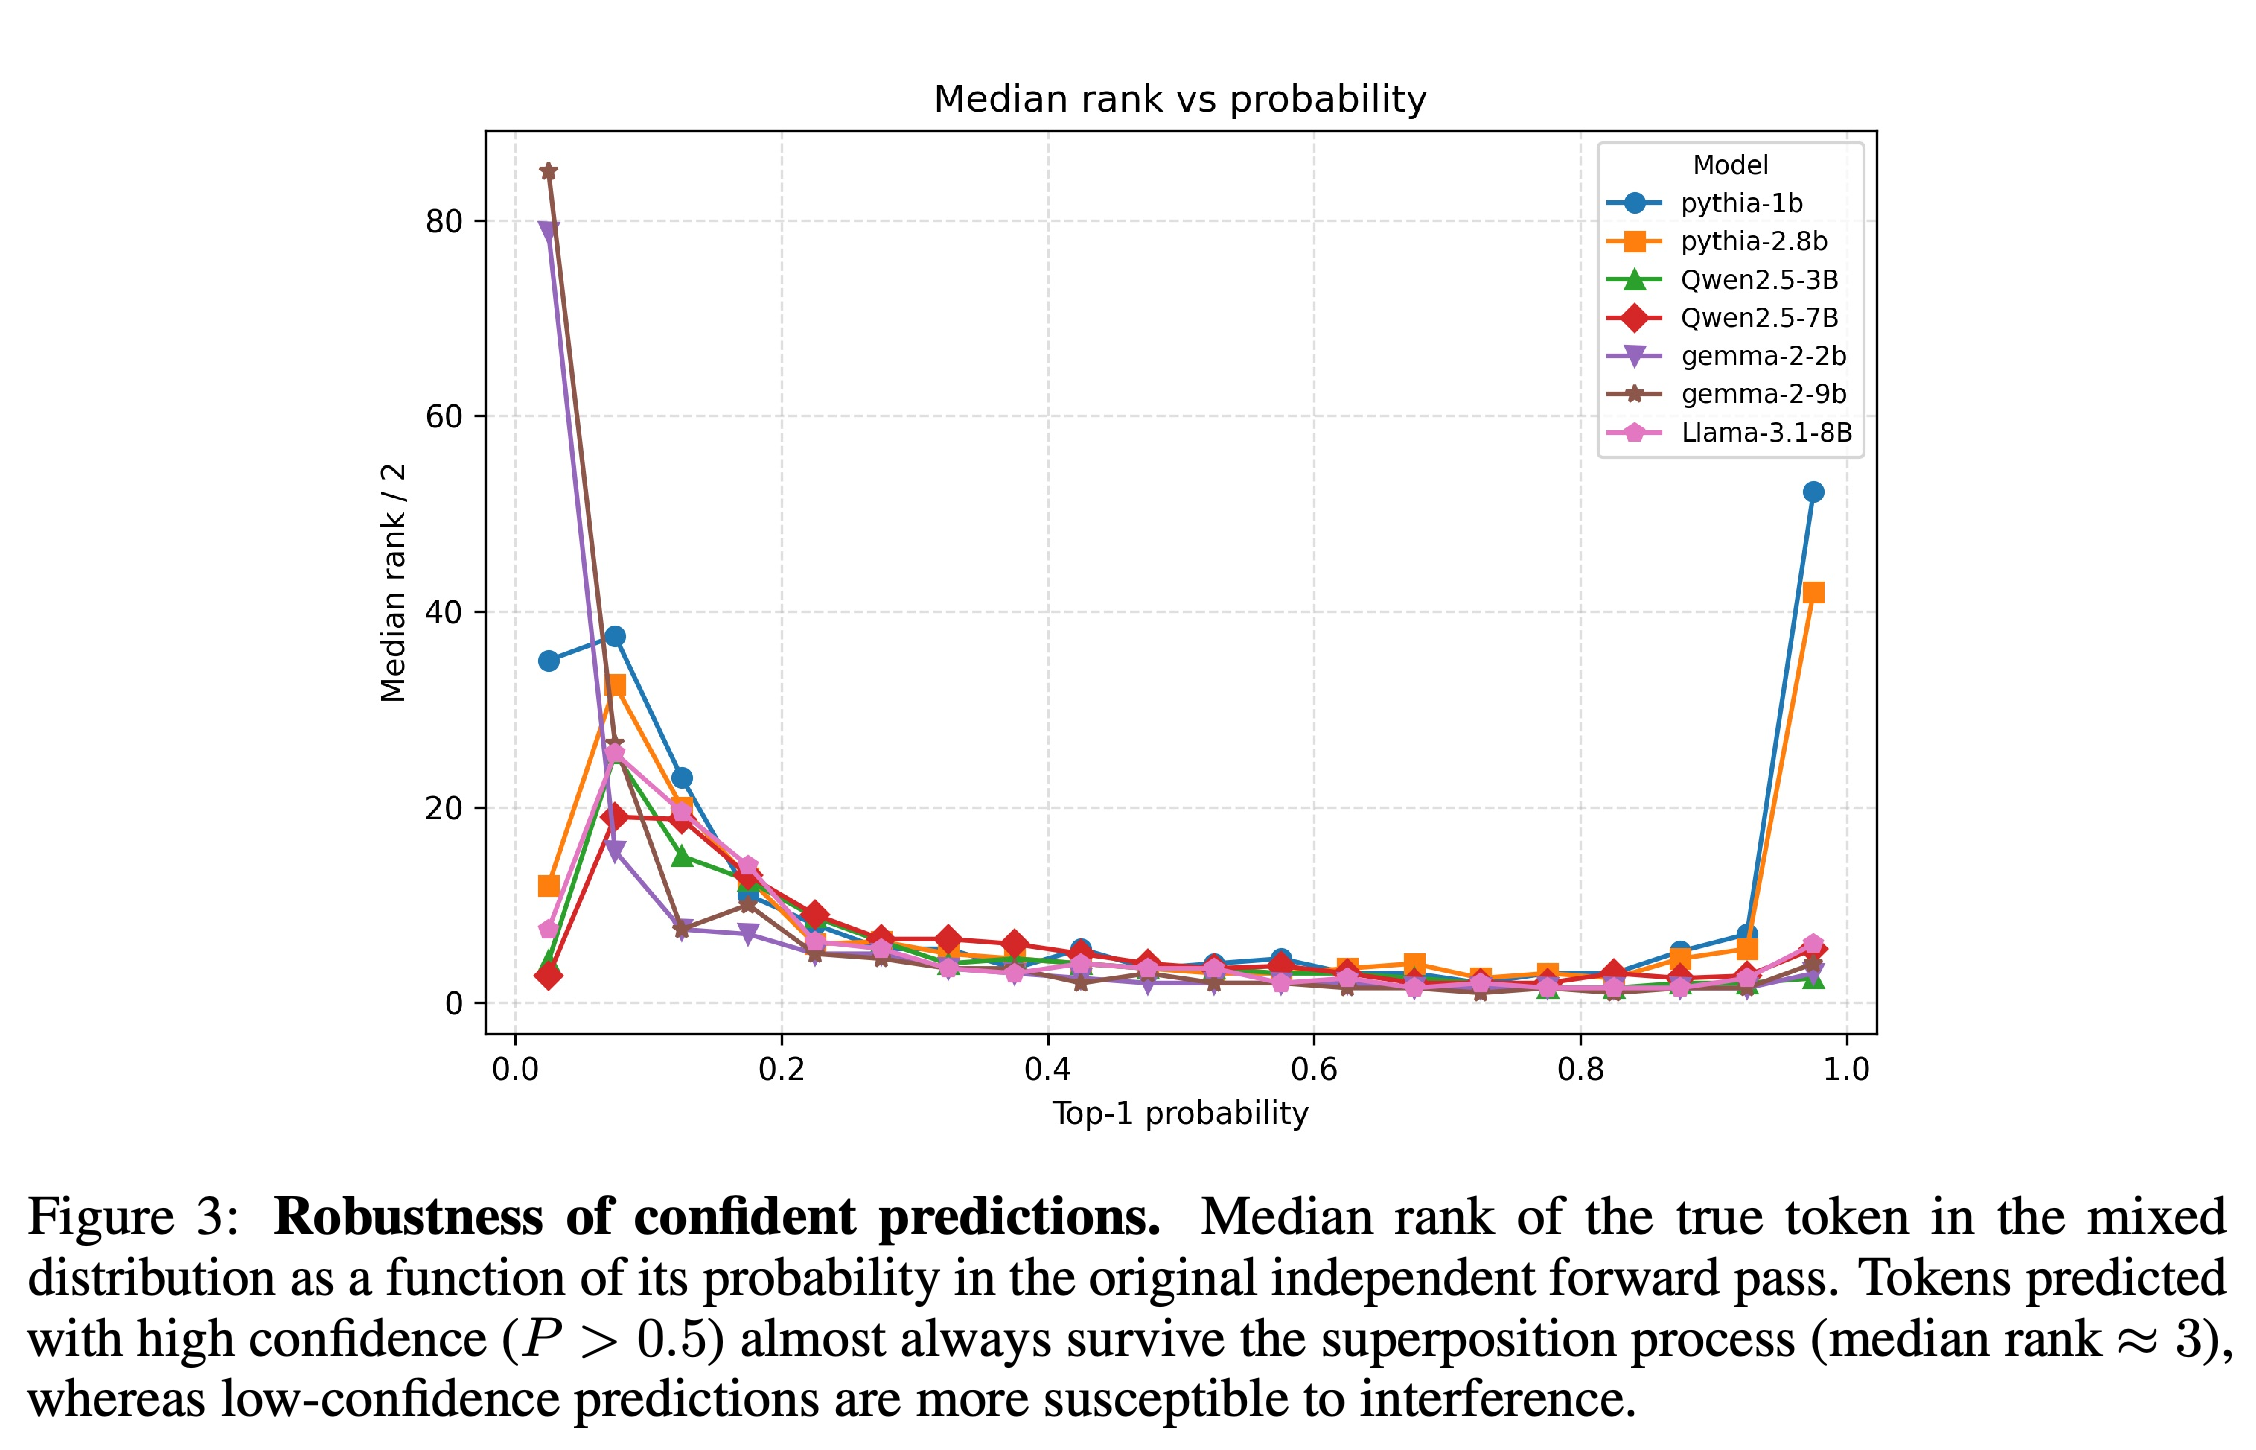
중간에서 높은 신뢰도의 예측은 대체로 낮은 신뢰도의 예측보다 혼합 출력에서 더 좋은 순위를 유지한다. Pythia의 최고 신뢰도 구간에서 성능이 급격히 나빠지므로, 높은 신뢰도의 예측을 안정적으로 복원한다는 캡션의 포괄적 주장에는 한계가 있다.
불일치는 가장 이른 위치에서부터 증가한 뒤 측정 구간에서 비교적 안정적으로 유지된다. 이는 위치에 따른 안정성을 뒷받침하지만, 가장 이른 위치에서 불일치가 더 크다는 본문의 설명과 상충한다.
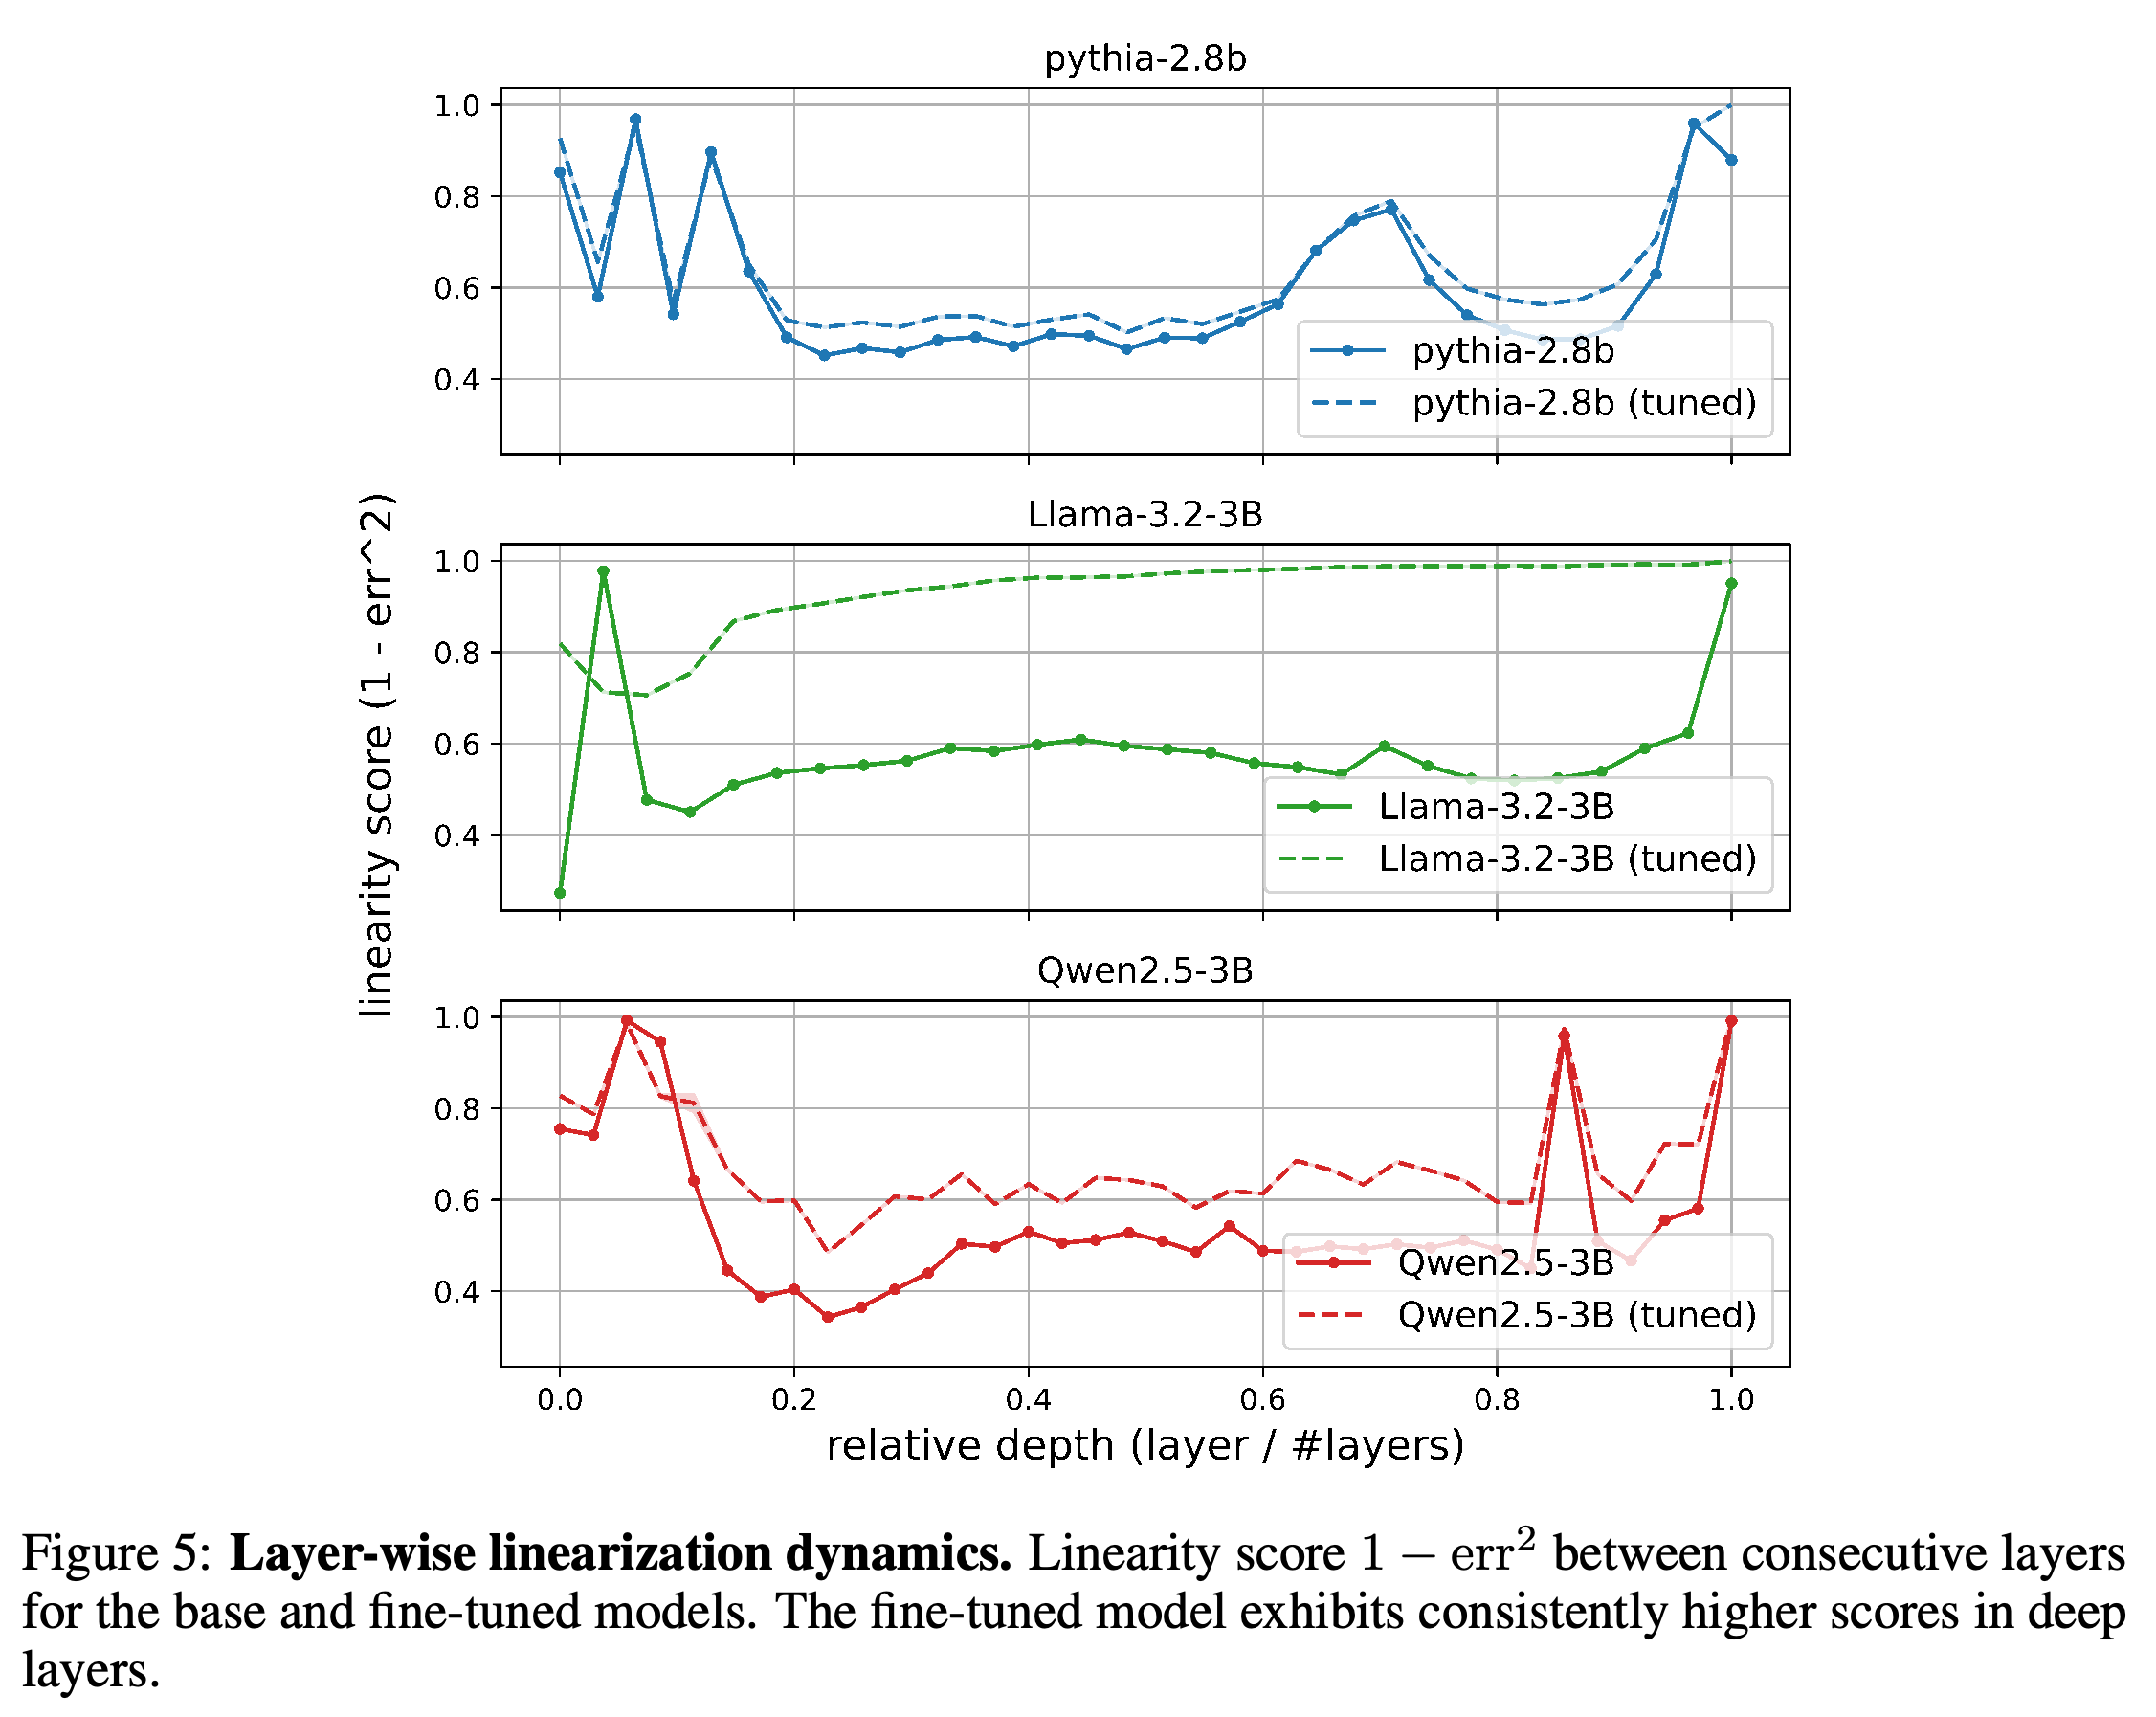
미세조정이 연속한 계층 사이의 선형성을 바꾸는 양상은 모델마다 다르며, Llama-3.2-3B에서 특히 크게 개선된다. 기본 모델의 곡선은 후반 계층이 거의 선형이라는 설명을 일관되게 뒷받침하지 않는다.
다른 분리 목적함수가 혼합 입력 정확도를 일관되게 높이지는 않는다. Llama의 Two Heads는 사전학습 혼합 베이스라인보다 낮지만, Pythia-2.8B의 Two Heads는 이를 개선한다. 부록의 인용과 달리 경사 최적화 추론을 별도로 표시한 행은 없다.
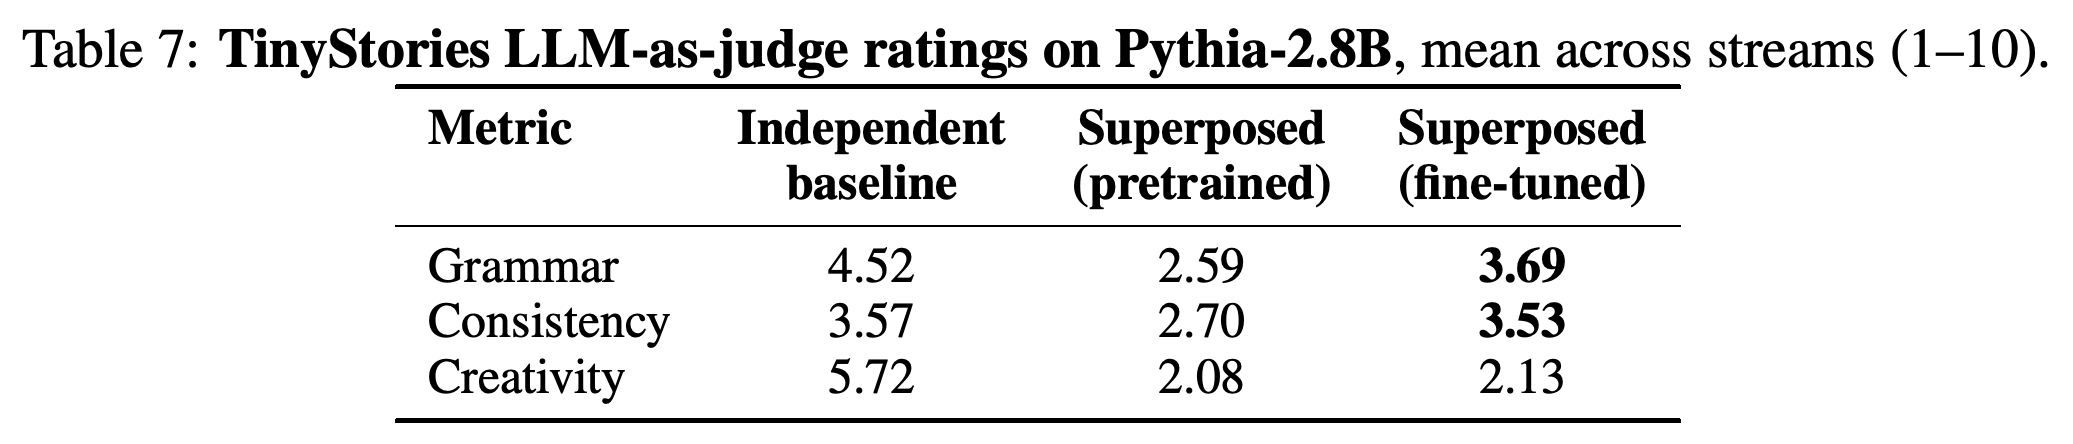
자동 평가자 기준으로 미세조정은 손실된 일관성을 상당 부분 복원하고 문법 품질도 일부 회복하지만, 창의성은 거의 개선하지 못한다. 평가 절차는 추가 출력을 요청하지만 표에는 3개 평가 차원만 보고한다.
증류를 통한 미세조정은 모델 계열 3개 모두에서 단일 스트림 우도를 크게 악화시킨다. Joint Contrastive 점수는 더 작은 독립 모델에 가깝게 유지되며, 큰 독립 백본과 비교하면 품질이 낮아짐을 보여준다.
Separate의 처리량은 순차 실행의 약 2배이며 일반적인 배치 크기 2의 추론에 가깝다. Guided 디코딩은 보고된 모든 비교 쌍에서 배치 추론보다 느리므로, 가장 빠른 모드와 가장 높은 가이드 정확도 결과는 따로 평가해야 한다.
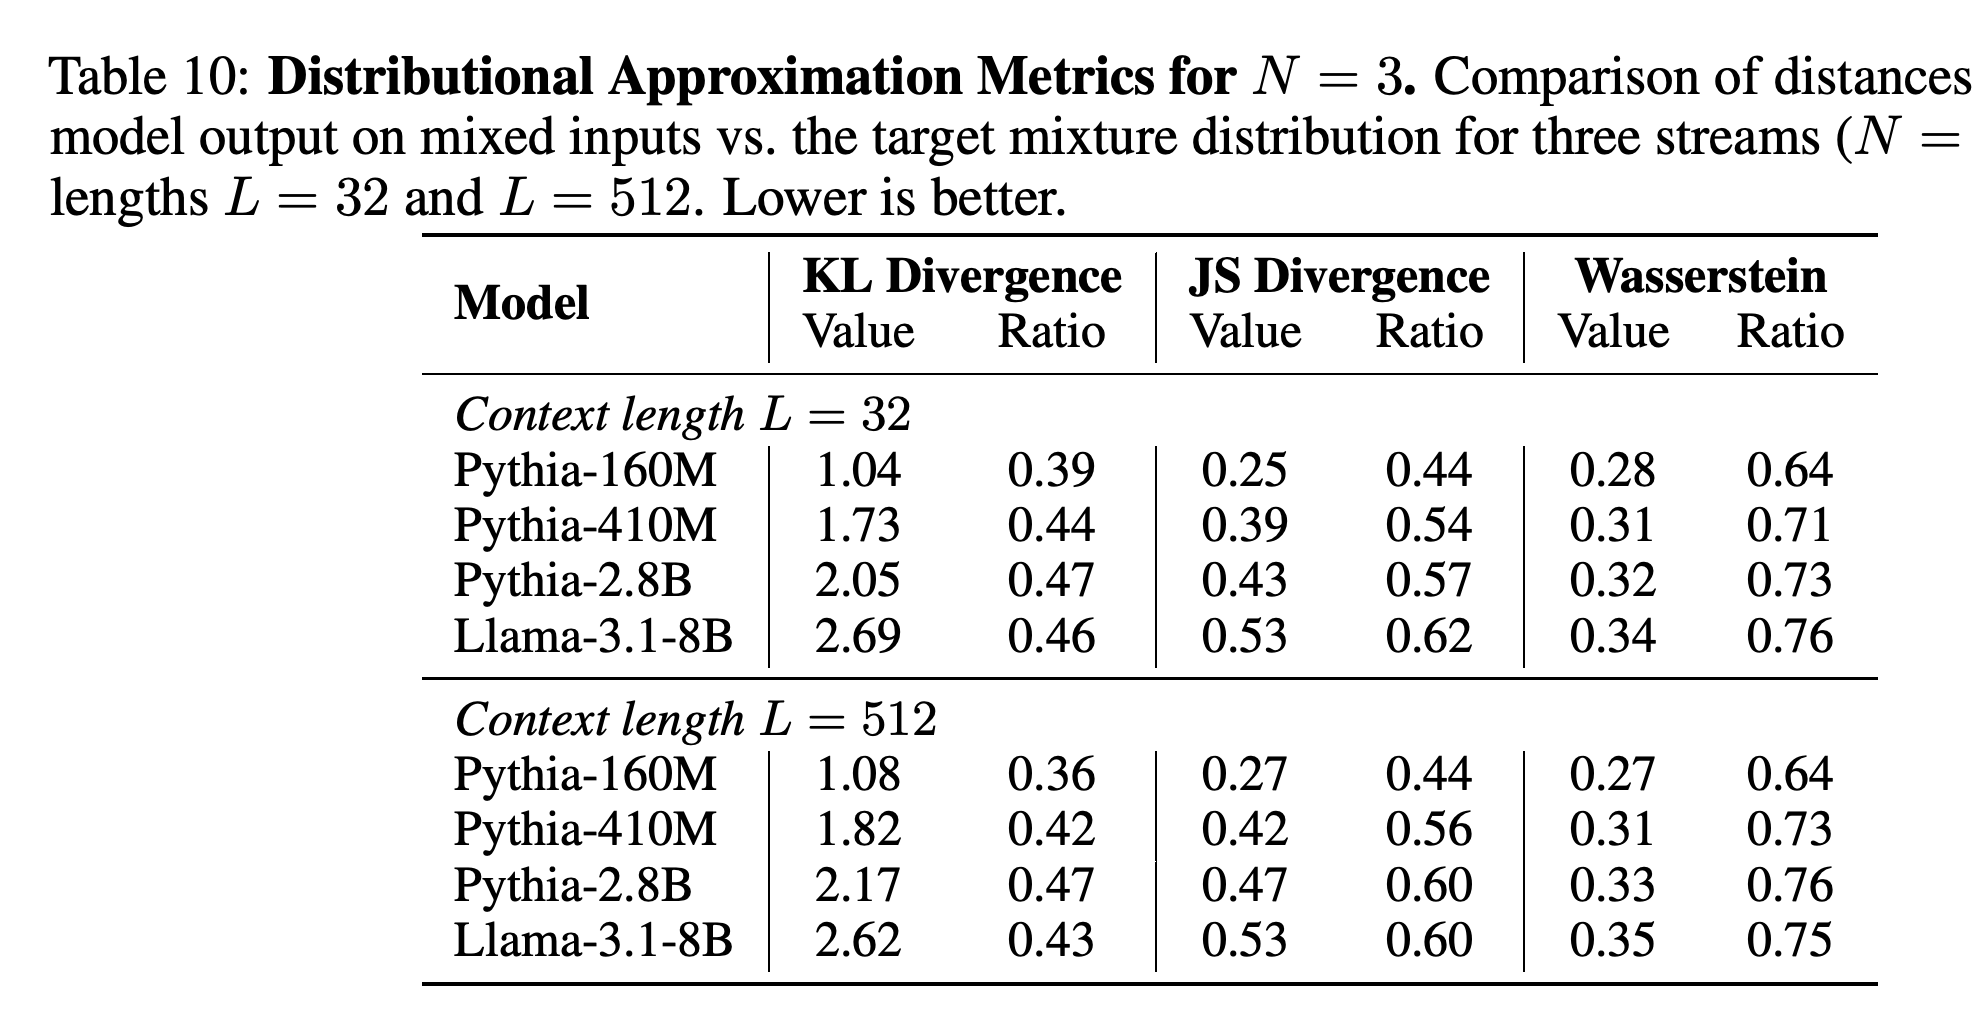
스트림 3개를 혼합해도 보고된 모든 지표와 길이에서 무관한 문맥 기준보다 목표 분포에 가깝다. 이는 분포 구조가 보존됨을 보여주지만, 스트림 3개를 독립적으로 생성할 수 있음을 입증하지는 않는다.
스트림을 2개에서 3개로 늘리면 보고된 모든 근사 비율이 나빠진다. KL의 최대 증가폭은 L = 512의 Pythia-2.8B에서 +0.10이며, 본문이 제시한 상한 +0.09를 넘는다.
부록
- A Compute Resources: Pythia-2.8B를 150,000 steps 동안 미세조정하는 데 2×A100 80GB 그래픽 처리 장치(GPU)에서 약 114시간이 걸린다. 같은 환경에서 Qwen2.5-3B와 Llama-3.2-3B 증류에는 각각 132시간과 128시간이 걸린다. 160M 가이드를 사용하는 Pythia-1.4B Joint Contrastive 학습에는 단일 A100 80GB GPU에서 68시간이 걸린다.
- B Frequency-Baseline Control: 단일 스트림 Pythia-2.8B로 무관한 스트림의 “정답 다음 토큰”을 예측하는 부록의 실험에서 top-3, top-10, top-100 복원율은 각각 1.12%, 2.63%, 10.41%이며, 같은 위치의 토큰 중복도는 0.2%다. 이 대조 실험의 복원율은 보고된 혼합 입력 복원율보다 훨씬 낮다. 다만 목표 토큰을 설명하는 용어가 독립 모델의 예측을 명시적으로 사용하는 Figure 1과 다르다.
- C Hidden-state additivity error: 각 표현에서 해당 계층의 평가셋 평균을 빼서 중심화한 뒤, 혼합 표현과 독립 표현의 합을 각각 정규화하고 유클리드 거리를 측정한다. 텍스트 쌍, 위치, 계층에 걸쳐 평균한 값을 사전학습 변화를 추적하는 요약 오차로 사용한다.
- D Confidence-vs-Rank Curve: Figure 3은 혼합 출력의 순위 중앙값과 독립 예측의 확률 사이의 관계를 보여준다. 캡션은 P > 0.5인 예측의 순위 중앙값이 약 3이라고 요약하지만, Pythia 곡선은 확률 1 부근에서 급격히 나빠진다. 따라서 이 관계가 모든 모델과 신뢰도 구간에서 일관되지는 않는다.
- E Contextual Stability of Superposition: Figure 4에서는 t < 20인 초기 위치에서 총변동거리가 더 낮고, 이후 약 128개 위치까지 모델별로 비교적 안정적인 수준을 유지한다. 이 위치들에서의 안정성은 시험한 구간에서 중첩이 지속됨을 뒷받침하지만, 상당한 불일치가 남아 있으므로 목표 분포에 가깝게 일치한다고 볼 수는 없다.
- F Layer-wise Linearization Dynamics: 연속한 계층의 표현을 중심화하고 Frobenius 정규화를 적용한다. 즉, 각 표현 행렬을 원소 제곱합의 제곱근으로 나눈 뒤, 가장 잘 맞는 선형 변환으로 비교한다. Figure 5는 모델별 양상과 미세조정 후 개선을 보여주며, 특히 Llama-3.2-3B에서 개선이 크다. 제시된 여러 기본 모델 곡선은 후반 계층이 거의 선형이라는 본문의 일반적인 설명을 뒷받침하지 않는다.
- G Additional Decoding Variants and Throughput: 이 부록은 혼합 분포 적합, 스트림 복원, 이야기 품질, 일반적인 언어 모델링, 실행 속도를 비교한다. 혼합 분포의 충실도가 개선되어도 개별 디코딩이 일관되게 좋아지거나 단일 스트림 품질이 유지되지는 않는다.
- G.1 Gradient-Optimized Inference (Logit Arithmetic): 모델 2개를 모두 동결한 상태에서 다음 토큰 교차엔트로피에 대한 경사하강법으로 스칼라 가이던스 계수를 보정한다. 본문은 이 사후 조정 방법이 Joint Contrastive 디코딩보다 성능이 낮다고 설명하지만, 인용한 Table 6에는 경사 최적화 결과를 별도로 식별할 수 있는 행이 없다.
- G.2 Two-Head Separation via Symmetry Breaking: 학습 가능한 입력 투영과 출력 헤드 2개로 스트림을 구분한다. 출력 헤드는 은닉 상태를 예측 점수로 바꾸는 별도의 매핑이며, 투영은 W_k = I + N(0, σ²), σ = 10⁻³으로 초기화한다. 동적 손실 균형 조정은 스트림 1개로 붕괴하는 현상에 대응하기 위해 스트림별 학습 가중치를 조절한다. Table 6의 혼합 입력 LAMBADA 정확도는 Pythia-2.8B에서 0.164, Llama-3.2-3B에서 0.105이며, 백본에 따라 이점이 일관되지 않는다.
- G.3 TinyStories LLM-as-Judge: OpenAI/GPT-5.2를 이야기 완성 결과의 자동 평가자로 사용한다. Pythia-2.8B에서 미세조정된 중첩은 문법 점수를 2.59에서 3.69로, 일관성 점수를 2.70에서 3.53으로 높인다. 창의성 점수는 2.08에서 2.13으로 바뀌며 독립 베이스라인의 5.72보다 낮다. Table 7에는 본문에서 설명한 줄거리 일관성과 추정 연령 결과가 빠져 있다.
- G.4 Single-stream Language Modeling Quality on FineWeb: Table 8은 각 목적함수로 학습한 뒤의 음의 로그우도와 퍼플렉시티를 보고한다. 음의 로그우도는 관측된 토큰에 부여하는 평균 손실이다. Joint Contrastive 결과는 작은 모델 베이스라인에 가깝지만, 증류를 통한 미세조정은 보고된 모델 계열 3개 모두에서 일반적인 언어 모델링 성능을 크게 떨어뜨린다.
- G.5 Throughput and Memory: 벤치마크는 프롬프트 길이 128, 생성 길이 128, n = 100회 실행을 사용하며, 평균 tokens/s와 95% 신뢰구간을 보고한다. Pythia-2.8B에서 헤드 2개를 사용하는 Separate는 109.6 ± 0.8 tokens/s, Guided는 79.4 ± 0.5, 일반적인 배치 크기 2의 추론은 113.1 ± 0.6, 순차 추론은 56.0 ± 0.3을 기록한다. Separate의 최대 메모리는 7.15 GB로 기본 추론의 순전파 1회에 필요한 6.34 GB보다 크며, Llama-3B+1B Guided의 최대 메모리는 12.93 GB다.
- H Attention-Patching: Stratified Examples: 순위 구간별로 균일하게 뽑은 예시에서 낮은 순위 [2,10]는 주로 문장부호와 기능어에, 중간 순위 [50,500]는 주로 내용어에, 높은 순위 [2000,20000]는 주로 내용어나 드문 토큰 조각에 해당한다. 이 예시들은 예측하기 쉬운 위치와 내용 토큰 위치의 정성적 구분을 뒷받침하지만, 일반적으로 적용할 수 있는 분류 절차를 완전히 명시하지는 않는다.
- I Distributional Metrics for N = 3 Superposition: 무관한 문맥 3개를 같은 가중치로 혼합하면, 보고된 모든 모델과 거리에서 L = 32와 L = 512의 근사 비율이 1보다 작다. 스트림 2개를 혼합할 때보다 KL 비율은 +0.04에서 +0.10, JS 비율은 +0.03에서 +0.09, Wasserstein 비율은 +0.01에서 +0.08만큼 증가한다. 이 실험은 분포 보존을 평가하며, 스트림 3개의 성공적인 디코딩을 평가하지는 않는다.
- J Hyperparameters and Implementation Details: 증류에는 AdamW 옵티마이저를 사용하며, 학습률은 헤드에 10⁻³, 백본에 10⁻⁴을 적용한다. ReduceLROnPlateau 학습률 스케줄러의 patience는 10, factor는 0.5이고, 온도는 2.0, 최대 길이는 128이다. Joint Contrastive 학습은 Qwen과 Llama에 학습률 5×10⁻⁵와 유효 배치 크기 16을, Pythia에 10⁻⁴과 배치 크기 8을 사용한다. 최대 길이는 512, 그래디언트 클리핑 기준은 1.0이며, bf16 저정밀도 연산과 scaled dot-product attention(SDPA)을 사용한다. 체크포인트는 Qwen과 Llama에서 30,000 steps, Pythia에서 700,000에 저장한다. 두 헤드 학습에서는 균형 조정 강도 γ = 5.0, 지수이동평균 모멘텀 0.99, 워밍업 100스텝을 사용하고 계수를 [0.1,10.0]으로 클리핑한다.
- K LLM as a Judge Prompt: Listing 1은 이야기 완성 결과의 평가 템플릿을 제시하며, 도입부와 후속 텍스트를 ***로 구분한다. 문법, 창의성, 일관성, 줄거리 일관성을 10점 만점으로 평가하고 추정 연령대를 제시하도록 요청한다. 이 코드 목록은 평가 절차를 문서화한다.
- L Impact Statement: 저자들은 처리량 향상으로 얻을 수 있는 인프라상의 이점을 제안하고, 무관하거나 민감한 스트림이 의도치 않게 섞이는 문제를 배포 시 우려 사항으로 제시한다. 논문은 후속 사용 단계에서 스트림 격리가 실패하는 문제를 실험으로 평가하지 않는다.
짧은 생각
가장 강한 근거는 토큰 유형별 분석과 중첩을 강화하는 미세조정을 결합한 결과다. 내용 토큰 위치의 순위 중앙값은 284에서 5로 개선되지만, 예측하기 쉬운 위치는 개선되지 않는다. donor patching 대조 실험에서는 높은 전체 일치도와 심각한 과제 실패가 함께 나타난다. 따라서 이 결과는 전체 순위 보존만으로는 확인할 수 없는 효과를 보여준다.
낮은 생성 정확도, 단일 스트림 성능 저하, 보조 모델 비용으로 인해 배포상의 이점은 아직 제한적이다. 메커니즘을 해석하고 개선 효과를 재현하려면 확률 분포의 산술평균을 사용하는 학습 목표와 조건부 기하평균 주장을 구분해야 한다. 초기 위치의 불일치에 관한 설명이 일관되지 않고, 인용한 결과 행이 빠져 있다는 점도 고려해야 한다.