


Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation 요약 설명
09 Oct 2026 | Paper Review Parallel Decoding Hierarchical Language Modeling Vector Quantization목차
이번 글에서는 Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 10월 9일(Arxiv)
- Kumbong, Hermann, Khare, Ishan S., Mlauzi, Iddah, Woen, Andrew, Ding, Charles, Buchanan, E. Kelly, Arora, Simran, Mirhoseini, Azalia, Ré, Christopher.
- Department of Computer Science, Stanford University, Department of Electrical Engineering, Stanford University, Together AI
- 논문 링크
- Github
- Project Page
요약
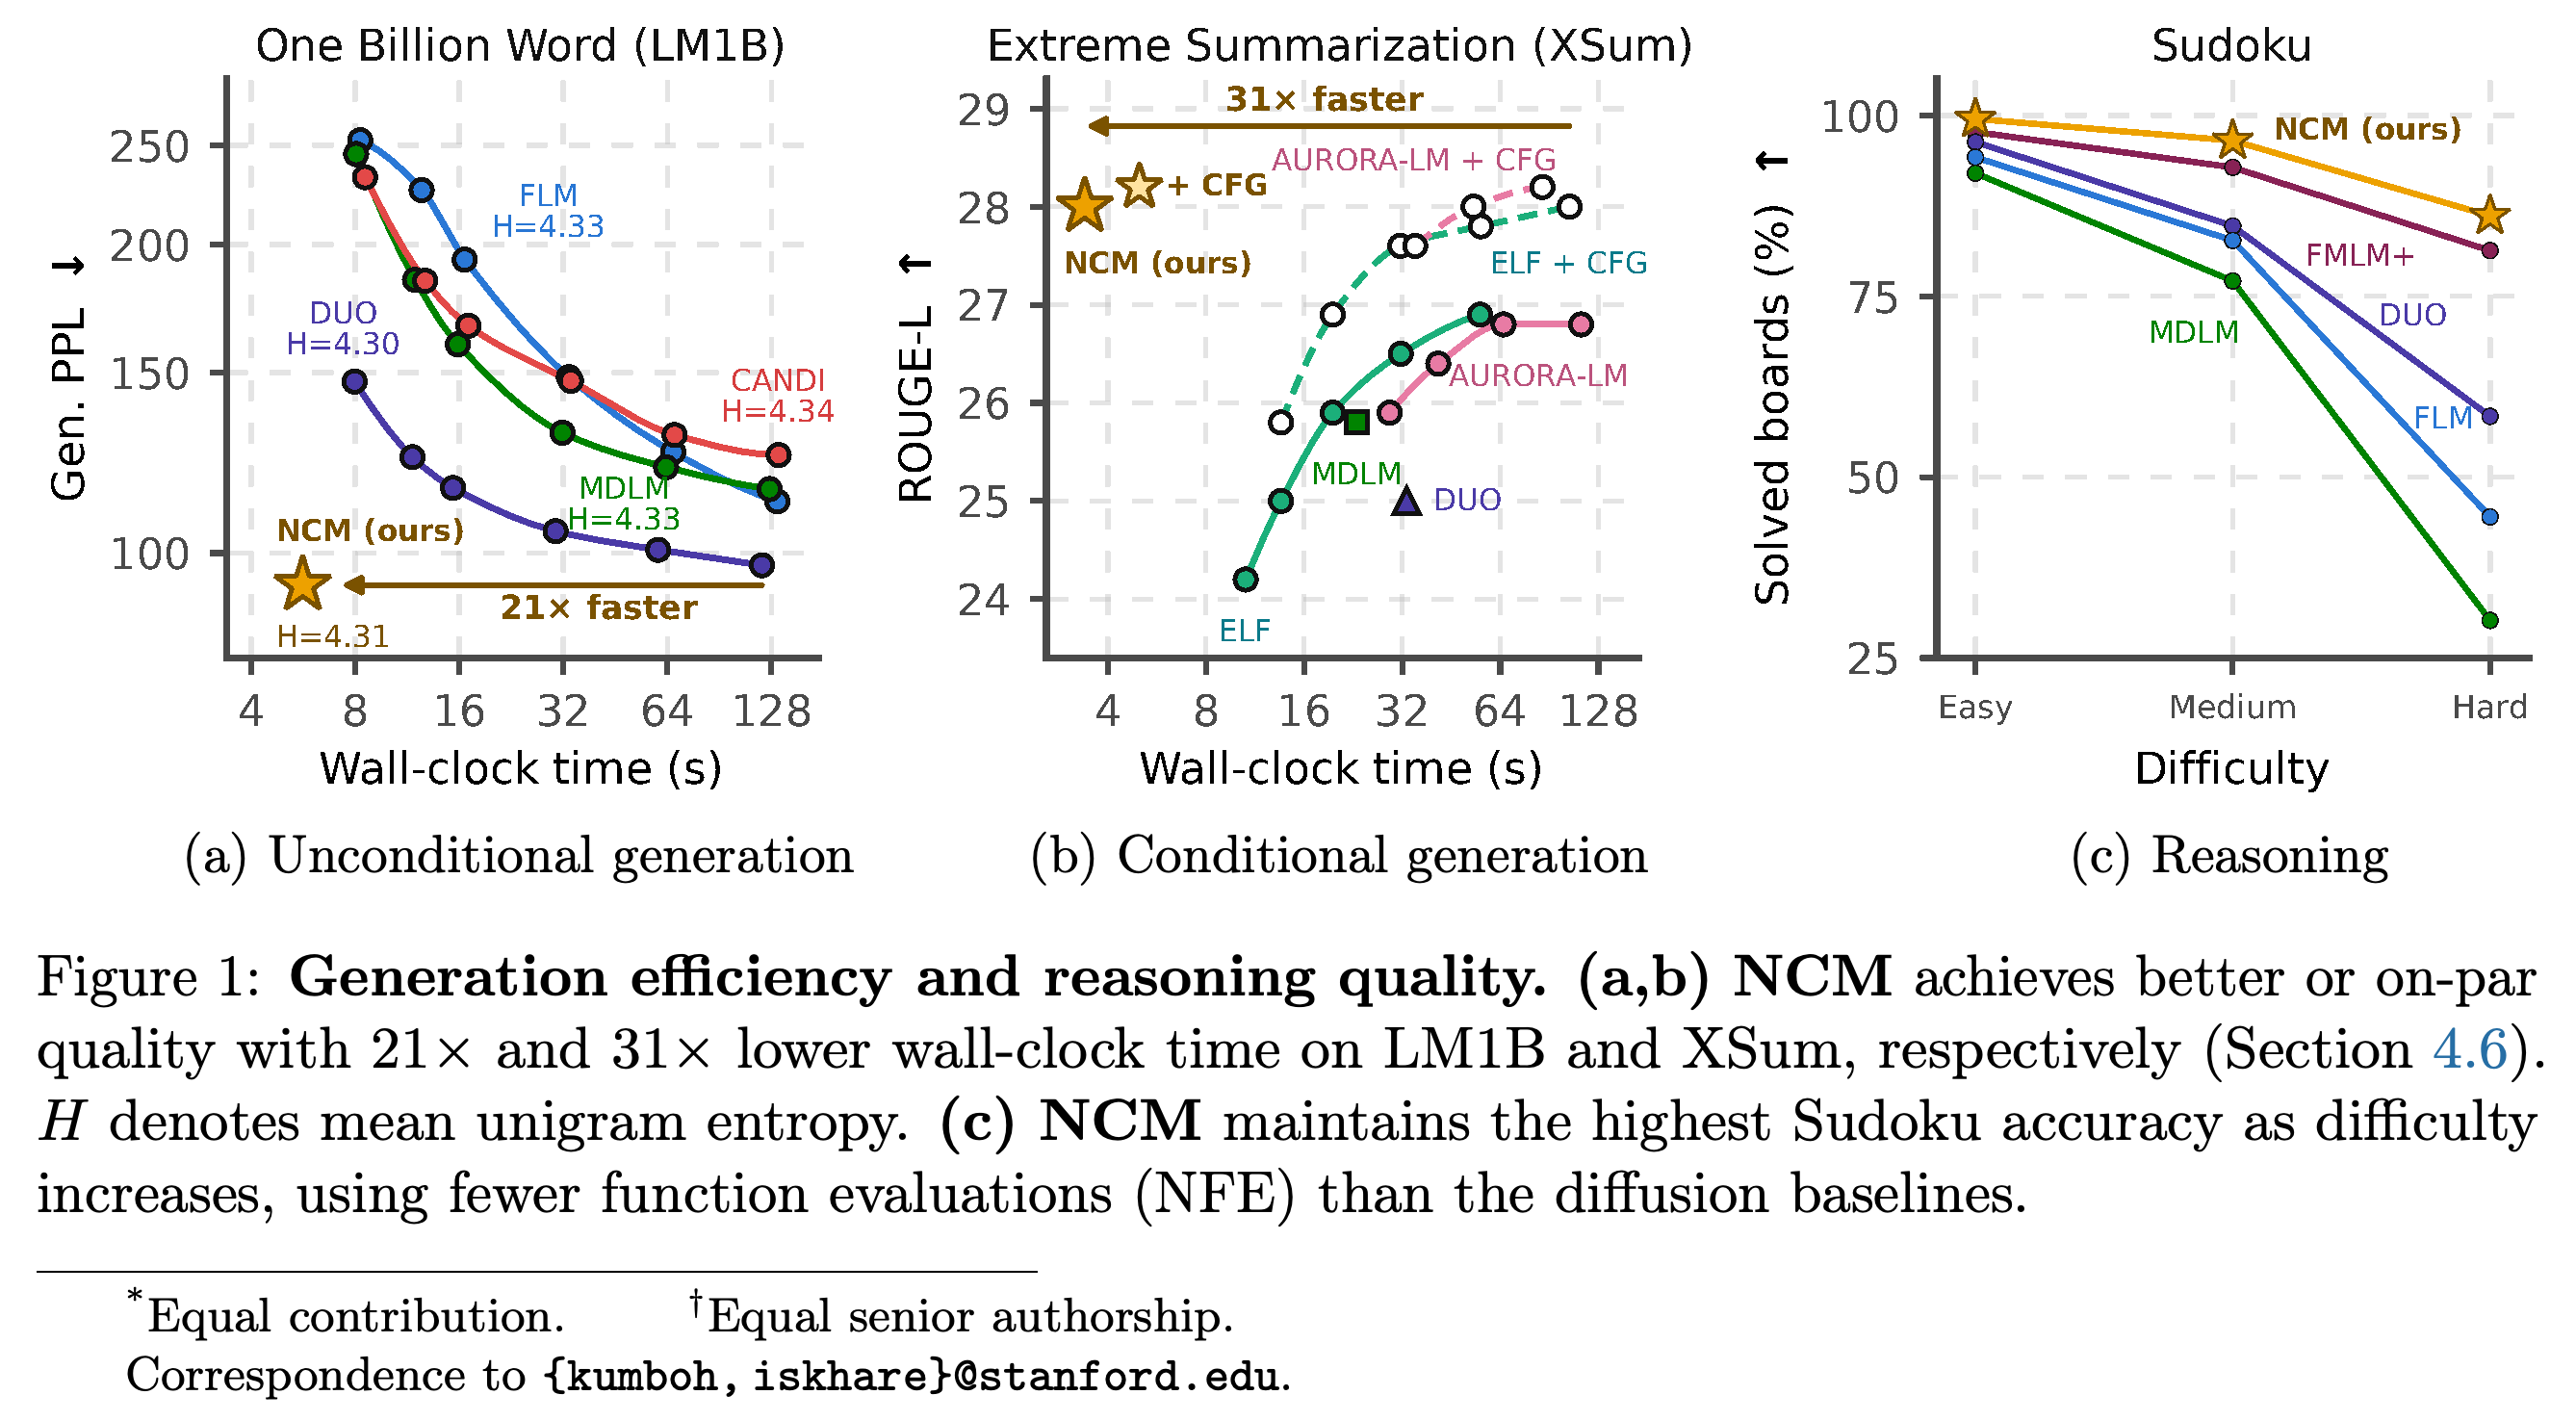
- 반복적 언어 모델이 전체 시퀀스를 여러 번 처리하면 병렬 텍스트 생성에도 많은 비용이 들 수 있다. 비슷한 크기의 생성 모델을 비교했을 때 Next-Concept Modeling (NCM)은 One Billion Word (LM1B)에서 가장 강력한 diffusion 베이스라인보다 generative perplexity가 낮았으며, 논문의 시간 측정 조건에서 21배 빠르게 실행됐다. Generative perplexity는 생성된 텍스트를 참조 모델로 평가한 점수다.
- NCM은 이산 표현의 계층을 학습하고 각 계층의 코드를 병렬로 예측하면서 계층을 순서대로 생성한다. 번역에서도 경쟁력 있는 성능을 보이고 요약과 Sudoku에서도 좋은 결과를 보고한다. 고정된 생성 일정과 복원 오류는 한계로 남는다.
속도와 생성 품질을 비교하며, 단서 수가 줄어들어도 Sudoku에서 우위가 유지됨을 보여준다.
1 Introduction
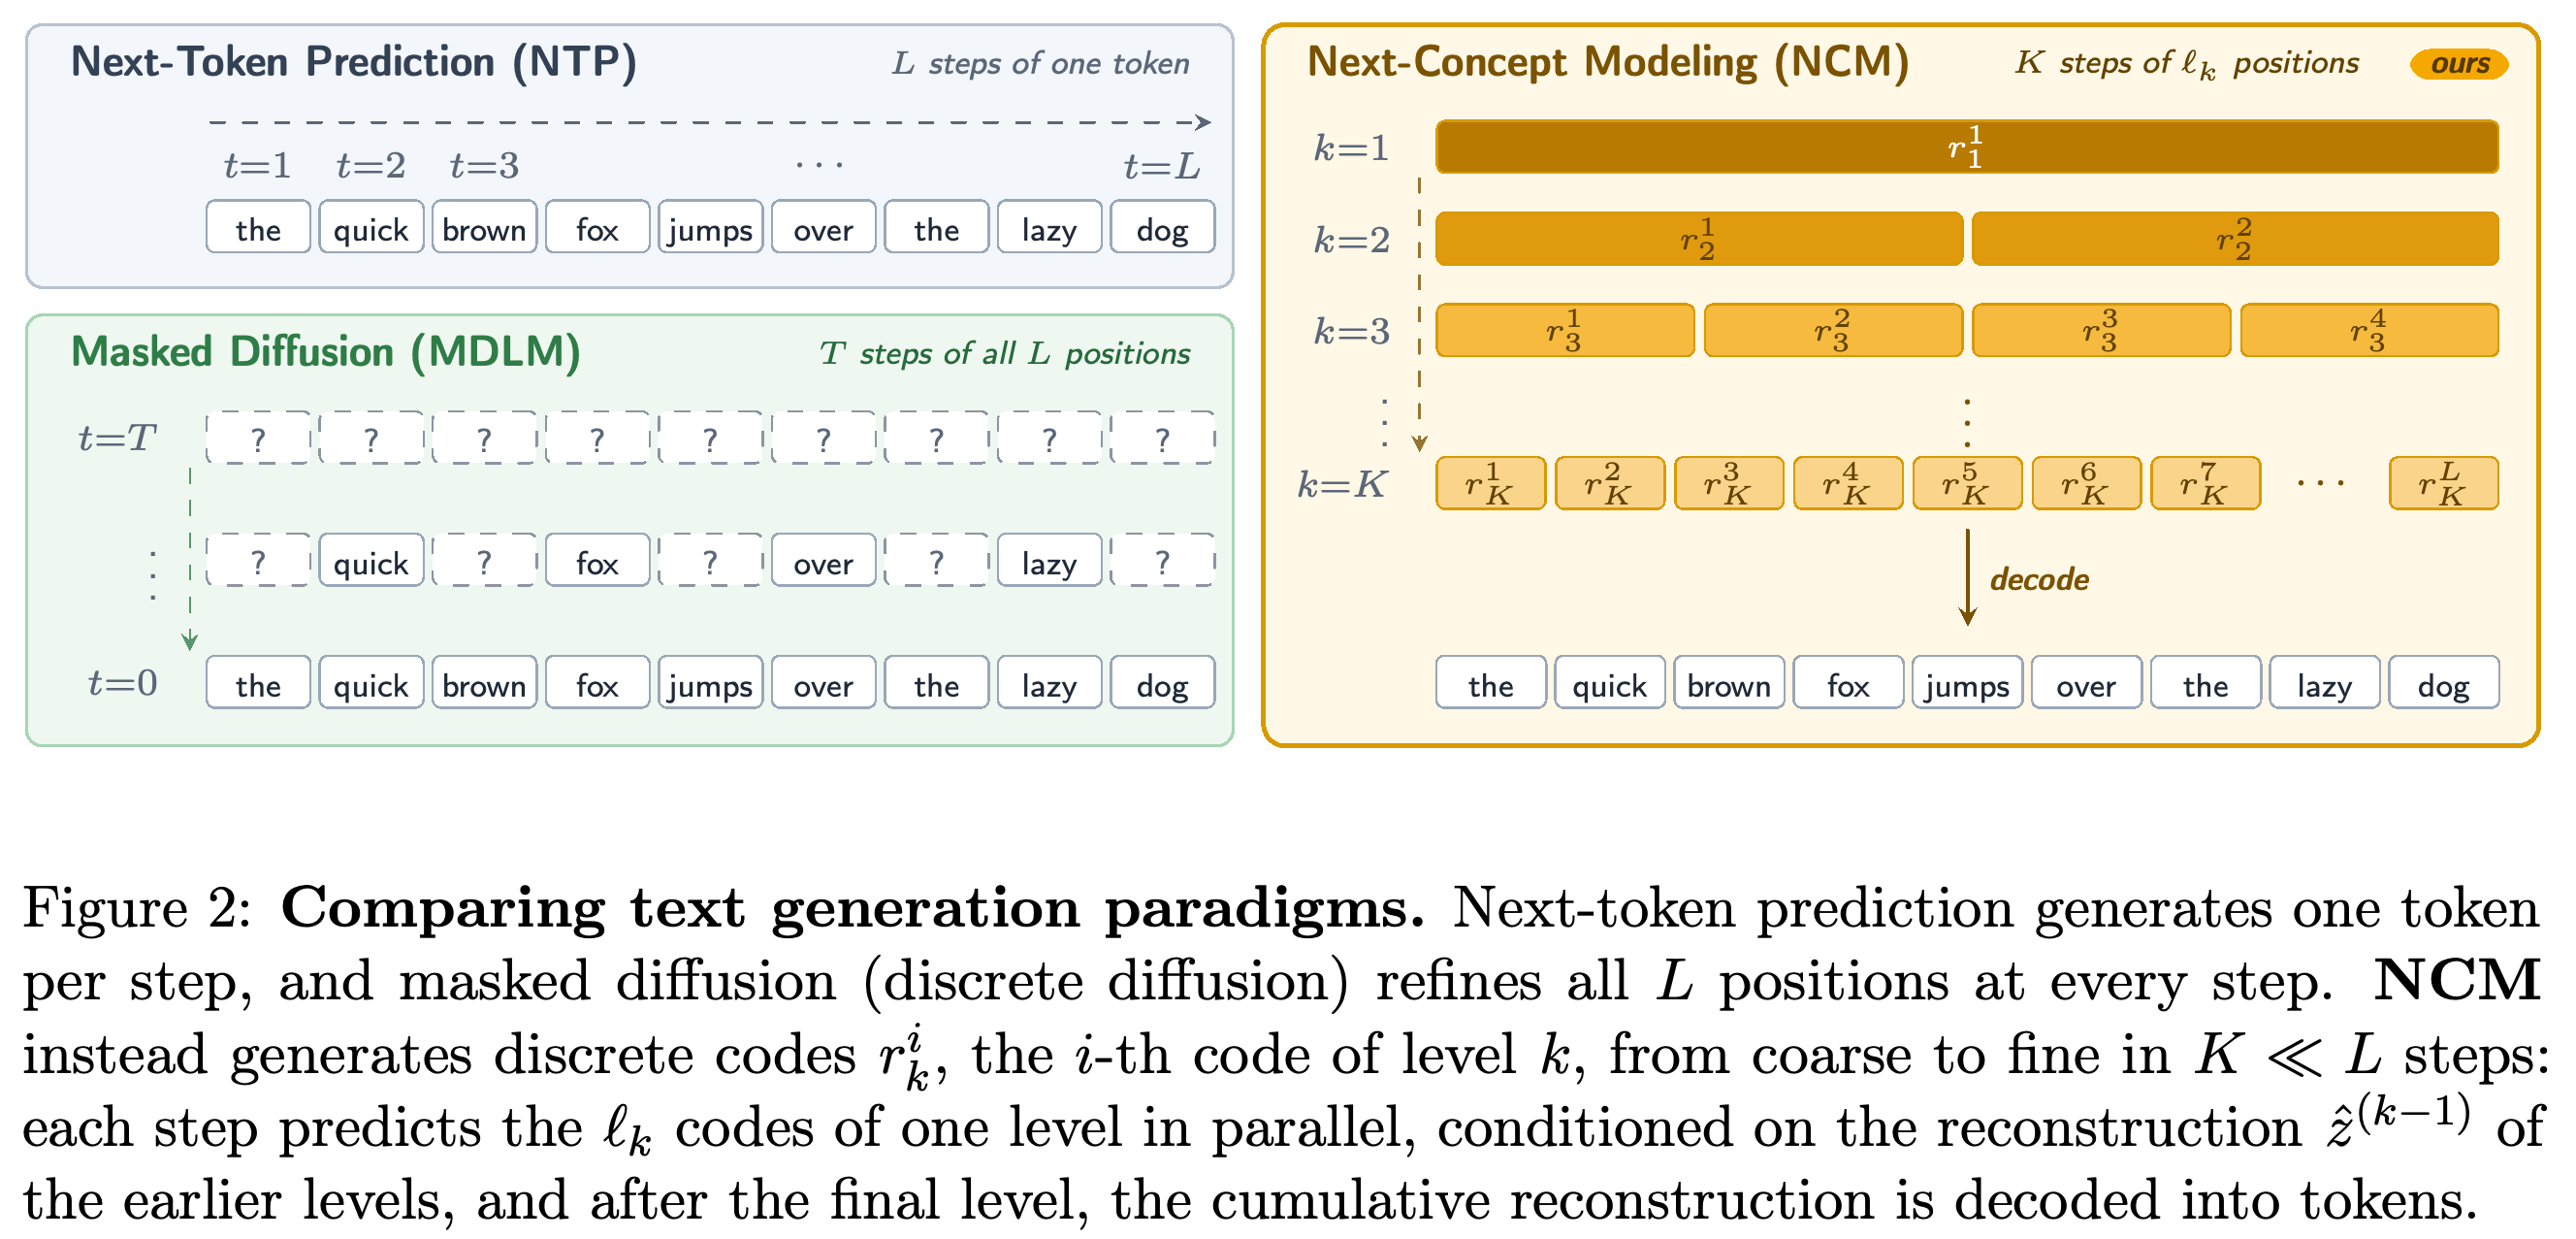
Diffusion 언어 모델은 반복적인 노이즈 제거로 여러 토큰을 생성하지만, 반복 횟수를 줄이면 품질이 떨어질 수 있고 각 반복에서 일반적으로 전체 시퀀스를 처리한다. NCM은 초기 계층에서 더 짧은 표현을 생성해 반복 횟수와 비용을 줄인다. Diffusion 언어 모델에 대해서는 Introspective Diffusion Language Models 요약 설명 글을 참조하라. Diffusion 언어 모델에 대해서는 Diffusion Language Models are Super Data Learners 요약 설명 글을 참조하라.
NCM은 코드 계층 전체를 한 번에 예측한다. 초기 계층은 출력보다 짧아 순차 반복과 초기 연산량을 줄인다.
2 Background & Related Work
NCM은 근사 오차를 순차적으로 표현하는 residual quantization과 해상도를 순서대로 생성하는 next-scale prediction을 이미지 생성에서 텍스트로 확장한다 [20, 21]. 이 계층 구조는 전체 시퀀스를 점차 높은 해상도로 표현한다.
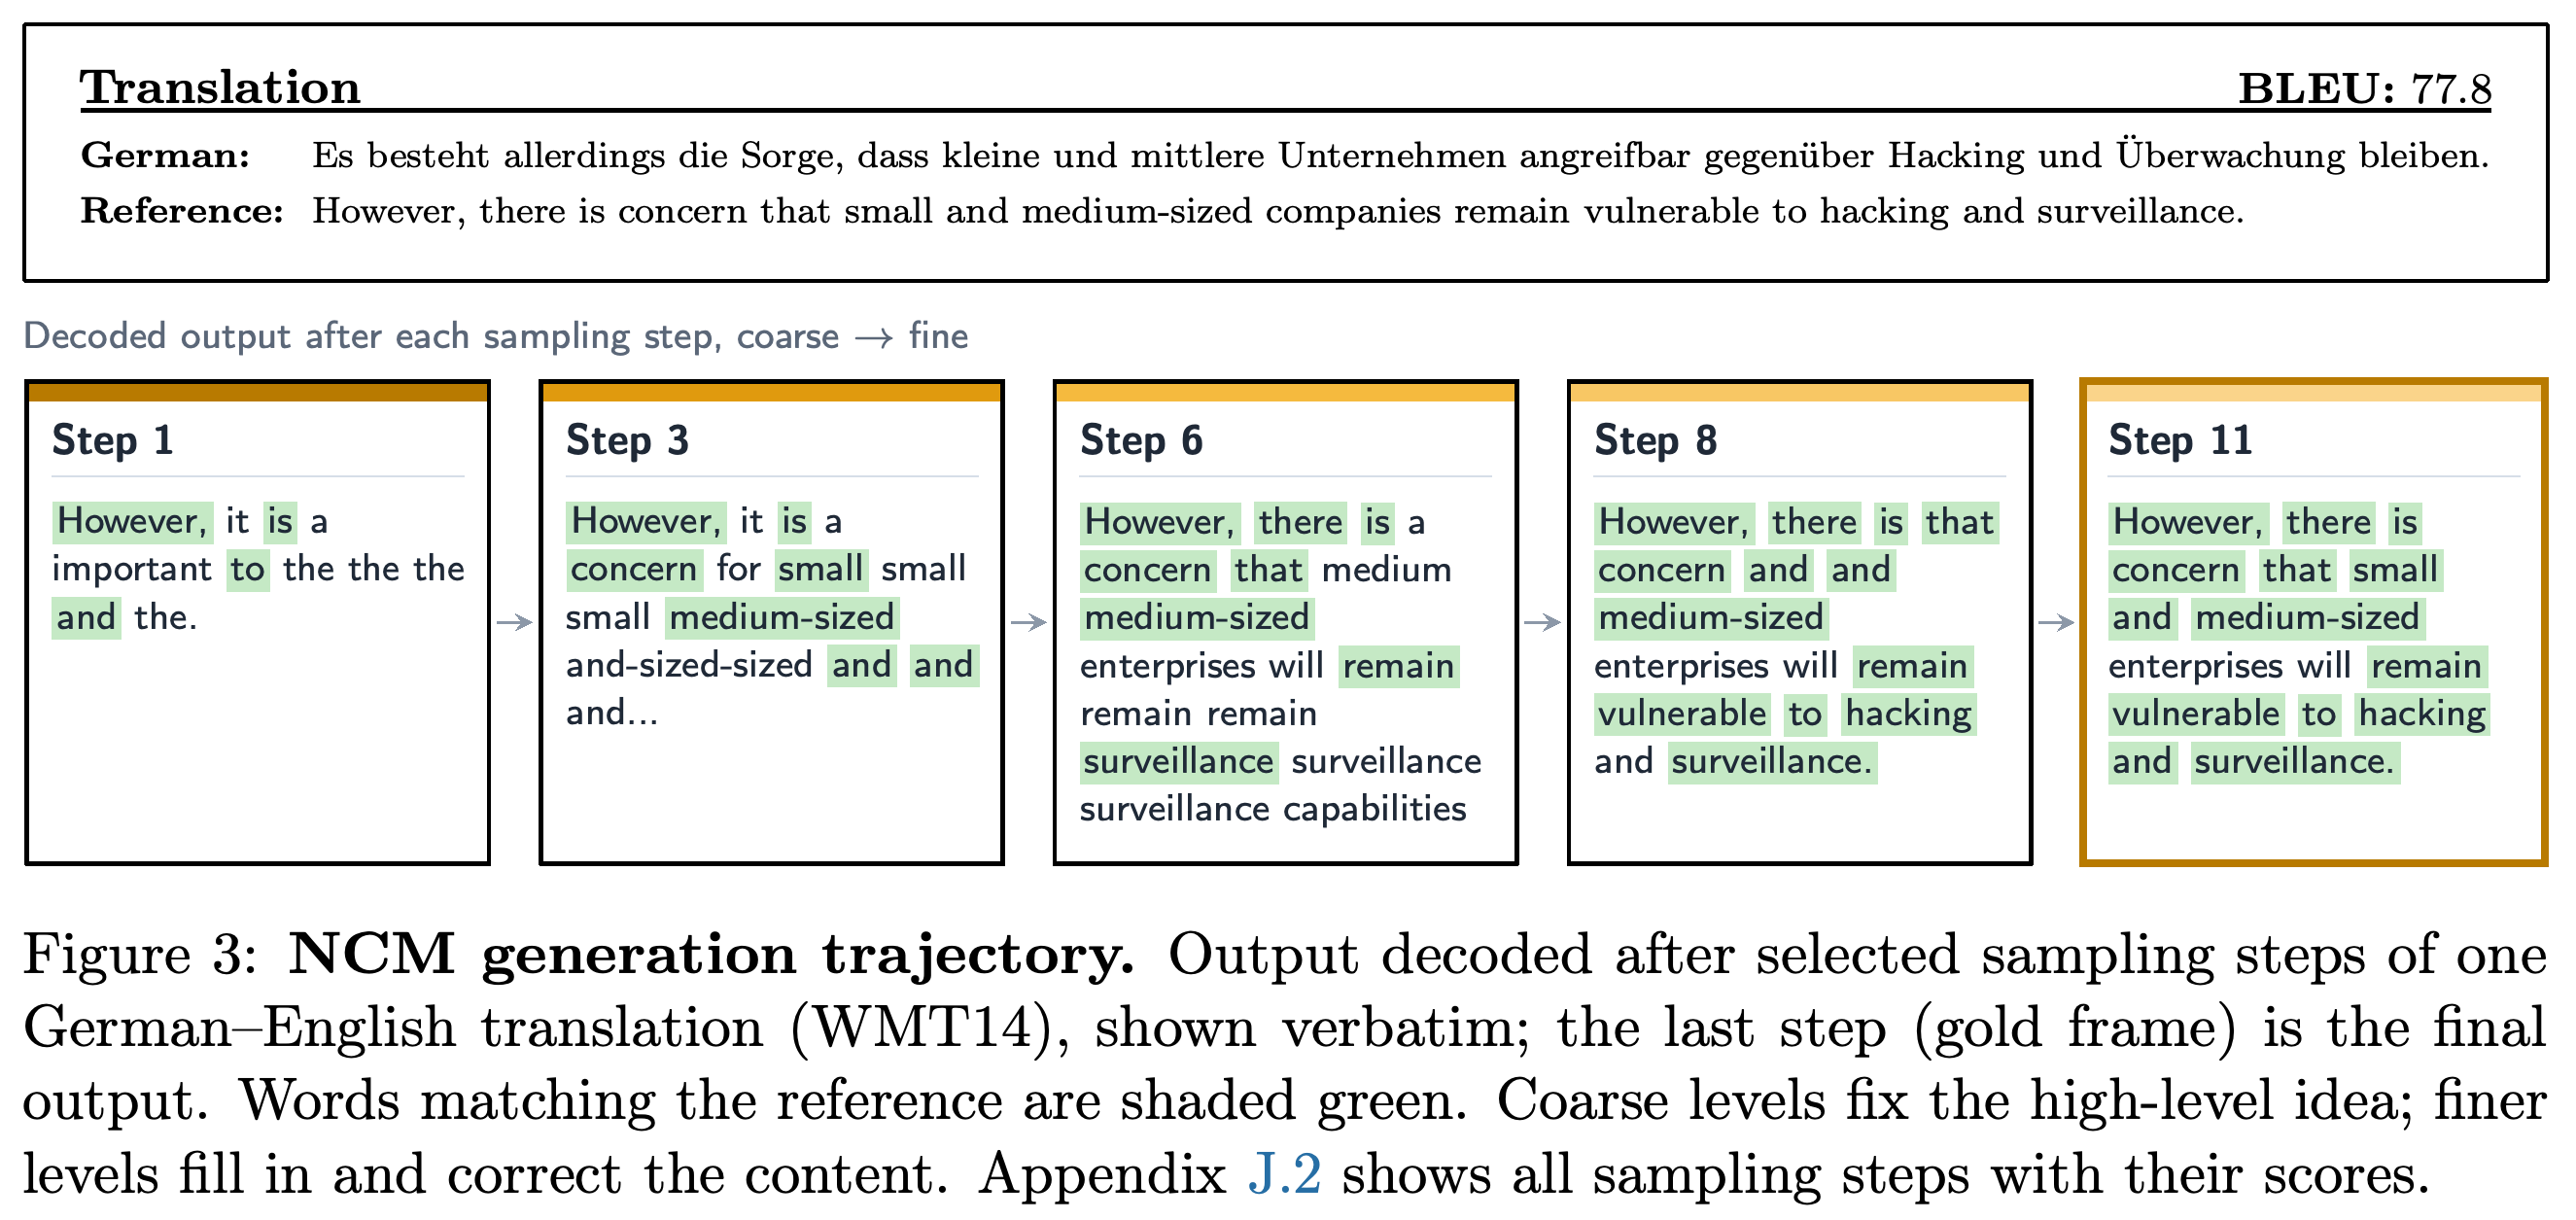
번역 1개가 반복적인 부분 텍스트에서 일관된 최종 문장으로 발전한다. 전체 생성 과정에서는 중간 품질이 단조롭게 증가하지 않는다.
3 Next-Concept Modeling
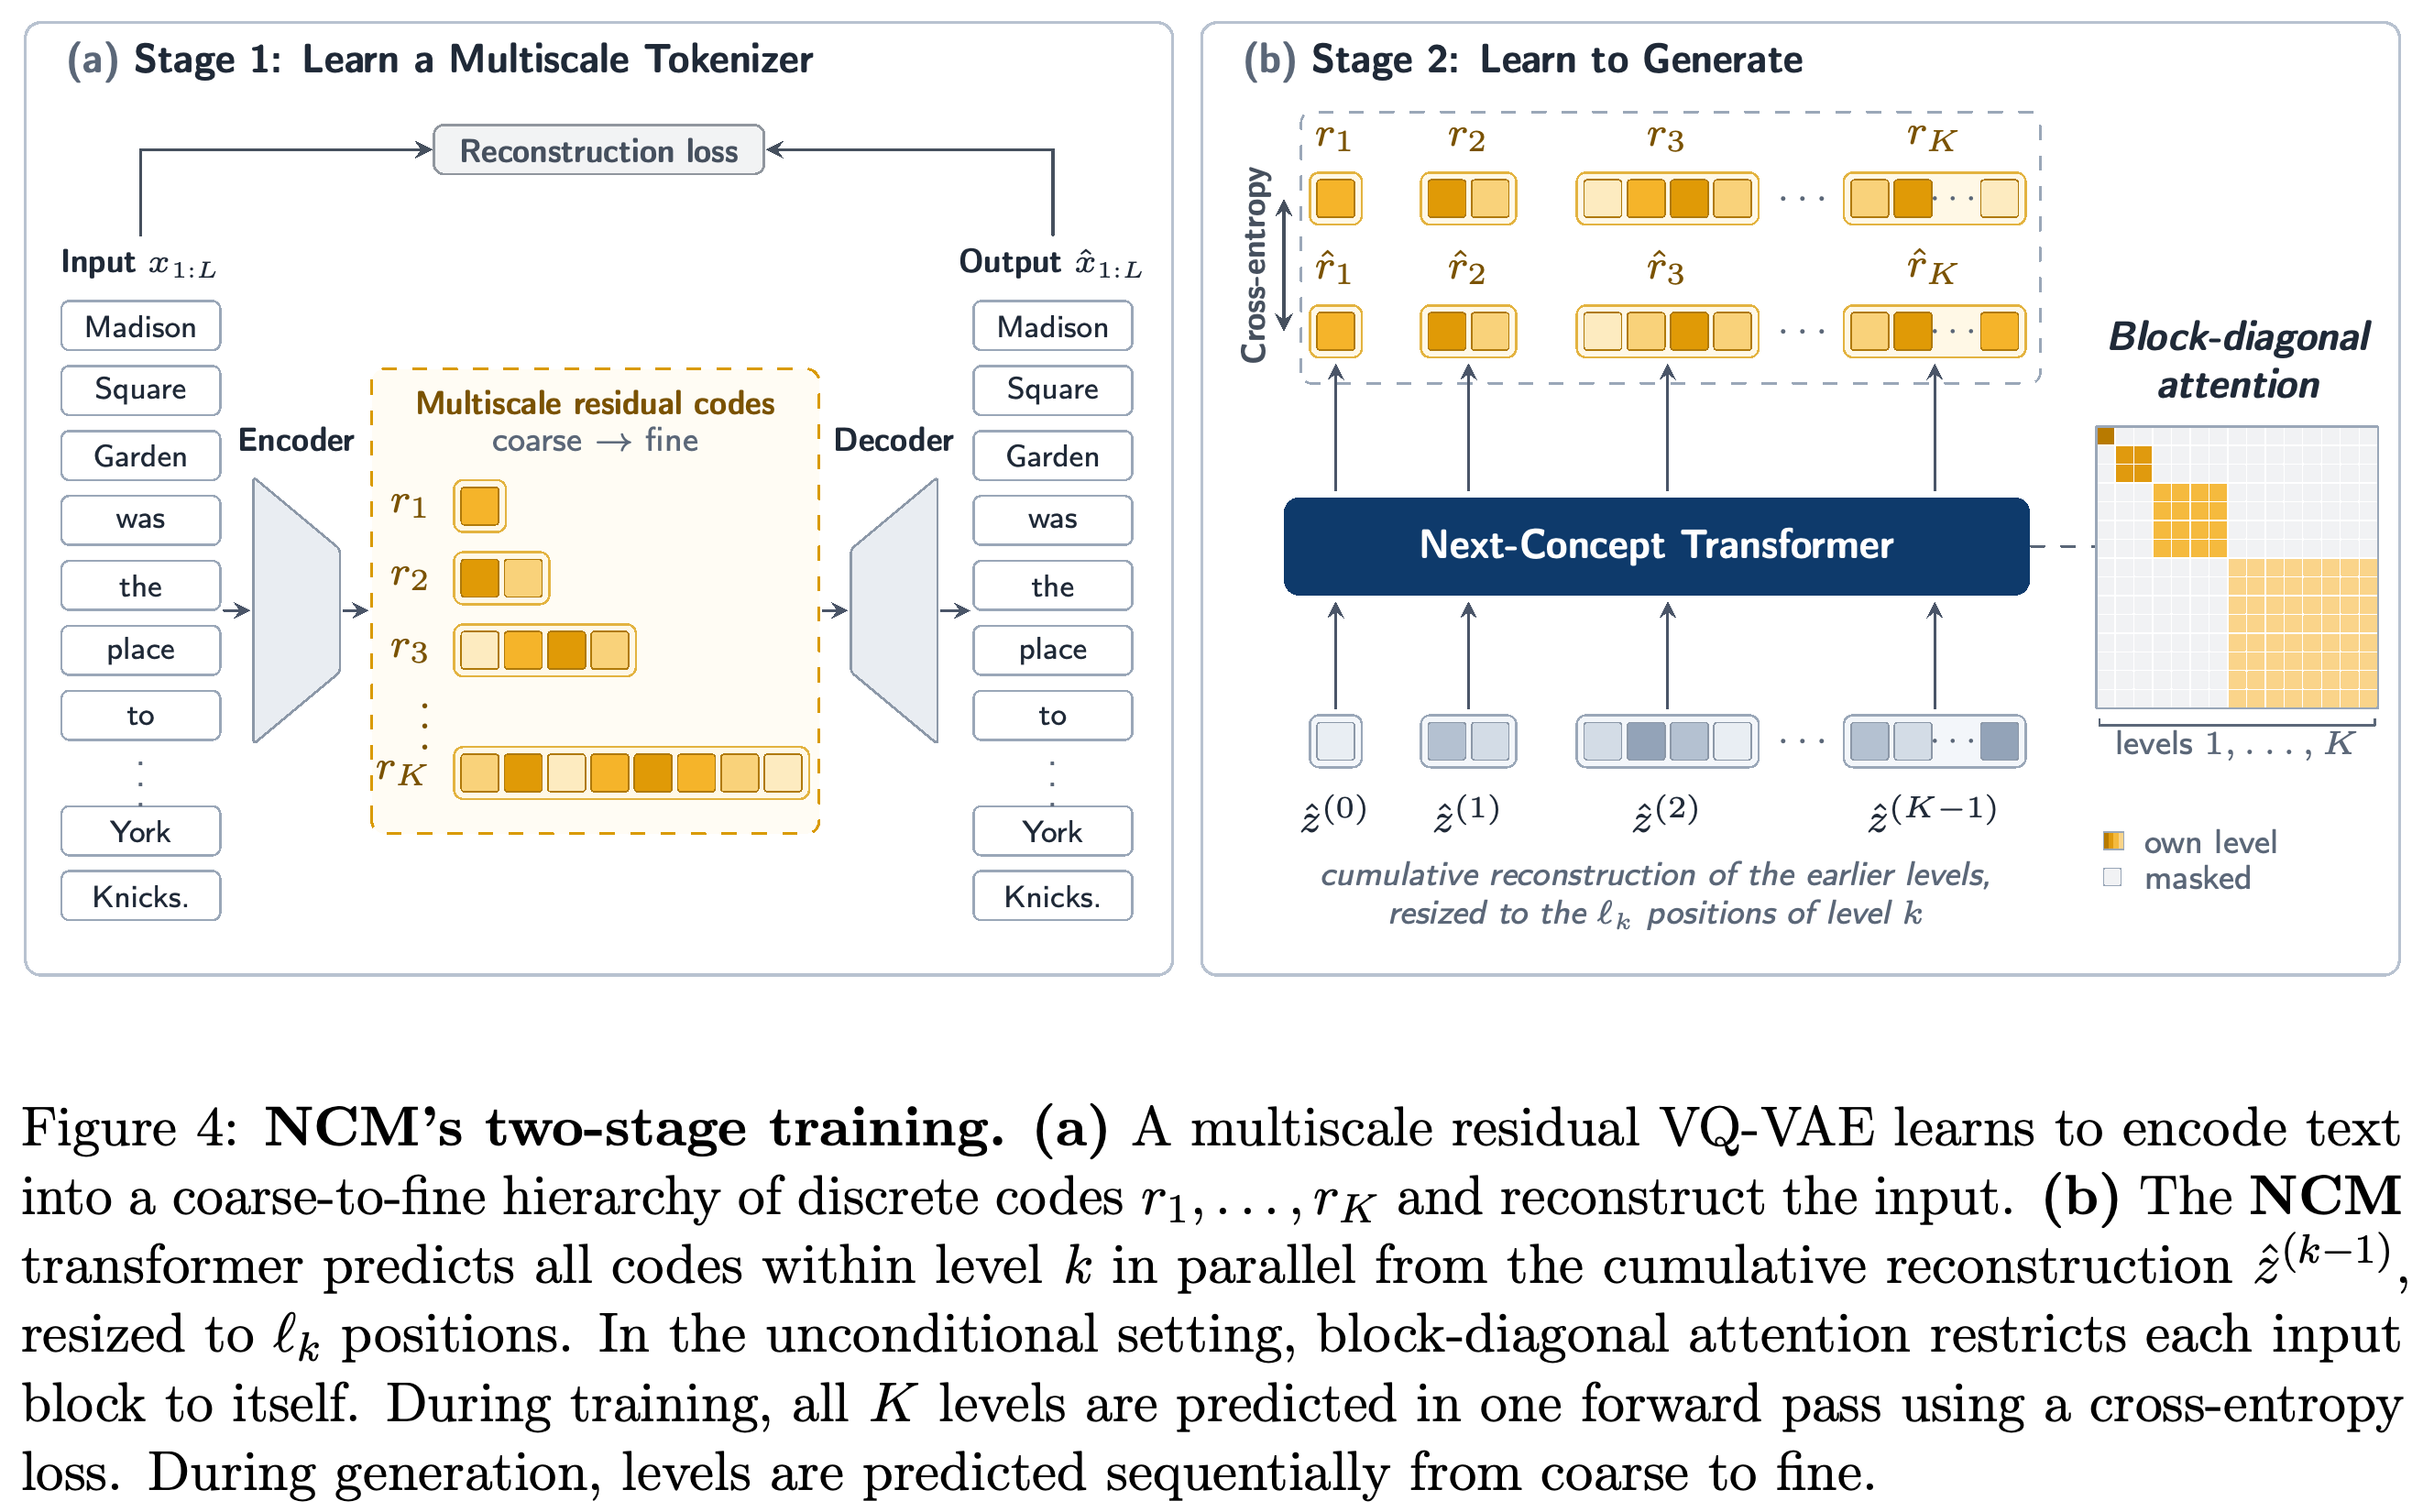
이 2단계 방법은 텍스트를 이산 코드로 표현하는 인코더-디코더인 multiscale residual vector-quantized variational autoencoder (VQ-VAE)를 먼저 학습한다. 이후 VQ-VAE를 고정하고 해당 코드를 생성하는 transformer를 학습한다. 논문은 거친 계층이 담는 정보를 “concept”이라고 부르며, 디코더는 완성된 표현을 다시 텍스트로 변환한다.
1단계에서는 이산 계층으로 텍스트를 복원하도록 학습하고, 2단계에서는 앞선 계층의 복원 결과를 사용해 각 계층을 예측한다.
3.1 Preliminaries
Vector quantization은 각 잠재 벡터를 학습된 코드북에서 가장 가까운 항목으로 대체한다. Residual quantization은 남은 오차를 근사하도록 코드북 항목을 추가하며, multiscale 방식은 점차 길어지는 코드 시퀀스를 전체 시퀀스 길이로 변환한다. Vector quantization에 대해서는 Scaling Image Tokenizers with Grouped Spherical Quantization 요약 설명 글을 참조하라.
3.2 Formulation
길이가 L인 시퀀스에 대해 토크나이저는 길이가 점차 증가하고 마지막 길이가 L인 K개 코드 계층을 생성한다. 생성 모델은 앞선 계층의 누적 복원 결과를 조건으로 삼아 각 계층의 코드를 독립적으로 병렬 샘플링하며, 순차 생성 단계는 K번 필요하다.
3.3 Multiscale Residual Tokenization
각 계층은 남은 잠재 오차를 다운샘플링하고 가장 가까운 코드북 항목을 선택한 뒤, 복원된 결과를 누적 표현에 더한다. 토크나이저 학습에서는 nested dropout으로 샘플링한 계층 접두부를 유지해 초기 계층이 유용한 부분 복원을 지원하도록 유도한다.
3.4 Coarse-to-Fine Generation
고정된 토크나이저는 모든 계층을 1번의 forward pass로 학습하는 transformer에 목표값을 제공한다. 추론 시에는 계층을 순서대로 생성한다. 학습 중에는 조건에 사용하는 코드 일부를 같은 코드북의 다른 항목으로 바꾸어 생성 코드의 오류에 덜 민감하도록 하며, 프롬프트 조건부 작업에는 prefix attention 패턴을 사용한다.
4 Experiments
저자들은 6개 데이터셋 각각에 별도의 토크나이저와 생성 모델을 학습하고 복원, 무조건 및 조건부 생성, Sudoku, 스케일링을 평가한다. 대부분의 생성 모델은 약 100M 파라미터를 가지며 Sudoku 생성 모델은 25M을 가진다.
4.1 Tokenizer Quality
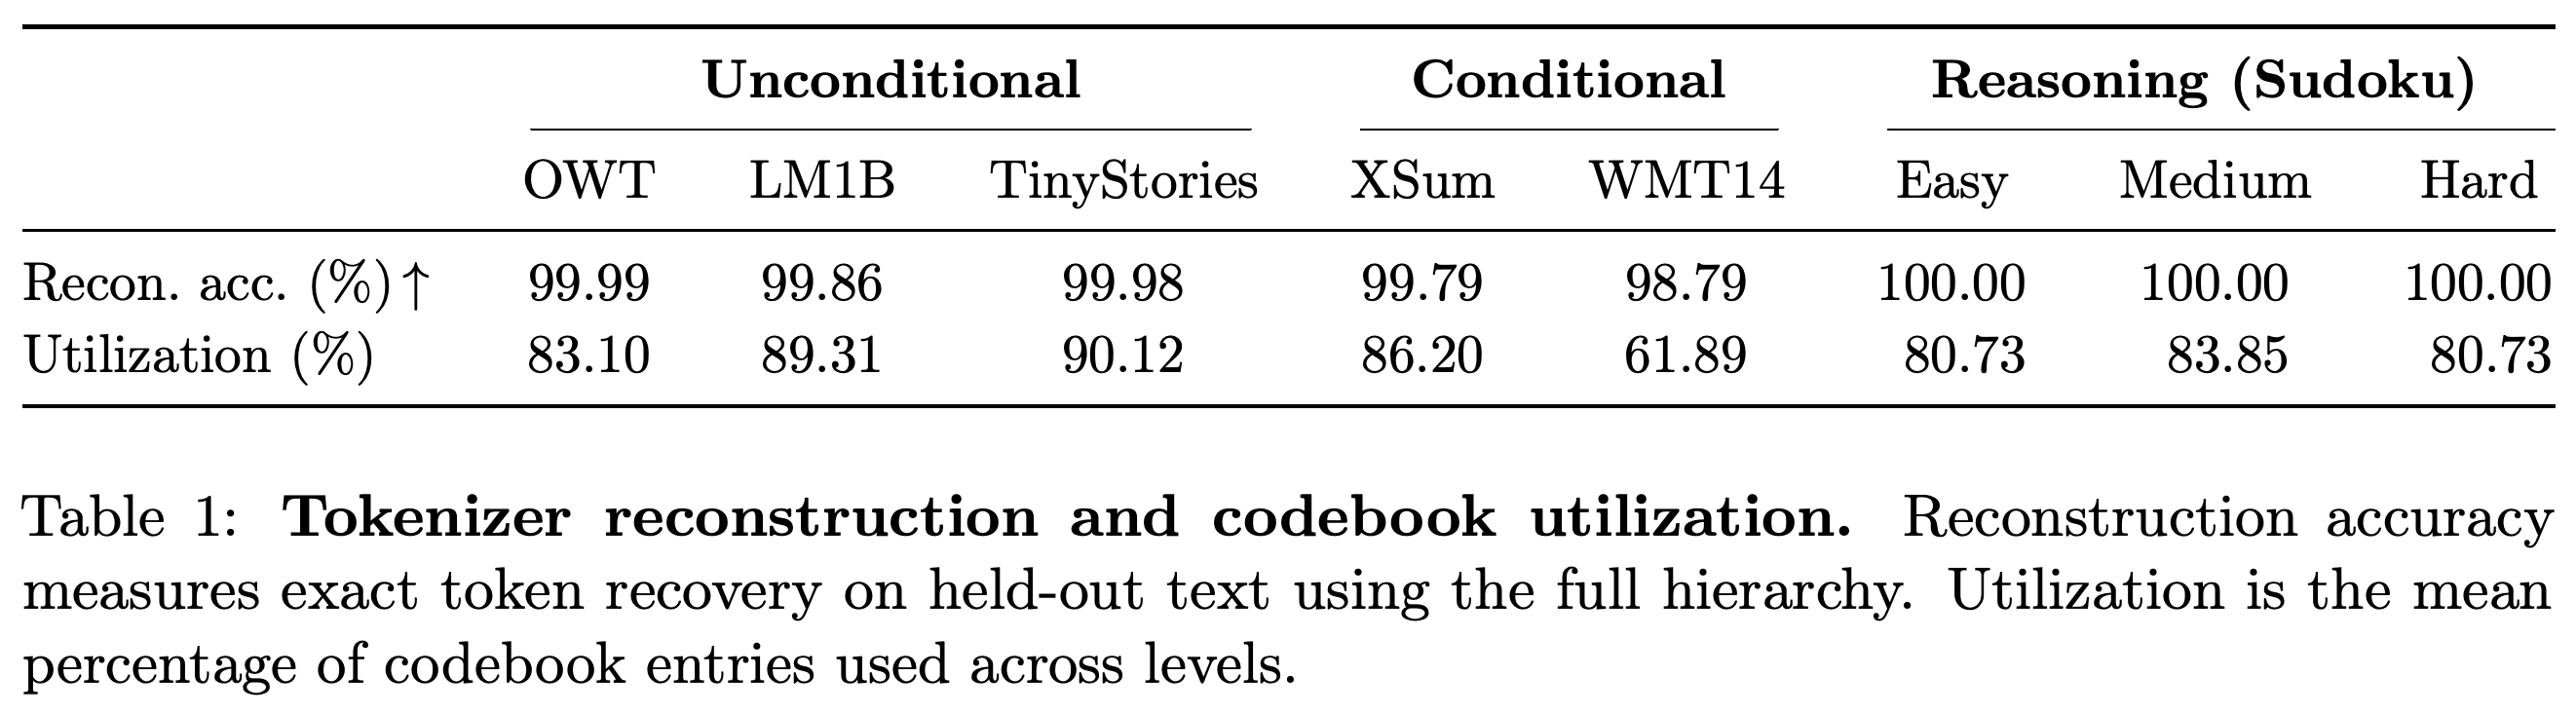
평가용 데이터에서 정확한 토큰 복원율은 OpenWebText 99.99%, LM1B 99.86%, XSum 99.79%, WMT14 98.79%이며, 3개 Sudoku 난이도에서는 모두 100.00%다. 계층별로 사용된 코드북 항목의 비율을 나타내는 평균 codebook utilization은 61.89%에서 90.12% 사이이며, 오류로 단어나 개체가 바뀔 수 있다.
나열된 데이터셋 중 WMT14의 복원 정확도가 가장 낮으며, 3개 Sudoku 설정에서는 평가용 데이터의 모든 토큰을 복원한다.
4.2 Unconditional Generation
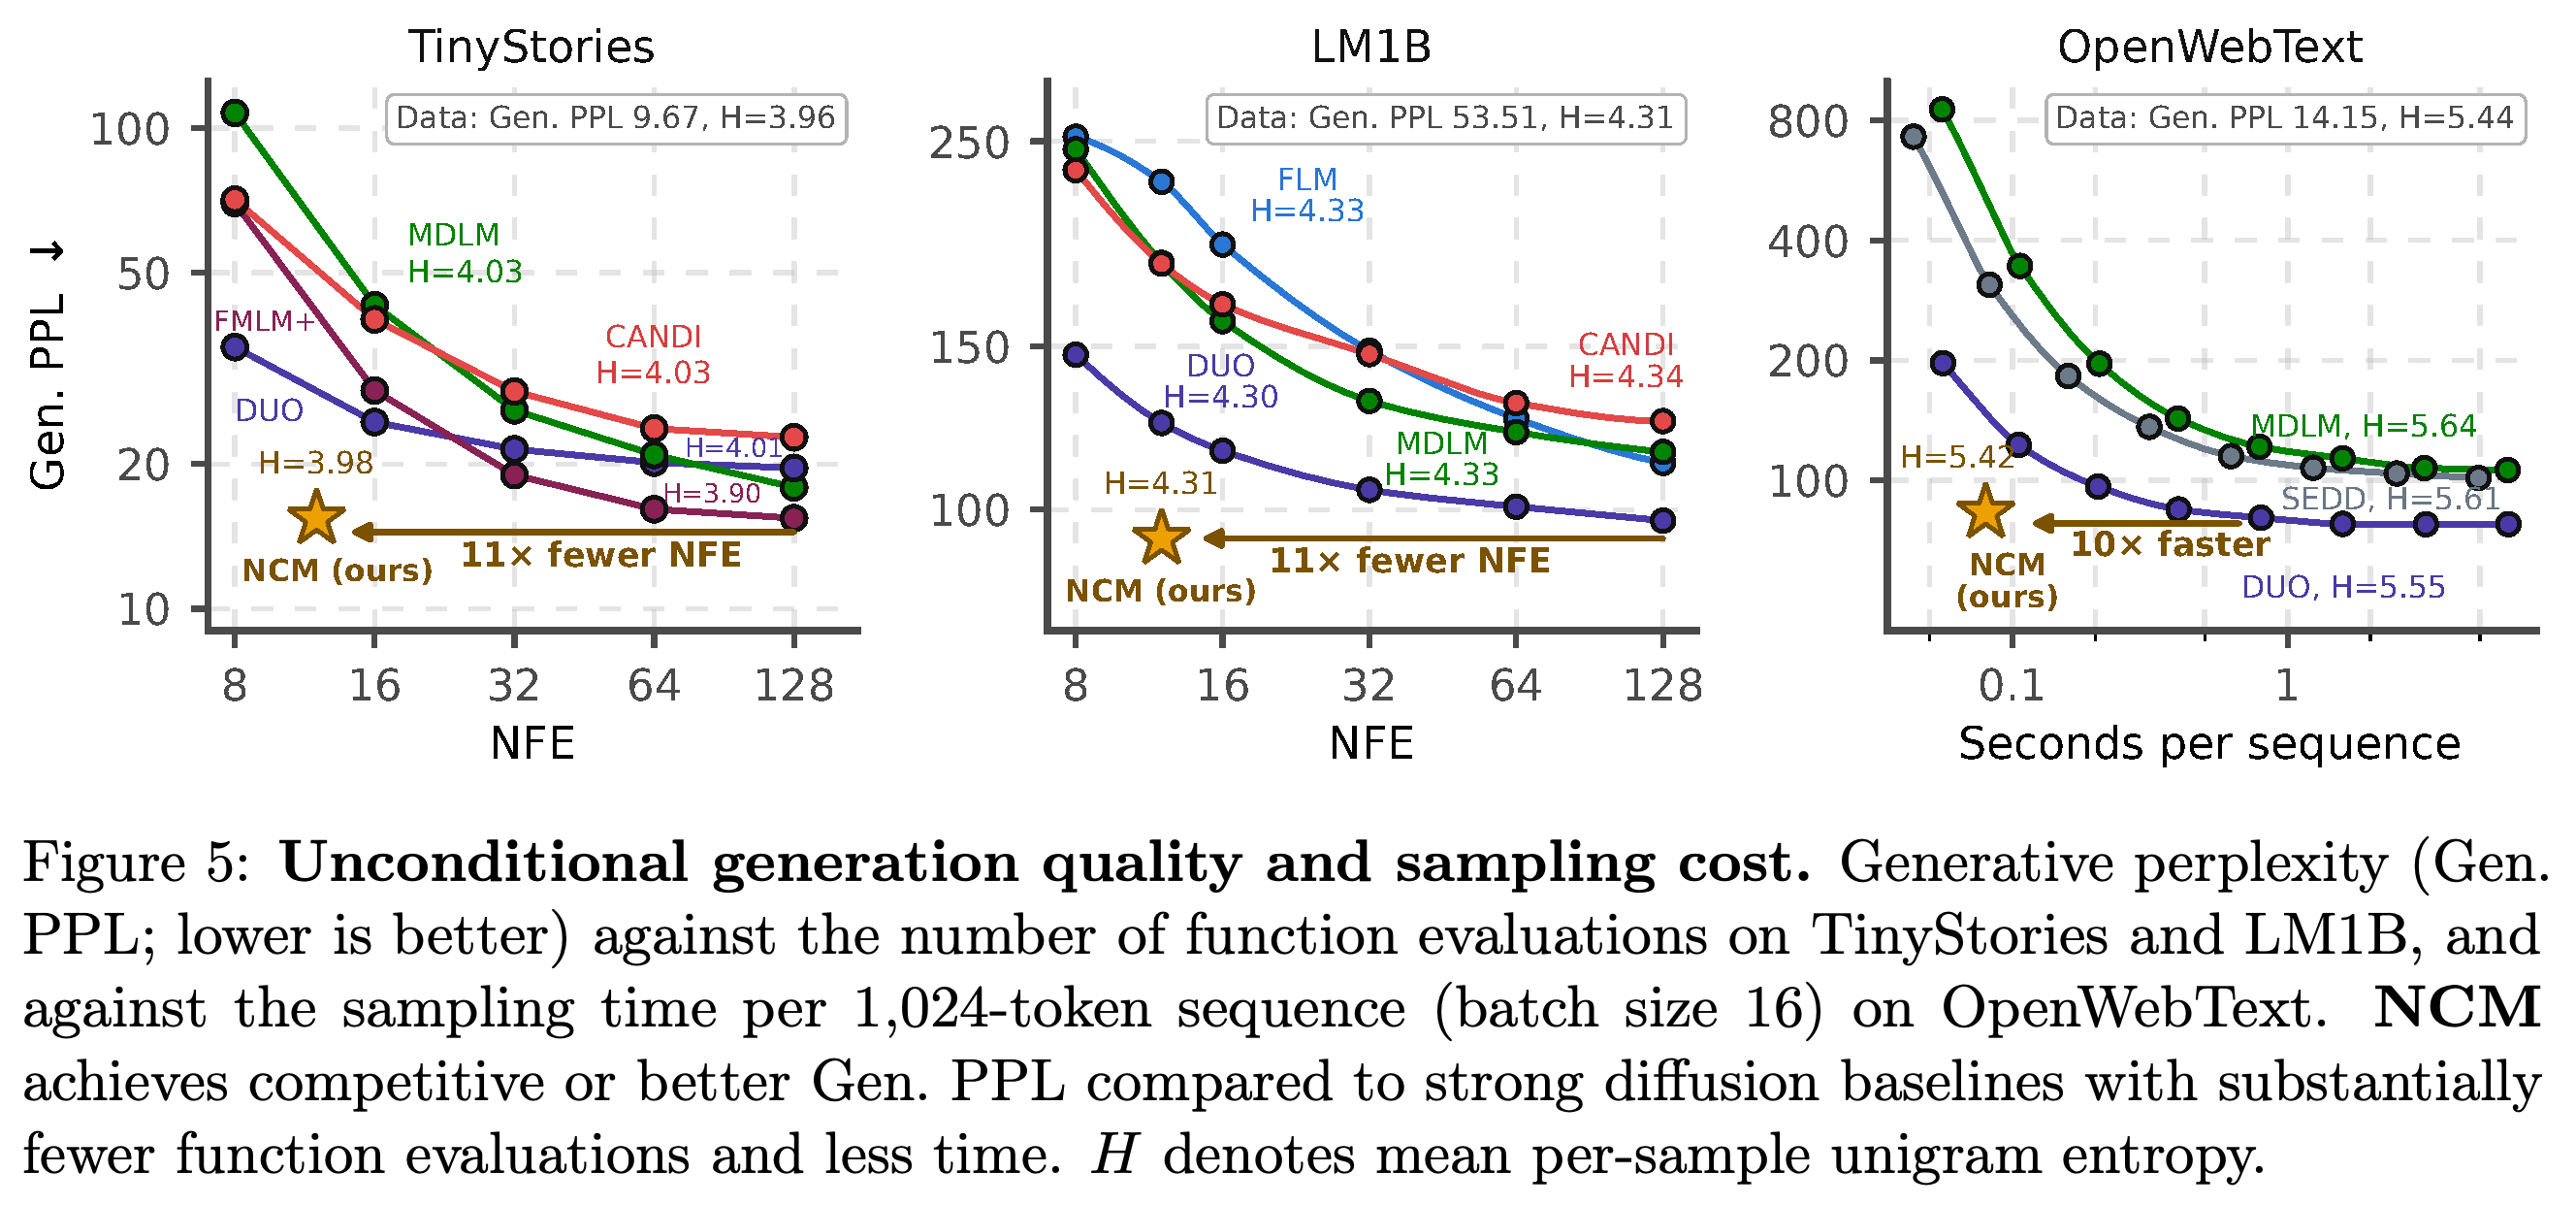
Generative perplexity는 토큰 다양성의 척도인 unigram entropy와 함께 보고한다. LM1B에서 NCM은 함수 평가, 즉 생성 모델 호출 12회에 93.05를 기록했고 DUO는 128회에 97.30을 기록했으며, entropy는 각각 4.31과 4.30이다. OpenWebText에서는 NCM이 83.12, DUO가 77.69를 기록했으며 NCM의 entropy가 데이터에 더 가깝다.
곡선은 함수 평가 횟수 또는 시간에 따른 품질을 비교하며, entropy 표기는 샘플 다양성을 이해할 단서를 제공한다.
4.3 Conditional Generation
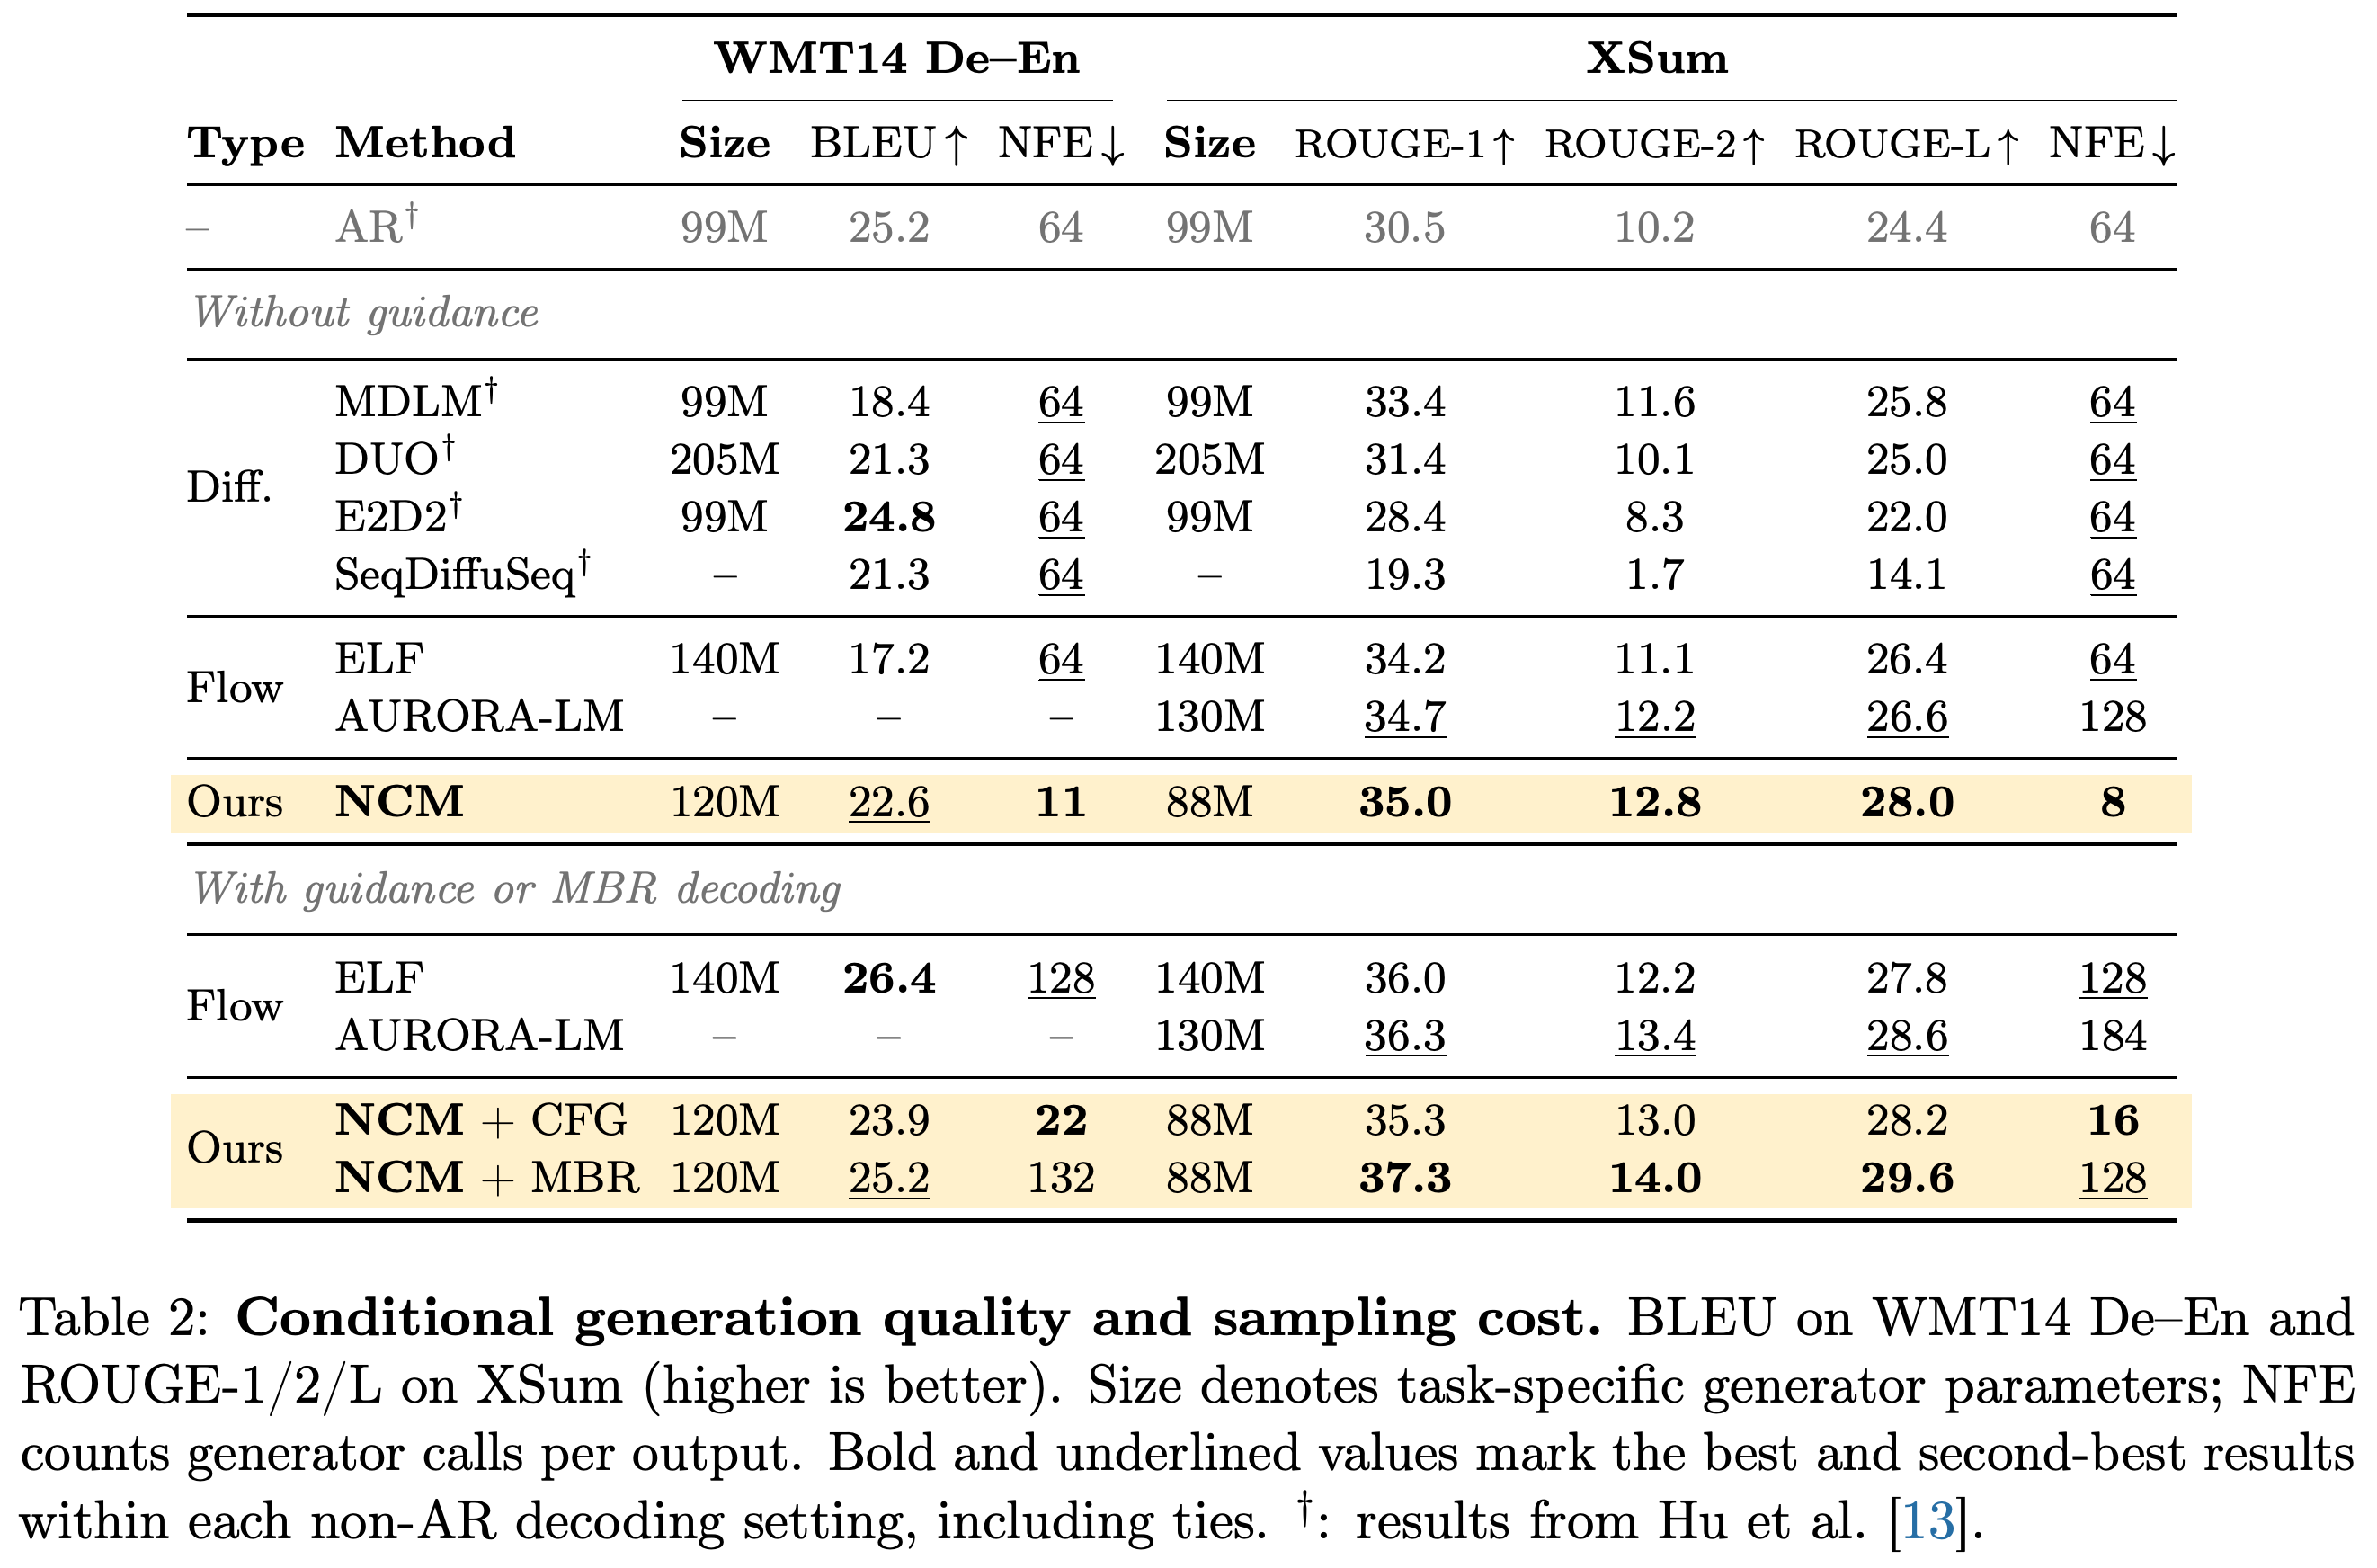
XSum에서 guidance를 사용하지 않은 NCM은 생성 모델 호출 8회에 ROUGE-1/2/L 점수 35.0/12.8/28.0을 기록했고, AURORA-LM은 128회에 34.7/12.2/26.6을 기록했다. ROUGE는 참조 요약과 겹치는 정도를 측정한다. WMT14 독일어–영어에서 NCM의 BLEU 번역 점수는 호출 11회에 22.6이며, E2D2는 64회에 24.8이다.
Guidance를 사용하지 않은 NCM은 나열된 XSum 시스템 중 ROUGE 지표 3개 모두에서 앞서며, WMT14에서는 guidance를 사용하지 않은 E2D2의 BLEU가 더 높다.
4.4 Reasoning
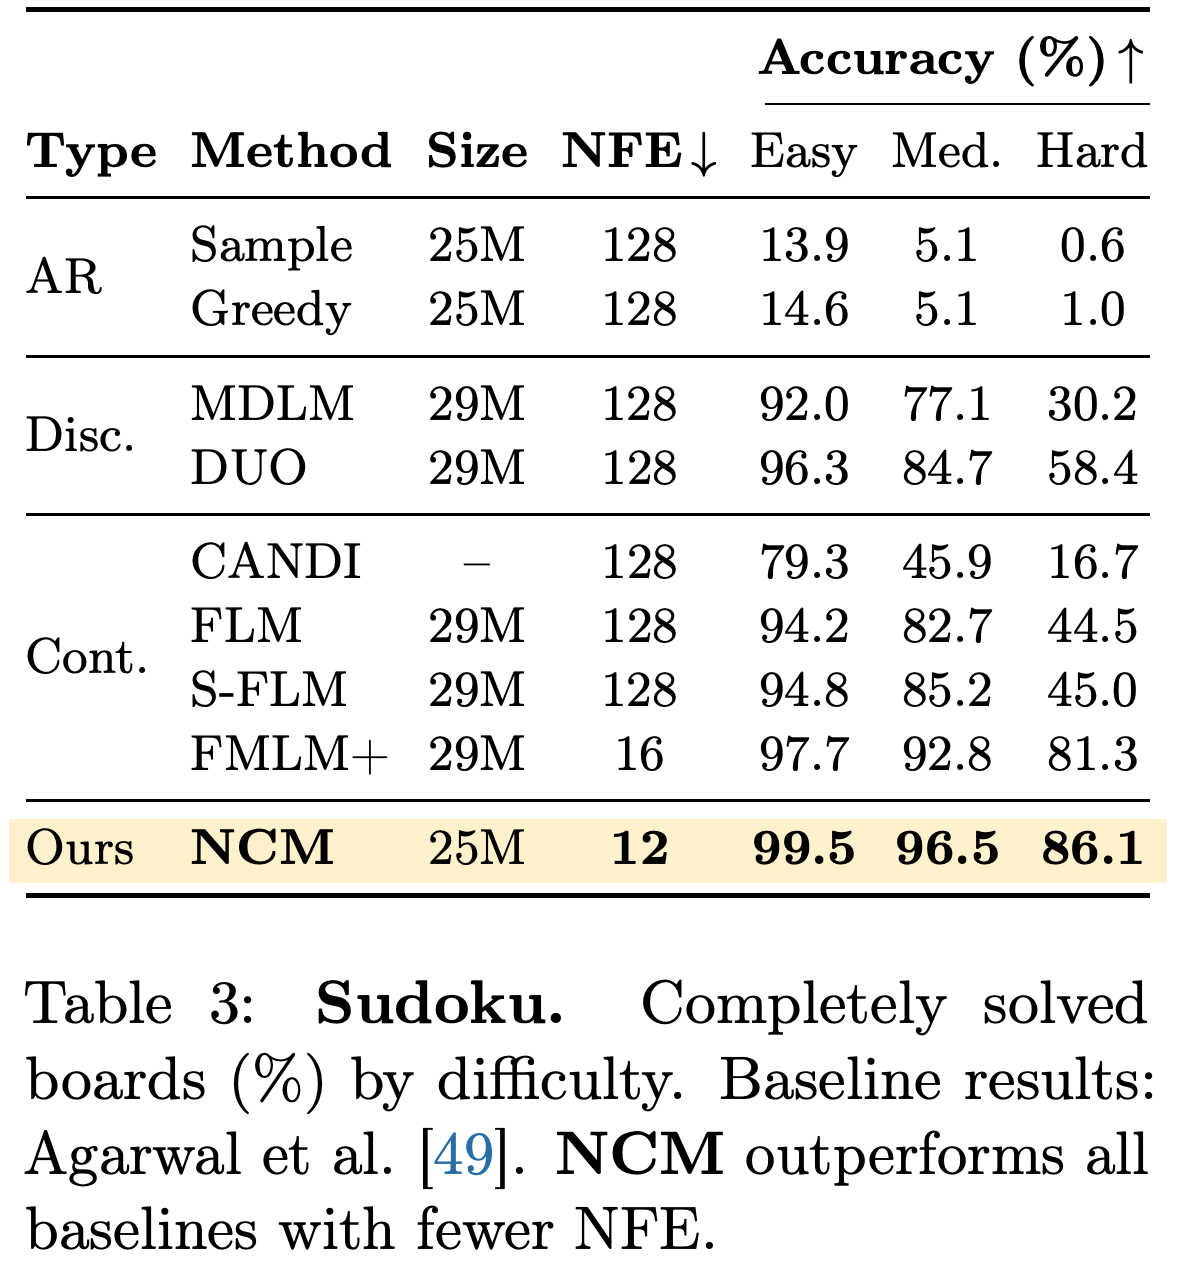
단서가 40개, 35개, 30개인 Sudoku에서 NCM은 함수 평가 12회에 각각 문제판의 99.5%, 96.5%, 86.1%를 해결한다. 보고된 가장 강력한 베이스라인 FMLM+는 평가 16회에 각각 97.7%, 92.8%, 81.3%를 해결한다.
FMLM+에 대한 NCM의 절대적 우위는 어려운 문제판에서 가장 크며, 각각 86.1%와 81.3%를 기록한다.
4.5 Scaling
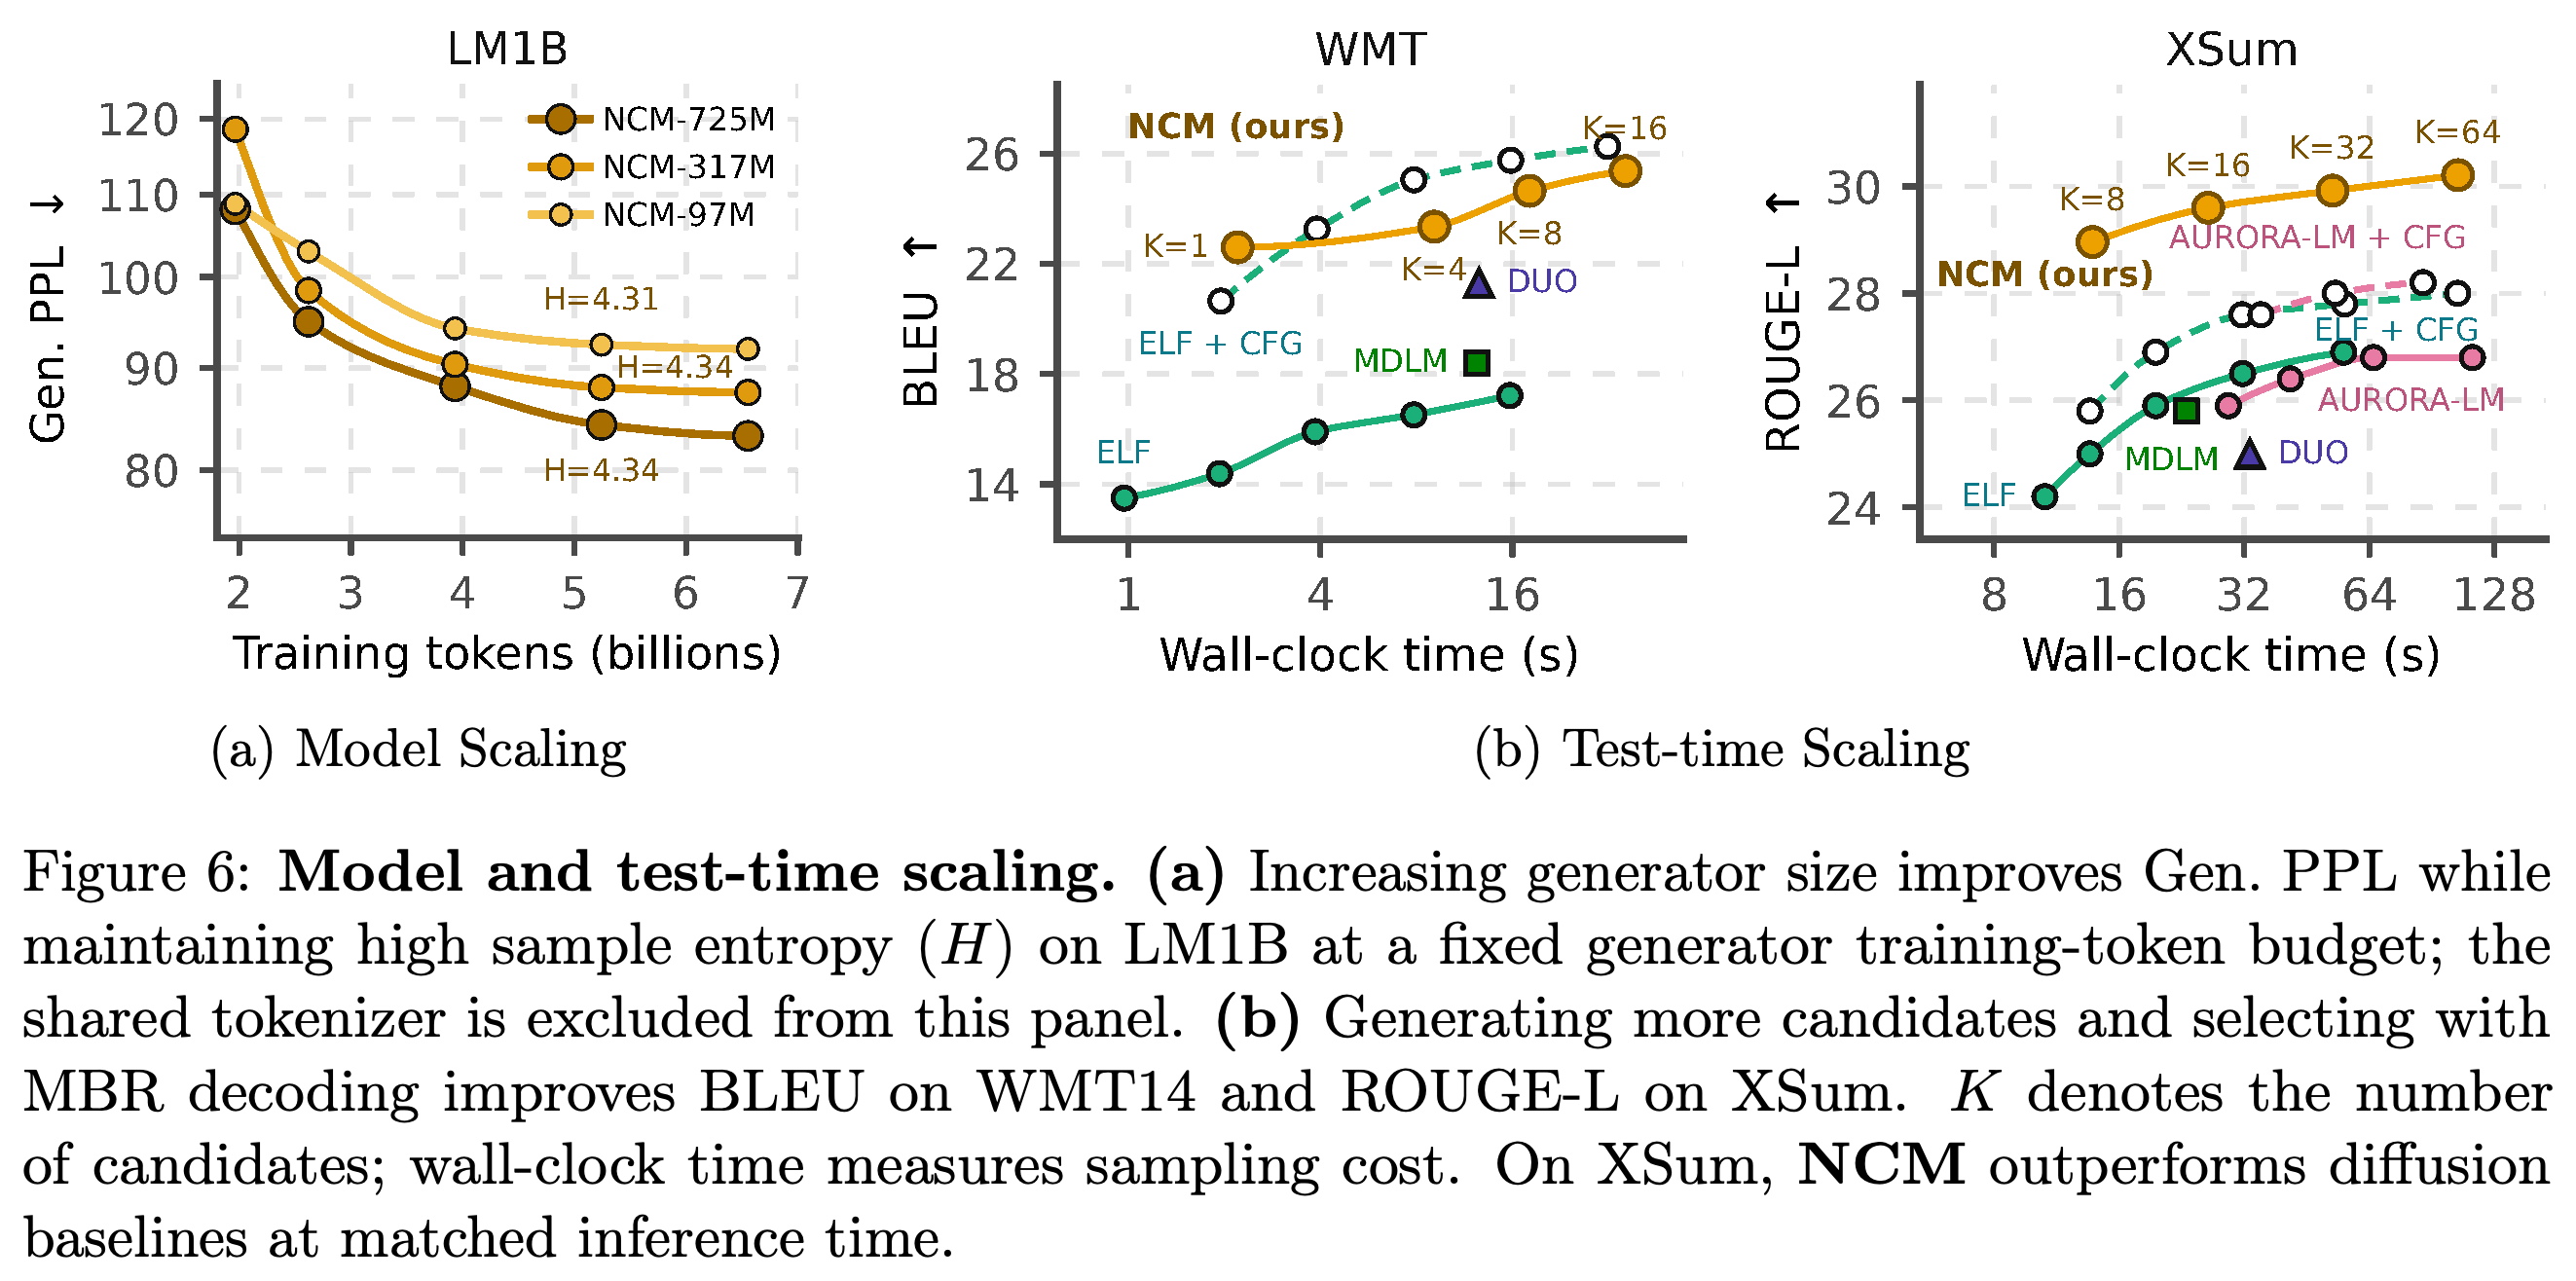
LM1B에서 고정된 토크나이저를 공유하는 97M, 317M, 725M 생성 모델은 생성 모델의 학습 토큰 예산을 고정했을 때 크기가 커질수록 generative perplexity가 개선된다. 샘플링한 다른 후보들과 평균적으로 가장 유사한 후보를 선택하는 minimum Bayes risk decoding은 후보를 더 많이 생성할수록 XSum과 WMT14 점수를 개선한다.
왼쪽 패널은 생성 모델의 토큰 노출량을 고정하고 모델 크기를 비교한다. 오른쪽 패널은 여러 샘플 중에서 선택할 때 얻는 개선을 보여준다.
4.6 Efficiency
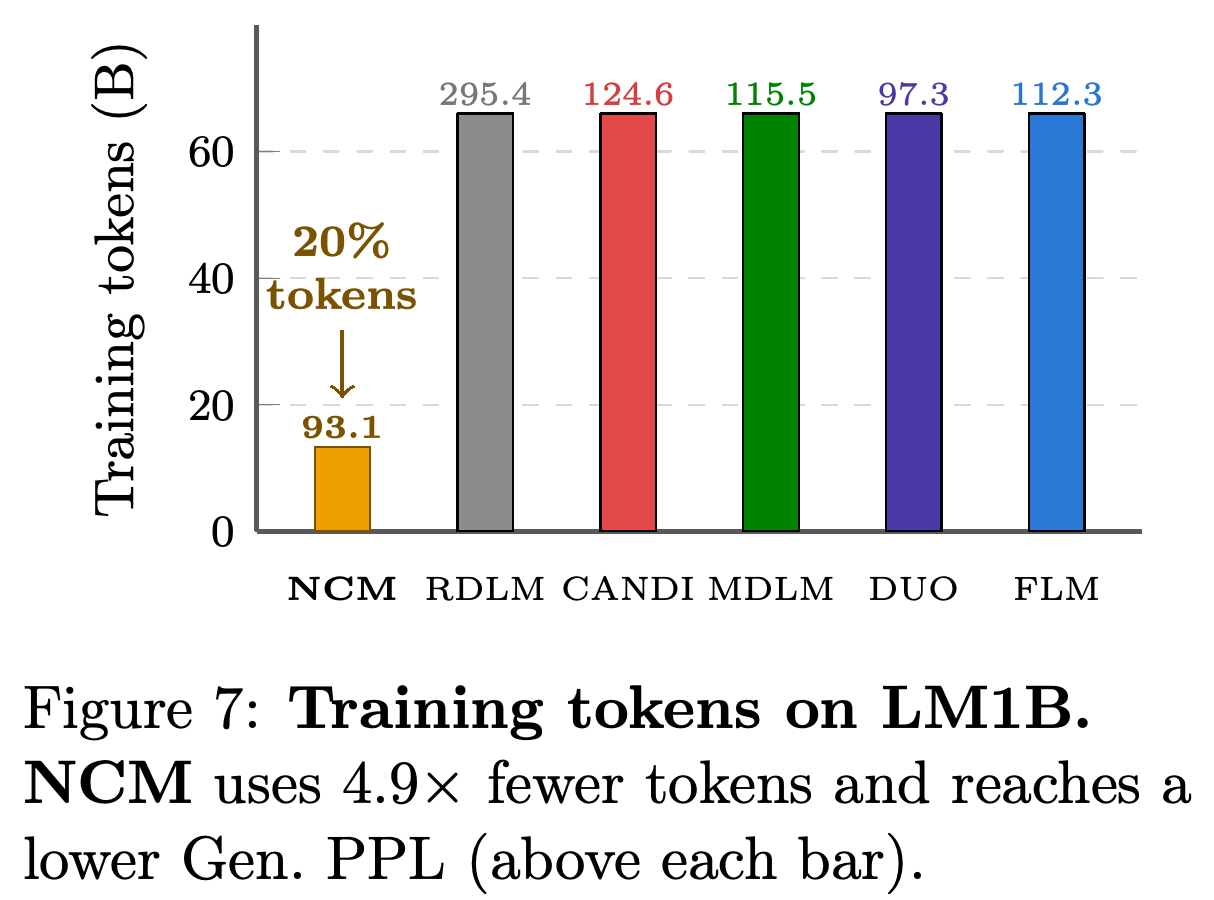
시간 측정에는 생성된 시퀀스 1,024개, 배치 크기 16, NVIDIA H100 SXM 80GB GPU 1개를 사용한다. NCM은 LM1B에서 DUO보다 perplexity가 낮으면서 21배 빠르고, XSum에서 AURORA-LM과 비슷한 ROUGE를 기록하면서 31배 빠르다. LM1B 토크나이저와 생성 모델의 학습에 사용된 전체 길이 토큰 위치는 합계 13.36B이며, 베이스라인은 66B다. 이 수치는 학습 부동소수점 연산량이 아닌 토큰 노출량을 측정한다.
막대는 학습 토큰 노출량을 비교하고 generative perplexity를 표시한다. 학습 부동소수점 연산량은 측정하지 않는다.
4.7 Qualitative Samples
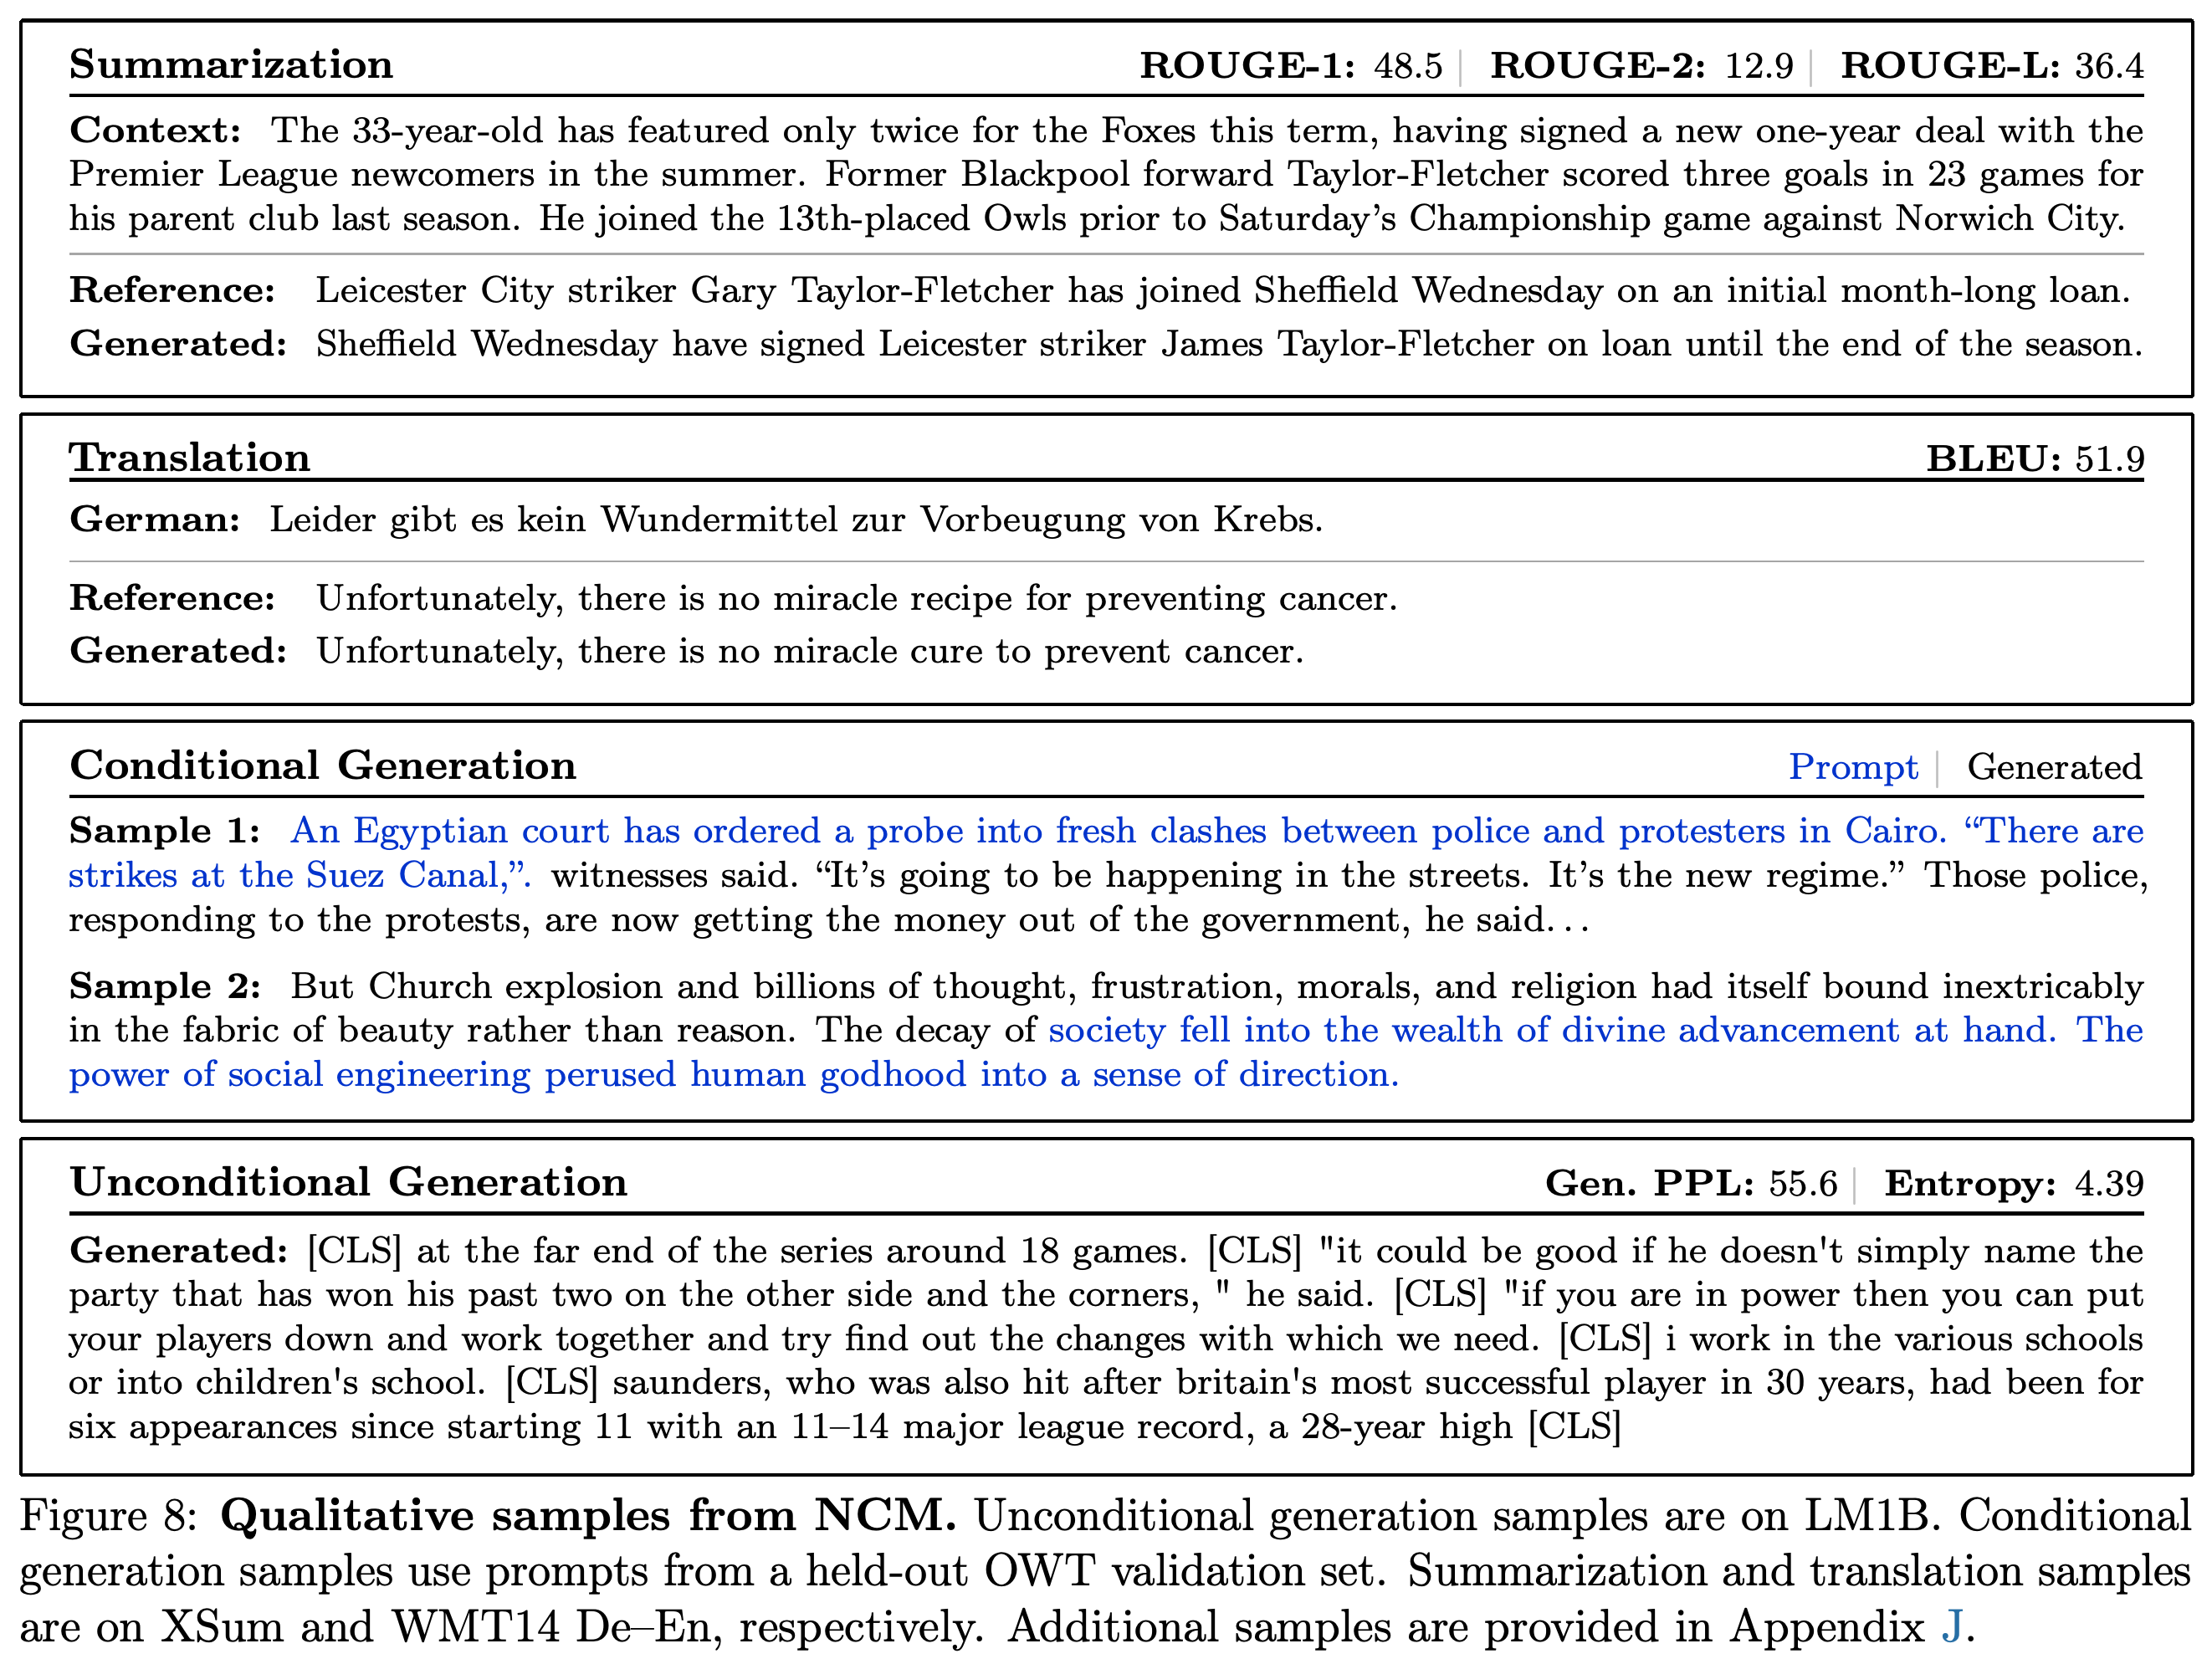
정성적 예시에는 유창한 번역과 문맥에 맞는 요약이 있지만 사실이 바뀐 사례도 있다. 생성된 요약 1개는 참조의 Gary Taylor-Fletcher를 James Taylor-Fletcher로 바꾸고 임대 기간도 변경한다. 이런 사례는 겹침 점수만으로 사실 충실도를 판단하는 데 한계가 있음을 보여준다.
예시에는 자연스러운 문장과 함께 사실 오류도 나타나며, 요약에서 이름과 임대 기간이 바뀐 사례가 포함된다.
5 Conclusion
저자들은 학습된 계층 구조가 짧은 병렬 생성 경로를 제공하며, 평가한 diffusion 베이스라인보다 적은 함수 평가와 학습 토큰으로 경쟁력 있는 품질을 달성한다고 결론짓는다. 보고된 스케일링 근거는 LM1B의 725M 생성 모델까지 포함한다.
부록
- A는 결정적인 최근접 이웃 토크나이저 할당에 대해 텍스트 로그 가능도의 하한인 evidence lower bound (ELBO)를 유도한다. 토크나이저와 디코더를 고정하고, 손상되지 않은 조건과 동일한 코드 위치 가중치를 사용하면 생성 모델의 손실을 최소화하는 것이 생성 모델 파라미터에 대한 ELBO를 최대화한다. 코드 손상과 불균등한 가중치는 이 목적 함수를 변경한다.
- B와 C는 목표 길이를 OpenWebText 1,024, LM1B와 TinyStories 128, XSum 48, WMT14 64, Sudoku 89로 지정한다. 토크나이저 계층 수는 각각 32, 12, 12, 8, 11, 12이며, XSum과 WMT14 생성 모델은 먼저 짝이 없는 텍스트로 학습한 뒤 원문–목표 쌍으로 학습한다. 실험에는 시드 42, BF16 혼합 정밀도, torch.compile을 사용한다.
- D는 무조건 생성, 조건부 생성, Sudoku 베이스라인에 사용한 공개 결과와 체크포인트를 명시한다. 체크포인트가 공개되지 않은 조건부 베이스라인은 시간 측정에만 무작위로 초기화한 모델을 사용한다. E는 추가 참조 모델 4개에서 NCM의 평균 LM1B perplexity가 83.24이고 DUO는 92.52라고 보고한다. 다만 Mistral-7B만 사용하면 DUO의 점수가 더 좋으며, 무조건 생성 점수와 entropy도 표로 제시한다.
- F는 계층 수를 늘리면 TinyStories perplexity가 개선되지만 개선 폭은 줄어들며, 계층 일정도 중요하다고 보고한다. 명시된 1,024개 샘플 조건에서 block-diagonal attention은 5.65초에 perplexity 15.41을 기록하고 block-causal attention은 7.90초에 19.63을 기록한다. 사전 학습된 T5-small context encoder는 파라미터 35.3M을 추가해 ROUGE를 소폭 개선한다. 손실 가중치는 시험한 동일 계층 가중치까지 perplexity에 영향을 거의 주지 않으며, 적당한 코드 손상은 품질을 개선하고 guidance나 후보 선택은 샘플링 점수를 개선할 수 있다.
- G는 개체, 숫자, 마크업, 단어 경계와 관련된 토크나이저 오류를 기록한다. H는 고정된 거친 코드가 큰 주제를 유지하는 동안 세밀한 코드가 세부 사항을 바꾸는 TinyStories 예시와, 거친 코드를 섞거나 교란하면 생성된 이야기가 달라지는 예시를 보여준다.
- I는 고정된 계층 깊이와 길이, 별도로 학습한 토크나이저, 제한된 모델 규모, 간헐적인 전환 아티팩트를 한계로 지적한다. J는 번역, XSum, TinyStories, LM1B, OpenWebText 샘플을 제공한다. 번역 생성 과정의 BLEU는 계층 8에서 51.7, 계층 9에서 38.9로 떨어진 뒤 계층 11에서 77.8에 도달하며, 어려운 Sudoku는 계층 12에서 완성된다.
짧은 생각
실제 경과 시간 측정, entropy 보고, 토크나이저를 포함한 토큰 수는 함수 평가 횟수만 비교할 때보다 효율성을 더 잘 설명한다. 더 큰 모델과 다른 작업으로 일반화할 수 있을지는 불확실하다. 주요 생성 모델은 약 100M 파라미터를 가지며, 데이터셋마다 별도의 토크나이저를 사용하고, 예시에서는 개체와 사실 오류가 드러난다.