


Scaling Image Tokenizers with Grouped Spherical Quantization 요약 설명
03 Dec 2024 | Paper Review Image Tokenization Vector Quantization Scaling Laws목차
이번 글에서는 Scaling Image Tokenizers with Grouped Spherical Quantization 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 3일(Arxiv)
- Wang, Jiangtao, Qin, Zhen, Zhang, Yifan, Hu, Vincent Tao, Ommer, Björn, Briq, Rania, Kesselheim, Stefan.
- Jülich Supercomputing Centre, TapTap, Tsinghua University, CompVis @ LMU Munich, MCML
- 논문 링크
- Github
요약
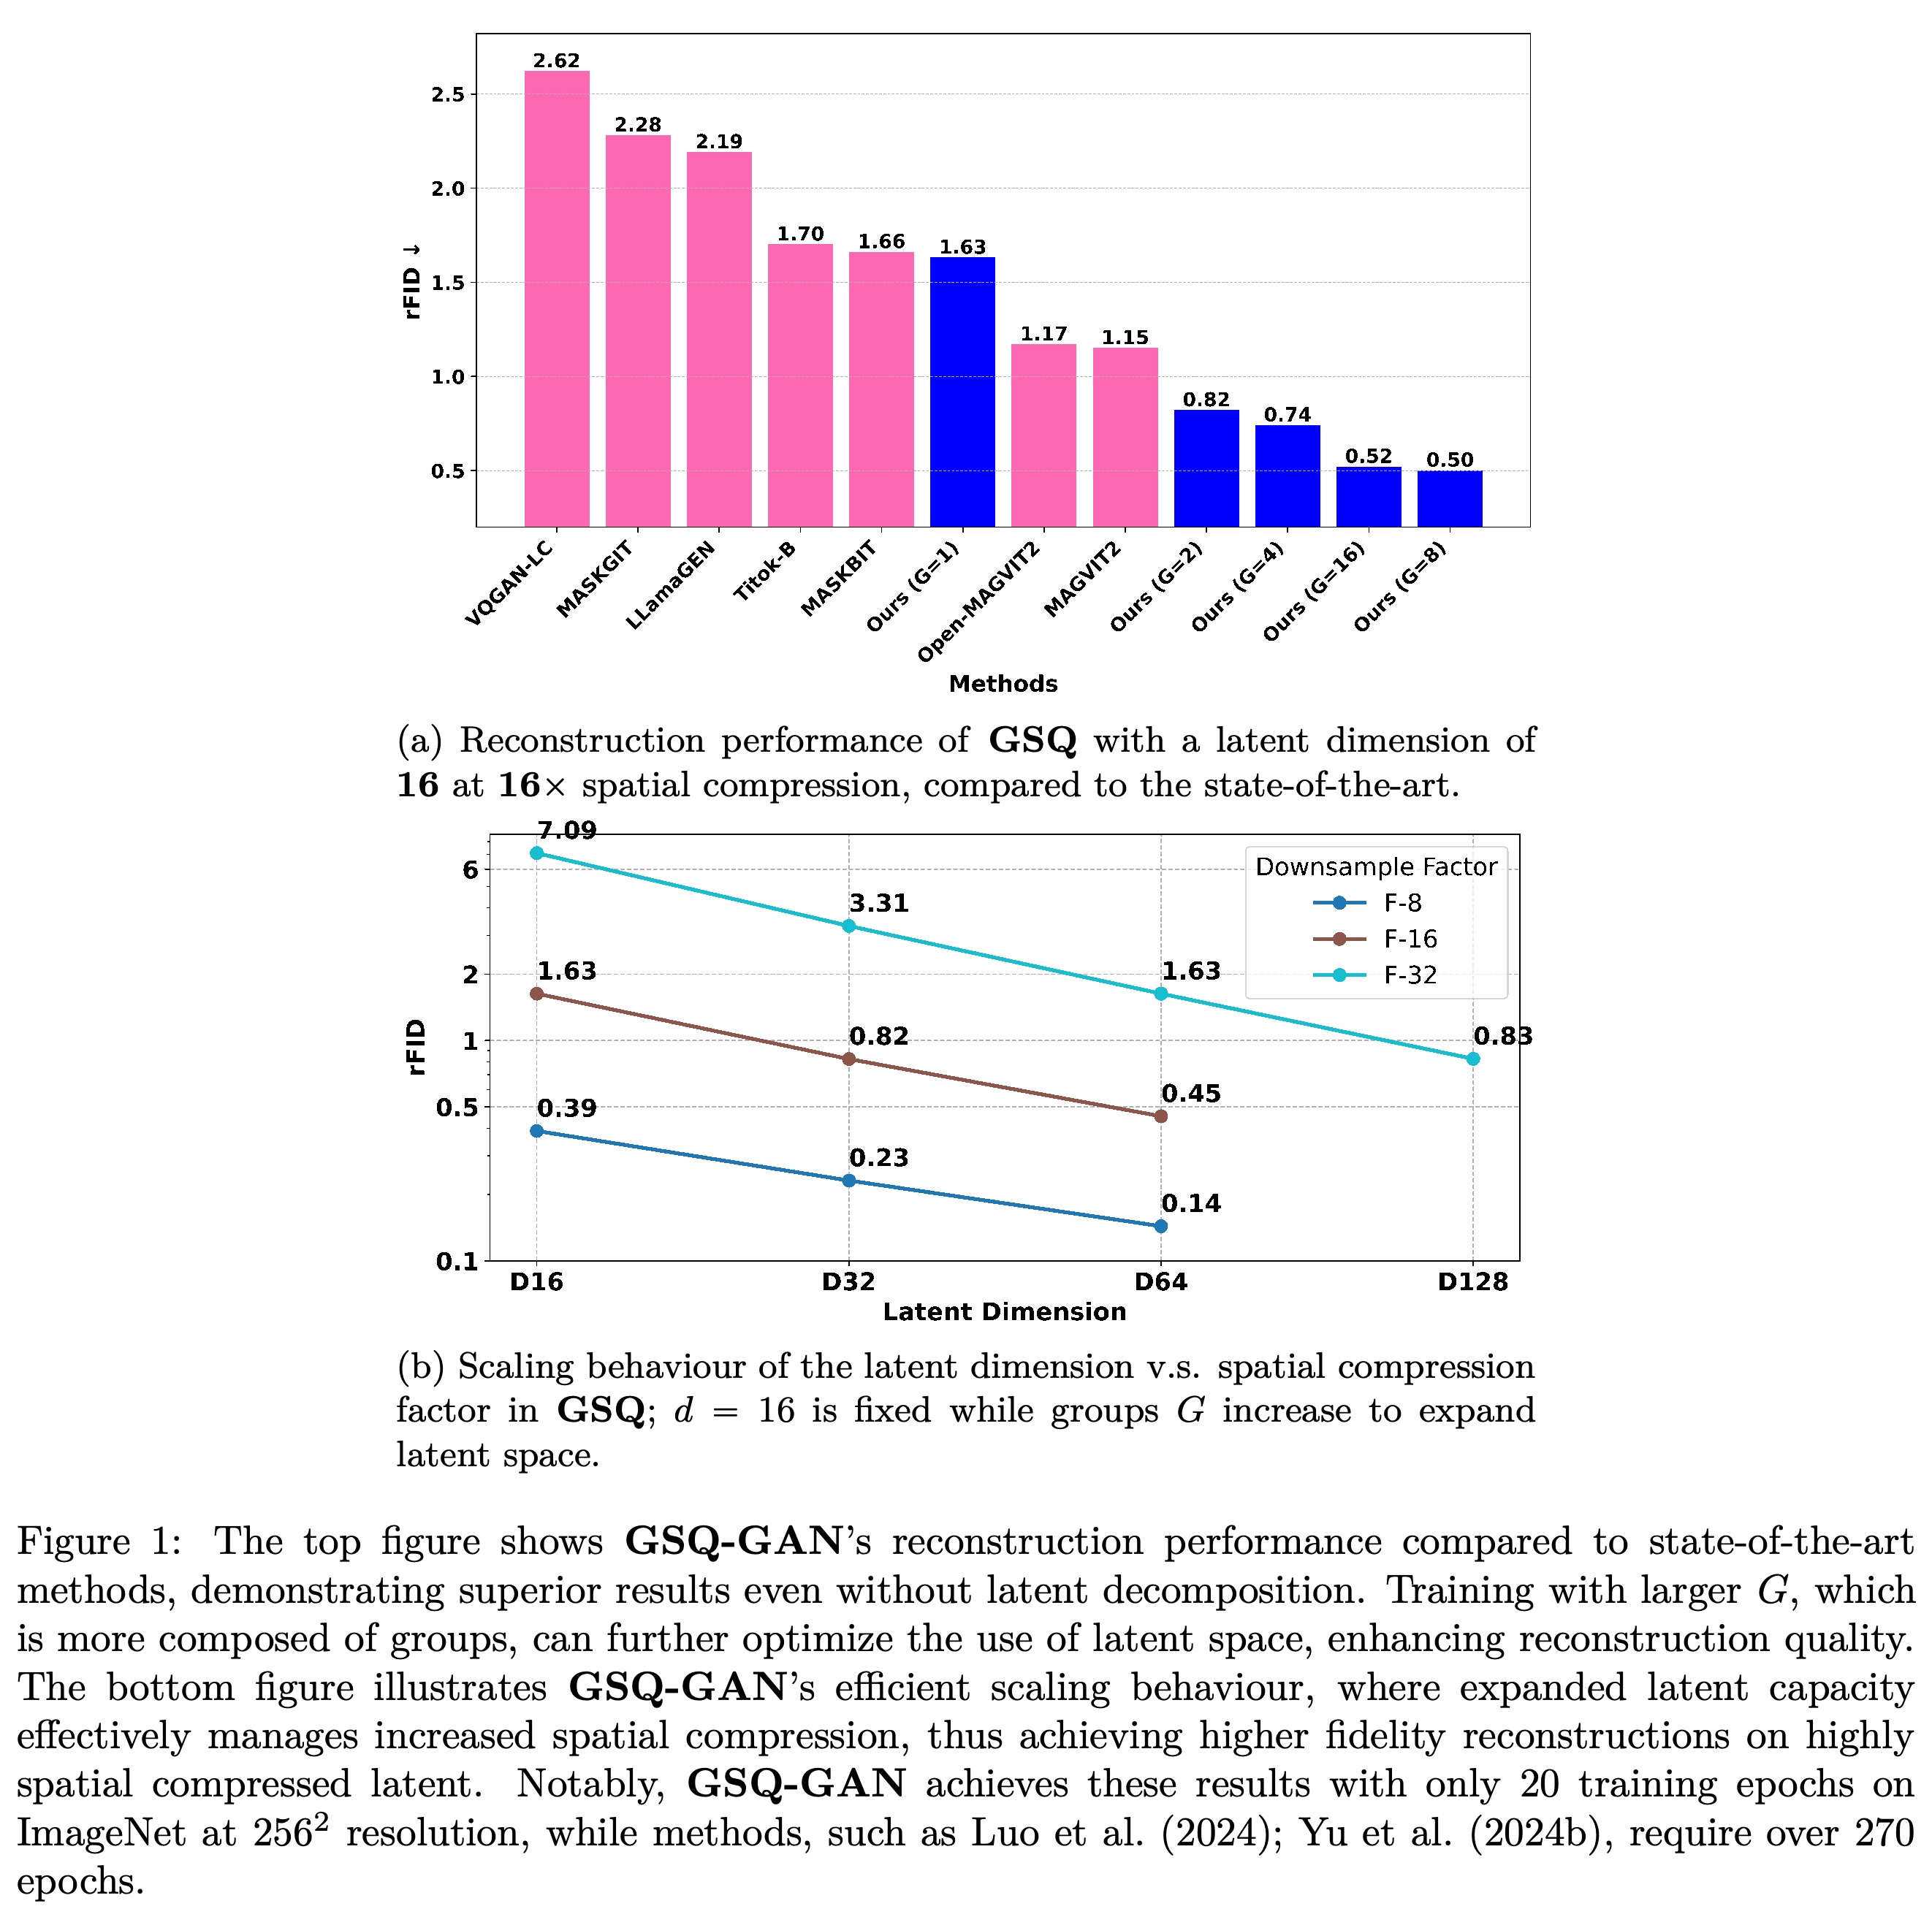
- 이미지를 이산 표현으로 압축하는 이미지 토크나이저는 공간 격자가 작아져도 재구성 품질을 유지해야 한다. 학습한 이미지 특징을 그룹별로 양자화하는 Grouped Spherical Quantization(GSQ)은 ImageNet의 256 × 256 해상도에서 각 공간 축을 16배 다운샘플링했을 때 reconstruction Fréchet Inception Distance(rFID) 0.50을 달성한다. rFID는 재구성 이미지의 분포를 평가하는 지표로, 낮을수록 좋다. 보고된 MAGVIT2의 1.15, Open-MAGVIT2의 1.17보다 낮지만, 학습 예산은 서로 다르다.
- GSQ는 양자화 벡터를 단위 구면에 배치하는 구면 코드북 초기화, 단위 길이 벡터를 비교하는 정규화 조회, 인코딩한 특징 채널을 그룹으로 나누는 잠재 표현 분해를 결합한다. 생성적 적대 신경망(GAN) 목적함수로 학습하는 토크나이저인 GSQ-GAN은 원본 이미지와 재구성 이미지를 구별하는 판별기를 사용한다. 스케일링 실험은 50,000스텝, 즉 20에포크 동안 진행한다.
- 스케일링 결과는 공간 압축 정도에 따라 달라진다. 그룹을 나누지 않으면 8배 다운샘플링에서 작은 잠재 차원이 더 좋은 성능을 보인다. 반면 16배와 32배 다운샘플링에서는 그룹화를 통해 더 큰 잠재 표현으로 재구성 품질을 높일 수 있다. 논문은 재구성을 평가하며, 후속 이미지 생성은 실험하지 않는다. 이미지를 표현하는 데 사용하는 비트 수인 인코딩 비트레이트를 맞춘 설정 간 비교도 수행하지 않는다.
1 Introduction
서론은 이미지 토크나이저 평가의 장애 요인을 3가지로 정리한다. 기존 GAN 하이퍼파라미터가 재구성 품질을 떨어뜨릴 수 있고, 기존 Vector Quantization(VQ) 구현이 약한 베이스라인을 제공할 수 있으며, 스케일링 연구도 불완전하다는 것이다. VQ는 벡터를 코드북에 저장된 항목으로 대체하는 방법이다. 개별 스칼라 채널을 양자화하는 Finite Scalar Quantization(FSQ)과 이진 잠재 성분을 사용하는 Lookup-Free Quantization(LFQ)은 잠재 차원과 가능한 코드 수가 서로 연동된다.
- 제안 방법은 최적화한 학습 설정을 사용하며, 그룹 차원, 그룹 수, 코드북 어휘 크기를 독립적으로 조절할 수 있다.
- Figure 1은 기존 토크나이저와의 비교, 8배, 16배, 32배 공간 다운샘플링에서의 스케일링 결과를 제시한다. GSQ는 20에포크 동안 학습하며, 캡션에 따르면 비교 대상인 MAGVIT2와 Open-MAGVIT2는 270에포크 넘게 학습한다.
위 패널은 그룹화로 얻은 0.50을 기존 16배 다운샘플링 토크나이저와 비교한다. 아래 패널은 그룹 차원을 고정하고 그룹을 추가하면 3가지 공간 다운샘플링 계수에서 재구성 품질이 개선됨을 보여준다. 보고된 학습 예산 20에포크는 인용한 기존 모델의 학습 예산보다 짧지만, 비트레이트나 학습 연산량을 고정한 비교는 아니다.
2 Related Work
논문은 GSQ를 압축 중심 이미지 토큰화 연구의 맥락에서 설명한다. 이미지를 연속 잠재 표현으로 인코딩하는 Variational Autoencoder(VAE)에 이어 VQ-VAE가 이산 코드북을 도입했다. VQ-GAN은 학습한 시각 특징을 비교하는 지각 손실과 적대적 목적함수를 추가해 시각적 재구성 품질을 높였다. VQ-VAE에 대해서는 VQ-VAE 논문 설명(Neural Discrete Representation Learning) 글을 참조하라.
- 후속 연구는 아키텍처, 양자화기, 손실을 변경한다. Residual Vector Quantization(RVQ)은 잔차 표현에 양자화를 순차적으로 적용한다.
- 별도의 연구 방향은 사전 학습한 시각 모델의 의미 표현을 토크나이저로 전달한다. GSQ는 압축과 재구성에 집중하며 의미 표현의 품질은 평가하지 않는다.
3 Methodology
제안 방법은 인코더, 양자화기, 디코더로 이어지는 구조를 유지하면서 양자화기의 기하 구조와 채널 구성을 바꾼다. 먼저 일반적인 최근접 코드 조회를 정의한 뒤, 고차원 잠재 표현을 작은 부분으로 나누어 양자화하는 그룹별 조회를 도입한다.
3.1 Preliminary: VQ Image Tokenizer
인코더는 높이 H, 너비 W인 이미지를 D차원 벡터로 구성된 h × w 격자로 변환하고, 디코더는 이 잠재 표현으로 이미지를 재구성한다. 논문은 공간 다운샘플링 계수를 f = H/h = W/w로, 이미지 원소 수 대비 잠재 원소 수의 비율을 R = D/(3f²)로 정의한다.
- 코드북에는 V개의 벡터가 저장된다. 일반적인 VQ는 각 잠재 벡터를 제곱 유클리드 거리가 가장 작은 코드북 항목에 할당한다.
- R은 이미지 원소 수 대비 잠재 원소 수를 나타내며, 이산 인덱스를 인코딩하는 데 필요한 비트 수는 반영하지 않는다.
3.2 Simple Scaling with GSQ
GSQ는 각 D차원 잠재 벡터를 d개 채널로 구성된 G개 그룹으로 나누고 각 그룹을 별도로 양자화한다. 이때 G × d = D이다. 코드북 항목은 표준 가우스 분포에서 추출한 표본을 정규화해 초기화하며, 정규화 조회는 단위 길이의 잠재 벡터와 코드북 벡터를 비교한다.
- 그룹들이 코드북을 공유하므로 코드북 어휘 크기와 독립적으로 그룹 수와 그룹 차원을 바꿀 수 있다.
- 본문은 정규화 예외를 G/D ∈ {1, 2}로 기술한다. 반면 Appendix C는 스칼라를 정규화하면 가능한 값이 2개로 줄어들기 때문에 d = 1에서 정규화를 생략한다고 명시한다. Appendix E도 그룹을 나누지 않은 GAN 설정에서 조회 정규화를 생략하므로, 일반적인 방법 설명만으로는 모든 실험 설정을 알 수 없다.
4.1 Optimized Training for GSQ-VAE
초기 비적대적 토크나이저 실험은 ImageNet의 128 × 128 해상도에서 f = 8, V = 8,192, D = 8, G = 1을 사용한다. 배치 크기 256, 학습률 1 × 10⁻⁴로 100,000스텝, 즉 20에포크 동안 학습한다. 연속적인 파라미터 갱신을 평활화하는 지수 이동 평균을 사용하며, 감쇠율은 0.999이다.
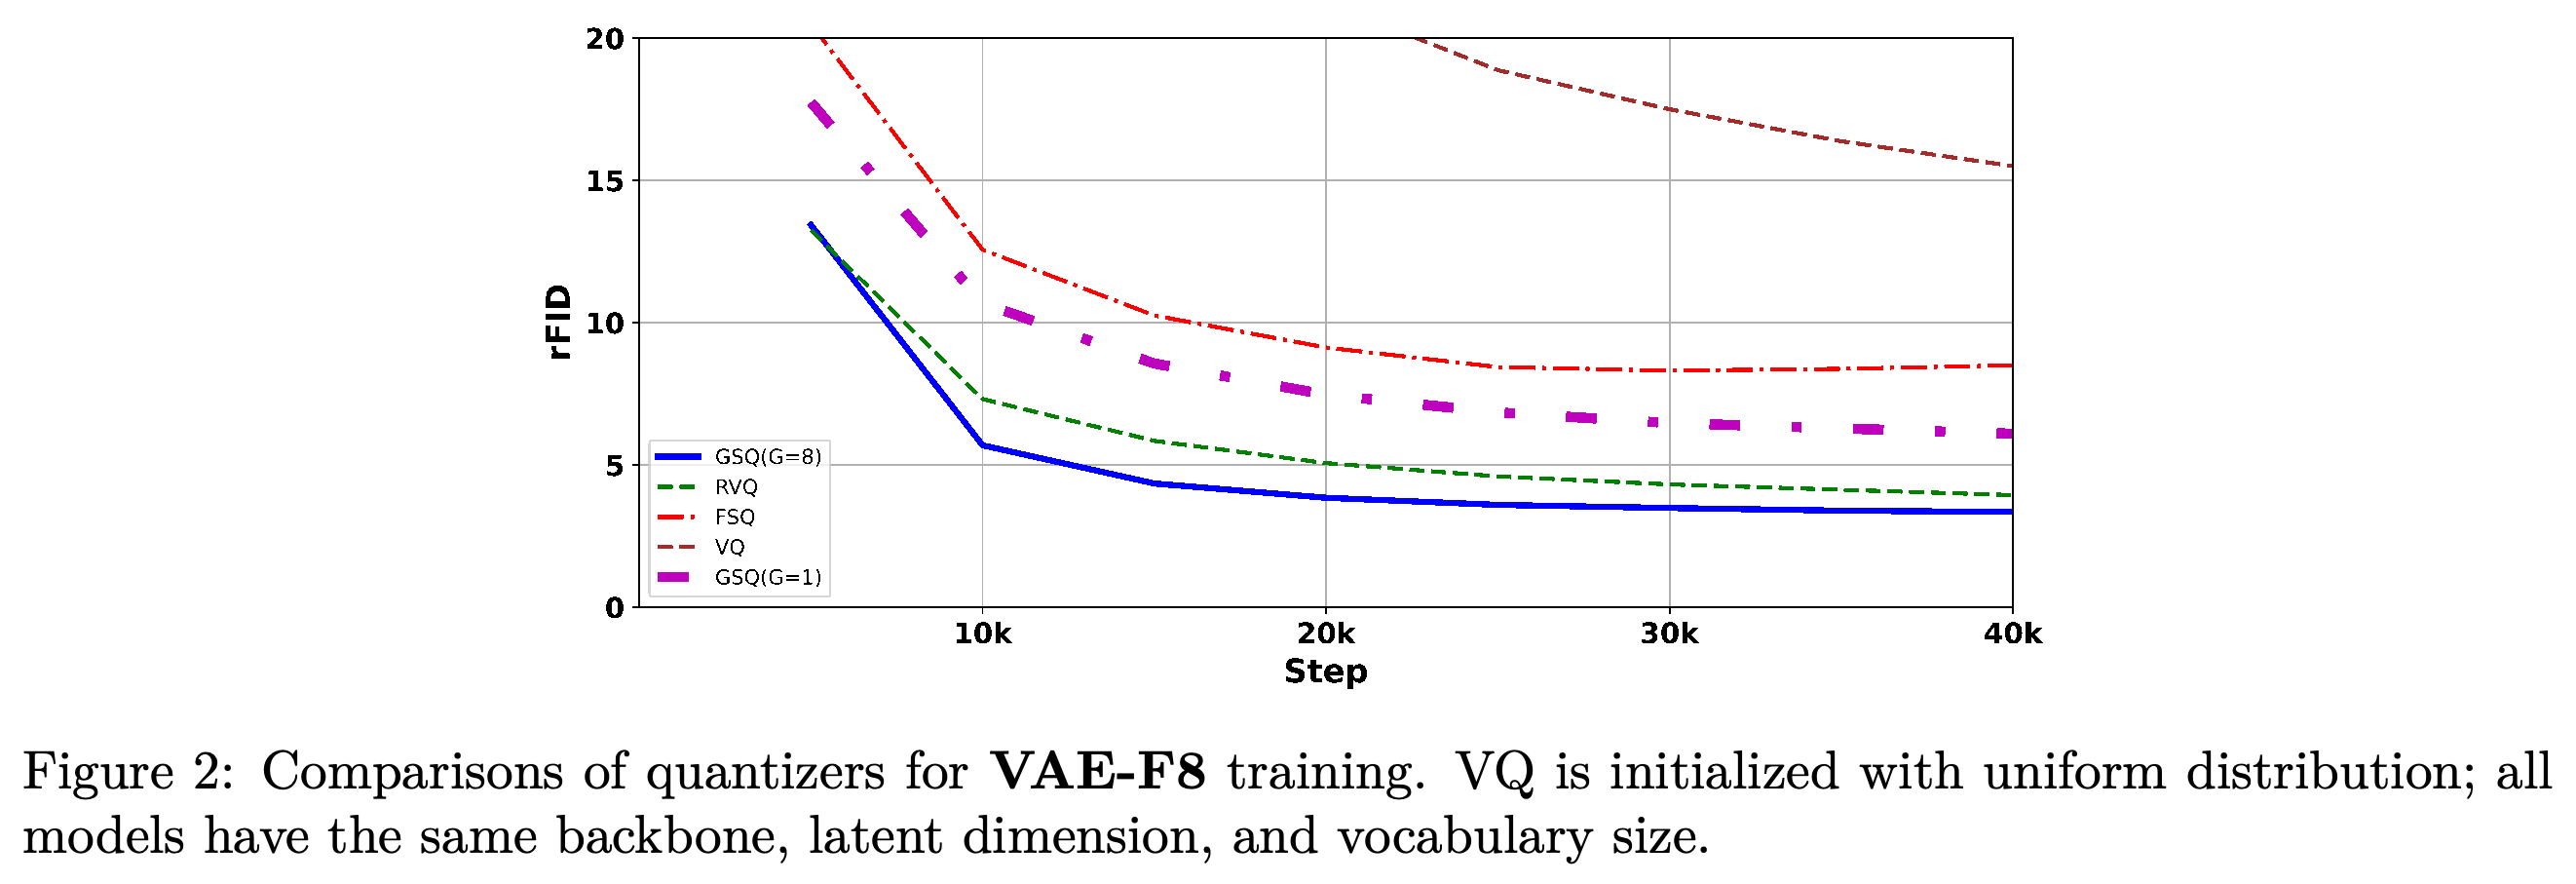
- 학습 기반 지각 이미지 유사도 손실인 LPIPS의 가중치는 1.0이다. 실험은 초기화, 조회 정규화, 보조 손실, 아키텍처, 지각 목적함수, 옵티마이저 설정을 각각 검토한다. Figure 2는 G = 8도 추가로 평가한다.
4.1.1 Effectiveness of Spherical Quantization
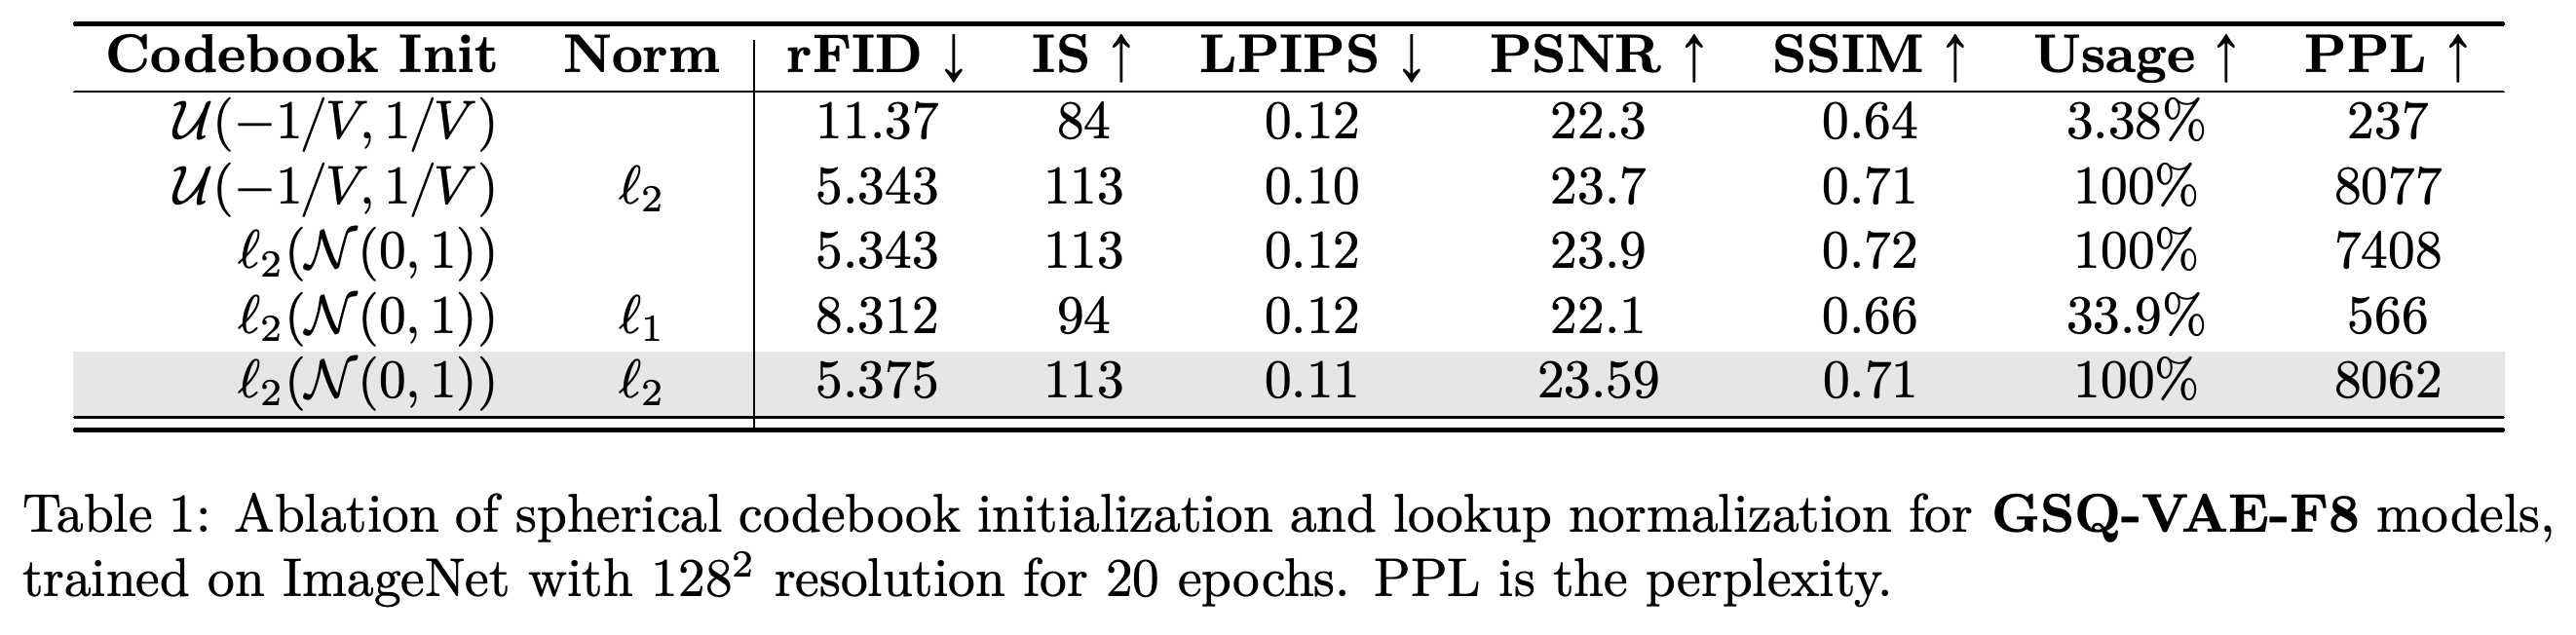
Table 1에서 균등 초기화를 사용하고 조회 정규화를 적용하지 않으면 rFID는 11.37, 코드북 사용률은 3.38%이다. 코드북 사용률은 선택된 항목의 비율이다. 구면 초기화와 정규화 조회를 함께 사용하면 rFID 5.375와 사용률 100%를 얻는다. 다만 균등 초기화에 정규화 조회를 적용해도 사용률은 100%에 도달하며, rFID는 5.343으로 조금 더 낮다.
- Figure 2는 백본, 잠재 차원, 보고된 어휘 크기를 동일하게 유지한다. 학습 곡선에서 G = 1인 GSQ는 FSQ보다 좋은 성능을 보이고, G = 8인 GSQ는 RVQ보다 좋은 성능을 보인다.
- Table 2에서 코드 사용을 촉진하는 보조 목적함수인 엔트로피 손실을 가중치 0.01로 적용하면 rFID가 5.375에서 5.281로 소폭 개선된다. 가중치가 커지면 사용률이 낮아지고, 실험한 행렬 정보 보조 손실은 재구성 품질을 떨어뜨린다. 저자들은 이러한 추가 목적함수를 제외한다.
정규화는 균등 초기화한 코드북의 사용률을 3.38%에서 100%로 높인다. 이는 낮은 베이스라인 성능이 조회의 기하 구조에 크게 좌우됨을 보여준다. 구면 초기화와 정규화 조회도 전체 항목을 사용하지만, rFID는 5.375로 정규화한 균등 초기화의 5.343보다 조금 나쁘다.
백본, 잠재 차원, 보고된 어휘 크기를 고정한 학습 곡선에서 GSQ는 그래프에 제시된 대안보다 좋은 성능을 보인다. G = 8 곡선은 G = 1보다 더 개선되지만, 이 비교에서는 그룹별 할당 수도 달라진다.
4.1.2 Ablation of Network Backbone
잠재 표현을 조건으로 디코더 정규화를 수행하는 Adaptive Group Normalization과 업샘플링 과정에서 채널 정보를 공간 해상도로 재배치하는 Depth2Scale은 비적대적 실험에서 rFID를 조금 악화시킨다. Table 3의 rFID는 어느 모듈도 사용하지 않으면 5.375, 적응형 정규화를 사용하면 5.406, Depth2Scale을 사용하면 5.562, 모듈 2개를 함께 사용하면 5.531이다.
- 픽셀 재구성 지표인 최대 신호 대 잡음비(PSNR)는 모듈 2개를 함께 사용하면 23.59에서 23.94로 개선된다. 이는 픽셀 정확도와 분포 수준의 재구성 품질이 서로 다르게 변할 수 있음을 보여준다.
- 저자들은 적응형 정규화를 유지하고 적대적 학습에서 Depth2Scale을 다시 검토한다.
4.1.3 Ablation of Perceptual Loss Selection
지각 손실 실험은 LPIPS를 ResNet, VGG-16, Dino의 출력 점수로 구성한 손실과 비교한다. ResNet과 VGG-16은 합성곱 시각 신경망이며, Dino는 비지도 방식으로 사전 학습한 시각 모델이다. Table 4에서 Dino는 지각 손실 가중치 0.1, 재구성 손실 가중치 5.0으로 rFID 4.250을 기록한다. LPIPS는 가중치 2개를 모두 1.0으로 설정했을 때 rFID 5.406을 기록한다.
- 실험한 ResNet 설정은 rFID가 9.625에서 204에 이르는 낮은 성능을 보인다. 이 결과는 해당 설정에 관한 근거이며, ResNet 특징 전반을 부정하는 근거는 아니다.
- 저자들은 rFID와 픽셀 오차 사이의 균형을 고려해 LPIPS를 기본값으로 유지한다. 가장 낮은 rFID만으로 손실을 선택하지는 않는다.
4.1.4 Hyper-parameters optimization for GSQ-VAE
선택한 Adam 옵티마이저 설정은 이동 평균을 제어하는 계수 β = [0.9, 0.99]와 가중치 감쇠 0.05를 사용하며, Table 5에서 rFID 5.343을 얻는다. 이는 실험한 설정 중 가장 낮은 rFID이지만, β를 높일 때마다 성능이 단조롭게 개선되지는 않는다.
- 초기에 학습률을 높이는 워밍업 없이 학습률을 1 × 10⁻⁴로 고정하면 rFID는 5.343이다. 워밍업 5,000스텝을 추가하면 5.406이며, 실험한 학습률 감쇠 스케줄은 5.468에서 5.781 사이의 값을 기록한다.
- Tables 5와 6의 모든 설정에서 코드북 사용률은 100%이다. 따라서 재구성 차이를 사용되지 않은 항목만으로 설명할 수는 없다.
4.2 Optimized Training for GSQ-GAN
적대적 실험은 토크나이저에 판별기와 적대적 손실을 추가하고, ImageNet의 128 × 128 해상도에서 최대 80,000스텝 동안 학습한다. 토크나이저와 판별기 2개 모두 초기 학습률을 1 × 10⁻⁴로 설정한다. 이어서 판별기 선택, 손실 조합, 최적화, 정규화, 아키텍처를 검토한다.
4.2.1 Ablations of Discriminator and Combinations of Adversarial Loss
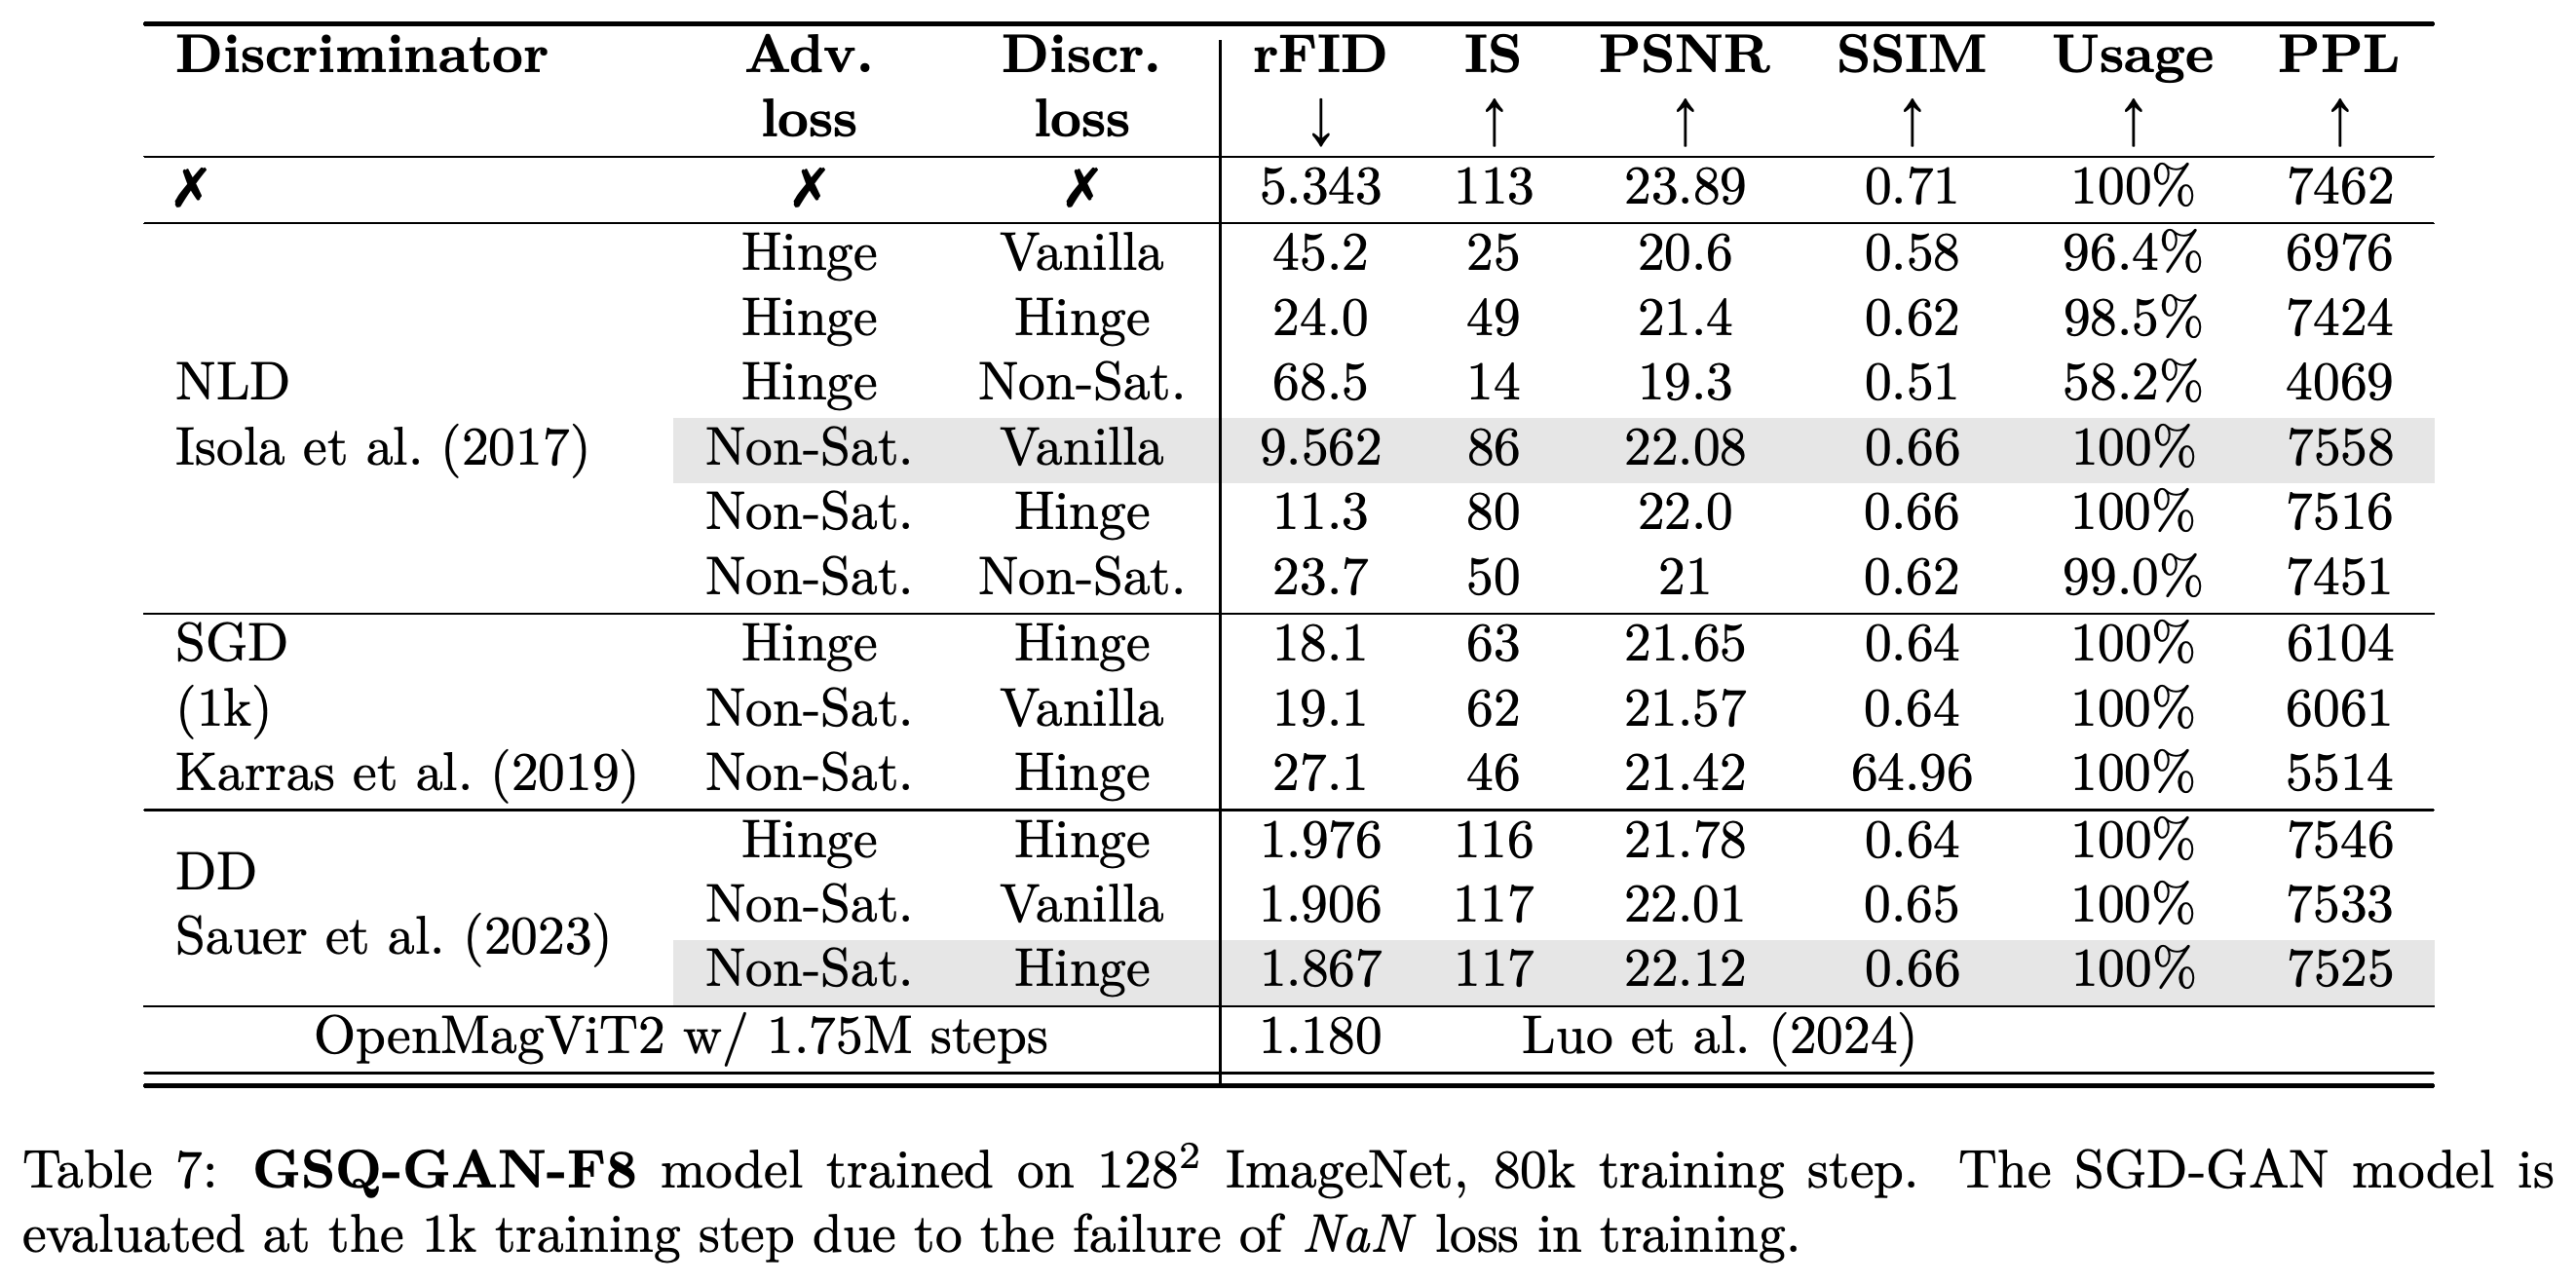
논문은 합성곱 판별기인 N-Layer Discriminator(NLD), StyleGAN Discriminator(SGD), 사전 학습한 Dino 시각 특징을 사용하는 Dino Discriminator(DD)를 비교한다. 손실 조합 식별자는 생성기 목적함수와 판별기 목적함수를 순서대로 나타낸다. V는 기본 비포화 손실, H는 마진 기반 판별기 페널티를 사용하는 힌지 손실, N은 논문에서 개선한 비포화 손실을 뜻한다.
- Table 7에서 DD-NH는 rFID 1.867을 기록한다. 초기 NLD 조합 중 가장 좋은 NLD-NV는 9.562이며, 비적대적 학습은 5.343이다. 여러 NLD 손실 조합은 재구성 품질을 크게 떨어뜨린다.
- StyleGAN 실행에서는 정의되지 않은 수치인 NaN이 발생하며, Table 7은 이 실행들을 1,000스텝에서만 평가한다. 이 항목들은 80,000스텝 학습을 완료한 비교 결과가 아니다.
- 이미지 영역을 가리는 Cutout에 색상 증강과 평행 이동을 결합하면 Table 8에서 128 해상도의 가장 좋은 결과를 얻는다. 256 해상도 평가에서는 색상 증강과 평행 이동만 사용한 설정이 가장 좋다.
DD-NH는 rFID 1.867에 도달하지만, 여러 NLD 손실 조합은 비적대적 베이스라인 5.343보다 성능이 크게 나쁘다. StyleGAN 항목은 수치적 실패로 1,000스텝에서 평가하므로, 같은 학습 기간을 완료한 결과를 나타내지 않는다.
4.2.2 Hyper-parameters Optimization for GSQ-GAN
적대적 옵티마이저 실험은 β = [0.9, 0.99]와 적대적 손실 가중치 0.1을 선택한다. Table 9에서 β를 [0.5, 0.9]에서 [0.9, 0.99]로 바꾸면 NLD-NV의 rFID는 9.562에서 3.390으로 개선된다. 반면 DD-NH는 1.867에서 1.859로만 변한다.
- 적대적 손실 가중치를 0.5로 높이면 실험한 DD 결과가 나빠진다.
- Table 10에서 배치 크기 256과 학습률 1 × 10⁻⁴를 배치 크기 512와 학습률 2 × 10⁻⁴로 바꾸면 rFID가 1.859에서 1.578로 개선된다. 배치 크기 768에서는 추가 개선이 없어, 이점이 단조롭게 증가하지 않음을 보여준다.
4.2.3 GAN Regularization Ablations
Table 11에서는 고정 적대적 가중치가 적응형 가중치보다 좋은 성능을 보이며, 판별기 갱신을 20,000스텝까지 늦춰도 개선이 없다. 기울기 크기를 제한하는 기울기 클리핑은 기본값 2.0을 유지한다. NLD의 가중치 감쇠를 1 × 10⁻⁴로 낮추면 rFID가 조금 개선되지만, DD에 같은 변경을 적용하면 조금 악화된다.
- 판별기 기울기에 적용하는 정규화 기법인 기울기 페널티는 실험한 NLD 결과를 악화시킨다. 논문에서 평가한 또 다른 판별기 정규화 기법인 LeCAM도 표에 제시된 NLD와 DD 베이스라인을 악화시킨다. 이는 결과가 조금 개선된다는 본문 설명과 다르다.
- StyleGAN 학습은 실험한 해결책을 적용해도 수치 문제가 지속된다. 기울기 페널티는 일부 실행을 안정화하지만 학습이 약 4 times 느려져, 80,000 training steps에 배정된 실제 시간 안에 완료하지 못한다.
4.2.4 Analysis of Attention Integration
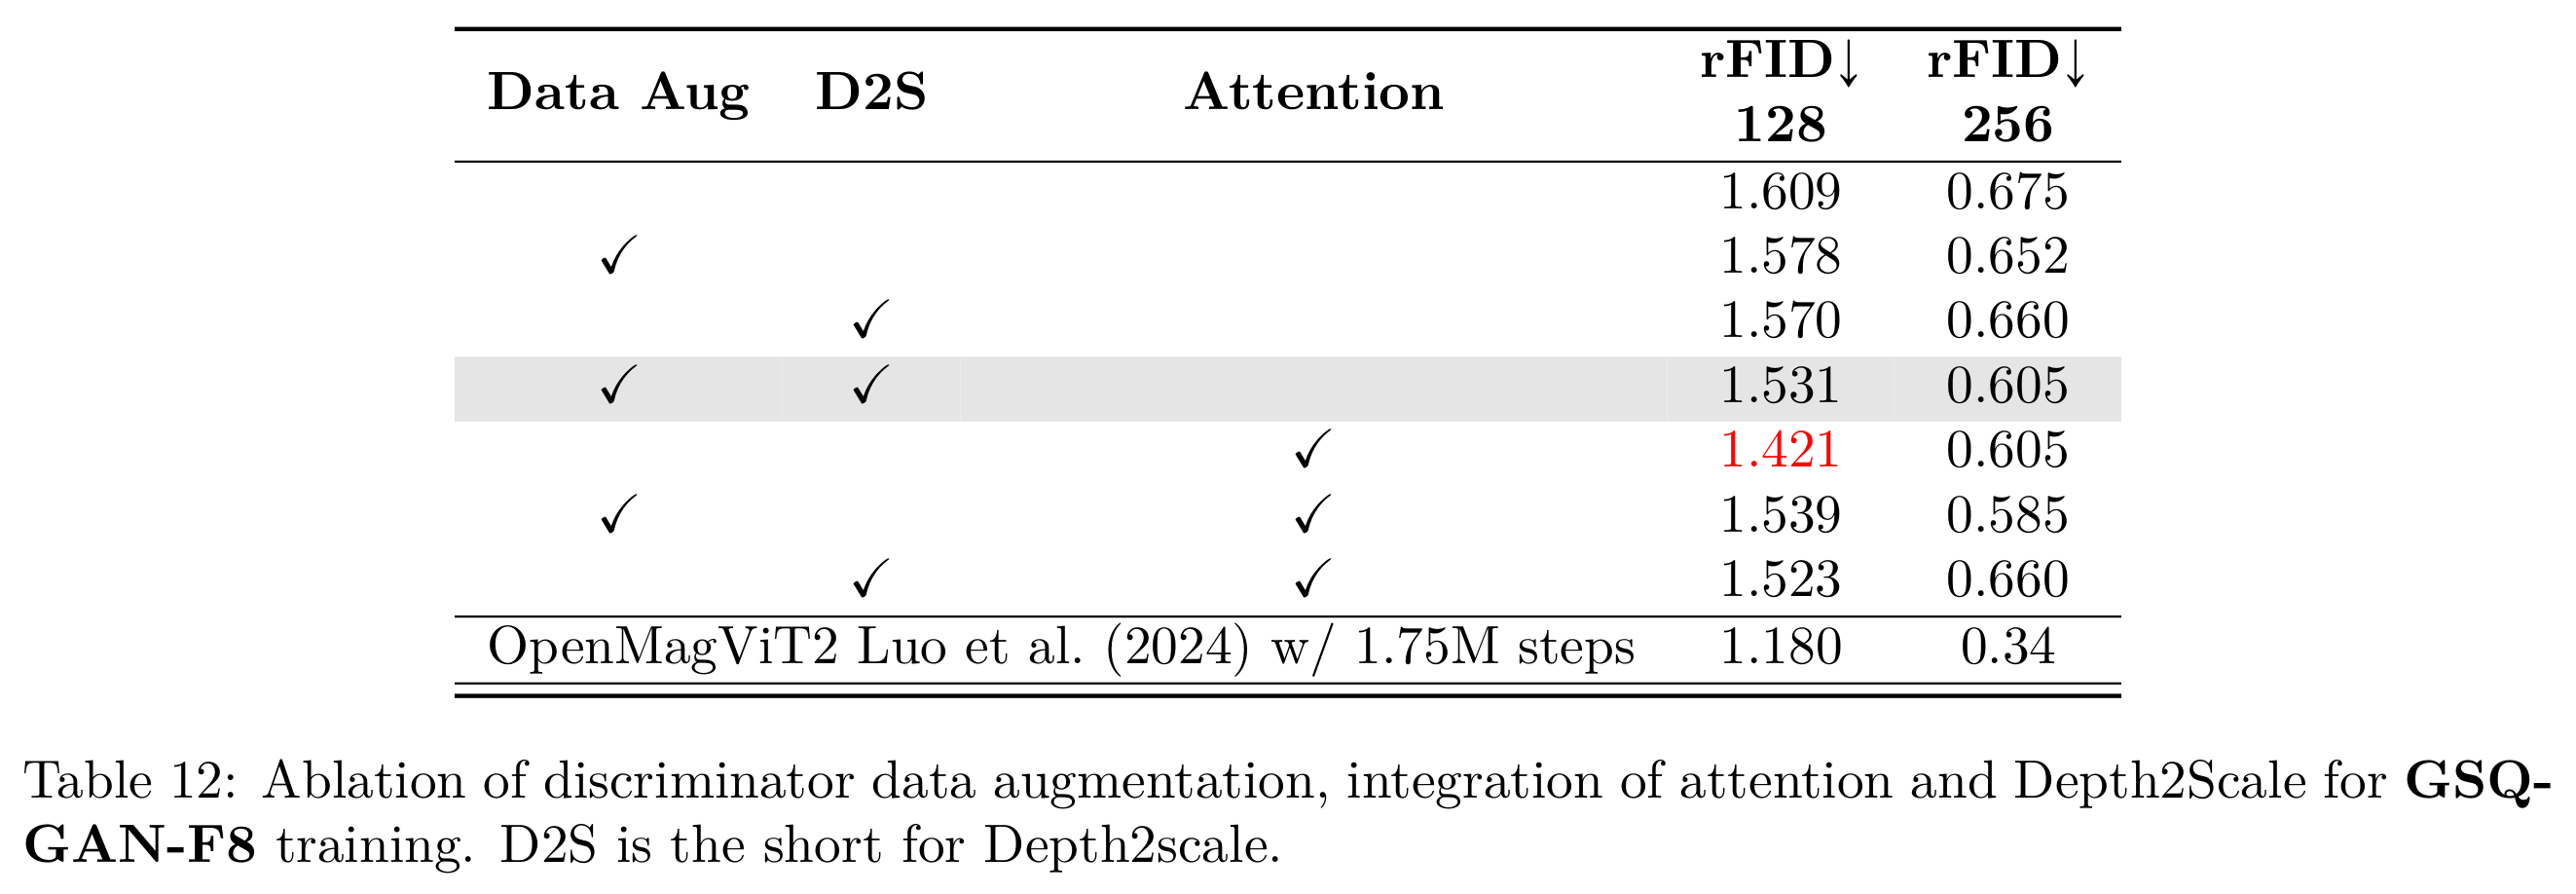
Depth2Scale은 비적대적 실험에서는 효과가 약했지만 적대적 학습에서는 도움이 된다. Table 12에서 데이터 증강과 Depth2Scale을 사용하면 rFID는 128 해상도에서 1.531, 256 해상도에서 0.605이다. 이러한 추가 요소를 사용하지 않으면 각각 1.609와 0.675이다.
- 잠재 위치 사이의 정보를 결합하는 어텐션을 단독으로 사용하면 표에 제시된 GSQ의 128 해상도 결과 중 가장 좋은 1.421을 얻는다. 어텐션과 데이터 증강을 함께 사용하면 GSQ의 256 해상도 결과 중 가장 좋은 0.585를 얻는다.
- 저자들은 어텐션이 학습 불안정을 일으킬 가능성을 언급한다. 표는 학습 해상도와 다른 해상도에서의 추론을 보여주지만, 최적 GSQ 설정은 평가 해상도에 따라 다르다. 별도로 보고된 Open-MAGVIT2 기준 결과는 1.75 million 스텝 학습 후 평가 해상도 2개 모두에서 더 낮은 rFID를 기록한다.
Depth2Scale과 어텐션은 적대적 재구성을 개선할 수 있지만, 효과는 증강과 평가 해상도에 따라 달라진다. 어텐션만 사용하면 표에 제시된 GSQ의 128 해상도 rFID가 가장 낮고, 어텐션과 증강을 함께 사용하면 GSQ의 256 해상도 rFID가 가장 낮다. 별도로 보고된 Open-MAGVIT2 기준 결과는 더 오래 학습한 뒤 평가 해상도 2개 모두에서 더 낮은 값을 기록한다.
4.3 Scaling Behaviors of GSQ-GAN
스케일링 실험은 ImageNet의 256 × 256 해상도에서 배치 크기 512로 50,000스텝, 즉 20에포크 동안 학습한다. 이 공통 설정으로 네트워크 용량, 잠재 차원, 코드북 어휘 크기, 그룹 분해, 공간 다운샘플링을 연구한다.
4.3.1 Network Capacity.
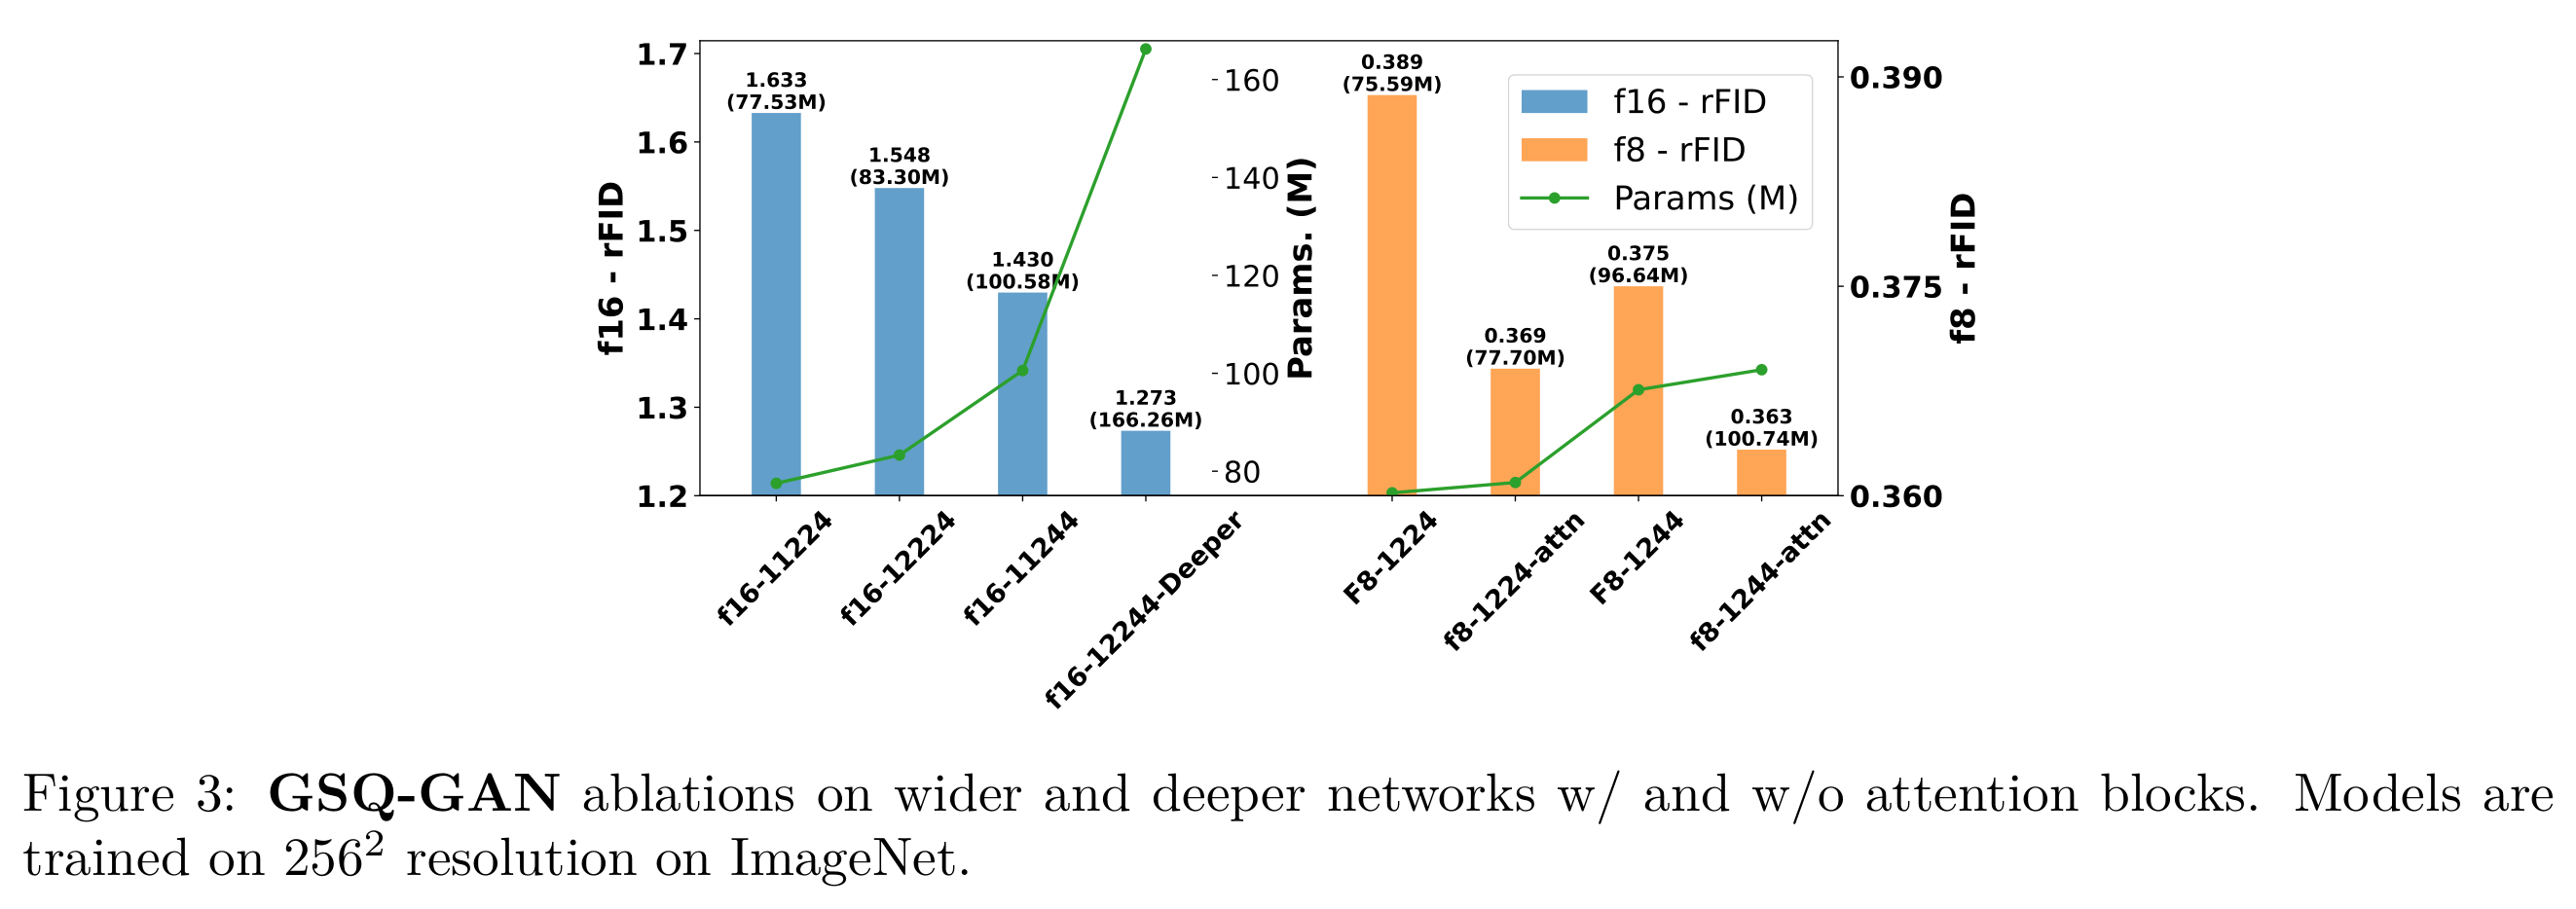
실험한 설정에서는 네트워크 너비와 깊이를 늘리면 재구성 품질이 개선된다. Figure 3에서 16배 다운샘플링 모델은 파라미터 수가 77.53 million일 때 rFID 1.633을, 166.26 million일 때 1.273을 기록한다.
- 8× 다운샘플링에서 어텐션은 너비가 좁은 설정을 0.389에서 0.369로, 너비가 넓은 설정을 0.375에서 0.363으로 개선한다.
- 이 결과는 해당 실험 안에서 품질과 용량 사이의 절충 관계를 보여준다. 파라미터 수만으로 학습이나 추론 효율을 판단할 수는 없다.
16배 다운샘플링 설정은 용량이 커질수록 개선되어, 파라미터 수가 166.26 million일 때 rFID 1.273에 도달한다. 8배 설정에서는 어텐션의 개선 폭이 더 작다. 이를 통해 개선의 크기와 그에 필요한 파라미터 비용을 확인할 수 있다.
4.3.2 Scaling of Latent Space and Vocabulary.
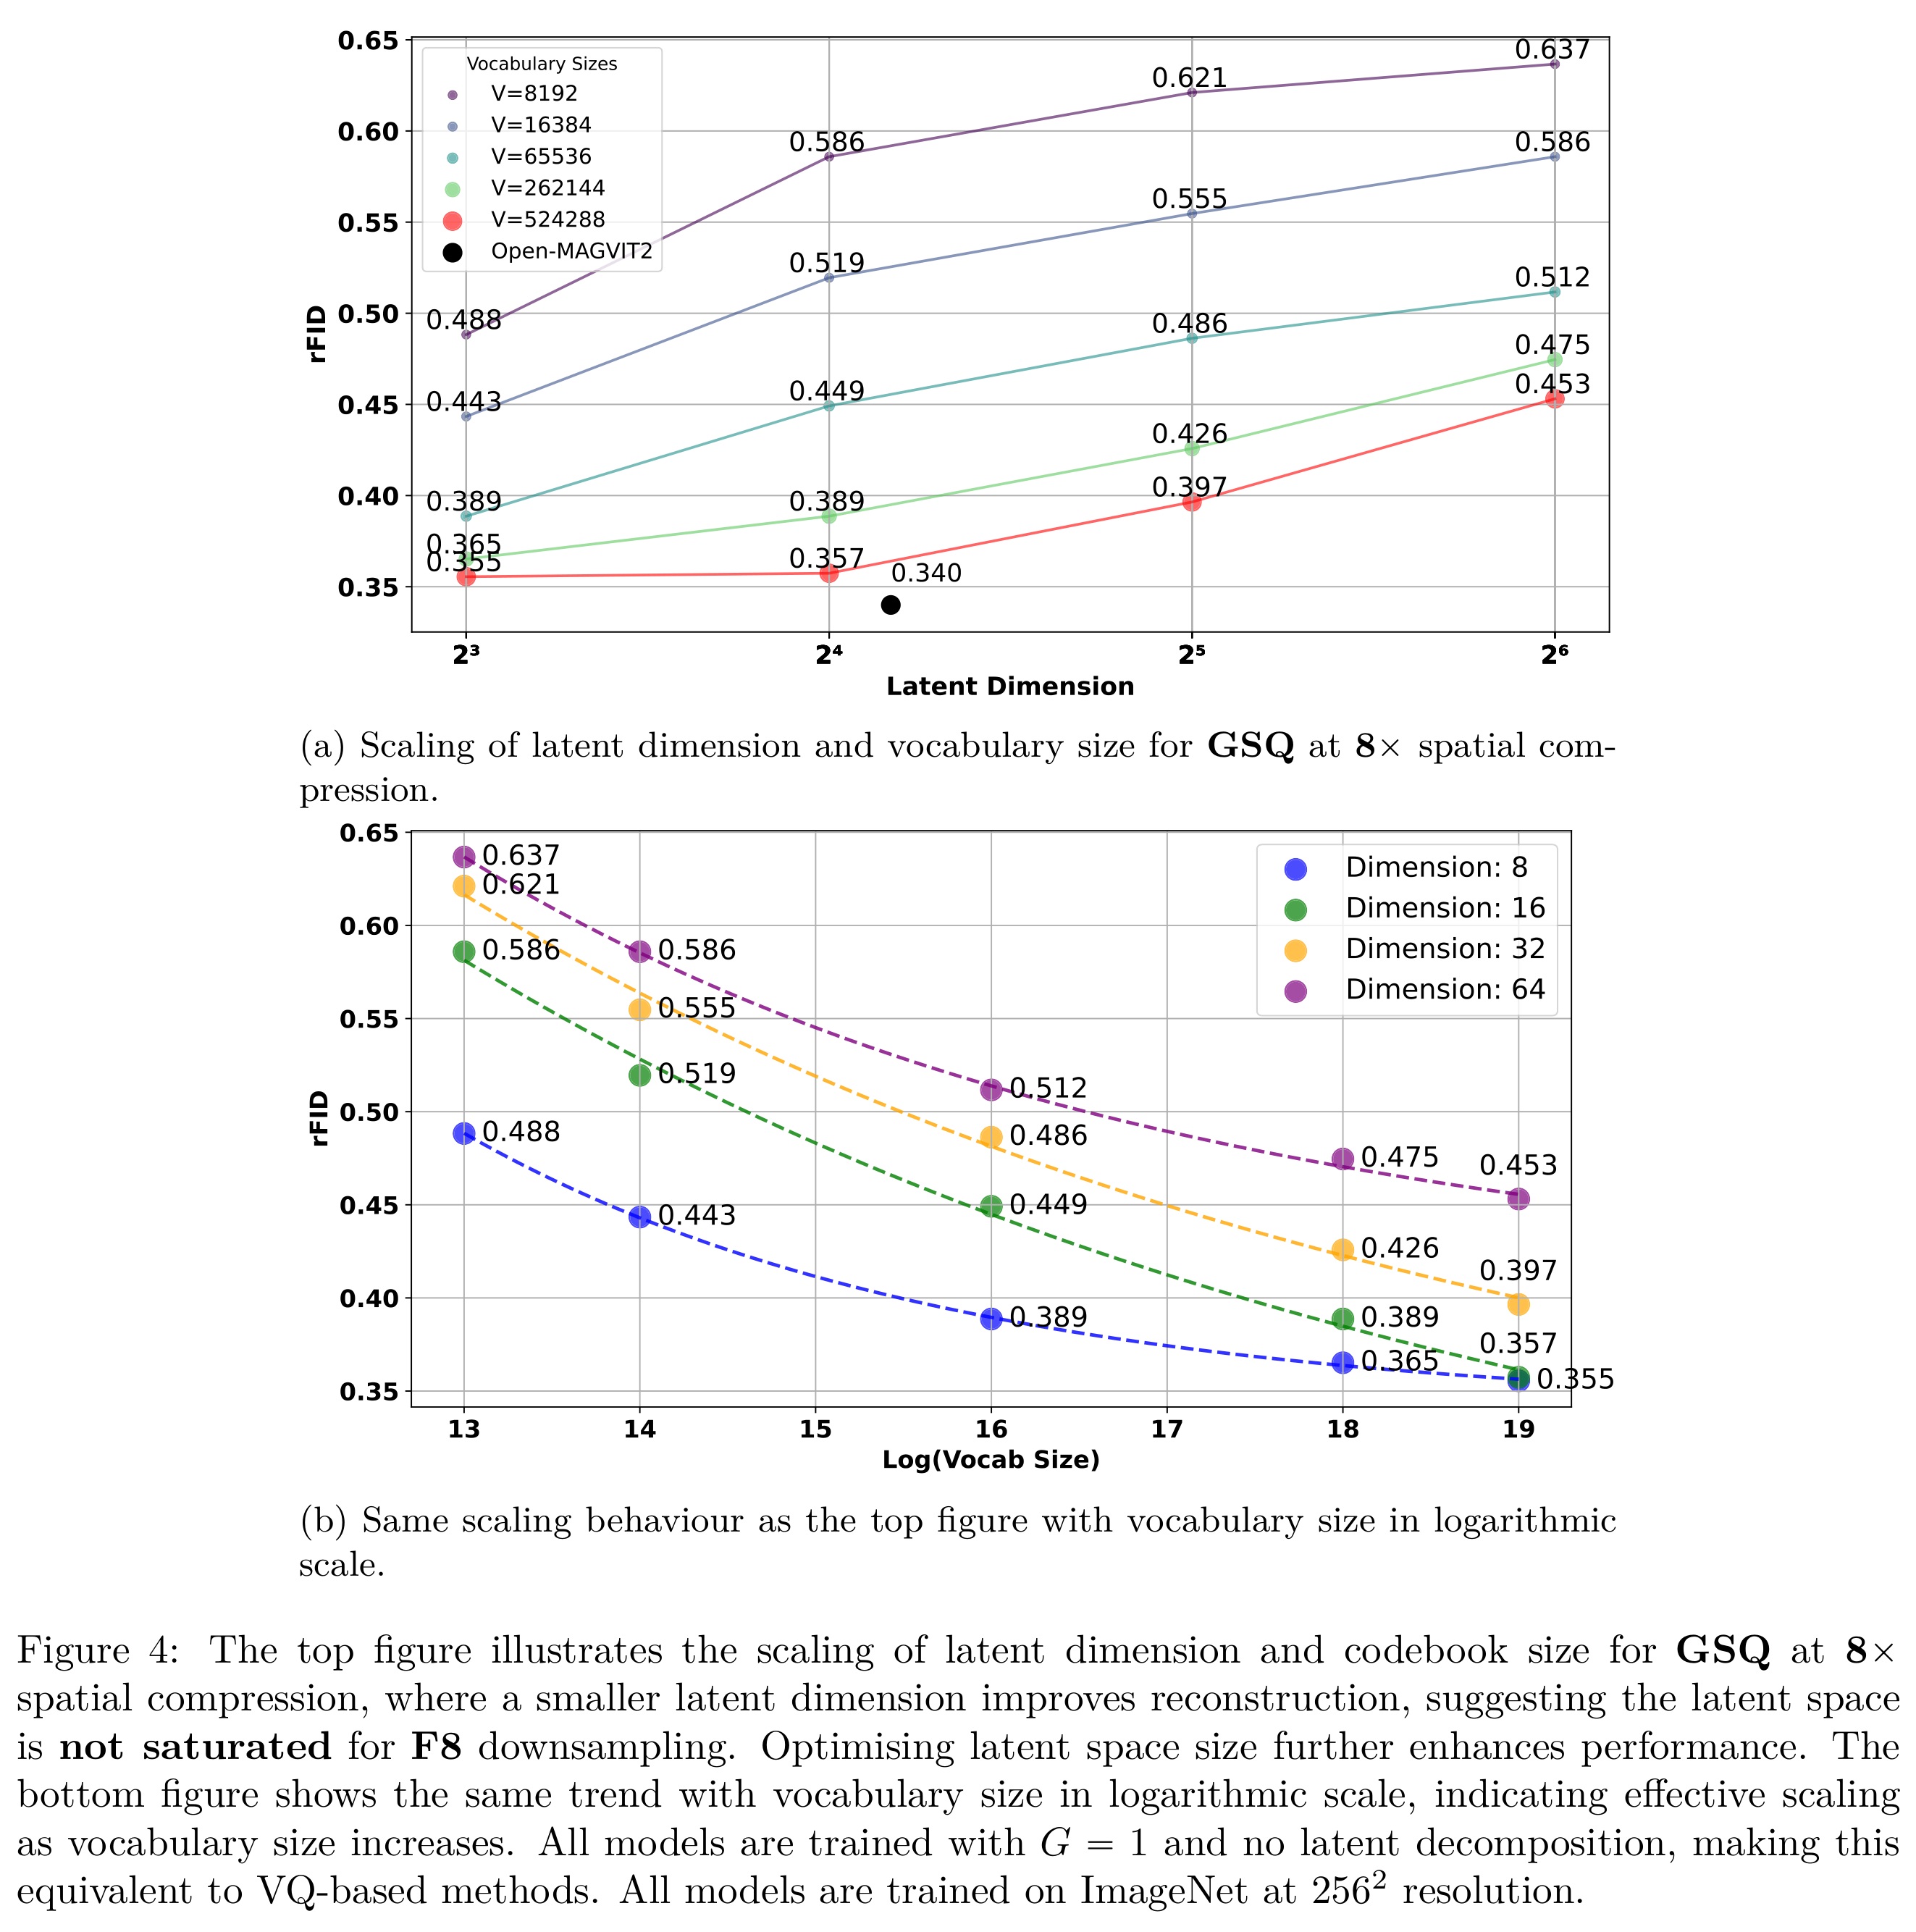
그룹을 나누지 않는 G = 1의 8배 다운샘플링 실험은 잠재 차원 8, 16, 32, 64와 어휘 크기 8,192, 16,384, 65,536, 262,144, 524,288을 조합해 평가한다. 이 탐색 범위 전체에서 어휘가 클수록 rFID가 개선되고, 잠재 차원이 작을수록 성능이 좋다.
- D = 8에서 어휘 크기를 8,192에서 524,288로 늘리면 rFID가 0.488에서 0.355로 개선된다. 어휘 크기 524,288에서 D를 64로 늘리면 rFID는 0.453으로 악화된다.
- Figure 4에 포함된 Open-MAGVIT2는 0.340으로, 여전히 0.355보다 낮다. 따라서 최신 토크나이저보다 우수하다는 본문 주장은 이 그래프의 비교가 뒷받침하는 범위보다 넓다.
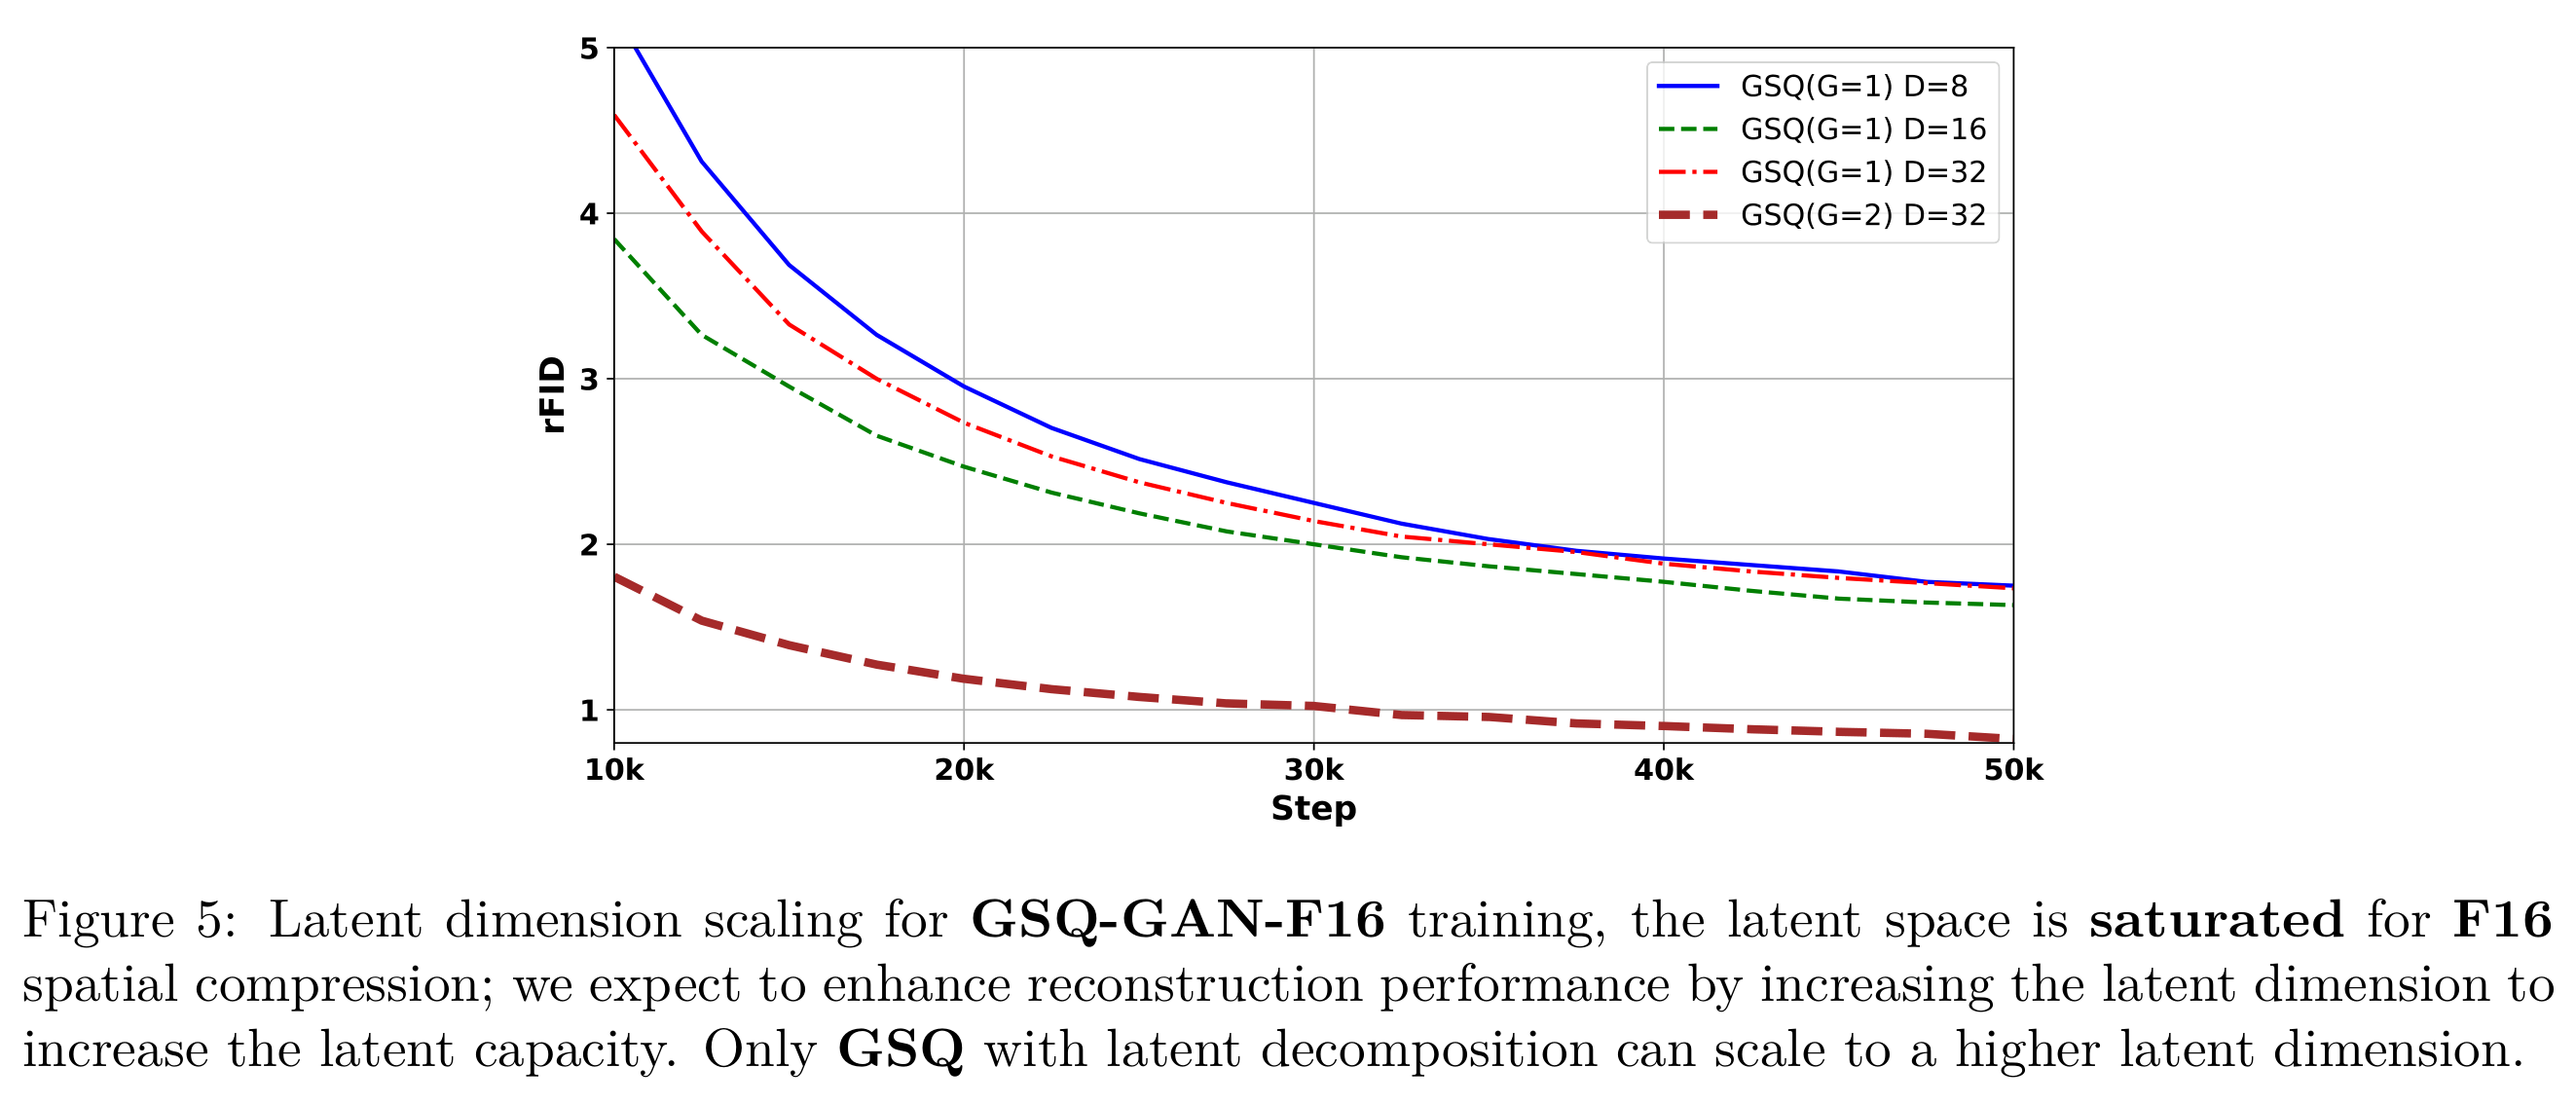
- 16배 다운샘플링에서는 그룹을 나누지 않은 잠재 차원을 D = 16보다 늘려도 더 이상 도움이 되지 않는다. Figure 5는 D = 32를 2개 그룹으로 나누면 훨씬 크게 개선됨을 보여준다.
8배 다운샘플링에서 모든 어휘 크기의 곡선은 그룹을 나누지 않은 잠재 차원이 작을수록 좋은 성능을 보이며, 모든 차원은 어휘가 커질수록 개선된다. 그래프에서 가장 좋은 GSQ 값은 0.355이고, 함께 제시된 Open-MAGVIT2 기준값은 0.340이다. 따라서 본문의 포괄적인 우위 주장에는 제한이 따른다.
4.3.3 Latent Space and Downsample Factor, and Better Scaling with GSQ
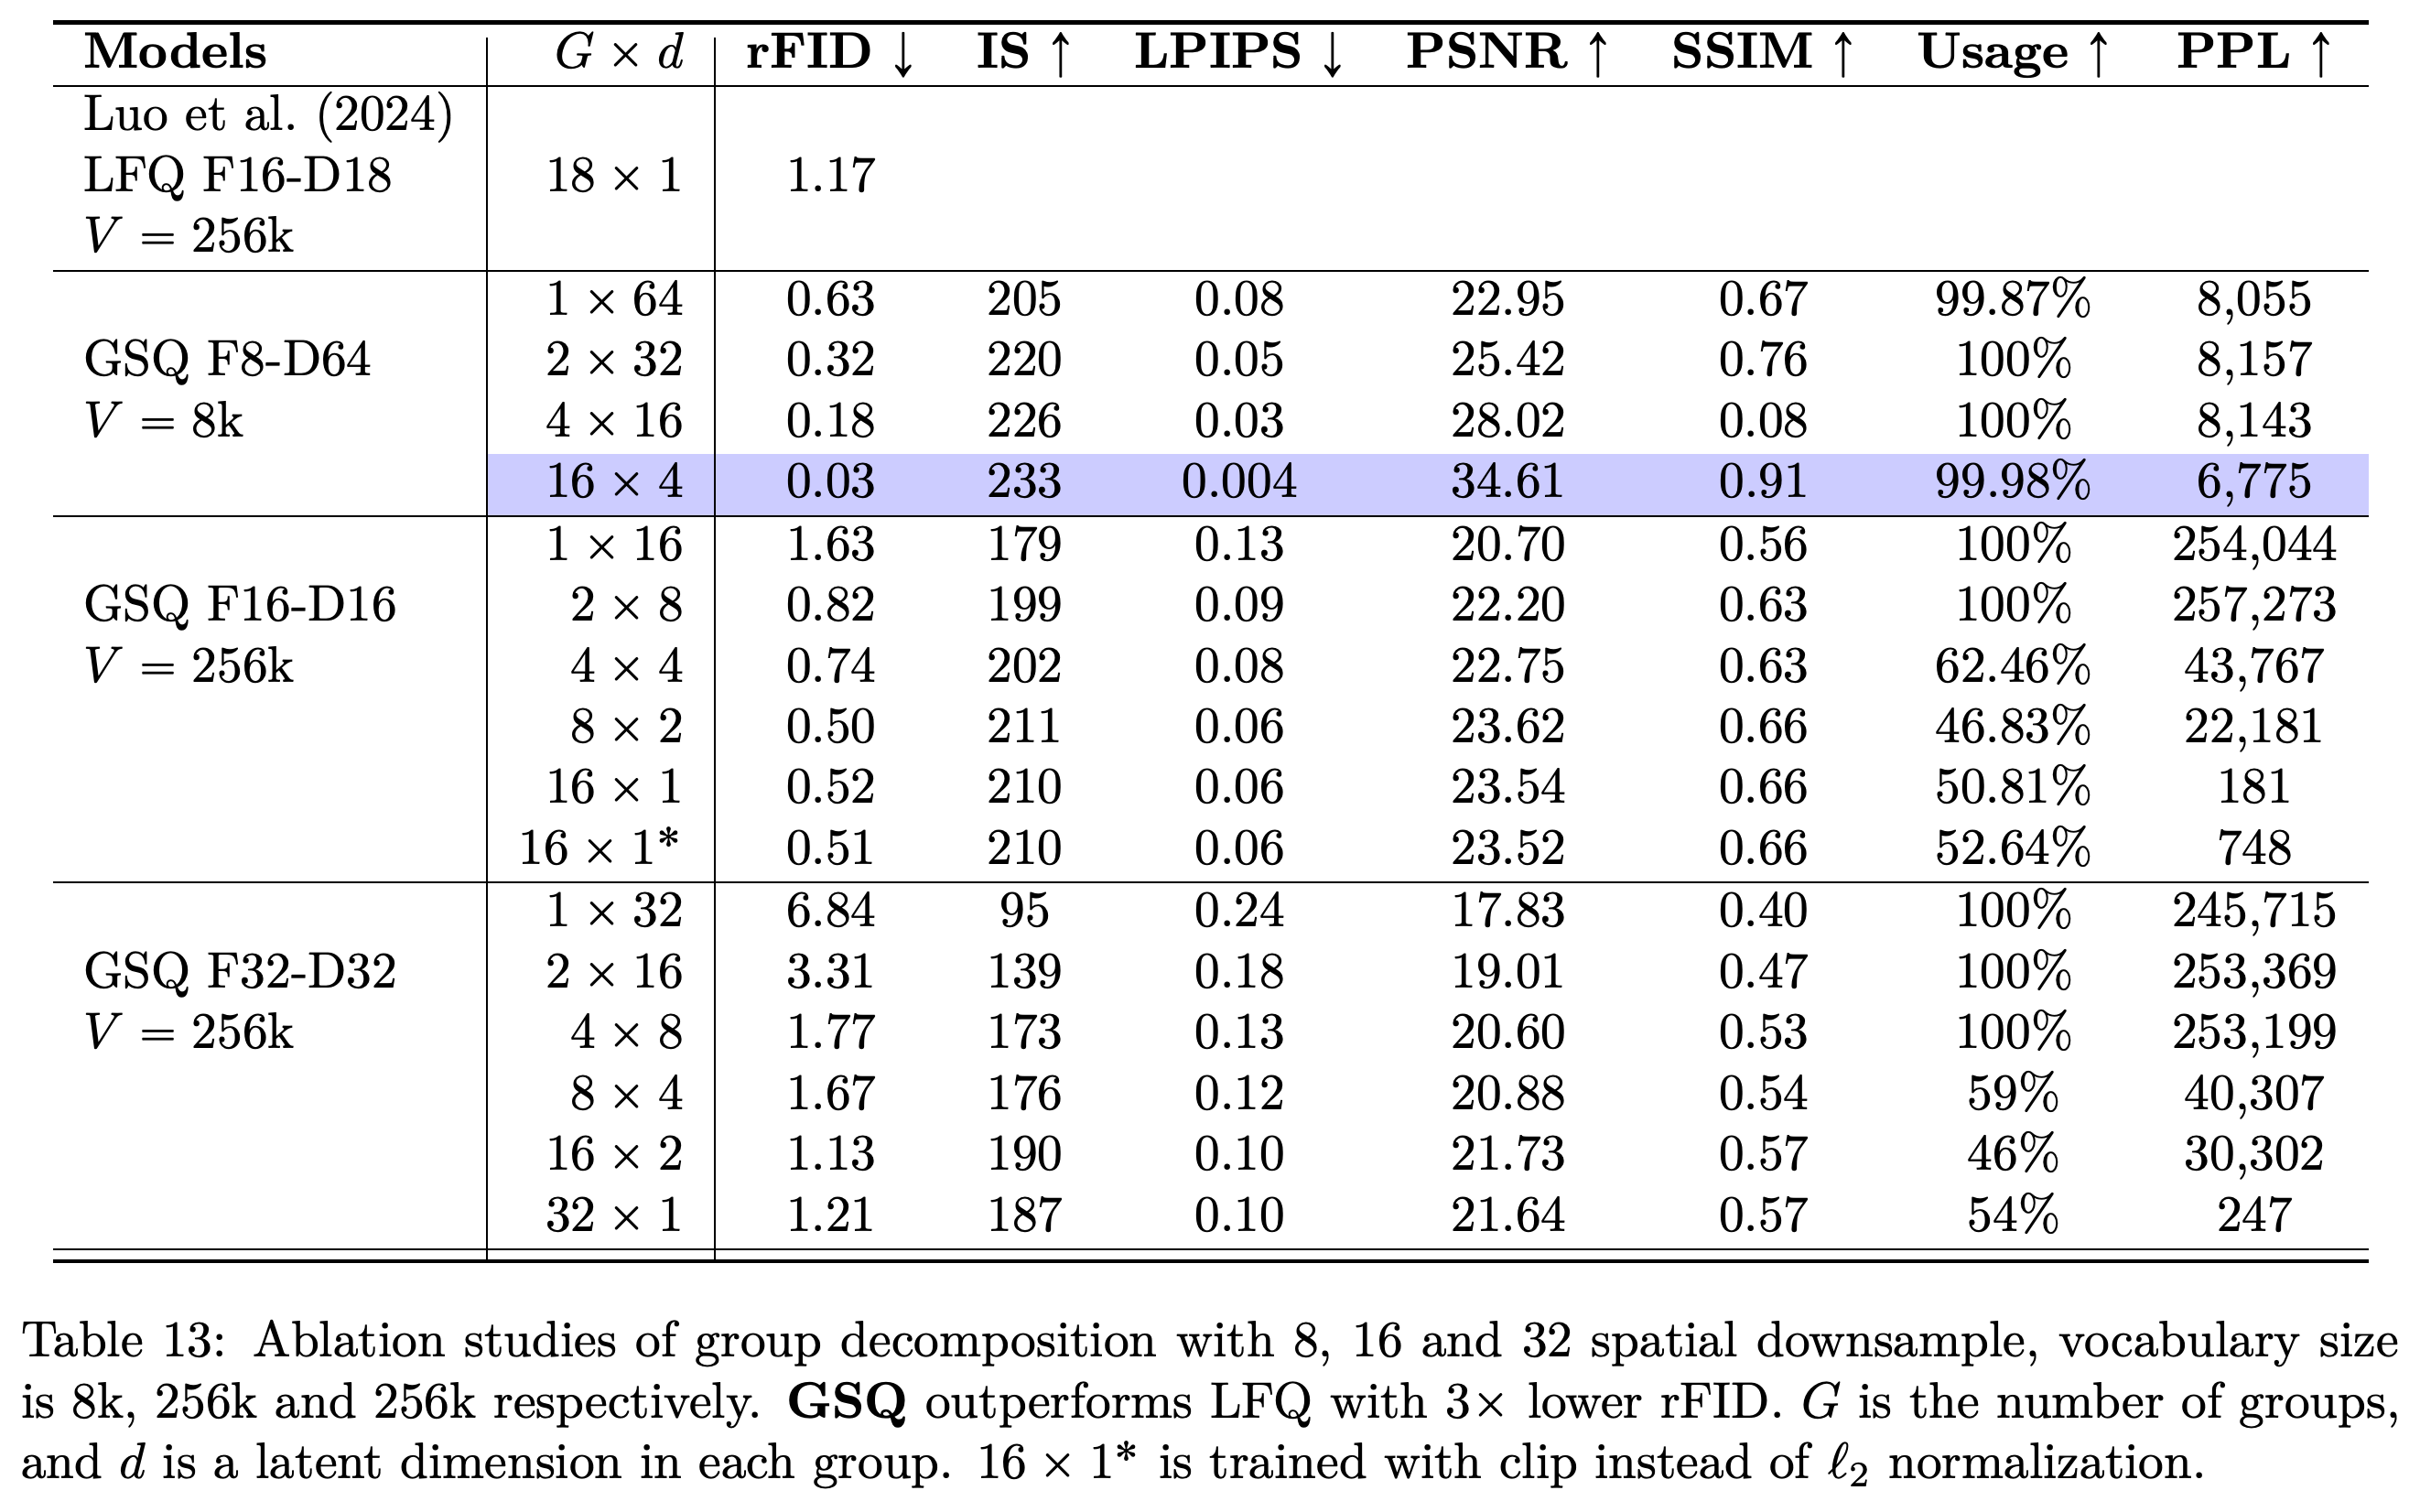
Table 13은 전체 잠재 차원과 그룹별 코드북 어휘 크기를 고정하고 그룹 분해를 실험한다. f = 16, D = 16, V = 256k에서 G를 1에서 8로 늘리면 rFID가 1.63에서 0.50으로 개선된다. f = 32, D = 32에서 G를 1에서 16으로 늘리면 6.84에서 1.13으로 개선된다.
- 그룹화는 공간 위치마다 출력하는 코드 인덱스 수와 가능한 조합의 유효 개수도 바꾼다. 따라서 그룹별 어휘 크기를 고정해도 인코딩 비트레이트가 고정되는 것은 아니다.
- f = 8, D = 64, V = 8k, G = 16에서 rFID는 0.03, PSNR은 34.61에 도달한다. 저자들은 이를 거의 무손실에 가까운 재구성으로 설명하면서도 실용적인 압축 가치는 제한적이라고 인정한다. 정확히 원본을 복원한 결과는 아니다.
- Figure 1b는 그룹 차원을 d = 16으로 고정하고 그룹을 추가해 전체 차원을 늘리면 f = 8, 16, 32에서 재구성 품질이 개선됨을 보여준다. f = 32에서는 D = 16일 때 rFID 7.09에서 D = 128일 때 0.83으로 낮아진다.
- 코드북 사용률이 항상 최대에 도달하는 것은 아니다. f = 16, G = 8 설정은 사용률 46.83%를 기록하므로, 사용률이 100%라는 일반적인 설명에는 제한이 따른다.
그룹을 나누지 않은 잠재 표현을 D = 16에서 D = 32로 늘려도 이점은 작지만, D = 32를 2개 그룹으로 나누면 재구성 곡선이 크게 낮아진다. 이는 공간 압축이 강할 때 그룹화가 유용함을 뒷받침한다. 다만 추가된 그룹별 할당은 이산 표현의 용량도 바꾼다.
전체 차원을 고정해도 그룹화는 3가지 다운샘플링 설정 모두에서 재구성 품질을 크게 개선한다. 동시에 전체 코드북을 사용한다는 주장에 한계가 있음을 보여준다. 주요 결과인 8개 그룹의 F16 설정은 코드북 항목의 46.83%를 사용하면서 rFID 0.50에 도달한다.
5 Conclusion
결론은 GSQ의 재구성 성능을 구면 초기화, 조회 정규화, 잠재 그룹화, 최적화한 학습 설정의 효과로 설명한다. 실험은 공간 다운샘플링이 작을 때와 클 때 서로 다른 스케일링 양상이 나타남을 뒷받침한다. 특히 더 큰 잠재 차원이 필요한 경우 그룹화가 유용하다.
- 실험으로 확인한 성과는 이미지 재구성 개선이다. 후속 생성 모델링의 이점은 이 논문에서 실험으로 입증한 결과가 아니라 연구 동기에 해당한다.
부록
- A Performance of State-of-the-Art Image Tokenizers는 공간 다운샘플링 설정별 재구성 비교를 확장한다. 부록에 보고한 GSQ 설정은 주요 결과의 설정과 다르므로 같은 실험으로 취급할 수 없다.
- B Networks는 해상도 블록과 중간 블록, 잔차 연결, 선택적 어텐션, 디코더의 적응형 정규화를 포함한 합성곱 인코더와 디코더 구조를 설명한다.
- C GSQ and Other Quantizers는 그룹화, 코드북 공유, 정규화에 따라 GSQ와 기존 양자화기의 관계를 설명한다. 거리 집중 현상을 논의하고 그룹을 나누지 않은 스케일링 결과를 경험적으로 피팅하지만, 별도의 외삽 평가는 제시하지 않는다. 그룹별 코드는 유효 표현 공간도 확장한다.
- D Ablation Studies of VAE는 학습, 초기화, 학습률 스케줄, 정성적 재구성 비교를 제시한다. 초기화 비교가 본문 표의 그룹 설정과 명확히 대응하지 않아 해당 결과에 적용한 설정은 불분명하다.
- E Ablation Studies of GAN은 학습, 판별기, 손실의 정의와 함께 그룹을 나누지 않은 설정에서 조회 정규화를 생략한 사실을 제시한다. StyleGAN 판별기의 수치적 실패와 계산 비용이 큰 안정화 시도를 기록하고, 판별기와 옵티마이저 선택에 따른 정성적 비교를 제공한다.
- F Scaling Behaviors는 스케일링 실험 설정과 잠재 차원, 그룹 수, 공간 다운샘플링 변화에 따른 정성적 재구성 비교를 제시한다. 이 예시들은 본문의 재구성 연구를 보완하며 후속 생성 품질을 입증하는 결과는 아니다.
짧은 생각
가장 명확한 근거는 조건을 통제한 학습 설정 비교 실험과 차원을 고정한 그룹화 실험에서 나온다. Table 1은 정규화가 약한 기존 베이스라인을 어떻게 개선하는지 보여주고, Table 13은 그룹화의 추가 이점을 보여준다. 이는 양자화기 비교가 학습 설정과 표현 구조 2가지 모두에 좌우된다는 주장을 뒷받침한다.
압축 결과는 출력 인덱스 수와 함께 해석해야 한다. 그룹을 추가하면 표현이 확장되지만, 논문은 인코딩 비트레이트, 후속 생성기의 비용, 생성 품질을 비교하지 않는다. 보고된 실험에는 시드를 바꿔 반복한 결과를 바탕으로 한 불확실성 추정도 없다. 본문과 표의 불일치로 일부 설정을 정확히 재현하기 어렵다는 점도 남는다.