


Scaling Laws for Looped Mixture of Experts 요약 설명
30 Sep 2026 | Paper Review Scaling Laws Mixture-of-Experts Looped Transformers목차
이번 글에서는 Scaling Laws for Looped Mixture of Experts 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 30일(Arxiv)
- Chen, Yanbei, Goyal, Anirudh, Krishnamoorthi, Raghuraman.
- Meta AI
- 논문 링크
요약
- 이 논문은 언어 모델의 용량을 recurrence와 Mixture-of-Experts(MoE)에 어떻게 배분할지 연구한다. Recurrence는 공유 계층을 반복해서 통과하는 방식이고, MoE는 토큰마다 일부 expert 네트워크를 선택하는 방식이다. 학습 연산량이 약 1.5×10^22 부동소수점 연산(FLOPs)일 때, 활성 파라미터가 0.3 billion이고 전체 파라미터가 1.3 billion인 모델은 반복 통과를 사용하지 않는 활성 파라미터 0.6 billion, 전체 파라미터 2.9 billion MoE와 추론 벤치마크 2개의 평균 성능이 대략 비슷하다. 이때 통과 횟수는 4–5회이며, 추론 연산량은 비교 모델의 1.5×–1.8×다. 더 작은 모델은 전체 14개 벤치마크 평균에서는 여전히 뒤처진다.
- Loop Scaling Laws는 활성 파라미터, 학습 토큰, recurrence, sparsity를 함께 모델링한다. 여기서 sparsity는 토큰마다 저장된 파라미터 중 비활성 상태로 남는 비중을 뜻한다. 유효 파라미터 매핑은 저장된 가중치 수가 아니라 피팅으로 추정한 용량을 나타낸다. 이 매핑에서는 통과 횟수가 늘수록 추가 이득이 줄어들며, sparsity가 높을수록 포화 한계가 높아지고 그 한계에 접근하는 과정도 더 많은 통과에 걸쳐 이어진다. 이 방식은 linear, power-law, sparsity-independent bounded 대안보다 홀드아웃 손실을 더 정확하게 예측한다. 각 대안은 추가 이득이 일정한 경우, 추가 이득은 줄지만 누적 이득은 한계 없이 증가하는 경우, sparsity에 따른 recurrence 매핑 없이 포화하는 경우를 각각 모델링한다.
- 스케일링 실험은 활성 파라미터 0.3B, 0.6B, 1.0B, 학습 토큰 100B–500B, 유효 expert 확장 비율 E∈{1,2,4,8,16}, recurrence R∈{1,2,3,4,6,8}을 다룬다. E는 선택 가능한 expert 수와 실제 선택하는 expert 수의 비율이고, R은 통과 횟수이며, B는 billions를 뜻한다. 학습 연산량이 5×10^20 FLOPs일 때 E≥8인 0.3B MoE models는 매번 모든 파라미터를 사용하는 1.0B dense model보다 성능이 높다. 10^21 FLOPs에서는 recurrence를 적용한 작은 MoE 모델이 반복 통과를 사용하지 않는 더 큰 모델과 비슷한 추론 성능을 낸다. 자원 배분 결과는 피팅한 법칙의 예측이며, 메모리 제약은 가중치만 고려한다.
1 Introduction
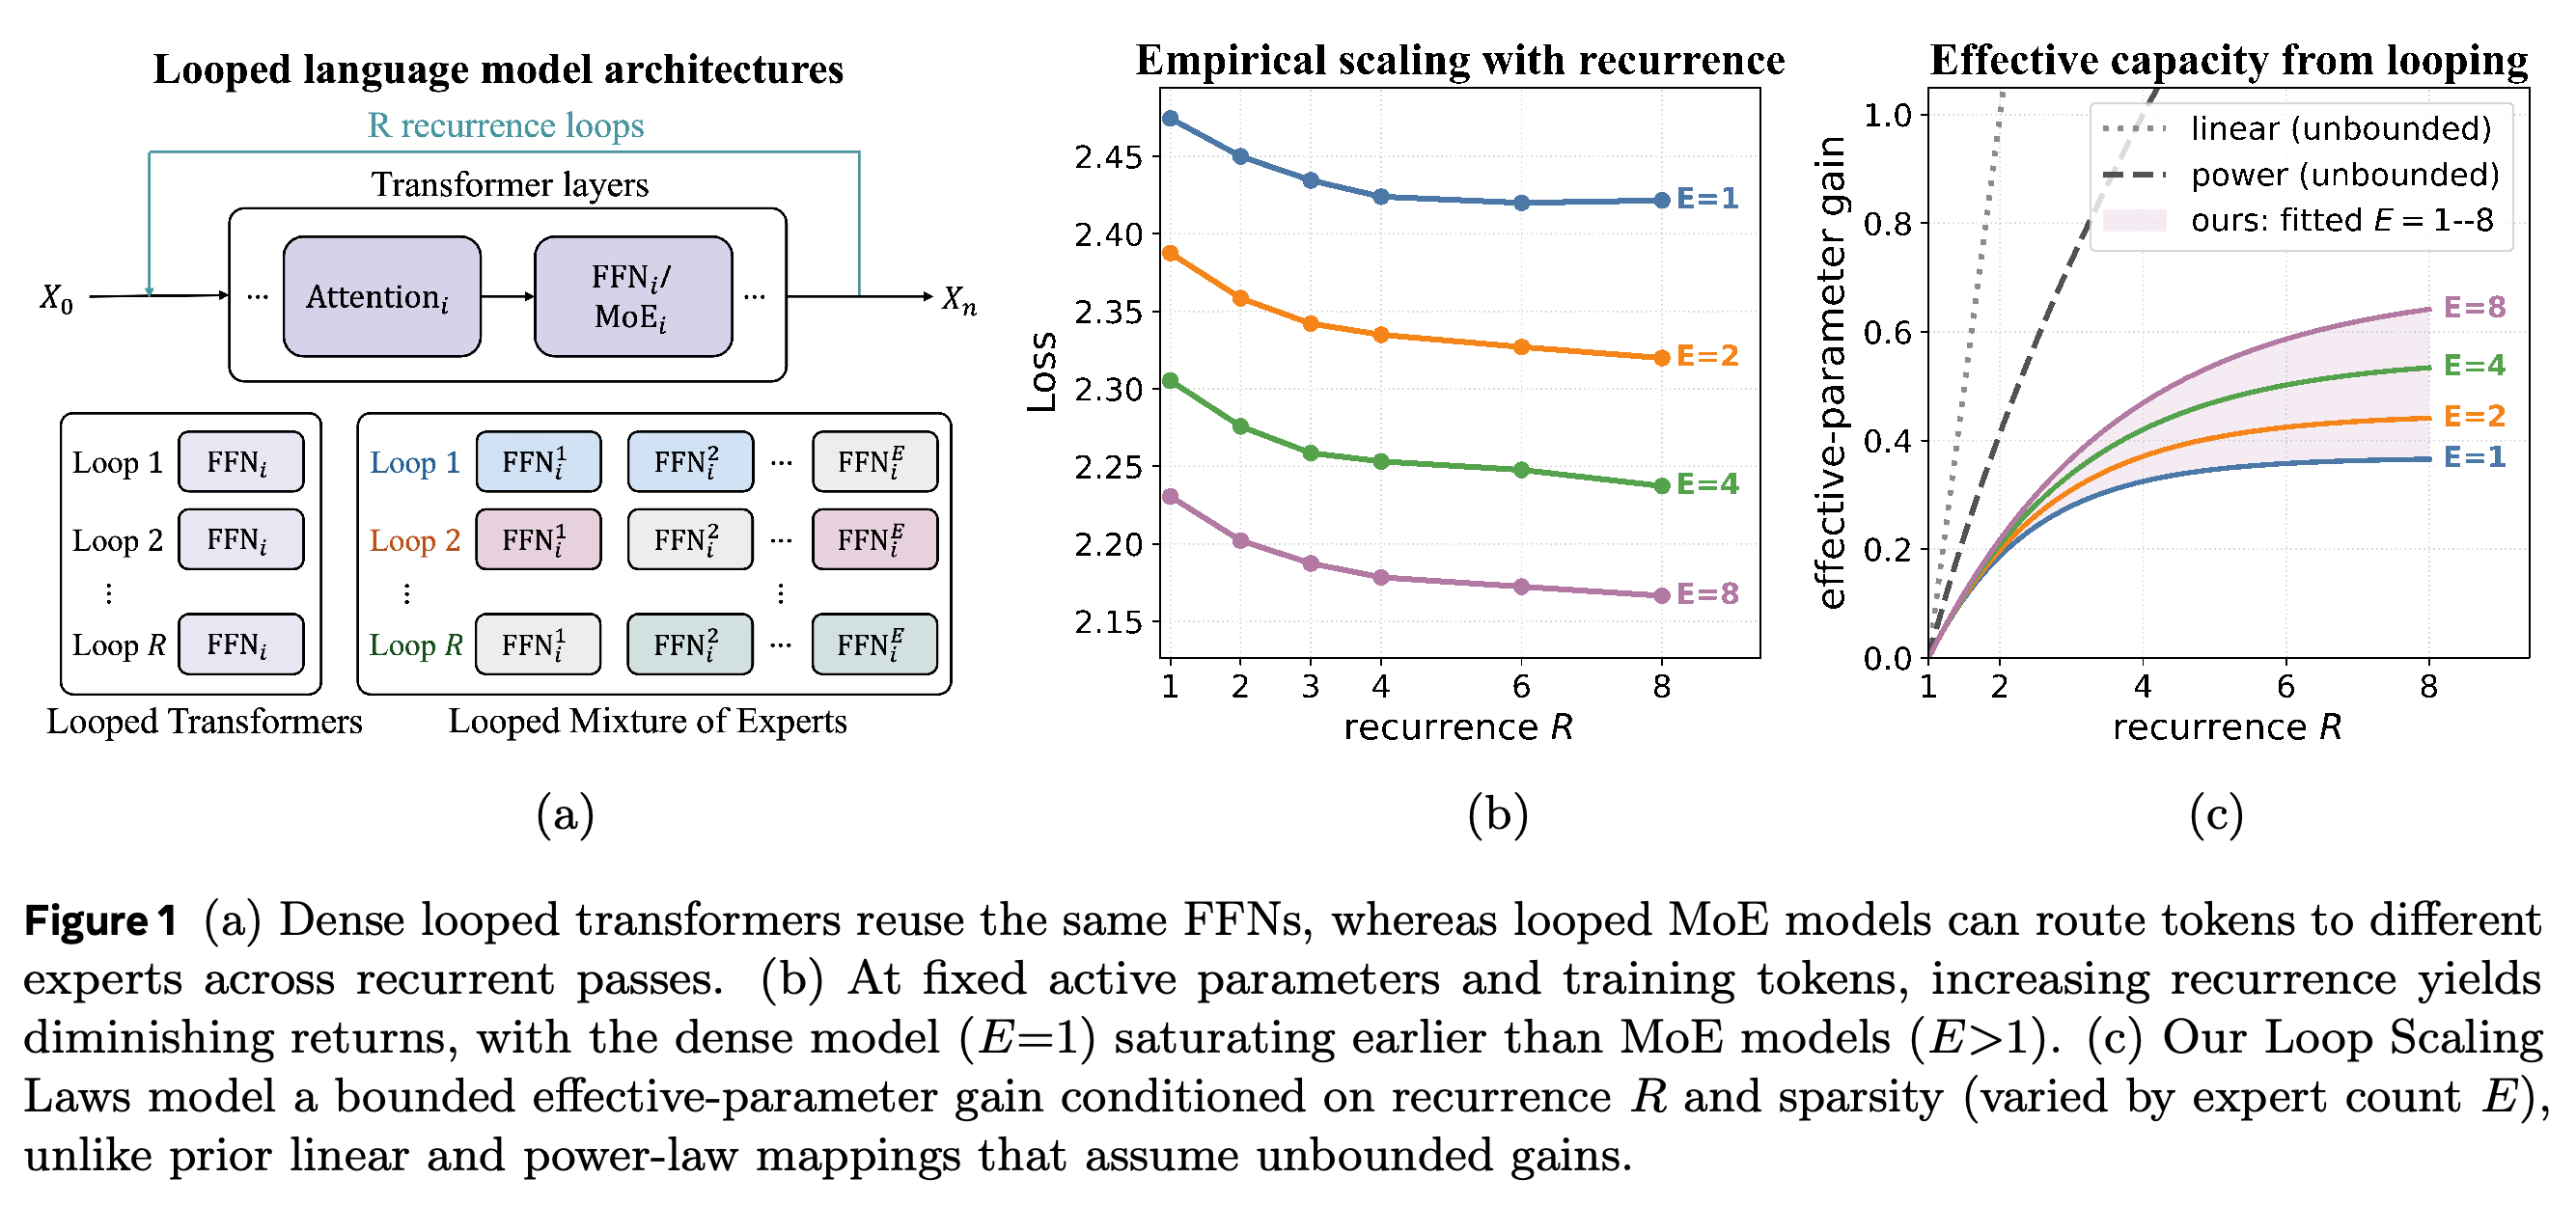
서론은 반복 통과마다 유효 용량이 얼마나 늘어나는지, MoE의 sparsity가 높아지면 그 이득이 더 오래 유지되는지 묻는다. 활성 파라미터와 학습 토큰을 고정하면 관측 손실은 초기 몇 차례 통과에서 빠르게 감소한 뒤 완만해진다. Expert가 많을수록 더 많은 통과에 걸쳐 낮은 손실을 유지한다. 논문은 계층 가중치를 공유하더라도 토큰마다 expert를 선택하는 router가 통과마다 다른 expert를 선택할 수 있다는 점으로 이를 설명한다.
아키텍처 도식은 공유 가중치를 사용하는 recurrence에서 연속된 통과마다 서로 다른 expert를 선택할 수 있음을 보여준다. 측정한 손실 곡선에서는 활성 파라미터와 학습 토큰을 고정할 때 추가 이득이 줄어든다. 이는 포화가 sparsity에 따라 달라지는 용량 매핑의 근거가 된다.
2 Related Work
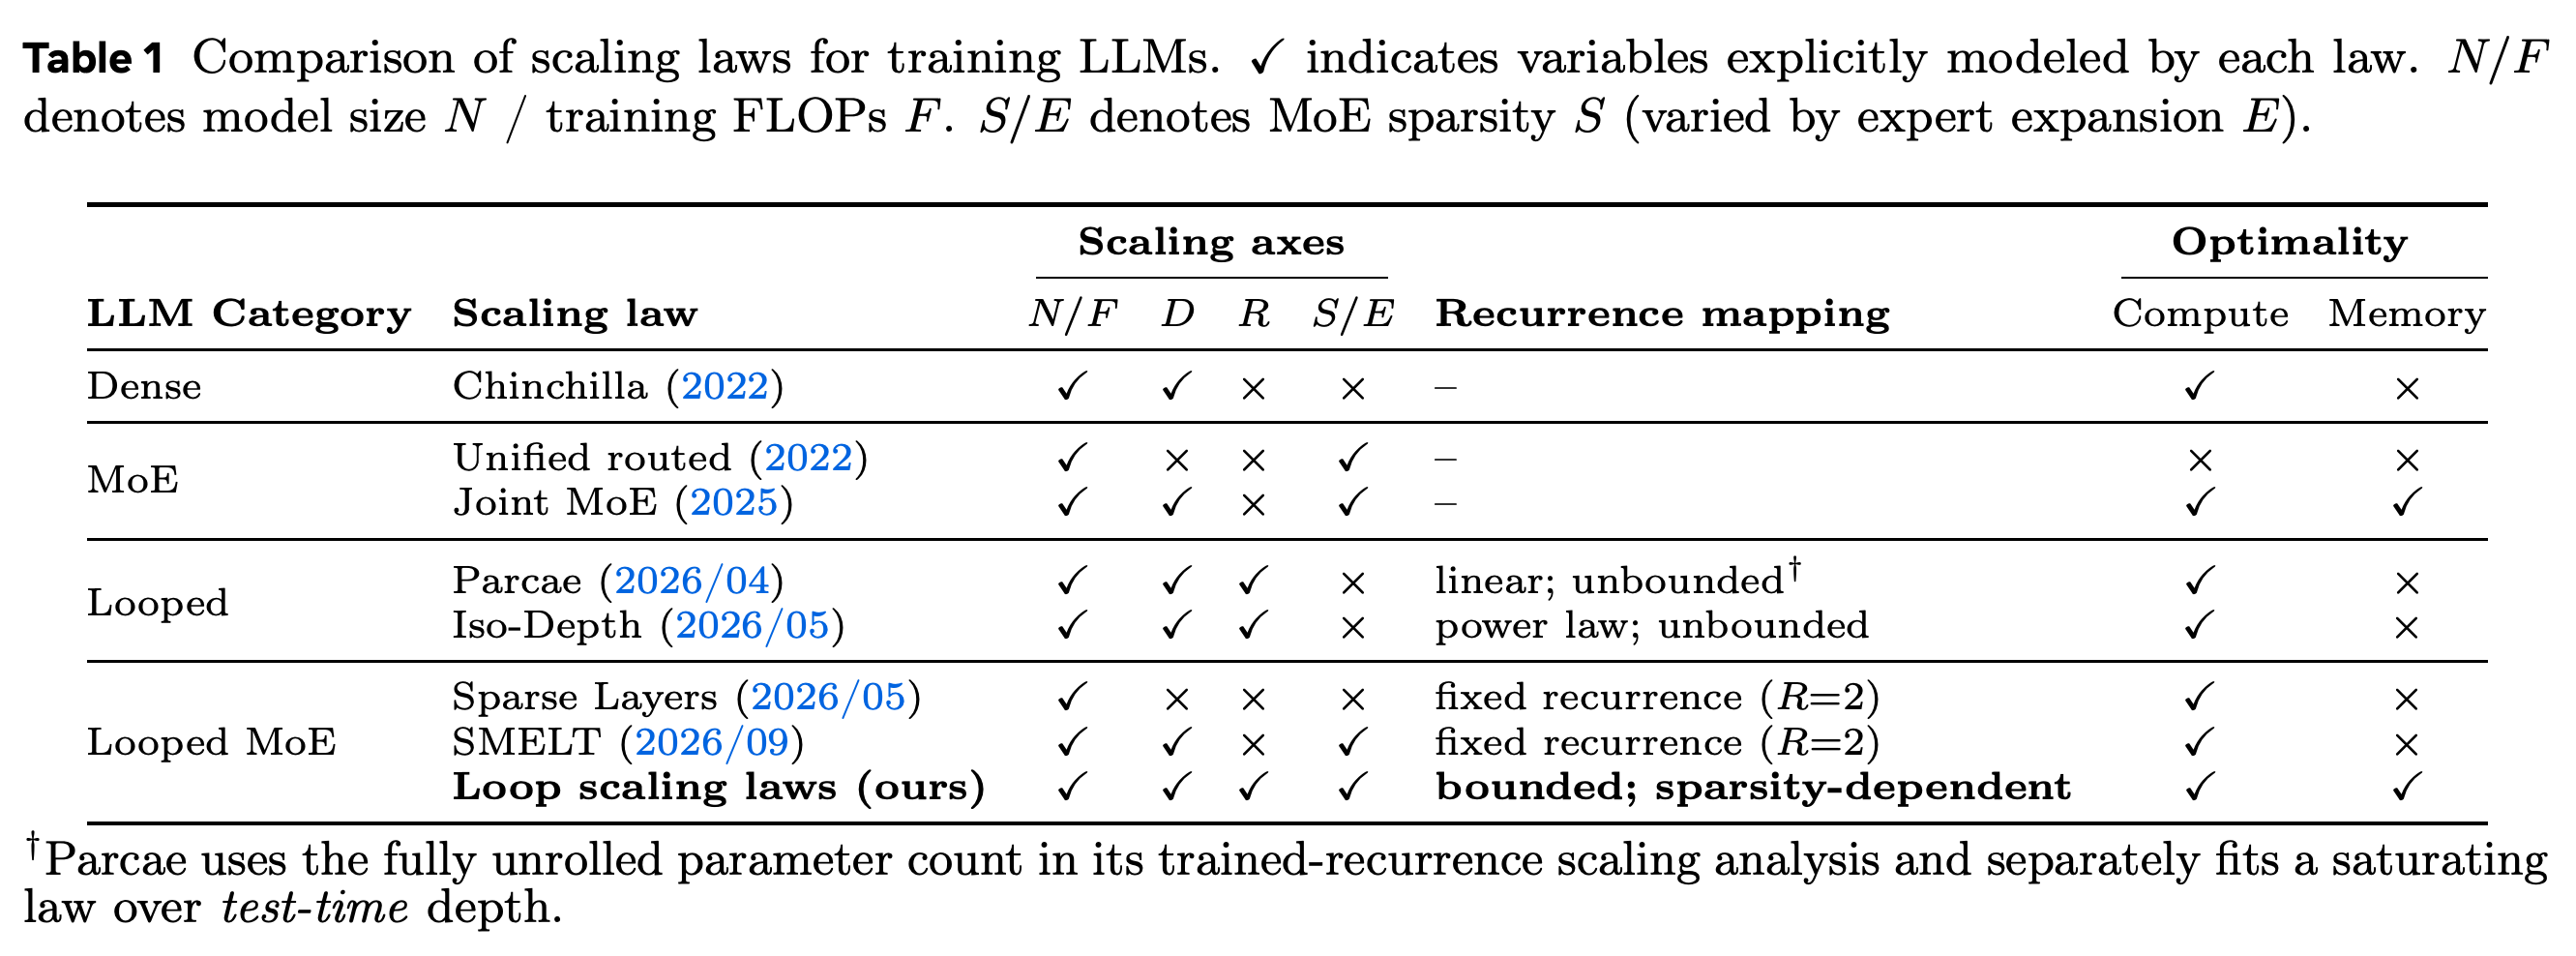
기존 looped transformer 법칙은 학습 시 recurrence를 linear 또는 power-law 용량 매핑으로 표현하며, 기존 MoE 법칙은 recurrence 없이 expert 확장을 모델링한다. 최근 looped MoE 스케일링 분석은 주로 recurrence를 R=2로 고정한다. Table 1은 모델 크기, 데이터, recurrence, sparsity를 함께 모델링하면서 sparsity에 따라 달라지는 유계 매핑을 사용한다는 점을 이 논문의 기여로 제시한다. 각주에서는 기존 looped 모델 스케일링 법칙인 Parcae의 학습 시 recurrence에 대한 선형 분석과, 별도로 피팅한 포화형 테스트 시점 깊이 법칙을 구분한다.
이 비교는 기존 법칙의 주된 스케일링 정식화가 recurrence와 sparsity를 함께 변화시키지 않는다는 연구 공백을 보여준다. Parcae 각주는 학습 시 recurrence 모델링과 해당 연구에서 별도로 피팅한 포화형 테스트 시점 깊이 법칙을 구분한다.
3 Loop Scaling Laws
먼저 표준 dense 언어 모델 스케일링 법칙에 recurrence에 따른 유효 파라미터 수를 도입한 뒤, 이 매핑이 MoE의 sparsity에 따라 달라지도록 확장한다. 공유 가중치를 반복 계산해서 얻는 용량과, 연산량을 추정하기 위해 파라미터의 반복 적용을 세는 unrolled 파라미터 수를 구분한다.
3.1 Preliminaries
기준 법칙은 \(\mathcal{L}(N,D)=AN^{\alpha}+BD^{\beta}+c\)다. N은 모델 파라미터 수, D는 학습 토큰 수, A와 B는 피팅 계수, α,β<0은 피팅한 스케일링 지수, c는 줄일 수 없는 손실이다. 활성 파라미터가 N_loop인 블록을 R회 재사용하면 N_unroll(R)=N_act+(R−1)N_loop가 된다. 여기서 N_act는 1회 통과에서 활성화되는 파라미터 수다. 모든 통과에 걸쳐 전체 역전파를 수행할 때 학습 연산량은 F_train=6N_unroll(R)D이고, 토큰당 추론 연산량은 F_inf=2N_unroll(R)다. Recurrence를 늘려도 저장된 파라미터 수는 바뀌지 않는다.
3.2 Loop Scaling Law
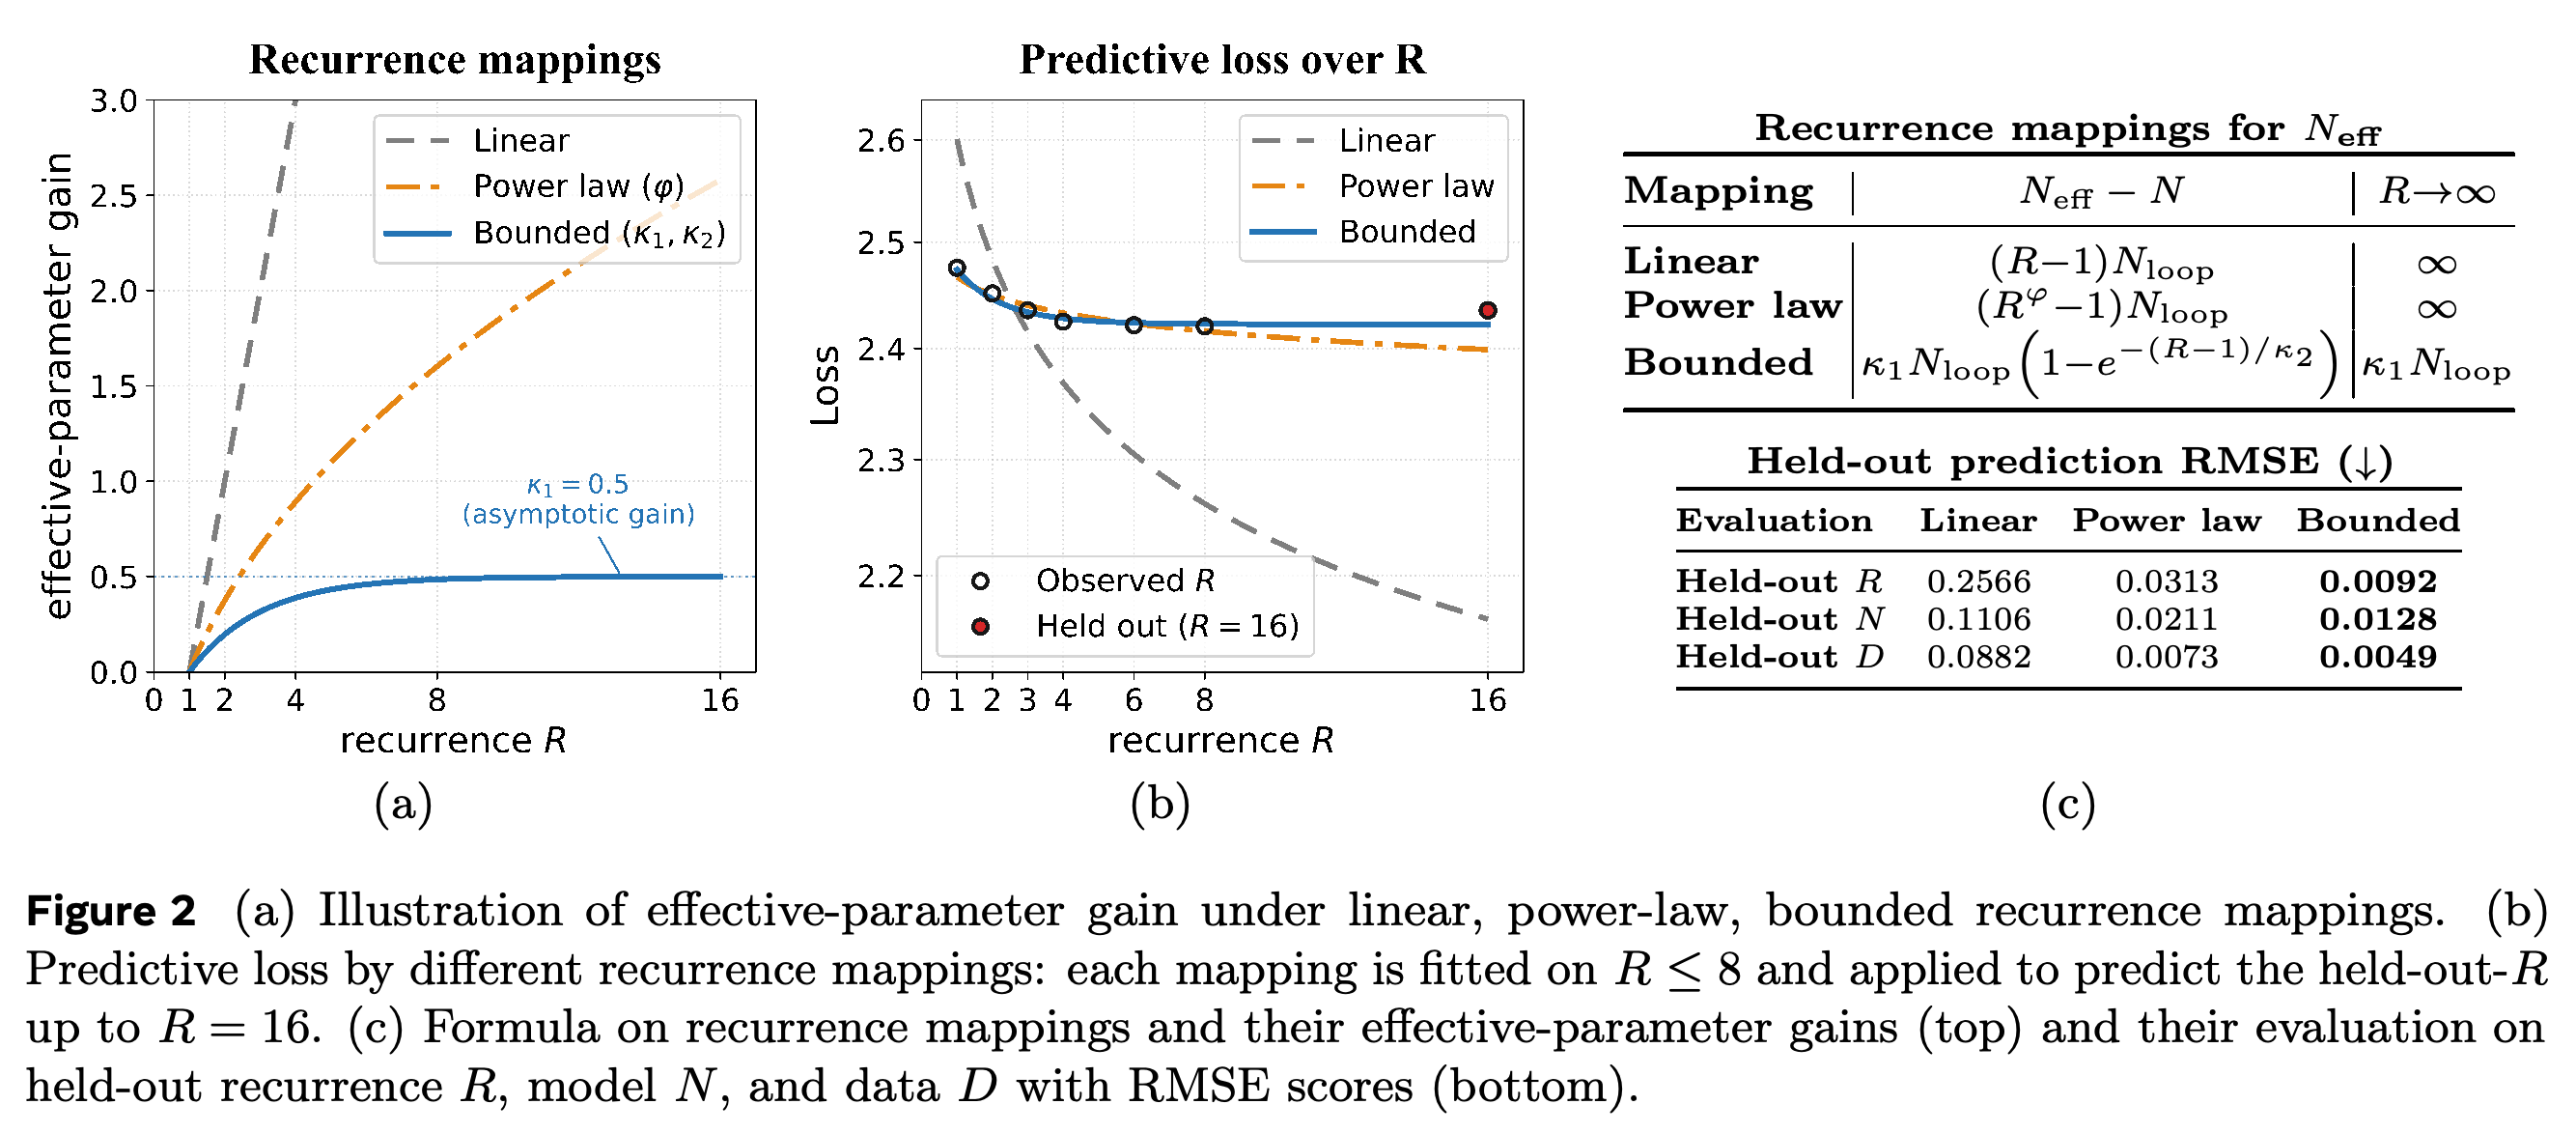
Dense looped 모델에 제안한 매핑은 N_eff(R)=N+κ₁N_loop(1−exp(−(R−1)/κ₂))이며, κ₁,κ₂>0이다. 손실 법칙은 L(N,D,R)=AN_eff(R)^α+BD^β+c가 된다. κ₁은 점근적인 용량 증가량을 정하고, κ₂는 그 한계에 접근하는 속도를 조절한다. R=1이면 반복 통과를 사용하지 않는 법칙으로 돌아간다. R≤8로 피팅하고 홀드아웃 R=16에서 평가하면, 이 유계 함수의 평균제곱근오차(RMSE)는 0.0092로 power-law 매핑의 0.0313, linear 매핑의 0.2566보다 낮다. RMSE는 예측 오차 제곱의 평균에 제곱근을 취한 값이다. Recurrence를 무한히 늘렸을 때의 극한은 피팅 함수의 성질이며, 관측 범위 밖에서 실증적으로 보장된 결과는 아니다.
R≤8에서 R=16으로 외삽하면 상한이 없는 recurrence 매핑의 예측이 지나치게 낙관적이라는 점이 드러난다. 유계 법칙은 recurrence, 모델 크기, 데이터의 홀드아웃 RMSE가 각각 0.0092, 0.0128, 0.0049로 더 낮다.
3.3 MoE Loop Scaling Law
MoE에서 m=N_act/N_total∈(0,1]은 전체 파라미터 대비 활성 파라미터의 비율이므로 m이 작을수록 sparsity가 높다. 매핑은 N_eff(R,m)=N_act+κ₁(m)N_loop(1−exp(−(R−1)/κ₂(m)))가 되며, j=1,2에 대해 κ_j(m)=κ_jm^(−θ)이고 θ≥0이다. Top-k routing이 E_route개 후보 중 k개 expert를 선택할 때 유효 expert 확장 비율은 E=E_route/k다. 이 매핑을 포함하는 손실 법칙은 L(N_act,D,R,E,m)=AÊ^δN_eff(R,m)^(α+γ ln Ê)+BÊ^ωD^(β+ζ ln Ê)+c다. Ê는 논문에서 정의한 expert 확장의 단조 변환으로, Ê^(−1)=(E−1+(E_start^(−1)−E_max^(−1))^(−1))^(−1)+E_max^(−1)을 만족한다. δ,γ,ω,ζ,E_start,E_max는 피팅 계수다.
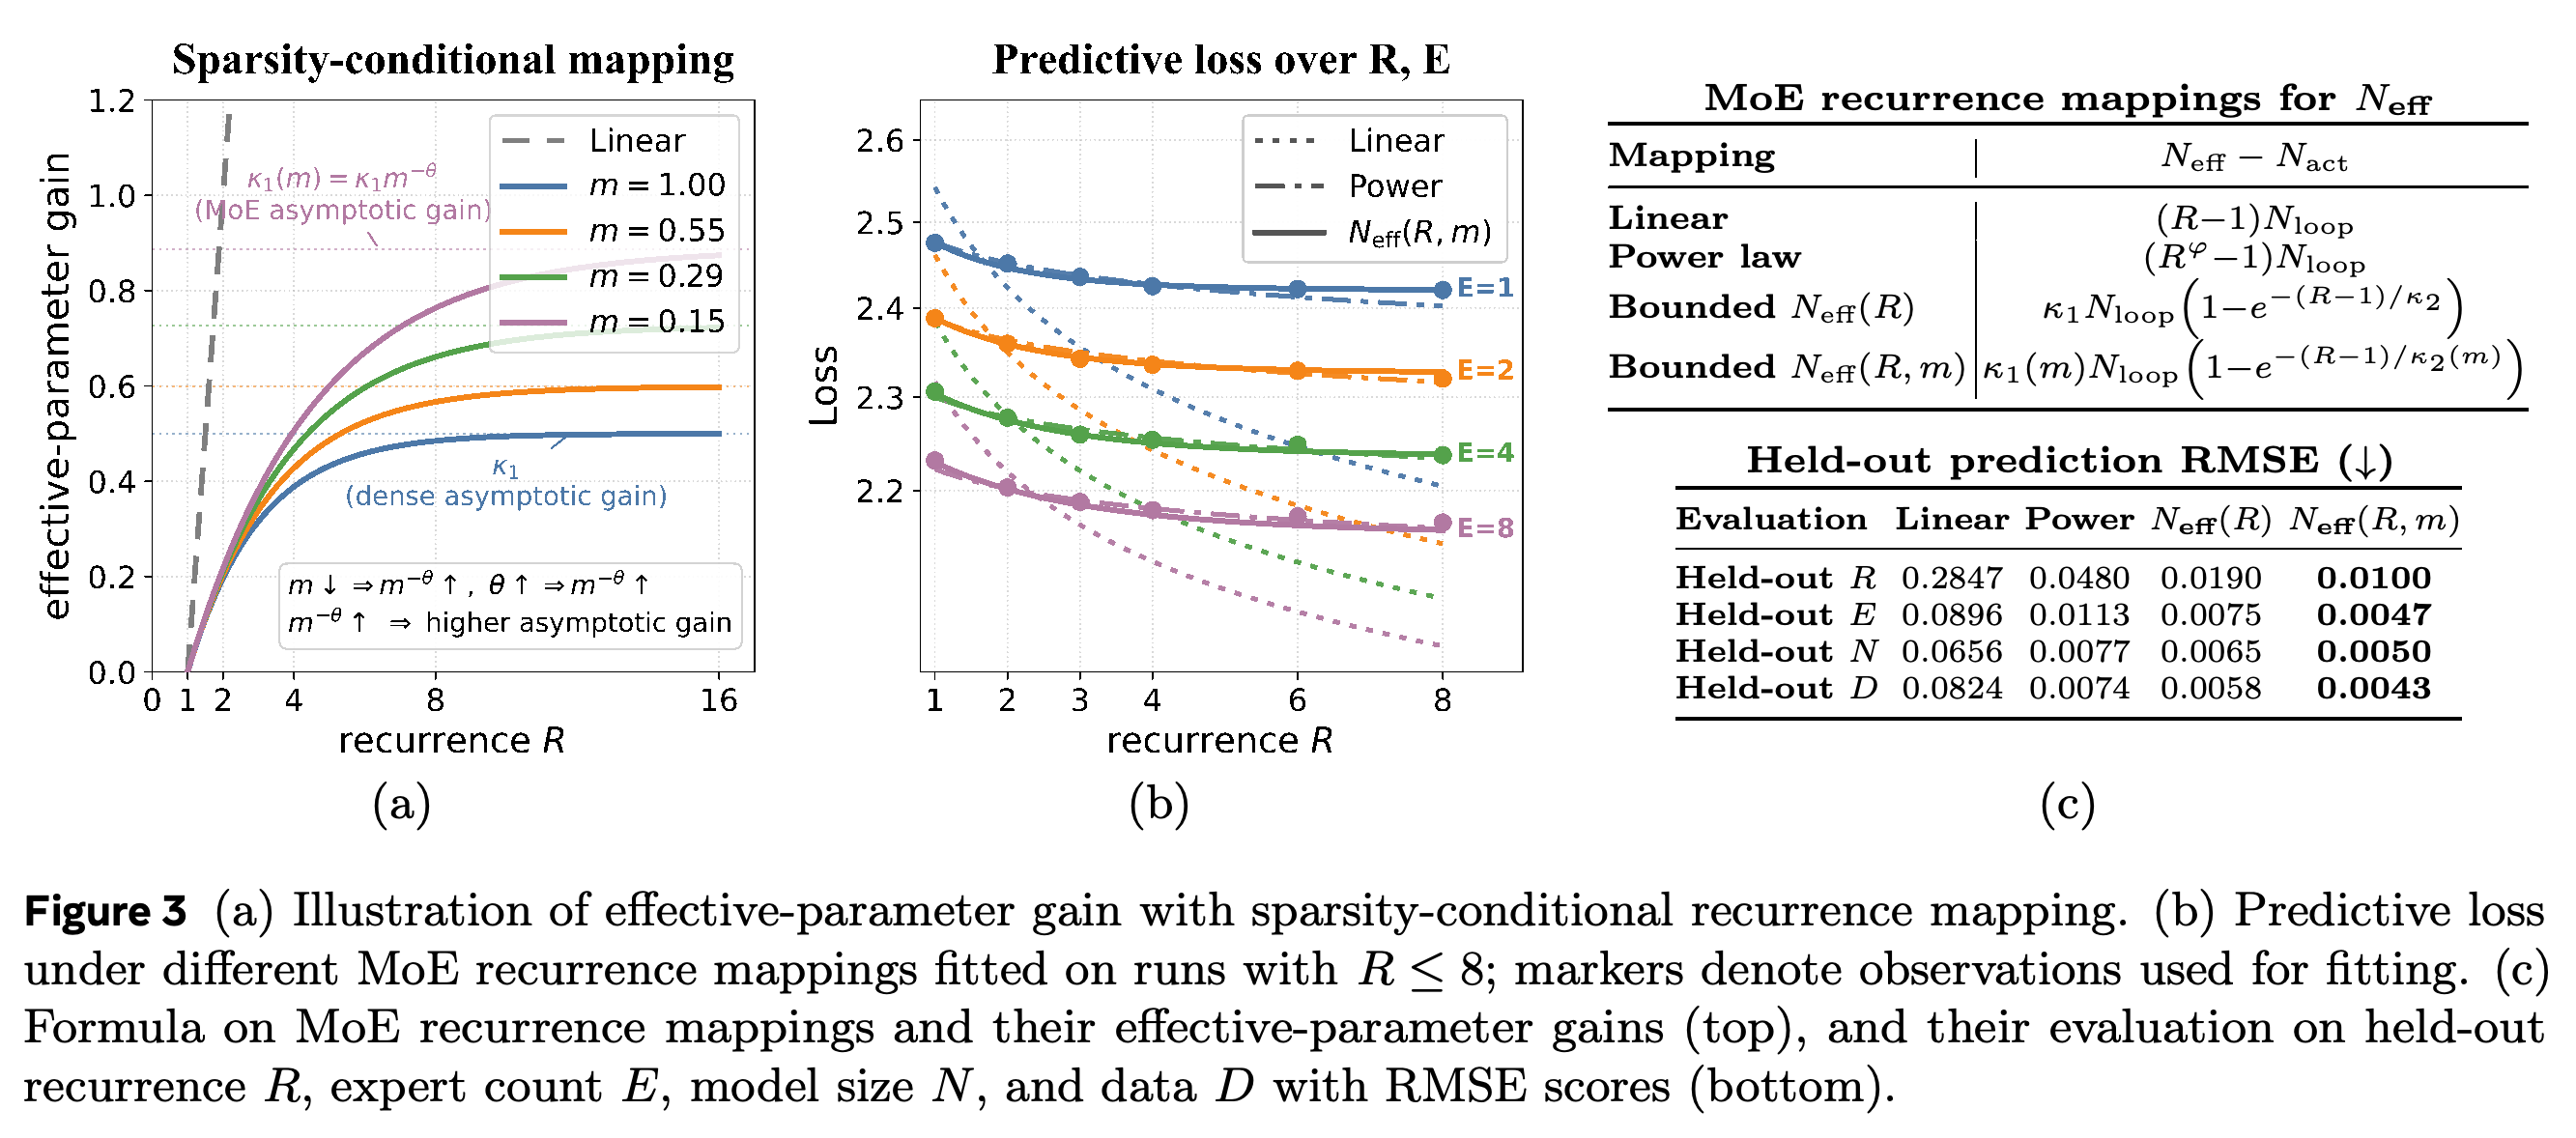
- m>0을 고정하면 용량 증가량은 κ₁m^(−θ)N_loop에서 포화한다. Sparsity가 높을수록 이 상한이 높아지고, 그 상한에 접근하는 과정도 더 많은 통과에 걸쳐 이어진다. 이 극한은 피팅 함수의 성질이며, 임의의 recurrence나 sparsity에서 실증적으로 보장되는 결과는 아니다.
- 계수를 재매개변수화하면 E=1에서 dense loop 법칙을 복원한다. R=1에서는 반복 통과를 사용하지 않는 MoE 법칙을 복원하며, E와 R 모두 1이면 표준 dense 법칙을 복원한다.
- 홀드아웃 RMSE는 recurrence에서 0.0100, expert 확장에서 0.0047, 모델 크기에서 0.0050, 데이터에서 0.0043이다. 각각 동일한 분할에서 비교한 대안 매핑 3개보다 모두 낮다.
포화 크기와 포화에 걸리는 시간 척도 2개 모두가 sparsity에 따라 달라지도록 하면, 이 상호작용을 제외한 유계 매핑보다 예측이 개선된다. 홀드아웃 recurrence RMSE는 0.0190에서 0.0100으로, 홀드아웃 expert 확장 RMSE는 0.0075에서 0.0047로 낮아진다.
4 Experiments and Findings
실험은 손실 예측, 자원 제약에 따른 아키텍처 선택, 다운스트림 벤치마크 성능을 평가한다. 손실과 벤치마크 비교에는 측정 결과를 사용하고, 자원 배분 분석에서는 피팅한 법칙으로 아키텍처 선택을 예측한다.
4.1 Scaling Experiments and Analysis
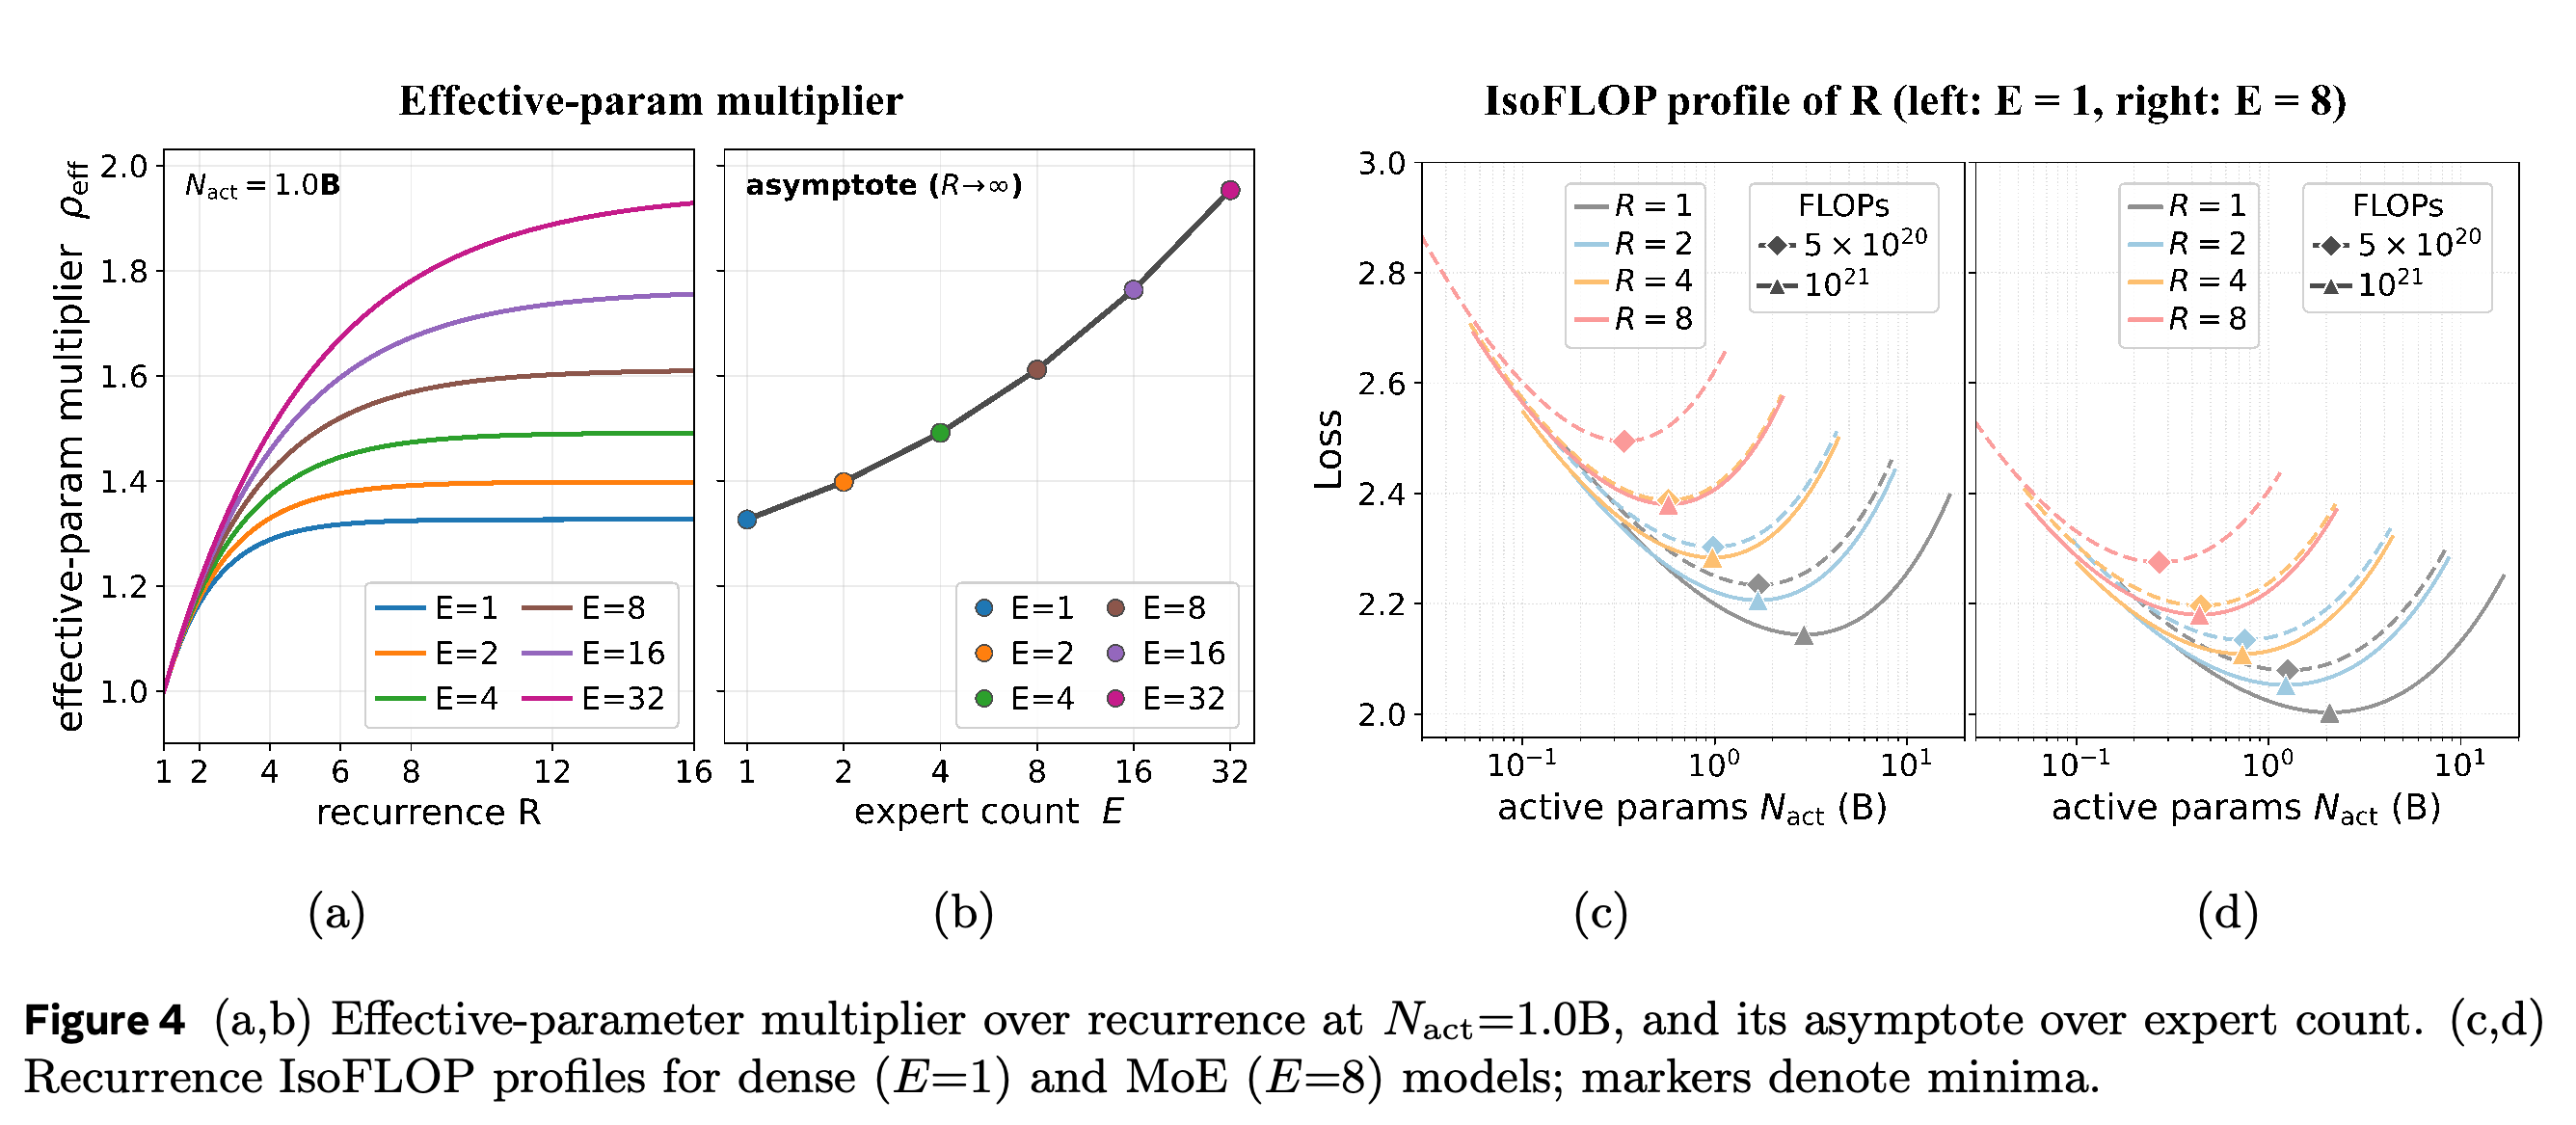
스케일링 실험에서는 N_act∈{0.3,0.6,1.0}B, D∈{100,200,300,400,500}B, E∈{1,2,4,8,16}, R∈{1,2,3,4,6,8}에 걸쳐 모델을 처음부터 학습한다. Middle-cycle looping은 처음 2개 계층과 마지막 2개 계층을 공유하지 않고 중간 블록을 반복한다. 피팅한 유효 파라미터 배수 ρ_eff=N_eff/N_act는 sparsity에 따라 달라지는 유한한 점근값에 접근한다. Sparsity가 높을수록 점근값이 높아지고 포화가 늦어진다.
- 학습 FLOPs를 동일하게 맞추는 IsoFLOP 비교에서는 5×10^20과 10^21의 예산을 사용한다. 피팅 곡선은 같은 예산에서 E=8의 손실이 E=1보다 낮을 것으로 예측한다.
- 활성 모델 크기가 같을 때, 10^21 FLOPs에서 R=2인 모델은 5×10^20 FLOPs에서 R=1인 모델보다 낮은 손실을 달성할 수 있다. 이 비교는 연산을 추가하면 품질이 좋아질 수 있음을 뒷받침하지만, 고정된 예산에서 통과 횟수를 늘리면 항상 최적 결과가 개선됨을 입증하지는 않는다.
피팅한 배수 곡선은 expert를 추가하면 반복 계산으로 얻는 것으로 추정한 용량이 커질 것으로 예측한다. 학습 연산량을 동일하게 맞춘 손실 곡선은 recurrence 선택이 모델 크기와 데이터 배분에 따라 달라짐을 보여준다. 통과 횟수만 늘린다고 고정 예산에서 더 나은 최적 결과가 보장되지는 않는다.
4.2 Compute- and Memory-Optimal Recurrence and Sparsity
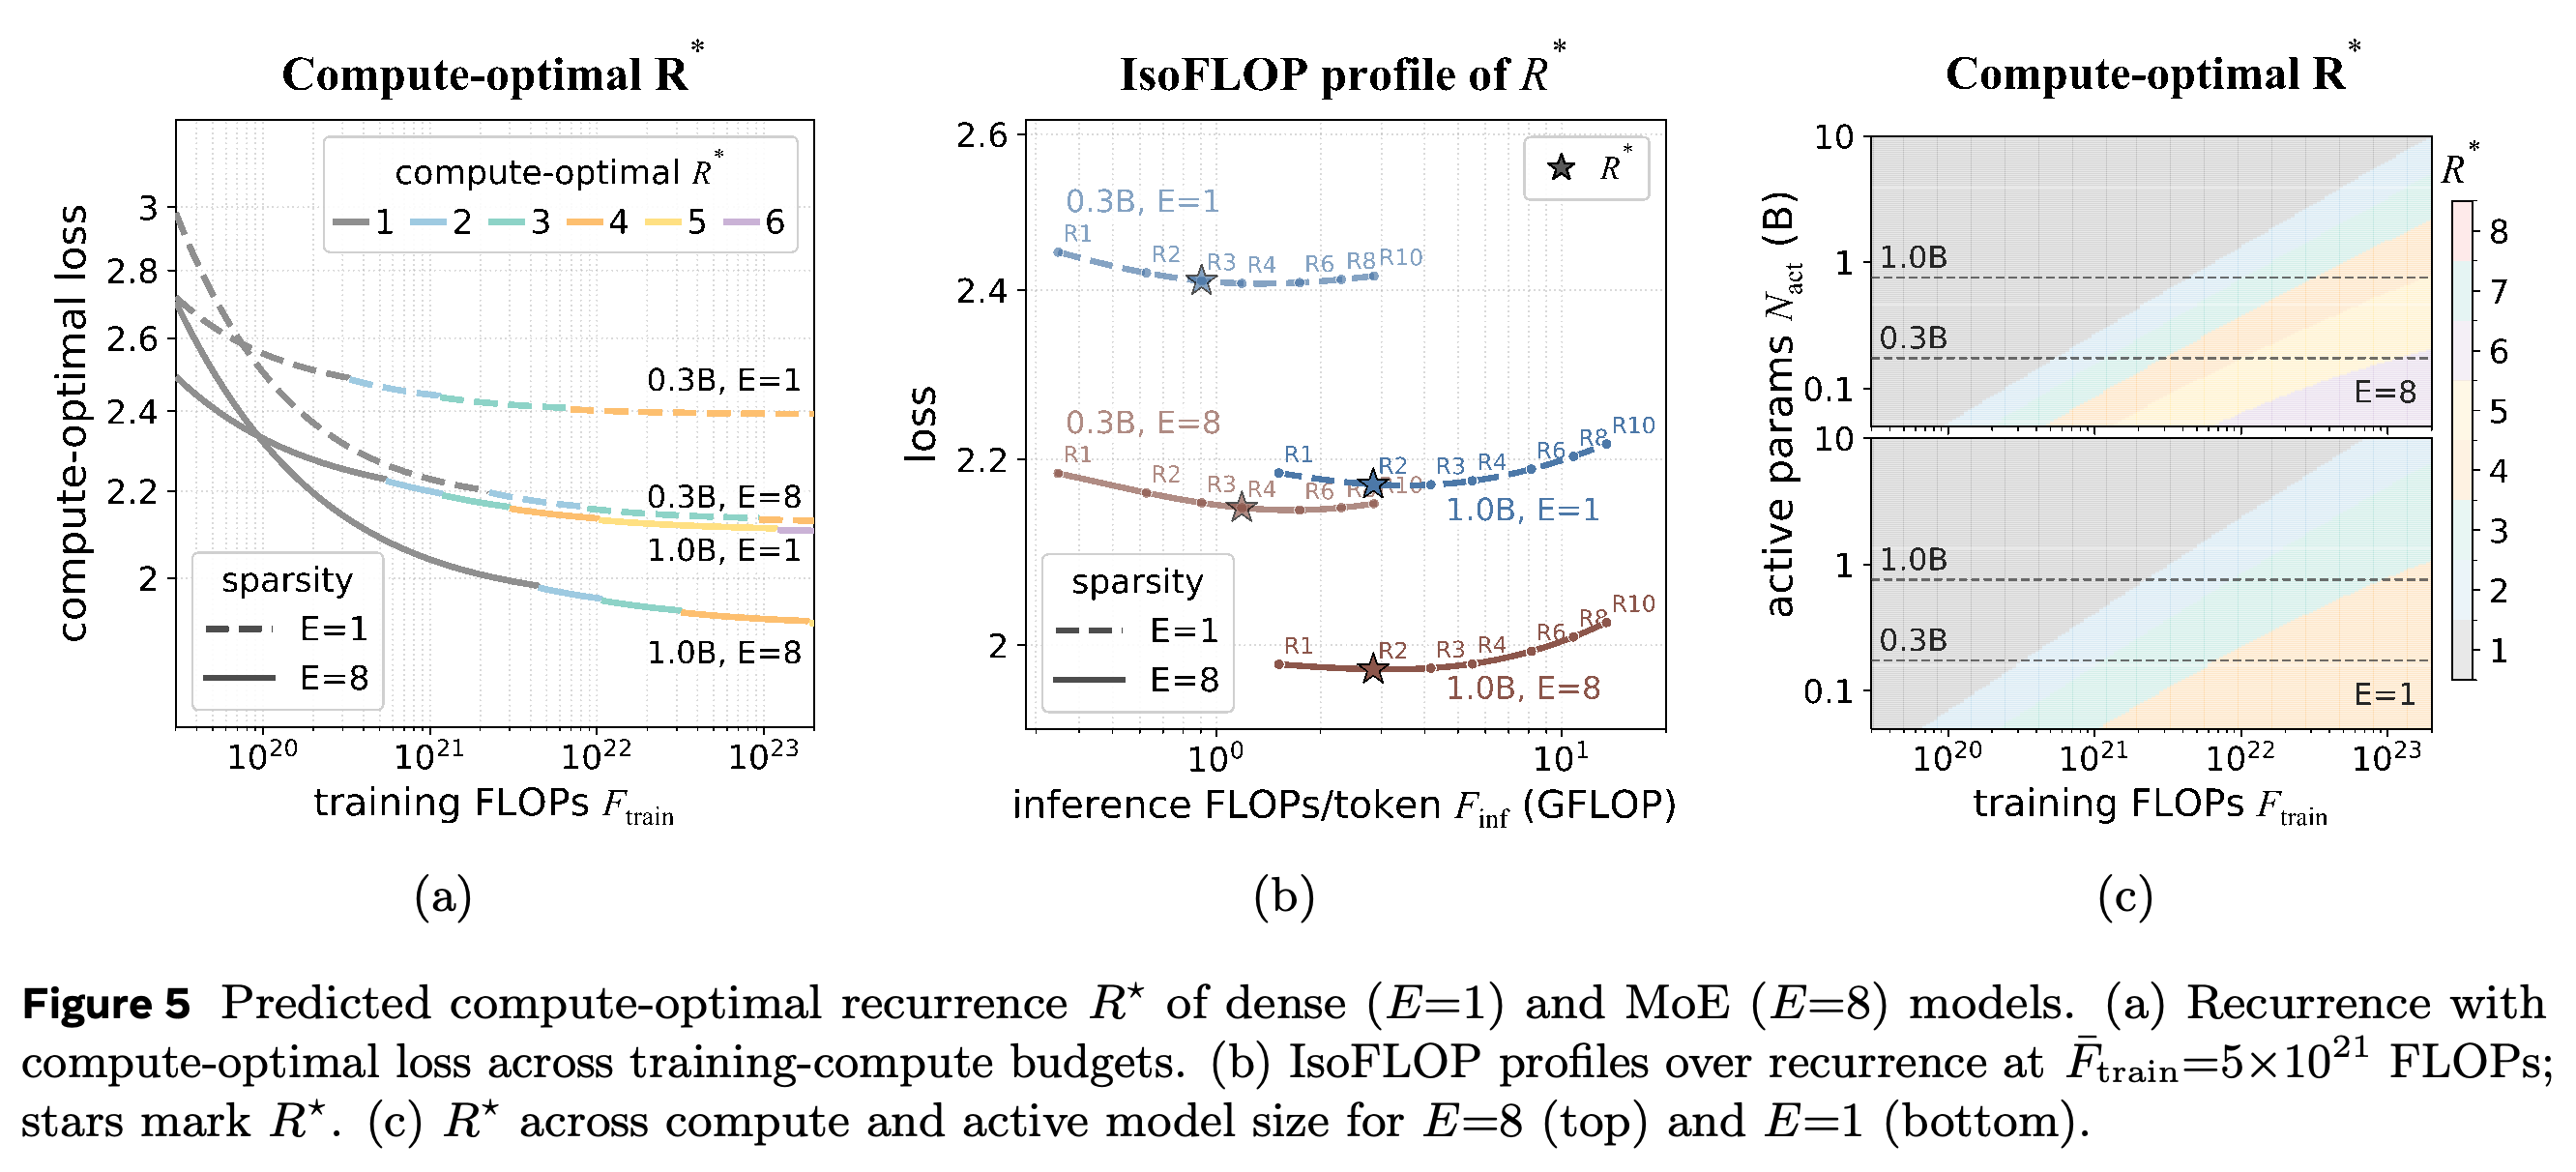
Sparsity와 학습 연산 예산을 고정한 recurrence 선택에서는 예측 손실을 최소화하되, 통과를 추가해서 얻는 개선량이 허용 기준 ε에 도달하도록 요구한다. 논문은 ε를 피팅한 법칙의 RMSE로 정하고, 그보다 작은 예측 개선량은 피팅 오차와 구분하기 어렵다고 본다. 추가 통과 중 이 기준을 만족하는 경우가 없으면 기본값 R*=1을 사용한다. 평가한 설계 공간에서는 학습 예산이 크고 sparsity가 높을수록 예측 최적 recurrence가 증가하며, 활성 모델이 작을수록 더 높다.
선택된 recurrence는 학습 연산량을 고정했을 때 예측 손실의 최솟값 부근에 있다. 설계 공간 지도는 활성 모델이 작고, 학습 예산이 크고, sparsity가 높을수록 최적 recurrence가 높아질 것으로 예측한다. 이 결과는 피팅한 법칙의 예측이다.
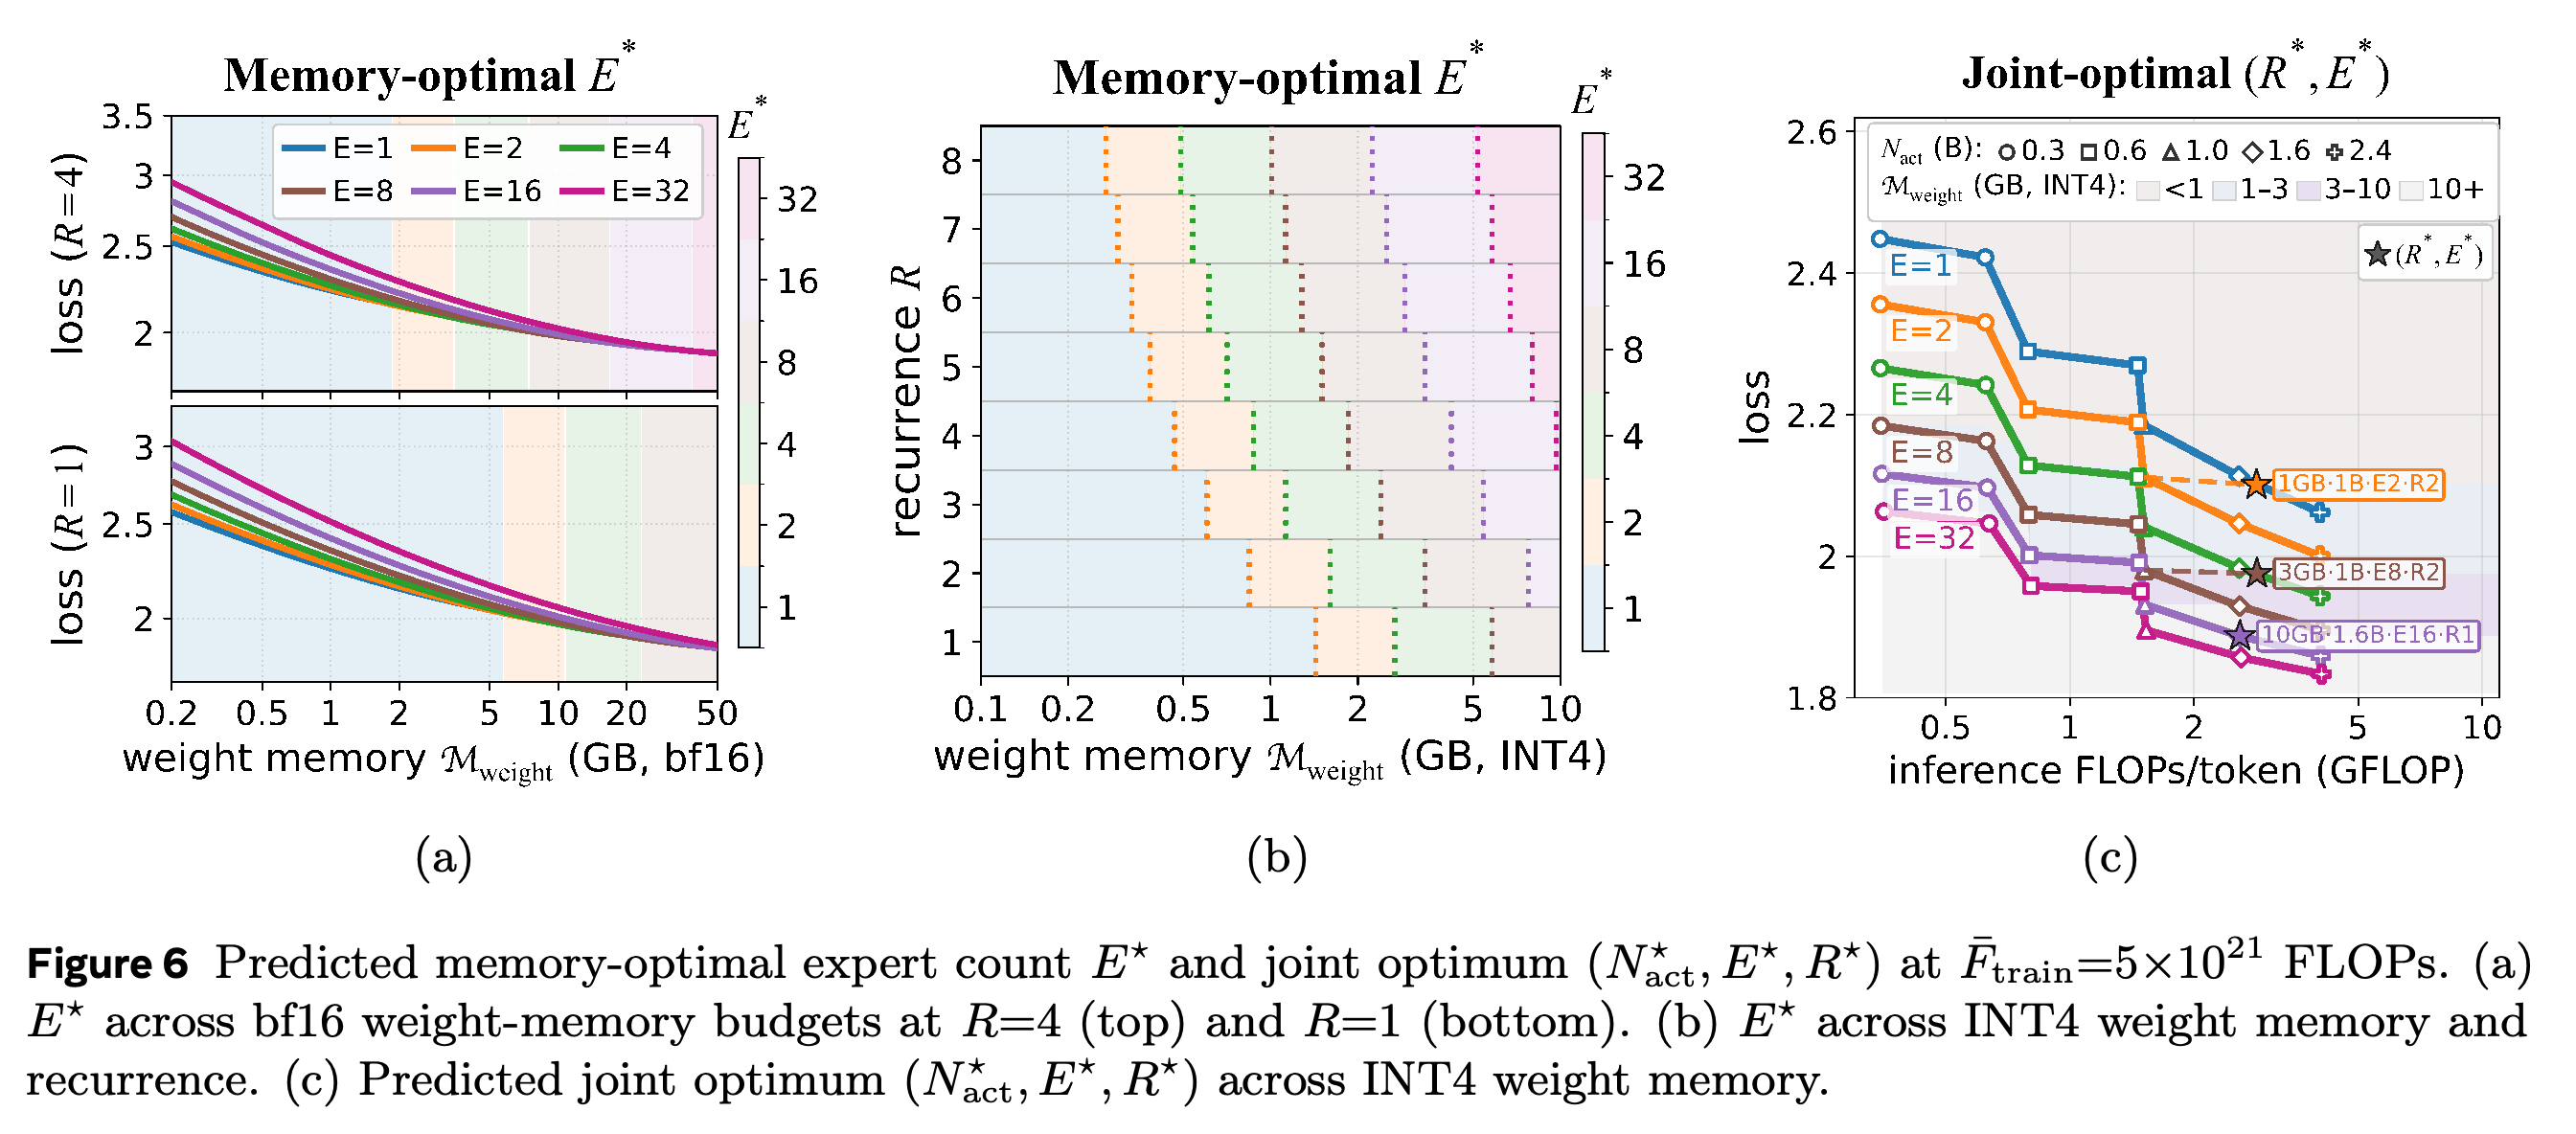
메모리 제약에 따른 선택은 M_weight=b_wN_total/8을 사용하며, b_w는 비트 단위 가중치 정밀도다. Expert 확장에도 같은 개선 기준을 적용한 뒤, 학습 연산량을 맞춘 상태에서 활성 모델 크기, expert 확장, recurrence를 함께 탐색한다. 5×10^21 FLOPs와 four-bit integer(INT4) 가중치를 사용할 때, 예측된 선택에는 3 GB 이내에서 E=8,R=2인 1.0B-active model과 10 GB 이내에서 E=16,R=1인 1.6B-active model이 포함된다. 가중치 메모리가 부족할수록 recurrence가 유리하고, 메모리가 많으면 sparsity를 더 높일 수 있다. 저장된 attention 상태인 key-value cache와 기타 실행 시 메모리는 이 최적화에서 제외한다.
학습 연산량이 5×10^21 FLOPs이고 INT4 가중치를 사용할 때, 공동 탐색은 메모리 예산이 3 GB에서 10 GB로 늘어나면 선택이 활성 파라미터 1.0B, E=8,R=2 구성에서 활성 파라미터 1.6B, E=16,R=1 구성으로 바뀔 것으로 예측한다. 이 선택은 가중치 메모리 제약을 만족하며, 캐시와 기타 실행 시 상태는 제외한다.
4.3 Downstream Scaling with Recurrence and Sparsity
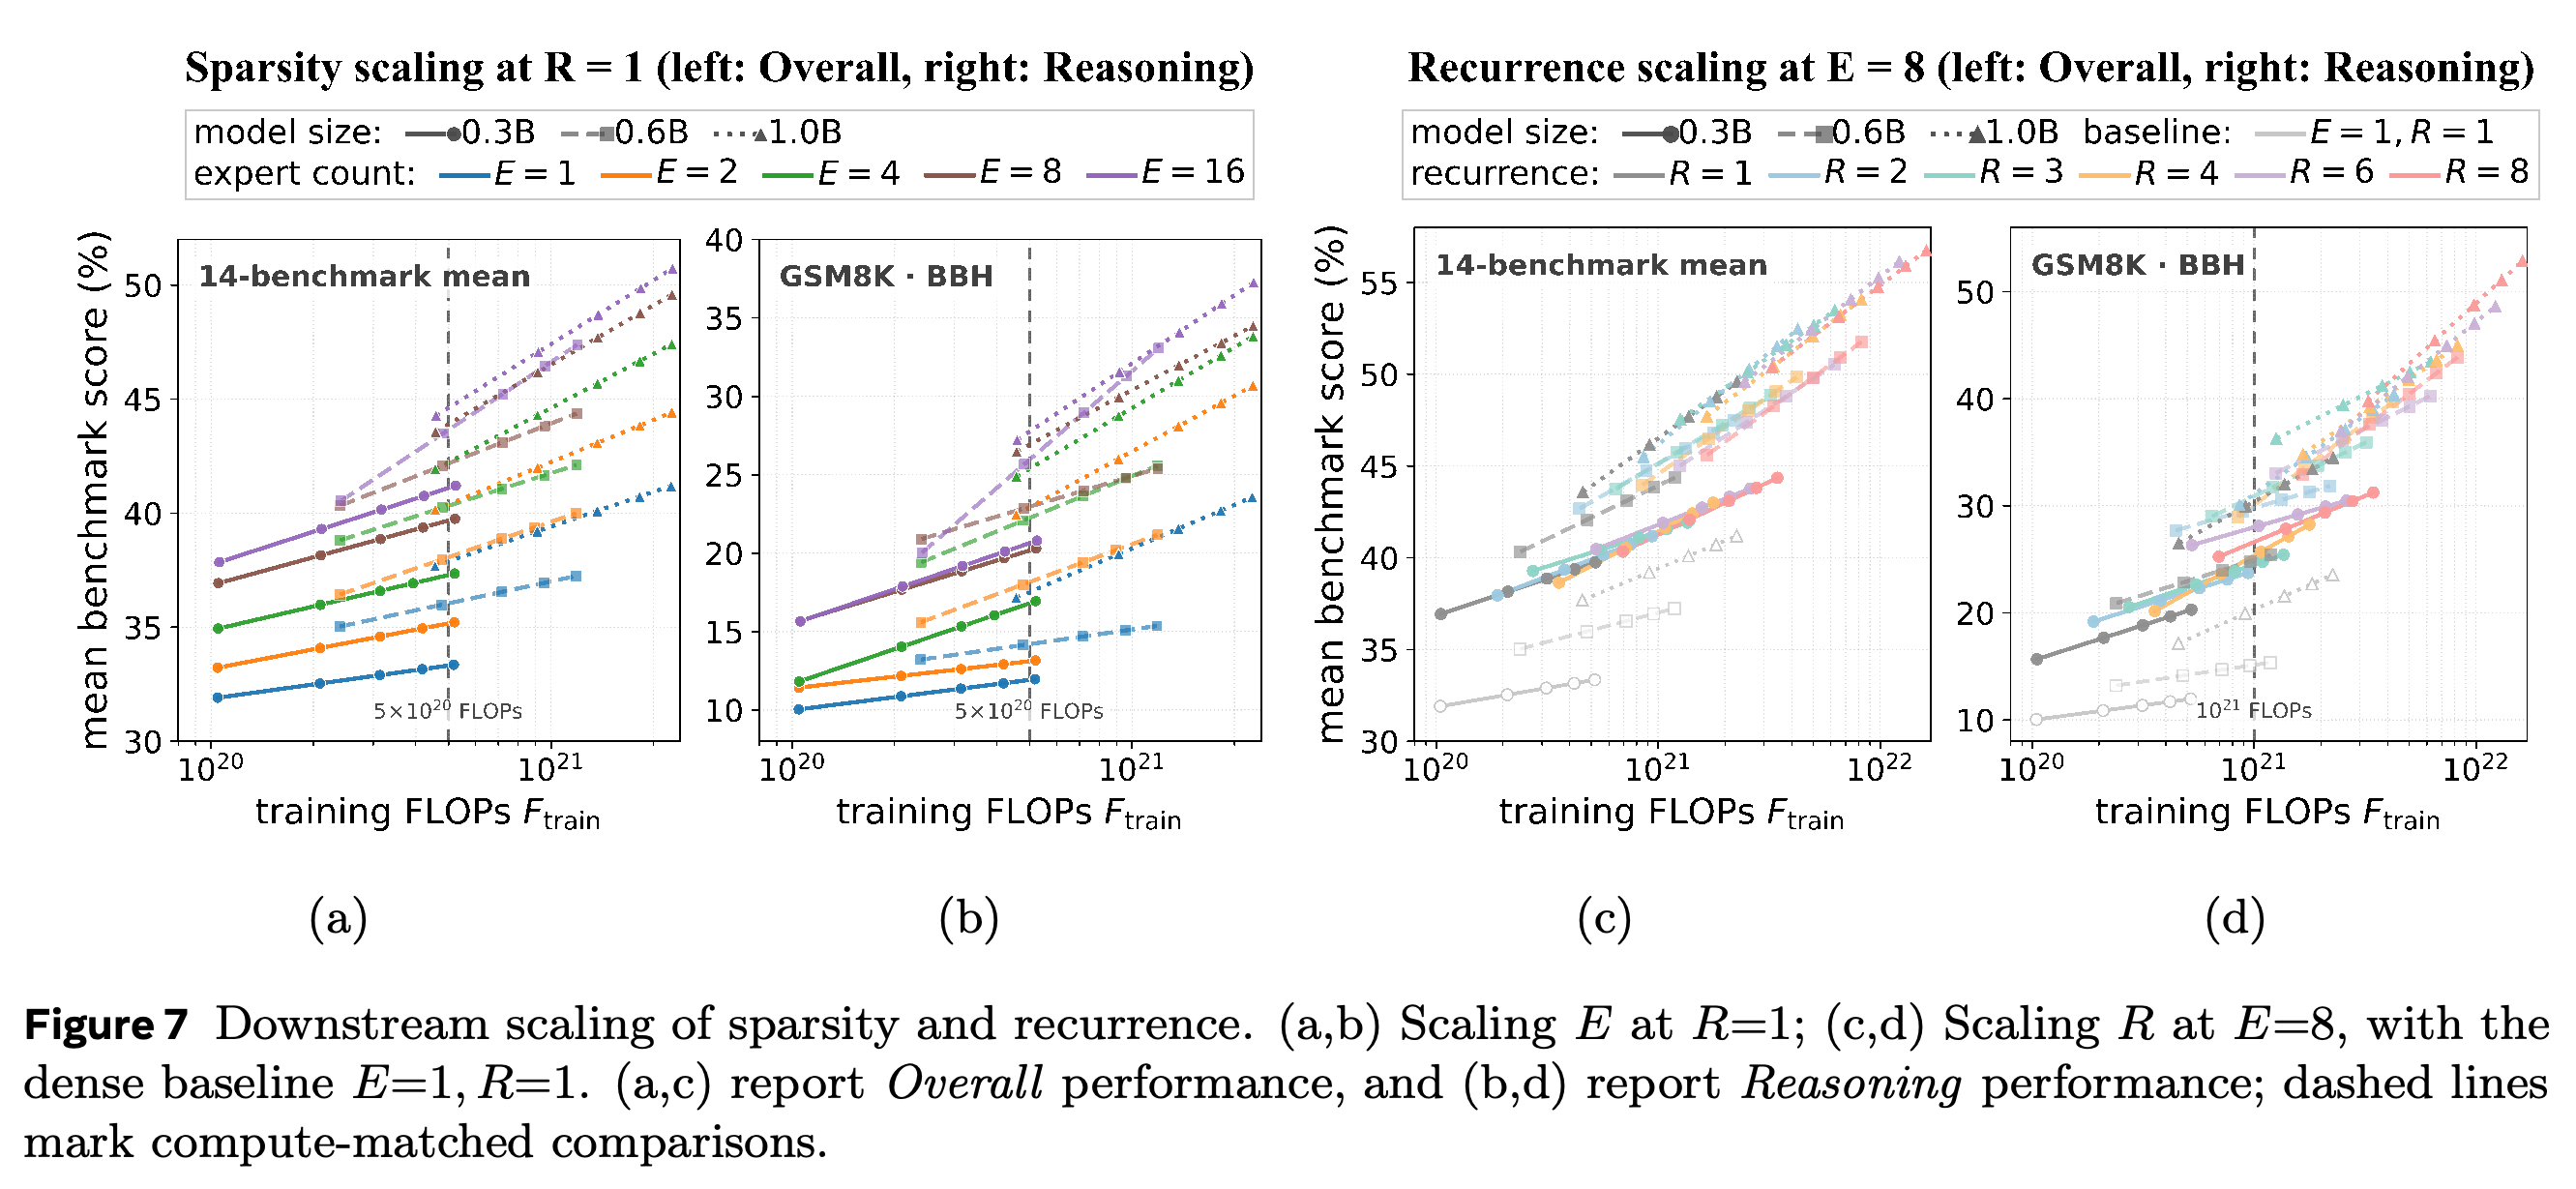
다운스트림 평가에서 Overall은 14개 벤치마크의 평균이고, Reasoning은 추론 벤치마크 BIG-Bench Hard(BBH)와 수학 문장제 벤치마크 GSM8K의 평균이다. 학습 연산량이 5×10^20 FLOPs이고 R=1일 때, E≥8인 0.3B MoE models는 Overall과 Reasoning 모두에서 1.0B dense model보다 성능이 높다. 10^21 FLOPs와 E=8에서는 R≥4인 0.3B 모델의 Reasoning이 R=1인 0.6B 모델과 같거나 더 높으며, R≥3인 0.6B 모델은 1.0B non-looped model과 비슷한 Reasoning 성능을 낸다.
학습 연산량을 맞춘 비교는 sparsity와 recurrence에서 얻는 이득을 구분한다. Sparsity를 높이면 0.3B-active models가 5×10^20 FLOPs에서 1.0B dense model보다 높은 성능을 낸다. Recurrence는 특히 추론에 도움이 되며, 10^21 FLOPs 비교에서 전체 파라미터가 대략 배증한 모델과의 성능 차이를 보완한다.
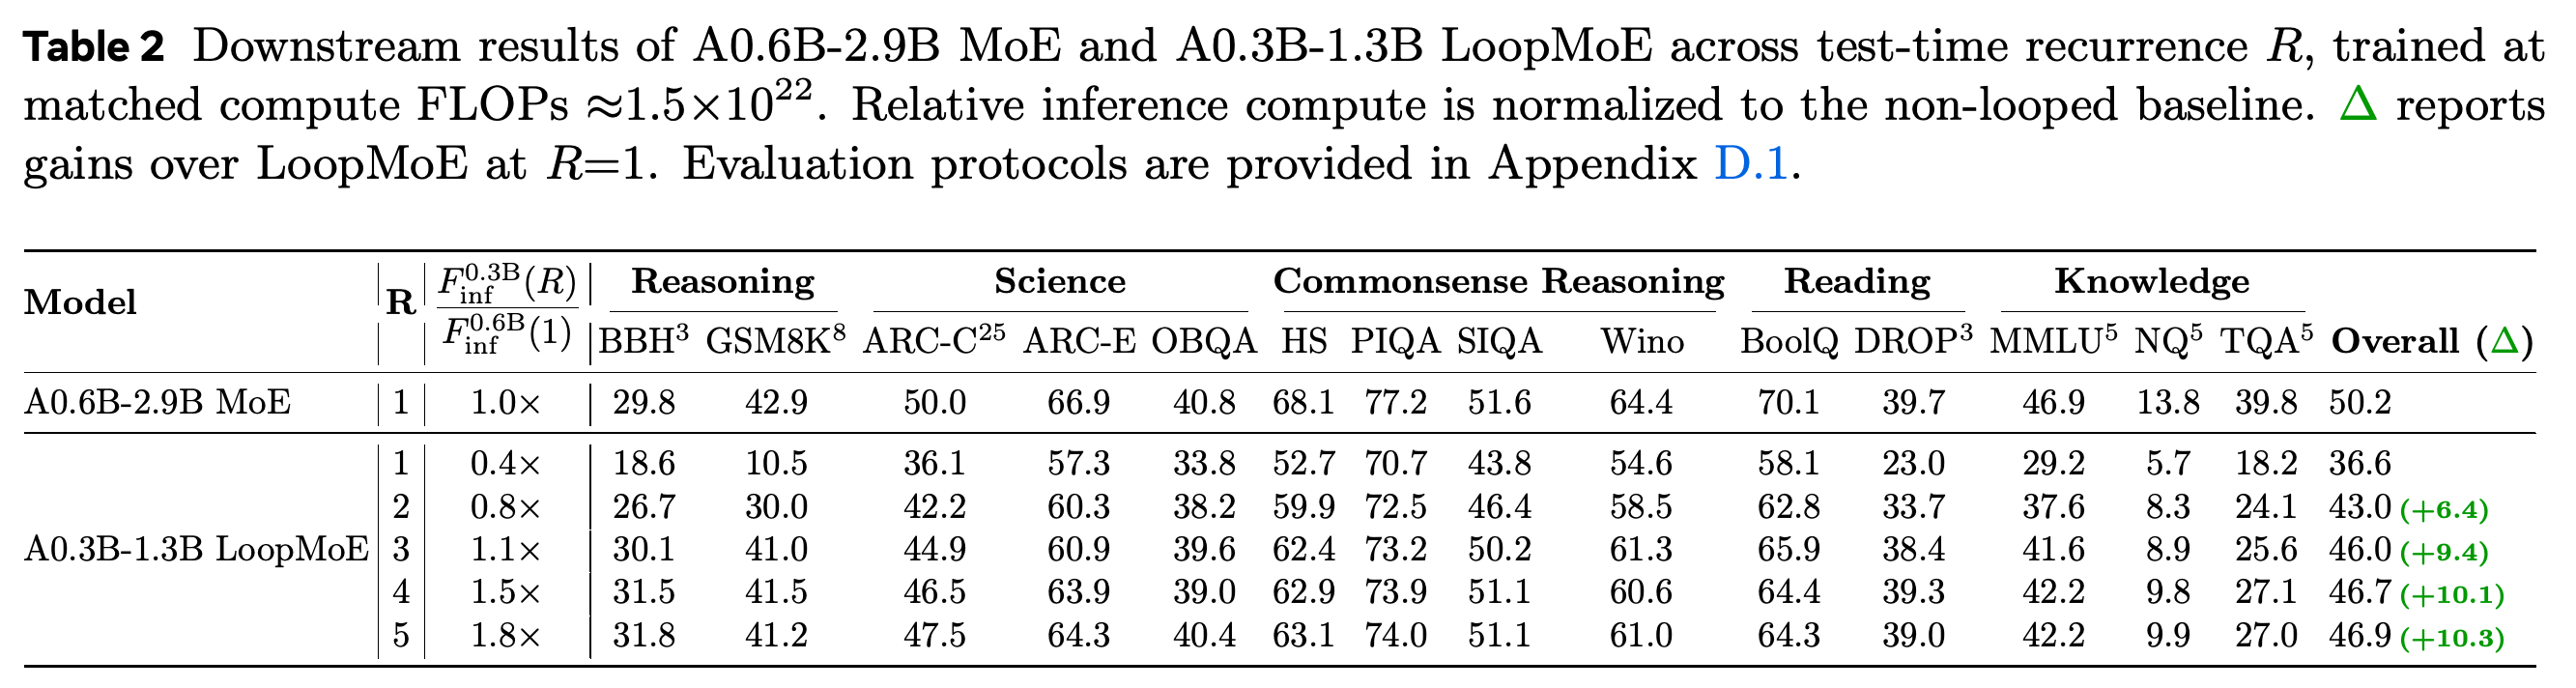
Trillion-token 사례 연구에서 이 법칙은 활성 파라미터 0.3B, 전체 파라미터 1.3B인 looped 모델 A0.3B-1.3B LoopMoE에 R*=5를 선택한다. 학습 연산량을 약 1.5×10^22 FLOPs로 맞추면 이 모델은 약 3T 토큰으로 학습하고, 비교 모델 A0.6B-2.9B MoE는 약 6T 토큰으로 학습한다. T는 trillions를 뜻한다. 테스트 시점 R=5에서 LoopMoE는 BBH 31.8, GSM8K 41.2를 기록하며, 더 큰 모델은 각각 29.8과 42.9를 기록한다. 다만 Overall은 46.9 대 50.2이고, 상대 추론 연산량은 1.8×다. 같은 LoopMoE 체크포인트에서 R=1을 R=5로 바꾸면 Overall이 36.6에서 46.9로 10.3점 오른다.
- R=4에서 더 작은 모델은 베이스라인 추론 연산량의 1.5×를 사용하며, BBH 31.5, GSM8K 41.5, Overall 46.7을 기록한다.
- 추론 성능이 비슷하다는 주장은 추론 벤치마크 2개를 종합했을 때 대략 비슷하다는 뜻이다. R=4–5에서 더 작은 모델은 BBH 점수가 높고 GSM8K 점수가 낮으며, Overall은 여전히 더 큰 모델보다 낮다.
더 작은 LoopMoE는 R=4–5에서 더 큰 모델의 추론 과제 2개 평균과 대략 비슷하지만, 상대 추론 연산량이 1.5×–1.8× 필요하고 Overall 점수는 여전히 낮다. 테스트 시점 통과 횟수를 1회에서 5회로 늘리면 Overall이 36.6에서 46.9로 오른다.
5 Conclusion
결론에서는 연산량과 가중치 메모리 제약에 맞춰 recurrence와 sparsity를 함께 선택해야 한다고 주장한다. 실험은 검증한 설정에서 홀드아웃 손실 예측이 개선된다는 점과, 추론 과제에서 저장 파라미터 수와 추론 연산량 사이에 절충이 있다는 점을 뒷받침한다. 다른 looping 전략, 더 넓은 모델 규모, recurrent state 최적화, 적절한 경우 모든 통과를 마치기 전에 계산을 중단하는 early-exit gating은 향후 과제로 남는다.
부록
- A Reduced Forms of Loop Scaling laws의 A.1 Dense Loop Scaling Law는 R=1이면 N_eff=N이 되어 표준 dense 손실 법칙을 복원함을 증명한다. A.2 MoE Loop Scaling Law는 E=1, R=1, 그리고 이 조건을 동시에 만족하는 경우의 축약형을 유도한다. 여기에는 변환된 expert 변수에 필요한 계수 재매개변수화도 포함된다.
- B Expert-Path Diversity Across Recurrence는 통과 전체에서 선택한 서로 다른 expert 수를 토큰과 recurrent 계층에 걸쳐 평균한 뒤, 통과당 선택하는 expert 수로 정규화해 측정한다. 동일한 프롬프트 800개의 검증 세트에서 R=8일 때 다양성은 E=2의 1.5088±0.0529에서 E=8의 1.7035±0.0861로 증가한다. 값은 평균 ± 표준편차이며, dense 모델은 1을 유지한다. 이 routing 통계는 제안한 접근의 근거를 뒷받침하지만, expert 다양성이 피팅된 용량 증가를 유발한다는 인과관계를 입증하지는 않는다.
- C Scaling Experiments and Parametric Fitting의 C.1 Training Details는 웹 데이터 비중이 높고 수학, 코드, 지식, 과학 데이터를 보충한 동일한 개방형 라이선스 데이터 혼합, 2,048토큰 문맥, 어휘 크기 202k의 llama tokenizer를 명시한다. 학습에는 적응형 옵티마이저인 AdamW를 사용하며, β₁=0.9, β₂=0.95, ε=10^−15, weight decay 0.1, gradient clipping 1.0을 적용한다. 하드웨어는 NVIDIA H100 96 GB 그래픽 처리 장치 64개다. 스케일링 실험에서는 마지막 통과에만 다음 토큰 예측 손실을 적용한다. Trillion-token LoopMoE는 추론 시 recurrence를 바꿀 수 있도록 모든 통과에 지도 신호를 추가한다.
- C.2 Model Ladder and Scaling Sweep는 {0.3,0.6,1.0,1.6,2.4}B에 해당하는 5 active model scales를 정의하며, 실제 측정한 스케일링 실험에서는 first three를 사용한다. 공동 아키텍처 탐색은 이 모델 규모 전체, E∈{1,2,4,8,16,32}, R∈{1,…,10}에 걸친 구성 300개를 평가한다. 따라서 1.6B and 2.4B active models, E>16, R>8은 외삽에 해당한다. 피팅에 사용하는 파라미터 수에서는 입력과 출력의 토큰 표현인 임베딩을 제외하지만, model ladder에 보고한 활성 파라미터 수와 전체 파라미터 수에는 이를 포함한다.
- C.3 Parametric Fitting은 먼저 R=1인 부분집합을 피팅한 뒤, 모든 스케일링 축에 걸쳐 계수를 함께 추정한다. 비교에서는 R=16, MoE의 E=16, 모델 크기 1.0B, 또는 D∈(400,500]B를 홀드아웃으로 두고 각 분할의 나머지 관측값에 피팅한다. 최종 법칙은 1,000개를 초과하는 손실 관측값을 사용한다. 비선형 최소제곱법과 평균제곱오차 목적함수를 사용하는 scipy.optimize.curve_fit으로 초기화하고, 수치 최적화 방법인 L-BFGS-B와 강건한 피팅 손실인 log-Huber 목적함수를 사용하는 scipy.optimize.minimize로 피팅을 개선한다. 피팅한 recurrence 계수는 κ₁=0.3682, κ₂=1.4037, θ=0.3286이며, 전체 데이터 RMSE는 0.0037이다. κ₁과 κ₂에 서로 다른 sparsity 지수를 허용해도 RMSE는 0.0037로 유지된다. 이 결과는 해당 관측값에서 지수를 공유하는 선택을 뒷받침한다.
- C.4 Bootstrap Results of the MoE Loop Scaling Law는 관측값의 90%를 비복원 추출한 부분집합 100개에 다시 피팅하여 피팅 민감도를 평가한다. 재피팅 결과의 5th 및 95th percentiles를 경계로 하는 90% 백분위 구간은 κ₁에서 [0.3658,0.3723], κ₂에서 [1.3896,1.4243], θ에서 [0.3183,0.3350]이다. 학습 연산량이 5×10^21 FLOPs일 때, 보고된 아키텍처 구간은 1 GB, 3 GB, 10 GB에서 각각 선택된 구성만을 포함한다. 이는 이 재표본추출 절차에서 선택이 안정적임을 보여준다.
- D Downstream Scaling and Evaluation의 D.1 Downstream Evaluation Protocols는 평가 프레임워크 Language Model Evaluation Harness와 추론 백엔드 vLLM을 사용한다. 각각의 주소는 https://github.com/EleutherAI/lm-evaluation-harness 와 https://github.com/vllm-project/vllm 이다. 생성 과제에는 16비트 부동소수점 형식인 bfloat16 정밀도와, 점수가 가장 높은 다음 토큰을 선택하는 greedy decoding을 사용한다. 벤치마크 14개는 추론, 과학, 상식, 독해, 지식을 다루며, 과제별 평가 지표와 시범 예시 수를 적용한다. 예시 수는 BBH 3개, GSM8K 8개, 과학 질의응답 벤치마크 ARC-Challenge 25개, 이산적 추론이 필요한 독해 벤치마크 DROP 3개다. 다중 과제 지식 벤치마크 MMLU, 질의응답 벤치마크 Natural Questions, 퀴즈 질의응답 벤치마크 TriviaQA는 각각 5개를 사용하며, 나머지 과제는 0개를 사용한다.
- D.2 Compute-Matched Trillion-Token Experiment는 Algorithm D.1을 상세히 설명한다. 각 recurrence 후보에 대해 N_unroll(R)을 계산하고, 학습 예산 F̄_train에 맞춰 D_target^R=F̄_train/[6N_unroll(R)]로 설정한 뒤 손실을 예측한다. 이후 RMSE 기반 개선 기준으로 recurrence를 선택한다. 이 절차는 더 작은 LoopMoE에 R*=5를 선택한다. 테스트 시점 평가에서는 R∈{1,2,…,5}로 바꾸며, 추론 FLOPs를 반복 통과를 사용하지 않는 더 큰 기준 모델에 대해 정규화한다.
짧은 생각
홀드아웃 비교는 recurrence와 sparsity의 상호작용을 명시적으로 모델링하는 방식을 뒷받침한다. Sparsity를 조건으로 반영한 매핑은 이 조건을 반영하지 않는 유계 매핑과 비교해도 검증한 4개 축 모두에서 예측을 개선한다. Expert 경로 측정은 이 상호작용에 대한 그럴듯한 설명을 제공하지만, 관측에 기반한 결과다.
실험으로 확인한 배포상의 절충은 추론 과제에서 저장 파라미터 수를 줄이는 대신 추론 연산량을 늘리는 것이다. Table 2의 Overall 46.9 대 50.2와 추론 연산량 비율 1.8×는 더 광범위한 효율성 주장을 제한한다. 아키텍처 탐색은 실행 시 메모리를 제외하며 일부 외삽에 의존한다. 안정적인 재피팅 결과는 확보한 관측값에 대한 민감도를 정량화하지만, 다른 데이터 혼합, looping 전략, 하드웨어 지연 시간, 훨씬 큰 모델로 결과가 일반화됨을 입증하지는 않는다.