


Decoding Looped Transformers Better for (Almost) Free 요약 설명
01 Oct 2026 | Paper Review Looped Transformers Contrastive Decoding목차
이번 글에서는 Decoding Looped Transformers Better for (Almost) Free 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 10월 1일(Arxiv)
- Liu, Weihao, Zheng, Huangjie, Chen, Tianrong, Dilip, Rohit, Bai, Richard He, Jiao, Yizhu, Wang, Yuyang, Zhang, Ruixiang.
- Apple
- 논문 링크
요약
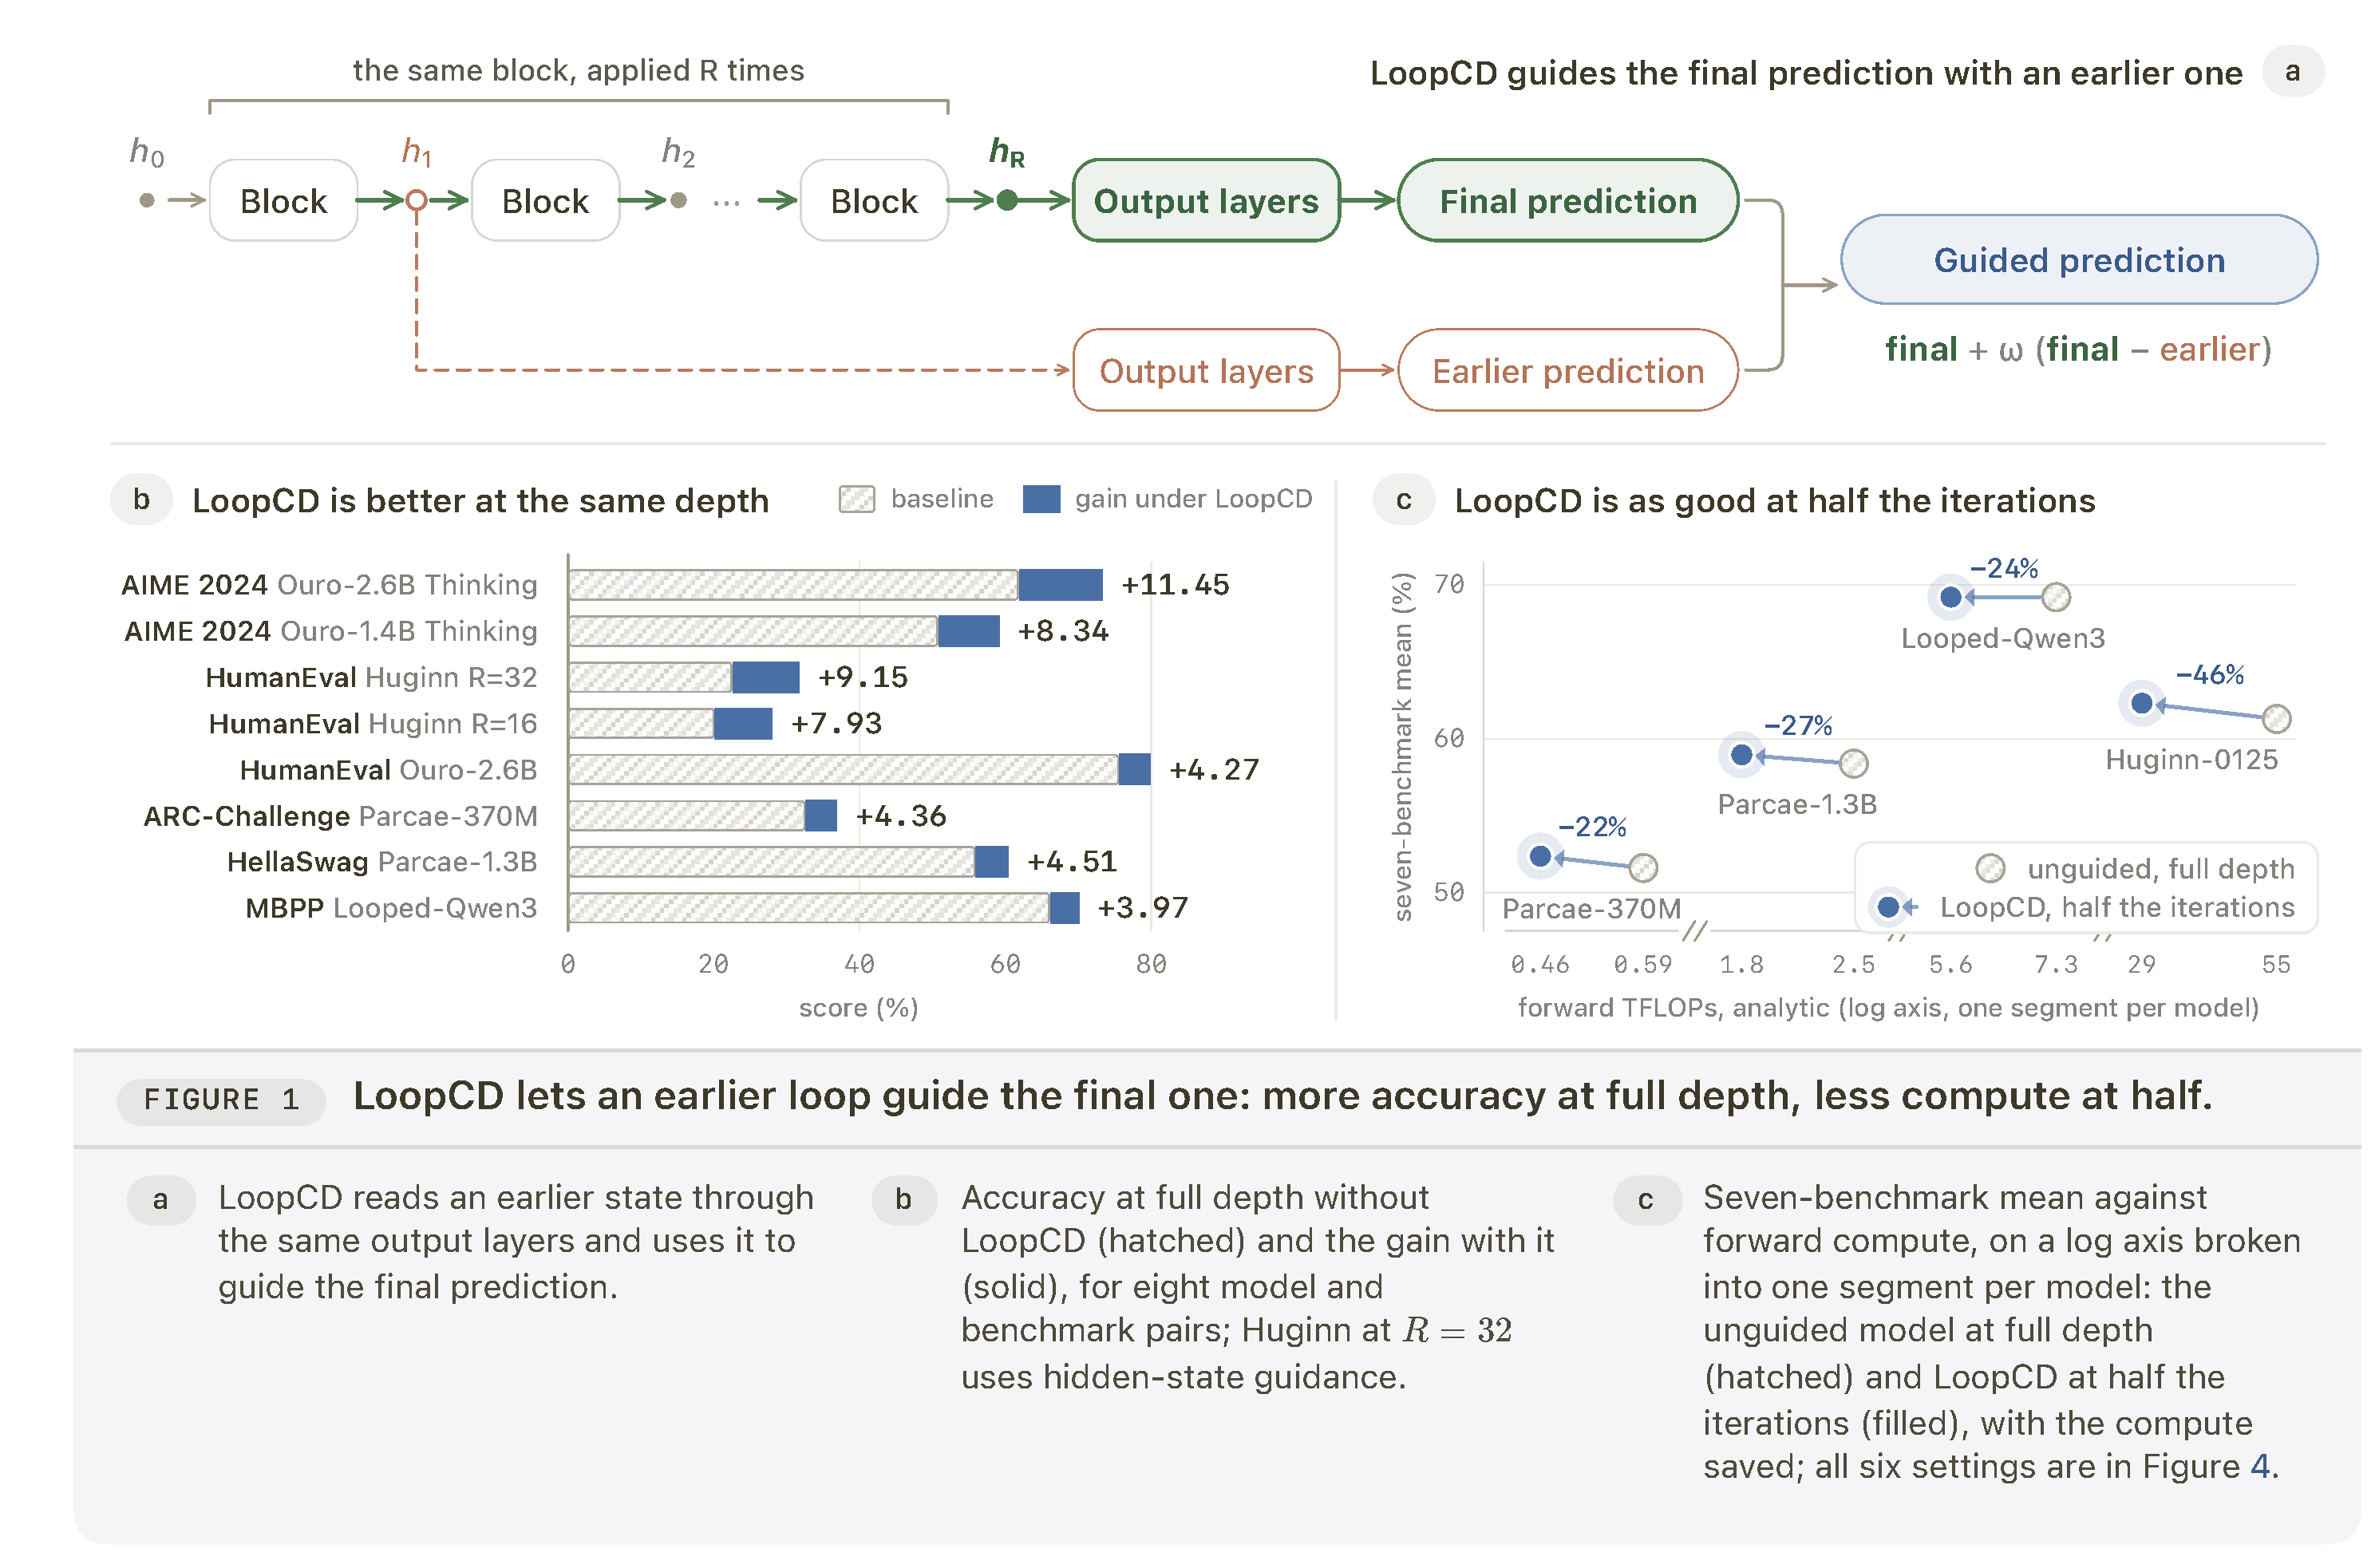
- Looped Transformers는 가중치를 공유하는 계층을 반복 적용하는 언어 모델이다. 일반적인 디코딩은 추가 학습 없이 다음 토큰 선택에 활용할 수 있는 이전 예측을 버린다. 재귀 반복 횟수가 같을 때, 적응형 LoopCD-Logits는 Ouro-2.6B-Thinking의 AIME 2024 수학 추론 pass@1을 61.88%에서 73.33%로 높인다. pass@1은 샘플링한 풀이 1개가 정답일 확률의 추정치다. 비교 대상은 체크포인트와 프롬프트가 같은 비유도 베이스라인이다.
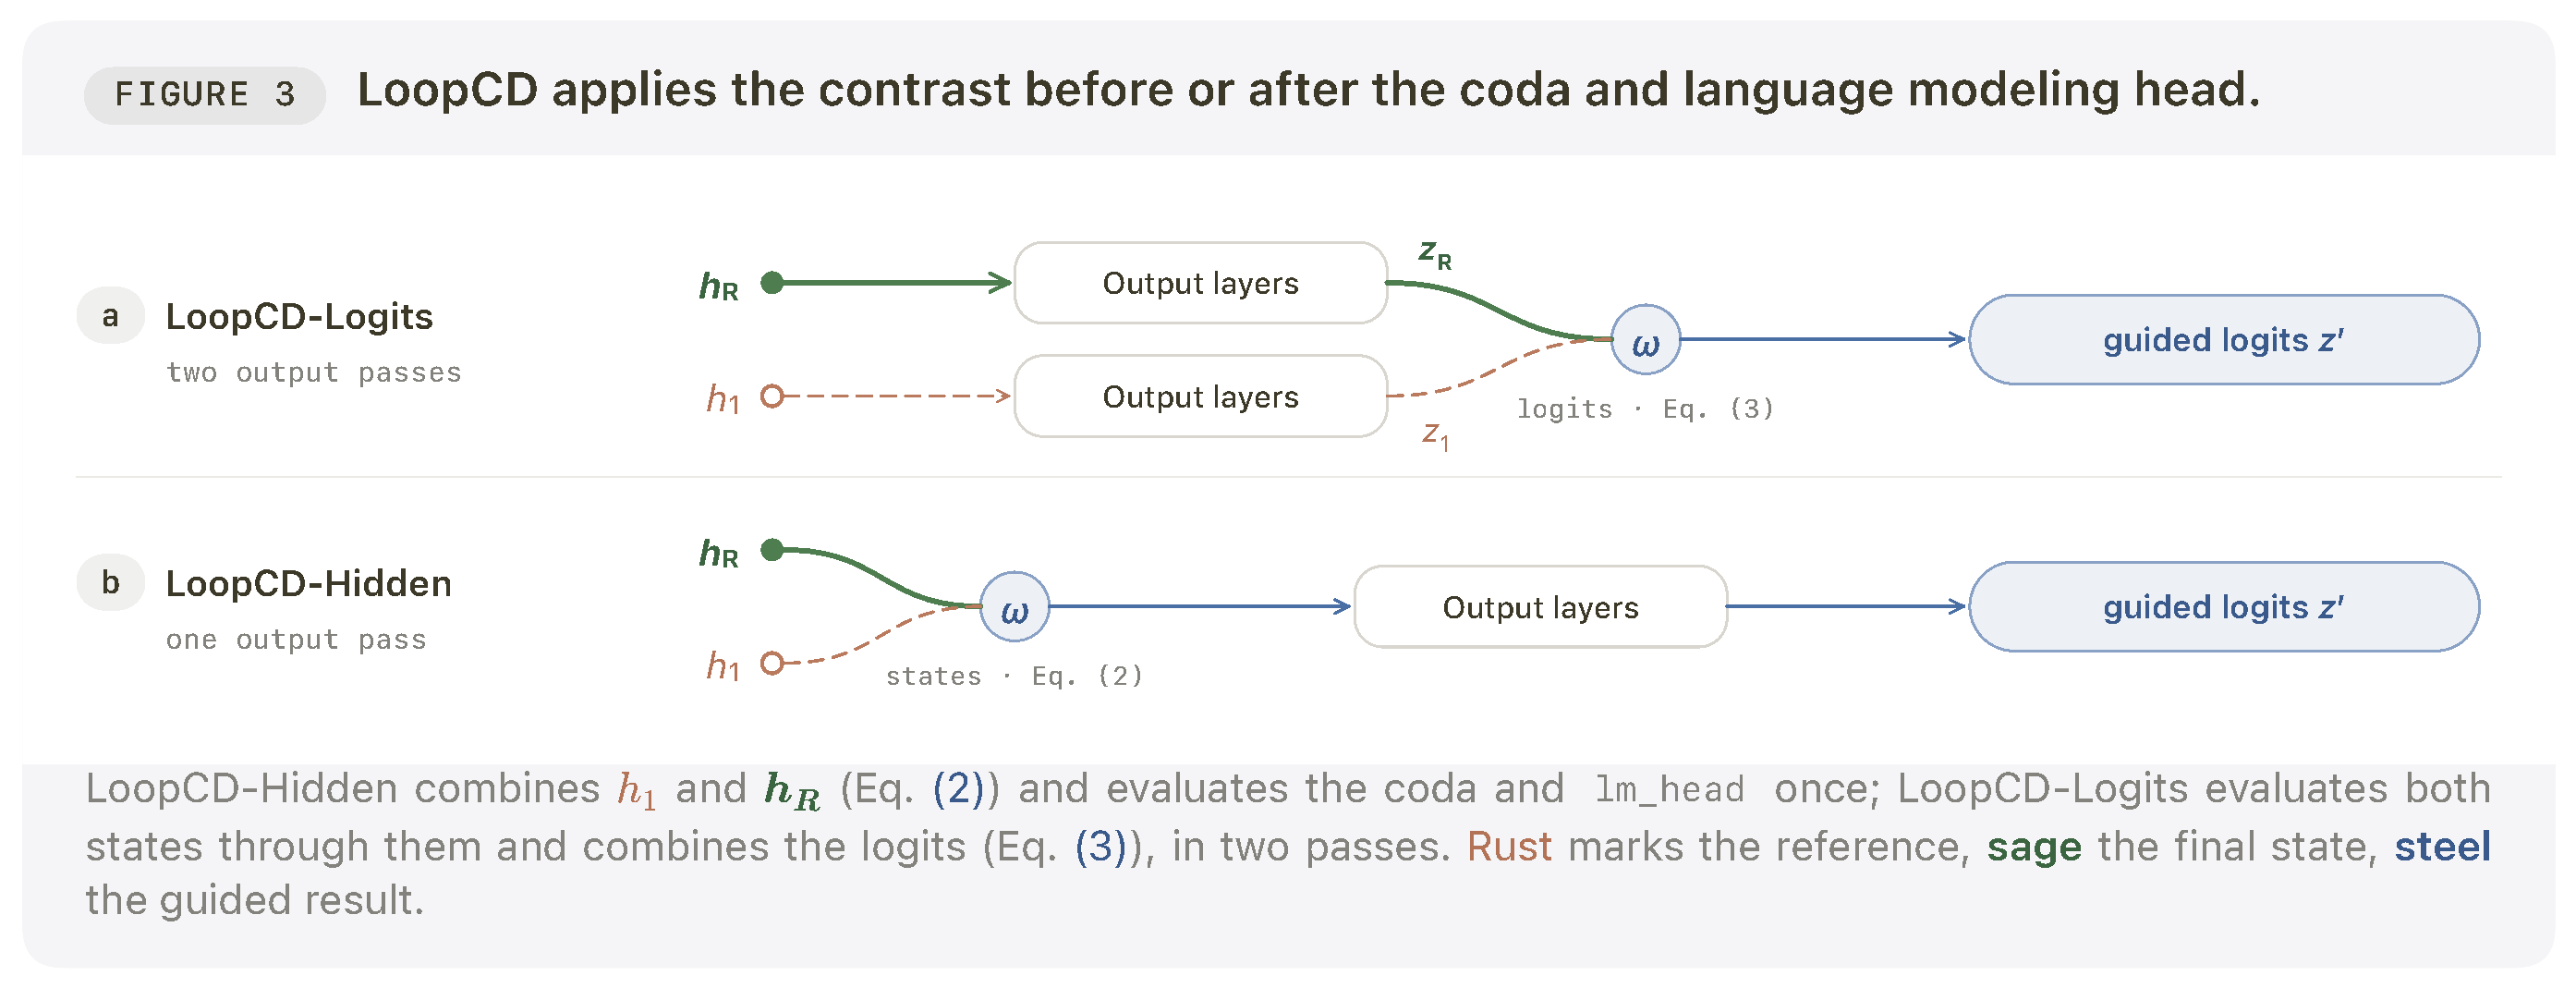
- LoopCD는 이전 반복에서 이미 생성한 상태로 contrastive decoding을 수행한다. 이는 강한 예측을 약한 참조 예측에서 멀어지는 방향으로 유도하는 방법이다. LoopCD-Logits는 출력 계층을 통과한 로짓, 즉 확률로 변환하기 전의 토큰 점수를 결합하므로 출력 계층을 추가로 통과해야 한다. LoopCD-Hidden은 출력 계층에 들어가기 전에 모델의 내부 표현인 은닉 상태를 결합하므로 출력 계층을 1회만 통과한다.
- LoopCD는 깊이를 줄인 6개 설정에서 객관식 벤치마크 7개의 평균을 전체 깊이의 비유도 모델과 같거나 높게 유지하면서, 재귀 반복 횟수를 절반으로 줄이고 이론적 순전파 부동소수점 연산량을 22.5%~48.2% 줄인다. 이 절감량은 입력 접두부를 처리하는 512토큰 프리필의 연산량 추정치다. 전체 실행 과정에서 측정한 속도 향상을 뜻하지는 않는다. 생성 작업에서도 유도 강도를 조정해야 하며, 개별 벤치마크에서 성능이 하락하는 경우가 있다.
1 Introduction
표준 디코딩은 이전 재귀 반복에서 얻은 예측을 버린다. 각 반복은 같은 입력 접두부에 같은 파라미터 블록을 적용하므로, 중간 예측을 구조적으로 정렬된 약한 참조로 활용할 수 있다. 별도 모델이나 프롬프트 수정도 필요하지 않다. LoopCD는 이전 예측에서 최종 예측으로 변한 방향을 따라 예측을 더 이동시키며, 추가 학습이나 재귀 반복을 요구하지 않는다.
개요는 결과 2가지를 연결한다. 이전 상태로 같은 깊이의 최종 예측을 유도할 수 있고, 그 향상으로 반복 횟수 감소에 따른 손실을 보완할 수 있다. 연산량 축소 패널은 객관식 평균을 요약한다. 전체 깊이 패널에 제시된 수학 추론 및 코드 점수가 절반 깊이에서도 유지됨을 보여주지는 않는다.
2 Preliminaries: Looped Transformers
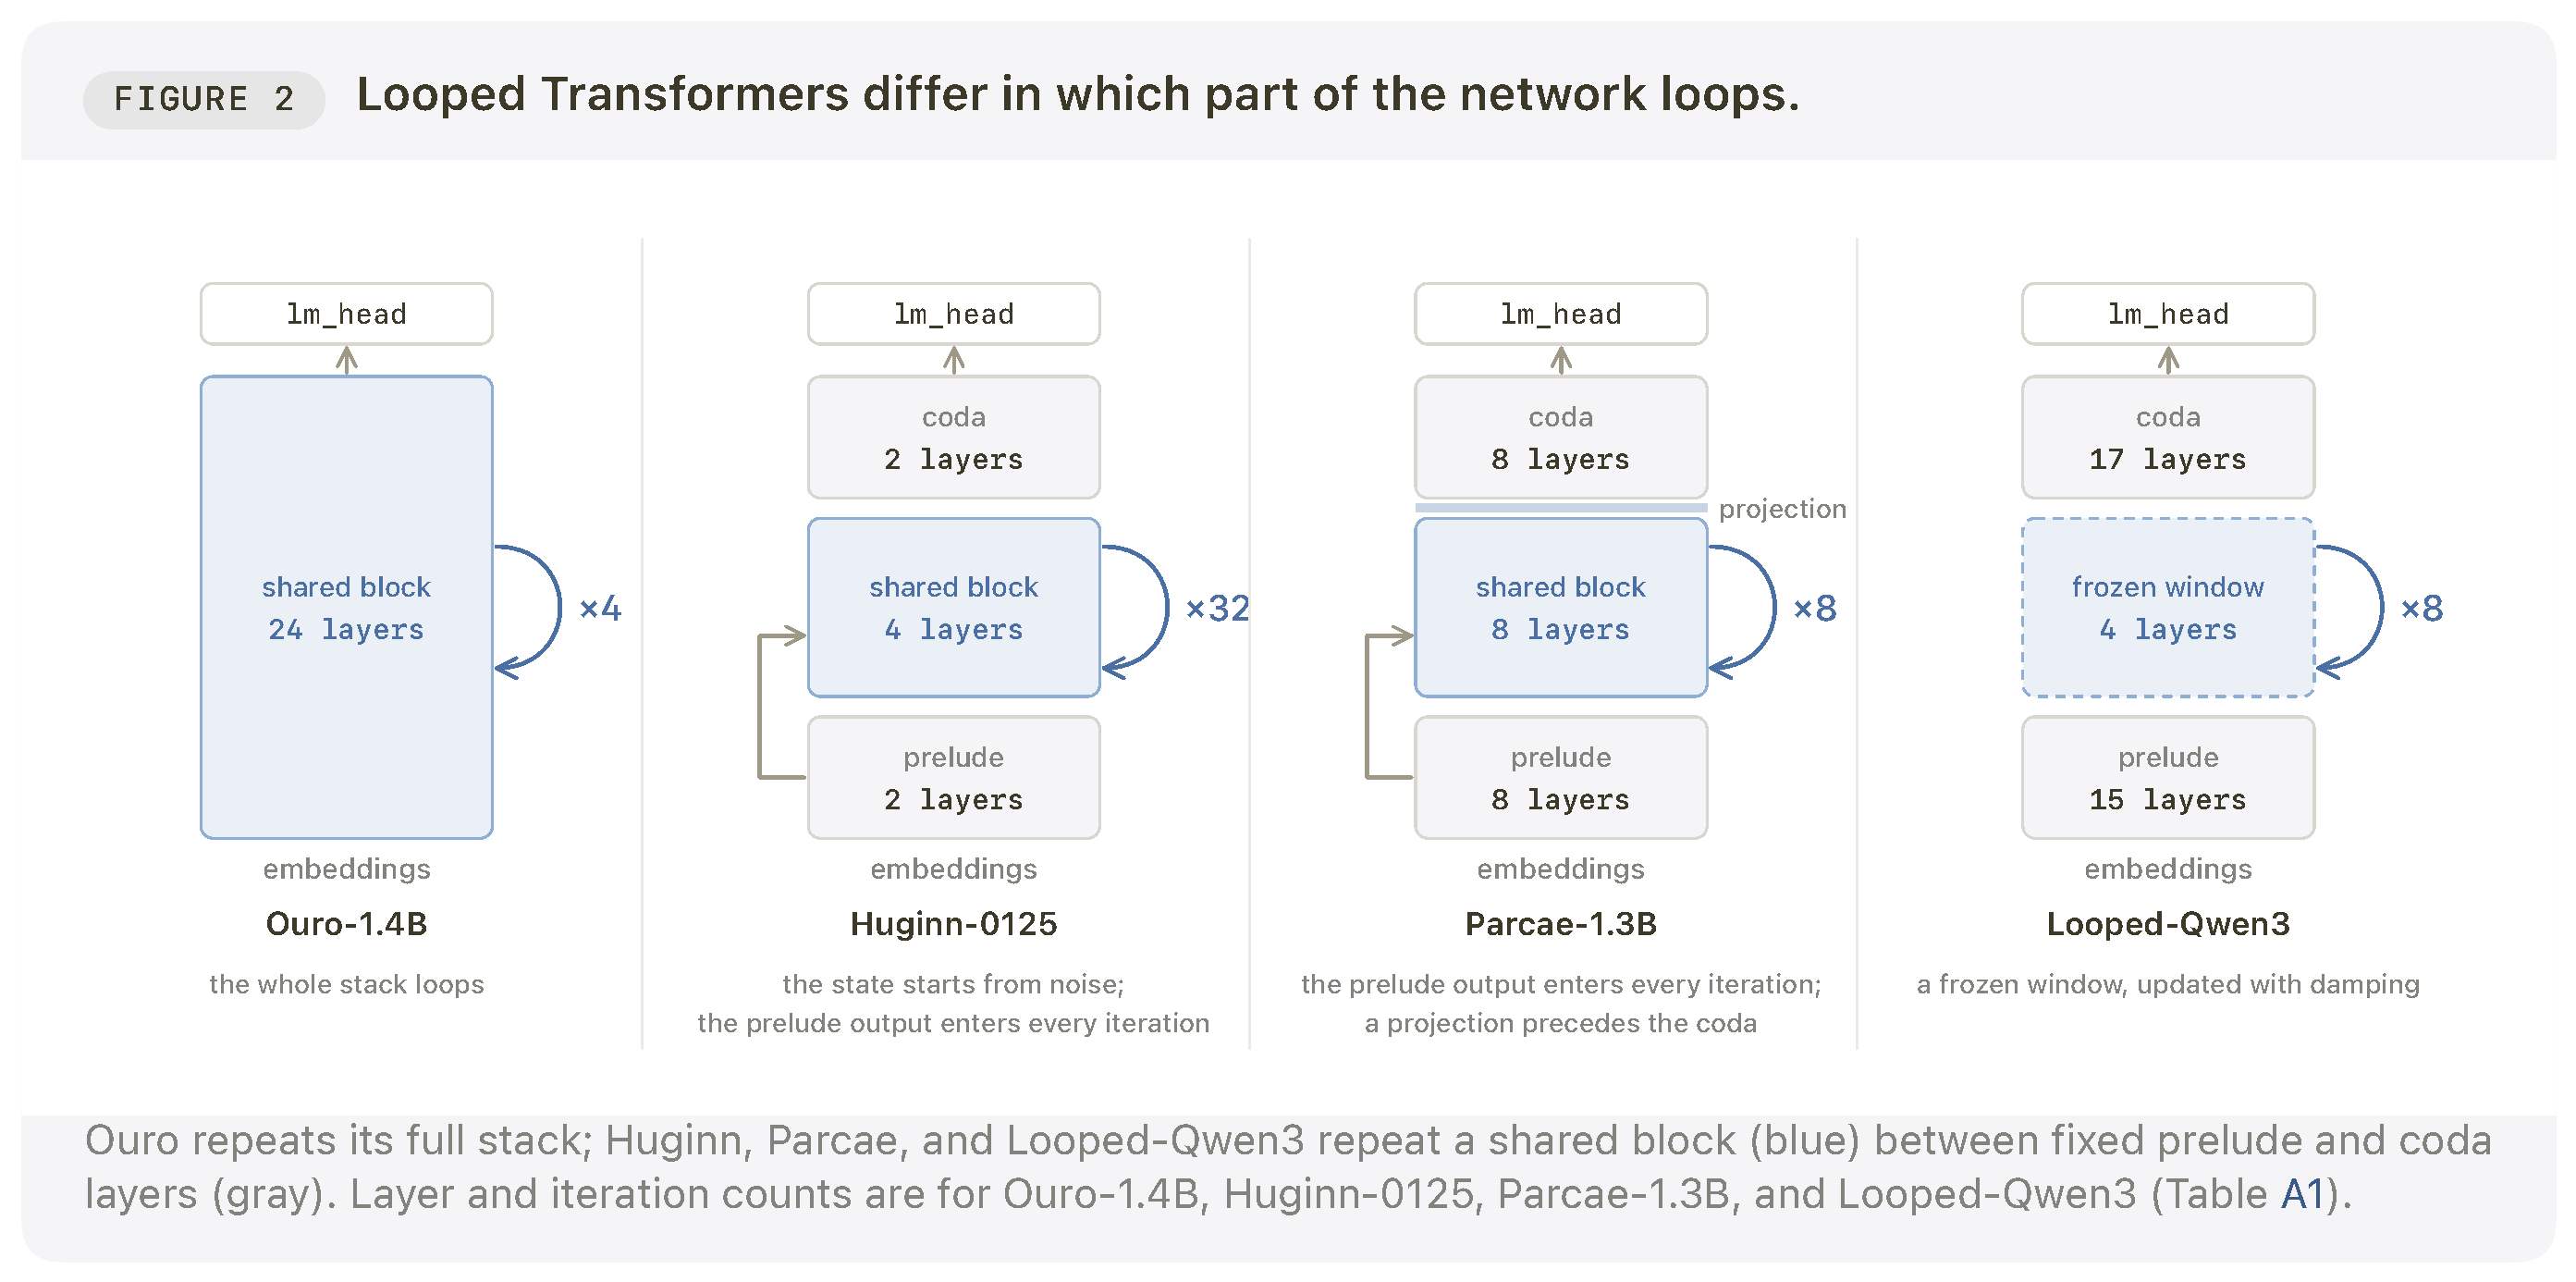
재귀 반복은 공유 블록을 적용해 저장된 파라미터는 유지하면서 유효 깊이와 연산량을 늘리는 과정이다. Ouro는 디코더 스택 전체를 반복한다. Huginn, Parcae, Looped-Qwen3는 입력을 처리하는 prelude와 반복 이후의 계층인 coda 사이에 재귀 구간을 둔다. Huginn은 prelude 표현을 각 갱신의 조건으로 사용하고, Parcae는 재귀 동역학을 학습한다. Looped-Qwen3는 고정된 중간 계층 구간을 반복 적용하며, 출력과 이전 상태를 섞는 감쇠 갱신을 사용한다.
- R회 반복한 최종 상태 h_R은 coda와 lm_head를 통과해 토큰 로짓을 만든다. lm_head는 최종 정규화와 어휘 공간으로의 투영으로 구성된다. 표준 디코딩은 점수를 지수화하고 정규화하는 softmax로 확률을 구한다.
- 평가한 아키텍처는 출력 비용이 크게 다르다. Ouro에는 coda Transformer 계층이 없지만, Looped-Qwen3에는 재귀 구간 뒤에 17개 계층이 있다.
아키텍처 비교는 출력 계층을 추가로 통과하는 비용이 모델마다 다른 이유를 설명한다. Ouro는 이전 상태의 출력을 얻을 때 최종 정규화와 head만 필요하지만, 다른 계열은 재귀 블록 뒤의 계층도 처리해야 한다. Looped-Qwen3는 이 후속 구간이 가장 길다.
3 LoopCD: Contrastive Decoding from Recurrent States
LoopCD는 보통 첫 재귀 반복을 완료한 상태 h_1을 최종 상태 h_R의 약한 참조로 사용한다. 은닉 상태 공간이나 로짓 공간에서 재귀 반복에 따른 개선 방향을 연장한다. 유도 공간과 음이 아닌 계수 ω가 이러한 외삽을 어디에 얼마나 강하게 적용할지 결정한다.
3.1 Guidance Space
LoopCD-Hidden은 h′ = h_R + ω(h_R − h_1)을 계산한 뒤 z′ = lm_head(coda(h′))를 구한다. LoopCD-Logits는 z_1 = lm_head(coda(h_1))과 z_R = lm_head(coda(h_R))을 각각 계산한 뒤 z′ = z_R + ω(z_R − z_1)을 구한다. 2개 방식 모두 softmax(z′)로 다음 토큰 확률을 얻으며, ω = 0이면 일반 디코딩과 같아진다.
- 은닉 상태 유도는 가벼운 벡터 연산을 추가하고 coda와 head를 1회 실행한다. 로짓 유도는 이 출력 계층들을 2회 실행하며, 추가 비용은 아키텍처에 따라 달라진다.
- h_1을 참조로 쓰는 규칙이 항상 적용되지는 않는다. Huginn의 은닉 상태 실험에서는 초기화 잡음을 증폭하지 않도록 더 나중의 상태를 참조로 사용한다.
출력 계층 앞에서 대조하면 추가 출력 평가를 없앨 수 있지만, 유도한 표현이 모델의 비선형 coda를 통과하게 된다. 따라서 방식마다 연산량뿐 아니라 갱신이 토큰 점수에 영향을 주는 방식도 다르다.
3.2 Guidance Strength
고정 유도는 각 평가 설정에서 모든 토큰에 같은 계수를 사용한다. 적응형 유도는 ω = ω_max[1 − (p_R,(1) − p_R,(2))]를 사용한다. 여기서 p_R,(1)과 p_R,(2)는 유도하지 않은 토큰 확률 중 가장 높은 값과 그다음 값이며, ω_max는 최대 강도다. 이 확률들이 비슷하면 유도 강도가 최댓값에 가까워지고, 토큰 1개의 확률이 압도적으로 높으면 강도가 줄어든다.
- 적응형 규칙은 어휘 전체의 엔트로피를 계산하지 않고, 상위 확률 2개의 차이인 확률 마진을 사용한다.
- LoopCD-Logits는 이 규칙에 필요한 비유도 확률을 이미 계산한다. LoopCD-Hidden에 적용하려면 출력 계층을 추가로 통과해야 하므로, 보고된 은닉 상태 설정은 고정 유도를 사용한다.
4 Experiments
실험은 Ouro, Huginn, Parcae, Looped-Qwen3를 대상으로 우도 기반 객관식 채점, 탐욕적 생성, 샘플링 기반 수학 추론을 평가한다. 우도 기반 채점은 모델이 부여한 확률로 후보 답변의 순위를 정하고, 탐욕적 생성은 각 단계에서 확률이 가장 높은 토큰을 선택한다. 유도 실험과 베이스라인은 체크포인트, 프롬프트, 예시 수, 생성 길이 제한, 종료 규칙, 답 추출기, 평가기를 공유한다. 전체 깊이 비교에서는 재귀 깊이도 맞춘다. 깊이를 줄인 실험에서는 절반 깊이의 유도 모델과 전체 깊이의 비유도 모델을 명시적으로 비교한다.
4.1 Gains on Mathematical Reasoning and Code Generation
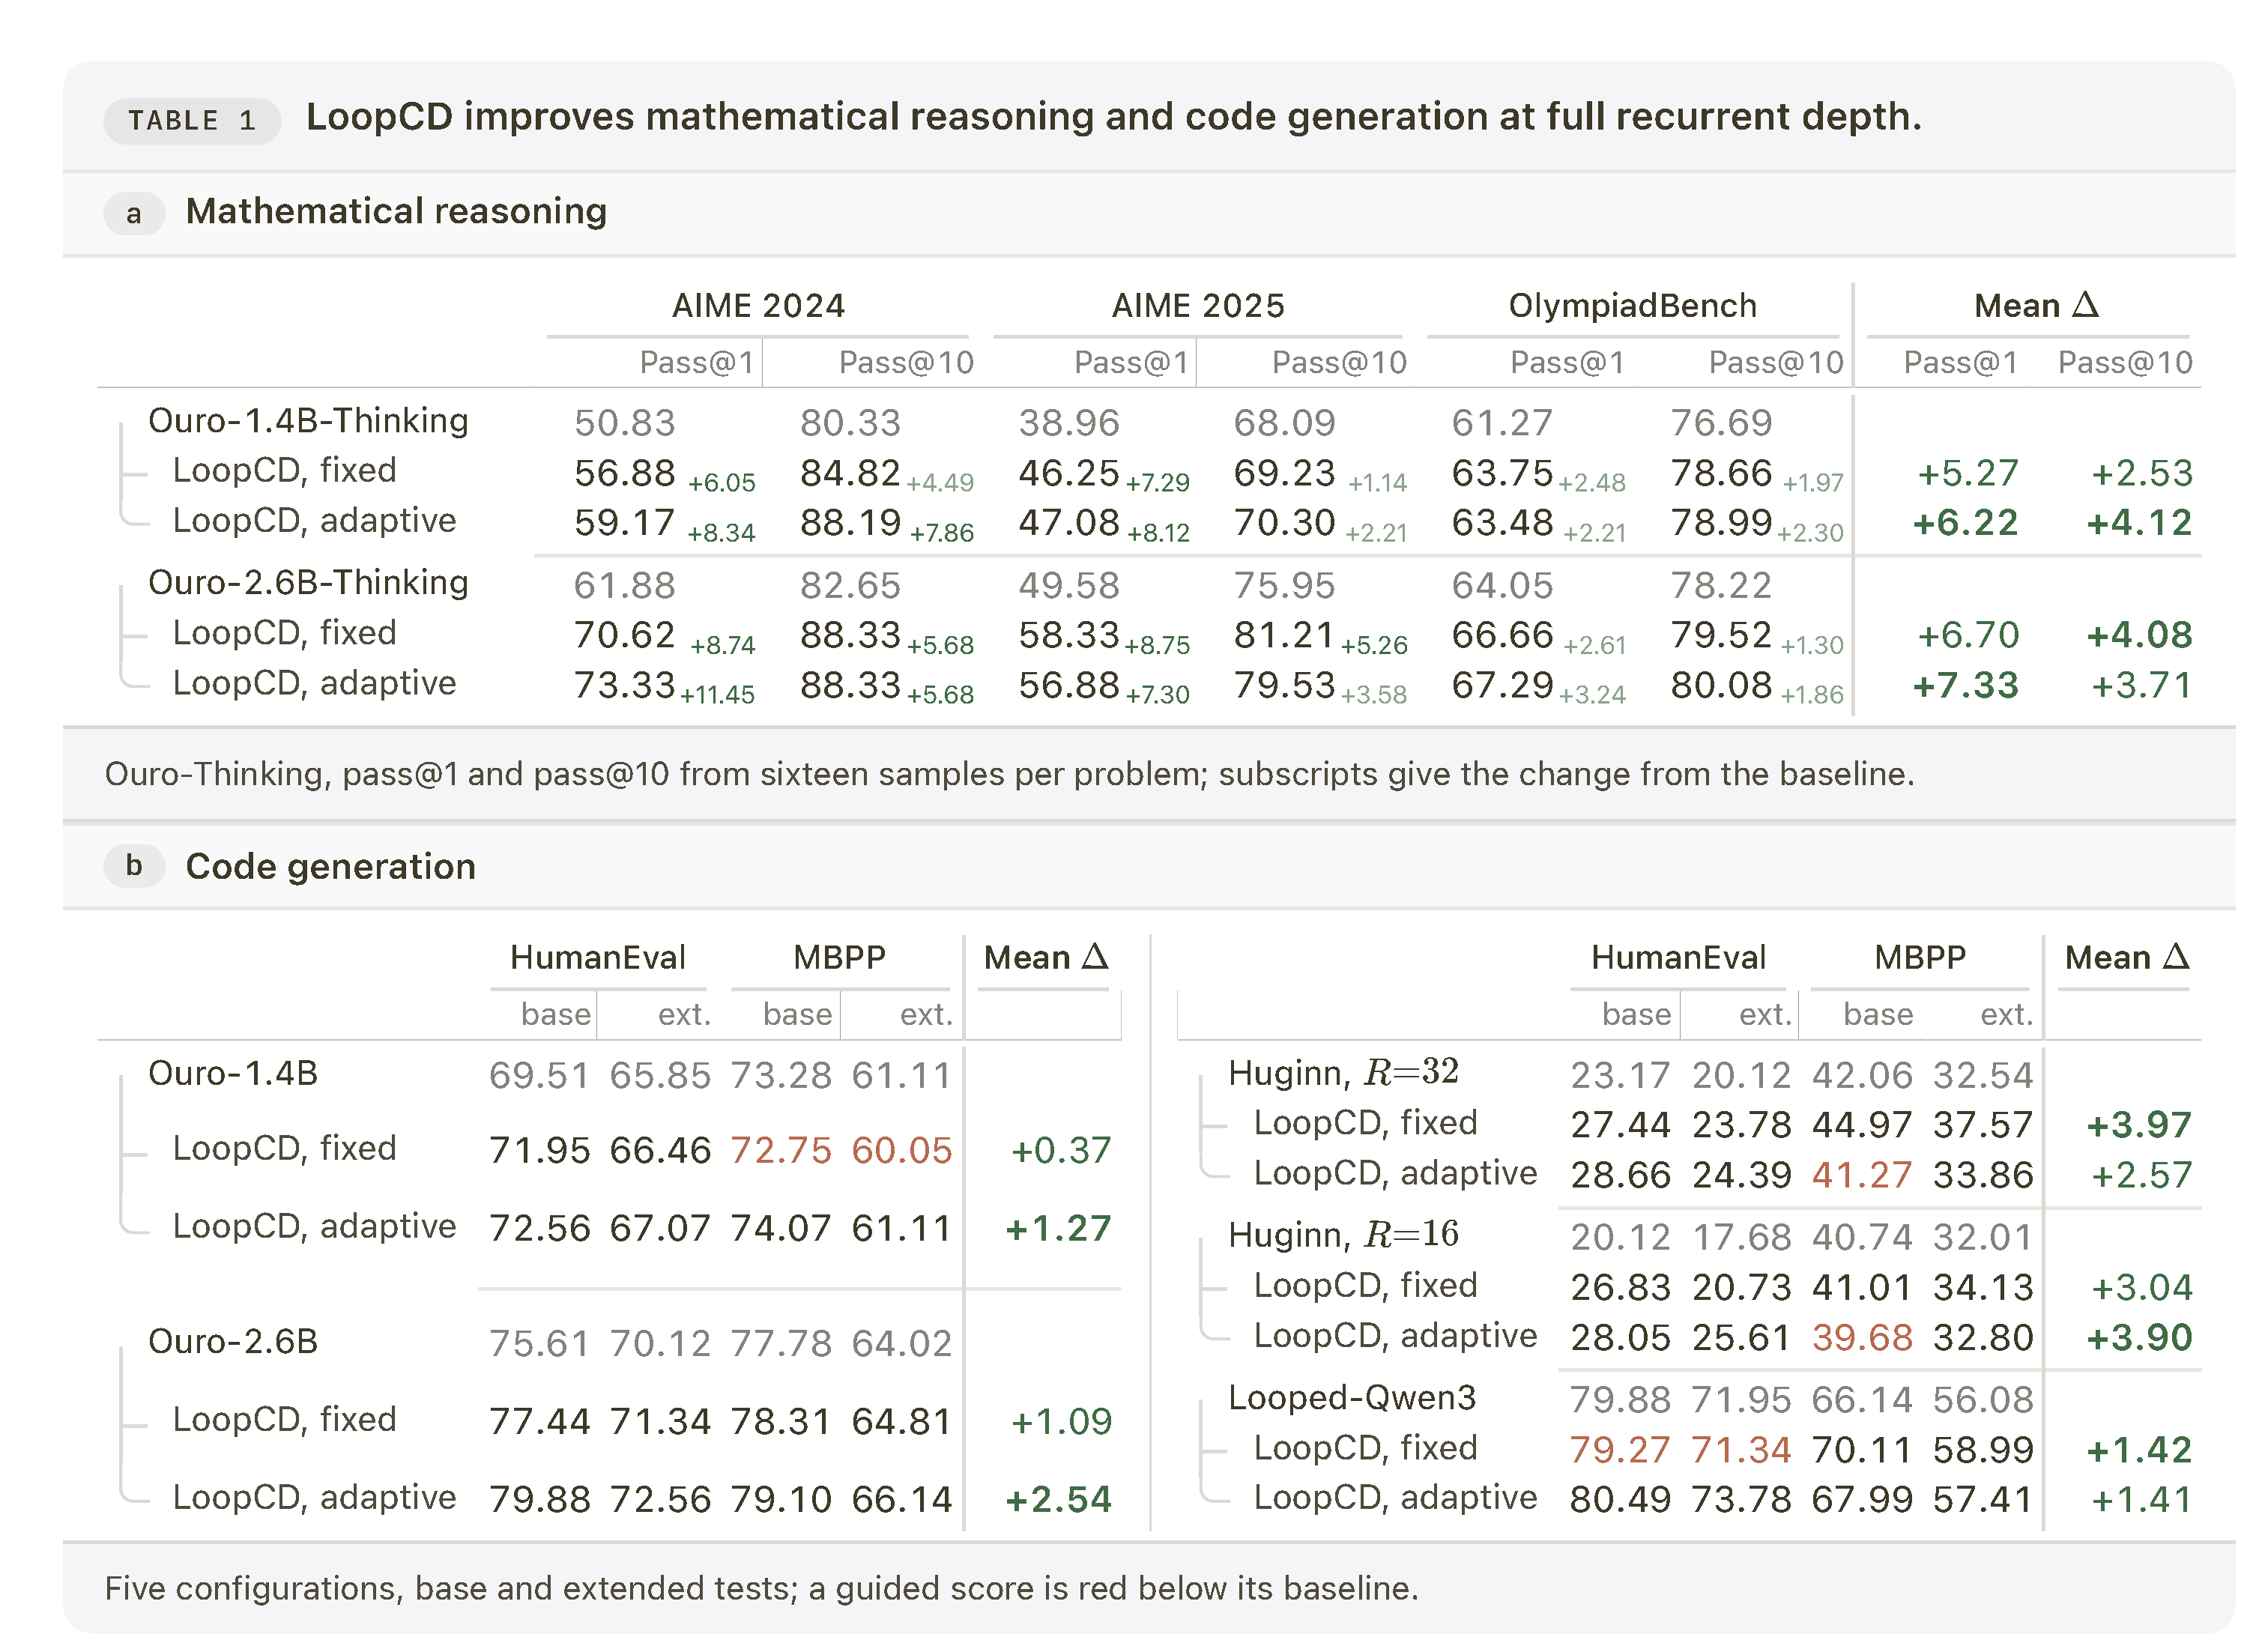
수학 추론 벤치마크 AIME 2024, AIME 2025, OlympiadBench에서 Ouro-Thinking 모델 2개 모두 고정 및 적응형 LoopCD-Logits를 적용하면 pass@1과 pass@10이 향상된다. pass@10은 샘플 10개 중 적어도 1개가 정답일 확률의 추정치다. 벤치마크 3개의 평균 pass@1 향상 폭은 5.27~7.33%포인트이며, 평균 pass@10 향상 폭은 2.53~4.12점이다. Ouro-2.6B-Thinking에서 적응형 유도는 AIME 2025 pass@1을 49.58%에서 56.88%로, OlympiadBench pass@1을 64.05%에서 67.29%로 높인다.
- HumanEval과 MBPP는 코드 평가 도구인 EvalPlus의 기본 및 확장 테스트로 생성 코드를 실행해 평가한다. 보고된 모든 로짓 설정에서 테스트 결과 4개 열의 평균이 향상되지만, 개별 열에서는 하락하는 경우도 있다.
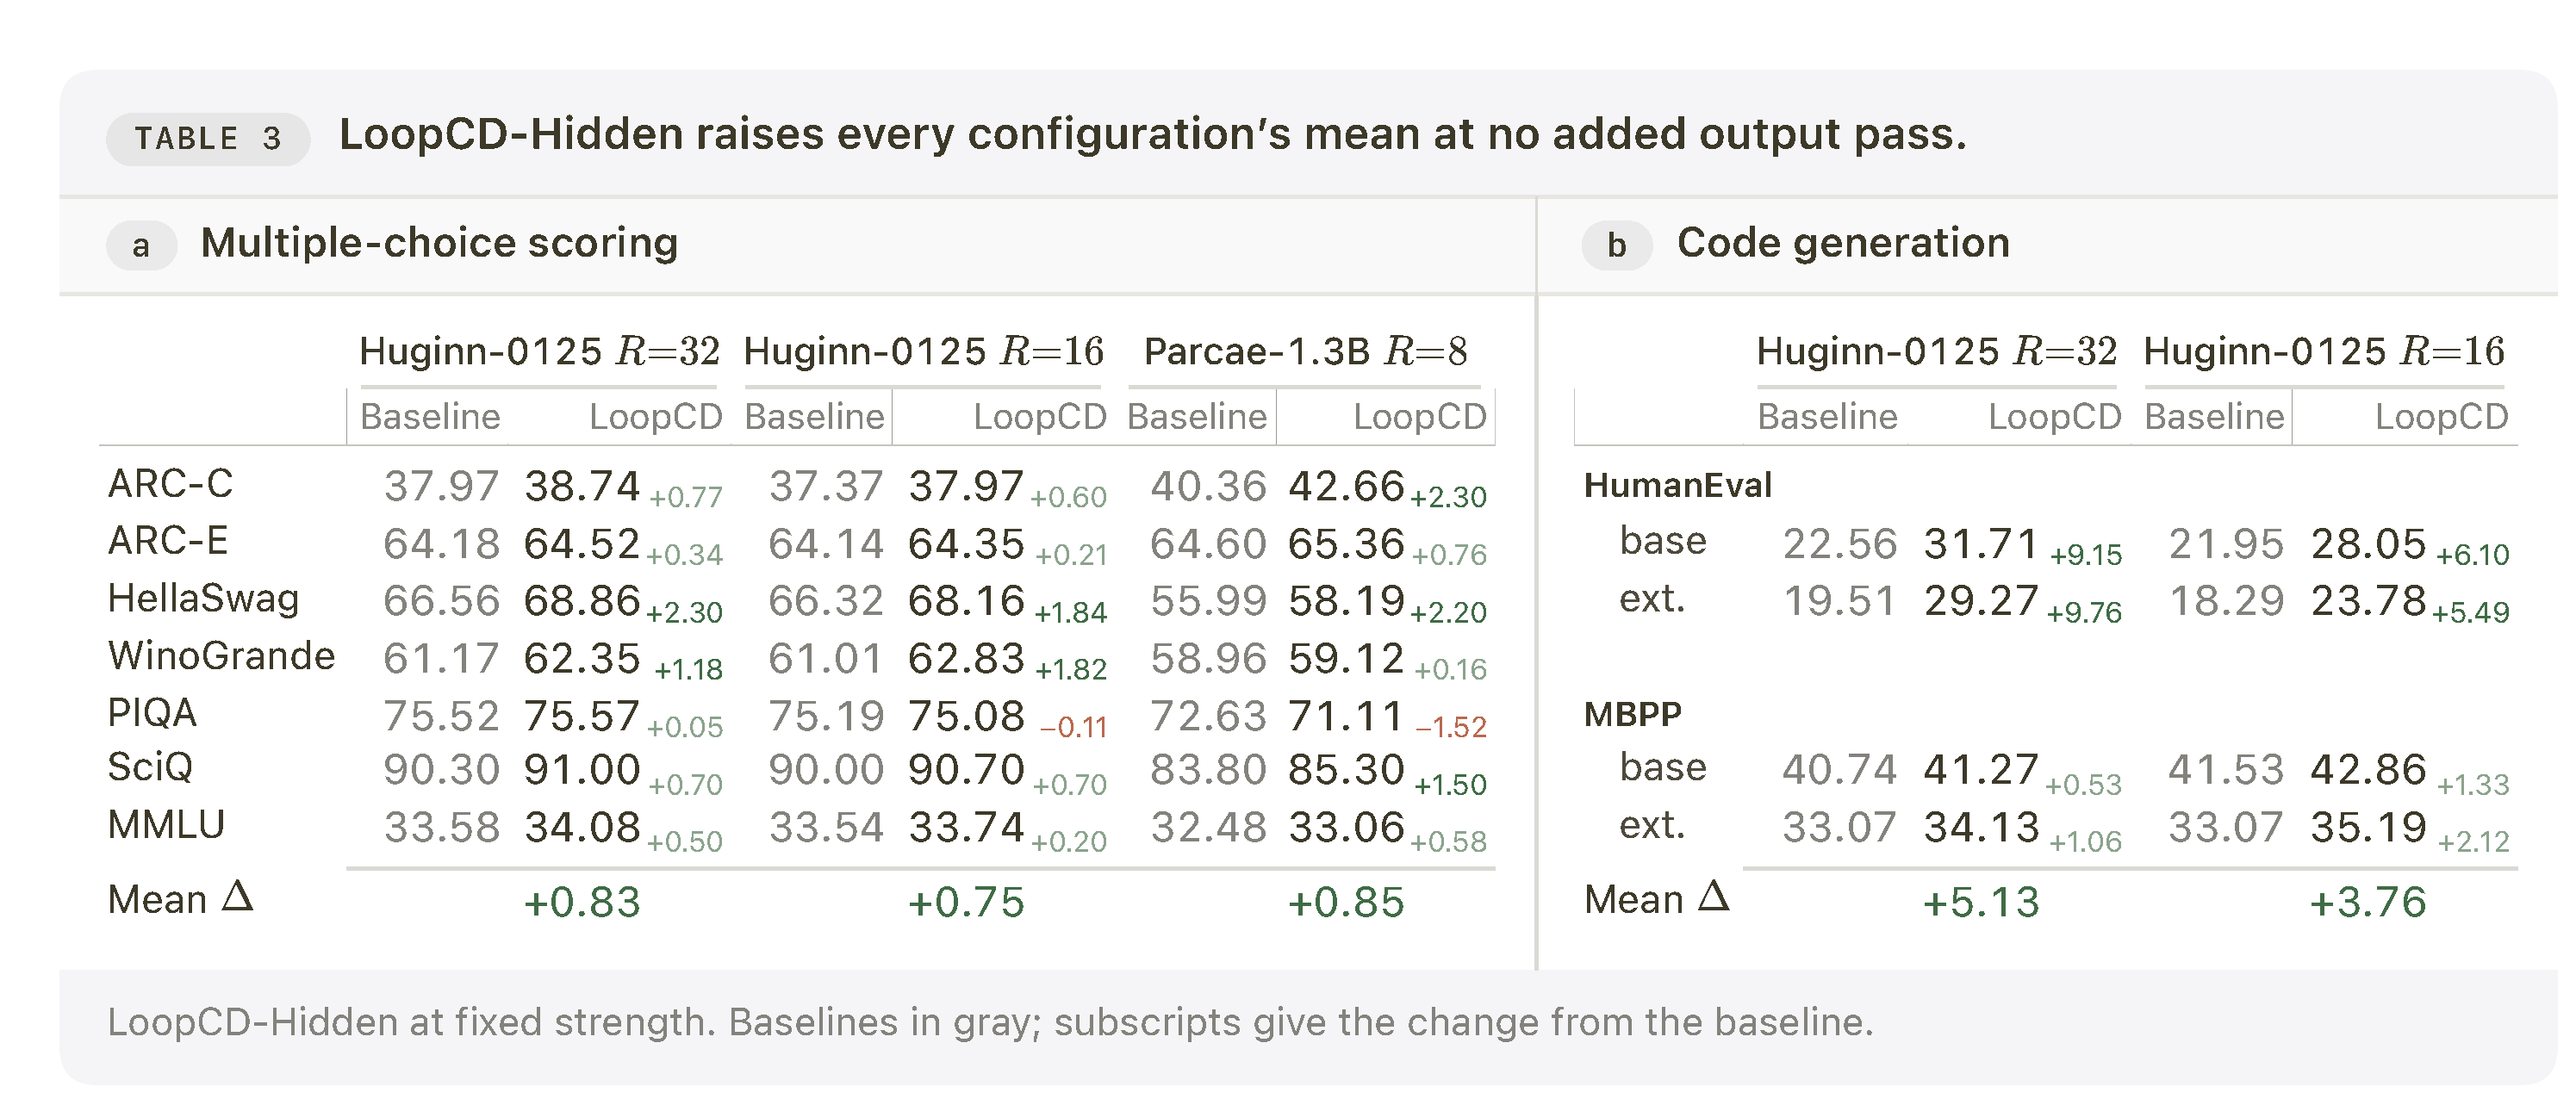
- 별도로 조건을 맞춘 베이스라인과 비교하면, R = 32인 Huginn은 LoopCD-Hidden을 적용했을 때 HumanEval pass@1이 22.56%에서 31.71%로 높아진다. 코드 평가 4개 열의 평균은 5.13점 상승하며, R = 16에서는 평균이 3.76점 상승한다.
수학 결과에서는 Ouro-Thinking 모델 2개 모두 샘플링 지표 2개가 향상된다. 코드 생성 평균도 제시된 모든 설정에서 향상된다. 다만 개별 열에는 예외가 있으며, 고정 유도를 적용한 Ouro-1.4B의 MBPP 점수와 Looped-Qwen3의 HumanEval 점수는 하락한다.
4.2 Consistent Improvements Across Architectures and Suites
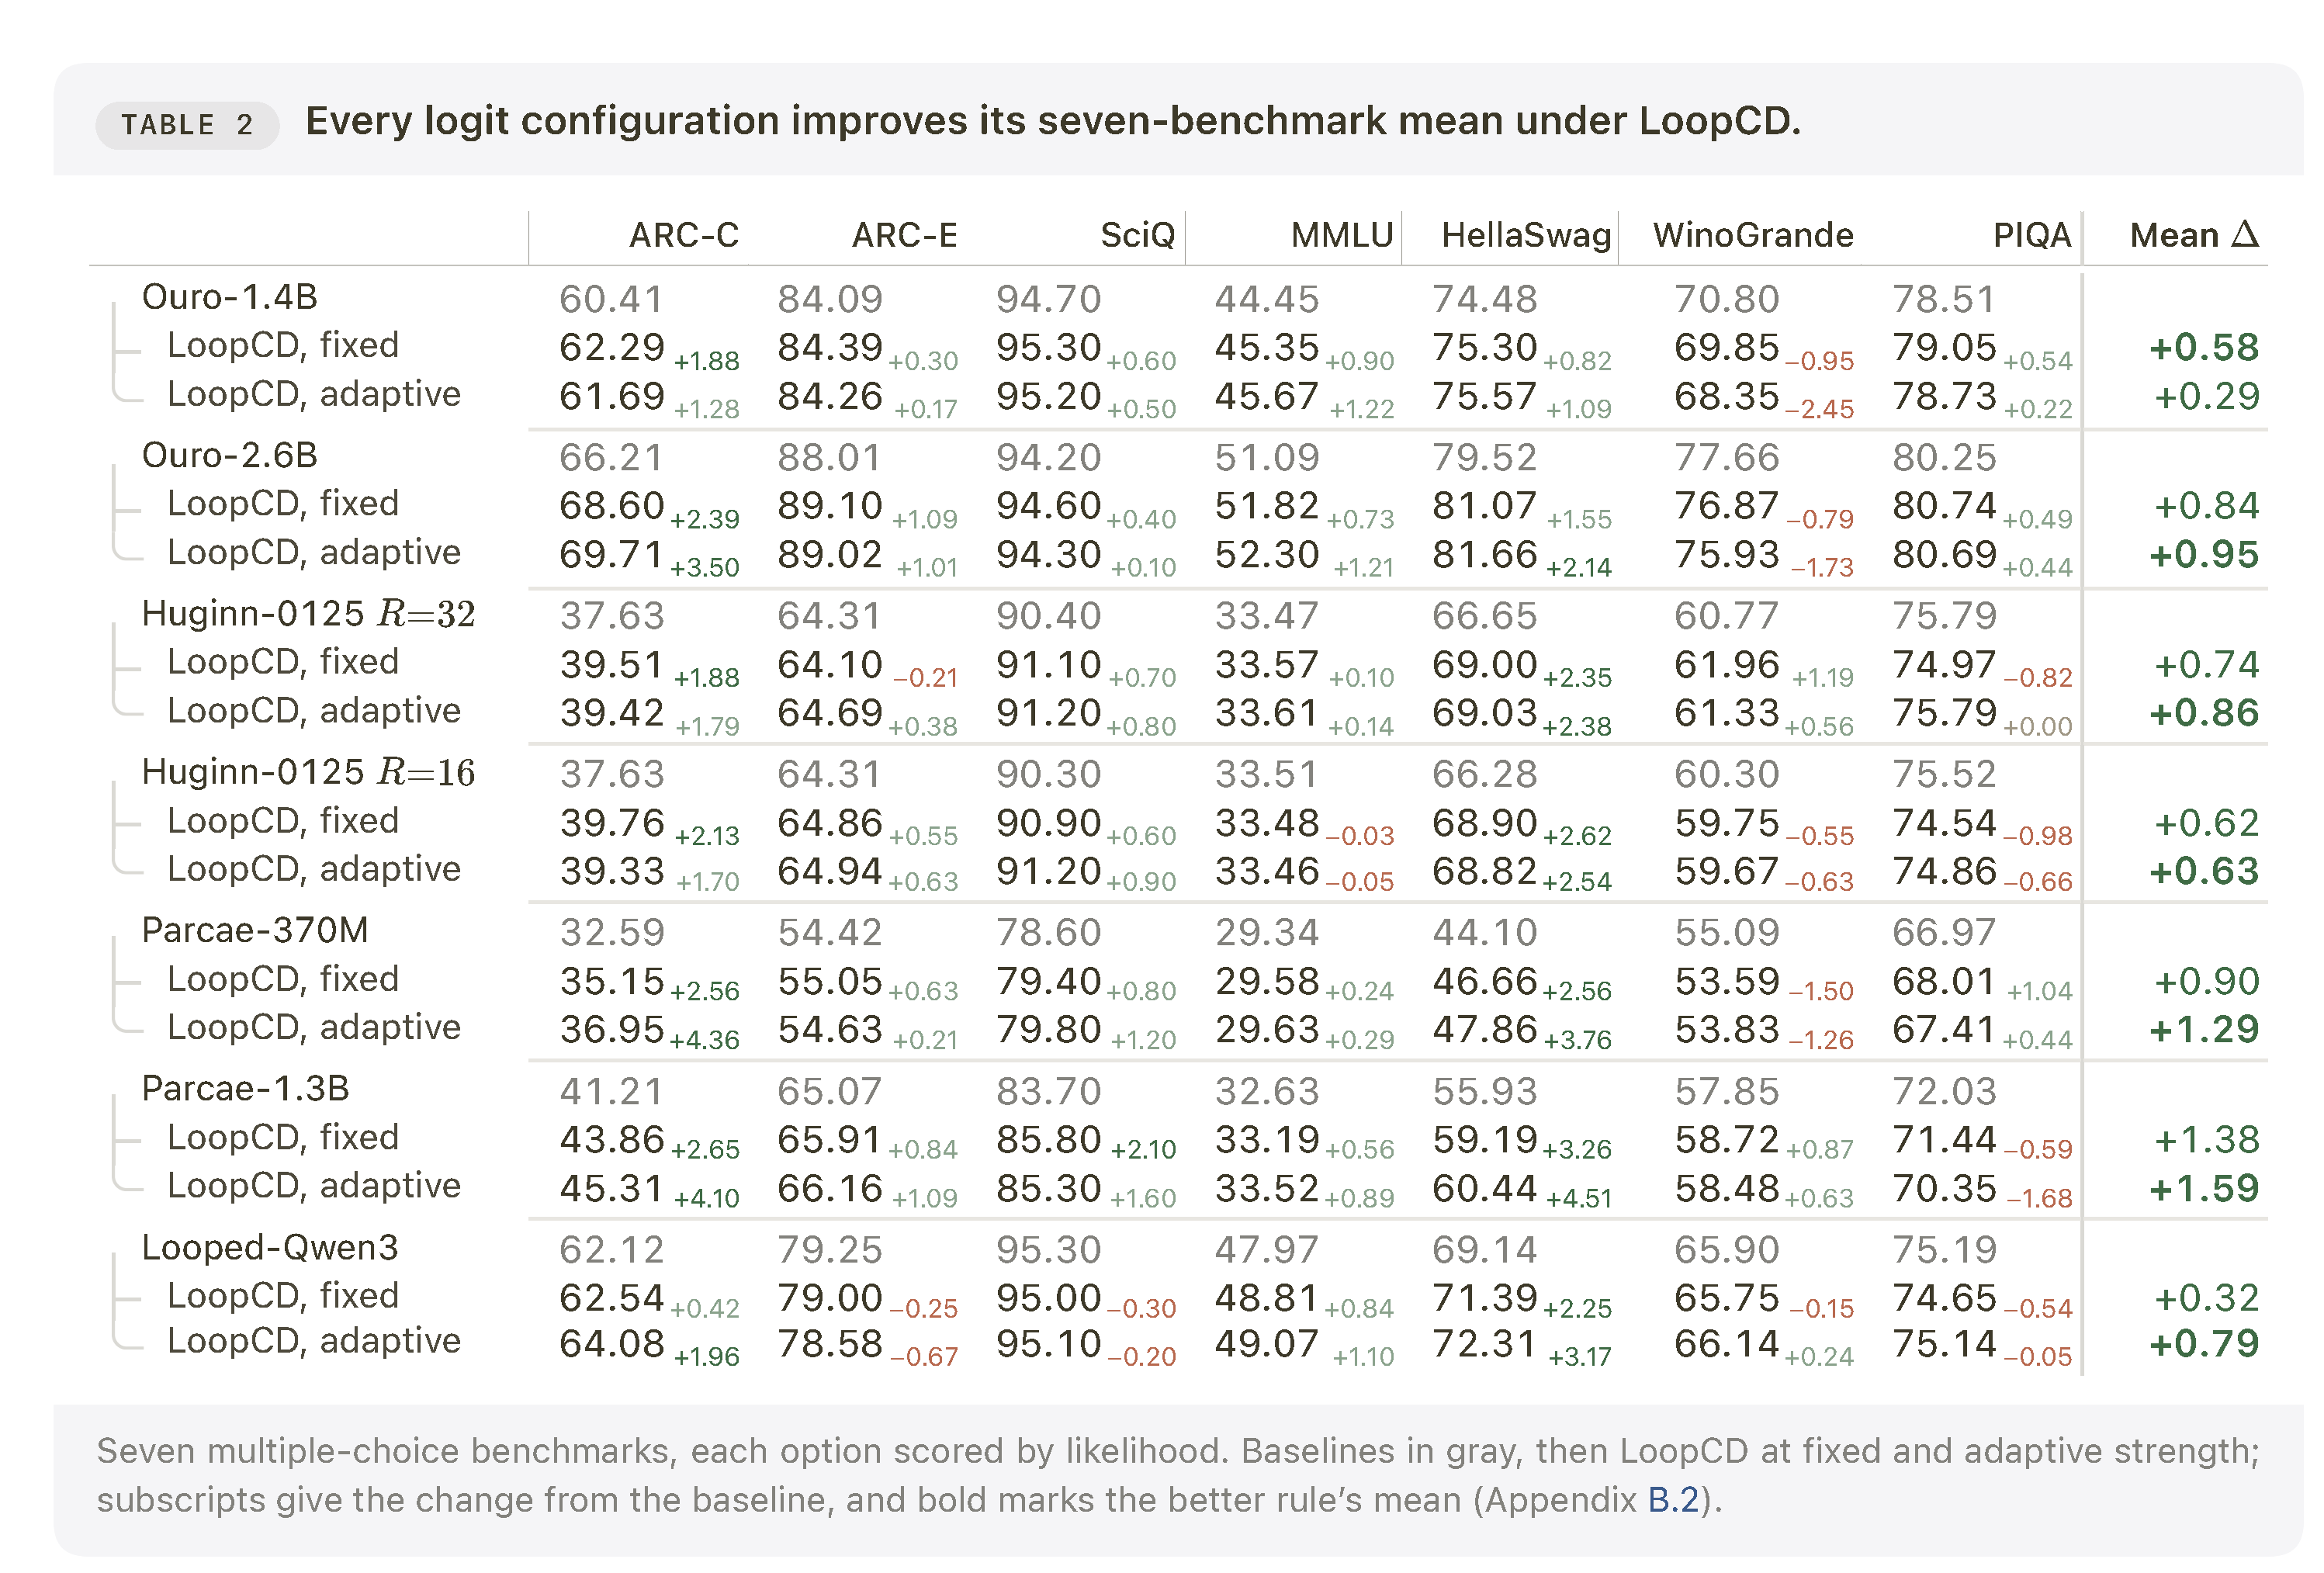
평가한 모든 LoopCD-Logits 설정에서 ARC-Challenge, ARC-Easy, SciQ, MMLU, HellaSwag, WinoGrande, PIQA의 동일 가중 평균이 향상된다. 이 객관식 평가 데이터셋 7개는 답변 우도로 채점한다. 고정 유도의 평균 향상 폭은 0.32~1.38점이며, 적응형 유도는 0.29~1.59점이다. 이러한 향상은 중간 예측에 지도 학습을 적용한 Ouro, 재귀 깊이를 샘플링해 학습한 Huginn과 Parcae, 고정된 기반 모델에 재귀 구조를 추가한 Looped-Qwen3에서 모두 나타난다.
- 일관된 향상은 평가 묶음의 평균에 해당하며, 모든 벤치마크에 해당하지는 않는다. Ouro의 WinoGrande 점수는 유도 규칙 2개 모두에서 하락하고, Parcae-1.3B의 PIQA 점수도 하락한다.
- LoopCD-Hidden은 벤치마크 7개의 평균을 R = 32인 Huginn에서 0.83점, R = 16에서 0.75점, Parcae-1.3B에서 0.85점 높인다.
- 프롬프트 형식은 아키텍처마다 다르며, 유도 방식에 따라 달라지는 경우도 있다. 각 향상 폭은 해당 설정과 조건을 맞춘 베이스라인을 기준으로 하므로, 절대 점수만으로 유도 방식을 직접 비교할 수 없는 경우가 있다.
제시된 모델 및 깊이 설정 7개 모두 유도 규칙 2개에서 평가 묶음의 평균이 향상된다. 6개 설정에서는 적응형 유도의 평균 향상 폭이 더 크지만, Ouro-1.4B에서는 고정 유도가 더 유리하며 일부 개별 데이터셋에서는 성능이 하락한다.
은닉 상태 유도는 제시된 객관식 평균 3개를 모두 높이며, Huginn의 깊이 설정 2개에서 모든 코드 생성 열의 성능을 높인다. 베이스라인 값은 로짓 실험과 다르므로, 효과를 비교할 때는 각 유도 방식 안에서의 변화량을 근거로 삼아야 한다.
4.3 Fewer Iterations, Matching or Superior Performance
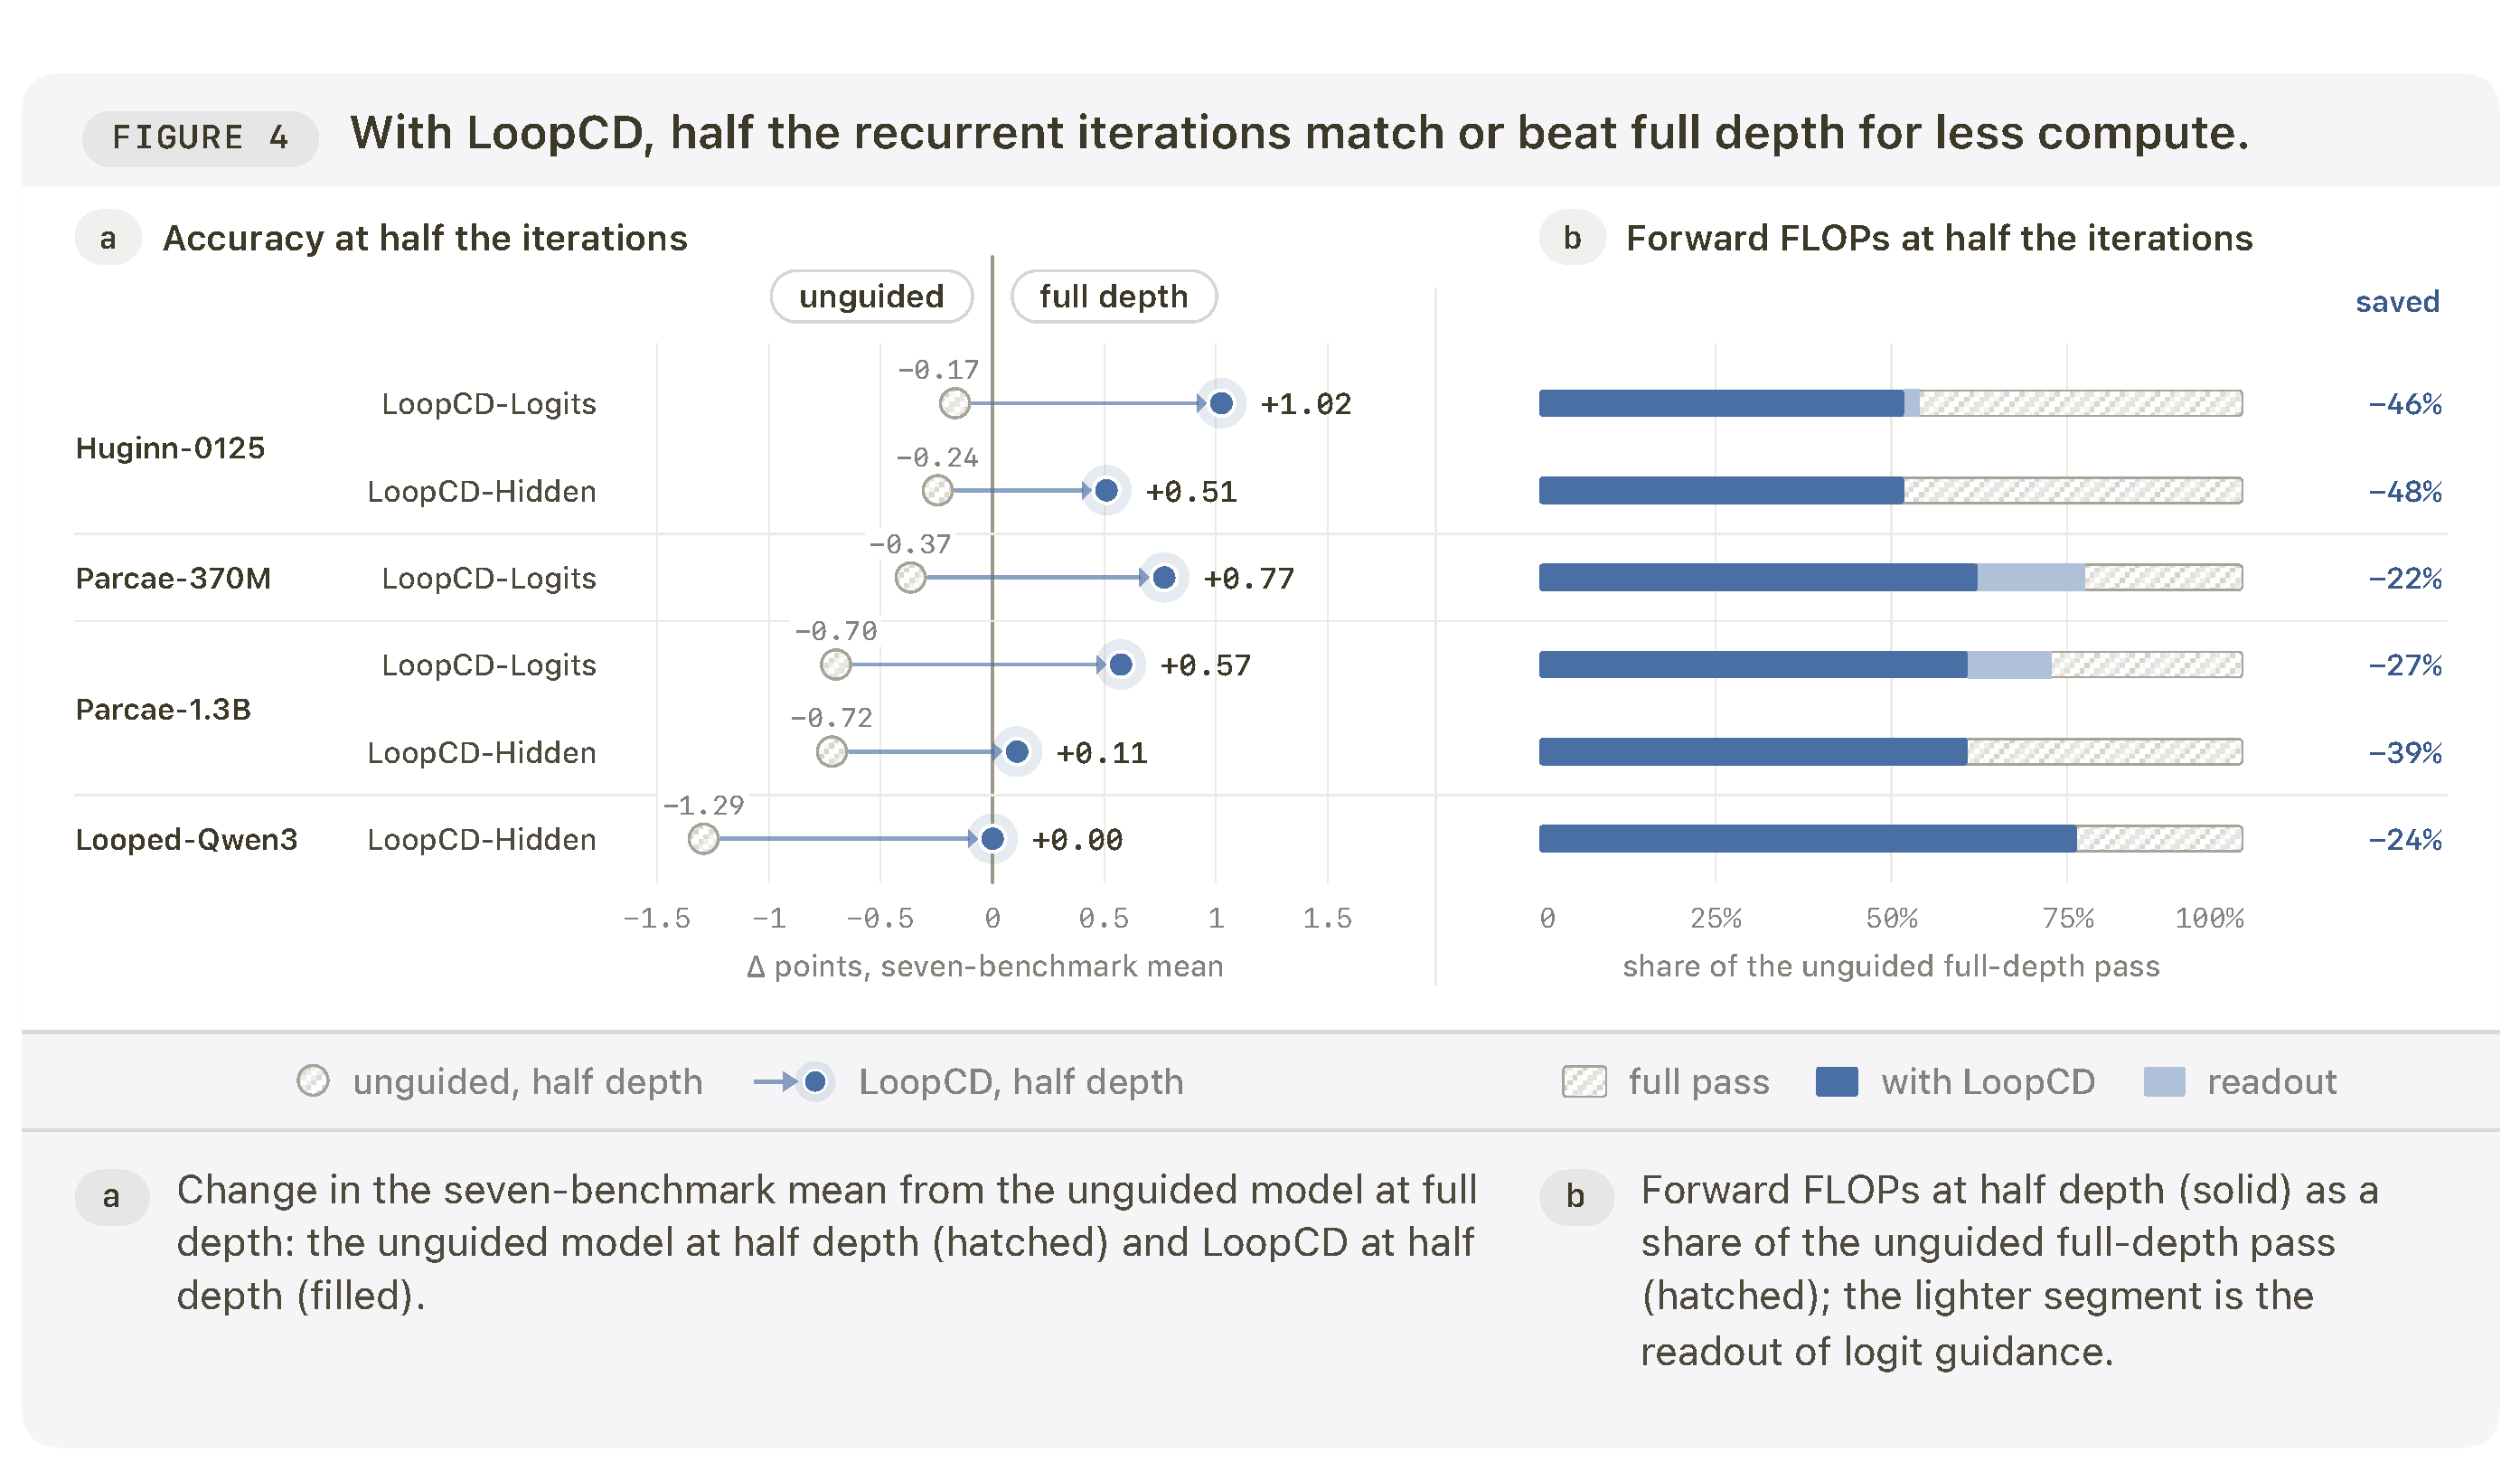
재귀 반복 횟수를 절반으로 줄이면 비유도 모델의 벤치마크 7개 평균이 0.17~1.29점 하락한다. 유도는 평가한 6개 설정 모두에서 이 손실을 회복한다. 전체 깊이의 비유도 베이스라인과 비교하면, 절반 깊이의 Huginn은 로짓 유도에서 1.02점, 은닉 상태 유도에서 0.51점 높다. Parcae-370M은 로짓 유도에서 0.77점 높고, Parcae-1.3B는 로짓 유도에서 0.57점, 은닉 상태 유도에서 0.11점 높다. Looped-Qwen3는 은닉 상태 유도에서 베이스라인과 같은 성능을 낸다.
- 유도에 드는 추가 비용을 포함한 순전파 연산량 절감률은 각각 46.0%, 48.2%, 22.5%, 27.3%, 39.2%, 23.6%다.
- 깊이를 줄인 실험의 근거는 객관식 평가에만 해당한다. 수학 추론이나 코드 생성 정확도를 유지하면서 같은 수준의 연산량을 절감할 수 있음을 입증하지는 않는다.
- 깊이를 줄인 설정에서는 참조 상태와 강도를 별도로 선택한다. Huginn의 축소 깊이 로짓 실험은 전체 깊이에서 사용하는 h_1 대신 h_5를 참조로 사용한다.
깊이를 절반으로 줄인 유도 결과 6개 모두 전체 깊이 베이스라인의 평균과 같거나 높다. 연산량 패널에는 로짓 유도에 필요한 추가 출력 연산도 포함된다. 은닉 상태 유도를 적용한 Huginn의 절감 폭이 가장 크며, Looped-Qwen3는 고정 계층이 많아 절감 폭이 제한된다.
5 How and Why LoopCD Works
작동 원리 분석은 재귀 반복이 유용한 약한 예측과 강한 예측을 제공하는지, 대조 연산의 어느 성분이 결정을 바꾸는지, 유도 강도가 안정성에 어떤 영향을 주는지 살펴본다. 참조 깊이를 바꾼 실험, 예측 분포 비교, 로짓 갱신의 기하학적 분해, 예측 확신도별 정확도 변화를 근거로 사용한다.
5.1 Built-in Weak and Strong Predictions Across Recurrence
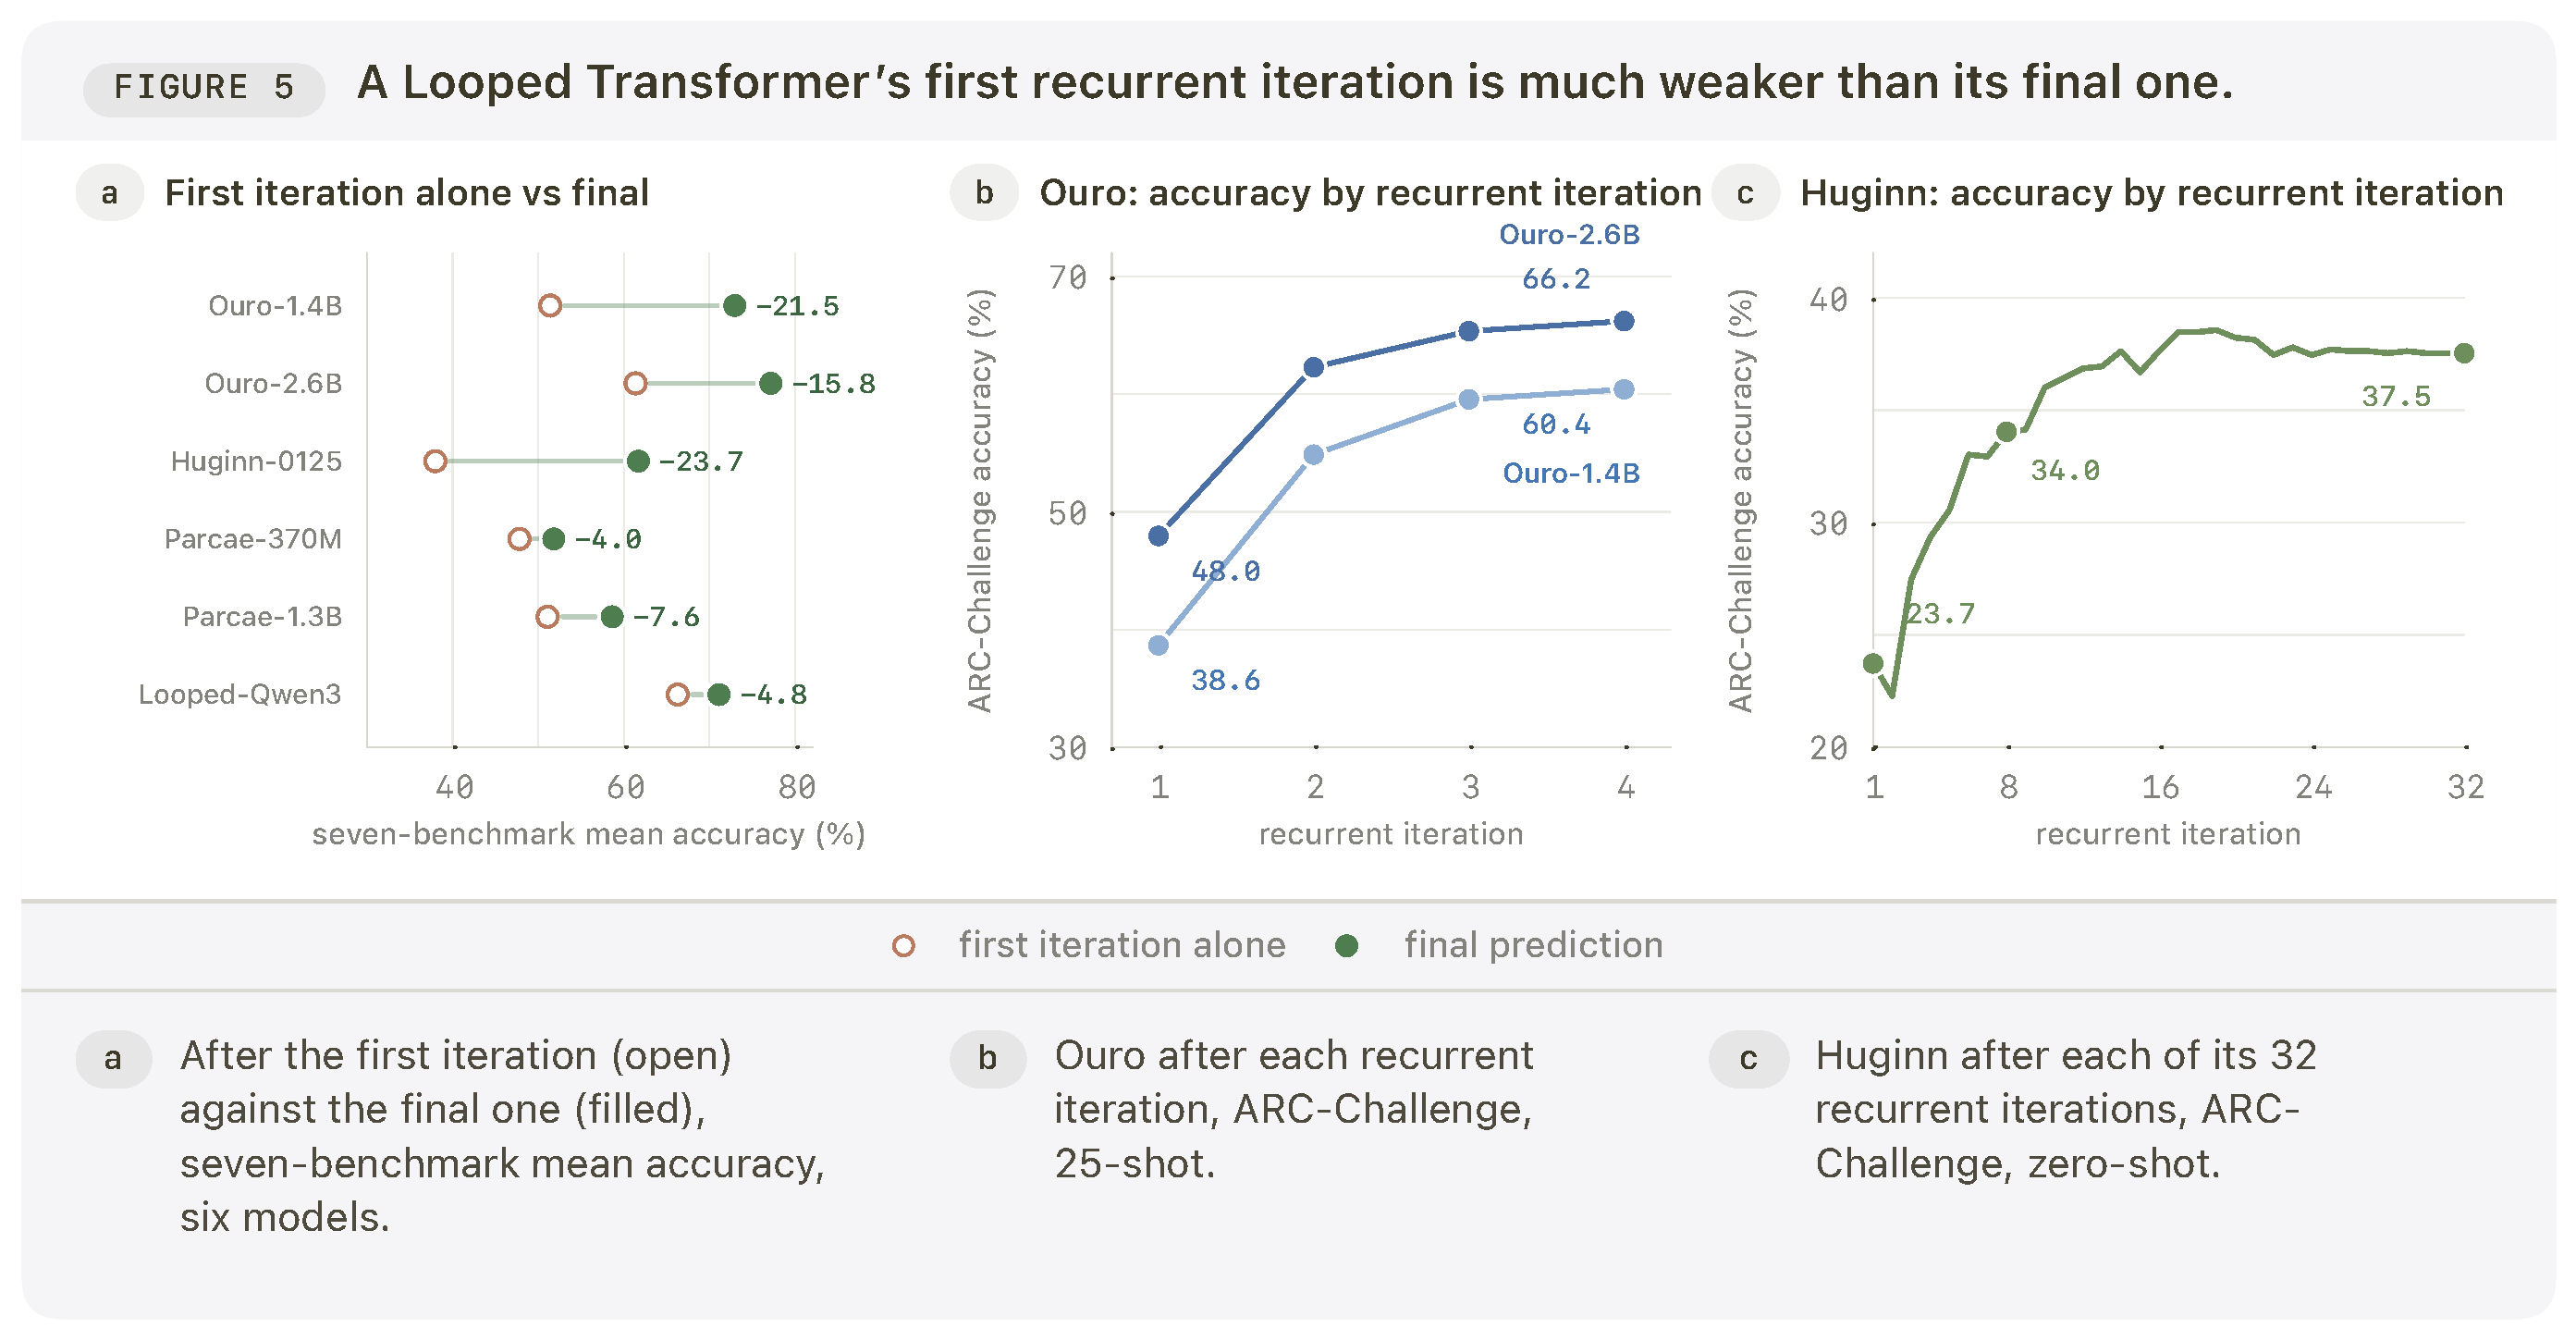
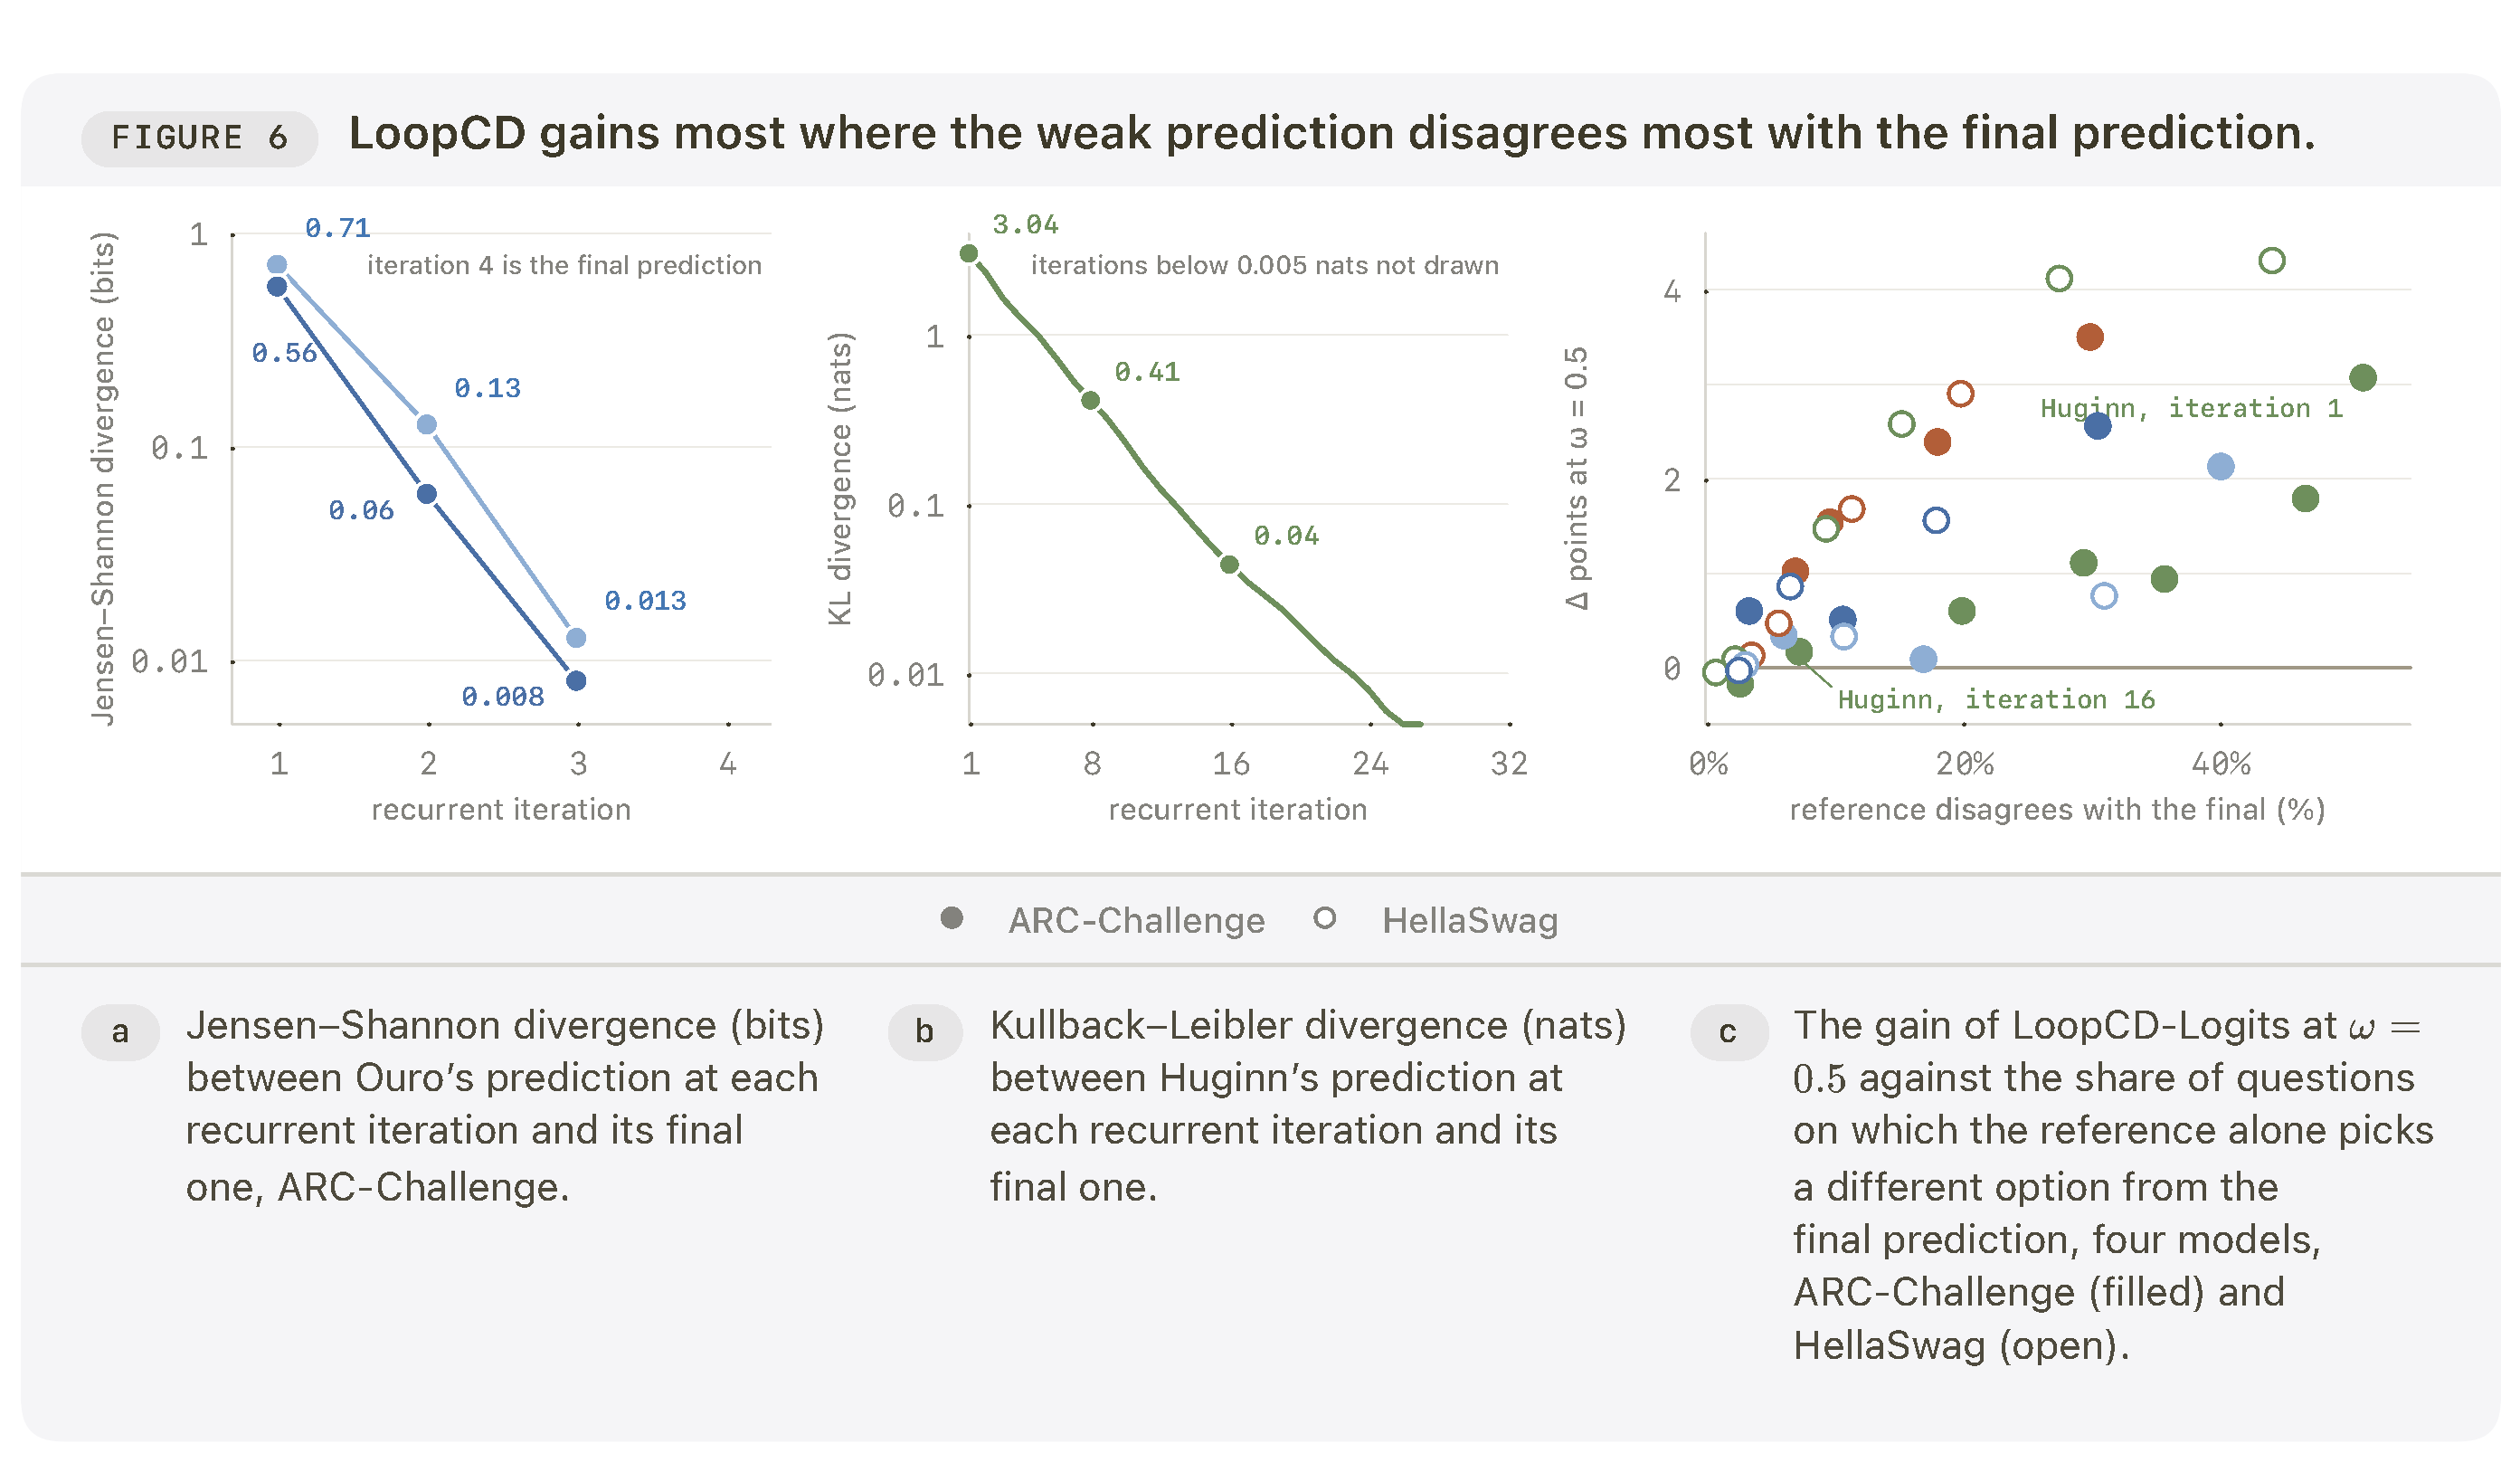
첫 재귀 예측만 사용하면 벤치마크 묶음의 평균이 최종 예측보다 4.0~23.7점 낮다. 이후 예측은 대체로 최종 분포에 수렴하므로 유도에 활용할 수 있는 차이가 줄어든다. ARC-Challenge에서 Huginn의 첫 참조는 문항의 51.3%에서 최종 선택과 다르며, ω = 0.5에서 3.07점의 향상을 만든다. 열여섯 번째 참조는 7.3%에서 최종 선택과 다르며, 향상 폭은 0.17점이다.
- 분포 차이를 대칭적으로 측정하는 Jensen–Shannon divergence는 Ouro-1.4B의 첫 통과 후 0.71 bits에서 세 번째 통과 후 0.013 bits로 줄어든다. 분포 차이를 방향에 따라 측정하는 Huginn의 Kullback–Leibler divergence는 첫 반복 후 3.04 nats에서 열여섯 번째 반복 후 약 0.04 nats로 줄어든다. bits는 이진 로그를, nats는 자연로그를 사용한다.
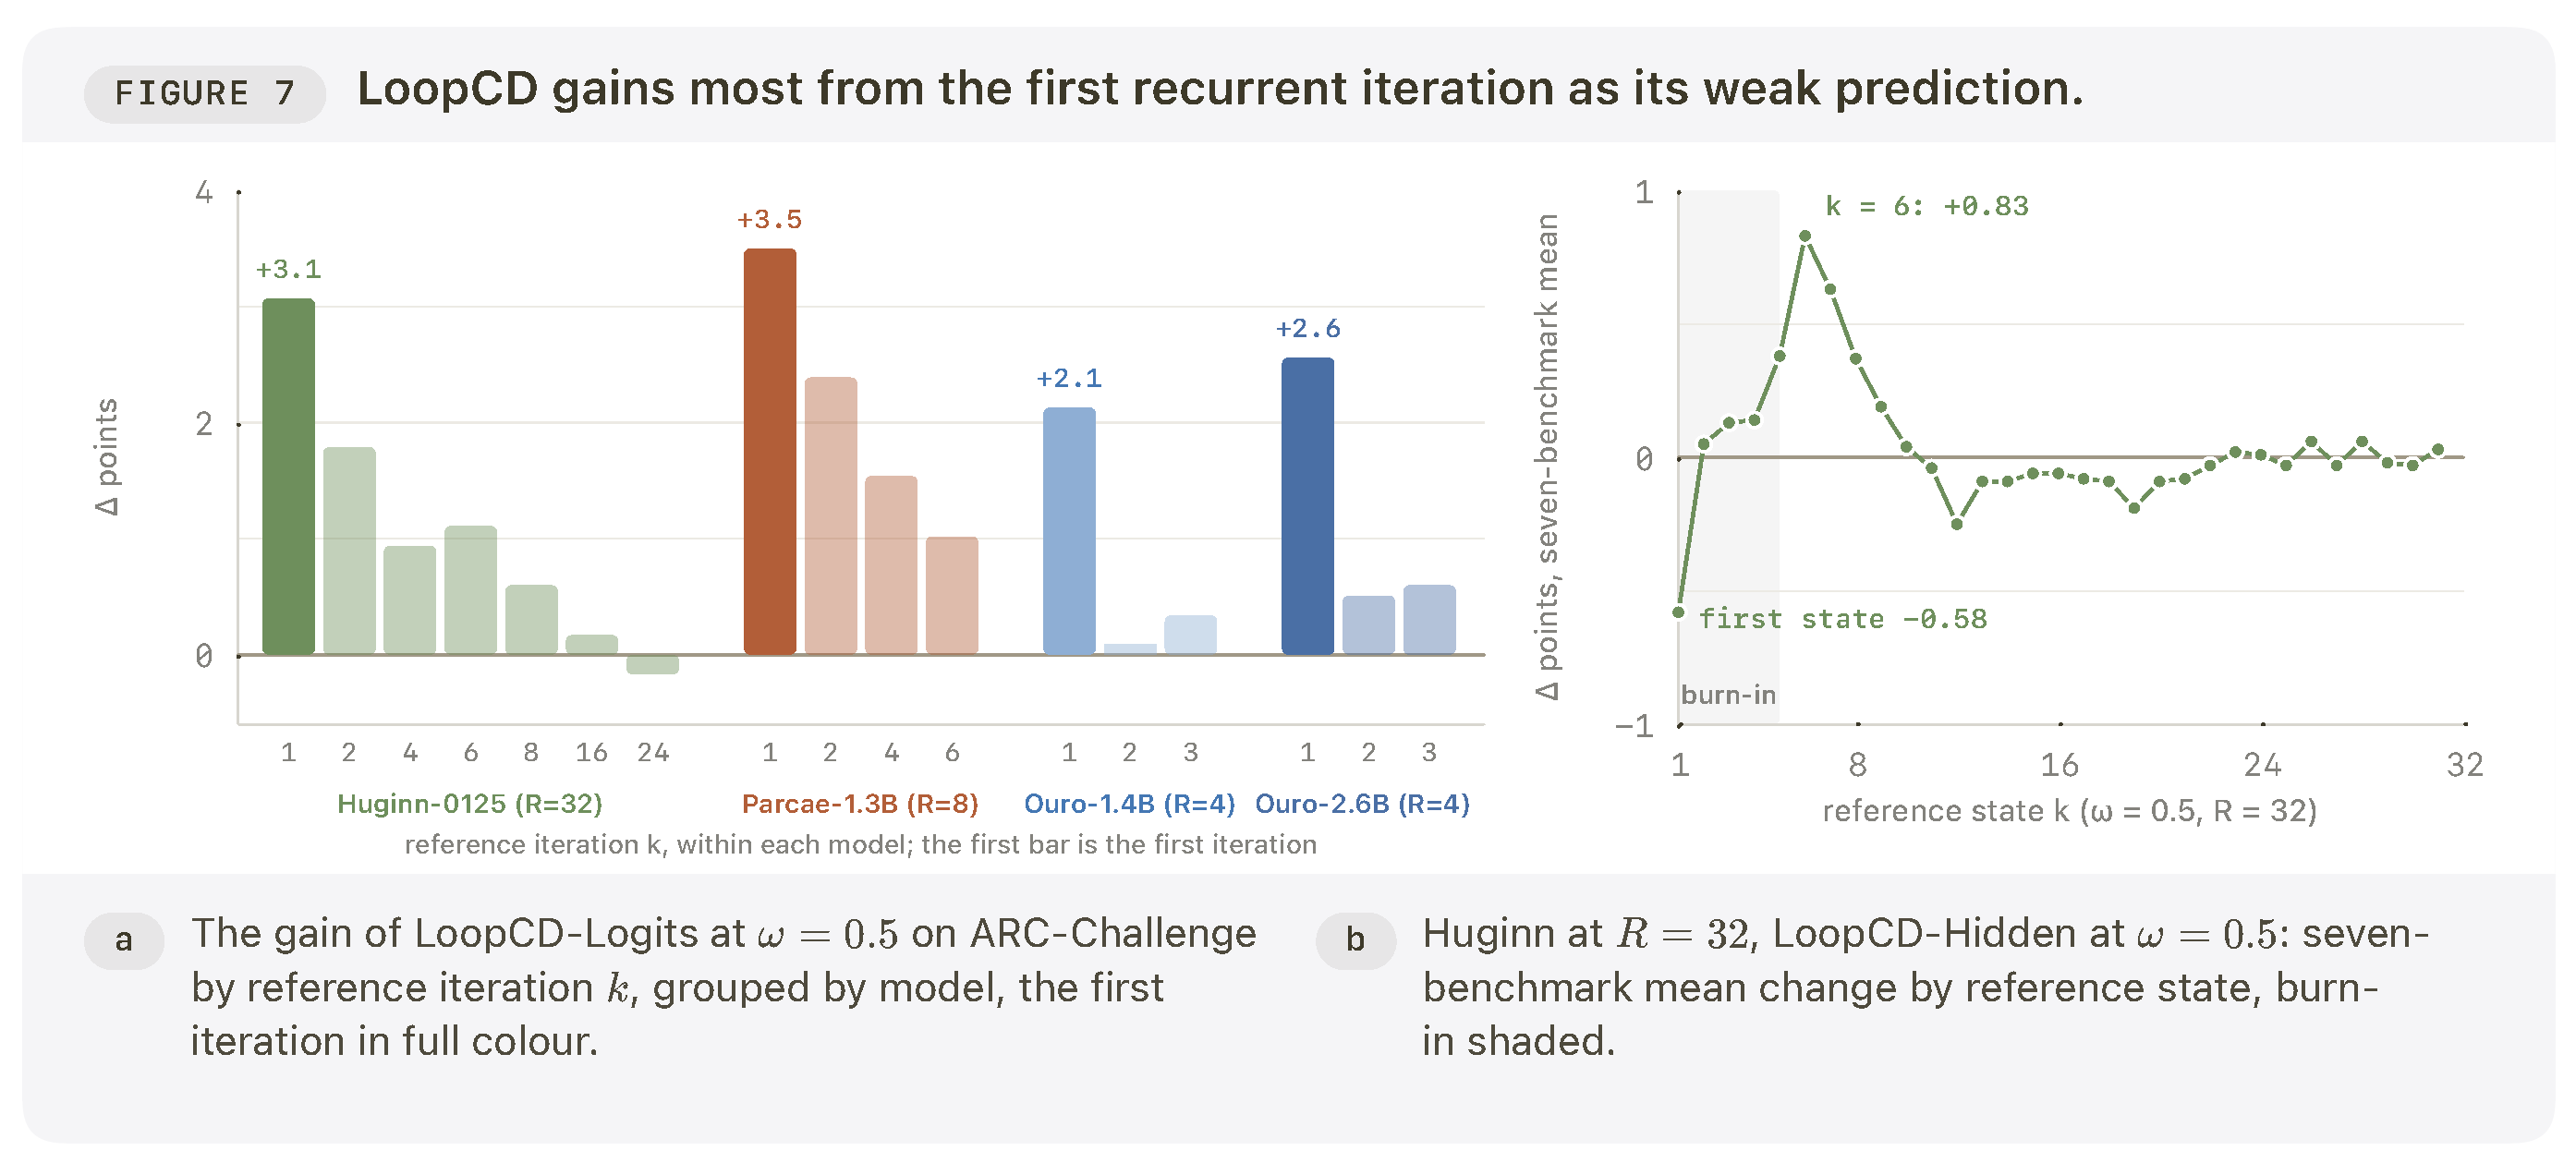
- 보고된 ARC-Challenge 참조 탐색에서는 첫 반복을 완료한 상태가 로짓 유도에서 가장 큰 향상을 만든다. Huginn의 은닉 상태 참조에는 초기화 잡음을 제거하는 초기 반복인 burn-in이 필요하다. R = 32, ω = 0.5에서 h_1은 평가 묶음의 평균을 0.58점 낮추지만, h_6은 0.83점 높인다.
첫 반복의 예측은 평가 묶음의 평균에서 더 약하며, LoopCD는 이 참조와 최종 예측의 성능 차이를 활용한다. 반복 곡선은 깊이가 커질수록 추가 이득이 줄어드는 양상도 보여준다. 다만 Huginn의 곡선은 반복마다 상승하지 않고 변동한다.
재귀 반복이 최종 예측에 가까워질수록 분포 차이가 줄어들며, 답변 불일치가 큰 참조는 대체로 더 큰 유도 향상을 만든다. 산점도는 불일치와 향상 폭 사이의 경험적 연관성을 뒷받침하며, 보편적인 스케일링 법칙을 입증하지는 않는다.
ARC-Challenge의 로짓 탐색에서는 첫 반복을 완료한 상태가 유리하지만, 은닉 상태 탐색에서는 Huginn의 초기화 예외가 드러난다. 가장 이른 은닉 상태 참조는 벤치마크 7개의 평균을 낮추는 반면, 더 나중의 참조는 평균을 높인다. 이는 참조를 선택할 때 유도 공간을 고려해야 함을 보여준다.
5.2 Re-ranking Close Decisions Under Uncertainty
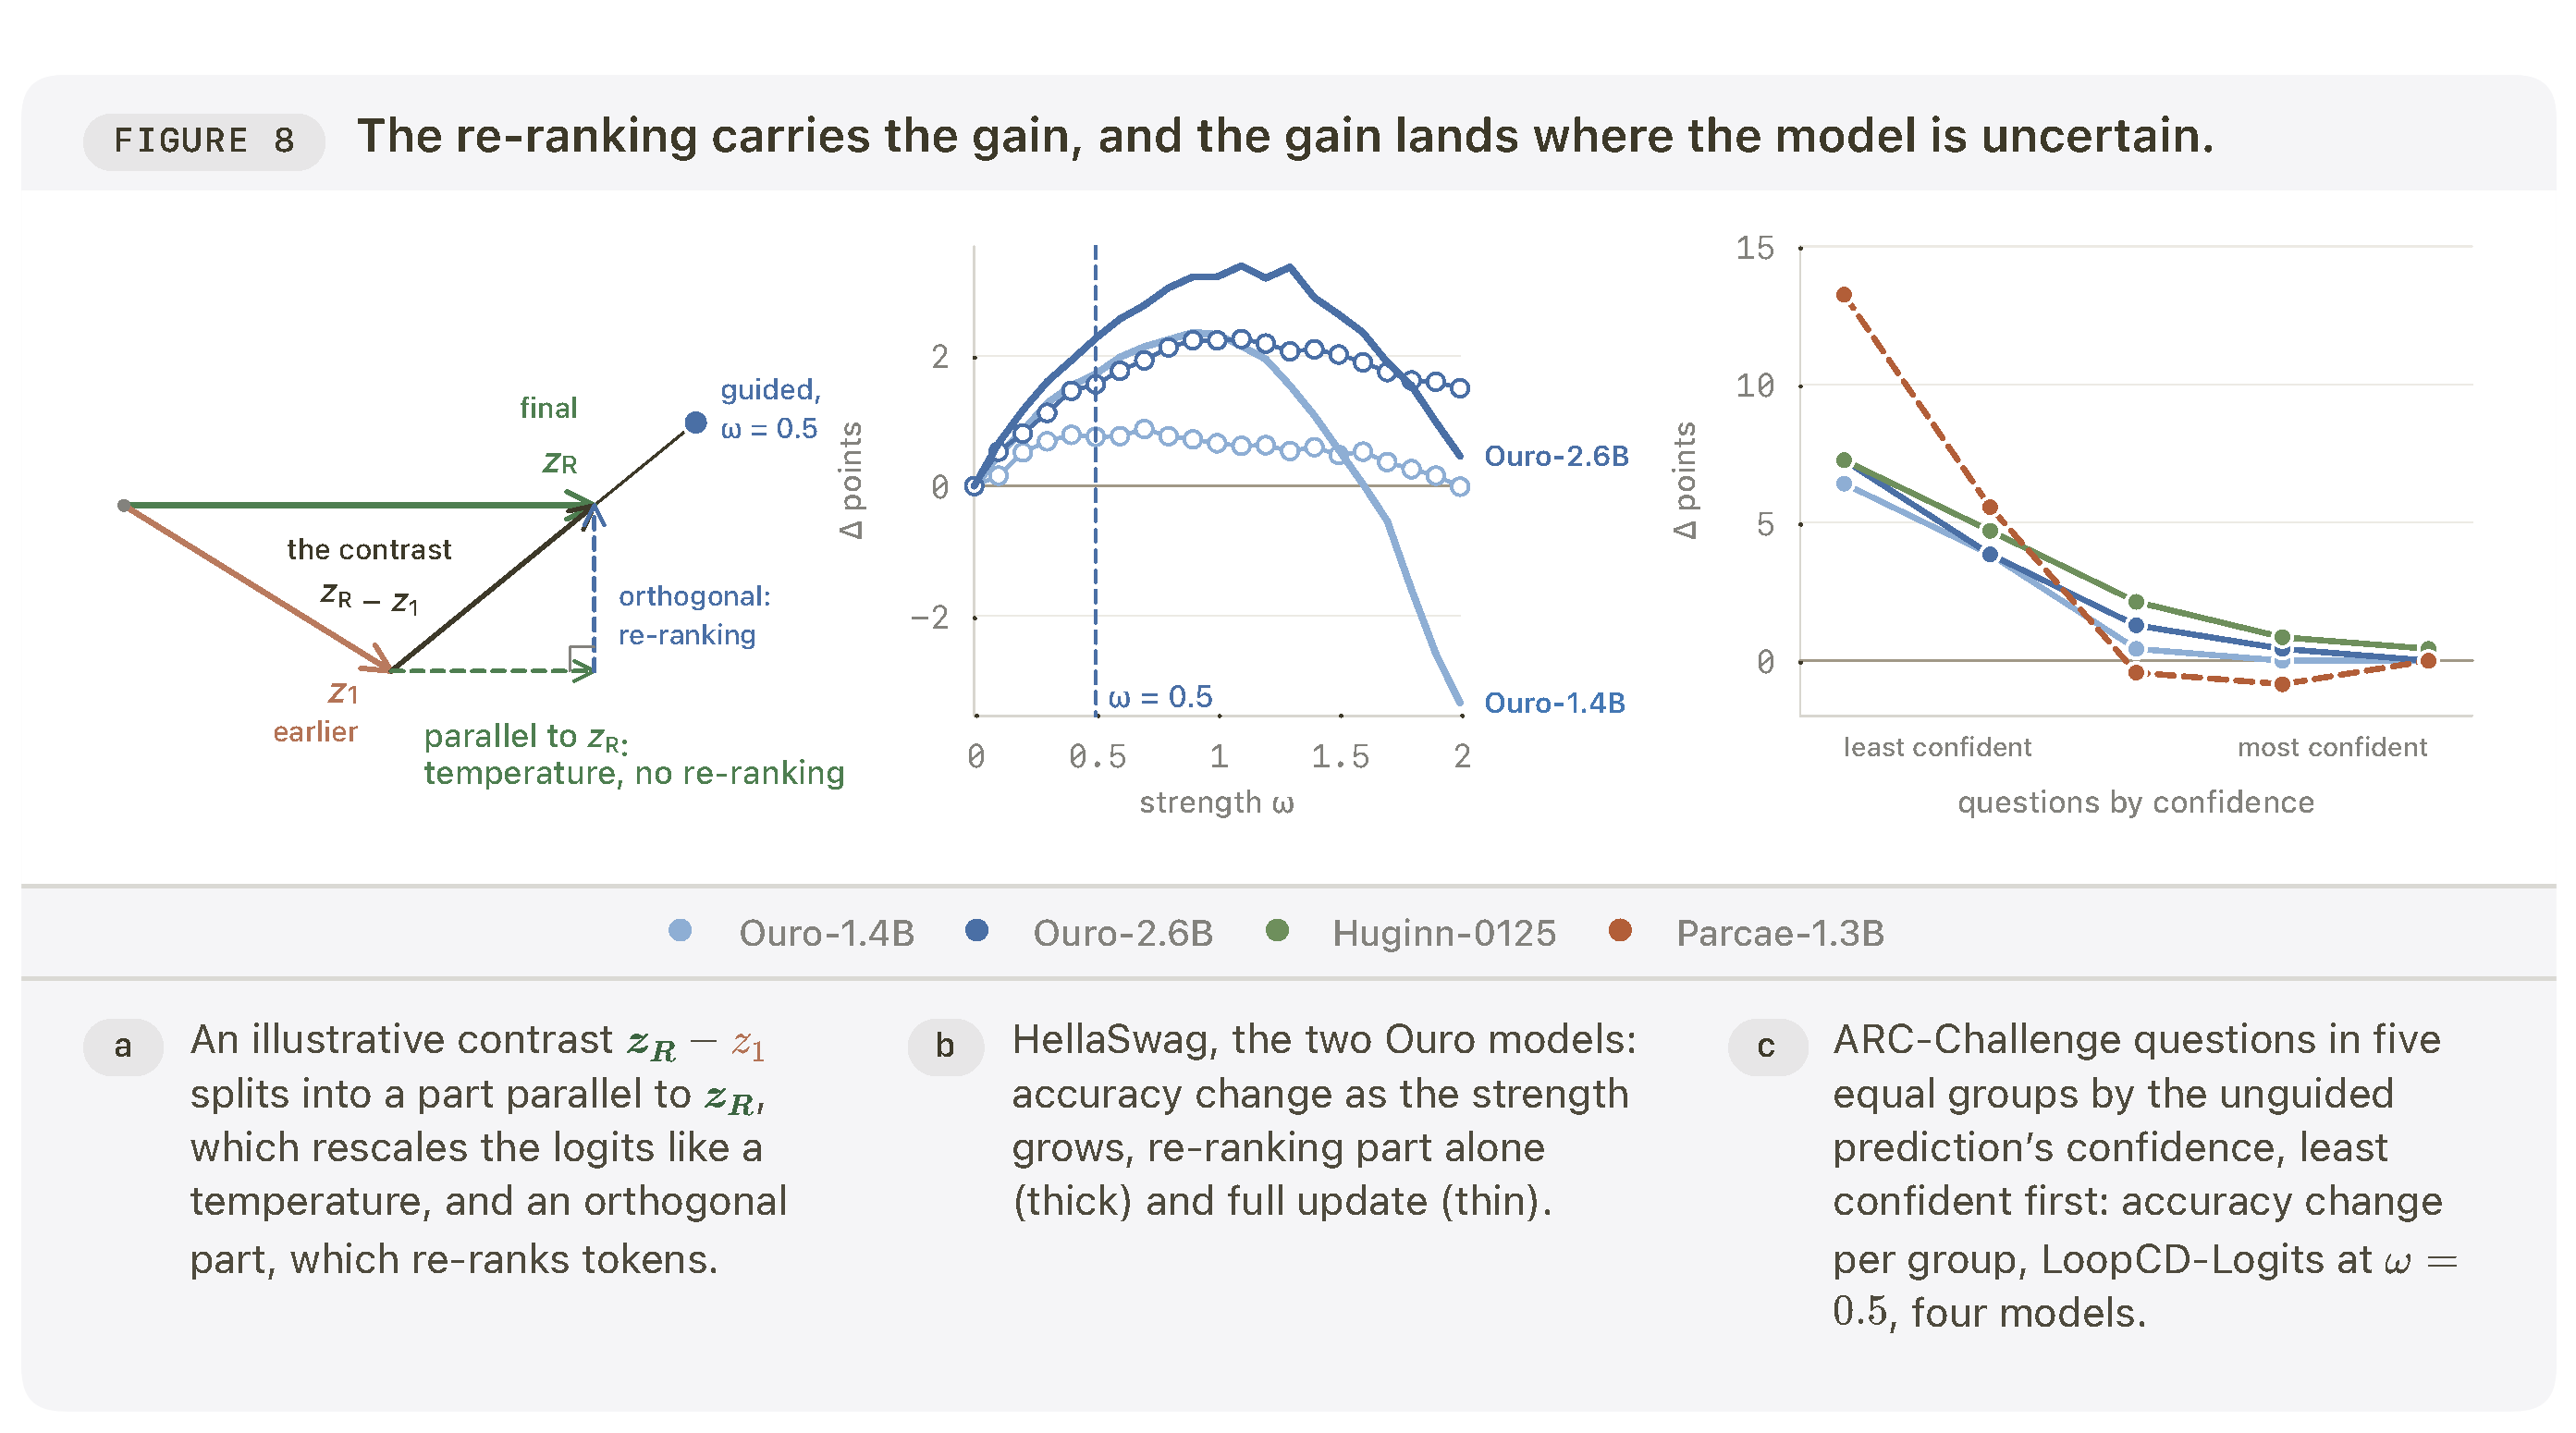
로짓 차이는 최종 로짓 벡터와 나란한 평행 성분과 그에 수직인 직교 성분으로 나뉜다. 평행 성분은 온도 조정처럼 점수의 크기를 바꾸고, 직교 성분은 토큰 순위를 바꿀 수 있다. HellaSwag에서 ω = 0.5일 때 순위 성분만 사용하면 Ouro-1.4B는 1.72점, Ouro-2.6B는 2.27점 향상된다. 전체 갱신의 향상 폭은 각각 0.76점과 1.56점이다. 이는 해당 실험에서 순위 변화가 성능 향상의 원인임을 뒷받침한다.
- ARC-Challenge에서 모델 4개의 확신도가 가장 낮은 오분위 문항은 약 6.4~13.3점 향상되지만, 확신도가 가장 높은 오분위 문항은 최대 약 0.4점 향상된다.
- ω = 0.5에서 바뀌는 ARC-Challenge 답변은 5.8%~14.9%에 불과하다. 새로 생긴 오류보다 수정된 답변이 많아 순향상 폭은 2.1~3.5점이다.
- 이 결과는 확률 마진에 따라 강도를 조절하는 방식의 근거가 되지만, 불확실한 모든 예측이 유도로 개선됨을 입증하지는 않는다.
분해 결과는 점수 크기 조정과 순위 변화를 구분한다. HellaSwag의 성분별 비교 실험에서는 순위 변화만으로 전체 갱신보다 더 좋은 성능을 낼 수 있다. 확신도 그룹 패널에서는 ARC-Challenge 향상의 대부분이 판단이 근소하게 갈리는 문항에 집중되며, 이는 적응형 강도의 근거가 된다.
5.3 Tuning Guidance Strength Across Scoring and Generation
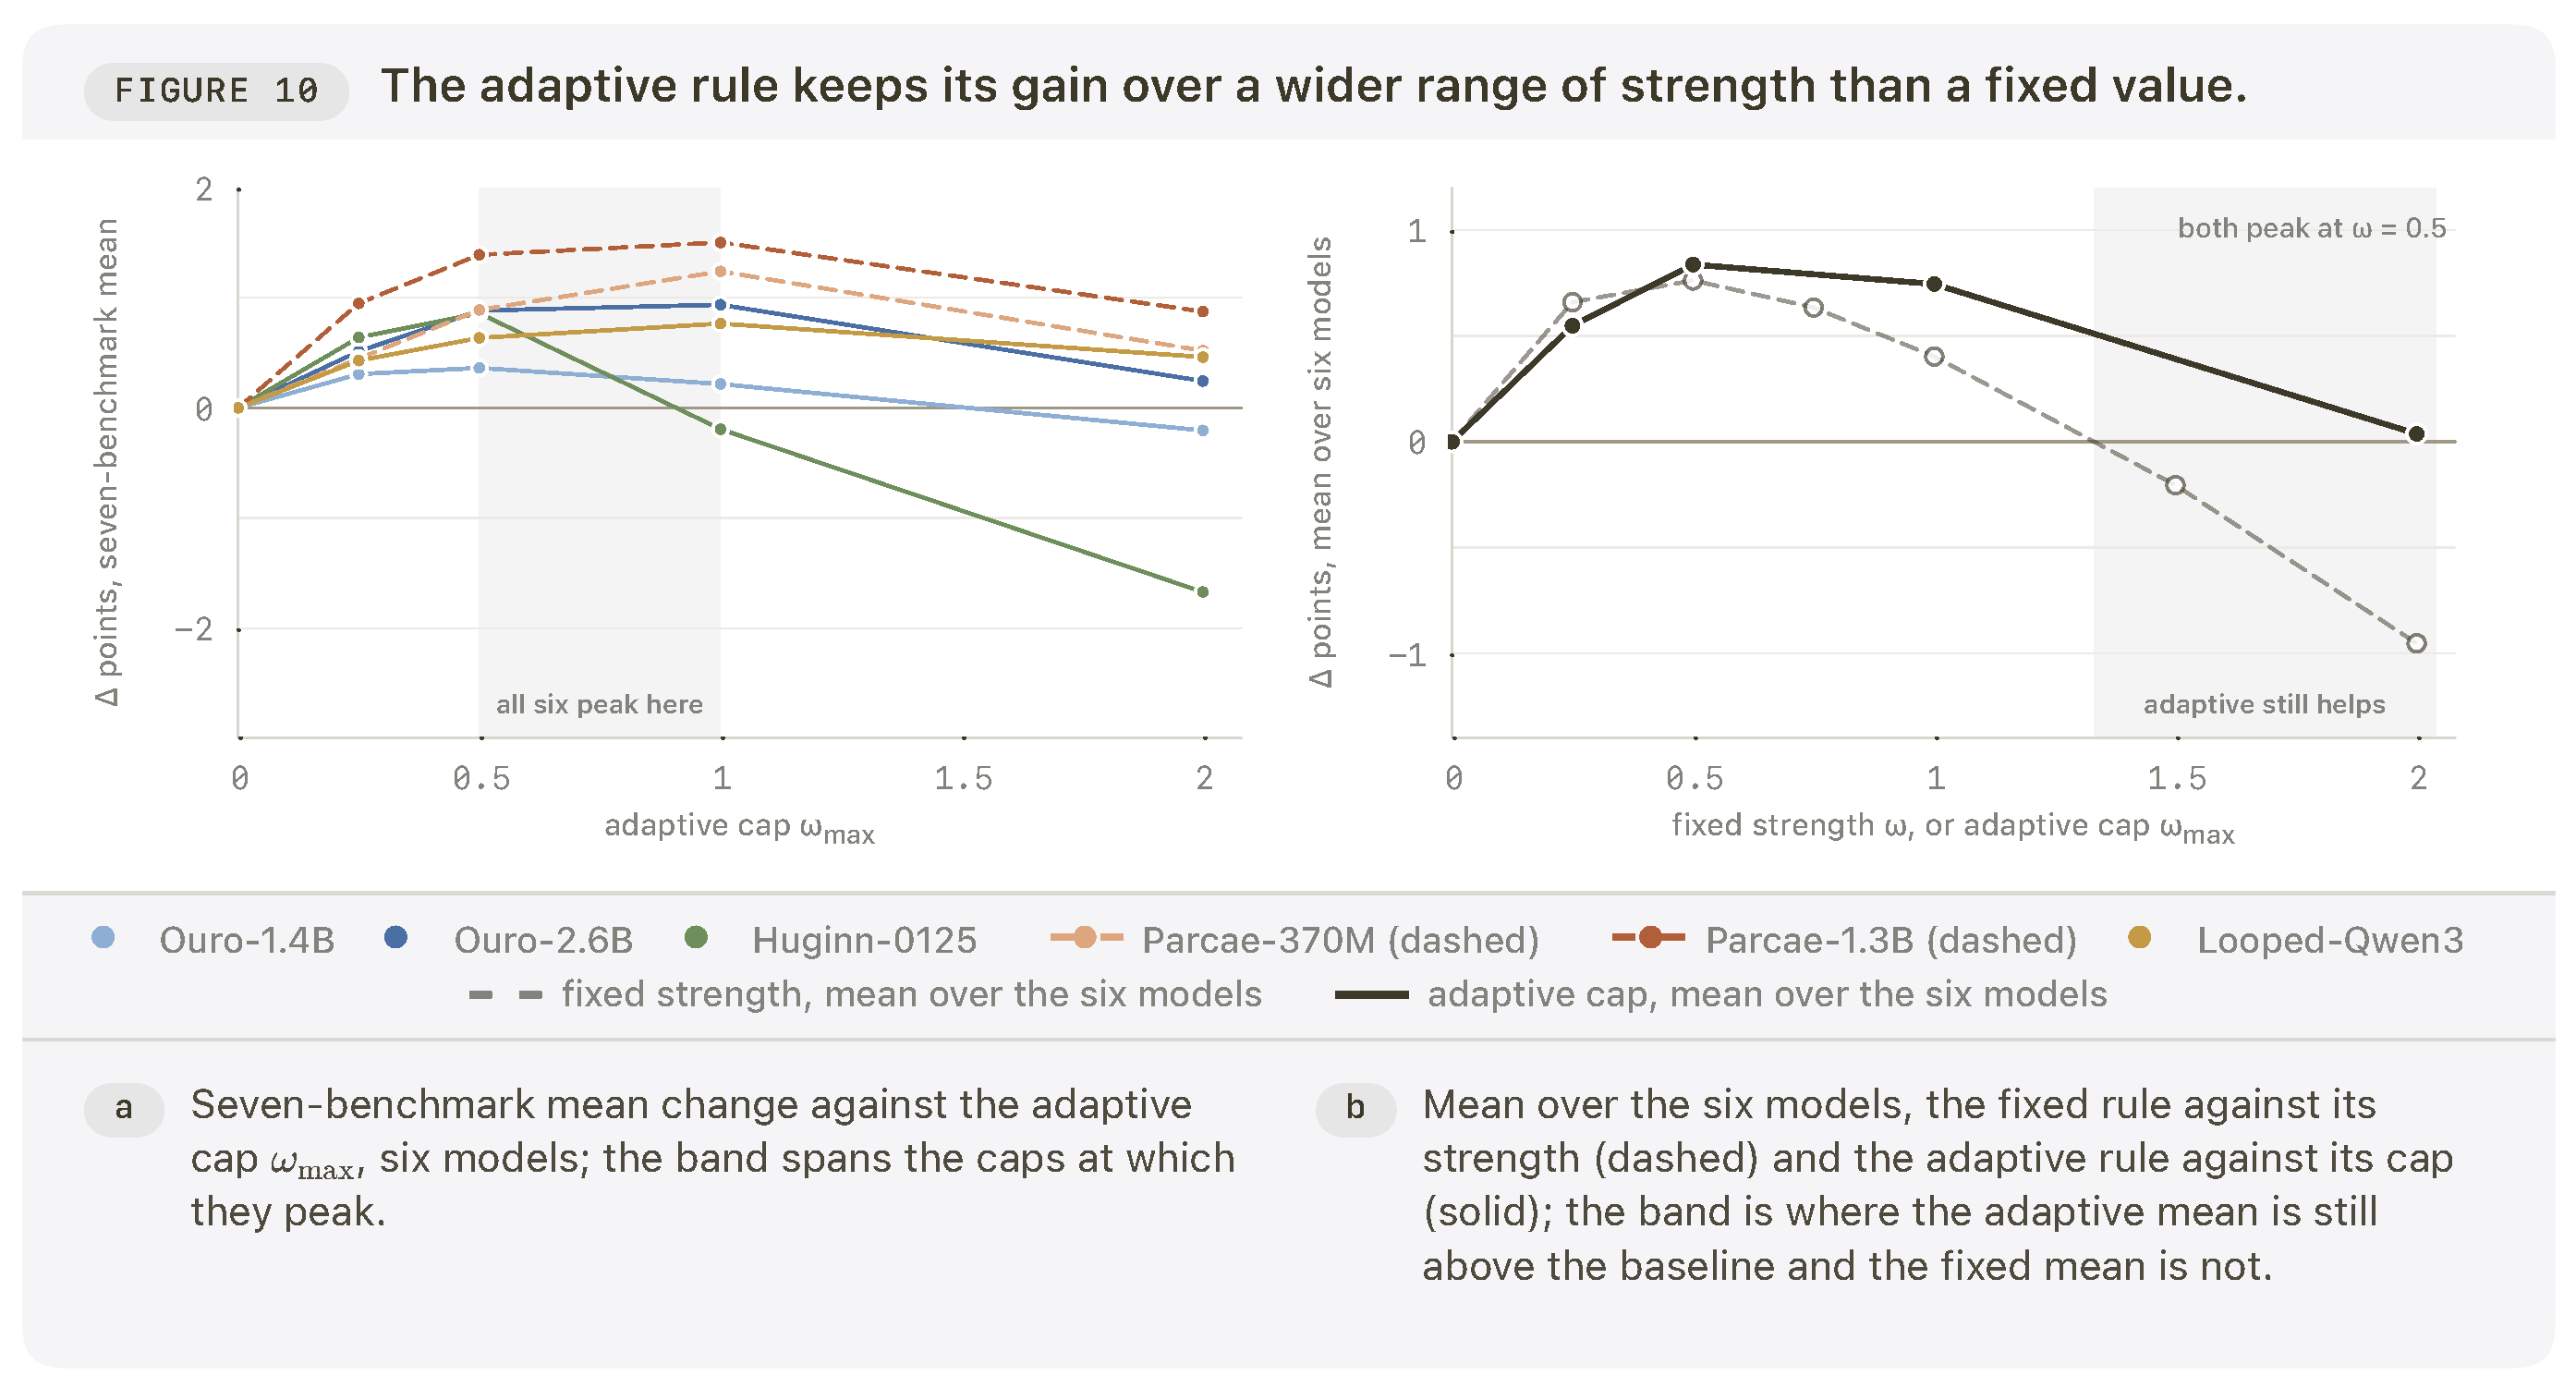
객관식 채점에서는 비교적 넓은 유도 강도 범위를 사용할 수 있으며, ω = 0.5 부근의 고정값이 공통 설정으로 유용하다. 생성한 접두부를 바탕으로 다음 토큰을 반복 예측하는 자기회귀 생성에서는 보통 [0.2, 0.3]의 더 작은 고정값을 사용한다. 초기 변화가 이후 토큰에 누적될 수 있기 때문이다. 보고된 생성 강도 탐색에서는 약 ω = 0.6을 넘으면 성능이 급격히 하락한다.
- 적응형 유도는 비유도 예측의 상위 확률 2개 사이의 마진이 클 때 갱신을 줄여, 더 넓은 계수 범위에서 양의 평균 향상 폭을 유지한다. 객관식 채점에서 주로 검토한 최대 강도 범위는 [0.5, 1.0]이다.
- 음의 계수는 예측을 약한 참조 쪽으로 이동시키며, 보고된 객관식 평균을 낮춘다. 양의 유도도 조정이 필요하다. 계수가 커지면 더 많은 답변이 바뀌지만, 앞서 유익했던 수정이 다시 뒤집힐 수 있다.
강도 탐색은 객관식 채점에 적합한 계수가 순차 생성에는 지나치게 클 수 있음을 보여준다. 생성 패널에서 성능이 급격히 하락하는 구간은 이 방법에 학습이 필요하지 않더라도 실제 사용에는 강도 조정이 필요함을 보여준다.
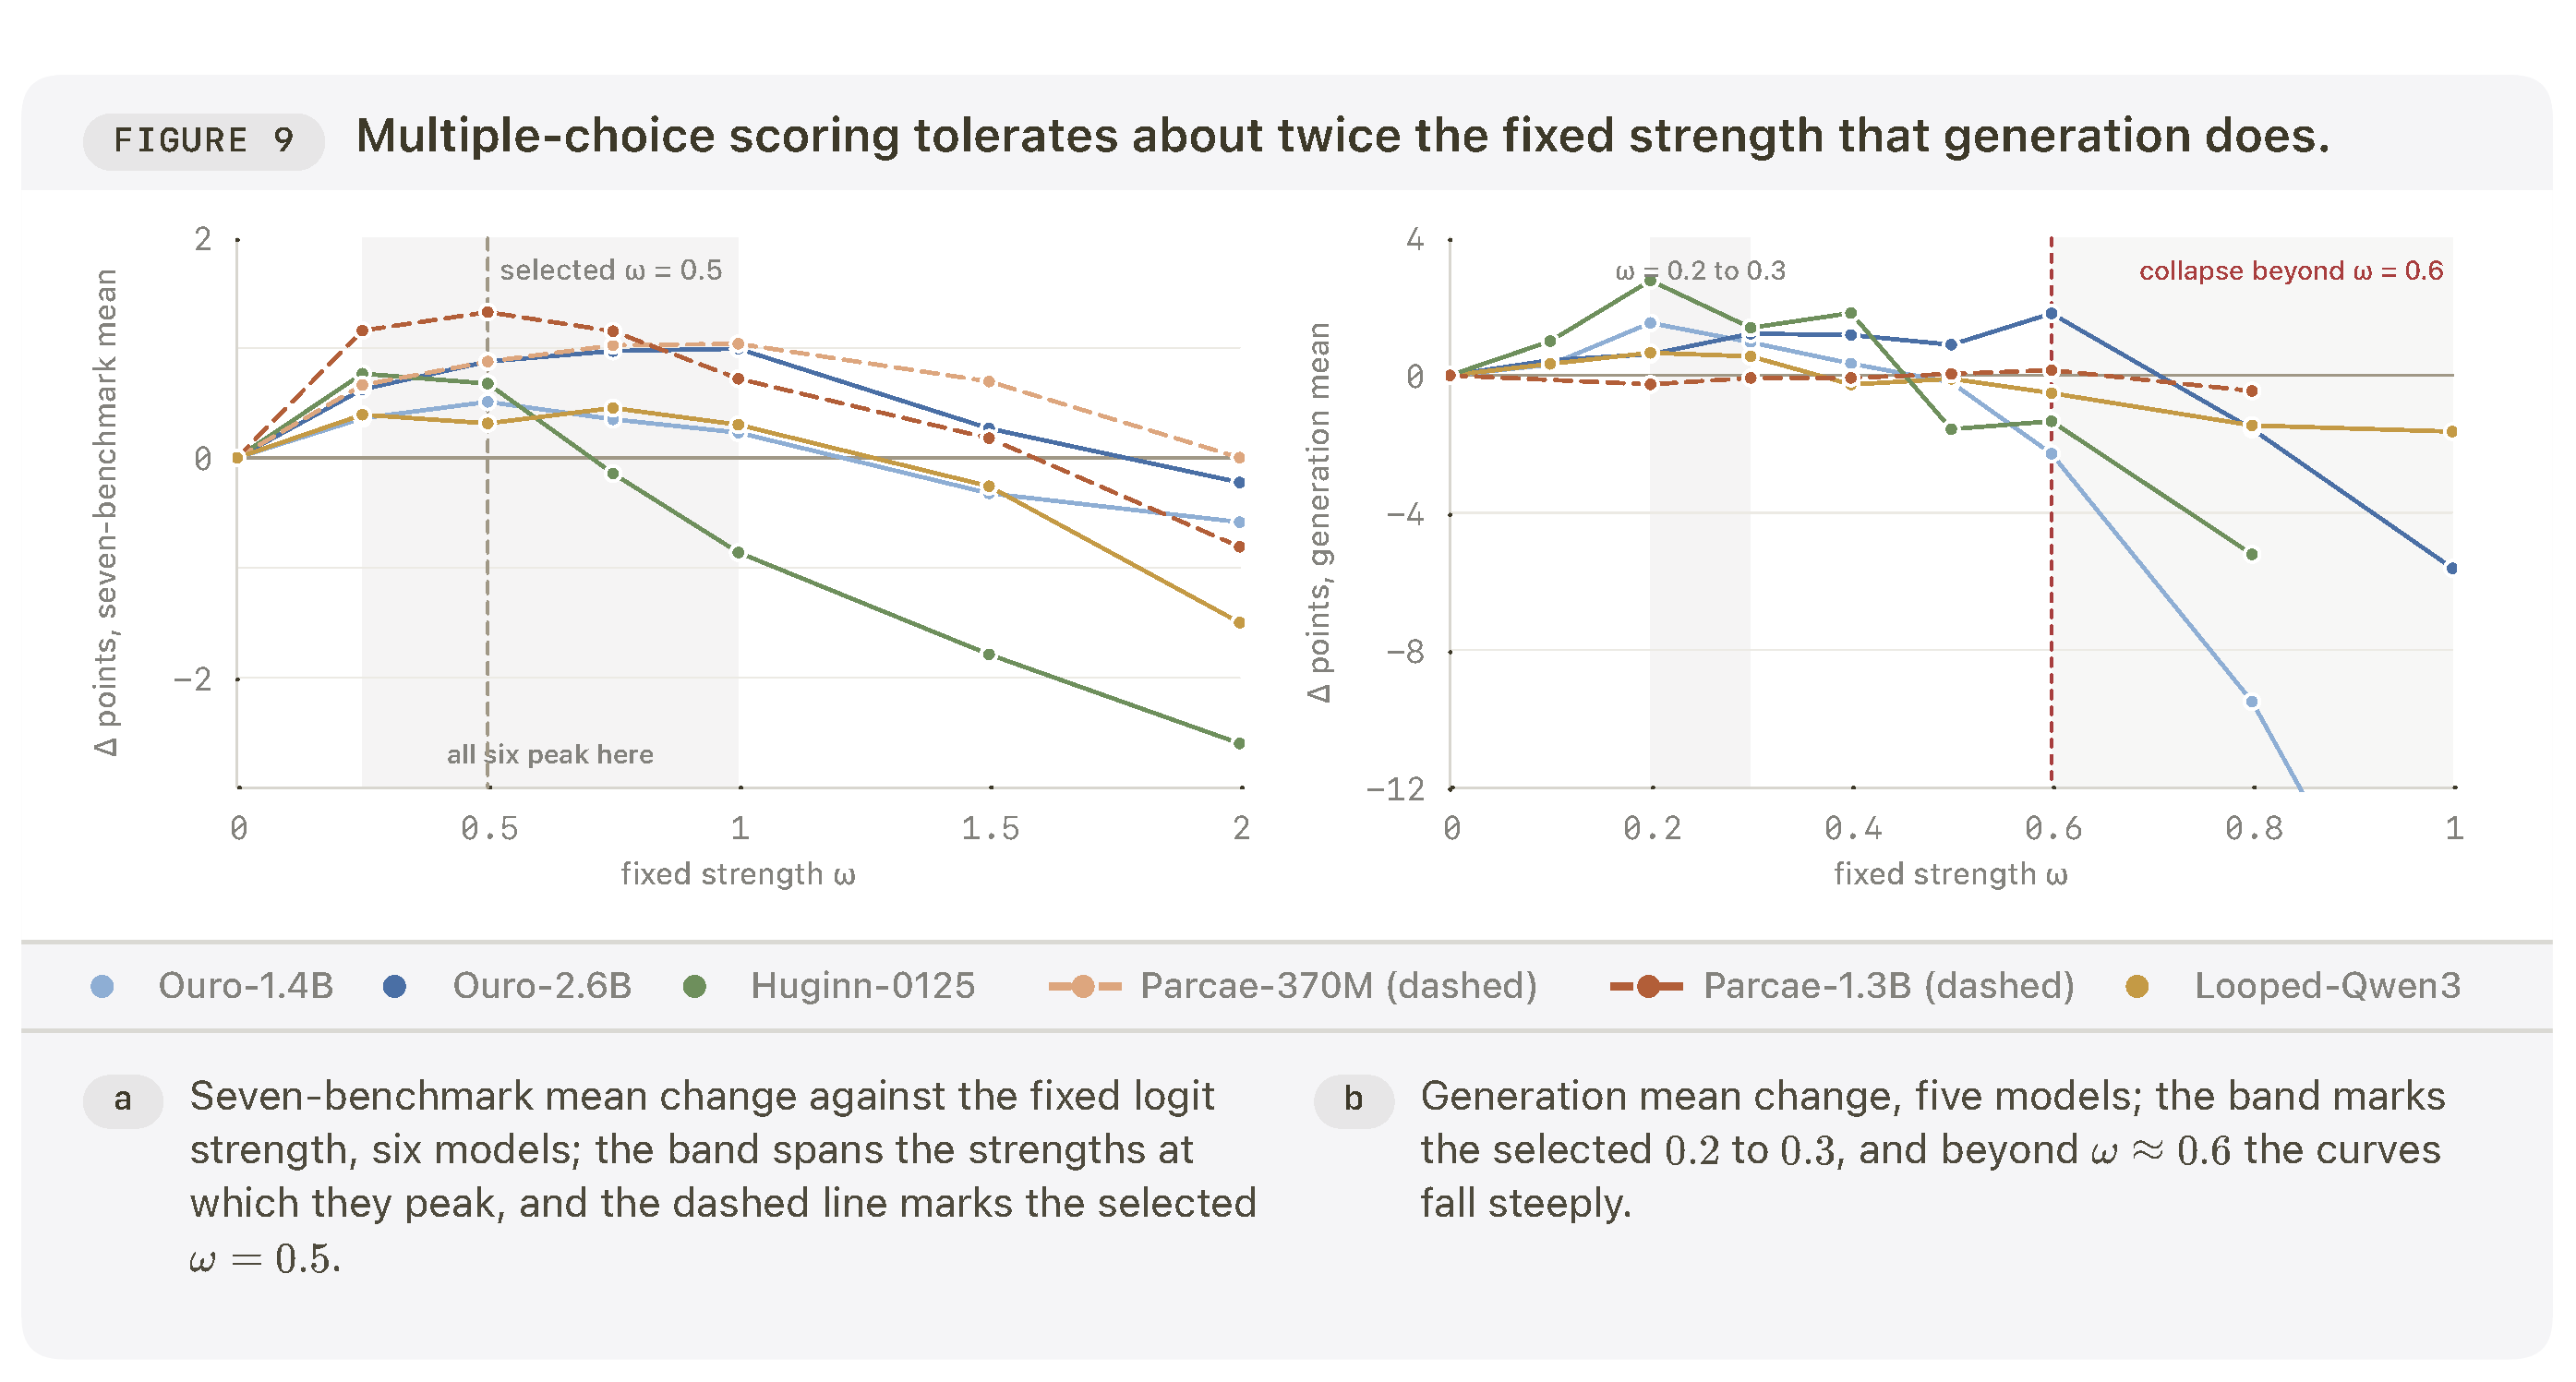
적응형 강도는 고정 유도가 성능을 낮추는 더 큰 계수 설정에서도 평균적인 이득을 유지한다. 개별 곡선은 여전히 모델마다 다르므로, 평균적으로 유용한 범위가 넓어져도 모델별 조정은 필요하다.
6 Conclusion
논문은 완료된 재귀 상태가 추론 시 대조에 재사용할 수 있는 예측 쌍을 제공한다고 정리한다. 주요 고정 깊이 비교에서는 평가 묶음의 평균이 향상되며, 절반 깊이의 6개 설정에서는 객관식 평균이 유지되거나 향상된다. 유용한 중간 예측을 명시적으로 학습하면 이 접근법을 강화할 수 있다는 제안은 연구 가설로 남아 있다.
부록
- A Looped Transformers and LoopCD의 A.1 States and coda layers는 완료된 반복에서 참조를 가져오고 모델의 기존 출력 인터페이스를 사용한다고 명시한다. A.2 Model architectures는 Ouro의 전체 스택 반복, prelude를 조건으로 사용하는 Huginn의 잡음 초기화 상태, Parcae의 학습된 재귀 갱신과 coda 이전 투영, Looped-Qwen3의 감쇠가 적용된 고정 계층 구간을 설명한다. Ouro-1.4B와 Ouro-2.6B는 각각 24개, 48개 계층을 4회 반복한다. Huginn은 R = 16 또는 R = 32에서 4개 계층으로 된 블록을 사용한다. Parcae-370M과 Parcae-1.3B는 각각 4개, 8개 계층을 8회 반복한다. Looped-Qwen3는 prelude 15개 계층과 coda 17개 계층 사이의 4개 계층에 8개 하위 단계를 적용한다. A.3 The probability form of LoopCD-Logits는 p′(v) ∝ p_s(v)(p_s(v)/p_w(v))^ω를 제시한다. v는 어휘 토큰이며, p_s와 p_w는 최종 및 이전 토큰 확률이다. 이 등식은 평가별 온도 조정이나 확률 절단을 적용하기 전에 성립한다. 비선형 coda 계층 때문에 LoopCD-Hidden으로 직접 확장할 수는 없다.
- B Detailed Experimental Setup의 B.1 Model configurations and paired comparisons는 은닉 상태 실험 전용 베이스라인을 포함해 체크포인트와 평가 조건을 맞춘 설정을 기록한다. B.2 Benchmarks and table conventions는 동일 가중치를 적용한 %포인트 변화를 정의한다. 각 AIME 시험은 30문항으로 구성되고, OlympiadBench는 영어 수학 하위 집합 674문항을 사용한다. pass@1과 pass@10은 문제마다 샘플링한 풀이 16개로 추정한다. B.3 Prompts and sampling은 수학 샘플링과 코드 생성에 풀이 예시를 제공하지 않는 0-shot 평가를 사용한다고 명시한다. 생성 답변으로 평가하는 다분야 언어 이해 벤치마크 MMLU-Pro는 중간 추론을 포함한 chain-of-thought 예시 5개를 사용한다. 수학 문장제 벤치마크 GSM8K는 기본적으로 예시 3개를, Huginn의 chain-of-thought 형식에서는 8개를 사용한다. B.4 Strengths and reference states는 사전 탐색 실험과 선택한 계수를 기록한다. 표준 로짓 객관식 채점은 ω = 0.5를 사용한다. 답변 및 코드 생성은 Ouro와 Looped-Qwen3에서 0.3을, Huginn에서 0.2를 사용한다. Huginn의 은닉 상태 채점은 ω = 0.5에서 R = 32일 때 h_6, R = 16일 때 h_7을 사용한다. 은닉 상태 코드 생성은 ω = 0.3에서 각각 h_7과 h_6을 사용한다.
- C Extended Results in Full Recurrent Depth의 C.1 GSM8K and MMLU-Pro under LoopCD-Logits는 MMLU-Pro의 10개 행 중 9개, GSM8K의 10개 행 중 6개에서 향상을 보고한다. GSM8K의 변화 폭은 −1.29~+2.04점이다. C.2 Reasoning metrics: pass@1 and pass@10 across sampled trajectories는 주요 추론 결과의 예외를 제시한다. Looped-Qwen3의 평균 pass@1은 고정 유도에서 1.11점, 적응형 유도에서 1.67점 하락하지만, 평균 pass@10은 각각 1.90점과 3.18점 상승한다. AIME 2024에서 고정 유도는 pass@1을 64.79%에서 61.88%로, pass@10을 82.91%에서 86.17%로 바꾼다. 저자들은 이 결과가 샘플링한 풀이들로 정답을 얻을 수 있는 문제의 범위가 넓어진다는 해석과 부합한다고 본다. 다만 집계한 pass@k가 풀이의 다양성을 직접 측정하지는 않는다고 명시한다.
- D Computation and Cost Analysis의 D.1 FLOP accounting은 512토큰 프리필 동안 행렬 곱의 곱셈 누산마다 2 FLOPs의 부동소수점 연산이 필요하다고 가정한다. 전체 깊이 LoopCD-Logits의 비용 배수는 Ouro-2.6B의 1.010×에서 Looped-Qwen3의 1.306×까지이며, LoopCD-Hidden은 반올림하면 1.000×다. D.2 Reduced-depth evaluation: performance recovery and computational tradeoffs는 깊이를 절반으로 줄인 6개 비교와 각각 별도로 선택한 참조 및 강도를 명시한다. Looped-Qwen3는 감쇠 계수 1/8을 유지하면서 여덟 하위 단계 중 넷을 마친 뒤 종료한다. D.3 Representational dynamics: LoopCD-Logits versus LoopCD-Hidden은 coda가 깊을수록 은닉 상태 유도가 약해지는 양상을 설명한다. Parcae-1.3B는 고정 로짓 유도의 평균 향상 폭 중 약 62%를 유지하지만, coda가 얕은 Huginn은 은닉 상태 유도에서도 비슷하거나 더 큰 향상을 보인다. 이 비교는 유도 방식별로 조건을 맞춘 베이스라인과 독립적으로 선택한 설정을 사용하므로, 차이의 원인을 coda 깊이만으로 설명하기는 어렵다.
- E The Reference Iteration의 E.1 Reference selection across iterations는 참조 단독 정확도보다 최종 선택과의 불일치가 유도 향상 폭과 더 밀접하게 연결된다는 결과를 제시한다. Huginn의 초기 은닉 상태 유도가 실패하는 원인은 초기화 잡음으로 설명한다. E.2 Geometric convergence in representation space는 은닉 차원을 표준화한 뒤 표현 벡터 사이의 정규화된 정렬 정도인 코사인 유사도를 측정한다. Ouro는 각 통과 안에서 최종 표현으로부터 멀어졌다가 다시 가까워지기를 반복하고, Looped-Qwen3는 더 점진적으로 변한다. E.3 Intra-iteration dynamics and output convergence는 실험한 내부 계층 참조가 ARC-Challenge 정확도를 Ouro-1.4B에서 최대 20.6점, Ouro-2.6B에서 최대 24.9점 낮춘다고 보고한다. 이는 해당 아키텍처에서 완료된 반복을 참조로 사용하는 방식을 뒷받침한다. 예측 불확실성을 나타내는 Huginn의 다음 토큰 엔트로피 중앙값은 16번째 반복에 이르면 약 2.7 nats에서 안정되지만, 32번째 반복에서도 답변 위치의 67%는 2 nats를 넘는다.
- F Re-ranking Close Decisions의 F.1 Concentration of guidance gains on uncertain decisions는 확신도 그룹별 결과와 ARC-Challenge 사례를 제시한다. 이 사례에서는 최종 예측에서 근소하게 뒤처졌던 정답 “a tornado”가 유도를 통해 “an earthquake”보다 높은 순위로 올라간다. F.2 Geometric equivalence of LoopCD-Hidden and orthogonal re-ranking은 ω = 0.5에서 HellaSwag 10,042문항을 비교한다. Ouro-1.4B의 은닉 상태 답변은 로짓 재순위화만 적용한 답변과 205문항에서 다르고, 전체 로짓 갱신과는 508문항에서 다르다. Ouro-2.6B의 해당 수치는 136문항과 357문항이다. 이 측정은 경험적으로 높은 일치도를 뒷받침하지만, 결정이 완전히 같다는 뜻은 아니다. F.3 The double-edged effect of temperature sharpening은 평행 성분으로 분포를 더 뾰족하게 만드는 효과가 벤치마크에 따라 다르다고 보고한다. 이 성분은 보고된 HellaSwag 비교에서는 성능을 낮추지만, ARC-Challenge에서는 더 작은 계수에서도 향상을 얻는 데 도움이 된다.
- G Guidance Strength Dynamics의 G.1 Strength boundaries: generation collapse and negative interpolation은 생성에 유용한 강도 범위가 좁다는 점을 기록한다. GSM8K에서 Ouro-1.4B는 ω = 0.8일 때 8점, ω = 1.0일 때 20점 하락한다. HumanEval은 같은 강도에서 각각 10과 22점 하락한다. G.2 The trade-off between decision reach and overshoot는 ω를 0.5에서 1.0으로 높이면 Ouro-1.4B의 ARC-Challenge 답변 변경 비율이 6.6%에서 9.0%로 늘지만, 확신도가 가장 낮은 오분위 문항의 향상 폭은 6.4에서 3.9점으로 줄어든다고 보고한다. 이러한 경험적 상충 관계는 적당한 강도나 불확실성에 따라 조절하는 유도를 뒷받침한다.
- H Related Work는 LoopCD를 계층 공유 재귀 연산, 약한 예측과 강한 예측을 대조하는 디코딩, 반복적 개선으로 샘플을 생성하는 확산 모델의 유도 기법과 비교한다. LoopCD의 차별점은 같은 블록에서 시간상 서로 다른 완료된 반복을 대조하고, 이미 수행한 연산에서 약한 참조를 얻는다는 점이다. 논의에서는 이러한 설계를 모델의 약한 버전을 참조로 사용하는 autoguidance와 연결한다. 내부 계층 실험은 평가한 looped 아키텍처에서 완료된 반복을 참조로 선택하는 방식을 뒷받침한다.
짧은 생각
LoopCD는 간단한 추론 시 연산으로 기존 재귀 궤적을 재사용한다. 아키텍처 계열 4개에서 조건을 맞춰 비교하고 출력 계층의 비용도 명시적으로 계산한다. 로짓 유도와 은닉 상태 유도 중 어느 쪽이 실용적인지는 출력 깊이, 참조 초기화, 작업에 따라 달라진다. Looped-Qwen3의 비용이 큰 추가 출력 연산과 Huginn의 잡음이 많은 첫 은닉 상태가 이러한 의존성을 구체적으로 보여준다. 효율성 주장을 확인하려면 서빙 구현에서 지연 시간을 검증해야 한다. 논문은 이론적인 프리필 연산량을 추정하며, 절반 깊이의 정확도 근거는 객관식 평가로 제한된다. 평가 묶음의 양의 평균 향상 폭은 GSM8K의 성능 하락, Looped-Qwen3의 추론 pass@1 하락, 유도 강도에 대한 민감도와 함께 해석해야 한다. 보고된 표에는 작은 향상 폭을 평가할 신뢰구간이 없다.