


BIG-Bench Extra Hard 요약 설명
26 Feb 2025 | Paper Review LLM Evaluation Reasoning Benchmark목차
이번 글에서는 BIG-Bench Extra Hard 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 2월 26일(Arxiv)
- Kazemi, Mehran, Fatemi, Bahare, Bansal, Hritik, Palowitch, John, Anastasiou, Chrysovalantis, Mehta, Sanket Vaibhav, Jain, Lalit K., Aglietti, Virginia, Jindal, Disha, Chen, Peter, et al.
- Google DeepMind, Google Research, UCLA
- 논문 링크
- Github
요약
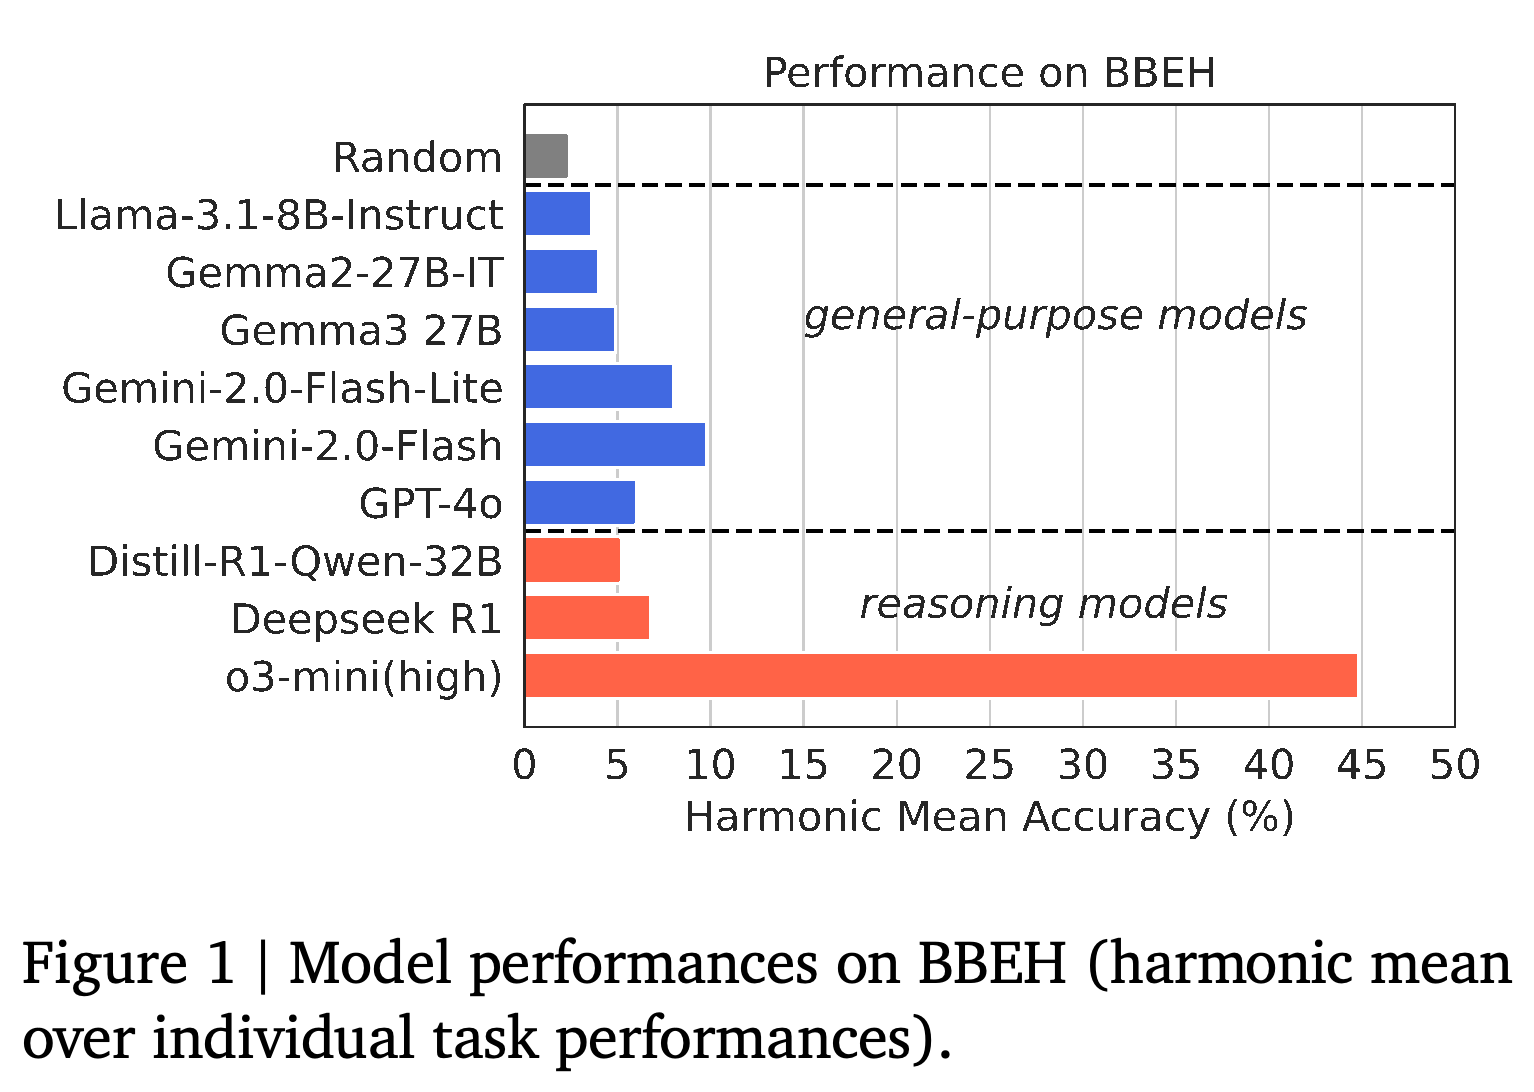
- 기존 범용 추론 벤치마크는 최근 대규모 언어 모델(LLM)의 역량 차이를 구분하기에 너무 쉬워졌다. 이 연구에서는 모델이 생성한 텍스트 응답으로 성능을 평가한다. BIG-Bench Extra Hard의 23개 과제에서 평가 대상 중 가장 우수한 추론 특화 모델인 o3-mini (high)는 44.8%, 가장 우수한 범용 모델인 Gemini 2.0 Flash는 9.8%를 기록한다. 이 수치는 개별 과제의 낮은 성능에 민감한 집계 지표인 보정 조화 평균 정확도다.
- BIG-Bench Extra Hard(BBEH)는 기존 범용 추론 벤치마크인 BIG-Bench Hard(BBH)의 모든 과제를 비슷한 역량을 평가하는 더 어려운 과제로 대체한다. 저자들은 기준 모델 2개가 각 과제에서 70% 미만의 점수를 받을 때까지 과제를 수정했다. 이 과정에서 더 긴 추론 과정, 주어진 맥락에서 학습해야 하는 낯선 규칙, 제공된 풀이의 오류 탐지를 추가했다.
- 추론 역량에 따라 성능 개선 폭이 다르다. o3-mini (high)는 개수 세기, 일정 계획, 산술에서 GPT-4o보다 크게 개선되지만, 유머, 비꼼, 인과 판단에서는 개선이 작거나 성능이 떨어진다. 인과 판단은 어떤 행동이 결과를 초래했는지를 판단하는 과제다. 기준 모델의 선택은 과제 구성에 편향을 유발하며, 일부 낮은 점수에는 응답에 허용된 출력 길이의 소진이나 추출 가능한 최종 답변의 부재도 영향을 준다.
1. Introduction
추론 평가는 수학, 과학, 코딩에 집중되어 논리적 연역, 시간과 공간 이해, 상식, 유머를 충분히 폭넓게 평가하지 못했다. BBH는 이러한 다양성을 제공했지만, 보고된 점수가 90%를 넘어서면서 최근 모델의 차이를 구분하는 능력이 줄었다.
BBEH는 23개 과제를 대체하여 BBH의 평가 범위를 유지하면서 난도와 요구 역량을 높인다. 서론에서 대표 결과로 제시한 최우수 범용 모델의 23.9%와 최우수 추론 특화 모델의 54.2%는 개별 예제를 모두 합쳐 계산한 마이크로 평균 정확도다. 이는 초록과 Figure 1에서 강조한 보정 조화 평균 결과와 다르다.
o3-mini (high)는 표시된 다른 모델보다 뚜렷하게 높은 성능을 보인다. DeepSeek R1과 Distill-R1-Qwen-32B는 여러 범용 모델과 비슷한 수준에 머문다. 따라서 추론 특화만으로는 이 과제 전반에서 높은 집계 점수를 예측할 수 없다.
2. Related Work
논문은 개별 추론 영역의 벤치마크와 여러 과제를 결합한 평가를 함께 검토하며 BBEH의 위치를 설명한다. BBEH는 고정된 규칙으로 정답 여부를 자동 판정하는 결정론적 채점 방식을 갖춘 고난도 과제를 공개한다. 또한 구체적인 실패를 분석할 수 있도록 과제별 결과를 보고한다.
3. Going Beyond BIG-Bench Hard
BBH는 다양한 역량과 간단한 정답 검증을 결합하지만, 정답 선택지가 적어 무작위 추측으로도 높은 정확도를 얻는 과제가 많다. 8/23개 과제는 이진 레이블을 사용하고, 다른 5/23은 선택지가 최대 다섯 개다. 문제 풀이를 우회하는 지름길, 과제별 평균에 같은 가중치를 부여한 매크로 평균 입력 길이가 700자라는 점, 필요한 추론 단계가 비교적 적다는 점도 한계다.
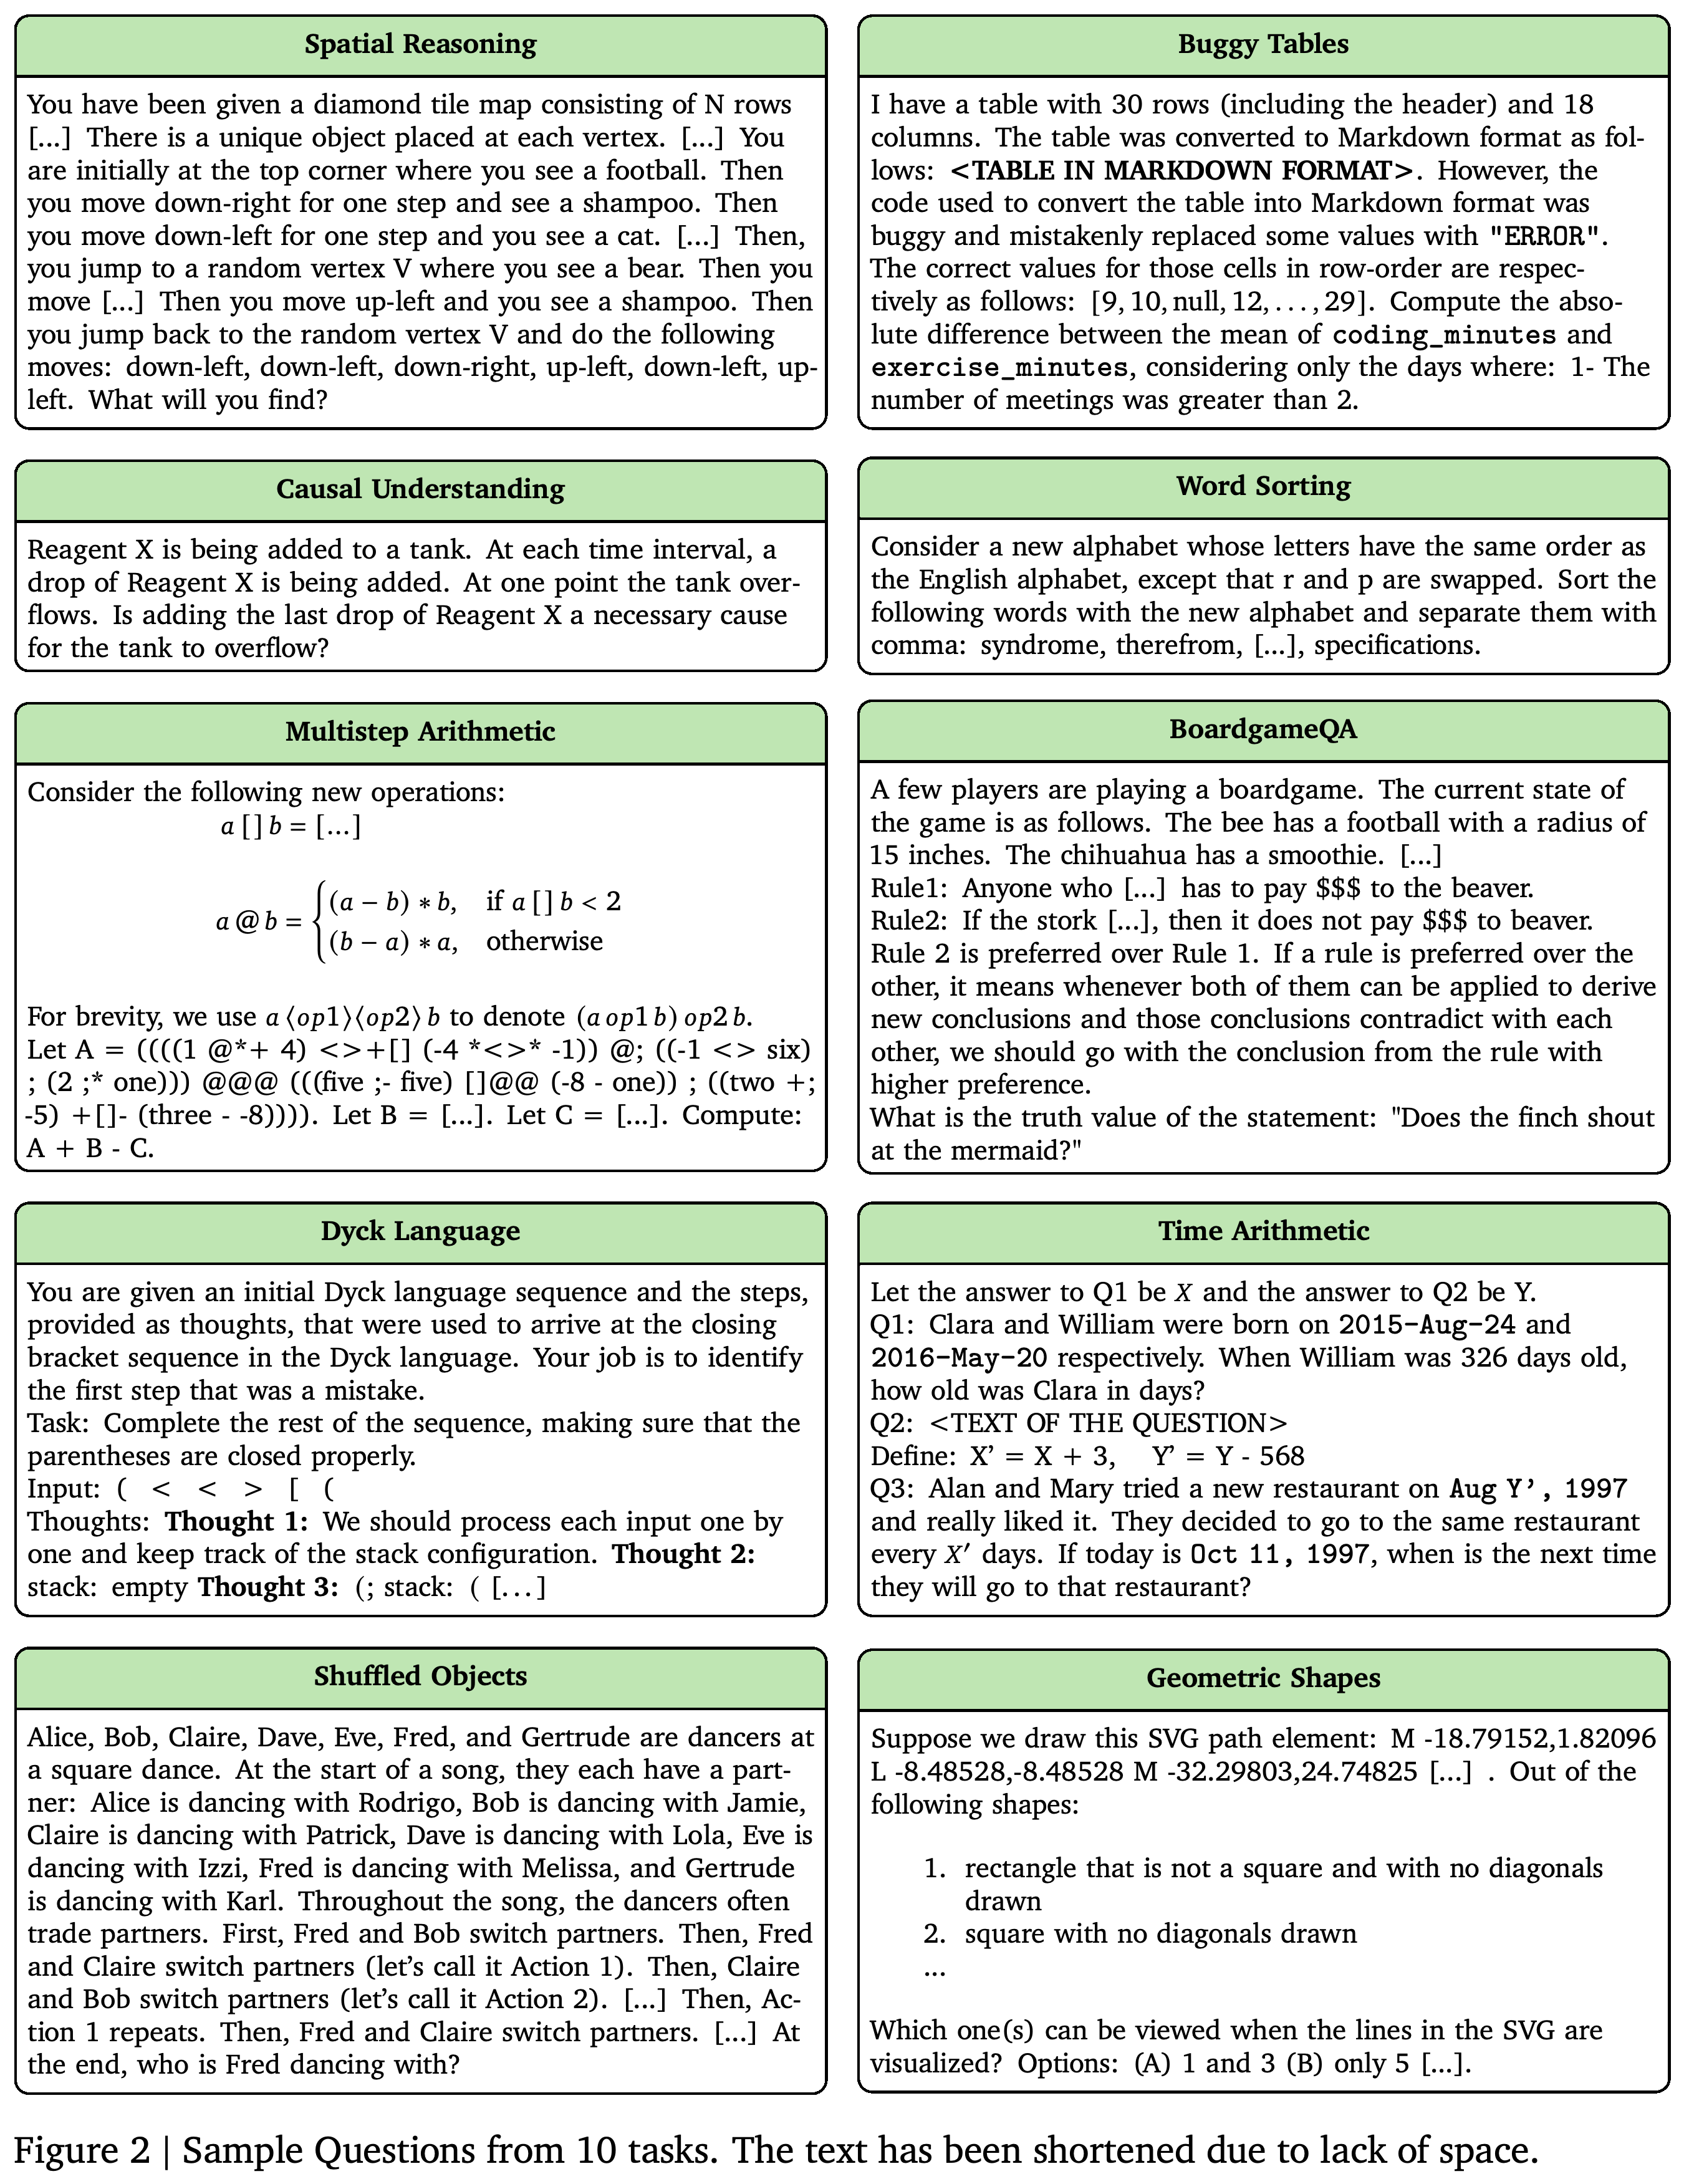
BBEH는 자동 검증을 유지하면서 지름길을 줄이고 입력 처리와 추론의 요구 수준을 높인다. Figure 2는 표 복원, 낯선 산술 연산, 반복적인 객체 교환, 중첩 괄호를 닫는 풀이의 오류 탐지를 보여 준다.
- 다단계 추론은 많은 중간 단계를 요구한다. 장거리 의존성은 맥락의 훨씬 앞부분에서 제공되거나 도출된 정보를 활용해야 하는 특성이다.
- 즉석 학습은 주어진 맥락에서 규칙을 학습하는 것이다. 강한 사전 지식에 반하는 추론은 해당 규칙이 익숙한 지식과 충돌해도 규칙을 따르는 것이다.
- 긴 맥락 추론은 긴 입력에 흩어진 정보를 결합한다. Needle-in-a-haystack 검색은 그 안에서 관련된 소량의 정보를 찾고, 방해 정보 처리는 무관한 정보를 배제한다.
- 귀납 추론은 예제에서 패턴을 도출하고, 제약 충족은 명시된 조건을 만족하는 해를 찾으며, 조합적 이해는 여러 문제가 결합된 문제를 해결한다. 지식 집약적 추론에는 상당한 분야 지식이 필요하다.
예제는 손상된 표 복원, 새로 정의한 산술 연산 적용, 이름 붙은 교환 추적, 제공된 괄호 풀이의 오류 탐지처럼 서로 다른 요구를 보여 준다. 과제의 변경은 익숙한 계산을 길게 만드는 수준을 넘어선다.
4. BIG-Bench Extra Hard
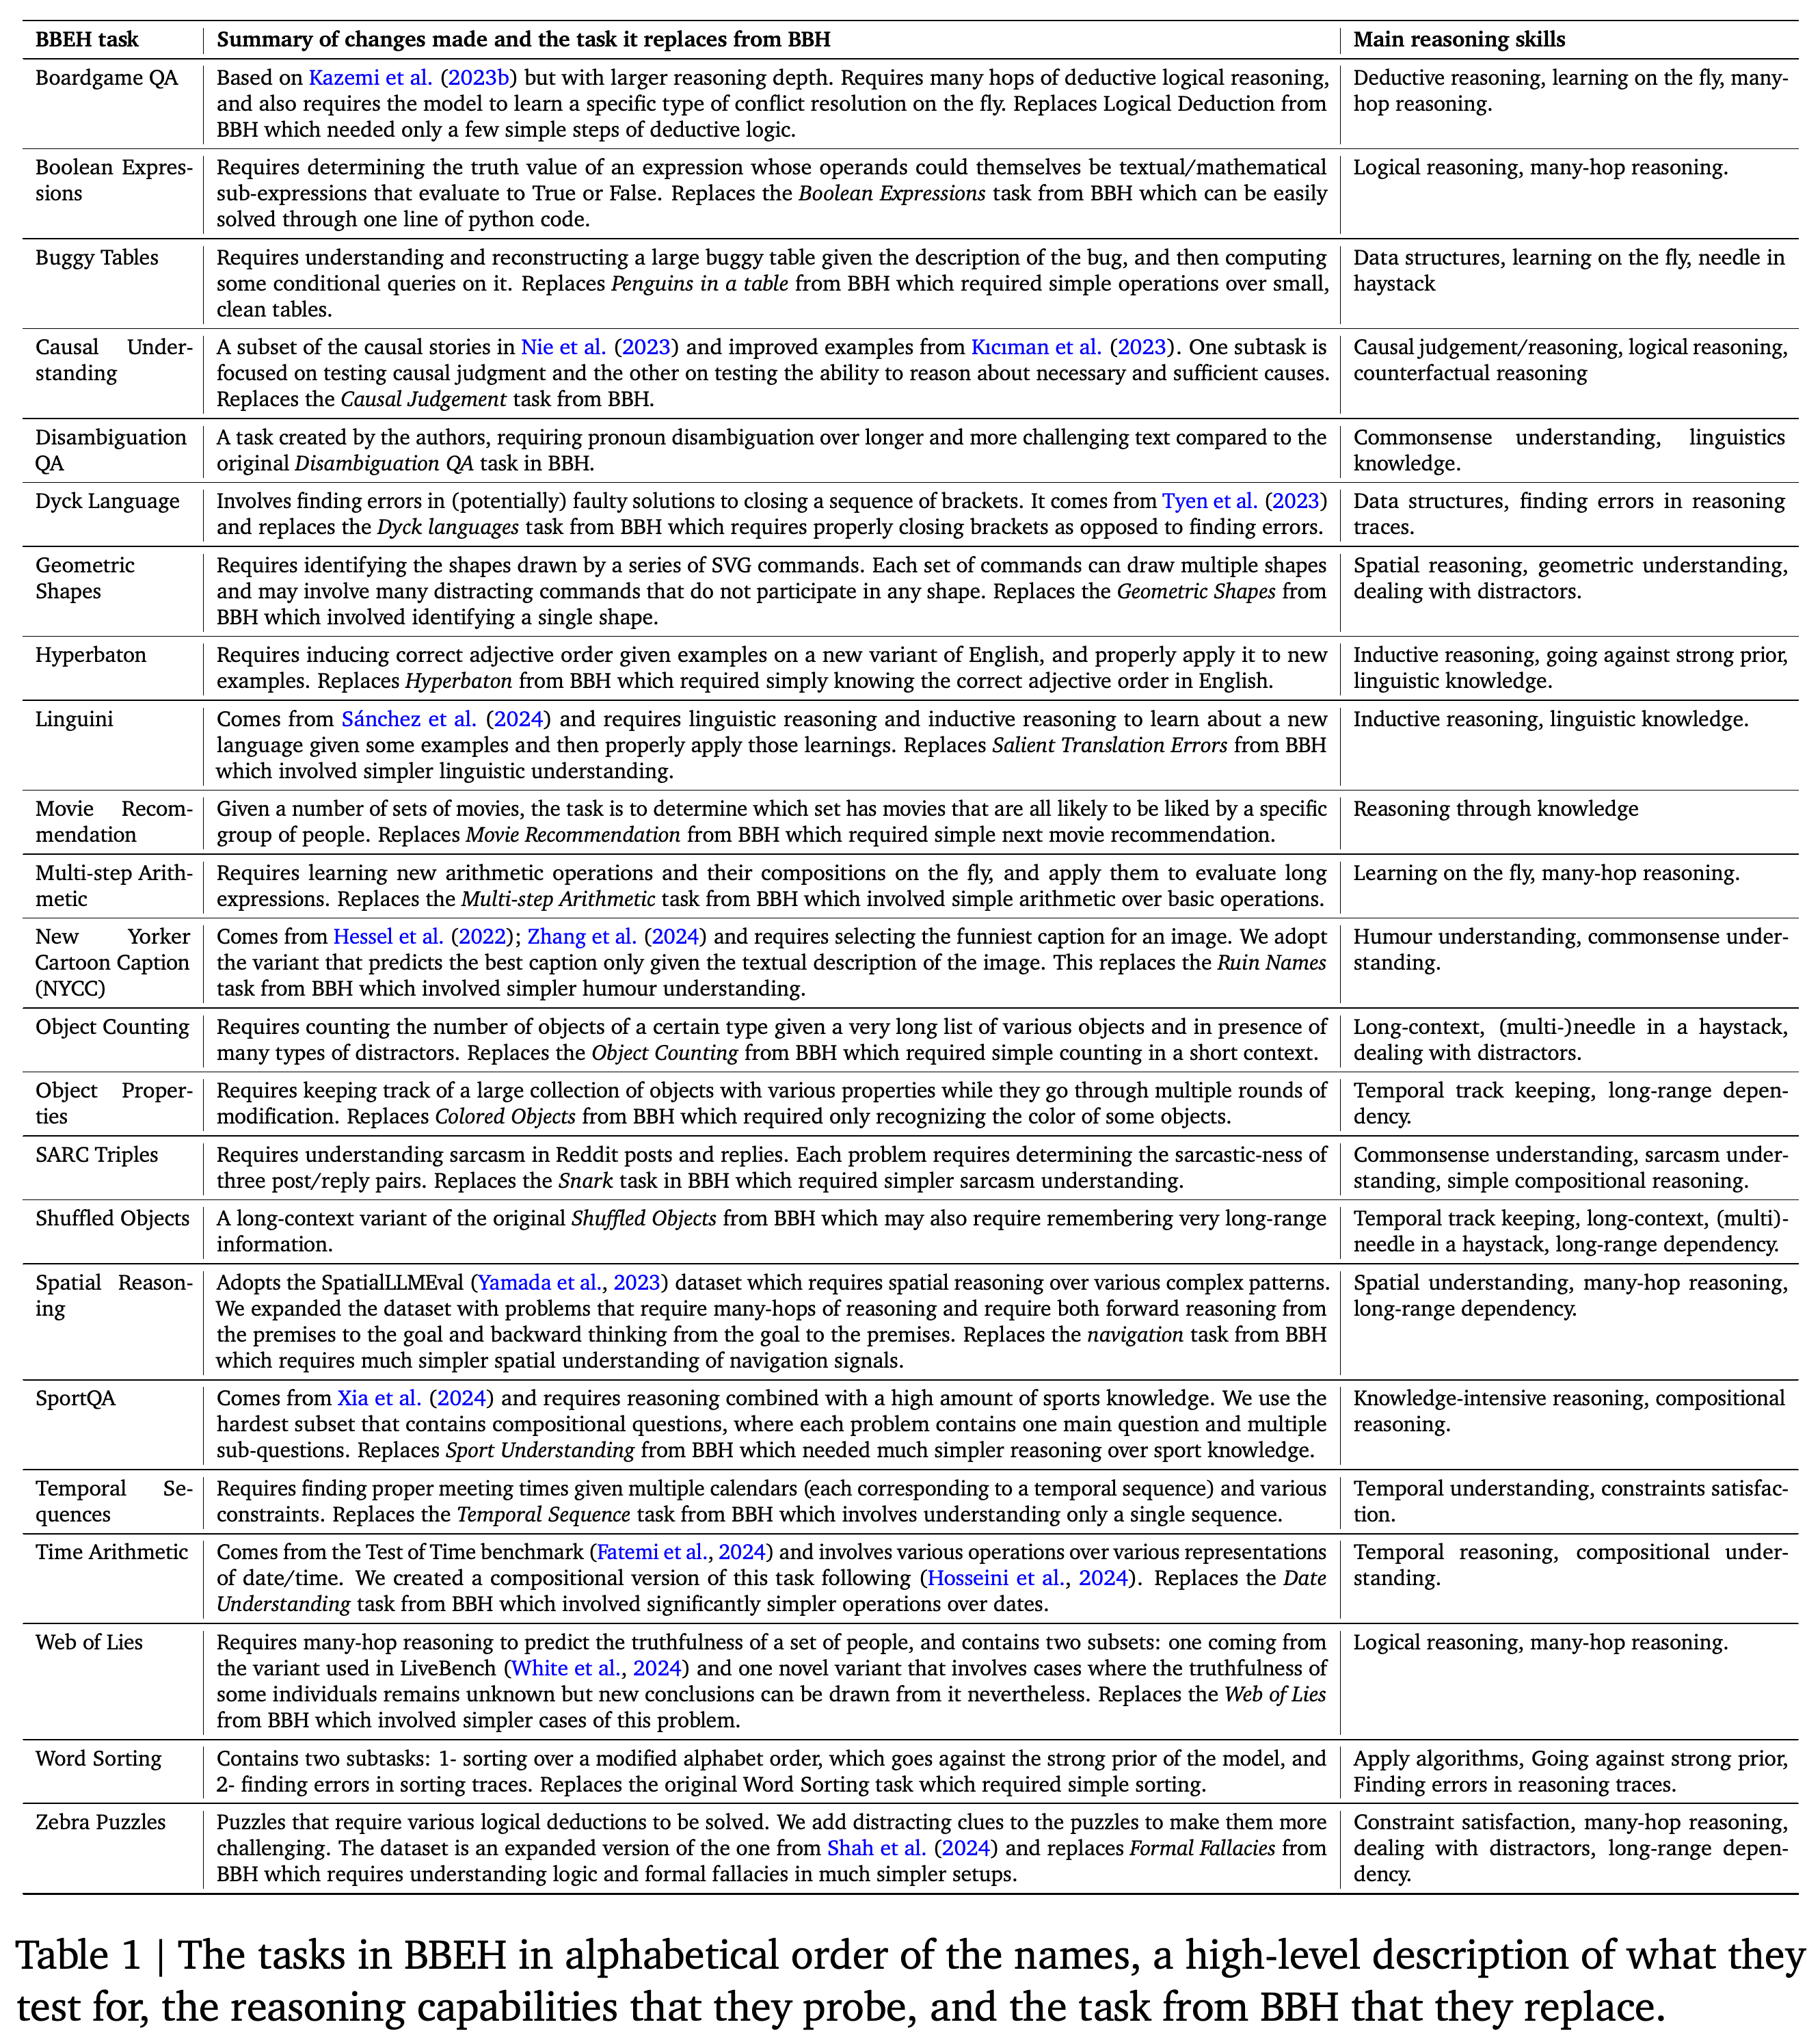
23개 BBH 과제 각각을 비슷한 추론 영역의 과제로 대체한다. 과제별 문항 수는 200개이며, 대명사의 지시 대상을 판별하는 Disambiguation QA만 120개다. Table 1은 대체 과제와 평가 역량을 대응시킨다. 평가 역량에는 사실과 규칙에 따른 연역, 언어적 추론, 시간에 따른 변화 추적, 공간 추론, 분야 지식을 활용한 추론이 포함된다.
대응 관계는 대체 과제가 넓은 추론 영역을 유지하면서 요구 연산을 어떻게 바꾸는지 보여 준다. 단순한 표 질의는 복원 후 질의로 바뀌고, 익숙한 형용사 순서 판단은 낯선 규칙의 추론으로 바뀐다.
반적대적 구성 과정에서는 기준 모델의 성능을 바탕으로 과제 난도를 단계적으로 높인다. 기준 모델은 Gemini 1.5 Flash와 Gemini Thinking Experimental이다. 후자는 처음에 2024년 12월 버전을 사용하고, 이후 Gemini-2.0-Flash-Thinking-Exp-01-21을 사용했다. 기준 모델 2개가 모두 모든 과제에서 70% 미만을 기록할 때까지 수정을 반복했다.
- 참 또는 거짓 값을 논리 연산자로 결합하는 Boolean 표현식은 길이를 늘려도 처음에는 쉬웠다. 기준 모델이 Python 코드를 생성해 계산했기 때문이다. 일부 True와 False 피연산자를 텍스트나 수학적 진술로 바꾸자 직접 계산하는 지름길을 활용하기 어려워졌다.
- 선택한 기준 모델은 벤치마크가 특정 실패에 치우치게 하며, 기준 모델과 그 외 모델을 공정하게 비교하기 어렵게 한다.
BBEH Mini는 더 빠르고 저렴한 실험을 위해 과제마다 무작위로 20개씩 선택한 총 460개 예제를 제공한다. 벤치마크는 https://github.com/google-deepmind/bbeh 에 공개되어 있다.
5. Results and Analyses
결과에서는 BBEH와 BBH를 비교하고, 모델의 과제별 성능과 전체 성능을 평가한다. 또한 모델 유형, 입력 길이, 생성 응답 길이에 따라 성능 차이가 어떻게 달라지는지 살펴본다. Appendix A는 과제별 구성 세부 사항과 실패 분석을 추가로 제공한다.
5.1. BBEH Analysis
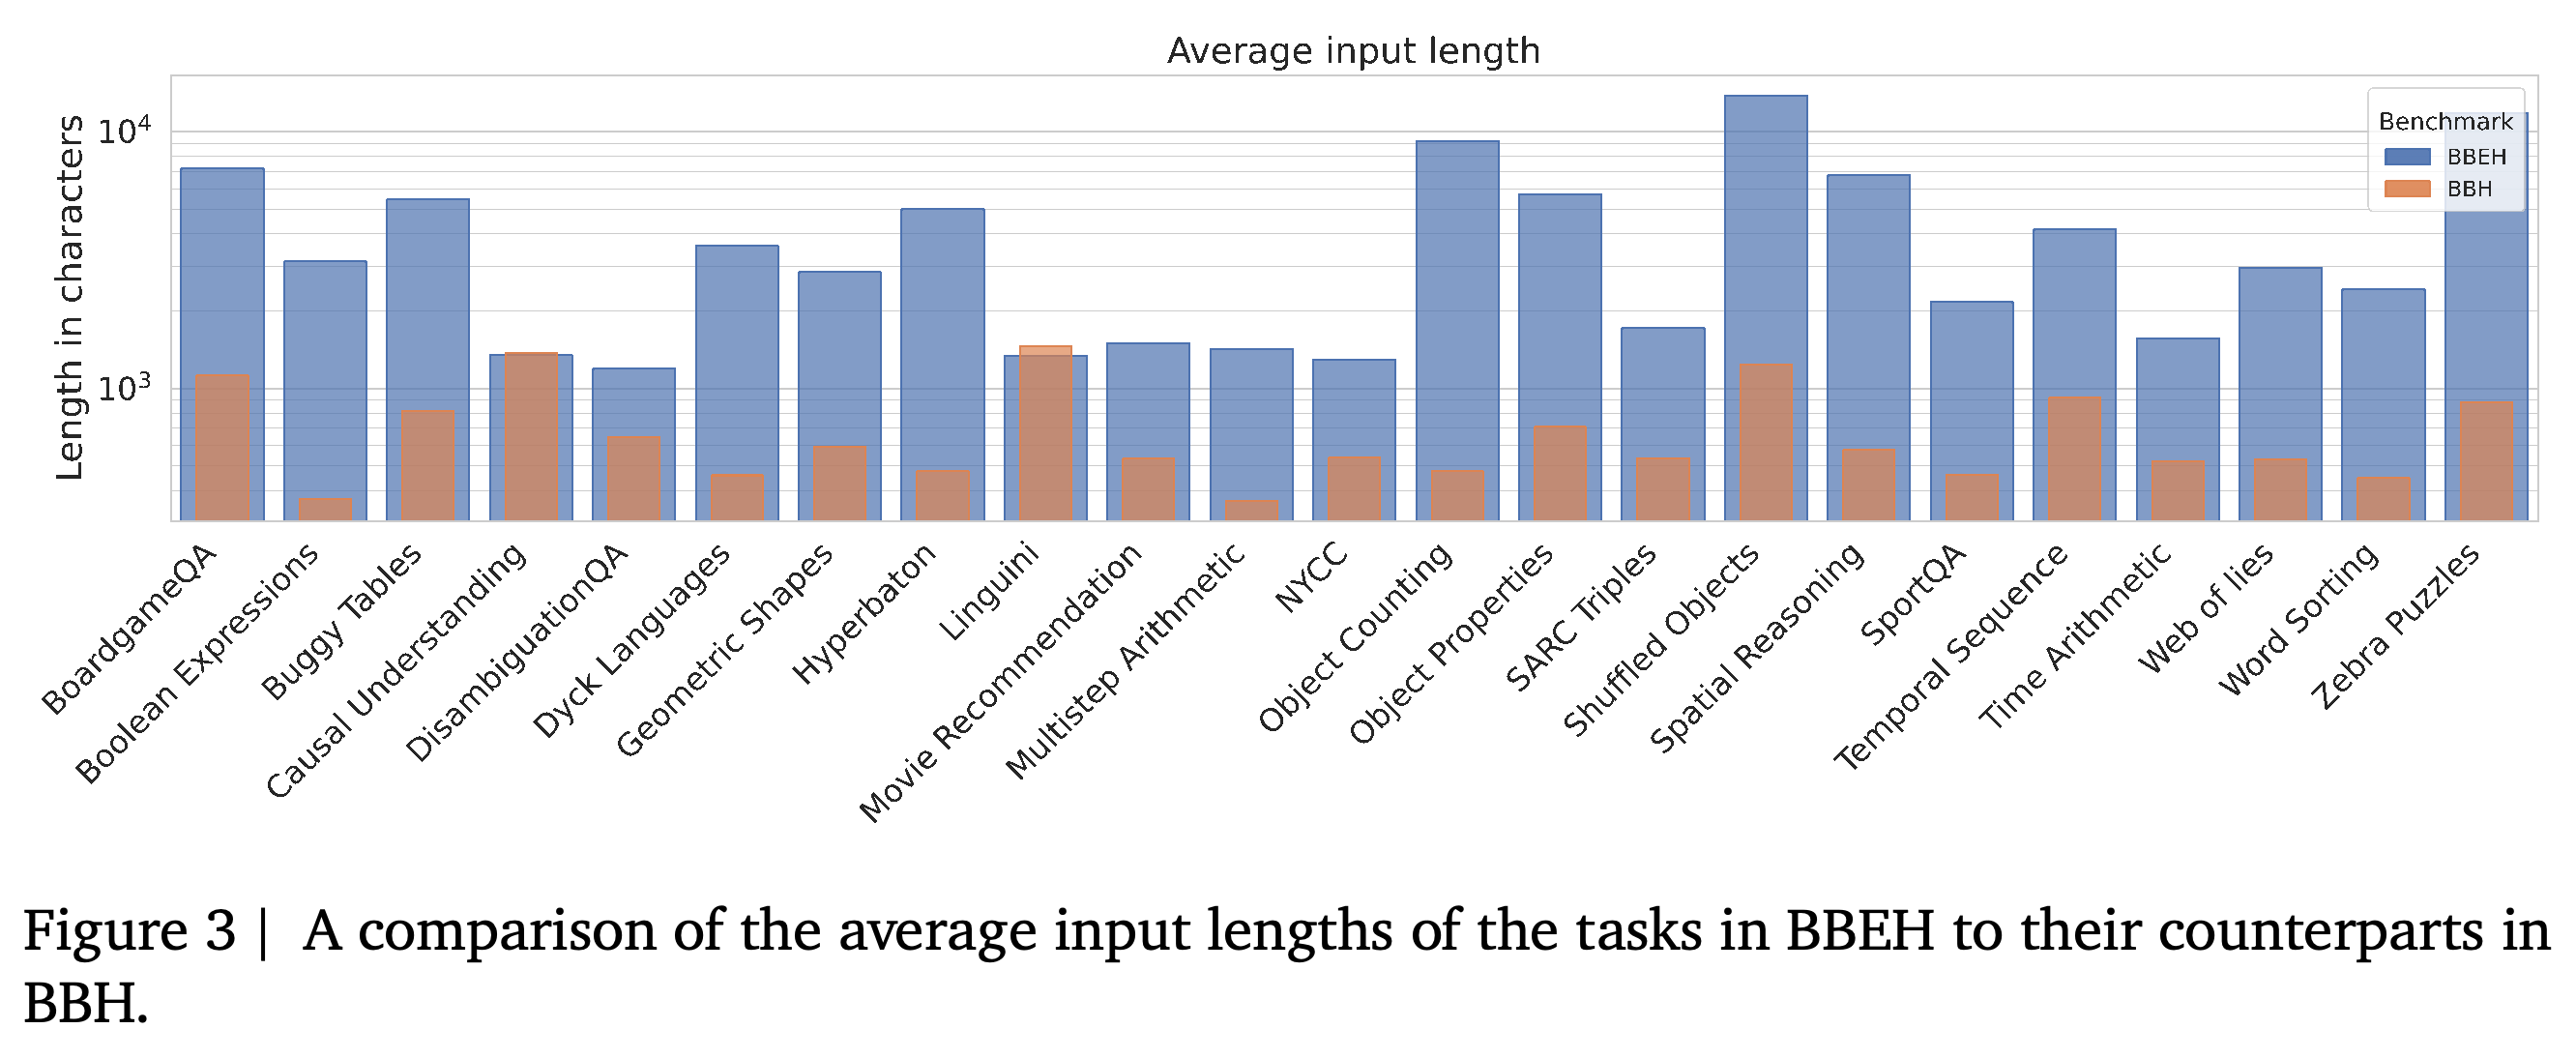
BBEH에서는 2개 과제를 제외한 모든 과제의 평균 입력이 더 길며, 매크로 평균 맥락 길이는 BBH의 약 6배 수준이다. Figure 3은 과제별 차이가 크다는 점을 보여 준다. 교환을 거치며 할당 관계를 추적하는 Shuffled Objects는 입력이 가장 긴 과제 중 하나다.
대부분의 대응 과제에서 입력 길이가 증가하지만 증가 폭은 서로 다르다. 세로축의 로그 척도는 짧은 과제의 차이를 지나치게 압축하지 않으면서 Shuffled Objects와 Object Counting의 특히 큰 변화를 비교하기 쉽게 한다.
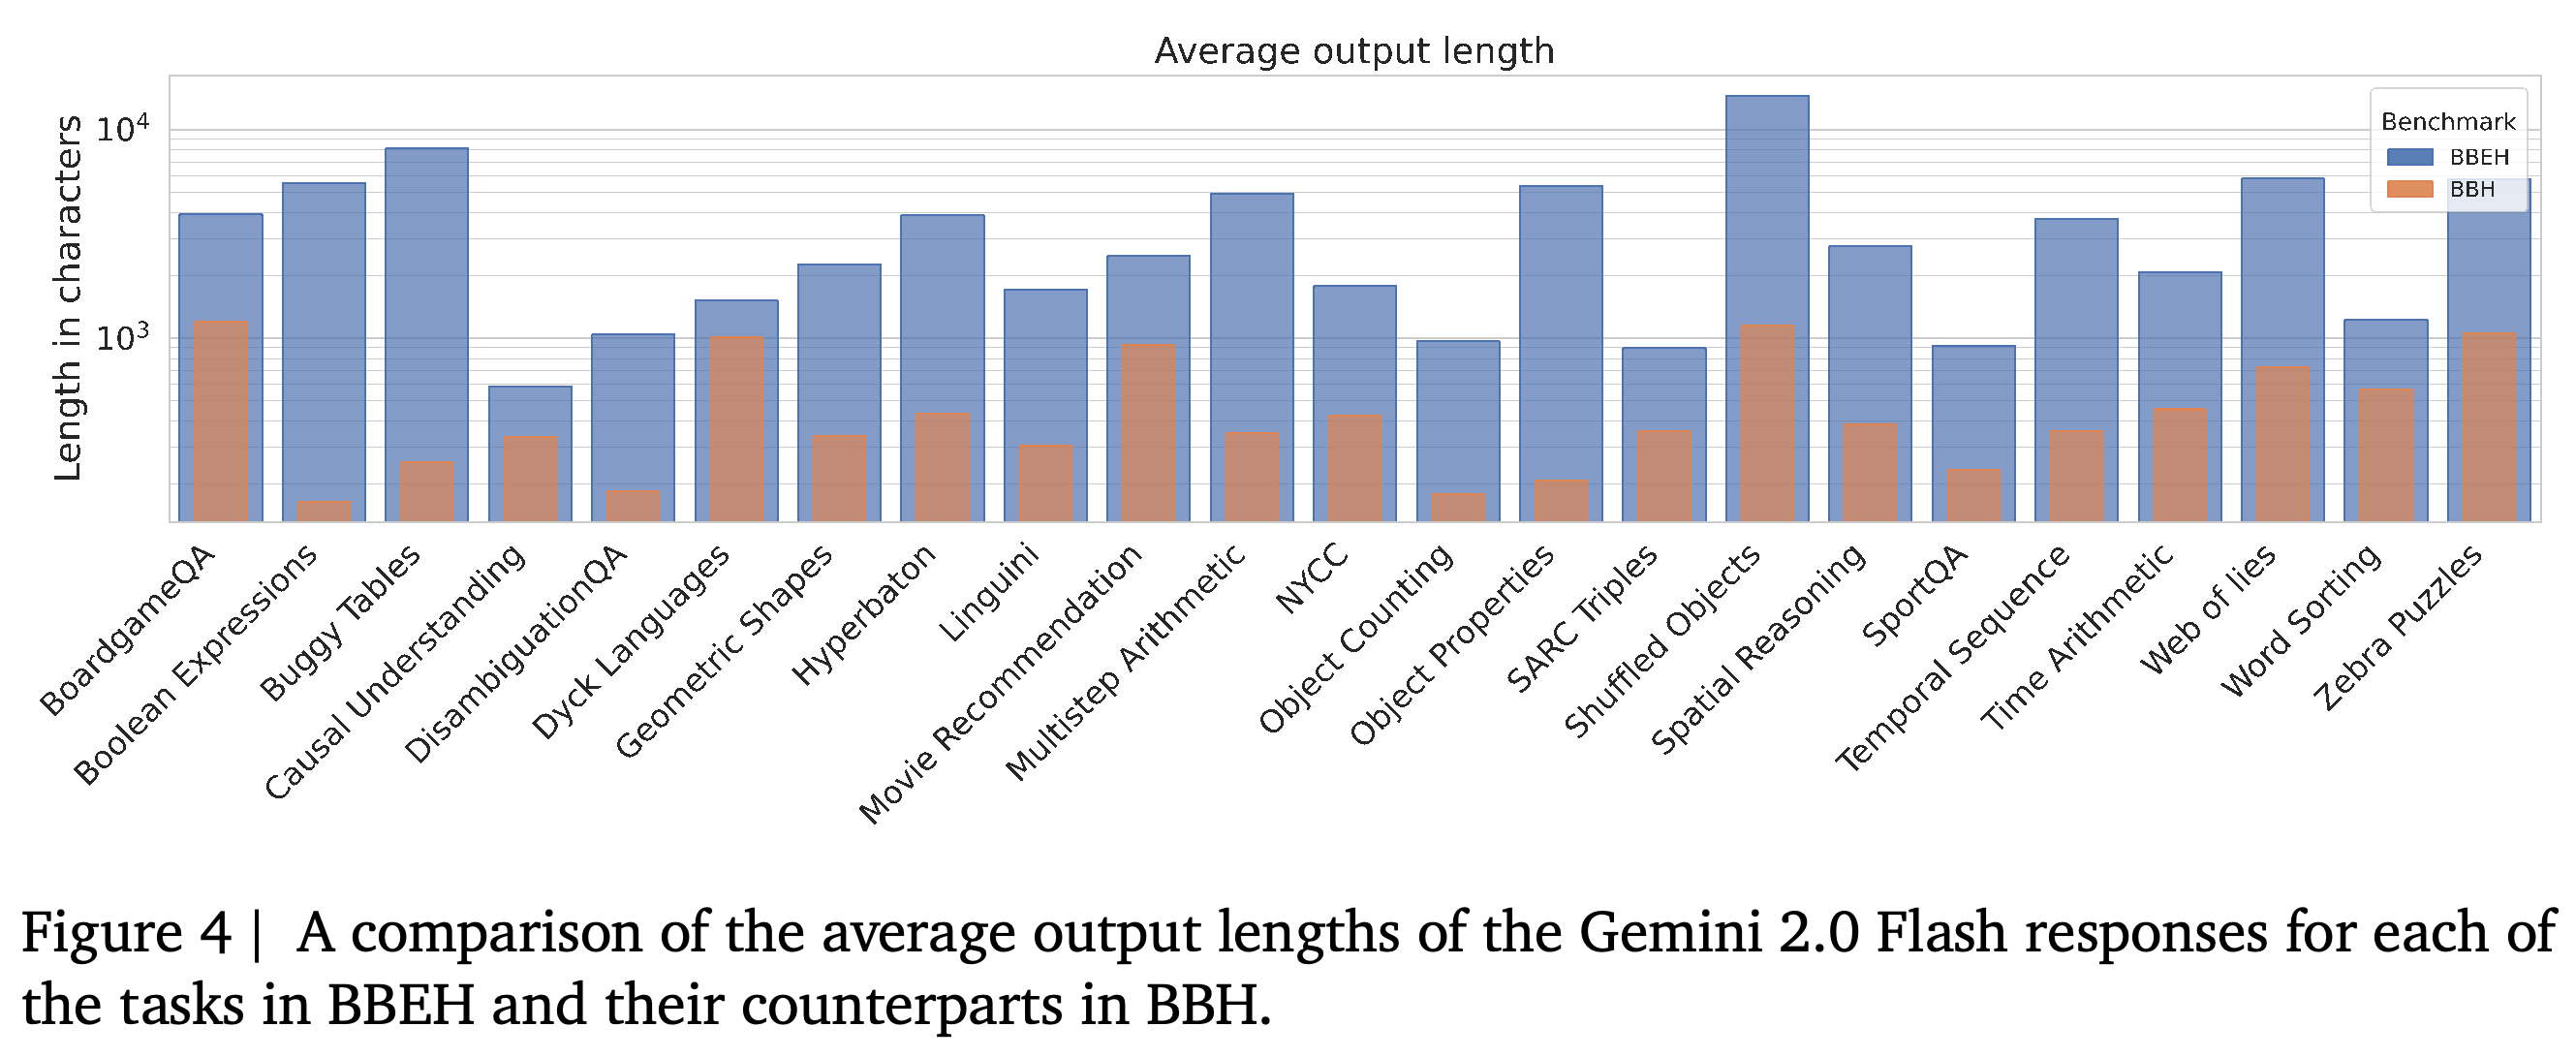
Gemini 2.0 Flash로 모델을 고정하면 모든 BBEH 과제에서 대응하는 BBH 과제보다 평균 생성 응답이 길다. 매크로 평균 출력 길이는 BBH의 약 7배 수준이다. 저자들은 출력 길이를 필요한 사고량의 대리 지표로 사용한다. Figure 4는 생성된 응답의 길이를 측정하며, 추론의 정확성은 측정하지 않는다.
데이터셋 2개에 모두 Gemini 2.0 Flash를 사용하여 생성 모델을 고정한다. 모든 대체 과제에서 평균 응답이 길어져 생성 요구량이 늘었음을 뒷받침한다. 다만 이 그래프는 추론의 정확성을 측정하지 않는다.
5.2. Model Evaluations
평가 대상은 Llama 3.1, Qwen 2.5, Gemma2, Gemma3, Gemini 2.0, GPT-4o의 2024-11-20 버전, DeepSeek R1, 이를 증류한 Qwen 32b 모델, o3-mini (high)다. 증류 모델은 다른 모델의 역량을 재현하도록 학습한 모델이다. 질문은 단계별 추론과 명시적으로 표시한 최종 답변을 요구하며, 결정론적 추출 및 정규화 규칙으로 답변을 채점한다.
BBEH의 주 지표는 과제별 정확도의 보정 조화 평균이며, 산술 평균보다 낮은 과제 점수에 더 큰 불이익을 준다. 논문은 영점을 처리하기 위해 각 정확도 수치에 1을 더한다고 명시한다. BBEH Mini는 과제당 예제가 20개뿐이므로 마이크로 평균 정확도를 사용한다.
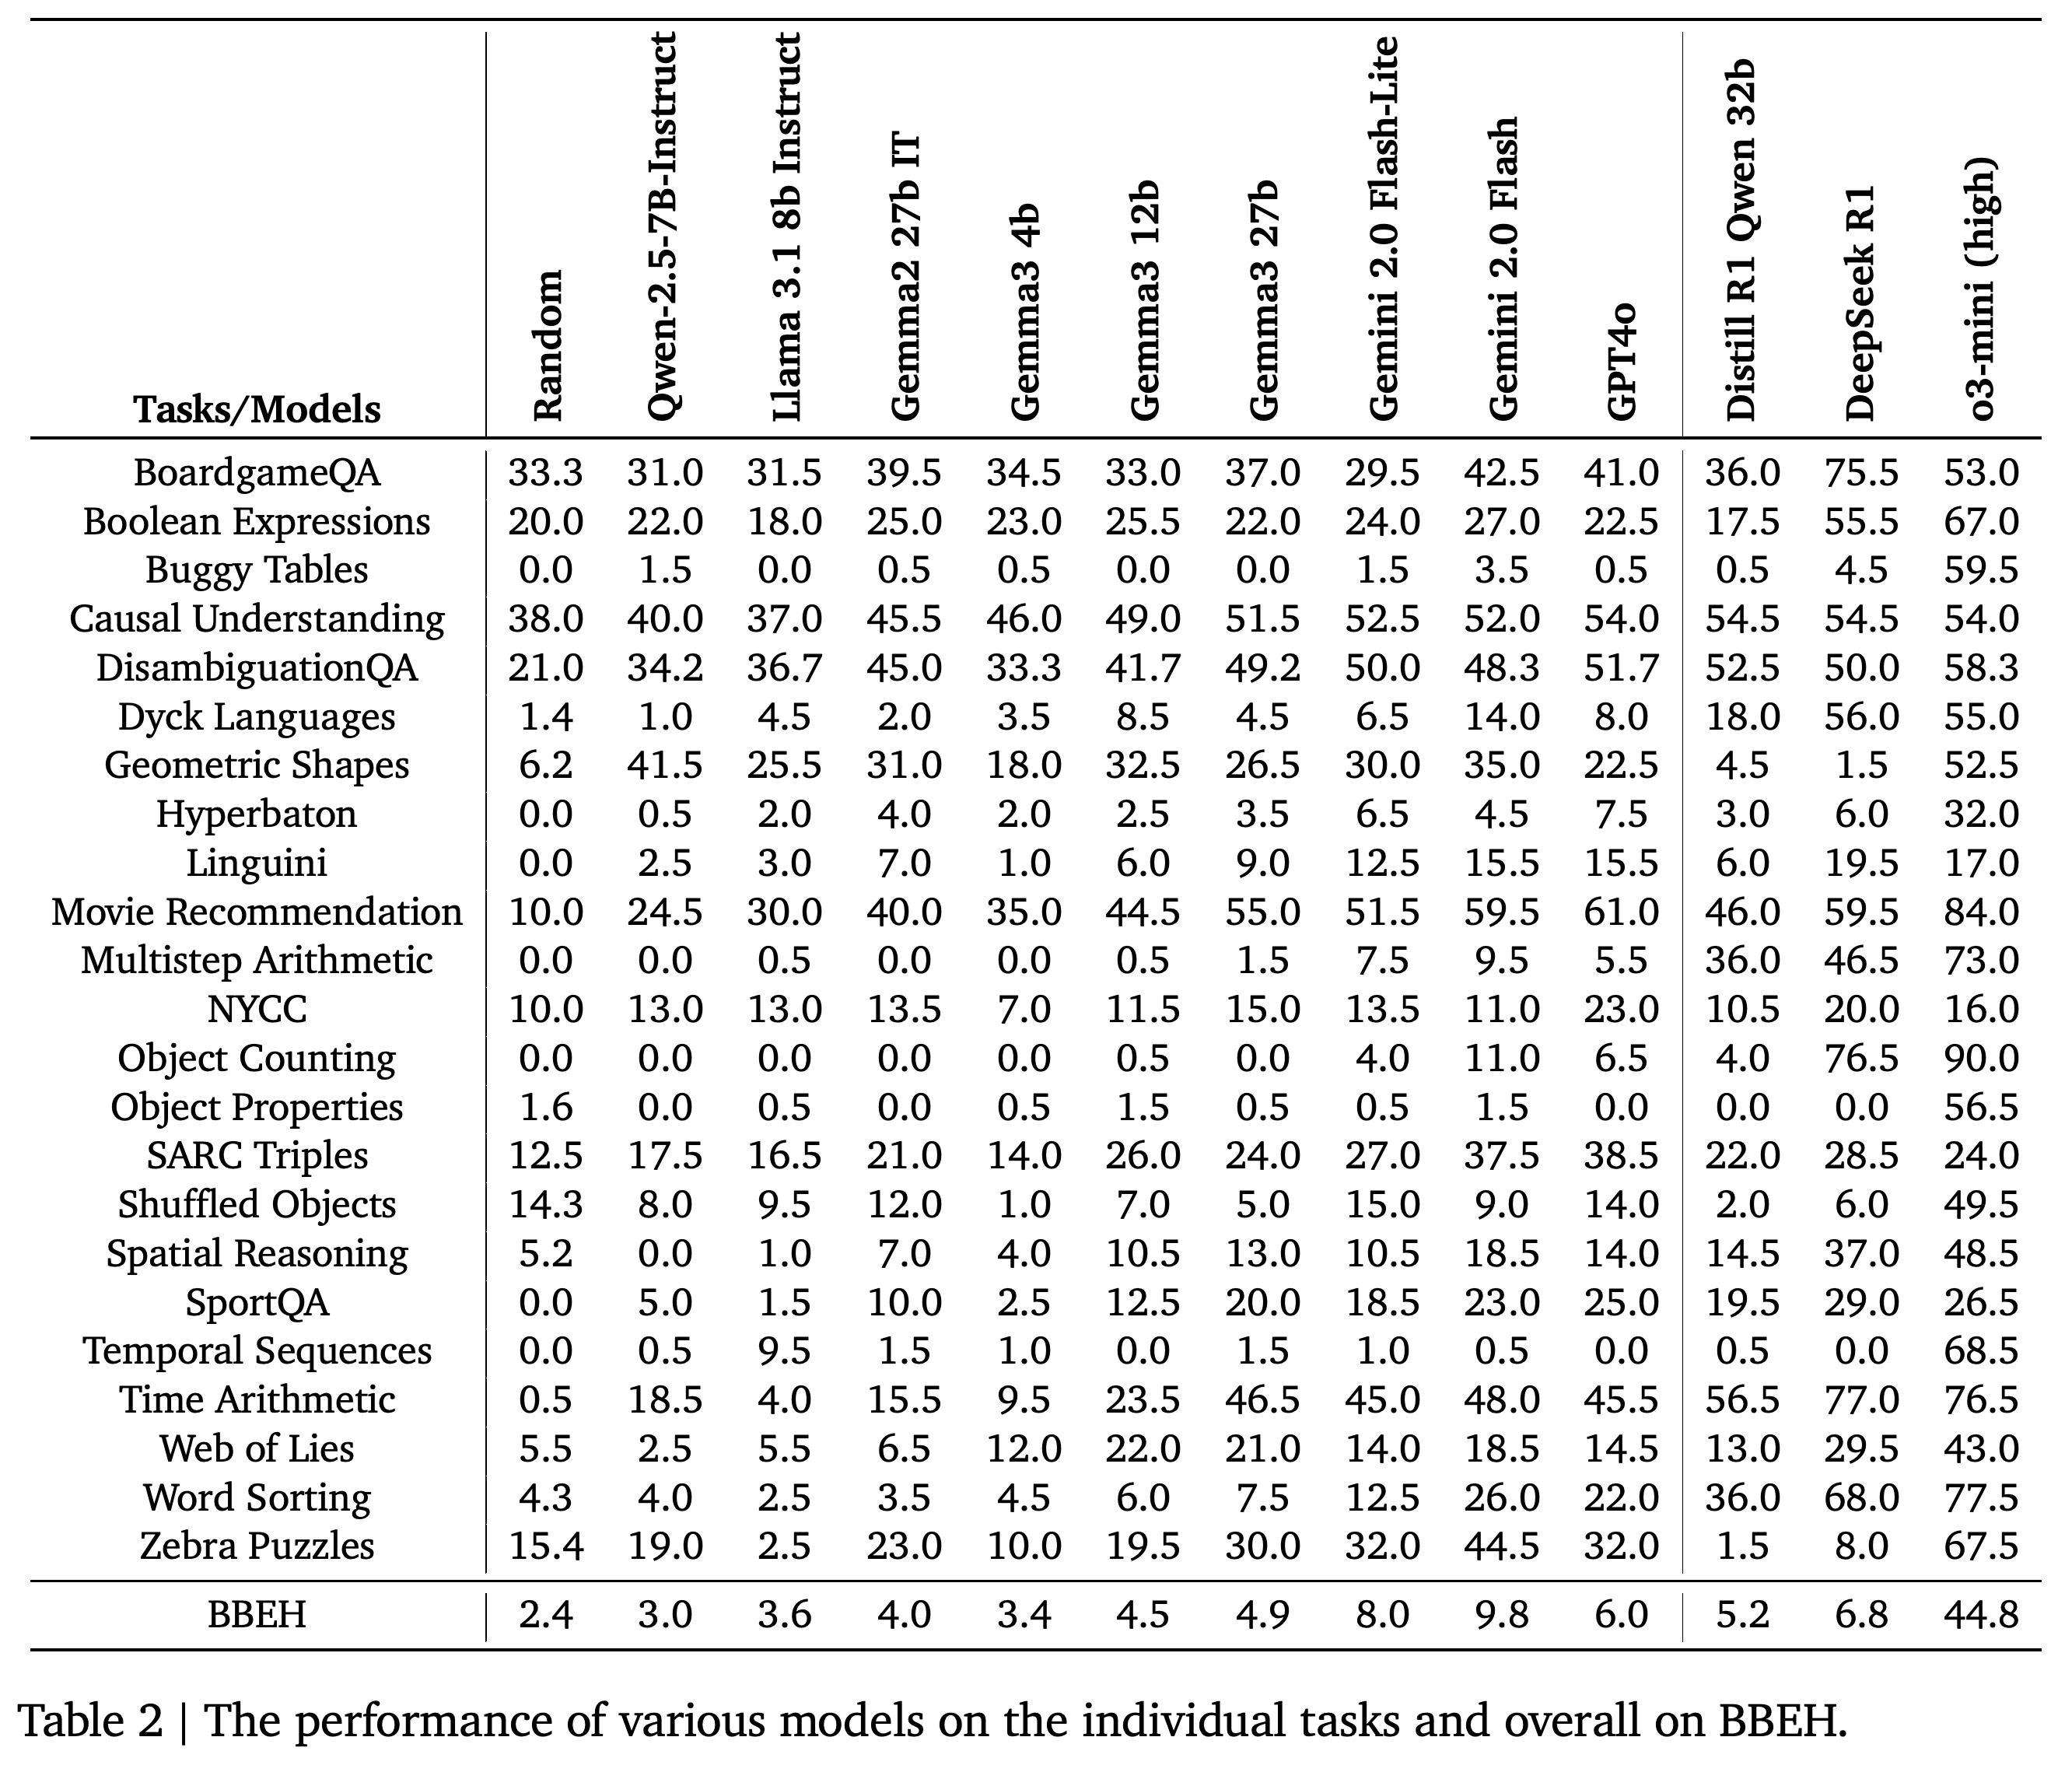
Table 2에서 보정 조화 평균 정확도는 Gemini 2.0 Flash가 9.8%, GPT-4o가 6.0%, DeepSeek R1이 6.8%, o3-mini (high)가 44.8%이며, 무작위 예측은 2.4%다. DeepSeek R1의 마이크로 평균은 34.9%로 평가한 모든 범용 모델보다 높다. 그러나 일부 과제의 낮은 점수 때문에 조화 평균 점수는 Gemini 2.0 Flash와 Flash-Lite보다 낮다.
- 전체 BBEH에서 가장 높은 마이크로 평균은 Gemini 2.0 Flash의 23.9%와 o3-mini (high)의 54.2%이며, 무작위 예측은 8.4%다. 이 값들은 Table 2의 전체 점수 행과 집계 방식이 다르다.
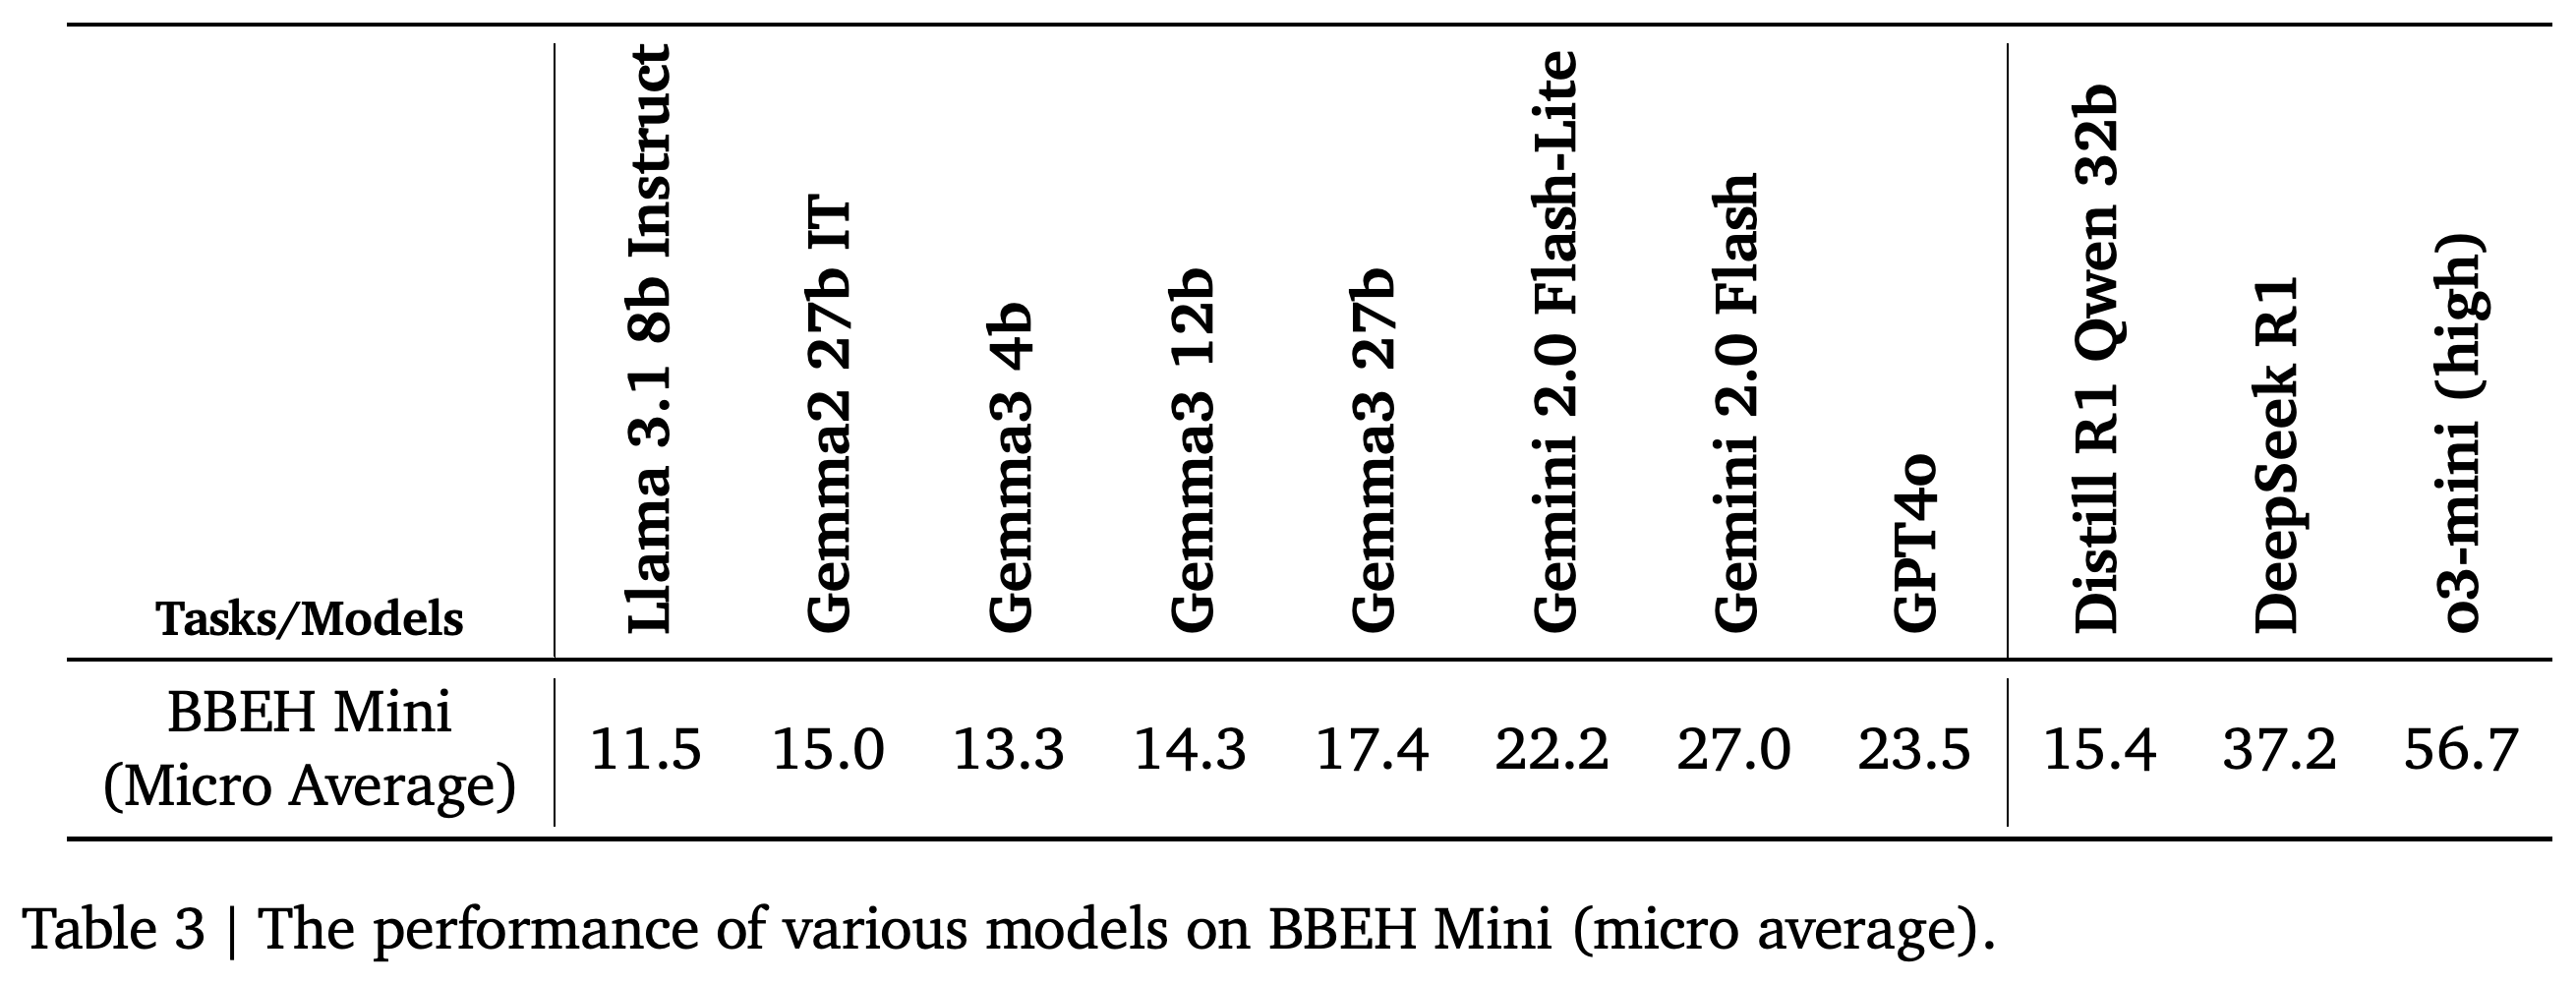
- BBEH Mini에서는 Gemini 2.0 Flash가 27.0%, DeepSeek R1이 37.2%, o3-mini (high)가 56.7%를 기록한다.
- 기준 Thinking 모델의 보정 조화 평균 정확도는 20.2%다. Table 2에서 o3-mini (high)는 과제 5개, DeepSeek R1은 과제 3개에서 70%를 넘으며, 표의 나머지 모델은 어느 과제에서도 70%를 넘지 못한다. 본문은 o3-mini (high)가 이 기준을 넘는 과제 수를 4개로 잘못 서술한다.
과제별 순위는 모델마다 강점이 다르다는 점을 보여 준다. DeepSeek R1은 충돌할 수 있는 규칙에서 연역해야 하는 BoardgameQA에서 75.5%를 기록한다. o3-mini (high)는 회의 일정 계획 과제인 Temporal Sequences에서 68.5%, 객체 집합의 변화를 추적하는 Object Properties에서 56.5%를 기록한다. GPT-4o는 만화의 텍스트 설명을 보고 유머러스한 캡션을 고르는 New Yorker Caption Contest 과제인 NYCC에서 23.0%로 가장 높다. Self-Annotated Corpus for Sarcasm의 답글 3개를 함께 분류하는 SARC Triples에서도 38.5%로 가장 높다.
- 일부 점수가 무작위 추측 수준보다 낮은 이유는 추출 가능한 최종 답변이 나오기 전에 모델이 실질적인 출력 길이를 소진하거나, 반복적이거나 품질이 저하된 응답을 생성하기 때문이다. 이 결과에는 추론 난도와 함께 응답 생성 및 답변 추출의 한계가 반영된다.
각 행은 성능 불균형에 조화 평균 집계가 민감한 이유를 보여 준다. DeepSeek R1은 BoardgameQA와 Object Counting에서 높은 점수를 얻지만, Object Properties와 Temporal Sequences에서는 모두 0.0%를 기록한다. o3-mini (high)는 이 2개 과제에서 각각 56.5%와 68.5%를 기록한다.
축소된 평가에서도 o3-mini (high), DeepSeek R1, Gemini 2.0 Flash의 상위 순서가 유지된다. 과제당 예제 20개를 합쳐 정확도를 계산하며, 전체 벤치마크의 주 지표인 조화 평균과는 다르다.
5.3. Further Analyses of the Results
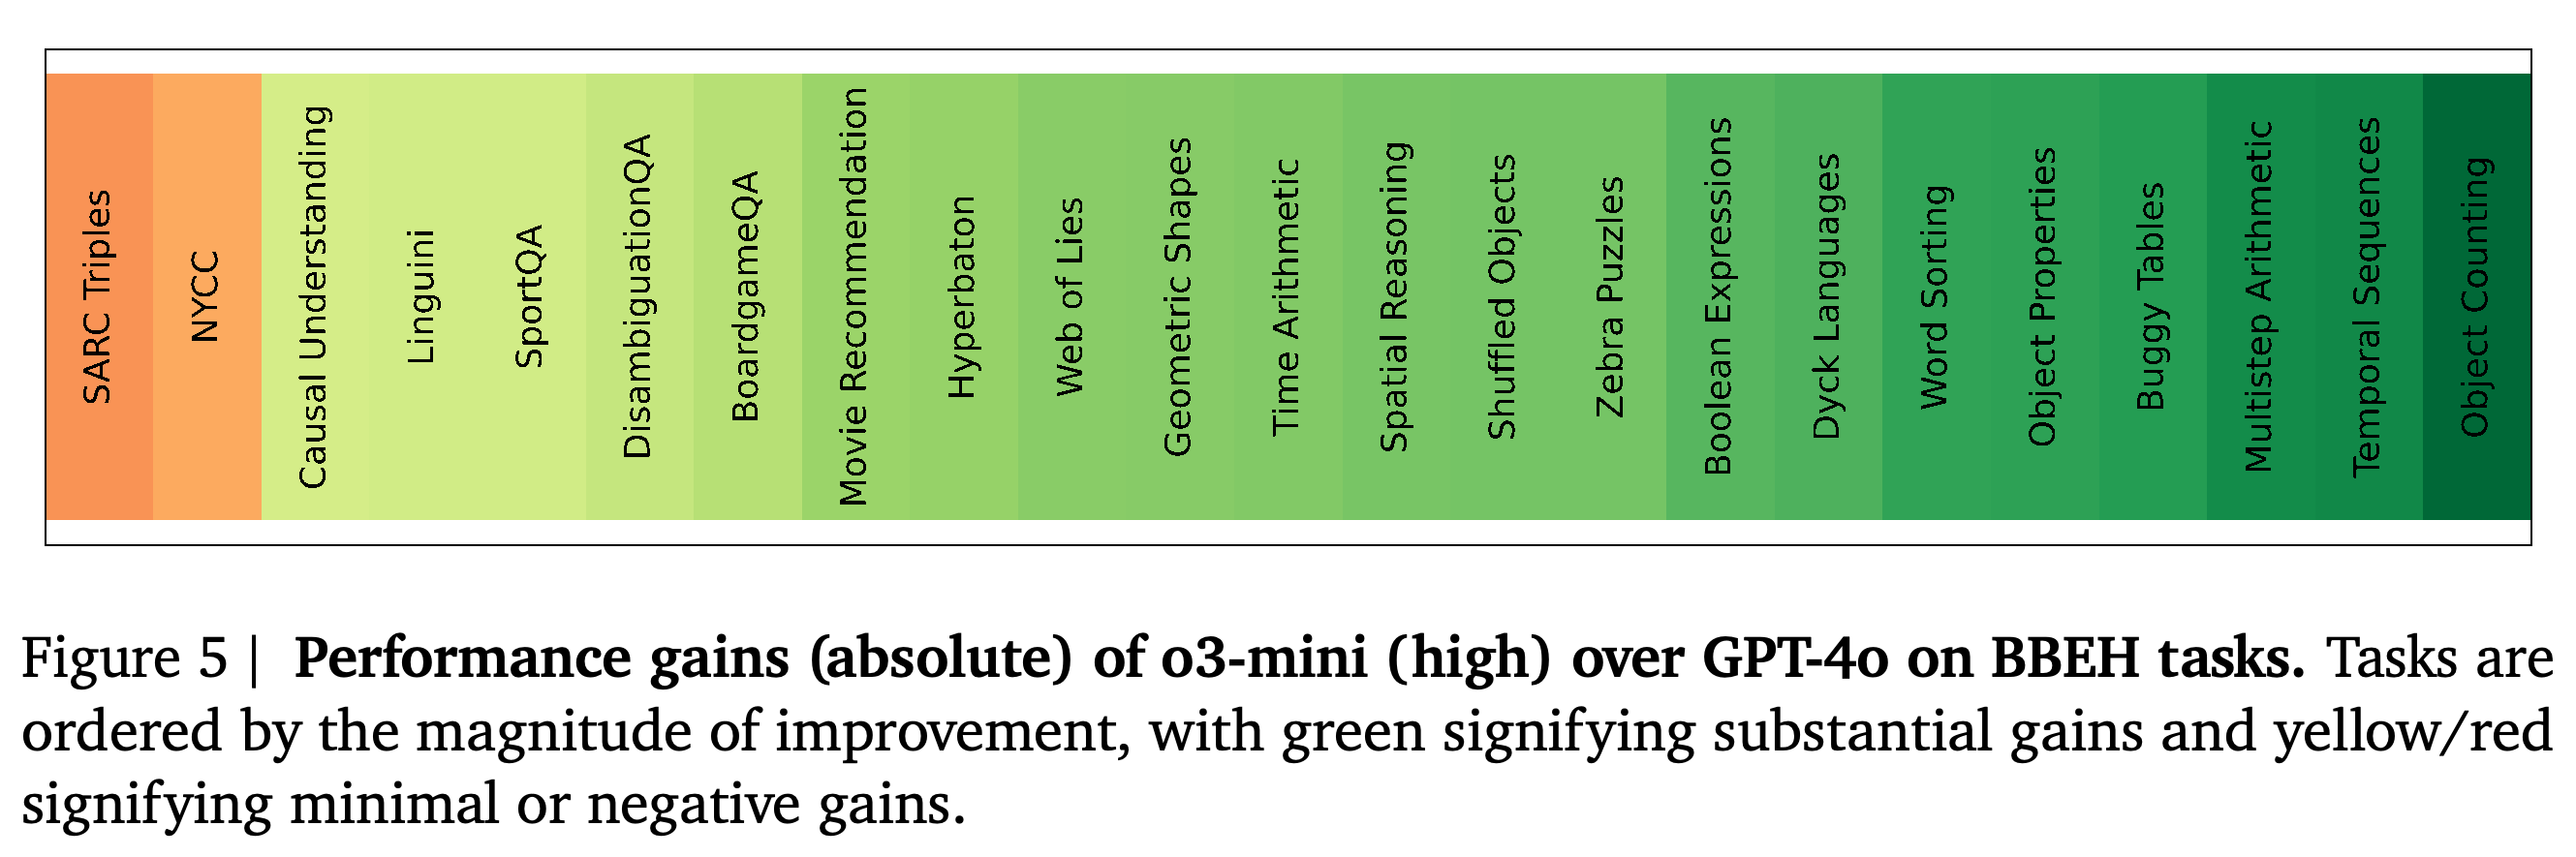
o3-mini (high)를 GPT-4o와 비교하면 개수 세기, 계획, 산술, 알고리즘을 다루는 형식적 과제에서 개선 폭이 가장 크다. Figure 5에서 상식, 유머, 비꼼, 인과관계를 다루는 여러 과제는 개선이 작거나 성능이 떨어진다. Object Counting은 6.5%에서 90.0%로 상승하지만, SARC Triples는 38.5%에서 24.0%로 하락한다.
개선 폭에 따라 정렬한 그래프에서 개수 세기, 일정 계획, 산술은 개선이 큰 쪽에 있고, 비꼼과 유머는 개선이 작거나 차이가 음수인 쪽에 있다. 이는 GPT-4o 대비 o3-mini (high)의 우위가 역량별로 크게 다름을 보여 준다.
Gemini 2.0 Flash와 Flash-Lite의 비교에서도 비슷하지만 덜 뚜렷한 패턴이 나타난다. 다단계 추론과 알고리즘 과제는 유머와 인과 추론보다 개선 폭이 큰 경우가 많다. Figure 6에서 Word Sorting은 개선 폭이 가장 큰 과제 중 하나다. SARC Triples는 전반적인 패턴의 예외이며, 저자들은 하위 질문 3개에 함께 답해야 한다는 점과 관련될 수 있다고 설명한다.
- 이 비교에서 저자들은 최종 답변 누락으로 인한 잡음을 줄이기 위해 무작위 추측 수준보다 낮은 과제 점수를 해당 무작위 기준 점수로 대체한다. 이 모델 비교는 파라미터 수를 통제된 실험 변수로 분리하지 않는다.
Flash-Lite 대비 Flash의 우위는 Word Sorting과 Zebra Puzzles 등의 과제에서 가장 크다. 유머, 모호성, 인과관계를 다루는 여러 과제에서는 개선이 작다. SARC Triples는 비꼼 관련 추론의 개선이 작다는 전반적인 패턴에서 뚜렷한 예외다.
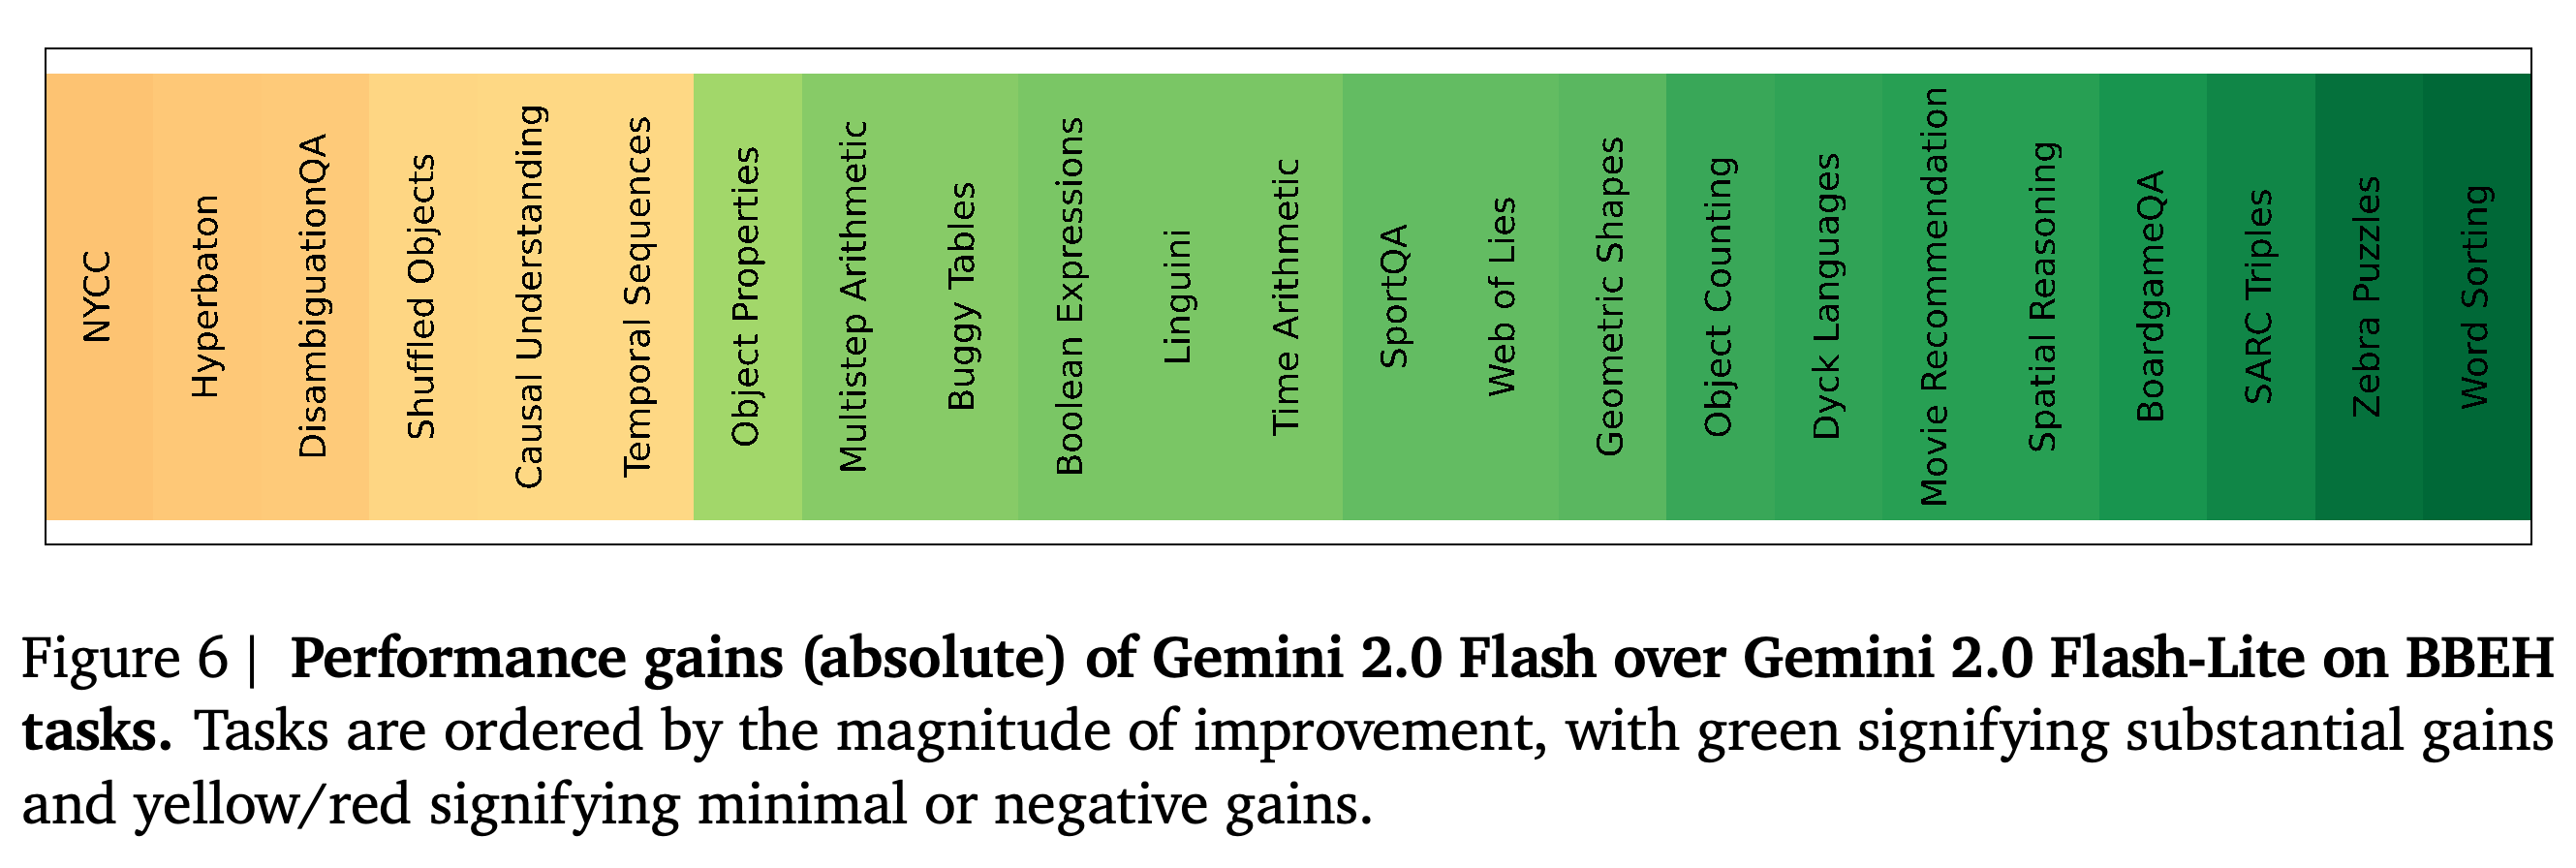
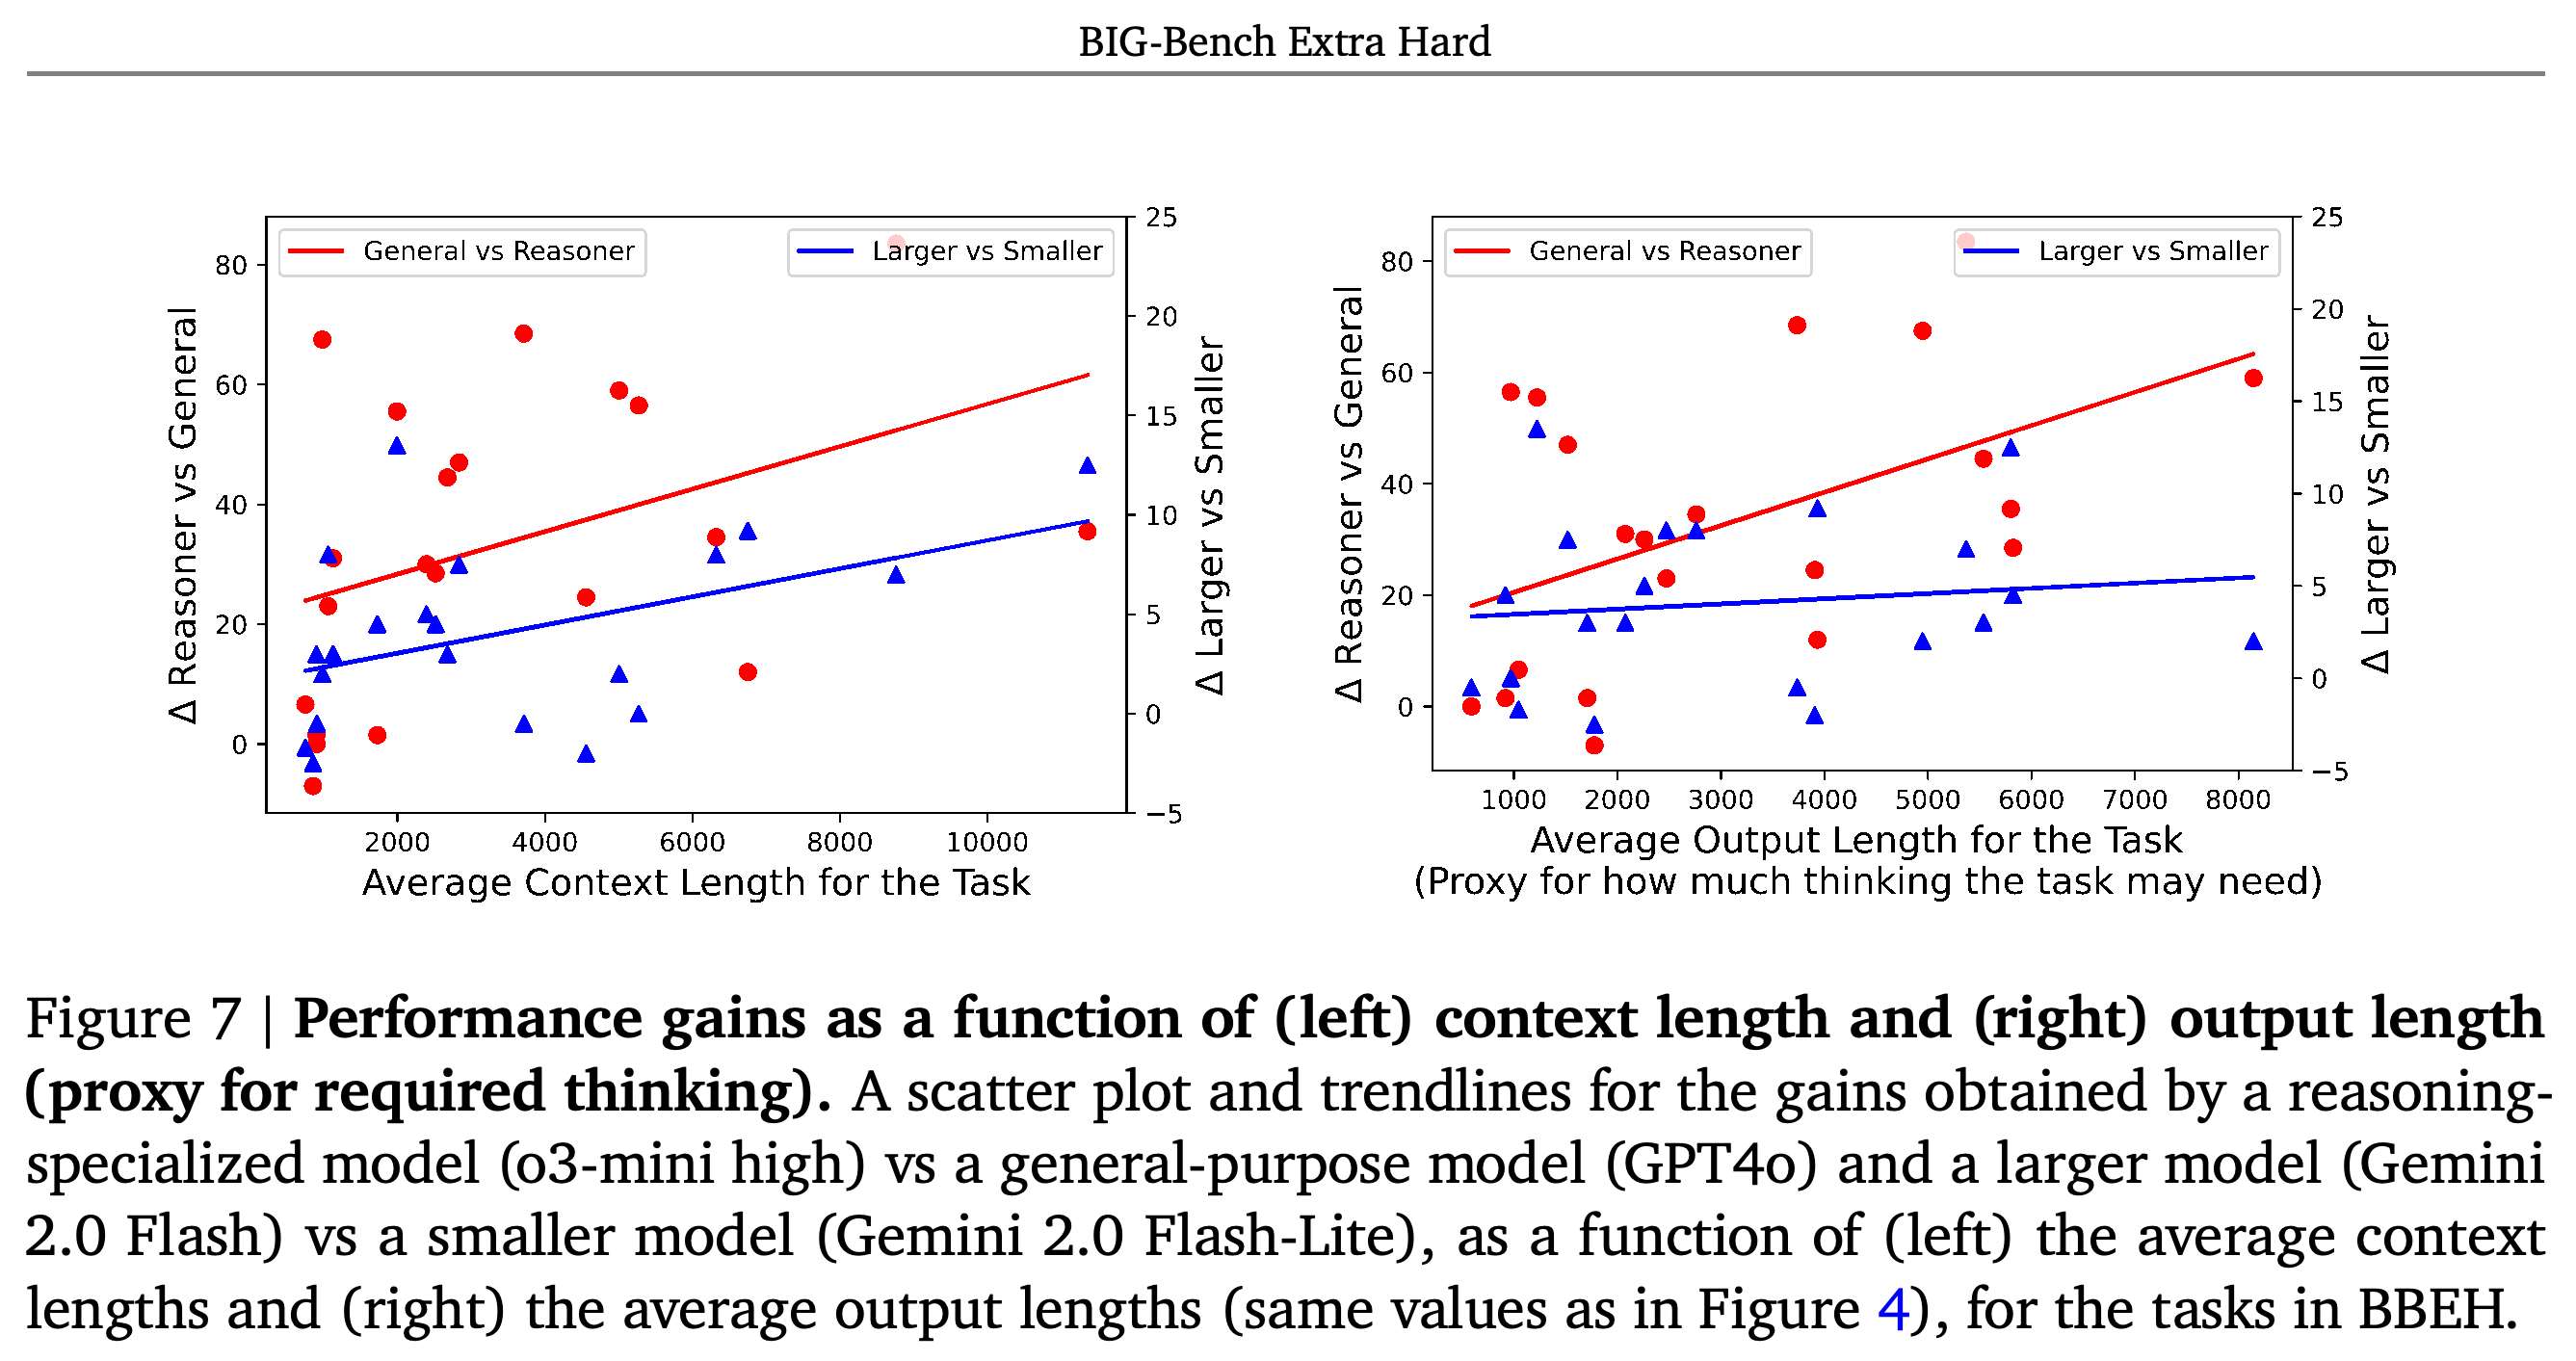
Figure 7에서 GPT-4o 대비 o3-mini (high)의 개선 폭은 평균 입력이 길수록, Gemini 2.0 Flash의 출력이 길수록 커지는 경향을 보인다. Flash-Lite 대비 Flash의 개선 폭도 입력 길이에 따라 커지지만, 출력 길이에 대해서는 대체로 일정하다. Shuffled Objects는 출력 예산 소진과 생성 품질 저하가 잡음을 더하므로 제외한다.
- 이 결과는 출력 길이를 필요한 사고량의 대리 지표로 삼아 서로 다른 과제 사이에서 관찰한 연관성이다. 입력 길이나 추론 요구량을 늘리는 것이 관찰된 성능 차이를 유발한다는 인과관계를 입증하지는 않는다.
데이터에 맞춘 추세선 2개는 모두 입력 길이에 따라 상승하지만, 출력 길이에 따라 뚜렷하게 상승하는 것은 o3-mini (high)와 GPT-4o의 비교뿐이다. 서로 다른 세로축 척도와 큰 산포 때문에 계열 2개를 직접 시각적으로 비교하는 데는 한계가 있다. 추세는 과제 간 연관성을 나타낸다.
6. Conclusion
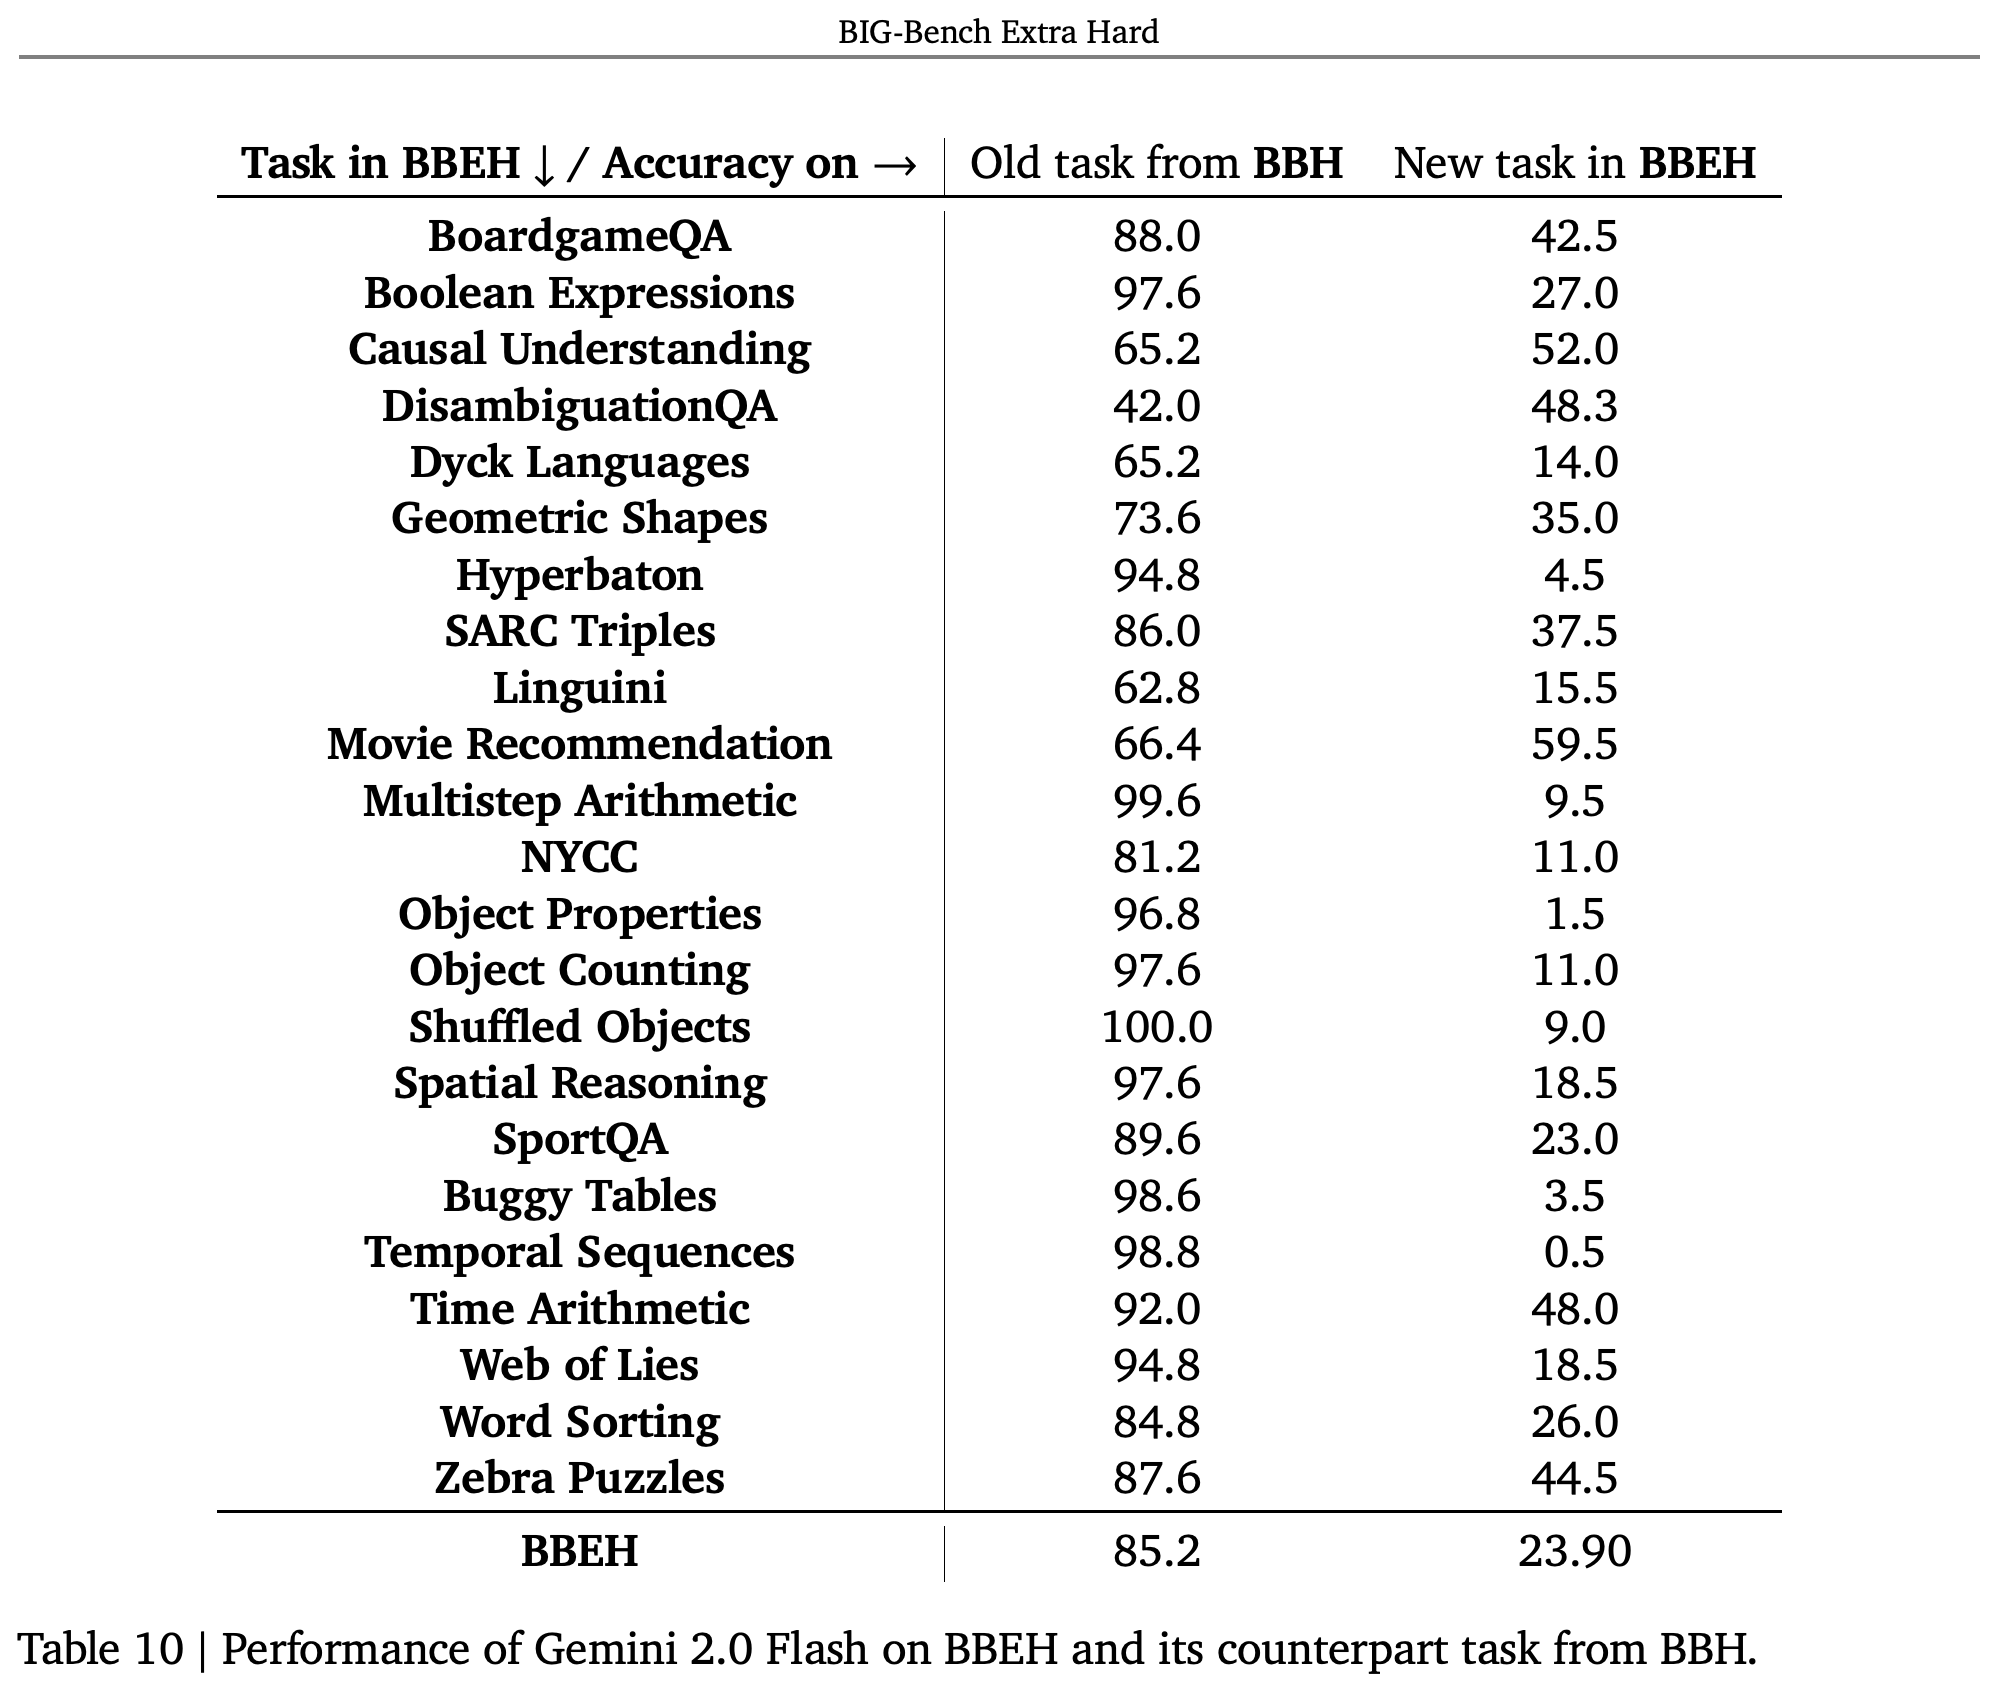
BBEH는 자동으로 채점하는 다양한 추론 과제에서 여전히 상당한 오류가 발생함을 보여 준다. 풀이 예제를 제공하지 않는 동일한 zero-shot 조건의 Table 10 비교는 난도 상승을 뒷받침한다. Gemini 2.0 Flash의 보고된 전체 정확도는 BBH의 85.2%에서 BBEH의 23.90%로 하락한다. 저자들은 풀이 예제를 포함하는 통상적인 few-shot 평가에서 예제를 제거하면 일부 BBH 프롬프트가 모호해질 수 있다고 지적한다.
평가 모델을 고정한 비교는 zero-shot 평가에서 대부분의 대체 과제가 더 어렵다는 직접적인 증거를 제공한다. 일정 계획, 표 처리, 상태 추적에서 큰 하락이 나타나는 한편 DisambiguationQA의 정확도는 개선된다. 부록은 이 개선을 원래 지시문의 모호성과 연결한다.
부록
- A. Detailed Description of the Tasks and Task-Specific Insights from Experiments는 23개 과제 전체의 구성과 개별 실패 양상을 설명한다. 실패 양상에는 불완전한 증명 탐색, 낯선 규칙의 적용 실패, 상태 추적 오류, 모호성 처리의 어려움, 여러 답변을 올바르게 결합하지 못하는 문제가 포함된다.
- A.1. BoardgameQA는 사실, 충돌할 수 있는 규칙, 규칙 간 우선순위를 이용해 진술이 증명되는지, 반증되는지, 알 수 없는지를 판정하며, 추론 깊이는 6, 7, 8이다. unknown 레이블은 예제의 1/3에 불과하지만, 인식 가능한 레이블이 포함된 응답 중 GPT-4o가 unknown을 예측하는 비율은 82.4%이며 DeepSeek R1은 39.7%다. 저자들은 과도한 unknown 예측을 주어진 사실과 규칙에서 증명을 찾는 데 어려움이 있다는 증거로 해석한다.
- A.2. Boolean Expressions는 텍스트와 수학적 진술을 포함한 피연산자를 and, or, not으로 결합한다. 각 질문은 5개 표현식 중 참인 것을 묻는다. 무작위 추측 정확도는 20%이며, 논리적으로 계산하기 전에 진술의 의미를 해석해야 한다.
- A.3. Buggy Tables는 손상된 데이터와 손상 방식에 대한 설명을 바탕으로 표를 복원한 뒤 조건부 통계 질의에 답하도록 요구한다. 손상 유형에는 null 값 제거, 불필요한 값 추가, 행 병합이 포함된다. 질의는 필터링한 행의 개수, 합계, 평균, 표준편차, 중앙값을 묻는다.
- A.4. Causal Understanding은 인과 판단 질문 142개와 필요원인 및 충분원인에 관한 질문 58개를 결합한다. 필요원인은 없으면 결과가 발생하지 않는 원인이며, 충분원인은 그것만으로 결과를 발생시키기에 충분한 원인이다. 인과 판단 부분집합은 사람 간 의견 불일치를 반영하여 Ambiguous 레이블 45개, Yes 48개, No 49개를 포함한다. 인과 추론 전문가 3명이 나머지 부분집합을 검토하고 모호성과 오류를 해소한 뒤 정답 6개를 변경했다. Gemini 2.0 Flash는 인과 판단에서 45%, 필요원인 및 충분원인에서 71%를 기록하며, Ambiguous 예제 45개 중 44개에서 오류를 낸다.
- A.5. Disambiguation QA는 대명사의 지시 대상을 판별하는 더 긴 예제 120개를 포함하며, 선택지를 늘리고 모호성을 해소할 수 없는 경우도 명시적으로 허용한다. 저자 10명이 예제를 작성하고 별도의 주석자가 독립적으로 검토했다. 의견 불일치는 조정이나 공동 수정으로 해소했으며, 예제 25개를 수정해야 했다.
- A.6. Dyck Languages는 올바르게 중첩된 괄호를 다루며, 제공된 chain-of-thought에서 최초 오류를 찾거나 오류가 없다고 판정하도록 요구한다. chain-of-thought는 중간 추론 단계의 연속이다. 추론 기록은 명시된 생성 설정인 temperature = 0에서 PaLM 2 Unicorn으로 생성한다. 추론 기록에 오류가 있고 o3-mini (high)가 오류 위치를 잘못 지목한 사례 중 98.7%는 최초 오류를 놓치고 그 뒤의 잘못된 단계를 지적한 경우다. 나머지 유형은 최초 오류보다 앞선 정상 단계를 오류로 지적한 경우다.
- A.7. Geometric Shapes는 도형을 그리는 언어인 SVG의 move 및 line 명령으로 지정한 도형을 식별하도록 요구한다. o3-mini (high)의 정확도는 선분을 나눈 횟수가 적을 때 58%, 많을 때 47%이며, 교차점이 없을 때 72%, 있을 때 33%다. 따라서 보고된 부분집합에서는 변경 2가지가 모두 난도를 높인다.
- A.8. Hyperbaton은 형용사 1~3개가 포함된 문장 50–250개에서 낯선 형용사 순서 규칙을 추론한 뒤 유효한 선택지를 모두 고르도록 요구한다. 예제는 부분 순서만 알려 준다. 제시된 o3-mini (high) 응답은 부분 순서 사슬 2개를 올바르게 추론하지만, 그 사이의 관계를 임의로 만들어 정답이 D뿐인 문제에서 ACDEHI를 선택한다.
- A.9. Linguini는 translation, fill blanks, num to text, text to num 범주에서 언어 추론 문제를 추출한다. 마지막 2개 범주는 숫자와 그 숫자를 나타내는 텍스트 사이의 변환을 다룬다. 원래 여러 답을 요구하던 질문은 요청된 답변 항목 중 1개를 무작위로 선택하여 단일 답변 질문으로 바꾼다.
- A.10. Movie Recommendation은 다음 영화 예측을 영화 집합 중 하나를 선택하는 문제로 바꾼다. 정답 집합은 원본 영화 평점 데이터셋인 MovieLens에서 많은 사용자가 공통으로 좋아한 영화 5개를 포함한다. 오답 집합에는 좋아한 영화와 싫어한 영화를 섞는다. 모델은 해당 사용자 집단이 좋아하는 영화만 포함할 가능성이 가장 높은 집합을 판단해야 한다.
- A.11. Multi-step Arithmetic은 낯설고 때로는 서로 의존하는 연산자와 그 합성을 소개한 뒤 긴 표현식을 계산하도록 요구한다. 저자들은 모델이 합성을 올바르게 설명하면서도 실제 계산에서는 연산을 누락할 수 있음을 관찰한다. 제시된 o3-mini 예제에서는 마지막 뺄셈을 빠뜨린다.
- A.12. NYCC는 쌍별 비교보다 선택 범위를 넓히고 선행 연구가 제공한 만화의 텍스트 설명을 사용하여 캡션 선택을 어렵게 만든다. 이 과제는 크라우드소싱으로 수집한 유머 평가와의 일치 여부를 측정한다. 제시된 질문의 정답 캡션은 9번이다.
- A.13. Object Properties는 색상, 크기, 원산지, 냄새, 재질 속성을 가진 객체 집합을 갱신한 뒤 개수를 묻는 질의에 답하도록 요구한다. 어떤 객체를 잃었는지 의도적으로 명시하지 않더라도, 질문에서 요구하는 최종 개수는 달라지지 않는다. 그런데도 이러한 문제를 풀 수 없다고 선언하는 비율은 Gemini 2.0 Flash가 93.5%, GPT-4o가 96.5%이며, o3-mini (high)는 8%다.
- A.14. Object Counting은 다른 사람의 소유물 등 무관한 정보가 섞인 상황에서 객체 유형 2개의 개수 합이나 절대 차이를 묻는다. 합을 묻는 부분집합에서 Gemini 2.0 Flash는 문제의 50.5%에서 실제보다 많이 세고 38.5%에서 실제보다 적게 센다. GPT-4o는 17.5%에서 실제보다 많이 세고 66.5%에서 실제보다 적게 세어, 오류 방향이 서로 다르게 나타난다.
- A.15. SARC Triples는 독립적인 Reddit 게시물과 답글 예제 3개를 묶어 모든 비꼼 레이블을 하나의 응답으로 답하도록 요구한다. 원본 테스트 세트에서 100자 미만이거나 답글이 없는 예제를 제외하면 양성 레이블 비율이 48.4%인 예제 679개가 남는다. 이 중 600개를 무작위로 추출해 200개 묶음으로 구성한다.
- A.16. Shuffled Objects는 객체 교환 추적에 서로 상쇄되는 연산과 나중에 참조하는 이름 붙은 동작을 추가한다. 모델은 상쇄되는 교환을 단순화하기보다 모든 상태를 갱신하는 경우가 많다. Gemini 2.0 Flash는 문제의 25%에서 출력 예산을 소진한다. 요청된 할당 관계에 영향을 주는 간접 교환을 무시하는 실패도 관찰된다.
- A.17. Spatial Reasoning은 더 긴 경로와 교차하는 관측을 추가하여, 나중의 관측으로 이전 위치를 추론하는 역방향 추론을 요구한다. o3-mini (high)는 순방향만 필요한 문제에서 58.8%, 역방향 문제에서 19.2%를 기록한다. DeepSeek R1은 각각 48.6%와 3.8%를 기록한다.
- A.18. SportQA는 가장 어려운 Level 3에서 6개 스포츠를 다루는 다단계 질문 200개를 선택한다. 각 예제는 주 질문과 하위 질문을 포함하며, 모든 항목에 올바르게 답해야 한다. 따라서 세부적인 스포츠 지식과 조합적 추론을 함께 요구한다.
- A.19. Temporal Sequences는 주간 달력과 시간대, 휴식, 참석 제한 등의 제약을 제공하고, 가능한 최장 회의 시간과 그 길이로 회의를 잡을 수 있는 경우의 수 2가지를 모두 묻는다. o3-mini (high)는 결합 과제에서 68.5%를 기록하지만, 최장 시간만 평가하면 78%를 기록한다. 이는 요구 사항을 결합할 때 난도가 추가로 높아짐을 보여 준다.
- A.20. Time Arithmetic은 시간 추론 벤치마크인 Test of Time의 날짜 및 시간 문제를 합성하며, 다른 과제에서 이미 다루는 일정 계획 문제는 제외한다. 첫 답변 X를 X’ = X + (A2 - A1)로 변환하여 뒤의 질문에 삽입한다. 여기서 A1은 원래 첫 질문의 정답이고, A2는 두 번째 질문에 사용된 숫자다. 이를 풀려면 중간값을 올바르게 전달해야 한다.
- A.21. Web of Lies는 LiveBench 벤치마크 변형의 예제 40개와 진술 간 순환 관계 및 알 수 없는 진릿값을 포함한 새 예제 160개를 결합한다. o3-mini (high)는 전자에서 100%, 후자에서 28.8%를 기록하며, Gemini 2.0 Flash는 각각 77.5%와 3.8%를 기록한다. 이는 새 변형의 난도가 더 높음을 보여 준다.
- A.22. Word Sorting은 제공된 정렬 기록의 최초 오류 찾기와 수정된 알파벳 순서에 따른 정렬을 결합한다. 제시된 Gemini 2.0 Flash 응답은 새 알파벳 순서를 올바르게 서술하지만 단어는 일반적인 영어 순서로 반환한다. 이는 명시적으로 인식한 규칙을 적용하지 못한 사례다.
- A.23. Zebra Puzzles는 언어로 제시한 단서에서 개체와 속성의 할당 관계를 추론하며, 격자 크기는 5x5, 6x6, 7x7, 8x8이다. 앞의 3개 크기에는 방해 단서가 포함된다. o3-mini (high)는 방해 단서가 있는 7x7 퍼즐에서 55.4%, 방해 단서가 없는 8x8 퍼즐에서 74.0%를 기록한다. 이는 방해 단서에 대한 민감성을 시사하지만, 크기와 방해 단서의 유무가 함께 달라진다는 한계가 있다.
- B. BBEH vs BBH Performance는 zero-shot 조건에서 대응하는 과제에 대한 Gemini 2.0 Flash의 성능을 비교한다. 거의 모든 대체 과제에서 정확도가 하락한다. Temporal Sequences는 98.8%에서 0.5%로, Hyperbaton은 94.8%에서 4.5%로 하락한다. DisambiguationQA는 예외적으로 42.0%에서 48.3%로 상승한다. 저자들은 모호한 BBH 지시에 대한 민감성을 확인하고, 문구를 수정하면 선택한 답이 달라질 수 있음을 보여 준다.
- C. Reproducibility는 AI Studio, OpenAI API, Together AI의 애플리케이션 프로그래밍 인터페이스로 요청을 보내 호스팅 모델에 접근하는 방법과, Llama 및 Distill R1 Qwen을 그래픽 처리 장치에서 로컬 실행하는 방법을 설명한다. 답변은 “The answer is:” 접두사의 인식 가능한 변형 4개를 사용해 추출한다. 대소문자, 서식 표식, 따옴표, 대괄호, 소괄호, 쉼표 뒤 공백을 제한적으로 정규화한 뒤 정답 여부를 확인한다. 부록은 답변 추출과 채점을 명시하지만, 평가한 모든 모델의 디코딩 설정과 출력 예산을 제공하지는 않는다.
짧은 생각
BBEH의 진단적 가치는 다양한 과제별 결과를 낮은 성능에 민감한 집계 지표와 함께 보고하는 데 있다. DeepSeek R1의 마이크로 평균 34.9%와 보정 조화 평균 6.8%는 일부 과제의 높은 성능과 다른 과제의 심각한 실패가 공존할 수 있음을 보여 준다.
실험은 벤치마크 난도가 높아졌고 역량별 개선이 고르지 않음을 보여 준다. 모델 크기나 추론 특화에 관한 더 넓은 주장을 뒷받침하는 범위는 제한적이다. 비교에서 학습 방식, 파라미터 수, 답변 생성 중 사용한 연산량을 분리하지 않으며, 일부 실패는 출력 소진이나 최종 답변 누락과 관련된다. 따라서 집계 순위를 해석하려면 과제별 점수와 실패 추론 기록을 함께 살펴봐야 한다.