


BOLT: Bootstrap Long Chain-of-Thought in Language Models without Distillation 요약 설명
06 Feb 2025 | Paper Review Reasoning Synthetic Data Direct Preference Optimization목차
이번 글에서는 BOLT: Bootstrap Long Chain-of-Thought in Language Models without Distillation 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 2월 6일(Arxiv)
- Pang, Bo, Dong, Hanze, Xu, Jiacheng, Savarese, Silvio, Zhou, Yingbo, Xiong, Caiming.
- Salesforce AI Research
- 논문 링크
요약
- Bootstrapping LongCoT(BOLT)는 기존 LongCoT 모델의 출력에서 추론을 증류하지 않고도 언어 모델이 긴 사고 과정(LongCoT)을 생성하도록 학습하는 방법을 다룬다. LongCoT는 최종 답변에 앞서 생성하는 긴 추론 과정이다. BOLT는 원래 Meta-Llama-3.1-8B-Instruct 모델과 비교해 응답 길이와 markdown 스타일을 통제하는 고난도 질의 평가인 Arena-Hard-SC 점수를 18.3에서 44.1로, 경시대회 수학 평가인 MATH500 점수를 52.9에서 60.0으로 높인다.
- 이 방법은 예시 10개로 구성된 풀을 사용해 Llama-3.1-70B-Instruct에 in-context learning을 적용한다. 프롬프트에 포함한 시범 예시를 조건으로 응답을 생성하는 방식이다. 생성한 응답을 필터링한 뒤, 선별한 예시 응답으로 지도 미세조정(SFT)을 수행한다. 이후 현재 모델에서 샘플링한 선호 응답과 비선호 응답으로 학습하는 온라인 Direct Preference Optimization(DPO)을 적용한다. 일반적인 사용자 지원, 논리, 수학을 다루는 벤치마크 5개에서 7B, 8B, 70B 모델 모두 성능이 향상된다. 여기서 B는 파라미터 10억 개를 뜻한다.
- 실험은 전체 파이프라인의 효과를 뒷받침하지만, 긴 추론 자체의 이점을 추가 학습이나 추론 연산의 효과와 분리하지는 않는다. 질의가 주어졌을 때 최종 답변에 점수를 매기는 outcome reward model(ORM)이 추론 단계를 직접 평가하지 않고 품질 피드백을 제공한다. 온라인 학습에서는 응답 형식 준수에도 보상을 부여한다. 부록의 긴 응답 사례에는 근거가 부족한 계산과 결론도 포함된다.
1. Introduction
서론은 분석, 계획, 대안 탐색, 성찰, 되돌아가기를 수행하는 LongCoT 모델과 더 짧고 단순하게 추론하는 일반적인 ShortCoT 모델을 구분한다. BOLT는 기존 LongCoT 모델이 생성한 추론으로 학습하는 지식 증류 없이 이러한 행동을 학습시키고, 평가 범위를 수학과 코딩 이외의 영역으로 넓히려 한다.
2. Related Work
관련 연구에서는 LongCoT 학습을 생성 응답에 부여한 보상으로 학습하는 강화학습, 그리고 모델 출력을 선별하거나 반복적으로 개선하는 방법과 연결한다. 저자들은 기존 LongCoT 교사 모델이 필요한 접근법과 BOLT를 비교하고, 671B-parameter 모델을 사용하는 동시기 DeepSeek 연구를 논의한다. 이 논의는 더 작은 모델을 실험하는 동기가 되지만, DeepSeek와 조건을 통제한 성능 비교는 제시하지 않는다.
3. BOLT
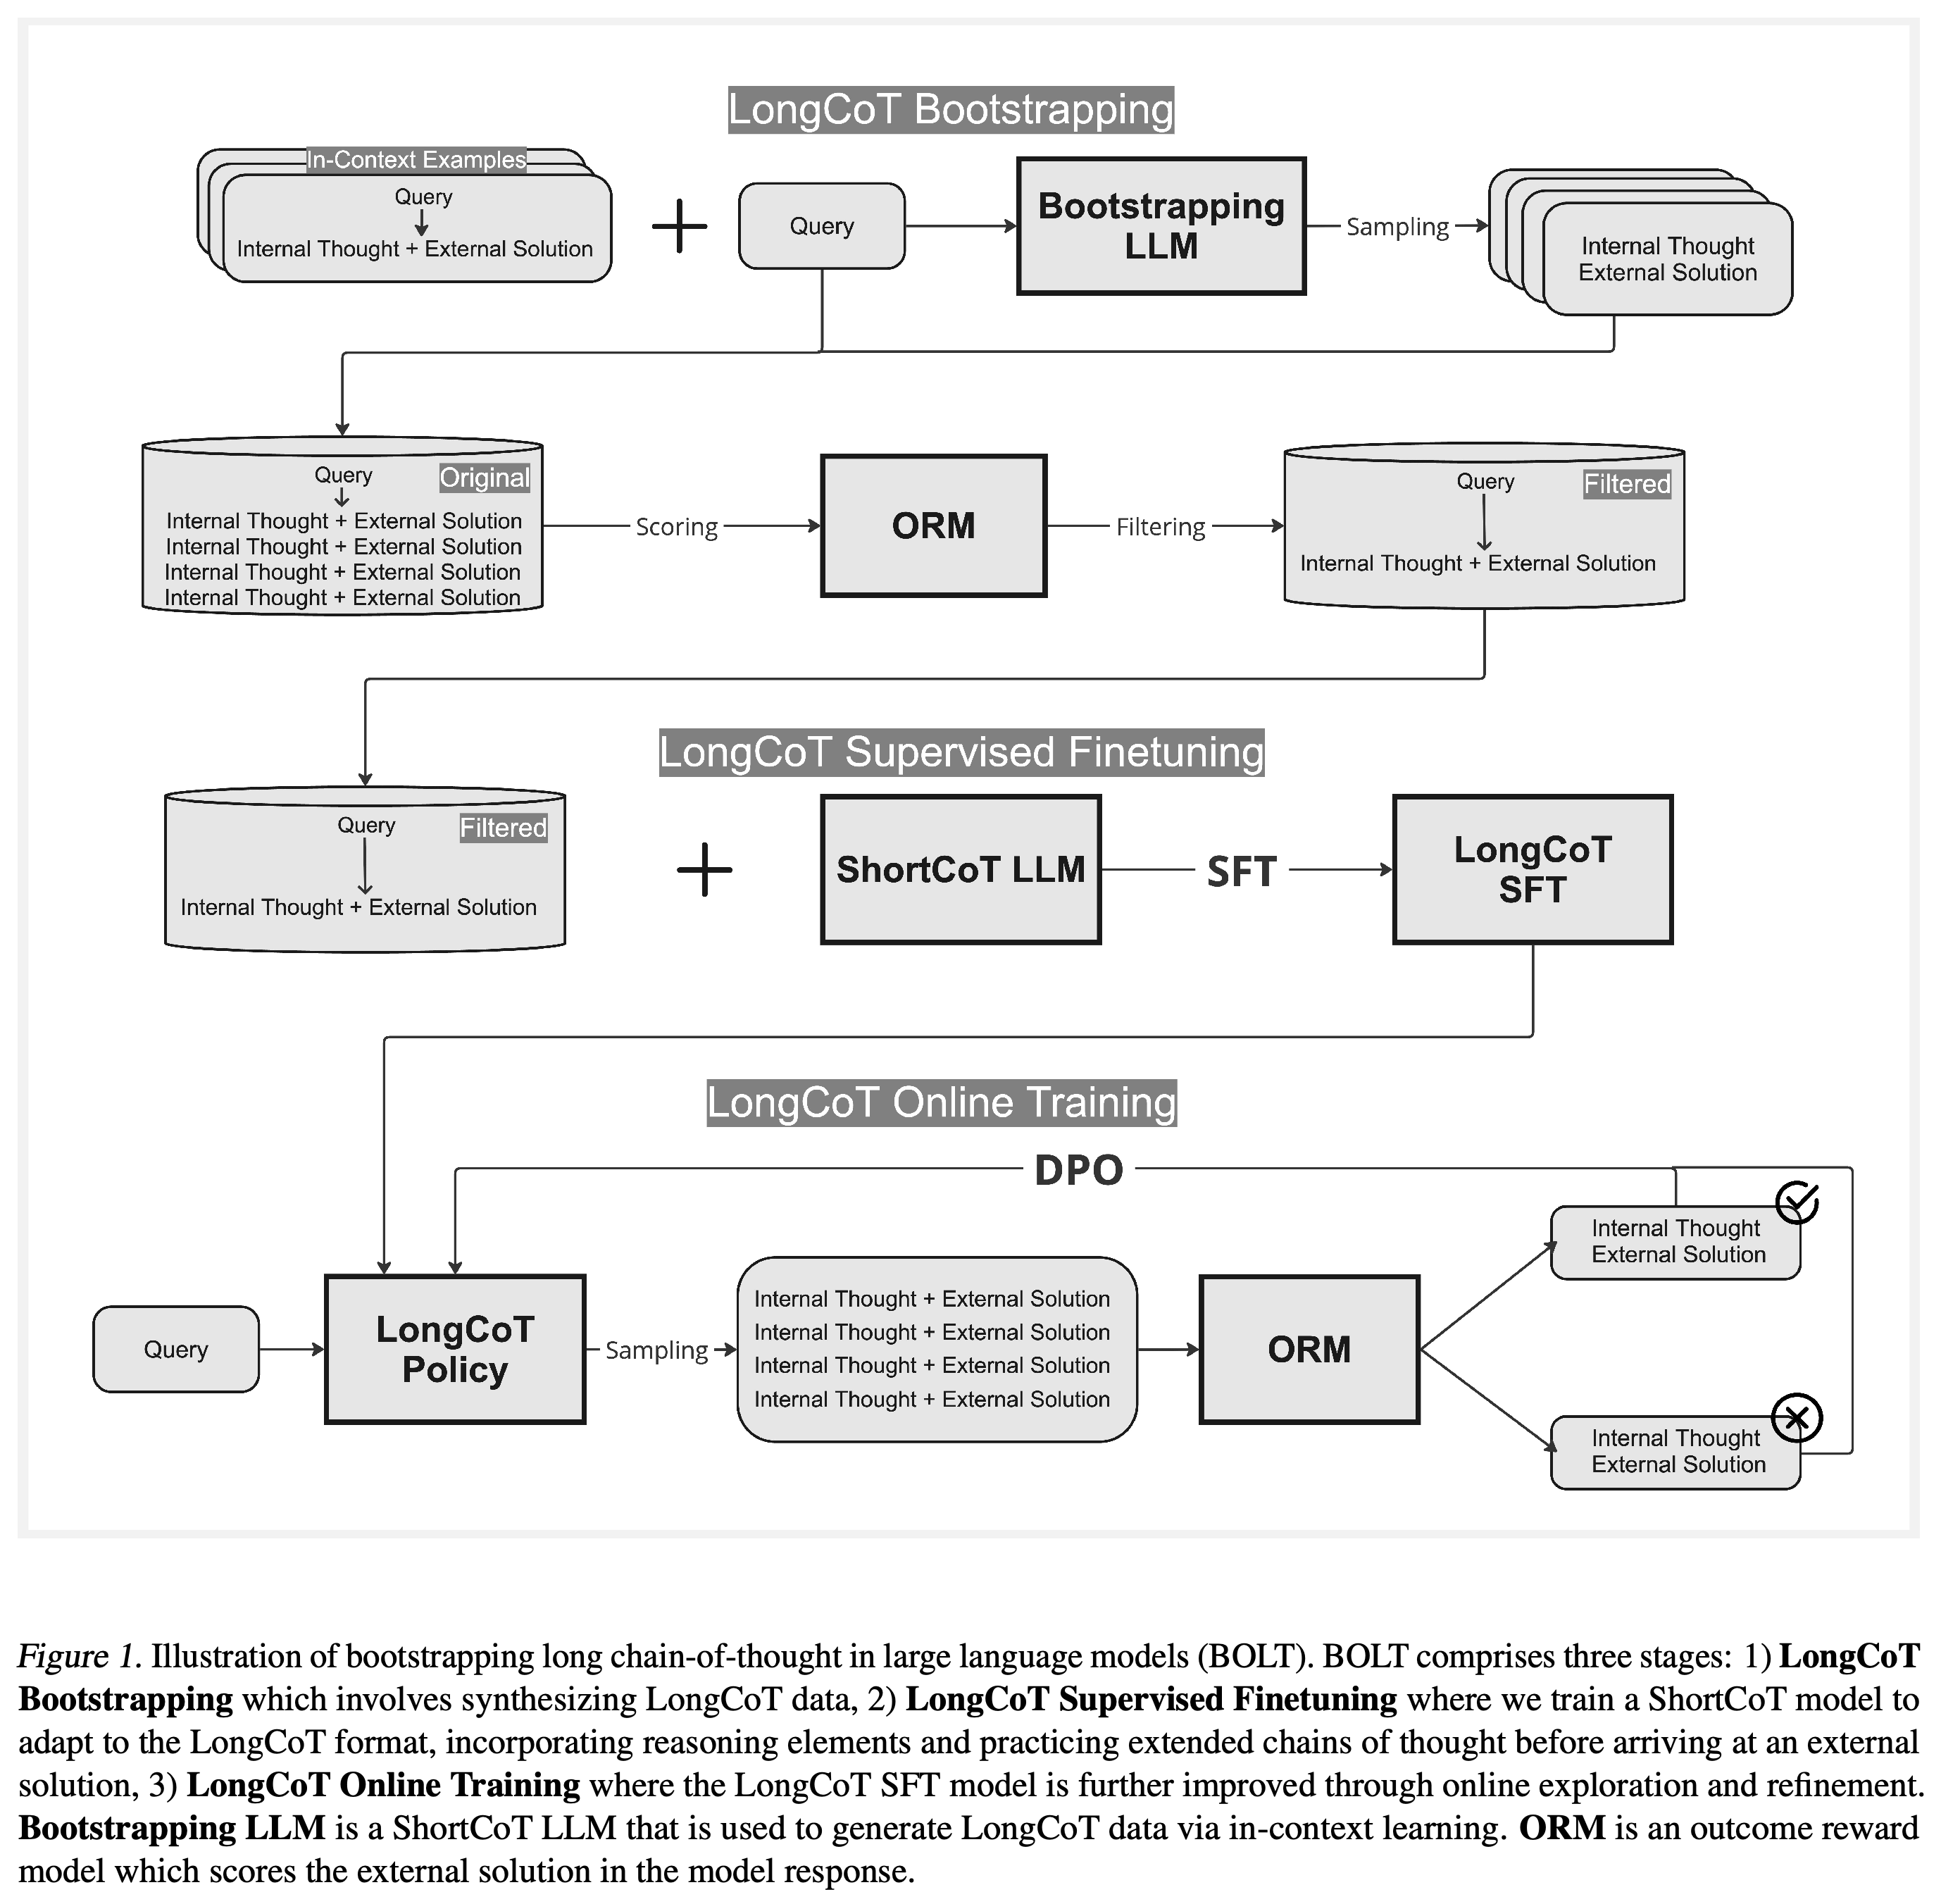
BOLT는 LongCoT Bootstrapping, LongCoT Supervised Finetuning, LongCoT Online Training을 결합한다. 각 예시는 질의 x, 생성한 내부 사고 z, 사용자에게 제시하는 외부 해답 y로 구성된다. 저자들은 초기 프롬프트 엔지니어링 시도와 응답을 생성하는 actor 및 이를 평가하는 judge를 활용한 멀티에이전트 시도가 불안정하거나 신뢰하기 어려웠다고 보고한다. 다만 이러한 초기 접근법에 대한 정량 비교는 제공하지 않는다.
데이터 흐름은 결과 점수의 2가지 용도를 보여준다. 지도학습 전에는 부트스트래핑 예시를 선별하고, 온라인 학습 중에는 선호 쌍을 구성한다. 이 경우 2가지 모두 채점기는 외부 해답을 평가한다. 이후 지도학습에서는 선택된 추론 과정의 정확성을 별도로 평가하지 않은 채 해당 추론을 학습시킨다.
3.1.1. LongCoT with in-Context Learning
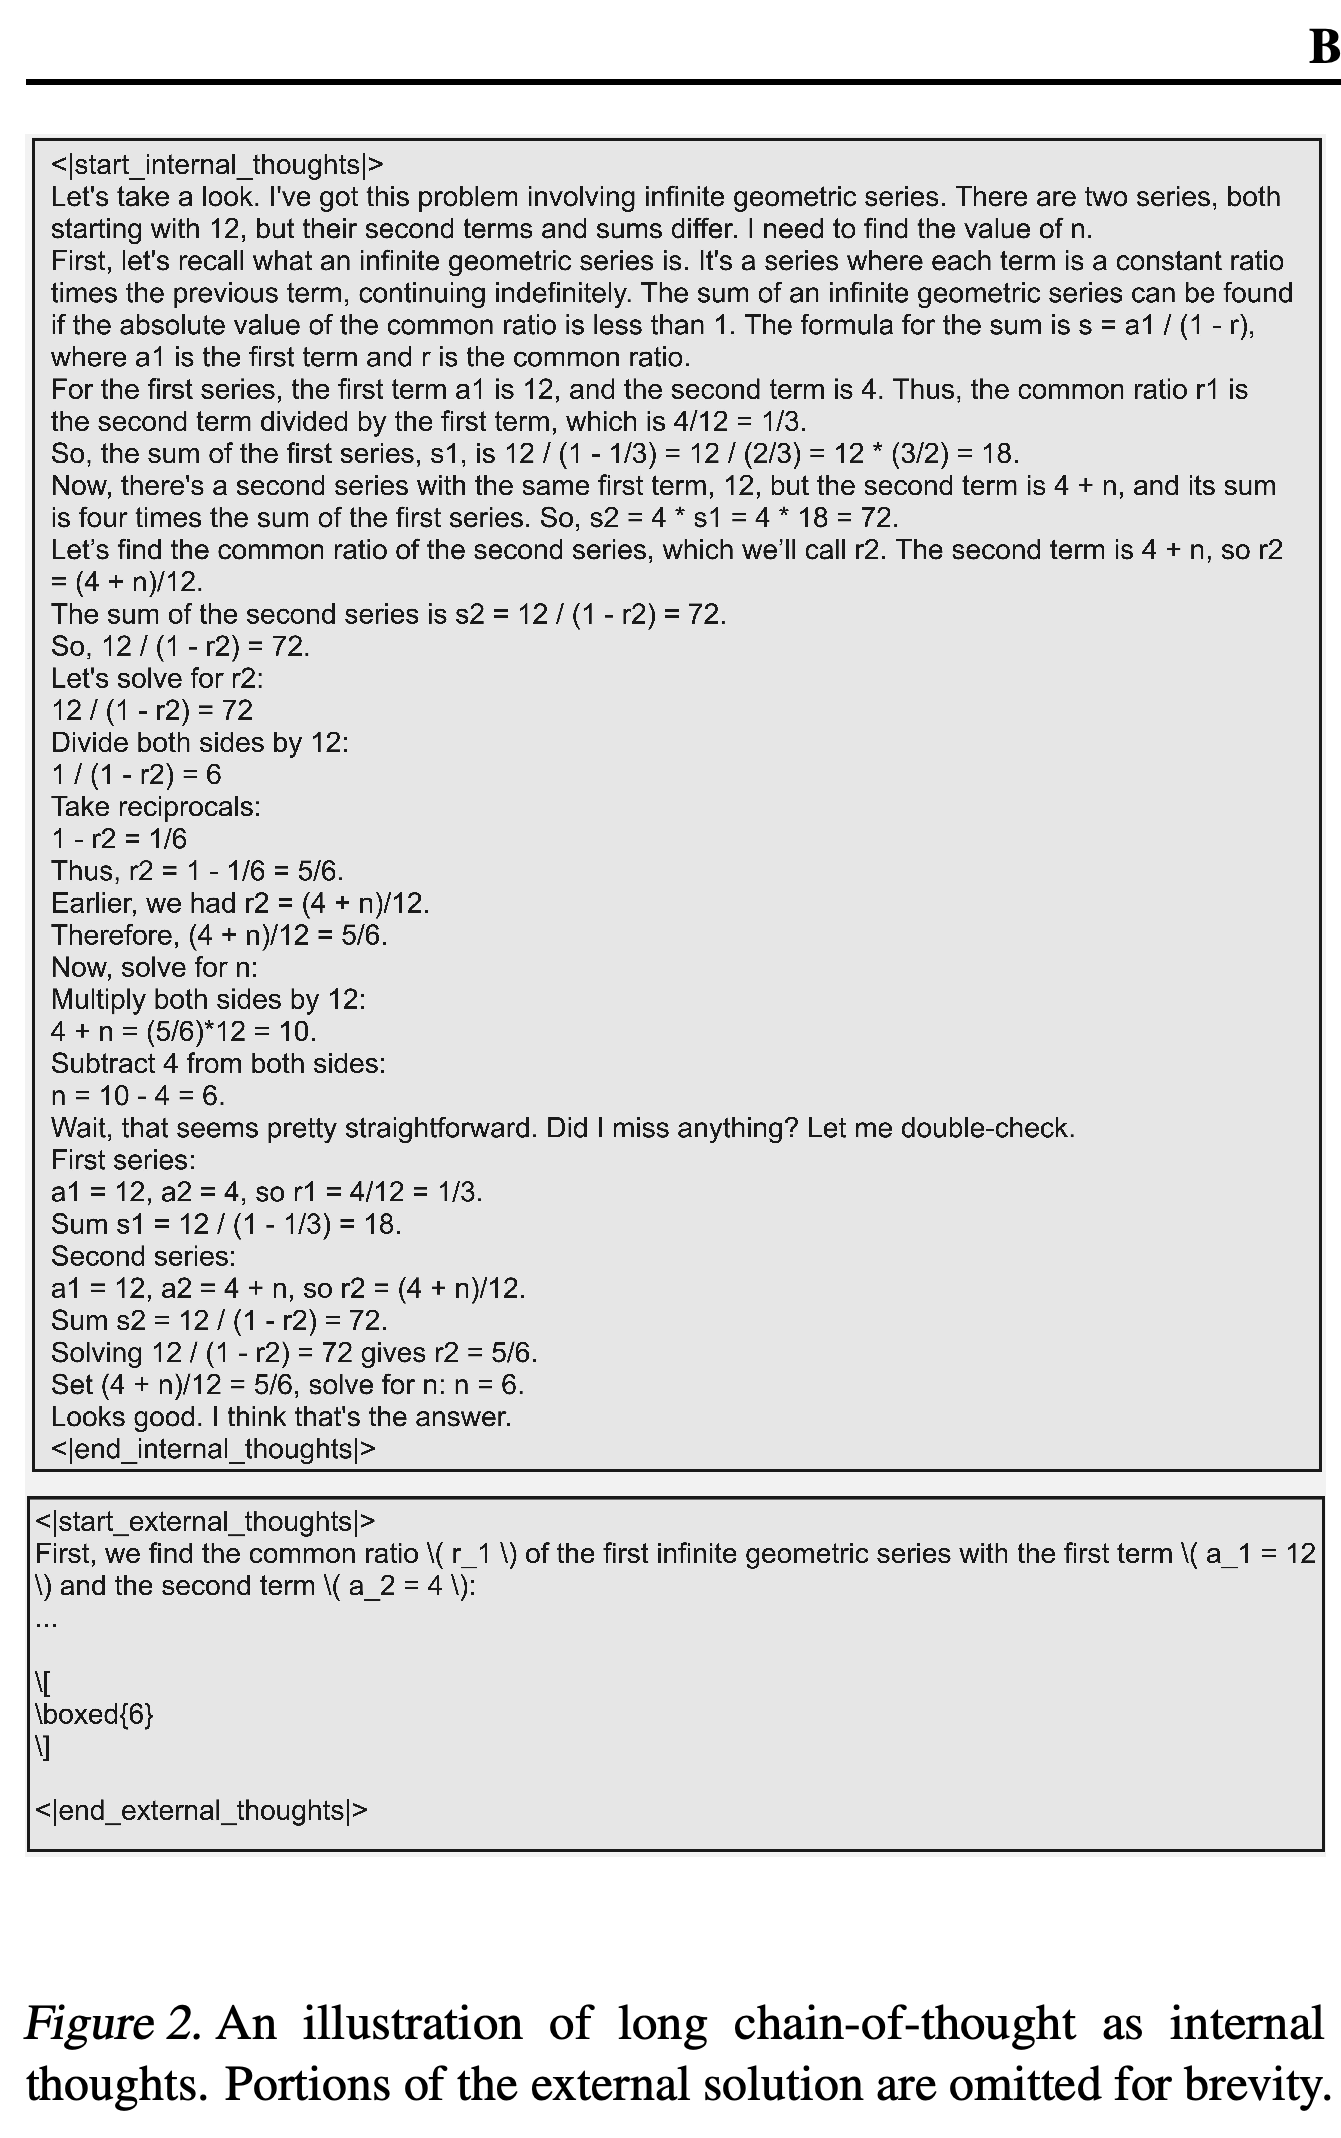
초기 LongCoT 행동은 충분한 역량을 갖춘 ShortCoT 모델에 시범 예시를 프롬프트로 제공해 유도한다. 저자들은 질의, 내부 사고, 외부 해답으로 구성된 예시 10개를 수집하며, 이 예시들은 문제 분석, 계획, 분기 탐색, 성찰을 보여준다. Figure 2는 탐색적 추론과 최종 응답을 구분하는 구조를 보여준다.
이 예시는 긴 계산과 검토 부분을 더 짧은 외부 해답과 구분한다. 의도한 응답 구조를 보여주지만, 생성 데이터 전반에서 검토가 얼마나 자주 이루어지거나 오류를 수정하는지는 측정하지 않는다.
3.1.2. Query Mixture Curation
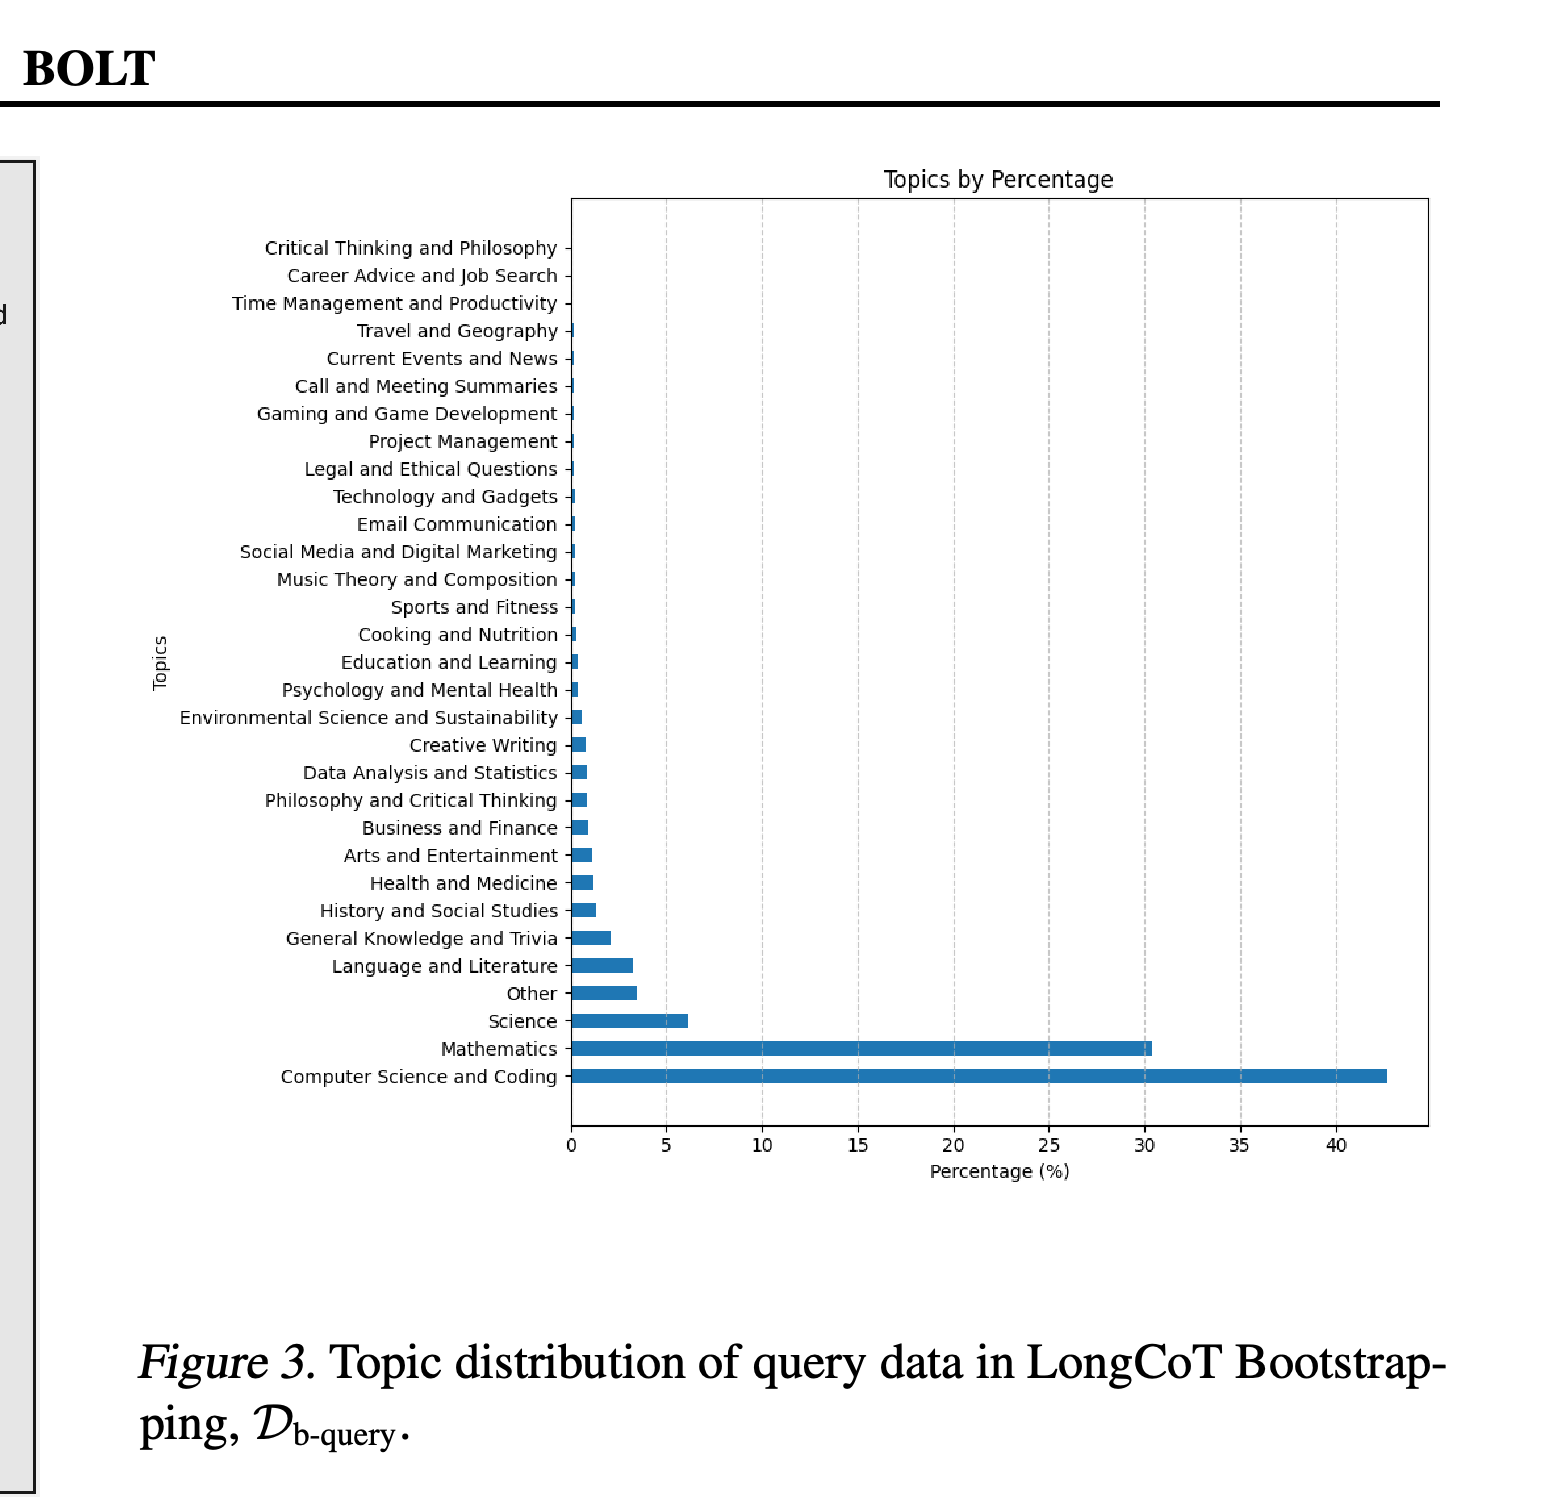
질의 선별 과정에서는 공개 instruction 데이터셋의 첫 번째 턴 질의를 남기고, 이진 기준 7개로 각 질의를 평가해 점수가 5 이상인 질의만 유지한다. 기준은 구체성, 도메인 지식, 복잡성, 문제 해결, 창의성, 기술적 정확성, 실제 적용 가능성이다. 이후 주제 태깅과 부분 샘플링으로 주제 분포를 조정한다. Figure 3에서는 여전히 코딩과 수학의 비중이 가장 크다. 저자들은 이를 과제 난도와 이용 가능한 원본 데이터셋의 구성 때문이라고 설명한다.
주제별 부분 샘플링 이후에도 Computer Science and Coding과 Mathematics의 비중이 가장 크다. 다른 주제도 포함되지만, 질의 구성은 이 2개 영역에 집중되어 있다.
3.1.3. Response Generation
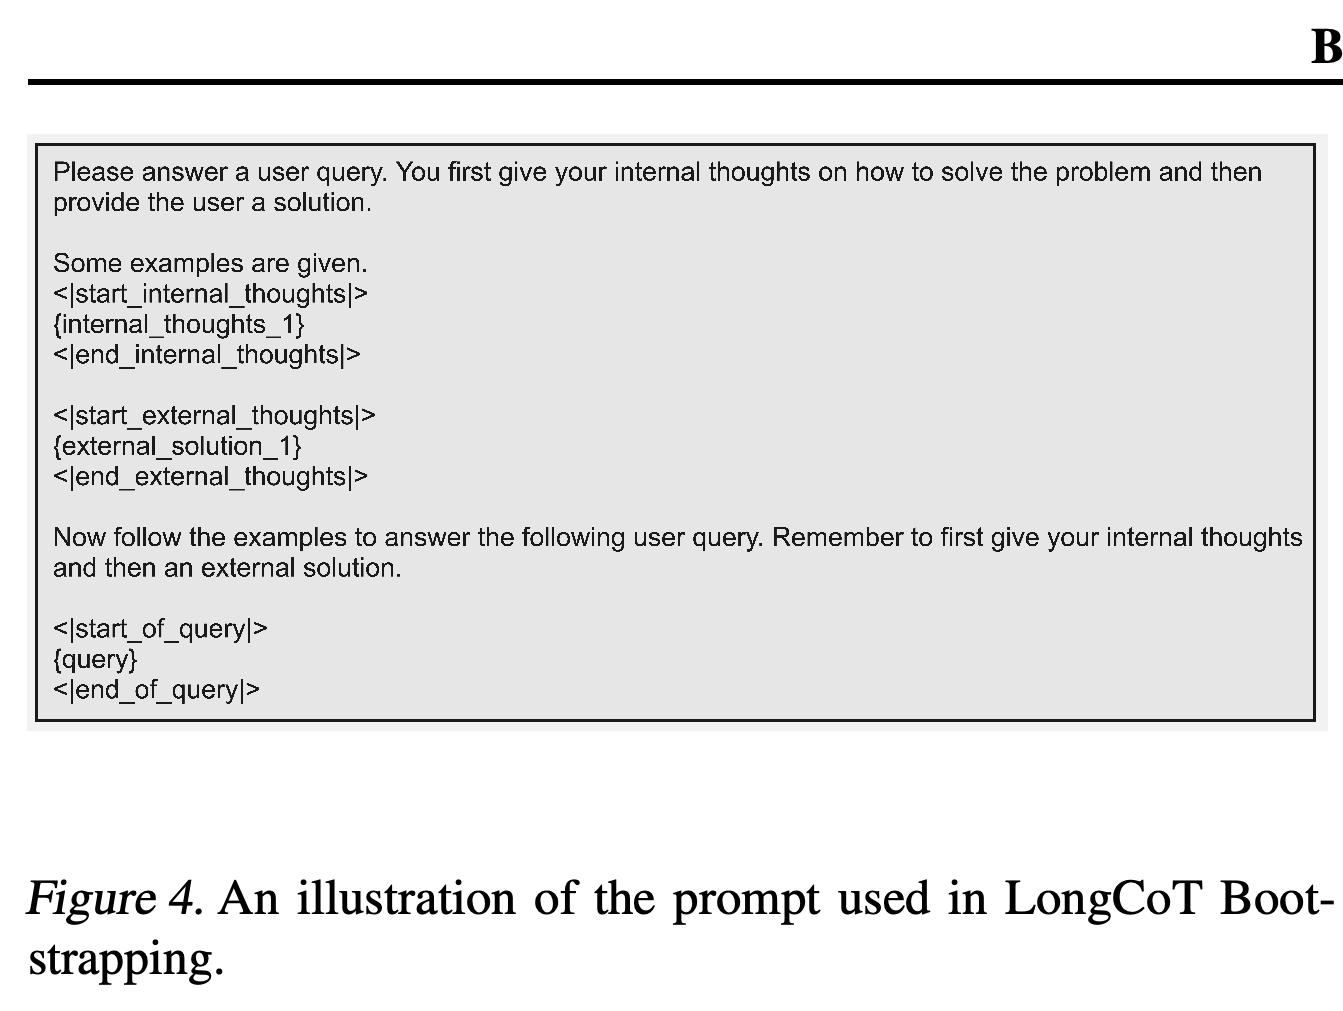
각 질의에 대해 Llama-3.1-70B-Instruct는 시범 예시 10개 중 3개를 사용해 후보 응답 8개를 생성한다. Figure 4는 내부 사고에 이어 외부 해답을 작성하도록 요청하는 프롬프트 템플릿을 보여준다. 저자들은 이 프롬프트 절차로 Llama-3.1-8B-Instruct가 요청된 LongCoT 응답을 안정적으로 생성하지 못한다고 보고한다. 따라서 충분한 역량을 갖춘 부트스트래핑 모델이 실제 적용에 필요하다.
이 템플릿은 시범 응답과 함께 새 질의, 내부 사고, 외부 해답을 구분하는 명시적인 구분자를 사용한다. BOLT 학습 전에 기존 instruction 모델이 원하는 출력 형식을 따르도록 프롬프트를 구성하는 방법을 보여준다.
3.1.4. Response Filtering
응답 필터링에서는 먼저 시범 예시의 형식을 따르지 않는 출력을 제거한다. 이후 ORM으로 외부 해답에 점수를 매기고, 전체 점수 분포의 30백분위수 미만인 후보를 제거한 뒤 질의마다 남은 응답 중 점수가 가장 높은 응답을 선택한다. 저자들에게는 내부 사고를 평가하는 보상 모델이 없으므로, 이 과정은 추론 과정을 직접 검증하지 않고 답변 품질을 기준으로 응답을 선별한다.
3.2. LongCoT Supervised Finetuning
필터링한 질의, 사고, 해답 예시로 ShortCoT 모델을 학습해 외부 응답 전에 내부 사고를 생성하도록 한다. 학습 대상 모델은 부트스트래핑 모델과 달라도 되므로, 생성한 데이터셋으로 다양한 아키텍처와 크기의 모델을 학습할 수 있다. 이렇게 얻은 모델을 온라인 학습의 초기 모델로 사용한다.
3.3. LongCoT Online Training
온라인 학습의 목적 함수는 기대 보상을 최대화하면서 Kullback–Leibler 발산으로 SFT 모델에서 벗어나는 정도에 페널티를 부여한다. 이 발산은 응답 분포 간 차이를 측정한다. 보상에는 외부 해답 점수와 정해진 형식을 따르는지에 대한 규칙 기반 보상이 포함된다. 채택한 구현에서는 현재 모델이 생성한 샘플 8개 중 점수가 가장 높은 응답과 가장 낮은 응답을 각각 선호 응답과 비선호 응답으로 삼아 DPO를 적용한다.
4. Experiments
실험에서는 여러 모델 크기와 과제 영역에 걸쳐 BOLT를 초기 모델과 비교한다. 이어 학습 중 성능 변화를 살펴보고, 보상 모델, 초기 모델, 온라인 학습 알고리즘을 바꾸어 각 선택이 보고된 점수에 미치는 영향을 평가한다.
4.1. Experiment Setup
주요 초기 모델은 Mistral-7B-Instruct-v0.3, Meta-Llama-3.1-8B-Instruct, Meta-Llama-3.1-70B-Instruct다. 파이프라인 구성 요소를 바꾸는 별도 ablation 실험에서는 Meta-Llama-3.1-8B-base에서 시작한다. 평가는 8개 영역의 멀티턴 사용자 지원을 다루는 MT-Bench, 실제 사용자의 어려운 질의를 다루는 Arena-Hard-SC와 WildBench, 논리 격자 퍼즐을 다루는 ZebraLogic, 경시대회 수학을 다루는 MATH500을 사용한다. ZebraLogic은 퍼즐 전체를 해결한 비율 대신 격자 항목 중 정답의 비율인 셀 단위 정확도를 보고한다.
SFT는 예시 220k개를 사용해 4에포크 동안 수행하며, 에포크는 데이터셋 전체를 순회하는 단위다. 최대 시퀀스 길이는 16,384, 배치 크기는 128, 학습률은 2e-5이며, 코사인 학습률 스케줄, 워밍업 비율 0.1, AdamW 옵티마이저를 사용한다. 온라인 학습에서는 생성의 무작위성을 조절하는 샘플링 온도를 1.0으로, 샘플링에 전체 확률 질량을 사용하는 top-p를 1.0으로 설정하고, 질의마다 샘플 8개를 생성한다. ORM은 ArmoRM-Llama3-8B이며, DPO 정규화 계수 β = 0.1, 학습률 5e-7, 코사인 스케줄, 워밍업 비율 0.1, 배치 크기 128, AdamW를 사용한다. 온라인 학습은 3회 반복하며, 반복마다 어려운 프롬프트 33k개로 2에포크 동안 학습한다. 보고된 SFT 시간은 7B/8B의 경우 8xH100 가속기 노드 1대에서 약 6시간, 70B의 경우 8xH100 노드 8대에서 약 5시간이다. 온라인 학습은 7B/8B의 경우 8xH100 노드 1대에서 약 14시간, 70B의 경우 8xH100 노드 8대에서 약 20시간이 걸린다.
4.2. Main Results
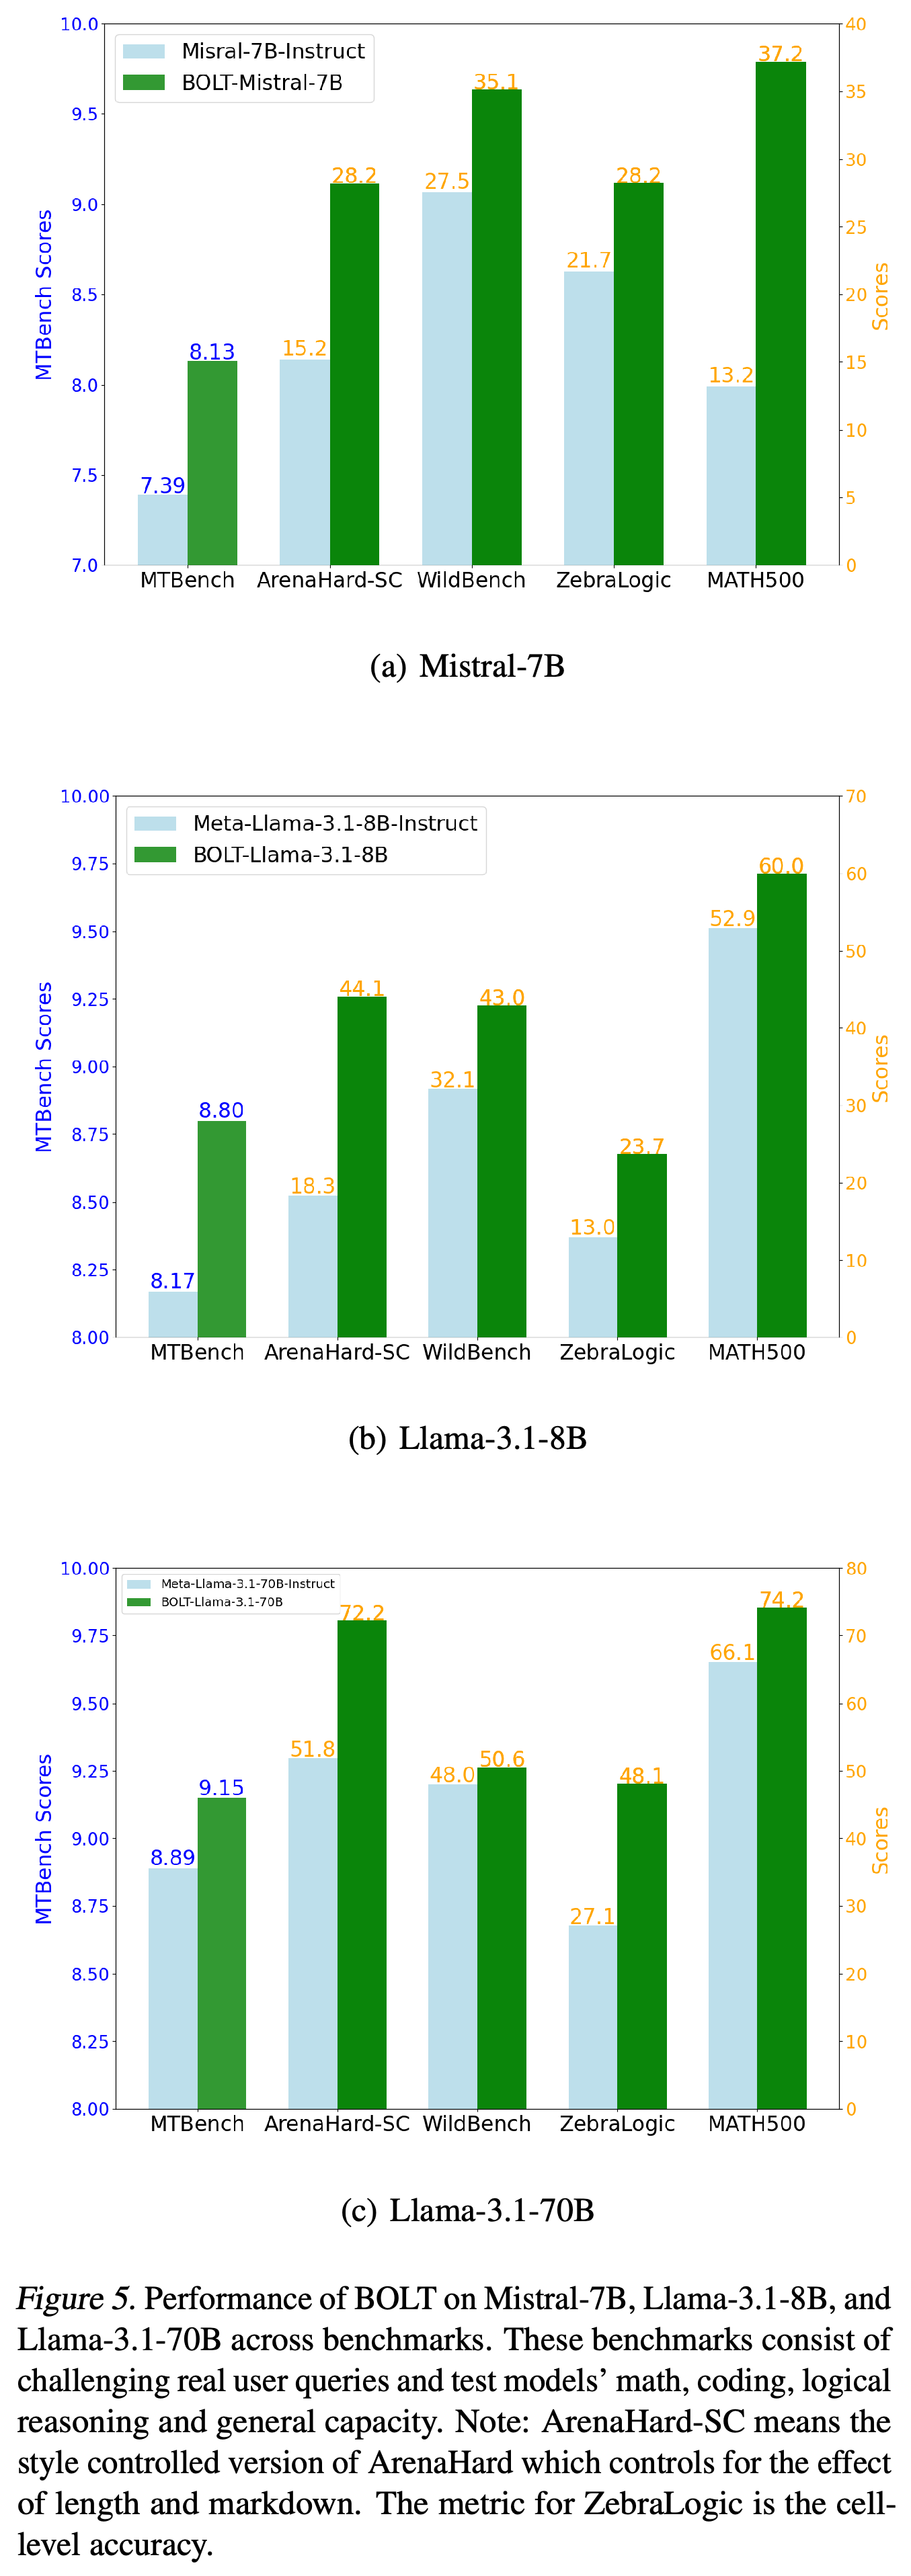
Figure 5는 벤치마크 5개 모두에서 각 원래 instruction 모델보다 성능이 향상되었음을 보고한다. Mistral-7B는 Arena-Hard-SC에서 15.2에서 28.2로, MATH500에서 13.2에서 37.2로 상승한다. Llama-3.1-8B는 같은 평가에서 각각 18.3에서 44.1로, 52.9에서 60.0으로 상승한다. Llama-3.1-70B는 Arena-Hard-SC에서 51.8에서 72.2로, ZebraLogic에서 27.1에서 48.1로, MATH500에서 66.1에서 74.2로 상승한다. WildBench에서는 48.0에서 50.6으로 상대적으로 작게 상승한다.
모든 모델과 벤치마크 조합에서 BOLT 적용 후 성능이 향상되지만, 향상 폭에는 큰 차이가 있다. Llama-3.1-70B는 Arena-Hard-SC에서 20.4점, WildBench에서 2.6점 상승한다. MT-Bench는 다른 평가와 별도의 세로축을 사용하고 ZebraLogic은 셀 단위 정확도를 측정하므로, 벤치마크 간 막대 높이를 직접 비교할 수 없다.
4.3. Performance Trajectory Over Training
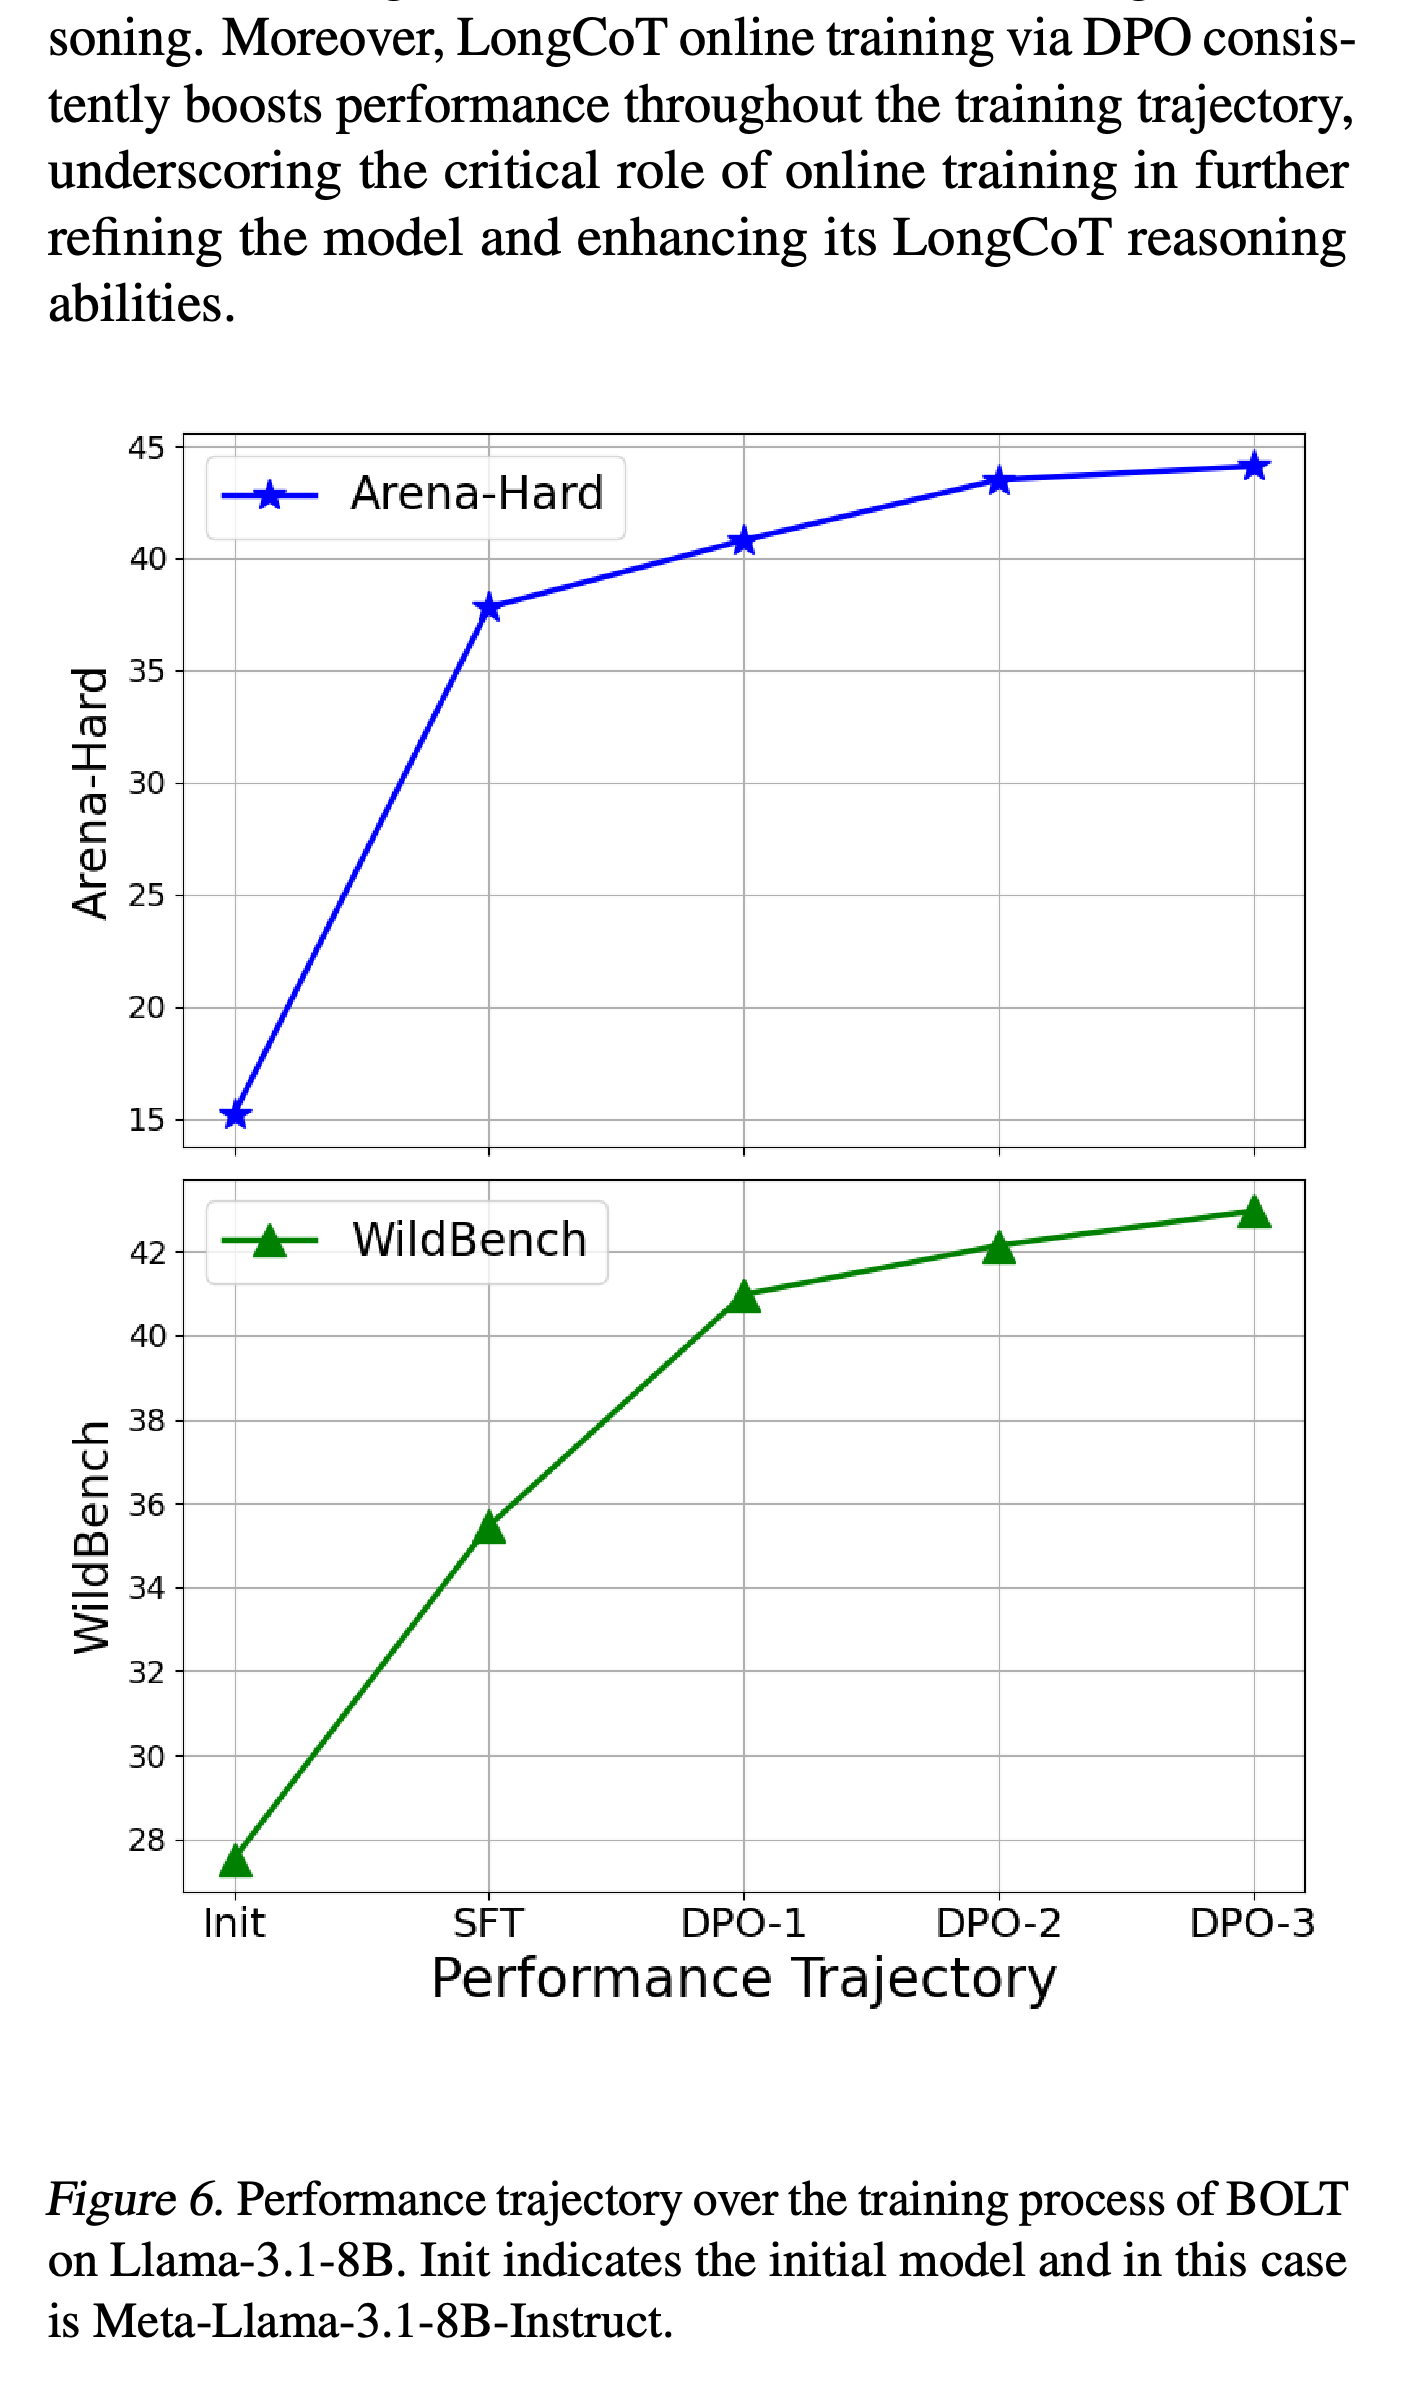
Figure 6는 Llama-3.1-8B의 초기 체크포인트부터 SFT와 DPO 3회 반복까지 성능 변화를 추적한다. SFT 직후 성능이 크게 향상되고, 이후 DPO를 반복할 때마다 그림에 표시된 Arena-Hard와 WildBench 결과가 개선된다. 이 변화는 학습 단계 2개 모두에서 성능이 향상됨을 보여준다. 다만 그림의 첫 번째 지표는 Arena-Hard로 표기되어 있으며, 주요 결과에서는 Arena-Hard-SC를 사용한다.
곡선은 SFT 이후 큰 성능 향상과 DPO-1, DPO-2, DPO-3을 거치며 이어지는 추가 향상을 보여준다. 이 그림은 온라인 선호 학습 중 점진적인 성능 향상을 뒷받침하지만, 불확실성 구간을 제공하지 않으며 위쪽 지표를 Arena-Hard로 표기한다.
4.4. Ablation on Reward Models
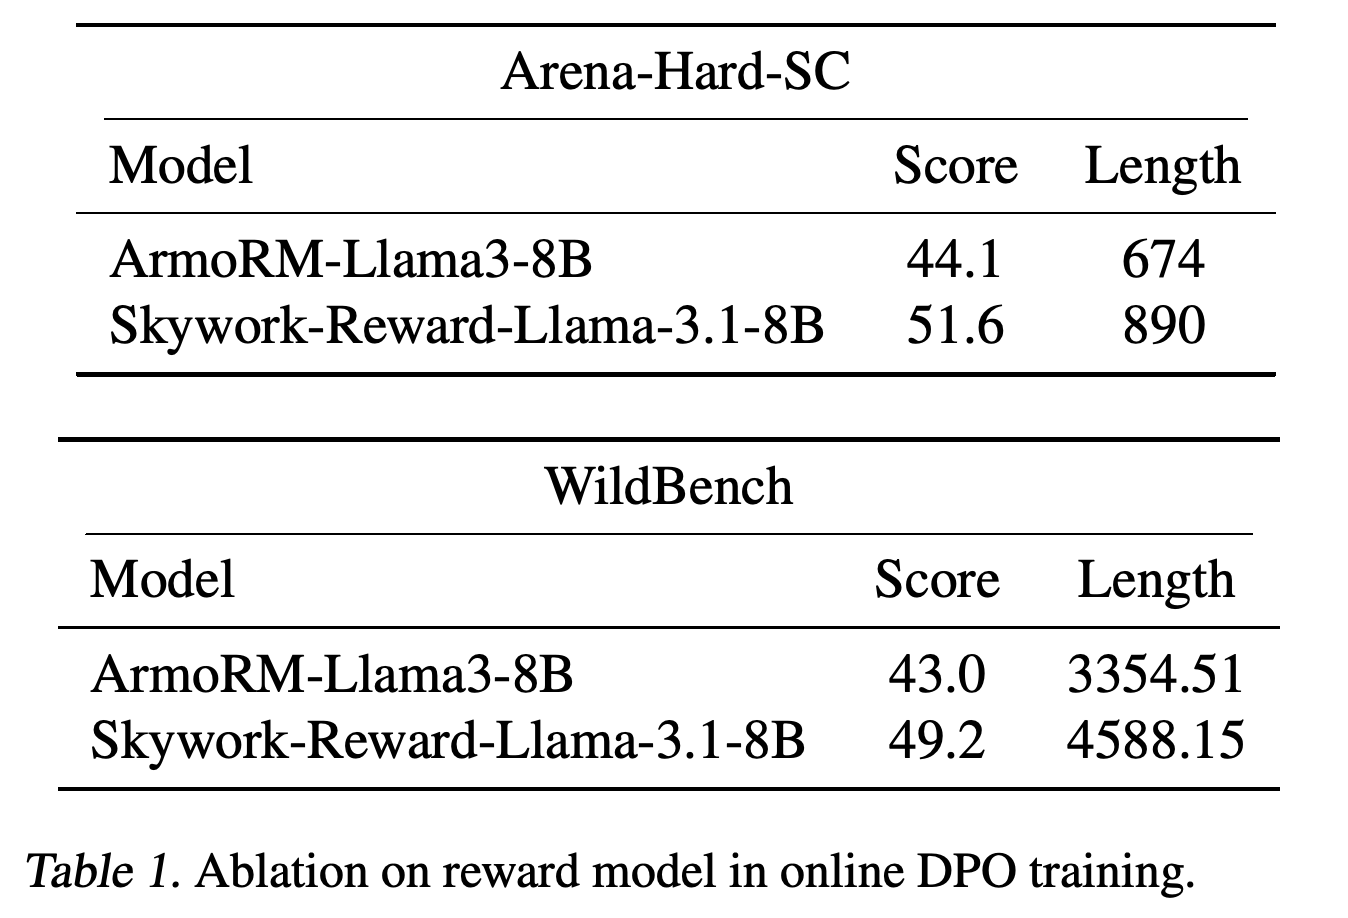
ArmoRM-Llama3-8B를 Skywork-Reward-Llama-3.1-8B로 교체하면 Arena-Hard-SC는 44.1에서 51.6으로, WildBench는 43.0에서 49.2로 상승한다. Table 1에서는 응답 길이도 Arena-Hard-SC에서 674에서 890으로, WildBench에서 3354.51에서 4588.15로 증가하지만, 길이 단위는 명시하지 않는다. 저자들은 더 짧은 응답을 선호하고 잠재적인 길이 편향을 줄이기 위해 주요 실험에서 ArmoRM-Llama3-8B를 선택한다.
Skywork-Reward-Llama-3.1-8B를 사용하면 벤치마크 2개 모두에서 평가 점수가 높아지는 동시에 응답도 길어진다. 이 비교는 저자들이 더 짧은 응답을 위해 ArmoRM-Llama3-8B를 선택한 이유를 설명한다. 다만 응답 길이가 점수 차이에 얼마나 기여했는지는 확인되지 않는다.
4.5. Ablation on Initial Models
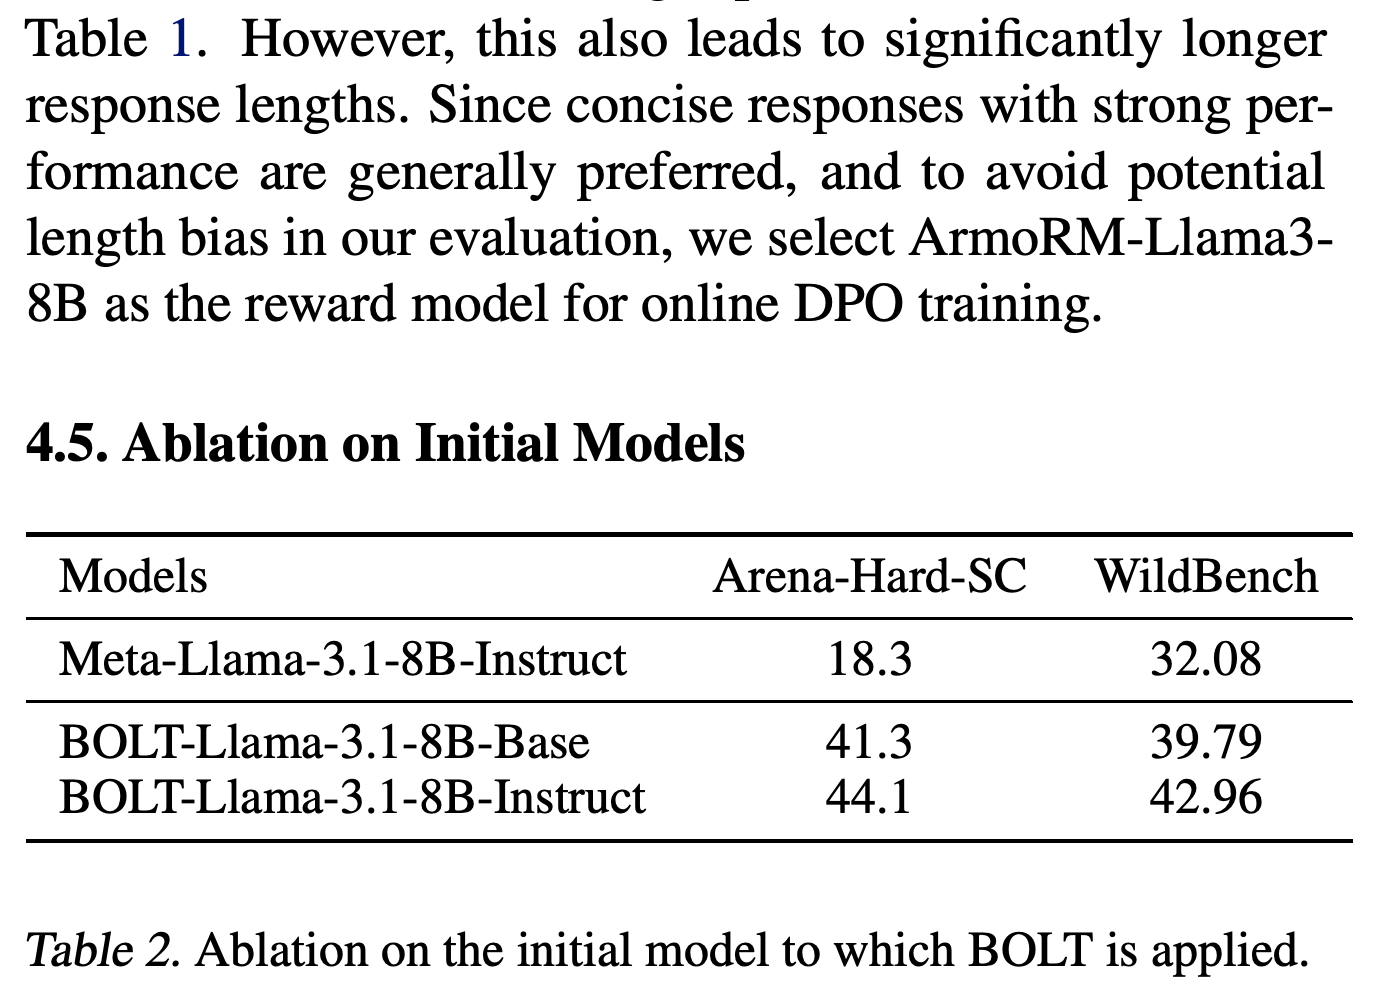
Meta-Llama-3.1-8B-base에서 시작한 BOLT는 Arena-Hard-SC에서 41.3, WildBench에서 39.79를 기록해, 수정하지 않은 instruction 모델의 18.3과 32.08을 넘어선다. instruction 모델에서 시작한 BOLT는 이보다 높은 44.1과 42.96을 기록한다. 따라서 학습 대상 모델이 반드시 instruction 모델일 필요는 없다. 다만 파이프라인은 데이터 생성에 계속 70B instruction 모델을 사용한다.
base 모델에 BOLT를 적용하면 보고된 벤치마크 2개 모두에서 원래 instruction 모델을 넘어선다. instruction 모델에 BOLT를 적용한 경우가 여전히 가장 높은 성능을 보인다. 이 비교는 학습 대상 모델의 초기화 방식을 유연하게 선택할 수 있음을 뒷받침한다. 다만 학습 데이터는 계속 instruction 모델에서 생성한다.
4.6. Ablation on Online Training Algorithms
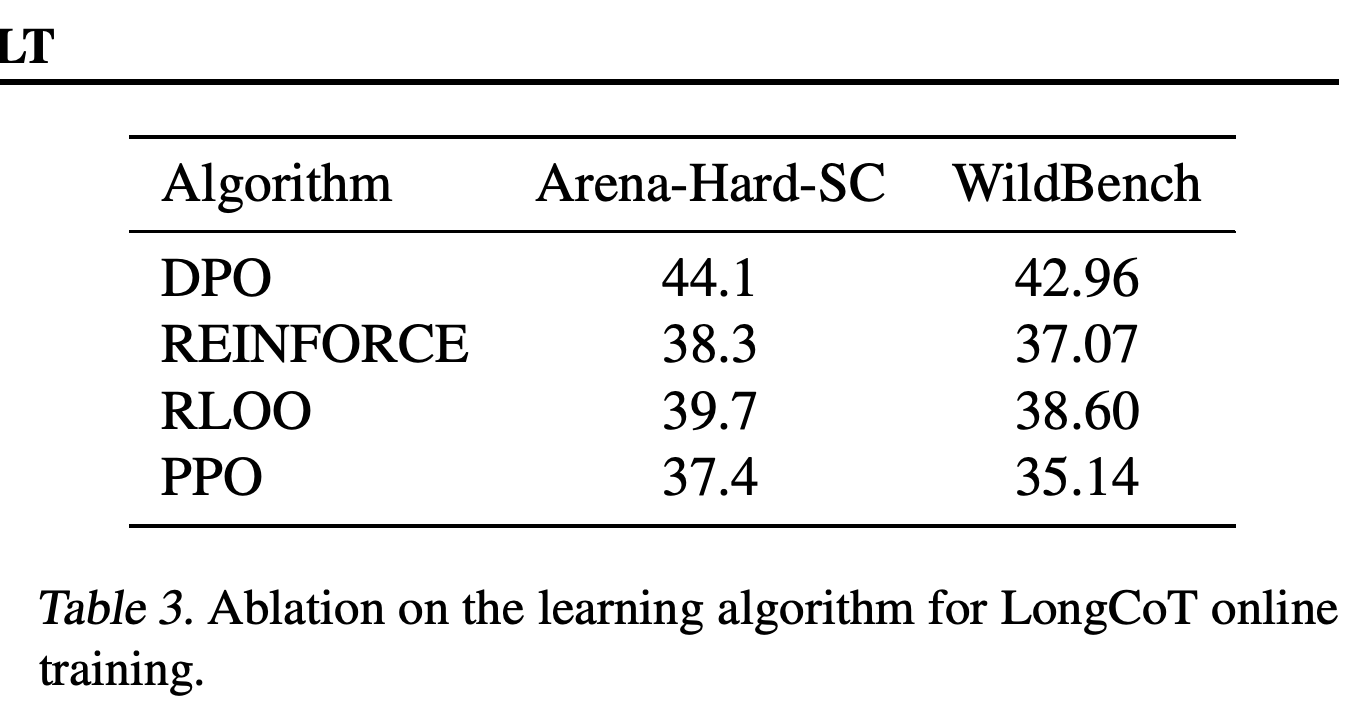
DPO는 Arena-Hard-SC에서 44.1, WildBench에서 42.96을 기록한다. 응답 보상으로 생성 확률을 갱신하는 REINFORCE는 38.3/37.07, 다른 샘플 응답을 보상 베이스라인으로 사용하는 REINFORCE 변형인 RLOO는 39.7/38.60, 보상 최적화 중 정책 갱신을 제한하는 Proximal Policy Optimization(PPO)은 37.4/35.14를 기록한다. 저자들은 DPO가 모든 샘플 응답으로 학습하는 대신 보상 점수의 양극단을 선택해 잡음이 많은 피드백을 줄이기 때문에 유리하다고 설명한다. Table 3은 이 설정에서 알고리즘 간 순위를 보여주지만, 제시한 설명을 독립적으로 검증하지는 않는다.
DPO는 평가 2개 모두에서 다른 방법 3개보다 높은 성능을 보인다. 대안 중에서는 RLOO가 Arena-Hard-SC 39.7, WildBench 38.60으로 가장 높다. 이 측정 결과는 실험한 구현 중 DPO를 선택하는 근거가 된다. 다만 보상 잡음이 줄어든다는 설명은 독립적으로 분리해 검증한 결과가 아니라 저자들의 해석이다.
5. Conclusion
결론에서는 초기 시범 예시 10개, 일반적인 instruction 모델을 통한 데이터 생성, SFT, 온라인 선호 학습으로 7B, 8B, 70B 모델에 LongCoT 행동을 학습시킬 수 있다는 근거로 BOLT를 제시한다. 입증된 기여는 기존 LongCoT 교사 모델 없이도 보고된 다운스트림 평가 성능을 높이는 학습 절차다. 논문은 학습 데이터, 학습 절차, 모델을 공개할 계획이라고 밝히지만, 제공된 PDF만으로는 공개가 이루어졌는지 확인할 수 없다.
Impact Statement
Impact Statement는 머신러닝의 발전을 목표로 제시하고 잠재적인 사회적 영향을 인정한다. 저자들은 별도로 논의해야 할 구체적인 영향을 지목하지 않으며, 별도의 안전성 평가나 완화 방안 분석도 제공하지 않는다.
부록
- A. Additional Experiment Details는 부트스트래핑 질의의 출처로 ShareGPT, Evol-Instruct, SlimOrca, MathInstruct, Magicoder-Evol-Instruct, GPT4-LLM, OrcaMath, GPTeacher, UltraInteract를 나열한다. 온라인 학습 질의는 UltraFeedback, HelpSteer, OpenOrca, UltraInteract, Capybara, DIBT-10K에서 가져오며, Section 3.1.2와 유사한 절차로 선별한다. DIBT-10K의 출처는 https://huggingface.co/datasets/DIBT/10k_prompts_ranked 이다.
- B. Qualitative Examples는 은퇴 계좌 조언, 한 진술로부터 다른 진술이 도출되는지를 판단하는 함의, 앱 리뷰, 캠페인 계획, 에세이 작성, 코드 최적화, 프로그래밍 문제, 무한급수, 질문 생성, 기만적인 이메일을 식별하는 피싱 분류를 다루는 긴 응답 10개를 제시한다. Example 7은 부분수열을 명시적으로 열거하는 방식을 입력 정수에서 켜진 비트를 합치는 직접적인 bitwise OR 계산으로 수정한다. Example 8은 급수 표현을 반복해서 바꾼 뒤 타당한 유도 과정 없이 0.084라는 값으로 끝난다. 이 사례들은 응답 형식과 수정 행동을 보여주는 동시에, 긴 추론에도 오류가 남을 수 있음을 보여준다.
짧은 생각
가장 강한 근거는 모델 크기 3개와 평가 5개에 걸친 성능 향상이며, 학습 중 추가적인 성능 향상도 이를 뒷받침한다. 생성 모델 비교는 실제 적용상의 제약도 보여준다. 8B 모델은 실험한 프롬프트 절차로 신뢰할 만한 LongCoT 응답을 생성하지 못하지만, 70B 모델이 만든 데이터로 학습하면 성능이 향상된다.
이 결과만으로는 생성한 추론의 인과적 역할과 신뢰성을 판단하기 어렵다. 논문은 추가 학습과 추론 연산량을 맞춘 상태에서 LongCoT를 제거한 비교를 보고하지 않으며, 보상 과정도 내부 추론의 정확성을 직접 평가하지 않는다. Example 8은 이 평가상의 공백을 보여준다. 주요 결과 그림과 ablation 표에는 오차 막대나 반복 실행에 따른 변동이 없어, 개별 성능 향상의 불확실성을 평가하는 데 한계가 있다.