


Do NOT Think That Much for 2+3=? On the Overthinking of o1-Like LLMs 요약 설명
30 Dec 2024 | Paper Review Efficient Inference Reasoning Self-Training Direct Preference Optimization목차
이번 글에서는 Do NOT Think That Much for 2+3=? On the Overthinking of o1-Like LLMs 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 30일(Arxiv)
- Chen, Xingyu, Xu, Jiahao, Liang, Tian, He, Zhiwei, Pang, Jianhui, Yu, Dian, Song, Linfeng, Liu, Qiuzhi, Zhou, Mengfei, Zhang, Zhuosheng, et al.
- Tencent AI Lab, Shanghai Jiao Tong University
- 논문 링크
요약
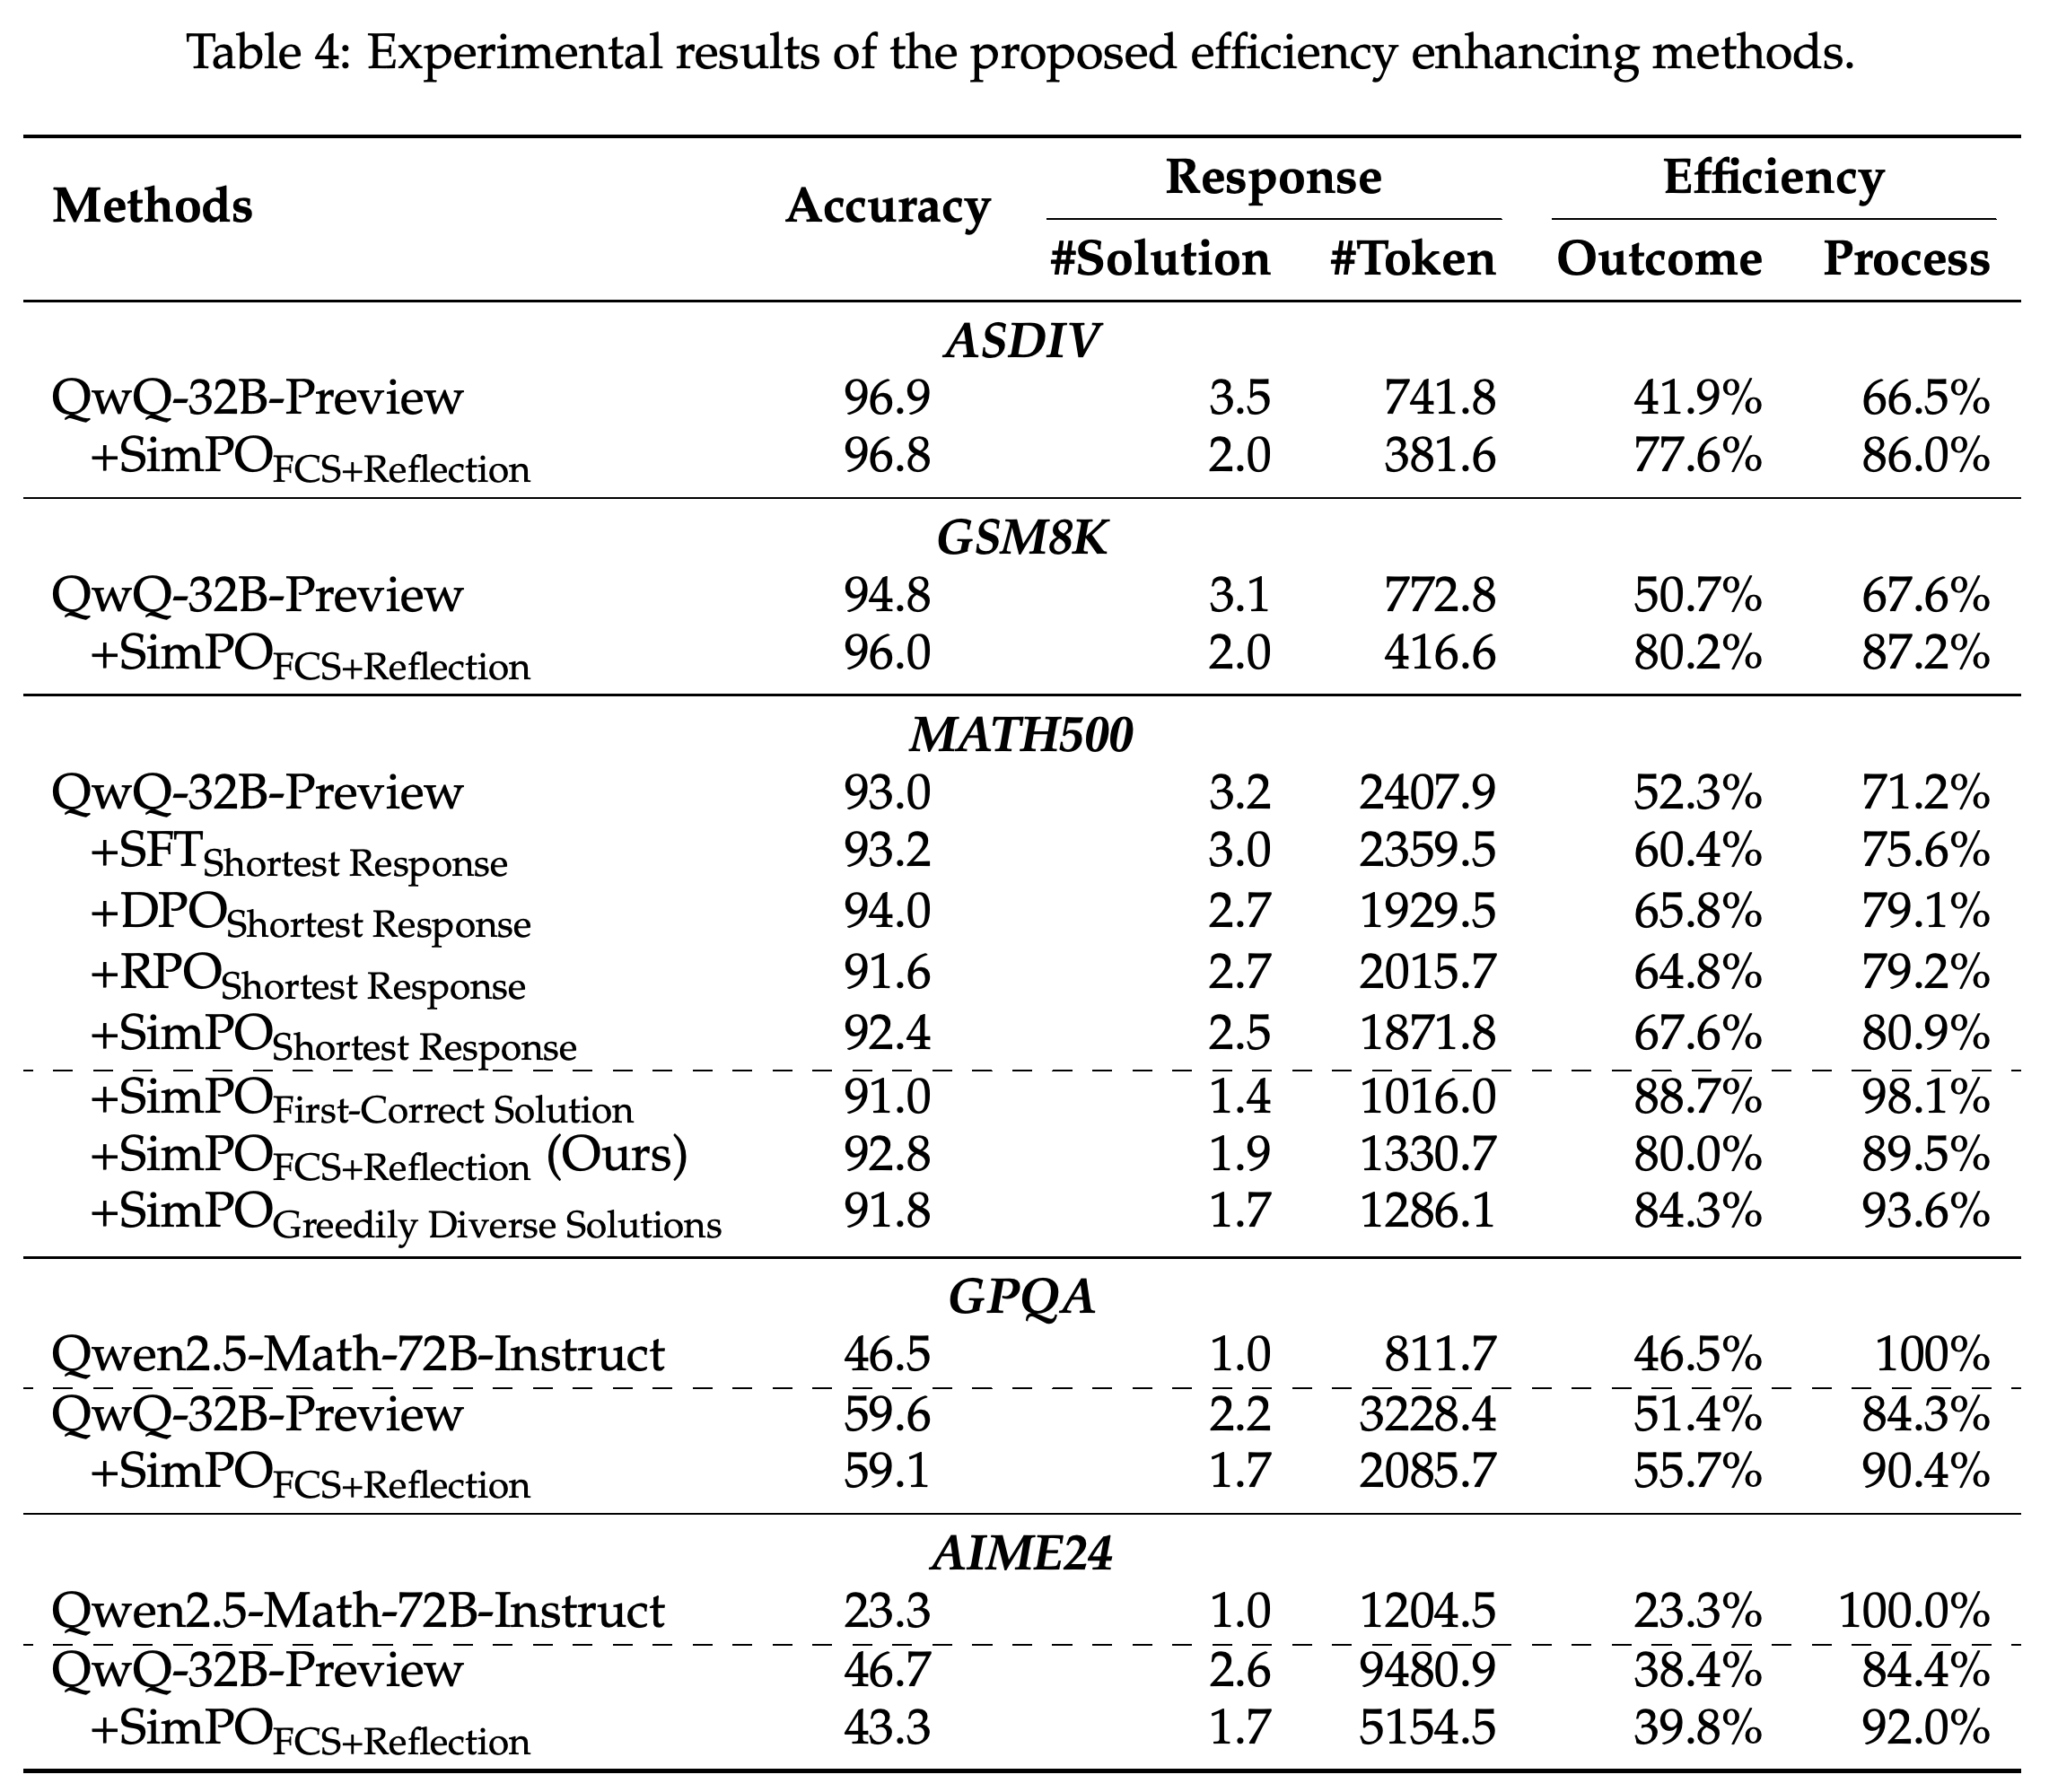
- 대규모 언어 모델(LLM)은 정답 도출이나 추론의 다양성에 거의 기여하지 않는 풀이를 추가로 생성하며 과도하게 추론할 수 있다. 자체 응답을 줄인 데이터로 QwQ-32B-Preview를 학습하면, 고등학교 수학 경시대회 벤치마크인 MATH500에서 평균 출력이 원본 모델의 2407.9토큰에서 1330.7토큰으로 약 44.7% 감소한다. Table 4에서 정확도는 93.0%에서 92.8%로 변한다.
- 분석에서는 추론 단계를 명시적으로 나열하는 chain-of-thought(CoT)를 답이 포함된 구간으로 나누고, 각 구간이 정답 도출과 풀이 전략의 다양성에 얼마나 기여하는지 측정한다. QwQ-32B-Preview와 DeepSeek-R1은 풀이를 자주 반복한다. 특히 쉬운 수학 문제에서는 정답에 처음 도달하는 데 필요한 토큰이 전체 생성 토큰에서 차지하는 비율이 작다.
- 논문에서 선택한 방법은 선호 응답을 다른 응답보다 우선하도록 학습하는 Simple Preference Optimization(SimPO)과, 2번째로 정답을 제시한 풀이까지 응답을 남기는 First-Correct Solutions plus Reflection(FCS+Reflection)을 결합한다. 이 자기 학습 방법은 모델이 직접 생성한 응답을 사용하며 출력 길이를 크게 줄인다. 다만 논문에서 사용한 2024년 수학 경시대회 평가인 AIME24에서는 정확도가 46.7%에서 43.3%로 떨어진다. 따라서 본문의 여러 정확도 유지 주장은 수치 결과에 맞춰 해석해야 한다.
1 Introduction
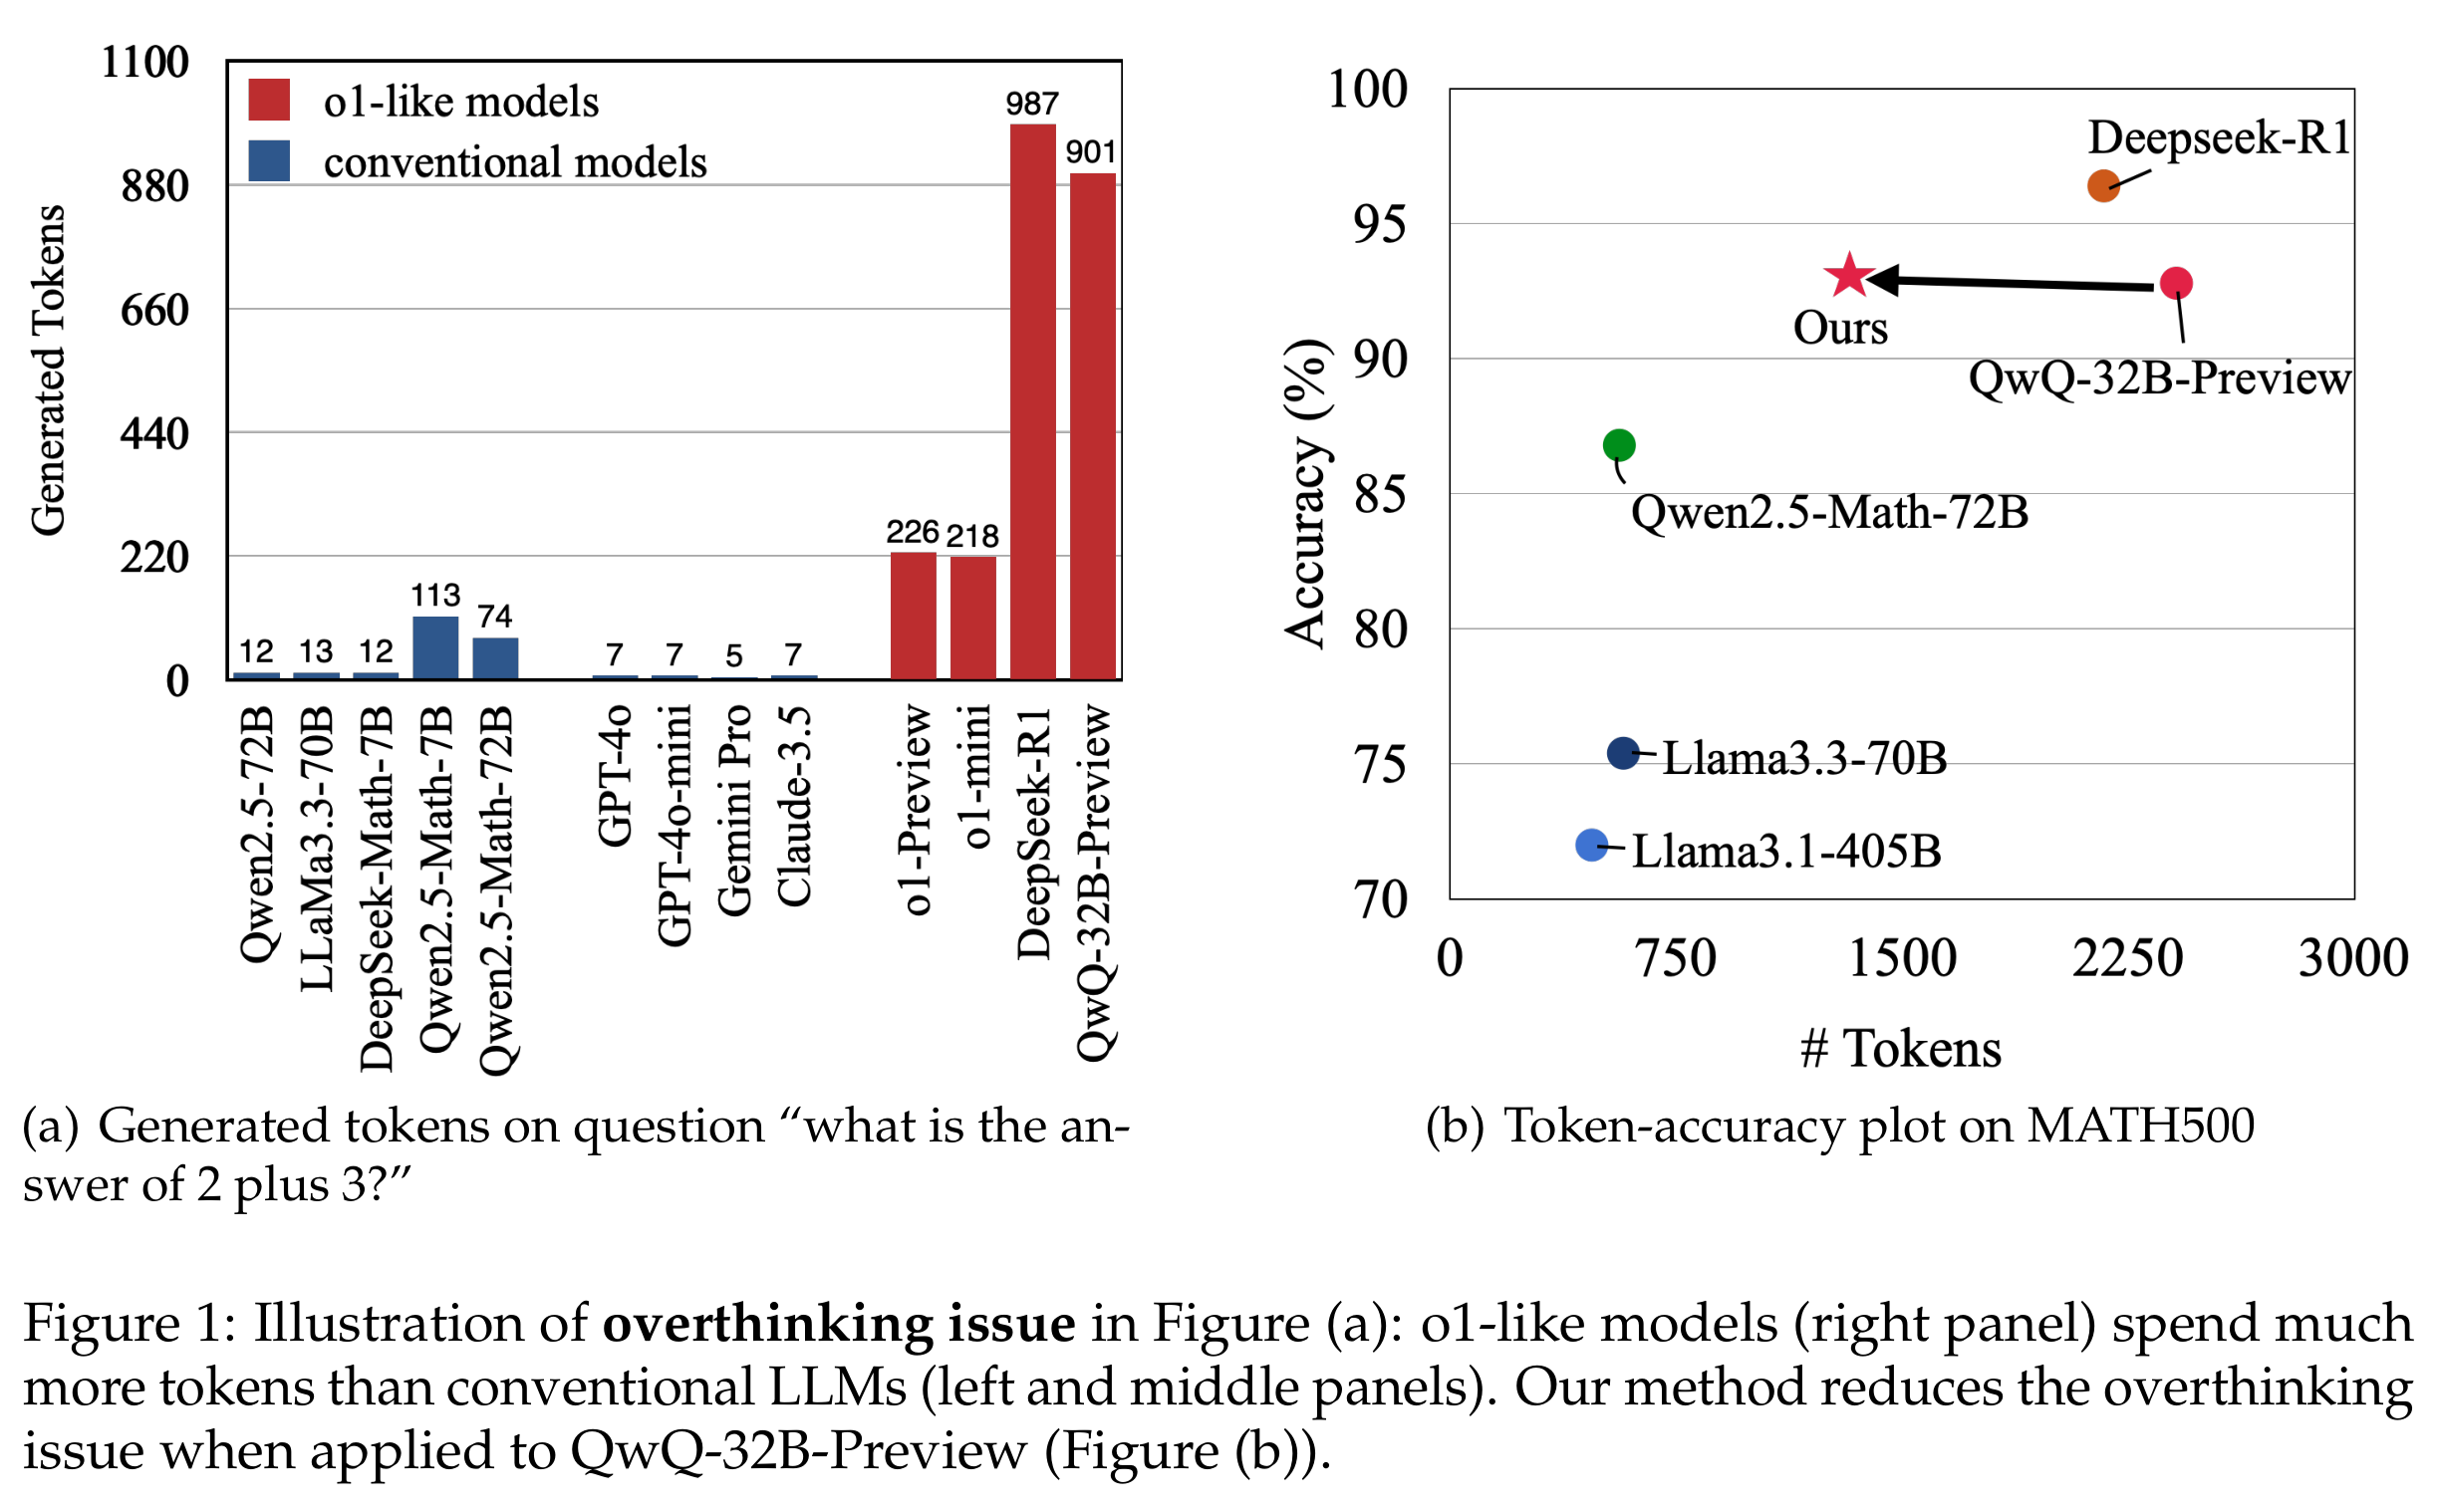
서론에서는 추론 시 추가 연산을 배정하는 test-time compute 확장이 자원을 효율적으로 사용하는지 묻는다. 이를 설명하는 사례는 2+3의 답을 구하는 문제다. 논문에 따르면 긴 추론과 반복 검증을 수행하는 o1-like 모델은 같은 답에 도달하는 데 기존 모델보다 평균 1,953% 더 많은 토큰을 사용한다. 주요 기여는 중복 추론 분석, 효율성 지표 2개, 검토 과정을 유지하면서 응답을 줄이는 자기 학습 방법이다.
산술 예시는 기존 모델이 짧게 답하는 문제에서도 긴 추론을 수행하는 모델이 수백 토큰을 생성할 수 있음을 보여준다. MATH500 패널은 비슷한 정확도에서 생성 길이가 줄어드는 양상을 보여주며, 여기서 사용하는 정확한 수치 비교는 Table 4에 제시되어 있다.
2 Observing Overthinking Issues
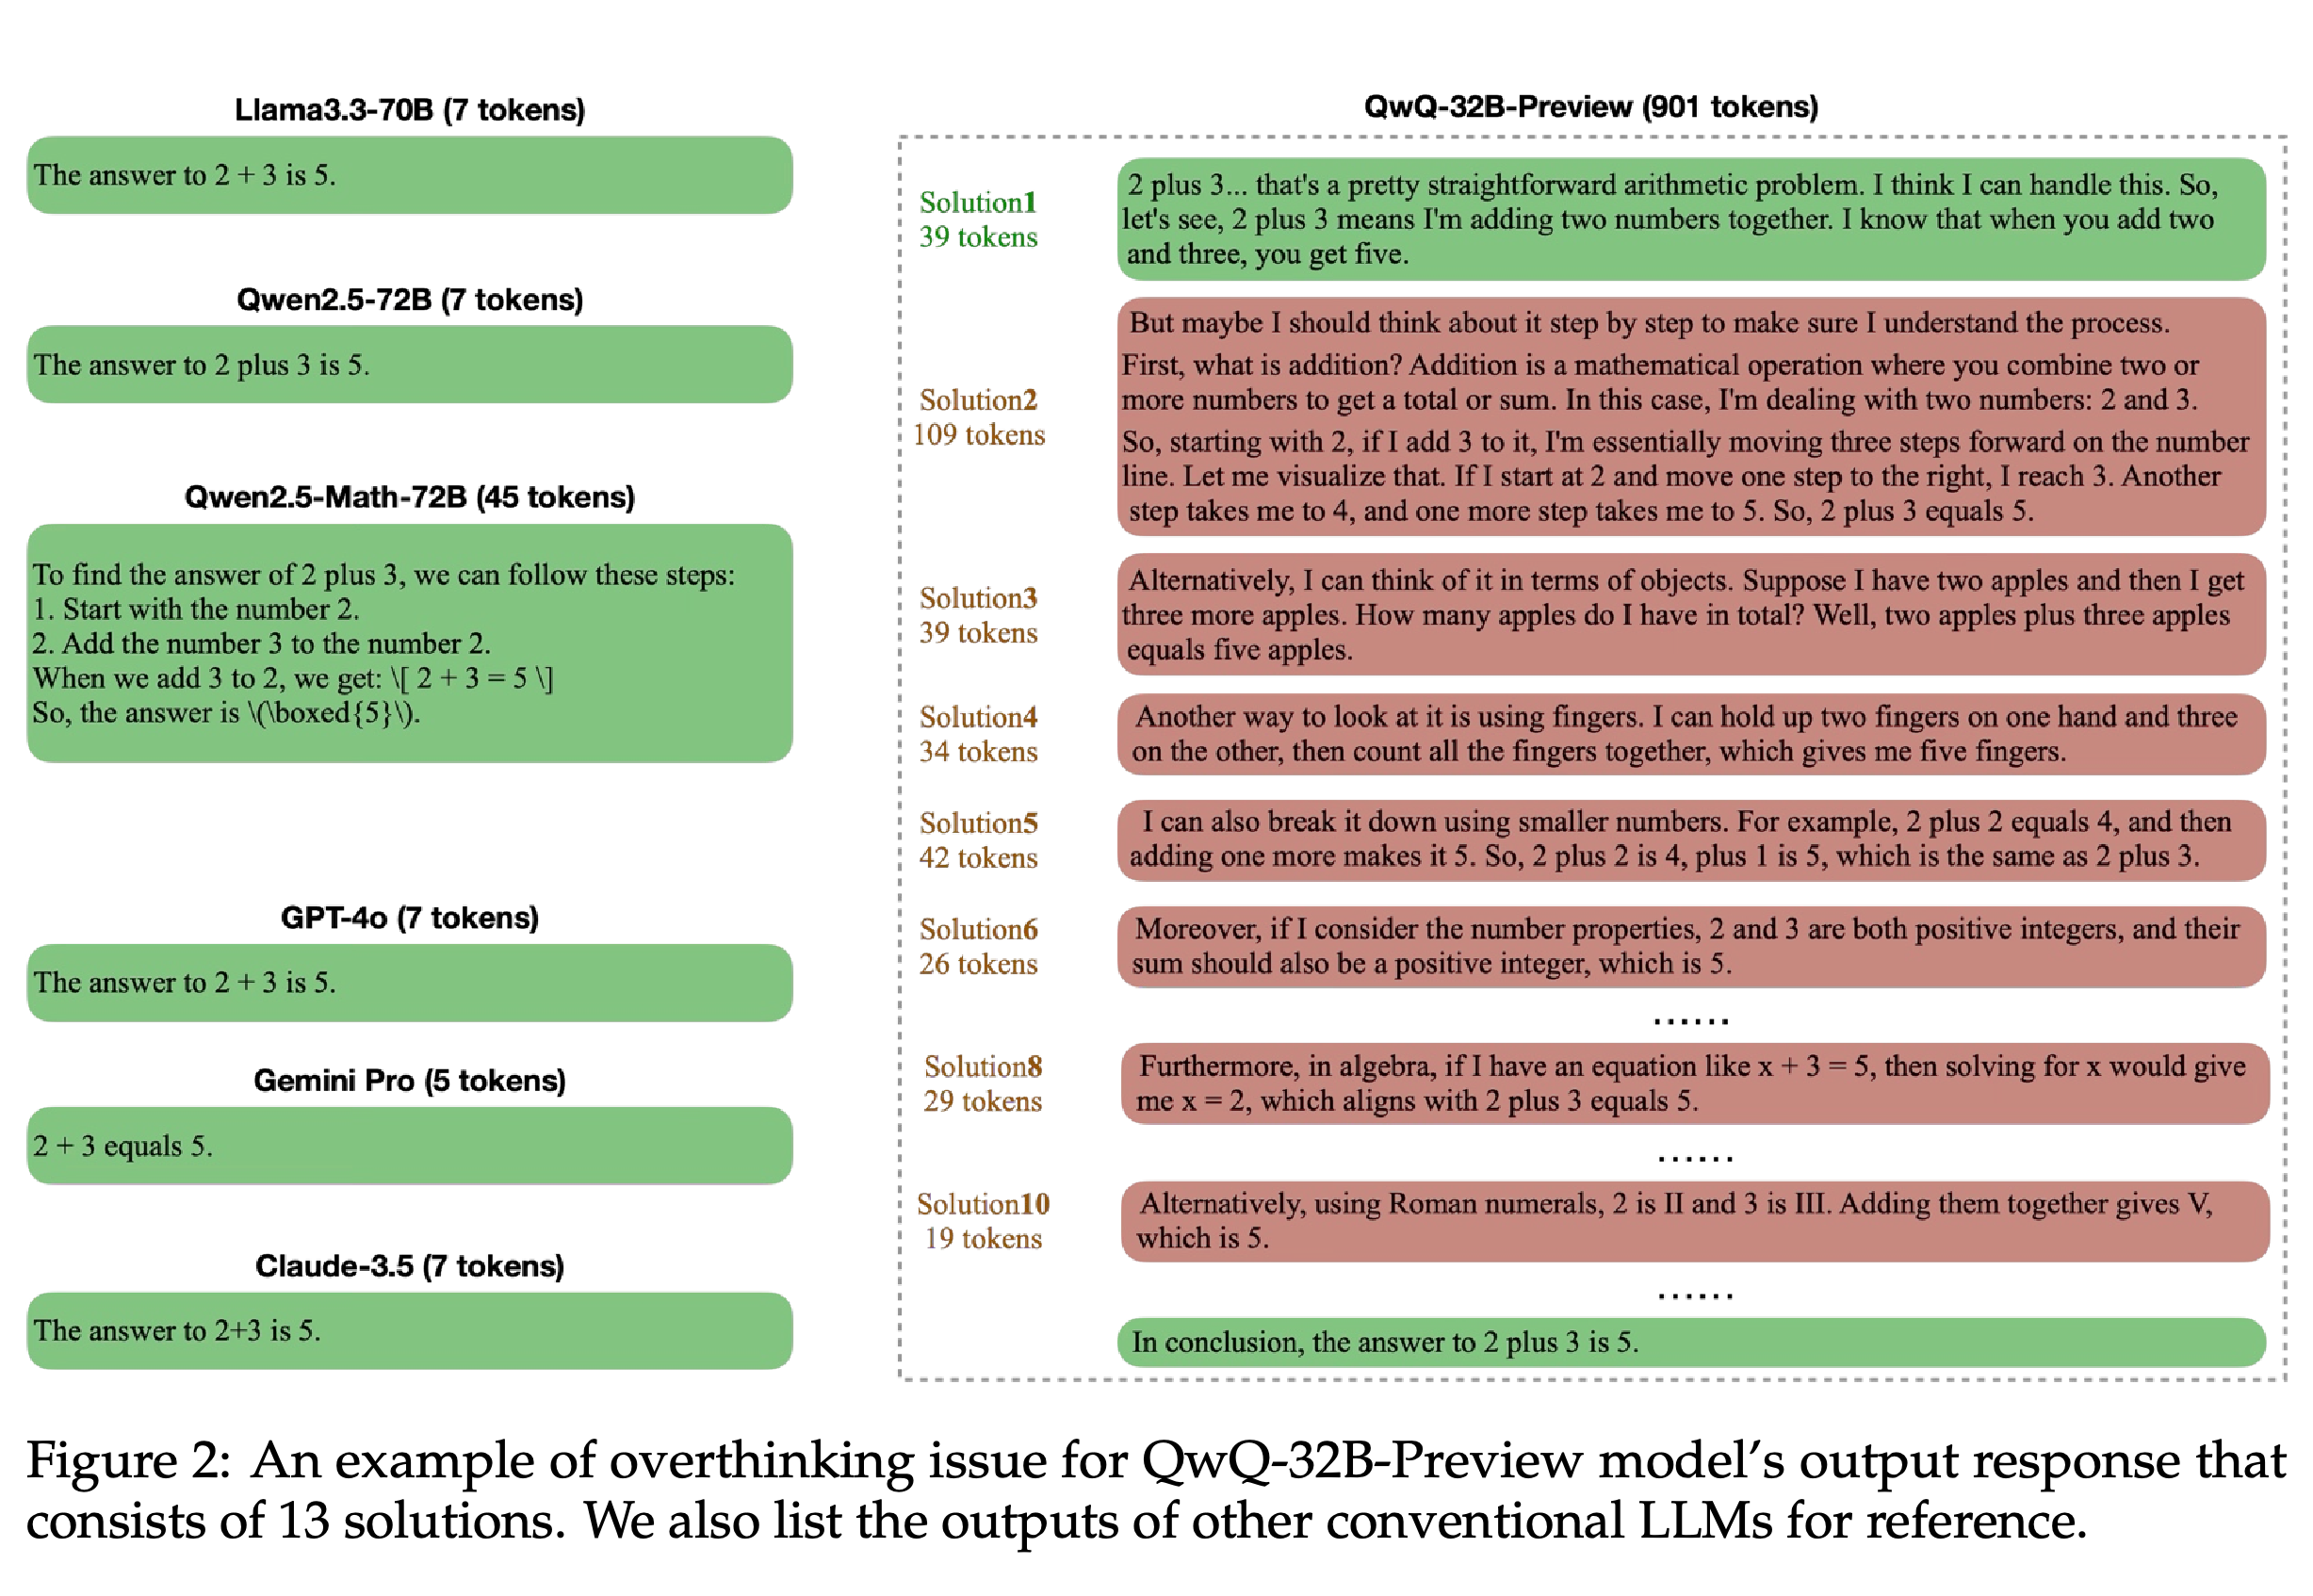
관찰 연구에서는 추가 풀이가 정확도를 높이거나 다른 추론 전략을 도입하는지 살펴본다. 이미 제시한 정답을 반복하면 최초 정답이나 새로운 접근법을 추가하지 않은 채 응답 길이만 늘어날 수 있다. Figure 2는 QwQ-32B-Preview가 2+3에 대해 생성한 응답에 풀이 13개가 포함된 사례로 이 현상을 보여준다.
QwQ-32B-Preview의 901토큰 응답은 첫 39토큰 풀이에서 정답에 도달했는데도 풀이 13개를 포함한다. 이 사례는 반복적인 답 생성을 보여주며, 효율성 지표 2개의 계산 예제로 사용된다.
2.1 Solution Distribution of o1-Like Models
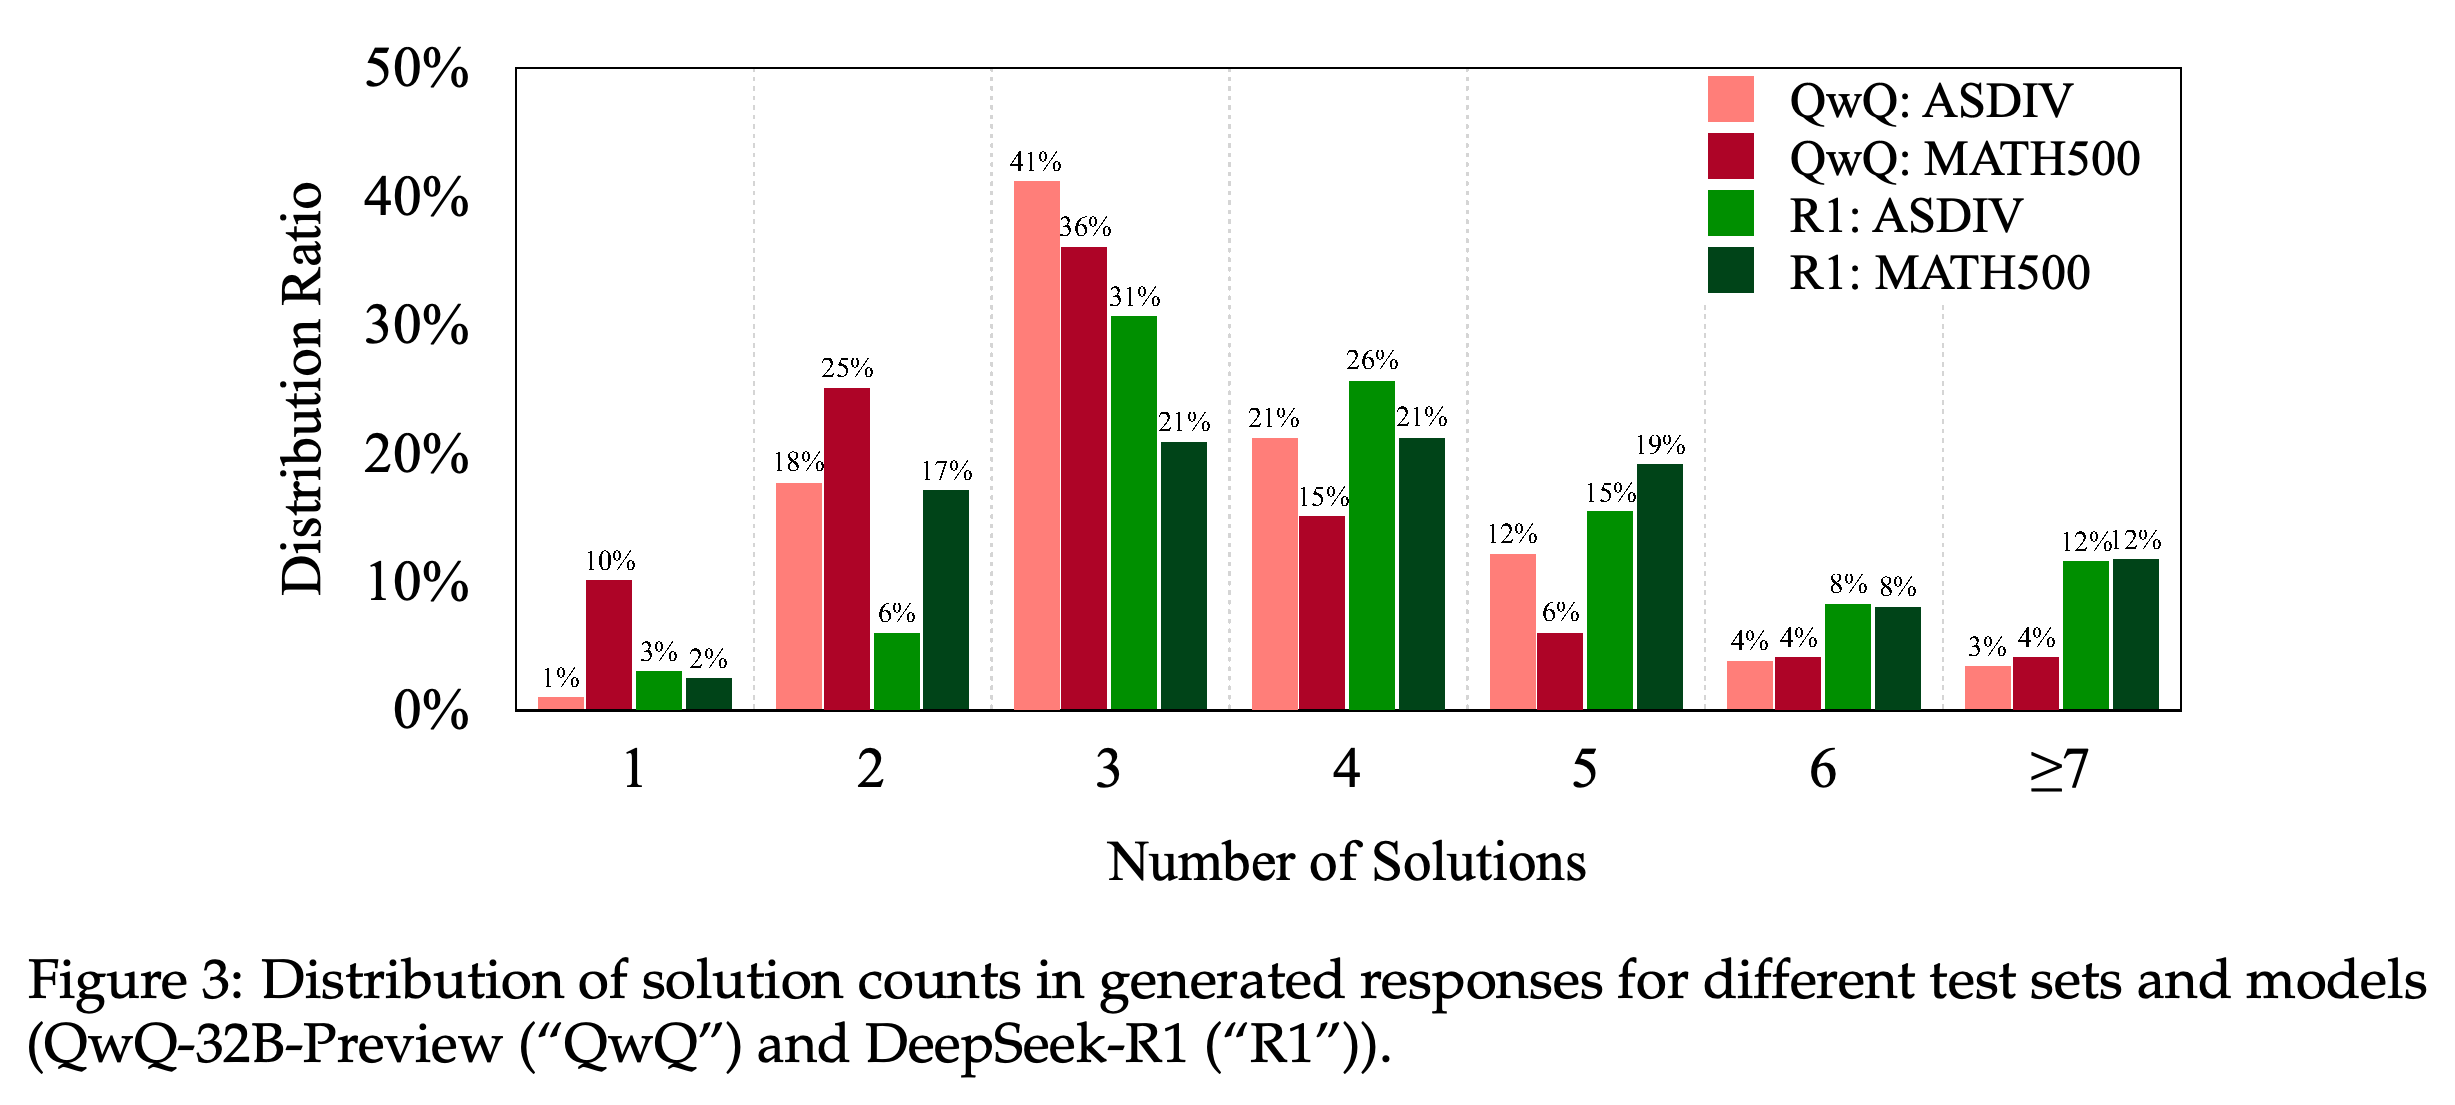
실험에서는 QwQ-32B-Preview와 DeepSeek-R1을 ASDIV, GSM8K, MATH500에서 분석한다. ASDIV는 문항 2,305개와 1–6학년 수준을 포함하는 영어 수학 문장제 코퍼스다. GSM8K는 평가 문제 1,319개로 구성된 초등학교 수준의 수학 벤치마크다. MATH500은 7개 분야와 난도 1–5를 다룬다. 풀이는 답을 명시적으로 포함하는 응답 구간으로 정의하며, Llama-3.3-70B로 응답을 이러한 구간으로 나눈다.
- 평가 데이터 전반에서 풀이가 2–4회인 응답은 QwQ-32B-Preview 응답의 76%–80%, DeepSeek-R1 응답의 59%–63%를 차지한다.
- ASDIV와 MATH500의 평균 풀이 수는 QwQ-32B-Preview에서 각각 3.5개와 3.2개, DeepSeek-R1에서 각각 4.5개와 4.3개다.
- MATH500의 난도 1–2에서 모델 2개의 평균 풀이 횟수는 각각 3.7회와 4.6회이며, 난도 4–5에서는 각각 3.0회와 3.9회다. 다만 난도가 높아질수록 토큰 수는 증가하므로, 풀이 횟수가 적다고 응답이 짧은 것은 아니다.
대부분의 응답에는 답을 포함한 풀이가 여러 개 들어 있다. DeepSeek-R1은 풀이가 많은 응답 쪽으로 분포가 더 길게 이어진다. 모델 2개 모두 MATH500보다 ASDIV에서 평균 풀이 수가 약간 더 많다.
2.2 Efficiency on Accuracy Improvements
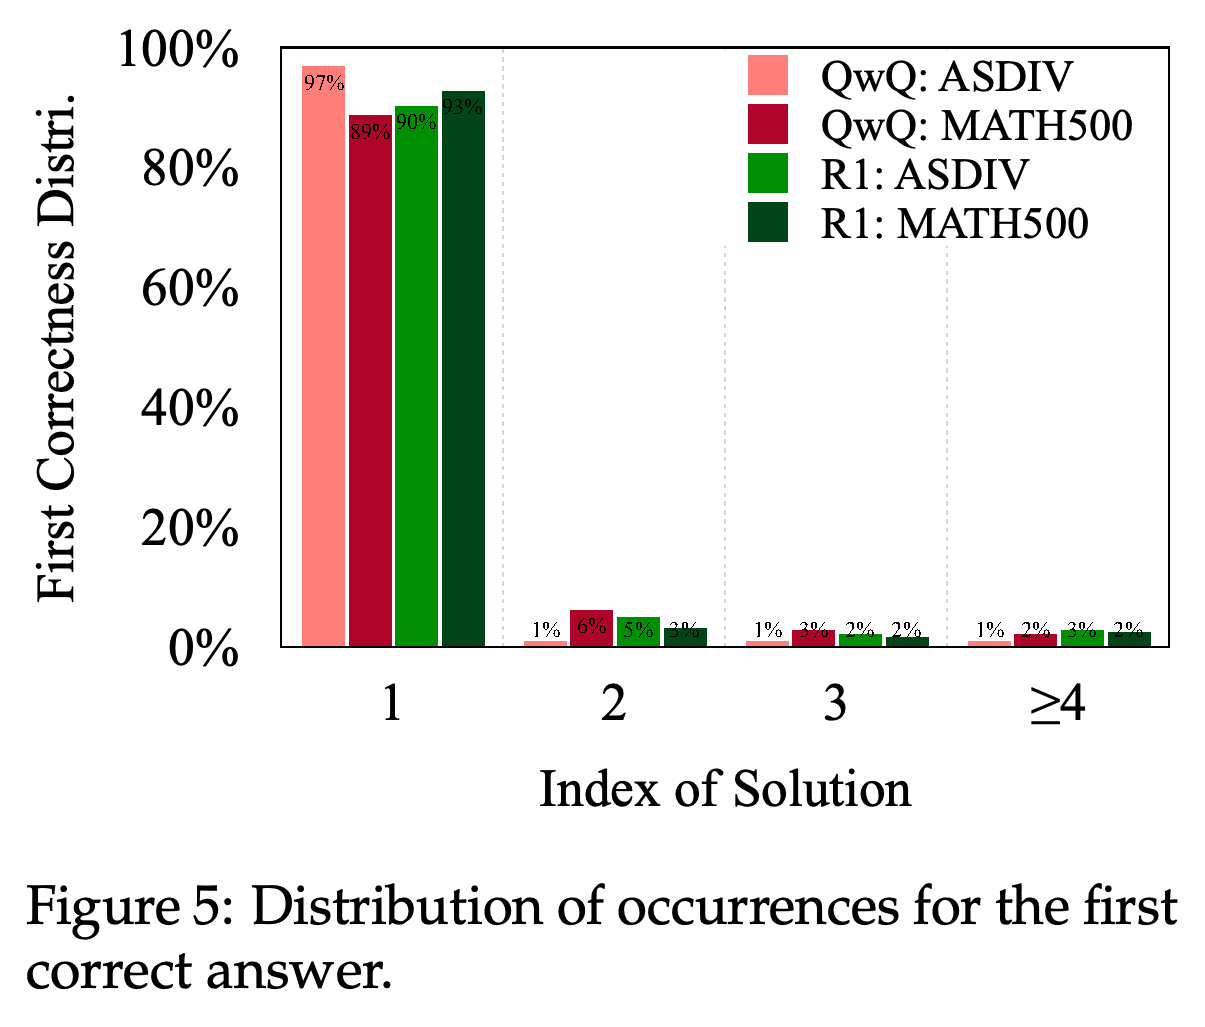
최초 정답 분포는 정답 풀이가 적어도 1개 포함된 응답을 대상으로, 처음 정답을 제시한 풀이의 위치를 기록한다. 본문에서는 92%가 넘는 경우에 첫 풀이가 정답이라고 서술하지만, Figure 5의 모델과 데이터셋별 값은 89%에서 97% 사이다. ASDIV에서 QwQ-32B-Preview의 첫 풀이는 평균 287토큰으로, 응답의 38.7%를 차지한다. 결과 효율성은 \(\xi_O=\frac{1}{N}\sum_{i=1}^{N}\sigma_i\frac{\hat{T}_i}{T_i}\)로 정의한다. 정답에 처음 도달하는 데 필요한 토큰이 전체 응답에서 차지하는 비율을 평균하며, 정답 풀이가 없는 응답에는 0을 부여한다.
- N은 평가 문항 수, T_i는 전체 응답 길이다. σ_i는 응답에 정답 풀이가 있으면 1, 없으면 0이다.
- σ_i = 1일 때 T̂_i는 정답에 처음 도달하는 데 필요한 토큰 수다. 그렇지 않으면 T_i와 같으며, σ_i = 0이므로 해당 항의 기여는 사라진다.
- Figure 2의 901토큰 응답에서는 최초 정답 풀이에 39토큰이 필요하므로 결과 효율성은 39/901 = 4.3%다. 이 지표는 정의상 정답이 나온 뒤 수행하는 검증에 추가 점수를 주지 않는다.
정답 풀이가 포함된 응답에서는 최초 정답 풀이가 대개 위치 1에 등장하며, 4개 조건의 표시 값은 89%–97%다. 뒤쪽 풀이가 최초 정답을 제시하는 경우는 드물지만, 이 관찰만으로 검증의 인과적 가치를 평가할 수는 없다.
2.3 Efficiency on Diverse Thinking
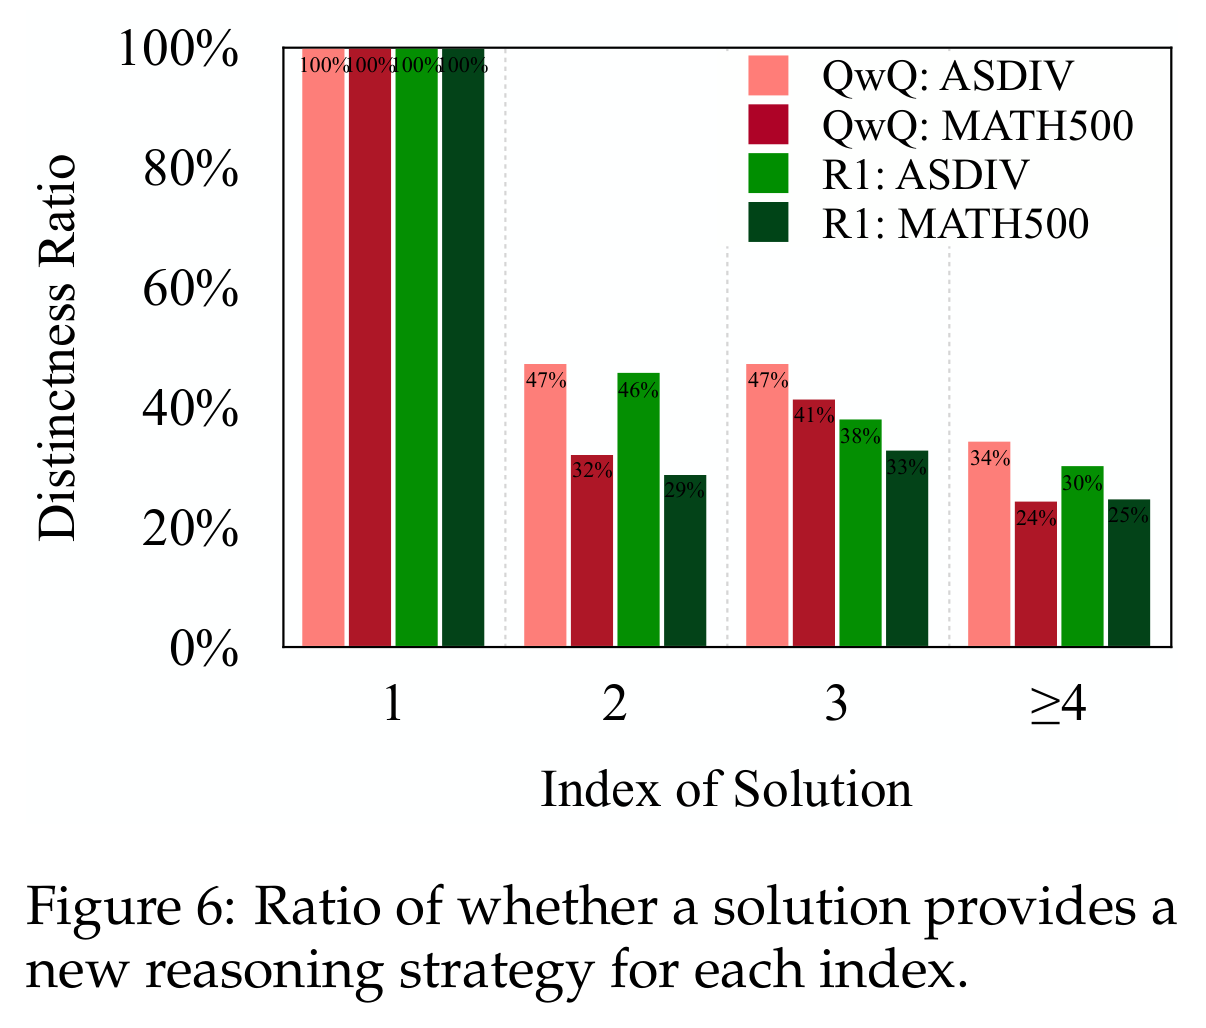
차별성 비율은 특정 위치의 풀이가 같은 응답의 앞선 풀이에 없던 추론 전략을 얼마나 자주 도입하는지 측정한다. GPT-4o가 전략에 따라 풀이를 군집화하며, 평가할 위치의 풀이가 없는 응답은 해당 위치의 분모에서 제외한다. 뒤쪽 풀이는 앞선 전략을 반복하는 경우가 많고, 2번째 풀이는 같은 접근법으로 첫 풀이를 확인하는 경우가 많다.
- 과정 효율성은 \(\xi_P=\frac{1}{N}\sum_{i=1}^{N}\frac{D_i}{T_i}\)이며, D_i는 전략을 처음 도입한 풀이들의 토큰 수를 합한 값이다. 정답 여부는 의도적으로 제외하므로, 오답 풀이도 새로운 전략을 제시하면 지표에 양의 기여를 할 수 있다.
- Figure 2의 풀이 13개는 기본 산술, 덧셈 분해, 사물 세기, 역방향 검증, 대수, 다른 수 표기 체계, 맥락에 따른 해석이라는 전략 군집 7개로 나뉜다.
- 각 군집에서 처음 등장한 풀이를 기준으로 계산한 과정 효율성은 35.8%다. Figure 6에서 위치 ≥4인 풀이의 차별성 비율은 24%–34%이며, 위치 3에서는 33%–47%다.
첫 풀이는 정의상 새로운 전략을 제시하지만, 뒤쪽 풀이는 앞선 전략을 재사용하는 경우가 많다. 4개 조건 중 3개에서 위치 2의 차별성 비율이 위치 3보다 낮다. 이는 바로 이어지는 2번째 풀이가 첫 풀이를 반복하며 확인하는 경우가 많다는 저자들의 관찰과 부합한다.
2.4 Empirical Efficiency Results
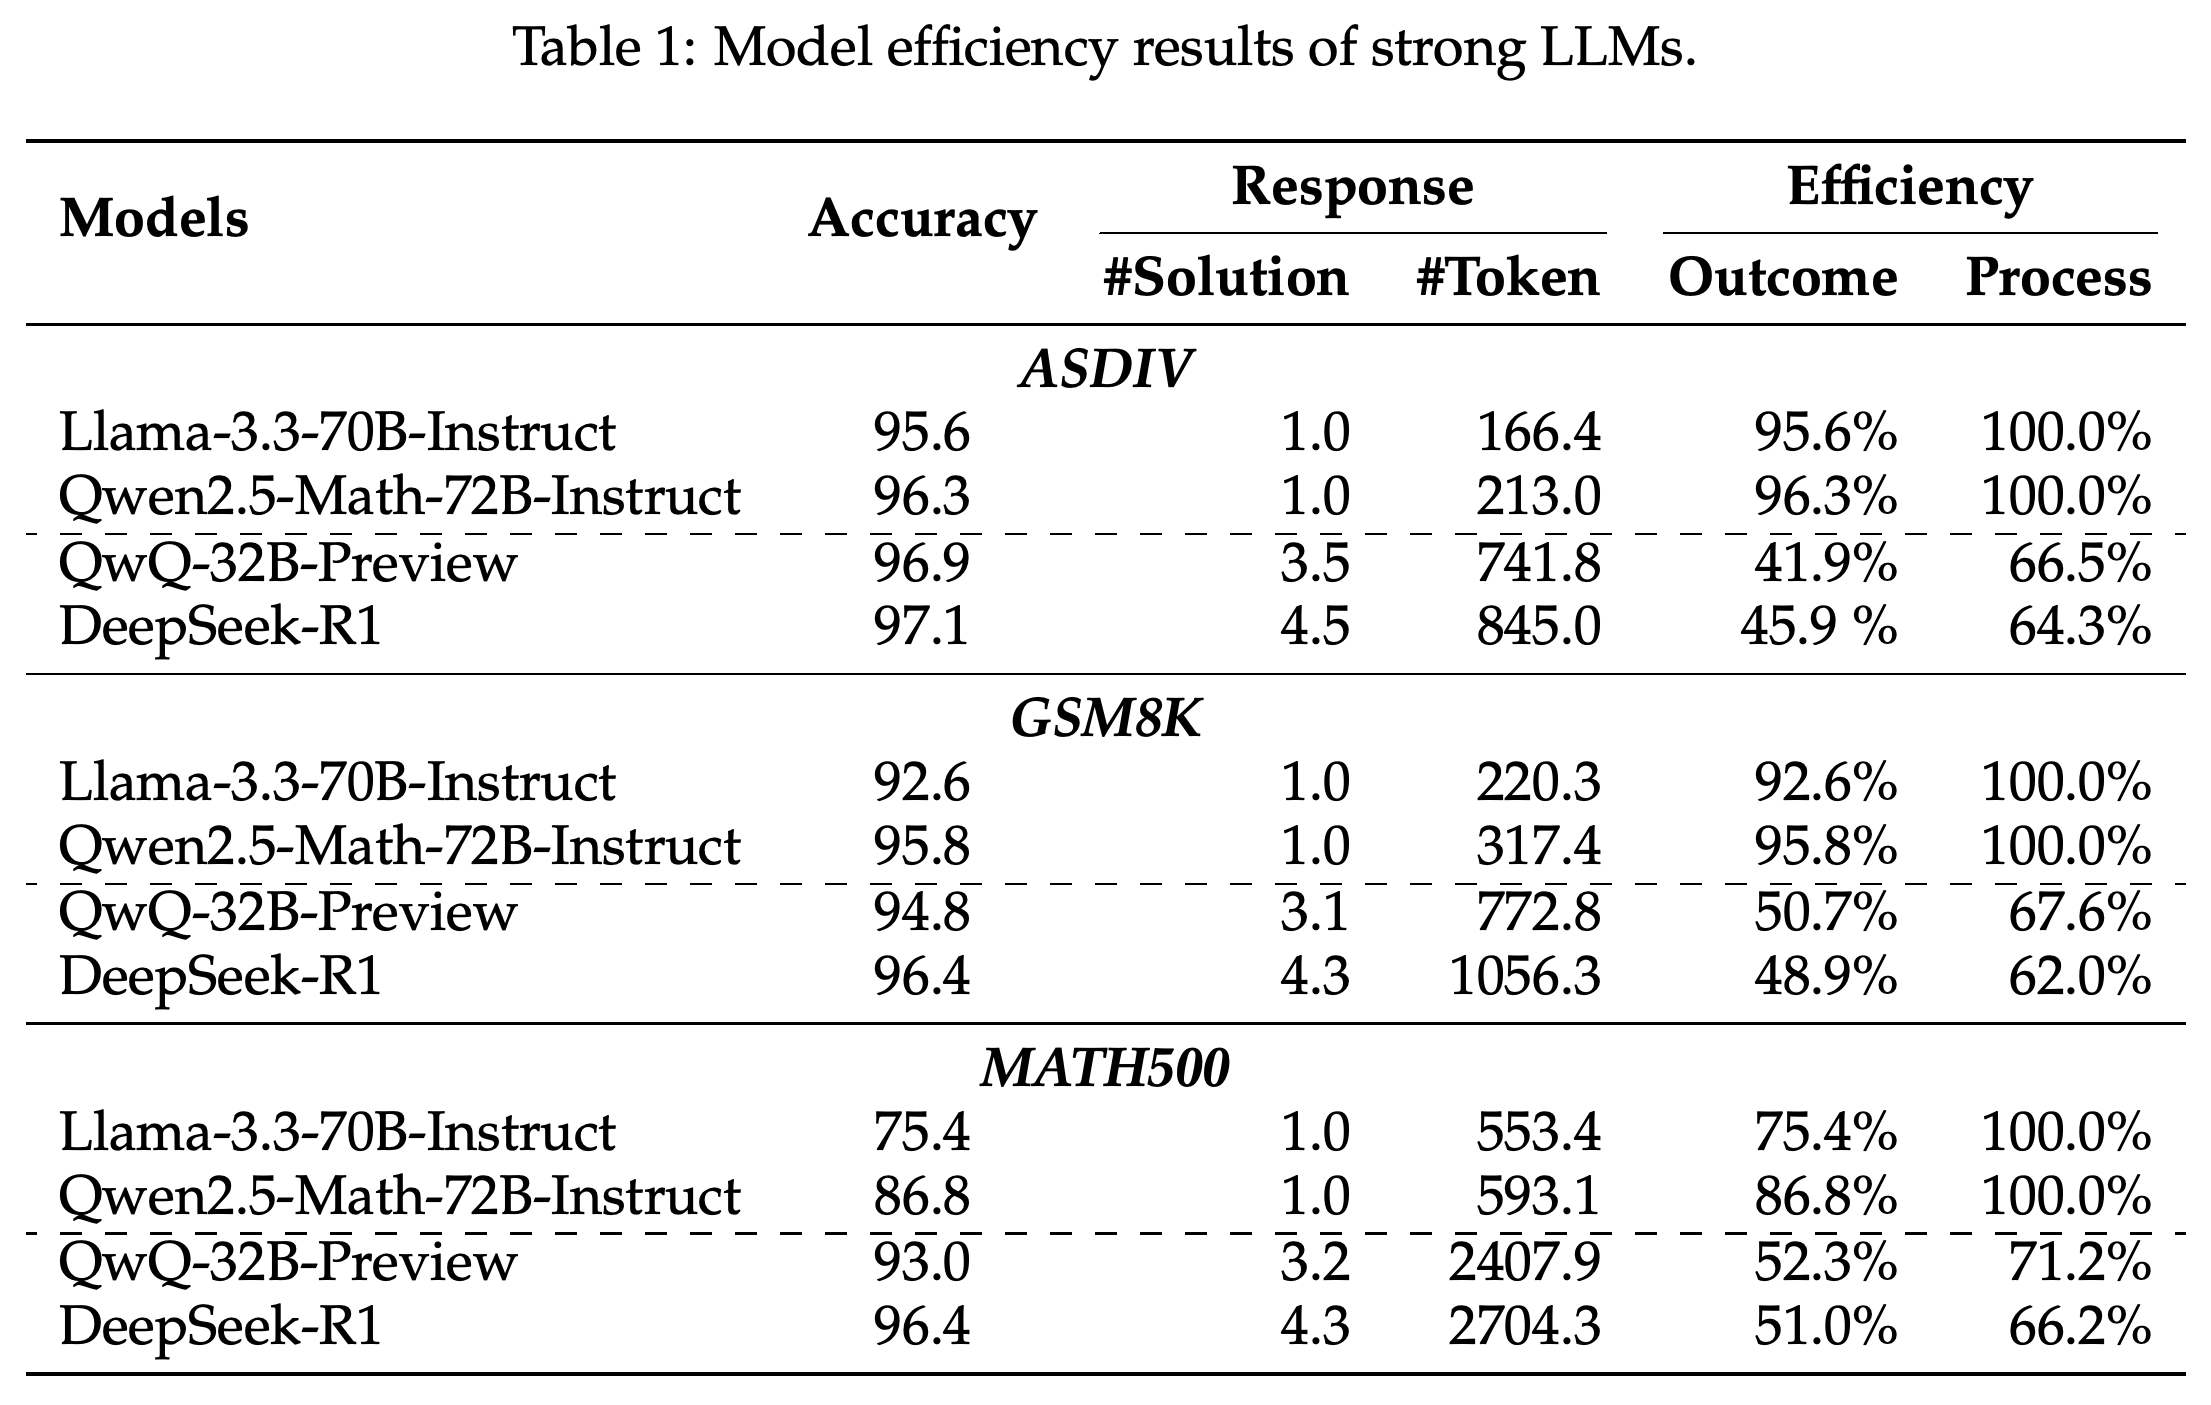
Table 1은 추론 모델을 Llama-3.3-70B-Instruct, Qwen2.5-Math-72B-Instruct와 비교한다. MATH500에서 QwQ-32B-Preview와 DeepSeek-R1은 각각 2407.9토큰과 2704.3토큰을 사용해 정확도 93.0%와 96.4%를 달성한다. Qwen2.5-Math-72B-Instruct는 593.1토큰으로 정확도 86.8%를 달성한다. 추론 모델의 결과 효율성은 각각 52.3%와 51.0%로, 높은 정확도와 함께 생성 길이도 크게 늘어난다.
- ASDIV에서 QwQ-32B-Preview와 DeepSeek-R1의 정확도는 각각 96.9%와 97.1%지만, 결과 효율성은 41.9%와 45.9%에 그친다. Qwen2.5-Math-72B-Instruct는 213.0토큰으로 정확도 96.3%를 달성하며, 추론 모델은 각각 741.8토큰과 845.0토큰을 사용한다.
- 기존 모델은 응답당 풀이를 1개 생성하므로, 이 정의에 따르면 과정 효율성은 100%이고 결과 효율성은 정확도와 같다.
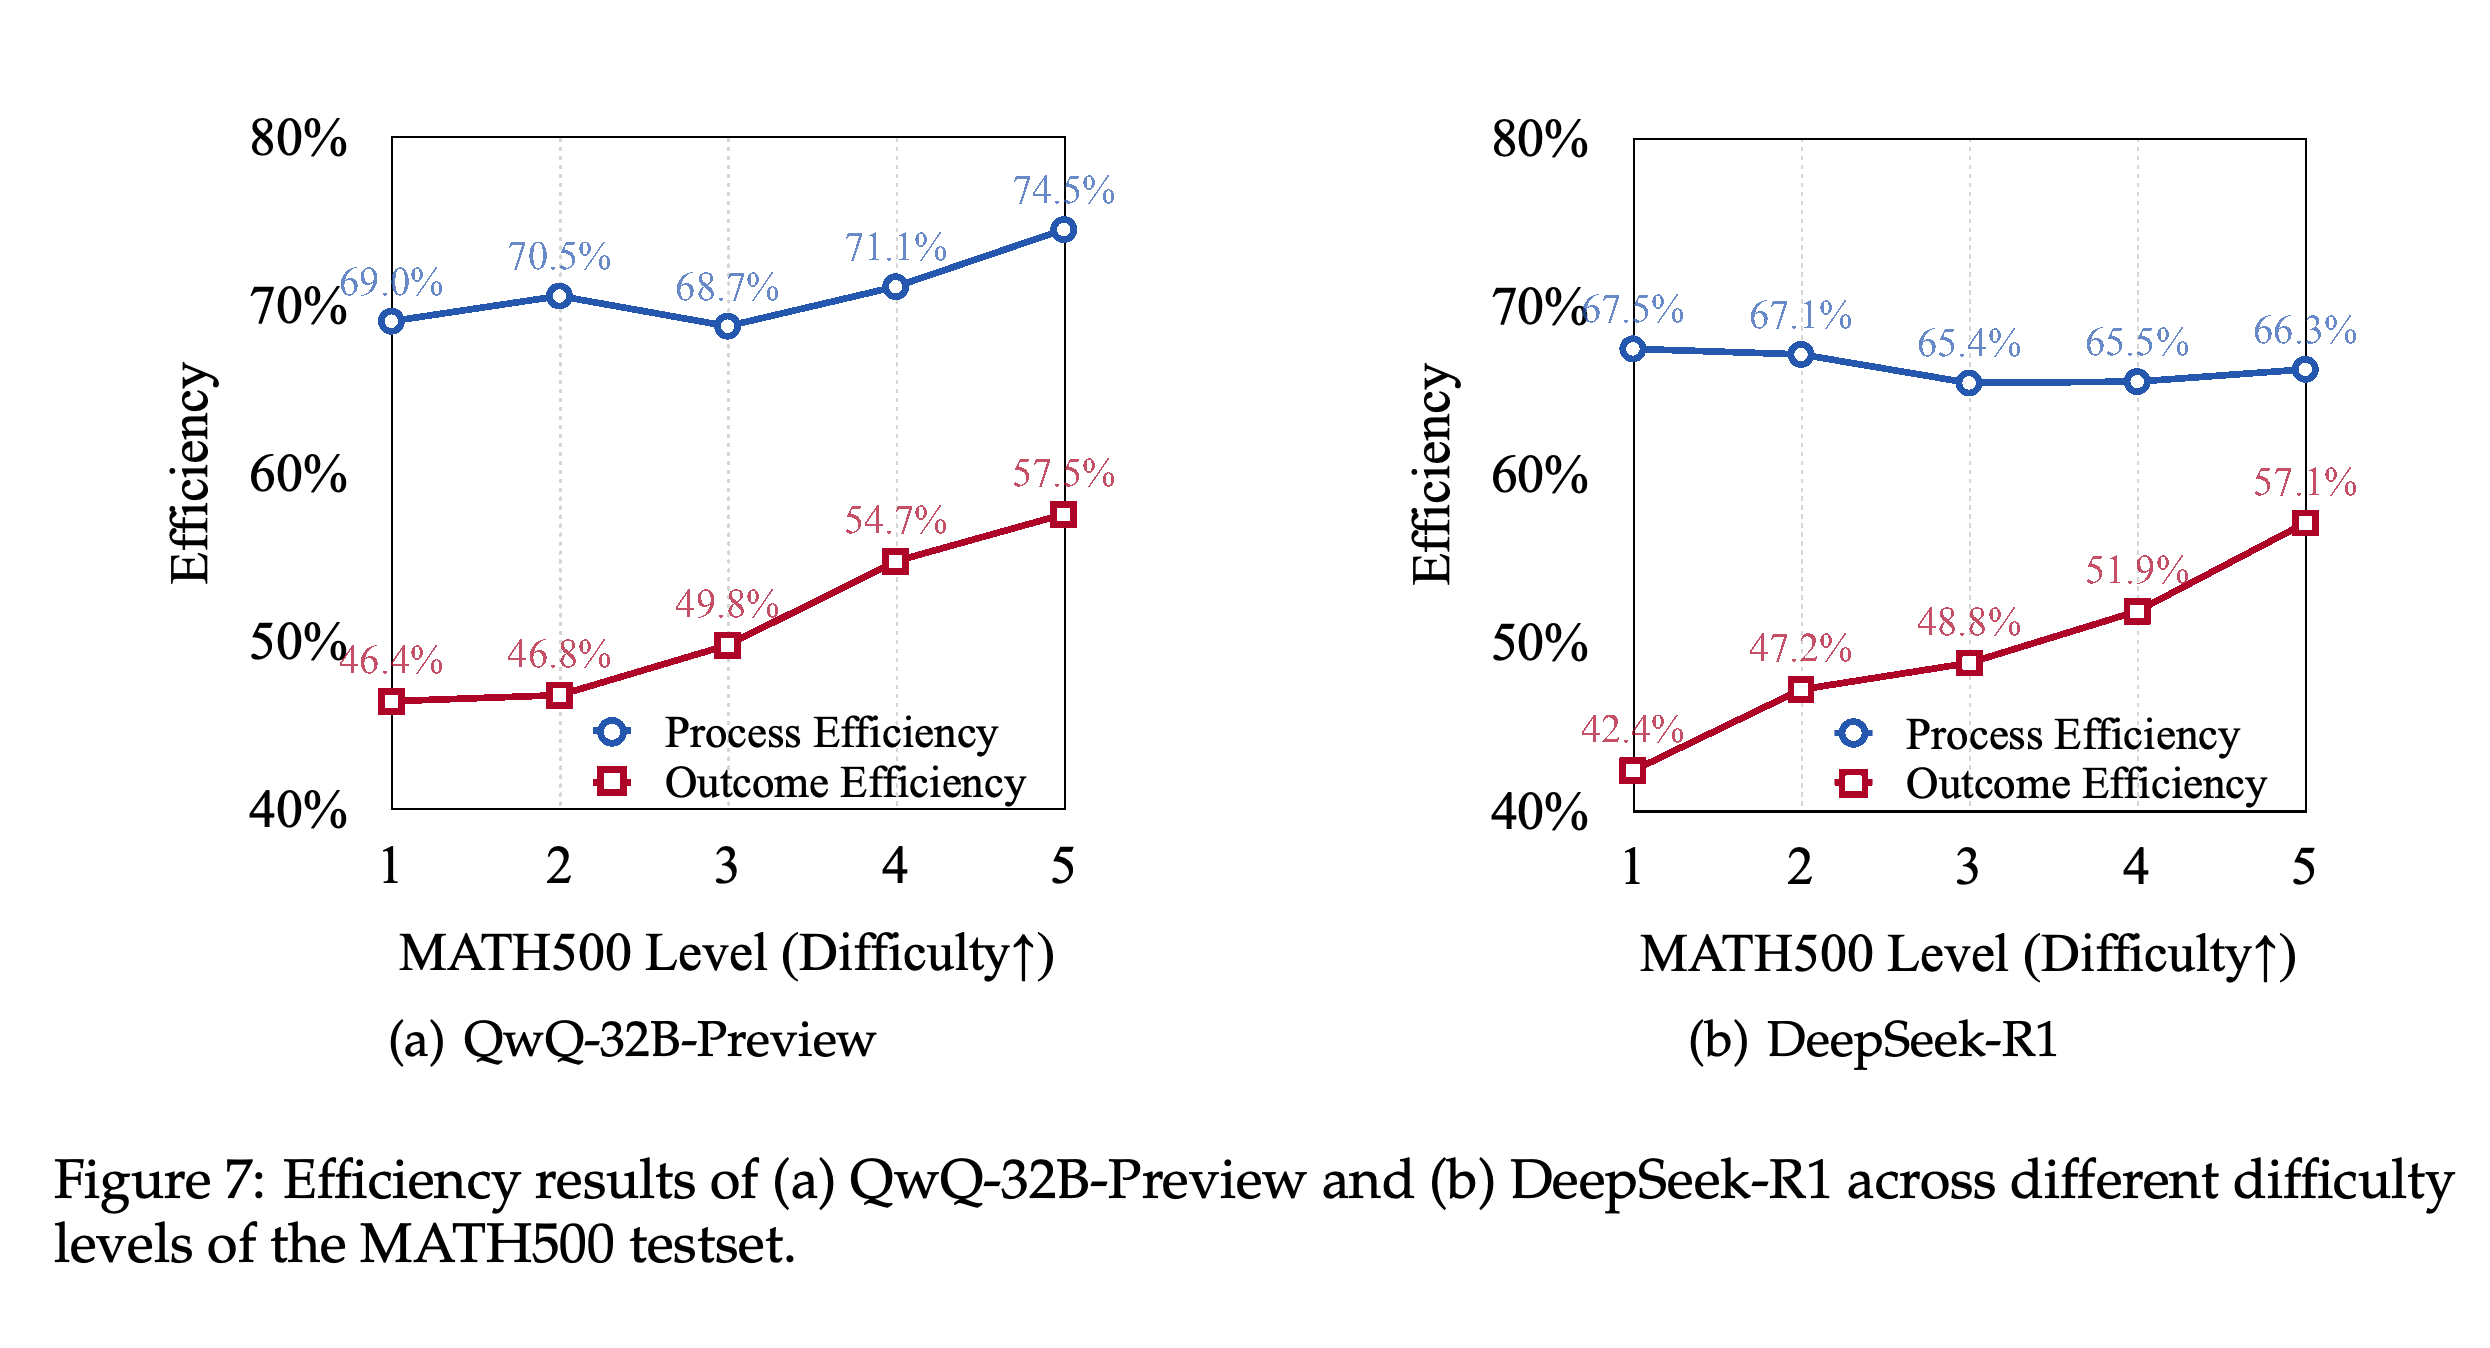
- MATH500 난도 1에서 결과 효율성은 QwQ-32B-Preview가 46.4%, DeepSeek-R1이 42.4%다. 난도 5에서는 각각 57.5%와 57.1%로 높아진다.
추론 모델은 기존 베이스라인보다 MATH500 정확도가 훨씬 높지만 응답도 훨씬 길다. ASDIV에서는 정확도 차이가 작아도 길이 차이는 여전히 크다. 이는 쉬운 문제에서의 토큰 사용에 관한 논문의 문제의식을 보여준다.
모델 2개 모두 결과 효율성이 난도 1에서 50% 미만이며, MATH500 난도가 높아질수록 상승한다. 과정 효율성의 변화는 덜 일관적이며, 이는 이 지표가 별도로 전략 다양성에 초점을 맞추기 때문이다.
3 Mitigating Overthinking Issues
과도한 추론을 줄이는 실험에서는 PRM12K에서 학습 문제를 가져오고, QwQ-32B-Preview로 응답을 생성해 자기 학습에 사용한다. QwQ-32B-Preview는 기본 모델을 구축한 뒤 추가로 학습하는 사후 학습이 가능하므로 실험 모델로 선택한다. 응답 선택과 선호 학습을 통해 더 짧은 응답을 생성하도록 학습한다.
3.1 Length Preference Optimization
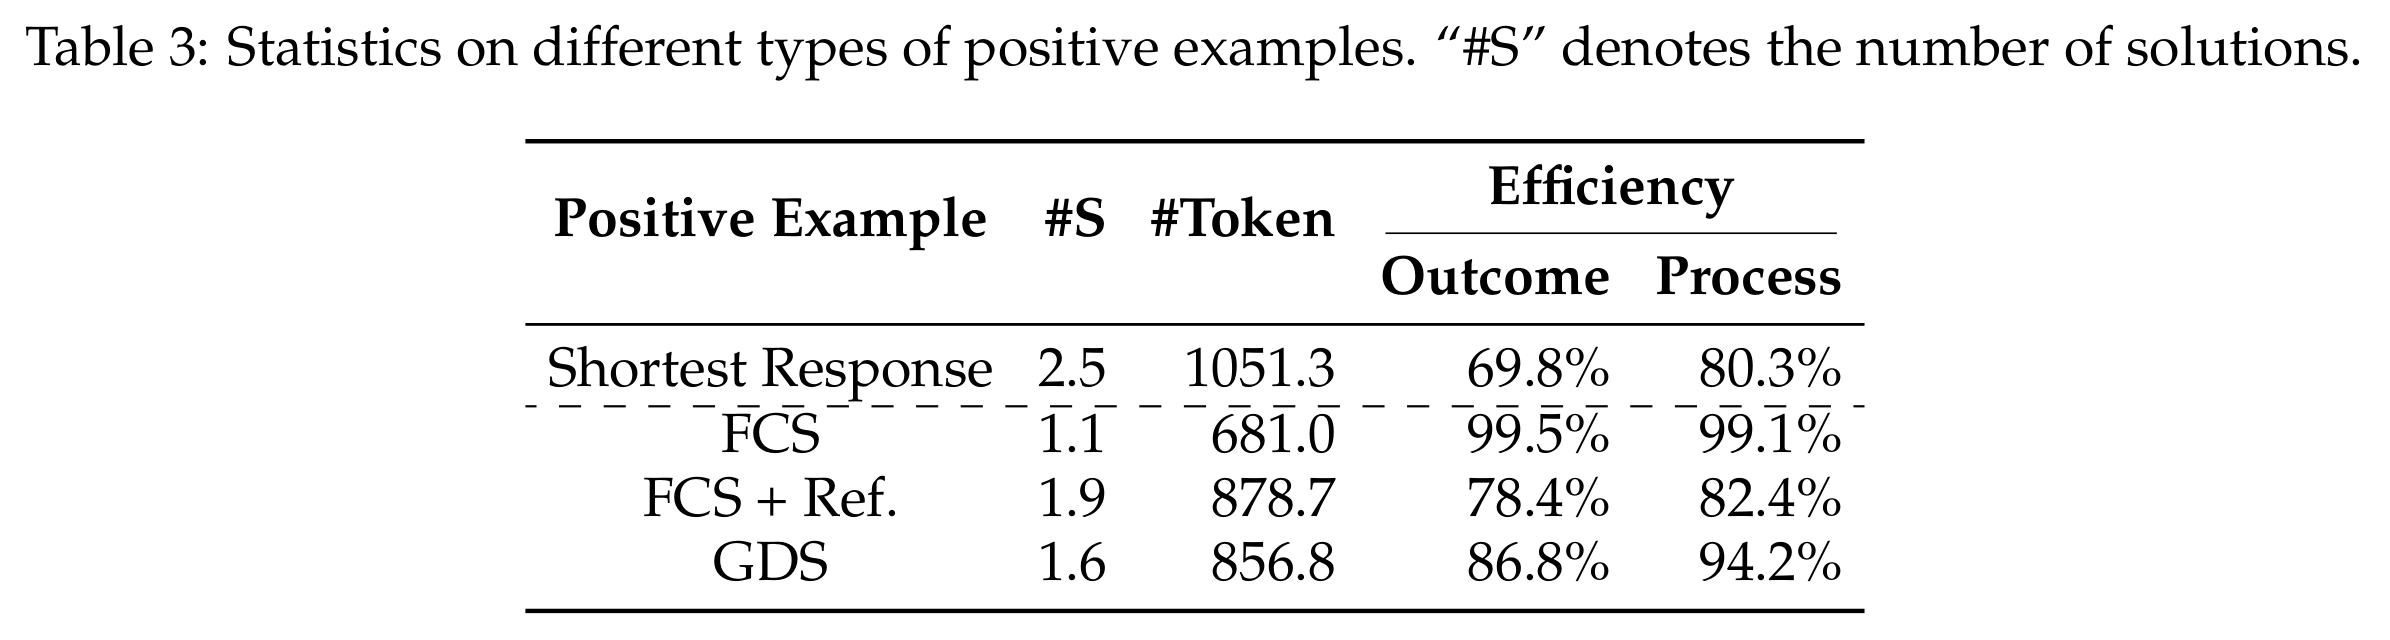
각 학습 문항에 대해 출력의 무작위성을 조절하는 temperature를 1.0으로 설정해 응답 10개를 생성하고, 정답을 내지 못한 응답은 제외한다. 남은 응답 중 가장 짧은 응답은 평균 1051.3토큰이며, 매 단계에서 확률이 가장 높은 다음 토큰을 선택하는 탐욕적 생성 응답보다 결과 효율성과 과정 효율성이 높다. 남은 응답 중 가장 긴 응답은 평균 2258.7토큰이다. 선호 학습에서는 짧은 응답을 선호 예제로, 샘플 중 가장 긴 응답을 비선호 예제로 묶는다. 예비 실험에서 이 방식은 탐욕적 생성 응답을 비선호 예제로 사용하는 방식보다 효과적이었다.
- Supervised Fine-Tuning(SFT)은 예제 토큰에 낮은 확률을 부여할수록 손실이 커지는 교차 엔트로피를 최소화해 선호 예제를 재현하도록 학습한다. 비선호 응답과 짝을 구성하지 않고, 샘플 중 가장 짧은 응답을 사용한다.
- Direct Preference Optimization(DPO)은 선호 응답을 다른 응답보다 우선하도록 학습한다. Reasoning Preference Optimization(RPO)은 선호 응답에 낮은 확률을 부여할 때 벌점을 주는 음의 로그 우도 항을 추가해, 학습 중 해당 응답의 확률을 유지하도록 돕는다.
- SimPO는 평가한 4번째 학습 방법이다. 이 실험에서는 새로 수집한 사람의 선호 대신 길이에 따라 자동으로 선택한 선호를 사용한다.
3.2 Streamlining Responses to Enhance Efficiency
First-Correct Solutions(FCS)는 최초 정답 풀이까지 응답의 앞부분을 남긴다. FCS+Reflection은 추가 검증을 보존하기 위해 2번째로 정답을 제시한 풀이까지 남긴다. Greedily Diverse Solutions(GDS)는 새로운 추론 전략을 선호하는 휴리스틱으로 남길 응답 구간을 확장한다. 각 전략별로 샘플 10개에서 처리 후 가장 짧은 응답을 선택하므로, 전략에 따라 서로 다른 원본 응답이 선택될 수 있다.
- FCS 학습 예제는 평균 풀이 수가 1.1개, 길이가 681.0토큰이며, 결과 효율성은 99.5%, 과정 효율성은 99.1%다.
- FCS+Reflection은 평균 풀이 수가 1.9개, 길이가 878.7토큰이며, 결과 효율성은 78.4%, 과정 효율성은 82.4%다.
- GDS는 평균 풀이 수가 1.6개, 길이가 856.8토큰이며, 결과 효율성은 86.8%, 과정 효율성은 94.2%다. 이 수치는 학습 예제의 통계이며, 학습된 모델의 평가 결과가 아니다.
최초 정답 풀이까지만 남기면 가장 짧은 학습 예제와 가장 높은 효율성 점수를 얻는다. 검토 과정을 유지하면 토큰이 늘고 이 점수들은 낮아진다. 이에 따라 후속 실험에서는 검토 과정이 학습 후 정확도를 더 많이 유지하는지 평가한다.
3.3 Experimental Results
MATH500에서 가장 짧은 응답으로 학습한 SimPO는 평균 길이를 2407.9토큰에서 1871.8토큰으로 줄인다. 논문에서 보고한 감소율은 22.3%이며, 정확도는 93.0%에서 92.4%로 변한다. FCS+Reflection 예제를 사용하면 정확도 92.8%에서 1330.7토큰을 생성하며, 결과 효율성은 52.3%에서 80.0%로, 과정 효율성은 71.2%에서 89.5%로 높아진다. FCS만 사용하면 길이는 1016.0토큰으로 더 짧지만 정확도는 91.0%다. 이는 응답을 적극적으로 줄이는 것과 검토 과정을 유지하는 것 사이의 절충을 보여준다.
- 가장 짧은 응답을 사용하는 방법 중 SFT는 2359.5토큰으로 정확도 93.2%, DPO는 1929.5토큰으로 94.0%, RPO는 2015.7토큰으로 91.6%를 달성한다. DPO의 정확도가 더 높지만, 길이를 더 많이 줄이는 SimPO를 선택한다.
- SimPO와 FCS+Reflection을 결합하면 ASDIV 정확도는 96.9%에서 96.8%로 변하고 토큰 수는 741.8에서 381.6으로 줄어든다. GSM8K 정확도는 94.8%에서 96.0%로 높아지고 토큰 수는 772.8에서 416.6으로 줄어든다.
- 논문에서 사용한 또 다른 고난도 추론 평가인 GPQA에서는 정확도가 59.6%에서 59.1%로, 토큰 수가 3228.4에서 2085.7로 변한다. AIME24에서는 정확도가 46.7%에서 43.3%로, 토큰 수가 9480.9에서 5154.5로 변한다.
SimPO와 FCS+Reflection을 결합하면 MATH500 정확도를 기본 모델에 가깝게 유지하면서 생성 길이를 크게 줄인다. 다만 이 표는 정확도 유지 주장의 한계도 보여준다. 토큰 수가 크게 줄어도 GPQA 정확도는 소폭 하락하고 AIME24 정확도는 46.7%에서 43.3%로 떨어진다.
4 Related Work
관련 연구에서는 추론 연산량을 늘리는 방법과 연산 효율성을 높이는 방법을 구분한다. 후보 답에 대한 탐색 확대, 응답 내부의 추론 확장, 과제에 배정할 연산량 제어를 다룬다. 논문은 응답 선택과 자기 학습을 마지막 문제에 대한 접근법으로 제시한다.
4.1 Scaling Test-Time Compute
탐색 기반 확장에는 여러 응답을 생성하고 다수결로 답을 고르는 self-consistency, 후보 선택, 가능한 추론 경로에 대한 구조적 탐색이 포함된다. 다른 계열은 CoT, 모델 간 토론, 자기 수정, 자기 비평, 계획, 잠재 표현에서의 추론으로 추론을 확장한다. 잠재 표현은 명시적인 텍스트 대신 사용하는 모델 내부 상태를 뜻한다. 이러한 구분을 바탕으로 응답 내부에서 추가하는 추론이 얼마나 유용한지 살펴본다. 가능한 추론 경로에 대한 구조적 탐색에 대해서는 Tree of Thoughts - Deliberate Problem Solving with Large Language Models (ToT) 요약 설명 글을 참조하라.
4.2 Efficient Thinking
효율적 추론에 관한 논의에서는 긴 추론 압축, 해결하기 어려운 시도의 중단, 토큰 예산을 지정한 프롬프팅, 추정 난도에 따른 연산 배분, 생성 조기 종료를 다룬다. 저자들은 사용자가 토큰 예산을 지정하지 않아도 사후 학습으로 효율적인 생성을 학습하는 것을 목표로 한다. 실험에서는 응답 선택과 선호 학습을 평가한다. 질문마다 연산량을 동적으로 조절하도록 학습한 배분기는 실증 결과에 포함되지 않는다.
5 Conclusion
결론에서는 중복 풀이 생성을 자원 배분 문제로 보고, 결과 효율성과 과정 효율성을 상호 보완적인 진단 지표로 제시한다. 자기 학습은 QwQ-32B-Preview의 벤치마크 정확도를 상당 부분 유지하면서 응답을 크게 줄이며, 평가별 변화는 Table 4에 제시한다. 향후 과제로는 문제 복잡도에 따른 적응적 연산과 효율성 지표 개선을 제안한다.
부록
- A A.1 Case Overview for Deepseek-R1-Preview는 2번째 정성적 사례를 제시한다. “What is the answer of 2 plus 3?”에 대한 936토큰 응답은 첫 풀이에서 이미 5를 얻지만 풀이 11개를 포함한다. Figure 8은 손가락, 수직선, 덧셈 순서 변경, 사물 세기 예시를 통한 반복 검증을 보여준다. 이 단일 응답은 중복을 보여주는 사례이며, 중복이 얼마나 널리 발생하는지는 추정하지 않는다. A.2 Prompts for Clustering Solutions는 추론 다양성을 평가하는 데 사용한 GPT-4o 군집화 기준을 제공한다. 같은 답을 내더라도 방법, 중간 단계, 가정, 일반화 범위, 복잡도의 실질적 차이에 따라 풀이를 구분할 수 있다. 프롬프트는 풀이 식별자와 이유를 포함한 군집을 요청하므로, 과정 효율성은 전략 차이에 대한 모델의 판단에 의존한다.
짧은 생각
가장 명확한 근거는 같은 기본 모델에서 응답 선택 전략을 비교한 결과다. FCS는 가장 짧은 출력을 생성하며, 정답 풀이를 추가로 유지하면 정확도가 일부 회복된다. 효율성 지표는 토큰 사용을 설명하지만 지연 시간이나 하드웨어 비용을 직접 측정하지 않는다. 또한 결과 효율성만으로는 최초 정답 이후의 검증이 인과적으로 불필요하다고 판단할 수 없다. 완화 실험은 기본 모델 1개를 다루며, 제공된 논문은 반복 실행에 따른 불확실성, 통계적 유의성, 학습 연산량, 측정된 추론 지연 시간을 보고하지 않는다. 따라서 근거는 배포 환경의 속도 향상을 정량화하기보다는 출력 길이 감소를 더 직접적으로 뒷받침한다. 서론은 MATH500 토큰 감소율을 48.6%로 제시하지만, Table 4의 2407.9토큰에서 1330.7토큰으로 줄어든 결과를 계산하면 약 44.7%다. 본문은 FCS+Reflection이 FCS보다 1.4% 높다고도 서술하지만, 표의 92.8%와 91.0%는 1.8%포인트 차이다. 본문은 고난도 평가에서도 성능을 유지한다고 설명하지만, Table 4에서는 AIME24 정확도가 3.4%포인트 하락한다. 따라서 정확도 유지는 모든 난도에서 성립한다고 가정하지 말고 평가별로 판단해야 한다.