


Cognitive Behaviors that Enable Self-Improving Reasoners, or, Four Habits of Highly Effective STaRs 요약 설명
03 Mar 2025 | Paper Review Reinforcement Learning Mathematical Reasoning Data Curation목차
이번 글에서는 Cognitive Behaviors that Enable Self-Improving Reasoners, or, Four Habits of Highly Effective STaRs 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 3일(Arxiv), COLM 2025
- Gandhi, Kanishk, Chakravarthy, Ayush, Singh, Anikait, Lile, Nathan, Goodman, Noah D..
- Stanford University, SynthLabs
- 논문 링크
- Github
요약
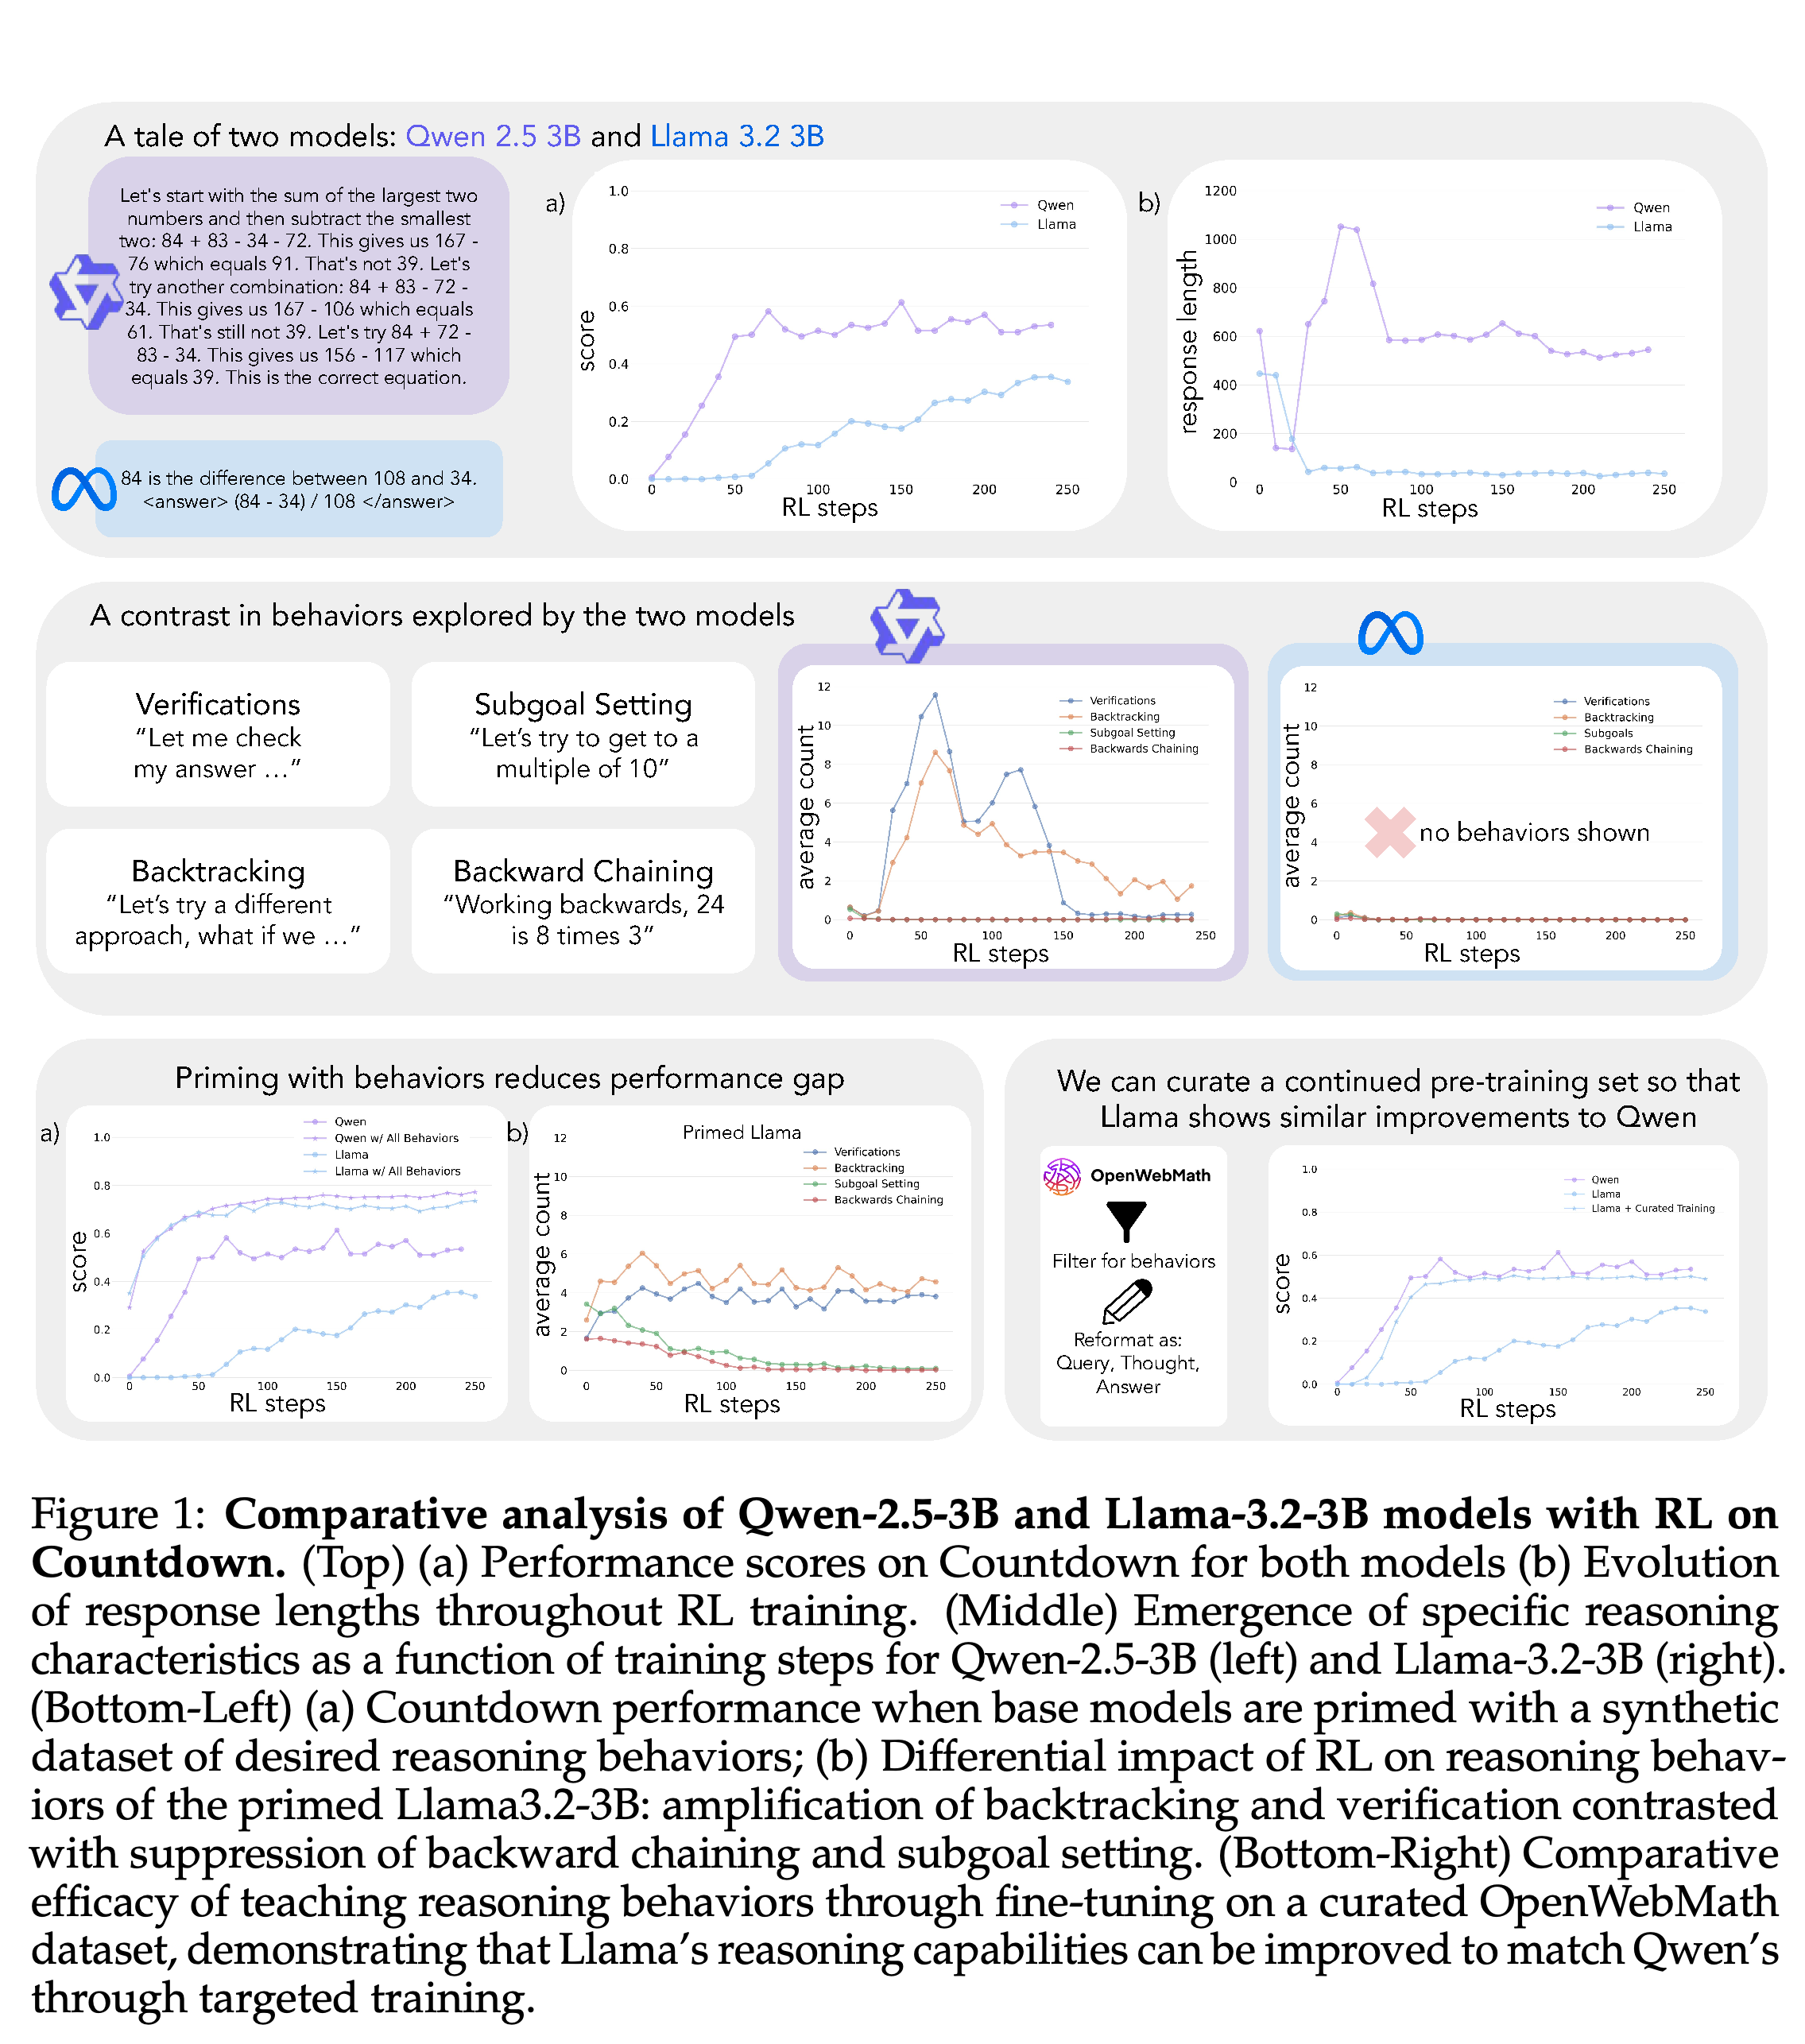
- 이 논문은 크기가 비슷한 언어 모델들이 강화학습(RL)에서 서로 다른 개선 양상을 보이는 이유를 연구한다. 여기서 RL은 정답을 검증할 수 있는 문제에서 생성된 풀이에 보상을 부여한다. 입력 숫자를 조합해 목표값을 만드는 산술 퍼즐인 Countdown에서 동일한 조건으로 250스텝을 학습한 뒤, Qwen-2.5-3B는 정확도가 약 60%에 도달하지만 Llama-3.2-3B는 30%에 그친다.
- 저자들은 중간 결과를 확인하는 verification, 실패한 접근을 포기하는 backtracking, 중간 목표를 제안하는 subgoal setting, 원하는 결과에서 거꾸로 추론하는 backward chaining을 연구한다. 이러한 행동이 포함된 예시로 Llama를 미세조정하는 priming을 적용하면, 이후 RL 성능이 priming을 적용하지 않은 Qwen과 같거나 더 높아진다. 반면 추론을 비우거나 자리표시자로 채운 대조 조건에서는 이와 비슷한 효과가 거의 나타나지 않는다.
- 목표 행동이 포함된 오답 풀이로 priming을 적용해도, 모든 전략을 포함한 표준 priming 조건과 비슷한 후속 개선이 나타난다. 표준 조건의 시연도 모두 정답인 것은 아니다. 수학 웹 텍스트 데이터셋인 OpenWebMath에서 해당 행동을 강화한 데이터로 추가 사전학습하면 Llama의 학습 경로가 Qwen에 가까워진다. 반면 동일한 8.3 million-token 예산으로 행동을 최소화한 대조 조건에서는 개선 폭이 작다.
- 개입 결과는 이 실험 환경에서 제공된 추론 행동, 특히 backtracking과 verification이 성능 개선에 인과적으로 기여함을 뒷받침한다. 다만 일반화 양상은 일관되지 않다. 행동 변화는 다른 질의응답 과제로 전이되지만, 추가 사전학습한 Llama 변형 2개는 행동 빈도가 서로 다른데도 대학원 수준 질의응답 벤치마크인 GPQA에서 모두 약 12%를 기록한다.
1 Introduction
Cognitive Behaviors that Enable Self-Improving Reasoners, or, Four Habits of Highly Effective STaRs는 초기 언어 모델의 어떤 특성이 test-time compute를 효과적으로 활용하게 하는지 묻는다. Test-time compute는 추론 시점에 풀이를 생성하는 데 사용하는 계산량이다. 저자들은 모델이 처음부터 갖춘 탐색형 행동이 RL을 통해 유용한 긴 추론 과정을 발견하는 데 도움이 된다고 가정하고, 합성 데이터를 이용한 행동 priming과 특정 행동을 목표로 한 추가 사전학습으로 이를 검증한다.
- 연구는 학습 경로의 차이를 관찰하는 데서 시작해 초기 모델에 직접 개입하는 단계로 나아간다. 이를 통해 모델 계열 간 비교를 넘어선 개입 근거를 제시한다.
- 코드와 프롬프트는 https://github.com/kanishkg/cognitive-behaviors 에 공개되어 있다.
초기 Qwen–Llama 학습 격차를 관찰 가능한 추론 행동의 차이와 연결하고, 이 격차를 줄이는 개입 2개를 보여준다. 행동 패널은 가설의 근거를 제공하며, priming 및 추가 사전학습 패널은 개입의 효과를 뒷받침한다.
2 Related Work
논문은 생성된 여러 후보를 평가하는 external search, 생성 텍스트 안에서 대안을 순차적으로 탐색하는 in-context search, 성공적인 추론 경로에 보상을 주는 RL 접근법을 구분한다. 이 연구는 초기 모델이 이후 RL을 통한 개선을 돕거나 제한하는 이유를 다룬다. 이는 탐색 절차, 자기 수정 예시, 길고 구조화된 추론 시연을 다룬 선행 연구를 보완한다.
- External search에서는 후보들이 탐색 이력을 공유하지 않으면 이미 탐색한 풀이를 반복할 수 있다.
- 명시적인 탐색 또는 수정 과정으로 학습하면 유용한 행동을 도입할 수 있지만, 이를 위해 학습 데이터를 의도적으로 구성해야 한다.
3 Identifying and Engineering Self-Improving Behavior
실험은 베이스 모델 2개를 비교하고, 관찰 가능한 행동 측정 기준을 정의하며, 초기 행동 분포에 개입한 뒤 더 폭넓은 수학 데이터를 이용한 개입을 검증한다. 이 과정을 통해 특정 추론 행동의 예시가 이후 보상 기반 학습에 도움이 되는지 살펴본다.
3.1 Initial Investigation: A tale of two models
Countdown은 수학 지식에 대한 의존도가 비교적 낮고 탐색 범위가 제한된 산술 문제를 제공한다. 예를 들어 입력값 25, 30, 3, 4로 (30 − 25 + 3) × 4를 계산하면 목표값 32에 도달한다.
- 저자들은 RL 최적화 알고리즘인 Proximal Policy Optimization(PPO)을 사용해 Qwen-2.5-3B와 Llama-3.2-3B를 250 steps 동안 학습한다. VERL 학습 라이브러리와 TinyZero 구현을 사용하며, 프롬프트마다 풀이 경로 4개를 생성해 샘플링한다.
- Qwen은 약 30스텝부터 정확도와 응답 길이가 증가하며, 최종 정확도는 약 60%로 Llama의 30%보다 높다. PPO는 여러 하이퍼파라미터 설정에서 안정적이어서 선택되었다. 다른 알고리즘에서도 비슷한 성능이 나왔다는 설명은 개별 관찰 수준으로 제시된다.
- 학습 후반의 Qwen 출력에서는 명시적인 언어적 확인 대신 서로 다른 풀이를 순차적으로 시도하는 경우가 나타난다. 이는 과제 성능이 높게 유지되는 동안에도 측정되는 명시적 행동은 달라질 수 있음을 보여준다.
3.2 A Framework for Analyzing Cognitive Behaviors
이 분석 체계는 생성된 추론에서 4가지 행동이 명시적으로 나타난 횟수를 센다. 이전 접근을 대체하는 수정, 풀이 조건을 충족하는지 확인하는 과정, 중간 목표 제안, 목표에서 거꾸로 구성한 경로가 이에 해당한다. GPT-4o-mini를 분류기로 사용해 이러한 패턴을 식별하고 횟수를 센다.
- 이 4개 범주는 텍스트에서 식별할 수 있고, 중단 없이 순차적으로 진행되는 풀이를 넘어 탐색형 추론을 설명하므로 선택되었다.
- 이 측정은 눈에 보이는 출력 패턴을 다루며, 모델 내부의 계산 과정을 직접 입증하지 않는다. 논문에 제시된 암묵적 확인 예시는 이러한 측정의 한계를 보여준다.
3.3 The Role of Initial Behaviors in Self-Improvement
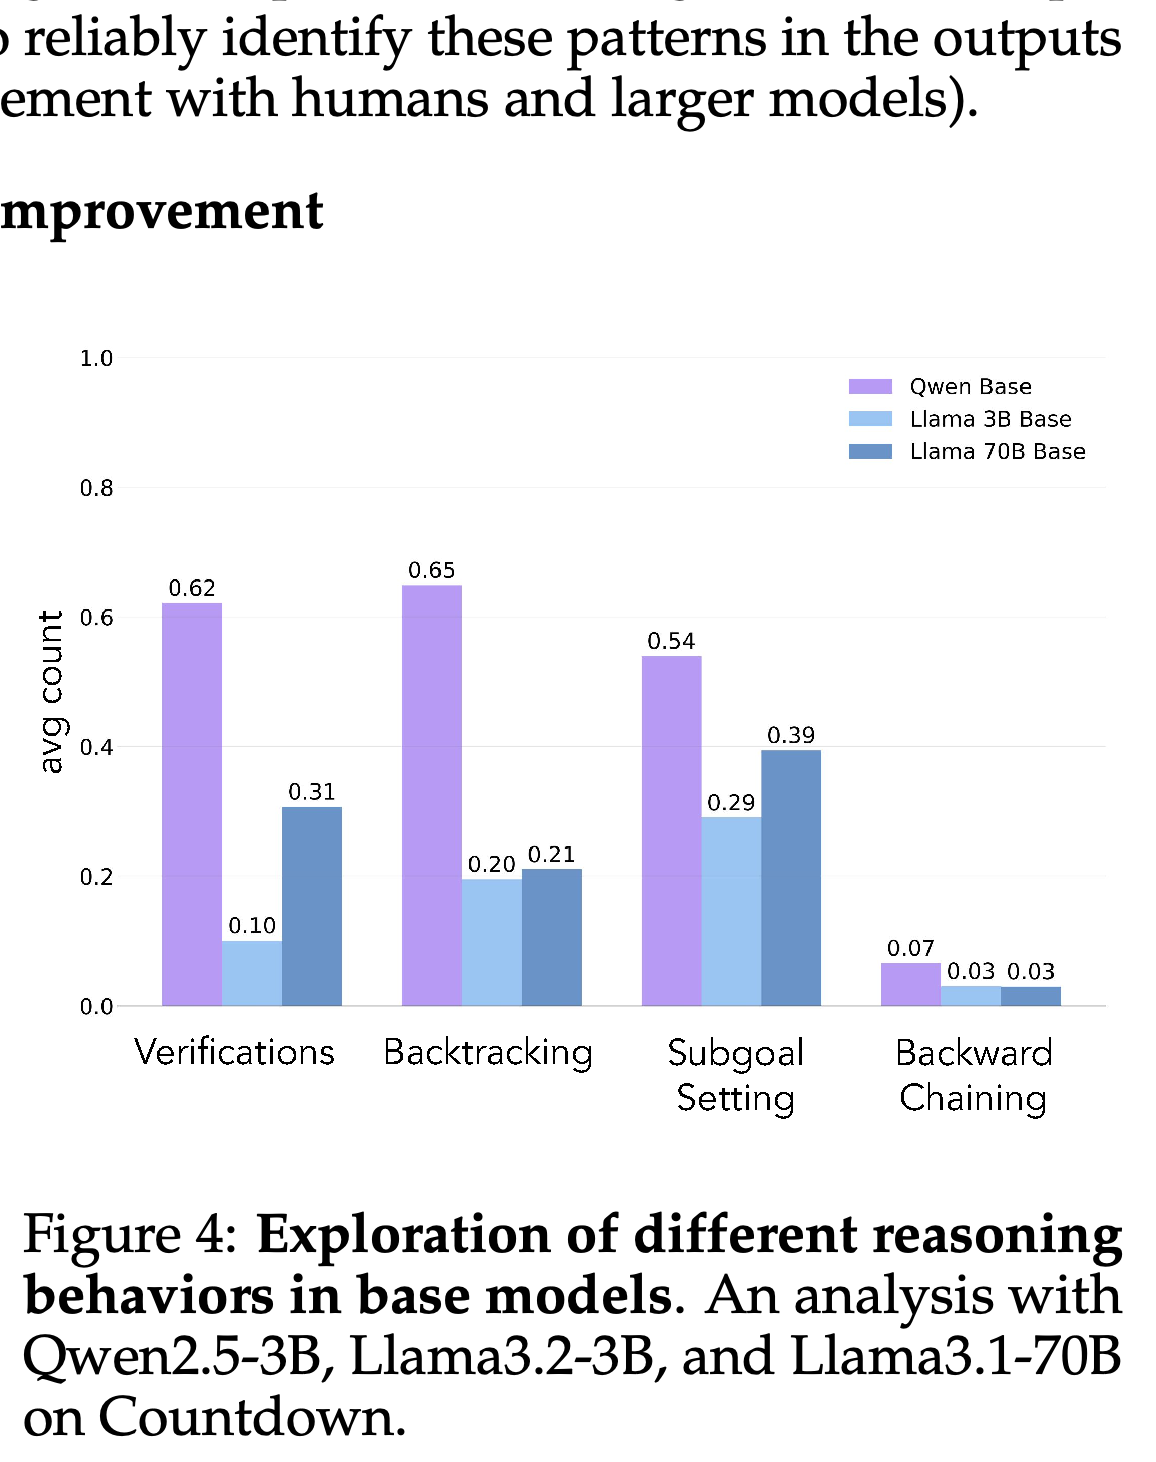
RL 이전에 Qwen은 Llama-3.2-3B와 Llama-3.1-70B보다 측정 대상인 4가지 행동을 모두 더 많이 보인다. RL 중에는 특히 verification과 backtracking이 성능 향상과 함께 나타나는 반면, 작은 Llama에서는 이 행동들이 거의 관찰되지 않는다.
- 학습 전 평균 verification 횟수는 Qwen이 0.62, Llama-3.2-3B가 0.10, Llama-3.1-70B가 0.31이다. 같은 순서로 backtracking 횟수는 0.65, 0.20, 0.21이다.
- 더 큰 Llama에서는 일부 행동의 빈도가 높아지지만, backtracking 횟수는 작은 Llama와 비슷하다. 따라서 모델 크기만으로 이 행동 차이를 설명할 수 없다.
- 이 관찰은 개입 실험의 근거가 된다. 다만 학습 전 상관관계만으로는 해당 행동이 더 나은 학습을 유발한다고 입증할 수 없다.
3.4 Intervening on initial behaviors
저자들은 RL 전에 제공된 추론 예시로 학습하는 지도 미세조정(SFT)을 통해 모델에 priming을 적용한다. Claude-3.5-Sonnet으로 5개 행동 데이터셋을 생성한다. 조건은 모든 전략, backtracking만 사용, backtracking과 verification, backtracking과 subgoal setting, backtracking과 backward chaining이다.
- 5개 행동 조건에는 모두 backtracking이 포함된다. 이후 모델 계열 2개 모두 성능이 크게 개선되며, priming을 적용한 Llama는 priming을 적용하지 않은 Qwen과 같거나 더 높은 성능을 보인다.
- 모든 전략을 제공하면 RL은 verification과 backtracking을 유지하면서 subgoal setting과 backward chaining을 줄인다. 뒤의 행동들은 각각 backtracking과만 결합했을 때 더 많이 유지된다.
- 이 설계는 backtracking이 포함된 개입의 유용성을 뒷받침하지만, verification만 사용하거나 subgoal setting만 사용하거나 backward chaining만 사용하는 priming을 독립적으로 검증하지는 않는다.
학습 전 Qwen의 backtracking 횟수는 0.65이며, Llama-3.2-3B는 0.20, Llama-3.1-70B는 0.21이다. 더 큰 Llama에서는 backtracking보다 verification과 subgoal setting의 빈도가 더 많이 증가한다. 이는 매개변수 수가 늘어도 측정 대상 행동이 모두 같은 정도로 증가하지는 않음을 보여준다.
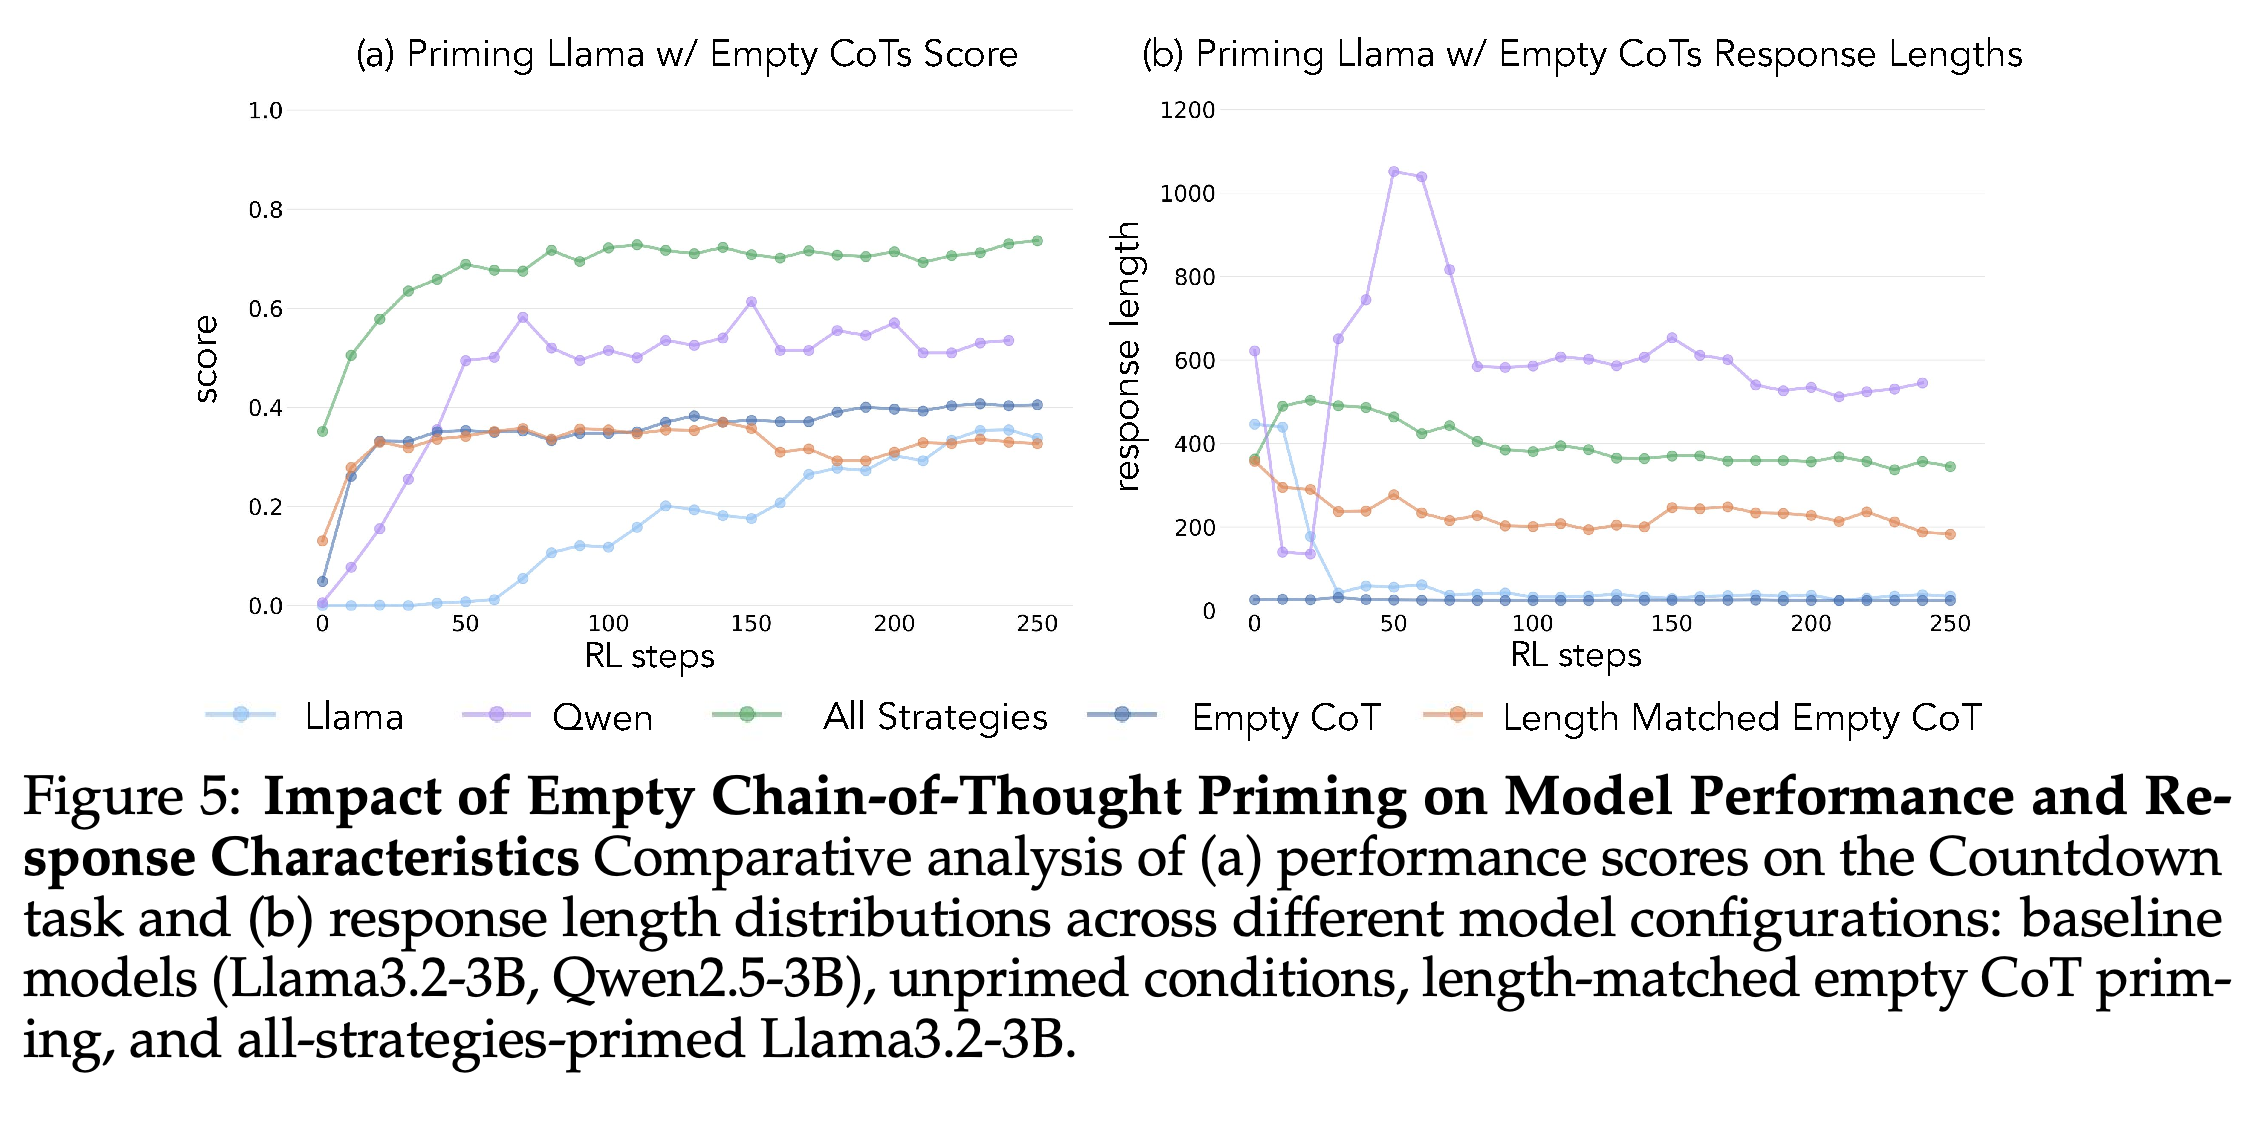
대조 조건 2개에서는 생성된 중간 추론 텍스트인 chain-of-thought(CoT)를 빈 시퀀스인 <think></think> 또는 길이를 맞춘 자리표시자 토큰으로 대체한다. 논문에 따르면 이 조건들의 성능은 약 30–35%로 베이스 Llama와 비슷하다. 반면 행동 priming에서는 훨씬 큰 개선이 나타난다.
- 길이를 맞춘 대조 조건은 추론 필드에 더 많은 학습 토큰을 배정한 것만으로 성능이 개선되었다는 설명의 설득력을 낮춘다.
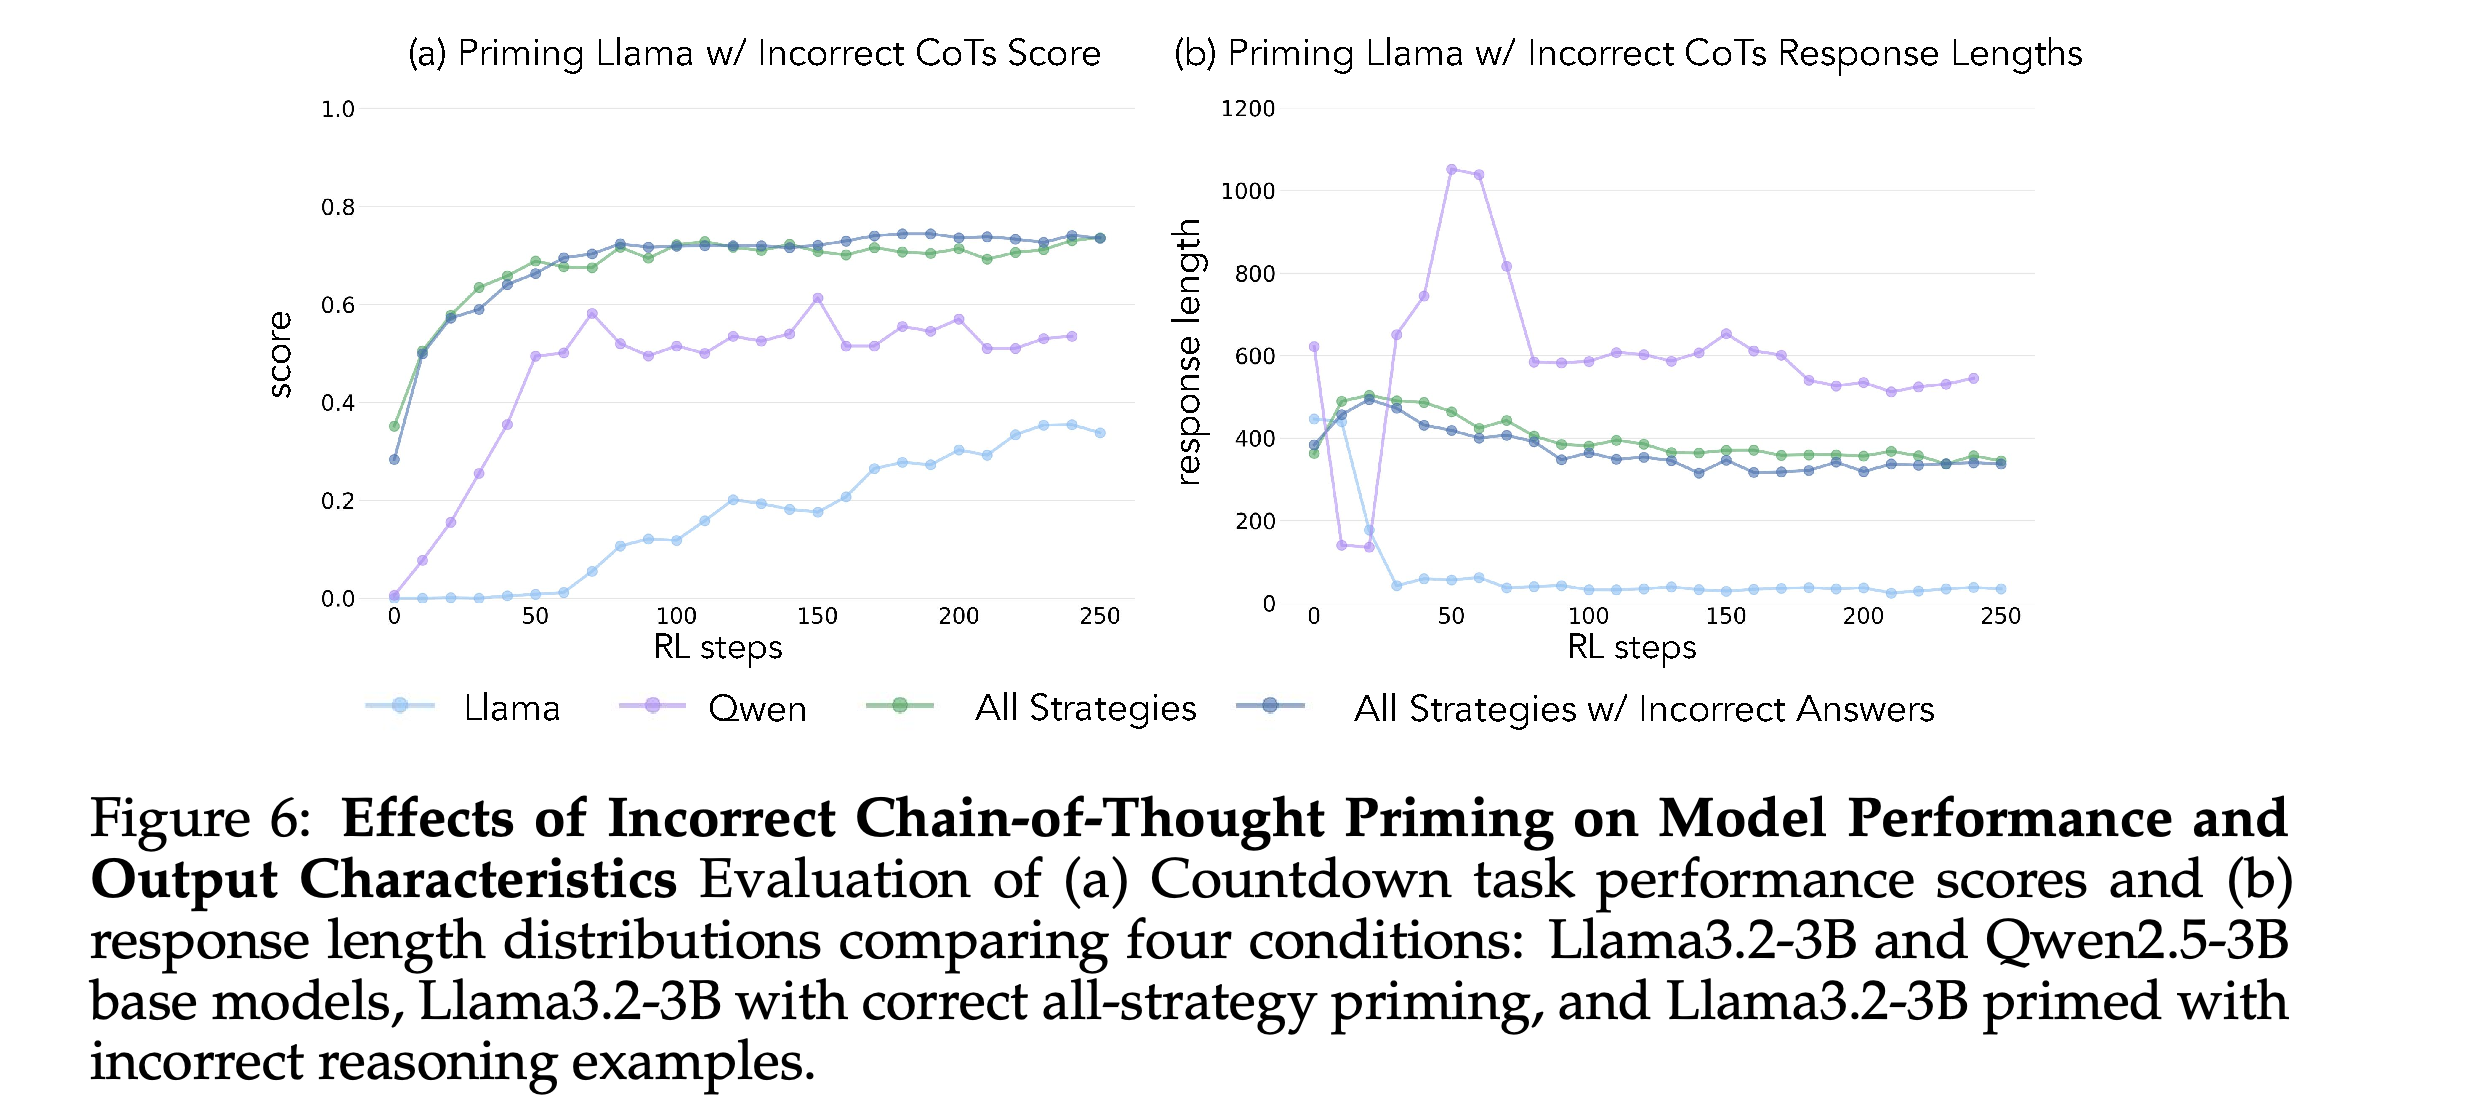
- 추가로 구성한 모든 전략 데이터셋은 원하는 행동을 유지하되 오답 풀이만 포함한다. 이후 학습 곡선은 불완전한 시연도 포함하는 표준 모든 전략 조건과 거의 일치한다. 이는 관찰된 성능 향상에 priming 예시의 정답이 필수는 아님을 보여준다.
- 오답 풀이에 관한 결과는 검증 가능한 보상을 사용하는 RL 이전의 priming에 한정된다. 학습 전 과정에서 정답 여부가 불필요하다는 의미는 아니다.
추론을 비우거나 길이를 맞춘 자리표시자로 priming하면 이후 Countdown 성능이 모든 전략 priming보다 훨씬 낮게 유지된다. 자리표시자 대조 조건은 행동 내용 없이 추론 필드의 길이만 제공하므로, 길이와 행동 내용의 영향을 구분하는 데 도움이 된다.
표준 모든 전략 priming과 오답만 사용하는 priming은 후반 성능과 응답 길이 모두에서 곡선이 거의 겹친다. 따라서 최종 답이 틀린 행동 시연도 이후 개선에 도움이 될 수 있다. 다만 후속 RL 단계는 여전히 정답 여부에 따른 보상을 사용하며, 표준 priming 데이터셋 자체에도 불완전한 풀이가 포함된다.
일반적인 수학 텍스트에 이러한 행동이 포함되는지 살펴보기 위해, 저자들은 수학 사전학습 코퍼스인 OpenWebMath와 FineMath에서 무작위로 추출한 문서 200,000개를 Qwen-2.5-32B로 분류한다. Verification과 backtracking은 드물게 나타나며, 측정된 행동 중에서는 subgoal setting이 가장 흔하다.
- 이 분석은 선택한 행동을 수학 사전학습 데이터에 더 많이 포함할 근거가 된다. 다만 비교 대상 베이스 모델의 실제 사전학습 분포를 조사하거나 복원하지는 않는다.
3.5 Selectively amplifying behaviors in pretraining data
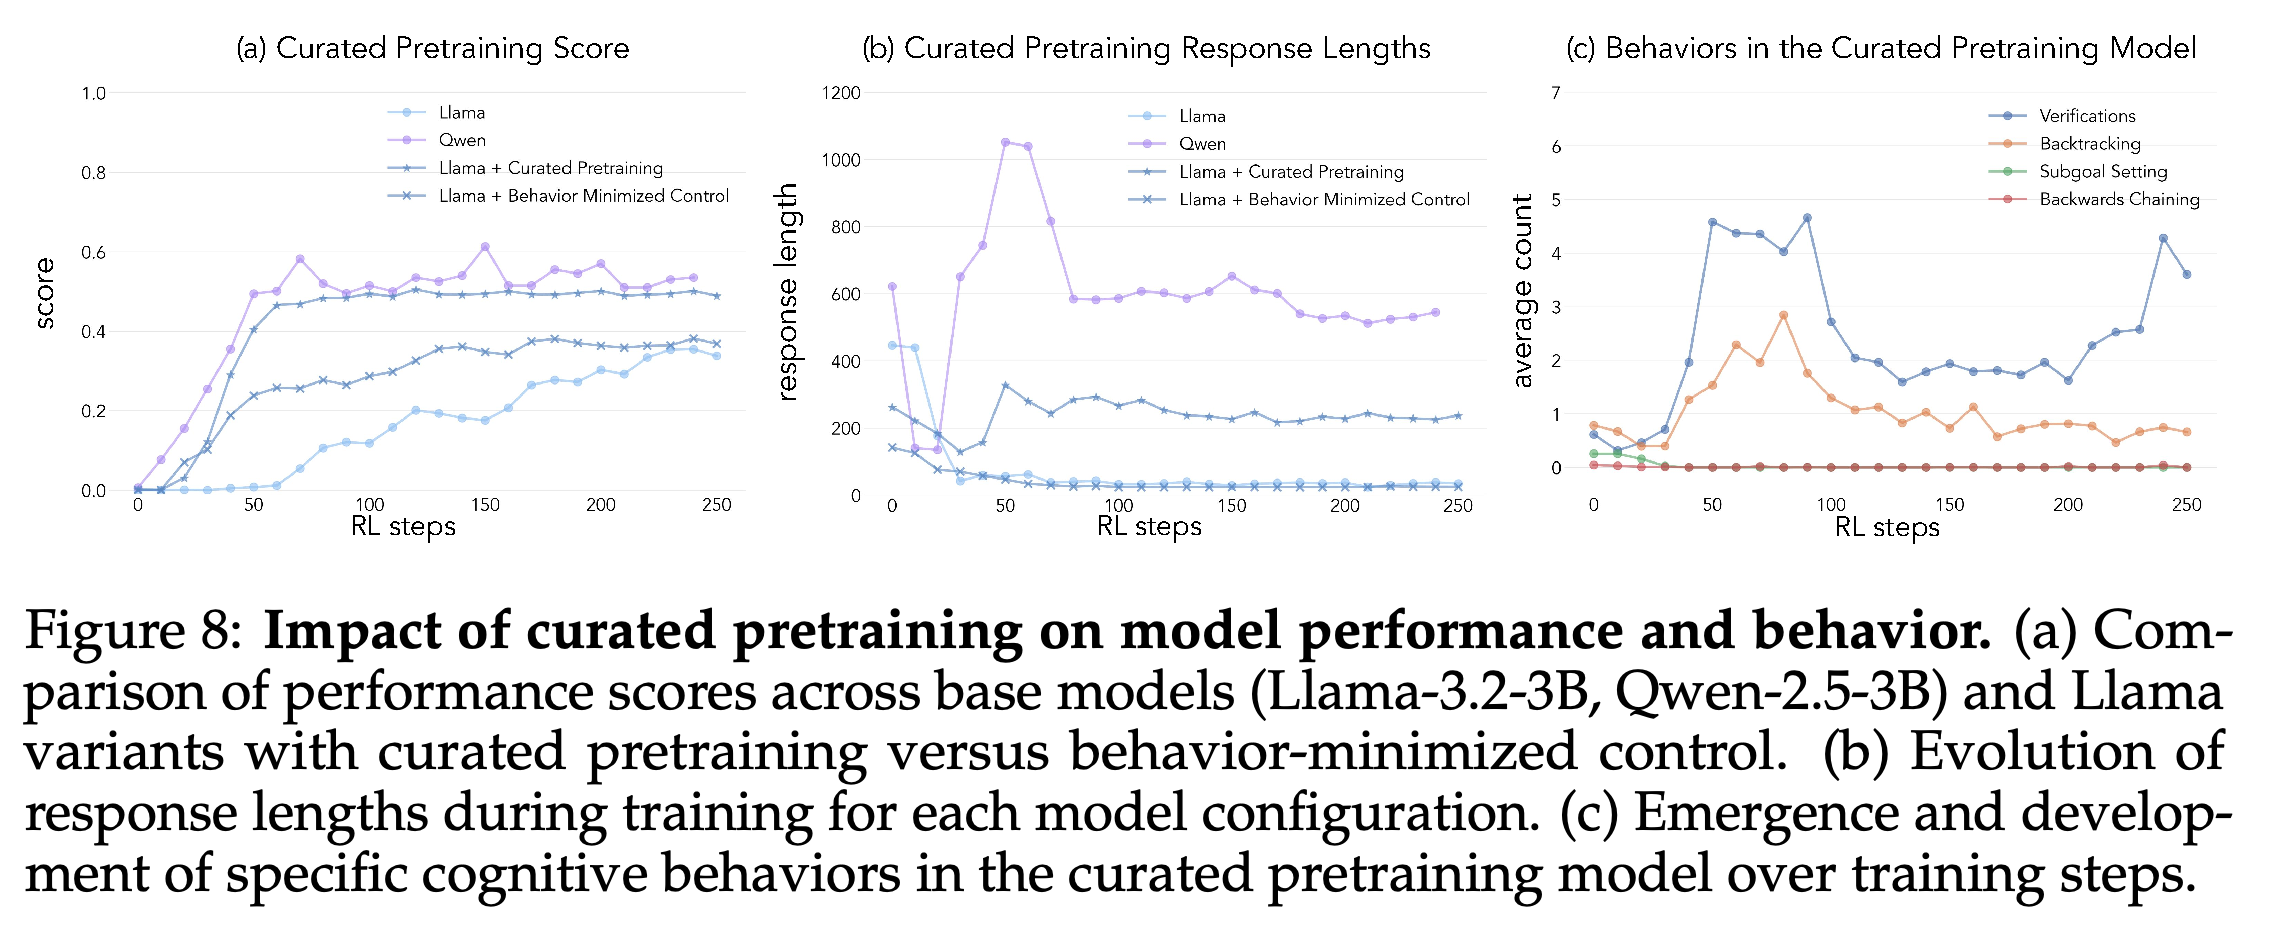
저자들은 행동을 강화한 OpenWebMath 데이터셋과 행동을 최소화한 데이터셋을 구성하며, 각 데이터셋은 8.3 million tokens를 포함한다. Qwen-2.5-32B로 문서를 선택하고 구조화된 question-thought-answer 형식으로 재작성하여, 토큰 예산과 출력 구조를 맞춘 비교를 수행한다.
- 추가 사전학습과 RL을 거친 뒤, 행동을 강화한 Llama는 Qwen과 비슷한 성능에 도달하고 verification과 backtracking을 지속적으로 보인다. 행동을 최소화한 모델은 개선 폭이 작다.
- 이 개입은 Countdown 시연을 넘어선 데이터를 사용한다. 이는 더 폭넓은 수학 행동 데이터가 이후 Countdown 학습에 유용함을 뒷받침한다.
- Appendix E에는 행동을 강화한 데이터셋을 재작성할 때 추가 행동 지시를 제공했다고 명시되어 있다. 따라서 이 실험은 데이터 선택과 재작성을 결합한 개입을 평가한다.
행동을 강화한 데이터로 추가 사전학습하면 Llama의 Countdown 학습 경로가 Qwen에 가까워지는 반면, 행동을 최소화한 대조 모델의 성능은 더 낮게 유지된다. 행동을 강화한 모델에서는 verification과 backtracking도 지속적으로 나타난다. 이는 데이터셋 예산을 8.3 million-token으로 맞춘 조건에서 성능 차이가 의도한 행동 변화와 연결됨을 보여준다.
4 Discussion
저자들은 개입 결과를 초기 추론 행동이 이후 RL 개선에 인과적으로 기여한다는 근거로 해석한다. 학습 중 선호되는 행동은 과제에 따라 달라지며, Countdown에서는 verification과 backtracking이 특히 유용하다고 강조한다.
- 이 4개 범주가 모든 행동을 포괄하는 것은 아니라고 명시한다. 논의에서는 유추와 현재 자신이 아는 내용에 대한 인식을 추가로 살펴볼 행동으로 제시한다.
- 주요 통제 실험의 근거는 약 3B 규모의 베이스 모델 2개와 산술 환경 1개에서 나온다. 코딩, 게임 플레이, 창작 글쓰기에 관한 더 넓은 주장은 향후 확장 방향으로 제안된다.
- 부록의 GPQA 결과가 보여주듯, 행동 빈도의 전이와 정답 정확도의 전이는 별도로 평가해야 한다.
부록
- A Data Generation: 논문은 “3-digit and 4-digit Countdown problems”를 50-50 비율로 나누고, 시작 숫자와 목표값을 무작위로 샘플링한다고 설명한다. 무작위화는 실험의 난이도 매개변수를 유지하면서 문제 사례를 다양하게 만든다.
- B Priming: 각 행동 데이터셋에는 서로 다른 Countdown 게임 1,200개가 포함되며, claude-3-5-sonnet-20241022로 추론 경로를 생성한다. 이를 학습 예시 1,000개와 검증 예시 200개로 나눈다. SFT는 2048토큰 컨텍스트 윈도, 학습/검증 배치 크기 64/64, AdamW 옵티마이저, 최대 학습률 1e-5, 전체 스텝의 5%에 걸친 선형 워밍업, 코사인 어닐링, 5에포크를 사용한다. 생성된 데이터셋에는 불완전한 풀이가 포함된다. 모든 전략 데이터셋의 점수는 0.43이며, backtracking과 verification을 결합한 데이터셋의 점수는 0.44이다.
- C Reinforcement Learning: PPO는 학습/검증 배치 크기 256/1312, 프롬프트 256토큰 + 응답 1024토큰의 컨텍스트 예산, actor/critic 학습률 1e-6/1e-5, 정책 발산 페널티를 위한 Kullback–Leibler(KL) 계수 0.001, 미니배치 크기 128, rollout 4개, rollout temperature 1.0을 사용한다. 보상은 정답에 1.0, 오답에 0.0을 부여하며, 올바른 형식에는 0.1의 보너스를 부여한다.
- D Metrics: 평가용 모델 출력에는 temperature 1.0과 최대 1024토큰을 사용한다. GPT-4o-mini에는 경로마다 각 범주를 정의하는 예시와 함께 행동 횟수를 묻는 별개의 질문 4개를 제공한다. 분류기 생성에는 512토큰과 temperature 0을 사용한다. 보고된 지표는 각 행동이 개별적으로 나타난 횟수의 평균이다.
- E Pretraining Data Interventions.: Qwen2.5-32B는 temperature 0과 행동별 생성 길이 1024토큰으로 수학 문서를 분류한다. 문서는 행동의 유무에 따라 나누고, 질문, 사고 과정, 답변 요소를 구분하는 마크업 형식인 XML로 재작성한다. 사고 과정 부분에는 1인칭 표현을 사용한다. 행동을 강화한 데이터셋을 재작성할 때는 목표 행동을 명시적으로 요청하며, 행동을 최소화한 대조 조건에서는 이 지시를 생략한다.
- F Interrater Reliability for Classifying Behaviors: 저자들은 무작위로 추출한 추론 경로 100개에서 GPT-4o-mini, Claude, 사람 평가자 2명을 비교한다. 평가자 간 일치도를 측정하는 Intraclass Correlation Coefficient(ICC3)를 사용한다. GPT-4o-mini와 사람 평가자 간 일치도는 verification에서 0.66/0.65, backtracking에서 0.67/0.67, subgoal setting에서 0.70/0.77이다. Backward chaining은 사람 평가자와의 일치도가 0.55/0.40으로 더 낮으므로, 이 범주가 포함된 결론을 해석할 때는 측정의 불확실성을 더 신중하게 고려해야 한다.
- G Test-time Scaling.: 모든 전략으로 priming한 Llama의 PPO 0~200스텝 체크포인트를 최대 응답 예산 128, 256, 512, 1024토큰으로 평가한다. 예산이 커질수록 성능이 개선되지만, 512토큰 이후에는 추가 효과가 줄어든다. 후반 체크포인트는 128토큰에서 약 0.4를 달성하고, 가장 좋은 체크포인트는 1024토큰에서 약 0.7에 도달한다. 이 결과는 고정된 예산에서의 성능과 추가 추론 토큰을 활용하는 능력이 모두 개선됨을 보여준다.
- H Transfer of Behaviors to Other Domains.: GPQA 질문 200개에서 행동을 강화한 Llama는 대조 모델보다 측정 대상 행동을 모두 더 많이 보인다. 예를 들어 질문당 subgoal setting은 약 6.5 대 0.7 instances로 나타나지만, 점수는 모두 약 12%이다. 별도의 비교에서는 Countdown으로 학습한 Qwen과 베이스 Qwen을 GPQA 및 수학 문제 벤치마크인 MATH에서 각각 질문 200개로 평가한다. 저자들의 프롬프트 형식에서 MATH 정확도는 38%에서 50%로 높아진다. 또한 Qwen의 프롬프트 형식에서는 four examples를 프롬프트에 넣었을 때 44%, 예시 없이 사용했을 때 50%를 기록했다고 보고한다. 프롬프트 조건이 다르므로, 뒤의 비교에서 나타난 차이를 학습만의 효과로 직접 해석하기는 어렵다.
- I Results for Instruction-tuned Models: 사용자 지시를 따르도록 이미 학습된 모델들은 이후 Countdown RL에서 verification과 backtracking을 보이며, 대응하는 베이스 모델보다 긴 응답을 생성한다. 그래프의 비교에서는 instruction-tuned 모델 계열 2개 모두 더 높은 과제 점수에 도달한다. 저자들은 instruction-tuning 데이터가 유용한 인지 행동을 제공할 가능성을 제시하지만, 해당 데이터셋을 직접 분석해 그 내용을 확인하지는 않는다.
짧은 생각
행동 priming, 길이를 통제한 조건, 오답 priming을 함께 보면 초기 추론 시연의 내용이 이후 보상 기반 학습에 영향을 준다는 근거를 얻을 수 있다. ML 엔지니어에게 이 결과는 초기화 데이터를 선택할 때 정답 정확도와 토큰 수에 더해 어떤 행동이 포함되어 있는지도 평가할 필요가 있음을 시사한다. 이 근거는 4가지 행동 모두가 보편적으로 필요하다는 주장보다, 실제로 검증한 개입의 효과를 더 강하게 뒷받침한다. 모든 합성 행동 조건에 backtracking이 포함되며, 추가 사전학습 개입은 선택과 재작성을 결합한다. 행동 횟수만으로는 성공을 판단하기에 충분하지 않다. GPQA 정확도가 같다는 결과와 backward chaining의 낮은 평가자 간 일치도는 과제 성과와 측정 신뢰도를 함께 확인해야 하는 이유를 보여준다.