


Comparison of biomedical relationship extraction methods and models for knowledge graph creation 요약 설명
05 Jan 2022 | Paper Review Relation Extraction Knowledge Graphs Supervised Fine-Tuning목차
이번 글에서는 Comparison of biomedical relationship extraction methods and models for knowledge graph creation 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 5일(Arxiv), Preprint submitted to Web Semantics
- Milosevic, Nikola, Thielemann, Wolfgang.
- University of Manchester, Faculty of Science and Engineering, Bayer Pharmaceuticals R&D, Berlin, Bayer Pharmaceuticals R&D, Wuppertal
- 논문 4판 (2022년 8월 7일 개정, 이 글은 개정판을 기준으로 작성했다)
요약
- 이 논문은 문헌에서 생의학 개체 사이의 유형별 관계를 식별하여 개념을 연결한 네트워크인 지식 그래프를 만드는 방법을 비교한다. 균형을 맞춘 gene-disease 데이터셋에서 5 epoch 학습한 결과, 생의학 언어 모델인 PubMedBERT의 가중 F1-score는 0.92였으며 DistilBERT는 0.91, T5는 0.88이었다.
- 저자들은 사람이 수정한 문장과 규칙으로 레이블을 부여한 문장으로 전통적인 분류기와 파인튜닝한 transformer 모델을 학습한다. 클래스 균형을 맞추자 전체 점수는 개선됐지만, 분류기 데이터가 규칙 기반 추출기가 선택한 문장에서 나왔으므로 필터링하지 않은 문헌에서의 성능을 보여 주는 근거는 제한적이다.
- 규칙 기반 방법으로 Medline 초록 약 3,500만 건을 검색해 유형이 지정된 관계 4,784,985건을 추출했다. 관계가 1개 이상 포함된 초록 100건을 사람이 평가한 결과, 추출기의 정밀도는 0.88, 재현율은 0.74, F1-score는 0.80이었다.
1. Introduction
저자들은 늘어나는 문헌에서 생의학 관련 주장을 찾고 검증하기 어려운 문제를 다룬다. 약물, 유전자, 질병 사이의 관계를 정규화하고 그래프의 각 간선을 뒷받침하는 문장에 연결하는 방식을 제안한다.
2. Background
논문은 관계의 존재 여부를 감지하는 작업, 제한 없이 서술어를 추출하는 작업, 관계를 미리 정의된 유형에 연결하는 작업을 구분한다. 세부 유형까지 사람이 주석을 단 생의학 관계 데이터셋은 드물며, 알려진 관계를 개체 언급에 레이블로 부여하는 distant learning은 잡음을 유발할 수 있다고 설명한다.
3. Method
비교 대상은 패턴 기반 추출, Naive Bayes와 Random Forest 분류기, 파인튜닝한 DistilBERT, PubMedBERT, T5, SciFive 모델이다. 모든 방법은 내부에서 수정한 동일한 Linnaeus 도구로 개체를 식별하고 정규화한다.
3.1. Named entity recognition and normalization (modification of Linnaeus)
Linnaeus는 개체 언급을 식별하고 내부에서 개발한 인간 유전자, 질병, 승인된 약물 사전을 사용해 동의어를 대표 식별자에 연결한다. 수정된 도구는 공백, 대소문자, 복수형, 그리스 문자, 발음 구별 부호, 정규 표현식, 최장 일치 선택을 처리한다.
3.2. Relationship data model
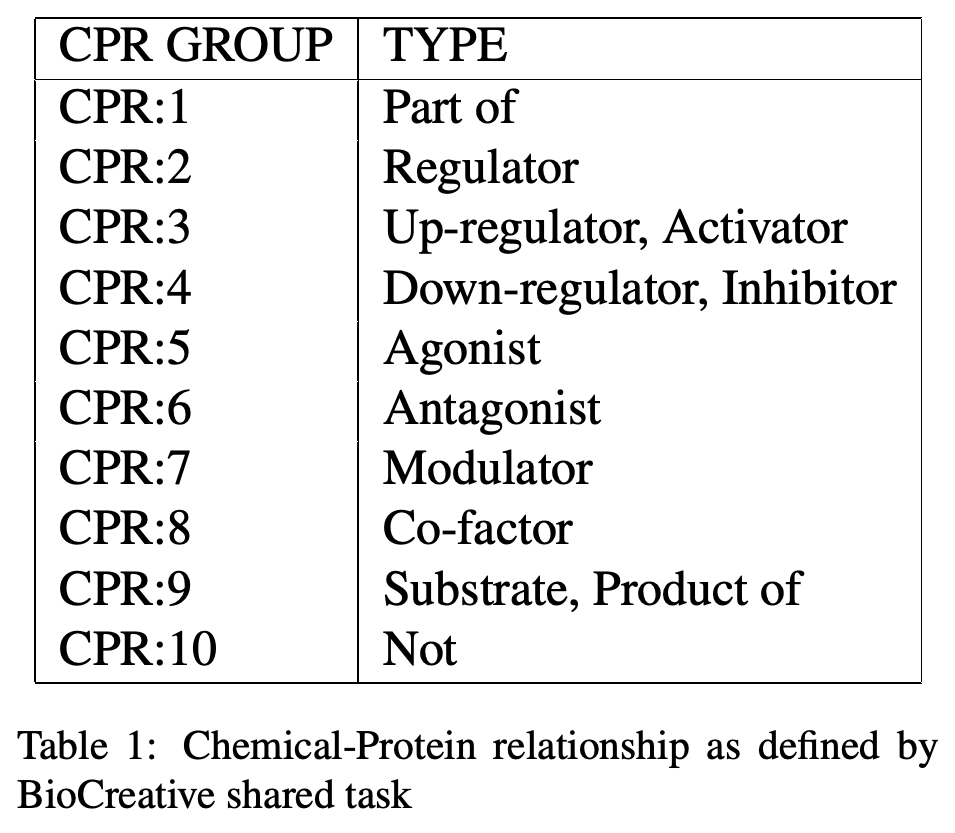
참여자 18명이 Drug-Gene, Drug-Disease, Gene-Disease 쌍을 다루는 관계 모델을 만드는 데 기여했다. Drug-Gene 유형은 BioCreative shared task의 chemical-protein 분류를 적용한다. Drug-Disease 유형은 치료, 이상 반응, 질병의 변화, 구체적으로 명시되지 않은 효과, 질병이나 병리 상태를 나타내는 바이오마커를 구분한다.
- Gene-Disease 유형에는 Plays a role, Target, Biomarker가 있으며, Target에는 원인과 질병 조절을 나타내는 하위 유형이 있다.
- Mode of action은 활성화, 억제, 변이처럼 유전자에 작용하는 방식을 나타내며, 모델은 부정과 추측도 기록한다.
BioCreative chemical-protein 분류 체계는 Drug-Gene 모델의 출발점이 된다. 저자들은 이를 적용하면서 일부 범주를 병합하거나 제외한다.
3.3. Relationship extraction using rule-based method
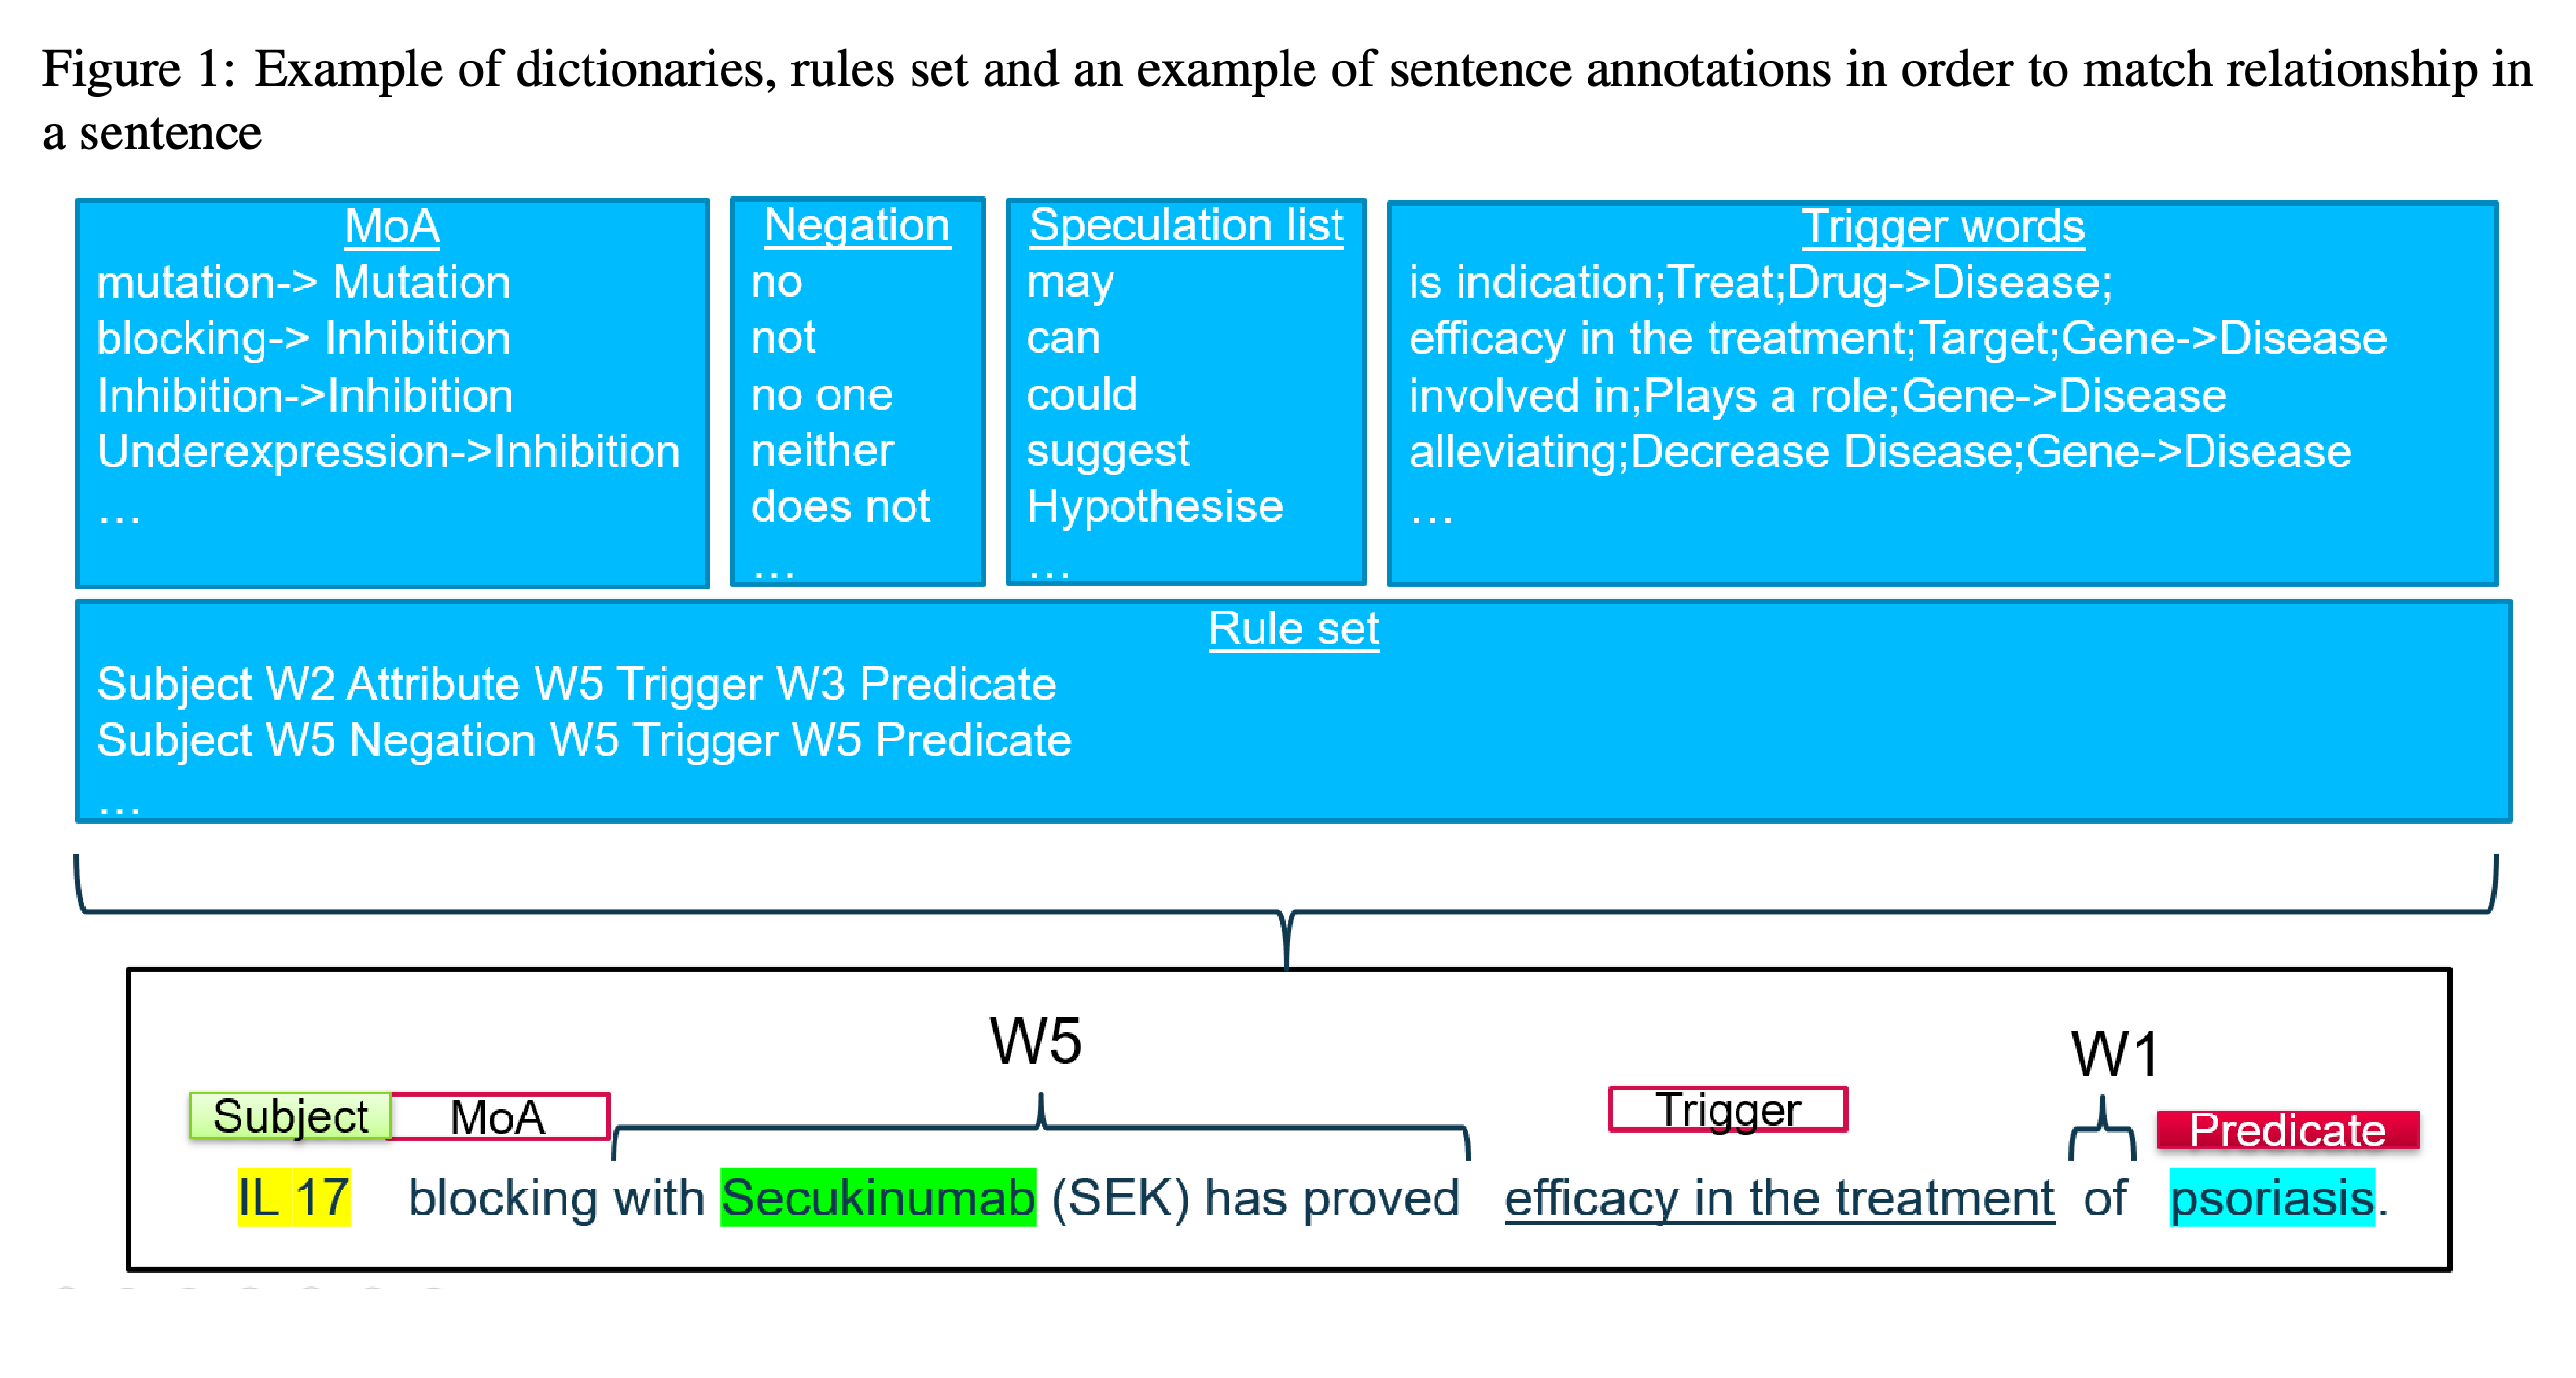
규칙 기반 추출기는 개체 쌍, 트리거 구문, mode of action과 부정 및 추측을 나타내는 단서를 허용된 단어 간격을 포함한 문법 패턴에 대조한다. 신뢰도 점수는 명명된 구문에 일치하는 단어 수를 일치한 패턴의 전체 단어 수로 나눈 값이다. 동시 출현에는 고정 점수 0.0001을 부여하며, 기록에는 근거 문장과 Medline ID를 유지한다.
이 예시는 단어 간 거리 규칙에 따라 트리거 구문과 mode-of-action 단서를 주어 및 서술어 개체와 일치시키는 방법을 보여 준다.
3.4. Machine learning
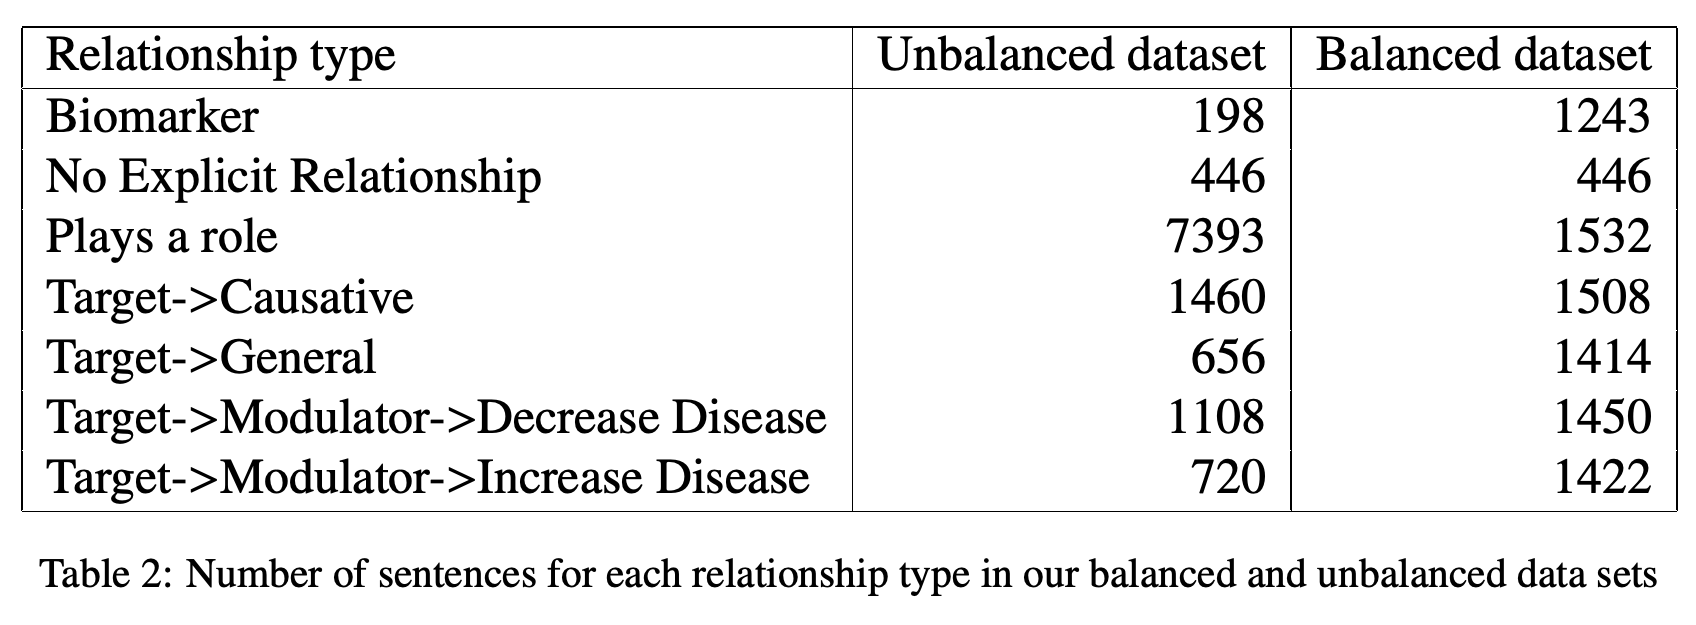
불균형 gene-disease 데이터셋은 사람이 검토한 문장 2,000개와 규칙으로 추출해 신뢰도 1을 부여한 문장 10,000개를 결합하며, 학습에 90%, 테스트에 10%를 사용한다. 균형을 더 맞춘 데이터셋은 검토된 문장에 규칙으로 추출한 일부 예시를 추가한다. No Explicit Relationship은 446개, Biomarker는 1,243개로 유지된다.
- Naive Bayes와 Random Forest는 어간 추출을 거친 1~4개 단어의 연속 구간을 특성으로 사용한다.
- Transformer 입력에서는 유전자와 질병 언급을 SUBJECT와 PREDICATE로 바꾼다. 모델은 학습률 0.00002로 5 epoch 동안 파인튜닝했다. T5와 생의학 변형 모델인 SciFive는 task prefix를 사용하며, T5에는 Adafactor optimizer를 지정했다.
- Mode-of-action 분류를 위해 저자들은 클래스당 300개 예시로 구성된 균형 데이터셋도 만들었으며, 예시가 부족한 클래스에서는 중복을 허용했다.
불균형 데이터셋에는 Plays a role 예시가 7,393개인 반면 Biomarker 예시는 198개에 불과하다. 균형 데이터셋은 이 차이를 줄이면서 No Explicit Relationship은 446개로 유지한다.
4. Results
평가는 규칙 기반 시스템의 추출 규모와 수동 검토 결과를 보고한 뒤, 전통적인 모델과 transformer 모델의 문장 단위 분류 결과를 제시한다. 규칙 기반 점수와 분류기 점수는 서로 다른 평가 세트에서 나왔으므로 직접 비교할 수 없다.
4.1. Rule-based relationship extraction
2021년 1월까지의 Medline 데이터를 처리하는 데 컴퓨터 1대에서 약 7일이 걸렸으며, 유형이 지정된 관계 4,784,985건을 추출했다. 동시 출현을 포함하면 35,900,521건이다. 관계가 1개 이상 포함된 초록 100건을 사람이 평가한 결과, 규칙 기반 방법의 정밀도는 0.88, 재현율은 0.74, F1-score는 0.80이었다.
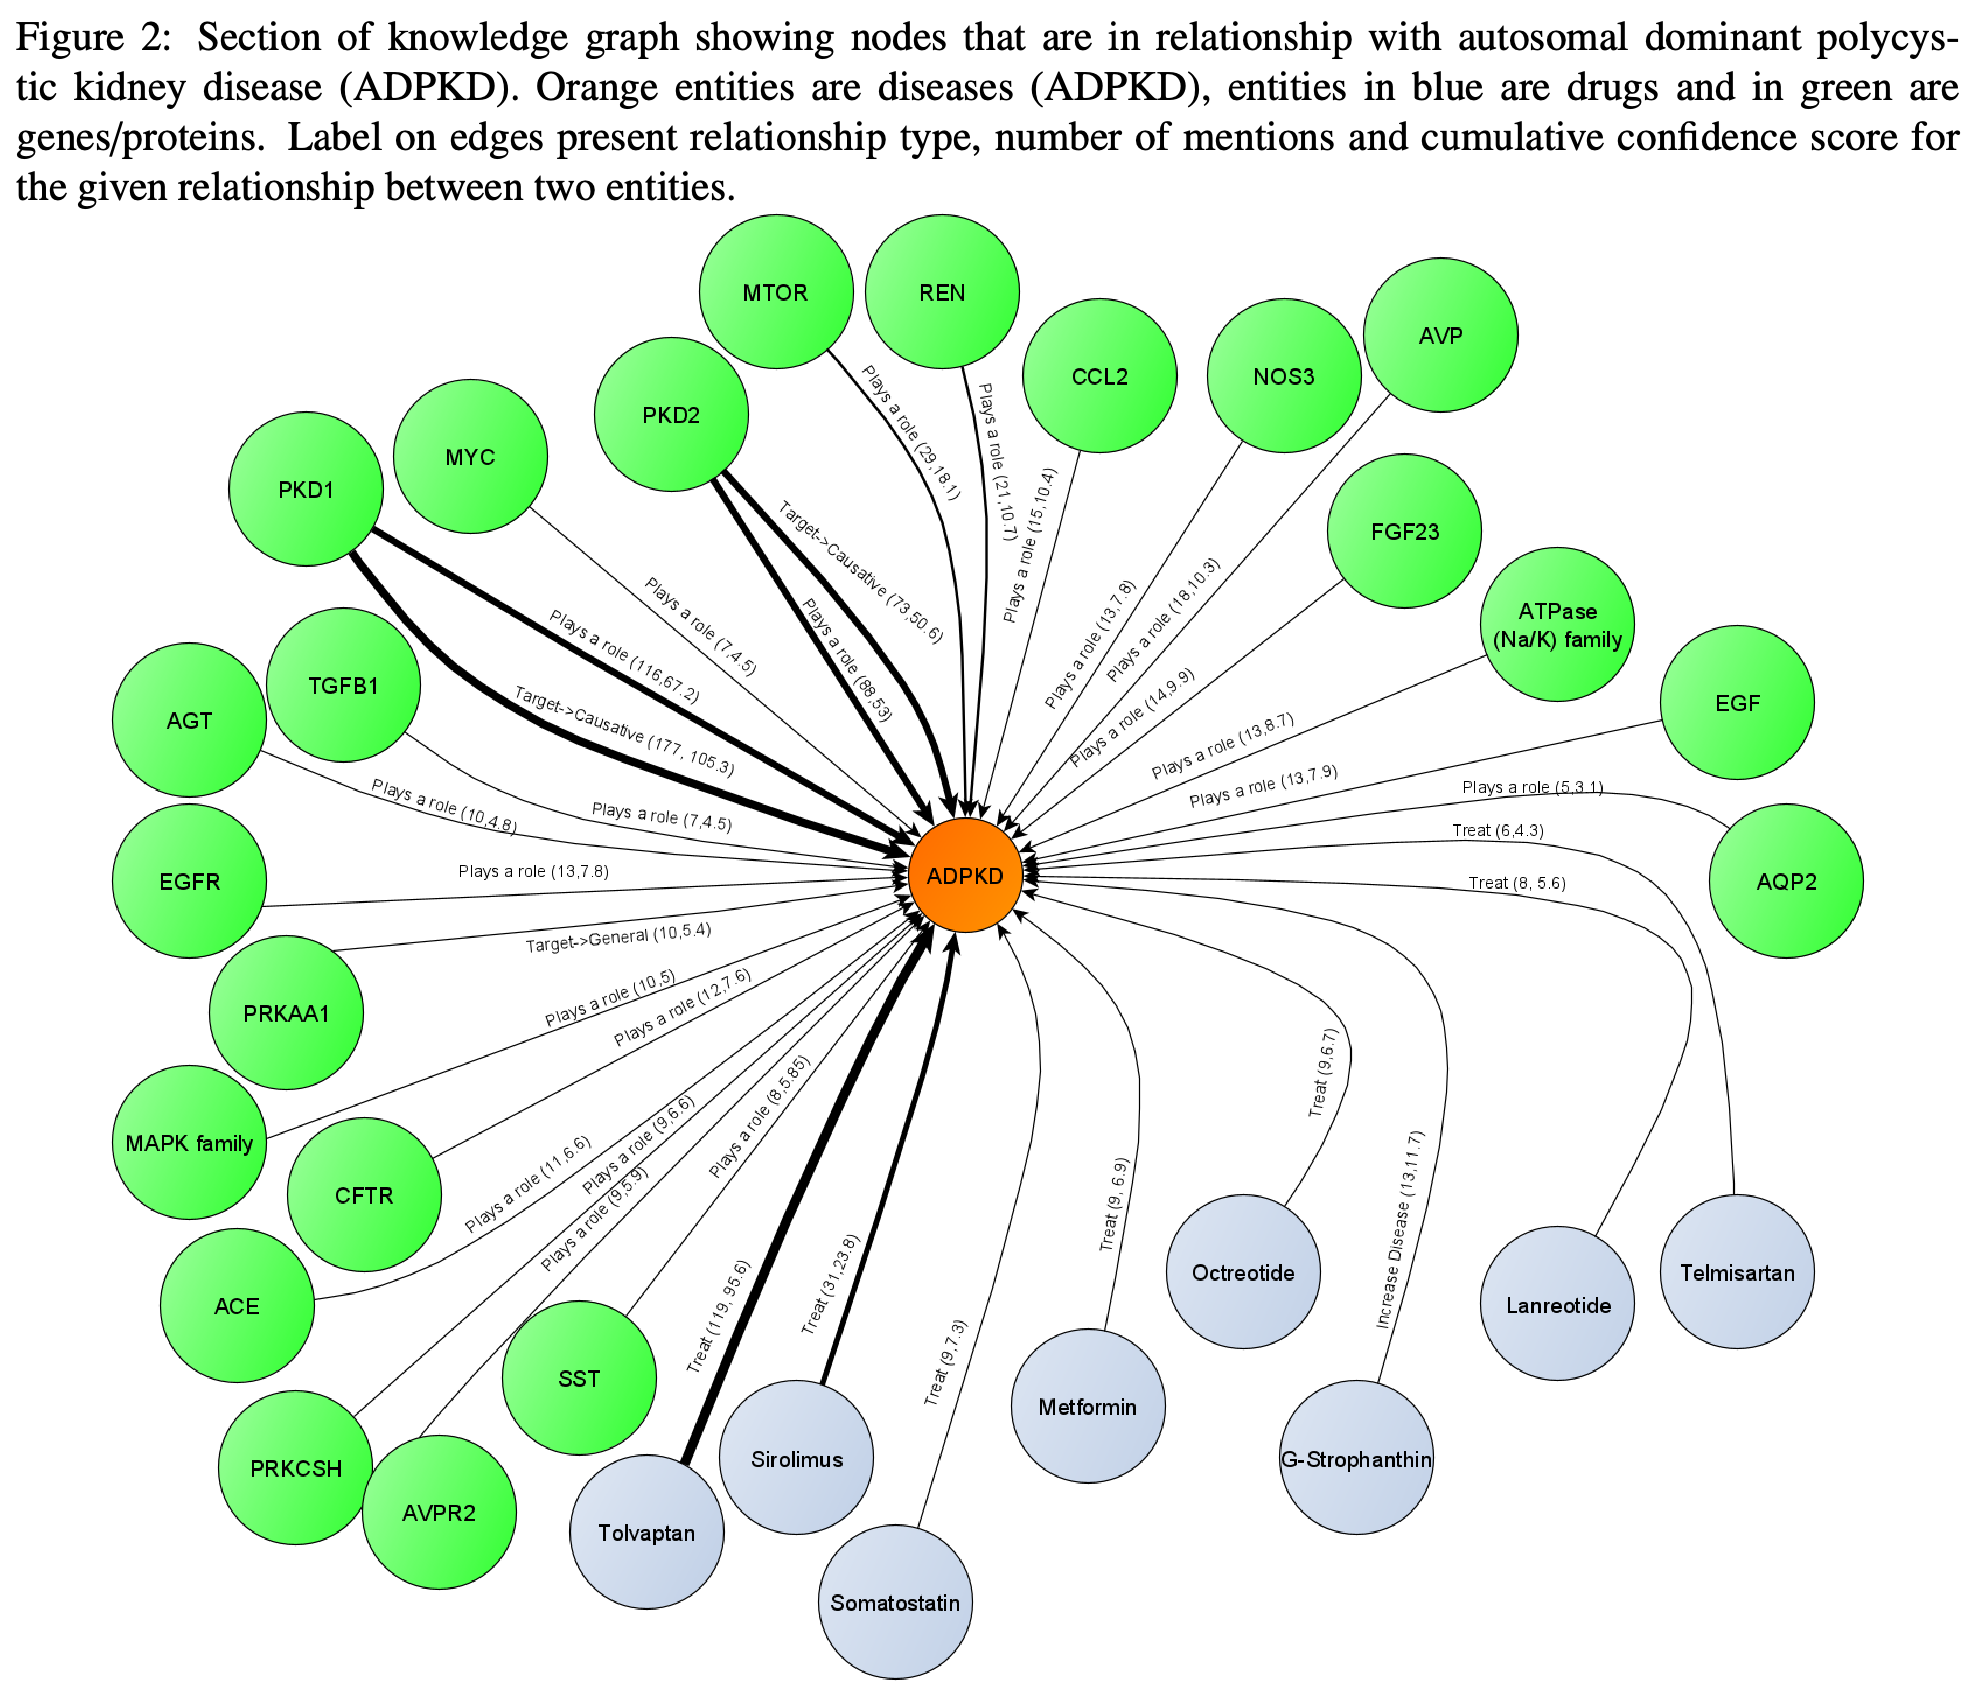
상염색체 우성 다낭성 신장질환 사례 연구에서 저자들은 PubMed에 5회 이상 언급된 그래프 간선을 유지했다. 신장 질환 전문가들은 표시된 모든 개체를 문헌에서 알고 있다고 답했지만, 이 평가만으로 추출된 모든 간선이 검증되는 것은 아니다.
질병을 중심으로 구성한 그래프에는 PKD1, PKD2와 Tolvaptan 같은 약물이 포함된다. 사례 연구는 5회 이상 언급된 관계를 유지한다.
4.2. Naive Bayes and Random Forests-based Relationship extraction
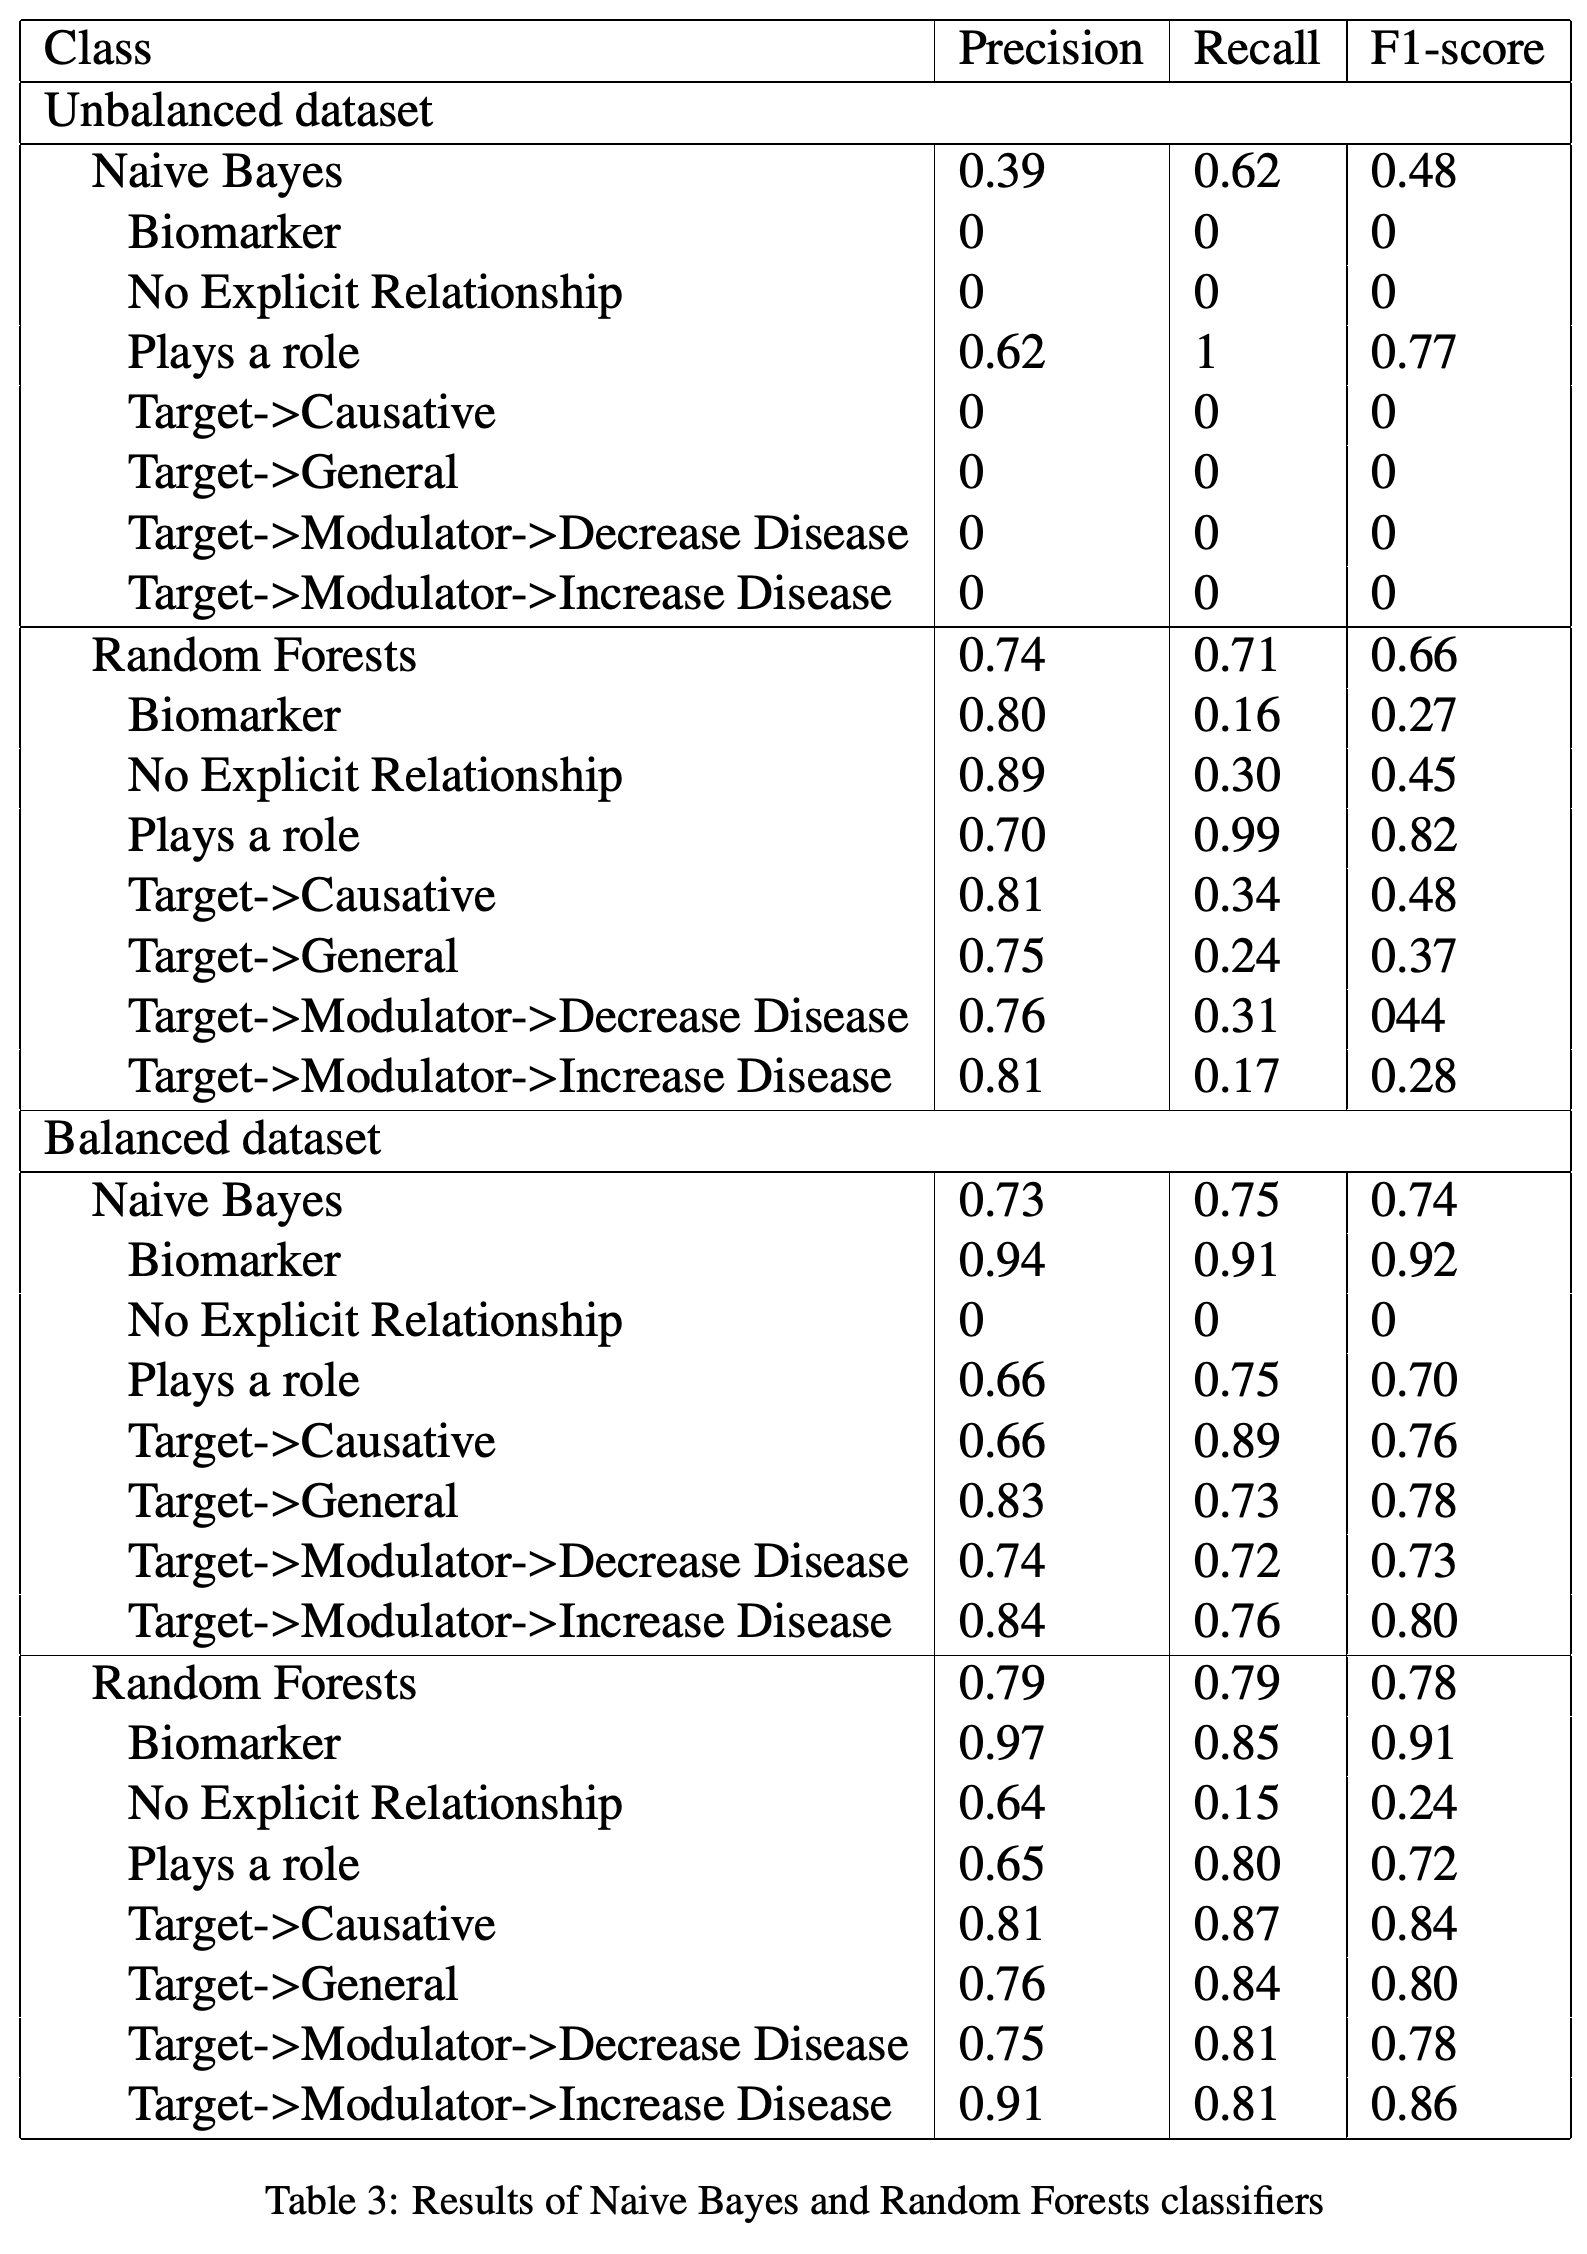
불균형 데이터셋에서 전체 F1-scores는 Naive Bayes가 0.48, Random Forests가 0.66이었고, 균형 데이터셋에서는 각각 0.74와 0.78로 상승했다. No Explicit Relationship 클래스는 여전히 어려웠으며, 균형 데이터셋에서 F1-score는 Naive Bayes가 0, Random Forests가 0.24였다.
클래스 균형을 맞추면 전통적인 분류기 2개의 전체 F1이 상승하지만, No Explicit Relationship 클래스는 여전히 제대로 인식하지 못한다.
4.3. Transformer-based relationship extraction
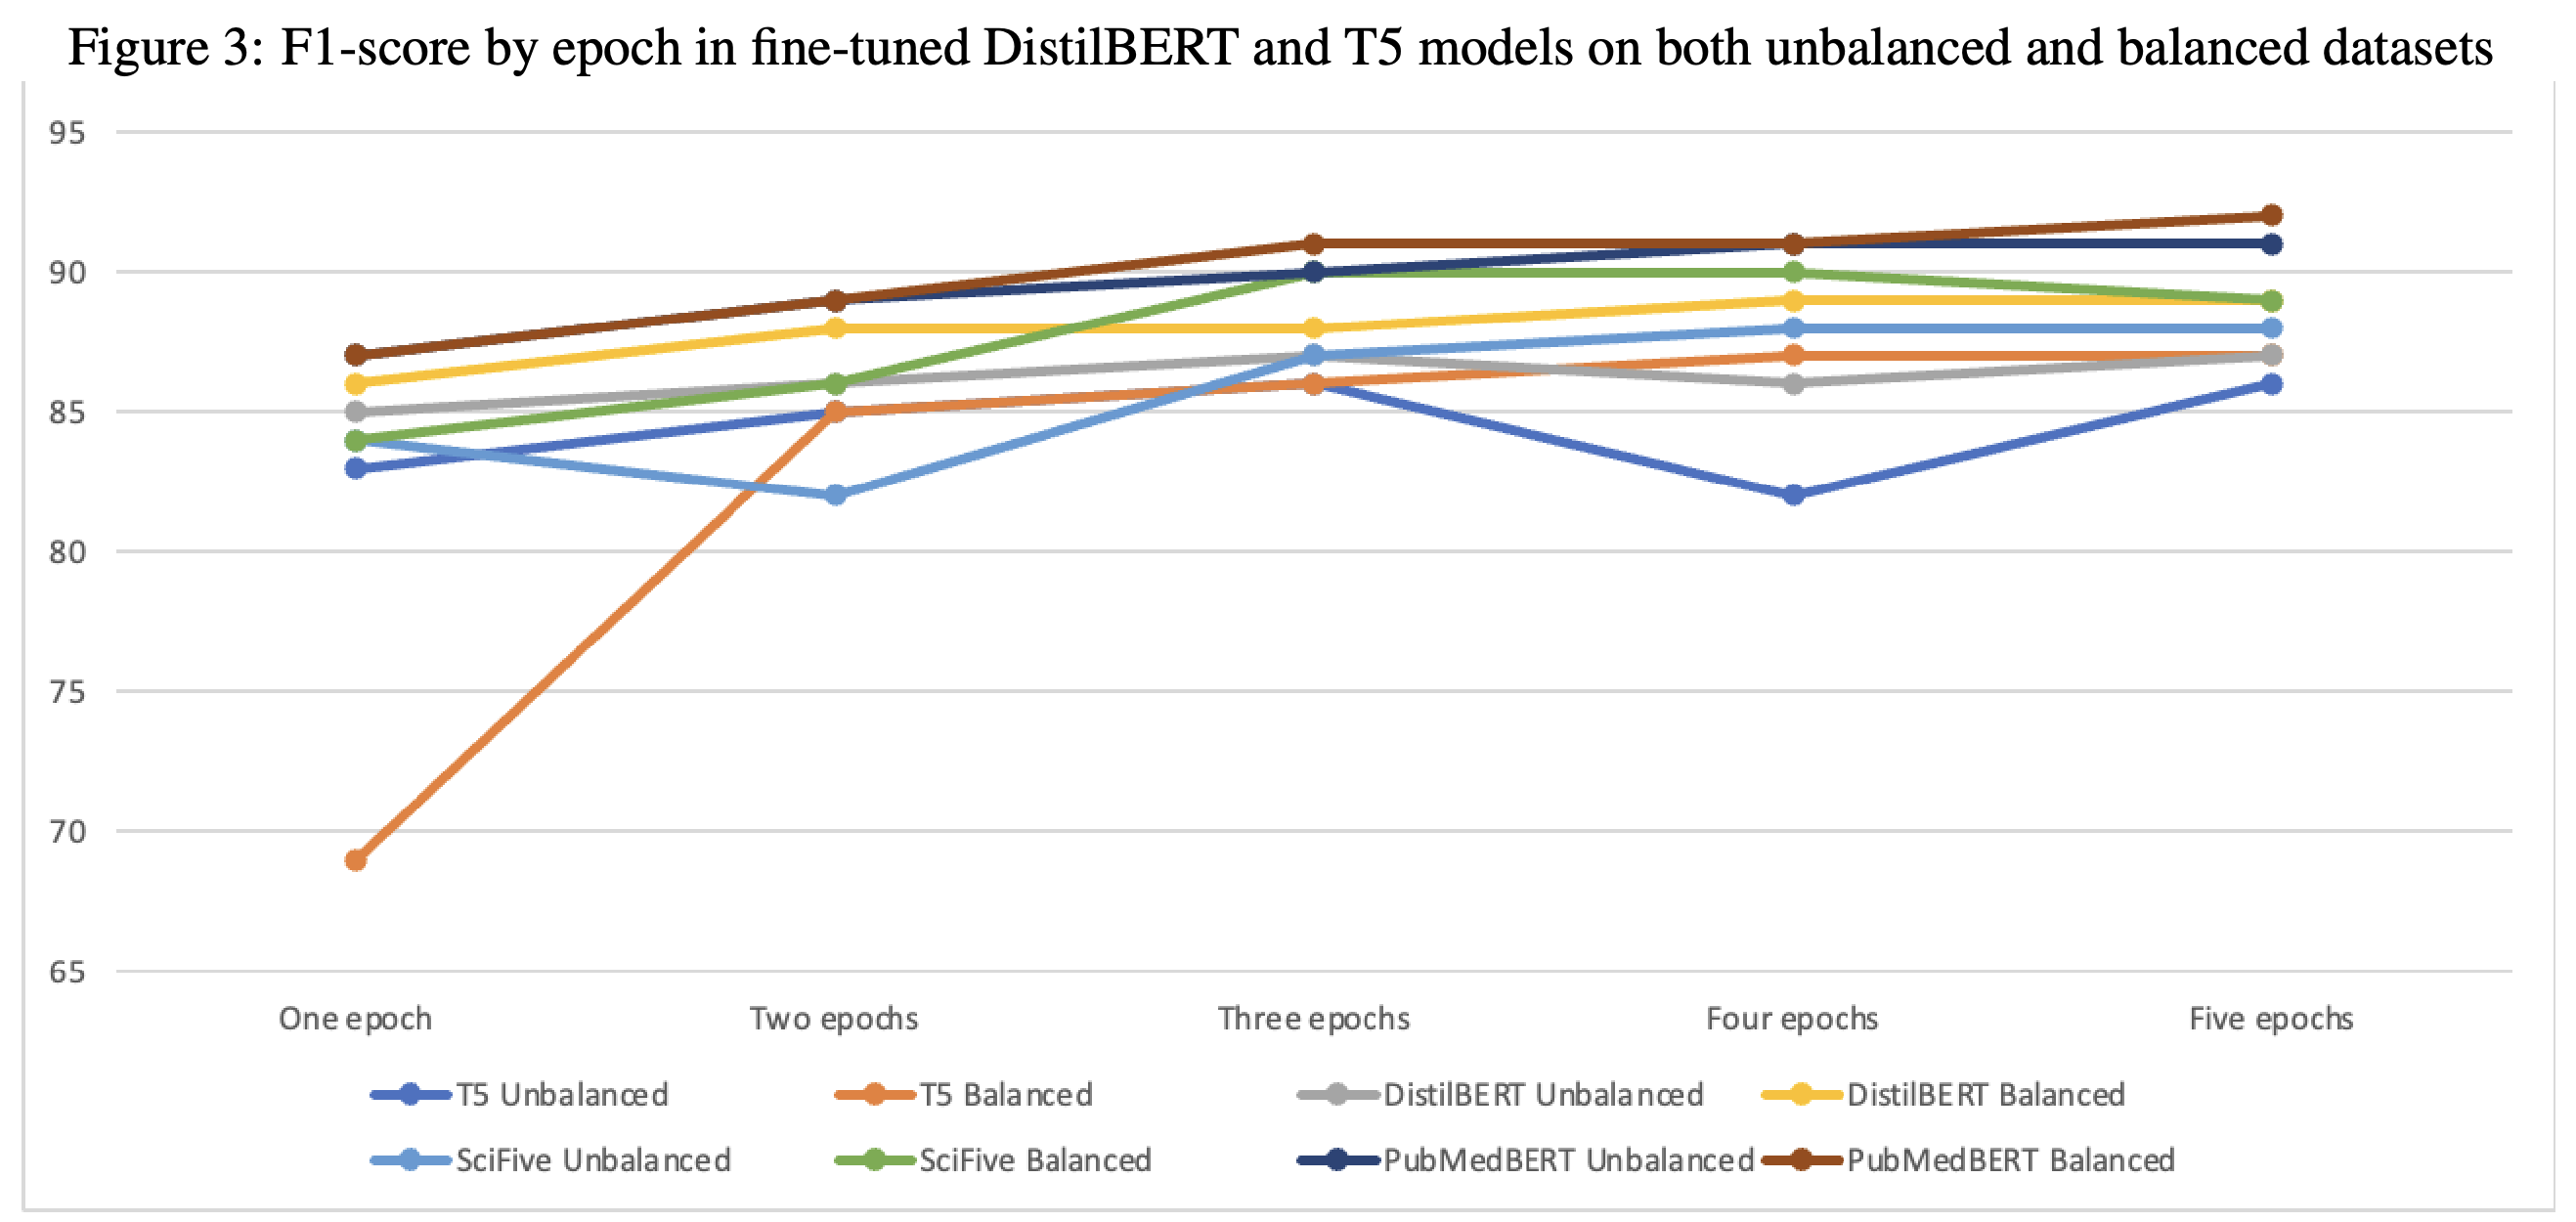
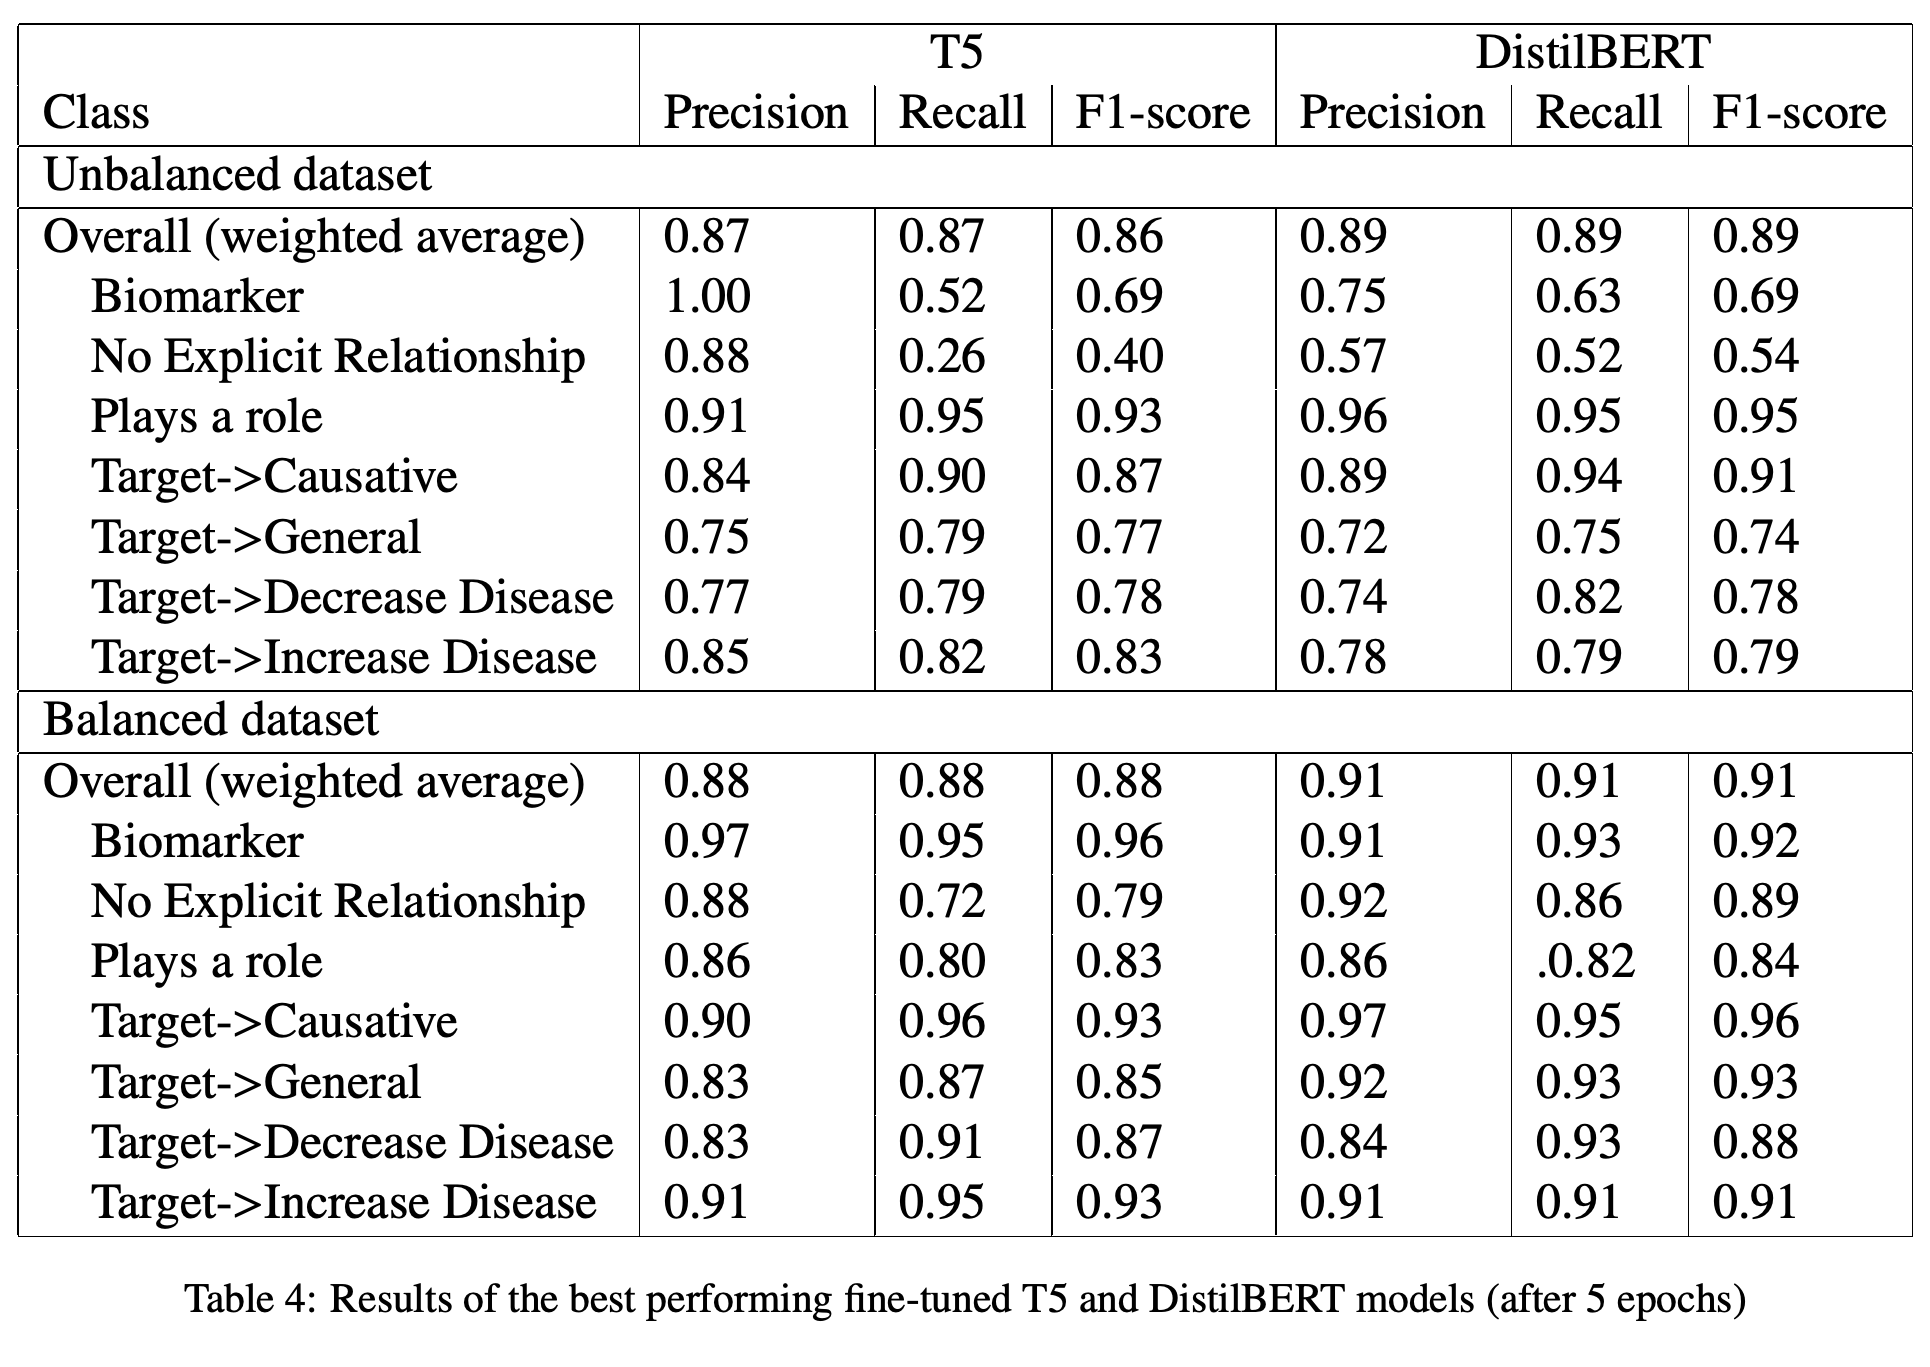
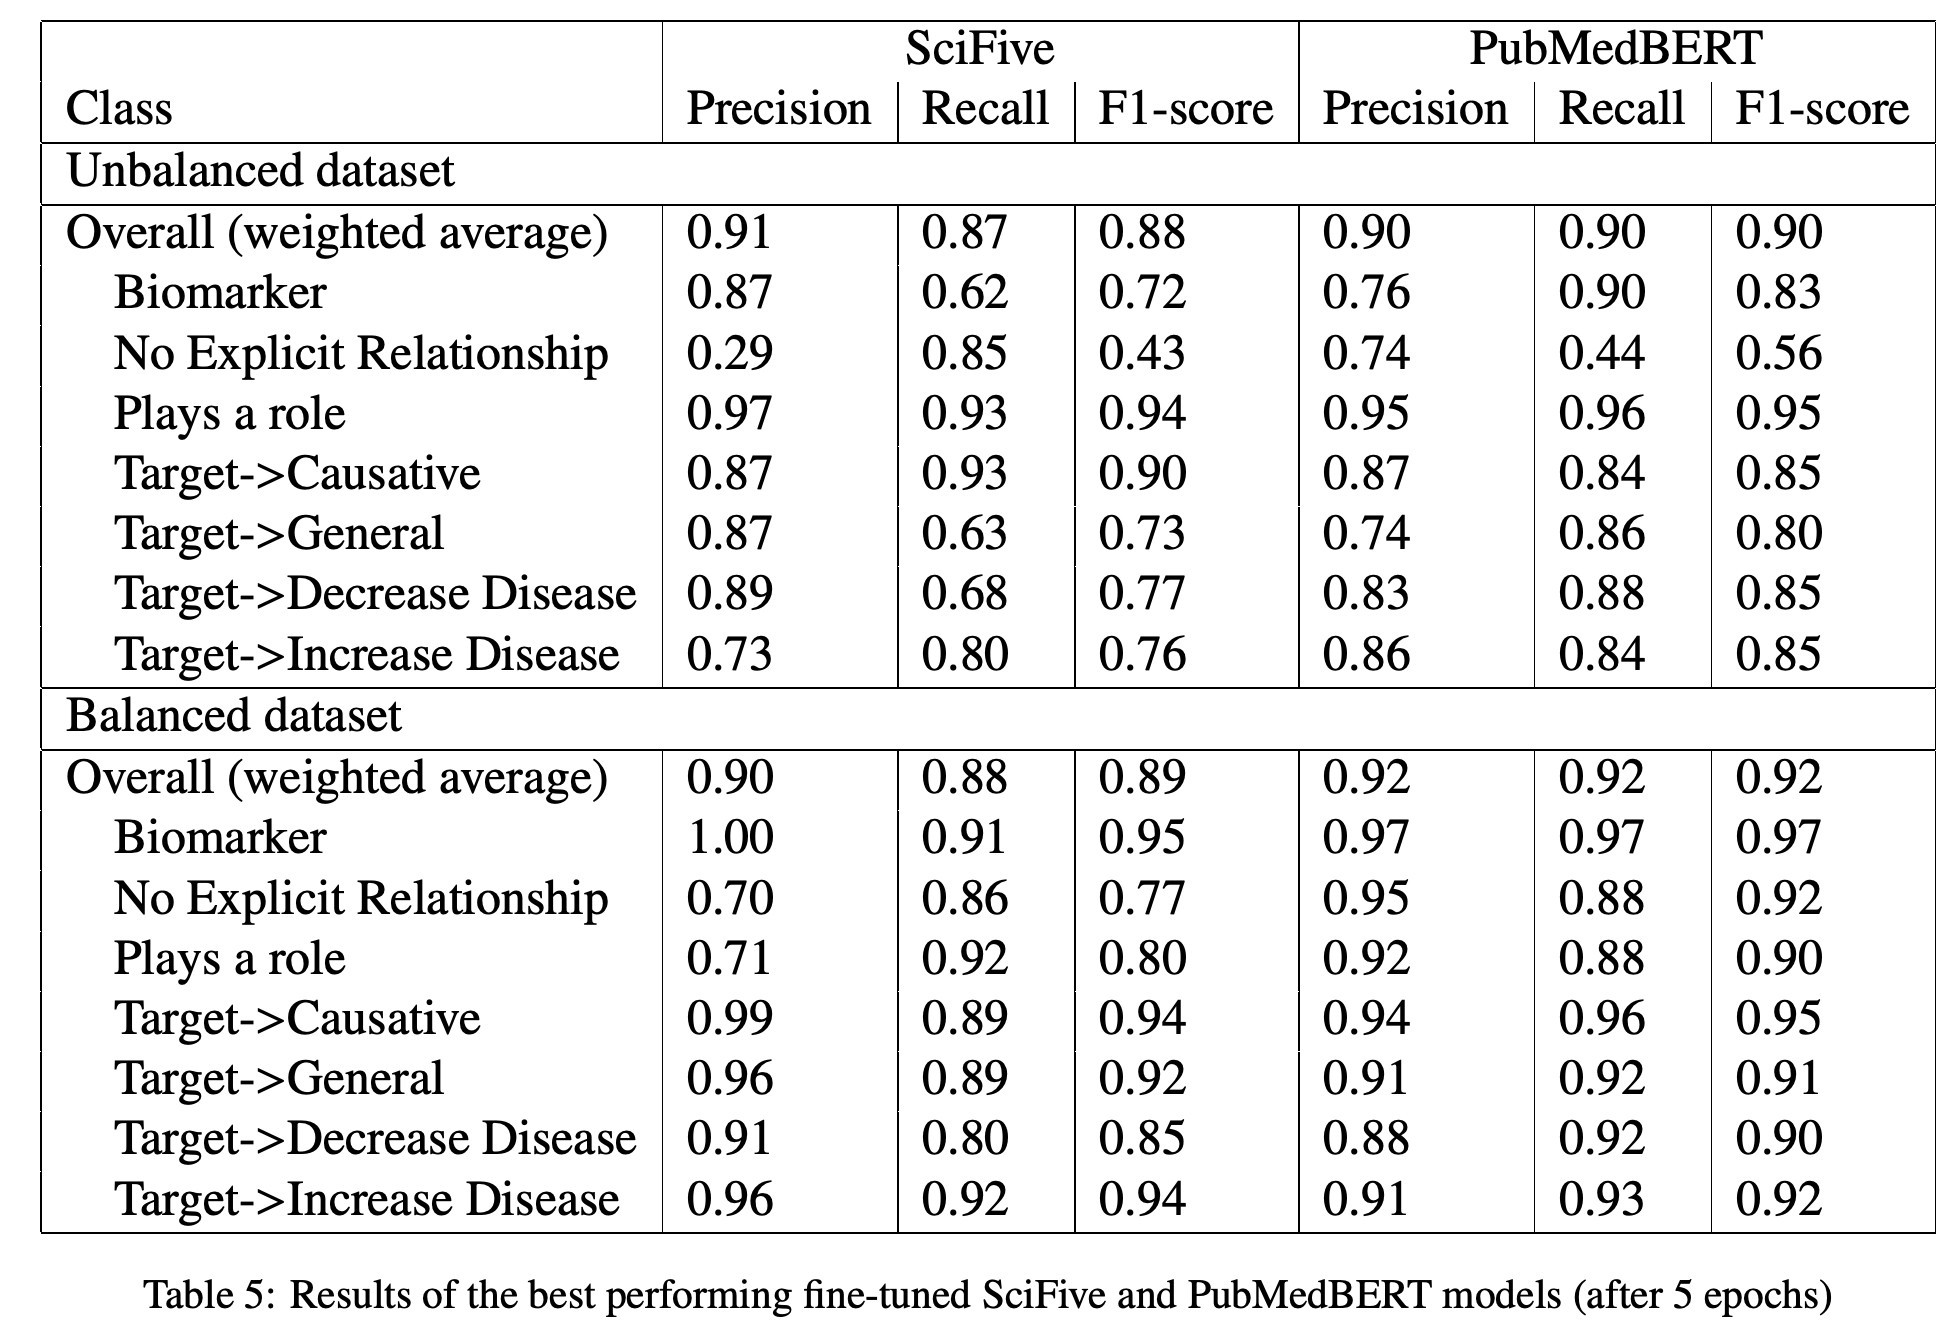
5 epoch 학습 후 균형 데이터셋에서 가중 F1-scores는 PubMedBERT가 0.92, DistilBERT가 0.91, SciFive가 0.89, T5가 0.88이었다. 불균형 데이터셋에서는 각각 0.90, 0.89, 0.88, 0.86이었다. 초록에 기재된 DistilBERT 점수 0.89는 불균형 데이터셋 결과와 일치하며, 균형 데이터셋 결과는 0.91이다.
- T5의 No Explicit Relationship 재현율은 불균형 데이터셋에서 0.26이었고 균형 데이터셋에서 0.72로 상승했으며, 정밀도는 2가지 경우 모두 0.88이었다.
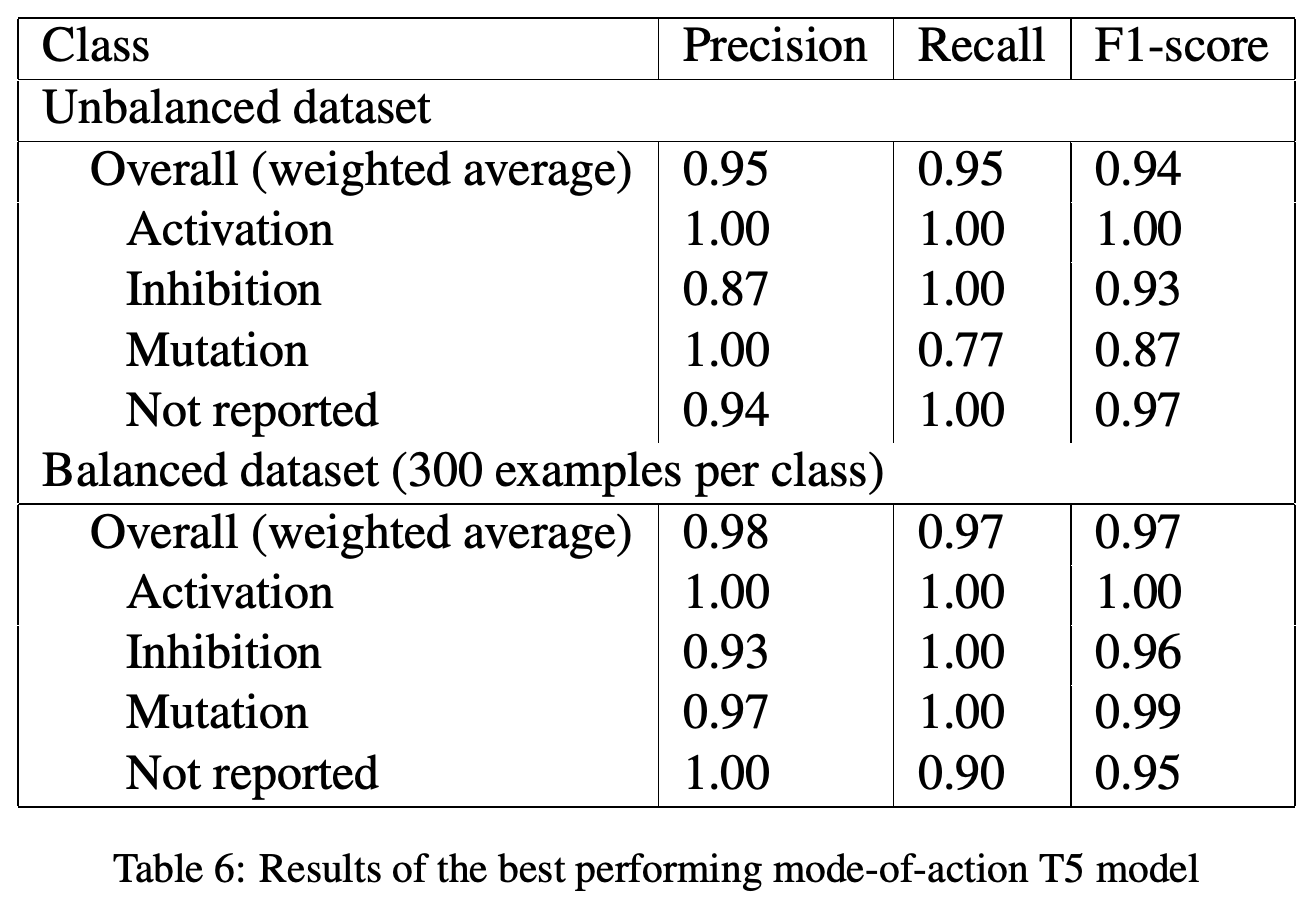
- T5의 mode-of-action 분류에서 가중 F1-scores는 불균형 데이터셋에서 0.94, 클래스당 예시 300개로 구성된 균형 데이터셋에서 0.97이었다. 일부 예시는 중복됐다.
곡선은 데이터 분포 2개에서 transformer 모델 4개의 성능을 5 epoch에 걸쳐 추적하며, 균형 데이터셋의 PubMedBERT가 가장 높은 점수로 마친다.
균형 데이터셋에서 DistilBERT의 가중 F1은 0.91이고 T5는 0.88이다. 클래스별 행을 보면 불균형 데이터에서 T5의 No Explicit Relationship 재현율이 훨씬 낮다.
PubMedBERT의 가중 F1은 균형 데이터에서 0.92, 불균형 데이터에서 0.90이며, SciFive는 각각 0.89와 0.88이다.
균형 mode-of-action 데이터셋의 가중 F1은 0.97이다. 저자들은 예시가 부족한 클래스에서 중복을 허용했다.
5. Discussion
저자들은 이 비교에서 도메인 특화 모델의 전체 F1이 일반 도메인 모델보다 약 1%포인트 높았다고 보고한다. 기존에 발표된 시스템과의 비교에는 서로 다른 데이터셋과 관계 정의가 사용됐으므로, 공통 benchmark에서 모델의 우열을 분리해 보여 주지는 못한다.
6. Future work
후속 연구로 추가 개체 쌍에 대한 모델 학습, 정형 및 비정형 소스의 결합, 관계와 근거를 살펴보는 인터페이스 구축, 후보 예측을 위한 시간 그래프 학습 탐색을 제안한다.
7. Conclusions
저자들은 transformer 모델이 전통적인 분류기보다 클래스 불균형에 덜 민감했으며, DistilBERT는 PubMedBERT와 비교할 때 크기와 속도 측면에서 선택지가 된다고 결론짓는다. 또한 외부에 의뢰한 문장 주석 약 7,000개의 비용이 16,200유로였으며, 인프라와 엔지니어링 비용은 별도로 들었다고 보고한다.
부록
- 논문은 https://zenodo.org/record/6466316#.Ylw3T-dS9Ea에서 생성된 데이터셋의 접근 권한을 요청할 수 있다고 명시한다.
짧은 생각
클래스별 결과는 가중 평균에 가려진 변화를 보여 준다. T5의 No Explicit Relationship 재현율은 0.26에서 0.72로 상승했다. 필터링하지 않은 문헌에서 추출해 독립적으로 주석을 단 테스트 세트가 있다면 규칙 기반 추출기가 선택한 패턴을 넘어서는 성능을 평가하는 데 도움이 될 것이다.