


DiLoCo: Distributed Low-Communication Training of Language Models 요약 설명
14 Nov 2023 | Paper Review Communication-Efficient Training Distributed Training LLM Pretraining목차
이번 글에서는 DiLoCo: Distributed Low-Communication Training of Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 11월 14일(Arxiv)
- Douillard, Arthur, Feng, Qixuan, Rusu, Andrei A., Chhaparia, Rachita, Donchev, Yani, Kuncoro, Adhiguna, Ranzato, Marc’Aurelio, Szlam, Arthur, Shen, Jiajun.
- Google DeepMind
- 논문 링크
요약
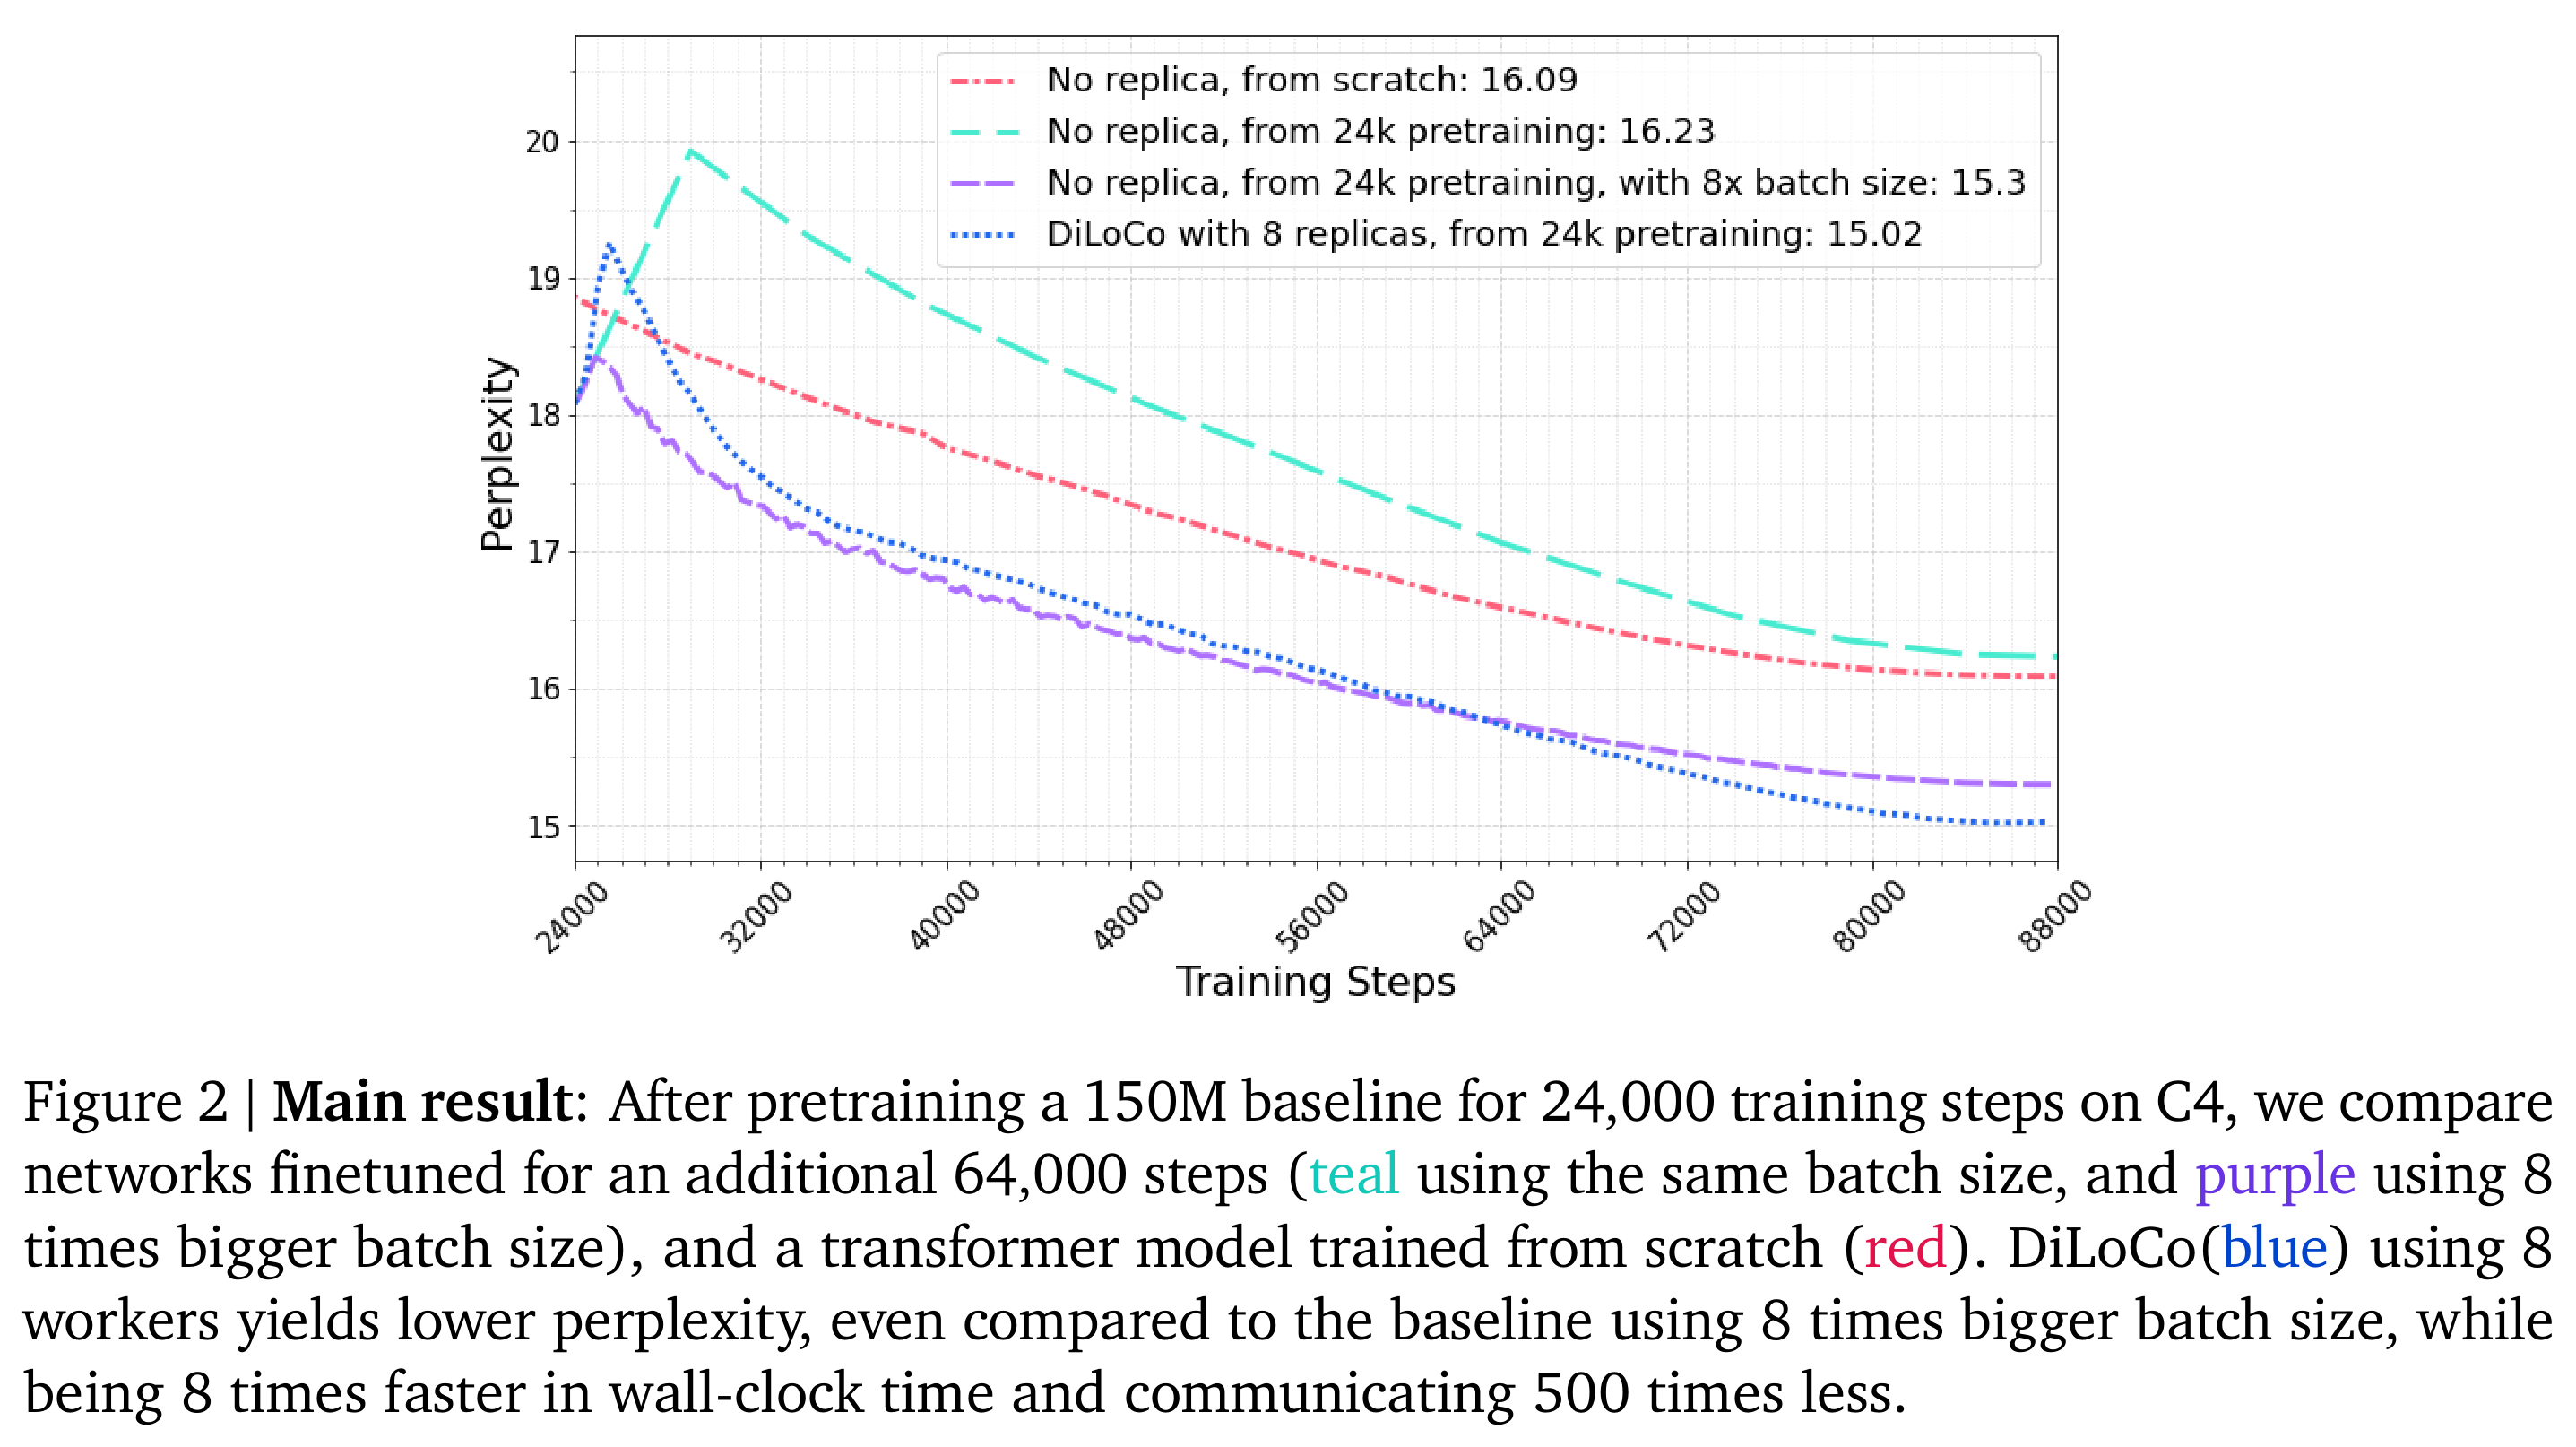
- 연결이 취약한 클러스터에 걸쳐 언어 모델을 학습하기는 어렵다. 기존 분산 학습은 최적화 단계마다 정보를 교환하기 때문이다. 웹 텍스트 데이터셋인 C4에서 worker 8개를 사용한 DiLoCo의 검증 perplexity는 15.02로, 같은 모델링 시간과 연산량에서 8배 큰 배치를 사용한 완전 동기식 베이스라인의 15.30보다 낮았다. Perplexity는 다음 토큰 예측 오류를 나타내며 낮을수록 좋다. 통신 횟수는 베이스라인의 1/500이었다.
- Distributed Low-Communication training(DiLoCo)은 각 worker가 AdamW로 모델 복제본을 로컬에서 학습한 뒤 외부 Nesterov momentum 옵티마이저로 파라미터 변화량을 결합한다. 주요 실험에서는 로컬 학습 500단계마다 동기화하며 24,000단계 동안 사전 학습한 모델에서 시작한다.
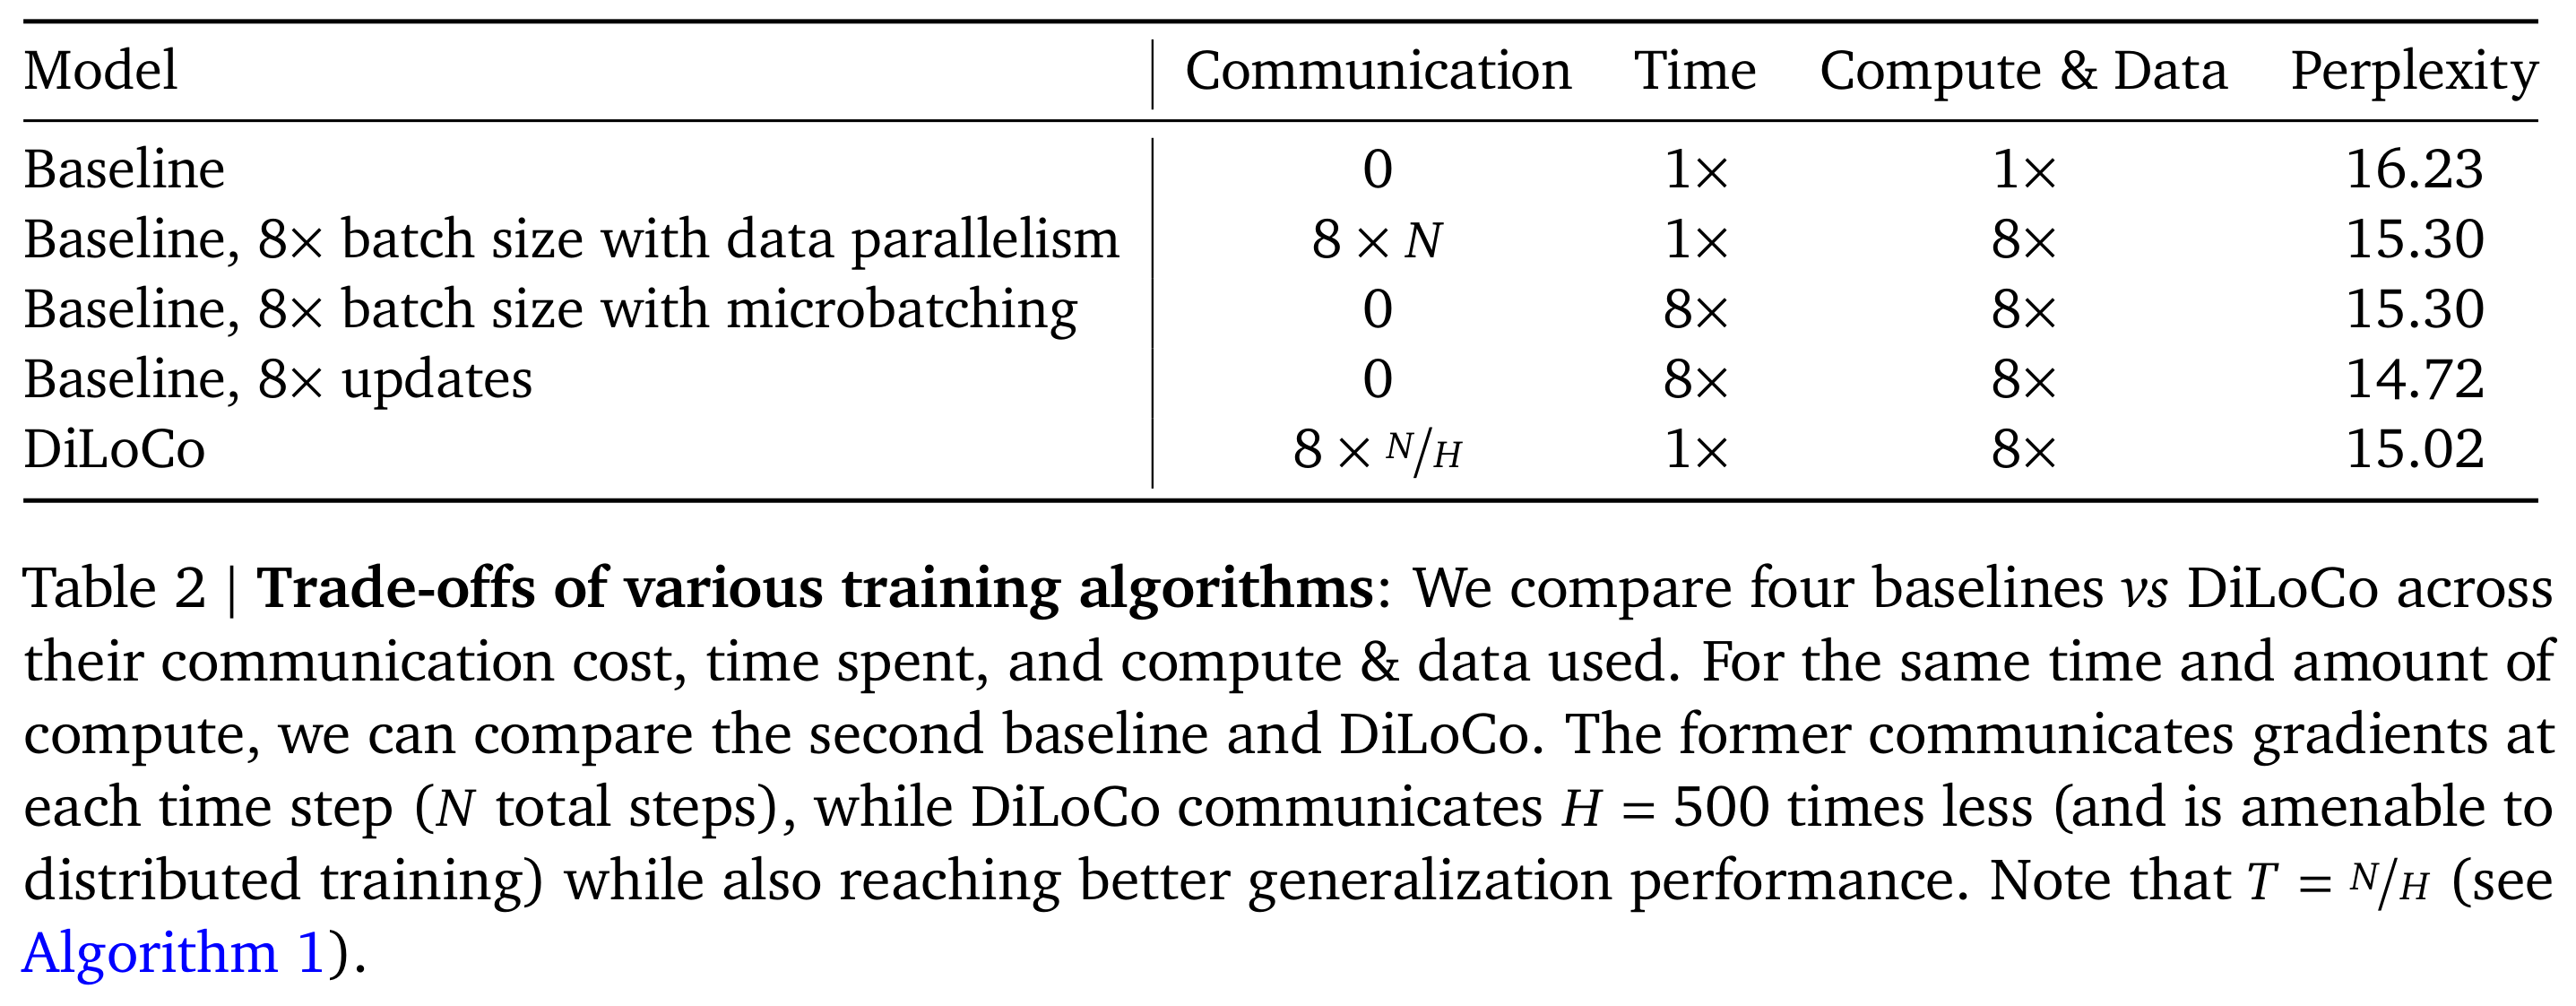
- 실험에서는 worker의 데이터 분포와 연산 일정이 달라도 최종 성능이 비슷했다. 다만 실험에 사용한 모델의 파라미터 수는 60 million~400 million이다. 업데이트를 8배 수행하는 베이스라인은 모델링한 학습 시간이 8배 걸리는 대신 더 낮은 perplexity를 달성했다. 이는 연산 및 데이터 효율과 시간 효율 사이의 상충 관계를 보여준다.
1. Introduction
동기식 학습에는 가속기 간 긴밀한 연결이 필요하며 장치 장애로 학습이 중단될 수 있다. DiLoCo는 장치를 worker로 나누어 로컬에서 학습하고 주기적으로 통신한다. 이를 통해 모델 크기와 추론 속도를 유지하면서 클러스터 간 고대역폭 연결의 필요성을 줄인다.
2. DiLoCo
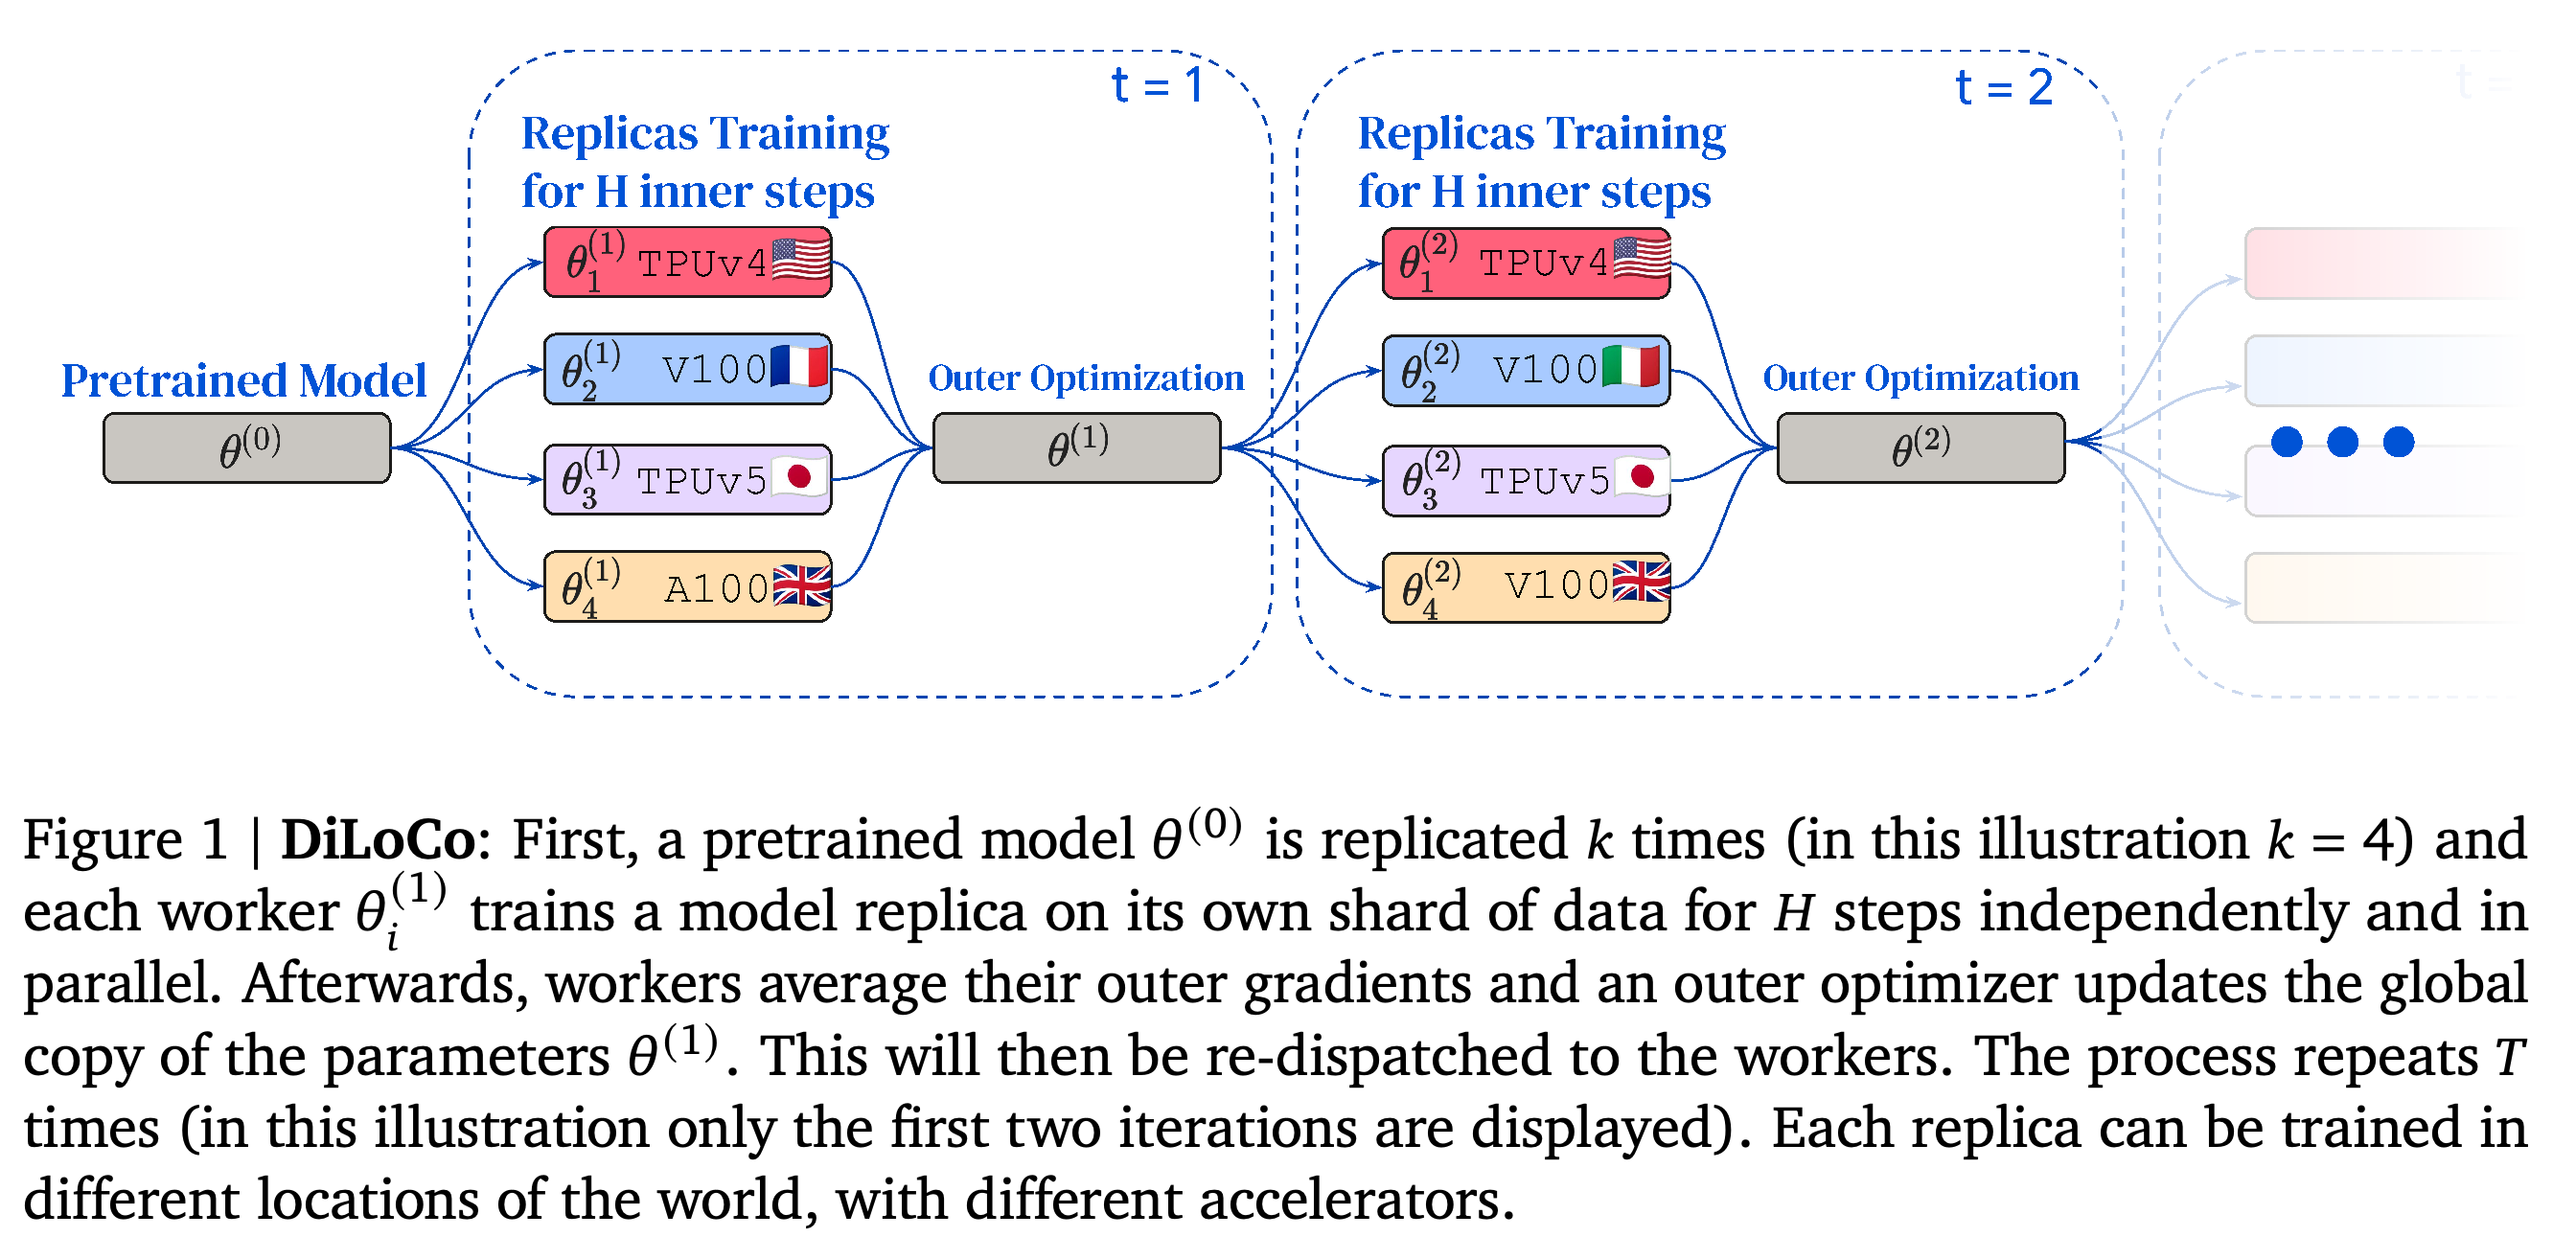
k개의 worker는 공유 파라미터에서 외부 라운드를 시작해 각자의 데이터 shard로 H번의 내부 단계를 독립적으로 학습한 뒤 시작과 종료 시점의 파라미터 차이를 반환한다. 외부 옵티마이저는 평균 차이를 공유 모델에 적용하고, 갱신된 모델은 다음 라운드를 위해 배포된다. 각 worker는 T번의 라운드에 걸쳐 N = T × H번의 내부 단계를 수행한다.
- 구현에서는 로컬 옵티마이저로 AdamW를, 외부 업데이트에 Nesterov momentum을 사용한다. 보충 자료에서는 무작위로 분할한 데이터에 균등 평균을, worker별 데이터 분포가 다른 non-i.i.d. 데이터에는 shard 크기에 따른 가중 평균을 적용한다.
복제본 4개가 독립적으로 학습한 뒤 파라미터 변화량을 결합하고, 갱신된 공유 모델로 다음 라운드를 시작한다.
3. Experiments
평가에는 C4에서 학습한 60M, 150M, 400M 파라미터의 decoder-only Chinchilla 스타일 transformer를 사용한다(Raffel et al., 2020; Hoffmann et al., 2022). 실험의 시퀀스 길이는 1,024 토큰, 배치 크기는 512, 전체 학습 단계는 88,000이다. 기본 설정에서 DiLoCo는 사전 학습 24,000단계 이후 시작하며 non-i.i.d. shard를 사용한다.
- 주요 150M 실험에서는 worker 8개가 각각 로컬 학습 500단계로 구성된 라운드 128회를 수행한다. Worker 간 통신이 드물기 때문에 학습 단계 수를 실제 경과 시간의 대리 지표로 사용한다.
- 모델링한 시간과 연산량이 같을 때 DiLoCo의 perplexity는 15.02로, 동기식 8× batch 베이스라인의 15.30보다 낮다. 8× updates 베이스라인은 DiLoCo와 동일한 모델링 연산량과 데이터를 사용해 14.72를 달성하지만 시간은 8배 걸린다.
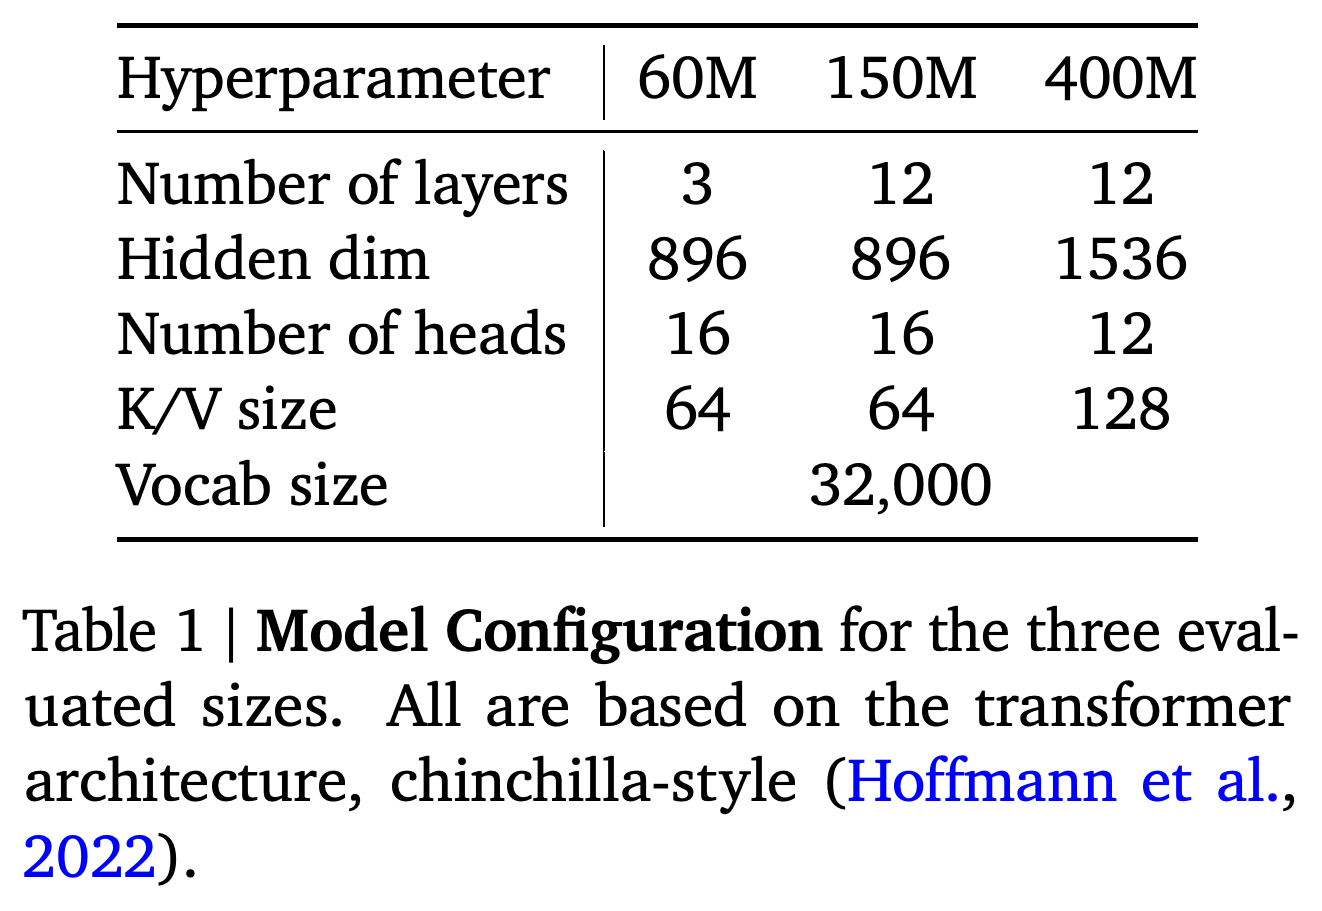
Transformer 설정 3가지는 깊이와 은닉 차원이 다르지만 32,000 토큰의 어휘를 공유한다.
Worker 8개를 사용한 DiLoCo 곡선의 최종 perplexity는 15.02로, 동일한 사전 학습과 추가 학습 단계를 거친 8배 큰 배치 베이스라인 곡선의 15.30보다 낮다.
이 비교는 모델링한 시간을 연산량, 데이터, 통신량과 구분한다. 8× updates 베이스라인은 perplexity 14.72를 달성하지만 DiLoCo에 할당된 시간의 8배가 걸린다.
3.1. Ablations
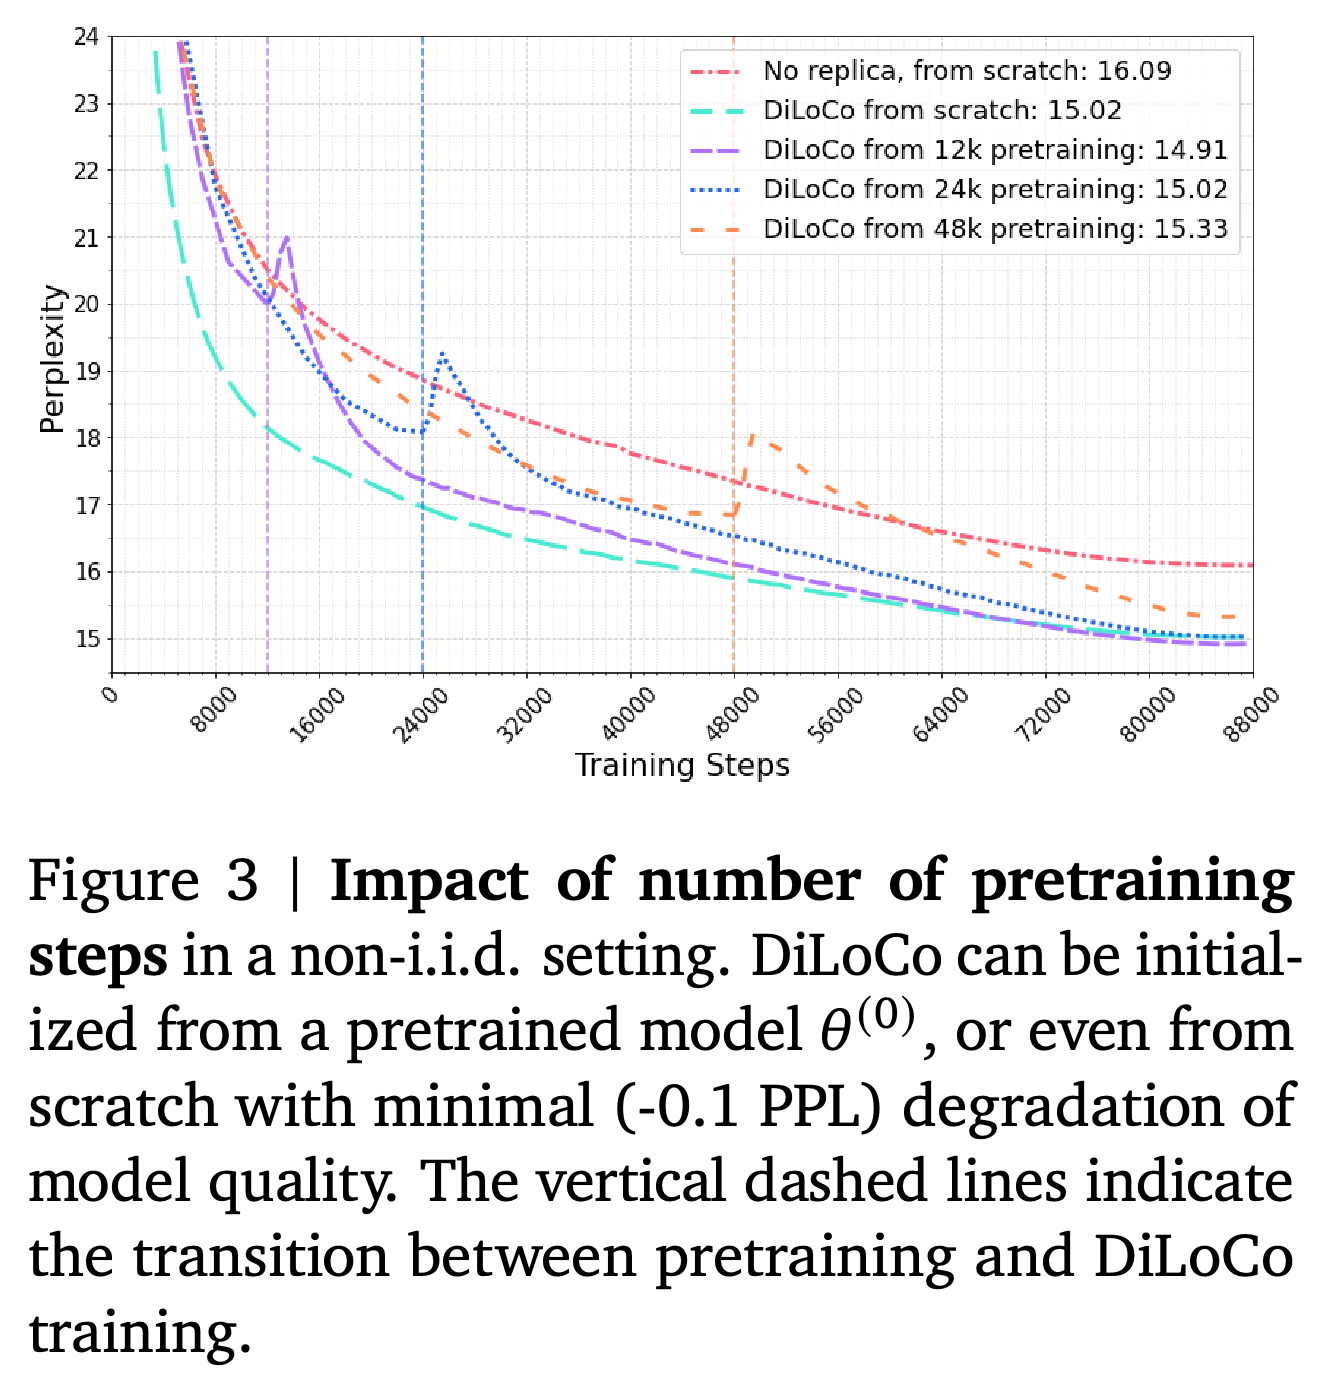
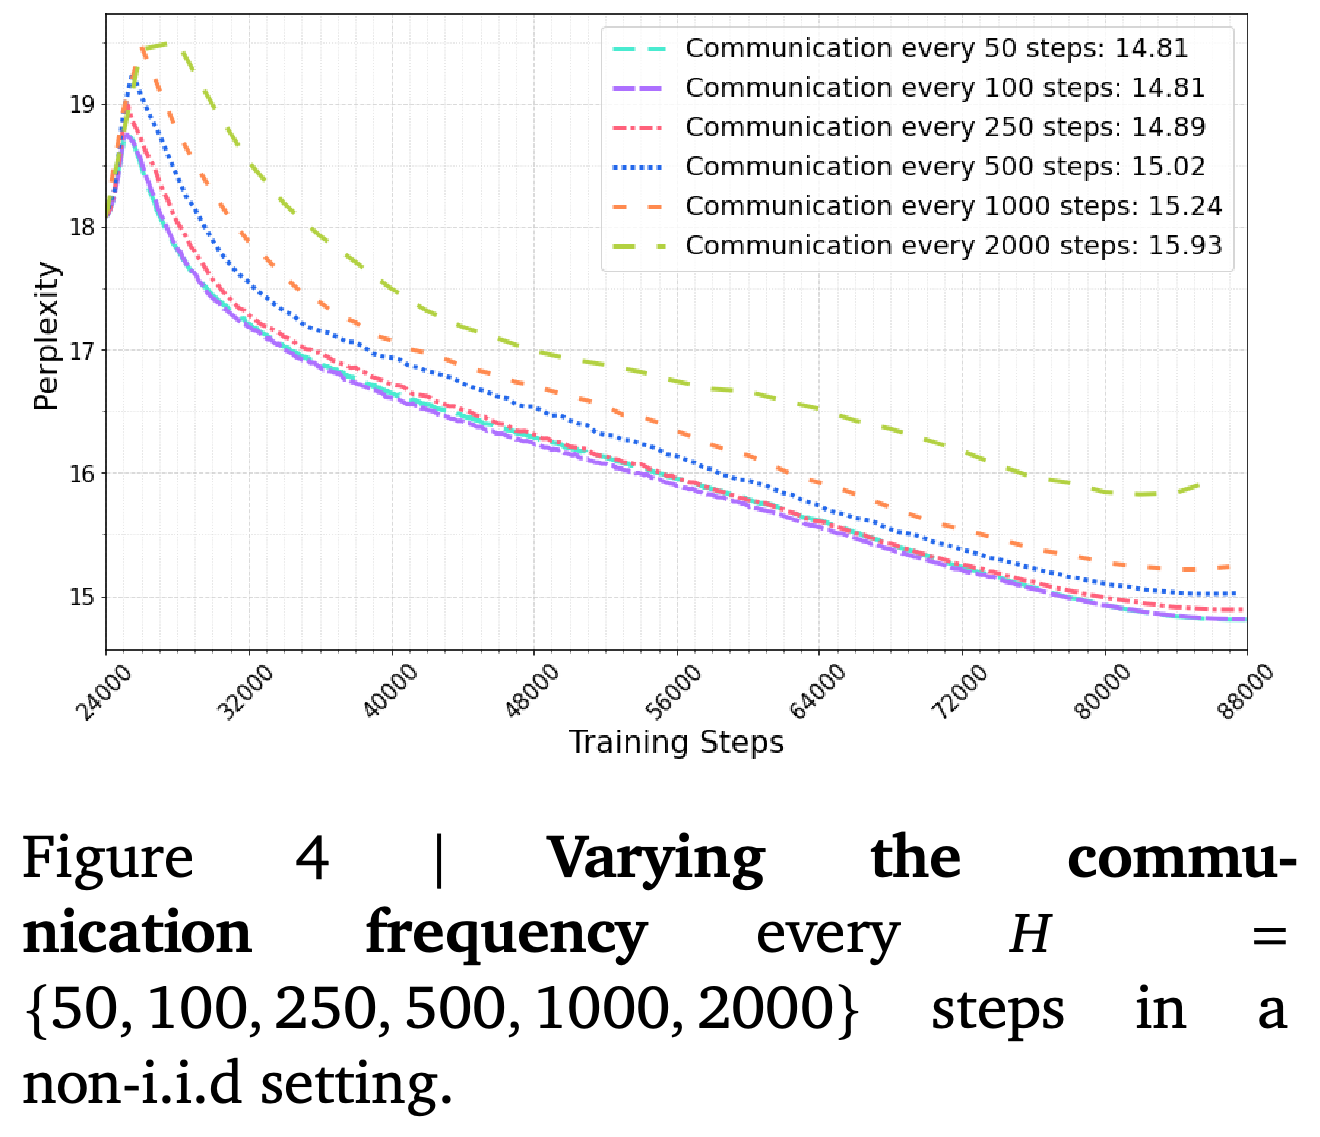
DiLoCo를 처음부터 시작하거나 사전 학습 12,000단계 또는 24,000단계 이후 시작해도 최종 perplexity는 비슷하다. 다만 단계 수가 같을 때 더 일찍 시작하면 전체 연산량이 증가한다. 150M 모델에서 1,000단계마다 통신하면 50단계마다 통신할 때보다 통신량은 20배 적지만 perplexity는 2.9% 높아진다. 저자들은 나머지 실험에서 H = 500을 선택한다.
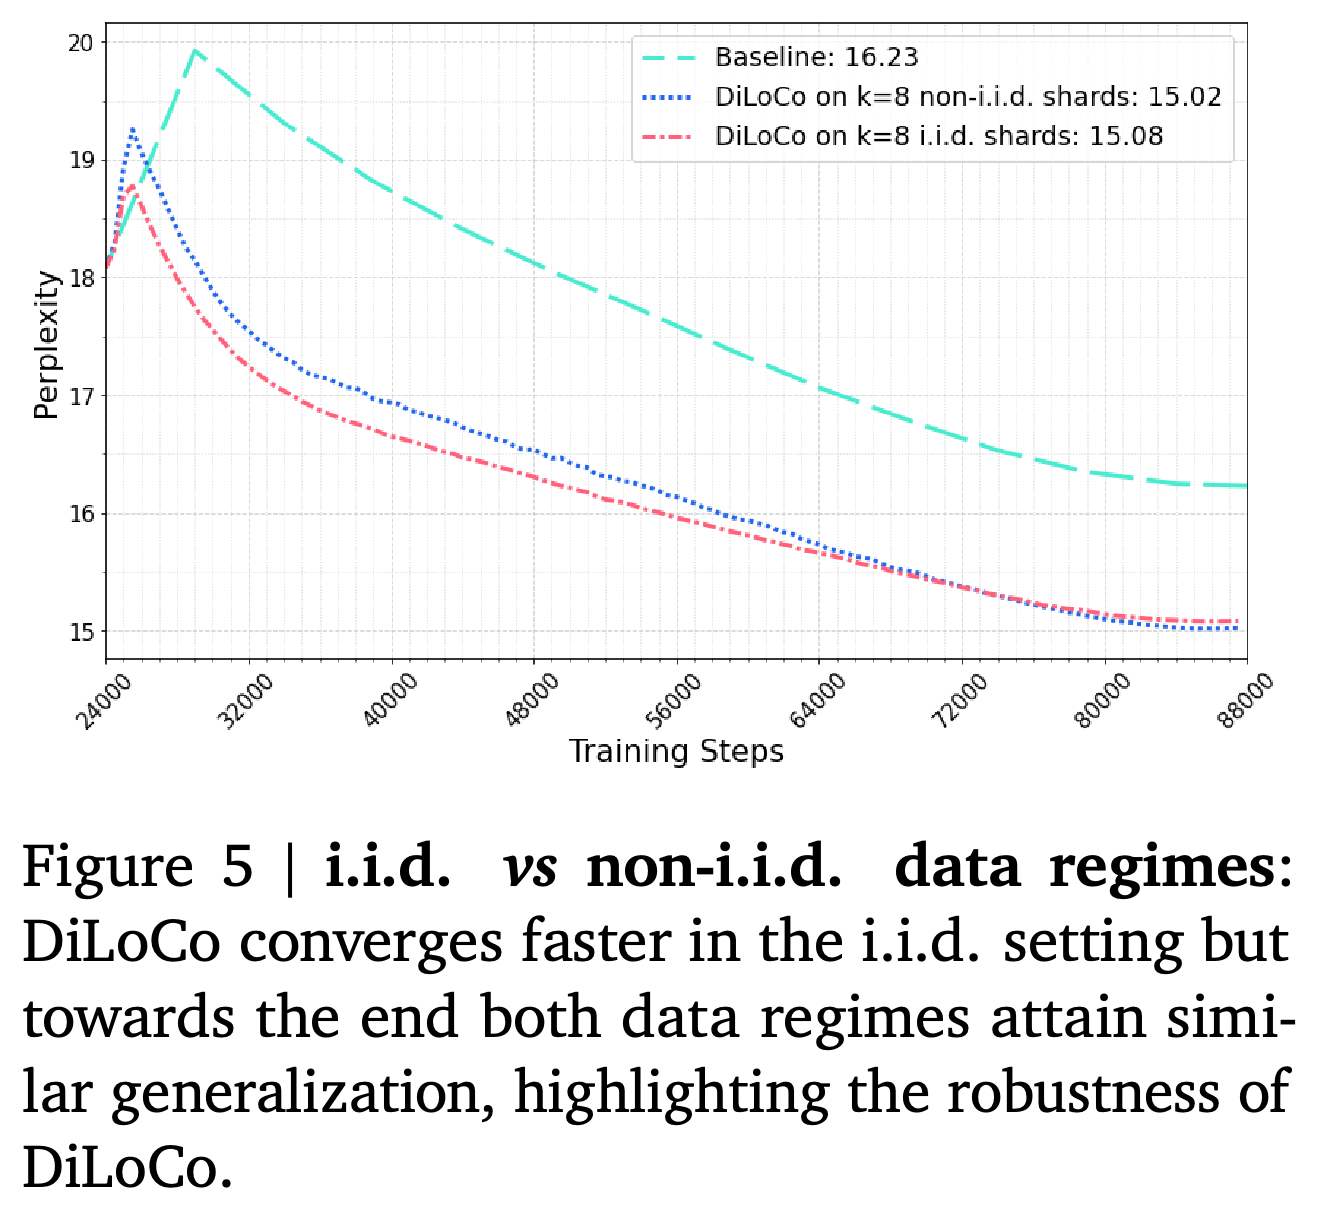
- Worker shard가 동일한 분포를 따르도록 무작위로 분할한 i.i.d. 데이터는 군집화된 non-i.i.d. 데이터보다 초기에 빠르게 수렴한다. 그러나 worker 8개를 사용했을 때 최종 perplexity는 각각 15.08과 15.02다.
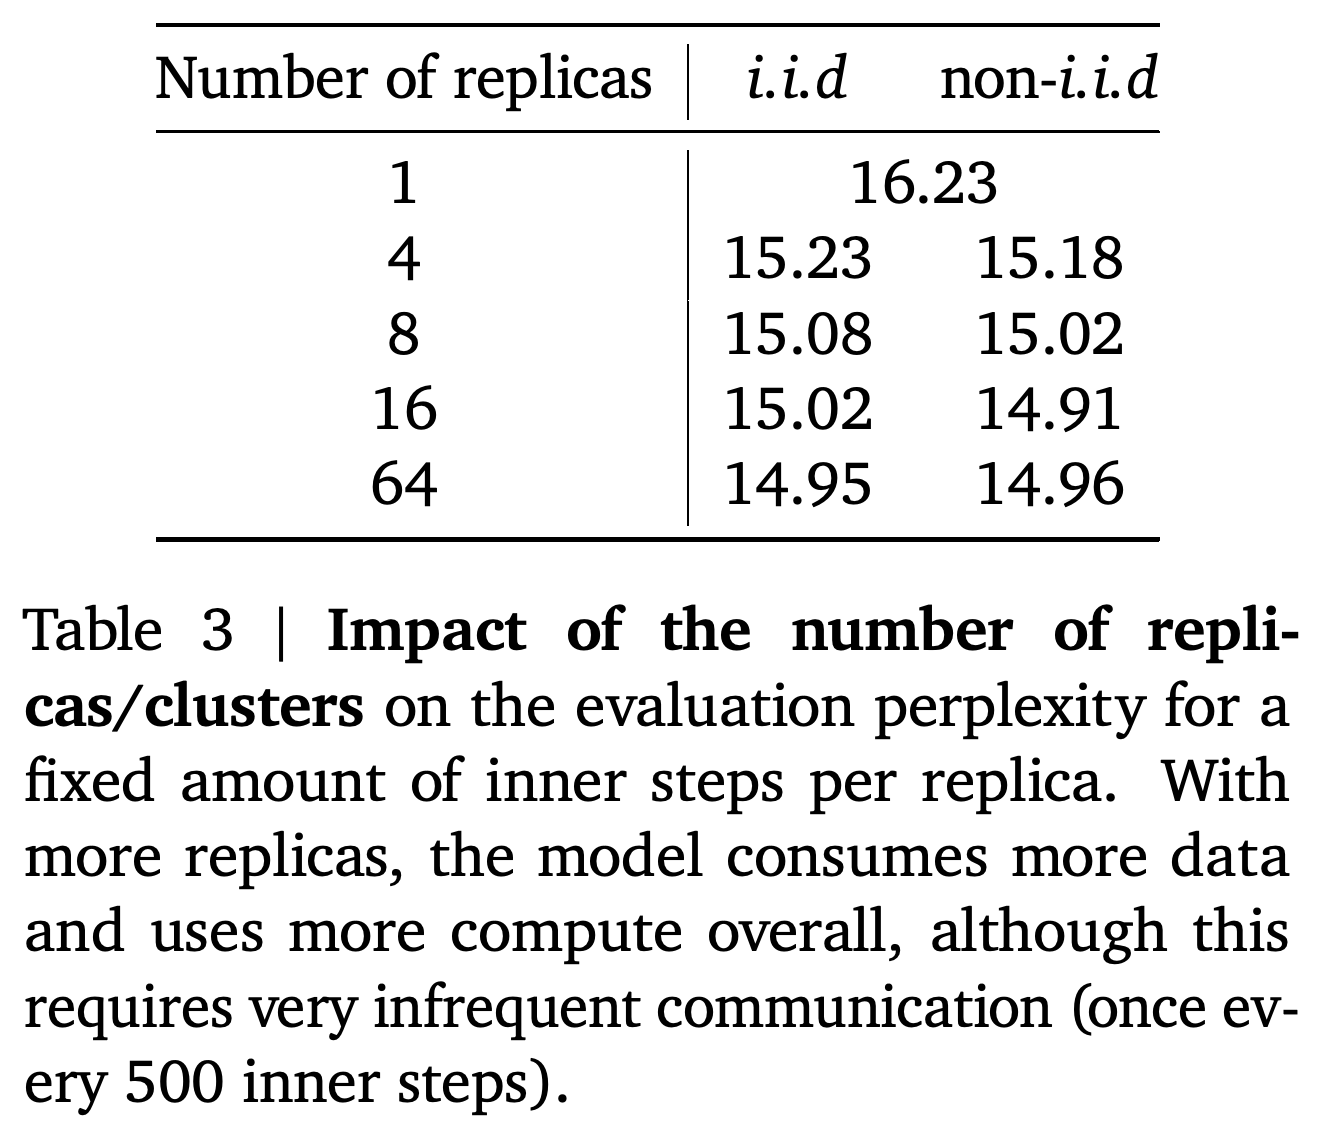
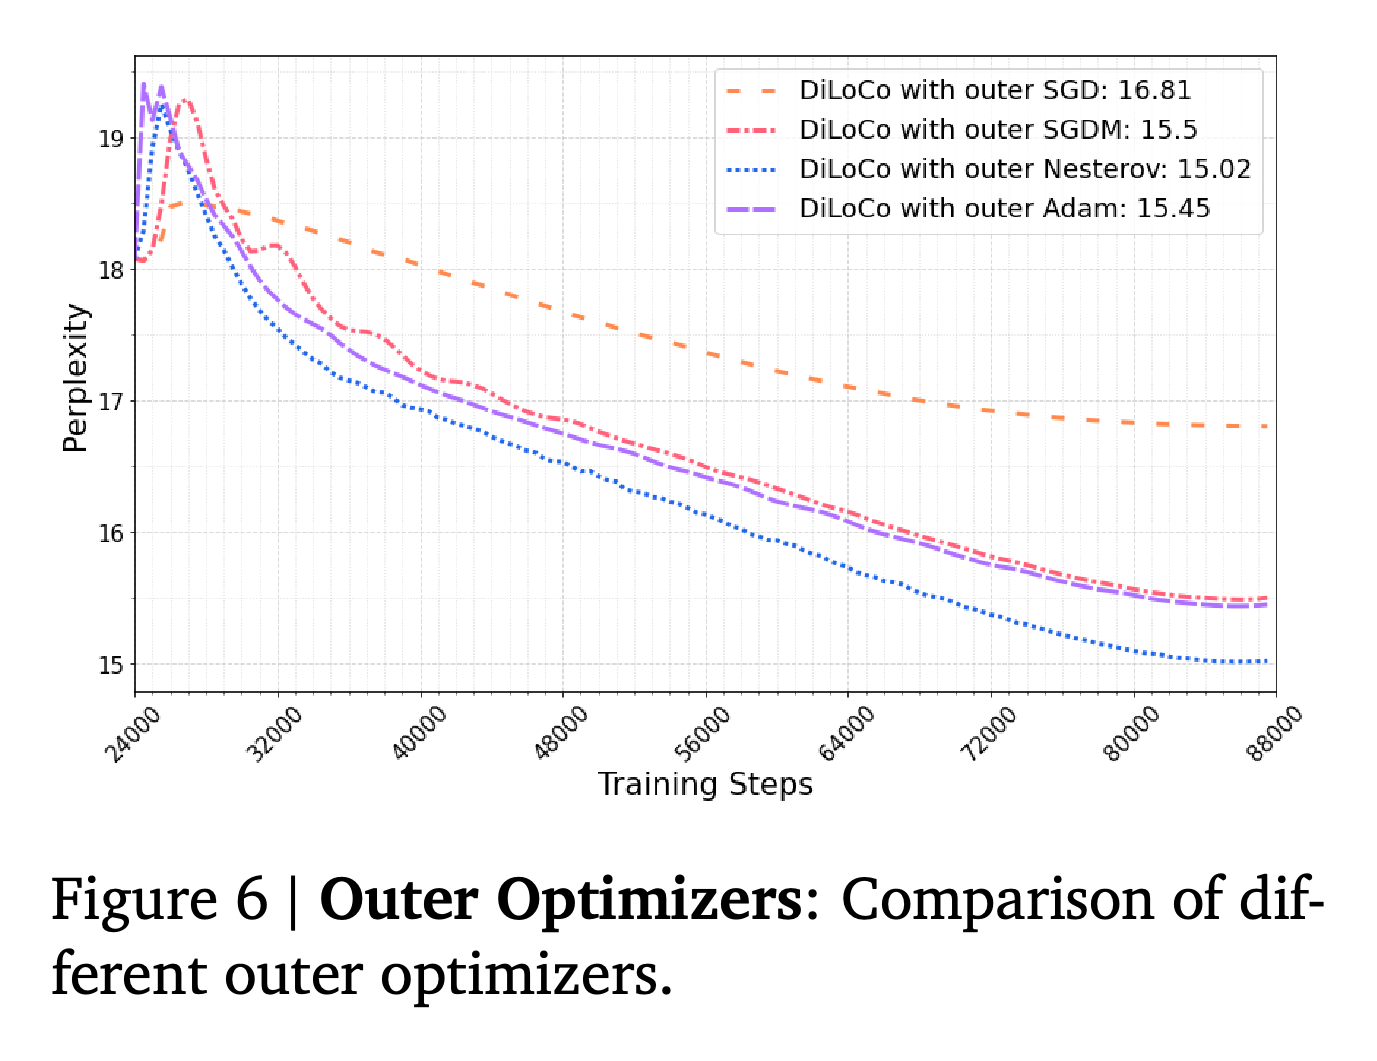
- 복제본을 늘리면 성능이 개선되지만 8개를 넘어서면 개선 폭이 줄고 전체 연산량과 데이터 사용량도 증가한다. 실험한 외부 옵티마이저 중에서는 학습률 0.7, momentum 0.9를 사용한 Nesterov momentum이 가장 좋은 성능을 보인다.
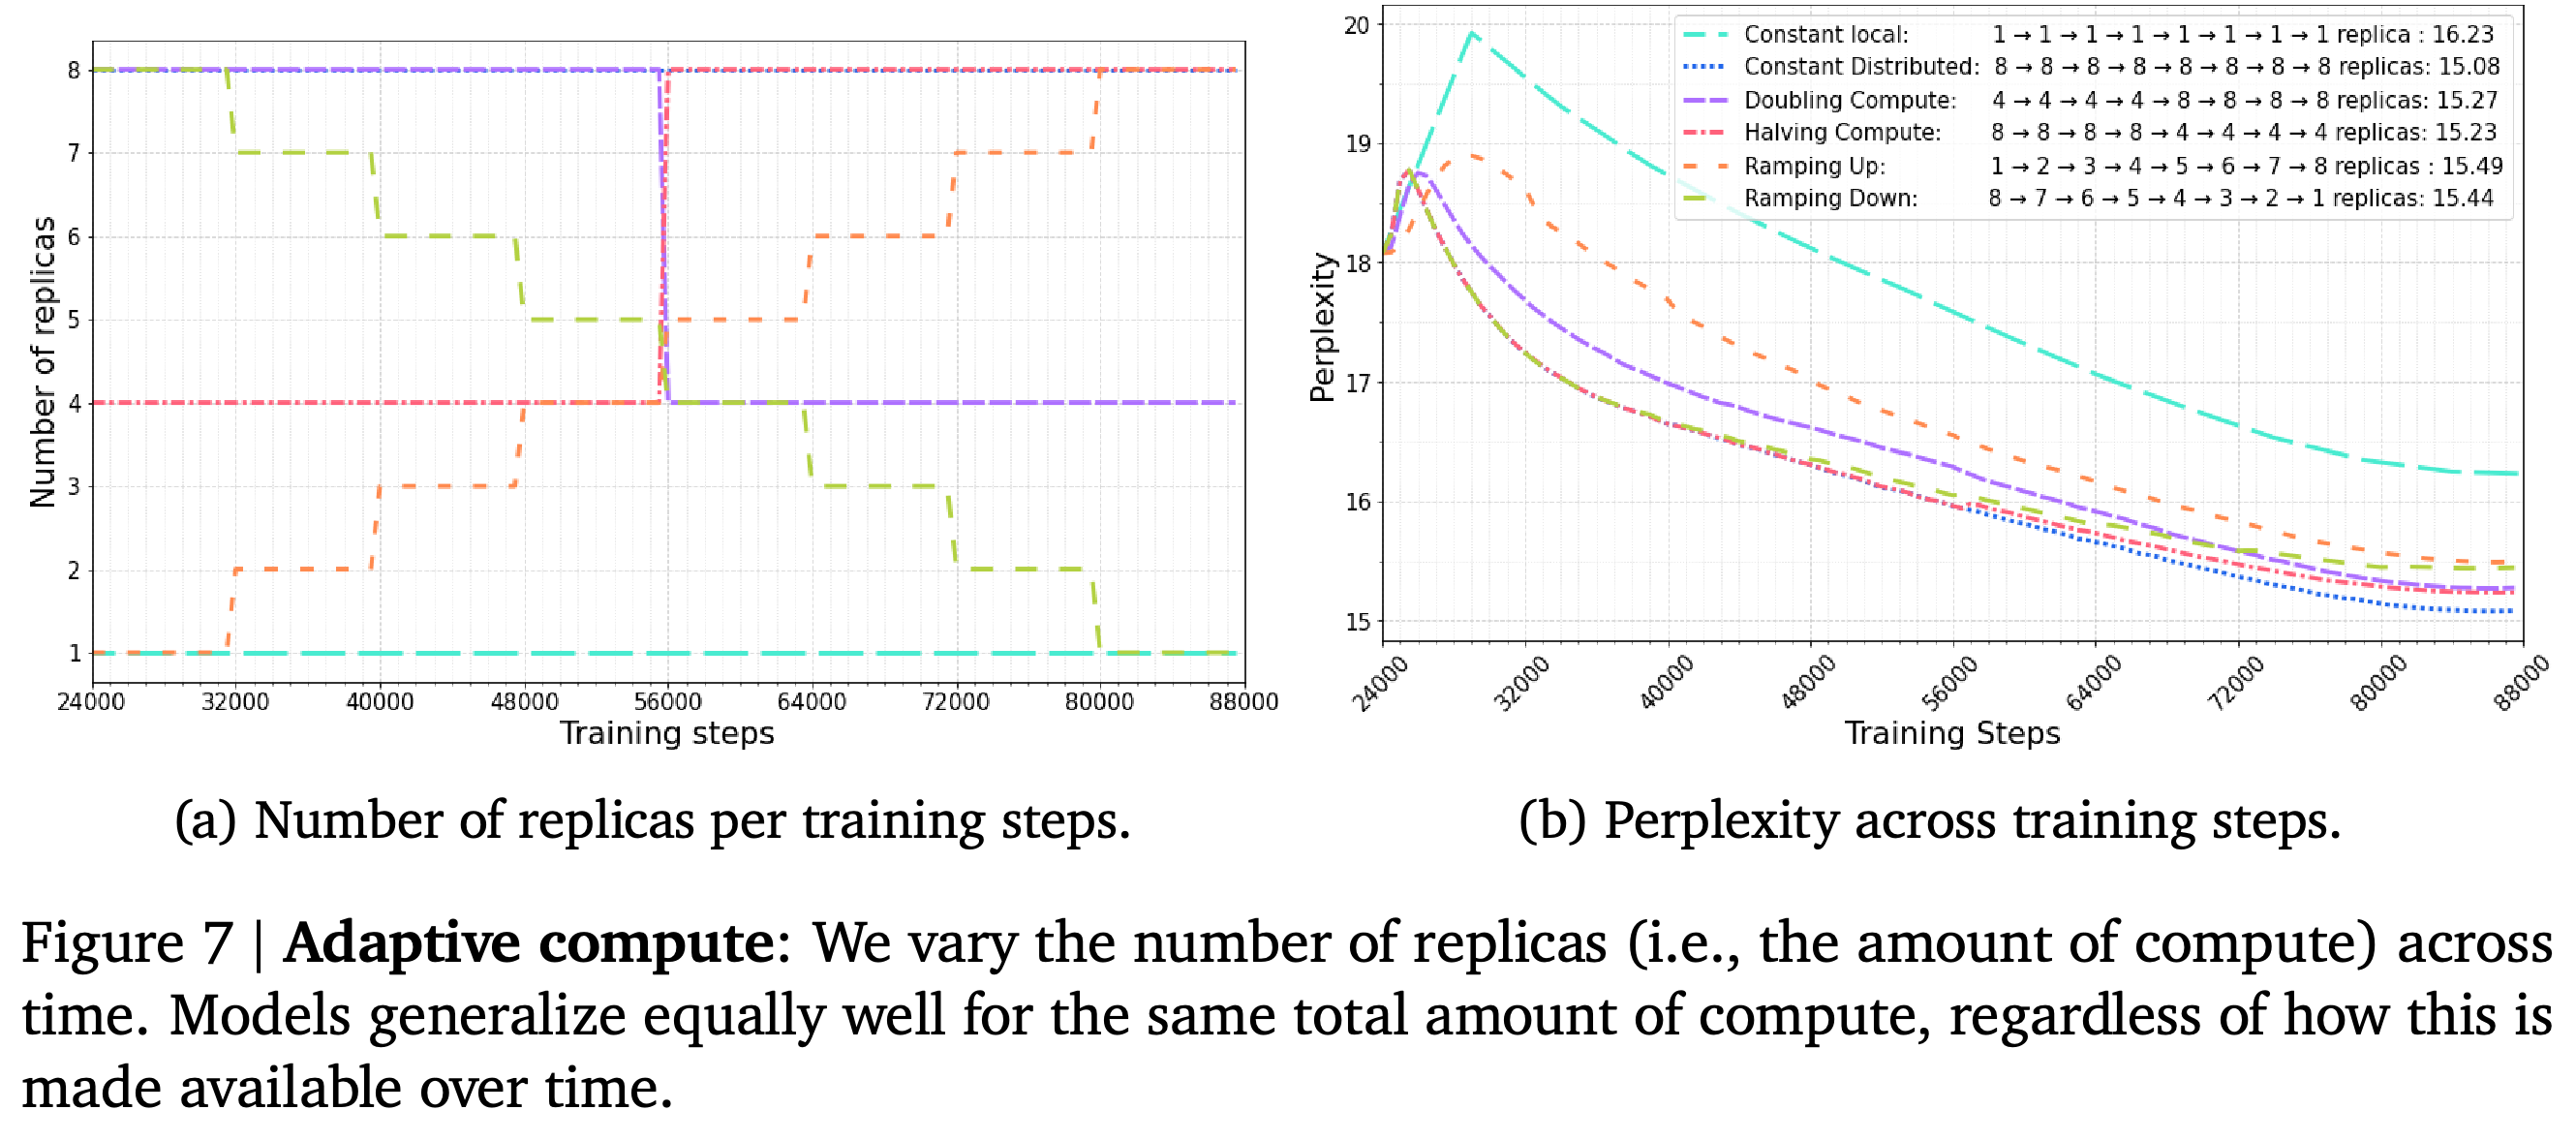
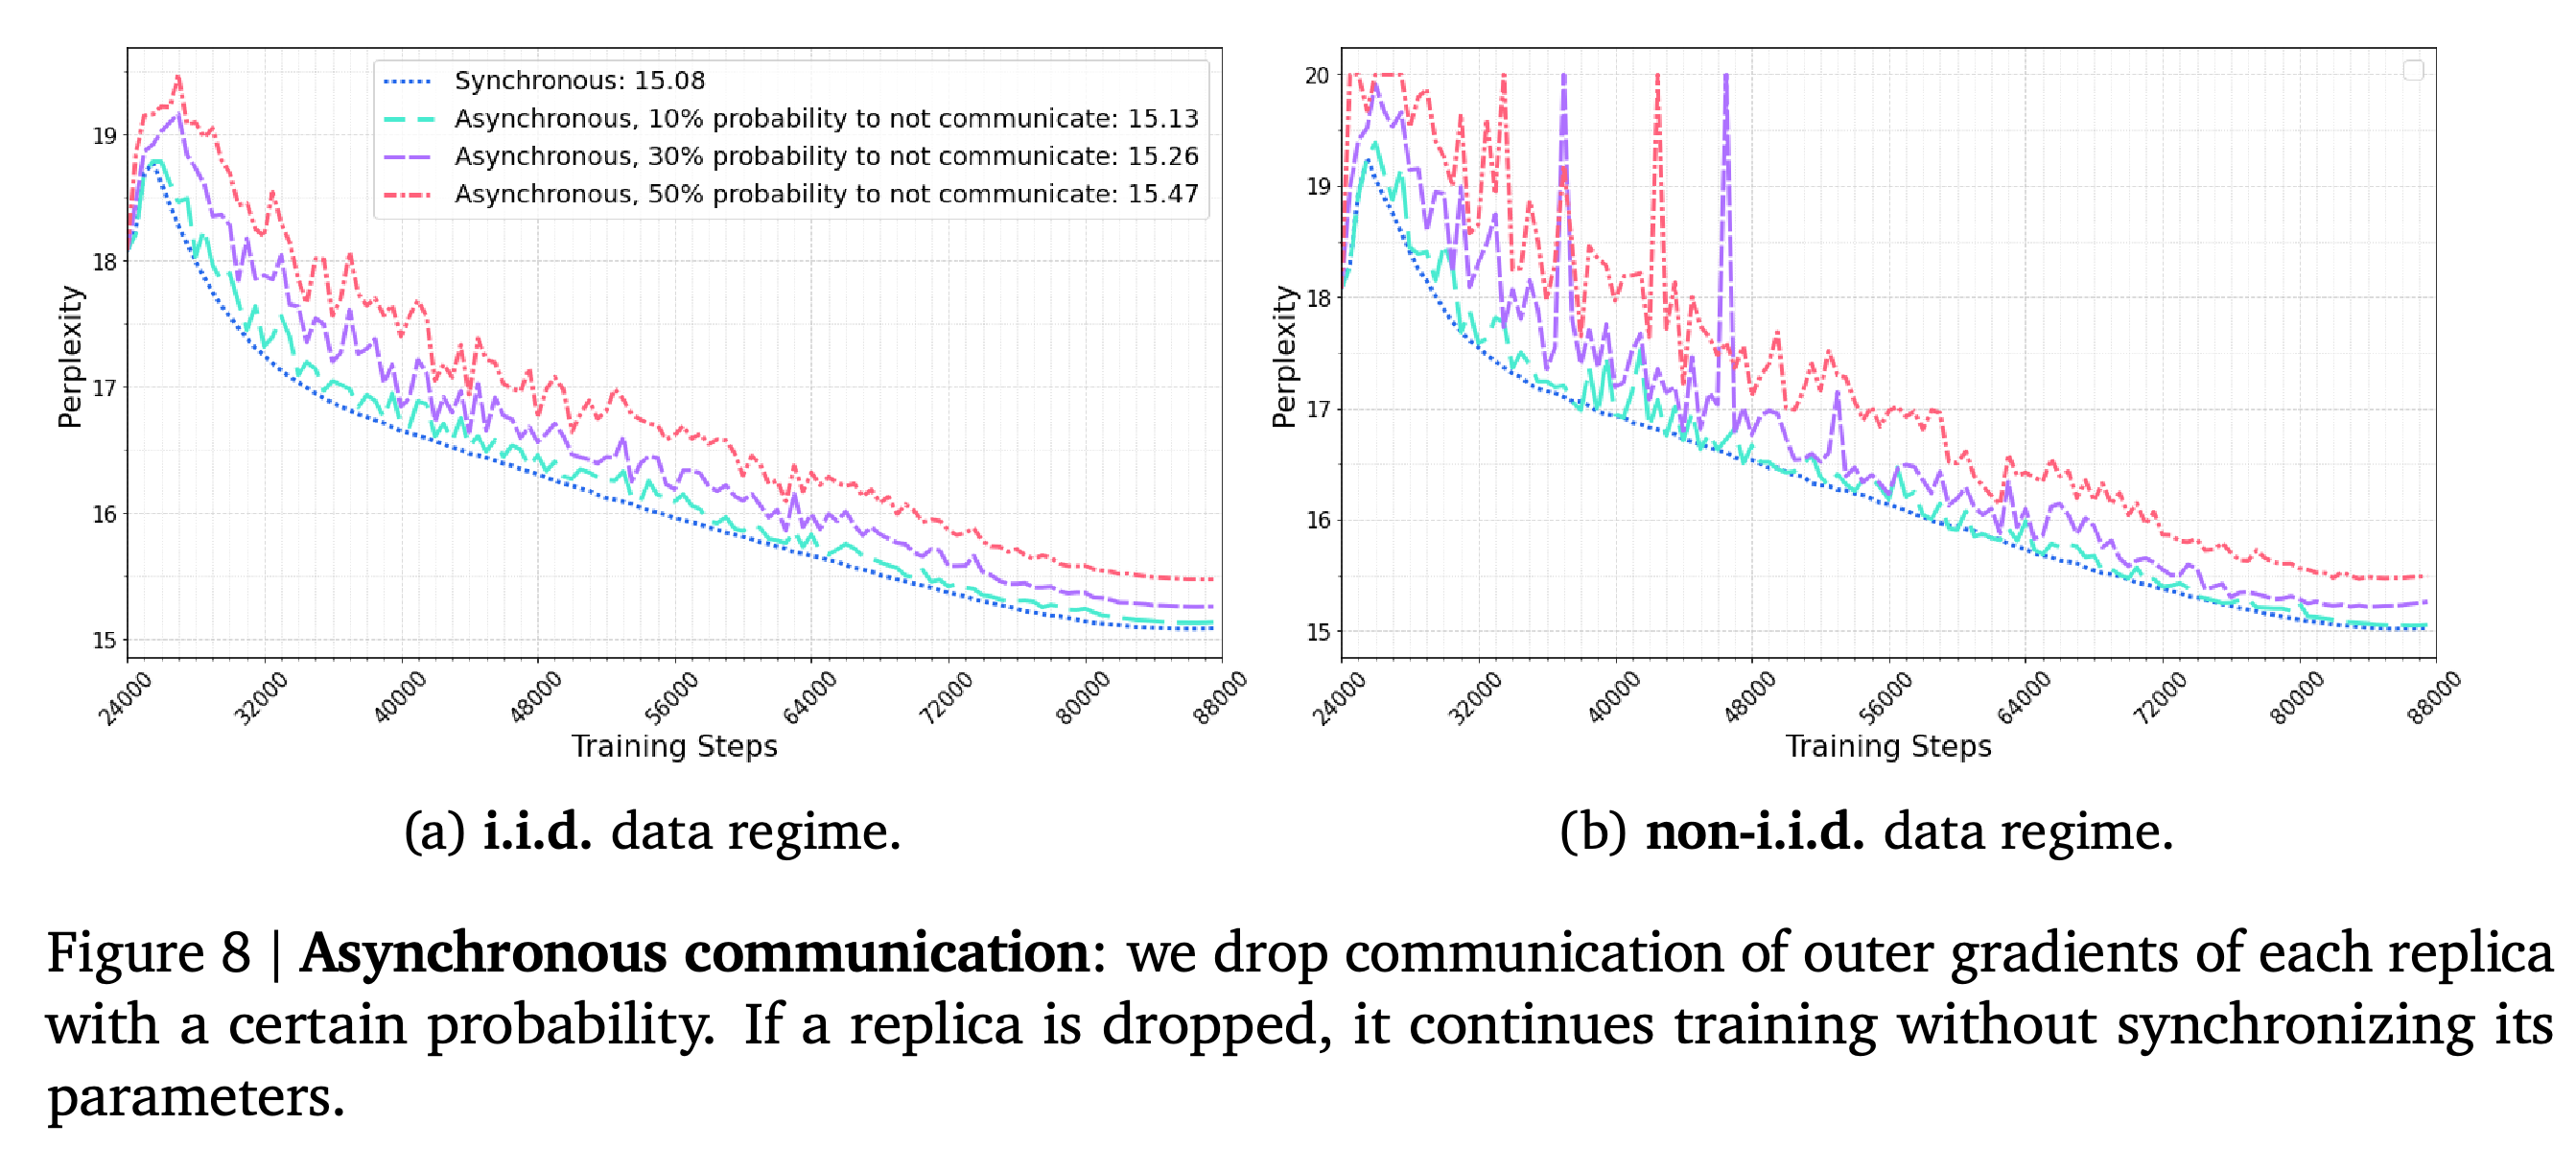
- 통신 실패를 시뮬레이션한 실험에서 각 worker의 통신이 누락될 확률을 50%로 설정하면 완벽한 통신에 비해 non-i.i.d. perplexity가 2.1% 증가한다. 시간에 따라 복제본 수를 변경해도 전체 연산량이 비슷한 실험 일정에서는 결과가 비슷하다.
처음부터 시작한 경우와 사전 학습 24,000단계 이후 시작한 경우 모두 최종 perplexity가 15.02이며, 12,000단계 이후 시작한 경우는 14.91이다.
동기화 빈도가 낮아질수록 최종 perplexity가 점차 나빠지며, 2,000단계 간격일 때의 성능 저하가 1,000단계 간격일 때보다 크다.
무작위 shard 실험은 학습 초기에 더 빠르게 개선되지만 최종 perplexity는 군집화된 shard 실험과 비슷하다.
로컬 단계 수가 같을 때 non-i.i.d. perplexity는 복제본 8개에서 15.02, 64개에서 14.96으로 변한다. 복제본을 추가하면 연산량과 데이터 사용량이 증가한다.
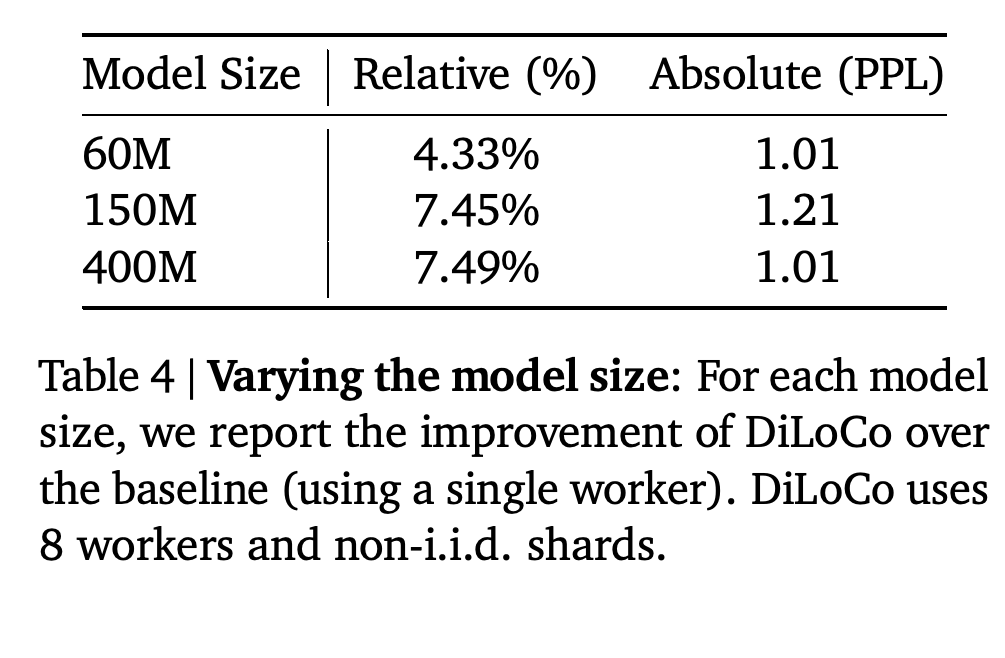
Worker 8개를 사용한 DiLoCo는 단일 worker 베이스라인에 비해 60M, 150M, 400M 모델의 perplexity를 각각 1.01, 1.21, 1.01만큼 개선한다.
그래프에서 Nesterov의 최종 perplexity는 15.02이며 Adam은 15.45, SGDM은 15.5, SGD는 16.81이다.
전체 연산량을 맞추면 복제본 수를 늘리는 일정과 절반으로 줄이는 일정의 최종 perplexity가 비슷하다. 복제본 수를 점진적으로 늘리는 일정과 줄이는 일정도 비슷한 결과를 낸다.
외부 gradient 통신이 누락될 확률이 높아지면 데이터 설정 2가지 모두에서 학습 곡선의 변동이 커지지만 학습은 계속된다.
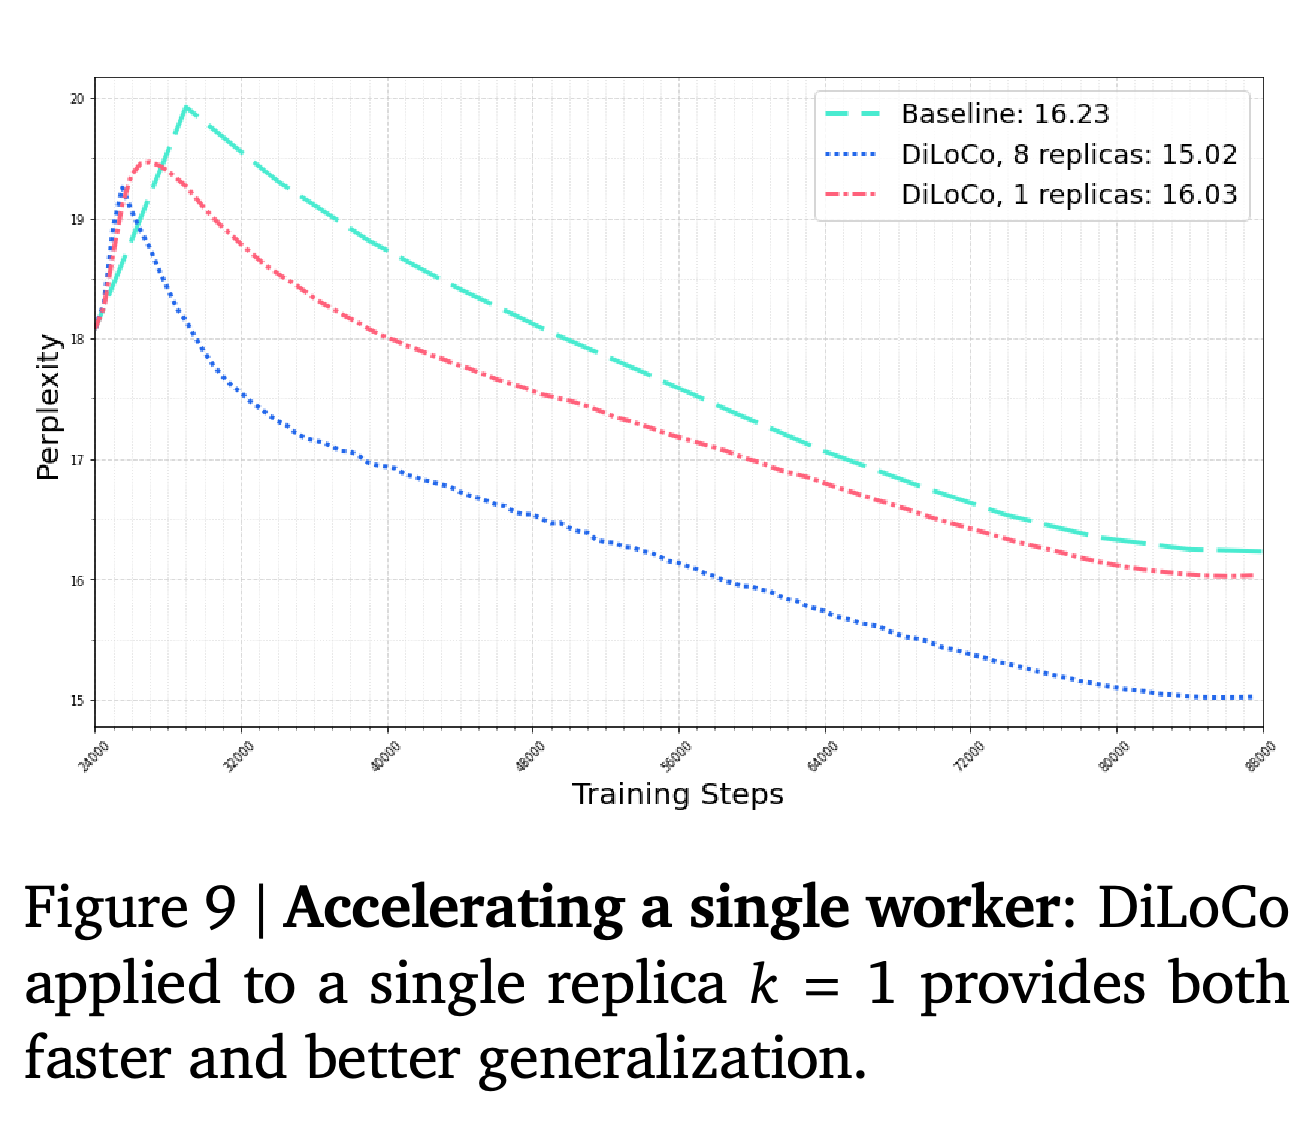
복제본 1개를 사용하면 worker 간 통신 없이 주기적인 외부 최적화로 perplexity 16.03을 달성하며, 베이스라인은 16.23이다.
4. Related Work
관련 연구에서는 DiLoCo를 통신 사이에 여러 차례 로컬 업데이트를 수행하는 local stochastic gradient descent(SGD), federated learning, linear mode connectivity와 연결한다. 이 연구들은 로컬 업데이트, 외부 최적화, 학습 중 모델 파라미터 결합의 동기를 제공한다.
4.1. Local SGD and Federated Learning
Federated averaging은 로컬에서 학습한 모델을 결합하며(McMahan et al., 2017), 후속 연구에서는 더 강력한 외부 옵티마이저를 도입했다(Reddi et al., 2021; Wang et al., 2020). 저자들은 DiLoCo를 FedMom(Huo et al., 2020)과 비교한다. FedMom도 외부 Nesterov momentum을 사용하지만, 복제본 2개를 사용하고 20단계마다 통신하는 1층 long short-term memory 네트워크를 연구한다. DiLoCo는 최대 400M 파라미터의 transformer와 복제본 최대 64개를 실험한다.
4.2. Linear Mode Connectivity
Linear mode connectivity는 모델 파라미터 사이를 낮은 손실의 경로로 보간하는 성질을 다룬다. DiLoCo는 학습 중 파라미터를 반복해서 업데이트하지만, 인용된 모델 병합 연구의 상당수는 fine-tuning 후 복제본을 평균한다. 논문은 관련 연구 중 예외로 branch-train-merge(BTM)와 population parameter averaging(PAPA)을 제시한다(Li et al., 2022; Jolicoeur-Martineau et al., 2023).
5. Limitations
이 연구는 언어 모델링이라는 태스크 1개와 transformer라는 아키텍처 계열 1개를 60M–400M 파라미터 범위에서 다룬다. 표준 절차는 모든 worker가 동일한 단계 수를 완료할 때까지 기다리므로 worker의 속도가 다르면 효율이 떨어질 수 있다. 통신 누락 시뮬레이션만으로는 완전한 비동기 구현이 입증되지 않는다.
- Worker가 8개를 넘으면 개선 폭이 줄어들며, 8× updates 베이스라인은 DiLoCo가 모델링 시간 효율을 위해 연산 및 데이터 효율을 일부 희생한다는 점을 보여준다. 더 큰 모델에서 개선될 수 있다는 논문의 제안은 가설로 남아 있다.
6. Conclusion
저자들은 로컬 AdamW와 외부 Nesterov momentum을 사용해 드물게 동기화하면 연결이 취약한 worker에 걸쳐 transformer 언어 모델을 학습할 수 있다고 결론 내린다. 실험은 통신 간격, 데이터 분포, worker 가용성의 변화를 다루지만 더 큰 규모와 다른 분야는 검증하지 않았다.
부록
- Supplementary Materials, 6.1. Implementation Details: 내부 학습률은 4e−4, warmup은 1,000단계, weight decay는 0.1이다. 각 복제본은 자체 AdamW 옵티마이저 상태를 유지한다. 이 상태를 동기화하면 전송 데이터가 세 배로 늘지만 유의미한 개선은 없었다. 실험에는 A100 GPU 16개가 장착된 머신과 외부 최적화를 위한 CPU 서버를 사용했다.
- 6.2. Experiments & Ablations: 개별 외부 gradient 값의 50%를 가지치기하면 perplexity가 15.02에서 15.08로, 즉 0.39% 증가한다. 75%를 가지치기하면 15.27로 증가한다. 방향의 일치도를 나타내는 cosine similarity를 살펴보면 non-i.i.d. shard의 외부 gradient 사이에서 변동성이 더 크다. 또한 non-i.i.d. 복제본 수가 4개에서 8개로 증가하면 유사도가 낮아진다.
짧은 생각
동일한 연산량을 사용한 비교는 통신량 감소를 구체적으로 보여주며, 추가된 8× updates 베이스라인은 모델링한 수렴 시간을 단축하는 데 드는 비용을 보여준다. 훨씬 큰 모델과 속도가 서로 다른 worker를 사용할 때 동기화 방식이 어떻게 작동하는지는 실제 배포에서 확인해야 할 문제다.