


Communication-Efficient Language Model Training Scales Reliably and Robustly: Scaling Laws for DiLoCo 요약 설명
12 Mar 2025 | Paper Review Scaling Laws Distributed Training LLM Pretraining목차
이번 글에서는 Communication-Efficient Language Model Training Scales Reliably and Robustly: Scaling Laws for DiLoCo 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 12일(Arxiv)
- Charles, Zachary, Teston, Gabriel, Dery, Lucio, Rush, Keith, Fallen, Nova, Garrett, Zachary, Szlam, Arthur, Douillard, Arthur.
- Google Research, Google Search, Google DeepMind
- 논문 링크
요약
- 장치 간 동기화가 잦으면 언어 모델 학습이 느려질 수 있다. 따라서 모델이 커져도 동기화 빈도를 낮추면서 품질을 유지할 수 있는지가 연구 과제다. Distributed Low-Communication의 약자인 DiLoCo는 독립적으로 학습한 모델 사본을 주기적으로 동기화한다. 모델 크기와 토큰 예산이 같을 때, 모델 사본 2개를 사용하는 DiLoCo는 4B와 10B 파라미터에서 매 스텝 기울기를 동기화하는 Data-Parallel보다 홀드아웃 손실이 낮다. 홀드아웃 손실은 학습에 사용하지 않은 데이터로 측정한다.
- 저자들은 35M부터 2.4B 파라미터까지 하이퍼파라미터를 탐색하여 손실과 적절한 학습 설정을 예측하는 경험적 함수인 scaling law를 적합하고, 이 범위를 벗어난 4B와 10B에서 예측을 검증한다. DiLoCo는 매 스텝 모든 모델 사본이 처리하는 토큰 수인 전역 배치 크기를 더 크게 설정해도 품질을 유지한다. 주기적 동기화 업데이트의 크기를 조절하는 최적 외부 학습률은 모델 크기보다 복제본 수와 동기화 주기에 주로 좌우된다. 동기화 주기는 업데이트 사이에 수행하는 로컬 스텝 수를 뜻한다.
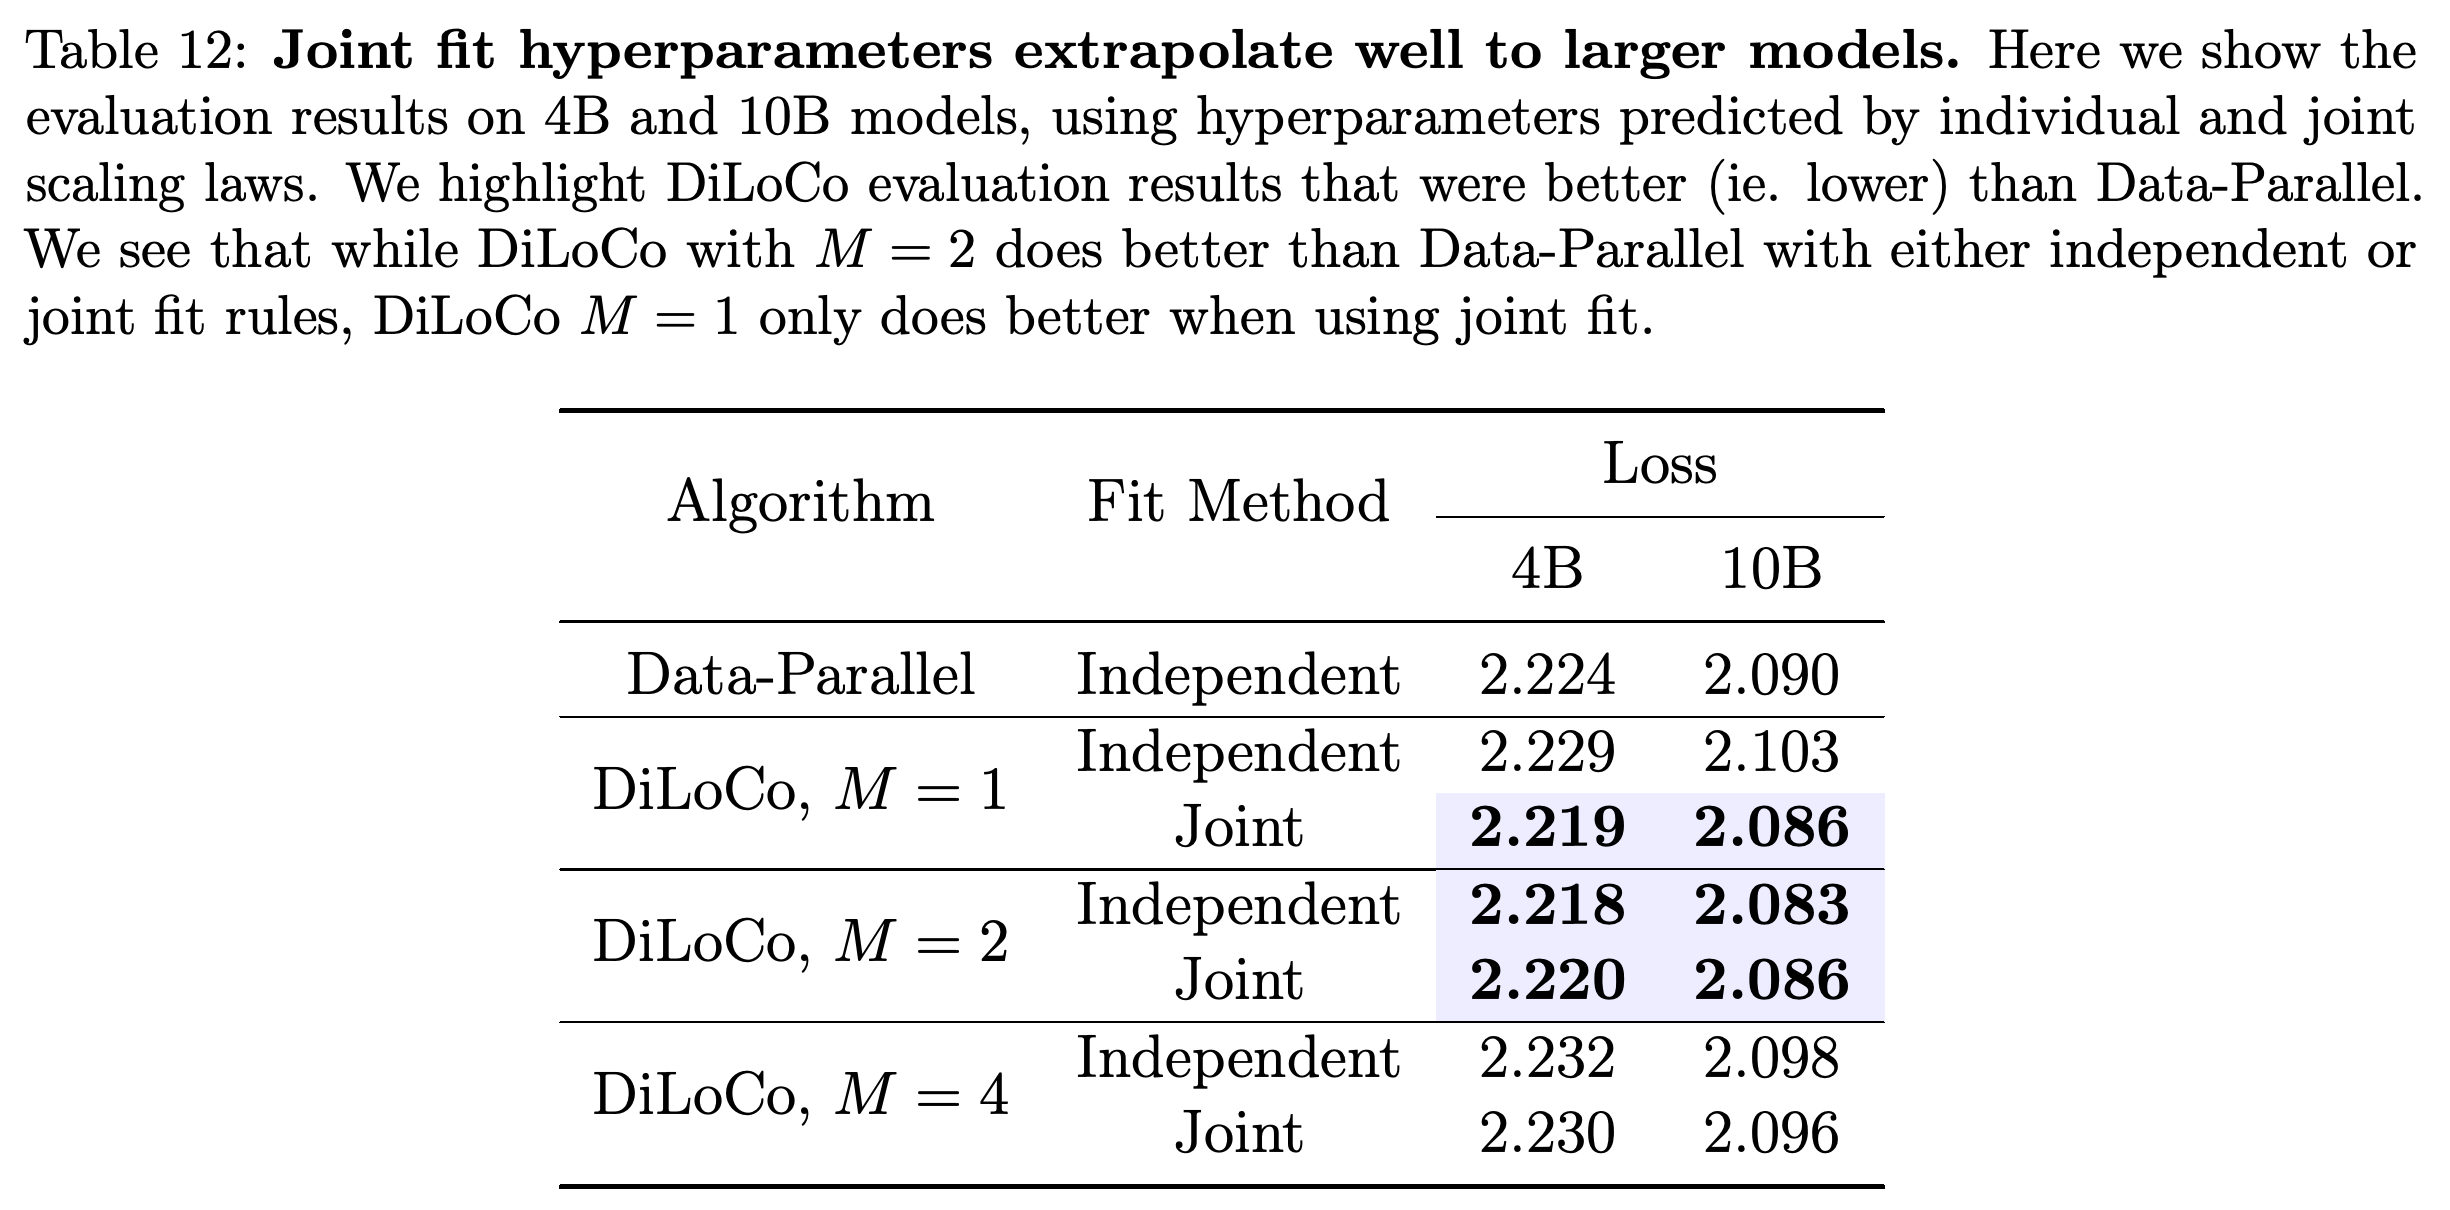
- 손실 개선 폭은 작다. 모델 크기와 복제본 수를 함께 사용해 예측한 하이퍼파라미터를 적용하면, 복제본 2개를 사용하는 DiLoCo의 손실은 4B에서 2.220으로 Data-Parallel의 2.224보다 낮고, 10B에서는 2.086으로 2.090보다 낮다. 통신 감소와 병렬성 증가로 예측되는 속도 이점은 더 크다. 다만 학습 경과 시간 비교는 실제 데이터센터 간 학습에서 측정한 결과가 아니라 이상화한 모델에 기반한다.
1 Introduction
Communication-Efficient Language Model Training Scales Reliably and Robustly: Scaling Laws for DiLoCo는 통신 효율적인 사전학습이 모델 크기에 따라 어떻게 달라지는지 연구한다. 기존 DiLoCo 연구는 추가 최적화 설정을 더 큰 모델에 어떻게 이전해야 하는지 규명하지 못했다. 큰 모델에서는 하이퍼파라미터를 광범위하게 탐색하는 비용이 커진다.
- 이 연구는 파라미터 수 N과, DiLoCo의 경우 복제본 수 M을 변수로 사용하여 홀드아웃 평가 손실과 최적 하이퍼파라미터를 예측한다.
- 대부분의 실험은 동기화 주기를 H = 30으로 고정하고 Chinchilla 토큰 배분 D = 20N을 따른다. 이는 모델 파라미터당 학습 토큰 20개를 사용한다는 뜻이다.
2 Preliminaries
표기에서는 모델 가중치 θ, 파라미터 수 N, 평가 손실 L, 학습 스텝 수 T, 토큰 예산 D, 총 부동소수점 연산량 C를 구분한다. DiLoCo는 추가로 모델 복제본 수 M, 동기화 주기 H, 로컬 업데이트에 사용하는 내부 학습률 γ, 외부 학습률 η, 토큰 단위 전역 배치 크기 B를 사용한다.
2.1 DiLoCo: Distributed Low-Communication
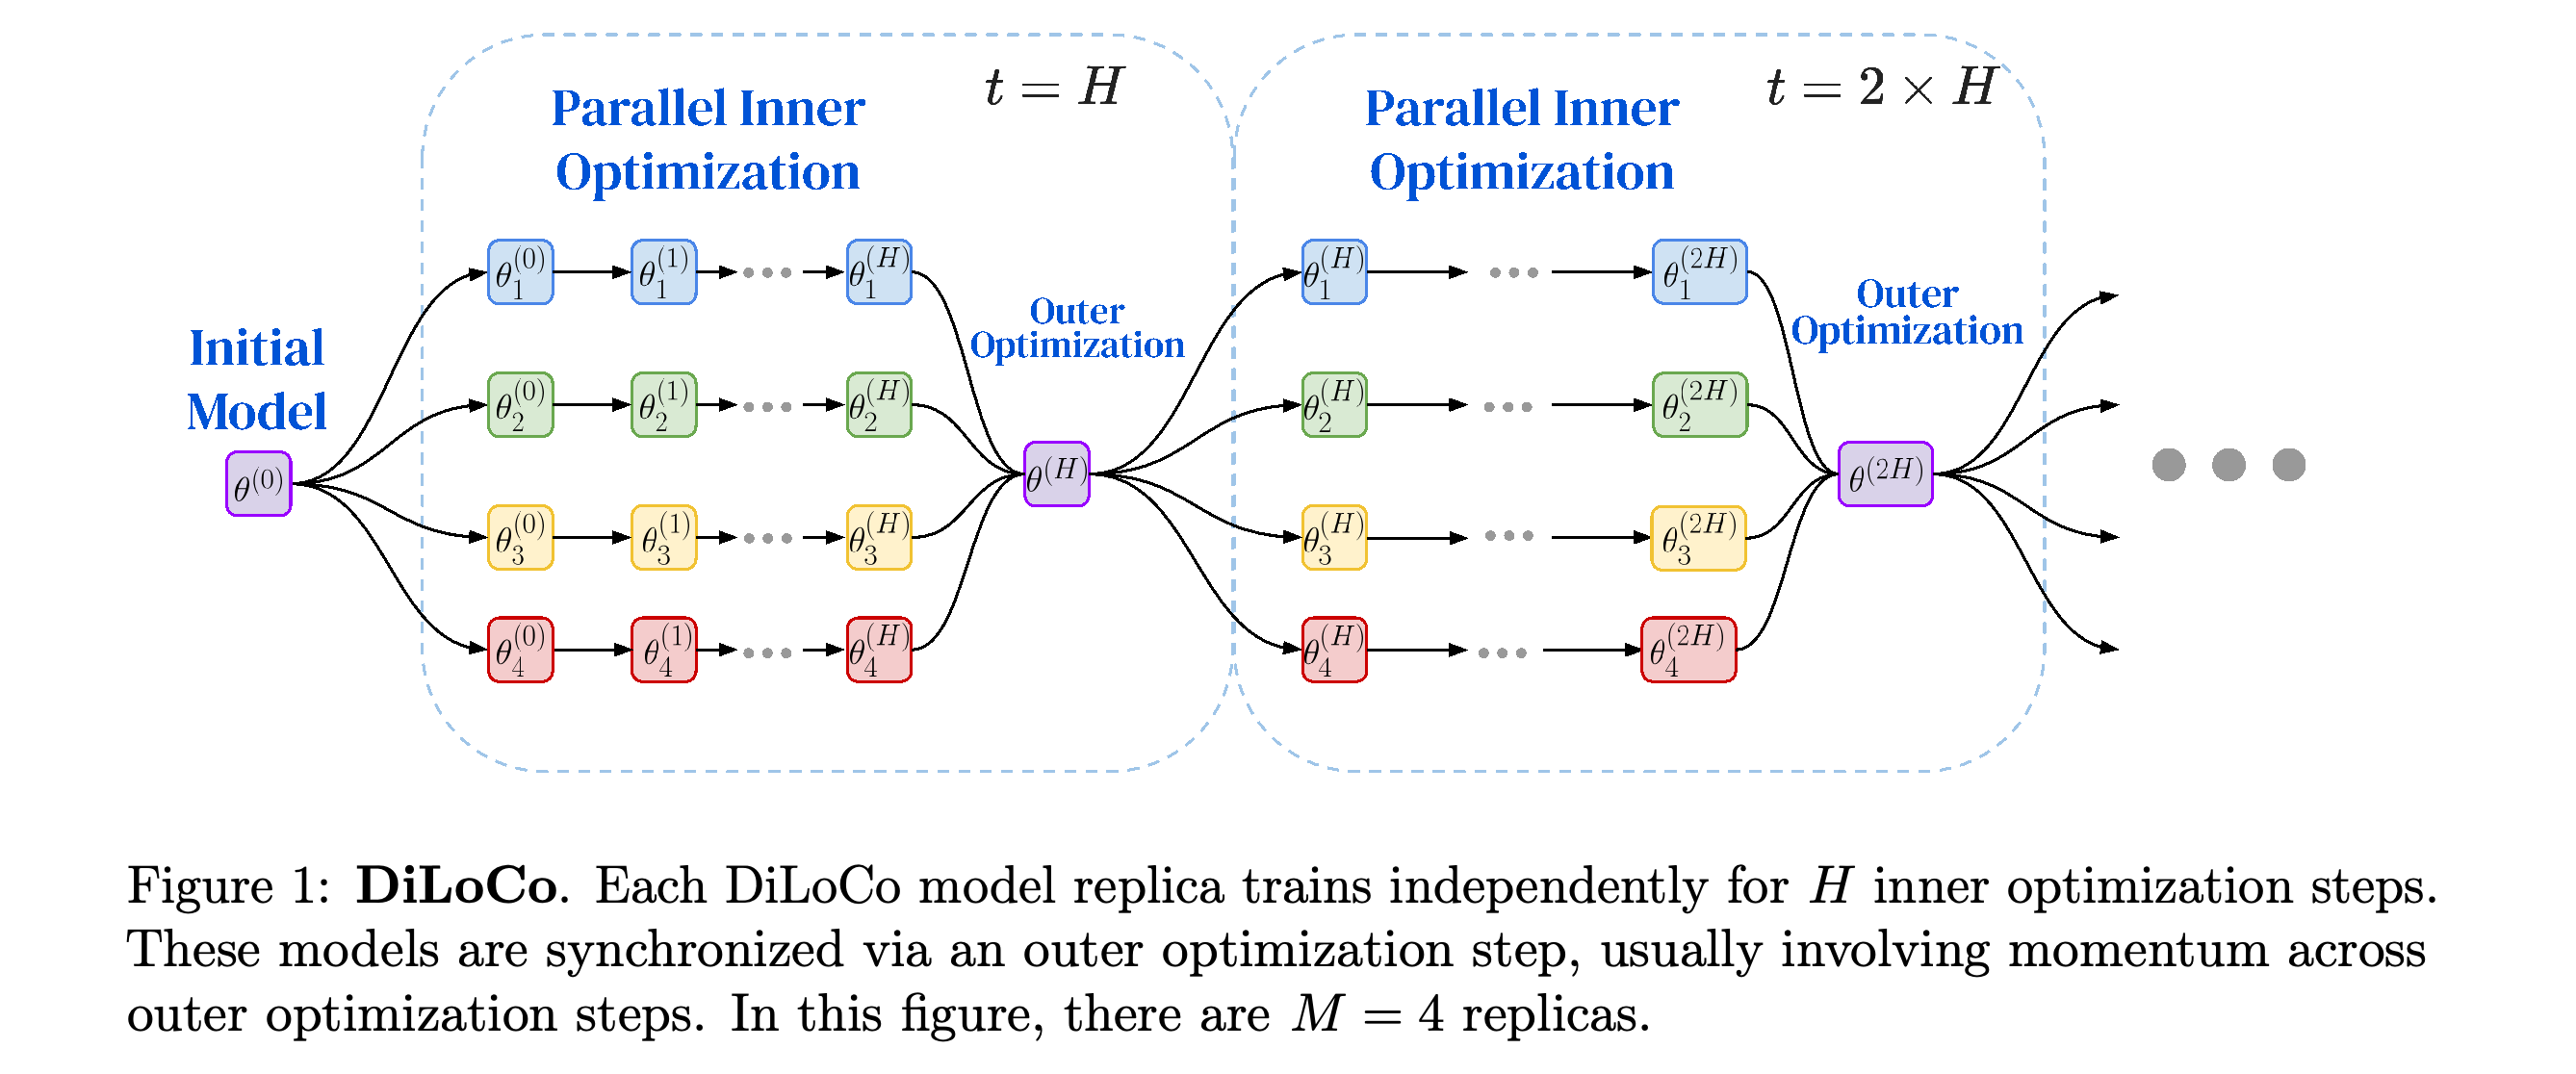
DiLoCo는 2단계로 최적화한다. 복제본마다 H번의 내부 스텝 동안 로컬 모델을 독립적으로 업데이트한 뒤 외부 옵티마이저로 동기화한다. 각 복제본은 이전 전역 모델과 현재 로컬 가중치의 차이를 계산한다. 이 차이를 평균한 뒤 외부 옵티마이저가 새로운 전역 모델을 만들고, 모든 복제본의 로컬 가중치를 이 모델의 가중치로 교체한다.
- 차이는 Δ_m^(t) = θ^(t−H) − θ_m^(t)이며, 평균은 Δ^(t) = (1/M) Σ_m Δ_m^(t)이다. 복제본은 동기화 라운드가 바뀌어도 내부 옵티마이저 상태를 유지한다.
- 저자들은 평균한 차이를 외부 기울기라고 부르지만, 일반적으로 어떤 함수의 기울기에 해당하지는 않는다고 명시한다.
독립적인 학습 경로 4개가 외부 업데이트 시점에 합쳐진다. 여러 로컬 스텝 동안 누적한 모델 차이를 동기화하므로, 통신 빈도뿐 아니라 최적화 경로도 달라진다.
2.2 Data-Parallel versus DiLoCo
Data-Parallel은 매 스텝 B개 토큰으로 기울기를 동기화하여 1회 업데이트한다. DiLoCo는 같은 전역 배치를 M개 복제본에 나누어 복제본마다 B/M개 토큰을 처리하고, H스텝마다 외부 업데이트를 적용한다.
- 비교에서는 N과 총 D를 고정한다. 평가에는 현재 Data-Parallel 모델과 가장 최근의 DiLoCo 전역 모델을 사용한다.
- M = 1이어도 DiLoCo는 외부 최적화를 수행한다. 이 경우 로컬에서 학습한 가중치로 느리게 변하는 모델을 주기적으로 업데이트하는 옵티마이저인 Lookahead의 변형이 된다. 이 연구의 설정에는 낮은 빈도로 수행하는 모멘텀 연산도 추가된다.
3 Experimental Methodology
실험에서는 다음 토큰을 예측하는 언어 모델인 Chinchilla 방식의 decoder-only Transformer를 처음부터 학습한다. 어휘 크기는 32,768이고 최대 시퀀스 길이는 2,048이다. 어텐션의 쿼리와 키를 정규화하는 QK-LayerNorm으로 학습률 민감도를 줄이고, z-loss 정규화 항으로 학습 안정성을 높인다.
- 대부분의 학습에는 텍스트 사전학습 데이터셋인 C4를 사용하고, 학습에서 제외한 검증 분할로 손실을 평가한다. 다운스트림 zero-shot 평가는 평가 시 과제 예시를 제공하지 않는 방식이며, HellaSwag 문장 완성, Piqa 물리적 상식 추론, Arc-Easy 질의응답을 포함한다.
- Data-Parallel과 DiLoCo의 내부 옵티마이저는 가중치 감쇠를 분리한 적응적 최적화 방법인 AdamW를 사용한다. 설정은 β₁ = 0.9, β₂ = 0.99, 워밍업 1000스텝, 최대 학습률의 5%까지 코사인 감쇠, 가중치 감쇠 T^−1, 내부 기울기 노름 클리핑 기준 1이다.
- 외부 옵티마이저는 외부 업데이트 사이에 정보를 유지하는 Nesterov 모멘텀 0.9를 적용한 확률적 경사하강법을 사용한다. η는 일정하게 유지하며 외부 기울기는 클리핑하지 않는다. 수정한 NanoDO 언어 모델 구현에서 복제본 병렬화에는 DrJAX를, 장치 간 업데이트 집계에는 all-reduce 연산을 사용한다. 가중치와 기울기는 bfloat16으로 표현하며, TPUv5e, TPUv6e, TPUv5 가속기를 사용한다.
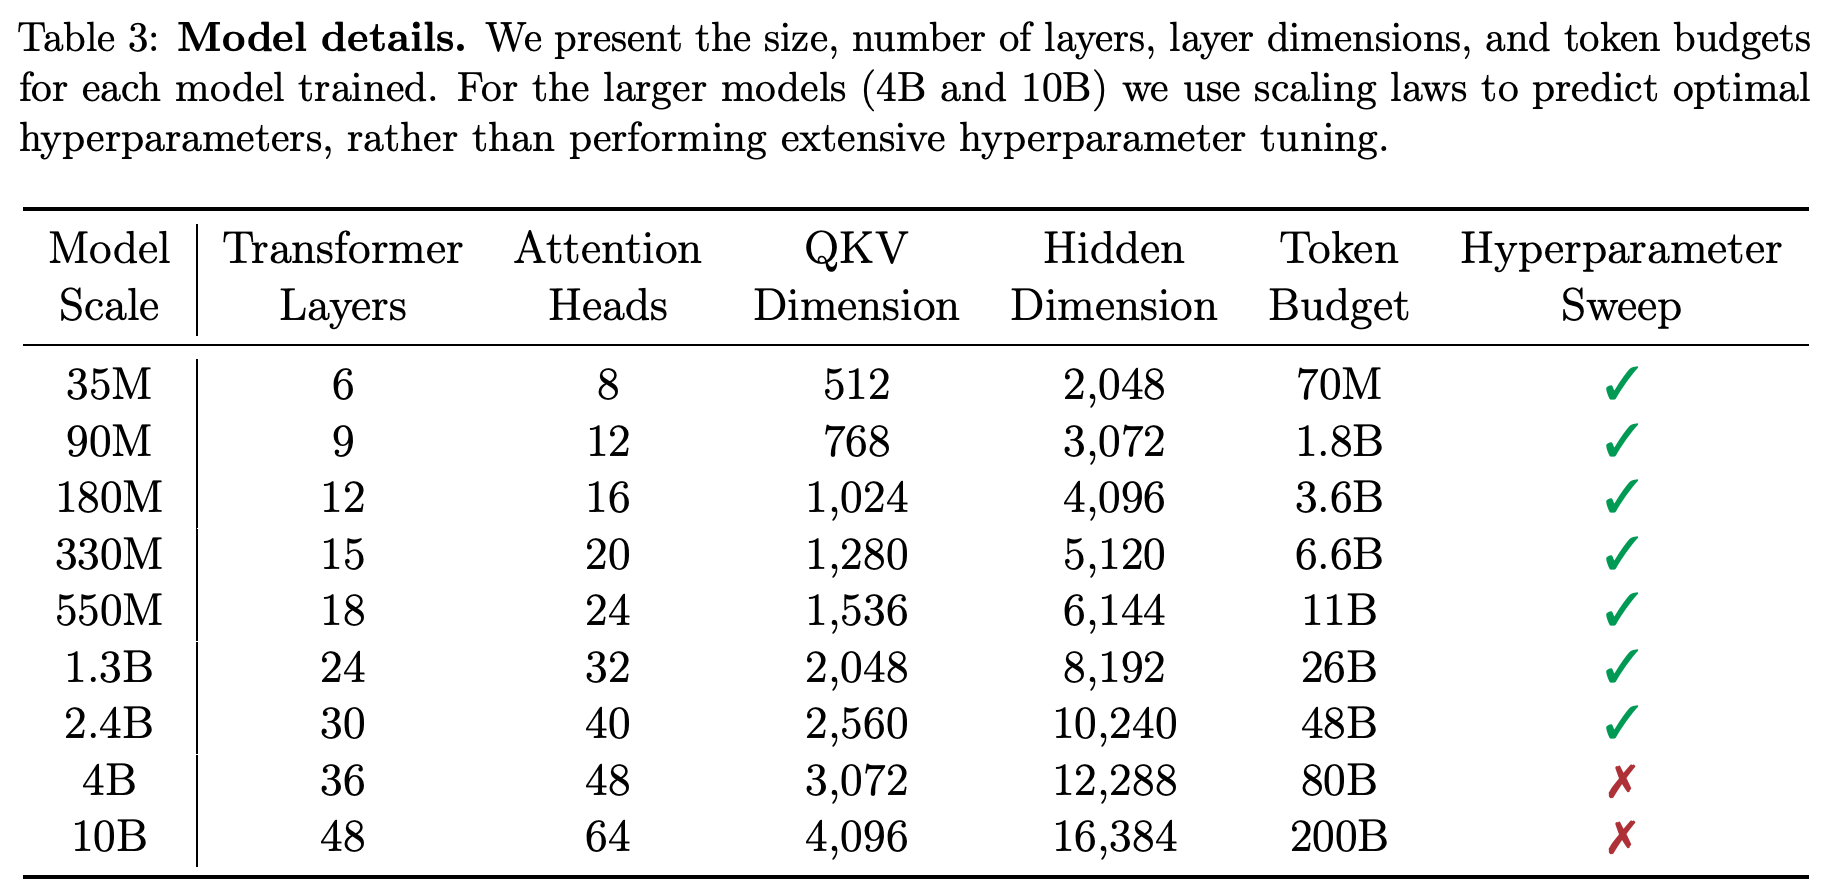
광범위한 튜닝에 사용한 모델과 4B 및 10B 외삽 실험에 사용한 모델을 구분한다. 35M 모델의 토큰 예산 항목과 330M 모델 표기는 기본 토큰 배분 및 이후 표기와 달라, 해당 항목을 해석할 때 이 불일치를 고려해야 한다.
3.1 Scaling Law Experiments
하이퍼파라미터 탐색은 35M부터 2.4B 파라미터 모델까지 수행한다. γ에는 √2의 정수 거듭제곱을, B에는 2의 거듭제곱을 사용한다. DiLoCo에서는 M ∈ {1,2,4,8}과 η ∈ {0.2,0.4,0.6,0.8,1.0}도 탐색한다. 최저 손실이 탐색 격자의 내부 지점에 놓일 때까지 범위를 확장한다.
- 4B와 10B 모델은 광범위한 탐색 대신 예측한 하이퍼파라미터를 사용하며, 토큰 예산은 각각 80B와 200B이다.
- 명시된 기본값 D = 20N에 따르면 N을 고정한 상태에서 B를 2배로 늘리면 학습 스텝 수는 절반이 된다. 그러나 Table 3은 35M 모델의 토큰 수를 70M으로 기재하고, 이후 결과에서 335M으로 표기한 중간 크기 모델을 330M으로 표기한다. 이는 원문의 불일치다.
4 Empirical Findings
발견 1은 모델 규모에 따른 개선이다. Data-Parallel 대비 DiLoCo의 손실은 대체로 모델이 커질수록 개선된다. 다만 작은 모델에서는 복제본을 여러 개 사용하면 손실이 소폭 증가하는 경우가 많다. 2.4B에서 복제본 2개를 사용하는 DiLoCo의 손실은 2.323으로 Data-Parallel의 2.326보다 낮다. 복제본 4개와 8개에서는 각각 2.332와 2.351로 여전히 더 높다.
- Table 5에서는 scaling law로 정한 하이퍼파라미터를 사용할 때 4B와 10B에서 M = 1과 M = 2의 손실이 더 낮지만, M = 4의 손실은 여전히 약간 높다.
- 품질 이점은 모델 크기, 복제본 수, 선택한 하이퍼파라미터에 따라 달라진다.
절대 손실은 서로 비슷하지만, 상대 손실 패널에서는 복제본을 여러 개 사용할 때 발생하는 손실 증가 폭이 모델 규모에 따라 줄어든다. 복제본 2개를 사용하는 곡선은 튜닝한 가장 큰 모델에서 Data-Parallel 베이스라인 아래로 내려간다.
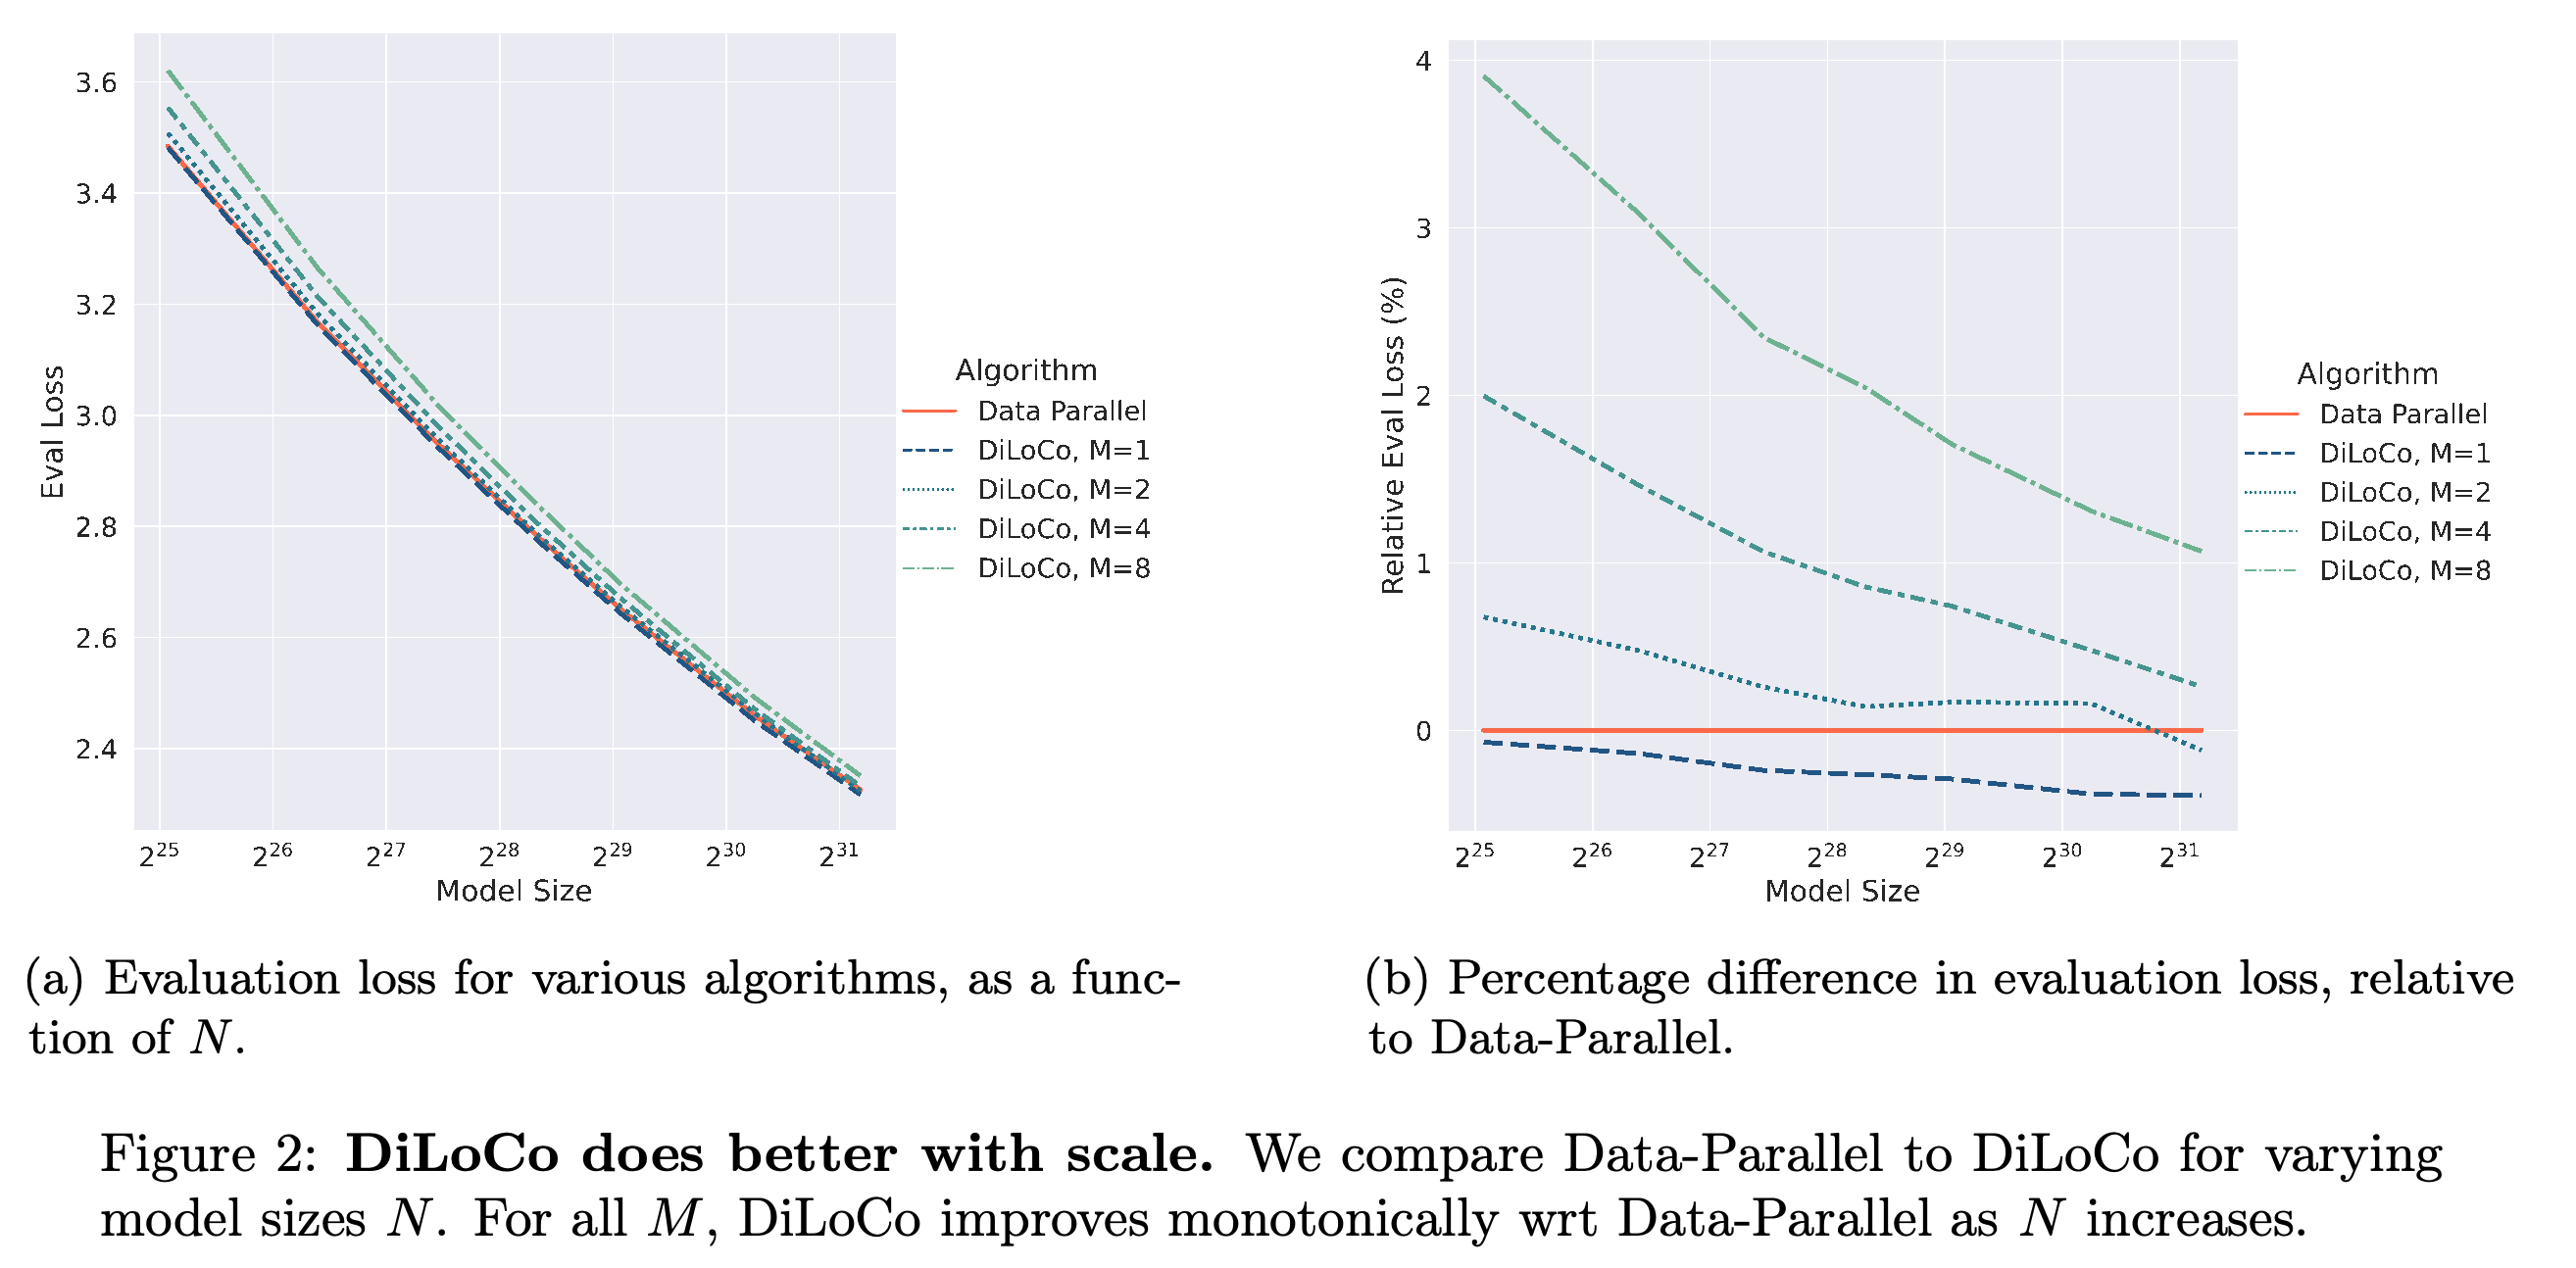
M = 1의 일관된 소폭 이점과 더 큰 M에서 규모에 따라 달라지는 절충 관계를 구분할 수 있다. 2.4B에서 M = 2는 손실을 2.326에서 2.323으로 줄이지만, M = 4와 M = 8은 여전히 손실이 더 높다.
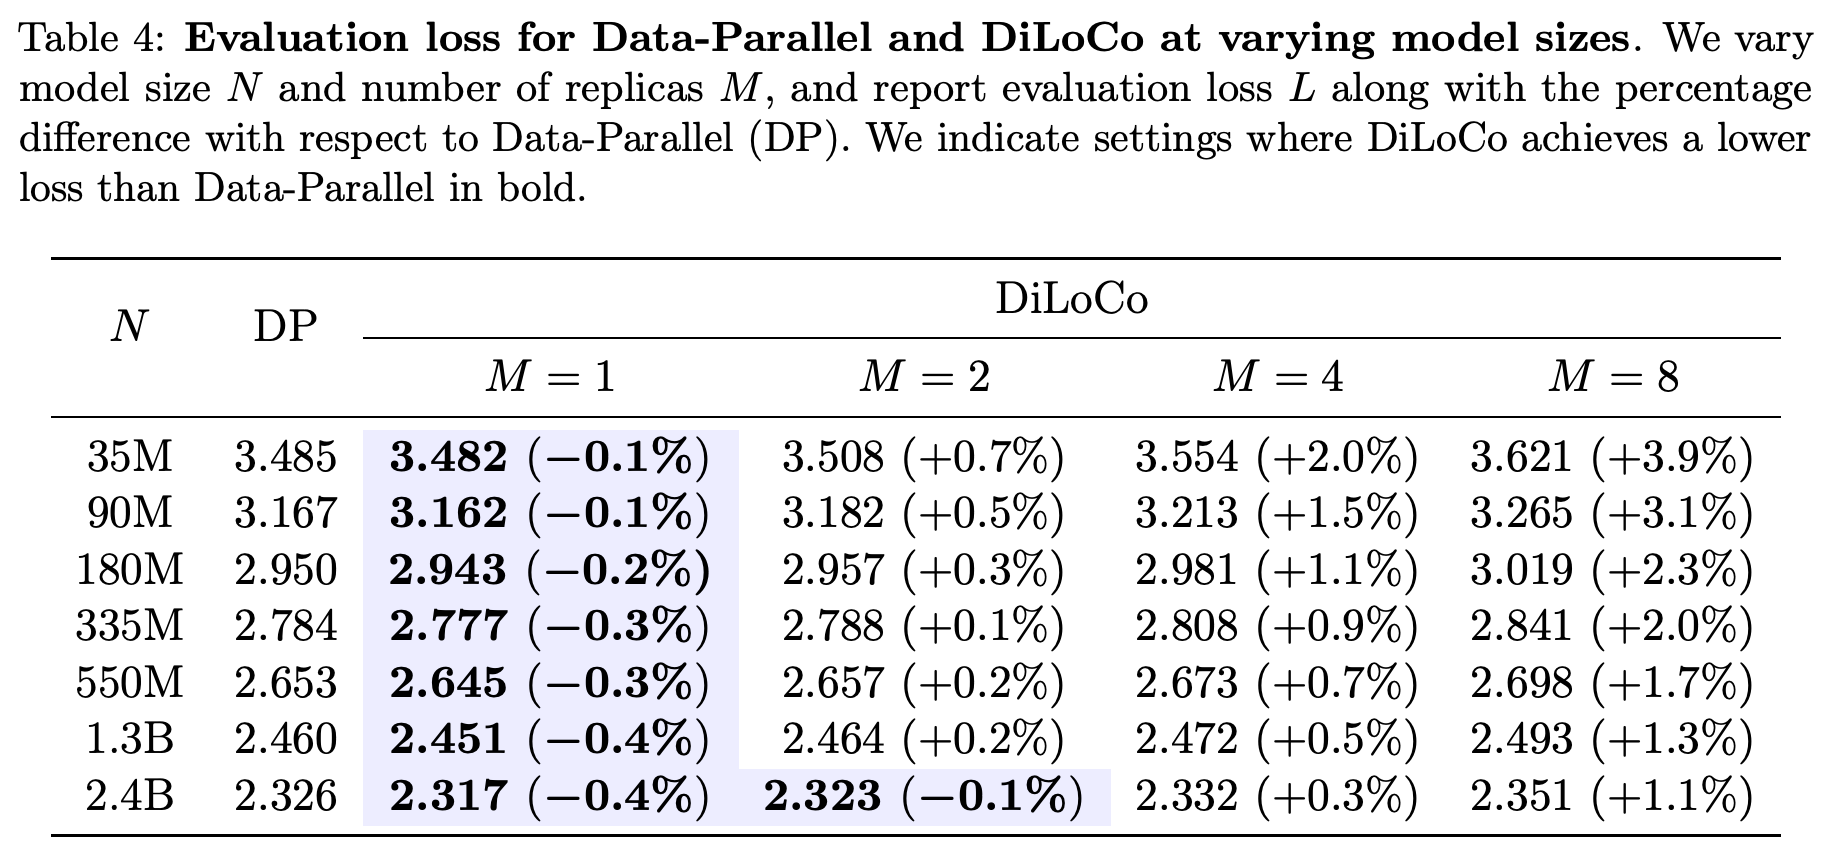
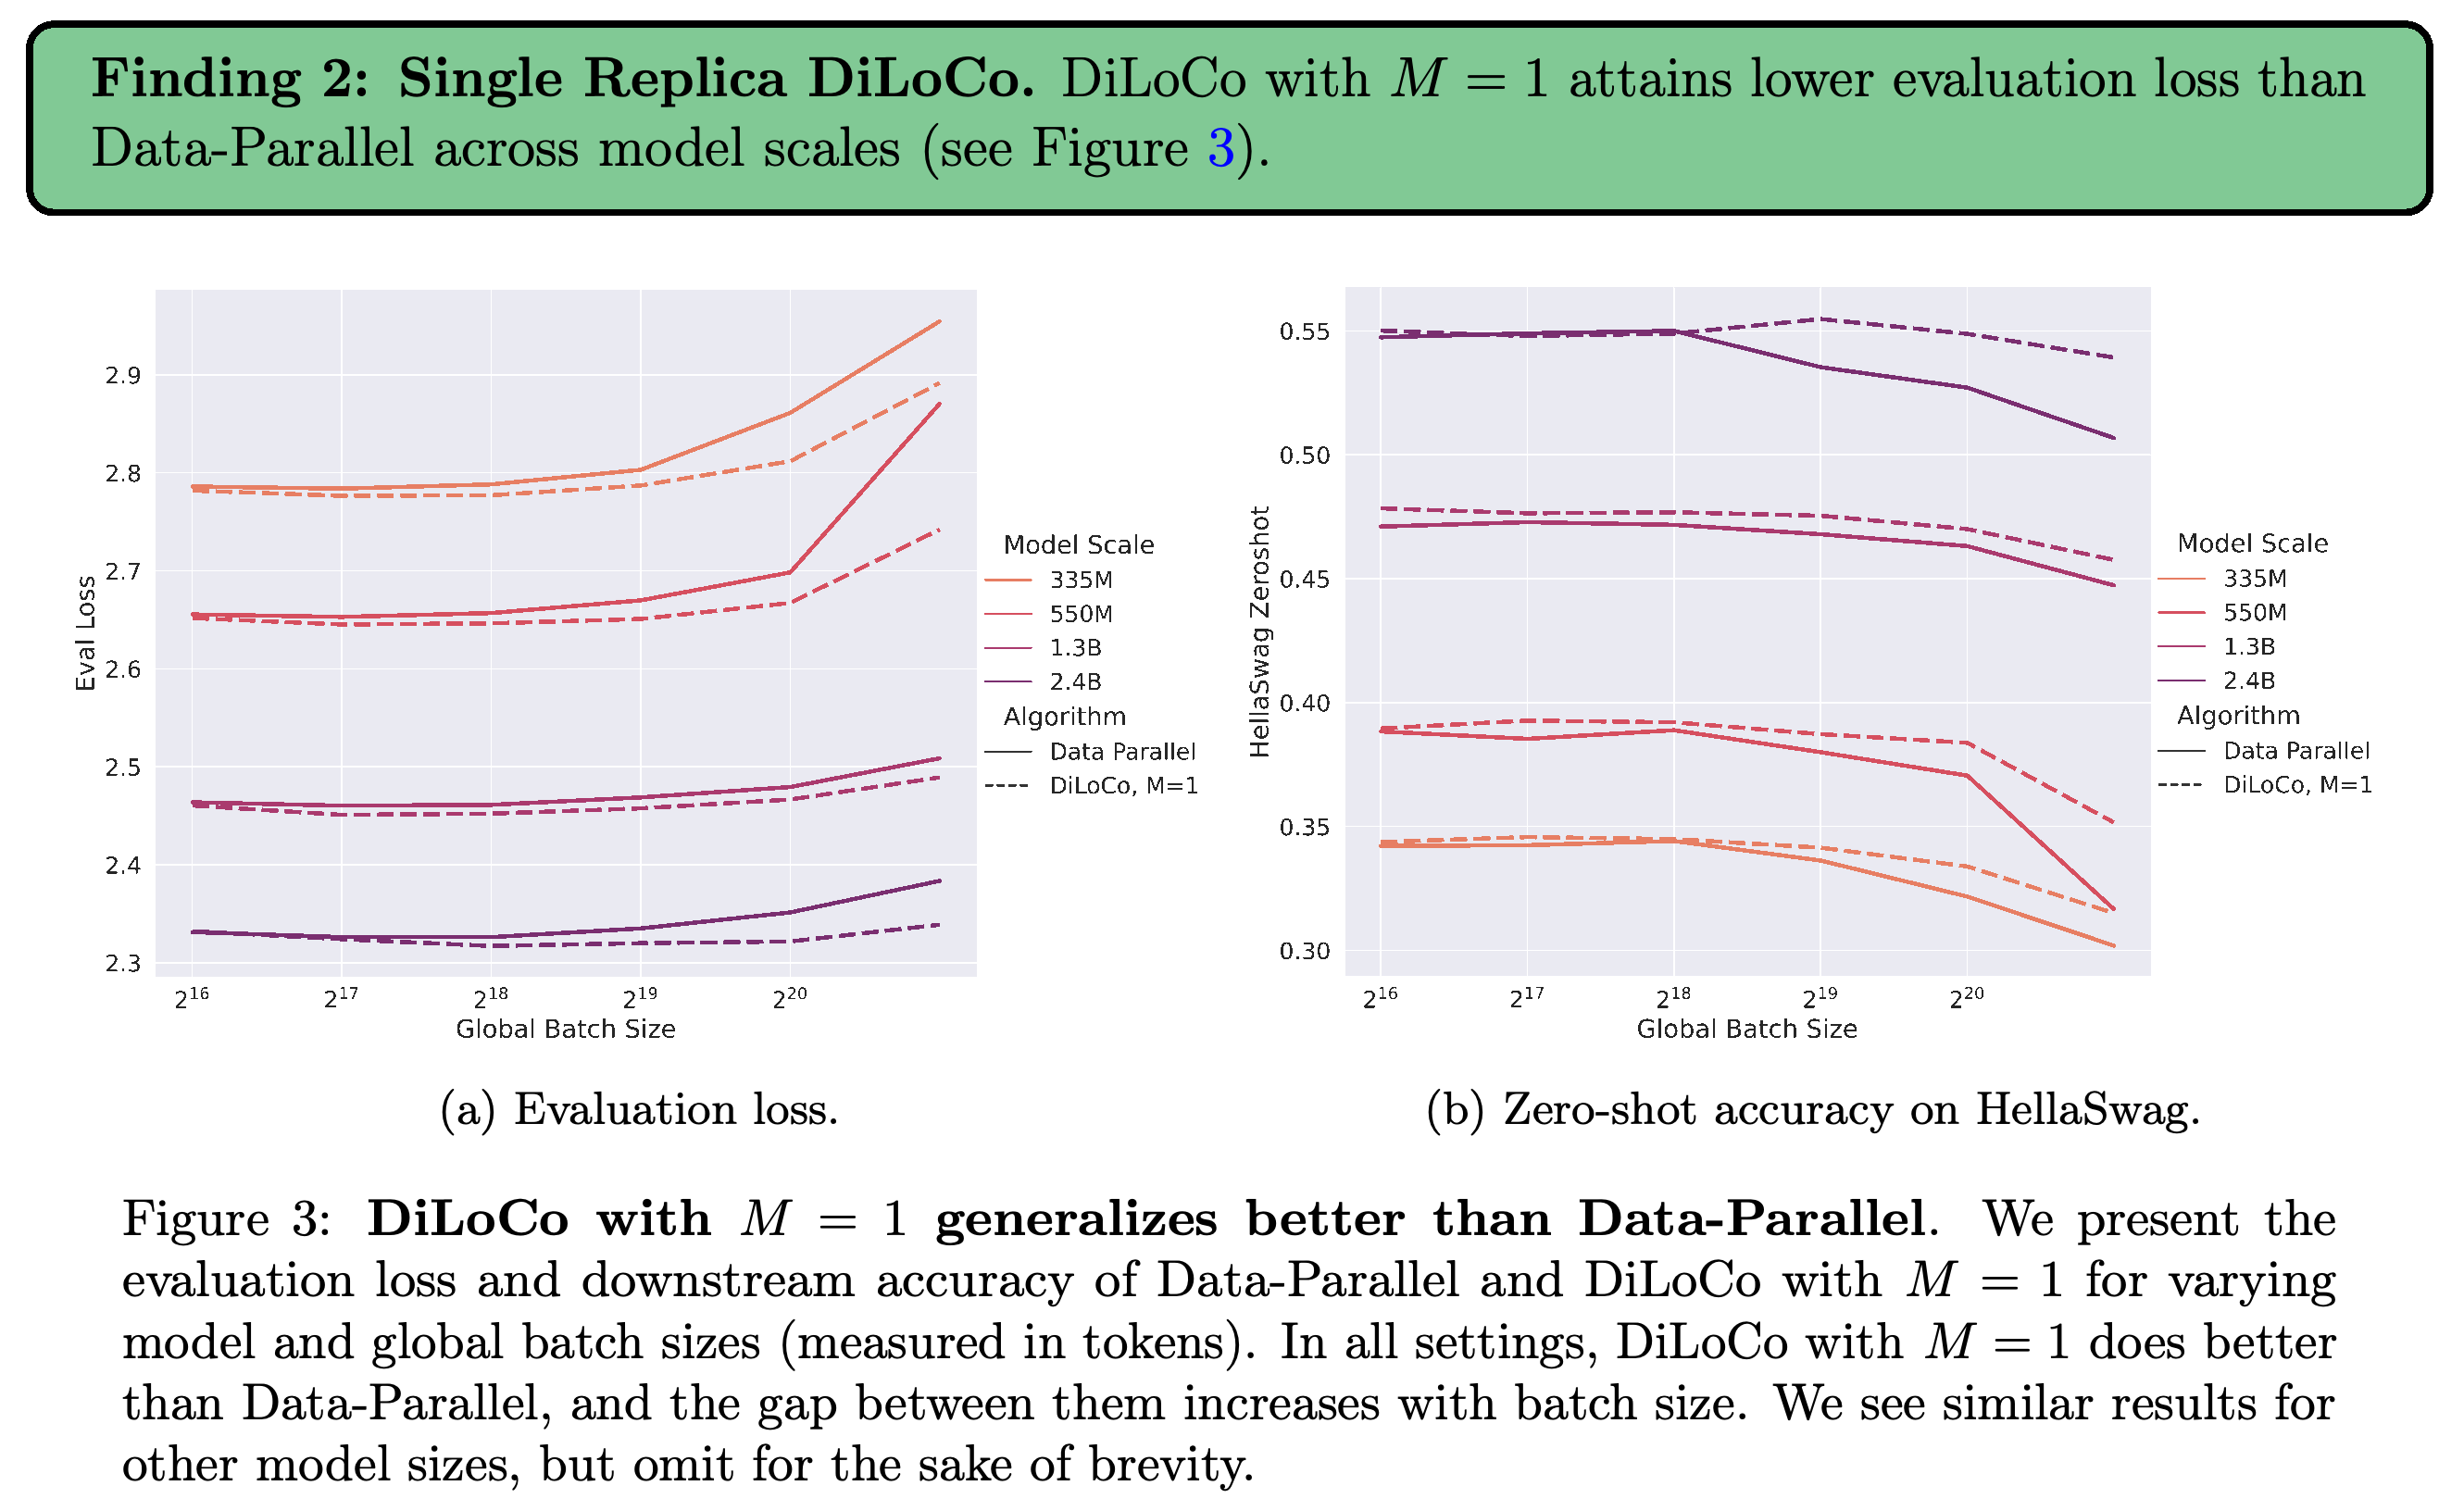
발견 2는 단일 복제본 DiLoCo의 이점이다. 광범위하게 튜닝한 범위에서는 보고된 모든 모델 크기에서 M = 1의 최저 손실이 더 낮다. 35M에서는 3.482로 Data-Parallel의 3.485보다 낮고, 2.4B에서는 2.317로 2.326보다 낮다. 배치 크기가 커질 때 손실과 HellaSwag 정확도의 악화 폭도 작다. 이는 통신 감소 없이도 최적화 이점이 있음을 보여준다.
단일 복제본 비교는 통신 감소 없이도 큰 배치에서의 성능이 개선됨을 보여준다. 큰 배치에서 Data-Parallel의 손실이 증가하고 HellaSwag 정확도가 떨어지는 구간에서 차이가 특히 뚜렷하다.
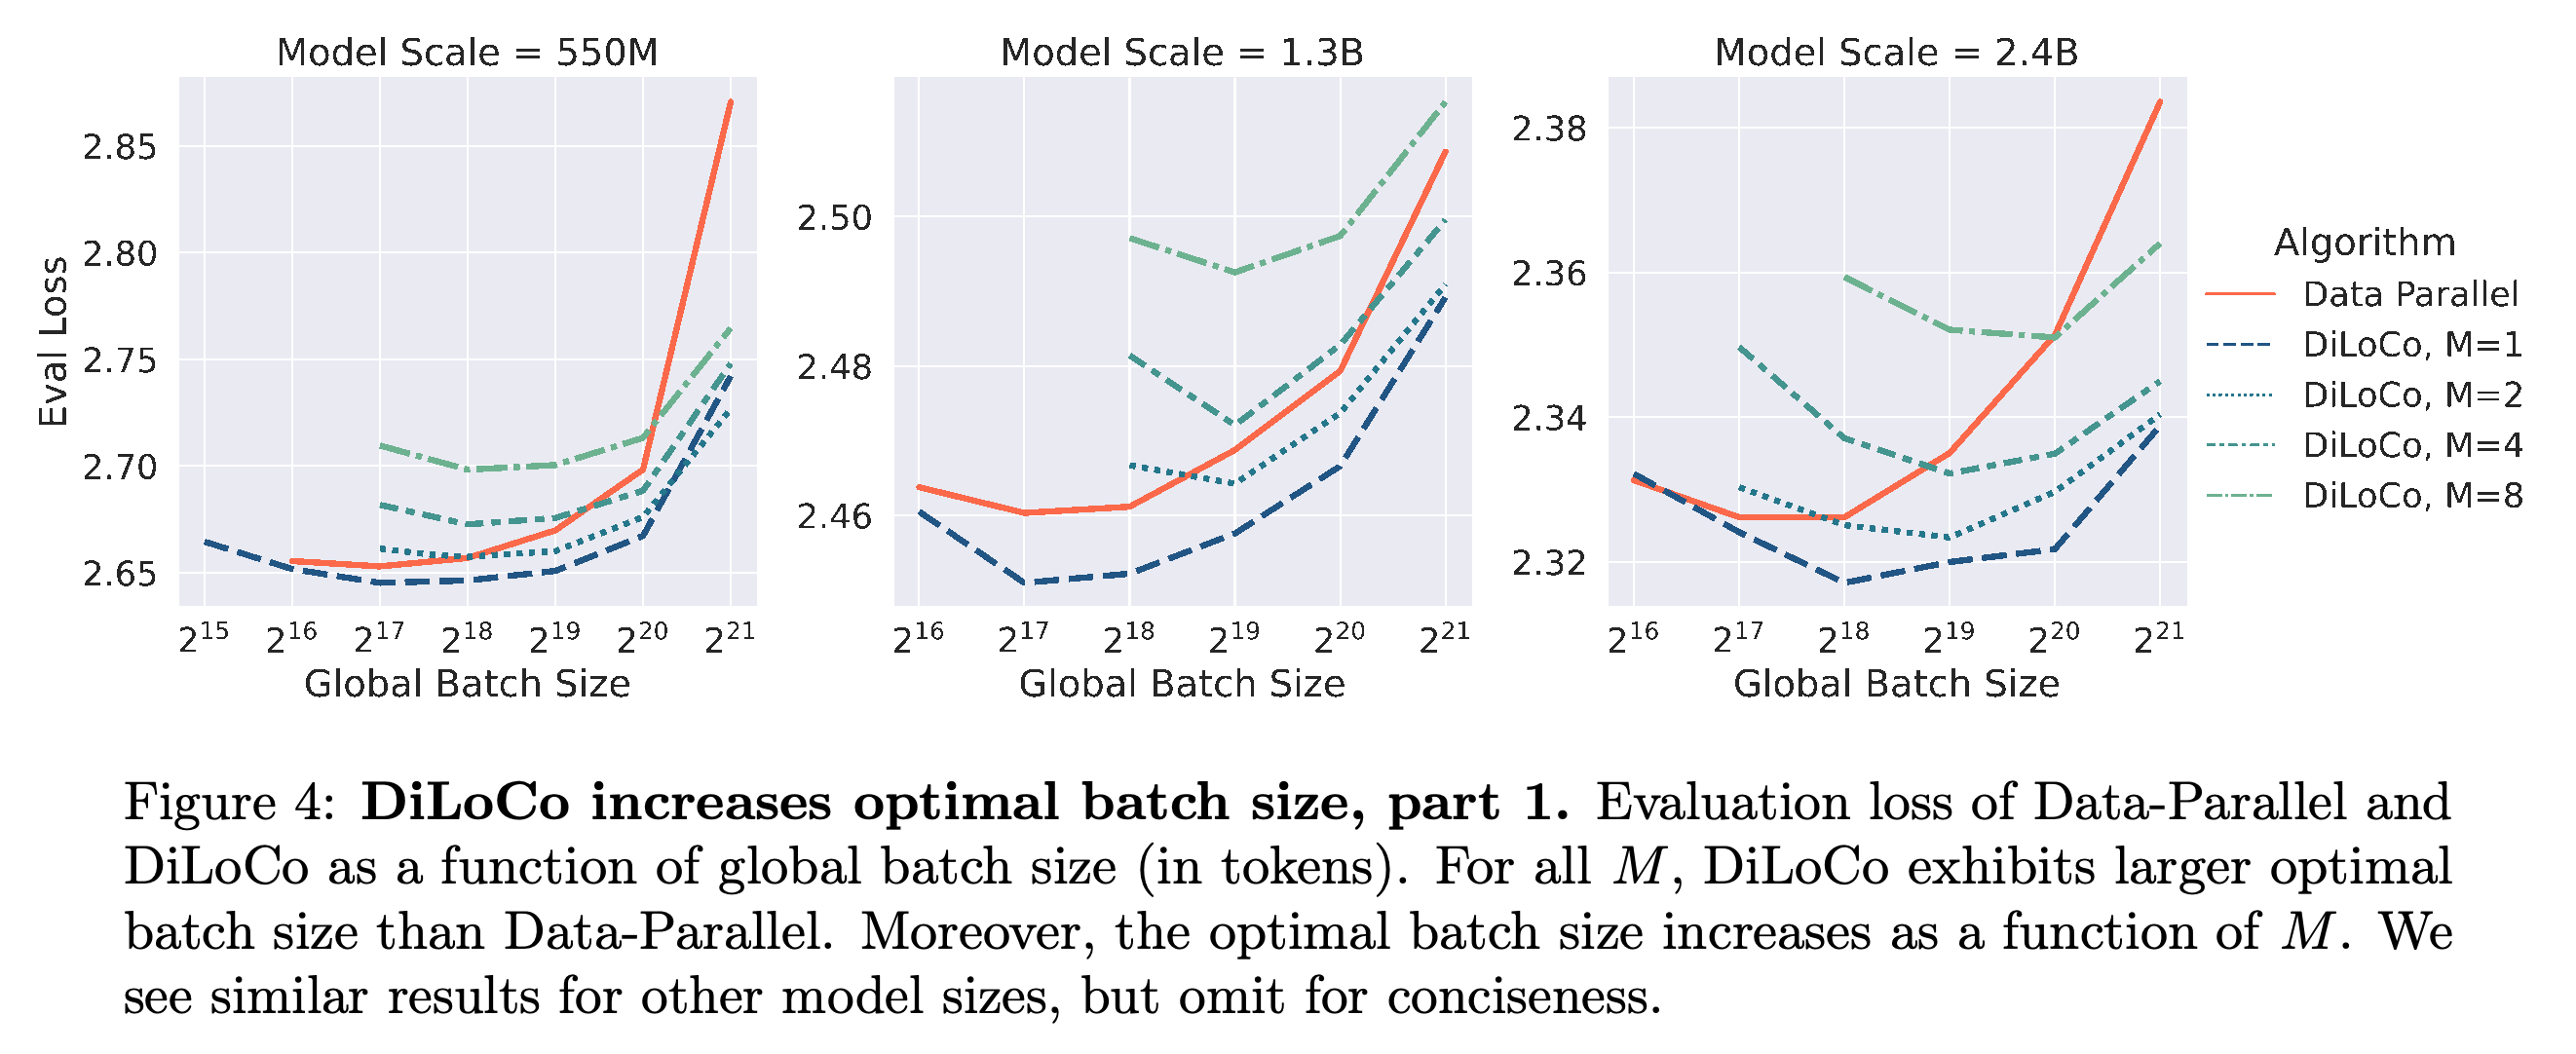
발견 3은 최적 배치 크기의 증가다. DiLoCo에서는 최적 전역 배치 크기가 커지며, 대체로 복제본 수가 많을수록 더 큰 배치를 사용할 수 있다. 토큰 예산을 고정하면 순차적으로 수행할 학습 스텝 수를 줄이고 수평 확장성을 높일 수 있다. 즉, 더 많은 연산을 동시에 실행할 수 있다.
- Figures 4와 5에서는 큰 배치에서 Data-Parallel의 품질이 더 빠르게 저하된다. 따라서 M > 1인 DiLoCo는 모든 배치 중 달성 가능한 최저 손실이 더 높더라도, 큰 배치에서는 Data-Parallel보다 우수할 수 있다.
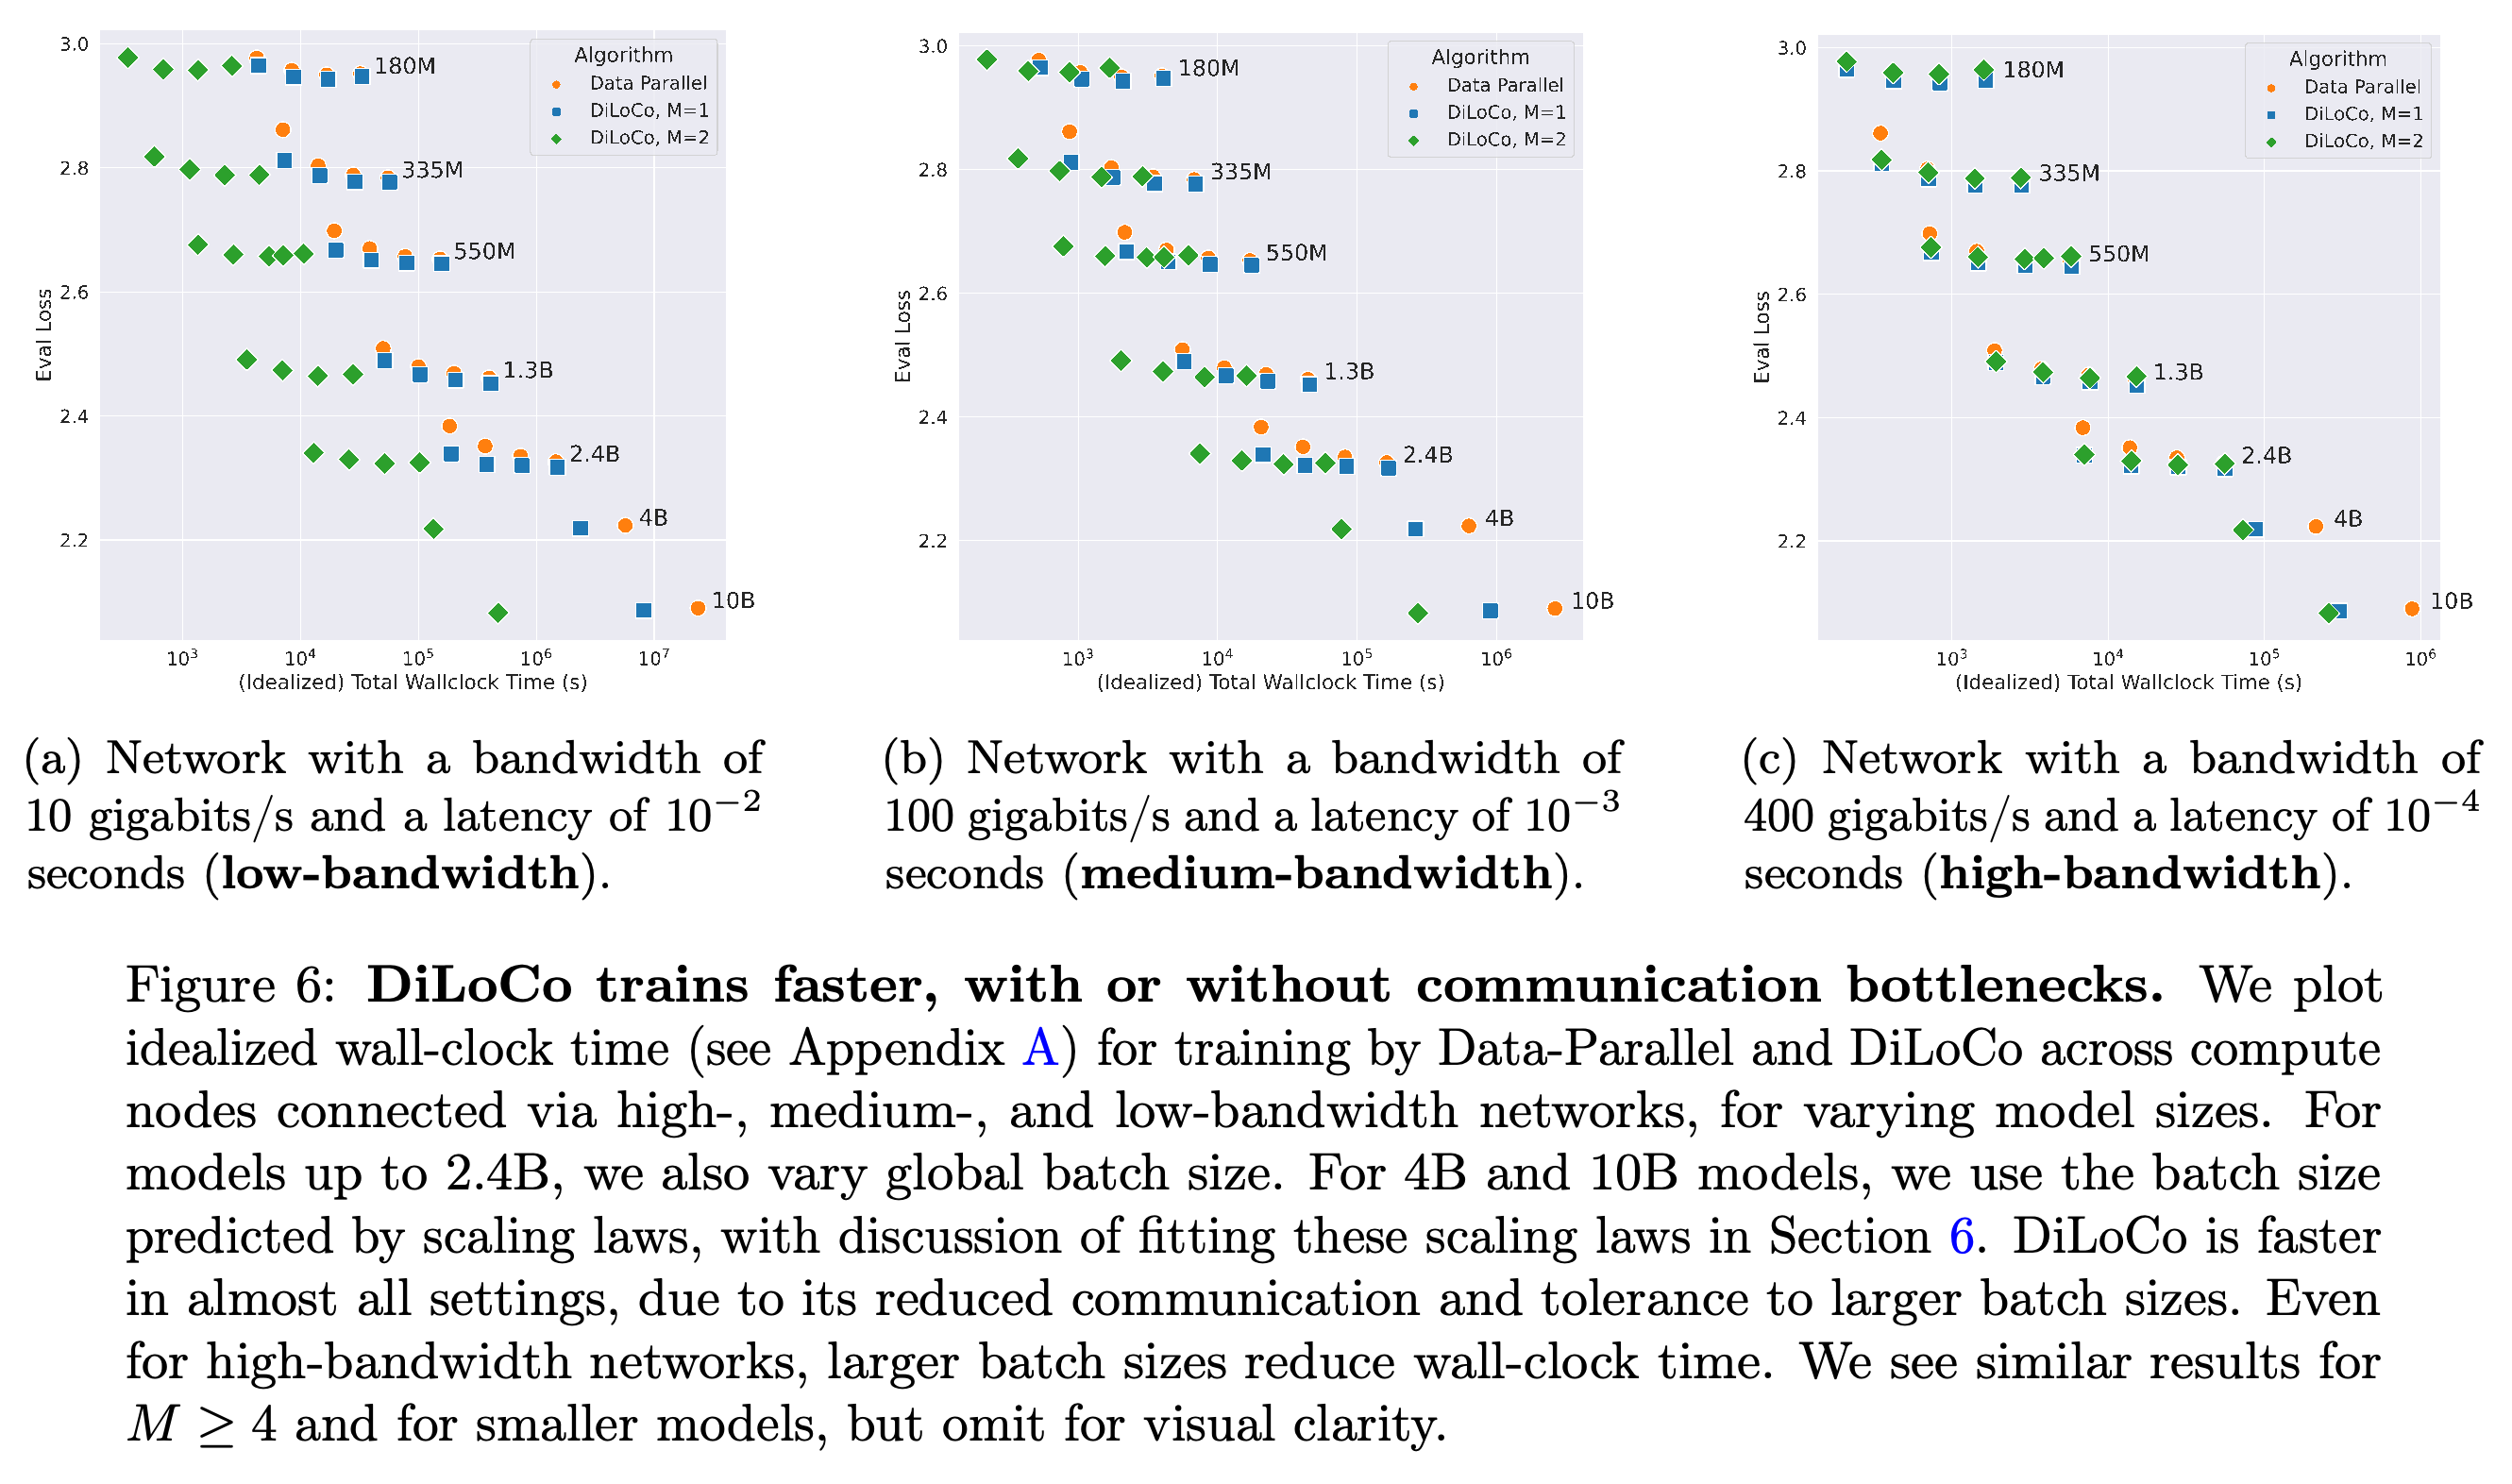
- Figure 6은 대역폭 10 gigabits/s와 지연 시간 10^−2초, 100 gigabits/s와 10^−3초, 400 gigabits/s와 10^−4초인 네트워크에서 학습 경과 시간이 짧아질 것으로 예측한다. 이 예측은 배치 크기가 커질수록 추가 칩을 사용할 수 있다고 가정한다.
복제본을 추가하면 대체로 최저 손실 지점이 더 큰 전역 배치 쪽으로 이동한다. 복제본이 많은 곡선은 최저 손실이 더 높아도 실제 사용하는 배치가 클 때는 유리할 수 있다. 이는 최상의 품질과 추가 병렬화에 대한 내성을 구분해 보여준다.
DiLoCo의 점은 손실이 비슷한 Data-Parallel의 점보다 왼쪽에 놓이는 경우가 많으며, 대역폭이 제한될 때 특히 그렇다. 이 위치는 측정한 평가 손실과 모델로 계산한 경과 시간을 결합한 결과이므로, 예측한 속도 향상은 명시된 네트워크와 자원 가정에 의존한다.
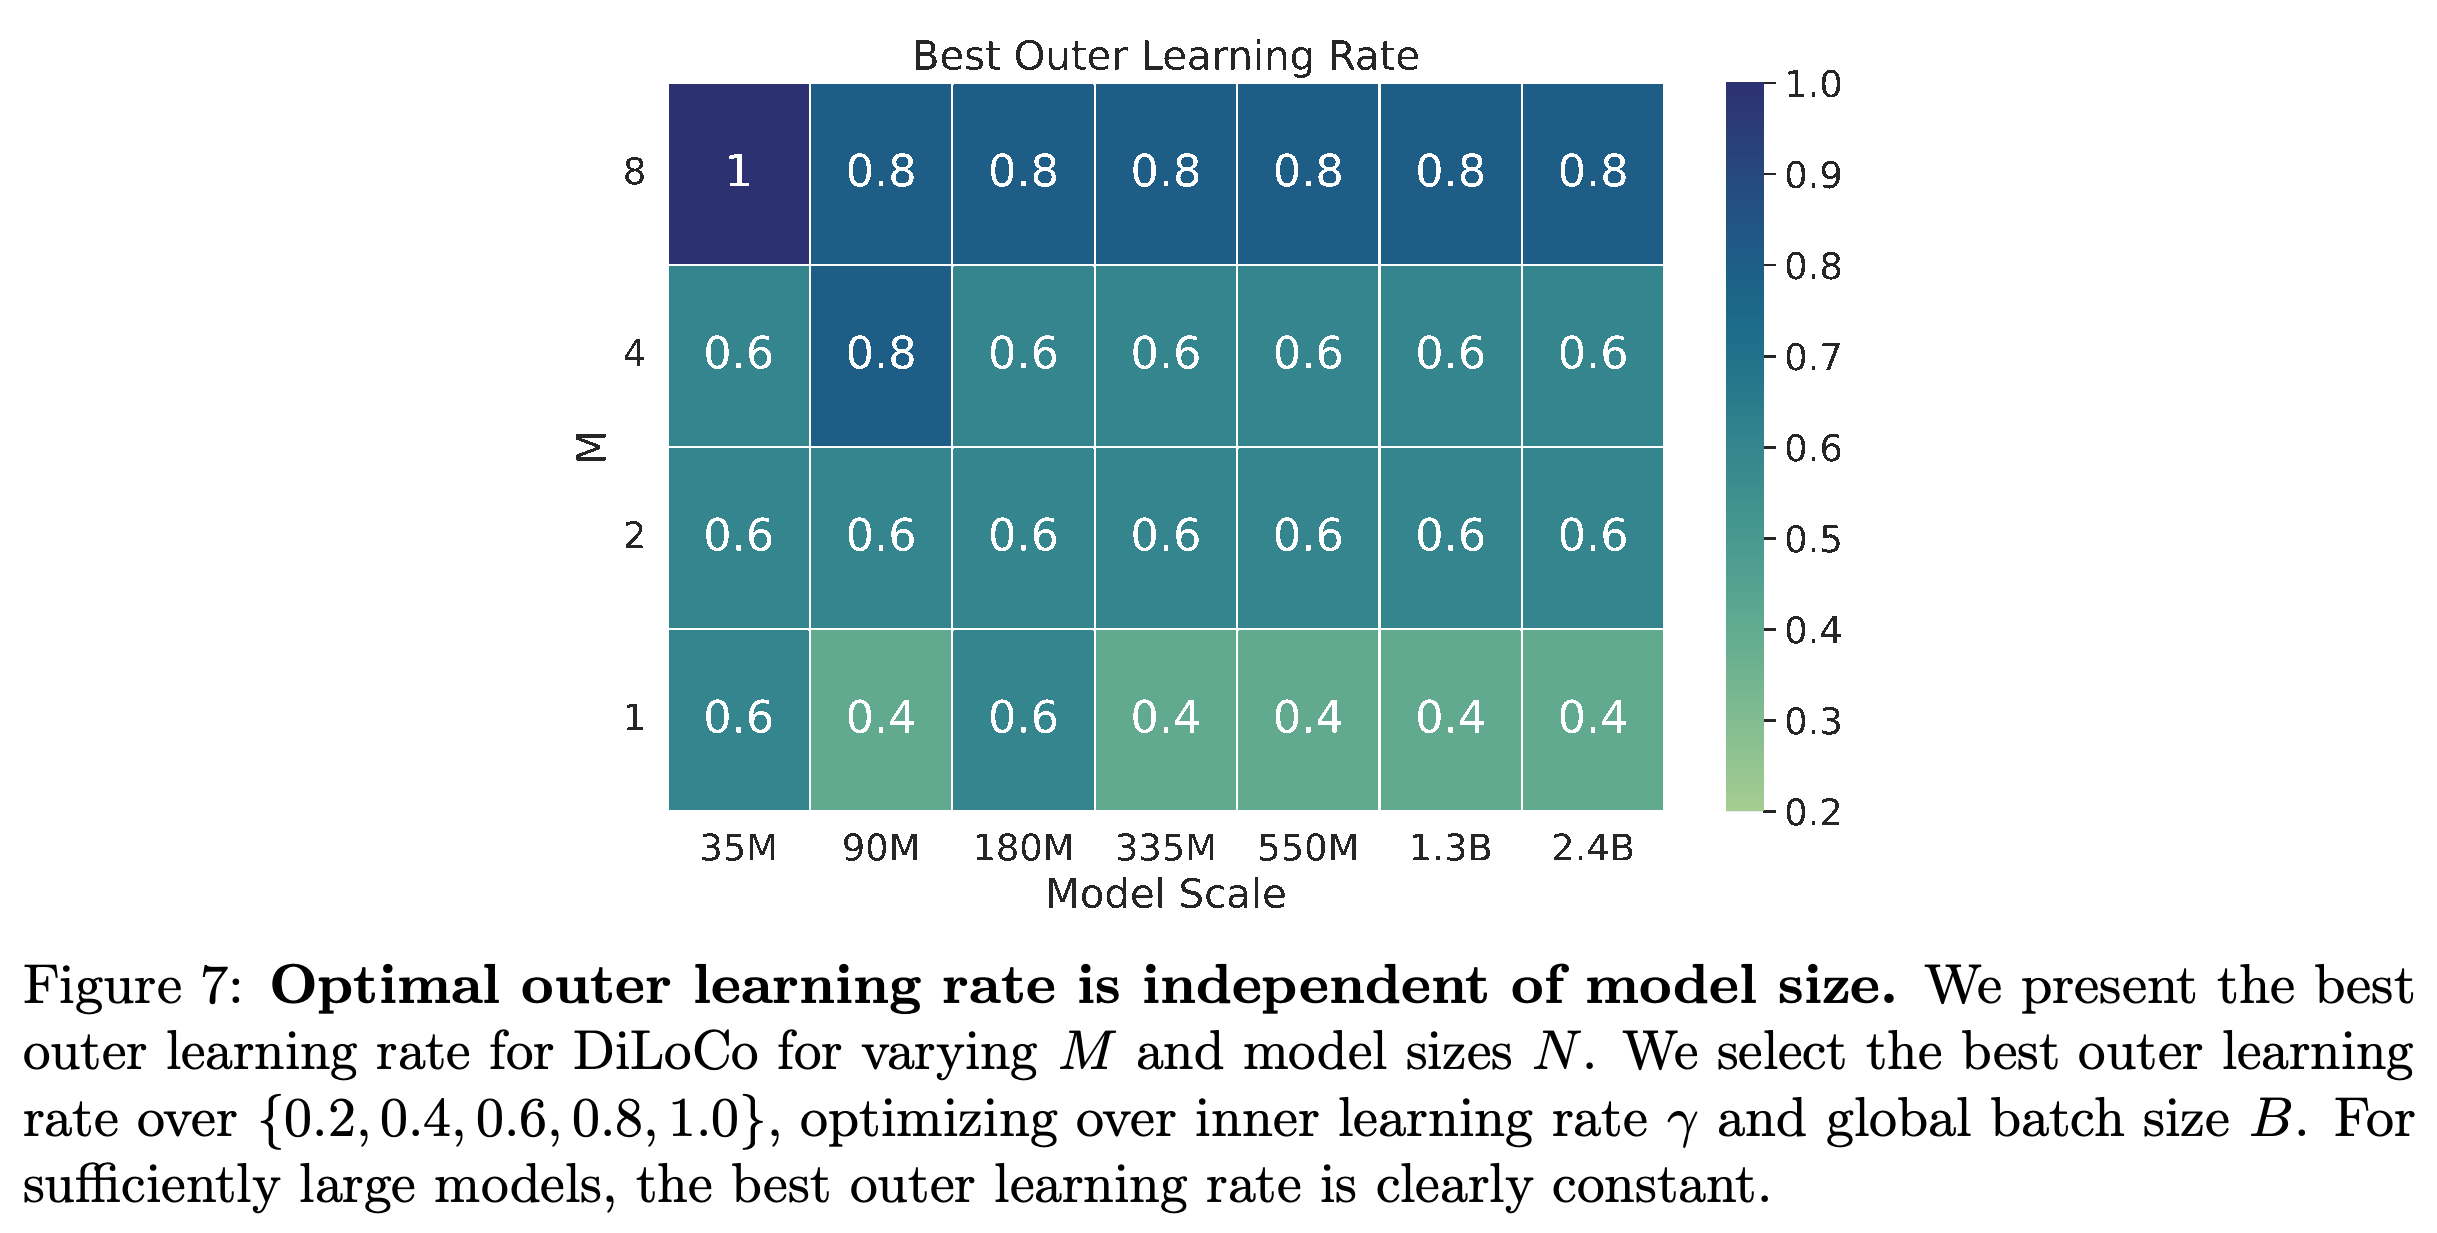
발견 4는 외부 학습률의 특성이다. N ≥ 335M이고 H = 30일 때, 시험한 설정 중 최적인 η는 모델 크기가 달라져도 일정하다. M = 1에서는 0.4, M = 2와 M = 4에서는 0.6, M = 8에서는 0.8이다. 이는 작은 모델에서 η를 선택하고 내부 학습률과 배치 크기는 별도로 확장하는 방식을 뒷받침한다.
335M부터는 복제본 수별 각 행에서 모델 크기가 달라져도 선택한 외부 학습률이 같다. 이 히트맵은 시험한 격자 안에서 M에 따른 차이를 유지하면서 해당 설정을 N이 다른 모델로 이전할 수 있음을 뒷받침한다.
5 Ablations
추가 비교 실험에서는 동기화 빈도를 바꾸거나 기본 배분보다 많은 토큰을 학습할 때도 주요 결과가 유지되는지 확인한다. 최적화 동작과 시뮬레이션한 통신 요구량을 함께 살펴본다.
5.1 Synchronization Cadence
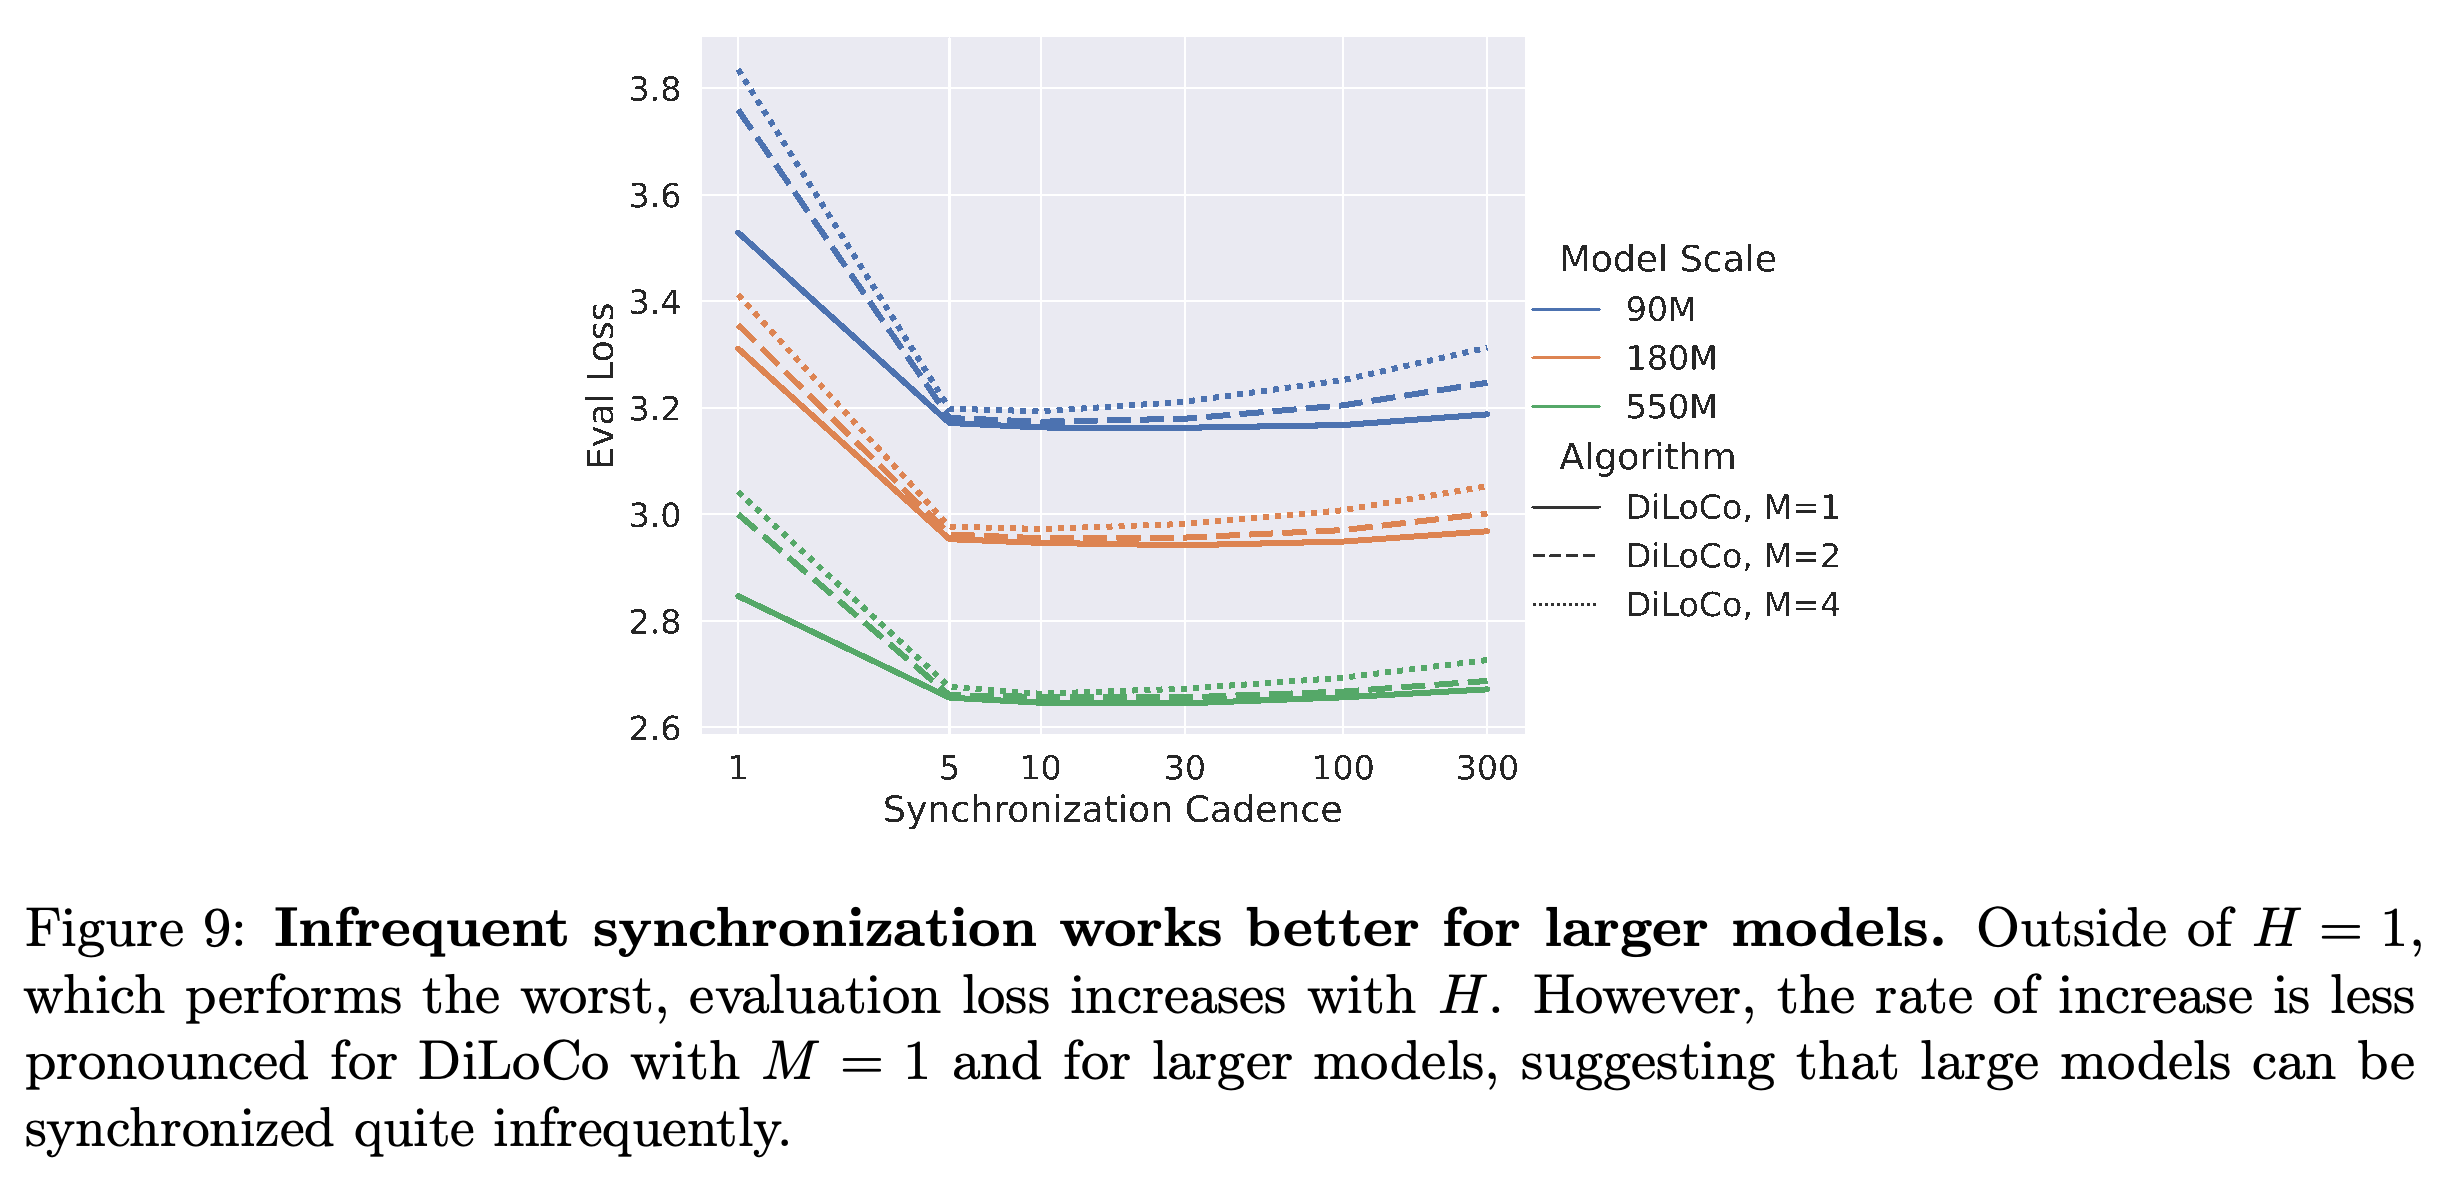
동기화 실험에서는 이전에 선택한 내부 학습률과 전역 배치 크기를 유지한 채 H ∈ {1,5,10,30,100,300}과 η ∈ {0.05,0.1,0.2,0.4,0.6,0.8,1.0}을 탐색한다. 최적 외부 학습률은 H와 M이 커질수록 증가하지만, N에는 대체로 무관하다.
- 이 실험 절차에서는 H = 1의 성능이 가장 낮다. 이 설정을 제외하면 H가 커질수록 손실이 증가하는 경향이 있지만, 모델이 크거나 M = 1일 때는 증가 폭이 작다.
- 각 H에 맞춰 내부 학습률과 배치 크기를 다시 튜닝하지 않았으므로, 이 곡선은 선택한 설정이 다른 동기화 주기에서도 얼마나 잘 작동하는지 보여준다. 각 주기에서 모든 설정을 최적화한 성능을 나타내지는 않는다.
이전한 내부 설정을 사용할 때 매 스텝 동기화하면 손실이 특히 높다. 짧은 간격의 구간을 지나 동기화 간격을 더 늘릴 때는 큰 모델의 손실 증가 폭이 작다. 다만 이 실험은 각 주기에서 모든 하이퍼파라미터를 다시 튜닝하지 않는다.
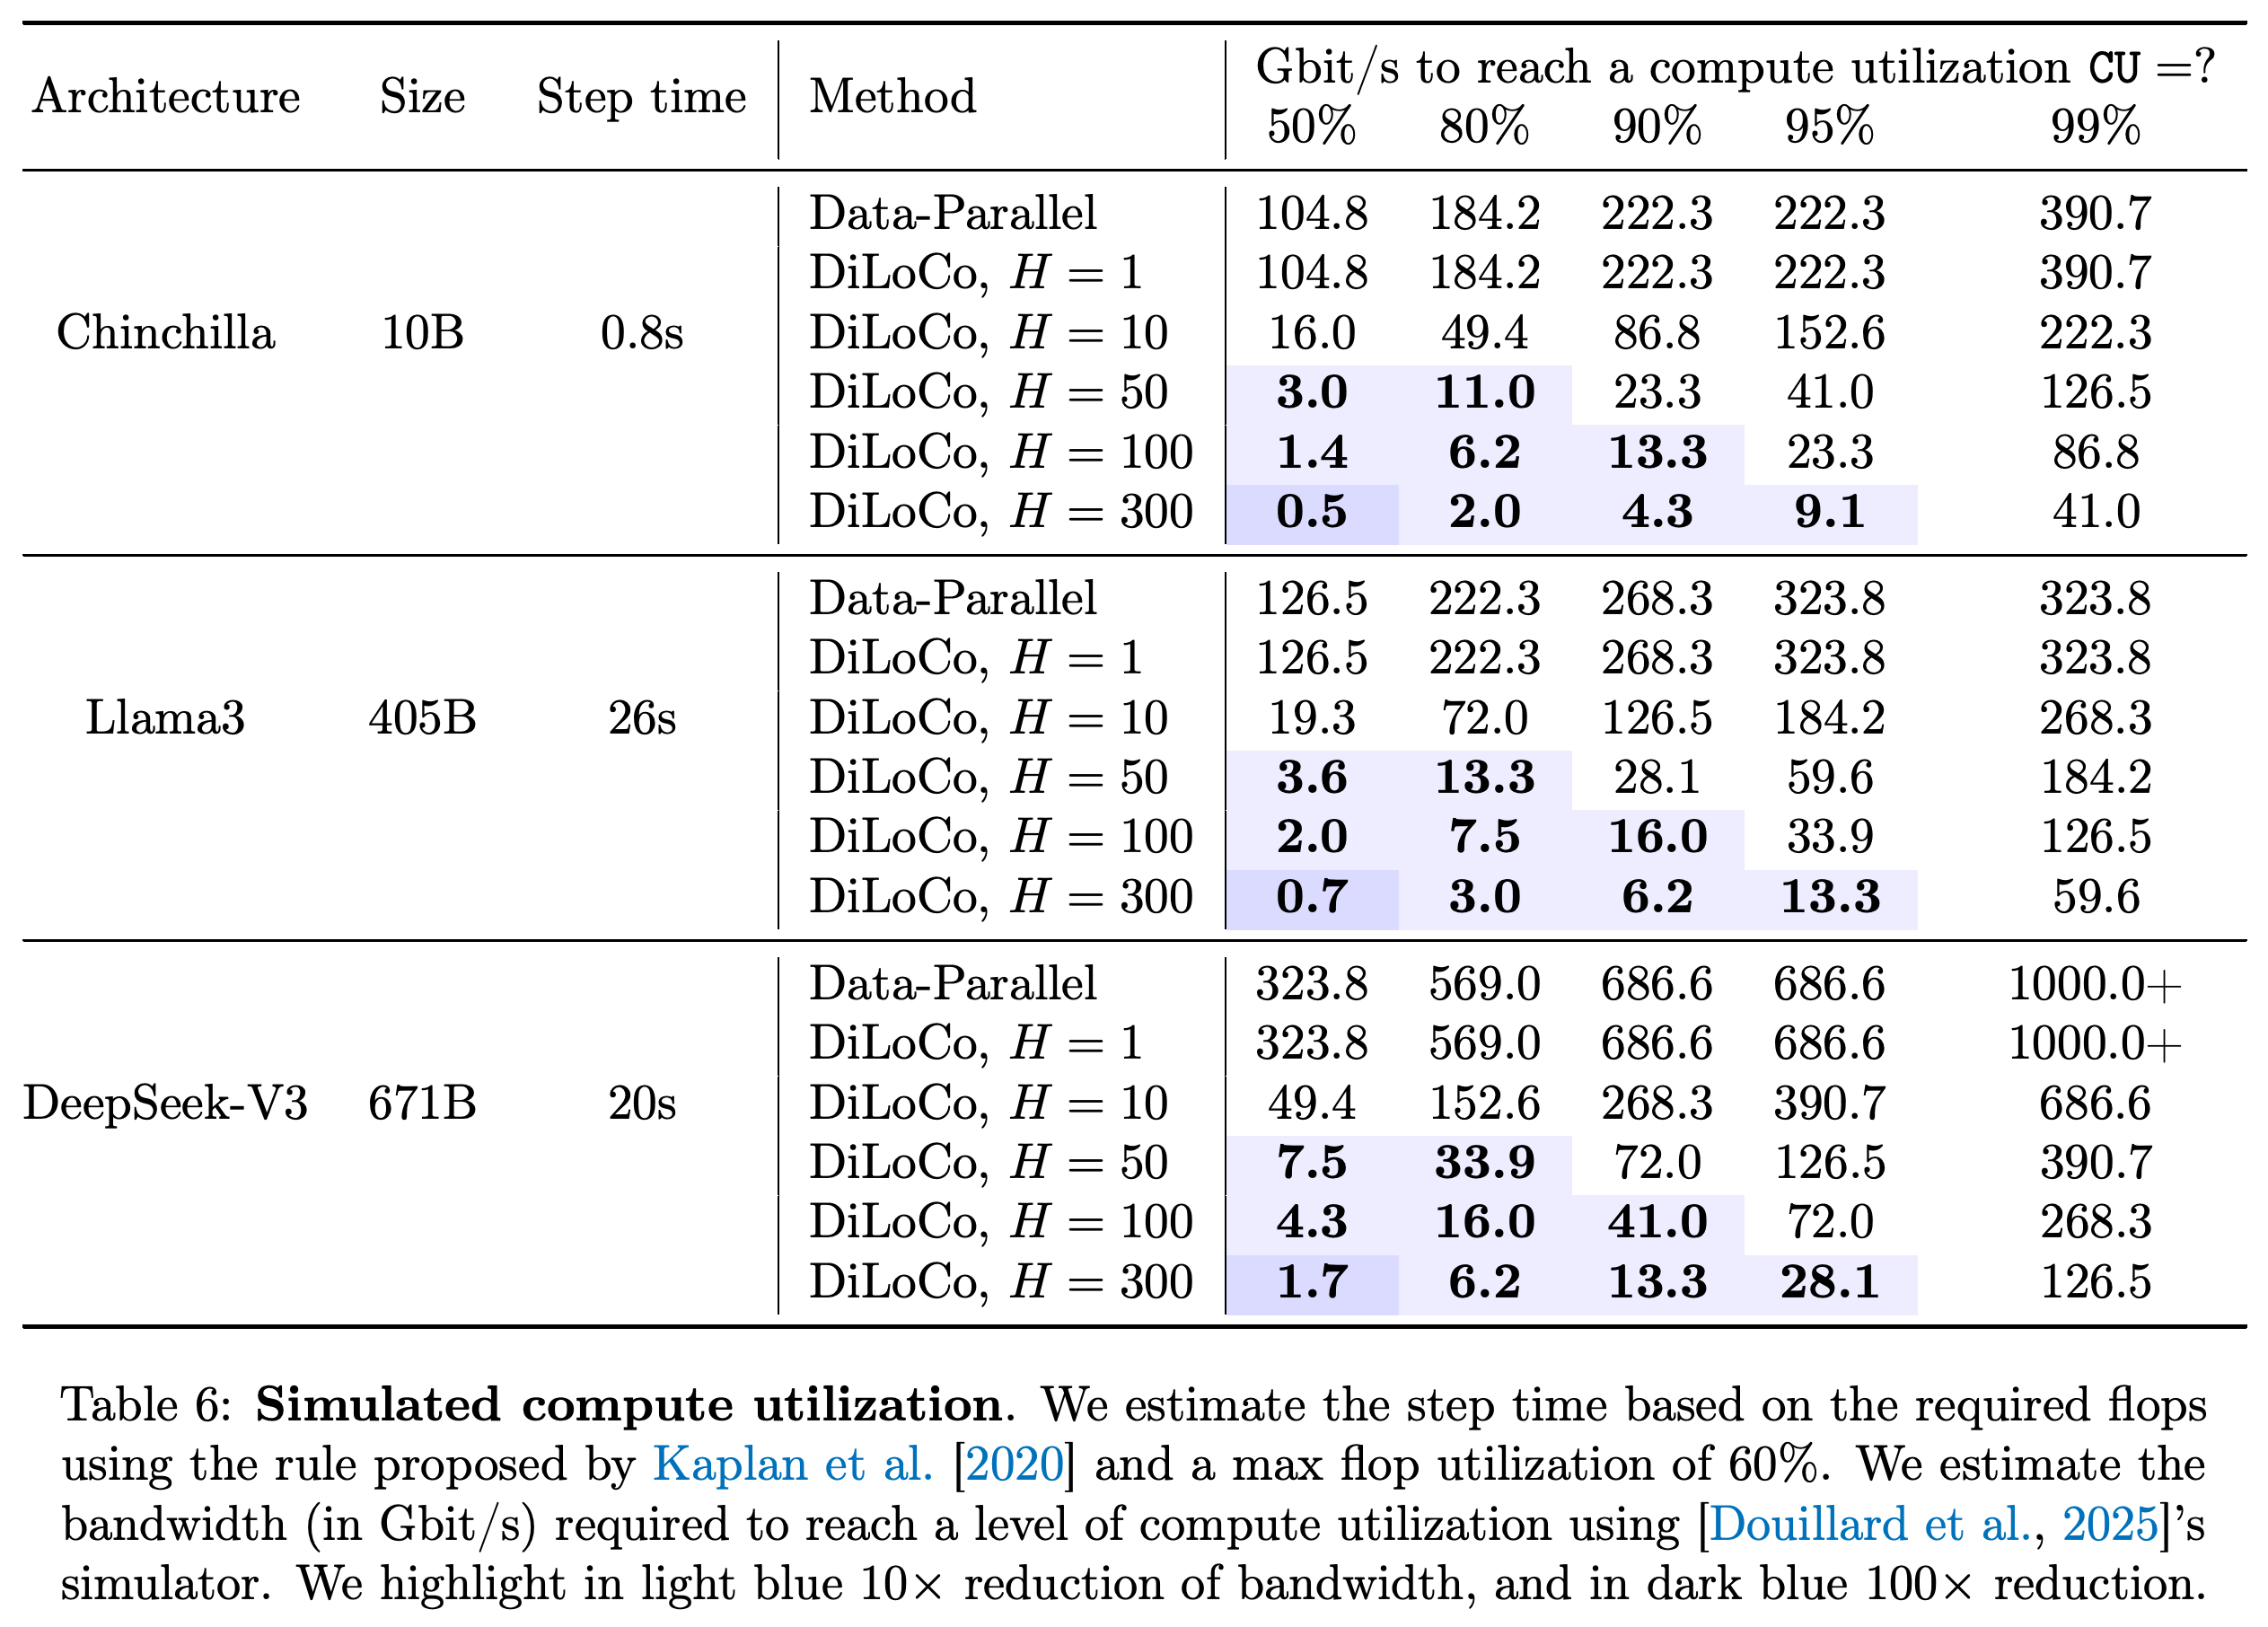
이 연구에서 연산 활용률은 총시간 중 연산 시간이 차지하는 비율로 정의한다. 10B Chinchilla, 405B Llama3, 671B DeepSeek-V3에 대해 이를 시뮬레이션한다. H를 늘리면 같은 활용률을 달성하는 데 필요한 데이터센터 간 대역폭이 크게 줄어든다.
- Table 6에서 10B Chinchilla의 활용률이 80%일 때 필요한 대역폭은 Data-Parallel이 184.2 Gbit/s이고, H = 300인 DiLoCo는 2.0 Gbit/s이다. 같은 비교에서 405B Llama3는 222.3 대 3.0 Gbit/s이고, 671B DeepSeek-V3는 569.0 대 6.2 Gbit/s이다.
- 이 값은 추정한 스텝 시간과 최대 부동소수점 연산 활용률 60%를 사용한 시뮬레이터 출력이다. 이 연구는 405B와 671B 모델을 학습하여 최적화 품질을 검증하지 않는다.
동기화 빈도를 낮추면 필요한 대역폭이 크게 줄어든다. 10B Chinchilla의 활용률이 80%일 때 Data-Parallel은 184.2 Gbit/s가 필요하지만 H = 300에서는 2.0 Gbit/s가 필요하다. 더 큰 아키텍처의 결과는 추가 학습 실험이 아니라 시뮬레이션 사례다.
5.2 Overtraining
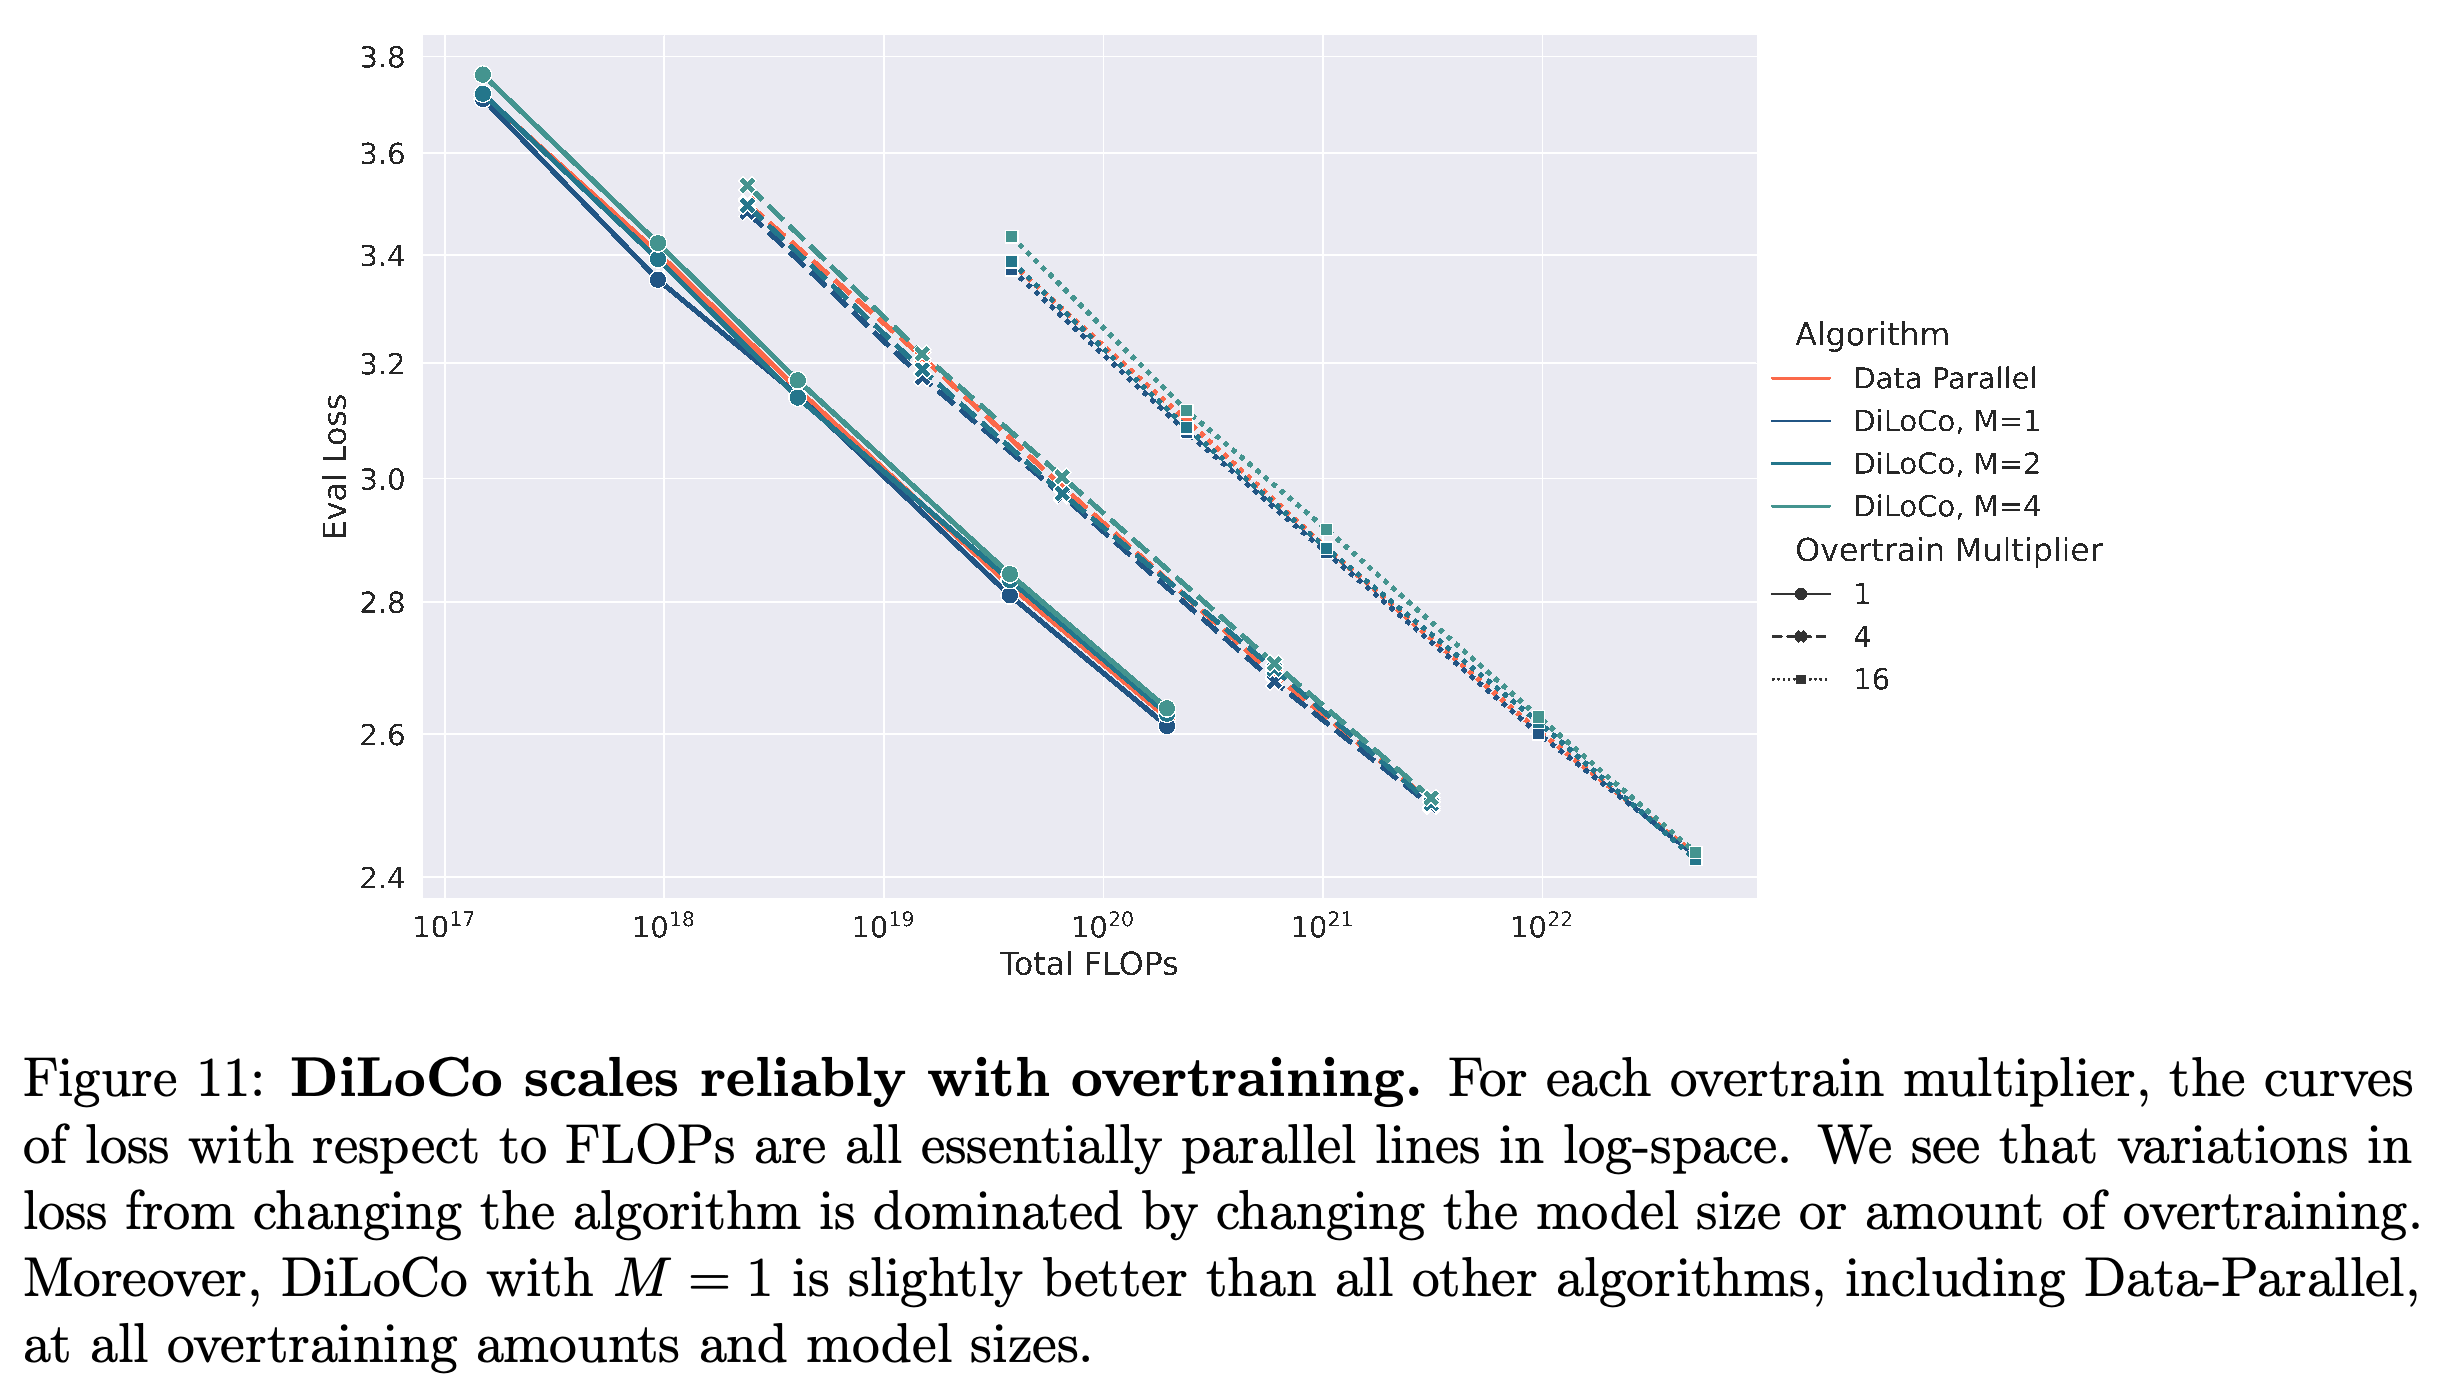
여기서 overtraining은 Chinchilla 배분보다 많은 토큰을 사용하는 것을 뜻한다. 설정은 D = 20Nλ이며 λ ∈ {1,4,16}이다. 저자들은 더 큰 텍스트 코퍼스인 Dolma로 학습하고 C4 검증 데이터로 평가한다. Data-Parallel과 M ∈ {1,2,4}인 DiLoCo에는 C4에서 선택한 하이퍼파라미터를 재사용한다.
- 배수가 달라져도 연산량에 따른 손실 추세는 정성적으로 비슷하며, 제시된 비교에서는 M = 1이 여전히 약간 우수하다. 알고리즘을 바꾸는 것보다 모델 크기와 학습 토큰 배분을 바꾸는 영향이 더 크다.
- 335M부터 2.4B까지의 모델을 대상으로 한 이상화된 시간 분석에서는, 더 큰 배치와 더 낮은 통신 빈도 덕분에 M = 2가 네트워크 설정 3개 모두에서 경과 시간을 줄일 것으로 예측한다.
Overtraining 배수를 바꾸어도 알고리즘별 연산량 대비 손실 추세는 비슷하게 유지된다. 이는 이전에 선택한 하이퍼파라미터를 Dolma에 재사용해도 확장 패턴이 안정적으로 유지됨을 뒷받침하지만, 해당 설정이 여전히 최적인지는 검증하지 않는다.
6 Scaling Laws
각 모델 크기와 알고리즘에서 관측한 최저 손실과 해당 하이퍼파라미터에 scaling law를 적합한다. 복제본 수마다 따로 모델링하는 독립 적합과 파라미터 수와 복제본 수를 함께 모델링하는 공동 적합을 비교한다.
6.1 Independent scaling laws
독립 손실 적합에는 멱법칙 L(N) ≈ AN^α를 사용한다. A는 척도를 정하고 α는 모델 크기에 따른 손실 변화를 결정한다. 적합한 지수는 Data-Parallel에서 −0.0953이고, M = 1,2,4,8인 DiLoCo에서는 각각 −0.0961, −0.0969, −0.0992, −0.1018이다. 이는 적합 범위에서 DiLoCo의 손실이 약간 더 가파르게 감소함을 나타낸다.
- 내부 학습률에도 멱법칙을 적합한다. 이산적인 탐색값 사이의 최적 배치 크기를 추정하기 위해 먼저 log₂(B)에 대한 손실을 이차함수로 적합하고, 그 최솟값에 해당하는 배치 크기에 멱법칙을 적합한다.
- 배치 크기 지수는 Data-Parallel에서 0.281이고, M = 1,2,4,8인 DiLoCo에서는 0.435, 0.479, 0.510, 0.455이다. 외부 학습률은 N에 대한 의존성을 적합하지 않고 M에 따라 직접 선택한다.
6.2 Joint scaling laws
공동 적합에는 f(N,M) ≈ AN^αM^β와 로그 좌표에서의 선형 회귀를 사용한다. Table 10은 L ≈ 19.226N^−0.0985M^0.0116, γ ≈ 22256N^−0.8827M^0.2929, B ≈ 0.00709N^0.4695M^0.3399를 제시한다.
- 이 적합식에서 복제본 수는 손실과 약한 양의 관계를 보이고, 최적 전역 배치 크기와는 더 강한 양의 관계를 보인다.
- 이 함수들은 실험한 토큰 배분과 최적화 절차를 기술한다. 임의의 토큰 예산이나 시험하지 않은 복제본 수에서도 정확한지는 검증되지 않았다.
6.3 Measuring goodness-of-fit
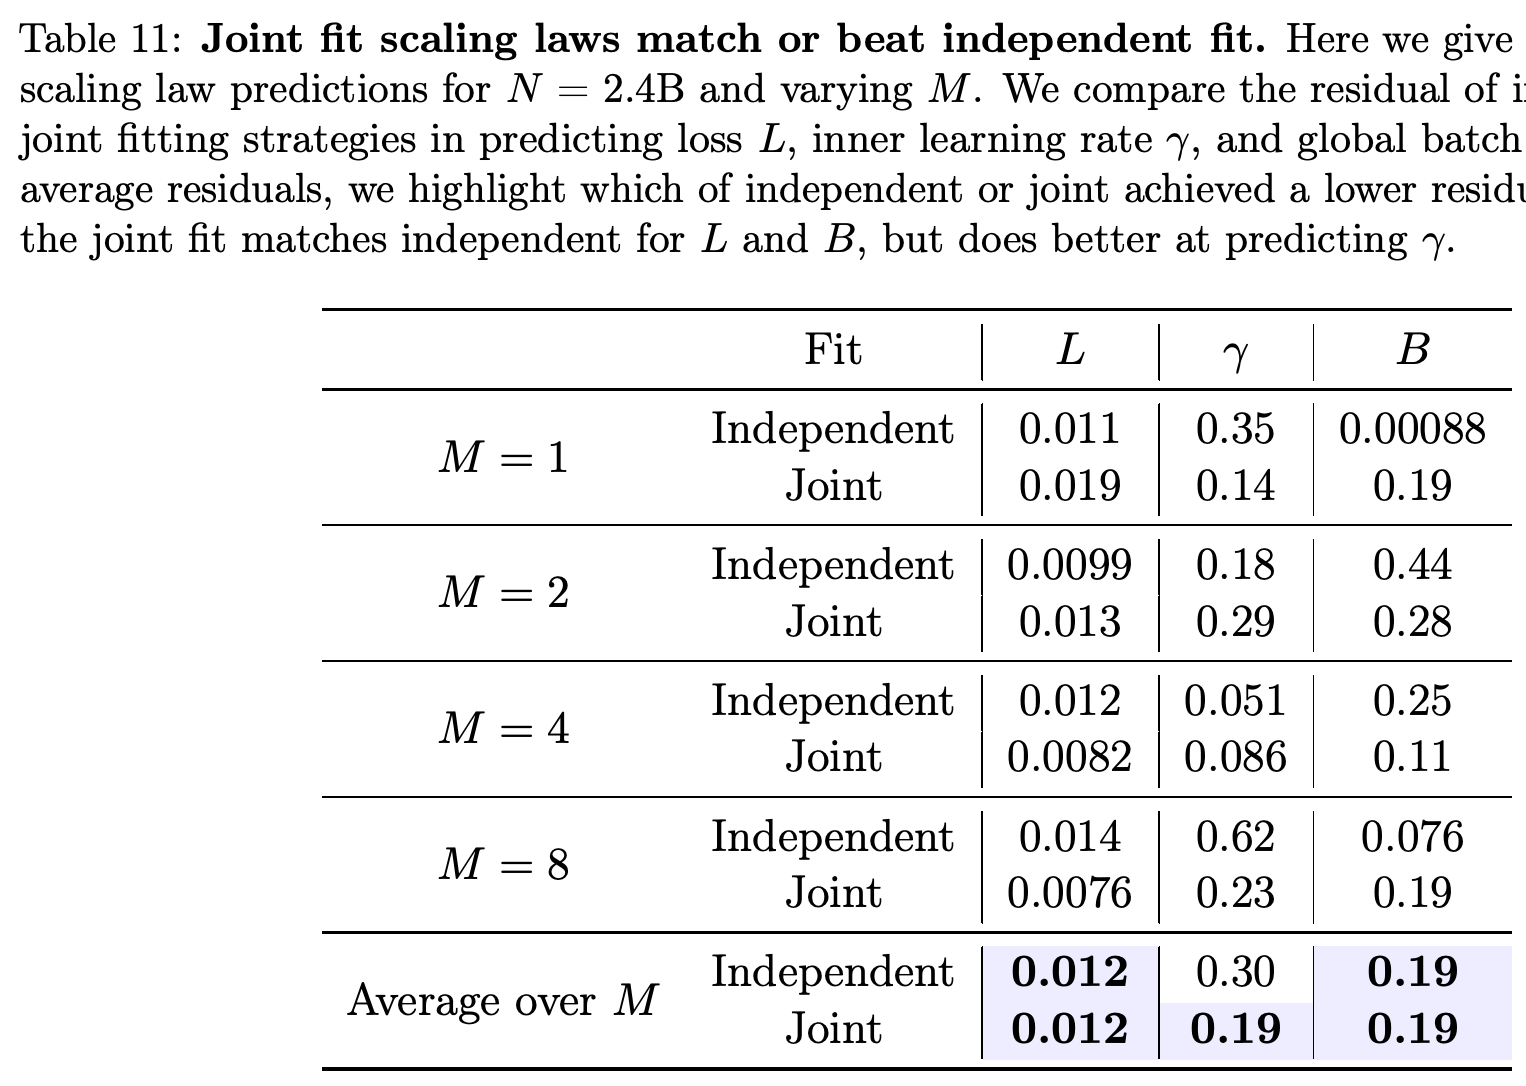
적합도는 1.3B 파라미터까지의 결과로 적합한 뒤, 적합에 사용하지 않은 2.4B 설정을 예측하여 검증한다. 손실, 내부 학습률, 전역 배치 크기의 예측 오차는 res(y,ỹ) = |log(y) − log(ỹ)|로 측정한다.
- Table 11에서 적합 방식 2개 모두 손실의 평균 잔차는 0.012이고 배치 크기의 평균 잔차는 0.19이다. 내부 학습률에서는 공동 적합이 평균 잔차를 0.30에서 0.19로 줄인다.
- Section 6.3의 본문은 학습률 비교를 반대로 서술한다. 수치 표와 캡션은 공동 적합이 더 우수함을 뒷받침한다.
평균 오차를 보면 예측 대상에 따른 차이가 드러난다. 표시된 정밀도에서 손실과 배치 크기의 잔차는 같지만, 공동 적합은 내부 학습률의 잔차를 0.30에서 0.19로 줄인다. 이 수치는 주변 본문의 상충하는 서술을 해석할 근거가 된다.
6.4 Extrapolating to larger models
4B와 10B 파라미터에서 M = 2는 독립 적합과 공동 적합으로 정한 하이퍼파라미터 어느 쪽을 사용해도 Data-Parallel보다 우수하다. 독립 적합의 손실은 2.218과 2.083이고, 공동 적합은 2.220과 2.086이다. Data-Parallel은 2.224와 2.090이다.
- M = 1은 공동 적합 설정에서만 Data-Parallel보다 우수하다. 공동 적합의 손실은 2.219와 2.086이고, 독립 적합은 2.229와 2.103이다. M = 4는 어느 적합 방식을 사용해도 손실이 약간 더 높다.
- Figure 13에서는 외삽한 손실이 적합 곡선 근처에 놓인다. 저자들은 전반적으로 하이퍼파라미터 공동 적합을 권장하지만, Table 12에서는 이 2개 규모에서 독립 적합이 보고된 M = 2 손실 중 가장 낮은 값을 보인다.
4B와 10B 외삽 결과를 나타내는 점은 작은 모델로 적합한 곡선 근처에 놓인다. 이는 평가한 확장 범위에서 손실을 예측할 수 있음을 뒷받침한다. 알고리즘 간의 더 작은 차이는 수치 표에서 확인할 수 있다.
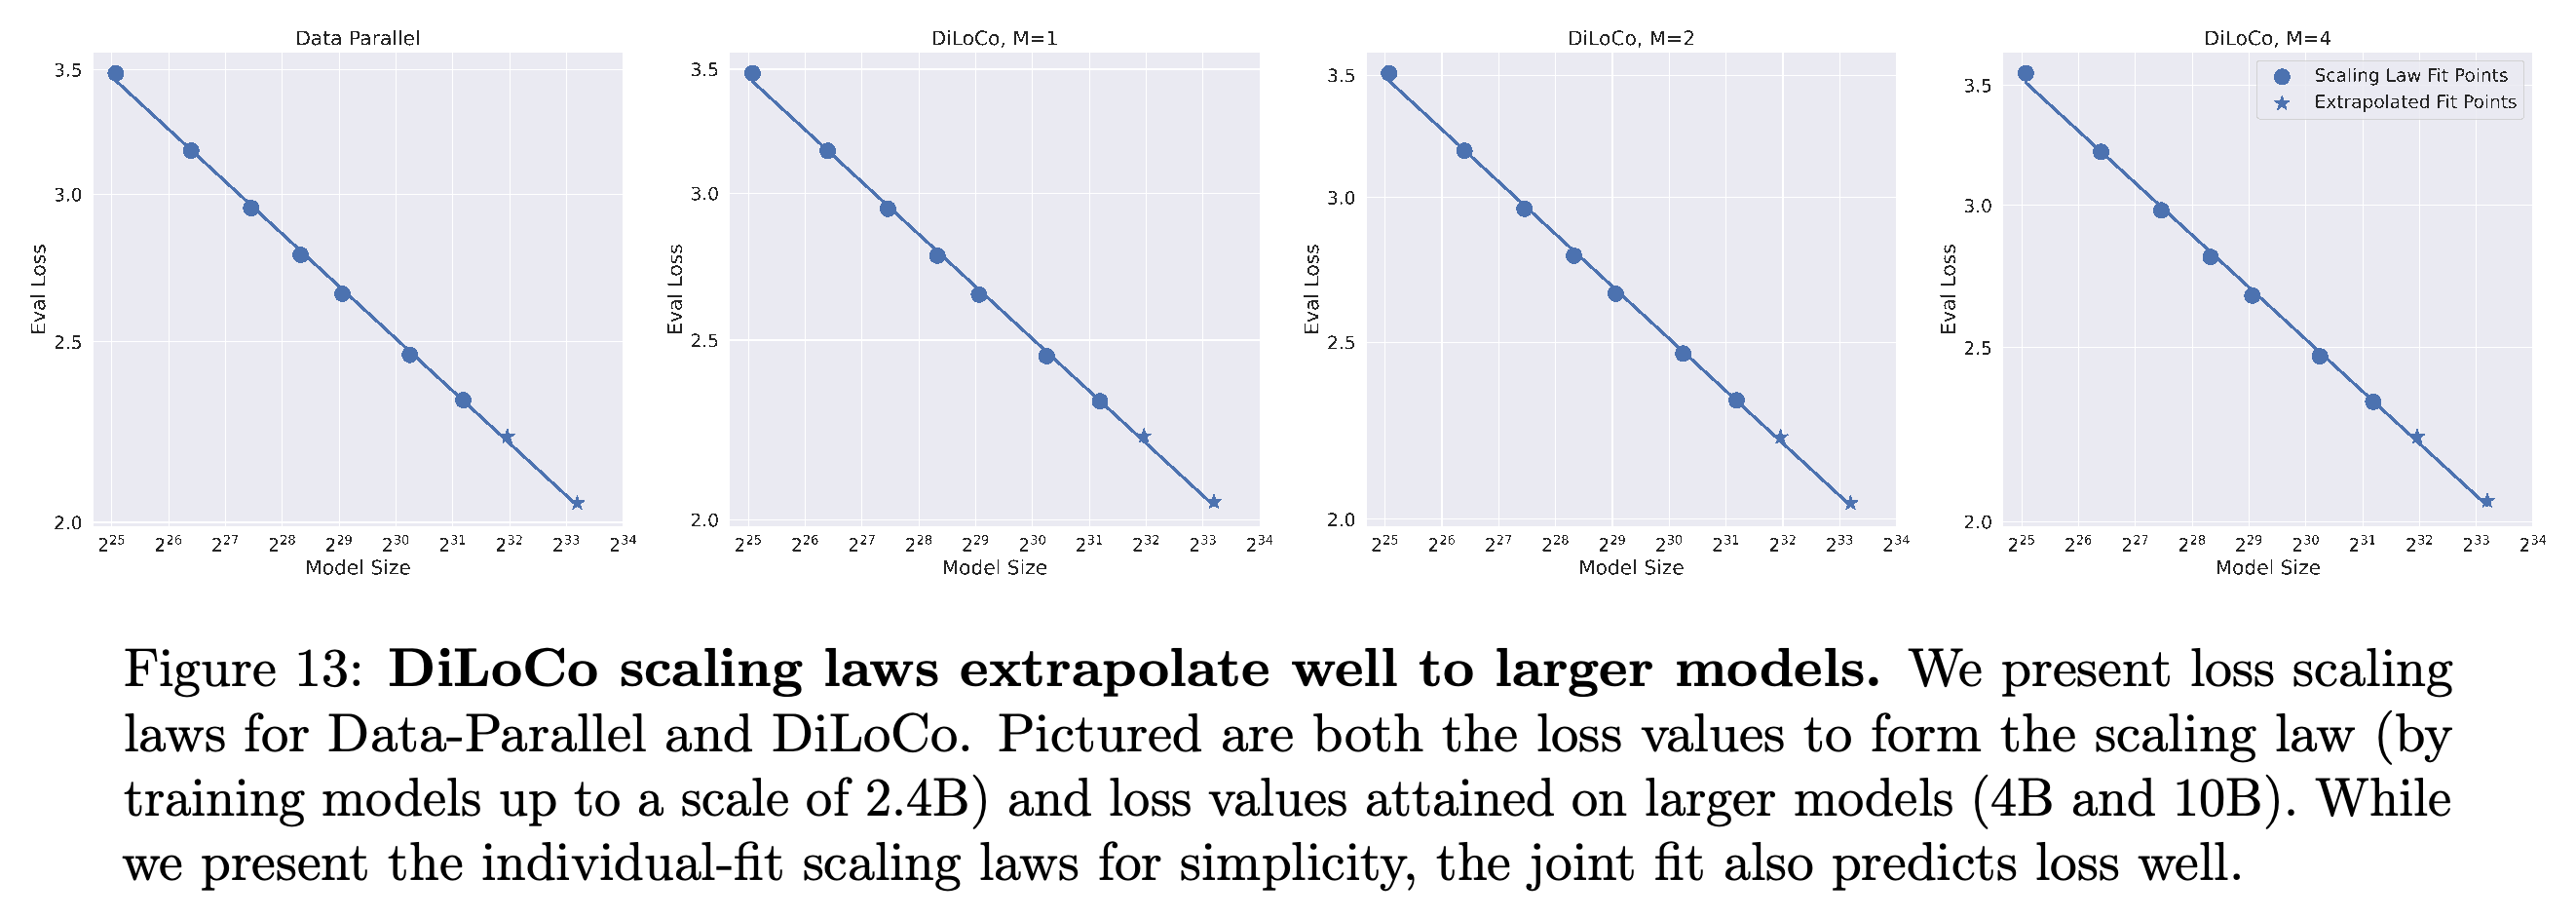
복제본 2개는 어느 적합 전략에서도 손실을 개선하지만, 복제본 1개는 공동 적합 하이퍼파라미터를 사용할 때만 개선한다. 독립 적합의 M = 2에서 제시된 최저 손실인 2.218과 2.083을 얻으므로, 공동 적합이 항상 가장 우수한 학습 모델을 만드는 것은 아니다.
6.5 Parametric Function Fitting
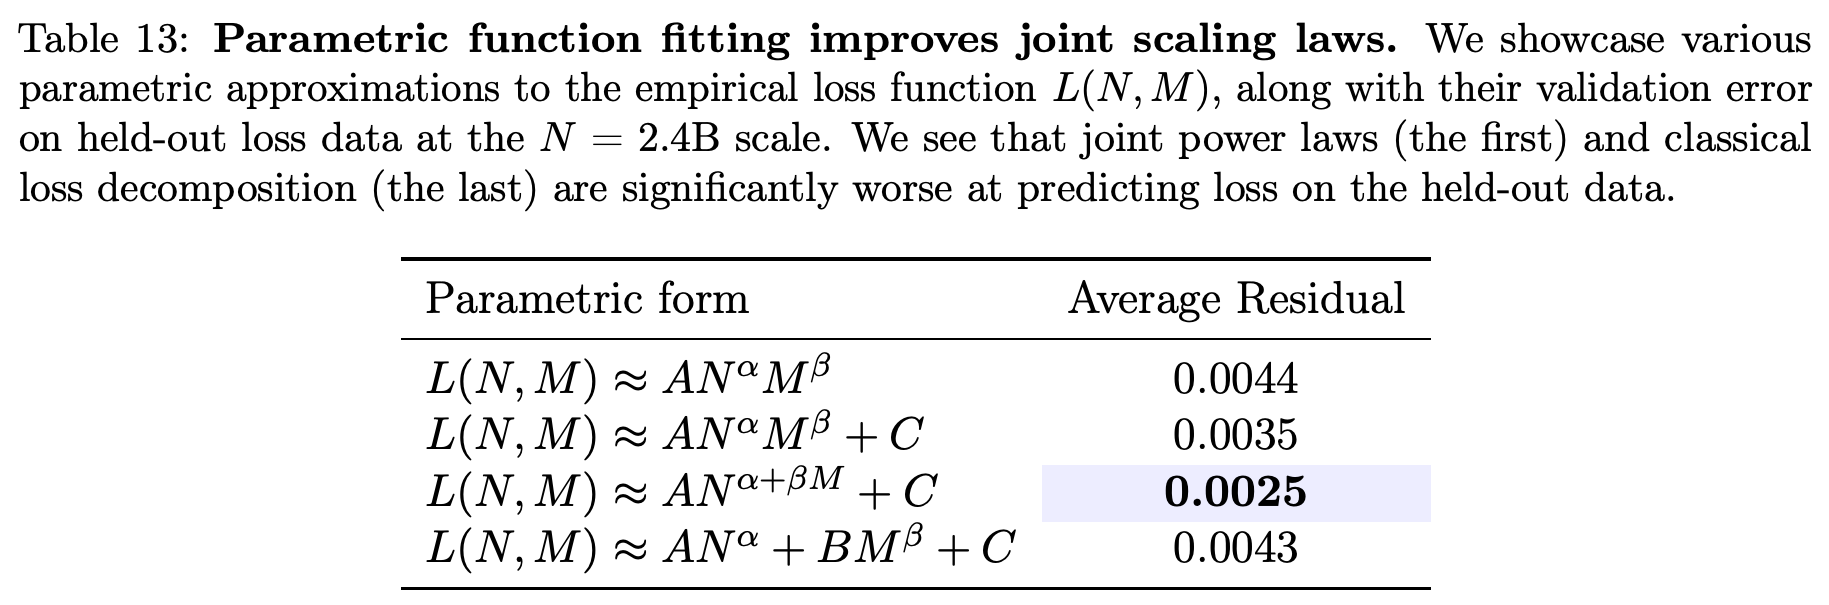
저자들은 모수적 손실 함수 4개인 AN^αM^β, AN^αM^β + C, AN^(α+βM) + C, AN^α + BM^β + C를 비교한다. 여기서 문자는 각 식의 적합 계수를 나타낸다. 큰 잔차의 영향을 줄이는 목적함수인 Huber 손실을 로그 예측 오차에 적용하고, 수치 최적화 방법인 L-BFGS로 최소화한다. 무작위 초기화 256개에서 최적화를 시작한다.
- 홀드아웃 2.4B 데이터로 적합 파라미터를 선택한다. 평균 잔차는 각각 0.0044, 0.0035, 0.0025, 0.0043으로, 시험한 함수 중 AN^(α+βM) + C가 가장 우수하다.
- 오차가 가장 작은 함수에서는 복제본 수가 모델 크기의 지수를 바꾼다. 홀드아웃 규모의 데이터를 선택에도 사용하므로, 이 잔차는 검증 근거에 해당하며 선택한 함수를 독립적으로 최종 평가한 결과는 아니다.
복제본 수가 모델 크기의 지수를 바꾸도록 허용한 식이 후보 함수 4개 중 가장 낮은 검증 잔차인 0.0025를 보인다. 같은 홀드아웃 규모를 사용하여 적합 파라미터를 선택하고 검증 오차를 비교한다.
7 Related Work
논문은 DiLoCo를 업데이트 빈도를 낮춰 통신을 줄이는 방법으로 분류하고, 주기적으로 동기화하는 확률적 경사하강법인 Local SGD 및 연합 최적화와 함께 다룬다. 연합학습은 분산된 데이터로 학습하며, 주기적 평균과 내부 및 외부 최적화 방식은 DiLoCo와 알고리즘적으로 밀접한 선행 사례다.
- 다른 통신 감소 계열에는 축소된 업데이트 표현을 전달하는 희소 업데이트와, 작업자가 같은 시점에 동기화할 필요가 없는 비동기 업데이트가 있다. 이 연구의 scaling law는 실험에서 다룬 동기식 DiLoCo 설정에 관한 것이다.
- He et al. [2024]와 비교하면, 저자들은 10배 큰 모델, M = 1을 포함한 여러 복제본 수, 명시적 토큰 배분과 overtraining, 하이퍼파라미터의 scaling 특성, 최적 배치 크기를 연구한다.
8 Conclusions and Future Work
결론에서는 예측 가능한 확장, 품질을 유지할 수 있는 더 큰 배치, 일부 DiLoCo 설정의 손실 개선을 강조한다. 후속 연구로는 다운스트림 과제의 확장 특성, 데이터가 제한된 학습, 추론 비용 분석, 비동기 업데이트, 모델 조각의 통신 시점을 분산하는 Streaming DiLoCo, 더 큰 배포 규모에서 통신 이점을 실현하는 시스템을 제안한다.
부록
- A Wall-Clock Time Model은 학습 경과 시간을 이상화한 연산 시간과 통신 시간의 합으로 정의한다. 더 큰 배치에 비례하여 더 많은 칩을 사용할 수 있으므로, 속도 비교는 고정된 토큰 예산에서 추가 병렬 자원을 확보할 수 있다고 가정한다.
- A.1 Computation Time은 부동소수점 연산량 C = 6ND와 연산 시간의 하한 C/(RQ)를 사용한다. R은 칩 수이고 Q는 칩당 초당 연산량이다. R은 학습 알고리즘이나 복제본 수에 직접 의존하지 않고 N과 B에 따라 달라진다.
- A.2 Communication Time은 대역폭 W와 지연 시간 ε에 대해 all-reduce 시간의 하한을 (2N/W)(1 − 1/R) + ε로 제시한다. Data-Parallel은 매 스텝 데이터센터 간 동기화를 수행한다. M ≥ 2인 DiLoCo는 내부 동기화를 각 데이터센터 안에서 수행하고, 데이터센터 간 동기화는 H스텝마다 수행한다. M = 1은 Data-Parallel의 통신을 유지하면서 주기적 외부 업데이트를 추가한다. 이 모델에서 Streaming DiLoCo는 총통신량을 줄이지 않고 순간적인 최대 통신 부하를 분산한다. 통신과 연산을 겹쳐 수행하는 방식은 별도의 알고리즘 설정이며, 그 확장 특성은 추가 연구가 필요하다.
- A.3 Total Wall-Clock Time은 Q = 300 teraflops를 사용하고, 전역 배치 크기가 2배가 되면 칩 수도 2배가 된다고 가정한다. 네트워크 유형은 대역폭 400 gigabits per second와 지연 시간 10^−4초, 100 gigabits per second와 10^−3초, 10 gigabits per second와 10^−2초다. 데이터센터 내부 통신에는 항상 대역폭이 가장 높은 경우를 적용한다. 저자들은 이 유형들이 실제 시스템에 기반하지 않았다고 명시한다.
- B Additional Experimental Results는 배치 크기 비교를 탐색한 모든 모델 크기와 다운스트림 과제 3개로 확장한다. Figures 14–19는 특히 M = 1에서 큰 배치에 대한 내성이 더 높음을 뒷받침한다. 다만 저자들은 Arc-Easy의 평가 잡음이 크다고 설명한다. Figure 19의 왼쪽 세로축에는 Piqa가 표시되어 있지만, 하위 캡션에는 Arc-Easy가 반복되어 있다.
짧은 생각
공학적 가치는 동기화 통신량 감소에 그치지 않는다. DiLoCo는 학습 품질을 유지할 수 있는 배치 크기를 바꾼다. M = 1 결과는 옵티마이저 자체의 이점을 보여주며, 4B/10B 실험은 시험한 토큰 배분에서 작은 모델로 도출한 설정을 이전할 수 있음을 보여준다. 예측한 속도 향상은 배치 크기에 비례한 칩 확보와 이상화한 네트워크에 의존한다. 405B와 671B 모델의 활용률 시뮬레이션은 DiLoCo에서 해당 모델의 학습 품질을 검증한 결과가 아니다. 보고된 대형 모델의 손실 개선 폭은 작으며, 핵심 표에는 반복 실행에 따른 불확실성 추정치가 없다. M = 4의 결과와 적합 전략에 민감한 M = 1의 결과를 고려하면, 복제본 수와 하이퍼파라미터 이전 방식은 품질 이점을 좌우하는 주요 조건이다.