


Distillation Scaling Laws 요약 설명
12 Feb 2025 | Paper Review Knowledge Distillation Scaling Laws LLM Pretraining목차
이번 글에서는 Distillation Scaling Laws 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 2월 12일(Arxiv), Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 2025
- Busbridge, Dan, Shidani, Amitis, Weers, Floris, Ramapuram, Jason, Littwin, Etai, Webb, Russ.
- Apple, University of Oxford, UK
- 논문 링크
요약
- 교사의 출력 확률로 작은 언어 모델을 학습하는 지식 증류에서는 교사와 학생에 계산량을 얼마나 배분할지 결정해야 한다. 관측된 다음 토큰으로 직접 지도 학습하는 방식과 비교하면, 교사 사전학습 비용을 제외하거나 여러 용도에 충분히 분담할 때 학생 크기에 따라 정해지는 자원 범위에서 증류가 더 낮은 검증 교차 엔트로피를 달성한다. 검증 교차 엔트로피는 관측된 토큰에 부여한 음의 로그 확률을 평균한 값이다.
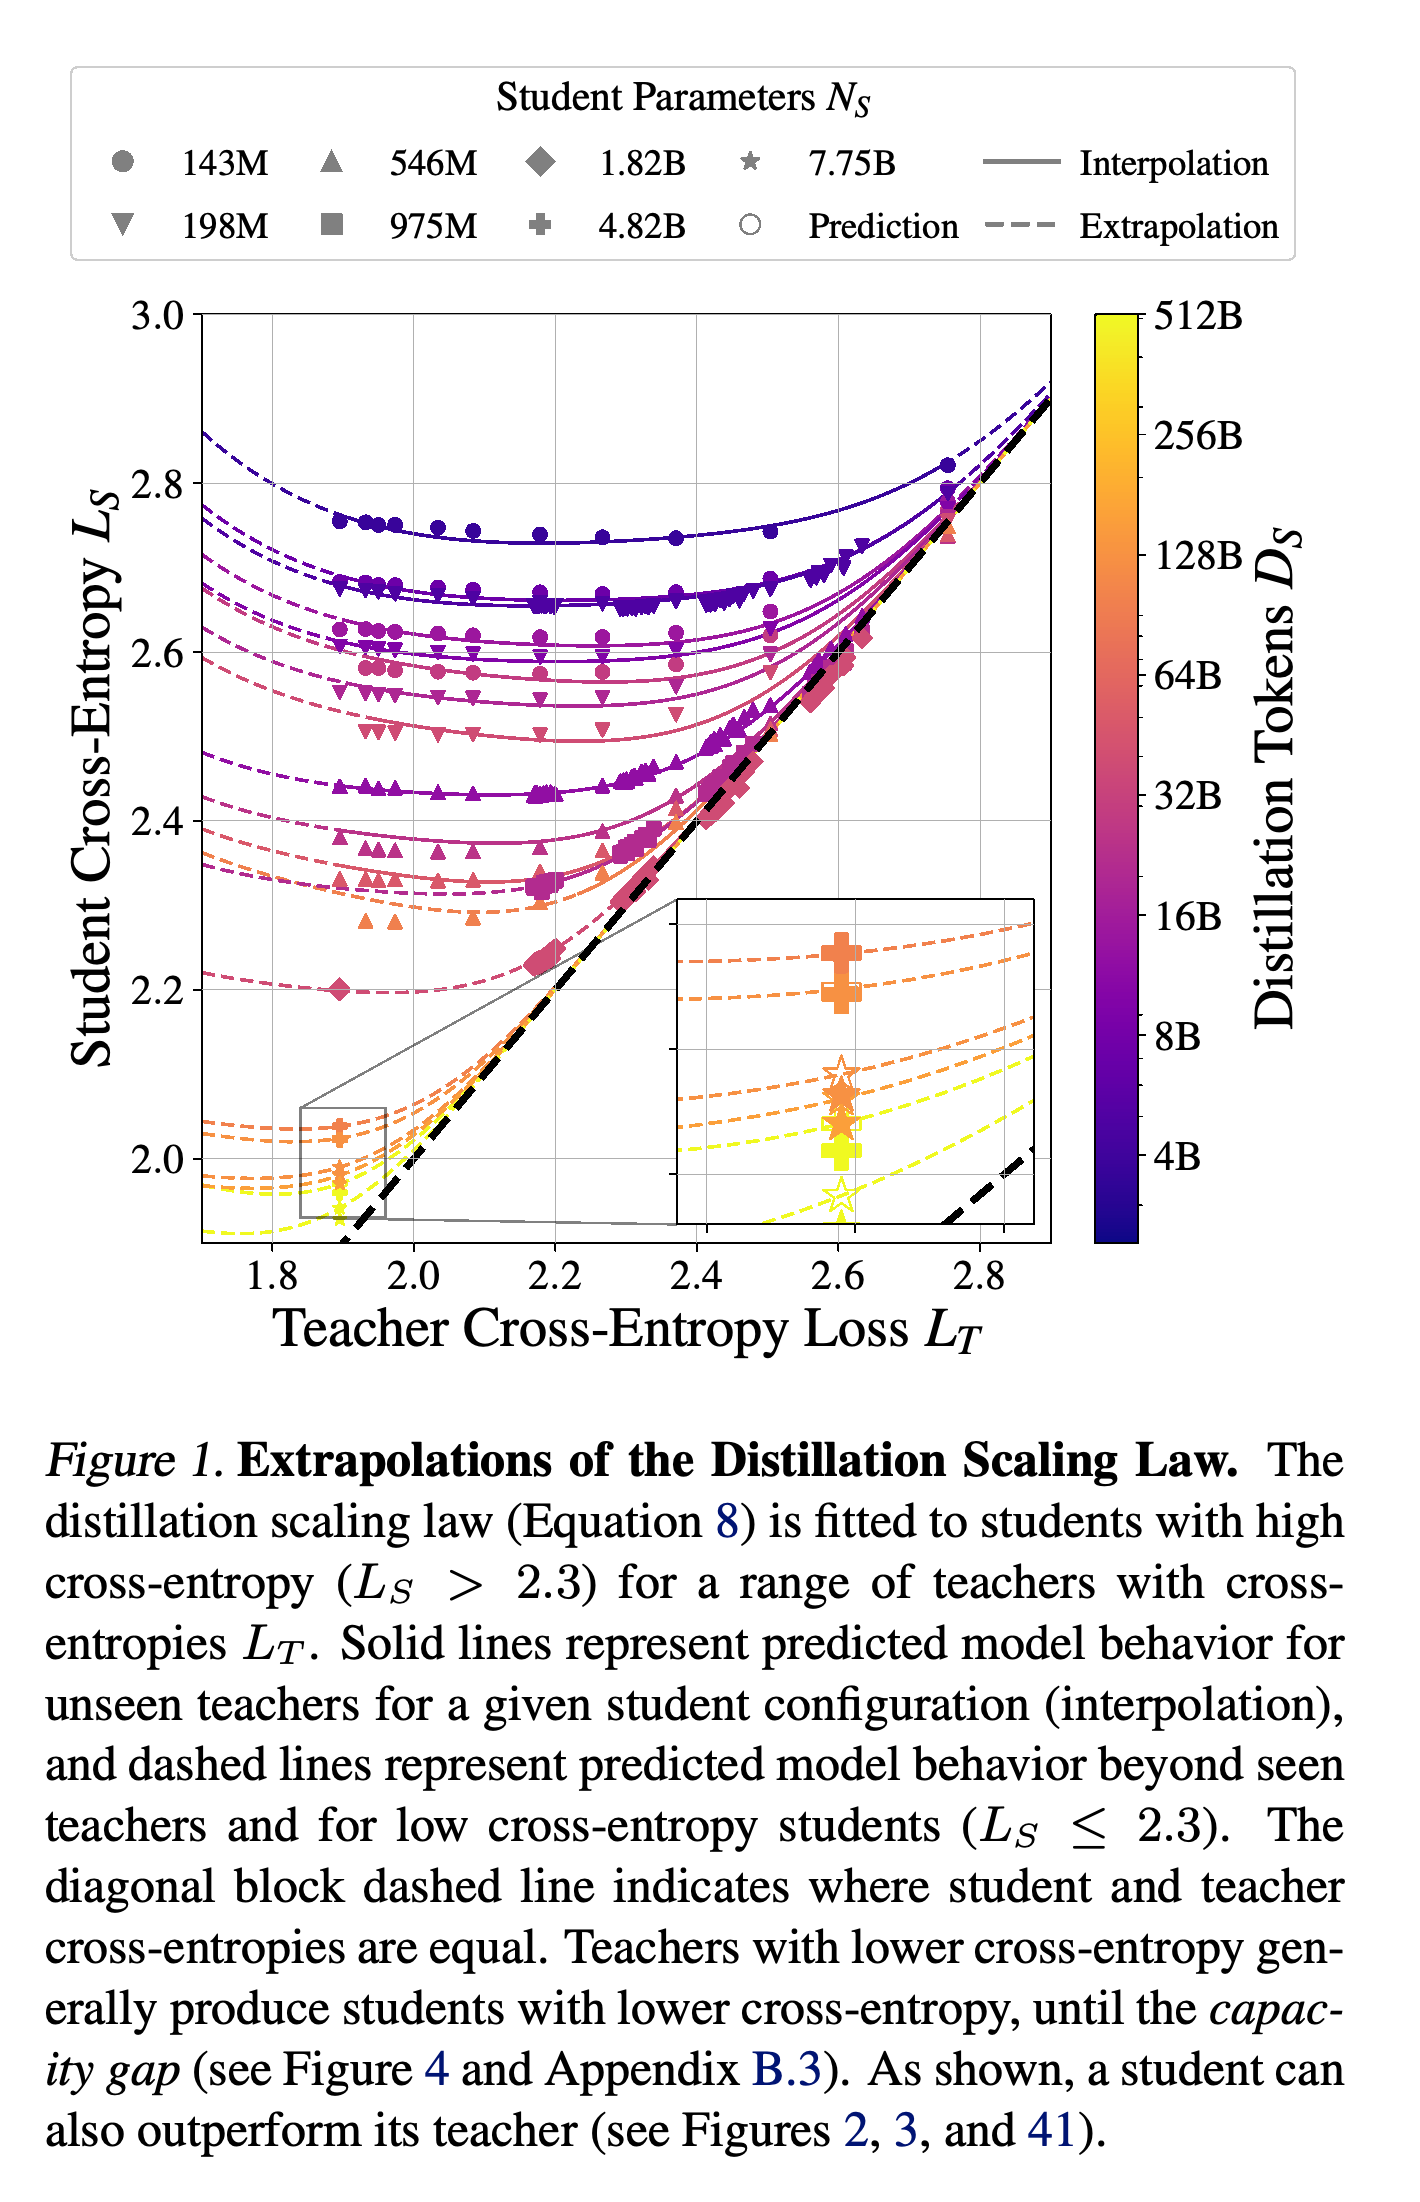
- 제안한 경험적 스케일링 법칙은 자원과 모델 손실 사이의 관계를 적합한 식으로, 학생 파라미터 수, 증류 토큰 수, 교사 검증 손실로 학생 손실을 예측한다. 697회의 증류 실험에 적합했으며, 약한 모델에서 강한 모델로 외삽한 검증을 포함해 보고된 상대 예측 오차는 약 1% 이하이다. 이 통제된 설정에서 교사 크기와 학습 토큰 수는 교사 손실을 통해 학생 성능에 영향을 준다.
- 교사와 학생의 학습 능력이 맞지 않는 capacity gap 때문에 교사가 강해질수록 오히려 학생 성능이 나빠질 수 있다. 교사 학습 비용 전부를 학생 1개에 부과하면, 고정된 계산 예산에서 손실을 최소화하는 논문의 계산 최적 비교에서는 직접 지도 학습이 더 유리하다. 학생 예산이 충분히 커지면 지도 학습도 최적으로 선택한 증류와 같은 성능에 도달한다.
- 실험에는 어텐션 기반 시퀀스 모델인 transformer를 사용한다. 토큰 임베딩 가중치를 제외한 파라미터 수는 143M부터 12.6B까지이며, 연구의 텍스트 사전학습 데이터셋인 English C4에서 최대 512B 토큰까지 학습한다. 적합한 계수는 이 아키텍처와 데이터셋에 한정된다. 결과만으로 교사가 생성한 시퀀스를 이용한 학습, 교사와 학생의 데이터 분포가 다른 경우, 추론 성능에 관한 스케일링 법칙을 확립할 수는 없다.
1. Introduction
연구의 동기는 과도한 학습 비용을 모두 지불하지 않으면서 추론 비용이 낮은 작은 모델을 만드는 데 있다. 여기서 과도한 학습은 사전학습 계산량을 최적으로 배분할 때보다 훨씬 많은 토큰으로 학습하는 것을 뜻한다. 증류에 관한 상충하는 보고를 검토하기 위해 학생 학습, 교사 학습, 교사 추론 비용을 구분한 통제 비교를 수행한다.
- 논문은 같은 자원 조건에서 증류가 성능을 높이는지, 어떤 교사와 학생 구성이 학생 손실을 최소화하는지 묻는다.
- 핵심은 이미 존재하거나 재사용할 수 있는 교사와 학생 1개를 만들기 위해서만 학습하는 교사를 구분하는 데 있다.
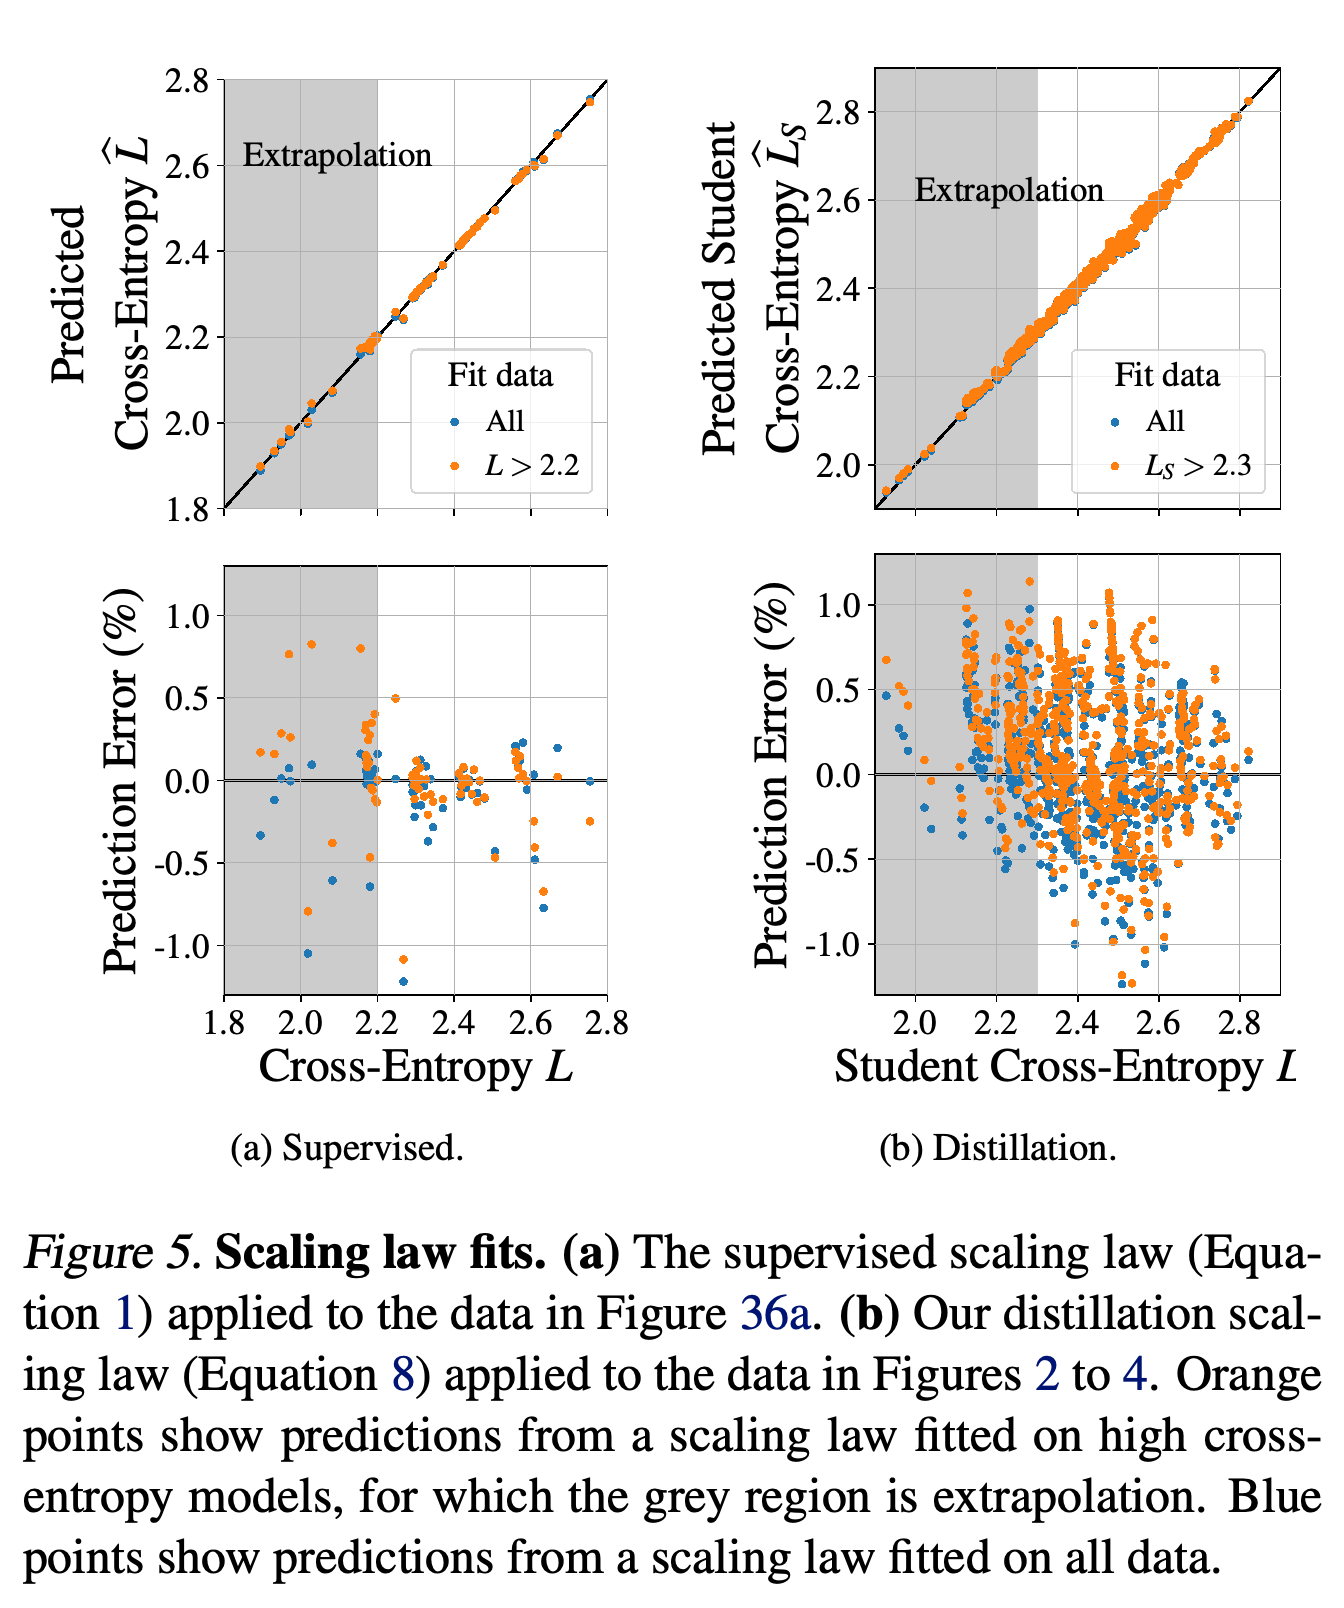
L_S > 2.3인 학생에 적합한 예측은 손실이 더 낮은 학생과 적합에서 보지 못한 교사 구성도 잘 따라간다. 곡선 관계는 교사 손실 개선이 학생에 따라 정해지는 최적점까지만 도움이 된다는 점을 보여주며, 외삽 검증을 capacity gap 현상과 연결한다.
2. Background
지도 학습 베이스라인은 식 1인 \(L(N,D)=E+\left(\frac{A}{N^\alpha}+\frac{B}{D^\beta}\right)^\gamma\)이다. N은 임베딩을 제외한 파라미터 수, D는 학습 토큰 수, E는 줄일 수 없는 오차를 나타낸다. 양의 계수는 보편적인 값으로 가정하지 않고 학습 실험에서 추정한다.
- 계산 최적 실험만 수행하면 토큰 대 파라미터 비율 M = D/N이 대체로 일정하게 유지되므로 파라미터와 데이터의 영향을 독립적으로 식별할 수 없다.
- 따라서 실험 설계에서는 모델 크기를 고정하고 데이터 양을 바꾸는 실험과 IsoFLOP 프로파일을 결합한다. IsoFLOP 프로파일은 부동소수점 연산 수를 고정한 채 모델 크기와 학습 토큰 수를 바꾸는 실험이다.
3. Preliminaries
자기회귀 언어 모델은 앞선 토큰으로 다음 토큰을 예측한다. 모델의 로짓은 점수이며, 지수 정규화 함수인 softmax를 거쳐 어휘별 확률로 변환된다. 지도 방식의 다음 토큰 예측은 관측된 토큰을 목표로 사용하고, 증류는 교사의 확률분포를 목표로 사용한다.
- 증류 목적함수는 교사 분포에서 학생 분포로의 차이를 측정하는 순방향 Kullback–Leibler divergence를 최소화하는 것과 동등하다. 이하에서는 이를 KL divergence로 줄여 쓴다.
- 식 7은 혼합 계수 λ로 지도 학습 손실과 증류 손실을 결합하고 Z-loss 정규화 항을 더한다. Z-loss는 softmax 정규화 합의 로그를 제곱한 값에 페널티를 부과해 학습을 안정화한다.
- 온도 τ는 증류 손실을 계산하기 전에 교사와 학생의 로짓을 재조정해 확률분포의 집중도를 바꾼다.
4. Distillation Scaling Laws
스케일링 법칙은 통제 실험, 함수 형태 선택, 계수 적합, 외삽 검증을 거쳐 구성한다. 예측 대상은 교사 출력과의 일치도를 측정하는 손실이 아니라 실제 데이터에 대한 학생 검증 손실이다.
4.1. Experimental Setup
주요 실험은 모두 English C4와 시퀀스 길이 4096인 transformer 모델을 사용한다. 여러 어텐션 계산을 결합하는 multi-headed attention을 사용하며, 모델 하위 계층에 들어가기 전에 제곱평균제곱근 정규화 방식인 RMSNorm을 적용한다. Rotary Position Embedding은 회전을 통해 토큰 위치를 인코딩한다. 단순화한 Maximal Update Parameterization인 µP는 모델 크기가 달라져도 학습률 설정을 이전할 수 있도록 파라미터 스케일을 정한다.
- 교사 사전학습과 학생 증류는 같은 데이터 분포에서 나눈 서로 다른 분할을 사용한다. Appendix I에 따르면 각 분할에는 약 90B개의 고유 토큰이 있으므로, 더 긴 실험에서는 각 분할 안의 데이터를 반복해 사용한다.
- 주요 스케일링 실험은 순수 증류인 λ = 1과 온도 τ = 1을 사용한다. Appendix G에서는 혼합 계수와 온도를 바꾸어 이 선택을 검토한다.
- 별도 언급이 없으면 파라미터 수에서 임베딩을 제외하며, 교사는 학생보다 작거나 클 수 있다.
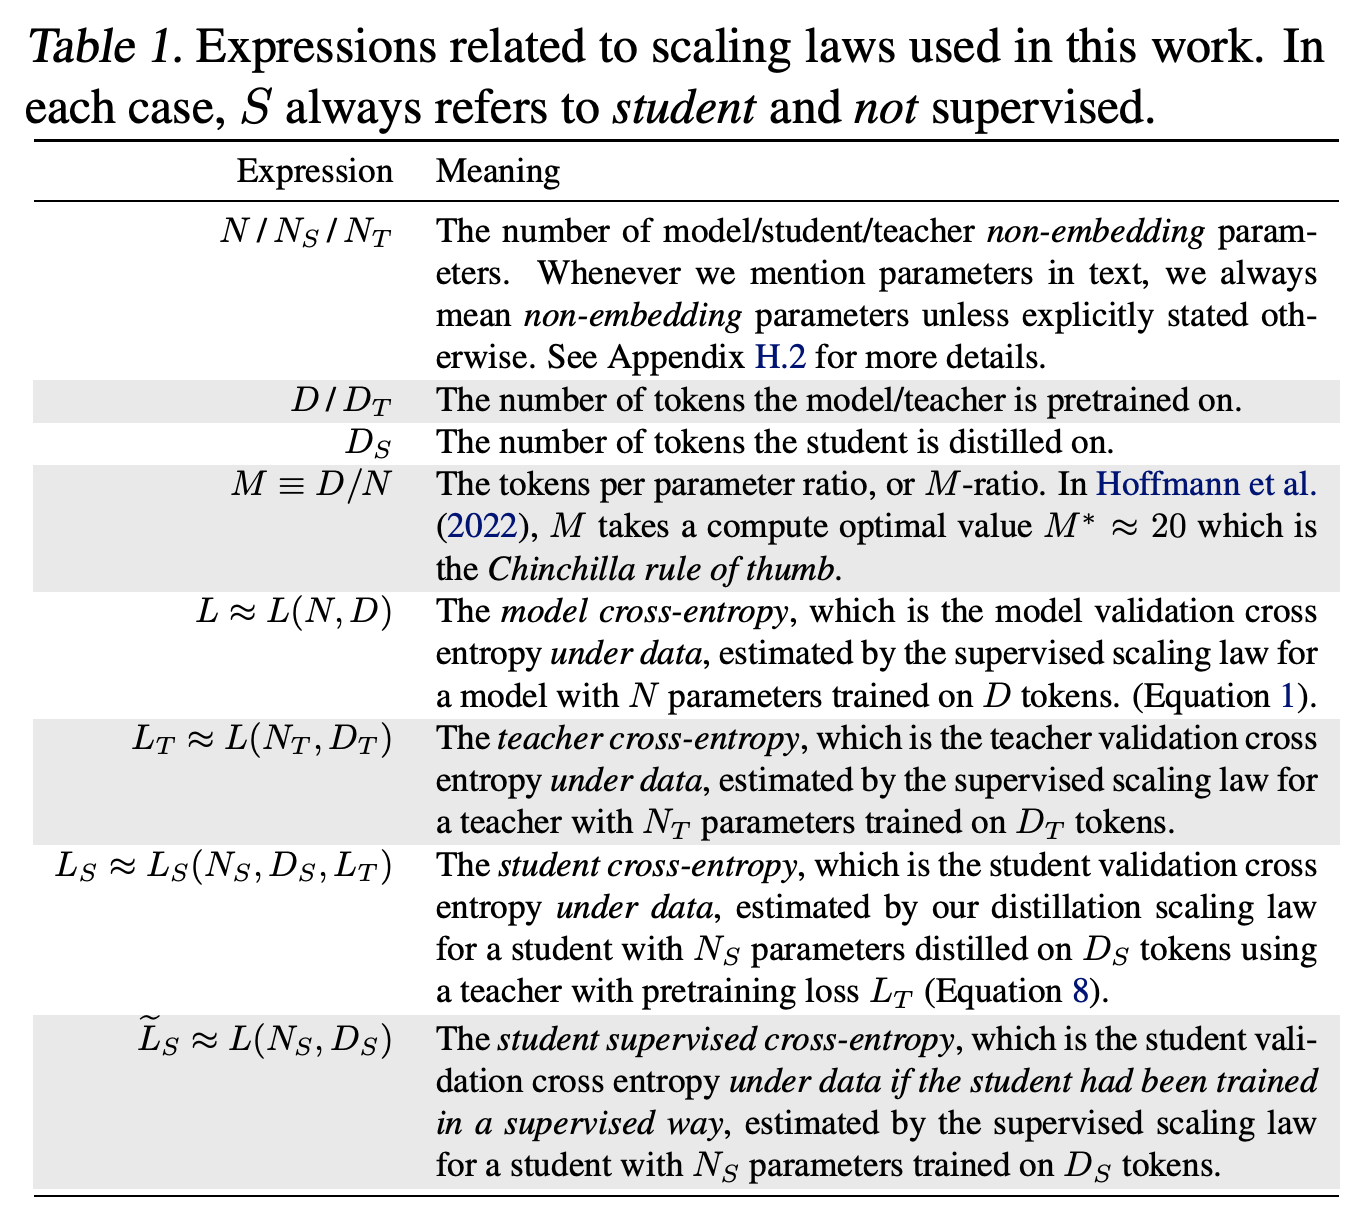
이 표기는 증류 학생 손실과, 같은 파라미터 및 토큰을 사용해 지도 학습했을 경우의 학생 손실을 구분한다. 이 구분은 capacity 전환과 동일 자원 비교를 해석하는 데 필요하다.
4.2. Distillation Scaling Law Experiments
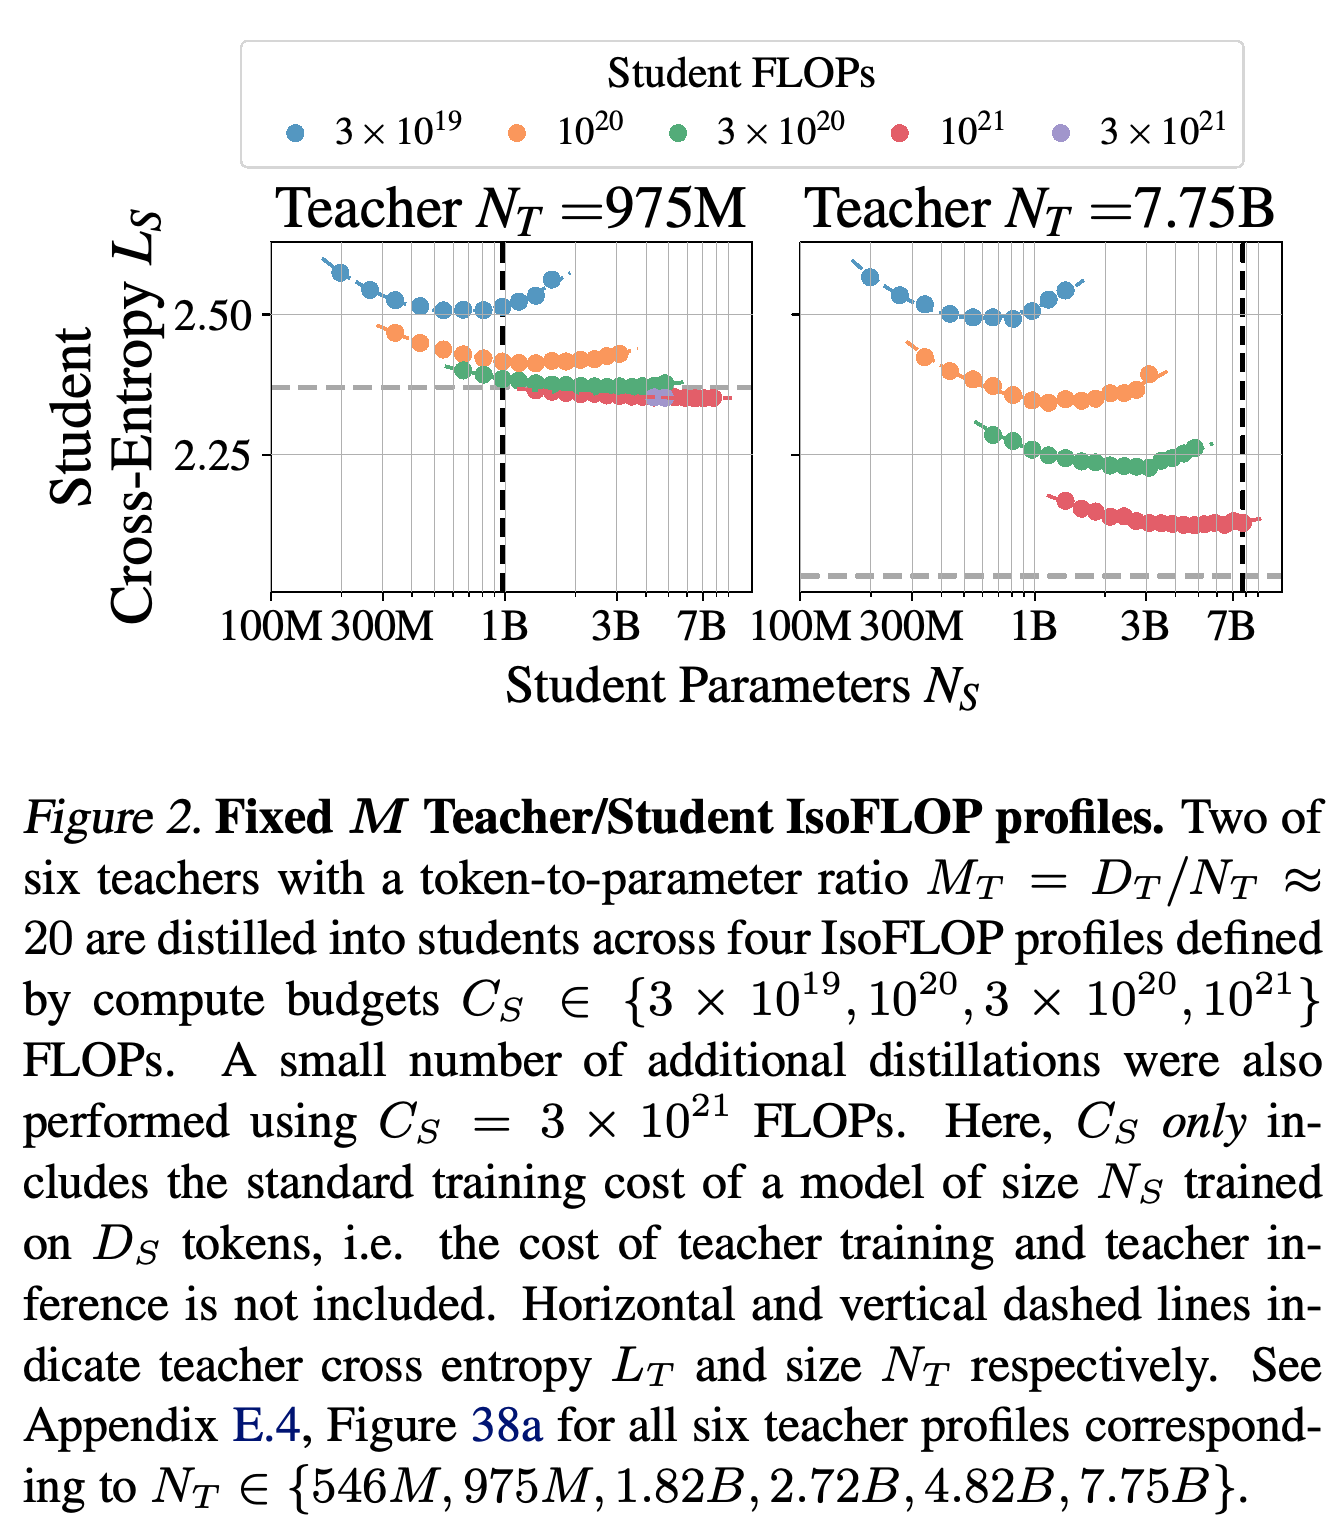
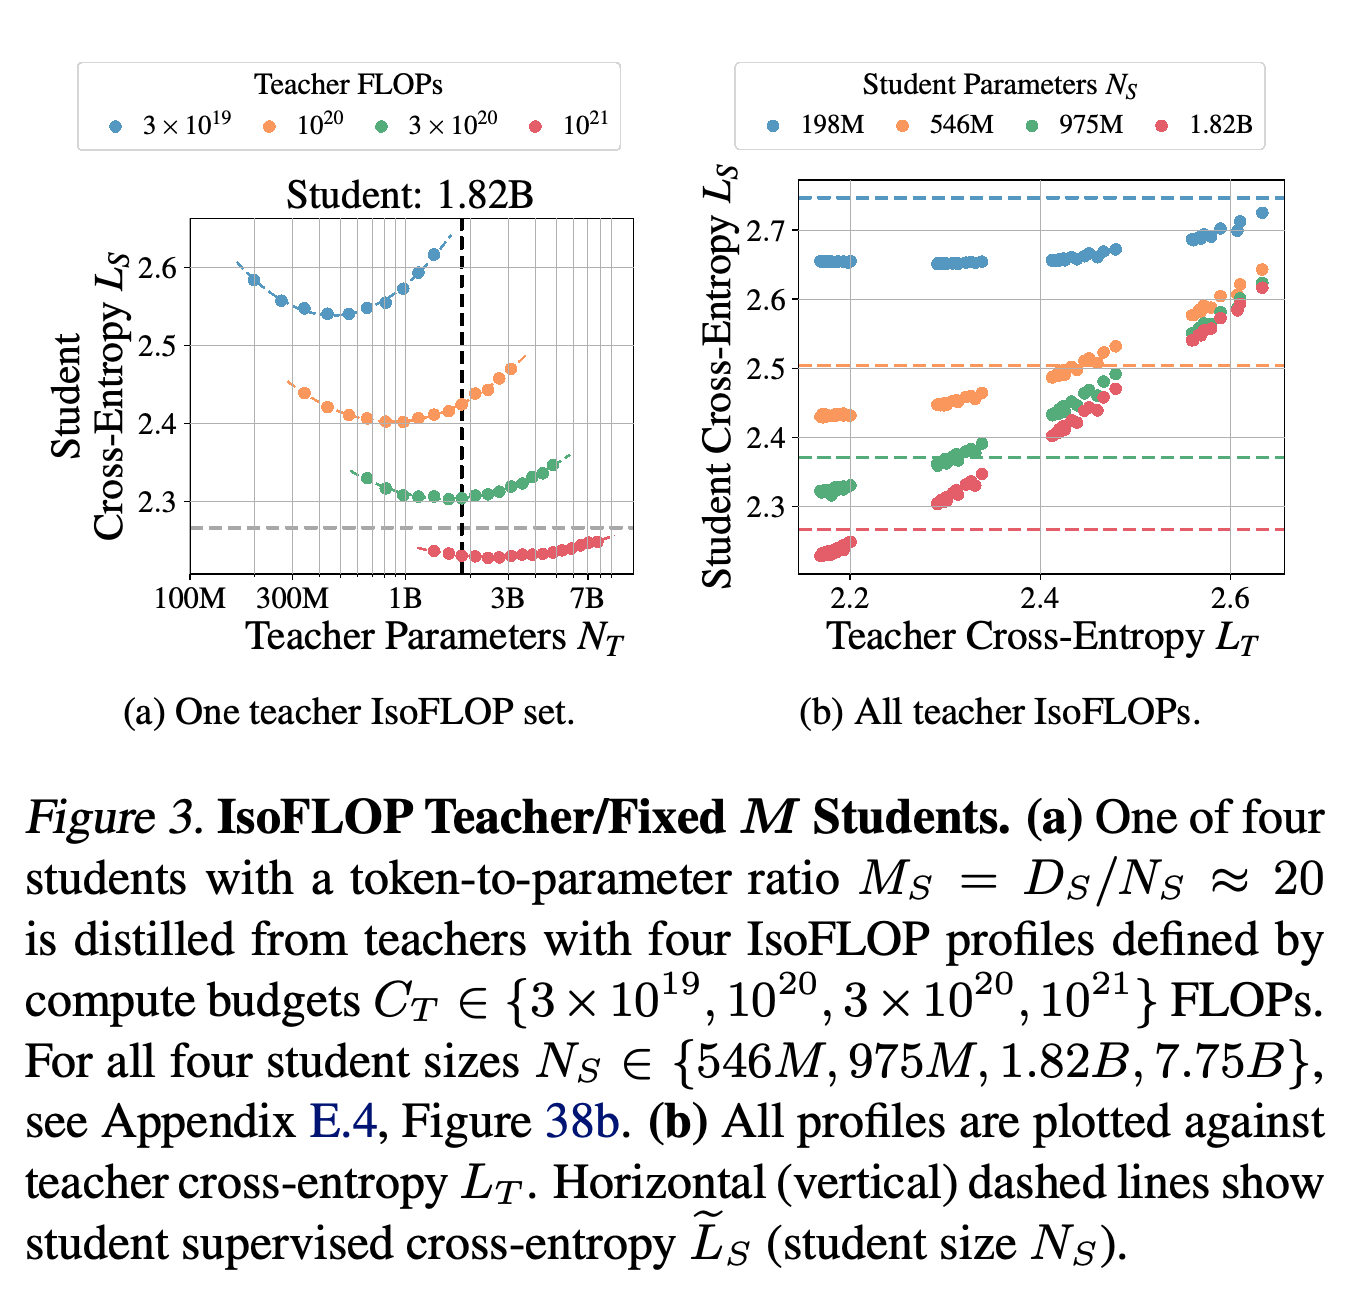
상호 보완적인 3가지 실험 방식으로 학생 자원의 영향과 교사 품질의 영향을 분리한다. fixed-M 교사에 대한 학생 IsoFLOP 프로파일, 고정된 학생에 대한 교사 IsoFLOP 프로파일, 학생 토큰 예산을 바꾼 fixed-M 교사와 학생 조합을 사용한다. fixed-M은 토큰 대 파라미터 비율이 일정하다는 뜻이며, 교사에서는 이 비율이 약 20이다. 주요 계산량 프로파일은 부동소수점 연산 3 × 10^19, 10^20, 3 × 10^20, 10^21을 사용하며, 3 × 10^21에서 수행한 학생 실험도 소수 포함한다.
- Figure 2는 학생 학습 계산량을 고정하면 학생 크기를 키우는 것이 결국 역효과를 낸다는 점을 보여준다. 사용할 수 있는 학습 토큰 수가 줄어들기 때문이다.
- Figure 3은 파라미터와 토큰 배분이 다른 교사도 교사 검증 손실을 기준으로 나타내면 학생 손실이 매끄러운 관계를 이룬다는 점을 보여준다.
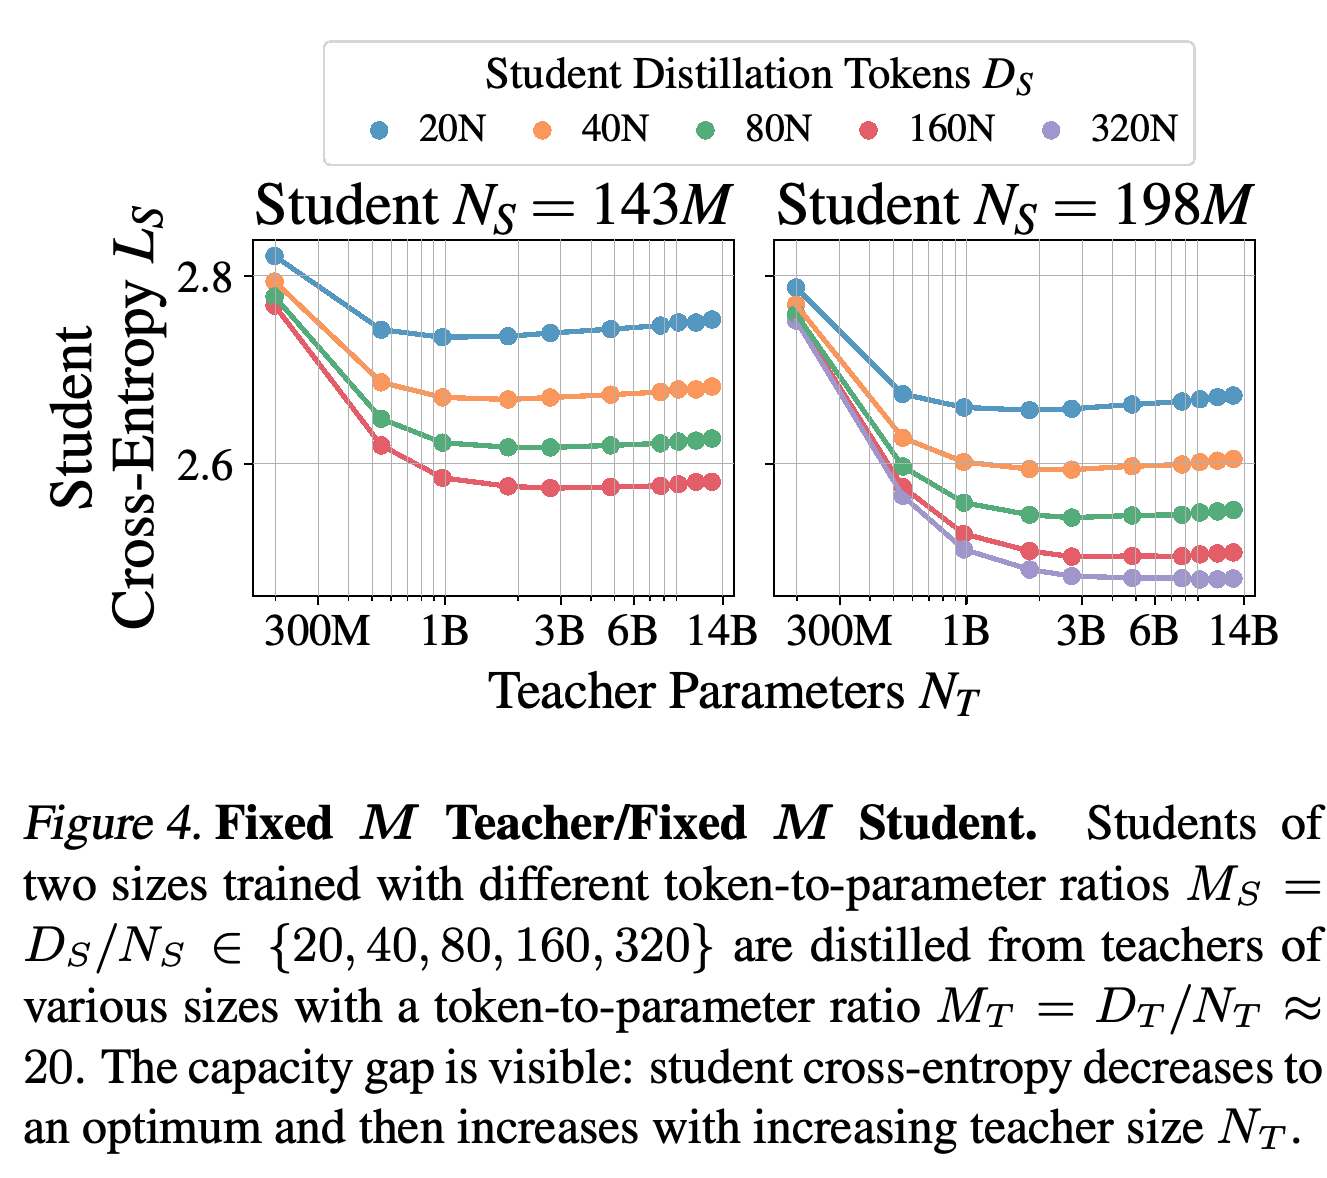
- Figure 4는 capacity gap을 보여준다. 학생 크기와 토큰 예산을 고정하면 교사가 강해질수록 학생 손실이 먼저 감소한 뒤 증가한다. 교사 검증 손실이 개선되는 동안에도 교사와 학생 사이의 KL divergence는 증가한다.
고정 계산량 프로파일은 파라미터 수와 학습 토큰 수를 함께 바꿔야 하는 이유를 보여준다. 학생 크기를 키우면 사용 가능한 토큰 수가 줄어 결국 손실이 높아질 수 있다. 교사 사전학습과 추론 비용을 제외해 학생 학습 자원 배분의 영향을 분리한다.
교사 크기에 따른 결과는 교사 학습 계산량에 따라 달라지지만, 교사 검증 손실을 기준으로 학생 손실을 그리면 각 학생 구성에서 매끄러운 관계가 나타난다. 이는 연구한 설정에서 교사 크기와 교사 토큰 수를 각각 입력하는 대신 교사 손실을 사용하는 방식을 뒷받침한다.
143M 및 198M 학생에서는 fixed-M 교사가 커질수록 학생 손실이 먼저 줄었다가 증가한다. 학생 토큰을 추가하면 곡선이 낮아지지만, 관측된 교사 품질의 최적점이 사라지지는 않는다.
4.3. Distillation Scaling Law Functional Form
식 8은 학생 파라미터와 토큰에 대한 멱법칙에 교사 손실에 대한 broken power law를 결합한다. broken power law는 2가지 멱법칙 구간 사이를 매끄럽게 전환하는 함수이다. 이 식은 능력이 무한한 학생이 교사를 따라가는 경우, 무작위 교사로부터 제대로 배우지 못하는 경우, 교사가 학생에 비해 지나치게 강해져 성능이 저하되는 경우를 포착하도록 설계했다.
- Appendix F.2에서 다시 제시한 프라임 계수 표기를 사용하면 함수 형태는 L_S(N_S,D_S,L_T) = L_T + L_T^(−c_0)[1 + (L_T/(ṼL_S d_1))^(1/f_1)]^(−c_1 f_1)(A′/N_S^α′ + B′/D_S^β′)^γ′이다. 여기서 ṼL_S = L(N_S,D_S)는 대응하는 지도 학습 학생의 손실이다.
- 전환은 L_T/ṼL_S로 나타낸 상대적 학습 능력과 전환 파라미터 d_1에 달려 있다. 따라서 교사 대 학생 파라미터 비율만 보는 것보다 학생 능력에 비춘 교사 품질이 더 유용한 정보를 준다.
4.4. Distillation Scaling Law Parametric Fit
저자들은 교사 실험에 지도 학습 법칙을, 학생 실험에 증류 법칙을 적합했으며 상대 예측 오차가 약 1% 이하라고 보고한다. Figure 5는 약한 모델만으로 적합해 외삽을 검증한다. 적합에 사용한 지도 학습 모델은 L > 2.2, 증류 학생은 L_S > 2.3을 만족한다.
- 제한된 데이터로 적합한 식은 검증 범위에서 손실이 더 낮은 모델도 비슷한 정확도로 예측한다. 이는 적합에 사용한 모델 사이의 보간을 넘어서는 근거를 제공한다.
- 별도의 수치 검증에서는 모델 크기를 고정했을 때 지도 학습과 최적 증류의 무한 데이터 극한이 대략 일치한다. 이 비교는 적합한 계수와 부과한 극한 조건에 의존하며, 무한 데이터 학습을 관측한 결과는 아니다.
제한된 데이터로 적합한 식은 음영으로 표시한 외삽 영역에서도 측정 손실에 가깝게 유지된다. 상대 오차 패널은 평가한 모델에서 보고된 약 1%의 예측 정확도를 뒷받침한다.
5. Distillation Scaling Law Applications
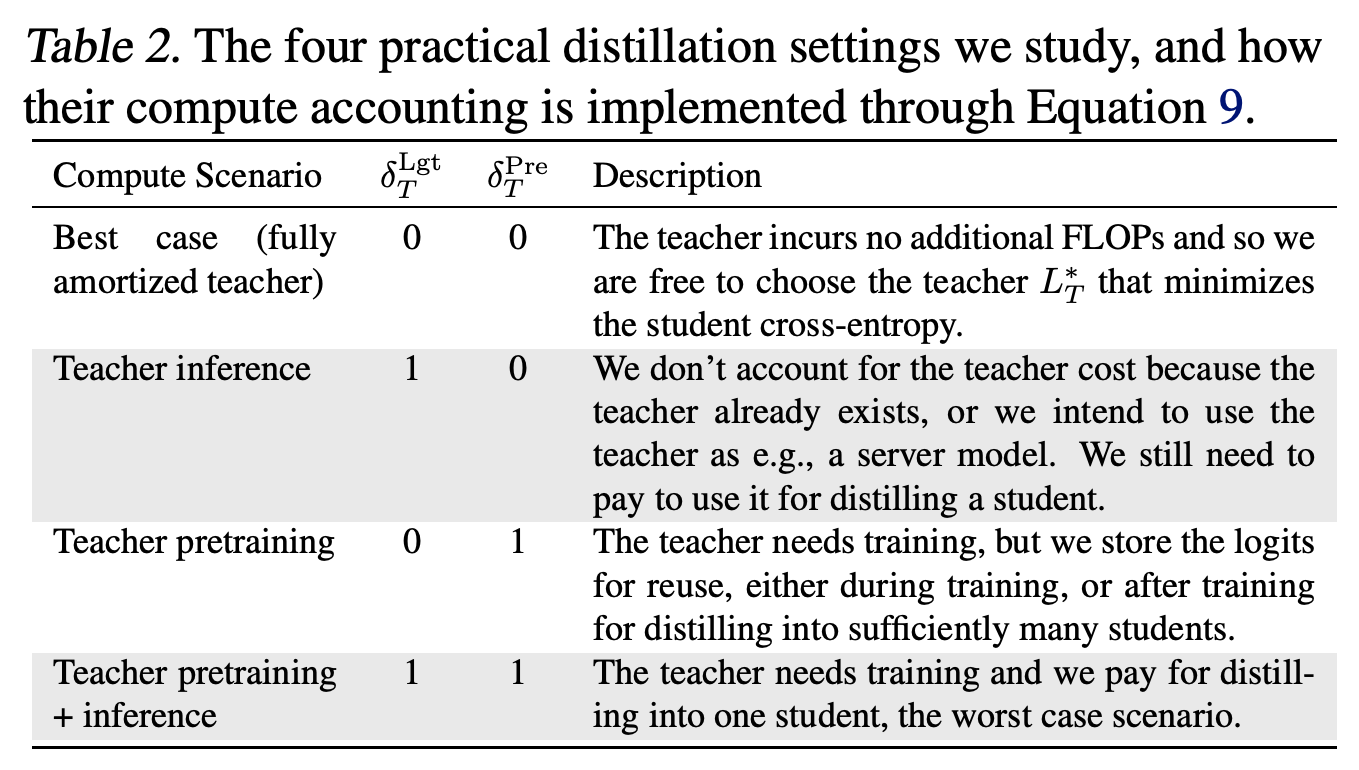
식 9는 학생 학습, 로짓 생성을 위한 교사 추론, 교사 사전학습을 구분해 계산한다. 식은 FLOPs ≈ 3F(N_S)D_S + F(N_T)(δ_T^Lgt D_S + 3δ_T^Pre D_T)이다. FLOPs는 부동소수점 연산 수, F(N)은 토큰당 순전파 부동소수점 연산 수이며, δ 항 2개는 교사 추론과 사전학습 비용을 예산에 포함할지 결정한다.
- Table 2는 교사 비용 2개를 모두 제외하는 설정, 교사 추론을 포함하는 설정, 교사 사전학습을 포함하는 설정, 교사 비용 2개를 모두 포함하는 설정을 정의한다.
- 통상적인 F(N) ≈ 2N 근사는 작은 모델에서 중요한 문맥 및 어휘 관련 비용을 과소평가한다. 논문은 모델 너비와 계층 수의 비율이 일정한 아키텍처에 대한 보정식을 유도한다.
교사 비용 항 2개는 비교에서 어떤 자원을 학생에 부과하는지 결정한다. 기존 교사도 출력이 이미 준비되어 있거나 비용을 분담하는 경우가 아니면 추론 비용이 발생한다. 학생 1개만을 위해 교사를 학습하면 비용 항 2개를 모두 포함한다.
5.1. Fixed Tokens or Compute (Best Case)
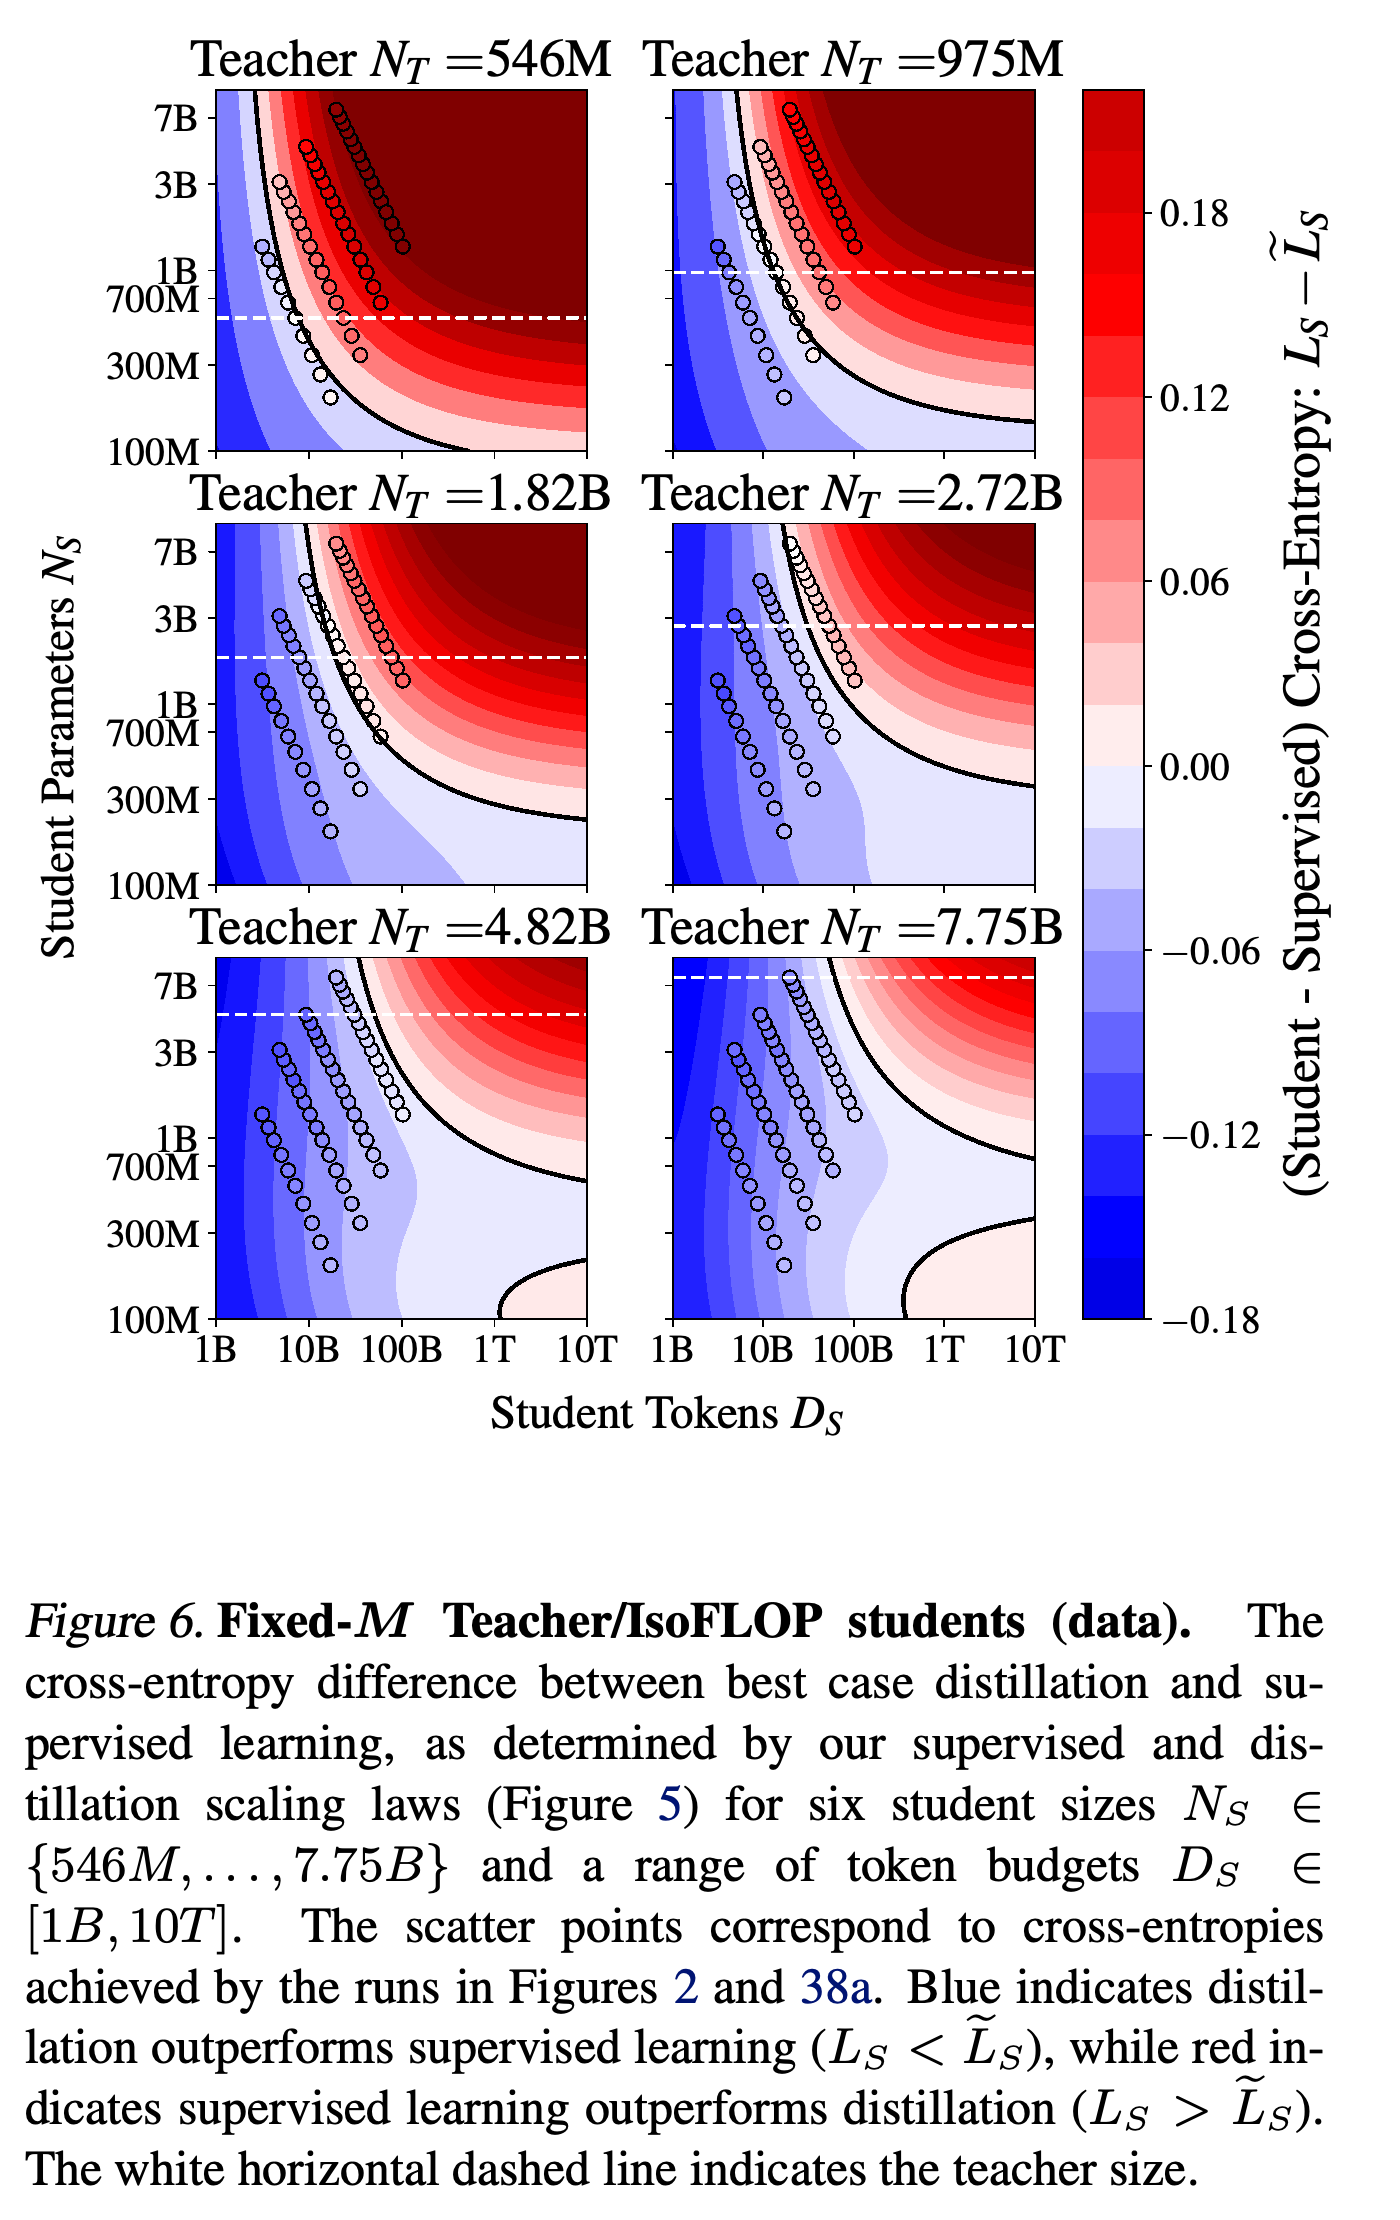
교사 비용을 제외하면 토큰 또는 계산 예산이 크지 않고 교사가 적절할 때 같은 학생 자원을 사용하는 지도 학습보다 증류가 더 좋은 성능을 낼 수 있다. 교사를 고정한 채 학생 자원을 늘리면, 교사를 최적으로 선택하지 않는 한 결국 지도 학습이 유리해진다. 최적으로 선택한 증류는 지도 학습과 같은 극한 성능에 접근한다.
- Figure 6은 학생 크기와 1B부터 10T까지의 토큰 예산에 따른 증류 손실과 지도 학습 손실의 차이를 나타낸다. 적합한 등고선 위에 관측된 실험 결과를 겹쳐 표시한다.
- 이 비교는 지도 학습 대비 효율성을 다룬다. 증류를 더 오래 수행하면 학생의 절대 성능은 개선되더라도 직접 학습보다 효율이 낮아질 수 있다.
파란 영역은 증류가 직접 학습보다 좋은 학생 구성을, 빨간 영역은 지도 학습 베이스라인이 유리한 구성을 나타낸다. 같은 교사를 유지하더라도 학생 토큰 예산을 늘리면 이 경계를 넘어갈 수 있다.
5.2. Fixed Tokens or Compute (Teacher Inference)
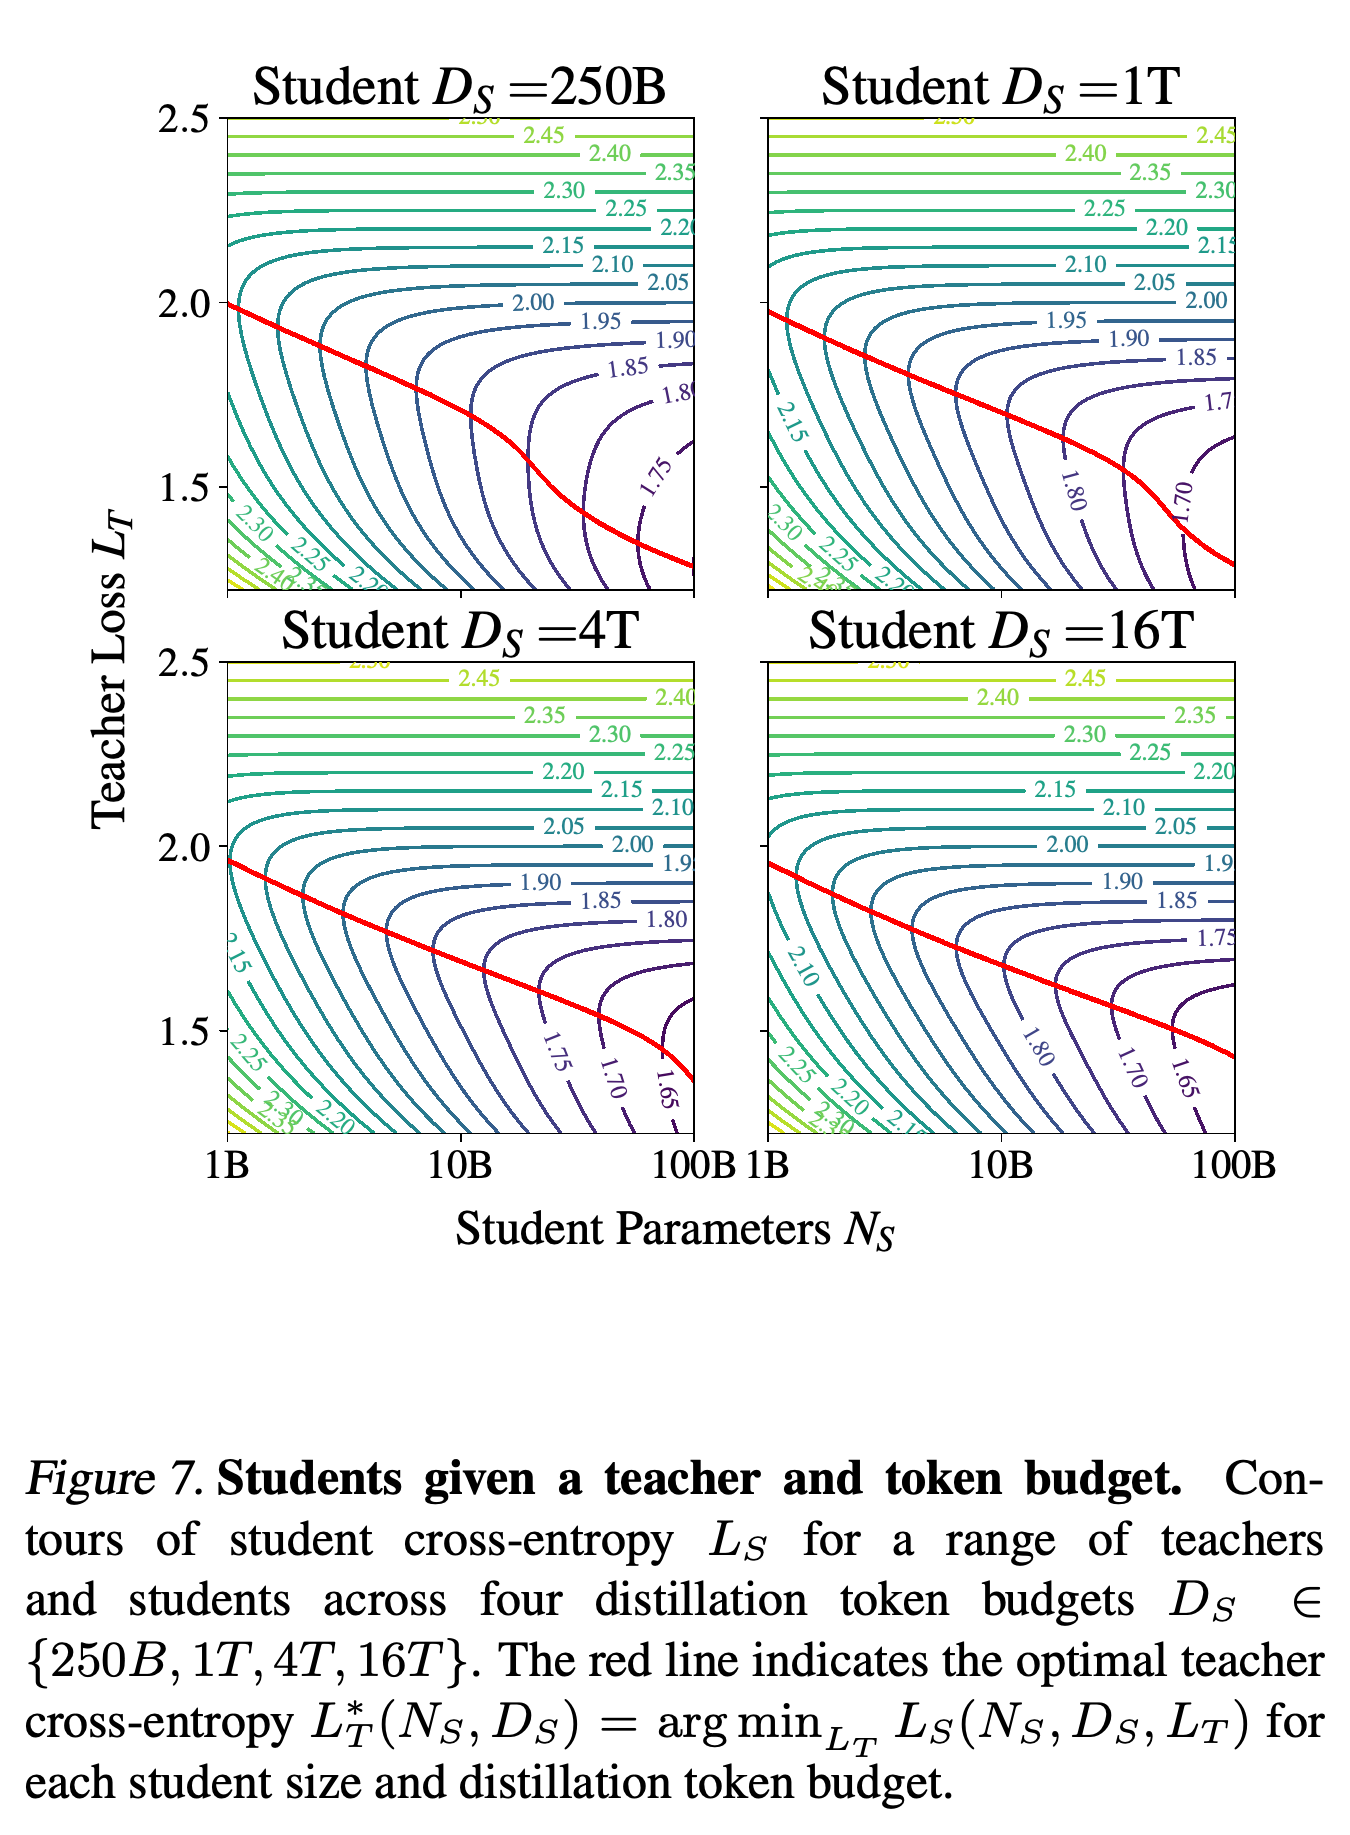
기존 교사 중에서 선택할 때는 교사 품질과 교사 추론 비용 사이에 상충 관계가 생긴다. 큰 교사는 학습 신호를 개선할 수 있지만, 고정된 계산 예산에서 학생에 사용할 수 있는 토큰 수를 줄인다. 토큰 예산을 고정하면 최적 교사 손실은 학생 크기에 따라 대략 멱법칙으로 감소한다. 최적 교사 손실이 대응하는 지도 학습 학생 손실과 같아지는 지점 근처에서는 변화가 더 급격하다.
- Figure 7은 250B, 1T, 4T, 16T의 토큰 예산을 평가하고, 각 학생 크기에서 학생 손실을 최소화하는 교사 손실을 찾는다.
- 품질을 나타내는 핵심 변수는 교사 검증 손실이다. 추론 비용을 예산에 포함하면 교사 파라미터 수도 추가로 중요해진다.
빨간 최소화 곡선은 교사 선택이 학생 크기와 토큰 예산에 달려 있음을 보여준다. 학생을 고려하지 않고 손실이 가장 낮은 교사를 선택하면 capacity gap 때문에 최적점에서 멀어질 수 있다.
5.3. Compute Optimal Distillation
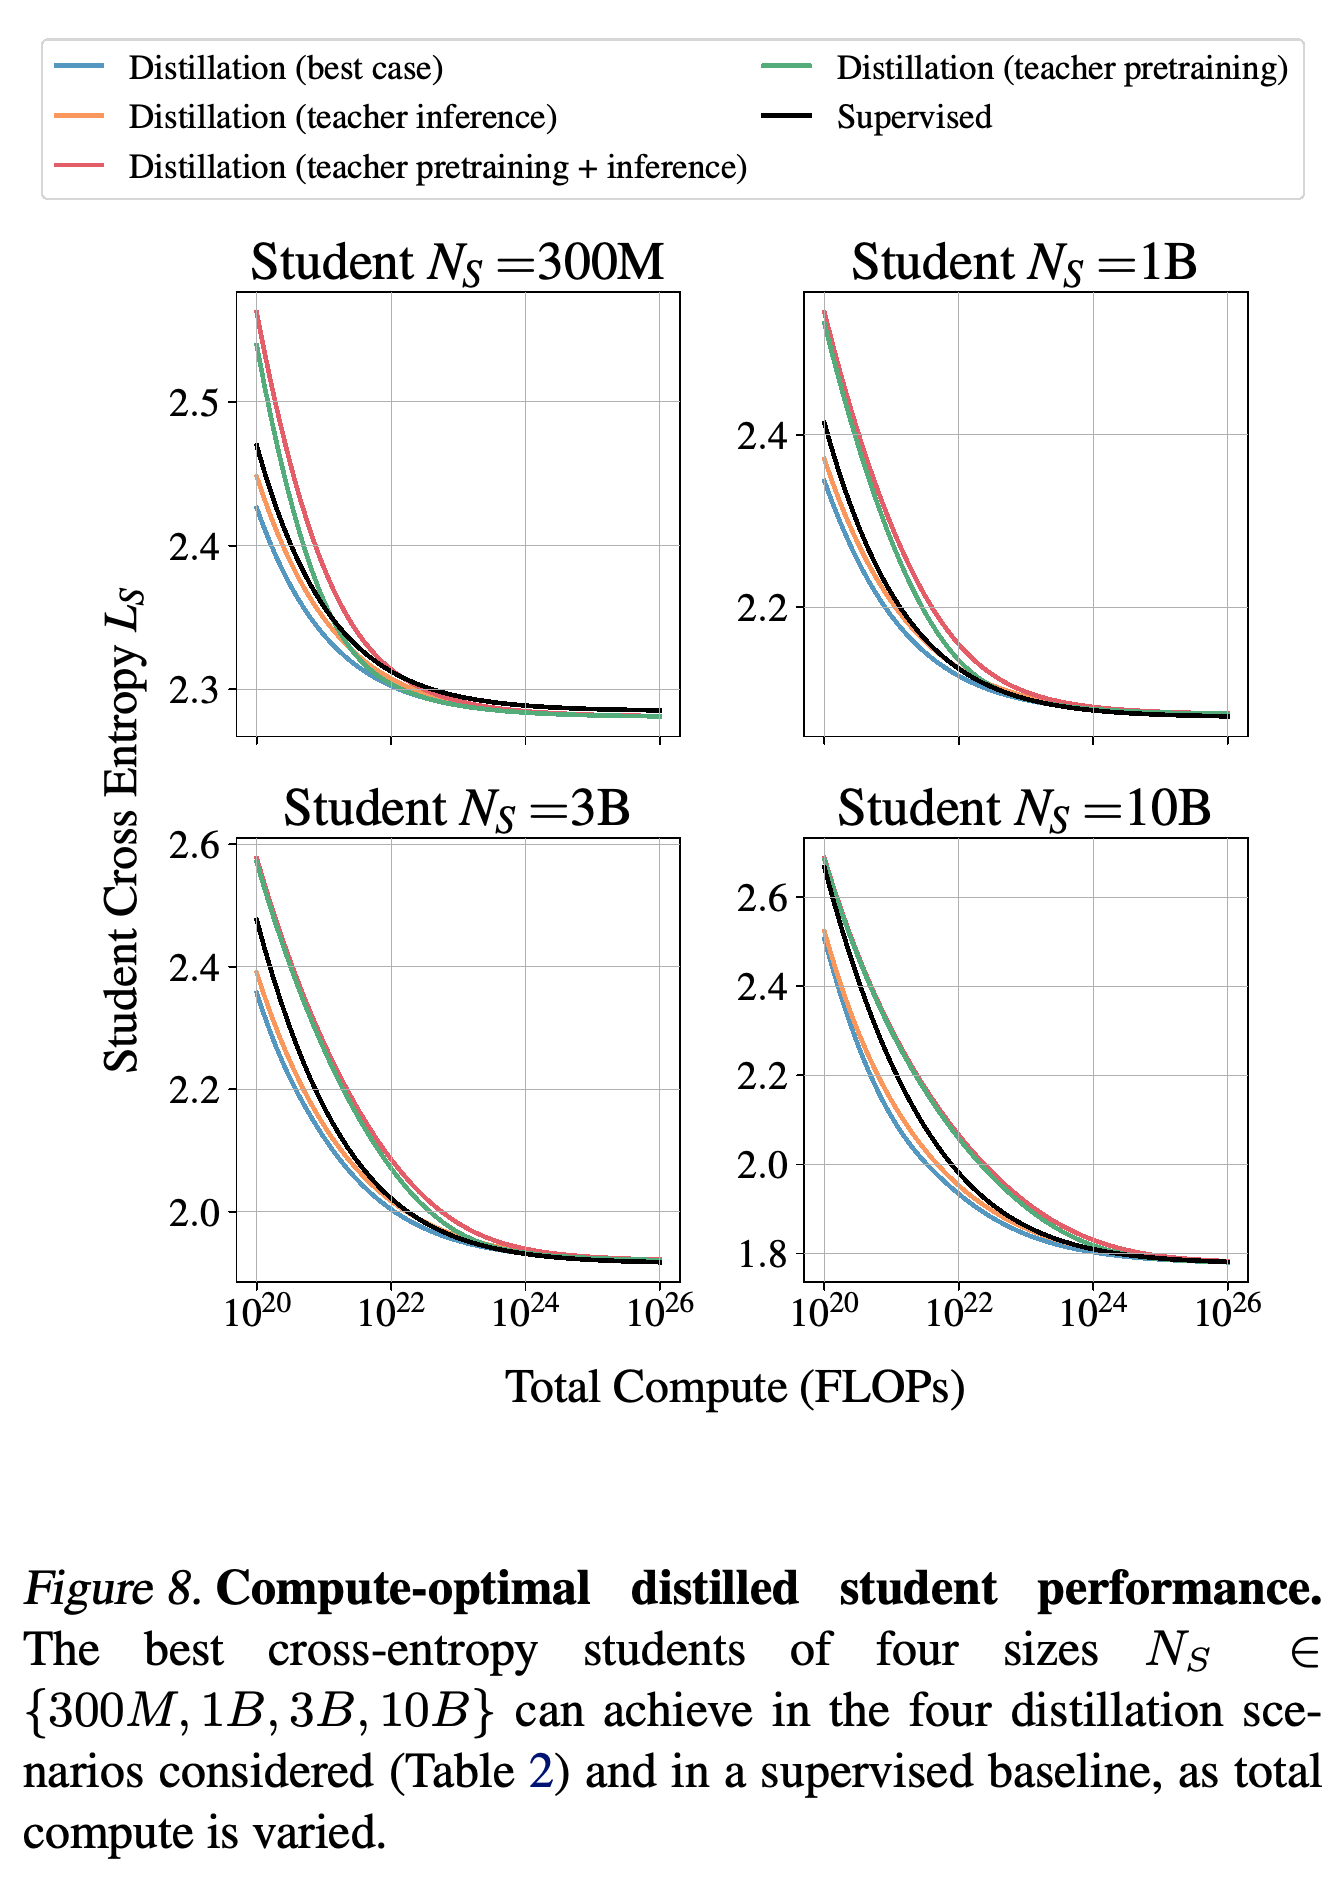
식 10은 학생 크기가 주어졌을 때 계산 예산 제약 아래에서 학생 토큰 수, 교사 크기, 교사 학습 토큰 수를 조정해 예측 학생 손실을 최소화한다. 수치해를 구할 때는 SciPy에 구현된 제약 최적화 방법인 Sequential Least SQuares Programming을 사용한다.
- Figure 8은 교사 사전학습을 제외하면 낮은 계산량에서 증류의 이득이 나타나고, 지도 학습이 이를 따라잡는 계산량은 학생 크기에 따라 증가한다는 점을 보여준다.
- 교사 사전학습 비용을 학생 1개에 부과하면 예측 손실이 직접 지도 학습보다 높다. 예산이 매우 커지면 손실은 서로 가까워진다. 교사를 재사용하거나 여러 학생이 비용을 분담하면 비용 계산이 달라질 수 있다.
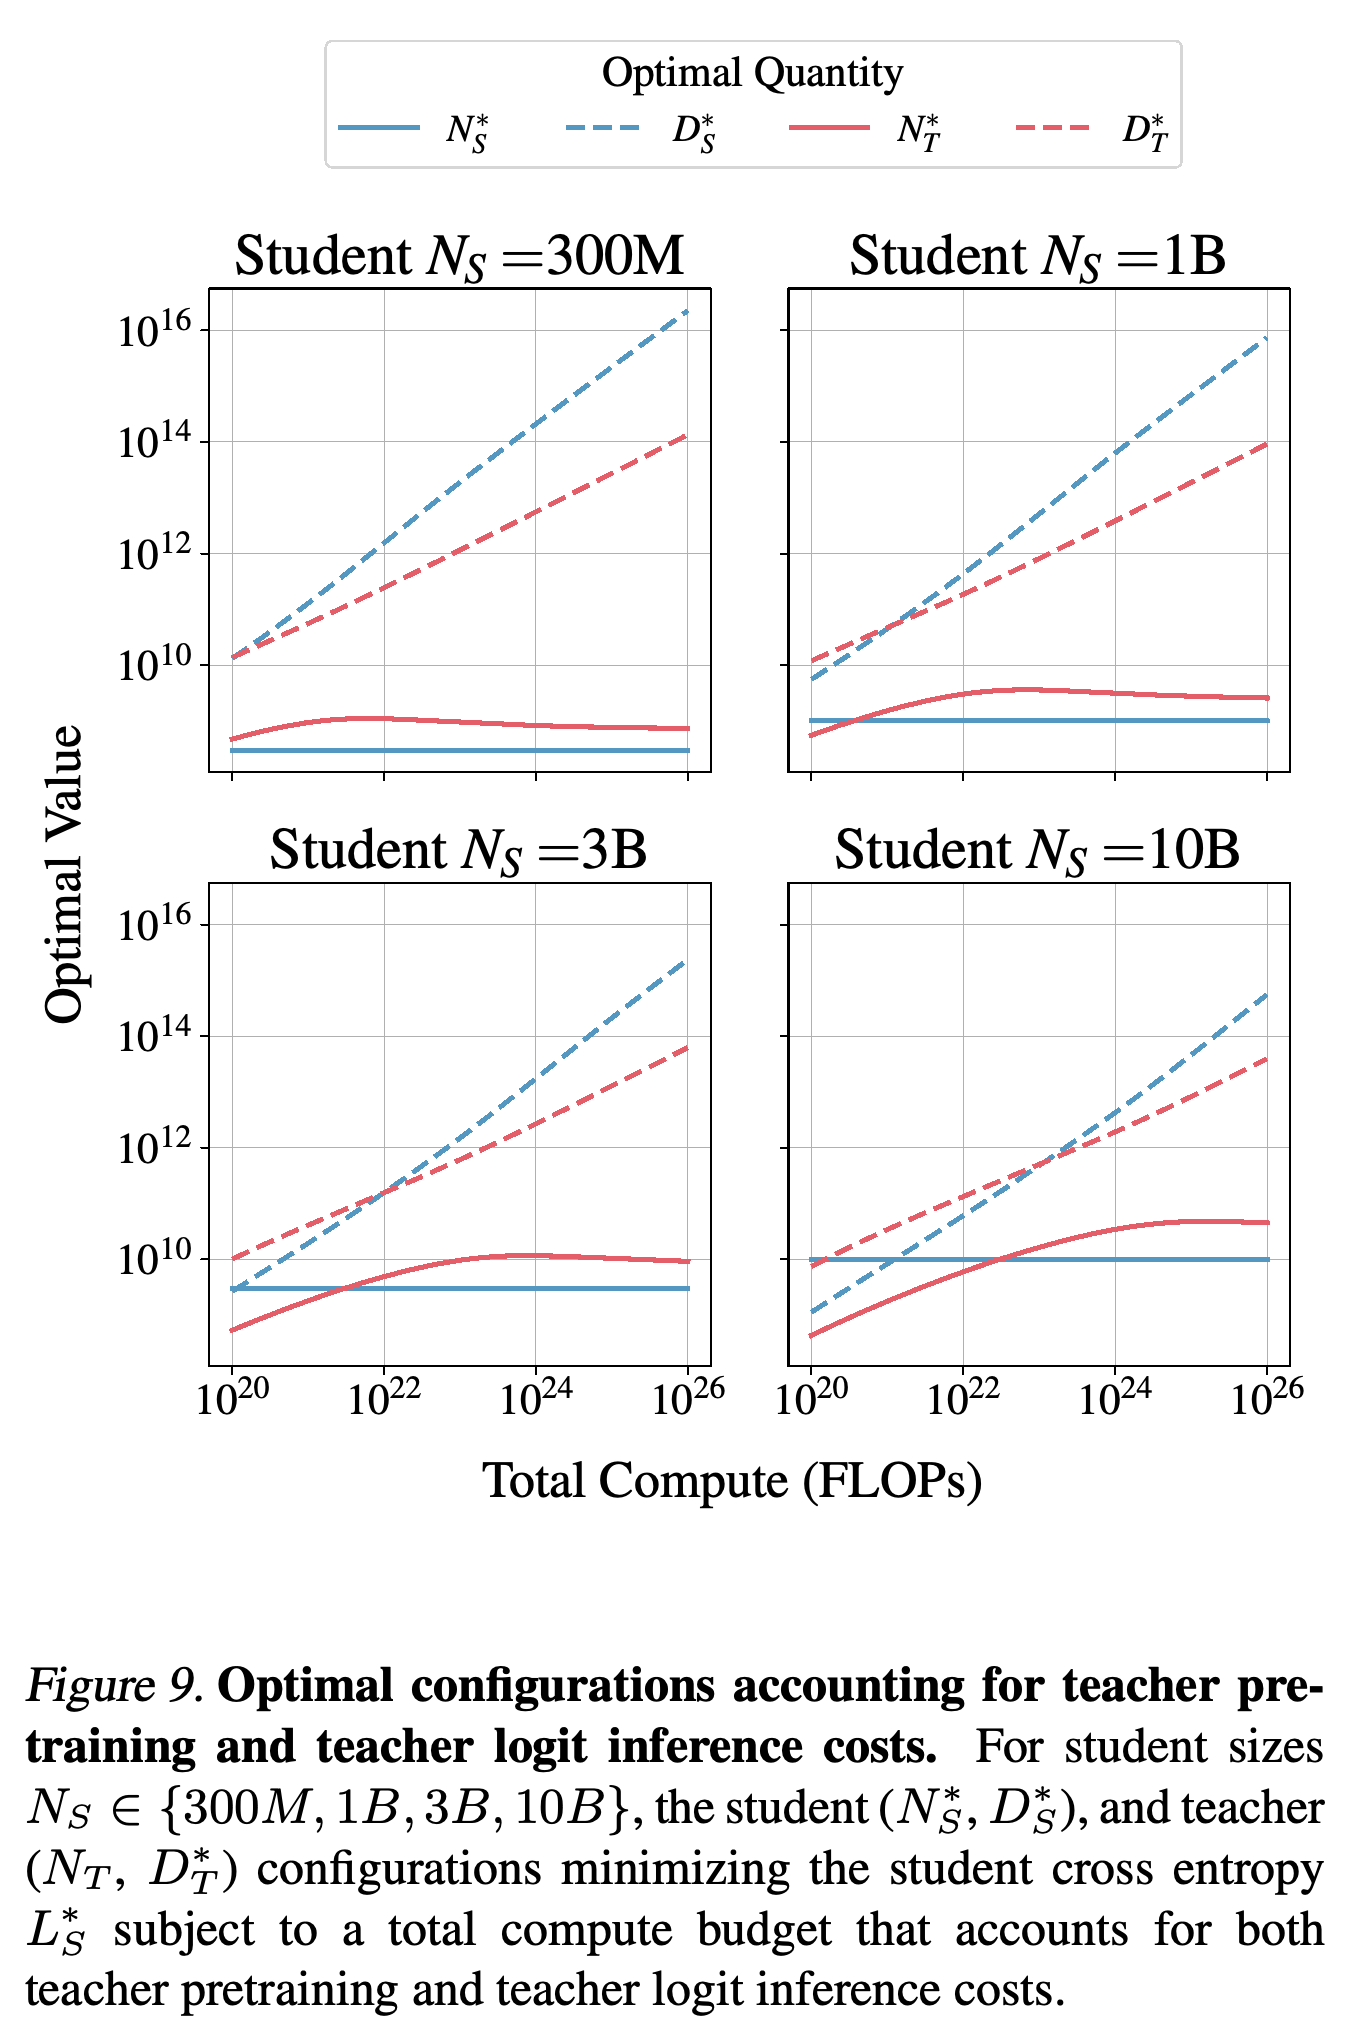
- 교사 비용 2개를 모두 포함하면 Figure 9는 학생 토큰 수가 교사 토큰 수보다 빠르게 증가한다고 예측한다. 교사 크기는 처음에 증가한 뒤 정체하거나 조금 감소하므로, 교사 크기를 계속 키우는 것보다 교사를 추가 학습하는 편이 더 경제적이다.
곡선은 교사 사전학습을 제외할 때 얻을 수 있는 이득과 교사를 만드는 비용까지 부과하는 비교를 구분한다. 증류가 유리한 계산량 범위는 학생 크기에 따라 넓어지며, 더 큰 예산에서는 지도 학습이 같은 극한 손실에 접근한다.
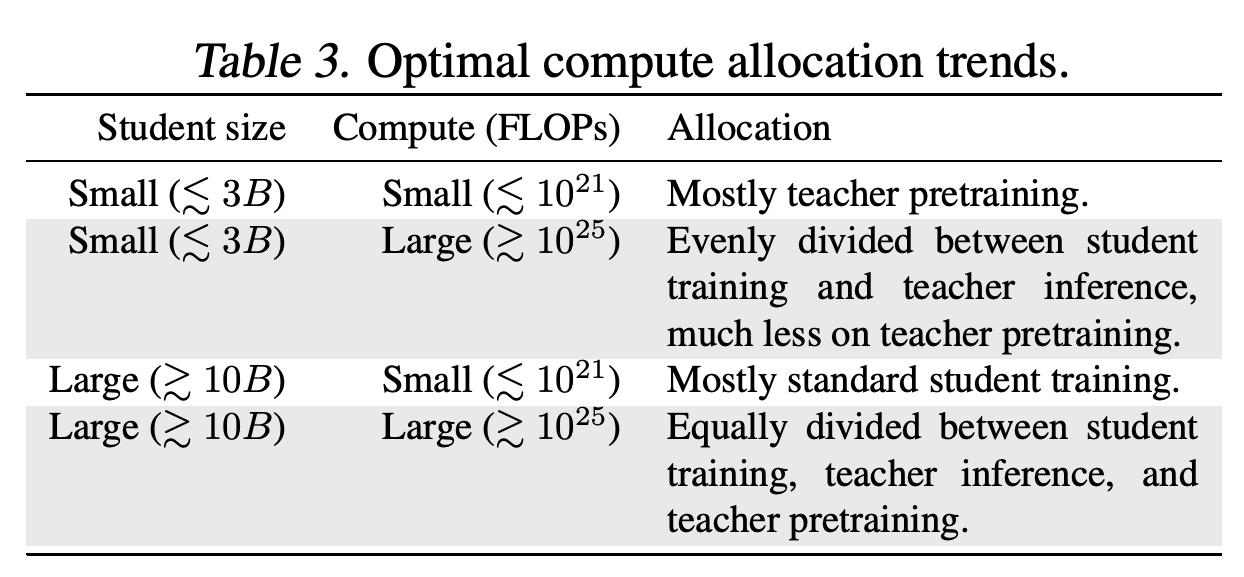
교사 비용 2개를 모두 포함하는 설정에서, 작은 예산의 작은 학생은 주로 교사 사전학습에, 작은 예산의 큰 학생은 주로 학생 학습에 계산량을 배분한다. 큰 예산의 작은 학생은 교사 사전학습에 거의 배분하지 않고 학생 학습과 교사 추론에 대략 균등하게 배분한다. 큰 학생은 3개 구성 요소 모두에 대략 같은 양을 배분한다. 이는 정확한 배분 규칙이 아니라 구간별 경향을 정성적으로 요약한 결과이다.
학생 토큰 수는 교사 토큰 수보다 빠르게 늘어나며, 교사 파라미터 수는 처음에 증가한 뒤 정체하거나 조금 감소한다. 적합한 법칙에서 구한 이 최적점들은 반복적인 교사 추론 비용이 커질 때 적당한 크기의 교사를 추가 학습하는 방향으로 이동하는 이유를 설명한다.
6. Conclusion
논문은 교사 선택과 비용 계산을 명시한 자원 배분 모델을 제공한다. 교사 비용을 이미 지불했거나 충분히 분담할 수 있다면, 학생 크기에 따라 정해지는 자원 임계값 아래에서 증류가 더 효율적일 수 있다. 논문의 비교에서는 학생 1개만을 위해 교사를 학습하는 방식이 대체로 직접 지도 사전학습보다 불리하다.
Impact Statement
Impact Statement는 추론 비용 절감, 불필요한 학습 실험 방지, 성능이 좋은 작은 모델의 접근성 향상을 잠재적 이점으로 제시한다. 이는 학습 자원 배분 개선으로 기대하는 결과이며, 배포나 탄소 배출량을 측정한 결과는 아니다.
- 저자들은 교사의 편향을 물려받는 문제와 표적 허위 정보 유포 등 악용 비용이 낮아지는 문제도 효율적인 증류 모델의 잠재적 부작용으로 지적한다.
부록
- A. Limitations는 근거의 범위를 English C4 언어 모델링, transformer 교사와 학생 아키텍처, 같은 분포에서 추출한 학습 분할로 제한한다. 긴 실험에서는 데이터를 반복하며, 추론 평가는 제한적이고, 적합한 계수는 해당 아키텍처와 데이터셋에 한정된다. 이 법칙은 제1원리에서 유도한 법칙이 아니라 경험적 법칙이며, 생성된 토큰 시퀀스로 학습하는 Sequence-Level Knowledge Distillation에 적용할 수 있는지는 검증되지 않았다.
- B. Extended background는 관련 근거를 검토한다. B.1. Knowledge Distillation은 교사의 예측 분포와 일치하는 정도인 fidelity를 학생의 일반화와 구분한다. 또한 증류를 오래 수행하면 절대 성능은 개선되면서도 같은 자원을 사용하는 지도 학습 베이스라인 대비 효율은 낮아질 수 있는 이유를 논의한다. B.2. Neural Scaling Laws는 이 연구를 자원 스케일링 및 데이터 분포 간 전이와 연결한다. B.3. The Knowledge Distillation Capacity Gap은 설명과 완화 방법을 검토하고, 교사 손실이 교사 크기와 학습 기간 모두의 영향을 포착한다고 주장한다.
- C. Teacher Student Capacity Gaps는 통제된 실증 2가지를 제공한다. C.1. Kernel Regression은 기저 함수가 생성하는 공간에서 함수를 적합하는 방법이다. C.1.1. SETUP과 C.1.2. DISTILLING THE TEACHER에서는 무한 데이터 조건에서 유한한 기저 집합과 노름 제약을 사용해 최적 교사 함수와 학생 함수를 유도한다. C.1.3. U-SHAPE IN THE STUDENT ERROR는 교사 용량 m이 학생 용량 n보다 작을 때 학생 오차가 증가하지 않고, m ≥ n에서는 감소하지 않는다는 점을 확립한다. 교사 기저 함수를 추가하면 학생이 표현할 수 있는 성분에 대한 교사의 배분이 줄어들 수 있다. C.2. MLPs on the Mapping Problem은 C.2.1. PROBLEM DEFINITION과 C.2.2. EXPERIMENTAL FINDINGS에서 직접적인 위치 식별과 문맥에 따른 재매핑을 결합한 합성 과제를 검증한다. 다층 퍼셉트론인 MLP는 순전파 신경망이며, 여기서는 너비가 같은 은닉층 2개를 사용한다. 적응형 경사 최적화 알고리즘인 Adam, 최대 학습률 3 × 10^−4, 배치 크기 512, 반복하지 않는 표본으로 학습한다. 너비가 256인 학생은 교사 너비나 교사 학습 기간이 늘어날수록 성능이 먼저 개선된 뒤 저하된다. 그림은 4회 실험에서 얻은 25%와 75% 값을 보고한다.
- D. Distillation scaling law applications (additional results)는 자원 비교를 확장한다. D.1. Experimental differences resolving the apparent contradiction with patient teachers는 데이터 접근과 지도 학습 베이스라인의 차이를 설명한다. D.2. Fixed tokens or compute (best case)는 교사 자원에 따른 이득과 학생이 결국 포화하는 현상을 구분한다. D.3. Fixed size or compute (teacher inference)는 추론 비용 때문에 학생 토큰이 너무 적게 남으면 더 강한 교사가 유리하지 않을 수 있음을 보여준다. D.4. Compute optimal distillation과 D.4.1. SETUP은 수치 최적화에서 교사 크기와 토큰 수를 [1M,100P] 범위까지 허용한다. P는 10^15를 뜻하며, 이 범위는 사용 가능한 데이터 자원을 의도적으로 넘어선다. D.4.2. CROSS-ENTROPY는 학생 크기 8개를 비교한다. D.4.3. DISTILLATION (BEST CASE)에서는 선택한 교사 손실에 대응하는 교사 크기와 학습 토큰 수가 유일하게 정해지지 않는다. D.4.4. DISTILLATION (TEACHER INFERENCE)은 과도하게 학습한 교사를 선호하며 교사 토큰 수를 최적화 상한인 10^17까지 늘린다. D.4.5. DISTILLATION (TEACHER PRETRAINING)은 지도 학습 계산 최적 교사를 선호한다. D.4.6. DISTILLATION (TEACHER PRETRAINING + INFERENCE)은 학생 토큰 비용이 커질수록 계산 최적 교사에서 과도하게 학습한 교사로 이동한다. D.4.7. OPTIMAL TEACHER TRAINING AND STUDENT DISTILLATION TOKENS는 시나리오별 수준 차이는 있지만 학생 토큰 수의 증가율은 비슷하고, 교사 토큰 수는 서로 다른 경로를 따른다는 점을 확인한다. D.4.8. OPTIMAL TEACHER SIZE도 비용 시나리오별 교사 크기의 변화 경로를 비교한다. D.5. Compute and data efficiency gains for distillation compared to supervised learning은 같은 학생 손실에 필요한 지도 학습 자원에 대한 비율로 증류 계산량과 토큰 수를 나타낸다. 교사 토큰은 교사 사전학습 비용을 부과할 때만 포함한다. 저자들은 증류로 시작해 포화에 가까워지면 지도 학습으로 전환하는 전략을 제안하지만, 이 전략을 검증하지는 않는다.
- E. Additional Results는 E.1. Downstream evaluations로 시작한다. 지도 학습 모델과 증류 모델은 검증 손실과 표준 영어 과제 성능 사이에서 비슷한 관계를 보인다. 과학 질문 벤치마크인 ARC Easy와 ARC Challenge, 문장 완성 벤치마크인 HellaSwag, 물리적 상식 벤치마크인 Piqa, 과학 질문 벤치마크인 Sciq, 대명사 지시 대상 판별 벤치마크인 WinoGrande, 문맥 기반 단어 예측 벤치마크인 Lambada OpenAI는 시범 예시를 0개 사용하는 zero-shot으로 평가한다. 질의응답 벤치마크인 TriviaQA와 WebQS는 예시 1개를 사용한다. 수학 문장제 벤치마크인 GSM8K는 중간 추론 시범이 포함된 예시 8개를 사용하고, 다중 과제 지식 벤치마크인 MMLU는 예시 5개를 사용한다. 다만 후자의 평가에서는 대부분의 모델이 무작위에 가까운 성능을 보여 추론 능력에 관한 결론이 제한된다. E.2. Teachers used in distillation은 fixed-M, 512B 토큰, IsoFLOP 지도 학습 교사 실험을 기록한다. E.3. Fixed-M teacher/fixed-M students and the capacity gap은 교사와 학생 사이의 divergence가 증가하는 현상을 보여준다. E.4. Full distillation scaling law IsoFLOP profiles와 E.5. Distillation scaling law IsoFLOP optima는 전체 자원 탐색 결과와 최솟값을 제공한다. E.6. Distillation with infinite data는 적합한 법칙에 부과한 조건 아래에서 최적 증류 손실과 지도 학습 손실의 극한이 수치적으로 대략 일치하는지 확인한다. E.7. Weak-to-strong generalization은 학생이 교사보다 좋은 성능을 내는 현상을 뜻한다. 검토한 설정에서는 이 현상이 유한 데이터 영역에서 나타나며, 증류를 충분히 오래 수행하면 학생이 교사의 동작에 수렴하는 모습을 관측한다. E.8. Model calibration은 21개 구간에 걸친 Expected Calibration Error인 ECE로 예측 확신도와 관측 정확도의 일치도를 측정한다. 또한 교사와 학생의 확률을 비교하는 분포 기반 변형을 도입한다. E.8.1. TEACHERS는 전반적으로 낮은 오차를 보여 교사의 보정 오류만으로 capacity gap을 설명할 수 없음을 나타낸다. E.8.2. 198M STUDENTS TRAINED ON 20N TOKENS와 E.8.3. 198M STUDENTS TRAINED ON 128B TOKENS는 전체 분포로 학습할 때 교사가 가장 높은 확률을 부여한 토큰만으로 학습할 때보다 실제 데이터에 대한 보정을 훨씬 잘 유지한다는 점을 보여준다. 학습 목표와 평가 대상이 일치하면 더 긴 학습이 보정을 개선한다.
- F. Scaling coefficients는 F.1. Supervised scaling law coefficient estimation, F.2. Distillation scaling law coefficient estimation, F.3. Scaling law coefficients parameteric fit으로 구성된다. 이 절은 이차 페널티와 선형 페널티를 결합하는 Huber loss, 임계값 δ = 10^−4, 여러 L-BFGS-B 초기화를 사용한 로그 공간 적합을 설명한다. L-BFGS-B는 변수 경계를 다루는 수치 최적화 절차이다. Table 6은 지도 학습 73회와 증류 697회의 적합 실험을 보고한다. 적합 데이터에서 표본을 반복 추출하는 부트스트랩 재표집 4096회로 90% 신뢰구간을 구한다. 증류 추정치에는 α′ = 0.321, β′ = 0.637, γ′ = 0.764, c_0 = 2.549, c_1 = 522.6, f_1 = 0.090, d_1 = 1.315가 포함된다.
- G. Distilling language models in practice는 구현상의 선택을 검증한다. G.1. Mixing coefficient (λ) sensitivity analysis는 약한 교사를 제외하면 λ > 0.5에서 학생 손실이 대체로 일정하다는 점을 확인한다. G.2. Temperature (τ) sensitivity analysis는 τ ∈ [0.5,10]에서 τ = 1이 가장 좋다는 점을 확인한다. G.3. Learning rate (η) sensitivity analysis, verification of µP for distillation은 검증한 구성에서 [0.001,0.1] 범위를 탐색해 η = 0.01을 뒷받침한다. G.4. Distribution truncation methods: Top-k and Top-p sensitivity는 교사 확률 중 가장 큰 k개 또는 누적 확률 p에 도달하는 최소 집합을 유지한다. 이는 순수 증류 성능을 저하시키지만, k = 128과 λ = 0.7을 사용하면 전체 분포 성능과의 차이가 0.01 nats 이내이다. nat는 자연로그를 사용하는 손실 단위이다. G.5. Forward and reverse KL divergence는 차이 측정식에서 교사와 학생 인수의 순서를 바꾼다. 1.82B 교사와 546M 학생의 손실은 순방향에서 2.42, 역방향에서 2.70으로, 이 비교에서는 순방향 KL이 0.28 nat만큼 유리하다.
- H. Parameters and Floating Operation Estimation은 H.1. Alternative approximation for FLOPs per token as a function of N, H.2. Model parameters, H.3. FLOPs per token을 통해 단순한 2N 추정에서 빠진 어텐션 문맥 비용과 어휘 투영 비용을 포함한다. 또한 미래 토큰을 제외하는 효율적인 causal attention을 반영한다. 식 69는 C_Forward = 2N(1 + σ_1 n_ctx/N^(1/3) + σ_2 n_vocab/N^(2/3))이다. n_ctx는 문맥 길이, n_vocab은 어휘 크기이며, σ_1과 σ_2는 아키텍처 비율에 따라 달라진다. Table 13은 보정의 효과를 보여준다. 143M 모델에서 2N 추정의 상대 오차는 −36.10%이고 보정 추정의 상대 오차는 −0.34%이다.
- I. Model architecture는 학습 라이브러리 AXLearn, 가중치 감쇠 10^−4, 최대 학습률 1e−2, 그래디언트 전역 노름 상한 1.0, 워밍업 2000스텝, 코사인 학습률 감쇠, Z-loss 계수 10^−4를 명시한다. 모델의 너비 대 계층 수 비율은 128, 순전파 계층 비율은 8/3, rotary embedding의 기본 주파수는 500k이다.
- J. Contributions는 실험, 적합, 이론, 평가, 절제 실험에 대한 저자별 기여를 명시하며, 모든 저자가 집필, 실험 설계, 논의에 기여했다고 밝힌다.
짧은 생각
교사 품질과 교사 비용을 명확히 구분하므로 실험 계획에 유용한 결과이다. Figures 3–5는 손실 기반 예측을 뒷받침하고, Table 2와 Figure 8은 비용 계산 방식에 따라 지도 학습과의 비교가 어떻게 달라지는지 보여준다. 검증한 외삽은 유사한 실험 설정에서 계획을 세우는 데 근거가 되지만, 관측한 모델 및 데이터 범위를 훨씬 벗어난 수치적 최적점을 실제 배포 지침으로 검증한 것은 아니다.
근거가 가장 강한 대상은 전체 분포를 사용하는 사전학습 증류이다. 생성 시퀀스 증류와 추론은 입증된 범위 밖에 있다. 부록의 일부 세부 사항은 주의해서 읽어야 한다. E.8.3의 제목은 128B 토큰을 명시하지만 첫 문단은 약 512B라고 서술한다. D.5에서 사전학습 + 추론 설정의 사례로 제시한 내용은 앞선 비교 및 그래프의 비용 비율과 충돌한다. 이 불일치 때문에 해당 부록의 구체적인 수치는 불확실하다. 본문의 비교는 교사 학습 비용 전부를 학생 1개에 부과하면 지도 학습이 유리하다는 결과를 일관되게 보인다.