


Dolphins: Multimodal Language Model for Driving 요약 설명
01 Dec 2023 | Paper Review Vision-Language Models Autonomous Driving Instruction Tuning Multimodal Learning목차
이번 글에서는 Dolphins: Multimodal Language Model for Driving 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 12월 1일(Arxiv)
- Ma, Yingzi, Cao, Yulong, Sun, Jiachen, Pavone, Marco, Xiao, Chaowei.
- University of Wisconsin-Madison, NVIDIA, University of Michigan, Stanford University
- 논문 링크
- Github
요약
- Dolphins는 주행 보조 시스템이 다양한 도로 상황에서 영상을 해석하고, 질문에 답하며, 차량 행동을 추론하는 문제를 다룬다. 터널을 다룬 정성적 사례에서 모델은 프롬프트에 예시가 주어지면 시간을 판단할 수 없다고 답하지만, 예시가 없으면 밤이라고 답한다. 논문은 비교 정확도 점수를 보고하지 않는다.
- 시각 입력과 언어를 결합하는 비전-언어 모델은 OpenFlamingo를 기반으로 하며, 먼저 근거에 기반한 추론 예시로 튜닝한 뒤 주행 지시 데이터로 튜닝한다. 시연에서는 인지, 계획, 대화, 교정 피드백에 대한 응답을 다룬다.
- 주행 데이터셋에는 영상, 지시, 답변으로 구성된 triplet 32k개가 있으며, 이 중 11k개는 ChatGPT로 생성한 상세 대화다. 저자들은 DriveLM에서 NVIDIA A100을 사용했을 때 평균 추론 시간이 1.34초라고 보고하고, 연산 비용을 배포의 제약으로 지목한다.
1 Introduction
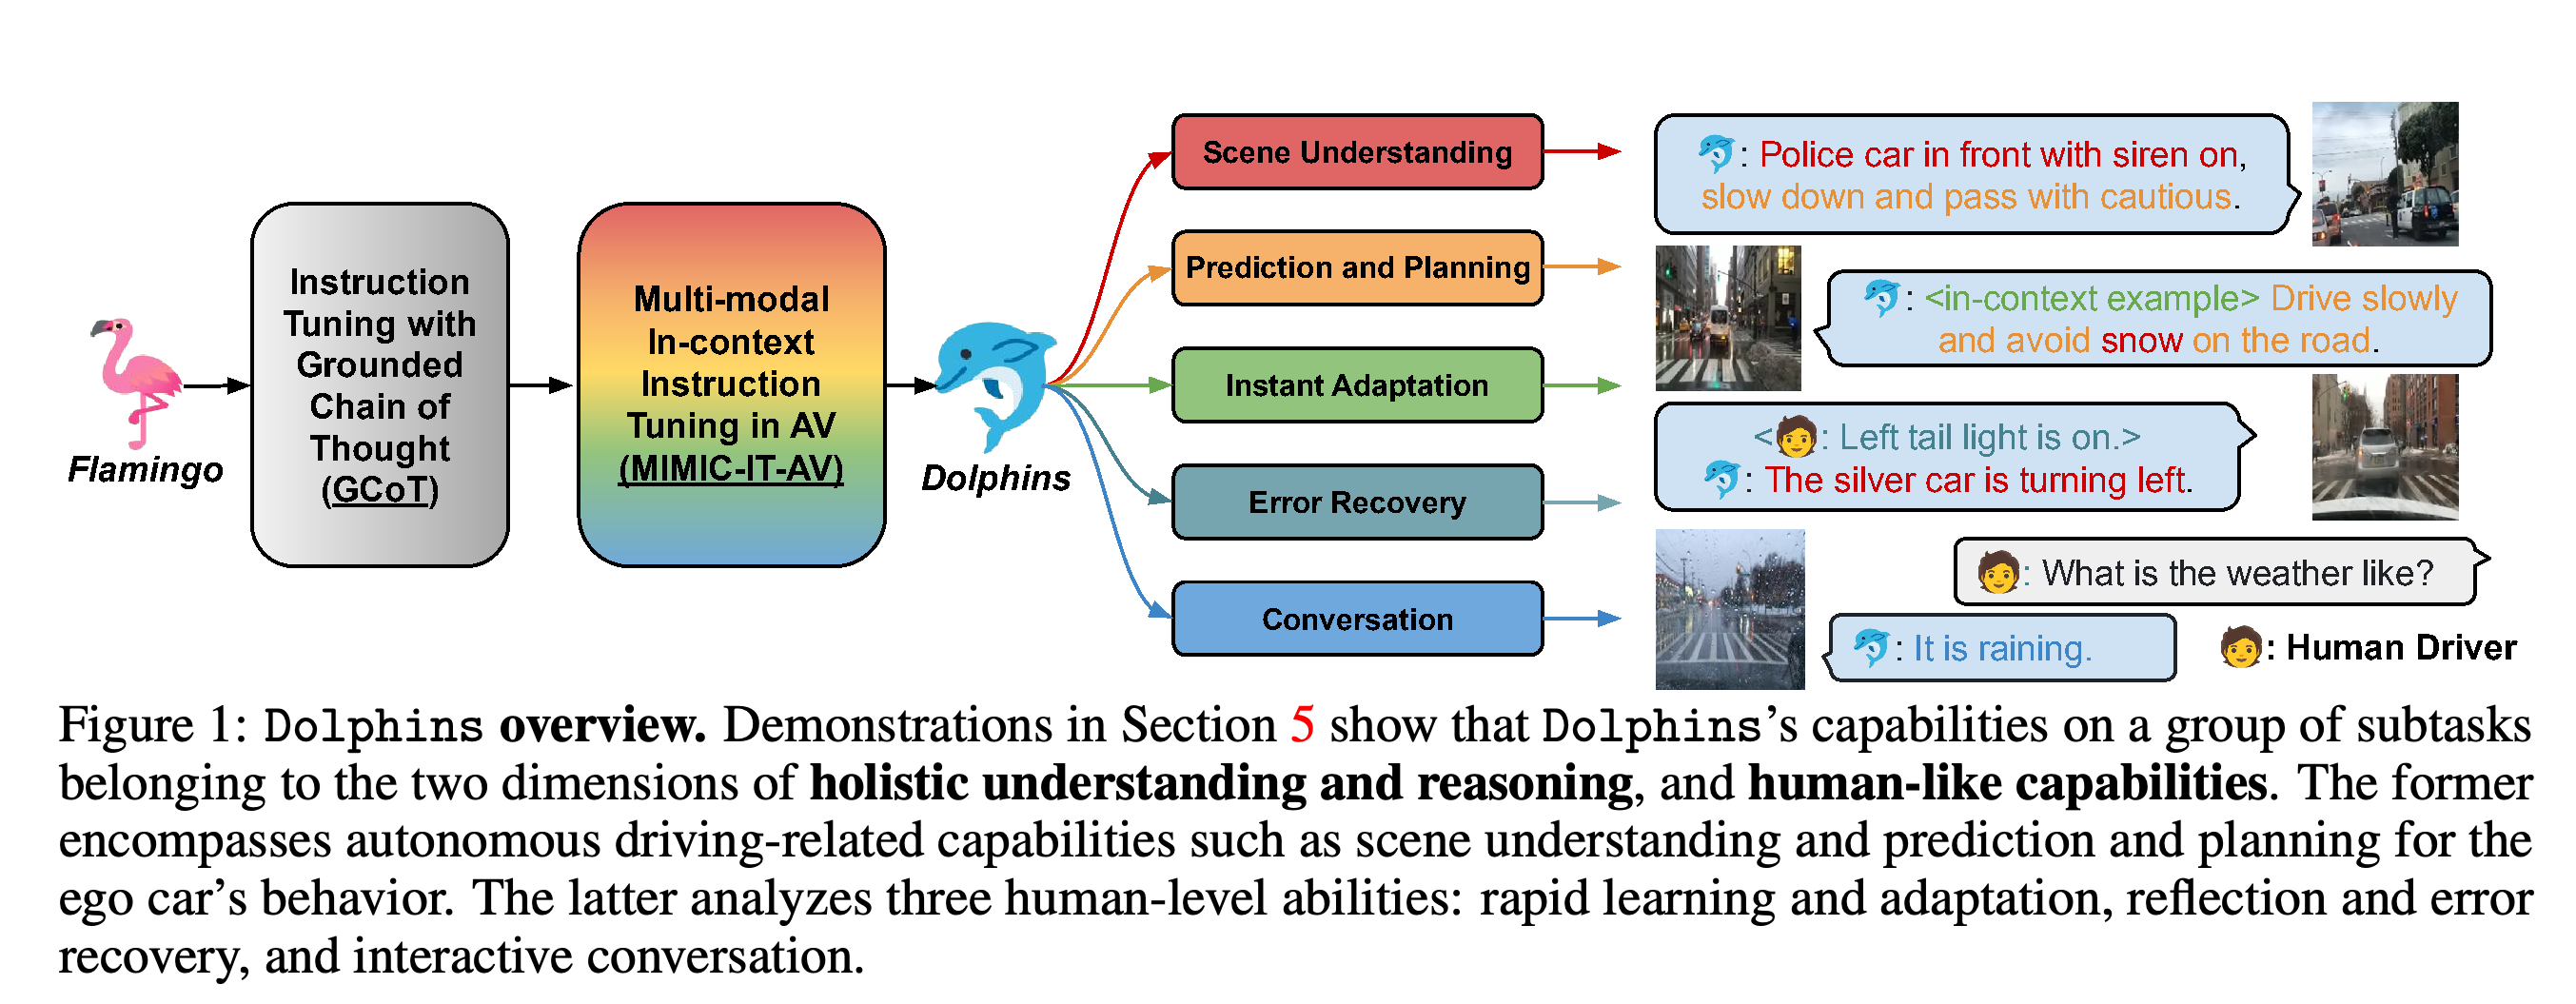
저자들은 자율주행 시스템의 과제로 장면 해석, 낯선 상황에 대한 적응, 피드백을 통한 교정을 제시한다. Dolphins는 영상이나 이미지, 지시, 과거 제어 신호를 입력받아 고수준 주행 결정을 지원하는 대화형 보조 시스템이다.
이 도식은 2단계 튜닝을 적응과 피드백을 통한 교정 등 이후 시연에서 보여주는 능력과 연결한다.
2 Related Work
논문은 언어 기반 주행 시스템, 비전-언어 모델, 프롬프트에 예시를 제공하는 multimodal in-context learning과 Dolphins의 관계를 설명한다. 저자들은 기존 주행 모델이 작업의 다양성이나 영상 입력 면에서 제한적이라고 설명하고, 이를 해결하기 위해 OpenFlamingo의 교차 배치 입력 방식을 사용한다.
3 Method
이 방법은 먼저 단계별로 근거를 제시하는 답변이 포함된 일반 이미지 질문으로 모델을 학습한 뒤, 얻은 능력을 주행 영상 지시 데이터셋에 적용한다. 새로운 작업에 대한 적응을 돕기 위해 주행 지시 튜닝 과정에 검색한 예시를 포함한다.
3.1 GCoT Instruction tuning
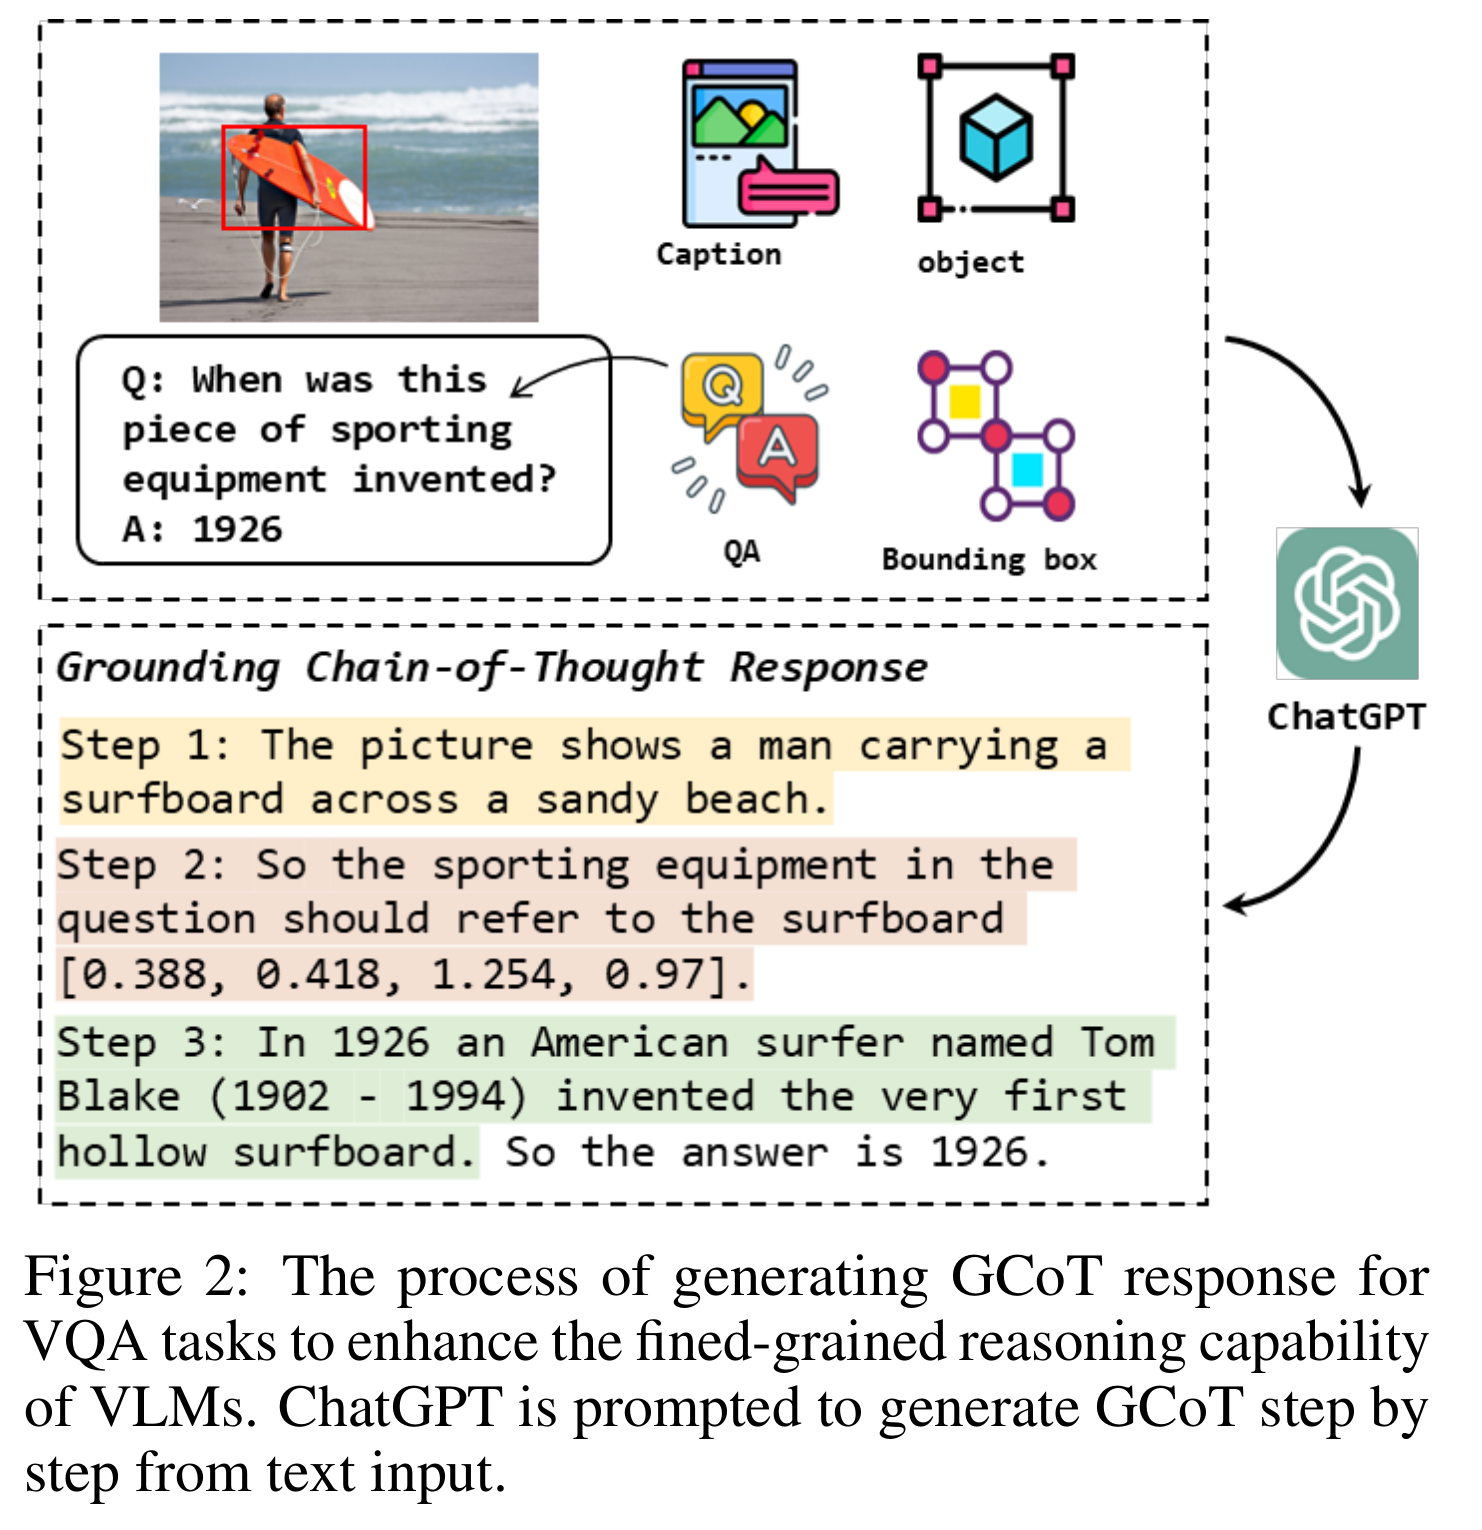
Grounded Chain of Thought (GCoT)는 ChatGPT를 사용해 이미지 설명을 생성하고, 질문 대상 객체와 그 위치를 식별하며, 필요할 때 추론을 제공한 뒤 참조 답변을 제시한다. 이 답변으로 주행 특화 fine-tuning에 앞서 이미지에 관한 질문에 답하는 일반 visual question answering을 학습한다.
서핑보드 사례는 캡션, 객체 주석, 질문, 답변을 단계별 학습 답변으로 변환하는 과정을 보여준다.
3.2 Devised Instruction Tasks for Autonomous Driving
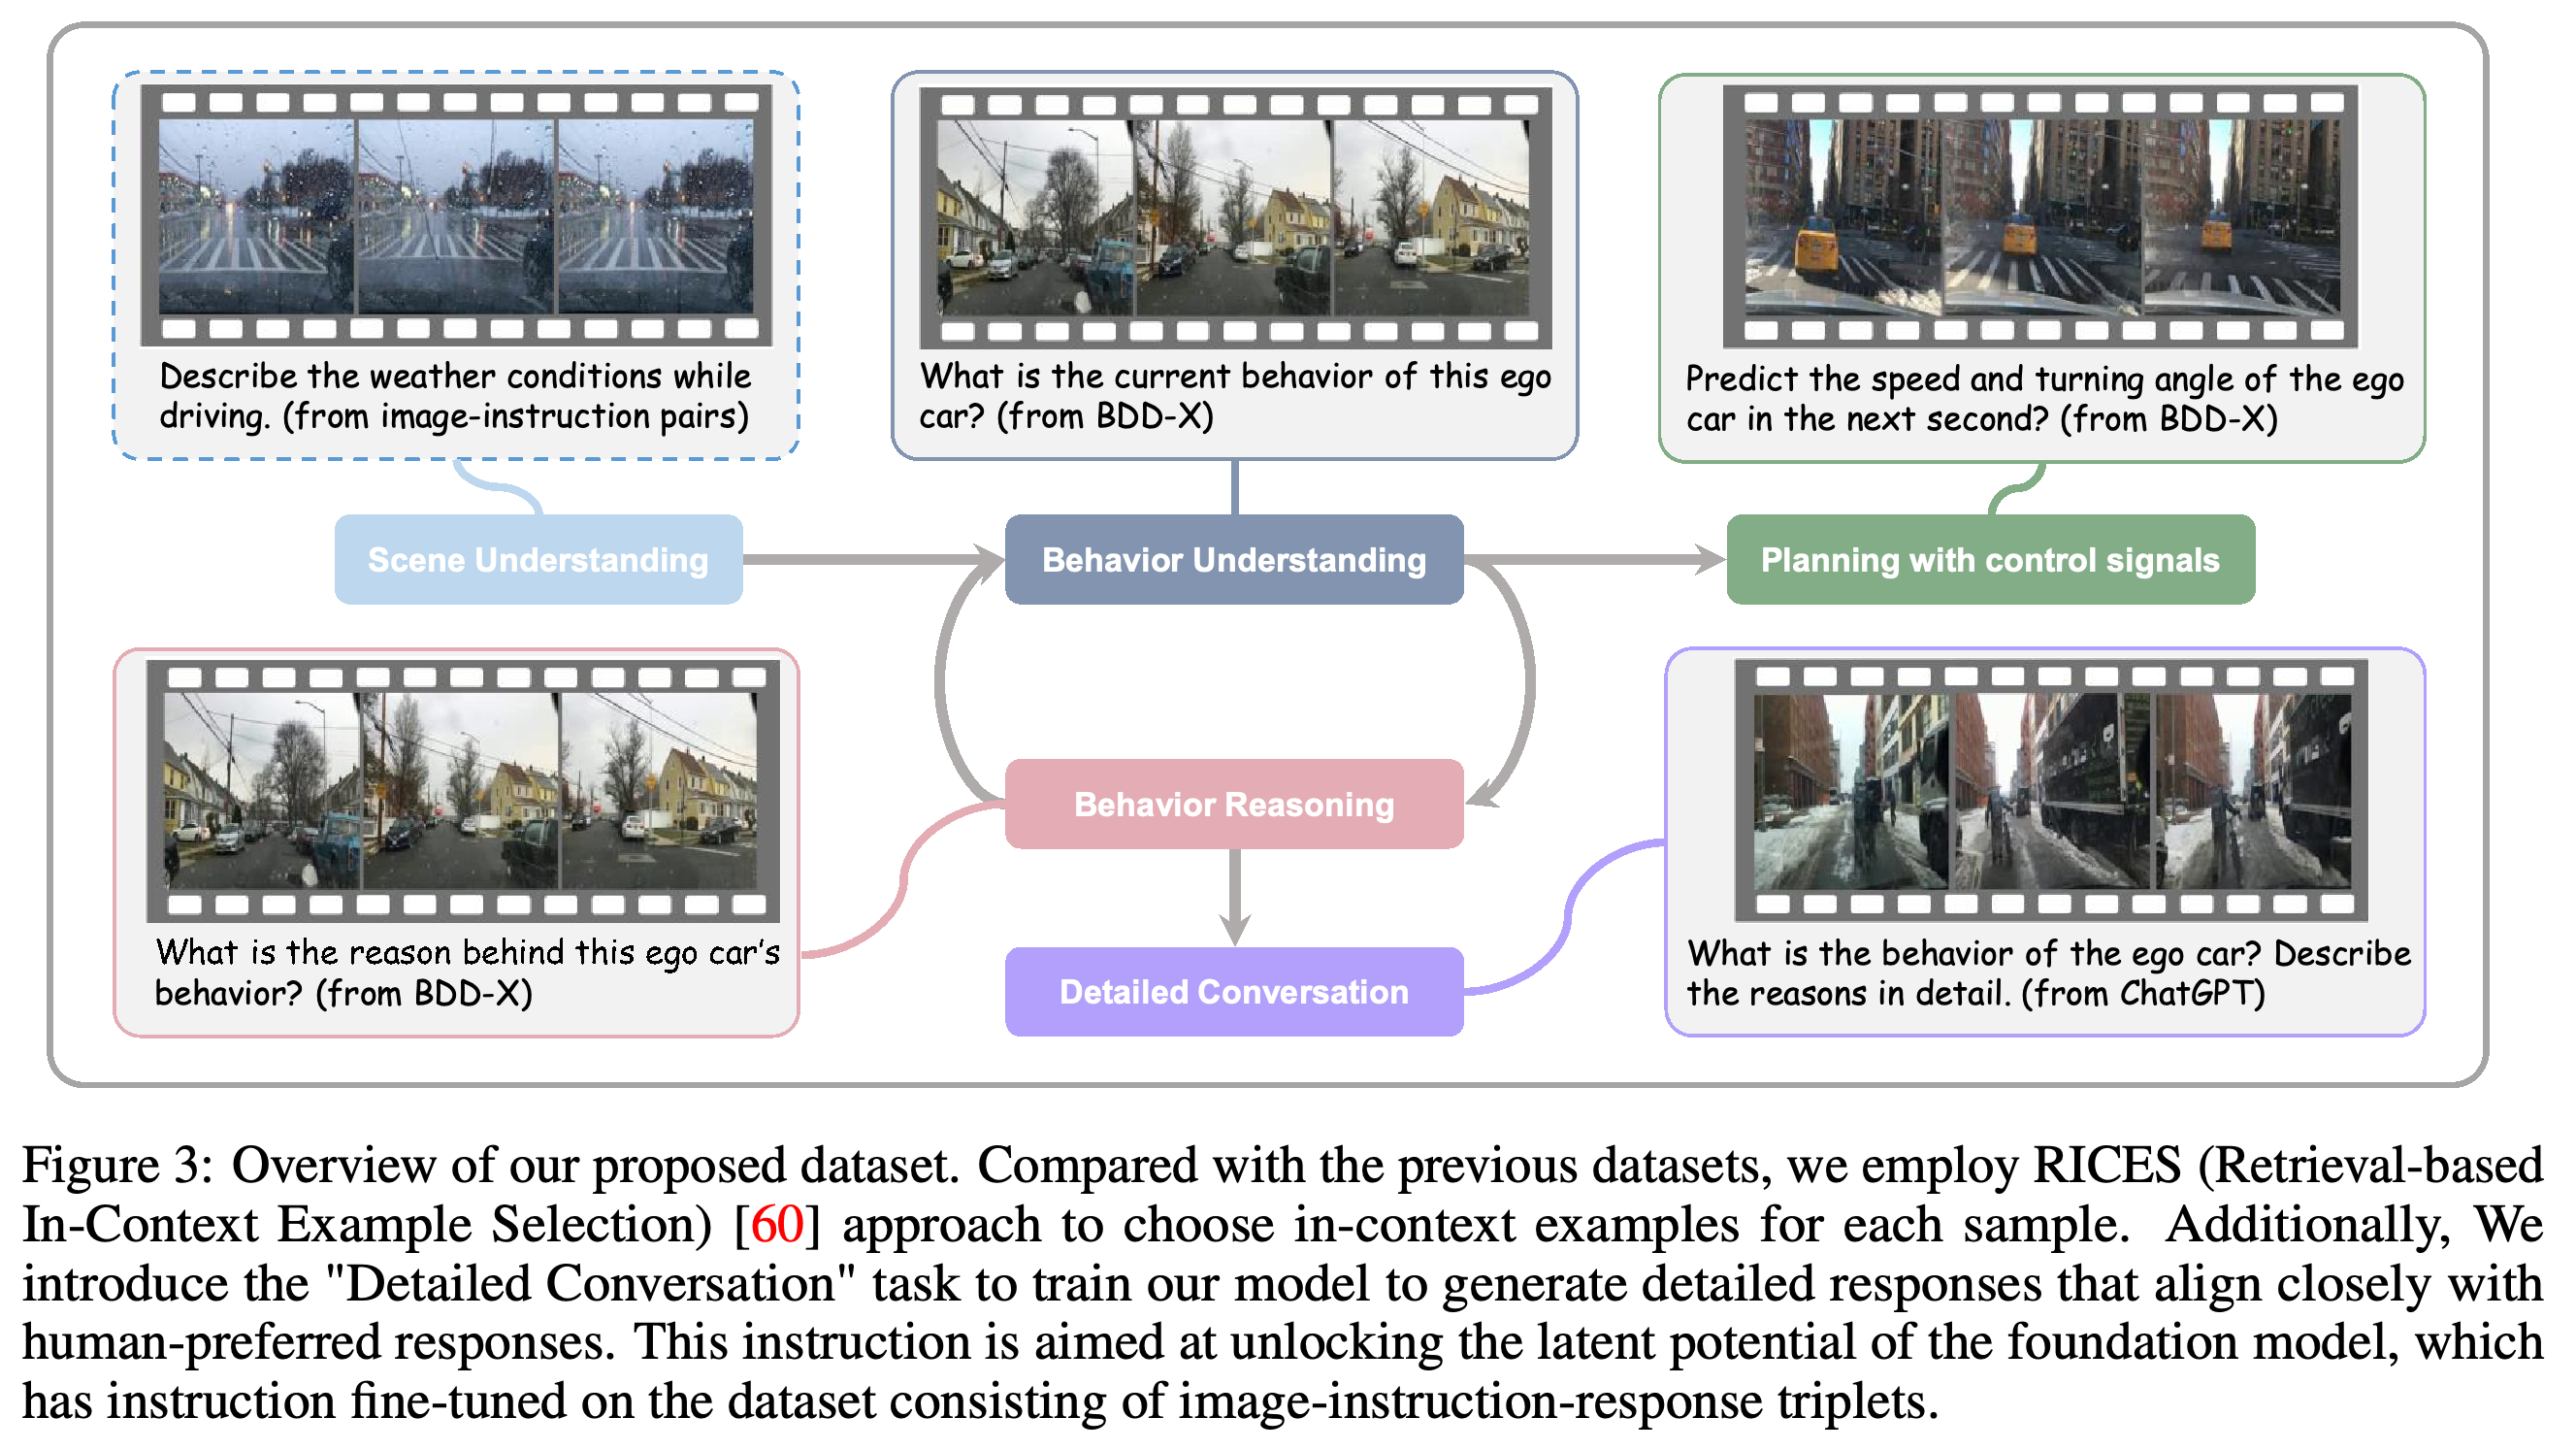
주행 작업 4개는 Behavior Understanding, Behavior Reasoning, Prediction with Control Signals, Detailed Conversation이다. 제어 작업은 과거 신호를 바탕으로 다음 초의 자차 속도와 회전각을 예측한다. 자차는 장면을 촬영하는 카메라가 장착된 차량이다.
BDD-X는 영상 약 7,000개와 주석이 달린 예시 약 25,000개를 제공한다. 최종 triplet 32k개는 BDD-X 레이블에서 얻은 21k개와 ChatGPT로 생성한 상세 대화 11k개로 구성된다. 상세 대화는 교통 규칙, 위험, 주의 사항을 추가해 설명을 확장한다.
이 예시들은 짧은 행동 및 제어 작업과 ChatGPT로 내용을 확장한 긴 대화 작업을 구분해 보여준다.
3.3 Multi-modal In-context Instruction Tuning in Autonomous Driving
검색 절차는 영상이나 텍스트 표현 간 코사인 유사도로 예시를 선택한다고 설명하지만, 학습에는 텍스트 유사도만 사용하며 triplet마다 최대 k = 3개의 예시를 사용한다. 텍스트 표현은 text-embedding-ada-002로 생성하고, 검색한 예시는 프롬프트에서 현재 인스턴스 앞에 배치한다.
4 Training
학습은 GCoT 템플릿을 활용한 이미지 지시 튜닝과 주행 영상 지시 튜닝의 2단계로 진행한다. 논문에서 논의한 영상 모델들이 사용하는 일반 영상-텍스트 정렬 단계는 생략한다.
4.1 Model Architecture
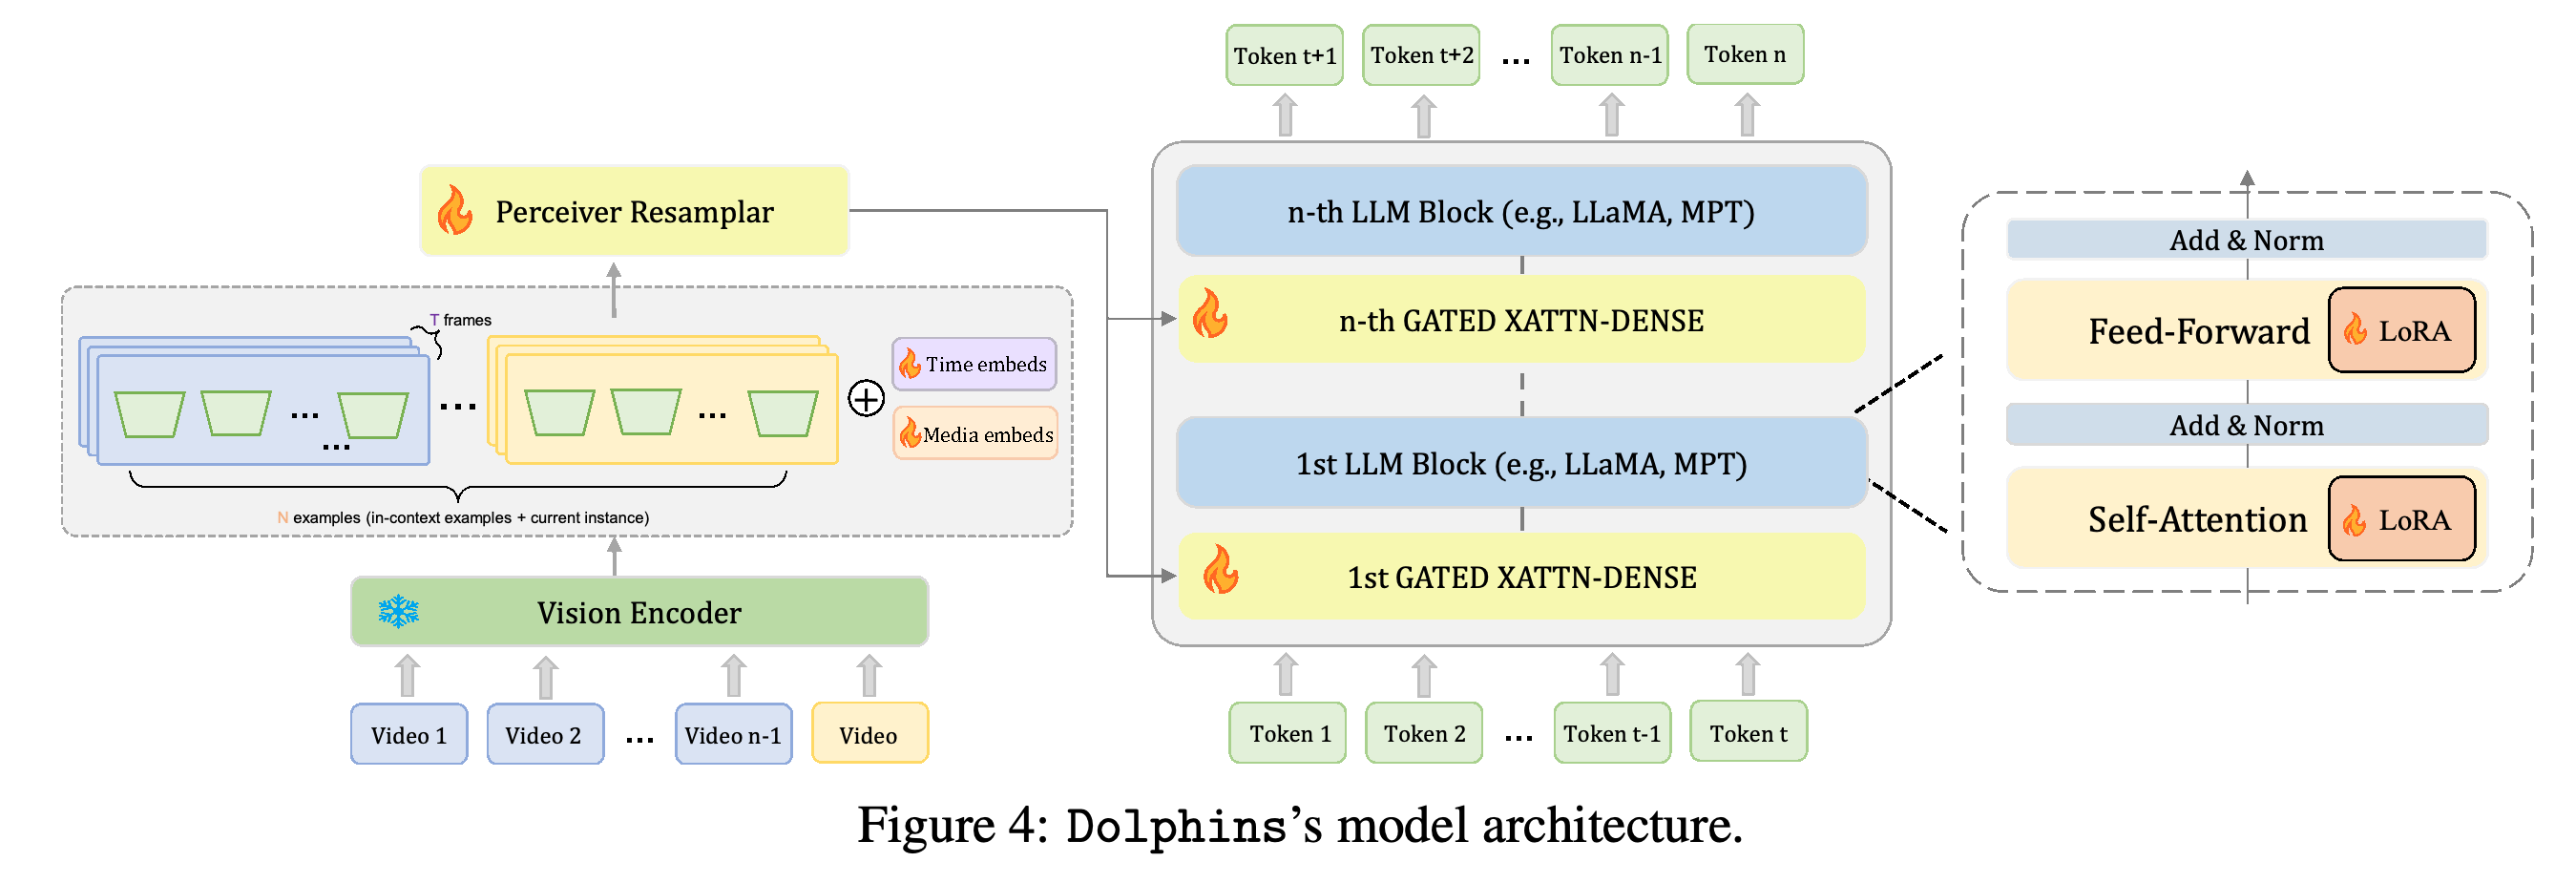
Dolphins는 CLIP 비전 인코더, 시각 특징을 처리하는 perceiver resampler, 그리고 gated cross-attention으로 시각 특징과 언어 특징을 연결하는 언어 모델을 결합한다. 학습된 시간 및 미디어 위치 임베딩은 프레임과 예시의 순서를 표현한다. 인코더는 고정하고 resampler, cross-attention 계층, low-rank adaptation (LoRA) 모듈을 fine-tuning한다. CLIP에 대해서는 CLIP 논문 리뷰(Learning Transferable Visual Models From Natural Language Supervision) 글을 참조하라.
이 구조는 시각 입력에 시간 및 미디어 임베딩을 적용하고, gated cross-attention을 통해 resampler가 처리한 특징을 언어 블록에 연결한다.
4.2 Implementation Details
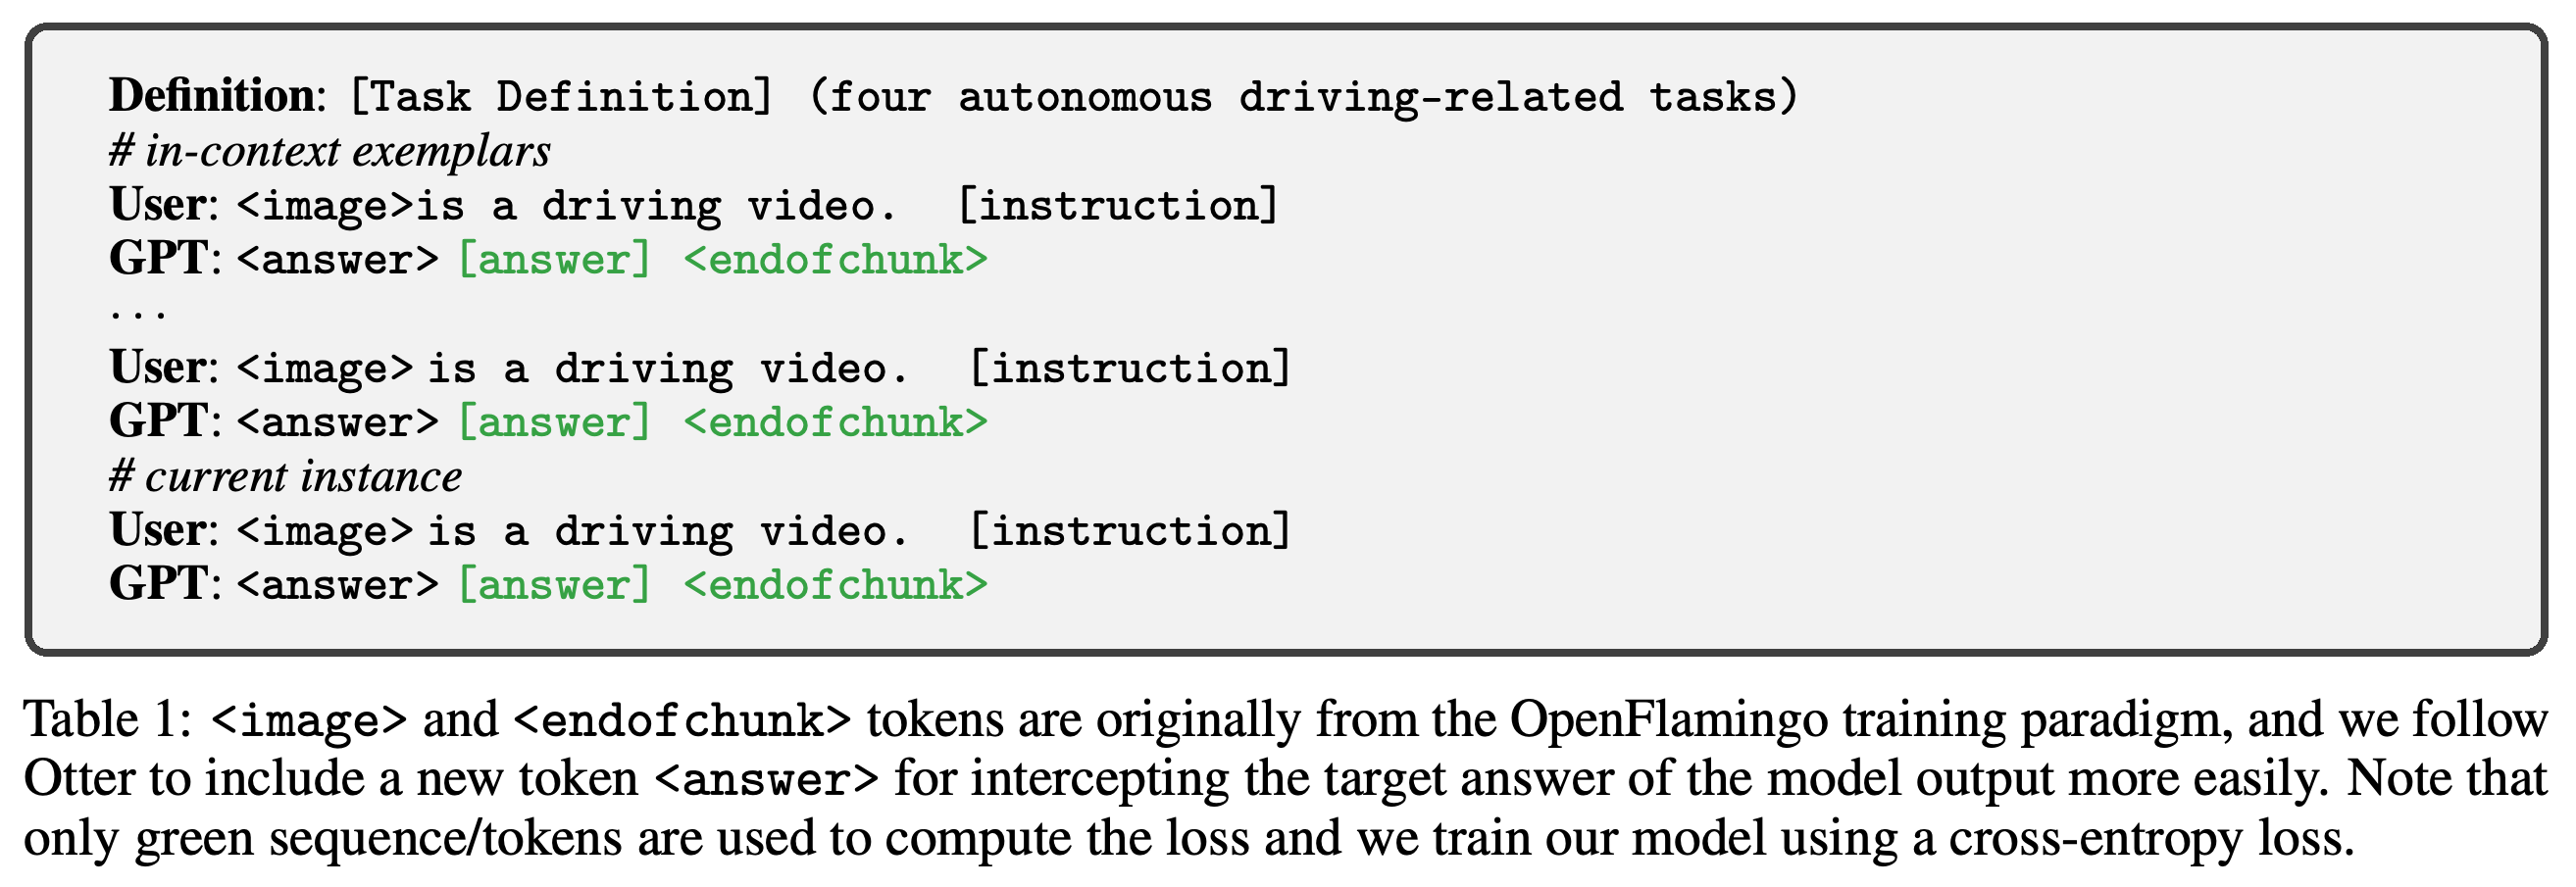
학습에는 답변 토큰에 대한 cross-entropy loss, DeepSpeed, AdamW를 사용하며 β1 = 0.9, β2 = 0.999, weight decay는 0.01이다. 저자들은 NVIDIA A100 GPU 4개, 배치 크기 128, 2단계 학습률 2 × 10⁻⁵, 최대 시퀀스 길이 1024를 사용하고, 학습과 추론에 BF16 정밀도를 적용한다.
이 템플릿은 현재 영상 앞에 작업 정의와 대화 예시를 배치하고 답변 시퀀스에 대한 loss를 계산한다.
5 Demonstration
시연에서는 장면 이해, 예측, 계획, 적응, 대화, 교정에 걸쳐 프롬프트에 작업 예시가 없는 zero-shot 사례와 소수의 예시가 포함된 few-shot 사례를 제시한다. 서론에서는 정량 지표를 언급하지만, 이 버전은 비교 성능 표보다 정성적 사례를 주로 제시한다.
5.1 Holistic Understanding and Reasoning
비가 내리는 교차로 사례에서 Dolphins는 장면을 설명하고 자차가 빨간불 때문에 멈췄다고 답한다. 다른 사례에서는 앞의 밴이 회전하거나 감속하면 속도를 줄이거나 멈추라고 권고한다. 저자들은 예측과 계획에 관련된 학습 지시가 부족하다고 인정하고, 예시와 대화, 제어 신호로 이 작업들을 보완할 것을 권고한다.
5.2 Human-like Capabilities
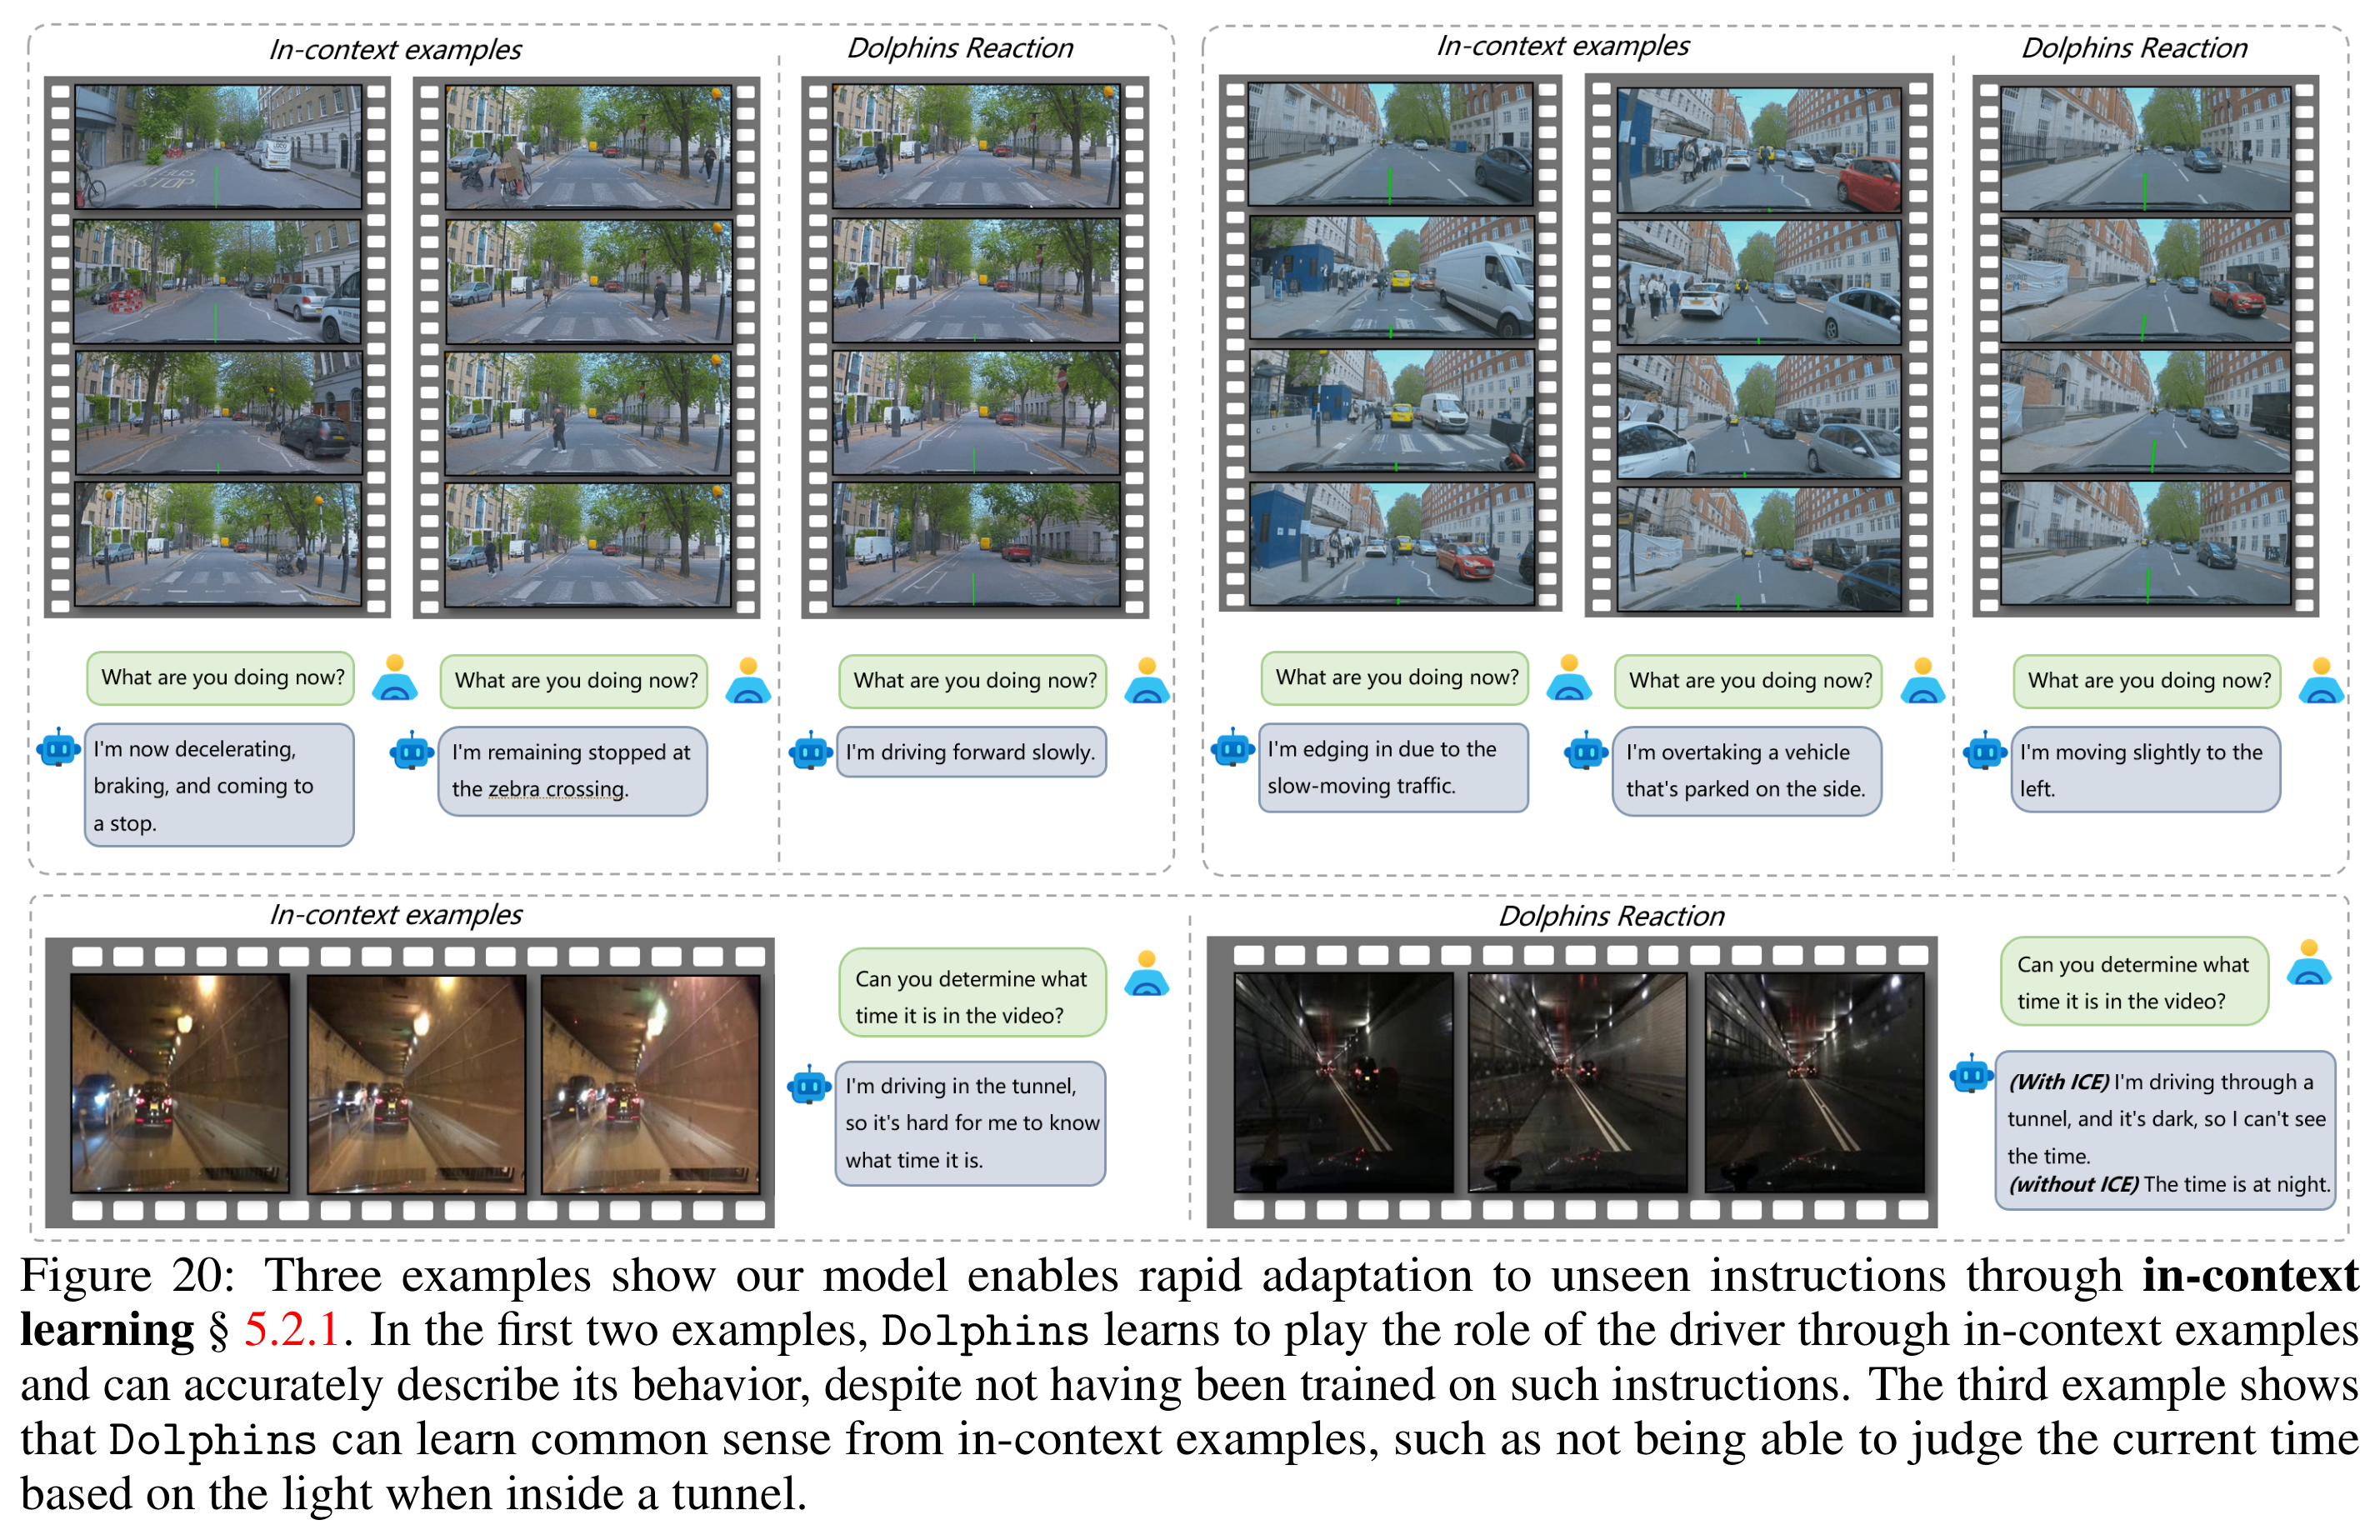
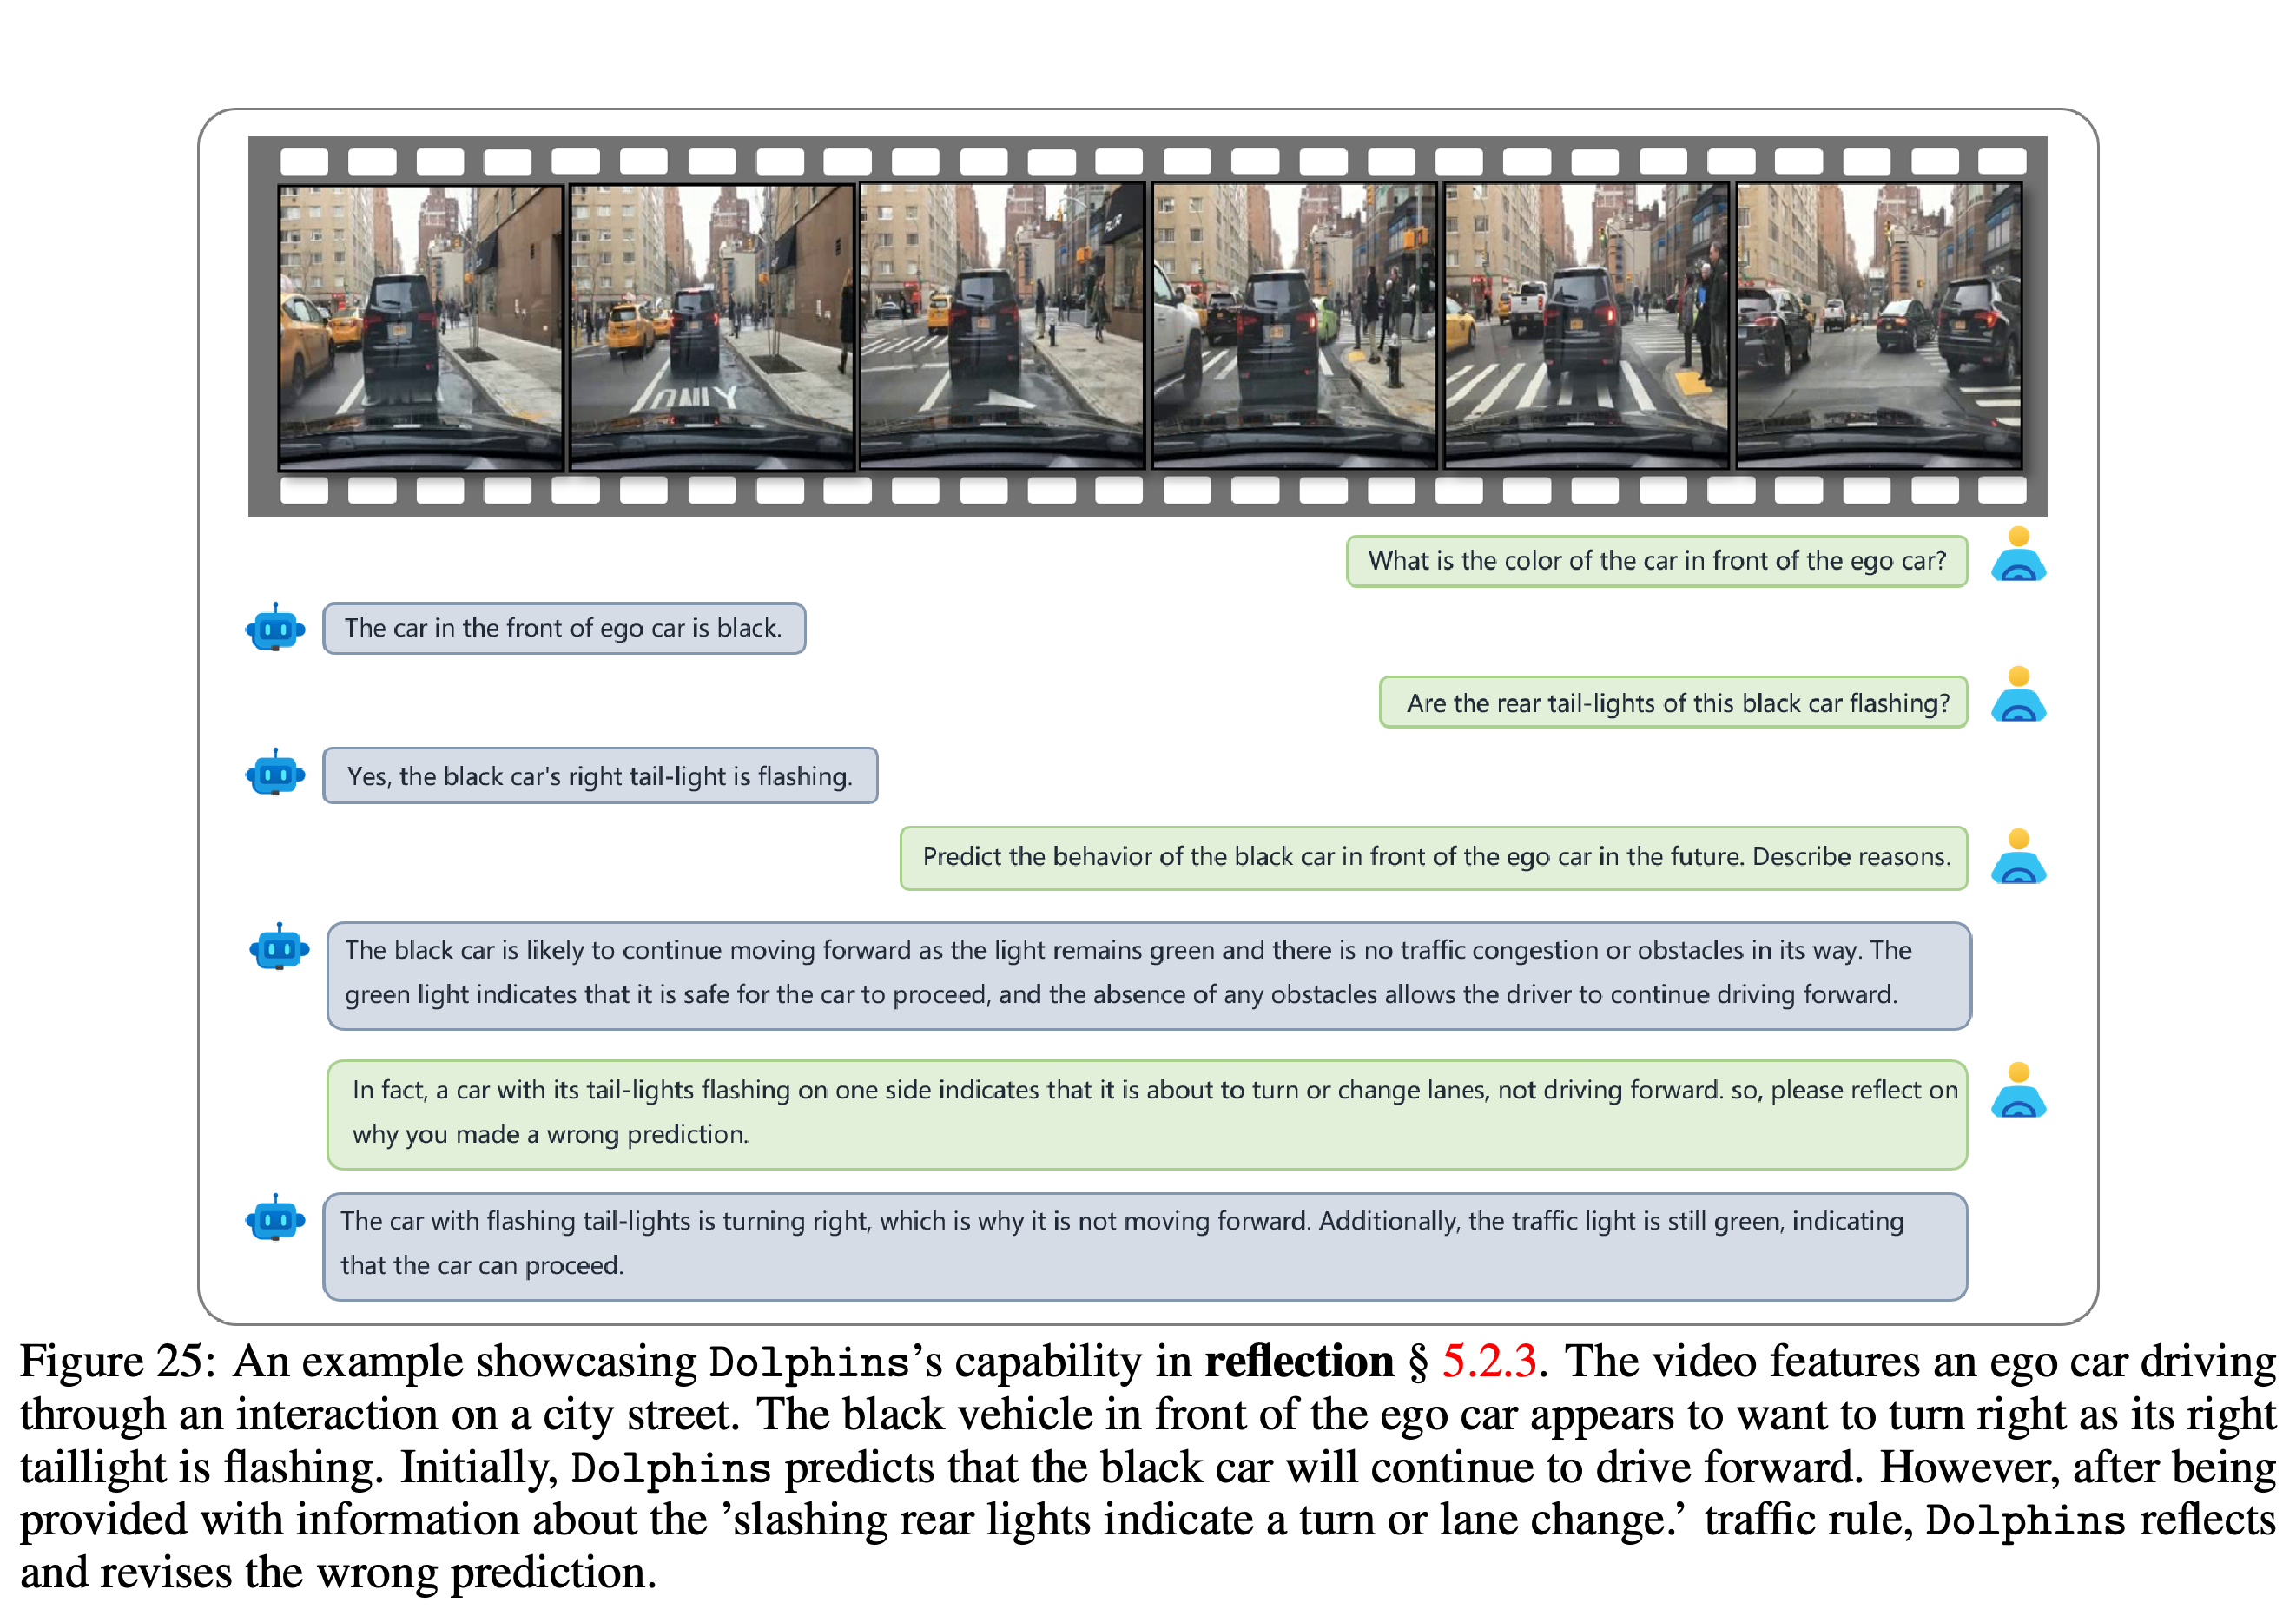
터널 사례에서는 in-context 예시를 제공하자 시간이 밤이라는 답변이 시간을 알 수 없다는 답변으로 바뀐다. 비가 내리는 교차로 대화에서 모델은 날씨, 주행 시 주의 사항, 신호등에 관한 연속 질문에 답한다. 다른 대화에서는 사용자가 깜박이는 불빛을 설명하자 직진할 것이라는 예측을 우회전할 것이라는 예측으로 수정한다.
터널 비교는 같은 사례에서 나타난 차이를 보여준다. 예시가 없으면 모델은 밤이라고 답하고, 예시가 있으면 시간을 판단할 수 없다고 답한다.
사용자가 방향 지시등을 명시적으로 설명한 뒤 예측이 수정되므로, 제공된 피드백에 따라 답변을 수정하는 사례를 보여준다.
6 Conclusion and Future Directions
저자들은 DriveLM 데이터셋에서 NVIDIA A100을 사용했을 때 평균 추론 시간이 1.34초라고 보고하며, 지연 시간과 차량 전력 소비를 배포의 장애 요인으로 지목한다. 향후 방향으로 더 효율적인 맞춤형 모델이나 증류 모델을 제안한다.
부록
- A Data: 1단계 이미지 데이터셋에는 약 10.7k개의 예시가 있으며, 이 중 9,645개는 ChatGPT가 생성한 GCoT 답변이 포함된 visual question answering 예시다. VQAv2, OK-VQA, GQA, TDIUC를 활용하고 Visual Genome으로 주석을 보완하며, LLaVA-instruct-80k와 SVIT 데이터도 포함한다.
- B Prompts: 부록은 캡션, 객체 위치, 질문, 참조 답변으로부터 3단계 GCoT 답변을 생성하는 프롬프트를 제공한다. 예시에서는 서핑보드를 식별하고 참조 답변으로 1926을 제시한다.
짧은 생각
사례들은 프롬프트 문맥과 명시적 피드백이 개별 답변을 바꿀 수 있음을 보여주지만, 테스트 세트에서 그런 변경이 얼마나 자주 올바른지는 입증하지 않는다. Figure 6과 Figure 9에는 환각으로 생성된 텍스트도 표시되어 있으며, 반성 사례에는 교정 정보가 제공된다. 따라서 독립적인 오류 탐지나 주행 안전성에 관한 주장은 제한된다.