VLM2Vec-V2: Advancing Multimodal Embedding for Videos, Images, and Visual Documents 요약 설명
07 Jul 2025 | Paper Review Multimodal Learning Contrastive Learning Instruction Tuning목차
이번 글에서는 VLM2Vec-V2: Advancing Multimodal Embedding for Videos, Images, and Visual Documents 논문의 핵심 포인트만 간단히 정리한다.
이 글은 2025년 7월 7일 공개된 arXiv v1을 기준으로 정리했습니다.
- 2025년 7월 7일(Arxiv)
- Meng, Rui, Jiang, Ziyan, Liu, Ye, Su, Mingyi, Yang, Xinyi, Fu, Yuepeng, Qin, Can, Chen, Zeyuan, Xu, Ran, Xiong, Caiming, et al.
- Salesforce Research, UC Santa Barbara, University of Waterloo, Tsinghua University
- 논문 링크
- Github
- Project Page
요약
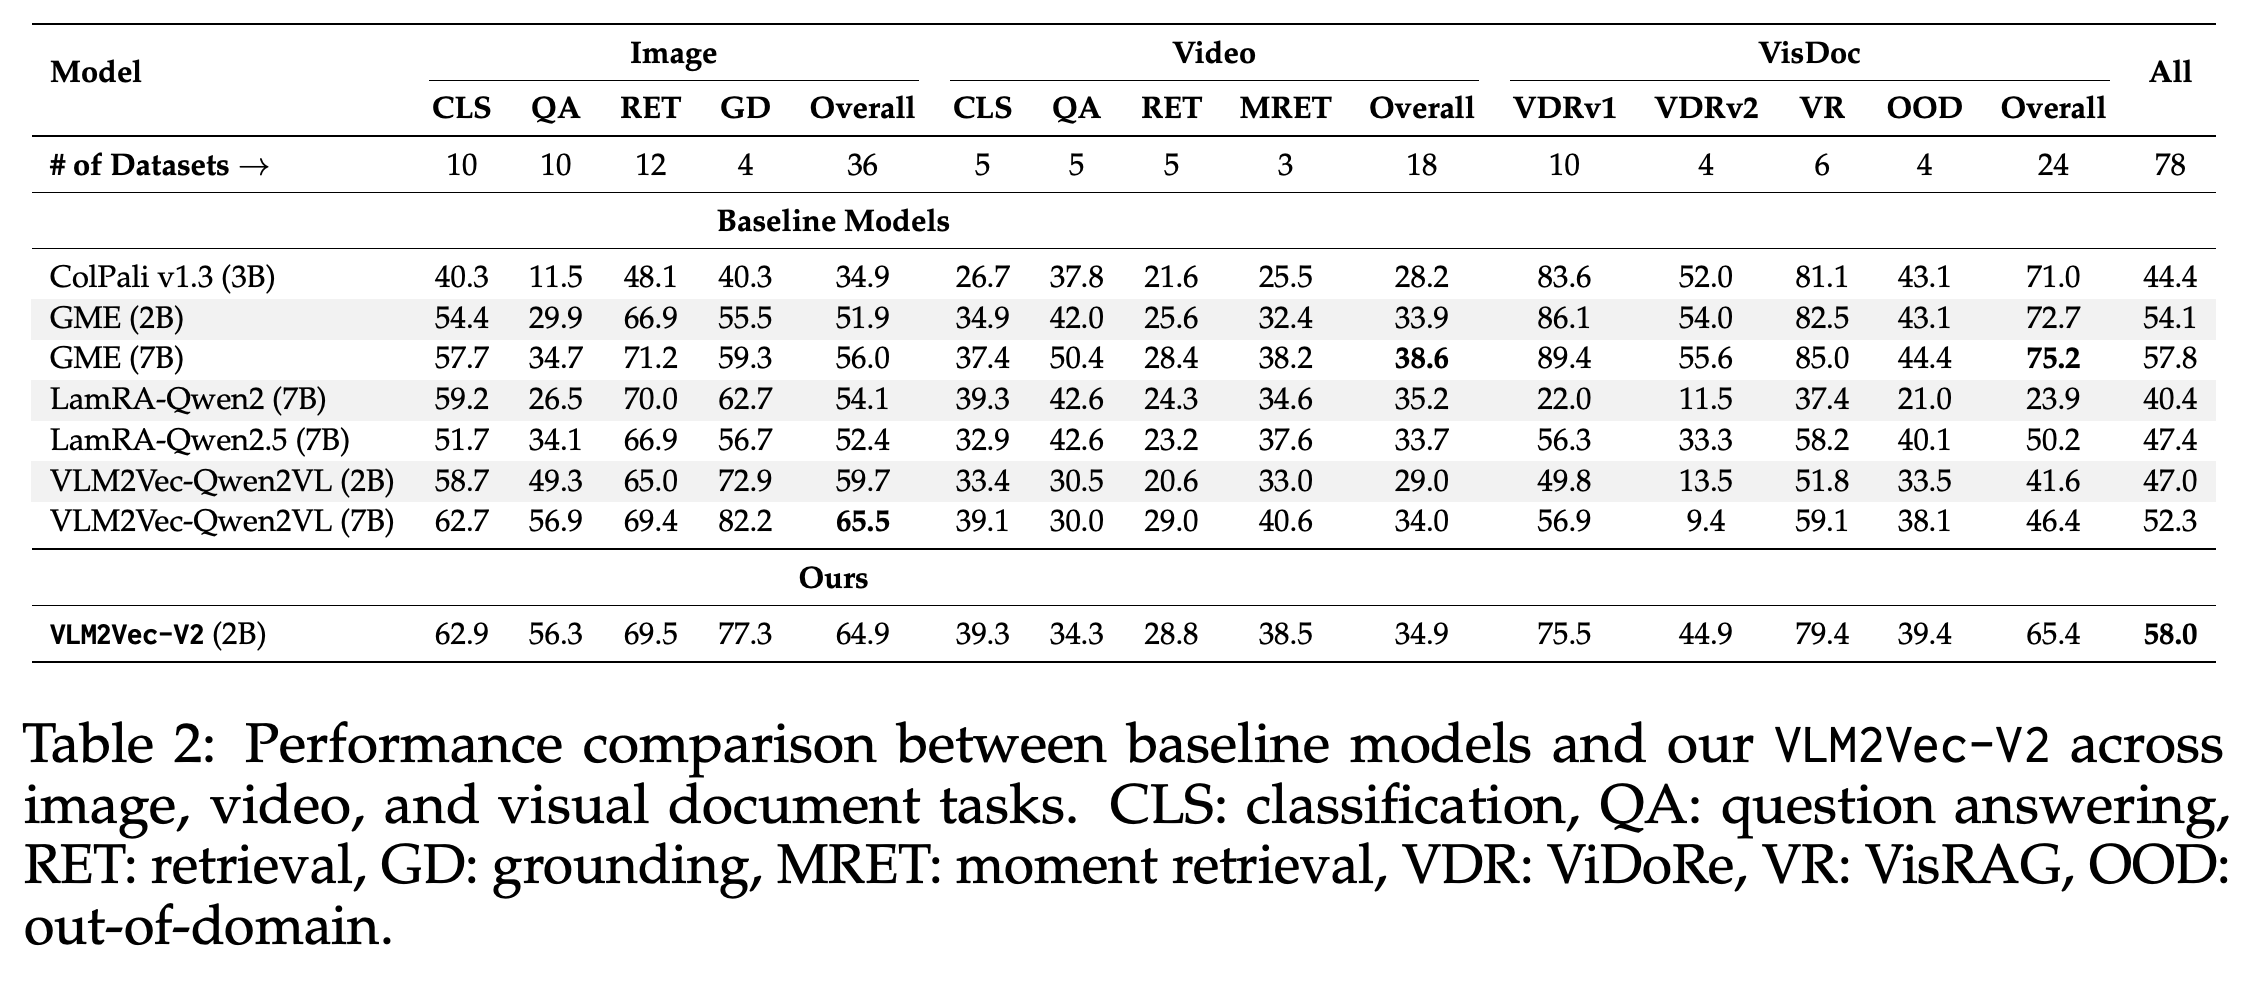
- 멀티모달 임베딩 모델은 서로 다른 입력 유형을 공통 벡터 공간에 매핑해 매칭과 검색에 활용하지만, 기존 모델은 동영상과 시각적 구조가 있는 문서를 제한적으로 지원한다. Massive Multimodal Embedding Benchmark를 확장한 MMEB-V2의 과제 78개에서 Table 2는 VLM2Vec-V2(2B)의 종합 점수를 58.0으로 보고한다. 비교 대상인 멀티모달 임베딩 기준 모델 GME(7B)는 57.8, 이전 VLM2Vec-Qwen2VL(2B)은 47.0이다.
- VLM2Vec-V2는 텍스트와 시각 입력을 처리하는 비전 언어 모델 Qwen2-VL에 지시문 조건부 대조 학습을 적용한다. 과제 지시문은 무엇을 매칭할지 지정하며, 학습 과정에서 일치하는 질의와 타깃의 유사도를 불일치하는 조합보다 높인다. 학습에는 이미지, 동영상, 문서 데이터를 함께 사용한다. 혼합된 전역 배치 안에서 개별 출처의 예제를 묶는 interleaved sub-batching을 적용한다.
- 이 모델은 보고된 종합 점수가 가장 높지만 모든 모달리티에서 선두를 차지하지는 않는다. Table 2의 이미지, 동영상, 문서 점수는 각각 64.9, 34.9, 65.4이다. GME (7B)는 동영상과 문서에서 더 높은 점수를 기록하며, 동영상 집계 점수 중 일부는 본문 표와 부록 표 사이에 차이가 있다.
1 Introduction
서론은 임베딩 학습과 평가에서 충분히 다루지 못한 입력 유형을 지적한다. MMEB와 기존 멀티모달 검색 벤치마크 M-BEIR은 주로 자연 이미지에 집중하지만, 실제 검색 대상에는 동영상, PDF, 웹사이트, 슬라이드도 포함된다. 논문은 확장된 벤치마크와 통합 모델을 제시하고, 시각 모달리티 간 전이, 학습 데이터 구성, 시간적 구조와 문서 구조의 표현을 분석한다.
2 MMEB-V2: Expanding Embedding Benchmarks Beyond Image-Text
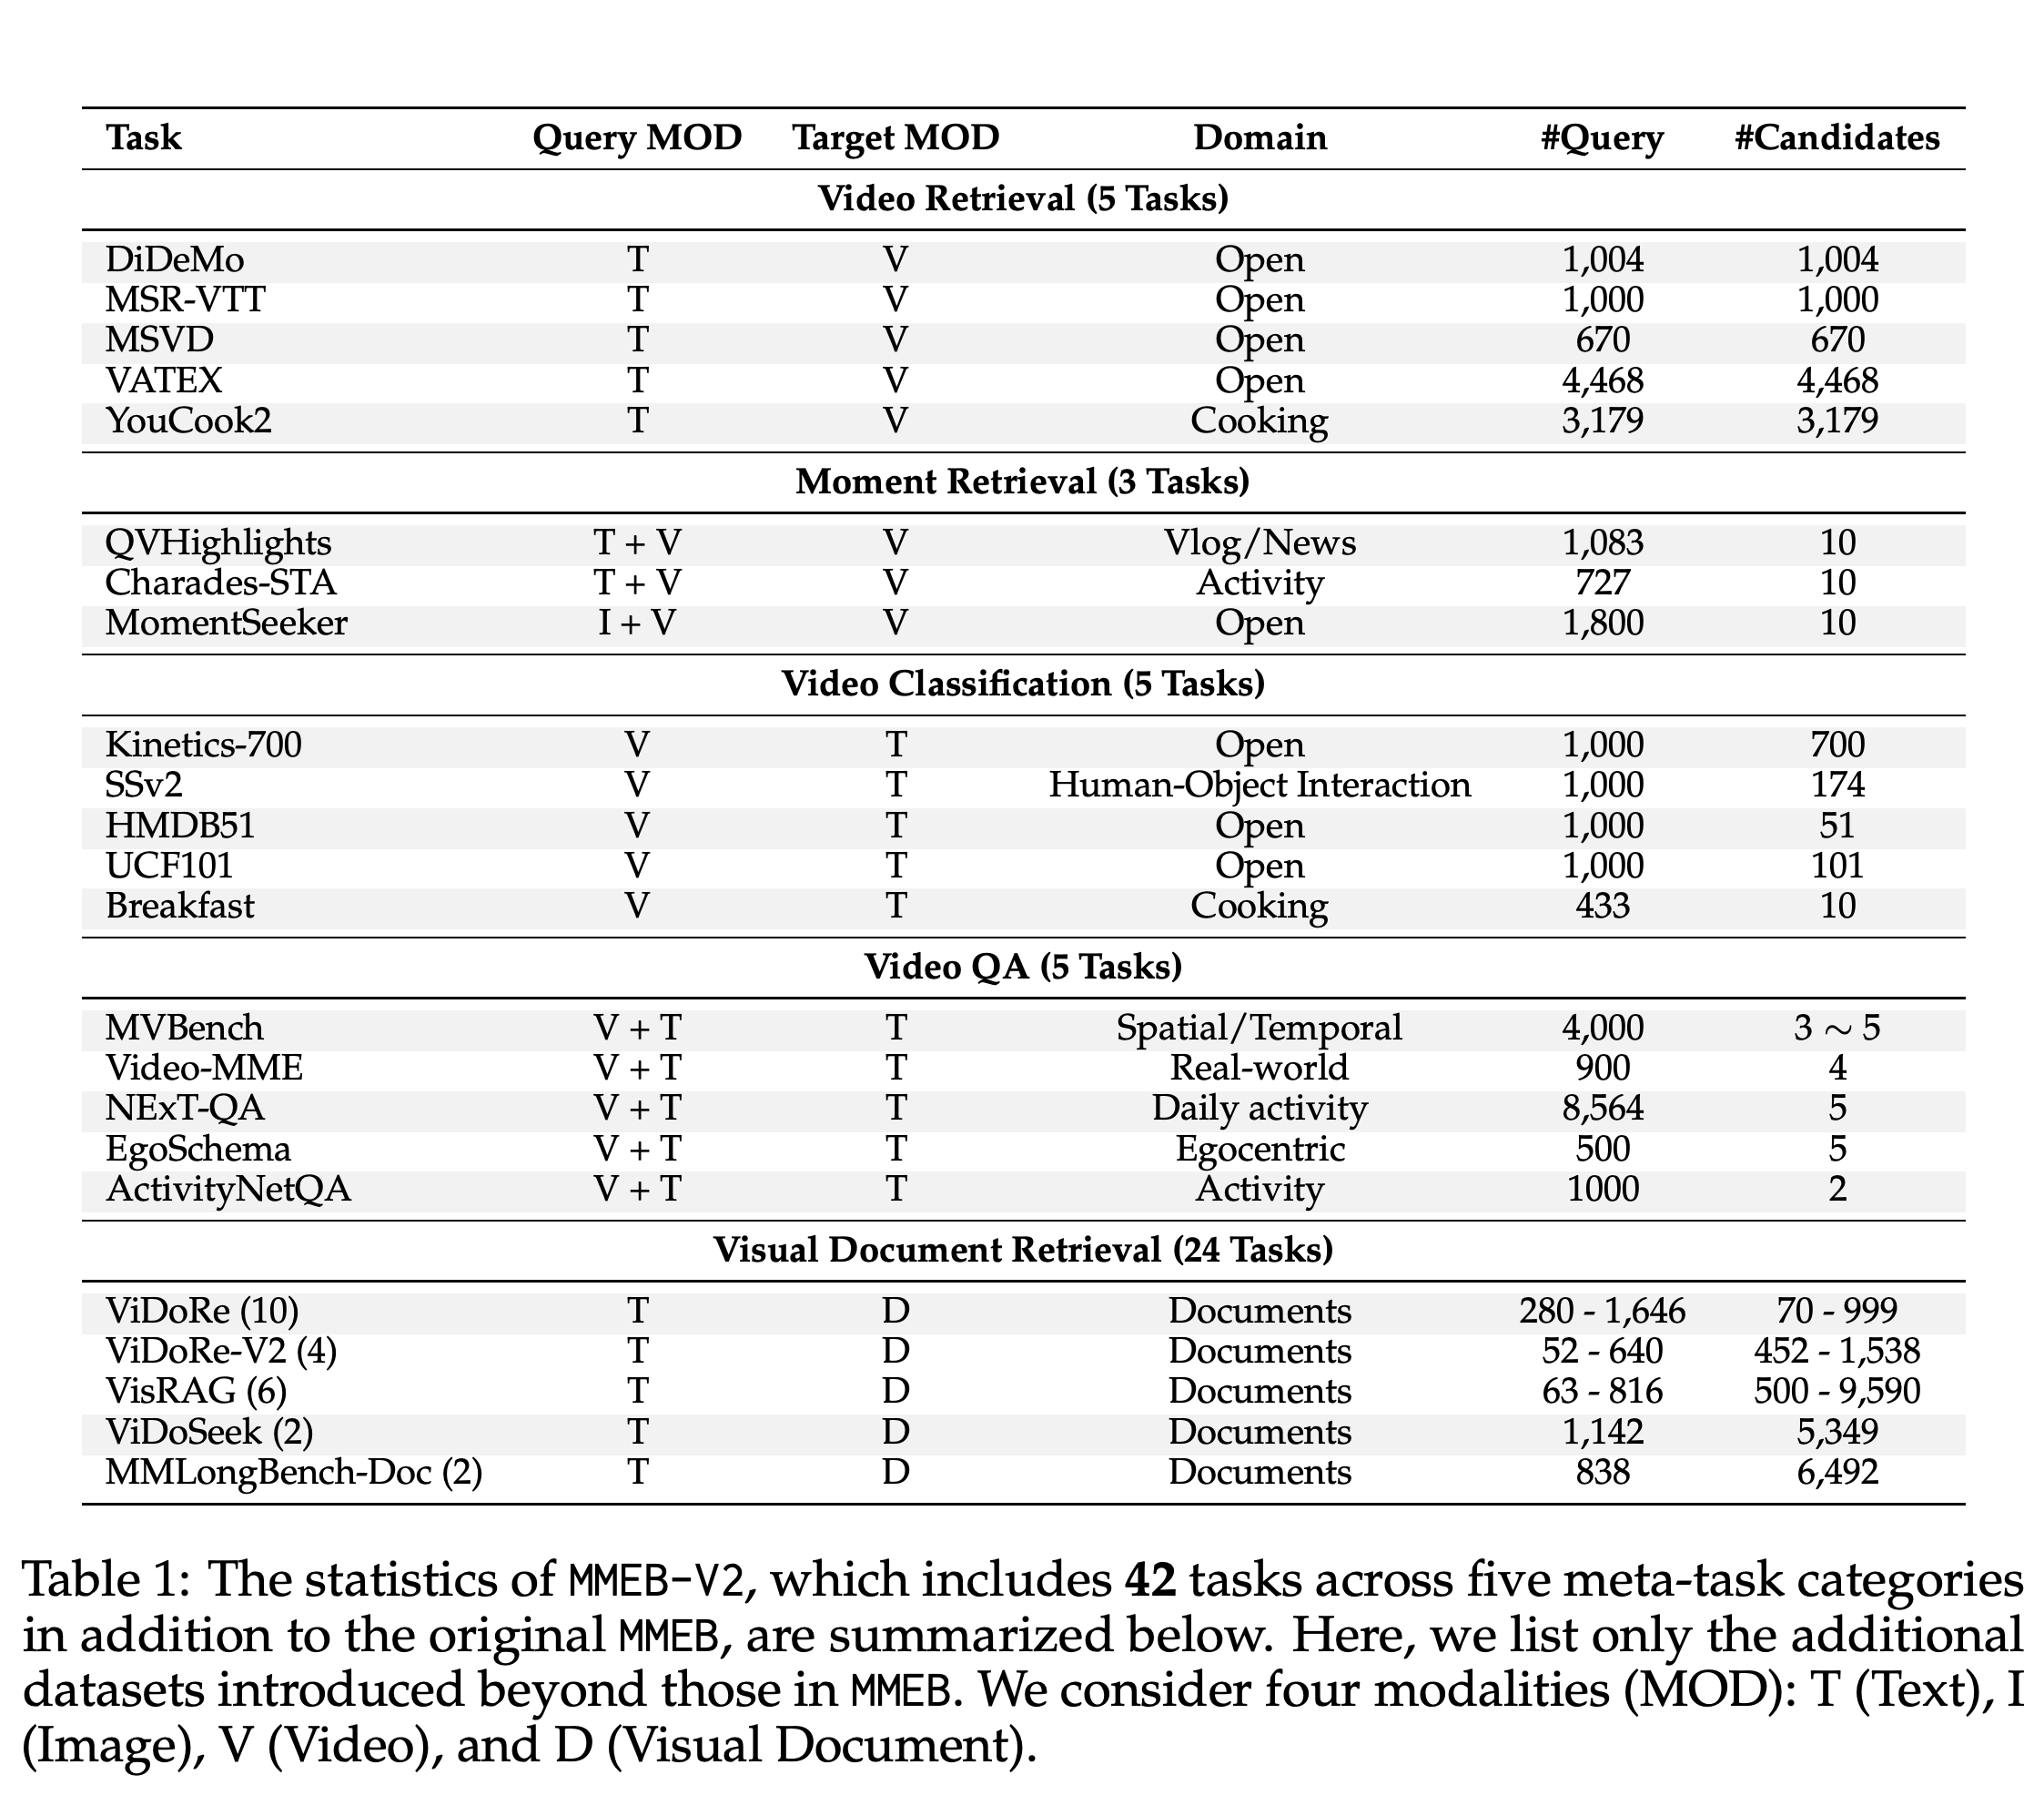
MMEB-V2는 기존 이미지 과제 36개에 동영상 검색 5개, 구간 검색 3개, 동영상 분류 5개, 동영상 질의응답 5개, 시각 문서 검색 24개로 구성된 42개 과제를 추가한다. Figure 1은 전체 78개 과제를 9개 메타 과제, 즉 과제 범주로 구분한다. 본문의 일부에서는 기존 범주를 5개로 설명하지만, 그림과 과제 수를 보면 기존 이미지 범주는 4개이다.
- 동영상 검색은 질의에 대해 후보 동영상의 순위를 매기며, 구간 검색은 약 10개 후보 클립에서 관련 시간 구간을 선택한다.
- 동영상 분류는 텍스트 클래스 레이블의 순위를 매기고, 동영상 질의응답은 동영상에 관한 질문에 대해 후보 답변의 순위를 매긴다.
- 시각 문서 검색은 자연어 질의에 대해 페이지나 문서의 순위를 매긴다. 문서 질의응답 데이터셋인 ViDoSeek와 MMLongBench-Doc, 2개를 검색용으로 변환한 페이지 단위 및 문서 단위 과제도 포함한다.
이 도식은 기존 이미지 과제 36개를 동영상 과제 18개 및 문서 검색 과제 24개와 구분한다. 기존 이미지 그룹 4개와 추가 그룹 5개를 합치면 총 9개 메타 과제가 되므로, 본문 일부에 나타나는 범주 수의 불일치를 확인할 수 있다.
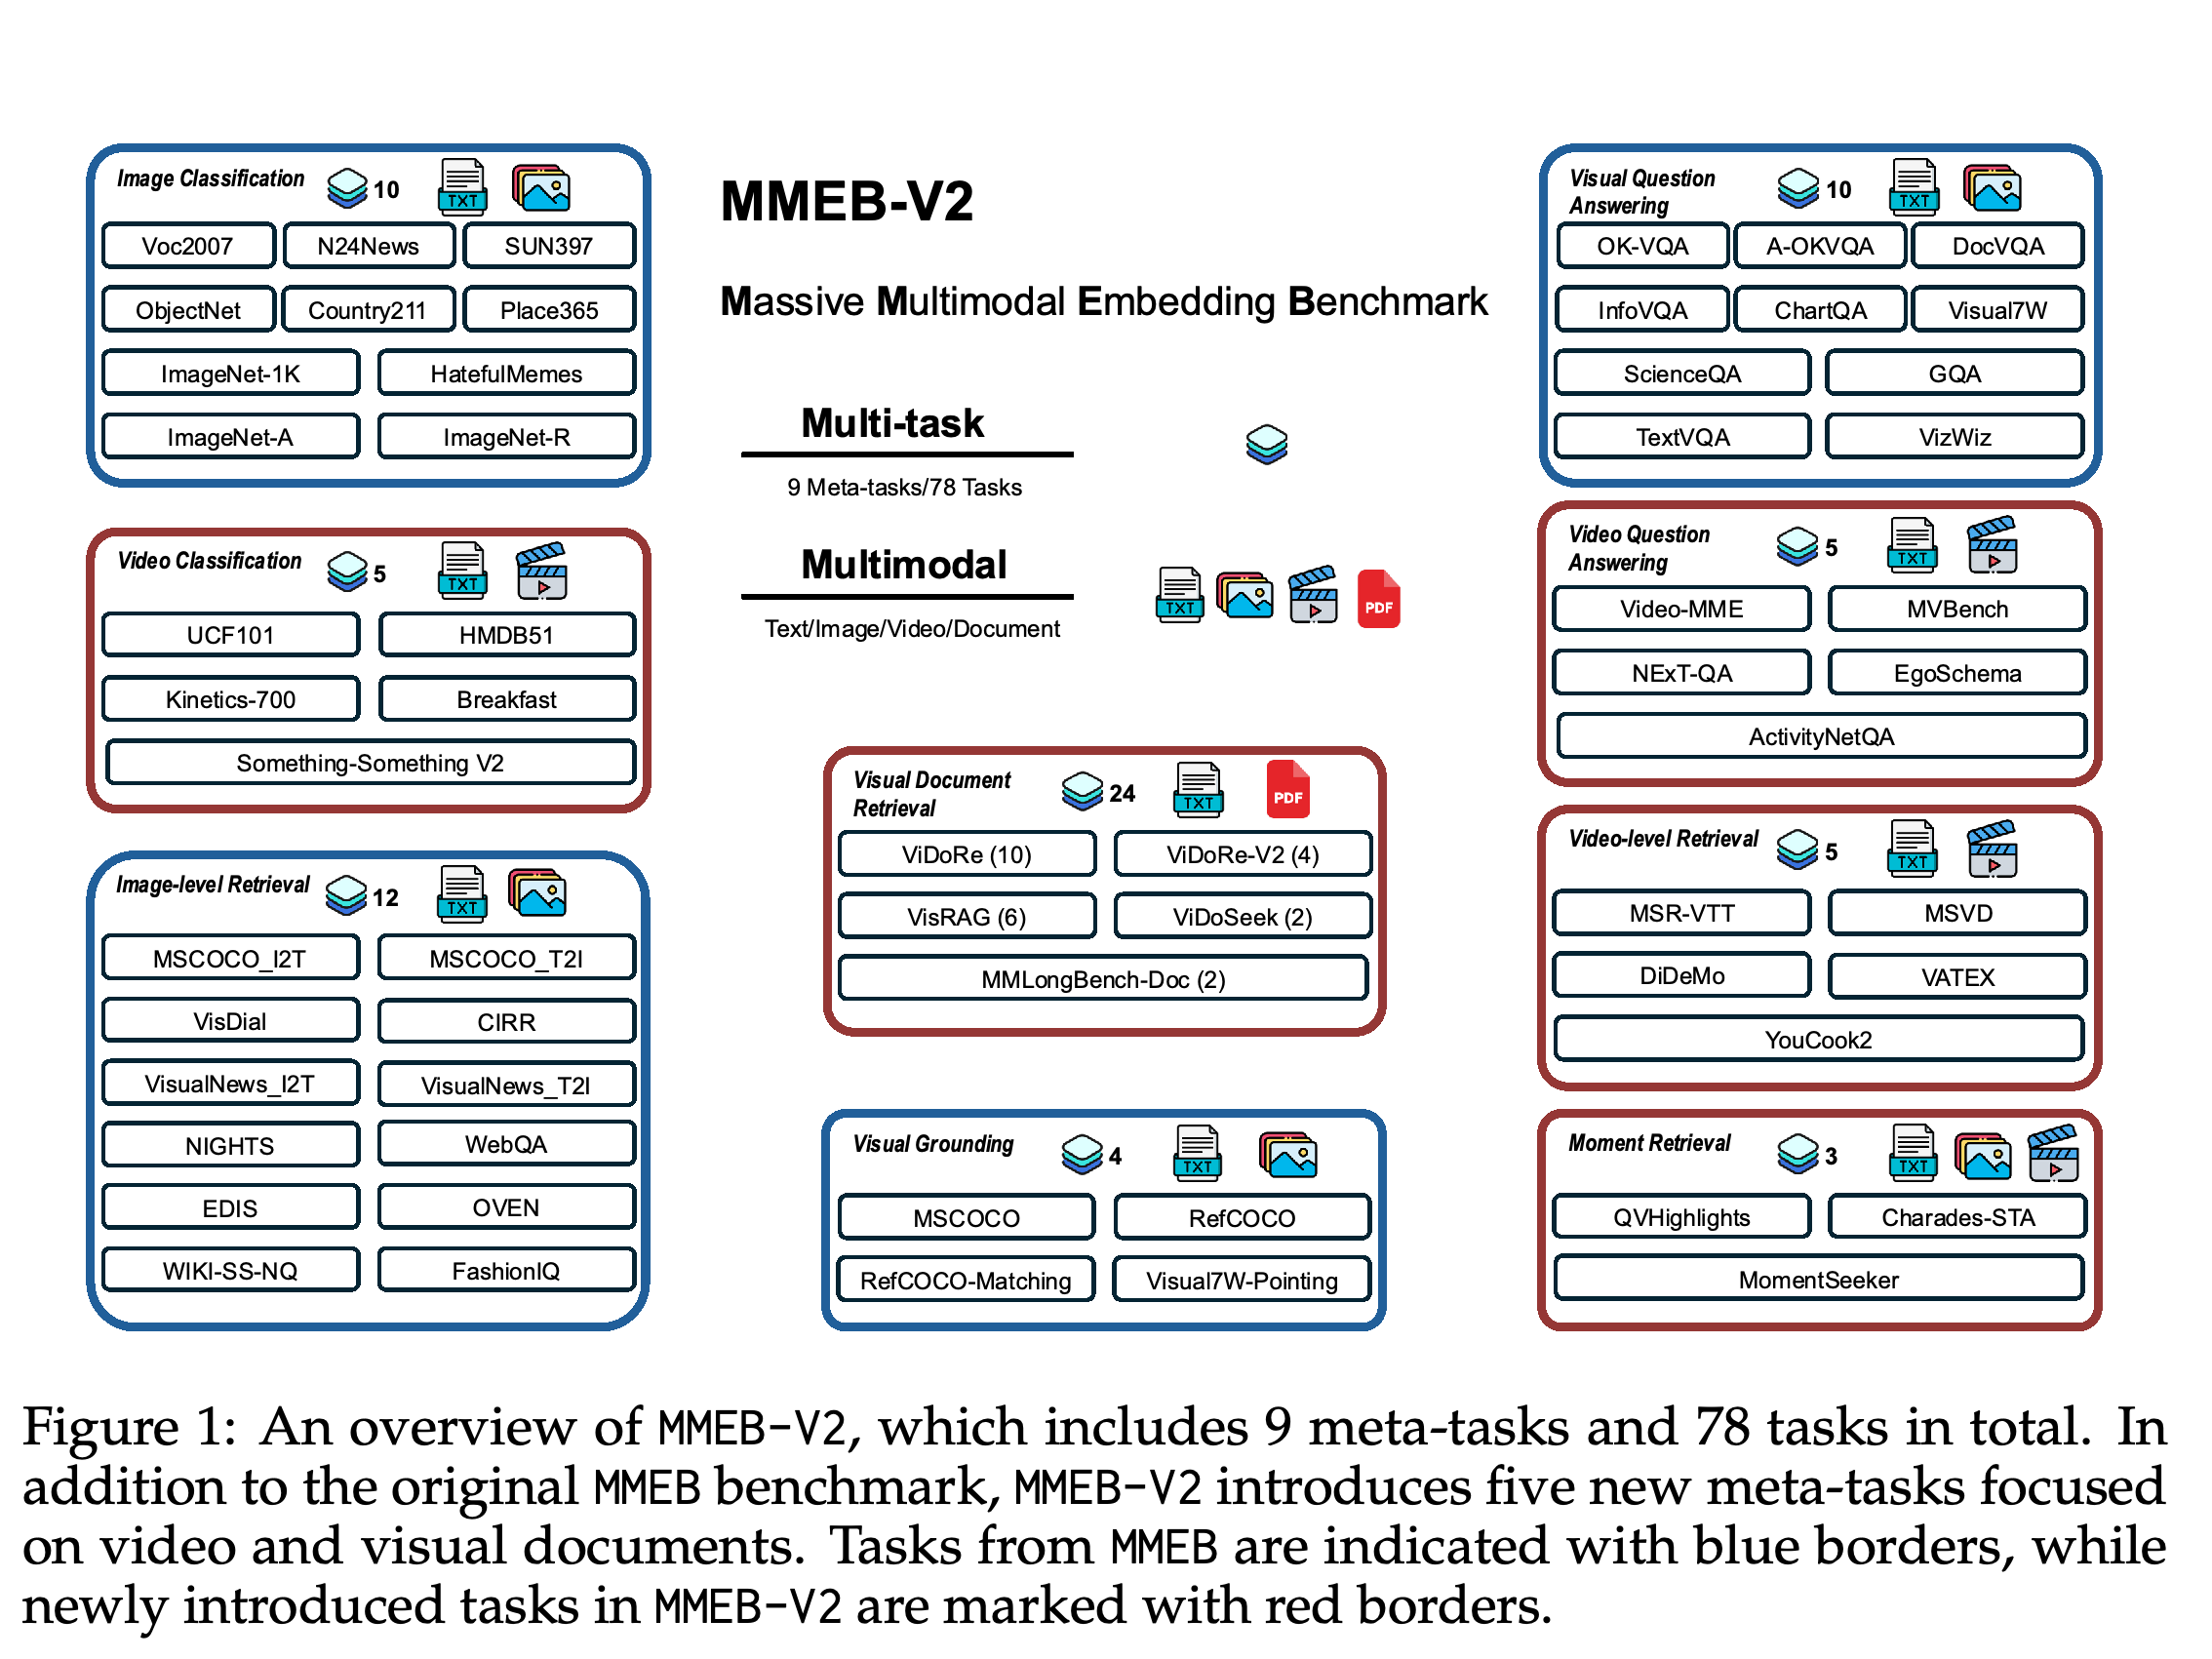
각 과제는 지시문으로 질의와 타깃 사이에 요구되는 관계를 지정하며, 현실적인 시간 안에 평가할 수 있도록 일부 데이터셋을 다운샘플링한다. 이미지와 동영상 과제에는 올바른 타깃이 1위에 오른 질의의 비율인 Hit@1을 사용한다. 문서 과제에는 상위 5개 결과의 순위 품질을 측정하는 정규화 할인 누적 이득 NDCG@5를 사용하고, 24개 과제의 점수를 평균한다.
후보 집합의 크기는 크게 다르다. 동영상 검색은 후보 670~4,468개를 사용하고, 구간 검색은 후보 10개를 제시하며, 동영상 질의응답은 작은 답변 집합을 사용한다. 따라서 점수에는 서로 다른 순위 평가 조건이 반영되며, 과제 난도를 공통 척도로 나타내지는 않는다.
3 Unified Embedding Model for Video, Image, and Visual Document
이 방법은 서로 다른 입력 유형을 공통 임베딩 공간에 정렬하고, 자연어 과제 지시문을 조건으로 질의 표현을 생성한다. 구성 요소는 공통 비전 언어 백본, 대조 최적화, 표준화된 입력 형식, 학습 데이터 출처별 샘플링이다.
3.1 Unified Representation of Multimodal Data
백본으로는 Qwen2-VL을 사용한다. 가변 해상도 시각 처리, 공간 및 시간 위치를 표현하는 Multimodal Rotary Position Embedding (M-RoPE), 이미지와 동영상을 위해 2차원 및 3차원 합성곱을 결합한 구조가 선정 근거이다. 이러한 백본 기능을 바탕으로 텍스트와 시각 입력이 교차 배치된 데이터를 공통 인코더로 처리한다.
3.2 Contrastive Learning
각 질의와 타깃은 마지막 토큰의 최종 레이어 표현으로 인코딩한다. 모델은 양성 타깃을 배치 내 음성 타깃 및 hard negative와 구분하는 대조 손실 InfoNCE를 최소화한다. 배치 내 음성 타깃은 배치에 포함된 불일치 타깃이고, hard negative는 구분하기 더 어려운 불일치 타깃이다. 손실은 L = −log[φ(h_qinst, h_t+) / (φ(h_qinst, h_t+) + Σ_{t−∈N} φ(h_qinst, h_t−))]이며, φ(h_q, h_t) = exp(cos(h_q, h_t)/τ)이다. 여기서 h는 임베딩, N은 음성 타깃 집합, τ는 점수의 스케일을 조절하는 온도이다.
3.3 Multi-modal Data Formatting
학습 예제는 질의와 양성 타깃으로 구성되며, 각 입력에는 텍스트, 1개 이상의 이미지, 텍스트와 이미지가 교차 배치된 시퀀스가 들어갈 수 있다. 질의 템플릿은 [VISUAL_TOKEN] Instruct: {task_instruction}\n Query: {q}이다. [VISUAL_TOKEN]은 <|image_pad|>와 <|video_pad|> 같은 모달리티별 토큰을 나타낸다.
- 과제 지시문은 특정 시각적 내용을 포함한 동영상을 찾는 것처럼 요구되는 관계를 설명한다.
- 선택적으로 추가하는 타깃 지시문은 “제공된 동영상의 내용을 이해하라:”와 같은 형태로 타깃 인코딩을 안내한다.
3.4 Data Sampling Strategies
미리 정한 샘플링 가중치 표가 학습 중 각 데이터셋을 선택할 확률을 제어한다. Interleaved sub-batching은 같은 출처의 유사한 예제를 묶어 대조 학습에서 구분을 어렵게 만든다. 동시에 여러 출처의 묶음을 전역 배치에 함께 넣어 과제 다양성을 유지한다.
- Section 3.4는 크기가 1,024인 배치를 크기가 128인 서브 배치 8개로 나누는 예를 들지만, Section 4.1.2의 학습 설정에서는 크기가 64인 서브 배치를 사용한다.
- 서브 배치 크기 절제 실험은 이러한 묶음 구성이 모달리티별 성능에 미치는 영향을 평가한다.
4 Experiments
실험에서는 이미지, 동영상, 시각 문서 과제에서 임베딩 모델을 비교한 뒤, 모달리티 조합, 샘플링 전략, 적응에 사용하는 파라미터 용량, 학습 기간을 바꿔 평가한다. 평가 범위에는 기존 이미지 벤치마크와 새로 추가한 동영상 및 문서 과제가 포함된다.
4.1 Experiment Setting
4.1.1 Training Data에서는 합성 동영상 언어 예제를 제공하는 LLaVA-Hound, 문서 검색 예제, MMEB-train의 이미지 텍스트 과제를 결합한다. 동영상 데이터에는 동영상과 캡션의 쌍 300k개, 동영상 질의응답 쌍 240k개가 포함된다. 문서 학습에는 colpali train set (118k), VisRAG synthetic (239k), VisRAG in-domain (123k)을 사용한다.
- 캡션 쌍은 텍스트로 동영상을 검색하는 형식과 동영상으로 캡션을 검색하는 형식에 모두 사용한다.
- MMEB-train은 이미지 분류, 질의응답, 검색, visual grounding 과제를 제공하며, grounding은 관련 시각 영역을 식별하는 과제이다.
4.1.2 Training Setting에서는 Qwen2-VL 2B, 전역 배치 크기 1,024, 학습 스텝 2K/5K, 서브 배치 크기 64, 온도 0.02를 사용한다. 파라미터 효율적 튜닝을 위한 저랭크 적응 기법 LoRA는 rank 16과 스케일링 계수 α = 32를 사용한다. 메모리 제약 아래에서 큰 대조 학습 배치를 사용할 수 있게 하는 GradCache를 적용해 H100 GPU 8개로 학습한다.
- 학습과 평가 모두에서 각 동영상을 균등하게 샘플링한 프레임 8개로 표현한다.
- 보고된 학습 설정에는 학습률, 옵티마이저, 실제 학습 소요 시간이 명시되어 있지 않다.
4.1.3 Baselines에는 GME, VLM2Vec, 멀티모달 검색 모델 LamRA, 문서 검색 모델 ColPali v1.3이 포함된다. 동영상 평가에서 GME와 LamRA는 중간 프레임 1개를 사용하고, 나머지 모델은 균등하게 샘플링한 프레임 8개를 사용한다. 따라서 비교에는 임베딩 학습뿐 아니라 시각 입력이 동영상을 포괄하는 범위의 차이도 반영된다.
- ColPali는 다중 벡터와 late interaction을 사용한다. Late interaction은 인코딩 이후 질의와 문서 표현을 비교하는 매칭 방식이다. VLM2Vec-V2는 마지막 토큰의 단일 표현을 사용한다.
4.2 Main Results
Table 2에서 VLM2Vec-V2 (2B)는 가장 높은 종합 점수인 58.0을 기록한다. GME (7B)는 57.8, GME (2B)는 54.1, VLM2Vec-Qwen2VL (2B)는 47.0이다. 이전 2B VLM2Vec와 비교하면 이미지 성능은 59.7에서 64.9로, 동영상은 29.0에서 34.9로, 문서 검색은 41.6에서 65.4로 높아진다.
- 이미지 점수 64.9는 VLM2Vec-Qwen2VL (7B)의 65.5보다 낮다.
- Table 2에서 GME (7B)는 동영상 38.6, 문서 검색 75.2로 선두를 차지한다. ColPali도 문서에서 71.0을 기록해 VLM2Vec-V2보다 높다.
- GME (7B)보다 종합 점수가 0.2점 높지만, 불확실성 추정치나 반복 실행 통계는 보고하지 않는다.
VLM2Vec-V2는 보고된 종합 점수가 58.0으로 가장 높지만, 이미지, 동영상, 문서 각각의 최고 점수에는 미치지 못한다. 문서 점수는 이전 2B VLM2Vec의 41.6에서 65.4로 상승하지만, GME (7B) 대비 종합 점수 차이는 0.2점이다.
4.3 Ablation Analysis
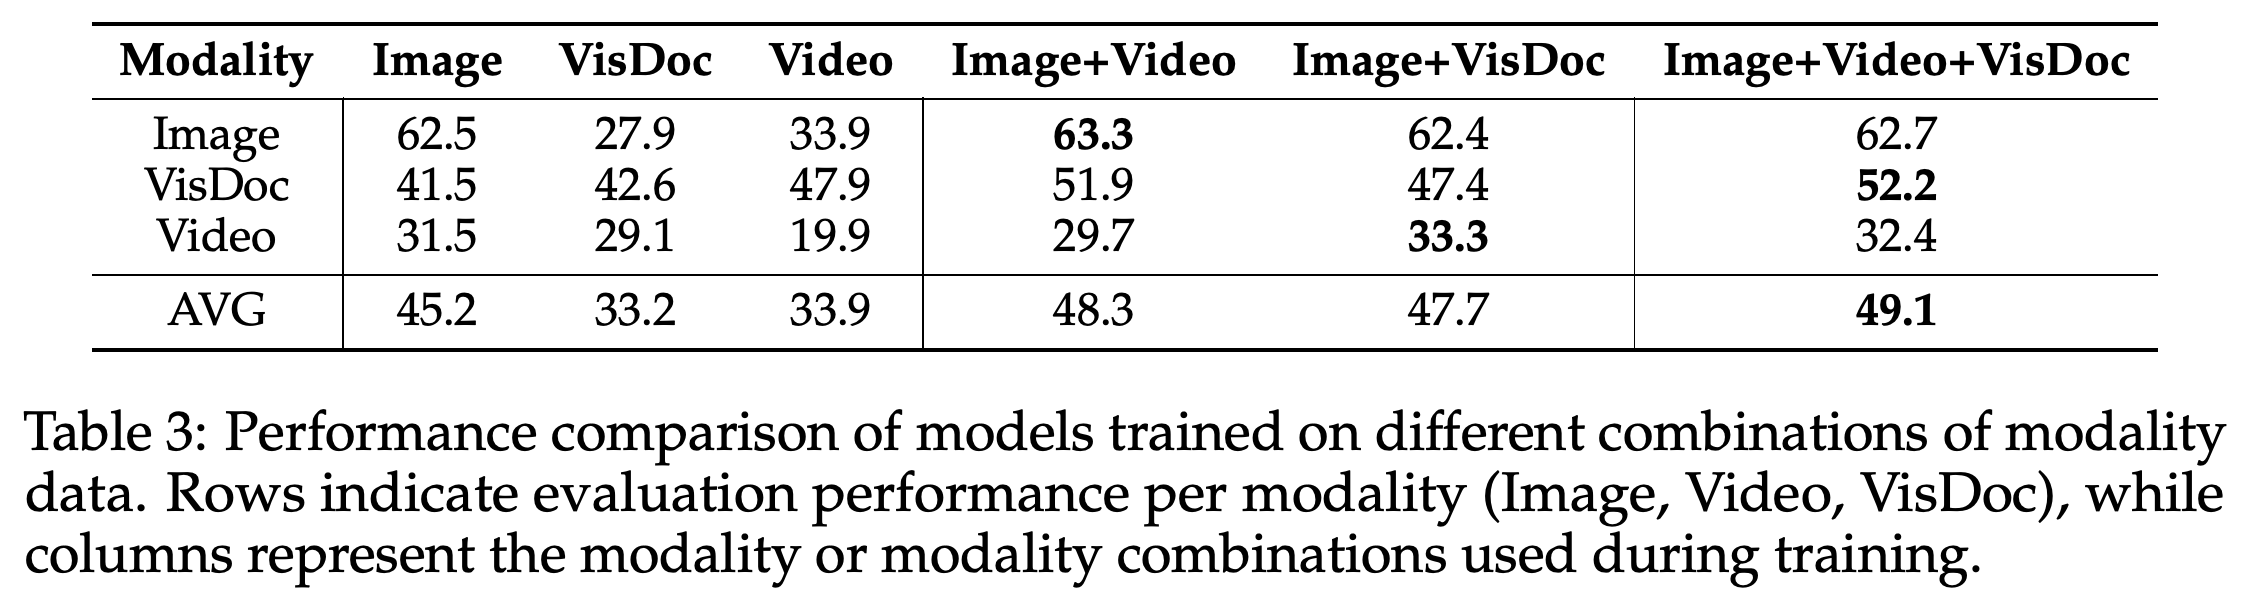
4.3.1 Generalization Across Modalities에서는 시각 문서 검색 벤치마크의 2번째 버전인 ViDoRe-V2를 제외하고, 개별 모달리티 및 일부 모달리티 조합으로 학습한 결과를 비교한다. 이미지로만 학습한 경우 단일 모달리티 중 가장 높은 평균 45.2를 기록한다. Image+Video는 48.3, Image+VisDoc은 47.7, 3개 모달리티 전체는 49.1을 기록하며, VisDoc은 시각 문서를 뜻한다.
- 이 절제 실험에서 3개 모달리티를 모두 사용하면 문서 점수가 가장 높은 52.2를 기록하지만, 이미지 점수는 Image+Video에서 63.3으로 가장 높다.
- 동영상 점수는 Image+VisDoc에서 33.3으로 가장 높고, 3개를 모두 사용하면 32.4이다. 동영상 학습 데이터를 추가한다고 동영상 평가 성능이 항상 높아지지는 않는다.
3개 학습 모달리티를 모두 결합하면 보고된 평균이 49.1로 가장 높지만, 모달리티별 최적 설정은 다르다. 동영상 평가는 Image+VisDoc 학습에서 33.3으로 가장 높아 3개 모달리티를 모두 사용한 32.4를 웃돈다. 따라서 성능 향상이 평가 모달리티 전반에서 동일하게 나타나지는 않는다.
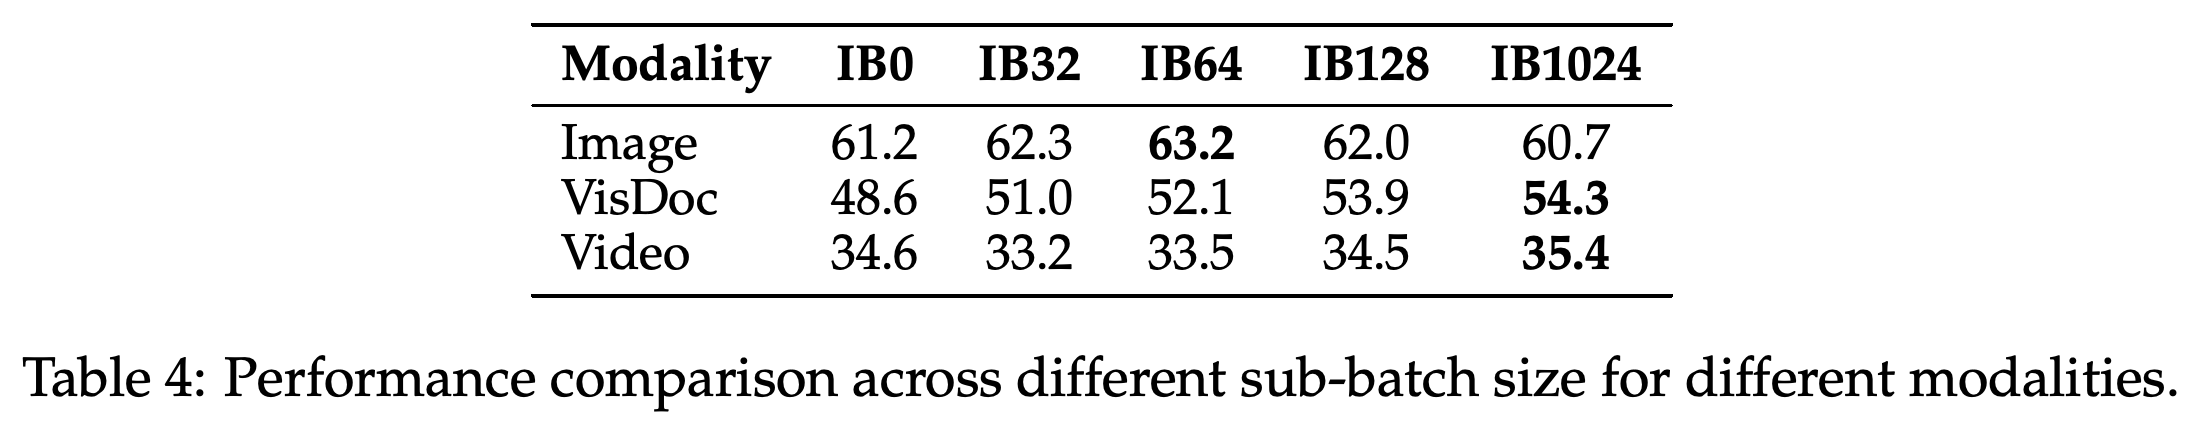
4.3.2 Ablation Study on Data Sampling Strategies에서는 interleaved sub-batch 크기 0, 32, 64, 128, 1024를 평가한다. 이미지 성능은 크기 64에서 63.2로 가장 높다. 문서 성능은 크기 0의 48.6에서 크기 1024의 54.3으로 상승한다. 동영상 성능은 34.6, 33.2, 33.5, 34.5, 35.4로 단조롭게 증가하지 않는다.
- 크기 0은 출처별로 묶지 않고 예제를 독립적으로 혼합하며, 크기 1024는 전체 배치를 1개 출처에서 뽑는다.
- 본문은 서브 배치 크기가 커질수록 동영상 성능이 일관되게 좋아진다고 주장하지만, Table 4에서는 크기 0에서 32로 바뀔 때 성능이 낮아진 뒤 상승한다.
이미지 성능은 서브 배치 크기 64에서 가장 높고, 문서 성능은 전체 배치를 1개 출처에서 구성할 때 가장 높다. 동영상 성능은 크기 0의 34.6에서 크기 32의 33.2로 낮아진 뒤 35.4까지 상승하므로, 동영상 점수가 일관되게 좋아진다는 본문 주장과 맞지 않는다.
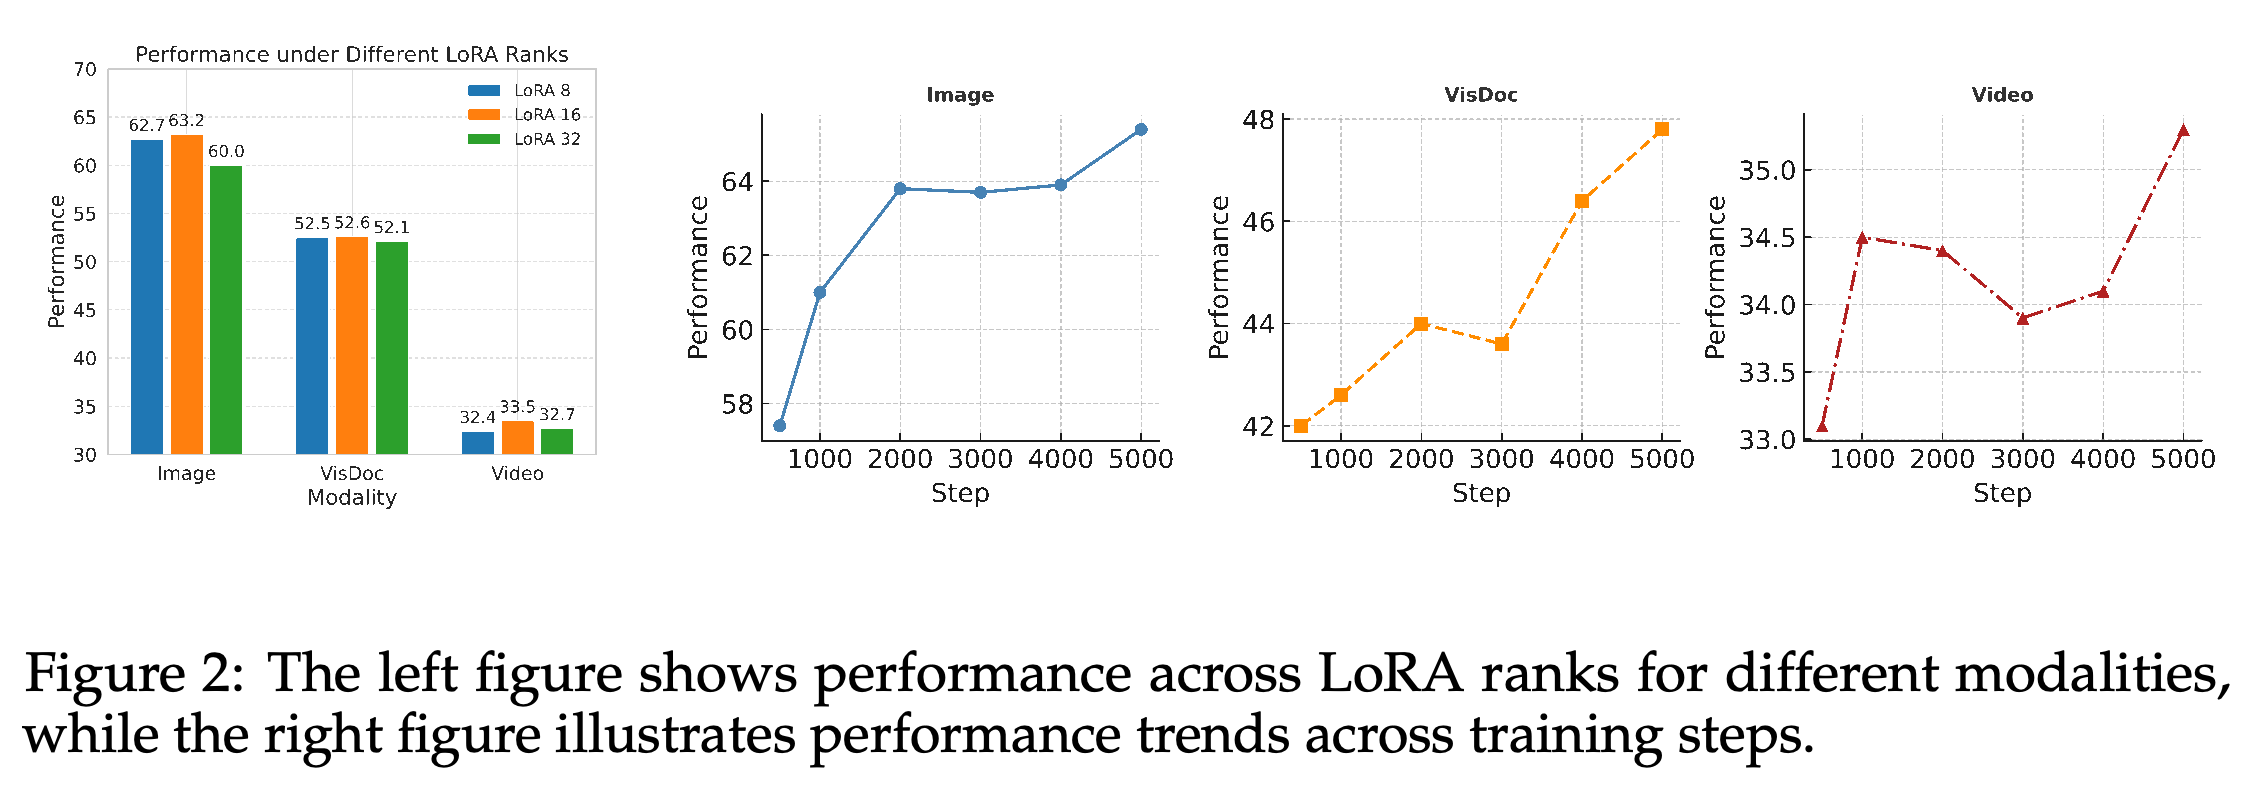
4.3.3 Ablation Study on Model Settings에서는 LoRA rank 8, 16, 32를 비교한다. Figure 2에 표시된 점수는 3개 모달리티 모두 rank 16에서 가장 높으며, 이미지 63.2, 문서 52.6, 동영상 33.5이다.
- 학습 스텝 그래프에서 5K 스텝의 최종 점수는 가장 이른 체크포인트보다 높지만, 중간에 하락하거나 정체되는 구간이 있다.
- 저자들은 특히 문서와 동영상에서 더 오래 학습하면 도움이 될 수 있다고 제안하지만, 5K 스텝을 넘는 학습은 평가하지 않는다.
Rank 8, 16, 32 중에서는 rank 16이 각 모달리티에서 그림에 표시된 최고 점수를 기록한다. 학습 곡선은 가장 이른 체크포인트보다 5K에서 높게 끝나지만, 정체와 하락 구간도 포함한다. 측정 범위를 넘어선 성능 향상을 입증하지는 않는다.
5 Related Works
관련 연구에서는 멀티모달 임베딩 벤치마크, 동영상 표현, 시각 문서 표현, 통합 검색을 다룬다. 논문은 MMEB-V2와 VLM2Vec-V2가 이러한 환경 전반으로 벤치마크와 모델의 적용 범위를 확장한다고 설명한다.
5.1 Multimodal Embedding Benchmarks
기존 이미지 텍스트 데이터셋은 캡셔닝과 검색을 지원하며, M-BEIR과 MMEB는 평가 범위를 여러 임베딩 과제로 넓힌다. 논문은 이러한 벤치마크도 여전히 정적 이미지와 짧은 문맥에 집중한다고 지적하며, 동영상과 구조화된 문서에 공통으로 적용할 수 있는 지시문 기반 평가의 필요성을 제시한다.
- 표현을 입력으로 선형 분류기를 학습하는 linear probing을 이미지 표현의 품질을 평가하는 기존 방법으로 소개한다.
- MSR-VTT와 QVHighlights 같은 동영상 벤치마크는 과제별 평가를 제공하지만, 그 자체로 통합 임베딩 평가 체계를 제공하지는 않는다.
5.2 Video Representation Learning
논문은 시각 처리와 언어 감독을 결합하는 동영상 표현 방법을 검토하며, 대조 학습 및 캡셔닝 목적함수와 관련해 VideoCLIP과 VideoCoCa를 논의한다. InternVideo2는 일부를 가린 동영상 입력에서 학습하는 masked video modeling, 서로 다른 입력 유형을 정렬하는 교차 모달 대조 학습, 시퀀스의 다음 요소를 예측하는 next-token prediction을 결합한다.
- LLaVE와 LamRA는 동영상 전용 학습 없이도 이미지 텍스트 학습이 텍스트 동영상 검색으로 전이될 수 있다는 근거로 인용된다.
- 보고된 기준 모델 비교만으로는 동영상 전문 모델보다 우수하다고 판단할 수 없다.
5.3 Visual Document Representation Learning
시각 문서 방법은 텍스트, 차트, 표, 레이아웃 등 페이지 이미지에 담긴 정보를 보존한다. ColPali는 문서 임베딩을 제공한다. VisRAG는 검색한 근거를 생성 모델에 제공하는 검색 증강 생성(RAG)을 위해 문서를 이미지로 임베딩한다. ViDoRAG는 여러 에이전트를 통해 시각 문서에 대해 반복적으로 추론한다.
- MMLongBench-Doc은 긴 문맥의 문서 이해를 평가하며, 이 논문이 검색용으로 전환해 사용하는 근거 페이지 주석을 제공한다.
5.4 Unified Modality Retrieval
GME와 Uni-Retrieval은 1개 프레임워크 안에서 서로 다른 입력 유형을 검색하는 방법을 추구한다. UniversalRAG와 UniRAG는 질의를 적합한 모달리티와 페이지 또는 문서 같은 검색 단위로 라우팅한다. 이 논문은 이미지, 동영상, 시각 문서 임베딩을 함께 다룬다는 점을 차별점으로 제시한다.
6 Conclusion
결론은 MMEB-V2를 평가 범위를 넓힌 벤치마크 모음으로, VLM2Vec-V2를 대조 학습으로 훈련한 통합 기준 모델로 제시한다. 보고된 결과는 비교 모델보다 높은 종합 성능을 보여주며, 시각 모달리티를 함께 학습할 때 참고할 수 있는 분석 결과를 제공한다.
부록
- A Appendix에는 저자 기여, 기준 모델 설명, 벤치마크 구성 세부 사항, 전체 점수가 포함된다. A.1 Author Contributions는 Rui Meng과 Ziyan Jiang이 기술적 연구 방향과 벤치마크 개발을 이끌었고, Ye Liu가 대부분의 학습 실험을, Can Qin이 전반적인 평가를 담당했으며, Xinyi Yang이 문서 데이터 구축과 평가에 기여했다고 명시한다. A.2 Details of Baseline Models는 VLM2Vec의 지시문 기반 순위 결정, ColPali의 다중 벡터 late interaction, LamRA의 언어 전용 사전 학습 후 멀티모달 지시 튜닝, GME의 대조 학습 기반 멀티모달 검색을 구분해 설명한다.
- A.3 Details of Benchmark Construction은 사용한 데이터 분할과 변환 방법을 설명한다. A.3.1 Video Retrieval은 MSR-VTT 쌍 1,000개, DiDeMo 문단 동영상 쌍 1,004개, MSVD 쌍 670개, 대규모 내레이션 동영상 데이터셋 HowTo100M과 중복된 항목을 제거한 YouCook2 쌍 3,179개, 사용 가능한 VATEX 동영상 4,468개를 사용한다.
- A.3.2 Moment Retrieval에서는 QVHighlights의 후보 클립 순위를 매기고, 관련 클립이 1위로 검색되는지를 측정하는 Recall@1으로 평가한다. Charades-STA는 관련 구간이 동영상의 1/3 미만인 예제로 제한하며, MomentSeeker에서는 질의마다 모든 양성 클립과 함께 음성 클립 9개를 샘플링한다. 이러한 후보 순위 평가는 예측 구간과 정답 시간 구간의 겹침 비율인 Intersection over Union (IoU)으로 평가하는 시간 구간 탐지와 다르다.
- A.3.3 Video Classification은 Kinetics-700, Something Something v2, HMDB51, UCF101에서 각각 예제 1,000개를 샘플링하며, Breakfast는 카메라 01의 클립 433개를 사용한다. A.3.4 Video QA는 MVBench, Video-MME, NExT-QA, 공개된 EgoSchema 질문 500개 하위 집합을 사용하는 객관식 평가를 설명한다. ActivityNetQA에 대해서는 이에 대응하는 구성 설명 문단을 제공하지 않는다.
- A.3.5 Visual Document Retrieval은 질문을 검색 질의로, 주석이 달린 페이지를 관련 타깃으로 바꾸는 방법을 설명한다. ViDoRe에는 학술 질의응답 데이터셋의 질의와 수집 문서에 대해 생성한 합성 질의가 포함된다. ViDoRe-V2는 난도가 높은 다국어 데이터셋 4개를 추가하고, VisRAG는 문맥 의존적인 질문을 걸러낸다. ViDoSeek와 MMLongBench-Doc은 검색용으로 변환한 과제에 근거 페이지 정보를 제공한다.
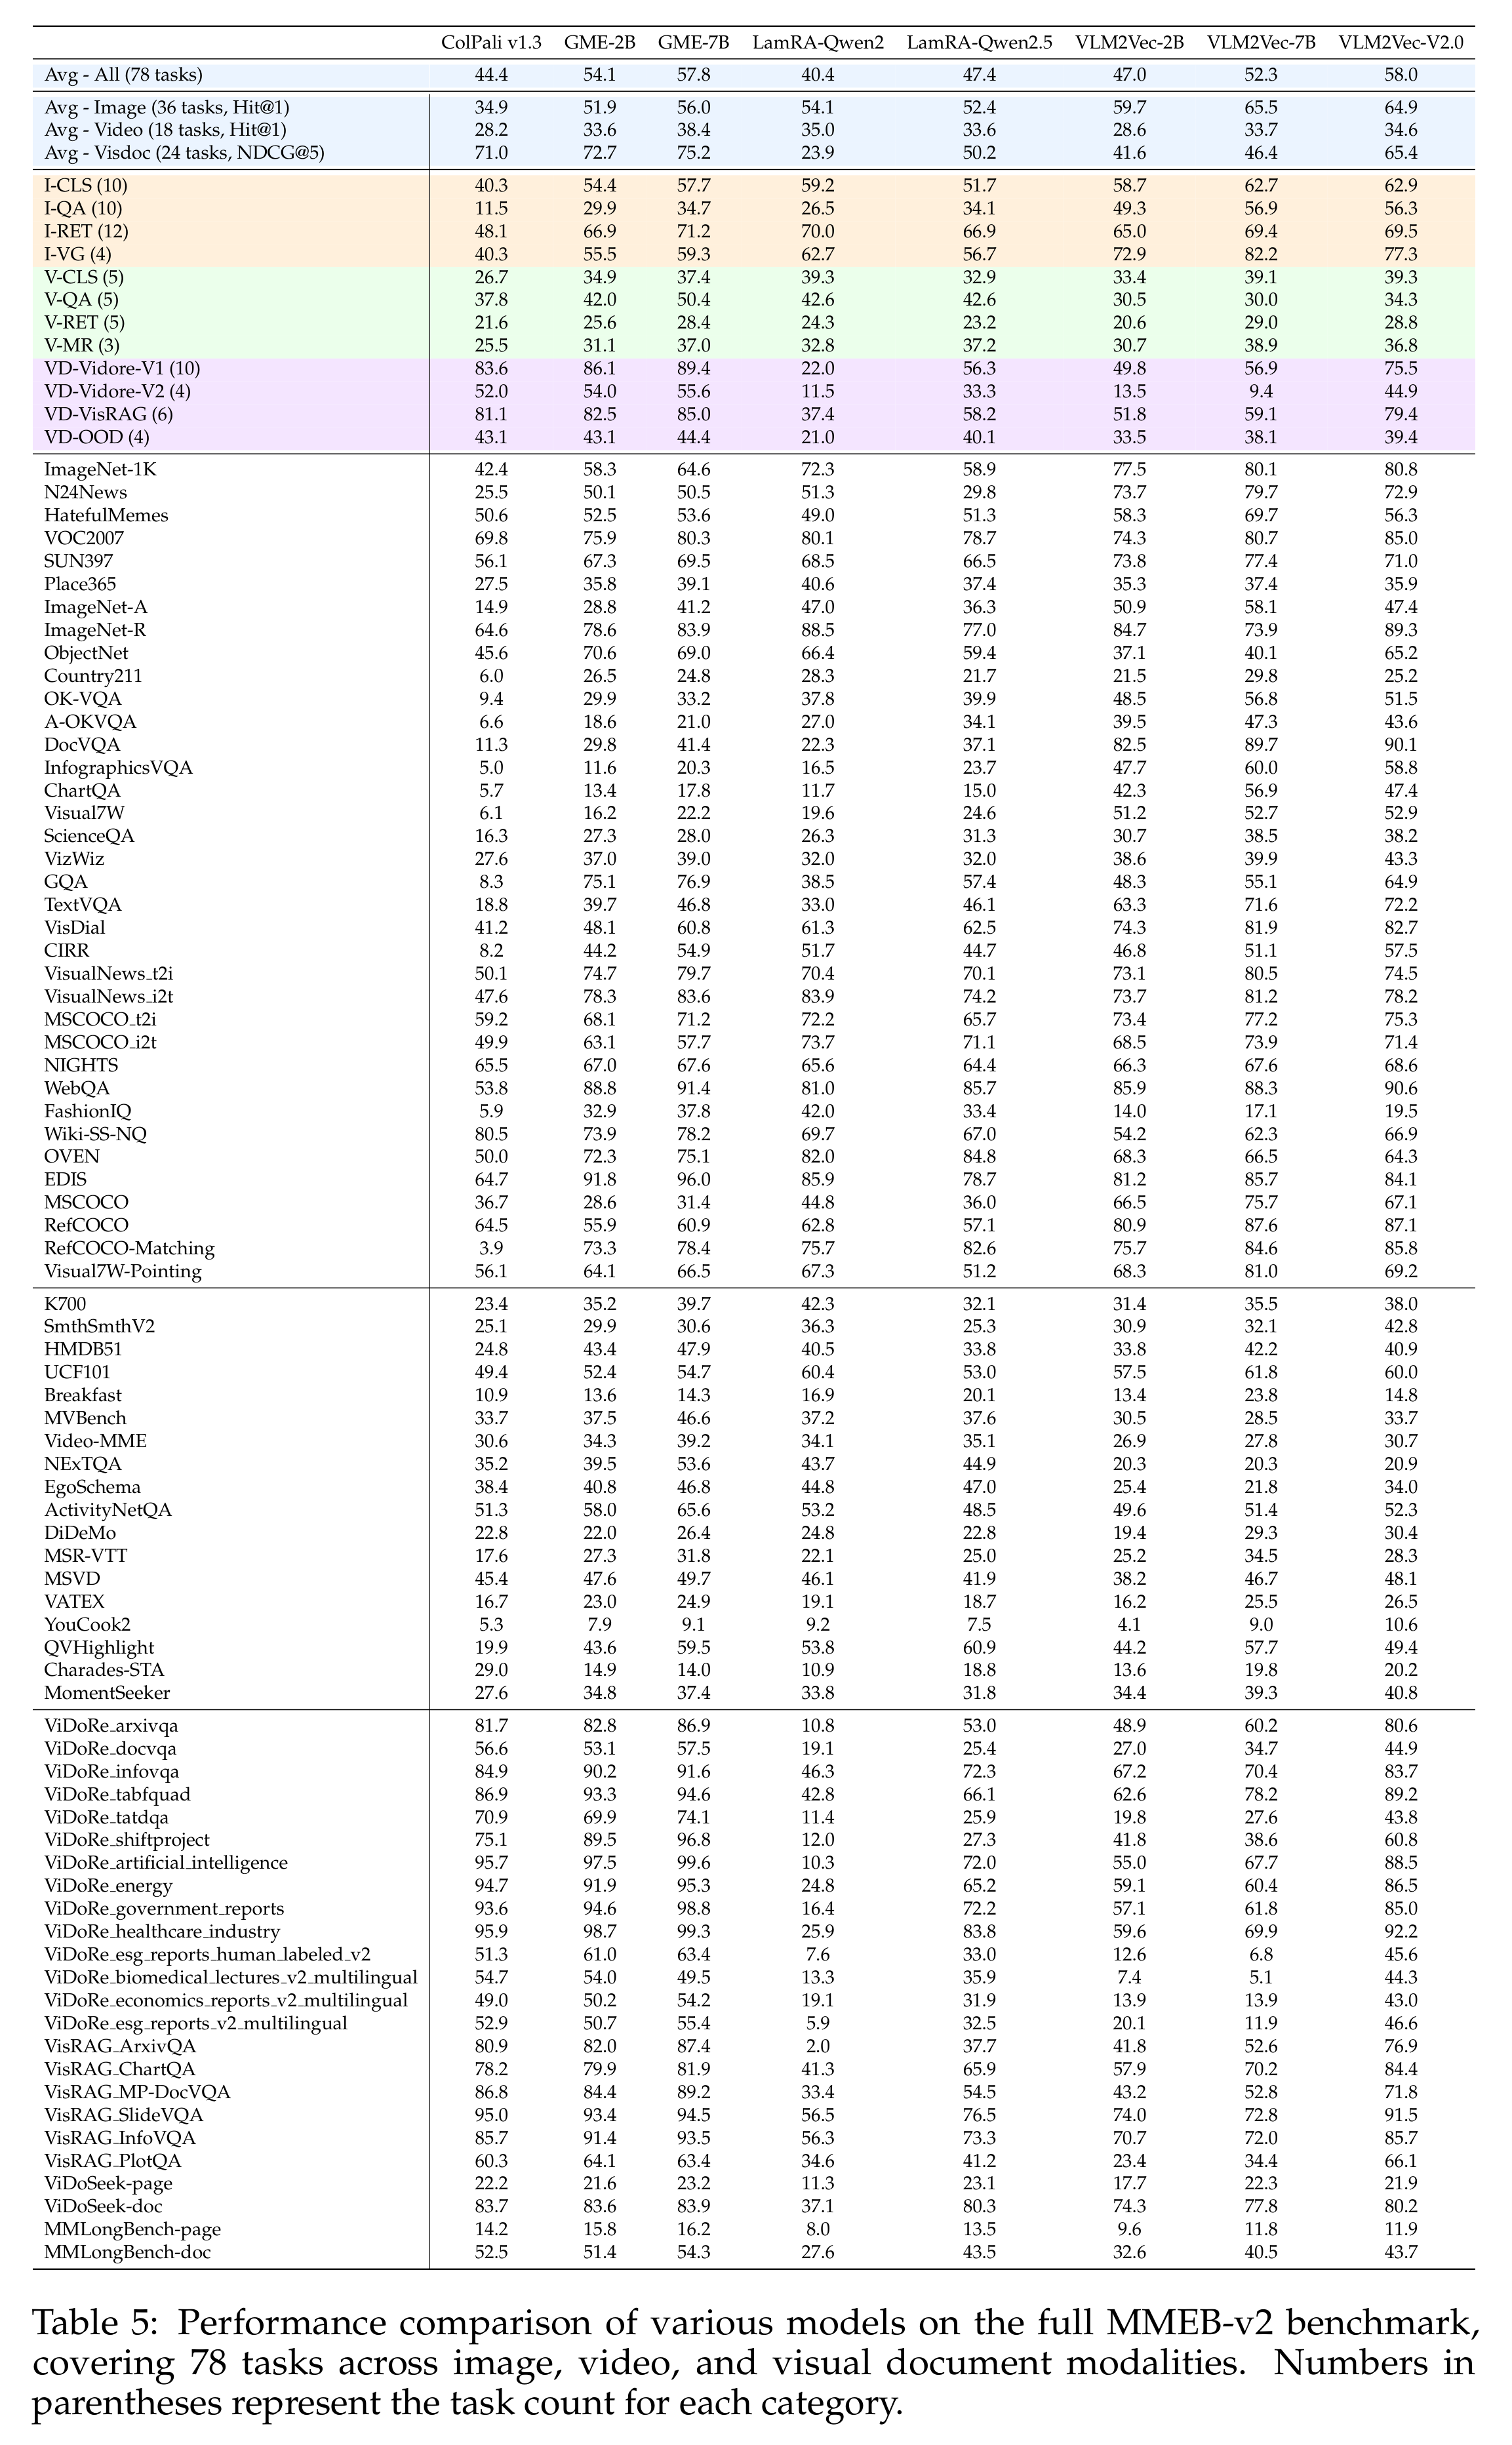
- A.4 Detailed Scores는 Table 5에서 전체 78개 과제의 결과를 제공한다. VLM2Vec-V2는 ViDoSeek-page에서 21.9, ViDoSeek-doc에서 80.2를 기록하고, MMLongBench-page에서 11.9, MMLongBench-doc에서 43.7을 기록한다. 페이지 단위와 문서 단위의 결과가 크게 다르다.
짧은 생각
이 벤치마크는 공통 순위 평가 형식을 사용하므로 여러 시각 데이터 형태에 걸쳐 1개 임베딩 모델을 비교하는 데 유용하다. VLM2Vec-V2는 이전 2B VLM2Vec보다 크게 개선되었지만, 종합 점수 58.0은 모달리티별 결과와 함께 해석해야 한다. 이미지 점수는 비교 대상 중 가장 높은 모델에 가깝지만, 동영상과 문서에서는 GME (7B)가 여전히 더 높다.
정확한 동영상 비교를 재현하려면 수치 근거의 불일치를 먼저 해소해야 한다. Table 2에서 VLM2Vec-V2의 동영상 종합 점수와 구간 검색 점수는 34.9와 38.5이지만, Table 5에서는 34.6과 36.8이다. 기준 모델 간 동영상 프레임 수 차이, 불확실성 추정치의 부재, 후보 순위 평가로의 변환 때문에 시간적 이해 능력과 GME (7B) 대비 종합 점수 0.2점 우위에 관해 결과가 입증하는 범위에는 한계가 있다.
절제 실험은 데이터 출처 구성과 배치 구조를 조정할 근거를 제공하지만, 평가한 설정 중 모든 모달리티의 성능을 최대화하는 설정은 없다. 프로젝트 URL은 https://tiger-ai-lab.github.io/VLM2Vec/ 이며, 검토한 원문은 2025년 7월 7일자 arXiv:2507.04590v1이다.
과제별 결과에서 VLM2Vec-V2는 페이지 단위 문서 검색에서 낮은 점수를 보이며, NExTQA에서는 20.9를 기록한다. 동영상 종합 점수와 구간 검색 집계 점수는 Table 2와 다르므로, 정확한 비교에 재사용하기 전에 수치의 불일치를 해소해야 한다.