


Expert Race: A Flexible Routing Strategy for Scaling Diffusion Transformer with Mixture of Experts 요약 설명
20 Mar 2025 | Paper Review Expert Routing Mixture-of-Experts Diffusion Transformers목차
이번 글에서는 Expert Race: A Flexible Routing Strategy for Scaling Diffusion Transformer with Mixture of Experts 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 20일(Arxiv)
- Yuan, Yike, Wang, Ziyu, Huang, Zihao, Zhu, Defa, Zhou, Xun, Yu, Jingyi, Min, Qiyang.
- ByteDance Seed, ShanghaiTech University
- 논문 링크
요약
- 이 논문은 Transformer로 노이즈를 점진적으로 제거해 이미지를 생성하는 diffusion transformer에서 이미지 영역과 denoising 단계에 연산을 배분하는 방법을 다룬다. ImageNet 256 × 256에서 RaceDiT-XL/2-4in32와 저자들이 재학습한 DiT-XL/2*는 보고된 학습량이 같고, 실제 연산에 사용하는 활성 파라미터 수도 각각 0.707B와 0.669B로 비슷하다. 이 조건에서 이미지 생성 품질 지표인 Fréchet Inception Distance(FID)는 각각 2.06과 3.02다. FID는 낮을수록 좋다.
- Expert Race는 배치, 이미지 시퀀스, expert 차원 전체에서 token–expert 점수가 가장 높은 항목을 선택한다. token은 이미지 패치를 나타내고, 점수는 token을 어떤 expert에 배정할지 결정한다. Mixture of Experts(MoE)는 입력을 expert라는 feed-forward network에 선택적으로 전달하는 층이다. Expert Race는 MoE에서 패치와 denoising timestep마다 연산량을 다르게 배분할 수 있게 한다. 과거 관측값의 비중을 점차 줄이는 이동 추정치인 exponential moving average(EMA)로 추론 임계값을 구해 샘플 간 경쟁 없이 추론한다.
- Router similarity loss는 expert들이 같은 token 집합을 반복해서 처리하는 현상을 억제하고, per-layer regularization은 최종 denoising 목표값으로 중간 표현을 직접 지도한다. 구성 요소를 누적해서 추가한 ablation에서 ImageNet 256 × 256의 FID가 16.47에서 8.03으로 낮아진다. 보고된 7.2× 가속은 같은 학습 손실에 도달하는 데 필요한 반복 횟수를 비교한 값이며, 실제 학습 시간도 같은 비율로 줄어드는지는 입증하지 않는다.
1 Introduction
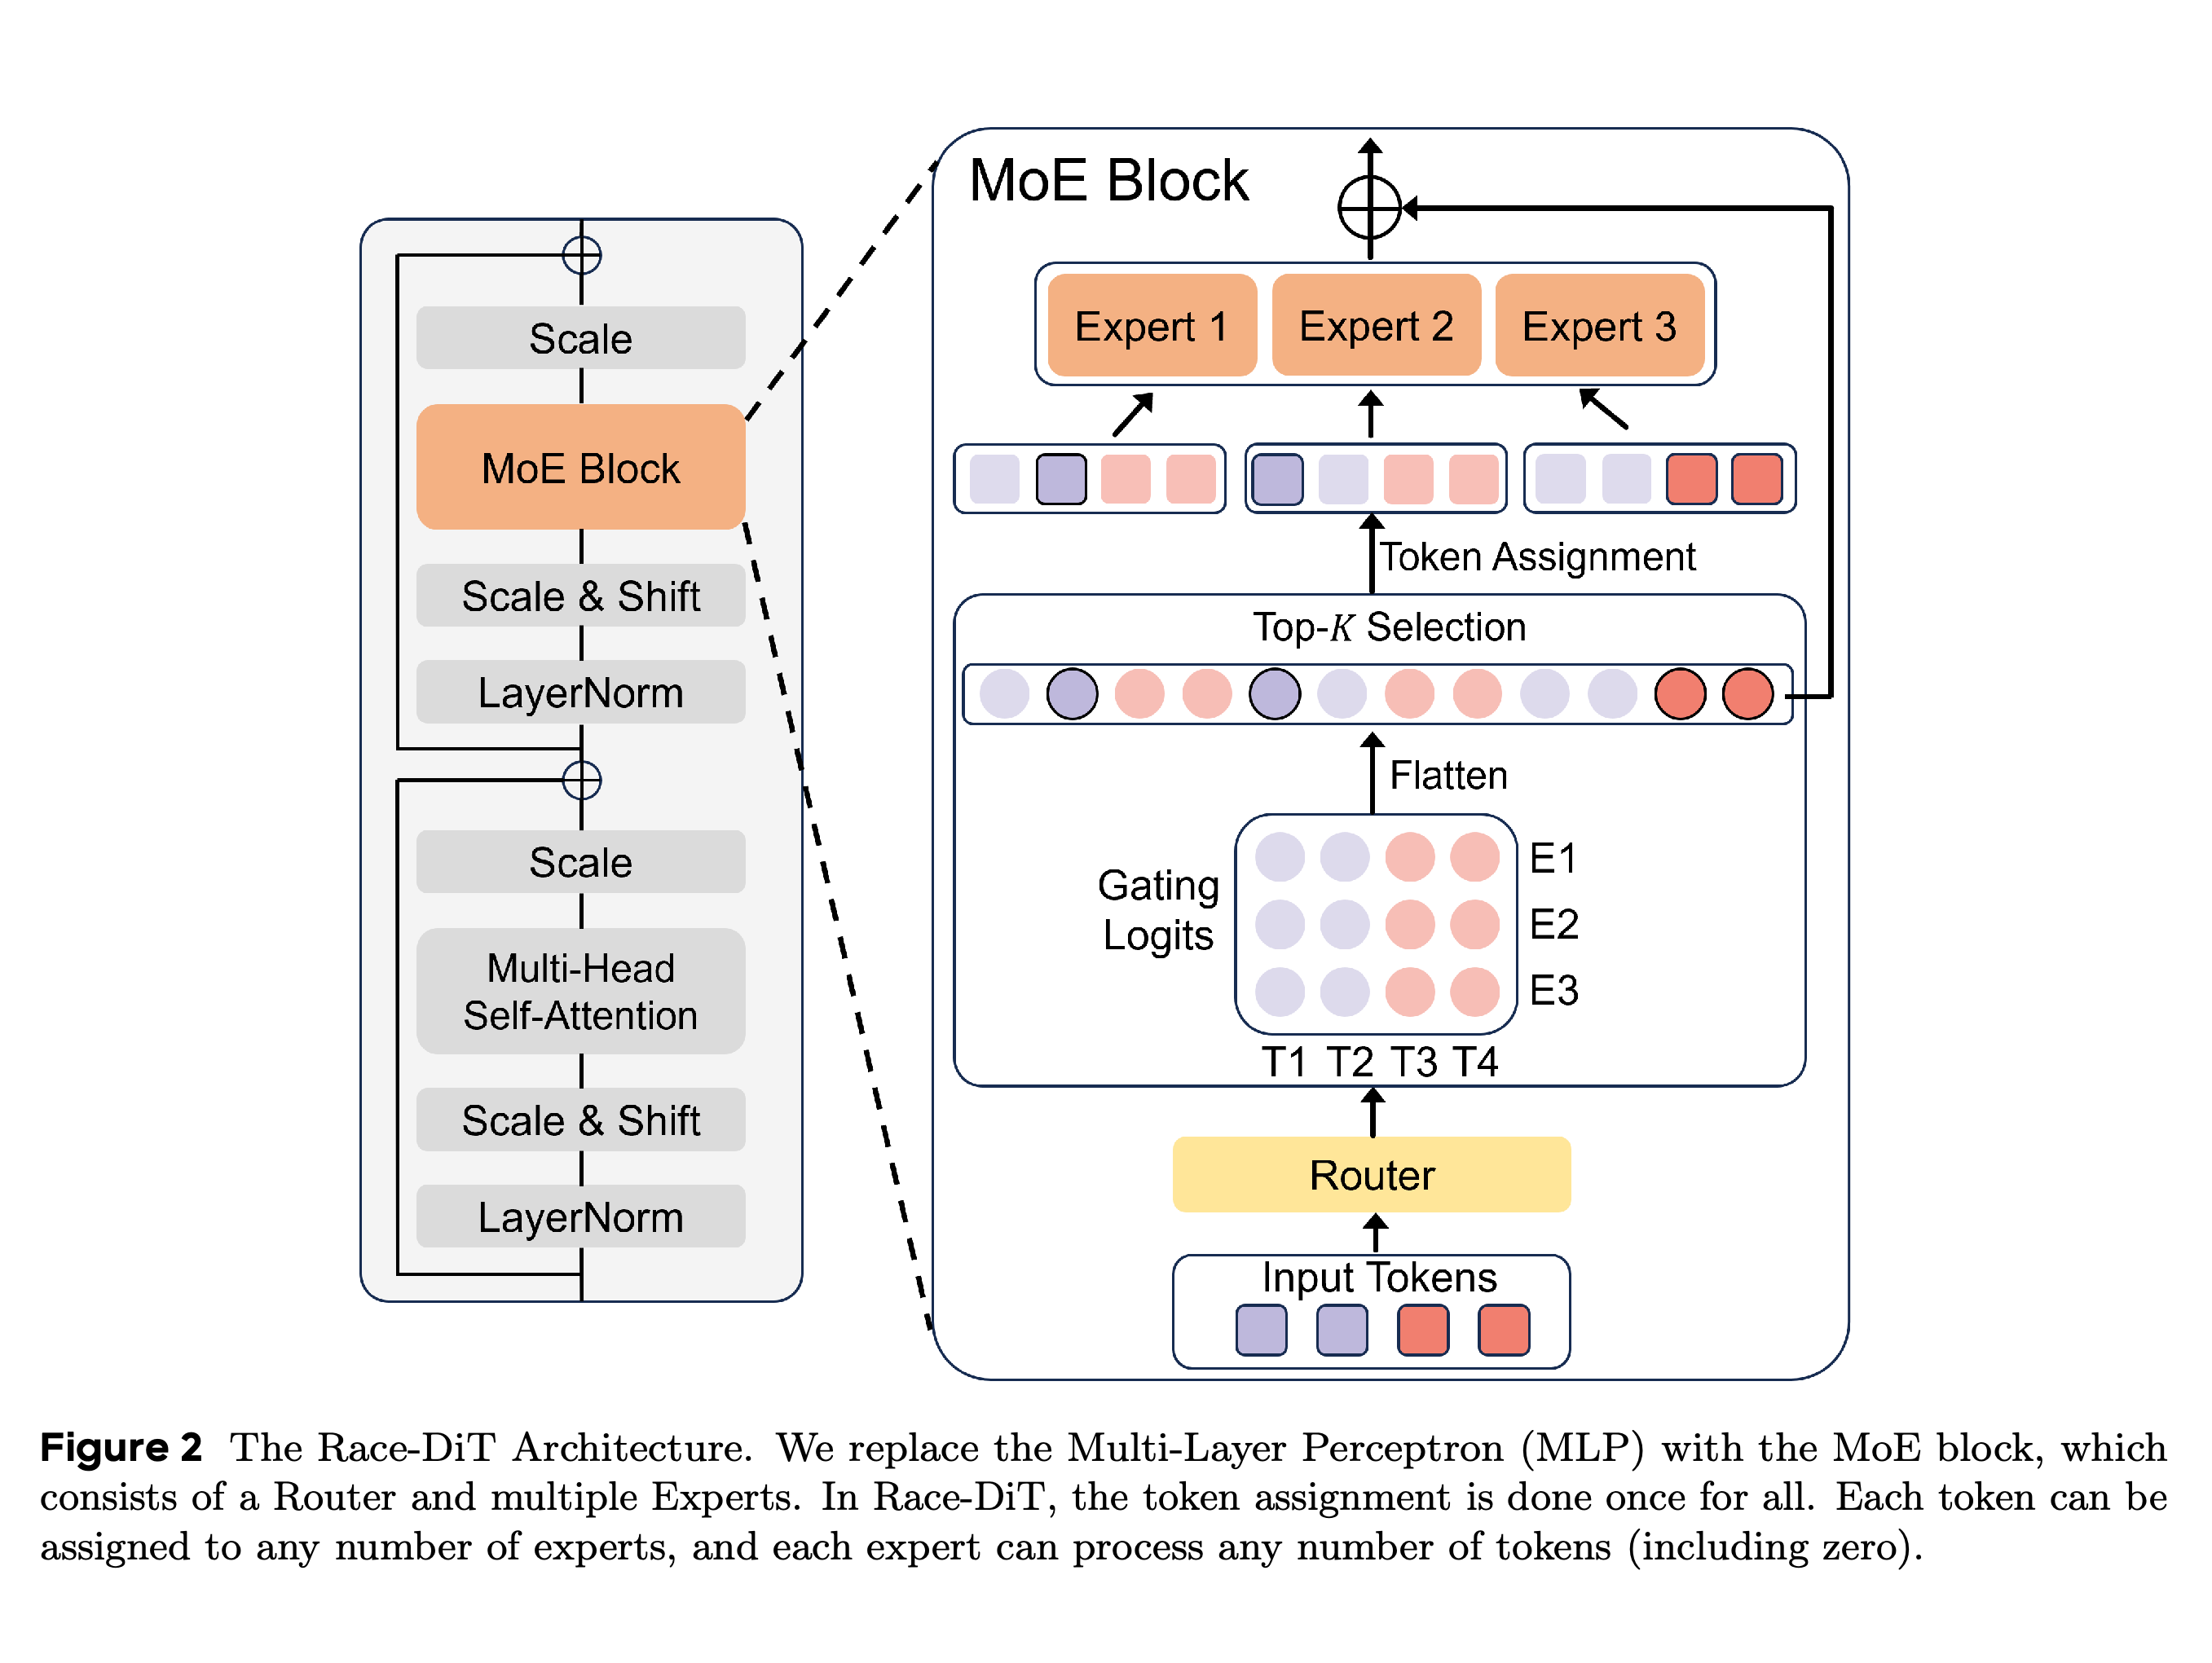
이미지 패치마다 정보 밀도가 다르고 denoising 단계마다 복원 난도가 다르다. 이에 저자들은 token–expert 배정 점수를 계산하는 router를 통해 어려운 token에 더 많은 expert를 배정하는 방법을 제안한다. Race-DiT는 Transformer의 feed-forward 하위 네트워크인 multi-layer perceptron(MLP)을 MoE 블록으로 교체하고, 얕은 층의 학습과 expert 다양성을 위한 목적 함수를 추가한다.
Routing 도식은 제한된 부분 집합에서 전체 점수 텐서로 선택 후보를 확장한다. 학습 곡선은 같은 손실에 도달하는 데 필요한 반복 횟수 기준으로 7.2× 가속을 보고한다. 반복 횟수 기준으로 최적화가 빨라짐을 뒷받침하지만 실제 학습 시간을 측정한 결과는 아니다.
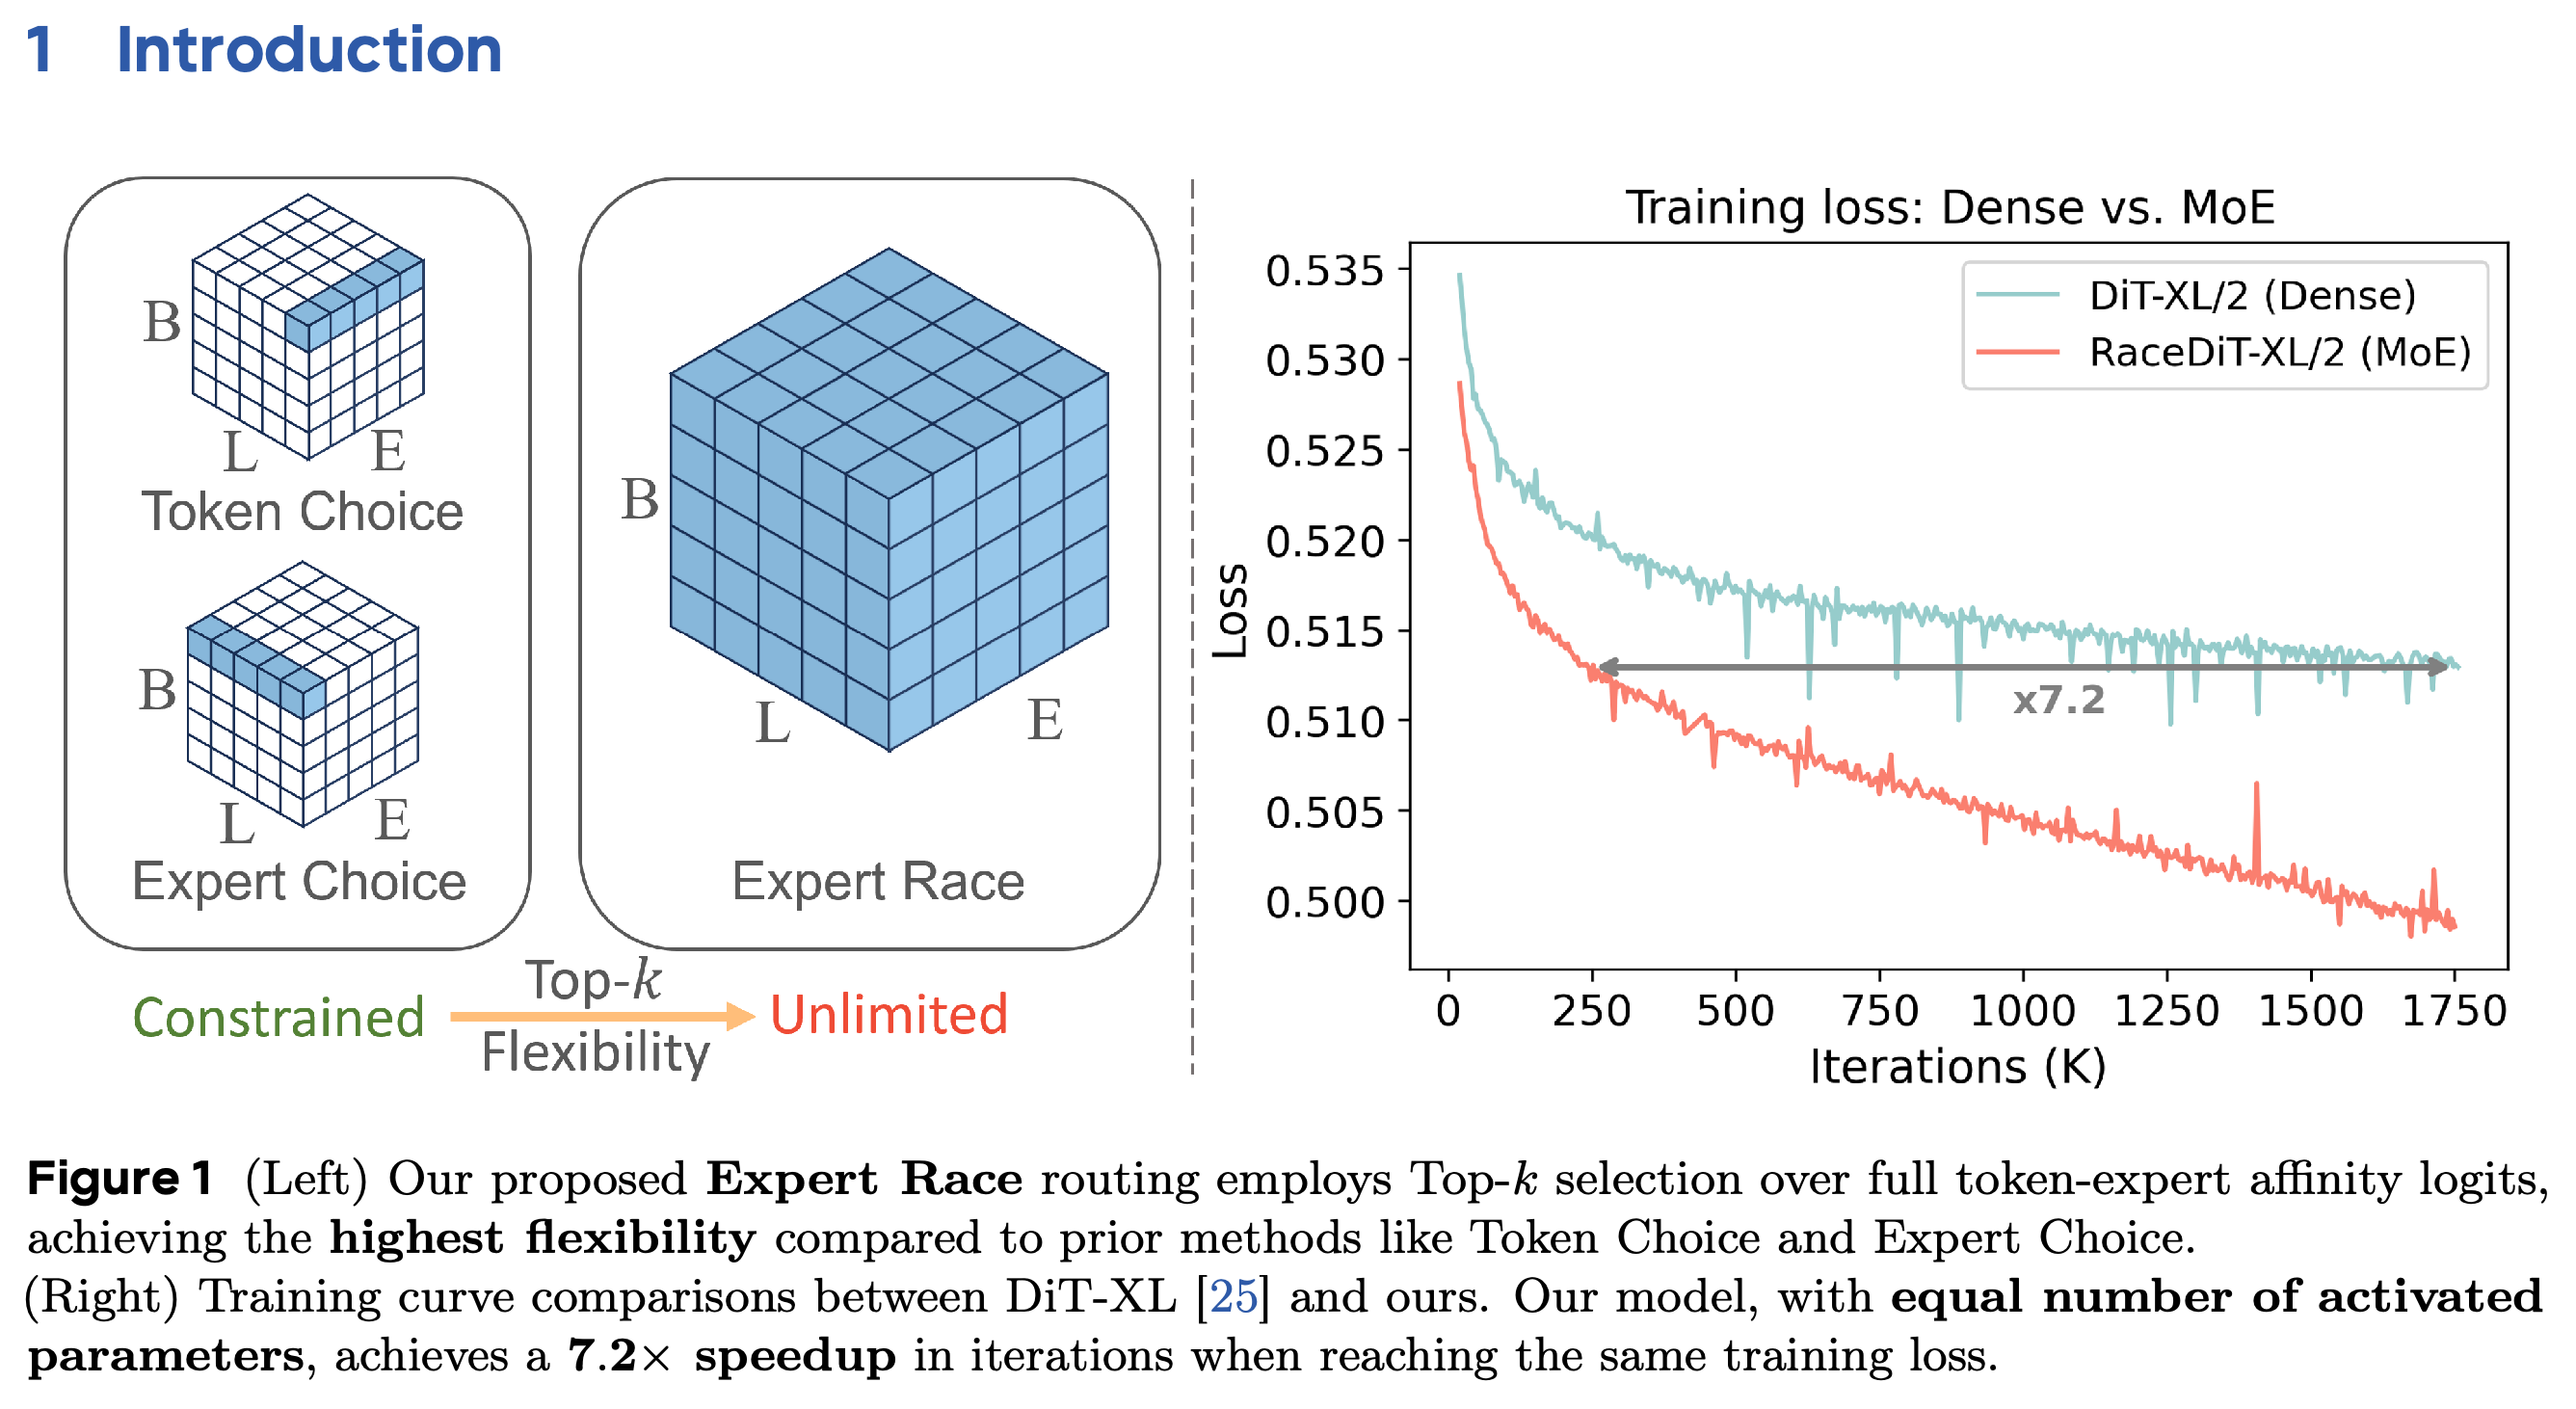
Routing 점수를 펼친 뒤 선택하면 일부 token에 여러 배정이 집중되는 반면 다른 token은 아무 배정도 받지 않을 수 있다. 이에 따라 Transformer 블록 내부에서 feed-forward 연산을 배분하는 방식이 달라진다.
2 Related Work
관련 연구에서는 선택된 expert만 활성화하는 sparse expert routing과 timestep, 채널, token에 따라 diffusion 연산을 나누는 방법을 함께 살펴본다. 논문은 routing 선택이 서로 경쟁하는 차원을 확장한 것을 기여로 제시한다.
2.1 Mixture of Experts
Token Choice에서는 각 token이 expert를 선택하며, 보통 선택 개수가 고정된다. Expert Choice에서는 각 expert가 token을 선택한다. 가변 expert 배정을 위한 기존 방법인 DYNMoE와 ReMoE도 이미 임계값과 연산 예산 정규화를 사용해 token별 expert 수를 조절한다. Expert Race는 학습 중 배치, 시퀀스, expert 차원 전체에 걸친 전역 경쟁을 도입한다.
2.2 Multiple Experts in Diffusion
기존 diffusion 시스템은 denoising 단계마다 별도 모델을 사용하거나, 서로 다른 네트워크, 채널 그룹, 마스크로 연산을 나눈다. DiT-MoE, EC-DiT, Raphael은 모델 내부에서 expert 배정을 학습하는 diffusion 아키텍처다. Expert Race는 어떤 token–expert 배정끼리 경쟁할 수 있는지에 관한 제약을 완화해 기존 접근을 확장한다.
3 Preliminaries
배경 지식에서는 denoising 목적 함수, 선택된 expert 출력의 가중 합산, 공간적 중복과 timestep별 난도에 맞춰 연산량을 조절하는 근거를 소개한다.
3.1 Diffusion Models
순방향 과정은 \(x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon\)에 따라 깨끗한 샘플과 Gaussian noise를 섞는다. 여기서 x_0는 깨끗한 샘플, ε은 노이즈이며, ᾱ_t는 timestep t가 증가할수록 감소한다. 조건부 네트워크는 예측 제곱 오차를 최소화하며 역방향 과정을 학습한다. 예측 목표는 노이즈, 깨끗한 데이터, 또는 노이즈와 깨끗한 데이터를 정해진 방식으로 선형 결합한 velocity가 될 수 있다. Diffusion Transformer(DiT)는 조건 정보에 따라 정규화를 조절하는 adaptive layer normalization(adaLN)을 사용한다.
3.2 Mixture of Experts
Router는 배치 크기 B, 시퀀스 길이 L, 은닉 차원 D인 입력을 E개 expert에 대한 점수로 변환한다. 선택된 expert의 출력은 각 출력의 기여도를 나타내는 gating score를 가중치로 사용해 합산한다. x-in-y 설정에서는 후보 expert가 y개이며, 각 expert의 중간 폭을 x로 나눈다. Expert Race에서 x는 모든 token에 똑같이 적용되는 개수가 아니라 평균 활성화 예산을 뜻한다.
3.3 The Rationality of Using MoE in Diffusion Models
논문은 timestep에 따라 복원 문제가 달라지므로 diffusion을 서로 관련된 여러 예측 과제로 본다. 이미지 패치마다 정보 밀도가 다르다는 점도 적응형 routing의 근거가 된다. 이러한 관찰은 유연한 연산 배분의 동기가 되지만, router는 token 난도에 대한 명시적 레이블 없이 점수를 학습한다.
4 Taming Diffusion Models with Expert Race
이 routing 프레임워크는 같은 점수 텐서를 서로 다른 형태로 변환한 뒤 가장 높은 점수를 선택하는 방식으로 기존 전략과 제안 전략을 표현한다. Expert Race는 기존 routing에서 따로 나누어 두었던 선택 후보 집합을 통합한다.
4.1 General Routing Formulation
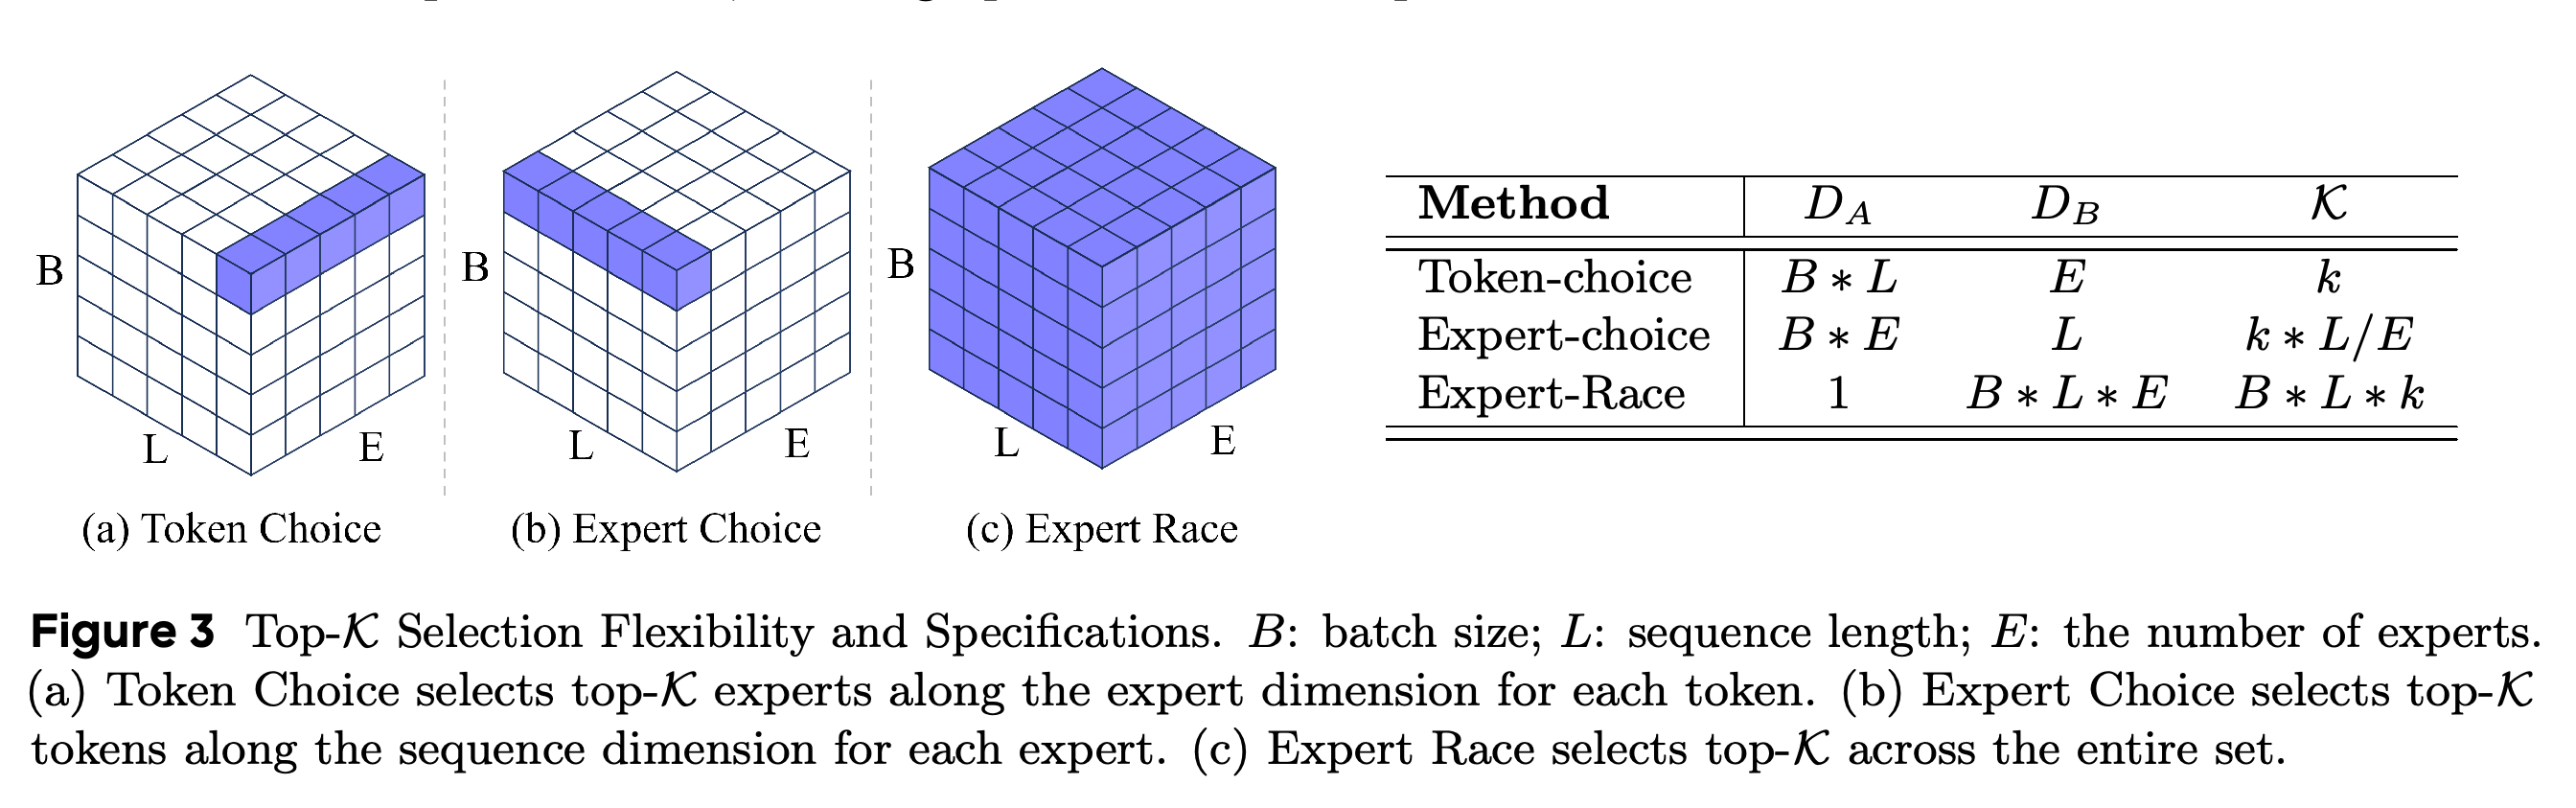
점수 텐서를 D_A개의 독립적인 선택 연산과 연산당 D_B개의 후보를 갖는 행렬로 변환한다. token당 활성 expert의 기대 개수가 k이고 전체 expert 수가 N_E이면 각 연산은 \(\mathcal K=\frac{k}{N_E}D_B\)개의 항목을 선택한다. Token Choice는 token마다 예산을 고정하고, Expert Choice는 sample–expert 쌍마다 예산을 고정한다. Expert Race는 B × L × E 점수를 모두 모아 B × L × k개의 배정을 선택한다.
큐브 3개는 각 선택 연산에서 어떤 점수 차원끼리 경쟁하는지 보여준다. Expert Race는 전체 B × L × E 후보에서 B × L × k개의 배정을 선택하지만, 기존 전략은 별도의 국소 예산을 적용한다.
4.2 Expert Race
Expert Race는 전역적으로 가장 높은 routing 점수를 한 번에 선택해, 주어진 배정 예산 안에서 점수의 합을 최대화한다. Identity gating은 점수를 그대로 유지한다. 각 token의 expert 점수를 합이 1인 확률로 바꾸는 expert-wise softmax에서 발생하는 token 간 점수 순서 변화를 피한다. 학습 중에는 선택 경계값으로 EMA 임계값을 갱신한다. 추론에서는 각 점수를 저장된 임계값과 비교하므로 배치 전체의 순위를 다시 계산하지 않고도 샘플을 독립적으로 처리하고 배정 개수를 달리할 수 있다.
5 Load Balancing via Router Similarity Loss
전역 routing은 배정이 일부 expert나 expert 그룹에 집중될 수 있어 부하 균형 문제가 생긴다. 제안한 손실은 개별 expert의 사용률과 expert 2개가 같은 token을 받는 공동 선택을 함께 조절한다.
5.1 Mode Collapse in Balancing Loss.
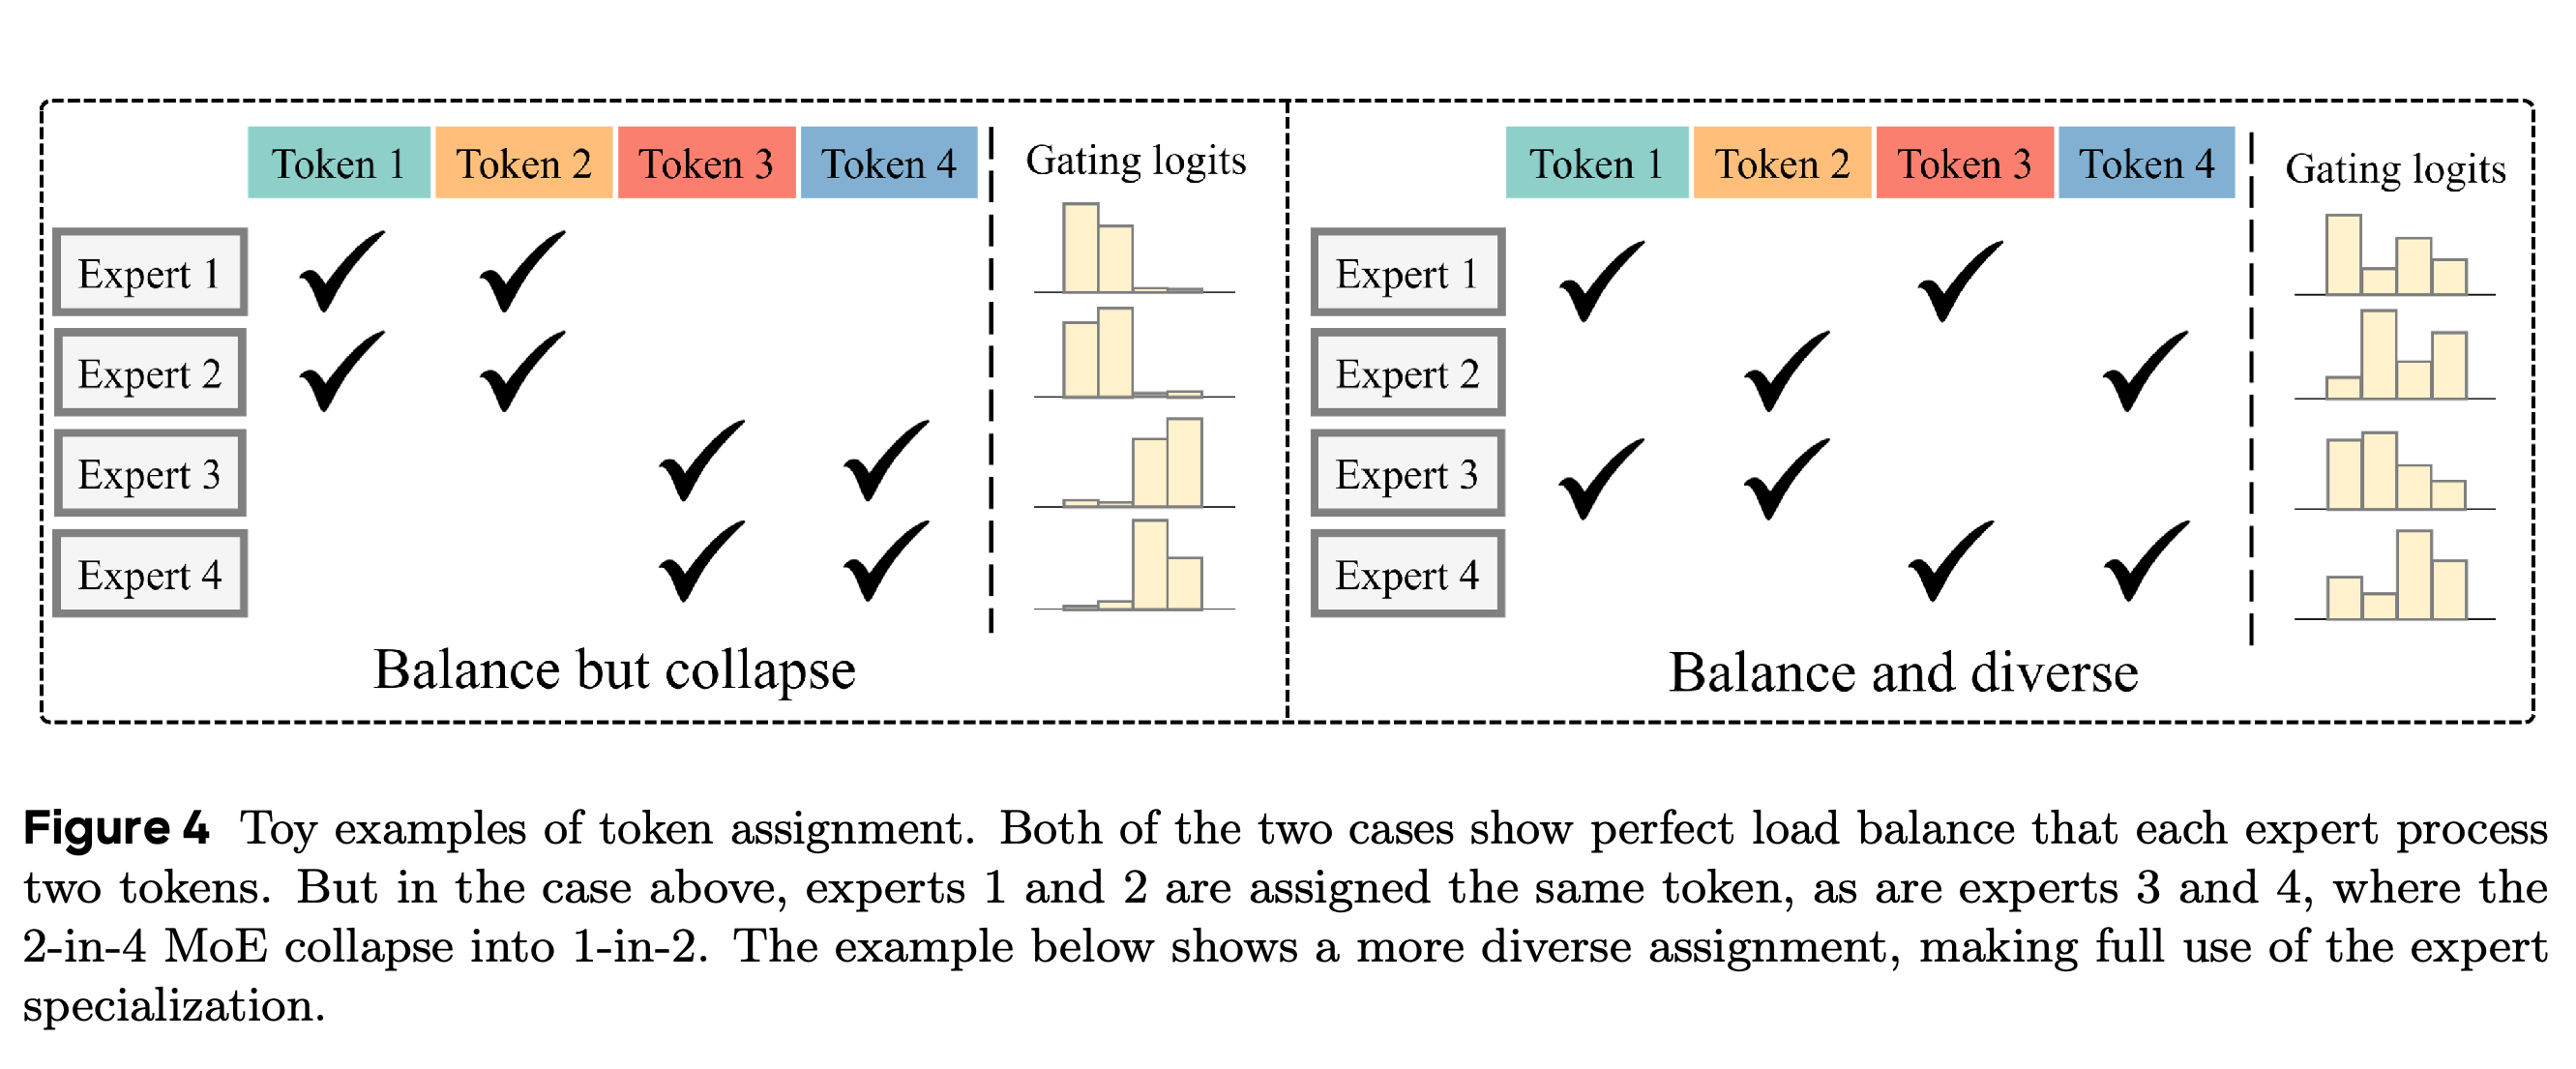
Token 수가 같다고 expert의 동작까지 서로 달라지는 것은 아니다. 예시에서는 모든 expert가 token을 2개씩 받지만, expert 2쌍이 항상 같은 입력을 받아 2-in-4 설정이 폭이 더 넓은 expert 2개처럼 동작한다. 기존의 개별 expert 부하 균형 방식은 이러한 반복적인 공동 선택에 직접 페널티를 주지 않는다.
예시 2개 모두 모든 expert에 같은 작업량을 배정하지만, 왼쪽 예시는 expert 쌍에 같은 token 집합을 반복해서 배정한다. 따라서 개별 부하가 같더라도 expert 조합의 다양성은 제한될 수 있다.
5.2 Router Similarity Loss.
이 방법은 M′ = MᵀM과 P′ = PᵀP를 계산한다. M은 이진 token 배정을 기록하고, P는 router 점수에서 구한 expert-wise softmax 확률을 담는다. Router similarity loss는 관측된 배정 횟수로 P′의 항목에 가중치를 주며, 대각 항과 비대각 항을 별도로 정규화한다. 대각 항은 개별 사용률을 조절하고, 비대각 항은 반복해서 함께 선택되는 expert 쌍에 배정이 집중되는 현상을 억제한다. Routing에는 identity gating을 사용하지만 보조 손실에는 softmax를 사용한다.
6 Per-Layer Regularization for Efficient Training
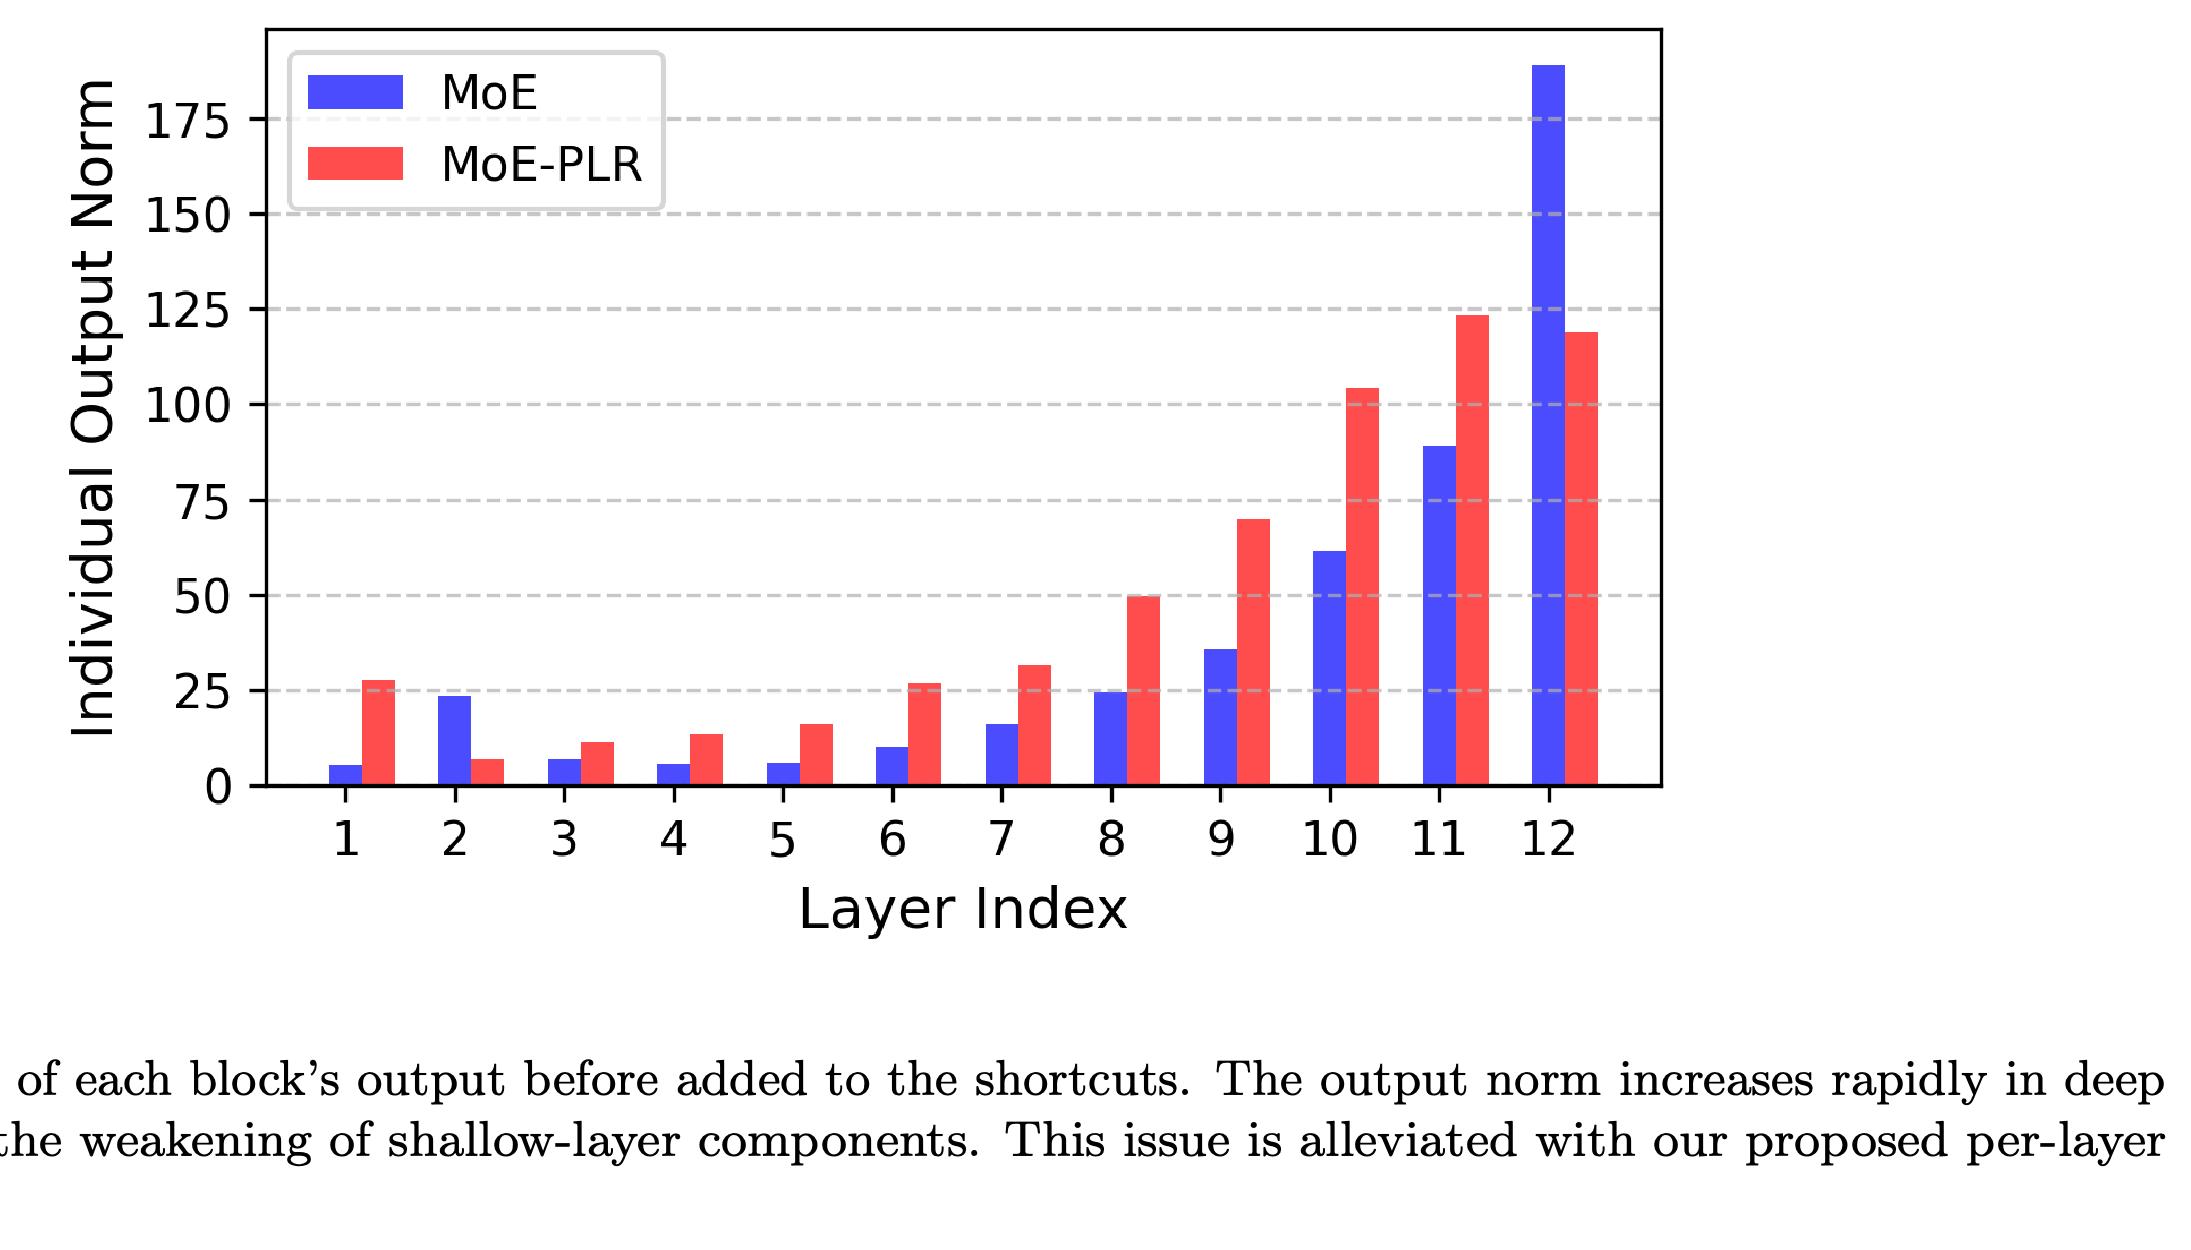
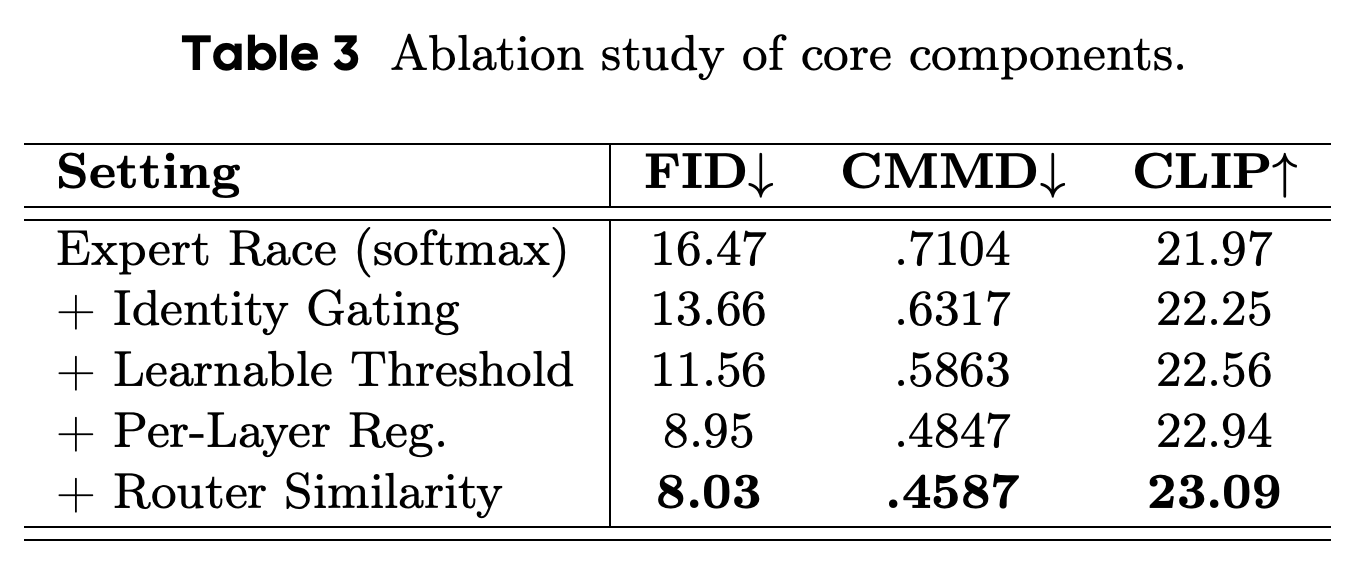
저자들은 깊은 층으로 갈수록 블록 출력의 norm이 빠르게 커져, shortcut 덧셈으로 표현을 누적하는 residual stream에서 얕은 층의 상대적 기여가 줄어드는 현상을 관찰한다. Per-layer regularization(PLR)은 중간 은닉 상태에서 최종 denoising 목표값을 보조적으로 예측하는 방법이다. Router에 통합한 projection head를 통해 제곱 오차로 직접 지도한다. Figure 5에서는 PLR을 적용했을 때 깊이에 따른 불균형이 완화되며, 구성 요소를 누적해서 추가한 ablation에서는 PLR을 추가하자 FID가 11.56에서 8.95로 개선된다.
PLR이 없으면 마지막 블록의 출력 norm이 얕은 블록 대부분보다 훨씬 크다. PLR은 앞쪽 여러 블록의 기여를 높이고 마지막 블록의 지배적인 비중을 줄인다. 이는 깊이에 따른 불균형에 관한 저자들의 설명을 뒷받침한다.
7 Experiments
실험에서는 ImageNet을 사용해 routing, gating, 부하 균형, 보조 지도, 모델 크기, expert 분할을 평가한다. 개별 설계 선택과 Race-DiT의 전체 학습 및 추론 절차를 별도 실험으로 살펴본다.
7.1 Implementation Details
기본 학습에는 AdamW optimizer, 배치 크기 256, 고정 학습률 1e-4를 사용하며 weight decay는 적용하지 않는다. 별도 명시가 없으면 ablation에서는 Base DiT 모델인 DiT-B와 2-in-8 변형을 500K회 반복 학습한다. PLR의 가중치는 1e-2, router similarity loss의 가중치는 1e-4이며, 평가에는 EMA 모델 가중치를 사용한다. FID 외에도 이미지 분포 차이를 측정하며 낮을수록 좋은 CMMD와, 이미지와 조건의 일치 정도를 측정하며 높을수록 좋은 CLIP Score를 보고한다.
7.2 Routing Strategy
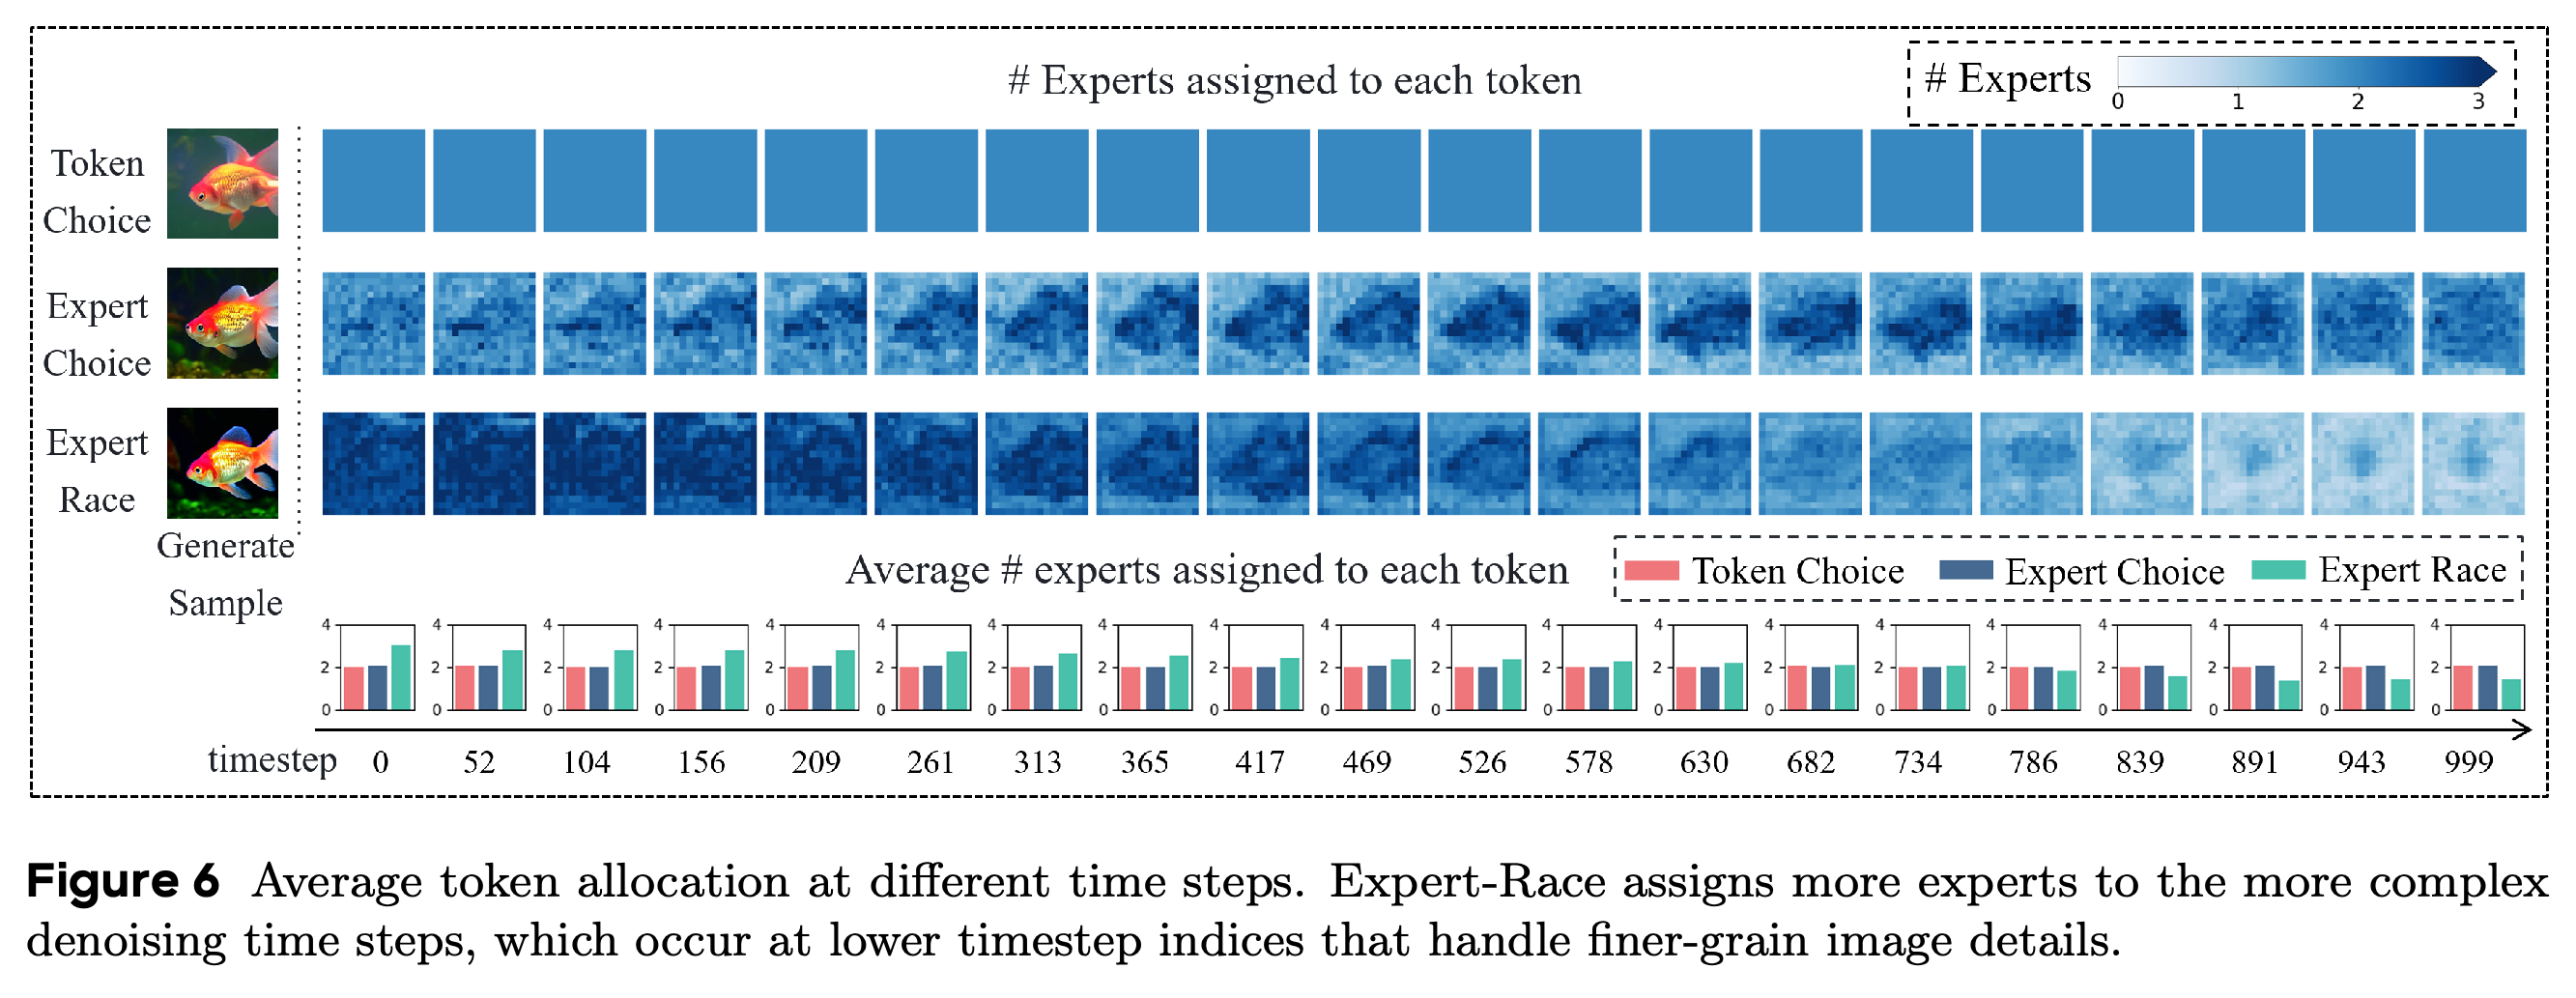
배정 시각화에서는 세부 묘사를 복원하는 denoising 후반부, 즉 timestep 인덱스가 낮은 구간에 expert를 더 많이 배정한다. 공간적 배정도 객체가 드러나는 과정에 따라 변한다. 비교에 사용한 정의에서 Token Choice와 Expert Choice는 timestep별 평균 배정량을 고정하지만, Expert Race는 timestep 간에 예산을 재배분한다.
Expert Race는 timestep에 따라 공간적 배정 지도와 평균 expert 수를 바꾼다. Timestep 인덱스가 낮을 때 더 많은 연산을 배정하는 결과는 denoising 후반부에 더 세밀한 복원이 필요하다는 저자들의 해석과 부합한다.
7.3 Gating Function
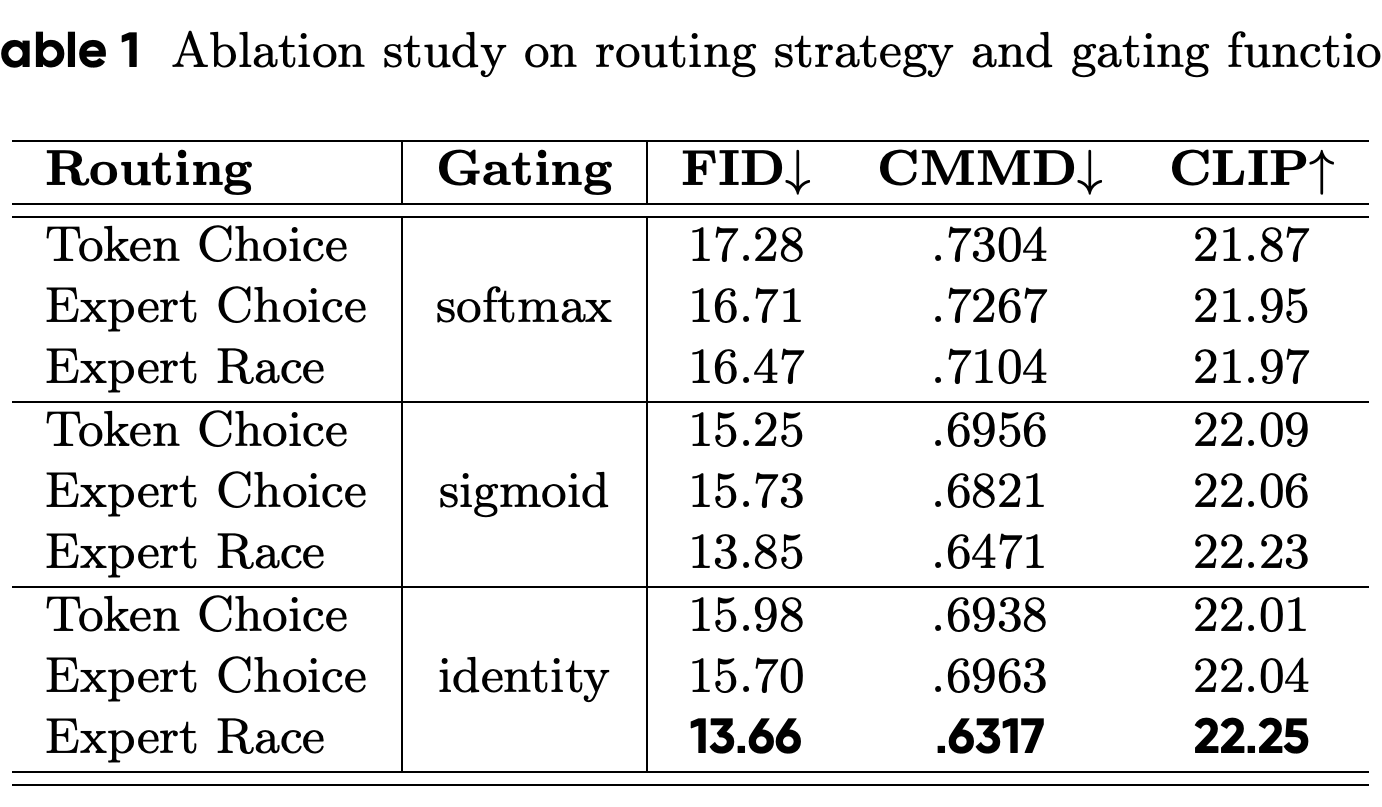
임계값과 정규화 구성 요소의 영향을 분리한 비교에서 Expert Race의 FID는 softmax일 때 16.47, 점수를 0과 1 사이로 변환하는 sigmoid일 때 13.85, identity gating일 때 13.66이다. Identity 변형은 identity gating을 적용한 Token Choice의 15.98과 Expert Choice의 15.70보다도 좋다. 저자들은 token 간 점수 순서를 유지하기 때문에 이러한 이점이 생긴다고 설명한다. Expert Race에서는 identity가 가장 좋지만, 이 표에서 Token Choice의 FID는 sigmoid를 사용했을 때 가장 좋다.
Expert Race는 각 gating 그룹 안에서 가장 좋은 성능을 보이며, identity gating을 적용하면 FID 13.66을 달성한다. 다만 모든 routing 방법에서 identity가 가장 좋은 것은 아니다. Token Choice는 sigmoid를 사용할 때 표에 제시된 최저 FID인 15.25를 달성한다.
7.4 Load Balance
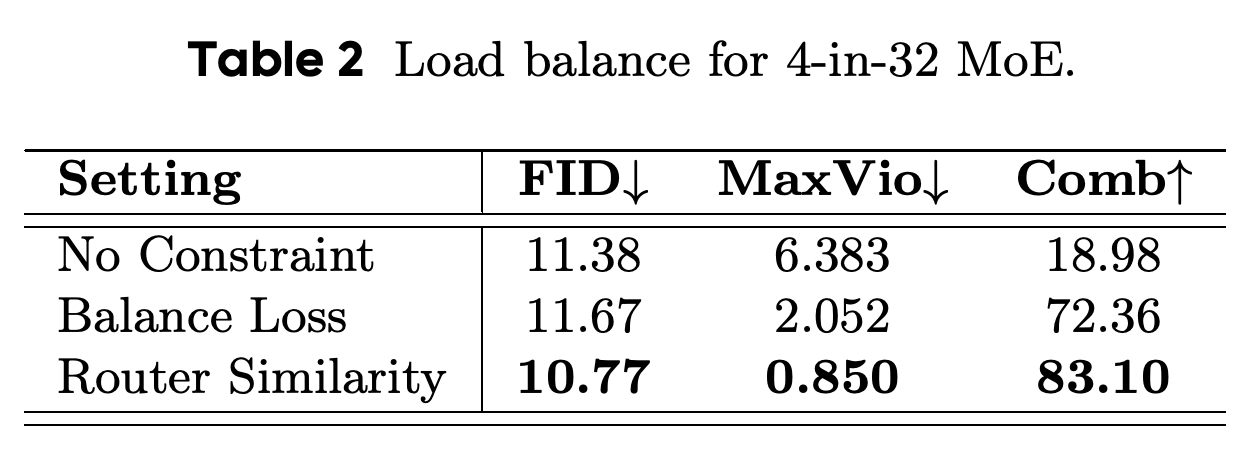
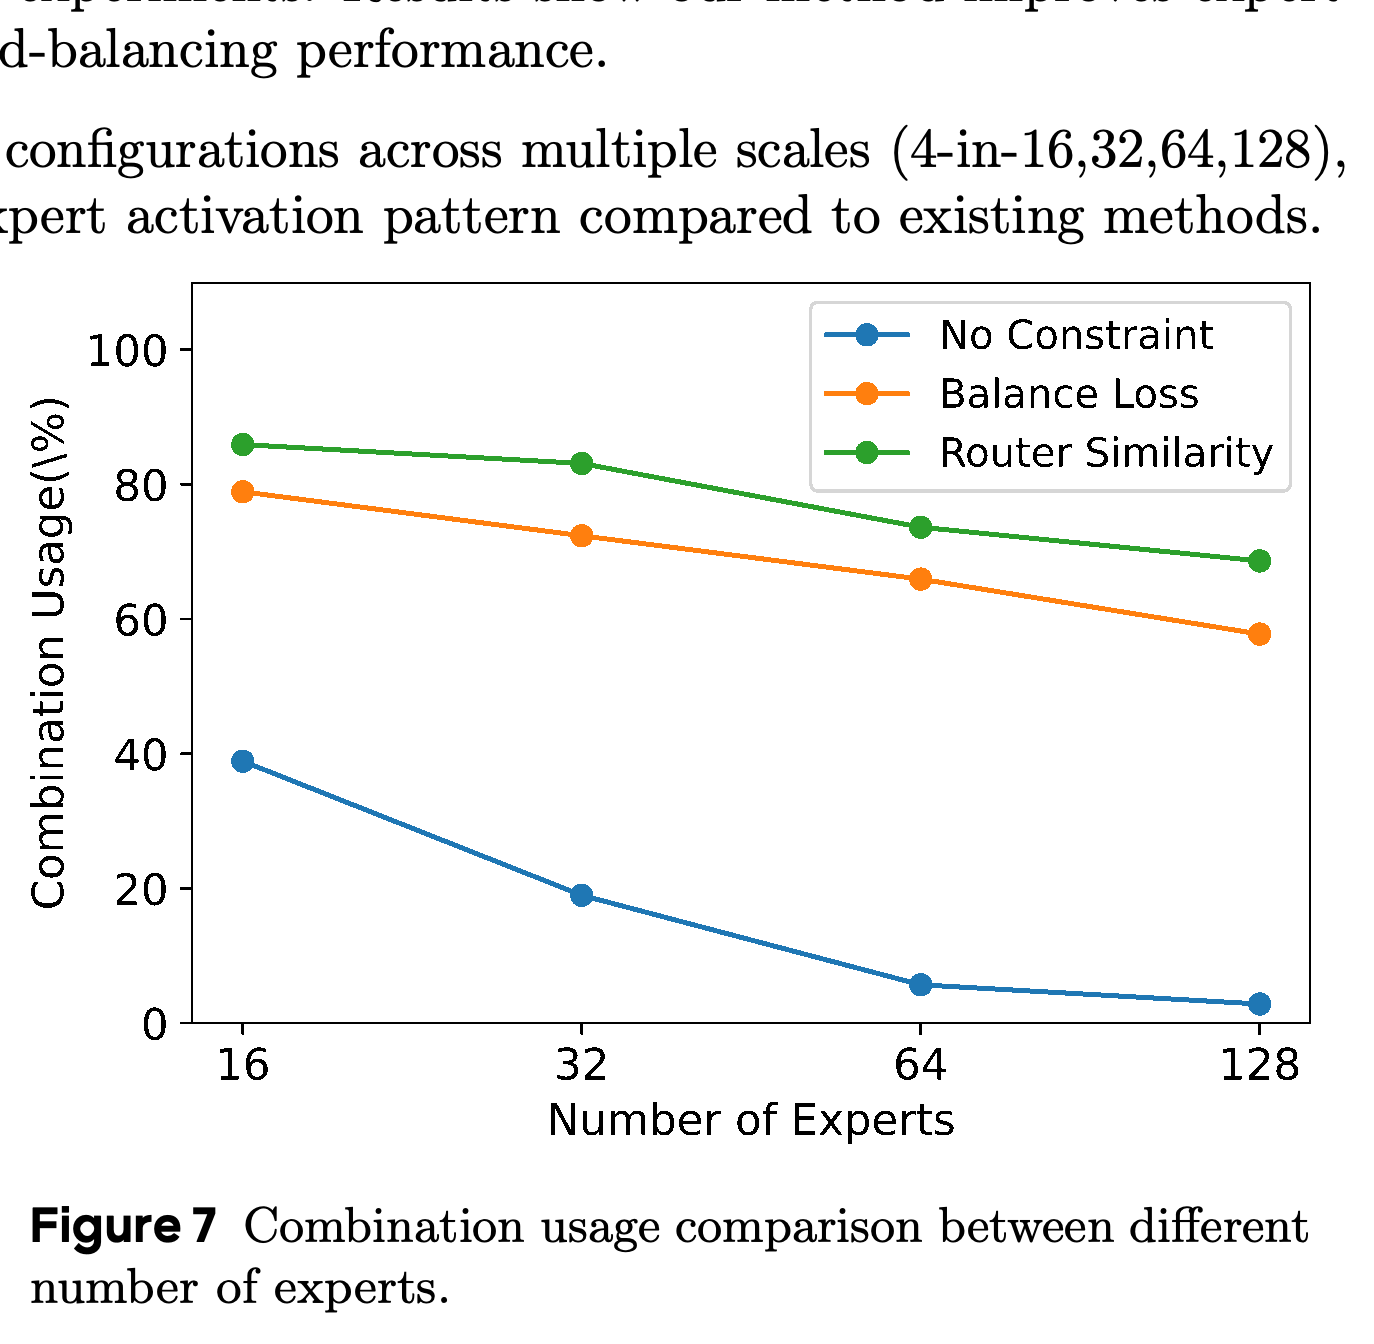
4-in-32 MoE에서 router similarity loss의 FID는 10.77로, 기존 balance loss의 11.67과 제약을 적용하지 않았을 때의 11.38보다 좋다. Expert 용량 위반의 최댓값인 MaxVio는 balance loss를 사용했을 때의 2.052에서 0.850으로 낮아진다. 부록의 누적 빈도 기준에 따라 활성 상태로 집계되는 expert 쌍의 백분율인 Combination Usage는 72.36에서 83.10으로 높아진다. 평균 활성화 수를 4개로 두고 expert 수를 16, 32, 64, 128로 늘렸을 때도 router similarity가 다른 방법보다 높은 쌍 사용률을 유지한다.
Router similarity는 기존 부하 균형 방식보다 보고된 지표 3개를 모두 개선한다. FID는 11.67에서 10.77로, MaxVio는 2.052에서 0.850으로 낮아지고, Combination Usage는 72.36에서 83.10으로 높아진다. 기존 balance loss는 사용률 지표를 개선하지만 제약이 없을 때보다 FID를 조금 악화시킨다.
후보 expert 수가 늘어나면 방법 3개 모두 쌍 사용률이 낮아진다. Router similarity는 시험한 범위 전체에서 가장 높은 사용률을 유지하며, 제약 없는 routing은 극히 적은 조합에 집중된다.
7.5 Core Components
구성 요소를 누적해서 추가한 ablation에서 FID는 softmax Expert Race의 16.47에서 identity gating 추가 후 13.66, 추론 임계값 추가 후 11.56, PLR 추가 후 8.95, router similarity loss 추가 후 8.03으로 낮아진다. 같은 순서에서 CMMD는 0.7104에서 0.4587로 낮아지고 CLIP Score는 21.97에서 23.09로 높아진다. 각 개선은 앞서 추가한 구성 요소가 있는 조건에서 얻은 결과이며, 모든 구성 요소 조합을 시험한 것은 아니다.
구성 요소를 차례로 추가할 때마다 보고된 모든 지표가 개선되며, identity gating과 PLR을 추가할 때 FID 감소 폭이 가장 크다. 각 행은 변경 사항을 누적하므로 행 간 차이는 앞서 추가한 구성 요소가 있는 조건에서의 개선을 나타낸다.
7.6 Scaling Law
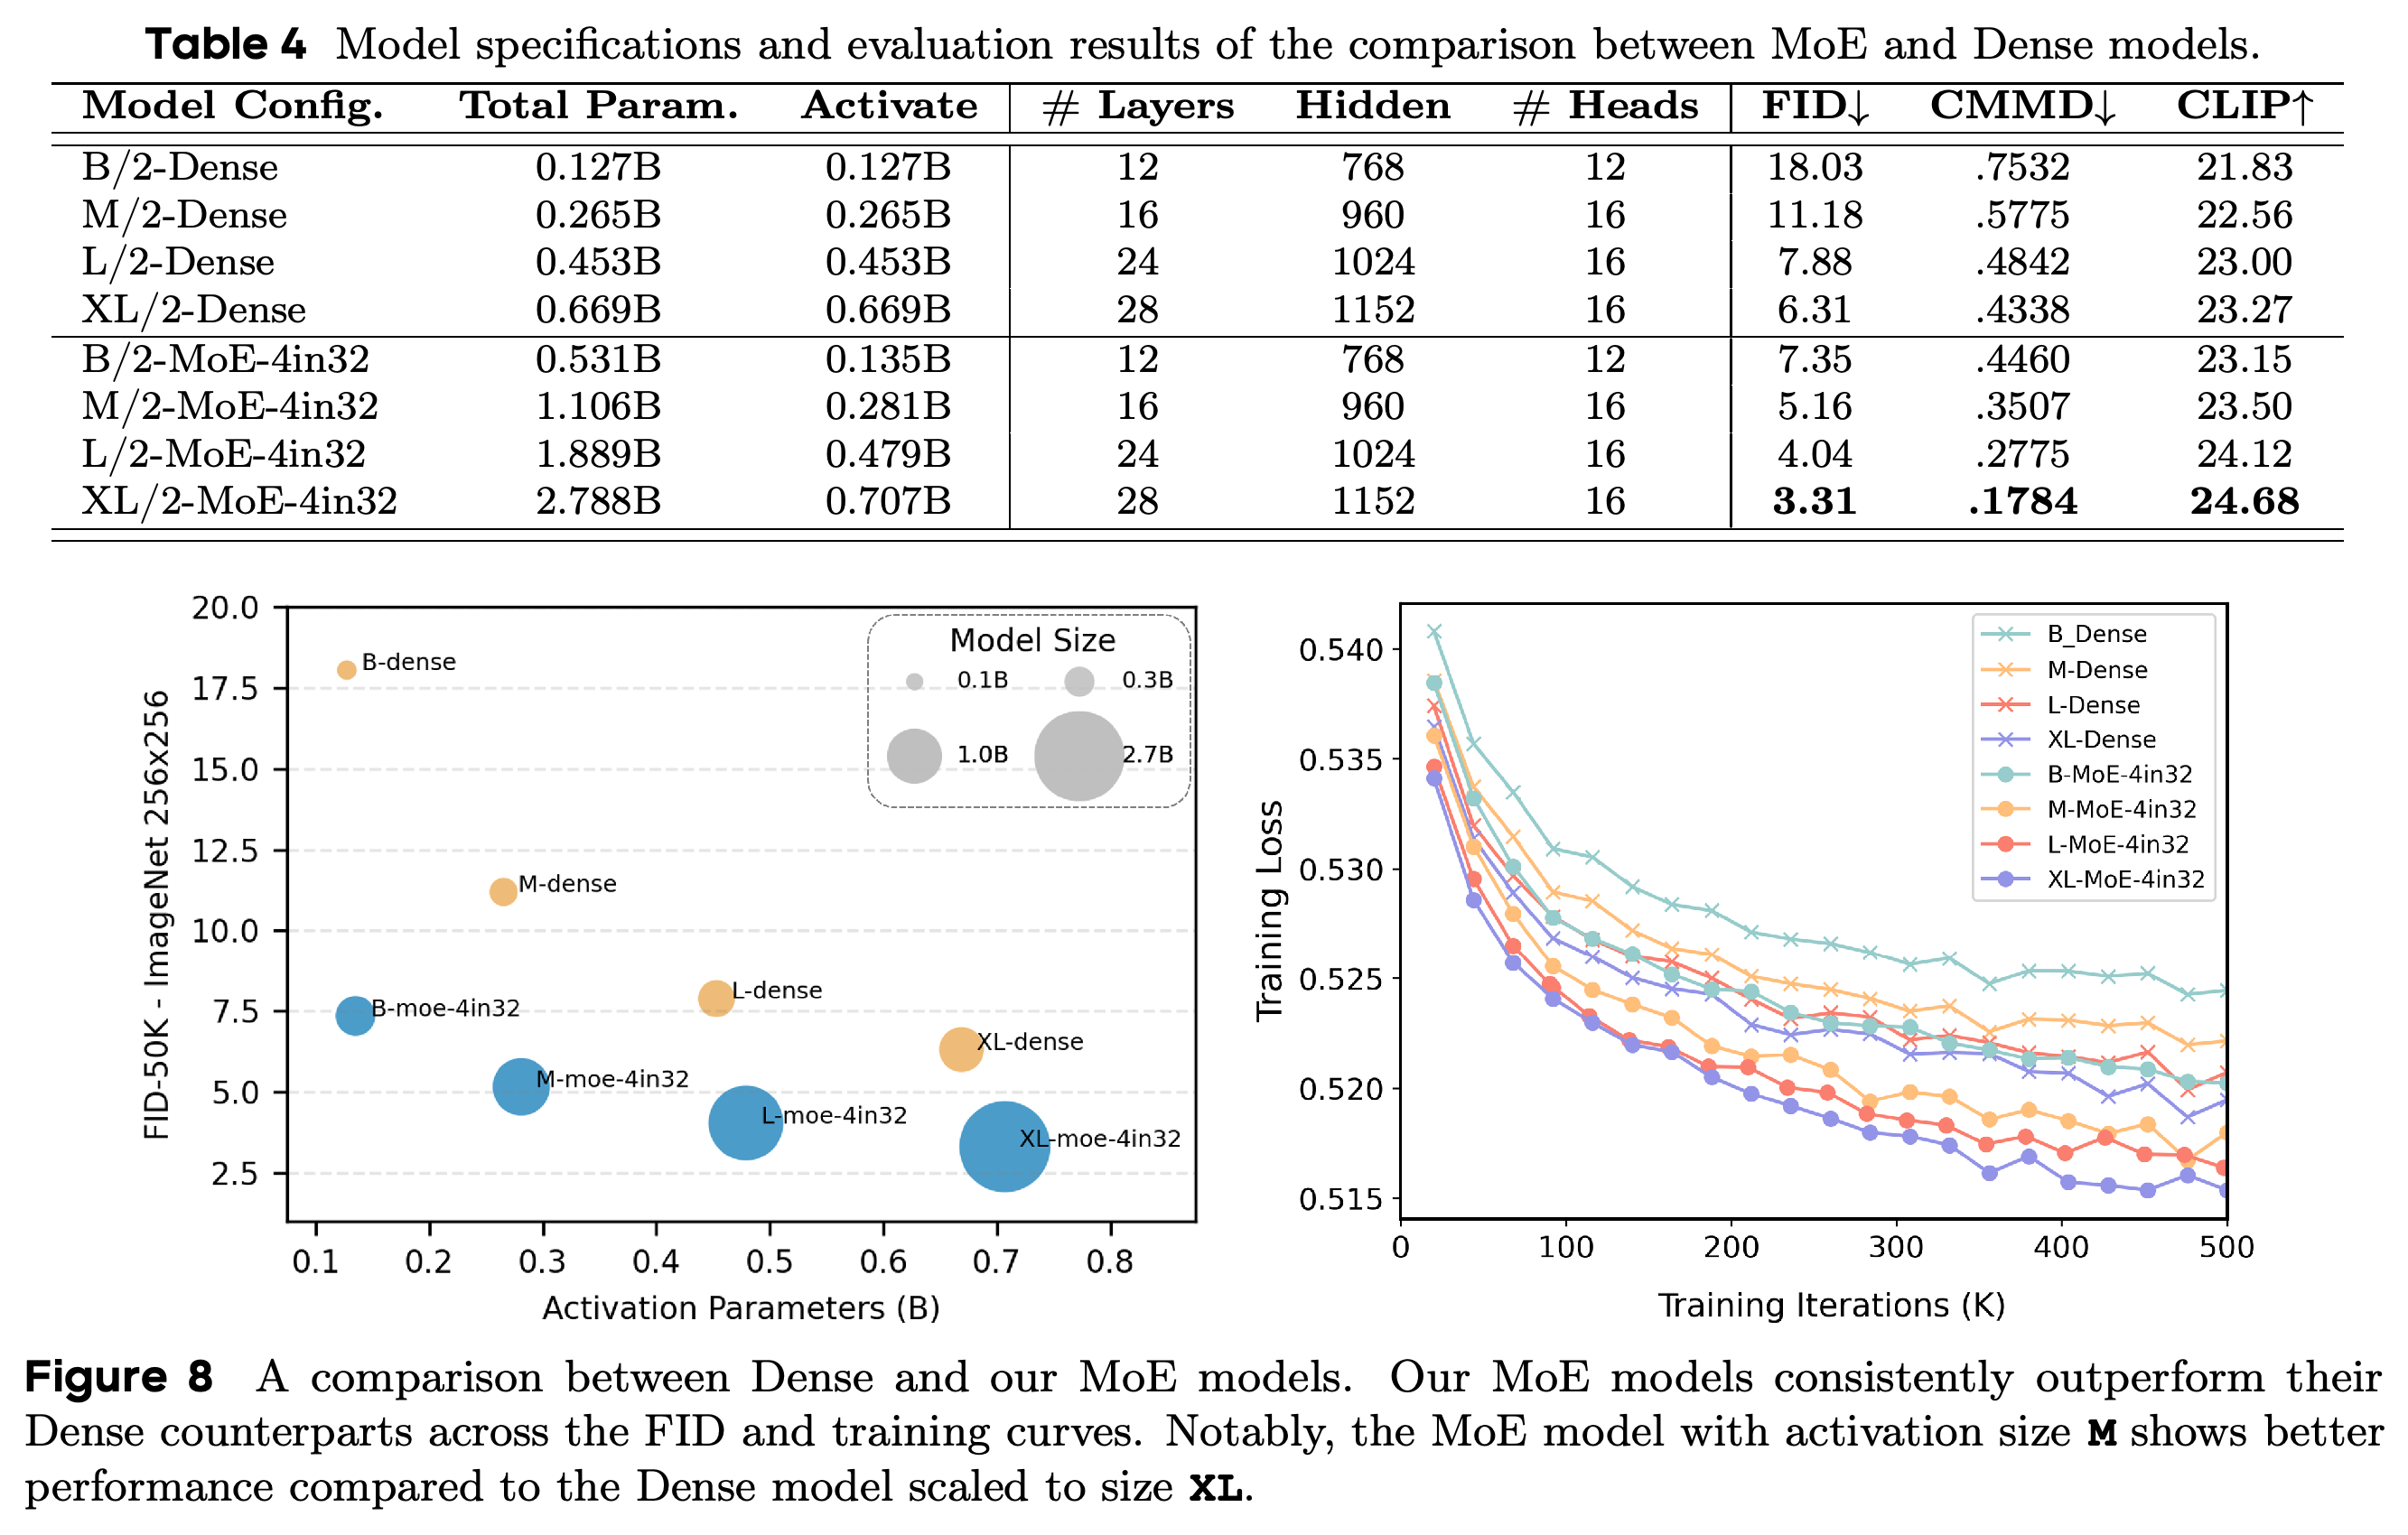
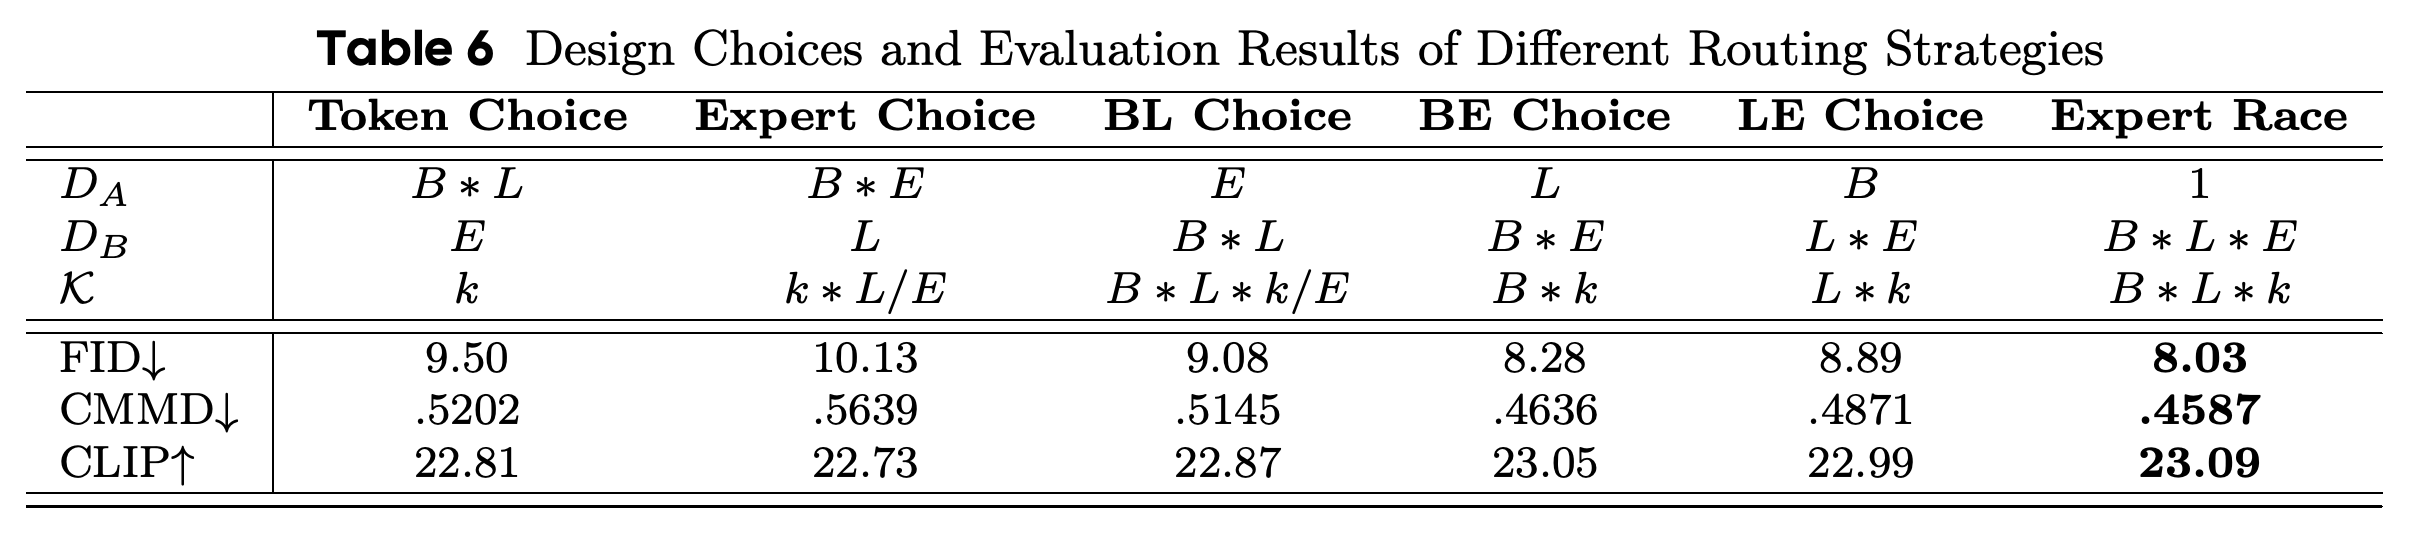
Base, Medium, Large, Extra-large backbone에서 4-in-32 모델은 활성 파라미터 수가 dense 모델과 비슷하지만 약간 더 많으며, FID를 각각 18.03, 11.18, 7.88, 6.31에서 7.35, 5.16, 4.04, 3.31로 개선한다. Medium MoE는 활성 파라미터 0.281B로 FID 5.16을 달성해 0.669B-parameter dense XL 모델의 6.31보다 좋지만, 전체 파라미터 수는 1.106B로 더 많다. Base backbone의 활성화 예산을 고정했을 때 expert의 중간 폭을 더 잘게 나누고 후보 expert 수를 늘리면, FID가 1-in-4의 9.70에서 8-in-128의 6.28로 개선된다.
MoE는 backbone 크기 4개 모두에서 생성 지표를 개선하지만, 활성 파라미터는 조금 더 많고 전체 파라미터는 훨씬 더 많다. Medium MoE의 전체 파라미터 1.106B는 dense XL의 0.669B보다 많다. 이는 활성 연산량과 저장되는 모델 용량을 구분해야 함을 보여준다.
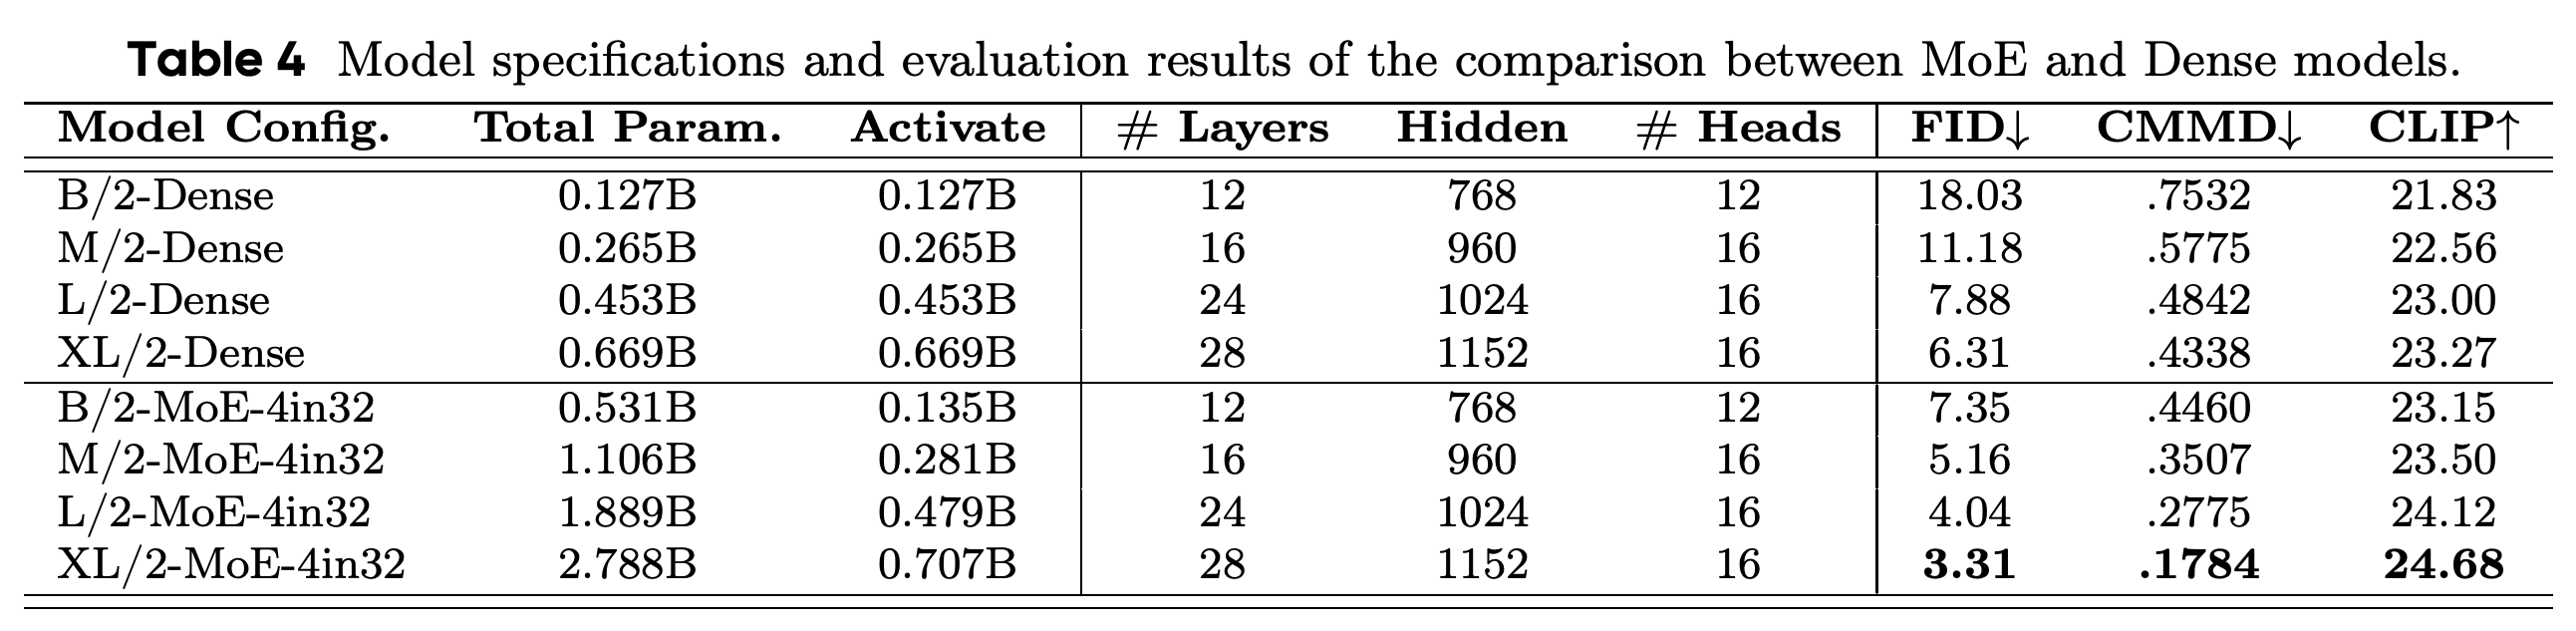
품질 그래프에서 MoE 모델은 활성 파라미터 규모가 비슷한 dense 모델보다 아래에 위치하며, 버블 크기는 MoE의 전체 용량이 더 큼을 보여준다. 학습 곡선도 MoE에 유리하므로 최종 품질 개선과 함께 최적화상의 이점을 뒷받침한다.
전체 크기가 비슷할 때 expert를 더 잘게 나누면 FID가 개선된다. 각 분할 그룹 안에서 후보를 추가해도 FID가 낮아진다. 표에서 가장 좋은 설정인 8-in-128은 6.28을 달성하지만, 다른 지표가 모든 중간 비교에서 단조롭게 개선되는 것은 아니다.
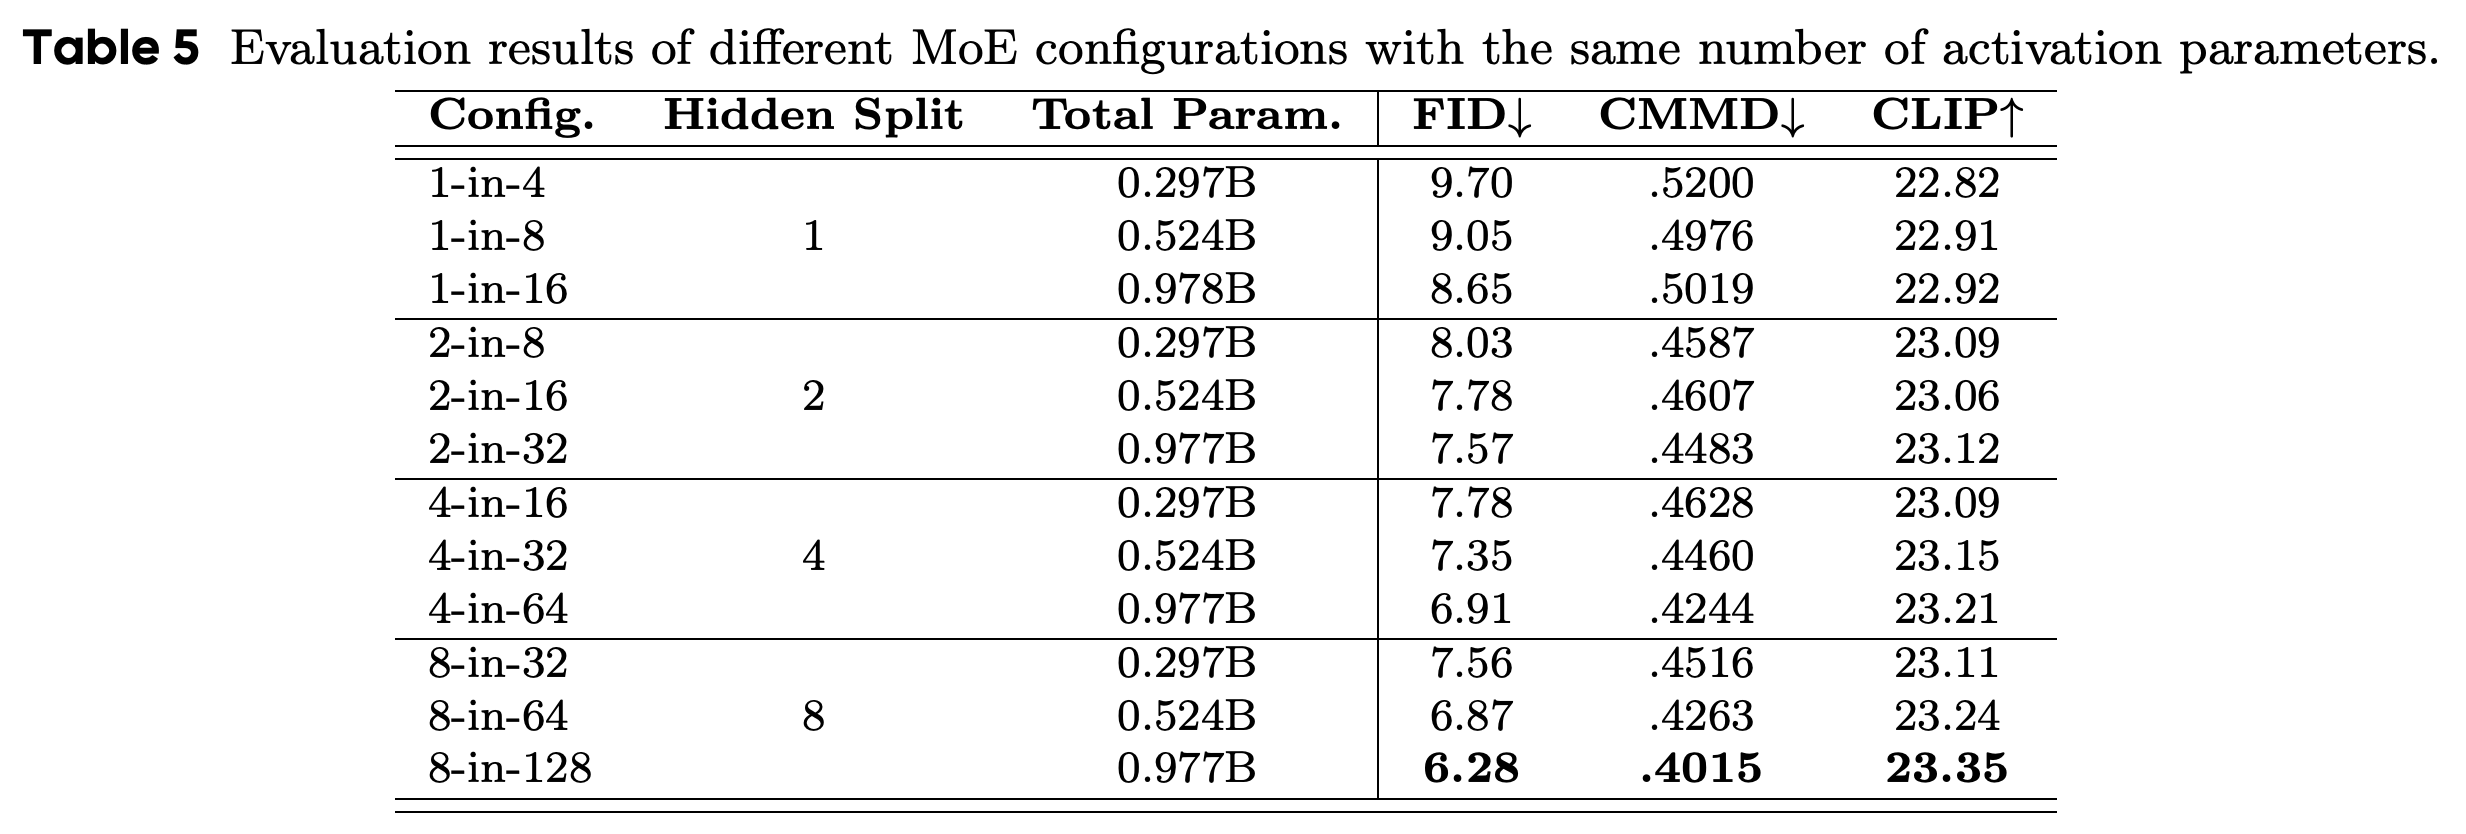
그래프에 제시된 설정에서는 expert를 더 잘게 나누고 후보 집합을 늘릴수록 FID가 낮아지지만, 학습 손실은 비교적 비슷하게 유지된다. 이 제한된 비교는 규모 확장에 따른 추세를 보여주며, 일반적인 선형 법칙을 독립적으로 입증하지는 않는다.
7.7 Extended Routing Strategy
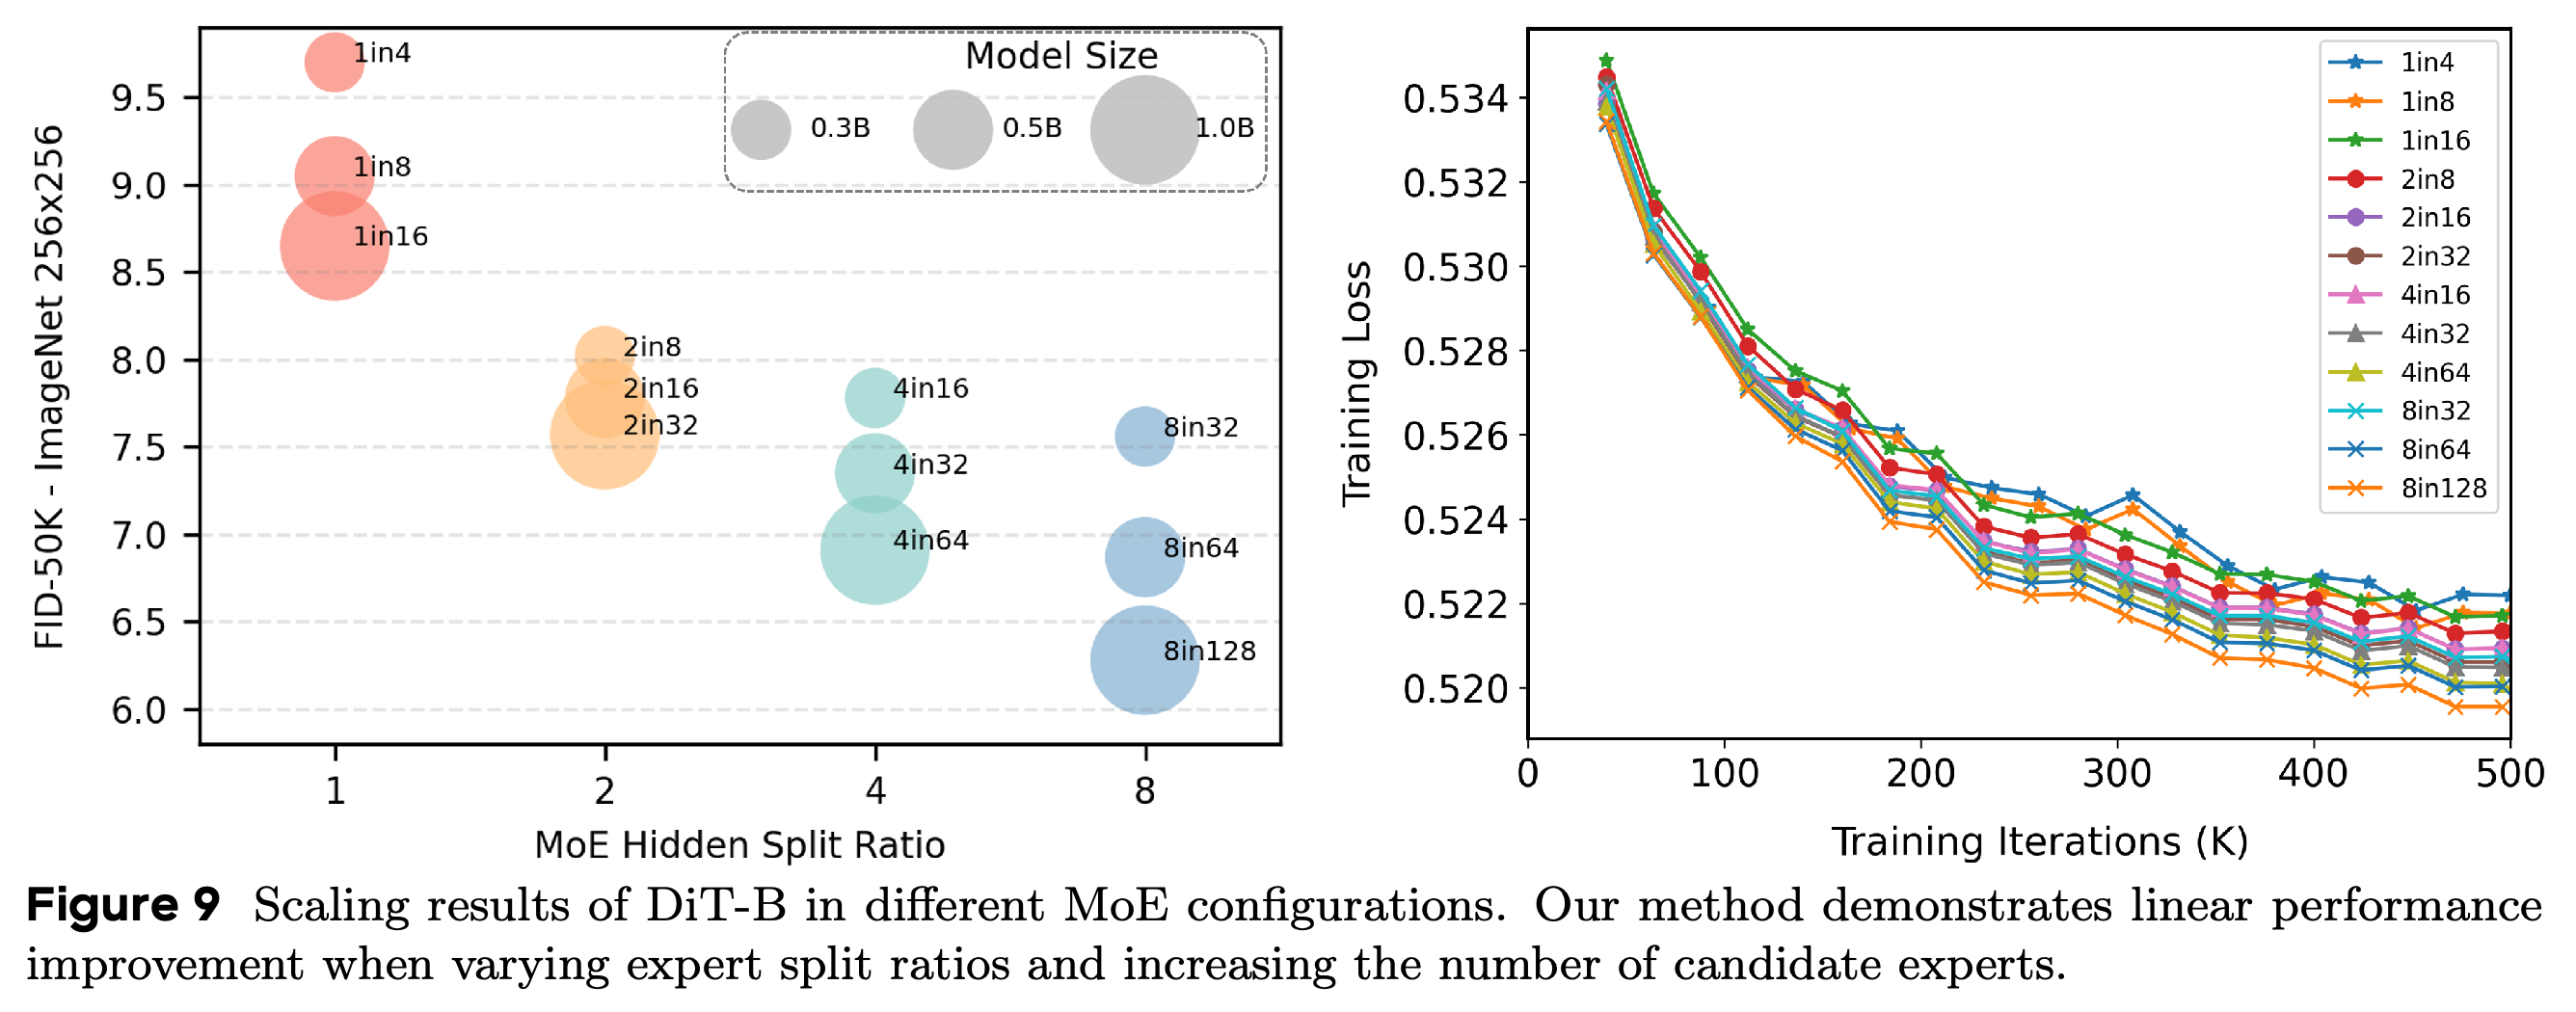
확장 routing 변형은 모두 전체 DiT-B/2-MoE-2-in-8 절차, 500K회 학습 반복, 추론 임계값을 사용한다. BL Choice는 배치와 시퀀스 위치, BE Choice는 배치와 expert, LE Choice는 시퀀스 위치와 expert를 하나의 선택 후보 집합으로 묶는다. Expert Race의 FID는 8.03으로 Token Choice의 9.50, Expert Choice의 10.13, BL Choice의 9.08, BE Choice의 8.28, LE Choice의 8.89보다 좋다. 이 결과는 해당 설정에서 3개 차원을 모두 통합하는 방식의 이점을 뒷받침한다.
음영으로 표시한 선택 영역은 1차원, 차원 쌍, 전체 통합 routing을 구분한다. 이 영역은 Table 6에서 시험한 각 변형이 어떤 예산 제약을 완화하는지 나타낸다.
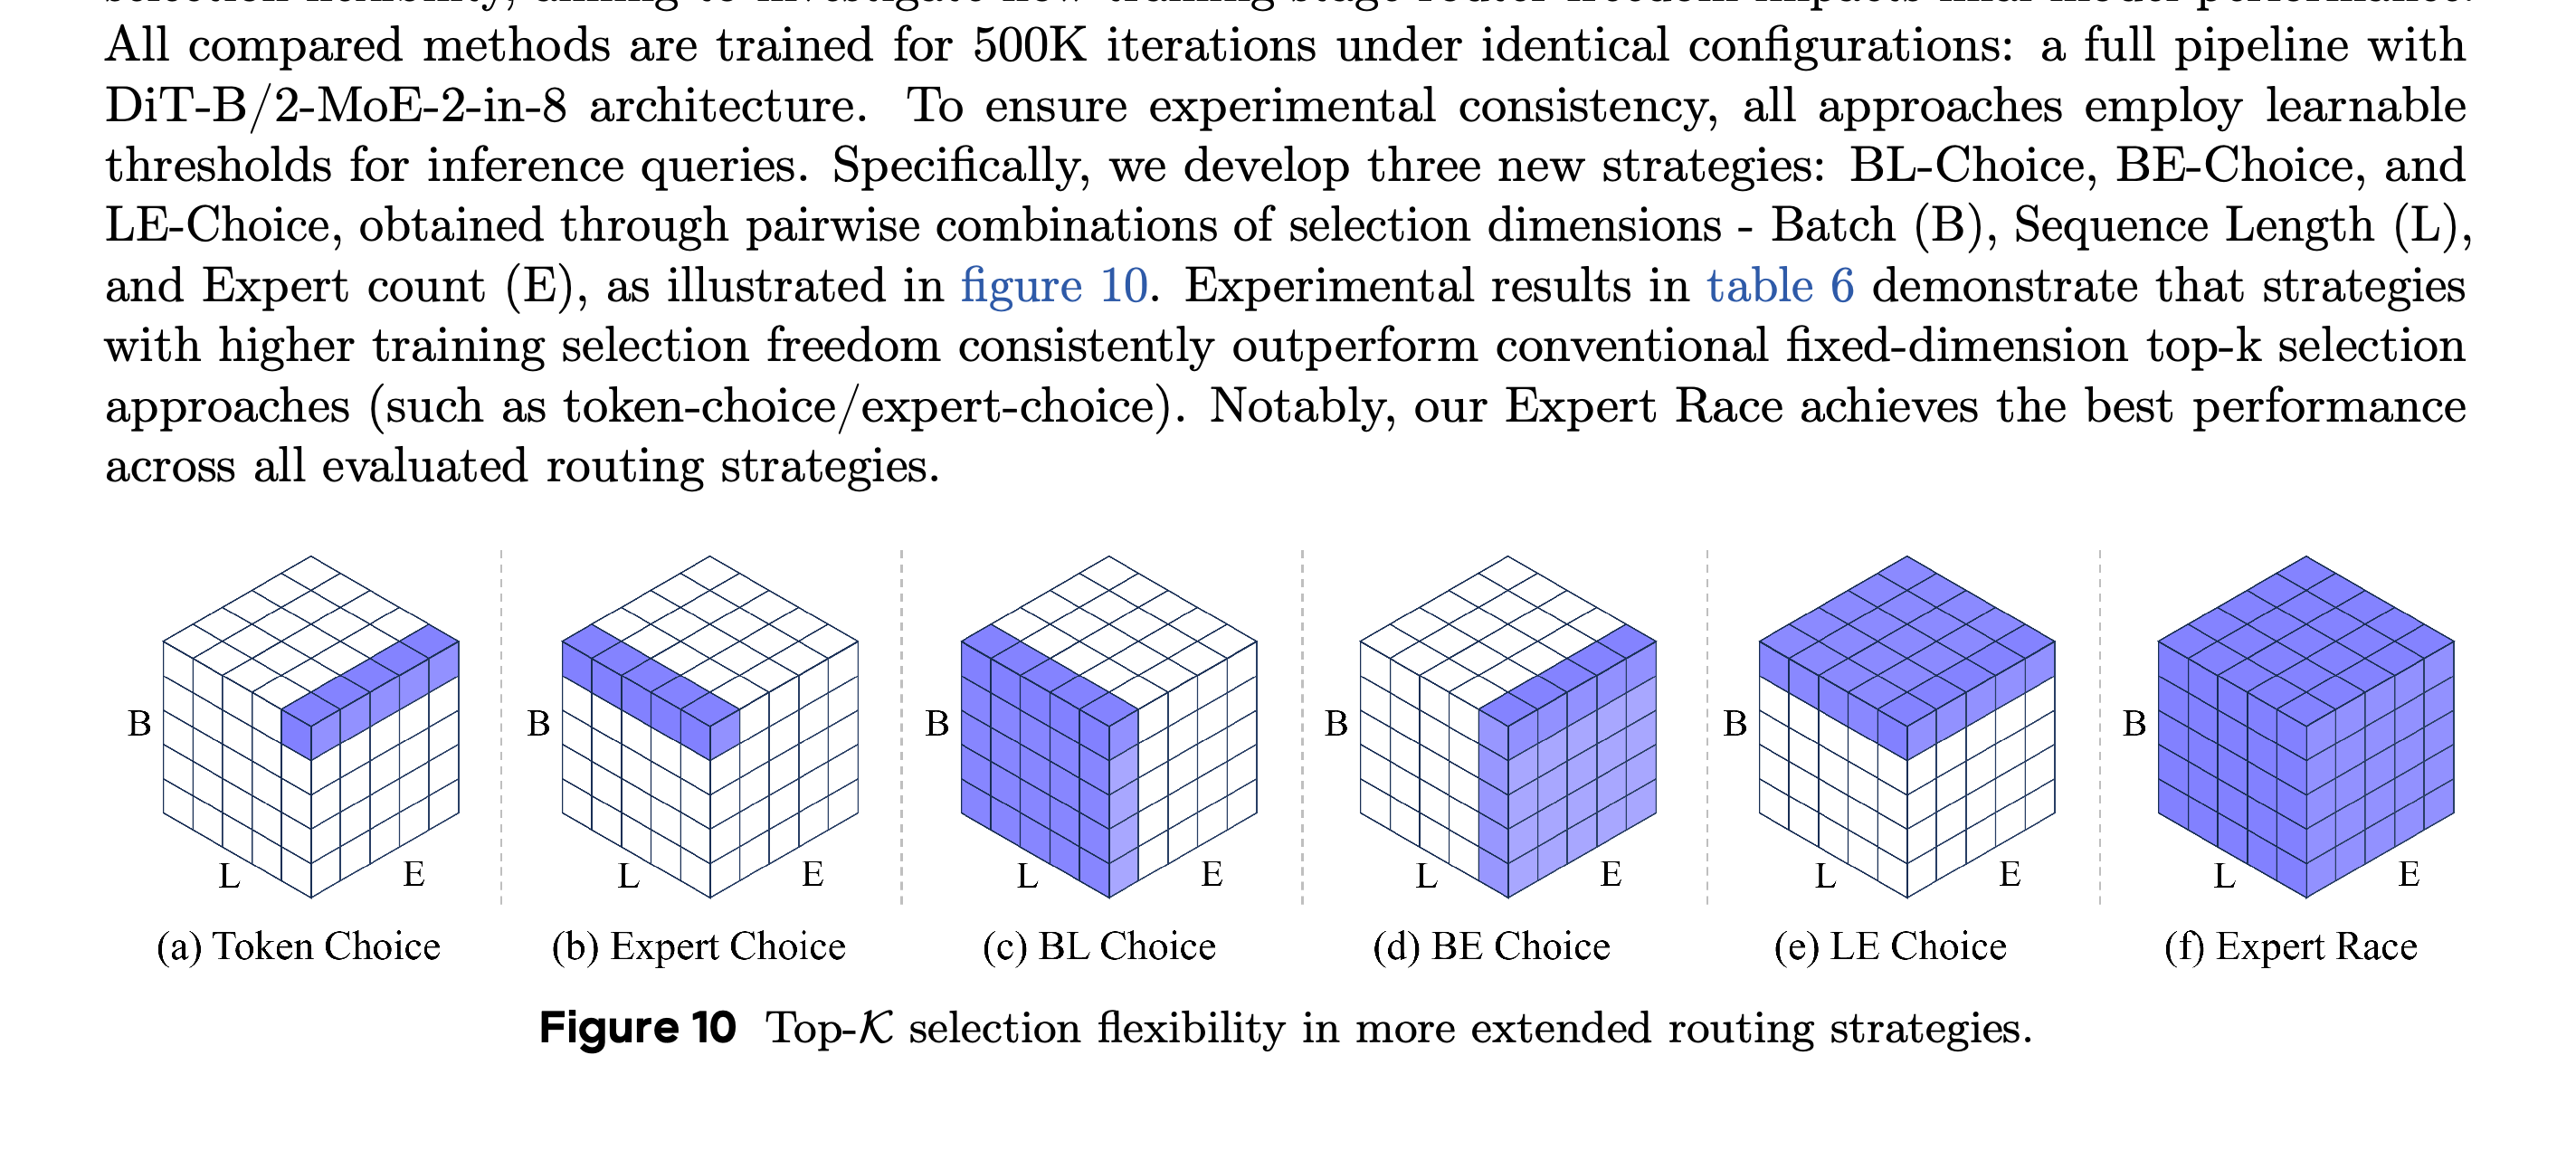
전체 절차와 추론 임계값을 공통으로 적용했을 때 Expert Race가 FID, CMMD, CLIP Score에서 가장 좋다. 가장 근접한 대안은 FID 8.28의 BE Choice다. 이 설정에서는 일부 차원만 통합해도 개선 효과의 상당 부분을 얻는다는 점을 보여준다.
7.8 More Results on ImageNet 256 × 256
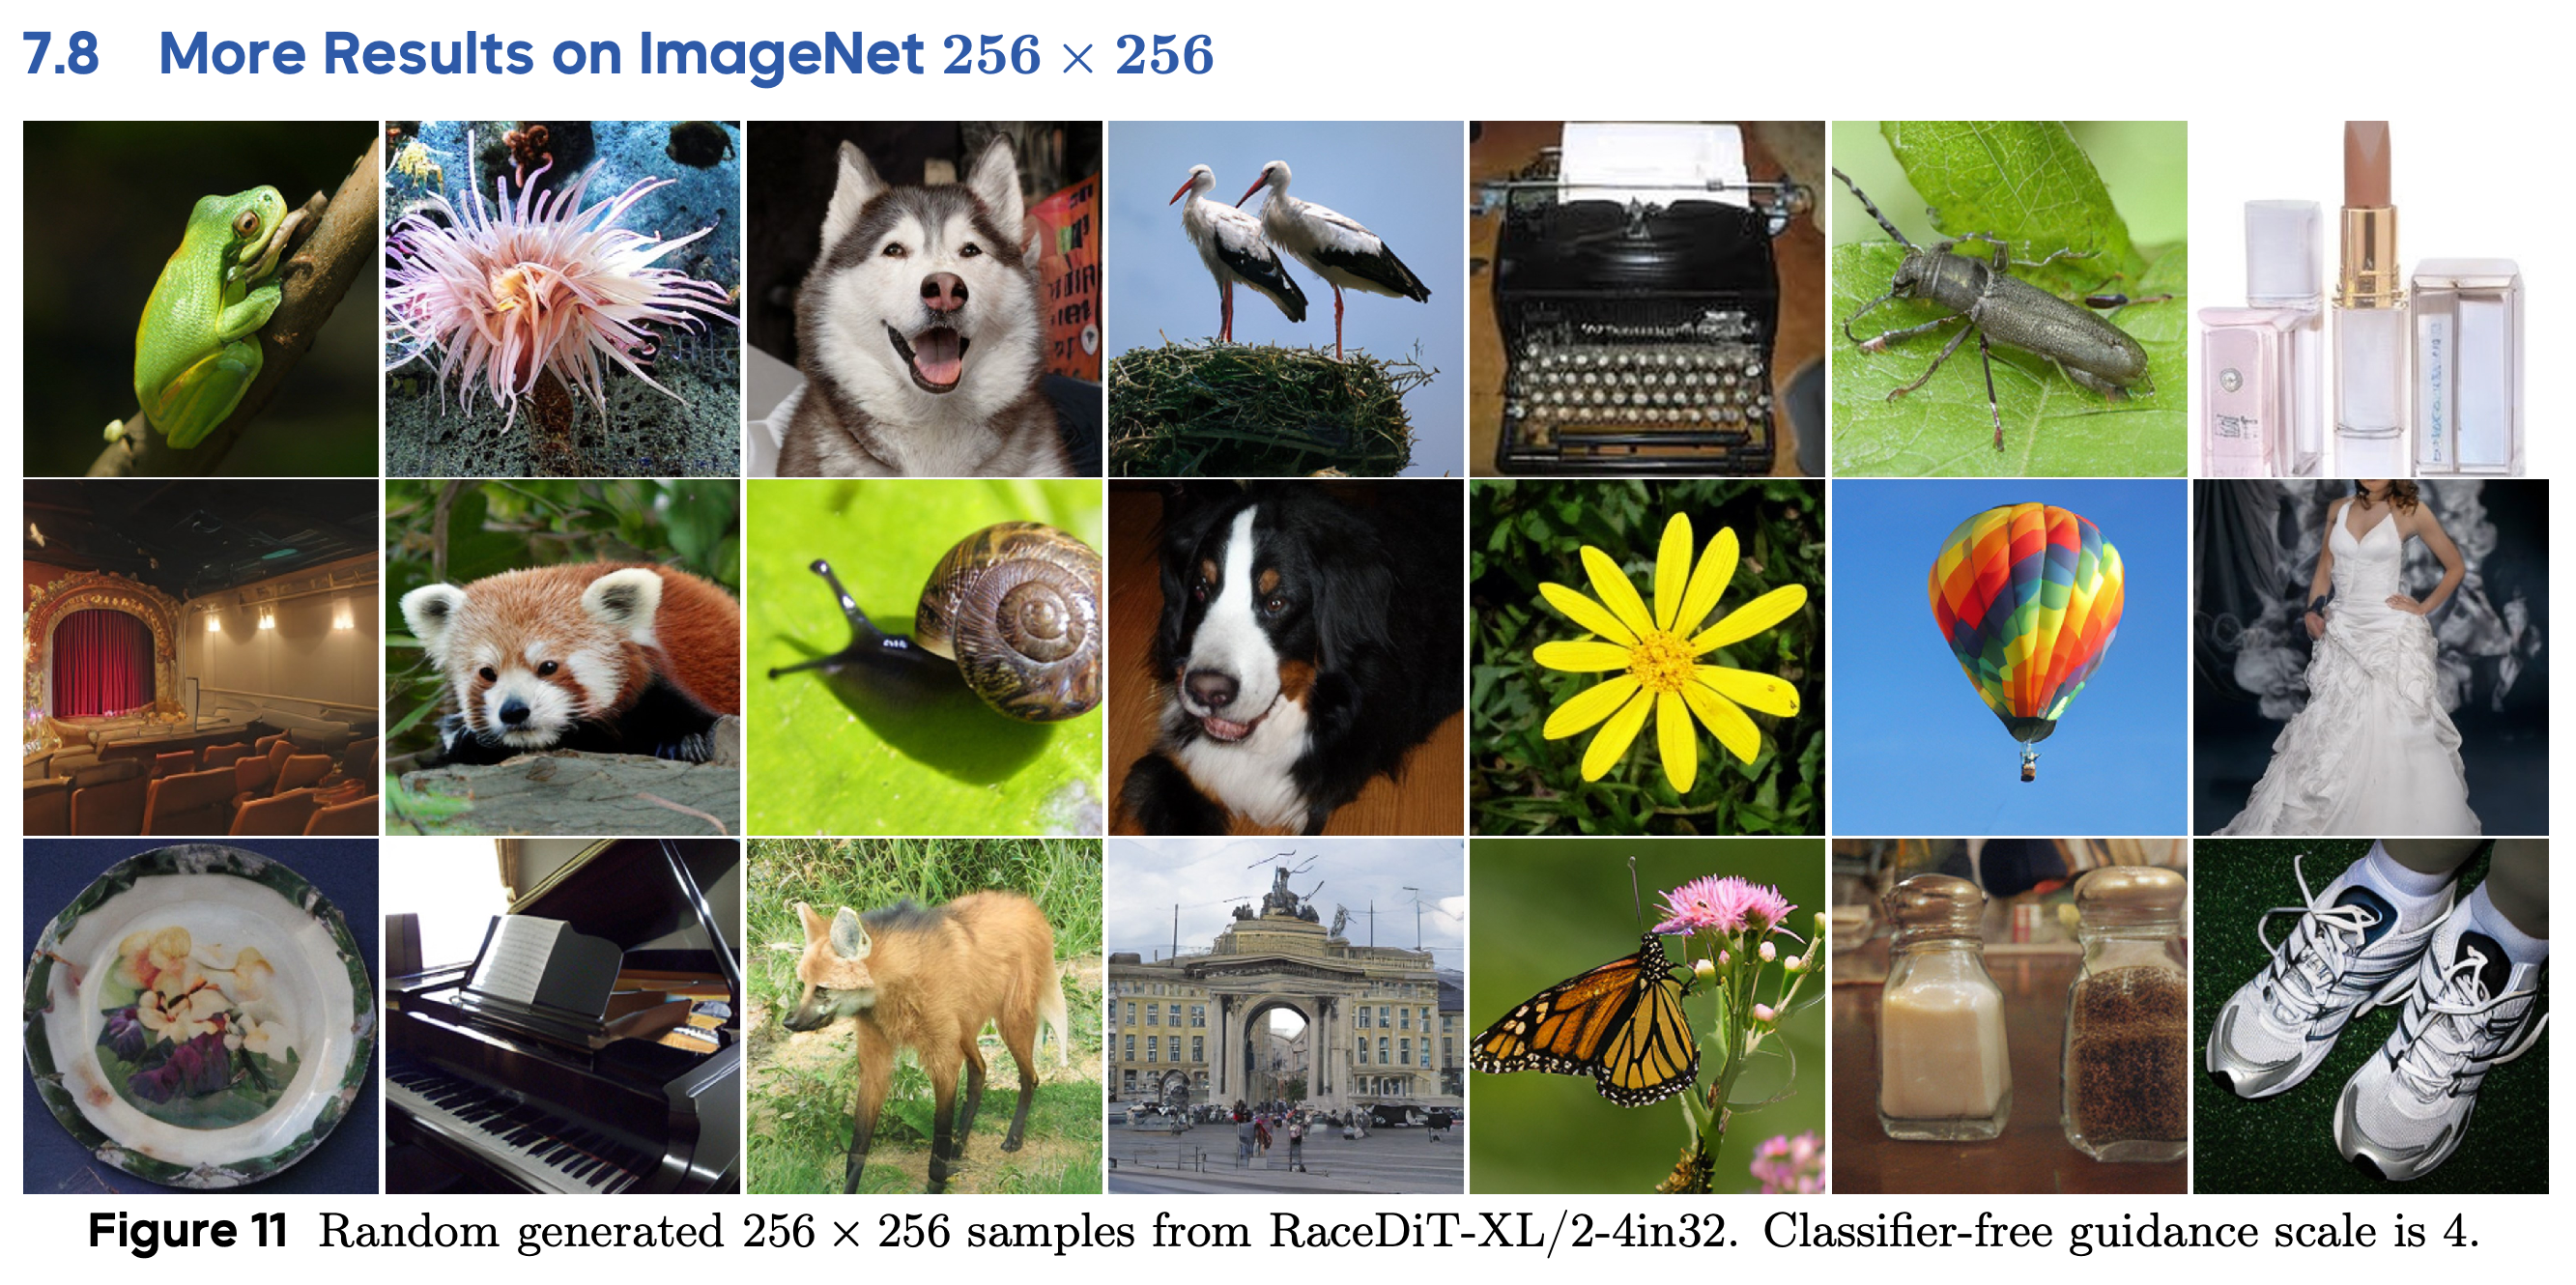
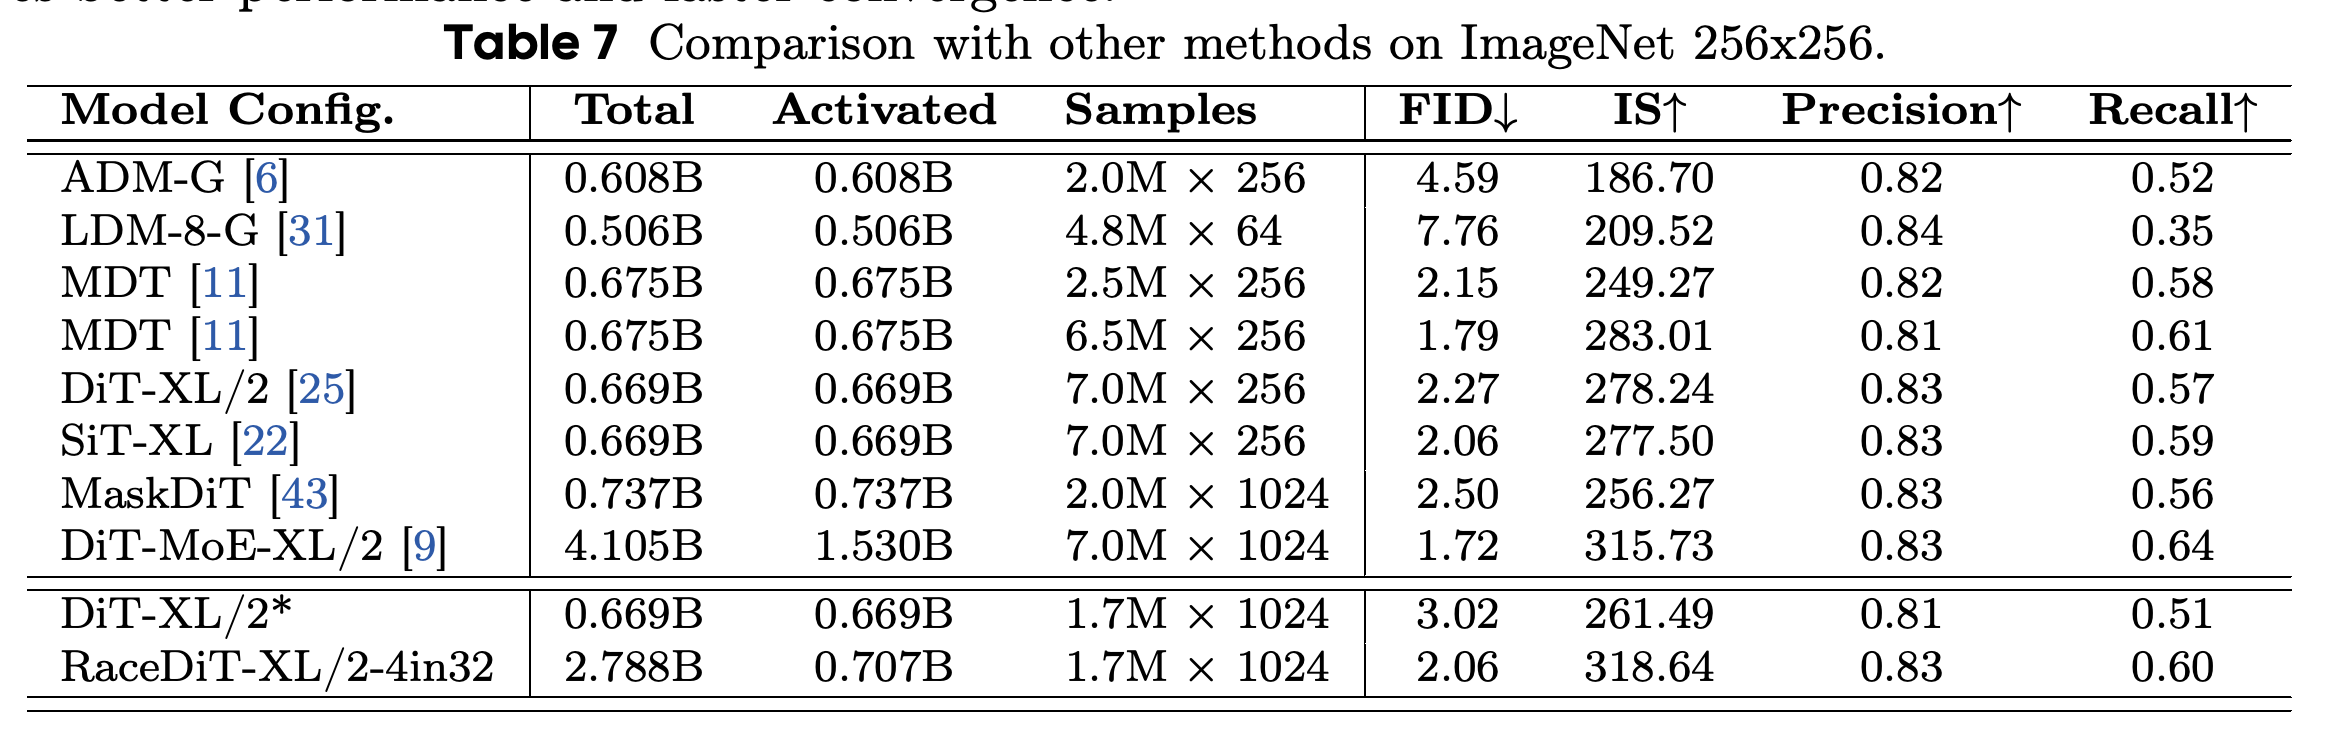
더 오래 학습한 XL 실험에서 본문은 배치 크기 1024, 학습 스텝 수 1.75M, 학습률 1e-4를 명시하지만, Table 7은 재학습한 모델 2개의 학습량을 모두 1.7M × 1024로 표시한다. 조건의 영향력을 강화하는 샘플링 제어값인 classifier-free guidance는 정량 지표 측정에 1.5, 제시한 이미지에 4.0을 사용한다. RaceDiT-XL/2-4in32는 DiT-XL/2* 대비 FID를 3.02에서 2.06으로 개선한다. 다만 Table 7에는 학습 조건이 다른 모델의 더 낮은 FID도 있으며, DiT-MoE-XL/2는 1.72를 기록한다.
샘플은 동물, 사물, 장면에 걸쳐 생성 가능한 ImageNet 범주의 폭을 보여준다. 정량 평가와 guidance scale이 다르므로 이 이미지 모음은 정성적 근거를 제공한다.
재학습 모델을 비교한 행에서는 표시된 학습량이 1.7M × 1024로 같을 때 FID가 3.02에서 2.06으로 개선된다. 다른 행은 아키텍처와 학습 예산이 다르다. DiT-MoE-XL/2는 활성 파라미터 1.530B와 학습량 7.0M × 1024로 FID 1.72를 달성한다.
8 Conclusion
논문은 전역 routing, EMA 추론 임계값, 중간 표현에 대한 지도, expert 쌍 정규화가 ImageNet 256 × 256에서 diffusion transformer의 규모 확장에 도움이 된다고 결론짓는다. 다른 diffusion 기반 시각 과제로의 확장은 향후 연구로 제시한다.
부록
- A Implemention of the Per-Layer Regularization: 2층 MLP router는 먼저 은닉 상태의 폭을 유지하면서 변환한 뒤 gating head와 목표값 예측 head로 분기한다. 각 층의 목표값 예측은 최종 denoising 목표값에 대한 제곱 오차로 지도한다.
- B Analysis of Router Similarity Loss: 부록에서는 이 손실을 개별 expert의 부하 균형을 쌍별 상호작용으로 확장한 것으로 해석한다. Routing 확률의 제곱을 사용해 대각 항의 기여를 유도한다. 또한 실제 expert 선택이 비복원 방식으로 이루어지므로 대각 항과 비대각 항을 별도로 정규화한다고 설명한다.
- C Combination Usage: 순서를 구분하지 않는 모든 expert 쌍의 빈도를 내림차순으로 정렬하고 정규화한다. 누적 비중이 95% 미만인 빈도 구간 수를 가능한 전체 쌍 수로 나누어, 배정이 expert 쌍 전반에 얼마나 넓게 분포하는지 측정한다.
- D Additional Comparisons with DiT-MoE: 500K회 반복 학습한 결과를 담은 Table 8에서 RaceDiT-B/2-2in8의 FID는 8.02, DiT-MoE-B/2-8E2A는 9.06이며, 활성 파라미터 수는 각각 0.135B와 0.286B다. Expert 구현과 shared expert 설계도 달라지므로 이 비교는 전체 아키텍처를 평가하며 routing의 영향만 분리하지는 못한다. Table 8의 8.02는 본문 ablation에서 보고한 8.03과 조금 다르다.
- E Additional Image Generation Results: Figures 15–22는 classifier-free guidance 4.0을 사용한 RaceDiT-XL/2-4in32의 256 × 256 샘플을 보여준다. 대상 클래스는 Macaw (88), loggerhead turtle (33), lion (291), lesser panda (387), convertible (511), balloon (417), lakeside (975), volcano (980)다. 클래스 내부의 다양성을 보여주지만 다른 방법과의 통제된 비교는 제공하지 않는다.
짧은 생각
Routing 전략을 가장 명확하게 비교하는 결과는 Table 6이다. 전체 절차, 학습 기간, 추론 임계값 방식을 공통으로 적용하며, Expert Race가 보고된 지표 3개에서 모두 가장 좋다. Table 2는 개별 expert 부하와 함께 expert 쌍 사용도 조절할 필요가 있음을 별도로 뒷받침한다.
효율성 근거는 대략 비슷한 활성 파라미터 수와 반복 횟수 기준의 빠른 최적화에 한정된다. 실제 시간 기준 처리량이나 통신 비용은 측정하지 않는다. Table 4는 dense XL보다 전체 파라미터가 절반 미만이면서 성능이 더 좋다는 인근 본문 설명과도 모순된다. Medium MoE는 활성 파라미터는 더 적지만 전체 파라미터는 더 많다. 더 넓은 과제로의 전이 성능과 반복 학습 간 변동성도 보고된 실험으로는 확인되지 않는다.