Fast and Simplex: 2-Simplicial Attention in Triton 요약 설명
03 Jul 2025 | Paper Review Attention Mechanisms Scaling Laws GPU Kernel Optimization목차
이번 글에서는 Fast and Simplex: 2-Simplicial Attention in Triton 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 7월 3일(Arxiv)
- Roy, Aurko, Chou, Timothy, Duvvuri, Sai Surya, Chen, Sijia, Yu, Jiecao, Wang, Xiaodong, Zaheer, Manzil, Anil, Rohan.
- Meta, Department of Computer Science, University of Texas at Austin
- 논문 링크
요약
- 이 논문은 각 쿼리를 키 1개가 아니라 키 2개와 함께 평가하는 2-simplicial attention을 사용하면 제한된 학습 토큰으로 더 많이 학습할 수 있는지 연구한다. 학습 토큰 수와 파라미터 수를 맞춰 비교했을 때, 토큰마다 활성 파라미터 35억 개를 사용하는 최대 모델은 4개 벤치마크에서 음의 로그 우도를 0.45%–2.27% 낮췄다고 보고한다. 음의 로그 우도는 정답 예측 오차를 나타내는 지표이며, 비교 대상인 표준 dot-product attention은 쿼리와 키의 쌍을 평가한다.
- 구현에서는 키 축을 크기 (512, 32)의 sliding window로 제한한다. 이 윈도는 각 쿼리를 따라 이동하는 국소 영역이며, 모델은 매 네 번째 레이어에 2-simplicial attention을 적용한다. 가속기 커널 구현 언어인 Triton으로 520 TFLOPS의 처리량을 달성했다고 보고한다. TFLOPS는 초당 1000000000000회의 부동소수점 연산을 나타내는 단위다. 시퀀스가 길어지면 측정 지연 시간이 최적화된 dot-product attention 구현인 FlashAttention v3와 경쟁할 만한 수준에 도달한다.
- 모델 크기가 커질 때 손실이 감소하는 정도를 나타내는 파라미터 스케일링 지수는 적합 결과에서 6.8%–20.2% 증가했다고 보고한다. 다만 모델 크기 3개만으로 적합했으며, 손실에 더해지는 상수항이 작다고 근사한다. 활성 파라미터가 10억 개인 모델에서는 의미 있는 개선이 나타나지 않았으며, 논문은 학습 토큰 수, 학습 데이터 구성, 반복 실행에 따른 불확실성을 명시하지 않는다.
1 Introduction
서론은 고품질 학습 데이터가 언어 모델의 스케일링을 제약할 수 있다는 문제를 제기한다. 고정된 연산 예산을 모델 크기와 학습 데이터에 배분하는 연산 최적 스케일링은 일반적으로 파라미터와 토큰을 함께 늘리도록 요구한다. 이 논문은 토큰 수가 고정된 상황에서 표현력이 더 높은 attention 연산으로 성능을 개선할 수 있는지 살펴본다.
- 저자들은 Clift et al. (2019)이 제안한 2-simplicial Transformer를 다시 검토한다. 고차 attention에 커널 구현과 회전 불변 삼중선형 형식을 이용한 이론적 구성을 결합한다. 삼중선형 형식은 입력 3개 각각에 대해 선형인 함수이며, 회전 불변성은 모든 입력에 같은 회전을 적용해도 함수값이 변하지 않는 성질이다.
- 토큰 수를 파라미터 수보다 느리게 늘릴 수 있다는 제안은 고정 토큰 실험에 대한 해석이다. 논문은 여러 토큰 예산에서 최적 배분을 측정하지 않는다.
2 Related Work
관련 연구에서는 시퀀스 길이에 따른 attention 비용을 줄이는 방법과 파라미터당 표현력을 높이는 고차 방법을 연결한다. 2-simplicial attention과 함께 삼자 상호작용을 모델링하는 Edge Transformer의 triangular attention, 단백질 구조의 triangle self-attention, Match3에 관한 이론적 결과를 다룬다. 이 과제는 특정 토큰이 포함된 토큰 삼중항의 합이 주어진 정수의 배수가 되는지 판별한다.
- 레이어를 반복 적용하는 Looped Transformers도 파라미터당 연산량을 늘리는 방법이다. 저자들은 이를 확장할 때 유효 깊이가 증가하고 학습이 어려워진다는 점을 우려한다.
- 이 연구는 기존 attention 계열의 구현 및 언어 모델 스케일링 실험에 행렬식 기반 이론적 구성을 결합한다. 행렬식은 정사각행렬로부터 계산하며, 부호가 있는 넓이나 부피를 나타내는 값이다.
3 Overview of Neural Scaling Laws
논문은 \(L(N,D)=E+\frac{A}{N^\alpha}+\frac{B}{D^\beta}\)를 사용한다. N은 파라미터 수, D는 학습 토큰 수, E는 기반 텍스트 분포에서 비롯되는 불가약 손실이며, 나머지 항은 유한한 모델 크기와 데이터 양이 손실에 미치는 영향을 나타낸다. 또한 연산 예산 C에 대해 최적 파라미터 수와 토큰 수가 각각 대략 C^0.49와 C^0.5에 비례한다는 기존 연산 최적 추정치를 검토한다.
- 이 틀은 스케일링 지수의 변화와 손실 곡선의 이동을 구분한다. 이후 실험에서는 D를 고정하고 전체 파라미터 대신 활성 파라미터를 사용해 파라미터 수에 따른 기울기를 추정한다.
4 The 2-SIMPLICIAL Transformer
표준 dot-product attention은 각 쿼리를 키 1개와 비교해 점수를 구하고, 해당 값 벡터를 결합한다. 값 벡터는 attention이 가져오는 내용을 담는다. 2-simplicial 방식은 두 번째 키 투영 K′와 값 투영 V′를 추가하고, 삼중선형 점수 \(A^{(2s)}_{ijk}=\frac{1}{\sqrt d}\sum_{l=1}^{d}Q_{il}K_{jl}K’_{kl}\)를 계산한다. 여기서 d는 헤드 차원이다. 이후 키 인덱스 2개에 걸쳐 softmax를 적용해 지수함수 기반 정규화로 확률 가중치를 얻는다.
- 출력은 키 쌍 전체에 대해 S^(2s)_ijk(v_j ◦ v′_k)를 합산한다. S는 정규화된 attention 가중치이며, ◦는 원소별 곱셈인 Hadamard product다. 따라서 가져오는 내용은 값 벡터의 쌍에 따라 결정된다.
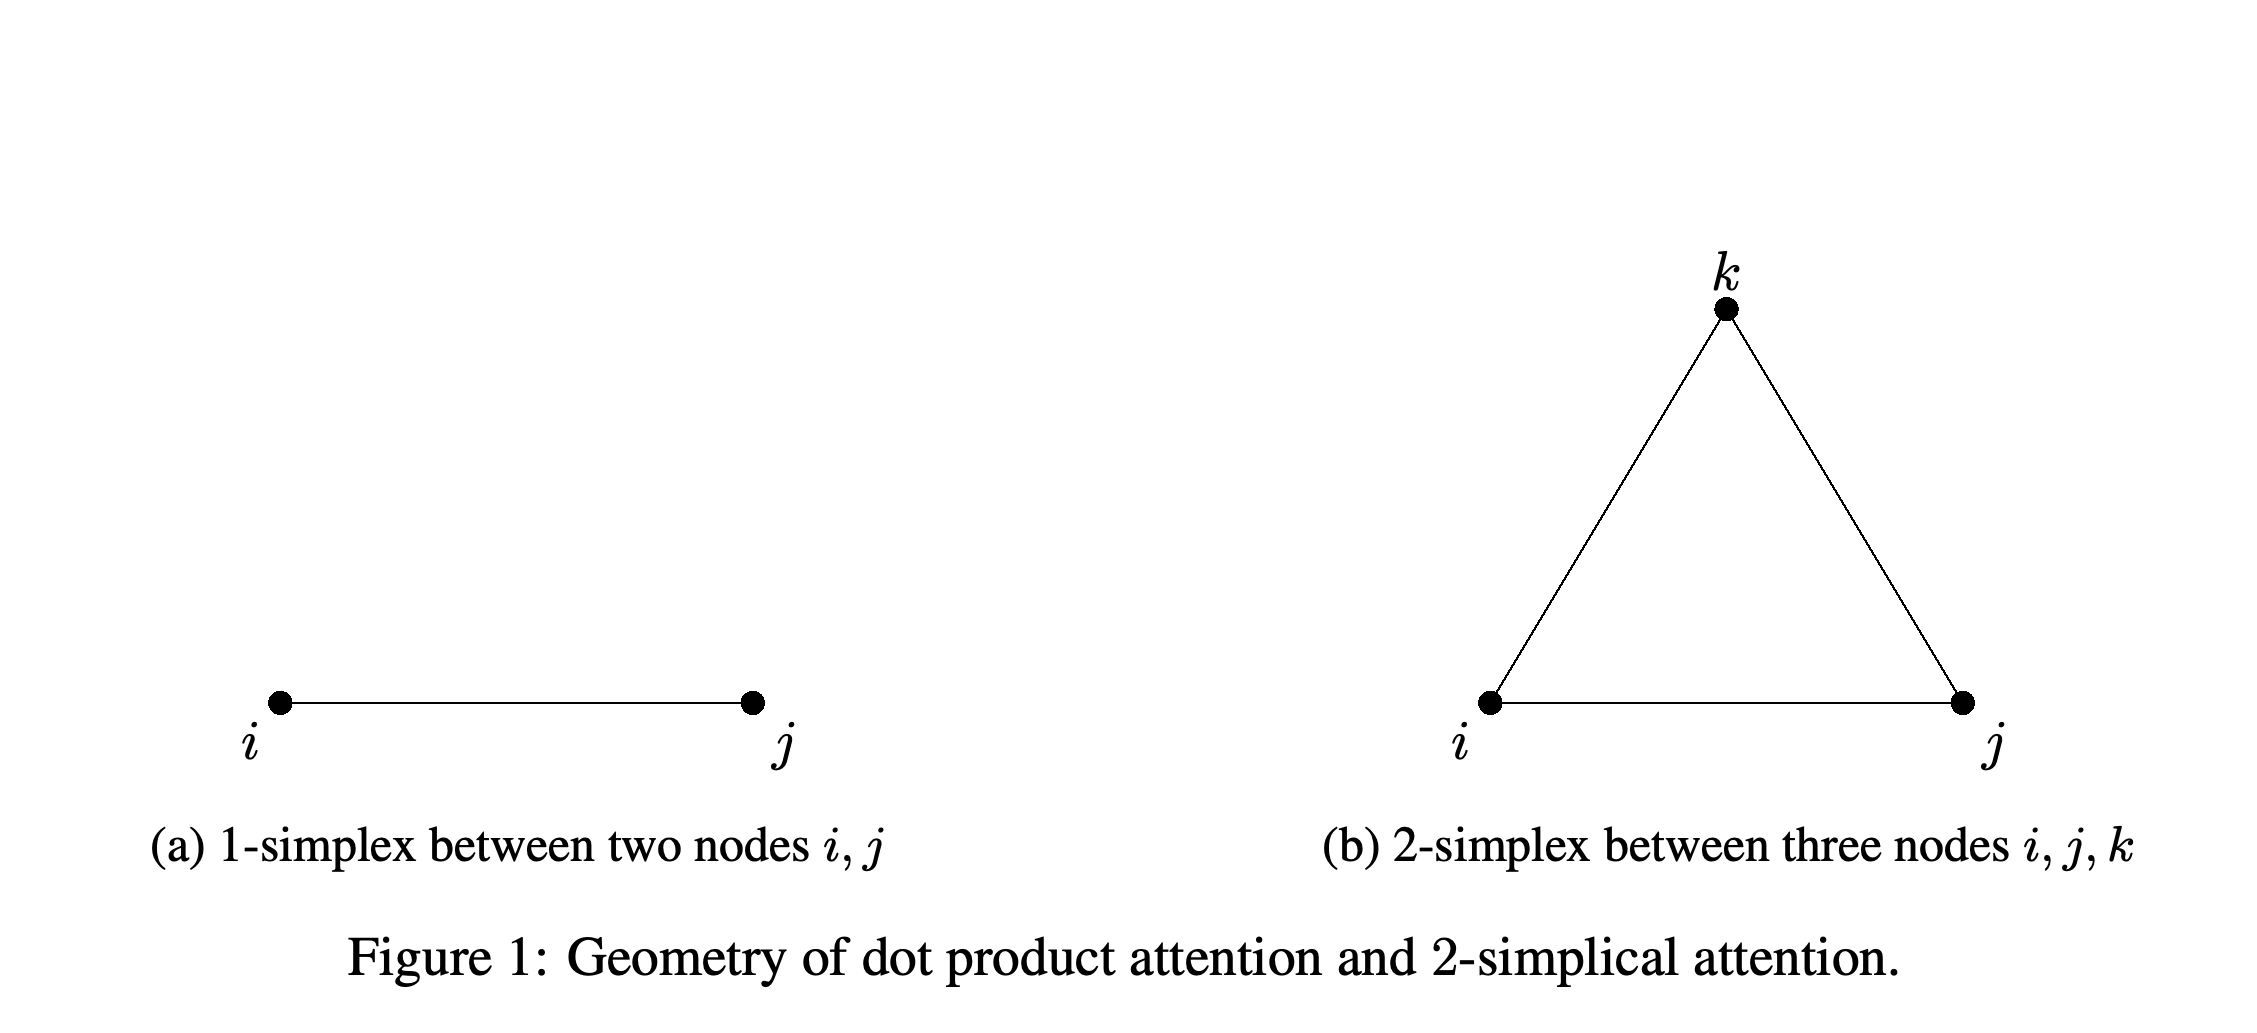
- Figure 1은 노드 2개를 잇는 간선에서 노드 3개로 이루어진 삼각형으로 바뀌는 구조를 보여준다. Algorithm 1은 공유 인덱스에 대해 곱을 합산하는 텐서 축약과 미래 위치를 제외하는 causal mask로 순전파 계산을 표현한다.
간선은 토큰 위치 2개 사이의 상호작용을 나타내고, 삼각형은 토큰 위치 3개가 함께하는 상호작용을 나타낸다. 이 기하학적 구조는 2-simplicial attention에서 각 쿼리가 키 1개 대신 키의 쌍을 인덱싱하는 이유를 설명한다.
5 Determinant Based TRILINEAR FORMS
RoPE, 즉 rotary position embedding은 쿼리와 키를 회전시켜 위치를 표현한다. 같은 회전을 적용하면 내적은 보존된다. 일반적인 삼중선형 곱에는 이러한 불변성이 없으므로, 저자들은 쿼리와 키 쌍을 3차원 단위로 나누고 각 단위에서 부호가 있는 행렬식을 구해 합산하는 방법을 제안한다.
- 각 행렬식은 동일한 3차원 회전을 적용해도 변하지 않는다. 3 × 3 행렬식을 전개하는 Sarrus rule을 적용하면 이 연산을 삼중선형 축약 2개의 차로 표현할 수 있지만, 산술 연산 비용이 증가한다.
- Theorem 5.1은 입력 범위가 다항식으로 제한될 때 차원 d = 7인 단일 attention 헤드로 x_i + x_j₁ + x_j₂ = 0 (mod M)을 만족하는 j₁과 j₂의 존재 여부를 판별할 수 있다고 서술한다. 이는 Match3에 대한 표현력 주장으로, 행렬식 기반 attention의 실험적 비교는 아니다.
- 이후 커널 유도에서는 더 단순한 삼중선형 형식을 사용한다. 실험에서는 행렬식 기반 점수의 기여를 분리해 측정하거나 위치 인코딩 대안을 비교하지 않는다.
6 Model Design
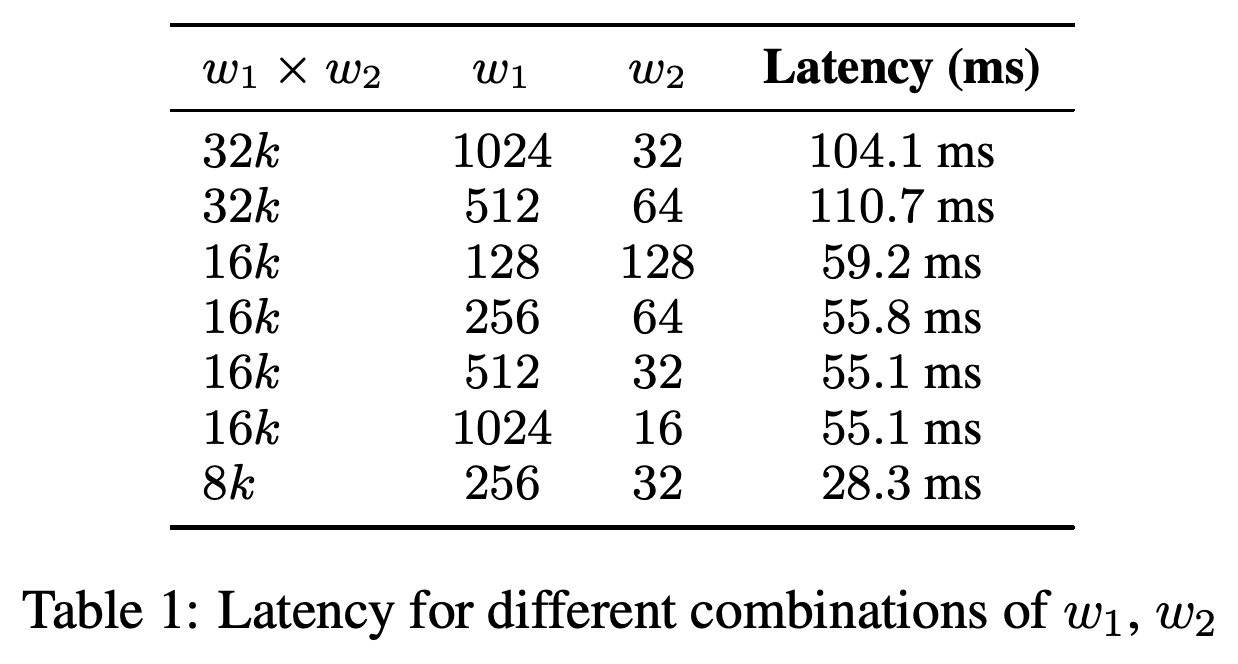
전체 2-simplicial attention은 시퀀스 길이에 대해 O(n³)의 복잡도를 가진다. 따라서 각 쿼리가 K의 키 w₁개와 K′의 키 w₂개만 사용하도록 제한해 복잡도를 \(O(nw_1w_2)\)로 줄인다. 저자들은 (w₁, w₂) = (512, 32)를 선택하며, Table 1에서 이 설정의 지연 시간은 55.1 ms로 보고된다.
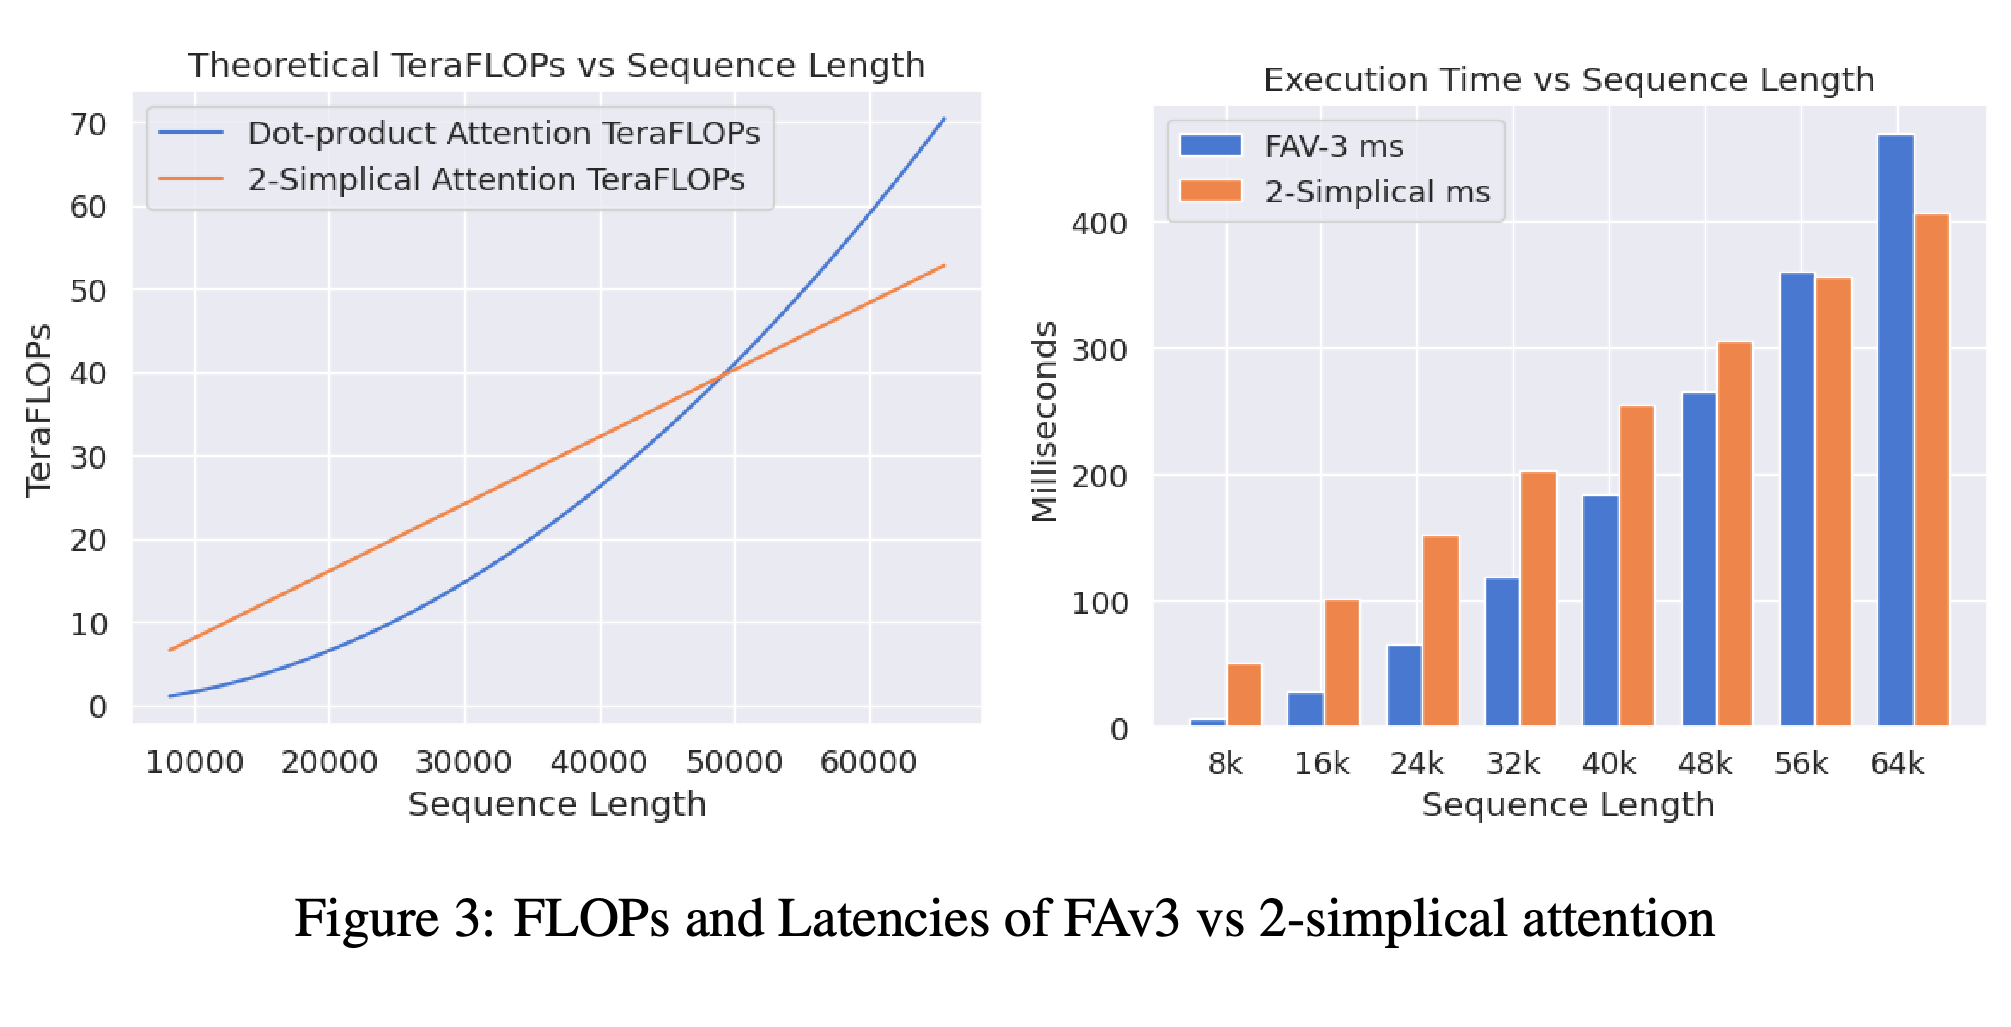
- 논문에 제시된 연산량 식은 causal dot-product attention의 경우 2n², 윈도를 적용한 2-simplicial attention의 경우 6nw₁w₂다. 저자들은 선택한 윈도에서 연산량이 같아지는 지점을 문맥 길이 48k로 제시한다.
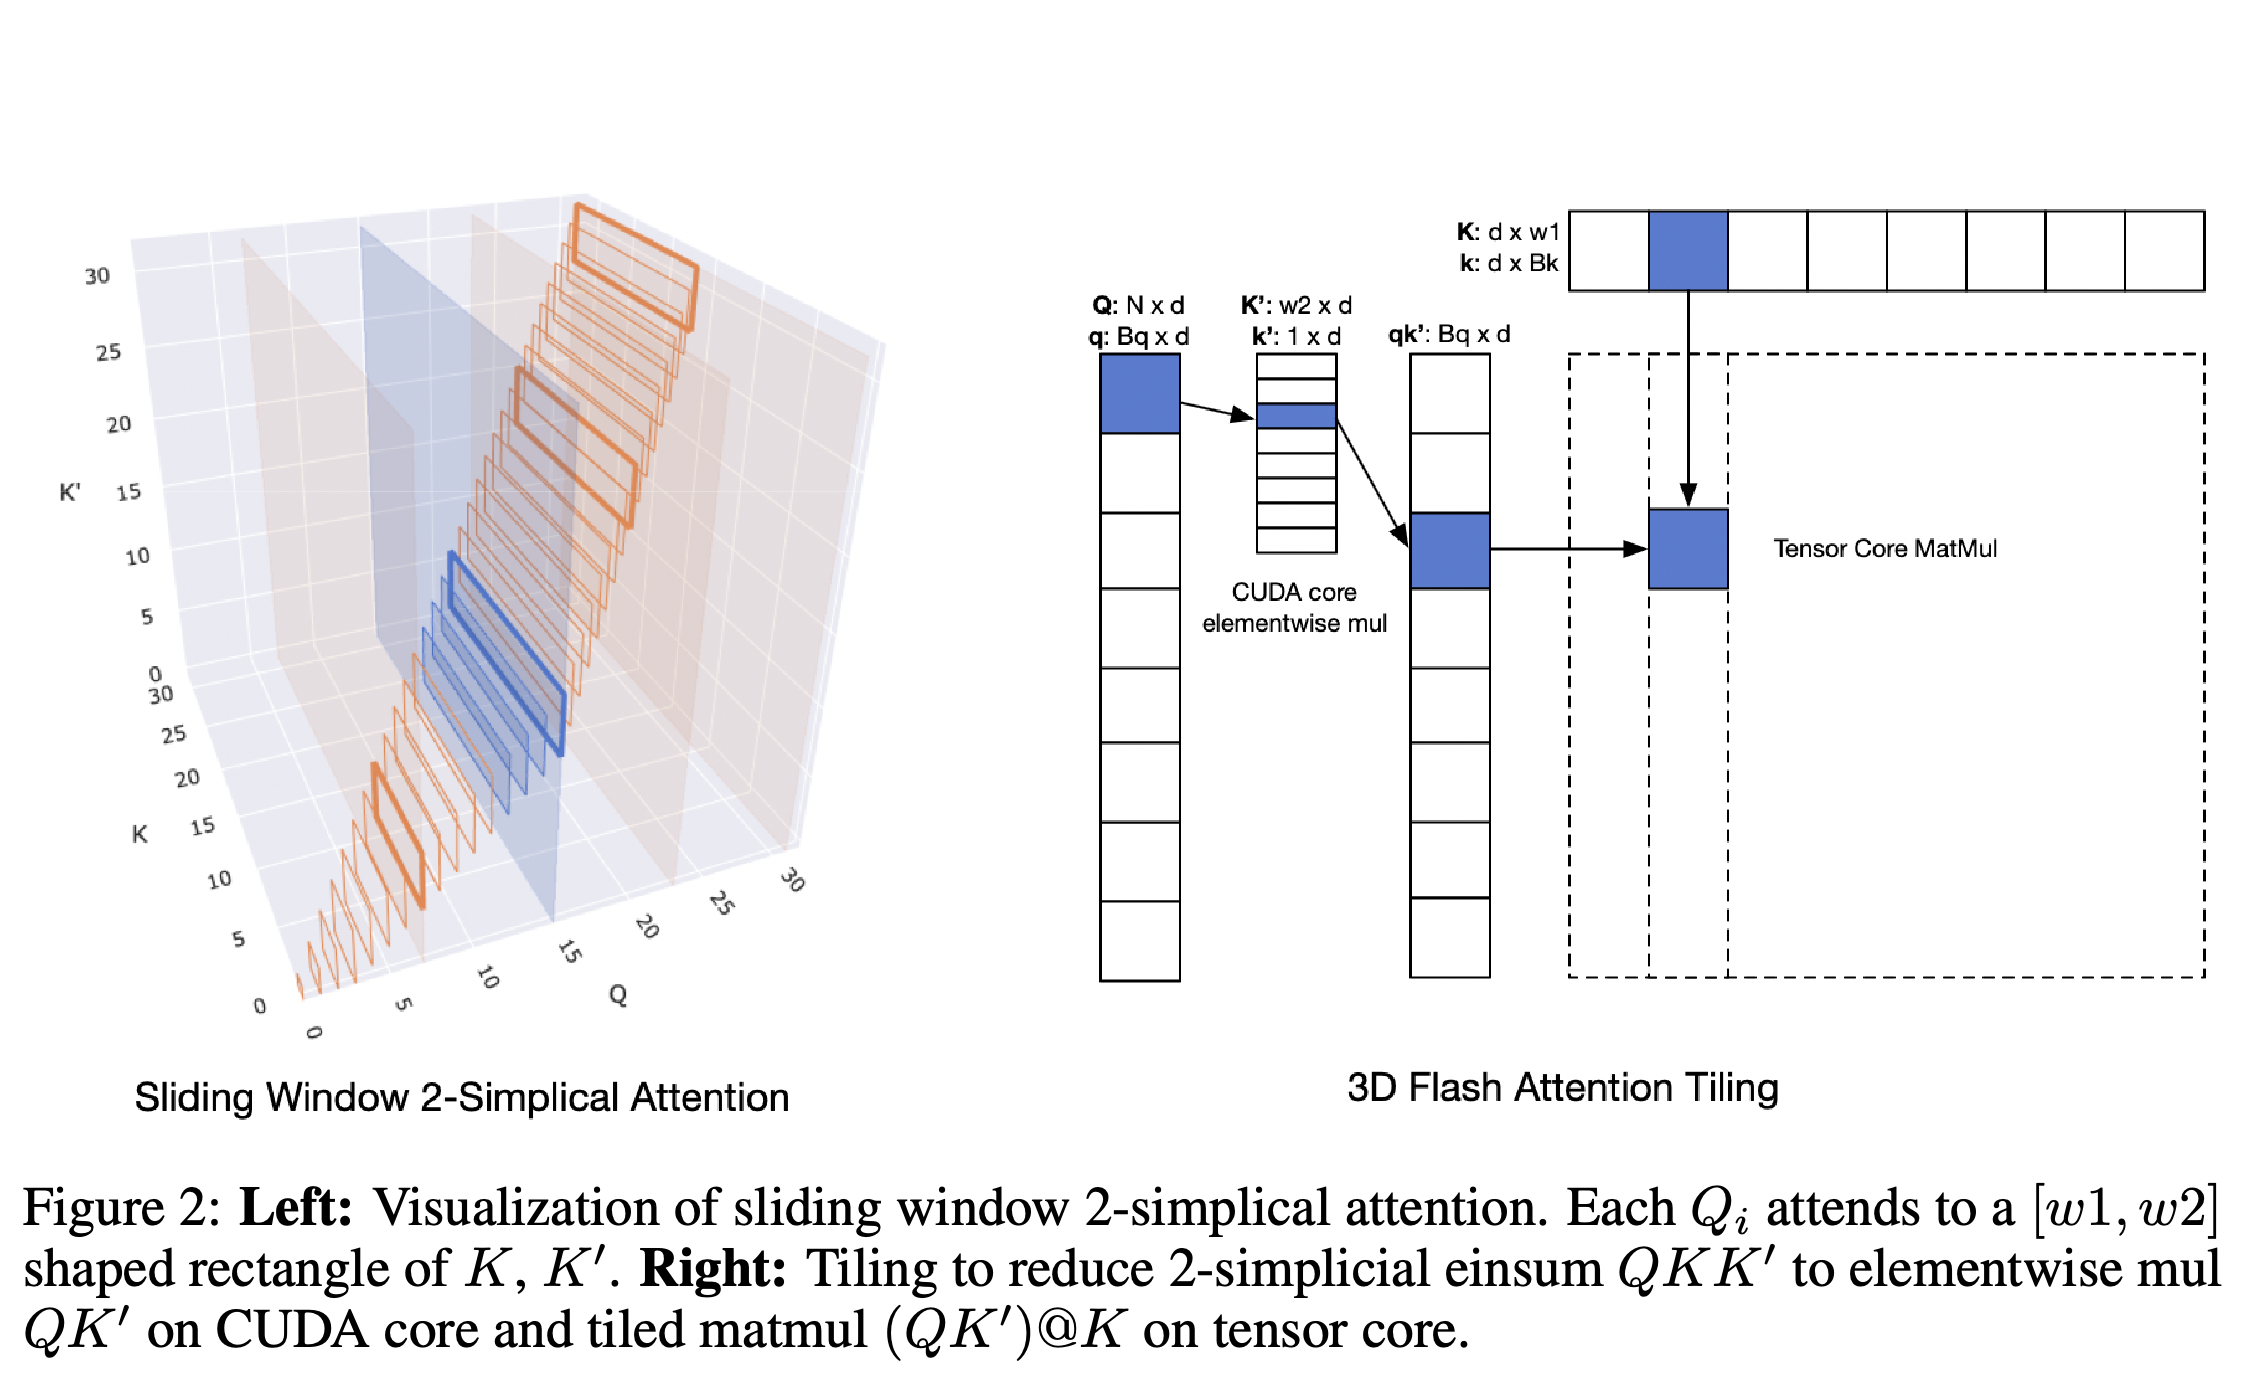
- Grouped Query Attention, 즉 GQA는 여러 쿼리 헤드가 키 헤드와 값 헤드를 공유하게 한다. GQA 비율 64를 사용하면 쿼리 헤드에 걸쳐 연산을 하드웨어에 맞는 블록으로 나누는 타일링이 가능해져 밀집 연산을 개선하고 마스킹 오버헤드를 줄인다.
- Table 1은 윈도 설정 7개의 지연 시간을 제시하지만, 언급한 지연 시간과 품질 간 절충을 평가할 품질 측정치는 제공하지 않는다.
지연 시간은 대체로 윈도 크기의 곱에 따라 증가한다. 표에 제시된 8k 설정은 28.3 ms, 16k 설정들은 55.1–59.2 ms, 32k 설정들은 104.1–110.7 ms가 걸린다. 선택한 (512, 32) 설정은 (1024, 16)과 동일한 55.1 ms를 기록한다. 표에는 이 설정들의 품질을 구분할 측정치가 없다.
7 KERNEL Optimization
순전파 커널은 원소별 곱셈, 타일 단위 행렬 곱셈, online softmax를 결합한다. Online softmax는 전체 점수 텐서를 저장하지 않고 attention을 점진적으로 정규화한다. 커널은 일반 산술 연산 장치인 CUDA 코어의 원소별 연산과 행렬 연산 전용 가속 장치인 Tensor Cores의 행렬 곱셈을 겹쳐 실행하며, 520 TFLOPS를 보고한다.
- Figure 2는 sliding window와 축약 분해를 통해 고차 attention을 행렬 곱셈 하드웨어에 대응시키는 방법을 보여준다. Figure 3은 측정한 시퀀스 길이 범위에서 긴 시퀀스로 갈수록 지연 시간이 경쟁력 있는 수준에 도달함을 보여준다.
- 역전파는 K와 V의 그래디언트 계산을 K′, V′, Q의 그래디언트 계산과 분리한다. 이 방식은 일부 중간 계산을 반복하지만, 저자들이 관찰한 atomic 연산의 더 큰 오버헤드를 피한다. Atomic 연산은 공유 메모리 위치에 대한 동시 갱신을 조정한다.
- w₂가 작을 때 Algorithm 2는 짝수 및 홀수 쿼리 타일을 별도 단계에서 처리해 atomic 덧셈 없이 그래디언트를 계산한다. 저자들은 Triton의 세밀하지 못한 파이프라인 제어가 추가 최적화를 방해할 수 있다고 지적한다.
왼쪽 패널은 키 쌍의 직사각형 영역이 각 쿼리를 따라 이동하는 모습을 보여준다. 오른쪽 패널은 삼중선형 축약을 원소별 곱셈과 타일 단위 행렬 곱셈으로 분해한다. 이를 통해 전체 3차원 상호작용 텐서를 실제로 생성하지 않고도 Tensor Cores를 사용할 수 있음을 보여준다.
연산량 곡선은 약 48k 토큰에서 교차하지만, 지연 시간 막대에서는 2-simplicial 커널이 48k에서 여전히 더 느리고, 56k에서 비슷하며, 64k에서 더 빠르다. 따라서 이론적 연산량이 같아지는 지점과 측정 지연 시간이 같아지는 지점은 다르다.
8 Experiments & Results
실험에서는 토큰마다 전체 파라미터 중 일부만 활성화하는 mixture-of-experts 모델을 학습한다. 활성/전체 파라미터 규모는 1B/57B, 2B/100B, 3.5B/176B이며, B는 1000000000을 뜻한다. 매 네 번째 레이어에 sliding-window 2-simplicial attention을 사용한다. 서로 다른 장치에 배정된 레이어 그룹인 파이프라인 스테이지에 attention 연산이 분산되도록 레이어 순서를 정한다.
- 학습에는 가중치 감쇠를 분리한 옵티마이저인 AdamW를 사용한다. 최대 학습률은 4 × 10⁻³, 가중치 감쇠는 0.0125이며, 4000 워밍업 스텝을 거친 뒤 cosine decay로 학습률을 최댓값의 0.01×까지 낮춘다.
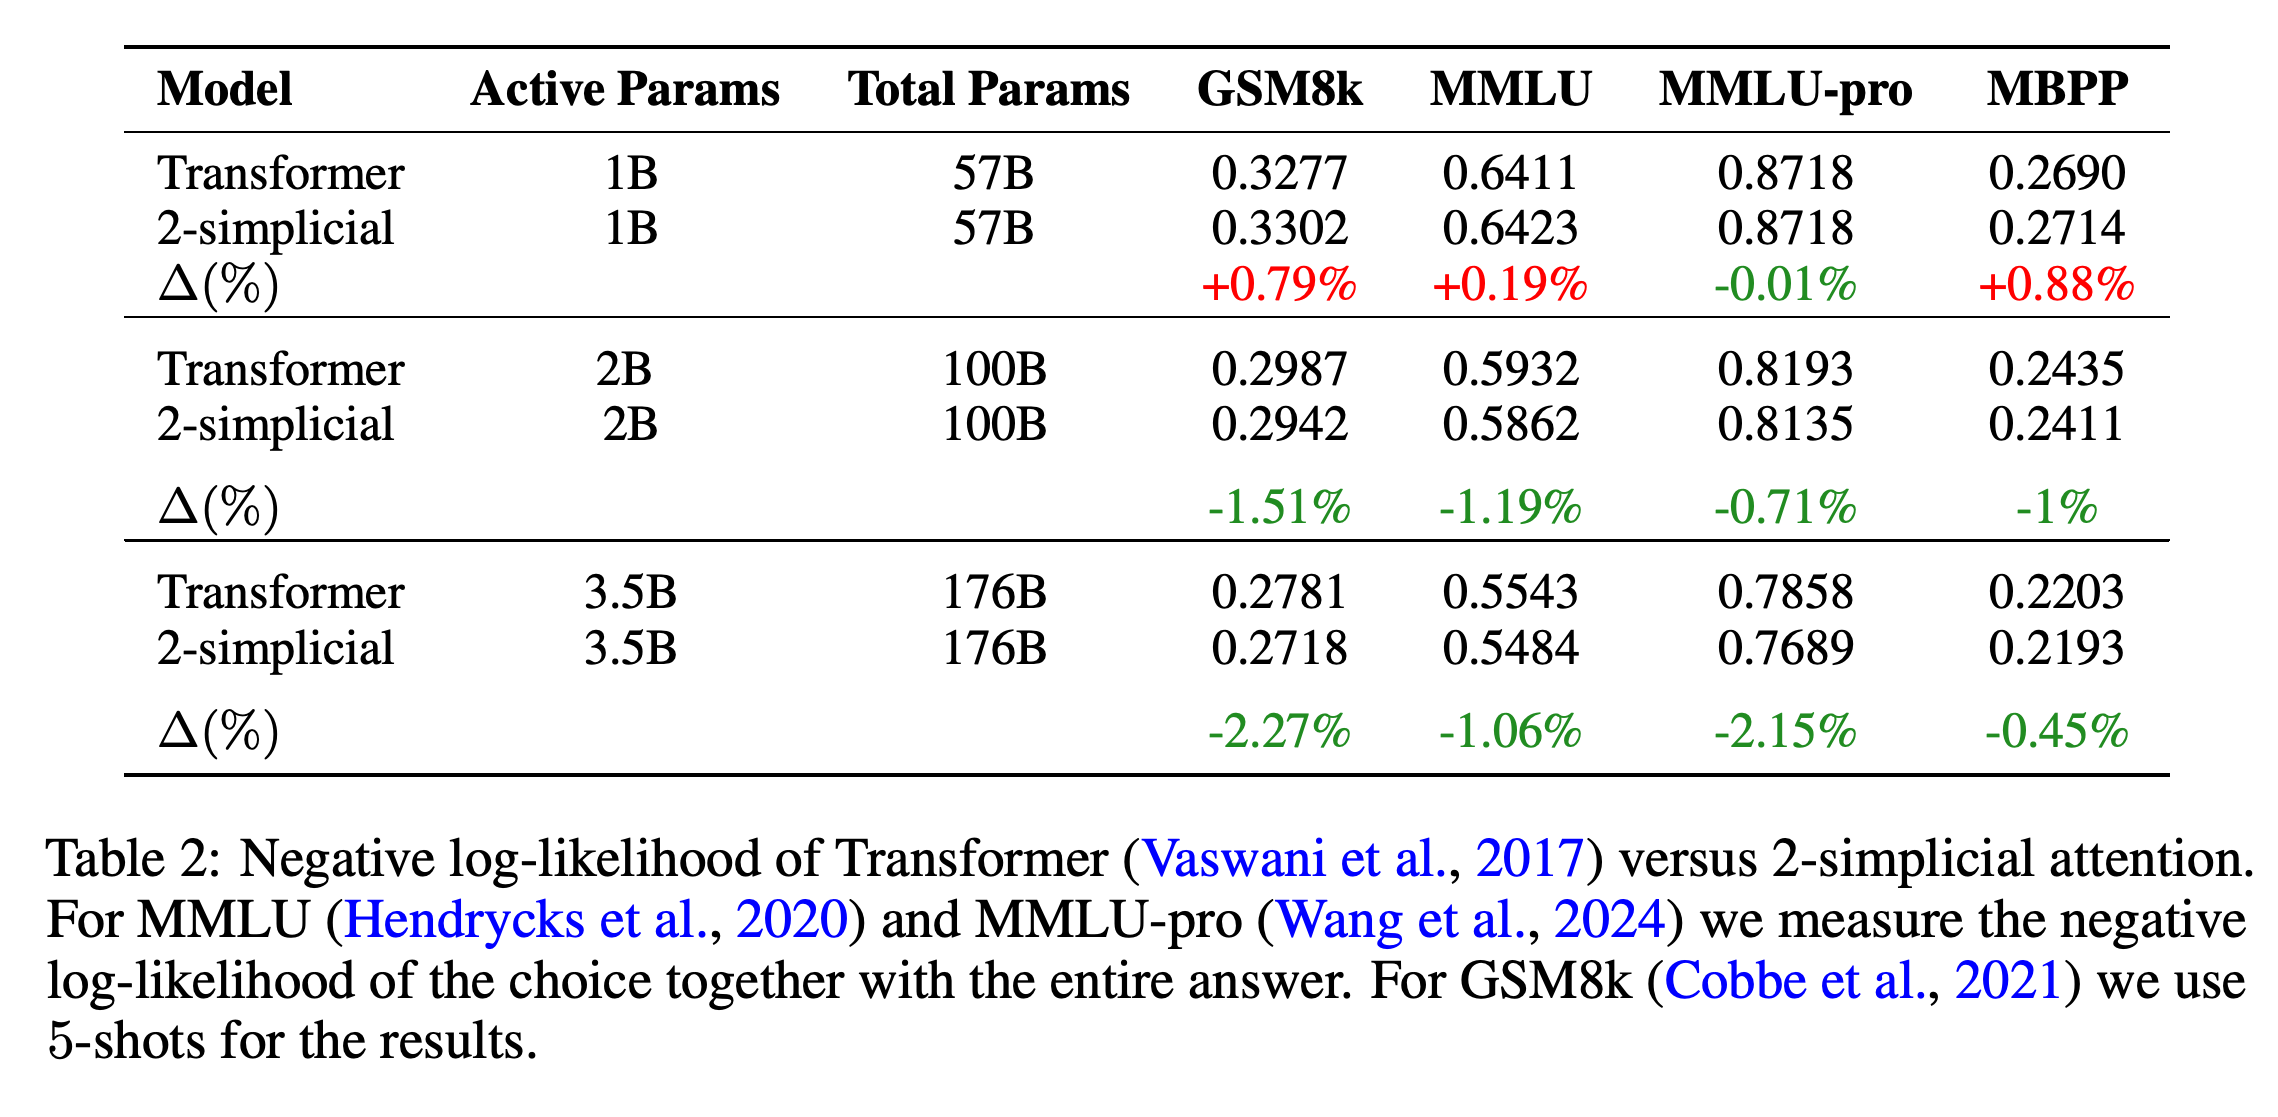
- 평가에서는 수학 벤치마크 GSM8k, 다중 과제 언어 이해 벤치마크 MMLU, 더 어려운 버전인 MMLU-pro, 프로그래밍 벤치마크 MBPP의 음의 로그 우도를 보고한다. GSM8k는 예시 5개를 제공하는 5-shot 평가를 사용한다. MMLU와 MMLU-pro는 선택지와 전체 답변을 함께 평가한다.
- 아키텍처 간 비교에서는 학습 토큰 수를 고정하지만, PDF에는 그 수치, 학습 데이터 혼합 구성, 전체 학습 연산량, 전체 학습 시간이 제시되지 않는다.
활성 파라미터가 2B일 때 Table 2는 4개 벤치마크 모두에서 더 낮은 음의 로그 우도를 보고한다. GSM8k, MMLU, MMLU-pro, MBPP의 상대 감소율은 각각 1.51%, 1.19%, 0.71%, 1%다. 3.5B에서는 각각 2.27%, 1.06%, 2.15%, 0.45%다. 1B에서 표에 표시된 손실은 벤치마크 3개에서 더 높고, MMLU-pro에서는 소수점 이하 4자리까지 같다.
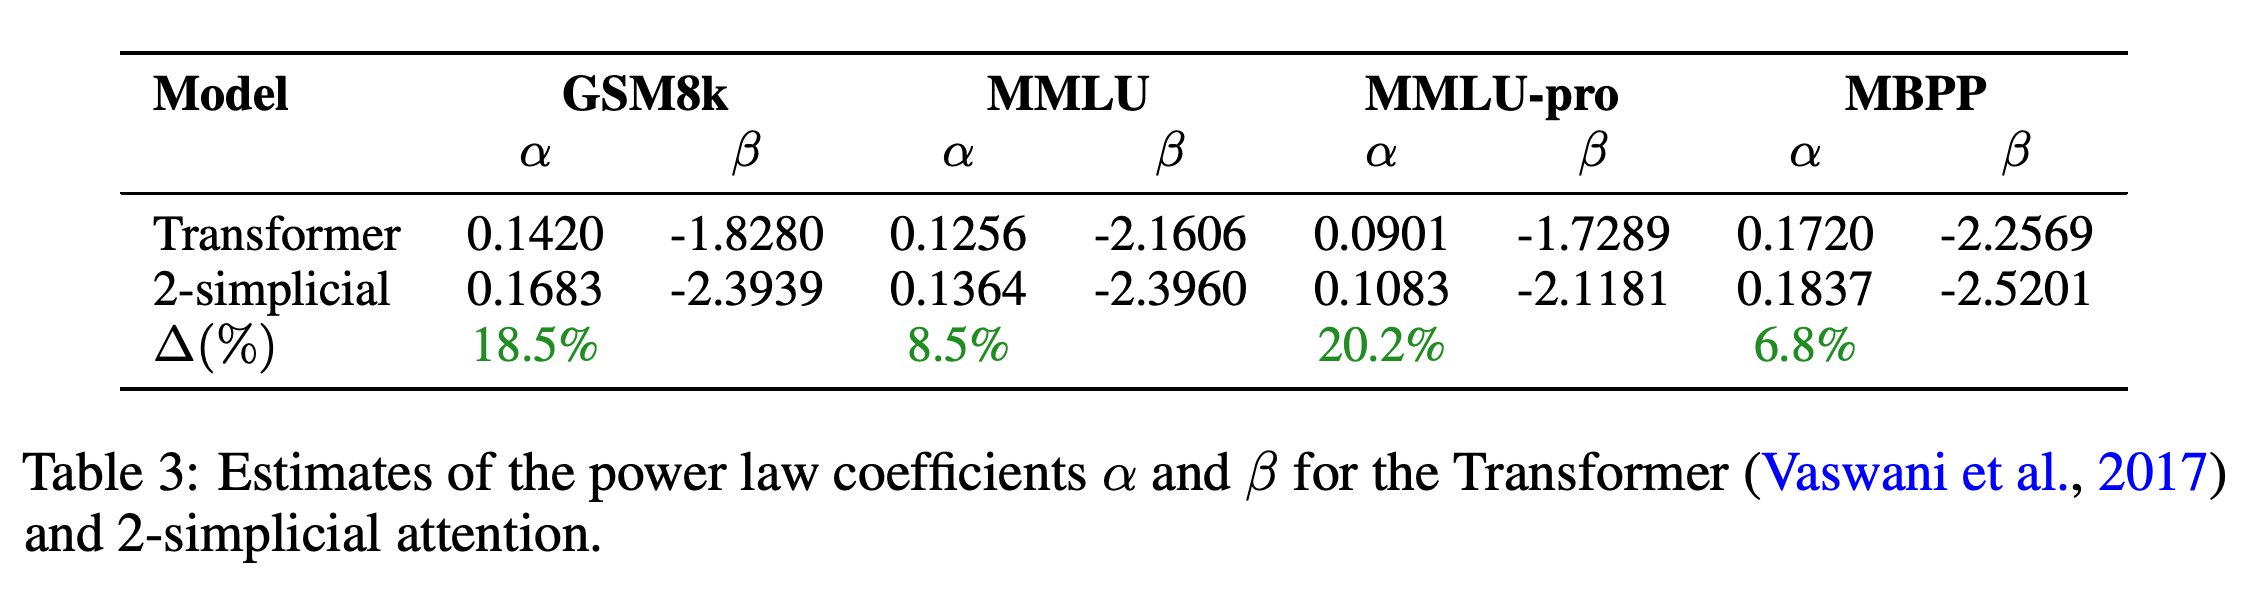
- Table 3은 활성 파라미터 수에 따라 \(-\log L(N)=\alpha\log N+\beta\)를 적합한다. 보고된 기울기는 GSM8k에서 0.1420에서 0.1683으로, MMLU에서 0.1256에서 0.1364로, MMLU-pro에서 0.0901에서 0.1083으로, MBPP에서 0.1720에서 0.1837로 증가한다.
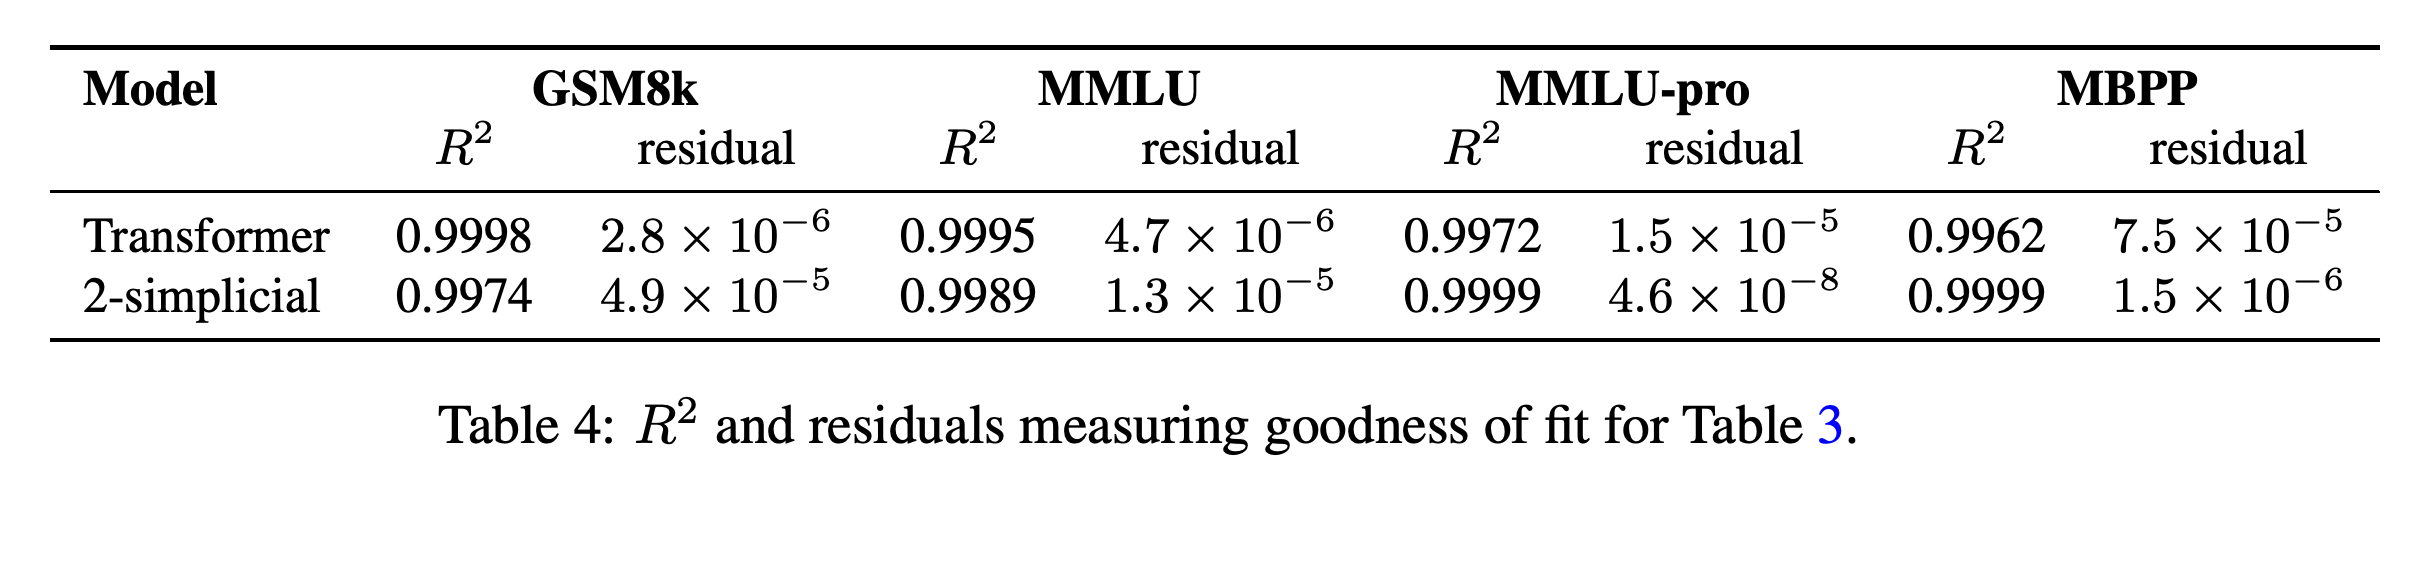
- 보고된 상대 기울기 증가율은 18.5%, 8.5%, 20.2%, 6.8%다. Table 4는 적합식이 관측 변동을 설명하는 비율인 R²를 0.9962에서 0.9999 사이로 보고한다.
- 이 적합에는 아키텍처마다 모델 크기 3개만 사용한다. 토큰 수를 고정하면 데이터 항은 0이 아니라 상수가 되며, 이후 로그 적합에서는 더해지는 상수항을 근사한다. 이 관측점들에서 R²가 높다고 해서 점근적 지수가 확립되지는 않는다. 또한 정답의 우도는 답변 정확도나 실행 가능한 코드의 성공 여부를 직접 측정하지 않는다.
모델 크기를 맞춘 비교에서는 활성 파라미터 1B에서 의미 있는 이점이 없지만, 2B와 3.5B에서는 4개 벤치마크 모두 손실이 낮아진다. 3.5B에서 GSM8k는 0.2781에서 0.2718로, MMLU-pro는 0.7858에서 0.7689로 변하며, 해당 크기에서 가장 큰 상대 감소율을 보인다. 표에 표시된 Transformer의 MBPP 손실은 0.2203이다. 상대 변화율은 표에 보고된 값이며, 반올림된 손실로 모두 정확히 재현되지는 않는다.
4개 벤치마크 모두 2-simplicial attention의 적합 기울기가 더 크다. 보고된 상대 증가율은 MBPP의 6.8%부터 MMLU-pro의 20.2%까지다. 이는 실험한 모델 크기 범위에서 손실이 더 가파르게 감소하는 경험적 경향을 나타낸다.
보고된 R² 값과 작은 잔차는 각 아키텍처에서 관측한 크기 3개에 적합식이 잘 맞음을 나타낸다. 이 값들은 관측 결과와의 일치도를 정량화하지만, 기울기의 신뢰구간이나 더 큰 모델로의 외삽에 관한 근거를 제공하지 않는다.
9 Discussion
논의에서는 토큰 효율이 특히 중요한 환경을 이 방법의 유력한 실용적 적용처로 제시한다. 저자들은 Triton 구현이 실제 서비스에 사용하기에는 아직 부족한 프로토타입이라고 명시하며, 특정 하드웨어 가속기에 맞춘 구현 공동 설계가 필요하다고 설명한다.
10 Conclusion
결론은 모델 크기와 학습 토큰 수를 맞춘 조건에서 벤치마크 음의 로그 우도가 낮아졌고, 적합한 파라미터 스케일링 기울기가 커졌다는 점을 강조한다. 상대 기울기 증가율은 MMLU-pro와 GSM8k에서 가장 크다. 추가 스케일링과 전용 구현에 따른 개선은 향후 가능성으로 남아 있다.
부록
- A ROTATION INVARIANT TRILINEAR FORMS와 A.1 PROOF FOR THEOREM 5.1은 Match3를 위한 7차원 쿼리 및 키 임베딩을 구성한다. 3차원 행렬식 항 2개가 cos(2π(x_i + x_j₁ + x_j₂)/M)에 비례하는 점수를 만들며, 7번째 차원은 값이 0인 빈 쌍을 제공한다. 점수 배율을 크게 하면 일치하는 쌍이 없을 때 attention 출력은 0에 가까워지고, 일치하는 쌍이 β_i개일 때는 β_i/(β_i + 1)에 가까워진다. 이후 순전파 신경망인 출력 다층 퍼셉트론이 명시된 임계값 1/2을 적용한다.
- B TRITON KERNEL: FORWARD PASS FOR 2-SIMPLICIAL ATTENTION은 Listing 1인 two_simplicial_attn_fwd_kernel을 제공한다. 제시된 설정은 BLOCK_SIZE_Q = 64, BLOCK_SIZE_KV = 32, num_stages = 1, num_warps = 4다. 저장할 출력과 행렬 곱셈 피연산자에는 16비트 부동소수점 형식인 bfloat16을 사용하고, 누산에는 32비트 형식인 float32를 사용한다. 이 커널은 국소 causal mask, 점진적 softmax 정규화, 값 쌍의 곱셈, 출력 및 로그 정규화 통계량 저장을 구현한다.
- C TRITON KERNEL: BACKWARD PASS FOR 2-SIMPLICIAL ATTENTION은 Listing 2인 two_simplicial_attn_bwd_kv1_kernel과 Listing 3인 two_simplicial_attn_bwd_kv2q_kernel을 제공한다. 전자는 쿼리 그래디언트에 대한 선택적 atomic 갱신을 포함한다. 후자는 w₂가 작을 때 짝수 및 홀수 타일을 별도로 처리해 atomic 덧셈을 피한다. 제시된 설정은 BLOCK_SIZE_Q = 32, BLOCK_SIZE_KV2 = 64이며, BLOCK_SIZE_KV2 == BLOCK_SIZE_Q + w2를 만족해야 한다.
짧은 생각
이 커널 설계는 일부 파라미터만 활성화하는 대규모 언어 모델에서 고차 attention을 평가할 수 있게 하며, 활성 파라미터 2B와 3.5B에서 일관된 우도 개선을 보인다. 다만 모델 크기가 3개뿐이고, 손실의 상수항을 근사하며, 불확실성을 보고하지 않아 스케일링 지수가 달라졌다는 근거는 제한적이다. 여러 토큰 예산에서의 비교, 과제 성공을 직접 측정하는 지표, 전체 학습 비용을 확인하면 관측된 토큰 효율이 추가 attention 연산을 감수할 만한지 판단하는 데 도움이 될 것이다.