HelpSteer3: Human-Annotated Feedback and Edit Data to Empower Inference-Time Scaling in Open-Ended General-Domain Tasks 요약 설명
06 Mar 2025 | Paper Review Test-Time Scaling Datasets Reinforcement Learning From Human Feedback목차
이번 글에서는 HelpSteer3: Human-Annotated Feedback and Edit Data to Empower Inference-Time Scaling in Open-Ended General-Domain Tasks 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 6일(Arxiv)
- Wang, Zhilin, Zeng, Jiaqi, Delalleau, Olivier, Egert, Daniel, Evans, Ellie, Shin, Hoo-Chang, Soares, Felipe, Dong, Yi, Kuchaiev, Oleksii.
- NVIDIA
- 논문 링크
요약
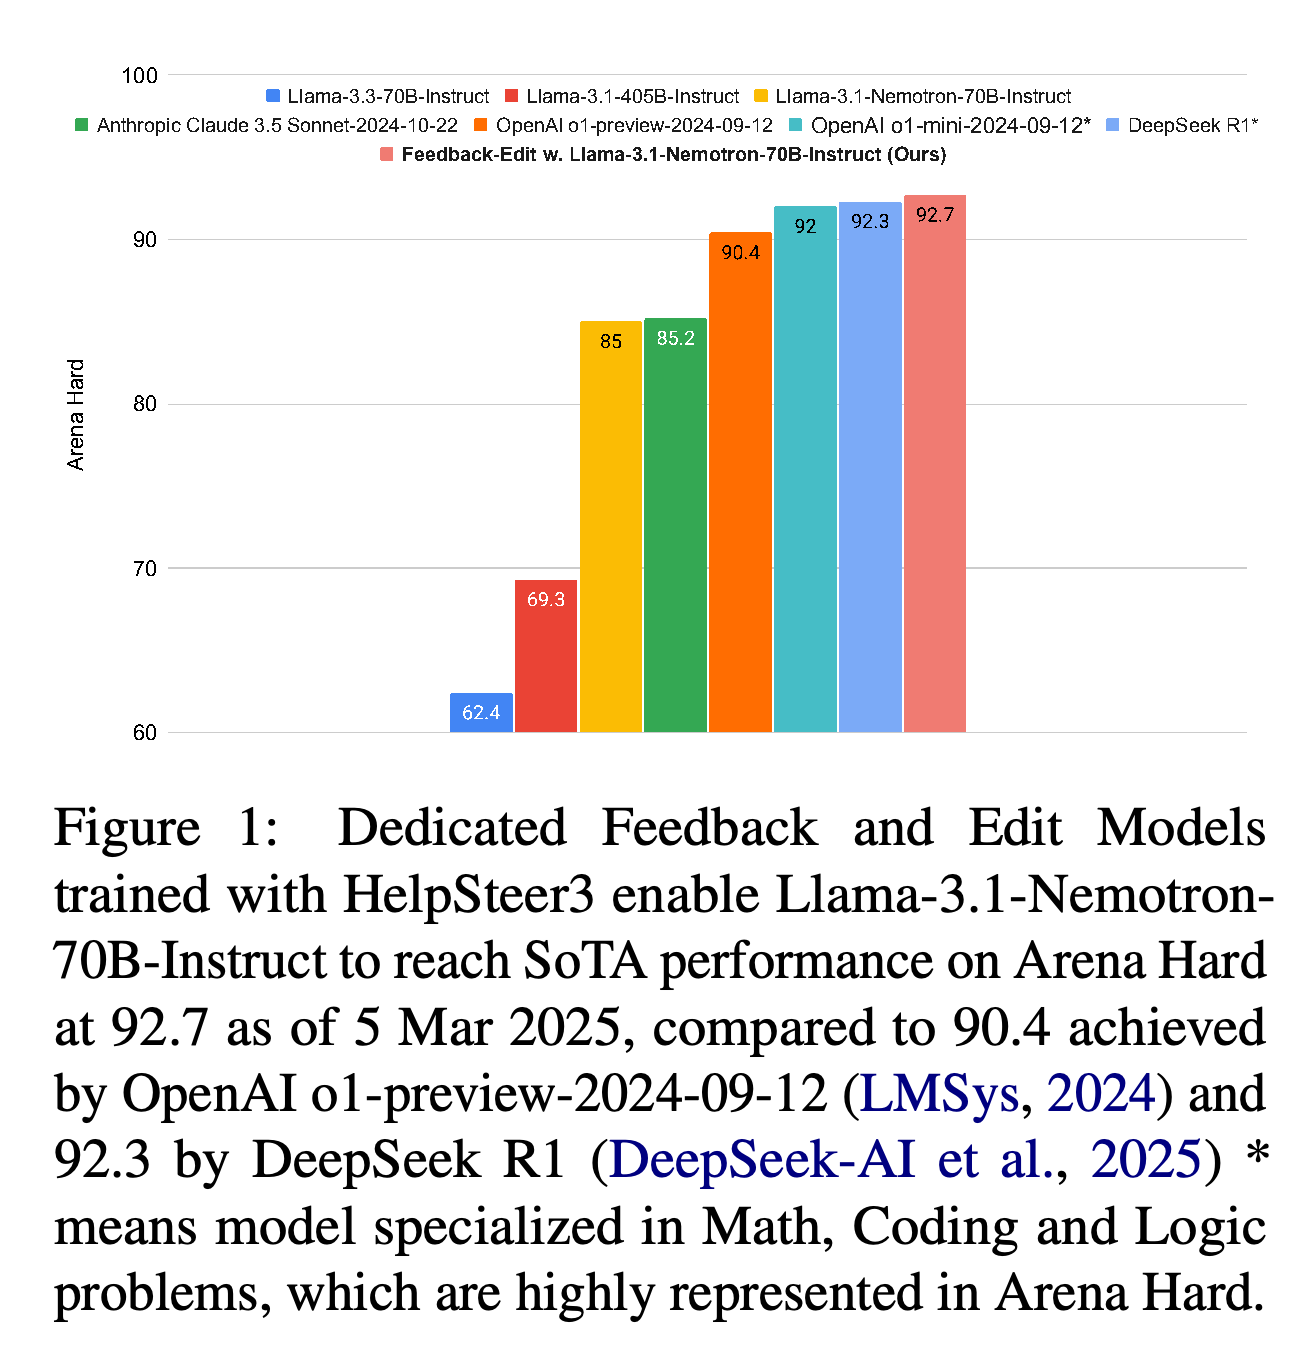
- HelpSteer3는 검증 가능한 정답에 의존하지 않고 개방형 과제에서 언어 모델의 답변을 개선하는 방법을 다룬다. 초안을 비평하고 수정하는 전용 70-billion-parameter Feedback 모델과 Edit 모델을 사용한다. 초기 답변에는 Llama-3.1-Nemotron-70B-Instruct를, 최종 선택에는 Llama-3.3-Nemotron-70B-Select를 사용하는 확장 시스템은 어려운 사용자 질문의 답변을 모델로 평가하는 벤치마크인 Arena Hard에서 92.7을 기록한다. 5 Mar 2025 기준으로 보고된 OpenAI o1-preview-2024-09-12와 DeepSeek R1의 점수는 각각 90.4와 92.3이다.
- 데이터셋에는 사람의 피드백이 달린 응답 81,642개, 사람이 수정한 원본 응답 14,461개, 수정 선호도 데이터의 바탕이 되는 원본 응답 3,274개가 포함된다. Arena Hard에서는 전용 피드백 모델과 수정 모델을 사용하는 방법이 초기 모델에 자기 답변을 비평하고 수정하도록 프롬프트로 지시하는 방법보다 성능이 높다.
- 추론 시점 확장은 답변 생성에 사용하는 연산량을 늘리는 방법이며, 여기서는 초안, 수정에 활용할 수 있는 피드백, 수정 후보를 추가로 생성한다. 매 단계에서 확률이 가장 높은 다음 토큰을 선택하는 greedy decoding보다 약 16배 많은 토큰을 생성할 때, 통합 구성은 91.0을 기록한다. 초기 답변 16개 중 최선의 답변을 선택하는 방법은 88.5를 기록한다. 최종 선택 모델을 교체하면 점수가 92.7로 높아지지만, 논문은 DeepSeek R1에 대한 통계적으로 신뢰할 만한 우위를 입증하지는 않는다.
1 Introduction
서론에서는 상세한 자연어 피드백이 선호도나 단일 수치 평점보다 응답에서 무엇을 바꿔야 하는지 더 정확하게 알려줄 수 있다고 주장한다. 추론 시점의 추론 능력을 학습하는 많은 방법은 검증 가능한 정답에 의존하므로, 연구 제안서, 연설문, 소프트웨어 계획과 같은 과제에는 적용하기 어렵다.
- 제안 시스템은 초기 응답 생성, 피드백 생성, 수정이라는 3가지 모델 역할을 분리한다.
- 주요 기여는 사람이 주석을 단 피드백과 수정 데이터, 전용 Feedback 모델과 Edit 모델, 각 생성 단계를 확장하는 실험을 결합한 데 있다.
그래프는 최종 92.7 system score를 o1-preview의 90.4, DeepSeek R1의 92.3과 함께 제시한다. 5 Mar 2025 기준으로 보고된 벤치마크 순위를 요약하지만, 불확실성을 표시하거나 비슷한 점수 사이의 통계적 차이를 입증하지는 않는다.
2 Dataset
HelpSteer3는 General, STEM, Coding, Multilingual 과제를 다룬다. STEM은 과학, 기술, 공학, 수학을 뜻한다. 공개 데이터는 피드백 생성, 피드백을 반영한 수정, 적절한 수정과 부적절한 수정의 구분을 학습하는 데 사용할 수 있다.
2.1 Data Collection
Coding과 Multilingual 프롬프트는 사용자가 자발적으로 공유한 대화 모음인 ShareGPT에서 가져오고, General과 STEM 프롬프트는 더 큰 대화 데이터셋인 WildChat에서 가져온다. 크기와 능력이 다른 모델을 사용해 프롬프트마다 응답 2개를 생성하며, temperature는 0, top p는 0.9, 최대 생성 길이는 3072토큰으로 설정한다. temperature는 샘플링의 무작위성을 조절하고, top p는 누적 확률 임계값에 따라 샘플링 범위를 제한한다. 대화 중간의 assistant 응답은 ChatGPT 대화에서 복사하지 않고 다시 생성한다.
- 잠재적으로 안전하지 않은 자료를 필터링하고, 주석 작업자에게 남아 있는 안전하지 않은 과제와 개인 식별 정보가 포함된 과제를 건너뛰도록 요청한다.
- 80개국이 넘는 국가에서 7,000명이 넘는 주석 작업자가 Scale AI와 Translated를 통해 참여한다. 각 과제에는 3–5명의 주석 작업자가 배정되며, STEM과 Coding 작업에는 관련 자격을 요구한다.
- Multilingual 응답을 포함해 피드백은 영어로 작성한다. 5단계 유용성 판단으로 시작하는 2–10문장 또는 50–250단어 분량을 요청한다. 주석 작업자는 사실 확인을 위해 인터넷 자료를 참고할 수 있지만, 대규모 언어 모델은 사용할 수 없다.
- 별도로 구성한 수정 작업자 집단은 유용성 판단이 가장 비슷한 주석 작업자 3명의 피드백을 사용해 응답을 수정한다. 주석 작업자 대부분이 완벽하게 유용하거나 유용하지 않다고 평가한 응답은 수정 대상에서 제외한다. 저자들은 전자는 의미 있게 개선하기 어렵고 후자는 전면적인 재작성이 필요하다고 판단한다.
2.2 Data Pre-processing
Feedback Demonstration은 응답마다 판단이 비슷한 비평 3개를 남기고, 그 뒤에도 상당한 의견 차이가 있는 사례는 제거한다. Edit Demonstration은 완벽하게 유용하다는 피드백을 제거하고, Llama-3.3-70B-Instruct로 주석 작업자가 작성한 변경 요약이 각 비평에서 지적한 문제를 다루는지 평가한다. 이를 통해 어떤 피드백이 적용됐는지 간접적인 레이블을 부여하는 distant supervision을 제공한다.
- 수정이 비평 순서에 의존하지 않도록 학습하기 위해, 남겨 둔 피드백 순서의 모든 순열을 포함한다.
- Edit Preference는 좋은 수정과 부정 예시를 짝짓는다. 부정 예시는 제공된 피드백에서 벗어난 수정과 원본 응답을 그대로 복사한 경우라는 2가지 유형으로 구성하며, 유형별 비중은 같다. 이 데이터셋은 General과 STEM만 다룬다.
- 원본을 그대로 복사한 부정 예시는 학습 과정에서 발생할 수 있는 편법을 방지하기 위한 것이다. 토큰 단위 모방 학습에서는 피드백이 변경을 요구하더라도 원본 답변 대부분을 유지하는 행동이 보상을 받을 수 있다.
2.3 Data Analysis
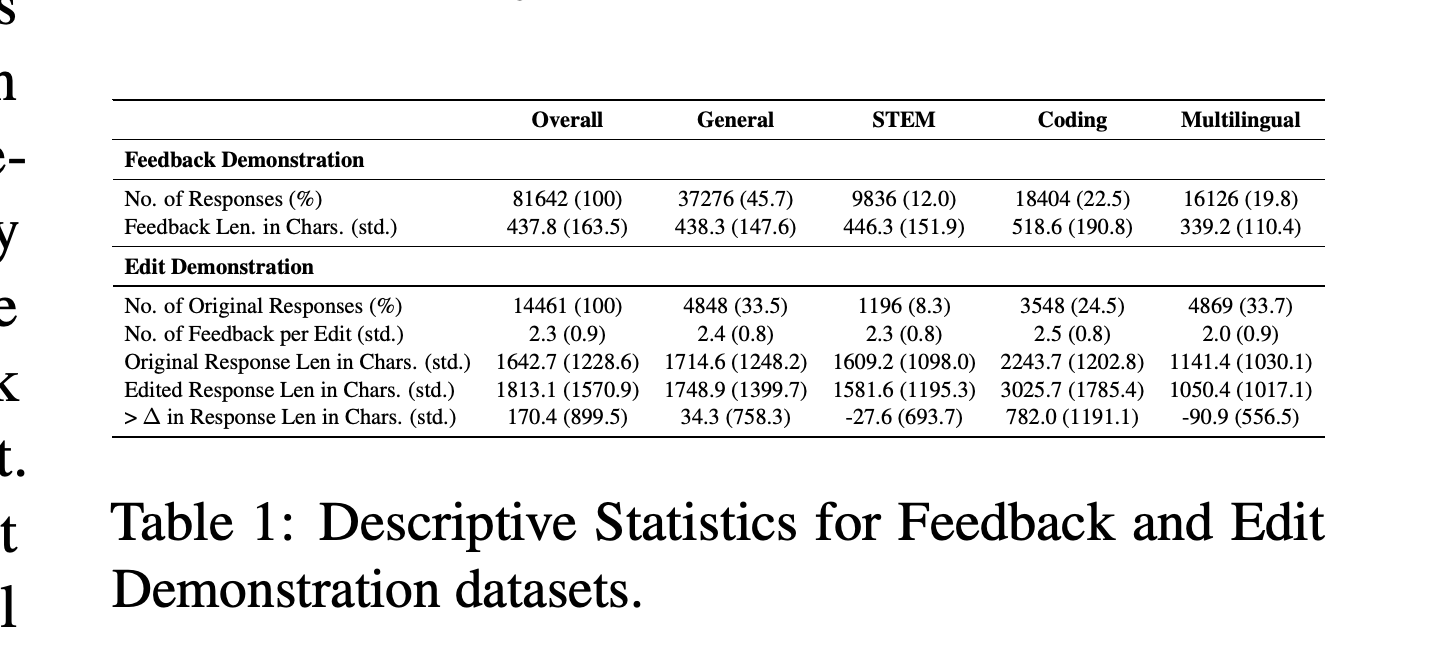
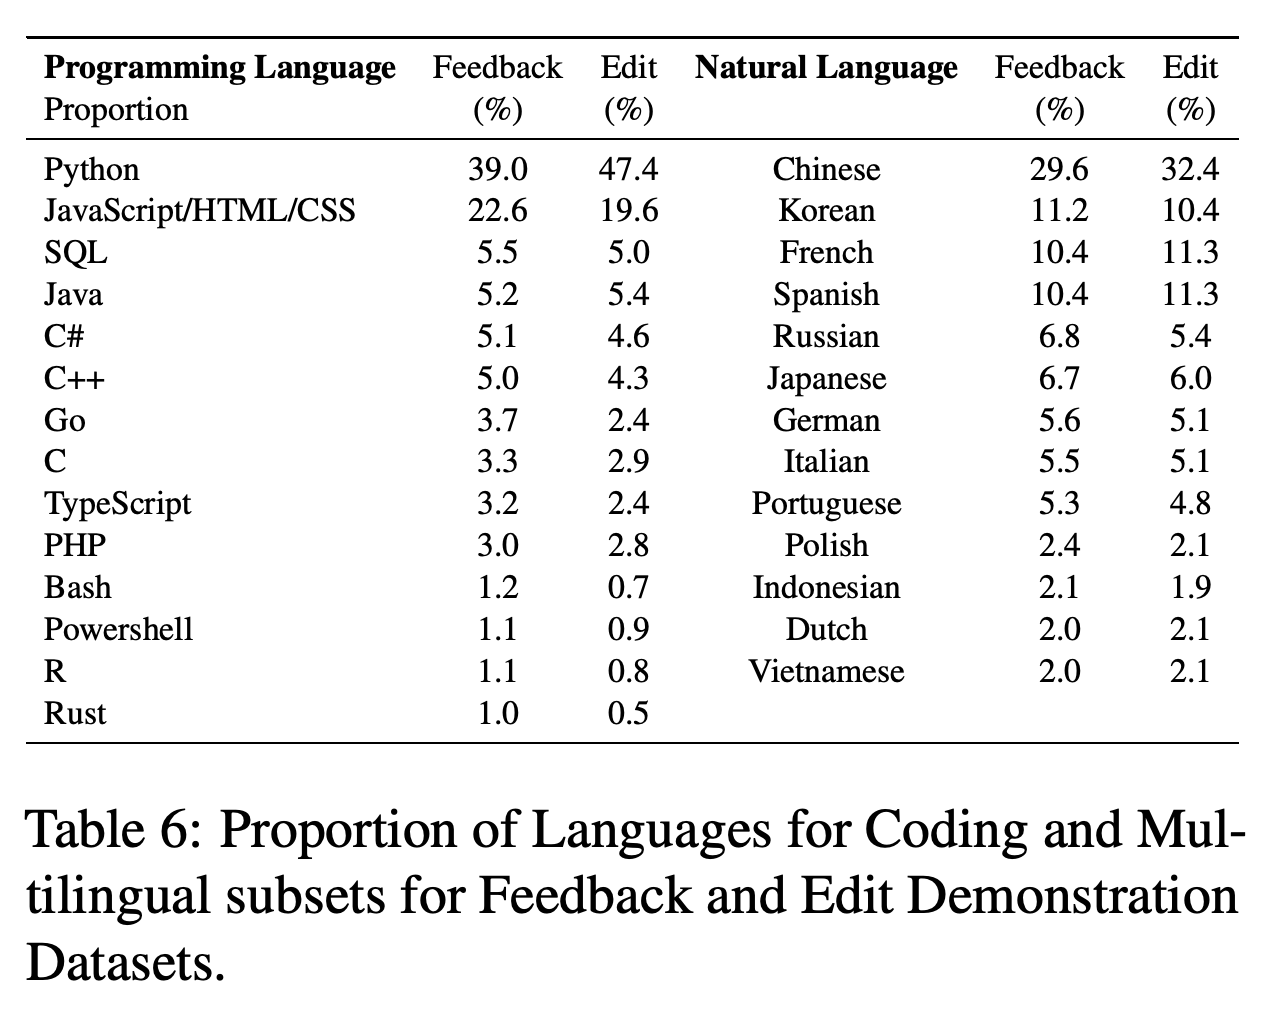
Feedback Demonstration에는 응답 81,642개, Edit Demonstration에는 원본 응답 14,461개, Edit Preference에는 원본 응답 3,274개가 포함된다. 각 demonstration 데이터셋의 절반 이상은 전문 분야 범주에서 수집했으며, 데이터셋은 프로그래밍 언어 14개와 자연어 13개를 다룬다.
- 피드백의 전체 평균 길이는 437.8자이며, Coding 피드백은 518.6자로 더 길고 Multilingual 피드백은 339.2자로 더 짧다.
- Edit Demonstration은 수정마다 평균 2.3개의 피드백을 포함한다. Coding 수정은 응답 길이를 평균 782.0자 늘리지만, General, STEM, Multilingual의 평균 변화량은 100자 이내다.
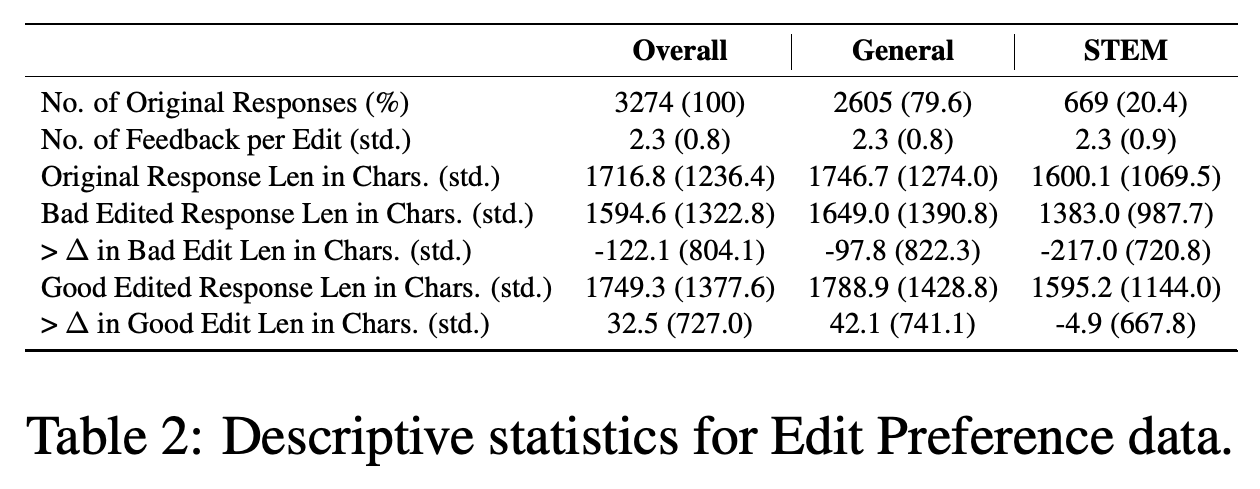
- Edit Preference에서 나쁜 수정은 답변을 평균 122.1자 줄이고, 좋은 수정은 평균 32.5자 늘린다. 저자들은 길이가 줄어드는 이유 중 하나로 수정 작업자의 불필요한 삭제를 제시하지만, 이 통계만으로 원인을 입증할 수는 없다.
범주별 분포는 demonstration 데이터셋 2개 모두에서 전문 분야 데이터가 절반 이상을 차지함을 보여준다. Coding 수정은 다른 범주의 수정보다 답변 길이를 훨씬 많이 늘리므로, 후속 평가 결과를 해석할 때 응답 길이를 고려해야 한다.
원본 응답 3,274개는 General과 STEM에 한정된다. 나쁜 수정은 응답을 평균 122.1자 줄이고, 좋은 수정은 평균 32.5자 늘린다. 이는 수정 품질과 길이 변화 사이의 연관성을 보여준다.
3 Experiments
실험에서는 학습한 피드백 모델과 수정 모델이 사용자 요청에 답하도록 학습된 기존 instruction-following 모델을 개선하는지 평가한다. 또한 구성 요소별 기여를 분리하고, 추론 시점의 연산량을 바꾸며, 시스템이 선택한 출력으로 모델을 학습하면 전체 파이프라인을 실행하지 않고도 답변을 개선할 수 있는지 검증한다.
3.1 Evaluation
평가에는 답변 길이를 보정한 모델 기반 선호도 지표인 AlpacaEval 2.0 Length Controlled, 여러 턴의 질문으로 구성된 점수형 평가인 MT Bench, Arena Hard를 사용한다. 논문은 이 평가들의 난도를 각각 대략 쉬움, 중간, 어려움으로 보고, 답변이 장황해지는 정도를 파악할 수 있도록 MT Bench 응답의 평균 길이도 보고한다.
- 기본 시스템은 초기 답변마다 temperature 0.7과 top p 0.9로 비평 10개를 샘플링한다. 답변이 완벽하게 유용하다고 판단한 비평을 제거하고, 남은 비평 중 최대 3개를 무작위로 선택한다.
- 프롬프트, 초기 답변, 선택된 비평을 입력받아 greedy decoding으로 수정 답변을 생성한다. 저장된 학습 상태 중 검증 성능이 좋은 체크포인트를 선택할 때도 MT Bench를 사용한다.
3.2 Model Training
Feedback 모델과 Edit 모델은 Llama-3.3-70B-Instruct에서 시작해 주석이 달린 출력을 모방하는 지도 미세조정을 거친다. 수정에 점수를 매기는 Edit Reward Model과 그 점수로 학습하는 강화학습 Edit 모델은 2개 모두 지도학습을 마친 Edit 모델에서 시작한다. 각 데이터셋은 학습용 95%와 검증용 5%로 나눈다.
- Feedback 미세조정은 global batch size 128로 학습 데이터를 1회 통과하는 1 epoch, 1,858 steps 동안 진행하며, step 1,400을 선택한다. Edit 미세조정은 global batch size 128로 1 epoch, 385 steps 동안 진행하며, step 385를 선택한다.
- 보상 모델은 쌍별 선호도 모델인 Bradley-Terry modeling을 사용해 global batch size 128로 최대 94 steps 동안 학습하며, step 80에서 검증 손실이 가장 낮다. 각 배치에는 동일한 문맥의 좋은 수정에 대해 나쁜 수정과 원본 복사본을 각각 비교하는 데이터가 모두 포함된다.
- Edit 강화학습은 보상에 따라 정책을 최적화하는 REINFORCE Leave One Out을 사용해 global/rollout batch size 64로 최대 47 steps 동안 진행한다. step 45를 선택한다.
4 Results
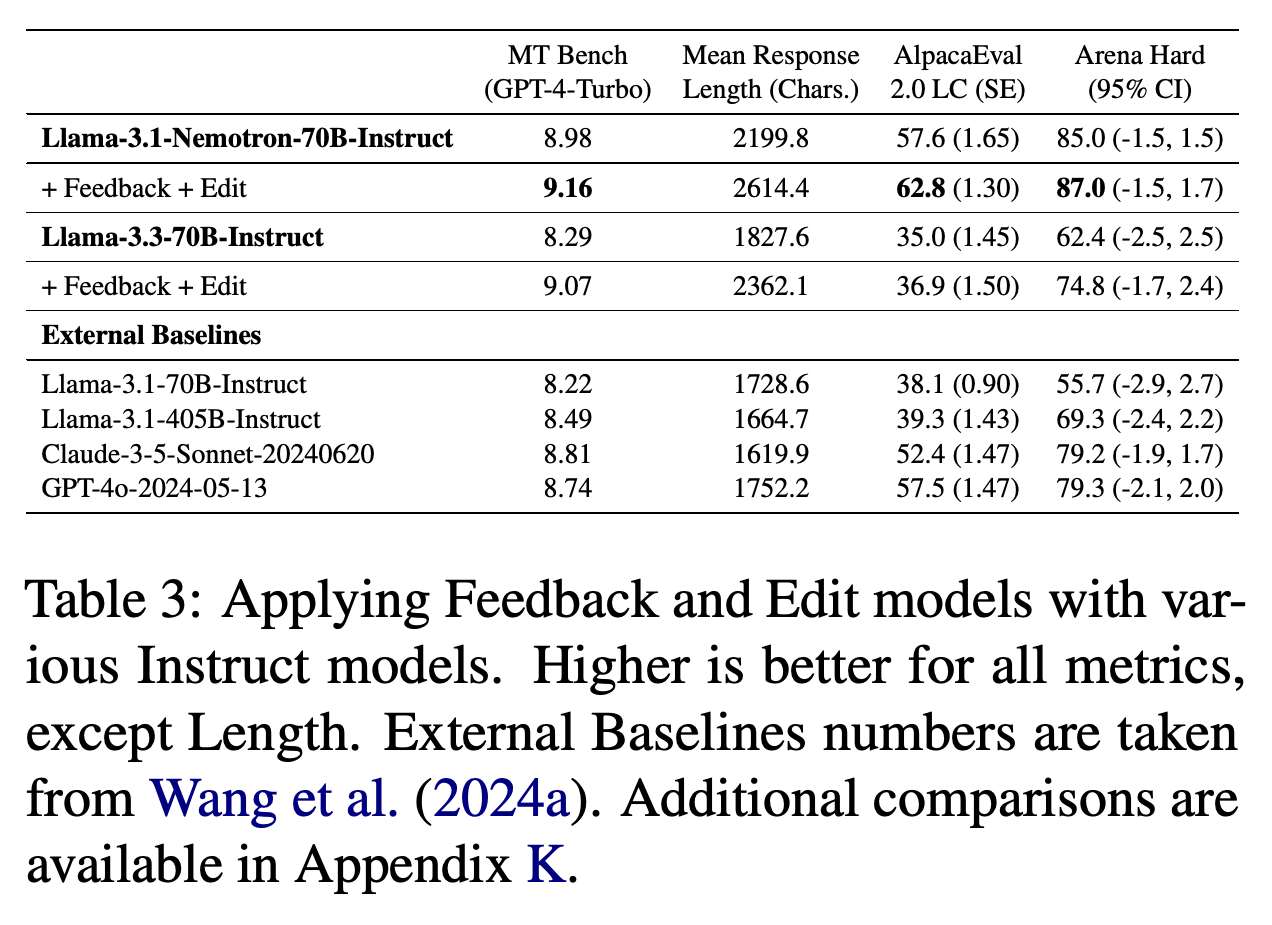
기본 Feedback + Edit 시스템을 적용하면 Llama-3.1-Nemotron-70B-Instruct의 점수가 MT Bench에서 8.98에서 9.16으로, AlpacaEval 2.0 Length Controlled에서 57.6에서 62.8로, Arena Hard에서 85.0에서 87.0으로 높아진다. 같은 평가에서 Llama-3.3-70B-Instruct의 점수는 각각 8.29에서 9.07로, 35.0에서 36.9로, 62.4에서 74.8로 높아진다.
- MT Bench 답변의 평균 길이는 Nemotron에서 2199.8자에서 2614.4자로, Llama-3.3에서 1827.6자에서 2362.1자로 늘어난다.
- AlpacaEval의 성능 향상은 길이 보정 후에도 유지된다. Arena Hard에 보고된 신뢰구간은 추정 점수의 불확실성을 나타내므로, 작은 점수 차이는 신중하게 해석해야 한다.
초기 모델 2개 모두 Feedback + Edit 적용 후 품질 평가 3개에서 성능이 높아진다. Llama-3.3-70B-Instruct는 Arena Hard 점수가 62.4에서 74.8로 더 크게 높아지며, 이는 초기 모델에 따라 개선 폭이 달라짐을 보여준다.
5 Ablation Studies
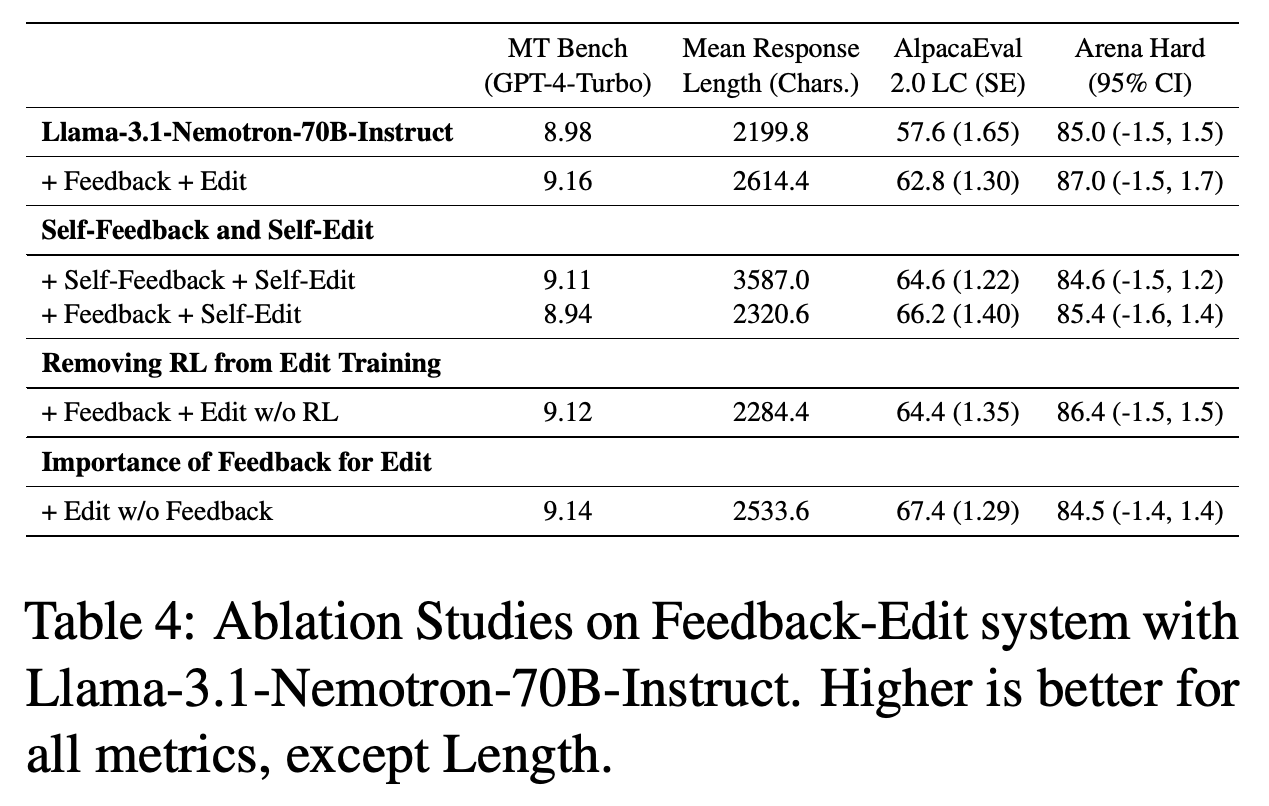
절제 실험은 구성 요소의 선택이 벤치마크마다 다른 영향을 준다는 점을 보여준다. 초기 모델에 자기 답변을 비평하고 수정하도록 지시하는 Self-Feedback + Self-Edit는 Nemotron의 AlpacaEval 점수를 57.6에서 64.6으로, MT Bench 점수를 8.98에서 9.11로 높인다. 그러나 Arena Hard 점수는 85.0에서 84.6으로 낮아지며, 답변 길이는 상당히 늘어난다.
- 학습한 피드백과 프롬프트 기반 Self-Edit를 함께 사용하면 Arena Hard에서 85.4, MT Bench에서 8.94를 기록한다. 이는 전용 Feedback + Edit 시스템의 87.0과 9.16보다 낮다.
- 지도학습만 적용한 Edit 모델은 수정에 활용할 수 있는 피드백이 있어도 응답의 약 30%를 그대로 유지한다. 저자들은 강화학습 후 이러한 복사가 사라진다고 보고한다. Arena Hard 점수는 86.4에서 87.0으로 높아지지만, AlpacaEval 점수는 64.4에서 62.8로 낮아진다.
- 피드백 없이 수정을 학습하면 AlpacaEval에서 67.4, Arena Hard에서 84.5를 기록한다. 강화학습 없이 피드백을 조건으로 수정한 경우에는 각각 64.4와 86.4를 기록한다. 어려운 평가에서는 피드백을 조건으로 사용하는 편이 유리하지만, 더 쉬운 프롬프트에서는 결과가 다르다.
절제 실험의 순위는 평가마다 다르다. 피드백 없는 수정은 제시된 AlpacaEval 점수가 가장 높고, 학습한 전체 시스템은 Arena Hard와 MT Bench 점수가 가장 높다. 따라서 이 실험에서 피드백과 전용 수정의 이점은 과제에 따라 달라진다.
6 Scaling
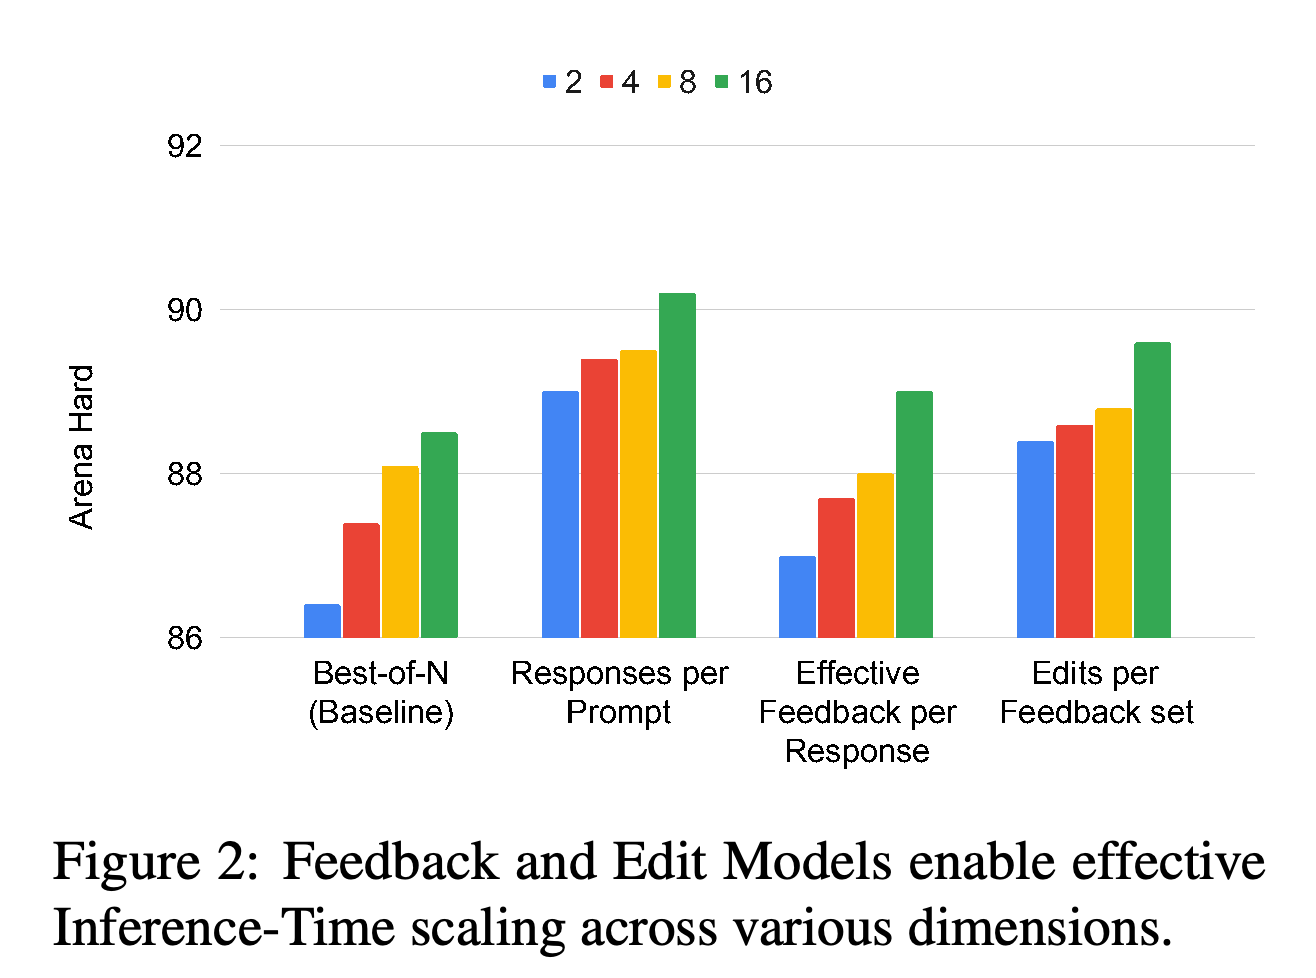
확장 실험에서는 Arena Hard에서 초기 답변 수, 수정에 활용할 수 있는 제안을 뜻하는 유효 피드백 수, 수정 후보 수를 바꾼다. 여러 답변을 생성하고 점수가 가장 높은 답변을 선택하는 Best-of-N sampling을 베이스라인으로 사용하며, 선택 모델로는 Llama-3.1-Nemotron-70B-Reward를 사용한다.
- 베이스라인의 후보 수를 2개에서 16개로 늘리면 Arena Hard 점수가 86.4에서 88.5로 높아진다. 각 후보에 Feedback-Edit를 적용한 뒤 선택하면 해당 점수가 89.0에서 90.2로 높아진다.
- 유효 피드백을 2개에서 16개로 늘리면 Arena Hard 점수가 87.0에서 89.0으로 높아진다. 유효 비평 4개, 8개, 16개를 얻기 위해 비평을 각각 16개, 32개, 64개 생성하고, 비판을 나타내는 키워드인 ‘However’, ‘improve’, ‘lack’, ‘benefit’, ‘but’으로 순위를 매긴다.
- 피드백 집합마다 생성하는 수정 수를 2개에서 16개로 늘리면 Arena Hard 점수가 88.4에서 89.6으로 높아진다. 초기 답변과 수정은 temperature 0.7과 top p 0.9로 샘플링한 뒤 보상에 따라 선택한다.
각 실험군은 서로 다른 후보 수를 2개에서 16개로 늘리며, Arena Hard의 점 추정치가 높아지는 모습을 보여준다. 프롬프트당 응답 수를 늘린 구성은 Best-of-N 베이스라인의 88.5보다 높은 90.2에 도달한다. 다만 그래프는 모든 축을 연산량으로 정규화하거나 신뢰구간을 표시하지는 않는다.
초기 응답 8개에 각각 유효 피드백 16개를 결합하면 기본 greedy 생성보다 약 16배 많은 토큰을 생성하며, 점수는 91.0이다. 보고된 95% 신뢰구간의 하한과 상한 편차는 -1.0과 +1.2다. 비슷한 생성 토큰 예산에서 Best-of-N 16의 점수는 88.5이며, 편차는 -1.2와 +1.5다.
- Llama-3.1-Nemotron-70B-Reward를 Llama-3.3-Nemotron-70B-Select로 교체하면 통합 시스템의 점수가 92.7로 높아지며, 95% 신뢰구간의 편차는 -1.2와 +0.9다.
- OpenAI o1-preview-2024-09-12의 점수는 90.4이며, 편차는 -1.1과 +1.3이다. DeepSeek R1은 92.3을 기록하지만 신뢰구간은 보고되지 않았다. 따라서 제안 시스템과의 0.4점 차이로 통계적 우위를 입증할 수는 없다.
- 저자들은 temperature 0.7에서 샘플 수가 16개를 넘으면 피드백 다양성이 거의 늘어나지 않는다고 관찰한다. 비평 32개를 생성할 때는 0.7에서 얻은 샘플 16개와 0.6에서 얻은 샘플 16개를 결합한다. 64개를 생성할 때는 0.5, 0.6, 0.7, 0.8에서 각각 16개를 사용한다.
Human Evaluation은 이전에 사용하지 않은 첫 턴 General 프롬프트 50개에서 초기 Nemotron 모델과 최적으로 확장한 시스템을 비교한다. 프롬프트마다 독립적인 판단 3개를 수집하며, 전체 사내 주석 작업자는 8명이다. 주석 작업자 중 적어도 1명이 답변 2개를 모두 유효하지 않다고 판단한 프롬프트 6개를 제외한다. 남은 44개에서는 시스템이 개선 16건, 동률 21건, 악화 7건을 보인다.
- 답변 순서를 무작위로 섞고, 판단 3개의 평균을 가장 가까운 선호도 등급으로 반올림해 최종 선호도를 구한다.
- 개선 판단은 약간 더 좋음 13건, 더 좋음 2건, 훨씬 더 좋음 1건으로 구성된다. 악화 판단은 약간 더 나쁨 6건, 더 나쁨 1건으로 구성된다.
- 선호도 설명에서는 개선의 주요 이유로 사실성, 일관성, 간결성을 꼽는다. 표본이 작고 General에만 한정되어 있으므로, 더 넓은 범위의 사람 선호도로 일반화하기는 어렵다.
7 Distillation
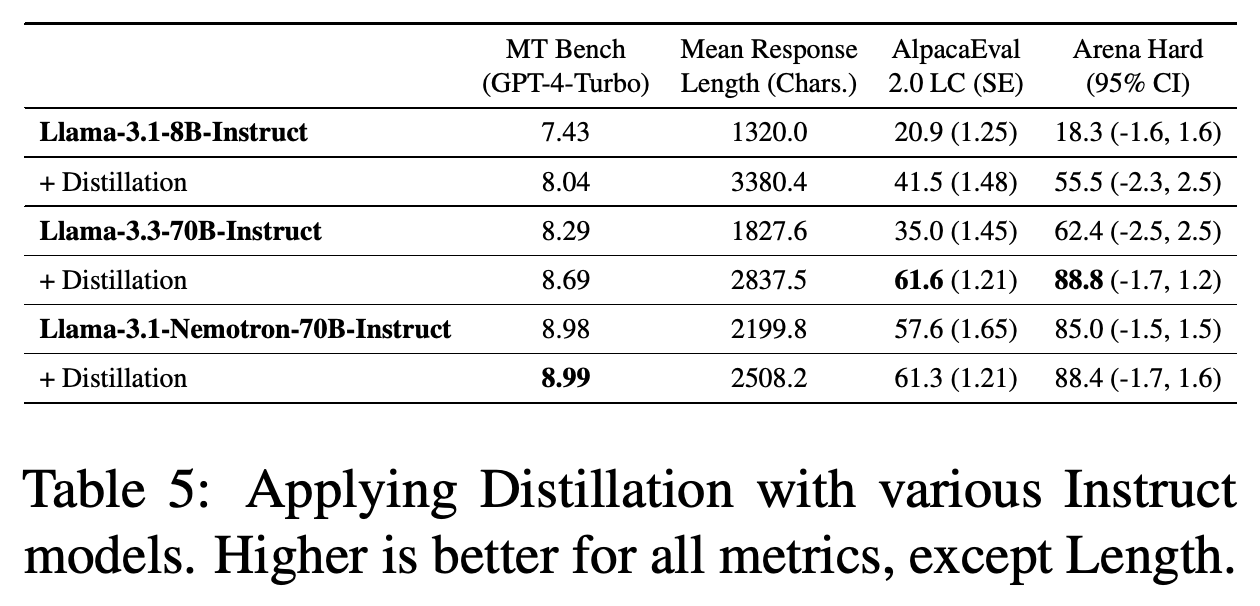
확장 시스템이 선택한 답변을 모델이 모방하도록 학습하는 증류에는 서로 다른 첫 턴 프롬프트 22,644개를 사용하며, 학습용은 21,850개, 검증용은 794개다. 초기 모델 3개를 global batch size 128로 1 epoch, 170 steps 동안 지도 미세조정한다. 이를 통해 추론 시 피드백과 수정 파이프라인 없이 단일 모델을 사용할 수 있다.
- Arena Hard 점수는 Llama-3.1-8B-Instruct에서 18.3에서 55.5로, Llama-3.3-70B-Instruct에서 62.4에서 88.8로, Llama-3.1-Nemotron-70B-Instruct에서 85.0에서 88.4로 높아진다. 선택된 체크포인트는 각각 step 120, 150, 160이다.
- 모델 3개 모두 MT Bench와 AlpacaEval에서도 성능이 높아진다. Llama-3.3-70B-Instruct의 AlpacaEval 점수는 35.0에서 61.6으로 높아진다.
- 증류는 여러 단계의 추론 절차를 제거하지만, 생성 답변은 더 길어진다. 성능 향상 폭은 대체로 추론 시 최적으로 확장한 시스템을 적용할 때보다 작다.
증류는 초기 모델 3개 모두의 품질 평가 성능을 높이면서 답변 길이도 늘린다. 8B 모델의 Arena Hard 점수가 18.3에서 55.5로 높아진 결과는, 선택된 파이프라인 출력으로 작은 모델을 개선하고 추론 시에는 파이프라인을 제거할 수 있음을 보여준다.
8 Conclusion
논문은 전용 Feedback 모델과 Edit 모델이 개방형 일반 도메인 과제의 추론 시점 확장을 지원한다고 결론짓는다. 가장 성능이 높은 구성은 Arena Hard에서 92.7을 기록하며, 기본 파이프라인과 증류 모델은 평가 3개 모두에서 점 추정치를 높인다.
Ethical Considerations
Ethical Considerations에서는 조절 가능한 추론 연산량, 모델 구성 요소별 독립 서빙, 후보의 병렬 생성을 잠재적인 배포상 이점으로 설명한다. 저자들은 후보를 병렬로 실행하면 지연 시간이 greedy 생성의 약 2배라고 추정하지만, 통제된 지연 시간 벤치마크는 제시하지 않는다.
- HelpSteer3는 https://huggingface.co/datasets/nvidia/HelpSteer3 에서 CC-BY-4.0으로 공개된다. 모델에는 각각의 Llama Community License Agreements가 적용된다.
- 저자들은 공급업체의 윤리 검토, 모델 학습에 대한 주석 작업자의 동의, 모델을 활용한 주석 작성을 방지하는 조치를 보고한다. 공급업체의 보상, 작업자 지원, 이의 제기 정책도 설명한다.
- 이해하기 쉬운 피드백을 선택하는 방법을 개인화된 수정의 수단으로 제안하지만, 개인화는 실험으로 평가하지 않는다.
Limitations
저자들은 비평의 과잉 샘플링, 필터링, 키워드 기반 순위 결정이 연산 측면에서 비효율적이라고 지적한다. 또한 2000단어보다 긴 응답이 필요한 프롬프트, 대화 전체에서 입력이 4,000단어를 넘는 프롬프트, 2024년 7월 이후 지식이 필요한 프롬프트는 데이터에 포함하지 않는다.
- ShareGPT와 WildChat의 질문은 각각 2023년 4월과 2024년 4월 이전에 수집했으므로, 더 최근의 요청을 충분히 다루지 못한다.
- 확장 실험은 프롬프트의 50% 초과가 코딩과 관련된 Arena Hard에 집중한다. 따라서 개방형 일반 도메인 과제 전반에서 확장이 유효하다는 근거는 제한적이다.
- 논문은 Feedback-Edit를 다른 추론 시점 확장 방법과 상호 보완적인 방법으로 제시한다. 보편적으로 최적인 연산량 배분을 입증하지는 않는다.
부록
- A Prompt Preprocessing: Nemotron 4 340B Instruct로 프로그래밍 언어와 자연어를 식별한 뒤, 사람이 표기를 정규화하고 언어별 집단 안에서 샘플링한다. General과 STEM을 선별할 때는 영어가 아닌 요청, 코드 생성 요청, 10자보다 짧은 프롬프트, 챗봇의 정체성과 관련된 프롬프트를 제외한다. 토픽 모델링 방법인 BERTopic으로 약 4,400개 토픽을 구성한다. 토픽별로 균등하게 샘플링하되, 복잡성이 5점 만점에 4점 또는 5점인 프롬프트는 더 많이 샘플링한다.
- B Prompt Templates: 부록은 언어 식별, 복잡성 점수 산정, 피드백 반영 여부 확인, 피드백 생성, 피드백을 사용하거나 사용하지 않는 수정의 템플릿을 제공한다. 수정에는 보통 최대 3개의 피드백을 입력하며, 사용할 피드백이 없으면 채움값으로 <None>을 그대로 사용한다.
- C Bad Edit Details: 의견이 엇갈린 사례를 검토한 연구진은 수정 작업자보다 피드백 주석 작업자의 판단이 맞는 경우가 더 많다는 점을 발견한다. 저자들은 수정 작업자에게 대규모 수정이 필요한 문제를 피하려는 유인이 있다고 설명한다. 이 설명은 의견 불일치 표본을 검토한 결과에 근거한다.
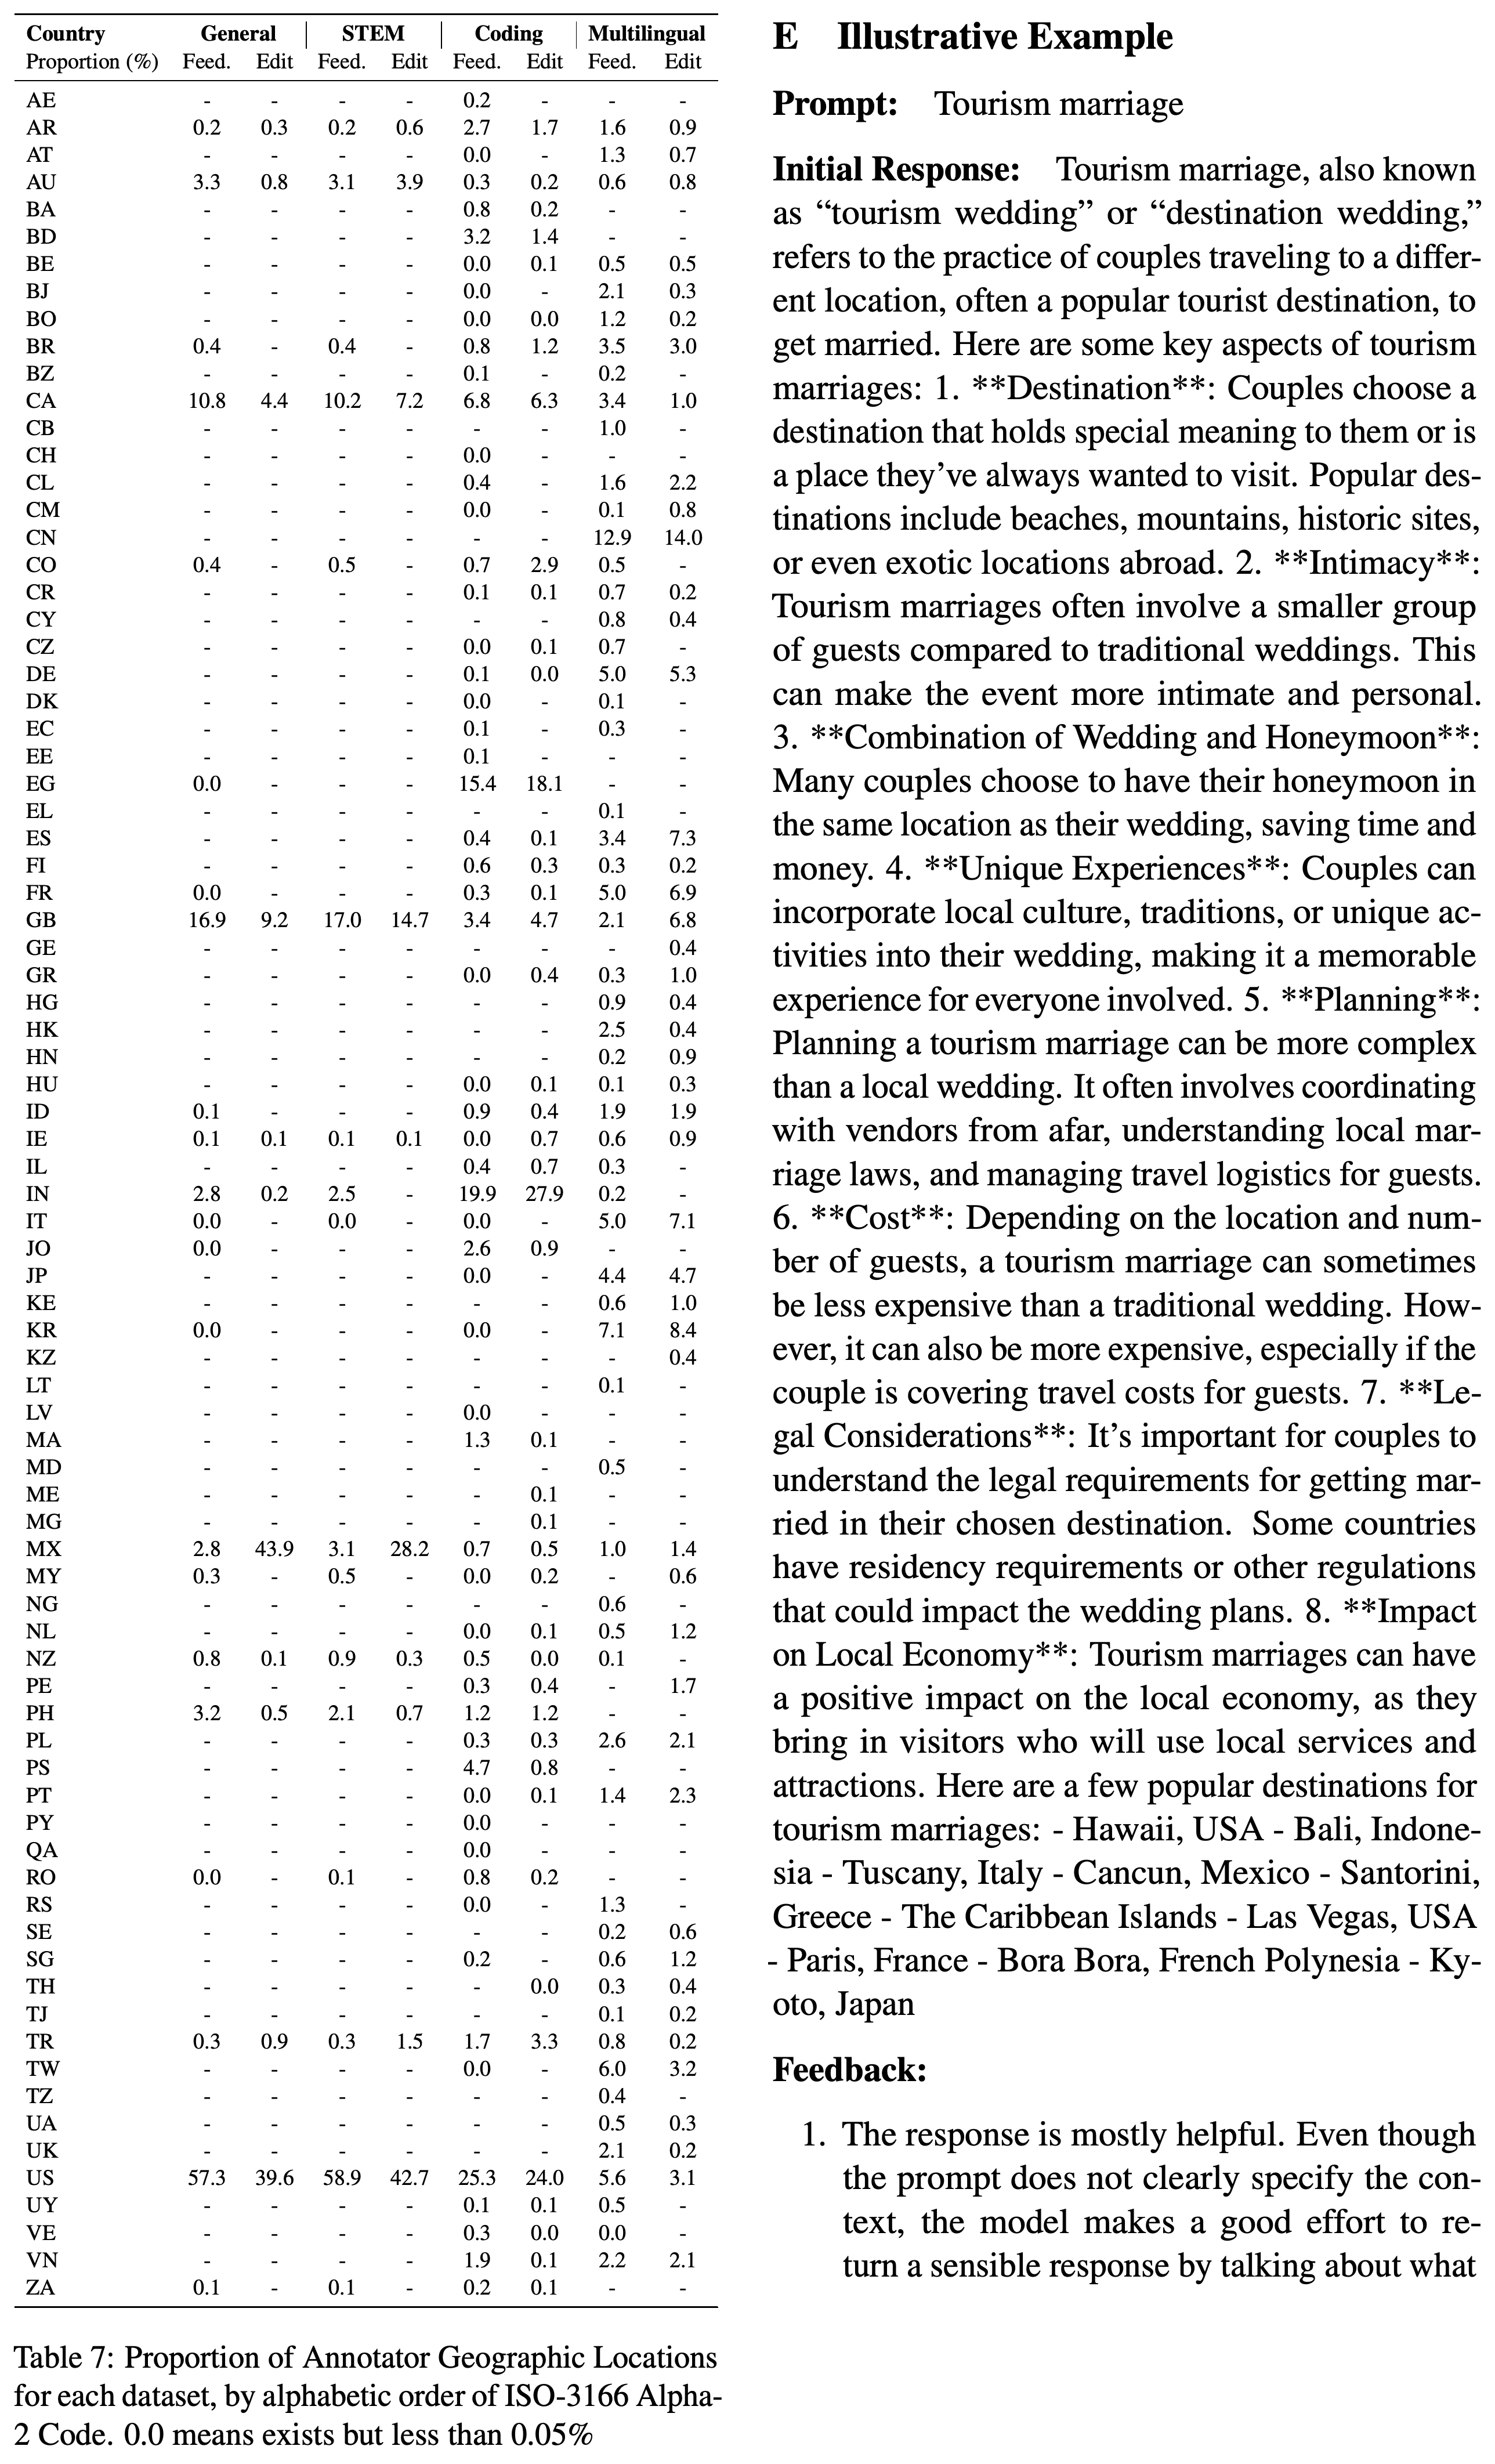
- D Further Dataset Statistics: 프로그래밍 언어 14개와 자연어 13개를 다루지만, 언어별 비중은 고르지 않다. Python은 Coding 피드백의 39.0%, 수정의 47.4%를 차지하며, 중국어는 Multilingual 피드백의 29.6%, 수정의 32.4%를 차지한다. 주석 작업자의 지역 분포도 범주마다 크게 다르다.
- E Illustrative Example: ‘Tourism marriage’ 프롬프트는 제공된 피드백이 좋은 수정의 범위를 어떻게 제한하는지 보여준다. 좋은 수정은 피드백에서 지적한 불필요한 항목을 제거하지만, 나쁜 수정은 피드백 범위를 넘어 추가로 내용을 바꾼다. 완벽하게 유용하다는 비평은 수정에 사용하지 않는다.
- F Aligned Model Evaluation Details: MT Bench는 2턴 질문 80개, 즉 프롬프트 160개로 구성되며, GPT-4-0125-Preview로 1점에서 10점까지 점수를 매긴다. greedy 답변은 1024토큰으로 제한한다. AlpacaEval은 첫 턴 지시 805개를 포함하고, GPT-4-1106-turbo와 길이 보정을 사용한다. Arena Hard는 첫 턴 지시 500개를 포함하고, GPT-4-1106-preview로 GPT-4-0314의 답변과 비교한다. AlpacaEval과 Arena Hard는 답변을 2048토큰으로 제한한다.
- G Training Details: 실험은 모델 정렬 학습 프레임워크인 Nemo-Aligner와 nvcr.io/nvidia/nemo:24.05.llama3.1을 사용한다. 최대 시퀀스 길이는 4096이며, 가중치 감쇠를 사용하는 최적화 방법인 AdamW와 warmup 10 steps를 적용한다. 각 데이터셋에서 이보다 긴 시퀀스는 3% 미만이며 제거한다. 선택한 고정 학습률은 Feedback/Edit 지도 미세조정과 8B 증류에서 1e-6, Edit Reward Model 학습과 70B 증류에서 3e-6, Edit 강화학습에서 5e-7이다. 기준 모델에서 벗어나는 정도를 제한하는 Kullback-Leibler divergence 계수는 0.01이다. 강화학습에서는 프롬프트마다 응답 4개를 샘플링하며, 최대 생성 길이는 2048토큰, temperature는 1, top p는 0.9로 설정한다. 추론 프레임워크인 vLLM은 0.6.6.post1 컨테이너를 사용한다.
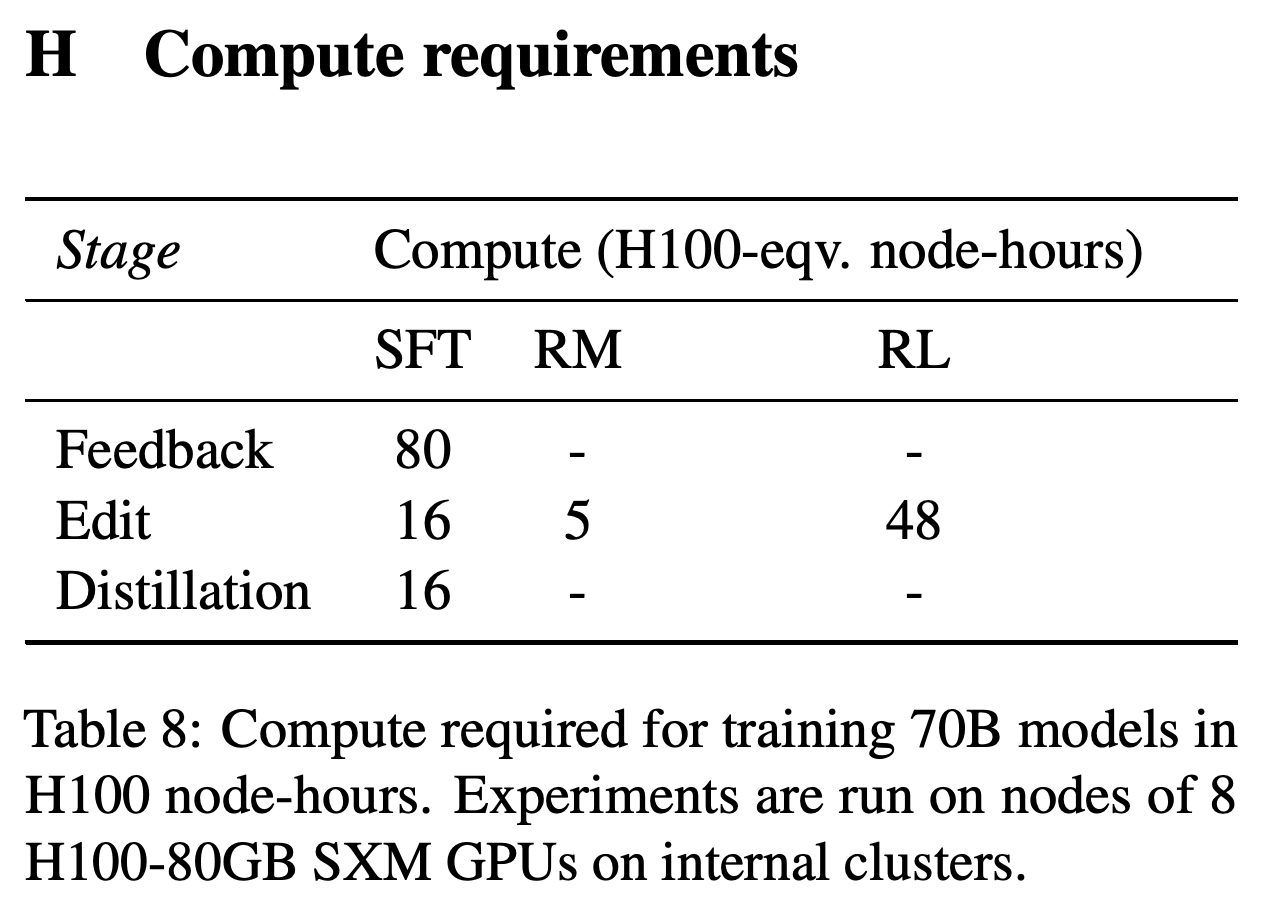
- H Compute requirements: 70B 모델 학습에 필요한 H100-equivalent node-hours는 Feedback 지도 미세조정 80, Edit 지도 미세조정 16, Edit Reward Model 학습 5, Edit 강화학습 48, 증류 16이다. node-hour는 연산 노드 1개를 1시간 실행한 양을 뜻하며, 각 노드에는 H100-80GB SXM 그래픽 처리 장치 8개가 포함된다.
- I Example Feedback by prompting Llama-3.1-Nemotron-70B-Instruct: 프롬프트로 생성한 비평 1개가 문헌 검토 답변의 인용, 깊이, 방법론, 함의 등을 포함한 강점과 약점을 다룬다. 이 예시는 프롬프트로 생성한 피드백의 길이와 범위를 보여주며, 비평의 사실 정확성을 독립적으로 검증한 결과는 아니다.
- J Example Feedback by Feedback Model: 같은 문헌 검토 답변에 대한 더 짧은 비평들이 중복, 난점에 대한 논의 부족, 관련성이 낮은 참고문헌을 지적한다. 이 예시들은 샘플링한 비평이 수정에 활용할 수 있는 서로 다른 제안을 제공할 수 있음을 보여준다.
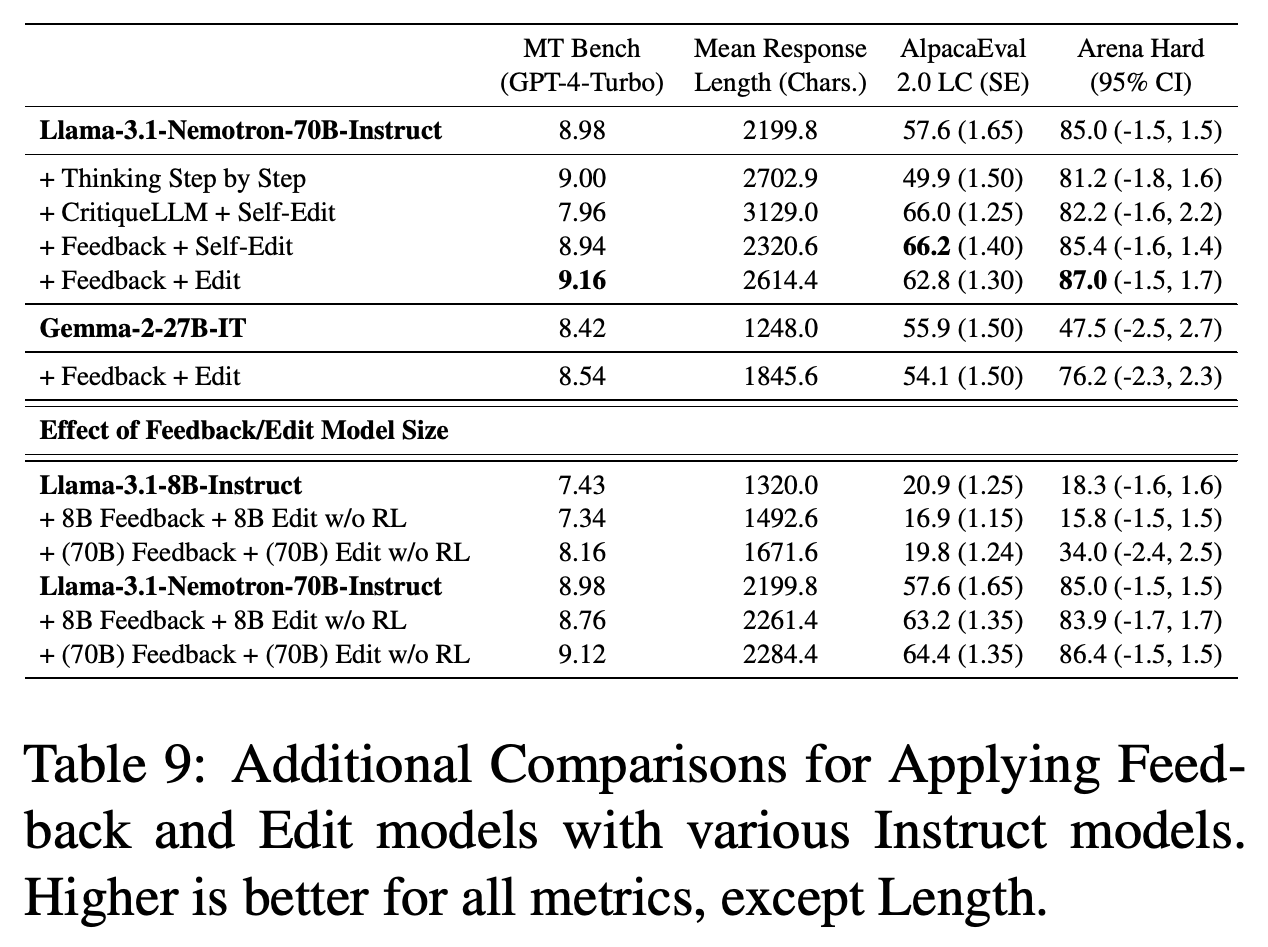
- K Additional Comparisons: ‘Let’s think step by step’이라는 프롬프트를 사용하면 Nemotron의 Arena Hard 점수가 85.0에서 81.2로 낮아진다. 별도의 비평 생성 모델인 CritiqueLLM과 프롬프트 기반 Self-Edit를 사용하면 82.2를 기록한다. 전용 파이프라인을 Gemma-2-27B-IT에 적용하면 Arena Hard 점수가 47.5에서 76.2로 높아진다. 강화학습을 제외하고 조건을 맞춘 비교에서 8B Feedback 모델과 Edit 모델은 대체로 70B 모델보다 성능이 낮으며, 초기 모델을 일관되게 개선하지 못한다.
짧은 생각
구성 요소 비교는 전용 피드백과 수정의 효과를 가장 명확하게 보여준다. 프롬프트 기반 자기 수정과 피드백 없는 수정이라는 방법 2개 모두 Arena Hard에서 전체 시스템보다 점수가 낮다. 대표 성과로 제시한 순위는 더 신중하게 해석해야 한다. 최종 응답 선택 모델이 바뀌고, DeepSeek R1과의 차이는 0.4점에 불과하며 해당 비교 모델의 신뢰구간이 보고되지 않았다. 사람 평가에서 남겨진 프롬프트도 44개뿐이다. 배포를 결정하려면 확장 파이프라인과 증류 모델을 동일한 지연 시간과 연산 예산에서 측정해야 한다. 특정 비교에서 생성 토큰 수가 비슷하다는 사실만으로 전체 서빙 비용이 같다고 볼 수는 없다.
Coding 하위 집합에서는 Python과 JavaScript/HTML/CSS의 비중이 높고, Multilingual에서는 중국어 집단이 가장 크다. 이 분포는 다양한 언어를 다루면서도 언어별 비중은 고르지 않음을 보여준다.
주석 작업자의 지역은 범주와 역할에 따라 크게 다르다. US는 General 피드백의 57.3%를 제공하고, 멕시코는 General 수정의 43.9%를 제공한다. 참여 지역은 다양하지만, 개별 하위 집합의 기여는 특정 지역에 집중된다.
제시된 학습 단계 중 Feedback 지도 미세조정의 연산량이 80 H100-equivalent node-hours로 가장 크고, Edit 강화학습이 48로 그다음이다. GPU 8개로 구성된 노드에서 측정한 이 학습 비용은 확장 시스템의 서빙 비용을 나타내지는 않는다.
추가 비교에서는 Gemma-2-27B-IT에서도 Arena Hard 점수가 47.5에서 76.2로 높아진다. 모델 크기 비교에서는 8B와 70B Feedback/Edit 구성 2개 모두를 강화학습 없이 학습한다. 70B 구성의 성능이 더 높지만, 이 결과만으로 강화학습 후 8B 구성의 성능을 알 수는 없다.