


Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents 요약 설명
30 Sep 2026 | Paper Review Terminal Agents Test-Time Scaling Knowledge Distillation목차
이번 글에서는 Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 9월 30일(Arxiv)
- Kang, Minki, Hachiuma, Ryo, Zhang, Shaokun, Radhakrishnan, Subhashree, Fu, Yonggan, Jiang, Jindong, Liu, Mingjie, Hosseini-Asl, Ehsan, Dong, Yi, Wang, Yu-Chiang Frank, et al.
- NVIDIA, KAIST
- 논문 링크
- Project Page
요약
- 터미널 에이전트는 언어 모델로 명령을 실행하는 시스템이다. 모델이 유용한 대안을 생성할 수 있어도 잘못된 행동을 선택하면 이후 작업을 방해할 수 있다. 터미널 작업 벤치마크인 TerminalBench-Lite에서 TMAX-9B 행동 생성기와 명령 실행 및 관찰 반환을 담당하는 실행 하네스를 고정했을 때, GPT-5.6 Sol 검증과 행동 후보 8개를 사용하는 Mid-Harness는 Pass@1을 50.00%에서 68.03%로 높인다. 여기서 Pass@1은 작업별 3회 실행에 걸쳐 완전 성공률을 평균한 값이다.
- Mid-Harness는 각 행동을 실행하기 전에 추론 연산을 추가한다. 같은 상호작용 이력에서 대안을 샘플링하고 검증한 뒤 1개를 실행한다. TMAX-9B가 미세조정 없이 자체 행동을 검증할 때 후보를 쌍으로 비교하면 Pass@1이 54.76%에 도달한다. 더 강한 교사 모델의 응답을 재현하도록 검증기를 학습하는 지도 증류를 적용하면 생성기를 바꾸지 않고도 57.14%까지 높아진다.
- 행동 검증은 완성된 궤적 중 하나를 선택하는 성능도 높인다. 궤적은 작업 실행 중 생성된 행동과 관찰의 연속이다. 증류한 Mid-Harness로 궤적 3개를 생성한 뒤 선택하면 Pass@1이 66.33%에 도달하며, 궤적 선택만 적용한 경우에는 55.10%다. 연구는 검증기 품질이 행동 확장의 제약임을 보여주지만, 정답 행동 레이블이 없고 추정 토큰 비용을 사용하며 불확실성과 작업별 성능 하락도 보고한다.
1. Introduction
Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents는 명령 실행 전 추가 연산이 어떤 조건에서 작업 완수율을 높이는지 연구한다. 실행한 명령은 이후 의사결정에 쓰이는 환경을 바꾸므로, 생성기가 유용한 대안을 제공하는지와 검증이 그 대안을 식별하는지를 함께 살핀다. 주요 비교에서는 생성기와 하네스를 고정하고 후보 수, 검증 방식, 검증기 역량을 바꾼다.
- 행동 수준 검증은 다음 명령을 선택하고, 궤적 수준 검증은 완료된 실행 중 하나를 선택한다.
- 강한 검증기를 사용하는 실험은 유용한 대안이 존재하는지 간접적으로 확인한다. 같은 모델이 행동 생성과 판단을 맡는 자체 검증 실험은 생성기가 그 가능성을 얼마나 활용할 수 있는지 확인한다.
도식은 후보 생성과 검증을 환경 실행 전에 배치해, 주변 에이전트 구조를 유지하면서 행동 선택을 바꾸는 방식을 보여준다. 수치 패널은 더 강한 검증기가 대안을 활용해 얻는 효과와 자체 검증 및 증류로 확보하는 더 작은 향상을 구분한다.
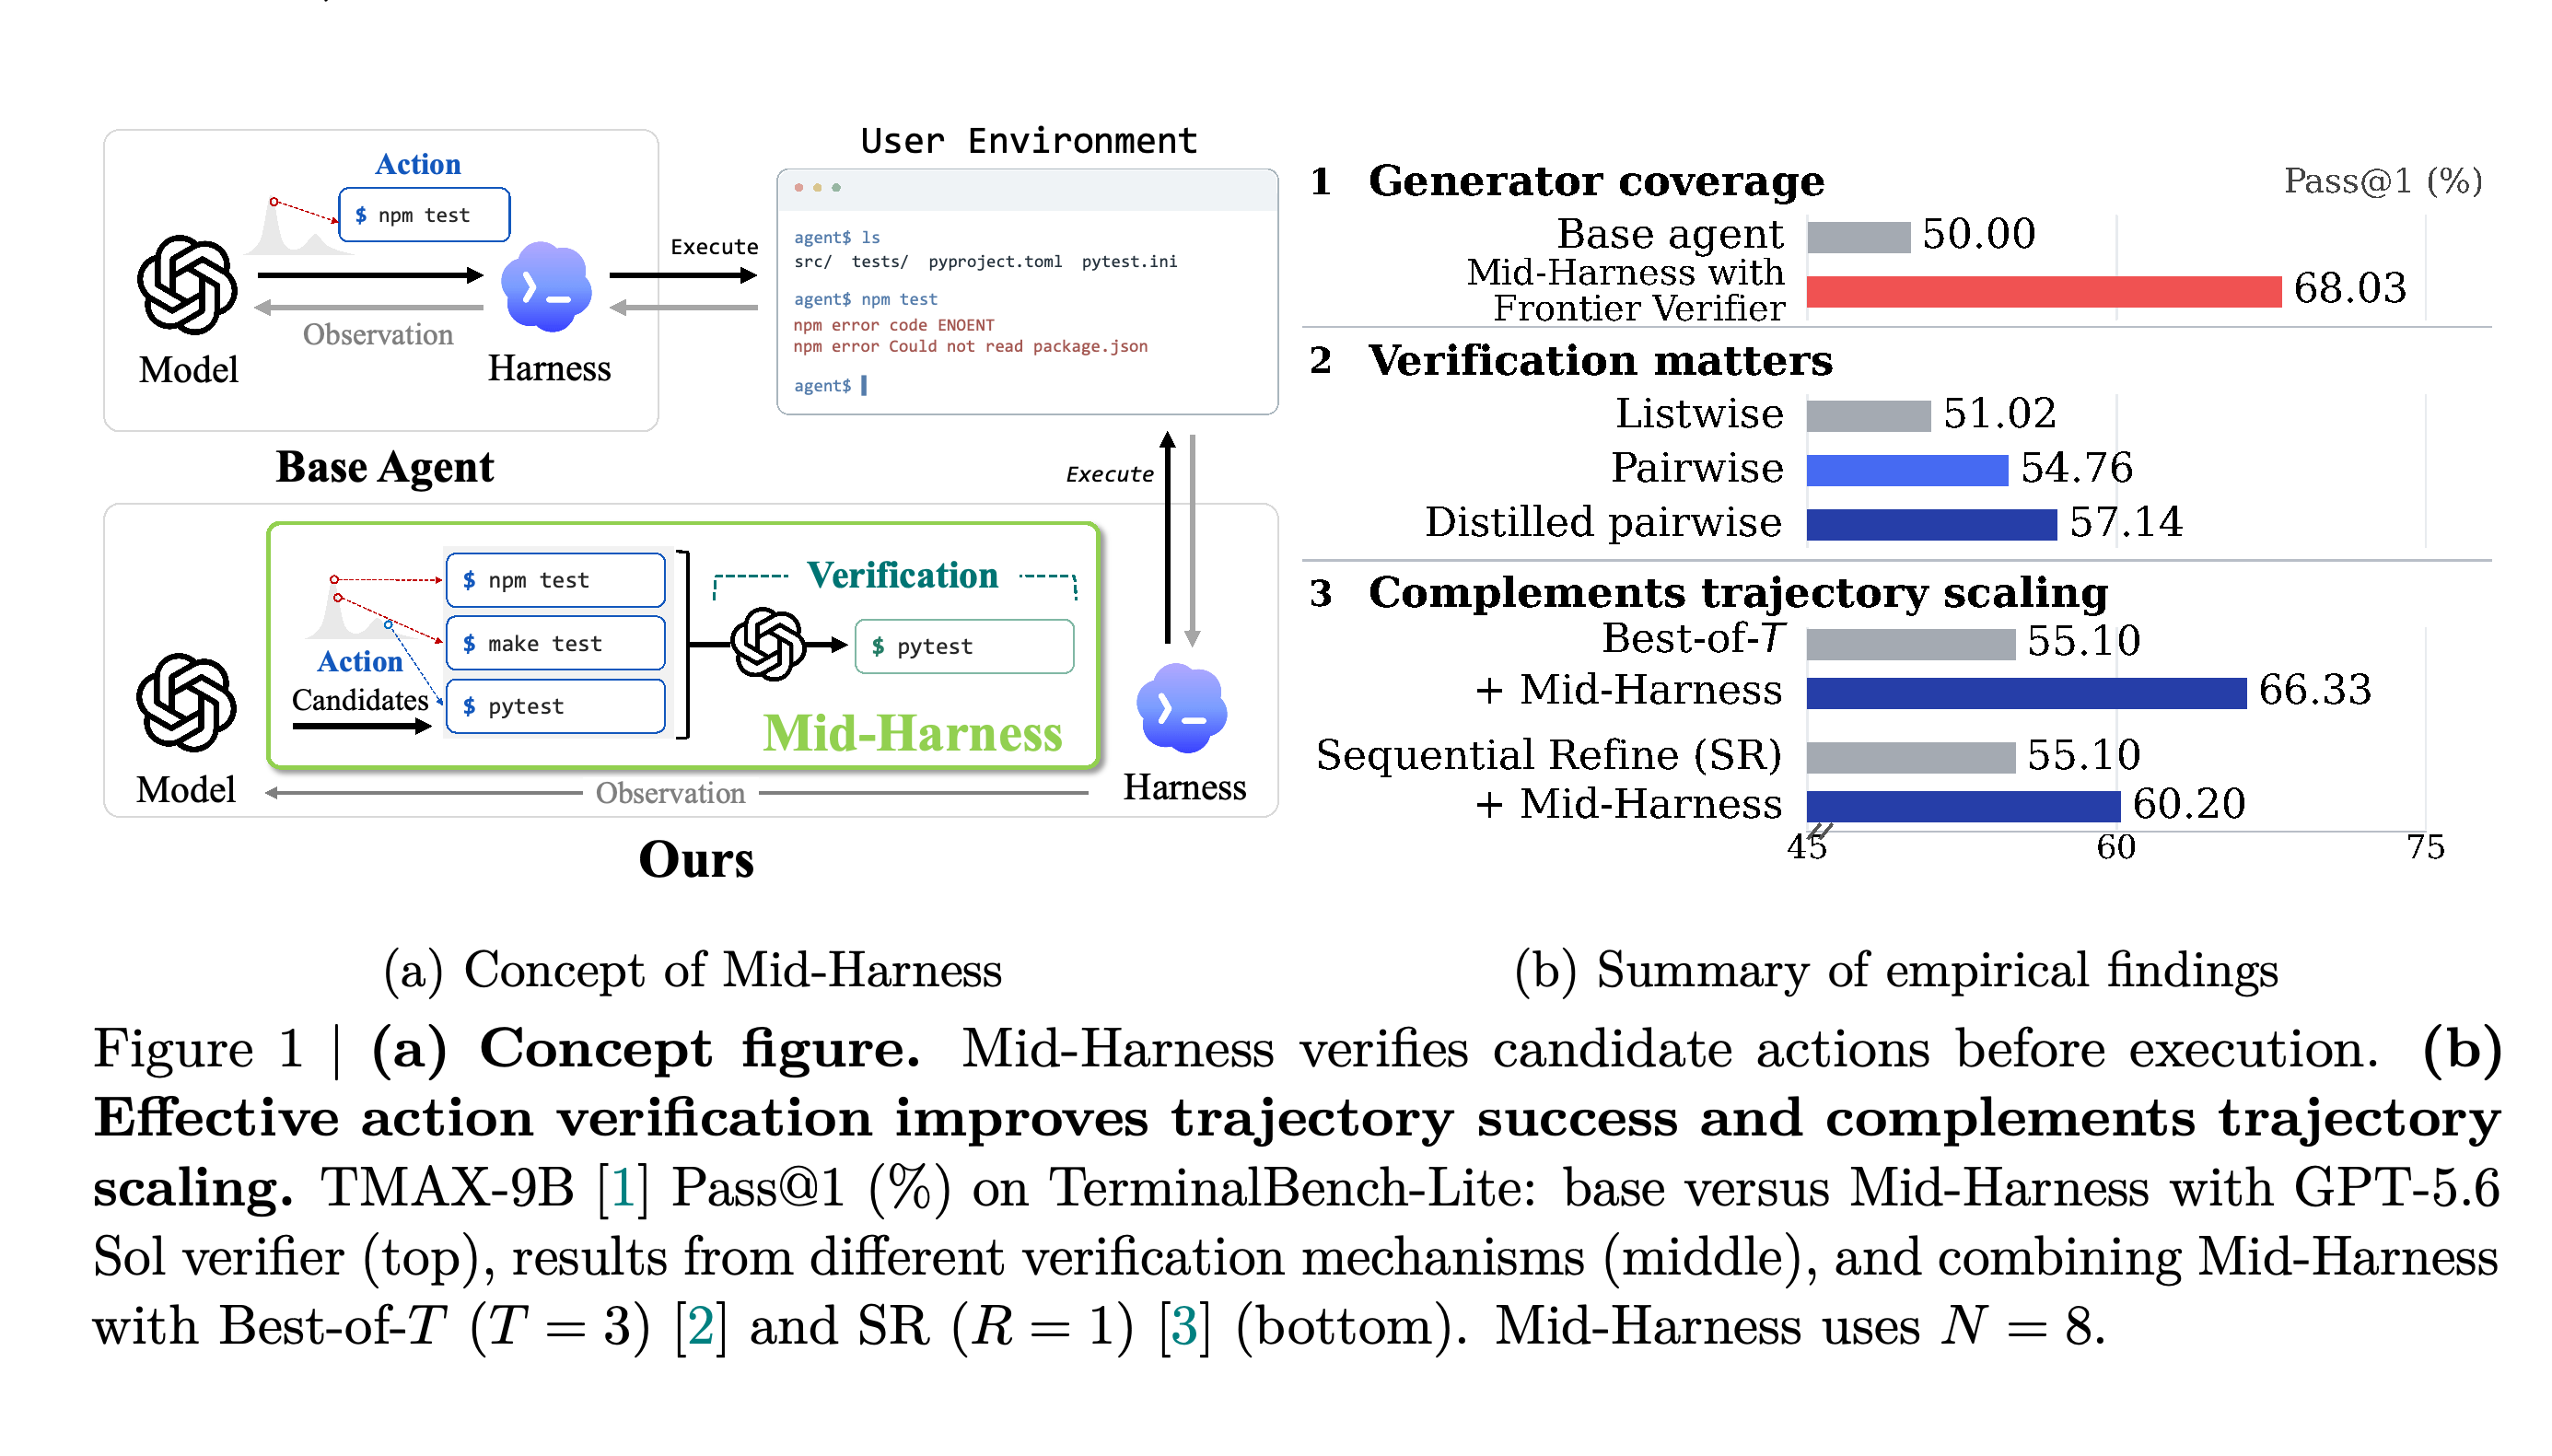
2. Mid-Harness
Mid-Harness는 하네스가 모델 출력을 요청하는 함수인 모델 호출 래퍼를 수정해 여러 행동 후보를 요청하고 검증기가 선택한 후보를 반환한다. 하네스 루프, 행동 생성기의 가중치, 서빙 구조는 그대로 유지하며, 이후 검증기 증류에서도 검증기만 수정한다.
2.1. Scaling Actions Within a Trajectory
단계 t에서 생성기는 같은 이력을 조건으로 행동 N개를 샘플링하고, 검증기는 그 후보 집합에서 1개를 반환한다. 하네스는 선택한 행동만 실행하고 관찰 결과를 이력에 추가한다. 나머지 후보는 버리고 다음 단계에서 새 후보 집합을 샘플링한다. 이 절차에는 환경 인스턴스 1개가 필요하다.
- 후보는 실패한 명령의 원인 진단이나 재시도처럼 목적이 다를 수 있으므로, 선택할 때 미해결 작업 요구사항과 현재 상태를 고려한다.
- 생성기는 각 행동 전에 <think> 태그를 사용해 추론을 생성한다. 검증기는 작업, 관찰 이력, 행동 후보를 받지만 해당 후보를 생성할 때 작성한 추론은 받지 않는다.
2.2. Verification Mechanisms
Listwise 검증은 프롬프트 1개에서 전체 후보 중 하나를 선택한다. Pointwise 검증은 각 후보를 독립적으로 채점한다. Pairwise 검증은 대안 2개를 비교하고 선호도를 집계한다. Listwise 선택에는 후보 전체의 순위 판단이 필요하고, pointwise 채점에는 목적이 다른 행동 사이에서도 비교 가능한 점수가 필요하다. Pairwise 비교는 공통 비교 기준을 제공하지만 호출 수가 늘어난다.
- 기본 pairwise 방식은 점수 차이로 가중한 승률에 따라 후보 순위를 정한다. 각 비교에서 부여한 점수 2개의 차이에 따라 가중치를 정하며 최소 가중치는 0.1이다.
- 후보가 8개일 때 listwise 검증은 1회, pointwise 검증은 8회 호출한다. 모든 쌍을 비교하면 28회 호출해야 한다. 구현된 8개 후보 토너먼트는 먼저 링에서 이웃 후보를 비교한 뒤, 선택한 피벗 4개를 기준으로 후보들을 비교한다.
3. Experimental Setup
주요 실험은 샌드박스 서비스 오류가 발생한 작업 2개를 제외한 TerminalBench-Lite 작업 98개에서 TMAX-9B와 Vanillux2 실행 하네스를 사용한다. TMAX-9B는 Qwen3.5-9B를 합성 터미널 작업에서 얻은 보상으로 학습하는 강화학습을 통해 훈련했다. 생성에는 temperature 0.8, 최대 64단계, 65,536토큰 컨텍스트, 단계별 16,384토큰 출력 한도를 적용한다. 각 작업은 3회 실행한다.
- Pass@3은 3회 실행 중 적어도 1회 성공한 작업의 비율이다. 실패도 분모에 포함하며, 부분 보상은 완전 성공으로 세지 않는다.
- Best-of-T Trajectories는 모델 기반 토너먼트로 완료된 실행 T개 중 출력 1개를 선택한다. Sequential Refine(SR)은 이전 실행을 요약해 새 실행을 안내하며, 이를 R회의 개선 라운드 동안 반복한다.
- Parallelized output tokens(POT)는 병렬 생성 또는 검증 단계마다 가장 긴 출력의 토큰 수를 합산해 이상적인 병렬 실행에서 디코딩 지연을 근사한다. 총 검증기 출력 토큰은 전체 디코딩 양을 측정하며, 기준 단가로 계산한 토큰 비용은 집계한 입력 및 출력 토큰에 고정 단가를 적용한다.
4. When Does Action Scaling Work?
행동 확장 실험은 TMAX-9B 생성기를 고정하고 후보 포괄성, 후보 수, 검증 방식, 검증기 증류, 추론 비용을 살핀다. 강한 검증기로 유용한 대안이 존재하는지 간접적으로 확인하고, TMAX-9B 검증기 간 비교로 자체 검증이 그 대안을 얼마나 효과적으로 선택하는지 확인한다.
4.1. Candidate Coverage
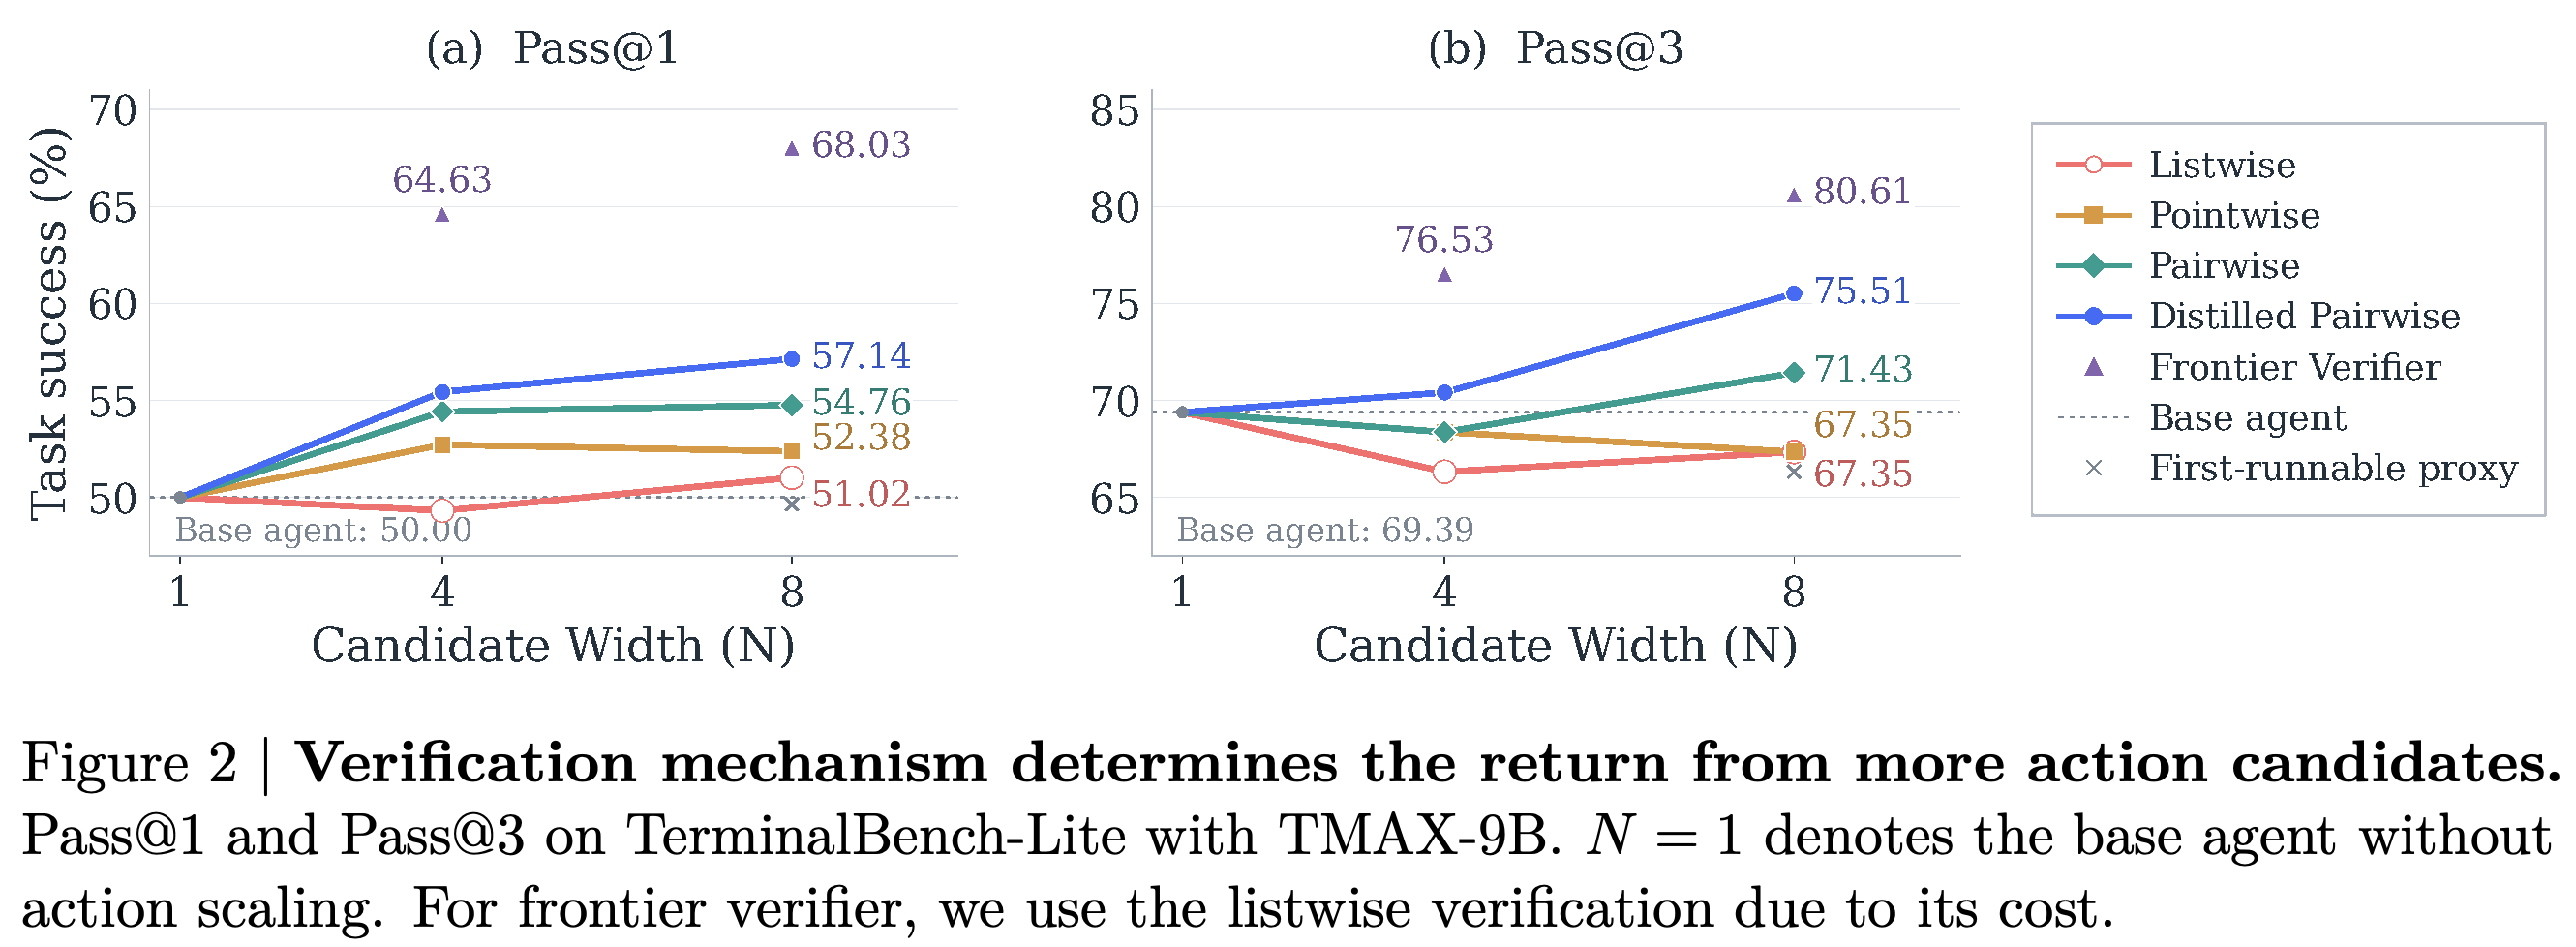
후보 포괄성은 샘플링한 행동에 유용한 대안이 포함되는지를 뜻한다. GPT-5.6 Sol의 listwise 검증은 N = 4에서 Pass@1 64.63%, N = 8에서 68.03%에 도달하며, 기본 에이전트는 50.00%다. 이러한 작업 수준의 성능 향상은 활용 가능한 대안이 있다는 간접 증거다. 다만 행동 수준 정답이 없으므로 포괄성을 직접 측정하거나 완벽한 검증의 성능 상한을 확정하지는 못한다.
4.2. Candidate Width and Verification
검증이 약하면 후보 수를 늘려도 이득이 작다. 검증기를 미세조정 없이 사용하는 zero-shot listwise 검증에서 N = 4를 N = 8로 늘리면 Pass@1은 49.32%에서 51.02%로, Pass@3은 66.33%에서 67.35%로 변한다. N = 8에서 pointwise 검증은 Pass@1 52.38%, Pass@3 67.35%에 도달한다. 평가한 zero-shot 방식 중 pairwise 검증이 가장 높으며, 각각 54.76%와 71.43%다.
후보 수를 4개에서 8개로 늘려도 약한 listwise 선택은 거의 개선되지 않지만, GPT-5.6 Sol listwise 검증은 Pass@1 68.03%에 도달한다. Pairwise 비교와 증류는 이 격차의 일부를 줄인다. 이는 후보 수만으로 행동 확장의 효과가 결정되지 않음을 보여준다.
4.3. Verifier Distillation
검증기 증류에는 TMAX-15k 작업 모음에서 추출한 어려운 작업 244개의 궤적 732개에서 수집한 GPT-5.6 Sol pairwise 응답 약 117k개를 사용한다. 모델 미세조정을 위한 저랭크 적응 기법인 LoRA로 교사의 추론, 점수, 선호 레이블을 재현하도록 검증기를 학습한다. 어댑터는 검증할 때만 활성화한다.
- N = 8에서 증류는 pairwise Pass@1을 54.76%에서 57.14%로, Pass@3을 71.43%에서 75.51%로 높인다. N = 4에서는 각각 54.42%에서 55.44%로, 68.37%에서 70.41%로 높인다.
- 증류한 pairwise 검증기는 N = 8에서 Pass@1 68.03%를 기록한 GPT-5.6 Sol listwise 검증보다 여전히 낮다. 이 비교에서는 검증기 모델과 검증 방식이라는 2개 요소가 모두 달라진다.
4.4. Cost for Action Scaling and Verification
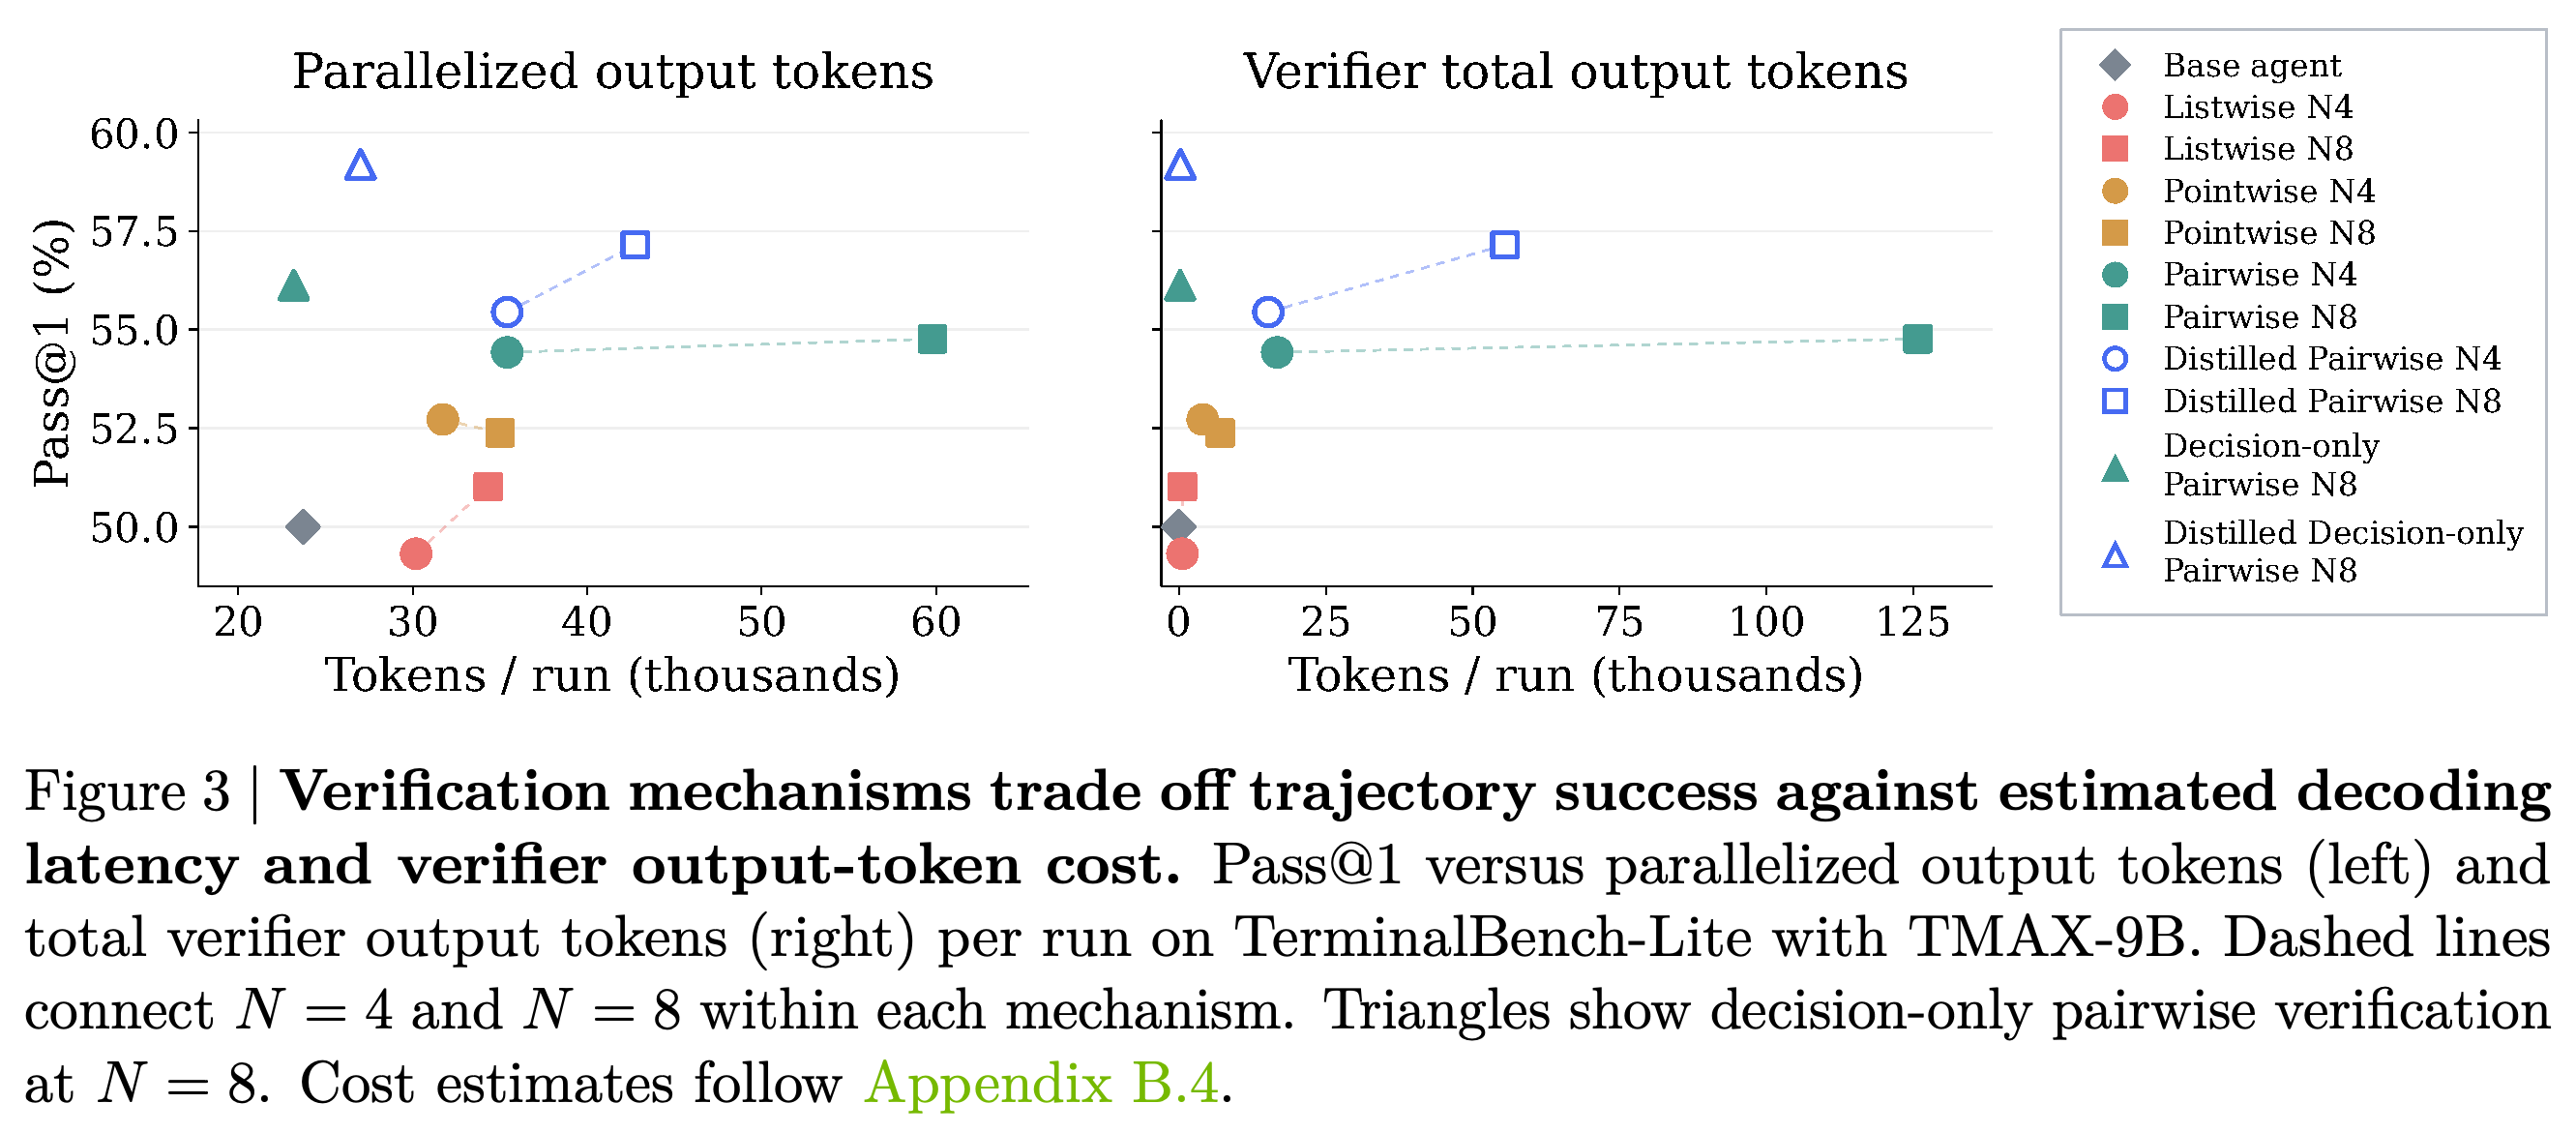
Pairwise 검증은 성공률을 높이지만 디코딩 연산도 크게 늘린다. N = 8에서 zero-shot pairwise 검증은 추정 POT를 26.6k 추가하며, listwise와 pointwise 검증은 최대 1.3k를 추가한다. 총 검증기 출력은 각각 125.7k, 0.6k, 7.0k토큰이다.
- Decision-only 검증은 A/B 선호 토큰 1개를 출력한다. TMAX-9B의 N = 8 설정에서 zero-shot과 증류 decision-only 변형은 Pass@1을 높이면서 기준 단가로 계산한 토큰 비용을 각각 20.9%, 24.1% 줄인다.
- Decision-only 검증은 4B와 27B에서 Pass@1을 낮춘다. TMAX-9B의 N = 4 설정에서도 decision-only 변형 2개 모두 대응하는 추론 기반 방식보다 Pass@1이 낮다. 관찰된 이득은 모델 규모와 후보 수에 따라 달라진다.
- POT는 이상적인 디코딩 대리 지표이며, 측정한 종단 간 지연 시간이 아니다. 검증기 출력을 줄여도 반복되는 검증기 입력 비용은 남는다. Decision-only 변형은 집계 방식도 바꾸며, 증류의 경우 학습 목표도 바꾼다.
패널 2개는 이상적인 병렬 디코딩 비용과 전체 검증기 출력량을 구분한다. 추론 기반 pairwise 검증은 성공률을 높이지만 검증기 디코딩을 훨씬 많이 요구한다. Decision-only 지점들은 평가한 후보 8개 설정에서 더 짧은 응답으로 TMAX-9B의 Pass@1이 높아짐을 보여준다.
5. Analysis: What Still Limits Verification?
오프라인 분석은 별도로 남겨 둔 TMAX-15k 작업 21개에서 N = 8로 생성해 저장한 TMAX-9B 궤적을 사용해 검증기 출력을 비교한다. Pairwise 일치도는 A/B/TIE 선호가 같은지를 측정하고, 검증 일치도는 검증기와 교사가 같은 최상위 후보를 식별하는지를 측정한다. 이 진단은 같은 상태에서 교사와 얼마나 일치하는지를 측정한다. 독립적으로 확정한 행동의 정확성이나 온라인 작업 성공률을 측정하지는 않는다.
5.1. What Distillation Improves
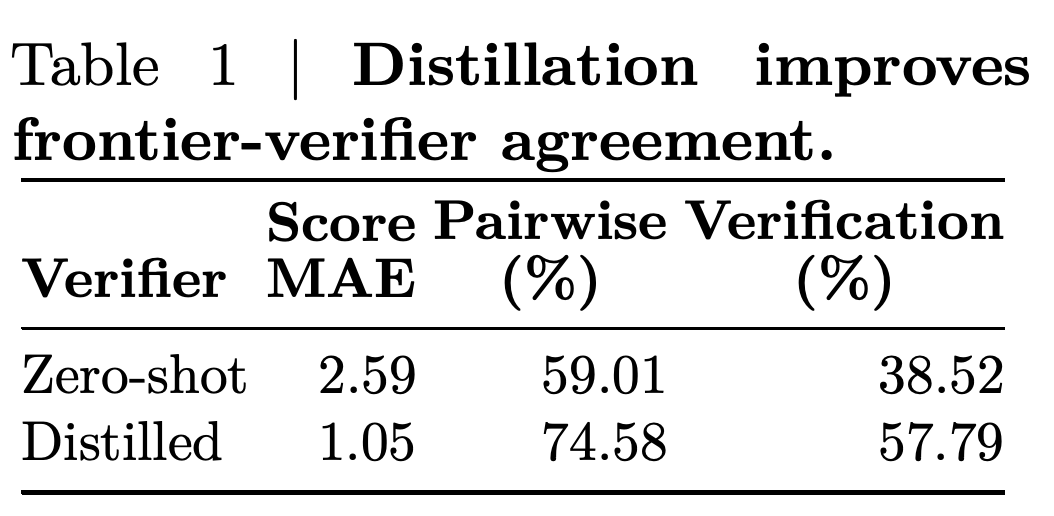
증류는 교사와 학생 간 점수 차이의 절댓값을 평균한 점수 평균 절대 오차(MAE)를 2.59에서 1.05로 줄인다. Pairwise 일치도는 59.01%에서 74.58%로, 검증 일치도는 38.52%에서 57.79%로 높아진다. 이는 저장된 상태에서 교사의 비교 판단을 더 가깝게 모방한다는 결과다.
5.2. Remaining Verification Challenges
증류는 모든 에피소드 턴 구간에서 검증 일치도를 높이지만, 궤적 후반의 일치도는 여전히 낮다. 증류한 검증기는 1–4턴에서 68.13%, 17–32턴에서 54.07%에 도달한다. GPT-5.6 Terra는 검토를 통해 명확한 검증기 실패를 증류 전 3,328건, 증류 후 1,810건으로 식별하며, 모든 범주에서 사례 수가 줄어든다.
- 후보 의미 해석은 명령이나 수정이 무엇을 하는지 판단하는 문제이고, 실행 가능성은 현재 환경에서 의도대로 실행할 수 있는지 판단하는 문제다. 이 범주들은 검토된 증류 검증기 실패의 67.4%를 차지한다.
- 이 집계에는 교사의 선호가 명확하고 근거로 뒷받침된다고 판단한 불일치만 포함한다. 이는 교사를 기준으로 모델이 판단한 실패이며, 독립적으로 검증한 행동 오류가 아니다.
- 턴 수준 일치도는 모델 2개 모두에서 비교가 유효한 상태만 남겨 1,624개 중 1,355개를 사용한다. 결과는 이 필터링을 조건으로 하며, 마지막 턴 구간에 포함된 작업 수는 앞선 구간보다 적다.
증류는 모든 턴 구간에서 교사 일치도를 높이지만 후반 상태는 여전히 어렵다. 범주별 막대는 명령 의미 해석과 실행 가능성이 검토된 잔여 실패에서 가장 큰 비중을 차지함을 보여준다. 이 집계는 모델이 검토한 교사와의 불일치에 관한 것이며, 독립적으로 확정한 행동 오류가 아니다.
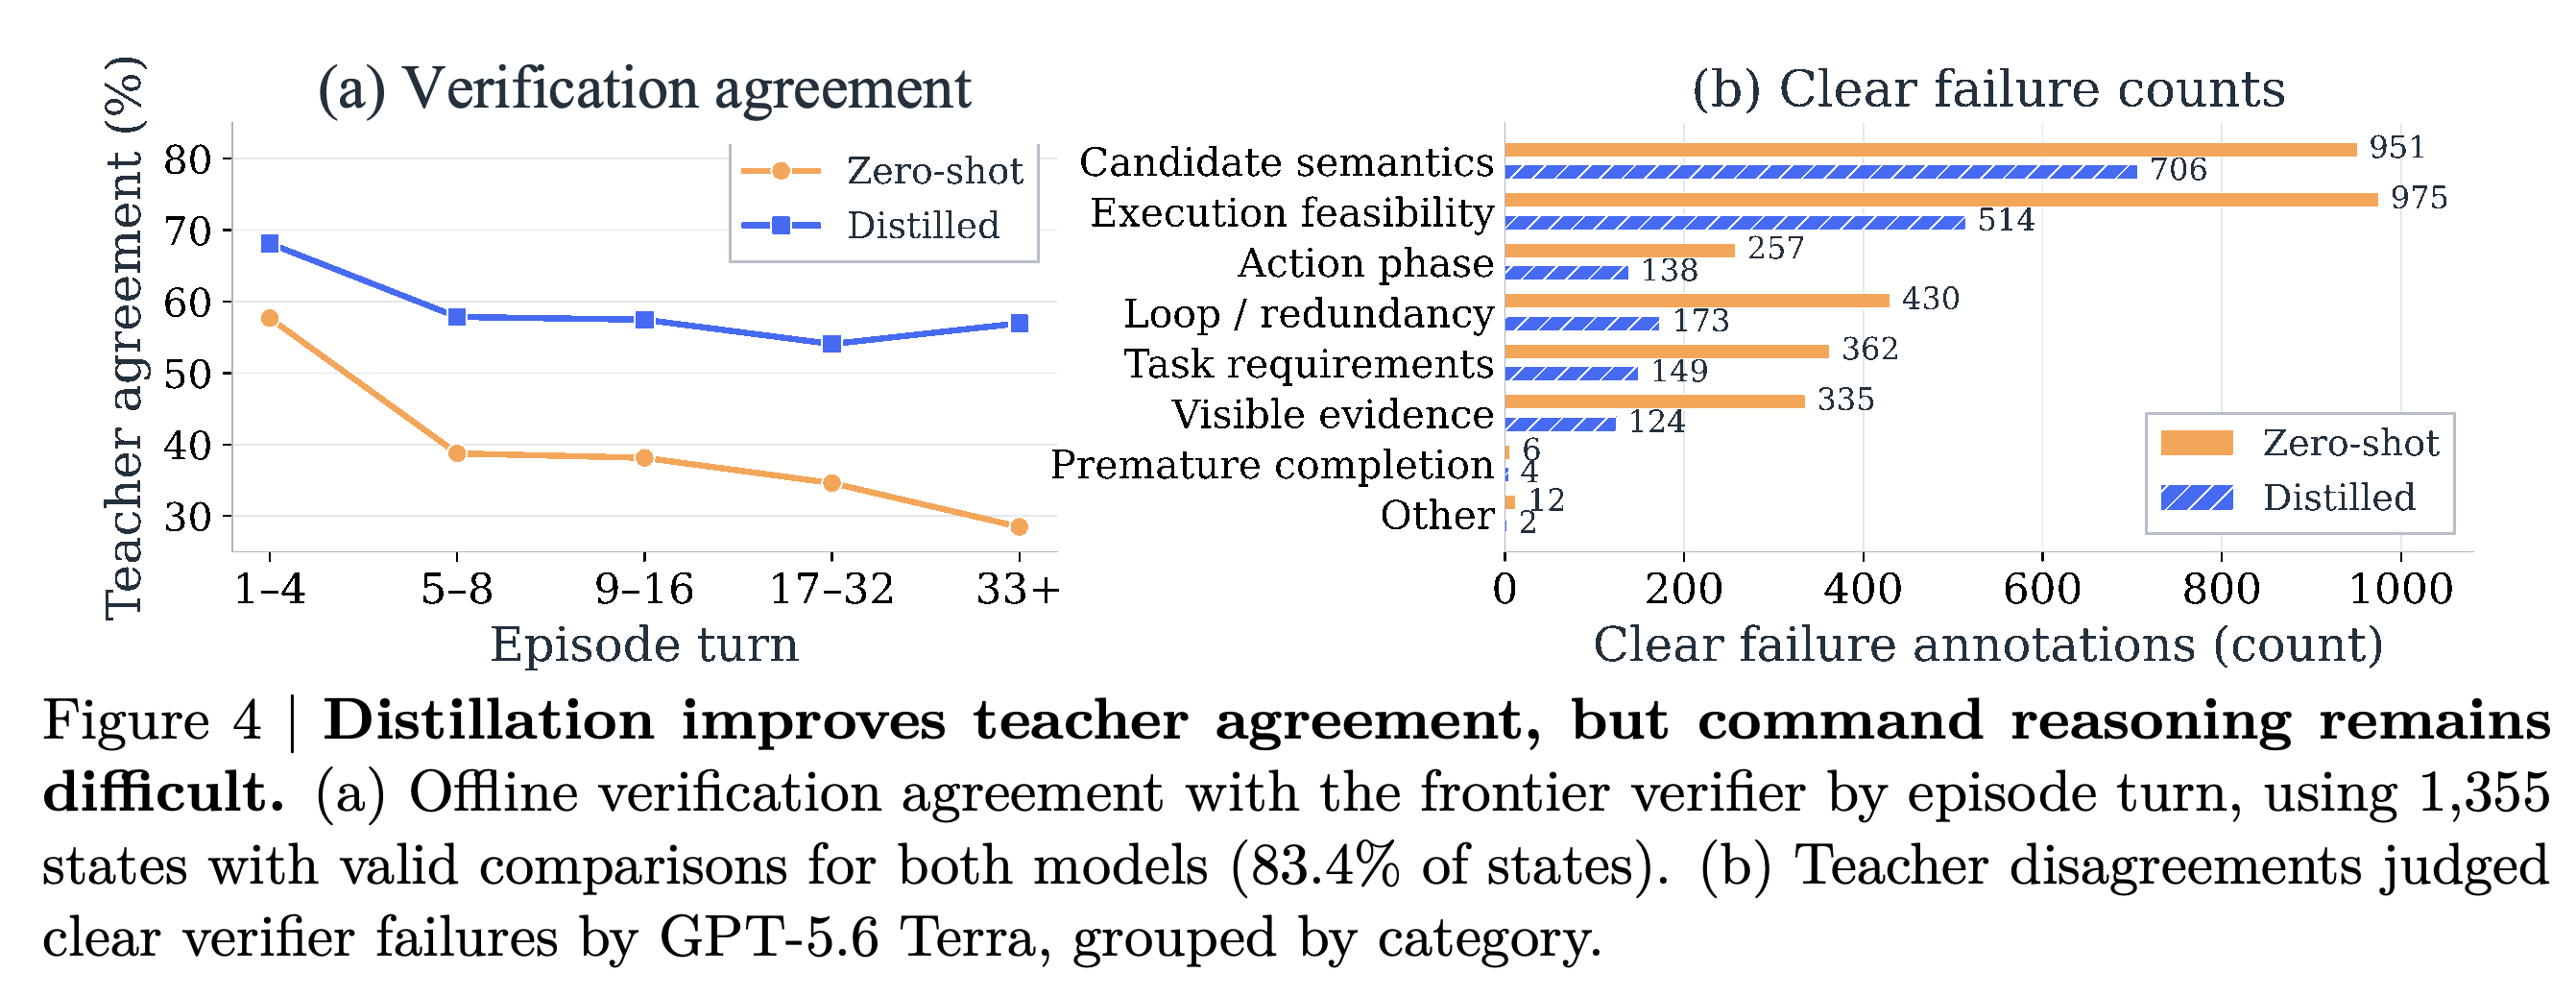
점수 오차가 줄면서 pairwise 선호와 선택 후보라는 2개 항목 모두에서 일치도가 높아진다. 이 측정은 저장된 상태에서 교사를 더 가깝게 모방함을 보여주며, 온라인 작업 성공률은 별도로 평가한다.
6. Composition and Transfer of Action Scaling
결합 실험은 환경 실행 횟수를 늘리지 않고도 행동 검증이 병렬 궤적 선택과 순차 개선의 성능을 높이는지 확인한다. 방법 2개 모두 새 환경에서 실행해야 한다. 환경 상태를 저장하고 복원하는 신뢰할 만한 상태 직렬화가 없으면 벤치마크 밖에서는 이를 수행하기 어려울 수 있다. 이어지는 전이 실험은 모델 규모, 모델 계열, 벤치마크, 하네스를 바꾼다.
6.1. Composition with Trajectory Scaling
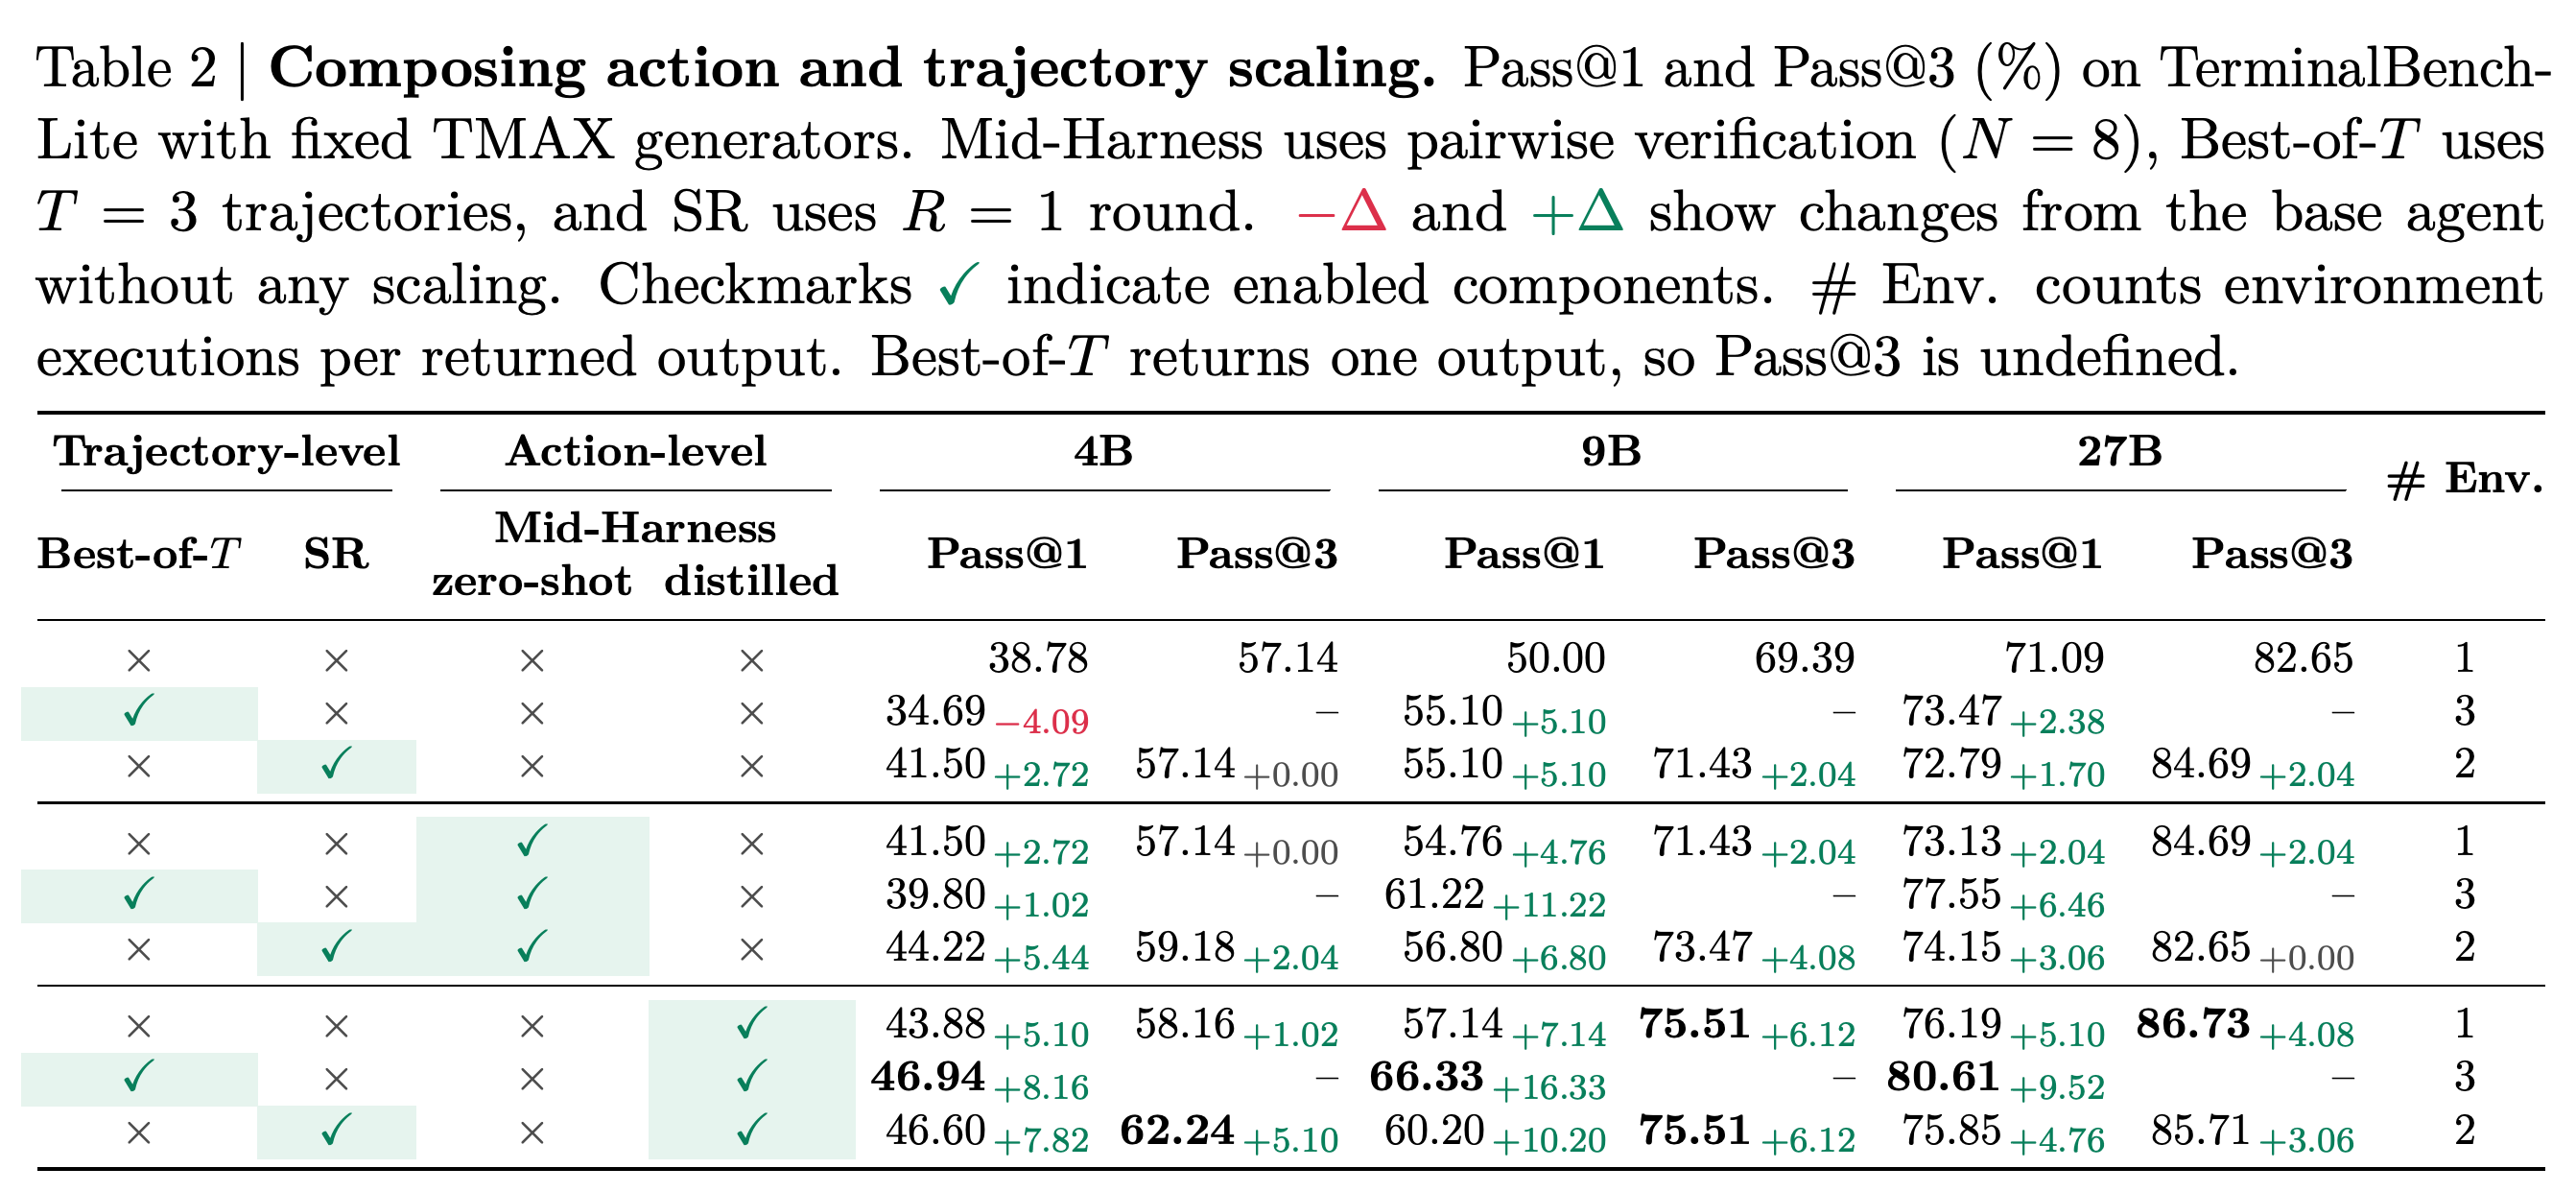
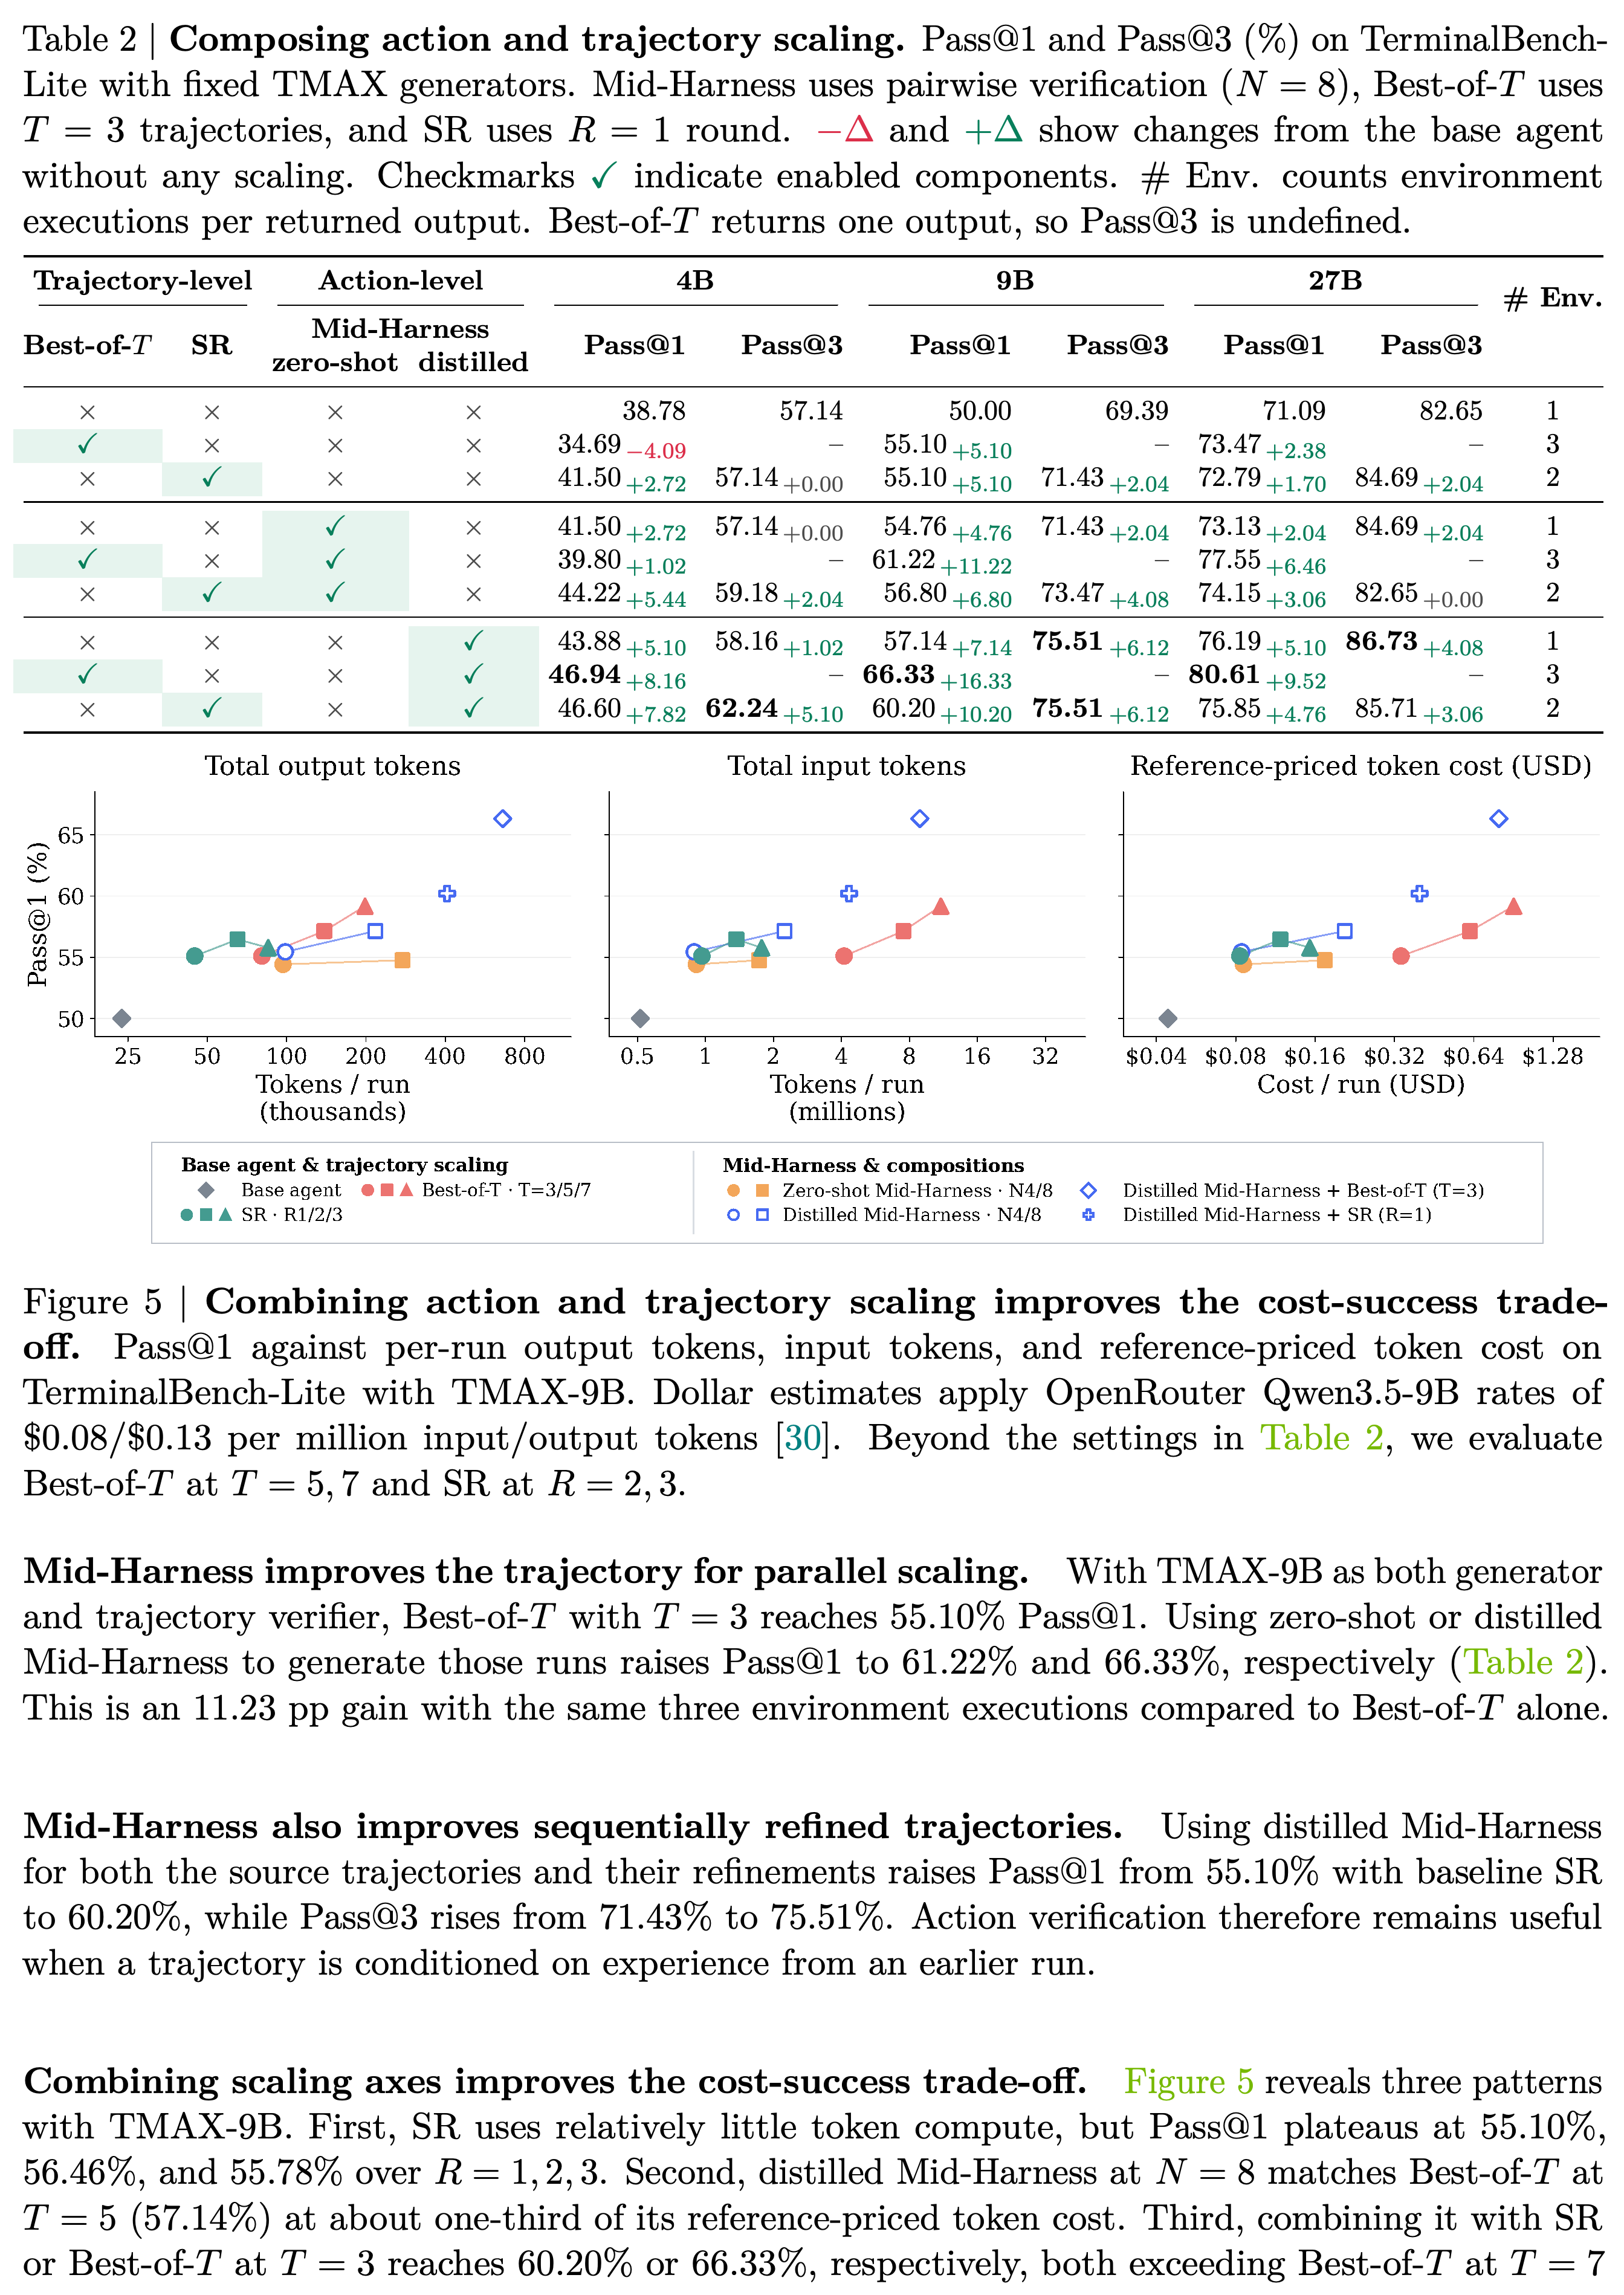
TMAX-9B에서 T = 3인 Best-of-T는 Pass@1 55.10%에 도달한다. 같은 환경 실행 3회를 사용하되 zero-shot 또는 증류 Mid-Harness로 궤적을 생성하면 성공률이 각각 61.22%, 66.33%로 높아진다. R = 1인 SR에서 원본 실행과 개선 실행 2개 모두에 증류 Mid-Harness를 적용하면 Pass@1은 55.10%에서 60.20%로, Pass@3은 71.43%에서 75.51%로 높아진다.
- 증류 Mid-Harness만 적용한 결과는 T = 5인 Best-of-T와 모두 Pass@1 57.14%이며, 기준 단가로 계산한 토큰 비용은 약 1/3이다.
- 증류 Mid-Harness를 R = 1인 SR 또는 T = 3인 Best-of-T와 결합하면 59.18%를 기록한 T = 7인 Best-of-T를 넘어선다. SR 결합의 추정 토큰 비용은 그 절반보다 작다.
- 비용 비교에는 OpenRouter의 Qwen3.5-9B 기준 단가인 입력 토큰 1,000,000개당 $0.08, 출력 토큰 1,000,000개당 $0.13을 사용한다. 이 단가는 로컬 서빙 모델의 비용을 근사하기 위한 값이다. 비용은 전체 파이프라인을 대상으로 집계하며, 각 행동 단계 안에서는 생성기 프롬프트를 공유한다고 가정한다.
구성 요소의 결합은 행동 검증이 선택과 개선에 제공하는 궤적을 어떻게 바꾸는지 보여준다. TMAX-9B에서 증류 Mid-Harness는 환경 실행 3회를 늘리지 않고 궤적 3개 선택의 Pass@1을 55.10%에서 66.33%로 높인다. 4B와 27B 결과는 성능이 모델 규모와 결합 방식에도 영향을 받음을 보여준다.
입력 토큰, 출력 토큰, 기준 단가 패널은 논문의 집계 가정에 따라 전체 파이프라인을 비교한다. 증류 행동 검증은 추정 비용 약 1/3로 궤적 5개 선택과 같은 Pass@1 57.14%에 도달한다. 이를 결합한 방식들은 더 낮은 추정 비용으로 궤적 7개 선택을 넘어선다.
6.2. Transfer Across Models, Benchmarks, Harnesses
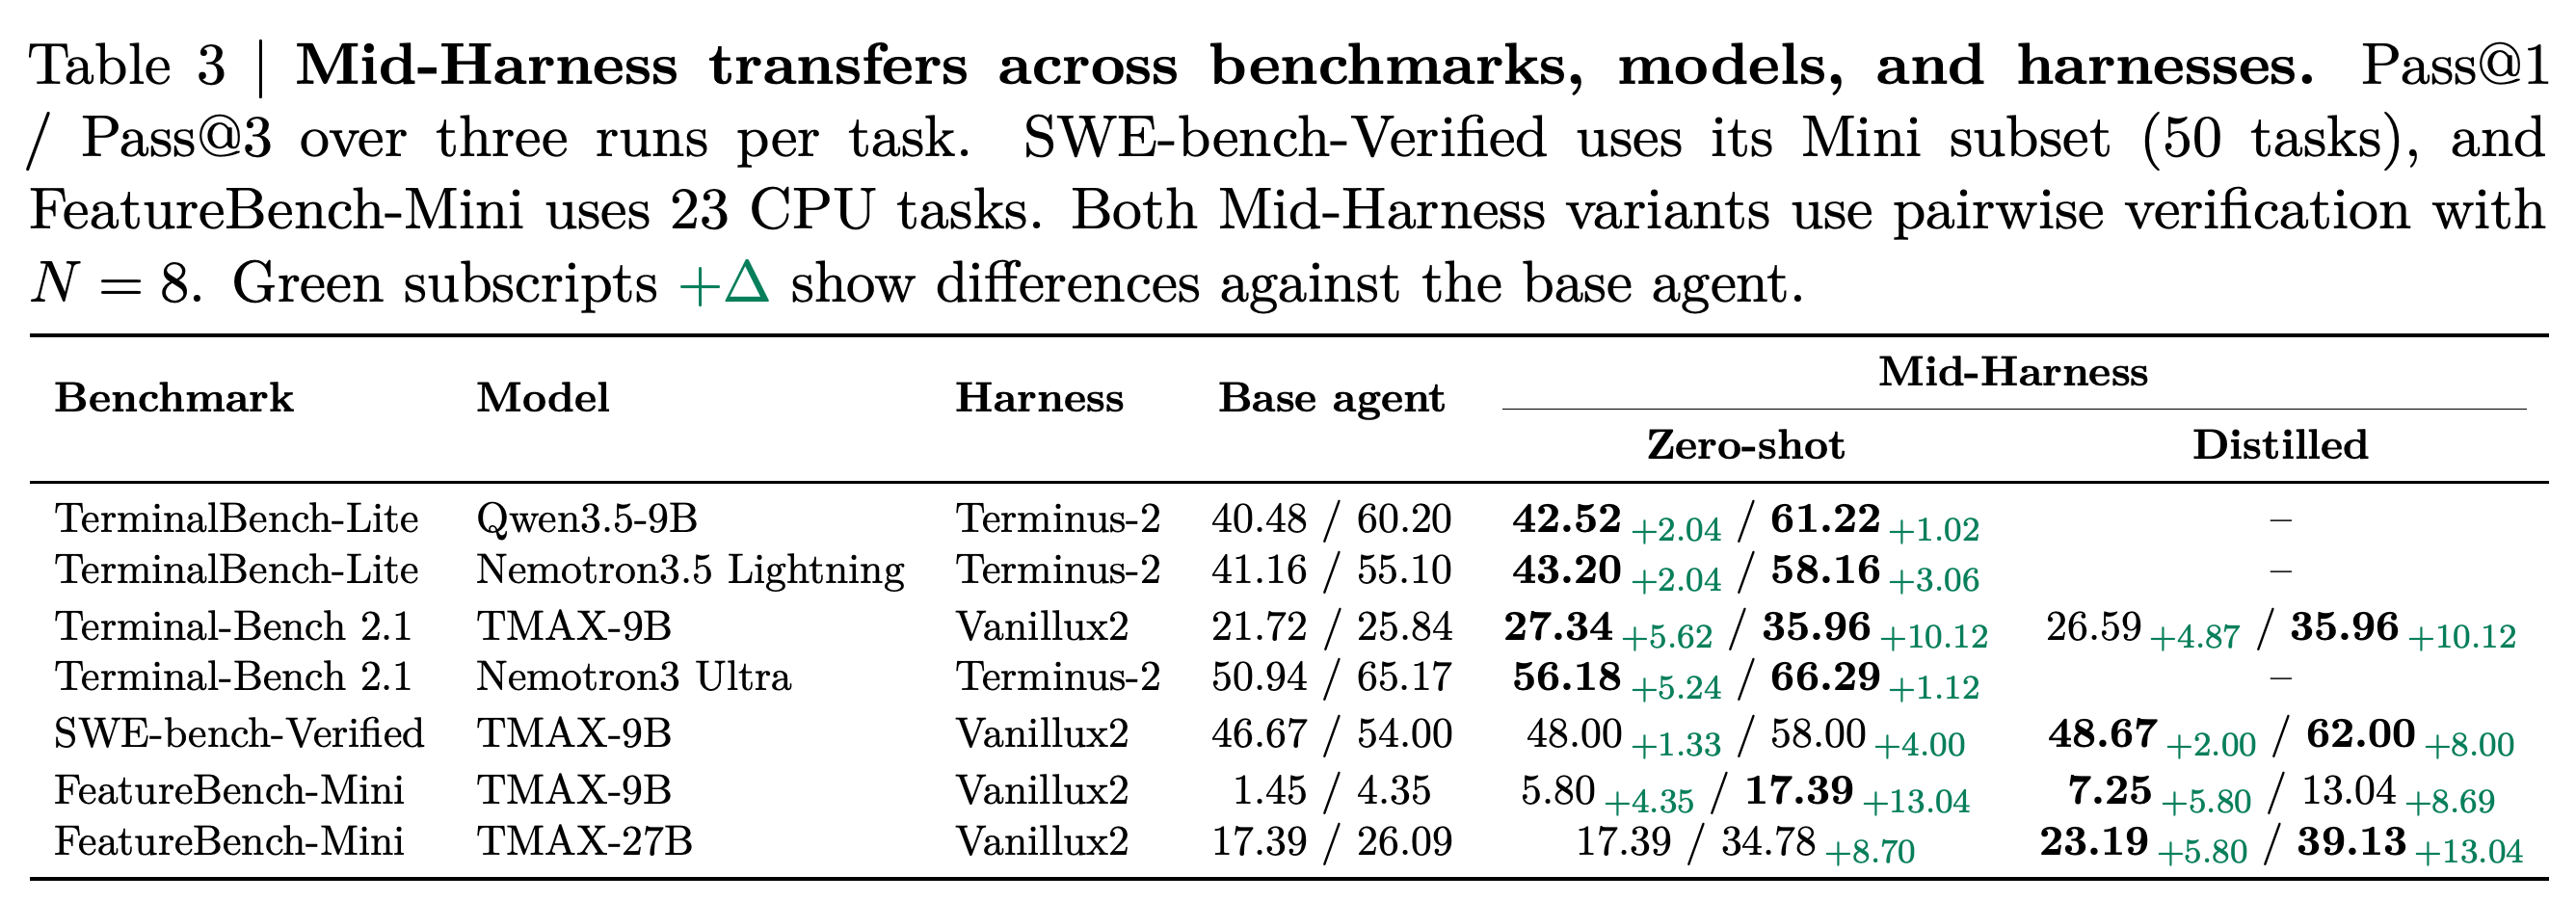
TerminalBench-Lite에서 기본, zero-shot, 증류 설정의 Pass@1은 4B에서 38.78%, 41.50%, 43.88%로, 27B에서 71.09%, 73.13%, 76.19%로 높아진다. 추가 벤치마크–모델–하네스 설정 7개에서 zero-shot Mid-Harness는 Pass@3을 높이고 Pass@1을 유지하거나 높인다.
- 현실적인 터미널 작업 벤치마크인 Terminal-Bench 2.1에서 TMAX-9B는 zero-shot 검증으로 Pass@1이 21.72%에서 27.34%로 높아진다. 증류 검증은 26.59%로 zero-shot 검증보다 낮다.
- 소프트웨어 기능 개발을 평가하는 CPU 전용 FeatureBench-Mini 부분집합의 작업 23개에서 TMAX-9B의 Pass@1은 1.45%에서 zero-shot 검증 시 5.80%, 증류 시 7.25%로 높아진다. 다만 증류는 zero-shot 검증보다 Pass@3을 17.39%에서 13.04%로 낮춘다.
- 연구는 저장소 이슈 해결을 평가하는 SWE-bench Verified Mini 부분집합의 작업 50개에서도 향상을 보고한다. Terminus-2 실행 하네스를 사용하는 Qwen3.5-9B, Nemotron3.5 Lightning (30B), Nemotron3 Ultra (550B)에서도 향상을 보고한다.
Zero-shot 검증은 전이 설정 7개 모두에서 Pass@3을 높이고 Pass@1을 유지하거나 높인다. 증류의 효과는 zero-shot 검증과 비교해 엇갈리며, Terminal-Bench 2.1의 Pass@1과 TMAX-9B FeatureBench-Mini의 Pass@3이 낮아지는 경우도 있다.
7. Related Work
논문은 Mid-Harness를 터미널 에이전트 인터페이스와 하네스, 테스트 시점 연산 확장, 중간 단계를 평가하는 과정 보상 모델, 에이전트 궤적 선택 및 개선 연구와 연결한다. 단계별 후보 검증과 행동 순위 및 궤적 선택의 결합은 선행 연구에도 있다. 이 연구는 더 폭넓은 터미널 작업에서 검증 방식과 생성기 기반 자체 검증을 통제된 조건으로 비교하는 데 초점을 둔다.
8. Conclusion
실험은 행동 확장이 추론 연산을 배분하는 보완적 방법임을 뒷받침한다. 검증이 유용한 대안을 식별하면 작업 성공률을 높일 수 있고, 검증기 학습은 더 강한 검증기의 이점 중 일부를 확보한다. 주요 한계는 논문에서 강한 모델의 기준으로 삼은 최상위 검증기와의 성능 격차와 정답 행동 레이블의 부재다. 정답 레이블이 없어 검증 정확성과 후보 포괄성을 직접 측정할 수 없다.
AI use statement
저자들은 합성 데이터셋, 구현, 방법론 또는 실험 피드백, 정성 분석과 주제 분석, 번역, 그림, 가독성 편집에 생성형 AI를 사용했다고 공개한다. 가설 제안이나 개선, 데이터셋 정제나 형식 변경, 결과 해석에는 AI를 사용하지 않았다고 밝힌다. AI의 도움을 받은 작업은 모두 검토했으며, 저자 2명이 생성된 코드를 확인하고 테스트했다고 설명한다.
Ethics statement
실험은 격리된 벤치마크 환경에서 작업 완수 여부를 측정한다. 저자들은 이러한 행동 신뢰성을 명령의 안전성이나 보안과 구분하며, 민감하거나 되돌릴 수 없는 행동에는 제한된 권한, 환경 격리, 사람의 승인을 유지할 것을 권고한다.
Reproducibility statement
재현성 진술은 평가 작업, 지표, 베이스라인 절차, 타임아웃 설정, 검증 방식과 프롬프트, 증류 데이터와 학습 설정, 추론 비용 계산, 오프라인 불일치 분석을 문서화했다고 설명한다. PDF에는 프로젝트 페이지 https://byungkwanlee.github.io/MidHarness-page/ 링크도 있다.
부록
- A. Limitations and Future Work는 검증기 학습, 평가, 연산 배분에서 해결되지 않은 문제를 다룬다. 연구는 행동 샘플링을 후보 1개에 더 많은 추론 노력을 쓰는 방식과 비교하지 않으며, 노력을 적응적으로 배분하는 대신 모든 행동 단계에서 검증한다. 선택한 행동이 바뀌면 이후 상태도 바뀌므로, 저장된 궤적을 재생하는 방식으로는 다른 검증기의 온라인 성능을 확정할 수 없다. 중간 상태에서 분기하려면 환경 복제나 복원이 필요하다. 제안한 확장에는 명령 결과를 통한 학습, 행동 효과 예측, 터미널 에이전트 밖의 설정 평가가 포함된다.
- B. Experimental Setup and Implementation과 B.1. Evaluation and Baseline Procedures는 network-log-normalization과 okhttp-trailers-crash를 제외한 TerminalBench-Lite의 98 tasks, Terminal-Bench 2.1 tasks 전체 89개, SWE-bench Verified Mini 작업 50개, CPU 전용 FeatureBench-Mini의 23 tasks를 명시한다. 모든 실험은 에이전트 타임아웃을 세 배로 설정한다. Best-of-T는 완료된 출력을 선택하고, SR은 이전 실행의 요약을 사용해 새 환경에서 시작한다. SWE-bench 부분집합은 https://github.com/mariushobbhahn/SWEBench-verified-mini 에 명시되어 있다.
- B.2. Verification Mechanisms and Hyperparameters는 N = 4에서 가능한 순서 없는 비교 6개와 N = 8에서 K = 4 피벗을 사용하는 2단계 링 및 피벗 토너먼트를 명시한다. 서로 다른 유효 후보 8개에는 피벗 위치에 따라 비교 22–25회가 필요하다. 도구 이름과 인자가 같은 후보는 중복 제거한다. 유효하지 않은 판단은 제외하며, 비교 근거가 부족하면 명시된 대체 규칙으로 후보를 반환한다.
- 기본 pairwise 판단에는 판단 근거, 1부터 10까지의 정수 점수, A/B/TIE 선호가 포함된다. 승률 가중치는 0.1과 점수 차이의 절댓값을 9로 나눈 값 중 큰 값이다. Decision-only 검증은 대신 첫 출력 위치의 A/B 토큰 확률을 정규화하고 선호 확률을 평균하므로, 응답 형식뿐 아니라 집계 방식도 바꾼다.
- B.3. Verifier Training Data and Settings는 244 tasks에서 얻은 학습 입력 117,631개와 학습 작업과 겹치지 않는 21 tasks에서 얻은 분석 입력 10,543개를 보고한다. 학습에는 A 승리 56,274개, B 승리 56,274개, 무승부 5,083개를 남긴다. LoRA 설정은 rank 64, alpha 128, dropout 0.05, 학습률 10⁻⁴, 2 epochs, 장치별 배치 크기 8, gradient accumulation 1이며 H200 GPU 네 대를 사용한다. 분석 작업은 최종 분석에만 사용하고, 4B와 27B에서도 같은 학습 데이터셋을 사용한다. 별도로 생성한 decision-only 코퍼스에는 학습 예제 113,728개와 개발 예제 10,188개가 있으며 무승부는 제외한다.
- B.4. Inference Cost Accounting은 POT를 구할 때 각 병렬 단계의 가장 긴 출력을 합산하고, 총 검증기 출력 비용을 구할 때 실행된 모든 검증기 출력을 합산한다. 기준 단가 계산에는 행동 단계마다 공유 생성기 프롬프트를 1회 집계하고, 모든 후보 출력과 실행된 모든 검증기 입력을 포함한다. 전체 궤적 선택 및 개선 파이프라인에는 원본 실행과 보조 호출도 포함한다. TMAX-9B의 비용은 (0.08I + 0.13O)/10⁶ 달러이며, I와 O는 집계한 입력 및 출력 토큰을 뜻한다. 4B 단가는 4/9배로 조정하고, 27B는 입력 및 출력 토큰 1,000,000개당 각각 $0.30과 $2.00을 사용한다. 이 고정 단가는 로컬 서빙 모델의 비용을 근사하기 위한 값이다.
- B.5. Evaluation Effort는 반복적인 상호작용 실행 비용 때문에 평가를 작업당 3회로 제한한다고 설명한다. TMAX-9B 기본 에이전트에서 작업별 평균 실행 시간의 중앙값은 TerminalBench-Lite에서 7.2분, Terminal-Bench 2.1에서 10.5분이며, 작업별 평균 단계 수의 중앙값은 각각 21.0과 28.3이다. 이 시간은 환경 설정과 최종 평가를 제외하고 타임아웃이 발생한 실행의 소요 시간은 포함하며, 저자들의 서빙 설정에서 측정한 값이다.
- B.6. Verifier Prompt Templates는 B.6.1. Listwise Verification, B.6.2. Pointwise Verification, B.6.3. Pairwise Verification을 제공한다. 템플릿은 원래 작업, 실행 이력, 현재 상태, 미해결 요구사항, 반복 작업, 완료 근거를 기준으로 명령을 평가한다. Listwise는 선택 결과를, pointwise는 독립적으로 평가한 점수와 예상 다음 상태를, pairwise는 비교 추론과 점수 2개 및 선호를 출력한다.
- C. Additional Experiments and Results와 C.1. Numerical Performance Results는 주요 그래프의 정확한 수치를 제공한다. 후보 8개를 샘플링하고 처음으로 파싱 가능한 행동을 실행하면 Pass@1은 49.66%로, 기본 에이전트의 50.00%와 비교해 이 샘플링 및 파싱 절차의 이득은 관찰되지 않는다. N = 8에서 증류 decision-only 검증은 Pass@1 59.18%, Pass@3 73.47%에 도달하며, 추론 기반 증류 검증은 각각 57.14%, 75.51%다.
- C.2. End-to-End Costs with Decision-Only Verification은 N = 8에서 증류 TMAX-9B 행동 검증의 기준 단가 비용이 최종 출력당 $0.207에서 $0.157로 줄어든다고 보고한다. T = 3인 Best-of-T 결합에서는 Pass@1이 66.33%에서 65.31%로 변하고 비용은 $0.797에서 $0.608로 줄어든다. R = 1인 SR 결합에서는 Pass@1이 60.20%에서 65.99%로 변하고 비용은 $0.399에서 $0.309로 줄어든다. 별도로 수행한 실제 실행, 서로 다른 학습 목표와 집계 방식, 누락된 토큰 사용량 때문에 이 변화를 응답 형식만의 효과로 보기에는 한계가 있다.
- C.3. Additional Verifier Inference Compute에서는 검증기 출력을 늘려도 일관된 이득을 얻지 못한다. 쌍마다 응답 5개를 생성하면 검증기 출력이 4.99배가 되지만 증류 Pass@1은 57.14%에서 53.40%로 낮아진다. Thinking을 활성화하면 출력이 4.86배가 되면서 zero-shot Pass@1이 54.76%에서 56.12%로 높아진다. 평가한 루브릭 기반 검증 변형인 rubric scaling은 출력 2.26배로 55.10%에 도달한다.
- C.4. Uncertainty in Comparisons against Base Agent는 작업별 실행 3회를 함께 유지하면서 대응 작업 블록 98개를 100,000회 재표집한다. 증류 9B와 27B의 Pass@1 향상에 대한 개별 비교의 주변 95% 부트스트랩 신뢰구간은 각각 [+1.36, +12.93]퍼센트포인트와 [+0.34, +9.86]퍼센트포인트다. 나머지 기본 에이전트 대비 Mid-Harness 비교 4개의 구간에는 0이 포함된다. 이 분석은 해당 증류 설정 2개의 차이가 양수임을 뒷받침하지만, 모든 작업이나 벤치마크에서의 향상을 확정하지는 못한다.
- C.5. Mid-Harness Across Task Groups는 전체 성능 향상과 도메인별 성능 하락이 함께 나타남을 보여준다. 증류 검증은 평가한 세 규모 모두에서 소프트웨어 엔지니어링, 머신러닝, 디버깅, 시스템 설정을 개선하지만, 27B의 과학 계산 Pass@1은 10.0%p 낮춘다. 모델 전반에서 관찰된 실행 길이가 길어질수록 향상 폭이 단조롭게 커지지는 않는다. Extreme 그룹에는 세 작업만 있고, 빌드/의존성 그룹에는 4 tasks만 있다.
- D. Verifier Analysis, D.1. Offline Verifier Agreement, D.1.1. Score and Turn Diagnostics는 공통으로 유효한 쌍 10,197개에서 얻은 점수 관측값 20,394개를 설명한다. 상태 수준 검증 일치도는 상태 1,624개 중 1,355개를 남기고 유효하지 않은 비교가 하나라도 있는 상태 269개를 제외한다. 온라인의 점수 차이 가중 집계와 달리 저장된 링 비교 승리 횟수를 사용한다. 비교에 쓰는 정수 점수는 보정된 작업 성공 확률이 아니다. 점수 분포와 A/B 점수 결합 그래프는 증류가 검증기 평점을 교사 분포에 더 가깝게 만든다는 점을 보여준다.
- D.2. Remaining Verifier Disagreements와 D.2.1. Examples of the Two Largest Failure Categories는 교사를 기준으로 모델이 판단한 명령 의미 및 실행 가능성 오류를 예시로 보여준다. 한 검증기는 동등한 C 덧셈식 ‘a’ + s1과 s1 + ‘a’의 유효성이 다르다고 잘못 판단한다. 다른 검증기는 계획된 서비스 실행을 높게 평가하지만, 그 전에 수행하는 프로세스 패턴 매칭 정리가 서비스 실행 전에 명령 자체나 부모 프로세스를 종료할 수 있다는 점을 놓친다.
- D.3. Qualitative Examples of Action Verification과 D.3.1. Detailed Action-Verification Traces는 후보 8개와 피벗 4개를 사용하는 TMAX-27B zero-shot 실행에서 복구 사례 1개와 오류 사례 1개를 제시한다. Recovery Example: React and TypeScript Production Build에서는 diagnostics.ignoreCodes: [6137]을 선택한 뒤 Jest 테스트 스위트 3개 전체, 테스트 16개, 외부 테스트 17/17개를 통과한다. 기본 에이전트는 0/3회, Mid-Harness는 3/3회 성공한다. 성공한 선호 판단에도 diagnostics.exclude가 유효하지 않다는 잘못된 주장이 남아 있다. 논문은 diagnostics.exclude가 파일 경로를 필터링하고 ignoreCodes는 진단 코드를 필터링한다고 설명한다.
- Verifier Error: Build-System Alias Canonicalization에서는 검증기가 명시적인 사전순 규칙과 풀이 예시 사이의 충돌을 조사하는 대신 재작성을 선호한다. 선택한 휴리스틱은 표준 이름을 고를 때 헤더 이름을 제외해 평가기가 기대하는 build 대신 compile을 생성한다. 이 실행은 테스트 11/12개를 통과하지만 최종 보상은 0이다. 이는 즉각적인 수정을 선호하면 요구 동작에 관한 미해결 근거를 놓칠 수 있음을 보여준다.
짧은 생각
이 논문에서 가장 유용한 결과는 생성기를 고정한 상태에서 약한 행동 선택과 강한 행동 선택 사이에 나타나는 차이다. 검증기만 학습해도 온라인 성공률이 높아지지만, 후보 수만 늘리면 이득이 작은 경우가 많다. 이는 추가 후보 명령, 검증기 학습, 전체 작업 실행 중 어디에 비용을 쓸지 비교할 실험적 근거를 제공한다.
실용적인 비교를 하려면 검증기 품질과 전체 파이프라인 비용을 함께 고려해야 한다. Pairwise 검증은 연산을 크게 늘리고, 교사 일치도는 모방 정도를 측정하며, 여러 신뢰구간에는 0이 포함된다. Decision-only 결과도 모델 규모와 후보 수에 따라 달라진다. 보고된 토큰 비용 추정치는 명시된 집계 가정 아래에서 비교를 뒷받침하지만, 실제 배포 지연 시간의 절감을 입증하지는 않는다.