2025년 2월 AI 논문 동향
28 Feb 2025 | Paper Review Monthly Papers Test-Time Scaling Knowledge Distillation Quantization목차
이달의 트렌드
2025년 2월의 주제는 언어 모델의 자원 배분이며, 선정된 논문 3편은 서로 다른 예산에서 추론 연산량, 교사의 지도 신호, 가중치 정밀도가 품질에 미치는 영향을 살펴본다. s1은 답변을 생성하는 동안 연산량을 늘리는 test-time scaling을 연구한다. Distillation Scaling Laws는 교사의 출력 확률로 학생을 학습하는 지식 증류를 연구한다. Matryoshka Quantization은 가중치를 더 적은 수의 이산값으로 표현하는 양자화를 연구한다. 세 연구는 제어하는 자원을 명확히 구분하면서 각각 추론 정확도, 검증 손실, 가중치 저장 공간 예산별 정확도를 측정한다. 1, 2, 3
교사의 지도 신호는 이들 학습 결과를 연결하지만, 지도 방식에는 차이가 있다. s1은 선별한 질문 1,000개와 교사가 생성한 reasoning trace로 사전학습 모델을 조정한다. Reasoning trace는 답변에 앞서 생성되는 중간 추론 과정이다. Distillation Scaling Laws는 교사의 전체 확률분포로 학습할 때 학생 성능을 예측하는 식을 적합한다. 또한 교사와 학생의 학습 능력이 맞지 않아 더 강한 교사가 오히려 학생 성능을 낮출 수 있는 capacity gap을 확인한다. 이 법칙은 생성된 시퀀스로 학습하는 경우에는 검증되지 않았으므로 s1의 결과를 직접 설명하지는 못한다. MatQuant도 고정밀도 출력으로 저정밀도 모델을 지도하는 co-distillation을 시험하며, 이득은 구성에 따라 달라진다.
공학적으로는 품질과 함께 전체 자원 비용을 비교해야 한다. s1에서 추론을 늘려 얻는 성능 향상은 결국 정체되며, 학습 예제 1,000개라는 집계에는 사전학습과 교사 데이터 생성 비용이 빠져 있다. 증류 연구는 고정된 연산 예산에서 예측 손실을 최소화하는 계산 최적 비교를 수행한다. 이 비교에서 교사의 학습 비용 전부를 학생 하나에 부과하면 직접 지도 학습이 유리하다. MatQuant는 낮은 가중치 정밀도에서 정확도를 높이지만, 지연 시간이나 처리량의 개선을 측정해 제시하지는 않는다. 이 결과들은 구체적인 자원 설정을 시험할 근거를 제공하지만, 종단 간 효율성을 비교하는 공통 척도를 확립하지는 않는다.
2025년 2월의 주요 논문
1. s1: Simple test-time scaling
- https://arxiv.org/abs/2501.19393
- s1: Simple test-time scaling 요약 설명
- s1: Simple test-time scaling은 품질, 난도, 다양성을 기준으로 선별한 예제 1,000개로 구성된 s1K와, 제공된 추론 과정 및 답변으로 학습하는 지도 미세조정을 결합한다. NVIDIA H100 그래픽 처리 장치 16개로 Qwen2.5-32B-Instruct를 조정하는 데 26분이 걸린다. 이후 budget forcing으로 추론 종료 시점을 제어한다. 사고 종료 표식을 삽입하면 추론이 짧아지고, 표식을 억제하면서 “Wait”를 덧붙이면 추론이 길어진다.
- 2024 American Invitational Mathematics Examination의 문제 30개로 구성된 AIME24에서 정확도는 기반 모델의 26.7%에서 미세조정 후 50.0%, budget forcing 적용 후 56.7%로 높아진다. 이 비교는 학습으로 얻은 향상과 추가 추론 개입으로 얻은 향상을 구분한다. 추론 중 생성하는 단위인 사고 토큰을 최대 약 30,000개로 동일하게 제한하면, 선별한 부분집합의 정확도는 50.0%, 전체 59K-example 데이터 풀의 정확도는 53.3%다. 학습에는 각각 약 7 H100 GPU 시간과 394 H100 GPU 시간이 필요하다.
- 추론 연장의 이점은 시험한 범위 안에서만 확인된다. 종료를 반복해서 억제하면 성능이 결국 정체되며, 같은 내용을 반복하거나 모델의 최대 시퀀스 길이를 초과할 수 있다. 독립적인 시도에서 가장 자주 나온 답을 선택하는 majority voting과의 비교는 학습과 추론 방법을 모두 바꾸므로 순차 연산과 병렬 연산의 효과를 분리하지 못한다. 전체 데이터 풀과 비교한 차이의 불확실성 구간에는 성능 향상과 하락이 모두 포함된다. 이는 s1K의 경쟁력을 뒷받침하지만 통계적 동등성을 입증하지는 않는다. s1.1의 부록 결과는 2025년 3월에 추가되었으며 원래 실험과 구분된다.
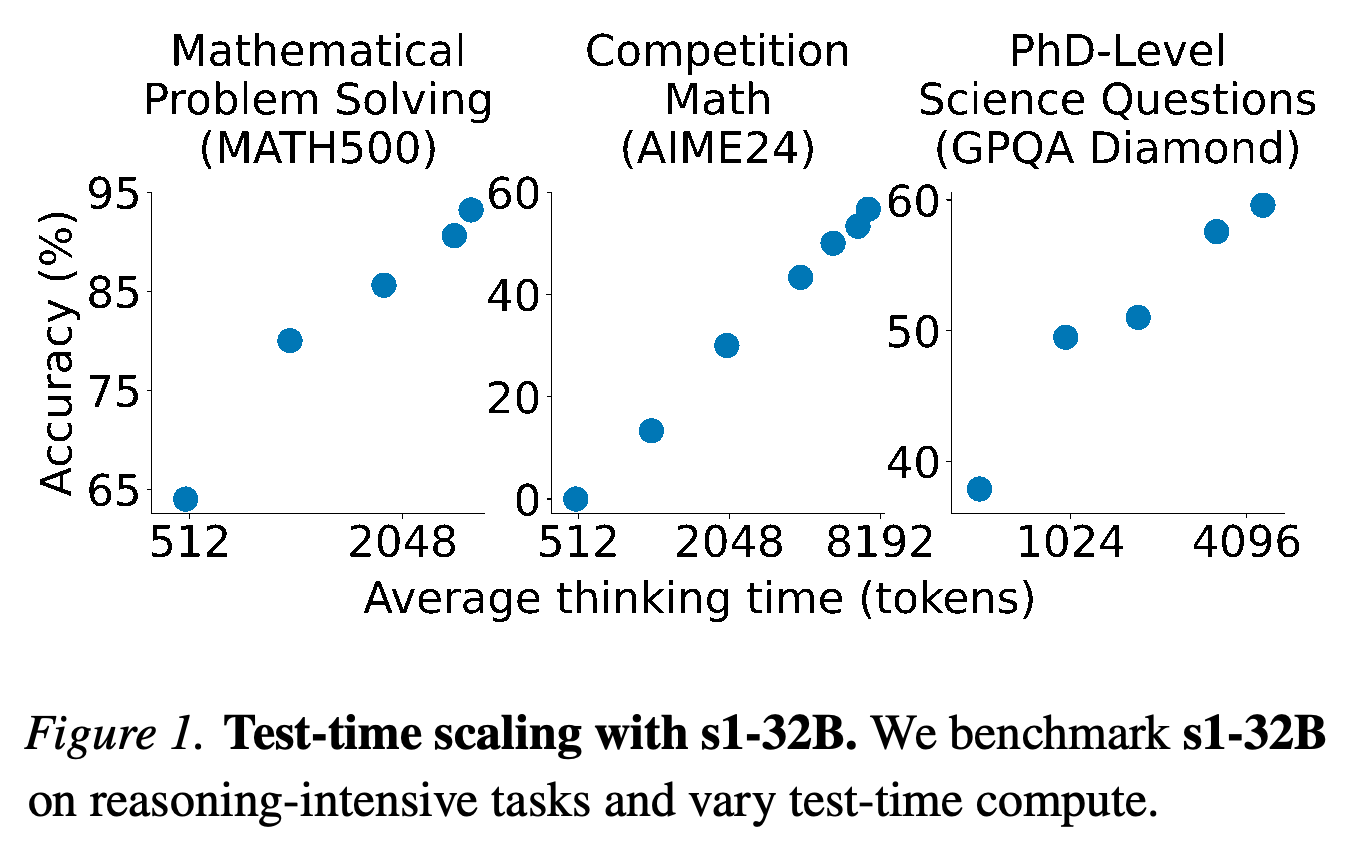
표시된 설정 범위에서는 벤치마크 3개 모두 평균 사고 토큰 사용량이 늘수록 정확도가 높아진다. 이 유한한 범위는 실험한 동작 지점을 보여주며, 범위 밖에서도 계속 개선됨을 입증하지는 않는다.
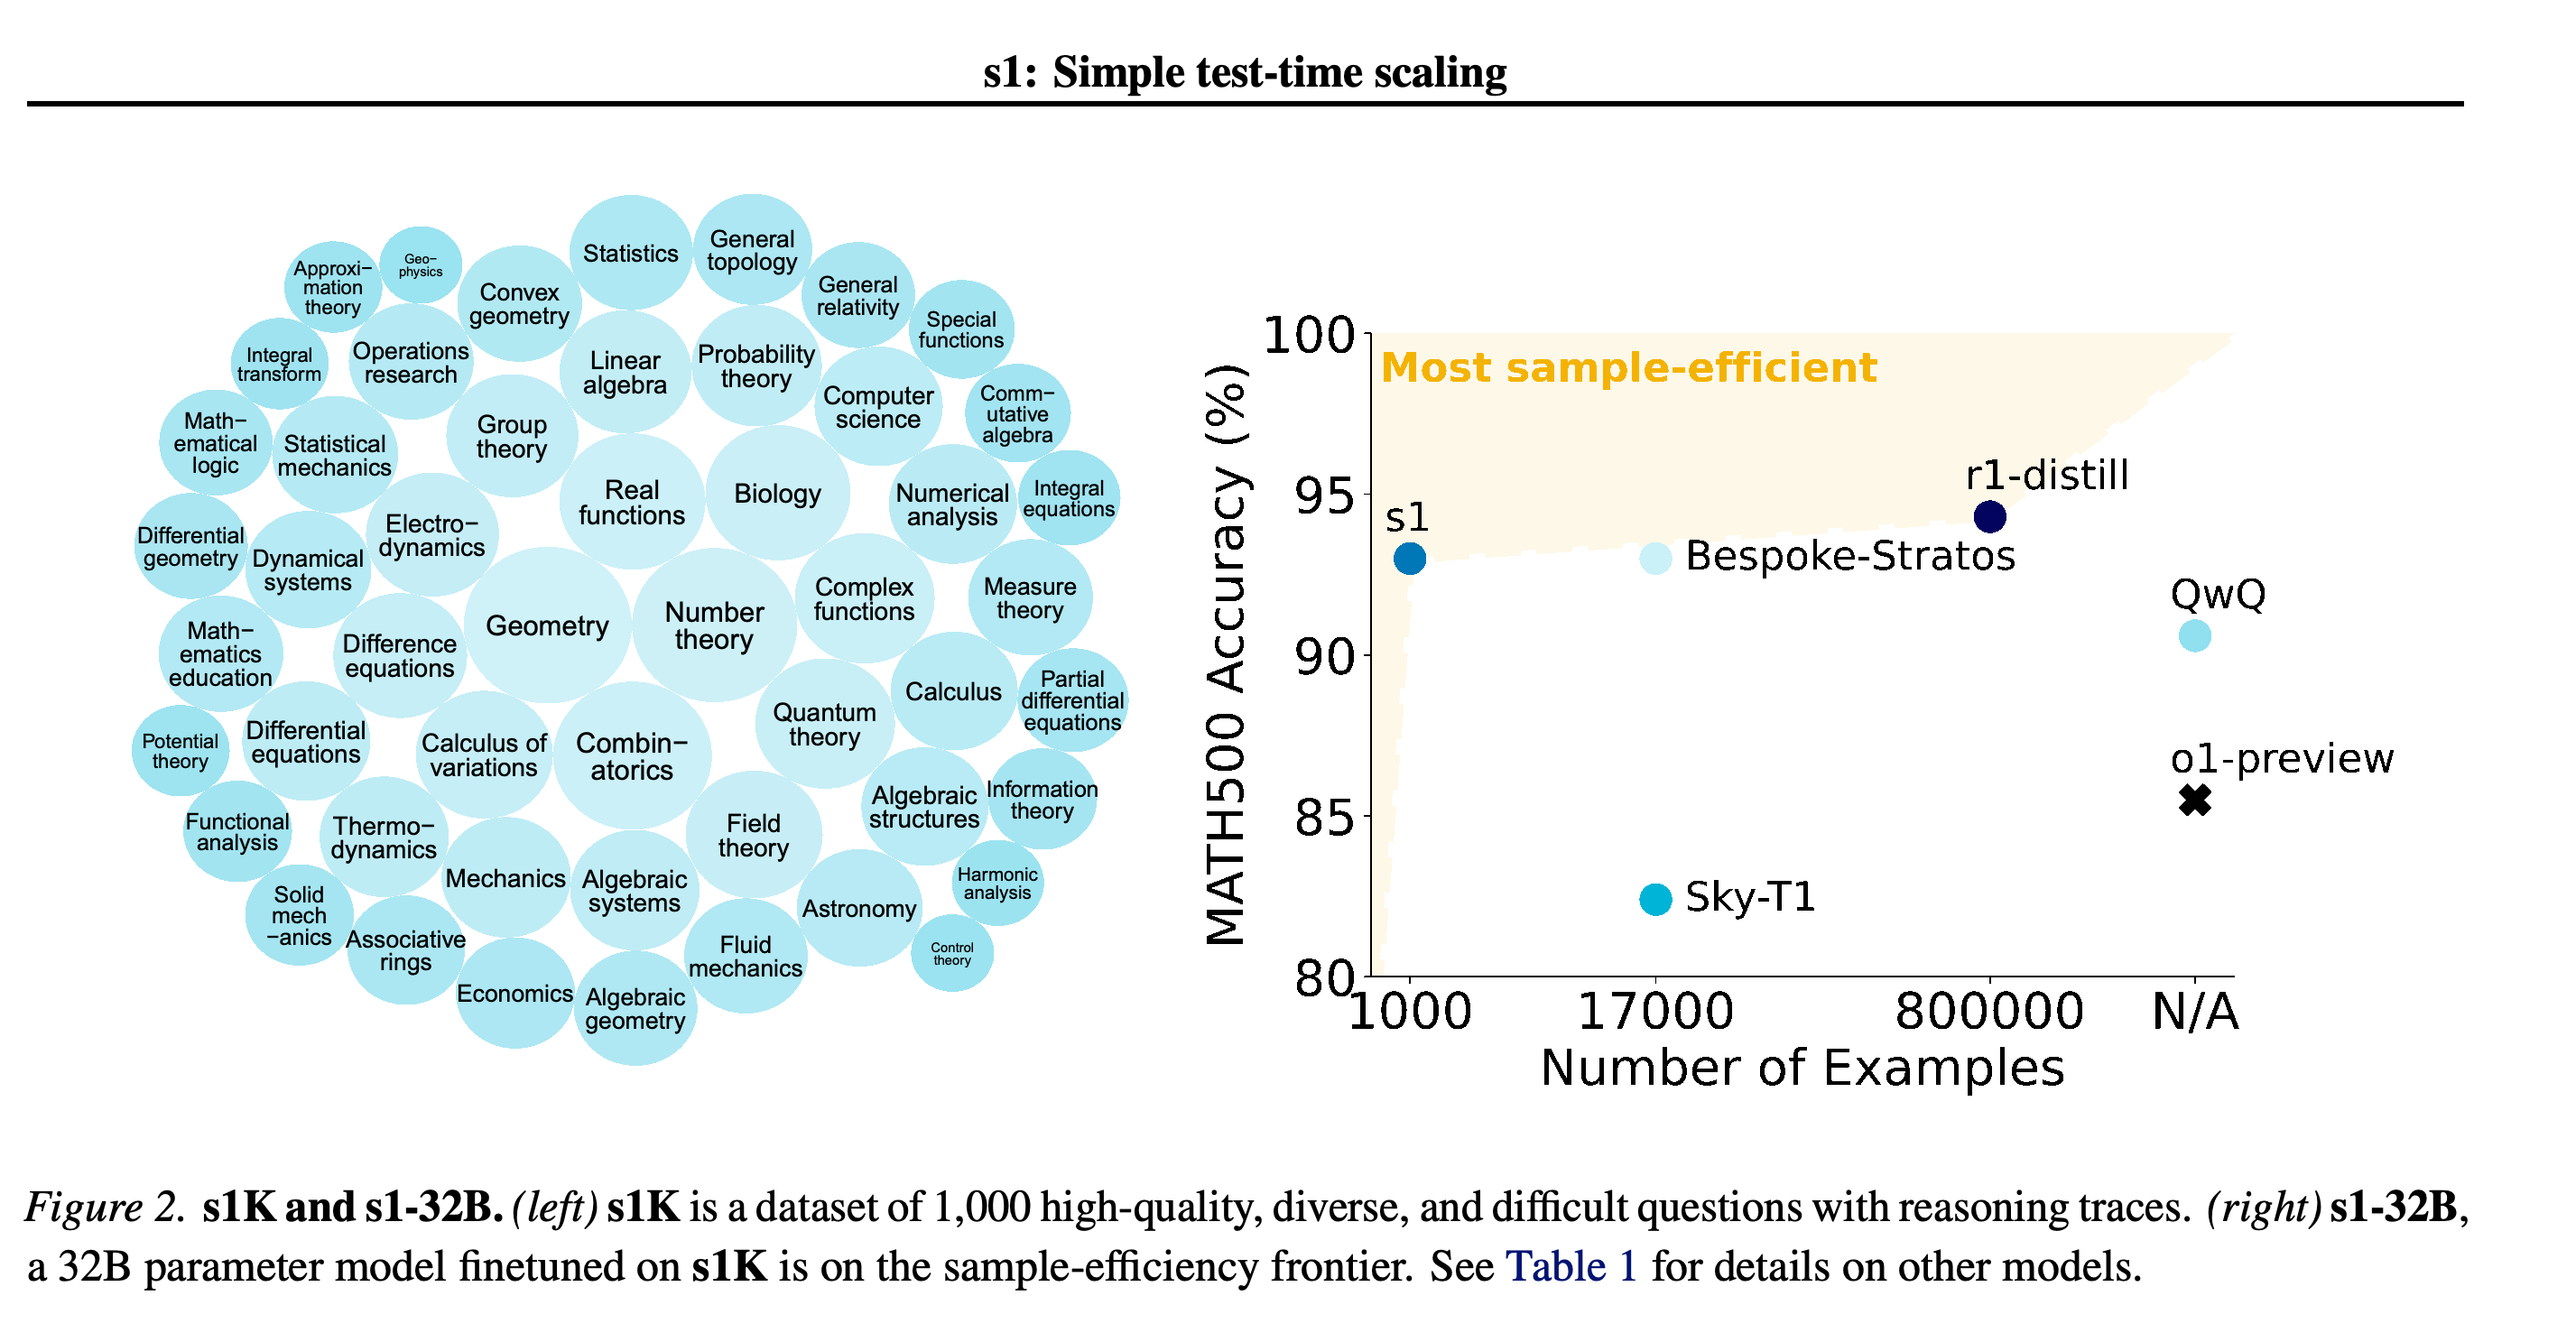
영역 분포는 선별한 예제가 다양한 주제를 포괄함을 보여준다. 비교 그래프에서 s1은 훨씬 큰 추론 데이터셋으로 학습한 모델과 비슷한 MATH500 정확도를 보인다. 예제 수에는 사전학습과 교사 데이터 생성 비용이 제외되어 있다.
2. Distillation Scaling Laws
- https://arxiv.org/abs/2502.08606
- Distillation Scaling Laws 요약 설명
- Distillation Scaling Laws는 학생 파라미터 수, 증류 토큰 수, 교사 검증 손실로 학생의 검증 교차 엔트로피를 예측한다. 검증 교차 엔트로피는 관측된 토큰에 부여한 음의 로그 확률의 평균이다. 이 경험적 법칙은 증류 실험 697회에 적합했으며, 약한 모델에서 강한 모델로 외삽한 검증을 포함해 보고된 상대 예측 오차는 약 1% 이하이다. 실험은 English C4 텍스트와 토큰 임베딩 가중치를 제외한 파라미터 수가 143M부터 12.6B까지인 모델을 사용하며, 최대 512B 토큰까지 학습한다.
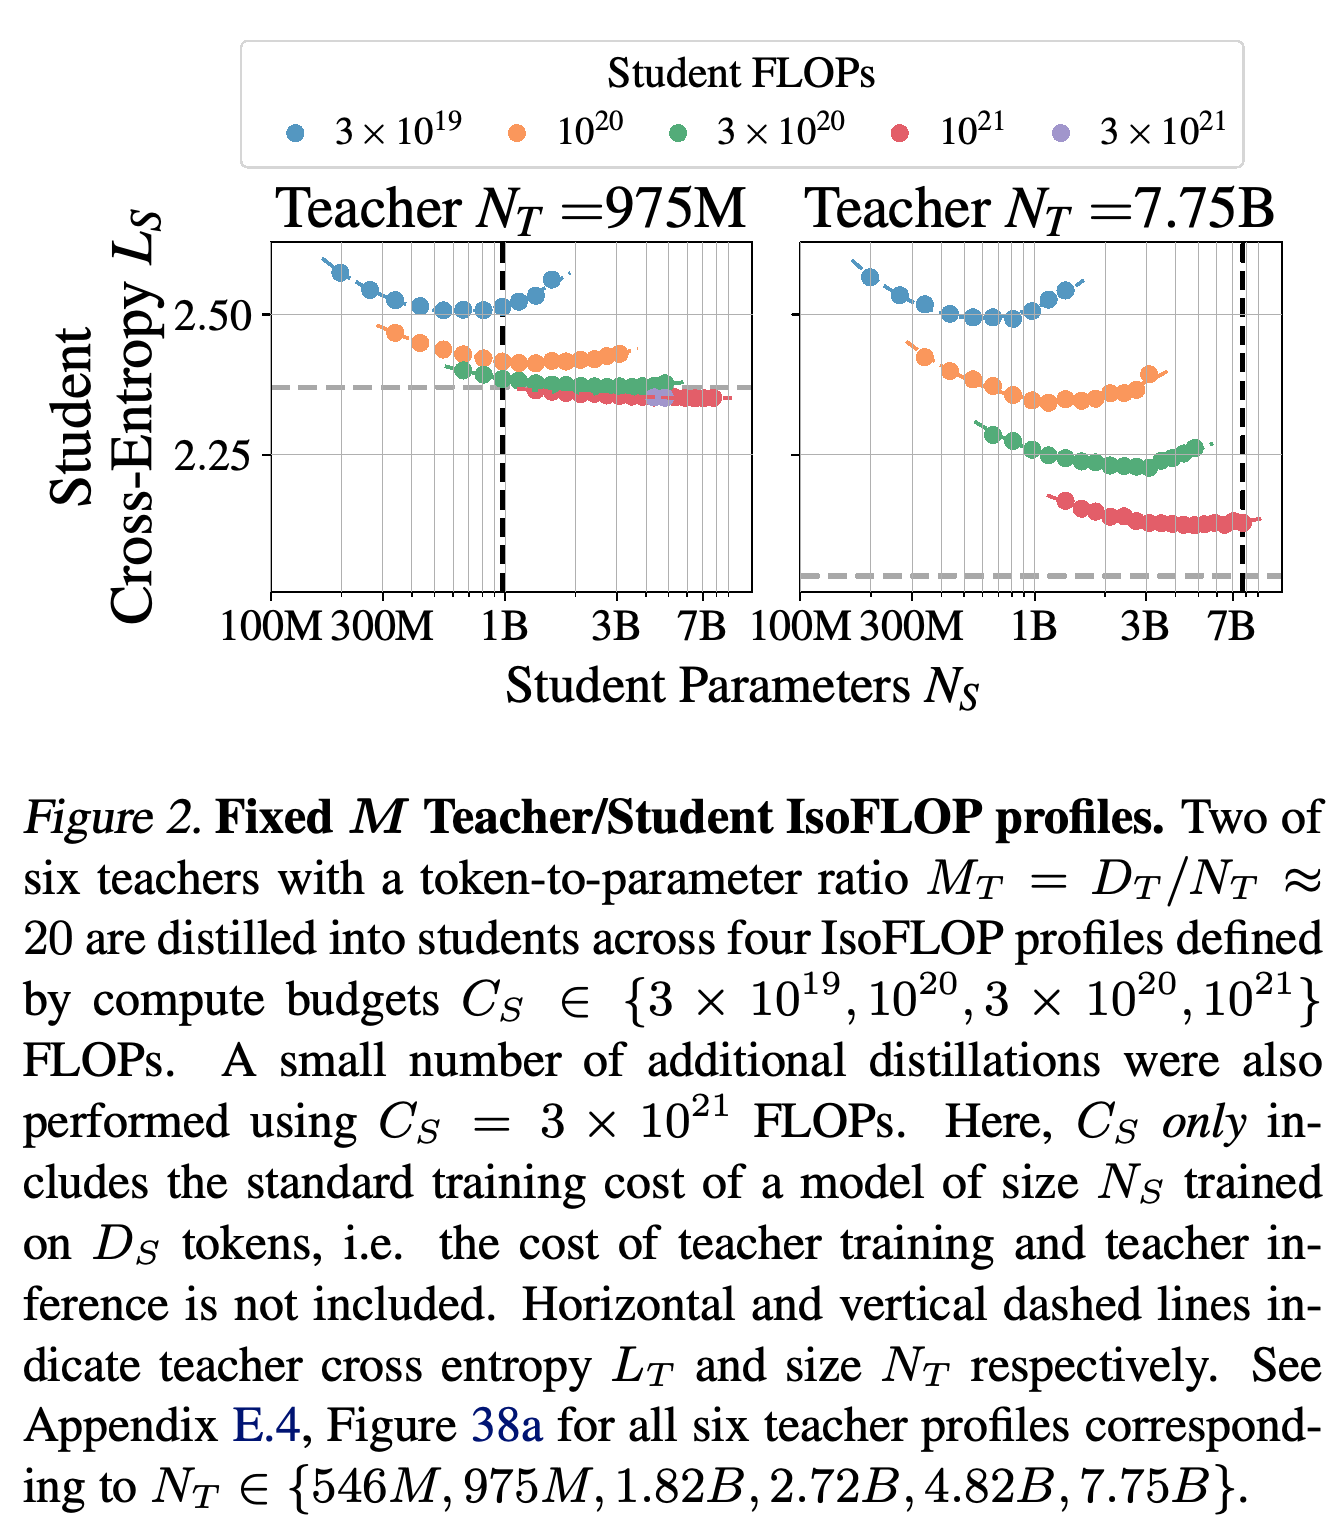
- 최적의 교사 품질은 학생에 따라 달라진다. 학생 크기와 토큰 예산을 고정하면 교사 검증 손실이 개선될수록 학생 손실이 먼저 줄다가 다시 늘어날 수 있다. 이는 capacity gap을 보여준다. 교사 비용을 제외하면 학생 예산이 크지 않을 때 적절한 교사를 사용하는 증류가 관측된 다음 토큰으로 직접 지도 학습하는 방식보다 우수할 수 있다. 교사 추론 비용을 포함하면 추가적인 상충 관계가 생긴다. 더 큰 교사는 지도 신호를 개선할 수 있지만, 예산 안에서 학생 학습에 사용할 수 있는 토큰 수를 줄인다.
- 적합한 법칙을 이용한 논문의 계산 최적 비교에서는 교사 학습 비용 전부를 학생 하나에 부과하면 직접 지도 학습이 유리하다. 교사를 재사용하거나 비용을 분담하면 비용 계산이 달라질 수 있다. 학생 예산이 충분히 커지면 지도 학습도 최적으로 선택한 증류와 같은 성능에 도달한다. 계수는 시험한 아키텍처와 데이터셋에 한정되며, 생성된 시퀀스를 이용한 증류와 추론 성능은 입증된 범위 밖에 있다. 관측된 학습 범위를 크게 벗어난 수치적 최적점은 적합한 식에서 얻은 예측이다.
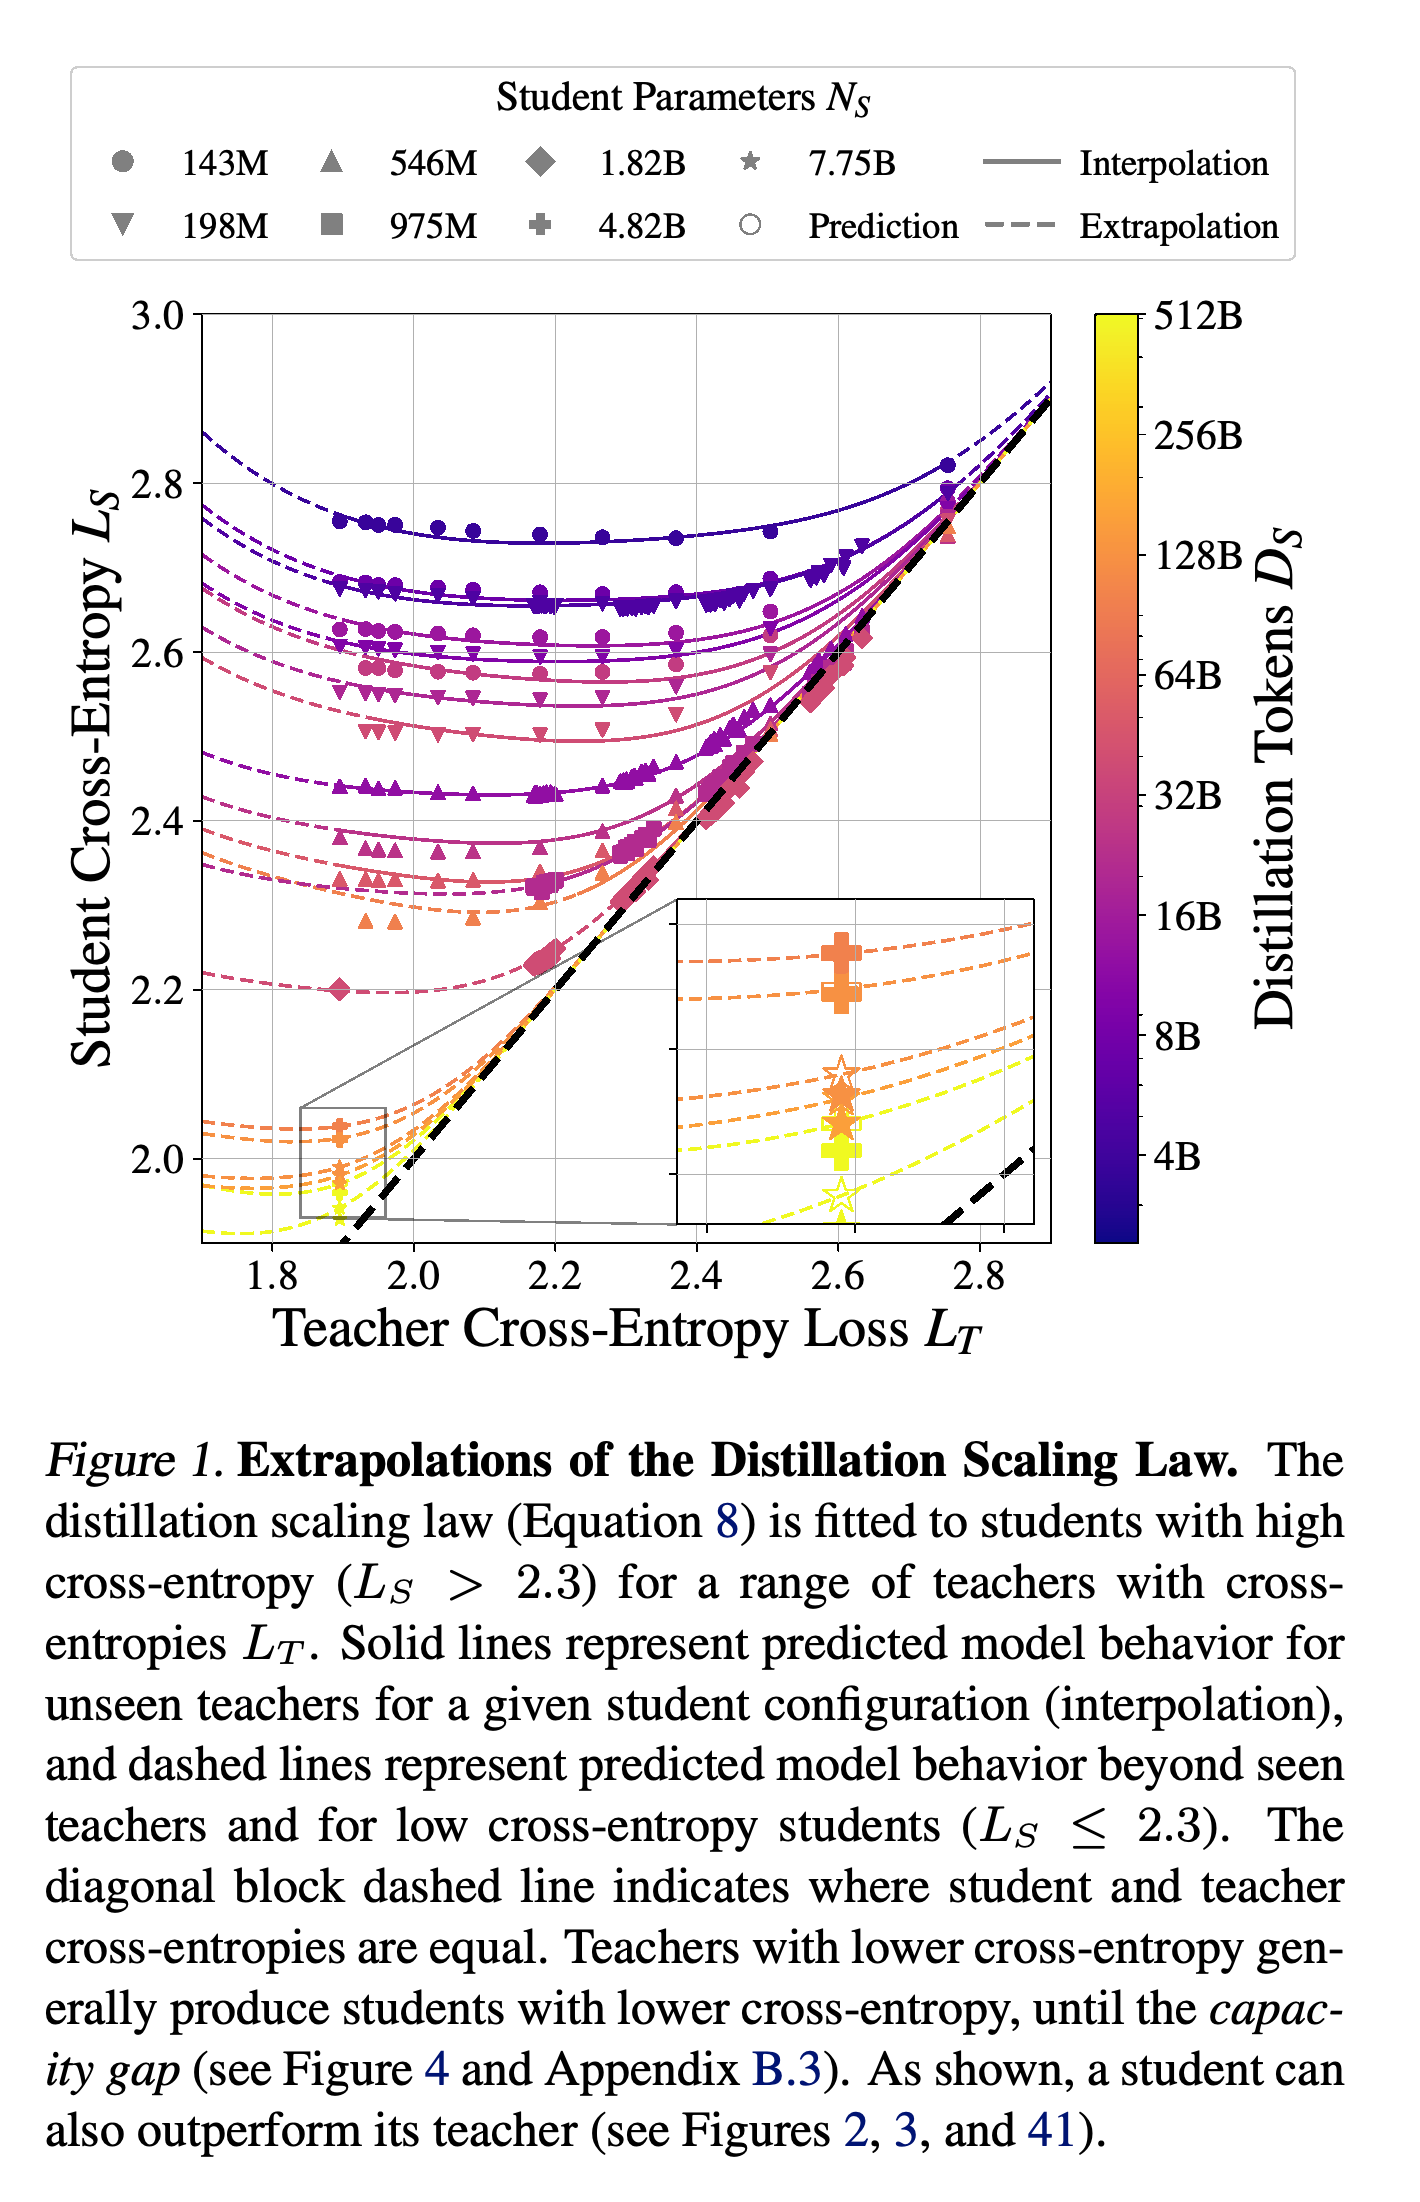
L_S > 2.3인 학생에 적합한 예측은 손실이 더 낮은 학생과 적합에서 보지 못한 교사 구성도 잘 따라간다. 곡선 관계는 교사 손실 개선이 학생에 따라 정해지는 최적점까지만 도움이 된다는 점을 보여주며, 외삽 검증을 capacity gap 현상과 연결한다.
고정 계산량 프로파일은 파라미터 수와 학습 토큰 수를 함께 바꿔야 하는 이유를 보여준다. 학생 크기를 키우면 사용 가능한 토큰 수가 줄어 결국 손실이 높아질 수 있다. 교사 사전학습과 추론 비용을 제외해 학생 학습 자원 배분의 영향을 분리한다.
3. Matryoshka Quantization
- https://arxiv.org/abs/2502.06786
- Matryoshka Quantization 요약 설명
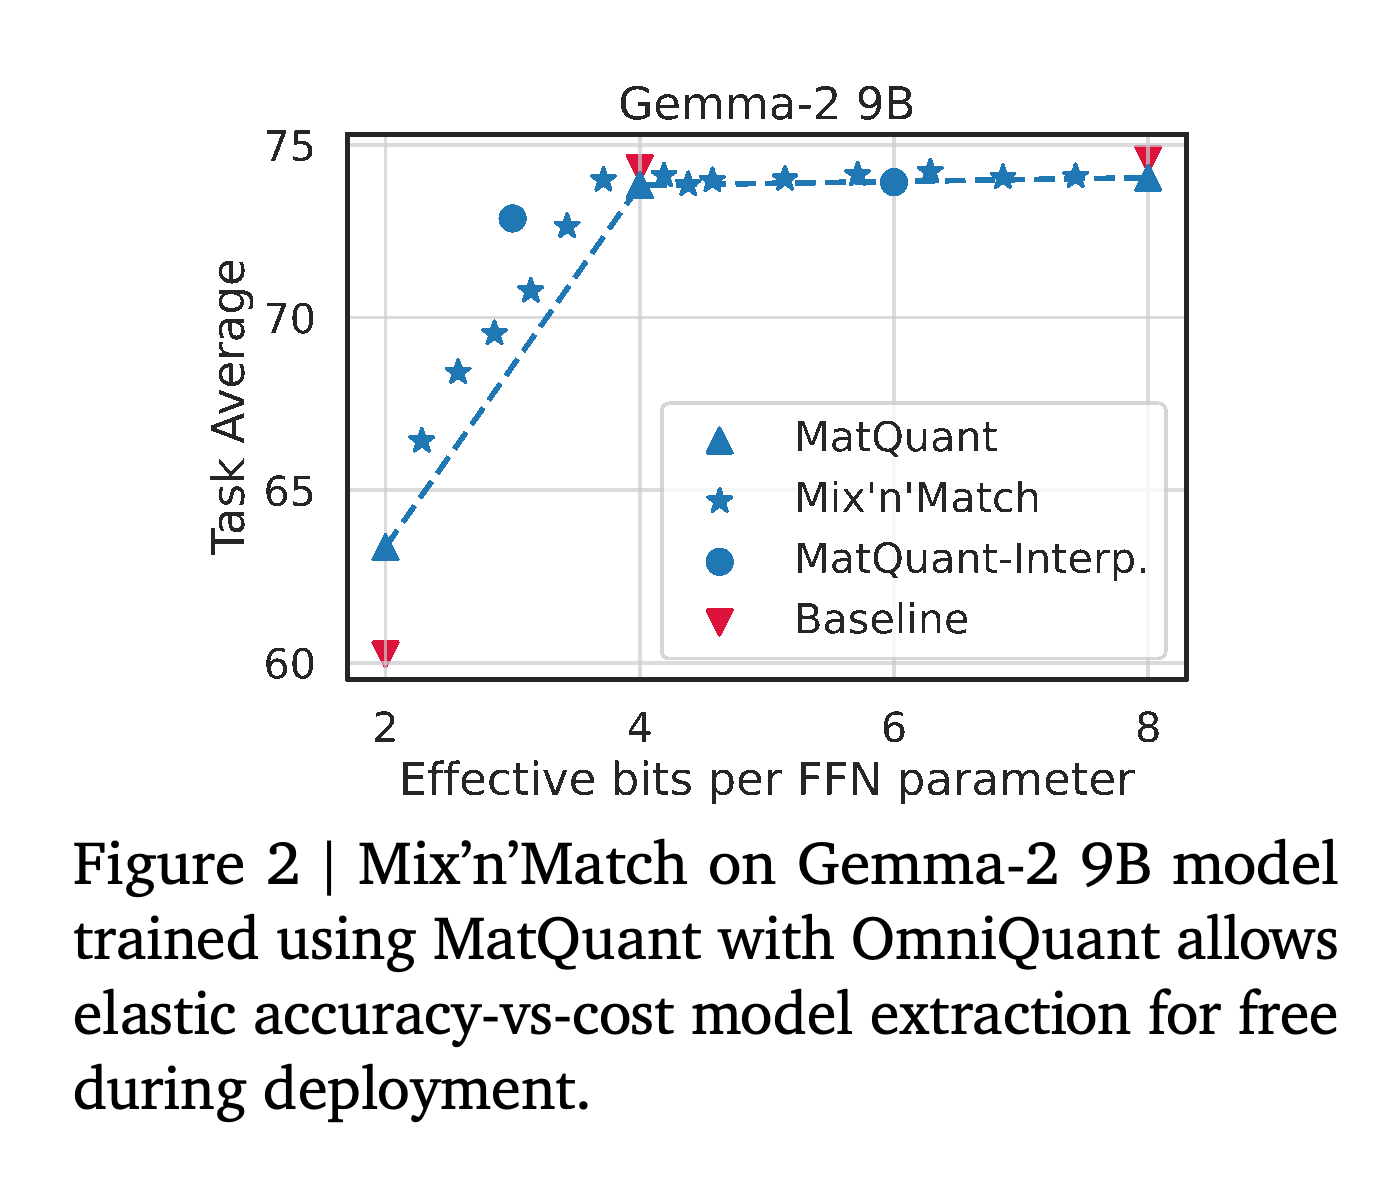
- Matryoshka Quantization, 줄여서 MatQuant는 공유 정수 가중치를 각각 8, 4, 2비트로 표현하는 int8, int4, int2를 함께 학습한다. 저정밀도 표현은 반올림, 목표 정수 범위로의 제한, 재스케일링을 거쳐 추출한다. 공유 표현에서 추가 학습 없이 int3와 int6 모델도 얻을 수 있다. 계층마다 서로 다른 정밀도를 할당하는 Mix’n’Match도 지원한다.
- Gemma-2 2B, Gemma-2 9B, Mistral 7B에서 각 계층의 feed-forward 블록에 속한 가중치만 양자화하면, 엄격한 int2 MatQuant는 독립적으로 학습한 int2 베이스라인보다 과제 6개의 평균 정확도를 높인다. 모델 가중치를 고정하고 양자화 매개변수를 학습하는 OmniQuant에서 향상 폭은 모델 순서대로 1.04, 3.11, 3.01%포인트다. 양자화한 순전파로 가중치를 갱신하는 Quantization Aware Training에서는 각각 4.46, 6.27, 7.02점이다. OmniQuant의 int2 베이스라인은 학습 토큰 20M개를 사용하고 MatQuant는 10M개를 사용한다.
- Errata는 엄격한 2-bit MatQuant와 Extra Precison MatQuant를 구분한다. 후자는 양자화 값을 추가로 유지하며, 양자화한 가중치당 평균 약 2.05비트를 사용한다. Gemma-2 9B에 OmniQuant와 co-distillation을 적용한 추가 정밀도 변형은 평균 정확도 70.17에 도달한다. 이 결과는 엄격한 int2와 표현에 필요한 자원량이 다르며, 추가 비트를 별도로 처리해야 한다. 중간 정밀도의 성능이 항상 독립 학습과 같은 수준에 도달하지는 않으며, 논문은 실행 속도 향상이나 종단 간 메모리 절감량을 벤치마크하지 않는다.
중첩 비트 도식은 여러 정밀도의 손실이 공유 정수 가중치에 작용하는 방식을 보여주며, 히스토그램은 공동 학습이 양자화 버킷의 점유율을 바꾼다는 점을 보여준다. 캡션의 int2 성능 향상 폭이 8%를 넘는다는 주장은 Table 1의 수정된 엄격한 int2 비교와 맞지 않으므로, Errata의 추가 정밀도 구분을 고려해 해석해야 한다.
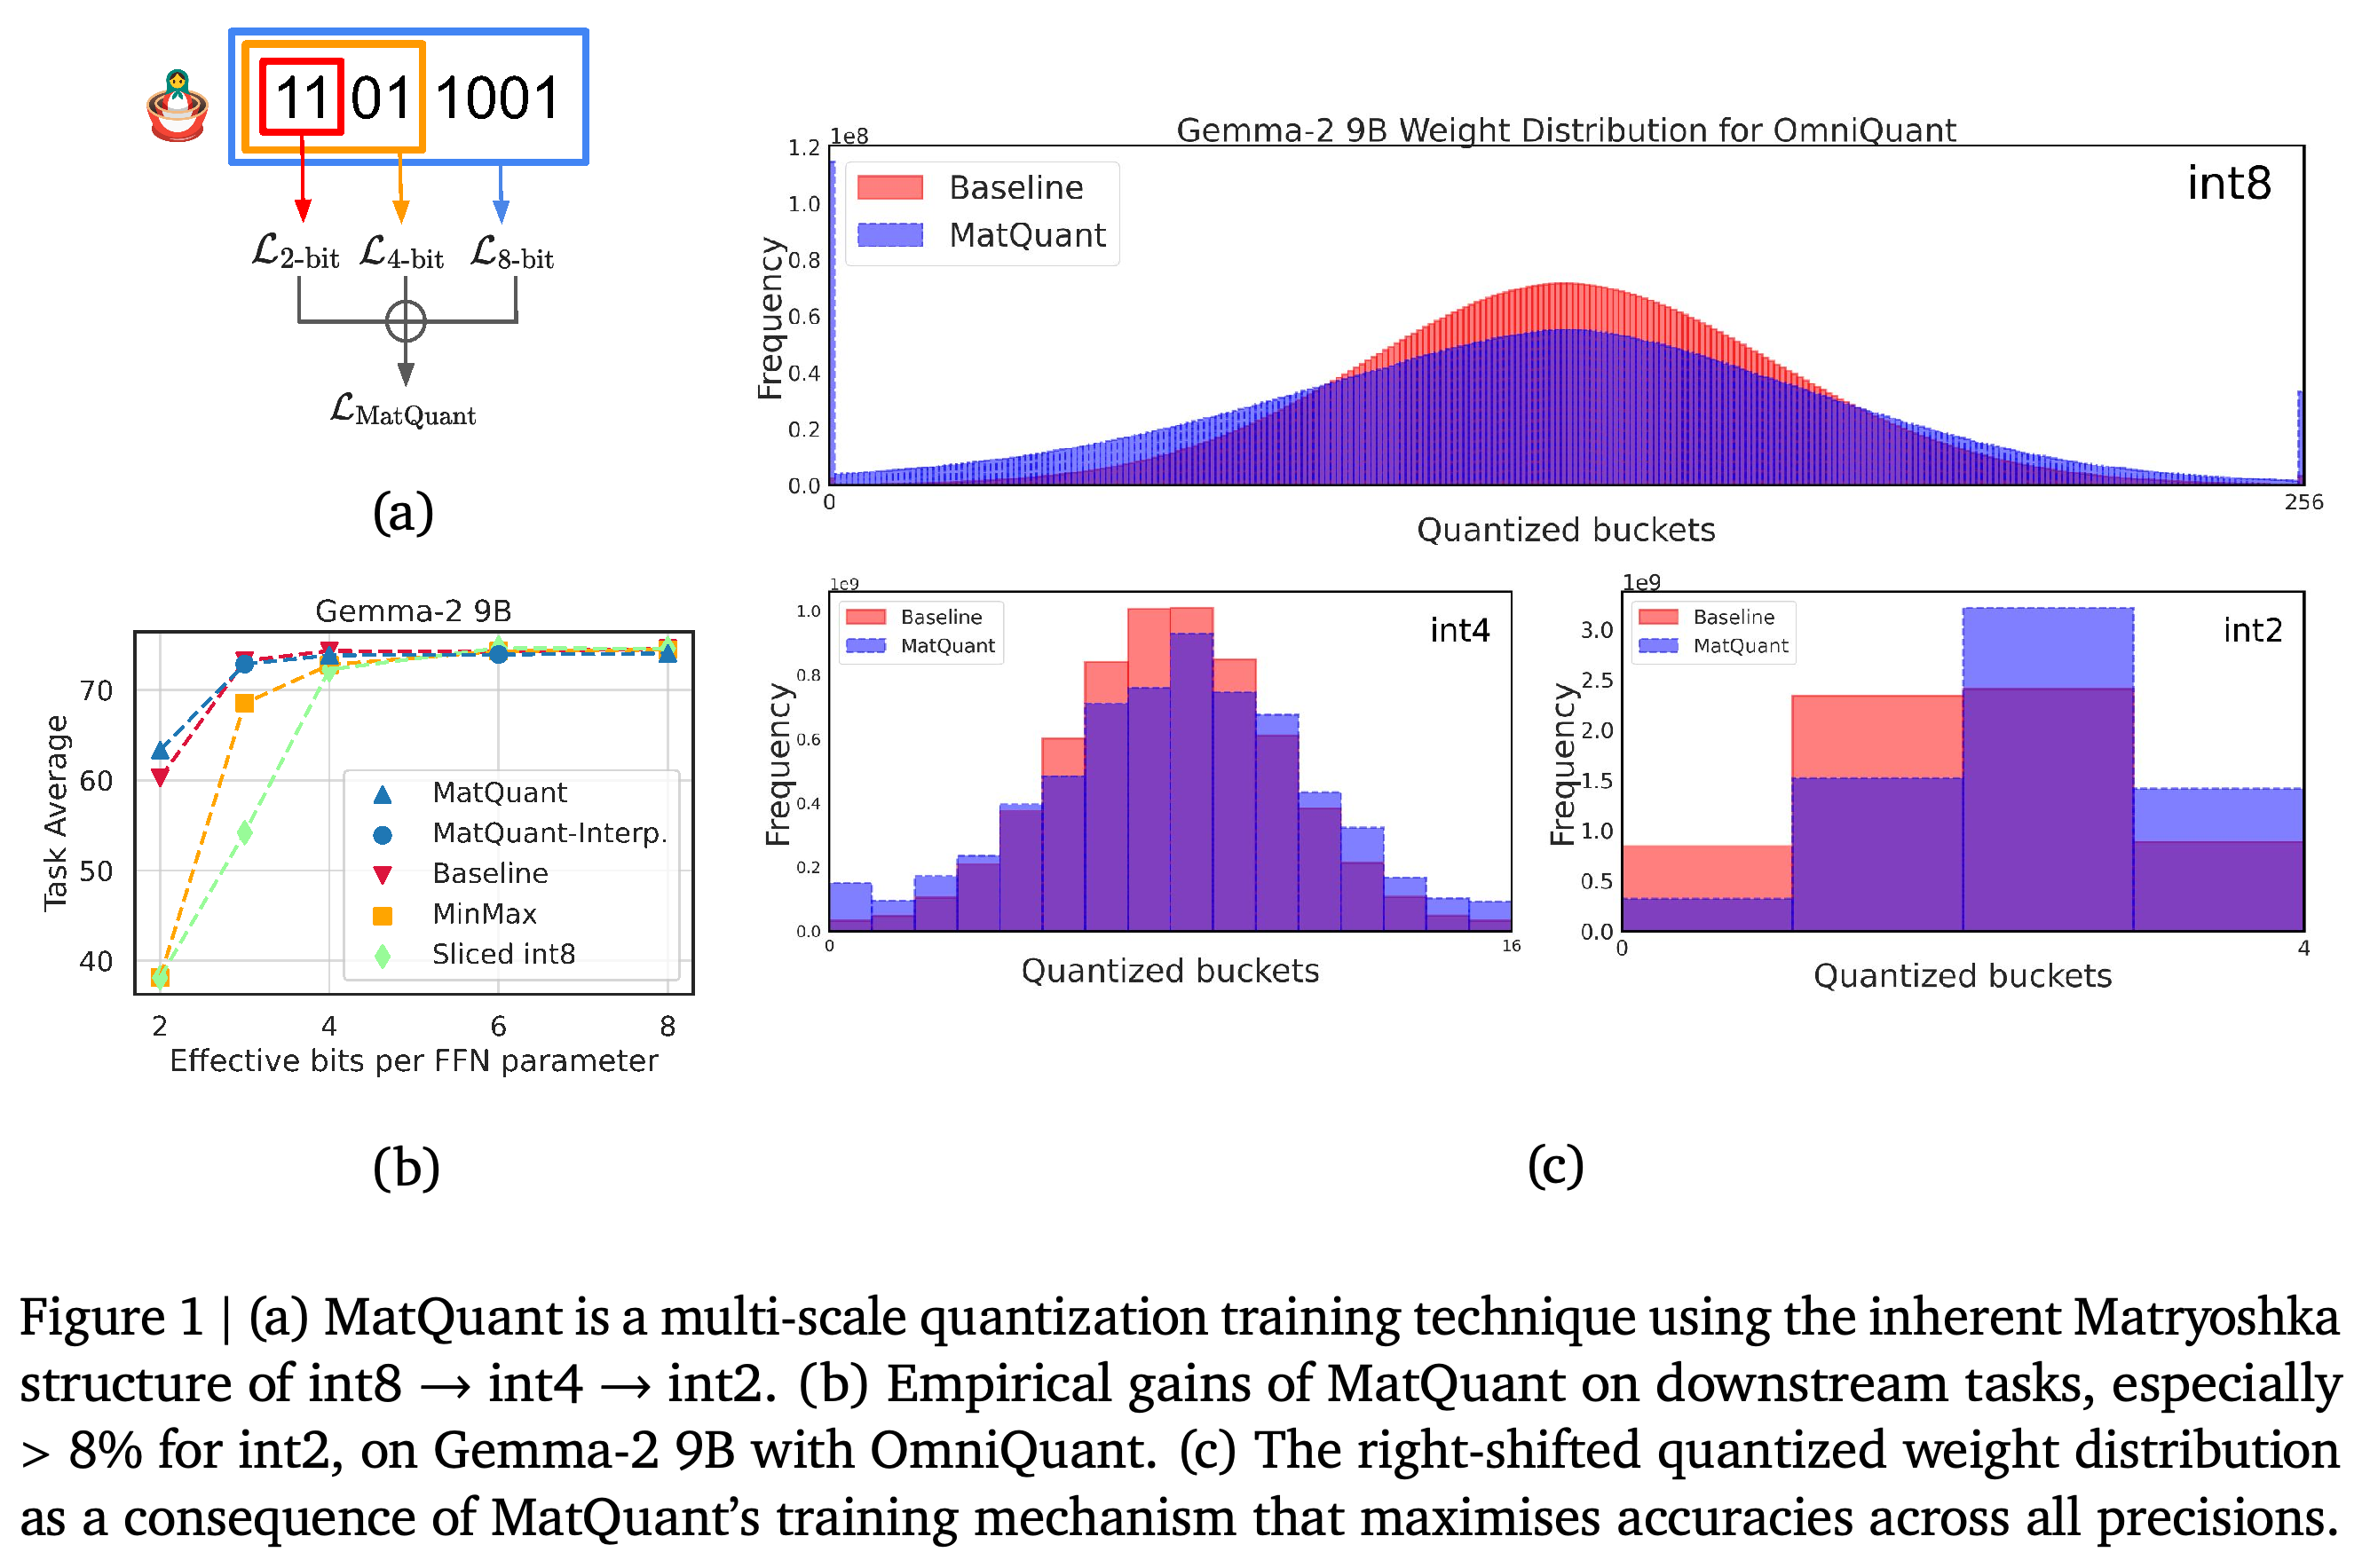
선택한 혼합 정밀도 구성들은 동일 정밀도 선택지 사이의 간격을 채운다. 유효 비트 수가 4 미만이면서 int4 슬라이스보다 정확도가 높은 구성도 포함된다. FFN 매개변수당 유효 비트 수는 가중치 저장 공간의 한도를 나타내며, 추론 지연 시간을 직접 측정하지는 않는다.