


Matryoshka Quantization 요약 설명
10 Feb 2025 | Paper Review Model Compression Quantization Aware Training Knowledge Distillation목차
이번 글에서는 Matryoshka Quantization 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 2월 10일(Arxiv)
- Nair, Pranav, Datta, Puranjay, Dean, Jeff, Jain, Prateek, Kusupati, Aditya.
- Google DeepMind
- 논문 링크
요약
- 양자화는 모델 가중치를 더 적은 수의 이산값으로 표현해 저장 공간을 줄이지만, 정확도를 낮출 수 있고 배포 환경의 자원 한도마다 별도의 모델을 요구할 수 있다. Feed-forward network(FFN) 가중치만 양자화했을 때, Matryoshka Quantization(MatQuant)은 독립적으로 학습한 2-bit baselines보다 평균 다운스트림 정확도를 OmniQuant에서 1.04–3.11%p, Quantization Aware Training(QAT)에서 4.46–7.02%p 높인다. 전자는 모델 가중치를 고정한 채 양자화 매개변수를 학습하며, 후자는 양자화한 순전파를 사용해 가중치를 갱신한다.
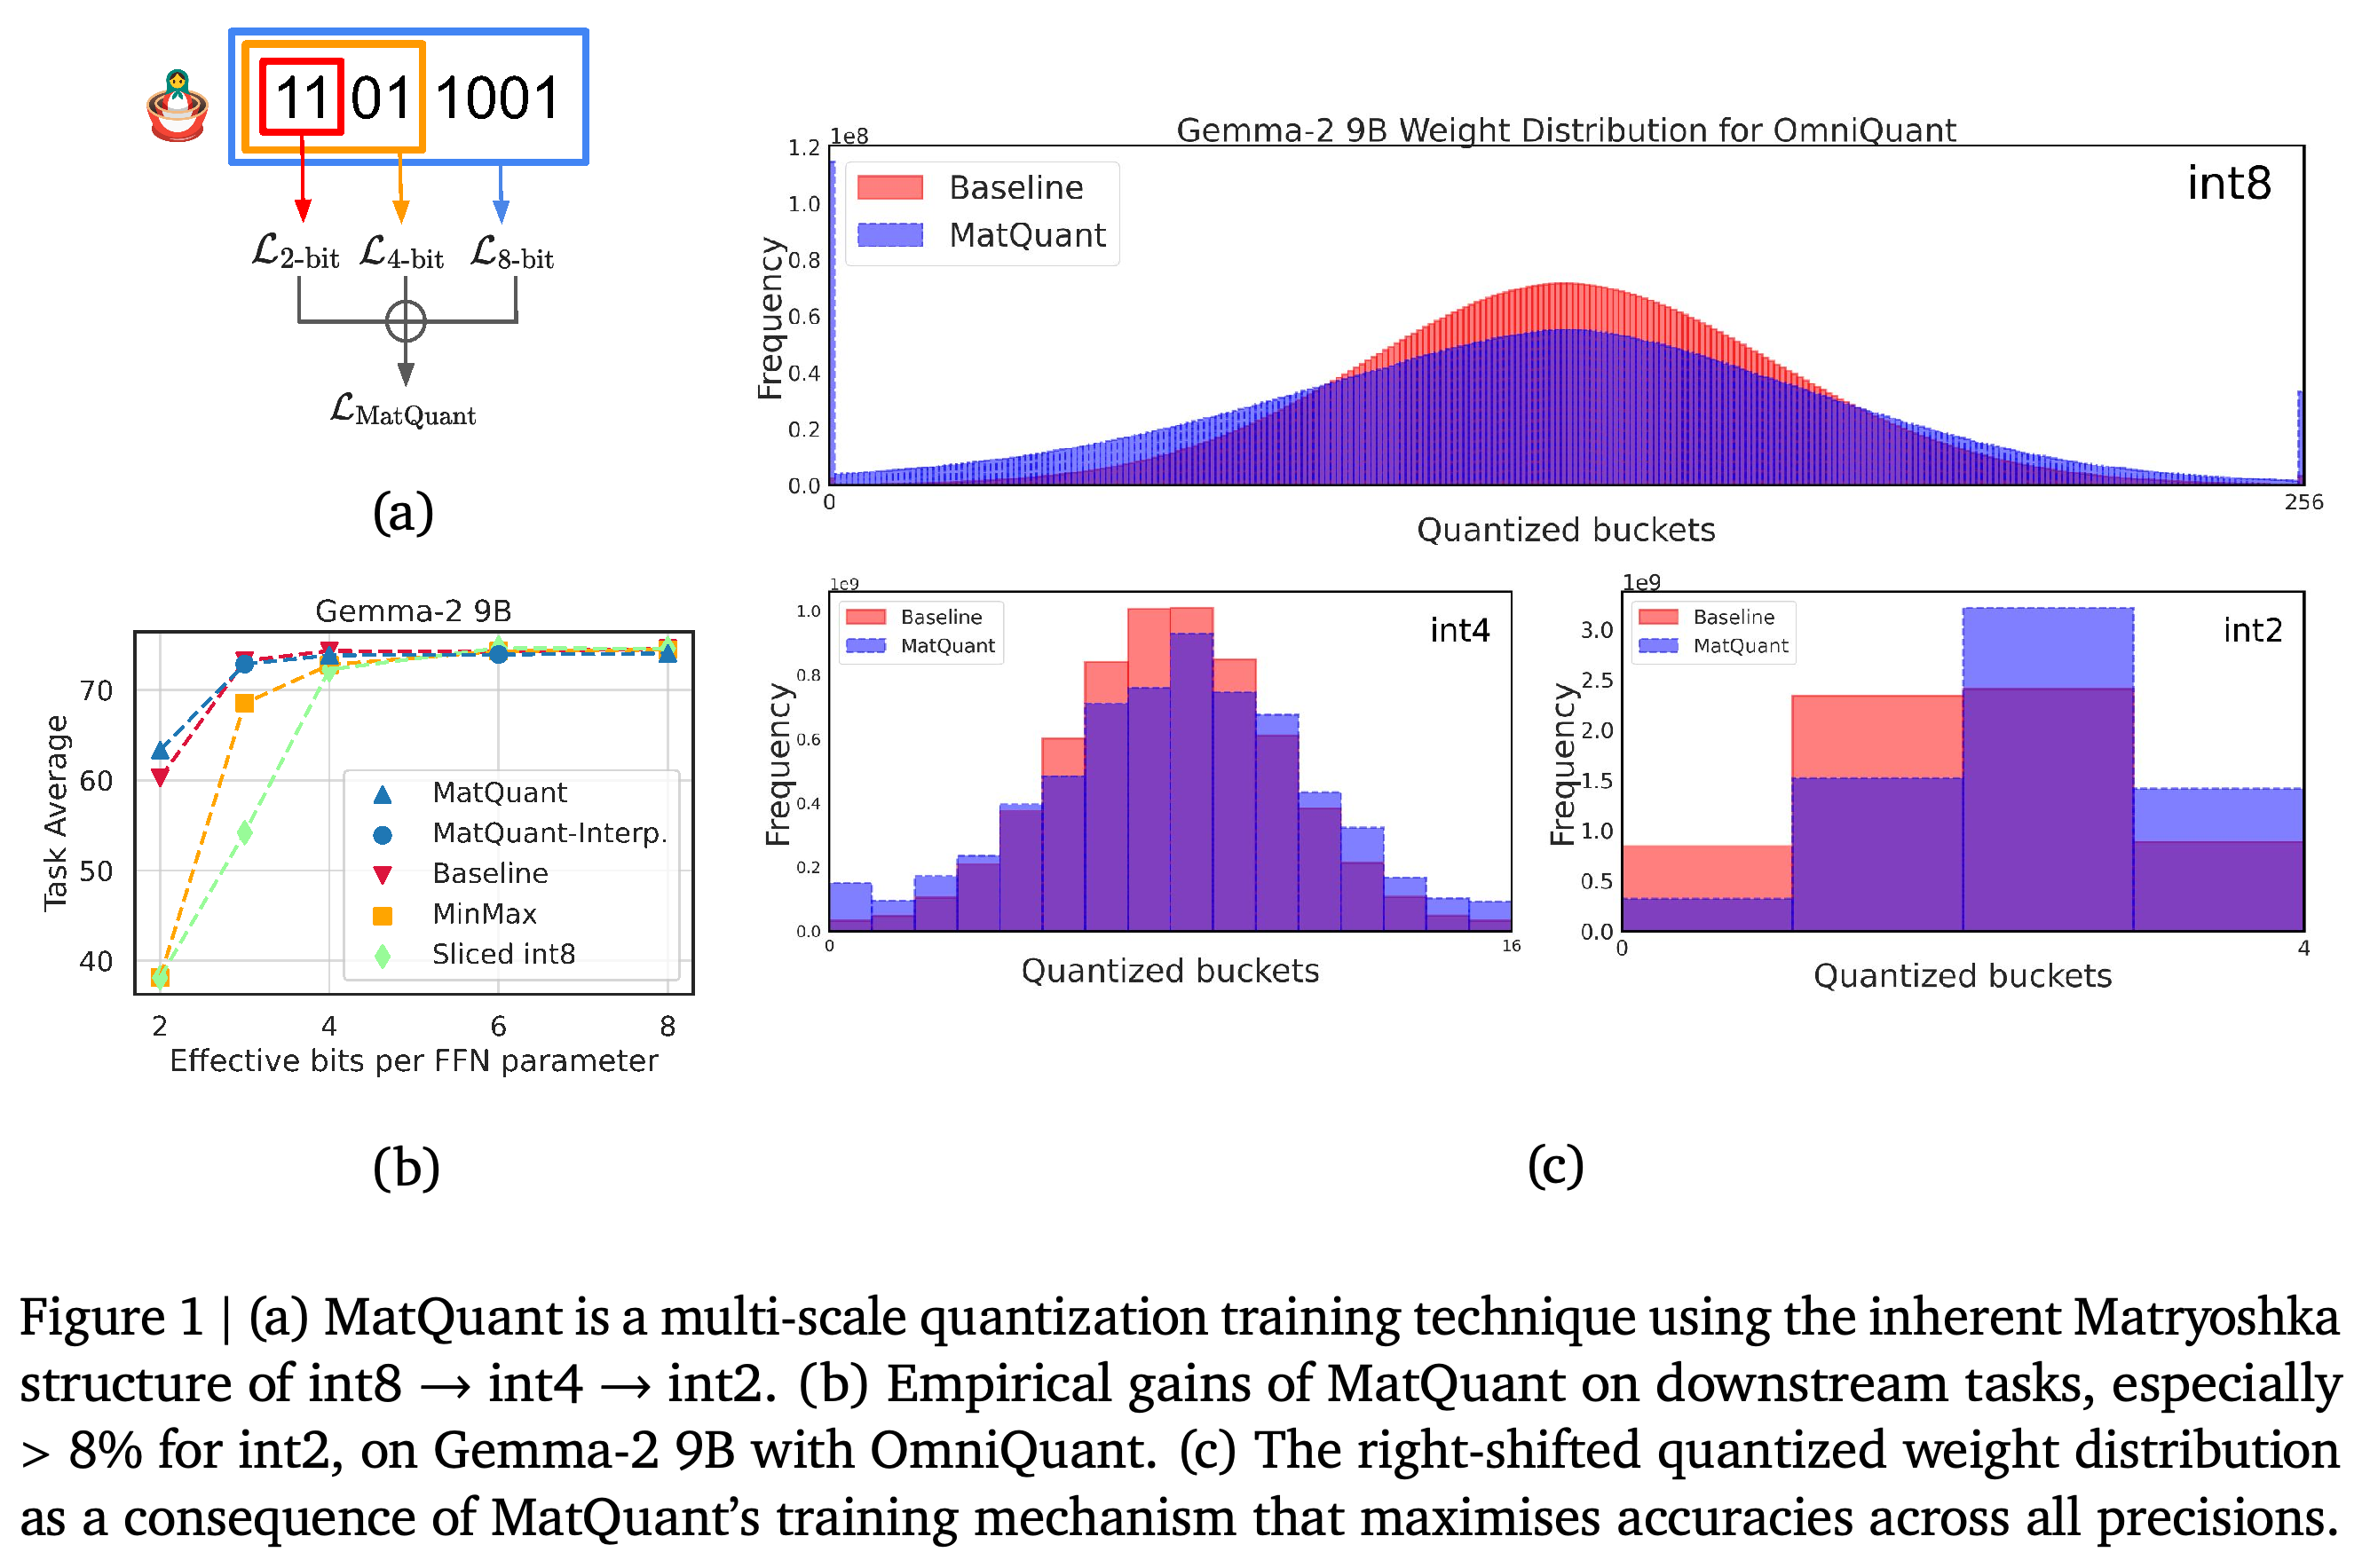
- MatQuant는 각각 8, 4, 2비트를 사용하는 정수 표현인 int8, int4, int2를 함께 최적화한다. 이를 위해 더 큰 자릿값을 나타내는 상위 비트를 공유한다. 학습한 표현에서는 추가 학습 없이 int3와 int6 모델을 추출할 수 있으며, 계층마다 다른 정밀도를 할당하는 Mix’n’Match도 지원한다.
- 주요 실험에서는 Gemma-2 2B, Gemma-2 9B, Mistral 7B의 FFN 가중치, 즉 각 Transformer 계층의 feed-forward 블록에 속한 매개변수를 양자화한다. 평가는 과제별 예시를 제공하지 않는 zero-shot 정확도를 다운스트림 과제 6개에 걸쳐 평균하고, 텍스트 데이터셋인 C4의 log perplexity도 보고한다. Log perplexity가 낮을수록 평가 텍스트를 더 잘 예측한다는 뜻이다.
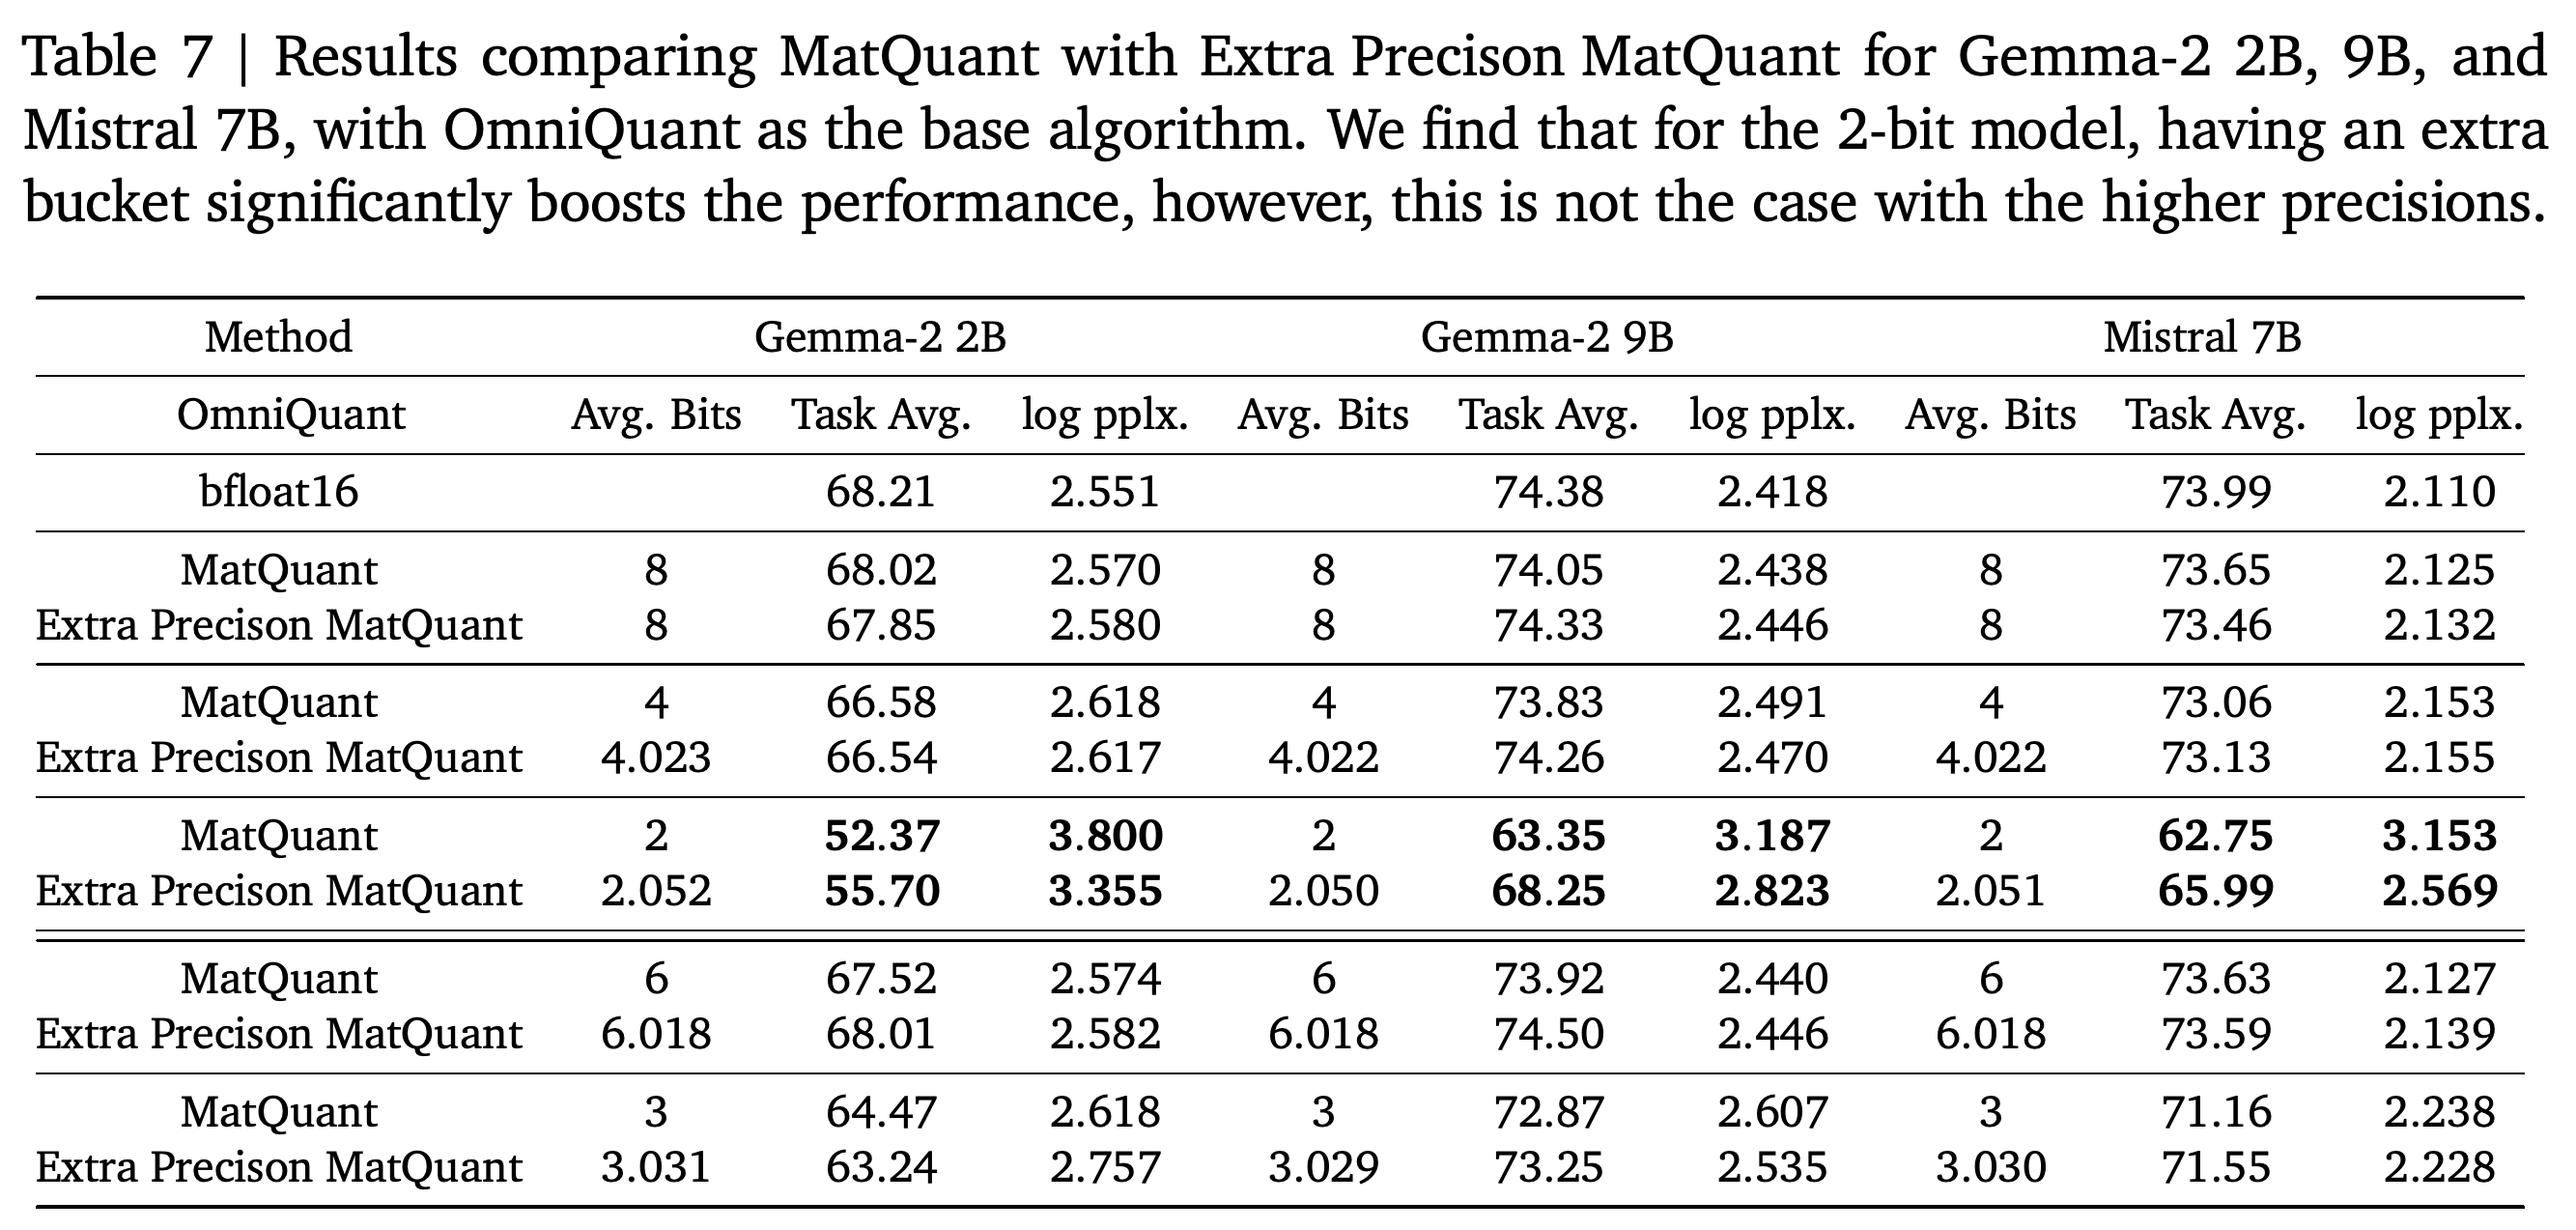
- Errata에서는 엄격한 2-bit MatQuant와 Extra Precison MatQuant를 구분한다. 후자는 양자화 값을 추가로 유지하며, 양자화한 가중치당 평균 약 2.05비트가 필요하다. Gemma-2 9B에 OmniQuant를 적용하고, 고정밀도 출력을 대상으로 저정밀도 모델을 학습하는 co-distillation을 사용하면 후자의 평균 정확도는 70.17에 도달한다. 다만 추가 비트를 처리하는 별도 구현이 필요하며, 논문은 실제 배포 속도 향상을 측정해 보고하지 않는다.
1. Introduction
서론은 모델이 토큰을 순차적으로 생성하는 자기회귀 디코딩에서 가중치를 전송하는 통신 비용을 양자화의 동기로 제시한다. 기존 최적화는 정밀도마다 독립적으로 수행한다. MatQuant는 공유 표현으로 여러 정확도 높은 배포 선택지를 제공할 수 있는지 탐구한다.
- 저정밀도 모델은 공통 int8 표현에서 추출한다.
- 주요 실험에서는 FFN 가중치를 양자화한다. 토큰 간 정보 교환을 결정하는 attention 가중치의 양자화는 별도로 살펴본다.
중첩 비트 도식은 여러 정밀도의 손실이 공유 정수 가중치에 작용하는 방식을 보여주며, 히스토그램은 공동 학습이 양자화 버킷의 점유율을 바꾼다는 점을 보여준다. 캡션의 int2 성능 향상 폭이 8%를 넘는다는 주장은 Table 1의 수정된 엄격한 int2 비교와 맞지 않으므로, Errata의 추가 정밀도 구분을 고려해 해석해야 한다.
2. Related Work
관련 연구에서는 경사 하강법 없이 표현을 보정하는 비학습 양자화와 모델 가중치나 보조 양자화 매개변수를 최적화하는 학습 기반 방법을 구분한다. 또한 용량이 다른 중첩 모델들이 매개변수를 공유하며 함께 학습하는 multi-scale training과 MatQuant의 연관성을 설명한다.
- 기존 방법은 원본 출력과 양자화한 출력의 차이인 재구성 오차를 줄이거나, 값이 유난히 큰 가중치나 활성값인 이상치를 처리한다. MatQuant는 중첩된 정밀도들을 함께 최적화하는 방식을 추가한다.
- 논문은 앞선 any-precision neural network 연구를 소개하고, 학습하지 않은 중간 정밀도 추출을 포함해 중첩 정밀도를 대규모 언어 모델로 확장한다.
3. Matryoshka Quantization
MatQuant는 학습 기반 양자화 방법의 기본 양자화 규칙을 유지하면서 여러 정밀도를 함께 학습하도록 확장한다. 여러 비트 폭의 손실을 결합하며, 학습할 매개변수와 학습 목표는 기반 방법의 선택을 유지한다.
- 실험에서 결합한 방법은 QAT와 OmniQuant다.
- 논문이 제시한 적용 조건은 모델 매개변수나 보조 매개변수를 경사 하강법으로 최적화할 수 있어야 한다는 것이다. 실험에서는 이 양자화 방법 2개를 검증한다.
3.1. Preliminaries
QAT는 순전파에서 양자화한 가중치를 사용하고, 양자화를 통과하는 기울기를 근사하는 straight through estimator(STE)를 통해 종단 간 cross-entropy를 최소화한다. Cross-entropy는 목표 토큰에 대한 예측 오차를 측정하는 손실이다. MinMax 양자화기는 스케일과 표현 내 영점의 위치를 정하는 오프셋인 zero point를 사용해 관측한 가중치 범위를 고정된 수의 정숫값으로 매핑한다.
- OmniQuant는 원본 모델 가중치를 고정하고, 전체 정밀도 계층 출력과 양자화한 계층 출력의 제곱 차이를 최소화해 clipping, scaling, shifting 매개변수를 학습한다.
- OmniQuant는 제한된 보정 데이터로 각 Transformer 계층을 독립적으로 최적화한다. QAT는 종단 간 예측 목표에 따라 모델 가중치를 갱신한다.
3.2. MatQuant
c-bit 양자화 벡터 qᶜ와 0 < r < c에 대해, MatQuant는 S(qᶜ,r) = clamp(round(qᶜ/2^(c−r)), 0, 2^r−1) × 2^(c−r)로 r-bit 표현을 추출한다. 반올림으로 저정밀도 값을 선택하고, clamping으로 r-bit 범위 안에 제한한 뒤, 다시 스케일링해 원래 양자화 스케일에 배치한다.
- 학습 목표는 예제와 목표 비트 폭에 걸쳐 기반 양자화기의 손실을 합산하고, 각 정밀도에 λᵣ 가중치를 부여한다. 기본 목표 집합은 R = {8,4,2}다.
- Interpolative Behavior에는 학습하지 않은 int3와 int6 정밀도로의 슬라이싱과 계층 간 Mix’n’Match가 포함된다.
- 공동 학습은 양자화기가 사용할 수 있는 이산값인 양자화 버킷 가운데 더 큰 값을 갖는 버킷의 점유율을 높인다. 저자들은 int8 표현이 더 제약적인 int2 표현을 수용할 수 있는 유연성을 제공한다고 가정한다.
4. Experiments
실험은 Gemma-2 2B, Gemma-2 9B, Mistral 7B를 사용하며, 주로 FFN 블록의 가중치만 양자화한다. OmniQuant는 시퀀스 길이 2048인 C4 예제 128개, 배치 크기 4, 학습 토큰 10M개를 사용한다. 다만 독립적으로 학습한 int2 베이스라인에는 토큰 20M개를 제공한다. QAT는 C4 토큰 100M개, 배치 크기 16, 시퀀스 길이 8192로 1 epoch 동안 학습한다.
- 주요 베이스라인은 목표 정밀도마다 독립적으로 학습한 모델과 기존 방식으로 학습한 int8 표현을 슬라이싱해 얻은 모델이다.
- MatQuant의 int3와 int6 모델은 추가 학습을 하지 않지만, 독립 베이스라인은 해당 정밀도에서 명시적으로 학습한다.
- 평가 과제 6개는 과학 질의응답인 ARC-c와 ARC-e, 예/아니요 질의응답인 BoolQ, 문장 완성인 HellaSwag, 물리적 상식 추론인 PIQA, 대명사 지시 대상 판별인 Winogrande다. 본문은 perplexity에 C4 test set을 사용한다고 설명하지만, 표 캡션은 validation set을 명시한다.
4.1. MatQuant with OmniQuant
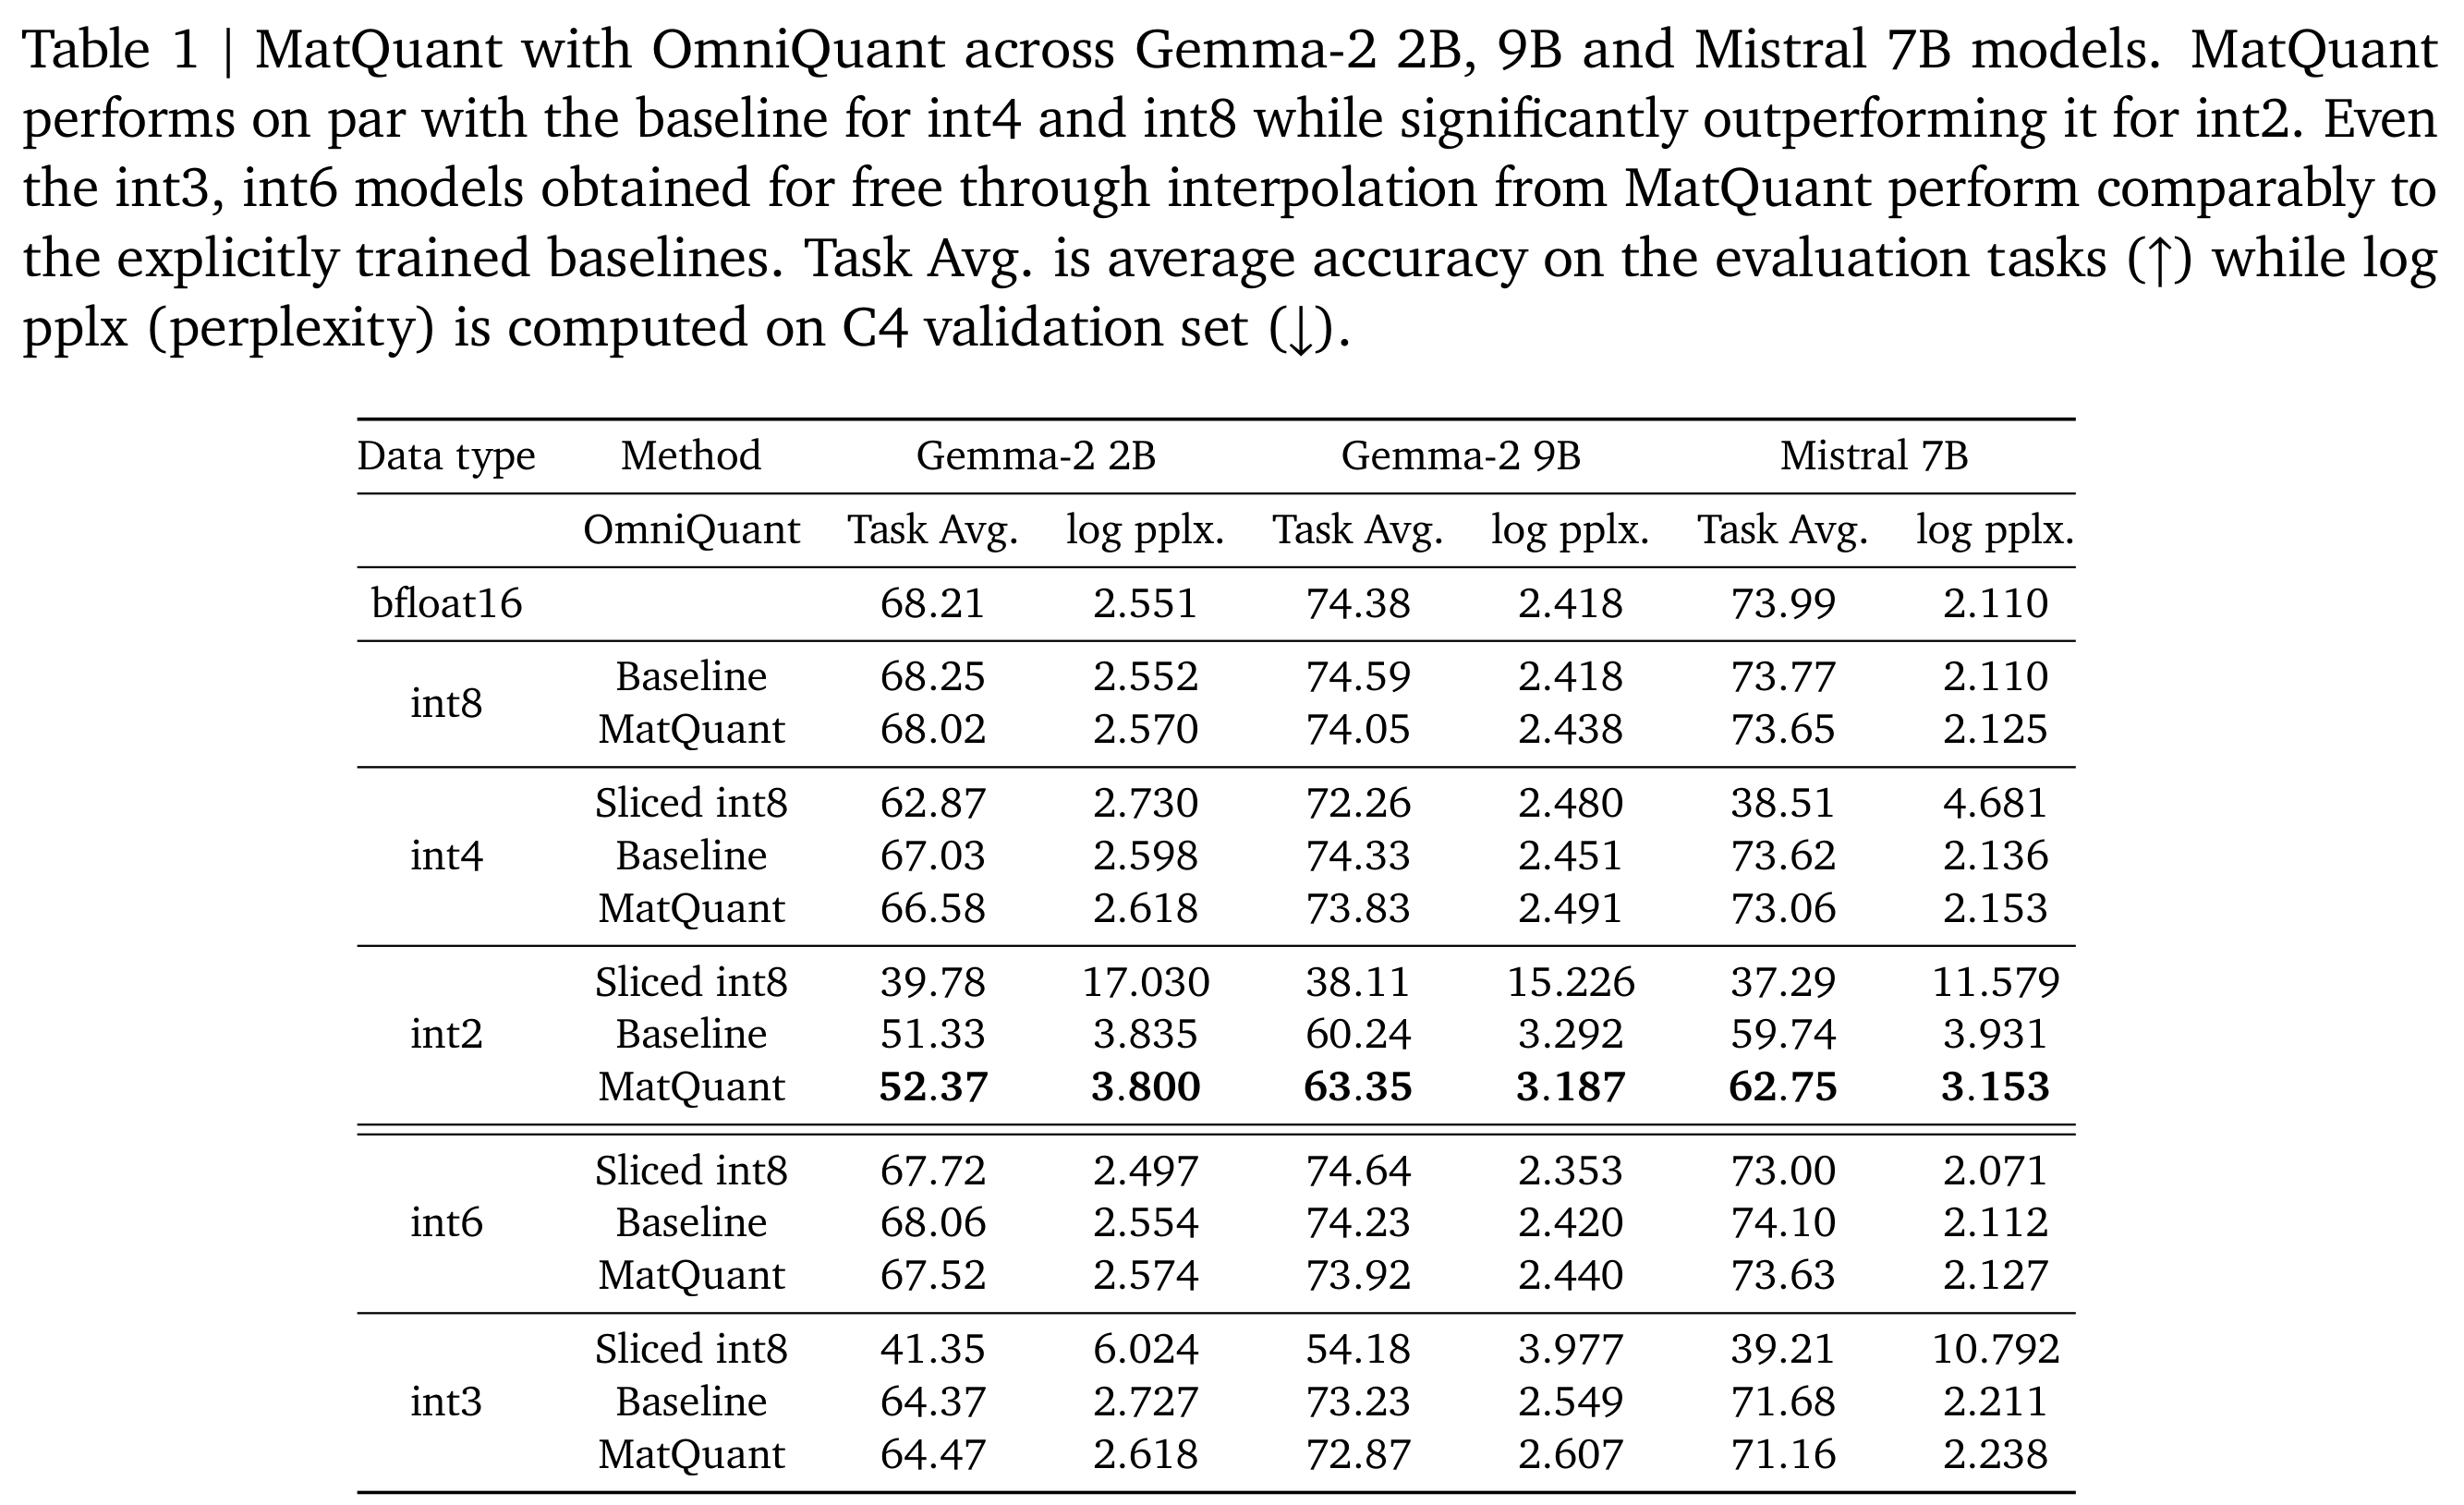
OmniQuant에서 엄격한 int2 MatQuant는 평균 다운스트림 정확도를 Gemma-2 2B에서 51.33에서 52.37로, Gemma-2 9B에서 60.24에서 63.35로, Mistral 7B에서 59.74에서 62.75로 높인다. 독립적으로 학습한 int2 모델 대비 향상 폭은 각각 1.04, 3.11, 3.01%p다.
- int8과 int4 결과는 독립적으로 학습한 모델과 대체로 비슷하다. 다만 Table 1에는 0.54와 0.56%p의 차이가 있어, 본문에 제시된 0.5% 한도를 조금 넘는다.
- 학습하지 않은 int3 추출의 평균 정확도는 64.47, 72.87, 71.16이며, 독립적으로 학습한 int3 베이스라인은 64.37, 73.23, 71.68이다.
- 기존 int8 모델을 슬라이싱하면 int2 평균 정확도는 39.78, 38.11, 37.29로 훨씬 낮다.
독립 학습, 공동 학습, int8 슬라이싱 행은 명시적인 중첩 최적화를 개별 학습 및 학습 후 추출과 비교한다. 엄격한 int2는 모델 3개 모두에서 개선되며, int3와 int6 추출도 추가 최적화 없이 독립 학습에 가까운 성능을 유지한다.
4.2. MatQuant with QAT
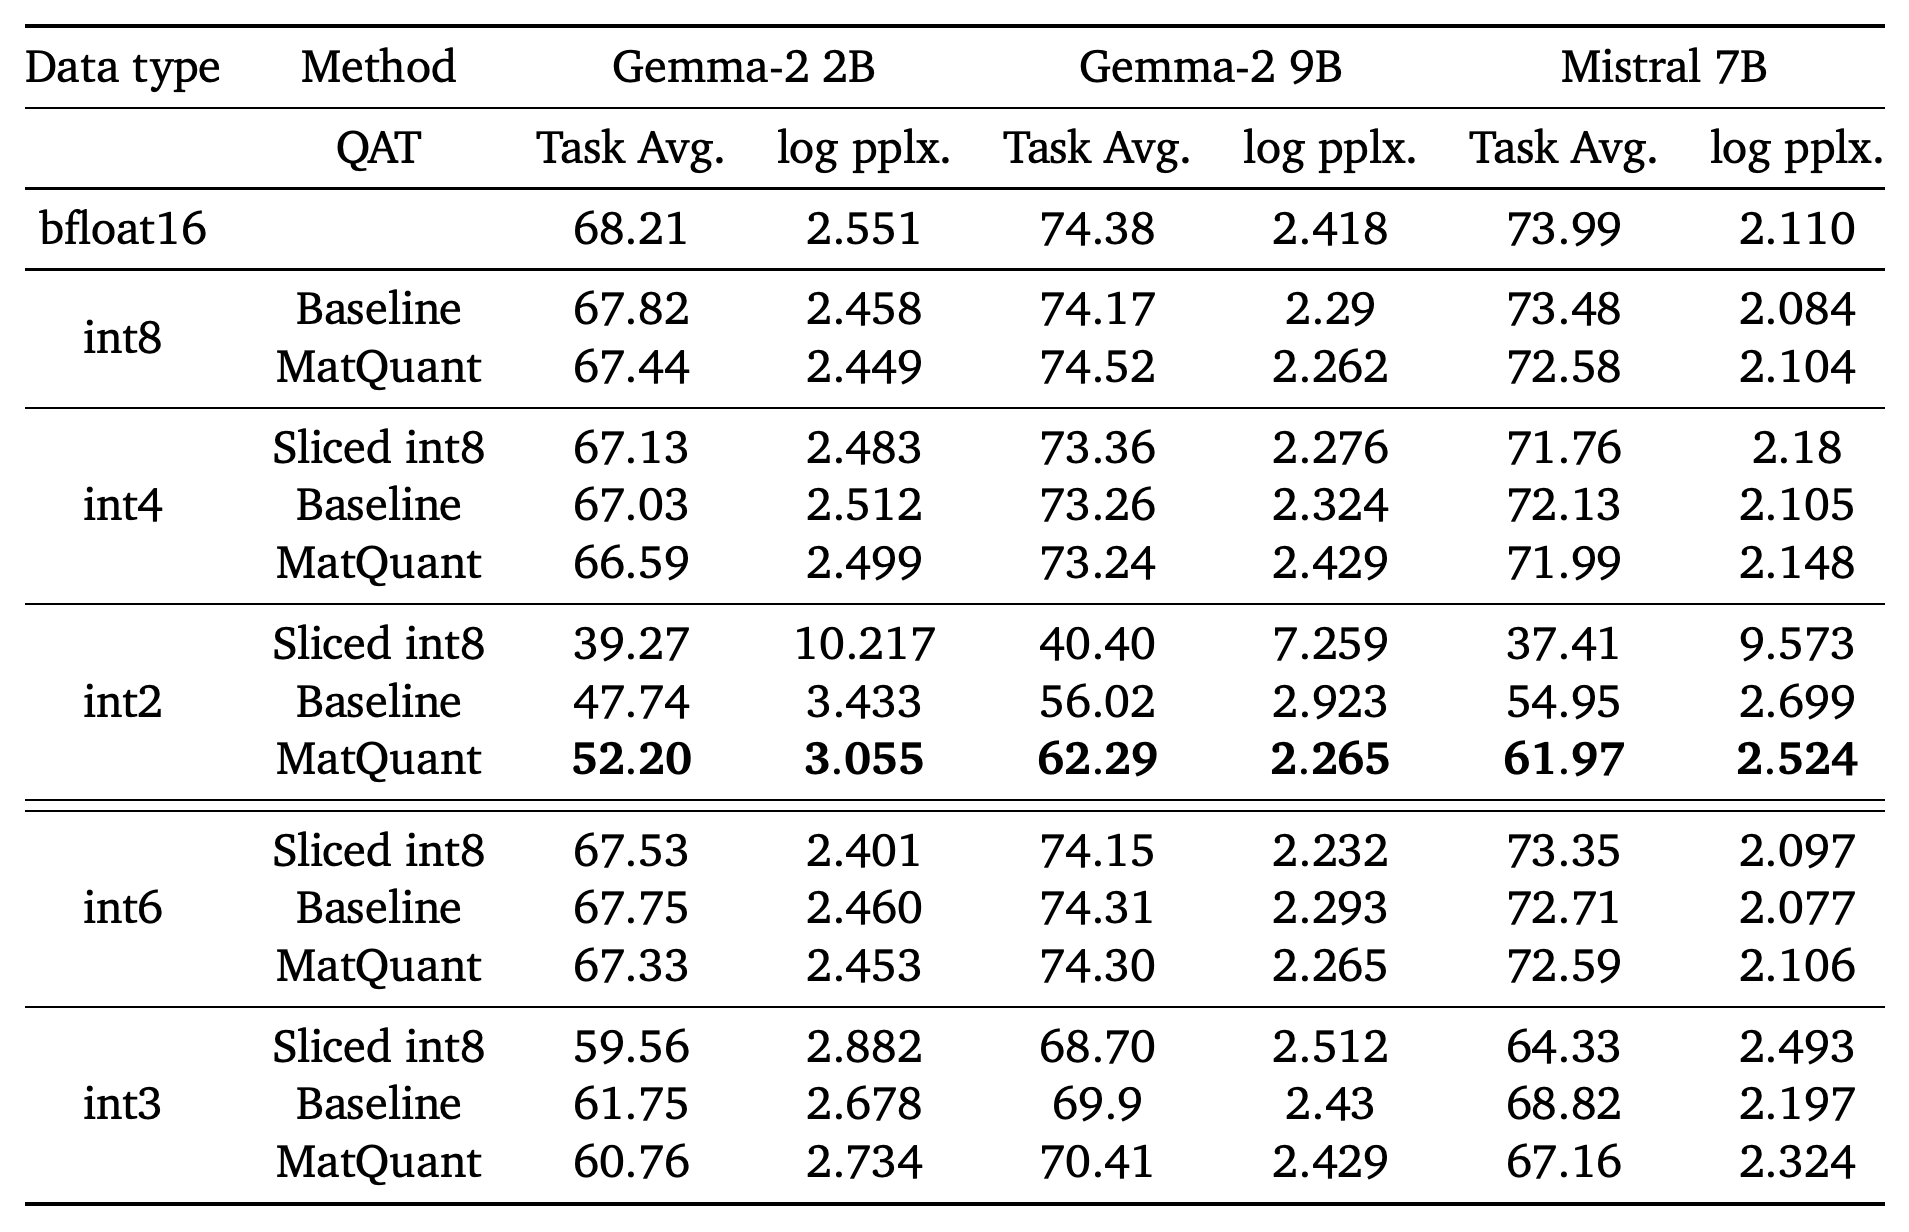
QAT에서 엄격한 int2 MatQuant는 평균 다운스트림 정확도를 Gemma-2 2B에서 47.74에서 52.20으로, Gemma-2 9B에서 56.02에서 62.29로, Mistral 7B에서 54.95에서 61.97로 높인다. 향상 폭은 각각 4.46, 6.27, 7.02%p다.
- 중간 정밀도 추출이 항상 독립 학습과 같은 수준의 성능을 내지는 않는다. Mistral 7B int3는 67.16으로 베이스라인의 68.82보다 낮다. int8에서 Mistral 7B는 72.58로 베이스라인의 73.48보다 낮다.
- 저자들은 OmniQuant보다 C4 log perplexity는 낮으면서 다운스트림 정확도는 떨어지는 현상을 C4 학습 부분집합에 대한 과적합의 근거로 해석한다. 이 설명은 지표 양상에서 추론한 것이며, 보고된 설정 가운데는 해당 양상에서 벗어나는 예외도 있다.
- Table 2는 Gemma-2 9B int2 MatQuant의 log perplexity를 2.265로 보고하지만, Tables 4, 5, 24, 30은 이에 대응하는 co-distillation 미적용 결과를 2.660으로 보고한다.
엄격한 int2 정확도 향상 폭은 모델 3개에서 각각 4.46, 6.27, 7.02%p다. 중간 정밀도 행에는 Mistral 7B int3의 1.66점 차이처럼 동등한 성능에 미치지 못하는 예외가 나타난다. Gemma-2 9B int2의 log perplexity 항목도 뒤의 표들과 다르다.
4.3. Layerwise Mix’n’Match
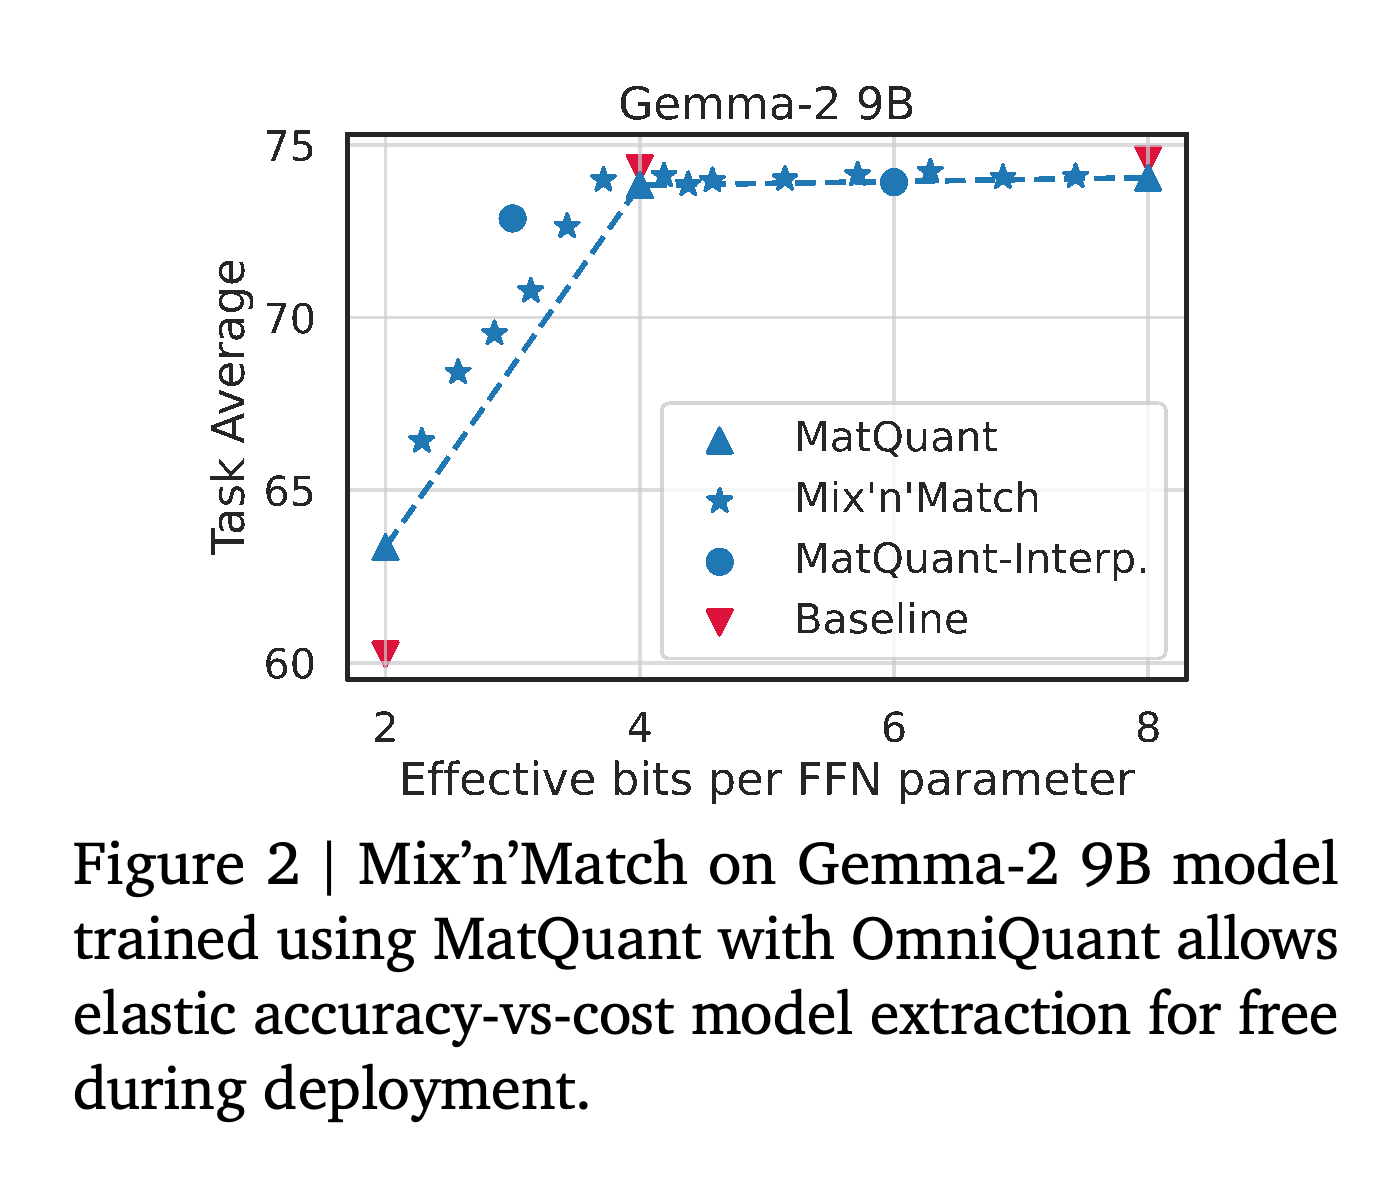
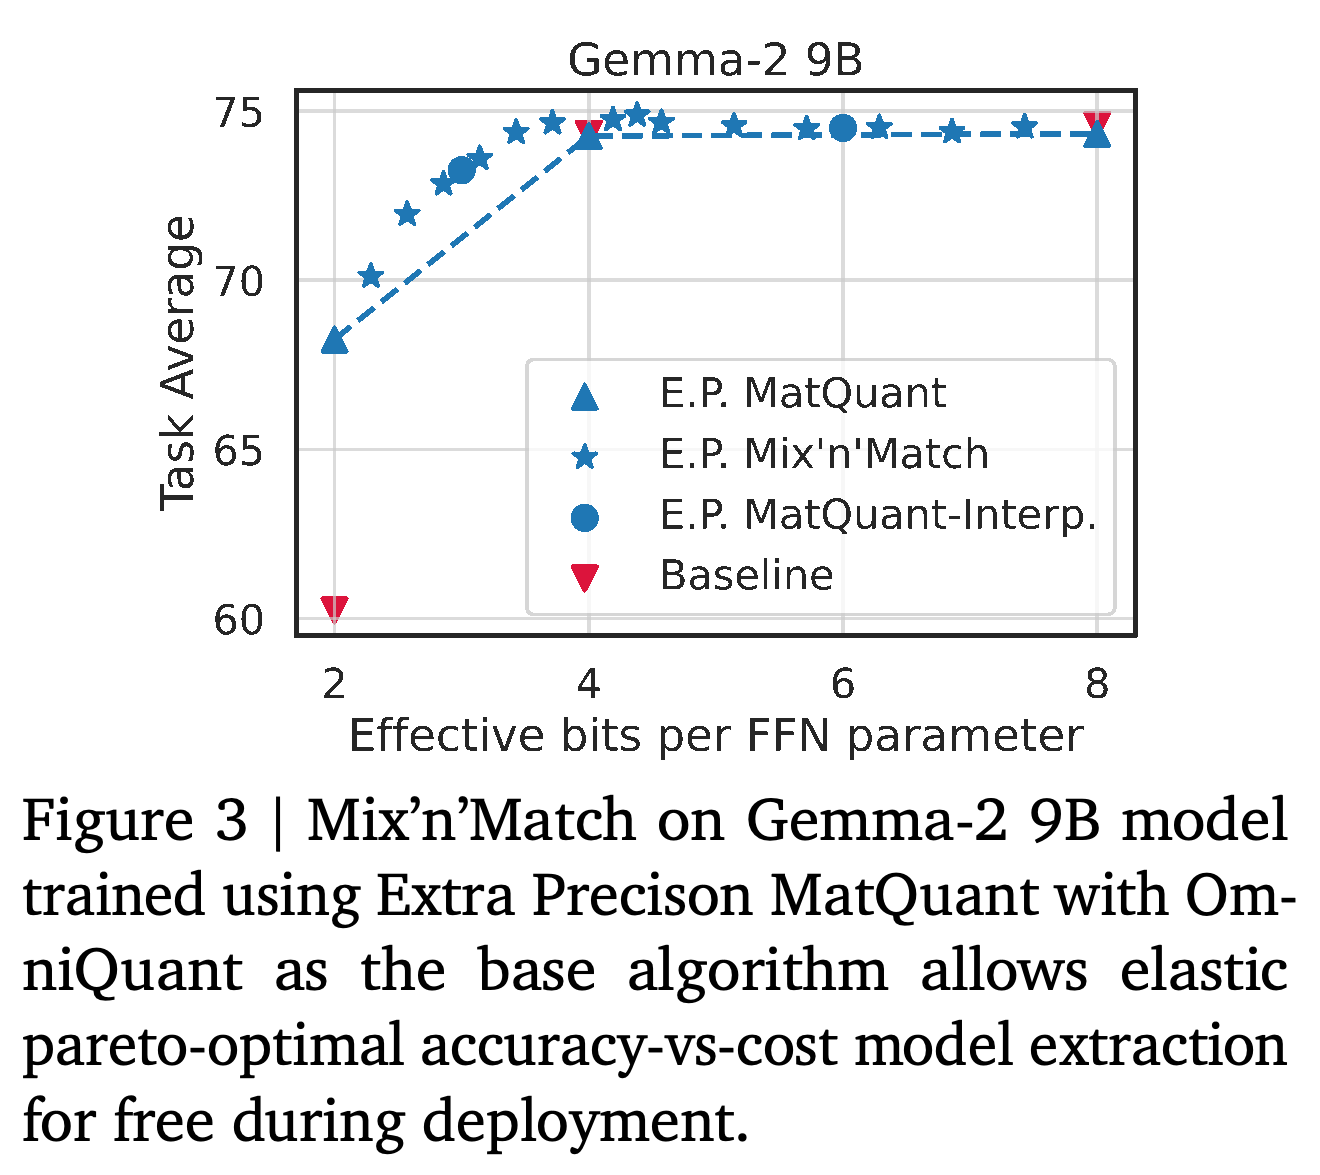
계층별 Mix’n’Match는 조합별 재학습 없이 각 계층에 int2, int4, int8을 할당해 모델을 구성한다. Gemma-2 9B에 OmniQuant를 적용한 경우, 선택한 혼합 구성들이 정확도와 유효 비트 수 사이의 곡선을 채운다. FFN 매개변수당 유효 비트 수가 4 미만인 구성도 동일 정밀도의 int4 슬라이스보다 높은 성능을 낸다.
- 탐색한 할당 전략 가운데 Pyramid는 중간 계층에 높은 정밀도를, 시작과 끝에 가까운 계층에 낮은 정밀도를 사용한다.
- FFN 매개변수당 유효 비트 수는 해당 가중치에 할당한 평균 정밀도를 측정한다. 그림은 선택한 구성들을 보고하며, 실행 지연 시간을 측정하거나 모든 계층 할당 중 최적임을 입증하지는 않는다.
선택한 혼합 정밀도 구성들은 동일 정밀도 선택지 사이의 간격을 채운다. 유효 비트 수가 4 미만이면서 int4 슬라이스보다 정확도가 높은 구성도 포함된다. FFN 매개변수당 유효 비트 수는 가중치 저장 공간의 한도를 나타내며, 추론 지연 시간을 직접 측정하지는 않는다.
5. Ablations and Discussion
절제 실험은 정밀도별 손실 가중치, 중첩 모델 간 지도 학습, 추출한 단일 정밀도의 최적화를 살펴본다. 논의에서는 FFN과 attention 가중치의 동시 양자화, 하드웨어 지원, 부동소수점 표현으로의 확장 가능성도 다룬다.
5.1. Weightings (𝜆𝑟) for MatQuant
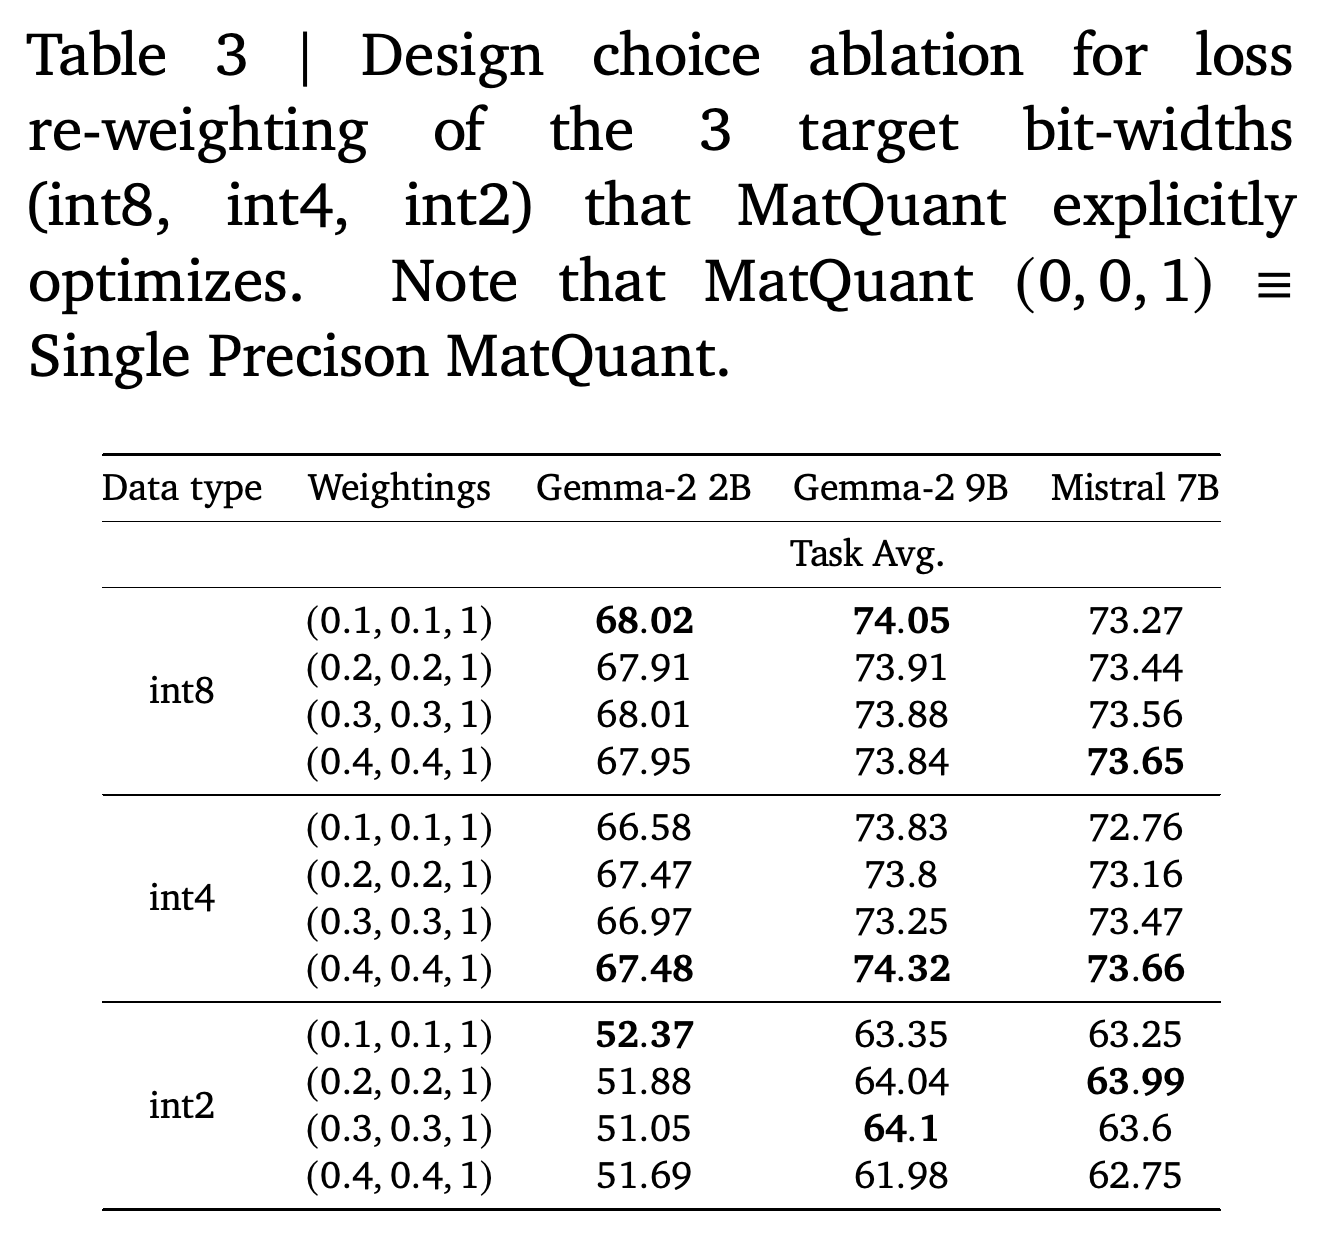
λᵣ를 바꾸면 정밀도별 학습 우선순위가 조정되어 추출 모델 간 상충 관계가 생긴다. 결과는 대체로 int2 손실에 비교적 큰 가중치를 부여하는 편이 유리하지만, 반응은 모델마다 다르고 단조롭지 않다.
- Gemma-2 2B에서 손실 가중치를 (0.1,0.1,1)에서 (0.4,0.4,1)로 바꾸면 int4 정확도는 66.58에서 67.48로 높아지지만, int2 정확도는 52.37에서 51.69로 낮아진다.
- Gemma-2 9B의 int2 정확도는 (0.3,0.3,1)에서 64.1로, (0.1,0.1,1)의 63.35보다 높다. 따라서 int2의 상대적 우선순위를 높인다고 항상 정확도가 향상되지는 않는다.
가중치 탐색 결과는 정밀도별 목표 사이의 경쟁을 보여준다. 고정밀도 손실의 가중치를 높이면 int2 정확도가 낮아질 수 있다. 시험한 최적 가중치는 모델마다 다르며, 반응은 단조롭지 않다.
5.2. Co-distillation for MatQuant
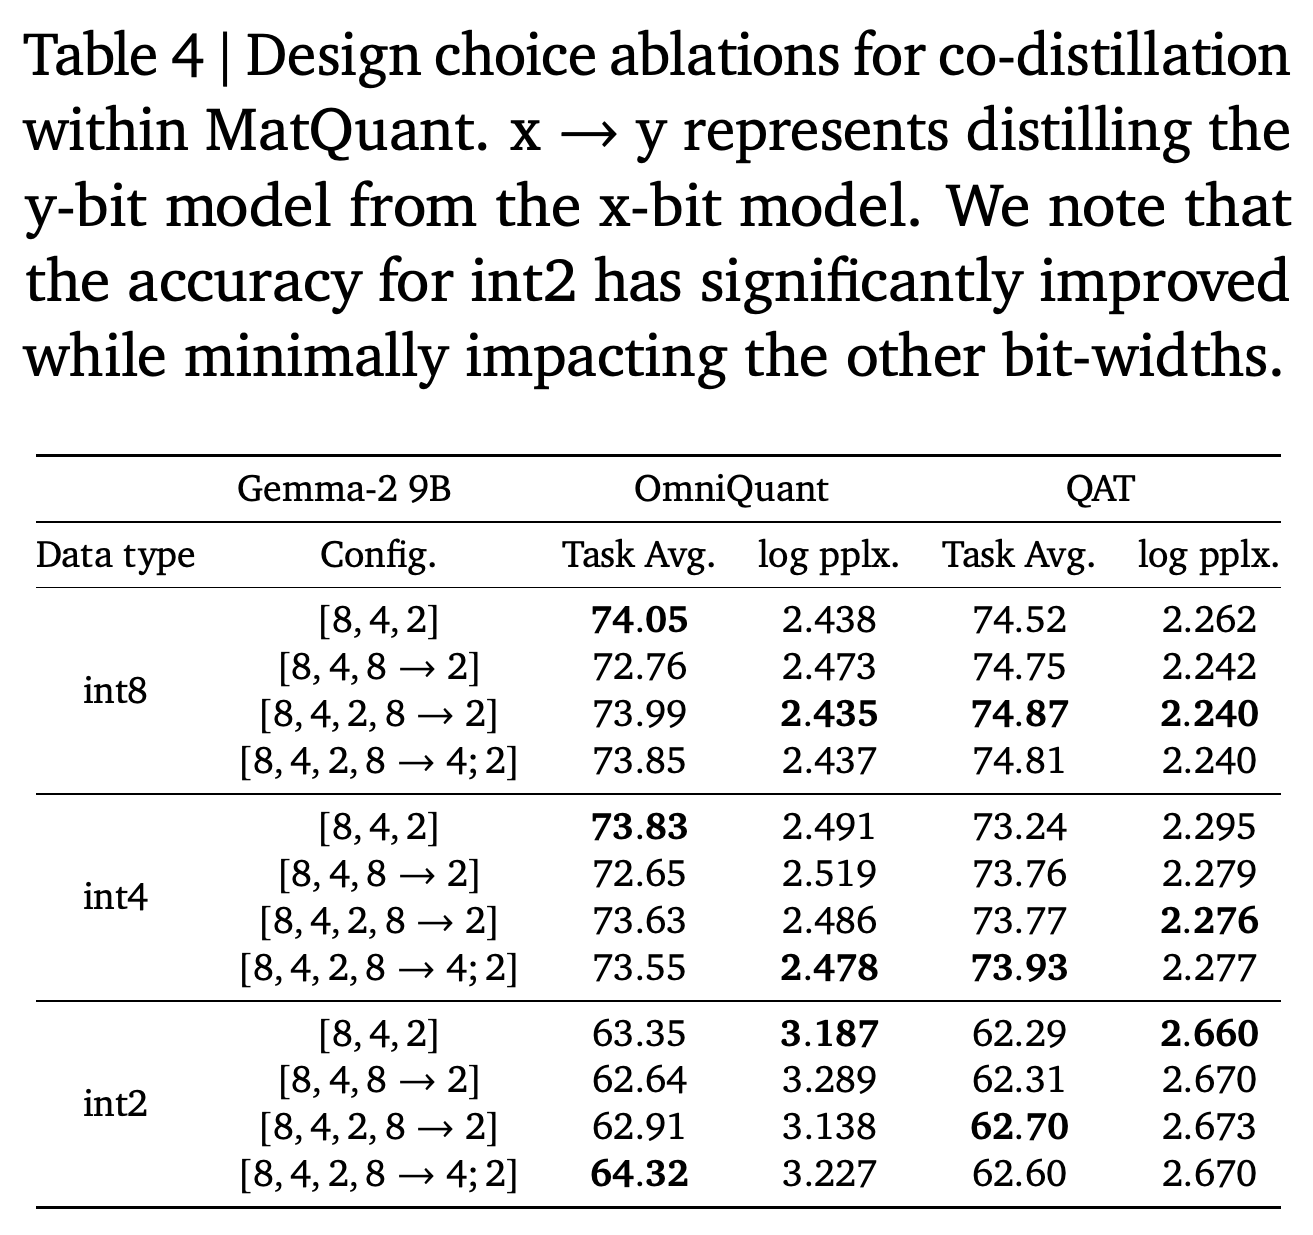
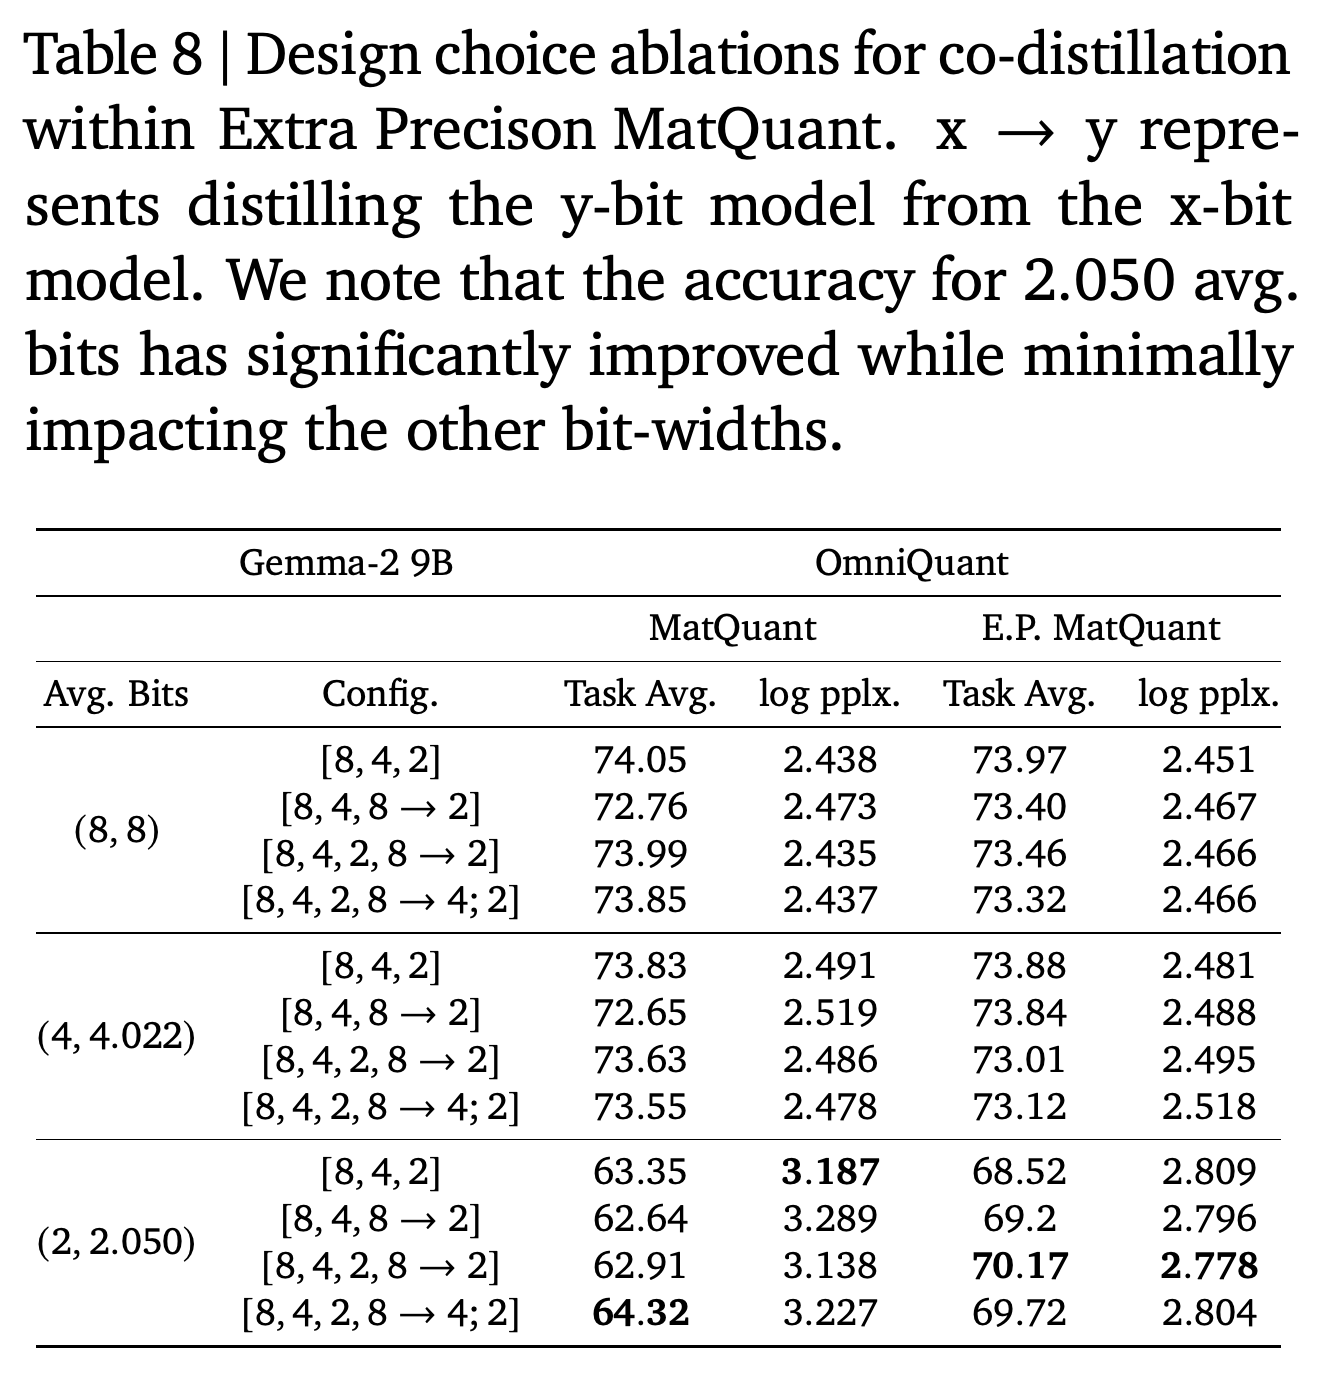
Co-distillation은 중첩된 int8 모델의 출력으로 저정밀도 모델을 지도한다. 기존 목표를 대체하거나, 동일한 가중치로 기존 목표에 추가한다. Gemma-2 9B에 OmniQuant를 적용하고 int4와 int2의 2개 정밀도를 모두 지도하면, 엄격한 int2 정확도는 63.35에서 64.32로 0.97퍼센트포인트 높아진다.
- 기존 목표를 유지하면서 int2만 지도하면 OmniQuant 정확도는 62.91로, co-distillation을 적용하지 않은 결과보다 낮다.
- QAT에서 시험한 co-distillation 구성 3개의 int2 정확도는 62.31, 62.70, 62.60이며, co-distillation을 적용하지 않으면 62.29다.
Co-distillation의 효과는 설정에 따라 다르다. OmniQuant에서 저정밀도 2개를 모두 지도하면 int2 정확도는 64.32다. 반면 int2 목표에만 지도를 추가하면 62.91로, co-distillation을 적용하지 않은 63.35보다 낮다.
5.3. Single Precison MatQuant
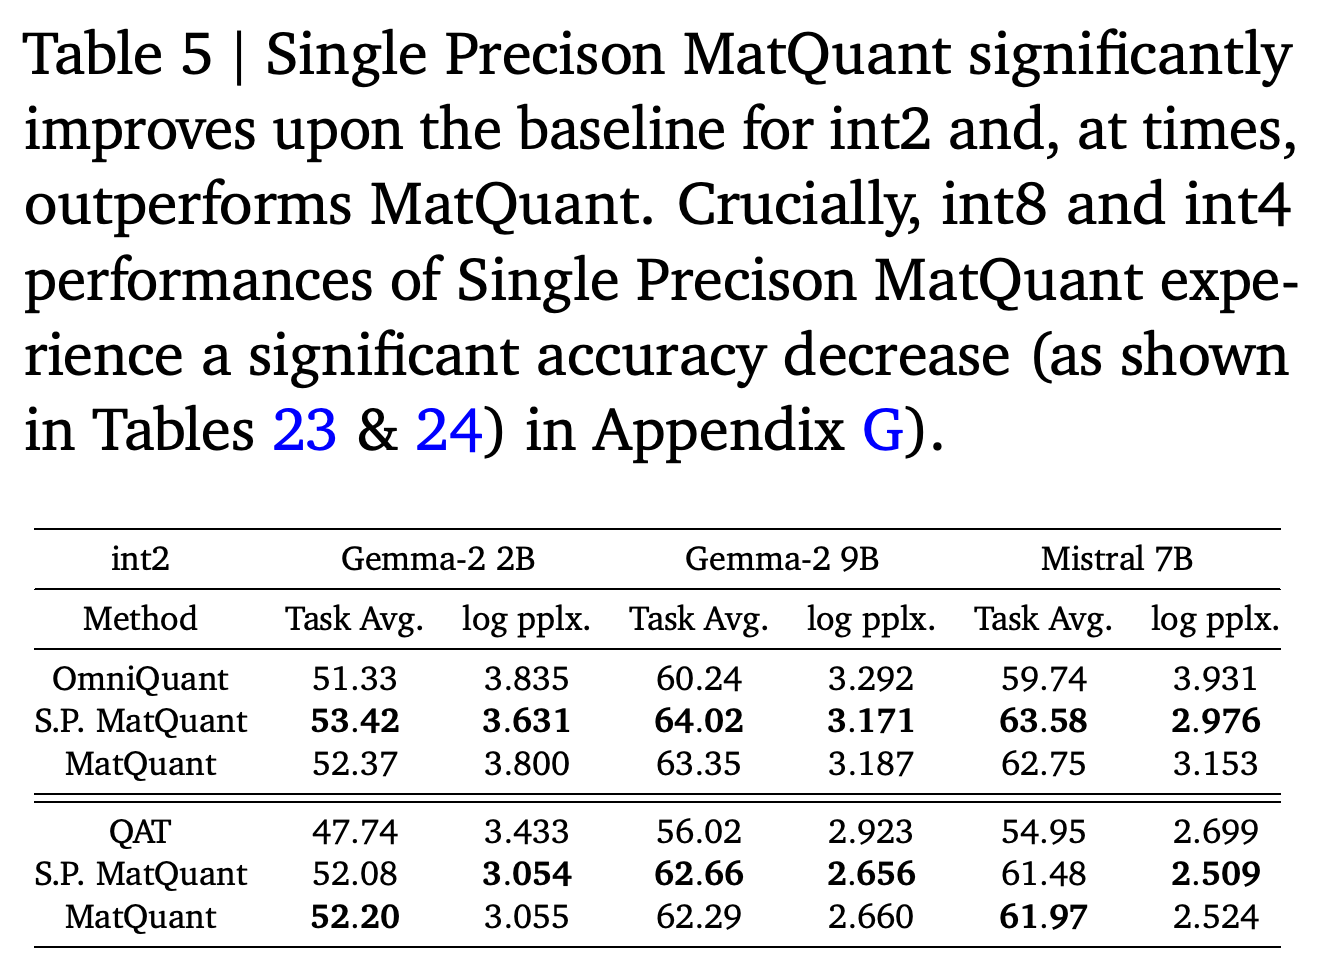
Single Precison MatQuant는 int4와 int8 손실 항을 제거하지만, int8 표현을 슬라이싱해 int2를 얻는 방식은 유지한다. OmniQuant에서 모델 3개의 평균 정확도는 53.42, 64.02, 63.58로, 다중 정밀도 MatQuant보다 최대 1.05%p 높다.
- 저자들은 추출한 int2 모델만 지도하더라도 기반 표현의 추가 6비트가 최적화의 유연성을 제공한다고 가정한다. 실험은 이 작동 원리를 분리해 검증하지는 않는다.
- 고정밀도 슬라이스의 성능은 떨어질 수 있다. Gemma-2 9B에 QAT를 적용하면 Single Precison MatQuant는 int8에서 72.71, int4에서 71.67이며, 다중 정밀도 MatQuant는 각각 74.52와 73.24다.
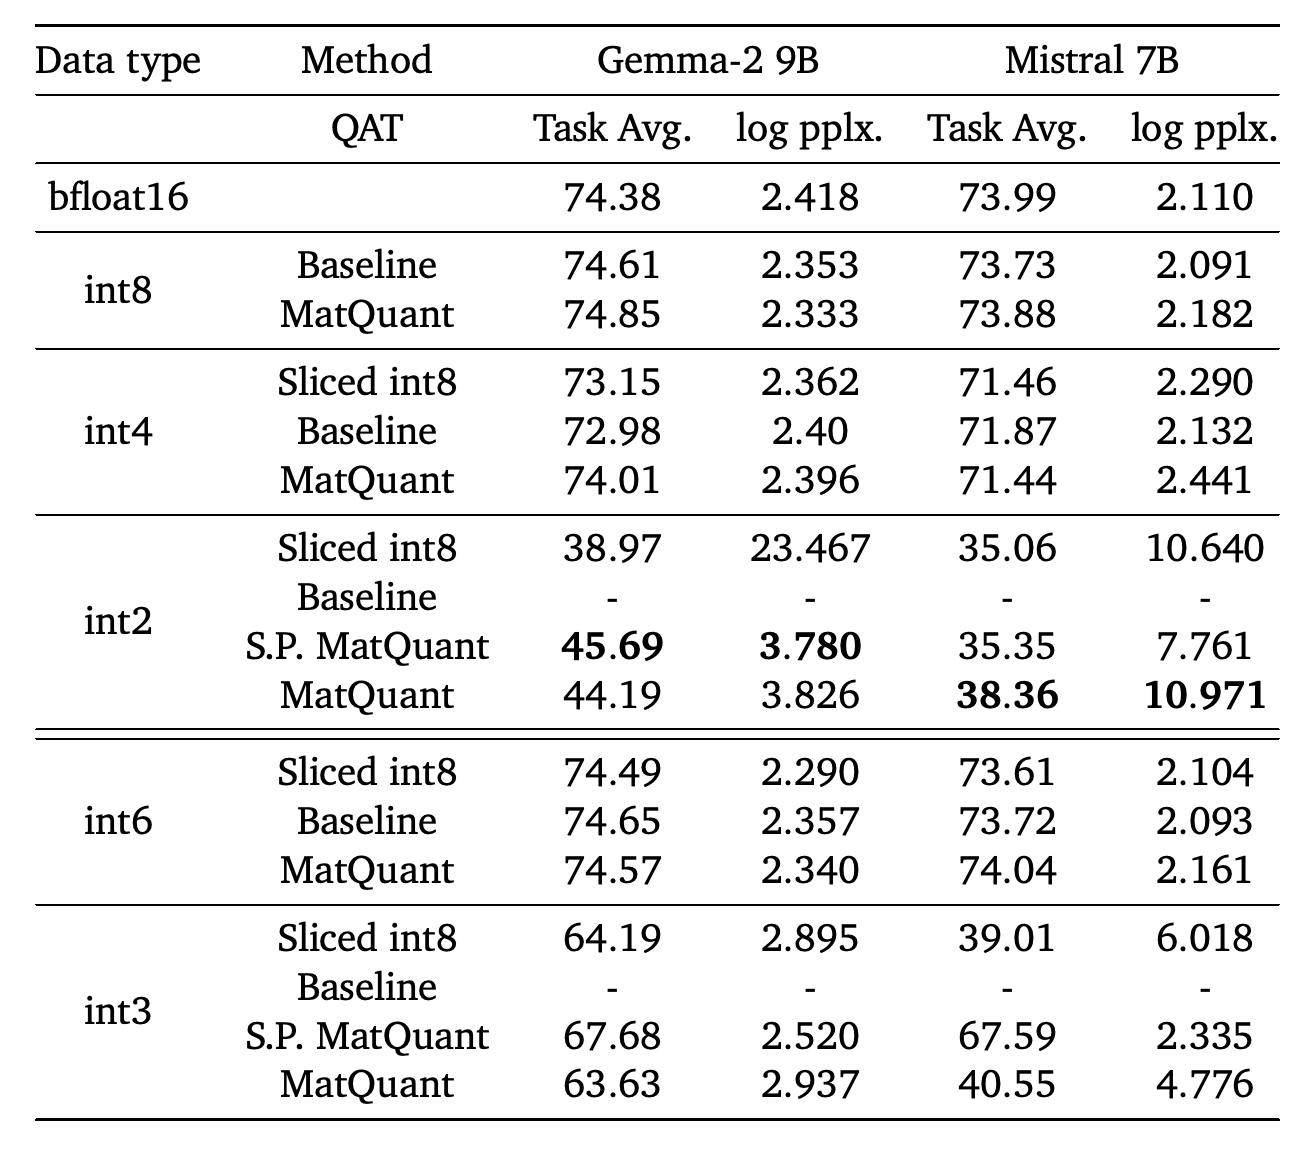
- FFN과 attention을 함께 양자화하면 독립 QAT는 int2와 int3에서 불안정하다. MatQuant 변형들은 평가 가능한 모델을 만들지만, 엄격한 int2 정확도는 여전히 낮다. 다중 정밀도 MatQuant에서 Gemma-2 9B는 44.19, Mistral 7B는 38.36이다.
Single Precison MatQuant는 표시된 모든 설정에서 독립 int2 베이스라인보다 높고, OmniQuant 설정 3개 모두에서 다중 정밀도 MatQuant보다 높다. QAT에서는 다중 정밀도 학습 대비 이점이 모든 설정에서 나타나지는 않는다.
int2와 int3의 독립 QAT 결과가 비어 있는 것은 FFN과 attention 가중치를 함께 양자화할 때 보고된 불안정성에 해당한다. MatQuant 변형들은 평가 가능한 결과를 내지만, 낮은 int2 정확도는 안정성만으로 모델 성능이 보존되지는 않는다는 점을 보여준다.
5.4. Deployment Considerations
배포 시에는 메모리 한도와 사용 가능한 정수 커널에 따라 동일 정밀도의 슬라이싱 모델이나 계층별 혼합 정밀도 할당을 선택할 수 있다. 논문은 네이티브 int8과 int4 지원을 논의하고, int2와 int3 같은 형식에는 저정밀도 연산을 GPU에서 수행하는 맞춤형 CUDA 커널을 제시한다.
- 최적화된 int3 지원이 없을 때는 int2/int4 혼합 구성으로 int3의 가중치 저장 공간에 근접할 수 있다.
- 실험은 가중치 정밀도에 따른 자원 한도별 정확도를 확인한다. 처리량, 지연 시간, 종단 간 메모리 절감량은 벤치마크하지 않는다.
5.5. Extension to Floating Point
MatQuant를 8-bit와 4-bit 부동소수점 표현인 FP8과 FP4로 확장하는 것은 향후 연구로 제안한다. 이 표현의 지수 비트는 2의 거듭제곱을 나타내므로, 슬라이싱해도 정수 구성에서 사용하는 표현 가능 값 사이의 일정한 간격이 유지되지 않는다.
- 정수 예시에서는 int8에서 0, 64, 128, 192를 추출하며, 값 사이의 간격은 64로 일정하다.
- 논문은 부동소수점 MatQuant 실험이나 검증된 부동소수점 슬라이싱 알고리즘을 제공하지 않는다.
6. Conclusions
결론은 공유 정수 표현으로 학습한 여러 정밀도, 학습하지 않은 중간 정밀도, 계층별 조합을 지원한다는 점을 강조한다. 독립적으로 학습한 베이스라인 대비 가장 큰 정확도 이점은 엄격한 int2에서 나타나며, int4와 int8은 대체로 베이스라인과 비슷한 수준을 유지한다.
- Single Precison MatQuant는 일부 고정 정밀도 결과를 개선한다. 이는 배포에 단일 정밀도만 필요하더라도 중첩 최적화가 도움이 될 수 있음을 보여준다.
- 근거는 실험한 모델과 학습 데이터에 한정되며, 주로 FFN 가중치만 양자화한 결과다.
7. Errata
Errata는 초안에서 반올림 뒤의 clamping을 빠뜨려 \(2^r+1\)개의 양자화 값을 허용했다고 설명한다. 이는 엄격한 r-bit MatQuant가 허용하는 \(2^r\)개보다 많다. Extra Precison MatQuant라는 이름의 이 변형은 추가 값에 배정된 소수의 가중치에 비트가 추가로 필요하므로, 엄격한 r-bit MatQuant와 표현에 필요한 자원량이 다르다.
- 부호 없는 int8 값 234를 int2로 추출하면 반올림 결과는 4다. 엄격한 MatQuant는 이를 3으로 제한하고 192로 다시 스케일링하지만, clamping을 생략한 변형은 256을 생성한다.
- Table 7은 Gemma-2 9B의 정확도가 2비트에서 63.35, 평균 2.050비트에서 68.25로 높아진다고 보고한다. 반면 Tables 8과 27은 co-distillation을 적용하지 않은 추가 정밀도 모델의 정확도를 68.52로 보고하며, PDF는 이 차이를 해명하지 않는다.
- Table 8은 기존 목표와 함께 int8로 int2를 지도하면 평균 2.050비트에서 70.17에 도달한다고 보고한다. Figure 3은 추가 정밀도 모델에 혼합 계층 할당을 적용하지만, 희소하게 추가되는 비트를 처리하려면 맞춤형 CUDA 커널이 필요하다.
평균 비트 열은 엄격한 정수 정밀도와 추가 값을 사용하는 표현을 구분한다. 가장 큰 성능 향상은 2비트 부근에서 나타난다. Gemma-2 9B는 2비트에서 63.35, 2.050비트에서 표에 표시된 68.25로 높아진다. 뒤의 표들은 co-distillation을 적용하지 않은 추가 정밀도 모델의 값을 68.52로 제시한다.
표시된 추가 정밀도 int2 구성 중 최고 결과는 기존 목표와 함께 int8-to-int2 지도를 제공할 때 평균 2.050비트에서 얻은 70.17이다. 이 조건은 엄격한 int2 MatQuant 및 co-distillation을 적용하지 않은 추가 정밀도 모델과 모두 다르다.
더 강력한 저비트 추가 정밀도 모델은 그림의 혼합 정밀도 정확도와 저장 공간 사이의 곡선을 높인다. 선택한 일부 구성은 모델의 16-bit 부동소수점 표현인 bfloat16 기준에 근접하거나 이를 넘는다. 다만 그래프는 희소한 추가 비트 보정에 드는 구현 비용을 정량화하지 않는다.
Impact Statement
Impact Statement는 대규모 언어 모델 배포에 필요한 자원을 줄이면 접근성을 넓히고 더 지속 가능한 시스템을 만들 수 있다고 설명한다. 이는 기대 효과다. 논문은 에너지 소비, 환경 영향, 접근성 변화를 측정하지 않으며, 강력한 모델의 배포 확대에 따르는 일반적인 위험도 인정한다.
부록
- A. Particulars of the Slicing Operation.은 추출 과정이 단순히 하위 비트를 버리는 것이 아니라 반올림을 포함한다고 명확히 설명한다. 예시를 통해 다음 비트가 반올림에 영향을 미치는 이유와 반올림 결과가 목표 정수 범위를 벗어날 때 clamping이 필요한 이유를 보여준다.
- B. Addition Training Details는 TPUv5e 가속기 하드웨어, OmniQuant 학습률 1e−3, 1e−5까지 warmup한 뒤 cosine decay를 적용하는 QAT 학습률을 보고한다. OmniQuant co-distillation은 토큰 8.3M개를 사용하며, FFN과 attention을 함께 양자화하는 QAT는 C4 토큰 300M개, 배치 크기 16으로 1 epoch 동안 학습한다. 같은 부록은 별도 명시가 없으면 Gemma 모델에 손실 가중치 (λ₈,λ₄,λ₂) = (0.1,0.1,1.0)을 사용한다고 설명한다. Mistral 7B에 OmniQuant를 적용할 때는 (0.4,0.4,1.0), Mistral 7B에 QAT를 적용할 때는 (0.2,0.2,1.0)을 사용하며, Extra Precison MatQuant는 (1.0,1.0,1.0)을 사용한다. Pyramid, Reverse Pyramid, Increasing, Decreasing 계층 할당을 비교하고, 시험한 전략 중 Pyramid가 일관되게 가장 좋은 성능을 낸다고 보고한다.
- C. Detailed Downstream Evaluations for OmniQuant and QAT는 Tables 9–14에서 과제별 결과를 제공한다. 성능 향상은 과제마다 다르다. Gemma-2 2B int2에 OmniQuant를 적용하면 과제 6개의 평균은 51.33에서 52.37로 높아지지만, ARC-c는 31.31에서 29.95로 낮아진다.
- D. Detailed Downstream Evaluations for MatQuant Re-weighting은 Tables 15–17에서 손실 가중치 절제 실험을 확장한다. 과제별 결과와 중간 정밀도 결과는 정밀도 우선순위 변경이 직접 지도한 모델과 보간으로 얻은 모델 2개 유형에 모두 영향을 준다는 점을 보여준다.
- E. Detailed Downstream Evaluations for Co-Distillation은 Tables 18과 19에서 Gemma-2 9B의 과제별 정확도와 log perplexity를 제공한다. 시험한 엄격한 int2 OmniQuant의 최고 평균 정확도는 64.32이며, int8이 저정밀도 2개를 모두 지도할 때 얻는다.
- F. Detailed Evaluations for FFN + Attention Quantization은 Tables 20과 21을 제공하며, 표 2개 모두 QAT 실험이라고 명시한다. 다만 부록 도입부는 OmniQuant와 QAT의 2개 방법을 모두 언급한다. 이 결과는 저정밀도에서 여전히 어려움이 있음을 보여준다. Mistral 7B의 int3 정확도는 다중 정밀도 MatQuant에서 40.55지만, Single Precison MatQuant에서는 67.59다.
- G. Detailed Evaluation for Single Precison MatQuant는 Tables 22–25와 베이스라인 대비 양자화 버킷의 가중치 분포 그림을 제공한다. 결과는 지도한 int2 정밀도의 개선과 고정밀도 슬라이스의 성능 저하를 함께 기록한다. 이는 단일 정밀도 최적화와 여러 정밀도의 성능 유지 사이에 상충 관계가 있음을 보여준다.
- H. Detailed Evaluation for Extra Precison MatQuant는 과제별 추가 정밀도 결과와 co-distillation 결과를 포함한 Tables 26–29를 제공한다. Table 30은 단일 정밀도와 추가 정밀도의 조합도 비교한다. OmniQuant에서 단일 정밀도와 추가 정밀도를 결합한 S.P. E.P. MatQuant의 평균 정확도는 57.38, 68.58, 67.36이다. 반면 추가 정밀도가 QAT 결과를 일관되게 개선하지는 않는다. 이 변형들에도 Errata에서 설명한 추가 값에 관한 조건이 적용된다.
짧은 생각
가장 분명한 결과는 시험한 모델 3개 전체와 기반 양자화 방법 2개 모두에서 독립적으로 학습한 모델보다 엄격한 int2 정확도가 높아졌다는 점이다. OmniQuant에서는 int2 베이스라인이 더 많은 학습 토큰을 사용했는데도 성능이 향상된다. 중간 정밀도 슬라이싱과 혼합 계층 할당도 정확도와 가중치 저장 공간 사이의 선택지를 추가로 제공한다. Errata는 저비트 결과의 해석을 바꾼다. 엄격한 2-bit 모델과 약 2.05-bit models는 표현에 필요한 자원량이 다르며, 추가 값을 사용하는 변형은 OmniQuant에서 성능을 더 높인다. 실제 배포 가치는 아직 측정하지 않았다. 실행 성능 벤치마크에서는 커널 지원과 추가 비트 처리를 고려해야 한다. 일부 FFN과 attention 동시 양자화 설정의 낮은 정확도와 표 항목 간 불일치도 더 넓은 주장에 제약을 준다.