


FFN Fusion: Rethinking Sequential Computation in Large Language Models 요약 설명
24 Mar 2025 | Paper Review Model Compression Transformer Architectures Knowledge Distillation목차
이번 글에서는 FFN Fusion: Rethinking Sequential Computation in Large Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 24일(Arxiv)
- Bercovich, Akhiad, Dabbah, Mohammad, Puny, Omri, Galil, Ido, Geifman, Amnon, Geifman, Yonatan, Golan, Izhak, Karpas, Ehud, Levy, Itay, Moshe, Zach, et al.
- NVIDIA
- 논문 링크
요약
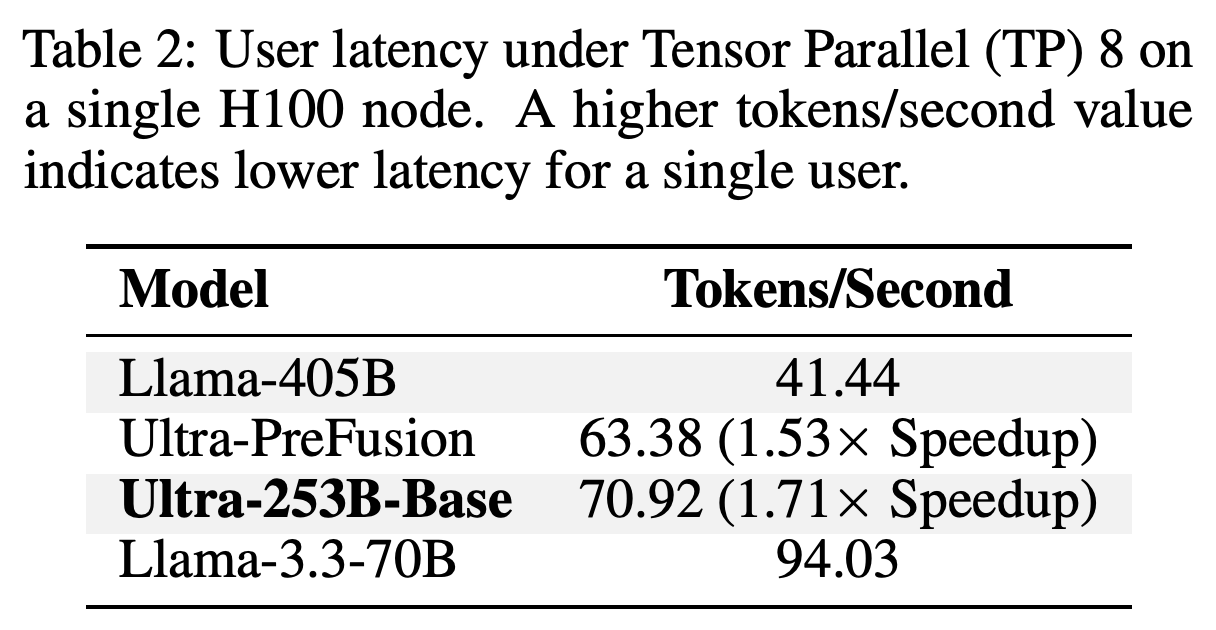
- 대규모 언어 모델의 계층을 순차적으로 실행하면 그래픽 처리 장치(GPU) 사이에서 통신과 동기화가 반복되어 추론이 지연된다. 논문의 전체 최적화 과정을 거친 Ultra-253B-Base는 1개 8×H100 노드에서 70.92 tokens/second를 생성하며, 같은 조건에서 Llama-3.1-405B-Instruct는 41.44 tokens/second를 생성한다. 계층 연산을 GPU에 분산하는 8-way tensor parallelism을 동일하게 적용한 결과다.
- FFN Fusion은 선택한 연속 feed-forward network(FFN) 구간을 입력을 공유하는 더 넓은 FFN으로 대체한다. FFN은 각 토큰을 독립적으로 변환하는 모듈이다. 토큰 사이의 관계를 모델링하는 attention 모듈을 가지치기하면 융합에 적합한 FFN 구간이 드러난다. 의존성을 측정하여 순차 실행을 대체해도 영향이 작은 구간을 찾는다.
- 가장 높은 품질은 가지치기, 융합, knowledge distillation(KD), 지시문과 인간 선호를 이용한 정렬 학습을 거친 뒤에 얻는다. KD는 파생 모델이 원본 모델의 동작을 유지하도록 학습하는 방법이다. 이미 가지치기를 마친 253B 모델에 융합을 적용하면 생성 속도가 63.38에서 70.92 tokens/second로 높아진다. 더 작은 모델의 구성 요소 비교 실험에서는 FFN 연산을 제거하는 것보다 유지하는 편이 품질을 더 잘 보존한다.
1 Introduction
서론은 수치 정밀도를 낮추는 양자화, 모델 구성 요소를 제거하는 가지치기와 함께 실행 깊이를 줄일 필요성을 제시한다. 연속 계층은 GPU 사이의 동기화 비용을 유발하며, 분산된 작은 연산은 가용 연산 자원을 충분히 활용하지 못할 수 있다. FFN Fusion은 유지할 연산을 더 적은 수의 큰 연산으로 모은다. 핵심 실험 주장은 attention을 제거해 드러난 FFN 구간에서 계층 간 의존성이 약하다는 것이다.
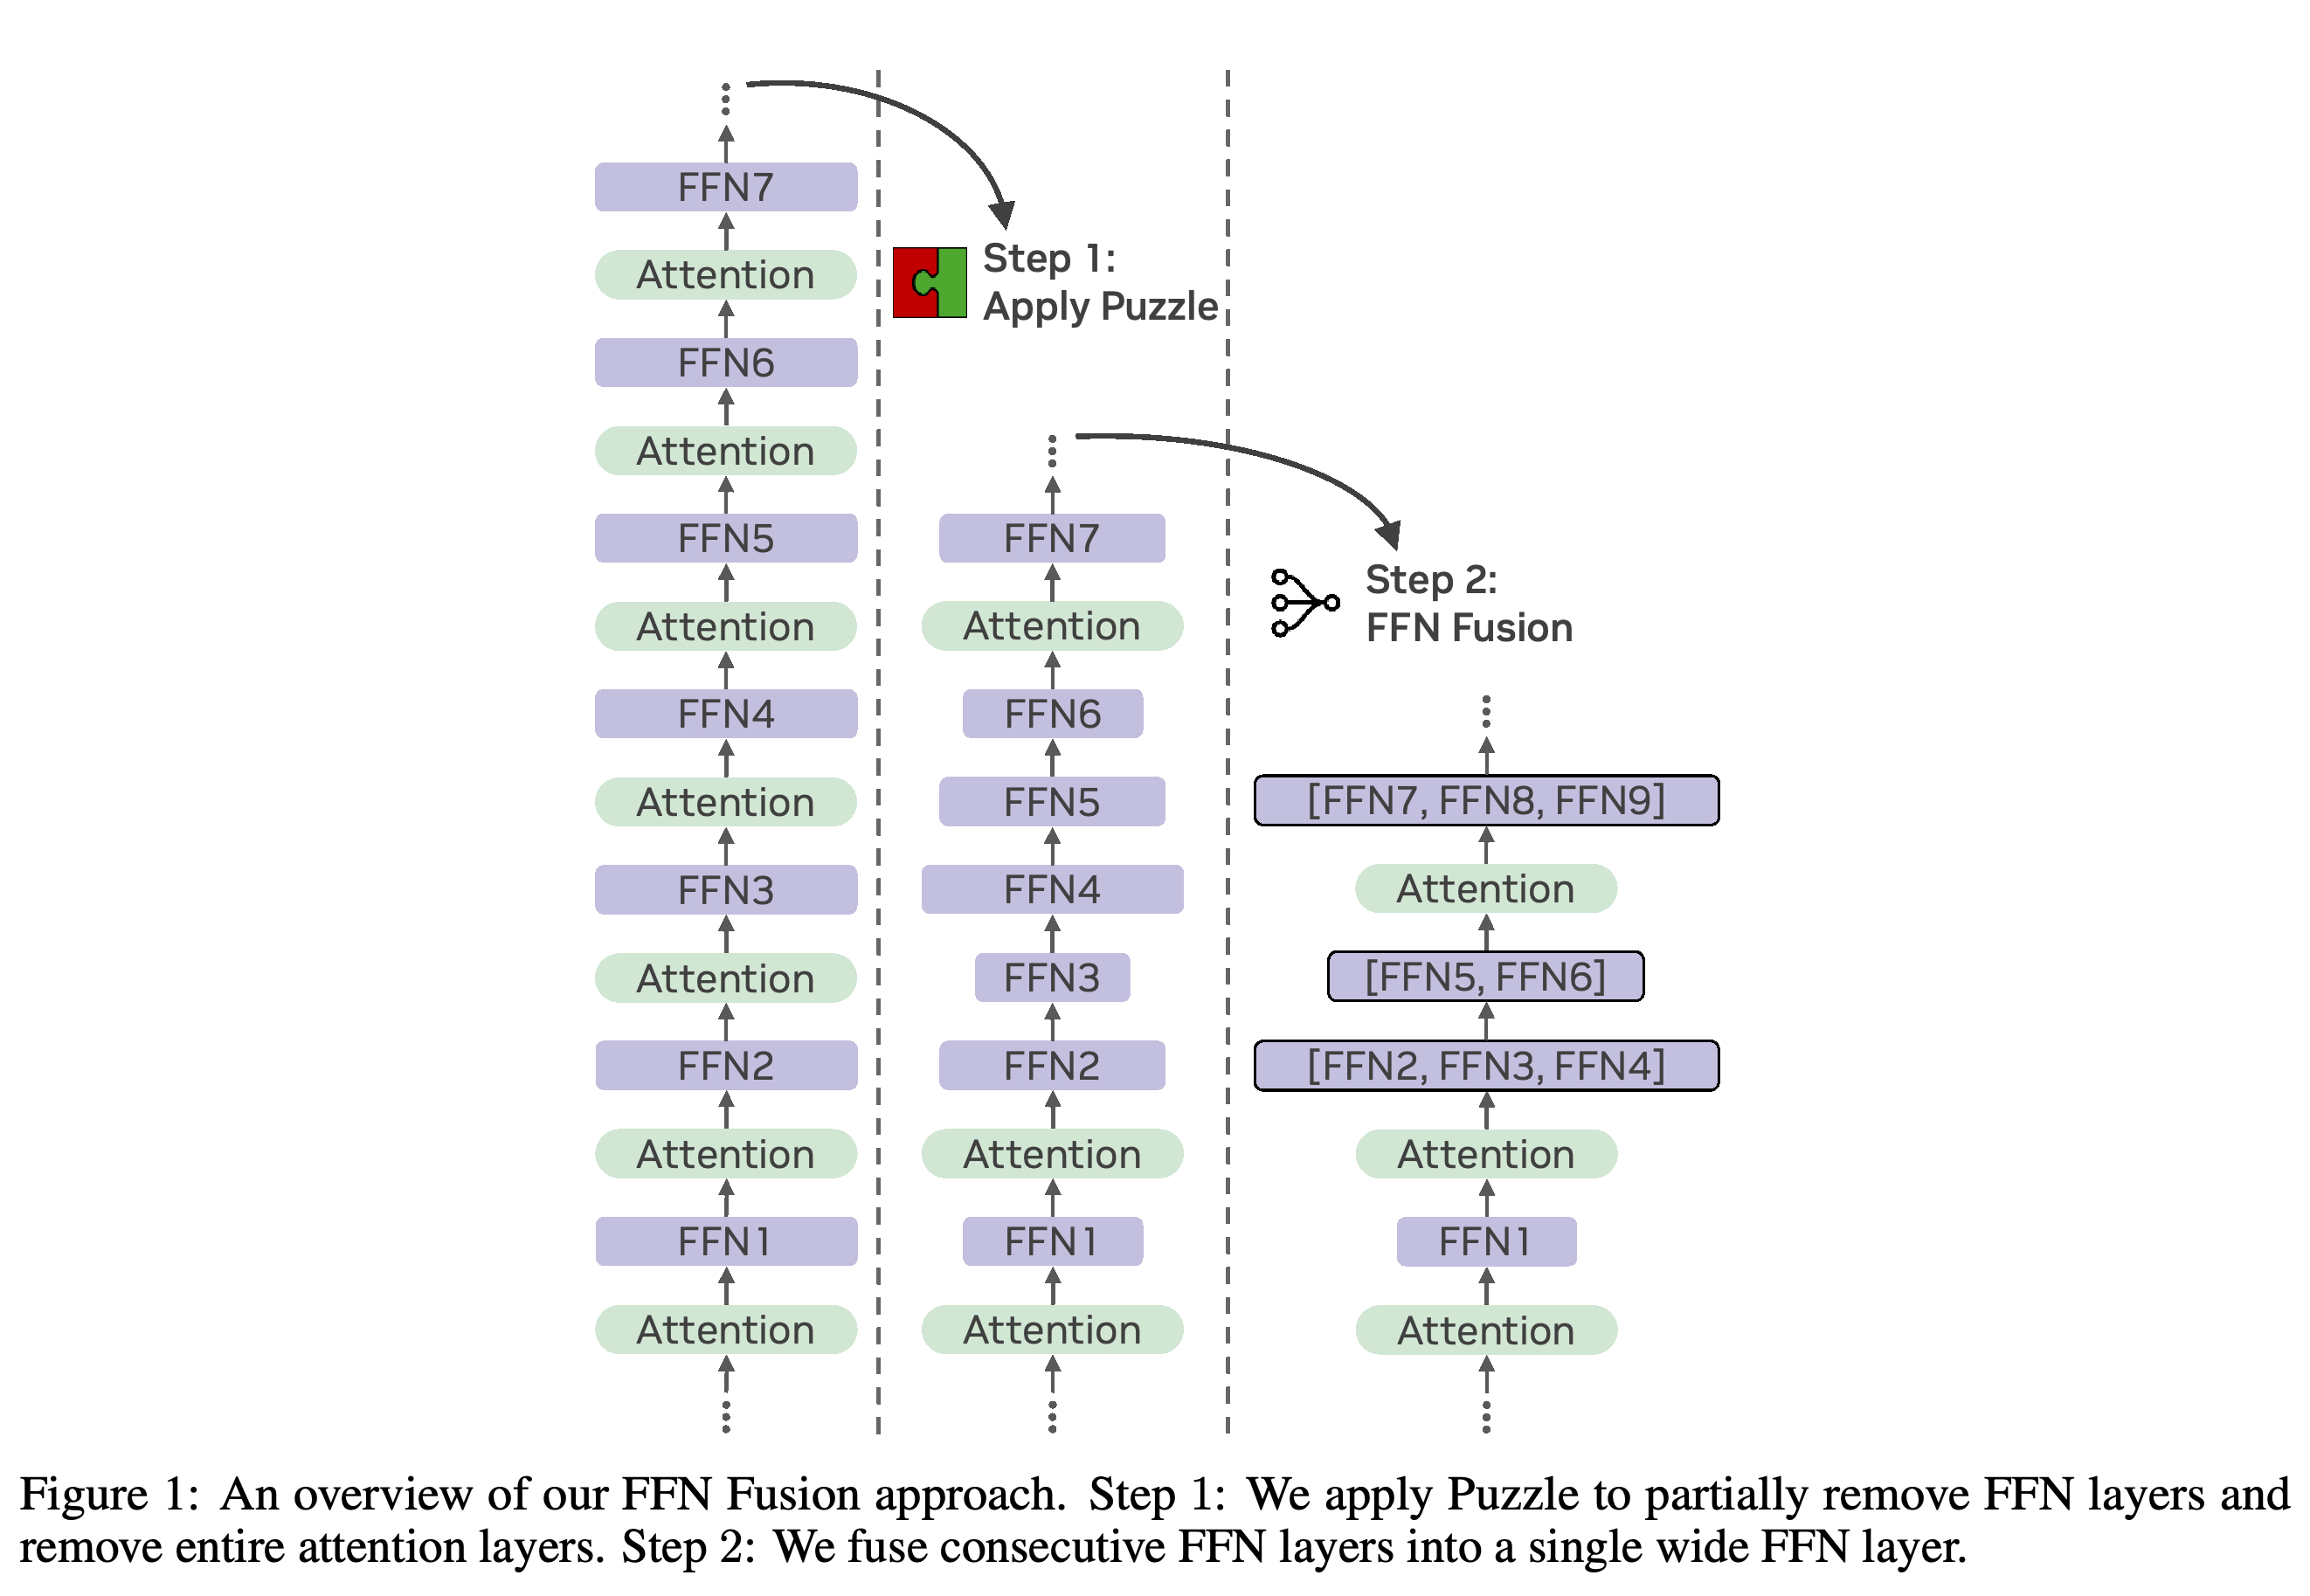
2단계 과정은 가지치기로 연속 FFN 구간을 만든 뒤 융합으로 실행 깊이를 줄인다는 점을 보여준다. 파라미터 감소는 가지치기에서 발생한다. 융합은 선택한 FFN의 가중치를 유지하면서 연산 실행 방식을 바꾼다.
2 Preliminaries
표준 transformer 블록은 attention과 FFN을 차례로 적용하고, 잔차 연결을 통해 각 모듈의 출력을 입력에 더한다. 실험에서는 입력 투영 2개를 원소별 게이트로 결합한 뒤 출력 투영을 적용하는 FFN인 SwiGLU를 사용한다. 토큰 수준 정규화는 각 토큰 벡터를 노름으로 나누고 학습한 스케일 계수를 곱한다. Puzzle은 사전 학습된 블록을 가지치기하거나 재구성하고 증류로 품질을 복구하는 기존 아키텍처 탐색 프레임워크다. 이 과정에서 FFN의 폭이 다양해지고 attention이 없는 연속 구간이 생긴다.
3 FFN Fusion
attention이 없는 연속 블록을 병렬 연산으로 대체한 식은 \(\hat f^{[i,i+c]}(X)=X+\sum_{j=0}^{c}\operatorname{FFN}^{i+j}(\eta_2(X))\)이며, 구간의 마지막 계층에 있는 정규화를 사용한다. 모든 FFN이 동일하게 정규화된 입력을 받으므로 각 FFN의 연산은 서로 독립적이다. Theorem 3.1은 투영 행렬을 이어 붙이면 이 합을 더 넓은 SwiGLU FFN으로 정확히 구현할 수 있음을 증명한다. 다만 원래의 순차 연산을 이 병렬 합으로 대체하는 것은 근사다.
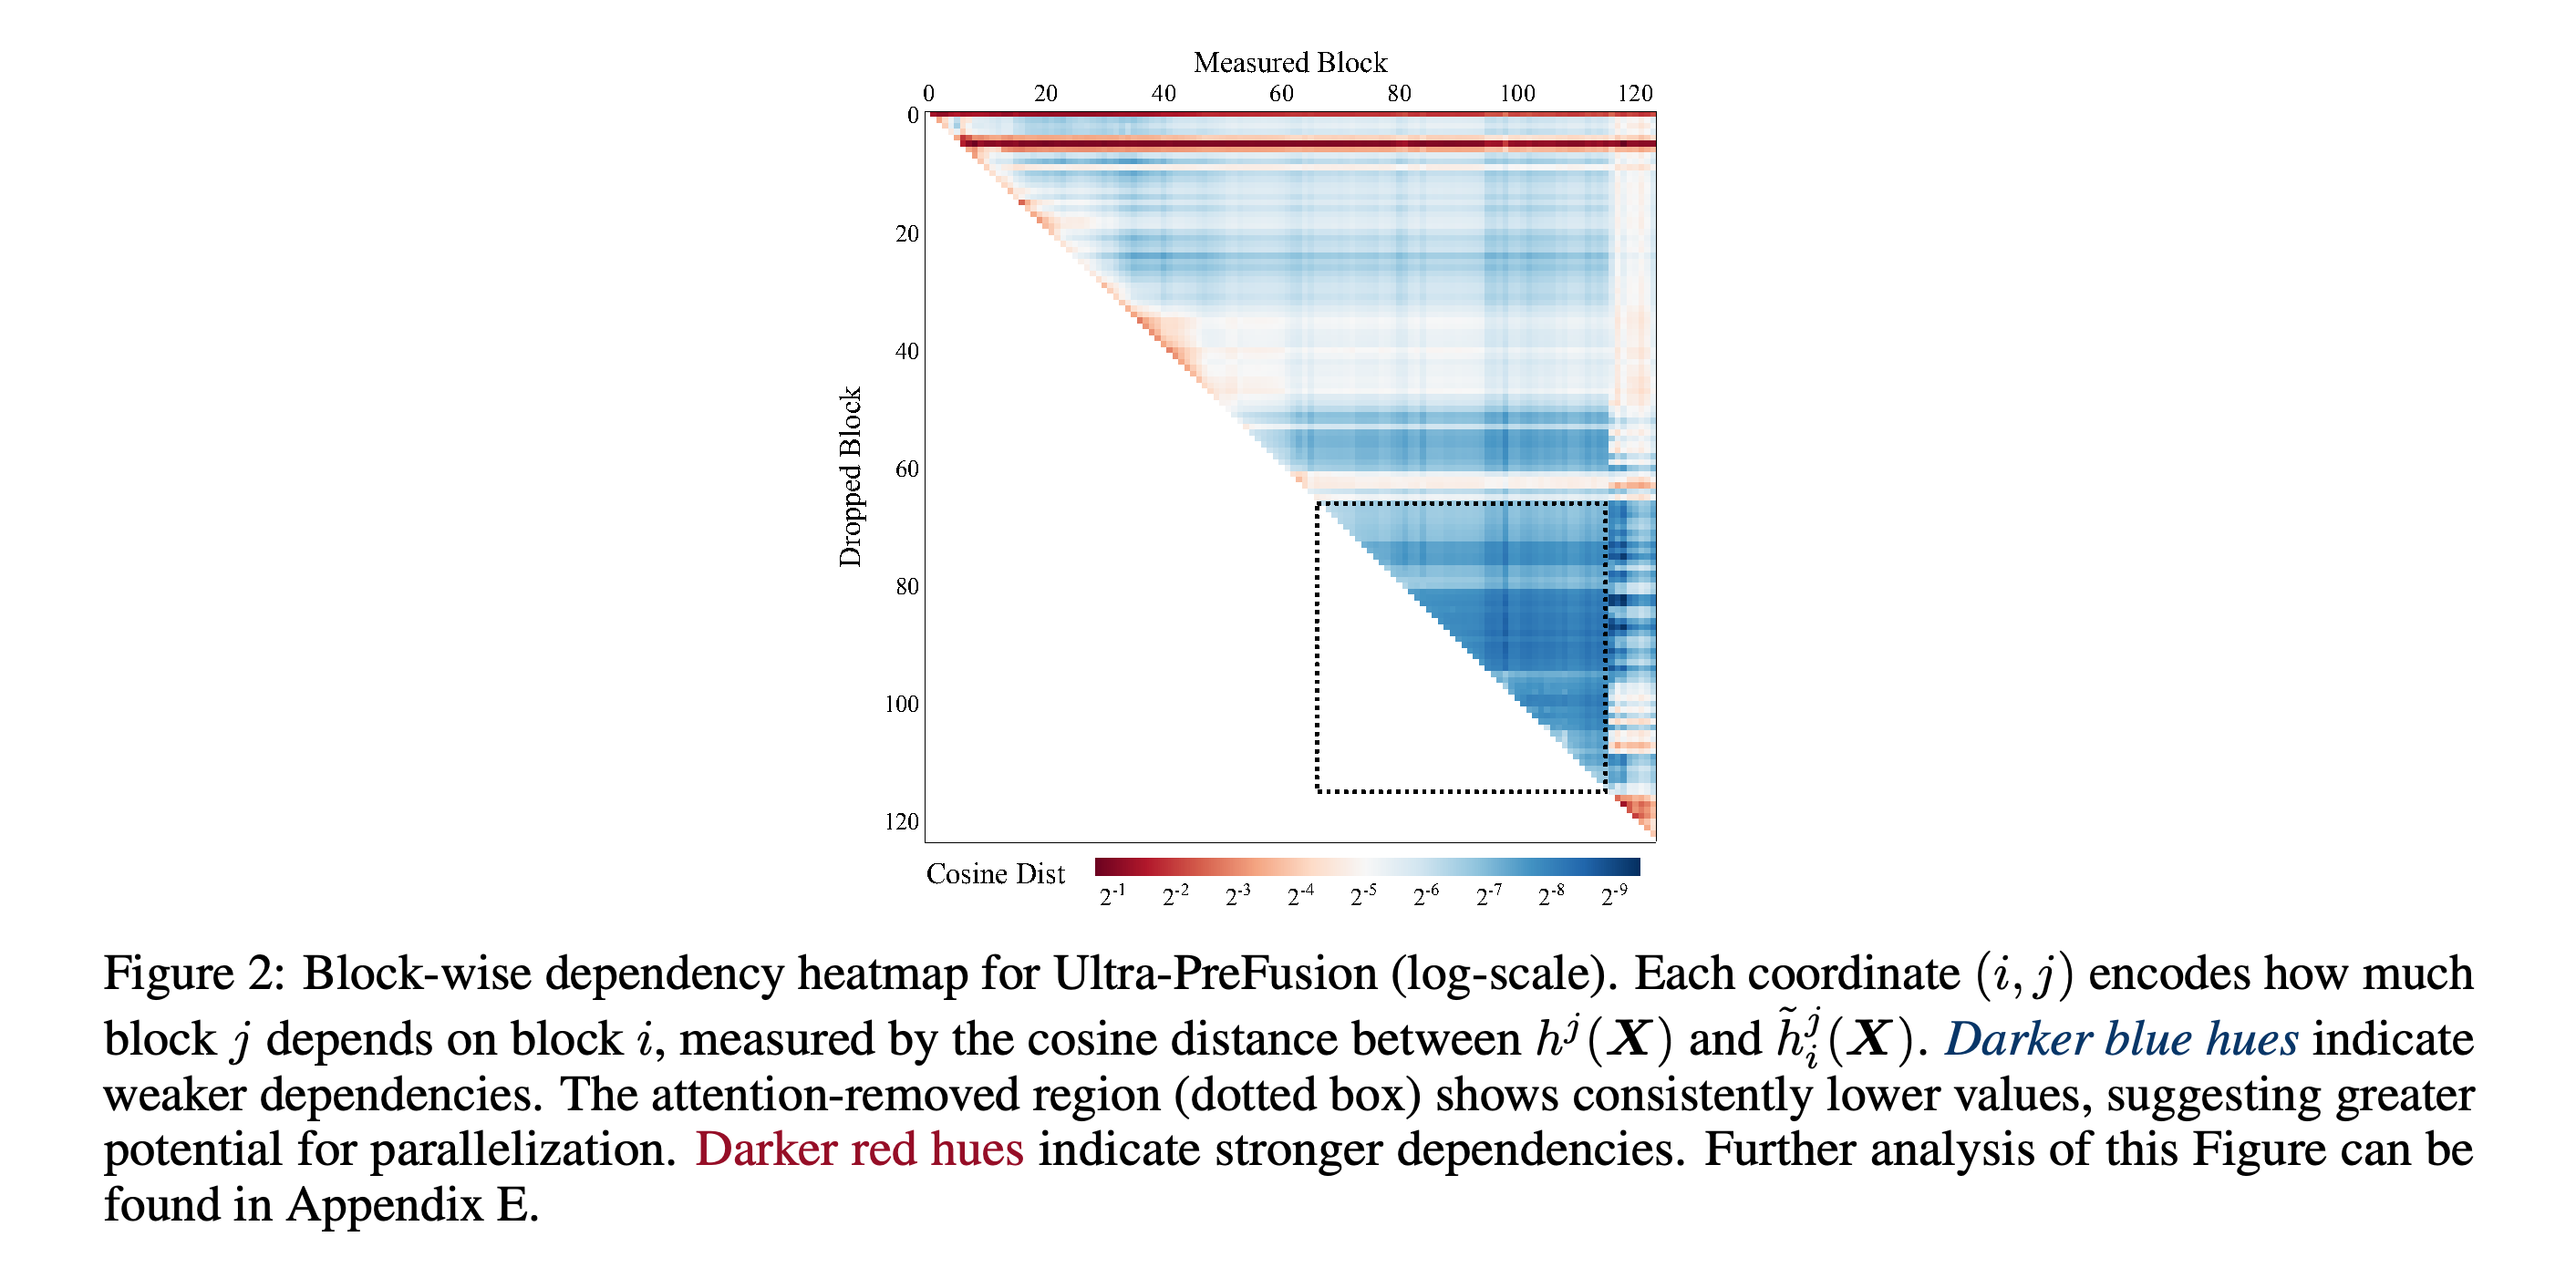
후보 구간은 특정 블록을 제거한 전후에 다른 블록의 잔차 기여분이 얼마나 달라지는지 코사인 거리로 측정하여 평가한다. 코사인 거리는 방향의 변화를 나타낸다. 논문에서 사용하는 텍스트와 코드 데이터 혼합물인 Distillation Mix에서 거리가 작으면 블록 간 의존성이 약하다고 본다. 융합 전 가지치기를 마친 253B 모델인 Ultra-PreFusion에는 의존성 값이 낮고 attention이 없는 긴 구간이 있다. 다만 GPU 메모리 제약 때문에 이 구간을 여러 융합 그룹으로 나누어야 한다.
상자로 표시한 attention 없는 구간은 쌍별 의존성이 일관되게 약하므로 융합 대상으로 선택할 근거가 된다. 초반 행의 강한 의존성은 이러한 특성이 모델 전체에 균일하게 나타나지 않음을 보여준다.
4 Producing Large-Scale Models with FFN Fusion
Puzzle은 먼저 지연 시간 기준 1.5배 가속을 목표로 Llama-405B 파생 모델을 탐색한다. 메모리 용량이 640 GB인 8×H100 노드와 192 GB인 단일 B100 GPU에 모델을 수용하는 것도 목표다. 결과로 얻은 253B 모델에는 attention이 없는 연속 블록 50개가 있다. FFN 49개를 [66,73], [74,85], [86,100], [101,114]의 4개 그룹으로 융합하고 마지막 FFN은 별도로 둔다. 추가 학습 전에 융합을 적용하면 다중 과제 언어 이해 벤치마크인 MMLU가 84.23에서 82.76으로, 대화 평가인 MT-Bench가 8.83에서 8.35로 변한다.
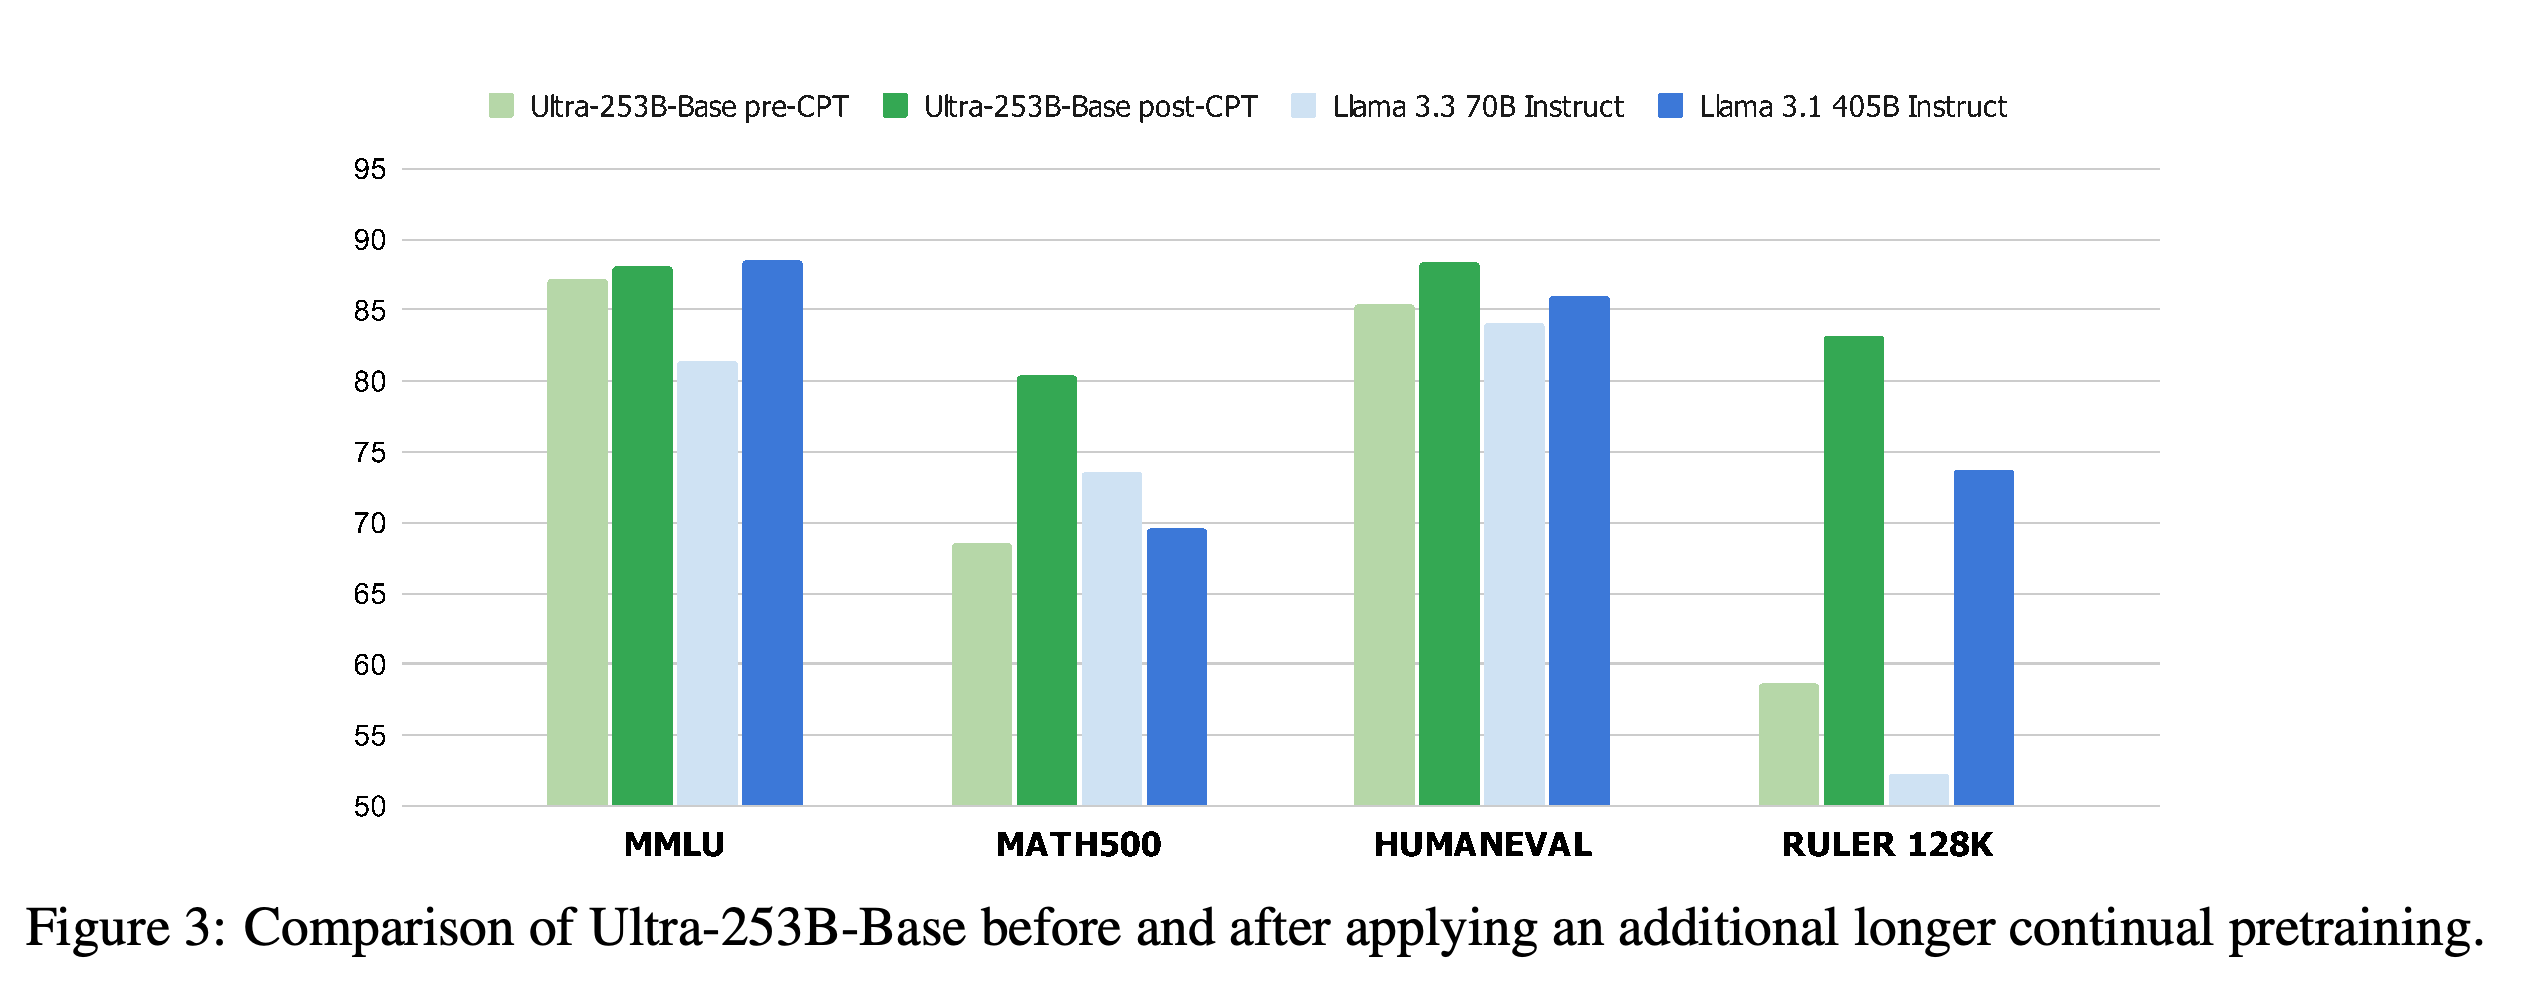
성능 복구를 위한 KD에는 8k 문맥에서 54B 토큰, 16k와 32k 문맥에서 각각 5B 토큰, 128k 문맥에서 0.8B 토큰을 사용한다. 이를 통해 MMLU는 85.17, MT-Bench는 9.10으로 높아진다. 이후 instruction tuning과 인간 선호 신호로 최적화하는 reinforcement learning from human feedback(RLHF)을 적용하면 보고된 여러 벤치마크가 개선된다. 별도의 continual pretraining(CPT) 실험에서는 정렬 없이 추가 데이터로 학습을 이어간다. 8k 문맥에서 73B 토큰을, 258k 문맥에서 15B를 추가로 학습하여 Figure 3에 제시된 평가 결과를 개선한다.
추가 continual pretraining은 표시된 평가 4개 모두를 개선하며, 특히 수학 평가인 MATH500과 긴 문맥 평가인 RULER 128K에서 변화가 크다. 이 개선은 추가 학습 실험의 결과이며 융합만의 효과를 분리해 보여주지는 않는다.
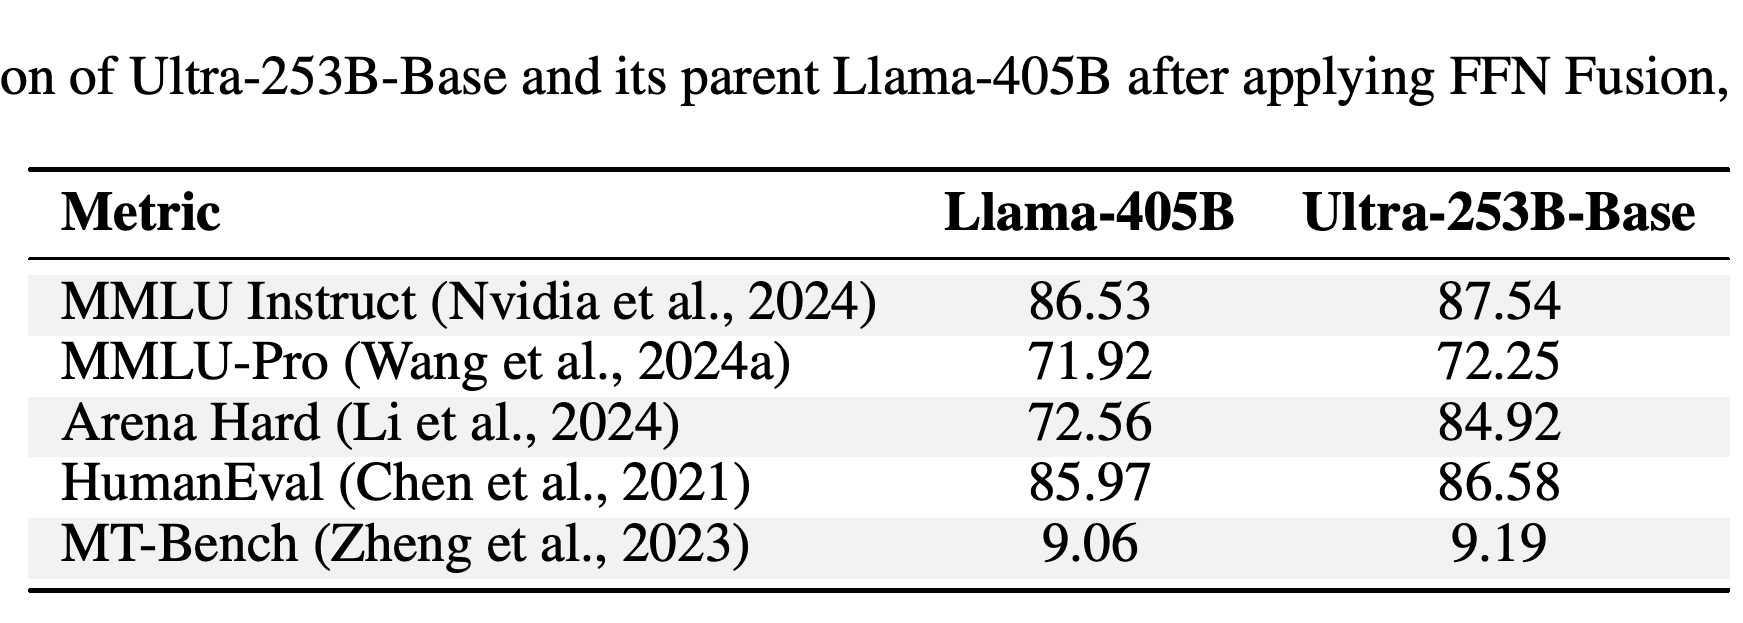
1개 8×H100 노드에서 생성 속도는 Llama-405B가 41.44 tokens/second, Ultra-PreFusion이 63.38, Ultra-253B-Base가 70.92다. Figure 4는 8비트 부동소수점 연산인 FP8을 사용한다고 명시한다. KD와 정렬을 거친 Ultra-253B-Base는 Table 3의 5개 지표 모두에서 원본 모델을 앞선다. 해당 지표는 지시문 기반 MMLU 평가인 MMLU Instruct, 더 어려운 다중 과제 언어 이해 벤치마크인 MMLU-Pro, 어려운 프롬프트로 구성된 Arena Hard, 코드 생성 벤치마크인 HumanEval, MT-Bench다. 논문은 배치 크기 32에서 토큰당 비용이 35배 낮고, attention의 상태를 저장하는 key-value cache 메모리가 절반이라고도 보고한다. 다만 이에 대응하는 비용 내역은 제시하지 않는다.
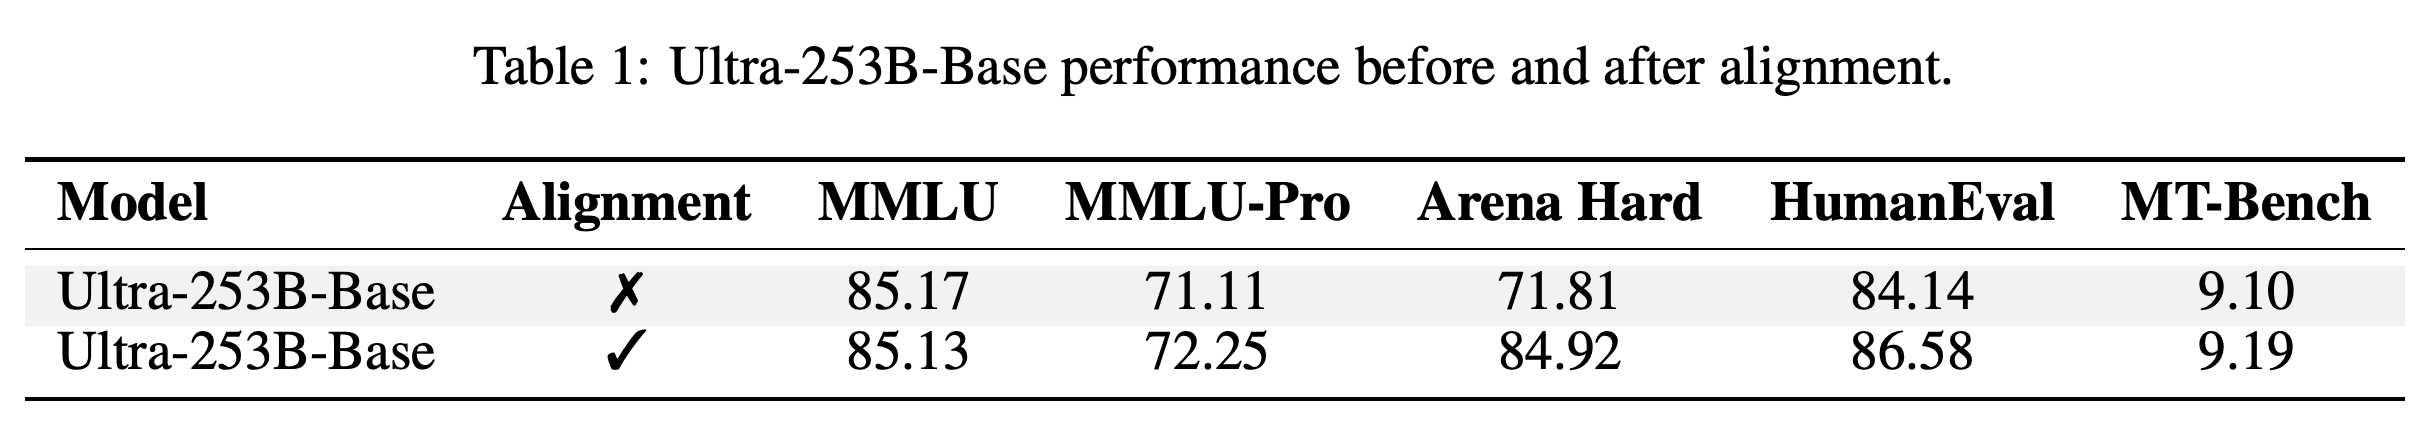
정렬을 적용하면 Arena Hard가 71.81에서 84.92로 높아지고 MMLU-Pro, HumanEval, MT-Bench도 개선된다. MMLU는 85.17에서 85.13으로 변한다. 이를 통해 정렬에 따른 개선과 앞선 융합 및 증류 단계의 결과를 구분할 수 있다.
중간 단계의 Ultra-PreFusion 기준 모델을 통해 융합이 추가로 기여한 속도 향상을 확인할 수 있다. 생성 속도는 63.38에서 70.92 tokens/second로 높아진다. 1.71배 비교는 원본 모델의 41.44 tokens/second를 기준으로 하므로 앞선 가지치기 단계도 포함한다.
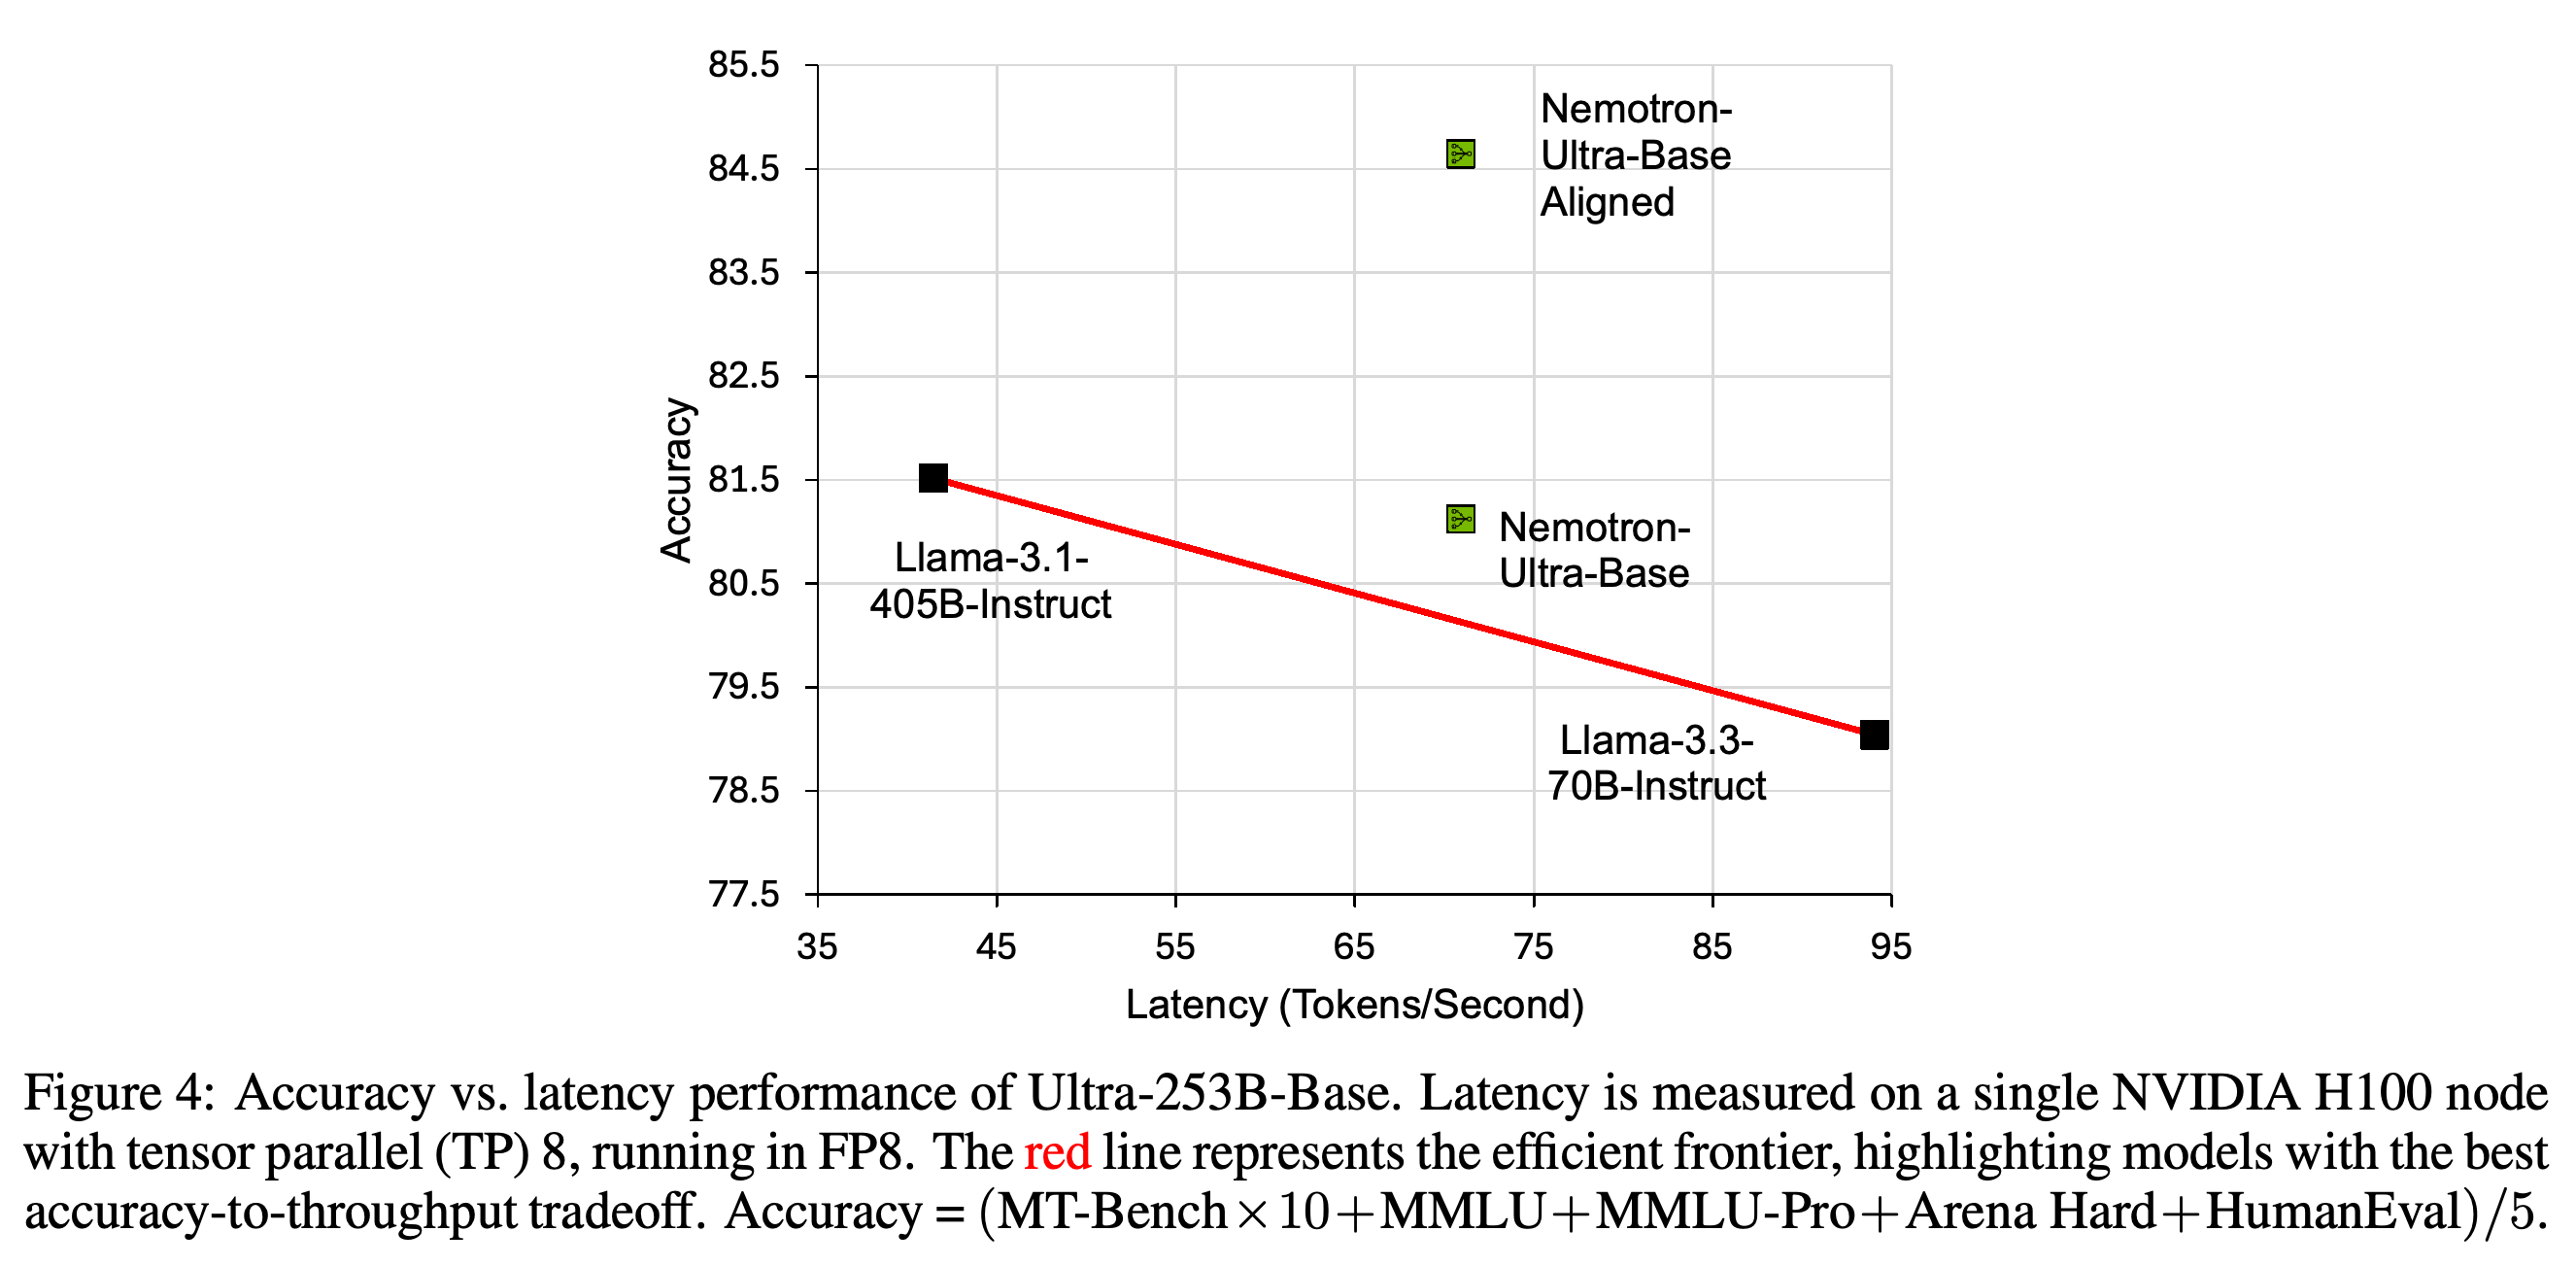
정렬을 거친 253B 모델은 FP8과 tensor parallelism 8 조건에서 Llama 기준 모델 2개보다 그래프상의 품질과 처리량 간 절충을 개선한다. 정확도 축은 MT-Bench에 10을 곱한 뒤 평가 5개를 평균하므로, 표시된 점수는 여러 평가를 결합한 종합 점수다.
최종 파생 모델은 융합, KD, 정렬을 거친 뒤 나열된 모든 지표에서 Llama-405B를 앞선다. MMLU Instruct는 87.54 대 86.53, MMLU-Pro는 72.25 대 71.92, Arena Hard는 84.92 대 72.56, HumanEval은 86.58 대 85.97, MT-Bench는 9.19 대 9.06이다. 이 비교는 전체 최적화 과정의 결과를 보여준다.
5 Additional Empirical Studies
추가 연구에서는 49B 파생 모델에 융합을 적용하고, 융합과 FFN 제거를 비교하며, 구간 경계의 민감도와 병렬화가 동작을 보존하는 이유를 살펴본다. 이 실험들은 실행 순서에 대한 의존성이 약하다는 사실과 해당 FFN 연산을 생략할 수 있다는 주장을 구분한다.
5.1 FFN Fusion in 70B Scale
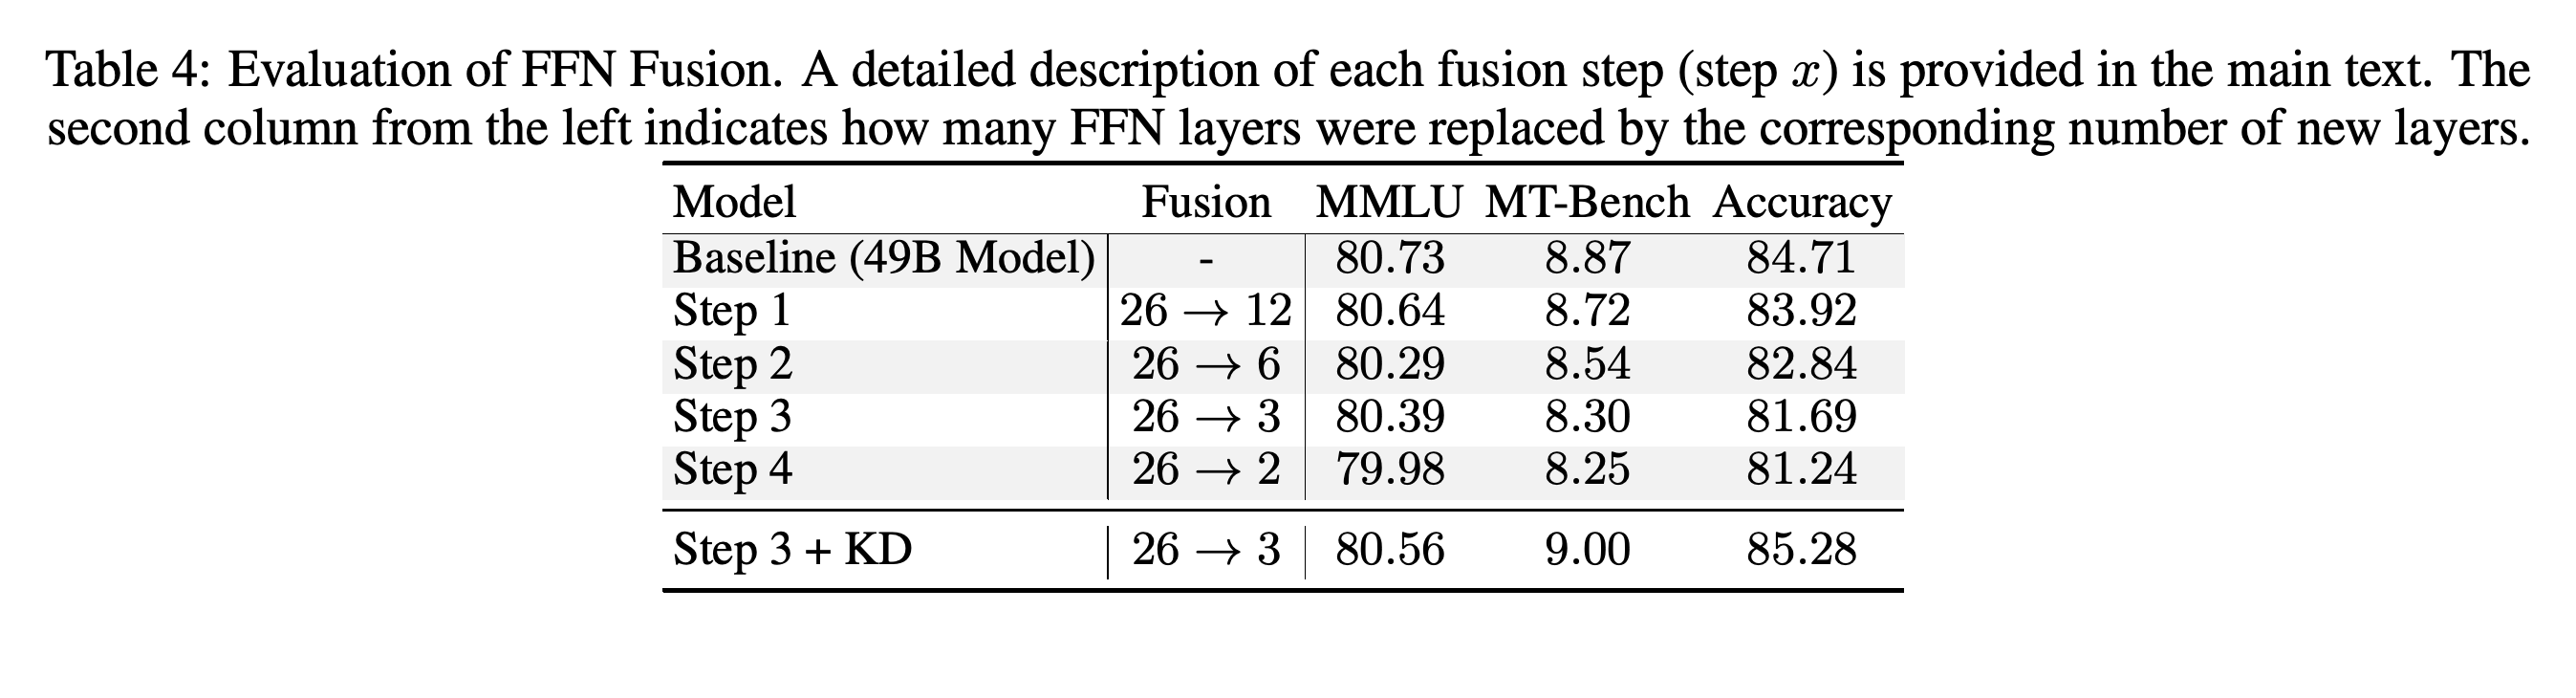
Puzzle-49B는 Llama-3.1-70B-Instruct에서 파생되었으며, 계층 42–51과 53–70에 attention이 없는 구간이 있다. 각 구간의 마지막 FFN을 제외하고 융합 강도를 점차 높이는 4가지 설정을 적용한다. 추가 학습 없이 FFN 26개를 12, 6, 3, 2개 계층으로 대체하면 MMLU와 MT-Bench를 결합한 점수는 각각 83.92, 82.84, 81.69, 81.24다. 기준 모델의 점수는 84.71이다. 점수 계산식은 \(\operatorname{Accuracy}=(\operatorname{MMLU}+10\times\operatorname{MT\text{-}Bench})/2\)이며, KD를 적용하면 3개 계층으로 융합한 모델의 점수가 85.28로 높아진다.
추가 학습 없이 융합 강도를 높이면 결합 점수가 점차 낮아진다. 반면 3개 계층으로 융합한 모델에 KD를 적용하면 기준 모델의 결합 점수를 넘는다. 이는 강한 융합에 따른 품질 손실과 복구 학습의 역할을 함께 보여준다.
5.2 Removing FFNs vs. FFN Fusion
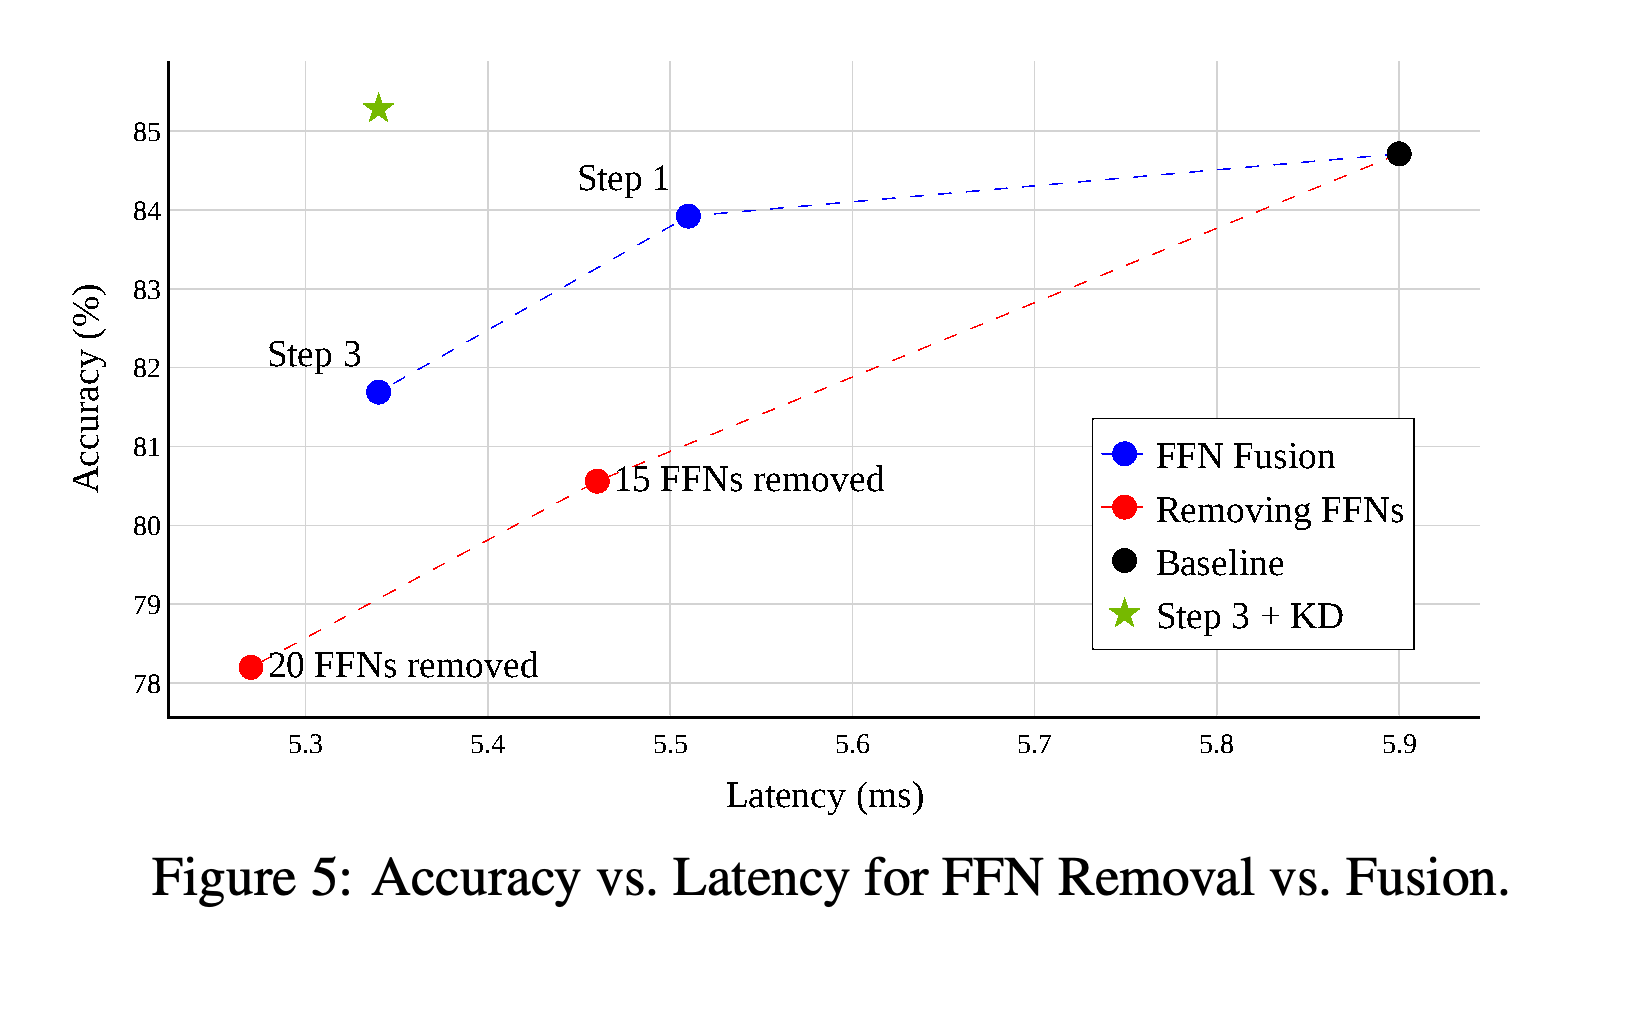
제거 방식의 기준 모델은 융합 가능한 구간 안에서 Puzzle의 중요도 점수가 가장 낮은 FFN부터 제거한다. 논문은 Step-3 융합으로 지연 시간이 10% 개선되고 정확도가 3.5% 하락한다고 보고한다. FFN을 15개 또는 20개 제거하면 지연 시간은 각각 7.5%, 11% 개선되지만 정확도는 각각 5%, 8.7% 하락한다. 융합 모델은 25B 토큰으로 KD를 거친 뒤 MMLU 80.56, MT-Bench 9.00을 기록한다. 결합 점수는 기준 모델을 넘지만 MMLU는 기준 모델의 80.73보다 약간 낮다.
융합은 지연 시간이 비슷한 FFN 제거보다 높은 결합 정확도를 유지한다. KD로 복구한 융합 모델은 융합 아키텍처의 낮은 지연 시간을 유지하면서 기준 모델의 결합 정확도를 넘는다.
5.3 The Final FFN in Each Sequence is Sensitive to Fusion
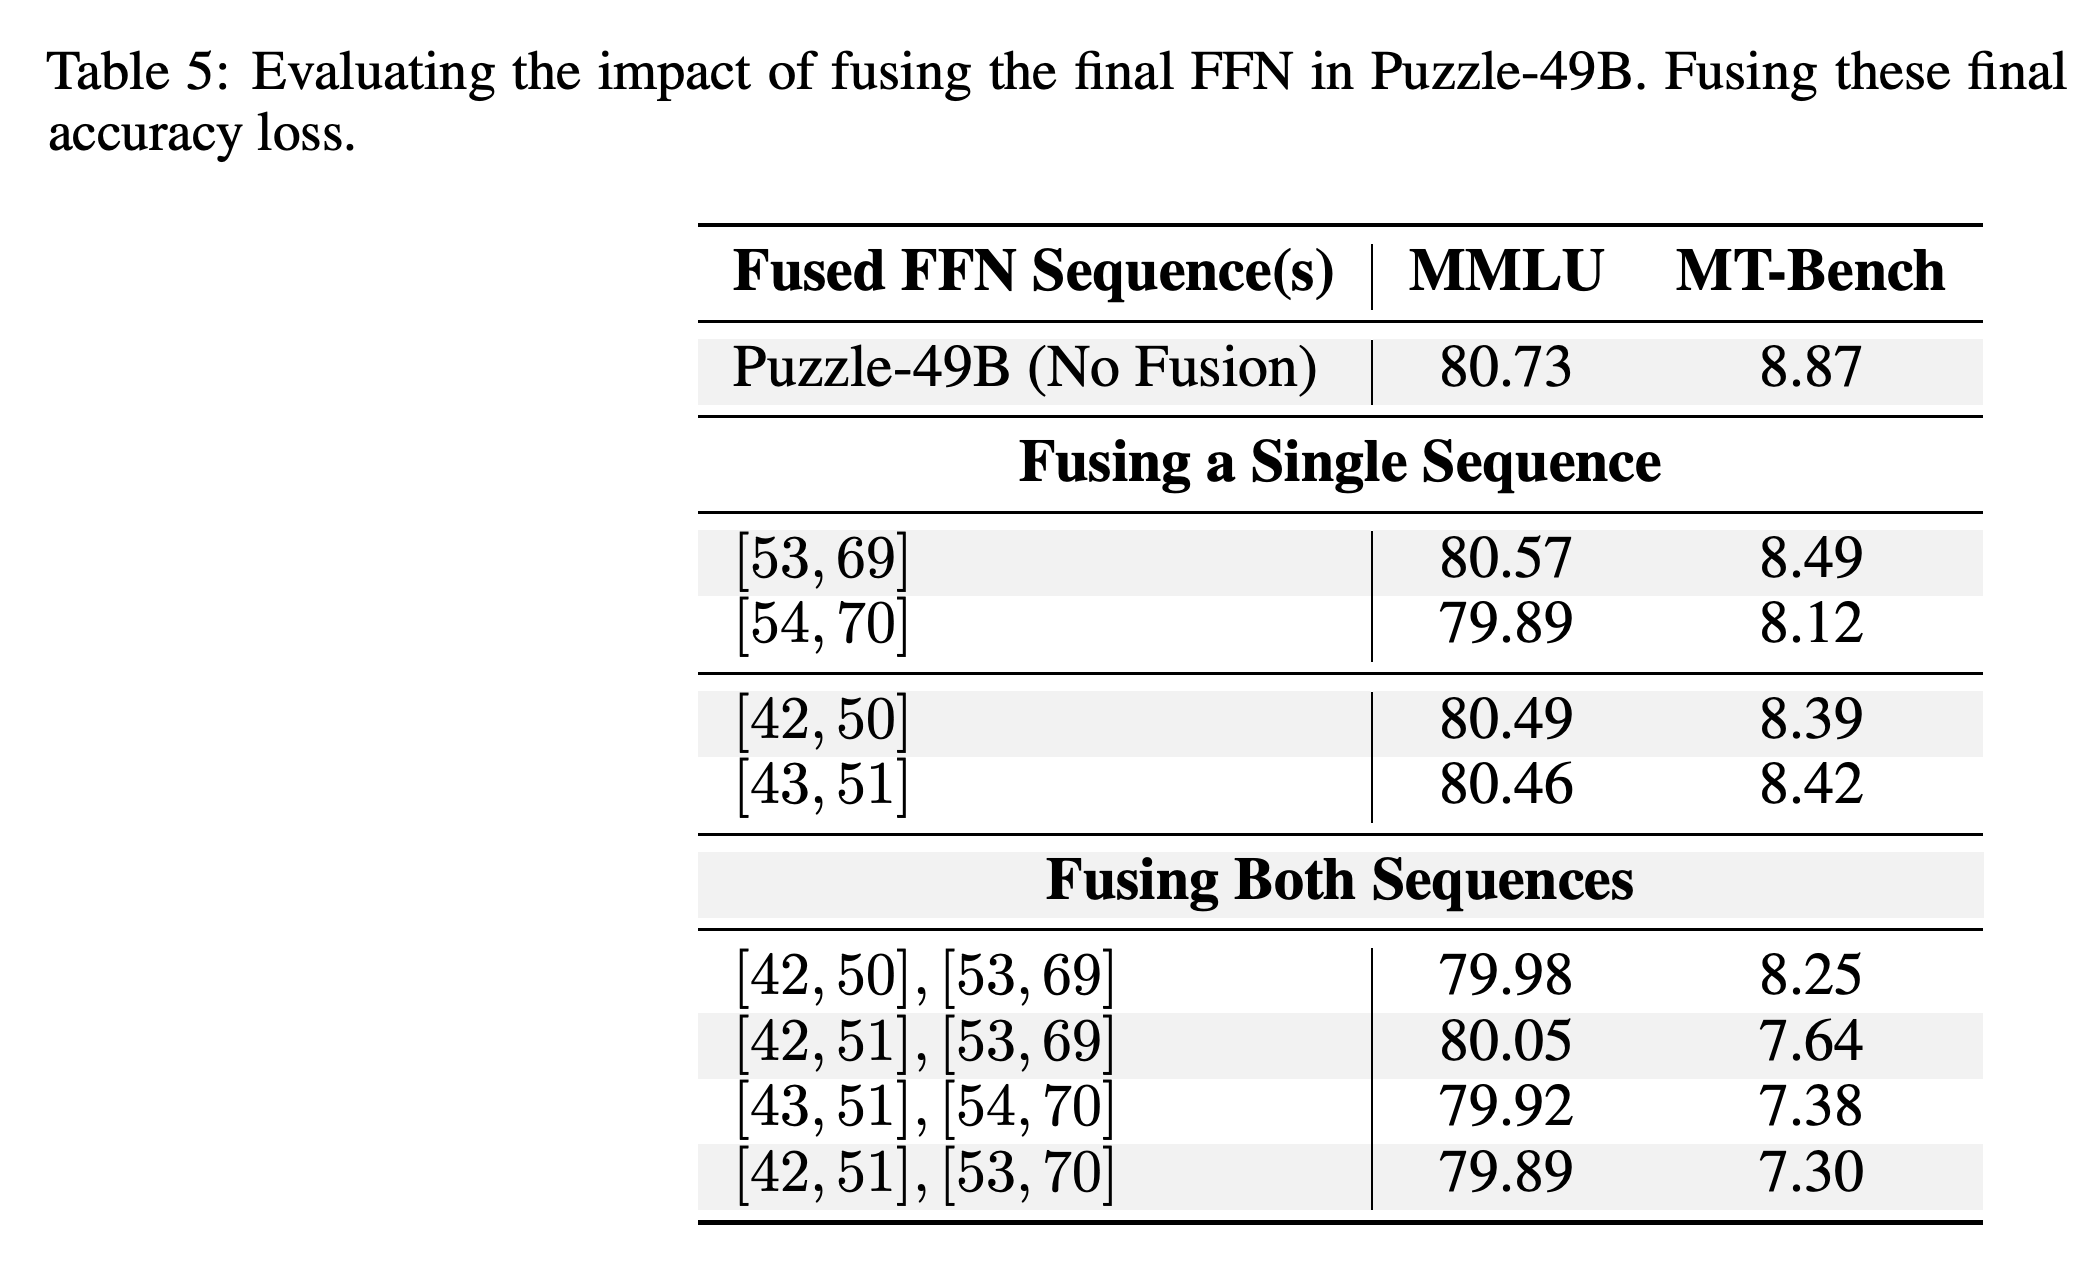
경계 계층 비교 실험은 특히 2개 구간을 모두 융합할 때 각 융합 그룹의 마지막 FFN을 제외하는 방식을 뒷받침한다. [42,50]과 [53,69]를 융합하면 MT-Bench가 8.25지만, 마지막 FFN까지 모두 포함해 [42,51]과 [53,70]을 융합하면 7.30으로 낮아진다. 단일 구간의 결과는 덜 일관적이다. [42,50]을 [43,51]로 옮기면 MT-Bench가 8.39에서 8.42로 약간 높아지지만, [53,69]를 [54,70]으로 옮기면 8.49에서 8.12로 낮아진다.
융합하는 2개 구간 모두에 마지막 FFN을 포함하면 MT-Bench가 크게 낮아진다. 이는 마지막 FFN을 별도로 두는 방식을 뒷받침한다. 첫 구간만 비교한 결과는 일관되지 않으므로, 이 표는 모든 지표에 적용되는 보편적 규칙보다는 실용적인 경향을 뒷받침한다.
5.4 Fusion Explainability
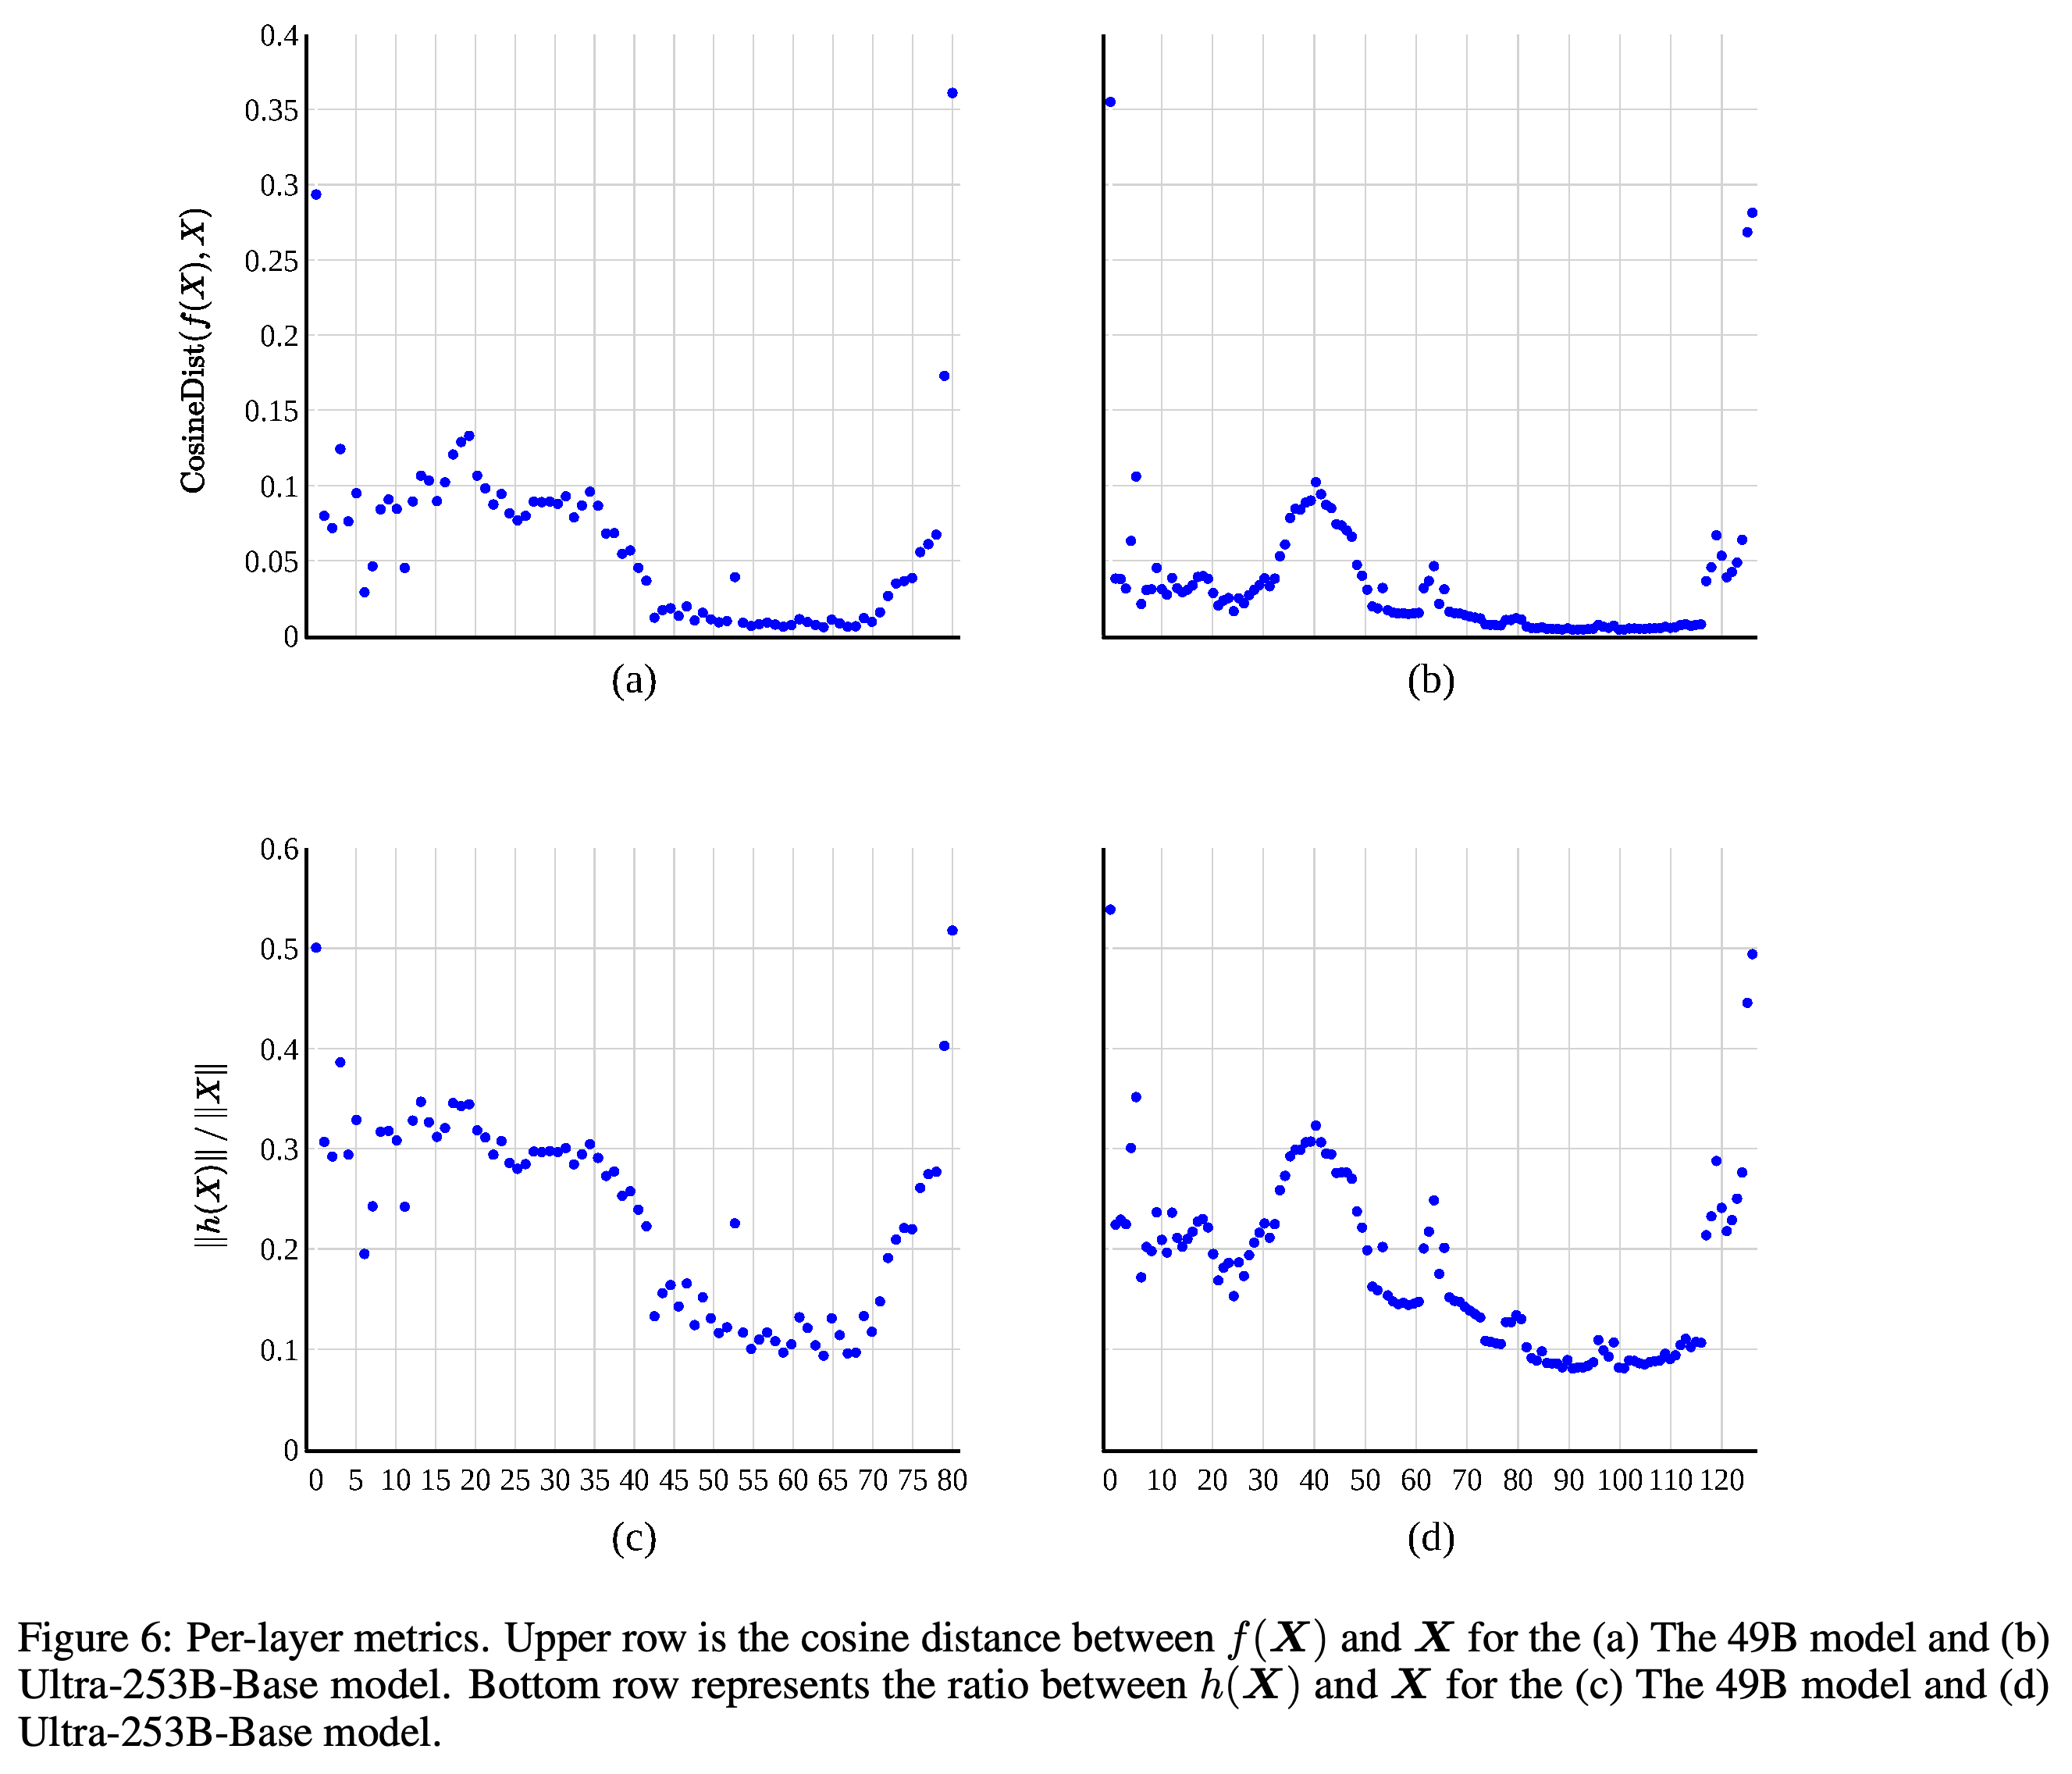
논문은 정규화로 인해 입력의 방향이 중요해지는 반면, 융합 구간의 FFN은 그 방향을 비교적 조금만 바꾸기 때문에 융합이 가능하다고 설명한다. 계층별 측정에서 이 구간은 입력과 출력 사이의 코사인 거리가 작고, 입력 대비 잔차의 노름 비율도 낮다. 이 비율은 블록의 갱신 크기가 입력에 비해 얼마나 큰지를 나타낸다. 선택한 FFN 구간의 실행 순서를 뒤집어도 융합과 비슷한 점수를 얻는다. 이 설명은 작은 입력 변화가 작은 출력 변화로 이어진다고 가정한다. 순차 실행을 대체할 때의 오차 한계를 수학적으로 제시한 것은 아니며, 실험 근거를 제공한다.
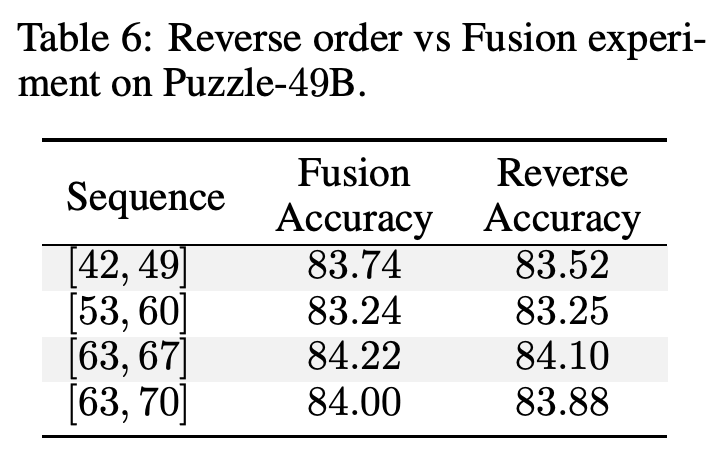
선택한 구간 4개에서 실행 순서를 뒤집으면 융합했을 때와 비슷한 결합 점수를 얻는다. [53,60]의 점수는 각각 83.25와 83.24다. 이는 선택한 구간의 순서 민감도가 낮다는 점을 뒷받침하지만, 해당 연산을 제거할 수 있음을 입증하지는 않는다.
평가한 모델 규모 2개 모두에서 융합 구간의 방향 변화와 잔차 기여가 더 작다. 이러한 측정은 갱신량이 작다는 설명을 뒷받침한다. 해당 구간 밖에서는 값이 더 높으므로 이 설명을 일률적으로 적용하는 데에는 주의가 필요하다.
6 Block Parallelization
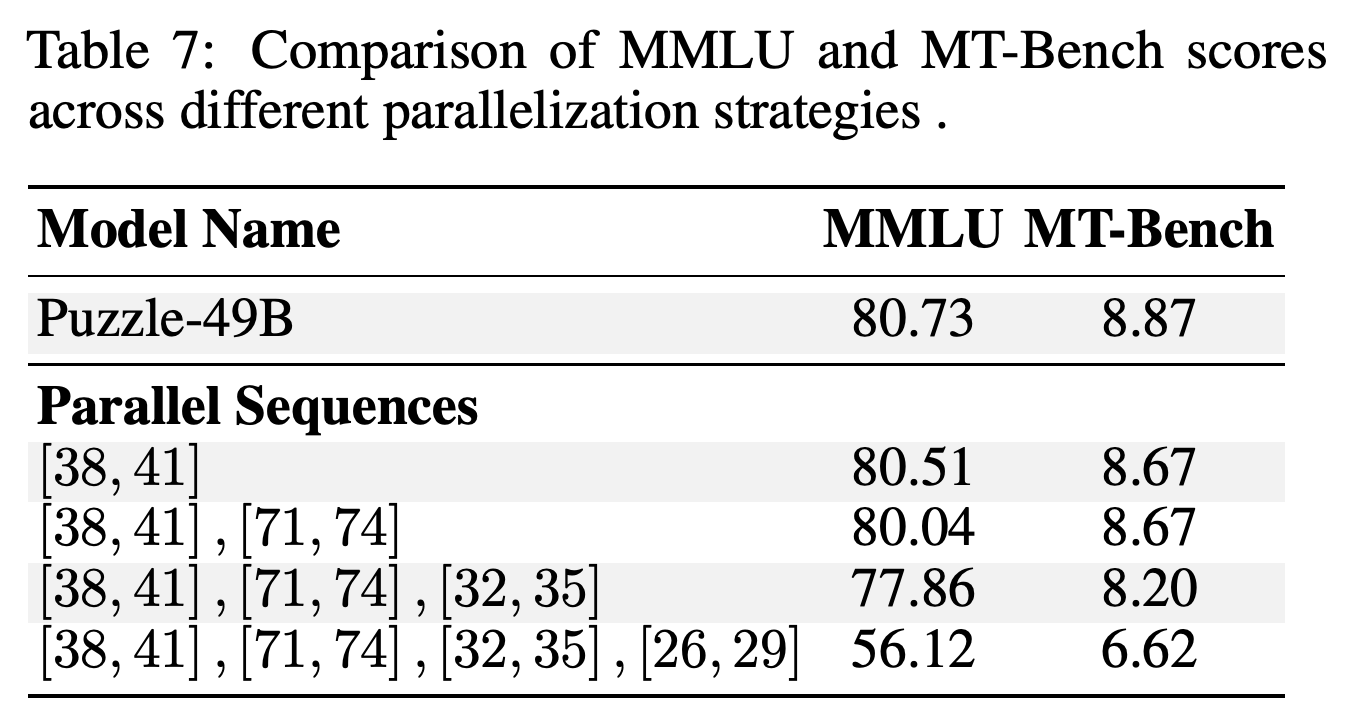
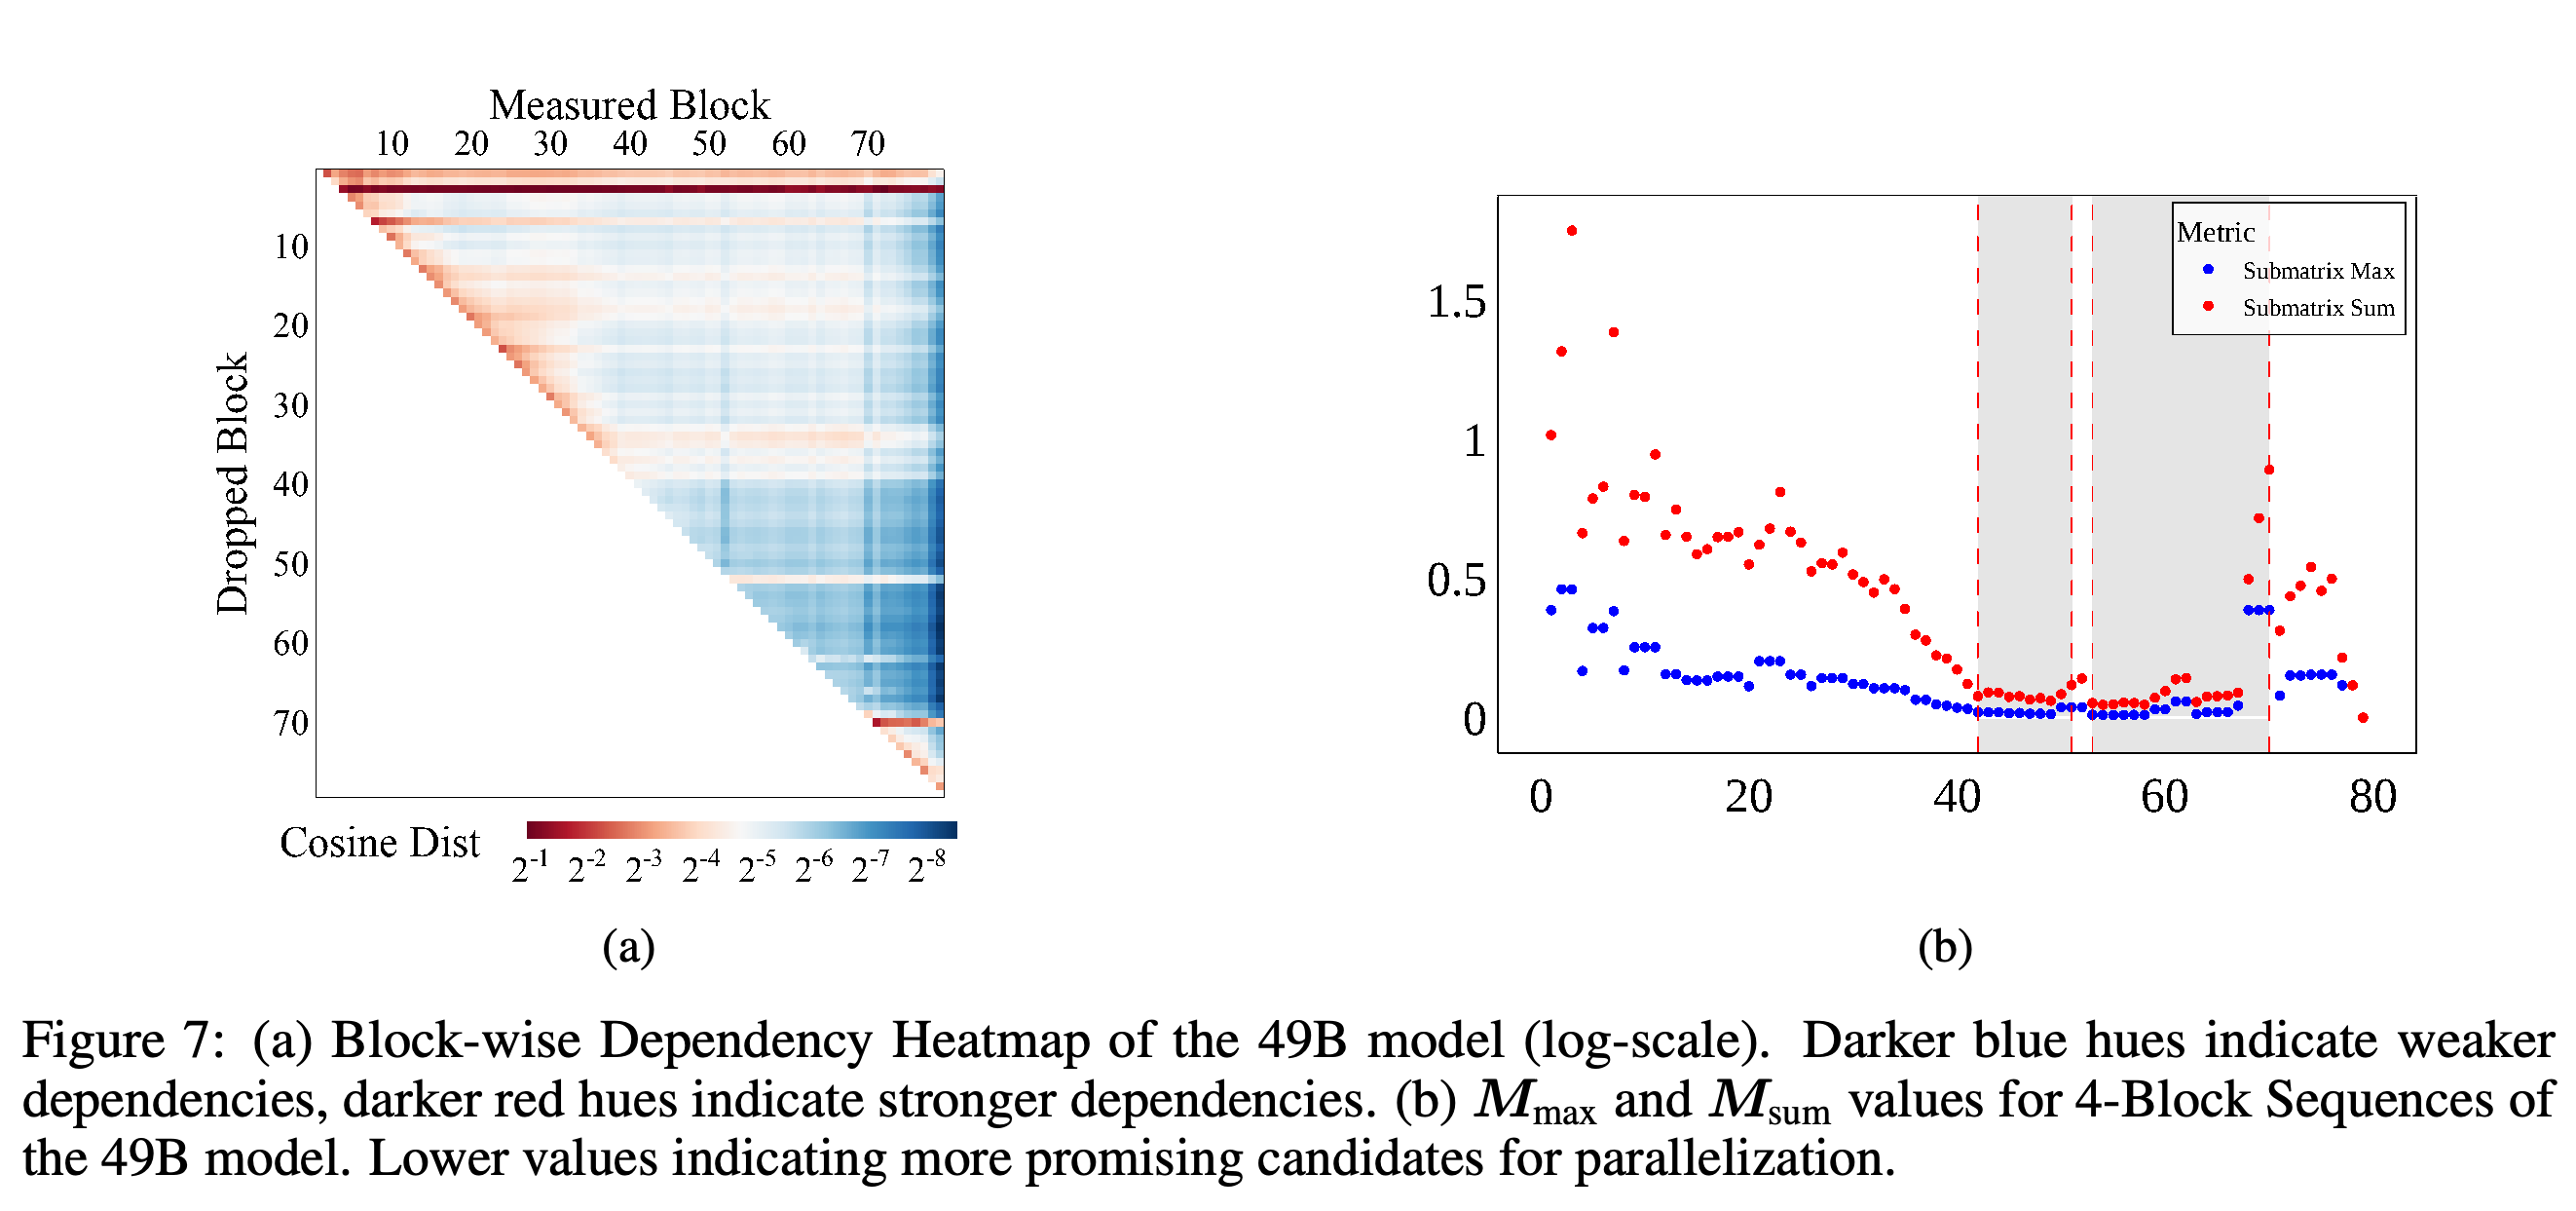
전체 블록 병렬화는 attention과 FFN을 포함한 완전한 블록들을 독립적으로 실행하므로, 같은 방식으로 가중치를 단순히 이어 붙일 수 없다. 탐욕 탐색은 연속된 전체 블록 4개로 구성된 후보 중 최대 쌍별 의존성이 가장 작은 그룹을 겹치지 않게 선택하고, 동률이면 의존성 합을 사용한다. Puzzle-49B에서 [38,41]과 [71,74]를 병렬화하면 MMLU는 80.73에서 80.04로, MT-Bench는 8.87에서 8.67로 변한다. [32,35]를 추가하면 점수는 77.86과 8.20으로 낮아지고, [26,29]까지 추가하면 56.12와 6.62로 낮아진다. 구현에는 모델 구현 라이브러리인 HuggingFace Transformers를 사용하며, 최적화된 프레임워크에서의 속도 향상은 측정하지 않았다.
처음 선택한 전체 블록 그룹 2개는 점수를 비교적 잘 보존하지만, 3번째와 4번째 그룹을 추가하면 성능 저하가 점차 심해진다. 이는 FFN만 있는 구간에서 전체 transformer 블록으로 접근법을 확장할 수 있다는 근거의 범위를 제한한다.
의존성 히트맵과 4개 블록 통계는 의존성이 낮고 FFN만 있는 구간이 전체 블록 후보와 다르다는 점을 보여준다. 탐색은 attention이 없는 구간을 제외하고, 나머지 그룹의 최대 의존성과 의존성 합으로 순위를 정한다.
7 Concluding Remarks
결론은 attention이 없는 구간에도 유용한 FFN 연산이 존재하며, 이 연산들의 실행 순서에 대한 제약은 약할 수 있다고 강조한다. 마지막 FFN은 융합에 더 민감한 경우가 많다. 실험 근거는 49B와 253B 파생 모델, 그리고 전체 253B 최적화 과정을 다룬다. 토큰마다 선택한 expert 모듈만 활성화하는 mixture-of-experts(MoE) 아키텍처와 더 폭넓은 블록 병렬화로 확장하는 방안을 향후 연구 방향으로 제안한다.
부록
- A Proof of Theorem 3.1은 입력 투영과 게이트 투영을 이어 붙이고 출력 투영을 결합하여 FFN 2개의 경우를 증명한다. 덧셈의 결합법칙을 통해 더 많은 FFN으로 구성을 확장한다. 이 증명은 입력을 공유하는 합과 더 넓은 FFN 사이의 정확한 동등성을 보인다. 원래의 순차 잔차 블록과 동등하다는 사실까지 증명하지는 않는다.
- B Datasets는 Distillation Mix가 FineWeb, Dolma, Buzz-V1.2에서 가져온 224 billion 토큰으로 구성되며 소스 코드, Wikipedia, 책, 뉴스와 기타 분야를 포함한다고 설명한다. Ultra-253B-Base의 KD에는 인용한 데이터 생성 방법에 따라 Llama-3.1-405B-Instruct로 생성한 합성 데이터도 사용한다.
- C Ultra-253B-Base and Puzzle-49B Architecture Overview는 블록 126개로 이루어진 253B 구성을 설명한다. FFN 폭 배수는 0.4875에서 4.875까지이며, 연속 계층 50개는 입력을 그대로 유지하는 연산인 no_op으로 attention을 우회한다. Puzzle-49B도 더 작은 규모에서 FFN 폭을 다양하게 조정하고 attention을 제거하는 유사한 구성을 갖는다.
- D MoE Inference Performance는 일부 expert만 활성화하면 연산량을 줄일 수 있지만 배포 시 오버헤드가 발생할 수 있다고 논의한다. 이 주장은 더 큰 dense 융합 연산을 사용하는 근거가 되지만, 부록은 MoE와의 실측 비교를 제시하지 않는다.
- D.1 Problems with Small Blocks는 GPU 연산 자원을 충분히 활용하지 못하는 문제와 all-reduce 통신을 비효율의 원인으로 지목한다. all-reduce는 분산된 결과를 결합하는 동기화 연산이다. 저자들은 작은 expert와 expert를 선택하는 routing 모듈이 이러한 오버헤드에 특히 취약하다고 주장한다. 융합은 연산 크기를 키우고 동기화 지점을 줄인다.
- D.2 Batch Size Effects는 배치 크기를 늘리면 활성화되는 expert의 범위가 포화되기 전까지 더 많은 expert가 활성화되어, 중간 규모 작업 부하에서 효율이 제한된다고 주장한다. 또한 초안 모델이 토큰을 생성한 뒤 검증하는 speculative decoding에서도 소수의 제안 토큰을 검증할 때 이러한 비효율이 발생할 수 있다고 주장한다. 이러한 포괄적 주장은 정성적이며, 이 부록에는 배치 크기별 측정 결과가 없다.
- E Further Pairwise Block Dependency Analysis는 Ultra-PreFusion 히트맵의 해석을 확장한다. 초반 블록의 강한 의존성, 순차 의존성이 나타나는 국소적인 띠 모양 영역, 마지막 계층 부근의 더 강한 의존성이 attention이 없고 의존성이 약한 구간과 함께 나타난다. 이러한 패턴은 모델 깊이 전반에 일률적으로 병렬화를 적용하기보다 융합 구간을 개별적으로 선택하는 방식을 뒷받침한다.
짧은 생각
FFN 제거와 비교한 실험은 FFN 연산을 유지하면서 실행 순서를 바꾸는 방식에 가장 명확한 근거를 제공한다. 비슷한 지연 시간에서 제거는 더 큰 품질 손실을 일으킨다. 대표 결과인 1.71배 가속에는 Puzzle 가지치기가 포함된다. 융합 자체의 추가 생성 속도 향상은 63.38에서 70.92 tokens/second로 약 1.12배이며, 가장 높은 품질을 얻은 결과에는 복구 학습과 정렬이 포함된다. 실험은 평가한 파생 모델에서 선택한 attention 없는 구간의 융합을 뒷받침한다. 최적화된 전체 블록 병렬화의 속도 향상은 측정하지 않았고, 보고된 35배 비용 절감에는 내역이 없다. 평가한 모델 규모 2개만으로 일반적인 스케일링 법칙을 입증할 수는 없다.