


s1: Simple test-time scaling 요약 설명
31 Jan 2025 | Paper Review Test-Time Scaling Data Curation Supervised Fine-Tuning목차
이번 글에서는 s1: Simple test-time scaling 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 31일(Arxiv)
- Muennighoff, Niklas, Yang, Zitong, Shi, Weijia, Li, Xiang Lisa, Fei-Fei, Li, Hajishirzi, Hannaneh, Zettlemoyer, Luke, Liang, Percy, Candès, Emmanuel, Hashimoto, Tatsunori.
- Stanford University, University of Washington, Seattle, Allen Institute for AI, Contextual AI
- 논문 링크
요약
- 이 논문은 언어 모델이 질문에 답하는 동안 더 많은 연산을 사용해 추론을 개선하는 test-time scaling을 연구한다. s1-32B 모델은 2024 American Invitational Mathematics Examination의 30문제로 구성된 AIME24에서 budget forcing 없이 50.0%, 적용하면 56.7%의 정확도를 달성한다. Budget forcing은 모델이 사고를 멈추는 시점을 제어하는 방법이다.
- 이 방법은 질문 1,000개에 생성된 reasoning trace와 답변을 붙인 s1K를 선별하고, 제공된 출력을 예측하도록 모델을 학습하는 supervised fine-tuning을 결합한다. Reasoning trace는 답변에 앞서 생성되는 중간 추론 과정이다. Qwen2.5-32B-Instruct를 NVIDIA H100 GPU 16개로 fine-tuning하는 데 26분이 걸린다. 이후 budget forcing은 답변 시작을 나타내는 구분자를 삽입해 추론을 줄이거나, 해당 구분자를 억제하고 “Wait”를 덧붙여 추론을 늘린다.
- 선별한 예제 1,000개로 학습해도 전체 59K 예제로 학습한 모델과 경쟁력 있는 성능을 유지하며, budget forcing은 실험한 scaling 방법 중 AIME24 정확도가 가장 높다. 다만 추론을 계속 늘리면 결국 같은 내용을 반복하거나 모델이 처리할 수 있는 최대 시퀀스 길이인 context window를 초과한다. 이 비교만으로는 앞선 연산 결과를 이후 연산에 사용하는 sequential scaling이 독립적인 시도를 결합하는 parallel sampling보다 항상 우수하다고 볼 수 없다.
1. Introduction
서론은 높은 추론 성능을 얻으면서 추론 시 연산을 추가해 정확도를 높일 수 있는 간단하고 공개적으로 재현 가능한 방법을 찾는다. Gemini Thinking Experimental이 제공한 reasoning trace와 답변을 증류 데이터로 사용하고, 시퀀스의 다음 요소를 예측하는 next-token prediction으로 학습한 뒤 생성 과정에 개입한다.
- 기여는 소규모 추론 데이터셋 선별과 학습 후 연산 제어라는 2가지 부분으로 구성된다.
- 모델 가중치, 추론 데이터, 코드는 https://github.com/simplescaling/s1 에 공개되어 있다.
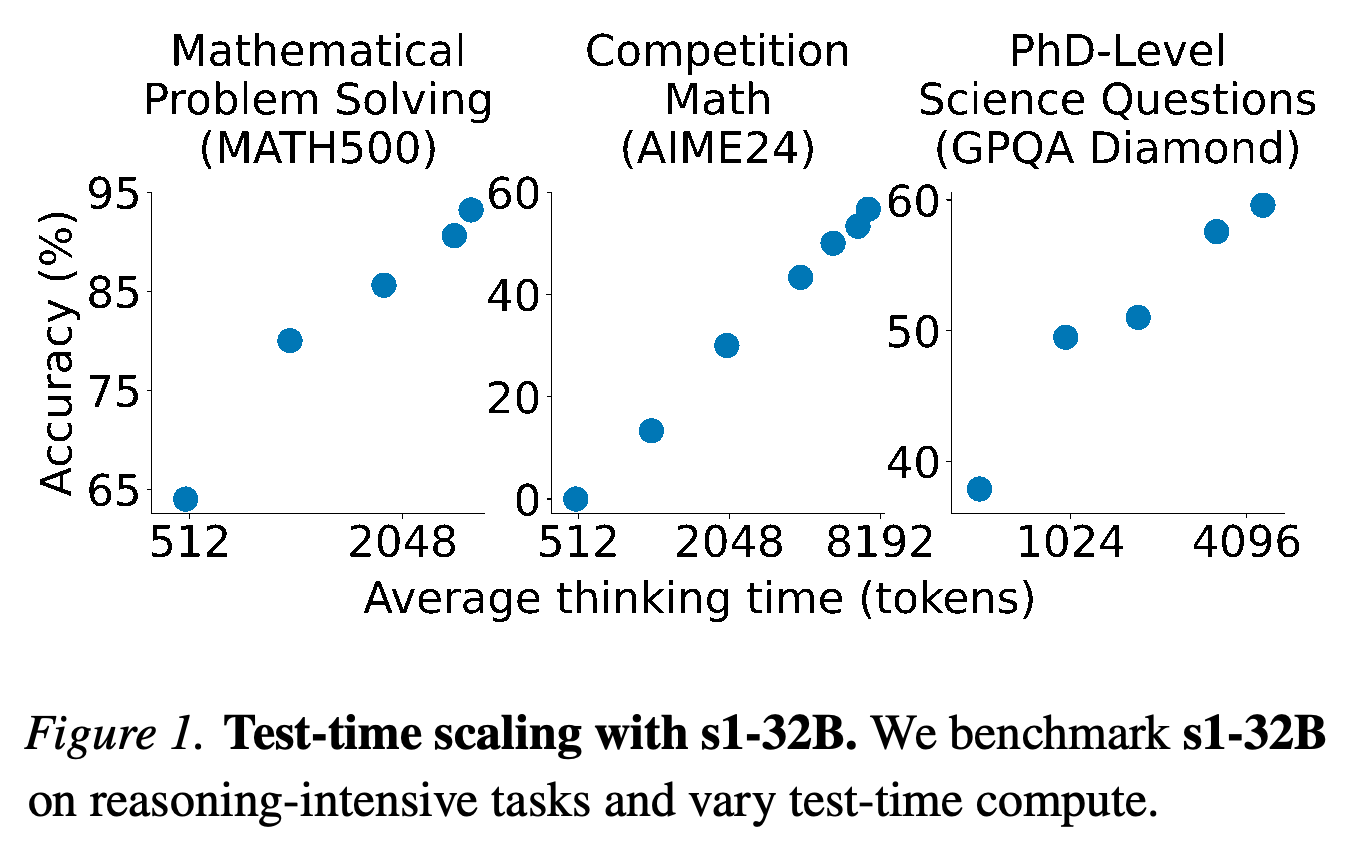
표시된 설정 범위에서는 벤치마크 3개 모두 평균 사고 토큰 사용량이 늘수록 정확도가 높아진다. 이 유한한 범위는 실험한 동작 지점을 보여주며, 범위 밖에서도 계속 개선됨을 입증하지는 않는다.
2. Reasoning data curation to create s1K
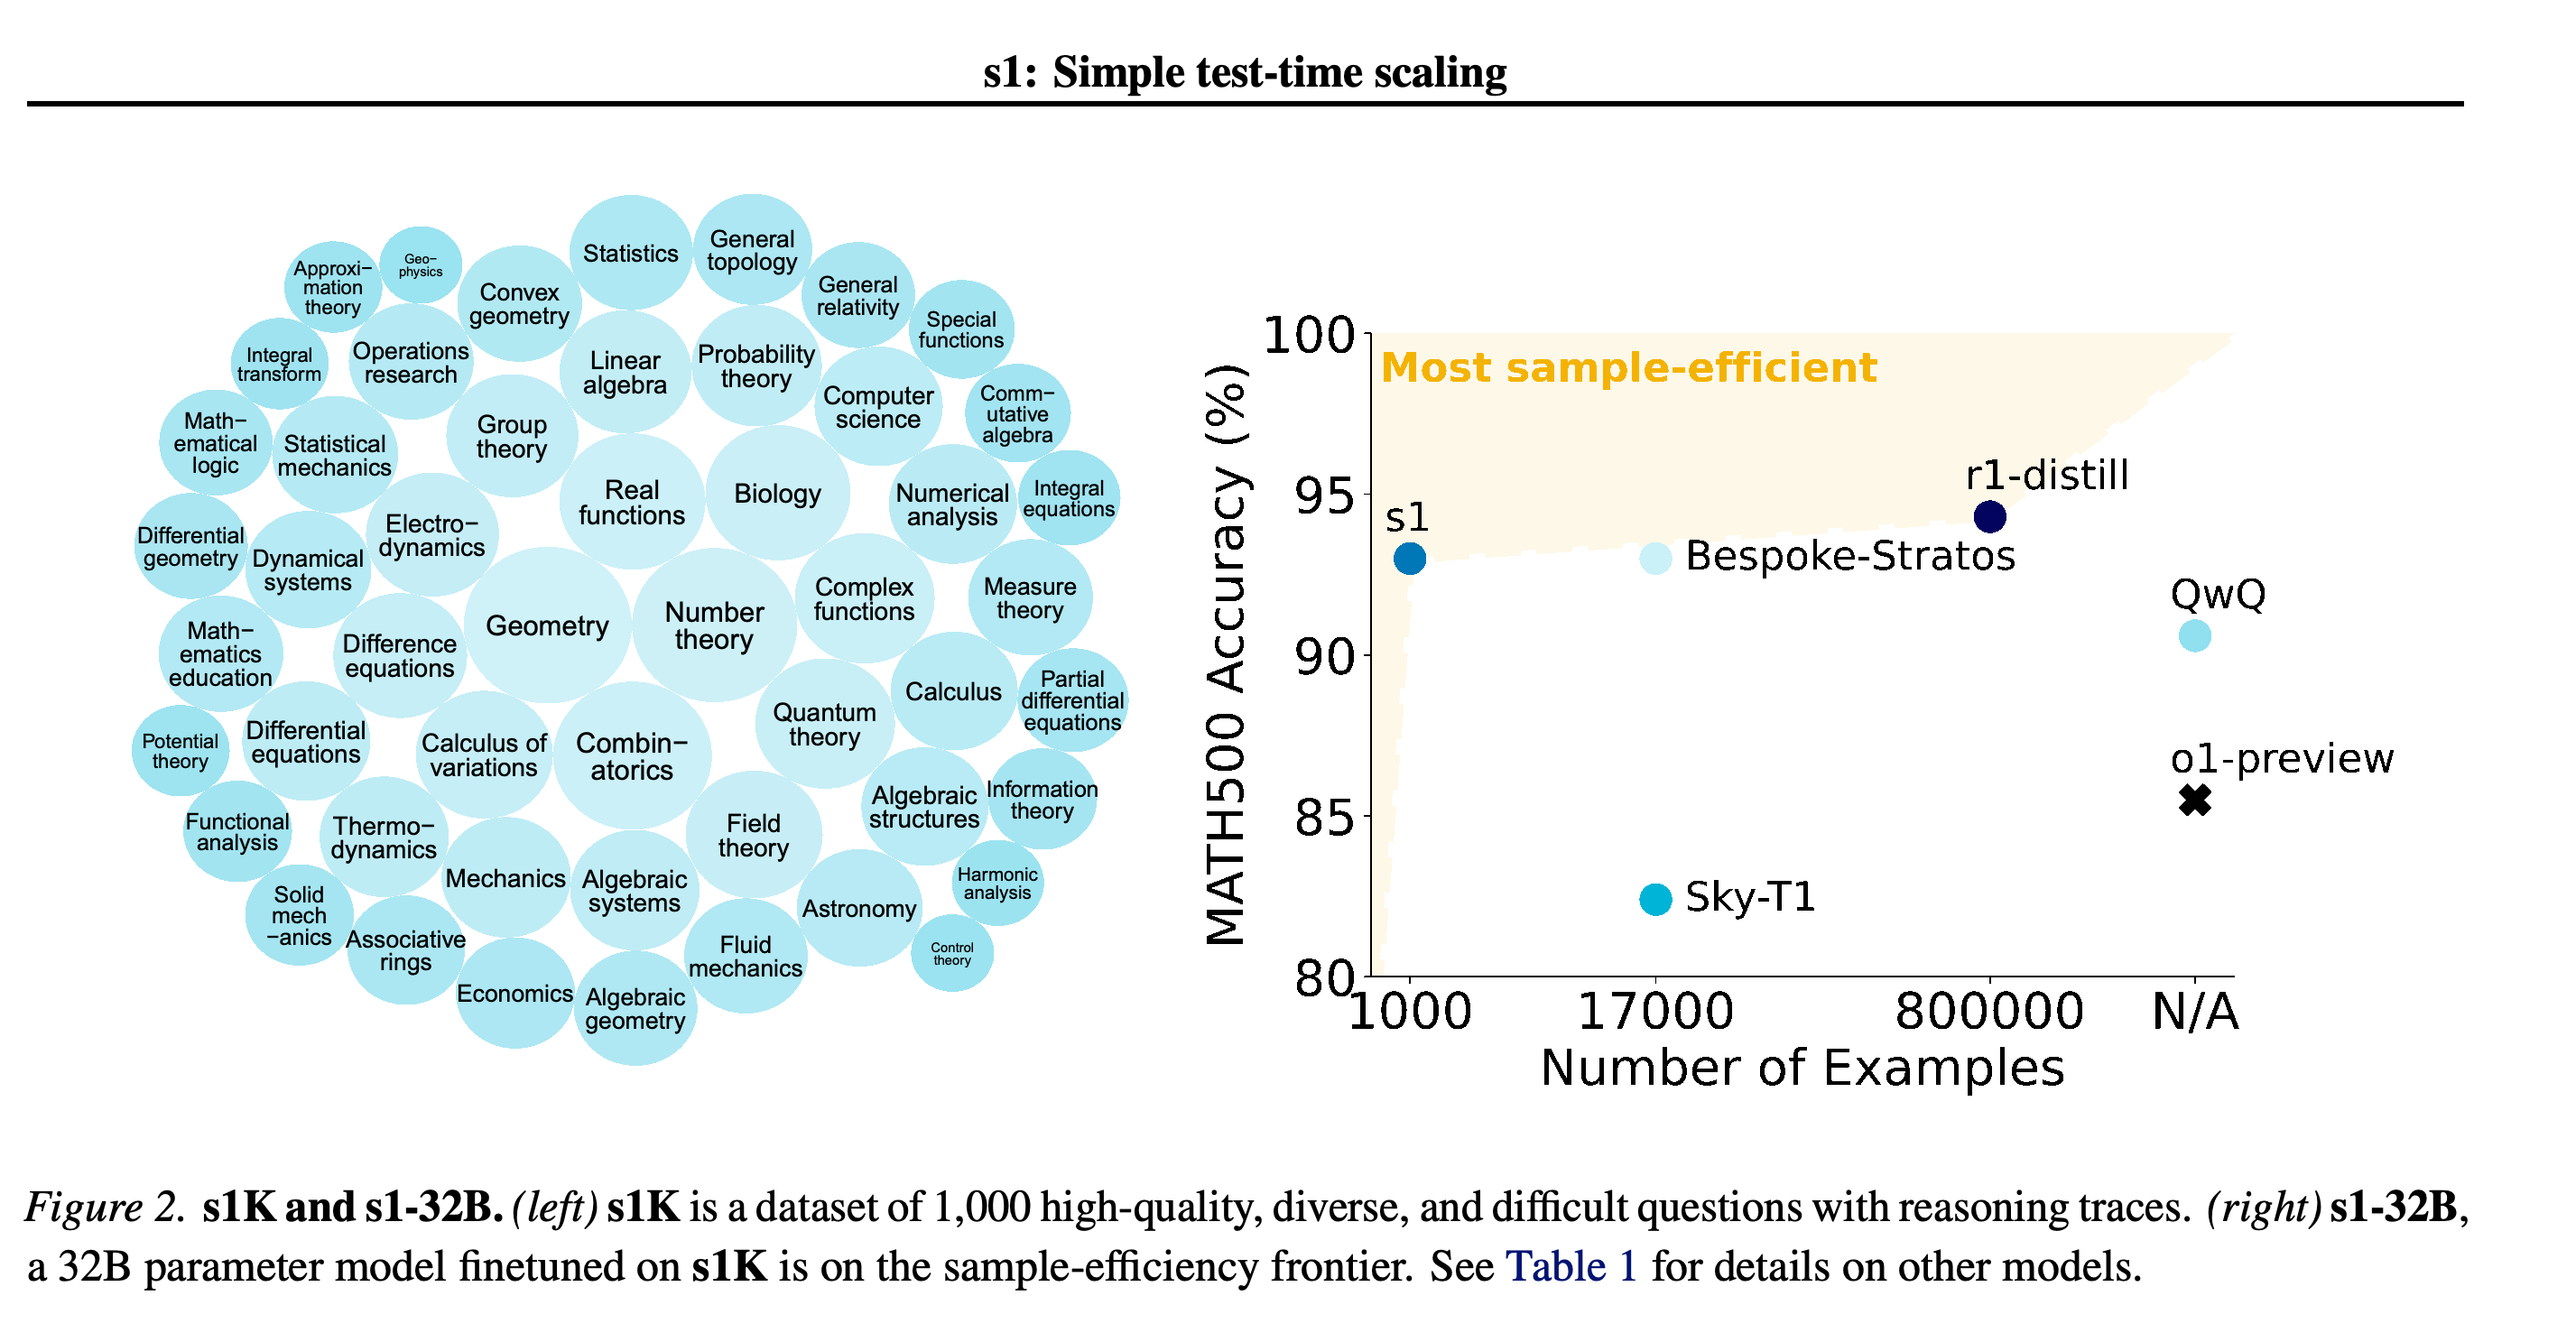
s1K는 먼저 대규모 후보 데이터를 수집한 뒤 품질, 난도, 다양성을 기준으로 예제 1,000개를 선별한다. 품질은 원자료와 형식이 사용 가능한지를, 난도는 상당한 추론이 필요한 문제인지를, 다양성은 여러 주제 영역을 포괄하는지를 뜻한다.
2.1. Initial collection of 59K samples
초기 데이터는 16개 출처에서 수집한 질문 59,029개로 구성된다. 여기에는 NuminaMATH 문제 30,660개, OlympicArena 질문 4,250개, OmniMath 문제 4,238개, AGIEval 질문 2,385개가 포함된다. 새로운 출처 2개에서는 Stanford 통계학 자격시험의 확률 문제 182개를 s1-prob로, PuzzledQuant의 “Hard” 등급 정량 면접 문제 23개를 s1-teasers로 추가한다.
- 각 질문에 대해 Gemini Flash Thinking이 reasoning trace와 응답을 생성한다. 학습 예제에는 질문과 생성된 구성 요소 2개가 모두 포함된다.
- 저자들은 중복 데이터를 제거하고, 경시 수학 문제 500개로 구성된 MATH500, 박사 수준 과학 질문 198개로 구성된 GPQA Diamond, AIME24와의 중복을 8-gram으로 확인한다. 이는 연속된 요소로 구성된 시퀀스이며, PDF는 이 요소가 단어인지 토큰인지 명시하지 않는다.
2.2. Final selection of 1K samples
생성 서비스 오류가 발생한 질문을 제거하면 예제 54,116개가 남고, 형식 문제를 걸러내면 51,581개가 남는다. 난도 필터링에서는 Qwen2.5-7B-Instruct나 Qwen2.5-32B-Instruct 중 어느 모델이든 해결한 질문을 제거한다. Claude 3.5 Sonnet이 각 풀이를 기준 풀이와 비교하며, 이 과정을 거치면 질문 24,496개가 남는다.
- 특히 적합하다고 판단한 출처에서 예제 384개를 유지한다. 이후 영역을 균등하게 반복 추출하고 각 영역 안에서 reasoning trace가 긴 예제를 우선하여 총 1,000개를 채운다.
- 영역은 Mathematics Subject Classification을 따르며, 저자들은 과학 주제에도 이 분류 체계를 사용한다. 본문에는 50개 영역, Appendix C.1에는 51개 영역으로 보고되어 있다.
- 생성된 풀이가 모두 정답일 필요는 없다. 최종 채점기는 s1K의 53.6%, s1K-1.1의 63.0%를 정답으로 판정한다. 저자들은 추론 과정 자체를 학습하는 것도 목표이므로 오답 생성물도 유지한다.
영역 분포는 선별한 예제가 다양한 주제를 포괄함을 보여준다. 비교 그래프에서 s1은 훨씬 큰 추론 데이터셋으로 학습한 모델과 비슷한 MATH500 정확도를 보인다. 예제 수에는 사전학습과 교사 데이터 생성 비용이 제외되어 있다.
3. Test-time scaling
논문은 sequential scaling과 parallel scaling을 구분하고, 단일 reasoning trace를 늘리거나 줄이는 데 초점을 맞춘다. 정확도와 함께 사용 연산량을 얼마나 잘 제어하는지도 평가한다.
3.1. Method
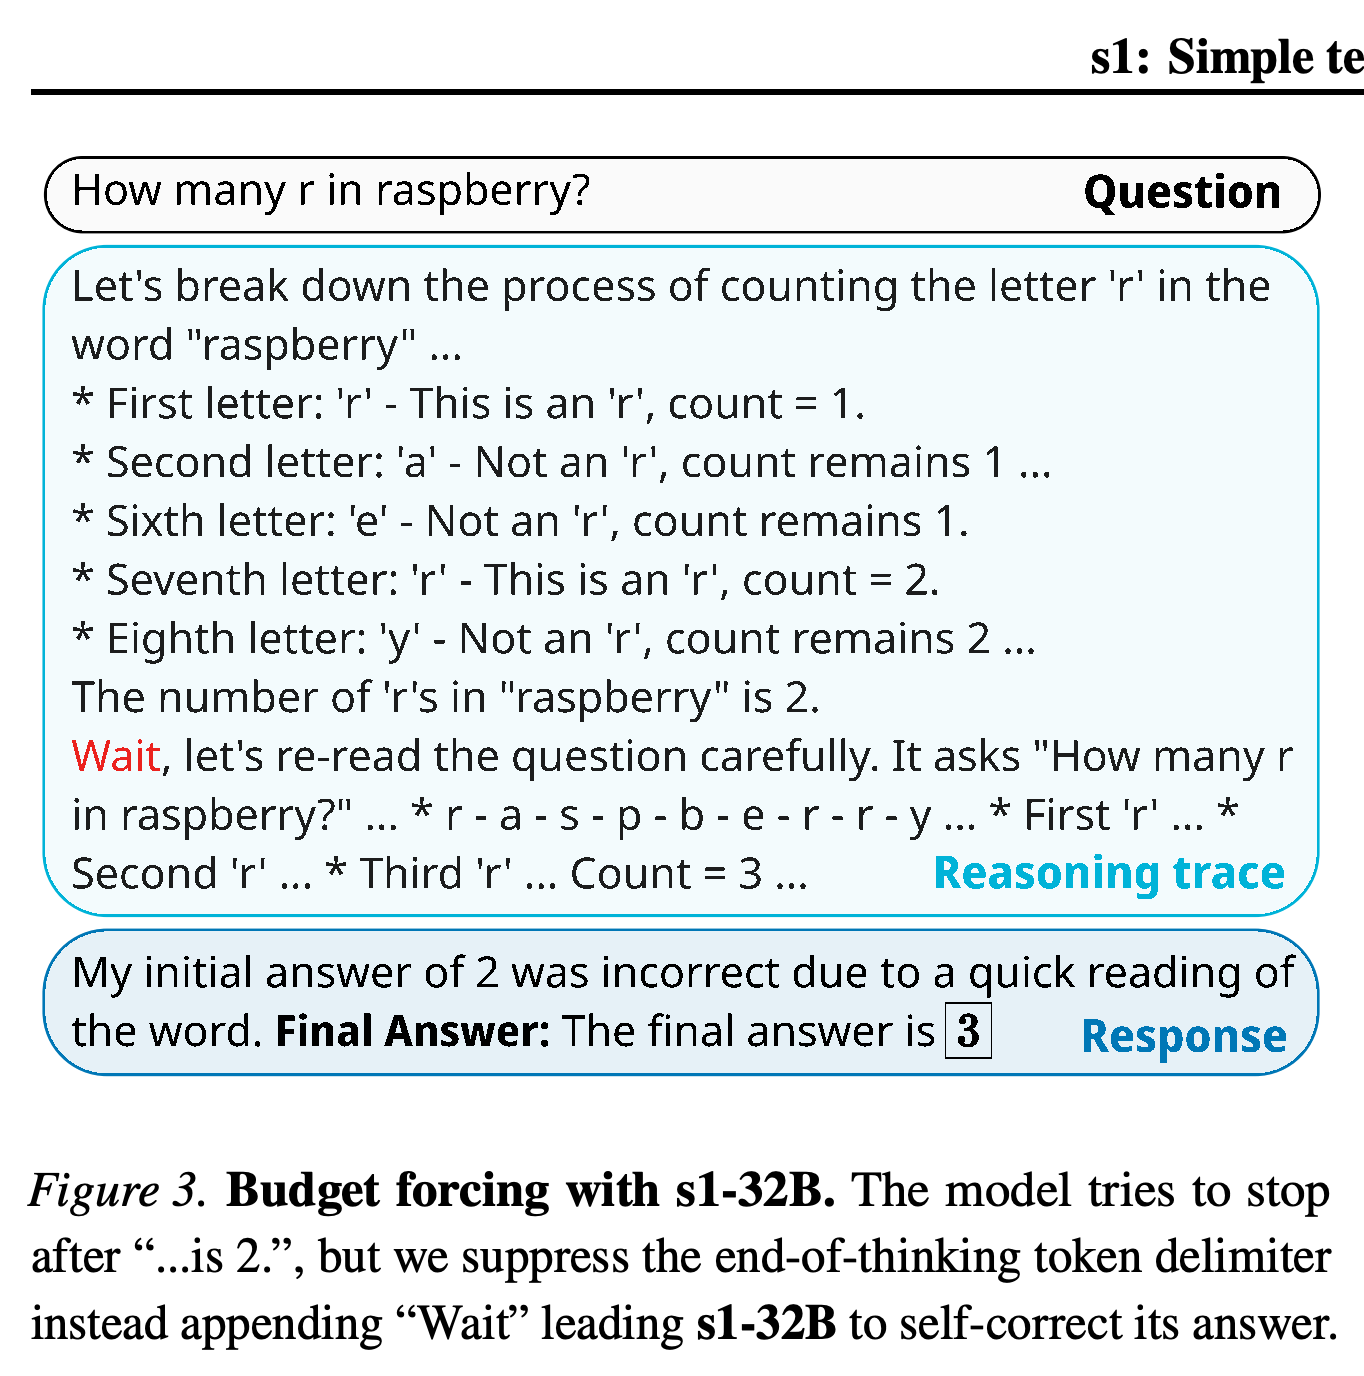
Budget forcing은 사고 종료 구분자를 삽입해 최대 사고 예산을 설정한다. 필요하면 뒤에 “Final Answer:”를 붙여 모델이 현재 답을 출력하도록 한다. 추론을 늘릴 때는 모델이 멈추려는 시점에 해당 구분자를 억제하고, 필요하면 “Wait”를 덧붙여 자신의 추론을 다시 검토하도록 유도한다.
- 조건부 길이 제어 베이스라인은 모델이 생성하는 단위인 토큰, 빈 줄로 구분되는 추론 구간인 단계, 또는 짧은 사고와 긴 사고 같은 범주로 길이를 요청한다. 제어 성능 비교에서는 요청한 단계마다 토큰 상한을 100개로 설정한다.
- Rejection sampling은 출력 길이가 지정된 예산에 맞을 때까지 생성을 반복한다. 따라서 채택된 출력은 길이를 조건으로 한 모델의 출력 분포를 따른다.
- raspberry 예제에서는 “Wait”를 덧붙인 뒤 “r”의 개수를 2개에서 3개로 수정한다. 이 예제는 가능한 결과를 보여주지만, 추론 연장이 얼마나 자주 도움이 되는지는 추정하지 않는다.
종료 구분자를 억제하고 “Wait”를 덧붙이자 모델이 “raspberry”에 포함된 “r”의 개수를 수정한다. 이 성공 예제는 개입 방법을 보여주지만 그 신뢰성을 정량화하지는 않는다.
3.2. Metrics
A는 평가한 연산 설정의 집합이고, f(a)는 사고 토큰 수 a에서의 정확도다. Control은 지정한 연산 범위의 준수율을 측정하고, Scaling은 연산량에 따른 정확도 변화의 기울기를 설정 쌍마다 구해 평균하며, Performance는 관측된 최고 정확도를 기록한다.
- Control = (1/|A|) Σ[a∈A] 𝟙(a_min ≤ a ≤ a_max). 지시 함수 𝟙은 범위를 만족하면 1, 그렇지 않으면 0이다. 실험에서는 대체로 최댓값만 제한한다.
- Scaling = (1/binom(|A|,2)) Σ[a,b∈A; b>a] (f(b)−f(a))/(b−a). 여기서 binom(|A|,2)는 서로 다른 설정 쌍의 개수다. 값이 양수이면 실험한 설정 전반에서 사고 토큰을 더 사용할수록 정확도가 높아졌음을 뜻한다.
- \(\mathrm{Performance}=\max_{a\in\mathcal A}f(a)\). 이 지표는 실험한 설정 중 최고 성능을 측정하며, 평가 범위를 넘어선 성능 향상을 보장하지 않는다.
4. Results
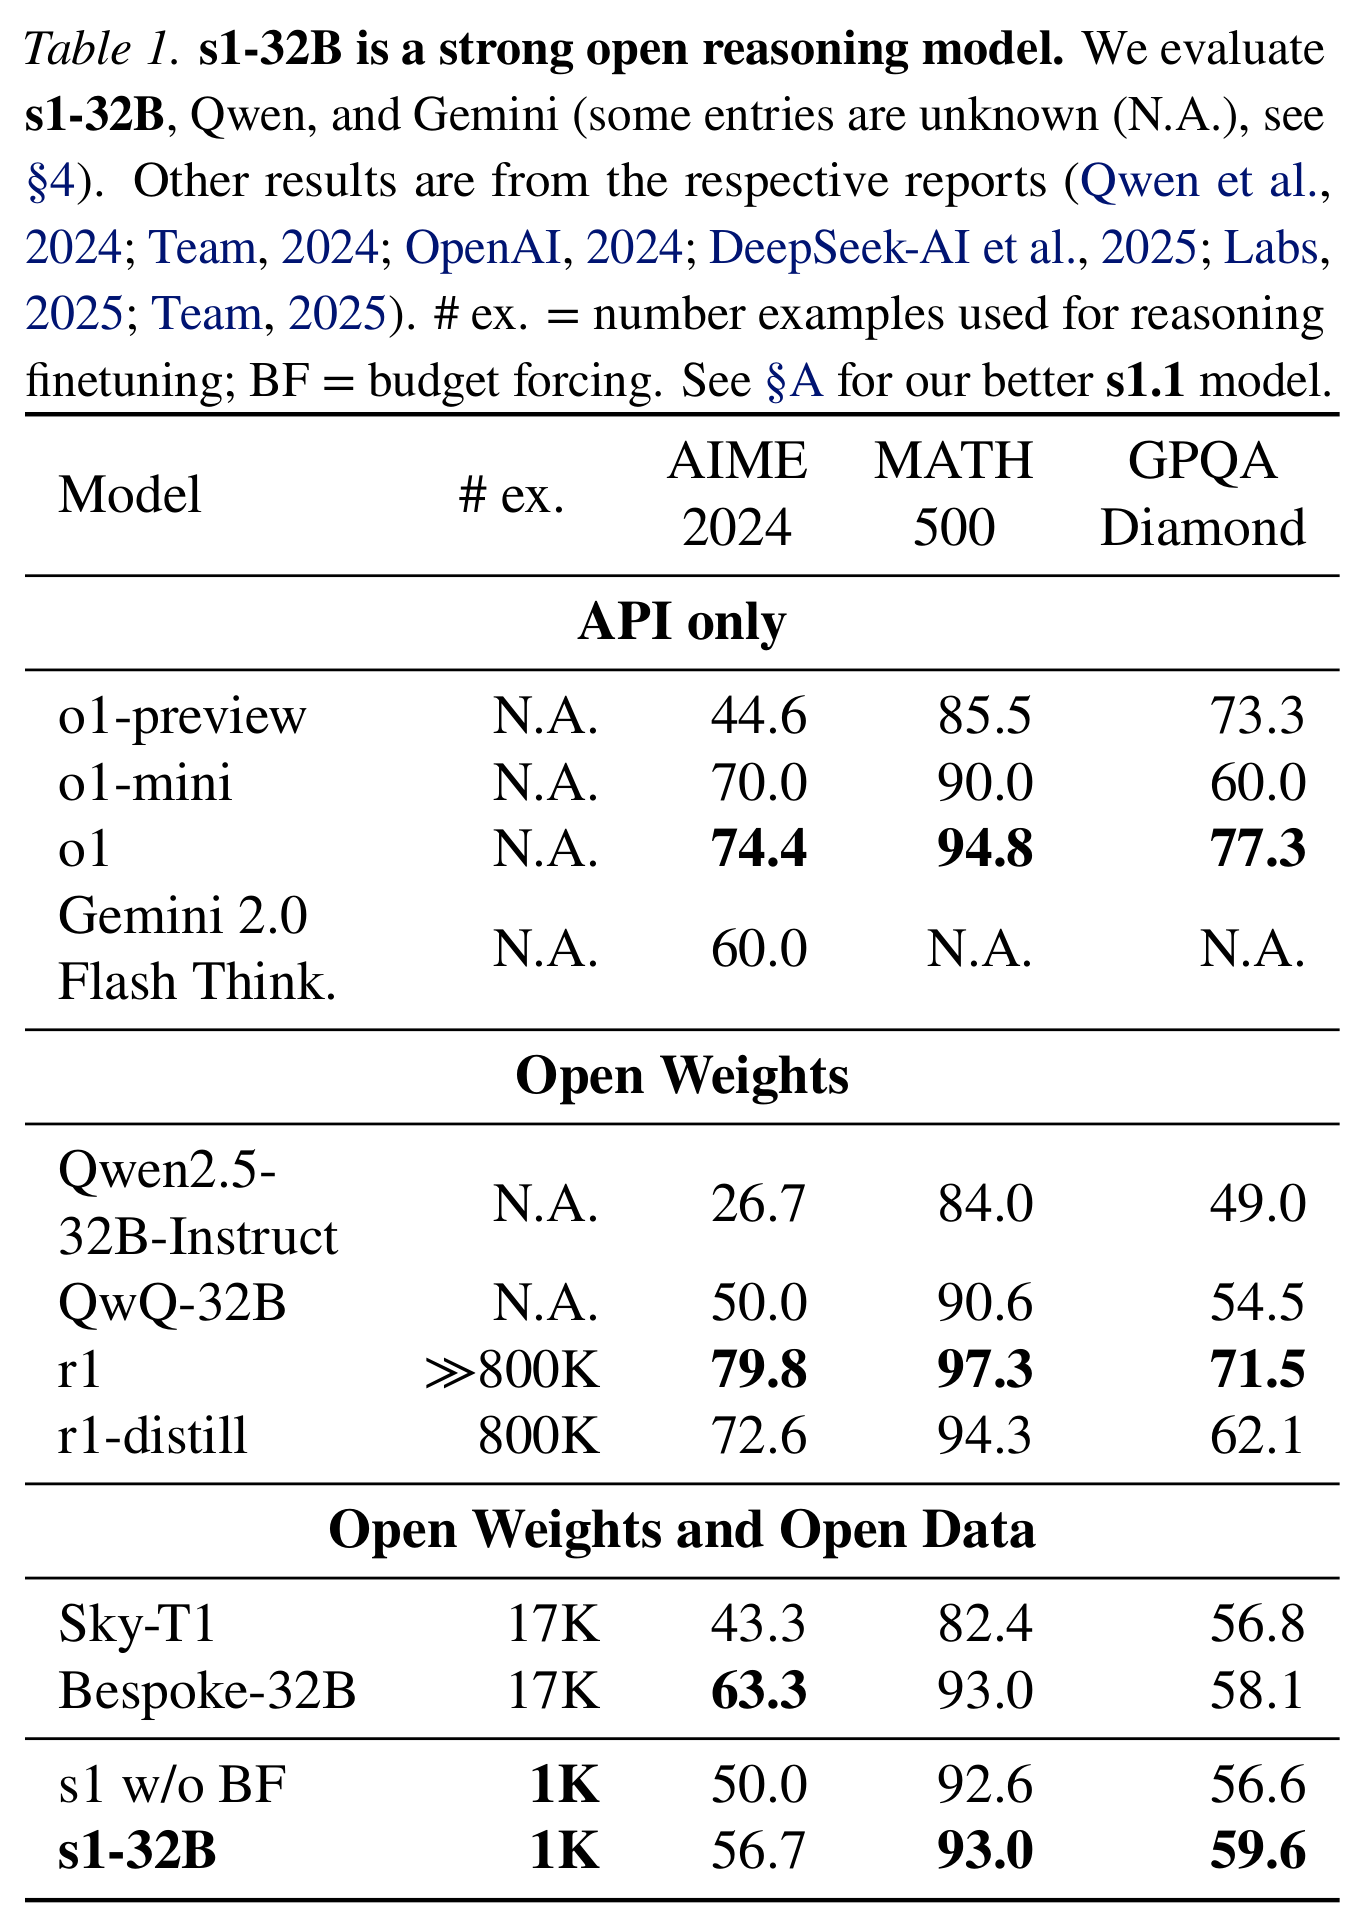
결과에서는 추론 정확도, 추론 시 연산량에 따른 변화, 사용한 추론 fine-tuning 예제 수를 평가한다. 주요 비교에서 s1-32B는 AIME24 56.7%, MATH500 93.0%, GPQA Diamond 59.6%를 기록한다.
4.1. Setup
Qwen2.5-32B-Instruct를 시작 모델로 삼아 s1K로 학습하며, 모델 학습 상태를 GPU에 분산하는 Fully Sharded Data Parallel 방식인 PyTorch FSDP를 사용한다. 평가에는 언어 모델 평가 프레임워크인 lm-evaluation-harness를 사용한다. 별도 명시가 없으면 temperature 0의 greedy decoding으로 점수가 가장 높은 다음 토큰을 선택한다. 정확도는 단일 생성 시도의 성공률인 pass@1에 해당한다.
- 벤치마크는 AIME24 문제 30개, MATH500 문제 500개, 생물학, 화학, 물리학 분야의 GPQA Diamond 질문 198개로 구성된다. 모델이 이미지를 입력받을 수 없어 AIME 도형은 Asymptote 벡터 그래픽 소스로 제공한다.
- 저자들은 s1-32B, Qwen, Gemini를 직접 평가하며, 비교 대상의 점수 상당수는 각 모델의 보고서에서 가져온다.
- Gemini의 생성 API는 recitation 오류를 반환해 평가를 방해한다. AIME24 점수 60.0%는 질문 30개를 모두 웹 인터페이스에 직접 제출해 얻었으며, MATH500과 GPQA Diamond 점수는 확보하지 못했다.
4.2. Performance
기반 모델은 AIME24, MATH500, GPQA Diamond에서 각각 26.7%, 84.0%, 49.0%를 기록하며, s1-32B는 각각 56.7%, 93.0%, 59.6%에 도달한다. Fine-tuning한 모델에 budget forcing을 적용하지 않으면 각각 50.0%, 92.6%, 56.6%다. 이 비교는 학습으로 얻은 향상과 추론 과정에 개입해 추가로 얻은 향상을 구분한다.
- o1-preview의 보고 점수인 AIME24 44.6%, MATH500 85.5%와 비교하면 s1-32B는 각각 12.1%포인트, 7.5%포인트 높다. 초록의 “최대 27%”는 AIME24의 상대적 향상률을 뜻한다. GPQA Diamond에서는 o1-preview가 73.3%로 여전히 앞선다.
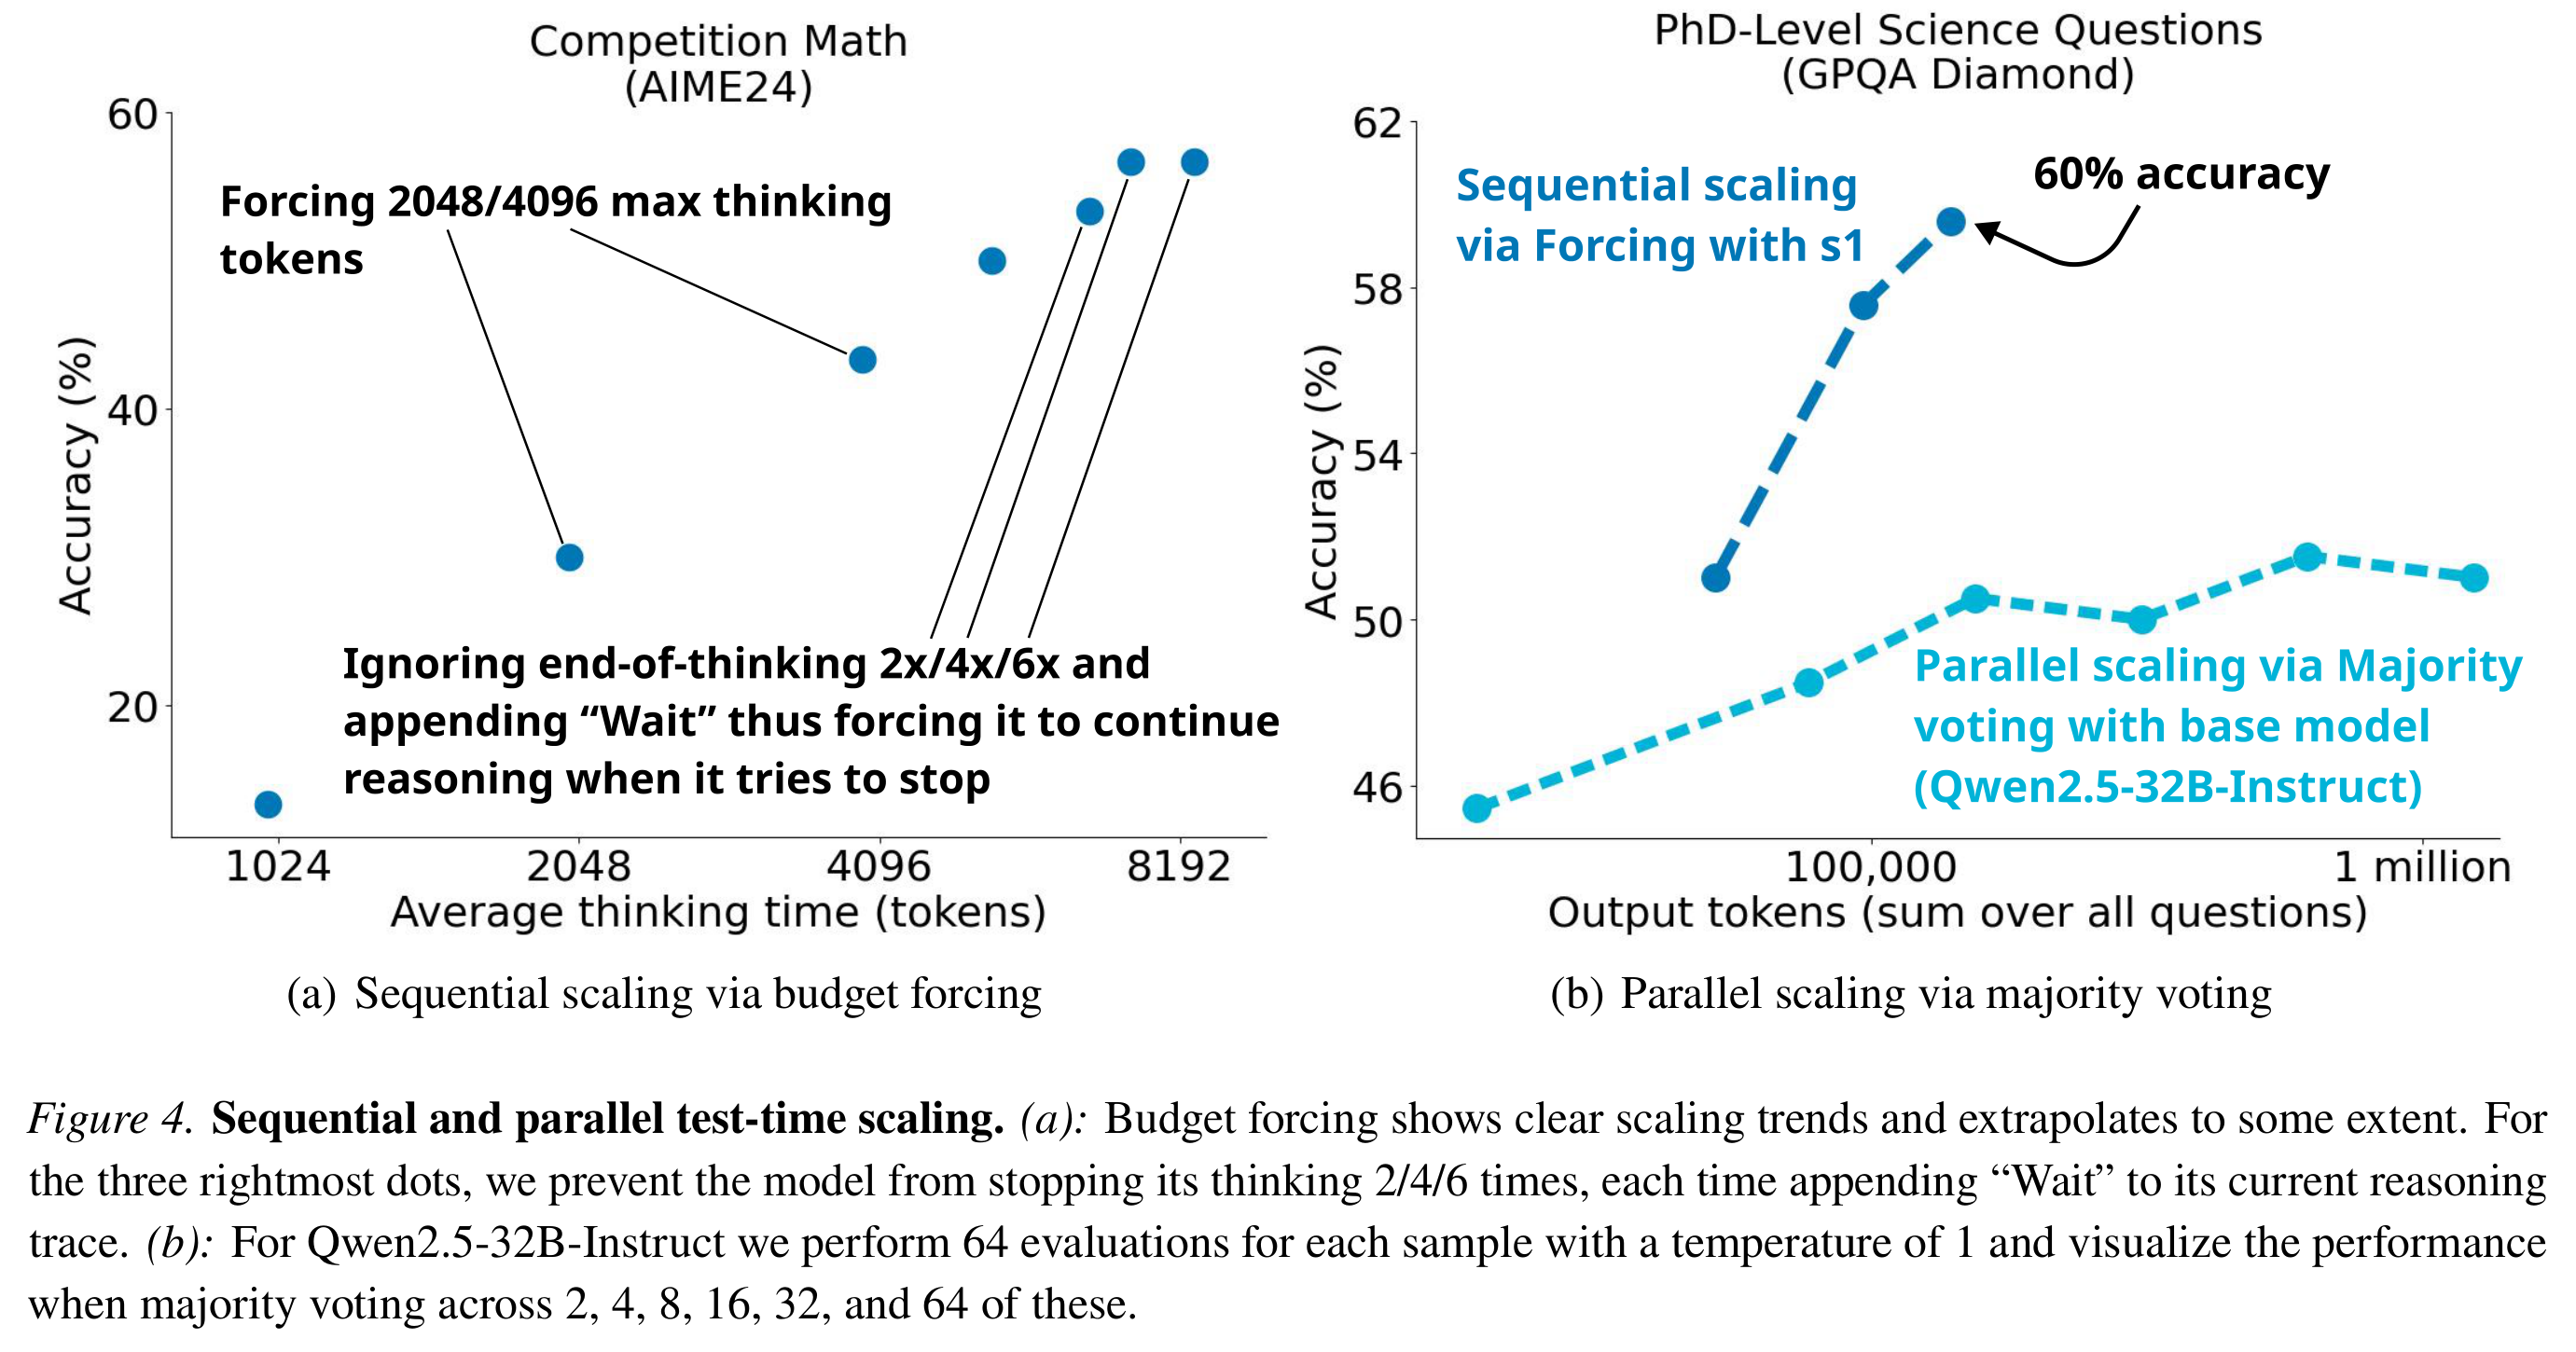
- GPQA Diamond에서 기반 모델을 temperature 1로 2, 4, 8, 16, 32, 64회 생성하고 가장 빈번한 답을 선택하는 majority voting을 적용해도 fine-tuning한 모델의 sequential scaling 정확도에 도달하지 못한다. 학습과 추론 방법이 모두 다르므로 이 비교는 sequential 연산과 parallel 연산의 효과를 분리하지 못한다.
- 종료를 2, 4, 6회 억제하면 AIME24 추론이 길어지지만, 6회 억제에서는 정확도가 정체된다. 과도한 종료 억제는 반복을 유발할 수 있다.
- 표본 효율성 비교는 추가 추론 예제 수를 센다. r1-distill은 800K, s1은 1K를 사용한다. 사전학습과 초기 후보 데이터의 생성 및 필터링 비용은 제외한다.
AIME24 패널에서는 종료를 반복해서 억제할수록 성능이 높아지다가 정체된다. GPQA Diamond에서는 실험 범위 안에서 fine-tuning한 모델의 sequential 연장이 기반 모델의 majority voting보다 높은 성능을 보이지만, 학습과 추론 방법이 모두 다르다.
기반 모델, budget forcing 없는 s1, s1-32B를 별도 행으로 제시해 fine-tuning과 추론 개입이 각각 성능을 개선함을 보여준다. o1-preview보다 우수한 성능은 수학에 한정되며, GPQA Diamond에서는 o1-preview의 점수가 훨씬 높다.
5. Ablations
구성 요소를 바꾸는 ablation 실험에서는 선별 기준을 결합한 효과와 budget forcing의 대안을 검증한다. 학습 예제 선별과 추론 시 연산 제어를 모두 살펴본다.
5.1. Data Quantity, Diversity, and Difficulty
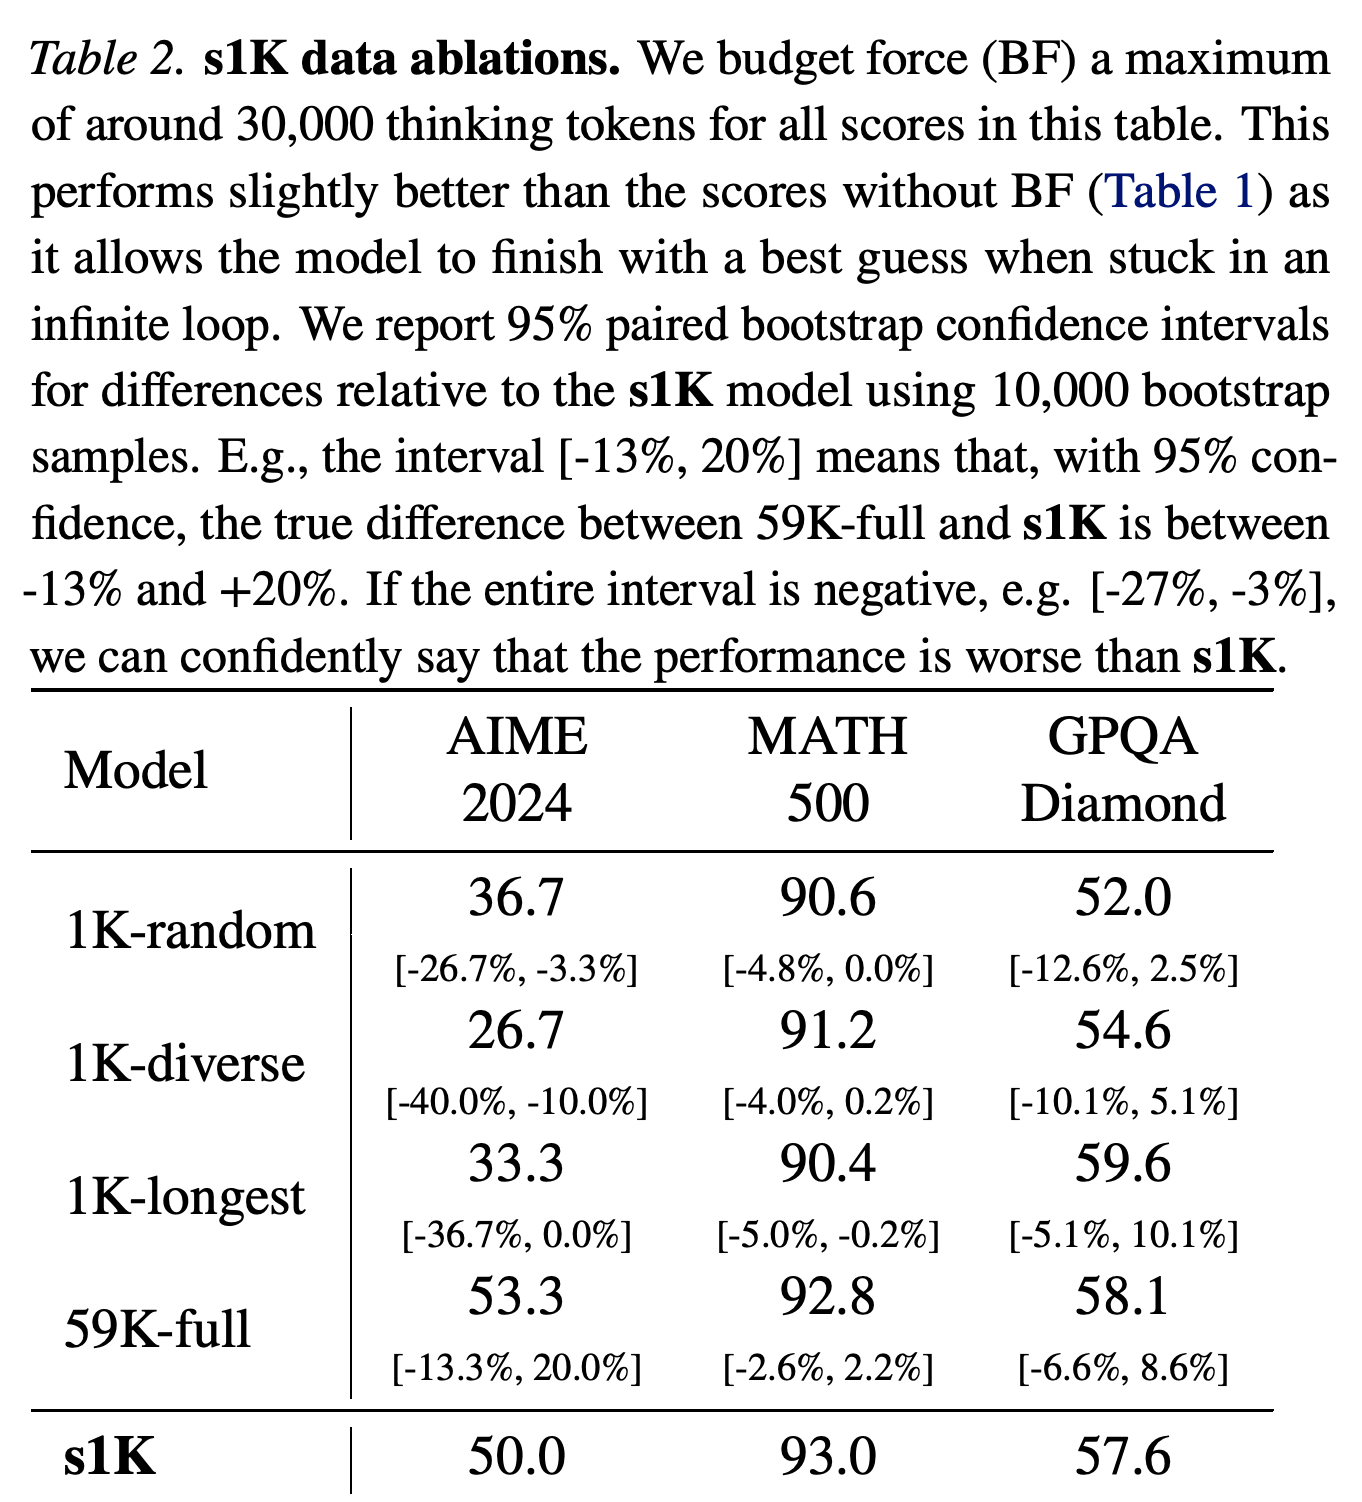
모든 데이터 ablation 모델에 최대 약 30,000개의 사고 토큰을 허용했을 때, s1K는 AIME24에서 50.0%를 기록한다. 1K-random은 36.7%, 1K-diverse는 26.7%, 1K-longest는 33.3%, 59K-full은 53.3%다. 전체 후보 데이터 학습에는 394 H100 GPU 시간이 필요하며, s1-32B에는 약 7 H100 GPU 시간이 필요하다.
- 95% paired bootstrap 신뢰구간은 모델 2개에 동일한 평가 질문을 적용하고 10,000회 재표집해 불확실성을 추정한다. AIME24에서 s1K 대비 차이의 구간은 1K-random [−26.7%, −3.3%], 1K-diverse [−40.0%, −10.0%], 1K-longest [−36.7%, 0.0%], 59K-full [−13.3%, 20.0%]다.
- 전체 후보 데이터의 신뢰구간은 성능 향상과 하락을 모두 포함한다. 이는 선별한 부분집합의 경쟁력을 뒷받침하지만 통계적 동등성을 입증하지는 않는다.
- 선별의 이점은 벤치마크마다 다르다. GPQA Diamond에서 1K-longest는 59.6%로, 이 ablation의 s1K 점수 57.6%보다 높다. 기준을 결합한 방법이 모든 과제에서 모든 선별 전략보다 우수한 것은 아니다.
최대 약 30,000개의 사고 토큰을 공통으로 허용했을 때 무작위 선별과 다양성만 고려한 선별은 s1K보다 AIME24 정확도가 낮고, 보고된 차이의 신뢰구간도 전부 0보다 작다. 전체 후보 데이터의 우위는 통계적으로 입증되지 않았으며, 가장 긴 trace로 구성한 부분집합은 GPQA Diamond에서 더 높은 점수를 기록한다.
5.2. Test-time scaling methods
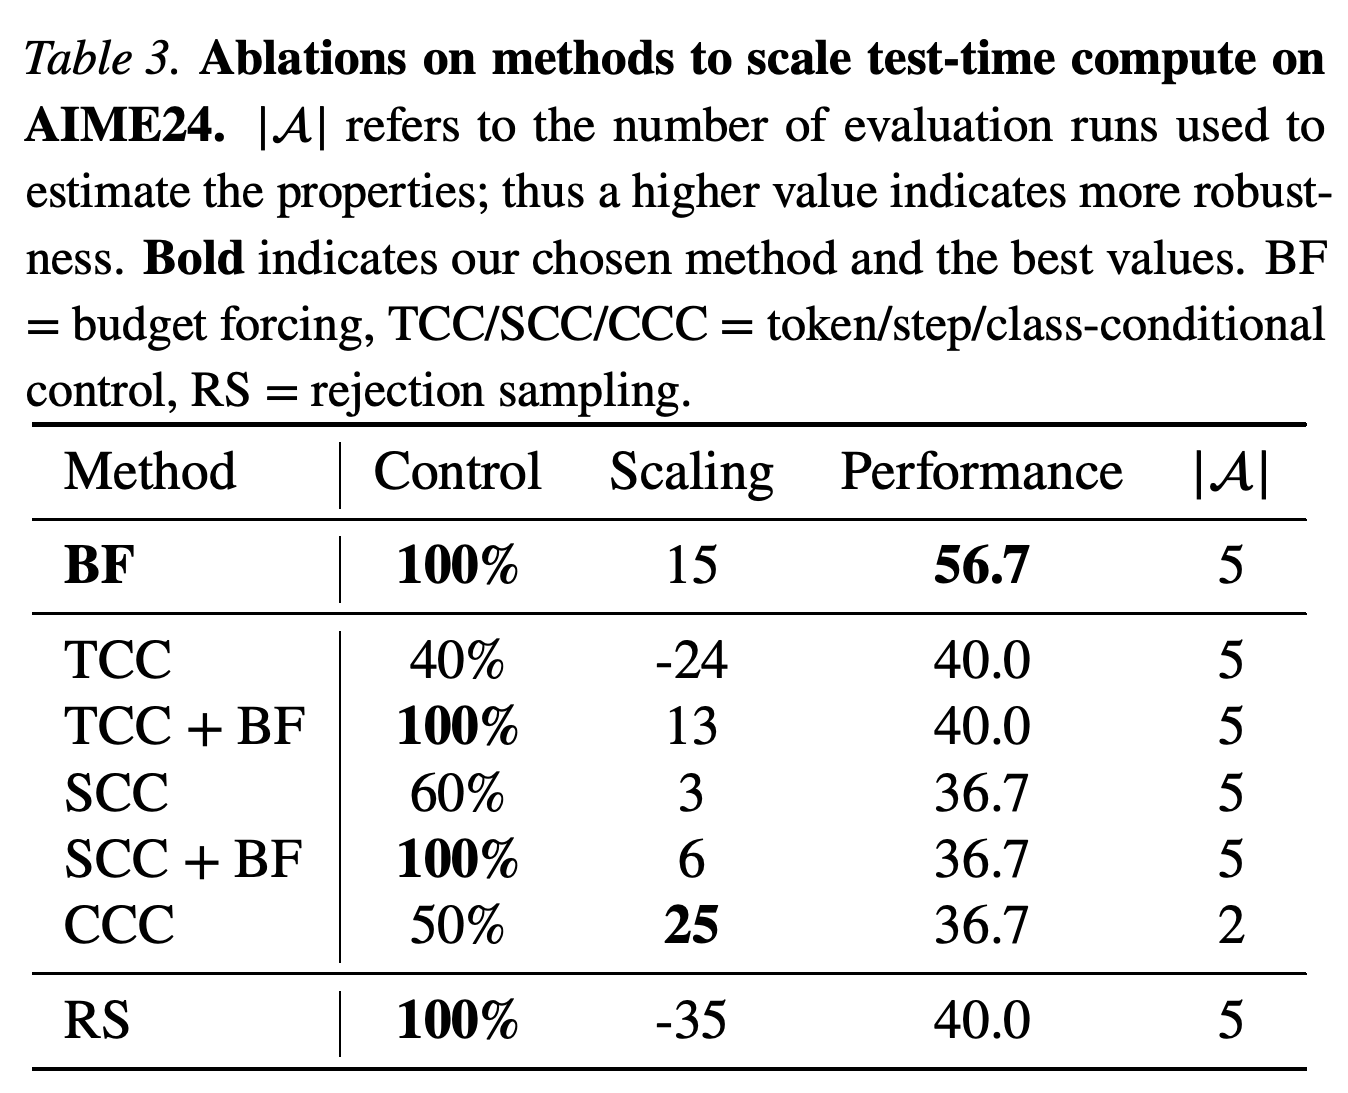
Budget forcing은 평가한 설정 5개에서 Control 100%, Scaling 15, AIME24 최고 정확도 56.7%를 달성한다. 토큰 조건부 제어는 Control 40%, Scaling −24에 그친다. 여기에 budget forcing을 추가하면 Control은 100%로 회복되지만 최고 정확도는 40.0%에 머문다.
- 단계 조건부 제어는 Control 60%, 최고 정확도 36.7%를 기록한다. 강제 종료를 적용하면 Control은 100%로 회복된다. 모델은 개별 단계를 더 길게 만들어 단계 수 감소를 일부 보완한다.
- 범주 조건부 제어는 설정 2개로 추정한 Scaling이 25지만, Control은 50%, 최고 정확도는 36.7%에 그친다. 기울기는 더 높아도 제어율과 최고 정확도는 낮다.
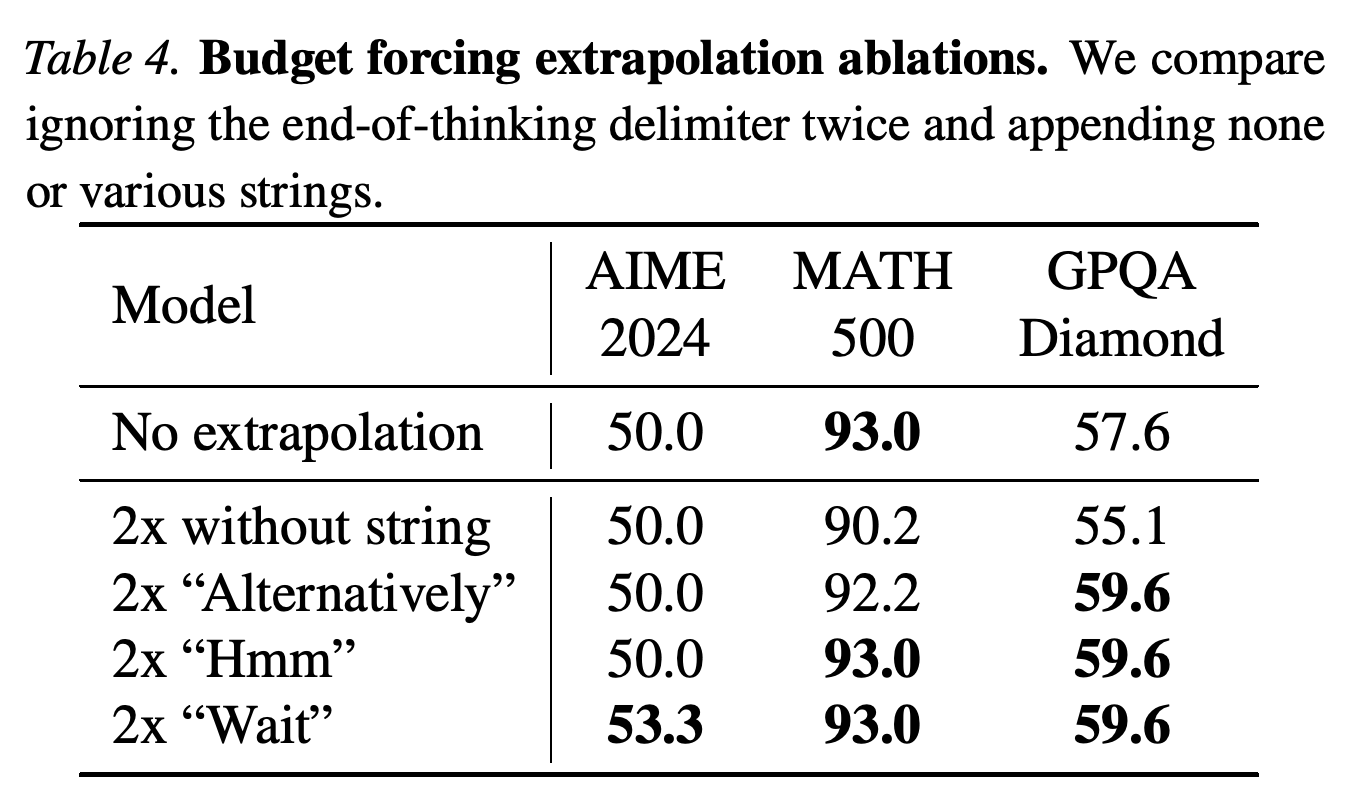
- 종료를 2회 억제할 때 “Wait”는 AIME24 정확도를 50.0%에서 53.3%로 높인다. 문자열을 넣지 않거나 “Alternatively”, “Hmm”을 넣으면 50.0%에 머문다. GPQA Diamond에서는 제공된 문자열 3개가 모두 59.6%를 기록하지만, 문자열 없이 종료만 억제하면 55.1%로 떨어진다.
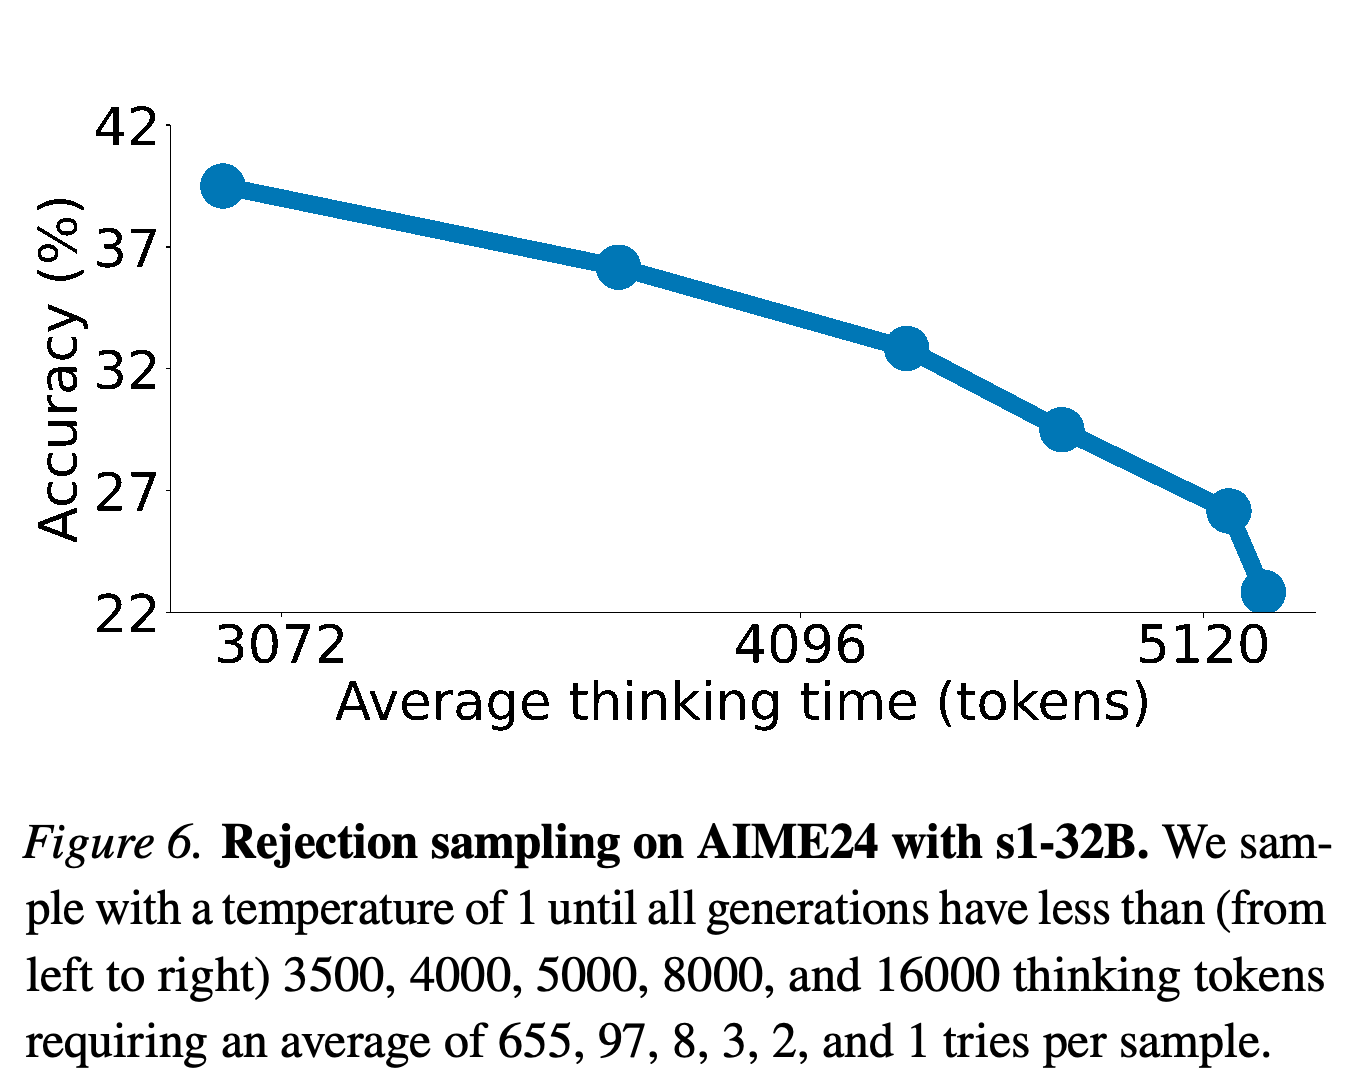
- Rejection sampling은 Control 100%를 달성하지만 Scaling은 −35다. 저자들은 채택된 긴 trace에 오류와 되돌아가기가 더 자주 포함된다고 가정한다. 검토한 예제는 이 설명을 보여주지만 인과관계를 입증하지는 않는다.
Budget forcing은 측정된 범위에서 완전한 예산 준수와 가장 높은 AIME24 정확도를 함께 달성한다. 범주 조건부 prompting은 보고된 기울기가 더 크지만 제어율과 정확도는 낮다. 따라서 지표 3개를 함께 해석해야 한다.
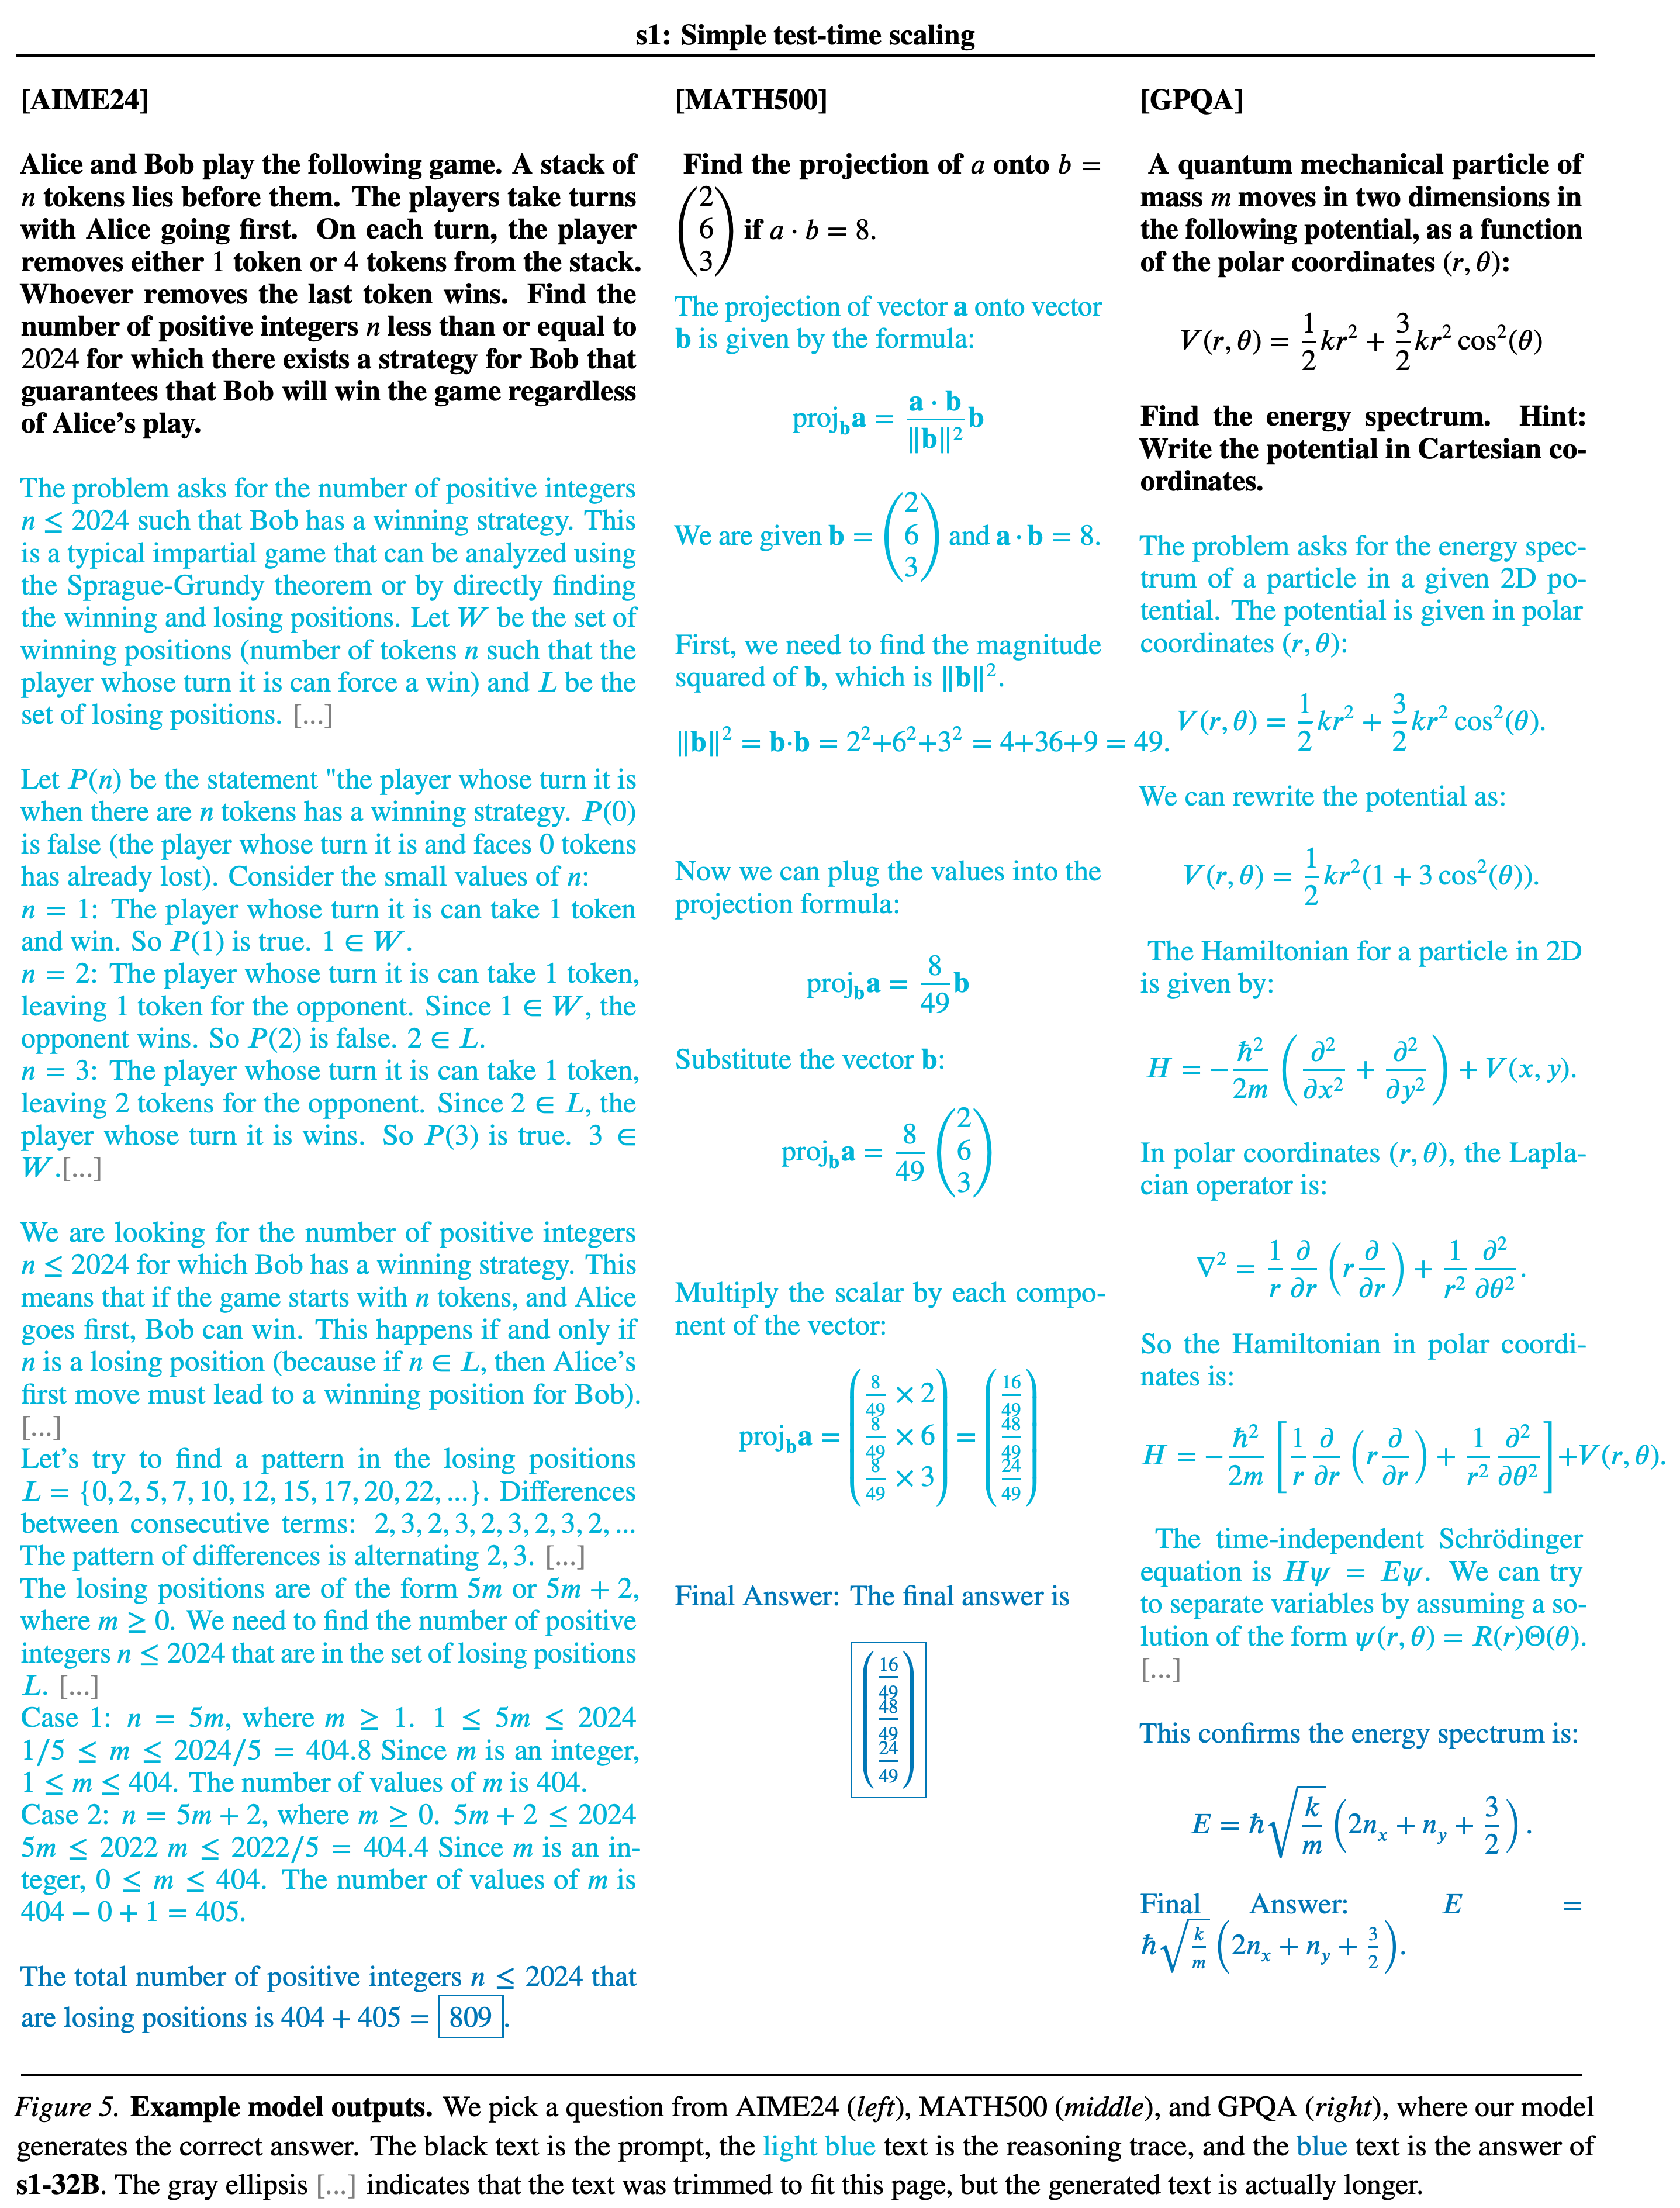
예제는 게임, 벡터 투영, 물리학 질문에 대한 응답 형식과 정답을 보여준다. 추론은 표시를 위해 축약되었고 정답인 예제를 선별했으므로, 모델의 전체 오류 분포를 나타내지는 않는다.
이어쓰기 문자열 없이 종료 구분자만 억제하면 연장하지 않은 경우보다 MATH500과 GPQA Diamond 정확도가 낮아진다. 2회 연장 비교에서 “Wait”는 AIME24를 개선한 유일한 실험 문자열이며, GPQA Diamond에서는 문자열 3개가 동률을 기록한다.
Rejection sampling으로 채택한 출력의 평균 길이가 늘어날수록 정확도가 낮아진다. 이 결과는 temperature 1에서 길이를 기준으로 출력을 채택한 sampling에 관한 것이며, 기존 reasoning trace를 연장하는 효과를 직접 측정하지는 않는다.
6. Discussion and related work
논의에서는 보상 신호로 학습하는 reinforcement learning 기반 추론 모델, 더 많은 증류 출력으로 학습한 모델과 이 방법을 비교한다. 소규모 fine-tuning 데이터가 효과적인 이유와 추론 시 연산을 늘려 얻는 추가 향상의 한계를 검토한다.
6.1. Sample-efficient reasoning
저자들은 사전학습으로 모델이 이미 추론 능력의 상당 부분을 습득했으며, 소규모 지도 데이터가 이를 이끌어낸다고 가정한다. 이 해석을 LIMA의 Superficial Alignment Hypothesis와 연결한다. LIMA는 비교적 적은 예제로도 사전학습 모델을 원하는 응답 행동에 맞출 수 있다고 주장한 선행 연구다.
- 예제 1,000개를 학습한 뒤 나타난 성능 향상은 효과적인 적응을 보여준다. 다만 실험은 어떤 추론 능력이 이미 존재했는지 밝히거나, 제안한 능력 활성화 메커니즘을 입증하지는 않는다.
- 관련 접근법에는 수학과 과학 데이터로 계속 학습하는 방법, 합성 추론 데이터, 답변 전에 중간 추론을 요청하는 Chain-of-Thought prompting이 있다.
6.2. Test-time scaling
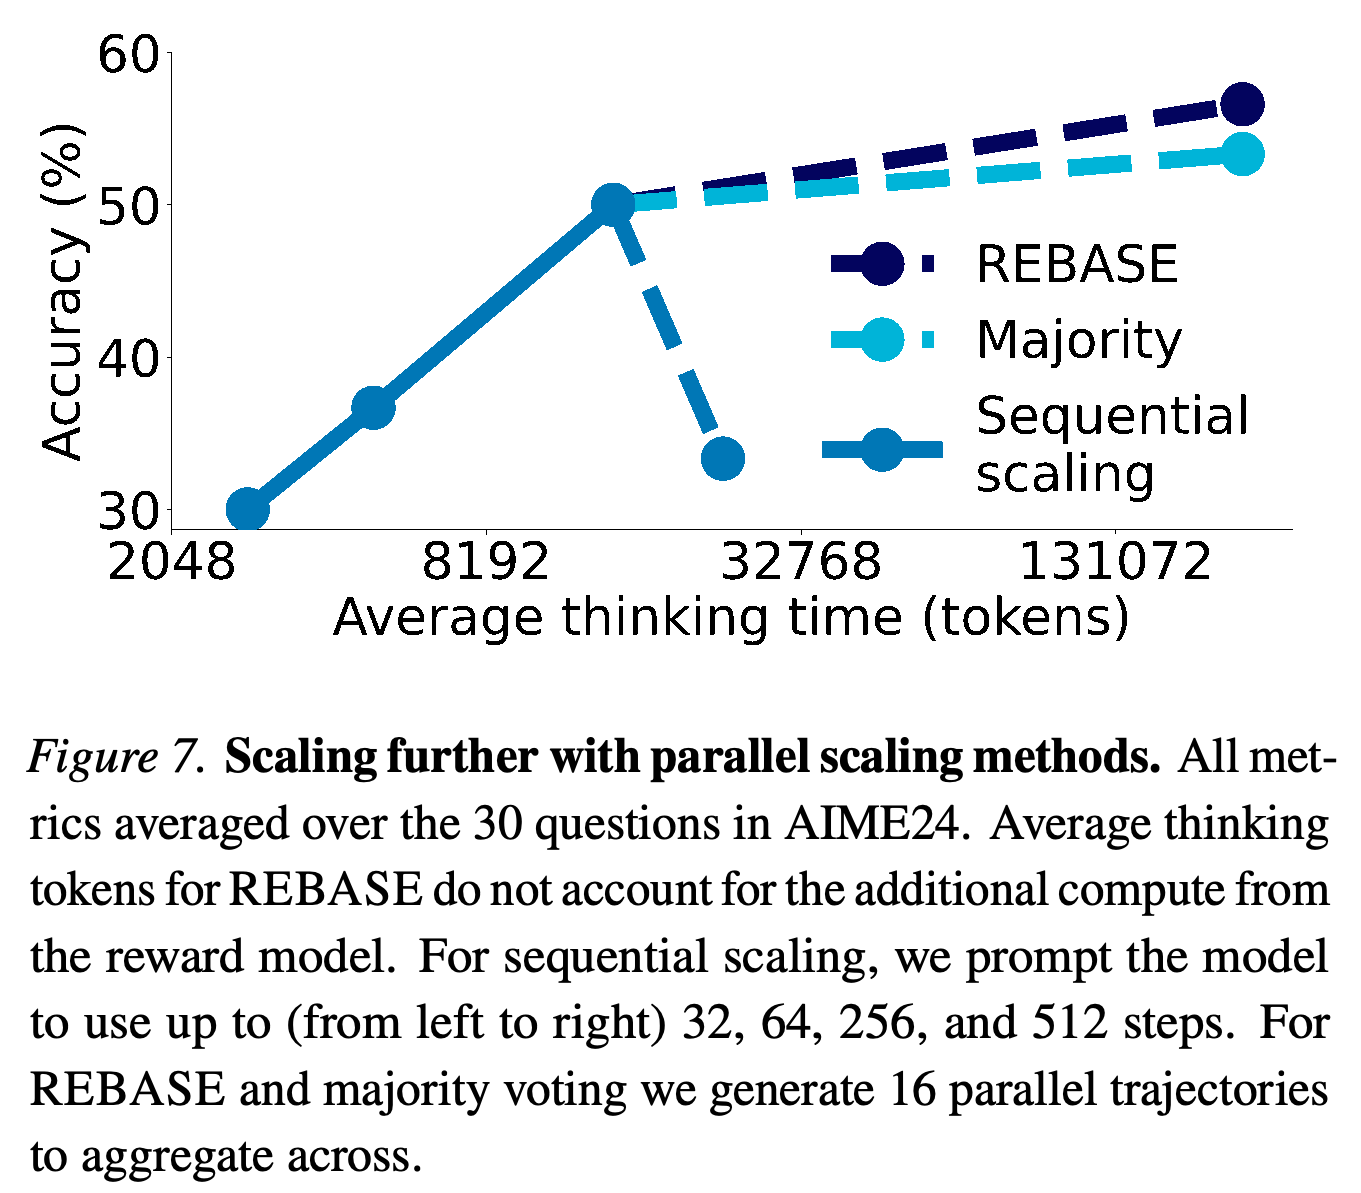
Sequential scaling은 추가 이득 감소, 반복 추론, 모델의 context window에 제약을 받는다. 논문은 병렬 풀이 경로 16개를 사용한 majority voting과 REBASE도 실험한다. REBASE는 중간 추론 단계에 점수를 매기는 process reward model로 탐색을 유도하는 tree-search 방법이다.
- 이 실험에서 REBASE는 majority voting보다 그래프의 scaling 추세를 더 효과적으로 이어가지만, 토큰 수에는 reward model에 필요한 추가 연산이 제외되어 있다.
- Sequential 모델에 최대 512단계를 사용하도록 지시하면 AIME24 응답 30개 중 12개가 context window를 초과해 정확도가 크게 떨어진다.
- Appendix E.1에 따르면 Figure 7은 이전 데이터 버전으로 학습한 단계 제어 모델과 이전 평가 코드를 사용한다. 이는 최종 주요 시스템 비교와 별개의 실험이다.
- 이어쓰기 문자열을 번갈아 사용하거나 생성 설정을 바꾸는 방법, budget forcing과 reinforcement learning을 결합하는 방법은 향후 연구 방향으로 제안되며, 이 논문에서 결과를 입증하지는 않는다.
병렬 결과를 결합하면 표시된 sequential 방법의 실질적 한계를 넘어 정확도가 높아지며, REBASE가 majority voting보다 앞선다. 이 실험은 이전 단계 제어 모델을 사용하고 REBASE의 토큰 수에서 reward model 연산을 제외하므로, 효율성을 직접 비교하는 데 한계가 있다.
Impact Statement
Impact Statement는 생산성, 복잡한 의사결정, 과학 연구의 개선 가능성을 공개 추론 연구의 동기로 제시한다. 모델 가중치, 추론 데이터, 코드 공개는 투명성이라는 목표를 뒷받침한다. 다만 이 진술은 사회적 편익이나 피해를 실증적으로 평가하지 않는다.
부록
- A. s1.1은 동일한 질문 1,000개에 대해 DeepSeek r1으로 reasoning trace를 다시 생성하고 학습 절차는 유지한다. Budget forcing 없이 s1.1은 MATH500 94.4%, GPQA 60.6%, AIME 2024 56.7%, AIME 2025 50.0%를 기록한다. “Wait”를 2회 덧붙이면 각각 95.4%, 63.6%, 56.7%, 50.0%다. 이 행들은 교사 모델의 trace 변경 효과와 추론 과정에 개입한 추가 효과를 구분한다.
- B. Evaluation determinism은 평가에 사용한 추론 엔진 vLLM이 동일한 seed와 greedy decoding에서도 batch size, 생성 이어가기, tensor parallelism에 따라 다른 답을 낼 수 있다고 보고한다. Tensor parallelism은 모델 연산을 GPU에 분산하는 방식이다. 긴 reasoning trace는 작은 수치 차이를 증폭할 수 있어, 저자들은 최종 평가에 대체로 full precision을 사용한다. 따라서 작은 점수 차이는 신중하게 해석해야 한다.
- C. s1K details는 데이터셋 구성, 채점, 다양성 기반 추출, 중복 제거를 설명한다. C.1. s1K summary는 51개 영역에 걸친 질문 1,000개와 4.7M 토큰을 보고한다. 기하학 질문은 109개, 정수론은 98개, 조합론은 75개다. C.2. Dataset composition for full 59K questions는 출처 16개를 나열하고 평균 사고 길이를 3.6K로 보고한다. 개발 과정에서 사용한 2022–2023년 AIME 질문 90개를 제외했다고도 명시한다. C.3. s1K grading prompt는 시도한 풀이를 기준 풀이와 비교한다. 선별에는 Claude 3.5를, 최종 표본 1,000개의 정답 여부 채점에는 Claude 3.7을 사용한다. C.4. s1K diversity selection은 Algorithm 1을 제시한다. ThinkingLength(q) > 5600인 MATH 예제를 포함해 지정한 출처의 정답 예제를 유지한 뒤, 영역을 균등하게 추출하고 예제에는 2^(−ranks)의 가중치를 적용해 추출한다. ranks는 사고 길이에 따른 순위로, 긴 trace를 우선하게 한다. C.5. Decontamination은 8-gram으로 평가 벤치마크와 중복되는 데이터를 제거하는 과정을 설명한다. 이 검사는 사전학습된 기반 모델이나 교사 모델에 데이터 오염이 없음을 입증하지는 않는다.
- D. Training details는 <|im_start|>think와 <|im_start|>answer로 사고와 답변을 구분한다. 데이터셋 전체를 통과하는 단위인 epoch를 기준으로 5 epochs 동안 학습하며, batch size는 16, gradient step 수는 315다. 손실은 reasoning trace와 풀이에만 적용한다. 학습에는 저정밀도 수치 형식인 bfloat16, 학습률 1e−5, 16단계 동안 진행되는 5% 선형 warmup, 299단계에 걸쳐 zero까지 감소하는 cosine decay를 사용한다. Optimizer는 weight decay를 분리한 AdamW이며, β₁ = 0.9, β₂ = 0.95, weight decay 1e−4를 적용한다. D.1. Training Ablations: Sequence length는 학습 표본의 74%가 잘리는 4096토큰 설정과 잘리는 표본이 없는 32768토큰 설정을 비교한다. 긴 설정에서는 AIME24 정확도가 30.0%에서 50.0%로 높아지고, 평균 사고 길이는 20721토큰에서 6984토큰으로 줄어든다. 저자들은 학습 중 답변 구간을 더 많이 보존한 결과라고 해석한다. D.2. Training Samples는 s1-prob, s1-teasers, OlympicArena 천문학의 전체 예제를 제공하며, 오류와 수정이 포함된 생성 추론을 보여준다.
- E. Test-time scaling details는 대안적인 제어 실험을 자세히 설명한다. E.1. Sequential scaling ablations에서는 1024부터 16384까지 토큰 한도를 요청해도 강제 종료가 없으면 여전히 약 7K–8K의 사고 토큰을 생성한다. 단계 제어도 개입이 필요하며 단계당 토큰 수를 바꾼다. 일반적인 짧게 또는 길게 생각하라는 프롬프트는 정확도를 안정적으로 높이지 못한다. E.2. Examples for rejection sampling ablation은 이전 s1-32B 버전으로 사고 토큰 3981개의 올바른 기하 풀이와 사고 토큰 5923개의 잘못된 시도를 비교한다. 이는 출력이 길다는 이유만으로 추론이 개선되지는 않음을 보여준다.
- F. Version Control은 V2 → V3 (2025-03)에서 Appendix A와 Section 2의 정답 수를 추가했다고 기록한다. V1 → V2 (2025-02)에서는 인용과 소규모 문구 수정을 추가했다. s1.1 결과는 이후 부록 업데이트에 속하며, 원래 s1 본문 실험과 구분된다.
짧은 생각
이 연구의 공학적 기여는 학습과 추론 구성 요소를 각각 평가한 간결한 방법이다. 선별한 추론 예제가 기반 모델을 개선하고, 명시적인 종료 제어가 추가 향상을 만든다. 데이터와 시퀀스 길이 ablation은 선별 데이터의 효과를 전체 후보 데이터 베이스라인과 비교하고, 답변까지 포함한 완전한 학습 예제를 보존할 필요성을 뒷받침한다. 긴 추론의 이점을 뒷받침하는 근거에는 조건이 따른다. 성능 향상은 정체되고, rejection sampling에서는 inverse scaling이 나타나며, 질문 30개로 구성된 AIME24에서는 답변 하나가 바뀔 때마다 정확도 차이가 크게 발생한다. Sequential과 parallel의 비교에서는 모델과 추론 방법이 함께 바뀌며, REBASE 그래프의 연산량은 reward model의 추가 비용을 제외한다. 더 넓은 효율성 주장을 뒷받침하려면 조건을 맞추고 전체 연산 비용을 반영한 비교가 필요하다.