


Hidden Agenda: a Social Deduction Game with Diverse Learned Equilibria 요약 설명
05 Jan 2022 | Paper Review Multi-Agent Coordination Reinforcement Learning Social Deduction Games목차
이번 글에서는 Hidden Agenda: a Social Deduction Game with Diverse Learned Equilibria 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 5일(Arxiv), Cooperative AI Workshop, 35th Conference on Neural Information Processing Systems (NeurIPS 2021)
- Kopparapu, Kavya, Duéñez-Guzmán, Edgar A., Matyas, Jayd, Vezhnevets, Alexander Sasha, Agapiou, John P., McKee, Kevin R., Everett, Richard, Marecki, Janusz, Leibo, Joel Z., Graepel, Thore.
- Harvard University, DeepMind
- 논문 링크
요약
- 이 논문은 다른 플레이어의 소속 팀과 동기가 숨겨져 있을 때 에이전트가 협력 대상을 선택하는 방법을 연구한다. 2개 팀으로 구성된 사회적 추론 게임에서 숨겨진 역할 정보를 사용해 학습한 에이전트는 10회 실행에서 서로 다른 3가지 플레이 양상을 보였다. 반면 표준 베이스라인은 10회 실행 모두에서 Impostor가 Crewmate를 얼려 승리하는 결과가 지배적이었다.
- Hidden Agenda에서는 연료를 모으는 Crewmate 4명이 모든 플레이어의 역할을 알고 이들을 얼릴 수 있는 Impostor 1명과 대결한다. 에이전트는 보상에 따라 행동을 학습하는 강화학습을 사용하며, 자연어 없이 반복적인 공개 투표로 행동을 조율할 수 있다.
- Hidden-Agenda Agent는 학습 중에 숨겨진 역할과 플레이어 간 거리를 사용하고, 관찰을 통해 역할을 예측하도록 학습한다. 평가 시 행동 정책에는 이러한 특권 정보가 제공되지 않는다. 보고된 결과는 고정된 그룹의 학습 과정에서 나타난 양상이며, 게임 이론에서 증명된 균형은 아니다.
1 Introduction
사회적 추론 게임에서 플레이어는 행동을 통해 숨겨진 역할을 추론하면서 동맹과 협력하고 상대와 경쟁해야 한다. Hidden Agenda는 이러한 설정을 2D 세계로 확장해 이동, 작업, 얼리기, 공개 투표를 통해 플레이어의 의도를 파악할 단서를 제공한다.
2 Hidden Agenda Environment
Hidden Agenda는 Melting Pot 컴포넌트 시스템을 사용해 Lab2D에서 구현했다 [4, 20]. 모든 실험에서 Crewmate 4명은 다른 플레이어의 역할을 모르지만 Impostor 1명은 모든 역할을 안다. 아바타 색상은 역할과 관계없이 무작위로 배정한다.
모서리에 있는 연료실과 중앙의 납품 지점 때문에 Crewmate가 공유 공간을 이동하게 된다. 이 과정에서 Impostor는 Crewmate를 가로막을 기회를 얻고, 다른 플레이어는 행동을 관찰할 수 있다.
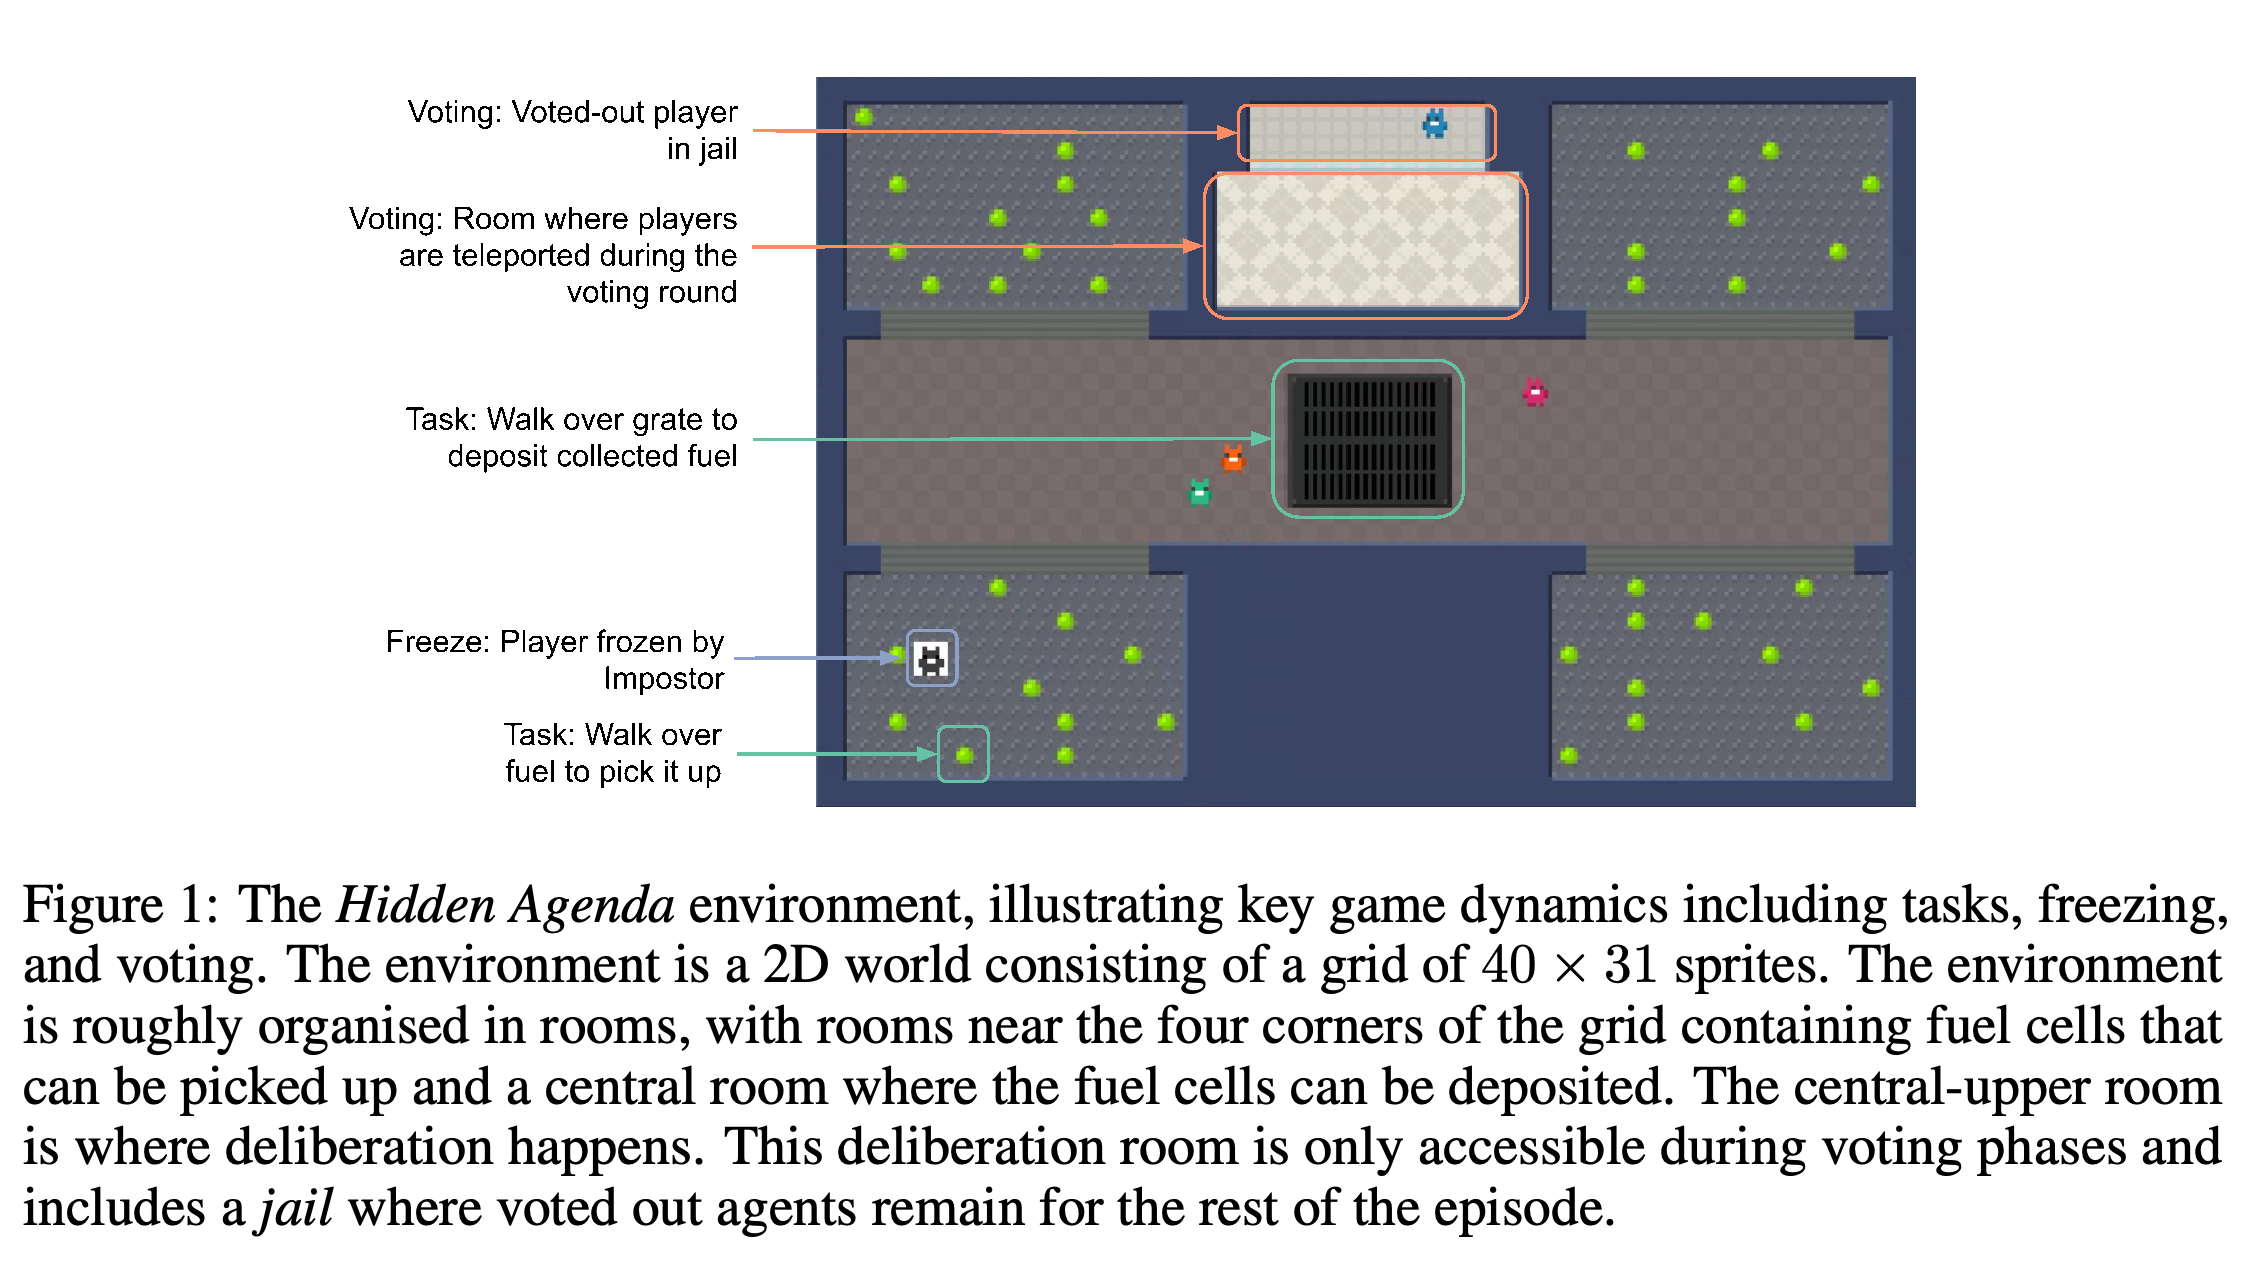
2.1 Overview of Gameplay
상황 단계에서 플레이어는 연료를 수집하고 납품하며, 최대 2개의 연료 셀을 운반할 수 있다. Impostor는 Crewmate를 영구적으로 얼릴 수 있다. 얼리기 범위 밖의 활성 Crewmate가 얼리기 행동을 목격하거나 이전 투표 단계가 끝난 뒤 또는 에피소드가 시작된 뒤 200 timesteps가 지나면 25-timestep 투표 단계가 시작된다. 활성 플레이어의 최종 투표 중 절반 이상을 받은 플레이어는 감옥에 갇힌다.
이 도식은 물리적 행동이 공개 투표 단계로 이어지는 과정과 25 timesteps 후 이동 단계로 돌아가는 과정을 보여준다.
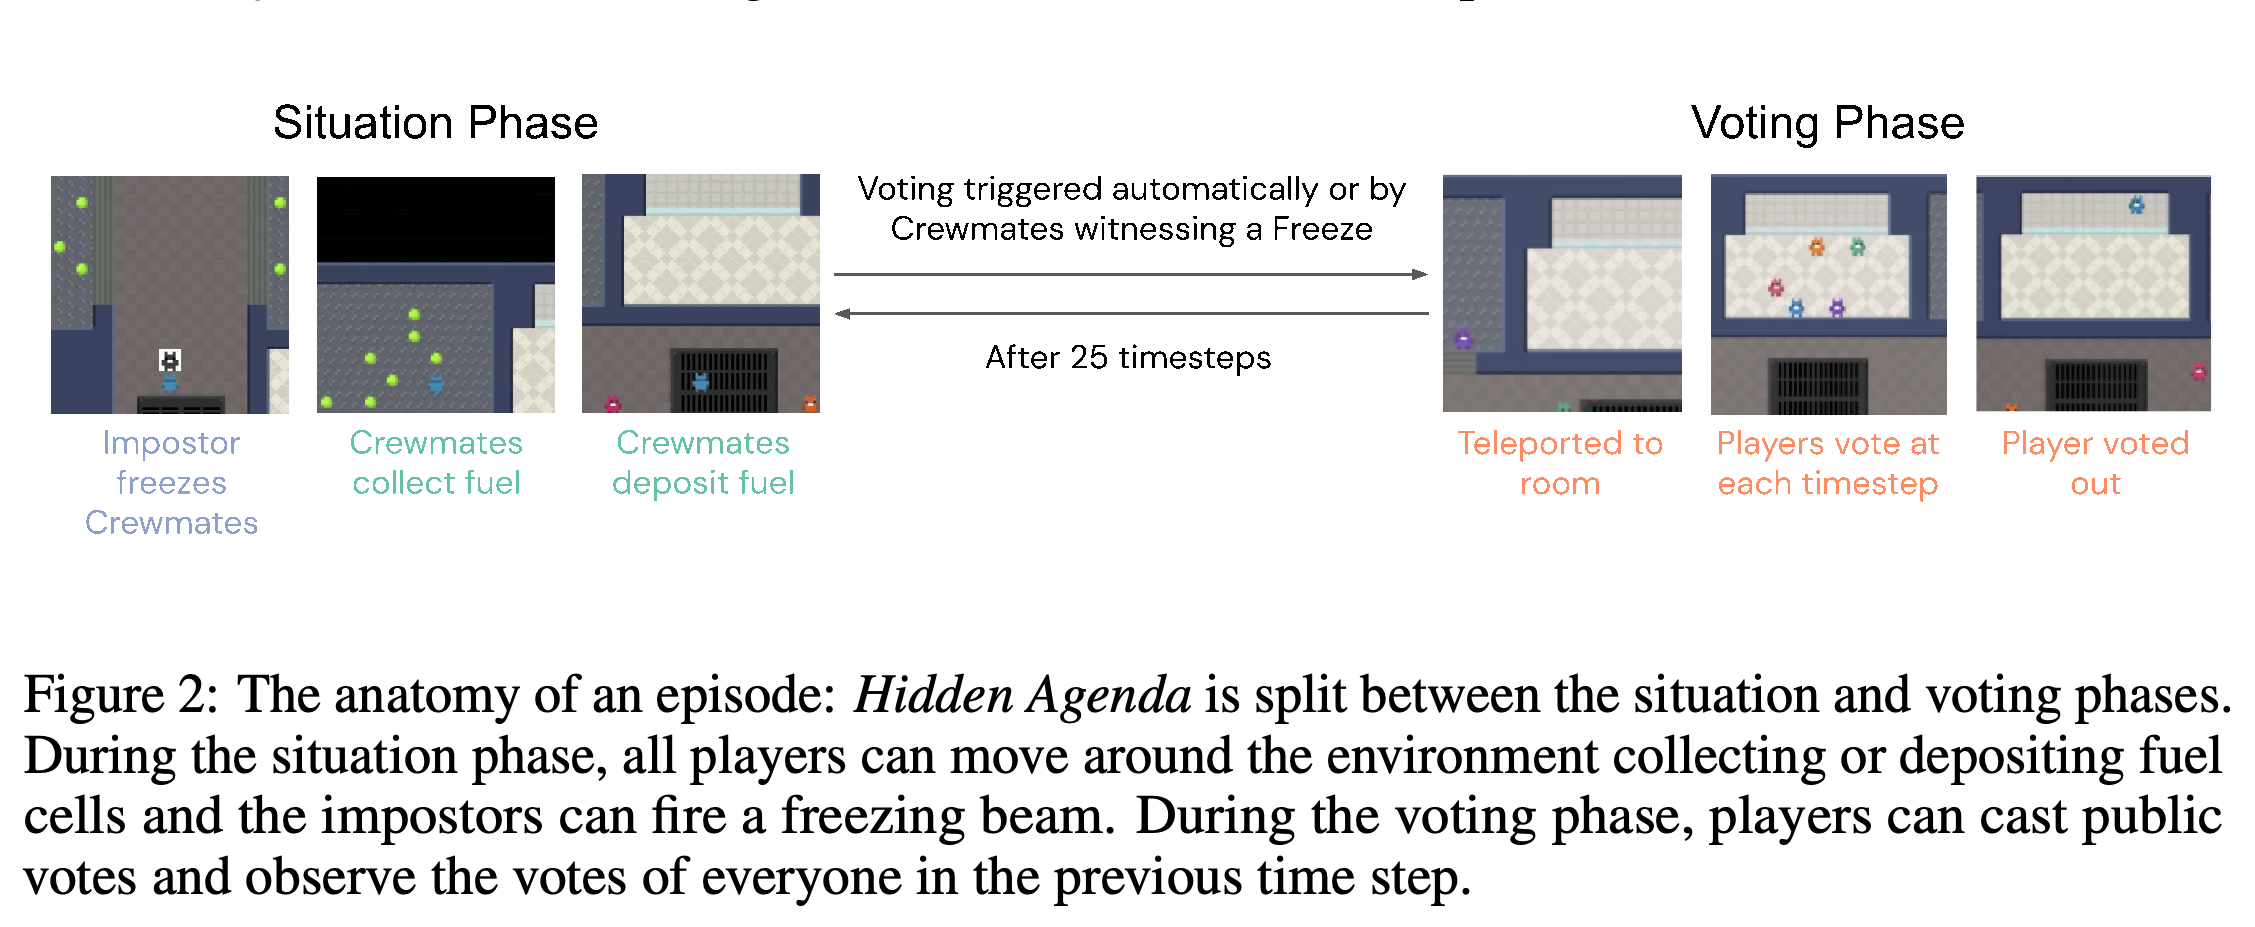
Crewmate는 충분한 연료를 납품하거나 투표로 Impostor를 퇴출하면 승리한다. Impostor는 Crewmate가 1명만 남고 모두 얼거나 투표로 퇴출되면 승리한다. 3000 timesteps가 지나면 에피소드는 무승부로 끝난다.
2.2 Environment Details
각 에이전트는 주변 시야를 담은 88 × 88 × 3 red-green-blue (RGB) 이미지, 연료 보유량의 비율, 전체 연료 납품 진행률, 5 × 7 투표 행렬을 관찰한다. 상황 단계에서는 이동과 회전이 가능하고, 투표 단계에서는 투표하거나 기권할 수 있다. 비활성 플레이어는 행동할 수 없다.
승리와 패배 시 각 팀원은 각각 +4와 −4의 보상을 받는다. 중간 학습 신호인 shaping reward로 Crewmate는 연료를 수집하고 납품할 때 각각 +0.25를 받고, Impostor는 얼리기에 성공하면 +1을 받으며, 얼어붙은 Crewmate는 −1을 받는다.
3 Reinforcement learning model
베이스라인은 정책과 가치를 예측하는 강화학습 구조인 asynchronous advantage actor-critic (A3C)이다 [23]. 이 구조는 채널이 각각 16개와 32개인 2층 합성곱 신경망, 층마다 유닛이 64개인 2층 multilayer perceptron, 순환 상태를 유지하는 long short-term memory network (LSTM)를 결합한다. LSTM의 은닉 유닛은 128개이고 unroll 길이는 100이다.
학습에는 경험을 보정하는 V-Trace importance sampling [11]과 LSTM 상태를 통해 가까운 시점을 구별하는 contrastive predictive coding 손실을 사용한다 [25]. RMSProp의 학습률은 0.0004, 감쇠율은 0.99이며 momentum은 사용하지 않고 미니배치 크기는 16이다.
3.1 Hidden-Agenda Agent
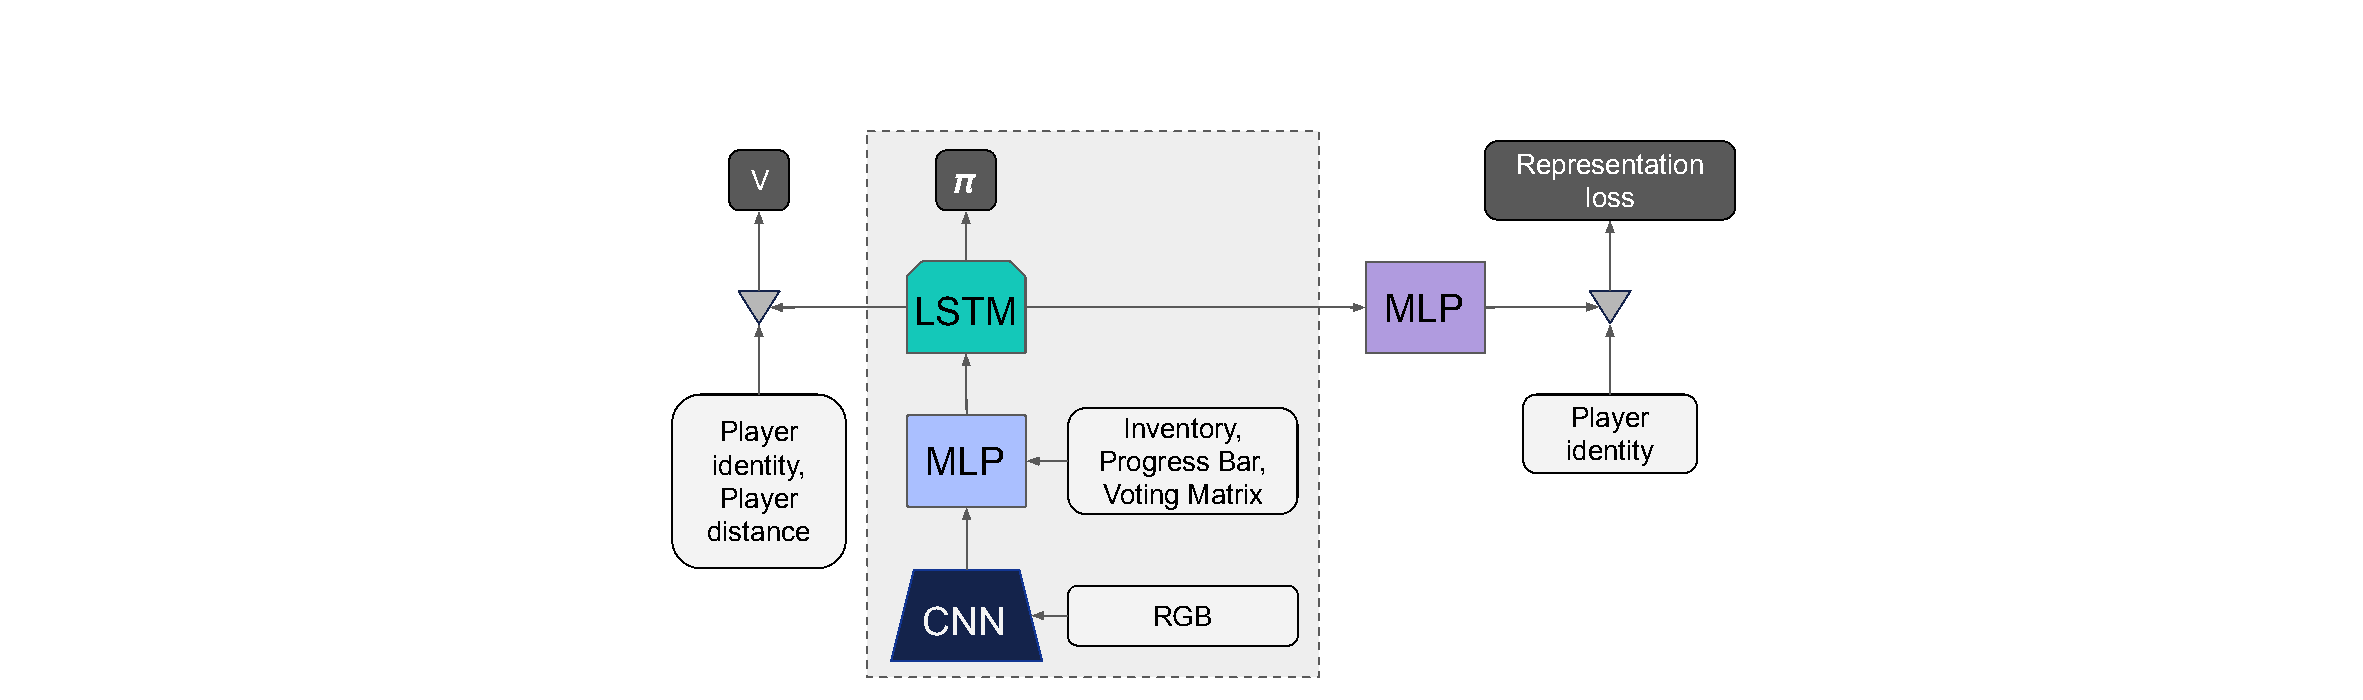
Hidden-Agenda Agent는 가치를 추정하는 학습용 critic에 플레이어 역할과 거리를 각각 5개 원소의 벡터로 제공한다. 계수가 1.0인 보조 cross-entropy 손실로 유닛이 각각 32개와 16개인 예측기를 학습해 LSTM 상태에서 역할을 추론한다. 평가 시 actor에는 특권 정보인 역할과 거리가 모두 제공되지 않는다.
음영으로 표시된 actor는 관찰을 처리해 행동을 선택한다. 플레이어의 신원과 거리는 가치 추정과 역할 예측 학습에 사용되며, 평가 시 actor에는 제공되지 않는다.
3.2 Co-training and evaluation of agents
에이전트 5개가 고정된 그룹에서 함께 학습한다. 이 중 1개는 항상 Impostor를, 4개는 항상 Crewmate를 맡으며, 색상은 에피소드마다 무작위로 배정한다. 학습 중 저장한 파라미터를 에피소드 반환값, 승리 조건별 빈도, 역할 표현 손실로 평가한다.
4 Experiments
실험에서는 먼저 게임 파라미터를 탐색한 다음, 동일한 공동 학습 방식으로 표준 A3C와 Hidden-Agenda Agent를 비교한다.
4.1 Game parameter sweep
자원 제약 때문에 전체 조합을 탐색하지 않았고 각 설정에 무작위 시드 1개를 사용했다. 선택한 설정은 승리에 필요한 연료 셀 32개, 200 timesteps마다 투표, 얼리기 재사용 대기 시간 50 timesteps, 연료 수집 및 납품 보상 +0.25, 얼리기 보상 ±1이며, 별도의 투표 보상은 없다.
4.2 Experimental setup
각 구조는 서로 다른 무작위 시드를 사용한 10회 실행에서 각각 10억 timesteps 동안 학습했다. 베이스라인은 Hidden-Agenda Agent가 추가한 2가지 수정 사항 없이 전략적 행동을 측정한다.
4.3 Co-training of agents converges to three distinct equilibria
Hidden-Agenda Agent 실행 중 3/10에서는 투표를 통한 Crewmate 승리, 2/10에서는 작업을 통한 Crewmate 승리, 5/10에서는 얼리기를 통한 Impostor 승리가 지배적이었다. 베이스라인 실행 10개는 모두 얼리기가 지배적인 결과로 수렴했지만, 해당하는 Hidden-Agenda 양상보다 투표로 결정된 결과의 비중이 컸다.
예시는 공통적으로 나타나는 작업 및 회피 행동과 특정 결과에 관련된 협력, 투표, 고립 행동을 구분해 보여준다.
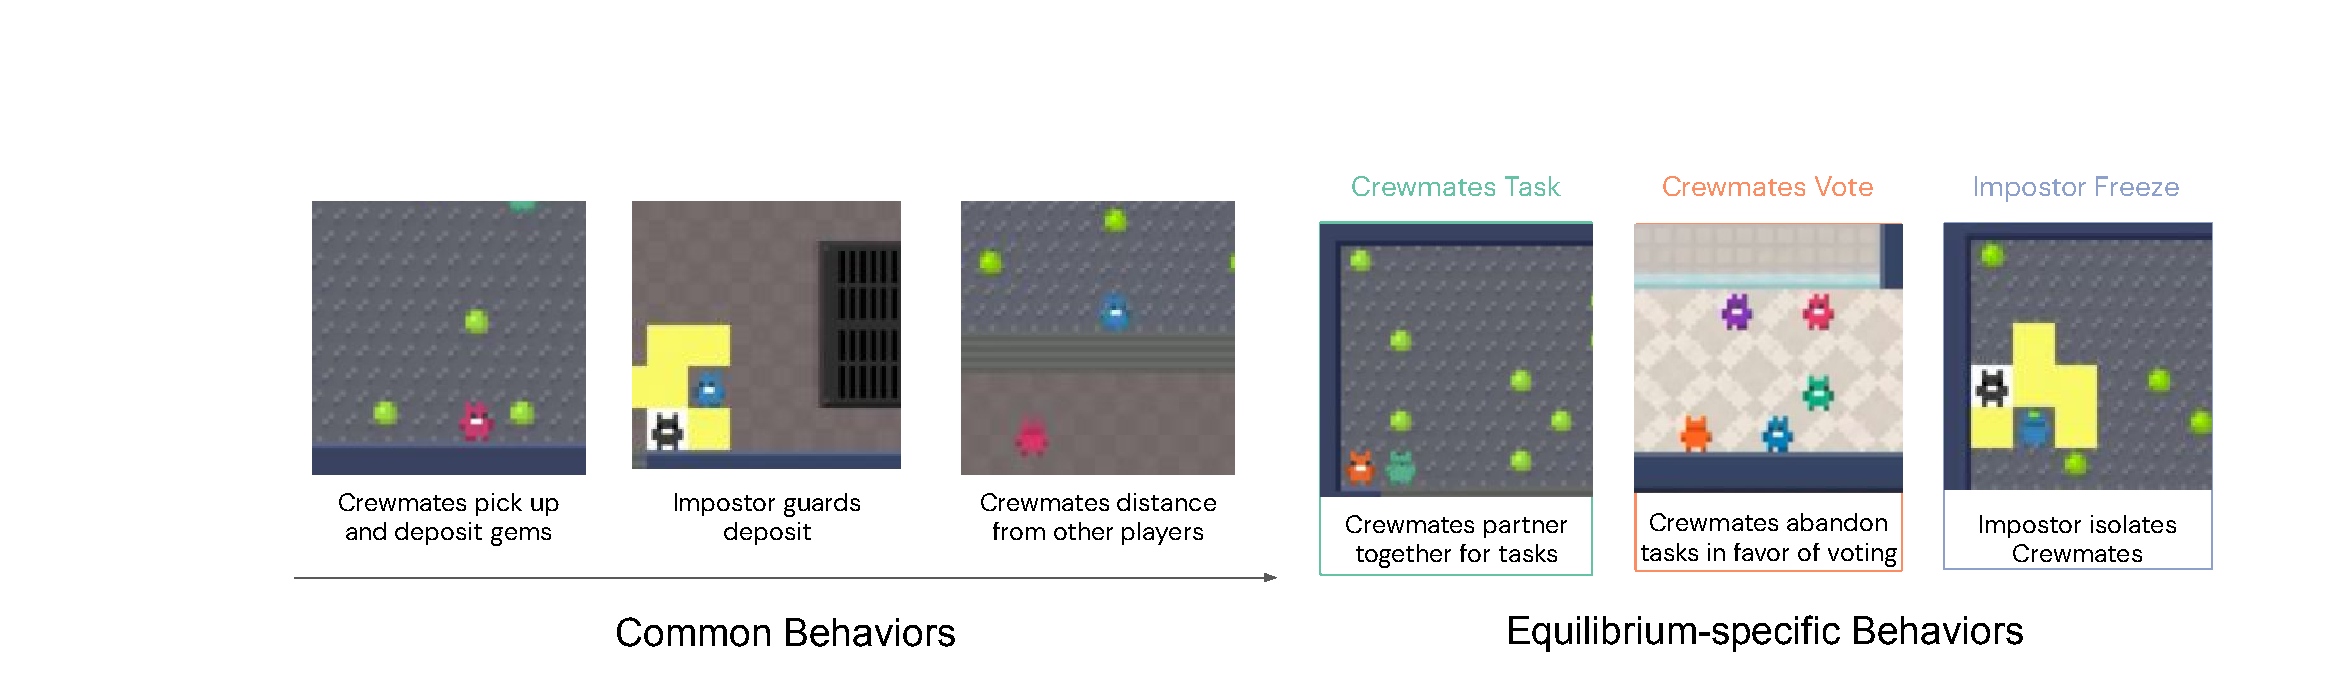
베이스라인 예시에서는 얼리기가 계속 지배적인 반면, Hidden-Agenda 예시 3개에서는 학습 중 서로 다른 승리 조건이 지배적으로 나타난다.
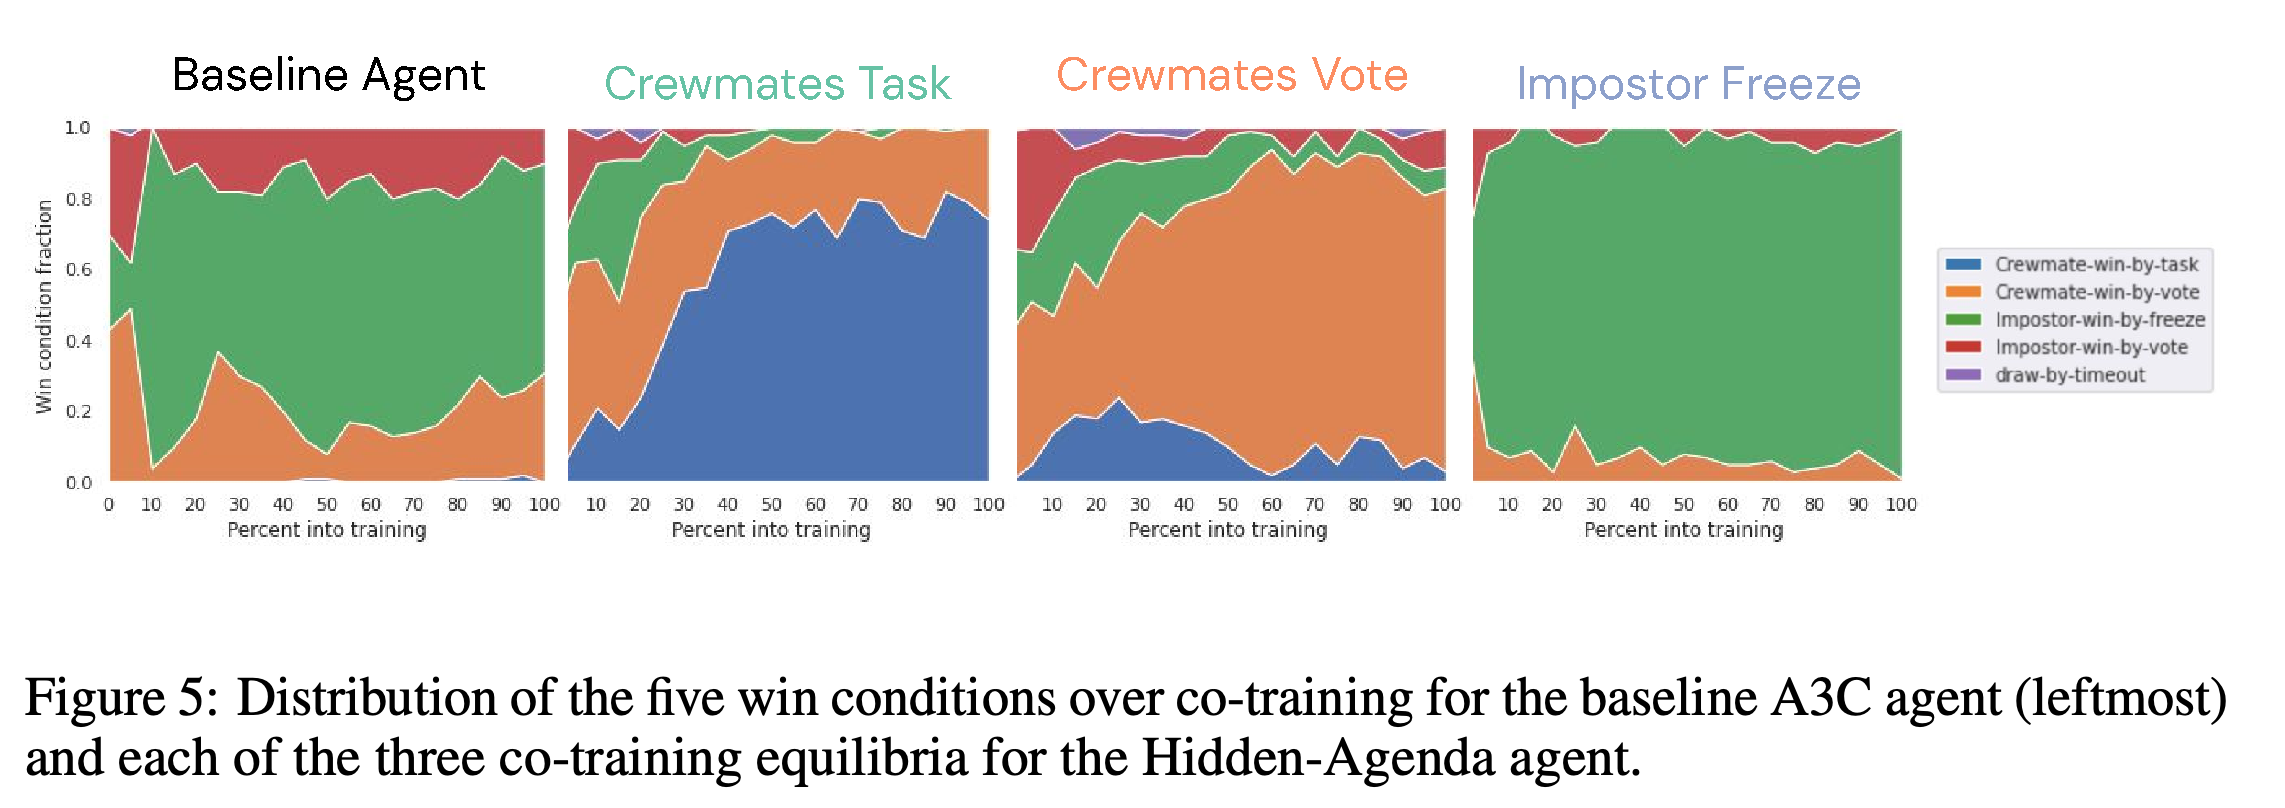
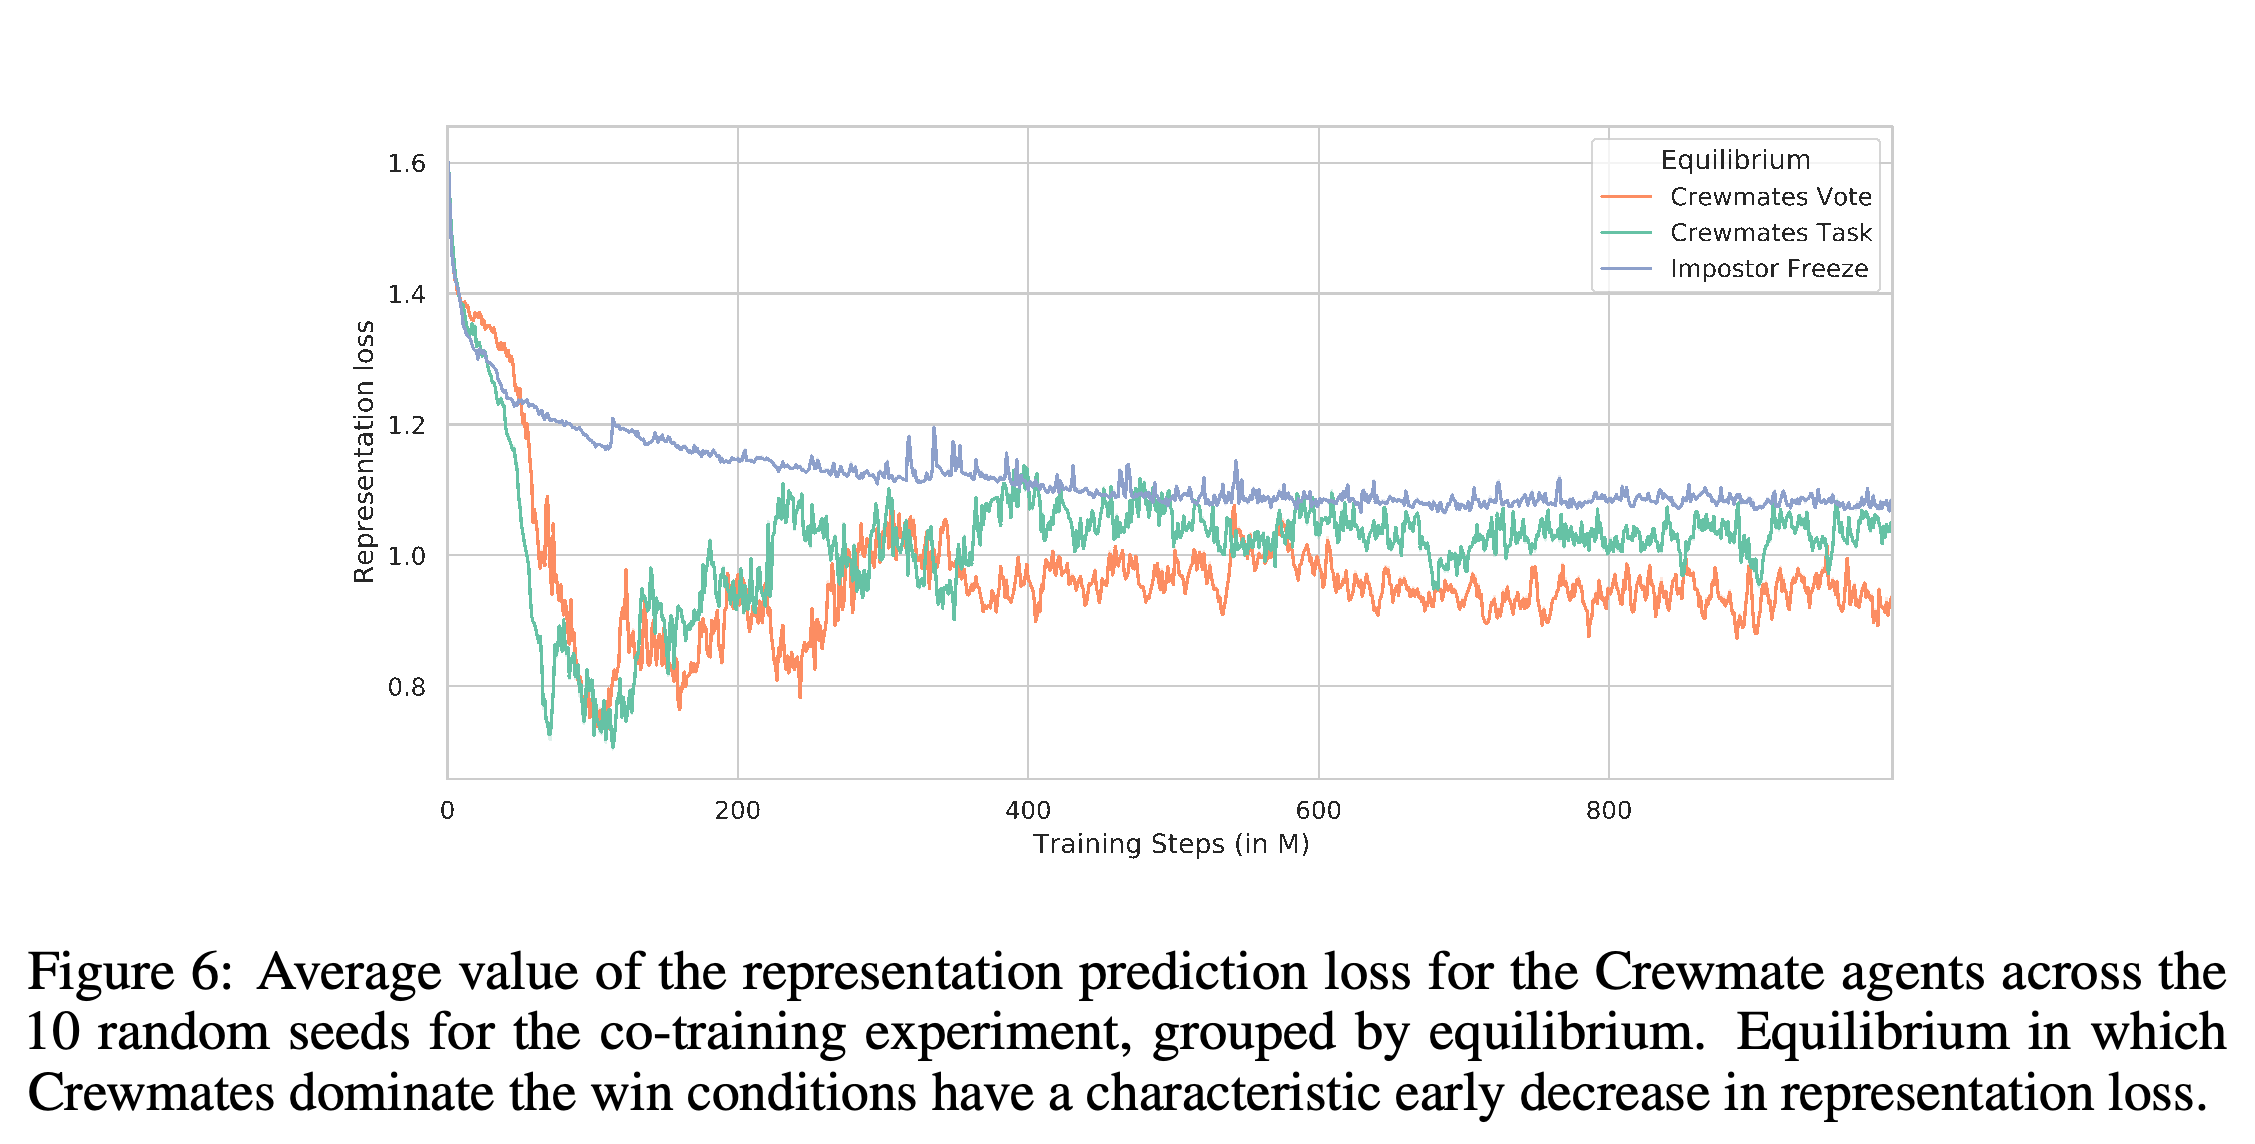
저자들은 이 양상을 공동 학습의 흡인 영역으로 설명하며, 어느 플레이어도 혼자 전략을 바꿔 이득을 얻을 수 없는 Nash equilibrium으로 규정하지 않는다. Crewmate가 지배적인 실행에서는 역할 예측 손실이 더 일찍 감소했지만 학습 종료 시점에는 손실이 비슷해졌다. 이 비교는 추가된 2가지 학습 요소의 효과를 개별적으로 분리하지 않는다.
역할 예측 손실은 Crewmate가 지배적인 2개 그룹에서 Impostor가 얼리기로 승리하는 그룹보다 더 일찍 감소하지만, 이후 곡선은 비슷한 값에 가까워진다.
4.4 Partnered Crewmates also vote together
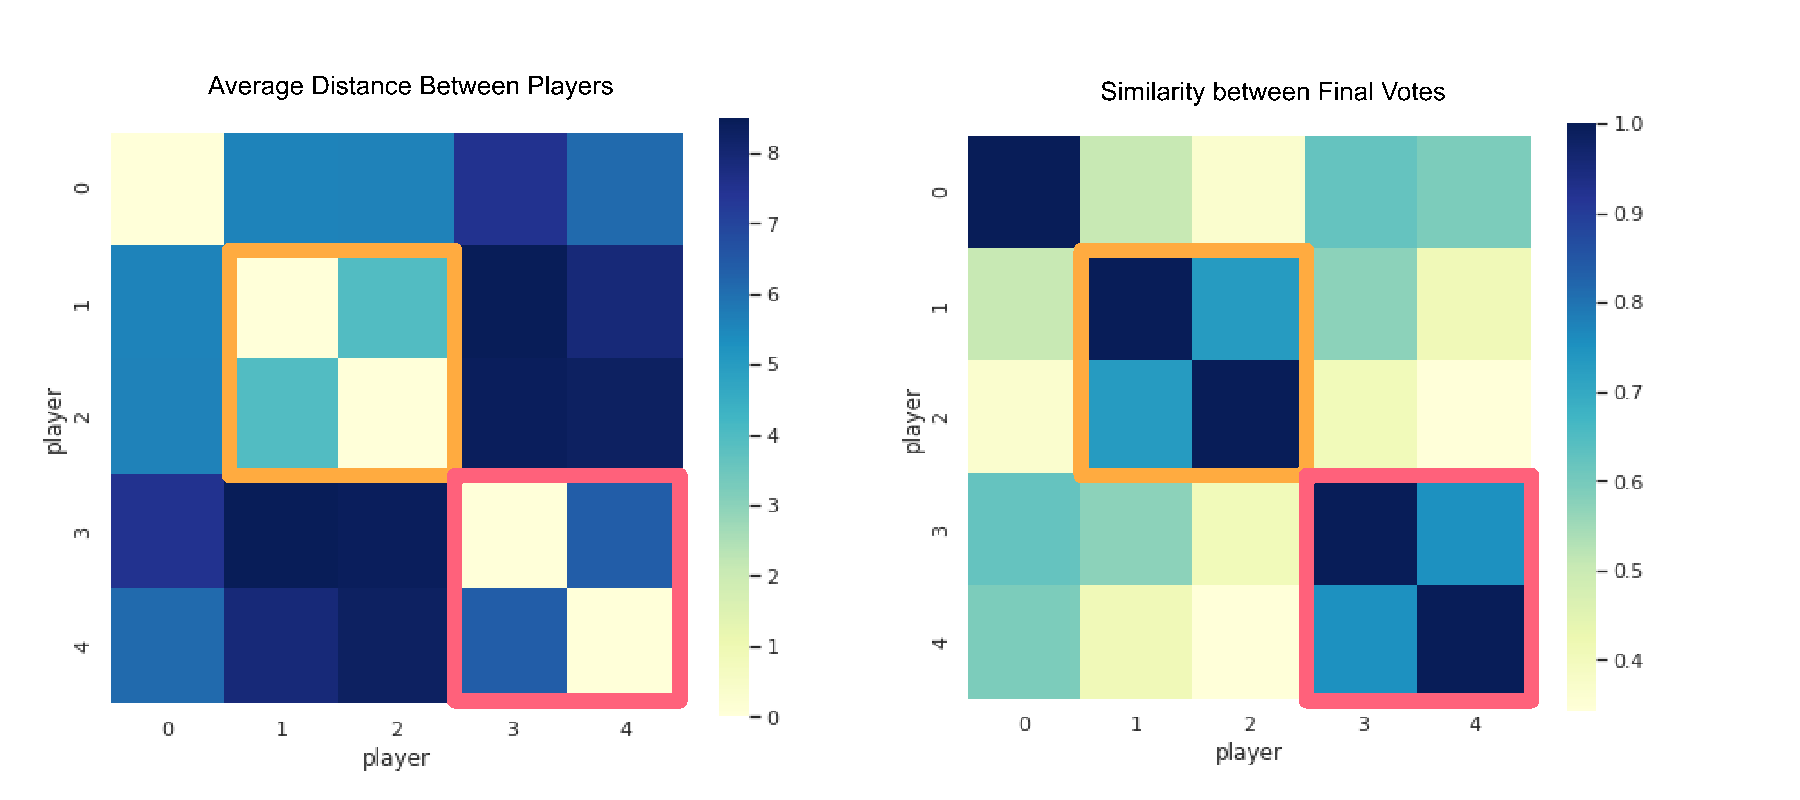
저자들은 작업이 지배적인 결과로 수렴한 그룹에서 시뮬레이션한 에피소드 10개를 대상으로 색상을 무작위로 배정한 뒤 플레이어 간 거리와 최종 투표의 일치 여부를 비교했다. 서로 가까운 Crewmate 2쌍은 비슷하게 투표하는 경향도 보여, 이 그룹에서는 근접성과 투표 유사성 사이의 연관성을 뒷받침한다.
분석한 에피소드에서 강조된 Crewmate 쌍은 쌍 내부의 거리가 비교적 짧고 최종 투표의 유사성이 높다.
4.5 Voting round richness
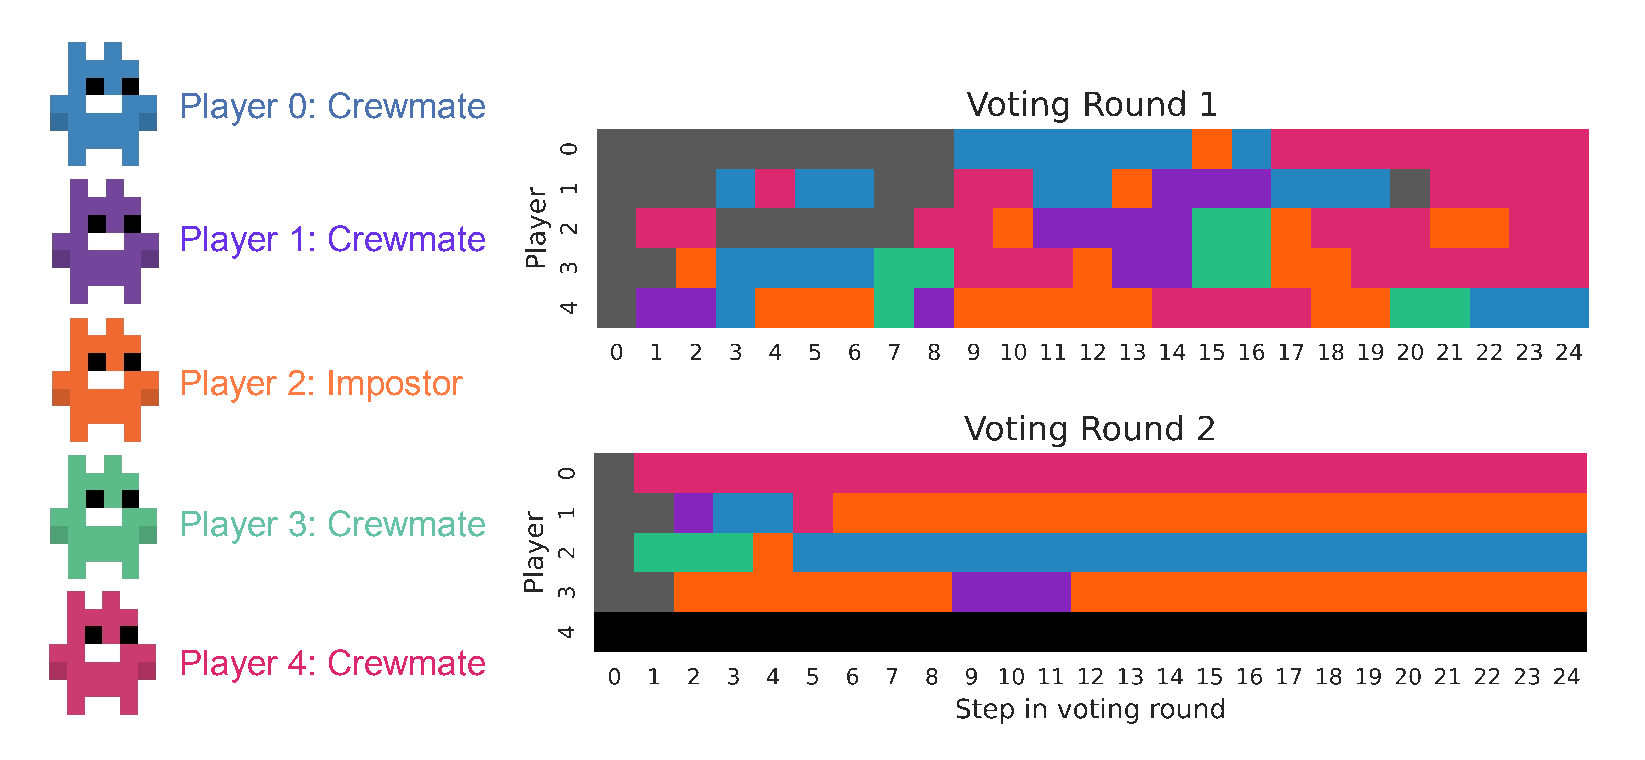
25-step 투표 단계에서는 다른 플레이어의 이전 투표를 관찰한 뒤 자신의 투표를 바꿀 수 있다. 사후 분석 사례에서 그룹은 먼저 상황이 불분명한 얼리기 시도 후 Crewmate를 투표로 퇴출했고, 2번째 얼리기 시도 후에는 Impostor를 퇴출했다. 해당 에피소드는 https://youtu.be/cImPUBvmIq0에서 볼 수 있다.
투표 순서는 첫 번째 투표에서 잘못된 플레이어가 퇴출된 뒤 두 번째 투표에서 충분한 수의 플레이어가 Impostor에게 투표하는 과정을 보여준다.
5 Conclusion
저자들은 숨겨진 역할과 신뢰할 수 없는 정보가 자연어 소통이 없는 공간 게임에서 협력 관계, 투표, 대립 전략을 만들어낼 수 있다고 결론짓는다. 이 근거는 보고된 게임 설정과 고정된 공동 학습 그룹에 관한 것이다.
짧은 생각
베이스라인 비교와 시드별 실행 결과를 통해 학습된 결과의 다양성을 확인할 수 있지만, critic에 정보를 제공한 것과 보조 손실 중 어느 요소가 다양성을 유발했는지는 알 수 없다. 시드 1개를 사용한 파라미터 탐색과 에피소드 10개를 대상으로 한 협력 관계 분석도 여러 설정과 그룹에 걸친 결과의 견고성을 판단하는 데 한계가 있다.