


Inference-Time Scaling for Diffusion Models beyond Scaling Denoising Steps 요약 설명
16 Jan 2025 | Paper Review Test-Time Scaling Diffusion Models Text-to-Image Generation목차
이번 글에서는 Inference-Time Scaling for Diffusion Models beyond Scaling Denoising Steps 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 16일(Arxiv)
- Ma, Nanye, Tong, Shangyuan, Jia, Haolin, Hu, Hexiang, Su, Yu-Chuan, Zhang, Mingda, Yang, Xuan, Li, Yandong, Jaakkola, Tommi, Jia, Xuhui, et al.
- NYU, MIT, Google
- 논문 링크
요약
- Diffusion model은 노이즈를 반복해서 제거하며 이미지를 생성하는 모델이다. Denoising 단계를 늘리는 것만으로는 품질 향상 폭이 점차 줄어든다. 텍스트 프롬프트 평가 벤치마크인 DrawBench에서 FLUX.1-dev에 앙상블 기반 Random Search를 적용하면, 대규모 언어 모델이 이미지 품질을 평가하는 LLM Grader 점수가 검색 없이 denoising 평가 30회만 수행했을 때의 84.29에서 검색 평가 2880회를 추가했을 때의 88.18로 높아진다. 앙상블은 후보에 점수를 매기는 모델 3개를 결합한다. 연산량은 생성 모델의 순전파 평가 횟수인 number of function evaluations(NFEs)로 센다.
- 이 프레임워크는 생성 후보에 점수를 매기는 모델이나 지표인 verifier와 검색 알고리즘을 구분한다. Random Search는 독립적으로 생성한 후보 중에서 선택하고, Zero-Order Search는 기울기를 계산하지 않고 인접한 초기 노이즈를 탐색하며 개선한다. Search over Paths는 중간 denoising 경로를 분기하고 선택한다. 클래스 라벨이 있는 이미지 벤치마크인 ImageNet에서 목표 클래스 라벨을 조건으로 사용하는 생성 실험과 텍스트 조건 생성 실험을 수행한 결과, 최적의 조합은 과제와 평가 기준에 따라 달라진다.
- 검색을 추가하면 verifier의 편향이 증폭될 수 있다. 개별 이미지 점수를 높이는 과정에서 생성 표본의 다양성이 줄거나 다른 품질 기준의 성능이 낮아질 수 있다. 후보의 변화 범위를 제한하는 지역 검색은 ImageNet에서 다양성 감소를 일부 완화한다. Verifier를 결합하면 DrawBench의 폭넓은 평가에서 성능이 좋아지지만, 지정한 속성과 객체 관계를 생성하는 벤치마크인 T2I-CompBench에서는 보고된 모든 범주에서 인간 선호를 학습한 평가 모델 ImageReward를 단독으로 사용한 경우보다 성능이 낮다.
1. Introduction
이 논문은 추론 시점의 연산을 학습 이후에도 사용할 수 있는 추가 자원으로 본다. 초기 노이즈와 이후에 주입하는 노이즈가 생성 이미지에 영향을 주므로, denoising 단계를 늘려 얻는 이득이 정체된 뒤에는 이 자원을 더 적합한 노이즈를 찾는 검색에 사용할 수 있다.
- 제안하는 설계 공간에는 후보 품질을 어떻게 측정할지와 새 후보를 어떻게 찾을지라는 축 2개가 있다.
- 실험은 ImageNet의 클래스 조건 생성에서 더 풍부한 텍스트 조건 생성으로 확장된다. 텍스트 조건 생성에서는 여러 평가기를 통해 이미지 품질 기준 사이의 상충 관계를 확인한다.
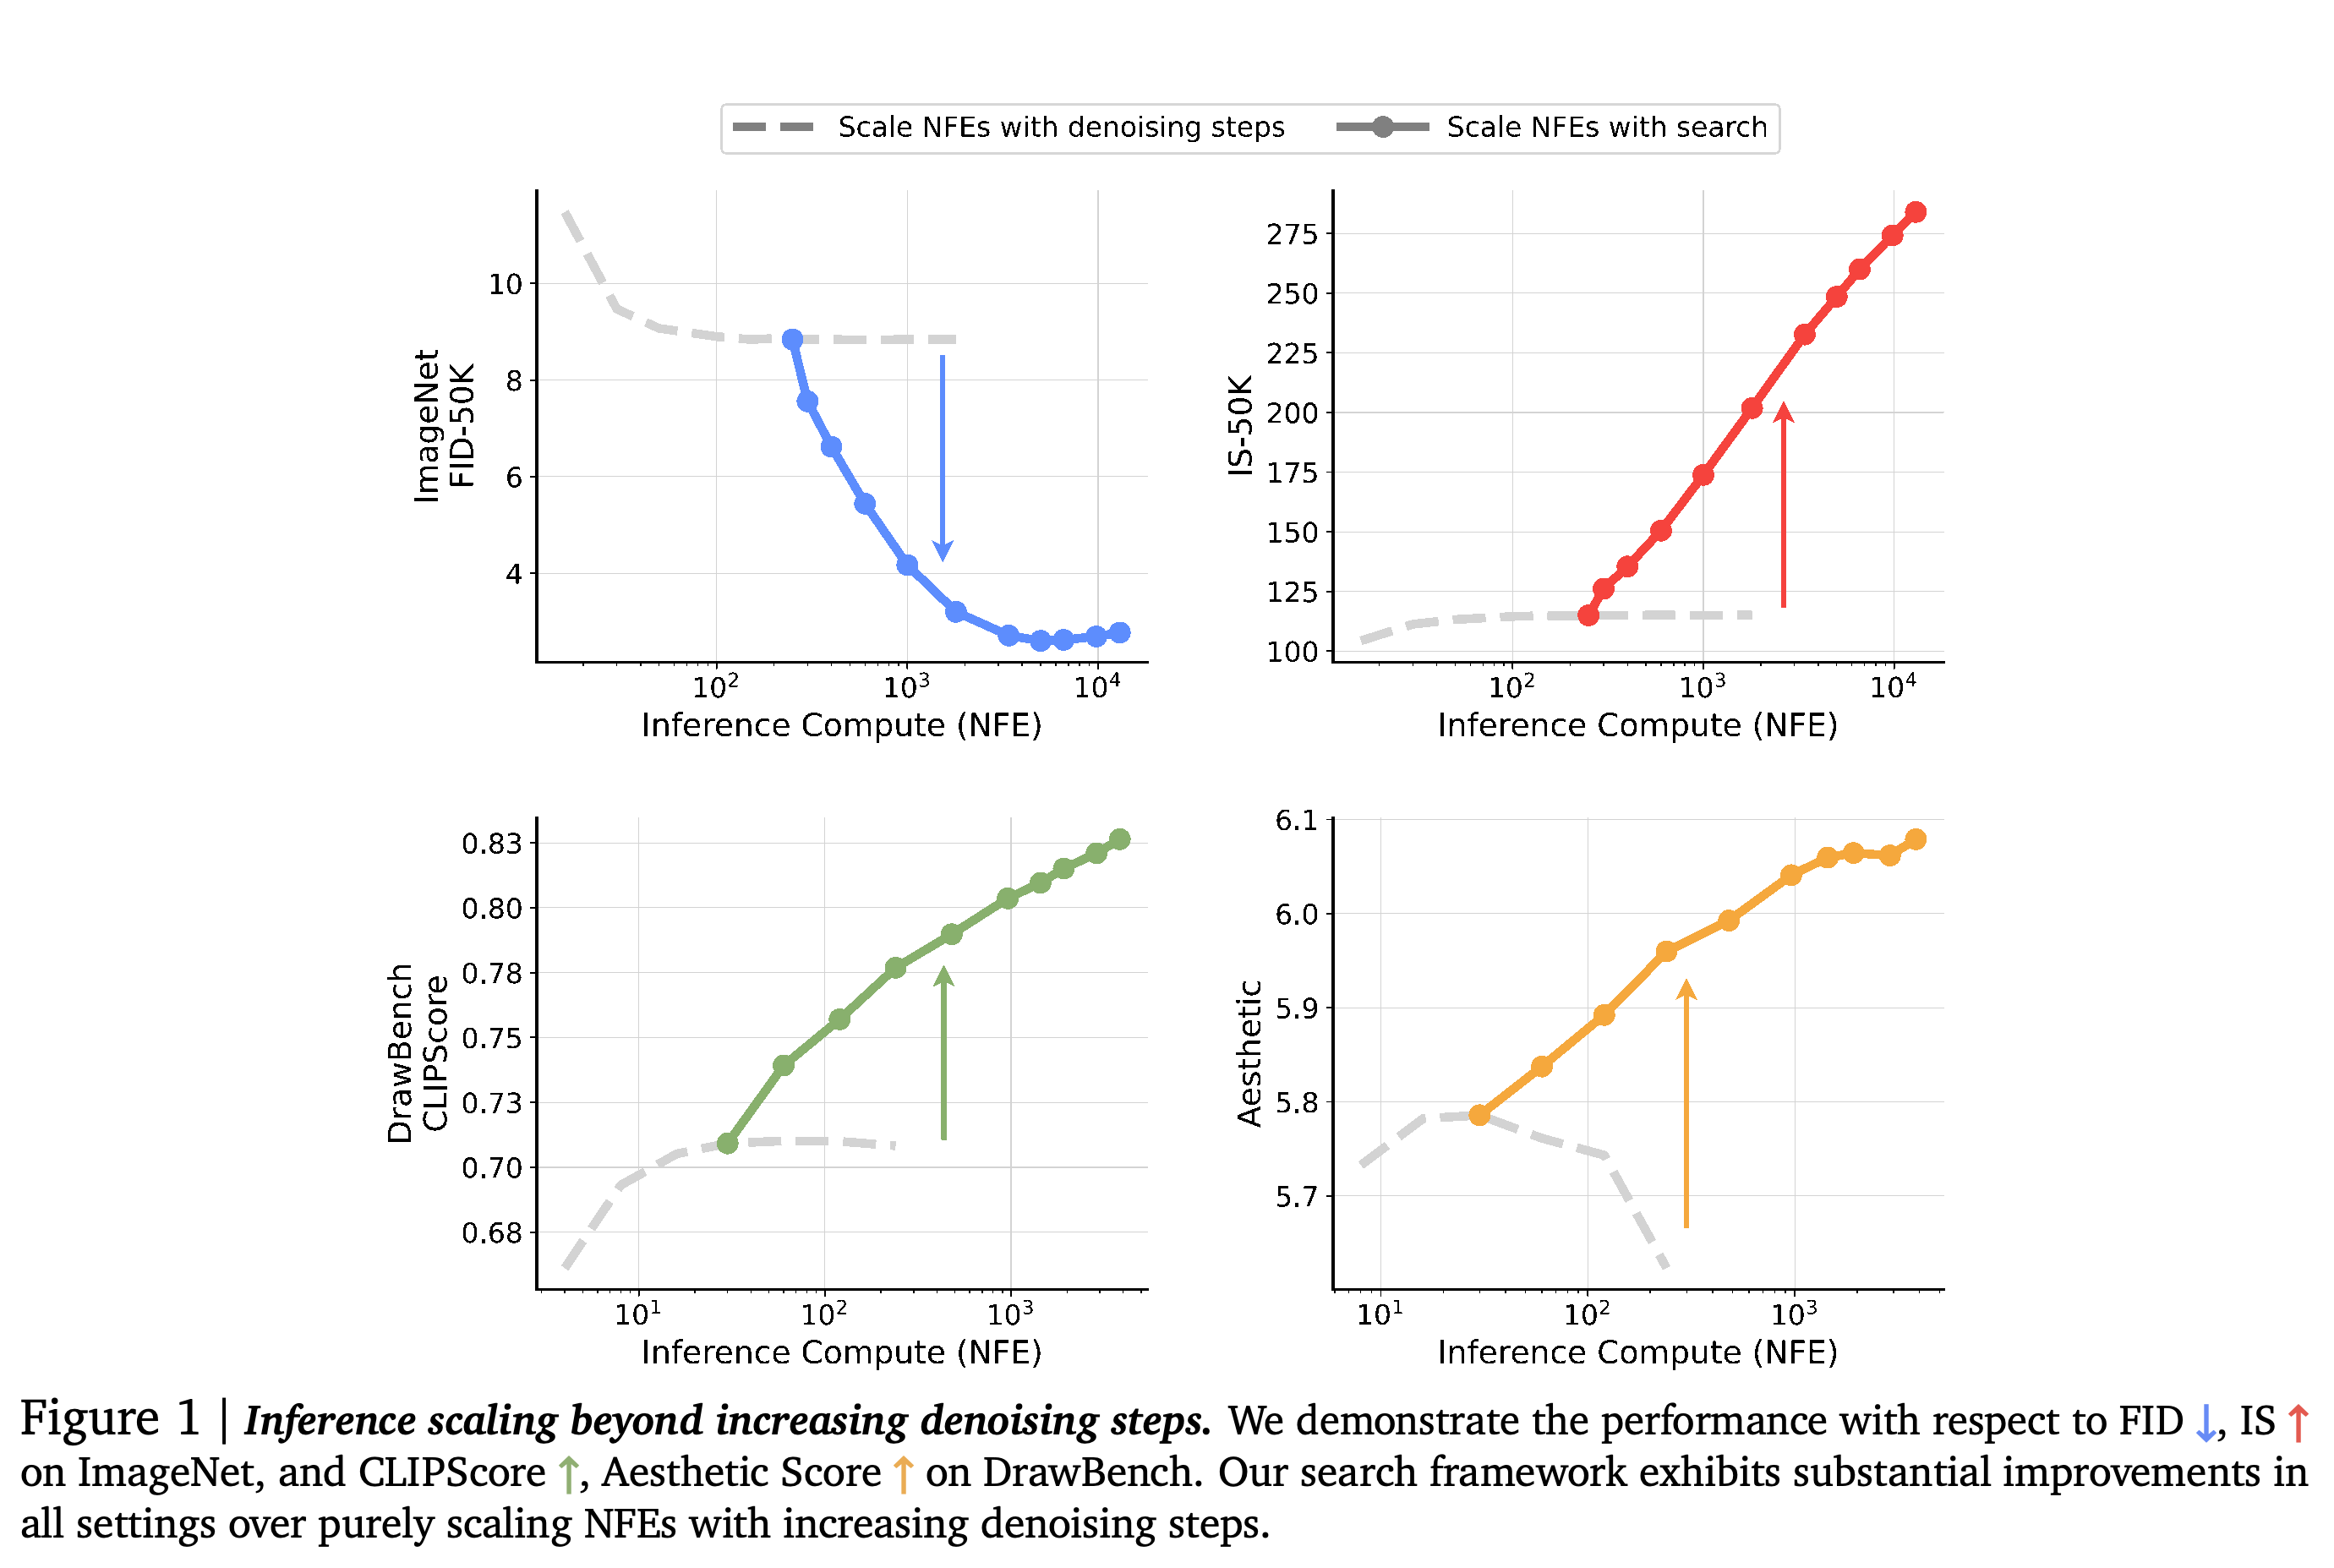
곡선 4개는 denoising 평가만 늘렸을 때 이득이 작아진 이후에도 생성 모델의 추가 평가를 검색에 배분하면 표시된 ImageNet과 DrawBench 지표가 계속 개선됨을 보여준다. 각 패널은 서로 다른 품질 기준을 측정하므로, 보편적으로 최적인 검색 구성을 입증하지는 않는다.
2. Background and Motivation
이 논문에서 다루는 diffusion model과 관련 flow 기반 생성 모델은 기준이 되는 노이즈 주입 과정을 역전하는 변환을 학습한다. 샘플링은 가우시안 노이즈에서 시작해 결정론적 변화를 나타내는 상미분방정식(ODE)이나 추가 무작위성이 개입하는 확률미분방정식(SDE)을 따른다. 학습한 모델은 각 노이즈 수준에서 표본이 깨끗한 데이터에 도달하도록 이동할 방향을 나타내는 벡터장을 근사한다.
- 샘플링 품질에는 모델의 근사 오차와 유한한 계산 단계에서 발생하는 수치 이산화 오차라는 요인 2개가 모두 영향을 주므로, denoising 연산을 늘릴수록 추가 이득이 줄어든다.
- 입력 노이즈와 샘플링 절차가 고정되면 생성 이미지가 결정되므로, 입력 노이즈를 검색 변수로 사용할 수 있다.
3. How to Scale at Inference Time
Verifier는 이미지와 선택적 조건 정보를 스칼라 점수로 변환한다. 검색 알고리즘은 이 점수와 사전 학습한 생성 모델을 이용해 샘플링 노이즈를 선택한다. ImageNet 실험에서는 사전 학습한 이미지 생성 모델 SiT-XL을 256 × 256 해상도로 사용하고, 최종 생성에는 2차 Heun 수치 해법과 250 NFEs를 사용한다. 별도 명시가 없으면 샘플링 중 조건의 영향을 강화하는 classifier-free guidance(cfg)의 가중치는 1.0이다. 이는 이 설정에서 추가 guidance 없이 조건부 생성을 수행한다는 뜻이다.
- Random Search는 독립적인 가우시안 노이즈 후보에서 이미지를 생성한 뒤 점수가 가장 높은 후보를 선택한다. 이는 N개 후보 중 가장 좋은 후보를 남기는 best-of-N 선택이다.
- Oracle Verifiers는 일반적으로 접근할 수 없는 평가 정보를 사용한다. 분류기 예측에 기반한 지표인 Inception Score(IS)는 조건 클래스에 대한 확신도를 기준으로 후보를 선택해 개선한다. 생성 이미지와 참조 이미지의 특징 통계 사이 거리를 측정하는 Fréchet Inception Distance(FID)는 ImageNet 통계를 기준으로 후보 배치를 탐욕적으로 선택해 개선한다.
- Oracle 실험은 노이즈 선택을 통해 성능을 높일 수 있음을 보여주지만, 최종 평가 정보에 접근하므로 개념 검증 결과에 해당한다.
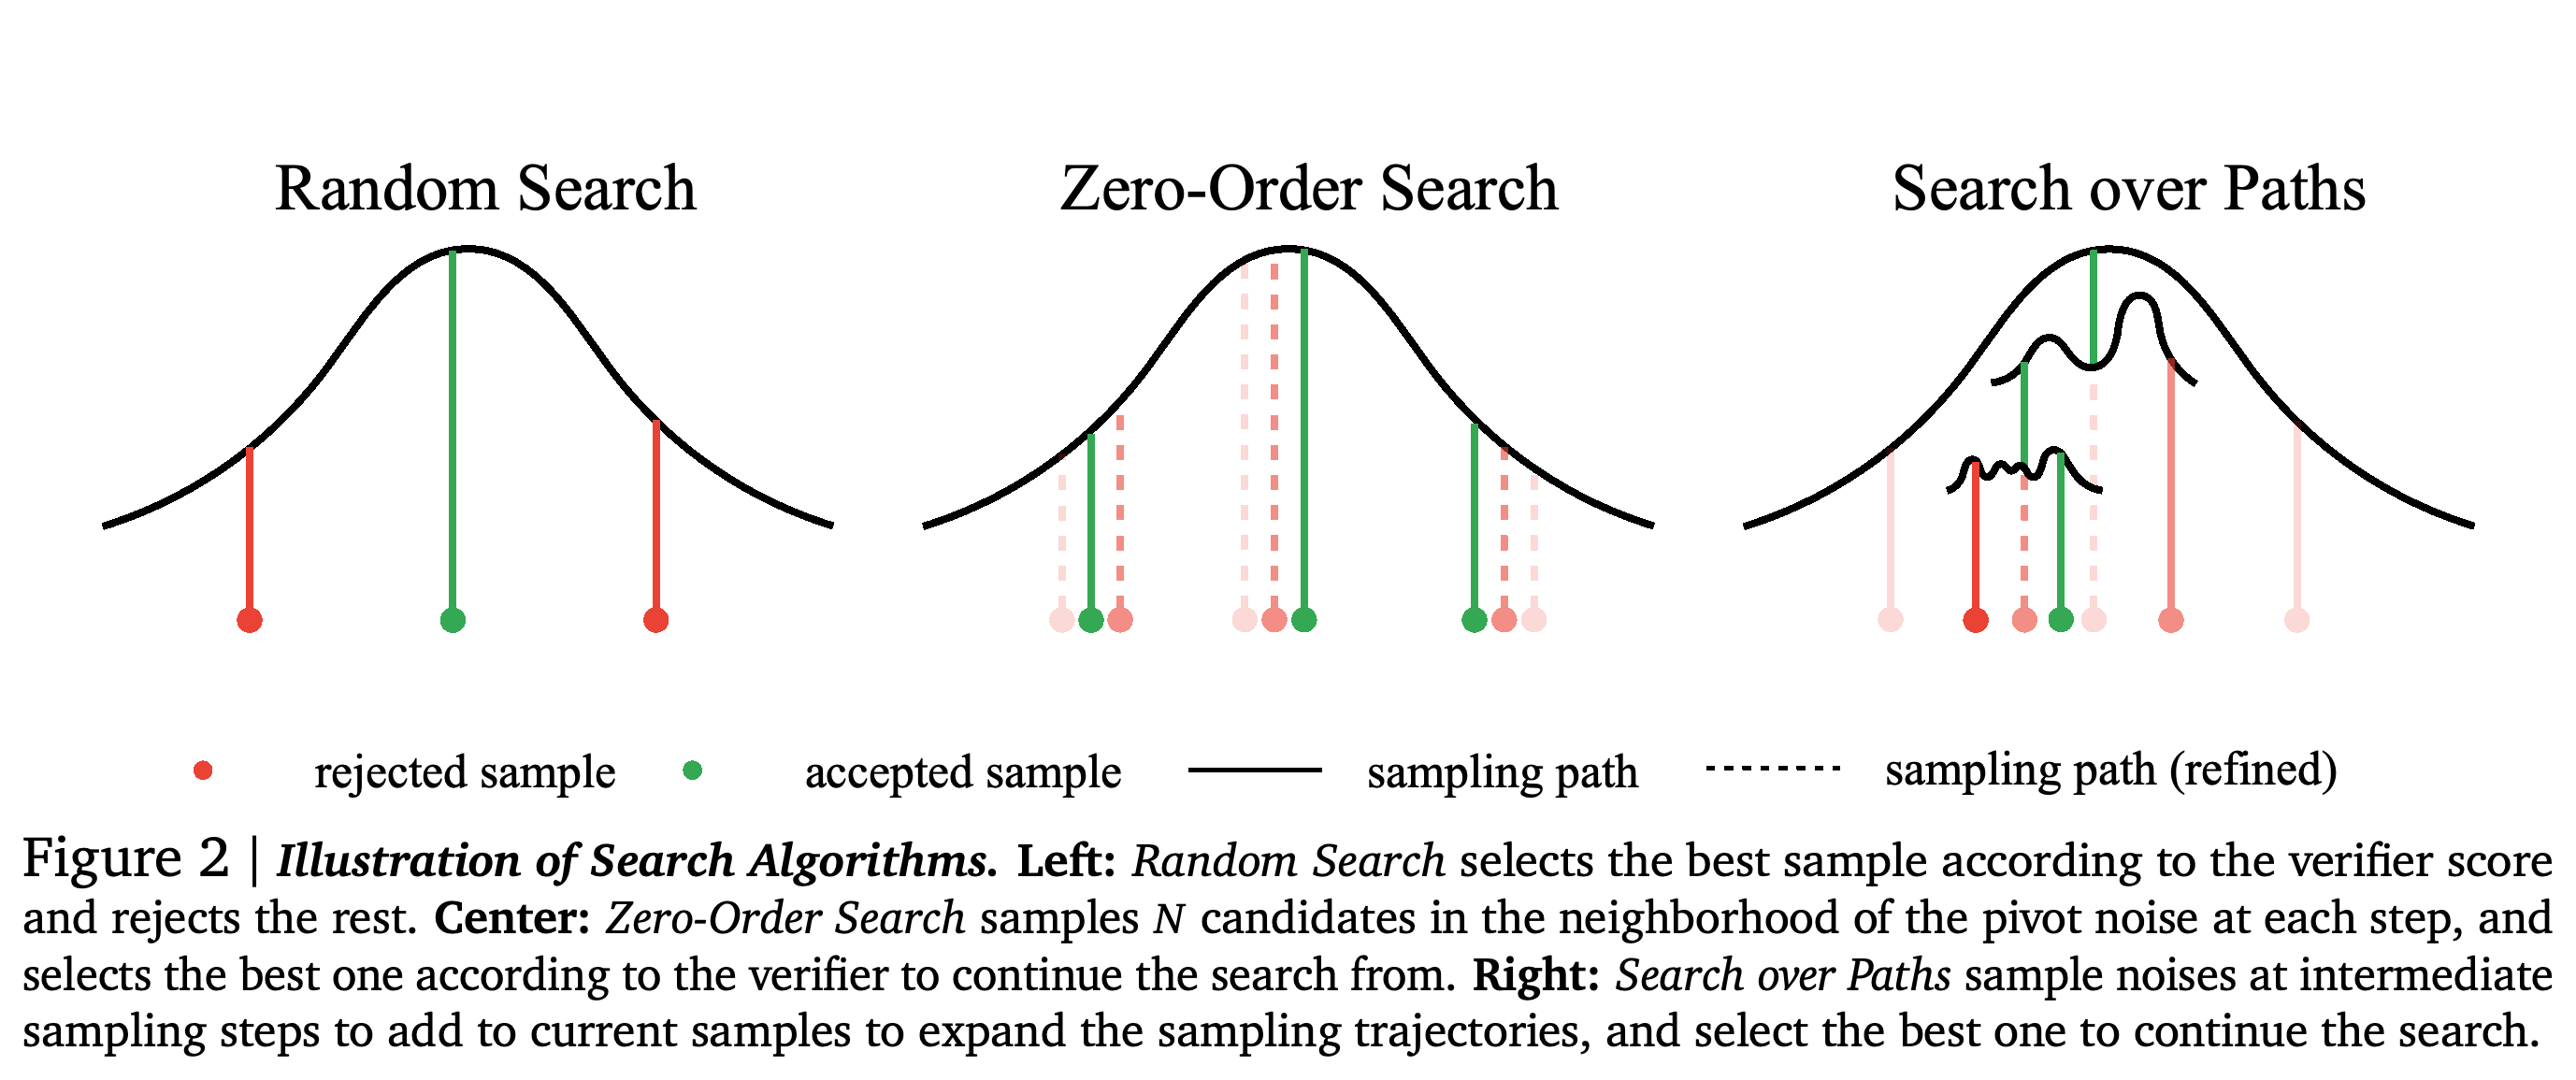
도식은 독립적인 후보 선택, 초기 노이즈의 국소적 개선, 중간 경로의 개선을 구분한다. 이러한 탐색 범위의 제한은 개별 이미지 점수를 극대화할 때 다양성이 줄어드는 상황에서 알고리즘마다 다른 양상을 보이는 이유를 해석하는 데 도움이 된다.
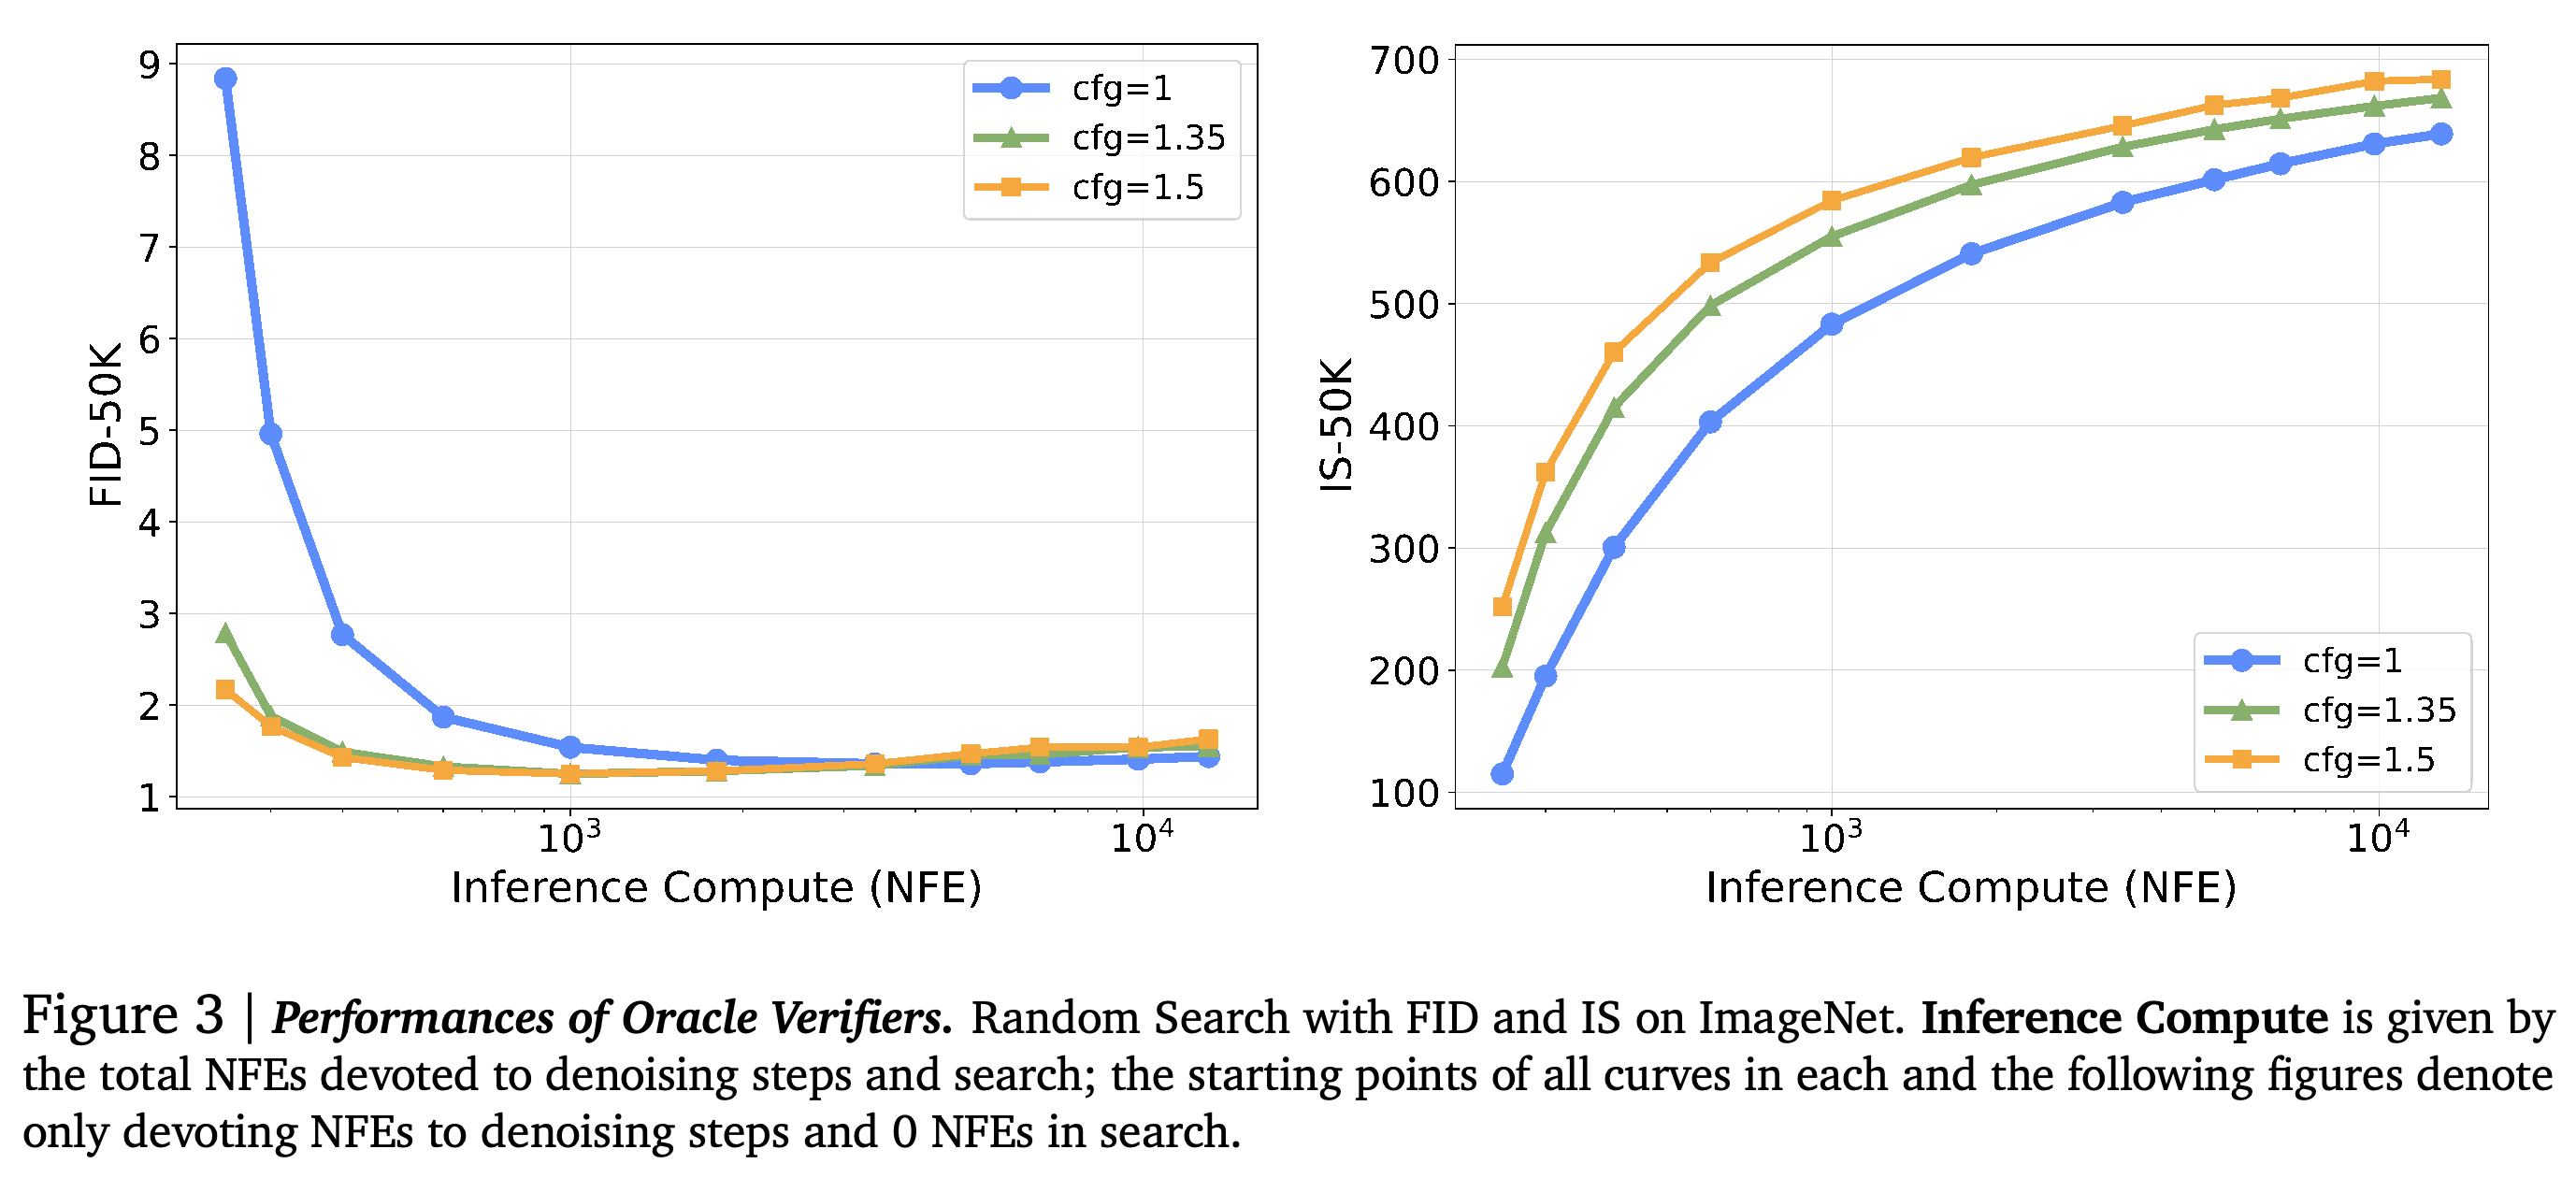
Oracle 기반 Random Search는 실험한 guidance 가중치 전반에서 목표 FID와 IS를 초기에 개선하지만, FID는 결국 정체되거나 조금 나빠진다. 후보 선택에 일반적으로 접근할 수 없는 평가 정보를 사용하므로, 이 곡선은 해당 조건에서 노이즈 선택이 지닌 가능성을 보여준다.
3.1. Search Verifiers
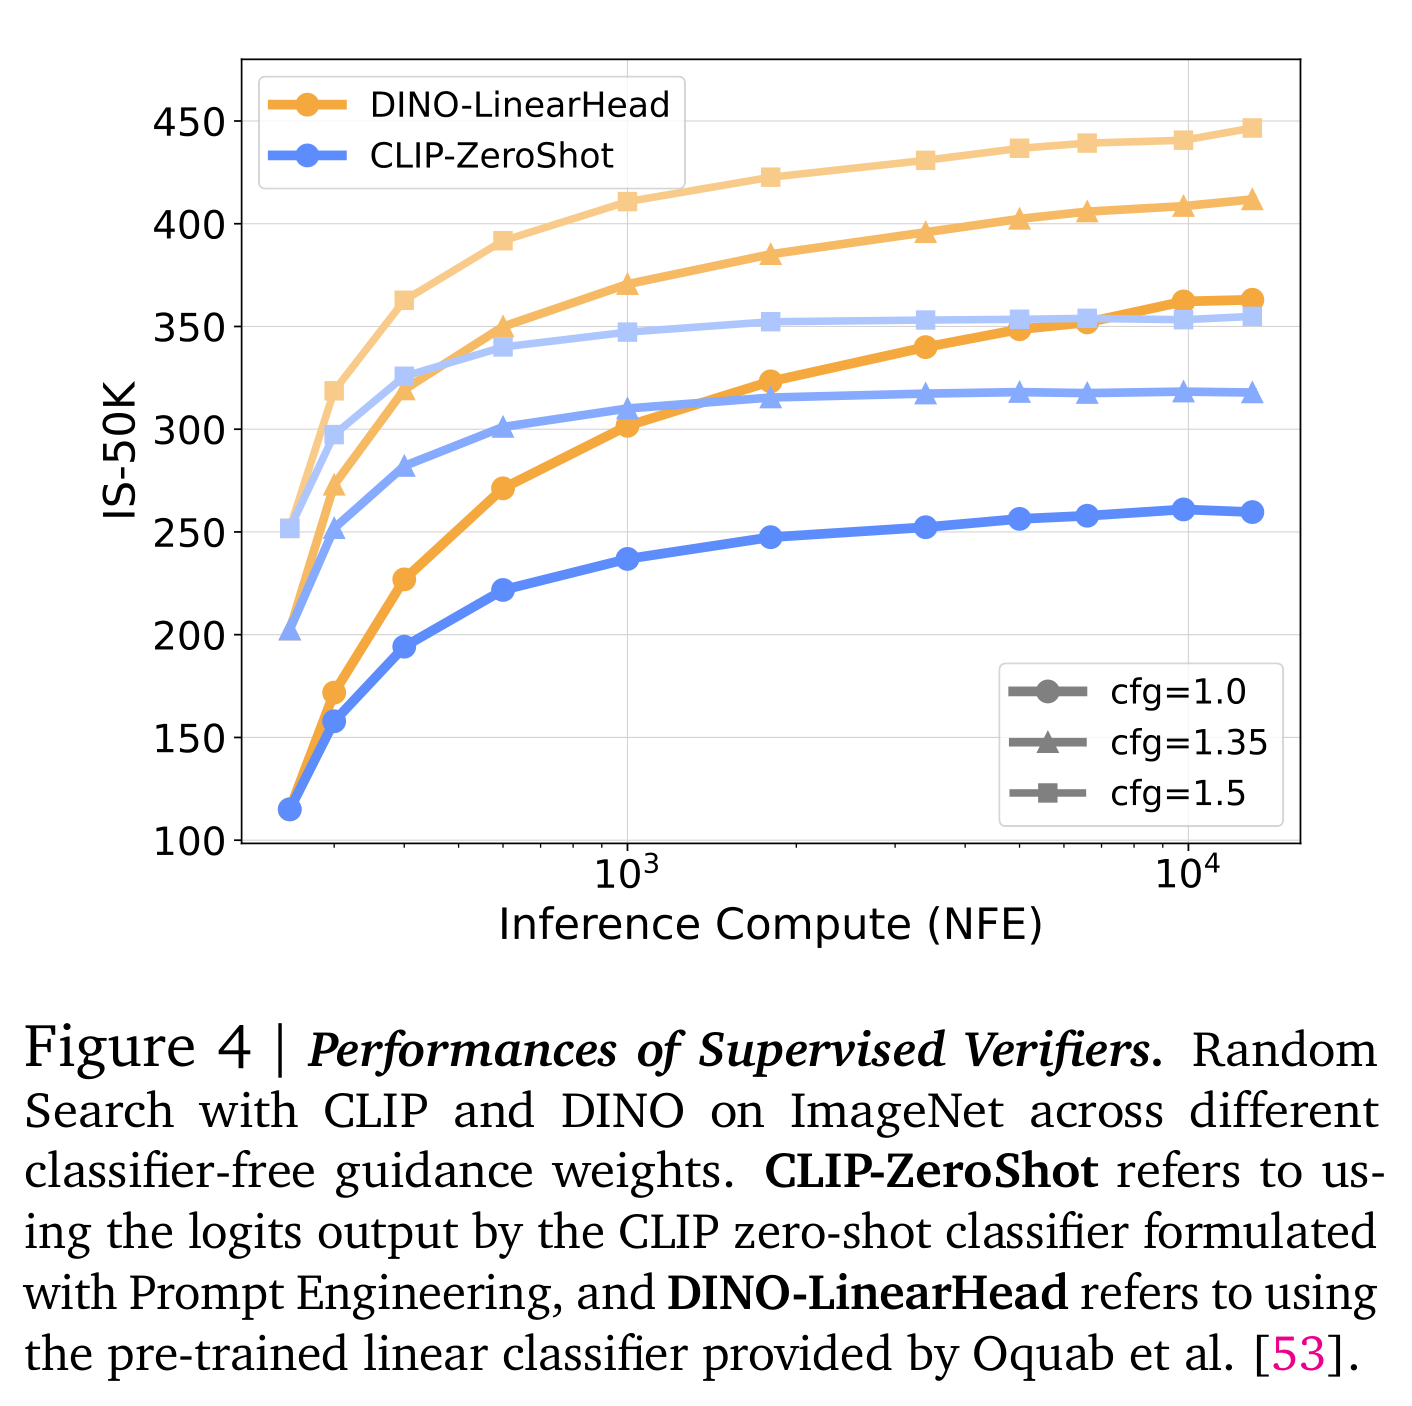
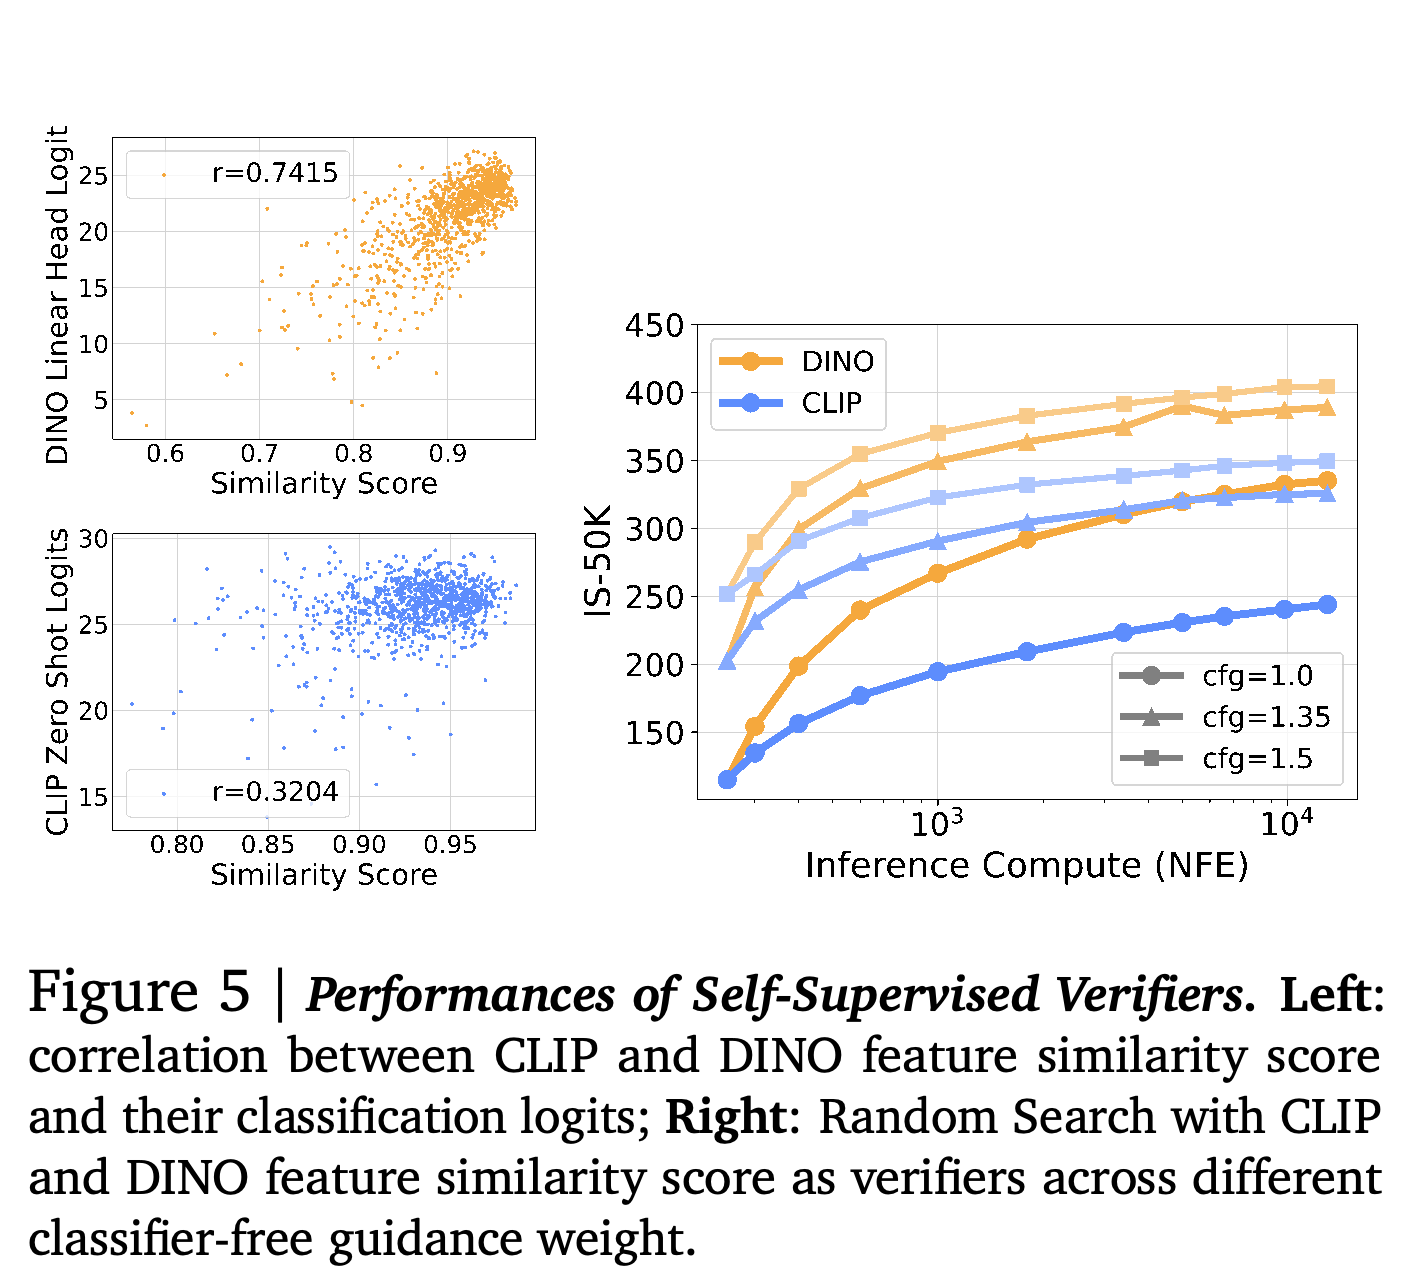
Supervised Verifiers는 이미지와 텍스트 표현을 연결하는 CLIP과 라벨 없이 학습한 시각 표현을 제공하는 DINO를 통해 조건 정보를 사용한다. ImageNet 검색에서는 과제별 분류기 학습 없이 텍스트로 클래스 표현을 구성하는 CLIP zero-shot 분류기나 사전 학습한 DINO 선형 분류기의 조건 클래스 점수를 사용한다. 분류기 2개 모두 검색 예산이 늘수록 IS를 높인다.
- 이 점수들은 전체 표본의 다양성을 명시적으로 보존하지 않고 개별 이미지를 평가한다. 따라서 검색을 늘리면 분류기의 확신도는 높아지면서 FID는 나빠질 수 있다. 저자들은 verifier를 최적화하는 동안 다른 평가 기준이 악화되는 현상을 Verifier Hacking이라고 부른다.
- Self-Supervised Verifiers는 조건 정보를 사용하지 않는다. 대신 노이즈 수준 σ = 0.4에서 모델이 예측한 깨끗한 이미지와 σ = 0에서 얻은 최종 표본 사이의 특징 코사인 유사도, 즉 이미지 표현의 방향 일치도를 측정한다.
- 분류기의 클래스 점수인 classification logits와의 상관계수는 DINO에서 r = 0.7415, CLIP에서 r = 0.3204로 보고된다. 이 결과는 유사도를 대리 지표로 사용하는 방법을 CLIP보다 DINO에서 더 강하게 뒷받침한다.
분류 verifier 2개 모두 검색 연산량이 늘수록 IS를 높이며, 표시된 설정에서는 DINO가 대체로 CLIP보다 높은 값에 도달한다. 이 그래프만으로 선택된 표본 집합이 다양성을 유지하는지는 알 수 없다.
상관계수는 DINO에서 r = 0.7415, CLIP에서 r = 0.3204로 큰 차이를 보인다. 함께 제시한 확장 곡선은 verifier에 조건 클래스를 제공하지 않아도 특징 유사도로 IS 개선을 유도할 수 있음을 보여준다.
3.2. Search Algorithms
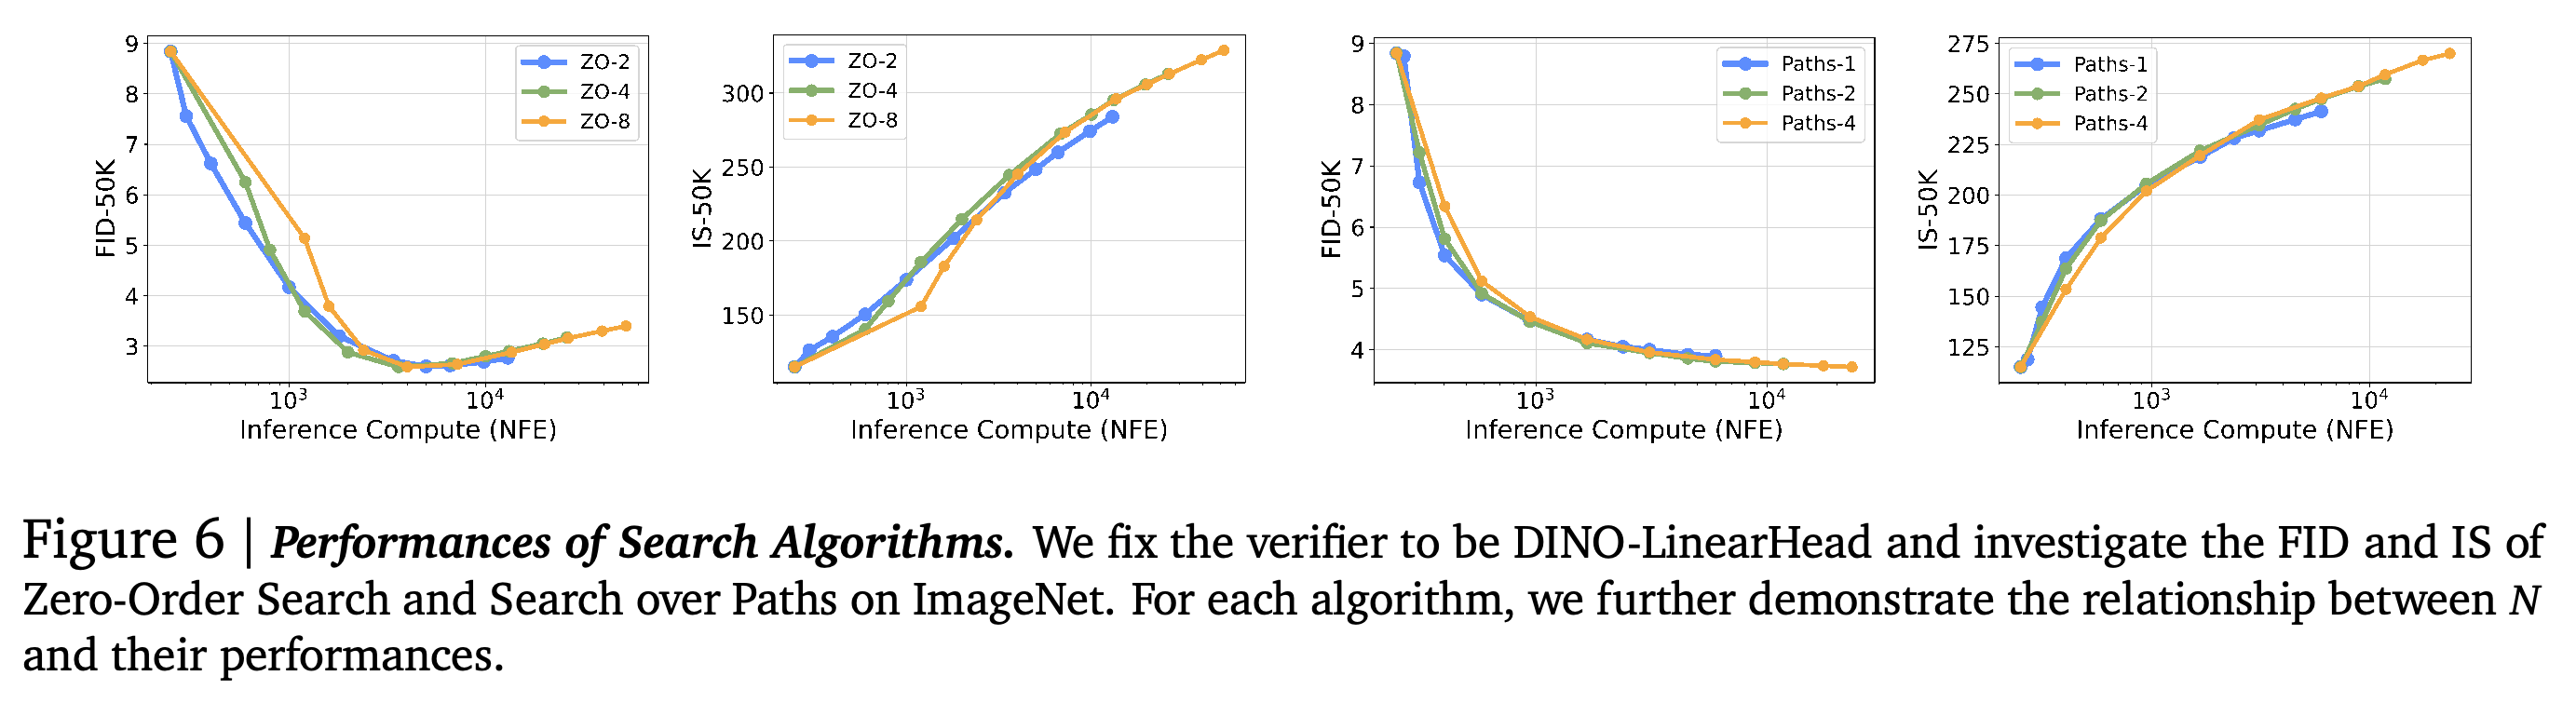
Zero-Order Search는 초기 가우시안 노이즈를 기준점으로 삼아 이웃 후보 N개를 만들고, 각 후보로 생성한 이미지를 평가한 뒤 가장 좋은 후보에서 검색을 이어 간다. 이 과정에서 기울기는 계산하지 않으며, 논문은 이 구성을 ZO-N으로 표기한다. Search over Paths는 중간 샘플링 경로에 노이즈를 추가해 분기하고, 각 분기에 denoising을 적용한 뒤 상위 N개 후보를 유지한다. 초기 경로가 N개인 구성은 Paths-N이라고 부른다.
- Search over Paths는 Δb > Δf를 요구한다. 역방향 denoising 구간 Δb가 정방향 노이즈 주입 구간 Δf보다 커야 깨끗한 표본을 향해 진행하기 때문이다. Verifier에는 노이즈가 있는 중간 상태 대신 깨끗한 이미지의 예측값을 입력한다.
- 알고리즘 2개 모두 검색을 국소적으로 제한해 IS 향상을 유지하면서 ImageNet의 다양성 문제를 일부 완화한다. 보고된 실험에서 Zero-Order Search의 이웃 후보 수를 N = 4보다 늘려도 추가 이득은 제한적이다.
- Search over Paths는 예산이 작을 때 초기 경로가 적은 편이 효율적이고, 예산이 늘면 경로가 많은 편이 유용해진다. 부록에서는 기울기 기반 검색이 초기에 더 빠르게 수렴하지만, 논문의 근사 연산량 비교에서 최종 성능의 이점은 작다고 보고한다.
DINO-LinearHead를 고정하면 지역 검색 알고리즘 2개 모두 시작점보다 FID와 IS를 개선한다. Zero-Order Search에서는 결국 FID가 나빠지므로, 검색을 국소적으로 제한해도 과도한 검색의 위험을 없애지는 못한다.
4. Inference-Time Scaling in Text-to-Image
Text-to-image 실험은 FLUX.1-dev를 사용한다. DrawBench에서는 11개 범주의 프롬프트 200개에 대해 프롬프트당 이미지 1개를 생성한다. T2I-CompBench에서는 검증 프롬프트 1800개에 대해 프롬프트당 이미지 2개를 생성한다. T2I-CompBench는 요청한 속성을 객체에 부여하는 attribute binding, 객체 관계, 복합 구성을 평가한다.
- Verifier로는 시각적 매력을 예측하는 Aesthetic Score Predictor, 이미지와 텍스트 특징의 정렬 정도를 측정하는 CLIPScore, 이미지에 대한 인간 선호를 추정하는 ImageReward를 사용한다.
- Verifier Ensemble은 각 후보가 verifier 3개의 출력에서 얻은 순위를 동일한 가중치로 평균한다. 이 방식은 수치 척도가 다른 점수를 직접 평균하는 문제를 피한다.
- Gemini-1.5-Flash-002는 Accuracy to Prompt, Originality, Visual Quality, Internal Consistency, Emotional Resonance를 기준으로 LLM Grader 점수를 산출한다. 본문은 각 항목을 0–100 척도로 평가하고 평균한 종합 점수를 사용한다고 설명한다.
- T2I-CompBench는 attribute binding에 이미지 질의응답 평가기인 BLIP-VQA를 사용하고, 공간 관계와 개수 평가에는 객체 탐지기인 UniDet을 사용한다. 복합 구성에는 평가기들의 가중 조합을 사용한다.
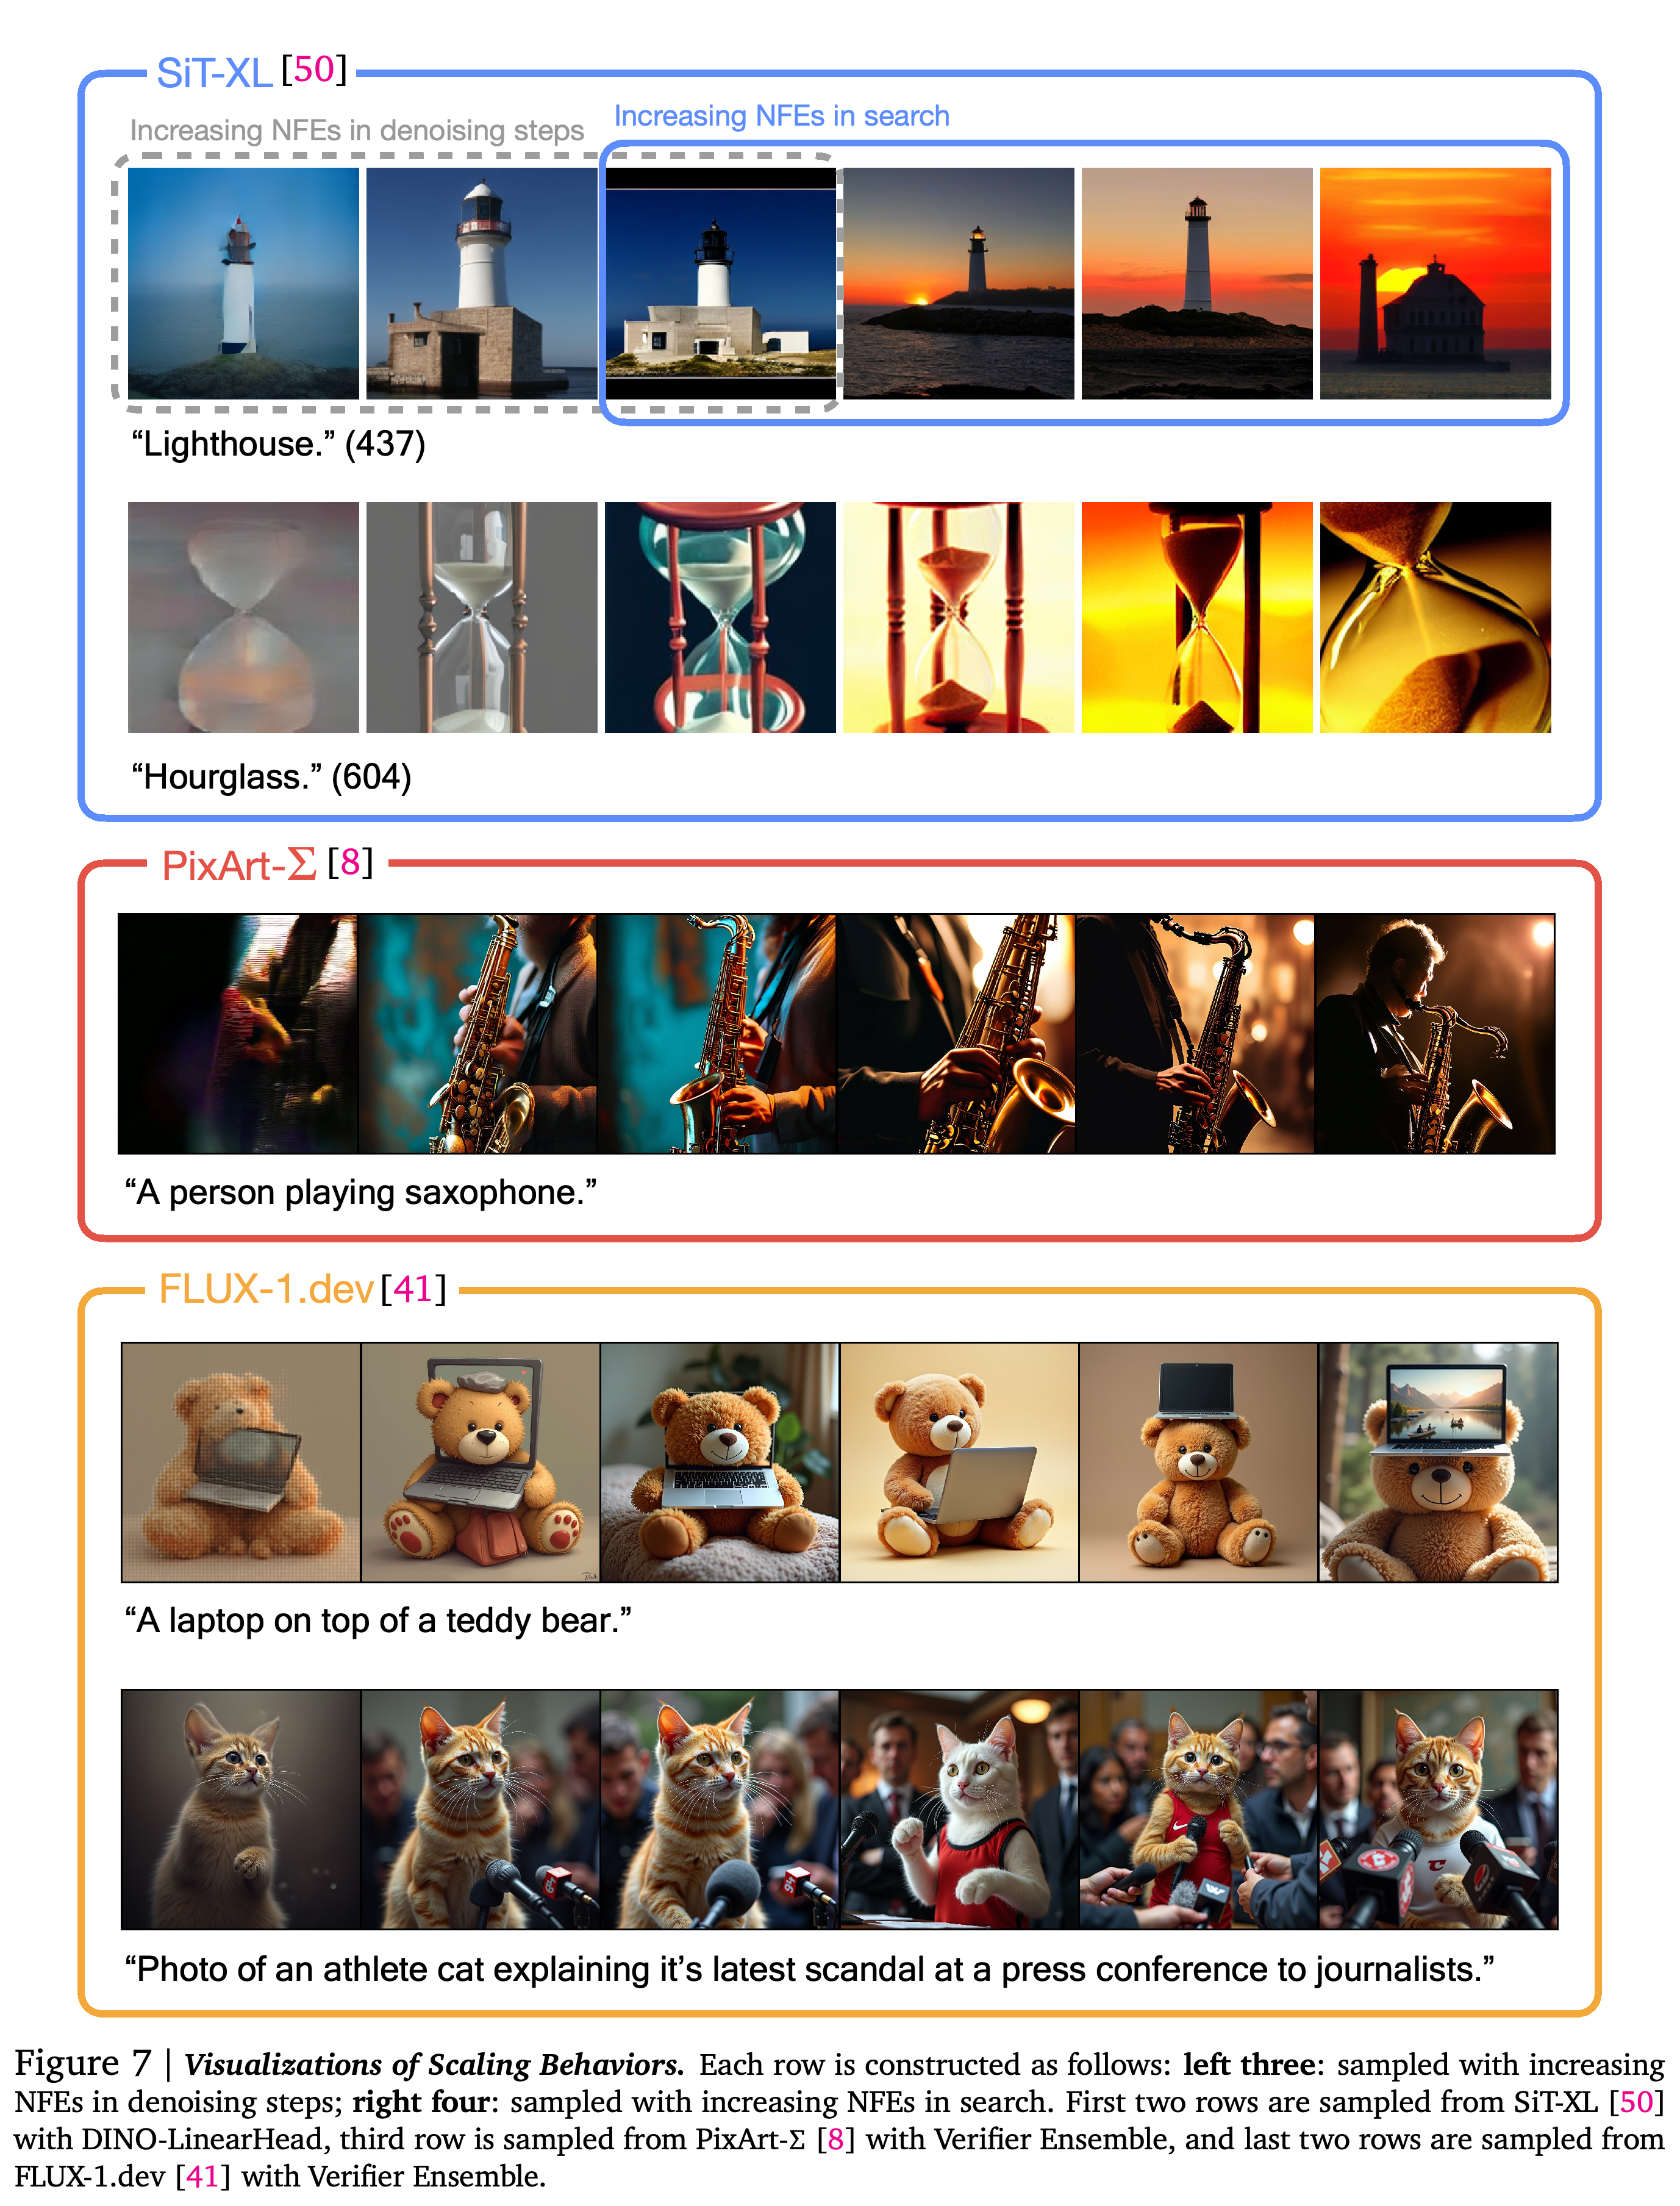
선별된 사례는 denoising만 적용한 출력이 안정된 이후에도 검색을 추가하면 구성, 구도, 의미 내용이 바뀔 수 있음을 보여준다. 생성 모델 3개에서 가능한 변화를 예시하지만, 변화의 빈도나 평균 크기를 정량화하지는 않는다.
4.1. Analysis Results: Verifier-Task Alignment
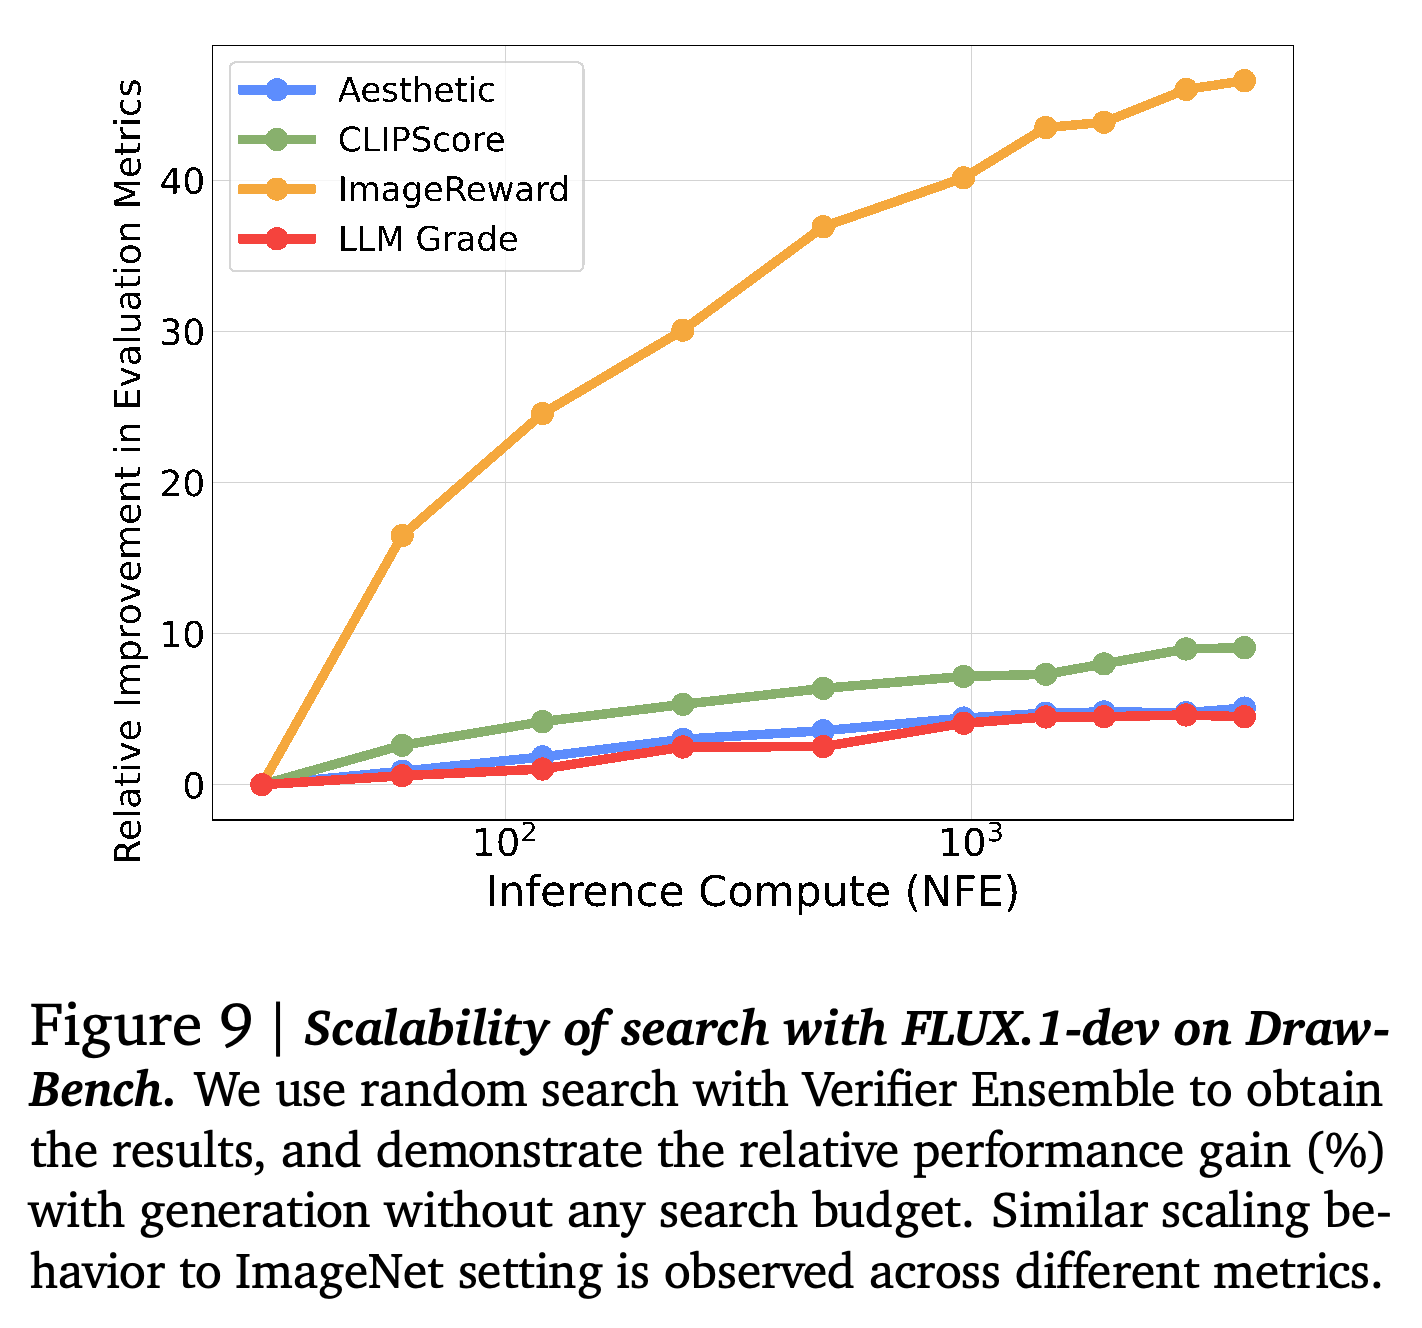
DrawBench에서는 verifier 선택에 따라 개선되는 품질이 달라진다. Random Search와 검색 예산 3840 NFEs를 사용할 때, Verifier Ensemble은 검색 없는 생성보다 Aesthetic Score를 5.1%, CLIPScore를 9.1%, ImageReward를 46.6%, LLM Grader를 4.5% 높인다.
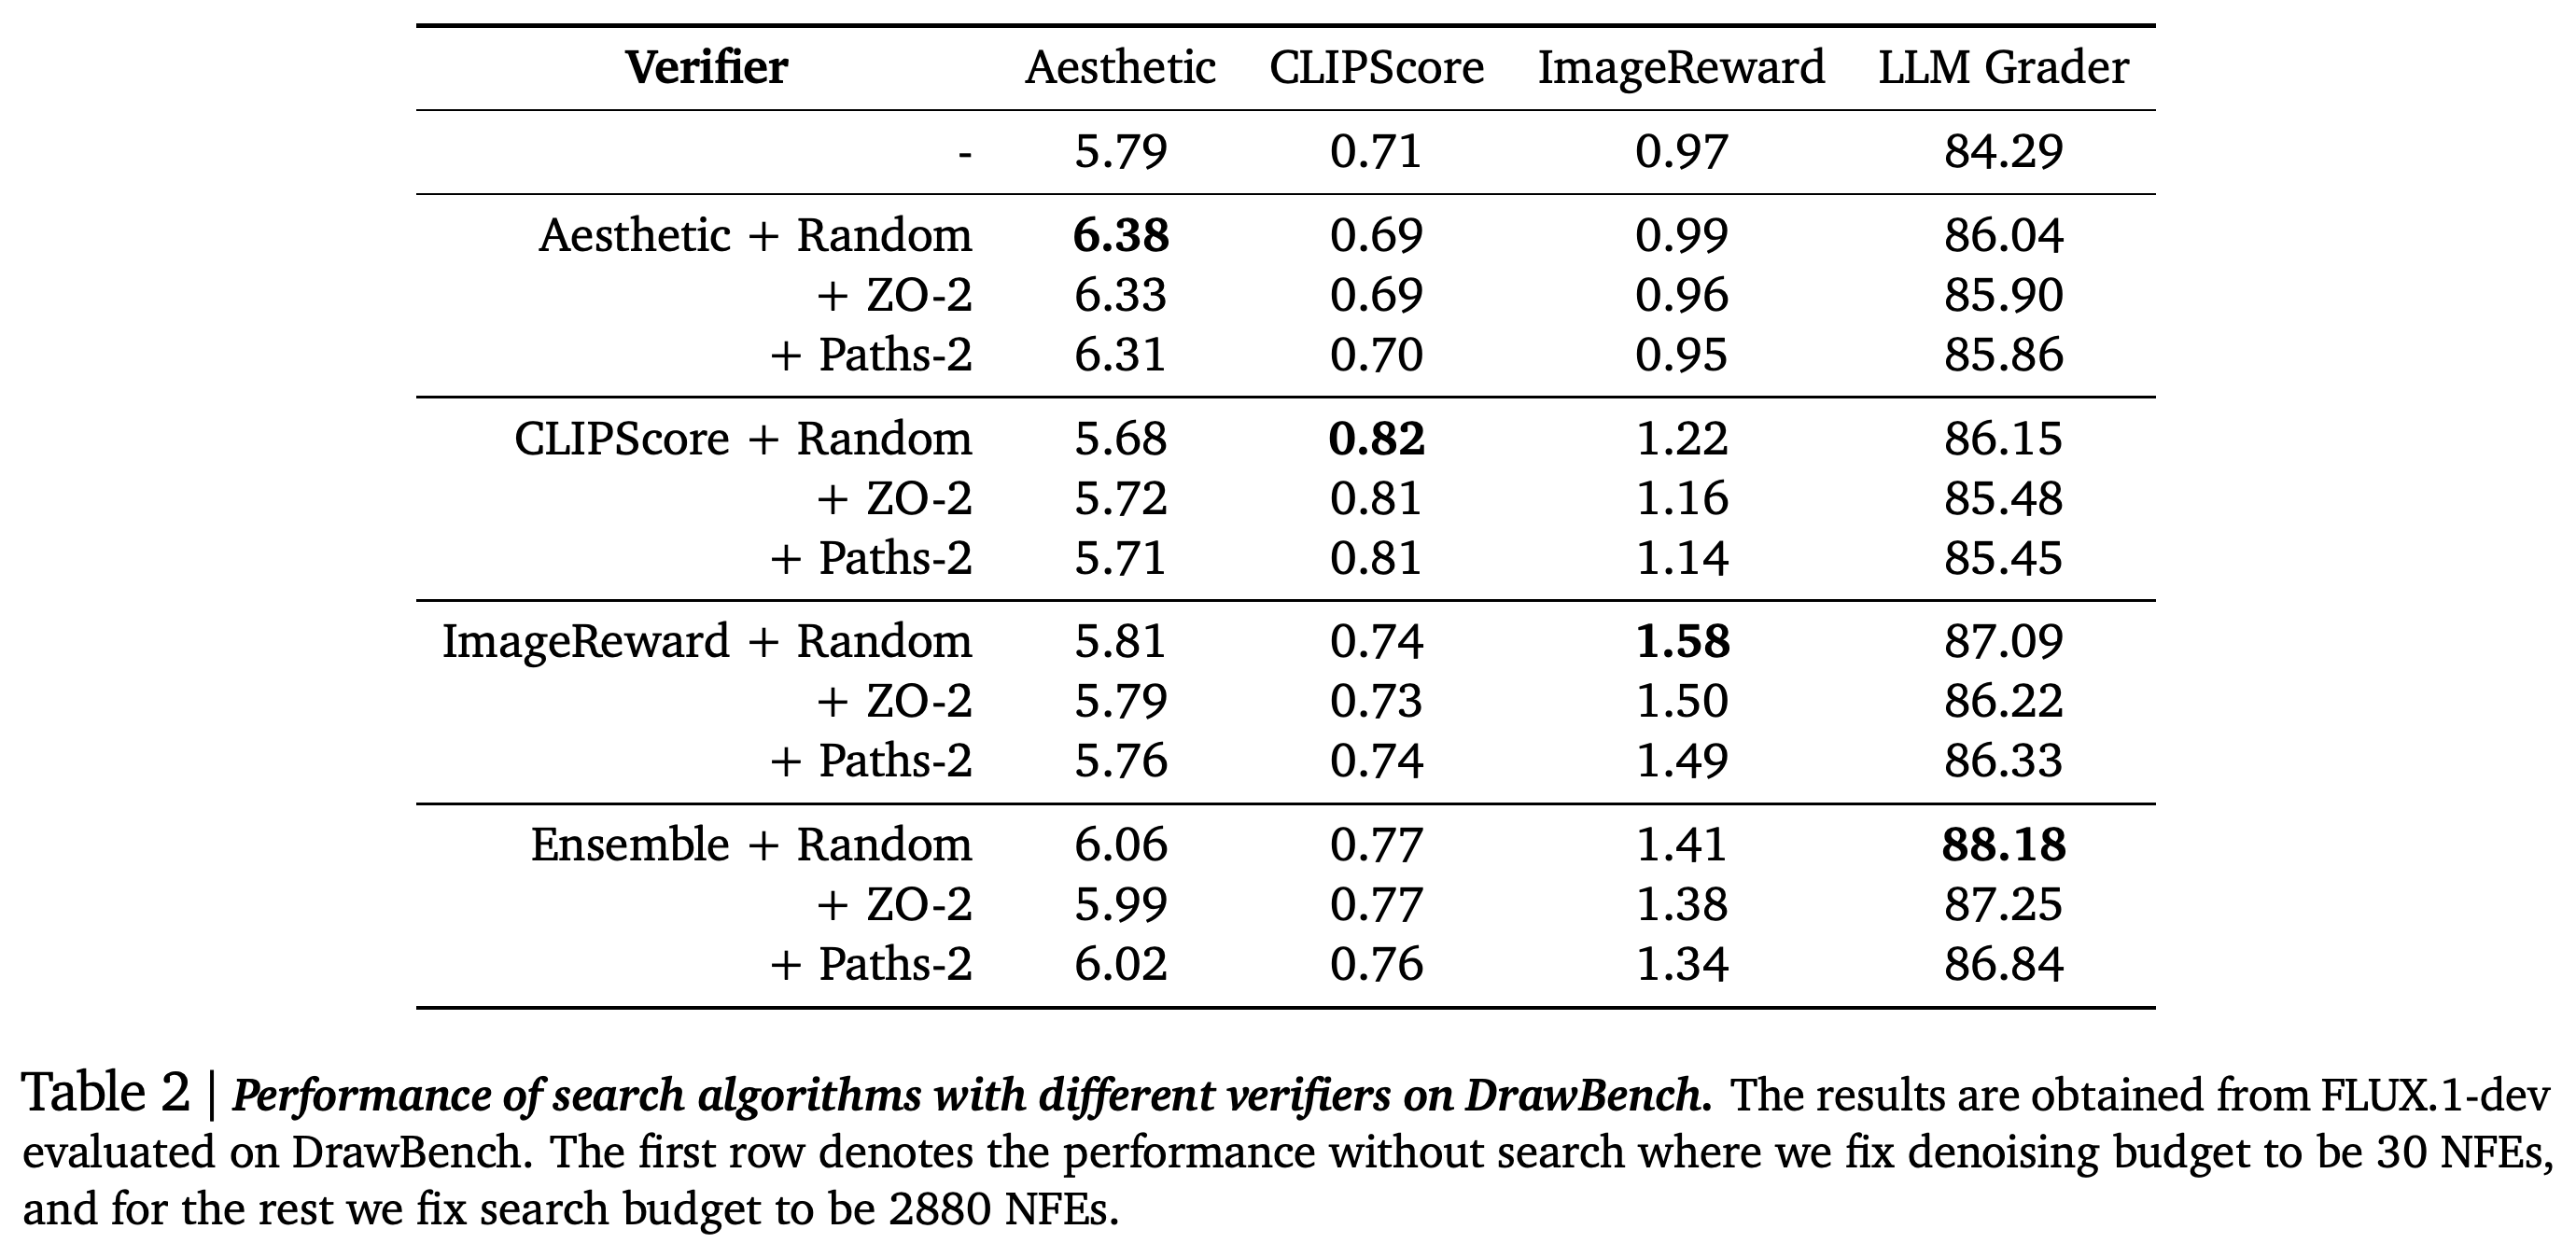
- Aesthetic Score만을 기준으로 검색하면 해당 점수는 10.6% 높아지지만 CLIPScore는 2.2% 낮아진다. CLIPScore를 기준으로 검색하면 해당 점수는 16.5% 높아지지만 Aesthetic Score는 2.0% 낮아진다. 이는 verifier의 목표가 부분적으로만 일치함을 보여준다.
- 검색 예산 2880 NFEs에서 앙상블 기반 Random Search의 LLM Grader 점수는 88.18이다. ZO-2는 87.25, Paths-2는 86.84이며, 검색 없는 베이스라인은 84.29이다.
- 저자들은 이러한 개별 이미지 평가에서 Random Search가 우세한 이유를 넓은 탐색 범위로 설명한다. 반면 지역 검색 방법은 현재 후보를 개선하는 데 연산을 사용한다.
검색 예산 3840 NFEs에서 Aesthetic과 CLIPScore를 최적화할 때 다른 지표가 하락하는 결과는 목표 간 상충을 드러낸다. ImageReward와 앙상블은 표시된 모든 지표를 개선하며, 앙상블은 보고된 LLM Grader 개선율 중 가장 높은 4.5%를 기록한다.
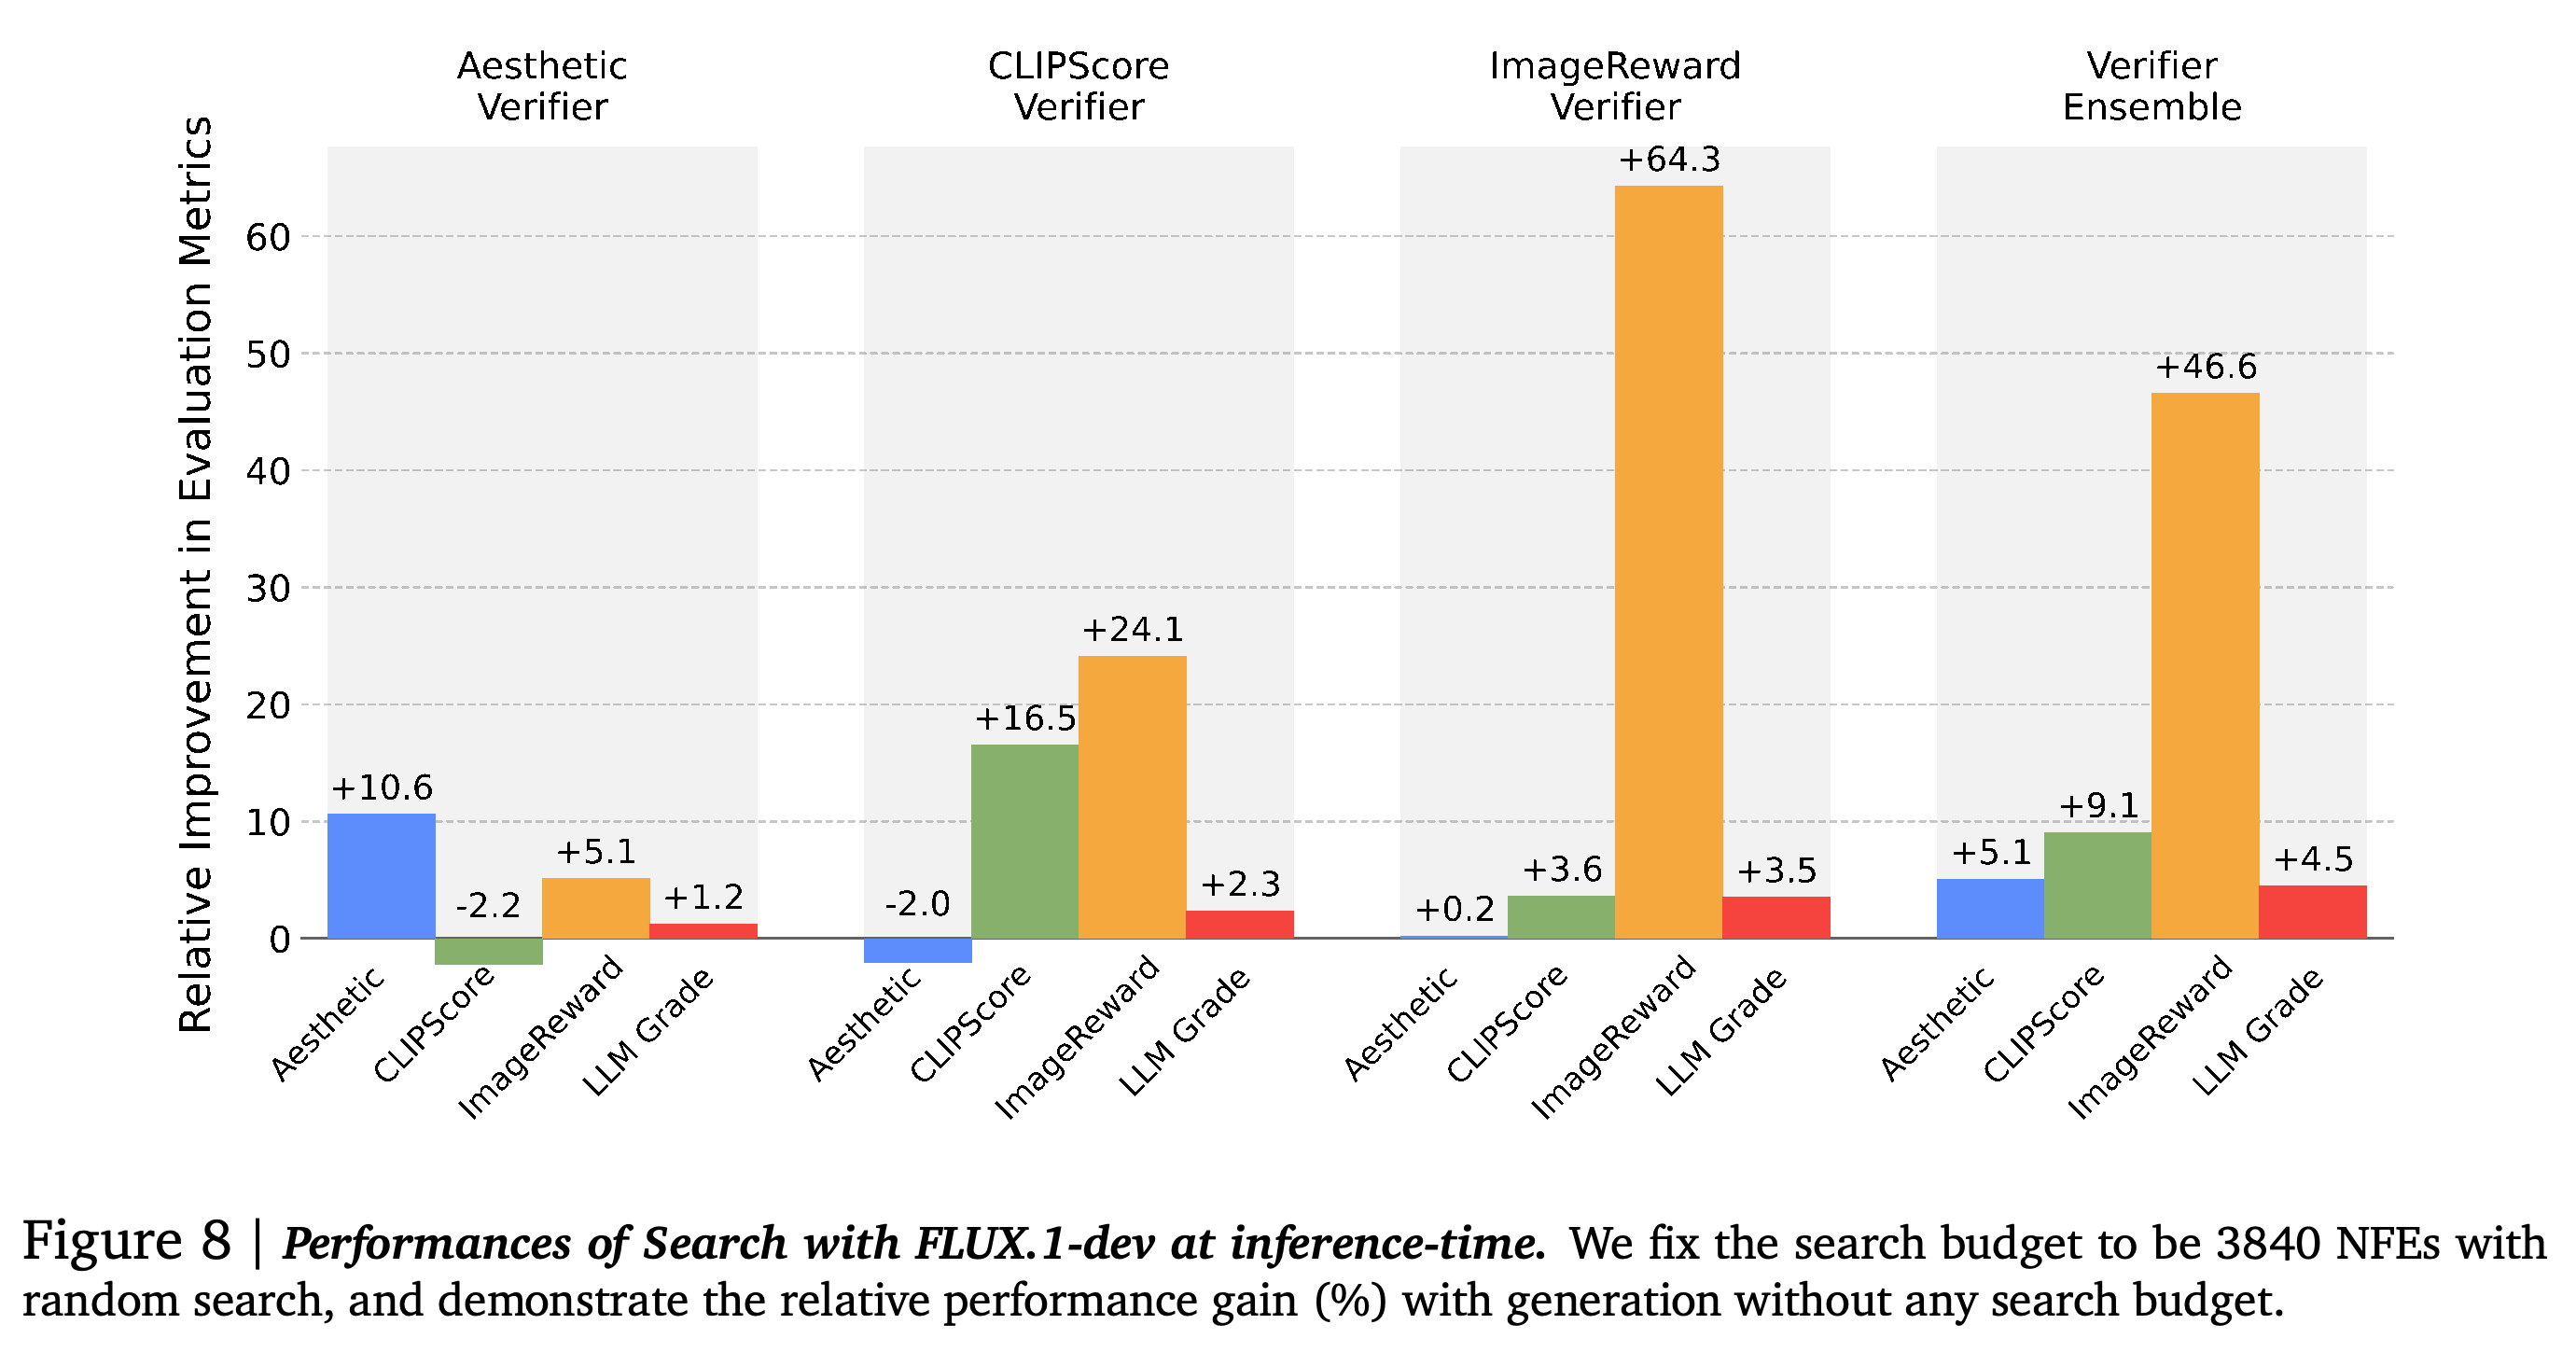
앙상블 기반 Random Search는 예산이 늘수록 표시된 지표 4개를 모두 개선하지만, 상대적인 개선 폭은 크게 다르다. ImageReward는 LLM Grader보다 훨씬 크게 증가하므로, 보상 점수가 증가한 만큼 전반적인 품질 평가도 향상되었다고 볼 수는 없다.
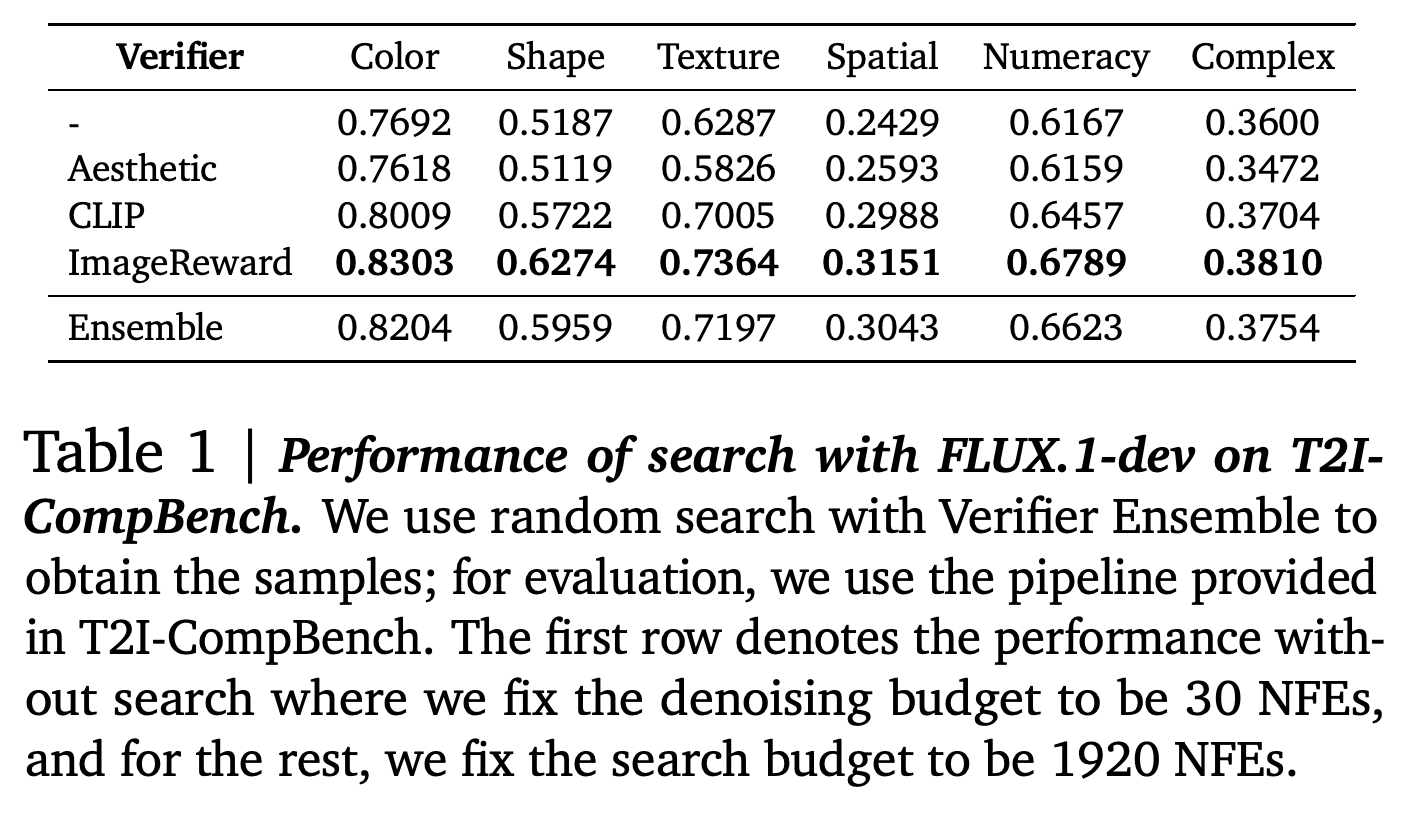
T2I-CompBench에서 검색 예산 1920 NFEs를 사용한 ImageReward 기반 Random Search는 모든 범주에서 앙상블보다 성능이 높다. NFE 30개를 사용하는 검색 없는 베이스라인과 비교하면 Color는 0.7692에서 0.8303으로, Shape는 0.5187에서 0.6274로, Texture는 0.6287에서 0.7364로, Spatial은 0.2429에서 0.3151로, Numeracy는 0.6167에서 0.6789로, Complex는 0.3600에서 0.3810으로 높아진다.
- Aesthetic 기반 검색은 6개 베이스라인 점수 중 Spatial을 제외한 5개를 낮춘다.
- 이 결과는 평가가 구성의 정확성을 중시할 때 미적 기준을 추가하면 앙상블 성능이 낮아질 수 있다는 저자들의 설명과 일치한다. 다만 이 실험은 해당 기준의 인과적 기여를 분리해 검증하지 않는다.
- 표의 verifier별 행과 주변 분석에서는 이러한 비교를 확인할 수 있지만, 캡션은 표본 전체가 Verifier Ensemble을 사용한 것으로 설명한다.
검색 예산 1920 NFEs에서 ImageReward는 모든 구성 평가 범주에서 최고 점수를 기록한다. Aesthetic 기반 검색은 5개 범주에서 검색 없는 베이스라인보다 낮아, 미적 목표가 이 벤치마크의 요구 사항과 충돌할 수 있다는 우려를 뒷받침한다.
표는 검색 예산을 2880 NFEs로 고정하고 지역 검색 방법 2개 모두에 N = 2를 사용한다. 앙상블 기반 Random Search는 가장 높은 LLM Grader 점수인 88.18을 기록한다. 각 개별 지표의 최고값은 해당 verifier의 목표를 따른다.
4.2. Search is Compatible with Finetuning
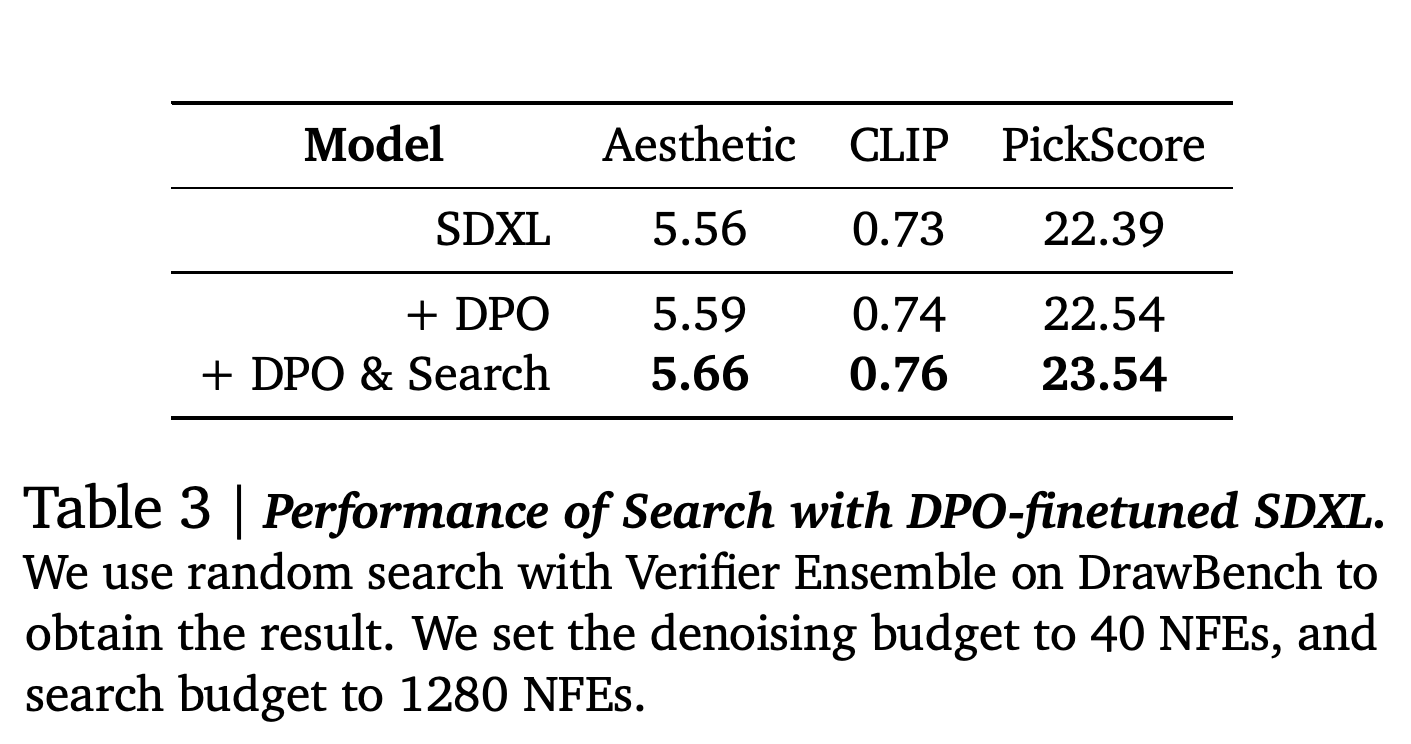
검색은 Diffusion-DPO를 적용한 Stable Diffusion XL(SDXL)의 성능도 높인다. Diffusion-DPO는 선호 데이터로 모델을 미세 조정하는 Direct Preference Optimization을 diffusion에 맞게 적용한 방법이다. DrawBench에서는 ImageReward를 Pick-a-Pic 데이터셋과 연관된 선호 평가기 PickScore로 대체한 앙상블로 Random Search를 수행하며, denoising에 40 NFEs, 검색에 1280 NFEs를 사용한다.
- DPO로 미세 조정한 모델은 Aesthetic에서 5.59, CLIP에서 0.74, PickScore에서 22.54를 기록한다. 검색을 추가하면 각각 5.66, 0.76, 23.54로 높아진다.
- 이 실험은 검증한 모델과 지표에서 검색과 선호 기반 미세 조정을 함께 사용할 수 있음을 뒷받침한다.
DPO로 미세 조정한 모델에 검색을 추가하면 보고된 모든 지표가 높아진다. 이 결과는 denoising 예산 40-NFE와 검색 예산 1280-NFE에서 선호 기반 미세 조정 이후에도 추론 시점 선택으로 추가 이득을 얻을 수 있음을 뒷받침한다.
5. Axes of Inference Compute Investment
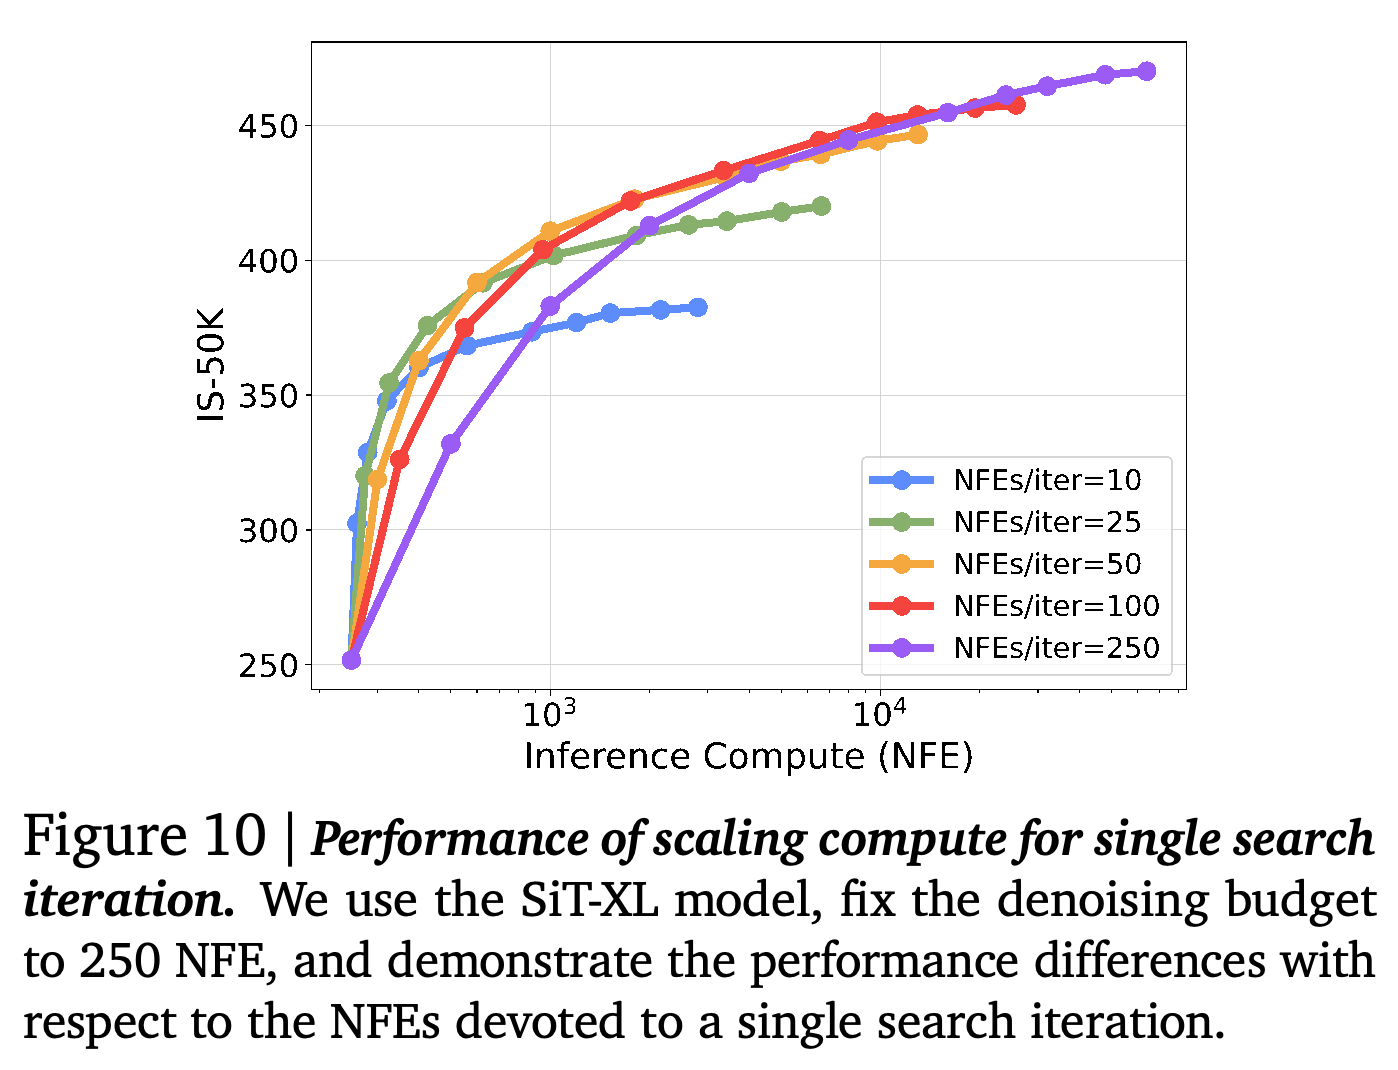
논문은 추론 연산을 검색 반복 횟수, 검색 반복당 denoising 평가 횟수, 최종 생성 평가 횟수로 구분한다. 비용이 낮은 검색 반복은 점수를 더 빨리 높이고, 더 정확한 후보 생성은 더 높은 최종 점수에 도달할 수 있게 한다. ImageNet에서는 검색 반복당 denoising 평가 횟수인 NFEs/iter를 50보다 늘려도 이득이 제한적이다.
- ImageNet의 기본 구성은 검색 반복당 50 NFEs, 최종 생성에 250 NFEs를 사용한다.
- Text-to-image의 기본 구성은 검색 반복당 30 NFEs, 최종 생성에 30 NFEs를 사용한다. 이는 FLUX.1-dev에서 denoising 성능이 더 일찍 정체되는 점을 반영한다.
곡선은 저렴한 후보 평가와 검색 중 더 정확한 denoising 사이의 절충 관계가 예산에 따라 달라짐을 보여준다. 반복당 예산이 매우 작으면 더 일찍 정체되며, 반복당 50 NFEs를 넘겨도 추가 연산에 비해 이득은 제한적이다.
5.1. Effectiveness of Investing Compute
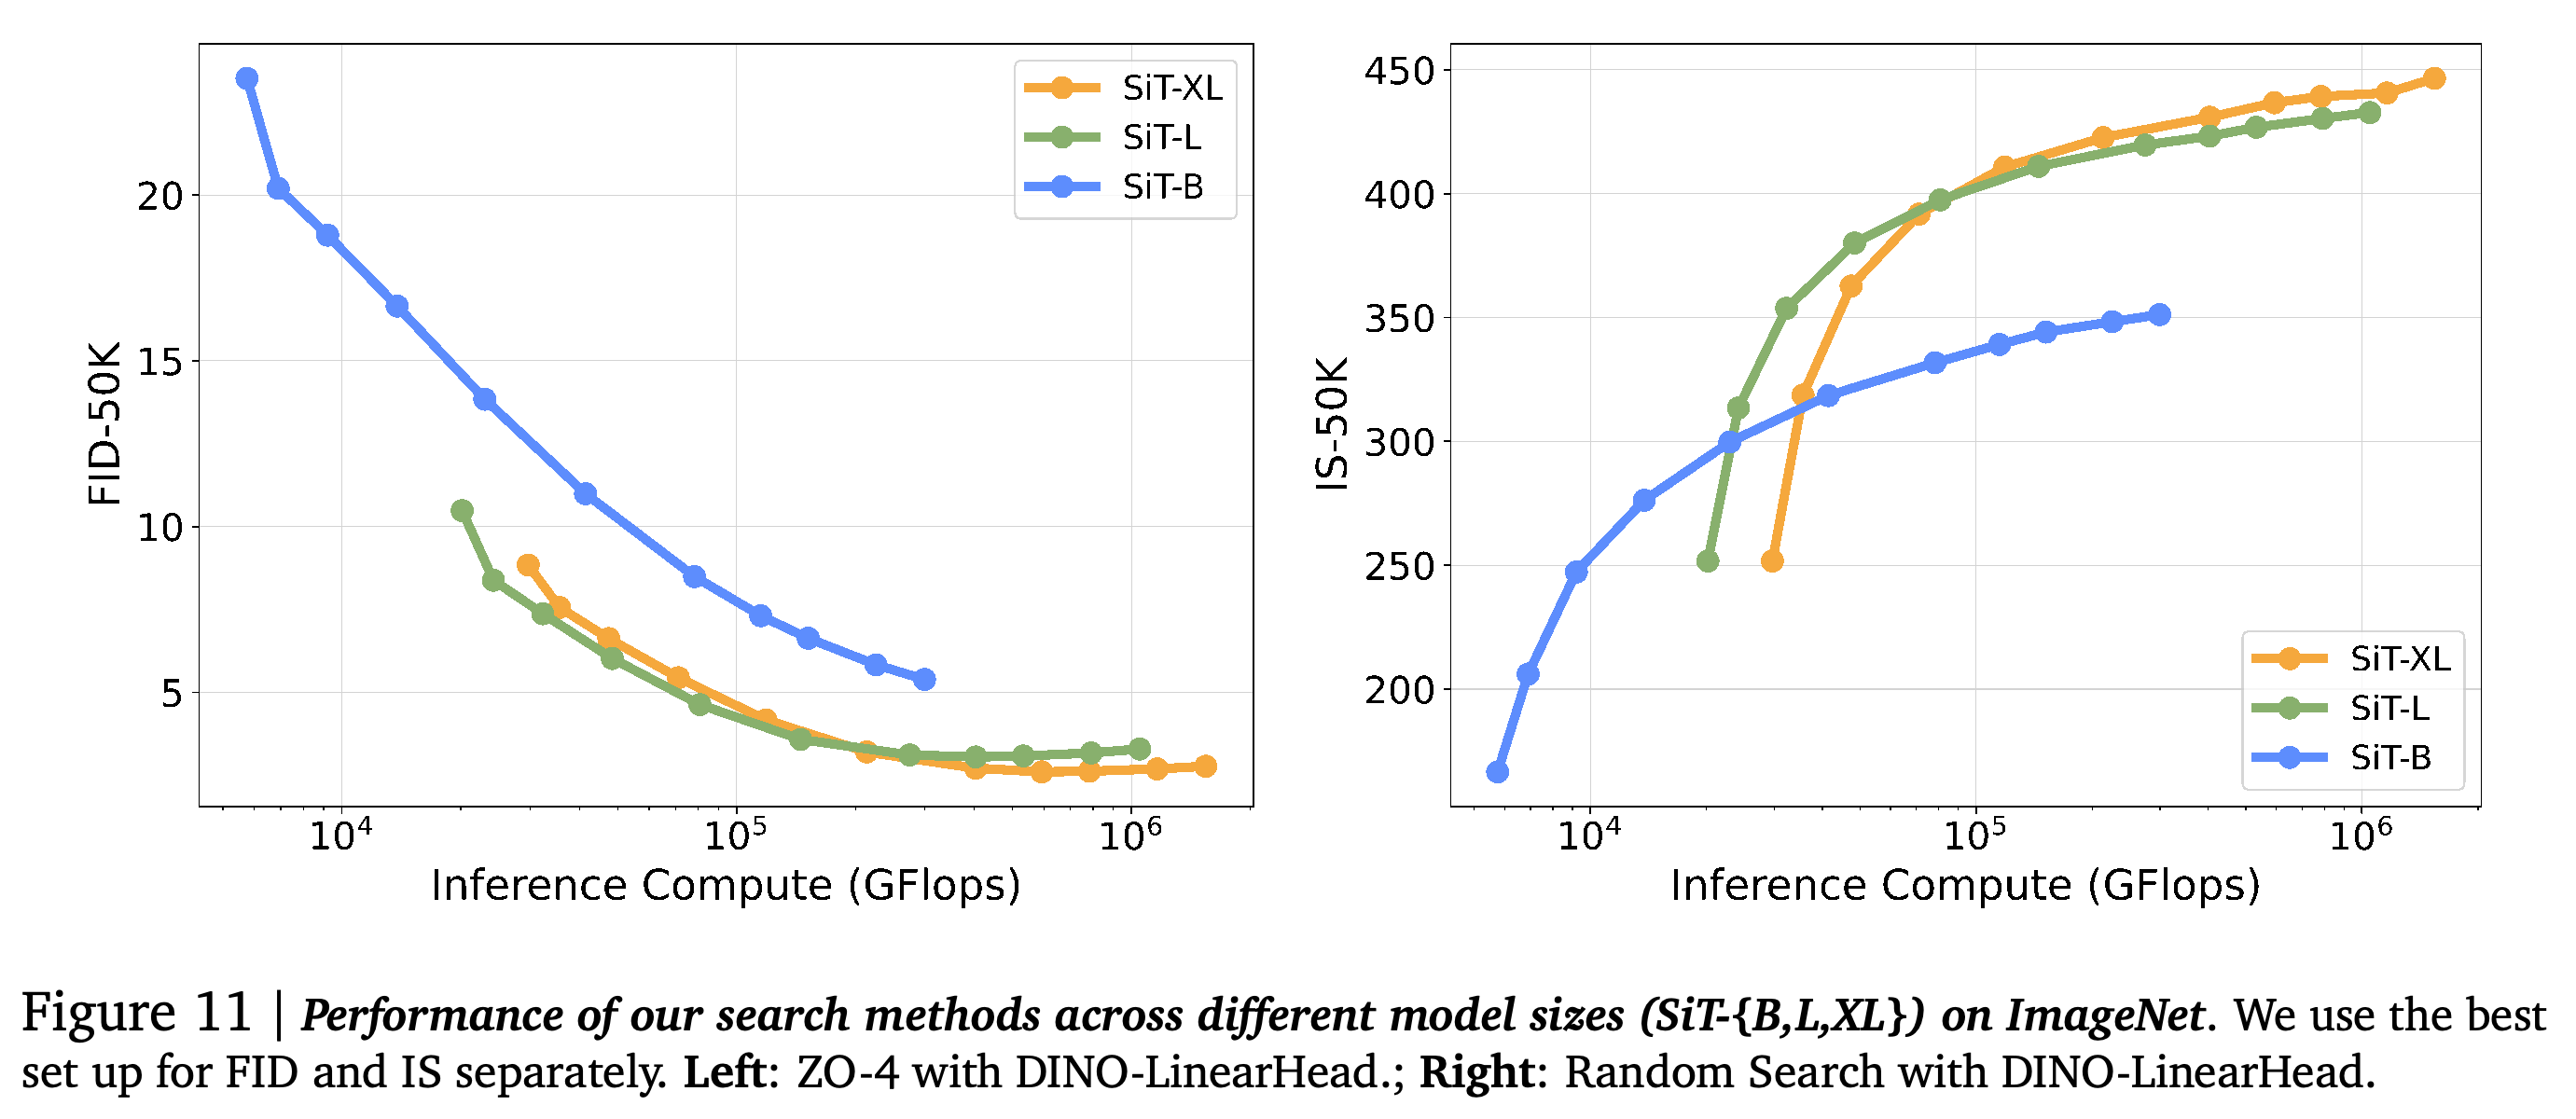
생성 모델마다 NFE당 비용이 다르므로, 모델 크기 간 비교에는 산술 연산량을 나타내는 추정 GFLOPs를 사용한다. 검색을 적용한 SiT-L은 연산 예산이 제한된 일부 구간에서 SiT-XL보다 성능이 높다. 반면 SiT-B는 베이스라인 성능이 낮아 검색을 추가해 도달할 수 있는 품질에 한계가 있다.
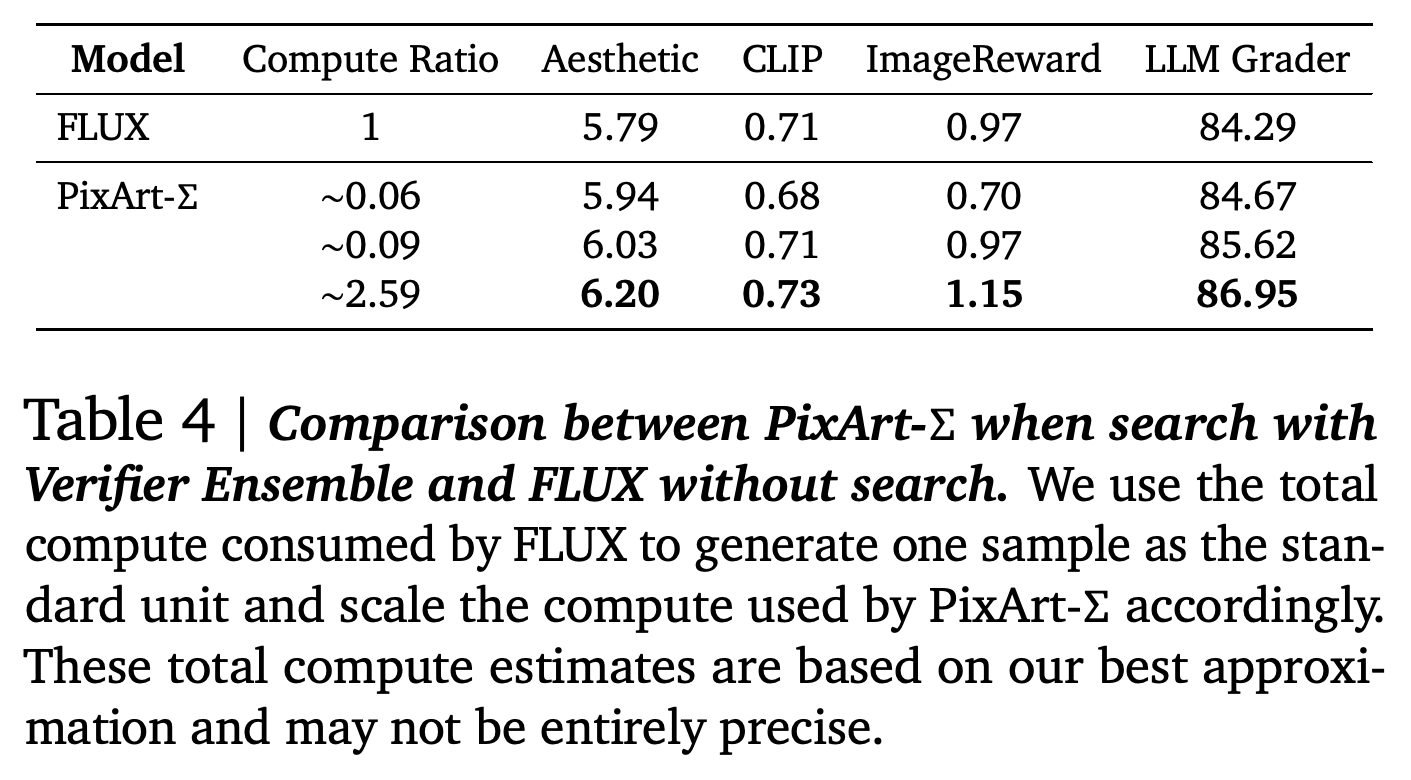
- DrawBench에서 더 작은 생성 모델 PixArt-Σ에 앙상블 기반 검색을 적용하면 LLM Grader 점수가 85.62에 도달한다. 이때 추정 연산량 비율은 검색 없는 FLUX.1-dev의 이미지 1개 생성에 드는 연산량 대비 ∼0.09이며, 해당 베이스라인 점수는 84.29이다.
- 연산량 비율 ∼0.09에서 PixArt-Σ는 Aesthetic 6.03, CLIP 0.71, ImageReward 0.97을 기록한다. FLUX 베이스라인은 각각 5.79, 0.71, 0.97이다. 연산량 비율 ∼2.59에서는 점수가 각각 6.20, 0.73, 1.15에 도달하고 LLM Grader는 86.95를 기록한다.
- 이 비교는 추정 산술 연산 비용에 기반한다. Table 4도 연산량 추정치가 부정확할 수 있음을 명시한다.
추정 GFLOPs를 사용해 크기가 다른 생성 모델을 비교하며, FID와 IS에 대해 검색 구성을 별도로 선택한다. SiT-L은 일부 연산량 구간에서 SiT-XL에 견줄 만한 성능을 보이지만, SiT-B는 낮은 생성 베이스라인 성능의 제약을 받는다.
추정 연산량 비율 ∼0.09에서 검색을 적용한 PixArt-Σ는 검색 없는 FLUX 베이스라인보다 Aesthetic과 LLM Grader가 높고, 반올림된 CLIP 및 ImageReward 점수는 같다. 연산량 비율 ∼2.59에서는 나열된 모든 지표에서 개선을 확인할 수 있다. 원문은 이 비율이 근삿값임을 명시한다.
6. Related Work
관련 연구에서는 이 프레임워크를 언어 모델의 추론 시점 검색, diffusion model의 선호 기반 미세 조정, 표본 선택, 기울기 기반 노이즈 최적화, 유리한 노이즈를 예측하도록 학습한 모델과 연결한다. 이 논문은 verifier 편향, 검색 알고리즘, 과제 요구 사항, 연산 예산을 함께 연구한다.
- 선호 기반 미세 조정은 모델 파라미터를 바꾸지만, 제안하는 검색은 생성 모델을 고정한 채 노이즈를 선택한다.
- 기울기 기반 방법은 샘플링 과정을 역전파하므로 시간과 메모리 비용이 발생한다. 학습 기반 노이즈 예측기는 연산을 추가 학습 단계로 옮기며, 적절한 학습 쌍이 필요하다.
7. Conclusion
실험은 검증한 이미지 생성 모델과 벤치마크에서 노이즈 검색이 추론 시점 확장의 추가 축이 될 수 있음을 보여준다. 추가 연산의 효과는 과제에 따라 달라진다. Verifier의 평가 기준이 과제와 얼마나 일치하는지와 검색의 국소성에 따라 선택한 점수의 향상이 구성 정확도 개선, 전반적인 품질 향상, 또는 다양성 감소와 함께 나타날 수 있다.
부록
- 부록은 A. Experiment Settings로 시작한다. A.1. Training Settings와 A.2. Sampling Settings에 따르면 SiT-XL, FLUX.1-dev, PixArt-Σ는 사전 학습 가중치를 사용하고, SiT-B와 SiT-L은 800K회 반복 학습한다. 기본 샘플링에서 SiT-XL은 2차 Heun을, FLUX.1-dev는 1차 수치 해법인 Euler를, PixArt-Σ는 결정론적 diffusion sampler인 DDIM을 사용한다. Guidance scale은 각각 1.0, 3.5, 4.5이며, 해상도는 각각 256, 1024, 1024이다. A.3. Search Settings에서는 Random Search의 후보 수 |S| = 2^k를 k ∈ {1, 2, 3, 4, 5, 6, 7, 8} 범위에서 검토하고, Zero-Order Search의 반복 횟수, 이웃 후보 수, 단계 파라미터 λ도 검토한다. Search over Paths에서는 경로당 노이즈 분기 수인 경로 폭 M, 초기 경로 수 N, 역방향 구간당 평가 횟수 L을 바꾸고, 나머지는 σ = 0.11, Δb = 0.81, Δf = 0.78로 고정한다. Ablation 결과는 IS에 유리한 설정이 FID를 악화시킬 수 있음을 보여준다. A.4. Verifier Settings는 분류기 특징, aesthetic predictor, CLIPScore 변환, ImageReward 모델, 순위 기반 앙상블을 자세히 설명한다. A.5. Evaluation Setting에서는 ImageNet 표본 50000개를 전역 배치 크기 256으로 생성하고, DrawBench 점수는 프롬프트 200개에 걸쳐 평균하며, T2I-CompBench는 프롬프트당 표본 2개를 평가한다. 수록된 LLM Grader 프롬프트는 세부 점수에 0–10 척도를 지정하고 종합 점수에는 가중 평균이나 단순 평균을 허용한다. 반면 본문과 부록의 평가 설명은 세부 점수에 0–100 척도를 지정하고 평균한 종합 점수를 사용한다고 설명한다.
- B. Verifier Hacking Leads to Degeneracy in Evaluation Metrics는 분류기 기반 Random Search에서 표본의 충실도를 나타내는 precision은 높아지고 참조 분포의 포괄 범위를 나타내는 recall은 낮아짐을 보여준다. 이는 다양성 감소가 FID 악화의 원인이라는 설명을 뒷받침한다.
- C. Zero-Order and First-Order Search는 학습률 η = 0.01인 기울기 기반 검색과 λ = 0.995인 Zero-Order Search를 비교한다. 중간 활성값을 다시 계산해 메모리를 절약하는 gradient checkpointing을 사용하고, 반복당 비용을 약 3배로 조정한다. 1차 검색은 초기에 더 빠르게 수렴하지만 최종 결과는 비슷하다.
- D. Self-Supervised Verifiers have Marginal Effect in Text-to-Image Setting은 DrawBench에서 CLIP, DINO, 그리고 추가 이미지-텍스트 표현 모델인 SigLIP을 특징 유사도 verifier로 사용했을 때 이득이 제한적이라고 보고한다. CLIPScore와의 상관계수는 각각 r = 0.3448, r = −0.0963, r = 0.3494이다. 저자들은 텍스트 정보의 부재와 샘플링 동역학의 차이를 원인으로 제안하지만, 실험으로 각 원인을 분리해 검증하지는 않는다.
- E. More Visualizations on Scaling Behavior는 N = 2, λ = 0.95인 Zero-Order Search를 사용해 E.1. SiT-XL, E.2. FLUX.1-dev, E.3. PixArt-Σ의 선별된 사례를 제시한다. SiT-XL은 denoising 10, 20, 250단계를 등가 비용이 각각 450, 1850, 6650 NFEs인 검색 구성과 비교한다. FLUX.1-dev는 4, 16, 30단계를 각각 120, 960, 2880 NFEs의 등가 비용이 드는 검색 구성과 비교하고, PixArt-Σ는 4, 8, 28단계를 각각 112, 896, 2688 NFEs의 등가 비용이 드는 검색 구성과 비교한다. SiT-XL은 guidance scale 4.0에서 DINO 분류 verifier를 사용한다. FLUX.1-dev와 PixArt-Σ는 Verifier Ensemble을 사용하며 guidance scale은 각각 3.5와 4.5이다.
짧은 생각
가장 유용한 근거는 연산량 확장에 따른 성능 향상과 대리 목표의 실패를 함께 측정한 결과다. 분류기의 확신도가 높아져도 다양성이 줄 수 있고, 앙상블이 DrawBench의 폭넓은 평가에는 도움이 되면서 구성 정확도 평가에는 불리할 수 있다. 따라서 생성 연산을 추가로 배분할 때는 verifier 선택과 검색 목표 밖의 기준을 이용한 평가를 고려해야 한다.
효율 비교는 추정 연산량에 기반하므로 실제 배포 지연 시간을 입증하지 않는다. 전반적인 이미지 품질은 모델 기반 평가기 1개로 평가하며, 인간 검증 연구나 불확실성 구간은 보고하지 않는다. 문서에 제시된 점수 척도도 일치하지 않는다. 따라서 보고된 점수 향상만으로 인간 선호가 얼마나 개선되는지 판단할 근거는 제한적이다.