


Inference-Time Scaling for Generalist Reward Modeling 요약 설명
03 Apr 2025 | Paper Review Reward Modeling Test-Time Scaling Reinforcement Learning목차
이번 글에서는 Inference-Time Scaling for Generalist Reward Modeling 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 3일(Arxiv)
- Liu, Zijun, Wang, Peiyi, Xu, Runxin, Ma, Shirong, Ruan, Chong, Li, Peng, Liu, Yang, Wu, Yu.
- DeepSeek-AI, Dept. of Computer Sci. & Tech., Tsinghua University, Institute for AI Industry Research (AIR), Tsinghua University
- 논문 링크
요약
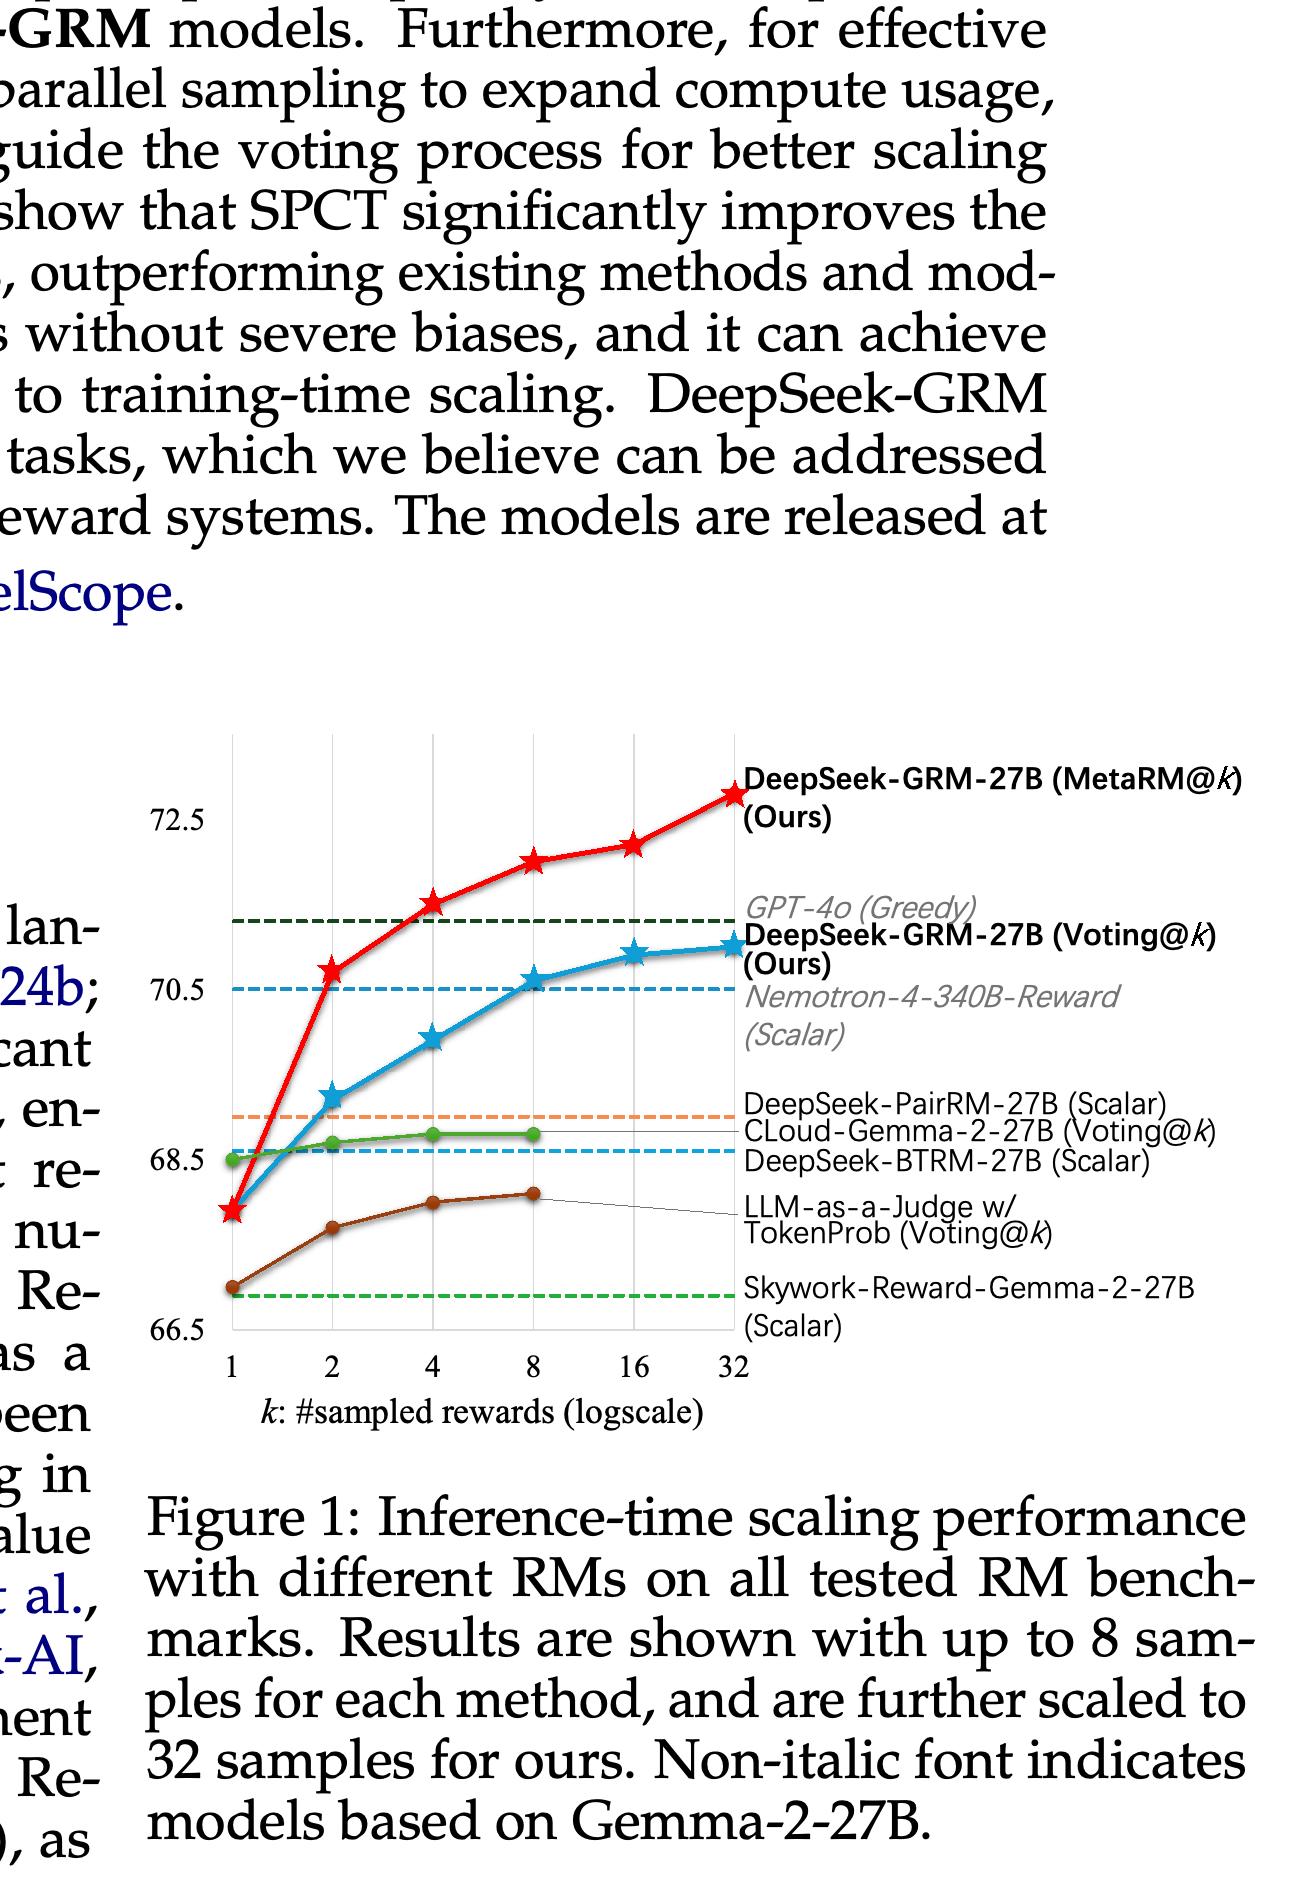
- 보상 모델은 언어 모델의 응답에 점수를 매긴다. 하지만 질문에 직접 검증할 수 있는 정답이 없으면 추론 연산을 늘려 판단을 개선하기 어렵다. 응답 선호도와 정확성을 평가하는 Reward Bench, PPE Preference, PPE Correctness, RMB에서 DeepSeek-GRM-27B는 평가 32개를 샘플링하고 학습된 평가기로 선별해 종합 점수 72.8을 달성한다. 매 단계에서 확률이 가장 높은 다음 토큰을 선택하는 greedy decoding에서는 69.9를 기록하며, 보고된 GPT-4o 결과는 71.3이다.
- Self-Principled Critique Tuning (SPCT)은 평가를 텍스트로 표현하는 생성형 보상 모델을 훈련한다. 모델은 평가 기준을 뜻하는 원칙을 생성한 뒤 비평과 응답별 점수를 출력한다. SPCT는 올바른 평가 시퀀스를 선별해 남기는 rejective fine-tuning과, 새로 샘플링한 평가의 판단 정확성에 보상을 주어 모델을 갱신하는 온라인 강화학습을 결합한다.
- 병렬 샘플링과 점수 집계는 재현한 생성형 및 준스칼라 기준 모델보다 DeepSeek-GRM-27B의 성능을 더 크게 높인다. 준스칼라 모델은 텍스트 비평과 수치 보상 출력을 결합한다. 생성된 평가를 판별하도록 학습한 meta reward model은 집계 전에 샘플을 선별해 종합 성능을 추가로 높인다. 다만 생성형 평가의 비용은 여전히 크고, 참조 정답 없는 정확성 평가에서는 재현한 스칼라 기준 모델 중 성능이 가장 높은 모델보다 뒤처진다. 모델 크기 비교만으로 동일한 연산량에서 우위가 입증되지는 않는다.
1 Introduction
범용 보상 모델링은 참조 정답이 없는 경우가 많은 여러 분야에서 다양한 응답 형식과 평가 기준을 처리해야 한다. 서론은 유연한 입력, 분야 전반에서 정확한 보상, 추론 연산 증가에 따른 보상 개선, 이러한 확장을 뒷받침하는 학습된 행동이라는 4가지 요구사항을 제시한다.
- 제안하는 pointwise 방식은 생성한 텍스트를 통해 응답마다 개별 점수를 부여하며, 단일 응답, 응답 쌍, 다중 응답을 지원한다.
- 저자들은 Gemma-2-27B를 기반으로 DeepSeek-GRM-27B를 훈련하고, 더 많은 원칙과 비평을 생성해 집계하면 판단을 개선할 수 있는지 조사한다.
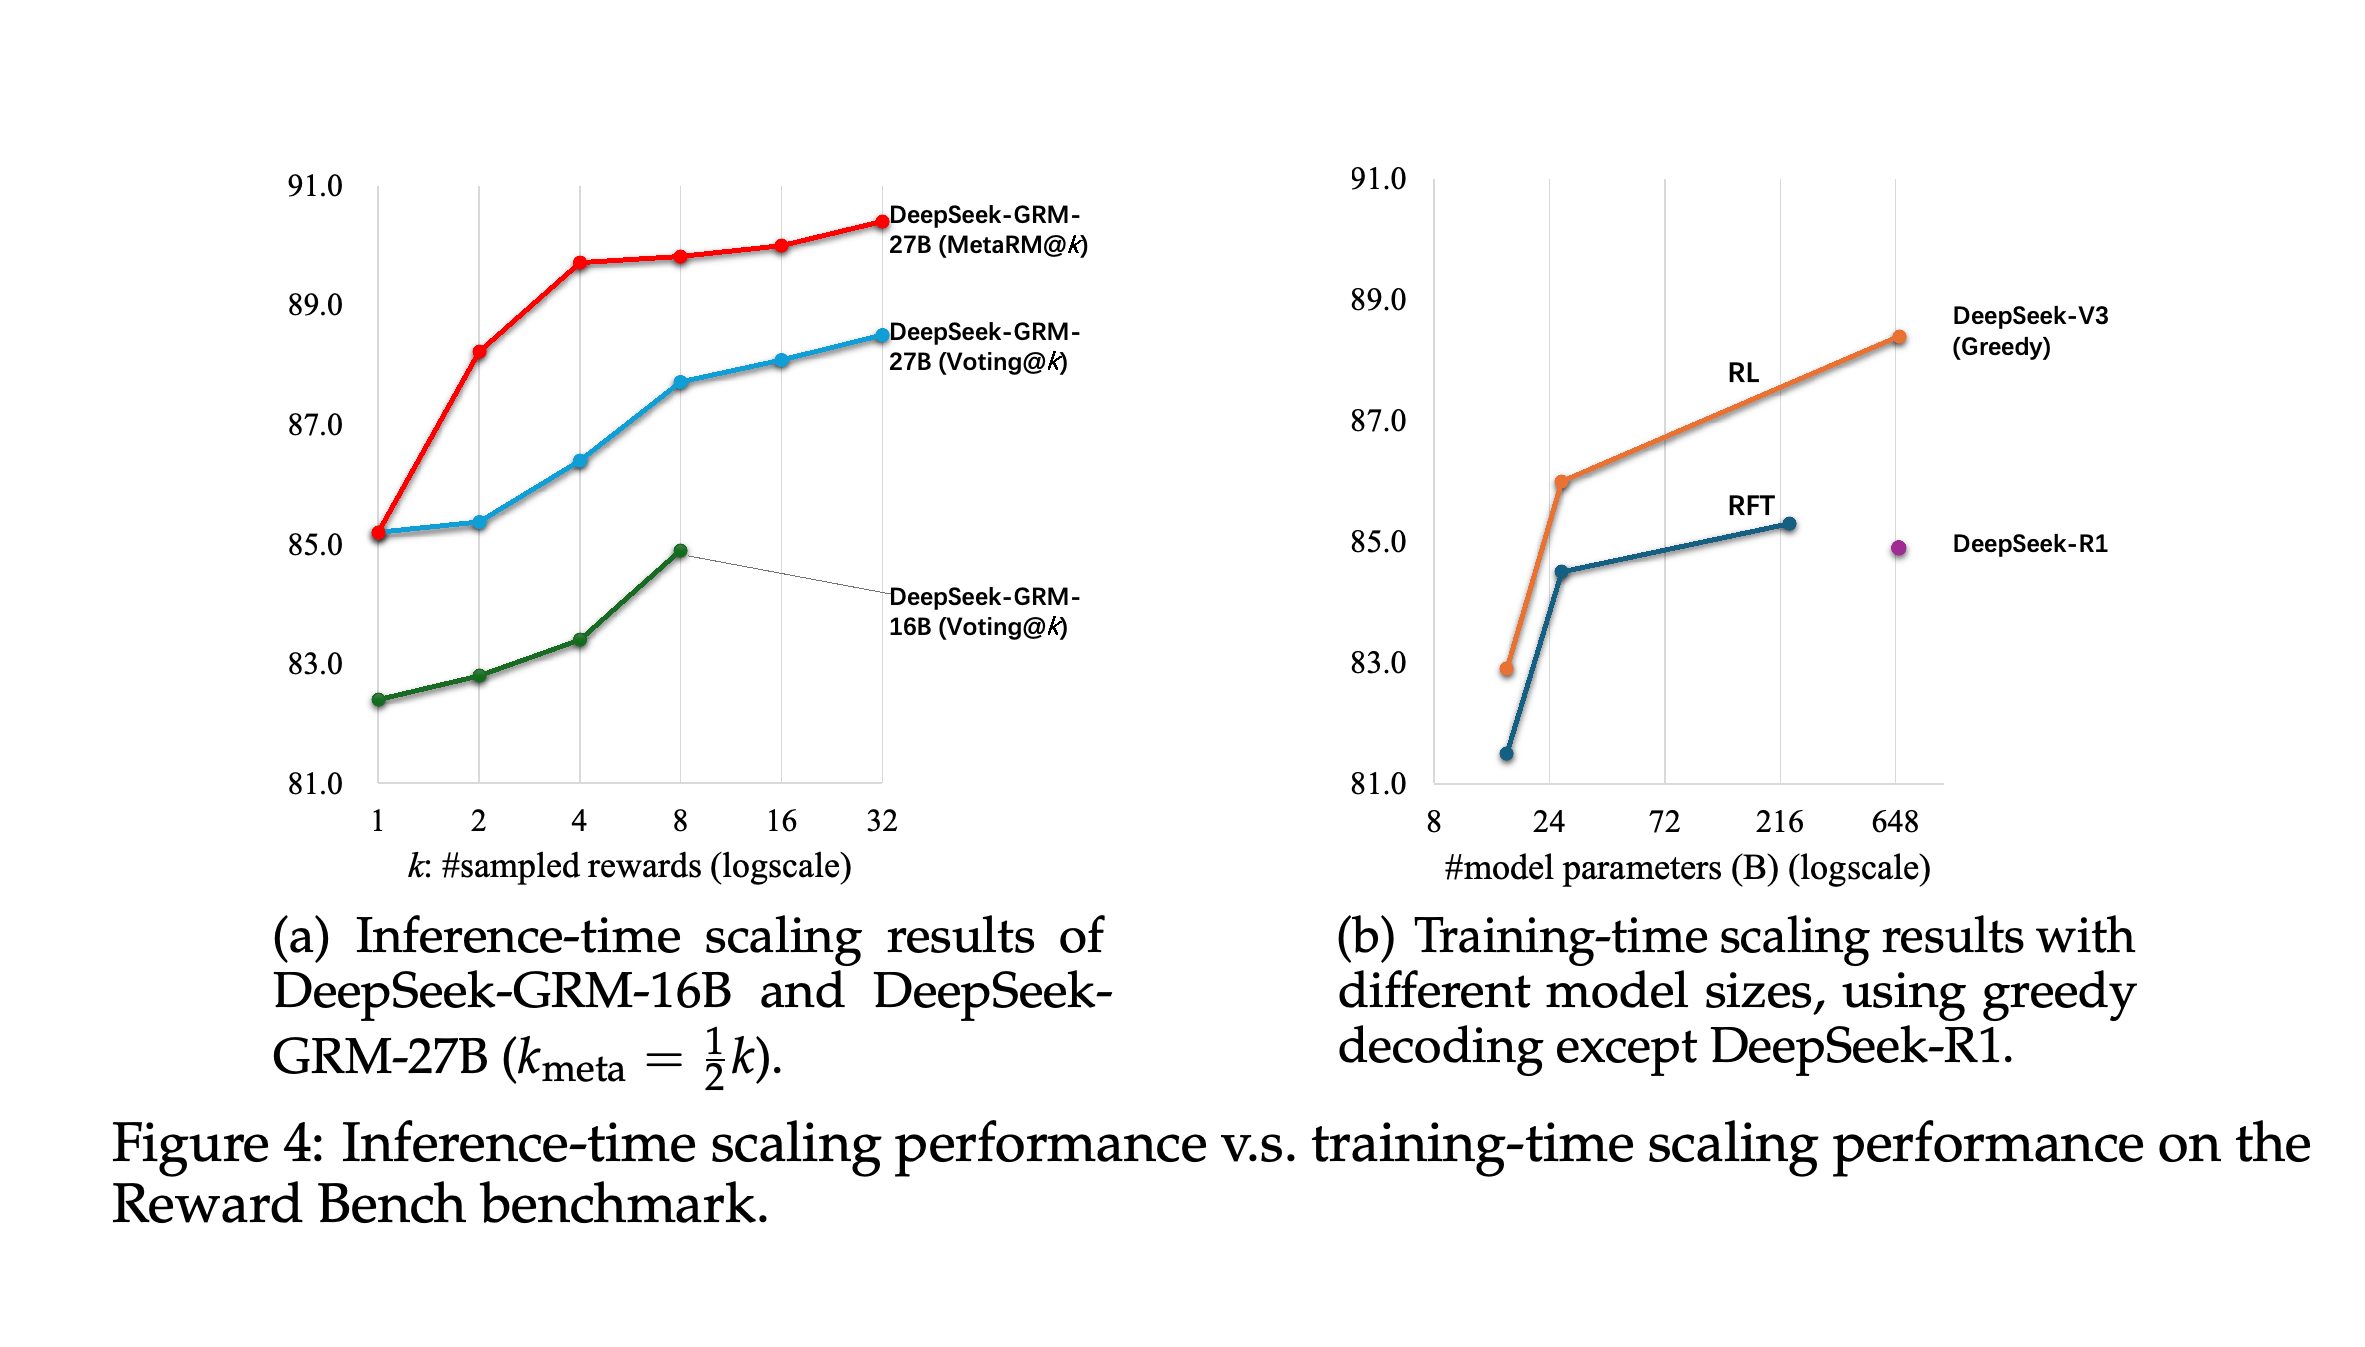
DeepSeek-GRM은 샘플링한 평가 수가 늘수록 성능이 높아지며, meta-guided 집계가 종합 성능에서 가장 뚜렷한 향상을 보인다. 그래프는 샘플링한 평가와 공개 모델의 고정된 참조 점수를 비교하므로, 연산 비용을 통제하지 않은 성능 비교를 제시한다.
2 Preliminaries
예비 지식에서는 보상을 표현하는 방식과 응답을 평가하는 채점 방식을 구분한다. 이 구분을 바탕으로 후보 응답 수가 달라도 처리하면서 다양한 평가를 생성할 수 있는 접근법을 도입한다.
2.1 Comparisons of Different RM approaches
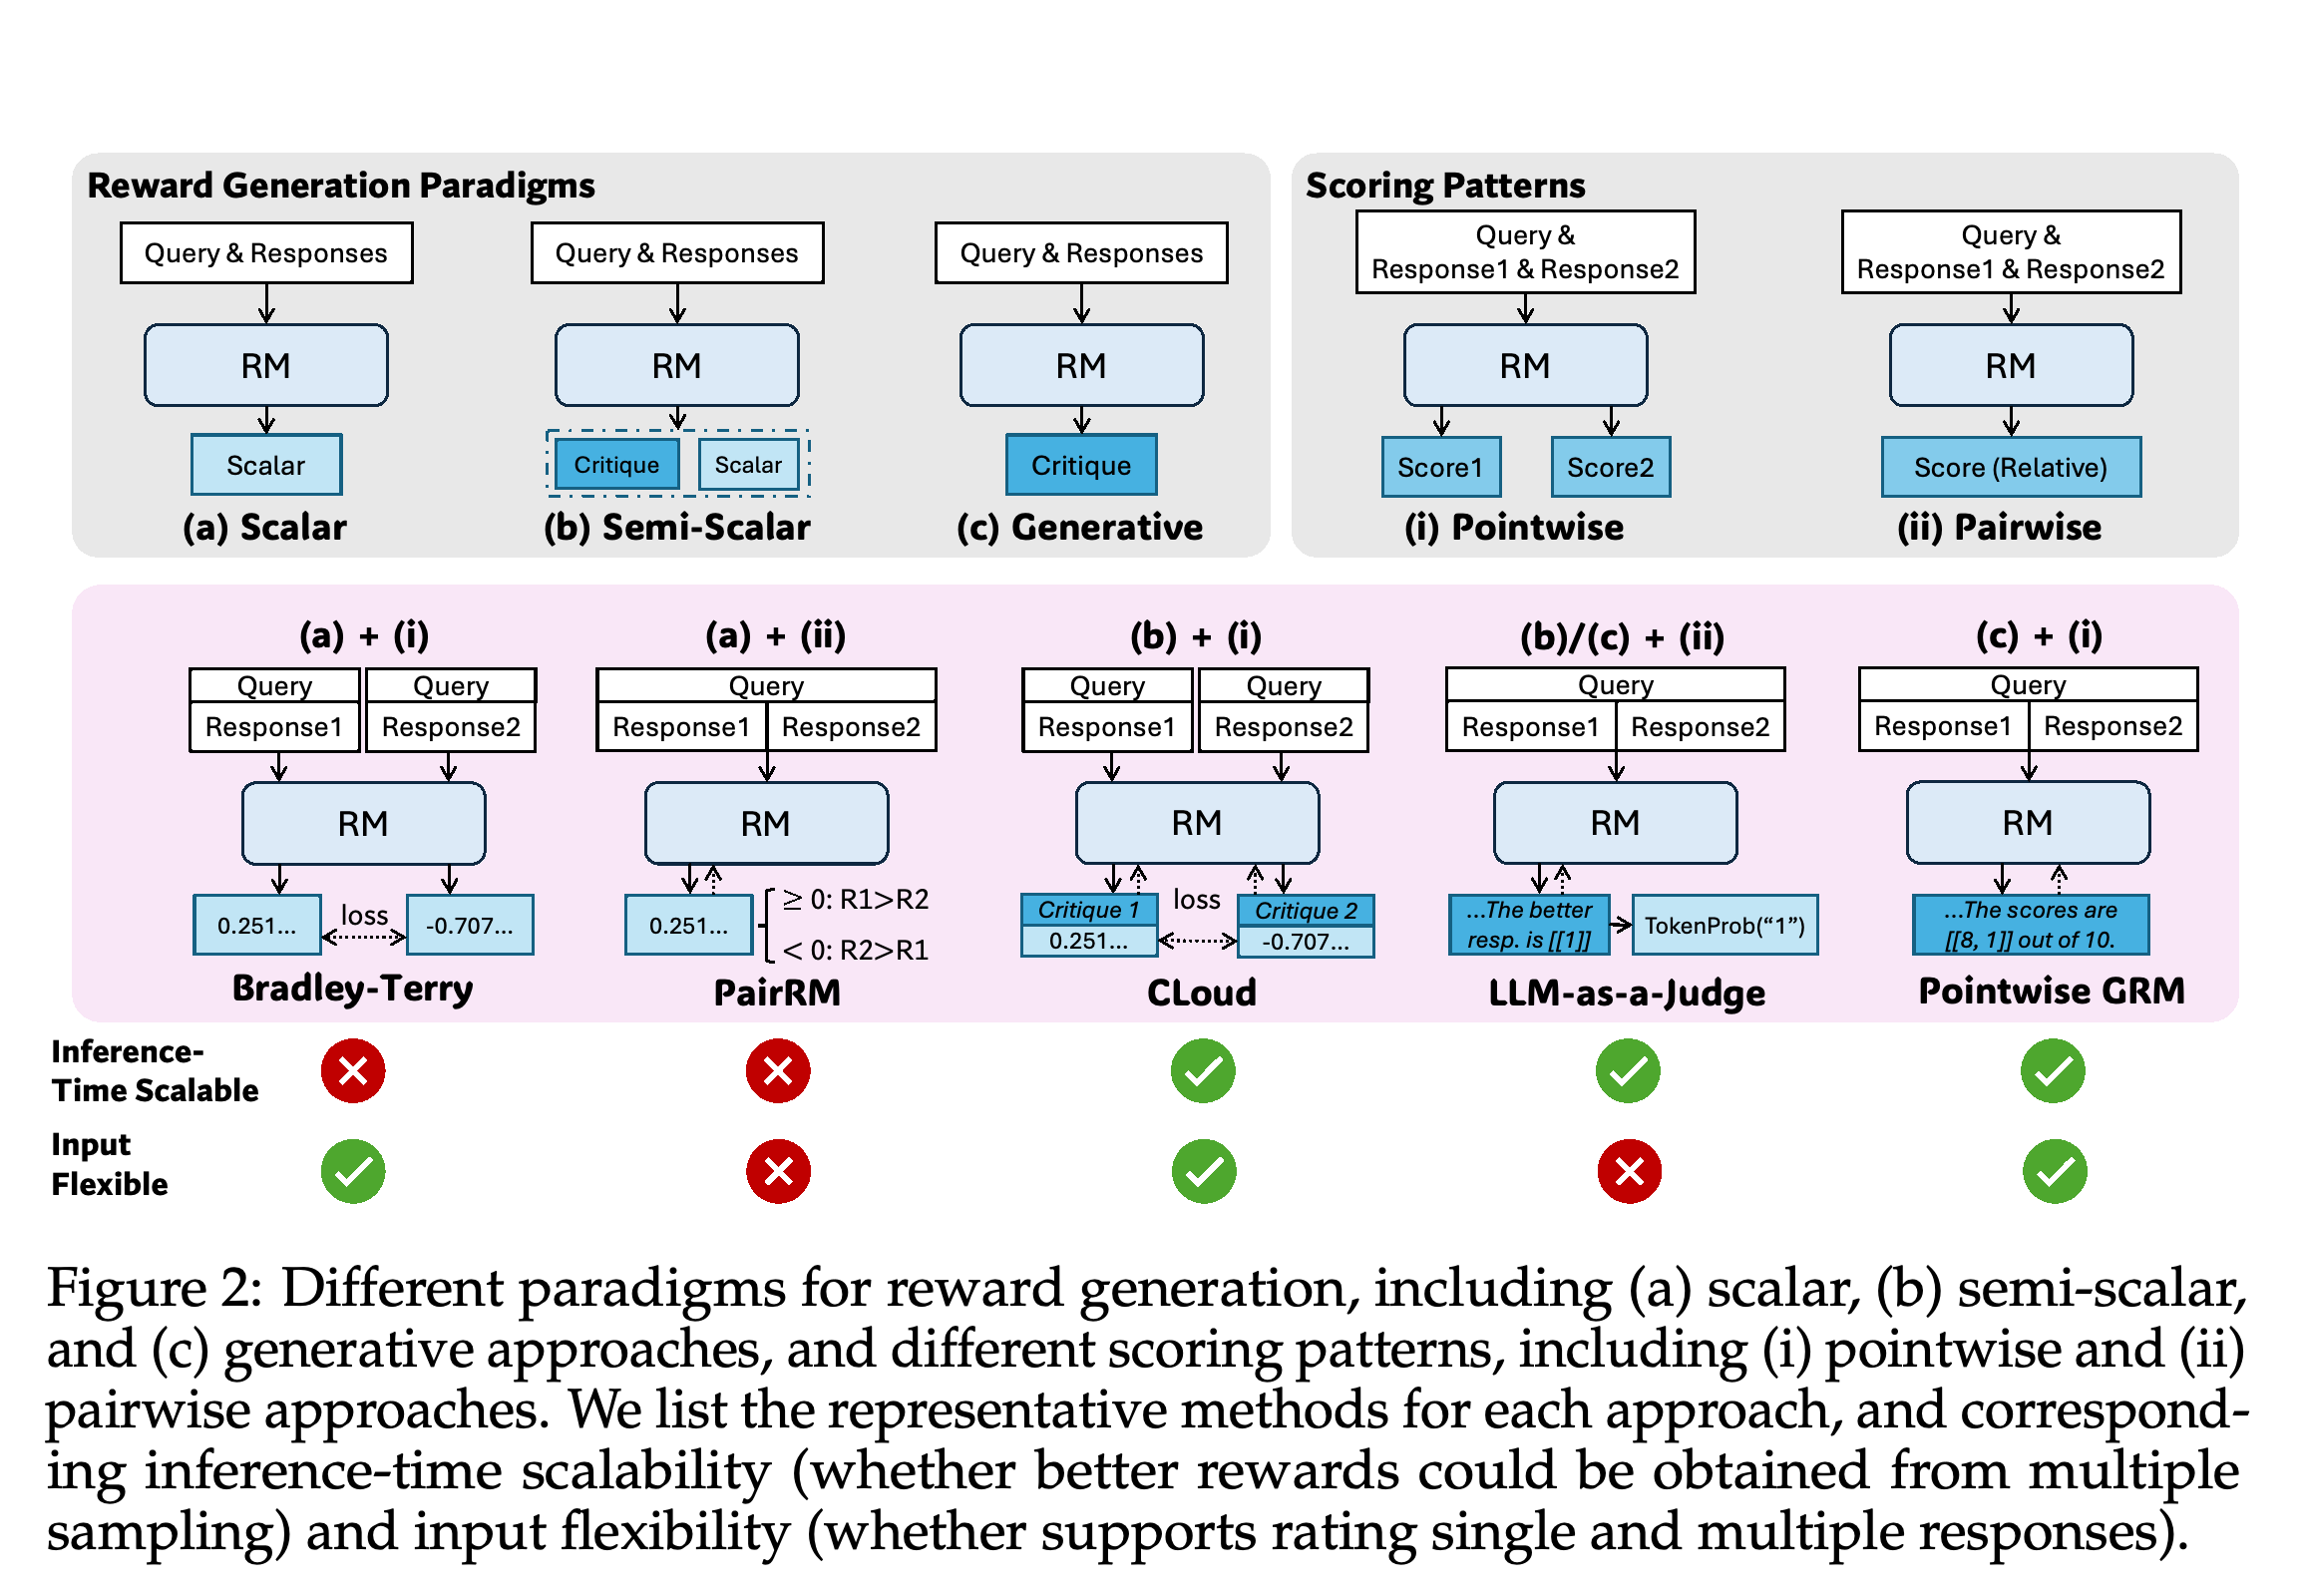
스칼라 보상 모델은 수치를 출력하고, 준스칼라 모델은 텍스트와 수치 보상을 함께 생성한다. 생성형 보상 모델은 점수를 추출할 수 있는 텍스트 평가를 생성한다. Pointwise 채점은 응답마다 개별 점수를 부여하며, pairwise 채점은 일반적으로 후보 2개 중 선호하는 응답을 선택한다.
- Bradley-Terry 모델은 응답 쌍의 선호도로부터 pointwise 스칼라 점수를 학습한다. PairRM은 상대적인 스칼라 판단을 출력하고, CLoud는 비평을 조건으로 점수를 생성하며, LLM-as-a-Judge는 대규모 언어 모델로 선호 판단을 텍스트로 생성한다.
- 논문은 샘플링을 통한 성능 확장에 초점을 둔다. 고정된 스칼라 출력은 평가를 반복해도 다양성이 작지만, 생성한 비평과 점수는 달라질 수 있다.
- DeepSeek-GRM은 일반적으로 1에서 10까지의 정수 점수를 추출한다. Pointwise 점수는 개별 평가 안에서 동점을 허용하며, 응답 1개 또는 여러 응답이 포함된 입력을 지원한다.
이 도식은 보상 표현과 채점 방식을 구분해 저자들이 pointwise 생성 점수를 선택한 이유를 설명한다. 이 조합은 다양한 입력 개수와 여러 평가 샘플을 지원한다. 도식의 확장성 표시는 논문에서 다루는 샘플링과 집계 설정에 관한 것이다.
2.2 Boosting Reward Quality with Principles
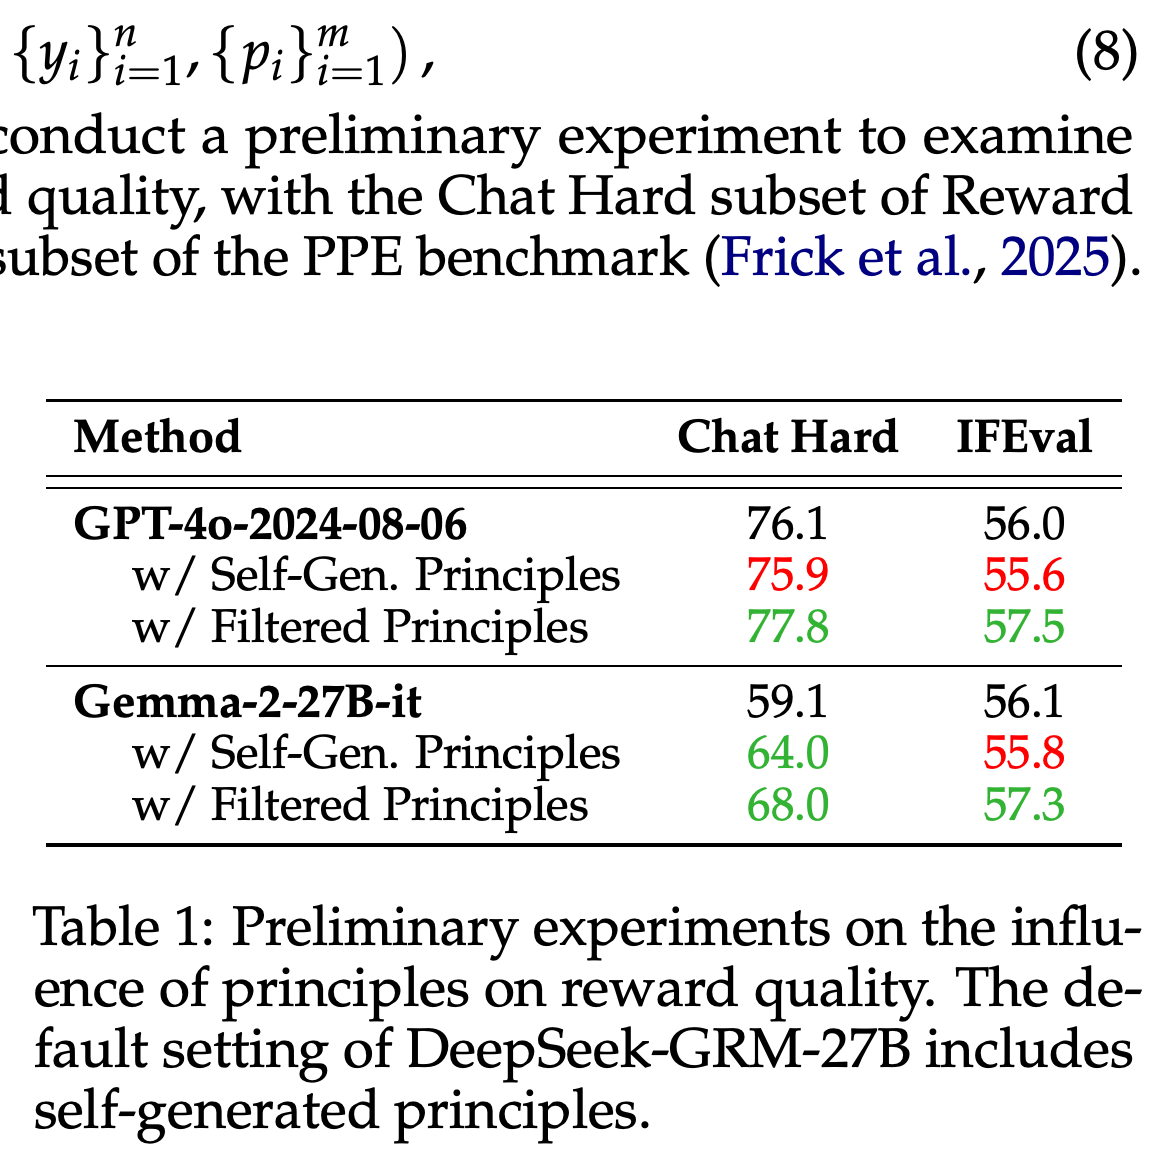
원칙은 비평의 방향을 정하는 명시적인 평가 기준이다. 어려운 대화 비교로 구성된 Reward Bench의 Chat Hard와 PPE의 지시 이행 평가 하위 집합인 IFEval에서 예비 실험을 수행한다. GPT-4o-2024-08-06으로 예시마다 원칙과 점수를 4회 생성하고, 선호도를 올바르게 판단한 평가에 사용된 원칙을 남겨 이후 평가에 사용한다.
- GPT-4o에서 필터링하지 않은 자체 생성 원칙을 사용하면 Chat Hard는 76.1에서 75.9로, IFEval은 56.0에서 55.6으로 변한다. 필터링한 원칙을 사용하면 각각 77.8과 57.5로 높아진다.
- Gemma-2-27B-it에서 필터링한 원칙을 사용하면 Chat Hard는 59.1에서 68.0으로, IFEval은 56.1에서 57.3으로 높아진다. 필터링하지 않은 자체 생성 원칙은 Chat Hard를 64.0으로 높이지만 IFEval을 55.8로 낮춘다.
- 이 결과는 유용한 원칙을 생성하도록 학습할 필요성을 뒷받침한다. 다만 필터링에 선호도 레이블을 사용하므로 레이블 없이도 개선된다는 증거는 아니다.
올바른 선호 판단을 기준으로 선별한 원칙은 시험한 2개 모델 모두에서 평가 하위 집합 모두의 성능을 높이지만, 필터링하지 않은 원칙의 효과는 엇갈린다. Gemma-2-27B-it는 필터링하지 않은 원칙으로 Chat Hard 성능이 높아지는 반면 IFEval에서는 조금 낮아져, 효과가 모델과 과제에 따라 달라짐을 보여준다.
3 Self-Principled Critique Tuning (SPCT)
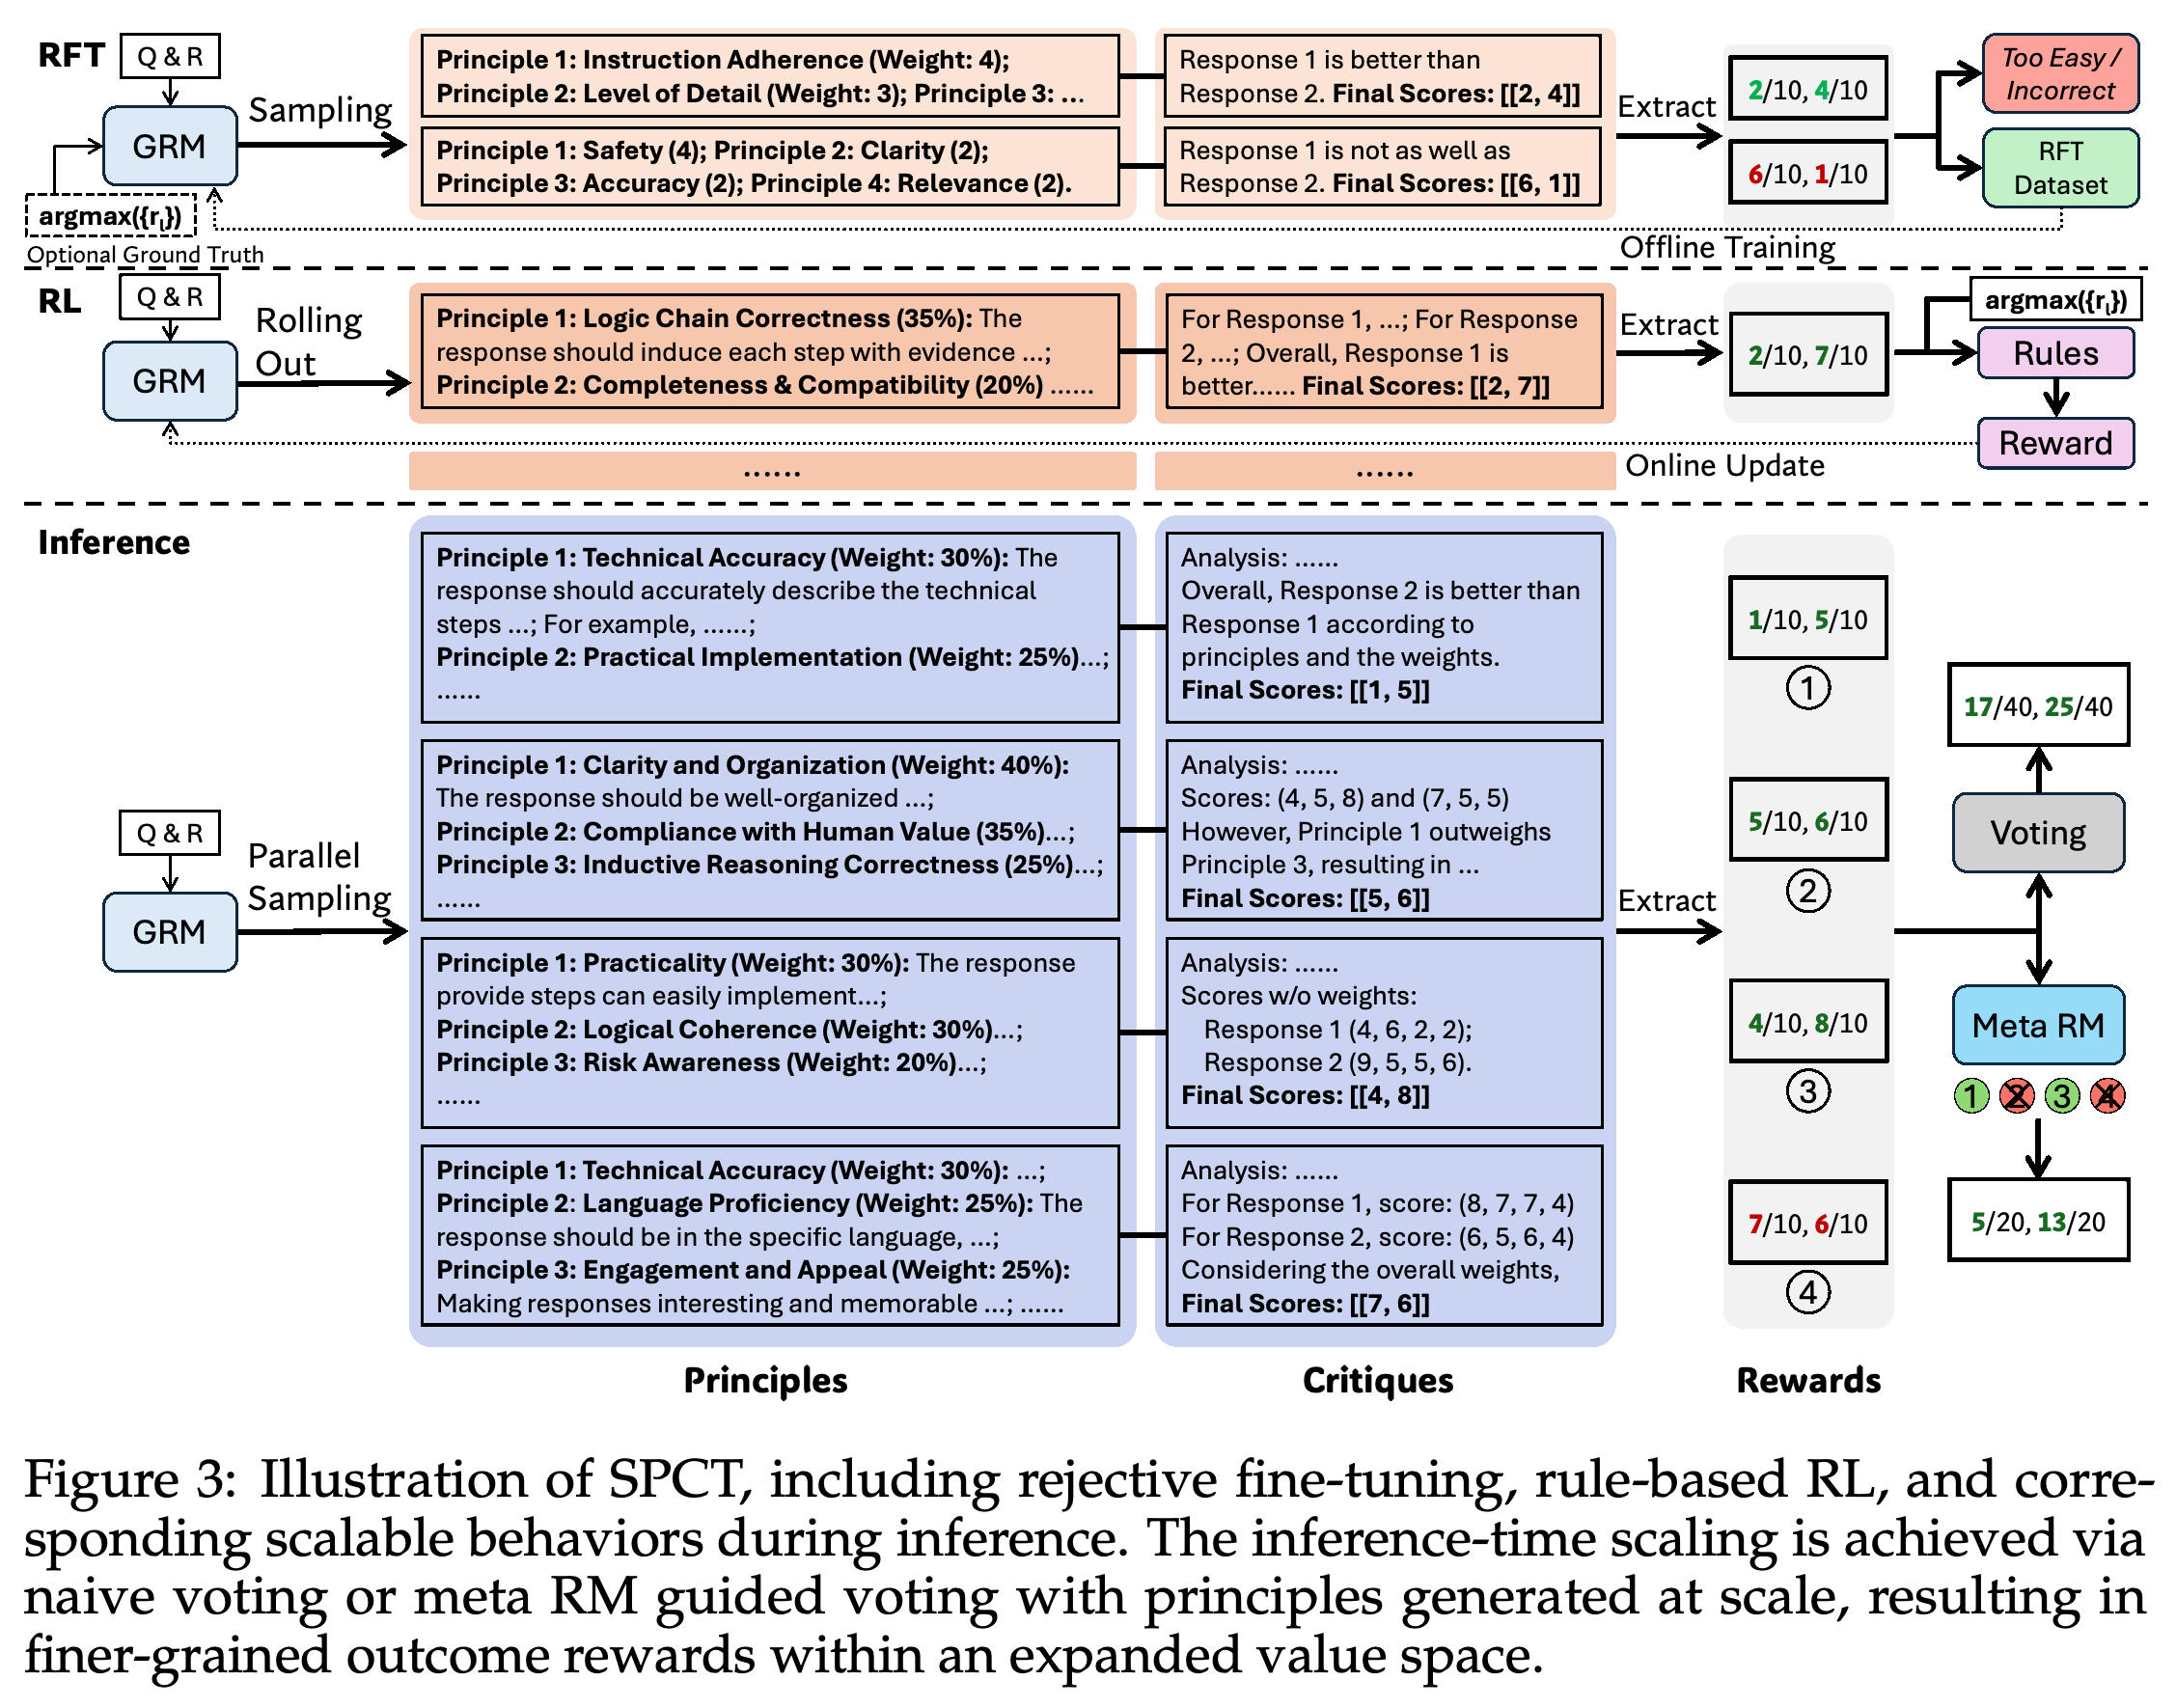
SPCT는 pointwise 생성형 보상 모델을 2단계로 훈련한다. 먼저 rejective fine-tuning으로 평가 행동과 출력 형식을 학습한 뒤, 규칙 기반 온라인 강화학습으로 생성하는 원칙과 비평을 개선한다. 추론 시 여러 샘플을 집계할수록 성능이 좋아지는 평가를 학습하는 것이 목표이며, 훈련 보상은 개별 판단의 정확성에 부여한다.
3.1 Unpinning Principles from Understanding to Generation
모델은 고정된 전처리 입력으로만 원칙을 받는 대신, 평가 과정에서 질문에 맞는 원칙을 생성한다. 원칙 생성과 비평 생성은 같은 언어 모델과 출력 헤드를 공유하므로 훈련을 통해 함께 개선할 수 있다.
- 샘플링한 각 평가는 서로 다른 기준과 가중치를 도입한 뒤 비평과 응답 점수를 생성할 수 있다.
- 논문은 집계를 통해 더 다양한 판단 관점을 반영하고 점수를 더 세밀하게 구분할 수 있기 때문에 성능이 확장된다고 설명한다. 다만 샘플링한 원칙들이 서로 독립적이거나 모든 기준을 빠짐없이 포괄한다는 점은 입증하지 않는다.
3.2 Rule-Based Reinforcement Learning
Rejective fine-tuning은 일반 지시 데이터와 샘플링한 평가 시퀀스를 섞어 사용한다. 잘못된 시퀀스와 힌트 없이 샘플링한 평가가 모두 정답인 예시는 제외한다. 어려운 질문에서도 훈련 예시를 확보하기 위해 hinted sampling에서 최선의 응답 레이블을 선택적으로 제공하지만, 저자들은 이렇게 생성한 일부 비평에서 편법을 관찰한다.
- 다중 응답에서는 유일한 최선으로 레이블이 붙은 응답의 점수가 모든 대안보다 엄격히 높아야 정답으로 인정한다. 단일 응답에서는 점수가 레이블과 일치해야 한다. Hinted sampling은 예시마다 평가 1개를 생성하고, 오답일 때만 제외한다.
- 온라인 훈련은 샘플 출력 그룹 안에서 보상을 정규화하는 group relative policy optimization (GRPO)을 사용한다. 결과 보상은 올바른 판단에 +1, 그 외에는 −1을 부여한다.
- 별도의 형식 보상은 사용하지 않는다. 참조 정책과의 차이를 제한하는 Kullback-Leibler (KL) 페널티는 형식을 유지하고 특정 분야에서 성능이 크게 저하되는 현상을 줄이는 데 도움을 준다.
훈련 및 추론 경로는 생성한 원칙을 비평, 추출한 점수, 판단 정확성 피드백과 연결한다. 추론에서는 여러 평가 시퀀스를 집계하며, meta reward model은 점수를 합치기 전에 시퀀스를 선별한다.
4 Inference-Time Scaling with SPCT
추론 시 DeepSeek-GRM은 원칙과 비평으로 구성된 시퀀스를 여러 개 샘플링하고, 응답별 pointwise 점수를 합산한다. 위치 편향을 줄이고 다양성을 높이기 위해 샘플링 전에 후보 응답 순서를 섞는다.
- 좁은 이산 척도의 점수를 합산하면 집계 보상이 가질 수 있는 범위가 넓어져 단일 평가보다 세밀하게 구분할 수 있다.
- Meta reward model은 생성된 평가가 올바르게 판단했는지 예측하는 스칼라 분류기다. 이진 예측용 손실인 binary cross-entropy로 훈련하며, 질문, 후보 응답, 원칙, 비평을 입력으로 받는다.
- Meta-guided voting은 meta 점수가 가장 높은 평가들을 남긴 뒤 응답 점수를 합산한다. 기본적으로 샘플링한 평가의 절반을 남긴다. 훈련 예시에는 rejective fine-tuning에서 힌트 없이 생성한 샘플과, 평가를 선별할 대상인 DeepSeek-GRM 모델이 생성한 샘플이 포함된다.
5 Results on Reward Modeling Benchmarks
실험에서는 전반적인 판단 품질, 추론 샘플 추가에 따른 성능 향상, 구성 요소 제거 효과, 더 큰 기반 모델과의 성능 차이를 평가한다. 재현한 기준 모델은 Gemma-2-27B 모델 계열 안에서 비교 기준이 되며, 공개 모델의 보고된 점수는 더 넓은 비교 기준을 제공한다.
5.1 Experiment Settings
Reward Bench는 대화, 추론, 안전성 선호도를 평가한다. PPE는 Preference와 검증 가능한 Correctness 하위 집합을 포함하며, RMB는 응답 쌍과 다중 응답의 유용성과 무해성을 평가한다. ReaLMistake는 단일 응답의 오류를 평가한다. 앞서 설명한 벤치마크에서는 최선의 응답을 선택하는 정확도를 사용한다. ReaLMistake에서는 분류 임계값 전반의 판별력을 측정하는 수신자 조작 특성 곡선 아래 면적(ROC-AUC)을 사용한다.
- 재현한 기준 모델은 LLM-as-a-Judge, DeepSeek-BTRM-27B, CLoud-Gemma-2-27B, DeepSeek-PairRM-27B다. 모두 Gemma-2-27B를 기반으로 하며, 비교 대상과 호환되는 훈련 데이터 및 설정을 사용한다.
- 기본 평가는 greedy decoding을 사용한다. 추론 시 확장 실험에서는 샘플링의 무작위성을 조절하는 temperature = 0.5를 사용한다. Meta reward model도 Gemma-2-27B를 사용한다.
- 더 큰 기반 모델로는 DeepSeek-V2-Lite, DeepSeek-V2.5, DeepSeek-V3를 사용한다. 이들은 입력에 따라 모델 매개변수의 일부를 선택해 연산하는 mixture-of-experts 모델이다.
5.2 Results and Analysis
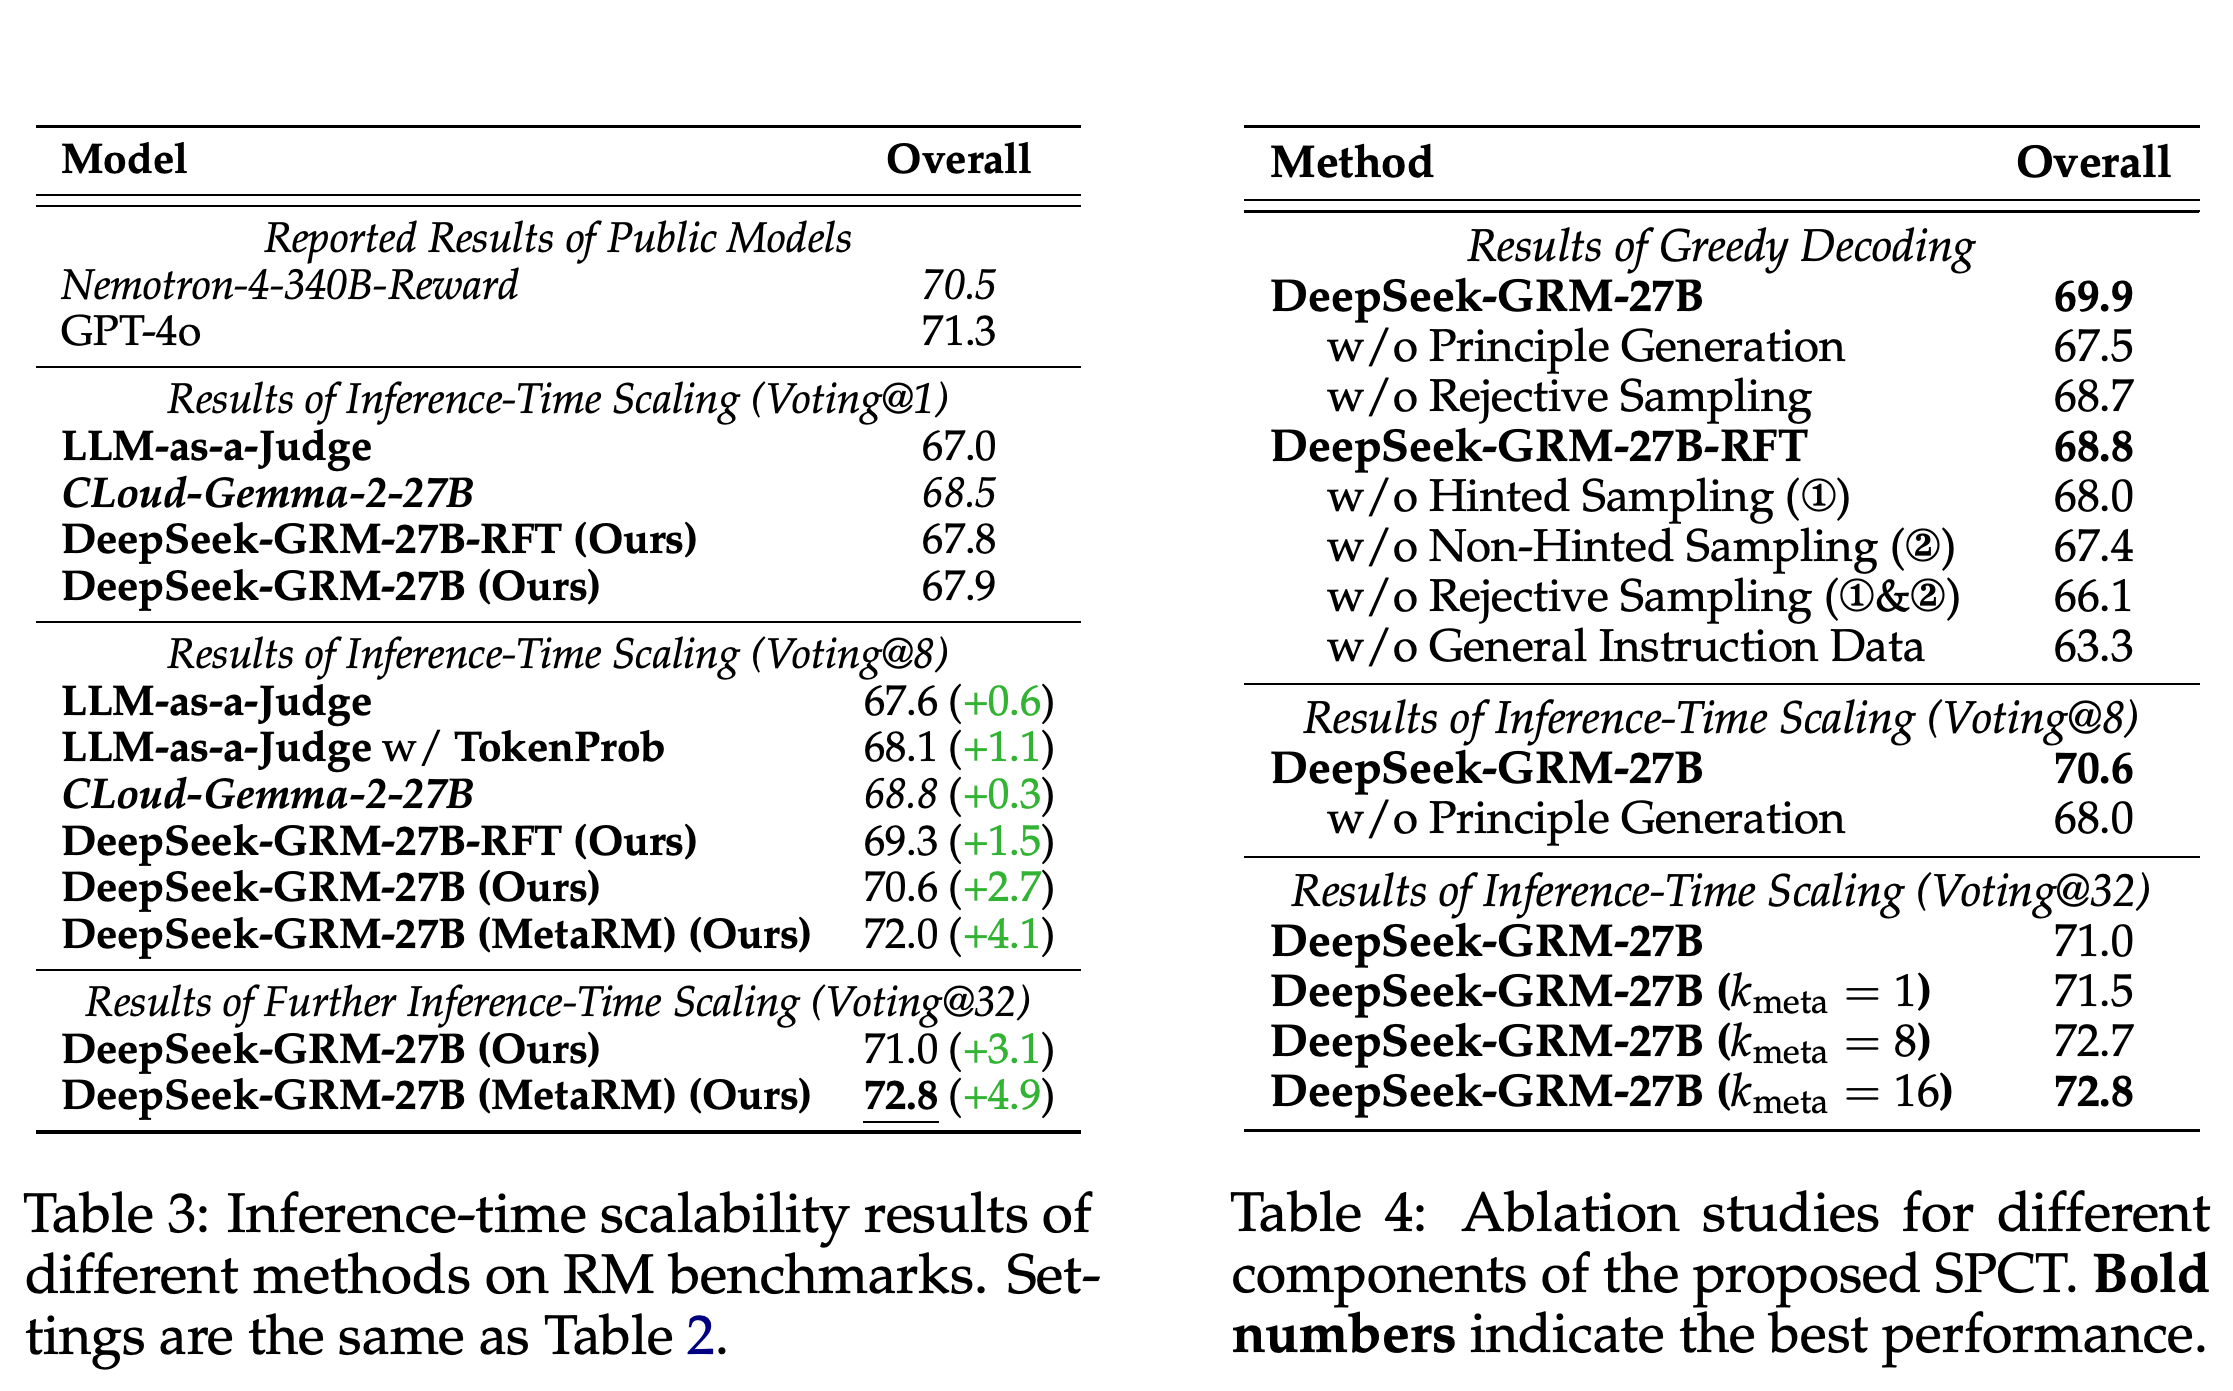
DeepSeek-GRM-27B는 greedy decoding에서 종합 점수 69.9를 기록한다. 온라인 강화학습 전에는 68.8이며, 재현한 기준 모델은 67.8–69.0이다. Temperature = 0.5 샘플링에서는 샘플 1개일 때 67.9, 8개일 때 70.6, 32개일 때 71.0으로 높아진다. Meta-guided voting은 샘플 8개와 32개에서 각각 72.0과 72.8에 도달한다.
- 샘플 8개를 단순 집계하면 샘플 1개 평가보다 2.7점 높아진다. LLM-as-a-Judge는 0.6점, CLoud-Gemma-2-27B는 0.3점 높아진다. 이 향상 폭은 69.9인 greedy decoding 결과가 아니라 샘플 1개를 사용하는 확률적 기준점에서 계산한다.
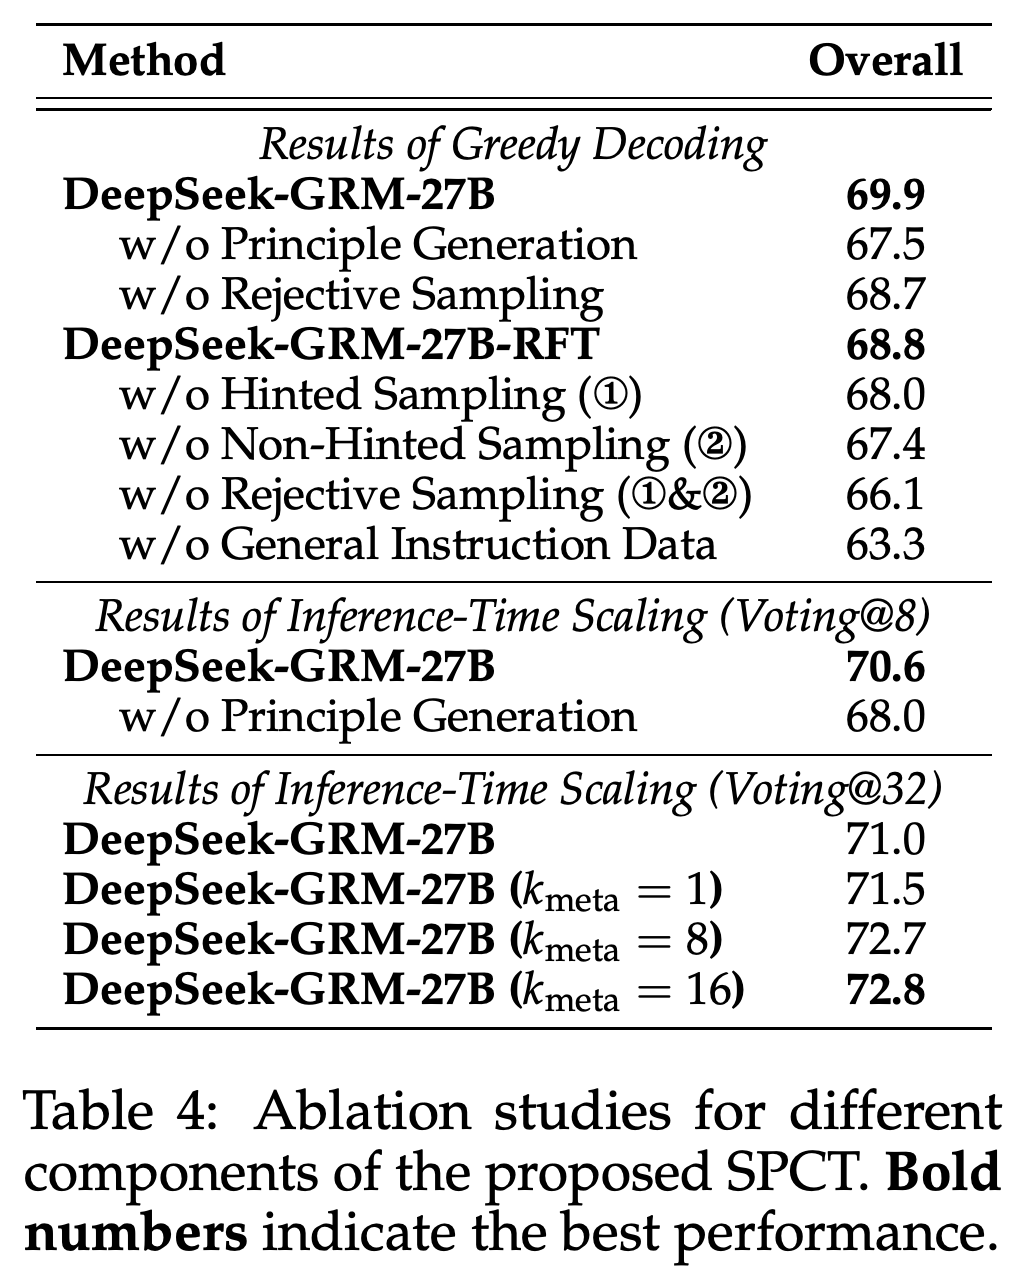
- 원칙 생성을 제거하면 greedy 성능은 69.9에서 67.5로, 샘플 8개 성능은 70.6에서 68.0으로 낮아진다. Rejective 방식으로 선별한 비평 샘플 데이터 없이 온라인 강화학습을 적용하면 66.1에서 68.7로 높아진다. Rejective fine-tuning에서 일반 지시 데이터를 제거하면 점수는 68.8에서 63.3으로 낮아진다.
- 샘플 32개를 사용하는 meta-guided DeepSeek-GRM은 PPE Correctness에서 63.2를 기록해 DeepSeek-BTRM-27B의 66.7보다 낮다. RMB에서는 meta guidance가 샘플 8개 점수를 69.5에서 68.8로 낮추지만, 종합 점수는 높인다.
- Reward Bench에서 샘플 32개를 사용하는 plain voting은 88.5로, 671B 모델의 88.4와 비슷하다. 샘플 8개를 사용하는 meta-guided voting은 89.8에 도달한다. 더 큰 모델은 훈련 방식이 다르며, 이 비교는 전체 훈련 및 추론 연산량을 동일하게 맞추지 않는다.
- DeepSeek-R1-0120은 추론 비용 때문에 Reward Bench에서 축소 추출한 예시 300개로만 평가한다. 종합 결과가 낮다는 점은 제한적인 비교만 뒷받침한다. 반면 Reasoning 하위 집합의 높은 성능은 긴 추론이 특정 판단 과제에 도움이 될 수 있음을 보여준다.
최고 종합 점수는 샘플 32개와 meta guidance를 사용한 72.8이지만, 벤치마크별 최고 모델은 다르다. PPE Correctness에서 DeepSeek-BTRM-27B는 66.7로 meta-guided 모델의 63.2보다 높으며, RMB에서는 보고된 GPT-4o 결과가 여전히 더 높다.
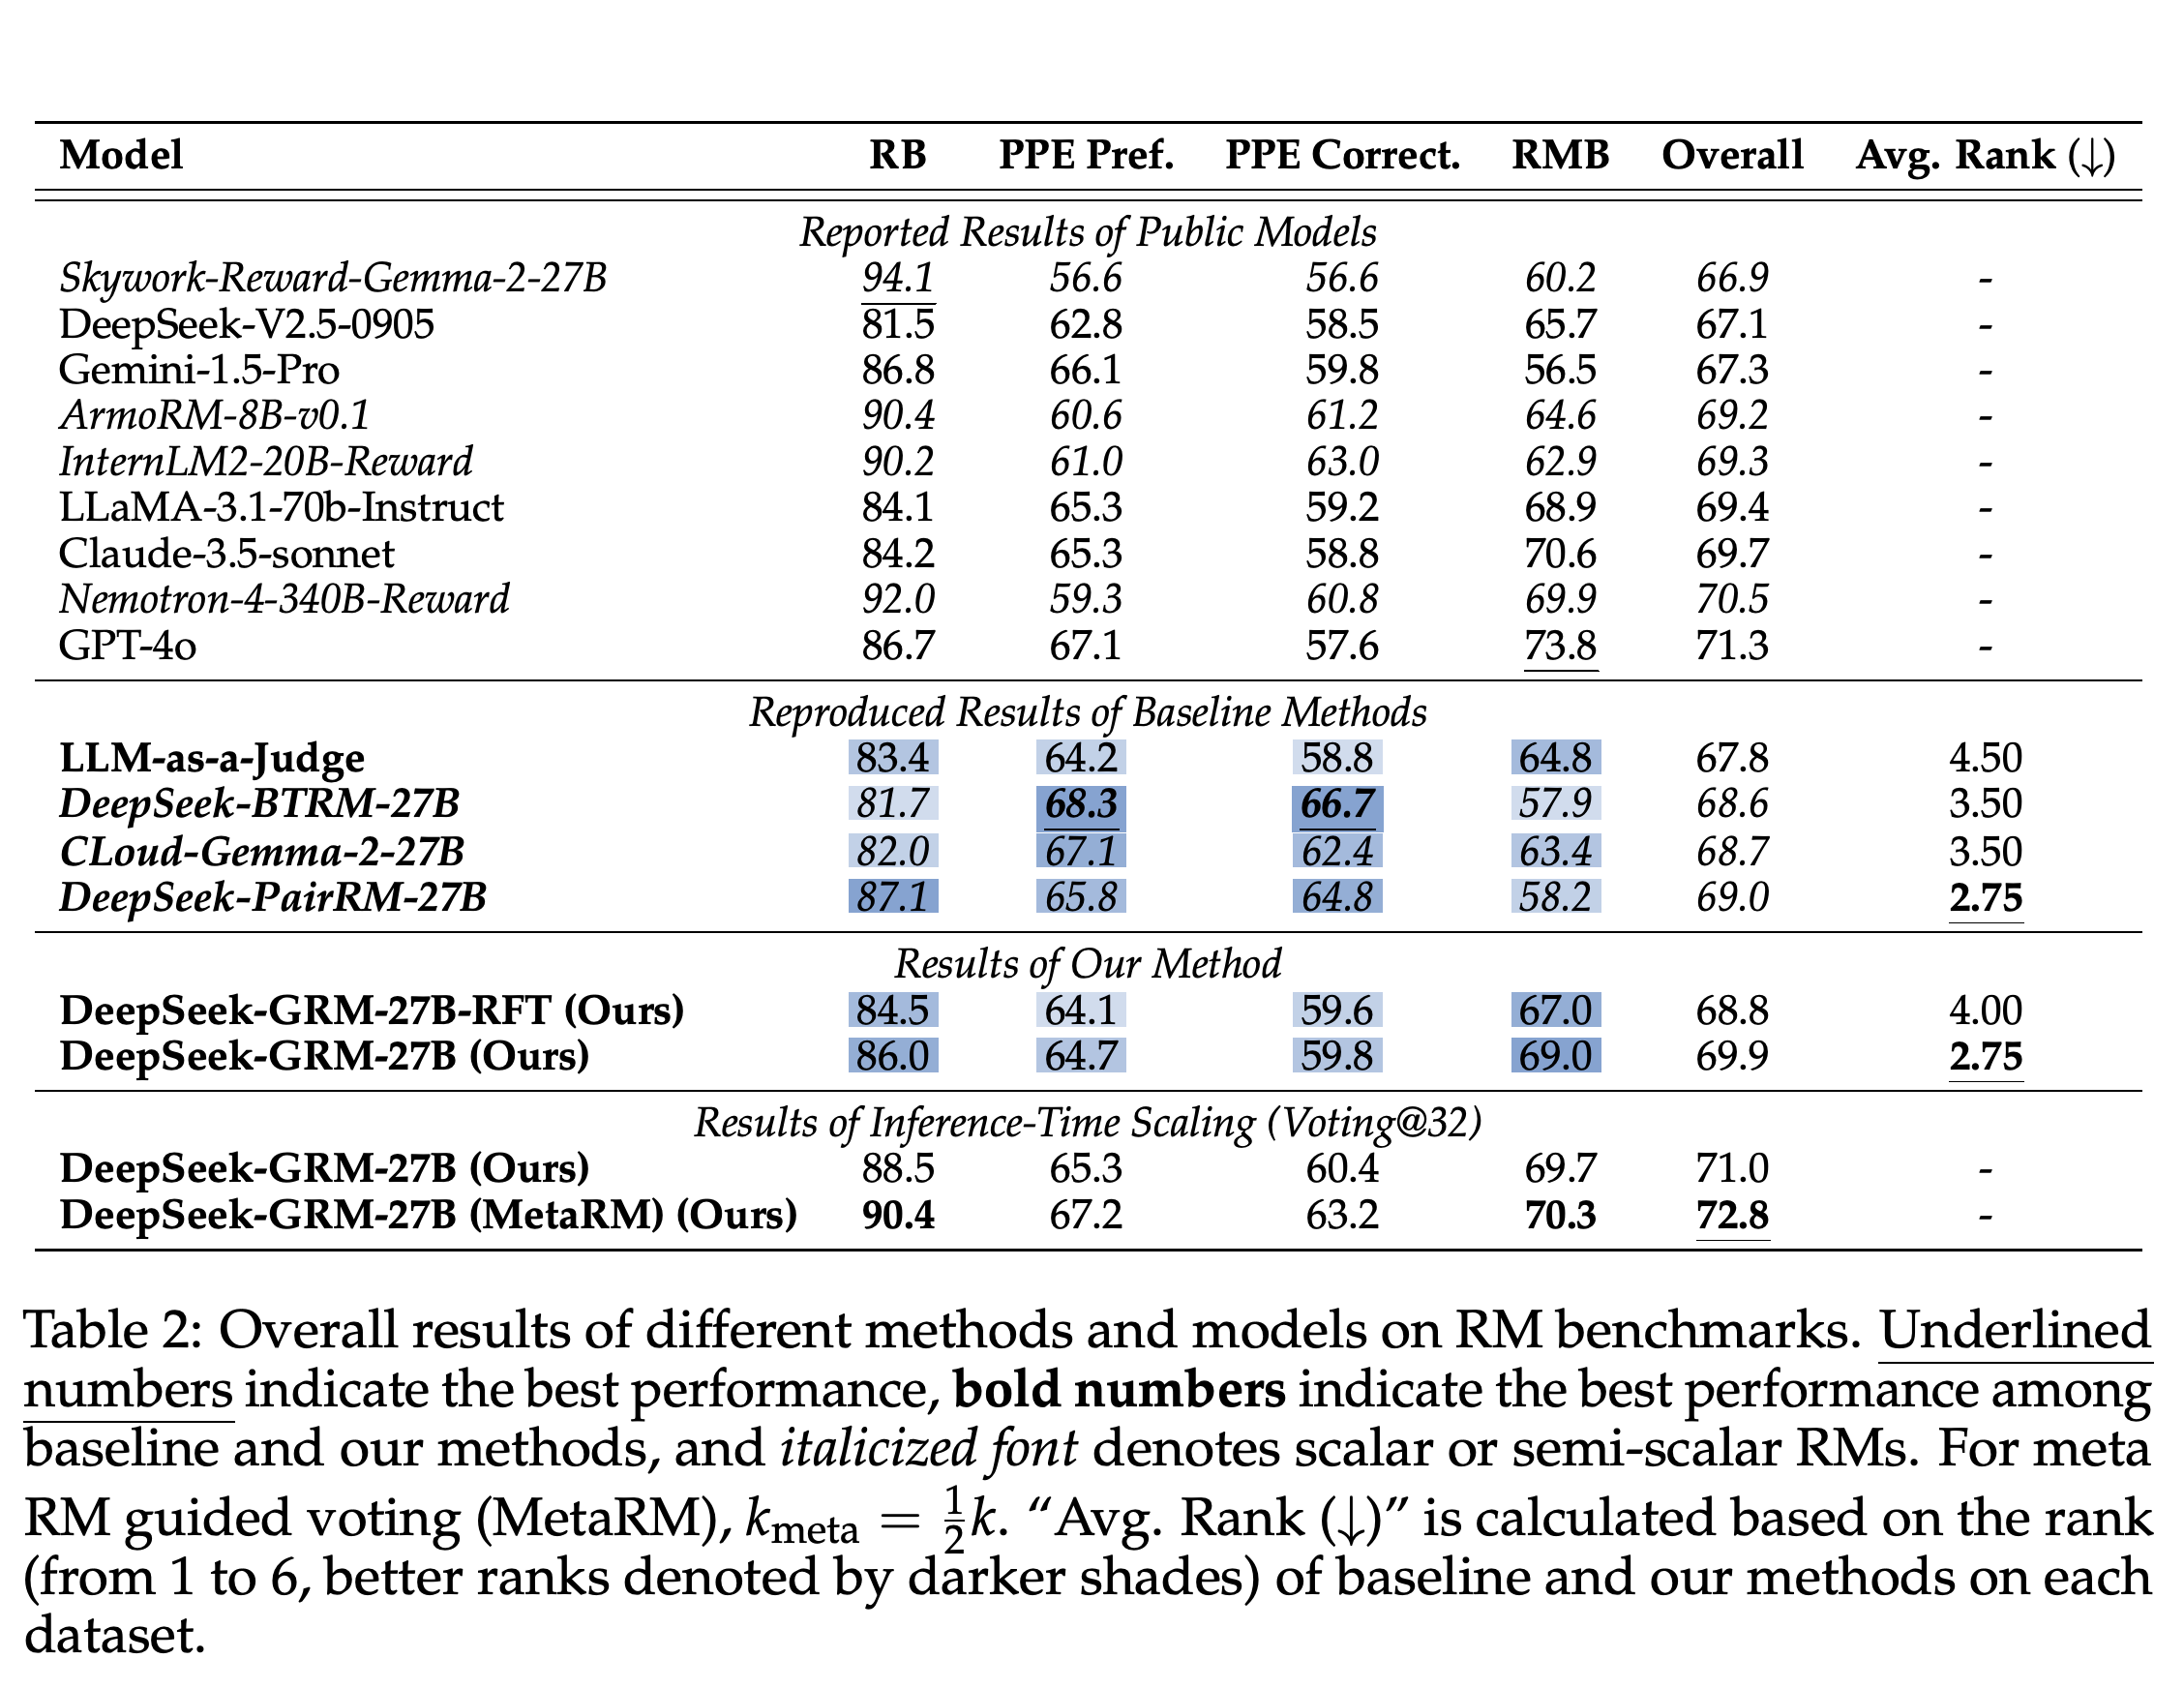
샘플 32개를 사용하는 meta-guided 평가의 +4.9점 향상은 샘플 1개를 사용하는 확률적 결과 67.9를 기준으로 계산한다. 별도로 제시한 greedy 결과 69.9는 디코딩 조건이 달라, 어느 기준을 사용하는지에 따라 확장에 따른 향상 폭이 달라 보인다.
원칙 생성을 제거하면 greedy 및 샘플 8개 성능이 모두 낮아진다. 반면 온라인 강화학습은 rejective 방식으로 선별한 평가 샘플 없이 훈련한 모델도 개선한다. 평가 32개 중 8개 또는 16개를 남기면 종합 점수는 각각 72.7과 72.8로 비슷하며, 1개만 남기면 71.5다.
Reward Bench에서 meta-guided 샘플 8개를 사용하는 27B 모델은 그래프의 671B greedy 결과를 넘어서며, 샘플 32개를 사용하는 plain voting은 그와 비슷하다. 서로 다른 기반 모델과 훈련 방식, 예시 300개로 제한된 DeepSeek-R1 평가 때문에 연산 효율성에 관한 결론에는 한계가 있다.
6 Related Work
관련 연구에서는 오프라인 또는 온라인 강화학습으로 훈련한 생성형 보상 모델, 도구나 외부 지식을 추가한 평가기, 샘플링이나 긴 추론을 통한 추론 시 확장을 다룬다. 이 논문은 확장 가능한 범용 보상 평가를 위해 상황에 맞는 원칙 생성을 학습하는 데 초점을 둔다.
- 저자들은 범용 평가에서 판단 전에 긴 추론을 수행하며 보상을 생성하도록 유도하는 효과적인 방법을 확립하지 못한다. 이를 원칙 기반 평가와 결합하는 문제는 향후 과제로 남긴다.
- 확장 가능한 보상 모델로 별도의 응답 생성 정책을 개선하는 방안은 가능한 응용으로 논의하며, 이 연구에서 실증하지는 않는다.
7 Conclusion and Future Work
결론에서는 SPCT로 학습한 적응적 원칙과 비평이 보상 품질과 샘플링 기반 확장성을 높이고, meta-guided voting이 추가 개선을 제공한다고 설명한다. 온라인 강화학습 보상 시스템, 응답 생성 정책과 함께 추론 연산을 늘리는 방식, 오프라인 모델 평가를 응용으로 제안하지만, 이들은 향후 연구 방향으로 남아 있다.
Ethics Statement
Ethics Statement는 편향된 훈련 데이터, 자동 생성 기준, 실제 판단 과정을 충실하게 반영하지 않을 수 있는 비평의 위험을 지적한다. 저자들은 지속적인 인간 감독, 공개 모델에 대한 외부 검토, 벤치마크와 실제 환경 전반의 평가를 권고한다. 벤치마크 분야별 성능이 더 균형 잡혔다고 해서 사회적 편향이 없다고 볼 수는 없다.
부록
- A Additional Related Work는 원칙으로 모델 행동을 정렬하는 Constitutional AI와 스칼라 및 준스칼라 보상 모델을 검토한다. B Limitations and Future Directions는 생성형 평가의 비용과 검증 가능한 과제에서 낮은 성능을 현재의 한계로 제시한다. 향후 연구로 도구 사용, 원칙 생성과 비평 생성의 분리, 오프라인 평가, 더 긴 추론을 제안한다. DeepSeek-GRM으로 중간 추론 단계를 평가하는 방안도 제안하지만 폭넓게 검증하지는 않는다.
- C Implementation Details와 C.1 Model Training은 rejective fine-tuning 예시 1256K개와 강화학습 예시 237K개를 보고한다. 전자는 일반 지시 예시 1070K개와 샘플링한 평가 186K개로 구성된다. 데이터는 내부 자료, 수학 문제 데이터셋 MATH, 선호도 데이터셋 UltraFeedback, OffsetBias, Skywork-Reward-Preference-80K-v0.2, HelpSteer2-Preference를 결합한다. 평가 샘플은 DeepSeek-v2.5-0905로 예시마다 힌트 없이 3개씩 생성한다. 훈련에는 그룹 크기 4를 사용하며, KL 계수는 27B 모델에서 0.08, 16B 모델에서 0.002를 사용한다.
- C.1 Model Training은 A100 그래픽 처리 장치(GPU) 128개와 단계별 900 steps를 사용한다고 보고한다. Rejective fine-tuning과 강화학습의 학습률은 각각 5 × 10⁻⁶과 4 × 10⁻⁷이고, 배치 크기는 각각 1024와 512이며, 소요 시간은 각각 19.2 h와 15.6 h다. 27B보다 큰 모델은 자원 제약으로 rejective 방식으로 선별한 샘플 예시 50K개만 사용하며 규칙 기반 강화학습은 적용하지 않는다. C.2 Baseline Implementation은 방법별 제약을 설명한다. LLM-as-a-Judge에는 응답 쌍으로 구성된 강화학습 데이터만 사용하며, 모델 표현을 수치 보상으로 변환하는 스칼라 값 헤드를 훈련할 때는 단일 응답 평점 데이터를 제외한다.
- D Experiment Details, D.1 Hyper-Parameters, D.2 Benchmarks, D.3 Detailed Results는 평가 설정과 벤치마크별 세부 결과를 제공한다. 별도로 보고하는 추가 선호도 데이터셋인 Reward Bench prior sets는 종합 점수 계산에서 제외한다. 보고된 GPT-4o 점수는 Reward Bench와 PPE에서 gpt-4o-2024-08-06을, RMB에서 gpt-4o-2024-05-13을 사용한다. 여러 응답 중 최선을 선택해야 하는 RMB best-of-N 하위 집합에서 기준 모델은 최선으로 레이블이 붙은 응답과 각 대안을 따로 비교한다. 반면 DeepSeek-GRM은 전체 응답 목록을 입력받으며, 부록은 이 평가 절차 차이를 검토한다.
- E Additional Experiments와 E.1 Input Flexibility of the Pointwise GRM Approach는 다중 응답, 단일 응답, 참조 정답을 제공한 입력을 시험한다. E.1.1 Generating Rewards for Many Responses에서 응답 쌍과 목록 입력 간 차이는 유용성에서 0.2점, 무해성에서 0.5점이다. E.1.2 Generating Rewards for Single Responses에서 DeepSeek-GRM-27B의 ReaLMistake ROC-AUC는 72.2이며, 샘플 8개를 사용하면 74.4다. GPT-4o-2024-08-06은 74.3이다. E.1.3 Generating Rewards with Reference에서는 참조 정답을 제공해 PPE Correctness가 59.8에서 91.6으로 높아진다. 이는 평가기가 이용할 수 있는 정보를 실질적으로 바꾼 조건이다.
- E.2 Transferability of Generated Principles에서 GPT-4o는 DeepSeek-GRM이 생성한 원칙을 사용해 Chat Hard에서 78.1, IFEval에서 58.3을 기록한다. 기본 설정에서는 각각 76.1과 56.0이다. E.3 Generalization beyond Training Data에서 MATH 보상 모델링 데이터를 제거하면 27B 모델의 Reward Bench 점수는 86.0에서 83.0으로 낮아진다. Chat Hard는 78.3에서 70.4로 낮아지지만 Chat은 94.1에서 96.1로 높아진다. E.4 Response Length Analysis for Rule-Based RL에서 응답 길이는 Reasoning에서 260토큰에서 376토큰으로 늘고, Chat Hard에서는 259토큰으로 유지되며, Safety에서는 245토큰에서 218토큰으로 줄어든다. DeepSeek-R1과 비교할 때는 모델마다 서로 다른 토크나이저를 사용하며, 토크나이저는 텍스트를 모델별 단위로 나눈다.
- F Qualitative Analysis와 F.1 Case Study는 스칼라 기준 모델이 놓친 차이를 올바르게 판단한 사례, 집계를 통해 프로그래밍 판단을 바로잡은 사례, 실시간 정보와 기준별 가중치가 관련된 실패 사례를 보여준다. F.2 Failure Mode Analysis는 벤치마크 그룹 4개에서 각각 오답 예시 10개를 수작업으로 검토한다. 잘못된 비평은 각각 4, 5, 7, 5건이며, 불균형한 원칙 가중치는 각각 4, 4, 3, 2건이다. 나머지 범주는 부적절한 원칙과 벤치마크 레이블에 대한 주석자 이견이다. 이 소규모 오류 표본은 정성적 진단을 뒷받침하며, 전체 모집단의 실패율을 나타내지는 않는다.
- G Prompt Templates는 DeepSeek-GRM (Default), DeepSeek-GRM (Training on Rating Single Response), Meta RM, LLM-as-a-Judge 템플릿을 제공한다. 기본 모델은 Specific Criteria, Analysis, 1에서 10까지의 정수 Scores를 생성한다. 단일 응답 훈련에서는 이진 정확성 점수를 사용하고, ReaLMistake 평가에서는 일반적인 점수 범위를 사용한다. Meta RM은 후보 응답과 생성된 원칙 및 비평을 입력받으며, LLM-as-a-Judge는 선호하는 응답의 인덱스를 출력한다.
짧은 생각
원칙 제거 실험과 fine-tuning만 수행한 모델의 낮은 확장성은 평가 기준 생성 학습이 반복 평가에 기여함을 뒷받침한다. 다만 이 실험만으로 원칙의 품질을 훈련의 다른 모든 효과와 분리하지는 못한다. 결과는 벤치마크 판단 개선을 입증하지만, 후속 정책 개선과 동일한 연산량에서의 우위는 검증하지 않는다.