


Orchard: An Open-Source Agentic Modeling Framework 요약 설명
14 May 2026 | Paper Review Agent Learning Rollout Infrastructure Reinforcement Learning Reward Modeling목차
- 요약
- 1 Introduction
- 2 Orchard Env
- 3 Orchard-SWE
- 3.1 Problem Setting
- 3.2 Trajectory Collection and Curation
- 3.3 Off-policy Learning: Supervised Fine-Tuning with credit assignment
- 3.4.1 Reinforcement Learning with Balanced Adaptive Rollout (BAR)
- 3.4.2 Denser Reward: On Policy Distillation (OPD)
- 3.4.3 Denser Reward: Rubric-based Process Reward (RPR)
- 3.5 Distilling Historical Rollouts into a Value Model
- 3.6 Main Results
- 3.7 Generalization to Unseen Harnesses and Tasks
- 3.8 Ablations and Analysis
- 4 Orchard-GUI
- 5 Orchard-Claw
- 6 Related Work
- 7 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Orchard: An Open-Source Agentic Modeling Framework 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 14일(Arxiv)
- Peng, Baolin, Yao, Wenlin, Wu, Qianhui, Cheng, Hao, Yu, Xiao, Yang, Rui, Ge, Tao, Sordoni, Alessandro, Yuan, Xingdi, Shen, Yelong, et al.
- Microsoft Research, Columbia University, UIUC
- 논문 링크
- Github
요약
- Orchard: An Open-Source Agentic Modeling Framework는 샌드박스 실행을 에이전트 하네스, 추론 서비스, 트레이너와 분리한다. Kubernetes 기반 Orchard Env는 공통 환경 인터페이스를 통해 궤적 수집, 지도 미세 조정(SFT), 강화 학습(RL), 평가를 지원한다.
- Orchard-SWE는 실패한 궤적에서도 유용한 구간을 감독 신호로 활용하고, 보상 균형을 맞춘 롤아웃 선택, 조밀한 교사 보상 또는 과정 보상, 과거 롤아웃을 활용한 가치 모델 학습을 결합한다. SWE-bench Verified에서 Qwen3.5-35B-A3B는 루브릭 기반 과정 보상으로 69.7%, 후보 6개의 가치 모델 재순위화로 73.0%를 달성한다.
- Orchard-GUI는 증류한 궤적 412개와 RL 과제 2,198개로 4B 비전 언어 에이전트를 학습하며, 브라우저 벤치마크 3개에서 평균 성공률 68.4%를 달성한다. Orchard-Claw는 합성 과제 192개를 사용하며, Claw-Eval의 ReAct 방식 하네스에서 pass@3 59.6%, ZeroClaw에서 73.9%를 달성한다. 하네스 2개 모두 학습에 사용한다.
- 시스템 실험에서는 평균 실행 지연 시간 0.280초를 보고하며, 이미지를 미리 내려받은 샌드박스 1,000개의 짧은 수명주기 시험에서 성공률 100%를 기록한다. 실험은 실행 서비스의 재사용과 상당한 에이전트 학습 성능 향상을 보여주지만, 하네스 독립성이나 전체 학습 비용의 효율성까지 입증하지는 않는다. 평가 조건이 서로 다르고, GUI 데이터 수집에는 교사 롤아웃 62,395개가 필요하며, SWE 재순위화에도 추가 추론 후보가 필요하다.
1 Introduction
논문은 환경 관리를 재현 가능한 에이전트 학습의 병목으로 지목한다. 롤아웃마다 저장소 설정, 의존성 설치, 반복적인 도구 실행, 정리가 필요할 수 있으며, 이러한 작업을 수천 개의 격리 환경에서 수행해야 한다. Orchard는 실행 관리를 특정 학습 스택에 내장하는 대신, 과제 도메인, 에이전트 하네스, 파이프라인 단계 전반에서 재사용할 수 있는 좁은 서비스 경계를 제안한다.
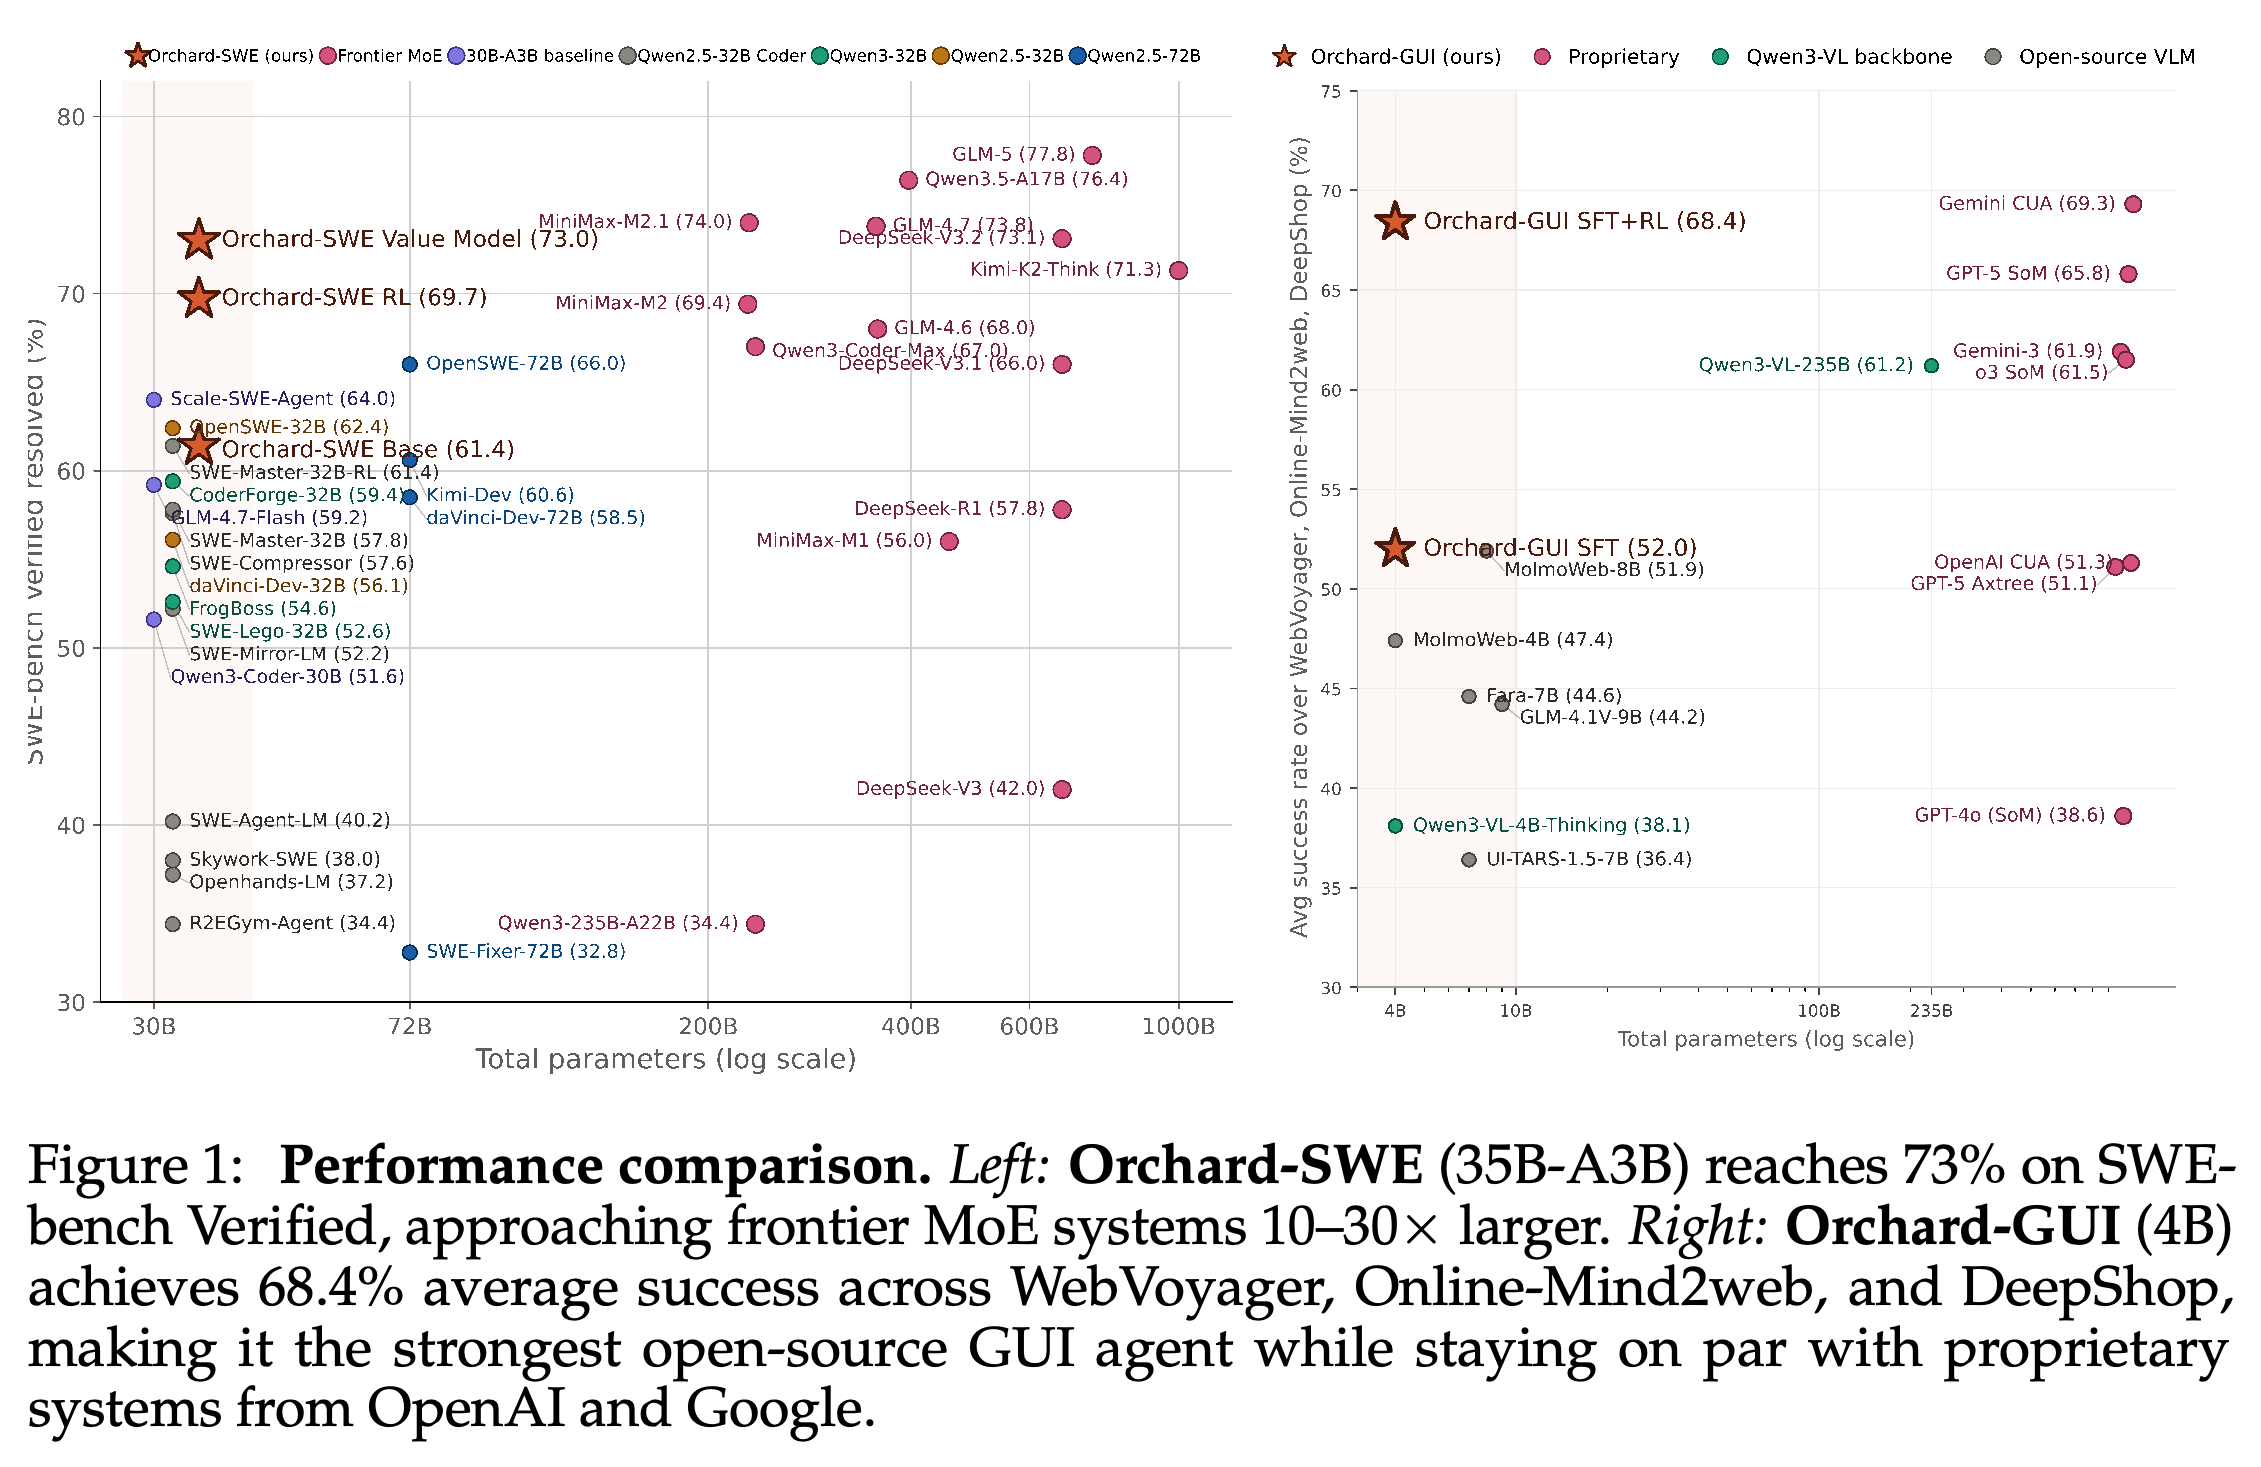
- Figure 1은 SWE와 GUI 성능을 전체 모델 파라미터 수에 따라 배치한다. 하네스, 학습 데이터, 추론 절차가 다르므로, 이는 파라미터 규모를 통제한 실험이 아니라 시스템 수준의 비교다.
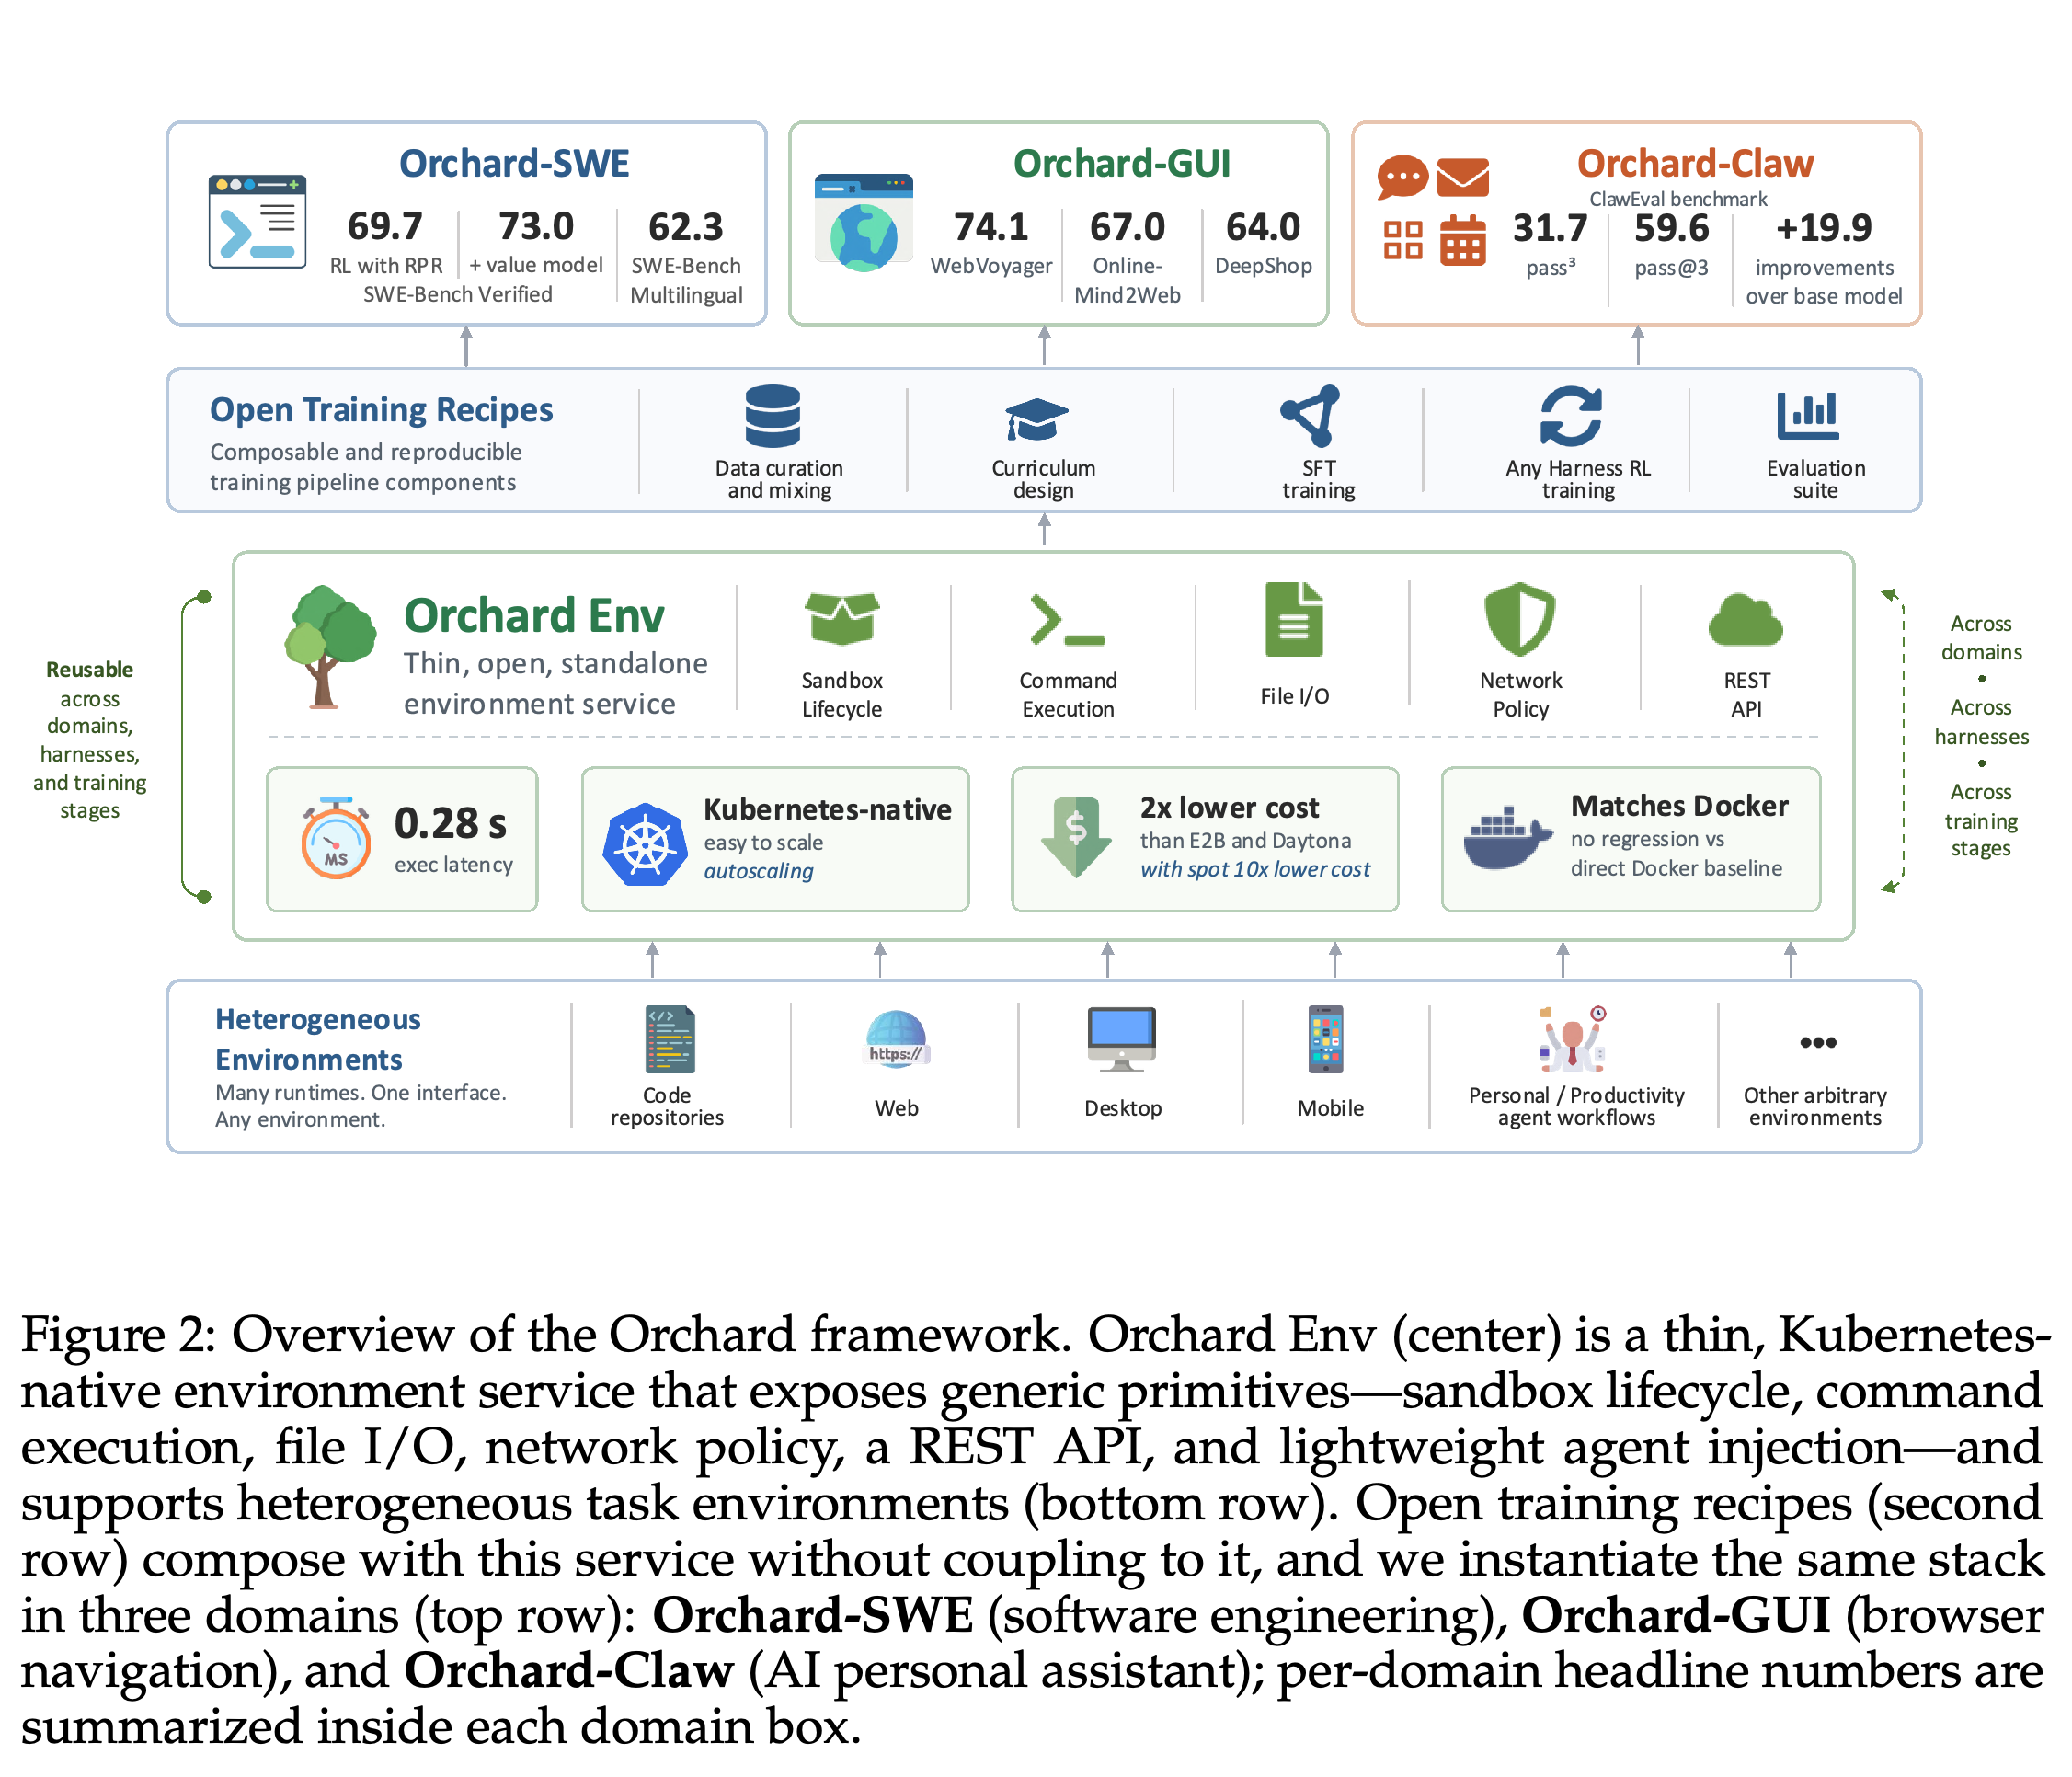
- Figure 2는 이질적인 환경, Orchard Env, 조합 가능한 학습 구성 요소, 도메인별 에이전트 3개를 구분한다. 데스크톱과 모바일 환경은 아키텍처가 지향하는 범위를 나타내며, 학습을 평가한 도메인은 아니다. SWE-bench Multilingual의 대표 수치인 62.3%는 Orchard-SWE-Qwen3에 대해 51.0%를 보고하는 Table 9로 설명되지 않는다.
- 저자들은 소프트웨어 엔지니어링, 브라우저 탐색, 개인 비서 워크플로를 위한 환경 서비스, 학습 레시피, 궤적 데이터셋을 공개한다고 밝힌다.
산점도는 각 벤치마크에서 Orchard의 SWE 및 GUI 시스템을 훨씬 큰 모델에 가까운 위치에 배치한다. 성능을 전체 파라미터 수와 비교하지만 학습 레시피, 하네스, 추론 절차가 섞여 있다. SWE 가치 모델 지점은 여러 후보 롤아웃을 포함한다.
도식은 Orchard Env 아래에 이질적인 환경을, 위에 학습 구성 요소와 도메인 에이전트를 배치해 의도한 서비스 경계를 명확히 한다. 데스크톱과 모바일 아이콘은 평가한 도메인이 아니라 아키텍처의 범위를 나타낸다. 대표 Multilingual 수치 62.3%는 Table 9의 Qwen3 결과 51.0%로 설명되지 않는다.
2 Orchard Env
Orchard Env는 3가지 요구사항을 다룬다. 얇은 독립형 서비스 경계, 적은 수정으로 다양한 Docker 이미지를 지원하는 호환성, 대규모에서도 실용적인 비용으로 쉽게 배포할 수 있는 구성이 필요하다. API는 특정 하네스, 추론 백엔드, 트레이너를 요구하지 않고 환경 연산을 제공한다.
2.1 Architecture Overview
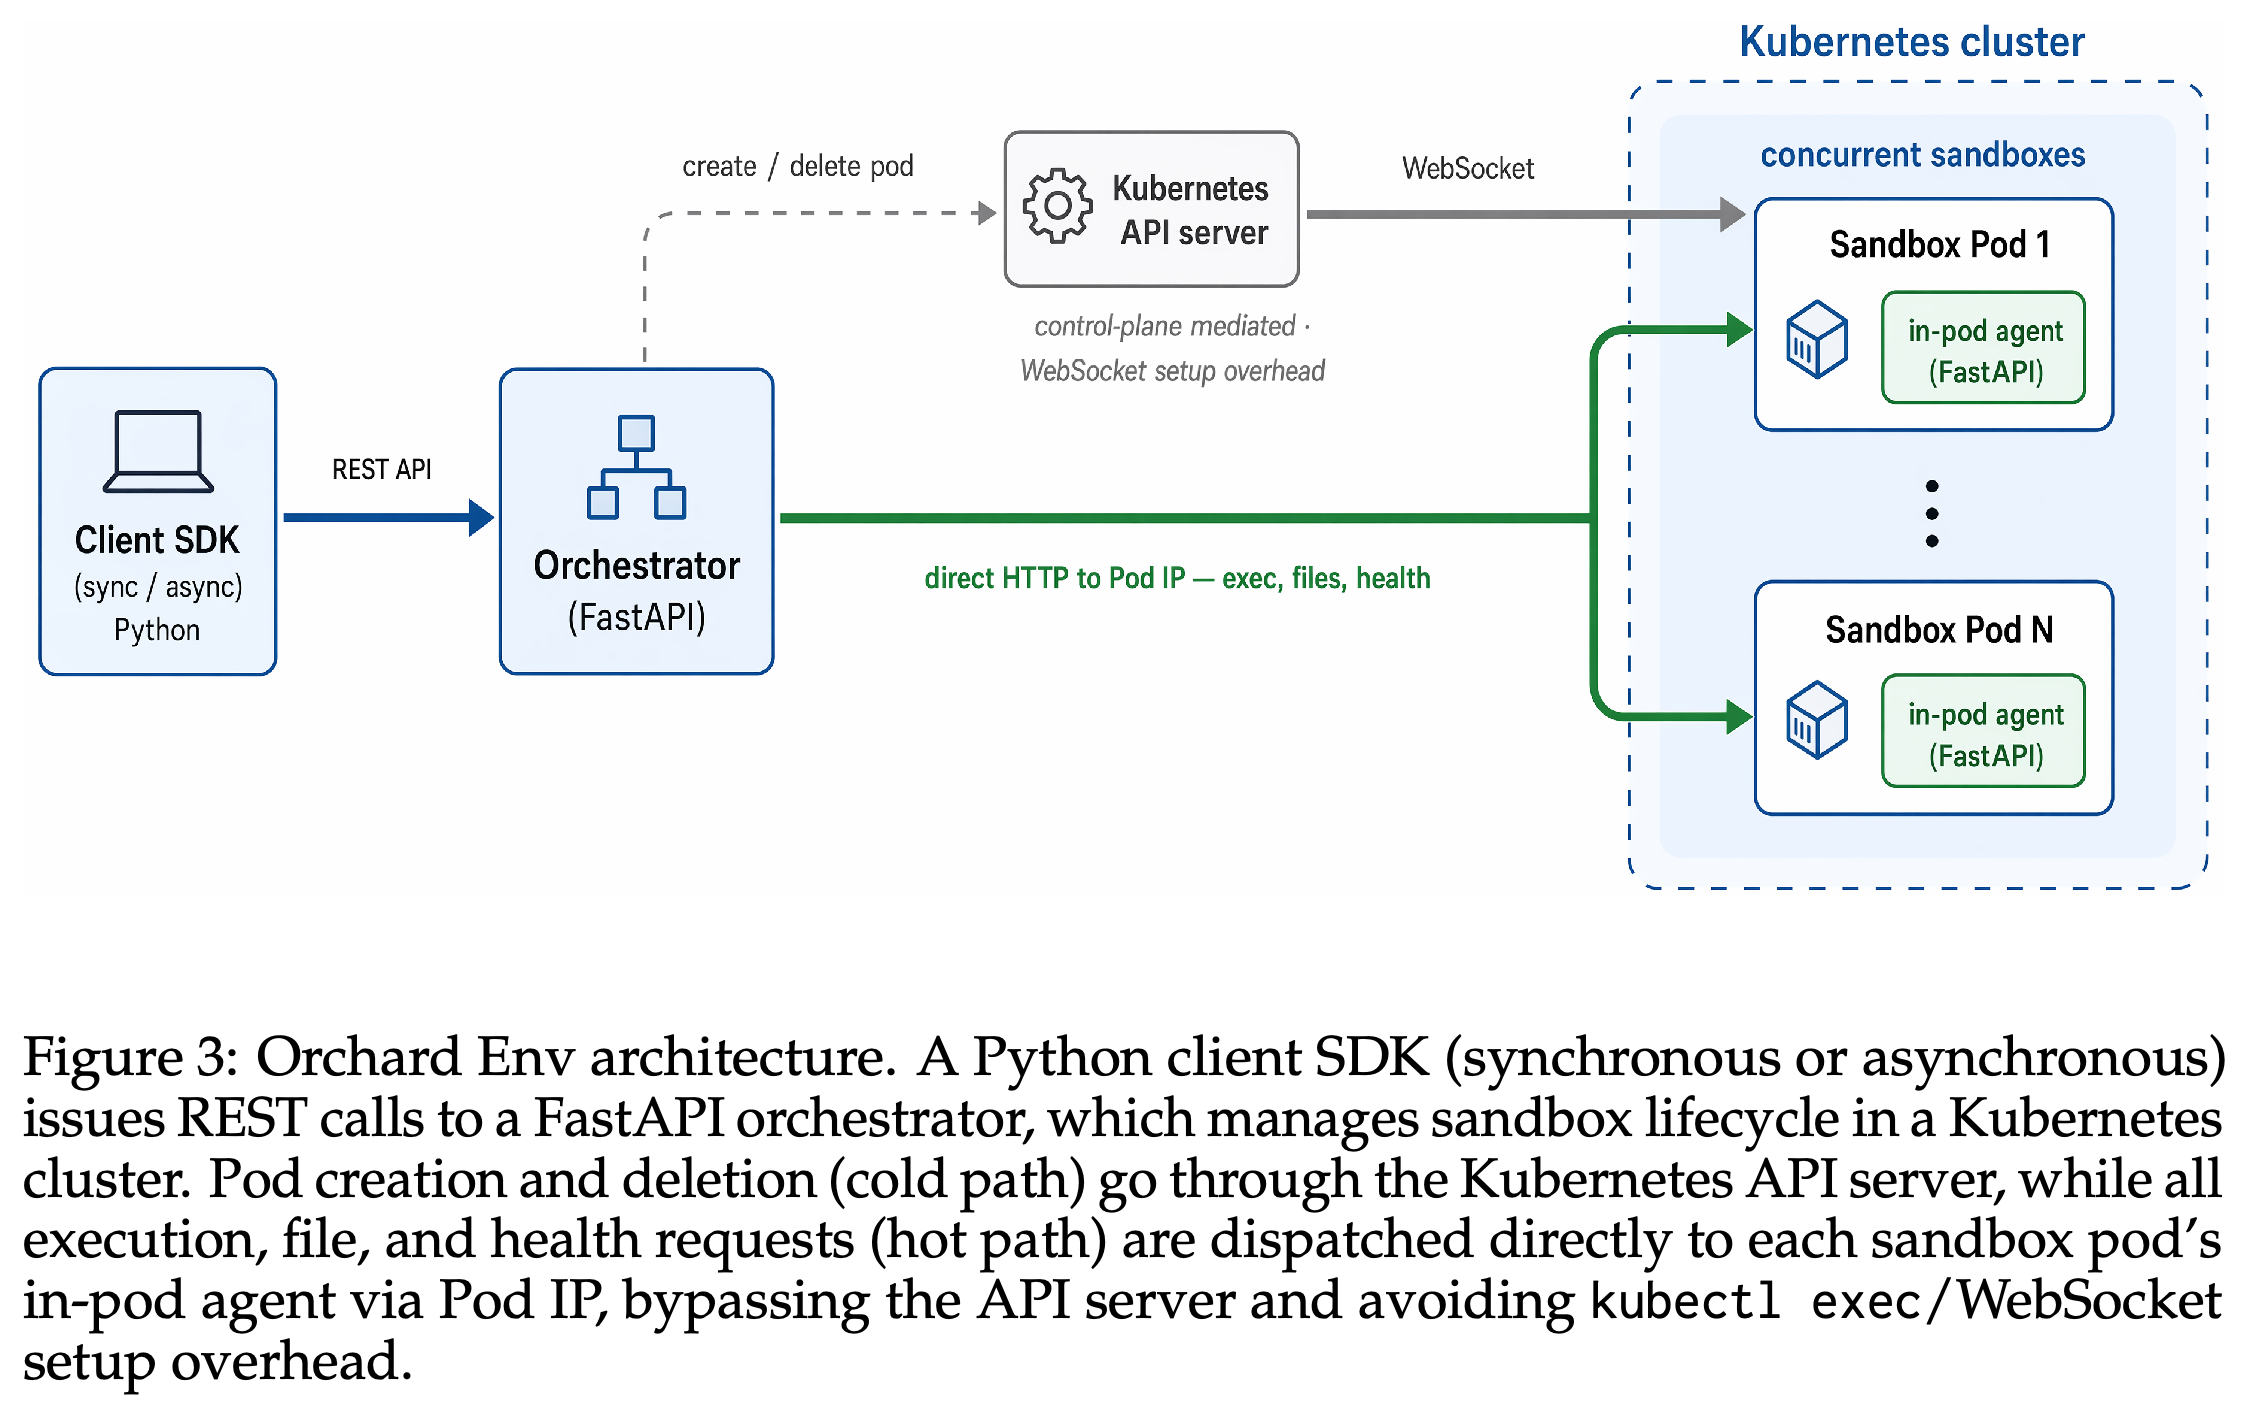
아키텍처는 동기 또는 비동기 Python 클라이언트, FastAPI 오케스트레이터, 각 샌드박스에 주입하는 경량 실행 에이전트의 3개 계층으로 구성된다. Figure 3은 Kubernetes를 거치는 수명주기 연산과 샌드박스 Pod IP로 직접 전달되는 실행, 파일, 상태 확인 요청을 구분한다.
- SandboxClient와 AsyncSandboxClient는 사용자 지정 이미지, 명령 실행, 파일 전송, 패치 적용, 자동 정리, 하트비트 유틸리티, 지수 백오프 재시도를 지원한다.
- 오케스트레이터는 Pod를 프로비저닝하고, 지속적인 LIST+WATCH 스트림으로 준비 상태를 추적하며, 샌드박스별 잠금으로 실행 요청을 직렬화한다. 만료되거나 퇴거된 샌드박스도 정리한다. 선택적 Redis 백엔드는 복제본 사이에서 메타데이터를 공유한다.
- Pod 내부의 FastAPI 에이전트는 설정 가능한 시간 제한을 적용해 하위 프로세스를 실행하며, 시간 초과 시 프로세스 트리를 종료한다. 런타임 주입으로 과제 이미지를 다시 빌드할 필요가 없다. 여기서 실행 에이전트는 LLM 정책이 아니라 샌드박스 서비스를 뜻한다.
실행 경로는 프로비저닝 이후 Kubernetes API 서버를 우회해 반복적인 상호작용 트래픽을 Pod 수명주기 연산과 분리한다. 지연 시간을 줄이려는 설계는 설명하지만, 절제 실험으로 해당 설계의 인과적 기여를 분리하지는 않는다.
2.2 Comparison with Existing Systems
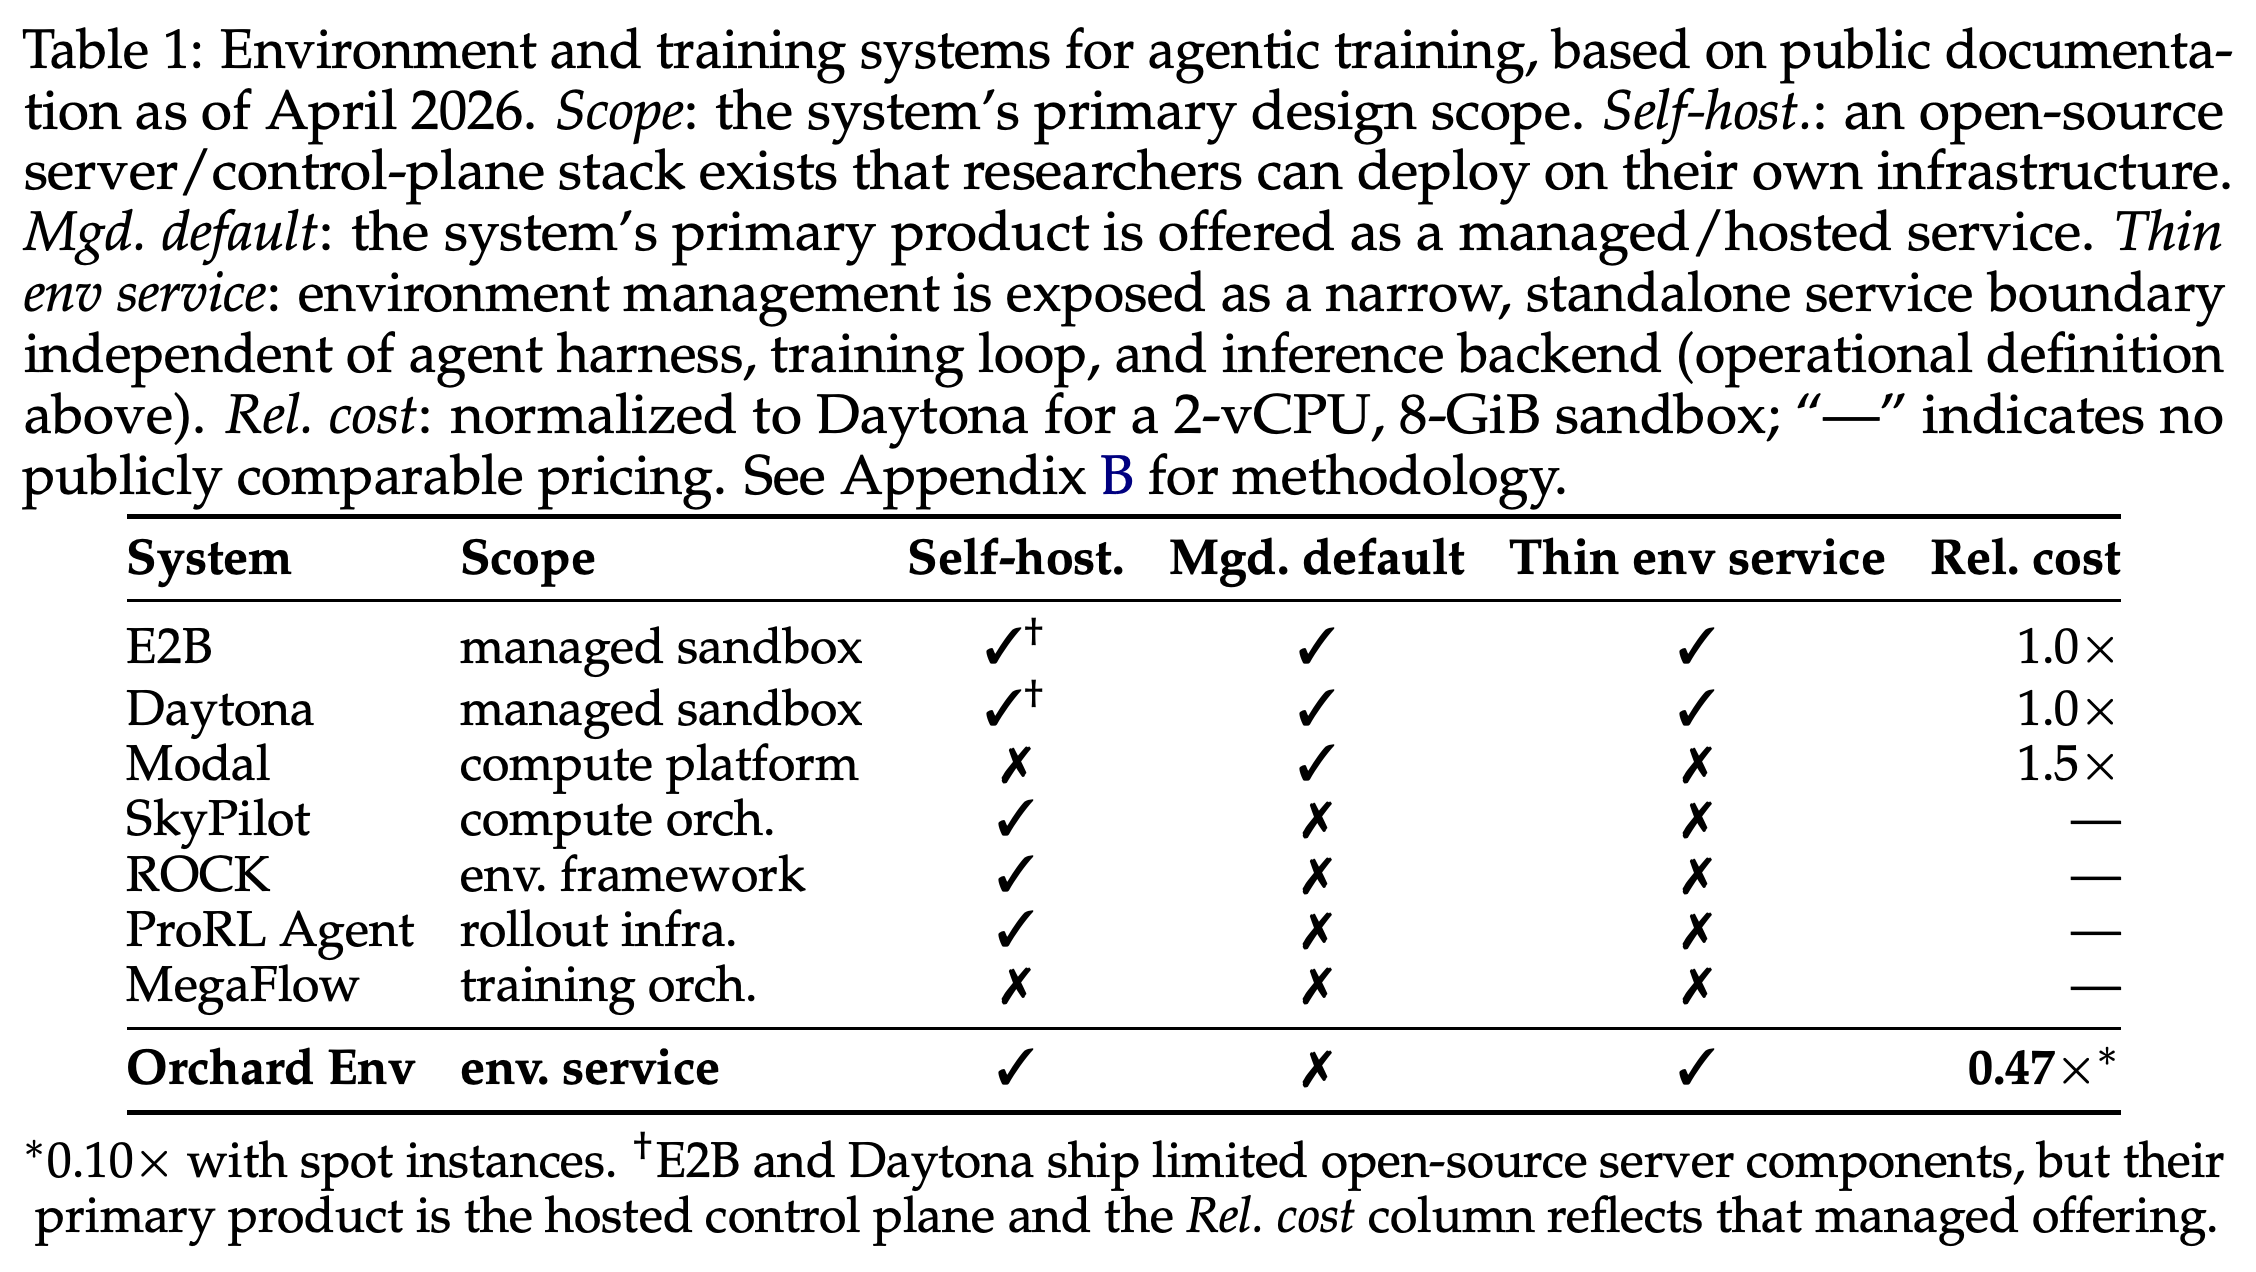
Table 1은 Orchard Env를 자체 호스팅이 가능하고 Kubernetes를 기반으로 하며 환경에만 범위를 한정한 시스템으로 제시한다. 관리형 샌드박스, 범용 컴퓨팅 플랫폼, 통합 학습 시스템과 비교한다. 비교는 2026년 4월 기준 공개 문서를 사용하며, 얇은 환경 서비스를 하네스, 트레이너, 추론 선택과 독립적인 안정된 환경 API로 정의한다.
- E2B와 Daytona도 독립형 샌드박스 서비스를 제공하지만, 비교에서는 관리형 상품의 가격을 사용한다. SkyPilot은 경쟁 환경 계층이 아니라 상호 보완적인 인프라로 설명한다.
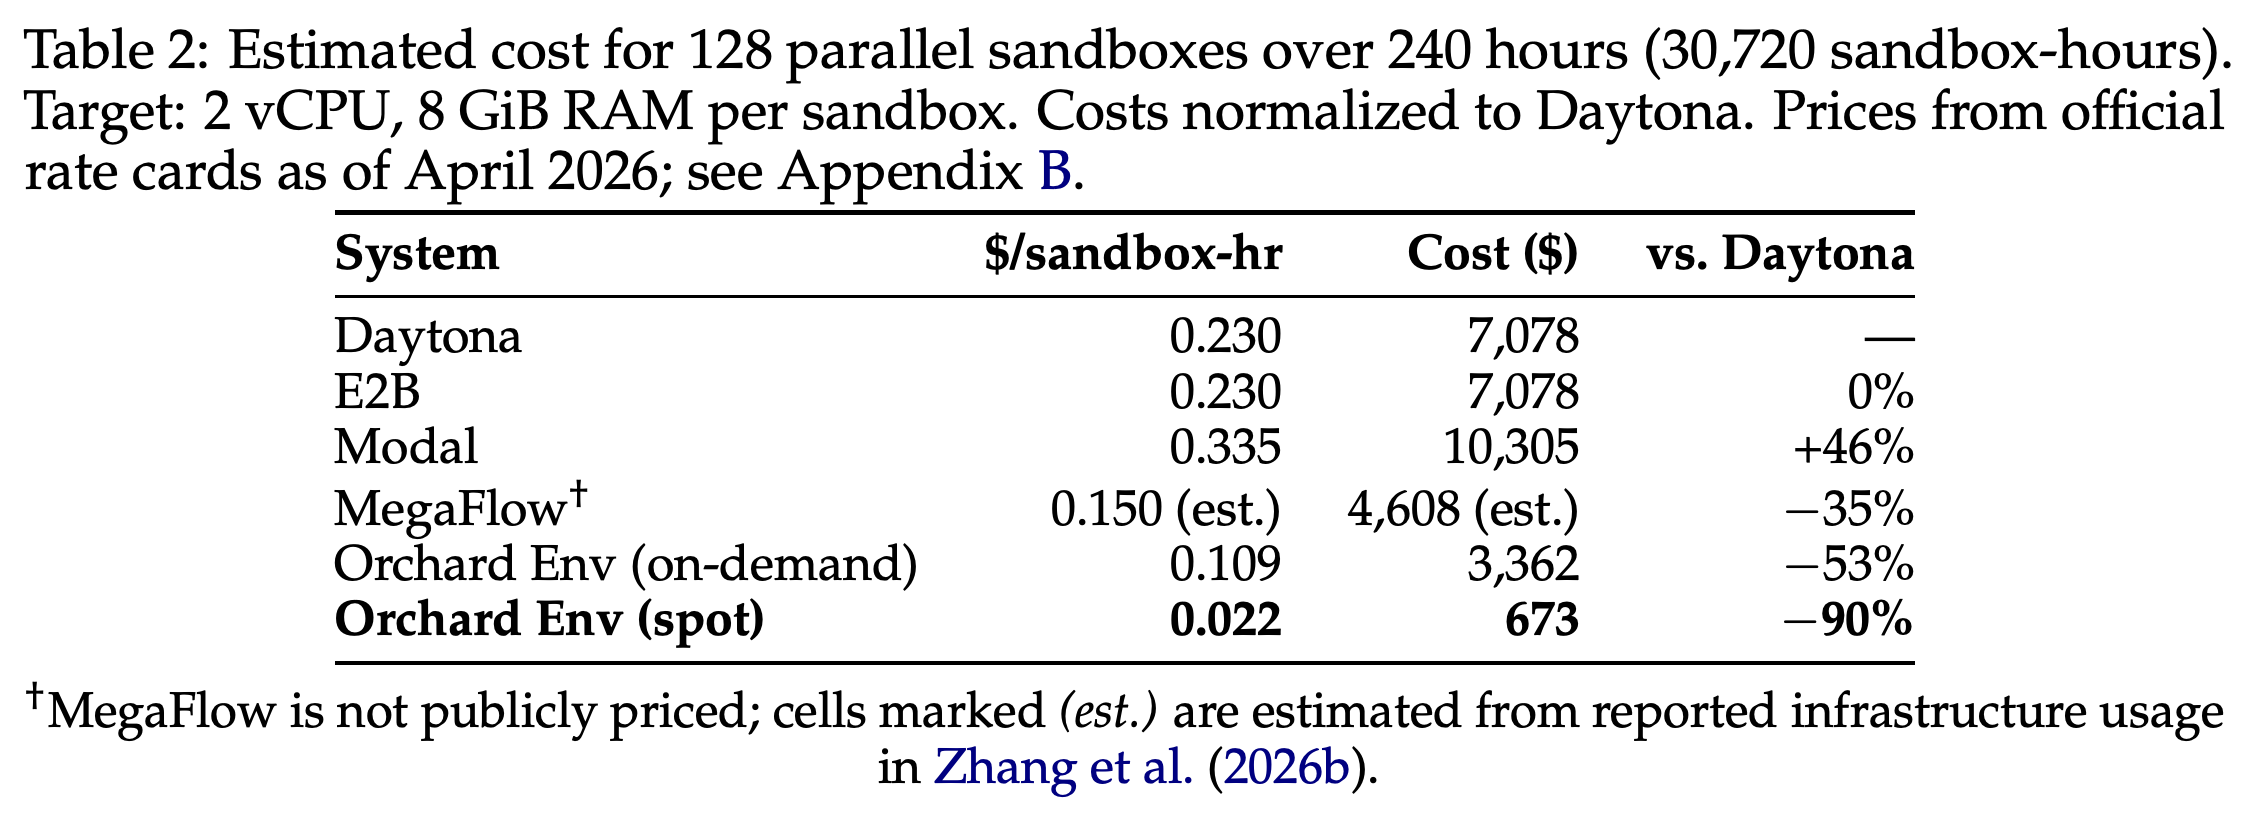
- Table 2는 각각 2 vCPU와 8 GiB RAM을 갖춘 병렬 샌드박스 128개를 240시간 사용하는 비용을 추정한다. Daytona 또는 E2B는 $7,078, Modal은 $10,305, Orchard 온디맨드는 $3,362, Orchard 스폿은 $673이다.
- 이는 전체 에이전트 학습 비용이 아니라 샌드박스 인프라 추정치다. VM 다중화, 요금표 가정, 스폿 가용성에 따라 달라진다. MegaFlow의 $4,608은 공개 가격이 아니라 보고된 인프라 사용량에서 추정한 값이며, 과제별 자원 할당도 다르다.
비교는 자체 호스팅 가능 여부, 관리형 배포, 좁은 환경 API를 구분한다. Orchard의 상대 비용은 자체 호스팅 배포를 사용하지만, E2B와 Daytona 항목은 관리형 상품의 가격을 사용하므로 배포와 운영 책임이 다르다.
샌드박스 사용량 30,720시간에 대해 Orchard가 보고한 온디맨드 $3,362와 스폿 $673은 관리형 샌드박스 대안의 $7,078보다 낮다. 수치는 가정한 샌드박스 인프라만 포함하며, 교사 데이터 생성, 심사, 모델 학습, 추론은 포함하지 않는다. 스폿 총액도 Appendix B의 혼합 요금 설정과 다르다.
2.3 System Evaluation
시스템 평가는 실행 지연 시간, 동시 실행 신뢰성, Docker 대비 후속 과제 동작을 측정한다. 별도 언급이 없으면 각 노드가 32 vCPU와 128 GiB RAM을 갖춘 노드 8개, 미리 내려받은 이미지, 2-vCPU, 8-GiB 샌드박스를 사용한다.
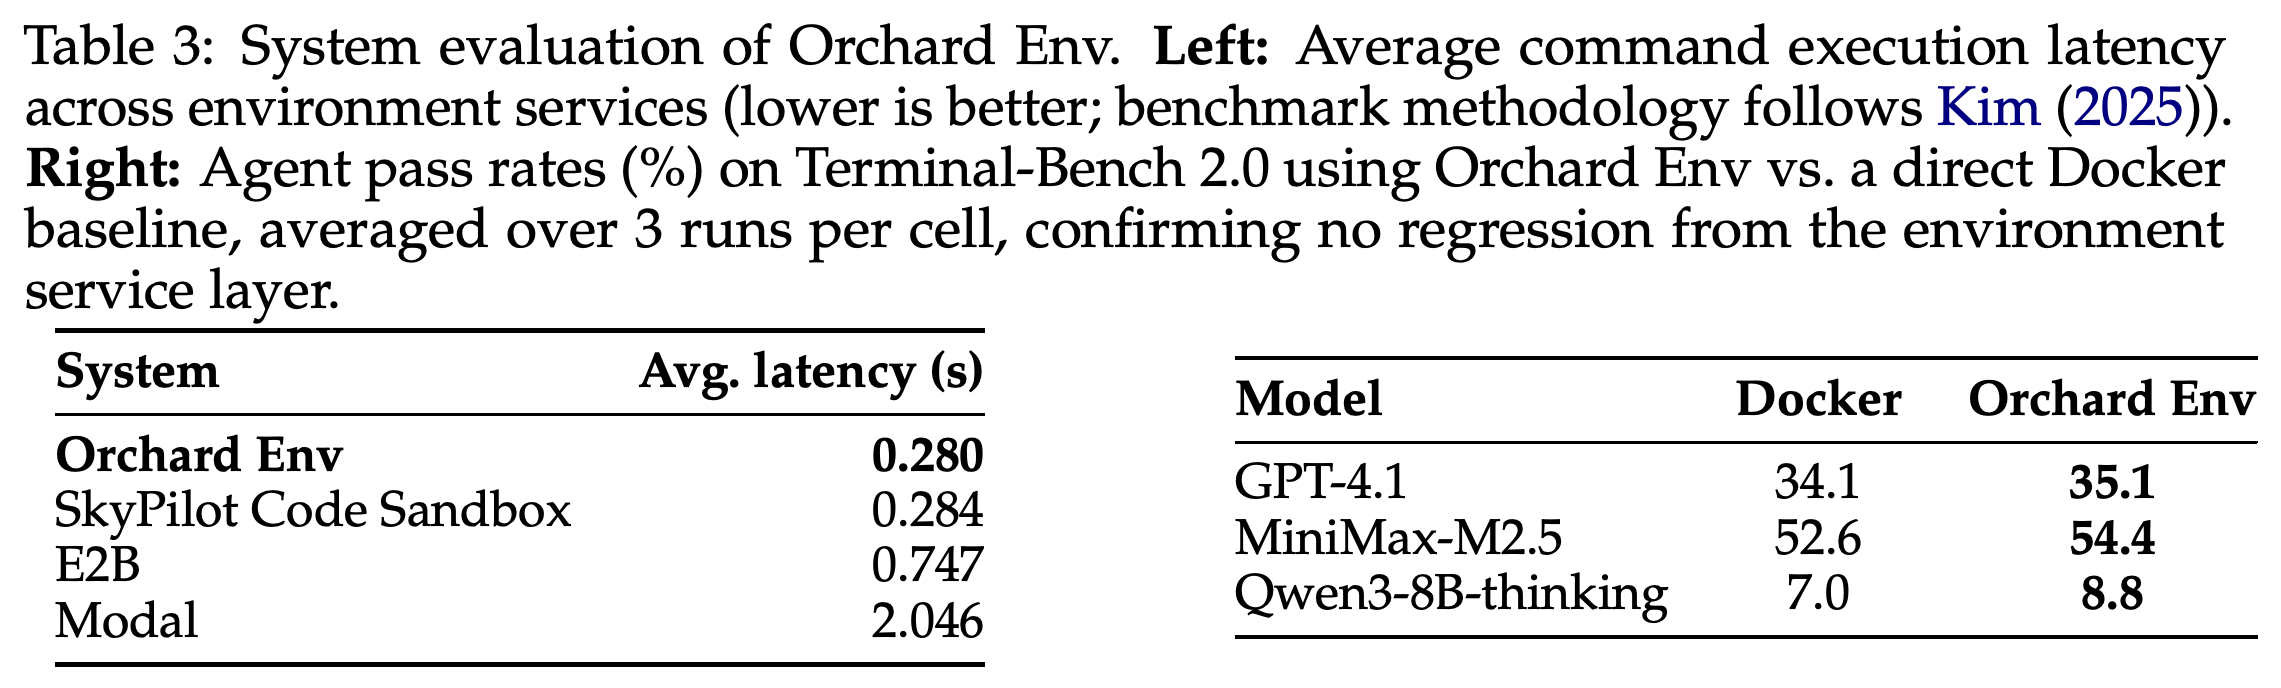
- Table 3의 평균 실행 지연 시간은 Orchard Env 0.280초, SkyPilot Code Sandbox 0.284초, E2B 0.747초, Modal 2.046초다. 직접적인 Pod-IP 라우팅은 Kubernetes exec/WebSocket 오버헤드를 피하지만, 측정된 지연 시간에 대한 기여를 분리한 라우팅 절제 실험은 없다.
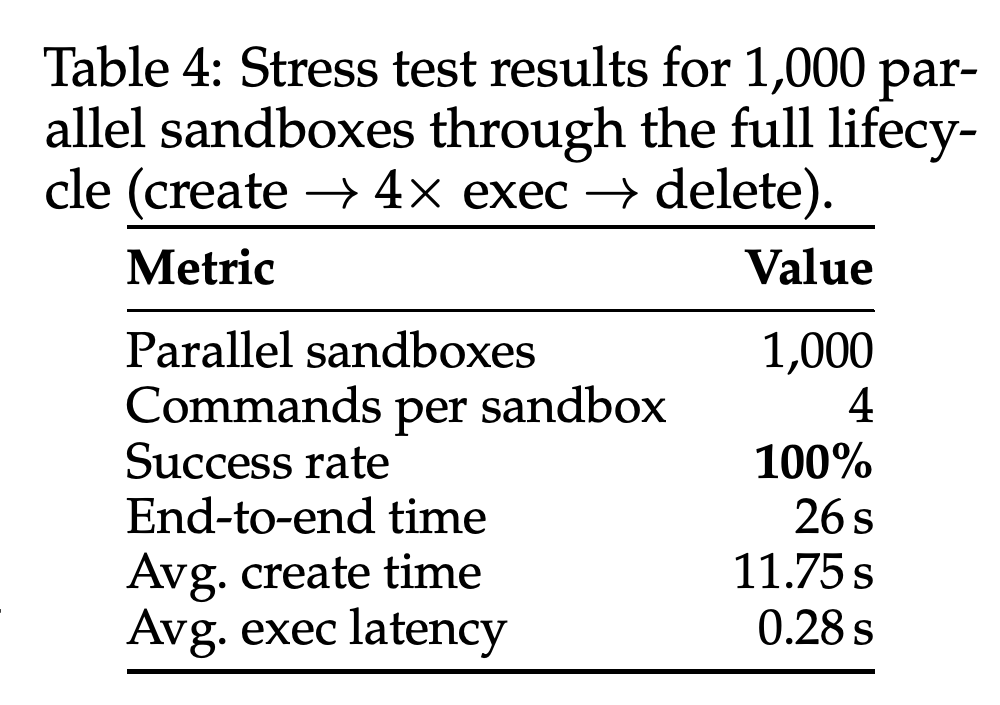
- Table 4는 동시 샌드박스 1,000개가 생성 → 명령 4개 → 삭제를 26초 안에 수행하며 성공률 100%를 기록했다고 보고한다. 평균 생성 시간은 11.75초, 평균 실행 지연 시간은 0.28초다. 이는 짧은 수명주기 작업을 시험한 결과이며, 장기간의 이질적인 학습이나 스폿 선점 이후 복구를 시험한 결과는 아니다.
- Terminal-Bench 2.0에서 Docker와 Orchard Env의 3회 실행 평균 통과율은 GPT-4.1이 34.1%와 35.1%, MiniMax-M2.5가 52.6%와 54.4%, Qwen3-8B-thinking이 7.0%와 8.8%다. 이 평균에서는 성능 저하가 관찰되지 않지만, 통계적 동등성을 입증하는 불확실성 구간은 보고하지 않는다.
Orchard의 평균 실행 지연 시간 0.280초는 SkyPilot의 0.284초와 거의 같다. Docker 비교에서 Orchard는 모델 3개 모두 3회 실행 평균 통과율이 조금 더 높다. 관찰된 성능 저하는 없지만, 동등성을 입증하는 신뢰 구간은 보고하지 않는다.
샌드박스 세션 1,000개 모두 생성, 명령 4개 실행, 삭제를 26초 안에 완료한다. 이는 이미지를 미리 내려받은 짧은 집중 작업의 신뢰성을 입증하며, 모든 학습 조건에서의 장기적인 강건성을 입증하지는 않는다.
3 Orchard-SWE
Orchard-SWE는 저장소 수준의 이슈 해결을 위해 프레임워크를 구현하며, 교사 증류 SFT 이후 환경에 근거한 RL을 수행한다. 학습 단계 2개 모두 Orchard Env를 사용한다. 학습 방법은 제한된 감독 신호, 희소한 결과 보상, 과거 롤아웃 재사용 문제를 다룬다.
3.1 Problem Setting
SWE 과제는 GitHub 이슈와 저장소 스냅샷을 제공하며, 에이전트는 해당 정답 테스트 모음을 통과하는 패치를 제출해야 한다. 주 벤치마크는 사람이 검증한 인스턴스 500개로 구성된 SWE-bench Verified이며, SWE-bench Multilingual과 Terminal-Bench 2.0에서도 보조 평가를 수행한다.
- ReAct 방식 에이전트는 셸 실행, 파일 확인과 편집, 패치 제출을 사용하면서 추론, 도구 호출, 환경 피드백을 번갈아 수행한다.
- 각 과제는 2 vCPU와 8 GiB 메모리를 갖춘 과제별 Docker 이미지에서 실행된다. 수집에는 OpenHands와 mini-swe-agent 2개를 모두 사용해 서로 다른 도구 의미 체계와 상호작용 관례를 경험하게 한다.
3.2 Trajectory Collection and Curation
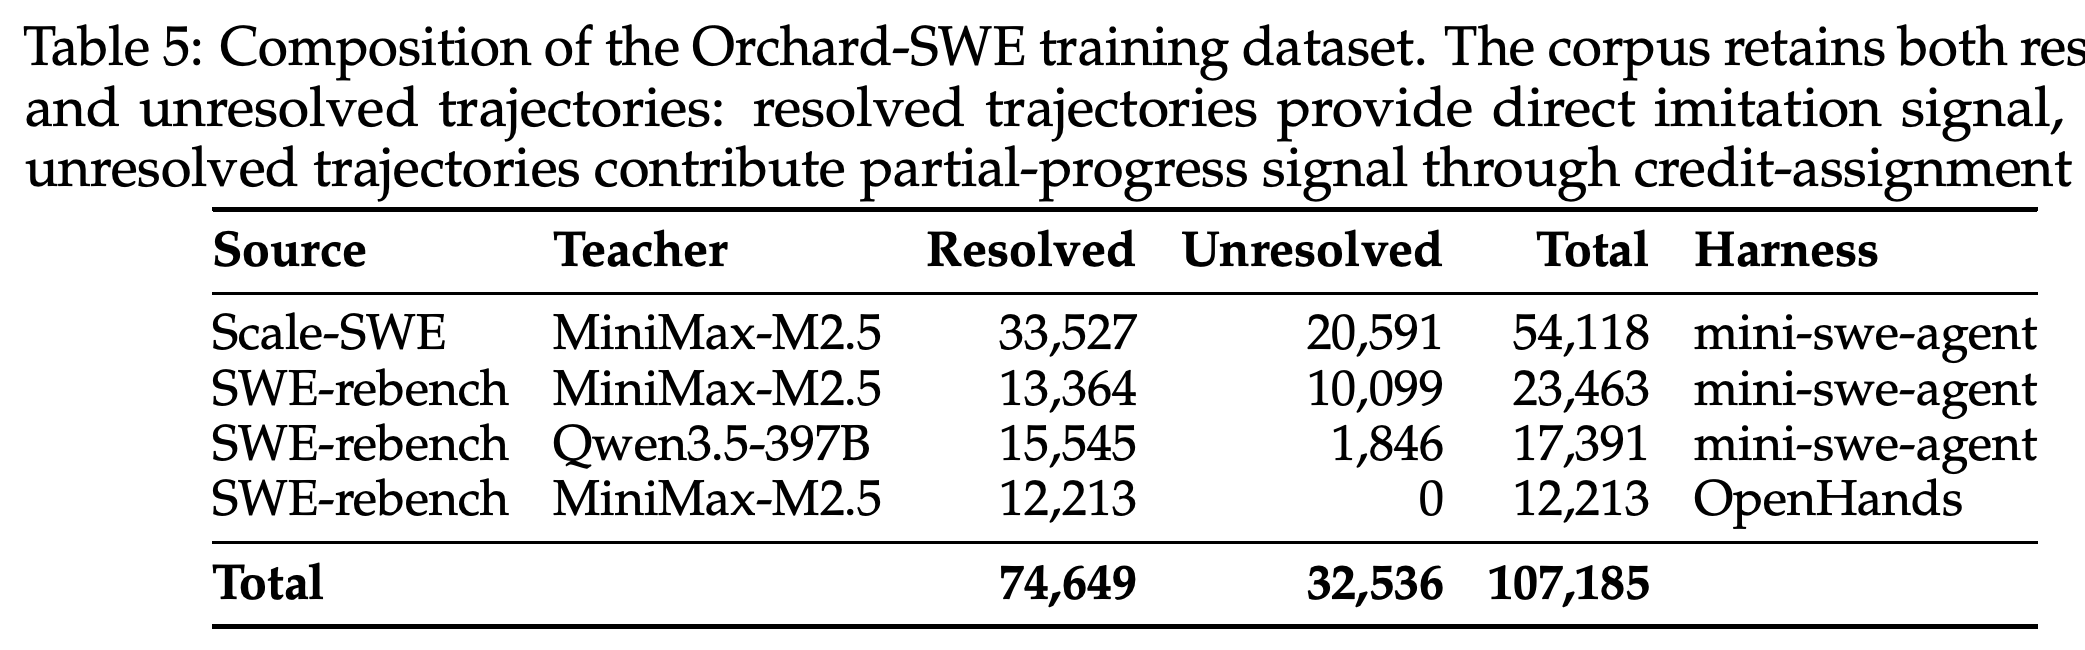
SWE 코퍼스는 고유 과제 인스턴스 19,287개에 대한 궤적 107,185개를 포함한다. 해결 궤적은 74,649개, 미해결 궤적은 32,536개다. Table 5는 mini-swe-agent 또는 OpenHands에서 MiniMax-M2.5와 Qwen3.5-397B로 생성한 SWE-rebench와 Scale-SWE 데이터의 구성을 제시한다.
- Scale-SWE는 MiniMax-M2.5 궤적 54,118개를 제공한다. SWE-rebench는 mini-swe-agent에서 MiniMax-M2.5 궤적 23,463개와 Qwen3.5-397B 궤적 17,391개를 제공하며, OpenHands에서 해결된 MiniMax-M2.5 궤적 12,213개도 제공한다.
- SWE-rebench V2는 RL용으로 남겨 둔다. 원본은 프로그래밍 언어 20개를 포함하지만, 실험은 주로 Python 과제를 사용한다. 교사 데이터 수집은 과제당 궤적 5개를 샘플링하며, 정제한 코퍼스에도 실패 궤적을 남겨 부분적인 진전을 감독 신호로 활용한다.
- 정제 과정은 64K 토큰을 초과하는 궤적을 제외하고, 정의되지 않았거나 유효하지 않거나 파싱할 수 없는 도구 호출을 제거한다. 최종 코퍼스는 궤적당 평균 상호작용 47.5턴과 약 21K 토큰을 포함한다.
코퍼스는 여러 교사와 출처, 하네스 2개를 결합하며, 예시 107,185개 중 실패 궤적은 32,536개다. 세부 구성에서 OpenHands는 해결 예시만 제공하고, 실패 궤적 감독은 mini-swe-agent 수집 데이터에서 나온다.
3.3 Off-policy Learning: Supervised Fine-Tuning with credit assignment
신용 할당 SFT는 미해결 궤적 전체를 버리는 대신 유용한 행동을 유지한다. 궤적을 생성한 교사가 사후에 V(s_t) = P(resolve | h_t, outcome)를 추정하고, 시간차 신용 c_t = V(s_{t+1}) − V(s_t)를 부여한다. 이어서 c_t ≥ ε를 만족하는 최대 연속 상승 구간을 추출하며, ε = 0.05다.
- 행동 토큰 목적함수는 L_SFT = −∑_{t∈S(τ)} log π_θ(a_t | h_t)다. 해결 궤적은 모든 행동 토큰을 감독하며, 미해결 궤적은 추출한 상승 구간만 감독한다. 이전 이력은 문맥으로 유지하고 환경 관측은 마스킹한다.
- 교사는 일부 핵심 단계에 값을 부여하고 나머지는 보간한다. 보고된 98.9%의 역 U자형 가치 곡선은 독립적인 보정 근거가 아니다. 부록 프롬프트가 올바른 탐색 중에는 값을 높이고, 알려진 실패에 이르기 전에는 값을 낮추도록 명시적으로 요청하기 때문이다.
- Qwen3-30B-A3B-Thinking은 slime으로 5에포크 학습한다. 전역 배치 크기는 128, 문맥 창은 64K이며, 학습률은 10⁻⁵에서 10⁻⁶까지 코사인 감쇠한다. 추론 문맥은 128K로 확장한다.
3.4.1 Reinforcement Learning with Balanced Adaptive Rollout (BAR)
온폴리시 단계는 롤아웃 샘플링과 보상 설계를 분리한다. Balanced Adaptive Rollout(BAR)은 양의 보상 비율 목표에 맞춰 고정 크기의 학습 그룹을 구성한다. 모두 성공하거나 모두 실패하거나 결과가 불균형한 그룹 대신, 유용한 그룹 상대 업데이트를 얻고자 한다.
- Algorithm 1은 정해진 묶음 단위로 궤적을 생성하고, 사용 가능한 양의 결과와 음의 결과를 나눈 뒤, [ρ_min, ρ_max]의 중간값에 가까운 비율로 정확히 N개의 궤적을 선택하려 한다. 정상 종료된 간결한 궤적을 우선하며, 예산이 소진되면 조건을 완화하거나 가능한 범위에서 선택한다. 이후 그룹 필터는 유용한 학습 신호가 없는 그룹을 제외한다.
- 보고된 설정은 N = 8, N_max = 16, stride s = 16, [ρ_min, ρ_max] = [0.375, 0.625]다. 묶음 크기가 최대 예산과 같으므로, 이 실험은 여러 묶음에 걸친 조기 중단을 시험하지 않는다. 균형 조정과 필터링은 여전히 적용된다.
- 그룹 상대 어드밴티지는 A_{i,t} = (r_i − mean({r_1,…,r_N}))/std({r_1,…,r_N})다. RL은 최대 150스텝 수행하며, 전역 배치 크기 128, 문맥 64K, 10⁻⁶에서 10⁻⁷까지 코사인 감쇠하는 학습률을 사용한다.
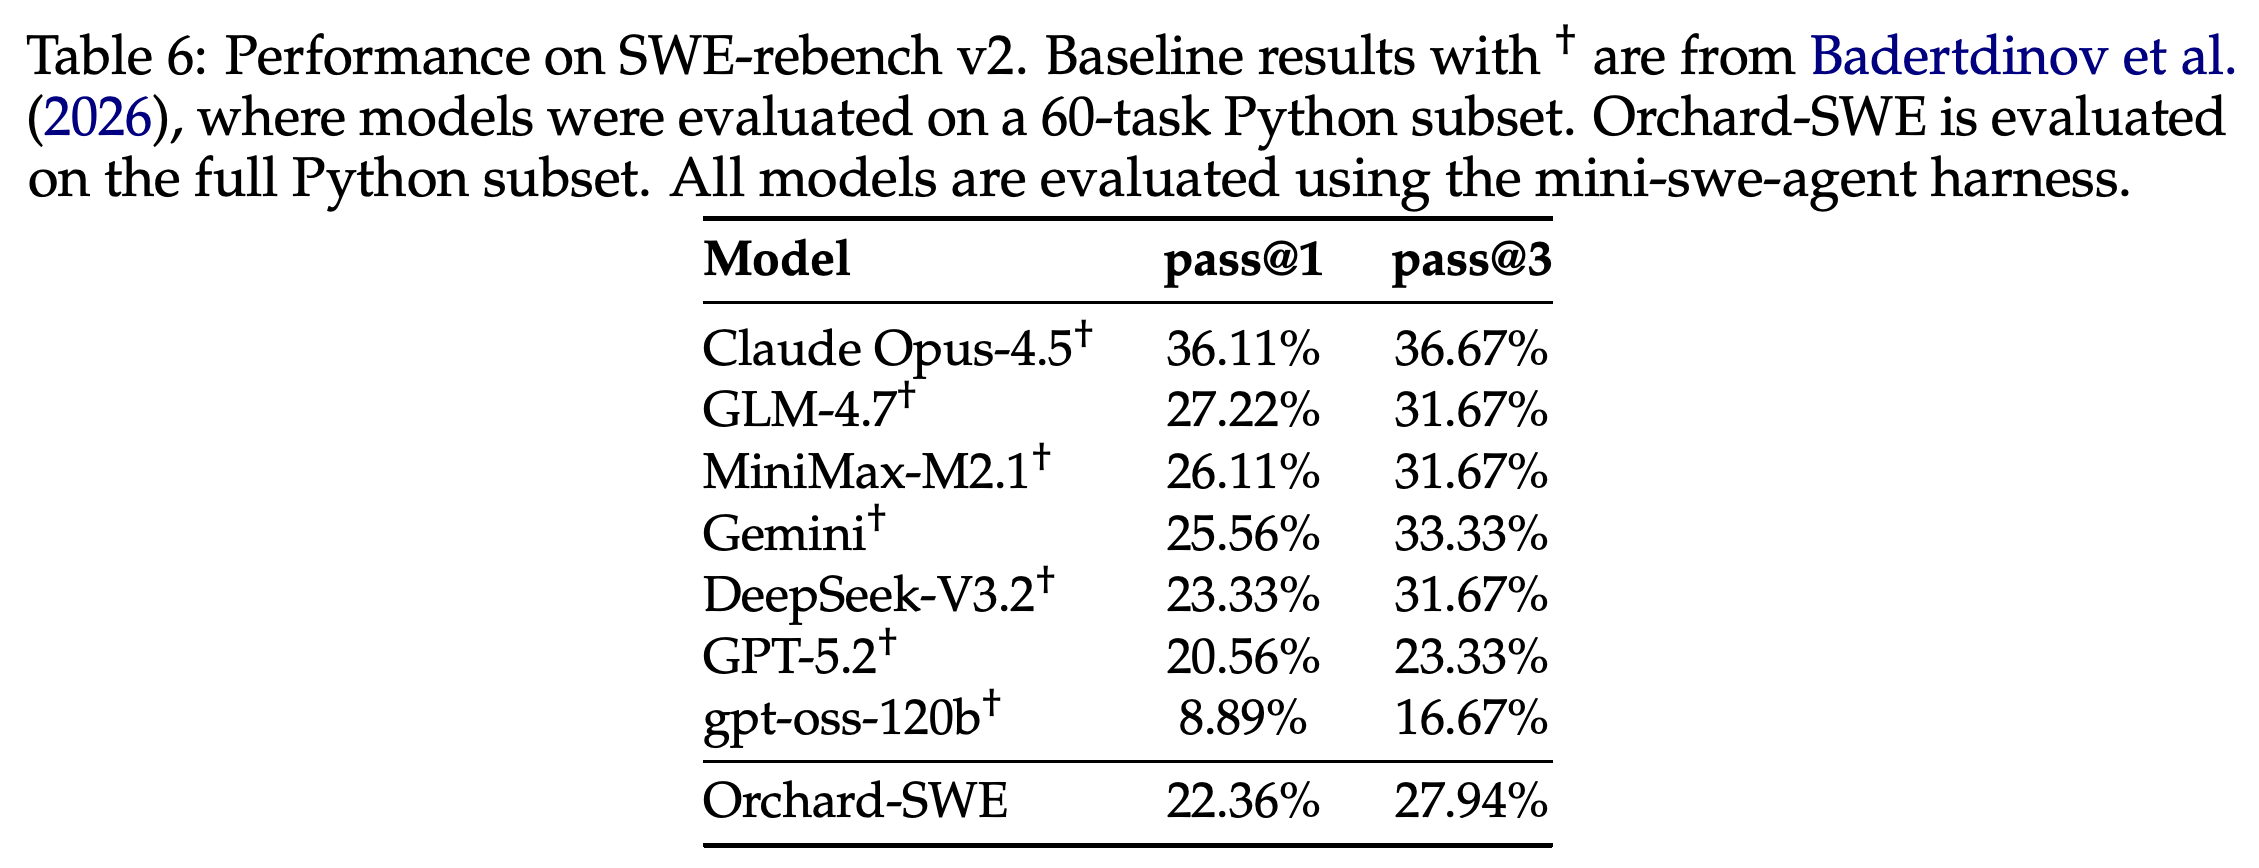
- 후보 RL 과제를 초기 롤아웃 8개로 평가하고 0 < p̂ ≤ 0.5일 때 유지한다. 이를 통해 SWE-rebench V2와 사용하지 않은 Scale-SWE 과제에서 약 2K 인스턴스를 얻는다. Table 6은 전체 Python 하위 집합에서 pass@1 22.36%와 pass@3 27.94%를 보고한다. 인용한 최첨단 베이스라인은 과제 60개의 하위 집합을 사용하므로 직접 대응하는 비교는 아니다.
초기 Orchard 체크포인트는 전체 Python 하위 집합에서 pass@1 22.36%와 pass@3 27.94%를 기록한다. 인용한 최첨단 결과는 과제 60개의 하위 집합을 사용하므로, 표의 항목으로 동일 조건의 모델 순위를 정할 수는 없다.
3.4.2 Denser Reward: On Policy Distillation (OPD)
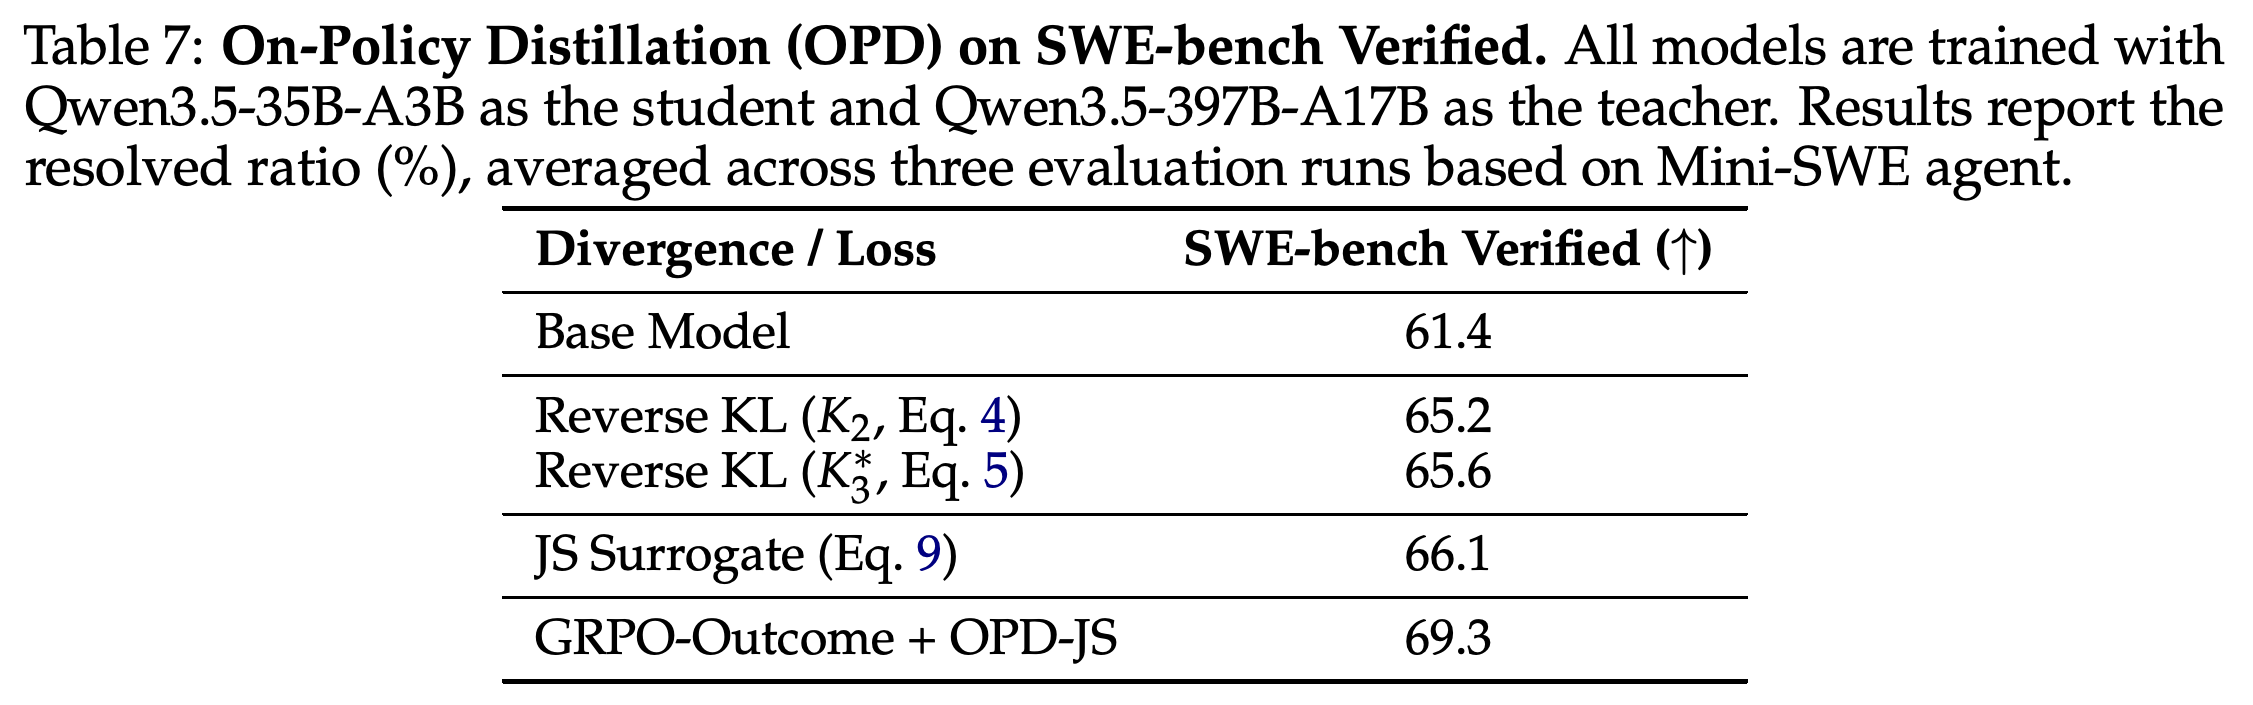
On Policy Distillation(OPD)은 Qwen3.5-397B-A17B를 교사로, Qwen3.5-35B-A3B를 학생으로 사용해 학생이 생성한 궤적에 토큰 수준 지도를 제공한다. 논문은 역방향 KL 샘플 추정량과 Jensen–Shannon(JS) 대리 목적함수를 비교하고, 후자를 BAR 없이 결과 보상 GRPO와 결합한다.
- 역방향 KL 목적함수는 D(π_θ || π_teacher) = E_{π_θ}[log π_θ − log π_teacher]다. K2는 로그 확률 차이를 제곱한 값의 0.5배이며, 안정화한 K3 변형은 K3에 π_θ/sg(π_θ)를 곱한다. 여기서 sg는 stop-gradient를 뜻한다.
- JS 대리 목적함수는 sg(log(π_θ/(λπ_θ + (1 − λ)π_teacher))) log π_θ이며, λ = 0.5다. 혼합 분포는 학생과 교사 사이의 극단적인 확률 불일치를 완화한다.
- Table 7은 SWE-bench Verified의 3회 실행 평균으로 기본 모델 61.4%, K2 65.2%, 안정화한 K3 65.6%, JS 단독 66.1%, GRPO-Outcome + OPD-JS 69.3%를 보고한다.
- 저자들은 그래디언트 급증과 롤아웃 비용이 줄었다고 보고하지만, 수치로 비교한 비용은 제공하지 않는다. 결합 설정의 69.3%에는 결과 감독이 포함되어 있다. 이는 뒤에서 OPD가 결과 검증 롤아웃을 없앤다고 설명하는 대목과 일치하지 않는다.
증류 손실 3개 모두 기본 점수 61.4%를 높이며, JS 단독은 66.1%에 도달한다. 최고 결과인 69.3%는 JS 증류와 결과 보상 GRPO를 결합한 것으로, 교사 신호만 사용하는 학습은 아니다.
3.4.3 Denser Reward: Rubric-based Process Reward (RPR)
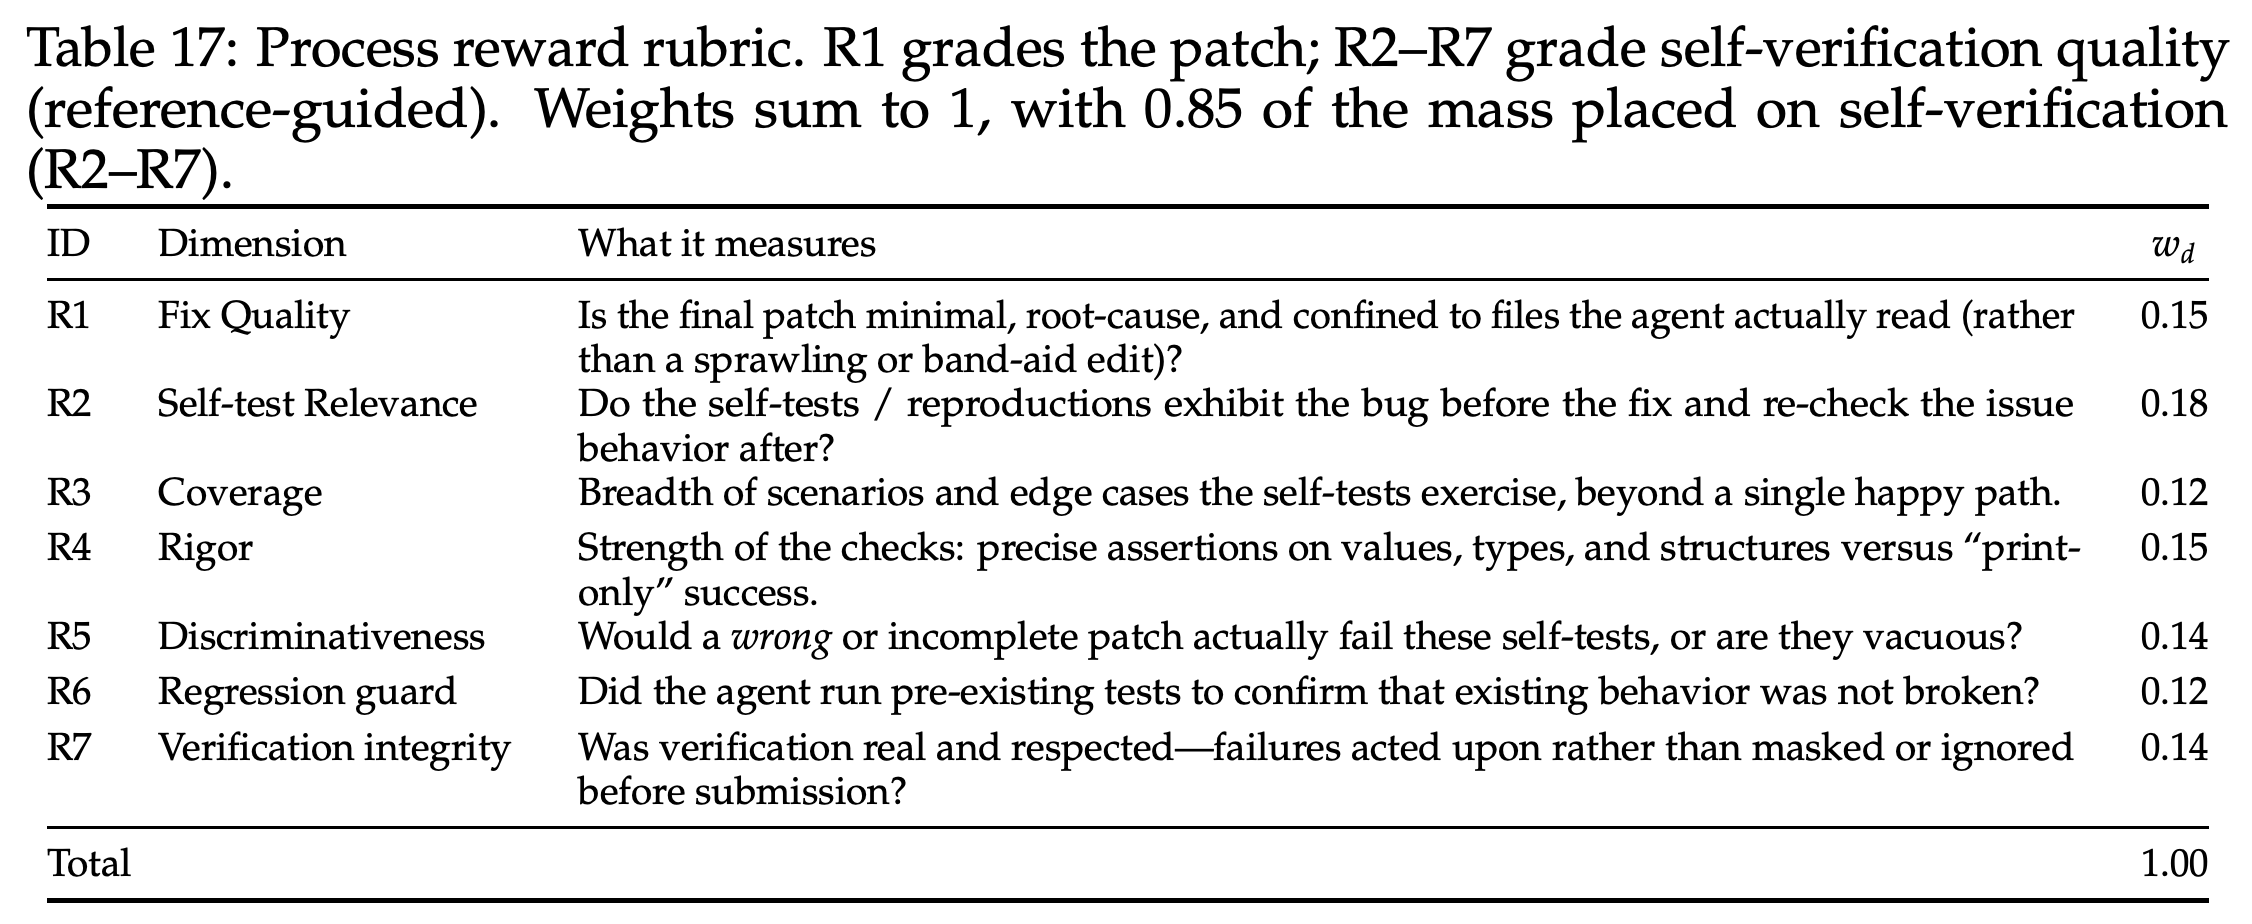
Rubric-based Process Reward(RPR)는 전체 궤적의 검증 행동을 채점해, 이진 패치 정답 여부가 규정하지 못하는 과정의 품질을 다룬다. LLM 심사자는 7개 차원을 독립적으로 평가한 뒤 [0, 1] 범위의 스칼라 보상으로 결합하며, 가중치 중 0.85를 패치 품질보다 자기 검증에 배정한다.
- Table 17의 가중치는 Fix Quality 0.15, Self-test Relevance 0.18, Coverage 0.12, Rigor 0.15, Discriminativeness 0.14, Regression guard 0.12, Verification integrity 0.14다.
- 선택적 참조 블록은 공식 FAIL_TO_PASS 식별자와 정답 패치를 제공하되, 자체 테스트의 관련성, 커버리지, 판별력을 판단하는 근거로만 사용한다. 채점 지침은 정확히 같은 수정인지 대조하거나, 숨겨진 테스트를 실행하지 않았다는 이유만으로 에이전트를 감점하는 것을 금지한다.
- 페널티는 탐색 중 트레이스백이 나타났다는 사실이 아니라, 실패를 무시하거나 검증 없이 제출하는 등 증거에 대응하는 방식을 대상으로 한다. 긴 관측은 앞부분과 뒷부분을 남겨 압축하며, 대규모 파일이나 디렉터리 덤프는 크기 표시로 대체할 수 있다.
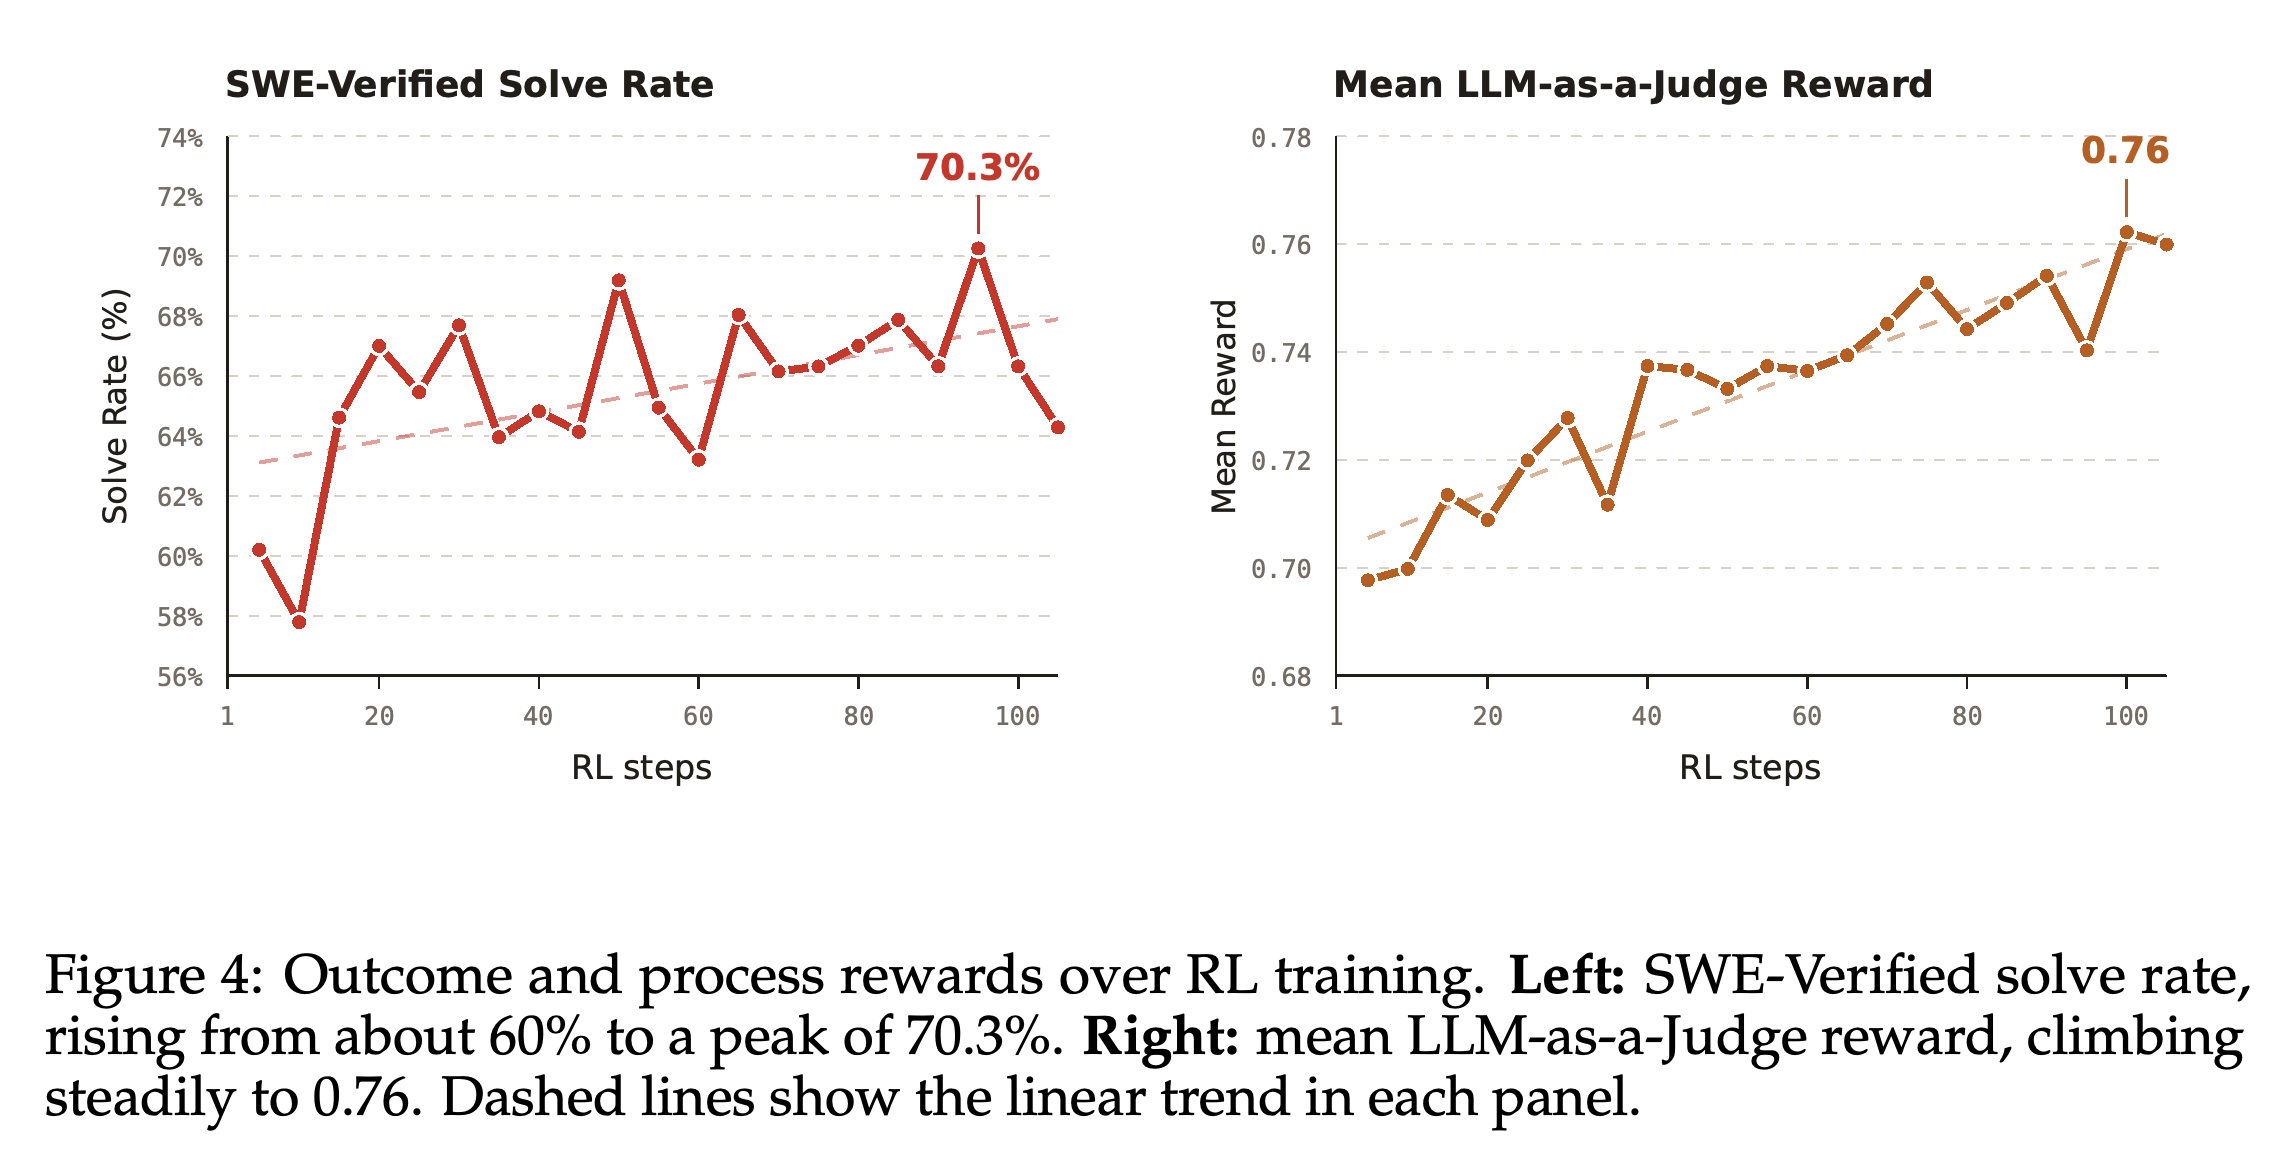
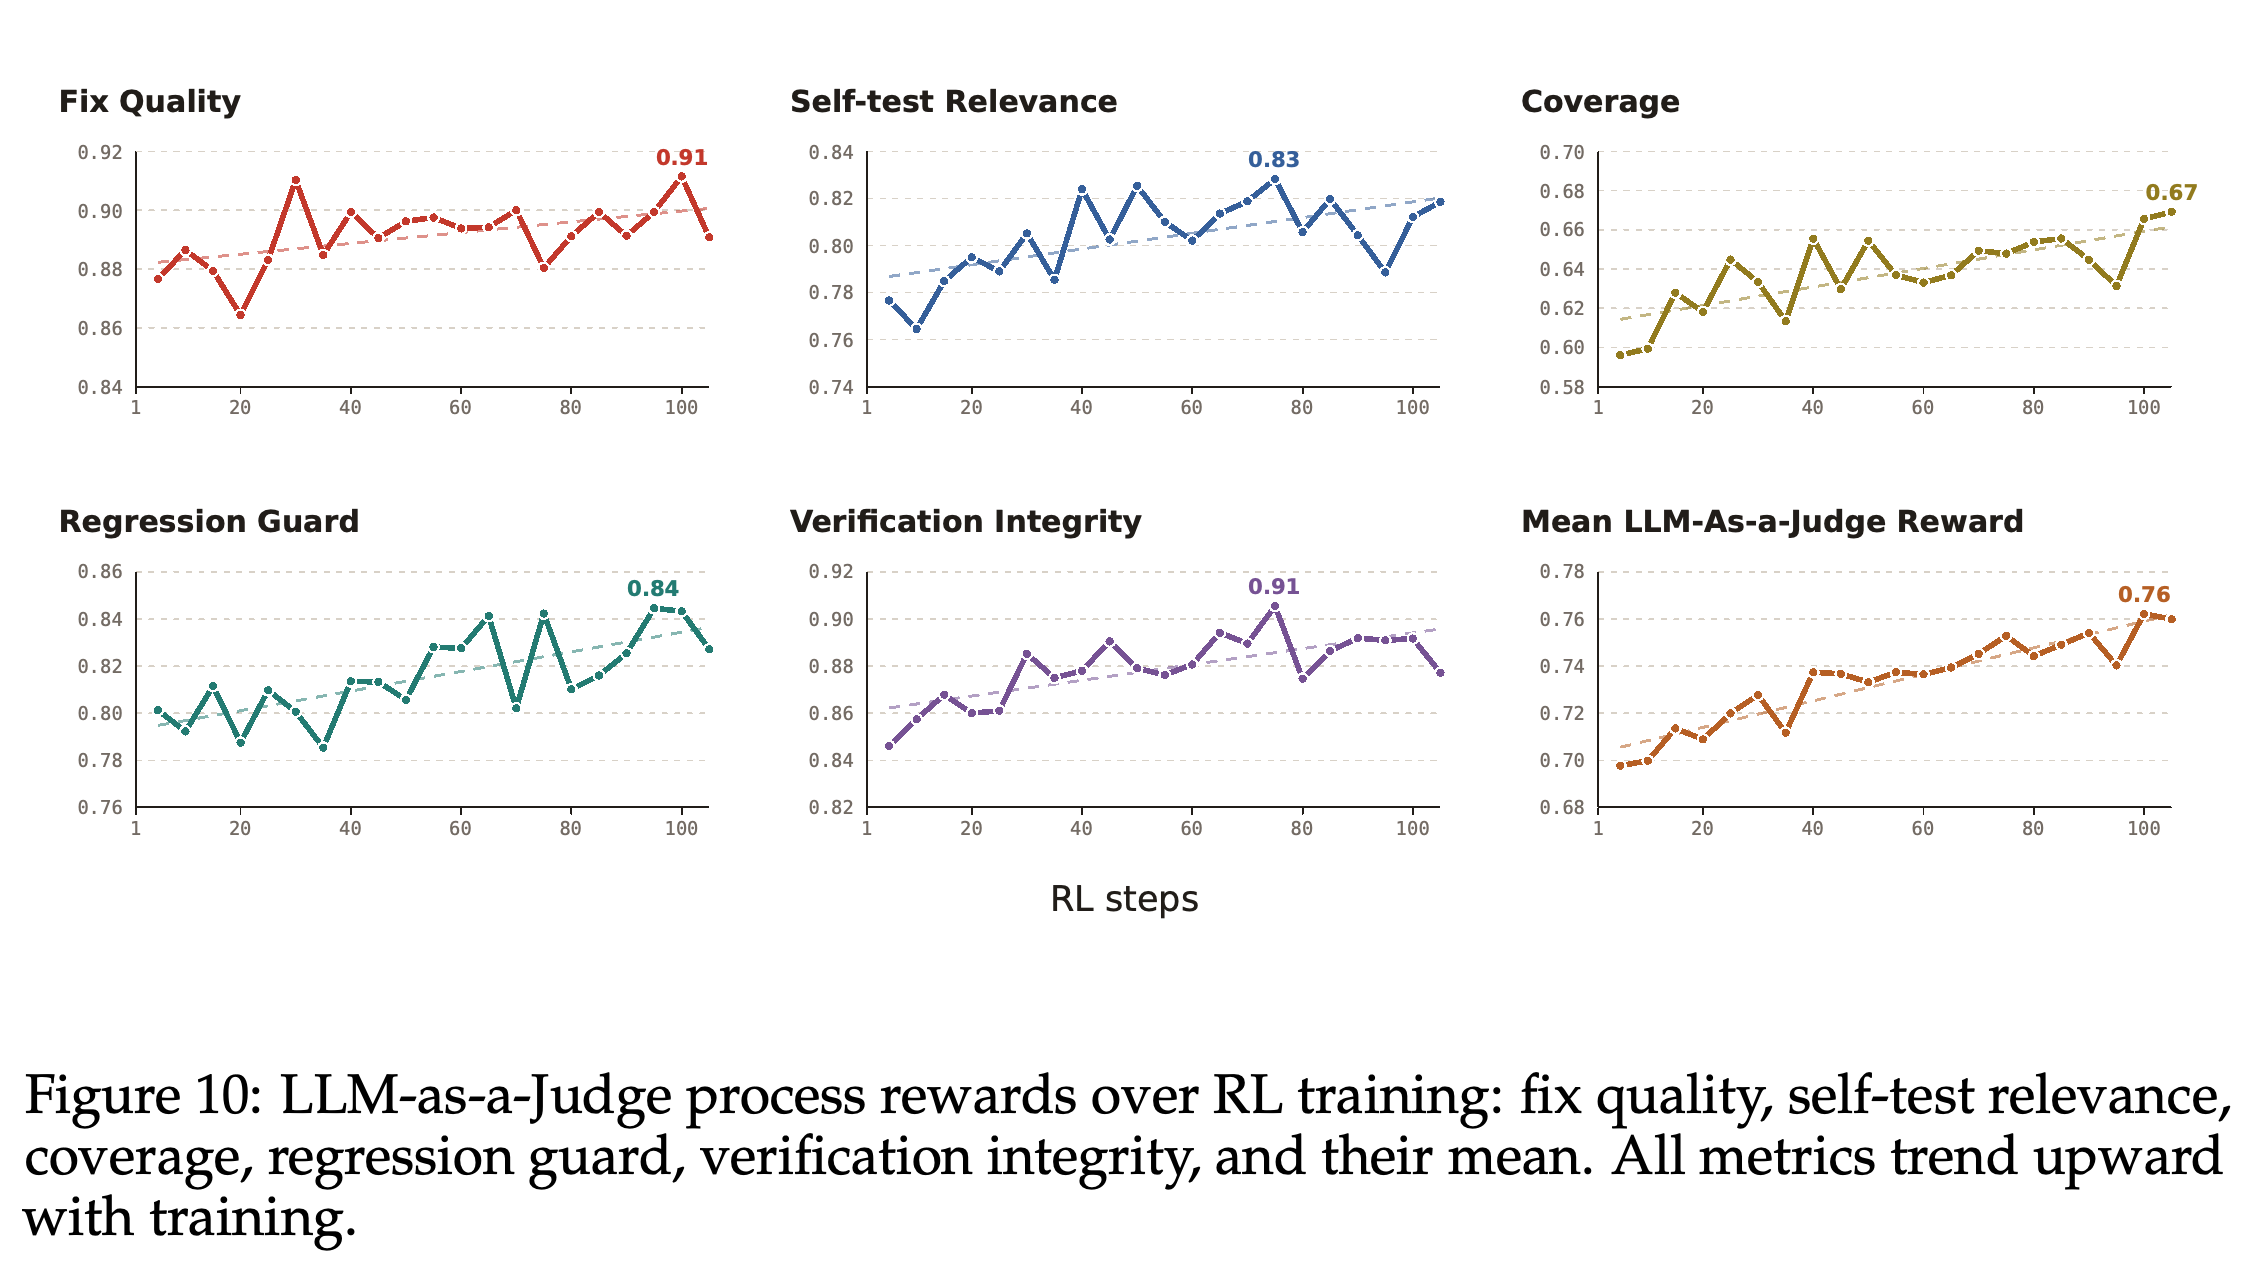
- Figure 4의 해결률 곡선은 변동하면서 최고 70.3%에 도달하고, 평균 심사 보상은 0.76에 도달한다. 이 최고점은 3회 실행 결과인 69.7%와 다르다. Figure 10은 선택한 루브릭 점수의 상승 추세를 보여주지만, 이는 독립적으로 검증한 행동 신뢰성이 아니라 심사자가 평가한 과정의 품질을 측정한다.
심사 보상은 해결률보다 매끄럽게 향상되며, 해결률은 변동하면서 최고 70.3%에 도달한다. 적합한 추세선 2개 모두 상승하지만, 해결률 최고점은 3회 실행 결과인 69.7%가 아니다. 이 곡선들은 과정 품질의 독립적인 검증을 입증하지 않는다.
자기 검증에 전체 가중치 중 0.85를 배정해 테스트 관련성, 엄밀성, 실패에 대한 대응을 우선한다. 이 고정 가중치는 경험적으로 학습한 가중치가 아니라 저자들이 선호하는 과정을 반영한다.
선택한 과정 차원은 개별 곡선의 변동에도 불구하고 종합 심사 보상과 함께 상승하는 추세를 보인다. Rigor와 Discriminativeness는 별도로 그리지 않는다. 루브릭이 학습 피드백도 제공하므로, 이 곡선들은 행동 신뢰성을 독립적으로 검증하지 않는다.
3.5 Distilling Historical Rollouts into a Value Model
과거 경험 증류는 이전 Orchard-SWE RL 실험 20개에서 축적한 결과 검증 궤적으로 독립적인 가치 모델을 학습한다. 가치 모델 학습에서 롤아웃을 제외한 새로운 정책으로 평가하므로, actor–critic 공동 학습이 아니라 정책 분포 간 전이를 시험한다.
- 과거 데이터 풀은 유효한 검증 결과가 있는 성공 궤적과 실패 궤적을 유지하고, 과제당 궤적 수를 제한하며, 결과 클래스의 균형을 맞춘다. Qwen3-4B 백본의 언어 모델링 헤드를 스칼라 가치 헤드로 교체한다.
- 연속된 각 어시스턴트 응답을 의사결정 단계로 취급하며, 환경 토큰은 손실에서 제외한다. 마지막 검증 보상은 γ = 0.98과 λ = 0.95를 사용하는 일반화 어드밴티지 추정으로 역방향 전파한다.
- 추론은 새로운 정책이 생성한 N개의 궤적에서 τ* = argmax_i V_ϕ(τ_i)를 선택한다. 가치 모델 학습에는 새로운 환경 상호작용이 필요하지 않지만, 추론 후보를 여러 개 생성하는 데에는 여전히 롤아웃 비용이 든다.
- 실험은 추론 시 재순위화를 입증한다. 오프라인 가치 모델이 임의의 미래 정책 학습까지 안정화할 수 있다는 더 넓은 제안은 입증하지 않는다.
3.6 Main Results
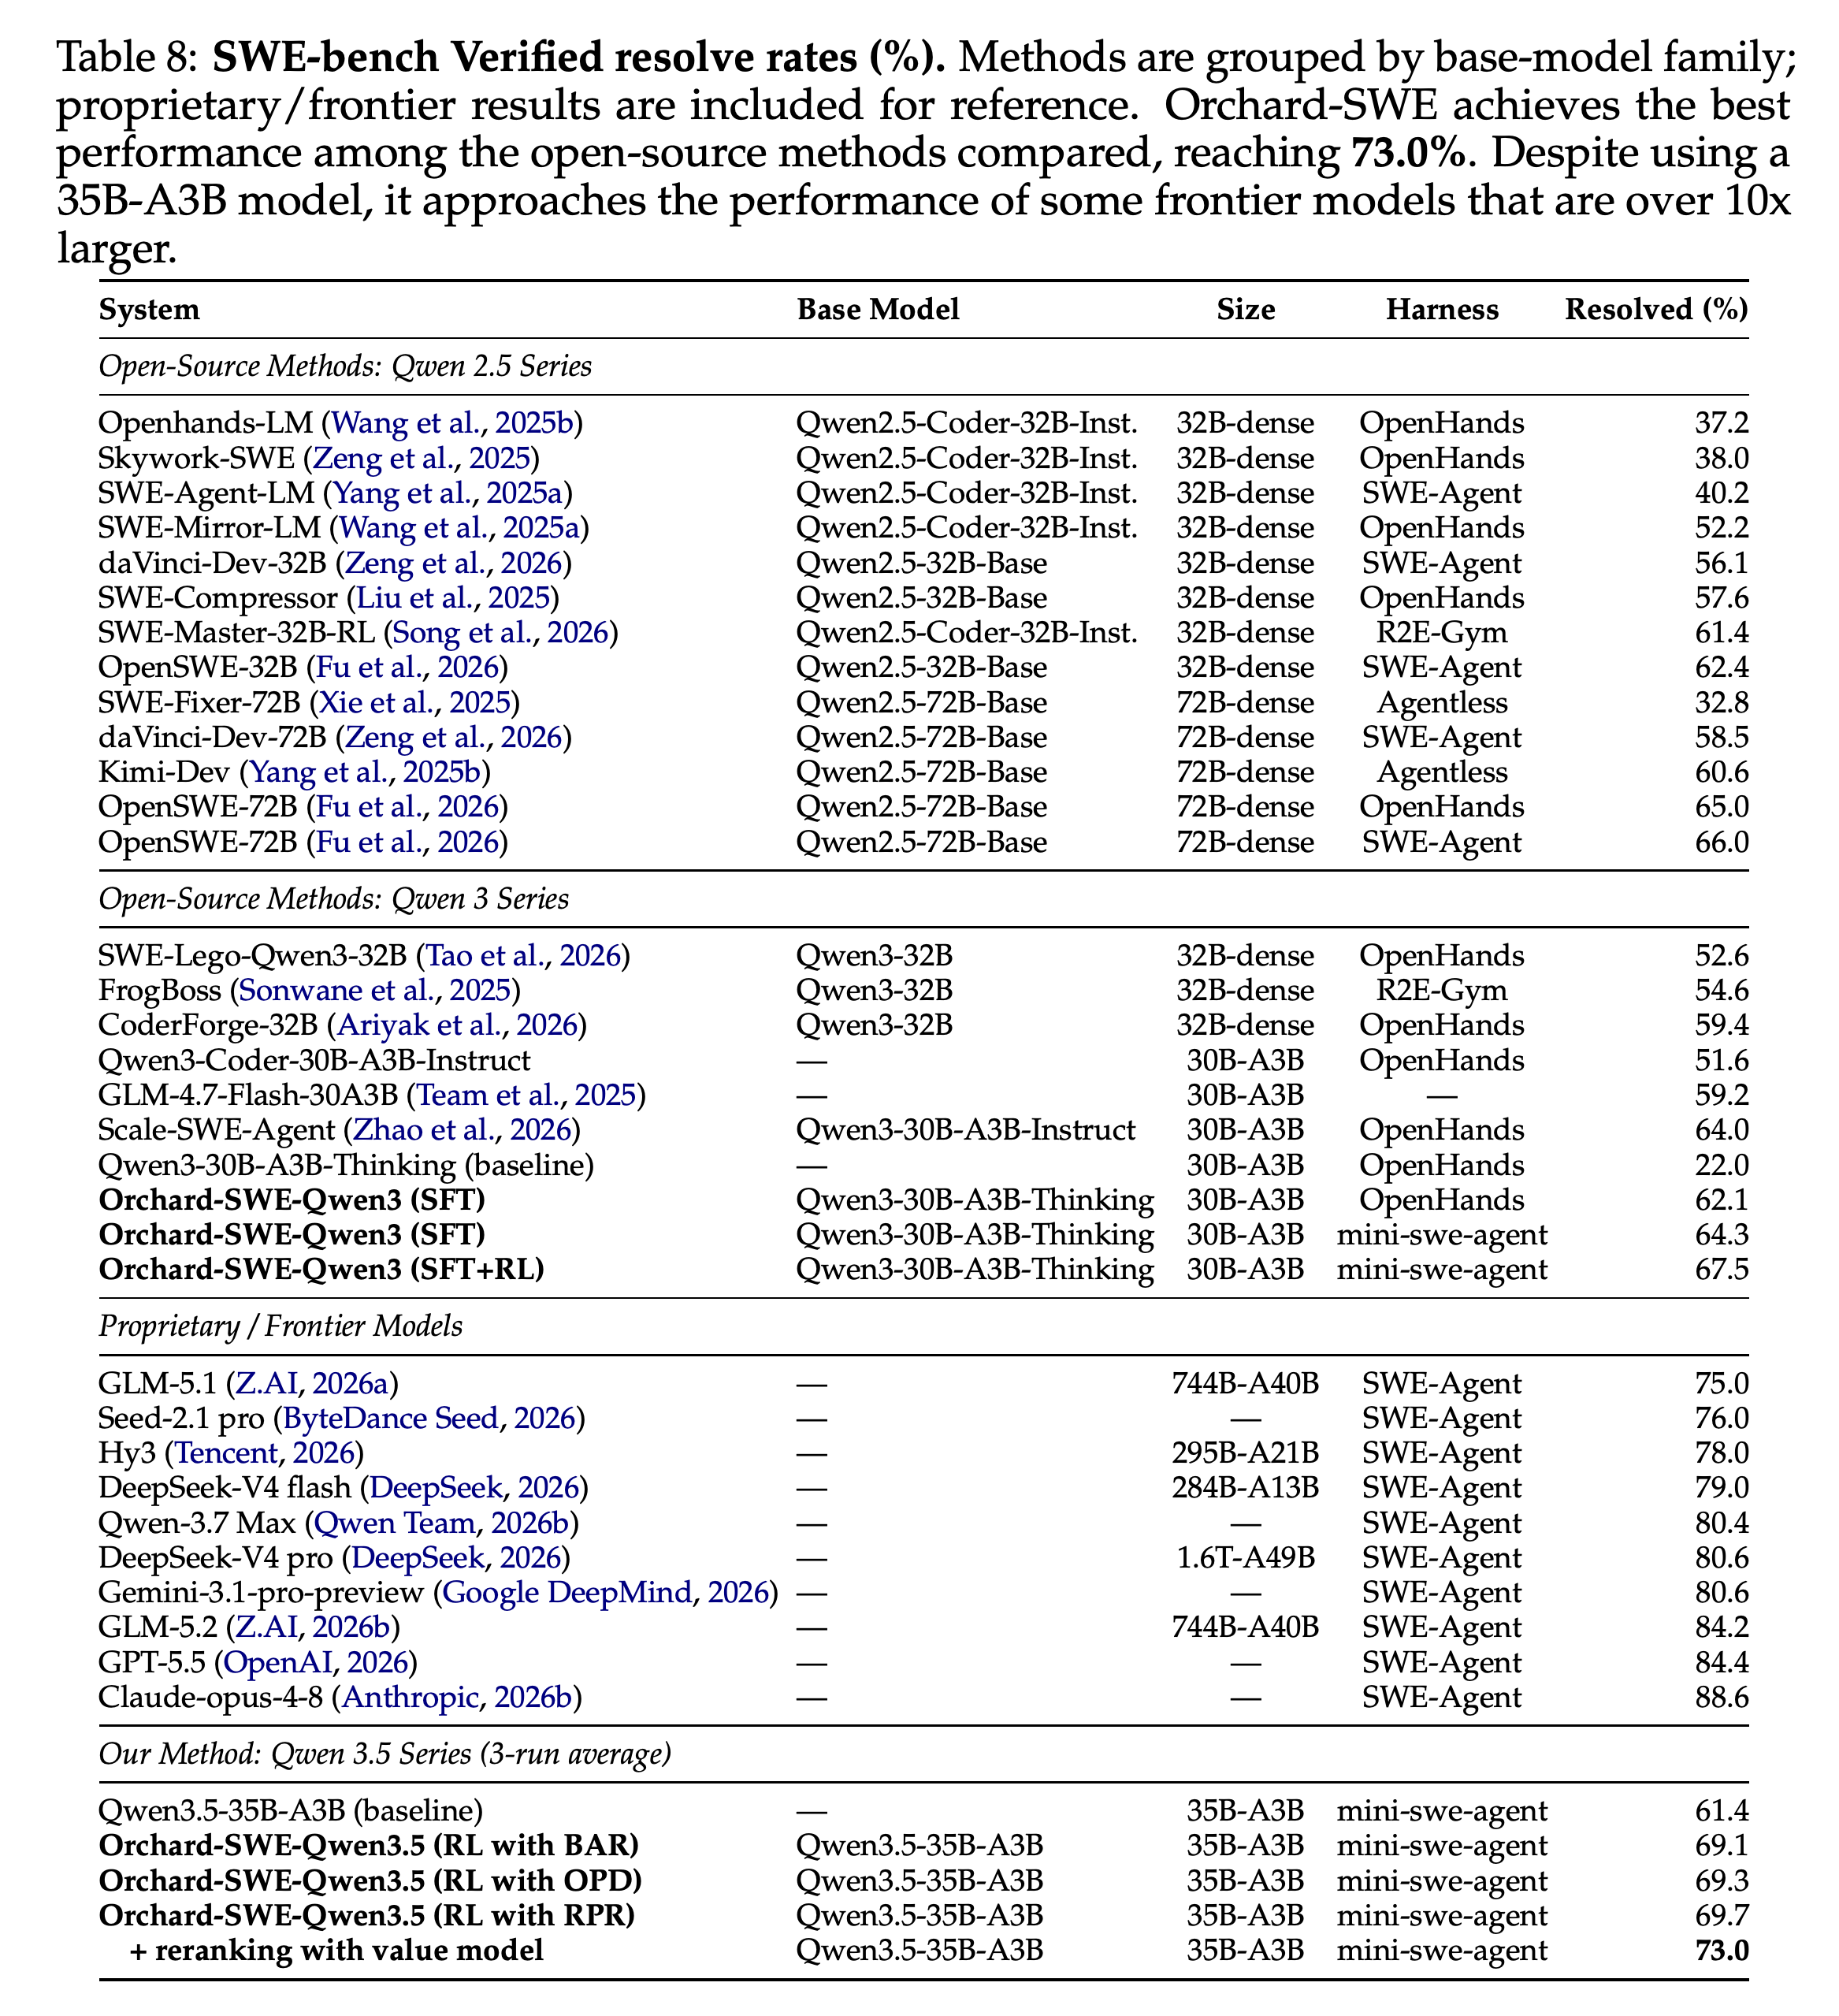
Table 8은 백본 계열 2개와 여러 하네스의 결과를 보고한다. Qwen3-30B-A3B-Thinking은 OpenHands 베이스라인의 22.0%에서 OpenHands SFT 62.1%, mini-swe-agent SFT 64.3%, mini-swe-agent SFT+RL 67.5%로 향상된다.
- mini-swe-agent에서 Qwen3.5-35B-A3B의 3회 실행 평균은 기본 모델 61.4%, BAR 69.1%, OPD 69.3%, RPR 69.7%다. RL의 성능 향상은 크지만, 변형 간의 더 작은 차이에는 불확실성 구간을 보고하지 않는다.
- N = 6인 Best-of-N 재순위화는 RPR 정책을 73.0%로 높이며, 이는 3.3점 향상이다. 오라클 선택은 82.4%에 도달해 실제 재순위화보다 9.4점 높다. 논문이 제시한 12.7점의 개선 여지는 단일 정책 결과인 69.7%를 기준으로 한 격차다.
- 73.0%는 Table 8에서 비교한 오픈소스 방법 중 가장 높으며, GLM-5.1의 75.0%와 Seed-2.1 pro의 76.0%에 가깝다. 다만 표에 제시한 여러 최첨단 시스템보다는 낮다. 특히 후보 6개를 선택하는 조건에서는 전체 또는 활성 파라미터 수만으로 추론 비용이 같다고 볼 수 없다.
- 대표 수치인 Qwen3의 45.5점 향상은 베이스라인과 하네스가 다르다. OpenHands를 동일하게 사용한 SFT 비교에서는 하네스를 바꾸지 않고 40.1점 향상한 결과를 뒷받침한다.
표는 Qwen3의 SFT+RL 레시피를 Qwen3.5 보상 변형 및 후보 6개의 가치 모델 선택과 구분한다. 73.0%는 표에 제시한 오픈소스 방법 중 가장 높지만, 여러 최첨단 항목은 이보다 높고 다른 하네스를 사용한다.
3.7 Generalization to Unseen Harnesses and Tasks
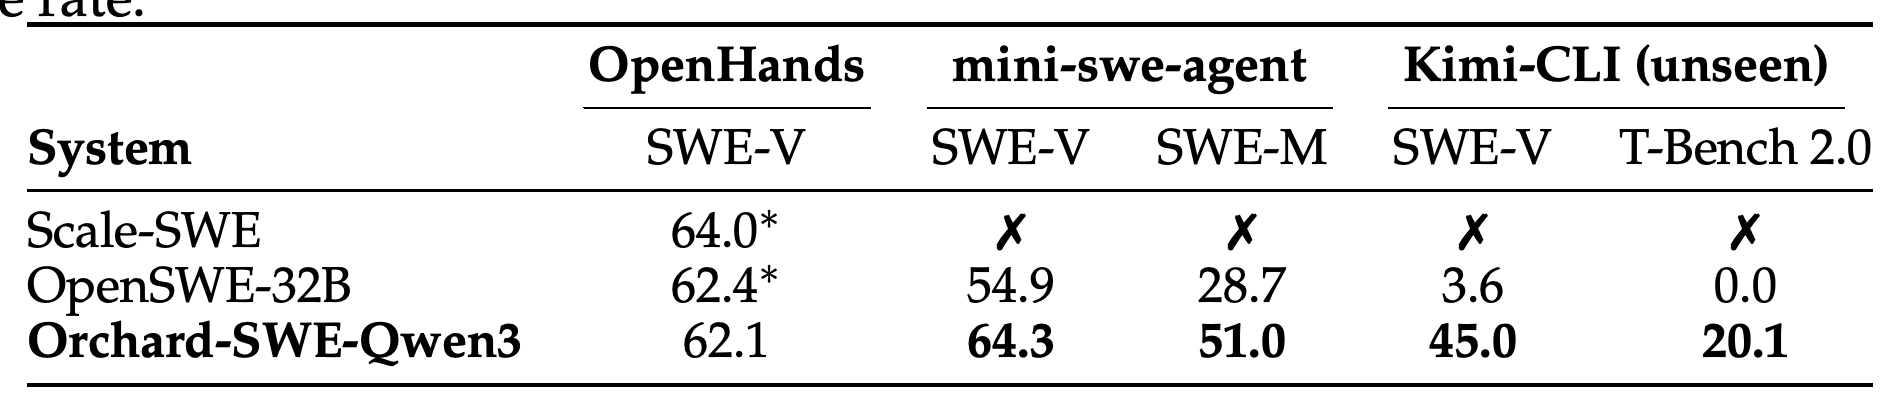
Table 9는 OpenHands, mini-swe-agent, 이전에 보지 못한 Kimi-CLI로 하네스와 과제 전이를 평가한다. Orchard-SWE-Qwen3는 하네스 3개 모두에서 사용할 수 있는 반면, Scale-SWE는 원래 하네스 밖에서 형식이 잘못된 호출을 생성하고 OpenSWE-32B는 Kimi-CLI에서 성능이 급격히 떨어진다.
- Orchard-SWE-Qwen3의 SWE-bench Verified 점수는 OpenHands 62.1%, mini-swe-agent 64.3%, Kimi-CLI 45.0%다. OpenSWE-32B는 각각 62.4%, 54.9%, 3.6%다. 비교 시스템의 원래 벤치마크 결과는 해당 논문에서 가져온다.
- mini-swe-agent에서 Orchard의 SWE-bench Multilingual 점수는 51.0%이며, OpenSWE-32B는 28.7%다. Kimi-CLI에서 Terminal-Bench 2.0 결과는 20.1%와 0.0%다.
- 이 결과는 전이 개선을 뒷받침하지만 하네스 독립성을 입증하지는 않는다. Orchard는 가장 좋은 Verified 조건에서 Kimi-CLI로 바꾸면 19.3점 하락한다. 교사, 과제 출처, 실패 궤적 감독, 인프라의 개별 기여는 절제 실험으로 일부만 분리된다.
Orchard는 하네스 3개에서 유효한 동작을 유지하며, Terminal-Bench에서도 0이 아닌 성능을 유지한다. 다만 Kimi-CLI의 Verified 점수 45.0%는 mini-swe-agent 결과보다 19.3점 낮다. 비교 시스템의 원래 결과는 재실행하지 않고 인용한다.
3.8 Ablations and Analysis
Qwen3 절제 실험은 데이터 규모, 선택 전략, 하네스 결합, 실패 궤적 감독, RL 초기화를 살펴본다. 결과는 상호작용 형식에 대한 의존성을 보여주며, RL이 분포 내 성능과 과제 전이에 서로 다르게 영향을 준다는 점을 보여준다.
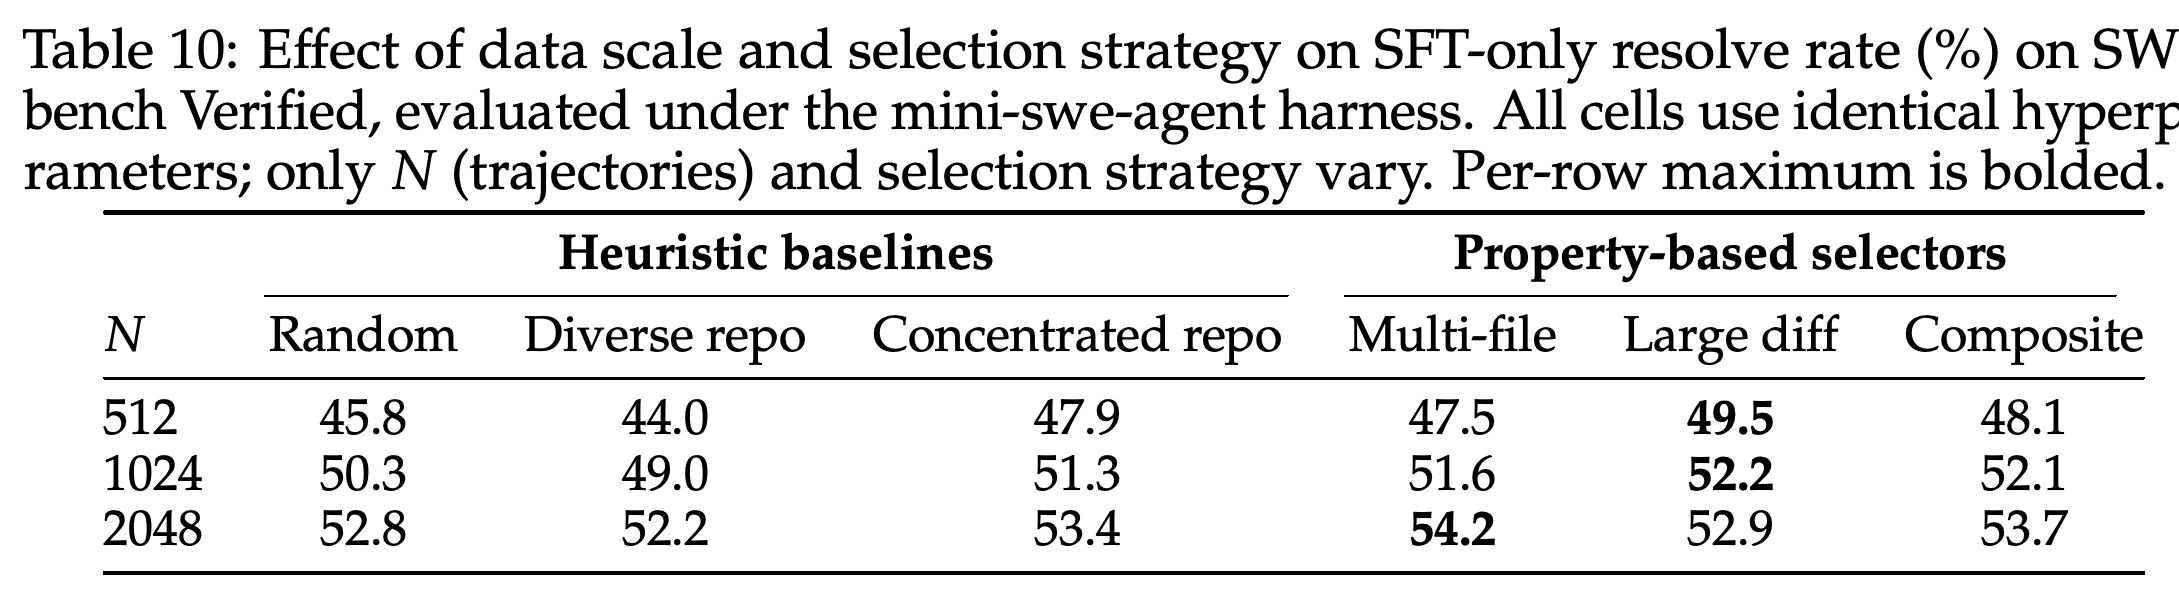
- Table 10은 SFT 하이퍼파라미터를 고정한 채 해결 궤적 수를 512개, 1,024개, 2,048개로 바꾸고 선택기 6개를 비교한다. 선택기 간 점수 범위는 5.5점에서 3.2점, 2.0점으로 줄어든다. 데이터가 많아지면 모든 선택기의 성능이 향상되며, 궤적 2,048개 조건의 최고 점수는 54.2%다.
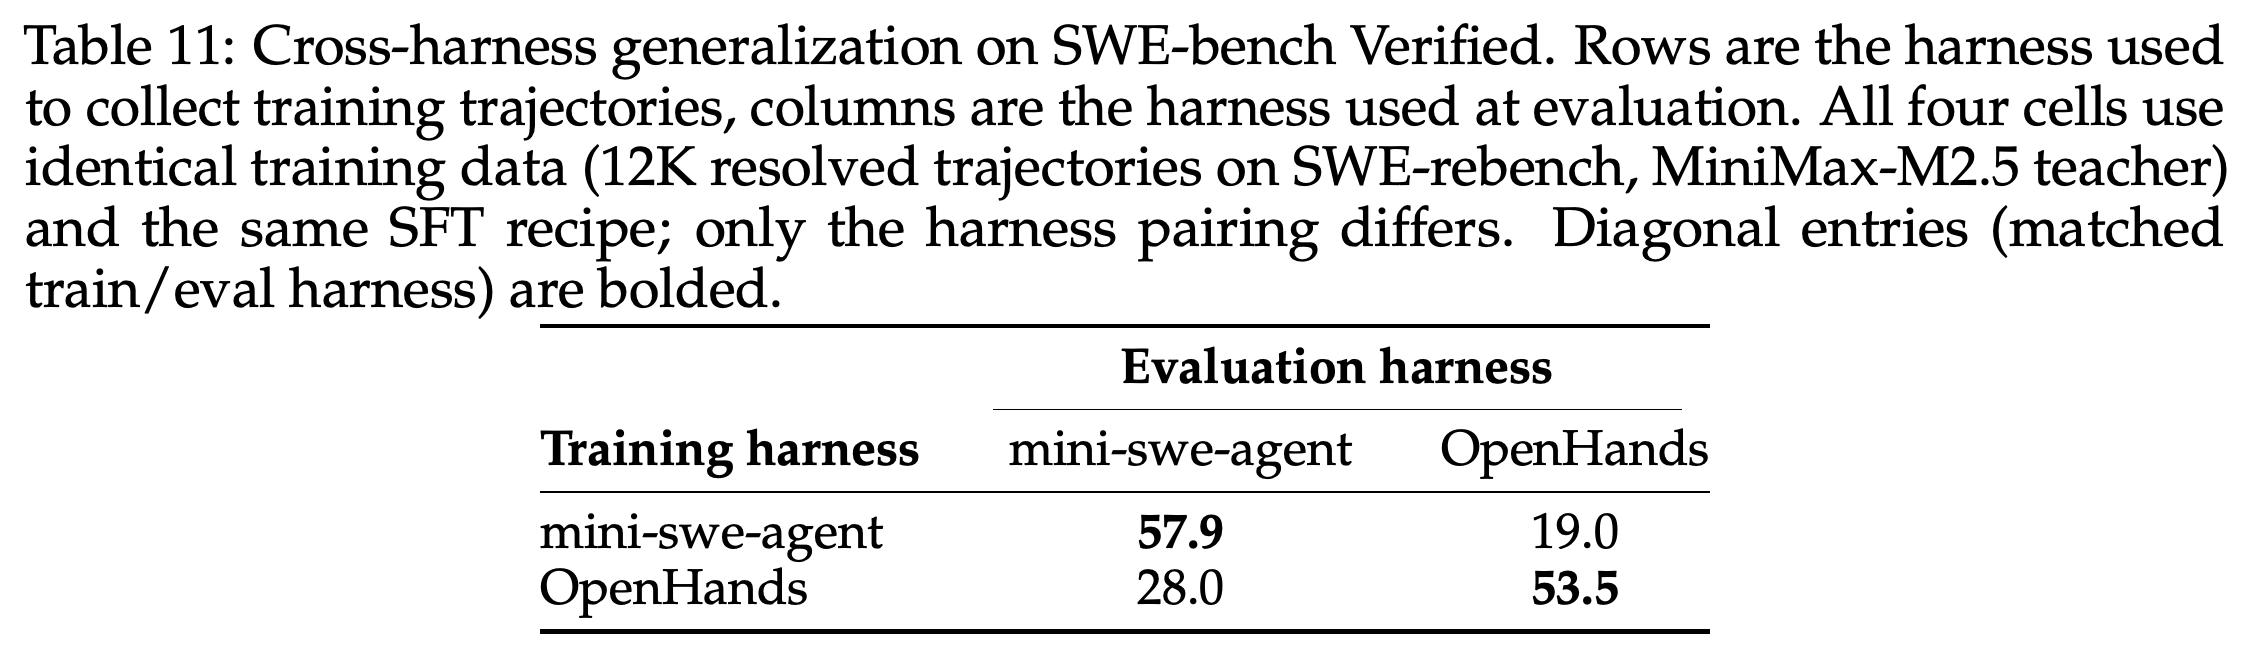
- Table 11은 과제 출처, 교사, 대략적인 수집 규모, SFT 레시피를 고정하고 수집 및 평가 하네스를 바꾼다. 하네스가 일치하는 mini-swe-agent와 OpenHands 조건은 각각 57.9%와 53.5%에 도달하지만, 불일치 평가에서는 19.0%와 28.0%로 하락한다. 수집 하네스에 따라 궤적이 달라지므로, 동일한 궤적을 비교한 실험이나 모든 단일 하네스 코퍼스가 일반화에 실패한다는 증거는 아니다.
- 해결 궤적 32K개의 베이스라인에 실패 궤적의 상승 구간 예시 약 32K개를 추가하면 Verified 성능이 59.3%에서 61.2%로 높아진다. 이는 유용한 추가 감독 신호를 입증하지만, 같은 수의 해결 예시를 추가하는 것보다 우수하다는 뜻은 아니다.
- 궤적 512개로 학습한 SFT 체크포인트에서 RL을 수행하면 Verified는 48.1%에서 50.1%, Multilingual은 22.0%에서 28.7%로 향상된다. 전체 SFT 체크포인트에서 RL을 수행하면 Verified는 64.3%에서 67.5%로 향상되지만 Multilingual은 소폭 하락한다. 최종 Multilingual 점수는 제공하지 않는다.
해결 궤적 수가 늘면 모든 선택기의 성능이 높아지며, 선택 전략 간 차이는 줄어든다. 정답 패치 휴리스틱은 데이터가 가장 적을 때 가장 유용하다. 비교 격자는 전체 코퍼스가 아니라 최대 궤적 2,048개를 다룬다.
과제 출처, 교사, 대략적인 수집 규모, SFT 레시피를 고정하면 일치하는 하네스는 53.5–57.9%에 도달하고, 불일치 조건은 19.0–28.0%로 하락한다. 수집 하네스가 상호작용 궤적을 바꾸므로, 이 실험은 동일한 궤적으로 학습하는 대신 레시피와 출처 조건을 통제한다.
4 Orchard-GUI
Orchard-GUI는 공통 실행 서비스를 스크린샷 기반 브라우저 에이전트로 확장한다. 브라우저 전용 오케스트레이션 프레임워크 대신 범용 도구 호출 하네스와 2단계 SFT+RL 레시피를 사용한다.
4.1 Problem Setting
각 브라우저 과제는 시작 URL과 자연어 의도를 제공하며, 성공하려면 실제 웹페이지를 탐색해 답을 반환하거나 요청한 행동을 완료해야 한다. 평가는 FARA와 Molmo-Web의 프로토콜을 따라 WebVoyager, Online-Mind2Web, DeepShop에서 최종 응답과 스크린샷 시퀀스를 LLM 심사자로 평가한다.
- 이는 전체 데스크톱이나 모바일 제어가 아니라 공개 웹에서의 브라우저 사용을 평가한다. 실제 사이트의 변경, 봇 차단, 심사자의 신뢰성이 측정 조건에 영향을 준다.
4.2 Generic Tool-Calling Agent Harness
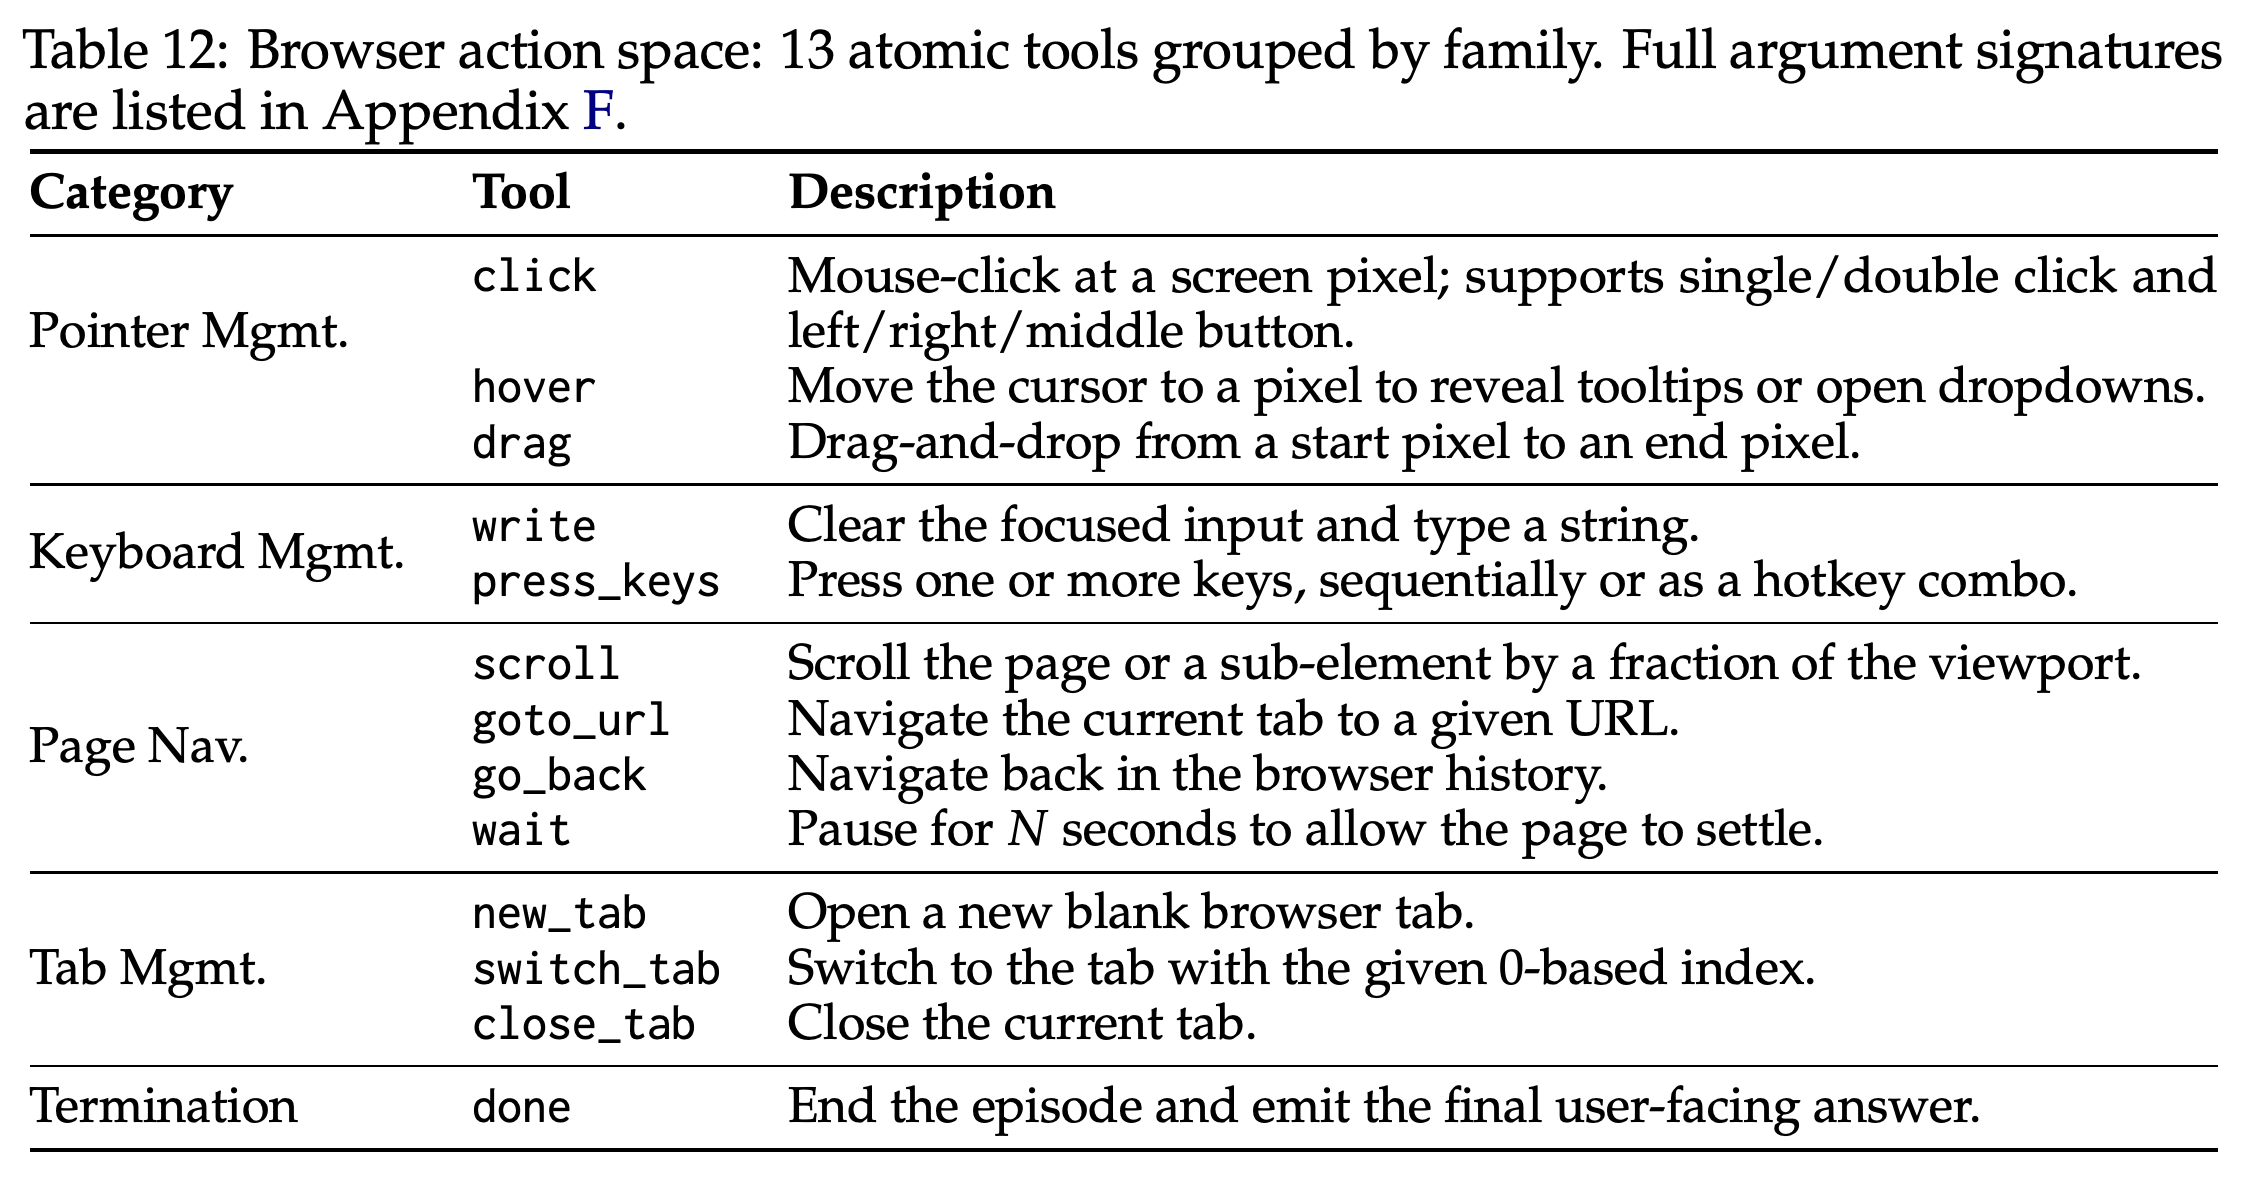
범용 ReAct 방식 하네스는 OpenAI 도구 호출 인터페이스로 원자적 도구 13개를 제공한다. Table 12는 이를 포인터, 키보드, 페이지 탐색, 탭 관리, 종료 행동으로 묶는다. done(response)은 유일한 명시적 종료 행동이며 최종 답변을 전달한다. 롤아웃은 예산이 소진되어도 끝날 수 있다.
- 행동 집합은 click, hover, drag, write, press_keys, scroll, goto_url, go_back, wait, new_tab, switch_tab, close_tab, done이다. 응답은 <think> 블록과 1개 이상의 <tool_call> 블록을 포함한다.
- 관측은 최신 스크린샷, 뷰포트 크기, 탭 URL과 제목을 포함한다. 마지막 k개의 스크린샷만 원본 그대로 유지하며, 이전의 텍스트 추론과 도구 피드백은 문맥에 남긴다.
- 실행에는 각각 1 vCPU와 8 GiB 메모리를 갖춘, Playwright로 제어하는 격리된 Chromium 인스턴스를 사용한다. Appendix G는 k = 1을 예시하지만, 모든 실험이 이 설정을 사용한다는 뜻은 아니다.
행동 집합은 원자적인 포인터, 키보드, 탐색, 탭 연산으로 브라우저 상호작용을 지원한다. 전용 done 행동은 명시적 완료와 최종 출력을 일반 상호작용 호출과 구분한다.
4.3 Trajectory Collection and Curation
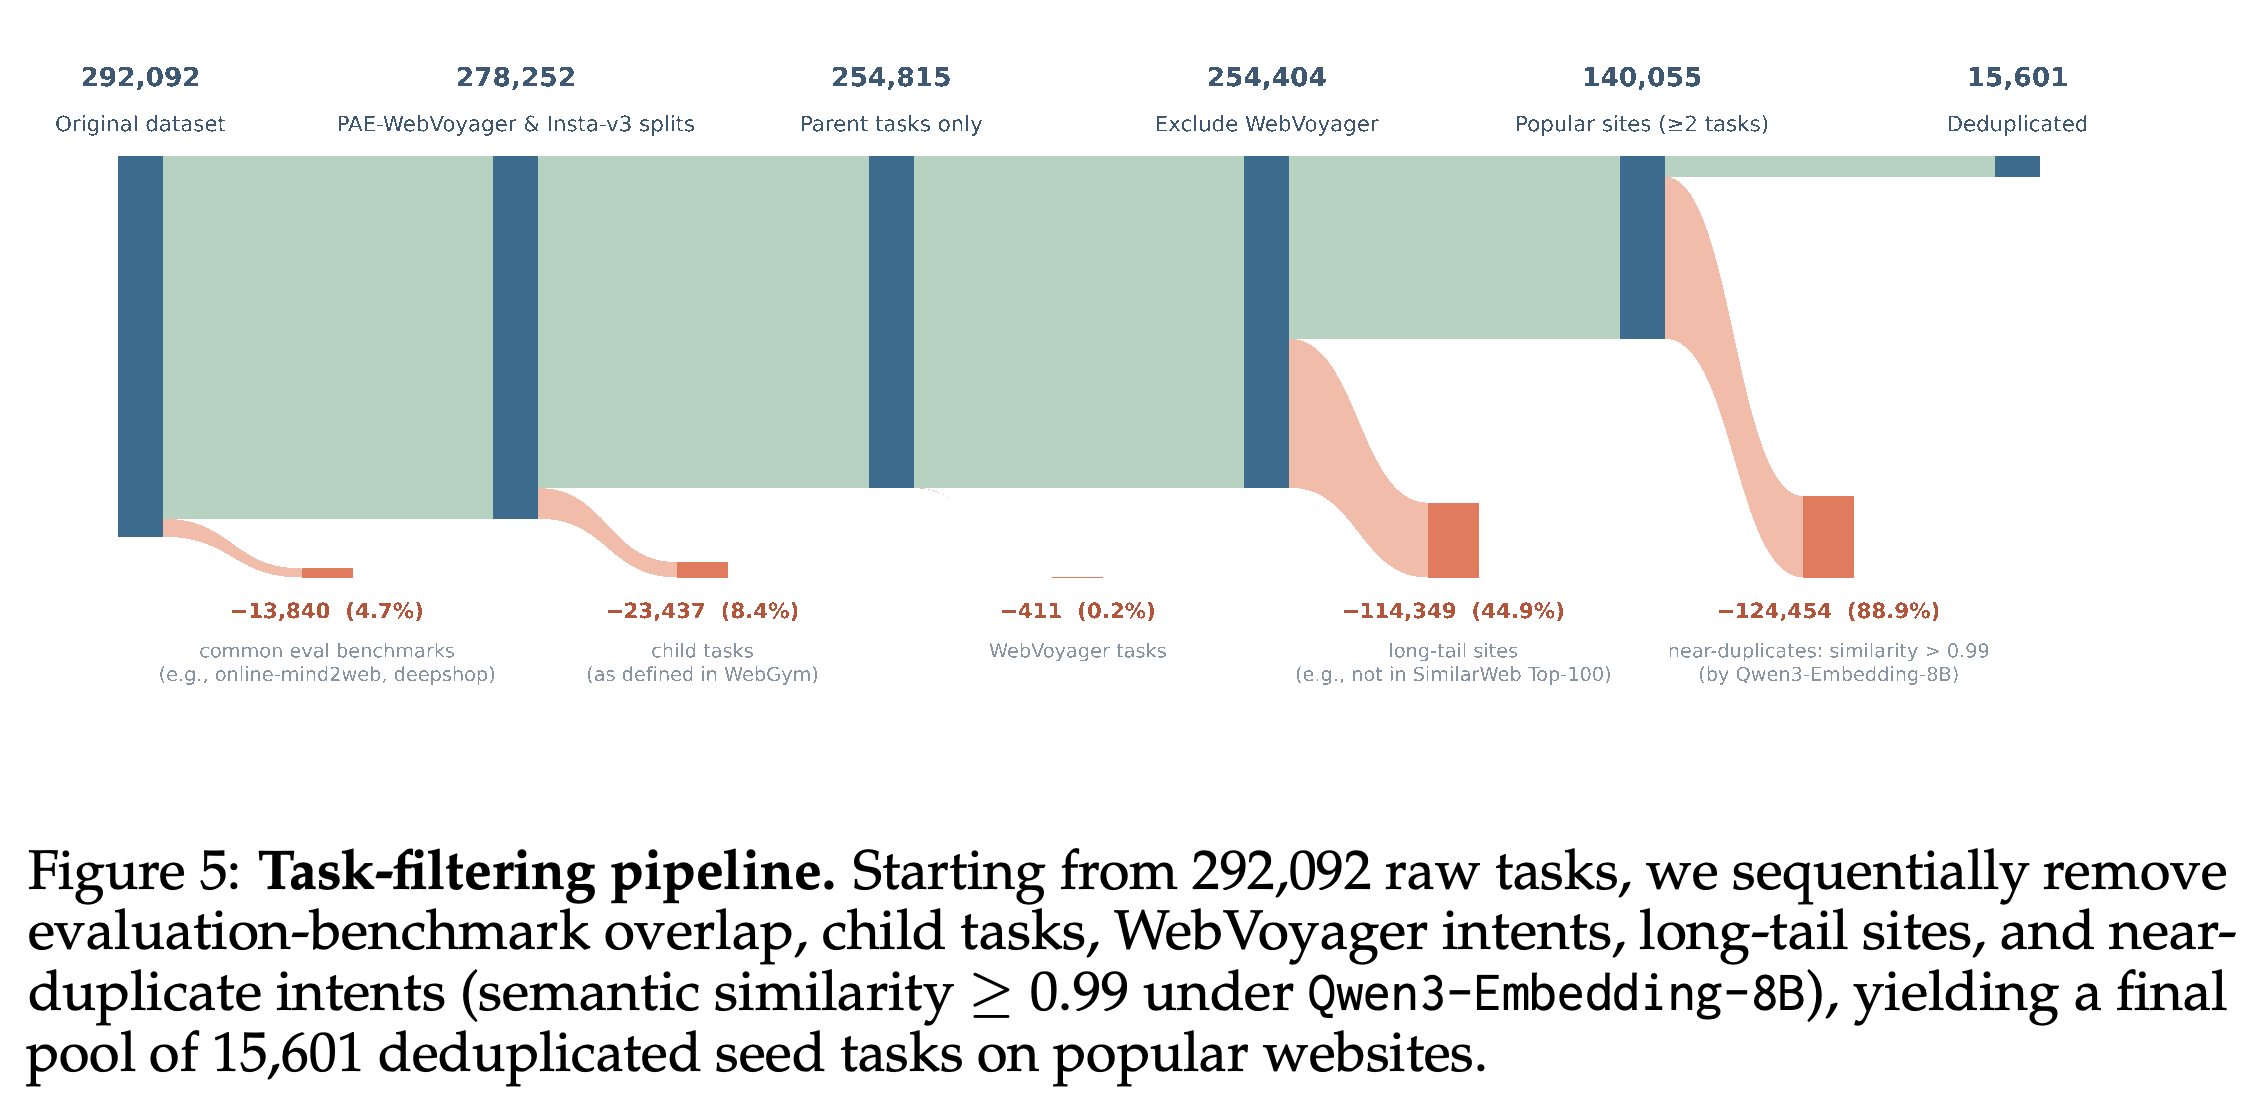
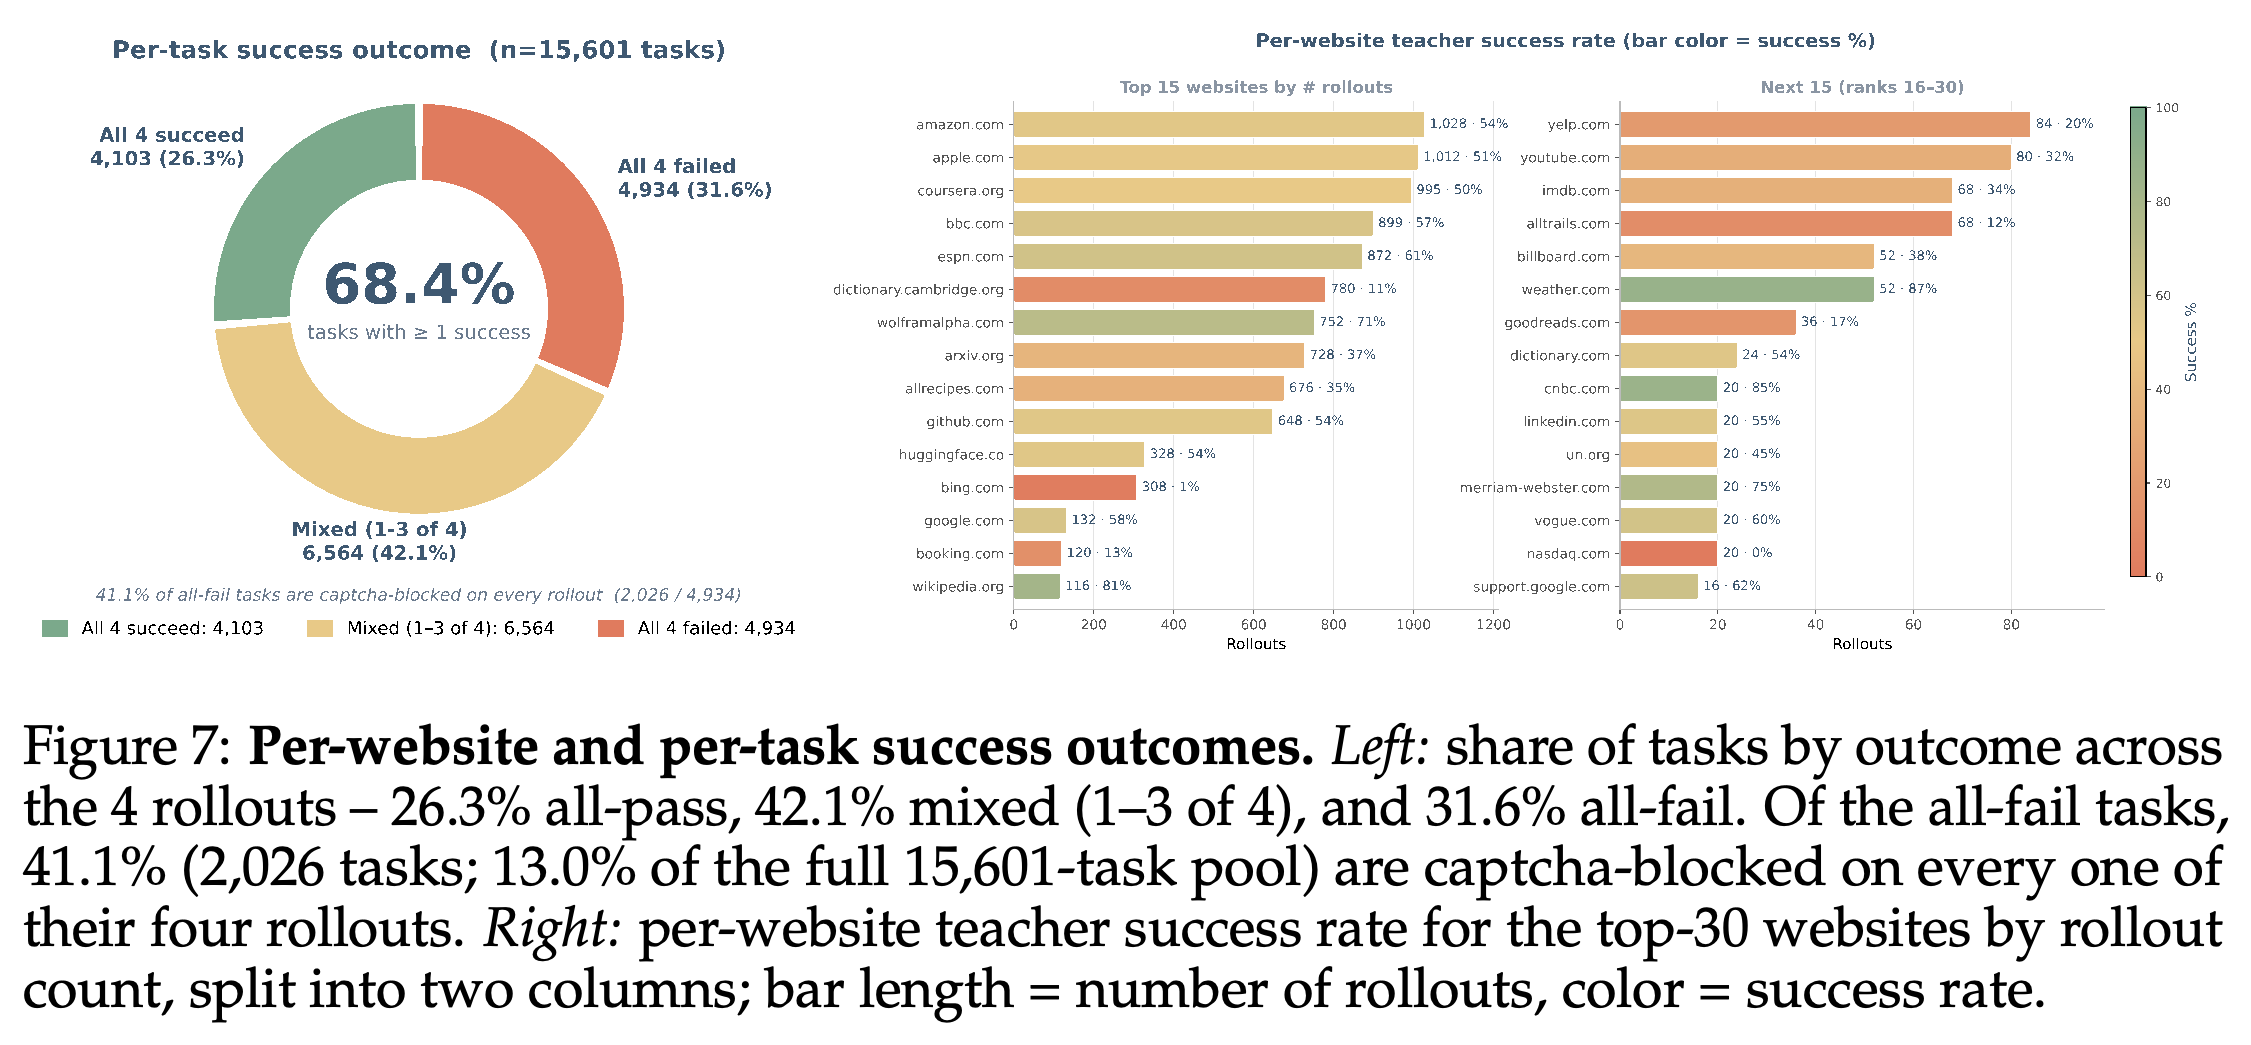
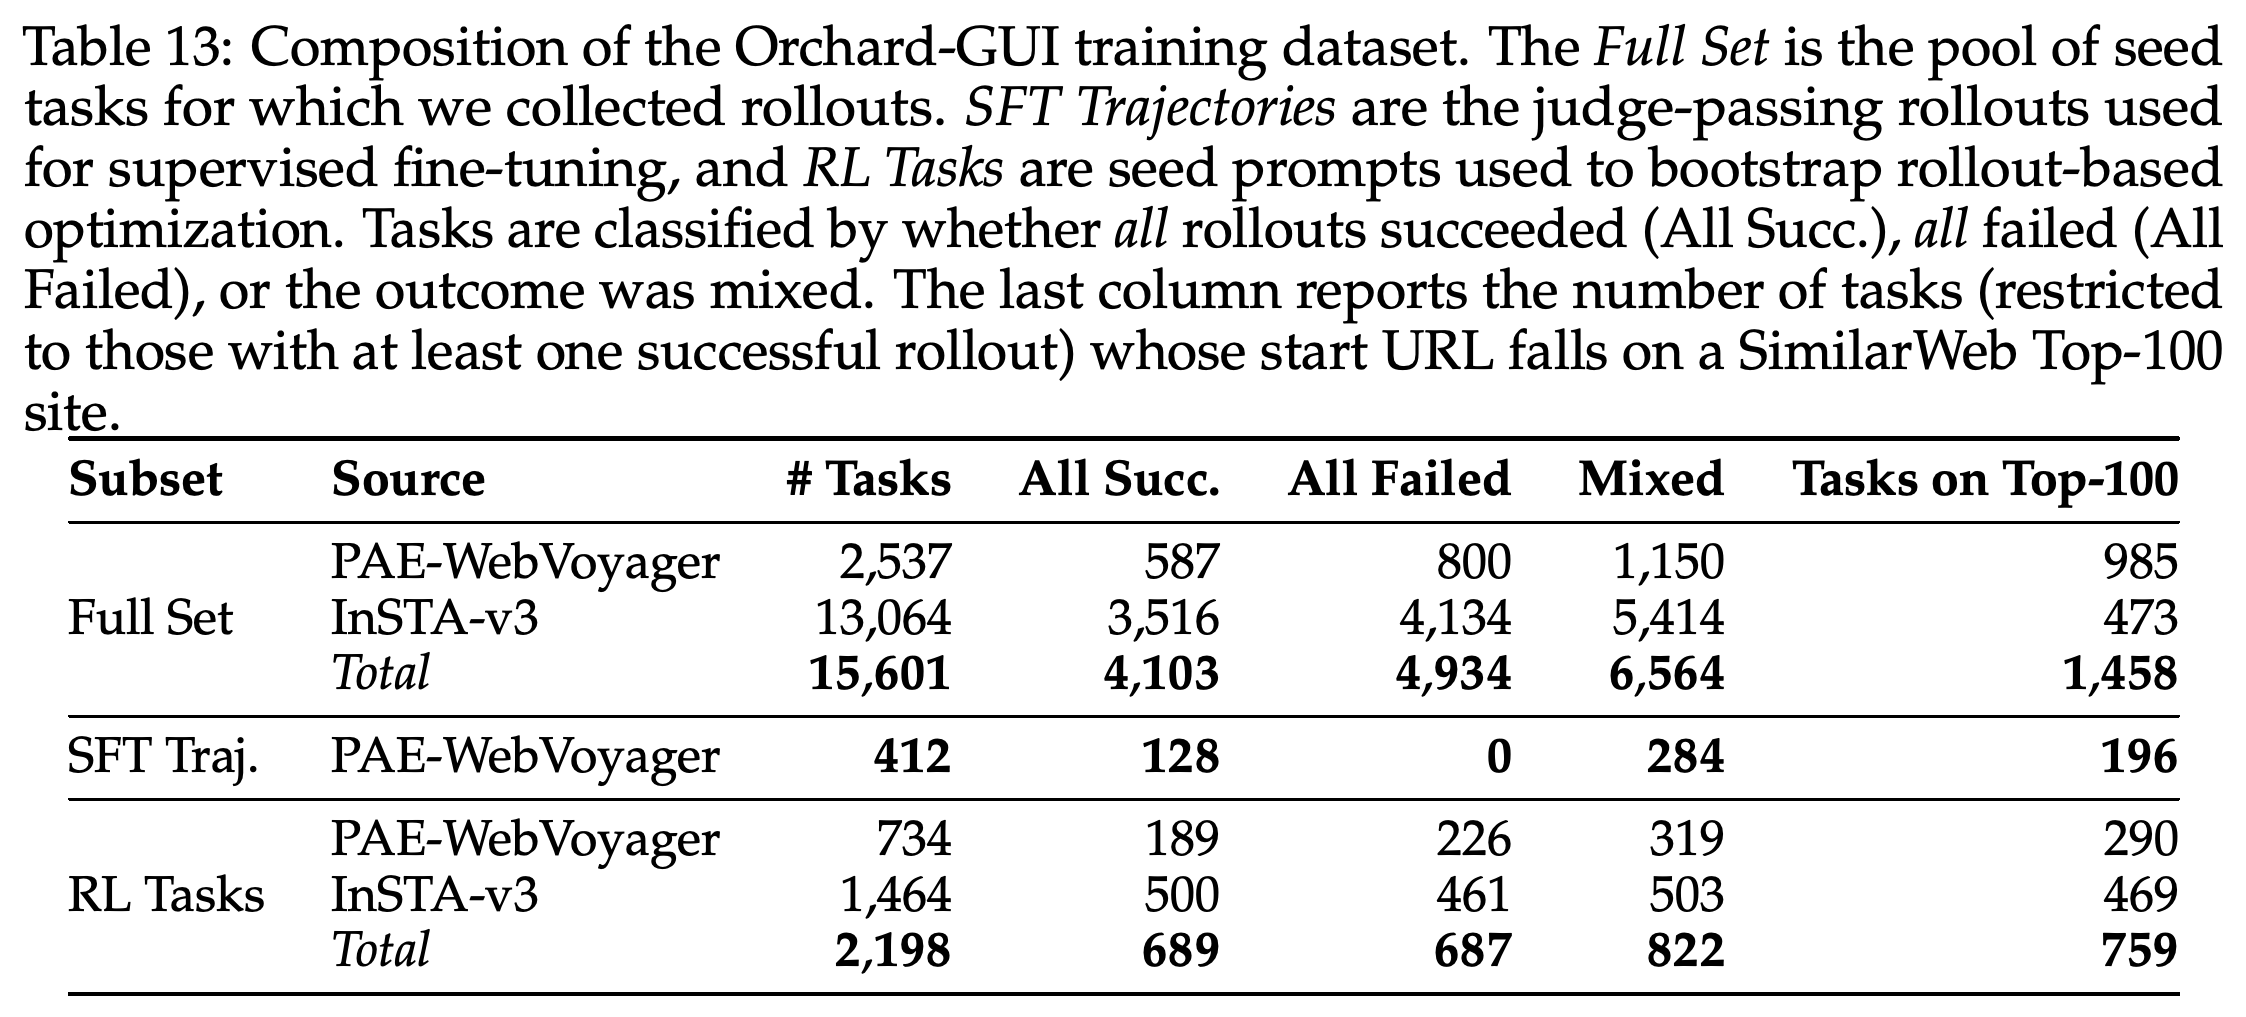
GUI 데이터 수집은 WebGym 과제 292,092개에서 시작해 시드 의도 15,601개로 필터링한다. 이는 PAE-WebVoyager 과제 2,537개와 InSTA-v3 과제 13,064개로 구성된다. Figures 5–7은 필터링, 웹사이트 커버리지, 교사 결과를 설명하며, Table 13은 수집 풀과 더 작은 학습 하위 집합을 구분한다.
- 필터링은 벤치마크 중복, 하위 과제, 원본 WebVoyager 의도, 빈도가 낮은 사이트를 제거하고, Qwen3-Embedding-8B로 의미가 거의 같은 중복도 제거한다. RL 풀은 더 엄격한 유사도 임계값 0.95를 사용하며 과제 2,198개를 포함한다.
- Qwen3-VL-235B-A22B-Thinking은 시드당 롤아웃 4개를 생성하며, 간헐적인 중단 이후 롤아웃 62,395개를 얻는다. GPT-4.1이 성공 여부를 판정한다. 과제의 26.3%는 시도 4개가 모두 성공하고, 42.1%는 성공과 실패가 섞이며, 31.6%는 시도 4개가 모두 실패한다.
- 모든 시도가 실패한 과제 4,934개 중 2,026개는 매번 captcha에 차단된다. 따라서 전체 실패 사례의 41.1%에는 환경적 장애가 기록되어 있다. 나머지 실패도 추가 분석 없이 모두 추론 한계로 돌릴 수는 없다.
- 성공한 PAE-WebVoyager 롤아웃 4,826개에서 SFT는 과제당 가장 짧은 성공 궤적을 유지하고 웹사이트당 과제 수를 K = 20으로 제한한다. 그 결과 웹사이트 70개의 궤적 412개를 얻는다. 대표 수치인 학습 과제 2.6K개는 전체 교사 롤아웃 수집량을 나타내지 않는다.
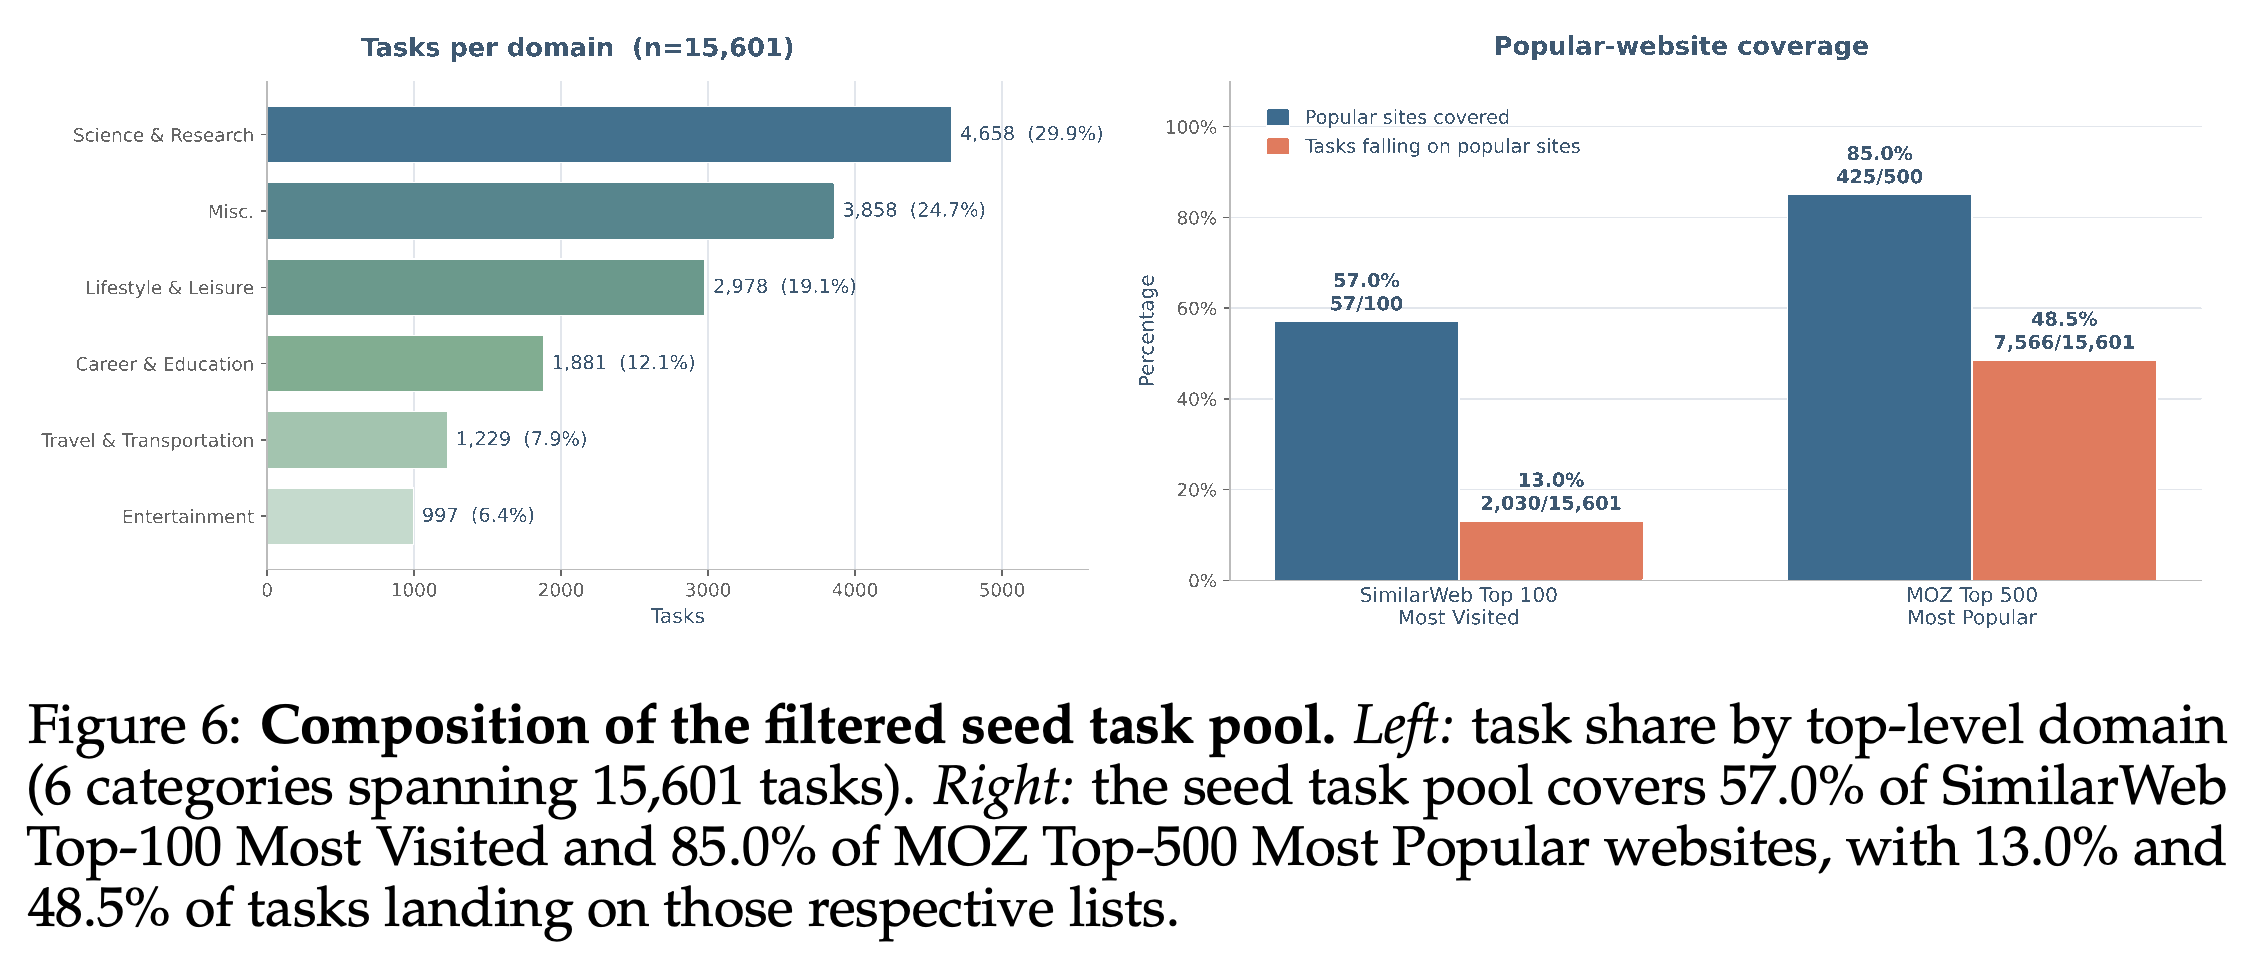
- Figure 6은 SimilarWeb 사이트 57/100개와 MOZ 사이트 425/500개를 포함한다고 보고하며, 각 목록에 해당하는 과제 수는 2,030개와 7,566개다. 보고된 고유 호스트 13,063개는 인기 사이트로 제한하고 사이트당 최소 과제 2개를 요구하는 Appendix H의 조건과 일치하기 어렵다.
가장 큰 감소는 의미 기반 중복 제거에서 발생하며, 남은 과제 140,055개 중 124,454개를 제거한다. 시드 풀은 무작위 샘플이 아니라 엄격하게 정제한 결과다. 도식과 부록은 > 0.99를 사용하지만 캡션은 ≥ 0.99를 사용한다.
풀은 도메인 범주 6개에 걸쳐 있으며 Science & Research가 29.9%를 차지한다. 웹사이트 커버리지와 과제 집중도는 다르다. MOZ Top-500 사이트의 85.0%를 포함하지만, 해당 목록에 속한 과제는 48.5%다.
롤아웃 4개에서 성공과 실패가 섞이는 경우가 흔하며, 이는 과제 난이도 추정과 궤적 선택에 정보를 제공한다. captcha 주석은 모든 시도가 실패한 과제의 41.1%에서 환경적 차단이 발생했음을 기록한다. 웹사이트별 막대는 수집량과 성공률 모두에서 큰 차이를 보여준다.
표는 수집한 시드 과제 15,601개를 SFT 궤적 412개, RL 과제 2,198개와 구분한다. Top-100 열은 성공한 롤아웃이 최소 1개 있는 과제로 제한하므로, Figure 6의 전체 Top-100 과제 커버리지와 같은 집계가 아니다.
4.4 Training Recipe
GUI SFT는 Qwen3-VL-4B-Thinking으로 초기화하고 비전 인코더와 멀티모달 프로젝터를 고정한다. 직렬화한 각 궤적 접두부에서 대상 어시스턴트 턴 1개를 사용해 언어 모델 가중치를 갱신한다. 학습은 3에포크, 최대 학습률 10⁻⁵, 코사인 감쇠, 워밍업 10%, 작업자 8개에 걸친 전역 배치 크기 128을 사용한다.
- 다중 턴 GRPO는 궤적 수준 어드밴티지를 어시스턴트 응답 토큰에 동일하게 적용하고 관측은 마스킹한다. 모든 어시스턴트 턴의 형식이 유효하고 심사자가 완료를 확인하면 보상 +1, 반복적인 형식 실패 후 종료하면 −1, 그 외에는 0을 부여한다.
- RL은 ε_low = 0.2와 ε_high = 0.28의 비대칭 PPO 클리핑을 사용하며, KL 또는 엔트로피 정규화와 궤적별 1/T_i 정규화는 적용하지 않는다. 동적 샘플링은 보상이 모두 0이거나 모두 양수인 그룹을 제외한다.
- 심사자 API 실패와 captcha로 중단된 실행은 remove_sample을 통해 손실 마스크를 0으로 만든다. 스텝 예산 커리큘럼은 먼저 15스텝으로 학습한 뒤 30스텝으로 확장한다.
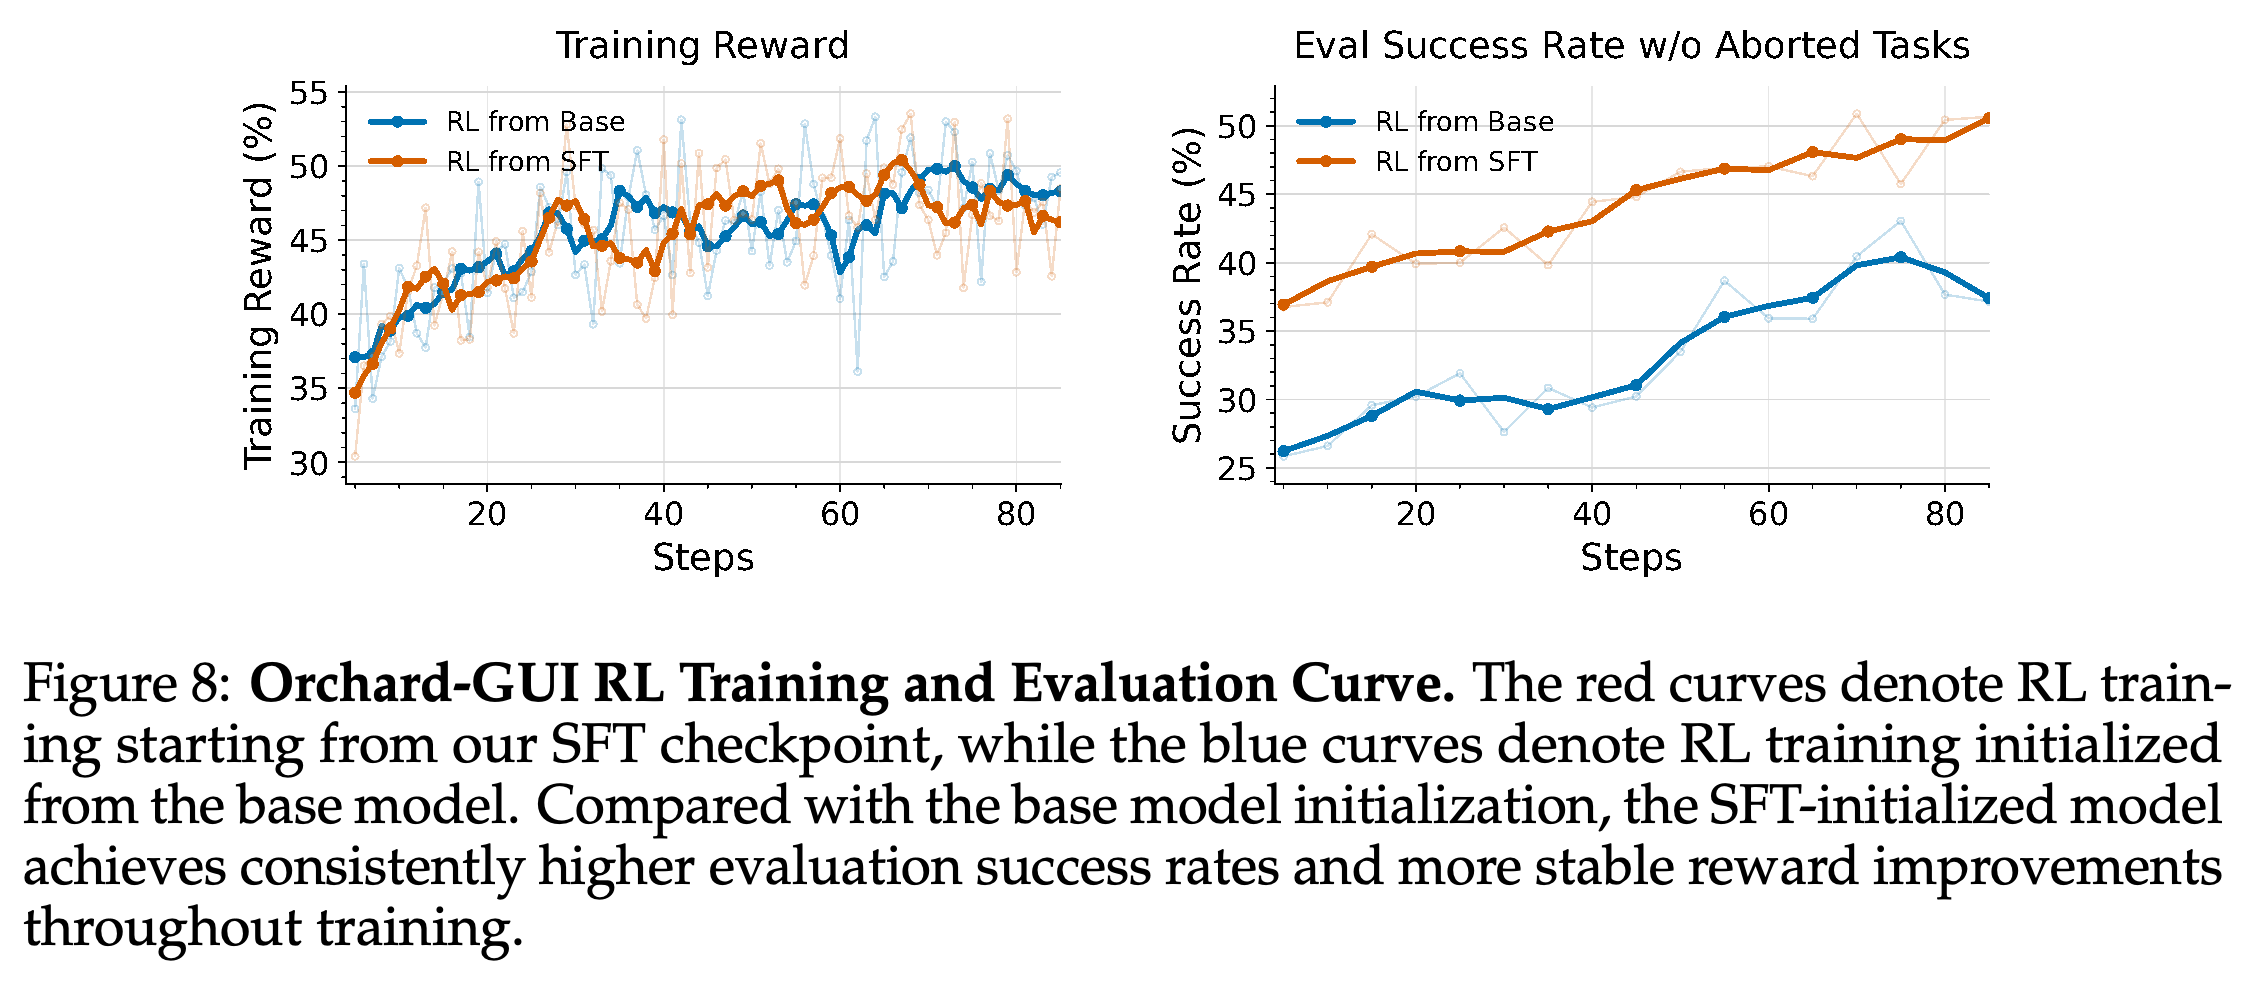
- Figure 8은 기본 모델과 SFT 초기화에서 시작한 RL을 비교한다. 학습 보상은 비슷하지만, 중단된 과제를 제외한 그래프의 평가 집합에서는 SFT 초기화가 일관되게 더 높은 성공률을 보인다.
기본 모델과 SFT에서 초기화한 RL은 비슷한 학습 보상을 얻지만, SFT 초기화는 더 높은 평가 성공률을 보인다. 평가 패널은 중단된 과제를 제외하므로, 해당 비율은 전체 시도를 포함한 종단 간 성공률이 아니다.
4.5 Main Results
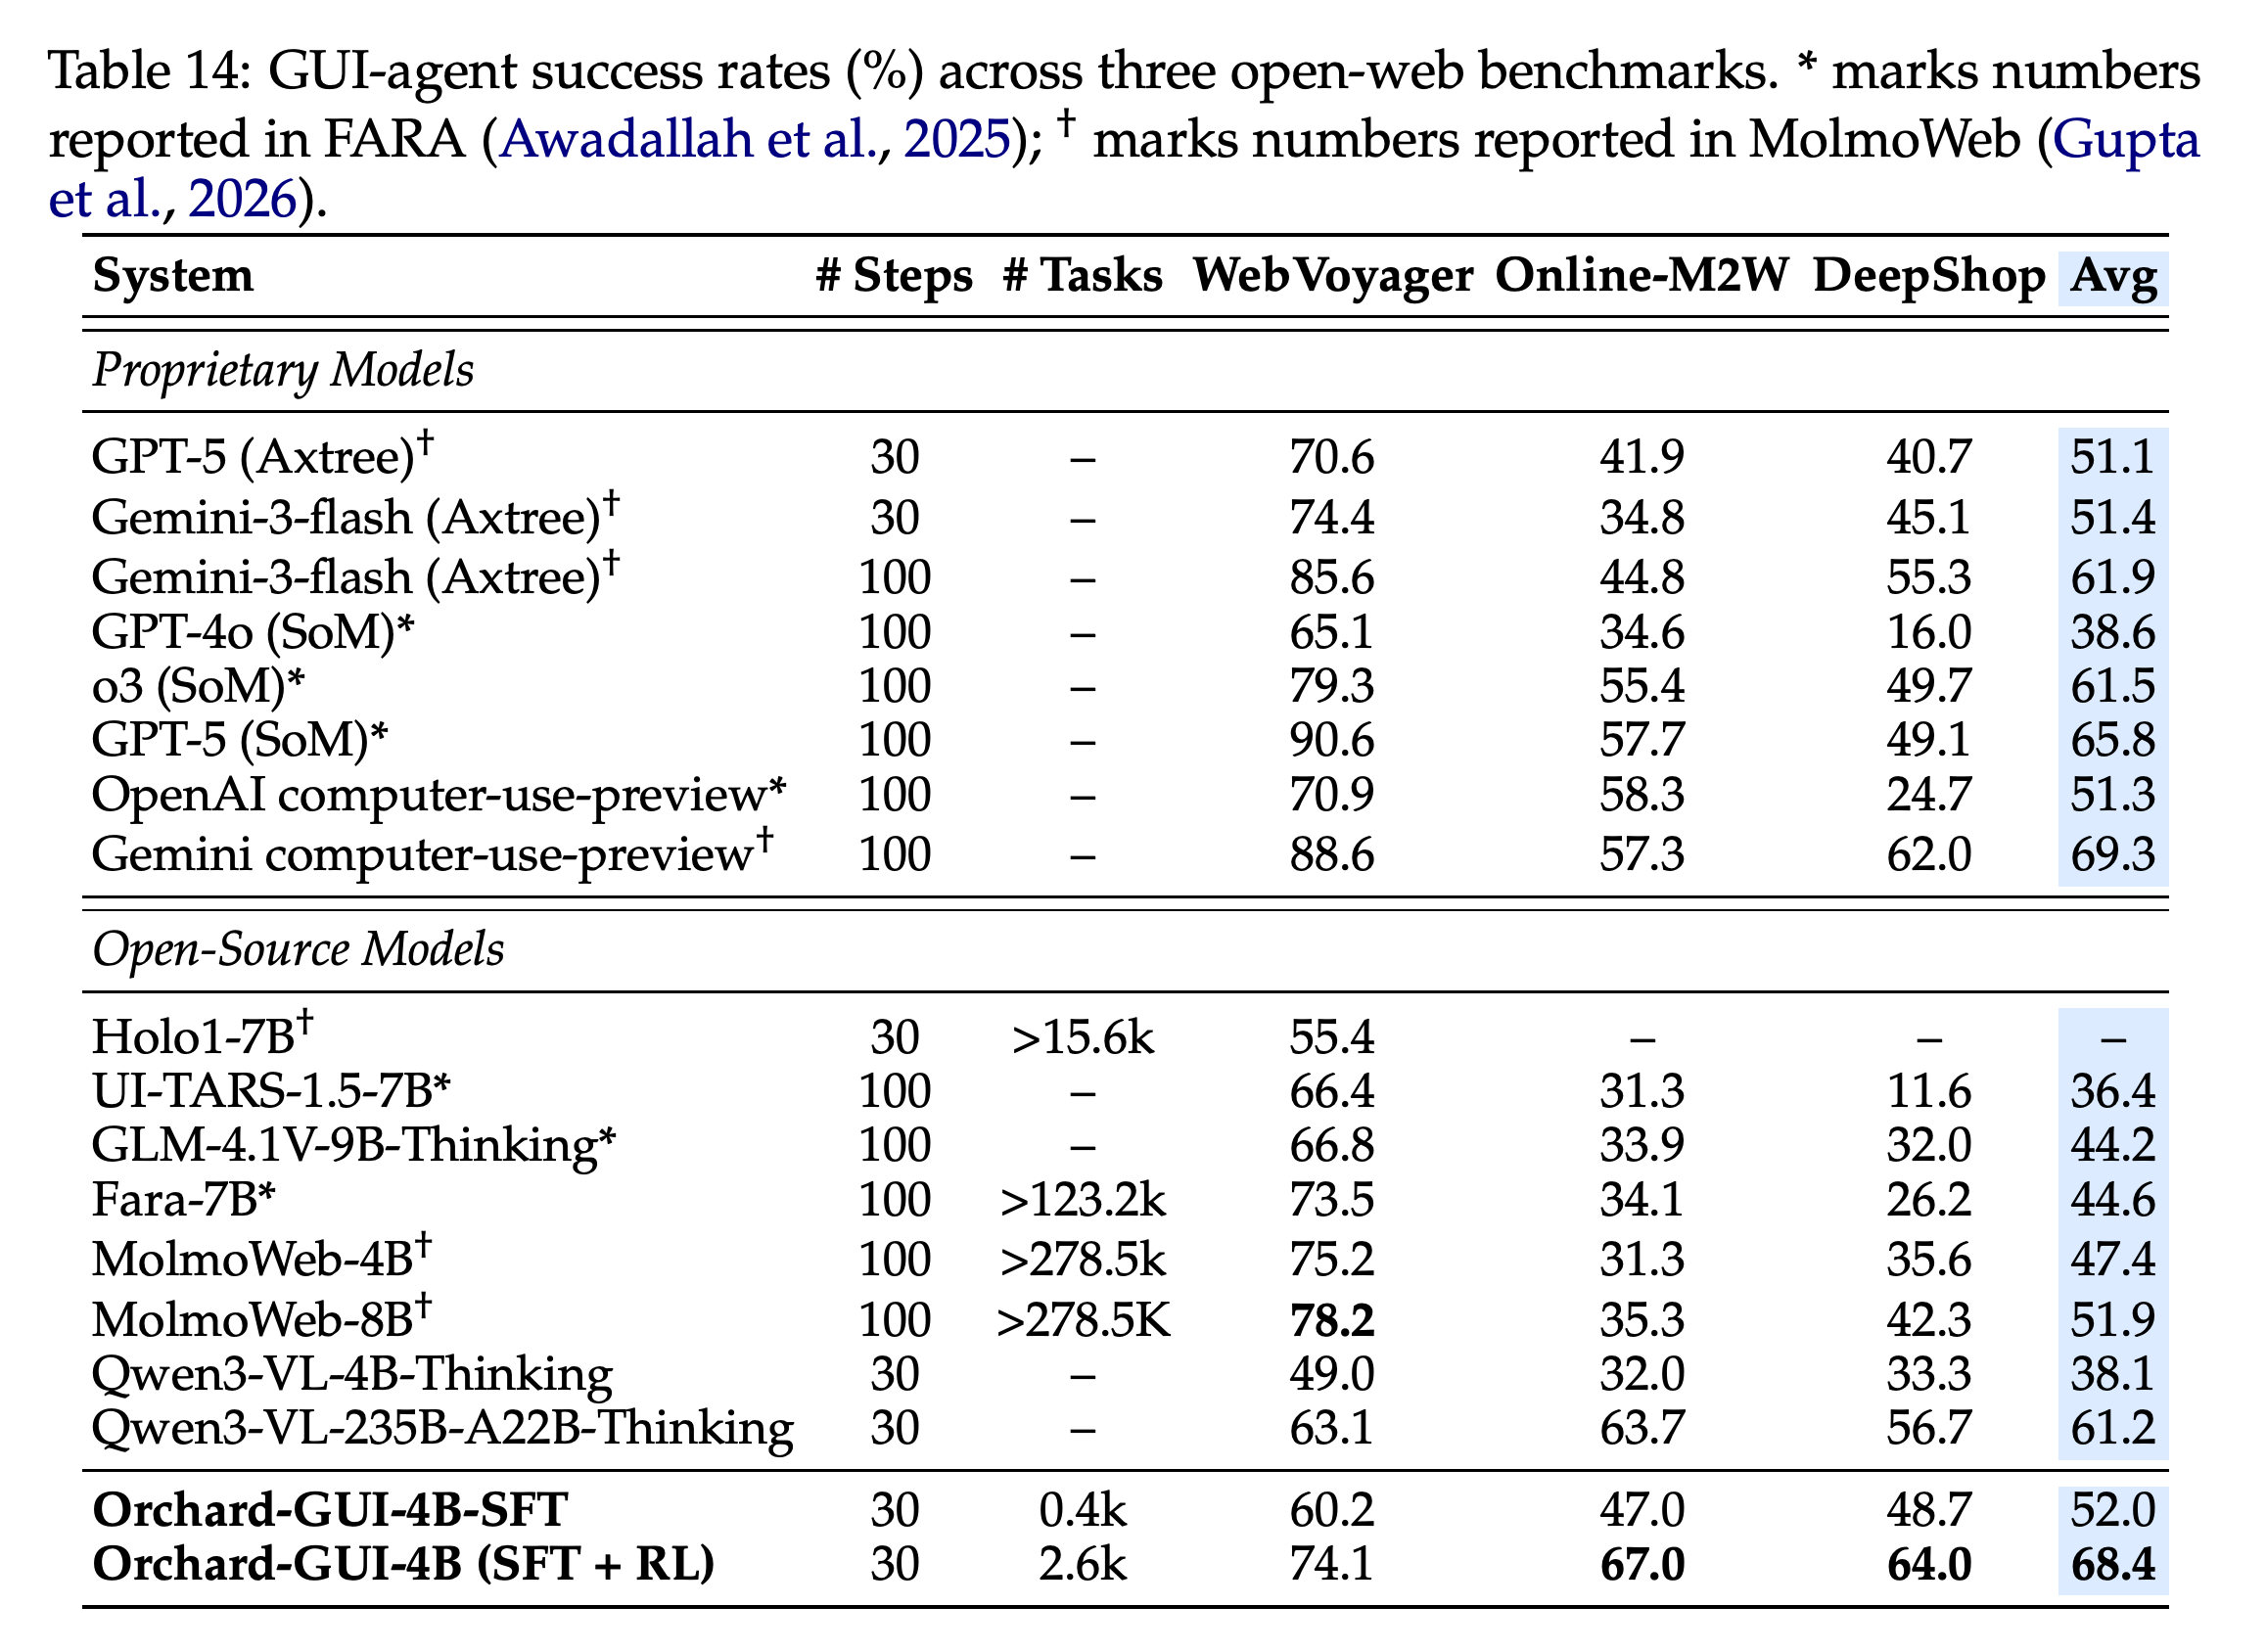
Table 14에서 Orchard-GUI의 성공률은 WebVoyager 74.1%, Online-Mind2Web 67.0%, DeepShop 64.0%이며, 평균은 68.4%다. SFT 체크포인트의 평균은 52.0%, 기본 Qwen3-VL-4B-Thinking 모델의 평균은 38.1%다.
- RL은 SFT 체크포인트 대비 벤치마크 3개에서 각각 13.9점, 20.0점, 15.3점 향상시킨다. 최종 모델은 235B 교사의 평균 61.2%와 표에 제시한 가장 강한 기존 오픈 베이스라인 MolmoWeb-8B의 51.9%를 넘어선다.
- 우위는 Online-Mind2Web과 DeepShop에 집중된다. Orchard는 MolmoWeb-8B보다 각각 31.7점과 21.7점 높다. 다만 WebVoyager의 74.1%는 MolmoWeb-4B의 75.2%와 MolmoWeb-8B의 78.2%보다 낮다.
- Gemini computer-use-preview의 평균은 69.3%이며, Orchard는 68.4%다. 비교 시스템 다수는 Orchard의 30스텝 대신 100스텝을 사용하며, 일부는 접근성 트리나 Set-of-Mark 표현을 사용하므로 하네스와 예산 조건이 다르다.
- 정제한 학습 하위 집합은 작지만, 전체 과정의 연산 효율성을 판단하려면 교사 롤아웃 62,395개, 심사자 호출, 반복적인 RL 샘플링을 고려해야 한다.
Orchard가 오픈소스 중 가장 높은 평균을 기록하는 데에는 Online-Mind2Web과 DeepShop이 기여하며, WebVoyager 점수가 가장 높아서 얻은 결과는 아니다. 스텝 예산, 관측 표현, 학습 과제 수, 비교 결과의 출처는 시스템마다 다르다.
5 Orchard-Claw
Orchard-Claw는 이메일, 캘린더, 재고, 일정 관리 및 기타 도구를 사용하는 개인 비서 워크플로를 연구한다. 합성 과제를 사용하며, 벤치마크의 ReAct 방식 하네스와 ZeroClaw 2개 모두에서 종단 간 학습을 수행한다.
5.1 Problem Setting
Claw-Eval은 자동화 스크립트와 LLM 심사자로 전체 궤적의 완료도, 안전성, 강건성을 점검한다. 이를 task_score = safety × (0.8 · completion + 0.2 · robustness)로 집계하고, task_score ≥ 0.75일 때 과제를 통과한 것으로 센다.
- 학습 및 평가 환경은 ClawEval과 ZeroClaw를 설치한 Python 기반 이미지로 구성하며, Orchard Env를 통해 격리된 2-vCPU, 2-GiB 샌드박스에서 실행한다.
- ZeroClaw는 OpenClaw 방식 하네스를 Rust로 구현한 경량 시스템이다. 시험한 하네스 2개 모두 학습에 사용하므로, ZeroClaw의 성능 향상은 보지 못한 하네스로의 전이가 아니라 호환성과 하네스 활용을 보여준다.
5.2 Trajectory Collection and Curation
Claude Opus 4.6은 Claw-Eval 시드와 ClawHub 워크플로에서 과제 제안, 환경 및 테스트 생성, MiniMax-M2.5의 해결, 개선 과정을 거쳐 과제 192개를 합성한다. 평균 합성 비용은 과제당 $4.9다.
- 각 과제에서 해당 하네스로 MiniMax-M2.5 롤아웃 5개를 샘플링하고, 성공한 궤적만 유지한다.
- 프록시 LLM 서버는 복잡한 하네스가 수행한 호출까지 포함해 개별 입력–출력 호출을 기록한 뒤 궤적으로 묶는다. SFT 집합은 궤적 561개와 학습 쌍 4,537개를 포함한다.
- Appendix I는 기록된 ZeroClaw 형식을 예시한다. 이는 작은 합성 풀을 사용한 예비 연구이며, 논문은 벤치마크 시드에서 합성한 데이터에 대해 상세한 오염 제거 분석을 제공하지 않는다.
5.3 Training Recipe
Orchard-Claw는 Qwen3-30B-A3B-Thinking-2507로 초기화하고, 프록시가 기록한 응답에 입력을 마스킹해 SFT를 1에포크 수행한다. SFT는 전역 배치 크기 16, 문맥 64K, 10⁻⁵에서 10⁻⁶까지 코사인 감쇠하는 학습률, 왼쪽 잘라내기를 사용한다. 추론 문맥은 256K로 확장한다.
- RL은 모든 테스트 스크립트를 통과한 궤적에서 기록된 모든 쌍에 +1, 그 외에는 −1을 부여한다. 표준 GRPO는 배치 크기 8, 그룹 크기 8, 학습 150스텝을 사용하며, 스텝마다 비동기 롤아웃 샌드박스 64개를 사용한다.
- 각 롤아웃에는 고정 스텝 제한 대신 실제 경과 시간 10분의 예산을 부여한다. 시간 초과 궤적은 중단하고 학습에서 제외한다.
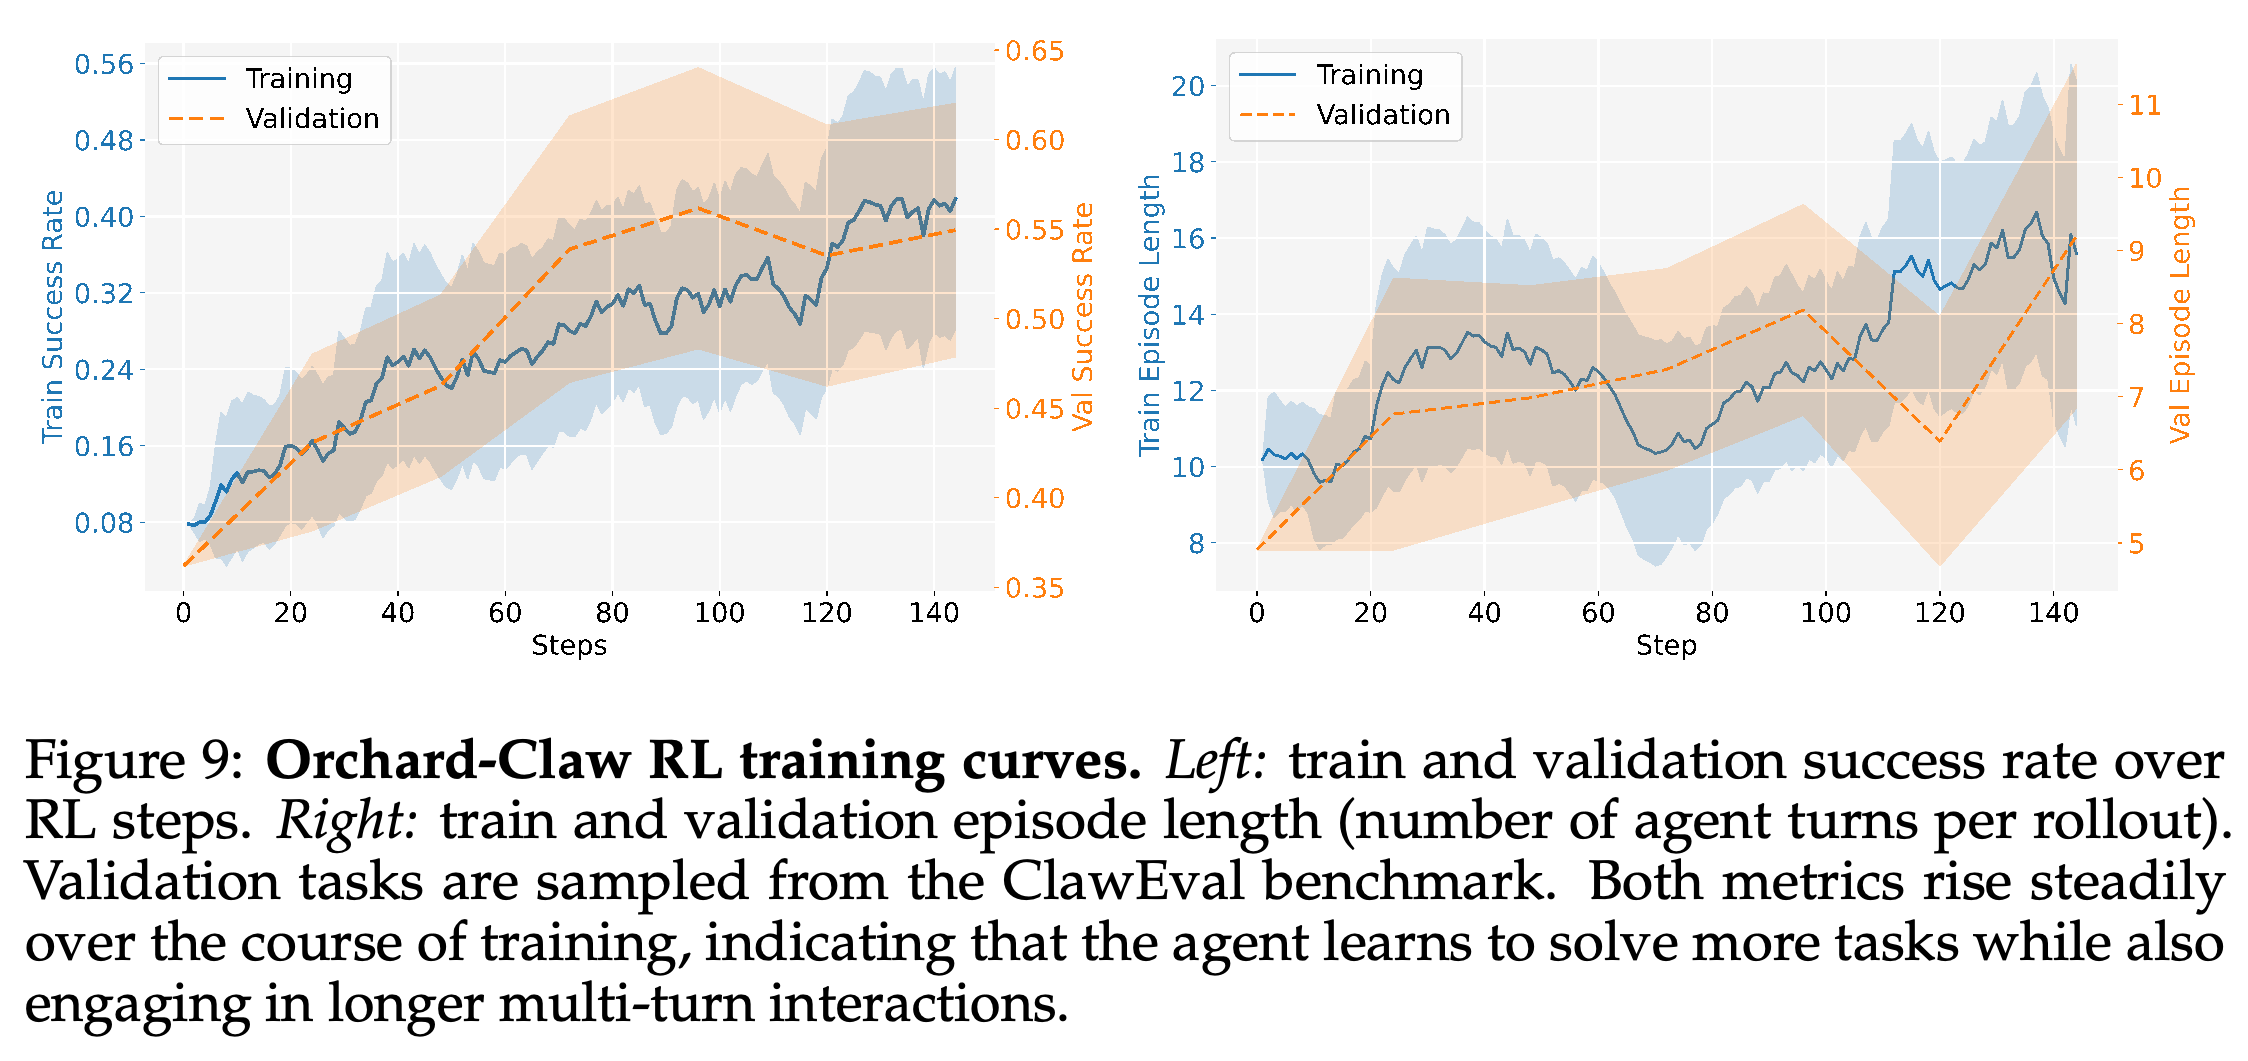
- Figure 9는 학습 및 검증 성공률이 높아지는 동시에 에피소드도 대체로 길어지는 모습을 보여준다. 학습과 검증은 서로 다른 축을 사용하며 곡선은 변동한다. 에피소드가 길어진다는 사실만으로 효율성이 높아졌다고 볼 수는 없다.
롤아웃 길이가 늘면서 성공률도 대체로 높아진다. 학습과 검증은 별도의 세로축을 사용하며 어느 시계열도 단조롭지 않다. 에피소드가 길어진다는 사실만으로 효율성이 높아졌다고 볼 수는 없다. 검증 과제는 ClawEval에서 샘플링한다.
5.4 Main Results
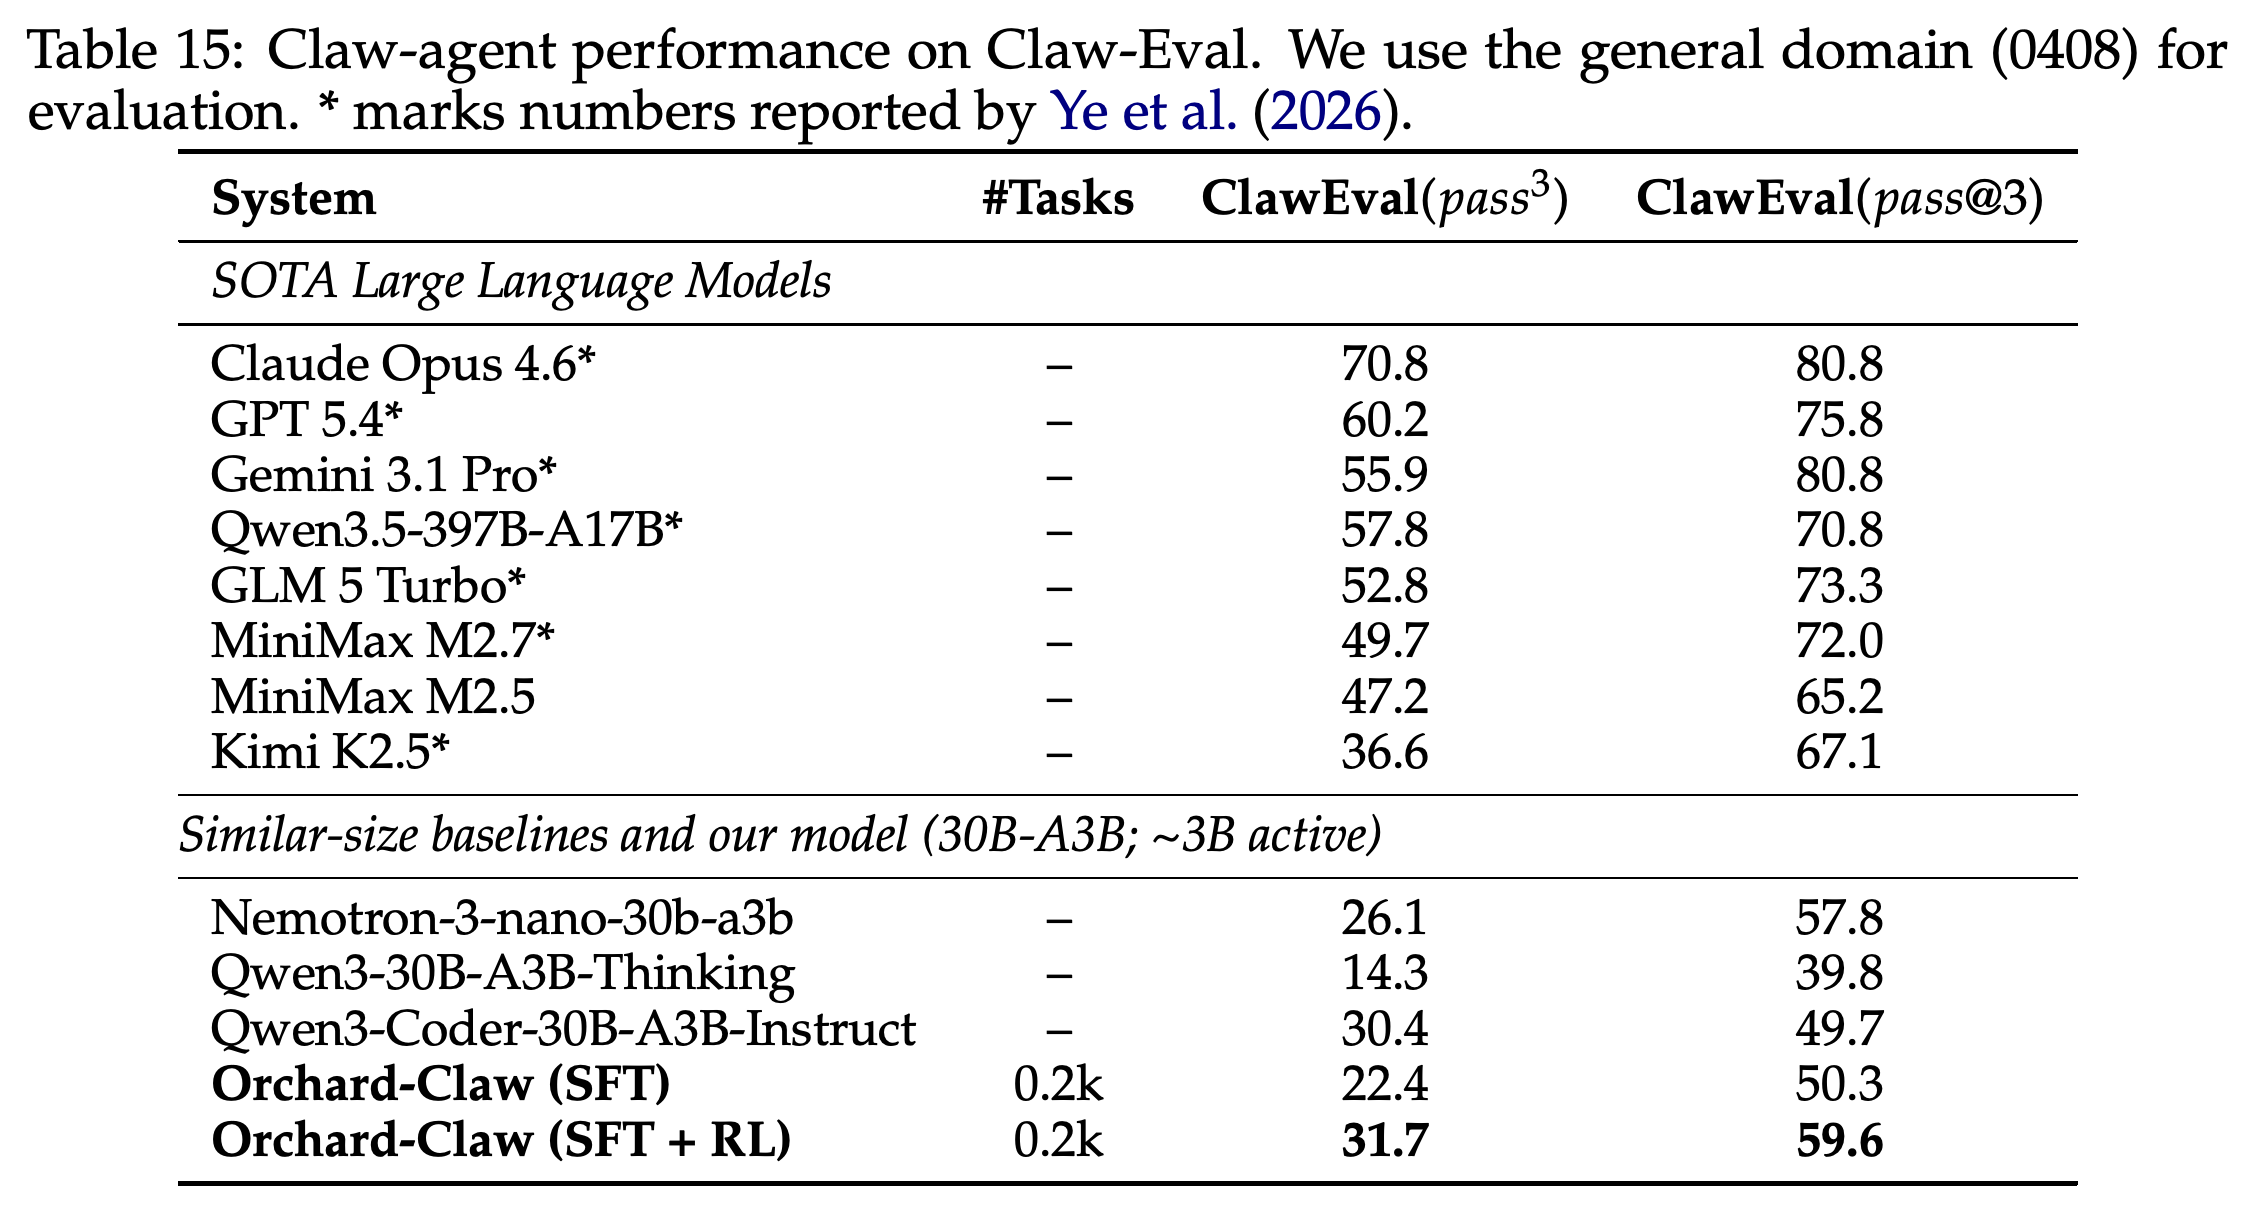
Claw-Eval의 일반 도메인(0408)에서 Table 15는 기본 ReAct 방식 하네스를 사용하는 Orchard-Claw의 pass³ 31.7%와 pass@3 59.6%를 보고한다. 기본 모델은 14.3%와 39.8%, SFT만 적용한 모델은 22.4%와 50.3%다.
- RL은 SFT 대비 지표 2개 모두 9.3점 높인다. Orchard는 표에서 비슷한 크기의 Nemotron-3-nano-30b-a3b와 Qwen3-Coder-30B-A3B-Instruct 베이스라인을 넘어선다. 다만 가장 강한 대형 모델 결과보다는 낮다.
- Table 16에서 ZeroClaw는 학습된 모델을 pass³ 41.0%, pass@3 73.9%로 높인다. ReAct 대비 각각 9.3점과 14.3점 향상이다. 같은 하네스 변경이 비교 모델에 주는 효과는 더 작거나 지표별로 엇갈린다.
- 저자들은 대상 하네스로 학습한 결과 하네스 활용 능력이 높아졌다고 해석한다. 표는 서브에이전트나 자동 문맥 압축 등 ZeroClaw의 어떤 기능이 성능 향상을 유발하는지 분리하지 않는다.
- pass³와 pass@3는 서로 다른 원문 지표로 모두 유지한다. 논문은 각 지표의 수학적 추정량을 명시적으로 정의하지 않는다.
약 0.2K개의 합성 과제를 사용하는 SFT와 RL은 보고된 Claw-Eval 지표 2개 모두를 단계적으로 개선한다. 최종 모델은 표에 제시한 비슷한 크기의 베이스라인을 넘어선다. 다만 여러 대형 시스템보다 낮으며, 특히 pass³에서 차이가 난다.
6 Related Work
관련 연구는 상호작용 환경 오케스트레이션, 소프트웨어 엔지니어링 에이전트, GUI 및 브라우저 에이전트, 장시간 실행되는 Claw 방식 비서를 다룬다. Orchard는 재사용할 수 있는 좁은 실행 경계를 제공하며, 기존 SFT와 그룹 상대 RL에 부분 진전 감독, 보상을 고려한 샘플링, 조밀한 보상 변형, 과거 데이터 기반 가치 모델 학습을 결합한다.
- MegaFlow와 ProRL Agent는 통합형 또는 부분적으로 분리된 롤아웃 시스템의 사례다. E2B, Daytona, Modal은 개발자용 샌드박스 또는 컴퓨팅 인터페이스를 제공하며, Orchard는 연구자가 통제하는 Kubernetes 배포를 강조한다.
- SWE-agent와 OpenHands는 에이전트 인터페이스를 제공한다. SWE-smith, BugPilot, SWE-rebench, Scale-SWE는 과제 또는 궤적 출처를 확장한다. Orchard는 SWE 과제 합성기를 새로 제안하지 않고 실제 이슈 출처를 사용한다.
- Fara와 MolmoWeb은 증류한 GUI 학습 데이터를 강조한다. UI-TARS와 기타 GUI RL 시스템은 모방을 넘어선 강화 학습의 동기를 제공한다. Claw-Eval, ClawGym, MetaClaw, OpenClaw-RL은 관련 평가, 합성, 적응 접근법을 제공한다.
7 Conclusion
결론은 확장 가능한 에이전트 개발에 실행 인프라와 학습 설계가 모두 필요하다고 주장한다. 도메인별 레시피 3개는 환경 API에 트레이너나 하네스를 포함하지 않고도 공통 샌드박스 서비스가 서로 다른 모달리티, 하네스, 감독 신호 출처, 보상을 지원할 수 있음을 보여준다.
- 입증한 재사용은 실행 추상화와 학습 구성 요소에 관한 것이다. 단일 정책이나 보상 함수를 SWE, GUI, 개인 비서 과제에 변경 없이 전이한 것은 아니다.
부록
- A Orchard Env Design Details는 init 컨테이너와 공유 emptyDir 볼륨을 통한 런타임 주입을 설명하며, 복사한 런타임을 /opt/sandbox-agent/start.sh로 실행한다. 구현은 Linux 컨테이너 이미지를 대상으로 하며 보통 sh -c로 시작한다. 직접적인 Pod-IP 라우팅, 선택적 예외를 둔 기본 차단형 아웃바운드 정책, 하트비트 정리, LIST+WATCH 준비 상태 추적이 설계를 완성한다.
- B Cost Analysis Details는 Azure Standard_D16ads_v5 인스턴스 17개를 가정한다. 샌드박스 노드 16개가 각각 샌드박스 8개를 호스팅하고, 노드 1개가 오케스트레이터를 실행한다. 약 $0.165/hr의 스폿 가격과 $0.824/hr의 온디맨드 가격을 비교하고, 관리형 서비스의 컴퓨팅 및 메모리 요금을 제시한다. 총액 $673은 노드 17개 모두에 스폿 가격을 적용한 값에 가깝지만, 명시된 배포는 온디맨드 오케스트레이터를 사용한다. 따라서 보고된 총액은 해당 혼합 요금 설정과 일치하지 않는다.
- C Orchard RL Implementation Details는 slime을 확장해 Ray 오케스트레이션, Megatron-LM 학습, SGLang 추론, Orchard 실행, 비동기 에이전트 루프 드라이버를 결합한다. 롤아웃과 학습의 파이프라인 처리, 어시스턴트 토큰 손실 마스킹, 계층별 시간 제한과 재시도, 자원 소진 후 할당 확대, 샌드박스 시작이 동시에 몰리는 현상을 줄이는 무작위 생성 지연을 설명한다.
- D Orchard-SWE Prompt List는 Value-Estimation Prompt와 Process-Reward Grading Prompt를 제공한다. 전자는 알려진 실패를 조건으로 가치를 추정하고, 초기 확률 0.3–0.5와 최종 확률 0.2 미만을 요청하며, 단조 증가하는 값을 금지한다. 후자는 증거에 근거한 R1–R7 점수를 요청하고, 참조 자료의 사용을 자체 테스트의 관련성, 커버리지, 판별력을 판단하는 근거로 제한한다.
- E Orchard-SWE RPR Rubrics and Curves는 Table 17에서 가중치를 부여한 차원 7개를, Figure 10에서 과정 점수의 추세를 제공한다. 그래프는 수정 품질, 자체 테스트 관련성, 커버리지, 회귀 방지, 검증 무결성, 종합 심사 보상을 보여주지만, Rigor와 Discriminativeness는 별도로 그리지 않는다.
- F Orchard-GUI Tool List는 Pointer Actions: click / hover / drag, Keyboard Actions: write / press_keys, Page-Navigation Actions: scroll / goto_url / go_back / wait, Tab-Management Actions: new_tab / switch_tab / close_tab, Termination Action: done의 전체 스키마를 제공한다. 좌표는 뷰포트 기준이고, 스크롤 양은 0.0에서 1.0 사이로 제한된다. switch_tab은 0부터 시작하는 tab_index를 사용하며, done은 완료 또는 실패를 보고하는 response 문자열을 요구한다.
- G Example GUI Agent Trajectory는 Inputs to LLM – full trajectory (last turn, 1 context image)와 Example response from LLM at the last turn을 포함한다. Amazon 과제는 길이가 최소 30인치인 세탁 가능한 반려견 침대를 찾는다. 궤적은 검색과 필터링을 거쳐 EHEYCIGA 제품을 확인하고, 크기가 35 × 23 × 3.5인치라고 보고하는 응답으로 끝난다. 이는 설명용 궤적이며 추가적인 종합 성능 실험은 아니다.
- H Orchard-GUI Task Filtering Pipeline은 단계별 풀 크기를 292,092 → 278,252 → 254,815 → 254,404 → 140,055 → 15,601로 기록한다. 벤치마크 분할, 하위 과제, WebVoyager 의도 중복, 부적합한 웹사이트를 제거한다. Qwen/Qwen3-Embedding-8B에서 유지된 과제와의 코사인 유사도가 0.99를 초과하는 의도도 제거한다. 이 임계값 표현은 본문 그림 캡션의 ≥ 0.99와 다르다.
- I Example Claw Agent Trajectory는 Example Model Input in the ZeroClaw Harness와 Example Response from LLM을 제공한다. 재고 워크플로는 gmail_list_messages, gmail_get_message, inventory_list_products를 사용하고, 재입고 비용이 $1000를 초과하면 HIGH PRIORITY로 표시하며, /home/user/rotation_plan.txt에 요약을 작성할 계획을 세운다. 발췌문은 프록시가 기록한 다중 도구 문맥을 보여주지만 워크플로가 완료되기 전에 끝난다.
짧은 생각
핵심 기여는 구체적인 에이전트 학습 레시피 3개로 시험한 재사용 가능한 실행 경계다. 지연 시간과 수명주기 시험은 실용적인 샌드박스 운영을 뒷받침한다. 하네스 간 통제 비교 행렬은 인프라 독립성이 정책 독립성을 뜻하지는 않음을 보여준다. 학습한 도구 형식과 관측 관례는 여전히 중요하다.
학습 성능 향상은 크지만, 해석은 비교 조건에 따라 달라진다. 실패 궤적 감독은 같은 양의 해결 데이터를 추가하는 조건과 비교하지 않았다. RPR의 과정 개선은 학습에 사용한 루브릭으로 측정하며, 가치 모델 재순위화는 추가 추론 롤아웃을 사용해 정확도를 높인다. 불확실성 추정의 부재, 불완전한 비용 산정, 보고 내용의 불일치, 남아 있는 하네스 전이 손실 때문에 일반적인 효율성이나 하네스 독립성에 관한 주장은 제한된다.