


Learning to Reason without External Rewards 요약 설명
26 May 2025 | Paper Review Mathematical Reasoning Reinforcement Learning With Verifiable Rewards Reward Design목차
원문 버전. 이 사후 검토는 2025년 5월 26일 공개된 arXiv:2505.19590v1을 다룬다.
Xuandong Zhao, Zhewei Kang, Aosong Feng, Sergey Levine, Dawn Song은 언어 모델이 생성한 응답의 확률 분포에서 계산한 자신감을 학습 보상으로 쓰는 강화학습 방법 INTUITOR를 연구한다. 논문, 코드.
요약
- 검증 가능한 보상 기반 강화학습(RLVR)은 수학 정답이나 코드 테스트처럼 답을 확인할 수단이 필요하다. INTUITOR는 학습 중 외부 보상 대신 모델 자신의 자기 확신도(self-certainty)를 사용해 그룹 상대 정책 최적화(GRPO)를 수행한다.
- MATH로 학습한 Qwen2.5-3B의 MATH500 점수는 INTUITOR 0.612, GRPO 0.636이었다. LiveCodeBench v6에서는 각각 0.153과 0.085, CRUXEval-O에서는 0.416과 0.341이었다. 자신감이 정답을 보장한다는 뜻은 아니다. [6쪽, 표 1]
- 고정된 모델로 점수를 계산한 실험에서는 보상 악용이 관찰됐고, 온라인 채점은 해당 실행에서 안정적이었다. 큰 모델의 초기 학습 붕괴와 설정 민감성도 보고됐다. v1 본문과 부록의 일부 하이퍼파라미터 값은 서로 달라 재현 전에 확인해야 한다. [9–10, 15–16쪽]
1. Introduction
RLVR은 답의 정오를 확인할 수 있는 과제에서 유용하지만, 수학 문제의 참조 정답이나 코드의 테스트 환경처럼 과제별 검증 수단이 필요하다. 저자들은 모델 내부 예측으로 계산한 신호만으로 학습할 수 있는지 묻고, 이 범주를 내부 피드백 기반 강화학습(RLIF)이라고 부른다. 사람이 정의한 질문, 사전학습 모델, 외부 평가는 여전히 필요하다. 외부 학습 보상을 쓰지 않는다는 뜻이다. [2–4쪽]
2. Related Work
논문은 선호도 기반 피드백, 검증 가능한 보상, 자체 생성 학습 신호를 함께 살펴본다. 피드백의 출처가 다르므로 모델이 생성한 텍스트를 사용한다는 공통점만으로 보상 방식이 같다고 볼 수는 없다. [3쪽]
3. Method
3.1 From External Supervision to Internal Feedback
저자들은 학습된 선호도 보상과 검증 가능한 과제 보상을 대비하고, 외부 감독이나 검증 기반 시설에 대한 의존성을 설명한다. [3–4쪽]
3.2 Reinforcement Learning from Internal Feedback (RLIF)
RLIF는 목적 함수의 외부 보상을 내부 신호로 바꾸면서 기준 정책과의 KL 항은 유지한다. [4쪽]
3.3 INTUITOR: Policy Optimization with Self-Certainty
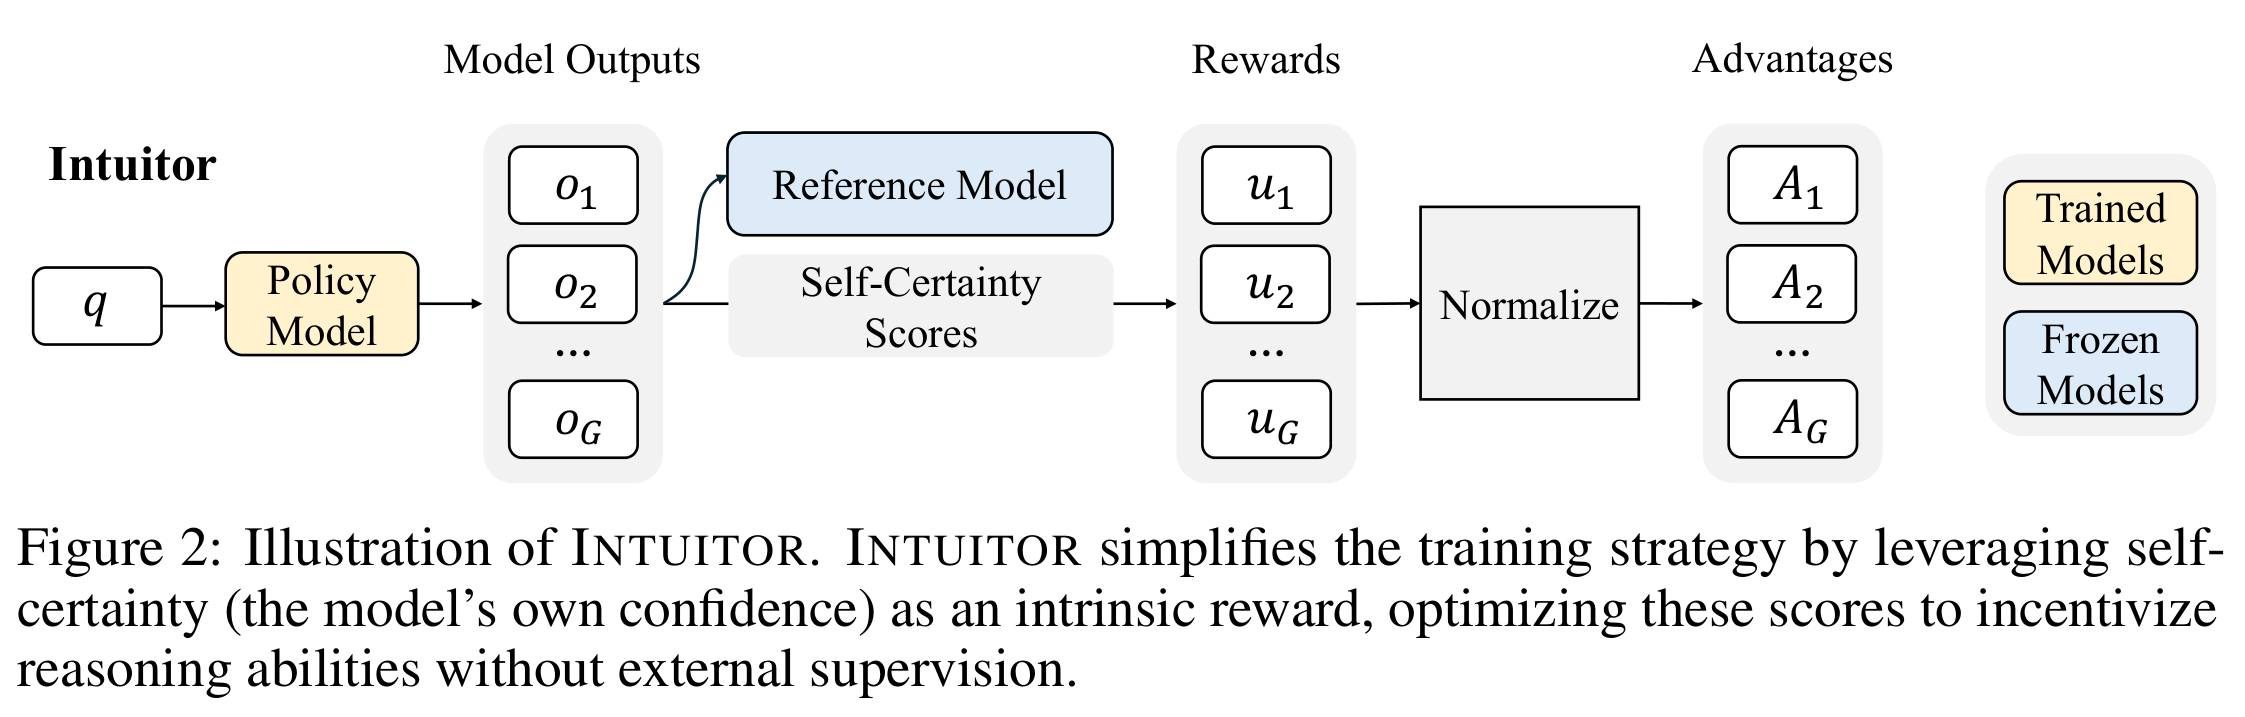
질문 \(q\), 생성 응답 \(o\), 어휘 \(V\), 균등분포 \(U\)에 대해 자기 확신도는 토큰 위치마다 계산한 다음 KL 발산의 평균이다.
\[ u(q,o)=\frac{1}{|o|}\sum_{i=1}^{|o|}D_{\mathrm{KL}}\!\left(U\,\|\,p_{\pi_\theta}(\cdot\mid q,o_{<i})\right). \]
방향은 \(D_{\mathrm{KL}}(U\|p)\)이며 \(D_{\mathrm{KL}}(p\|U)\)가 아니다. 단순한 음의 토큰 엔트로피와도 다르다. 저자들은 값이 클수록 자기 확신도가 높다고 해석한다. GRPO는 질문마다 여러 응답을 샘플링하고, INTUITOR는 각 응답의 점수를 그룹 안에서 정규화해 상대 advantage로 사용한다. 기준 정책과의 KL 항은 정책 이탈을 제한한다. 모델이 자신 있게 틀릴 수 있으므로, 이 신호와 정답의 관계는 실험으로 확인해야 한다. [4–6쪽]
원문의 도식은 응답을 점수화하고 정규화하는 과정을 보여 준다. 기준 모델은 정책 이탈을 제한하는 KL 항의 비교 기준이며, 정답 검증기가 아니다.
4. Experimental Setup
주요 실험은 Qwen2.5-1.5B, 3B 모델과 7,500문제로 구성된 MATH 학습 분할을 사용한다. 저자들은 주요 GRPO와 INTUITOR 비교가 같은 설정을 사용하며 질문당 응답 7개, 갱신당 질문 128개를 처리한다고 설명한다. GRPO-PV는 정답 대신 가장 많이 나온 답을 기준으로 삼는다. 평가는 greedy decoding으로 수행하며 GSM8K, MATH500, LiveCodeBench v6, CRUXEval-O, MMLU-Pro, 길이 보정 AlpacaEval을 포함한다. 학습 보상에 외부 정답을 쓰지 않아도 평가에는 외부 정오 기준을 사용할 수 있다. [6쪽]
INTUITOR-Code는 Codeforces로 학습한 별도 조건이며 질문당 응답 14개와 학습 50단계를 사용한다. 본문은 코드 학습률을 \(3\times10^{-5}\)에서 \(1\times10^{-5}\)로 줄이고 MATH의 기본 KL 계수를 0.005로 사용했다고 설명한다. 하지만 부록 표 5는 MATH와 Codeforces 학습률을 \(3\times10^{-6}\), \(1\times10^{-6}\), MATH KL 계수를 0.0005로 적는다. 또한 7B와 14B 실험에 대해 본문은 질문당 응답 16개를, 표 5는 그룹 크기 14를 제시한다. 이 불일치는 v1에도 있으므로 재현 전에 저자 코드와 설정 기록을 대조해야 한다. [6, 16쪽]
5. Results and Analysis
표 1의 Qwen2.5-3B 결과는 다음과 같다. GRPO와 INTUITOR는 MATH로 학습했고, 기본 모델은 이 비교에서 추가 학습하지 않았다. [6쪽]
| 방법 | GSM8K | MATH500 | LiveCodeBench v6 | CRUXEval-O |
|---|---|---|---|---|
| 기본 모델 | 0.673 | 0.544 | 0.093 | 0.236 |
| GRPO | 0.826 | 0.636 | 0.085 | 0.341 |
| INTUITOR | 0.792 | 0.612 | 0.153 | 0.416 |
원본 표에는 추가 평가 열과 Codeforces로 학습한 별도 조건도 있다. 위의 네 열 표는 여기서 설명하는 비교만 발췌한 것이다.
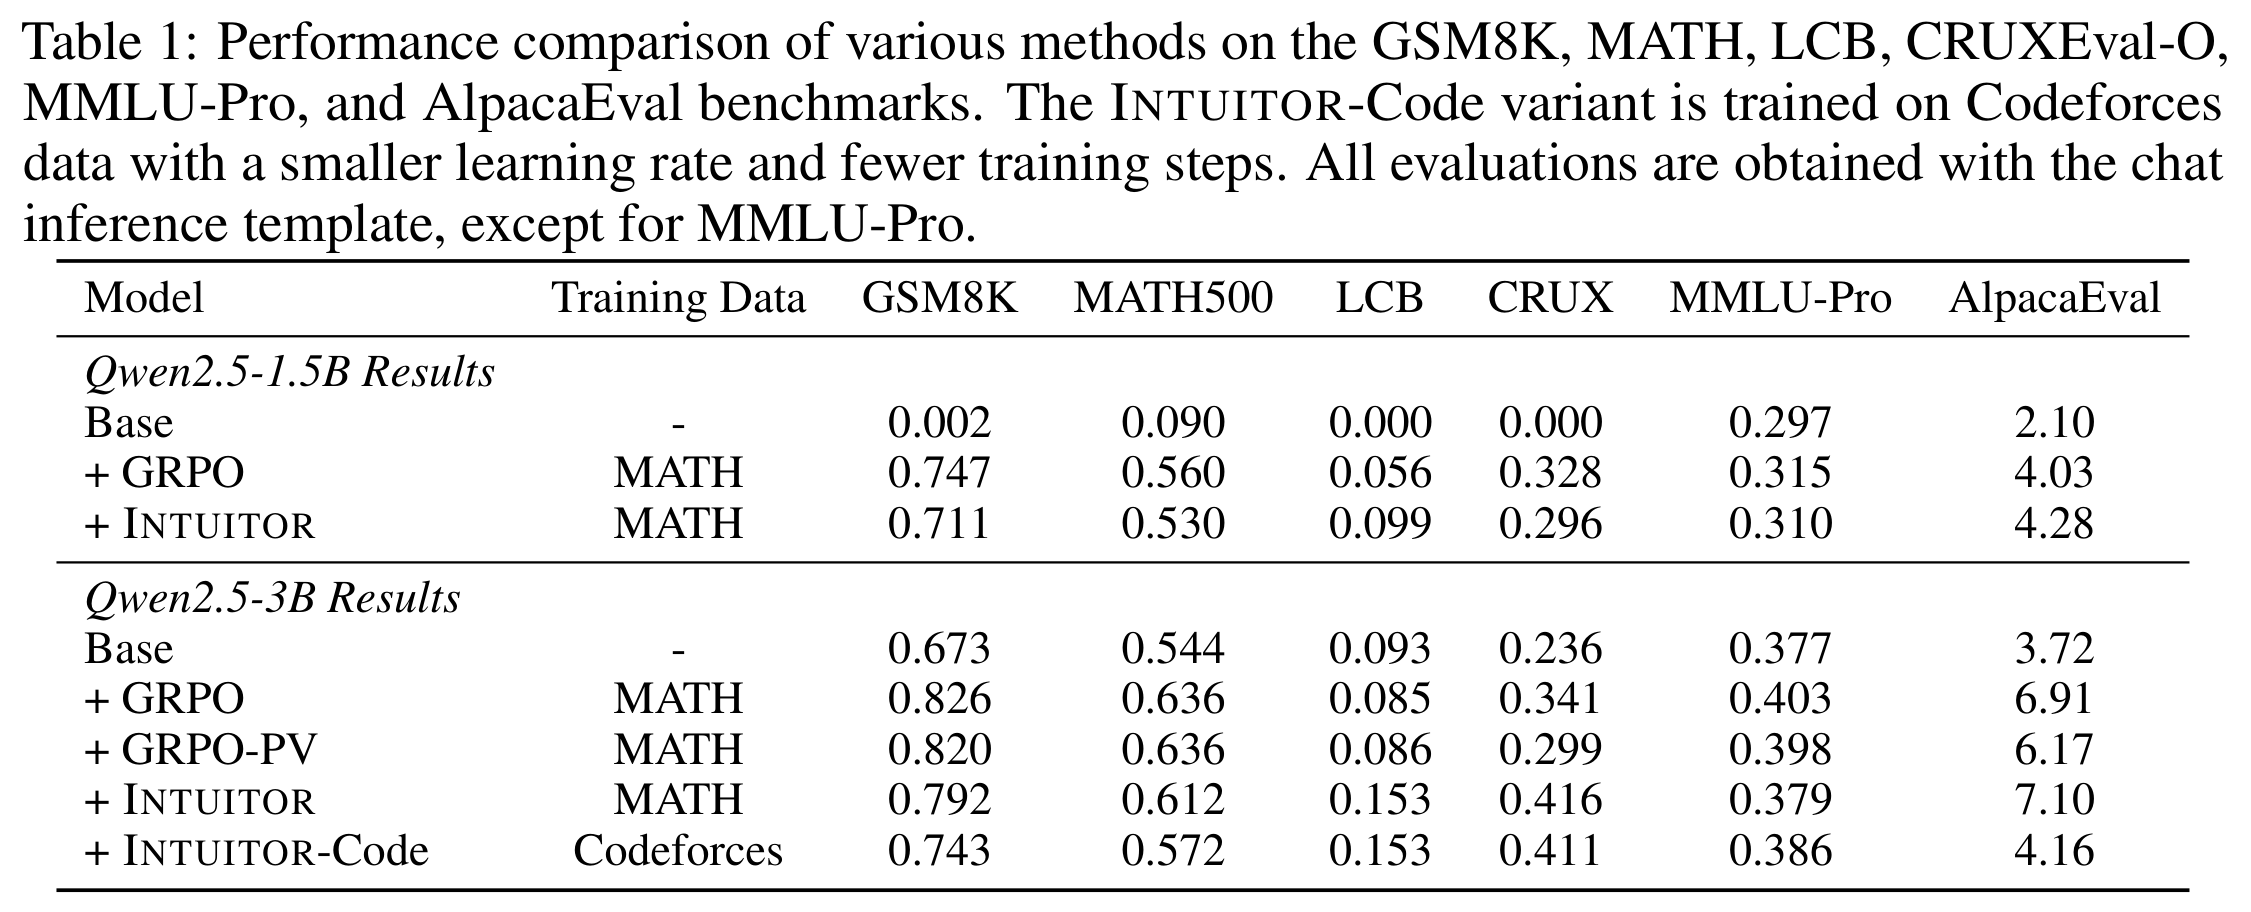
이 표에서 INTUITOR는 두 수학 지표가 GRPO보다 낮고 두 코드 지표는 높다. 기본 점수 0.093을 기준으로 0.153은 약 65%의 상대 향상이며, 절대 차이는 6%포인트이다. Qwen2.5-1.5B의 LiveCodeBench 점수는 기본 0.000에서 INTUITOR 후 0.099, GRPO 후 0.056이다. 기본 모델은 채팅 형식 평가에서 반복적이거나 잘못된 출력을 자주 냈으므로, 유효한 지시 이행의 개선도 함께 반영된다. [6–7쪽]
5.1 Learning to Follow Instructions
논문은 작은 기본 모델에서 학습 후 반복적이거나 잘못된 채팅 형식 출력이 줄었다고 설명한다. [7쪽]
5.2 Fostering Structured Reasoning
학습 10단계의 표에서 INTUITOR는 작은 모델 크기 2개 모두 GSM8K와 MATH 점수가 GRPO보다 높다. 이는 한 초기 시점의 관찰이며 모든 설정의 학습 속도 우위를 보장하지 않는다. 일부 응답은 요구된 JSON이나 코드 앞에 자유 형식 추론을 보여 준다. 정성적 LiveCodeBench 분석은 무작위 질문 10개를 사용했으므로, 행동 변화의 사례로 읽어야 한다. [7–9쪽, 표 2와 그림 5–6]
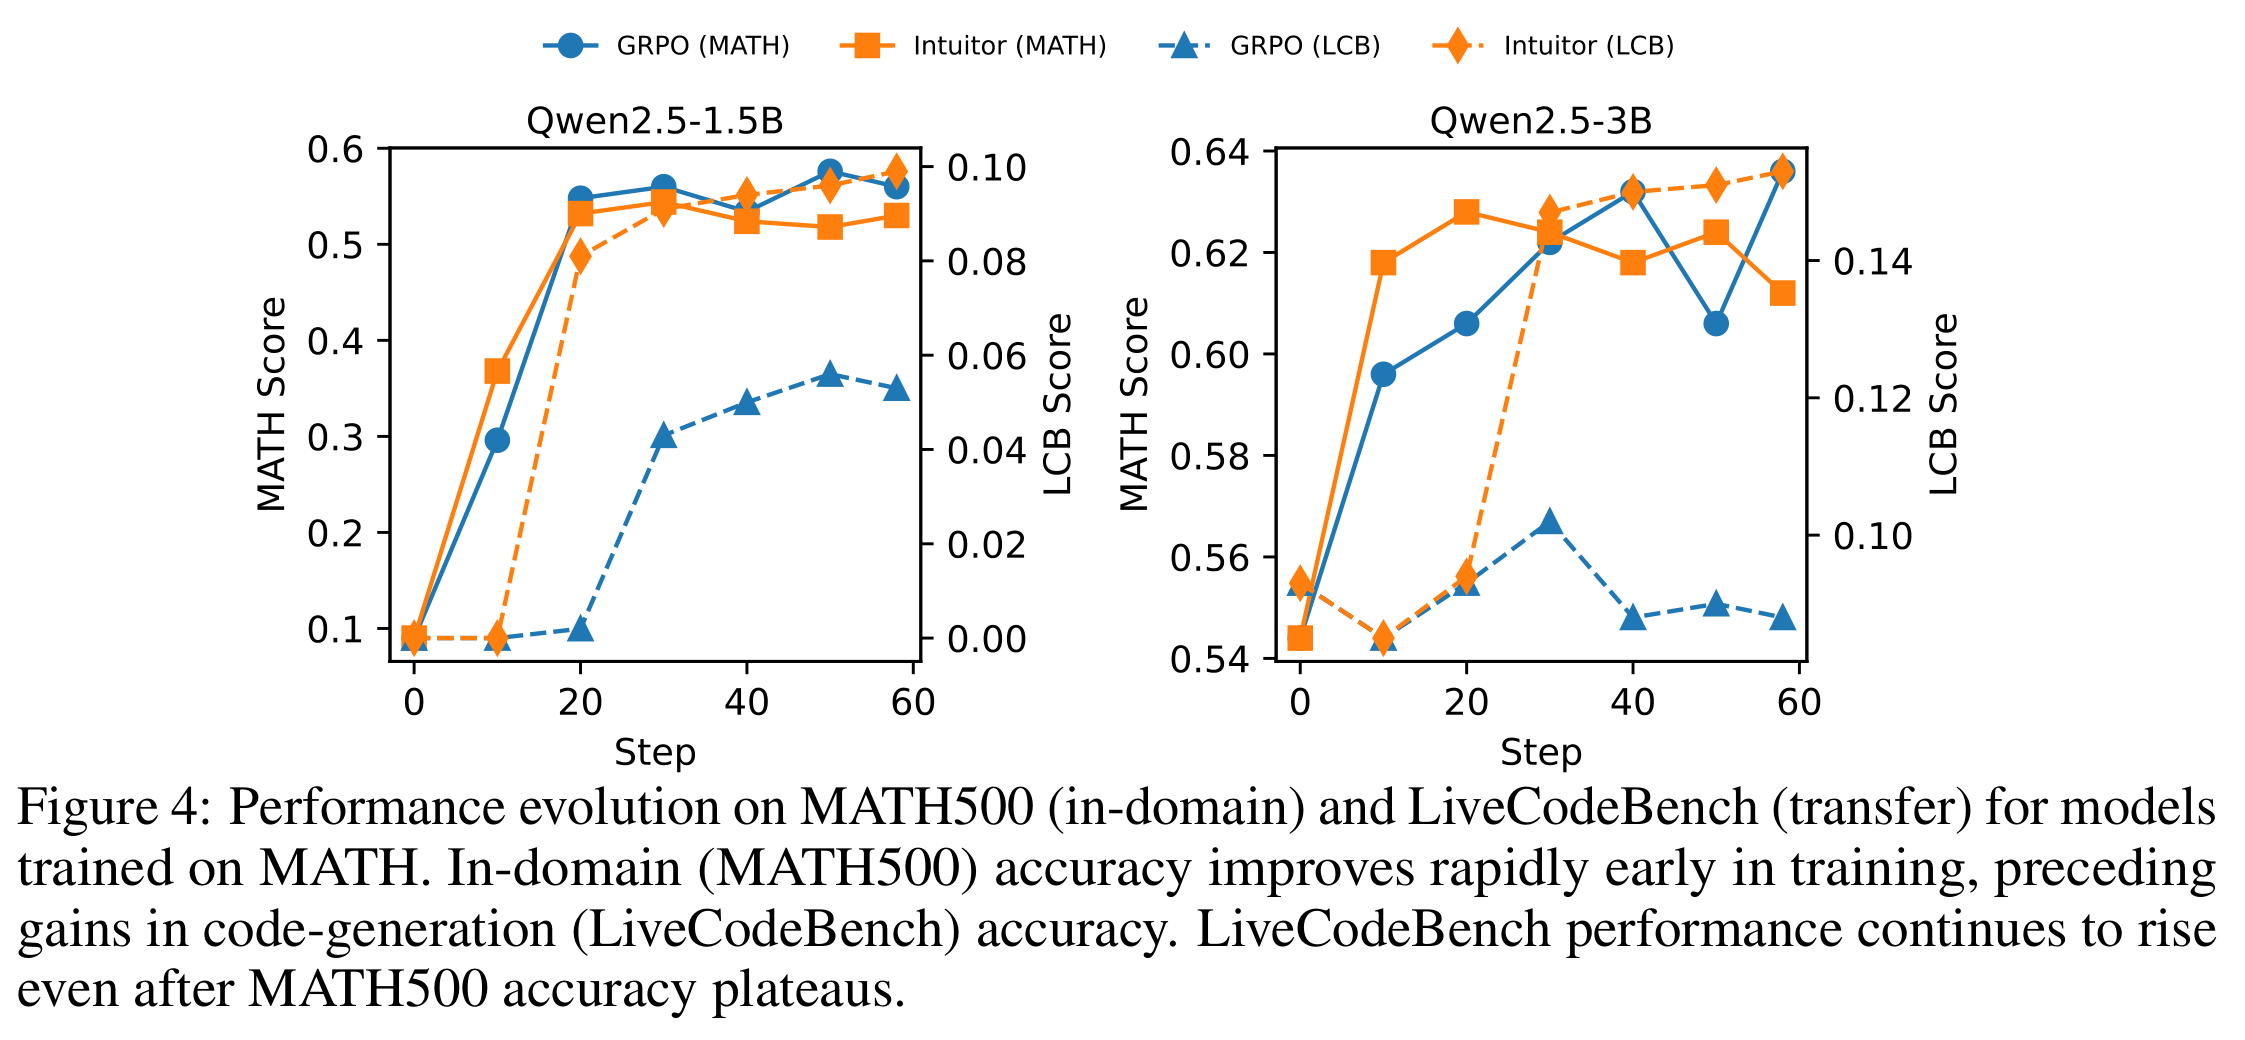
그림 4에서 MATH500 정확도는 학습 초기에 상승하고 LiveCodeBench 성능은 그 뒤에 오른다. 제시된 두 INTUITOR 곡선에서는 수학 정확도가 정체된 뒤에 LiveCodeBench 점수가 상승한다. 이 양상이 모든 곡선에서 동일하게 나타나는 것은 아니다. 이 시간적 양상은 전이 가능성과 부합하지만 수학 성능 향상이 이후 코드 성능 향상의 원인임을 입증하지는 않는다. [8쪽]
5.3 Understanding Emergent Long-Form Reasoning
저자들은 일부 샘플에서 코드 앞에 나타나는 추론이 성능에 기여할 가능성을 제시하지만, 제시된 정성적 사례만으로 그 인과관계가 입증되는 것은 아니다. [8–9쪽]
5.4 Online Self-Certainty Prevents Reward Exploitation
축소된 배치 실험에서 저자들은 정책과 함께 변하는 온라인 자기 확신도와, 기본 모델을 고정해 채점하는 오프라인 조건을 비교했다. 오프라인 실행에서는 약 100번째 갱신 무렵 이미 풀린 보조 문제를 답에 덧붙이는 방식으로 보상을 높였고, 응답 길이가 늘면서 검증 정확도가 떨어졌다. 온라인 조건은 해당 비교에서 안정적이었다. 이 결과가 모든 설정에서 보상 악용이 불가능하다는 뜻은 아니다. [9–10쪽, 그림 7]
왼쪽은 정확도, 오른쪽은 응답 길이를 나타낸다. 이 실험에서 오프라인 조건의 정확도 하락과 응답 길이 증가는 함께 나타났다.
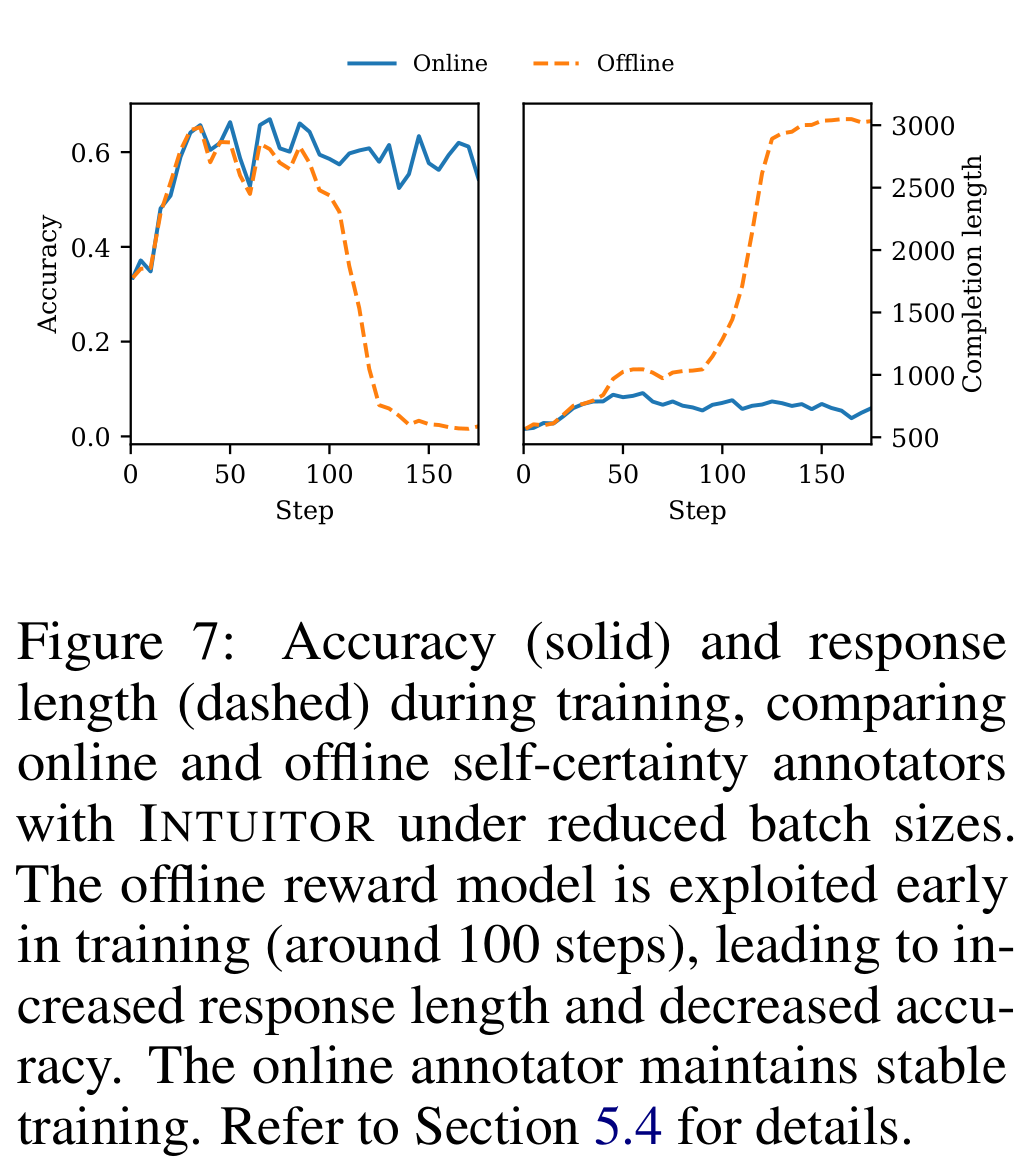
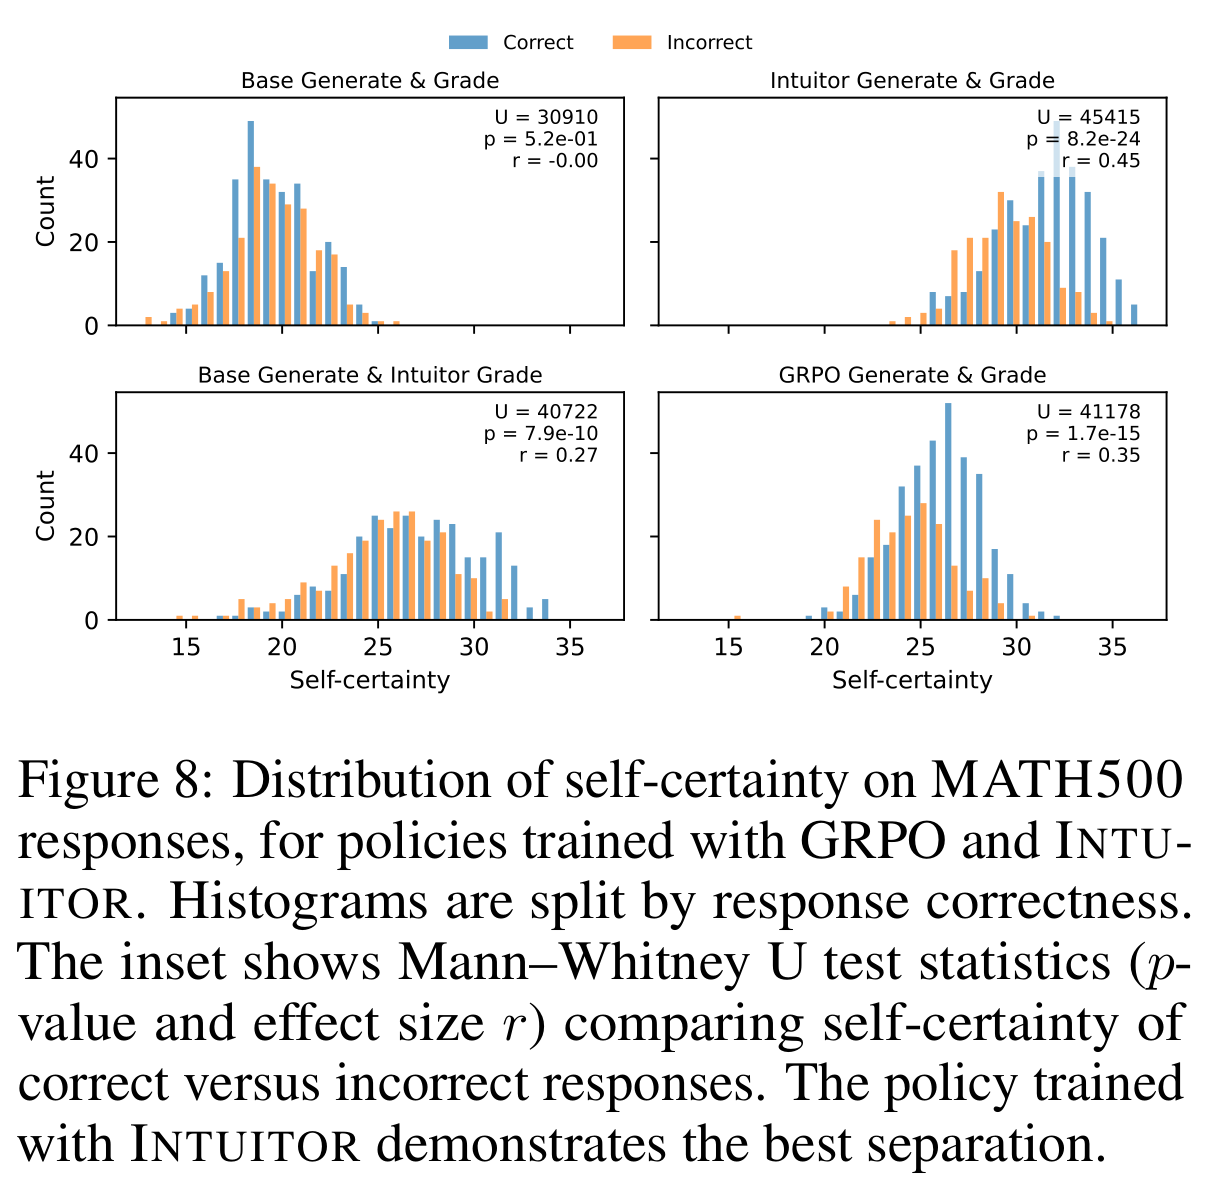
그림 8은 MATH500에서 정답과 오답의 자기 확신도 분포를 비교한다. 저자가 보고한 Mann–Whitney 분석에서 기본 모델이 생성과 채점을 모두 수행한 경우 U = 30910, p = 0.52, r = -0.00이고, INTUITOR가 생성과 채점을 수행한 경우 U = 45415, p = 8.2e-24, r = 0.45이다. 이는 해당 평가 조건에서 관찰된 연관성이며 인과 기제나 확신도가 높은 개별 답변의 정답을 보장하지 않는다. [9–10쪽]
5.5 Ablation Studies
KL 계수 비교에서 코드 지표는 제시된 설정에 따라 크게 달라졌다. 부록에서는 Qwen2.5-7B와 14B에 원래 학습 방식을 적용했을 때 초기에 붕괴가 발생해 시스템 프롬프트, 학습률과 샘플 수를 바꿨고, 포괄적인 설정 탐색은 하지 않았다고 설명한다. Llama3.2-3B-Instruct 실험도 별도로 보고한다. [9–10, 15–16쪽]
6. Discussion and Future Research
이 논문은 모델 자신의 확률 분포가 특정 학습 조건에서 유용한 신호가 될 수 있음을 보여 준다. 자신감이 곧 정답이라고 증명하거나, 다른 정책 최적화 알고리즘과 임의의 과제에서도 같은 성능을 보장하지는 않는다. 내부 학습 보상과 외부 평가 기준의 차이를 구분해야 한다. [4–6, 10–11쪽]
7. Conclusion
저자들은 내부 자기 확신도를 학습 신호로 제안하고 위에서 설명한 결과와 한계를 보고한다. [11쪽]
부록
- A.1–A.3은 더 큰 모델의 설정, Llama3.2-3B-Instruct 실험과 하이퍼파라미터를 다룬다. 본문과 부록의 설정 불일치는 위에 유지했다. [15–16쪽]
- B.1–B.6은 프롬프트와 코드, CRUXEval-O 응답 사례 및 학습 중 rollout 변화를 제시한다. 이 예시는 출력 행동을 보여 주며 새로운 전체 벤치마크 점수는 아니다. [17–29쪽]
짧은 생각
내부 자신감은 학습 신호로 연구할 가치가 있지만, 자신 있는 출력과 정답을 구분하려면 외부 평가가 여전히 필요하다.