


Reinforcement Learning for Reasoning in Small LLMs: What Works and What Doesn't 요약 설명
20 Mar 2025 | Paper Review Mathematical Reasoning Reinforcement Learning With Verifiable Rewards Reward Design목차
이번 글에서는 Reinforcement Learning for Reasoning in Small LLMs: What Works and What Doesn't 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 20일(Arxiv)
- Dang, Quy-Anh, Ngo, Chris.
- VNU University of Science, Vietnam, Knovel Engineering Lab, Singapore
- 논문 링크
- Github
요약
- 이 논문은 보상 피드백으로 학습하는 강화학습(RL)이 제한된 연산 자원으로 소형 대규모 언어 모델(LLM)의 수학 추론 능력을 높일 수 있는지 실험한다. DeepSeek-R1-Distill-Qwen-1.5B에서 출발한 Open-RS3는 2024 American Invitational Mathematics Examination인 AIME24에서 46.7%를 기록한다. 이는 외부에서 보고된 o1-preview의 44.6%와 비교한 결과이며, 예시 없이 첫 시도에서 문제를 해결한 비율인 zero-shot pass@1을 사용한다. 저자들은 학습 문제 7,000개를 사용하며, 24-hour training run의 비용을 $42로 추정한다.
- 제안 방법은 선별한 수학 문제와 Group Relative Policy Optimization(GRPO)을 결합한다. GRPO는 기대 보상을 추정하는 별도의 critic 모델 없이, 생성한 답변 그룹 안에서 보상을 비교하는 RL 알고리즘이다. 실험 3개에서 문제 난이도, 응답 길이 제한, 정확성, 구조, 길이에 대한 보상을 바꾼다. Open-RS2는 2023 American Mathematics Competition인 AMC23에서 80.0%를 기록하며, 기본 모델에 보고된 점수는 62.9%다.
- 성능 향상은 대부분 이 연구에서 학습 업데이트 횟수를 나타내는 global training step 50–100 이내에 나타난다. 학습을 계속하면 정확도가 떨어지고 여러 언어가 섞인 출력이 나타난다. Open-RS3의 벤치마크 5개 평균은 56.3%로, DeepScaleR-1.5B-Preview의 57.0%보다 낮다. 일부 수학 과제에서는 적은 비용으로 성능을 높일 수 있지만, 지속적인 최적화와 수학 외 영역으로의 일반화는 해결되지 않은 과제로 남는다.
1 Introduction
Reinforcement Learning for Reasoning in Small LLMs: What Works and What Doesn’t는 엄격한 학습 제약에서 소형 모델이 어떻게 동작하며, DeepSeek-R1에서 착안한 접근법으로 추론 능력을 높일 수 있는지 살펴본다. 이 연구는 1.5B 모델을 각각 메모리 48 GB를 갖춘 NVIDIA A40 그래픽 처리 장치(GPU) 4개로 24시간 이내에 학습한다. 코드와 데이터셋은 https://github.com/knoveleng/open-rs 에 공개한다.
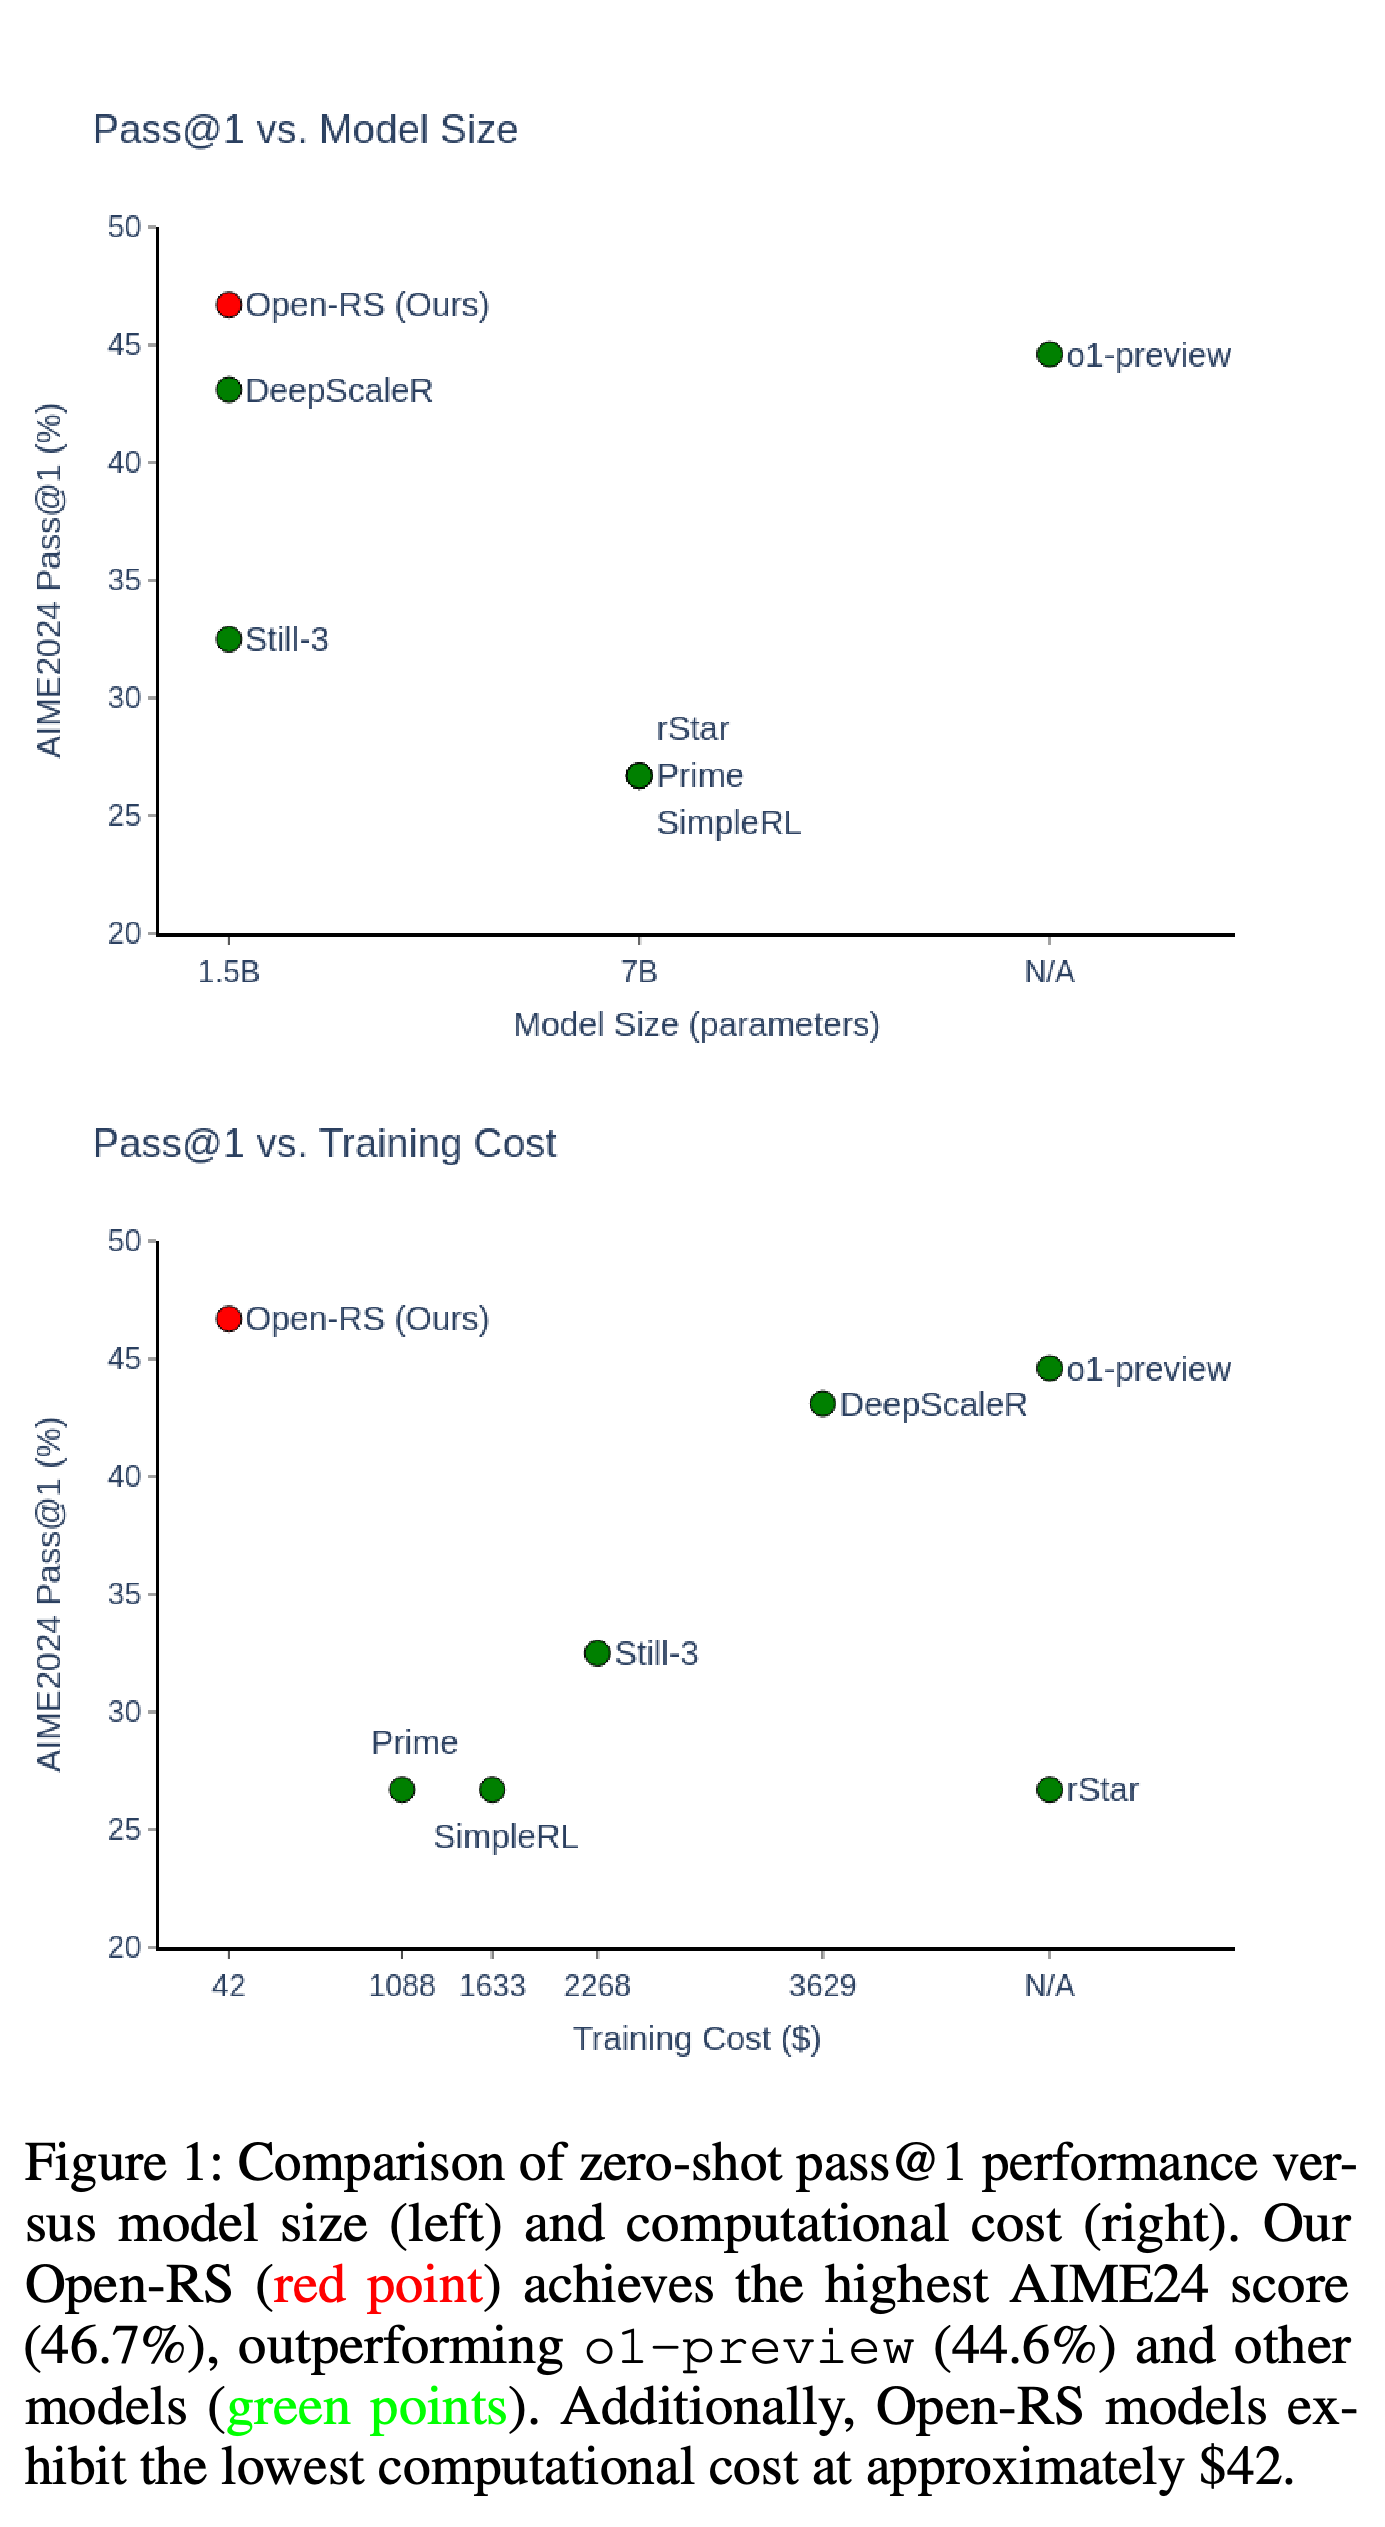
- 이 연구의 기여는 자원이 제한된 학습에서 초반 성능 향상과 이후 불안정성을 실증적으로 살펴보고, 더 크거나 더 많이 학습한 모델과 비교한 데 있다. Figure 1은 보고된 AIME24 성능, 모델 크기, 추정 학습 비용을 정리한다.
보고된 AIME24 비교에서 Open-RS는 파라미터 1.5B와 추정 학습 예산 $42로 46.7%를 기록하며, o1-preview는 44.6%를 기록한다. 각 점은 서로 다른 모델과 학습 절차를 나타내므로, 이 그래프만으로 제안한 학습 변경의 효과를 분리해 판단할 수 없다.
2 Methodology
방법론은 2개 요소로 구성된다. 소형 모델에 도전적인 수학 문제를 선별한 뒤, GRPO를 적용해 보상 피드백으로 학습한다. 규칙 기반 보상은 별도로 학습한 신경망 보상 모델 없이 정확성, 응답 구조, 길이를 평가한다.
High-Quality Dataset Curation
저자들은 범용 추론 문제 모음인 s1과 수학 문제 모음인 DeepScaleR를 정제해 open-s1과 open-deepscaler를 만든다. 총 수학 문제는 39,659개다. 서로 다른 필터링 모델을 사용해 선별 기준을 다양화하고 과도한 중복을 줄이고자 한다.
- s1의 초기 문제 59,029개 중 LaTeX 정답 명령어 \boxed{}가 포함된 풀이만 남기면 31,323개가 된다. DeepSeek-R1-Distill-Qwen-1.5B로 너무 쉬운 문제를 제거하면 21,533개가 남고, Qwen2.5-7B-Instruct로 잡음이 있거나 여러 하위 문항으로 구성된 문제를 제거하면 open-s1 예제 18,615개가 남는다.
- DeepScaleR는 처음에 AIME(1984–2023), AMC(2023년 이전), Omni-MATH, Still에서 수집한 수학 문제 40,315개를 포함한다. Qwen2.5-Math-7B-Instruct로 쉬운 문제를 제거하면 open-deepscaler 예제 21,044개가 남는다.
- 이후 문제 7,000개를 사용하는 실험에서는 open-s1 문제 3,000개, open-deepscaler 문제 3,000개, 원본 DeepScaleR의 더 쉬운 문제 1,000개를 사용한다. 따라서 이 실험들은 사용 가능한 문제 중 일부를 사용한다.
Reinforcement Learning Algorithm
GRPO는 문제마다 답변 그룹을 샘플링하고, 그룹의 평균과 표준편차로 각 답변의 보상을 정규화한다. 목적함수는 이전 모델에 비해 답변 확률이 바뀌는 정도를 제한하는 clipped update와 Kullback–Leibler(KL) 발산 페널티를 결합한다. KL 발산 페널티는 학습 모델의 출력 분포가 참조 모델에서 멀어지는 것을 억제한다.
- 정확도 보상은 최종 답이 맞으면 1, 그렇지 않으면 0을 부여한다. 검증을 위해 정답은 \boxed{} 형식으로 작성해야 한다.
- 코사인 보상은 응답 길이에 따른 코사인 스케줄로 정확성 피드백을 조절한다. 짧고 정확한 풀이는 더 높은 보상을 받고, 길고 틀린 풀이는 더 약한 페널티를 받는다.
- 형식 보상은 추론이 <think>와 </think> 태그 안에 있으면 양의 피드백을 제공한다. 이 규칙들은 함께 정답 정확성, 출력 길이, 응답 구조를 목표로 한다.
3 Experiments
실험 3개는 고품질 데이터만 사용하는 경우, 쉬운 문제와 어려운 문제를 혼합하는 경우, 응답 길이에 따라 달라지는 보상을 사용하는 경우를 살펴본다. 평가에서는 학습 중 동작을 추적하고, 특정 학습 단계에서 저장한 모델 상태인 체크포인트를 선별해 수학 벤치마크 5개에서 비교한다.
Experimental Setup
모든 실험은 더 큰 모델에서 증류한 소형 모델인 DeepSeek-R1-Distill-Qwen-1.5B에서 출발하며, 제공된 목표 응답으로 학습하는 추가 지도 미세조정(SFT) 단계를 생략한다. 구현은 DeepSeek-R1의 오픈소스 재현 프로젝트인 Hugging Face의 open-r1을 수정해 사용한다. NVIDIA A40 GPU 4개를 사용하며, 문제마다 답변 6개를 생성하고 생성 길이를 4096 또는 3584토큰으로 제한한다. 토큰은 생성 텍스트의 단위다.
- 설정에는 학습 데이터셋을 통과하는 단위인 1 epoch가 명시되어 있다. 다만 Experiment 1은 24시간 안에 최대 500 global step으로 제한되며, 전체 데이터셋을 처리하려면 약 1500 step이 필요하다.
- Appendix E는 learning_rate = 1.0e-06, gradient_accumulation_steps = 4, temperature = 0.7, seed = 42, 50 step마다 체크포인트 저장을 명시한다. 이 설정들은 각각 업데이트 크기, 업데이트 전 그래디언트 누적, 샘플링의 무작위성, 실행의 무작위 초기화, 저장 빈도를 제어한다.
Benchmark Datasets
평가에는 AIME24, MATH-500, AMC23, Minerva, OlympiadBench를 사용하며, 각각 문제 30개, 500개, 40개, 272개, 675개를 포함한다. MATH-500은 수학 경시 문제의 부분집합이다. Minerva는 학부 수준의 정량적 추론을 평가하며, 여기서는 수학 부분집합을 사용한다. OlympiadBench는 올림피아드 수준의 수학과 물리 문제를 포함한다.
- 논문은 AIME24와 AMC23의 데이터셋으로 각각 https://huggingface.co/datasets/AI-MO/aimo-validation-aime 과 https://huggingface.co/datasets/AI-MO/aimo-validation-amc 를 제시한다.
Baseline Models
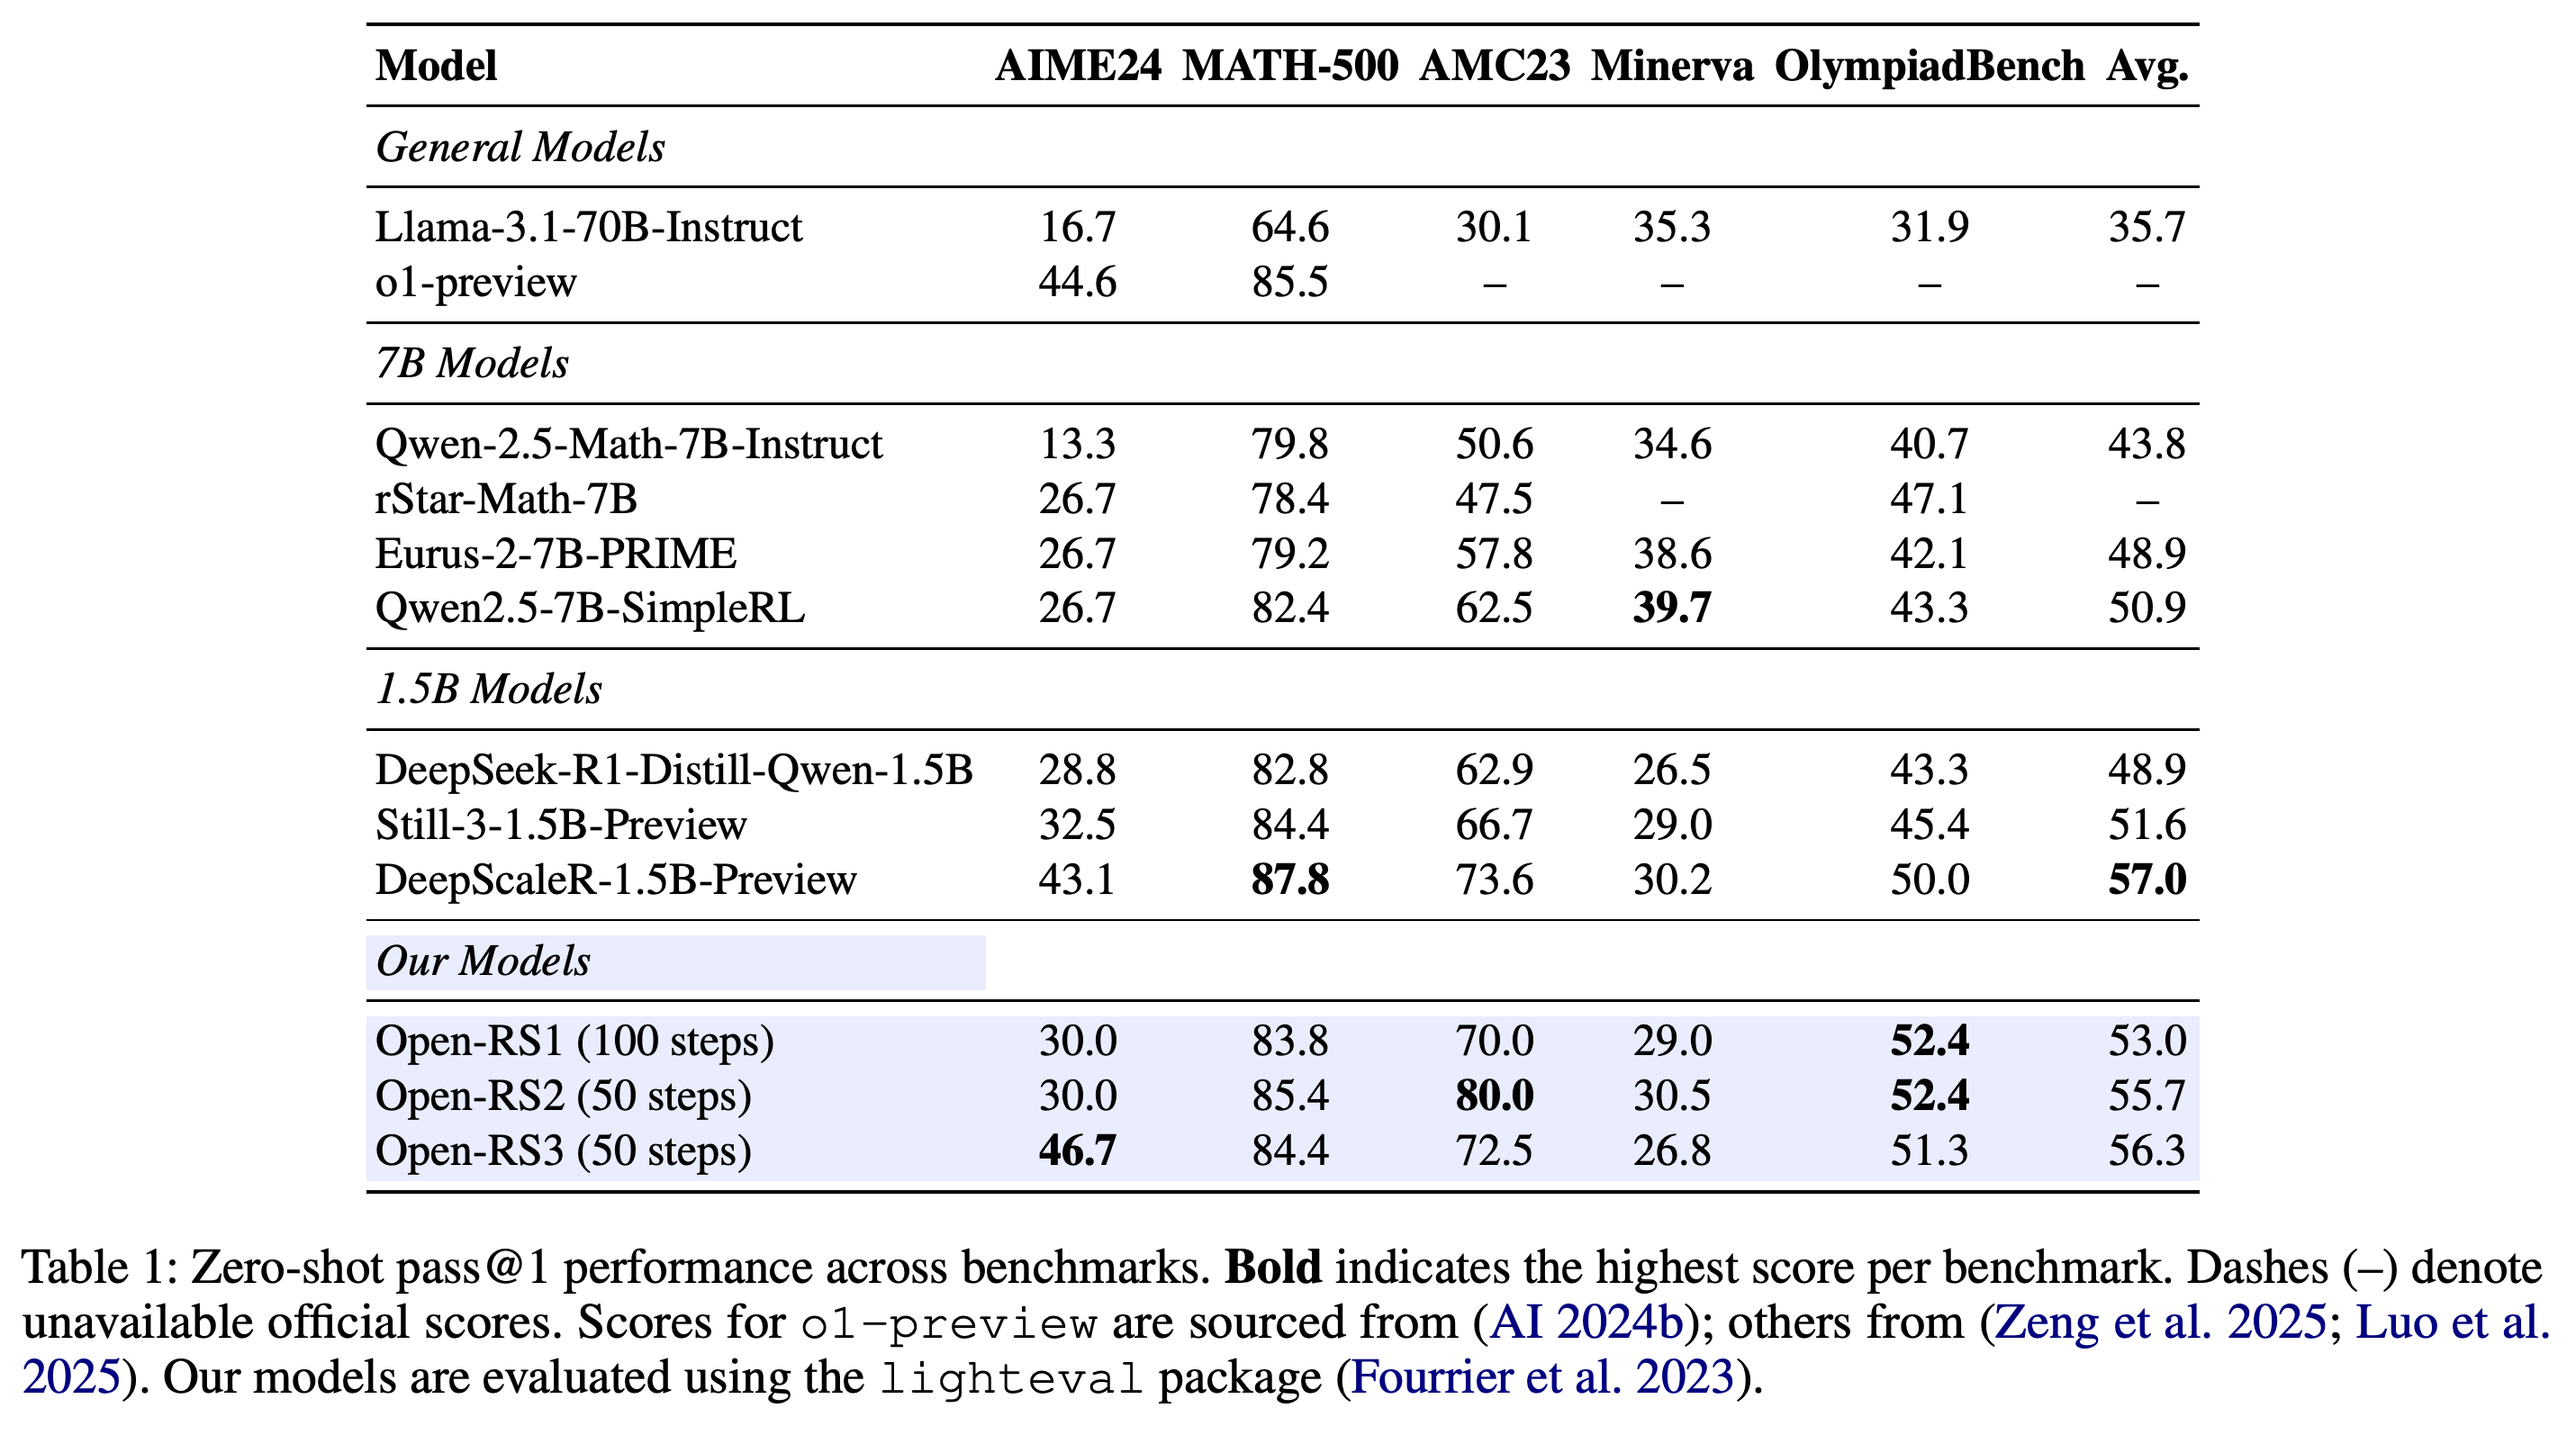
베이스라인에는 Llama-3.1-70B-Instruct와 o1-preview, 7B 모델인 Qwen-2.5-Math-7B-Instruct, rStar-Math-7B, Eurus-2-7B-PRIME, Qwen2.5-7B-SimpleRL, 1.5B 모델인 DeepSeek-R1-Distill-Qwen-1.5B, DeepScaleR-1.5B-Preview, Still-3-1.5B-Preview가 포함된다. Table 1은 외부에서 보고된 베이스라인 점수와 저자들이 평가 패키지 lighteval로 측정한 Open-RS 결과를 함께 제시한다.
Evaluation Metric
평가에는 프롬프트에 예시를 제시하지 않고 첫 답변이 맞는지 측정하는 zero-shot pass@1을 사용한다. 자동 평가를 위해 최종 정답은 \boxed{} 형식으로 작성해야 한다.
Process and Results
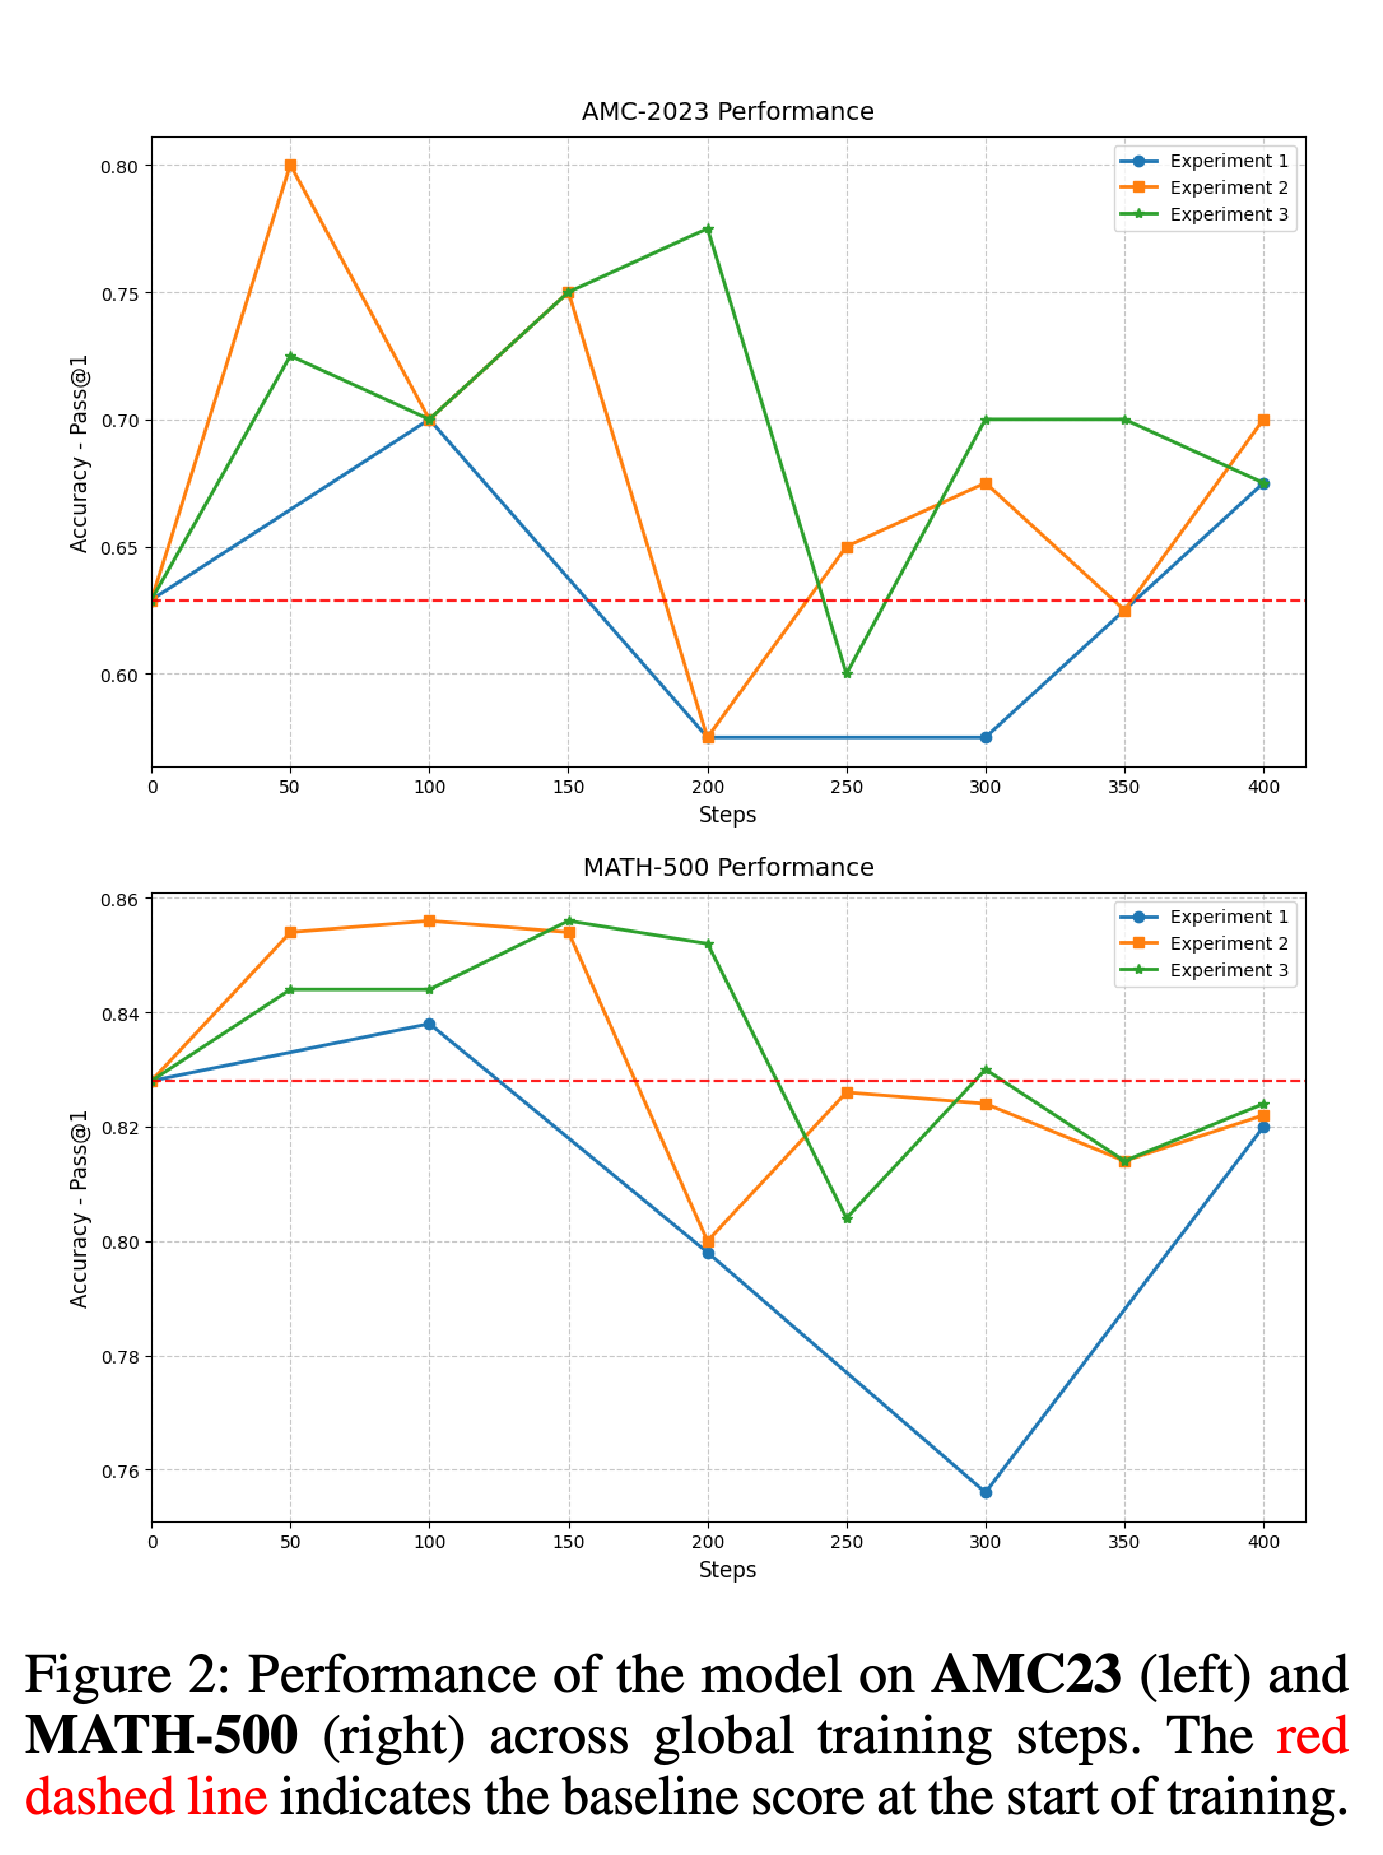
Experiment 1: Impact of High-Quality Data는 open-s1 문제 18,615개를 사용하고, 정확도 보상과 형식 보상을 적용하며 생성 길이를 4096토큰으로 제한한다. 50–100 step 이내에 AMC23은 약 63%에서 70%로, MATH-500은 약 83%에서 84%로 오른다. 그러나 약 200 step부터 정확도가 떨어지고, 이후 체크포인트에서도 초반 최고점보다 낮은 수준에 머문다.
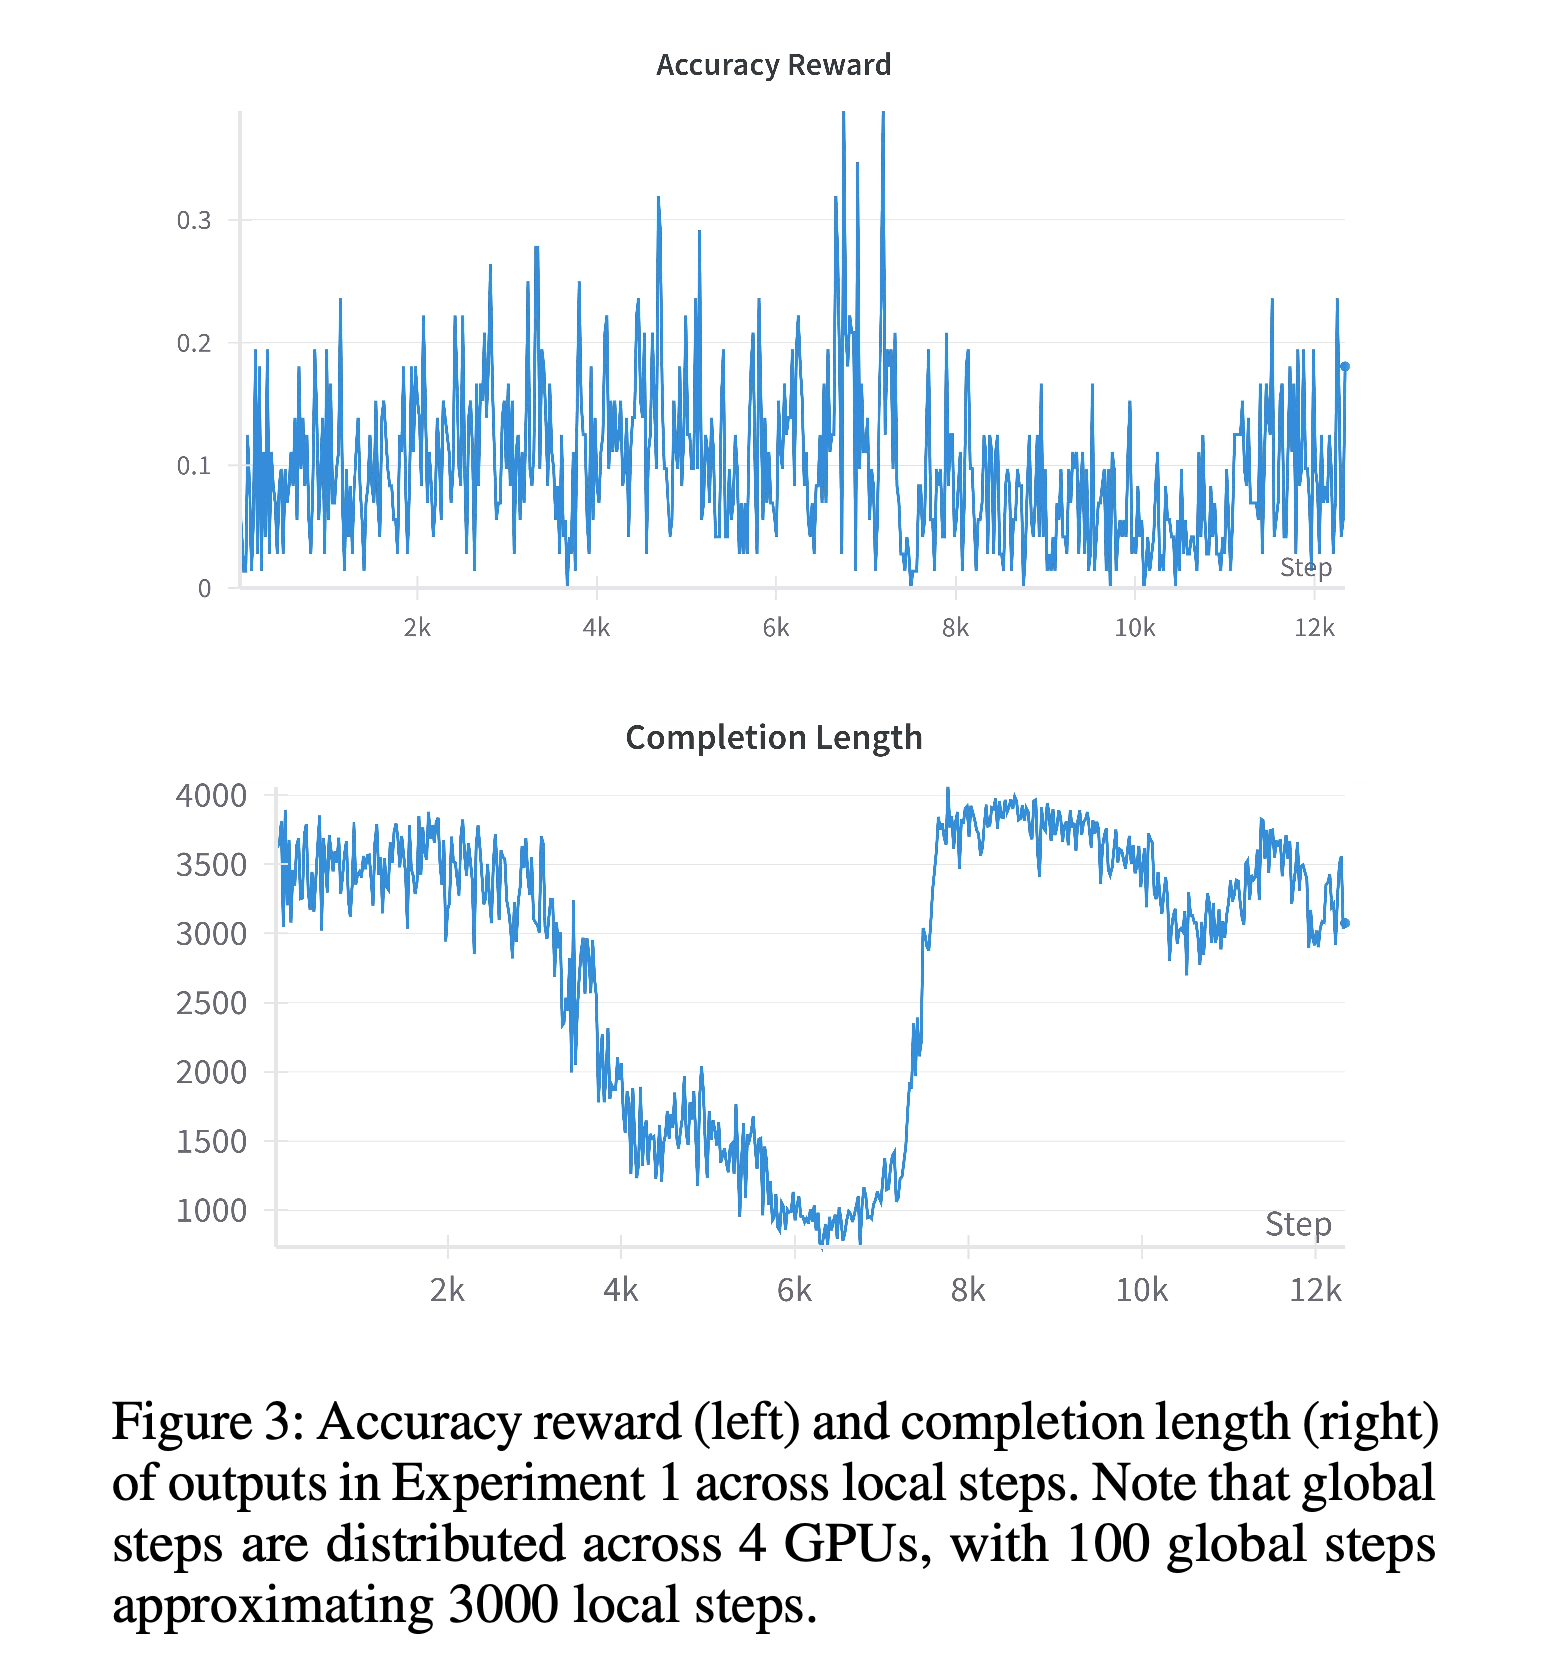
- Figure 2는 벤치마크 성능 하락을 보여준다. Figure 3은 정확도 보상의 큰 변동과, 생성 길이가 짧아졌다가 다시 급격히 길어지는 모습을 보여준다.
- 저자들은 학습 후반에 읽기 어렵거나 영어가 아닌 출력이 나타났다고 보고한다. 최종 정답을 내기 전에 길이 제한에 도달하는 응답과 이후 언어 이탈을, open-s1 문제의 어려움과 보상 불일치의 증거로 해석한다. 보상 불일치는 보상을 최적화해도 의도한 동작이 유지되지 않는 상황을 뜻한다.
최고 점수는 초반에 나타나며 실험마다 다르다. Experiment 2는 AMC23에서 80%에 도달하지만, 이후 여러 체크포인트는 초기 베이스라인에 가까워지거나 그 아래로 떨어진다. 따라서 어떤 체크포인트를 선택하는지가 보고된 성능 향상에 실질적인 영향을 준다.
Experiment 1의 정확도 보상은 크게 변동하며, 생성 길이는 짧아졌다가 길이 제한에 가까워지도록 급격히 늘어난다. 이 변화와 함께 후반 벤치마크 성능이 떨어진다. 논문은 100 global step이 약 3000 local step에 해당한다고 설명하며, local step은 GPU별 추적 횟수다.
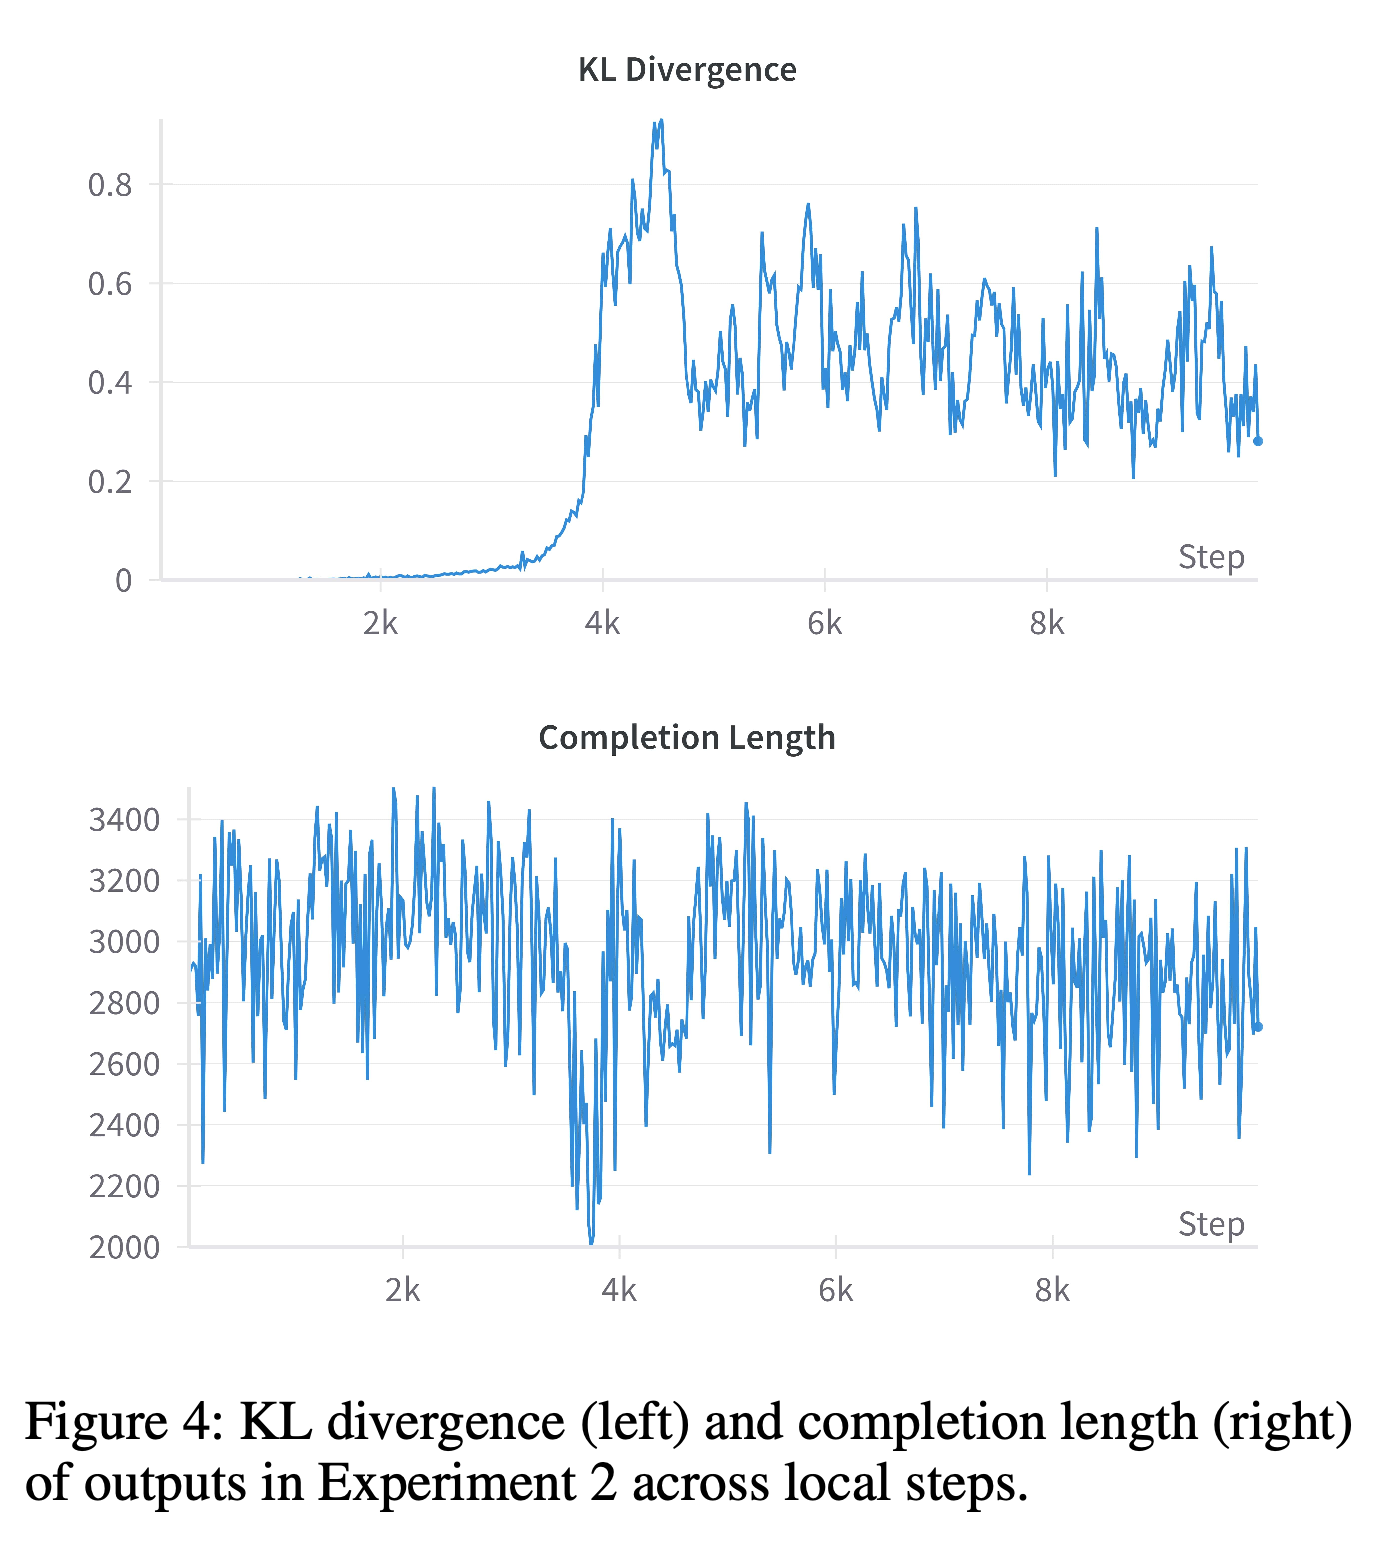
Experiment 2: Balancing Easy and Hard Problems는 문제 7,000개를 혼합해 사용하고, 정확도 보상과 형식 보상을 유지하며 생성 길이 제한을 3584토큰으로 낮춘다. 50–100 step 이내에 AMC23은 80%, MATH-500은 약 85%에 도달한다. 그러나 150–200 step 이후에는 KL 발산이 급격히 커지고 여러 언어가 섞인 출력이 다시 나타나면서 성능이 떨어진다.
- 초기 생성 길이는 약 2800토큰으로 짧아진다. 수정한 설정은 초반 성능을 높이지만, 데이터셋 구성과 생성 길이를 함께 바꿨기 때문에 어느 변경이 성능 향상을 가져왔는지 개별적으로 판단할 수 없다.
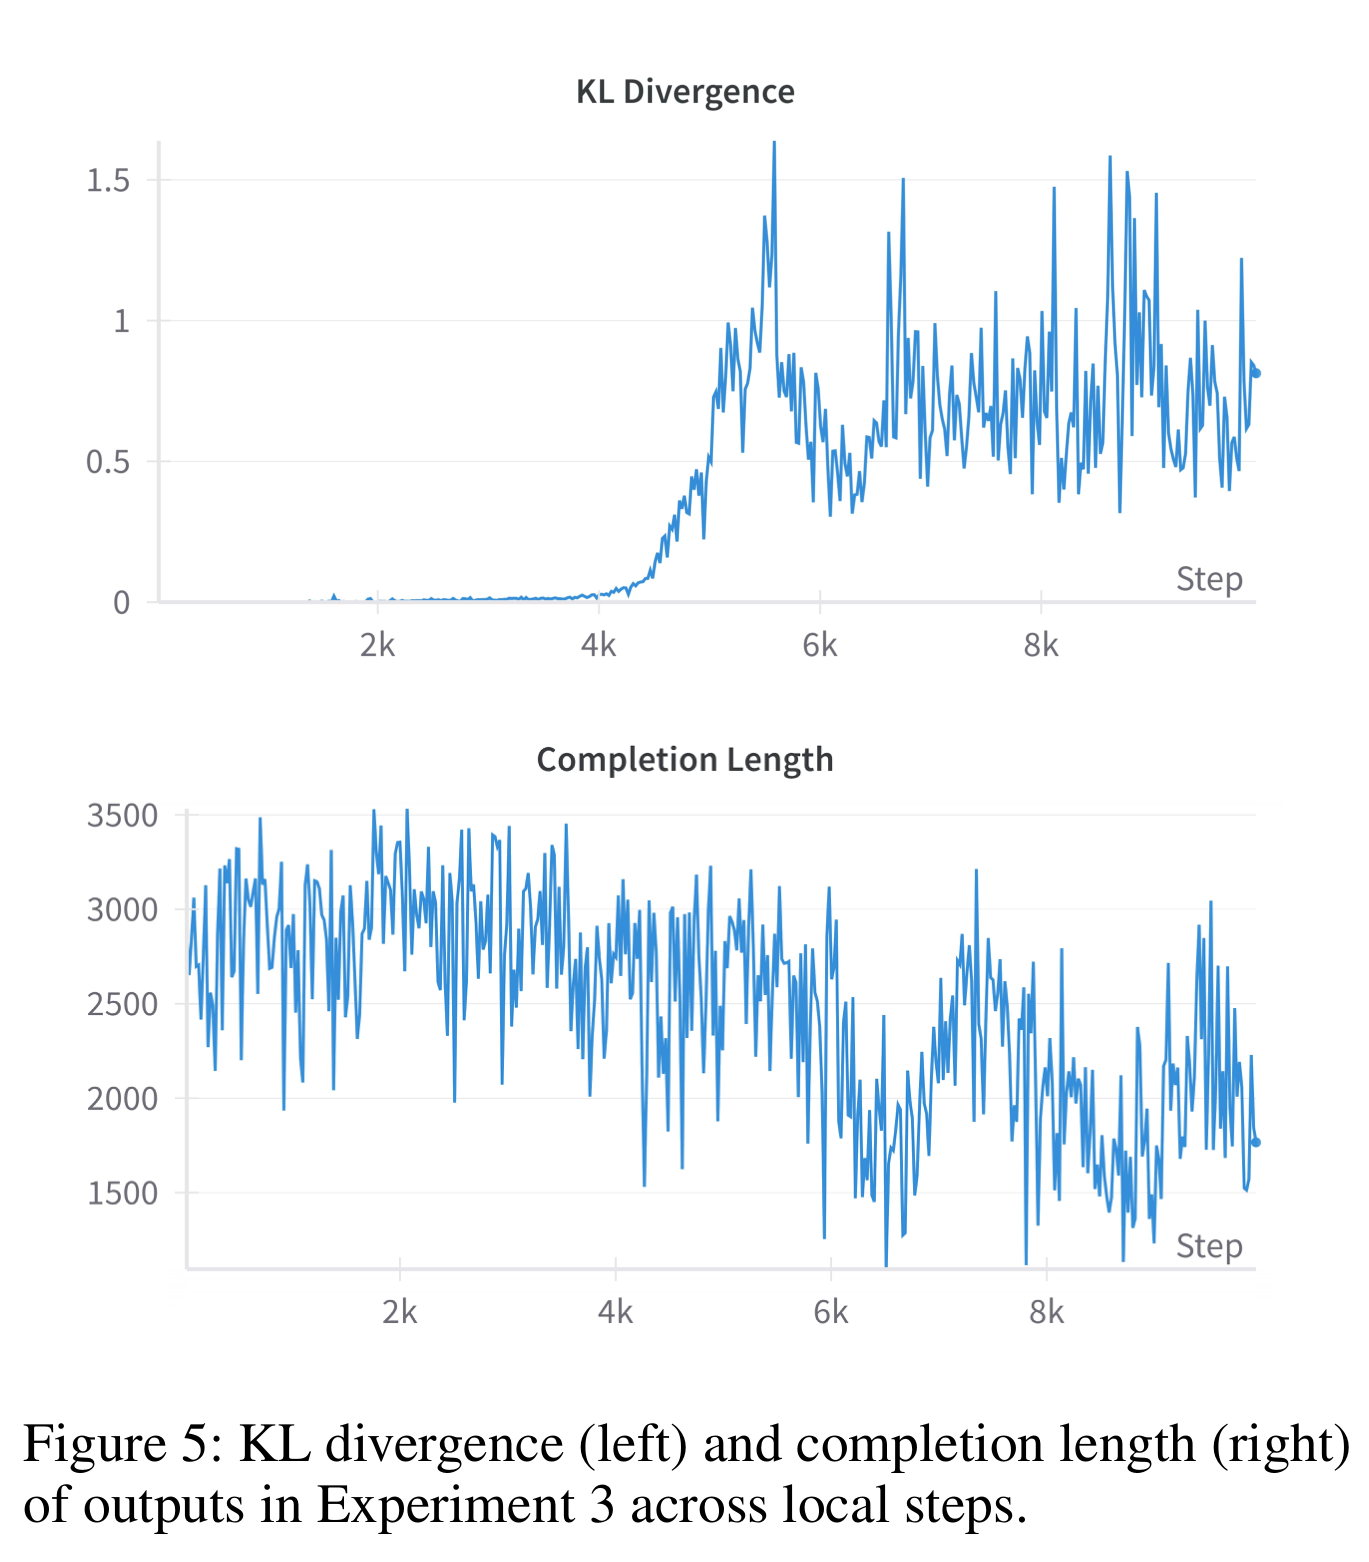
KL 발산은 약 4000 local step에서 급격히 커지고 이후에도 변동한다. 생성 길이는 대체로 2000–3500 tokens 수준에 머문다. 출력이 짧아져도 참조 모델과의 상당한 차이와 벤치마크 정확도 하락이 함께 나타날 수 있음을 보여준다.
Experiment 3: Controlling Length with Cosine Reward는 같은 문제 7,000개와 3584토큰 제한을 유지하고, 정확도 보상을 코사인 보상으로 바꾸며, 프롬프트에 “영어로만 답하고 다른 언어는 사용하지 말라”는 지시를 추가한다. 50 step에서 AMC23은 72.5%, MATH-500은 84.4%를 기록한다. 보고된 생성 길이는 약 1000–3500 tokens이지만, 200 step 이후에도 여러 언어가 섞인 내용이 계속 나타난다.
- 저자들은 이 길이 변화가 응답 길이 제어의 개선을 보여준다고 해석한다. 다만 Figure 5에서는 후반에도 참조 모델과의 상당한 차이가 나타나므로, 관찰된 길이 조절만으로 학습 전반의 안정성이 입증되지는 않는다.
Overall Comparison에서는 Open-RS1의 100 step, Open-RS2의 50 step, Open-RS3의 50 step 체크포인트를 선택한다. 벤치마크 5개 평균은 각각 53.0%, 55.7%, 56.3%다. Open-RS3는 보고된 AIME24 비교에서 46.7%로 가장 높다. Open-RS2는 AMC23에서 80.0%를 기록하며, OlympiadBench에서는 Open-RS1과 같은 52.4%를 기록한다.
- DeepScaleR-1.5B-Preview는 평균 57.0%와 MATH-500 점수 87.8%로 각각 최고 성능을 유지한다. Open-RS3의 Minerva 점수는 26.8%로, 결과가 제시된 7B 베이스라인보다 낮다.
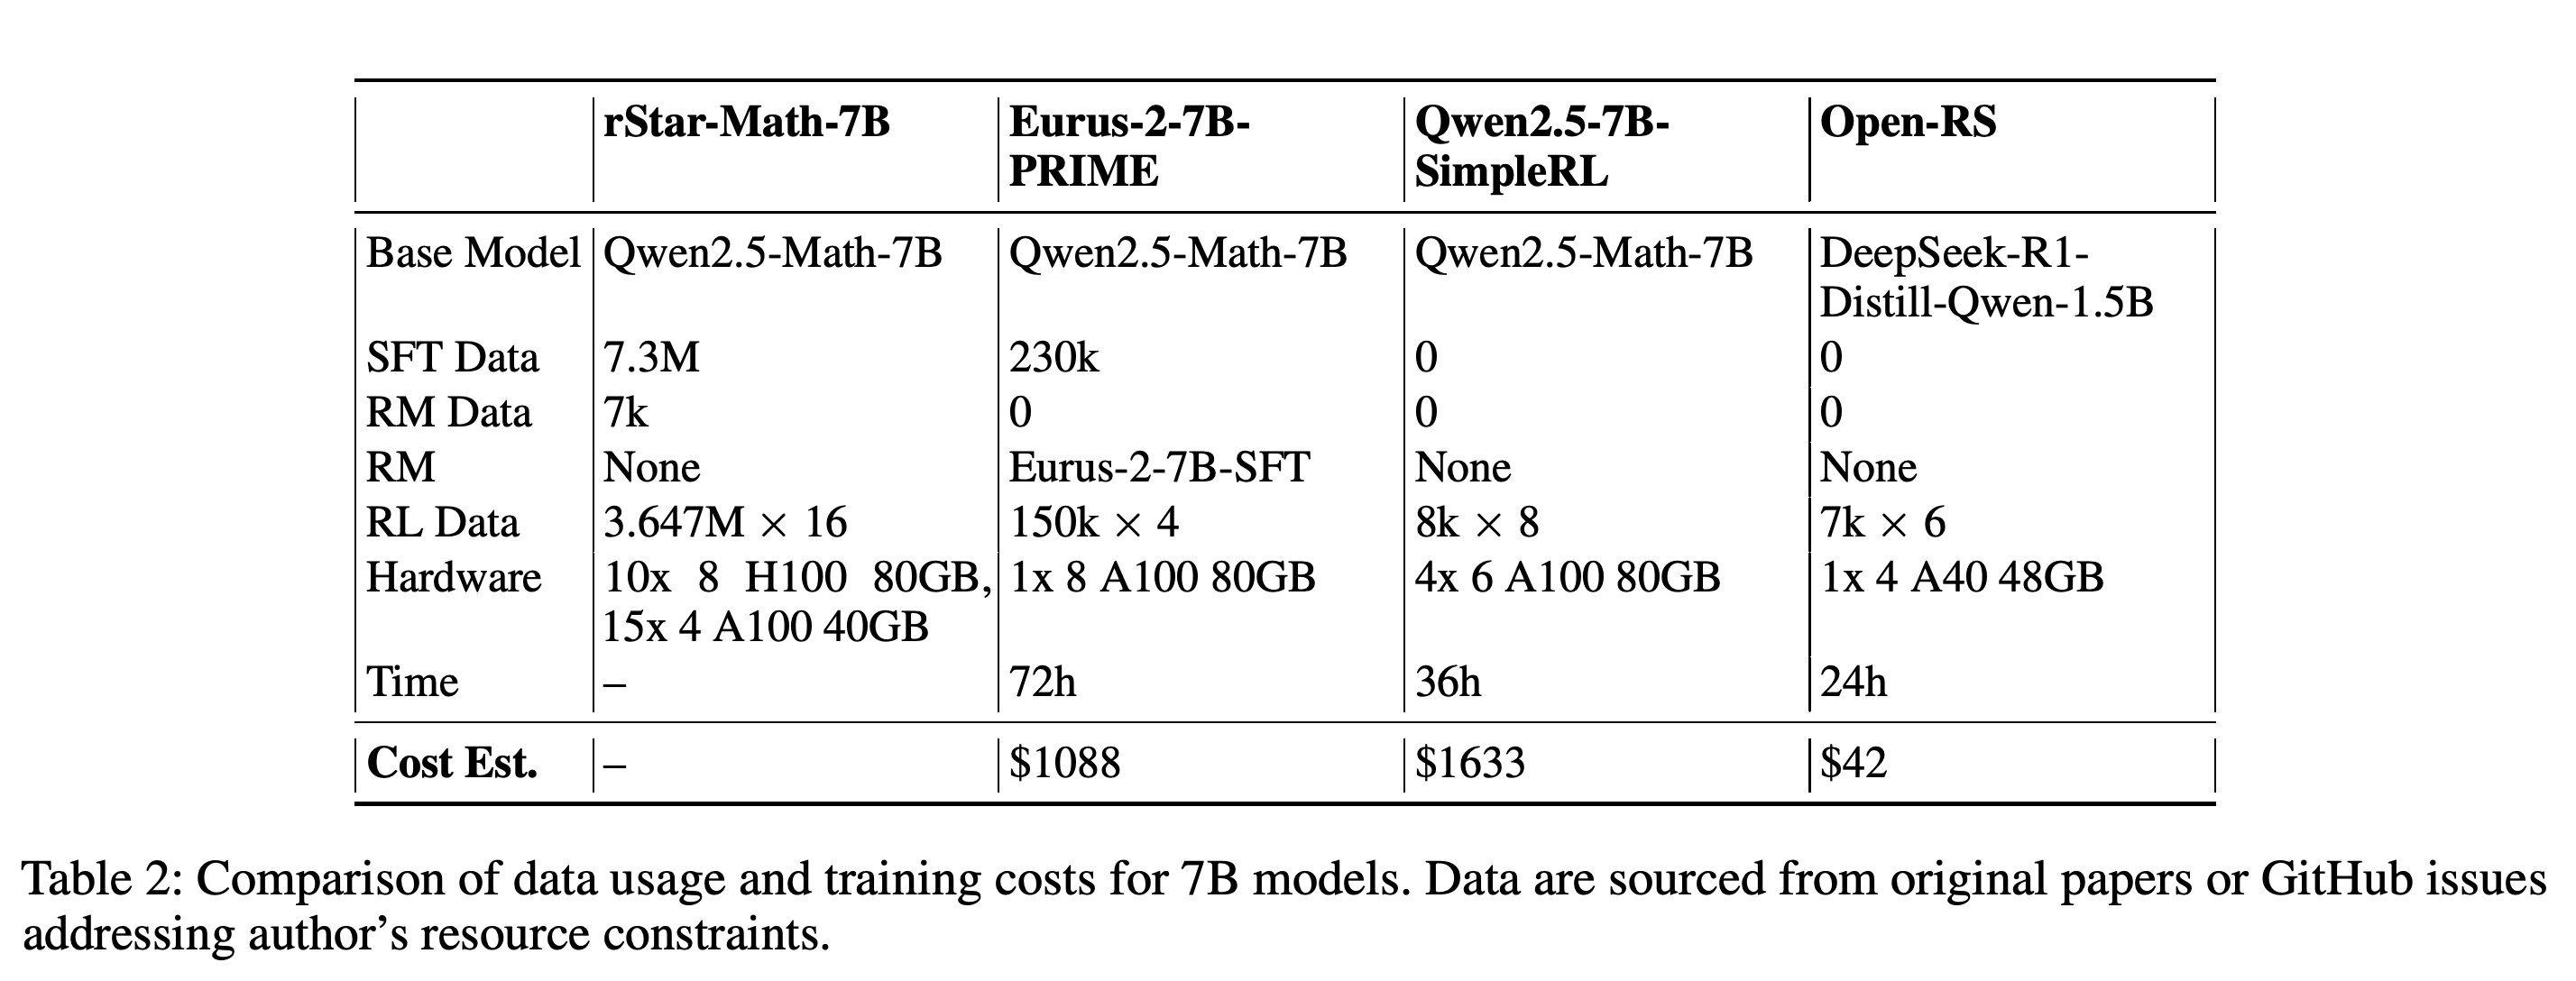
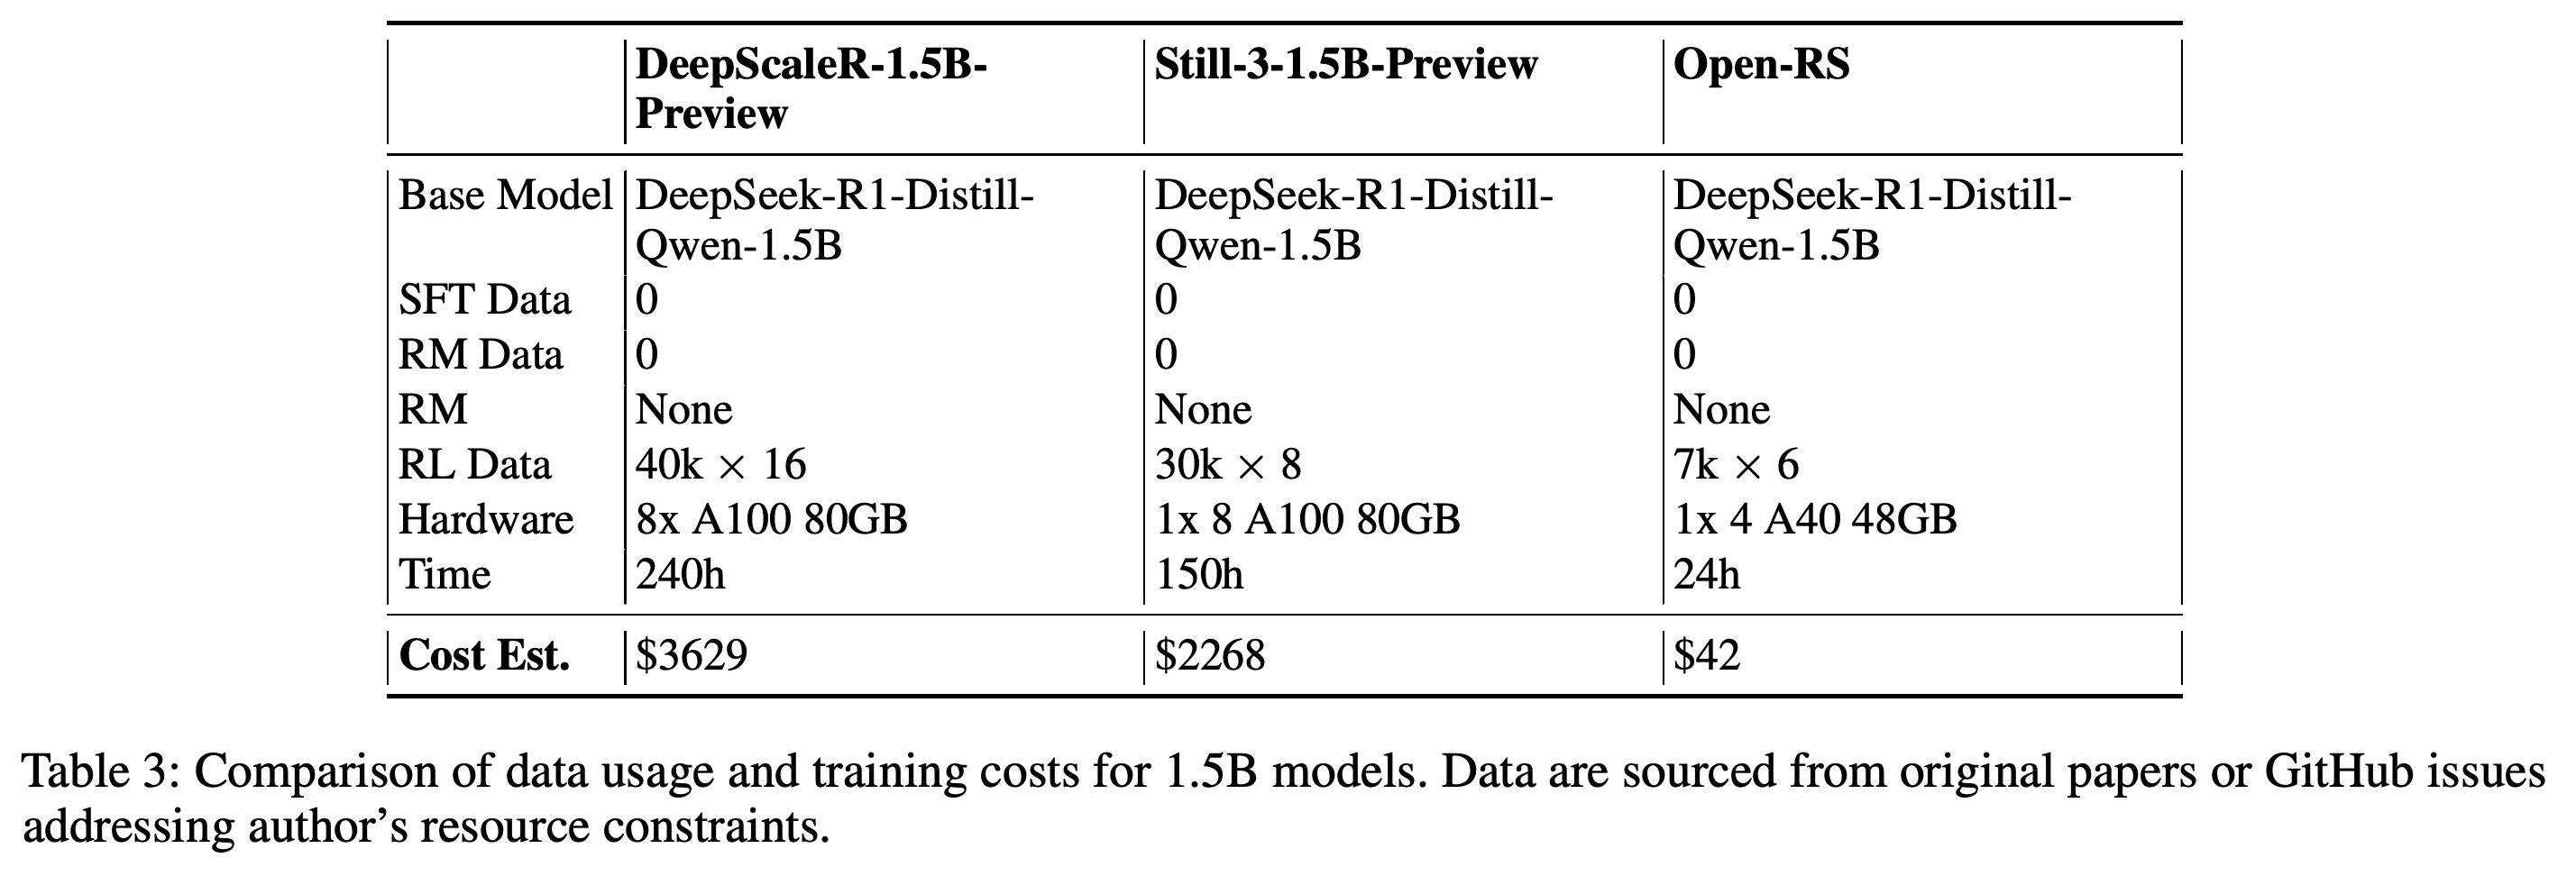
- 논문은 A40 GPU 4개로 24시간 학습하는 비용을 약 $42로 추정한다. 비교 모델의 추정 비용은 Eurus-2-7B-PRIME이 $1088, Qwen2.5-7B-SimpleRL이 $1633, DeepScaleR-1.5B-Preview가 $3629, Still-3-1.5B-Preview가 $2268이다. $42는 보고된 학습 예산이며, 선택한 50 step 체크포인트에 도달하는 데 실제로 든 비용을 측정한 값은 아니다.
- Tables 2와 3은 학습 데이터, 하드웨어, 시간을 비교한다. 비용은 https://www.runpod.io/pricing 과 외부에 보고된 설정을 바탕으로 계산하므로, 학습 절차가 다른 모델들의 자원 추정치를 제공한다. 통제된 조건에서 효율성을 비교한 결과는 아니다.
결과는 개별 벤치마크의 최고 성능과 벤치마크 5개 평균을 구분해 보여준다. Open-RS3는 AIME24에서 46.7%, Open-RS2는 AMC23에서 80.0%를 기록하며, Open-RS1과 Open-RS2는 OlympiadBench에서 모두 52.4%를 기록한다. DeepScaleR-1.5B-Preview는 평균 57.0%로 Open-RS3의 56.3%보다 높아 최고 평균을 유지한다. 일부 베이스라인 결과가 없어 나열된 모든 모델의 평균을 계산할 수는 없다.
코사인 보상 실험은 학습 후반에 약 1000–2000 tokens 범위의 더 짧은 응답을 생성하지만, KL 발산은 커지고 변동한다. 이 변화는 길이 조절의 효과를 뒷받침하지만, 이 조치가 학습 모델을 참조 모델에 가깝게 유지하지는 못함을 보여준다.
Open-RS에는 생성한 학습 응답 7k × 6, A40 48GB GPU 4개, 24시간, 추정 비용 $42가 기재되어 있다. 비교 대상인 7B 모델들은 기본 모델, 데이터 규모, 하드웨어, 학습 절차가 다르다. 따라서 이들의 더 높은 비용은 자원 사용의 맥락을 제공하며, 통제된 효율성 비교를 제공하지는 않는다.
시스템 3개 모두 DeepSeek-R1-Distill-Qwen-1.5B에서 출발한다. Open-RS에는 생성한 학습 응답 7k × 6과 24시간이 기재되어 있다. DeepScaleR-1.5B-Preview는 40k × 16과 240시간, Still-3-1.5B-Preview는 30k × 8과 150시간을 사용한다. 비용을 비교할 때는 서로 다른 하드웨어와 절차도 고려해야 한다.
4 Conclusion
논문은 제한된 데이터와 연산 자원으로 추가 RL 학습을 수행해 기존 소형 추론 모델의 성능을 높일 수 있다고 결론짓는다. 실험에서는 수학 벤치마크 성능이 초반에 오른 뒤, 학습을 계속하면 반복적으로 떨어진다. 따라서 보고된 결과를 해석할 때 체크포인트 선택과 생성 길이 제한이 핵심 요소가 된다.
부록
- A Related Work는 Reasoning in Large Language Models와 Reasoning with Reinforcement Learning을 다룬다. 중간 계산을 요청하는 scratchpad prompting, 중간 추론 단계를 유도하는 chain-of-thought prompting, 생성한 답변의 검증, 모델이 자신의 추론을 수정하는 self-reflection, SFT, 보상 기반 학습을 논의한다. 이 절은 추론 모델 학습에 필요한 자원을 줄이려는 연구들 속에서 이 연구의 위치를 설명한다.
- B Limitations & Discussion은 4개 한계를 제시한다. 24시간으로 제한된 학습 시간, 매우 어려운 문제를 풀기에 부족한 생성 길이, 약 150–200 step 이후 의도하지 않은 언어로의 이탈, 수학 추론에 한정된 평가다. Discussion은 결과를 효율성, 추론 깊이, 학습 안정성 사이의 절충으로 해석한다. 코사인 보상은 길이를 조절하지만 AMC23이나 MATH-500에서 최고 점수를 내지는 못한다.
- Future Directions는 더 긴 학습이나 다단계 길이 스케줄, 경량 언어 보상이나 단일 언어 필터링, 수학 외 영역의 평가, GRPO와 Monte Carlo Tree Search의 결합을 제안한다. Monte Carlo Tree Search는 후보 추론 경로로 구성된 트리를 탐색하는 방법이다. 이 제안들은 실험에서 평가하지 않았다.
- C Datasets는 AIME24를 고급 고등학교 수학, AMC23을 기초 경시 수학, MATH-500을 경시 문제 부분집합, Minerva를 학부 수준의 정량적 추론으로 설명하며 Minerva에서는 수학 부분집합을 사용한다. OlympiadBench는 올림피아드 수준의 수학과 물리를 다룬다. D Baseline Models는 비교 대상을 범용 모델, 수학 중심 7B 모델, 수학 중심 1.5B 모델로 나눈다. 각 설명은 탐색, 중간 추론 단계에 대한 보상, 최종 정답 보상을 사용하는 방법을 구분하며, 증류 모델을 이 연구에서 수행한 추가 학습 이전의 베이스라인으로 명시한다.
- E Hyperparameter Setup은 GRPO trainer 설정을 제시한다. 주요 설정은 낮은 정밀도의 수치 형식을 활성화하는 bf16 = true, vLLM 생성 엔진을 활성화하는 use_vllm = true, vllm_gpu_memory_utilization = 0.7, vllm_max_model_len = 4608, max_prompt_length = 512, max_steps = 500, num_generations = 6이다. reward_weights = 1.0, 2.0은 각각 형식 보상과 정확도 또는 코사인 보상에 적용한다. 학습률 스케줄러는 cosine_with_min_lr이며, min_lr_rate = 0.1과 warmup_ratio = 0.1을 사용해 최소 학습률과 초기 워밍업 구간을 갖춘 코사인 스케줄을 지정한다.
짧은 생각
가장 분명한 실무적 발견은 초기 체크포인트를 평가할 가치가 있다는 점이다. 실험 3개 모두 빠르게 성능이 향상되지만, 학습을 계속하면 정확도가 반복적으로 떨어진다. 이 연구는 이미 증류된 추론 모델을 적은 비용으로 추가 학습할 수 있음을 보여준다. 같은 예산으로 일반 사전학습 모델에서도 비슷한 추론 능력을 얻을 수 있는지는 실험하지 않는다.
Experiment 2는 데이터셋과 생성 길이 제한을 모두 바꾸고, Experiment 3은 보상과 언어 프롬프트를 모두 바꾸므로 원인을 개별적으로 규명하는 데 한계가 있다. 논문은 여러 seed로 반복한 결과나 불확실성 구간을 보고하지 않는다. 대표 성과로 제시한 AIME24 비교는 평가 문제 30개와 외부에서 보고된 베이스라인 점수를 사용한다.