


Model-Preserving Adaptive Rounding 요약 설명
29 May 2025 | Paper Review Post-Training Quantization Model Compression Hessian Approximations목차
버전 안내: 이 글은 2025-W22에 선정된 논문을 돌아보며, ICML 2026 개정 내용을 포함한 2026년 6월 3일자 arXiv:2505.22988v3를 해설한다. 2025년 5월 당시 버전만을 다루는 글은 아니다.
이번 글에서는 Model-Preserving Adaptive Rounding 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 5월 29일(Arxiv), Proceedings of the 43rd International Conference on Machine Learning, PMLR 306, 2026
- Tseng, Albert, Sun, Zhaofeng, De Sa, Christopher.
- Department of Computer Science, Cornell University
- 논문 링크
- Github
요약
- 대규모 언어 모델(LLM)의 가중치를 저정밀도로 압축하면 개별 층의 활성값이 비슷하게 유지되어도 출력 확률분포가 달라질 수 있다. Yet Another Quantization Algorithm(YAQA)은 동일한 quantizer와 전처리를 사용하고 추가 finetuning을 수행하지 않은 조건에서 GPTQ/LDLQ보다 Kullback–Leibler(KL) divergence를 약 30% 낮췄다고 보고한다. KL divergence는 출력 분포의 차이를 측정하며, GPTQ와 LDLQ는 국소 활성값 오차를 기준으로 가중치를 반올림하는 동등한 방법이다.
- YAQA는 반올림 오차의 피드백으로 양자화할 가중치를 선택하는 adaptive rounding에 입력 채널과 출력 채널 정보를 함께 반영한다. 이를 위해 출력 divergence의 2차 미분 행렬을 더 작은 행렬 2개의 Kronecker 곱으로 근사하는 Kronecker-factored Hessian approximation을 사용한다. 이 방식은 반올림 계산을 감당할 수 있는 수준으로 유지하면서 후속 층의 영향을 반영한다.
- 실험은 Llama, Gemma, Qwen 모델에서 여러 quantizer와 선택적인 recovery finetuning을 평가한다. Quantizer는 표현 가능한 가중치 값을 정하는 규칙이며, recovery finetuning은 아직 양자화하지 않은 매개변수를 조정해 앞선 양자화의 영향을 보완하는 과정이다. 가장 일관된 결과는 분포 보존 성능이다. 다운스트림 정확도가 모든 조건에서 향상되지는 않으며, 이론적 보장은 단일 층에서 출력 divergence를 2차로 근사한 값의 상한을 제시한다.
1. Introduction
양자화에서는 표현 가능한 값을 정하는 과정과 원래 가중치를 그 값에 할당하는 반올림 알고리즘을 구분한다. 이 논문은 후자를 다룬다. 현재 층의 활성값 오차만 최소화하면 후속 층이 그 오차를 어떻게 변환하는지 놓칠 수 있으므로, YAQA는 모델 출력의 divergence와 관련된 곡률을 바탕으로 반올림 피드백을 구성한다.
2. Background
배경 절에서는 가중치 양자화를 최적화에 쓰이는 구조화된 곡률 근사와 연결한다. 국소 활성값 재구성을 근사하는 문제와 원래 모델의 전체 출력 분포 보존을 근사하는 문제를 구분한다.
2.1. Large Language Model Quantization
Post-training quantization(PTQ)은 이미 학습한 모델을 압축하고, quantization aware training(QAT)은 학습 과정에 양자화 표현을 반영한다. 논문은 제한된 매개변수 공간에서 양자화된 가중치나 할당을 최적화하는 중간적 접근법도 설명한다.
- 2.1.1. LOCAL LAYERWISE ROUNDING: GPTQ와 LDLQ는 층 입력의 외적에 대한 기댓값인 입력 활성값의 2차 모멘트와 입력 채널 방향의 피드백을 사용한다. 이 통계는 순전파만으로 수집할 수 있다. Incoherence는 중요한 반올림 방향이 얼마나 고르게 분산되어 있는지를 나타내며, 무작위 직교 전처리는 이 방향들의 집중도를 낮춘다.
- 2.1.2. FULL MODEL ADAPTIVE ROUNDING: SqueezeLLM과 GuidedQuant 등의 방법은 다음 토큰 과제 손실에서 계산한 그래디언트의 2차 모멘트 행렬인 empirical Fisher를 반영한다. 논문은 이 행렬을 원래 모델에 대한 divergence의 곡률과 구분하고, 둘을 연결하는 데 쓰이는 학습 수렴 가정에 의문을 제기한다.
- 2.1.3. GRADIENT-DESCENT-BASED METHODS: PV-Tuning은 표현 가능한 가중치 벡터의 집합인 codebook과 그 할당을 학습한다. DiscQuant는 제약된 부분공간 안에서 가중치를 갱신하고, cross-block quantization(CBQ)은 학습 가능한 adapter와 반올림 정규화를 사용한다. 논문은 이러한 방법에서 실용적으로 선택할 수 있는 표현이 대체로 가중치를 개별적으로 표현하는 scalar quantizer나 가중치 그룹을 표현하는 비구조적 vector quantizer로 제한된다고 주장한다.
2.2. Hessian Approximations
원래 모델에 대한 divergence의 Hessian은 real Fisher와 같으며, 이때 그래디언트 표본의 정답은 해당 모델의 출력 분포에서 추출한다. 이는 관측된 정답을 사용하는 empirical Fisher와 다르다. 논문은 Kronecker-factored approximate curvature를 사용하는 optimizer인 KFAC와 행렬 형태의 그래디언트 통계를 사용하는 optimizer인 Shampoo를 바탕으로 입력 측과 출력 측의 별도 인자를 도입한다.
3. Yet Another Quantization Algorithm
YAQA는 LDLQ 반올림의 일반화와 확장 가능한 Hessian sketch 2개를 결합한다. Hessian sketch는 그대로 다루기에는 지나치게 큰 곡률 행렬을 구조적으로 추정한다. YAQA는 전체 모델의 출력 오차 정보를 사용하면서 층별로 반올림을 수행한다. 기존 양자화 표현 안에서 가중치 할당을 바꾸므로, 추론 효율은 선택한 quantizer가 계속 결정한다.
3.1. End-to-End Layerwise Adaptive Rounding
3.1.1. WHEN IS ADAPTIVE ROUNDING FAST? 논문은 삼각형 반올림 피드백에서 0이 아닌 원소의 패턴이 만드는 의존 깊이를 structural nilpotence degree(SND)로 정의한다. m-by-n 가중치 행렬에서 밀집 근사는 mn개의 순차 단계를 요구할 수 있지만, Kronecker 인자를 사용하면 O(m+n) 단계와 효율적인 행렬 곱셈으로 계산할 수 있다.
- Equation 6은 LDLQ의 입력 채널 보정에 출력 채널 피드백과 입력 채널 피드백 및 출력 채널 피드백 사이의 상호작용을 추가한다.
- 논문은 실제 반올림 자체에 걸리는 시간이 LDLQ의 약 2배라고 보고한다. 이 비용은 곡률 통계 수집 비용과 별개이며, quantizer가 고정되어 있으면 추가 추론 연산은 발생하지 않는다.
3.1.2. END-TO-END BOUNDS & HESSIAN DESIDERATA: Theorem 3.4는 근사 행렬과 Hessian 사이의 방향 일치도를 나타내는 cosine similarity, quantizer 오차, 양쪽 인자의 특성을 이용해 실제 2차 오차의 상한을 제시한다. 방향 일치도가 높을수록 불일치 항이 줄어든다. 낮은 incoherence와 적절한 저랭크 구조, 즉 비교적 적은 방향이 인자를 지배하는 구조는 상한의 다른 항들을 개선한다.
- 출력 인자에 단위행렬을 사용하고 입력 인자에 국소 입력 인자를 사용하면 LDLQ가 된다. 논문에서 유도한 인자 및 랭크 조건에서는 trace 기반 상한을 비교했을 때 YAQA가 유리하다.
- 정리는 0이 아닌 벡터에 대해 이차형식이 양수인 양의 정부호 인자와, 평균제곱오차가 제한된 최근접 반올림 또는 확률적 반올림을 가정한다. 다른 가중치는 원래 값으로 고정하고 한 층만 변경했을 때 얻는 이차 근사를 다룬다.
3.2. Scalable Near-Optimal Kronecker Factored Hessian Sketches
3.2.1. HESSIAN SKETCH A는 선형 층 내부의 토큰이 독립이라고 가정하고, 이 근사 곡률에 power iteration을 적용해 가장 잘 맞는 인자를 향해 반복적으로 갱신한다. 이 가정은 편향을 도입하지만 토큰을 표본으로 취급해 추정 분산을 줄인다. 초기화에는 LDLQ의 입력 통계와 단위 출력 인자를 사용한다.
- Sketch A는 실험에서 전체 반복 횟수가 3 이하일 때 수렴한다. 보고된 기준 비용은 10B-parameter 모델과 20M tokens에서 약 20 GPU-hours이며, 이는 그래픽 프로세서 실행 시간을 합산한 값이다.
3.2.2. HESSIAN SKETCH B는 단위 인자에서 시작해 전체 시퀀스의 그래디언트로 power iteration을 1회 수행하며, 토큰 사이의 의존성을 유지한다. 데이터셋을 1회 통과하면서 양쪽 인자를 수집한다. 기준 비용은 10B 모델에서 길이가 2K tokens인 64K sequences를 사용할 때 약 30 GPU-hours다.
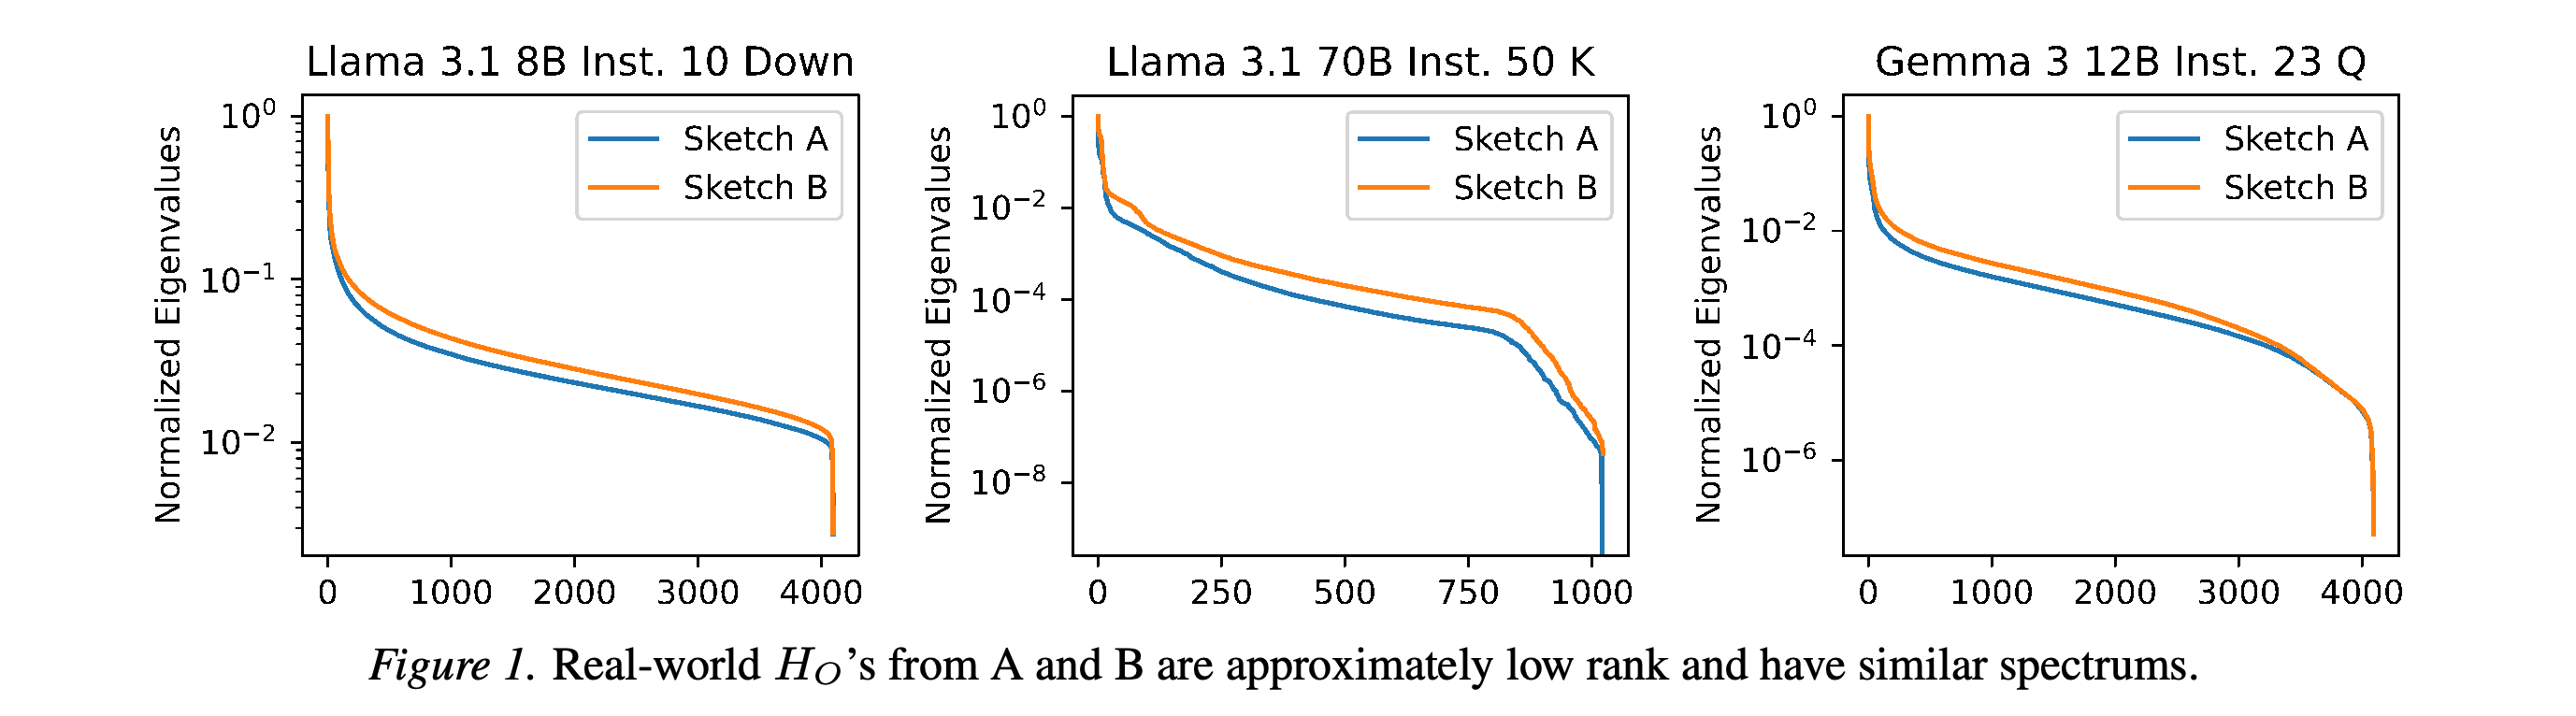
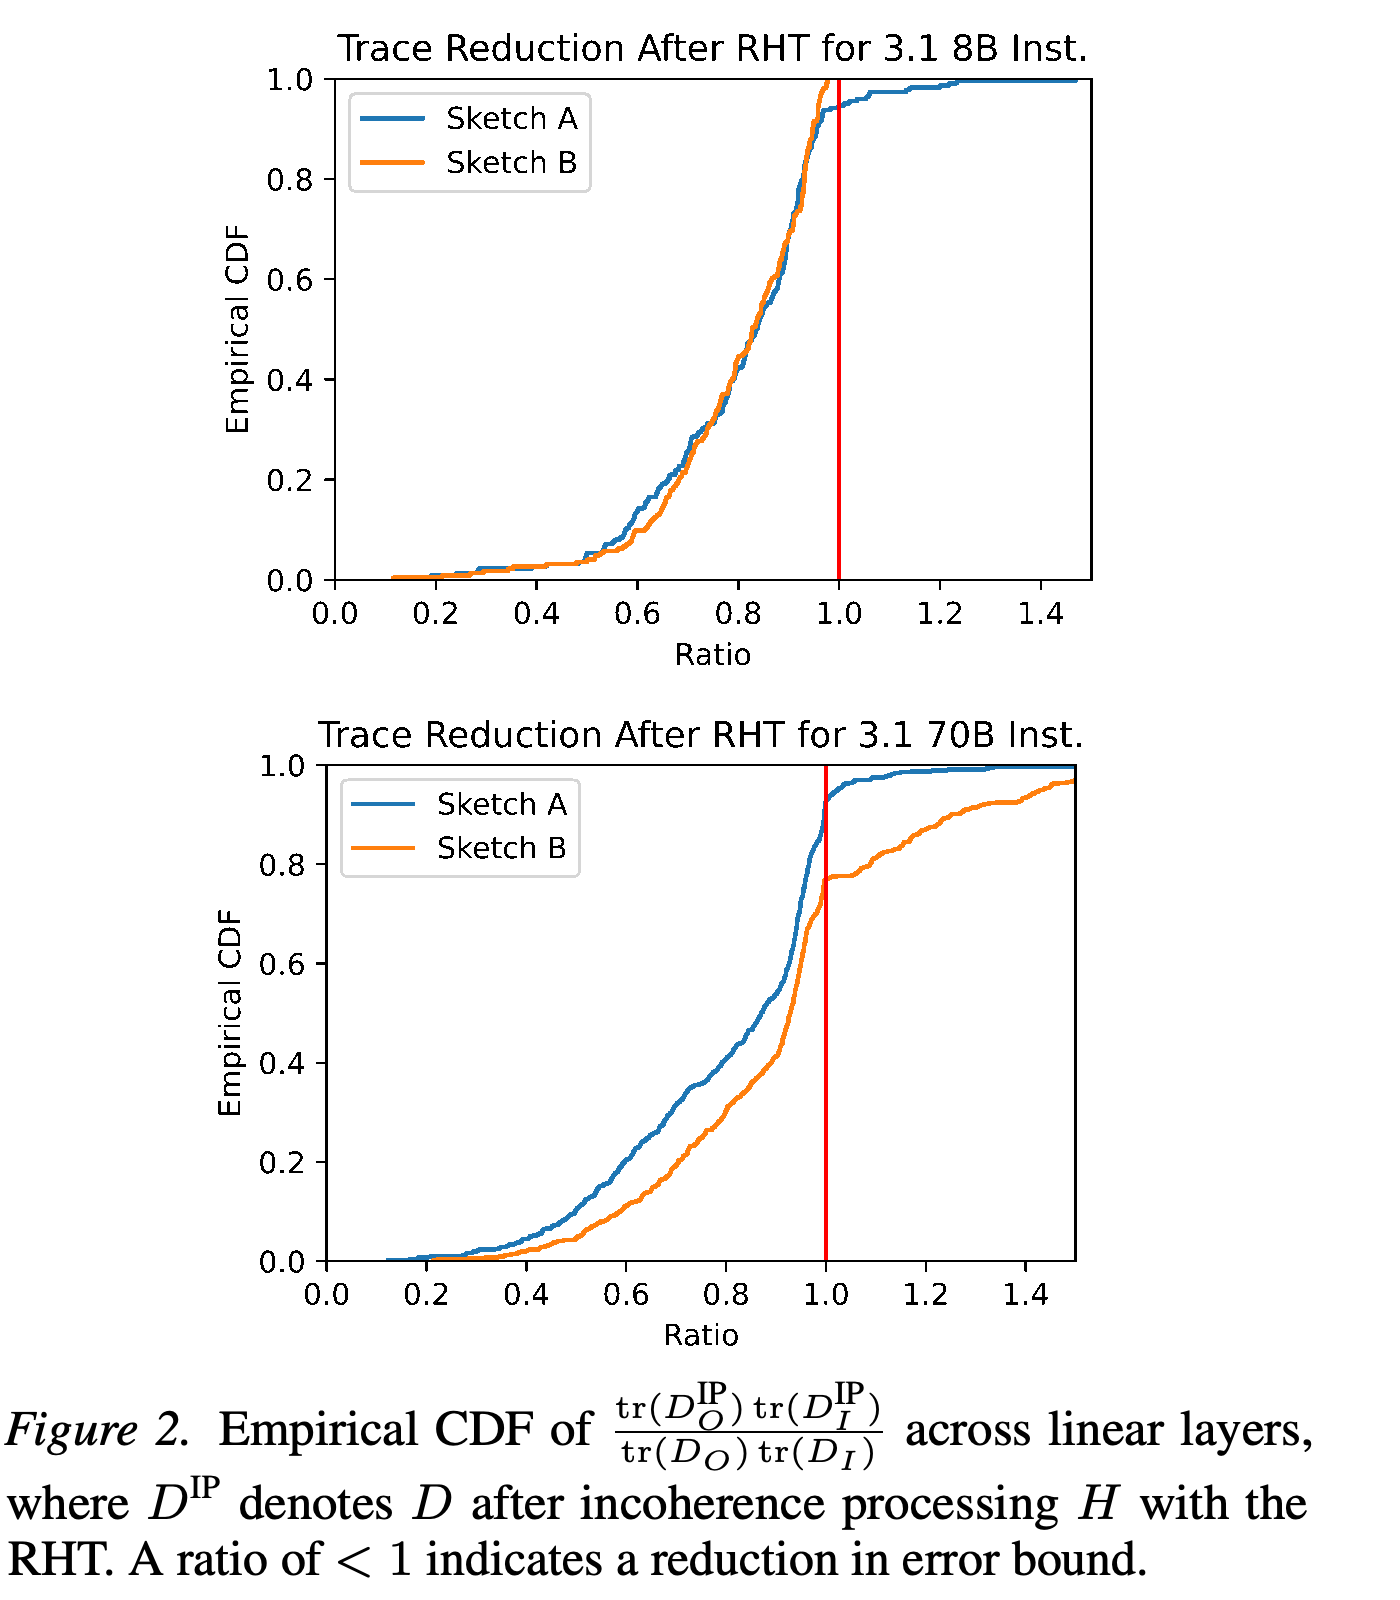
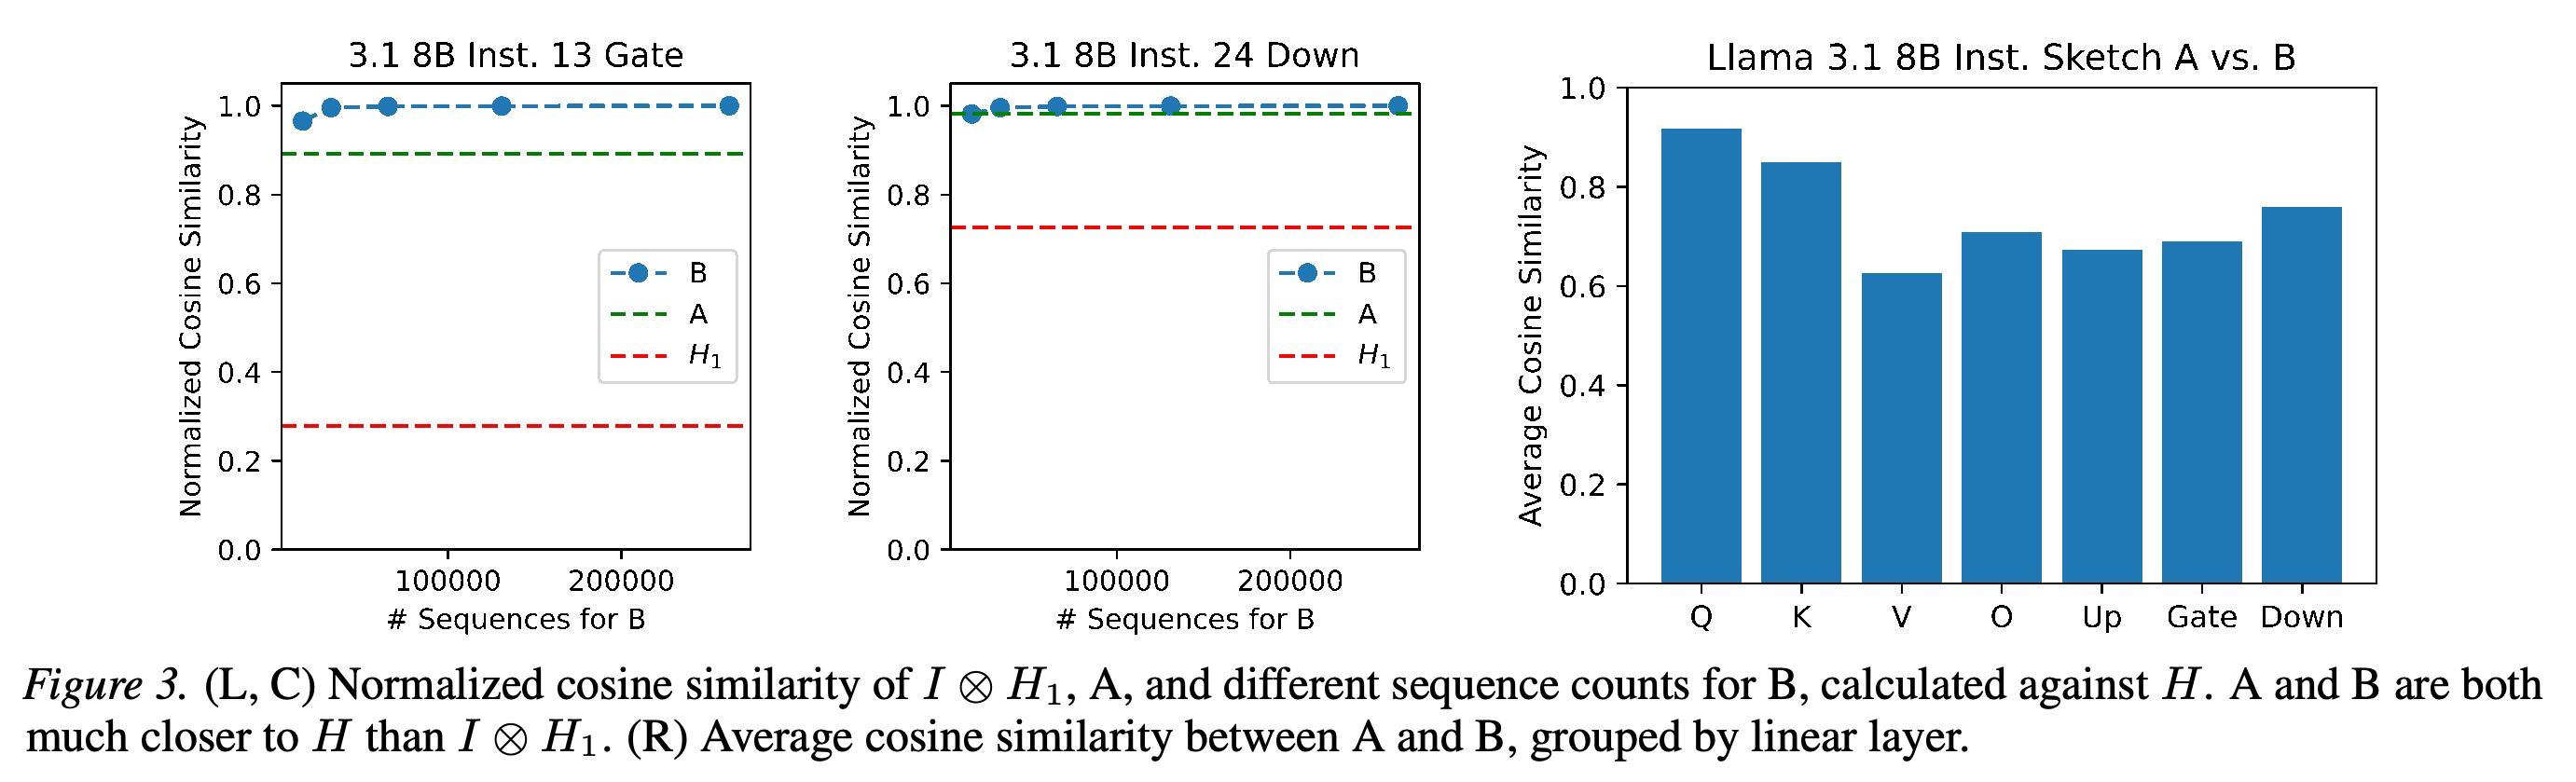
- 3.2.3. EVALUATING SKETCH A AND B: Figure 1은 출력 인자의 스펙트럼이 감소하는 양상을, Figure 2는 무작위 직교 전처리가 trace 기반 상한에 미치는 영향을, Figure 3은 LDLQ 근사보다 높은 Hessian 정렬도를 보여준다.
- Sketch B는 일반적으로 시퀀스가 많을수록 유리하다. 다만 데이터가 적어 Sketch B의 추정 분산이 Sketch A의 편향보다 크게 작용하면 Sketch A의 정렬도가 더 높을 수 있다.
선택한 3개 층과 모델에서 출력 인자의 스펙트럼이 감소하며, 이는 더 작은 반올림 상한의 근거로 사용한 근사적 저랭크 구조를 뒷받침한다. Sketch A와 Sketch B의 스펙트럼이 비슷하다는 사실만으로 전체 Hessian과의 정렬도도 같다고 볼 수는 없다.
비율이 1보다 작으면 무작위 Hadamard 전처리가 오차 상한의 trace 기반 항을 줄였다는 뜻이다. 누적분포는 각 비율보다 낮은 층의 비중을 나타내며, 표시된 층 대부분에서 개선이 나타난다. 다만 70B Sketch B 곡선에는 비율이 1보다 큰 층도 상당 부분 포함된다.
선택한 층에서는 YAQA의 양쪽 sketch가 LDLQ 근사보다 훨씬 높은 곡률 정렬도를 보인다. 왼쪽과 가운데 패널은 절대 cosine similarity를 제시하지 않고, 표시된 최댓값이 1이 되도록 정렬도를 재조정한다. Attention score를 형성하는 query 및 key projection에서 sketch 간 일치도가 더 높은 양상은 Sketch A가 토큰 의존성을 처리하는 방식과 부합한다.
4. Experiments
주요 실험은 가중치만 압축하고 활성값은 양자화하지 않는 weight-only PTQ를 평가하며, 주로 추가 finetuning 없이 진행한다. YAQA-A는 8K context, 20M tokens, 전체 power iteration 3회로 Sketch A를 사용한다. YAQA-B는 2K context와 64K sequences로 Sketch B를 사용한다.
- 평가 지표는 출력 KL divergence, 정답 토큰에 대한 예측 적합도를 나타내는 perplexity, 과제 시범 없이 측정한 성능인 zero-shot 정확도다. 비교 대상에는 LDLQ, GuidedQuant, DiscQuant, Google의 Gemma 3 QAT 모델이 포함된다.
- 정답 토큰의 likelihood나 벤치마크 정확도가 비슷하다고 해서 모델 2개의 전체 출력 분포가 비슷하다고 볼 수는 없으므로, 논문은 KL을 우선시한다.
4.1. Second Order Quantization Algorithms
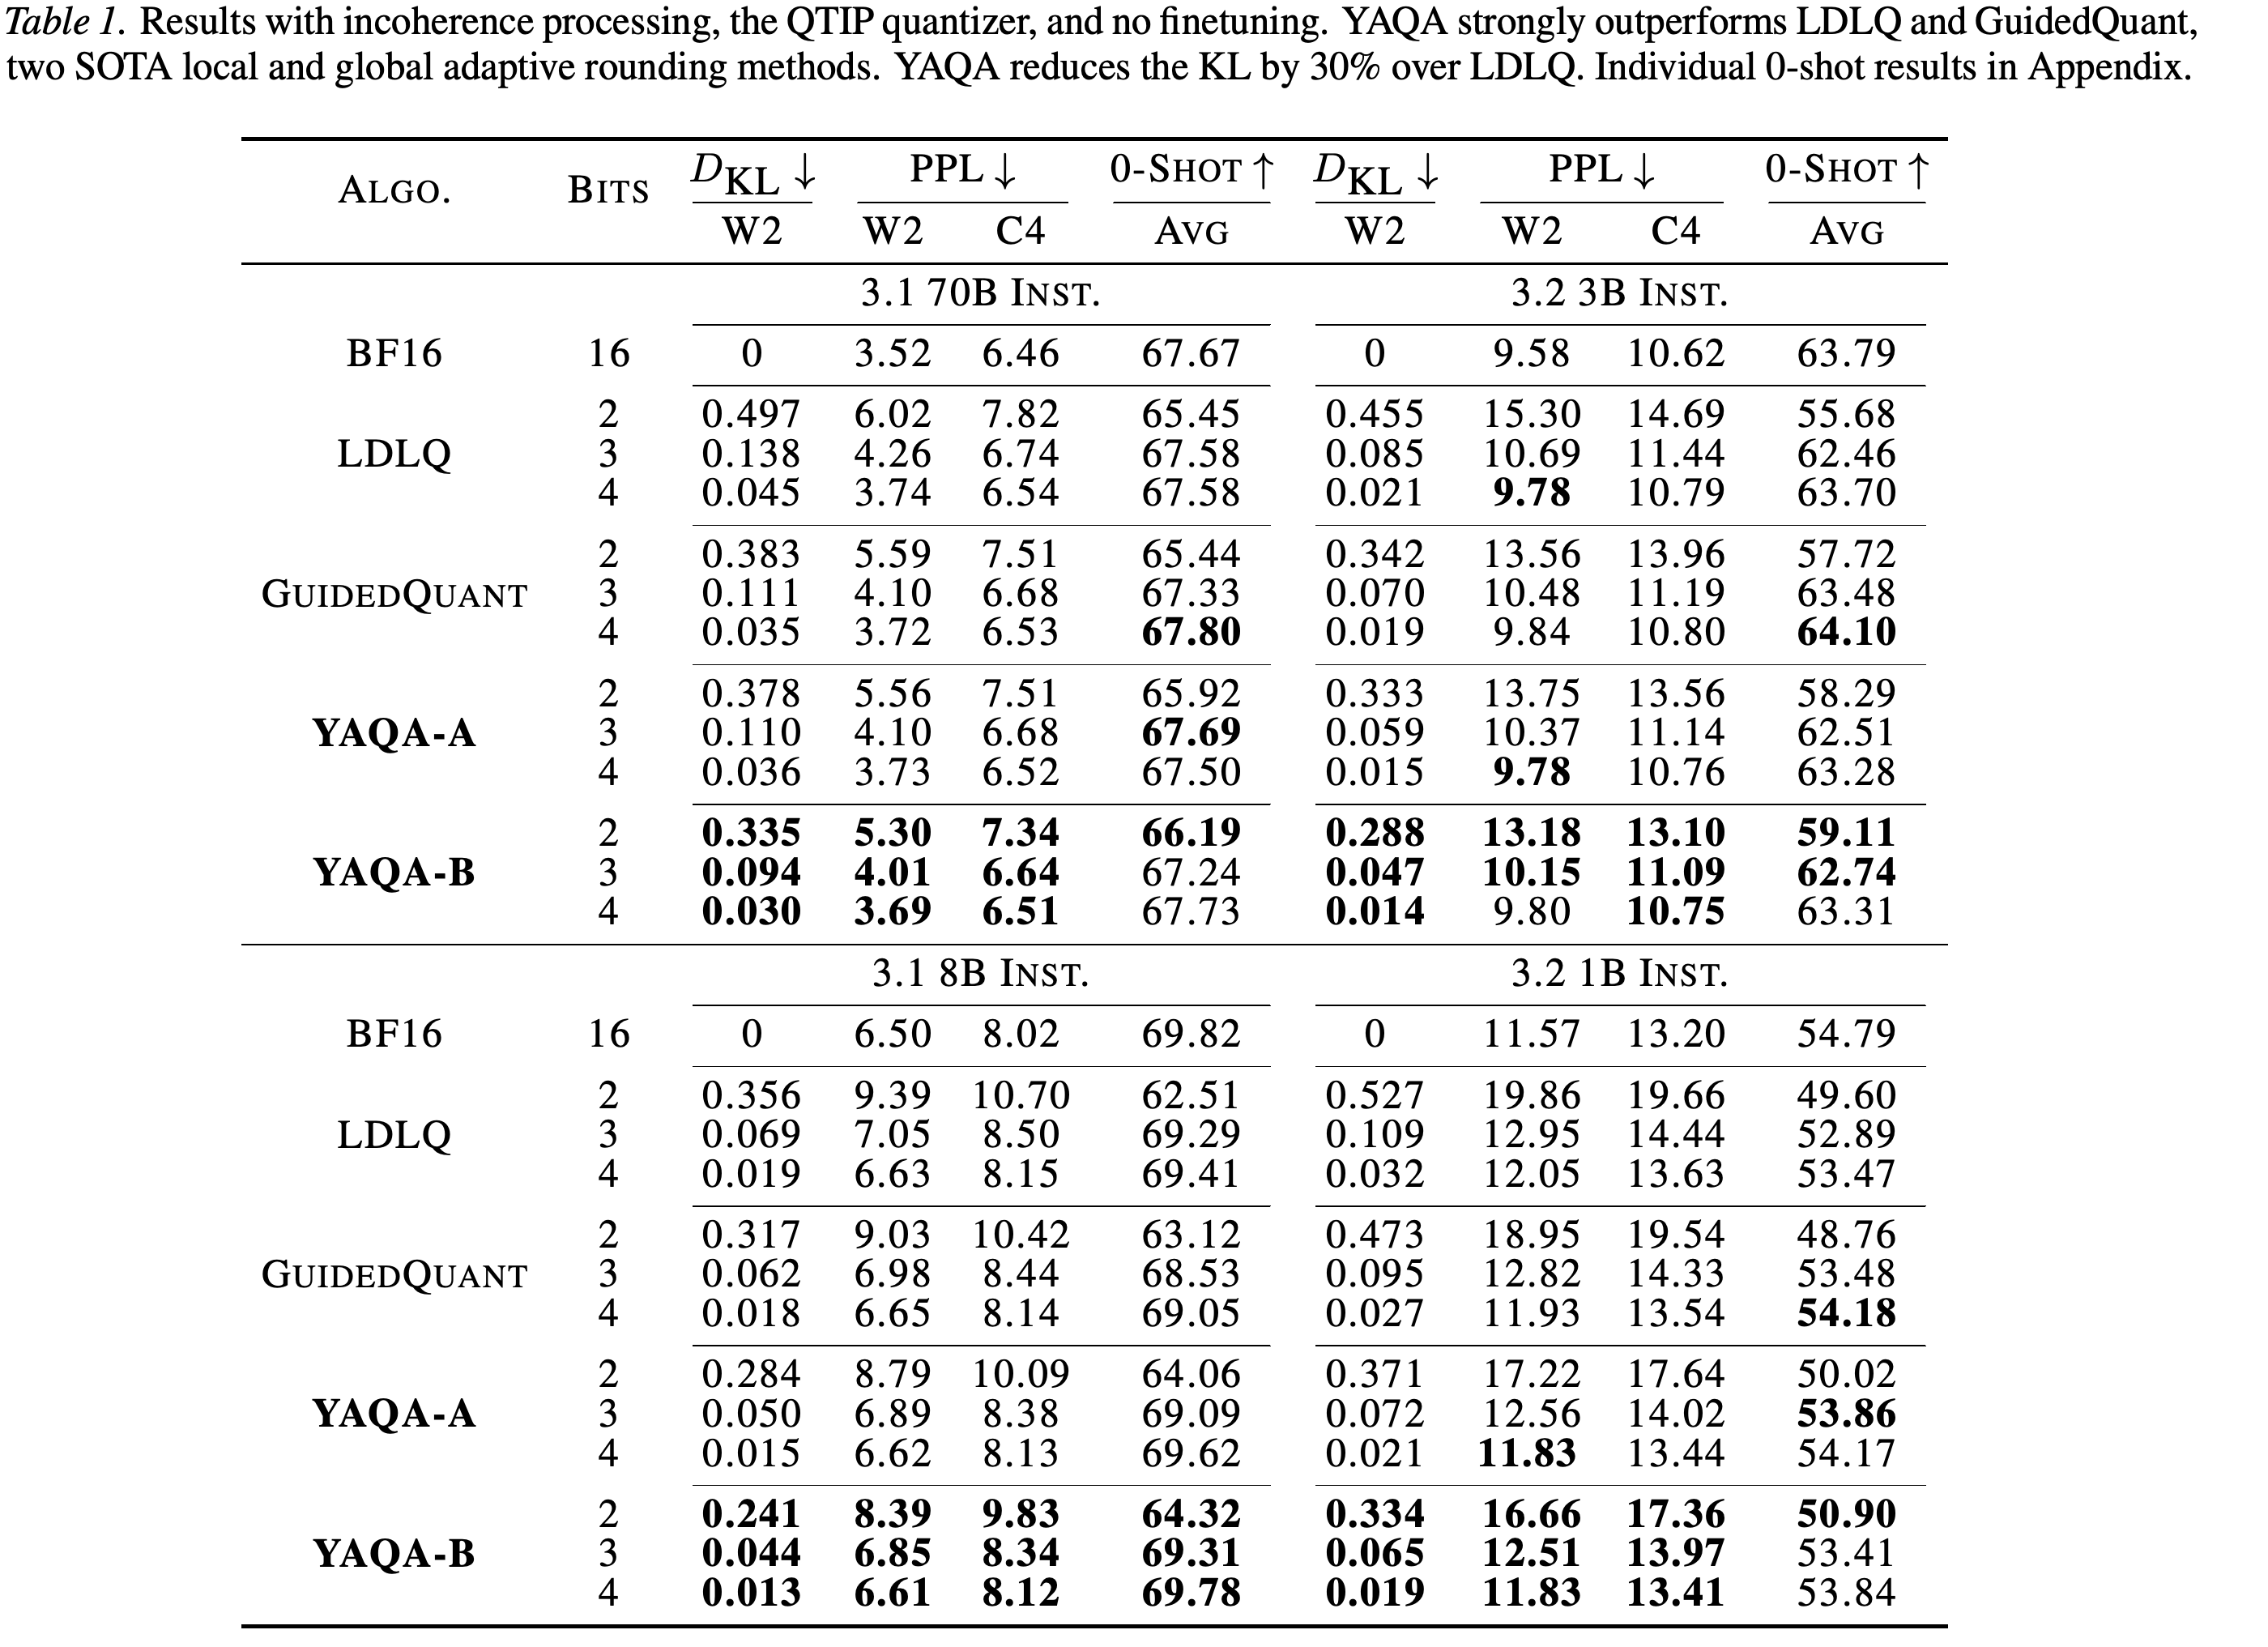
Table 1은 trellis 구조의 표현을 사용하는 quantizer인 QTIP에 incoherence processing을 적용하고 finetuning을 수행하지 않은 조건에서 LDLQ, GuidedQuant, YAQA를 비교한다. Llama 3.1 8B Instruct의 2 bits 조건에서 YAQA-B는 Wikitext2 KL을 0.356에서 0.241로, perplexity를 9.39에서 8.39로 낮추고 평균 zero-shot 정확도를 62.51에서 64.32로 높인다.
- YAQA-B는 Table 1에 제시된 모든 모델과 비트 폭 조건에서 KL이 가장 낮다. 정확도 순위는 달라진다. Llama 3.2 3B Instruct의 4 bits 조건에서 GuidedQuant의 평균 정확도는 64.10이고 YAQA-B는 63.31이다.
- 이 결과는 분포 보존 측면에서 일관된 우위를 뒷받침한다. 원문 해당 절에서 주장하는 모든 지표에 걸친 전반적 우위를 뒷받침하지는 않는다.
QTIP과 전처리를 고정해 반올림 및 곡률 추정의 효과를 분리한다. YAQA-B는 표시된 모든 조건에서 KL이 가장 낮지만, 평균 zero-shot 정확도는 일부 조건에서 GuidedQuant, LDLQ 또는 YAQA-A가 더 높다.
4.2. First Order Quantization Methods
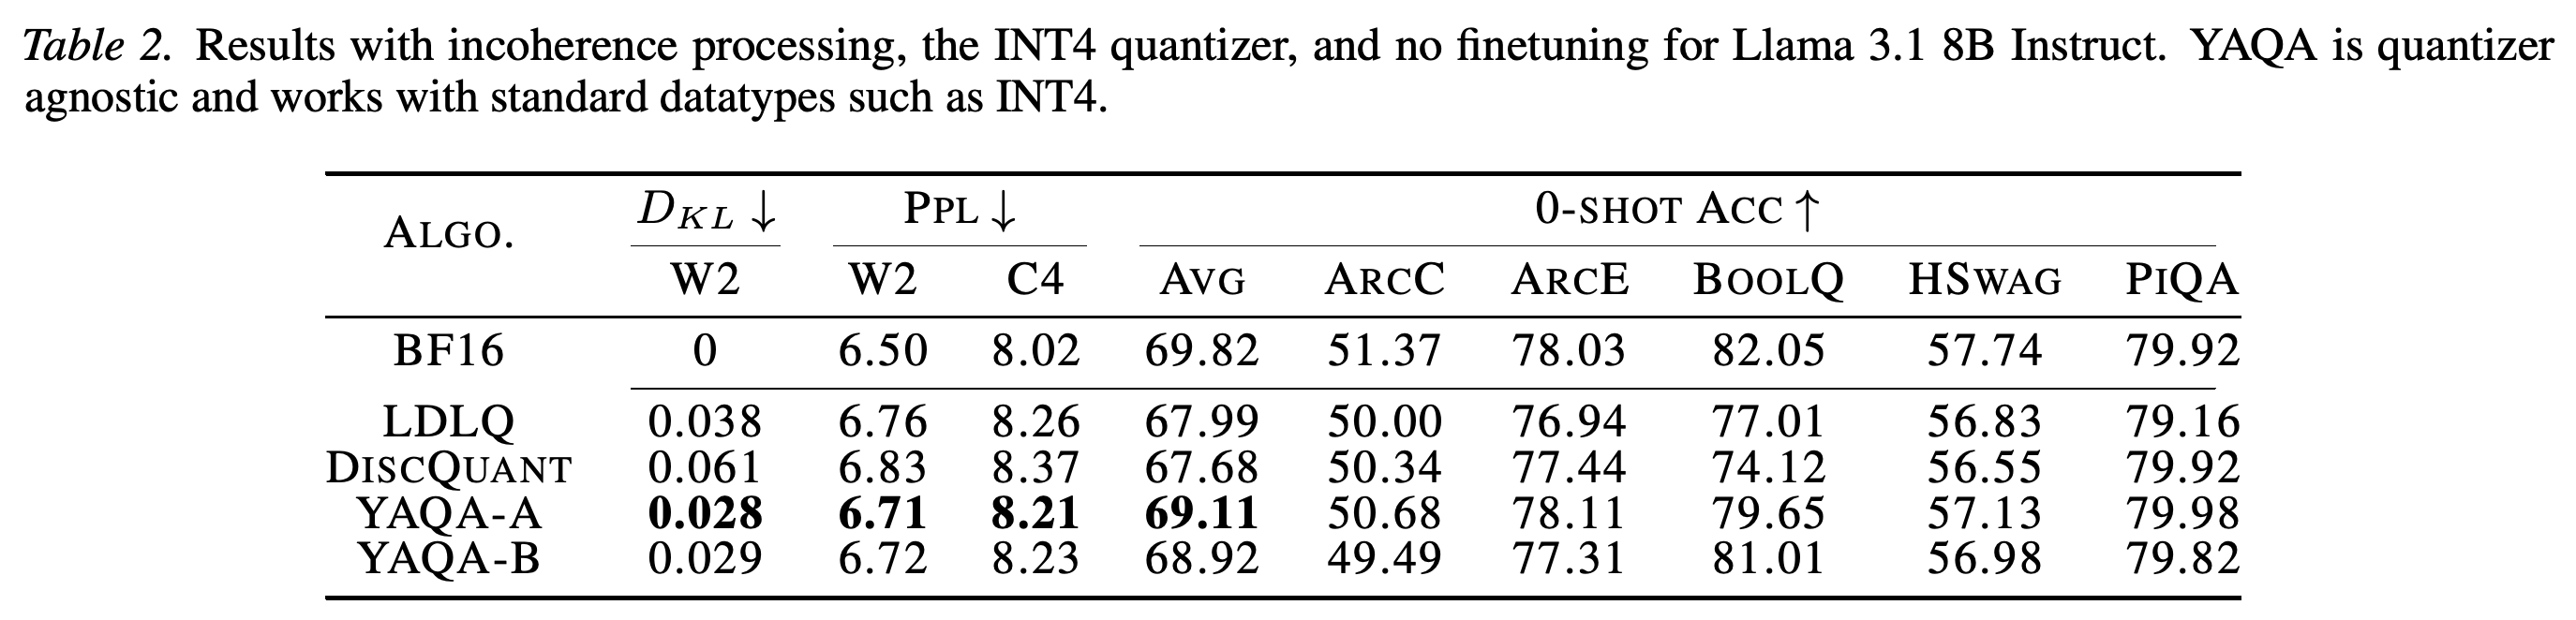
Table 2는 4-bit 정수 quantizer인 INT4에서도 YAQA가 표준 scalar 표현을 개선함을 보여준다. Llama 3.1 8B Instruct에서 YAQA-A의 KL은 0.028, 평균 zero-shot 정확도는 69.11이며, DiscQuant는 각각 0.061과 67.68이다. 이 조건에서는 YAQA-A가 KL, perplexity, 평균 정확도에서 YAQA-B보다도 소폭 앞선다.
- Table 3은 4-bit YAQA PTQ와 Google의 4.5-bit QAT Gemma 3 12B Instruct 모델을 비교한다. YAQA-B의 KL은 0.056으로 QAT의 0.089보다 낮지만, QAT는 평균 정확도가 70.83으로 YAQA-B의 69.90보다 높고 Wikitext2 perplexity는 7.56으로 YAQA-B의 7.94보다 낮다.
- Gemma 결과는 원래 분포를 더 잘 보존한다는 점을 뒷받침한다. 저자들은 QAT가 100× 더 많은 데이터를 사용했다고 추정한다. 이는 추정치이며, 비교한 표현의 유효 비트 폭도 서로 다르다.
Scalar INT4 양자화에서도 YAQA의 이점이 나타난다. YAQA-A는 LDLQ와 DiscQuant보다 KL, perplexity, 평균 정확도가 좋다. YAQA-A가 YAQA-B보다 소폭 앞선다는 점은 Sketch B가 모든 실험 조건에서 우세하지는 않음을 보여준다.
4.3. Finetuning
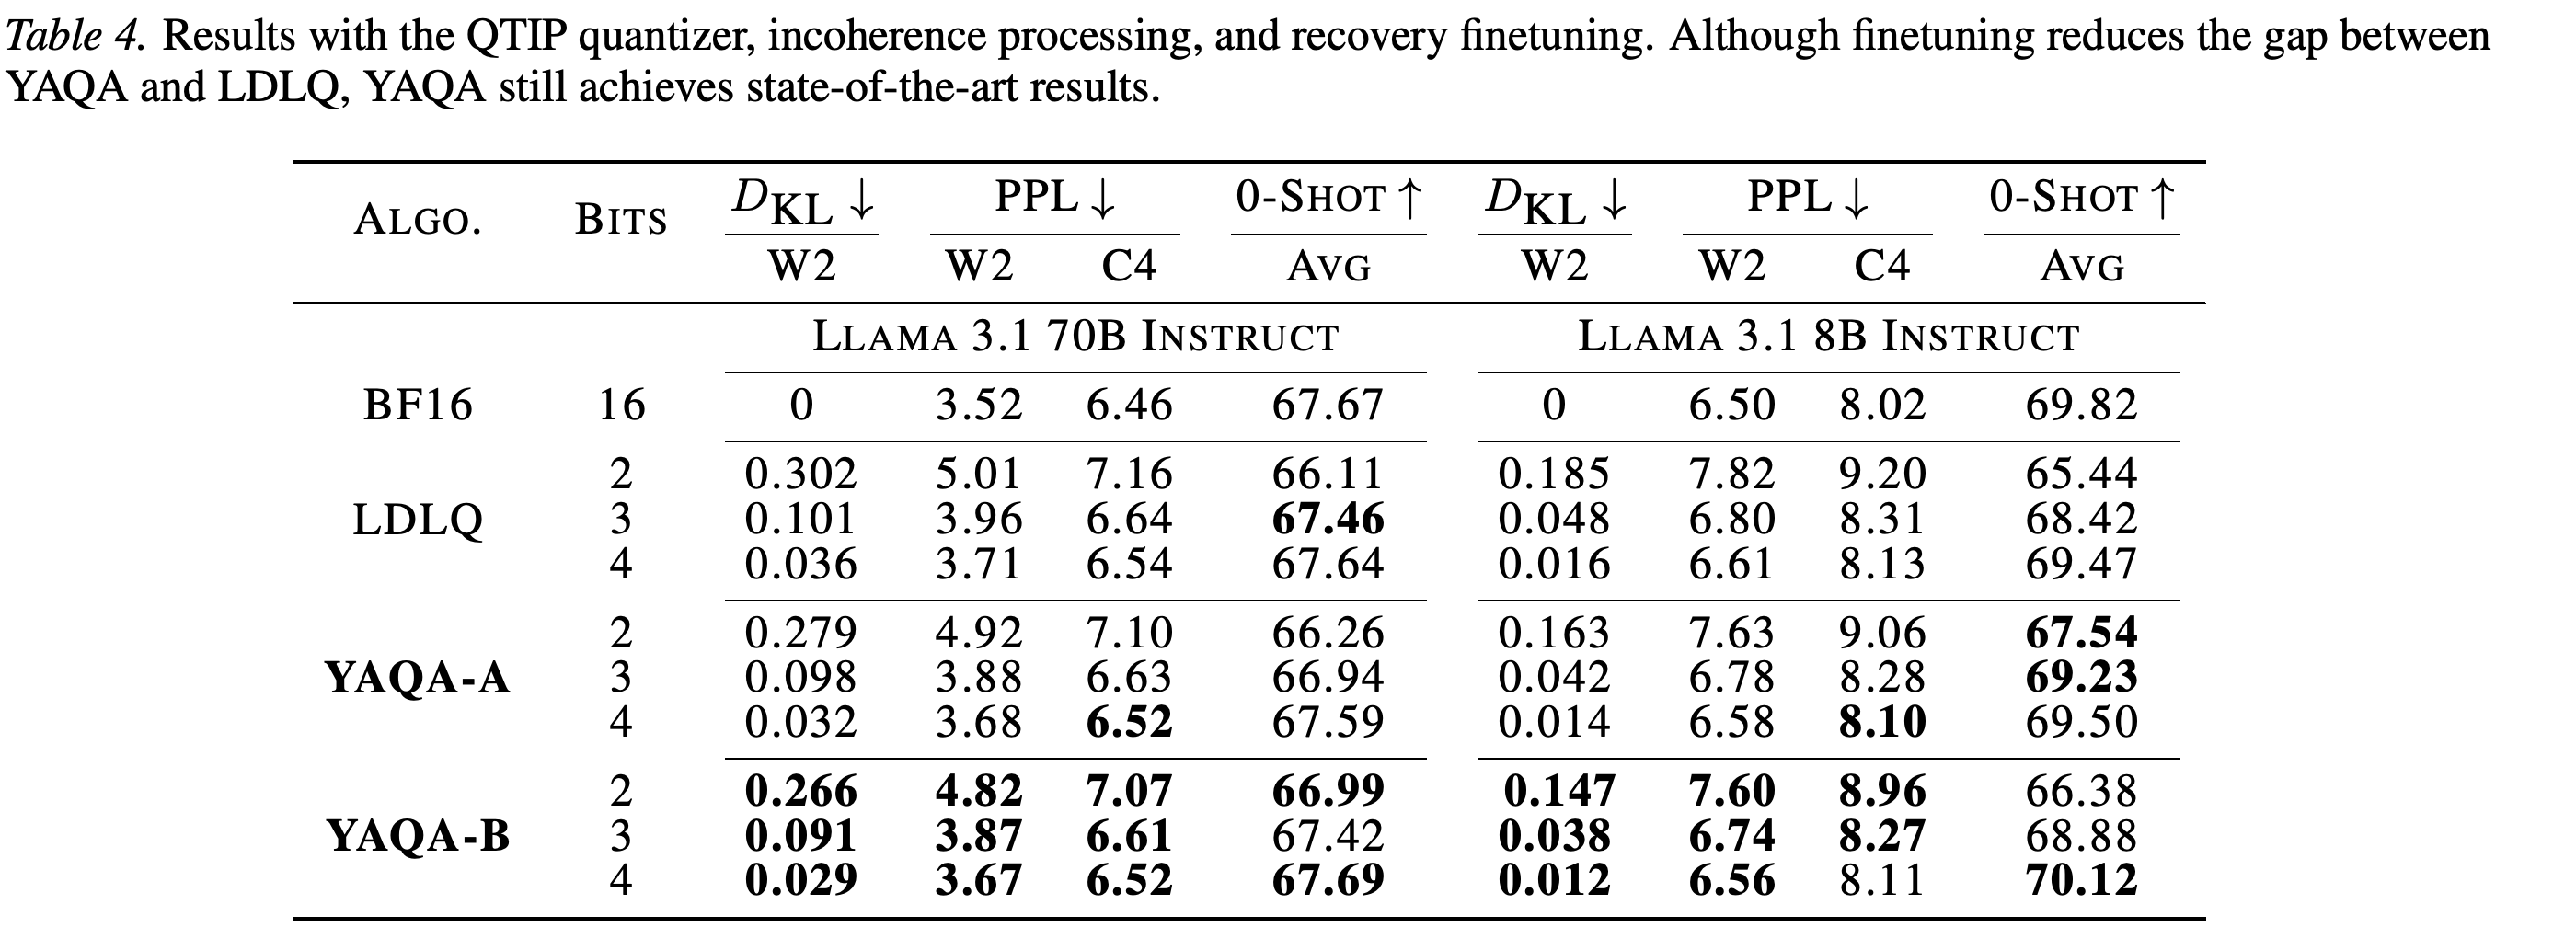
Table 4는 QTIP과 incoherence processing을 사용해 recovery finetuning을 평가한다. Finetuning은 LDLQ와 YAQA의 격차를 줄이지만, YAQA-B는 보고된 Llama 3.1 8B 및 70B 조건 전반에서 더 낮은 KL을 유지한다.
- 8B 모델의 2 bits 조건에서 KL은 LDLQ의 0.185에서 YAQA-B의 0.147로 낮아지고, 평균 zero-shot 정확도는 65.44에서 66.38로 높아진다. 같은 조건에서 YAQA-A는 더 높은 정확도인 67.54를 기록한다.
- 70B 모델의 4 bits 조건에서 YAQA-B의 KL은 0.029이고 LDLQ는 0.036이다. 이 결과는 finetuning과의 호환성을 보여주며, 다운스트림 성능 순위는 여전히 조건에 따라 달라진다.
YAQA-B는 recovery finetuning 이후에도 2개 모델 크기와 표시된 모든 비트 폭에서 LDLQ보다 낮은 KL을 유지한다. 평균 정확도에는 일관된 순위가 없으므로, 분포 보존의 이점과 다운스트림 성능 향상을 별도로 평가해야 한다.
5. Conclusion
결론에서는 계산 가능한 반올림 의존 구조, Kronecker-factored curvature, 확장 가능한 추정을 모델 출력 보존 방법으로 연결한다. GPTQ/LDLQ보다 KL이 약 30% 낮고 추가 추론 오버헤드가 없다고 보고한다. 추가 추론 오버헤드가 없다는 설명은 quantizer를 바꾸지 않았을 때의 반올림 알고리즘에 해당한다.
Impact Statement
Impact Statement는 이 연구가 머신러닝 발전을 목표로 하며 사회적 영향을 미칠 수 있음을 인정하지만, 추가로 논의할 구체적인 영향은 제시하지 않는다. 사회적 영향에 대한 별도의 실증 평가도 제공하지 않는다.
부록
- A.1. Experimental Setup and Implementation Details: 곡률 통계에는 텍스트 calibration 데이터셋인 RedPajama v1을 사용하고, KL과 perplexity 평가에는 OPTQ의 Wikitext2 및 C4 데이터셋 분할을 사용한다. 부록은 이 평가의 시퀀스 길이를 8192로 명시하고 zero-shot 평가용 chat template도 제시한다. Tables 8과 9는 Qwen 평가에 4K context를 사용했다고 명시한다. Llama 3.1 70B Instruct에서는 0_v 층을 양자화하지 않는다. Gemma 비교에는 google/gemma-3-12b-it-qat-q4_0-gguf를 사용하며, Transformers 4.52.0.dev0으로 역양자화한다. 코드는 https://github.com/Cornell-RelaxML/yaqa-quantization 에서 제공한다.
- A.2. Hessian Sketch Memory and Compute Requirements: m-by-n 가중치 행렬에서 양쪽 인자를 저장하려면 O(n²+m²) 메모리가 필요하며, 보고된 설정에서는 입력 측 정보만 사용하는 방법의 Hessian 저장량보다 약 2배 많다. 저자들은 32-bit 부동소수점 연산인 FP32와 작은 대각 정규화를 사용했을 때 수치적으로 안정적이었다고 보고한다. 대안으로 시험한 연산 형식인 TF32에서는 안정적이지 않았다. Sketch B는 허용할 만한 분산을 얻는 데 더 많은 시퀀스가 필요해 실험에서 더 느리다.
- A.3. GuidedQuant as LDLQ는 GuidedQuant를 출력 채널 그룹별로 별도의 LDLQ 계산을 수행하는 방법으로 해석한다. 순차 깊이는 n이지만 연산량은 그룹 수에 따라 늘어난다. A.4. KL Divergence vs. Perplexity는 Llama 1 7B와 Llama 2 7B를 통해 차이를 설명한다. Wikitext2 perplexity는 각각 5.68과 5.47이지만, 모델 간 KL divergence는 0.197로 로그 perplexity 비율인 0.038보다 훨씬 크다.
- A.5. Incoherence Processing with the Random Hadamard Transform은 무작위 부호 변경 후 Hadamard 변환을 수행하는 과정을 설명한다. 이는 가중치와 곡률에 적용하는 빠른 직교 혼합 연산이다. A.6. YAQA Rounding Algorithm은 반올림 갱신 결과가 더 이상 바뀌지 않을 때까지 반복하는 고정점 의사코드와 반복형 Python 구현을 제공한다. 저자들은 느린 quantizer에서는 후자가 더 빠르다고 설명한다.
- A.7. Proofs는 반올림 의존 그래프에서 수렴성을 유도하고 scalar 및 block quantizer의 오차 상한을 세운 뒤, cosine similarity를 통해 대리 목적함수의 상한을 실제 곡률로 확장한다. A.8. Modified Pytorch Backward Pass to Compute Sketch A와 A.9. Modified Backward Pass to Compute Sketch B는 각 인자를 수집하는 분산 구현을 제공한다.
- A.10. Additional Results는 과제별 zero-shot 결과, CBQ 비교, incoherence processing을 적용하지 않은 실험, Qwen 3 8B 평가를 포함한다. YAQA-B는 제시된 perplexity 결과 대부분에서 CBQ보다 좋지만, INT4의 Wikitext2 perplexity는 5.54로 CBQ의 5.52보다 높다. PV-Tuning과는 기존에 보고된 QTIP 결과를 통해 간접적으로 비교한다. Incoherence processing 없이 연속된 가중치 32개마다 16-bit scale을 사용하는 INT4를 적용하면, 가중치당 유효 비트 수는 4.5 bits이며 YAQA-B는 KL을 0.033에서 0.021로 낮춘다. QTIP을 사용하고 finetuning을 하지 않은 2-bit Qwen 3 8B에서는 KL이 0.285에서 0.205로 낮아진다. 4 bits 조건에서 보고된 zero-shot 지식 벤치마크인 MMLU는 LDLQ의 정확도가 73.04로 YAQA-B의 72.78보다 높다.
- A.11. Number of Sequences Needed for Sketch B는 2-bit Qwen 3 8B에서 calibration 시퀀스 수를 2K에서 64K까지 늘려 평가한다. YAQA-B는 2K sequences와 1 GPU-hour로 KL 0.227을 달성하며, LDLQ는 4K sequences와 1.5 GPU-hours를 사용해 KL 0.285를 기록한다. YAQA-B의 시퀀스 수를 64K sequences로, 계산 시간을 30 GPU-hours로 늘리면 KL은 0.205로 낮아진다. 다만 과제 정확도는 시퀀스 수에 따라 단조롭게 향상되지 않는다.
짧은 생각
핵심 기여는 계산 가능한 반올림 피드백을 명시적인 곡률 근사 목적함수와 연결한 데 있다. 동일한 quantizer를 사용한 실험은 더 낮은 KL을 일관되게 뒷받침하며, Gemma 비교는 출력 분포가 더 가까워지는 것과 벤치마크 정확도가 높아지는 것이 별개의 결과임을 보여준다. 배포를 결정할 때는 역전파를 사용하는 calibration과 추가 곡률 저장 공간을 고려해야 한다. 정리는 완전히 양자화한 모델의 실제 divergence가 아니라 단일 층의 이차 근사에 대한 상한을 제시한다.