


optimize_anything: A Universal API for Optimizing any Text Parameter 요약 설명
19 May 2026 | Paper Review Evolutionary Search Multi-Task Search Agent System Optimization목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 The optimize_anything API
- 4 Method
- 5 Experiments
- 5.1 Coding Agent Skills (Generalization)
- 5.2 Cloud Scheduling Algorithms (Generalization)
- 5.3 ARC-AGI Agent Architecture (Generalization)
- 5.4 AIME Prompt Optimization (Generalization)
- 5.5 CUDA Kernel Generation (Multi-Task Search)
- 5.6 Circle Packing (Single-Task Search)
- 5.7 Image Generation (Multi-Task Search)
- 5.8 Ablation: Multi-Task vs. Single-Task Search
- 5.9 Ablation: Side Information
- 5.10 Proposer Sensitivity and Optimization Cost
- 6 Why the Framework Works: Optimization Trajectory Analysis
- 7 Discussion
- 8 Limitations
- 9 Conclusion
- 부록
- 짧은 생각
이번 글에서는 optimize_anything: A Universal API for Optimizing any Text Parameter 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 19일(Arxiv), ACM Conference on AI and Agentic Systems (CAIS ’26)
- Agrawal, Lakshya A, Lee, Donghyun, Tan, Shangyin, Ma, Wenjie, Elmaaroufi, Karim, Sandadi, Rohit, Seshia, Sanjit A., Sen, Koushik, Klein, Dan, Stoica, Ion, et al.
- UC Berkeley, MIT
- 논문 링크
- Project Page
요약
- 코드, 프롬프트, 에이전트 시스템을 최적화할 때는 보통 별도의 탐색 도구가 필요하다. 이 논문은 대규모 언어 모델(LLM) 시스템 1개가 공통 텍스트 인터페이스로 이들을 개선할 수 있는지 살펴본다. optimize_anything은 탐색 후보 제안과 에이전트 실행에 모두 Gemini 3 Flash를 사용하며, 격자 변환 퍼즐 벤치마크인 ARC-AGI에서 정확도를 단일 호출 초기 에이전트의 32.5%에서 진화한 에이전트의 89.5%로 높인다.
- 응용 프로그램 인터페이스(API)는 초기 산출물, 평가기, 선택적 데이터셋을 결합한다. 평가기는 점수와 함께 후보의 동작을 진단하는 Side Information(SI)을 선택적으로 반환한다. 기본 백엔드는 성찰 기반 진화 탐색 방법인 GEPA를 확장하여 단일 과제 탐색, 관련 과제 간 공동 탐색, 미관측 입력을 위한 최적화를 지원한다. 예제나 지표별로 상호 보완적인 강점을 지닌 후보를 보존하는 후보 집합인 파레토 프런티어가 후보 선택과 전이를 지원한다.
- 보고된 결과로는 Dijkstra 최단 경로 라우팅 대비 CloudCast 비용 40.2% 절감, 생성한 CUDA 커널 중 87%에서 PyTorch와 동등하거나 더 나은 성능 달성 등이 있다. CUDA 커널은 개별 연산을 구현하는 GPU 프로그램이다. 원 채우기에서는 같은 GPT-5.1 제안 모델을 사용했을 때 63회 평가로 2.63598을 얻어, 200회 평가로 2.6307을 얻은 OpenEvolve를 앞선다. 절제 실험은 진단 피드백과 관련 과제 간 전이의 효과를 뒷받침하지만, 원의 개수가 다른 과제들을 공동 탐색하면 원 채우기 성능이 낮아진다. 성능은 제안 모델의 역량, 평가 비용, 피드백 설계에 필요한 도메인 전문성에 좌우된다.
1 Introduction
논문은 최적화 과제의 공통 구조를 제시한다. 산출물을 텍스트로 직렬화하고, 자동으로 평가한 뒤, 진단 피드백을 바탕으로 LLM에 수정을 요청하는 구조다. 선언형 인터페이스를 통해 사용자는 문제를 정의하고, 시스템은 프롬프트 구성, 성찰, 후보 선택, 탐색을 처리한다. 폭넓은 산출물 지원, 3가지 최적화 모드, 통일된 진단 피드백 규약을 결합한 것이 기여다.
평가기는 후보 순위를 정하는 스칼라와 수정을 안내하는 진단 정보라는 신호 2개를 생성한다. 예제들은 도메인별 산출물과 평가기를 유지하면서 이 탐색 인터페이스를 공유한다.
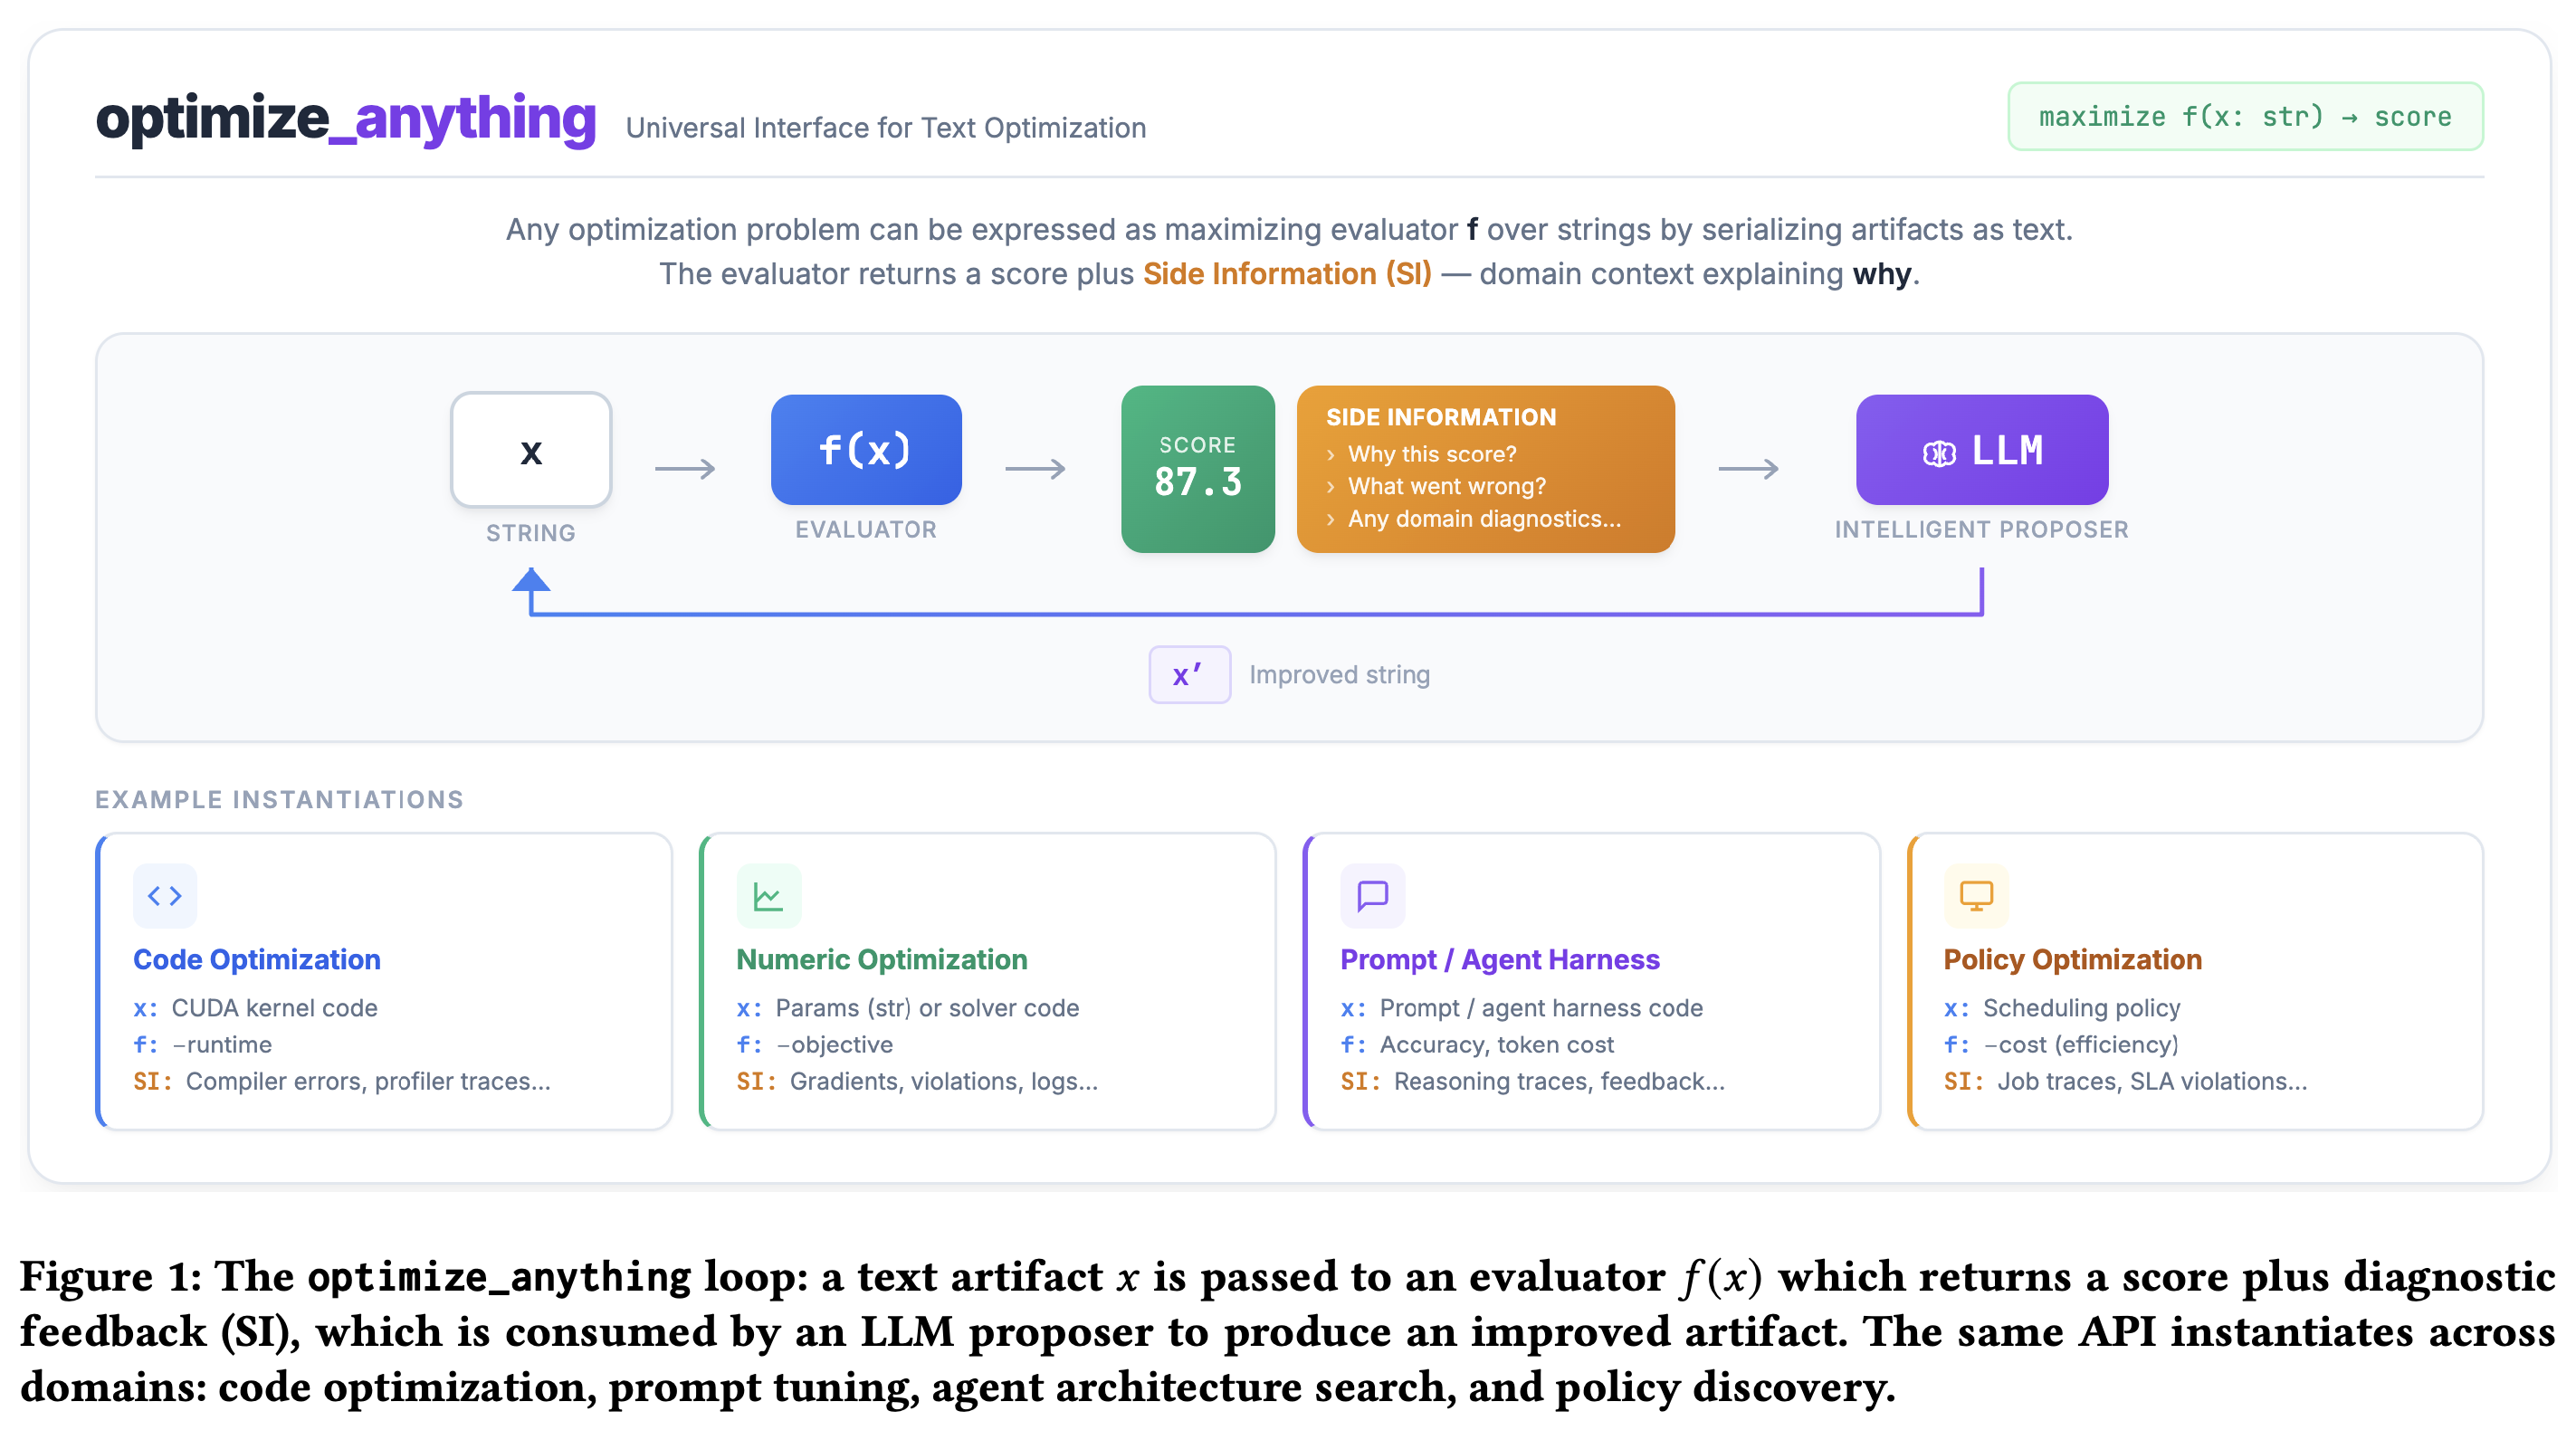
2 Related Work
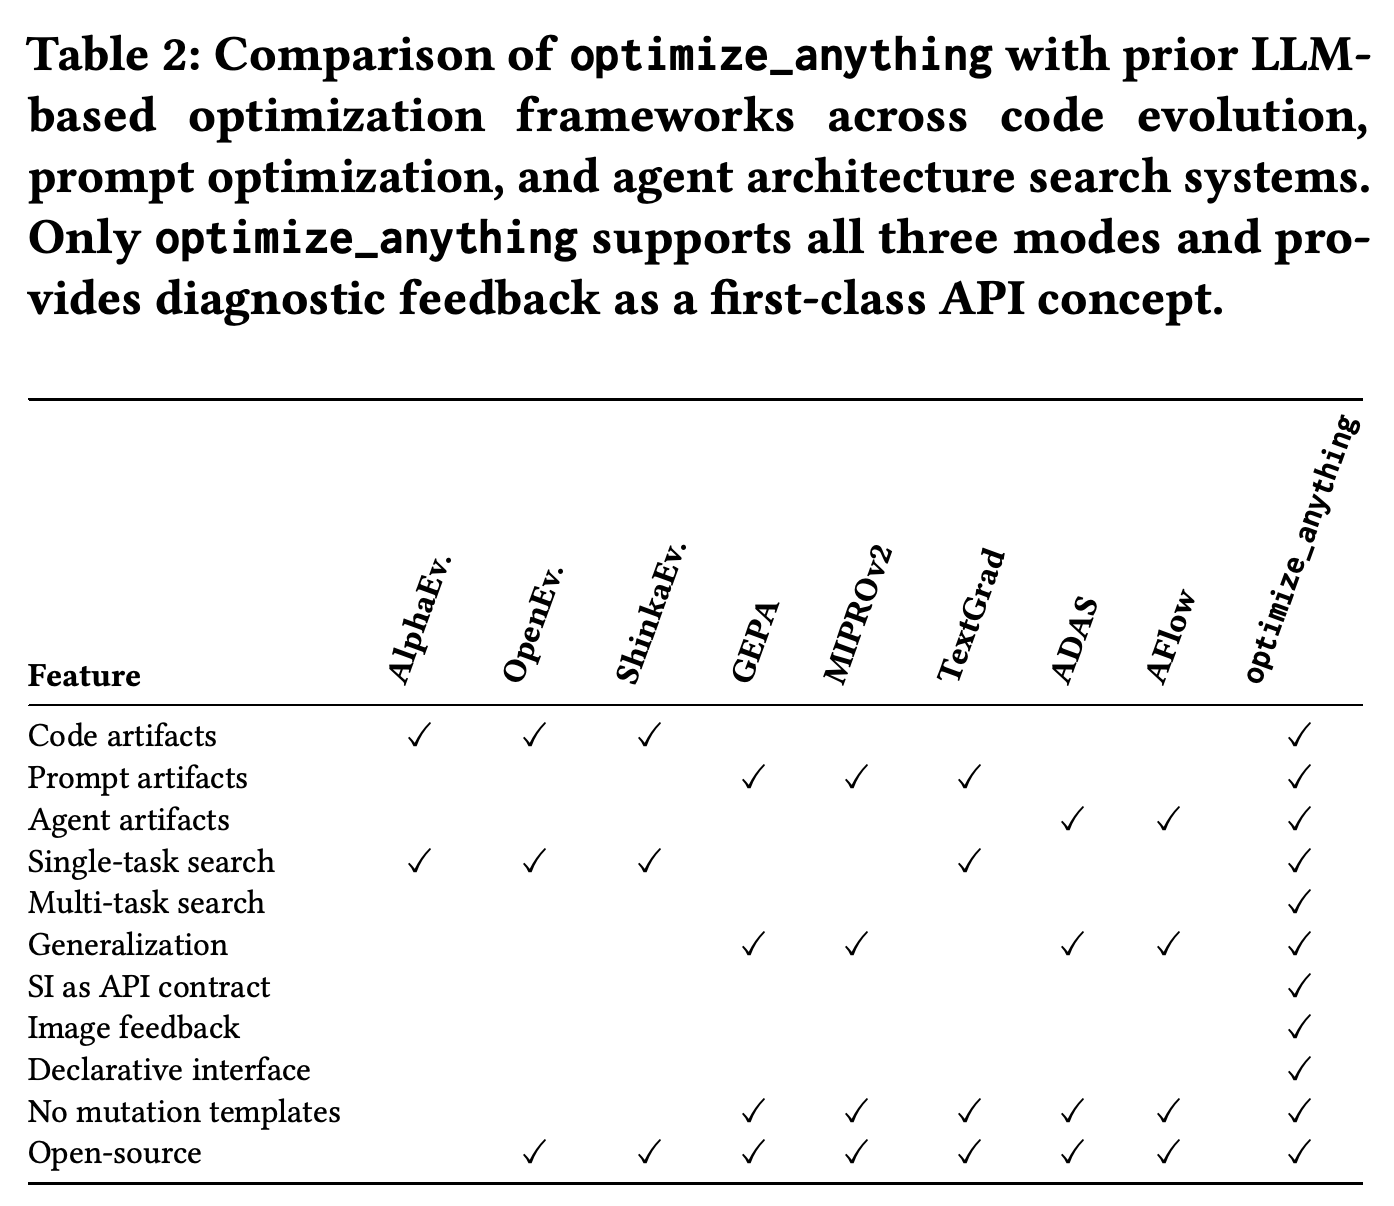
관련 연구로는 프로그램 진화 시스템인 AlphaEvolve, OpenEvolve, ShinkaEvolve, 프롬프트 최적화 도구인 GEPA, MIPROv2, TextGrad, 반복적 자기 수정 방법인 Reflexion, Self-Refine, 에이전트 아키텍처 탐색 시스템인 ADAS, AFlow를 비교한다. optimize_anything은 GEPA의 성찰 기반 파레토 탐색을 기본 백엔드로 사용하며, 적용 범위를 프롬프트 외의 산출물로 확장한다. Table 2는 저자들의 기능 비교표로, 공통 인터페이스를 통해 제공하는 다중 과제 탐색과 진단 피드백을 강조한다.
3 The optimize_anything API
optimize_anything API는 최적화 문제와 탐색 구현을 분리한다. 사용자는 산출물, 평가기, 선택적 예제, 도메인 맥락을 지정한다. 같은 인터페이스로 프롬프트, 실행 가능한 코드, 전체 에이전트 시스템, 이미지나 모델을 생성하는 코드를 다룬다.
3.1 Core Interface
최소 호출에는 seed_candidate와 evaluator를 제공한다. 평가기는 후보 문자열을 받아 클수록 좋은 점수와 선택적 진단 딕셔너리를 반환한다. 추가 인자는 dataset, valset, objective, background, config이며, oa.Image는 시각 정보를 처리할 수 있는 언어 모델(VLM)에 이미지 피드백을 전달한다. seed_candidate=None으로 설정한 seedless 모드는 자연어 목표로 초기 산출물을 생성하며, 이때도 평가기는 필요하다.
3.2 Three Optimization Modes
단일 과제 탐색은 데이터셋 없이 원 채우기 알고리즘처럼 직접 평가하는 해법 1개를 최적화한다. 다중 과제 탐색은 관련 문제들을 제공받아 탐색 중 프런티어를 공유하고, 이후 과제별로 특화된 출력을 선택한다. 일반화 모드는 dataset과 별도 검증 세트인 valset이라는 인자 2개를 모두 제공받아, 미관측 예제에도 적용할 산출물 1개를 만든다.
4 Method
인터페이스는 여러 최적화 백엔드를 지원한다. 기본 구현은 추가 모드에 필요한 프런티어 유형과 선택 규칙을 GEPA에 더한다. 임의의 산출물을 지원하려면 평가 전에 흔한 생성 오류를 수정하는 refiner, 내용이 같은 후보의 평가 결과를 재사용하는 캐싱, 타입이 지정된 진단 피드백, 백엔드와 인터페이스를 연결하는 어댑터도 필요하다. 통합 API를 제공하면서 기존 탐색 방법에 이러한 기능을 추가한다.
4.1 Problem Formulation
평가기는 텍스트 산출물과 선택적 예제를 스칼라 점수와 진단 정보로 매핑한다. 이 관계는 f(x,e)=(s(x,e),ι(x,e))로 표현한다. 단일 과제 탐색은 산출물의 직접 점수를 최대화하고, 다중 과제 탐색은 관련 문제들의 평균 성능을 최대화한다. 일반화 모드는 학습 피드백을 활용하면서 별도 검증 세트에서 성능을 측정한다. 수식화에서는 다중 과제의 통합 목적함수를 제시하고, Section 3.2에서는 과제별로 가장 좋은 특화 후보를 선택한다고 추가로 명시한다.
4.2 Side Information (SI)
SI에는 컴파일러 오류 같은 텍스트, 테스트별 결과와 목적별 세부 점수 같은 구조화된 데이터, 렌더링한 후보 같은 이미지가 포함될 수 있다. 성찰 단계에서 제안 모델은 이 정보로 실패를 진단하고 구체적인 수정을 제안한다. 논문이 수치적 기울기에 빗댄 것은 개선 방향을 안내한다는 의미다. 피드백은 선택 사항이며, capture_stdio=True로 기존에 출력하던 진단 정보를 수집할 수 있다.
4.3 Pareto-Based Search
탐색은 예제나 지표별 점수를 따로 추적하여, 평균 점수가 낮더라도 특정 강점이 있는 후보를 보존한다. 기본 백엔드는 후보가 최고 점수를 달성한 목적의 개수에 비례하여 후보를 샘플링하고, 2–3개 예제로 구성한 미니배치에서 성찰한 뒤, 미니배치 성능이 개선된 수정안을 전체 평가한다. 이렇게 보존한 후보들은 후속 제안에 다양한 전략을 제공하고 관련 과제 간 전이를 가능하게 한다.
5 Experiments
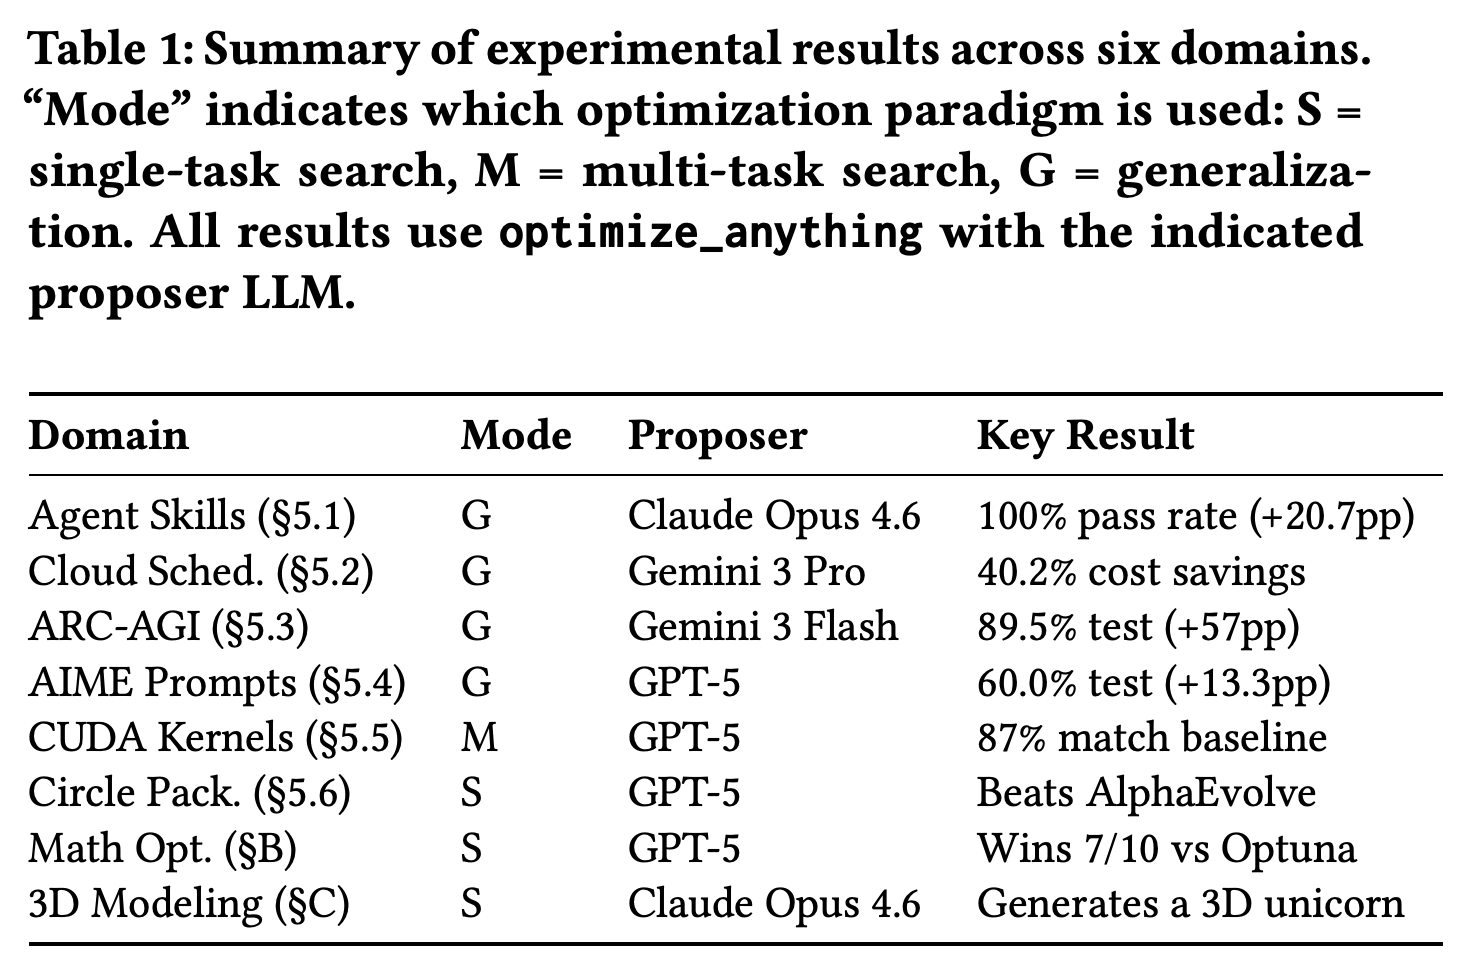
실험은 코딩 에이전트 스킬, 클라우드 스케줄링, ARC-AGI 에이전트, 수학 프롬프트, CUDA 커널, 원 채우기, 이미지 생성에 대해 산출물, 평가기, 피드백, 결과를 설명한다. 논문은 주요 도메인이 6개라고 반복해서 서술하지만, 응용 하위 절은 7개다. 수학 블랙박스 최적화와 초기 산출물 없는 3D 모델링은 부록에서 추가로 다룬다. 도메인별로 제안 모델과 평가 예산이 달라 응용 간 직접 비교에는 한계가 있다.
각 행은 도메인에 탐색 모드와 제안 모델을 대응시켜, 주요 결과에 서로 다른 모델이 사용되었음을 보여준다. 캡션은 도메인 6개를 설명한다고 하지만, 예비 수학 최적화와 3D 모델링도 포함된다.
저자들이 표시한 체크 표시는 산출물 유형, 탐색 모드, 피드백, 인터페이스 요구 사항을 비교한다. 이 기능 목록은 동일한 예산에서 최적화 성능을 측정한 결과가 아니다.
5.1 Coding Agent Skills (Generalization)
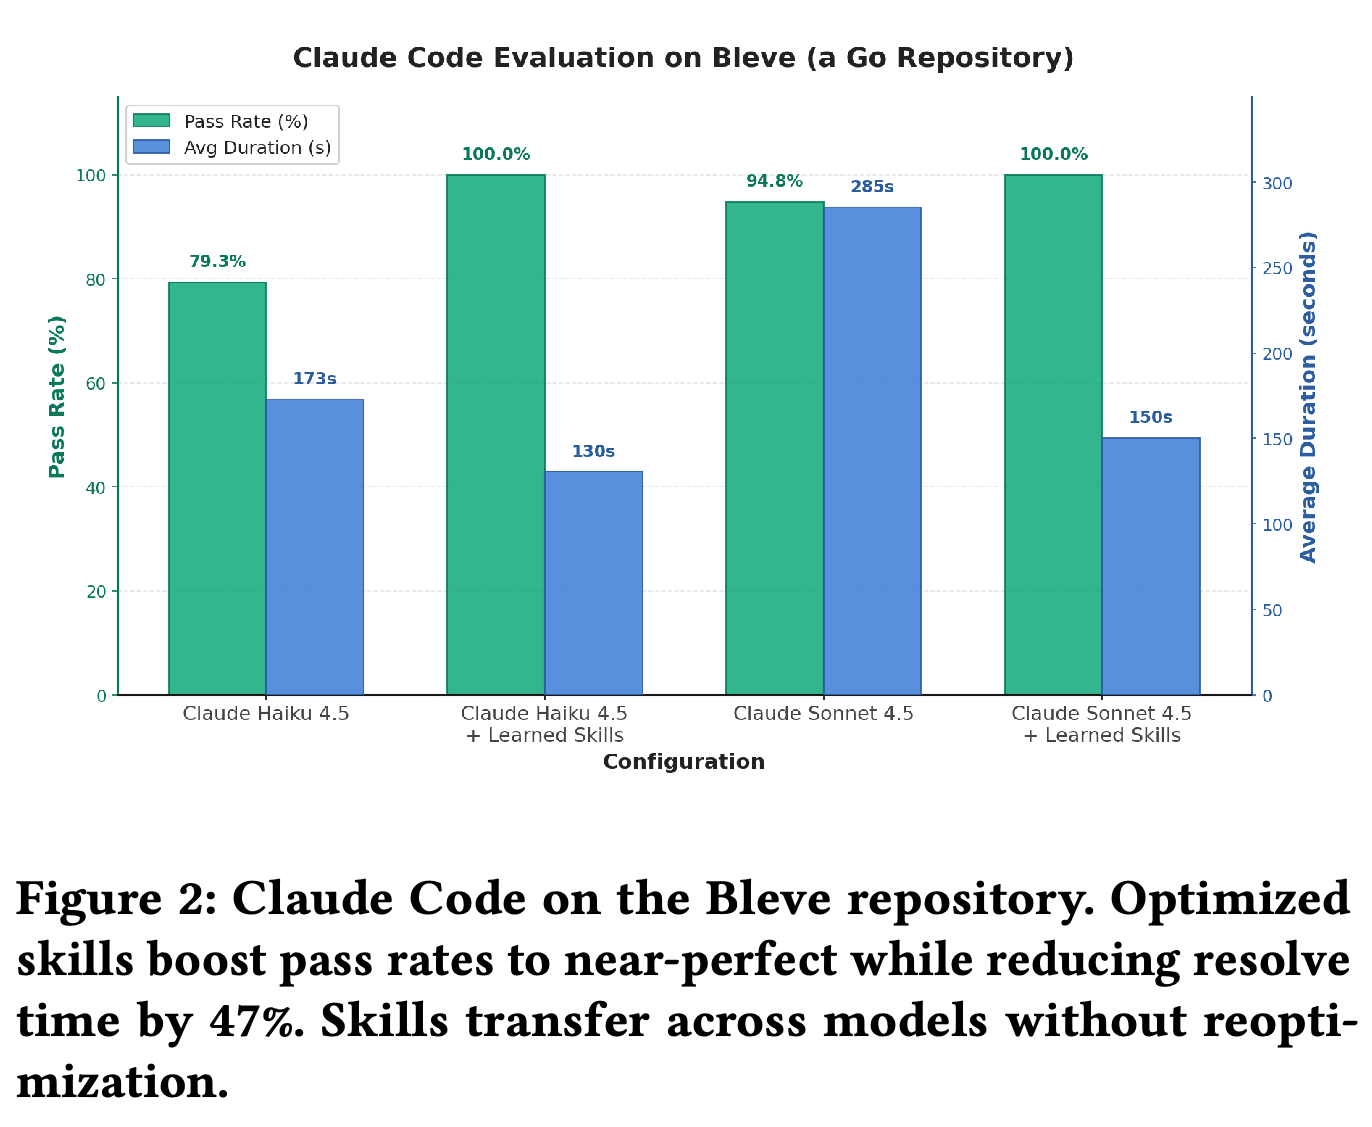
Bleve 검색 라이브러리에서는 자연어 지침과 코드베이스 작업 관행으로 구성된 스킬 집합을 최적화한다. 평가는 코딩 에이전트가 미관측 저장소 과제를 해결하는지로 판단한다. 피드백에는 과제 설명, 도구 사용과 편집 기록, 오류, 테스트 결과, 해결 시간이 포함된다. Section 5.1은 Haiku 4.5가 79.3%에서 98.3%로, Sonnet 4.5가 94.8%에서 100%로 향상되었다고 보고하며, 스킬이 재최적화 없이 전이된다고 설명한다. 반면 Figure 2는 Haiku의 학습된 스킬 적용 결과를 100.0%로 표시한다.
그래프에서 Haiku의 통과율은 79.3%에서 100.0%로 높아지고 소요 시간은 173s에서 130s로 줄어든다. Sonnet의 통과율은 94.8%에서 100.0%로 높아지고 소요 시간은 285s에서 150s로 줄어든다. Haiku의 최종값은 Section 5.1의 98.3%와 상충하며, 약 47%의 시간 단축은 Sonnet에 해당한다.
5.2 Cloud Scheduling Algorithms (Generalization)
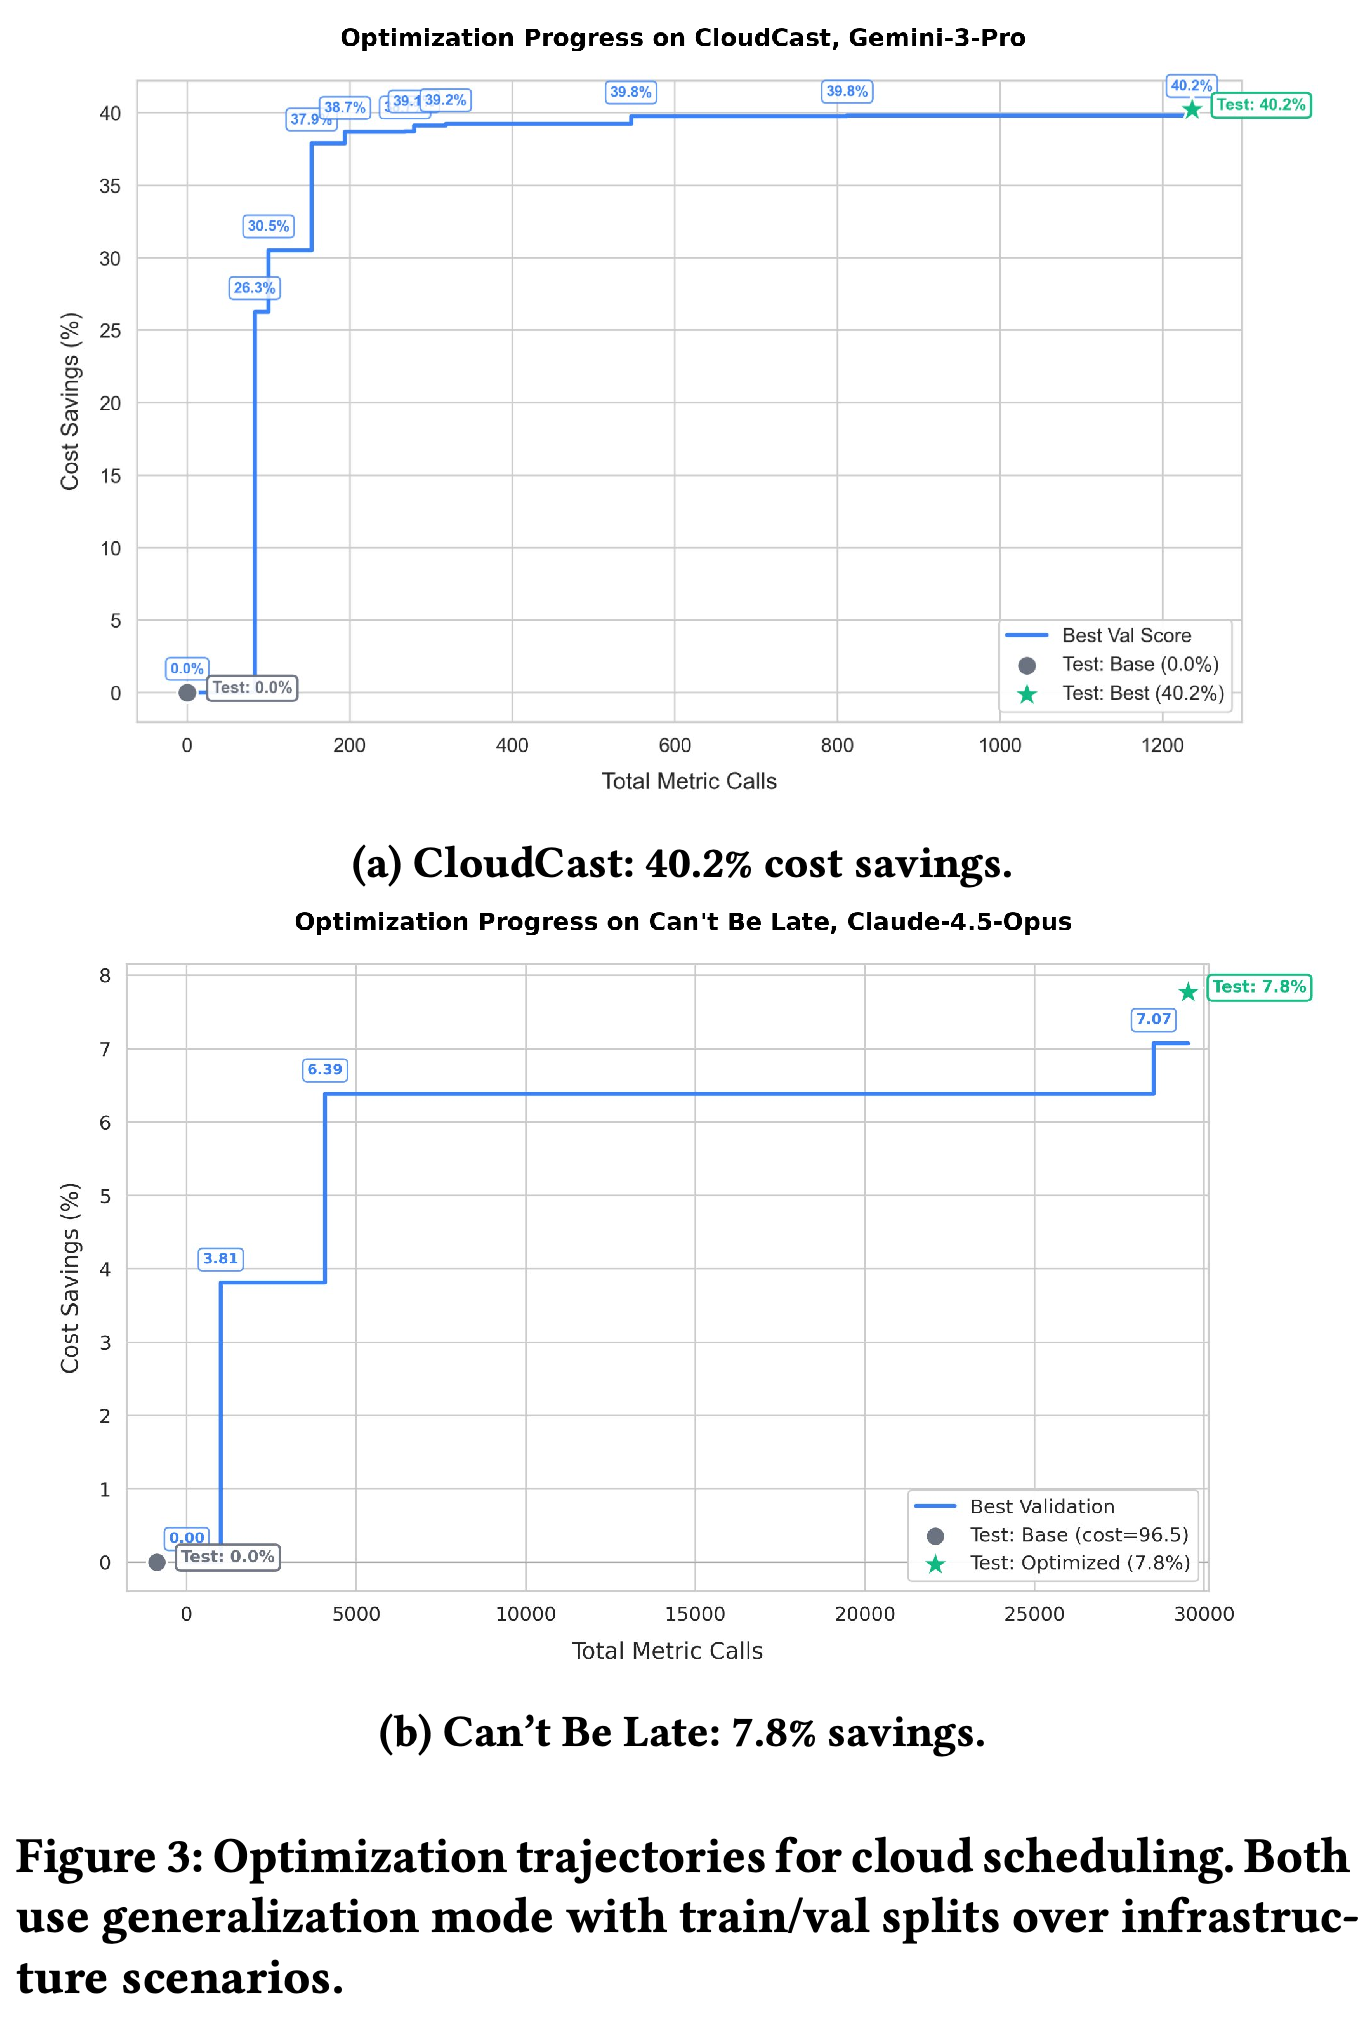
CloudCast는 다중 클라우드 브로드캐스트 라우팅을 최적화한다. Can’t Be Late는 마감 기한을 지키도록 저렴하지만 중단될 수 있는 SPOT 인스턴스와 안정적인 ON_DEMAND 인스턴스 중에서 선택한다. 이 2개 과제는 모두 인프라 시나리오를 학습 세트와 검증 세트로 나눈다. CloudCast는 제공자별 비용을 고려하는 브로드캐스트 트리 전략인 provider-aware Steiner tree 라우팅으로 진화하여 Dijkstra 라우팅 대비 비용을 40.2% 절감한다. Can’t Be Late는 가용성 추적, 전환 비용 분석, 마감 기한에 따른 임계값을 추가하여 7.8%를 절감한다. 논문은 클라우드 인프라 벤치마크인 ADRS에서 종합 점수 96.6을 보고하며, OpenEvolve는 92.9, ShinkaEvolve는 72.0이다.
그래프는 검증 과정과 최종 테스트 표시를 구분하며, 스케줄링 문제 2개의 평가 예산이 다름을 보여준다. 최종 테스트 절감률은 CloudCast가 40.2%, Can’t Be Late가 7.8%다.
5.3 ARC-AGI Agent Architecture (Generalization)
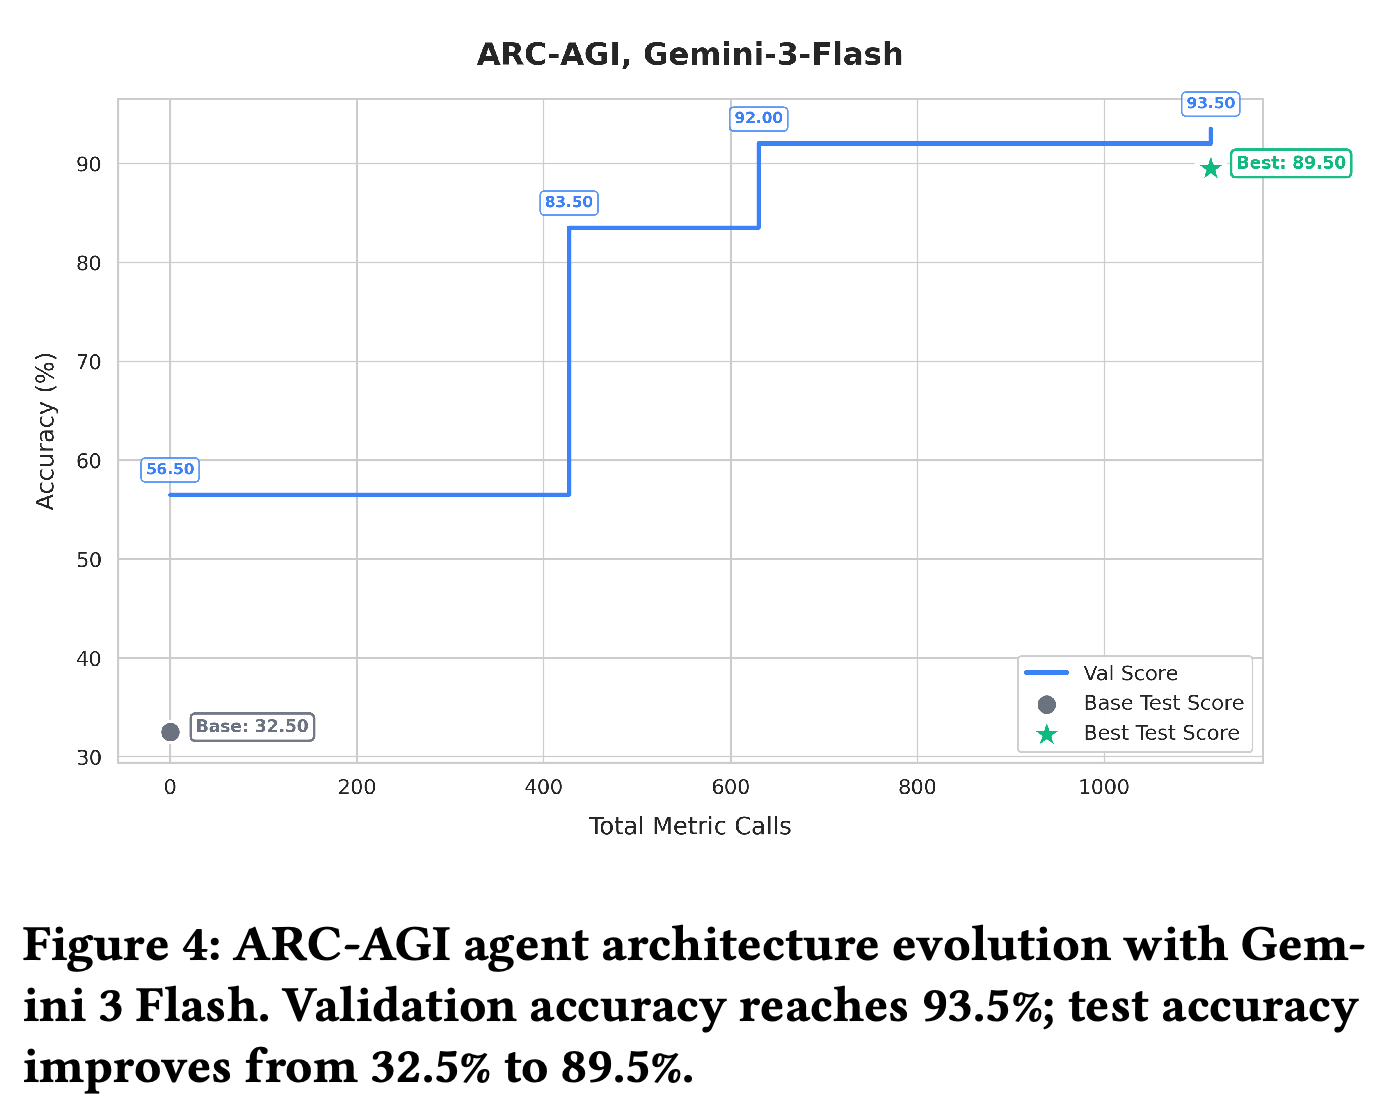
코드, 제어 흐름, 보조 함수, 하위 에이전트 구조, 프롬프트를 포함한 ARC-AGI 에이전트 전체를 텍스트 산출물 1개로 최적화한다. 피드백에는 격자 예제, 퍼즐별 결과, 실행 오류, 모델 출력, 비용을 사용한다. 제안과 실행에 모두 Gemini 3 Flash를 사용했을 때 10줄짜리 단일 호출 초기 에이전트가 300+줄 시스템으로 발전하며, 테스트 정확도는 32.5%에서 89.5%로 높아진다. 검증 정확도는 93.5%에 도달한다. 최종 파이프라인은 규칙을 추론하고, 코드를 생성한 뒤 exec()로 검증하며, 최대 2회 디버깅하고 필요하면 모델의 직접 예측으로 전환한다.
에이전트 성능은 계단식으로 개선되어 검증 정확도 93.5%에 도달한다. 별도 테스트 표시는 초기 에이전트의 32.5%와 최적화한 에이전트의 89.5%를 보여준다.
5.4 AIME Prompt Optimization (Generalization)
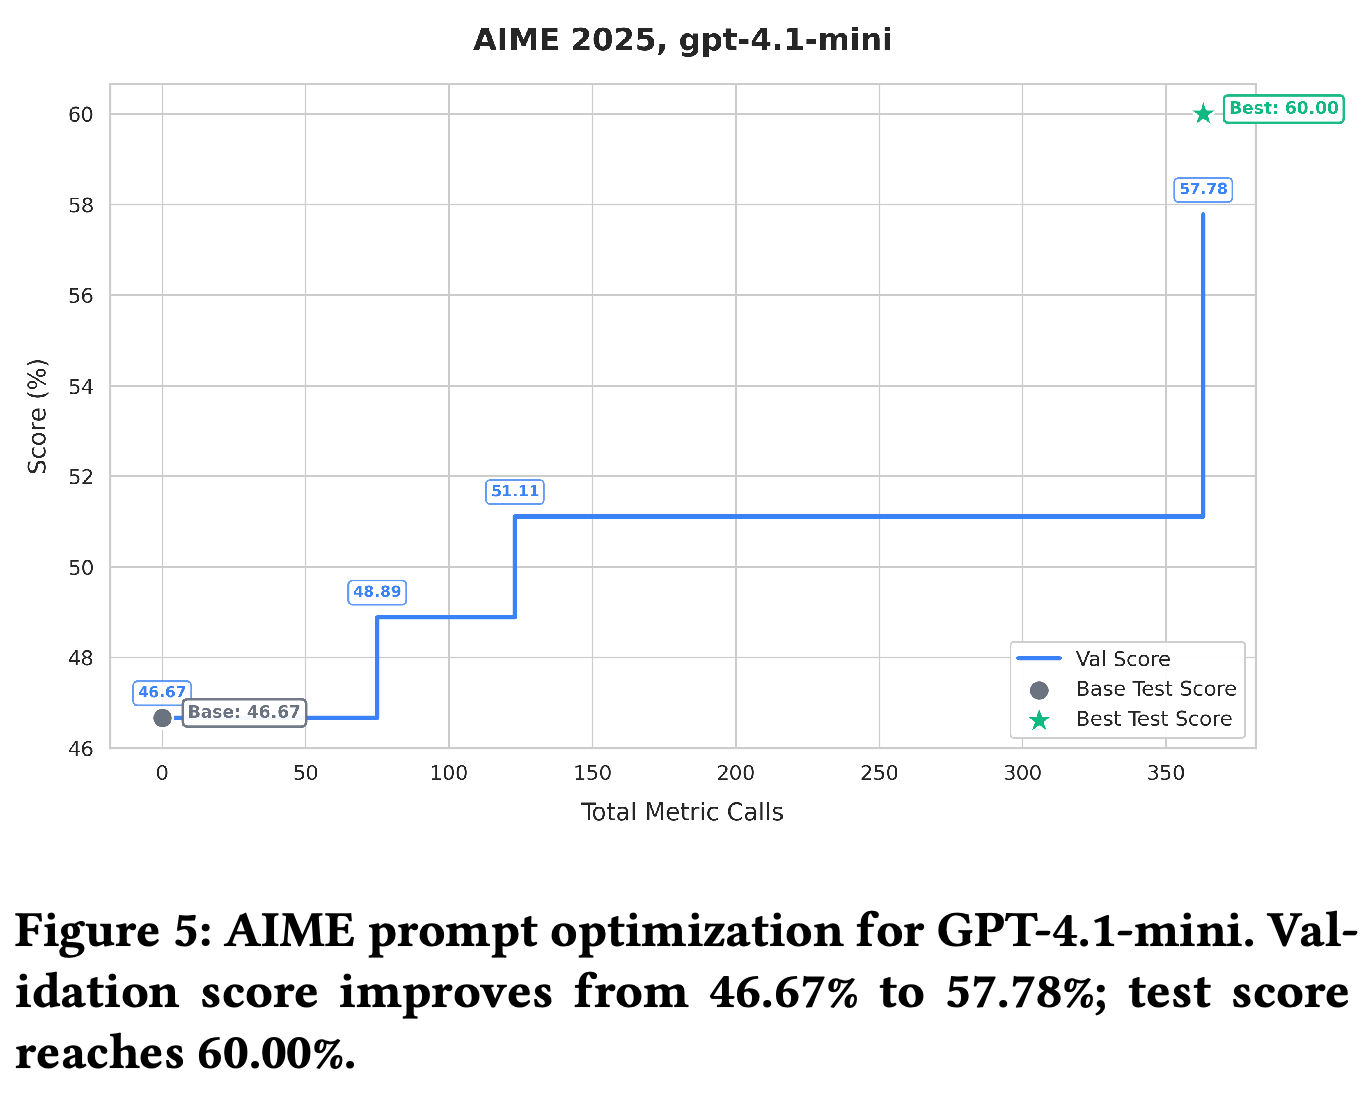
시스템은 American Invitational Mathematics Examination인 AIME에서 GPT-4.1-mini의 시스템 프롬프트를 최적화한다. 2022–2024년 문제로 학습하고 AIME 2025에서 테스트한다. 피드백은 문제, 추론 과정, 추출한 답, 기준 정답, 정답 여부를 제공한다. 테스트 정확도는 46.67%에서 60.00%로 높아지며, 같은 벤치마크에서 보고된 MIPROv2의 51.33%와 비교된다. 검증 정확도는 57.78%에 도달하고, 프롬프트는 구조화된 추론 규칙 6개로 발전한다.
최종 검증 점수 57.78%와 테스트 결과 60.00%는 서로 다른 평가 세트에서 얻은 값이다. 이 2개 값은 모두 베이스라인 46.67%보다 높으며, 검증 과정에는 개선 사이에 긴 정체 구간이 나타난다.
5.5 CUDA Kernel Generation (Multi-Task Search)
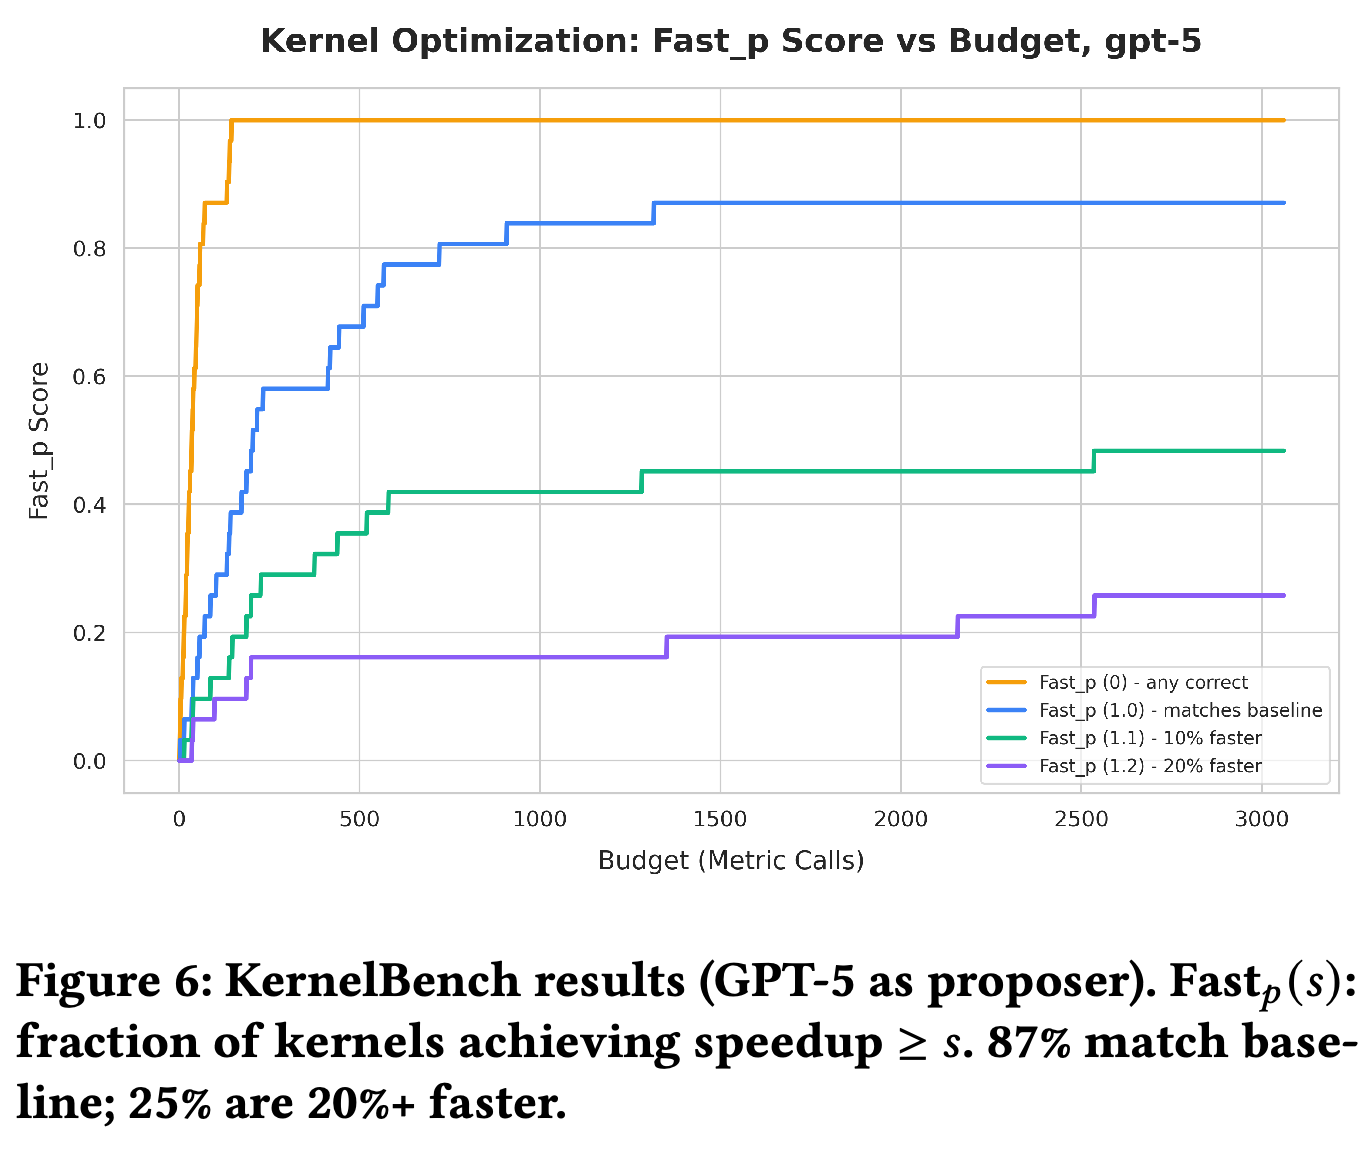
커널 생성은 GPU 연산 벤치마크인 KernelBench의 기준 PyTorch 연산 31개를 대상으로 한다. GPT-5를 제안 모델로 사용하고 NVIDIA V100 32GB GPU에서 평가한다. 시스템은 여러 과제에 걸쳐 커널 생성 프롬프트를 진화시킨다. 피드백에는 컴파일러 오류, 수치적 정확성 검사 실패, 관련 문서, PyTorch 대비 측정 실행 시간이 포함된다. 선택한 연산과 하드웨어에서 커널의 87%가 베이스라인과 동등하거나 더 빠르고, 48%가 최소 10%, 25%가 최소 20%의 속도 향상을 달성했다고 보고한다.
정확성 곡선은 모든 과제를 충족하는 수준에 도달하지만, 속도 임계값이 엄격해질수록 이를 충족하는 커널은 줄어든다. 본문은 베이스라인 이상 성능 87%, 1.1× 속도 향상 48%, 1.2× 속도 향상 25%를 보고한다. 그래프에서 뒤에 언급한 임계값들의 최종값은 이보다 조금 높아 보인다.
5.6 Circle Packing (Single-Task Search)
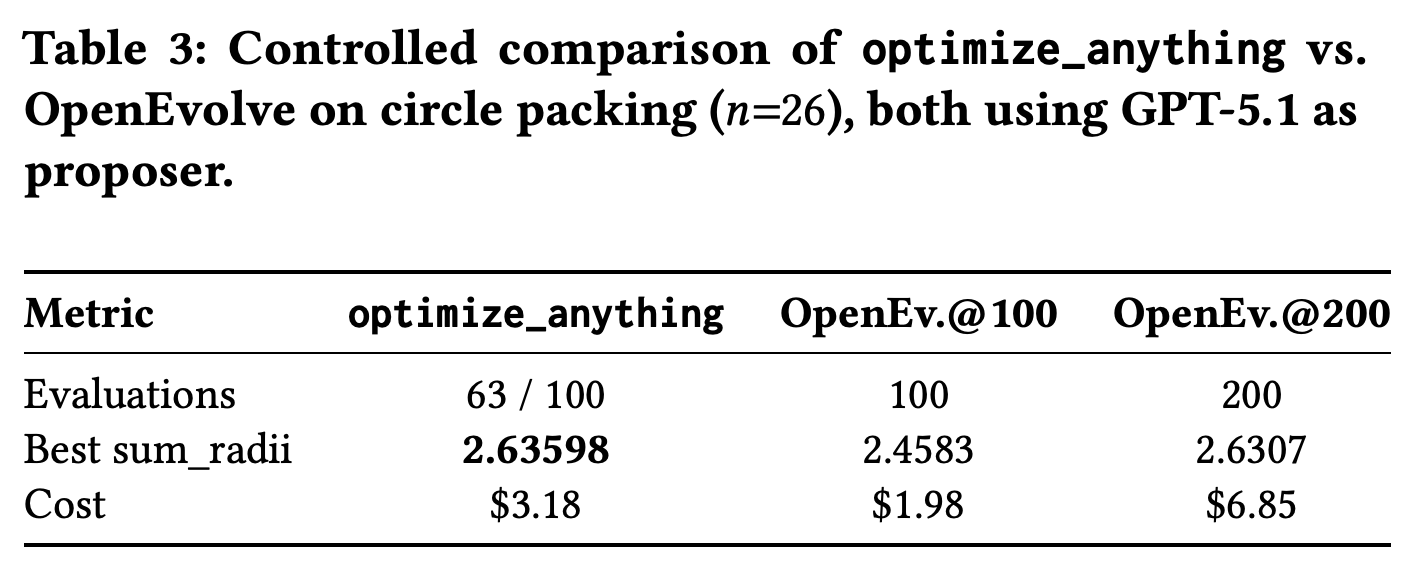
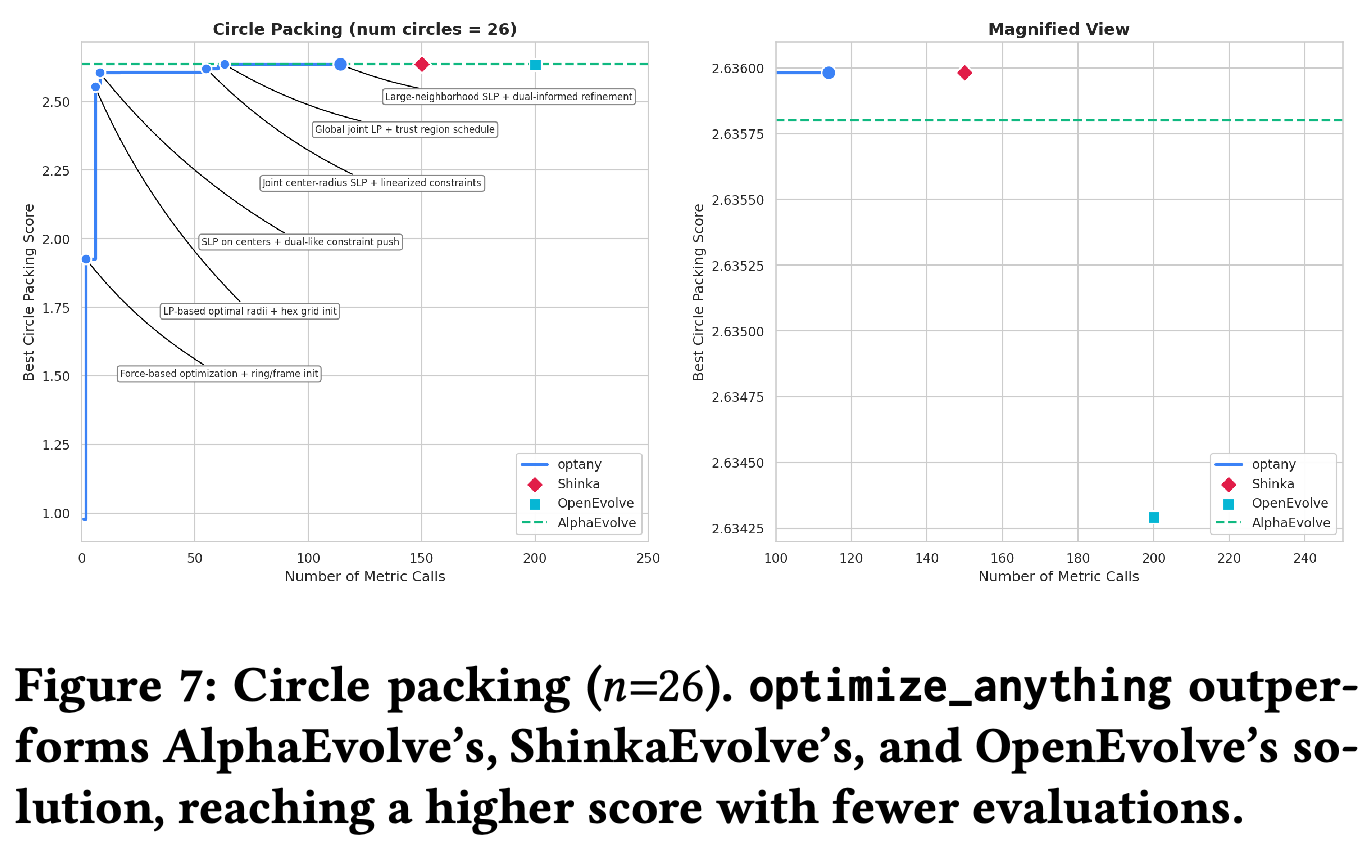
원 채우기는 단위 정사각형 안에 겹치지 않는 n=26개의 원을 배치하여 반지름 합을 최대화한다. 코드는 기하학적 진단 정보와 렌더링한 배치로 평가한다. 발견한 해법은 중심을 고정한 상태에서 선형 제약 아래 반지름을 최적화하는 선형계획법(LP), 중심 최적화를 위한 경계 제약 수치 기법인 L-BFGS-B, 탐색을 위한 진화적 수치 최적화 기법인 CMA-ES를 결합한다. GPT-5.1을 동일하게 사용한 통제 비교에서 optimize_anything은 약 $3.18로 63회 평가 후 2.63598에 도달한다. OpenEvolve는 $1.98로 100회 평가 후 2.4583, $6.85로 200회 평가 후 2.6307에 도달한다. AlphaEvolve와의 비교에는 공개된 결과를 사용한다.
GPT-5.1을 동일하게 사용했을 때 optimize_anything은 $3.18로 63회 평가 후 2.63598을 달성하여, $6.85로 200회 평가 후 2.6307을 얻은 OpenEvolve를 앞선다. OpenEvolve의 100회 평가 실행은 $1.98가 들지만 2.4583에 그친다. optimize_anything의 평가 횟수 항목은 63 / 100으로 표시된다.
전체 탐색 과정은 성능이 낮은 초기 해법에서 개선되는 과정을 보여주며, 확대 패널은 최고 점수들 사이의 작은 차이를 드러낸다. AlphaEvolve와 ShinkaEvolve 비교에는 보고된 결과를 사용한다. Table 3은 별도로 통제한 OpenEvolve 재실행을 기록한다.
5.7 Image Generation (Multi-Task Search)
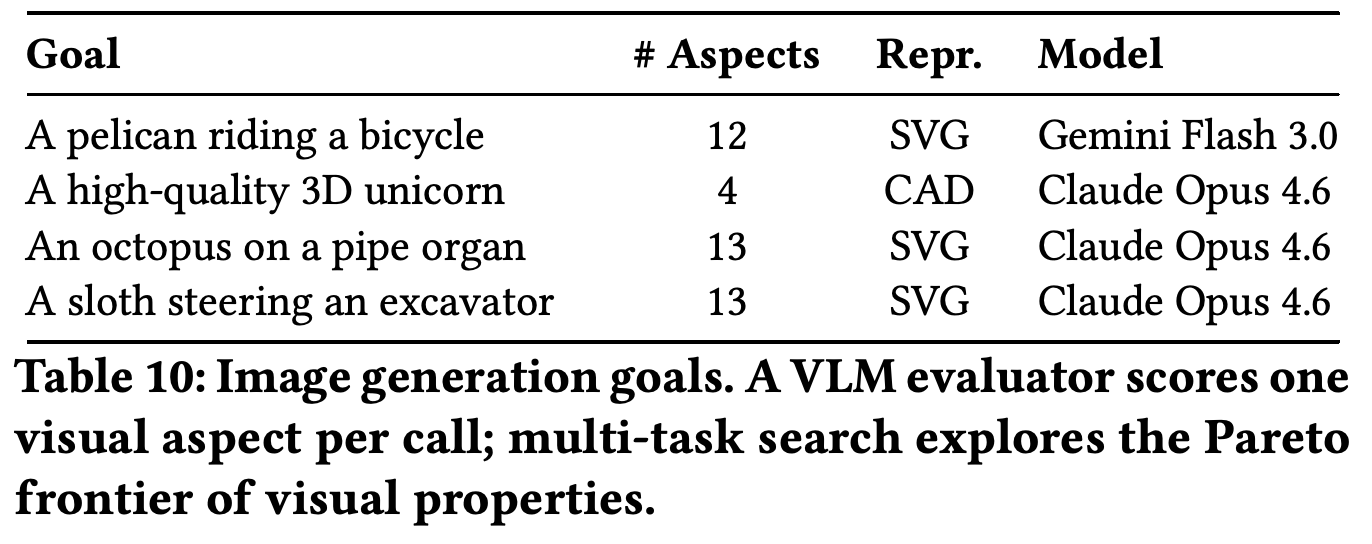
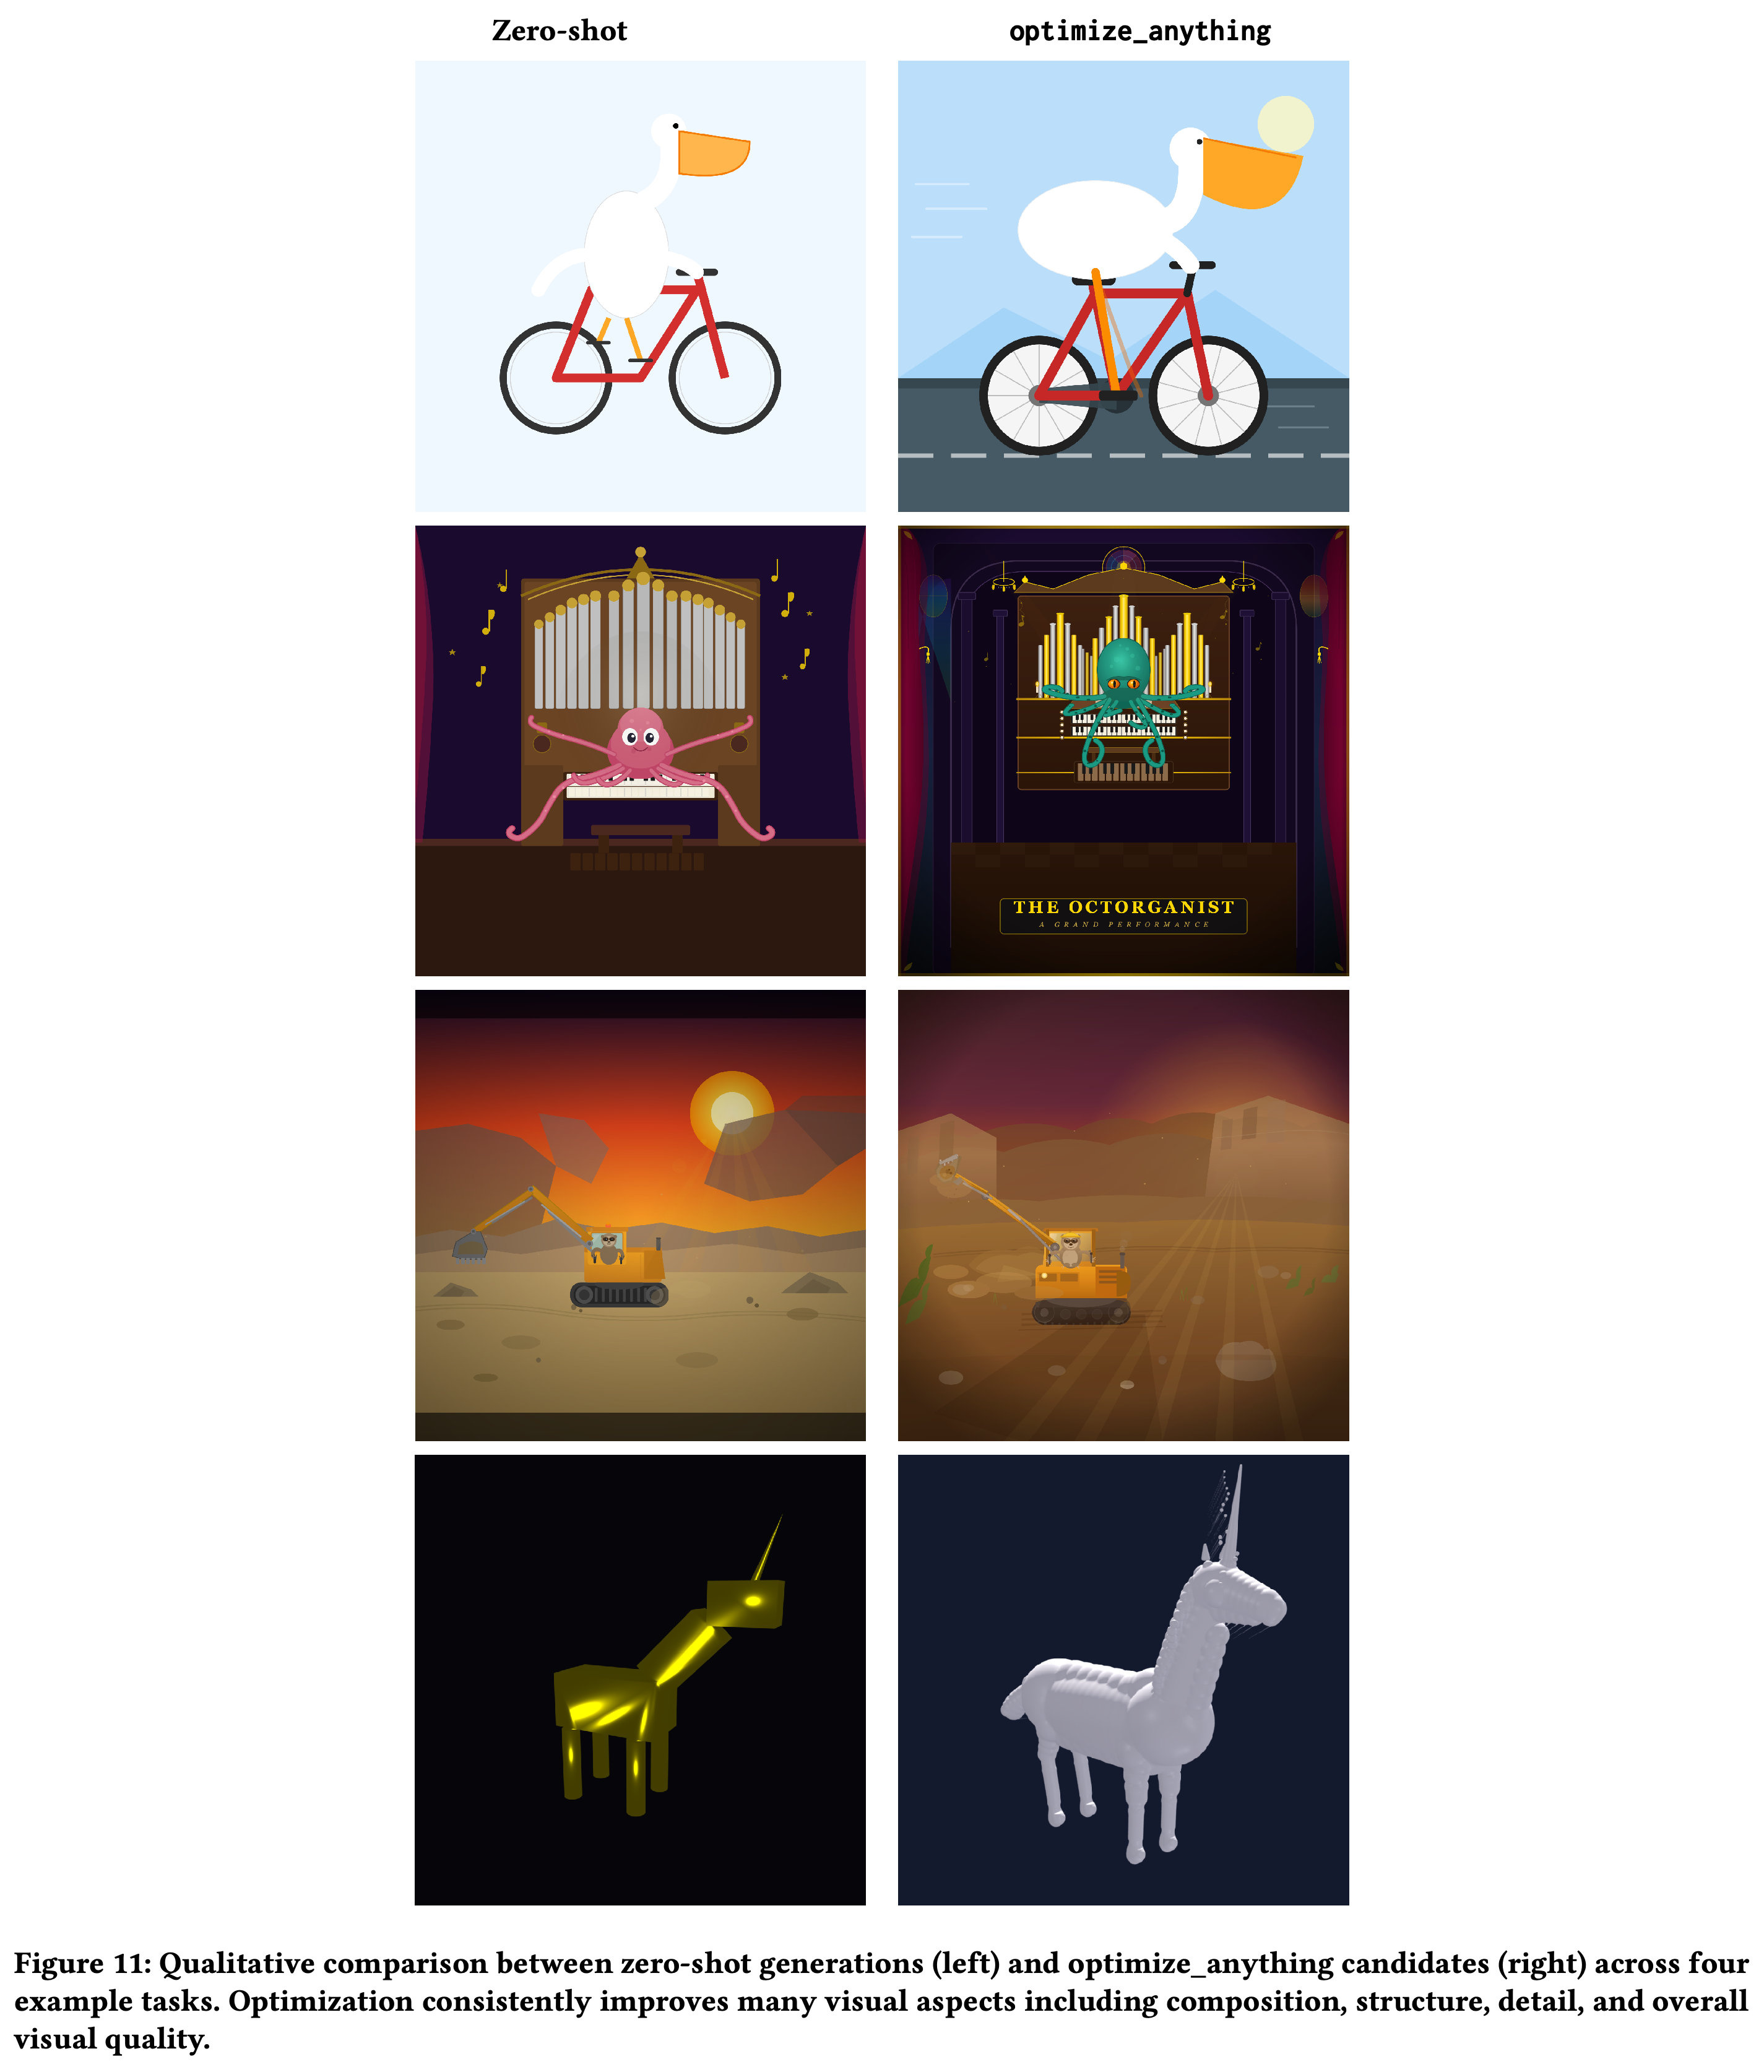
이미지 생성은 시각적 목표 네 가지에 걸쳐 Scalable Vector Graphics(SVG) 코드와 build123d로 만든 컴퓨터 지원 설계(CAD) 모델을 최적화한다. VLM은 평가기 호출마다 시각적 측면 하나를 0–100 척도로 채점하고, 측면별 점수를 별도 탐색 목적으로 취급한다. 사람 평가자 다섯 명은 목표 네 가지 모두에서 최적화한 출력을 만장일치로 선호한다. 자전거를 타는 펠리컨 예제의 보고된 VLM 점수는 0.726이며, 예시를 0개 제공하고 반복 최적화 없이 생성한 베이스라인은 0.330이다. 논문은 이 점수와 명시된 0–100 척도 사이의 변환을 설명하지 않는다.
5.8 Ablation: Multi-Task vs. Single-Task Search
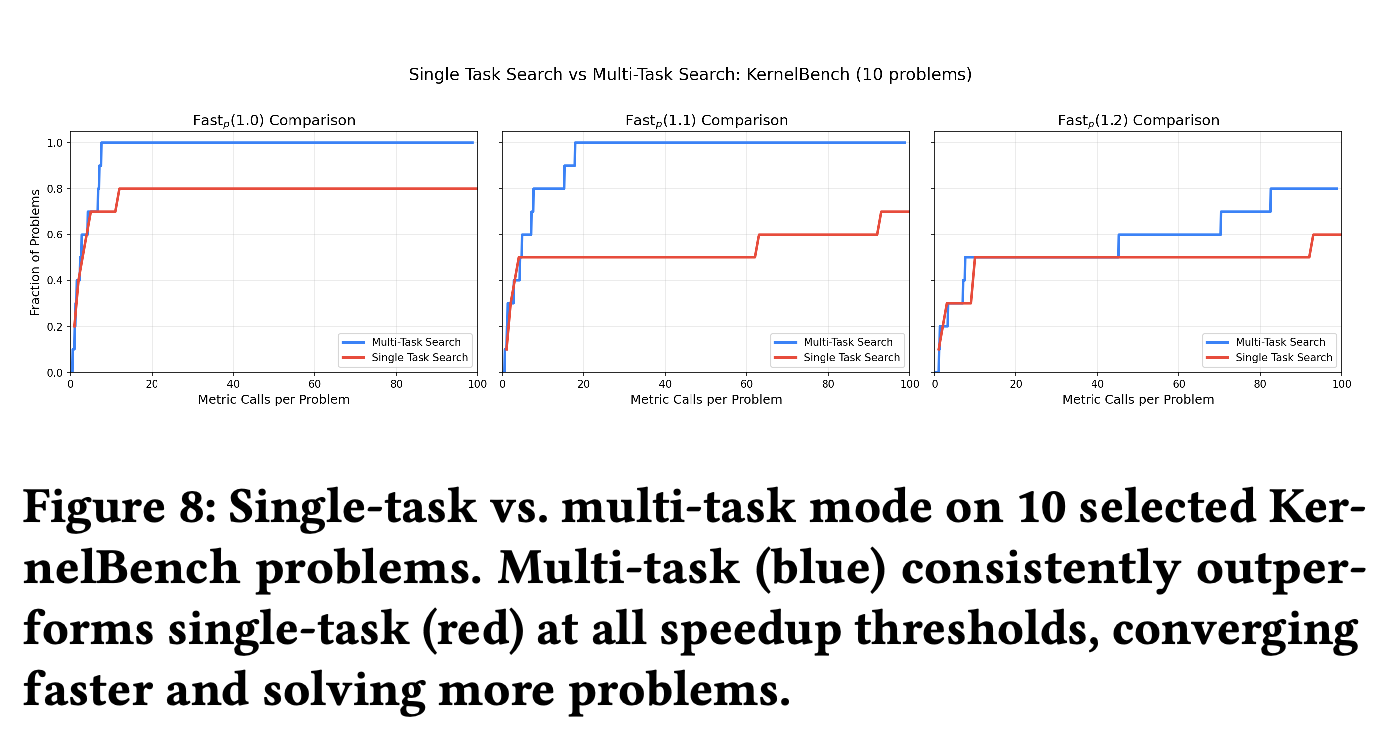
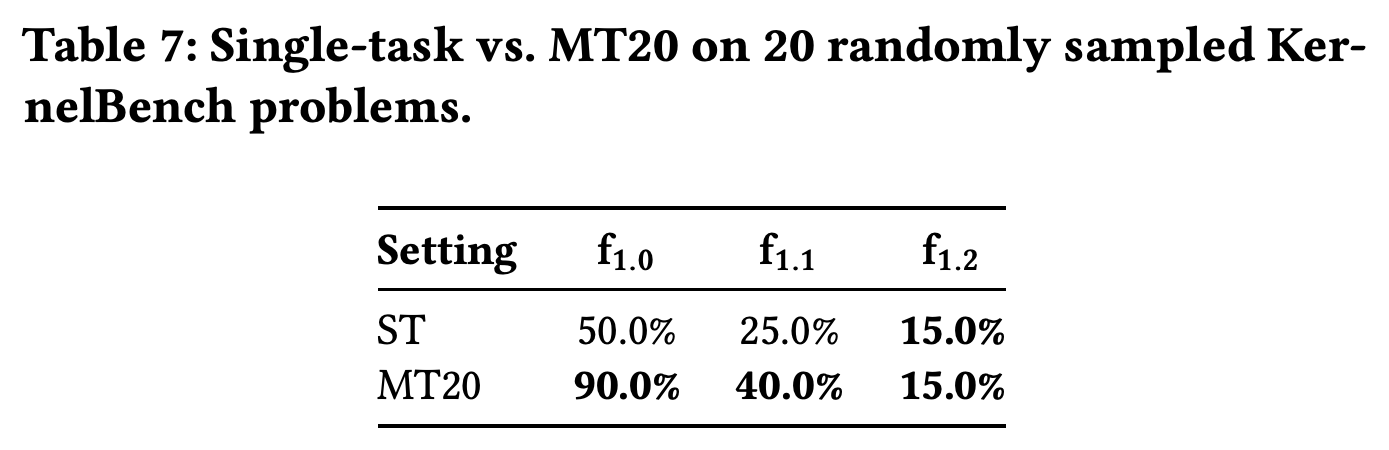
주요 전이 절제 실험은 다중 과제 탐색 성능이 가장 좋았던 KernelBench 문제 10개를 문제별 예산이 같도록 독립적으로 다시 실행한다. 공동 탐색이 더 빠르게 수렴하고 더 좋은 결과를 얻었다고 보고한다. 이 부분집합은 다중 과제 성능을 기준으로 선정했으므로, 무작위로 뽑은 문제 20개를 비교한 부록 실험이 추가 근거가 된다. 이 실험에서 베이스라인 이상 성능을 낸 비율은 50.0%에서 90.0%로, 1.1× 속도 향상에 도달한 비율은 25.0%에서 40.0%로 높아진다. 1.2× 임계값에서는 2개 조건 모두 15.0%에 머물러, 최종 이득이 모든 임계값에 걸쳐 나타나지는 않는다.
문제별 예산이 같을 때 공동 탐색은 표시된 임계값 전반에서 독립 탐색보다 성능이 좋다. 다중 과제 성능이 가장 좋았던 문제 10개를 사용하므로, 전이 이득을 해석할 때 선정 조건을 고려해야 한다.
5.9 Ablation: Side Information
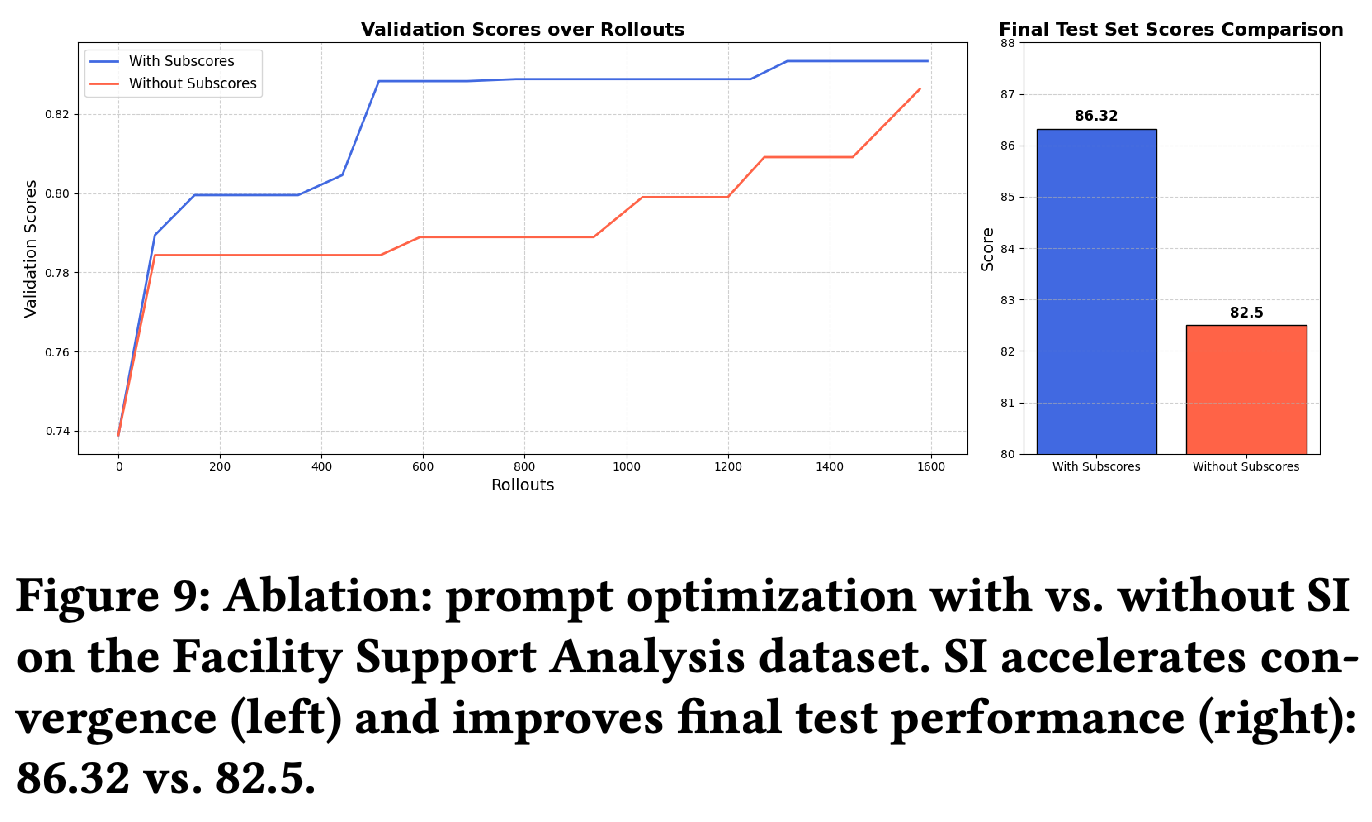
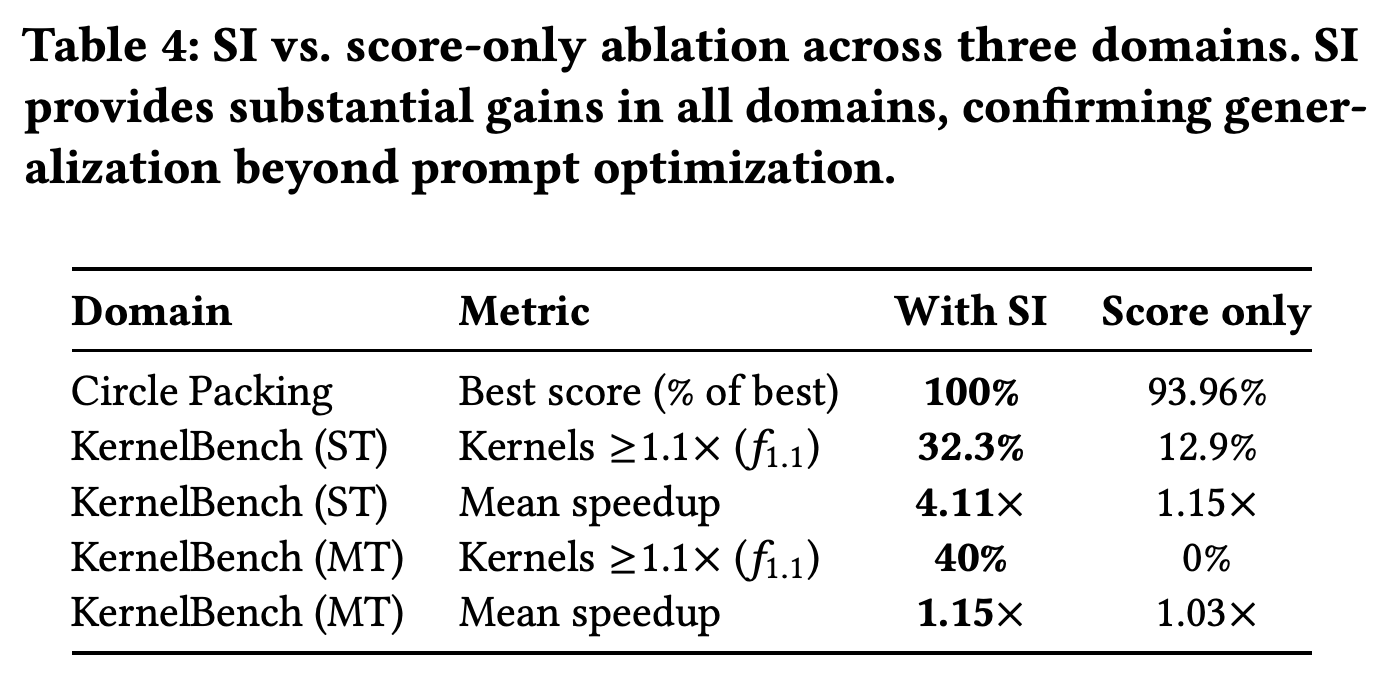
Facility Support Analysis 프롬프트 최적화에서 종합 점수와 함께 측면별 세부 점수를 반환하면 후보 평가 실행인 rollout 100회 이내에 검증 점수 0.80에 도달한다. 종합 점수만 제공하면 약 600회가 필요하며, 최종 테스트 점수는 각각 86.32와 82.5다. 추가 절제 실험에서 원 채우기는 최고 점수 대비 100%와 93.96%의 성능을 보이고, 단일 과제 KernelBench에서 1.1× 속도 향상에 도달한 비율은 32.3%와 12.9%다. 다중 과제 KernelBench의 해당 비율은 40%와 0%다. 이 결과들은 해당 설정에서 피드백의 유용성을 뒷받침하지만, 도메인 전체에 공통으로 적용할 수렴 배수를 입증하지는 않는다.
측면별 세부 점수는 검증 과정과 최종 테스트 지표를 모두 개선한다. 보고된 비교에서 검증 점수 0.80에 도달하는 데 필요한 rollout은 약 100회와 600회이며, 테스트 지표는 86.32와 82.5다.
이 절제 실험은 피드백의 효과를 뒷받침하는 근거를 원 채우기와 커널로 확장한다. 단일 과제의 평균 속도 향상은 4.11×와 1.15×, 다중 과제의 평균은 1.15×와 1.03×다. 행마다 측정량이 달라 이득을 공통 개선 배수로 환산할 수는 없다.
5.10 Proposer Sensitivity and Optimization Cost
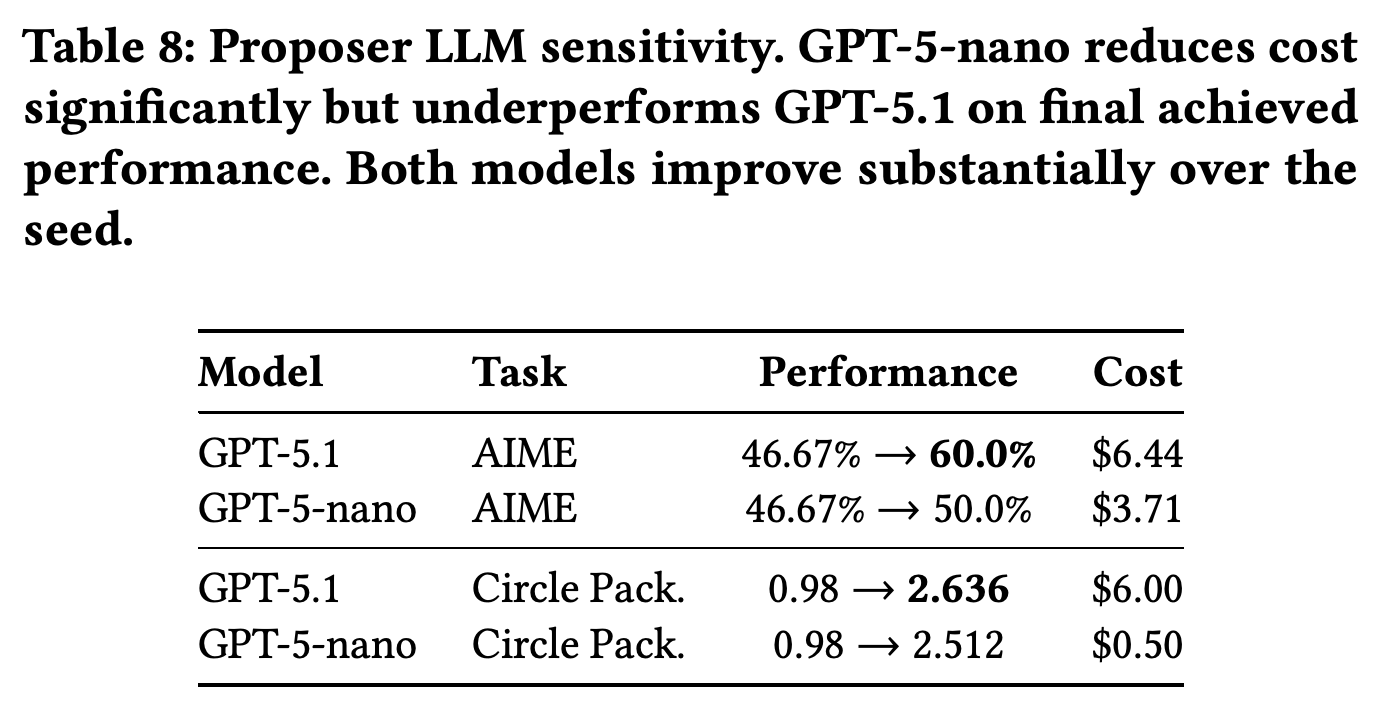
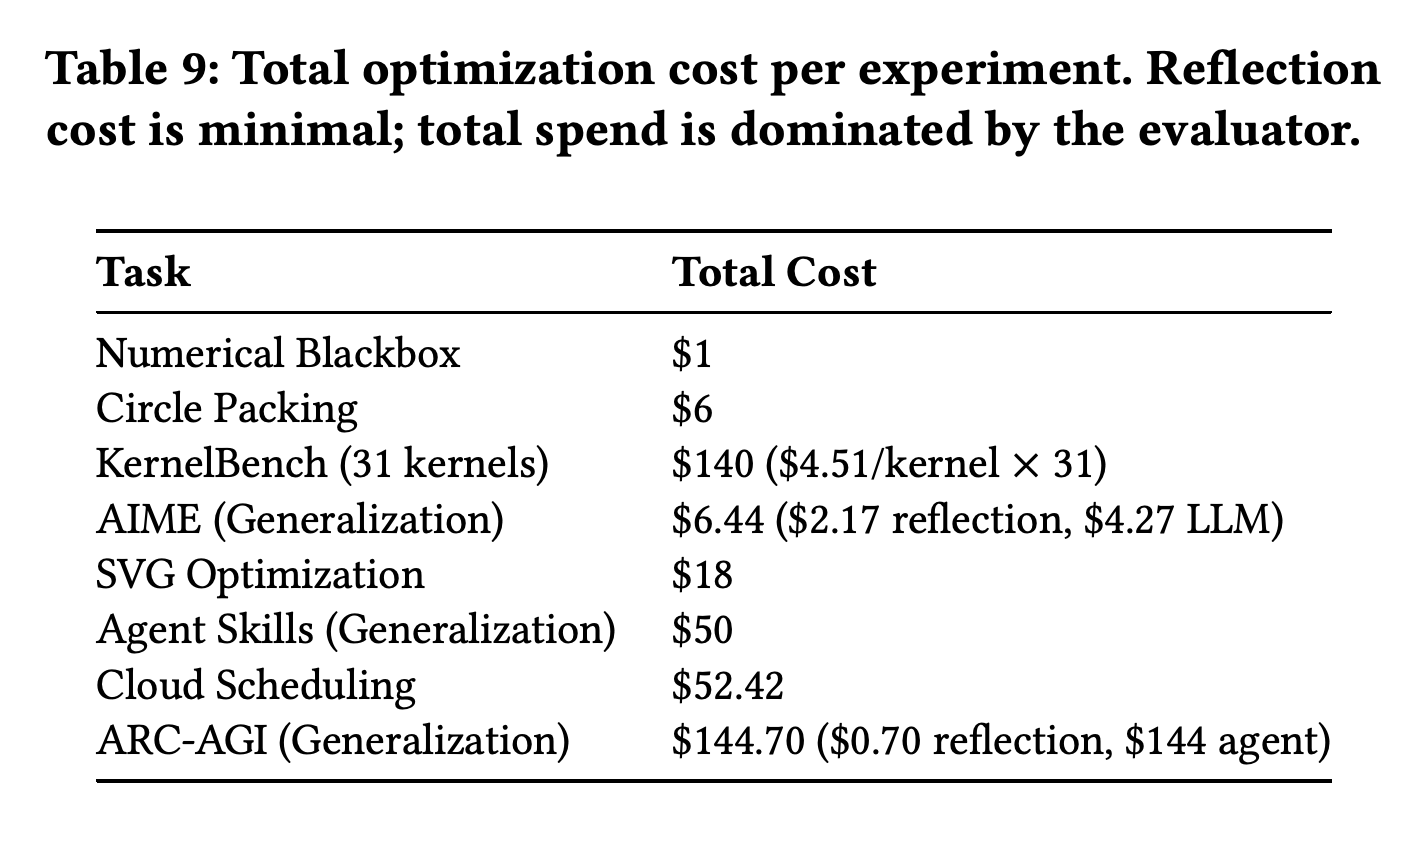
제안 모델 비교에서 GPT-5-nano는 비용과 최종 품질이 모두 낮다. 원 채우기에서는 $0.50로 2.512에 도달하며, GPT-5.1은 $6.00로 2.636에 도달한다. AIME에서는 $3.71로 50.0%에 도달하며, GPT-5.1은 $6.44로 60.0%에 도달한다. 보고된 실험 비용은 수치 블랙박스 최적화의 $1부터 ARC-AGI의 $144.70까지이며, KernelBench는 커널 31개에 $140가 든다. 비용이 가장 큰 설정에서는 평가기 실행이 지출의 대부분을 차지한다. ARC-AGI에서는 에이전트 비용이 $144, 성찰 비용이 $0.70다.
6 Why the Framework Works: Optimization Trajectory Analysis
원 채우기 탐색 과정 분석은 3가지 메커니즘을 제안한다. 진단 피드백이 구체적인 알고리즘 변경을 유도하고, 코드 산출물과 refiner 프롬프트가 공유 프런티어를 통해 개선되며, 다양한 후보 계열이 특정 접근법에 일찍 고정되는 것을 막는다는 설명이다. 반지름이 지나치게 작아지면 LP로 전환하고, 중심 배치가 제약이 되면 선형화한 국소 갱신을 수행하는 순차 선형계획법(SLP)으로 전환하는 사례를 든다. 피드백 절제 실험은 SI의 기여를 직접 검증하지만, 모듈 간 상호작용과 다양성에 관한 설명은 주로 관찰한 탐색 과정을 해석한 것이다.
7 Discussion
논문은 관련 문제들이 재사용 가능한 최적화 패턴을 공유할 때 다중 과제 탐색이 유리하다고 주장한다. CUDA 연산은 벡터화된 메모리 접근과 리덕션 전략을 통해 이러한 패턴을 공유한다. 반례로 원의 개수가 다른 원 채우기 과제를 보고한다. 단일 과제 탐색 점수는 2.6360인 반면, 각각 과제 7개와 11개를 공동 탐색하는 MT7과 MT11은 2.6313과 2.5973이다. 이 결과는 시험한 설정에서 부정적 전이가 발생했음을 보여준다. 원의 개수가 다르면 전이 가능한 구조가 부족하다는 더 넓은 설명은 저자들의 해석이다.
8 Limitations
저자들은 한계 5가지를 제시한다. 제안 품질은 LLM에 의존하고, 평가 비용이 클 수 있으며, 산출물에는 텍스트 표현이나 대리 표현이 필요하다. 또한 다중 과제의 이득은 과제 간 관련성에 좌우되고, 유용한 피드백에는 여전히 도메인 전문성이 필요하다. 제안 모델 절제 실험, 비용 내역, 원 채우기의 부정적 전이 실험은 이 제약들 가운데 일부를 뒷받침한다. 공통 인터페이스는 탐색 시스템 설정 부담을 줄이지만, 평가기와 진단 설계는 사용자에게 맡긴다.
9 Conclusion
논문은 선언형 인터페이스가 3가지 탐색 모드, 진단 피드백, 파레토 기반 후보 보존을 통해 서로 다른 산출물에서도 경쟁력 있는 최적화를 지원할 수 있다고 결론짓는다. 백엔드에 독립적인 설계 덕분에 같은 사용자 인터페이스를 유지하면서 탐색 구현을 바꿀 수 있다. 구현은 GEPA 프로젝트의 https://github.com/gepa-ai/gepa 에 공개되어 있다.
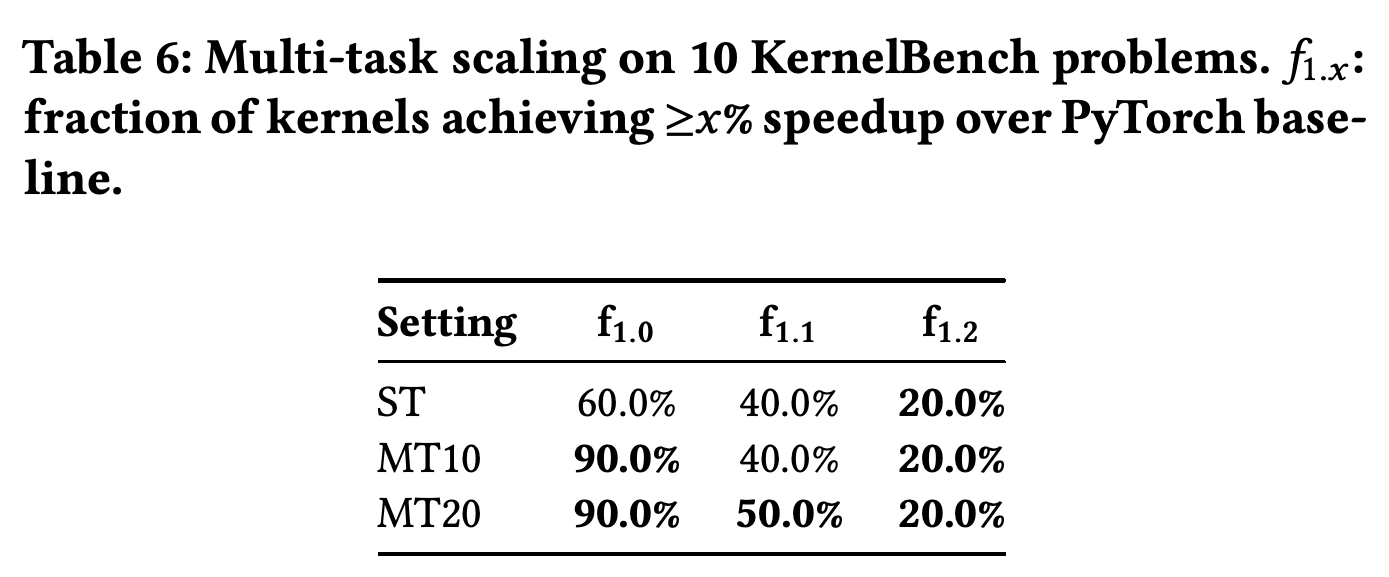
베이스라인 이상 성능을 낸 비율은 단일 과제 탐색의 60.0%에서 다중 과제 설정 2개 모두 90.0%로 높아진다. MT20만 1.1× 도달 비율을 40.0%보다 높은 50.0%로 개선한다. 1.2× 속도 향상에서는 모든 설정이 최종 20.0%를 기록한다.
무작위 표본에서 MT20은 베이스라인 이상 성능 비율을 50.0%에서 90.0%로, 1.1× 도달 비율을 25.0%에서 40.0%로 높인다. 1.2×에서는 설정 2개 모두 15.0%에 도달하여, 전이의 이득이 임계값에 따라 달라짐을 보여준다.
제안 모델 2개 모두 초기 후보보다 개선되지만, GPT-5-nano의 최종 성능은 과제 2개 모두에서 더 낮다. 원 채우기에서는 비용이 $6.00에서 $0.50로 줄어드는 동시에 점수도 2.636에서 2.512로 낮아진다.
보고된 비용은 수치 블랙박스 최적화의 $1부터 ARC-AGI의 $144.70까지 도메인에 따라 크게 다르다. ARC-AGI 내역에서 에이전트 실행 비용은 $144, 성찰 비용은 $0.70로, 평가기 비용이 지출의 대부분을 차지할 수 있음을 보여준다.
목표 4개에 사용한 시각적 평가 측면의 수는 4개에서 13개 사이이며, 사용한 모델도 서로 다르다. 표는 평가 설계를 기록하고, 시각적 근거가 소수의 목표에 한정됨을 보여준다.
나란히 놓인 출력은 최적화 후 장면 구성, 물체의 세부 묘사, 유니콘의 해부학적 형태가 달라진 모습을 보여준다. 평가한 목표 4개를 예시하며 보고된 사람 평가 선호를 보완한다. 여기서는 더 넓은 시각적 품질 분포를 검증하지 않는다.
부록
- A Use of Generative AI: 저자들은 텍스트, 표, 그래프, 코드 생성에 ChatGPT, Gemini, Claude, Cursor를 활용했다고 공개한다. 실험 설계와 세부 내용은 자신들의 독창적인 아이디어라고 밝힌다.
- B Blackbox Mathematical Optimization: 문제 56개로 구성된 EvalSet 벤치마크에서 문제당 8,000회 평가로 솔버 코드를 최적화했을 때, 수치 최적화 프레임워크인 Optuna와 40개 문제에서 동률을 이루고 7개에서 이기며 9개에서 진다. Optuna가 어려움을 겪는 문제 중 10개를 선정하여 평가 예산을 2,000회로 낮추면 7개에서 이긴다. 선정된 부분집합의 결과만으로 EvalSet 전체에서 우월하다고 볼 수는 없다.
- C Seedless Mode: 3D Unicorn: seed_candidate=None으로 설정하면 시스템은 자연어 목표를 바탕으로 Python 스크립트를 생성한다. 모델링에는 build123d, 렌더링에는 pyrender를 사용한다. 여러 시점에서 렌더링한 이미지가 채점과 피드백을 제공하므로, 초기 코드 산출물 없이도 기하 구조, 비율, 해부학적 세부 형태를 반복해서 개선할 수 있다.
- D Detailed Algorithm: Algorithm 1은 초기 후보를 설정하고 평가한 뒤, 프런티어에서 후보를 선택하고, 미니배치 피드백을 수집하여 수정안을 제안한다. 미니배치 성능이 개선된 수정안은 전체 평가한다. 후보 점수를 갱신하고 지배당하는 후보를 제거하며, 평가 예산을 소진할 때까지 반복한다. 제시된 반환 규칙은 평균 점수가 가장 높은 후보를 선택한다. 단일 과제 탐색에서는 단일 원소 데이터셋을 사용하여 예제별 추적을 지표별 추적으로 축소한다.
- E Multi-Task Scaling Tables: KernelBench 문제 10개에 대해 Table 6은 단일 과제, MT10, MT20 탐색의 베이스라인 이상 성능 비율을 각각 60.0%, 90.0%, 90.0%로 보고한다. MT10과 MT20은 각각 과제 10개와 20개를 공동 탐색한다. 1.1× 속도 향상에 도달한 비율은 40.0%, 40.0%, 50.0%이며, 1.2×에서는 모두 20.0%다. 무작위로 뽑은 문제 20개에 대해 Table 7은 단일 과제와 MT20의 결과를 1.0×에서 50.0%와 90.0%, 1.1×에서 25.0%와 40.0%, 1.2×에서 15.0%와 15.0%로 보고한다.
- F Optimization Trajectory Analysis: Full Details: 부록은 피드백에 따른 알고리즘 계열 전환, 코드와 refiner 모듈의 교대 개선, 서로 다른 품질 지표에서 구조가 다른 후보들이 살아남는 과정을 추적한다. refiner의 점수가 1.93일 때 코드 모듈의 점수는 0.98이다. 이후 코드는 LP 접근법을 반영하여 약 2.61에 도달하고, SLP 개선을 거쳐 약 2.63에 도달한다. 이 관찰은 탐색 과정을 설명하지만, 제안한 각 메커니즘의 효과를 독립적으로 분리하지는 않는다.
- G Proposer Sensitivity and Optimization Cost: Tables 8–9는 GPT-5.1과 GPT-5-nano의 품질 및 비용 비교와 실험별 지출을 제공한다. 본문에 보고된 총액 외에 SVG 최적화는 $18, 코딩 에이전트 스킬은 $50, 클라우드 스케줄링은 $52.42가 든다. AIME 총비용 $6.44는 성찰 비용 $2.17과 모델 실행 비용 $4.27로 구성된다.
- H Image Generation Details: 목표 4개는 자전거를 타는 펠리컨에 평가 측면 12개, 3D 유니콘에 4개, 파이프 오르간 위의 문어와 굴착기를 조종하는 나무늘보에 각각 13개를 사용한다. Table 10은 펠리컨에 Gemini Flash 3.0, 나머지 목표에 Claude Opus 4.6을 사용한다고 명시한다. CAD 평가는 동일한 간격의 시점 3개를 사용하며, 평가기 호출마다 측면 1개를 채점한다.
- I Optimized AIME Prompt: 공개된 프롬프트의 규칙 6개는 문제 재서술, 표기와 제약 정의, 추론 정당화, 막힌 추론에서 마지막으로 옳았던 단계로 돌아가기, 정확성을 유지하면서 추론에 집중하기, 최종 답을 따로 제시하기를 다룬다. 프롬프트만 최적화한 실험에서 사용한 산출물을 제시한다.
- J Discovered solutions: 부록은 평가한 도메인들의 최종 산출물 일부를 제공한다. 이를 통해 종합 점수를 저장소 지침, 에이전트 제어 흐름, 스케줄링 로직, GPU 구현, 수치 솔버 구조의 구체적인 변화와 연결한다. J.1 Coding Agent Skills: Bleve Repository: 최적화한 SKILL.MD 발췌문은 테스트와 스택 추적으로 실패를 진단하고, 테스트 범위를 좁히며, 검토 가능한 변경을 만들고, 필요한 부분에 집중적인 테스트를 추가하도록 강조한다. 최적화한 산출물에 담긴 저장소 작업 관행을 보여준다. J.2 ARC-AGI Agent Architecture: Figure 10은 생성된 시스템의 프로그래머, 검증기, 코드 실행, fallback 구성 요소를 상세히 보여준다. 검증 결과에 따라 최대 2회 디버깅할 수 있으며, 최종 예측은 코드 기반 시도와 모델의 직접 예측 fallback을 결합한다. J.3 CloudCast Routing Algorithm: 178줄짜리 산출물은 제공자별 경로 가중치, 비용과 시간의 절충에 따른 후보 선택, 여러 Steiner tree 전략, 대역폭 경합을 고려하는 탐욕적 할당을 포함한다. 발췌문은 search_algorithm 진입점을 보여주며, 보충 산출물에는 전체 구현이 있다. J.4 Can’t Be Late Scheduling Policy: 110줄짜리 정책은 SPOT 인스턴스를 지속적으로 사용할 수 없는 상태를 추적하고, 전환 오버헤드와 예상 절감액을 비교하며, 마감까지 남은 여유에 따라 결정을 바꾼다. _step 메서드가 이러한 동작을 보여주고, 전체 산출물에는 reset()과 추가 조건 검사도 포함된다. J.5 CUDA Kernel: LayerNorm: 소개한 층 정규화 커널은 PyTorch 대비 3.32× 속도 향상을 달성했다고 보고된다. float4 벡터화로 값 4개를 한 번에 읽고, 통계 계산과 정규화를 분리한다. GPU 스레드 그룹인 warp 안에서는 __shfl_down_sync로 레지스터 수준에서 부분합을 교환한다. J.6 Circle Packing Algorithm: 480+줄 산출물은 중심 최적화를 위한 LP 기반 기울기, 경계 제약 수치 최적화, 국소 선형화 갱신, 재시작을 포함한 진화적 탐색, 작은 원의 재배치를 결합한다. hexagonal, uniform, edge-ring, farthest-point, corner-spokes, edge-biased hex의 초기화 전략 6개가 n=26에 서로 다른 초기 배치를 제공한다. Section 7은 원 채우기 산출물을 별도로 900+줄이라고 설명하므로, 논문 안에서 길이에 관한 서술이 일치하지 않는다.
- K Demonstration: 4분짜리 영상과 관련 산출물은 Jupyter notebook을 통해 ARC-AGI 에이전트 진화와 원 채우기 최적화를 보여준다. 시연은 중간 후보와 진단 피드백을 공개하며, https://drive.google.com/drive/folders/1mfd8xny_YRri5UYwTxKoBs3CJ_cpxpMr 에서 확인할 수 있다.
- L Artifact Availability: 재현 저장소는 https://github.com/gepa-ai/optimize-anything-artifact 이다. acm_cais_artifact_evaluation/ 아래에 관련 자료가 있고, domains/ 아래에 도메인별 코드, README.md 파일, 저장된 GEPAState 탐색 체크포인트가 있다. 대부분의 도메인에는 CPU 호스트와 모델 API 접근 권한이 필요하다. KernelBench에는 CUDA 12.1+를 갖춘 NVIDIA V100 32GB GPU가 필요하다. PDF에는 산출물 공개, 기능 검증, 결과 재현에 관한 ACM 배지가 표시되어 있다.
짧은 생각
가장 명확한 공학적 기여는 산출물 유형에 관계없이 공통 인터페이스로 진단 피드백을 제공하는 평가기 규약이다. 제안 모델을 맞춘 OpenEvolve 비교와 SI 절제 실험은 효과에 관한 구체적인 근거를 제공한다. 다만 선정된 과제의 전이 절제 실험, 목표 4개에 대한 시각 평가, 상충하는 Bleve 결과는 더 넓은 주장을 제한한다. 실제 활용에는 신뢰할 수 있는 평가기, 유용한 진단 정보, 공동 탐색 과제들이 전이 가능한 패턴을 공유한다는 근거가 여전히 필요하다.