


OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use 요약 설명
15 Oct 2026 | Paper Review Computer-Use Agents Code Execution Agent System Optimization목차
이번 글에서는 OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 10월 15일(Arxiv)
- Zhou, Hanzhang, Li, Long, Kong, Quyu, Wang, Lei, Tong, Panrong, Chen, Long, Xia, Tianyu, Zhang, Gongjie, Zhang, Xu, Liu, Chen, et al.
- Alibaba Token Hub, Alibaba Group
- 논문 링크
요약
- OpenGCUA는 컴퓨터 사용 에이전트가 화면 조작과 프로그래밍 방식의 접근을 통해 작업을 수행하면서 관찰 대상과 행동 방식을 선택하는 방법을 연구한다. 컴퓨터 사용 벤치마크인 OSWorld-v2의 오프라인 작업 82개에서 전체 구성은 행동을 일괄 실행하는 GUI 베이스라인보다 모델 8개의 평균 부분 점수를 19.6점 높이고 작업당 모델 호출을 평균 53.0% 줄였다.
- 이 설계는 실행 가능한 프로그램과 harness-to-model decision transfer를 결합한다. 에이전트 실행 시스템인 하네스의 고정 규칙으로 처리하던 일부 관찰 및 작업 상태 관련 결정을 모델에 넘긴다. 공개 자료에는 구현, 프롬프트, 실행 궤적과 초기 실기기 인프라가 포함되지만 새로 학습한 모델은 포함되지 않는다. 하네스에 대해서는 An Empirical Study of Harness Design for Coding Agents 요약 설명 글을 참조하라. 실행 궤적에 대해서는 2025년 9월 AI 논문 동향 글을 참조하라.
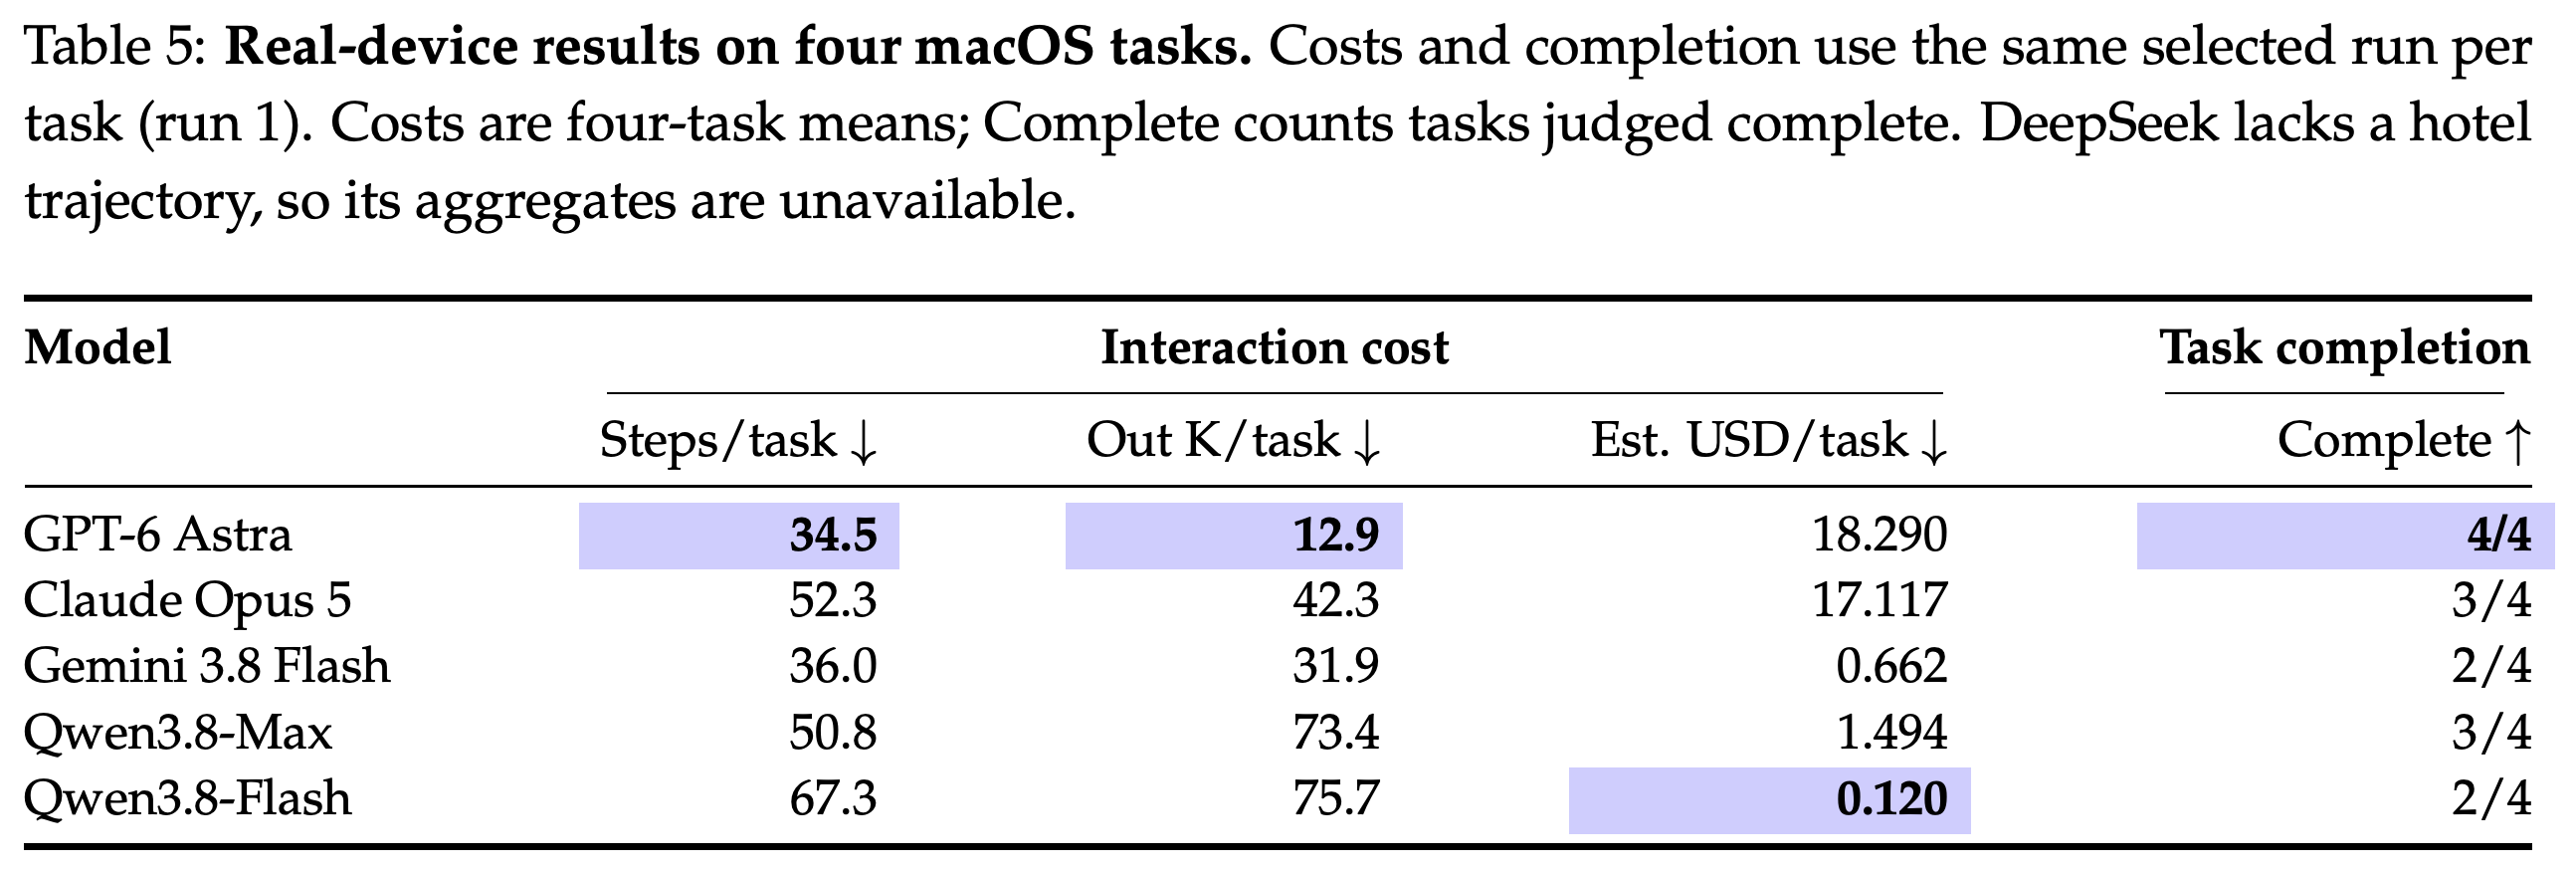
- macOS 작업 4개에서 선택한 실행을 비교하면 Qwen3.8-Max는 작업당 보고된 추론 토큰을 50.2K 사용했고 GPT-6 Astra는 2.6K 사용했다. 완료한 작업은 각각 3개와 4개였다. 이 예비 결과는 작업과 모델마다 선택한 실행 1개를 사용하므로 일반적인 모델 순위를 확립하지 못한다.
1 Introduction
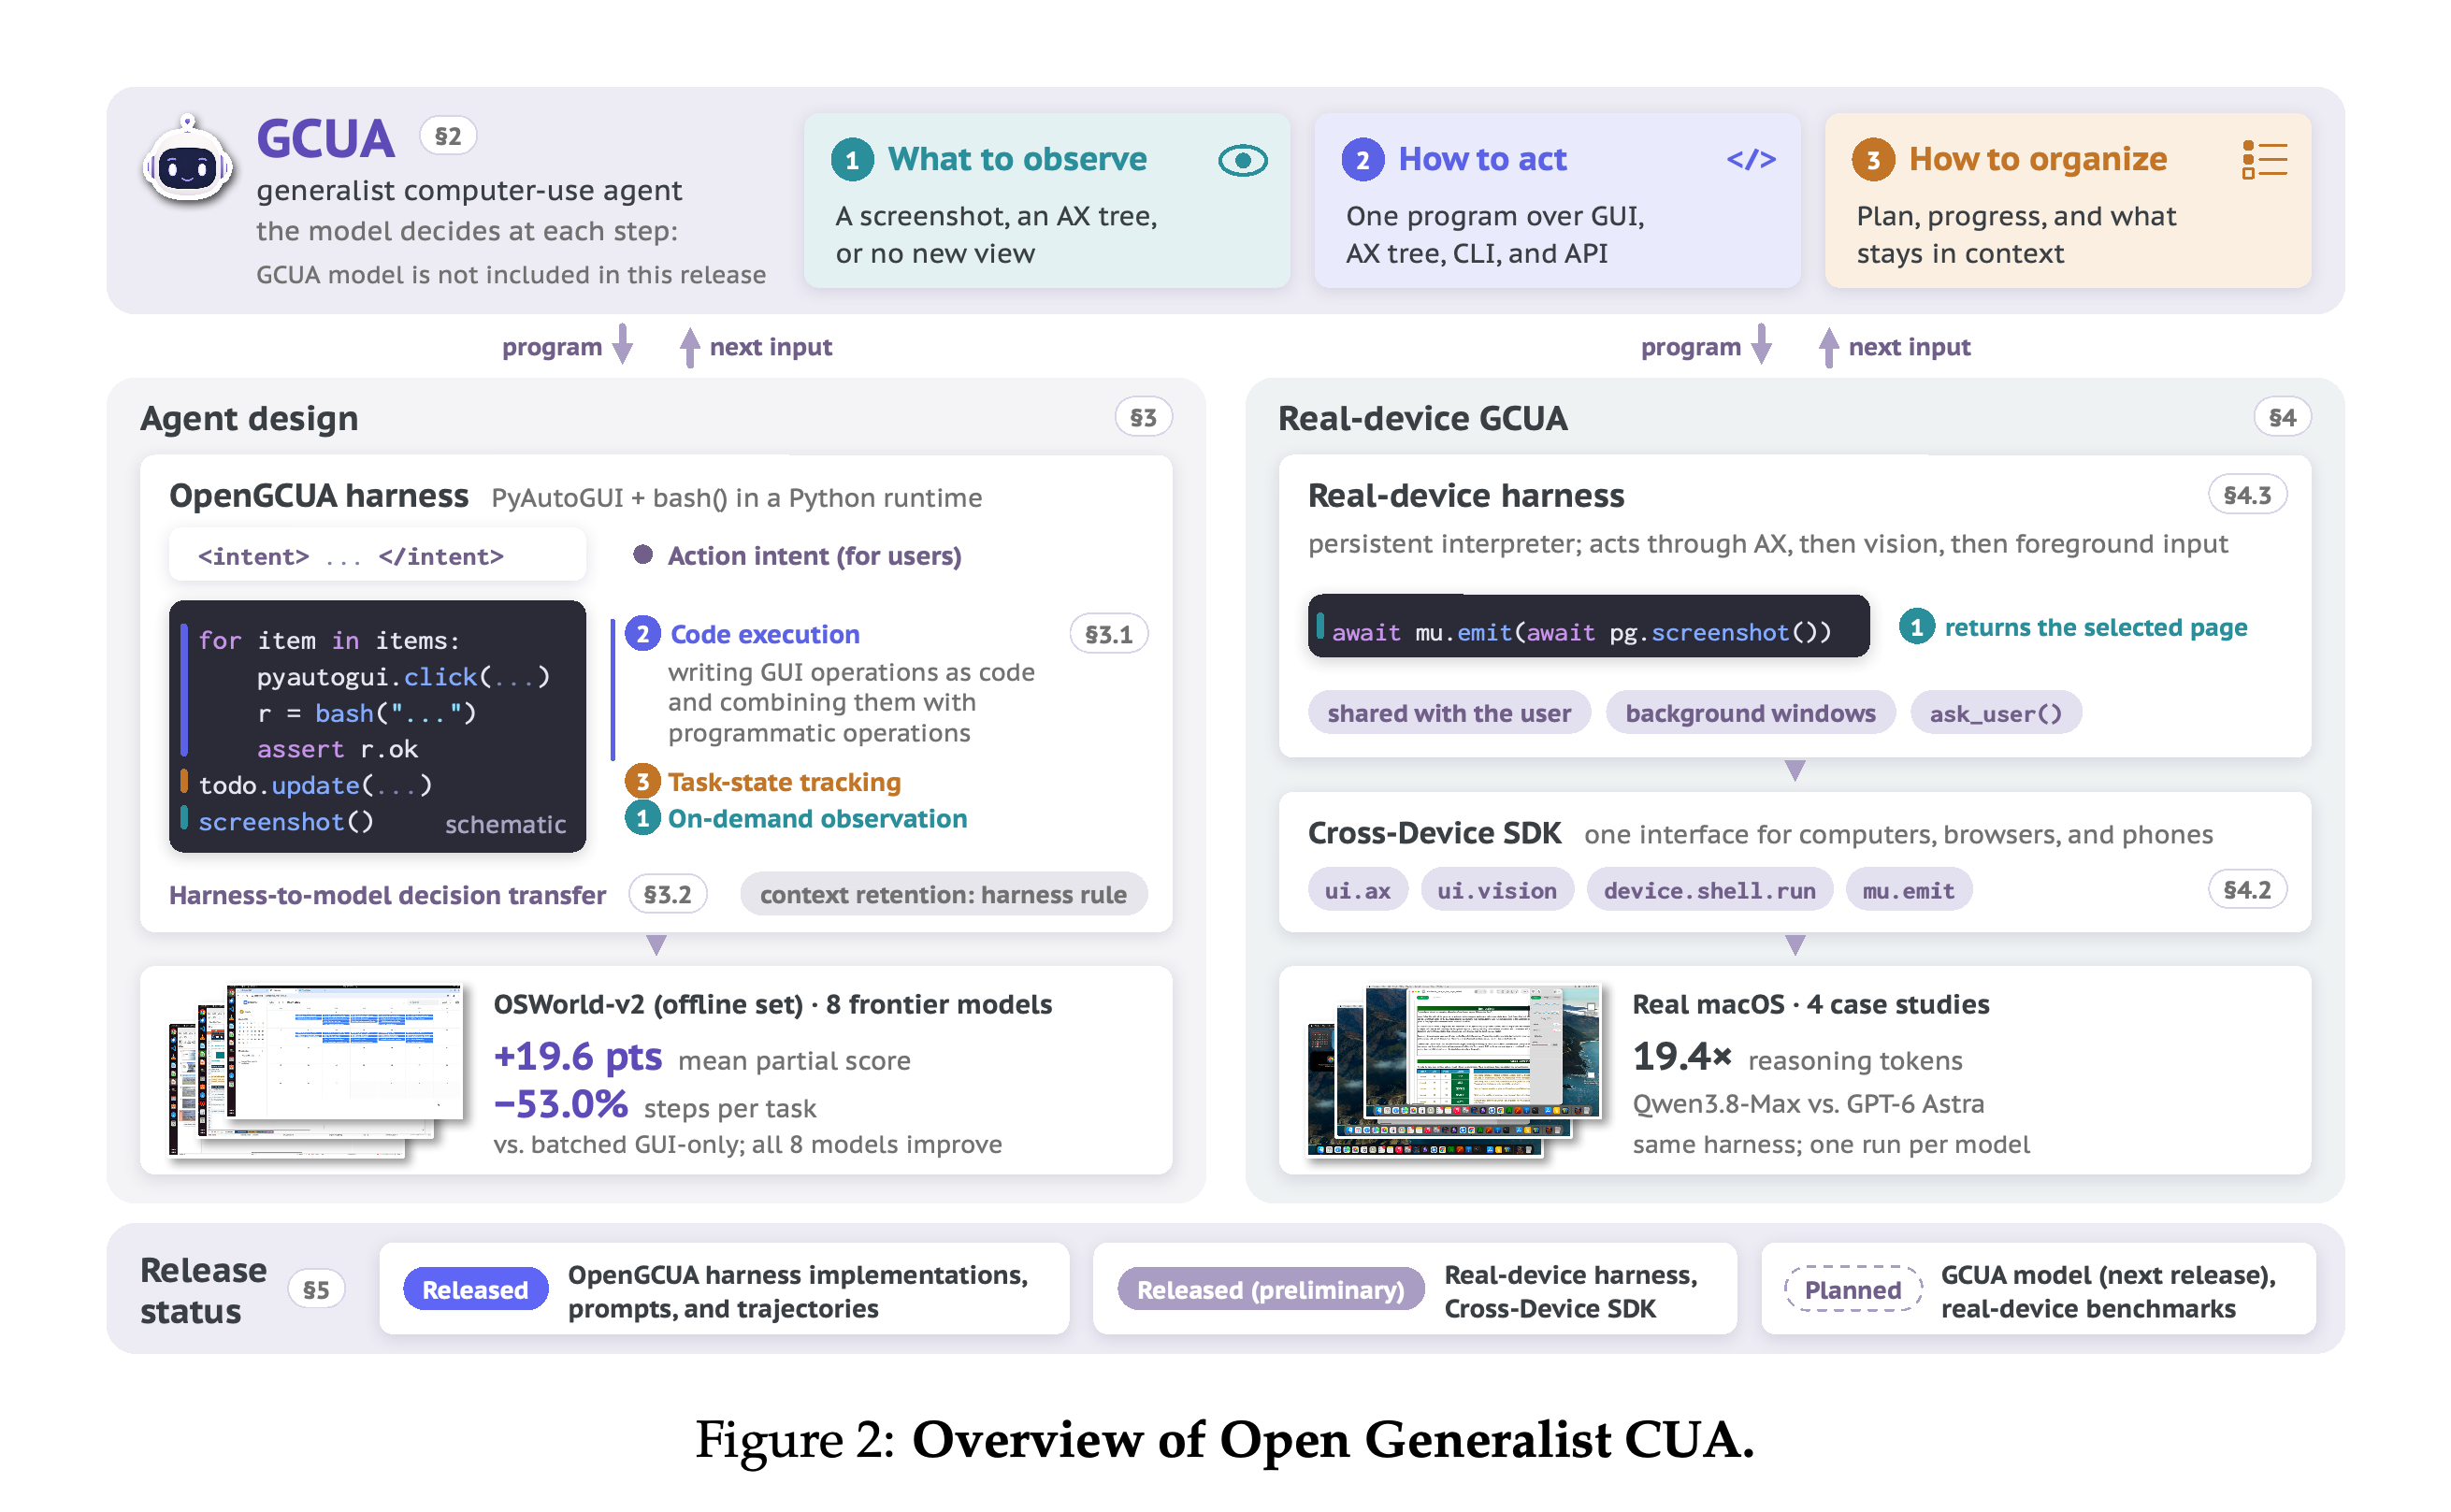
저자들은 최첨단 컴퓨터 사용 시스템의 핵심 구현 세부 사항과 실행 궤적을 확인하기 어렵다는 점에서 공개 연구 스택의 필요성을 제시한다. OpenGCUA는 https://github.com/Tongyi-MAI/OpenGCUA 에서 하네스, 프롬프트, 실행 궤적과 초기 실기기 도구를 공개한다. 프로젝트 웹사이트는 https://tongyi-mai.github.io/OpenGCUA/ 이다.
개요는 벤치마크 하네스와 초기 실기기 인프라를 구분하고, 학습된 GCUA 모델을 향후 계획으로 표시한다.
2 Generalist CUA: Definition and Positioning
논문은 범용 컴퓨터 사용 에이전트(GCUA)를 모델이 매 단계에서 무엇을 관찰하고, 어떻게 행동하고, 작업을 어떻게 구성할지 결정하는 에이전트로 설명한다. 이 정의는 사용 가능한 인터페이스뿐 아니라 누가 해당 결정을 내리는지도 다룬다.
2.1 Definition
GCUA는 스크린샷이나 인터페이스 요소를 구조화한 접근성 트리를 선택하고, 프로그램에서 GUI 동작, 셸 명령, API 호출을 결합할 수 있다. 작업 상태에는 계획, 진행 상황, 보존한 관찰 정보가 포함된다. 형식적으로 정의한 정책은 관찰 요청, 프로그램, 다음 작업 상태를 함께 선택한다.
2.2 Relation to Existing Agents
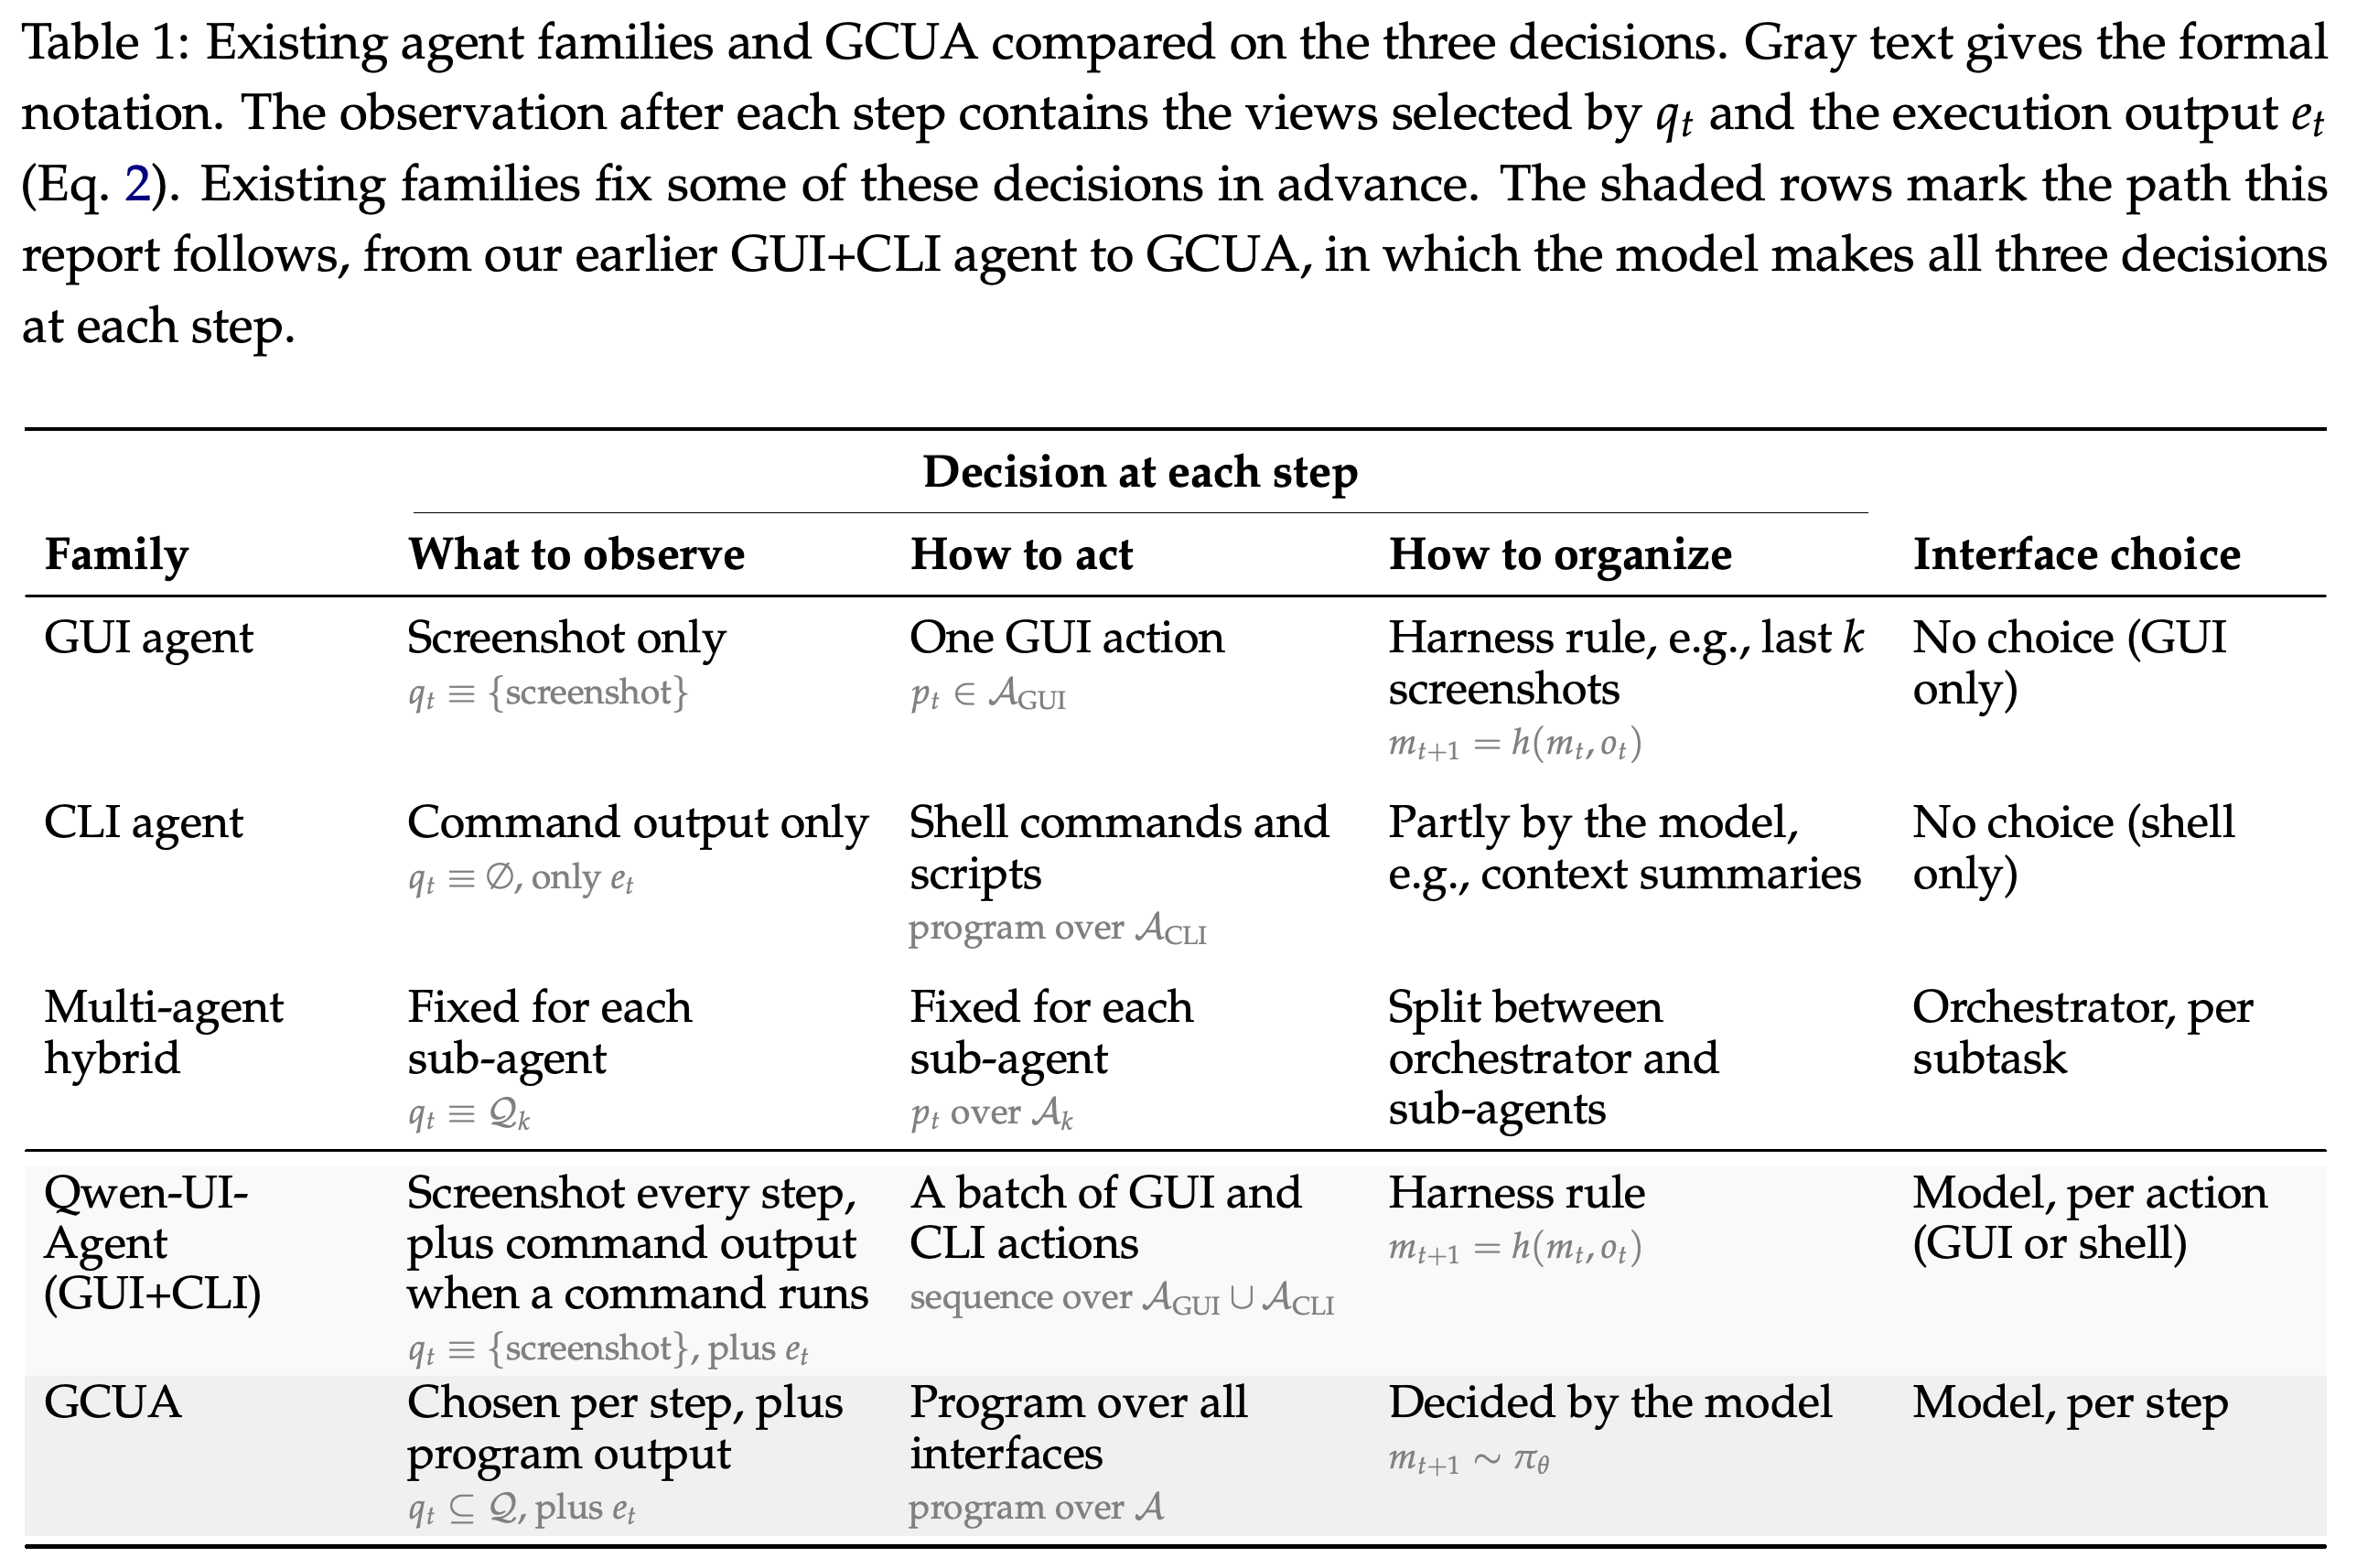
GUI 에이전트는 스크린샷과 고정된 인터페이스 동작을 사용하고, CLI 에이전트는 셸을 통해 작업하며, 멀티 에이전트 하이브리드는 하위 에이전트에 고정된 인터페이스를 할당한다. 논문은 동작을 일괄 실행하는 GUI+CLI 에이전트를 제한된 사례로 본다. 이 에이전트는 행동을 선택하지만 매 단계에서 스크린샷을 받고 고정된 컨텍스트 규칙을 따른다.
각 에이전트 유형에서 관찰, 행동, 작업 구성에 관한 결정 중 고정된 항목과 모델에 맡긴 항목을 구분한다.
2.3 Why Now: The Route Flip to Code Execution
일괄 실행은 실행 전에 행동 순서를 고정하지만, 프로그램은 모델 호출 1개 안에서 반복문, 조건문, 중간 결과 확인을 사용할 수 있다. 저자들은 코드 기반 컴퓨터 사용으로 전환하는 추세를 인용하지만, 외부에서 보고한 지연 시간 개선을 코드 실행의 효과로 특정하지 않는다.
2.4 Efficiency as a First-Class Metric
평가에서는 작업 성공률과 함께 단계 수, 출력 토큰, 추론 토큰, 추정 비용을 보고한다. 단계는 모델 호출 1개를 뜻하고 추론 토큰은 출력 토큰에 포함된다. 단계 수가 적다는 사실만으로 전체 지연 시간이 짧다고 판단할 수 없다.
3 Agent Design: Code Execution and Harness-to-Model Decision Transfer
이 연구는 기존 모델에서 서로 보완적인 설계 선택 2가지를 시험한다. 하나는 컴퓨터 작업을 조정하는 프로그램이고, 다른 하나는 관찰과 작업 상태에 관해 모델이 주도하는 결정이다. 새 모델을 학습하지 않고 프롬프트, 도구 인터페이스, 실행 런타임으로 이러한 동작을 구현한다.
3.1 Code Execution over GUI and CLI
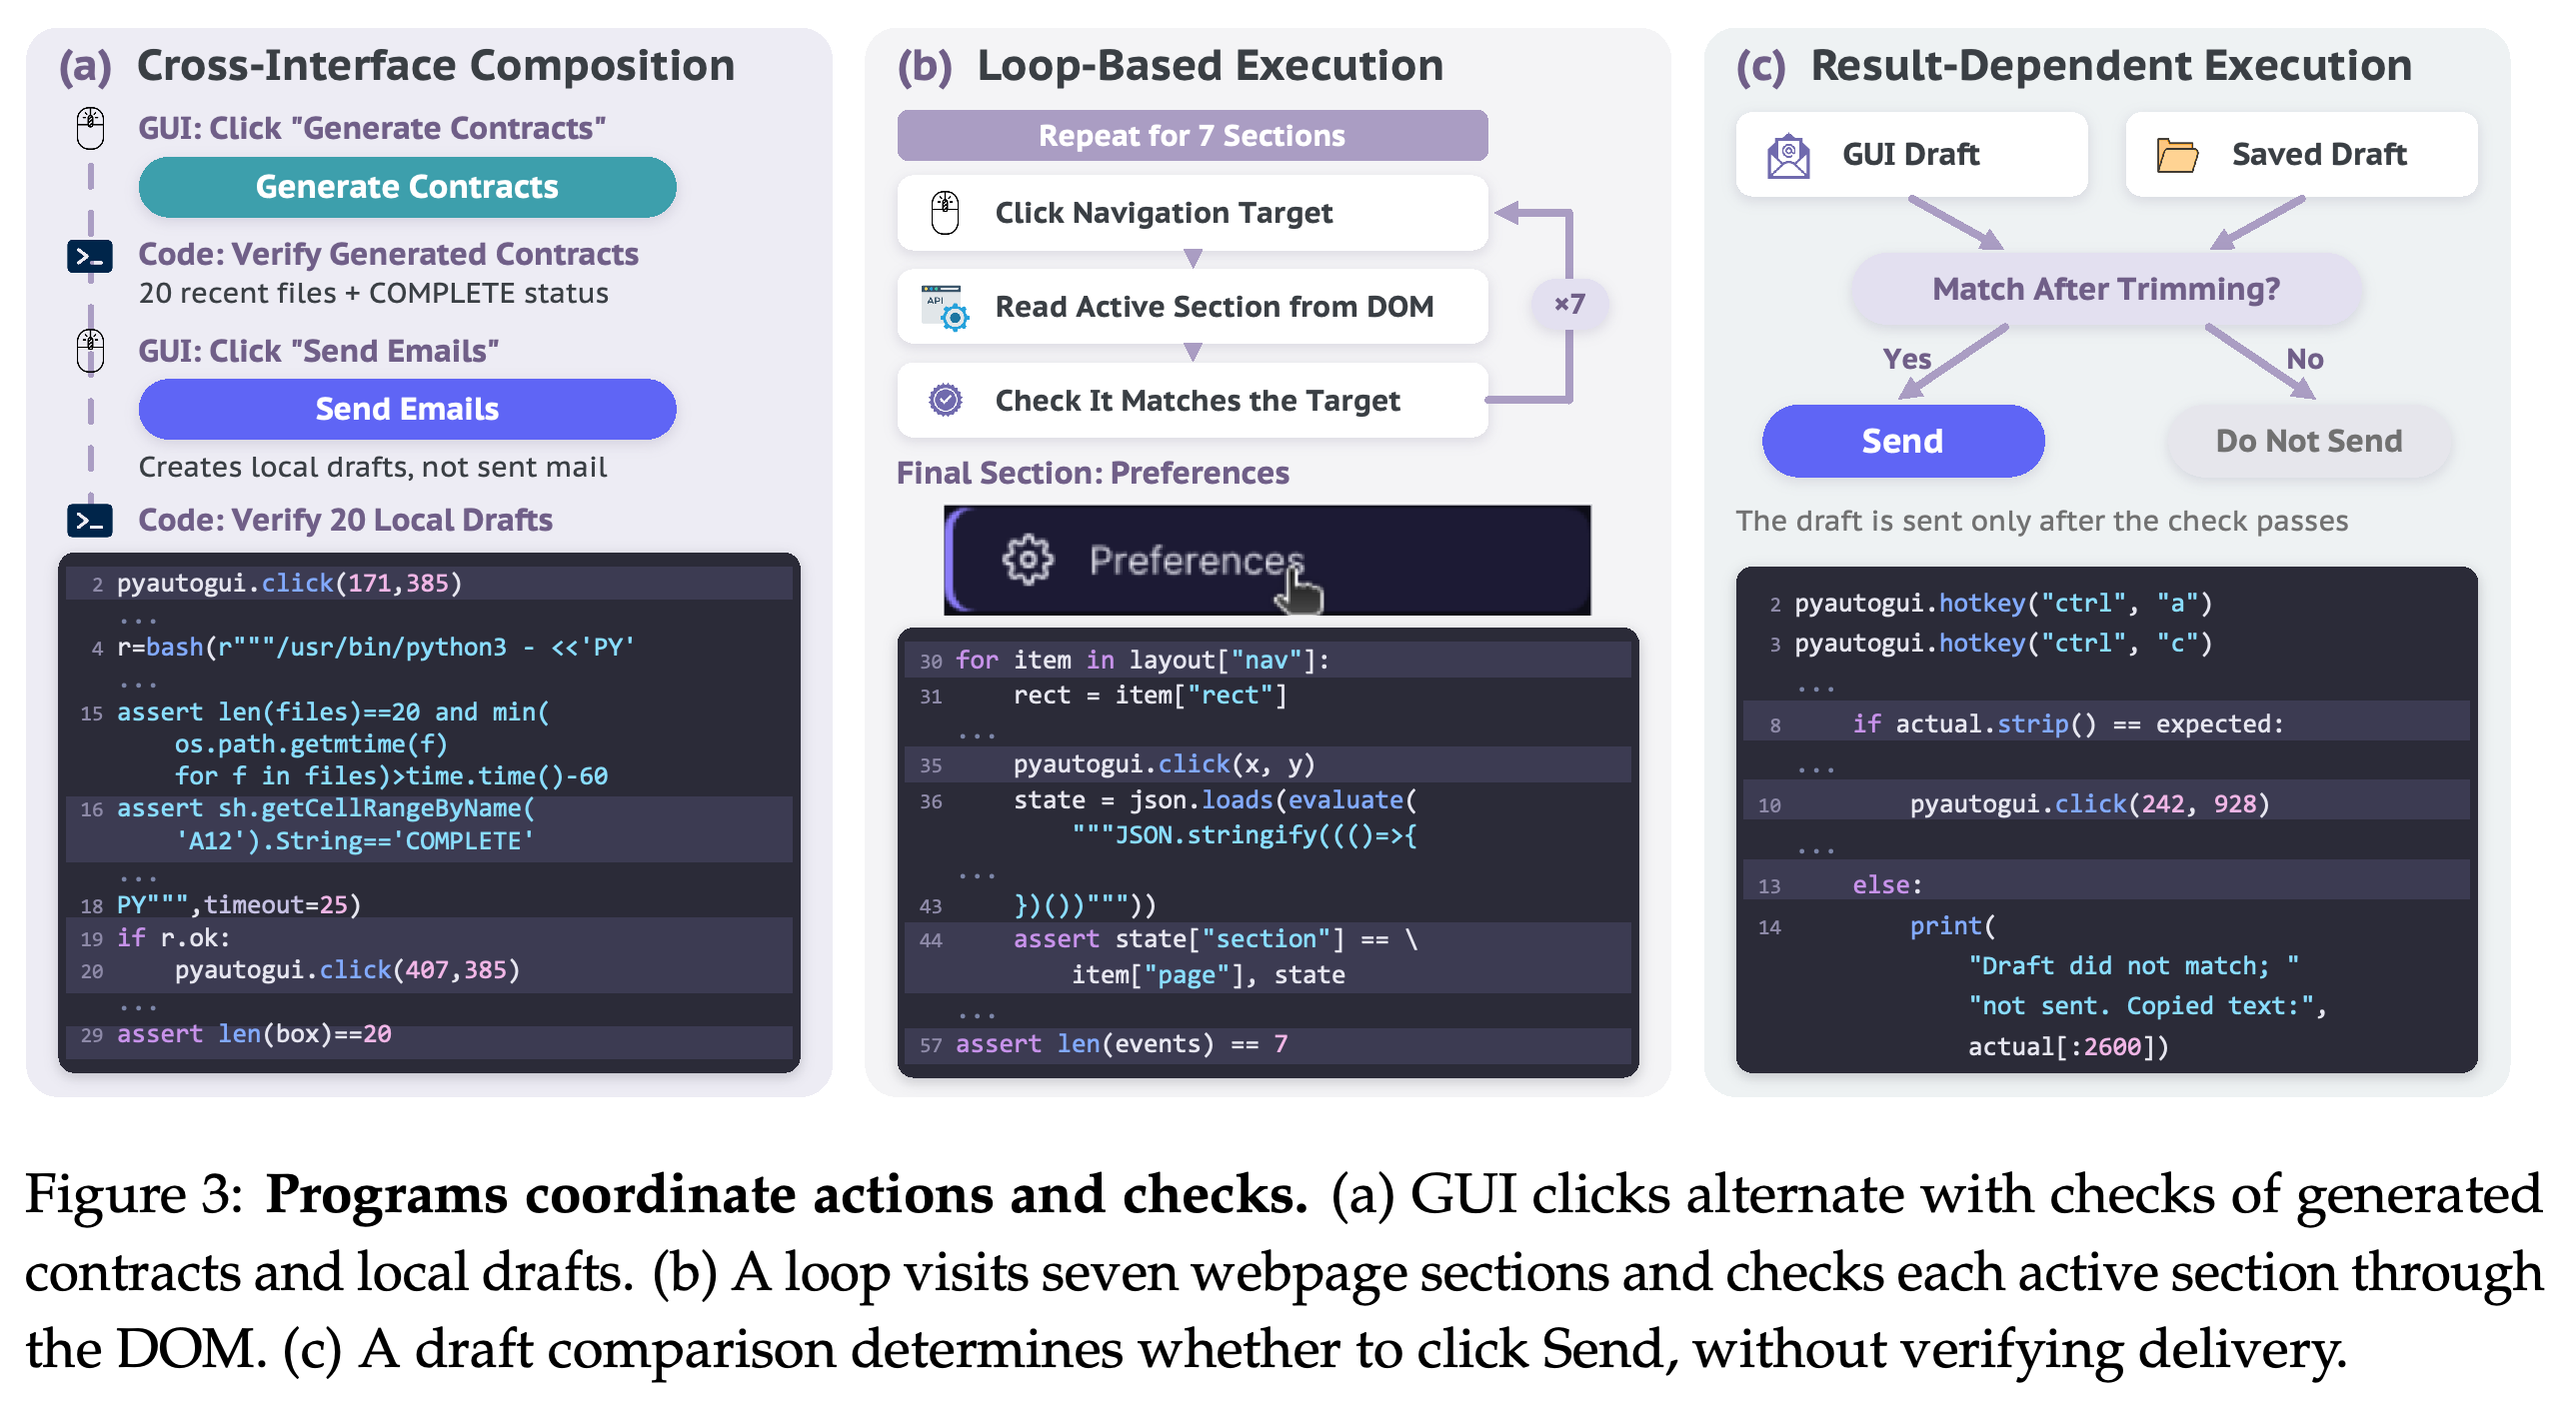
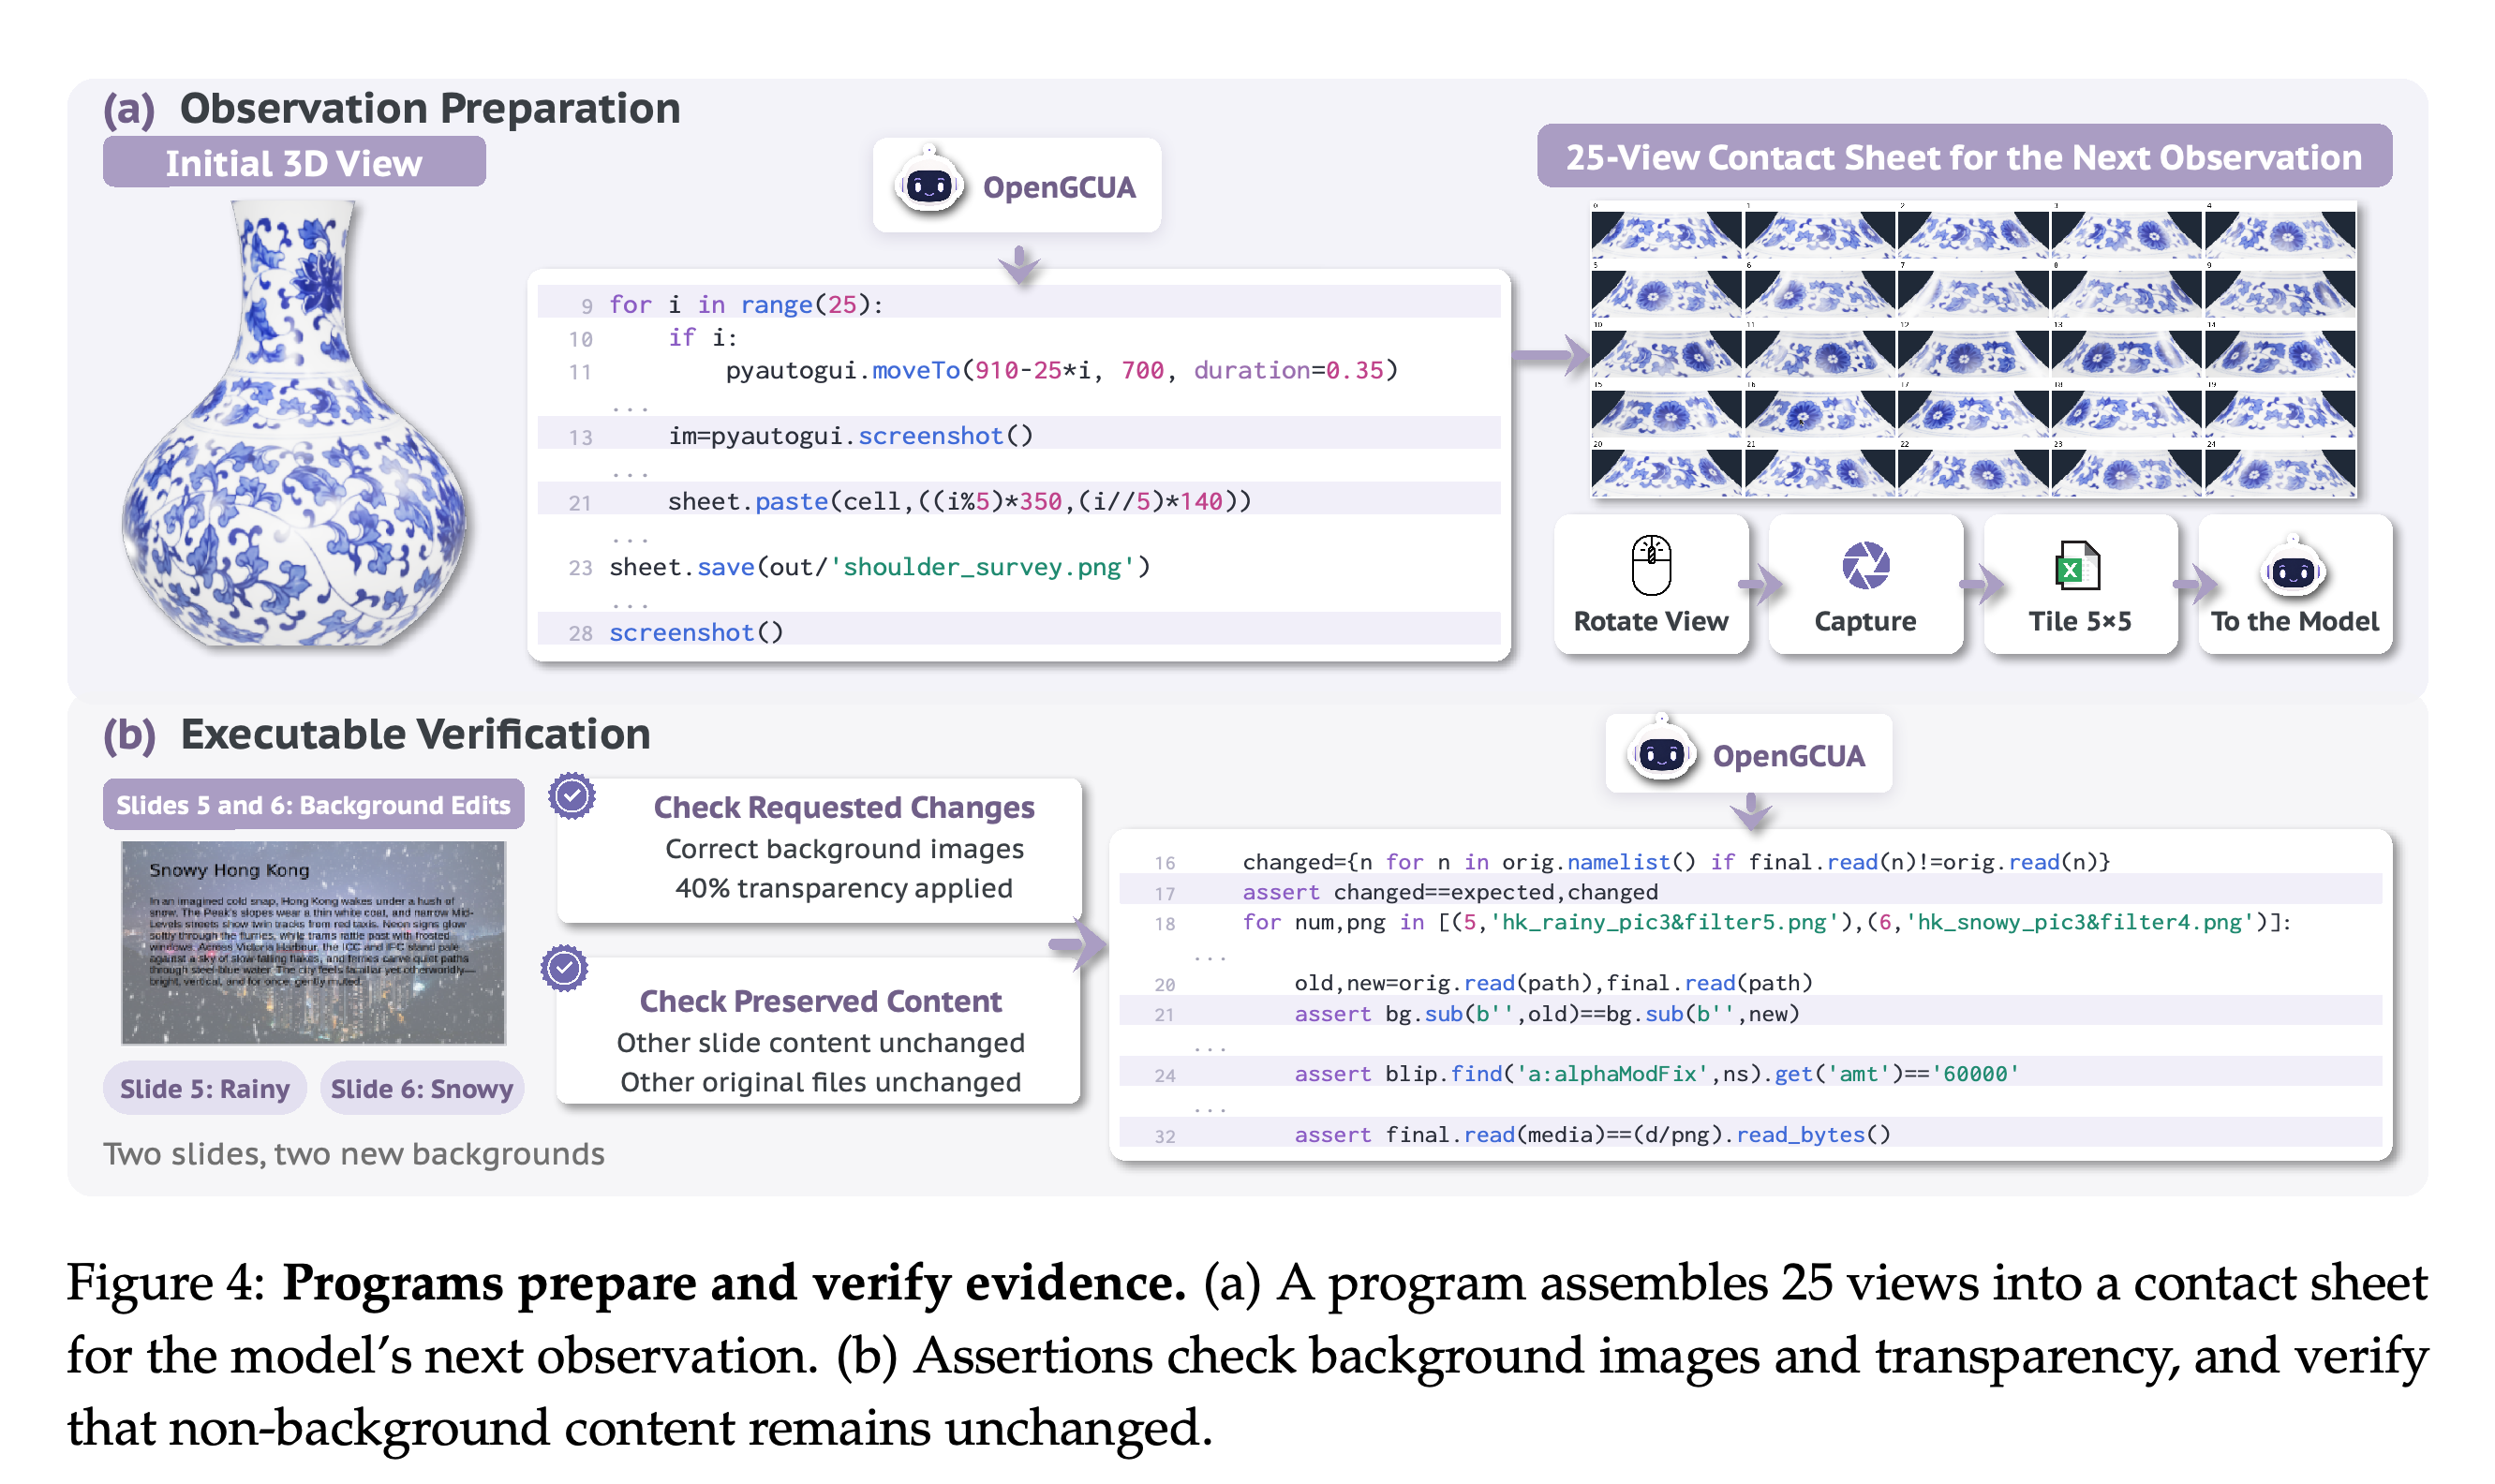
벤치마크 하네스는 단계마다 PyAutoGUI와 bash()를 사용하는 Python 프로그램을 실행하고 실행 결과와 상태를 반환한다. 예시에서는 인터페이스 동작에 확인, 반복문, 결과에 따른 분기, 관찰 준비, 실행 가능한 검증을 결합한다. 스크린샷만으로는 모든 인터페이스 상태를 프로그램이 읽을 수 있는 값으로 제공하지 못한다.
프로그램 1개에서 GUI 동작과 확인을 번갈아 수행하고, 탐색을 반복하거나, 계산 결과에 따라 동작을 결정할 수 있다. 이메일 예시는 전송 완료를 검증하지 않는다.
콘택트 시트는 시각적 화면 25개를 모아서 보여주고, assertion은 의도한 슬라이드 변경과 보존된 콘텐츠를 모두 확인한다.
3.2 Harness-to-Model Decision Transfer
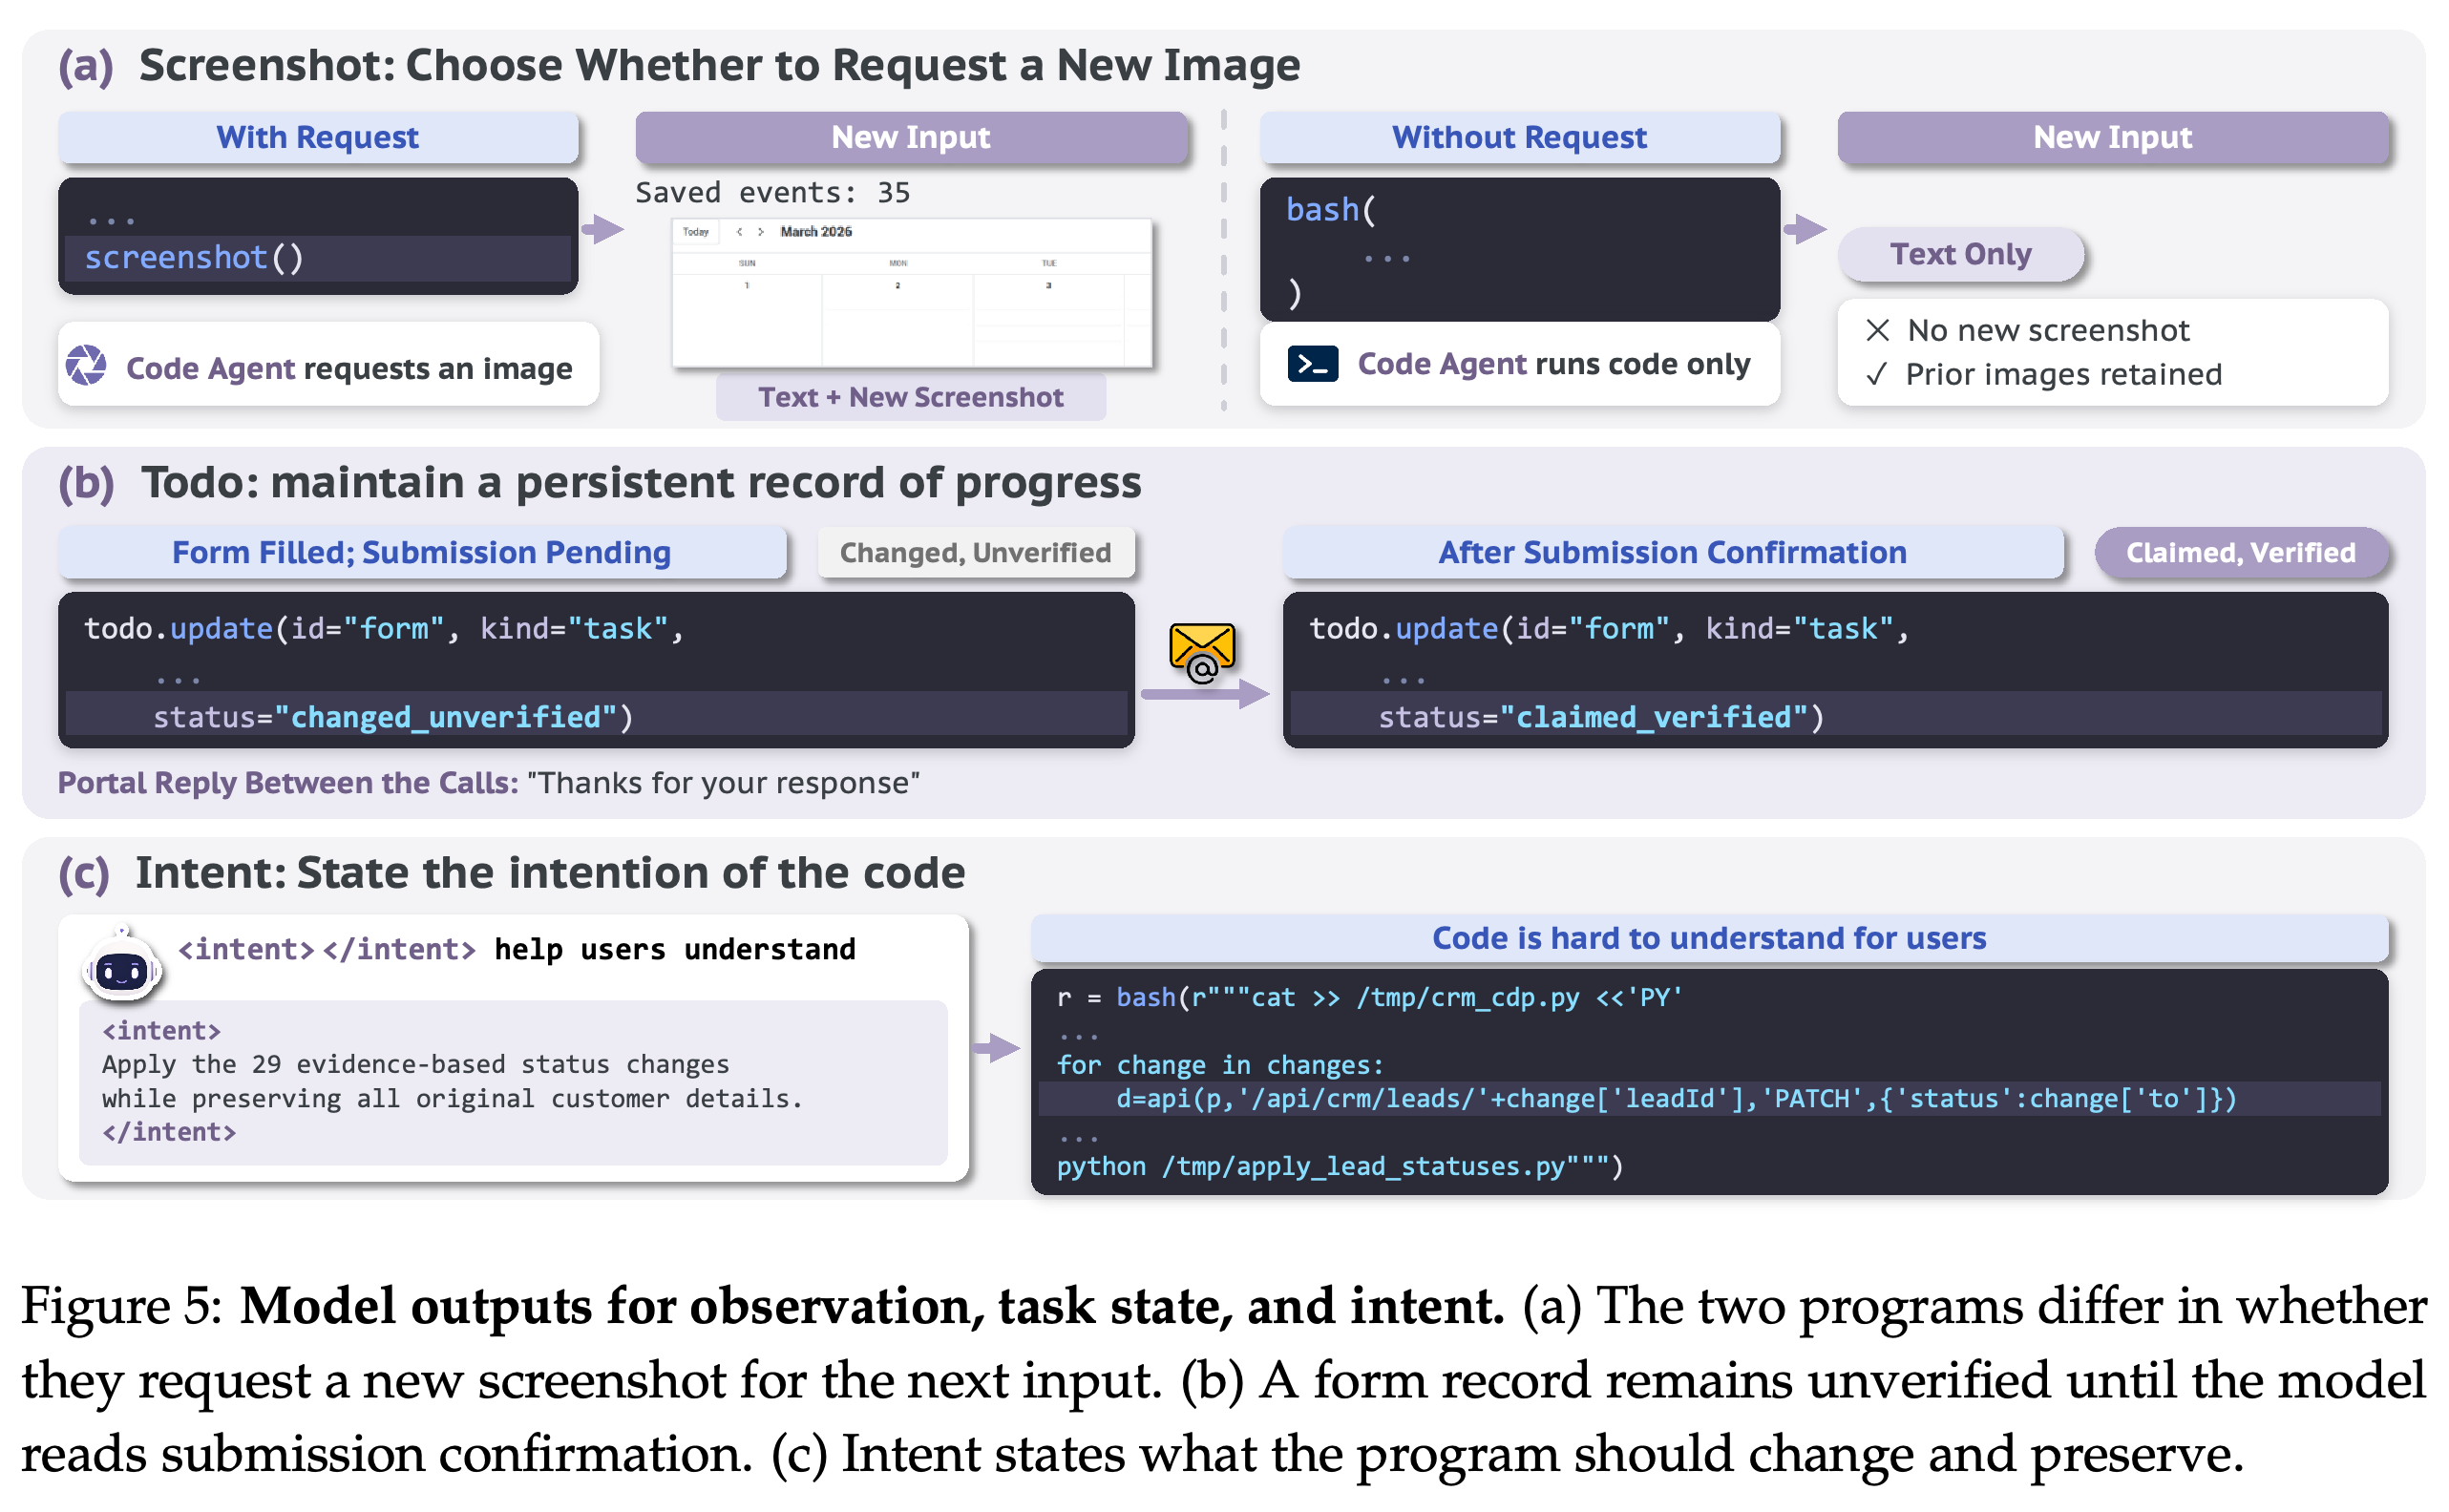
모델은 screenshot()을 요청하고, 지속되는 todo 기록을 갱신하고, <intent> 주석에 프로그램의 목적을 명시할 수 있다. 컨텍스트 보존은 여전히 하네스가 관리하며, claimed_verified 작업 기록은 독립적인 검증이 아니라 모델의 판단이다.
예시는 새 스크린샷 요청, 작업의 검증 상태 기록, 프로그램이 의도한 변경 설명을 구분한다.
3.3 Experiments on Agent Design
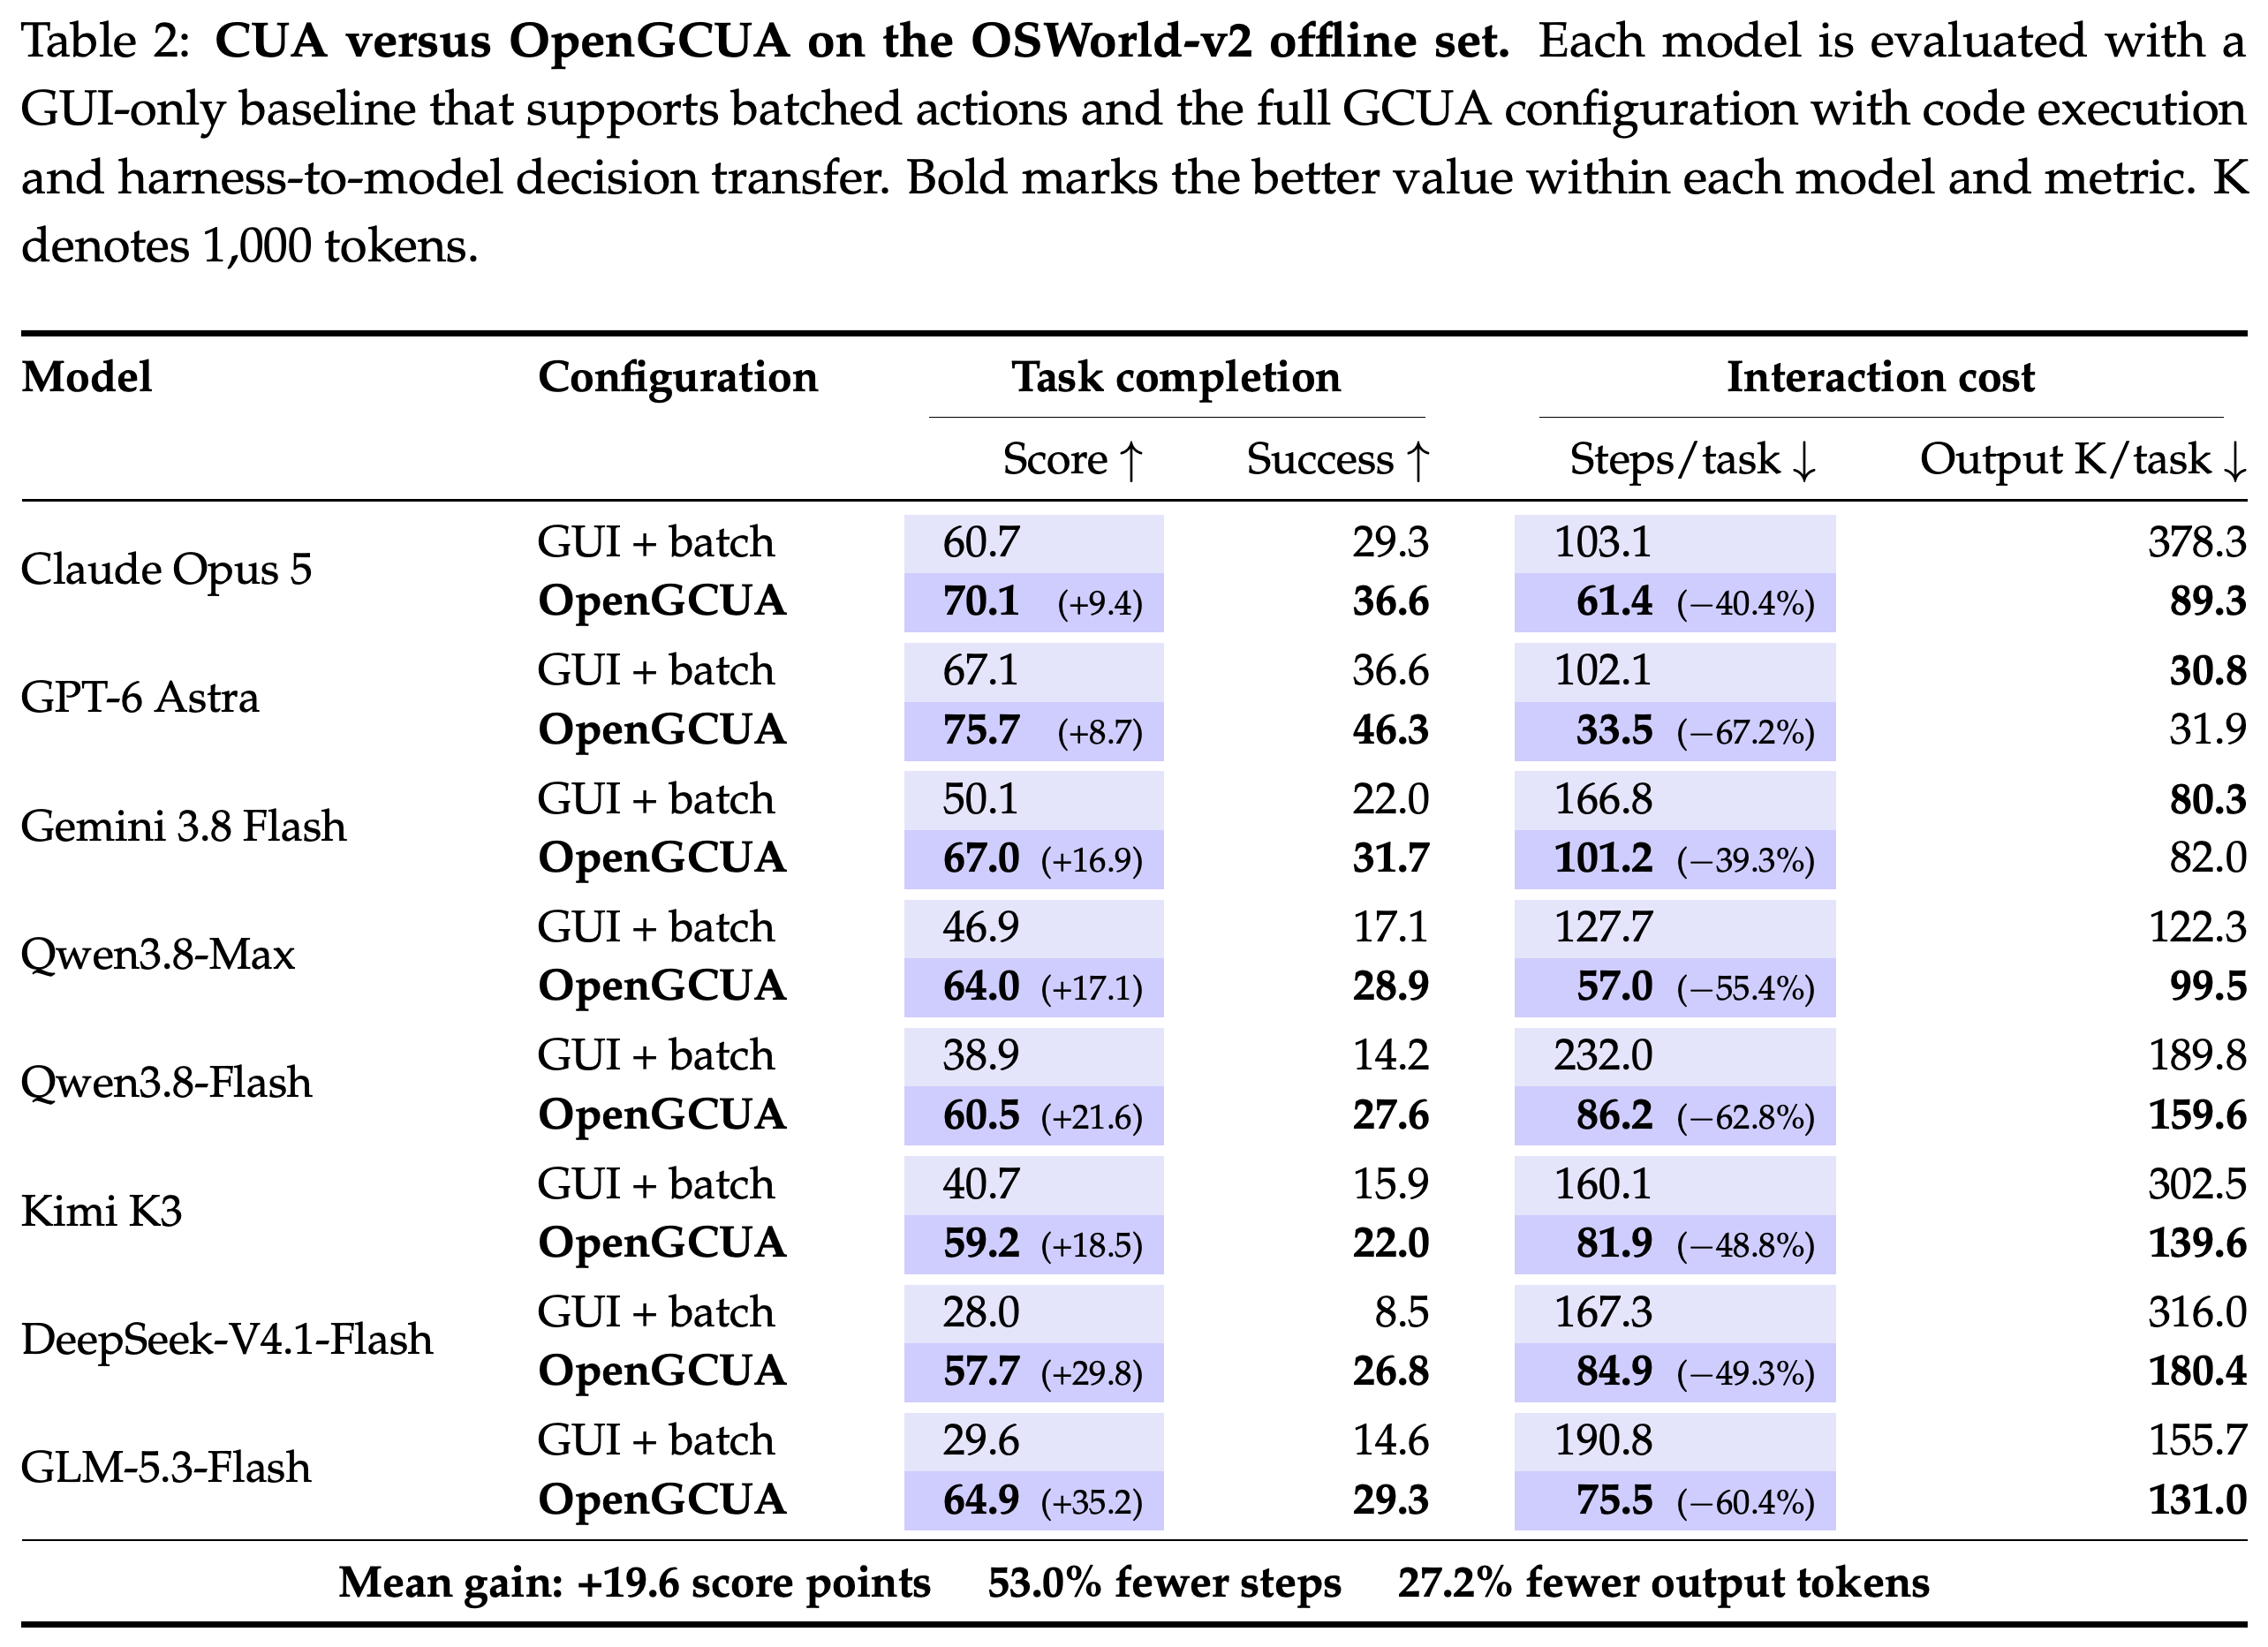
주요 비교는 외부 인터넷 접속이 필요한 작업 26개를 제외한 OSWorld-v2 v2.1 오프라인 작업 82개에서 모델 8개를 평가한다. GUI 동작만 일괄 실행하는 방식과 비교해 평균 부분 점수는 45.3에서 64.9로 올랐고 모든 모델의 전체 작업 성공률이 개선됐다. 출력 토큰은 모델 8개 중 6개에서 감소했다.
표는 모델별 점수, 성공률, 단계 수, 출력 토큰을 보고한다. GPT-6 Astra와 Gemini 3.8 Flash는 단계 수가 줄었지만 토큰 사용량은 소폭 증가했다.
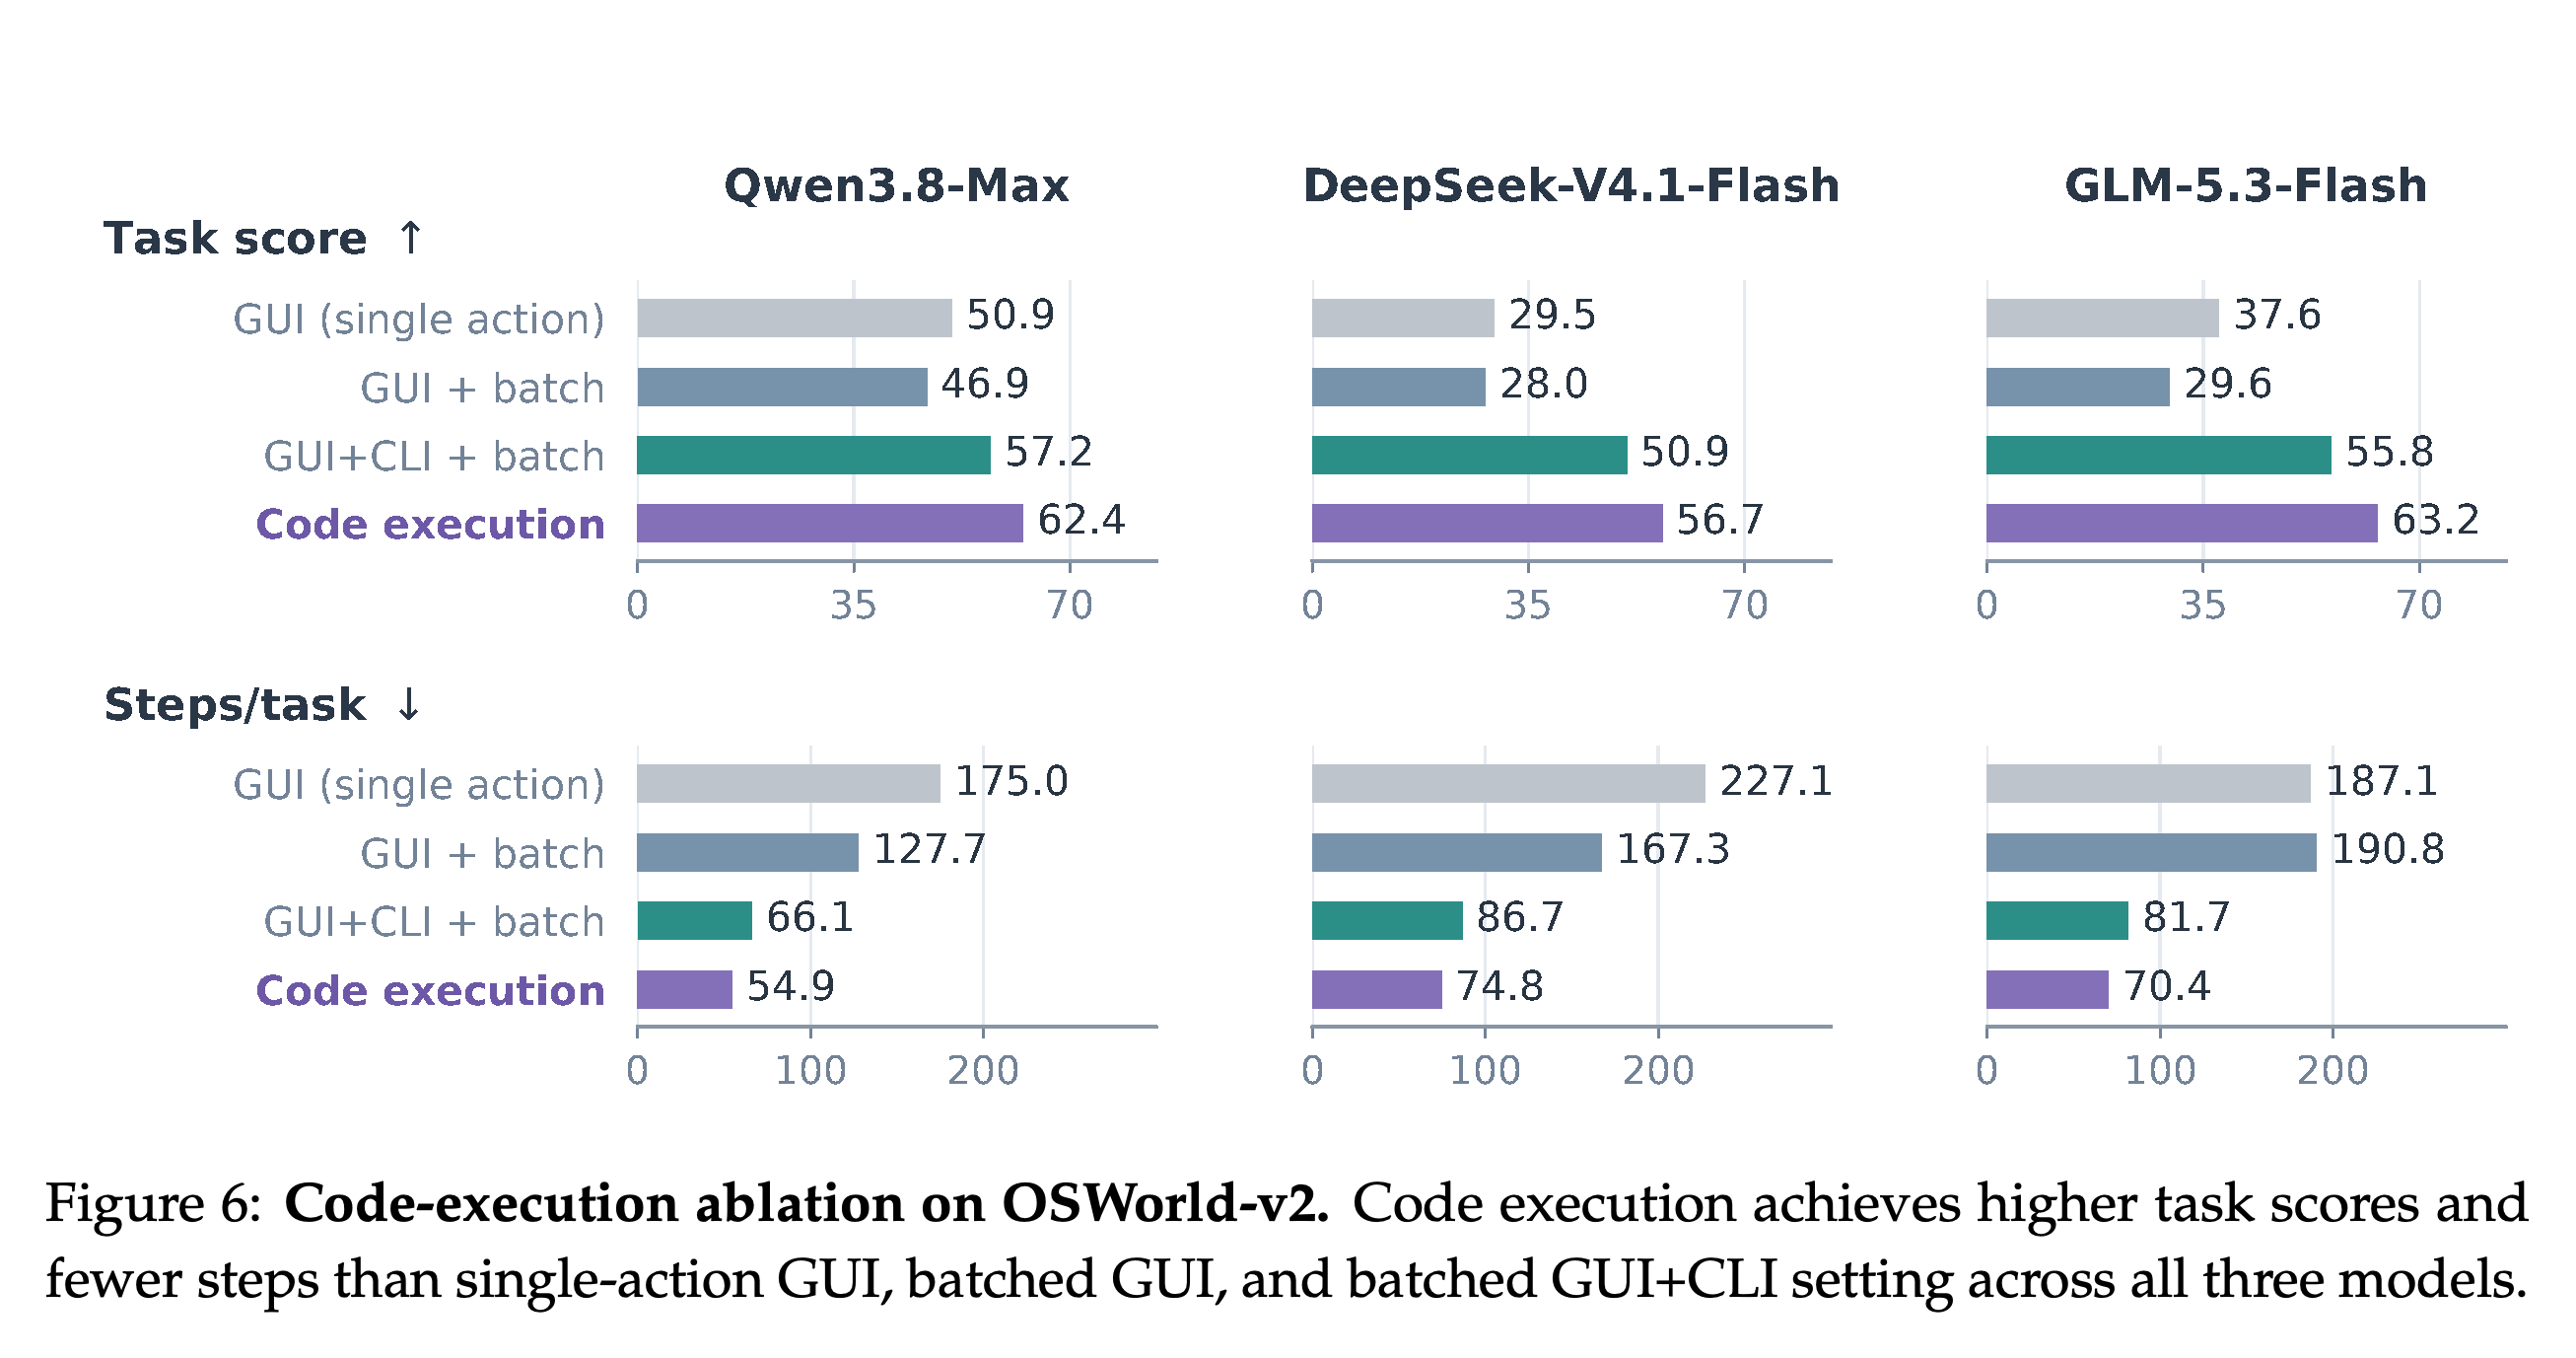
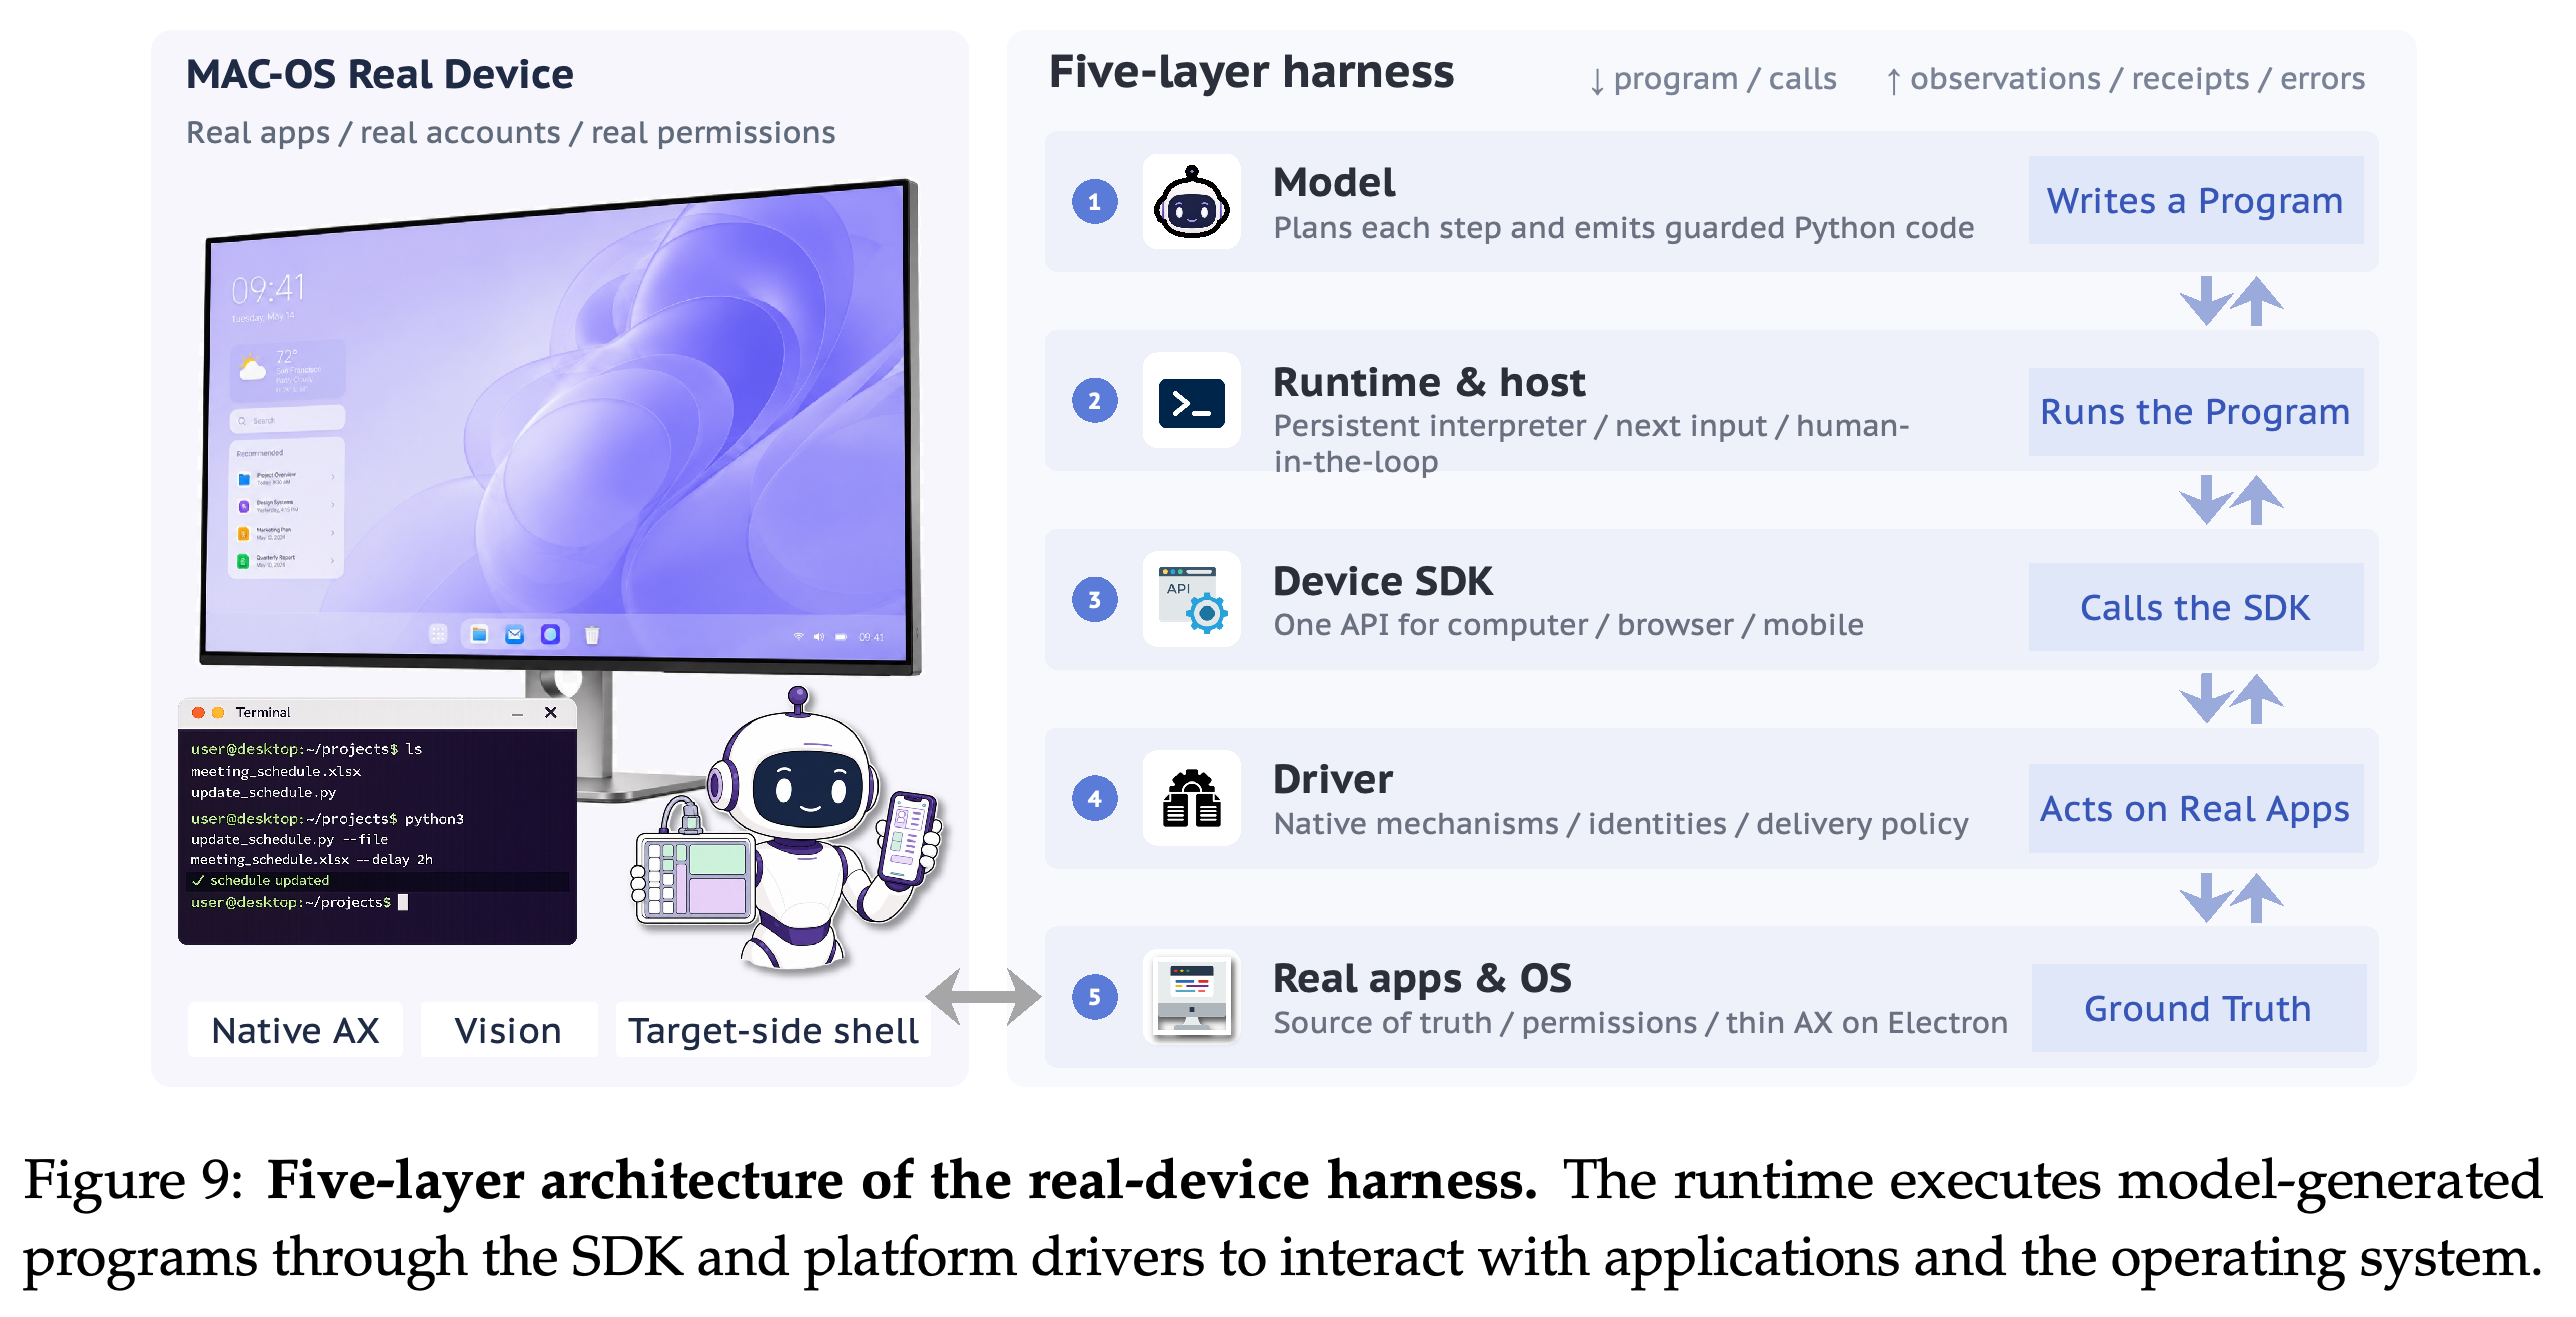
동일한 GUI 및 셸 접근을 제공한 모델 3개의 선택된 실행에서 코드 실행은 GUI+CLI 동작을 일괄 실행하는 방식보다 우수했다. GLM-5.3-Flash의 점수는 55.8에서 63.2로 올랐고, Qwen3.8-Max의 작업당 단계 수는 66.1에서 54.9단계로 줄었다. 필요할 때 스크린샷을 요청하자 캐시에서 제공된 입력 토큰의 비율인 캐시 적중률이 Qwen3.8-Max에서는 75.6%에서 86.1%로, DeepSeek-V4.1-Flash에서는 61.9%에서 76.3%로 상승했다. 선택된 비교 2개 모두에서 점수도 높아졌다.
선택된 모델 3개에서 코드 실행 설정은 표시된 대안 3개 각각보다 점수가 높고 단계 수가 적다.
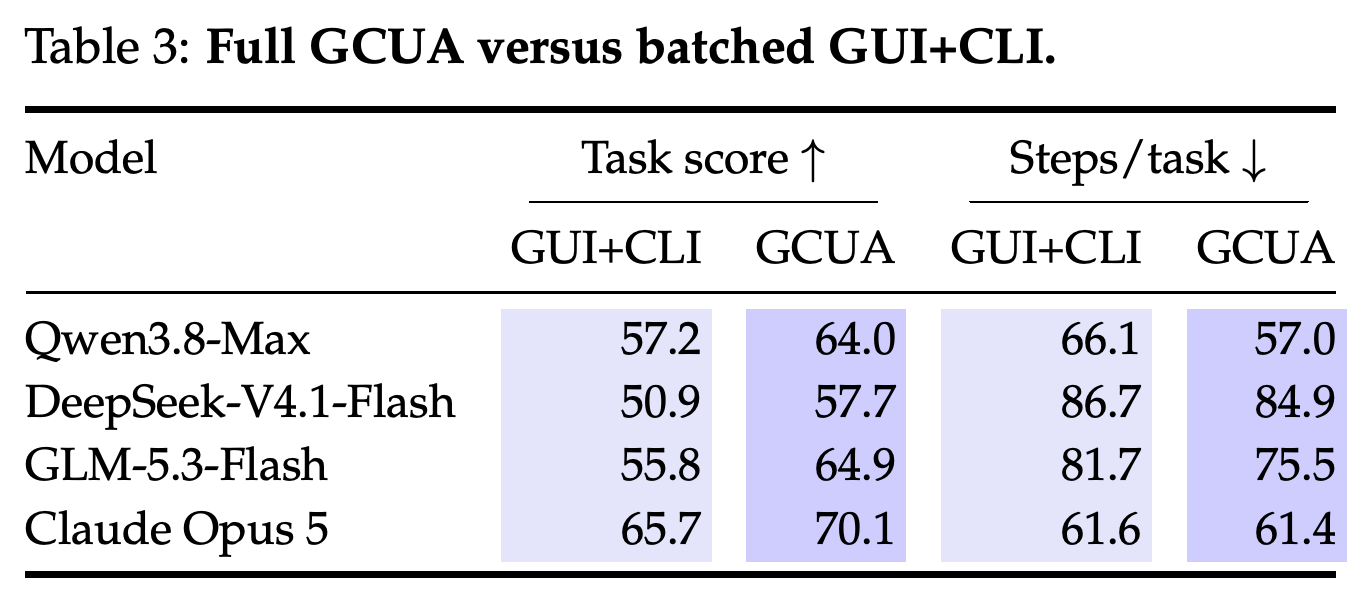
선택된 모델 4개에서 전체 구성은 GUI+CLI 일괄 실행보다 점수를 4.4~9.1점 높였고 보고된 단계 수도 줄였다.
각 메커니즘은 점수와 캐시 재사용에 서로 다른 영향을 준다. 필요할 때 관찰하면 선택된 모델 2개 모두에서 캐시 적중률이 개선되는 반면 intent는 해당 모델들의 점수를 낮춘다.
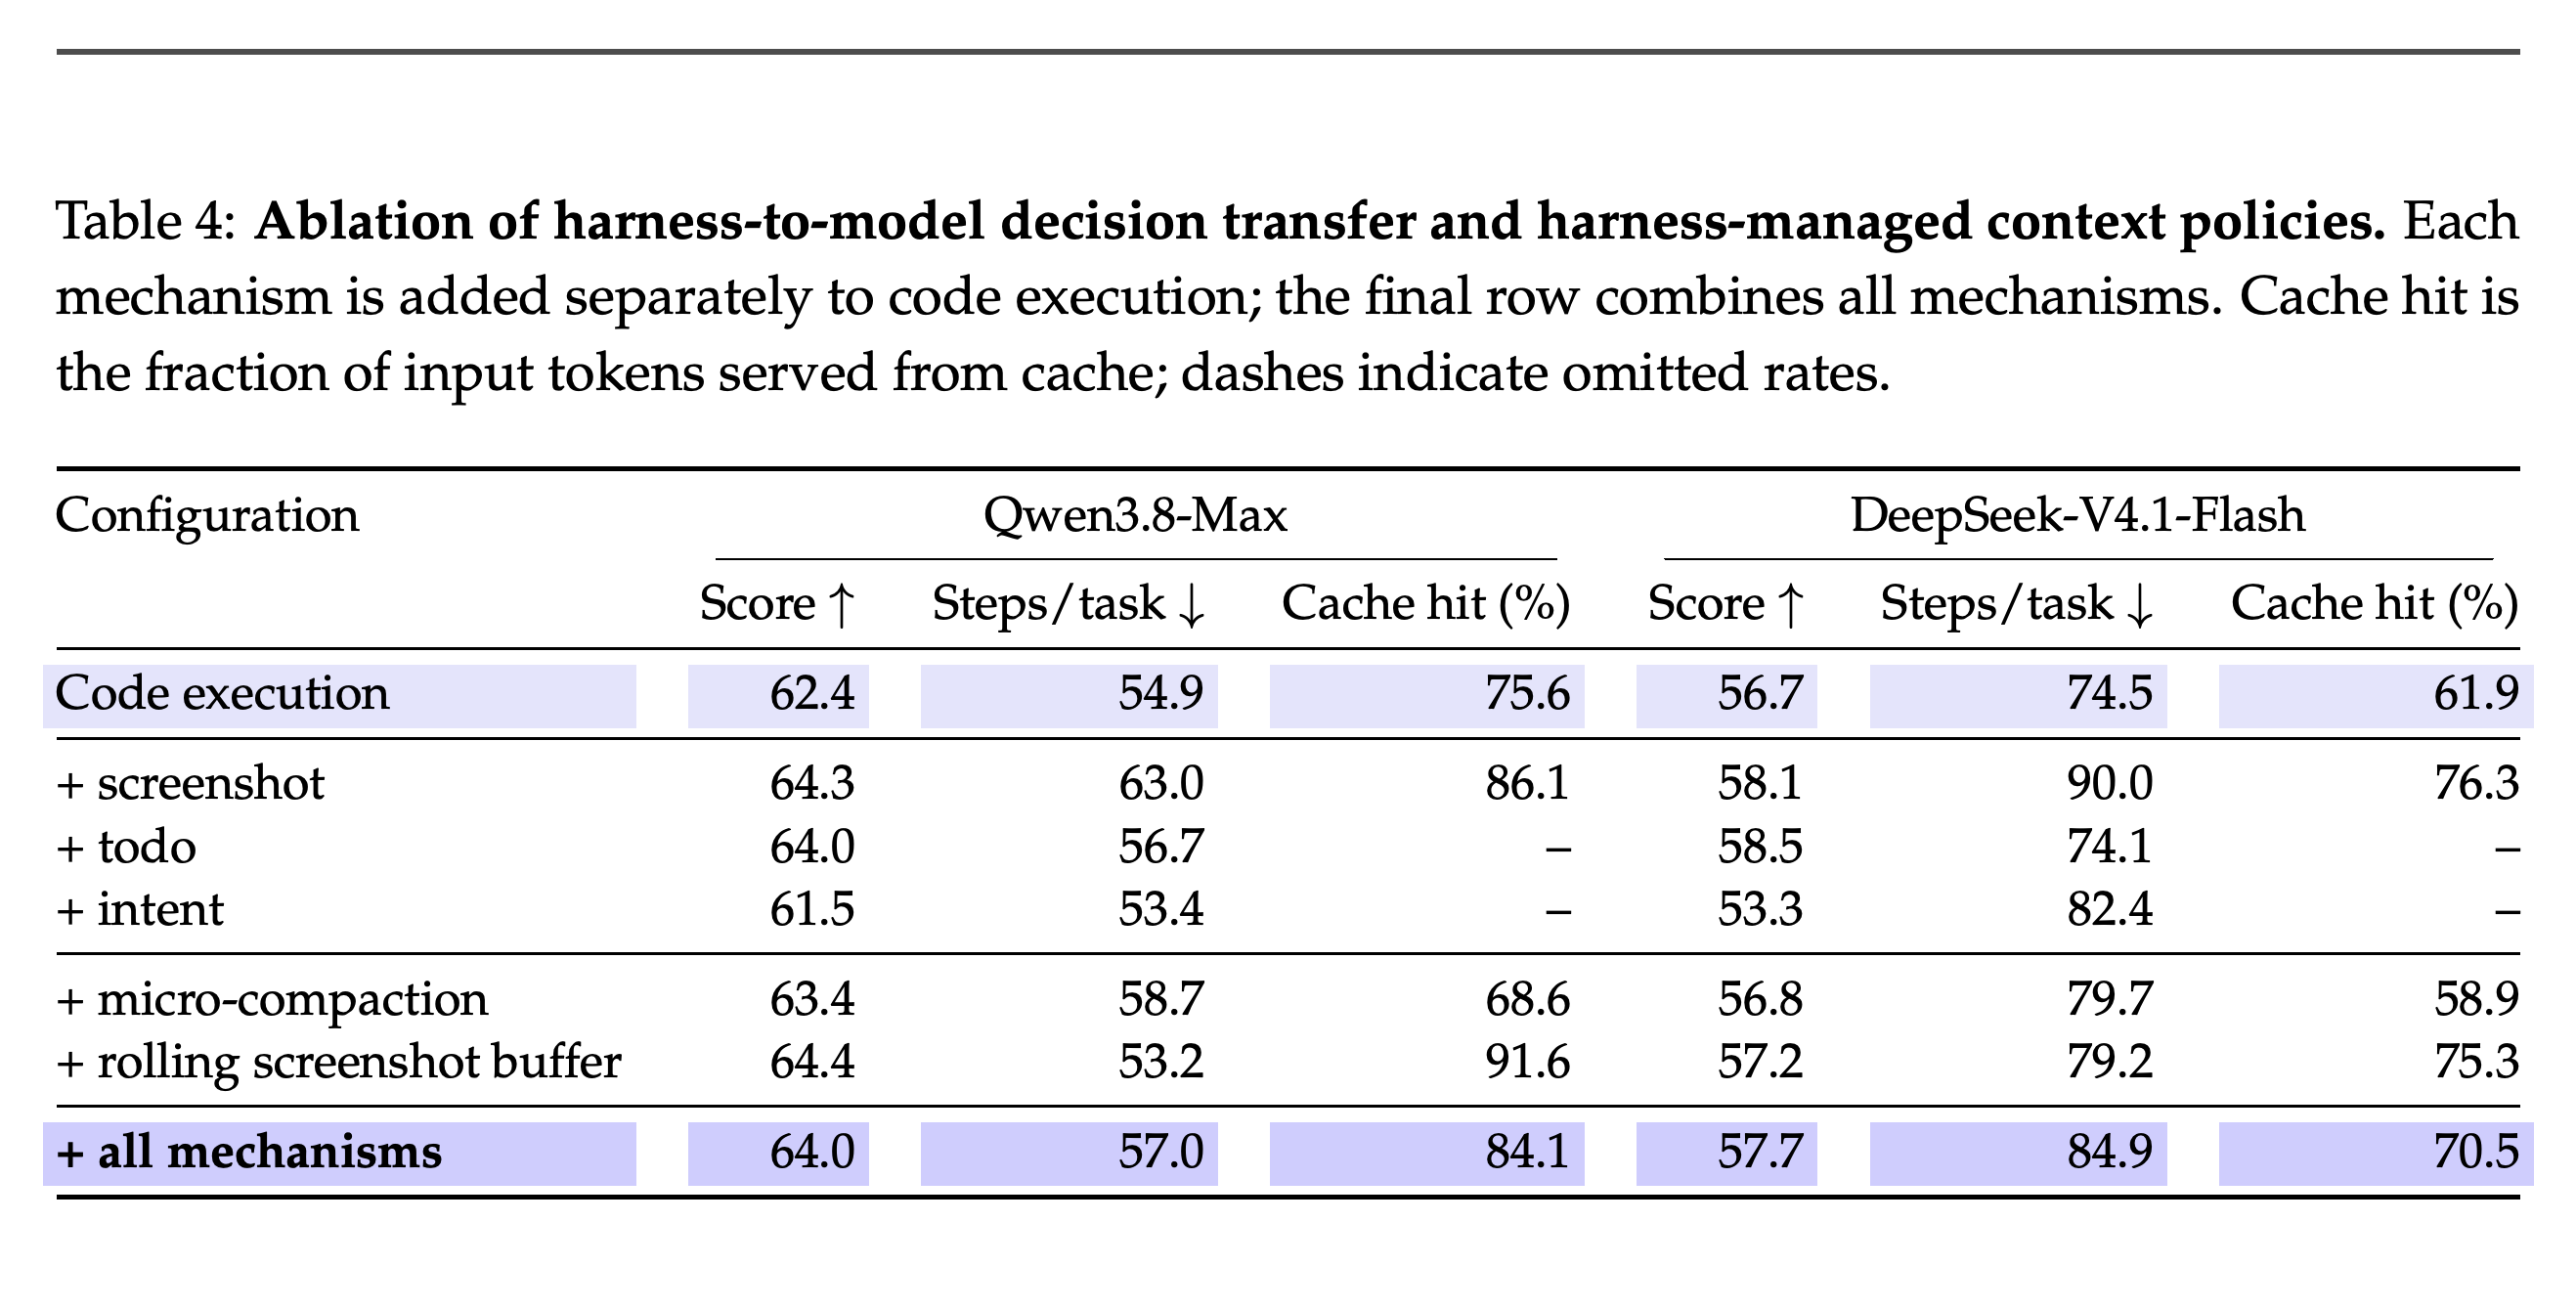
사후 지출 한도 분석에서 Qwen3.8-Flash는 작업당 약 $0.38에 60.5점을, GPT-6 Astra는 약 $15.26에 75.7점을 기록했다. 기록된 시간 비교는 제공업체의 대기열, 요청 제한, 동시 실행, 도구 지연을 모델 간에 통제하지 않았으므로 탐색적 결과다.
예산에 따라 최고 점수 모델이 달라진다. 시간 곡선은 제공업체 간 실행 조건을 통제하지 않았으므로 탐색적 결과다.
4 Real-Device Generalist CUA
실기기 연구는 초기 하네스와 Cross-Device SDK를 사용해 사용자가 함께 쓰는 기기에 에이전트 설계를 확장한다. 이 평가는 통제된 OSWorld-v2 벤치마크와 별도로 진행했다.
4.1 The Gap Between Benchmarks and Real Machines
실제 기기에는 계속 바뀌는 창, 기존 파일과 세션, 변화하는 요청이 있으며 사용자가 동시에 작업할 수도 있다. 관찰과 행동은 의도한 애플리케이션, 창 또는 탭을 대상으로 해야 한다. 백그라운드 관찰이 가능하더라도 백그라운드 제어가 지원된다는 보장은 없다.
4.2 Cross-Device SDK
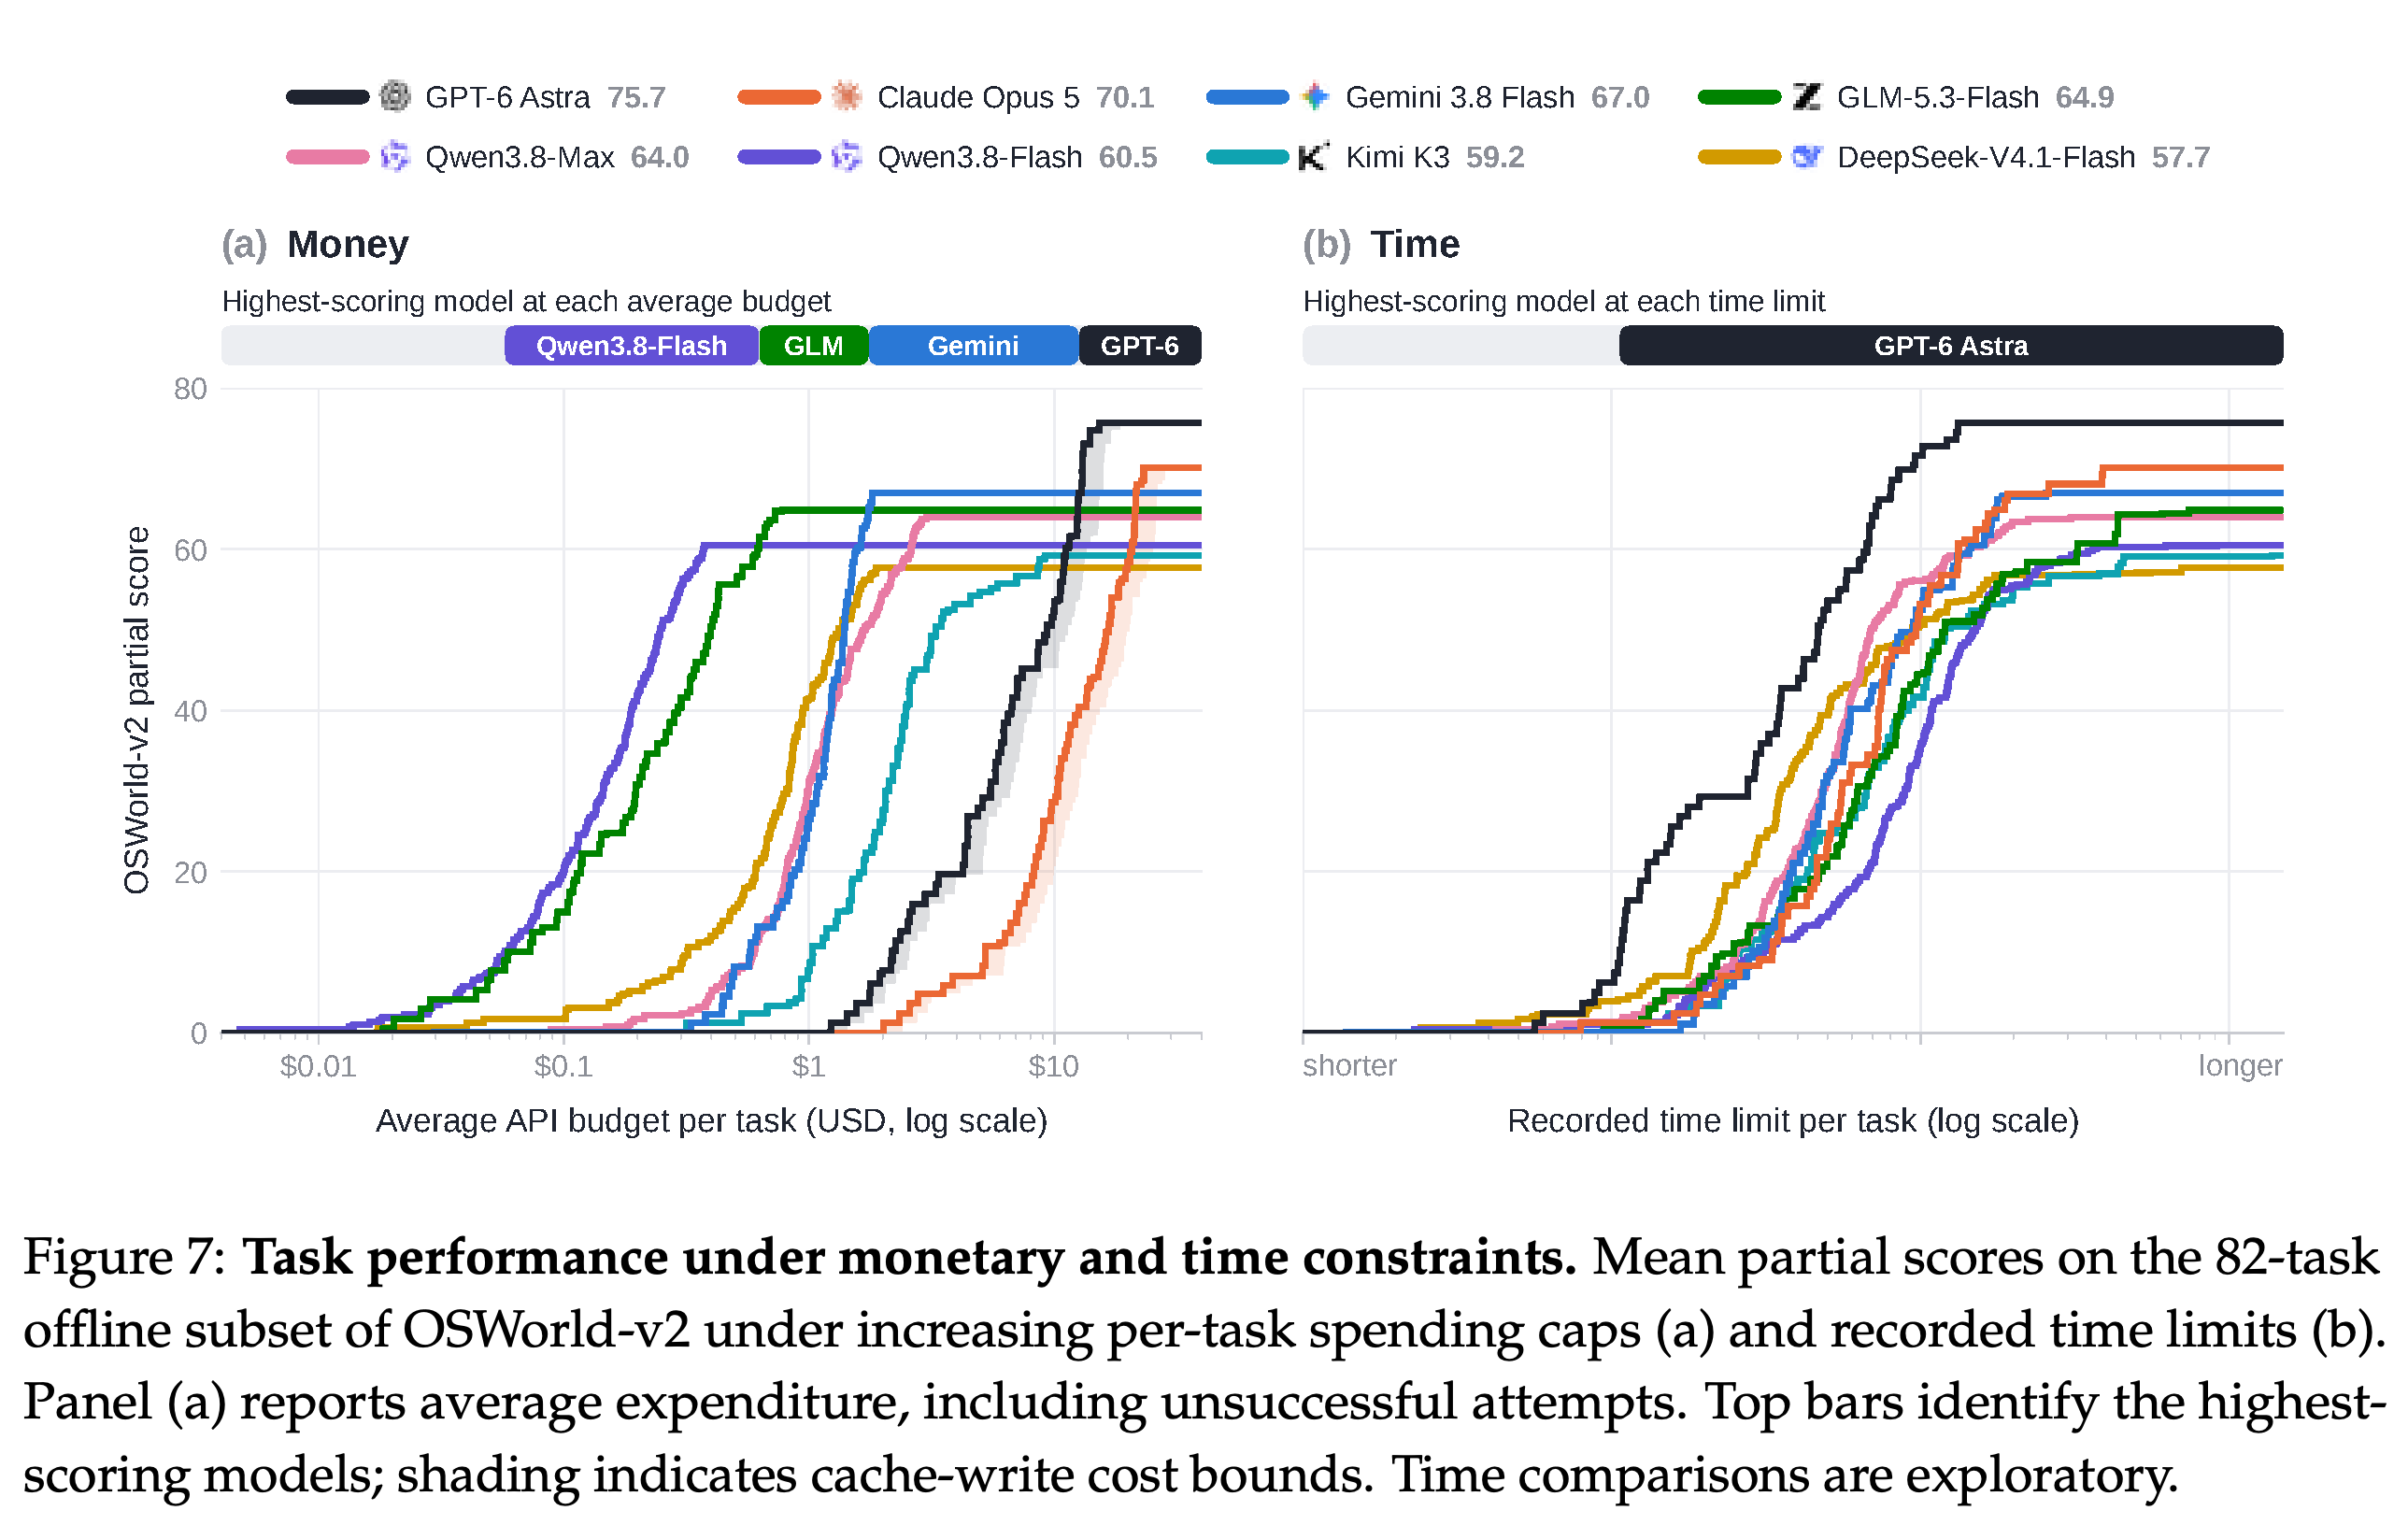
Cross-Device SDK는 동작을 명시적인 리소스에 연결하고 구조화된 접근성 관찰을 위한 ui.ax와 이미지를 위한 ui.vision을 제공한다. 프로그램은 데이터를 로컬에서 살펴보고 mu.emit을 사용해 선택한 정보를 모델에 전달할 수 있다. 플랫폼별 지원 기능도 명시한다.
명시적인 리소스 핸들과 플랫폼 어댑터를 사용하면 프로그램 1개가 기기를 조정하면서 선택한 관찰 정보를 모델에 반환할 수 있다.
4.3 Real-Device Harness
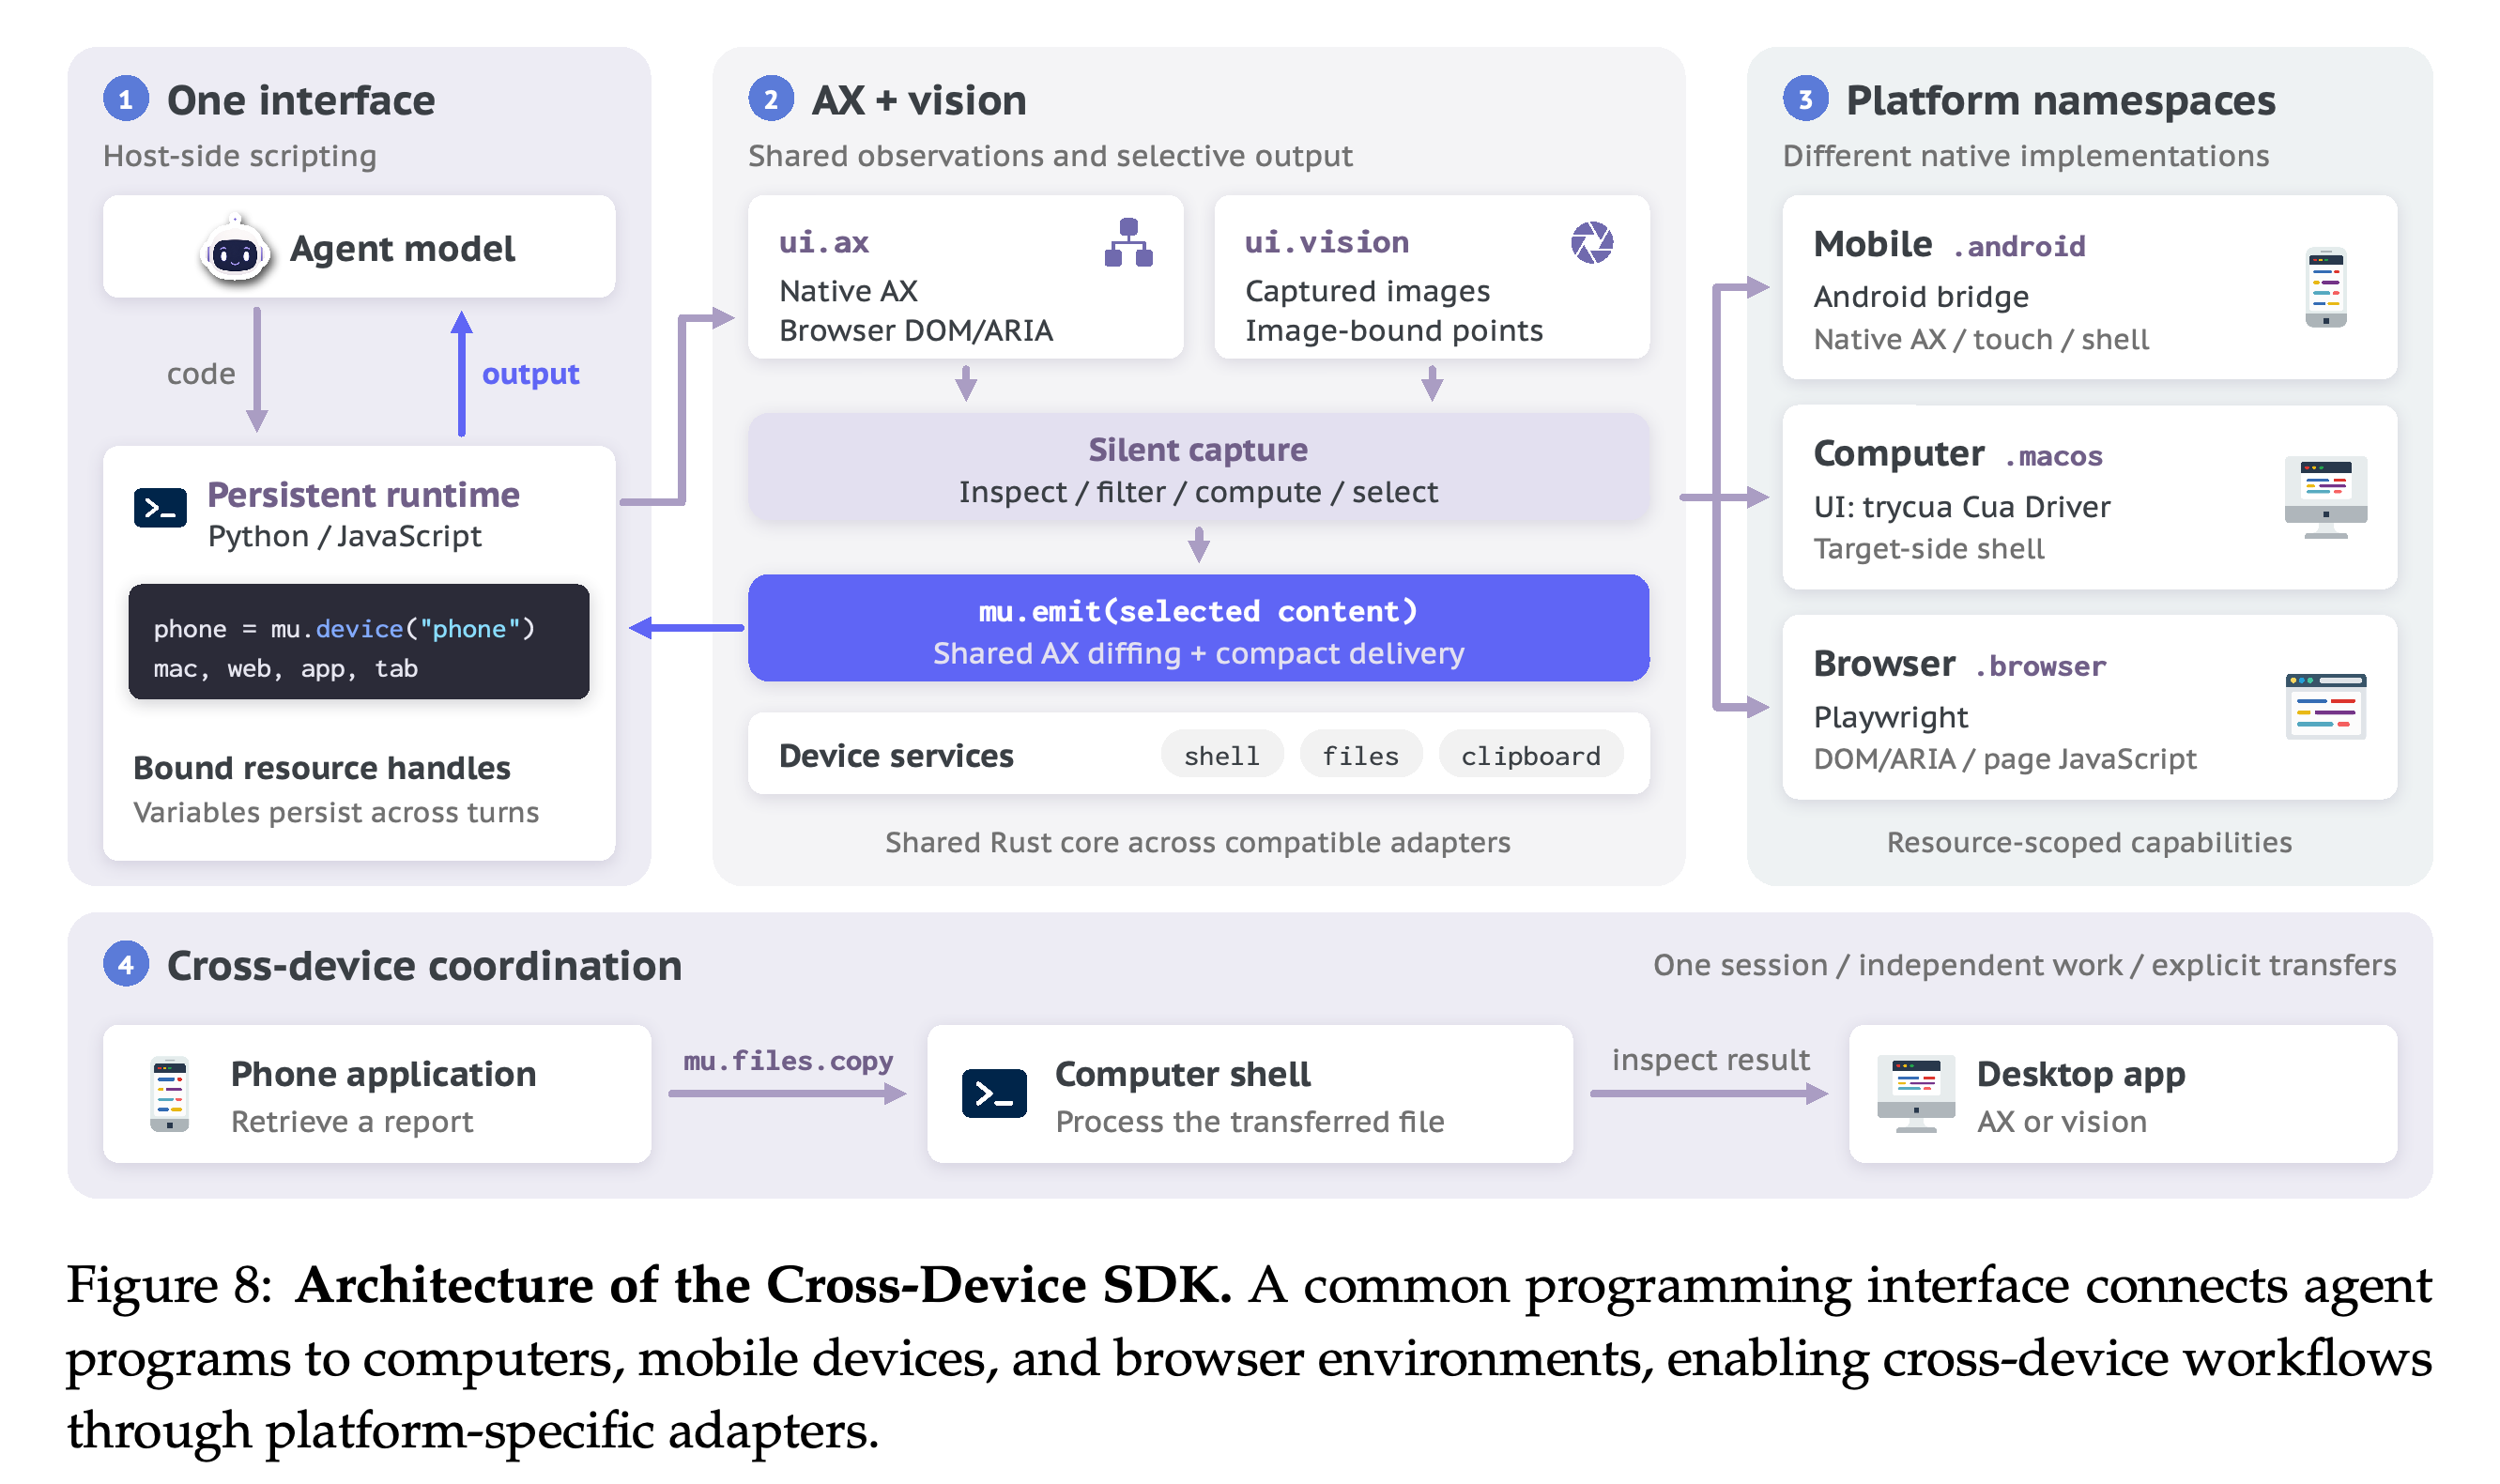
실기기 하네스는 모델, 지속 실행 런타임, 기기 SDK, 드라이버, 애플리케이션 및 운영체제를 분리한다. 지원되는 경우 접근성 동작을 우선하고, 사용자와 포그라운드 입력을 조율하며, 사용자 상호작용 사이에 상태를 유지한다.
계층형 구조는 모델의 결정을 런타임 실행, 리소스 연결, 네이티브 전달, 애플리케이션 상태와 분리한다.
macOS 작업 4개에서 선택된 GPT-6 Astra 실행은 작업당 평균 34.5단계, 출력 토큰 12.9K, $18.290을 기록하고 4/4를 완료했다. Qwen3.8-Max는 평균 50.8단계, 토큰 73.4K, $1.494를 기록하고 3/4를 완료했다. 비교에는 미완료 작업이 포함되며 작업마다 선택된 실행 1개를 사용한다. 논문은 사례 연구의 실행 궤적이 이 실행들과 별개라고 설명한다.
선택된 실행은 완료율, 토큰 소비, 추정 비용 사이의 차이를 보여준다. 표는 작업 4개와 구성 5개를 다룬다.
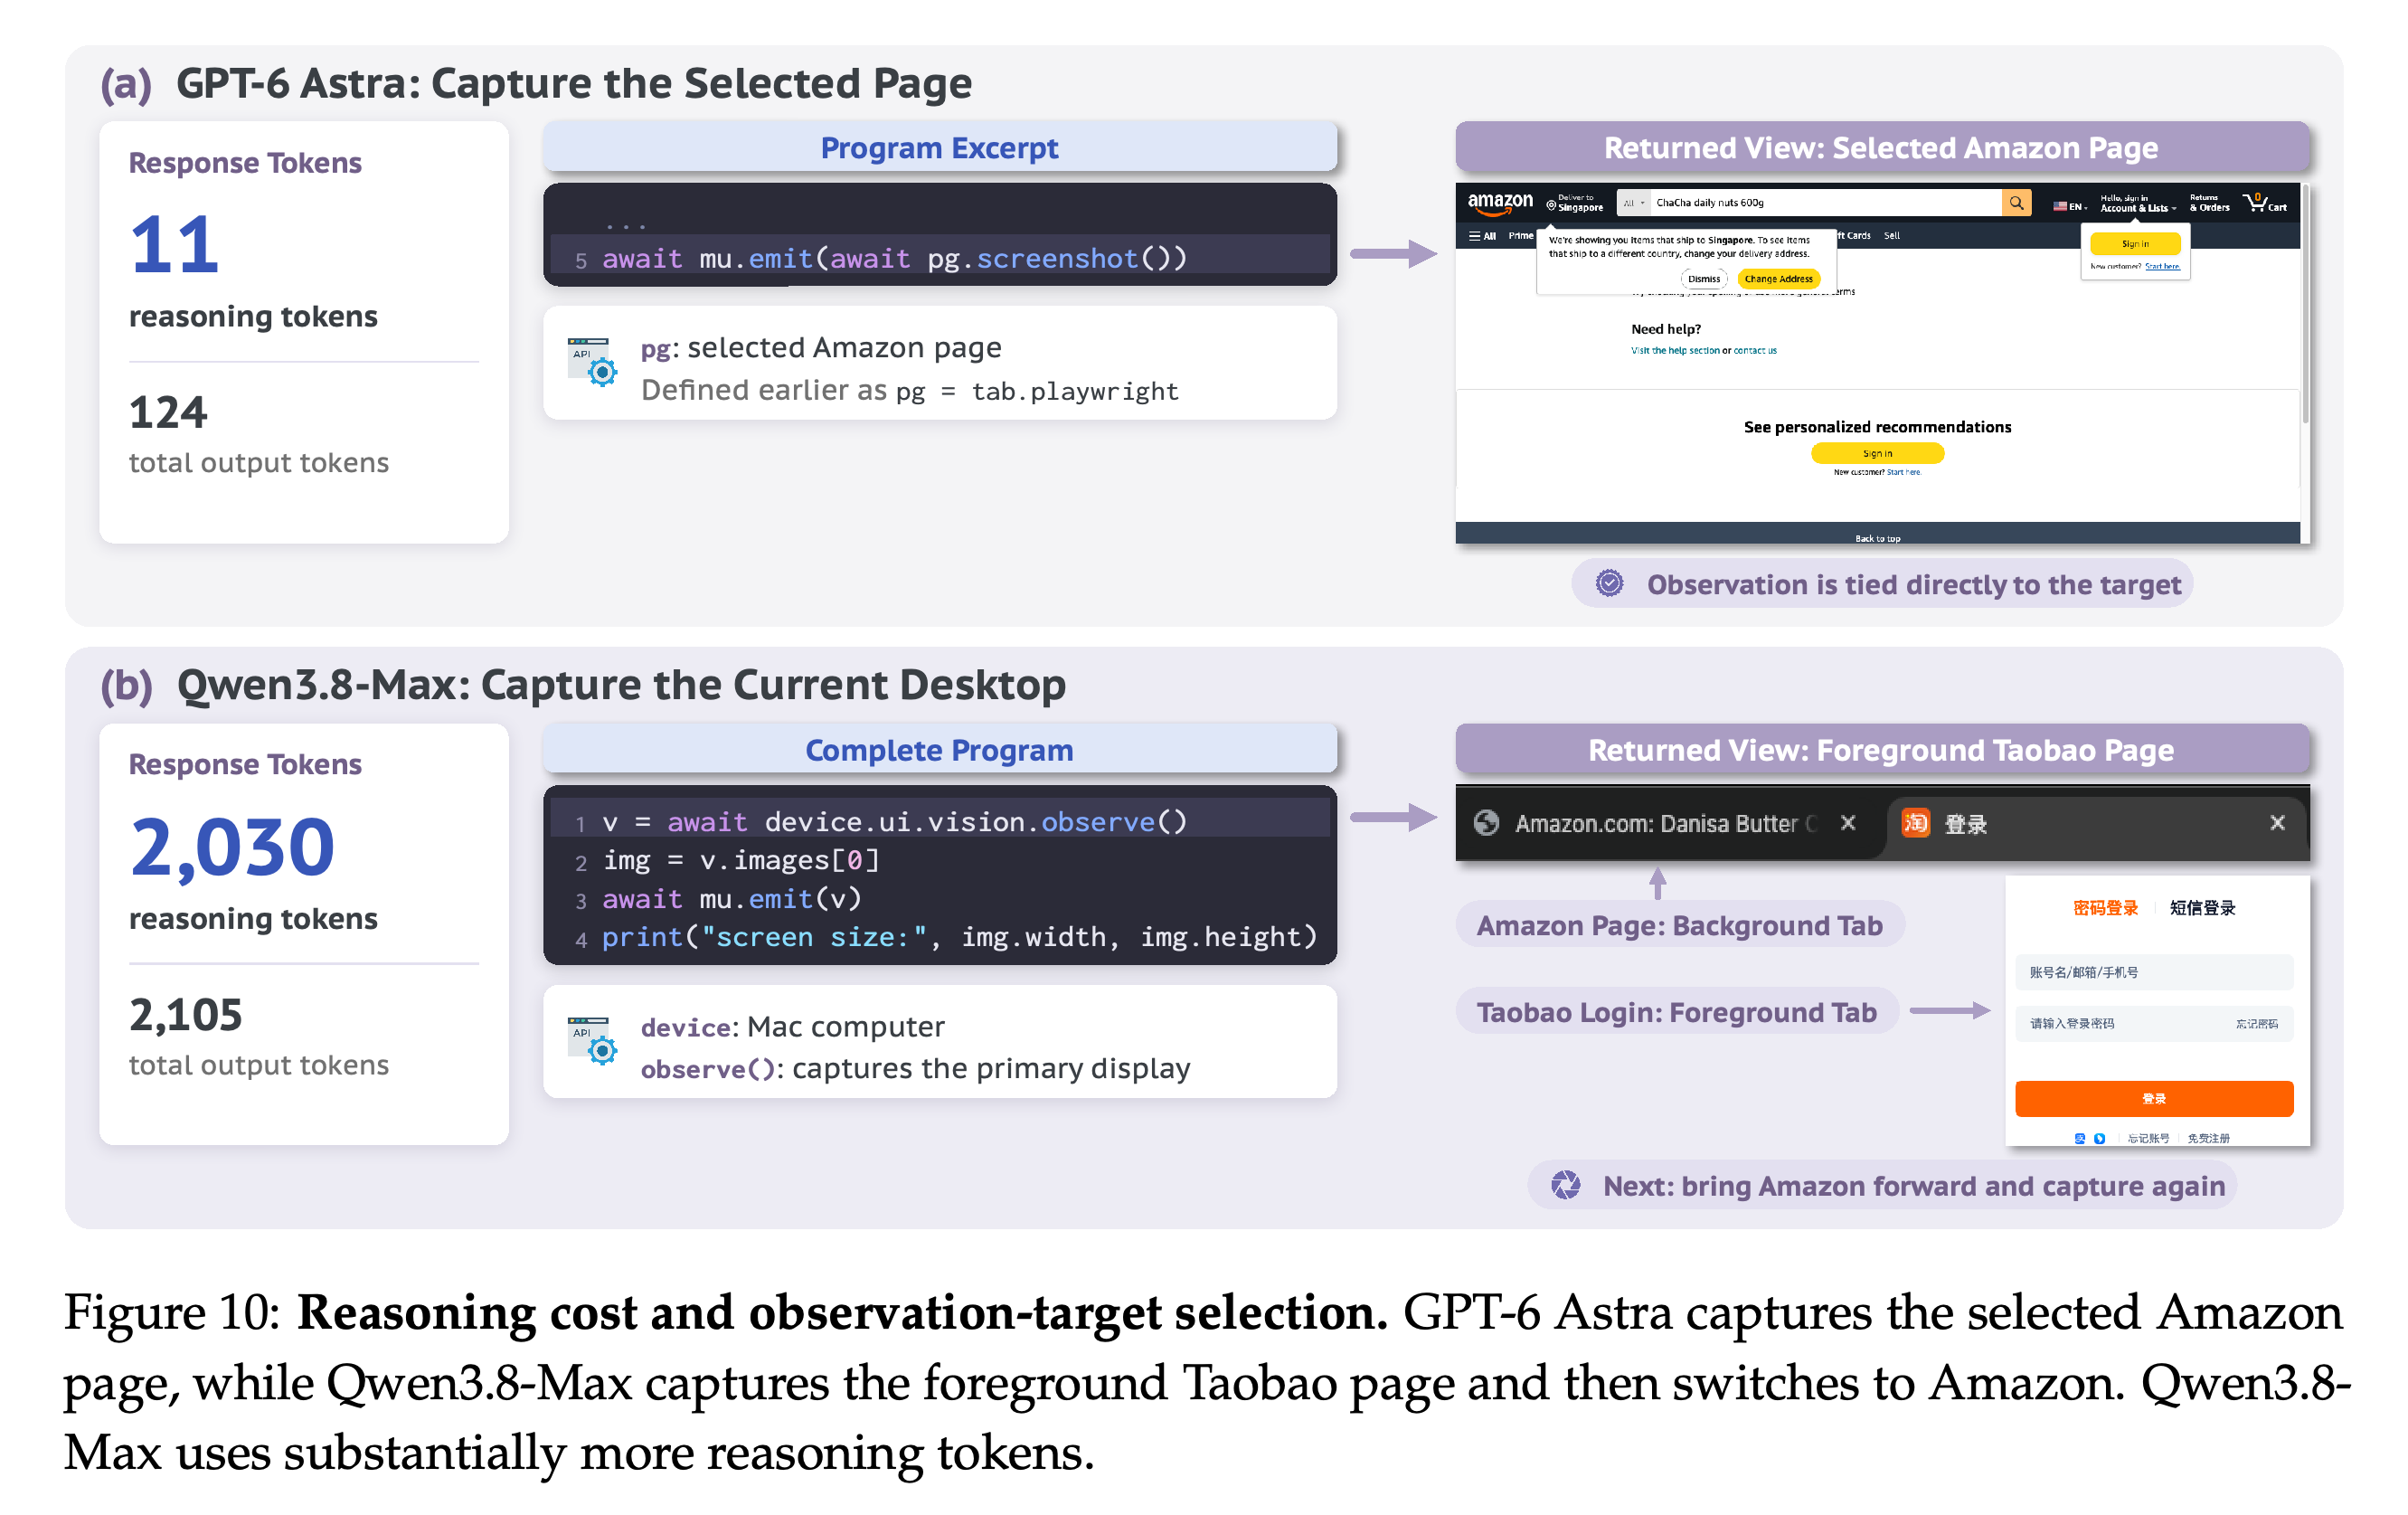
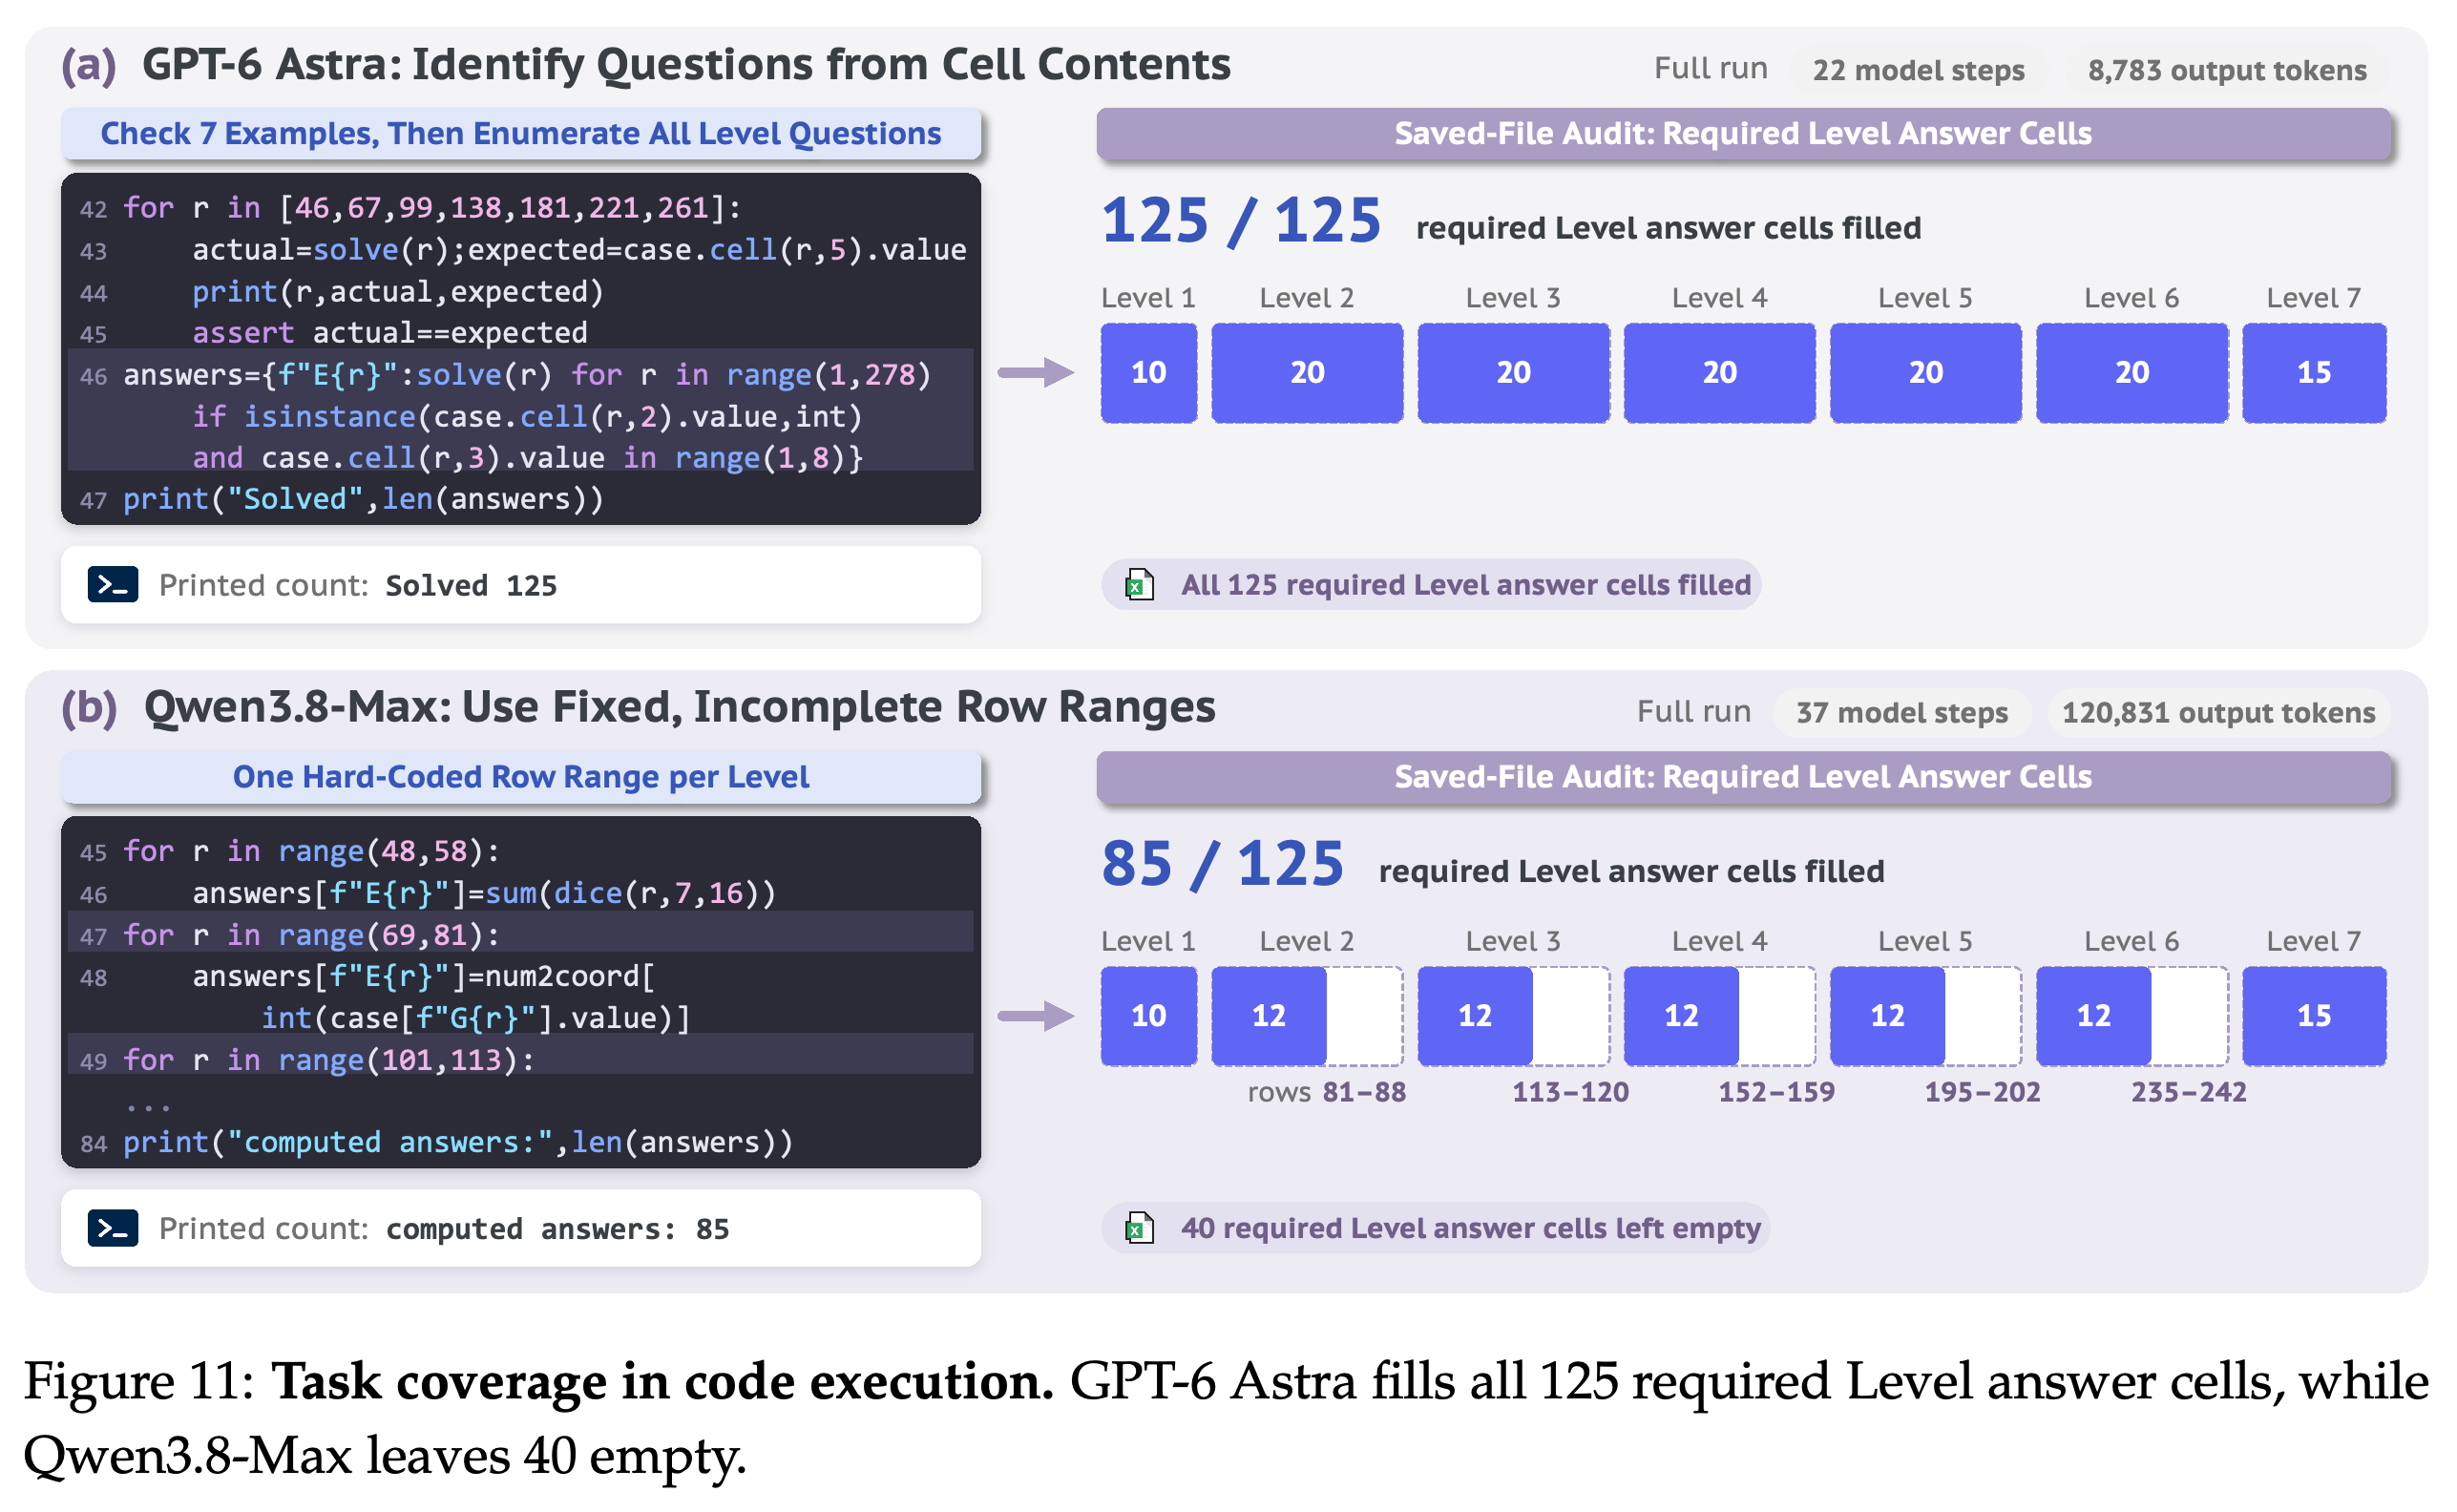
쇼핑 사례는 대상 선택의 차이를 보여준다. Qwen3.8-Max는 선택된 Amazon 페이지 대신 포그라운드 데스크톱을 캡처했고 GPT-6 Astra는 선택된 페이지를 캡처했다. 워크북 감사에서는 GPT-6 Astra가 필수 답변 셀 125개를 채웠고 Qwen3.8-Max는 85개를 채우고 40개를 비워 두었다.
쇼핑 작업 예시는 스크린샷 작업에서 관찰 범위와 보고된 추론 토큰의 차이를 보여준다.
저장된 파일을 감사한 결과 Qwen3.8-Max가 고정한 행 범위와 채우지 못한 셀 40개 사이의 관계가 드러난다. GPT-6 Astra는 워크북 내용에서 질문 행을 식별한다.
5 Roadmap
로드맵은 모델 개발, 실행 인프라, 실기기 평가를 계속 추진할 프로젝트 목표로 연결한다.
5.1 From Design Validation to Model Release
첫 공개 버전은 기존 모델로 설계를 검증한다. 컴퓨터와 브라우저 사용을 통합하는 GCUA 모델은 다음 공개 버전에 계획돼 있다.
5.2 Research Priorities
저자들은 간결한 추론, 실행 및 컨텍스트 효율, 신뢰할 수 있는 대상 선택과 복구, 특히 macOS를 중심으로 한 더 폭넓은 실기기 벤치마크를 우선 과제로 제시한다.
5.3 How to Contribute
프로젝트는 하네스와 SDK, 실기기 평가 환경과 기준, 연구 목표에 대한 기여를 요청한다. 로드맵에는 출시 일정이 명시돼 있지 않다.
6 Related Work
관련 연구에는 GUI 중심 공개 모델, GUI와 프로그래밍 방식을 결합한 에이전트, cua와 Agent S 같은 공개 인프라가 포함된다. 저자들은 OpenGCUA를 앞으로 학습할 모델과 실기기 인프라 및 실행 궤적을 연결하려는 시도로 규정한다.
7 Conclusion
보고된 결과는 인터페이스 접근과 함께 실행 설계를 연구할 필요성을 뒷받침한다. 전체 구성은 테스트한 모델 8개 모두에서 GUI 일괄 실행 베이스라인보다 개선됐고, 선택된 제거 실험에서는 코드 실행이 GUI+CLI 일괄 실행보다 향상된 결과를 보였다. 학습된 모델과 포괄적인 실기기 평가는 향후 과제로 남아 있다.
부록
- A Evaluation Details는 작업 점수를 0–100 척도의 평균 부분 점수로, 전체 성공을 0.999999보다 큰 정규화 평가 점수로 정의한다. 자원 사용량은 실패한 작업을 포함해 평균하고, 가장 최근에 평가한 시도를 유지하며, 모델 간 요약에서는 모델에 동일한 가중치를 부여한다.
- B Real-Device Evaluation Details는 워크북 추론, 합성 데이터를 사용한 PDF 양식 작성, 간식 후보 22개에 관한 조사, 제약 조건이 있는 파리 호텔 비교를 설명한다. 번역된 작업 지시와 자료도 제공하며, 여기에는 워크북의 Level 질문 125개와 풀이 예제 7개가 포함된다.
- C Prompts는 벤치마크의 코드 실행 규약, 스크린샷 요청, 작업 기록, intent 주석, 전체 OSWorld-v2 하네스 프롬프트를 문서화한다. 지속되는 실기기 인터프리터와 달리 벤치마크 프롬프트는 단계마다 새로운 Python 프로세스를 지정한다.
- D Trajectory Examples는 GPT-6 Astra의 슬라이드 배경 작업과 Claude Opus 5 dashboard GIF task를 제시한다. 각각 저장된 평가 결과는 1.0이다. 보충 자료는 내보낸 실행 궤적을 독립적으로 재실행할 수 있는 프로그램이 아닌 증거 기록으로 설명한다.
짧은 생각
GUI+CLI 일괄 실행과의 비교는 사용 가능한 인터페이스를 대체로 동일하게 유지해 실행 설계의 기여를 분리해 살펴보는 데 도움이 된다. 모델 3개를 대상으로 한 제거 실험은 모델 8개를 대상으로 한 주요 비교보다 범위가 좁다. 실기기 연구의 작업 4개와 통제되지 않은 시간 측정 조건은 일반적인 배포 성능이나 속도에 관한 주장을 제한한다.