


2025년 9월 AI 논문 동향
30 Sep 2025 | Paper Review Monthly Papers Agent Training Multimodal Models Factuality Evaluation목차
이달의 트렌드
2025년 9월의 주제는 데이터와 평가 조건을 명시한 모델 역량 측정이며, 논문 3편은 각각 LIMI의 상호작용 과제 수행 학습, Qwen3-Omni의 텍스트, 이미지, 오디오, 비디오 통합, SimpleQA Verified의 사실 기억 능력 채점 방식 개선을 다룬다. 이들이 공유하는 공학적 관심사는 보고된 성능 향상이 실제로 무엇을 측정하는지다. 시연 개수를 해석하려면 전체 상호작용 기록인 궤적의 길이를 함께 살펴봐야 한다. 통합 모델은 개별 입력 유형에 특화된 역량과 비교해야 하며, 사실성 점수는 정답과 답변을 시도하지 않는 응답인 답변 보류의 판정 규칙을 함께 확인해야 한다. 1, 2, 3
데이터 구성은 학습과 평가 모두에 직접 영향을 준다. LIMI의 시연 78개는 추론, 도구 호출, 관찰을 순서대로 담은 완전한 궤적이며, 각각 평균 42.4k 토큰을 포함한다. SimpleQA Verified는 중복 제거, 출처 확인, 분포 균형 조정, 난도 선별을 통해 질문 4,326개를 1,000개로 줄인다. 이 결과는 예제 개수만으로 학습 자원이나 벤치마크의 평가 범위를 충분히 설명하기 어렵다는 점을 보여준다. LIMI는 데이터셋 간 학습 토큰 수나 수집 작업량을 맞추지 않았으며, SimpleQA Verified의 필터는 평가하는 지식의 분포를 바꾼다.
종합 점수도 과제별로 살펴봐야 한다. Qwen3-Omni는 조건을 맞춘 기본 모델 비교에서 텍스트와 시각 역량을 전반적으로 유지하지만, 개별 과제에서는 성능이 하락한다. LIMI가 보고한 실행 환경 사용 여부에 따른 평균은 서로 다른 벤치마크 집합을 포함하므로, 이 비교로 실행 환경의 기여를 분리할 수 없다. SimpleQA Verified는 전체 정확도, 답변을 시도한 질문에서의 정확도, 답변 시도율을 함께 보고해 답변하려는 성향이 사실성 순위에 미치는 영향을 드러낸다. 이 연구들은 대표 결과를 비교 조건과 세부 지표에 비추어 해석해야 한다는 점을 뒷받침한다.
2025년 9월의 주요 논문
1. LIMI: Less is More for Agency
- https://arxiv.org/abs/2509.17567
- LIMI: Less is More for Agency 요약 설명
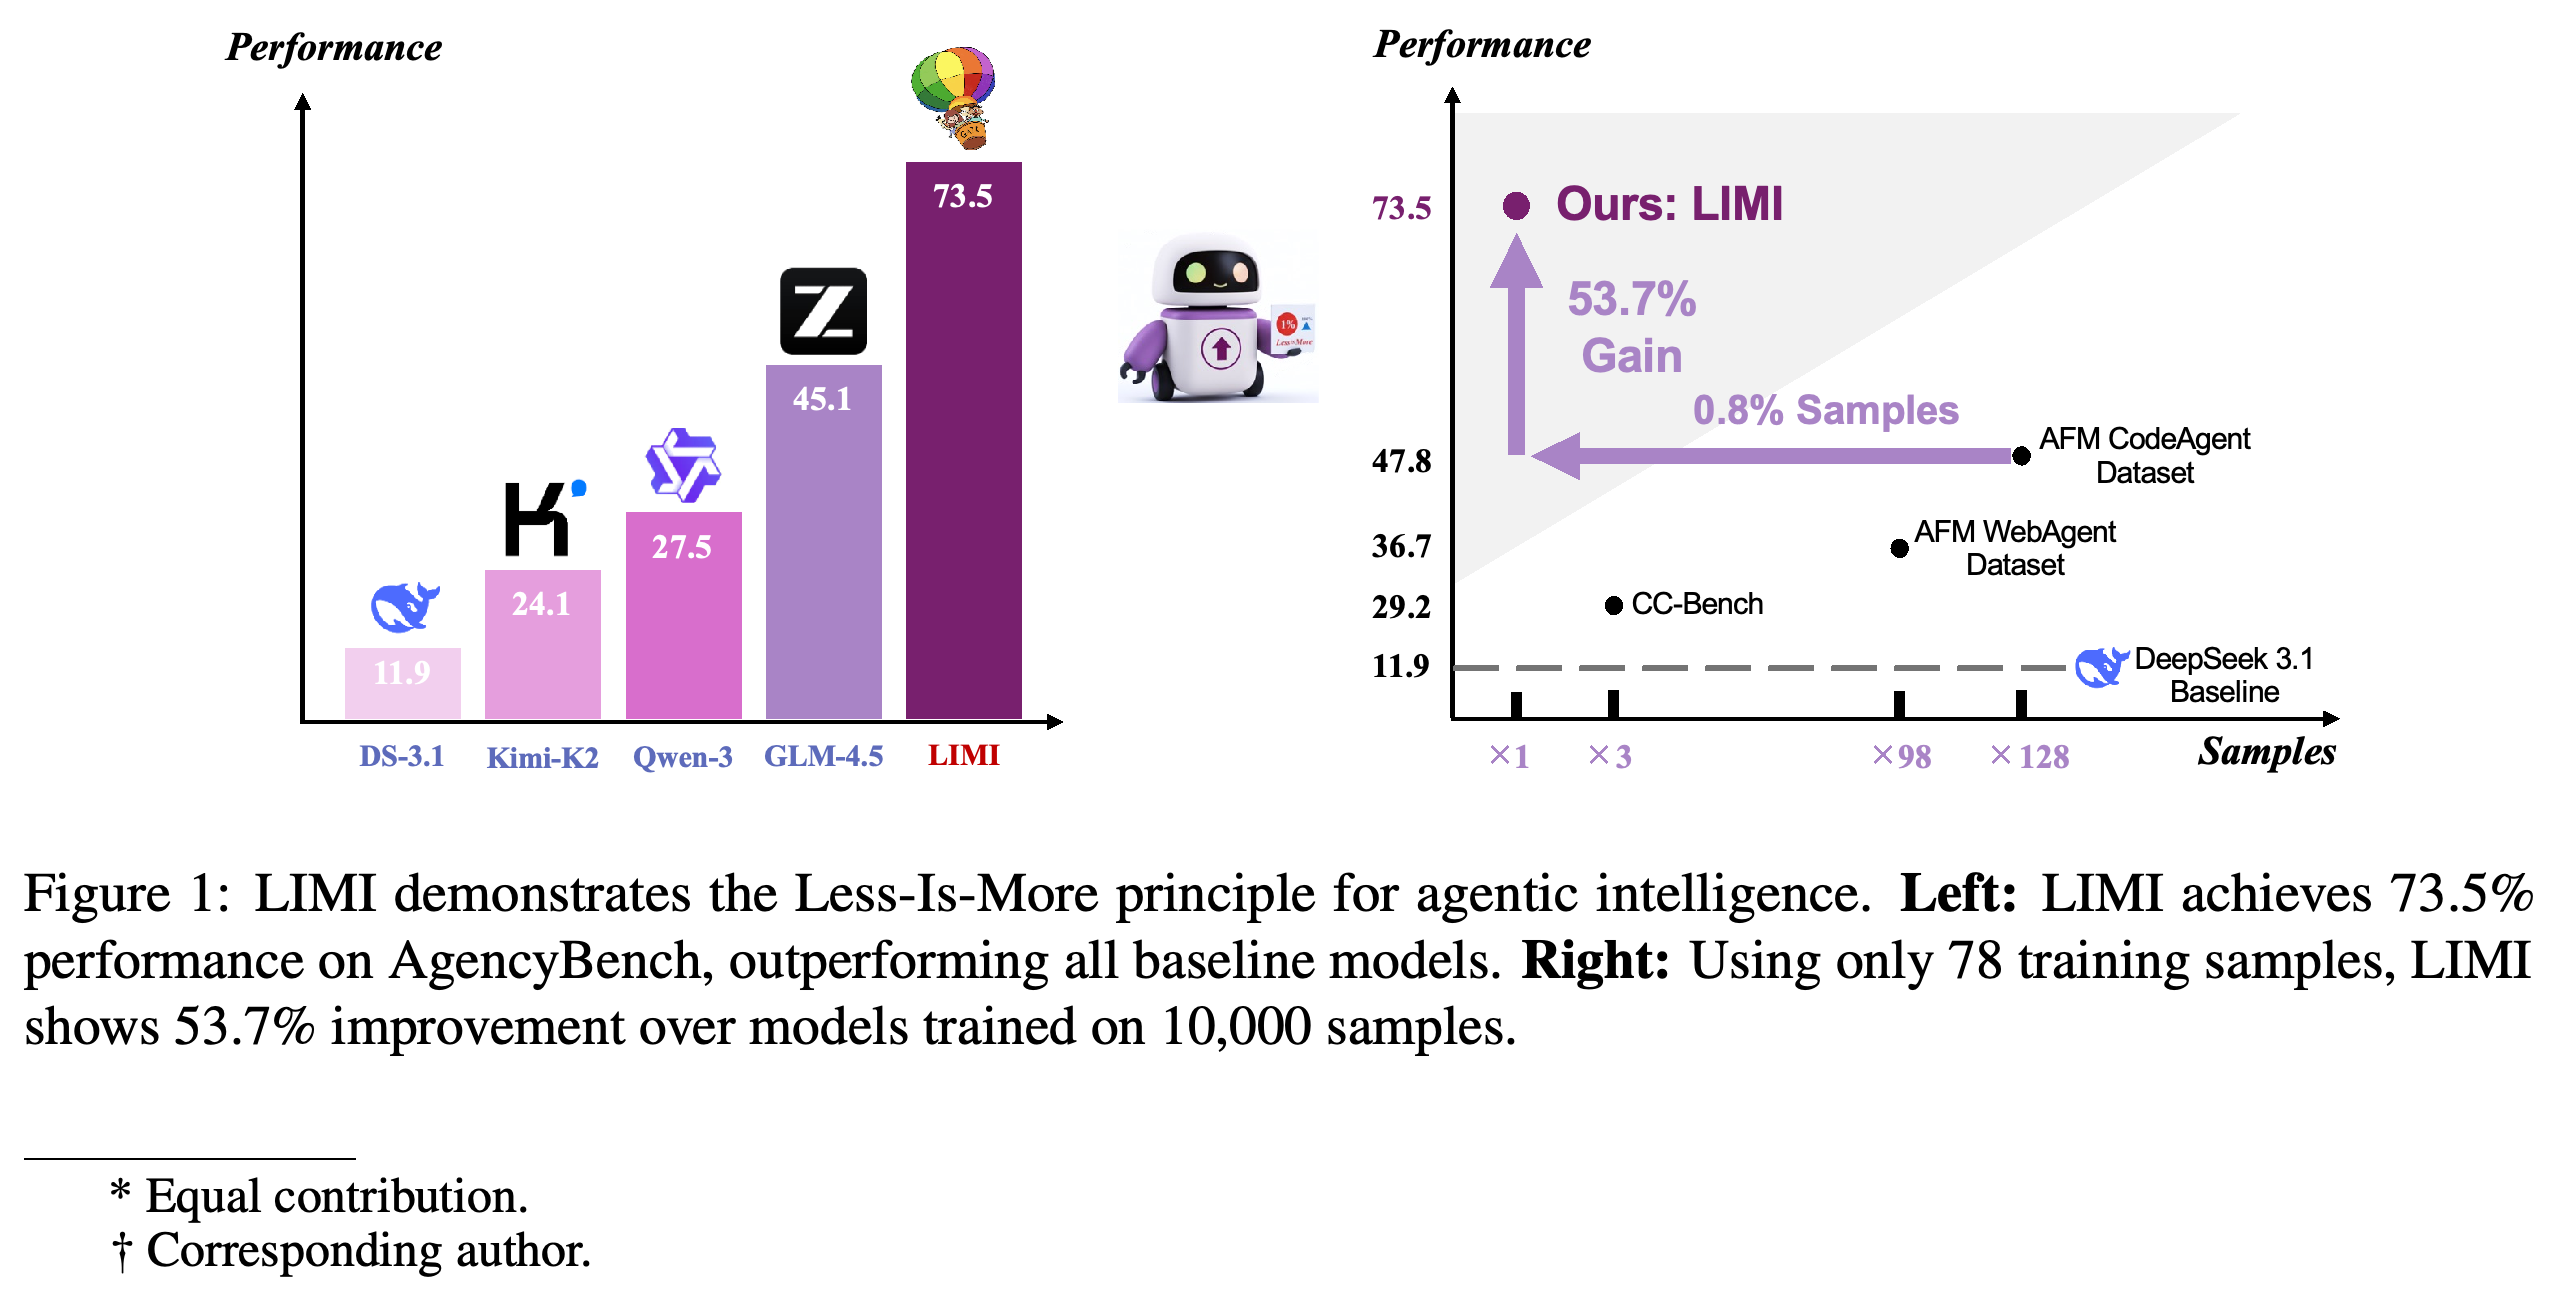
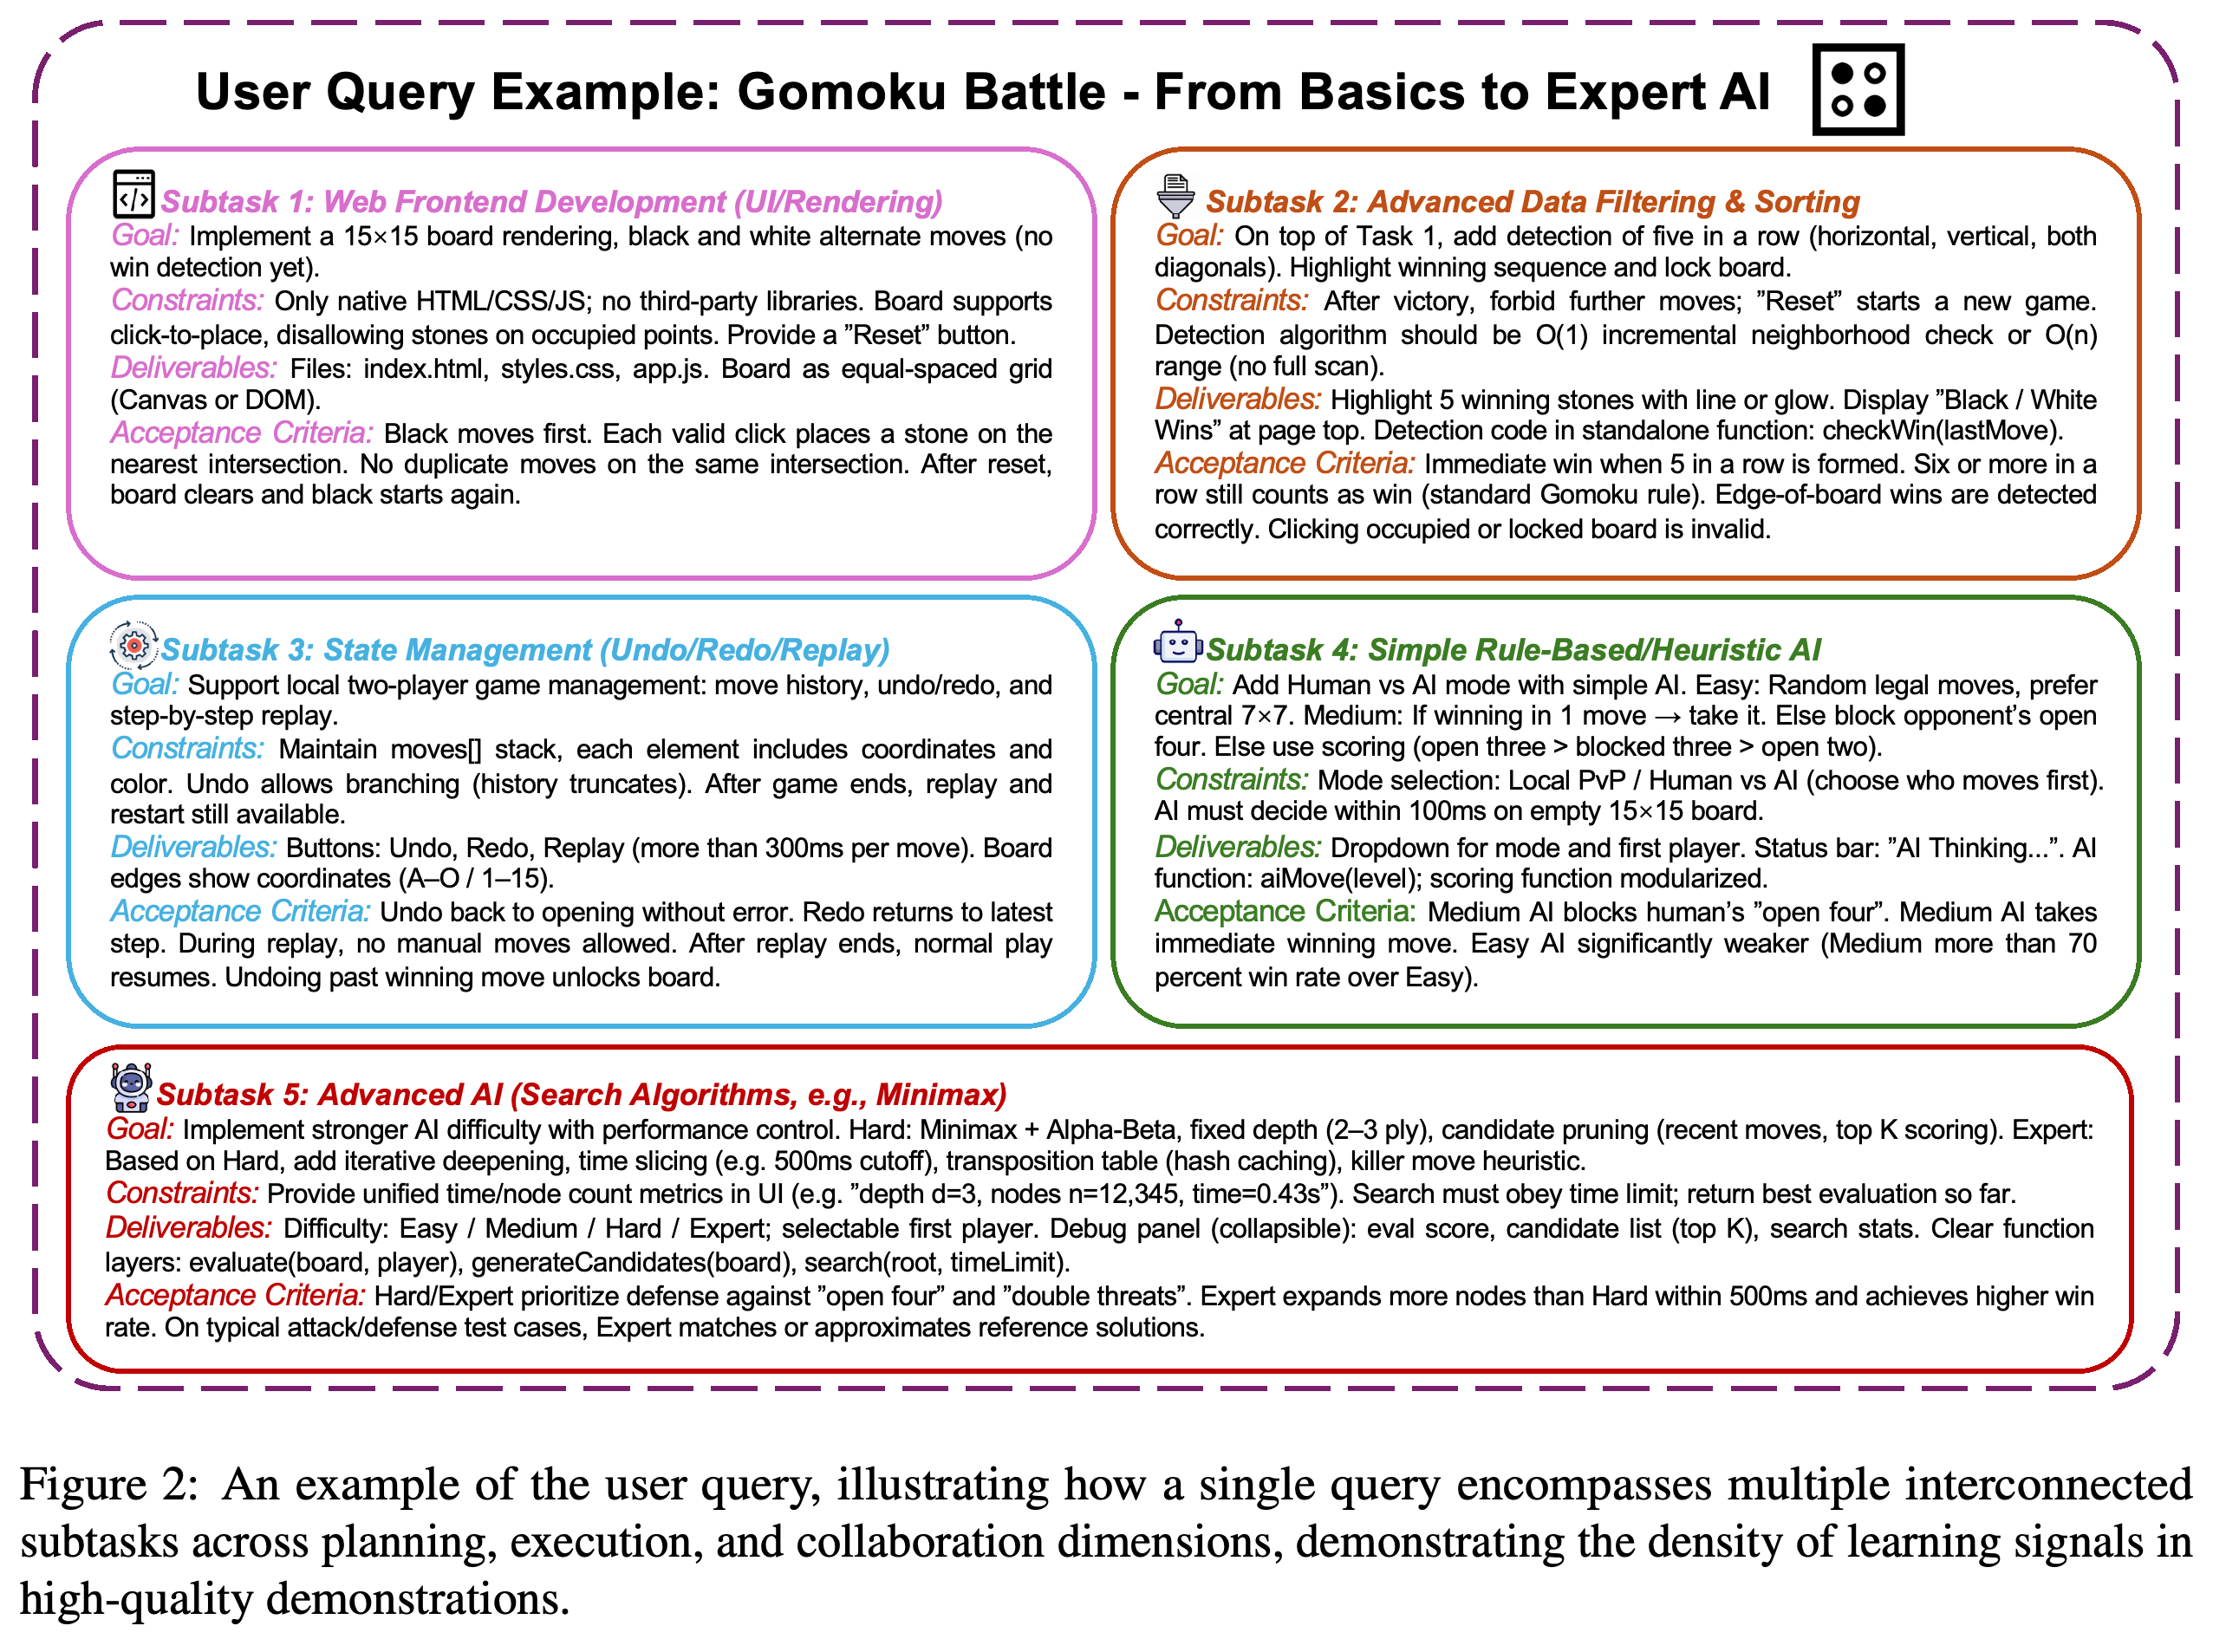
- LIMI: Less is More for Agency는 환경과 도구를 활용해 문제를 발견하고 가설을 세우며 해결책을 실행하는 능력인 agency를 연구한다. 기록된 시연으로 학습하는 지도 미세조정을 통해 GLM-4.5를 조정한다. 학습에는 실제 업무 질의 60개와 저장소의 코드 변경 제안인 GitHub pull request에서 합성한 질의 18개를 사용한다. GPT-5와 인간 협업자 4명이 피드백과 중간 실패에서의 복구를 포함한 성공 궤적을 수집한다.
- 협업 코딩 과제 4개와 연구 또는 정보 처리 과제 6개로 구성된 실행 기반 벤치마크 AgencyBench에서 LIMI는 GLM-4.5의 보고된 평균 45.1%를 73.5%로 높인다. 초기 응답에서 요구사항을 올바르게 구현한 비율인 First-Turn Functional Completeness는 37.8%에서 71.7%로 상승한다. 할당된 3라운드 안에 과제를 완료한 비율은 47.4%에서 74.6%로 상승한다.
- 같은 기반 모델을 AFM-CodeAgent-SFT-Dataset 샘플 10,000개로 미세조정하면 47.8%를 기록하며, LIMI는 시연 78개로 73.5%를 기록한다. 차이는 25.7%포인트이며 상대 향상률은 약 53.7%다. 궤적 길이는 13k부터 152k 토큰까지이므로, 이 비교는 예제 개수 기준의 이점을 보여준다. 학습 토큰 수, 주석 작업량, 수집 비용도 같은 비율로 절감된다는 점을 입증하지는 않는다.
2. Qwen3-Omni Technical Report
- https://arxiv.org/abs/2509.17765
- Qwen3-Omni Technical Report 요약 설명
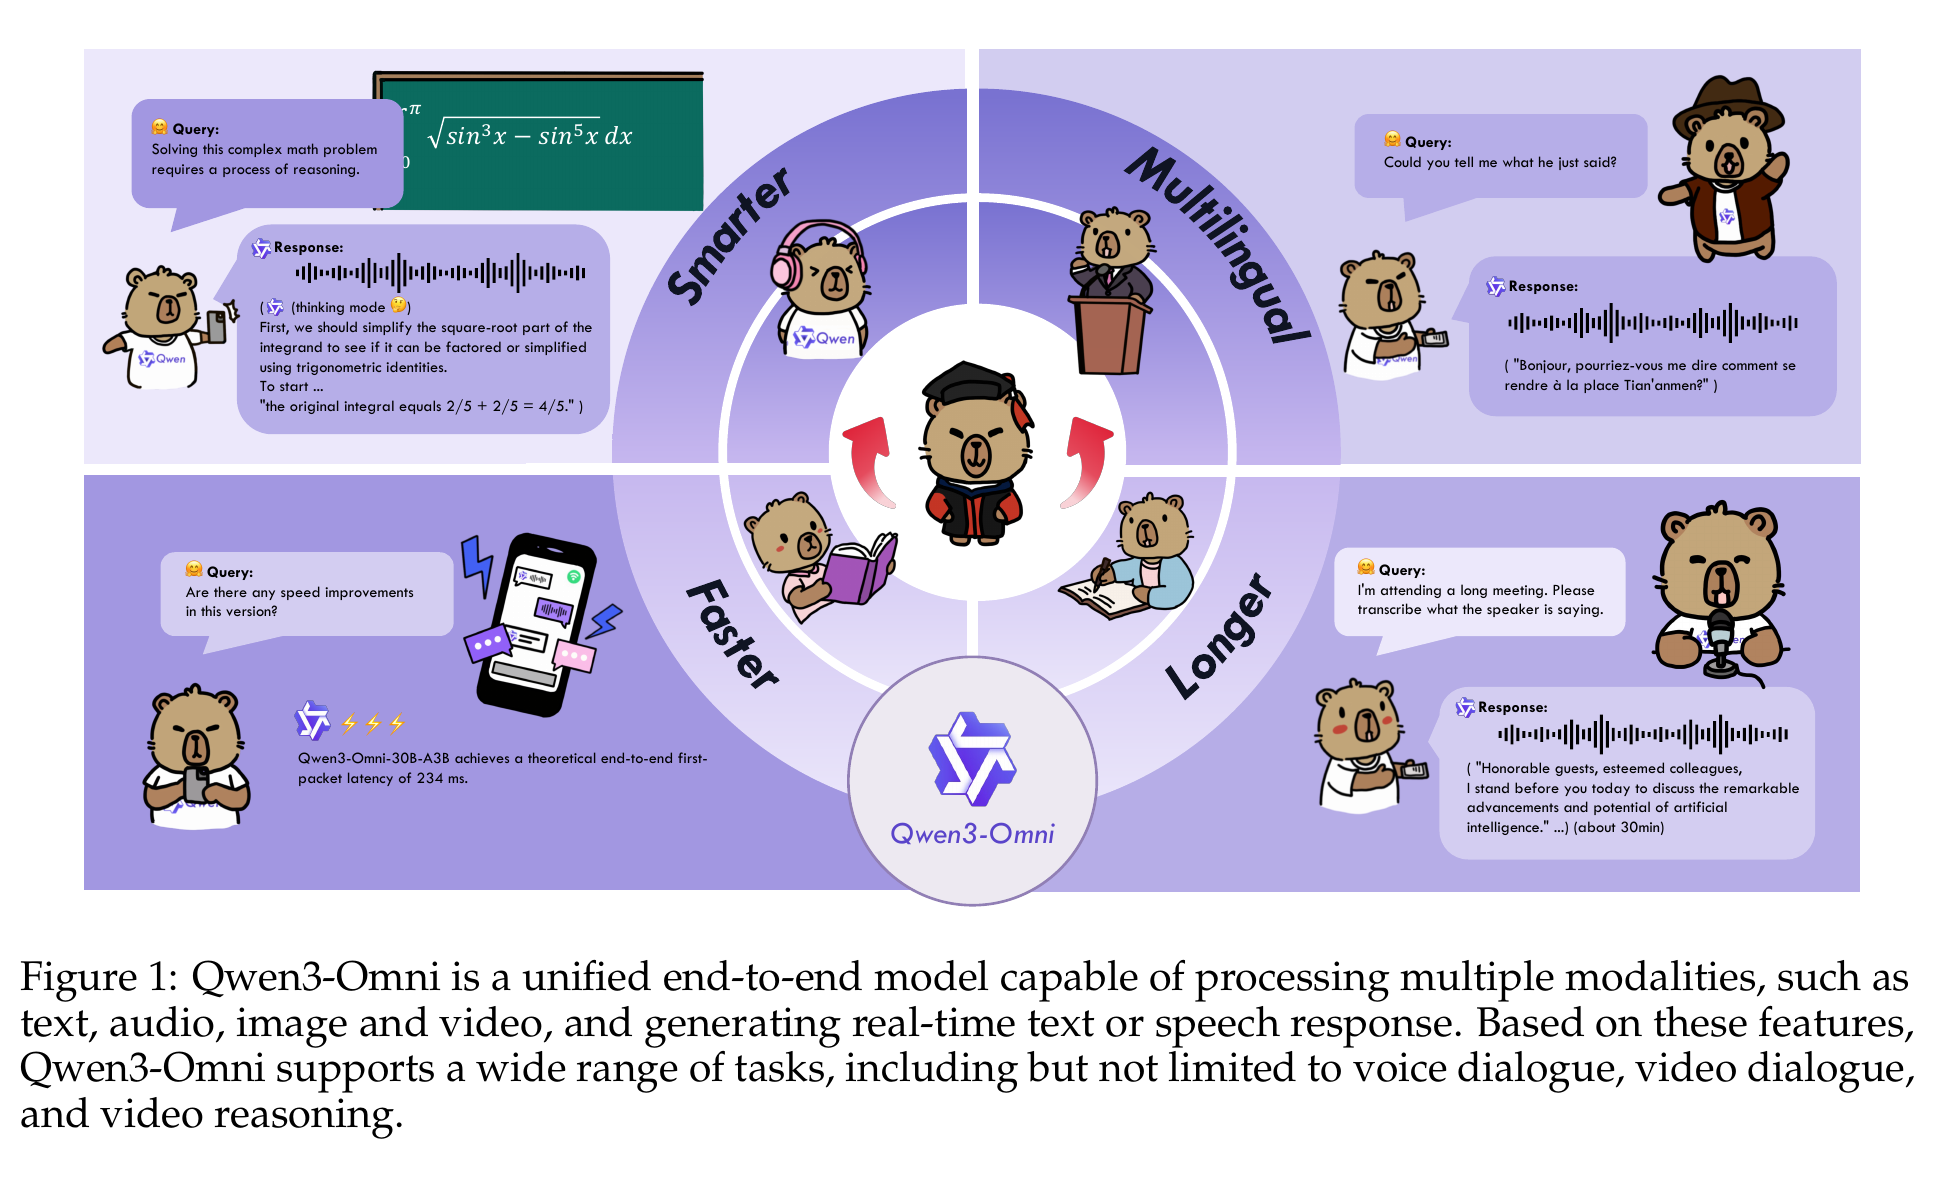
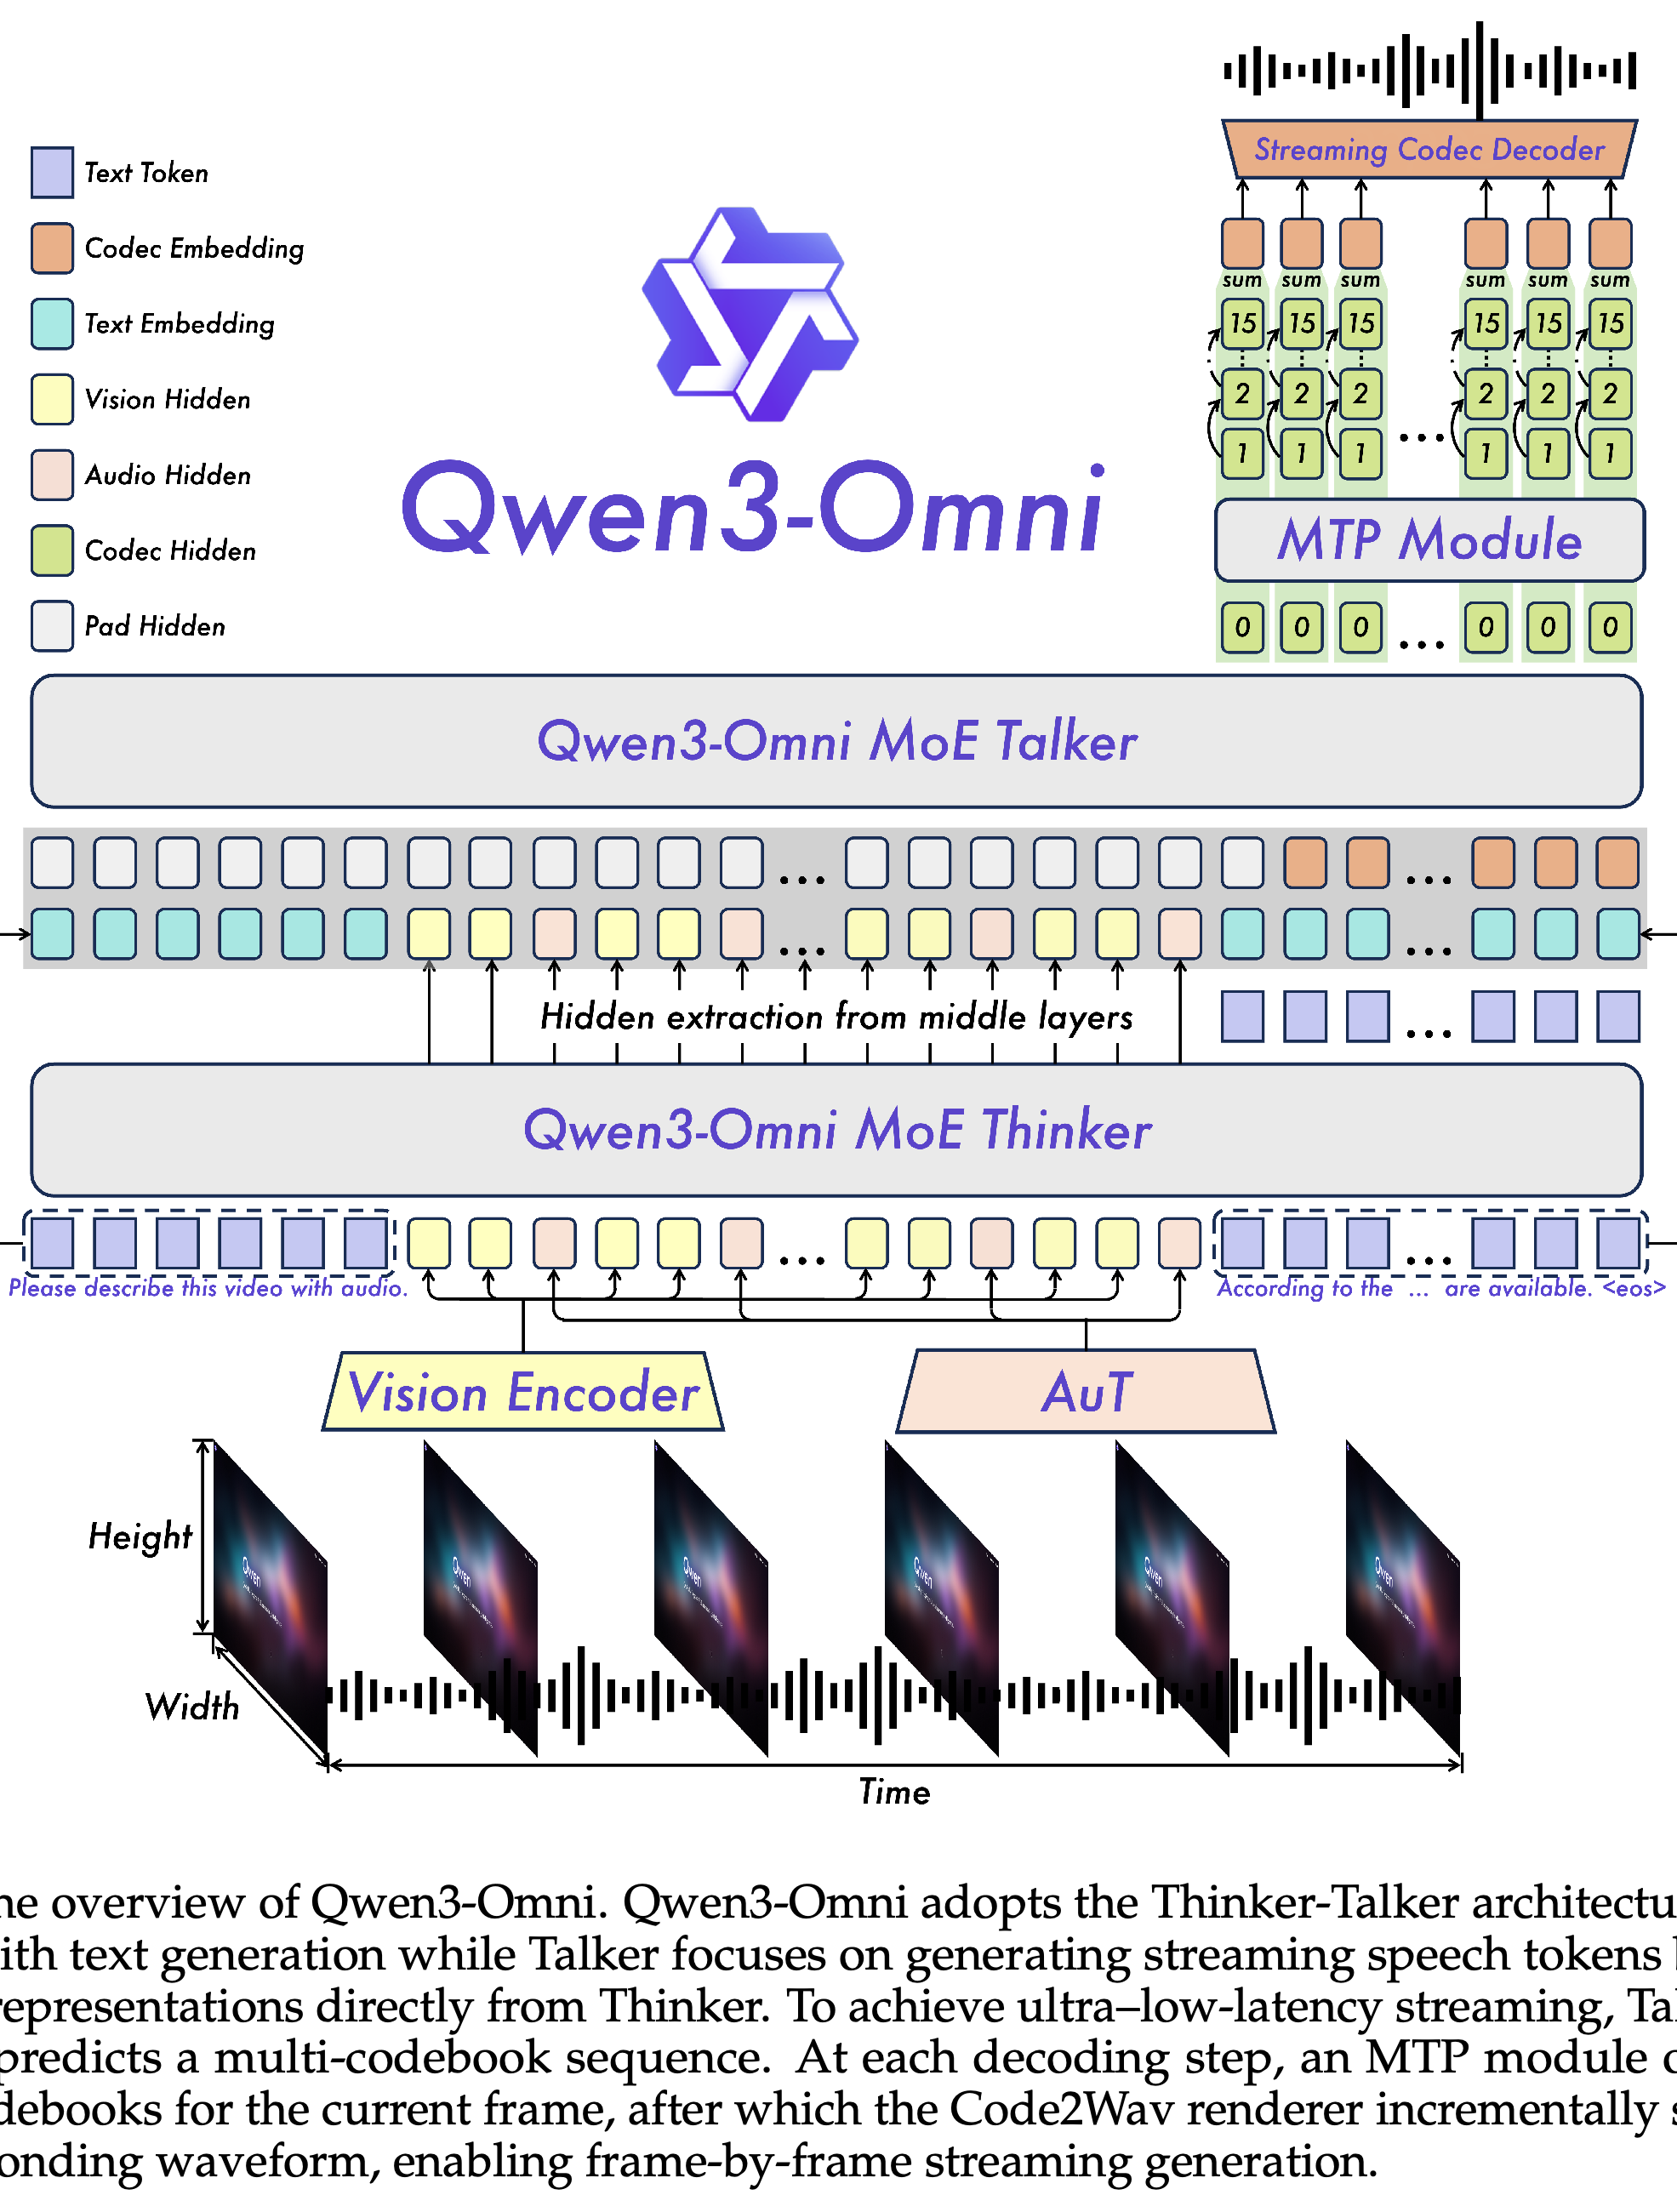
- Qwen3-Omni Technical Report는 텍스트, 이미지, 오디오, 비디오 입력과 텍스트, 음성 출력을 통합한다. Thinker는 입력을 해석하고 텍스트를 생성하며, Talker는 음성을 생성한다. 두 모듈은 모두 전문가 구성 요소를 선택적으로 활성화하는 Mixture-of-Experts 아키텍처를 사용한다. 각 오디오 프레임을 표현하는 이산 코드의 집합인 코드북을 여러 개 사용하고, 현재와 이전 문맥을 사용하는 디코더로 파형을 스트리밍한다. Mixture-of-Experts 구조를 다룬 Expert Race: A Flexible Routing Strategy for Scaling Diffusion Transformer with Mixture of Experts 요약 설명과 Grove MoE: Towards Efficient and Superior MoE LLMs with Adjugate Experts 요약 설명도 함께 참고할 수 있다.
- 통제 비교에서는 같은 시기의 30B-A3B 기본 모델 간 학습 일정, 공통 모달리티 데이터셋, 배치 크기, 모달리티별 유효 에포크, 연산량을 맞춘다. 모델 식별자는 전체 파라미터 수와 활성 파라미터 수를 구분한다. 결과는 이 규모에서 전반적인 역량 유지를 뒷받침한다. 여러 분야의 시각 질문을 평가하는 MMMU validation 점수는 57.22에서 59.33으로 상승하지만, 비디오 이해를 평가하는 MVBench 점수는 71.87에서 69.50으로 하락한다. 모델 규모를 포괄적으로 비교한 실험이나 불확실성 추정치는 제공하지 않는다.
- 이전 문맥 없이 최초 음성 패킷을 생성하는 데 걸리는 이론적 콜드 스타트 지연 시간은 동시 요청 1개에서 오디오 234 ms, 비디오 547 ms로 보고된다. 동시 요청 6개에서는 각각 1172 ms와 2284 ms로 늘어난다. 처리 시간을 생성한 오디오 길이로 나눈 생성 real-time factor는 요청 6개에서 0.66으로, 1 미만을 유지한다. 해당 표는 추론 하드웨어를 명시하지 않는다.
3. SimpleQA Verified: A Reliable Factuality Benchmark to Measure Parametric Knowledge
- https://arxiv.org/abs/2509.07968
- SimpleQA Verified: A Reliable Factuality Benchmark to Measure Parametric Knowledge 요약 설명
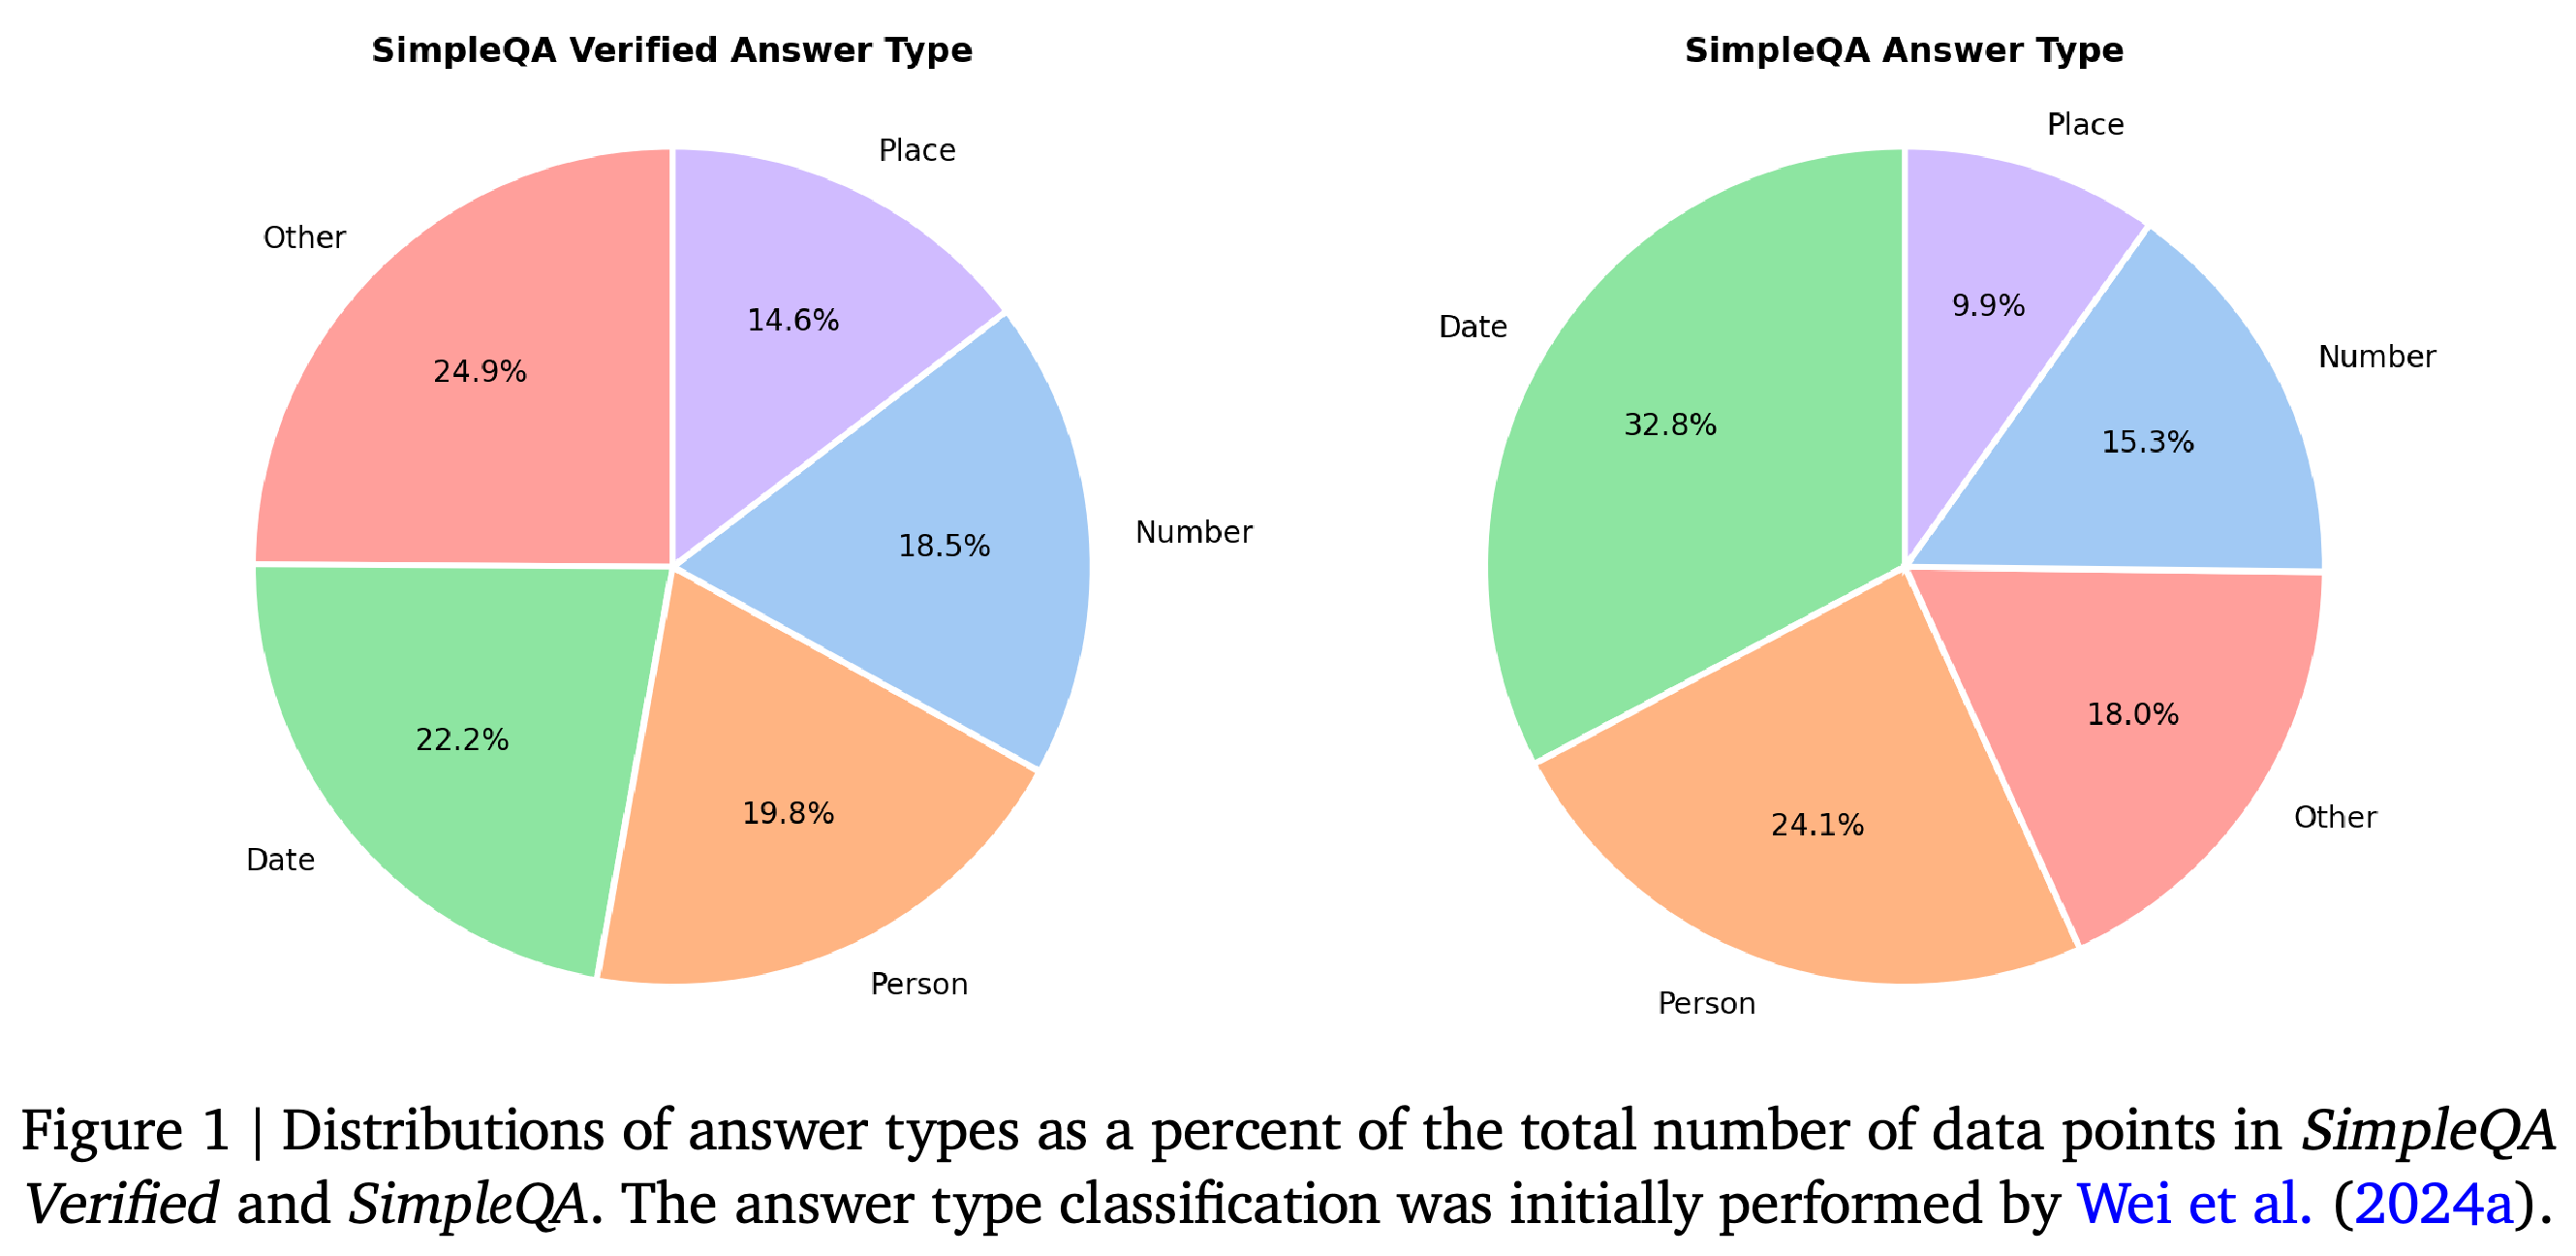
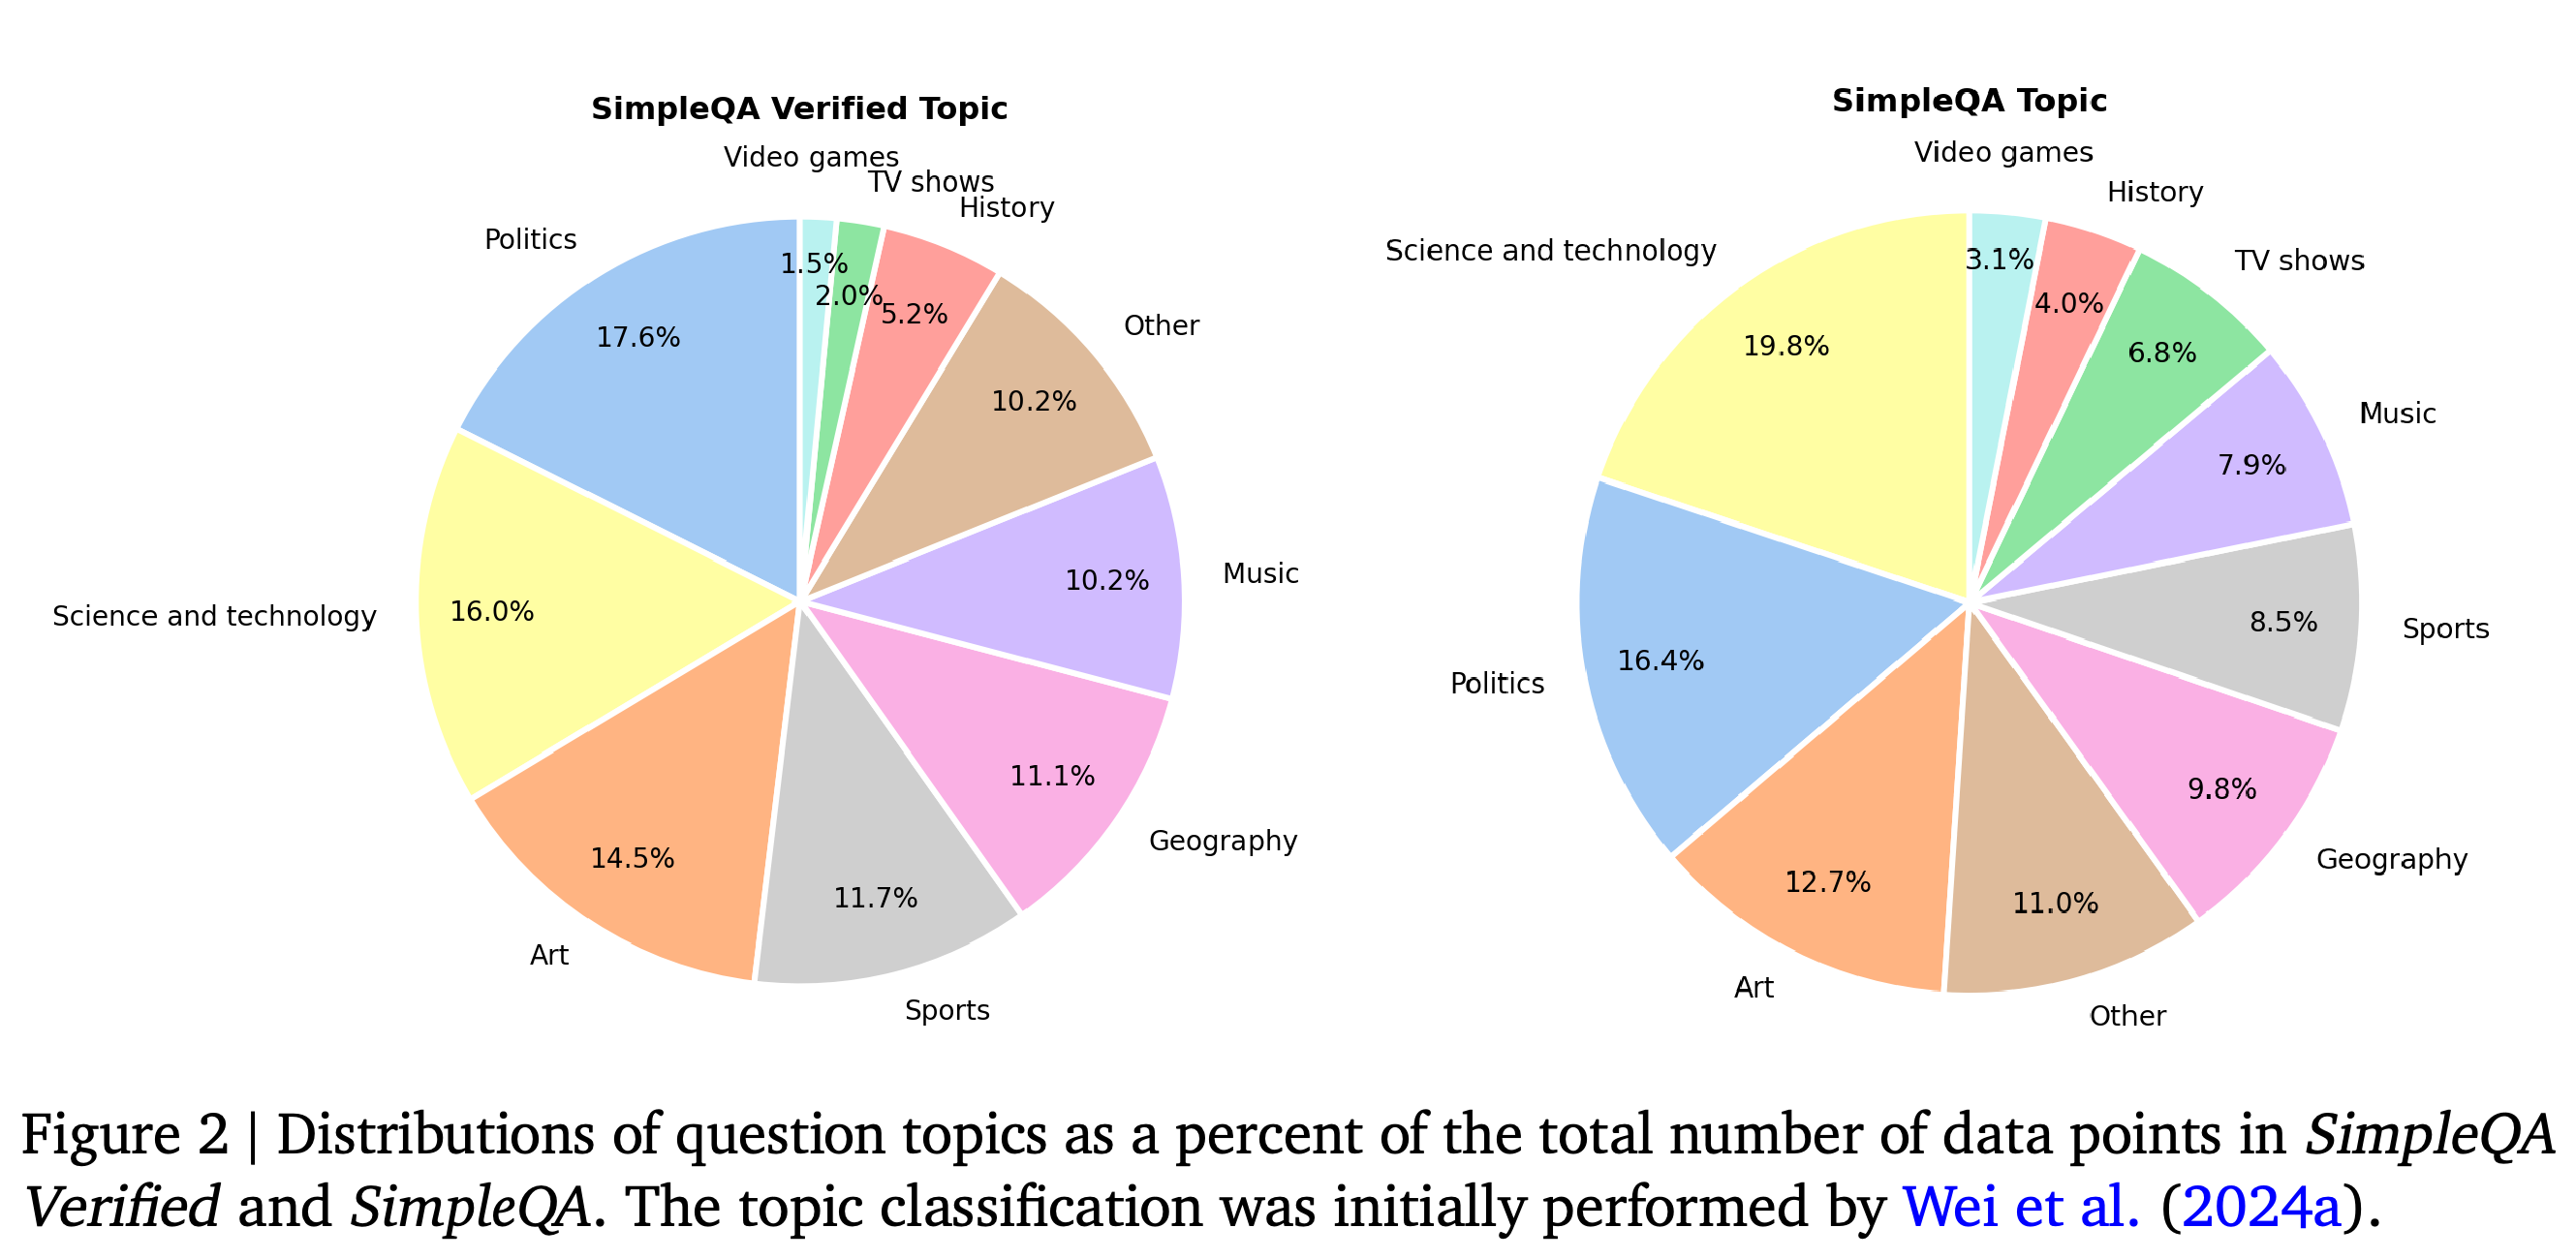
- SimpleQA Verified: A Reliable Factuality Benchmark to Measure Parametric Knowledge는 외부 도움 없이 모델 파라미터에 저장된 사실을 기억해 내는 능력인 parametric factuality를 평가한다. SimpleQA 질문 4,326개에 출처와 질문의 중복 제거, 발행자 접근 제한에 따른 필터링, 답변 유형과 주제의 균형 조정, 출처 간 불일치 해소, 난도 선별을 적용해 단답형 질문 1,000개를 구성한다.
- 애플리케이션 프로그래밍 인터페이스의 표준 매개변수를 사용하고 도구를 허용하지 않은 조건에서 Gemini 2.5 Pro의 F1-Score는 55.6%이며, GPT 5는 52.3%, o3는 51.9%를 기록한다. 여기서 F1-Score는 전체 질문에 대한 정확도와 답변을 시도한 질문에 대한 정확도의 조화평균이다. Claude Opus 4는 답변 보류의 영향을 보여준다. 답변을 시도한 질문의 정확도는 54.1%지만 답변 시도율이 35.5%이므로, 전체 정확도는 19.2%, F1-Score는 28.3%다.
- 수정한 autorater는 프롬프트에 따라 답변을 채점하는 언어 모델이며, 질문별 수치 허용 범위와 직접적인 답변, 불확실성 표현, 답변 보류에 관한 더 명확한 규칙을 사용한다. 평가에서는 gpt-4.1-2025-04-14를 autorater로 사용한다. 제시된 사례는 수정의 근거를 제공하지만, 독립적인 인간 라벨과 비교한 종합 검증 결과는 보고하지 않는다. 채점 시 기준 답변과 모순되지 않는 추가 정보는 무시하므로, 점수는 질문이 요구한 사실을 기억해 내는 능력을 측정하며 긴 응답에 담긴 모든 문장의 정확성을 측정하지는 않는다. autorater에 대해서는 J1: Incentivizing Thinking in LLM-as-a-Judge via Reinforcement Learning 요약 설명 글을 참조하라.
출처
[1] LIMI: Less is More for Agency
[2] Qwen3-Omni Technical Report
[3] SimpleQA Verified: A Reliable Factuality Benchmark to Measure Parametric Knowledge